

HP OmniBook Ultra 16 は、NVIDIA の N1X スーパーチップと 3K OLED ディスプレイを中心に構築された厚さ 0.62 インチの HP 製 16 インチ NVIDIA RTX Spark ノートブックです。私たちは 2 つのユニットを並べてテストしました。1 つはフル 20 コアの N1X、128GB の LPDDR5X、2TB Gen5 SSD を搭載したもので、もう 1 つは同じチップ、32GB、1TB Gen5 SSD を搭載したものです。テストした 32GB、1TB ユニットは、Best Buy の $3,199.99 の構成で、これは HP の開始価格でもあります。64GB、2TB モデルは HP.com で $4,999.99 でリストされており、テストした 128GB、2TB の構成は HP.com のコンフィギュレーターでのみ入手可能で、HP は 10 月 14 日時点でこれを $6,229.99 で販売しています。
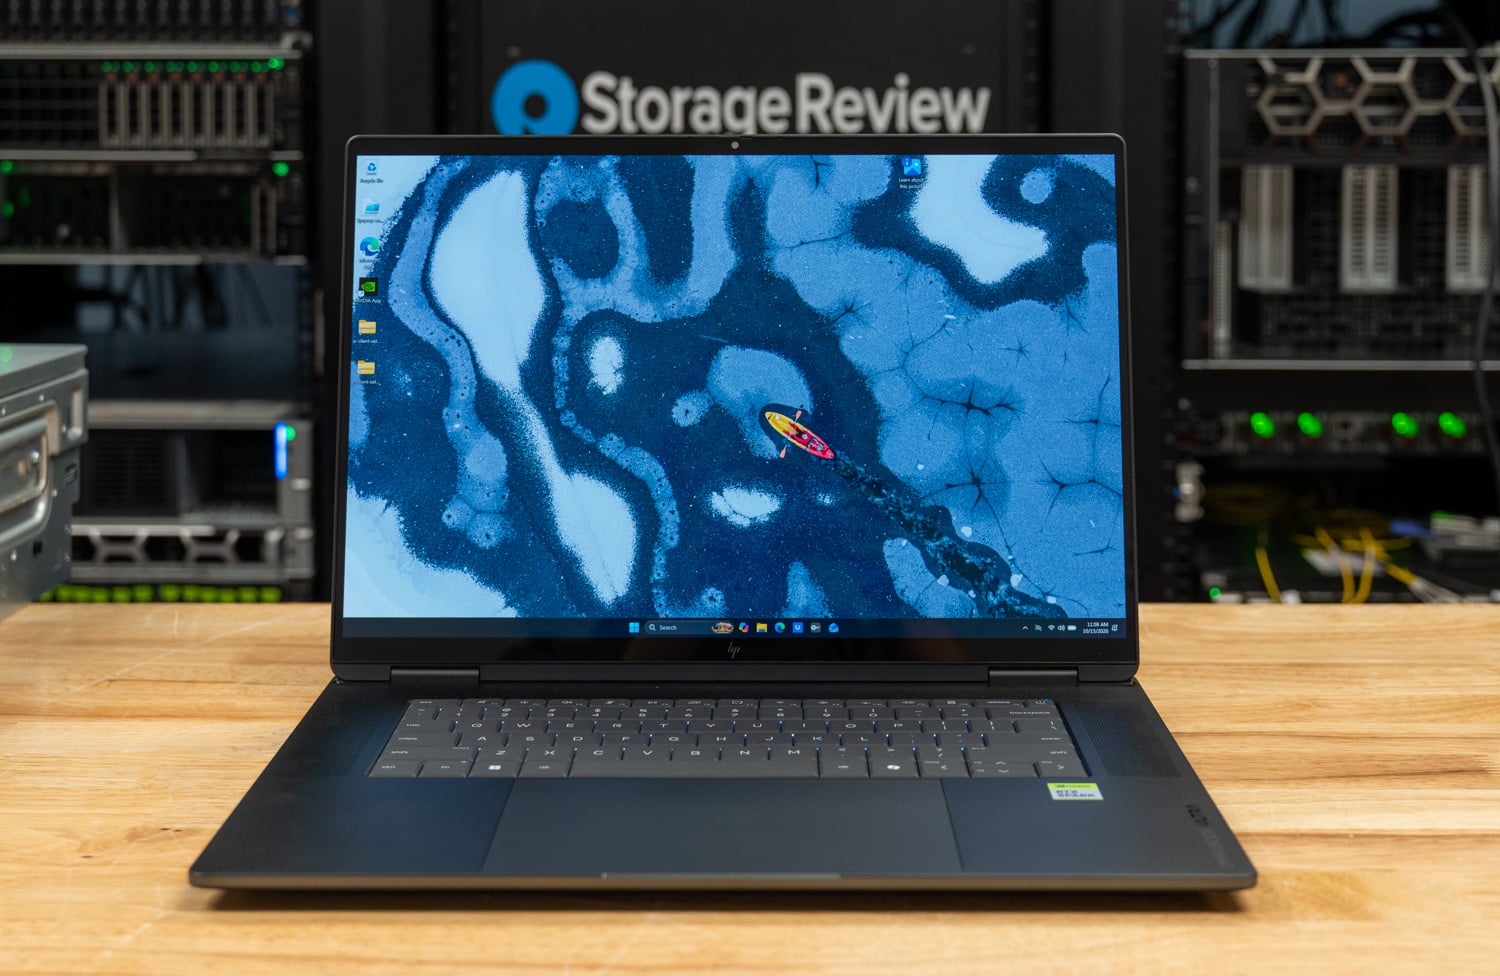
2台のHP製品に加え、テスト済みのもう1つの128GB RTX Spark搭載ノートPCであるMicrosoft Surface Laptop Ultra 、32GB版HPと同じ12GB GPU構成のLenovo Pro 9n 15、そしてRTX 5090を搭載し、今回の比較対象の中で最も強力なx64ノートPCであるRazer Blade 16も比較対象としています。バッテリーに関する結果は、新しいテストハーネスが完成次第掲載します。
まず最初に、128GB OmniBookは、私たちがテストした中で最も完成度の高いRTX Sparkシステムです。このグループの中で最高のマルチコアCinebench 2026スコア7,004を記録し、ティアMのQwen3.6コーディングタスクを他のどのシステムよりも速く完了し、2台のSurfaceユニットをフル稼働させた全コアOpenBLASソルブを98℃で最後まで実行しました。32GBユニットは、CPU、MLPerf、RAGの作業において、このシステムの約2%以内の性能に留まっています。これらのシステムすべてにおいて、メモリが制約となっており、購入時のサイズ決定の参考にすべきです。GPUの割り当てが少ないと、搭載できるモデルと快適に動作するモデルが制限されます。
主要なポイント(要点)
- 128GBのユニットは、テストしたすべてのローカルAIティアを実行します。 62.5GBのGPU使用可能メモリを搭載したGPUでは、gpt-oss:20bとQwen3.6-35B-A3Bがそれぞれ毎秒58.0トークンと89.5トークンを生成し、Qwen3.6コーディングタスクは3回の実行すべてを72.0秒でクリアし、グループ内で最速でした。Blade 16のRTX 5090は、24GBのメモリを搭載したモデルでは2.3倍高速です。
- 32GBモデルは速度は維持するものの、容量は低下する。 MLPerf Llama 3.1 8Bは、128GBユニットの56.5トークン/秒に対し、56.4トークン/秒で動作しましたが、12GBのGPU分割のため、モデルロードとコーディングエージェントのテストには参加できませんでした。
- グループ内で最速のマルチコア性能: Cinebench 2026のマルチコアスコアは7,004で、Razer Blade 16を35%上回り、LLVMビルド時間はBladeの327.0秒に対し206.6秒でした。
- 高温で、限界域でも安定している。 両方のHP製端末は、すべての全コアテストにおいて98℃を維持したままパフォーマンスが低下しず、両方とも全コアOpenBLASソルバーテストを完了しました。このテストでは、2台のSurface Laptop Ultraで電力消費が抑制されました。
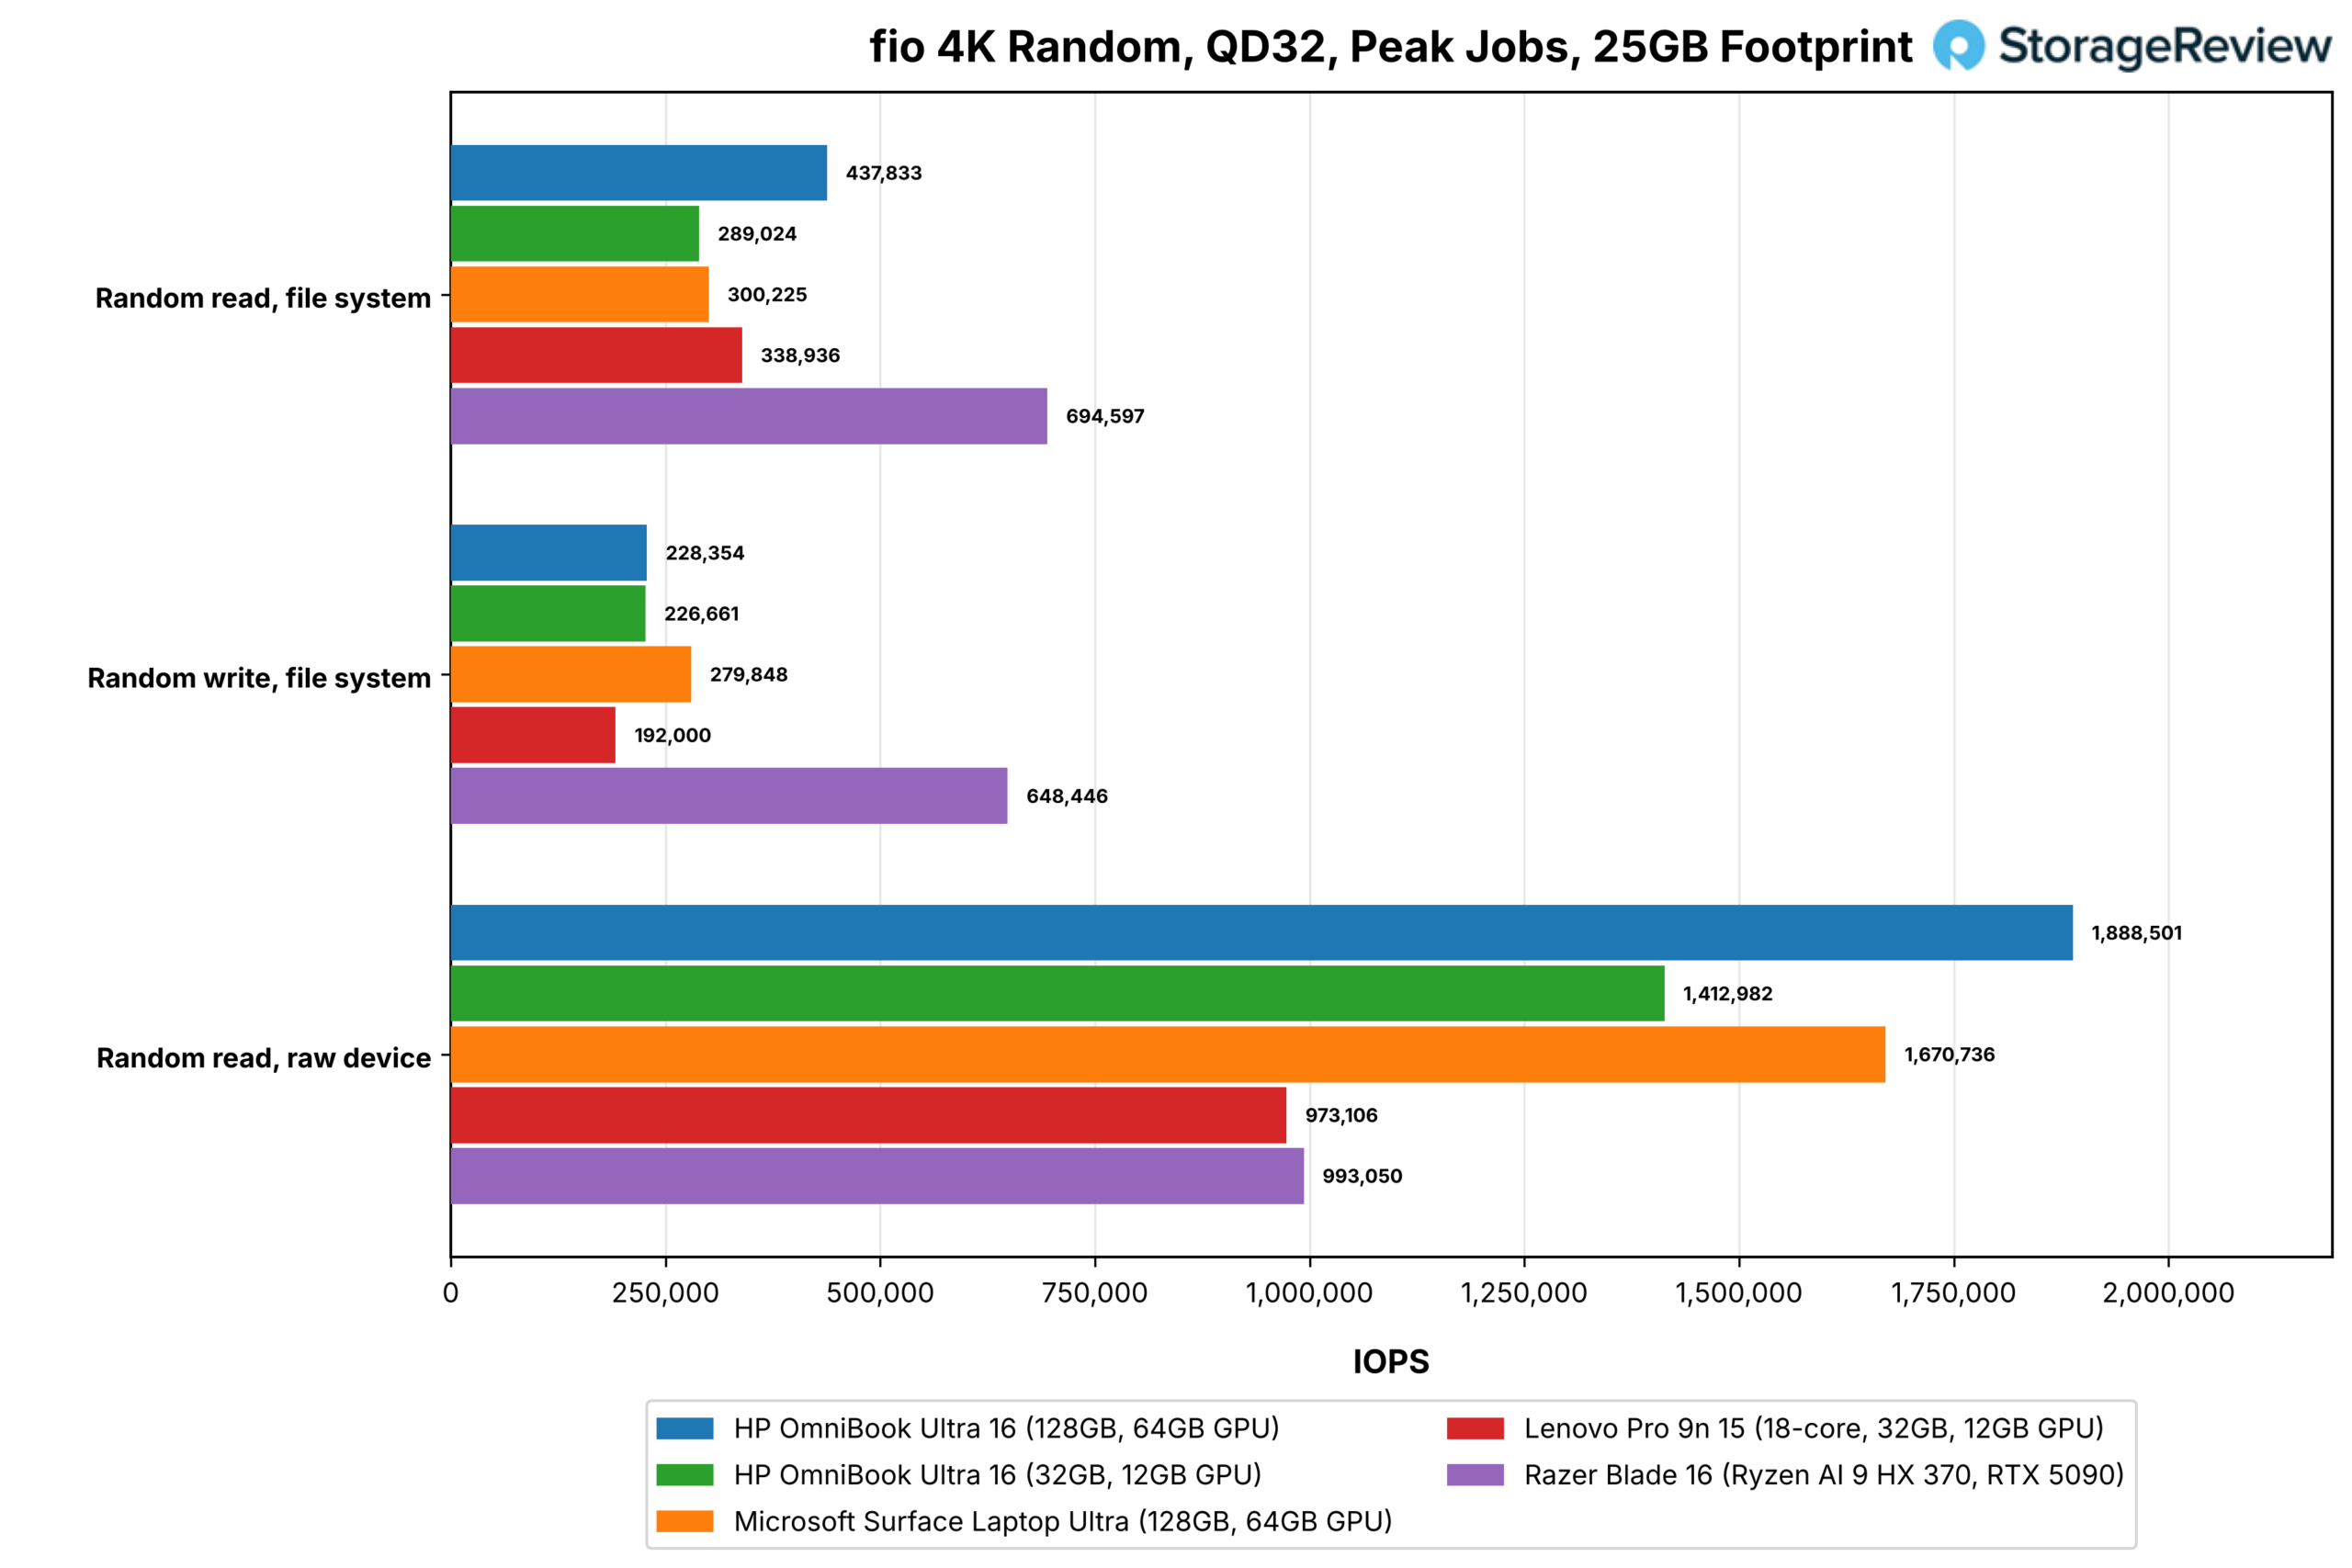
- Windows on Arm対応の天井パネルの背後にある第5世代ストレージ: 128GBユニットのSandisk SN8050Sは、生のデバイスから13,833MB/sのシーケンシャル読み取りと1.89M IOPSを記録したが、NTFSとBitLockerを介した4Kランダム読み取りでは437.8K IOPSが上限だった。
ビルドとデザイン
HP は OmniBook Ultra 16 を、CNC 加工された湾曲したエッジと凹面を持つ、HP が Eclipse gray と呼ぶダークカラーの 3 ピース アルミニウムシャーシを中心に構築しました。サイズは 14.01 x 10.1 インチで、背面が 15.7 mm から前面が 11.6 mm にテーパー状になっており、重量は 4.89 ポンドです。HP は、これをこれまでの RTX Spark PC の中で最も薄いとしています。カバーには 50% リサイクル金属が使用され、キーボード部品は 85% 使用済みリサイクルプラスチックで、スピーカー エンクロージャーには海洋プラスチックが含まれています。両方のユニットは同じシャーシを共有しているため、このセクションのすべての内容はどちらの構成にも適用されます。
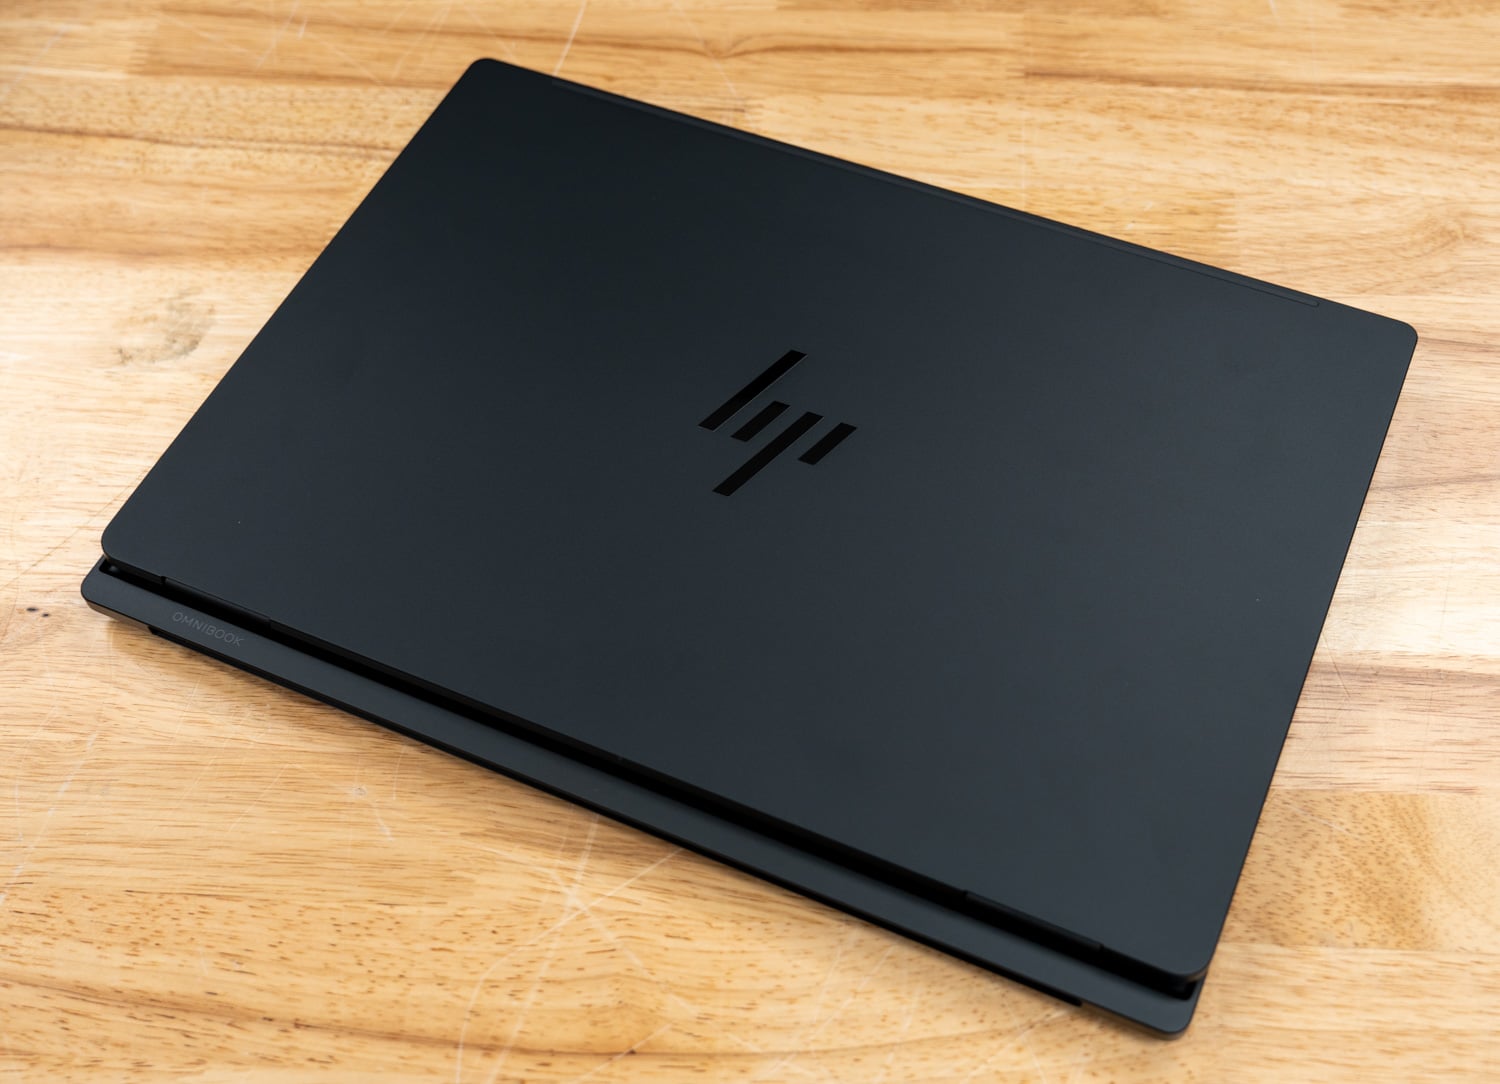
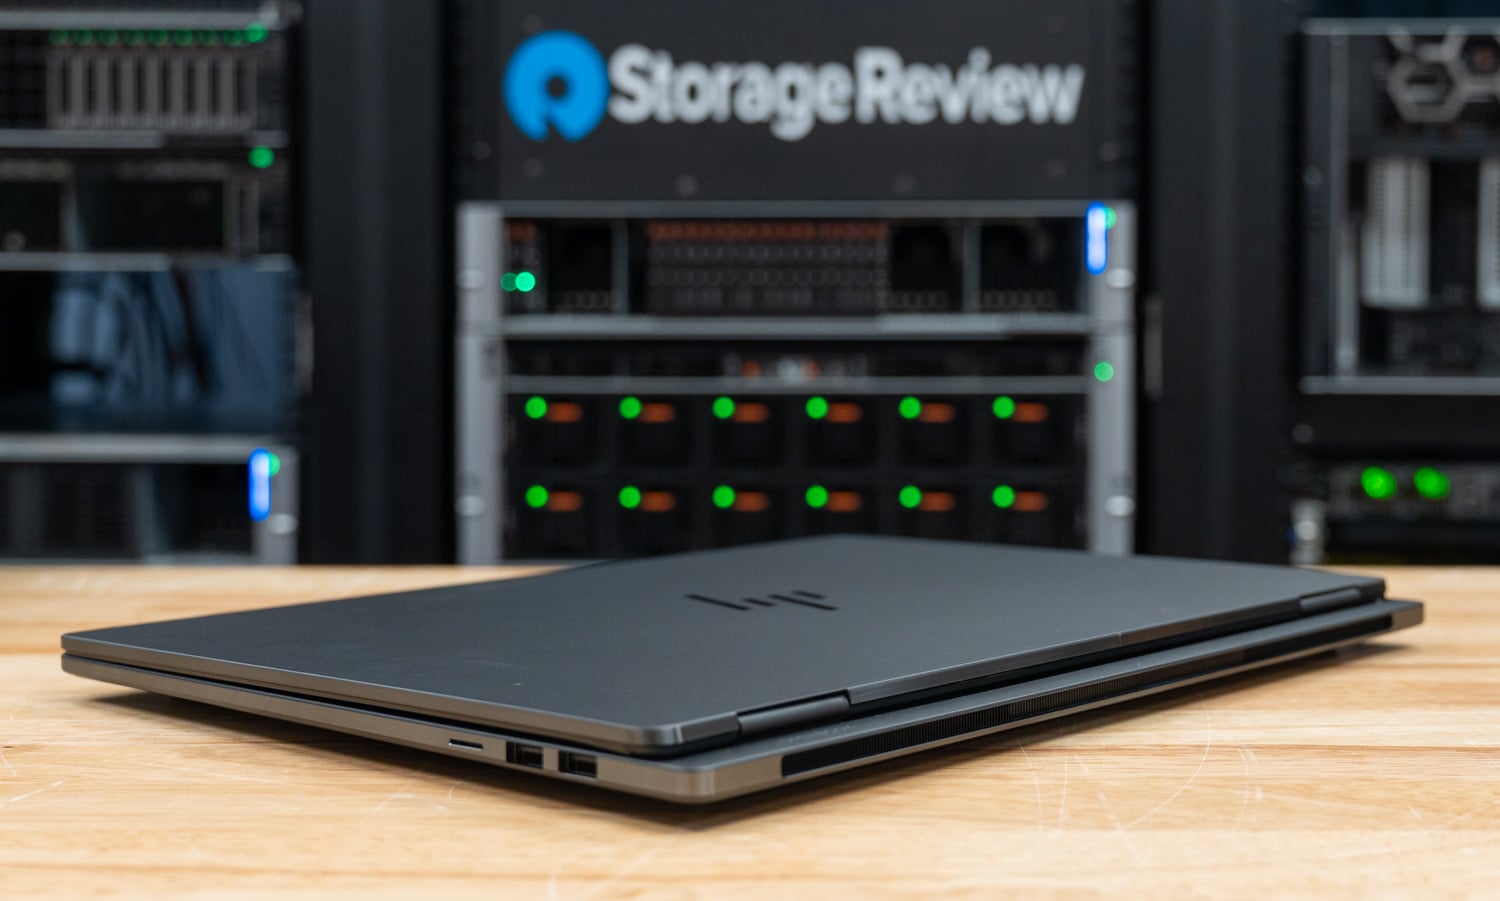
OmniBookは、今回の初期レビューでテストしたRTX Spark搭載ノートPCの中で、最も手触りの良い製品です。質感のある金属表面とスリムなフォルムにより、薄さからは想像できないほどの高級感と堅牢な質感を実現しており、このサイズの筐体によく見られるようなたわみは一切ありません(まるで本格的なZBookシステムのような感触です)。ノートPCとしては珍しく、本体背面の縁がディスプレイヒンジよりも外側に伸びており、熱の排出経路が変わります。蓋を開けても閉じても、排気は筐体背面からまっすぐ排出され、ヒンジやディスプレイ下部に熱が吹き込むことはありません。
この拡張部分は、HPが「タワーヒンジ&トランクデザイン」と呼ぶもので、HPのコンシューマー向けノートパソコンとしては初の試みです。従来のクラムシェル型ノートパソコンでは、ディスプレイとヒンジが本体背面を圧迫するため、HPはヒンジの後ろの筐体を拡張し、背面から空気がまっすぐ排出されるようにしました。OmniBookのパフォーマンスモード時の消費電力は最大70Wです。
HPはこのデザインについて、持続的なパフォーマンスと低い表面温度を謳っていますが、前半部分はテストで確認できました。N1Xは30分間の連続ループでクロックをフルに稼働させました。すべてのCPUテストで98℃の上限に達し、Pro 9nやLenovo Yoga 9n 2-in-1 16よりも高温になりました。そのため、トランクはCPU自体を冷却することなく排気を移動させており、今回のレビューでは表面温度は測定していません。
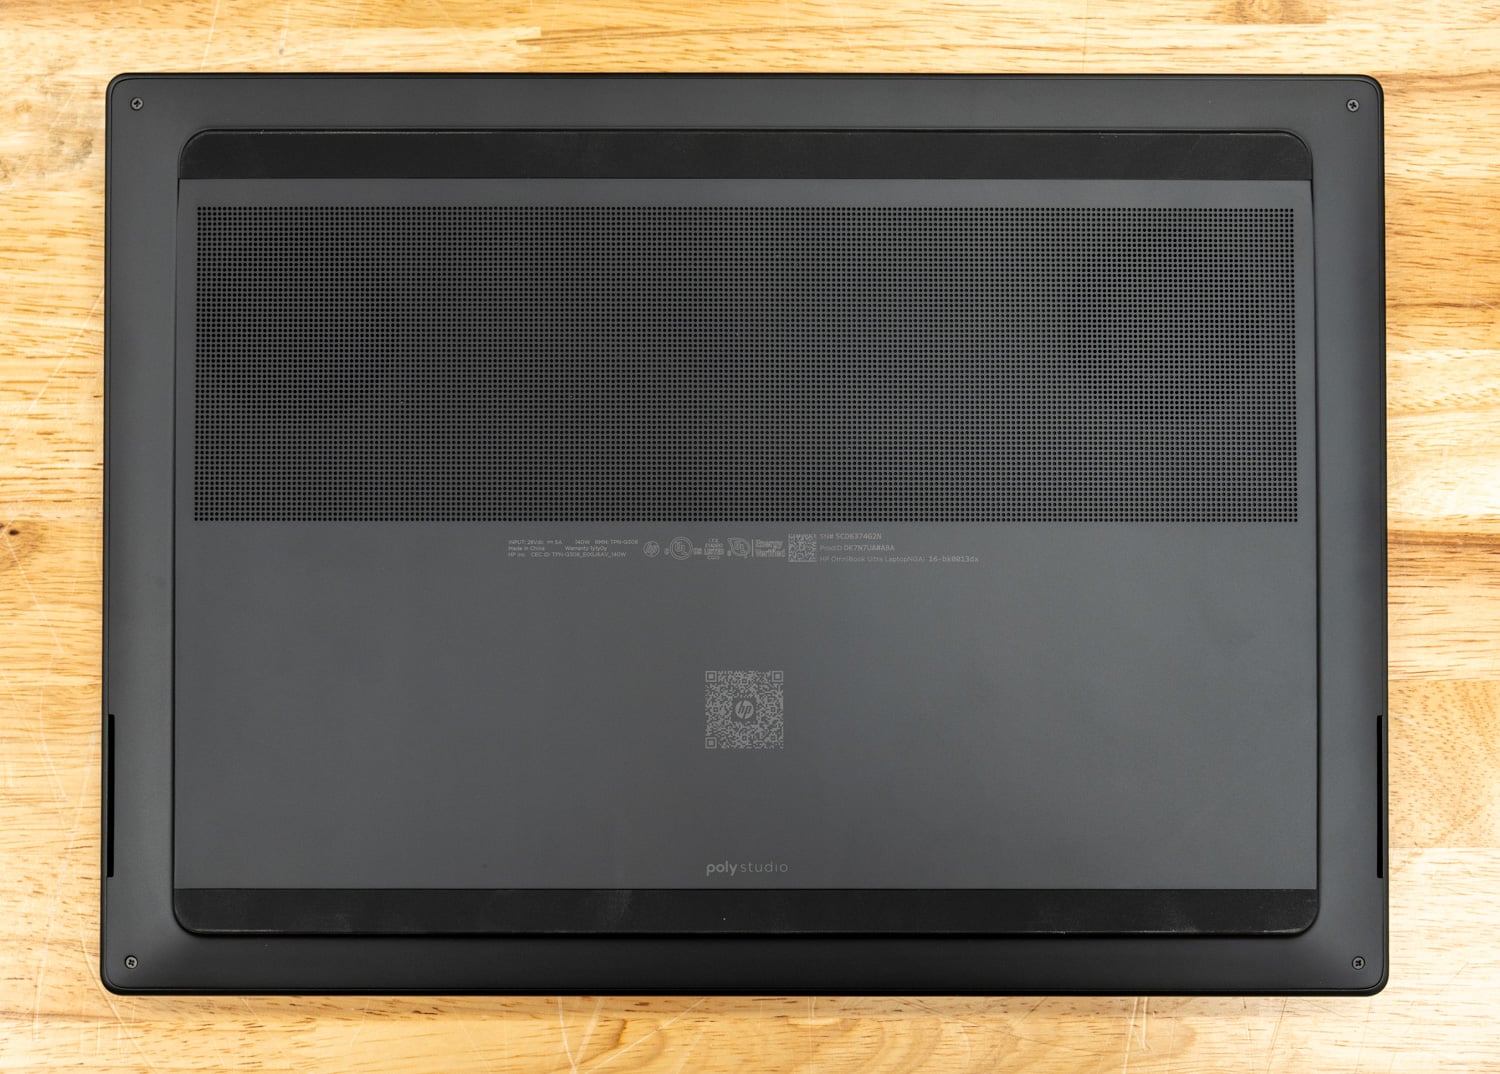
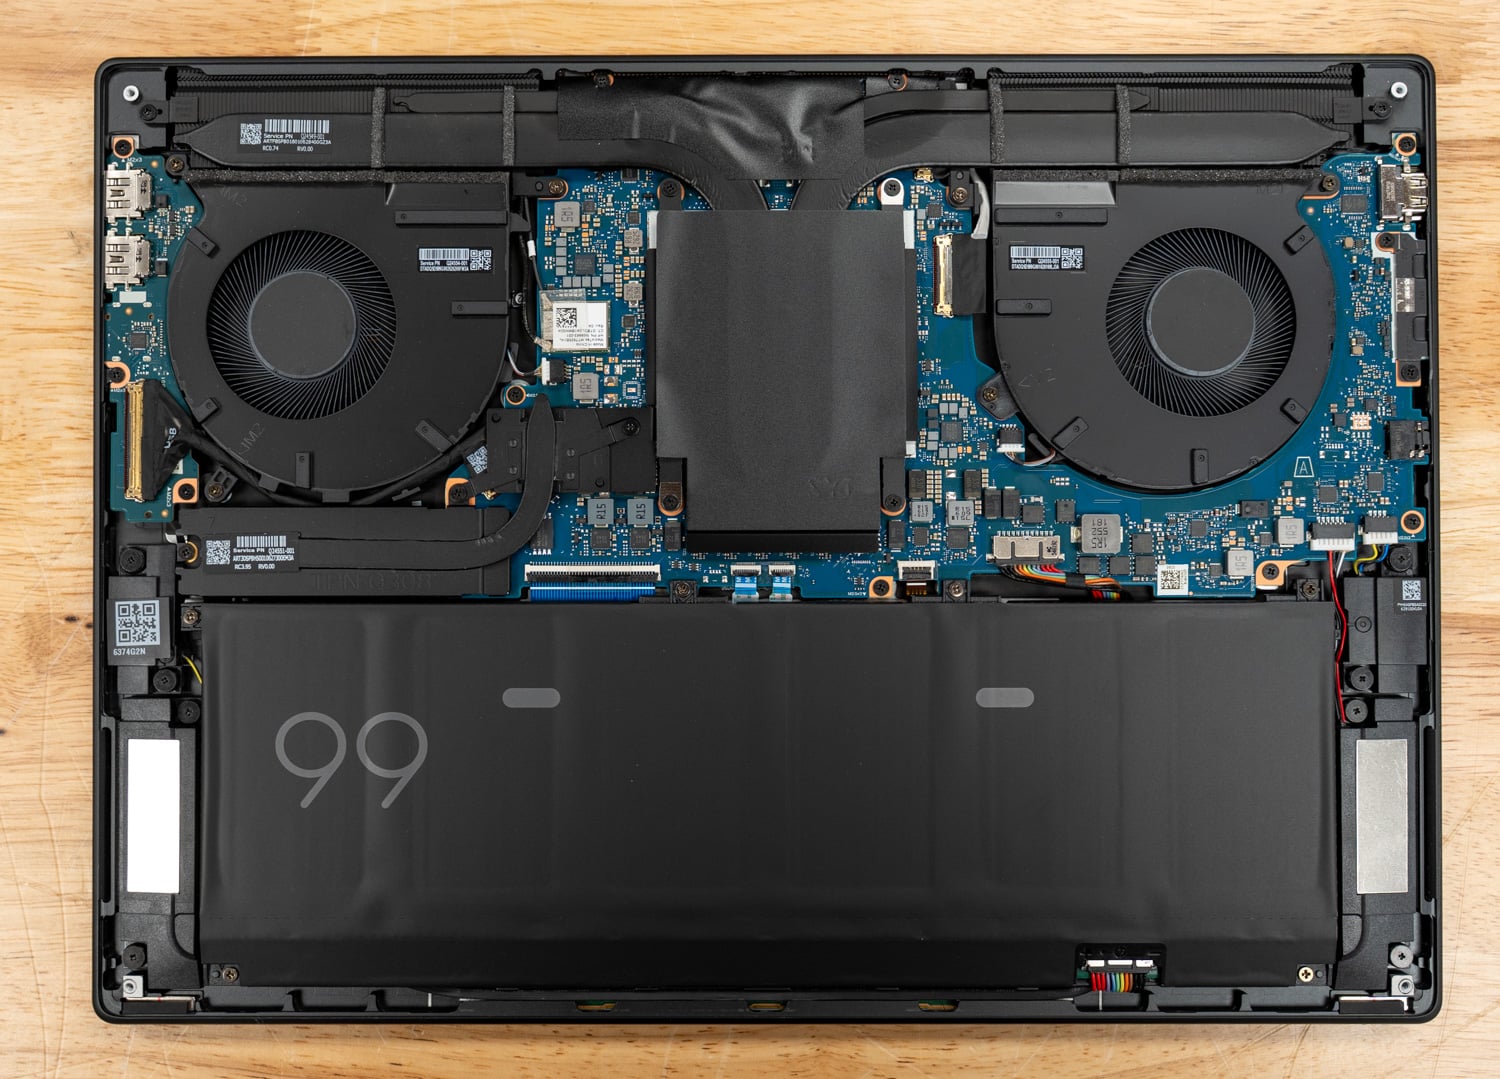
底面には、大きな吸気グリルが底面パネルの後半部分の大部分を覆っています。パネルを取り外すと、シールドされた中央部分の両側の後隅に2つのファンがあり、その間にヒートパイプが通っています。シャーシの前半分には99Whのバッテリーが収まっています。HPによると、各ファンには厚さ0.15mmのブレードが79枚付いており、2本の幅広ヒートパイプがプロセッサを覆い、3本目がSSDの上を通っており、パイプの厚さは1~1.8mmです。また、サーミスタが内部温度を監視し、IRセンサーが表面温度を監視しています。
メモリはLPDDR5Xで基板に直接はんだ付けされているため、購入した構成がそのまま使用できます。これは、メモリ容量がGPUが使用できるメモリ量も左右するため、ほとんどのノートパソコンよりもRTX Sparkシステムにおいてより重要になります。
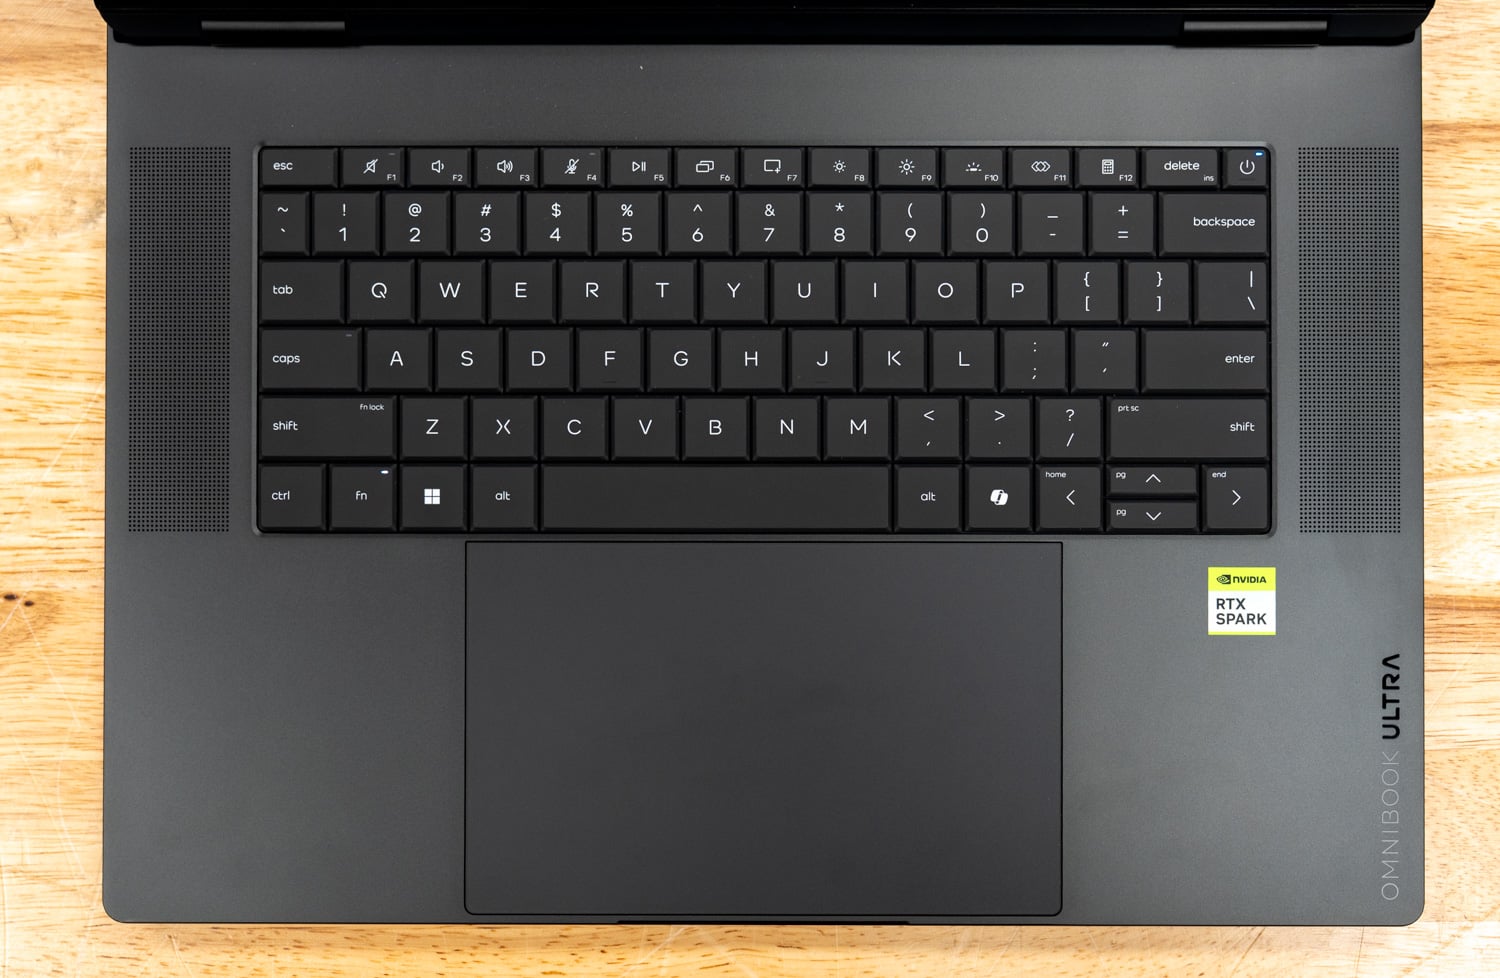
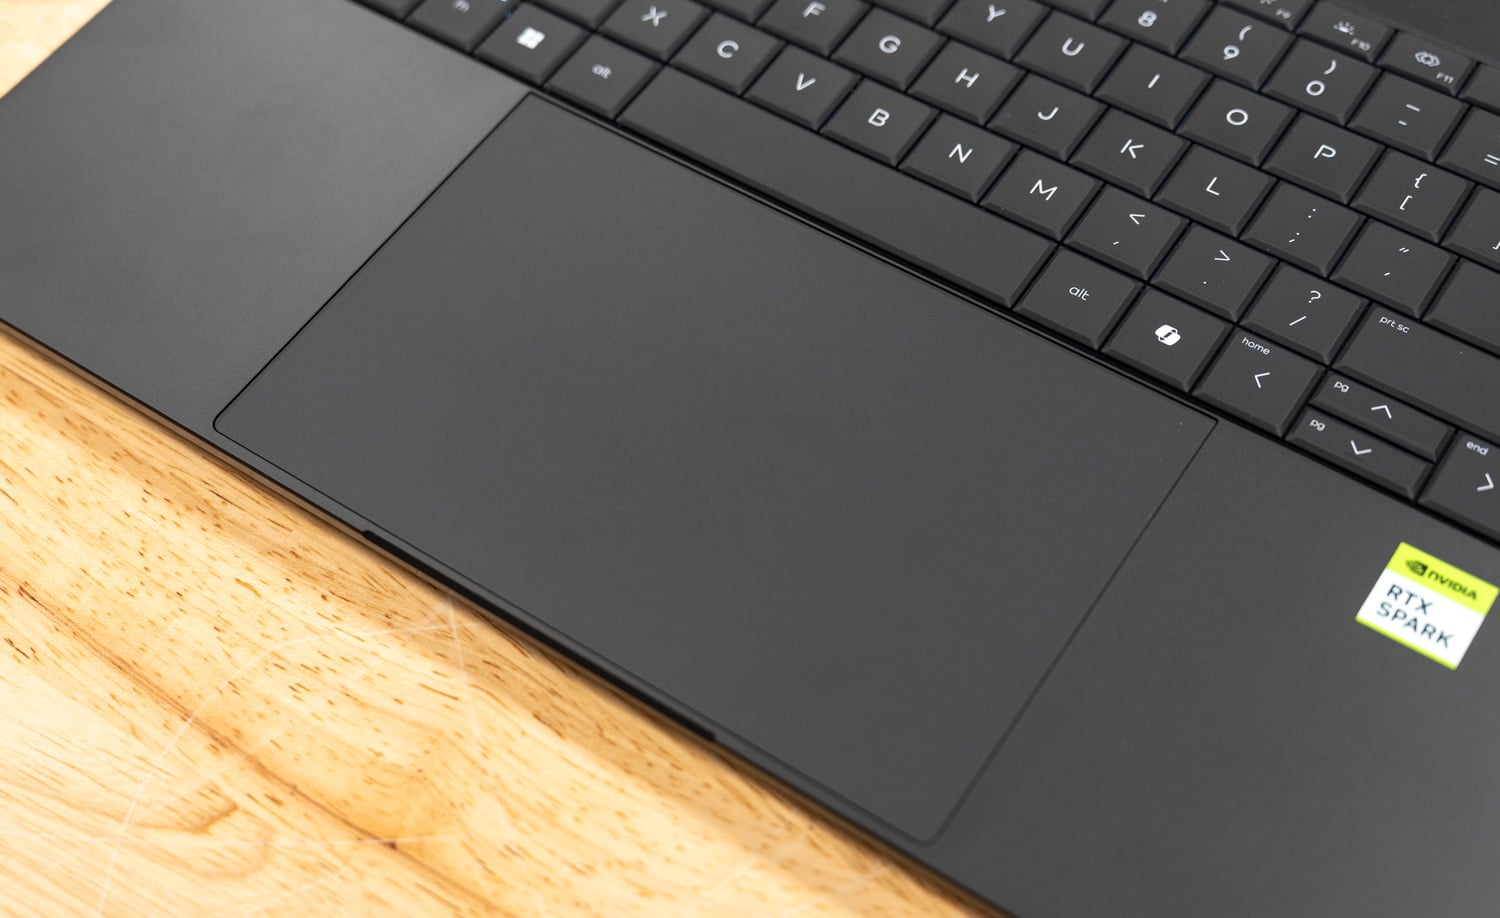
キーボードはHPの第2世代格子なしレイアウトで、フルサイズ、バックライト付き、キー間隔は3mm、第1世代よりも深くなっています。キーボードの両側には、DTS空間オーディオとPoly Studioチューニングに対応した独立したスマートアンプに搭載された2つのメインドライバーと2つのツイーターからなるクアッドスピーカーのグリルが配置されています。その下には、160 x 100mmの巨大な触覚タッチパッドがあり、表面のどこでもクリックでき、クリック力の調整、サイレントクリック機能、音量と明るさのジェスチャー操作が可能です。5MPの赤外線カメラには物理的なプライバシーシャッターがあり、専用キーでマイクをミュートできます。
ディスプレイは、Corning Gorilla Glass 3を採用した16インチ3K(2880 x 1800)OLEDタッチスクリーンで、最大120Hzのリフレッシュレート、可変リフレッシュレート、0.2msの応答速度を実現しています。HPは、SDRで500nit、HDRで1,100nitの輝度、DCI-P3色域カバー率100%、VESA DisplayHDR True Black 1000認証、Delta E値1未満と評価しており、パネルは蓋の91%を占めています。
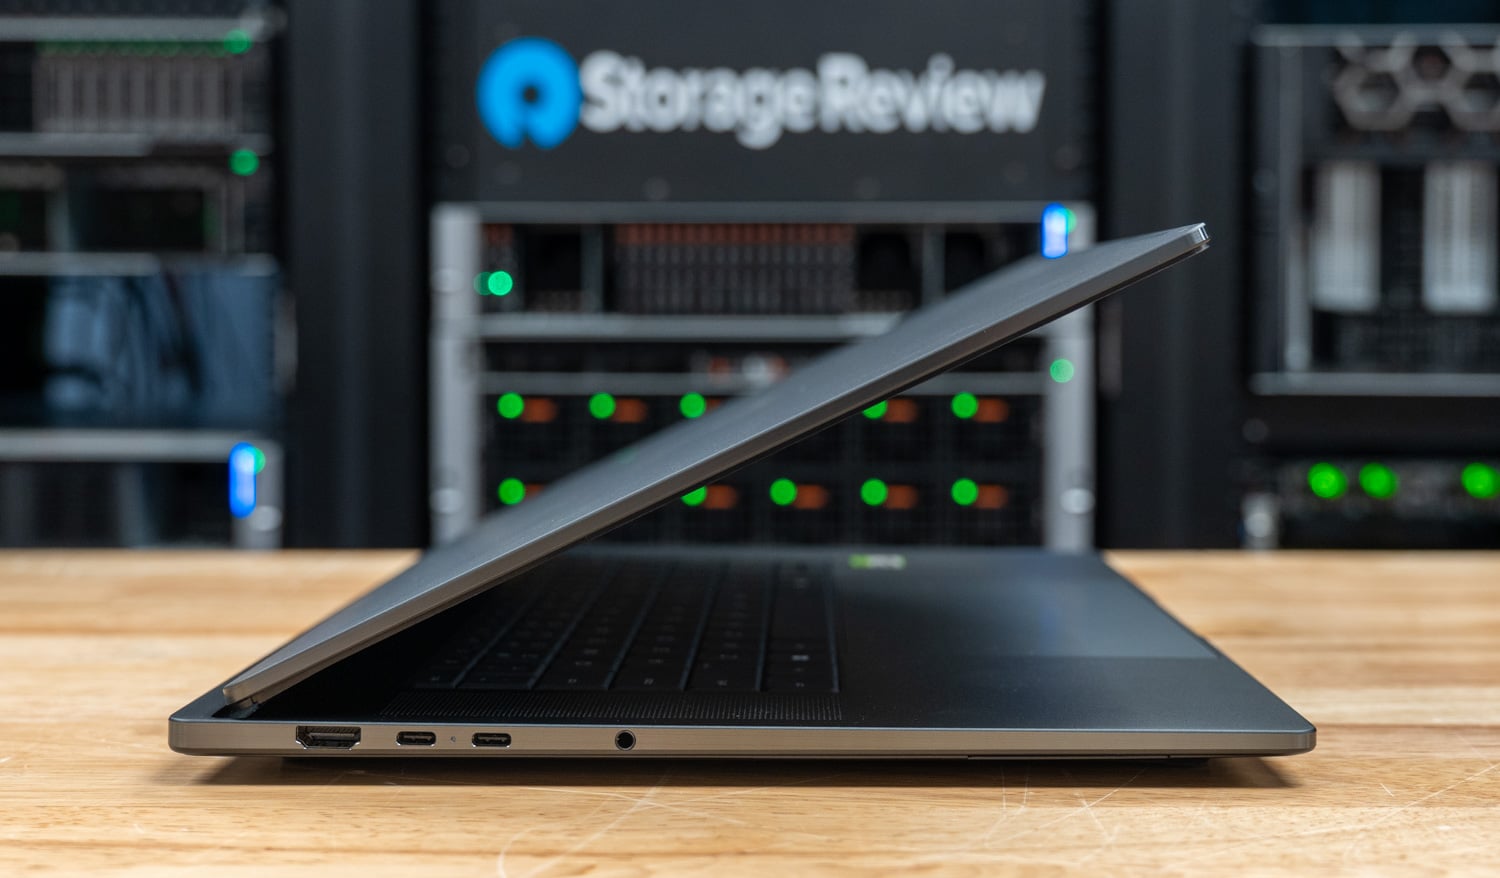
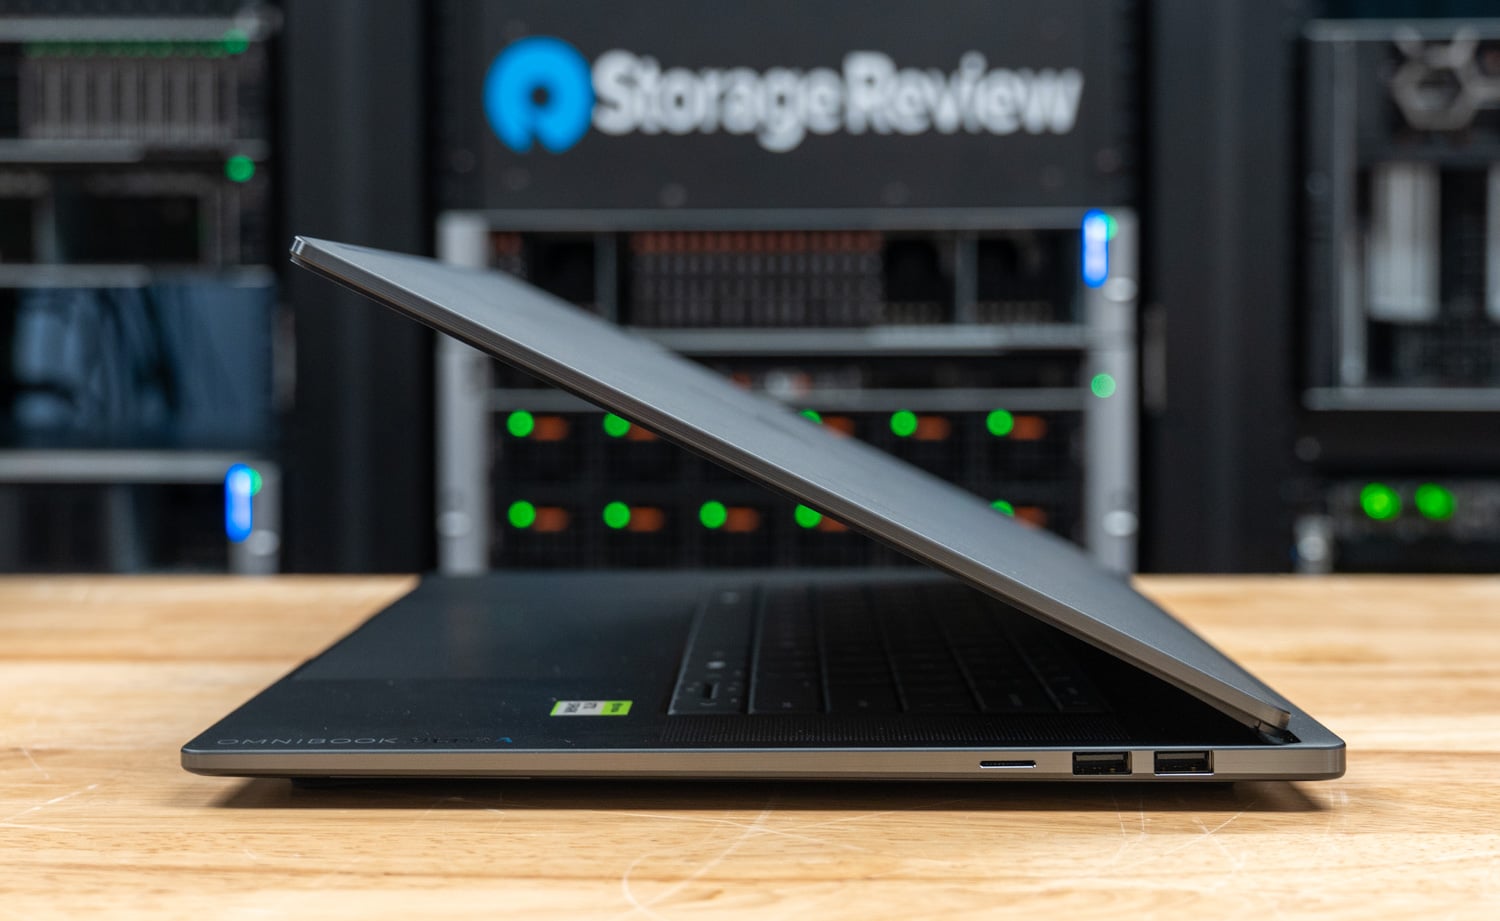
左側面にはHDMI 2.1、USB Power DeliveryとDisplayPort 2.1に対応した40GbpsのUSB-Cポートが2つ、ヘッドホンジャックが配置されています。右側面にはmicroSDカードリーダーと10GbpsのUSB-Aポートが2つあります。ワイヤレスはMediaTek MT7925カードで、Wi-Fi 7とBluetooth 6.0に対応しています。HPは99Whバッテリーの駆動時間を最大17時間としており、折りたたみ式のプラグと着脱可能な2mケーブルを備えた140W USB-C GaNアダプターを同梱しています。HPによると、このアダプターは以前の140Wアダプターよりも43%小型で28%軽量化されており、約30分で50%まで充電できるとのことです。
RTX Spark N1Xプラットフォーム
RTX Spark は、 DGX Sparkの GB10 のノートパソコン版である N1X スーパーチップをベースにした Windows PC ファミリーです。Surface Laptop Ultra のレビューでプラットフォームを詳しく解説したので、このセクションでは OmniBook の結果を読む上で重要な点に絞って説明します。HP の両機種とも最上位のビンを搭載しており、20 コアの Grace CPU (10 コアの高速コアと 10 コアの効率コア、SMT なし) と 6,144 コアの Blackwell RTX GPU を組み合わせています。HP は、この比較対象の Lenovo Pro 9n と同じ 18 コア、5,120 コア GPU バージョンも販売しています。
N1XのLPDDR5Xは、256ビットインターフェースで9,400MT/sの速度で動作し、CPUとGPUで共有されます。NVIDIAアプリの設定で、WindowsがGPUにどれだけのメモリを専用メモリとして割り当てるかが決定されます。これはBIOSの設定ではなくWindowsの設定変更なので、分割設定は簡単に変更できます。
128GBモデルはGPUメモリ64GB、CPUメモリ64GBで動作し、GPU使用可能メモリは62.5GBとなり、当社のローカルAIモデルティアの両方に該当します。32GBモデルはGPUメモリ12GB、CPUメモリ20GBに設定し、Lenovo Pro 9nと同じ構成にすることで、2つの32GBシステムを直接比較できるようにしました。12GB構成では、どちらのシステムもモデルティアテストの対象になりません。
固定分割はNVIDIAの制限ではなく、Windowsの制限です。Windowsは、DGX SparkのLinuxスタックのようにCPUとGPU間でメモリを統合する機能をまだサポートしていないため、割り当てを事前に設定する必要があります。NVIDIAとMicrosoftの間で、この機能のサポートが開発中であると理解しています。
OmniBookはArm64上でWindows 11 26H1を実行するため、x64アプリケーションはPrismエミュレーションを経由します。また、当社のスイートでは、すべてのオープンソースワークロードのネイティブArm64ビルドを使用しているため、CPUの行ではシリコンの性能を比較しています。Arm64ポートが未成熟な場合、またはx64ビルドしか選択肢がない場合は、その旨を明記しています。これは、以下のいくつかの行がそれに依存しているためです。
HP OmniBook Ultra 16 の仕様
| 製品仕様 | HP OmniBook Ultra 16 (16-bk0xxx) |
|---|---|
| プラットフォームの概要 | |
| プロセッサ | NVIDIA RTX Spark N1X、20コアCPUと6,144コアBlackwell RTX GPU(いずれもテスト対象ユニット) NVIDIA RTX Spark N1X、18コアCPU、5,120コアBlackwell RTX GPU |
| メモリ | 32GB、64GB、または128GBのLPDDR5X-9400(オンボード) 128GB、GPU用64GB / システム用64GB(テスト対象はユニット1) 32GB、GPU用12GB / システム用20GB(テスト対象はユニット2) |
| Storage | 1TB PCIe Gen5 NVMe M.2 SSD または 2TB PCIe Gen5 NVMe Performance M.2 SSD 2TB Sandisk PC SN8050S(テスト対象ユニット1) 1TB KIOXIA KBG80ZNV(テスト対象ユニット2) |
| オペレーティングシステム | Windows 11 Home または Windows 11 Pro (Arm64) テスト対象:Windows 11 Pro(ユニット1)、Windows 11 Home(ユニット2) |
| ディスプレイとI/O | |
| ディスプレイ | 16インチ3K(2880 x 1800)OLEDタッチスクリーン、最大120Hz、VRR、0.2ms 500 ニト SDR、1,100 ニト HDR、100% DCI-P3、デルタ E <1 VESA DisplayHDR True Black 1000、Corning Gorilla Glass 3 |
| ポート | USB-Cポート×2(40Gbps、USB Power Delivery、DisplayPort 2.1対応) 2x USB-A 10Gbps 1×HDMI 2.1 1xmicroSDカードリーダー ヘッドホン/マイクコンボジャック×1 |
| 無線 | MediaTek Wi-Fi 7 MT7925 (2×2)、Bluetooth 6.0 |
| カメラ | プライバシーシャッター付き5MP赤外線カメラ |
| オーディオ | 独立したスマートアンプを搭載したクアッドスピーカー(メインスピーカー2基、ツイーター2基)、DTS空間オーディオ、Poly Studioチューニング |
| 入力 | 第2世代格子なしバックライトキーボード 160 x 100mmの触覚フィードバック付きタッチパッド(ジェスチャーコントロール対応) |
| パワーと身体 | |
| 電池 | 6セル、99Whリチウムイオンポリマーバッテリー搭載。最大17時間駆動(HP社公称値)。 |
| 充電 | 140W USB-C GaNアダプター搭載。約30分で50%充電可能(HP公称値)。 |
| 熱設計 | タワー型ヒンジとトランク、ファン2基、ヒートパイプ3本、サーミスタ、IRセンサー、最大TDP 70W(HP定格) |
| 寸法 | 14.01 x 10.1 x 0.62インチ(背面15.7mm、前面11.6mm) |
| 重量 | 4.89ポンド |
| 色圏 | エクリプスグレー |
| セキュリティと価格 | |
| セキュリティ | マイクミュートキー、カメラプライバシーシャッター、TPM搭載。両ユニットともBitLocker XTS-AES-128に対応。 |
| 価格 | 3,199.99ドル(32GB、1TB、Best BuyおよびHP.com、テスト対象モデル);4,999.99ドル(64GB、2TB、HP.com) 6,229.99ドル(128GB、2TB、HP.comコンフィギュレーターによるテスト結果。HPの価格は2026年10月14日時点) |
テストのセットアップと方法論
今回テストした2台のOmniBook Ultra 16は、6,144コアのBlackwell GPUを搭載したRTX Spark N1Xを使用しています。1台は128GBのLPDDR5X-9400メモリ(64/64分割)と2TBのSandisk SN8050S Gen5 SSDを搭載し、Windows 11 Pro 26H1で動作しています。もう1台は32GBのメモリ(12/20分割)と1TBのKIOXIA Gen5 SSDを搭載し、Windows 11 Home 26H1で動作しています。どちらもArm64アーキテクチャです。ベンチマークは、HPのパフォーマンスモードで、Windowsを「最高のパフォーマンス」に設定し、電源を接続した状態で実行しました。
すべてのシステムで、スクリプト化されたWindowsクライアントベンチマークスイートであるsr-client 1.2を実行しました。このスイートは、すべての環境で同じラボ設定を適用します。具体的には、Windowsの電源モードを「最高のパフォーマンス」に設定し、ディスプレイの輝度を50%に設定、スリープタイマーとディスプレイオフタイマーをすべて無効にし、WindowsファイアウォールとUACプロンプトを無効にします。各結果は複数回のテストの中央値であり、ばらつきが2%を超えるテストは、スイートが再実行してから結果を受け入れます。
| システム | CPU | メモリ | GPUとAIのテストに使用されるGPU | SSD | OSとパフォーマンスモード |
|---|---|---|---|---|---|
| HP OmniBook Ultra 16 (128GB) | NVIDIA RTX Spark N1X、20コア/20スレッド | 128GB LPDDR5X-9400(GPU用64GB、システム用64GBに分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ62.5GB) | サンディスク PC SN8050S 2TB、Gen5 x4 | Windows 11 Pro 26H1 (Arm64)、HPパフォーマンス |
| HP OmniBook Ultra 16 (32GB) | NVIDIA RTX Spark N1X、20コア/20スレッド | 32GB LPDDR5X-9400(GPU用12GB、システム用20GBに分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ12GB) | KIOXIA KBG80ZNV 1TB、Gen5 x4 | Windows 11 Home 26H1 (Arm64)、HPパフォーマンス |
| Microsoft Surface Laptop Ultra | NVIDIA RTX Spark N1X、20コア/20スレッド | 128GB LPDDR5X-9400(GPU用64GB、システム用64GBに分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ62.5GB) | SK hynix HFS001TFM9X 1TB、Gen5 x4 | Windows 11 Pro 26H1 (Arm64)、最高のパフォーマンス |
| Lenovo Pro 9n 15 | NVIDIA RTX Spark N1X、18コア/18スレッド | 32GB LPDDR5X-9400(GPU用12GB、システム用20GBに分割) | 5,120コアのBlackwell RTX(統合型、使用可能メモリ12GB) | サムスン MZAL81T0HFLB 1TB、Gen4 x4 | Windows 11 Pro 26H1 (Arm64)、Lenovoパフォーマンスモード |
| Razerのブレード16 | AMD Ryzen AI 9 HX 370、12コア/24スレッド | 32GB LPDDR5X-8000 | NVIDIA GeForce RTX 5090 ノートパソコン用GPU、24GB | Samsung MZVL22T0 2TB、Gen4 x4 | Windows 11 Home 25H2 (x64)、Razer Synapse Performance |
以下のデータを見ると、完了した数値以外に理解しておくべき重要な表示が 2 つあります。DNF は、テストが開始されたものの完了しなかった、または失敗後にスキップされたことを意味します。ここでは、テストがラップトップの電源を切った後にスキップされた Surface の OpenBLAS 実行にのみ適用されます。実行されなかったとは、ハードウェアが条件を満たしていないため、テストスイートがテストの開始を拒否したことを意味します。これは、多くの場合、モデルが使用可能な GPU メモリを超えているためです。32GB の OmniBook と、使用可能な GPU メモリが 12GB の Pro 9n は、最小モデル ティアを下回っており、Blade 16 の 24GB は、ティア M を下回っています。
「N/A」は、そのハードウェアにはテストが適用されないことを意味します。例えば、SMT非対応のチップ上のSMTシングルコアや、ネイティブビルドを実行するx64システム上のエミュレーション行などが該当します。RTX SparkシステムがPrism経由でx64ソフトウェアを実行した場合は、その旨が行に記載されます。
ローカルAIパフォーマンス
これらのノートPCにおけるローカルAIの性能は、GPUがモデルをどれだけ高速に実行できるか、そしてそもそもそのモデルがノートPCに収まるかどうかにかかっています。128GBのOmniBookとSurfaceは、62.5GBのGPU使用可能メモリによってティアMモデルを実行できるため、容量の面では十分な性能を発揮します。一方、32GBのOmniBookとPro 9nは、小型モデルでは同等の速度を発揮しますが、それ以上の性能は期待できません。
MLPerfクライアントv2.0
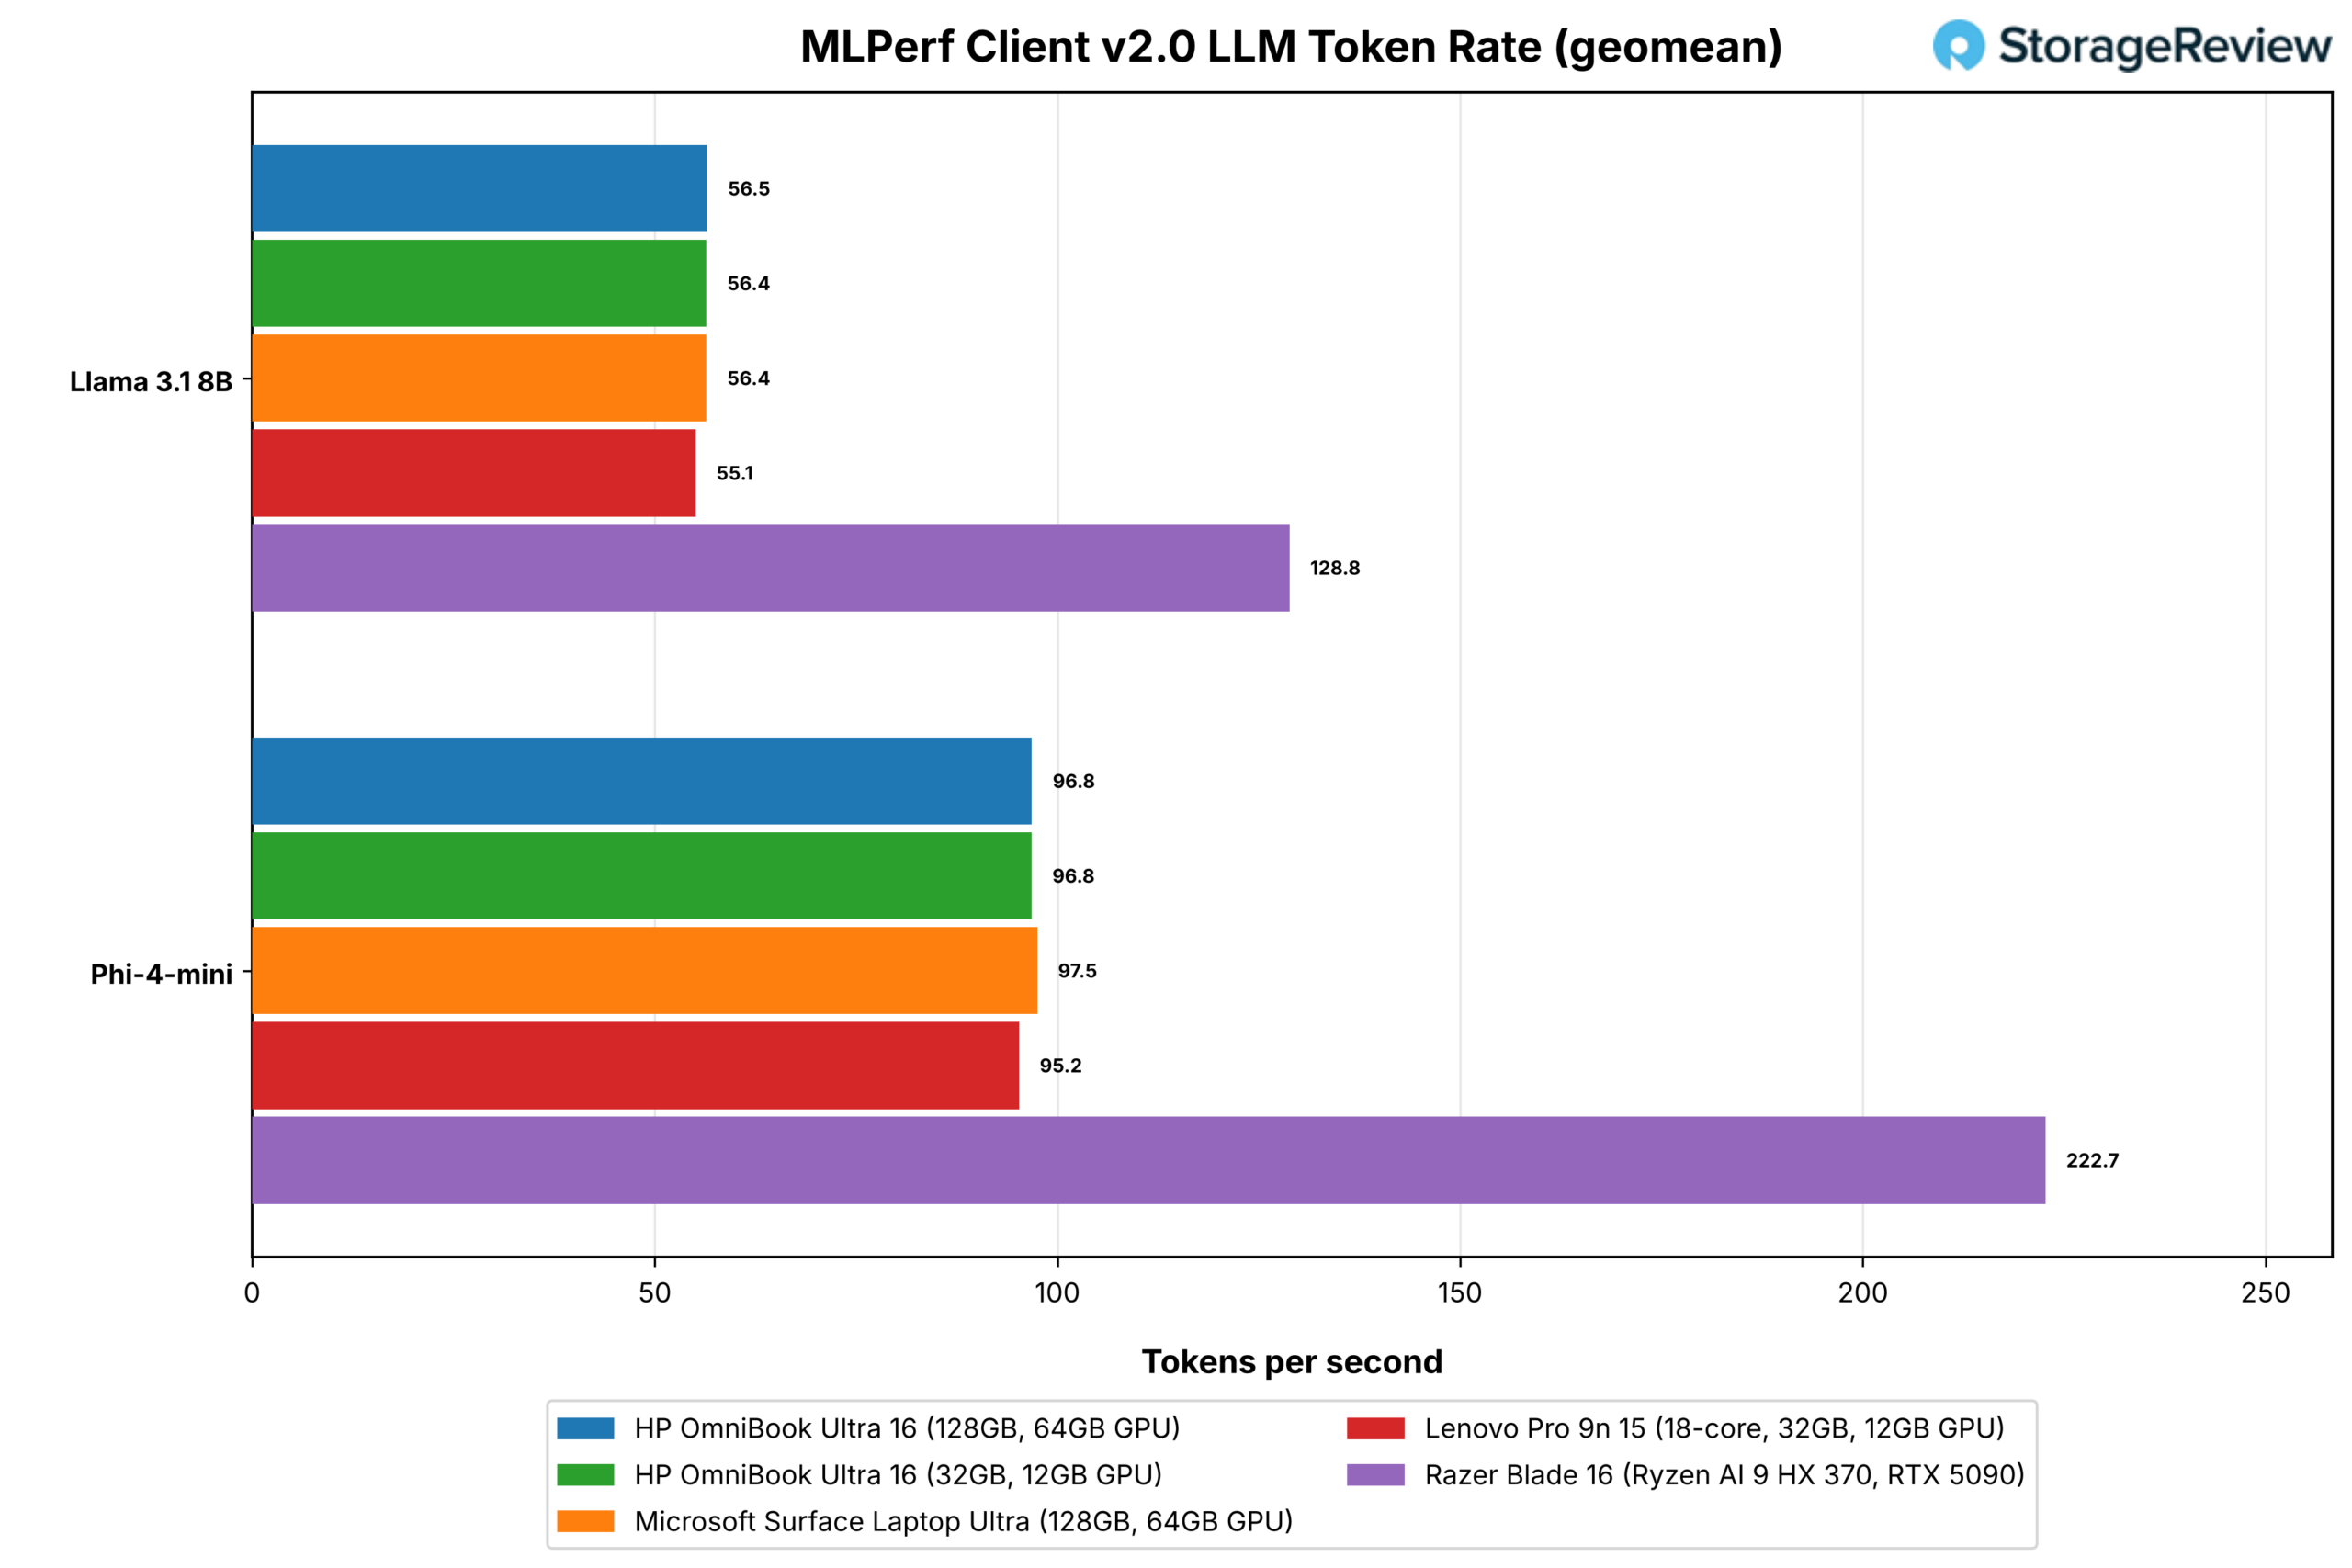
MLPerf Client は、Llama 3.1 8B と Phi-4-mini を 5 つのプロンプト カテゴリで実行し、最初のトークンまでの時間と、その後のトークンレートをカテゴリ全体の幾何平均として報告します。このレビュー対象のすべてのシステムは LLama.cpp と CUDA を使用しているため、エンジンは同じであり、行はハードウェアを比較しています。エージェント シナリオでは、Llama 3.1 8B をソフトウェア エンジニアリング エージェントおよびデータ アナリスト エージェントとして実行し、複数のターンにわたってツールを呼び出します。
| MLPerfクライアントv2.0 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| Llama 3.1 8B、最初のトークン取得までの時間、幾何平均(秒、値が小さいほど良い) | 0.274 | 0.275 | 0.284 | 0.303 | 0.149 |
| Llama 3.1 8B、トークンレート、幾何平均(トークン/秒) | 56.5 | 56.4 | 56.4 | 55.1 | 128.8 |
| Phi-4-mini、最初のトークンまでの時間、幾何平均(s、値が小さいほど良い) | 0.130 | 0.123 | 0.127 | 0.135 | 0.074 |
| Phi-4-mini、トークンレート、幾何平均(トークン/秒) | 96.8 | 96.8 | 97.5 | 95.2 | 222.7 |
| データアナリストエージェント、エンドツーエンド(s、数値が低いほど良い) | 53.0 | 52.4 | 52.6 | 56.2 | 27.8 |
| データアナリストエージェント、トークンレート(tok/秒) | 48.5 | 49.0 | 48.9 | 46.9 | 108.3 |
| SWEエージェント、エンドツーエンド(s、数値が小さいほど良い) | 45.3 | 46.2 | 46.0 | 48.0 | 24.6 |
| SWEエージェント、トークンレート(tok/秒) | 46.6 | 46.6 | 46.4 | 44.5 | 102.5 |
2台のOmniBookは、Llama 3.1 8Bを毎秒56.5トークンと56.4トークン、Phi-4-miniを毎秒96.8トークンと96.8トークン生成し、実質的に互いに同じでSurfaceとも同等でした。これは、メモリ容量が適合するモデルではN1X GPUの速度に影響を与えないことを裏付けています。Pro 9nの5,120コアGPUは、この規模のトークン生成はGPUコアよりもメモリ帯域幅によって制限されるため、両モデルで3%以内の差に収まりました。Blade 16は毎秒128.8トークンと222.7トークンでトップでした。
エージェントシナリオも同様の傾向を示し、RTX Sparkシステムはいずれもデータアナリストシナリオを52.4~56.2秒、ソフトウェアエンジニアリングシナリオを45.3~48.0秒で完了したが、Blade 16はどちらのシナリオでも約半分の時間で完了した。
モデルのロード
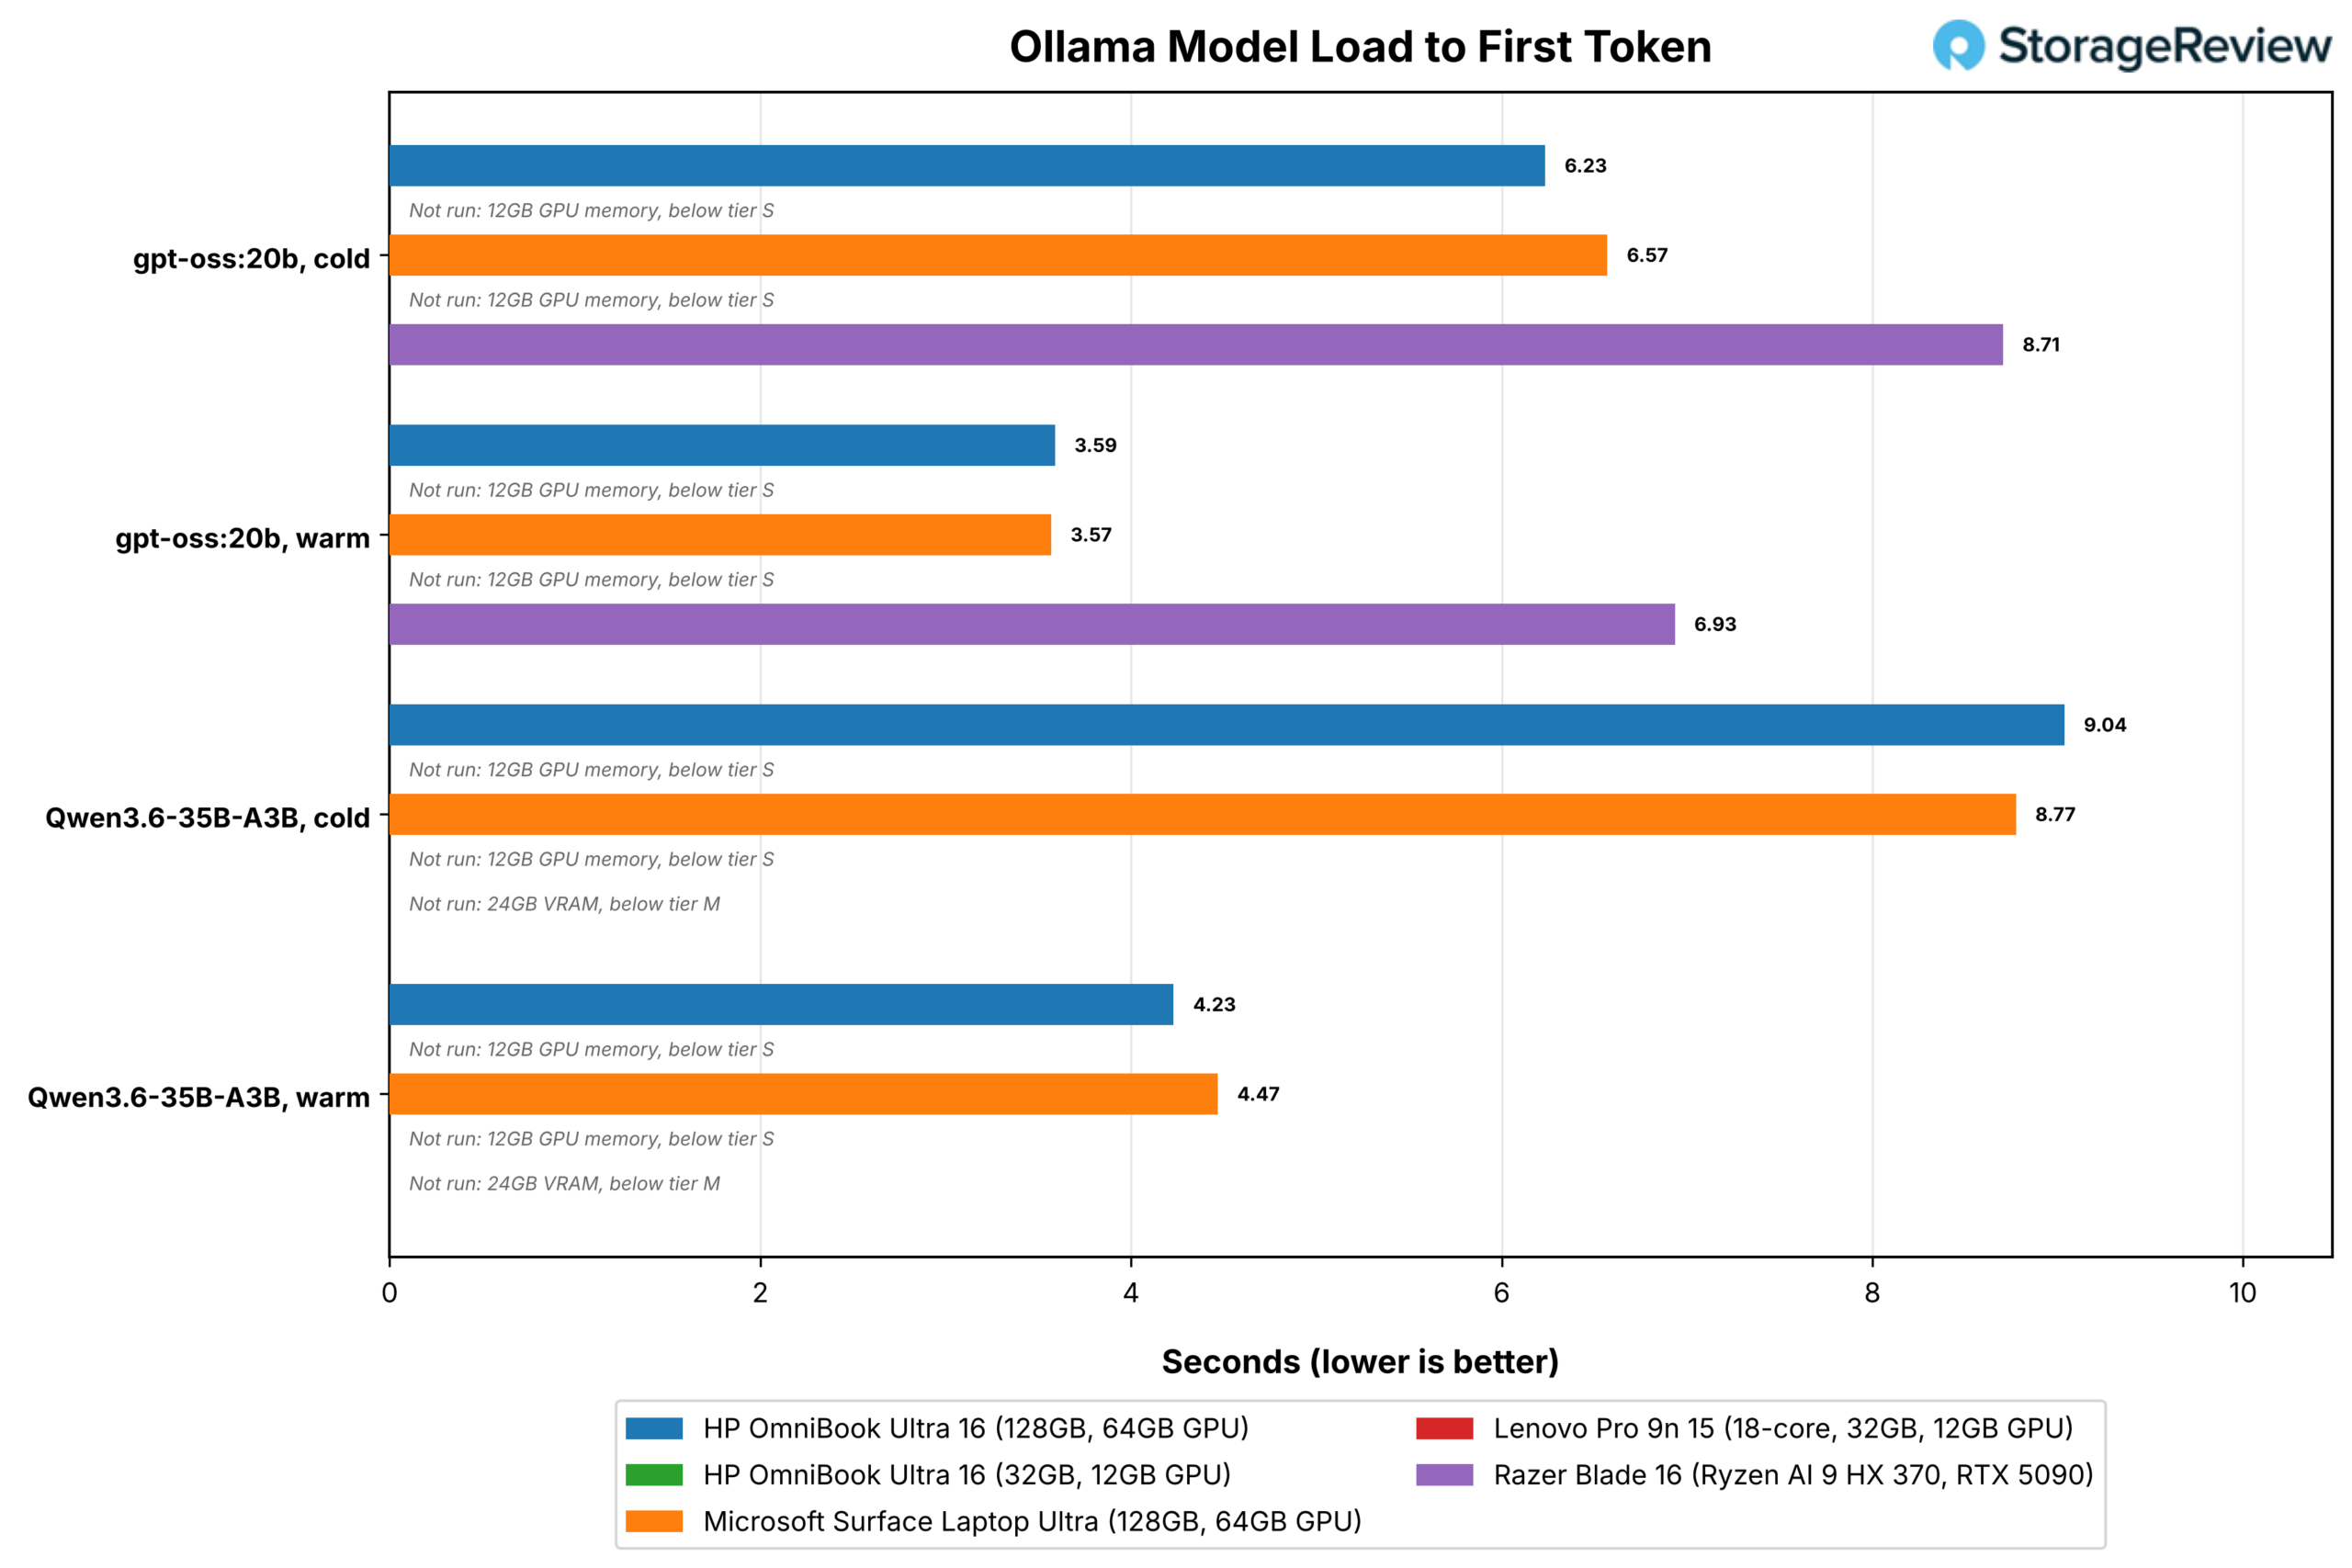
このテストでは、Ollama のローカル モデルが SSD から最初のトークンを生成するまでの時間を、コールド (ファイル キャッシュがフラッシュされた状態) とウォーム (ファイルが既にメモリにロードされている状態) で計測し、コールド ロード中に SSD がどれだけ速く読み込まれたかを報告します。ティア S では、GPU で使用可能なメモリが 16GB 以上のシステムで gpt-oss:20b (12.8GB) を使用します。ティア M では、約 40GB 以上のシステムで Qwen3.6-35B-A3B (21.1GB) を追加します。
| モデルの読み込み(メモリマッピング有効) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| gpt-oss:20b、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 6.23 | 実行されません(GPUメモリ12GB) | 6.57 | 実行されません(GPUメモリ12GB) | 8.71 |
| gpt-oss:20b、最初のトークンをウォームロードします(s、数値が小さいほど良い) | 3.59 | 実行されません(GPUメモリ12GB) | 3.57 | 実行されません(GPUメモリ12GB) | 6.93 |
| gpt-oss:20b、コールドロード時の読み取りスループット(MB/秒) | 3,044 | 実行されません(GPUメモリ12GB) | 3,080 | 実行されません(GPUメモリ12GB) | 3,874 |
| Qwen3.6-35B-A3B、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 9.04 | 実行されません(GPUメモリ12GB) | 8.77 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| Qwen3.6-35B-A3B、最初のトークンへのウォームロード(s、数値が小さいほど良い) | 4.23 | 実行されません(GPUメモリ12GB) | 4.47 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
128GB OmniBook は、gpt-oss:20b をコールド状態で 6.23 秒で最初のトークンに到達し、グループの中で最速でした。これは Surface の 6.57 秒、Blade 16 の 8.71 秒を上回り、ウォーム状態では 3.59 秒でした。Blade は 3,874MB/s でファイルを最速で読み込みましたが、最初のトークンに到達したのは最後でした。これは、Blade の重みがまだ PCIe を越えて VRAM に移動する必要があるのに対し、統合メモリは読み込まれた時点で重みが所定の位置にあるためです。HP のドライブはここで制限ではありません。ロード中の 3,044MB/s は、テスト独自の DiskSpd パスが同じモデルファイルを 1MB ブロックで読み取った 12,866MB/s のほんの一部です。
ティアMでは、OmniBookとSurfaceが0.3秒差で互角の勝負を繰り広げ、コールドスタートで9.04秒と8.77秒、ウォームスタートで4.23秒と4.47秒を記録した。32GB版OmniBookとPro 9nはGPU使用可能メモリが12GBのため、どちらのティアにも該当せず、VRAMが24GBのBlade 16はティアMから外れている。
コーディングエージェント
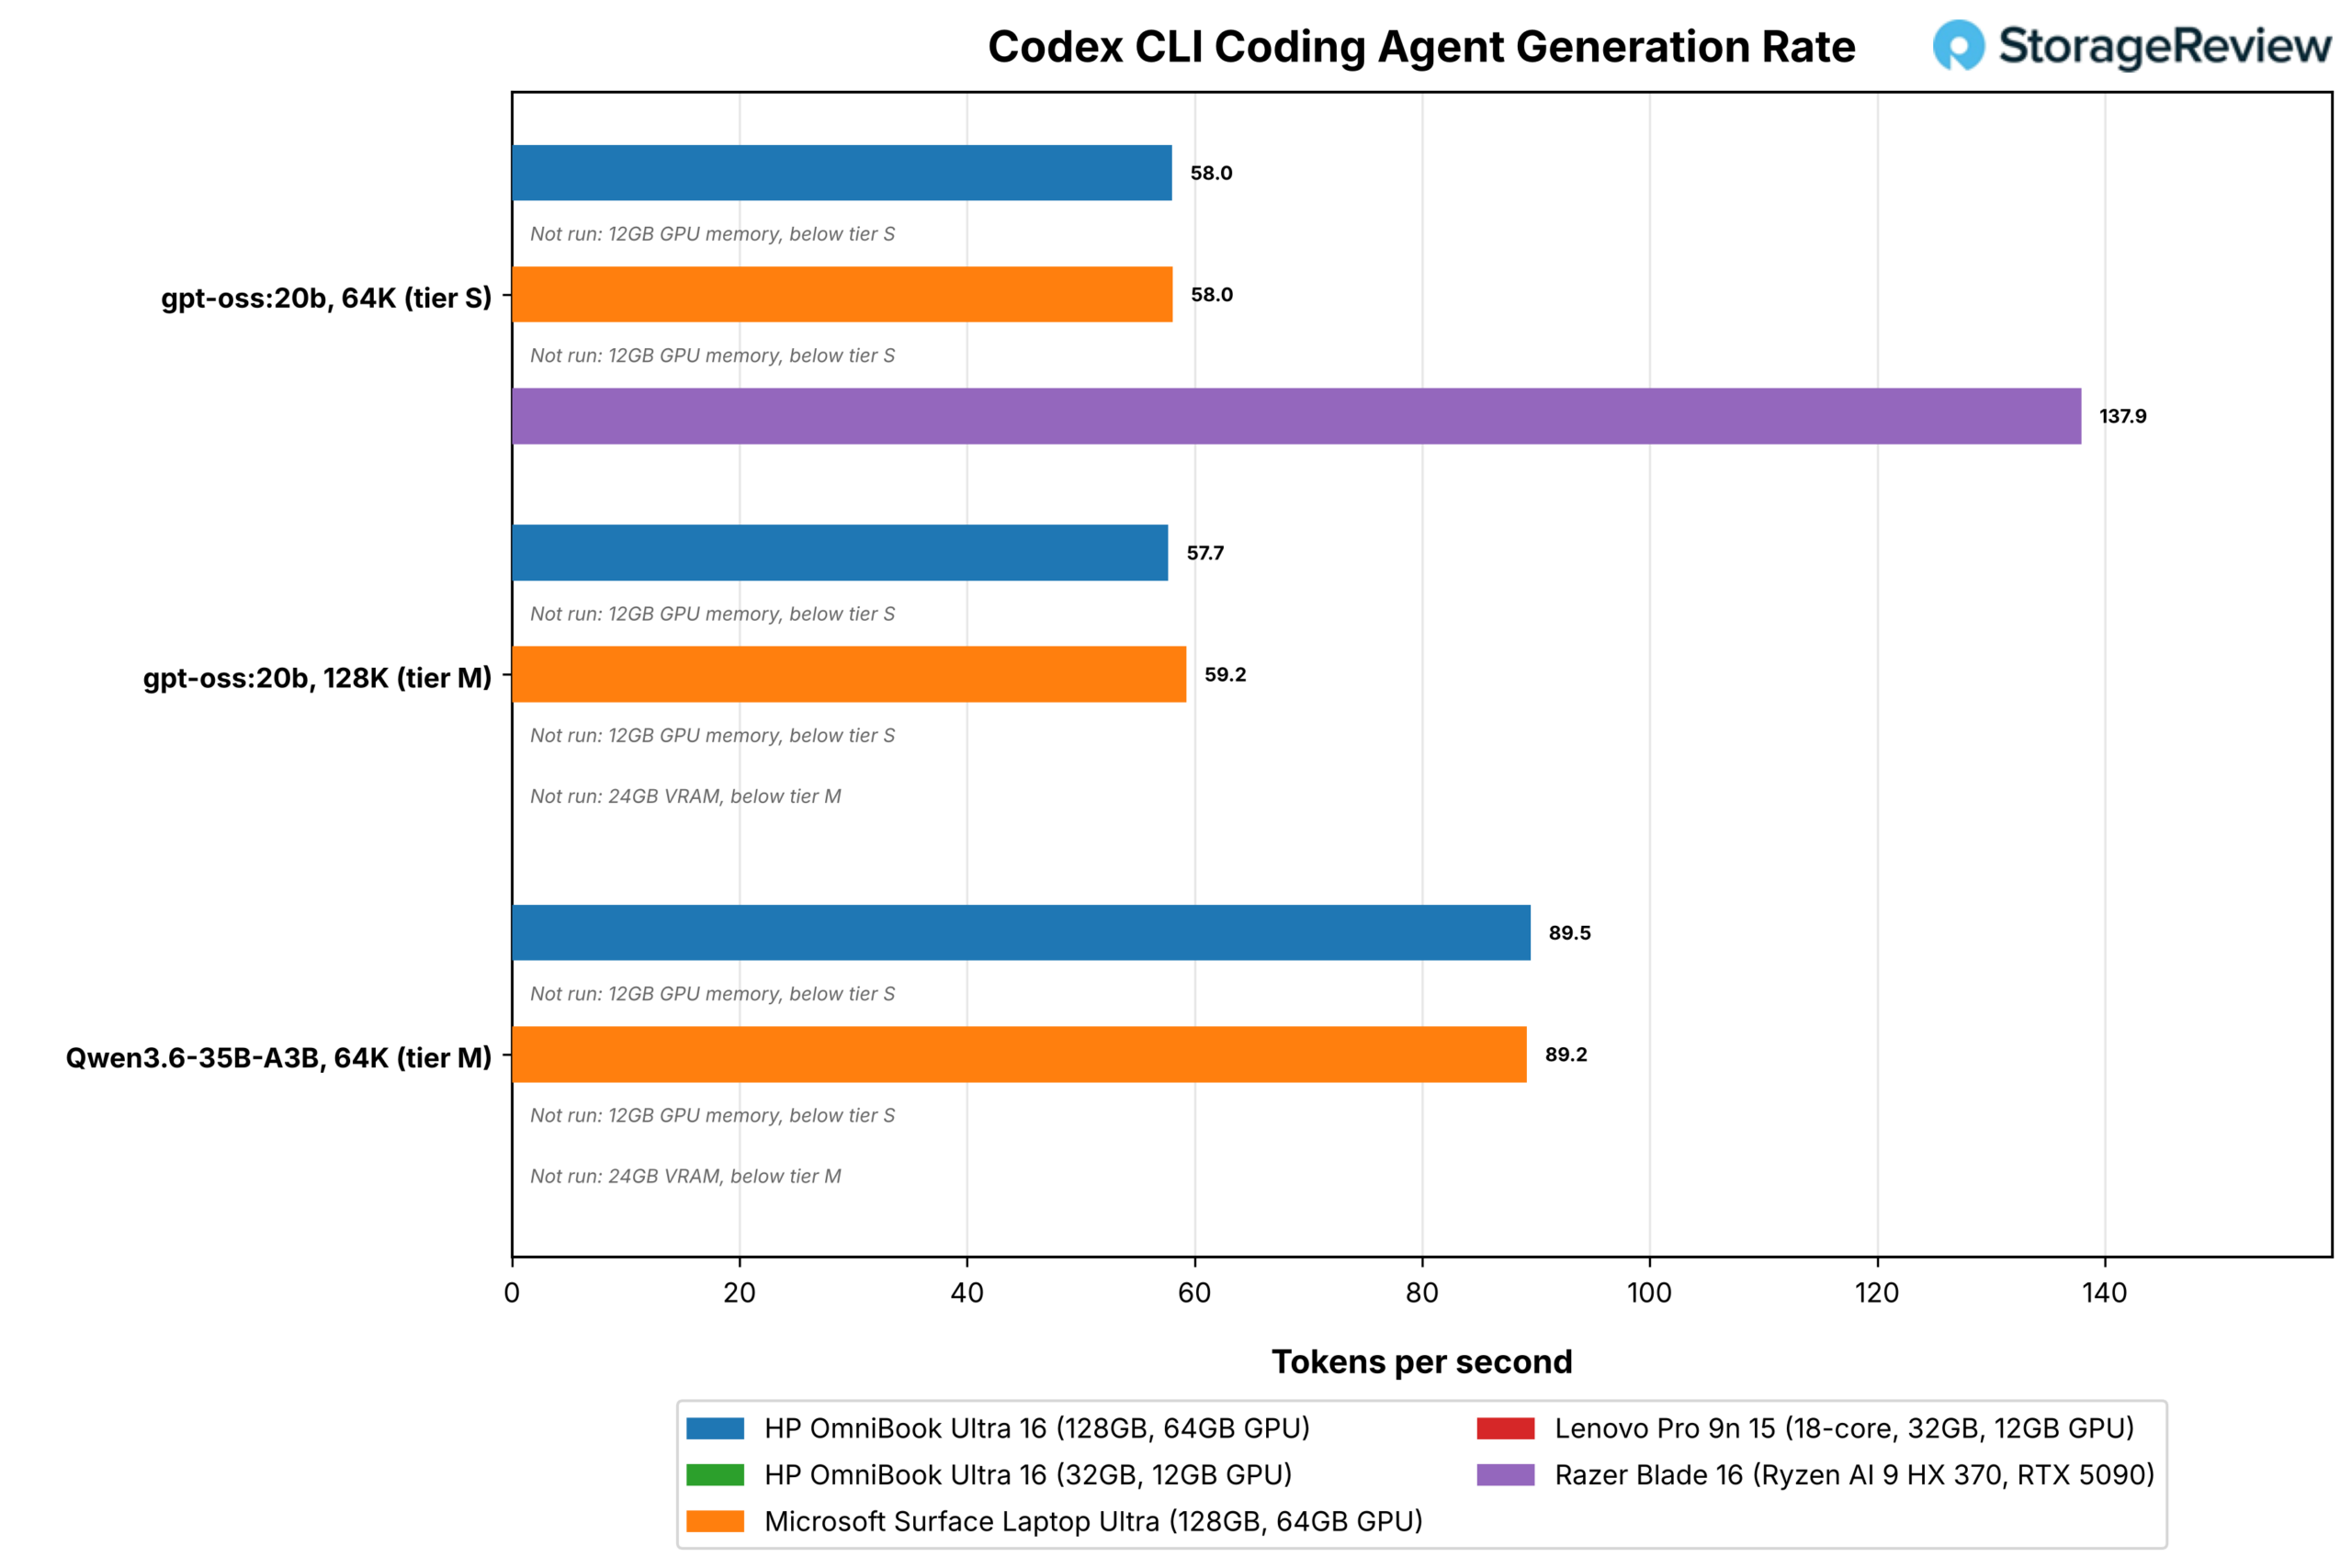
Codex CLI は、Ollama が提供するローカル モデルを、固定リポジトリ内の固定コーディング タスクに通します。リポジトリの 11 個のテストがすべて合格すると、実行は成功となります。ここでは、3 回の実行における平均実行時間、成功回数、および生成率を報告します。エージェントとユーザーの同時実行テストでは、エージェントと Speedometer を同時に実行し、それぞれ単独で実行した場合と比較してどれだけ処理速度が低下するかを報告します。
| Codex CLI コーディングエージェント | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| ティアS、gpt-oss:20b 64K: ウォールタイム(秒、数値が低いほど良い) | 115.3 | 実行されません(GPUメモリ12GB) | 191.8 | 実行されません(GPUメモリ12GB) | 64.4 |
| ティアS:成功(3件中) | 3 | 実行されません(GPUメモリ12GB) | 3 | 実行されません(GPUメモリ12GB) | 2 |
| ティアS:生成速度(tok/秒) | 58.0 | 実行されません(GPUメモリ12GB) | 58.0 | 実行されません(GPUメモリ12GB) | 137.9 |
| ティアM、gpt-oss:20b 128K: ウォールタイム(秒、数値が低いほど良い) | 152.1 | 実行されません(GPUメモリ12GB) | 87.5 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、gpt-oss:20b 128K: 成功数(3件中) | 3 | 実行されません(GPUメモリ12GB) | 2 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:ウォールタイム(秒、数値が低いほど良い) | 72.0 | 実行されません(GPUメモリ12GB) | 88.6 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:成功(3回中) | 3 | 実行されません(GPUメモリ12GB) | 3 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| ティアM、Qwen3.6-35B-A3B 64K:生成速度(tok/秒) | 89.5 | 実行されません(GPUメモリ12GB) | 89.2 | 実行されません(GPUメモリ12GB) | 動作しません(24GB VRAM、ティアM未満) |
| エージェント(スコア)の横にあるスピードメーター | 21.2 | 実行されません(GPUメモリ12GB) | 18.1 | 実行されません(GPUメモリ12GB) | 36.3 |
| エージェント横のスピードメーターの減速(x、数値が低いほど良い) | 1.73 | 実行されません(GPUメモリ12GB) | 1.92 | 実行されません(GPUメモリ12GB) | 1.06 |
| スピードメーター横のエージェント減速度(x、数値が低いほど良い) | 1.04 | 実行されません(GPUメモリ12GB) | 1.10 | 実行されません(GPUメモリ12GB) | 1.05 |
128GB OmniBook は、9 つのコーディング実行すべてに合格しました。Qwen3.6-35B-A3B タスクは、毎秒 89.5 トークンで 72.0 秒で完了し、同じレートで Surface の 88.6 秒を上回りました。また、ティア S タスクは、Surface の 191.8 秒に対し、115.3 秒で完了しました。ティア M gpt-oss:20b の実行は、Surface の 87.5 秒に対し 152.1 秒と、Surface より時間がかかりました。これは、HP 上でモデルがより多くのツール呼び出しを行い、より多くのトークンを生成したためです。生成レートは毎秒 57.7 トークンと 59.2 トークンで、ハードウェアの比較としてはより明確です。
Blade 16 は、1 秒あたり 137.9 トークンで 64.4 秒でティア S タスクを完了し、3 回の実行のうち 2 回に合格しました。ディスクリート GPU が効果を発揮するのは、同時実行テストです。エージェントが実行されると Blade のブラウザ スコアは 5 パーセント低下しましたが、これはモデルが RTX 5090 上で動作しているためです。エージェントが他のすべてと統合 GPU およびメモリ バスを共有する OmniBook では、Speedometer は 36.7 から 21.2 に低下し、1.73 倍の速度低下となりましたが、これは Surface の 1.92 倍よりは緩やかです。
検索拡張生成
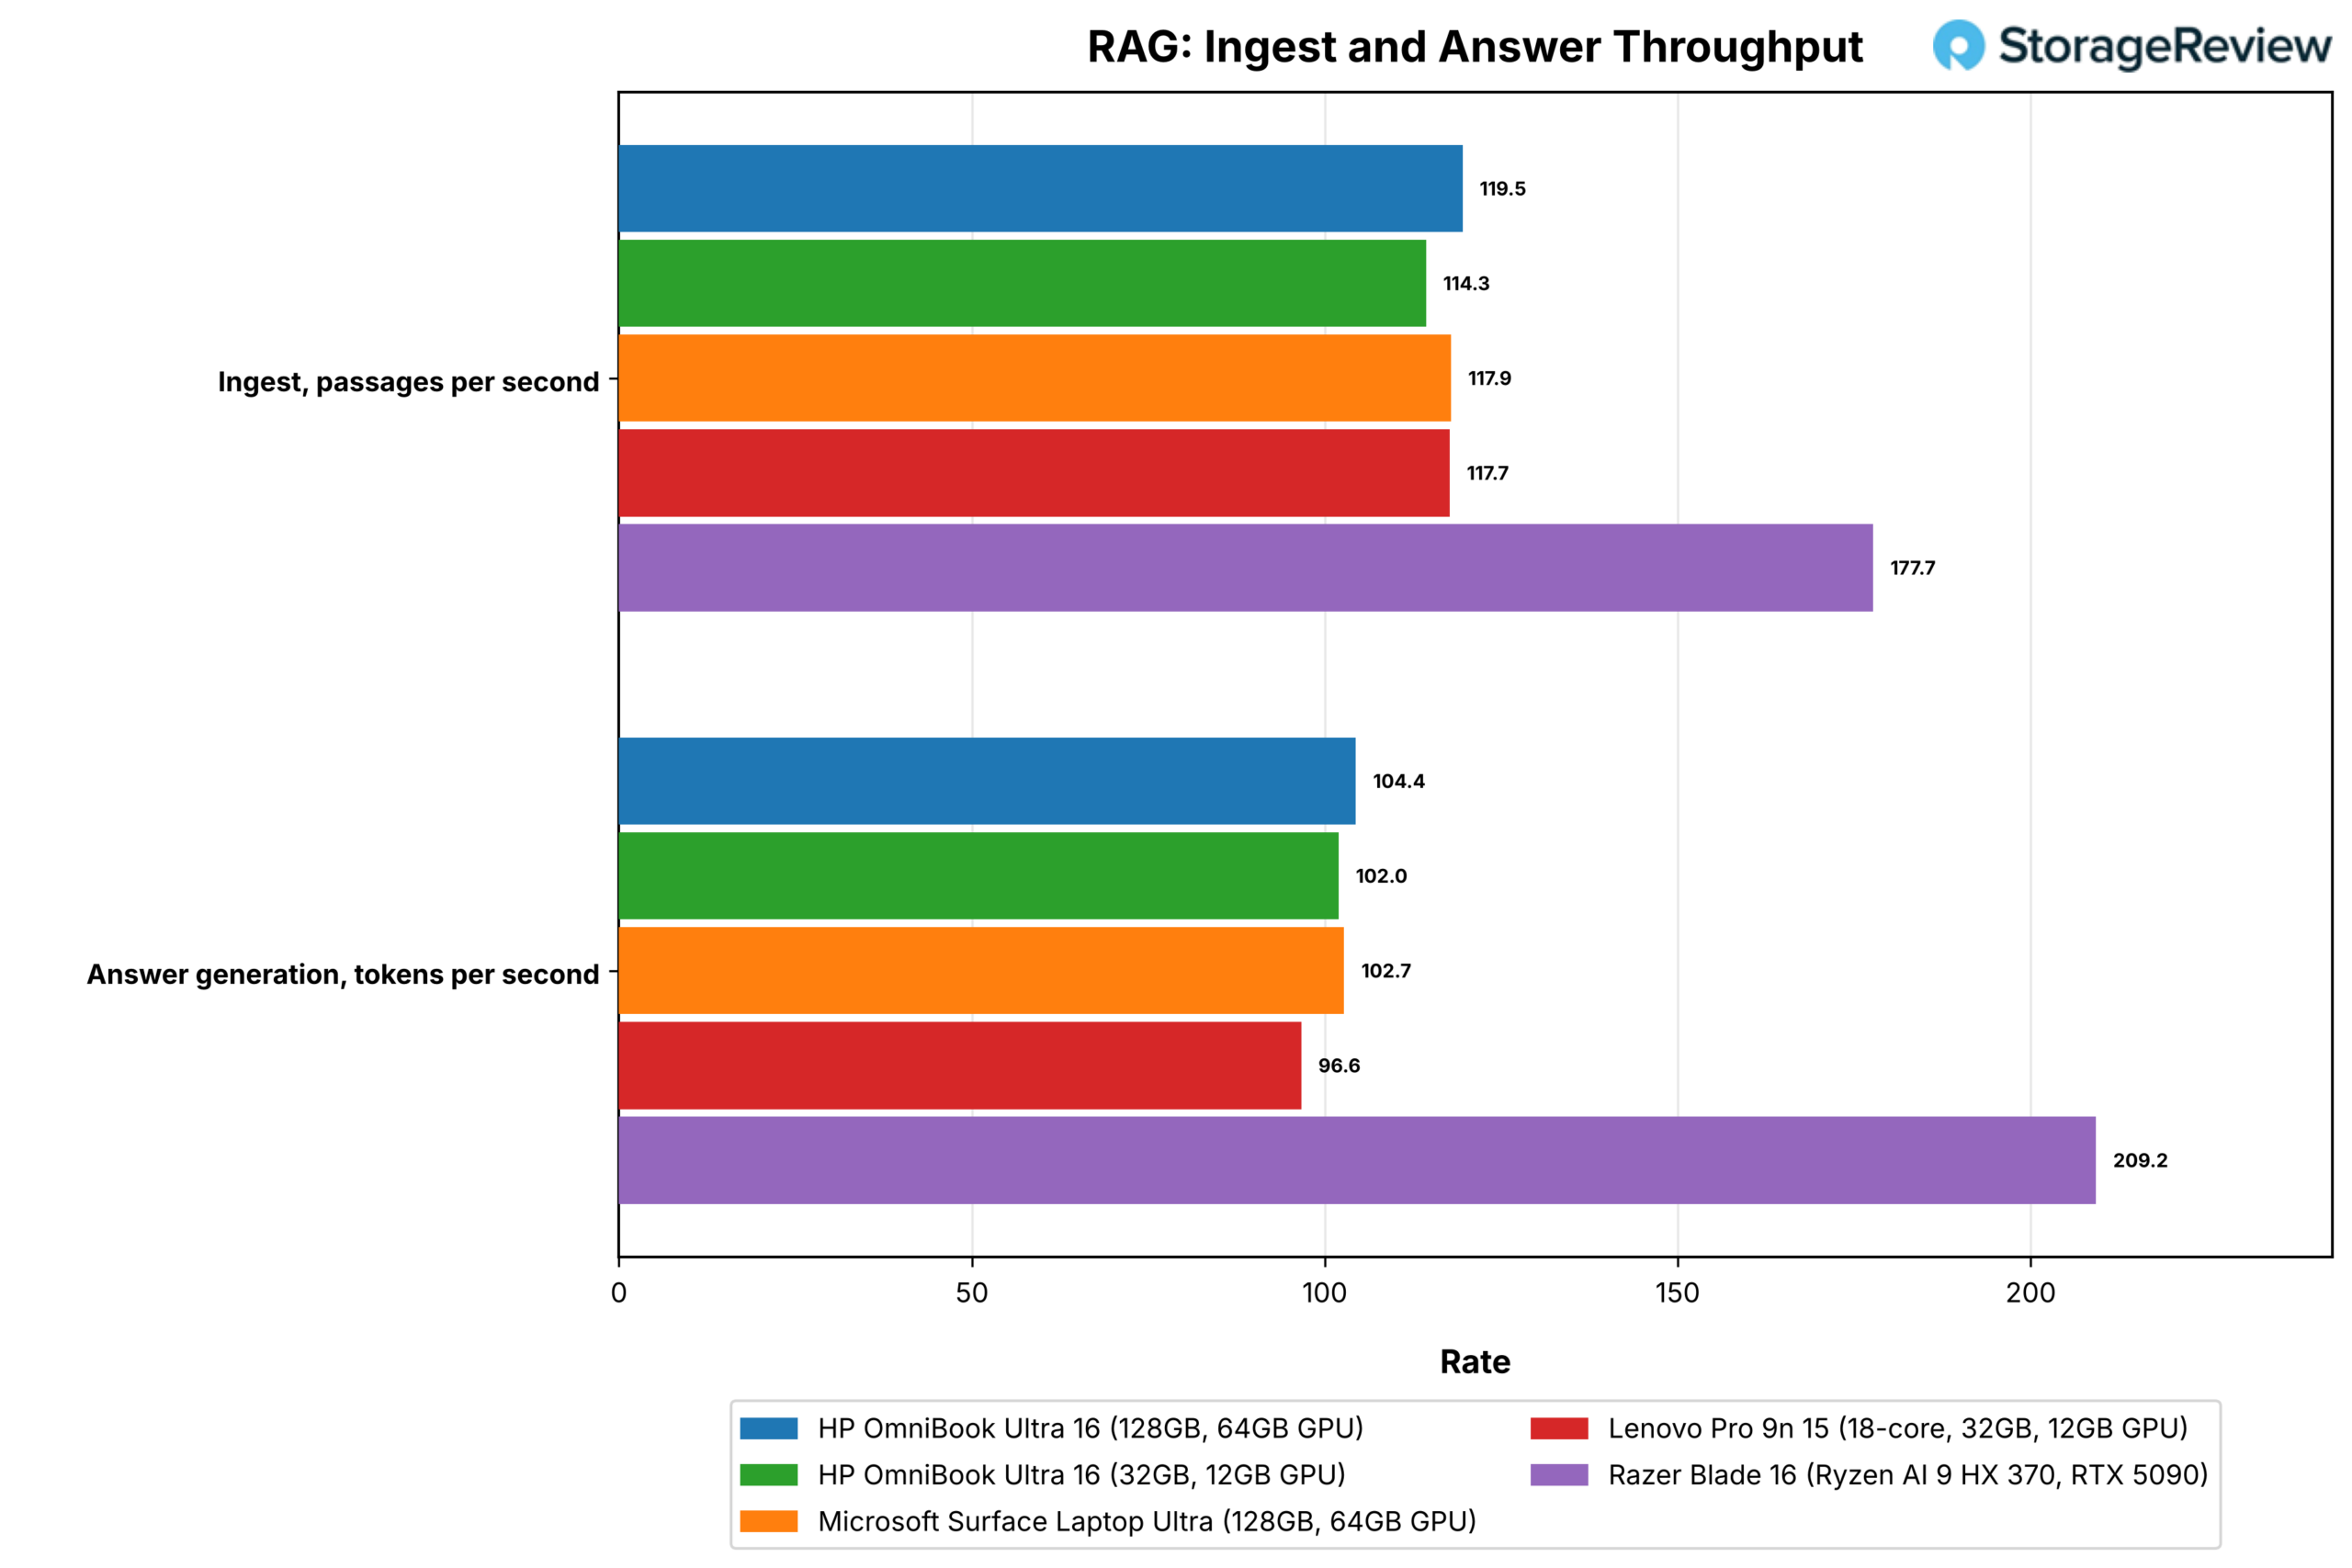
RAGテストでは、20,963個のSQuAD v1.1パッセージをnomic-embed-textで埋め込み、2,000問それぞれについて上位5つのパッセージを取得し、そのうち400問にPhi-4-miniで解答します。解答は、参照解答との完全一致率とF1スコアで評価されます。モデルはどのシステムでも実行できるほど小さいため、これは速度比較です。
| RAG | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| 摂取壁時間:20,963回(秒、数値が低いほど良い) | 187.0 | 195.2 | 189.8 | 191.8 | 131.0 |
| 検索クエリ時間、p50(ミリ秒、数値が低いほど良い) | 23.3 | 22.5 | 23.4 | 24.2 | 20.9 |
| 回答、最初のトークンまでのPhi-4-mini時間、p50(秒、数値が小さいほど良い) | 0.155 | 0.156 | 0.161 | 0.171 | 0.109 |
| 回答、即時処理(tok/s) | 7,142 | 7,139 | 6,955 | 6,268 | 11,560 |
| 回答、生成速度(tok/秒) | 104.4 | 102.0 | 102.7 | 96.6 | 209.2 |
| 質問への回答、p50(数値が低いほど良い) | 0.227 | 0.231 | 0.235 | 0.252 | 0.159 |
| 回答 F1 (%) | 73.97 | 73.97 | 73.97 | 74.27 | 74.47 |
4台のRTX Sparkシステムは、8秒以内にデータの取り込みを完了し、128GBのOmniBookが187.0秒で最速でした。また、典型的な質問には0.227秒から0.252秒で回答しました。Blade 16は131.0秒でコーパスを取り込み、1秒あたり209.2トークンの回答を生成しました。これはOmniBookの104.4トークンの2倍です。精度は3台の20コアシステムで同一であり、Pro 9nとBladeではF1スコアから0.5ポイント以内でした。これは、温度0の同じモデルであれば当然のことです。
CPUパフォーマンス
3台の20コアRTX SparkノートブックはCPU作業において1つのプラットフォームとして動作し、2台のOmniBookとSurfaceはほとんどのマルチスレッドテストで1〜2パーセント以内の差で完了し、18コアのPro 9nはそれらより約7〜11パーセント遅れています。Razer Blade 16のRyzen AI 9 HX 370と比較すると、N1Xはレンダリング、圧縮、コンパイルで約18〜50パーセントの差で勝ち、GROMACS、OpenBLAS、シングルスレッドPython、primesieveでは負けています。これらのテストでは、Zen 5のコアごとの速度またはx64ソフトウェアの成熟度が結果を左右します。
Cinebench 2026と持続負荷
Cinebench 2026は、CPU上でMaxonのRedshiftエンジンを使用してシーンをレンダリングし、シングルコア、SMTシングルコア(1つの物理コアで2つのスレッドを実行)、およびマルチコアのスループットを測定します。続いて、マルチコア実行を約30分間繰り返す持続ループを実行し、定常状態を最初の実行結果と比較します。これにより、ノートPCが熱を吸収した後にどれだけ性能が向上するかがわかります。
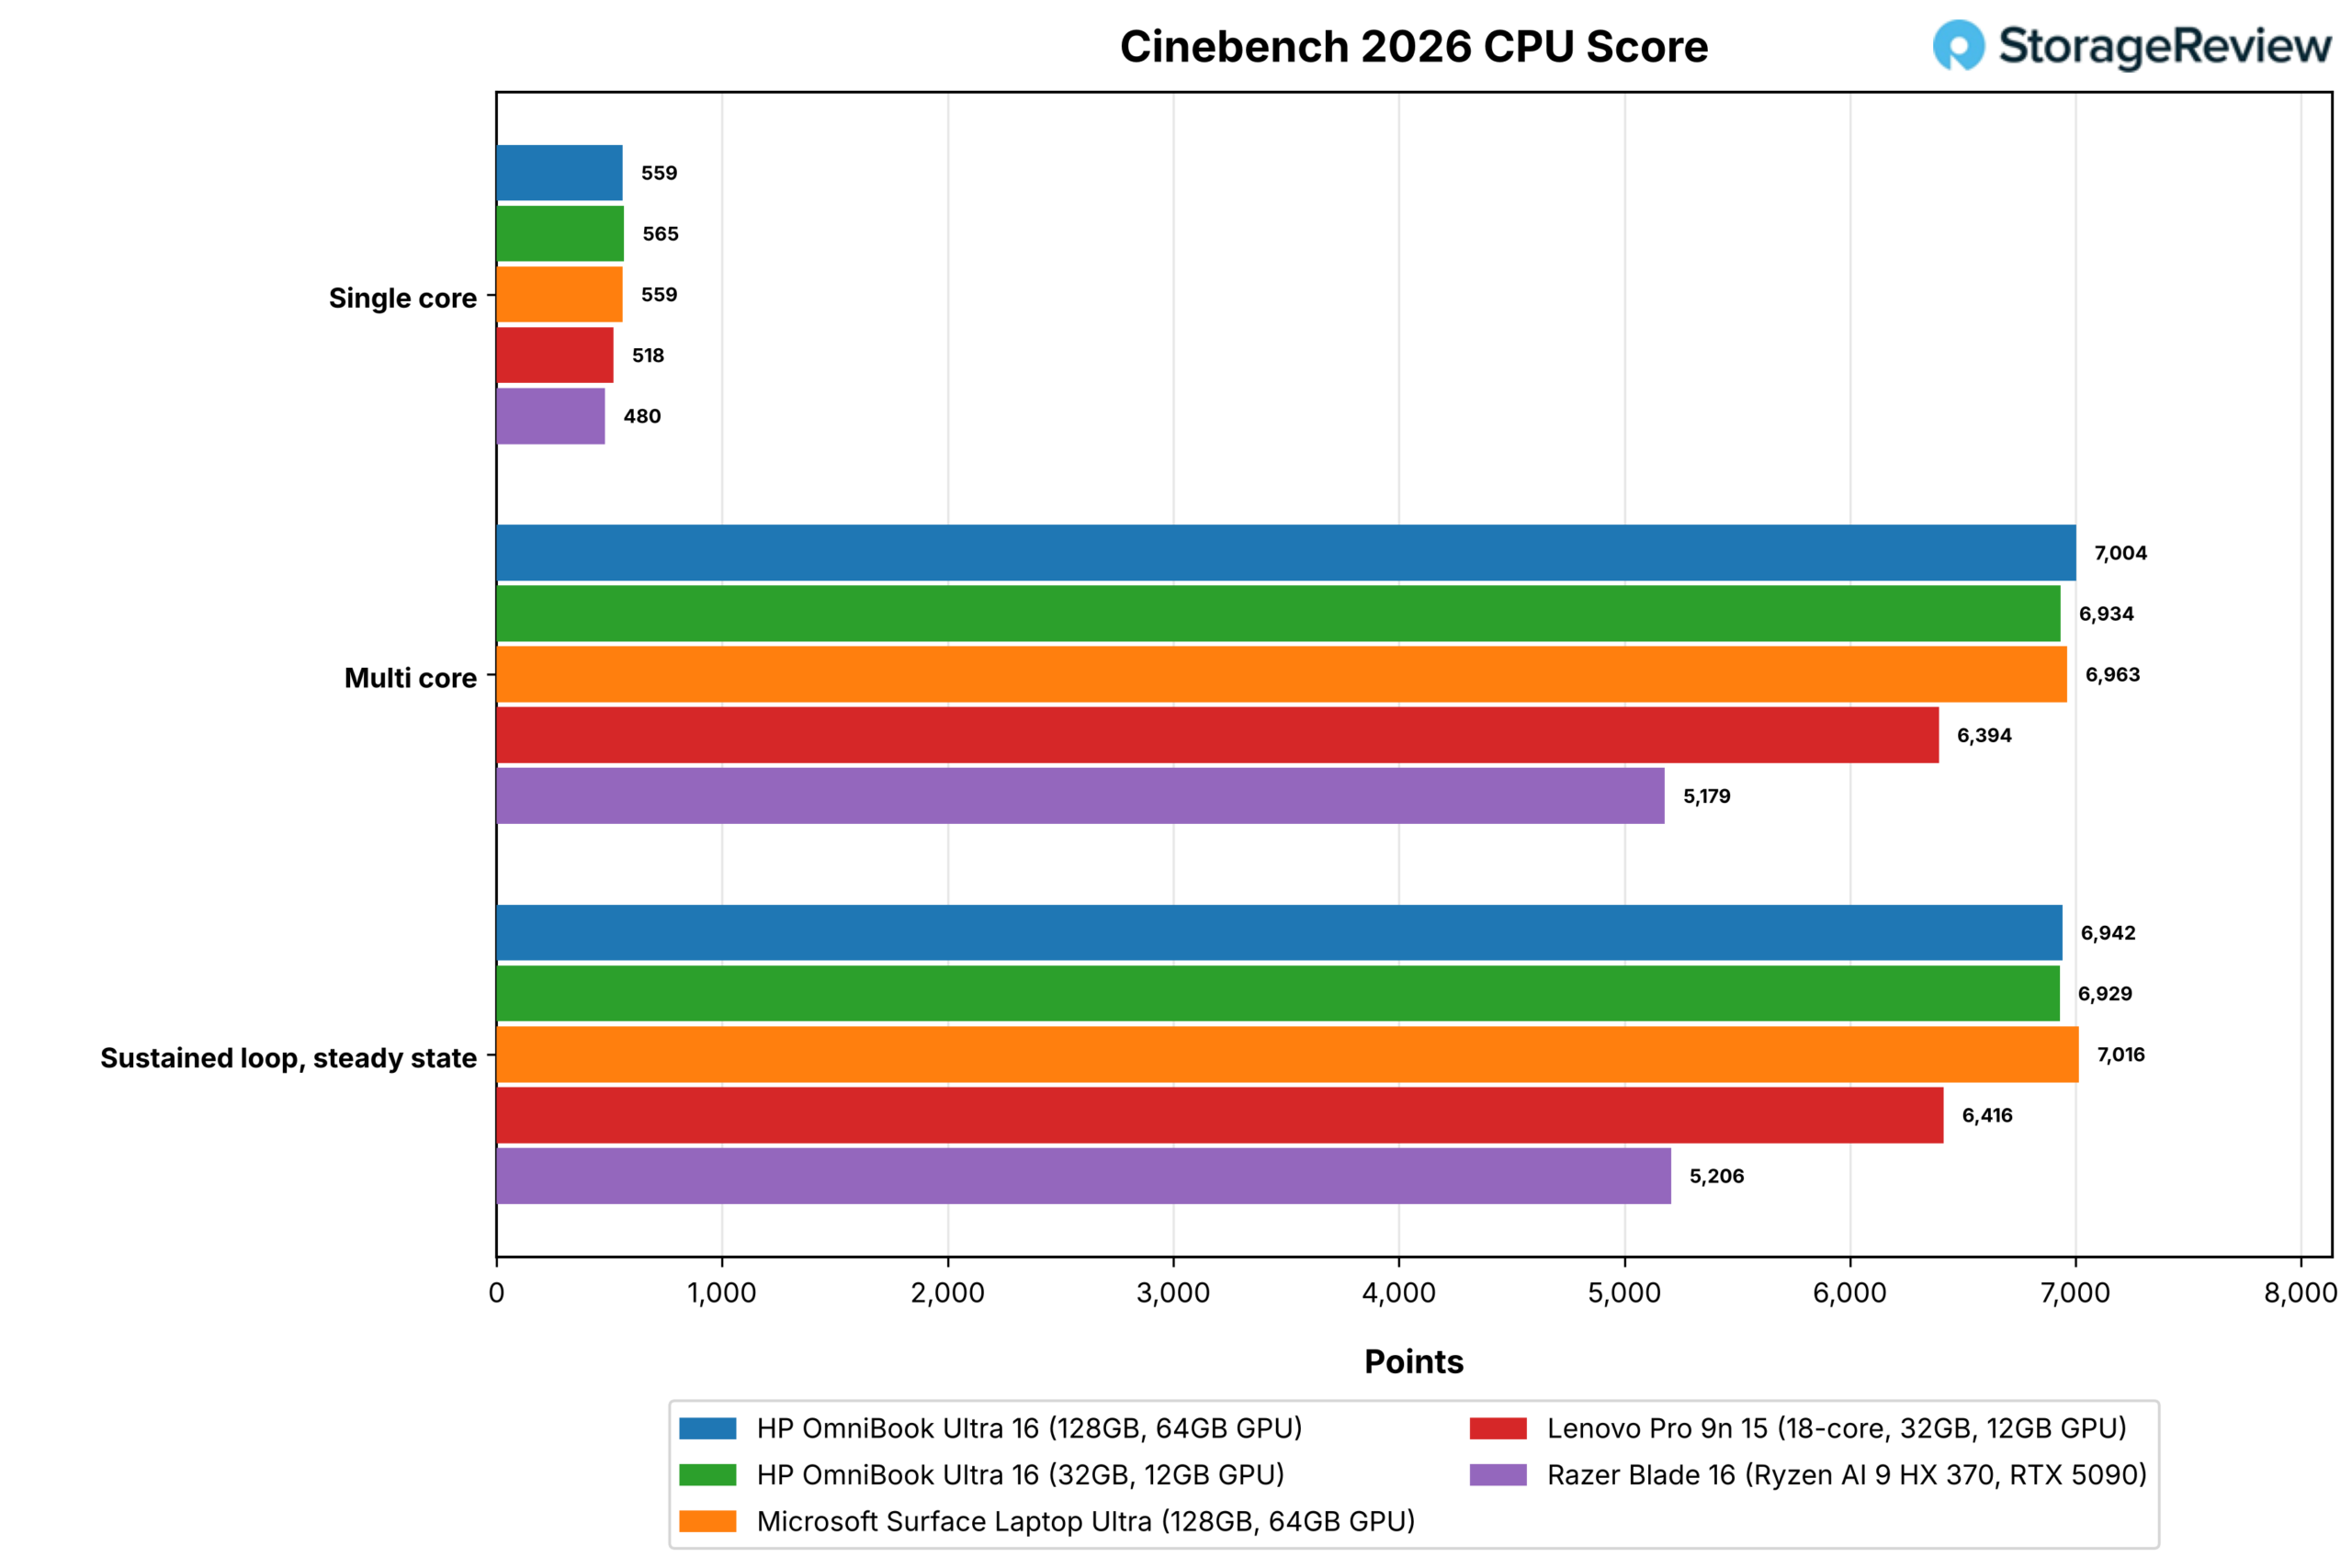
| Cinebench 2026(ポイント、数値が高いほど性能が良い) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| シングルコア | 558.6 | 564.7 | 558.5 | 518.2 | 480.0 |
| SMTシングルコア | 無し | 無し | 無し | 無し | 661.3 |
| マルチコア | 7,004 | 6,934 | 6,963 | 6,394 | 5,179 |
| 持続ループ、1回目の通過 | 6,954 | 6,943 | 6,938 | 6,346 | 5,162 |
| 持続ループ、定常状態 | 6,942 | 6,929 | 7,016 | 6,416 | 5,206 |
| 定常状態/初回通過 | 0.998 | 0.998 | 1.011 | 1.011 | 1.009 |
128GBのOmniBookはマルチコアで7,004を記録し、この中で最高スコアとなり、Blade 16を35%上回りました。32GBモデルは6,934、Surfaceは6,963でした。シングルコアでは、32GBのOmniBookが564.7でトップとなりました。HPの2機種は、持続ループを通してスコアを維持し、最初のパスの99.8%で終了し、CPUは98℃、約3.23GHzでした。SurfaceとPro 9nは、同じ30分間で約1%スコアが向上しました。
7-Zip
7-Zipに内蔵されているベンチマーク機能は、LZMA圧縮および解凍のスループットをギガ命令/秒単位で報告します。この数値は、各スレッドで1回、単一コアに固定した場合で1回表示されます。LZMAは整数スループット、分岐予測、キャッシュおよびメモリのレイテンシに依存するため、ベクトル幅よりもコア数の多さと高速なメモリパスが有利に働く傾向があります。
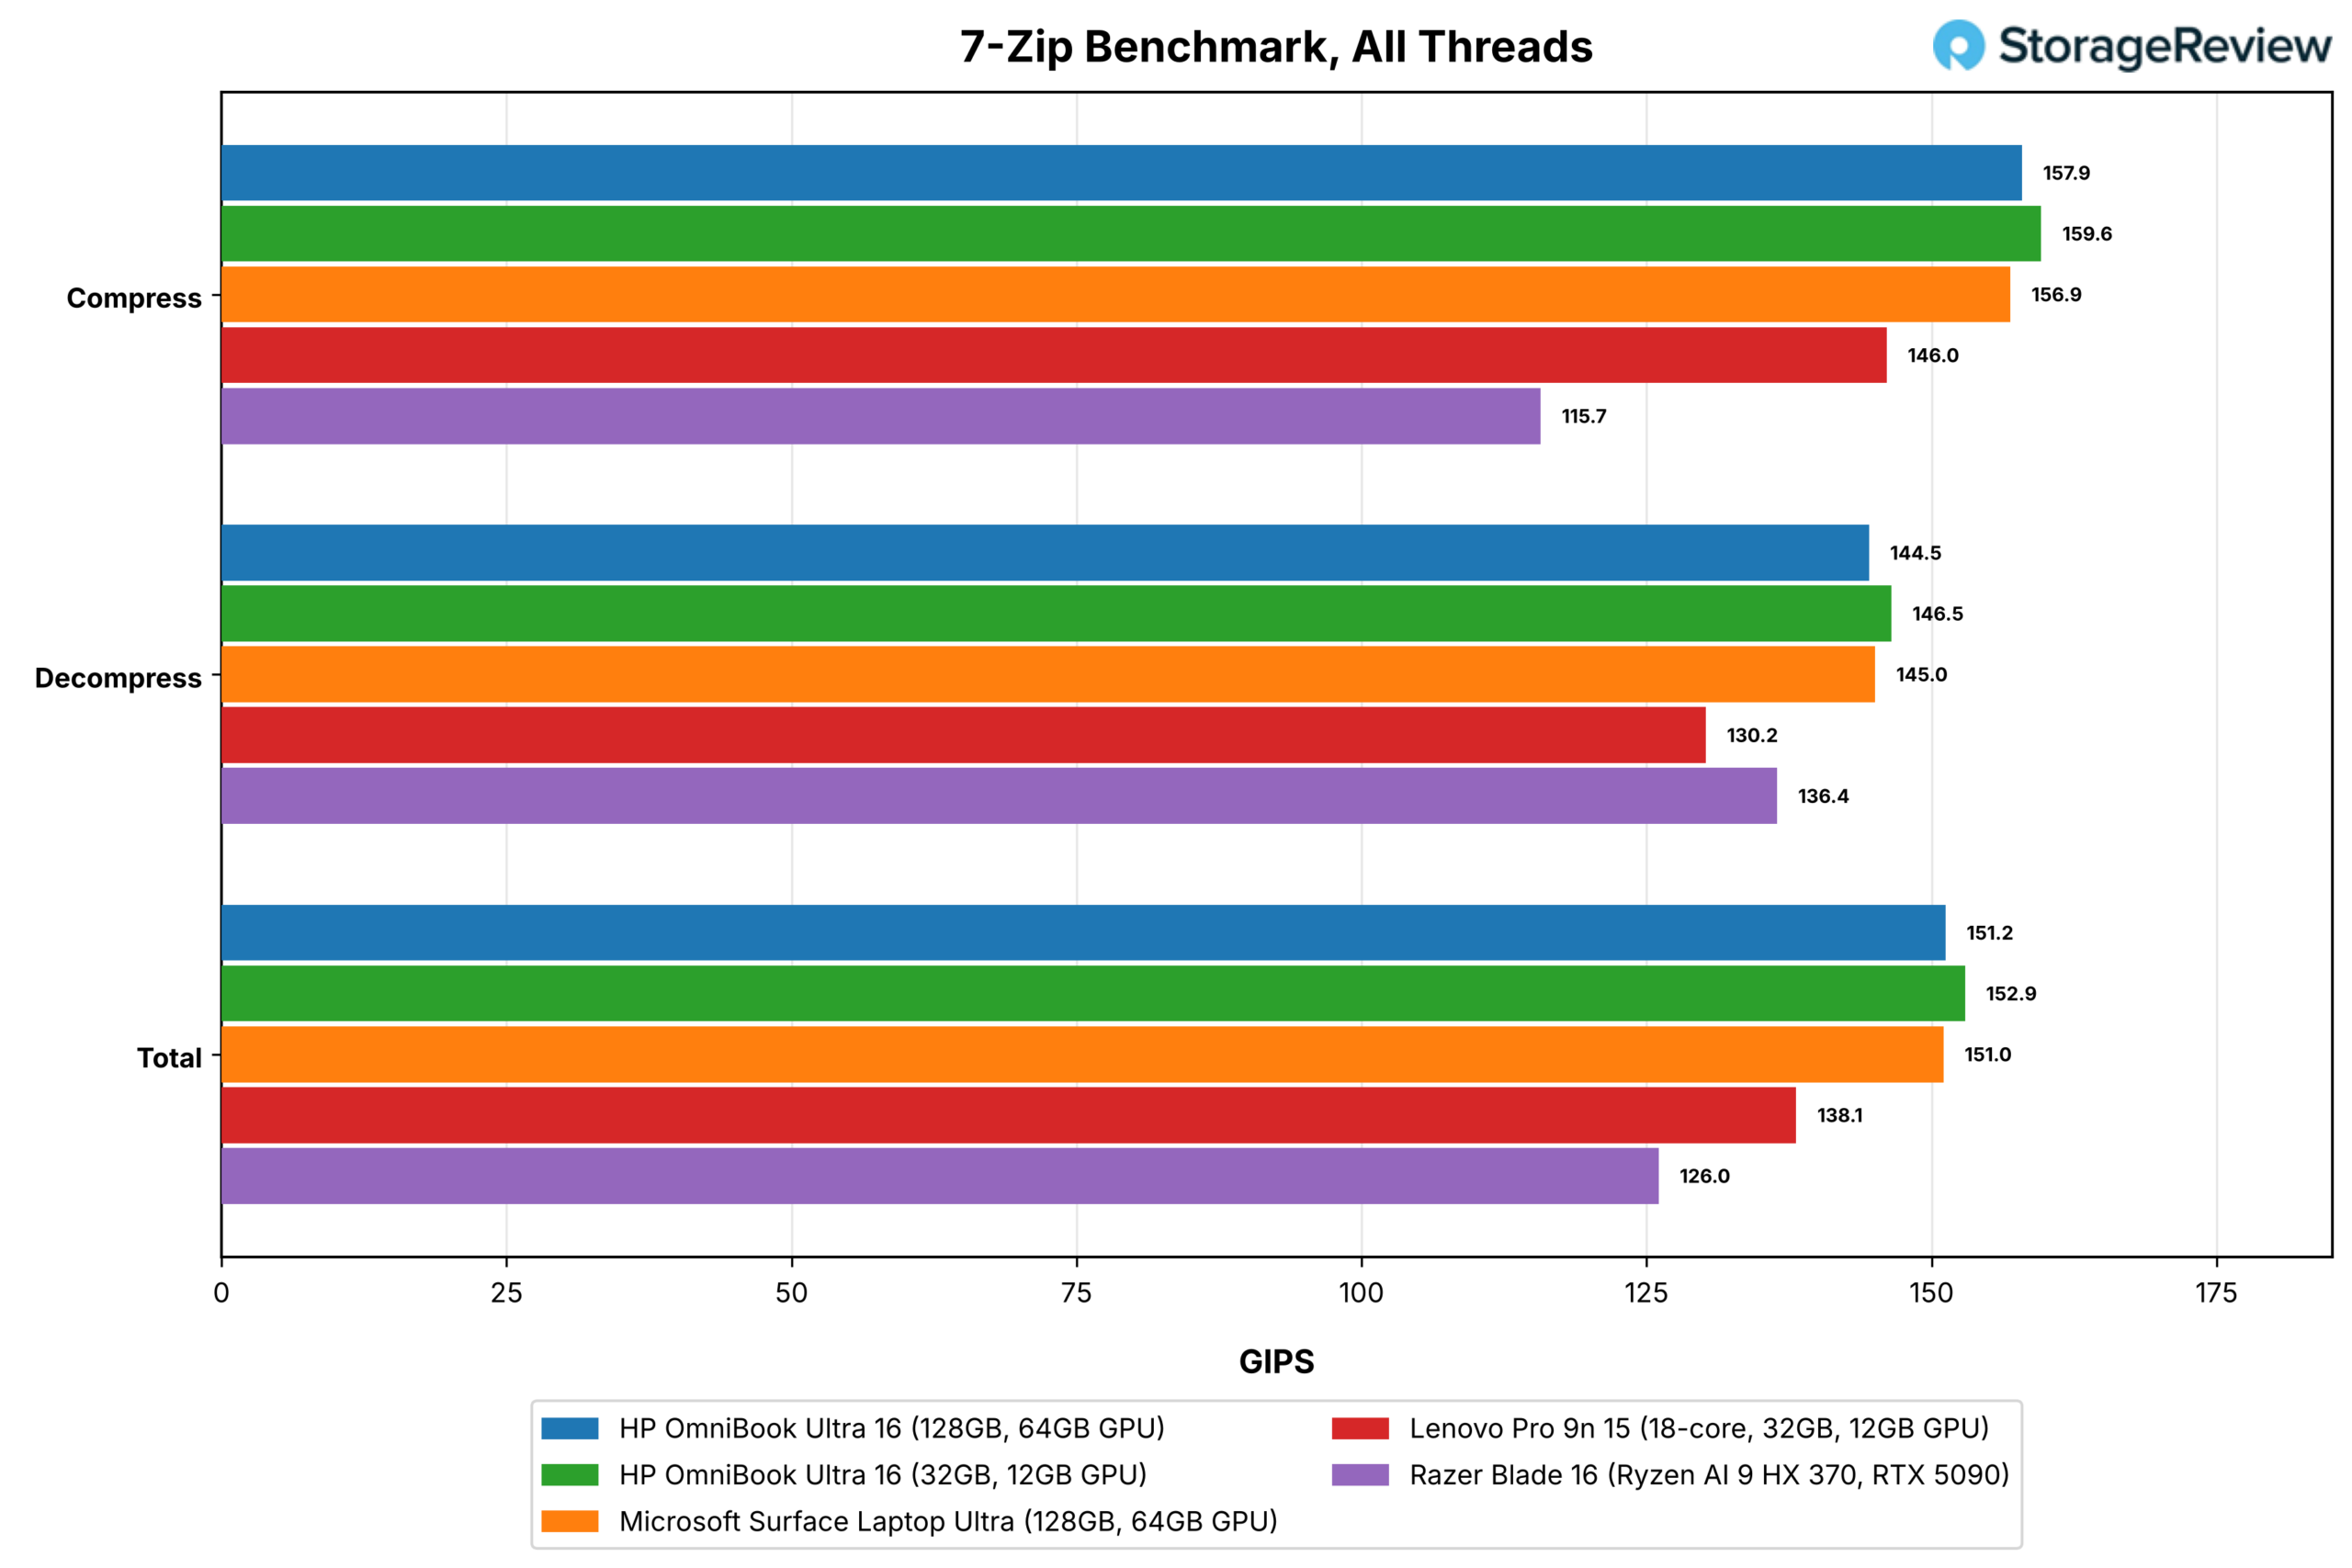
32GBと128GBのOmniBookは、全スレッドテストで152.9 GIPSと151.2 GIPSを記録し、Blade 16を20%上回りました。圧縮率もBladeを約37%上回っています。シングルスレッドでは、Bladeが9.24 GIPSでトップ、HPが9.09と9.10で続きました。OmniBookは、Surfaceをシングルスレッドで7.16 GIPSに抑えていた低速コア状態を示さないため、ここでのシングルスレッドの行はN1X自体を反映しています。
| 7-Zip、シングルスレッド(GIPS、数値が高いほど良い) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| トータル | 9.09 | 9.10 | 7.16 | 8.93 | 9.24 |
| 圧縮する | 7.31 | 7.33 | 4.62 | 7.26 | 7.28 |
| 圧縮解除する | 10.87 | 10.87 | 9.70 | 10.59 | 11.20 |
Blender、HandBrake、およびLLVM
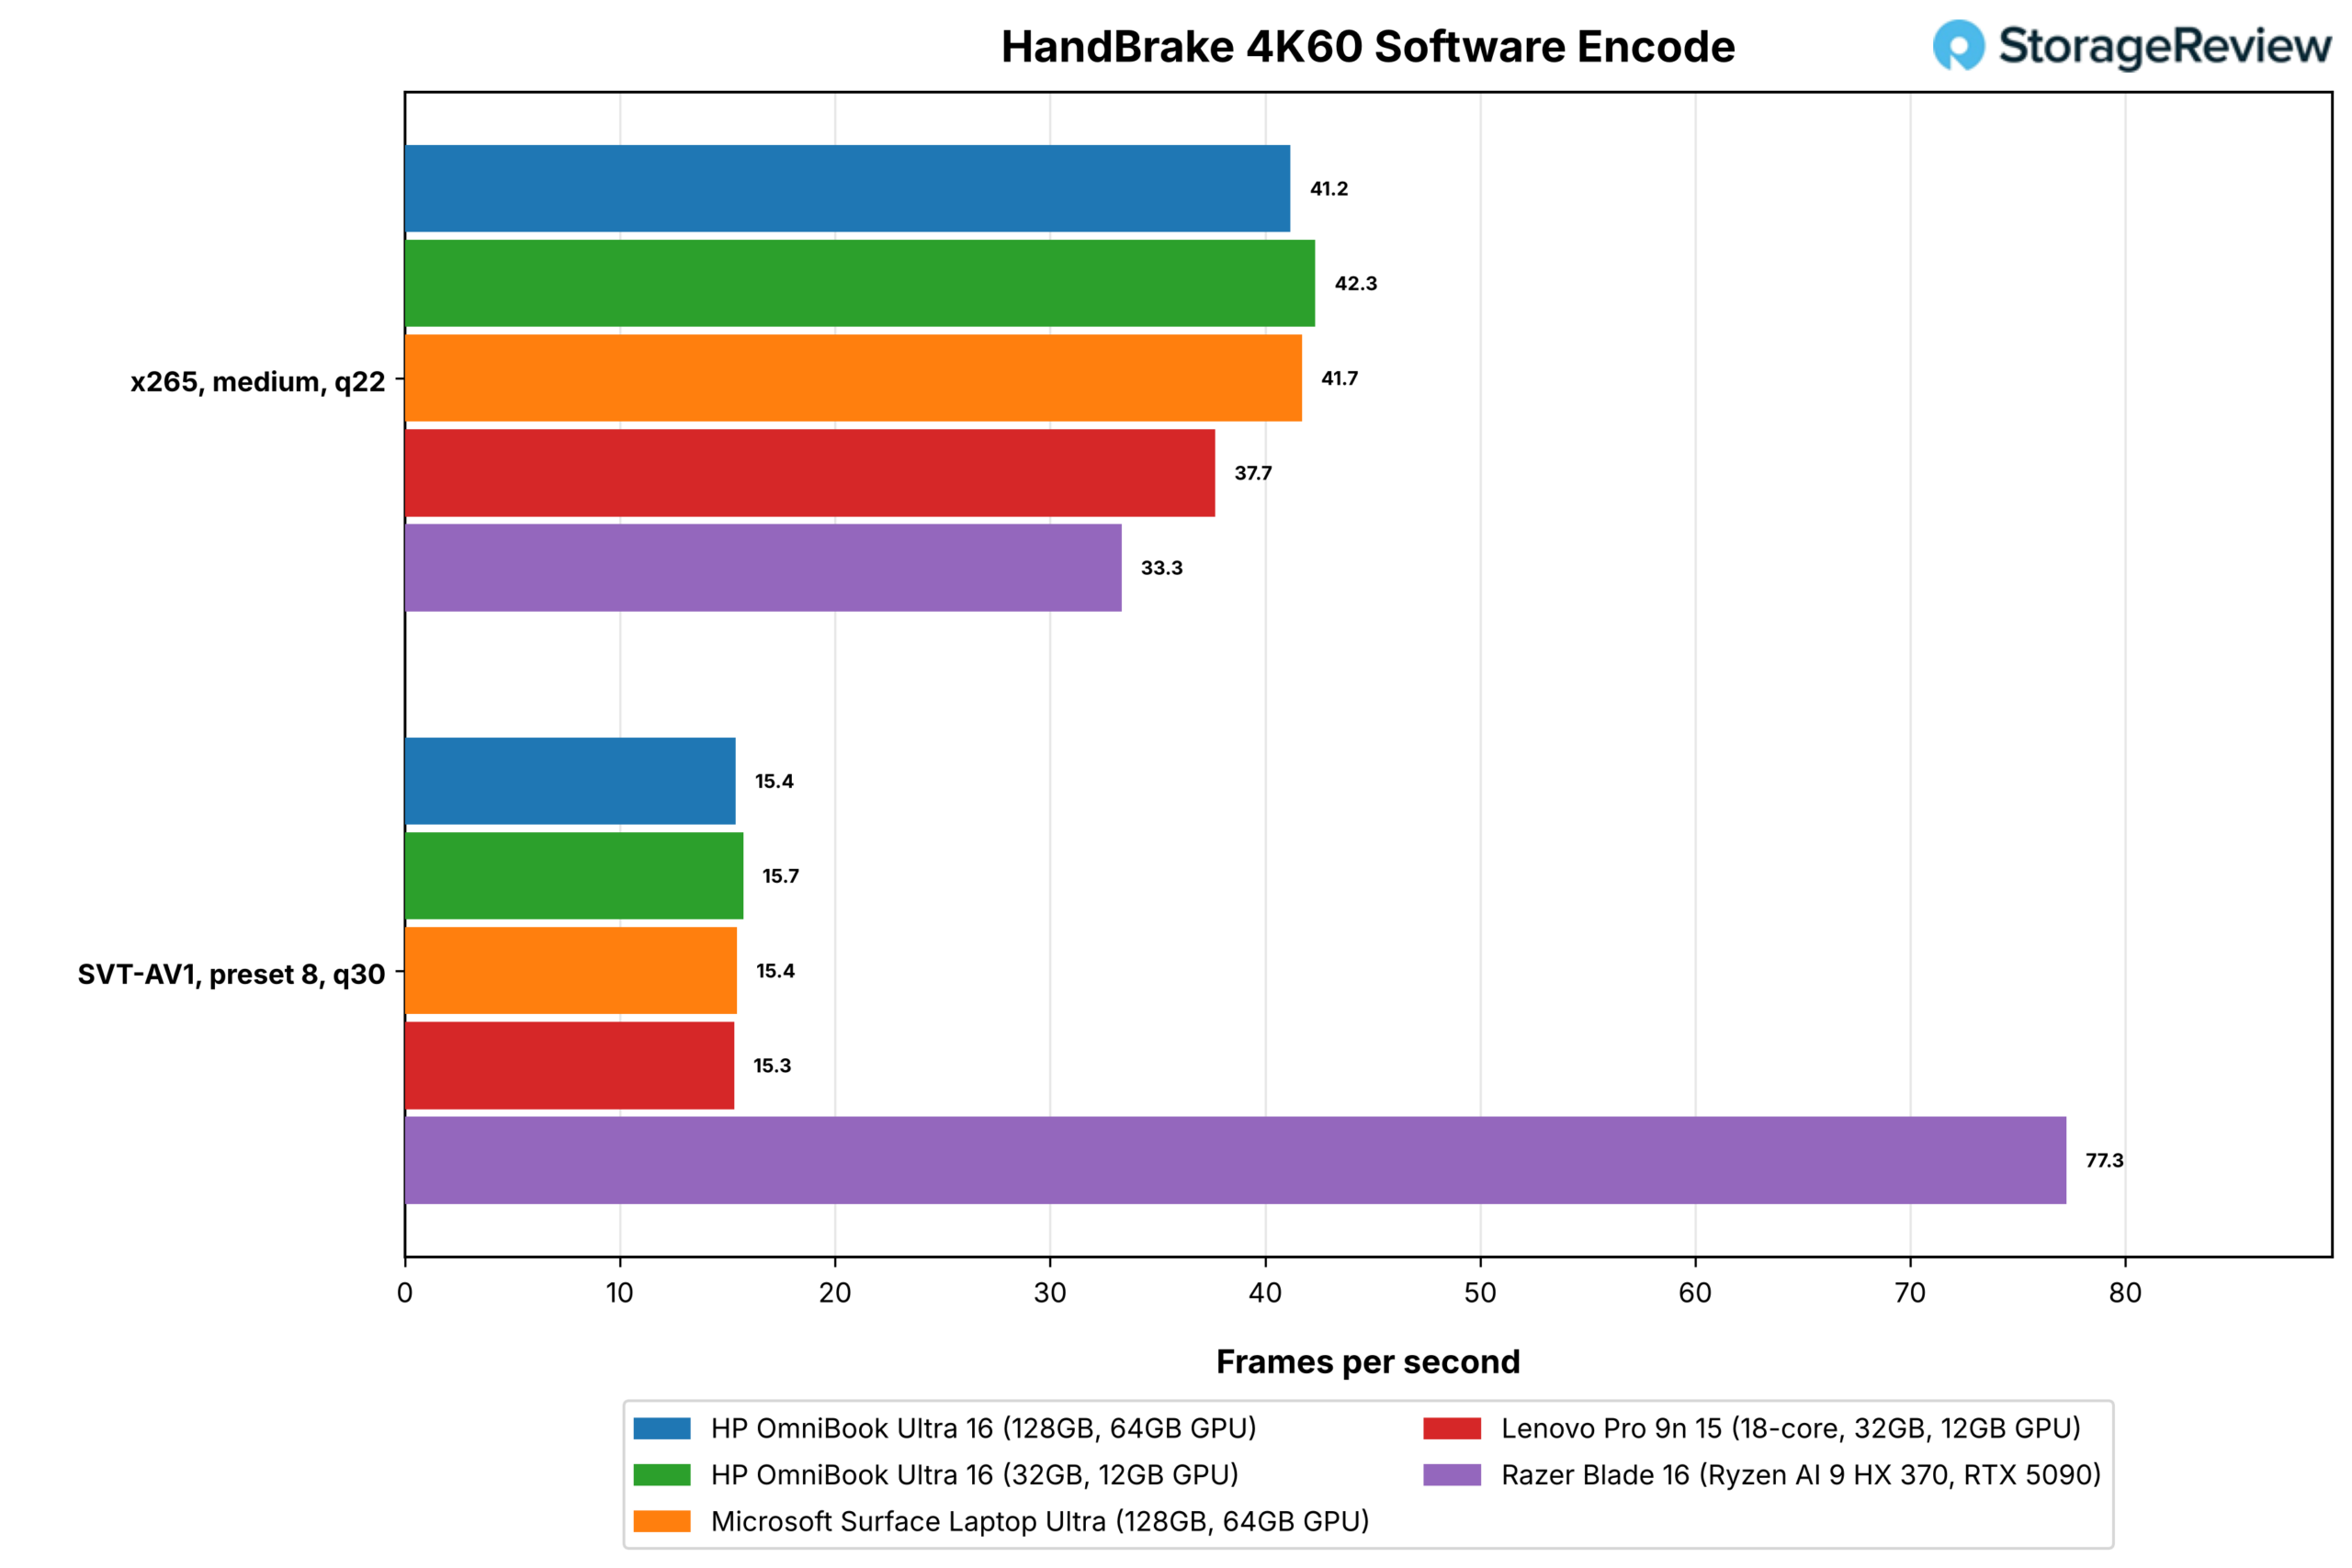
Blender 4.5 は、CPU 上で Cycles を使用して Monster、Junkshop、および Classroom シーンをレンダリングします。HandBrake は、4K60 クリップの 60 秒をソフトウェアで x265 (HEVC、中程度のプリセット、品質 22) と SVT-AV1 (プリセット 8、品質 30) を使用してエンコードします。LLVM テストは、スイート内で最長の全コアワークロードである Clang と Ninja を使用して、LLVM 21.1.4 ツリー全体をコンパイルします。
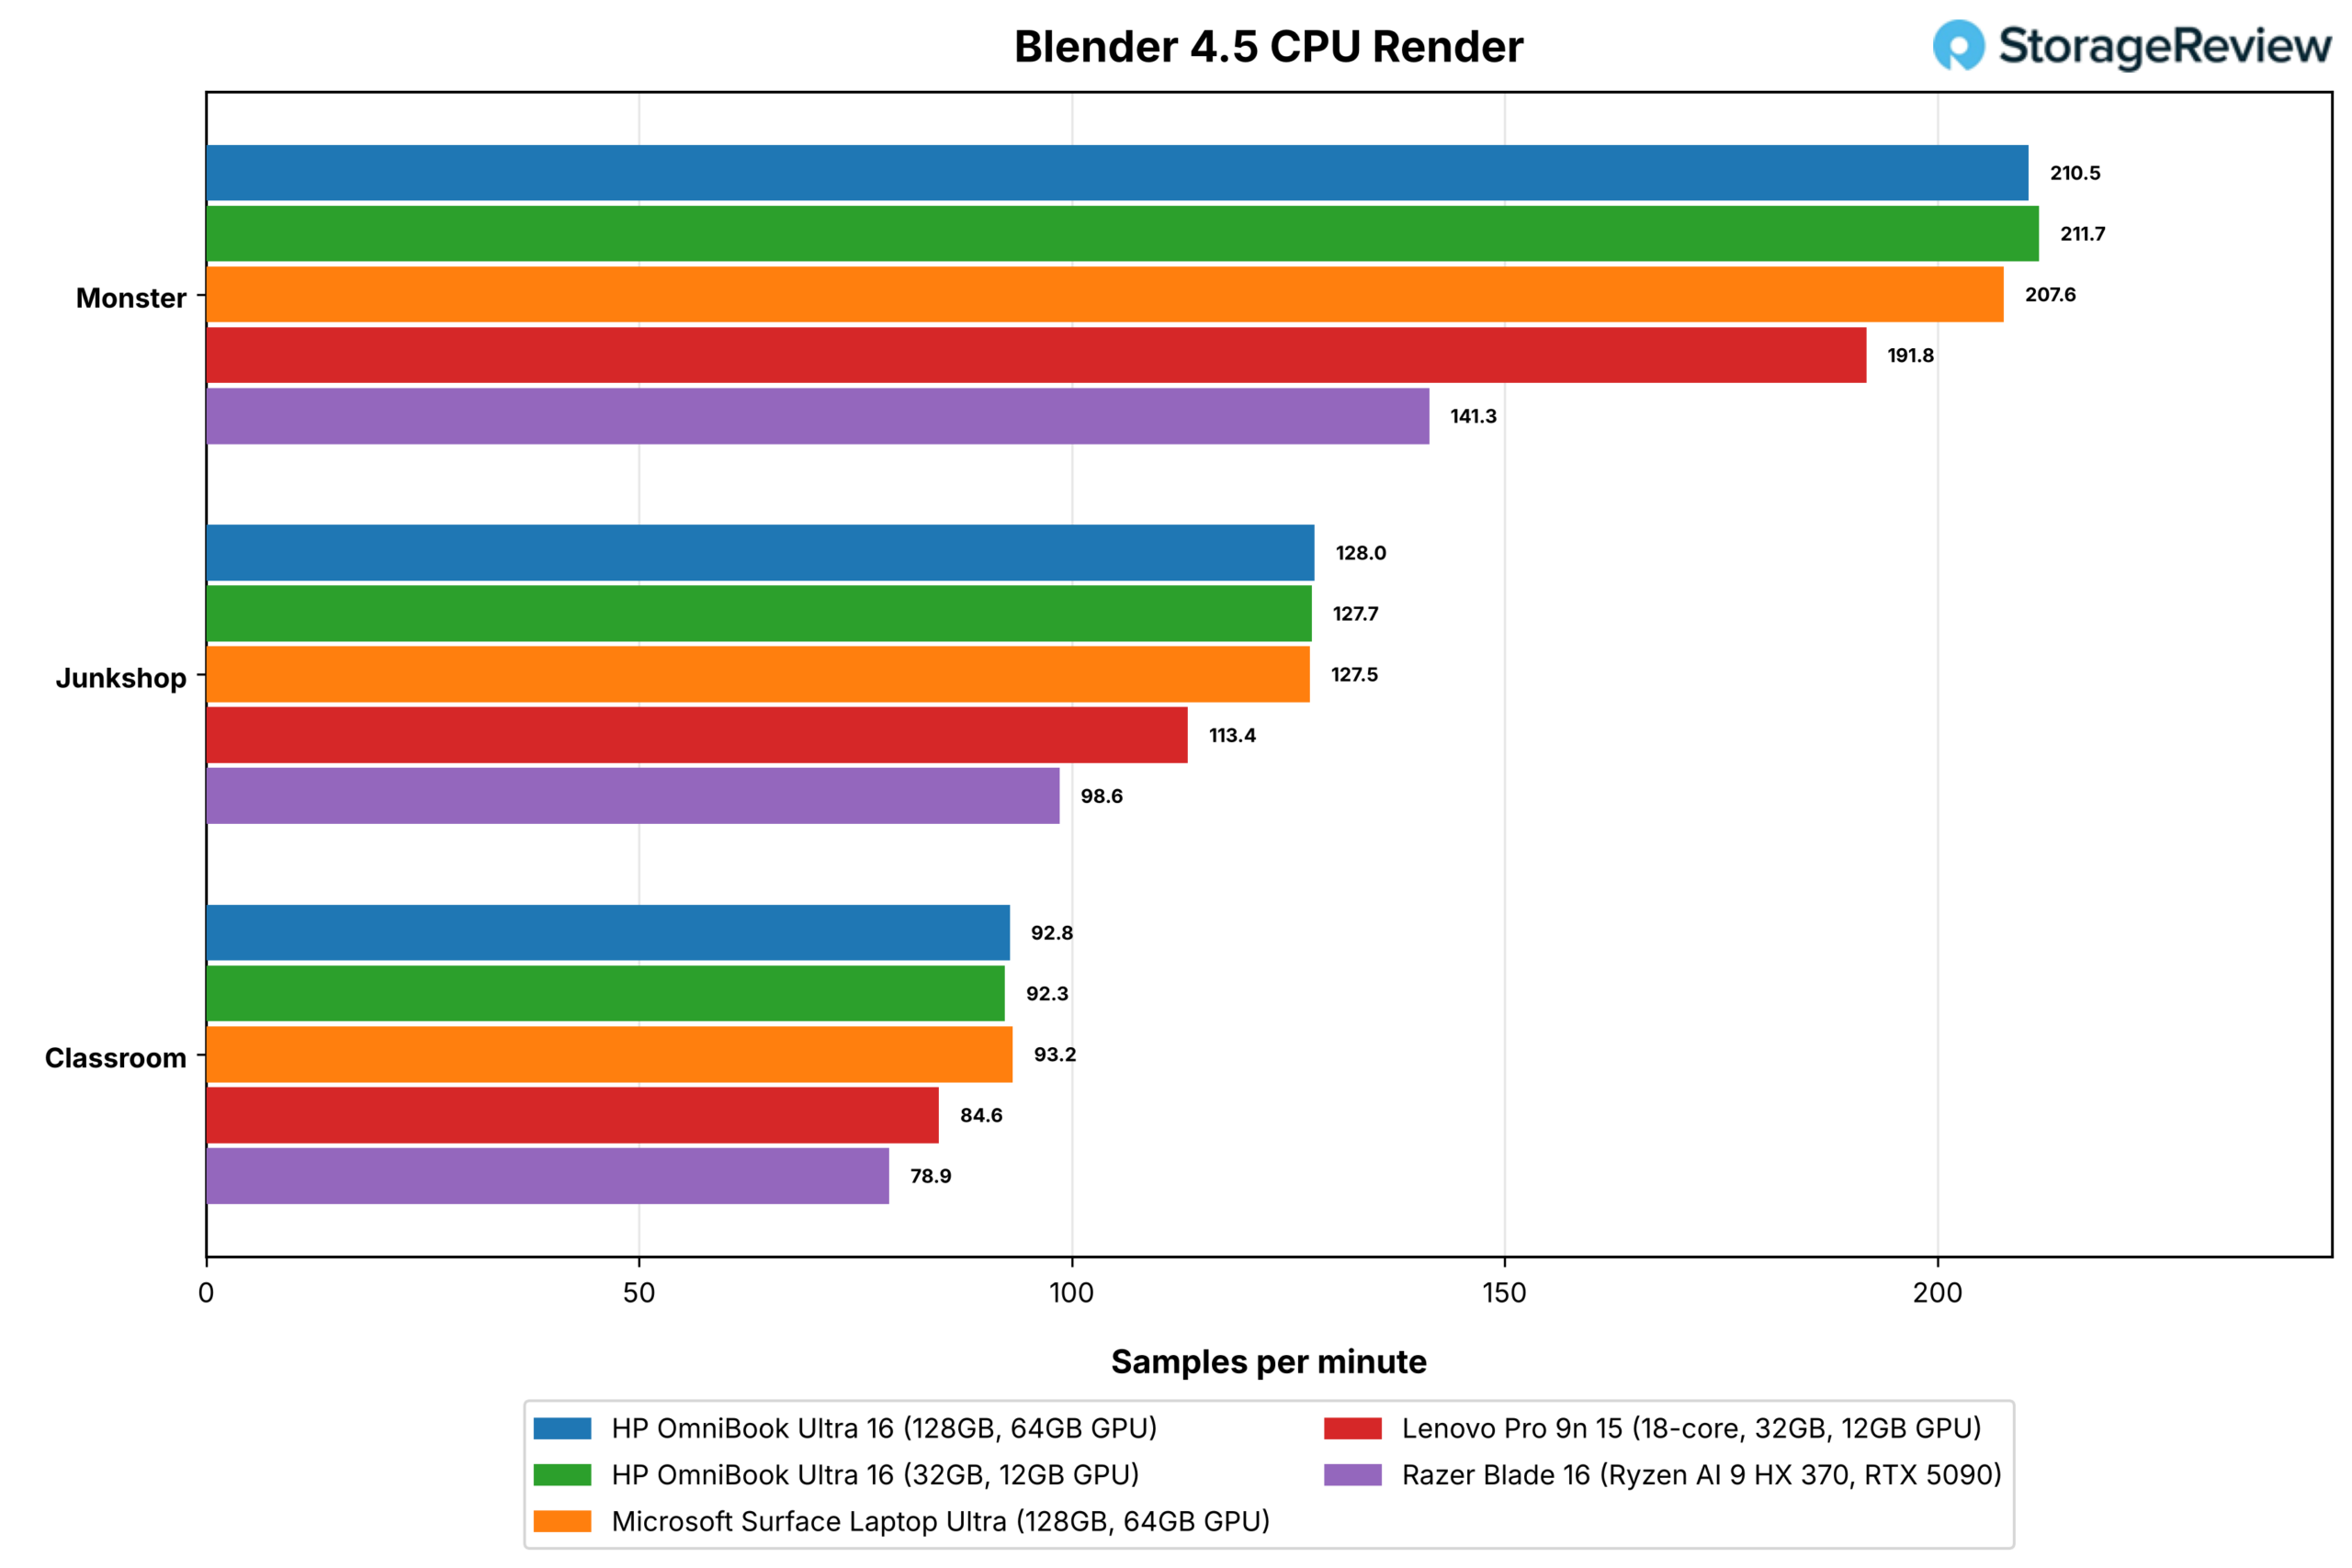
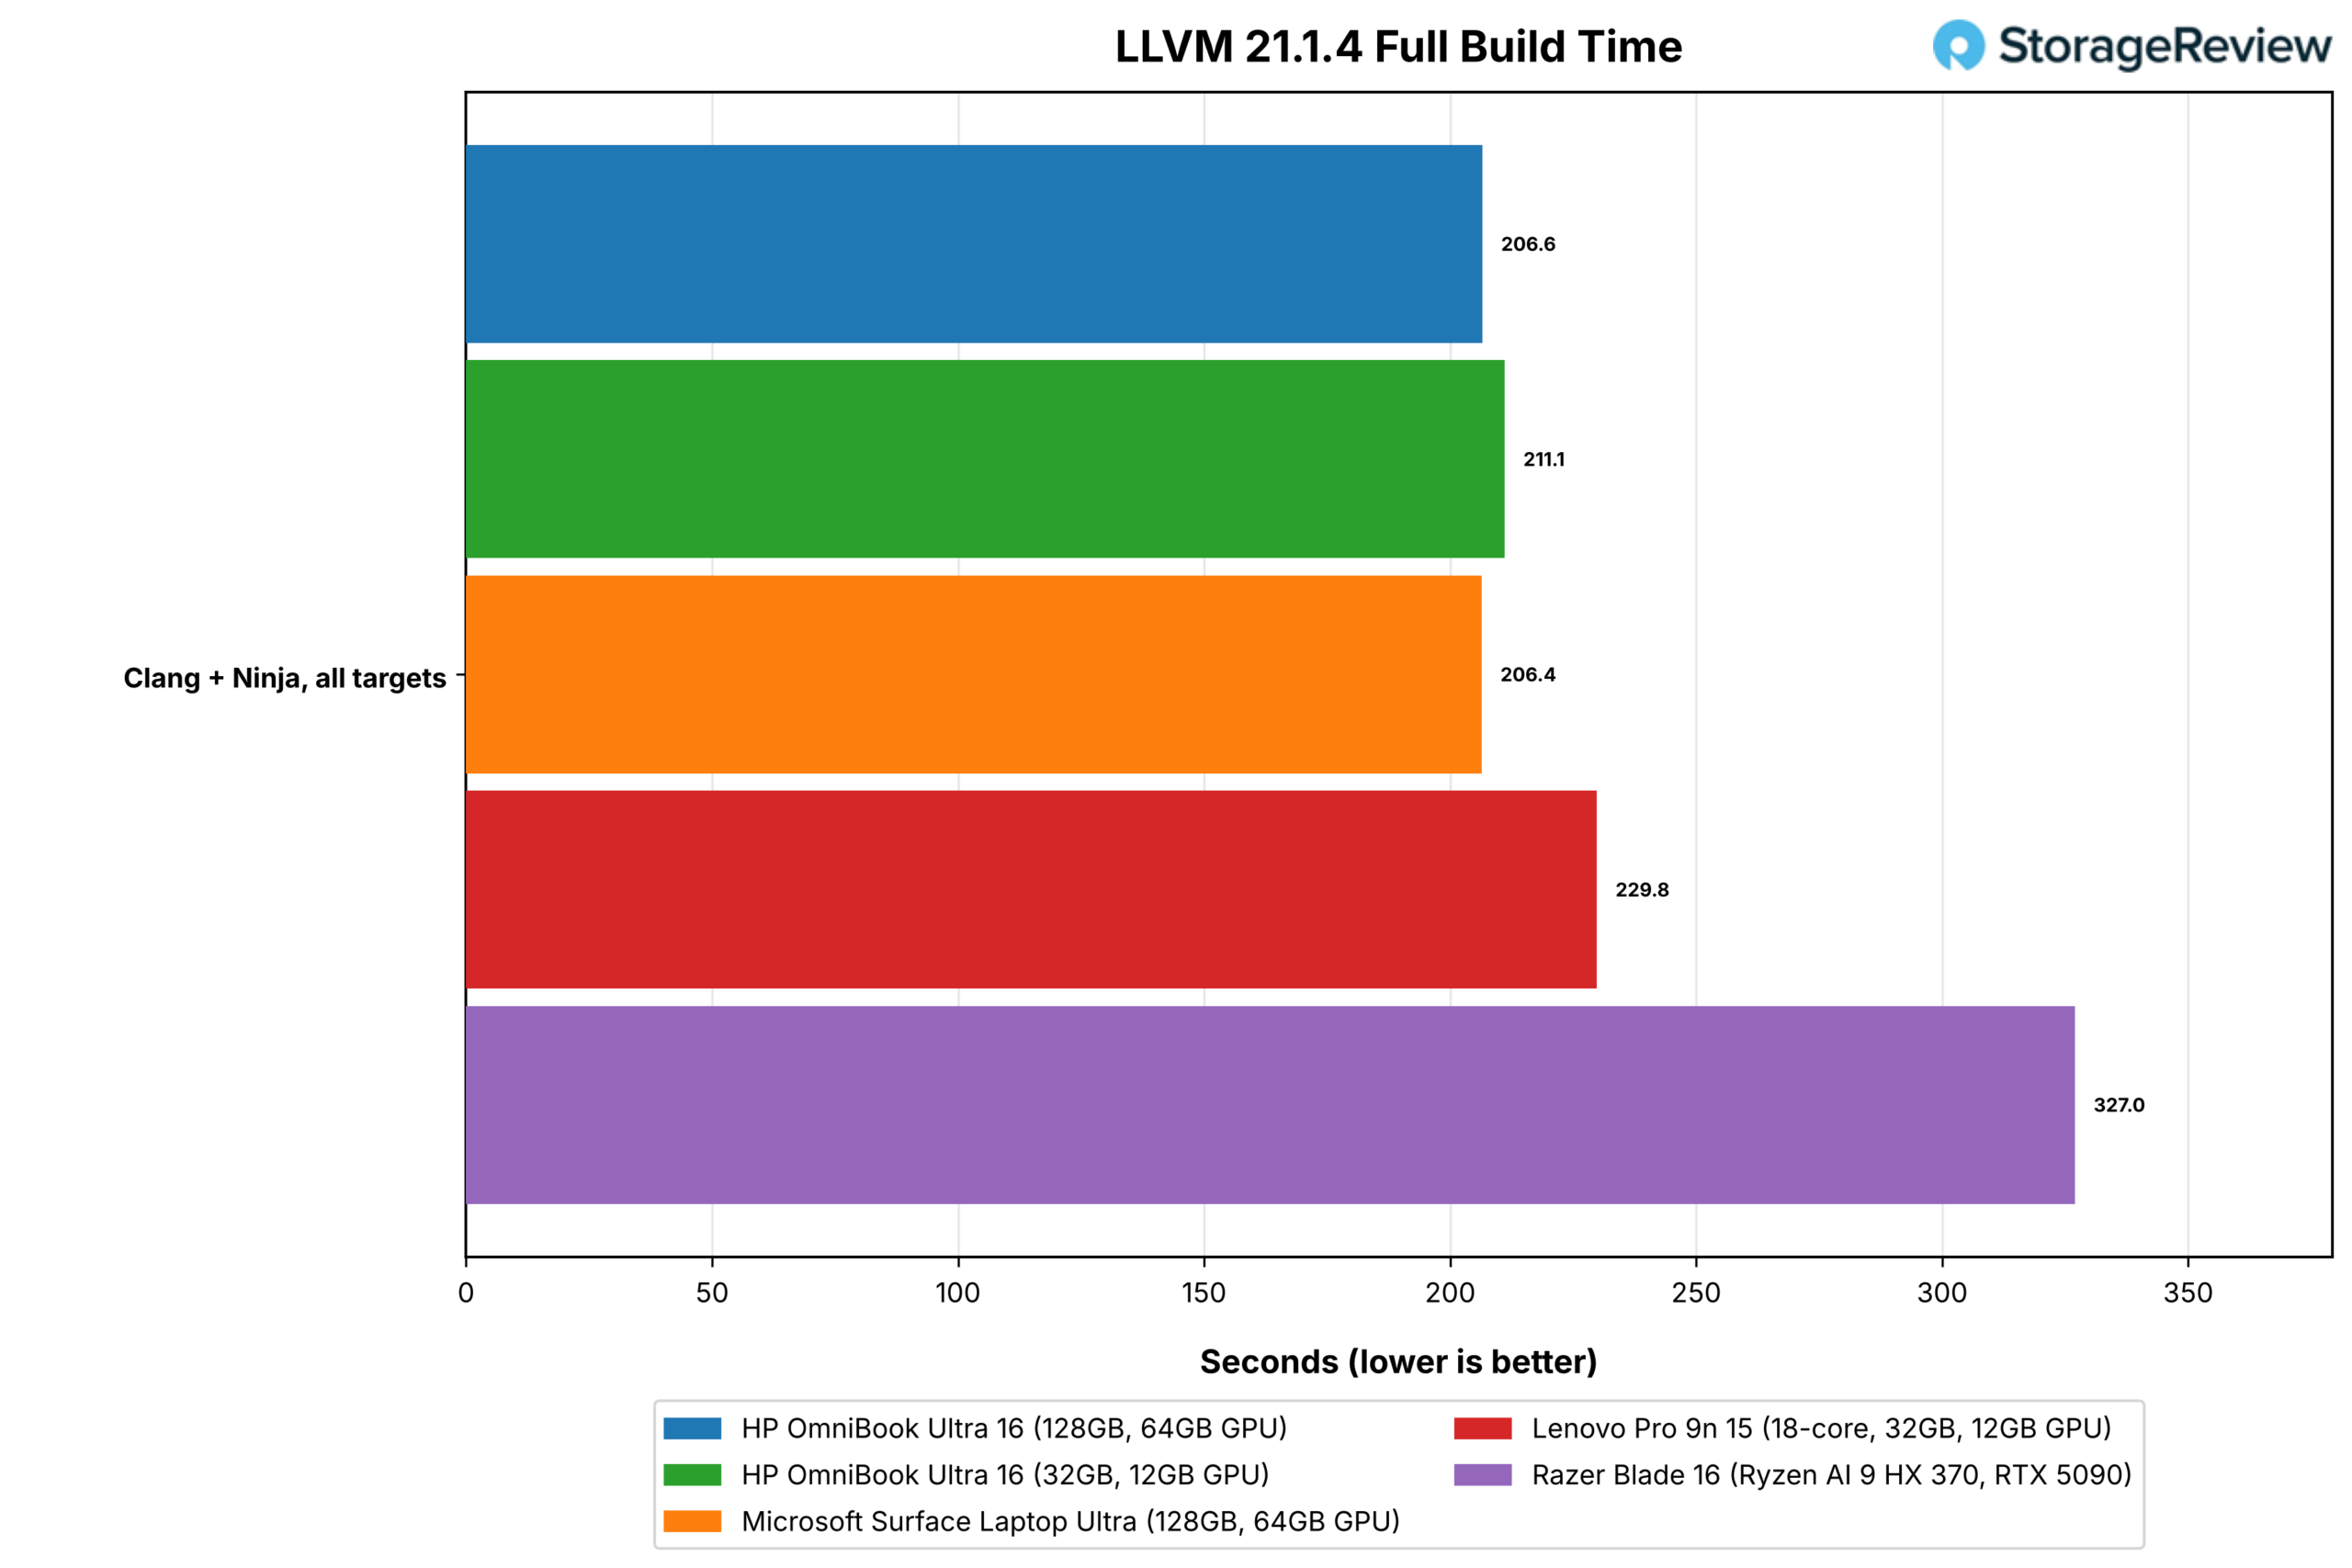
3台の20コアノートPCは、3つのBlenderシーンすべてにおいて、互いに2%以内の差で終了しました。Monsterでは32GB OmniBookが毎分211.7サンプルでリードし、ClassroomではSurfaceが毎分93.2サンプルでリードしました。128GB OmniBookはMonsterでBlade 16を49%、Classroomで18%上回りました。LLVMビルドは128GB OmniBookで206.6秒かかり、Surfaceと同等で、Blade 16の327.0秒より37%短い時間でした。
HandBrakeはソフトウェアの性能によって結果が分かれ、32GBのOmniBookがx265で42.3fpsを記録し、Blade 16を27%上回った一方、N1XシステムはSVT-AV1でBladeの77.3fpsに対し、わずか15fps程度しか出せなかった。x265でトップの性能を発揮するコアはシリコン上で5倍も遅いということはあり得ないため、この差はSVT-AV1のArm64コードパスにあると考えられる。
Stockfish、Primesieve、Python、そしてブラウザ
Stockfish の組み込みベンチマークは、チェスの検索速度を毎秒数百万ノード単位で報告します。primesieve は、すべてのスレッドで 10^12 未満の素数を、1 つのスレッドで 10^11 未満の素数をカウントします。PyPerformance は、1 つの高速コアに固定して 3 つの CPython ベンチマーク (go、nbody、regex_compile) を実行し、Speedometer 3.1 は Microsoft Edge での Web アプリケーションの応答性を測定します。最後の 2 行は、Prism エミュレーションで 7-Zip の x64 ビルドを実行し、これらのシステムで x64 専用アプリケーションがどれくらいのコストがかかるかを示します。
| ホイール試乗 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| Stockfishベンチ、全スレッド(Mnps、数値が高いほど良い) | 16.28 | 15.12 | 15.51 | 15.20 | 17.96 |
| Stockfishベンチ、スレッド1つ(Mnps、数値が高いほど良い) | 1.73 | 1.73 | 1.33 | 1.70 | 2.04 |
| primesieve 1e12、全スレッド(s、数値が小さいほど良い) | 9.57 | 9.54 | 9.82 | 10.56 | 10.60 |
| プライムシーブ 1e11、スレッド1つ(s、数値が低いほど良い) | 12.03 | 12.02 | 12.03 | 12.34 | 6.67 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 111.2 | 111.2 | 123.9 | 114.1 | 75.2 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 80.4 | 80.6 | 89.8 | 82.5 | 60.8 |
| PyPerformance regex_compile (ミリ秒、数値が小さいほど良い) | 84.6 | 84.5 | 94.1 | 86.7 | 69.7 |
| スピードメーター 3.1、エッジ(スコア、数値が高いほど良い) | 36.7 | 35.4 | 34.7 | 33.9 | 38.4 |
| x64 7-Zip エミュレーション、全スレッド (GIPS) | 127.0 | 127.8 | 127.2 | 117.6 | 該当なし(ネイティブx64) |
| エミュレーション環境下のx64 7-Zip、シングルスレッド(GIPS) | 8.26 | 8.36 | 8.27 | 7.94 | 該当なし(ネイティブx64) |
Blade 16 は Stockfish の全スレッドで 17.96 Mnps を記録し、128GB OmniBook を 10% 上回り、シングルスレッドのすべての行でもトップでした。primesieve は 1 つのスレッドで 6.67 秒で完了し、N1X システムでは約 12 秒でした。PyPerformance go は 75.2 ms で、HP の 111.2 ms を上回りました。OmniBook は primesieve の全スレッドで最速で、9.54 秒と 9.57 秒でした。128GB モデルの Speedometer スコアは 36.7 で、Blade の 38.4 から 5% 以内でした。
このプラットフォームでのエミュレーションのコストは以前より低く、7-Zipのx64ビルドは128GBのOmniBookで全スレッドで127.0 GIPSの速度を記録しました。これはネイティブArm64の結果の84%に相当し、独自のネイティブx64ビルドを実行しているBlade 16よりもわずかに優れています。Cinebench 2026のx64ビルドは、テストしたすべてのN1Xシステムでエミュレーション中にクラッシュしたため、それらの行は除外されています。
GROMACS、OpenBLAS、およびメモリ
GROMACSは、4つのランクとスレッド構成で16コアを使用してbenchMEM分子動力学ケースを実行し、最適な構成における1日あたりのシミュレーション時間をナノ秒単位で報告します。OpenBLASテストでは、3つの問題サイズでHPLスタイルの倍精度LU分解とDGEMM行列乗算を、すべてのコアと最上位コアクラスのみで実行し、スイートの中で最も負荷の高い持続的な浮動小数点処理となっています。STREAMは持続的なメモリ帯域幅を測定し、レイテンシ行はメモリへの単一アクセスとコア間のアクセスを測定します。
| テスト(数値が高いほど良い) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| GROMACS benchMEM、最適なレイアウト(ns/日) | 17.47 | 17.43 | 17.29 | 16.88 | 26.41 |
| OpenBLAS LU N=10000、すべてのコア (GFLOPS) | 324.0 | 326.9 | リタイア | 303.4 | 400.9 |
| OpenBLAS LU N=20000、すべてのコア (GFLOPS) | 329.6 | 322.4 | リタイア | 318.1 | 454.4 |
| OpenBLAS LU N=40000、すべてのコア (GFLOPS) | 348.8 | 実行不可(11.9GB必要) | リタイア | 実行不可(11.9GB必要) | 498.5 |
| OpenBLAS LU N=20000、最高コアクラス(GFLOPS) | 380.5 | 432.2 | リタイア | 403.8 | 240.4 |
| OpenBLAS DGEMM M=8000、全コア(GFLOPS) | 398.5 | 368.9 | リタイア | 357.6 | 455.4 |
| OpenBLAS DGEMM M=8000、最高コアクラス(GFLOPS) | 488.7 | 488.7 | リタイア | 448.3 | 252.4 |
Blade 16 は GROMACS で 26.41 ns/日を記録し、OmniBook の約 17.4 ns/日を上回り、全コア OpenBLAS 行でも Surface と同じパターンで約 14 ~ 43 パーセント上回りました。より重要な結果は、両方の OmniBook が OpenBLAS を完了したことです。128GB ユニットは、N=40000 を含むすべてのサイズを 348.8 GFLOPS で実行し、32GB ユニットは、N=40000 を除くすべてを実行しました。N=40000 は 11.9GB を必要とし、Windows のメモリの半分を超えるシステムではスキップされます。Surface は N=20000 のソルブで 3 回電源を失いましたが、両方の HP は 98 ℃ でこれを完了しました。
N1Xの最上位コアクラスは、OpenBLASにおいて20コアすべてを使用した場合よりも単独で使用した方が優れた性能を発揮します。32GB版OmniBookの高速コア10個は、N=20000を432.2 GFLOPSで解決しましたが、20コアすべてを使用した場合は322.4 GFLOPSでした。また、128GB版のDGEMMは、10コアで488.7 GFLOPSに達しました。このことから、このテストでは効率コアが共有処理の速度を向上させるよりも、むしろ低下させていることが示唆されます。
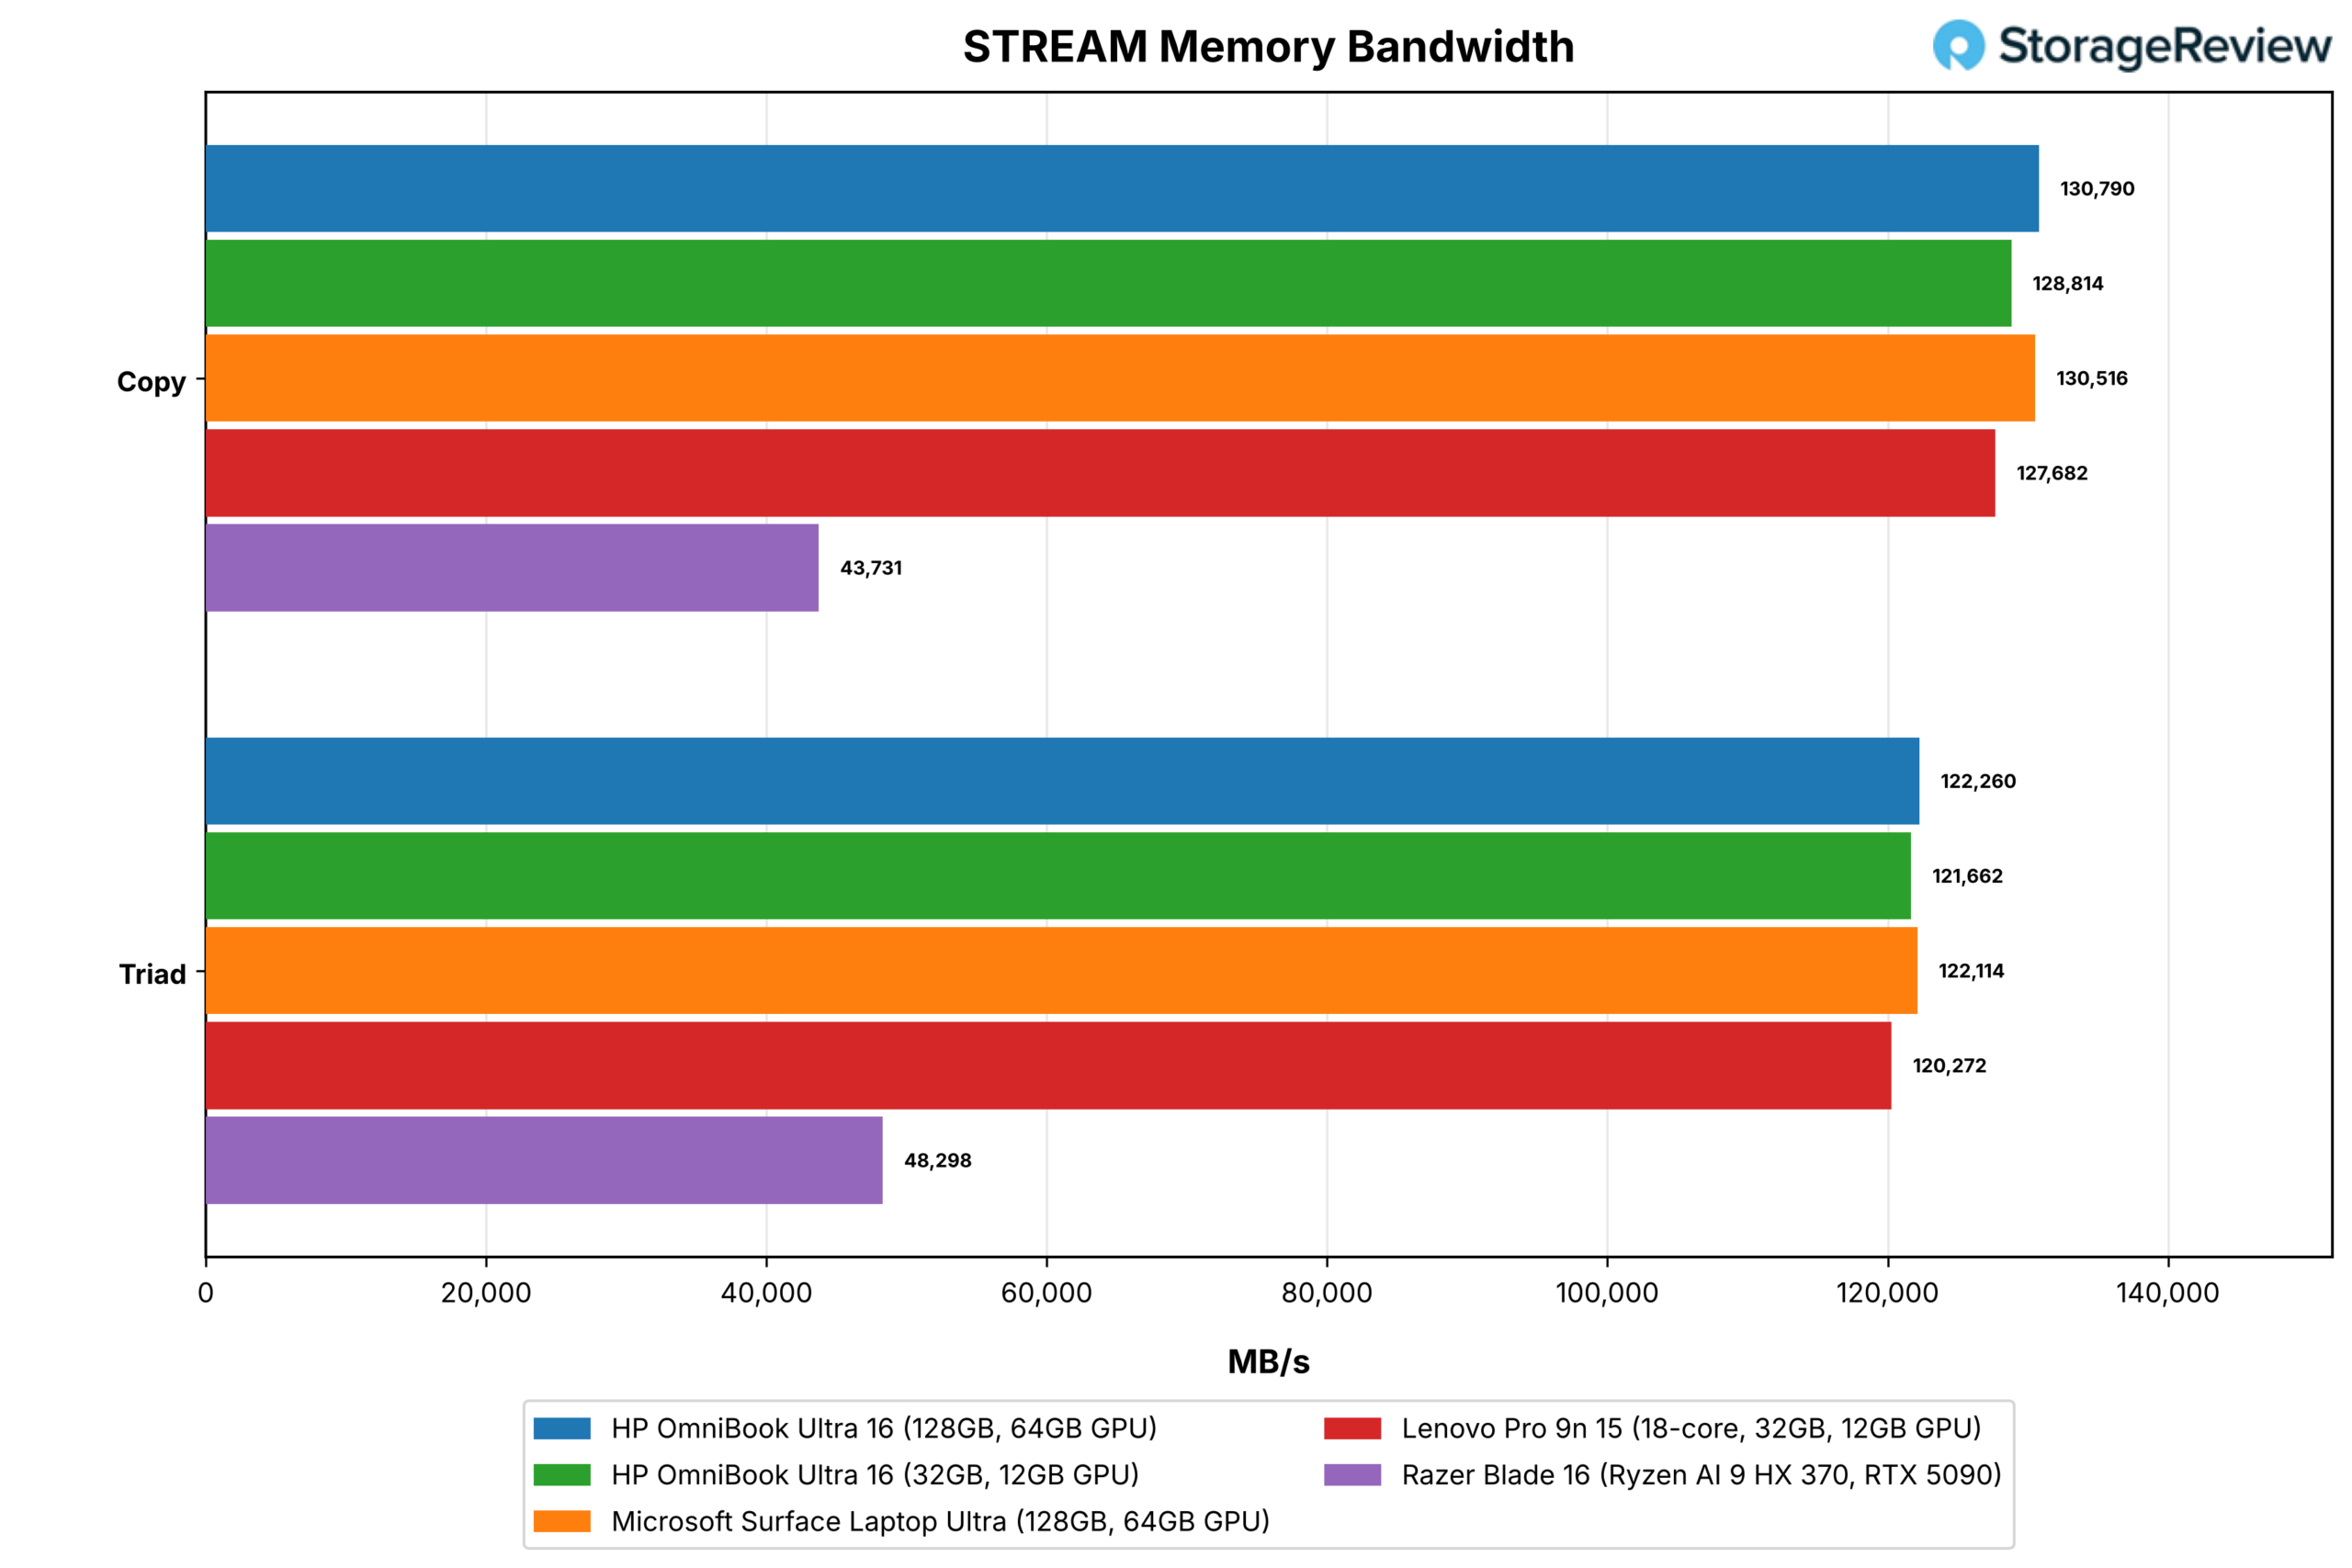
| ホイール試乗 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| ストリームコピー(MB/秒、数値が高いほど良い) | 130,790 | 128,814 | 130,516 | 127,682 | 43,731 |
| ストリームトライアド(MB/s、数値が高いほど良い) | 122,260 | 121,662 | 122,114 | 120,272 | 48,298 |
| メモリレイテンシ、1GiBバッファ、4KiBページ(ナノ秒、数値が小さいほど良い) | 143.1 | 143.5 | 251.1 | 143.4 | 129.6 |
| コア間レイテンシ、全ペアの平均値(ns、数値が小さいほど良好) | 156.8 | 160.9 | 171.6 | 160.6 | 57.0 |
メモリ帯域幅は、RTX Sparkプラットフォームの最も明確なハードウェア上の利点です。すべてのN1XシステムはSTREAM Triadで120~122GB/sの読み取り速度を記録し、Blade 16の48,298MB/sの2.5倍となりました。OmniBookのメモリレイテンシは約143nsで、Surfaceの251.1nsよりははるかに低いものの、Bladeの129.6nsよりは遅く、コア間レイテンシは156.8~160.9nsで、Bladeの57.0nsの約3倍です。これが、N1Xがシングルスレッド処理でx64に劣る理由を説明するのに役立ちます。
ゲームおよびGPUエンコーディング
SuperTuxKart 1.5 は、内蔵ベンチマークを 1080p フルスクリーン、最高プリセット、垂直同期オフで実行します。1 回はゲームのネイティブ Arm64 ビルドで、もう 1 回はエミュレーション下の x64 ビルドで実行します。平均フレームレートと安定したフレームレートを報告します。FFmpeg は、同じ 4K60 クリップを NVIDIA システムでは NVENC HEVC 8Mbps でエンコードし、利用可能な場合は Media Foundation HEVC エンコーダーでエンコードします。
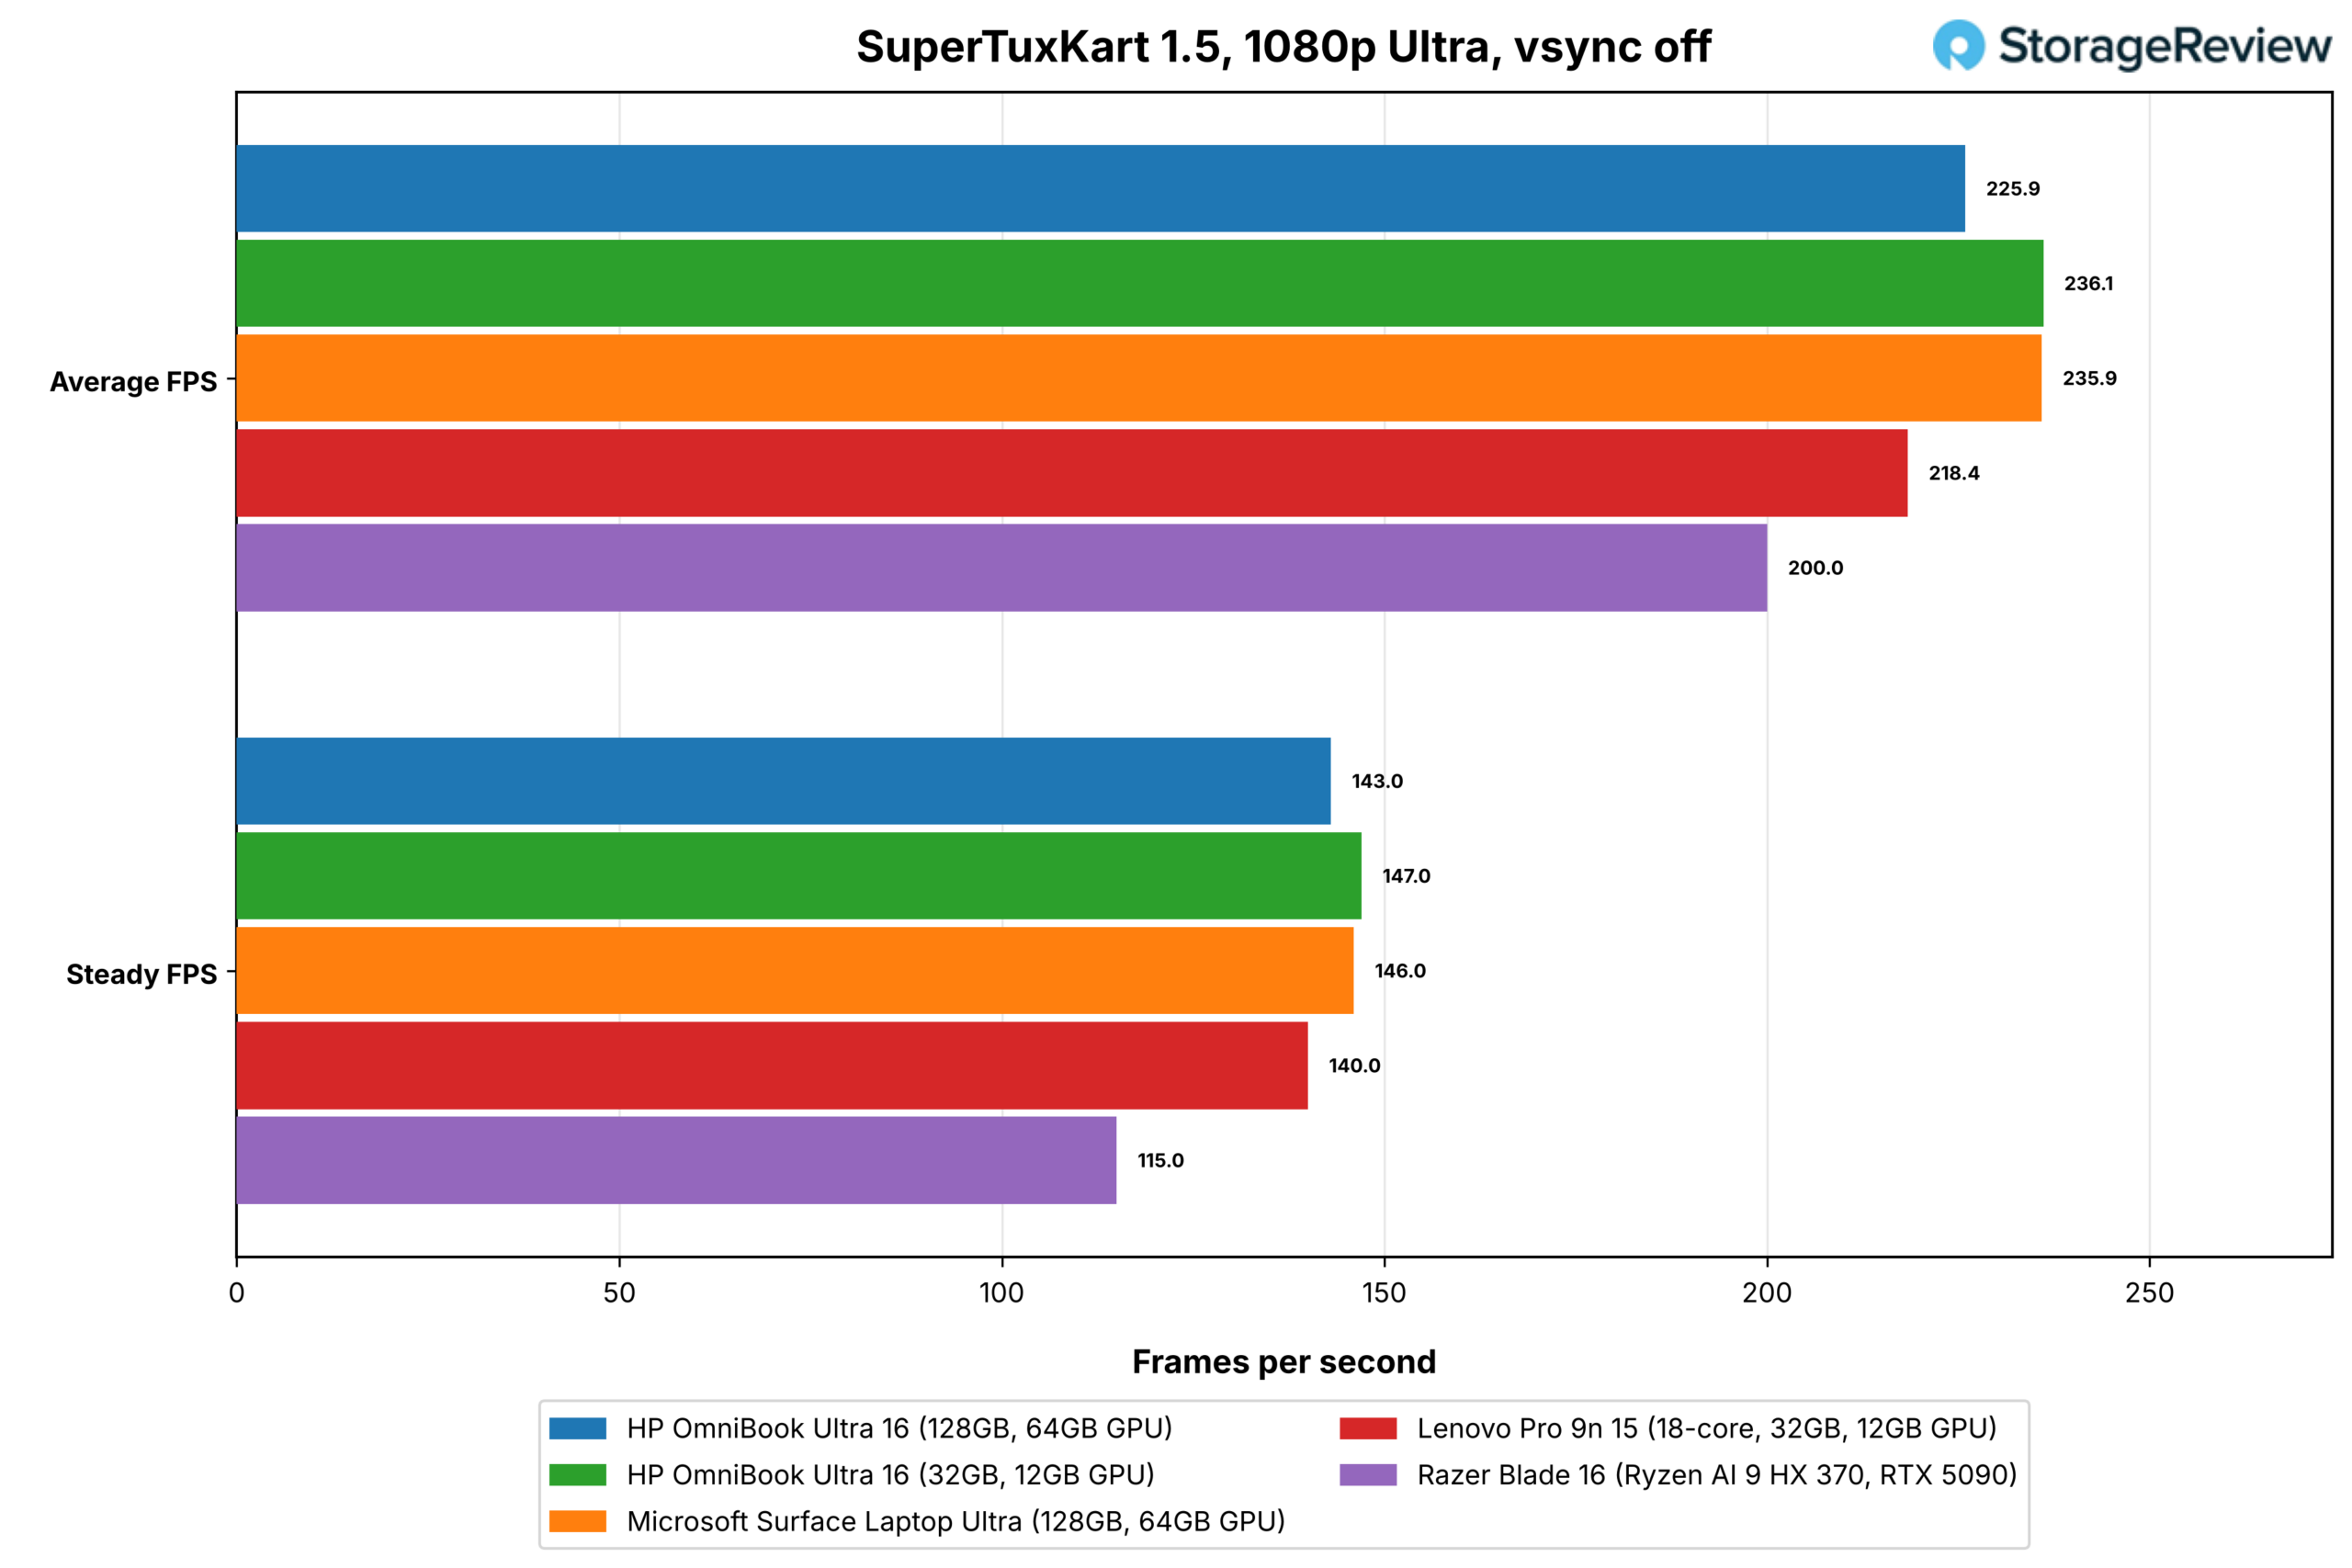
| テスト(数値が高いほど良い) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| SuperTuxKart 1080p Ultra、ネイティブ、平均(fps) | 225.9 | 236.1 | 235.9 | 218.4 | 200.0 |
| SuperTuxKart 1080p Ultra、ネイティブ、安定(fps) | 143 | 147 | 146 | 140 | 115 |
| SuperTuxKart 1080p Ultra、x64 エミュレーション下、平均 (fps) | 266.5 | 265.4 | 264.6 | 248.6 | 該当なし(ネイティブx64) |
| SuperTuxKart 1080p Ultra、x64 エミュレーション下、安定した (fps) | 141 | 143 | 129 | 94 | 該当なし(ネイティブx64) |
| FFmpeg NVENC HEVC、4K60fps、8Mbps(フレームレート) | 138 | 137 | 135 | 139 | 132 |
| FFmpeg Media Foundation HEVC (fps) | 66 | 55 | 55 | 55 | 無し |
32GB OmniBookとSurfaceはネイティブで約236fpsで同率首位となり、128GB OmniBookは225.9fps、Blade 16は200.0fpsを記録しました。この解像度では、CPUがフレームレートを決定し、RTX 5090には使用できない余裕があるため、この結果はGPUよりも各システムのコアについて多くを物語っています。エミュレーション下のx64ビルドは両方のHPで平均約266fpsを記録し、ネイティブArm64ビルドよりも高かったことから、ゲームのWindows on Arm版は2つのうち遅い方であることが示唆されます。
NVENCは固定機能であるため、ハードウェアエンコーディングはほぼ全機種で同じ性能を発揮します。OmniBooksはHEVCを138fpsと137fpsでエンコードしましたが、Blade 16は132fpsでした。また、128GBモデルのMedia Foundationエンコーダーは66fpsで動作しました。
サーマル
どちらの OmniBook も、設計上 N1X を限界まで動作させています。すべての全コアワークロードで 98 ℃ に留まり、Stockfish、Blender、GROMACS、および 30 分間の連続ループでは平均 96 ~ 98 ℃ でしたが、パフォーマンスはどちらも低下しませんでした。2 つのユニットは、ほぼすべてのテストで 1 度以内の差に収まり、これは同一のシャーシであれば当然の結果です。RTX Spark システムは、GPU の読み取りを行わず、Windows のサーマル ゾーンを通じてのみ CPU 温度を報告するため、以下の表は CPU を対象としています。
| CPU温度、最大値/平均値(℃) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| Cinebench 2026 | 98 / 83 | 98 / 83 | 98 / 88 | 92 / 70 | 96 / 78 |
| 7-Zip | 98 / 78 | 98 / 77 | 98 / 65 | 83 / 63 | 99 / 84 |
| 干し魚 | 98 / 97 | 98 / 96 | 98 / 96 | 88 / 83 | 92 / 90 |
| ブレンダー | 98 / 96 | 98 / 97 | 98 / 93 | 91 / 80 | 95 / 87 |
| ハンドブレーキ | 98 / 86 | 98 / 87 | 98 / 84 | 93 / 74 | 92 / 86 |
| LLVMビルド | 98 / 92 | 98 / 92 | 98 / 92 | 87 / 79 | 98 / 93 |
| GROMACS | 98 / 96 | 98 / 96 | 98 / 96 | 89 / 85 | 97 / 94 |
| OpenBLAS | 98 / 95 | 97 / 93 | リタイア | 92 / 83 | 91 / 87 |
| STREAM | 98 / 96 | 95 / 89 | 98 / 92 | 78 / 66 | 75 / 71 |
| スーパータックスカート | 95 / 82 | 94 / 86 | 90 / 80 | 74 / 68 | 89 / 82 |
| MLPerfクライアント | 93 / 84 | 93 / 85 | 93 / 77 | 76 / 66 | 97 / 76 |
| コーディングエージェント | 90 / 79 | 実行しない | 86 / 78 | 実行しない | 91 / 84 |
| RAG | 94 / 90 | 94 / 90 | 94 / 86 | 76 / 71 | 88 / 83 |
| 持続ループ | 98 / 98 | 98 / 98 | 98 / 97 | 92 / 87 | 94 / 90 |
Surface Laptop Ultra は、持続ループで損失なく 98 ℃ で熱的に同じように動作するため、OpenBLAS の電源オフが際立っています。OmniBook は、同じ OpenBLAS シーケンスを最大 98 ℃、平均 95 ℃ と 93 ℃、約 3.0GHz で実行しましたが、障害は発生しませんでした。Pro 9n は、CPU テストで HP より 5 ~ 18 ℃ 低いピーク値となり、クロックは HP の約 1 パーセント以内でした。Blade 16 の Zen 5 コアは、7-Zip と LLVM ビルドで 98 ~ 99 ℃ に達しました。
| 平均CPUクロック周波数(MHz) | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| Cinebench 2026 | 2,962 | 2,964 | 2,952 | 2,951 | 4,158 |
| 7-Zip | 2,838 | 2,862 | 2,405 | 2,849 | 4,014 |
| 干し魚 | 3,269 | 3,269 | 3,263 | 3,292 | 3,645 |
| ブレンダー | 3,123 | 3,241 | 3,174 | 3,216 | 3,729 |
| ハンドブレーキ | 2,756 | 2,865 | 2,739 | 2,834 | 3,814 |
| LLVMビルド | 3,151 | 3,193 | 3,160 | 3,197 | 3,697 |
| GROMACS | 3,308 | 3,315 | 3,325 | 3,367 | 3,874 |
| OpenBLAS | 3,024 | 3,057 | リタイア | 3,192 | 4,274 |
| STREAM | 3,258 | 3,251 | 3,255 | 3,101 | 3,684 |
| スーパータックスカート | 1,957 | 2,008 | 2,049 | 2,017 | 4,349 |
| MLPerfクライアント | 2,114 | 2,241 | 2,165 | 2,027 | 3,593 |
| コーディングエージェント | 2,078 | 実行しない | 2,242 | 実行しない | 3,789 |
| RAG | 2,749 | 2,724 | 2,751 | 2,760 | 3,764 |
| 持続ループ | 3,239 | 3,232 | 3,270 | 3,288 | 3,726 |
全コア負荷時、OmniBook、Surface、およびPro 9nは3.1~3.4GHzに落ち着き、これはこれらのシャーシでN1Xが保持する限界速度です。HPは、安定したスコアで持続ループを通して3,239MHzと3,232MHzを維持しました。ファームウェアはクロックを発振することなく限界まで保持するため、スコアは平坦になります。SSDも負荷がかかった状態で低温で動作し、80回のfioパスを通して、128GBユニットのSandiskでは最高52℃、32GBユニットのKIOXIAでは最高64℃でした。
貯蔵性能
ストレージ テストでは、fio の four corners を 5GB と 25GB のフットプリントでブート ドライブに対して実行し、ファイルシステムを介して、また raw デバイスに対して再度実行し、ここでは 25GB の結果を報告します。raw デバイスの行は NTFS と BitLocker をバイパスするため、2 つの間のギャップは、ドライブの能力のうち Windows I/O パスを通過する部分がどの程度残っているかを示します。4 台の N1X システムはすべて、BitLocker デバイス暗号化が有効になっている Windows on Arm を実行しています。HP の 2 台では BitLocker 保護が有効でしたが、Pro 9n では無効でした。
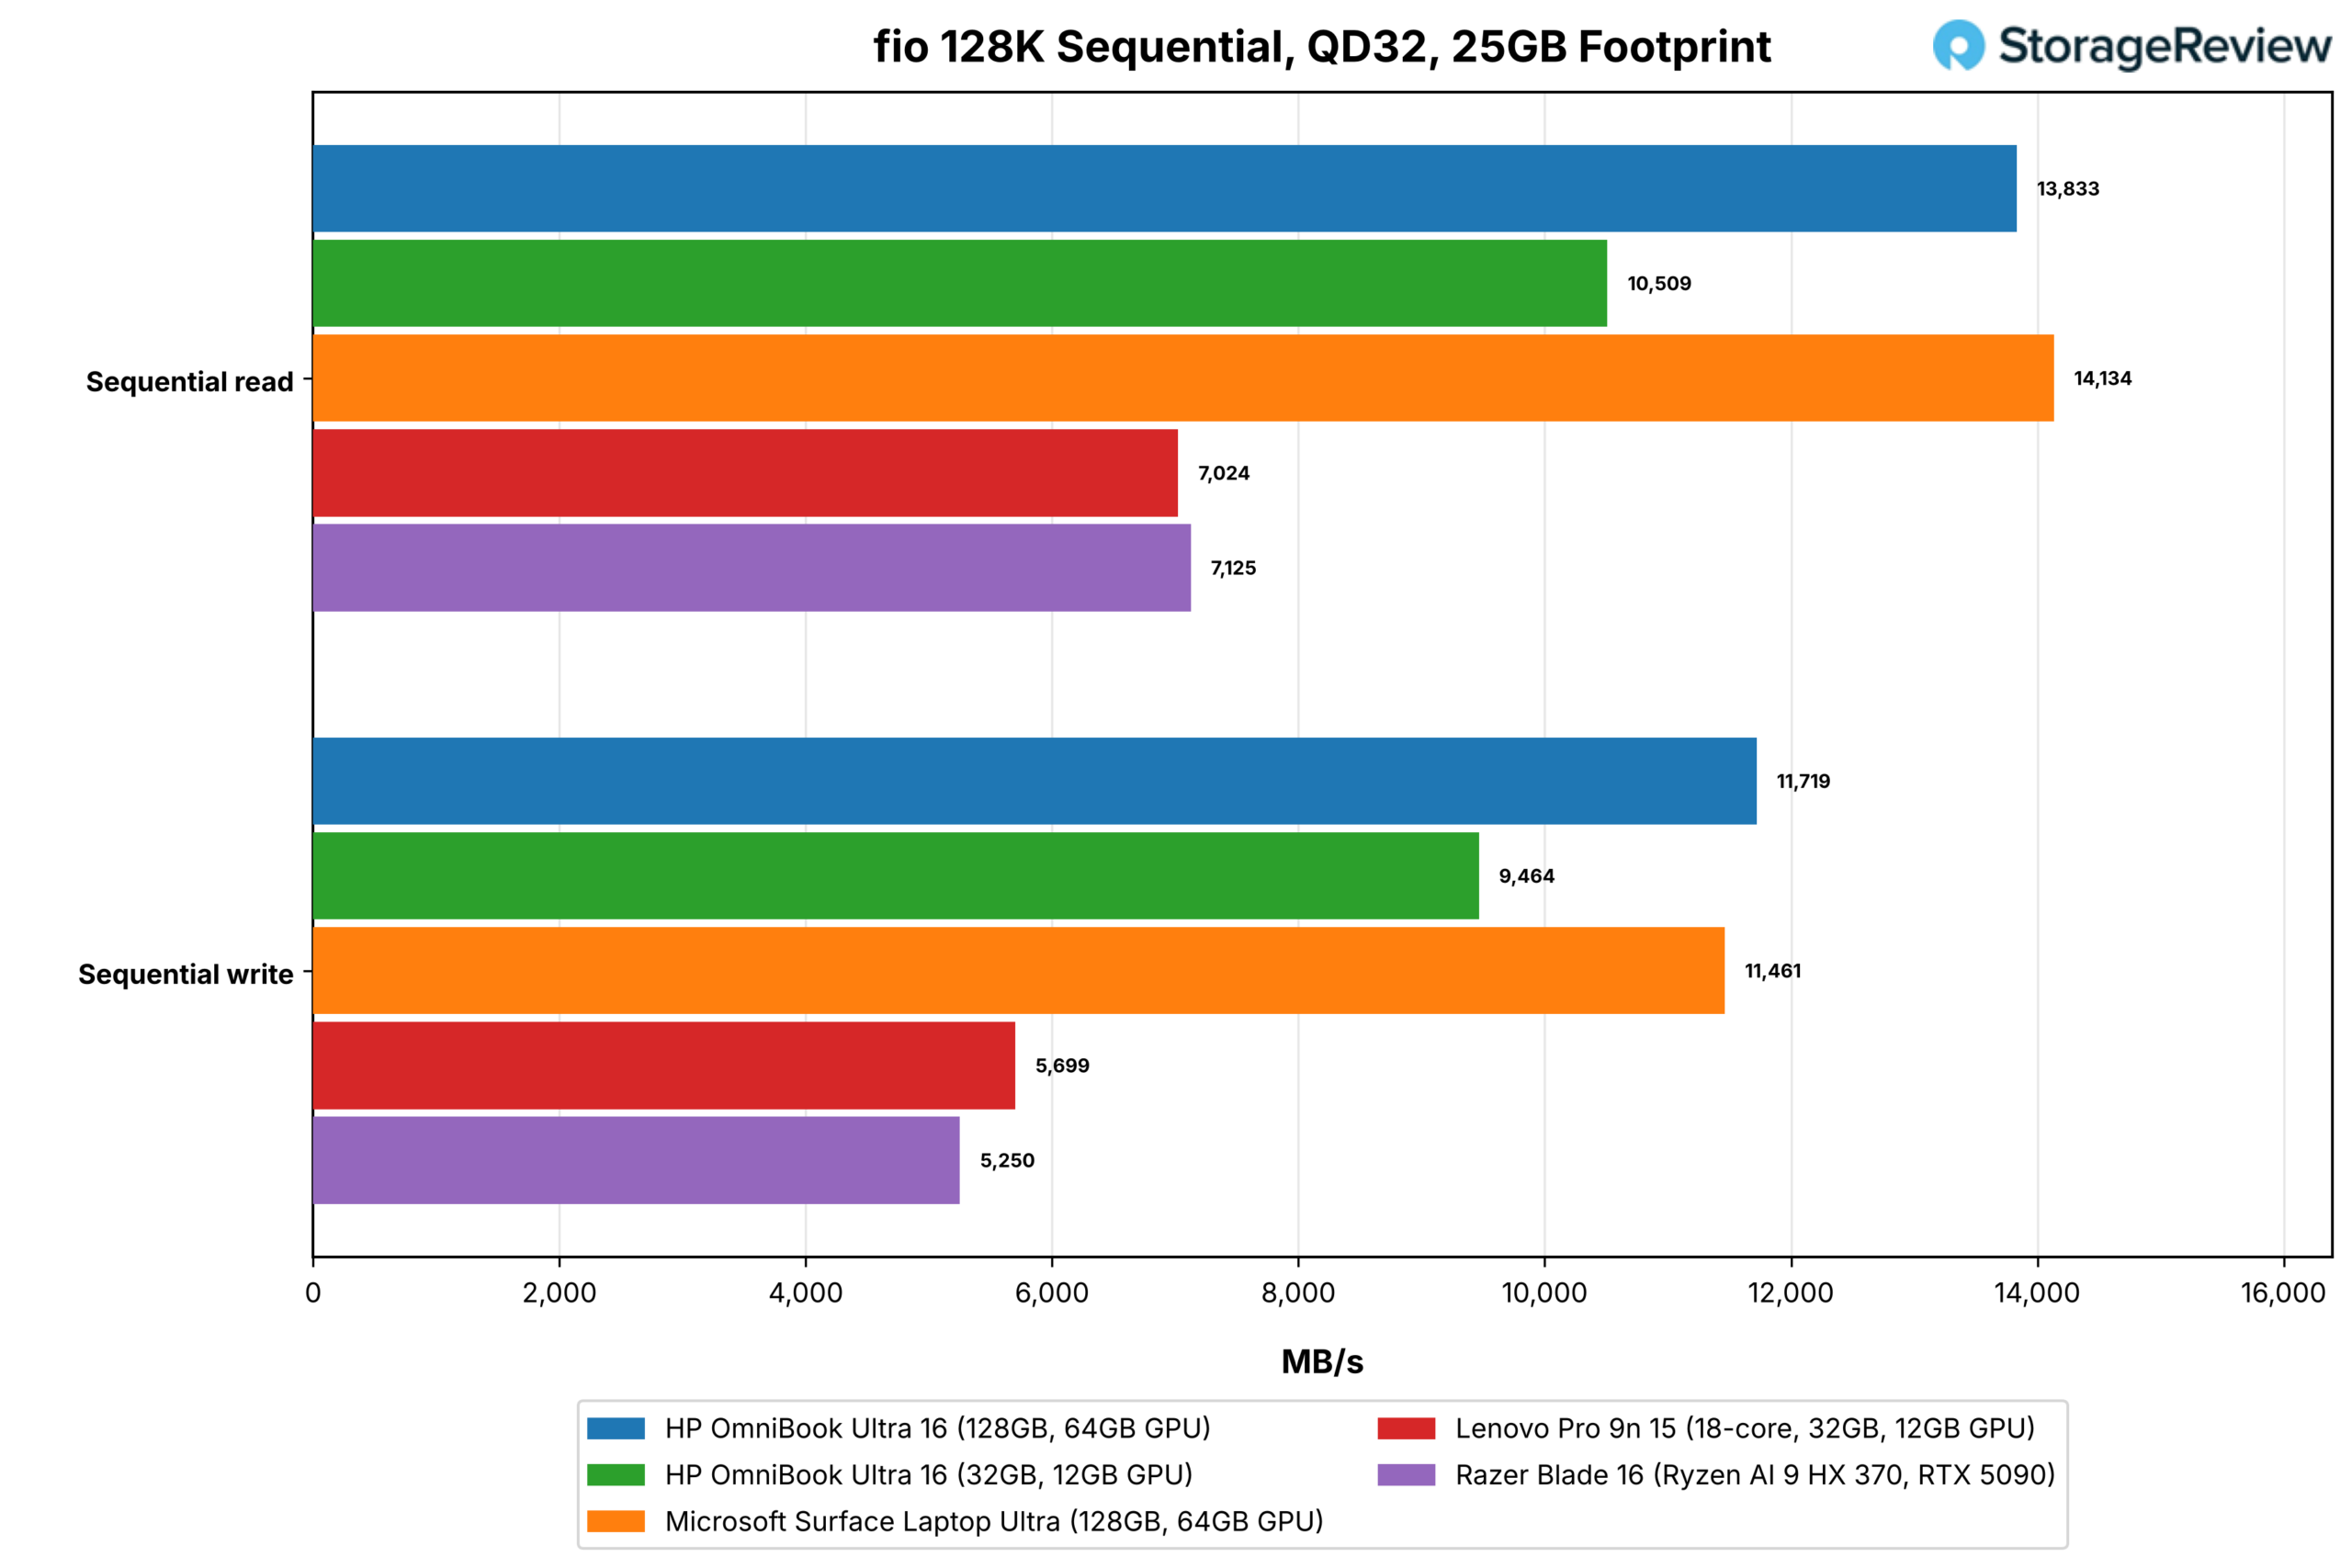
| fio、25GBのフットプリント、QD32 | OmniBook Ultra 16 (128GB) | OmniBook Ultra 16 (32GB) | Surface Laptop Ultra | プロ9n15 | Razerのブレード16 |
|---|---|---|---|---|---|
| シーケンシャル読み取り 128K、ファイルシステム (MB/秒) | 13,833 | 10,509 | 14,134 | 7,024 | 7,125 |
| シーケンシャル読み取り 128K、生デバイス (MB/秒) | 12,479 | 10,047 | 13,815 | 7,165 | 7,134 |
| シーケンシャル書き込み速度 128K (MB/秒) | 11,719 | 9,464 | 11,461 | 5,699 | 5,250 |
| ランダム読み取り 4K、ファイルシステム、ピーク (IOPS) | 437,833 | 289,024 | 300,225 | 338,936 | 694,597 |
| ランダム読み取り4K、デバイス生データ、ピーク値(IOPS) | 1,888,501 | 1,412,982 | 1,670,736 | 973,106 | 993,050 |
| ランダム書き込み4K、ピーク値(IOPS) | 228,354 | 226,661 | 279,848 | 192,000 | 648,446 |
| 生データ/ファイルシステムランダム読み取り | 4.31x | 4.89x | 5.56x | 2.87x | 1.43x |
| ランダム読み取り4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 643 | 494 | 477 | 578 | 444 |
| ランダム書き込み4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 586 | 602 | 449 | 758 | 371 |
| 駆動温度、最大(℃) | 52 | 64 | 56 | 78 | 60 |
128GB版OmniBookに搭載されている2TBのSandisk SN8050Sは、シーケンシャル読み取り速度が13,833MB/s、書き込み速度が11,719MB/sで、このグループの中で最速の書き込み速度を記録し、読み取り速度はSurfaceのSK hynixに次ぐ2位となった。32GB版の1TB KIOXIA Gen5ドライブは10,509MB/sと9,464MB/sに達し、Pro 9nとBlade 16に搭載されている2つのGen4ドライブは7GB/s前後の速度を記録した。
ランダム I/O は、Windows on Arm ストレージ パスが示す部分です。SN8050S は、raw デバイスから 4K ランダム読み取りで 1.89M IOPS を達成しましたが、ファイルシステム経由では 437.8K で、4.3 倍の差があり、KIOXIA の差は 4.9 倍でした。Blade 16 の x64 パスは、raw で 993.0K のドライブからファイルシステム経由で 694.6K IOPS を読み取るため、損失ははるかに少なかったです。最も可能性の高い原因は、VBS とメモリ整合性がオンになっている BitLocker のソフトウェア暗号化であり、BitLocker 保護がオフになっている Pro 9n では、2.9 倍の小さな差が示されています。HP は、これらのレビュー システムを BitLocker をオンにして構成しました。
ファイルシステムパスでも長時間停止が発生しました。ジョブ数が16の場合、ランダム読み取りの最も遅い0.01%は、128GBのOmniBookでは3.2秒、32GBのユニットでは6.2秒かかりましたが、Blade 16では14ミリ秒でした。このジョブ数で設定された128GBの行のうち1つは、再実行後も2%のスプレッド制限を超えており、部分的なものとしてマークされています。ピーク値とraw-Deviceの結果には影響はありません。
結論
128GBメモリを搭載したHP OmniBook Ultra 16は、今回のプラットフォーム発表でテストした中で最も完成度の高いRTX Sparkノートブックとして、非常に魅力的な製品です。CPU、AI、ゲーム性能においてSurface Laptop Ultraと数パーセントの差で同等の結果を出し、62.5GBのGPU使用可能メモリでローカルAIの2つの階層を両方とも実行し、Qwen3.6コーディングタスクをグループ内のどのシステムよりも速く完了させ、2台のSurfaceユニットを98℃まで加熱させた全コアOpenBLASソルブも問題なく実行しました。
HPのタワー型ヒンジとトランク冷却システムにより、N1Xは負荷が続く限り常に限界性能を維持し、30分間にわたって性能低下は一切見られなかった。さらに重要なことに、HPシステムはテストを一度も失敗することなく完了した。
32GB版のOmniBookは、N1XのCPUとGPUのパフォーマンスがメモリ容量に依存しないことを証明しています。CPU、MLPerf、RAGの各テストにおいて、128GB版とほぼ2%以内の差に収まり、CinebenchシングルコアとSuperTuxKartではグループをリードしました。ただし、ローカルモデルの容量は犠牲になります。12GBのGPUメモリがメモリに分割されているため、モデルロードやコーディングエージェントのテストでは一切使用できません。N1XをCPU性能重視で購入するユーザーは32GB版でもほとんど損失を感じませんが、ローカルAIを重視するユーザーは64GB版または128GB版を検討すべきでしょう。
Windows on Arm ストレージパスでは、4K ランダム読み取りがドライブの性能の 4 分の 1 未満に抑えられています。SVT-AV1 や GROMACS などの一部の Arm64 ポートは、x64 ビルドに比べて著しく遅延し、シングルスレッドの Python は Blade 16 よりも 20 ~ 50 % 長くかかり、シングルスレッドの primesieve は約 80 % 長くかかります。統合 GPU はシステムの他の部分とメモリ バスを共有しているため、コーディング エージェントの実行中はブラウザが 1.73 倍遅くなりました。これらはプラットフォーム/ソフトウェアの問題であり、HP の問題ではありません。新しいパッチやリリースによってエコシステムが改善し続けることを期待しています。
20Bから35Bのモデルをローカルで実行したり、大規模なツリーをコンパイルしたり、薄型の16インチノートパソコンのCPUでレンダリングしたりできる、非常に優れたモバイルプラットフォームを求める開発者やクリエイターにとって、128GBのOmniBook Ultra 16は、今回の比較対象の中で他のどのノートパソコンよりも優れた性能を発揮します。
リーダーボード: 128GBのHP OmniBook Ultra 16は、ローカルAI向けベストノートパソコンのリーダーボードで、最高のRTX Spark搭載ノートパソコンの座を獲得しています。



 Amazon