

기술은 주기적으로 움직이며, 현재 에지에서 AI를 강조하는 것보다 더 분명한 주기는 없습니다. 특히, 우리는 에지 추론에 대한 엄청난 스윙을 발견하고 있습니다. NVIDIA는 데이터 센터 외부에서 GPU 채택을 촉진하고자 하는 이러한 노력의 큰 부분을 차지하고 있습니다. 그럼에도 불구하고 기업은 더 많은 의사 결정을 더 빨리 내려야 하므로 AI 인프라가 데이터에 더 가까워져야 합니다.
허브 앤 스포크를 기억하십니까?
"예전"에는 데이터 생성 측면에서 에지와 기존의 허브 앤 스포크 방법론을 사용하여 해당 데이터를 빠르고 효율적으로 데이터 센터로 가져오는 방법에 대해 이야기했습니다. 이 설계는 중복 및 하드웨어가 많고 데이터를 기본 데이터 센터로 다시 가져오는 유일한 목적을 가진 코어, 액세스 및 배포를 기반으로 하는 계층적 설계에 자리를 내주었습니다. 에지에서 수집된 모든 데이터는 처리를 위해 메인 데이터 센터로 다시 전송된 다음 에지 장치로 다시 푸시되어 비효율적이고 비용이 많이 들고 시간이 많이 소요되었습니다.
어쩌면 허브 앤 스포크 설계 방식이 그렇게 나쁜 것만은 아니었을지도 모릅니다. AI를 활용한 엣지 컴퓨팅의 발전과 클라우드 컴퓨팅의 등장으로 네트워크 설계, 엣지 구축, 그리고 데이터 처리 방식에 상당한 변화가 일어나고 있습니다. 실제로 올해 HPE Discover 컨퍼런스의 슬로건은 클라우드 열풍 이전 시대에도 쓰였을 법한 "엣지 투 클라우드 컨퍼런스(The Edge-to-Cloud Conference)"였습니다.
에지 모멘텀에 뛰어들다
Dell Technologies World 행사에서 Dell Technologies가 비슷한 이야기를 전하면서 업계에서 Edge-to-Cloud 컴퓨팅의 중요성을 인식한 공급업체는 HPE만이 아니었습니다. IBM, Lenovo, NetApp 및 Supermicro도 클라우드 리소스를 보다 효과적으로 활용하면서 에지에서 더 많은 작업을 수행해야 할 필요성에 대해 목소리를 높였습니다.
에지 컴퓨팅의 레이저 초점을 주도하는 것은 무엇입니까? 고객은 센서, IoT 장치 및 자율 주행 차량 데이터 수집에서 수집된 에지에서 대량의 데이터를 생성하고 있습니다. 소스에서 데이터에 대한 근접성은 정확한 예측을 통한 더 빠른 통찰력과 더 나은 대역폭 활용으로 더 빠른 응답 시간을 포함하여 비즈니스 이점을 제공합니다. 에지에서의 AI 추론(AI 기술을 사용한 실행 가능한 인텔리전스)은 성능을 개선하고, 시간(추론 시간)을 줄이며, 네트워크 연결에 대한 의존성을 줄여 궁극적으로 비즈니스 수익을 개선합니다.
클라우드에서 에지 추론을 수행하지 않는 이유는 무엇입니까?
클라우드에서 에지 추론을 수행할 수 없는 이유는 무엇입니까? 시간에 민감하지 않고 중요하지 않은 것으로 간주되는 애플리케이션의 경우 클라우드 AI 추론이 해결책이 될 수 있습니다. 그러나 실시간 추론에는 많은 기술적 문제가 있으며 그 중 대기 시간이 가장 중요합니다. 또한 IoT 장치 및 에지에서 처리해야 하는 관련 응용 프로그램이 지속적으로 증가함에 따라 모든 장치에서 고속 클라우드 연결을 사용하는 것이 불가능할 수 있습니다.
에지 컴퓨팅은 현장 지원, 물리적 및 애플리케이션 보안, 제한된 공간으로 이어지는 제한된 스토리지를 포함하는 고유한 문제를 가져옵니다. 오늘날의 에지 서버는 기존의 에지 워크로드에 적합한 컴퓨팅 성능을 제공하며, GPU는 복잡함 없이 더 많은 성능을 추가합니다.
에지 옵션의 성장
흥미롭게도 소규모 시스템 제공업체가 주로 에지 인프라 시장을 지배해 왔습니다. 예를 들어, Supermicro는 수년간 전신주에서 5G 및 데이터 센터에 대해 이야기해 왔으며 Advantech 및 기타 많은 전문 서버 제공업체도 동일한 작업을 수행해 왔습니다. 그러나 GPU가 개선되고 더 중요한 것은 이를 지원하는 소프트웨어가 향상됨에 따라 에지에서 AI의 전체 개념이 더욱 현실화되고 있습니다.
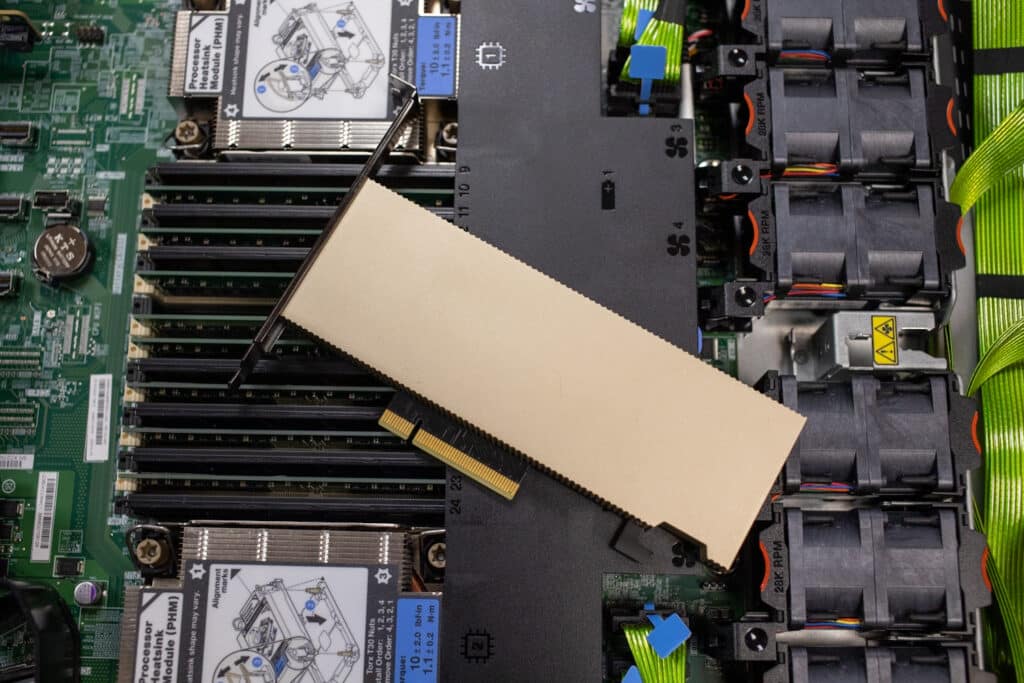
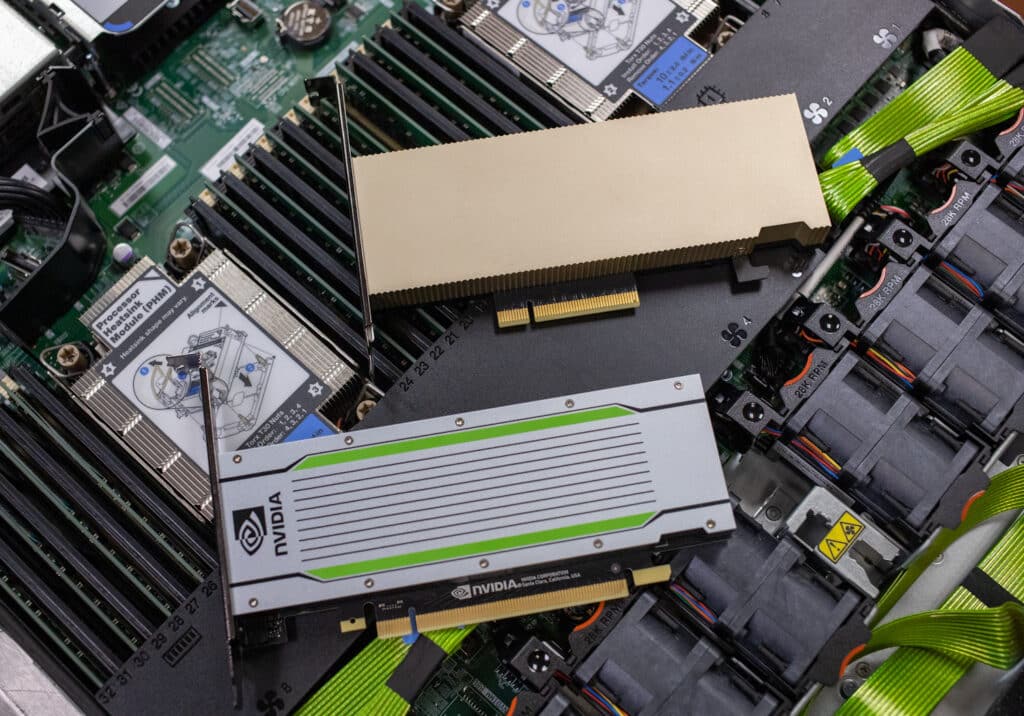
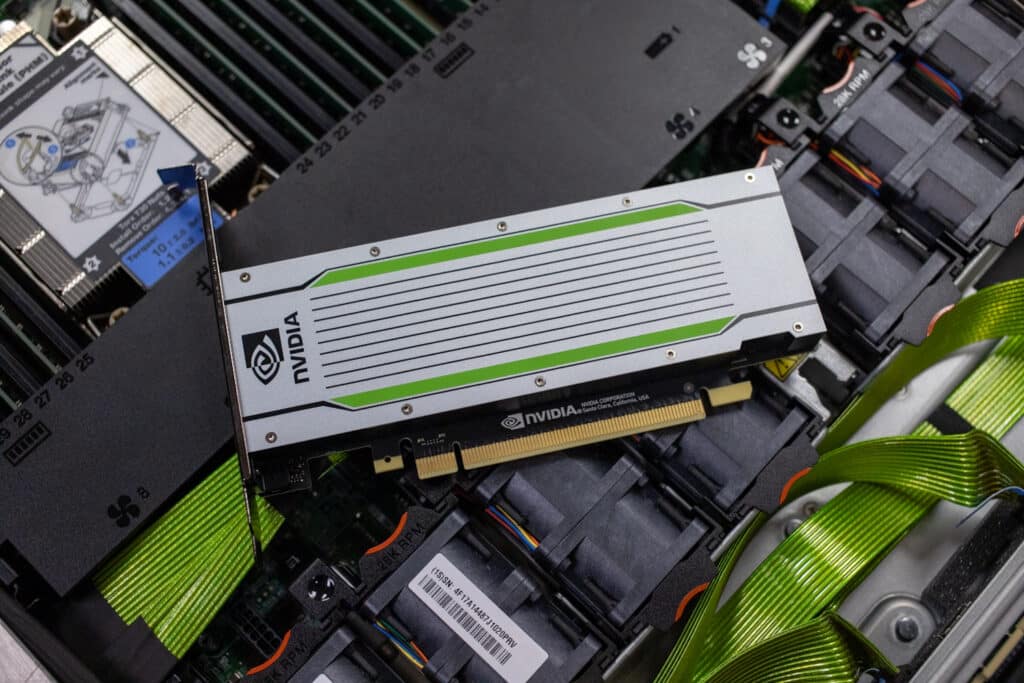
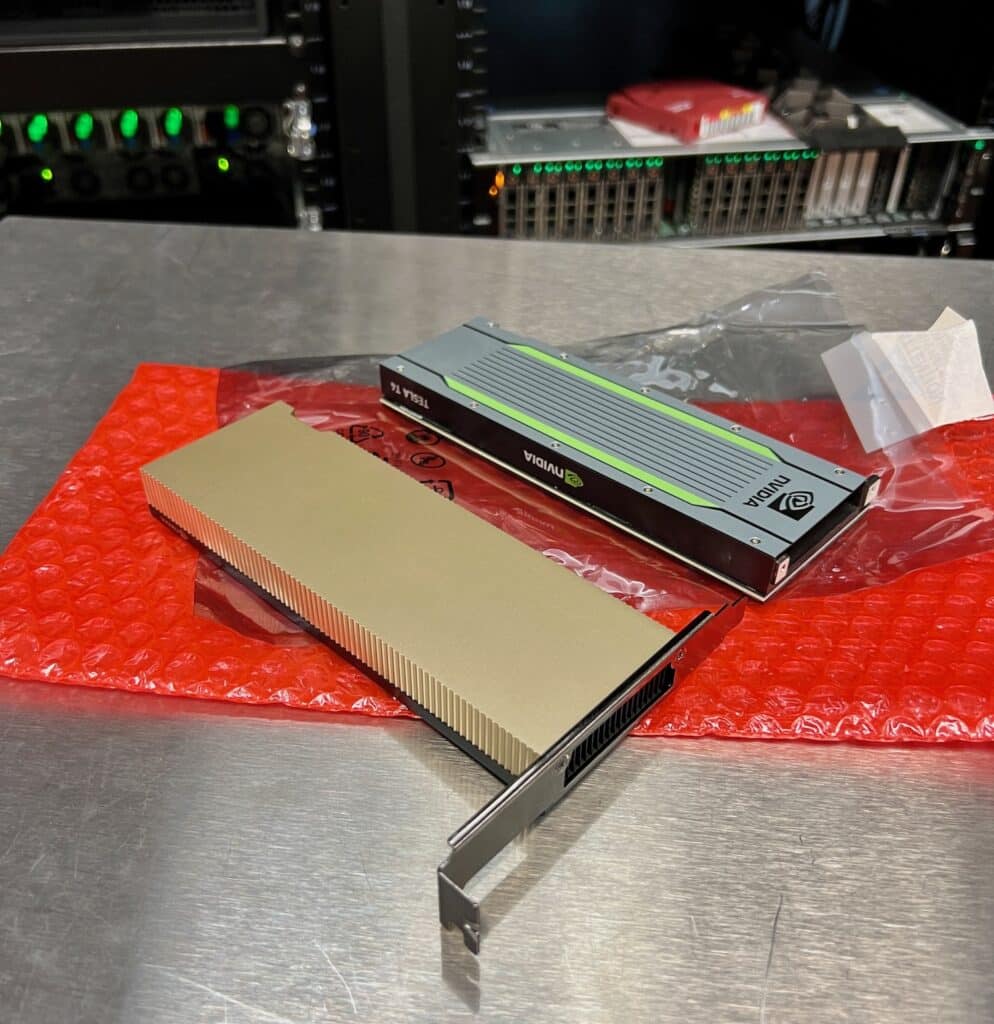
우리는 최근 실험실에서 몇 가지 다른 방식으로 이러한 전환을 목격했습니다. 첫째, 새로운 서버 디자인은 NVIDIA의 단일 슬롯, A2 및 항상 인기 있는 T4와 같은 저전력 GPU를 제공합니다. 최근 Lenovo와 Supermicro는 이러한 GPU를 통합한 평가를 위해 서버를 보냈으며 성능이 인상적이었습니다.
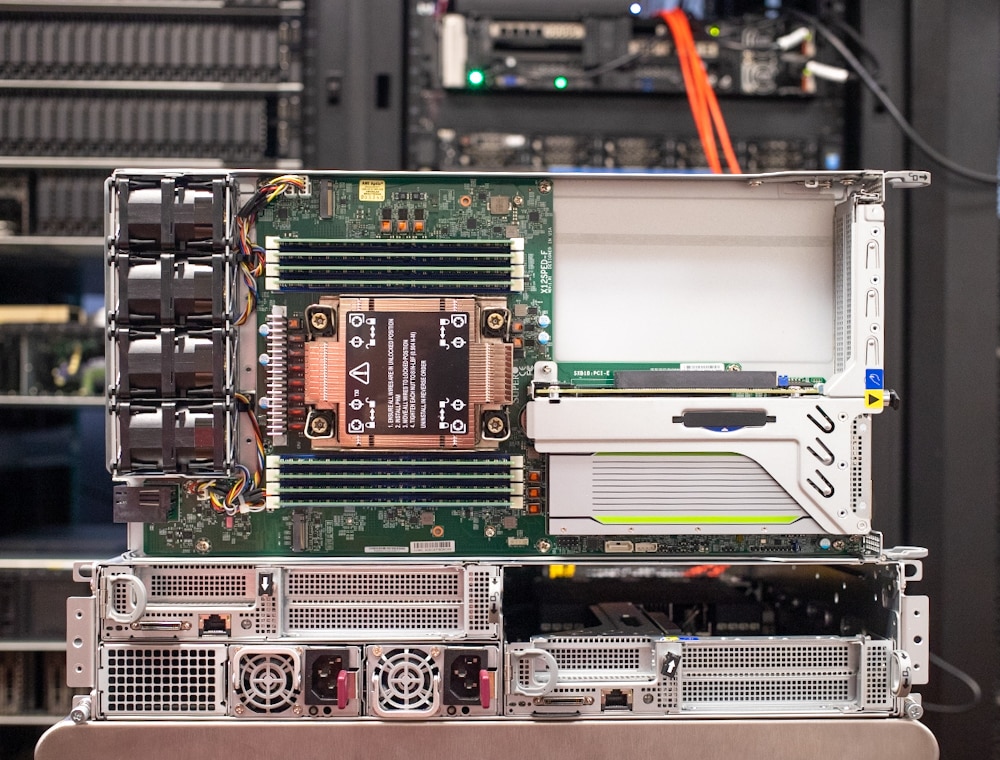 슈퍼마이크로 IoT 슈퍼서버 SYS-210SE-31A 엔비디아 T4
둘째로, 인프라 제공업체들은 낮은 지연 시간과 보안과 같은 데이터 센터의 핵심 요소와 직접적으로 연관된 지표를 제공하는 엣지 솔루션에 상당한 비중을 두고 있습니다. 최근 저희는 Dell PowerVault ME5 를 통해 이러한 사용 사례들을 살펴보았습니다 . ME5는 SMB 스토리지 솔루션으로 출시되었지만, 뛰어난 비용 대비 성능 덕분에 엣지 환경에서의 활용 가능성에 대한 관심이 높습니다.
그러나 궁극적으로 에지 추론 이야기는 매우 간단합니다. 그것은 종종 즉석에서 데이터를 처리하는 GPU의 능력에 달려 있습니다. 우리는 이러한 새로운 서버와 GPU가 에지 추론 역할에 대해 어떻게 작동할 수 있는지에 대한 더 나은 아이디어를 얻기 위해 테스트를 확장하기 위해 노력해 왔습니다. 특히 이미지 인식 및 자연어 처리 모델과 같은 인기 있는 에지 워크로드를 살펴보았습니다.
테스트 배경
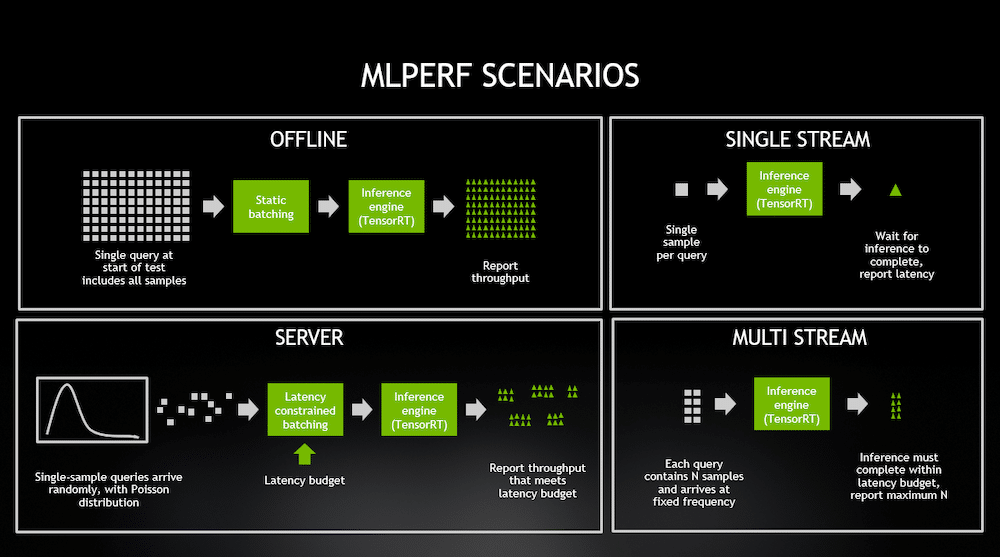
우리는 MLPerf Inference: Edge 벤치마크 제품군을 사용하고 있습니다. 이 도구 세트는 다양한 실제 에지 시나리오에서 인기 있는 DL 모델의 추론 성능을 비교합니다. 테스트에서 질문 답변 작업을 위한 ResNet50 이미지 분류 모델 및 BERT-Large NLP 모델에 대한 숫자가 있습니다. 둘 다 오프라인 및 SingleStream 구성에서 실행됩니다.
오프라인 시나리오는 모든 테스트 데이터를 즉시 사용할 수 있고 대기 시간이 고려 사항이 아닌 "배치 모드"에서 추론 성능을 평가합니다. 이 작업에서 추론 스크립트는 임의의 순서로 테스트 데이터를 처리할 수 있으며 목표는 초당 쿼리 수(QPS=처리량)를 최대화하는 것입니다. QPS 수치가 높을수록 좋습니다.
반대로 단일 스트림 구성은 한 번에 하나의 테스트 샘플을 처리합니다. 단일 입력에 대해 추론이 수행되면(ResNet50의 경우 입력은 단일 이미지임) 대기 시간이 측정되고 추론 도구에서 다음 샘플을 사용할 수 있습니다. 목표는 각 쿼리를 처리하는 대기 시간을 최소화하는 것입니다. 대기 시간이 낮을수록 좋습니다. 쿼리 스트림의 90번째 백분위수 대기 시간은 간결함을 위해 대상 메트릭으로 캡처됩니다.
아래 이미지는 NVIDIA 블로그의 MLPerf 추론 0.5 관련 게시물에서 발췌한 것으로, 다양한 시나리오를 매우 잘 시각화하고 있습니다. MLPerf 추론에 대한 자세한 내용은 원본 논문(여기) 에서 확인할 수 있습니다.
에지 추론 – Lenovo ThinkEdge SE450
ThinkEdge SE450을 검토한 후 , Lenovo와 협력하여 시스템에 탑재된 NVIDIA A2 및 T4 GPU에서 MLPerf를 실행했습니다. 목표는 SE450이 단일 GPU로 어떤 성능을 발휘할 수 있는지 파악하는 것이었습니다. 이 시스템은 저전력 NVIDIA GPU를 최대 4개까지 지원하므로, 이 결과를 바탕으로 원하는 GPU 개수에 대해서도 성능을 예측해 볼 수 있습니다.
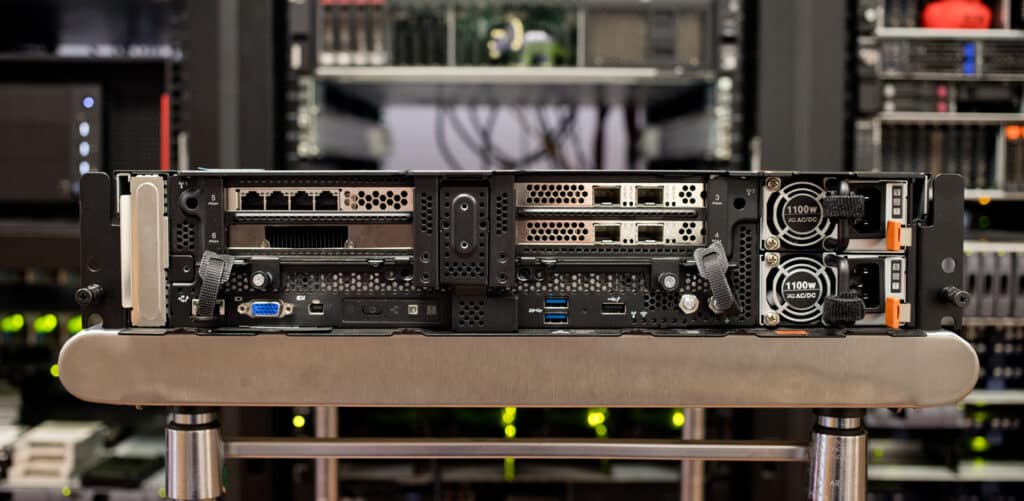
이 테스트를 위해 우리는 Lenovo와 직접 협력하여 NVIDIA A2 및 T4를 사용하여 실험실의 다양한 구성을 테스트했습니다. MLPerf를 사용하면 공급업체는 특정 플랫폼에 맞게 조정된 특정 테스트 도구를 갖게 됩니다. 우리는 이 에지 추론 벤치마킹에 Lenovo의 테스트 장치를 사용하여 인기 있는 GPU가 어디에서 나오는지 아이디어를 얻었습니다.
우리 연구실에서 SE2의 A4 및 T450에 대한 테스트 결과:
| 기준 | NVIDIA A2(40-60W TDP) | NVIDIA T4(70W TDP) |
|---|---|---|
| ResNet50 싱글스트림 | 0.714ms 지연 | 0.867 대기 시간 |
| ResNet50 오프라인 | 3,032.18개 샘플/초 | 5,576.01개 샘플/초 |
| BERT 싱글스트림 | 8.986ms 지연 | 8.527ms 지연 |
| BERT 오프라인 | 244.213개 샘플/초 | 392.285개 샘플/초 |
흥미롭게도 NVIDIA T4는 전반적으로 정말 좋은 성능을 보였는데, 일부 사람들은 나이만 보고도 놀라워했습니다. T4의 성능 프로파일은 T4가 여전히 큰 인기를 끌고 있는 꽤 분명한 이유입니다. 즉, A2는 실시간 이미지 추론에서 T4보다 의미 있는 지연 시간 이점이 있습니다.
궁극적으로 GPU에 대한 결정은 당면한 특정 작업에 맞게 조정됩니다. 이전 NVIDIA T4는 더 많은 전력(70W)을 소비하고 PCIe Gen3 x16 슬롯을 사용하는 반면 최신 A2는 더 적은 전력(40-60W)에서 작동하도록 설계되었으며 PCIe Gen4 x8 슬롯을 사용합니다. 조직이 에지의 인프라에서 요구하는 사항을 더 잘 파악하면 결과가 더 의미 있고 에지 추론 프로젝트의 성공 가능성이 높아집니다.
최종 생각
공급업체는 에지 시장을 위해 더 작고, 더 빠르고, 더 견고한 서버를 개발하기 위해 경쟁하고 있습니다. 소매에서 공장, 의료에 이르기까지 조직은 소스에서 수집된 데이터에 대한 더 빠른 통찰력을 얻기 위해 노력하고 있습니다. 추론 시간을 개선하고 대기 시간을 줄이며 성능을 개선할 수 있는 옵션과 최신 기술을 활용하면 승자와 패자가 빠르게 갈릴 것입니다.
조직이 끊임없이 증가하는 IoT 장치에서 수집한 통찰력을 활용하는 새로운 방법을 찾으면서 에지 시장은 가만히 있지 않습니다. 우리 팀은 각 산업에서 빠르게 움직일 수 있는 사람들이 이 에지 추론 사용 사례를 포함하여 에지에서 AI를 활용할 수 있는 중요한 기회를 봅니다.
우리는 주요 IT 인프라 업체들이 향후 1년 동안 이러한 특정 사용 사례에 대한 혁신적인 솔루션을 내놓을 것으로 기대합니다. 또한, 어쩌면 더 중요하게는, 이러한 엣지 컴퓨팅 사용 사례에서 GPU 활용을 보편화하는 데 도움이 되는 소프트웨어 분야에서도 많은 발전이 있을 것으로 예상합니다. 이 기술이 진정한 혁신을 가져오려면 현재보다 배포가 훨씬 쉬워야 합니다. NVIDIA뿐만 아니라 Vantiq , Viso.ai 등 여러 소프트웨어 회사들의 노력을 고려할 때, 더 많은 조직들이 이 기술을 현실로 구현할 수 있을 것으로 낙관합니다.



 아마존