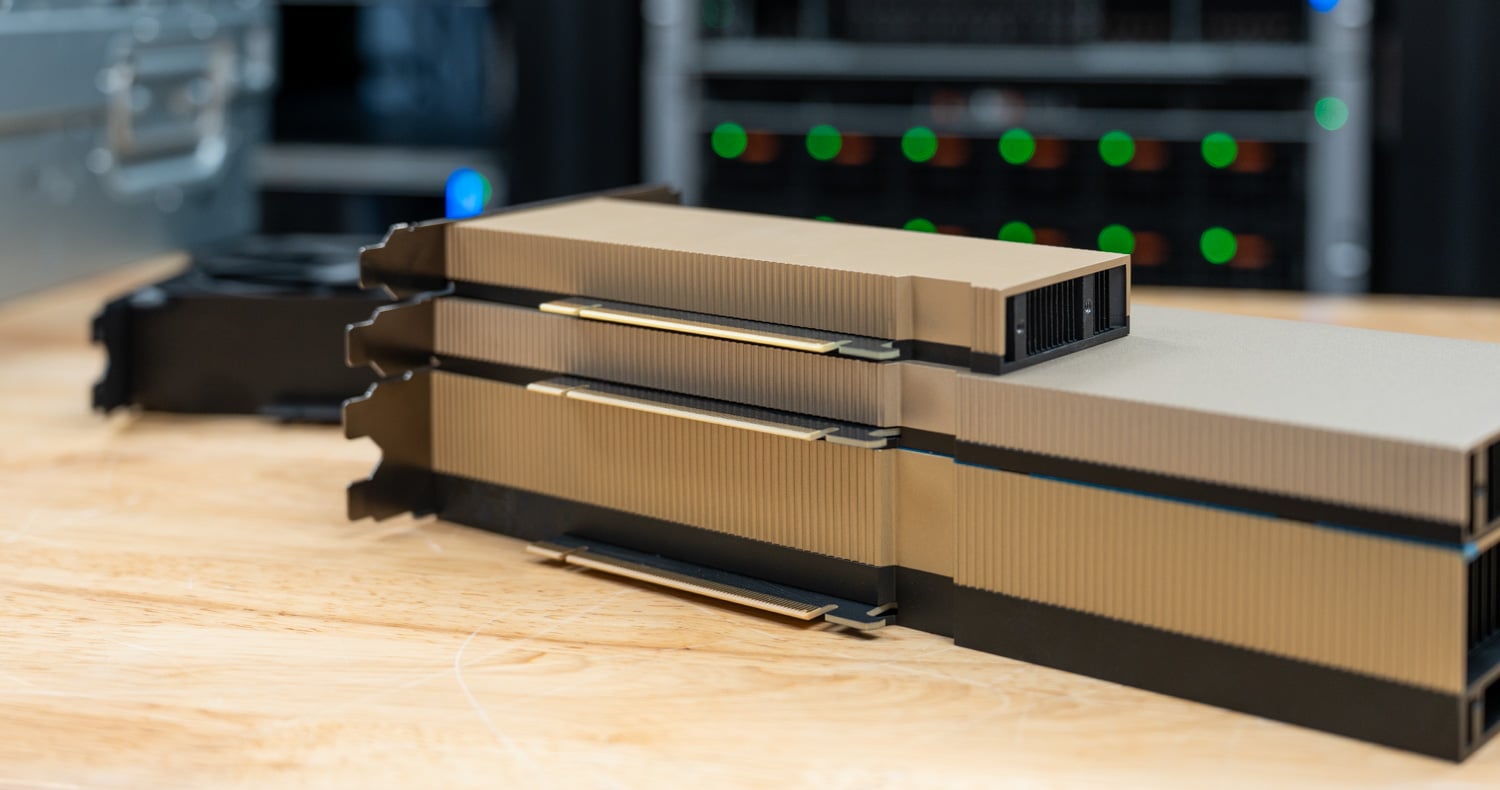
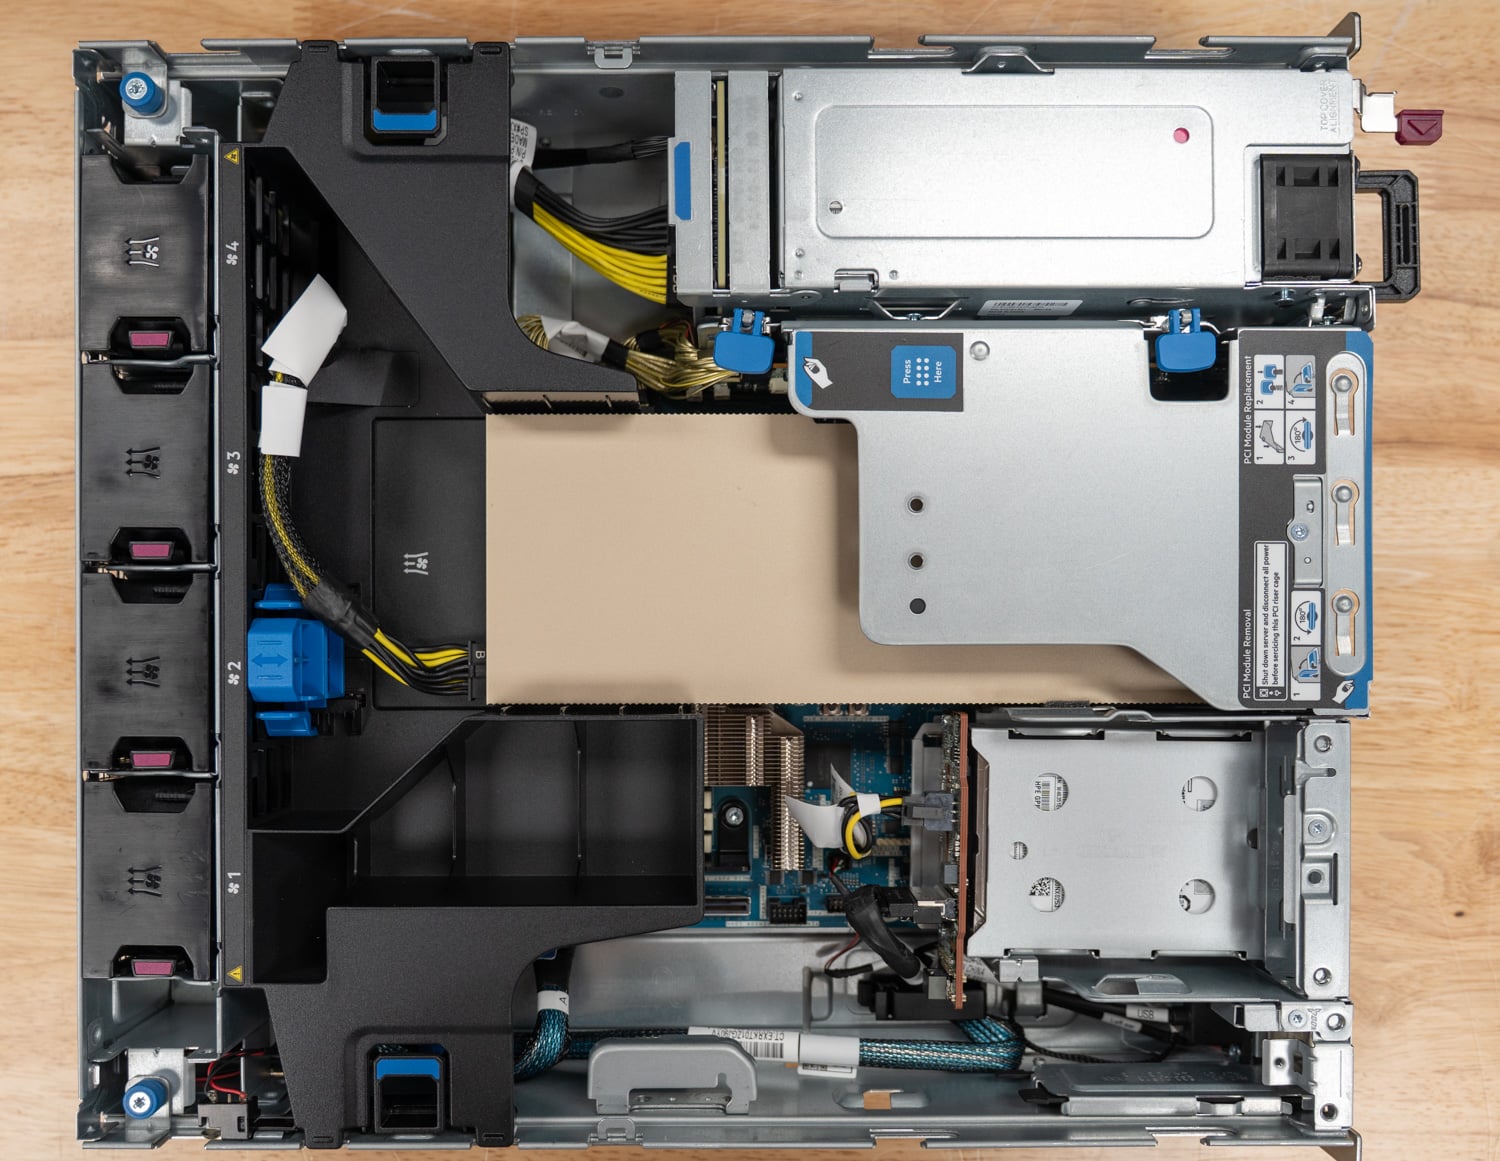
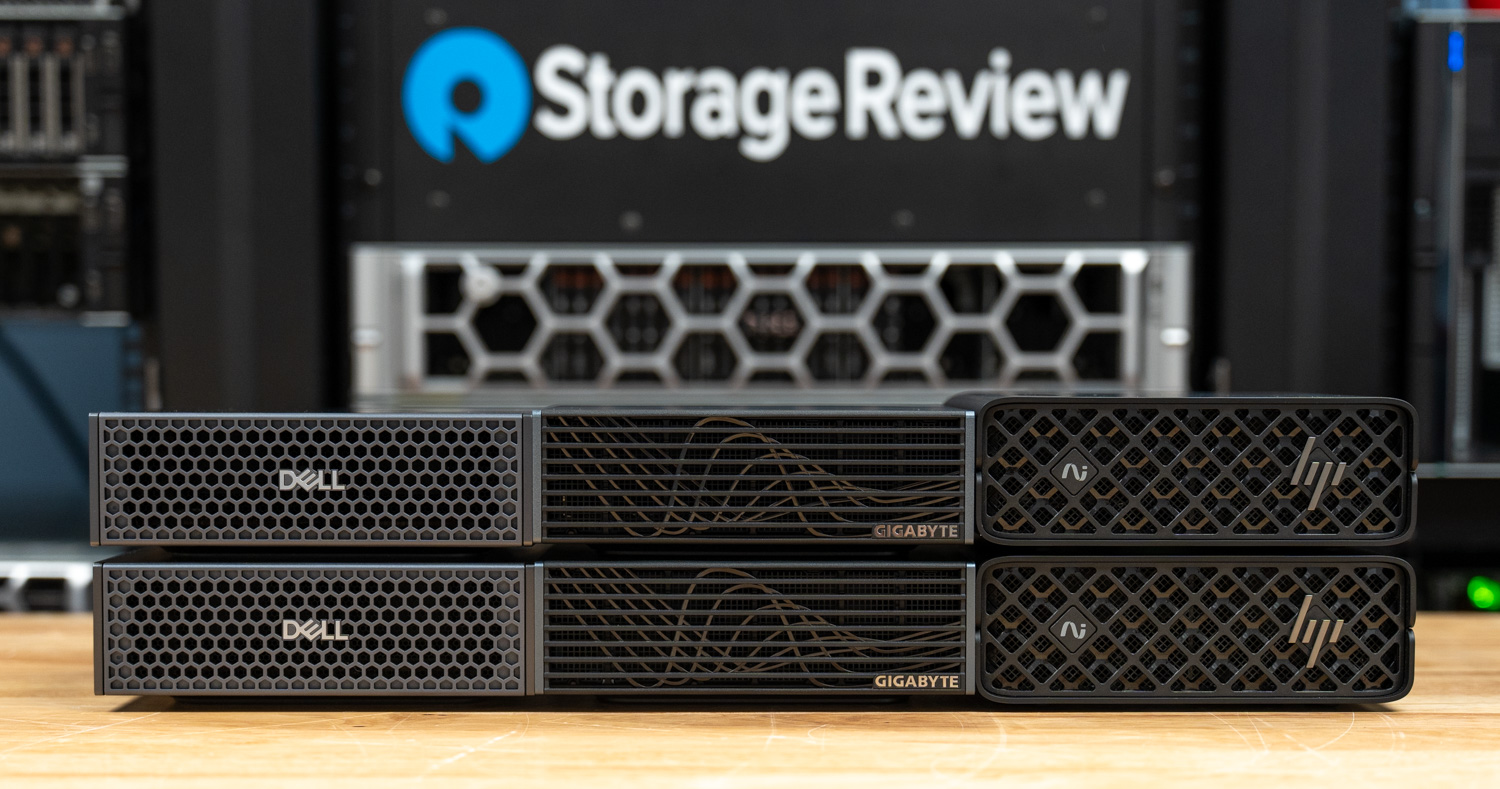
현재 저희는 연구실 환경에서 Llama, Qwen, DeepSeek, gpt-oss 계열의 오픈웨이트 모델을 사용하여 추론 서빙을 중심으로 AI 시스템 리뷰를 진행하고 있으며, vLLM 또는 SGLang을 통해 실행하고 출력 처리량과 첫 번째 토큰 지연 시간을 측정하고 있습니다. 엣지 컴퓨팅부터 풀 GPU 노드까지 다양한 환경을 테스트했습니다. NVIDIA RTX PRO 4500 서버 에디션은 HPE ProLiant DL145 Gen11에 탑재된 L4 서버보다 초당 평균 2.7배 높은 출력 토큰 처리량을 제공했으며, 전력 소비량은 약 105W 더 높았습니다. Dell, GIGABYTE, HP 버전의 DGX Spark는 200Gb 패브릭을 통해 2노드 클러스터로 분산 추론을 실행했습니다. 또한 Supermicro JumpStart를 통해 NVIDIA HGX B200과 AMD Instinct MI350X 시스템을 직접 사용해 볼 수 있었습니다. 스토리지도 동일한 방식으로 처리됩니다. 데이터 경로가 GPU의 사용률을 결정하기 때문입니다. 따라서 GPUDirect 스토리지 처리량은 GDSIO로 측정하고, 장기 컨텍스트 및 에이전트 워크로드에 대해 KV 캐시 오프로드를 플래시 메모리로 테스트합니다.
AI용 하드웨어를 구성할 때, ' 최고의 서버' 페이지에서는 이 리뷰 데이터를 기반으로 현재 AI 추론 및 엣지 컴퓨팅에 가장 적합한 서버를 소개하고 있으며, '최고의 엔터프라이즈 SSD' 페이지에서는 GPU에 필요한 드라이브를, ' 최고의 스토리지 어레이' 페이지 에서는 학습 클러스터 및 네오클라우드에 사용되는 AI 스토리지 플랫폼을 다룹니다.




 아마존