

NVIDIA의 DGX Spark 플랫폼 출시 이후, 여러 제조사들이 GB10 Grace Blackwell 기반을 활용한 소형 데스크톱 시스템을 자체적으로 출시하고 있습니다. 핵심 보드와 실리콘은 표준화되어 있지만, 케이스 디자인, 쿨링 방식, 스토리지 구성, 그리고 전반적인 성능 면에서 차이가 나타납니다. 이번 리뷰에서는 GIGABYTE의 AI TOP ATOM을 사용한 제품을 집중적으로 살펴보겠습니다.
내부에는 동일한 GB10 슈퍼칩이 탑재되어 있으며, 20코어 Arm CPU 복합체와 Blackwell AI 가속 기능, 그리고 128GB의 통합 LPDDR5X 메모리가 결합되어 있습니다. 이러한 기반은 최대 1페타플롭의 FP4 연산 능력과 최대 200천억 개의 파라미터 모델링을 지원하여 워크스테이션급 AI 환경에 확실히 자리매김하게 합니다.
AI TOP ATOM은 150 x 150 x 50.5mm 크기의 1리터 소형 섀시에 담겨 있으며 240W 외부 어댑터로 전원을 공급받습니다. 컴퓨팅 코어는 다른 Spark 시스템과 동일하지만, GIGABYTE의 설계 선택이 발열, 지속적인 작업 부하 동작, 스토리지 성능 및 일상적인 사용성에 어떤 영향을 미치는지 살펴보겠습니다.
스토리지 옵션은 최대 4TB의 Gen5 NVMe까지 확장 가능하며, 시스템에는 Ubuntu 기반의 NVIDIA DGX OS가 탑재되어 있어 AI 워크로드를 바로 실행할 수 있습니다. 요컨대, 핵심 컴퓨팅 하드웨어는 다른 Spark급 시스템과 동일하지만, 사용자 경험, 발열, 소음 및 전반적인 디자인은 GIGABYTE가 이 컴팩트한 본체에 담아낸 역량에 따라 달라집니다.
이번 리뷰에서는 GIGABYTE의 Spark 플랫폼 제품이 지속적인 작업 부하, 냉각 성능, 일상적인 사용성 측면에서 어떤 차이를 보이는지, 그리고 컴팩트한 폼팩터로 인해 눈에 띄는 단점이 있는지 살펴보겠습니다.
| 스펙 | 기가바이트 AI 탑 아톰(GB10) |
|---|---|
| 크기 및 무게 | |
| 높이 | 2의 |
| 폭 | 5.9의 |
| 깊이 | 5.9의 |
| 중량(평량) | 2.64 파운드 |
| 프로세서 | |
| 프로세서 종류 | NVIDIA GB10 (그레이스 블랙웰 슈퍼칩) (20코어) |
| 통합 그래픽 | NVIDIA Blackwell GPU(통합형) |
| 메모리 | |
| 메모리 유형 | LPDDR5x (통합 시스템 메모리) |
| 메모리 구성 | 128GB LPDDR5x 통합 시스템 메모리 |
| 메모리 대역폭 | 273 GB/s (8533 MT/s) |
| 운영체제 | |
| 지원되는 운영 체제 | 엔비디아 DGX OS |
| 외부 포트 및 슬롯 | |
| 네트워크 포트 | RJ45(10GbE) 1개 NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB 포트 | USB 3.2 Gen 2×2 Type-C 포트 3개(20Gbps) PD 기능이 있는 USB 3.2 Gen 2×2 Type-C 포트 1개 |
| 비디오 포트 | HDMI 2.1a 포트 1개 |
| 전원 어댑터 포트 | USB 타입 C (PD 입력) |
| 보안 슬롯 | 없음 |
| Wireless | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| 스토리지 | |
| 저장 옵션 | 최대 4TB Gen5 NVMe (자체 암호화 지원) |
| 전원 어댑터 | |
| 타입 | 240W 외부 어댑터(USB Type-C) |
기가바이트 AI 탑 아톰 설계 및 조립
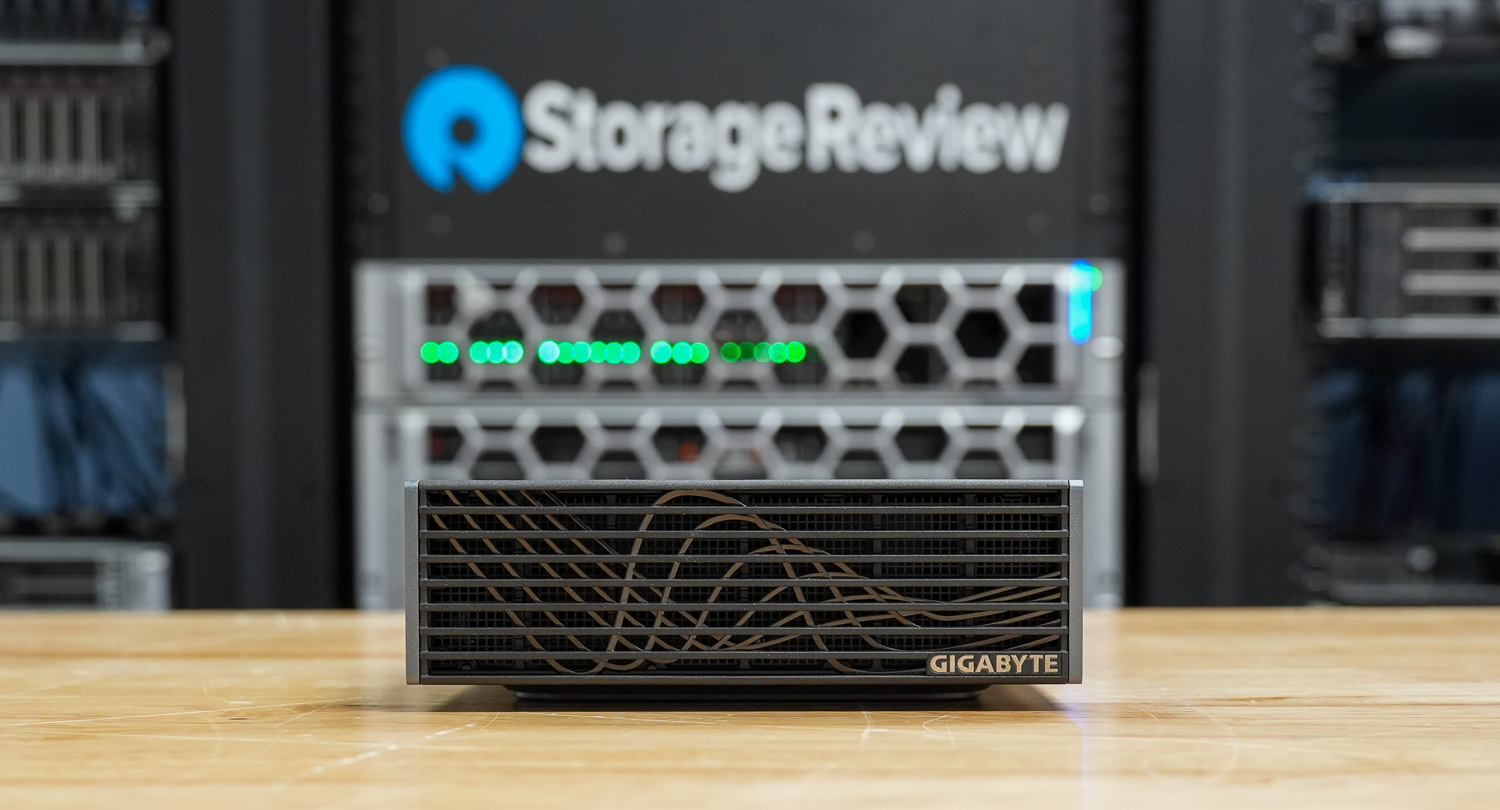
GIGABYTE AI TOP ATOM은 기존 Spark 기반 시스템들과 동일한 150 x 150mm 크기를 유지하며, 높이는 50.5mm, 무게는 1.2kg입니다. 책상 위에 올려놓기에 충분히 컴팩트한 크기이지만, 실제로 들어보면 묵직하고 견고한 느낌을 줍니다. 표면은 어둡고 무광택으로 마감되어 워크스테이션에 어울리는 분위기를 연출합니다.
단순한 평면 그릴 대신, 전면 전체에 수평 슬랫이 겹겹이 쌓여 있고 그 뒤에는 은은한 물결무늬 패턴이 있어 보는 각도에 따라 깊이감과 질감을 더합니다. 이는 냉각 성능 향상에 초점을 맞춘 디자인입니다. GIGABYTE 로고는 하단 모서리에 위치하며, 전면에는 데이터 포트나 전원 버튼조차 없어 깔끔한 외관을 유지하고 공기 흐름에 최적화되어 있습니다.
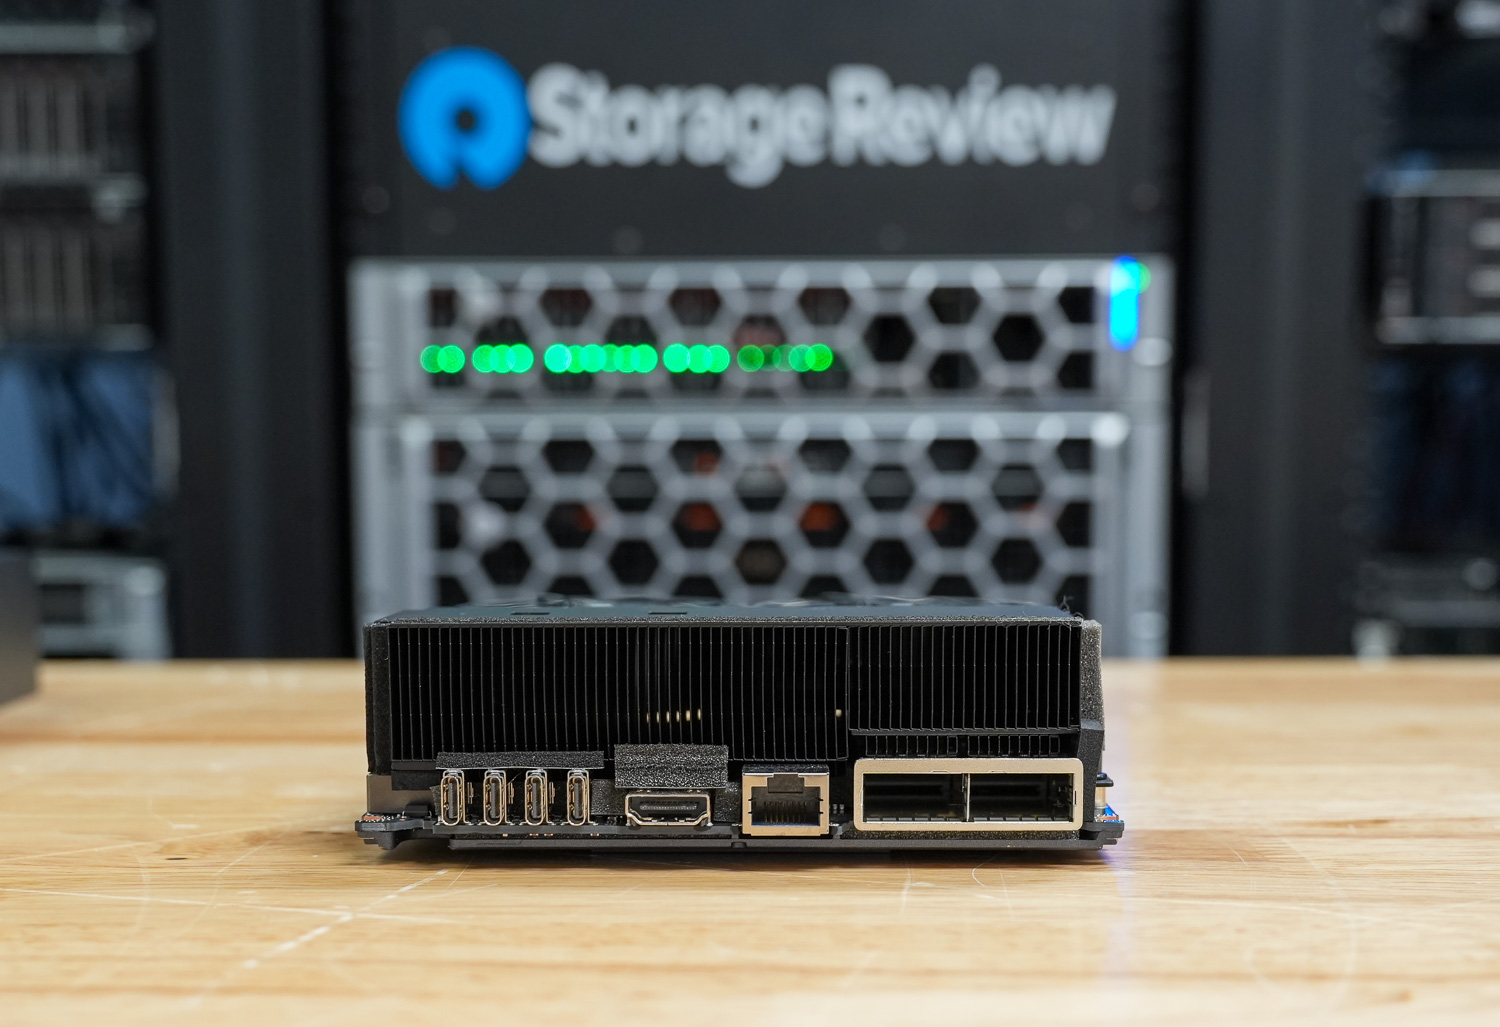
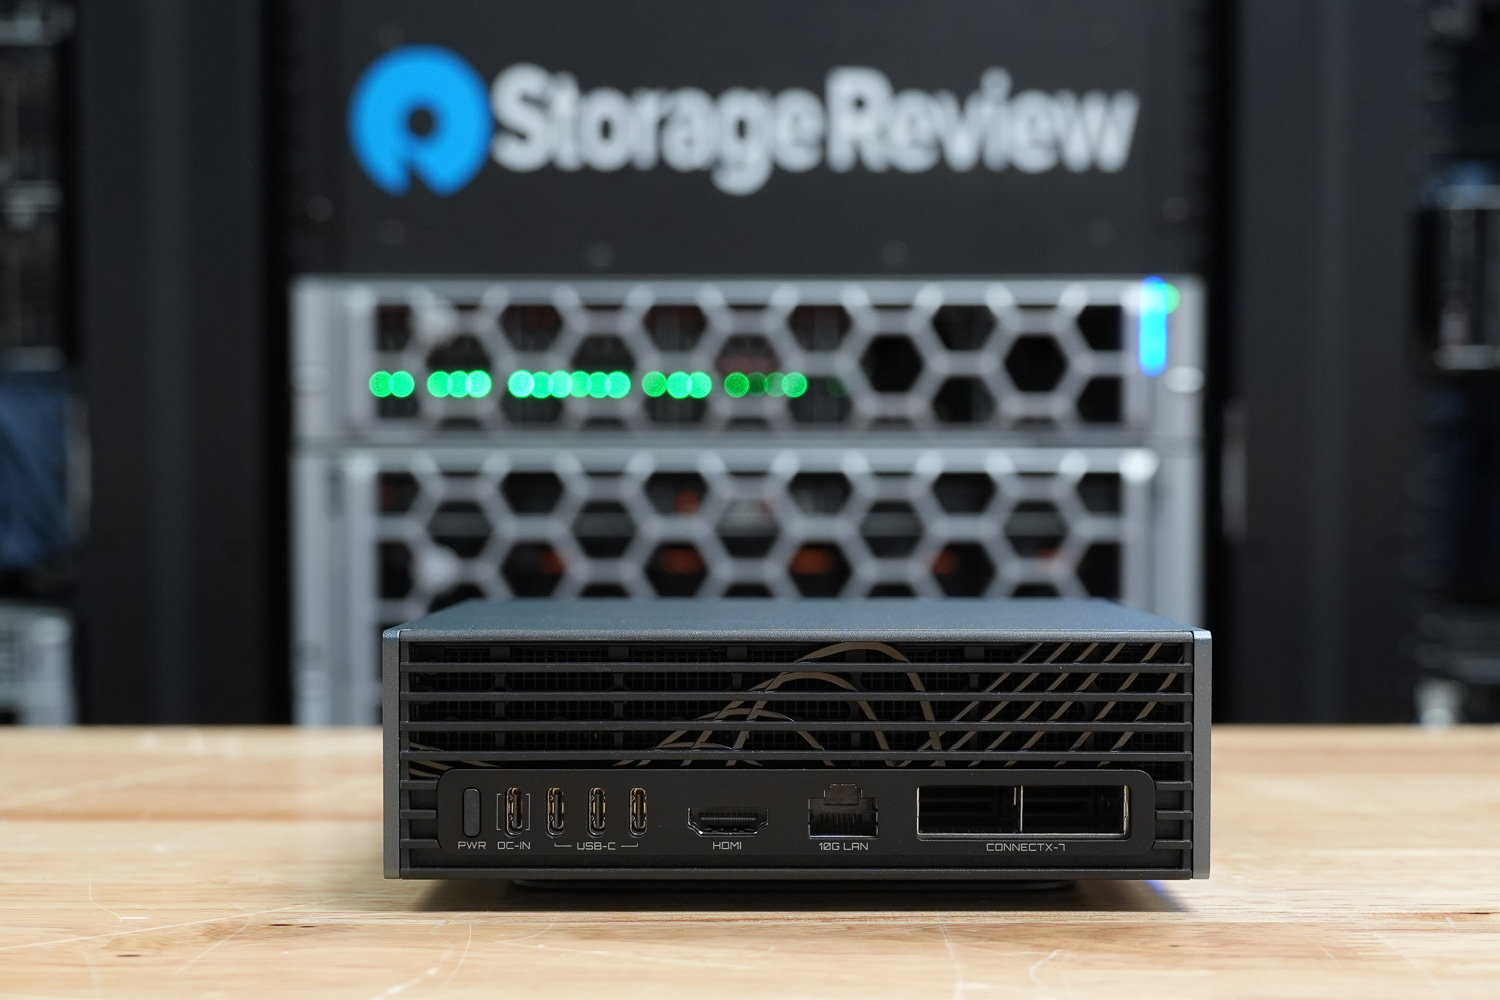
모든 연결 포트는 후면 패널에 있습니다. 최대 20Gbps 속도를 지원하는 USB 3.2 Gen 2×2 Type-C 포트 3개와 전원 입력용 USB Type-C 포트 1개가 제공됩니다. 디스플레이 출력은 HDMI 2.1a 포트 1개를 포함합니다. 네트워크는 10GbE RJ-45 포트와 고속 데이터 전송을 지원하고 여러 시스템을 연결하여 대규모 네트워크를 구축할 수 있는 NVIDIA ConnectX-7 SmartNIC를 갖추고 있습니다. 측면 패널에는 GIGABYTE Kensington Nano 잠금 슬롯이 있습니다.
내부에는 NVIDIA의 GB10 Grace Blackwell Superchip이 탑재되어 있으며, 20코어 Arm CPU 구성과 통합 Blackwell 그래픽을 결합했습니다. 256비트 인터페이스의 128GB LPDDR5x 통합 메모리가 지원되어 최대 273GB/s의 대역폭을 제공합니다. 다른 GB10 시스템과 마찬가지로 CPU와 GPU는 동일한 메모리 풀을 공유하는데, 이는 이러한 시스템이 AI 워크로드를 처리하도록 설계된 핵심 요소입니다.
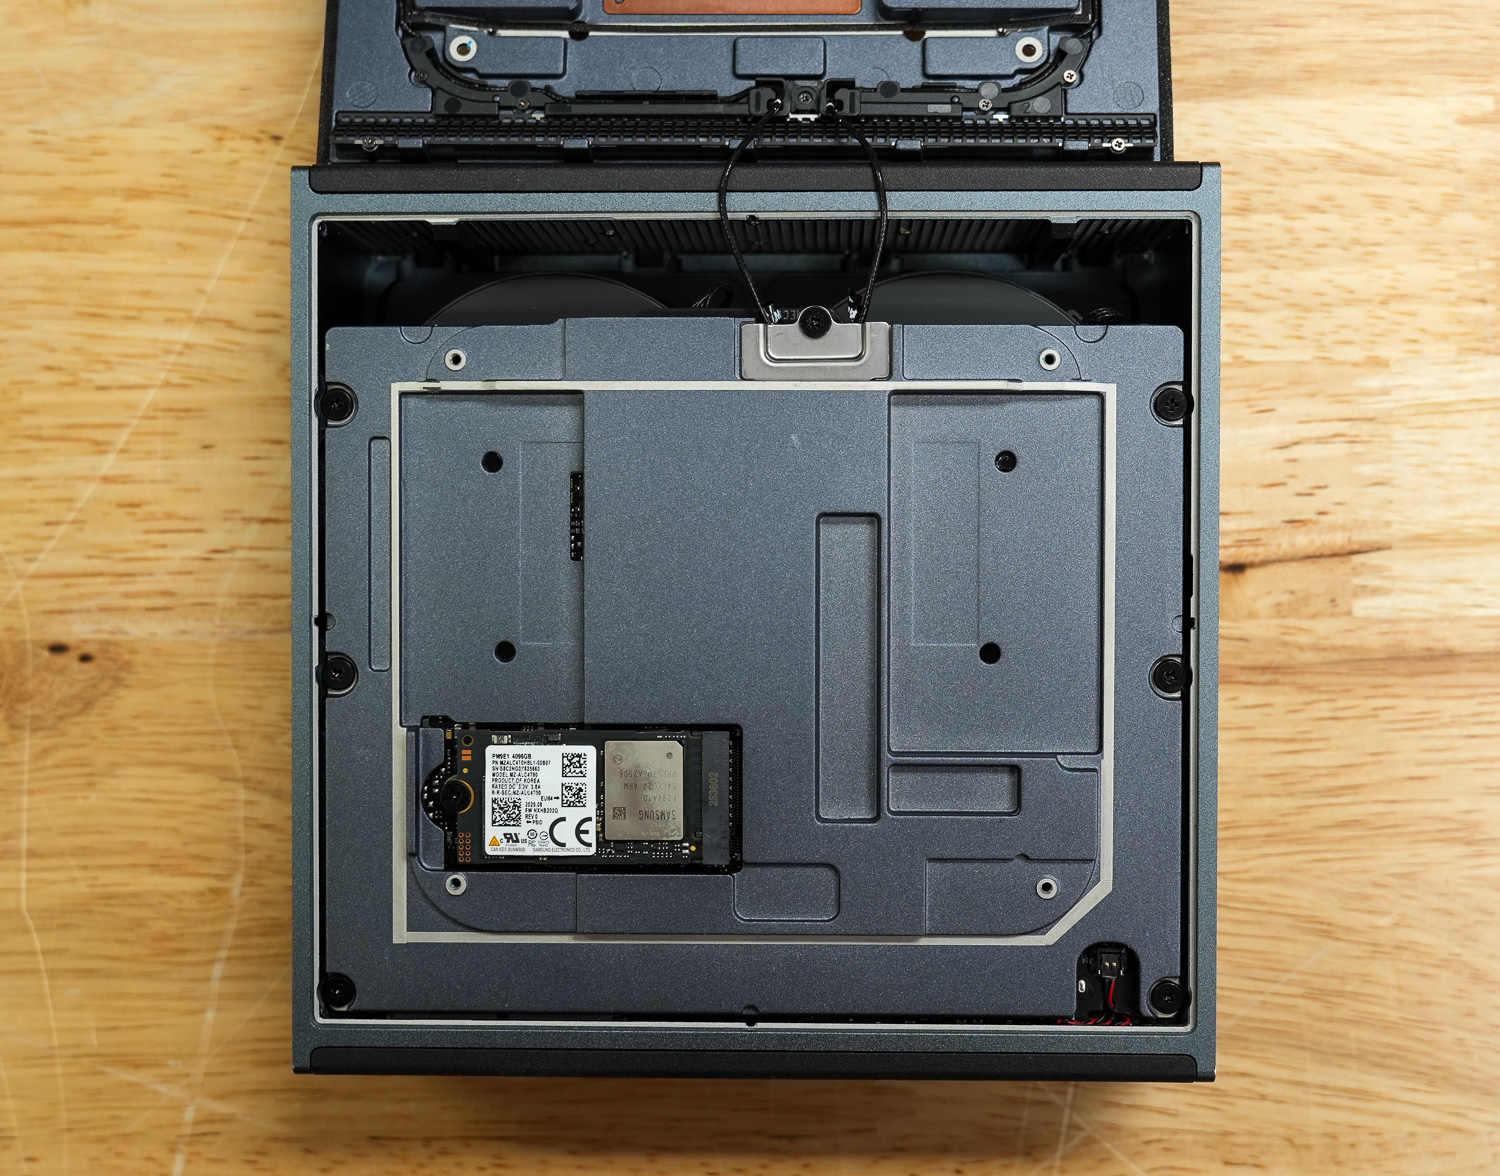
구성에 따라 최대 4TB Gen5 NVMe SSD까지 저장 장치를 지원하며, 240W 외장 어댑터를 통해 전원을 공급받습니다. 무선 연결은 Wi-Fi 7과 Bluetooth 5.4를 지원하며, 유선 연결을 위한 10GbE 네트워크도 내장되어 있습니다.
기가바이트 AI 탑 아톰 발열 테스트
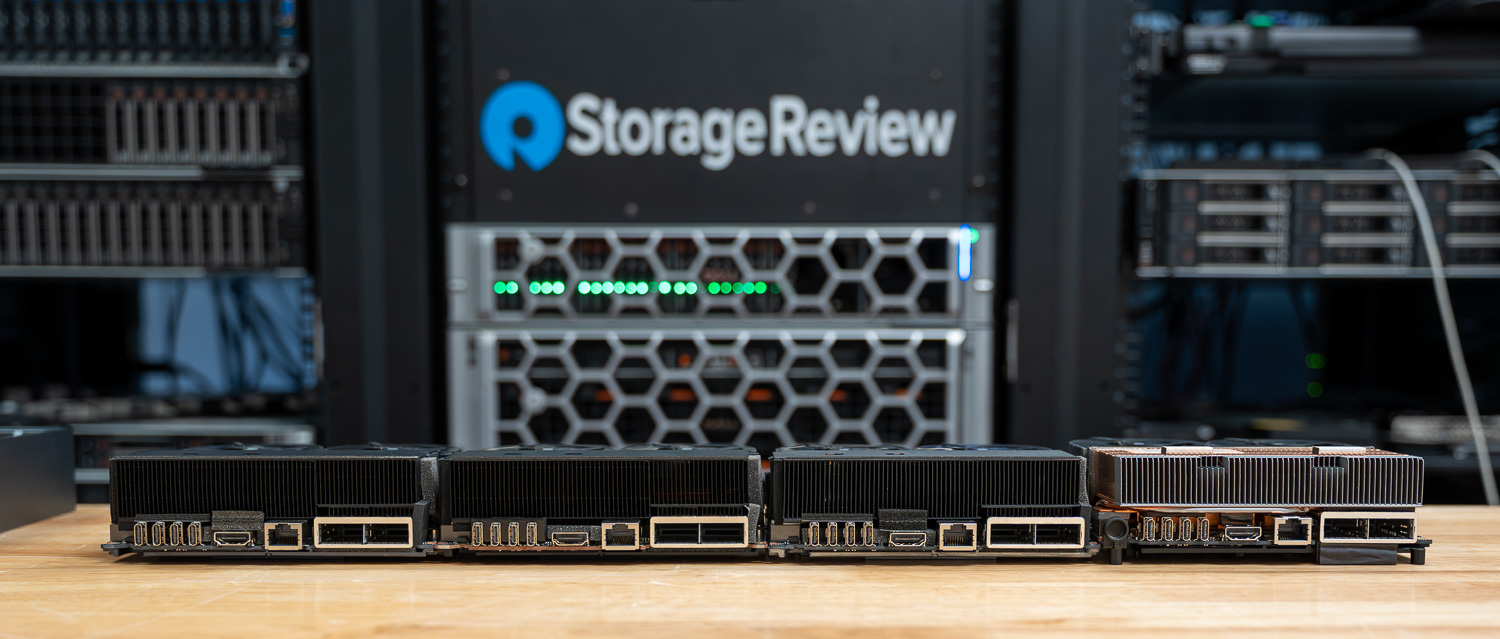
GIGABYTE AI TOP ATOM 내부 부품의 발열을 테스트하기 위해 파운더스 에디션 및 Asus, Acer, Dell과 같은 OEM 제품과 비교했습니다. 이에 대한 자세한 내용은 Spark 열 테스트 보고서 에서 확인할 수 있습니다.
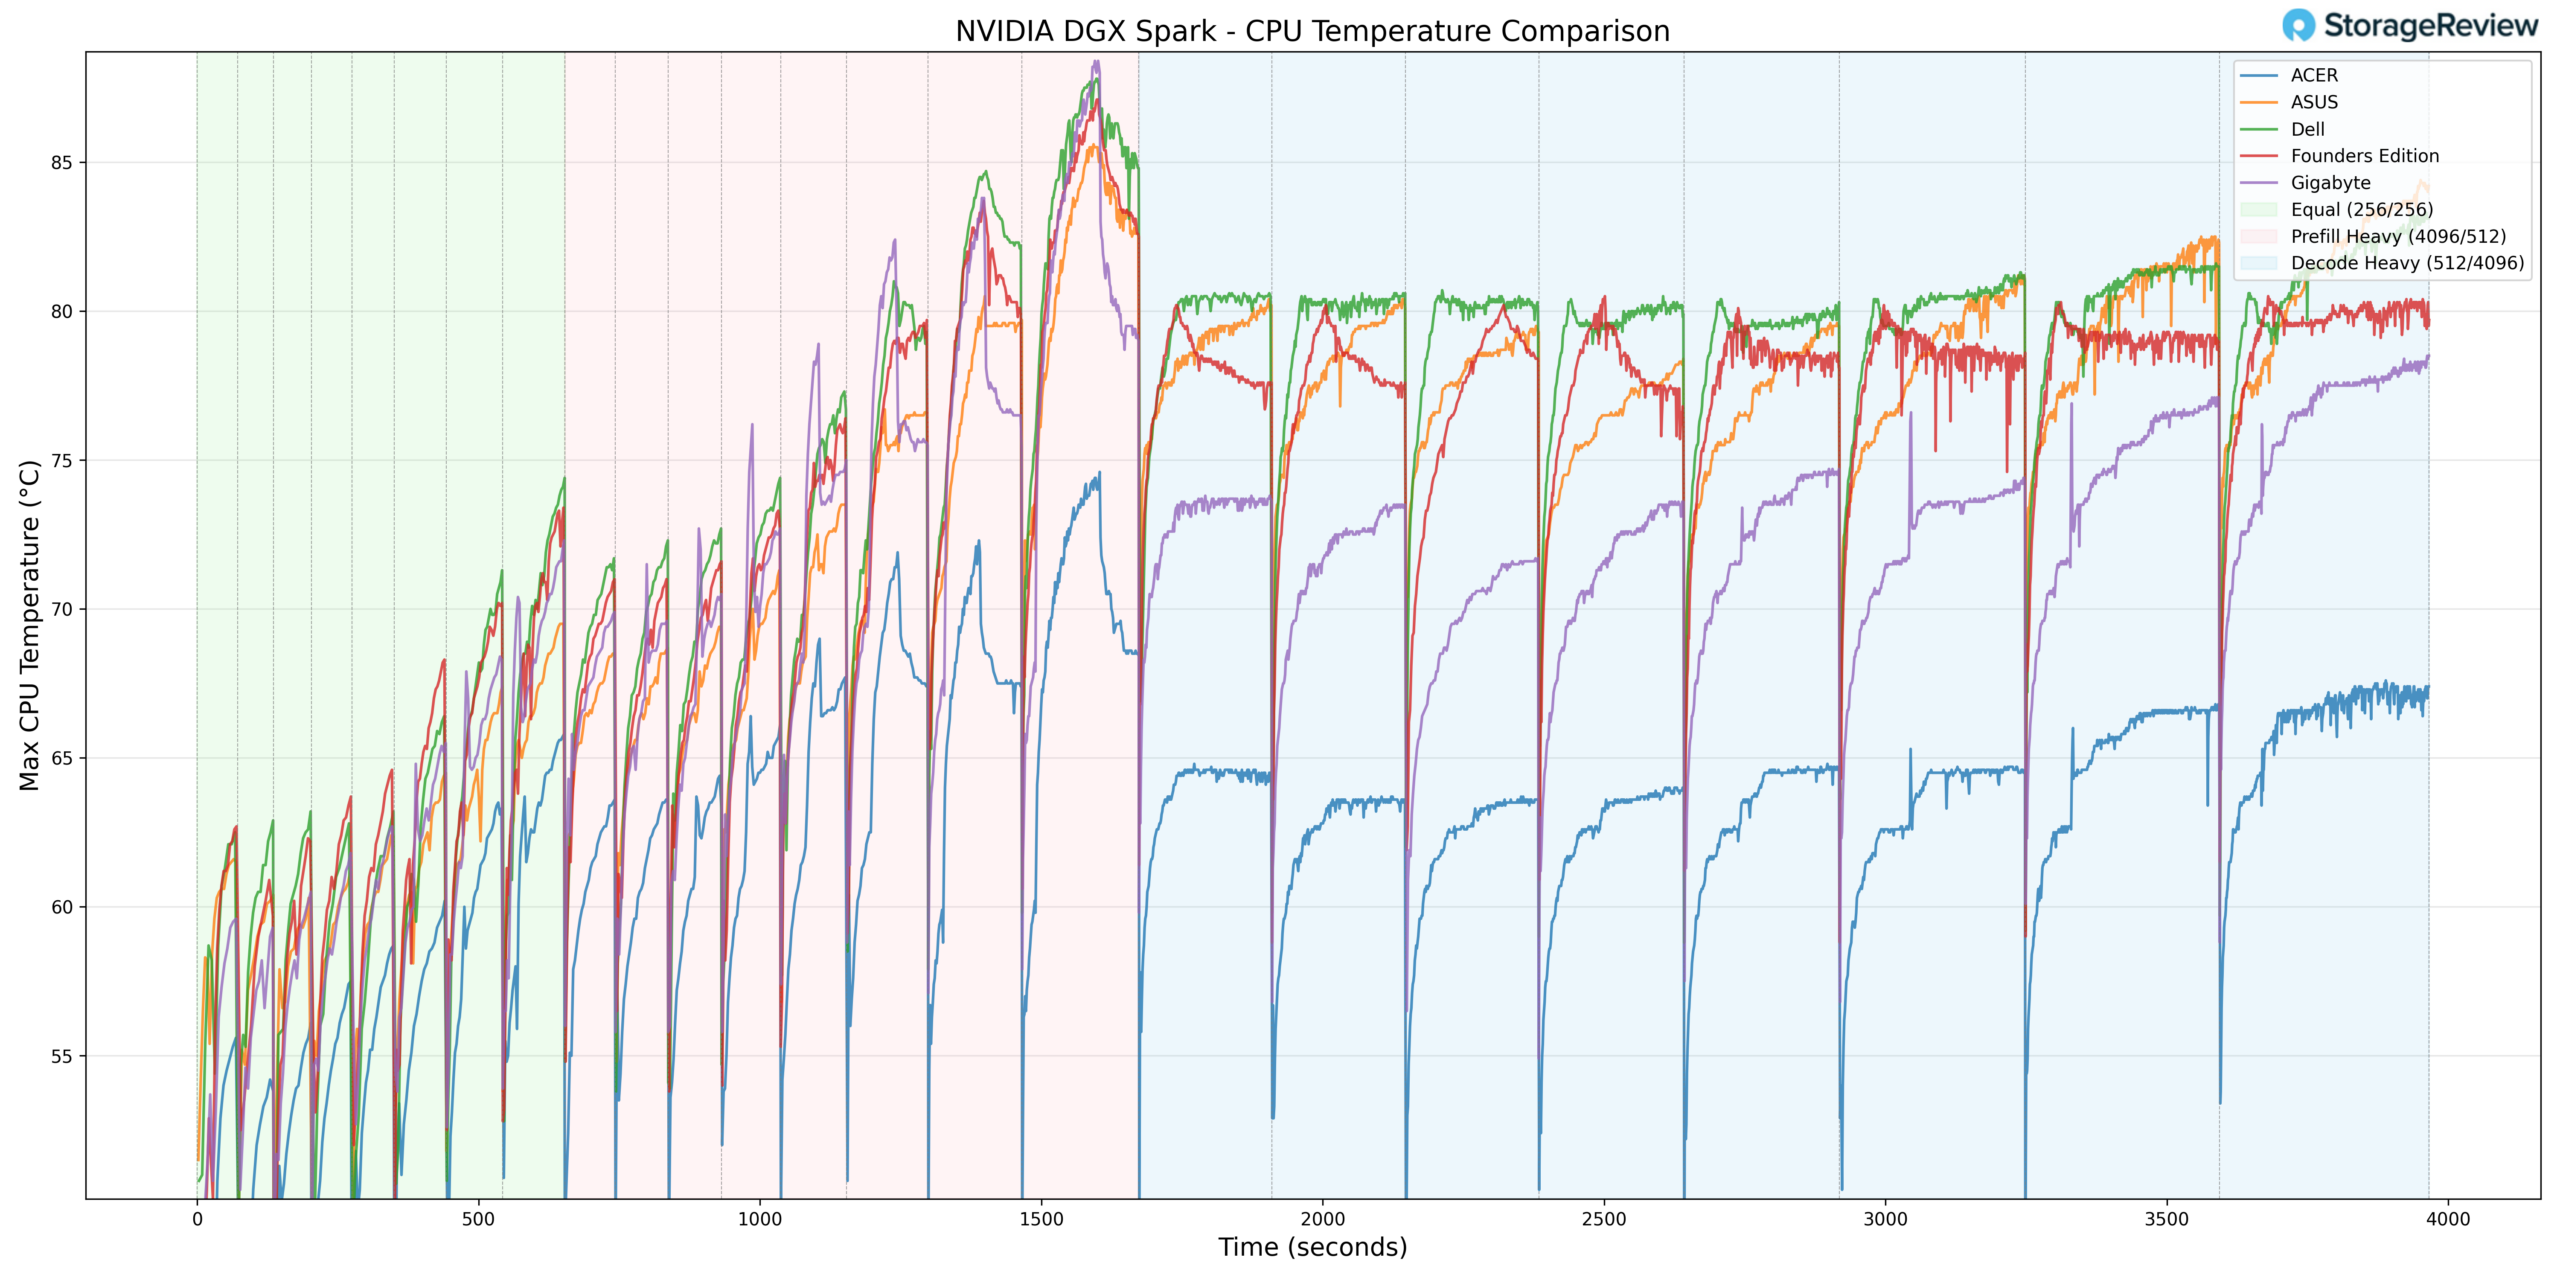
전체 스택에 걸쳐 특정 시간 동안 구성 요소를 모니터링했으며, 워크로드를 3단계로 나누어 약 1시간에 걸쳐 사용률을 점진적으로 증가시켰습니다. 이를 통해 장치가 장시간 사용되고 다양한 워크로드 단계에 노출되는 것을 확인할 수 있었습니다. CPU, GPU, 네트워크, NVMe 온도 및 총 전력 소비량을 모니터링했습니다.
CPU 온도
CPU 열 테스트 중 GIGABYTE 시스템은 부하가 집중되는 프리필 전환 과정에서 최고 90°C에 도달했습니다. 이는 급격한 워크로드 증가 시 비교 그룹에서 관찰된 CPU 최고 온도 범위의 상한선에 가까운 수치입니다.
Equal ISL/OSL 및 최종적으로 Decode Heavy 워크로드로 전환됨에 따라 온도 곡선은 계속 상승하는 대신 안정화되었습니다. 지속적인 부하 상태에서 CPU는 제어된 열 범위 내에 머물렀으며, 이는 높은 최고 온도가 장기적인 냉각 용량 부족이 아닌 단시간의 램프 활동과 관련이 있음을 보여줍니다.
CPU는 유휴 또는 저부하 조건에서 최저 38.7°C의 온도를 기록했습니다. 이 낮은 기준 온도는 휴지 상태에서 효율적인 열 방출을 반영하며, 고부하 단계 외에도 냉각 솔루션이 충분한 여유 온도를 유지하고 있음을 나타냅니다.
전반적으로 GIGABYTE는 순간적으로 CPU 발열이 높게 나타났지만, 작업 부하가 정상화된 후에는 안정적인 작동을 유지했습니다.
GPU 온도
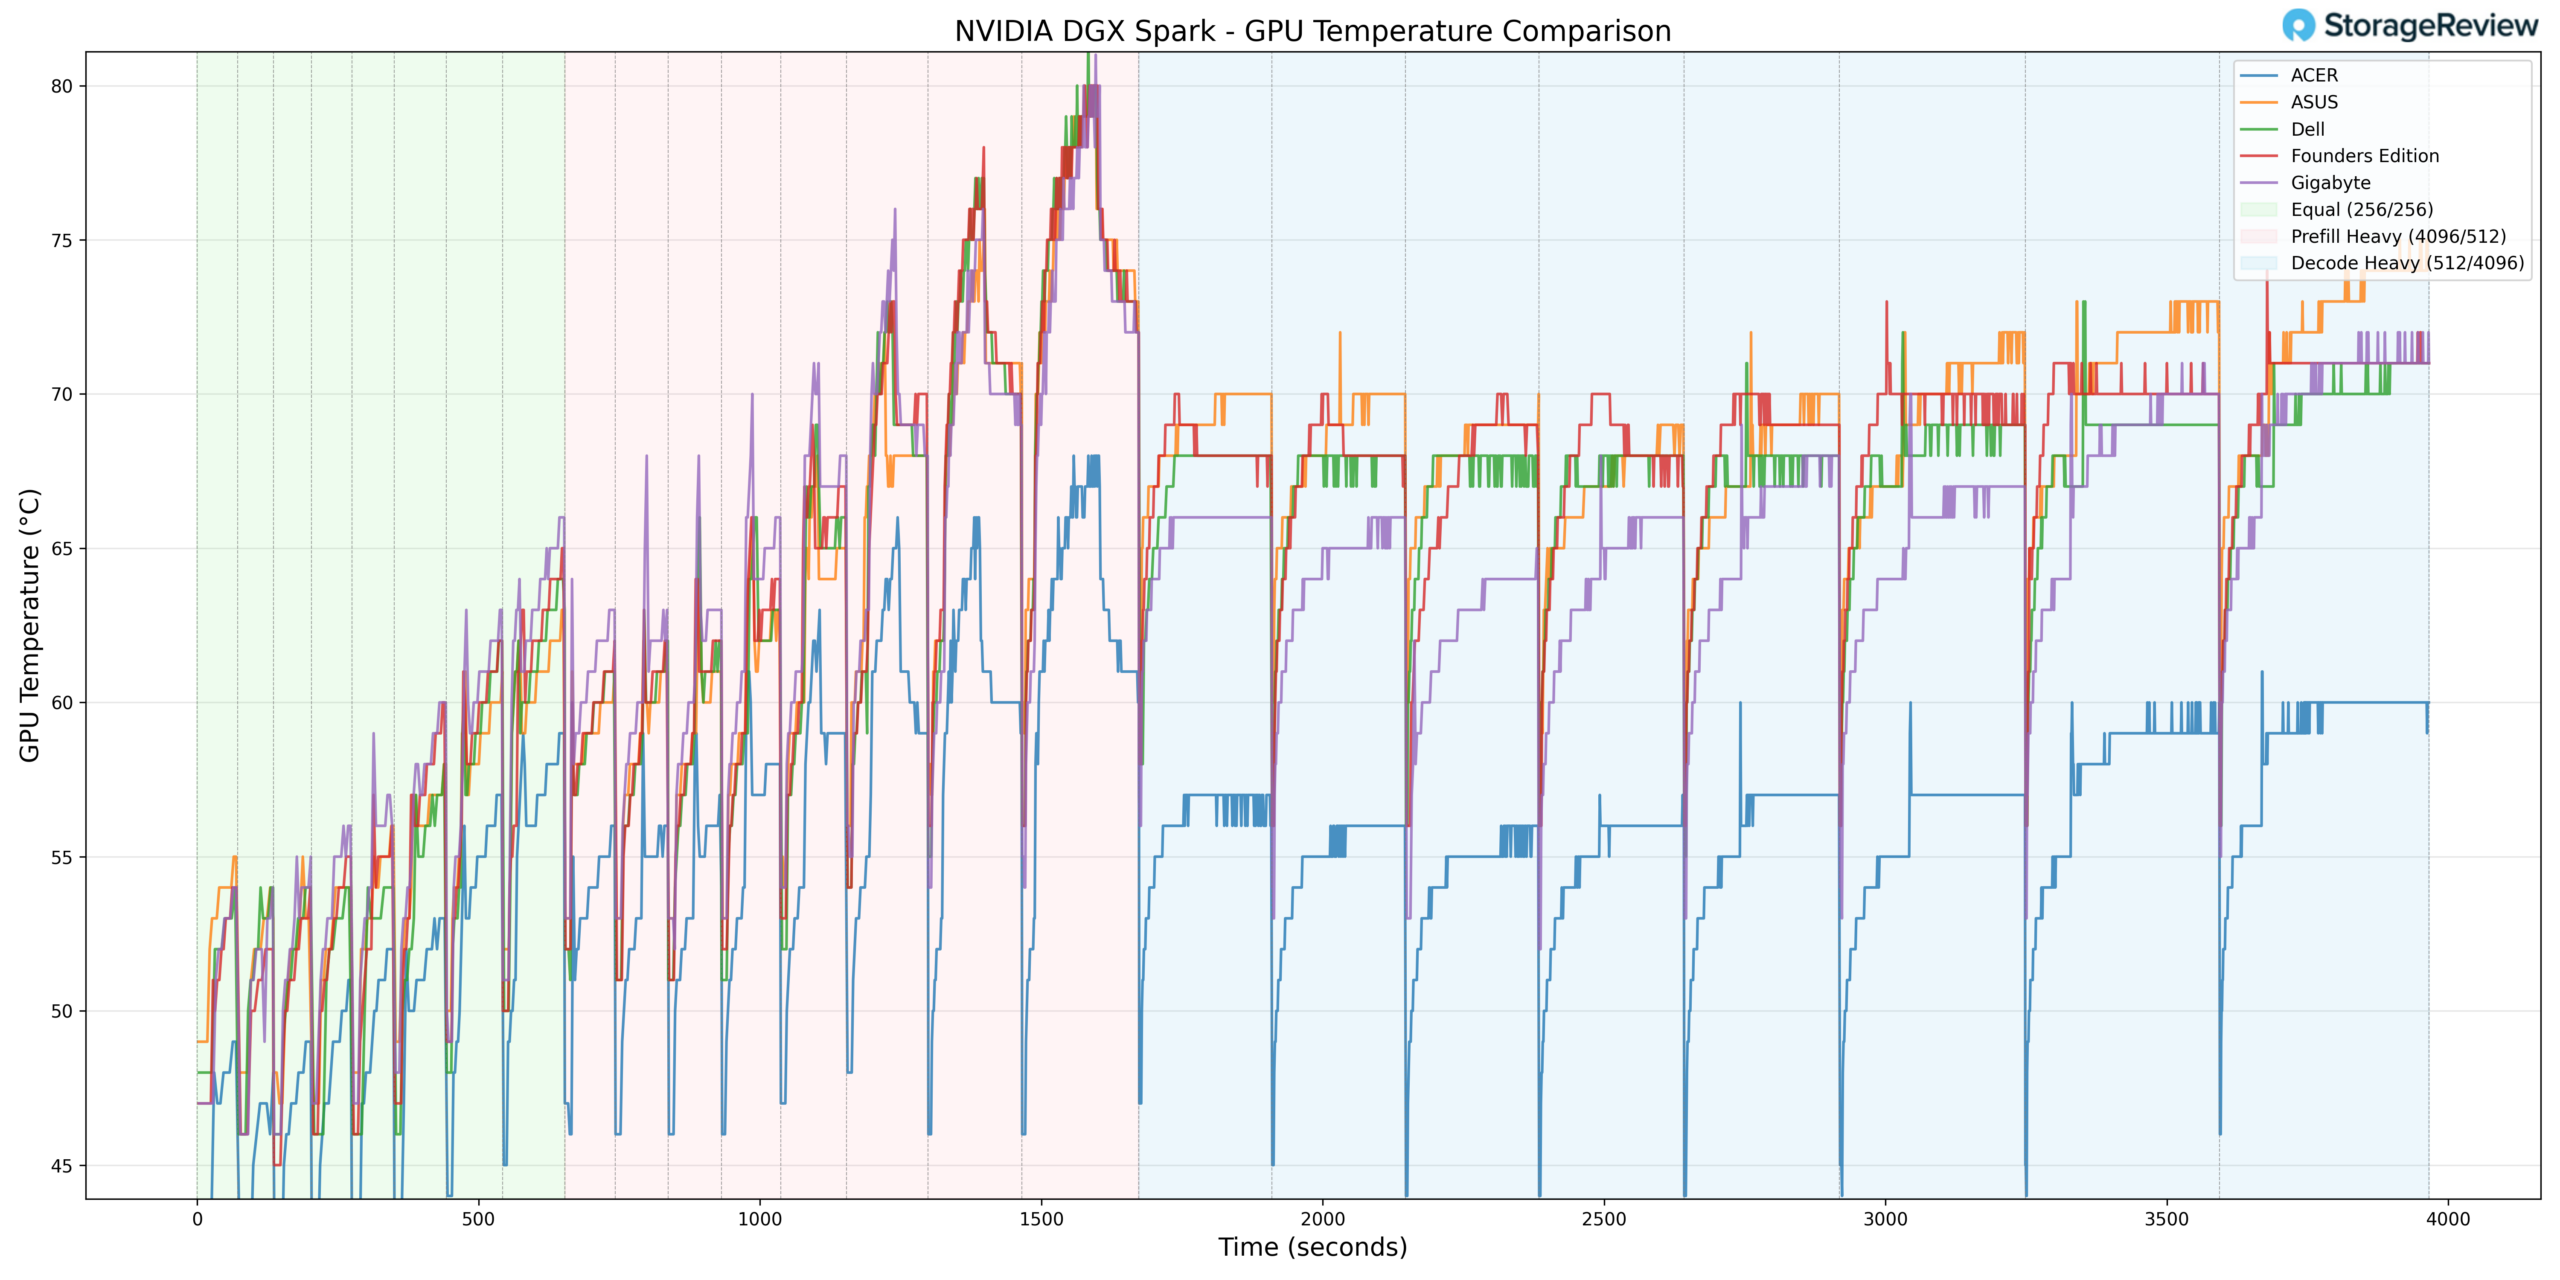
GPU 발열 또한 비슷한 양상을 보였습니다. 프리필 헤비(Prefill Heavy) 작업 중 GPU 온도는 최대 81°C에 도달했습니다. 이는 고부하 가속 작업 시 온도가 다소 높은 편에 속하지만, GB10 플랫폼의 예상 작동 사양 범위 내에 있습니다.
작업 부하가 Equal ISL/OSL 및 Decode Heavy 단계로 전환됨에 따라 GPU 온도는 계속 상승하는 대신 안정화되었습니다.
시스템이 유휴 상태이거나 사용률이 낮을 때 GPU 온도는 최저 37°C를 기록하여 시스템에 연산 부하가 걸리지 않을 때 안정적인 기본 열 제어 기능을 보여줍니다.
종합적으로 볼 때, GIGABYTE의 GPU 동작은 공격적인 순간 활용률과 안정적인 지속 온도 유지를 보여줍니다.
NVMe 온도
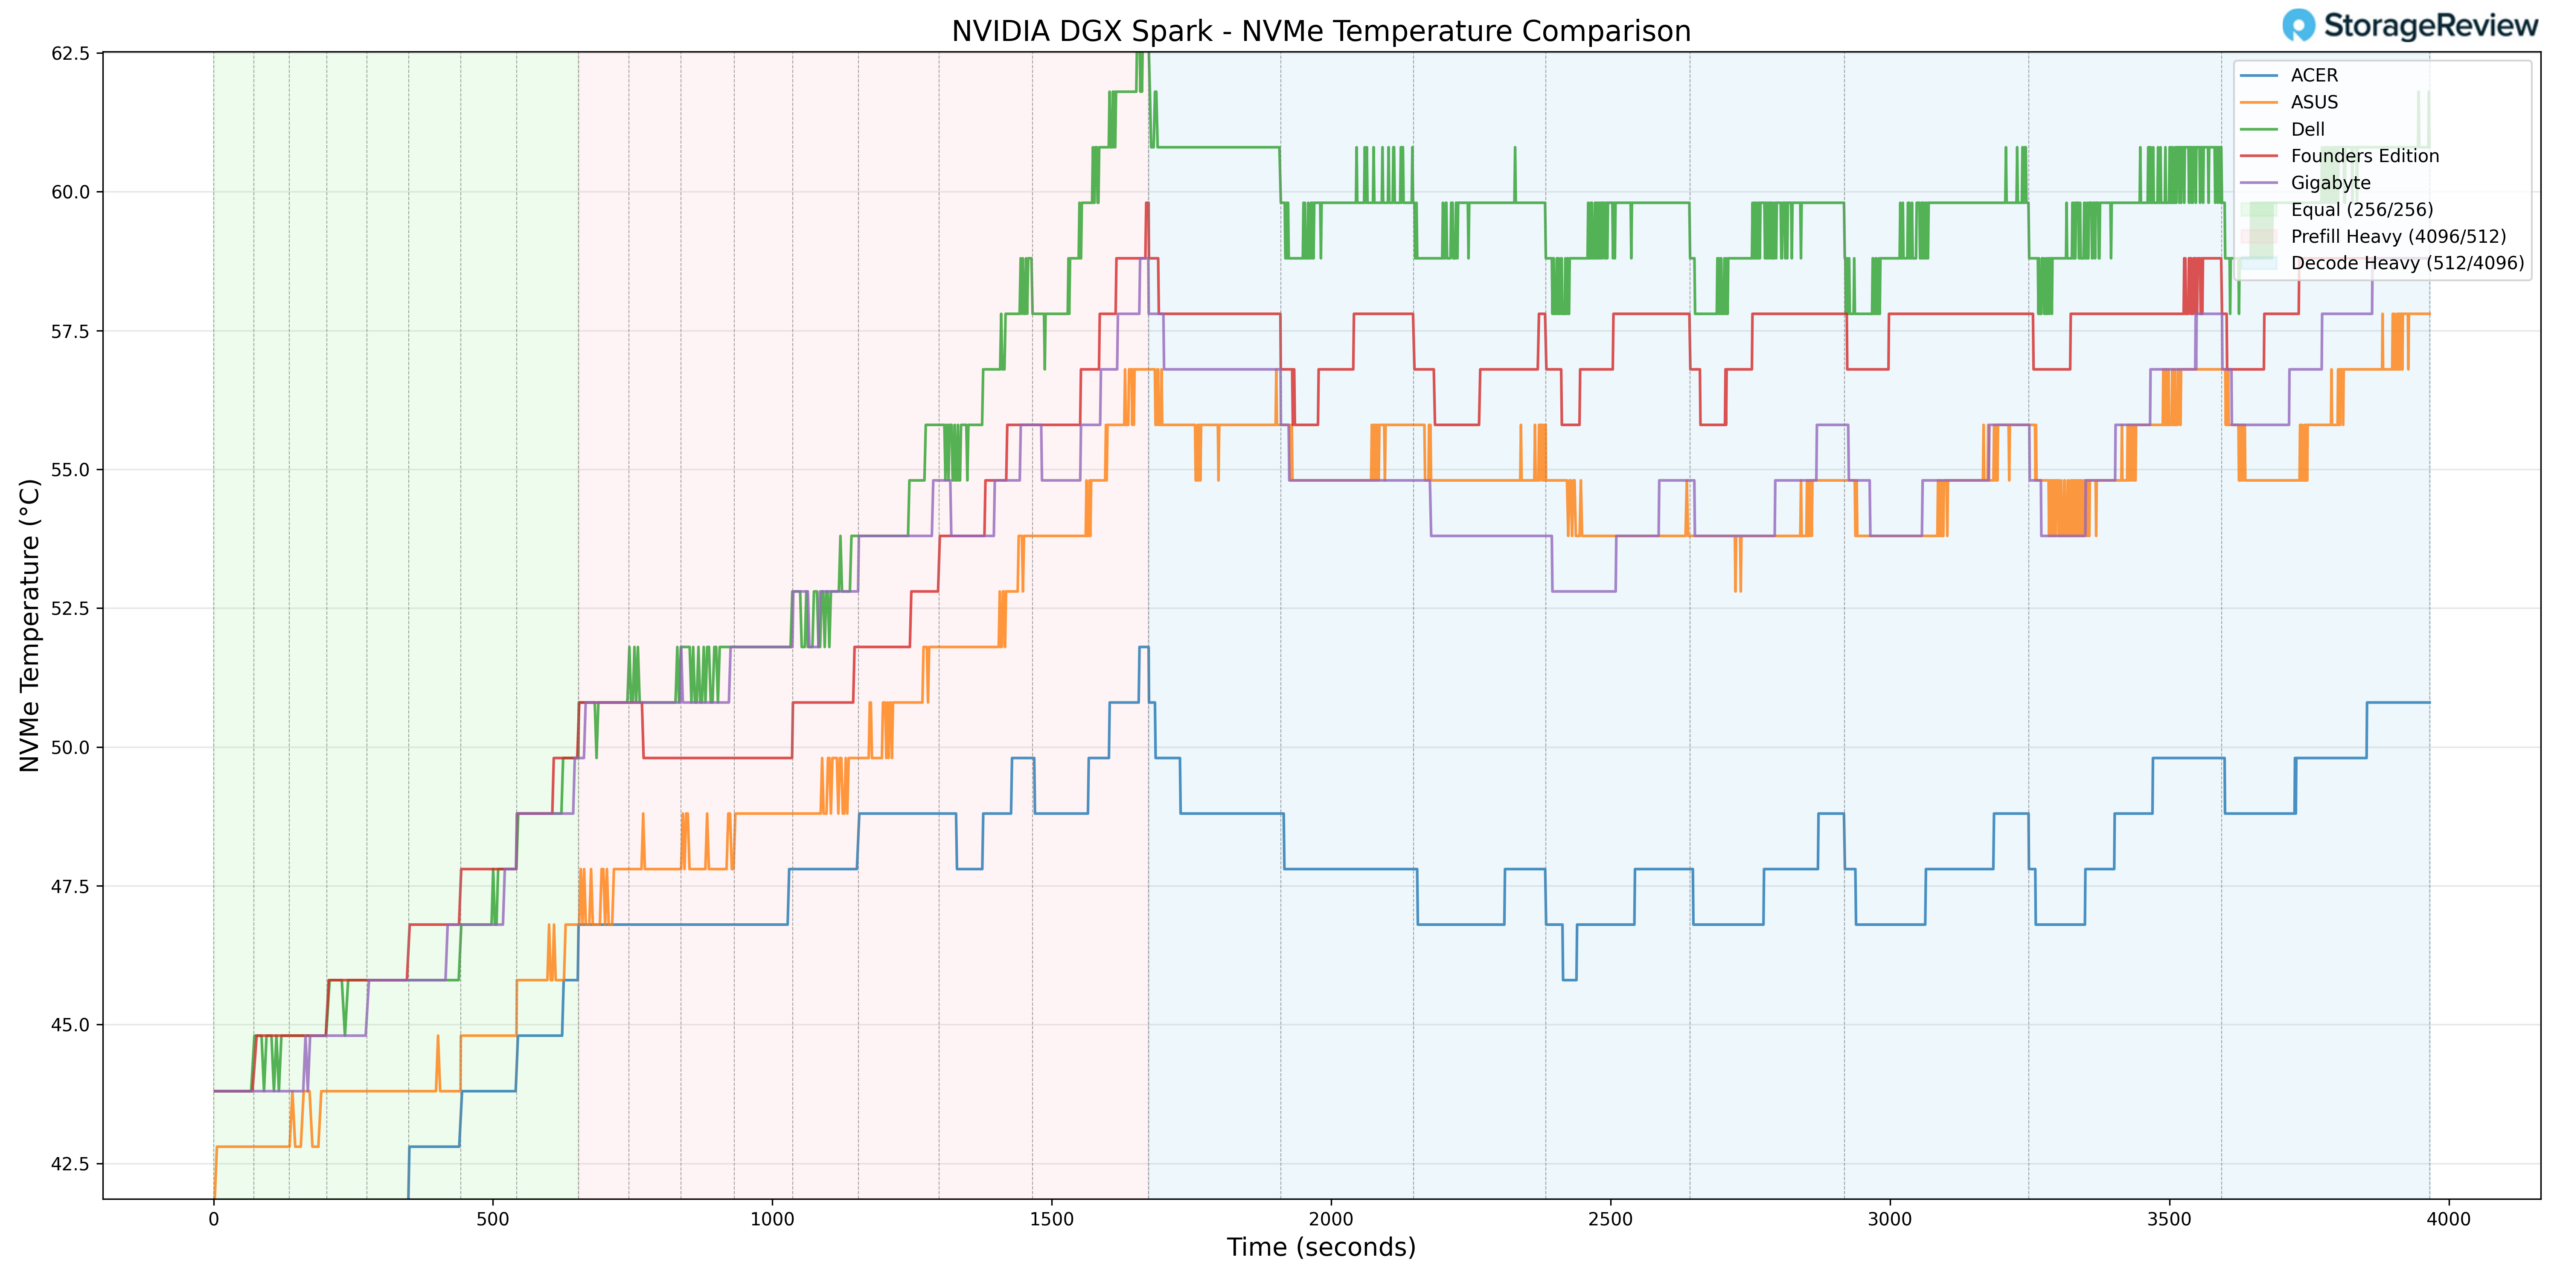
테스트 전반에 걸쳐 스토리지의 온도는 안정적으로 제어되었습니다. NVMe 드라이브는 부하가 높은 작동 단계에서 최대 59.8°C의 온도를 기록했습니다. 이 최고 온도는 일반적인 스로틀링 임계값보다 훨씬 낮았으며, 이는 섀시 내부의 공기 흐름이 원활하거나 드라이브 배치가 적절했음을 시사합니다.
부하가 적은 단계에서는 NVMe 드라이브 온도가 최저 37.8°C까지 떨어져, 스토리지의 열 관리가 휴면 상태에서는 제한되지 않는다는 것을 보여줍니다.
일부 소형 데스크톱용 구현 방식과 비교했을 때, 부하 시 60°C 미만을 유지하는 것은 뛰어난 스토리지 열 관리 성능을 보여줍니다.
NIC 온도
NIC 온도는 작업 부하가 높은 단계에서 최고 72°C까지 상승했으며, 이는 프리필 및 디코딩 전환 중 처리량 증가와 일치합니다. 이는 네트워크 컨트롤러가 최대 활동 시 스택에서 온도가 높은 영역에 위치함을 의미하지만, 온도는 작동 허용 범위 내에 머물렀고 급격한 온도 상승은 나타나지 않았습니다.
기록된 최저 NIC 온도는 41°C였으며, 이는 가벼운 단계에서의 정상적인 기준선 동작을 반영합니다.
전반적으로 NIC는 전체 시스템 부하에 따라 예측 가능한 방식으로 작동했으며 비정상적인 확장성을 보이지 않았습니다.
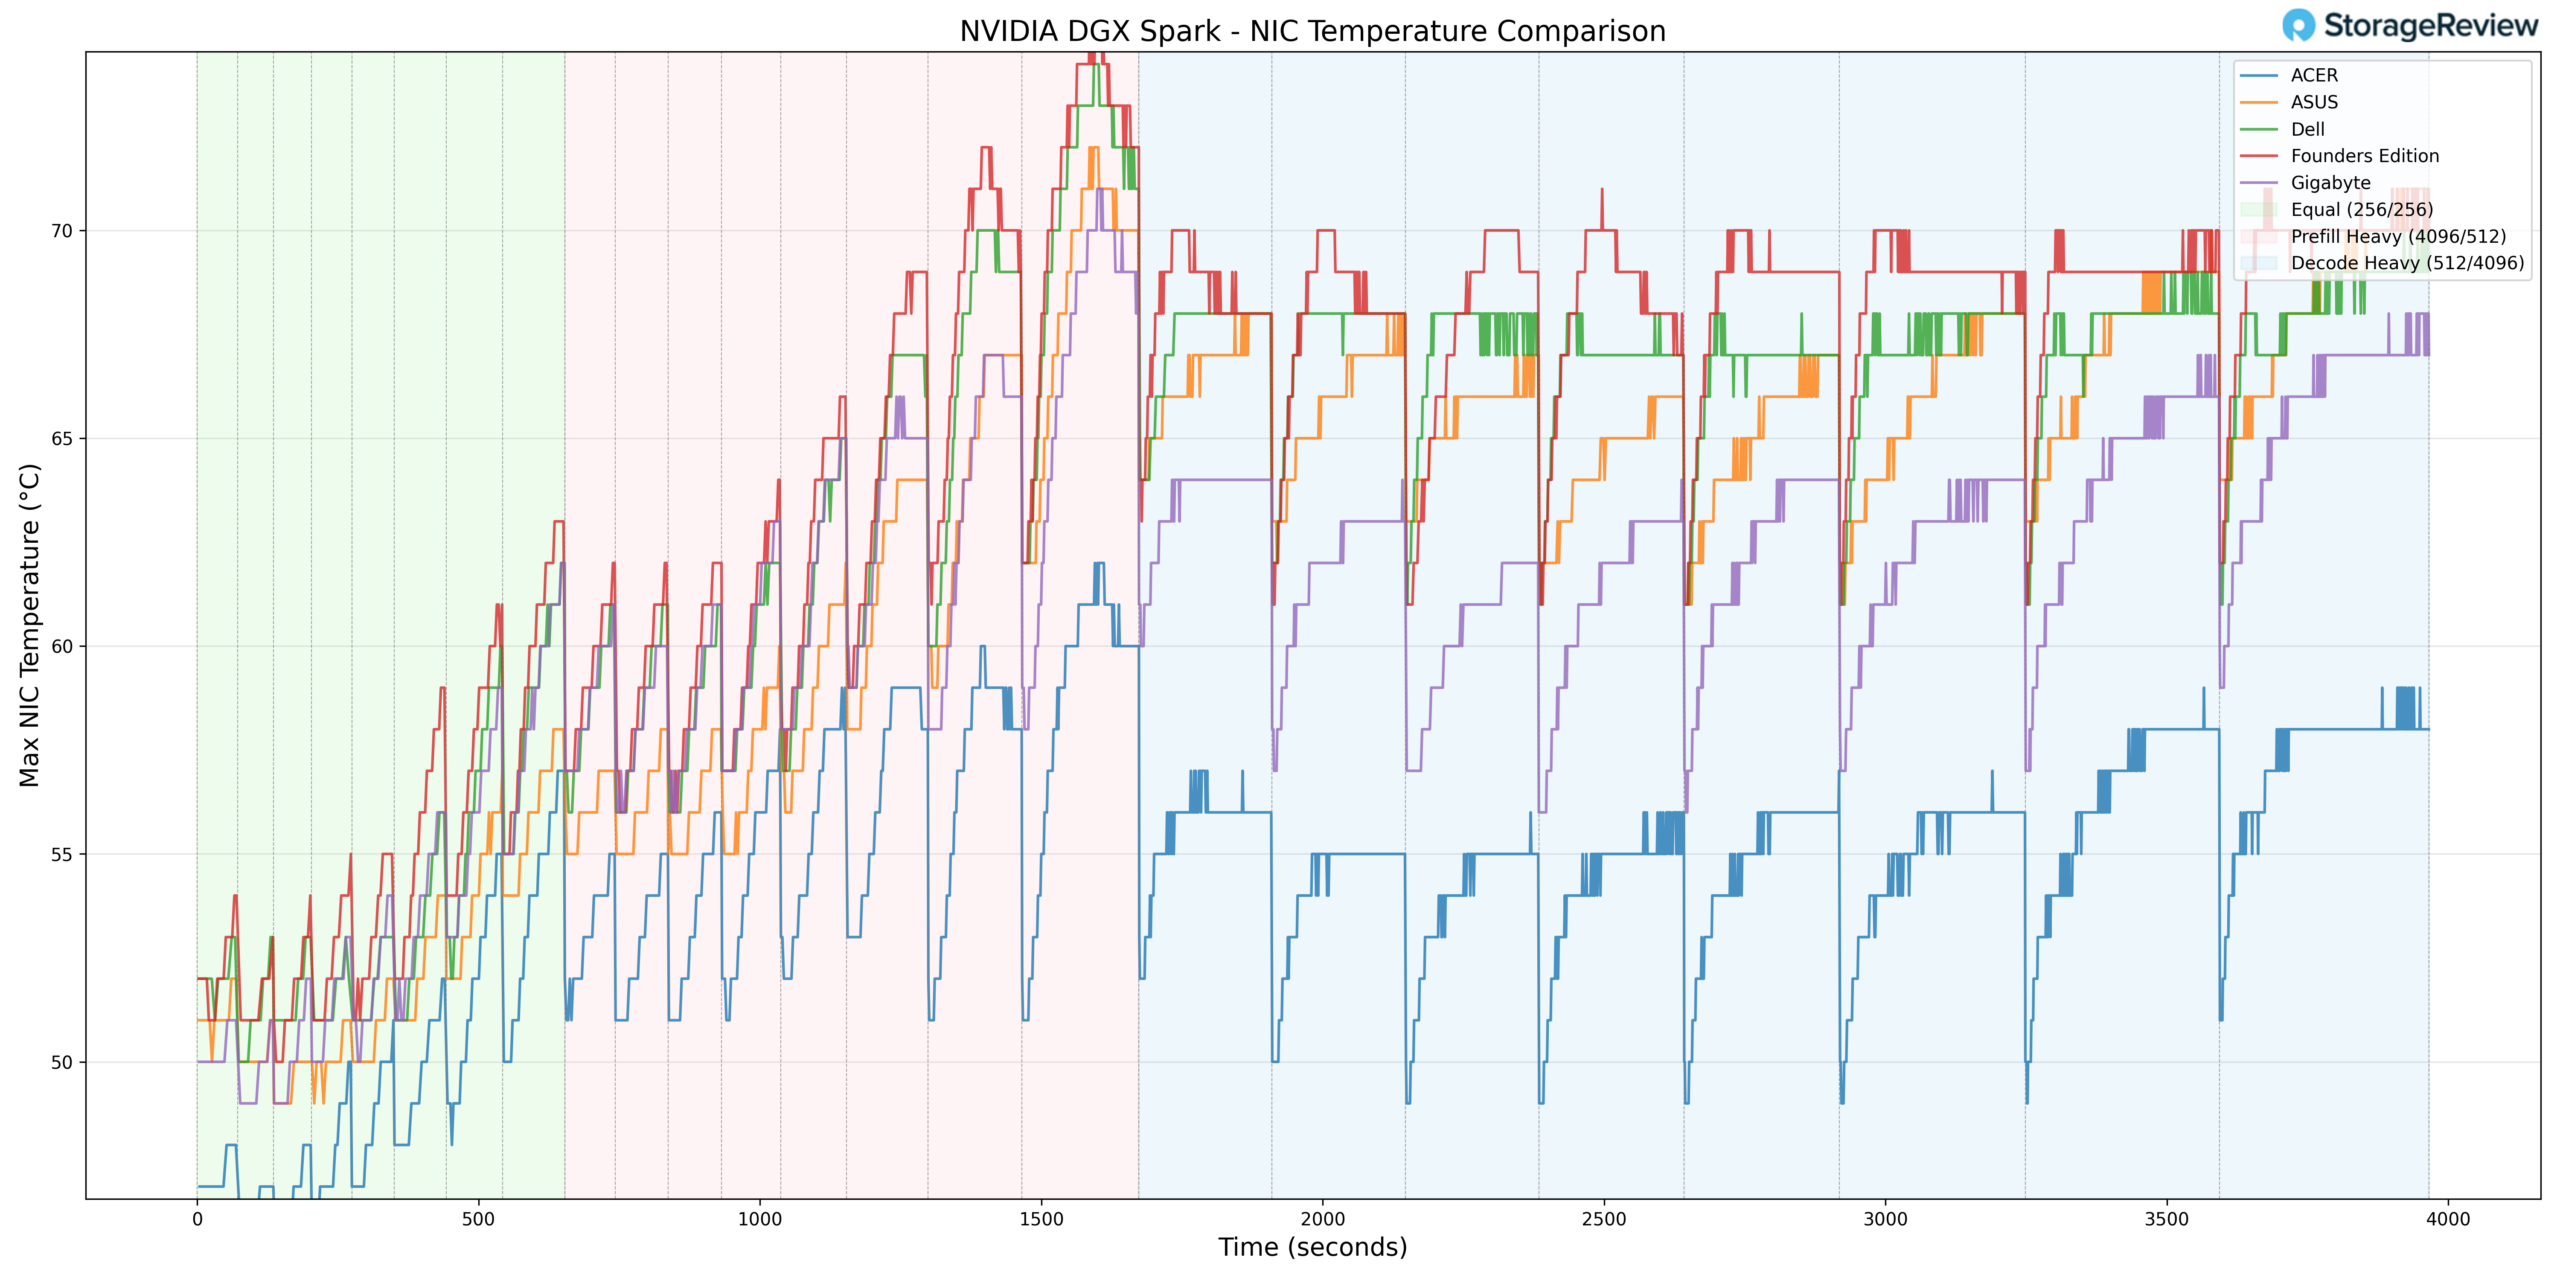
GPU 전력 소비량
GPU 전력 소모 양상을 살펴보면 순간적인 발열 증가 현상을 이해하는 데 도움이 됩니다. GIGABYTE는 프리필 헤비(Prefill Heavy) 전환 과정에서 최대 75.54W의 GPU 전력 소모를 기록했습니다. 이는 테스트된 GB10 제품 중 관찰된 전력 소모 범위의 최상단에 해당합니다.
GIGABYTE는 GPU 전력을 인위적으로 제한하는 대신, 거의 최대치에 가까운 전력 소모를 허용하는 것으로 보이며, 이는 GPU 최고 온도가 더 높게 나타나는 현상과 직접적인 관련이 있습니다. 워크로드가 지속적인 디코딩 단계로 전환됨에 따라 전력 소모는 그에 따라 안정화되었습니다.
전력 소비 측면에서 볼 때, GIGABYTE 시스템은 과도하게 과부하되는 것처럼 보이지 않습니다. 오히려 고속 작동 시 발생하는 높은 최고 온도는 제어되지 않은 열 설계 때문이 아니라 성능 향상을 위한 전력 할당 결정과 관련이 있습니다.
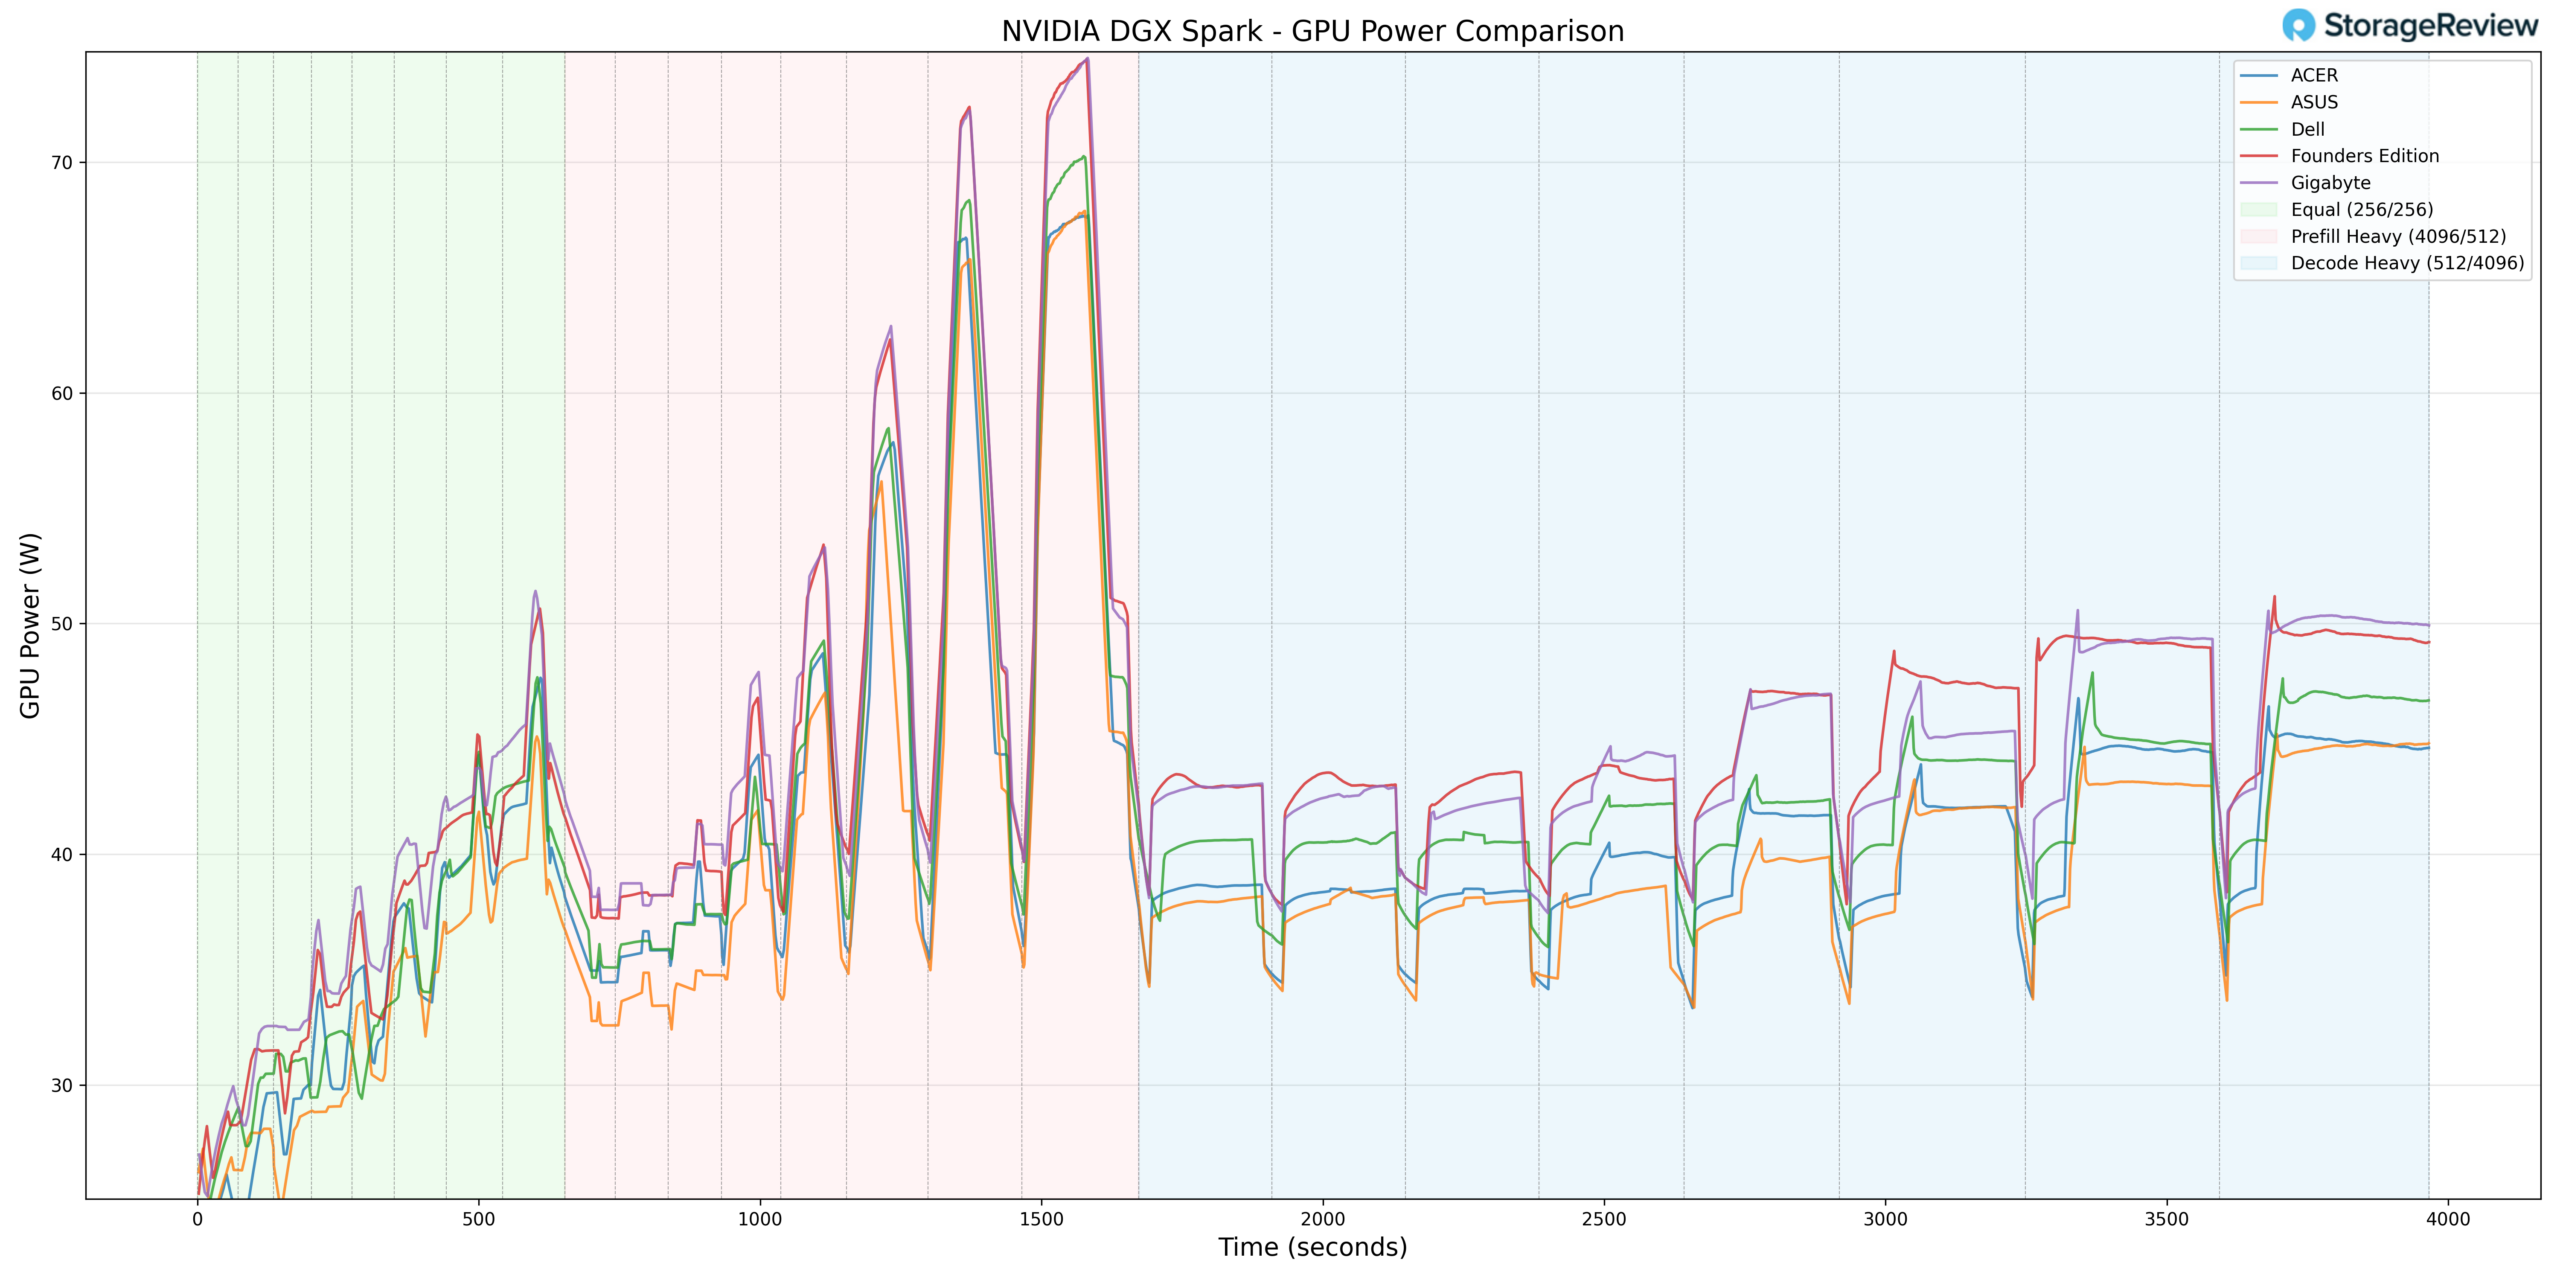
열 요약
CPU, GPU, NVMe 및 NIC 모니터링 결과, GIGABYTE GB10은 경쟁력 있는 유휴 온도 수준을 유지했으며, 프리필 부하가 높은 전환 시에는 더 높은 순간 최고 온도를 기록했습니다. CPU는 최대 가속 시 90°C, GPU는 81°C에 도달했고, NVMe는 60°C 미만, NIC는 72°C를 기록했습니다. GPU 전력 소모는 최대 75.54W로, 거의 최대치에 근접한 순간 최고치를 나타냈습니다.
지속적인 디코딩 작업 부하에서도 온도는 더 이상 상승하지 않고 안정화되었습니다. 이는 GIGABYTE가 단시간 동안은 공격적인 성능을 허용하면서도 장시간 작동 시에는 예측 가능하고 제어된 발열을 유지한다는 것을 시사합니다.
기가바이트 AI 탑 아톰 성능 테스트
GIGABYTE AI TOP ATOM의 성능을 평가하기 위해, 대규모 언어 모델을 위한 가장 널리 사용되는 고처리량 추론 및 서비스 엔진인 vLLM 온라인 서비스 벤치마크를 사용하여 Spark 유닛을 테스트했습니다. vLLM 온라인 서비스 벤치마크는 실행 중인 vLLM 서버에 동시 요청을 전송하여 실제 운영 환경을 시뮬레이션하고, 다양한 부하 조건에서 총 토큰 처리량(초당 토큰 수), 첫 번째 토큰 획득 시간, 출력 토큰당 시간 등의 주요 지표를 측정합니다.
저희는 밀집 아키텍처부터 마이크로 스케일링 데이터 유형에 이르기까지 다양한 모델을 대상으로 테스트를 진행했습니다. 또한, ISL/OSL 균등, 사전 입력 작업량 많음, 디코딩 작업량 많음의 세 가지 워크로드 시나리오에서 성능을 평가했습니다. 이러한 시나리오는 균형 잡힌 입력 및 출력 부하부터 연산 집약적인 프롬프트 처리 및 메모리 대역폭 제약이 있는 토큰 생성에 이르기까지 실제 서비스 환경에서 발생하는 다양한 패턴을 반영합니다.
GIGABYTE AI TOP ATOM 외에도, 기준점으로 NVIDIA Founders Edition Spark를 비롯하여 Asus, Acer, Dell의 OEM 시스템들을 벤치마킹했습니다. 이를 통해 GIGABYTE 제품의 성능을 보다 광범위한 경쟁 환경 속에서 살펴보고, 다양한 모델과 워크로드 유형에서 어떤 부분에서 선두를 달리고, 어떤 부분에서 경쟁 제품들과 비슷한 수준을 유지하며, 어떤 부분에서 뒤처지는지 파악할 수 있었습니다.
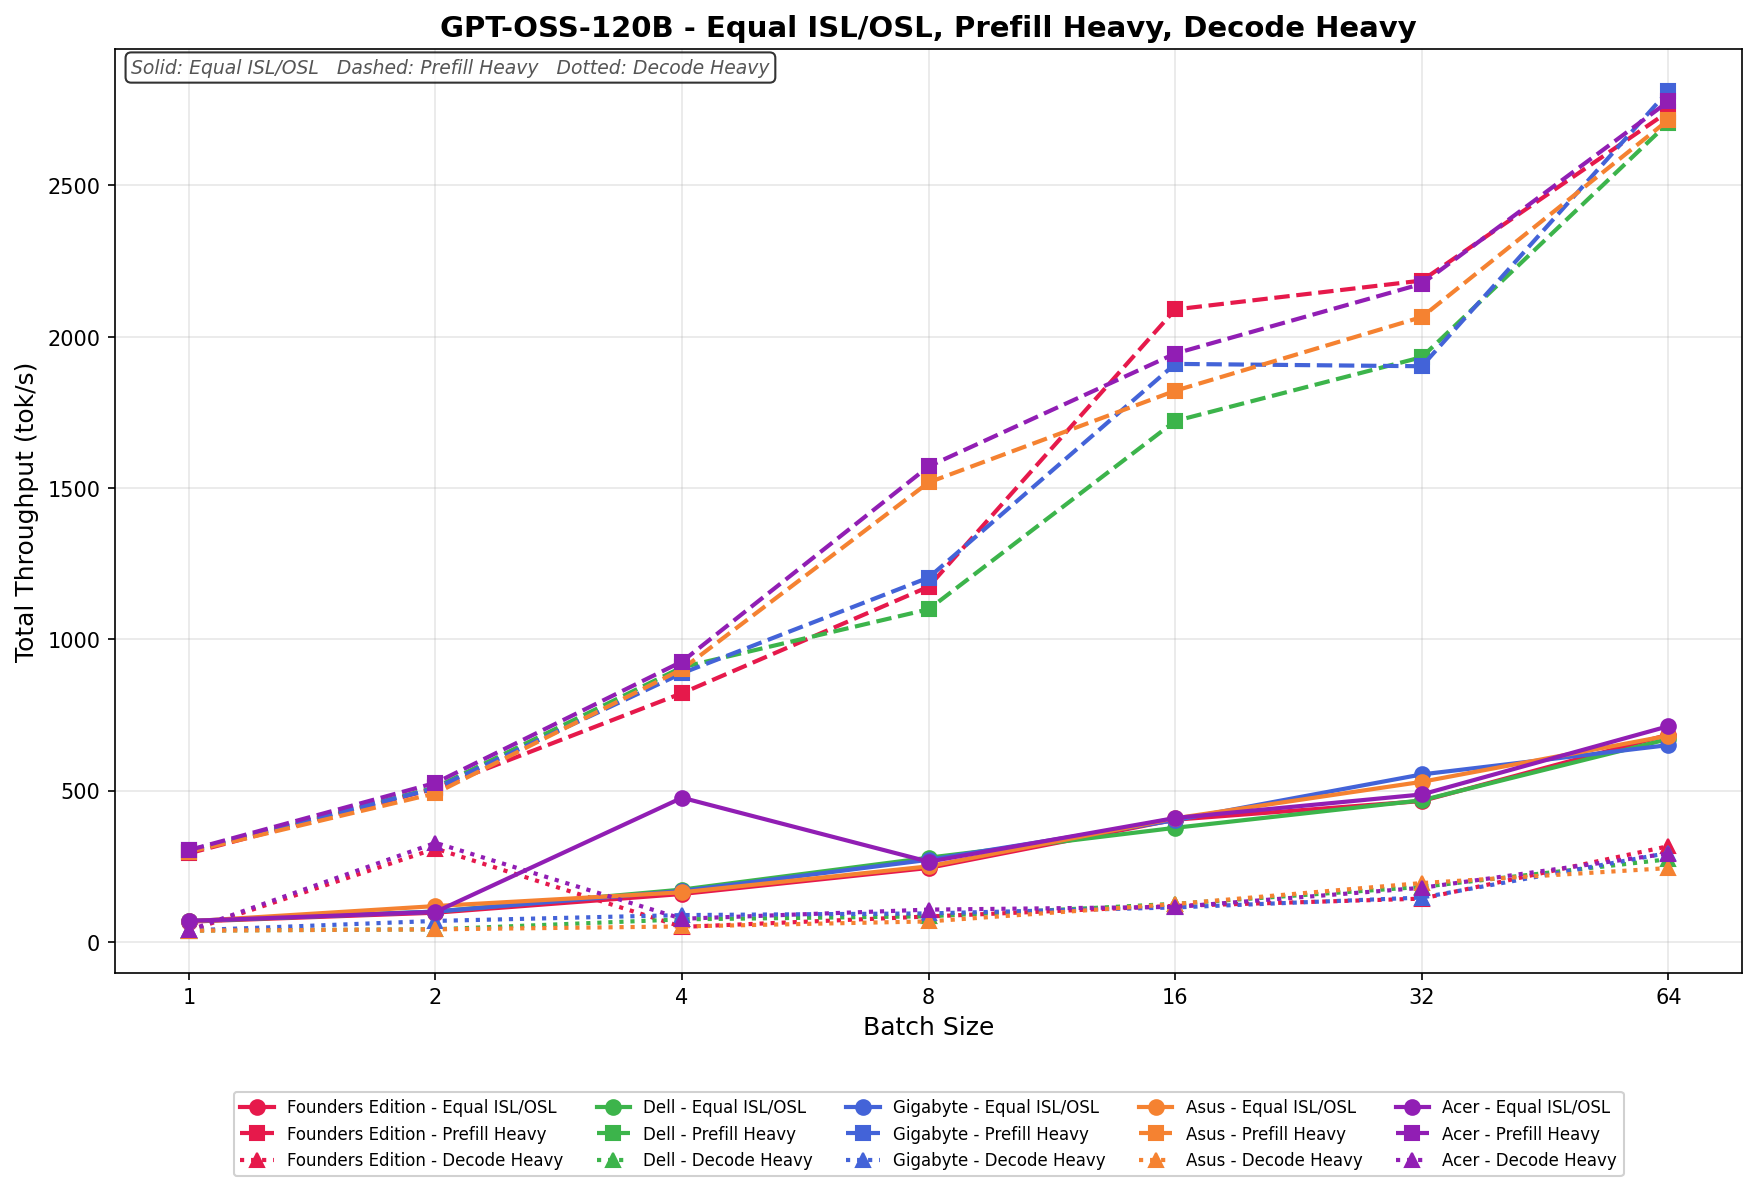
GPT-OSS-120B
동일한 ISL/OSL 조건에서 GIGABYTE는 60.71 tok/s에서 649.62 tok/s까지 확장되는 성능을 보여주며, 업계 중간 수준을 꾸준히 유지하고 높은 배치 크기에서는 Dell 및 Asus와 유사한 성능을 보입니다. 확장성은 배치 32까지 꾸준하고 선형적으로 나타나며, 배치 64에서도 지속적인 향상을 보이지만, 최고 성능 제품들을 완전히 따라잡지는 못합니다.
Prefill Heavy는 304.63 tok/s에서 시작하여 배치 크기 64에서 2,771.38 tok/s까지 상승합니다. 배치 16까지 강력한 성장세를 보이며, GIGABYTE는 잠시 상위 3위권에 머물렀다가 더 큰 배치 크기에서는 다른 업체들과 비슷한 수준으로 수렴합니다. 전반적인 확장성은 특히 중간 배치 크기에서 공격적이고 경쟁력이 있습니다.
Decode Heavy의 처리 속도는 47.01~299.41 tok/s 범위이며, 배치 스윕 전반에 걸쳐 점진적이고 일관된 스케일링을 보입니다.
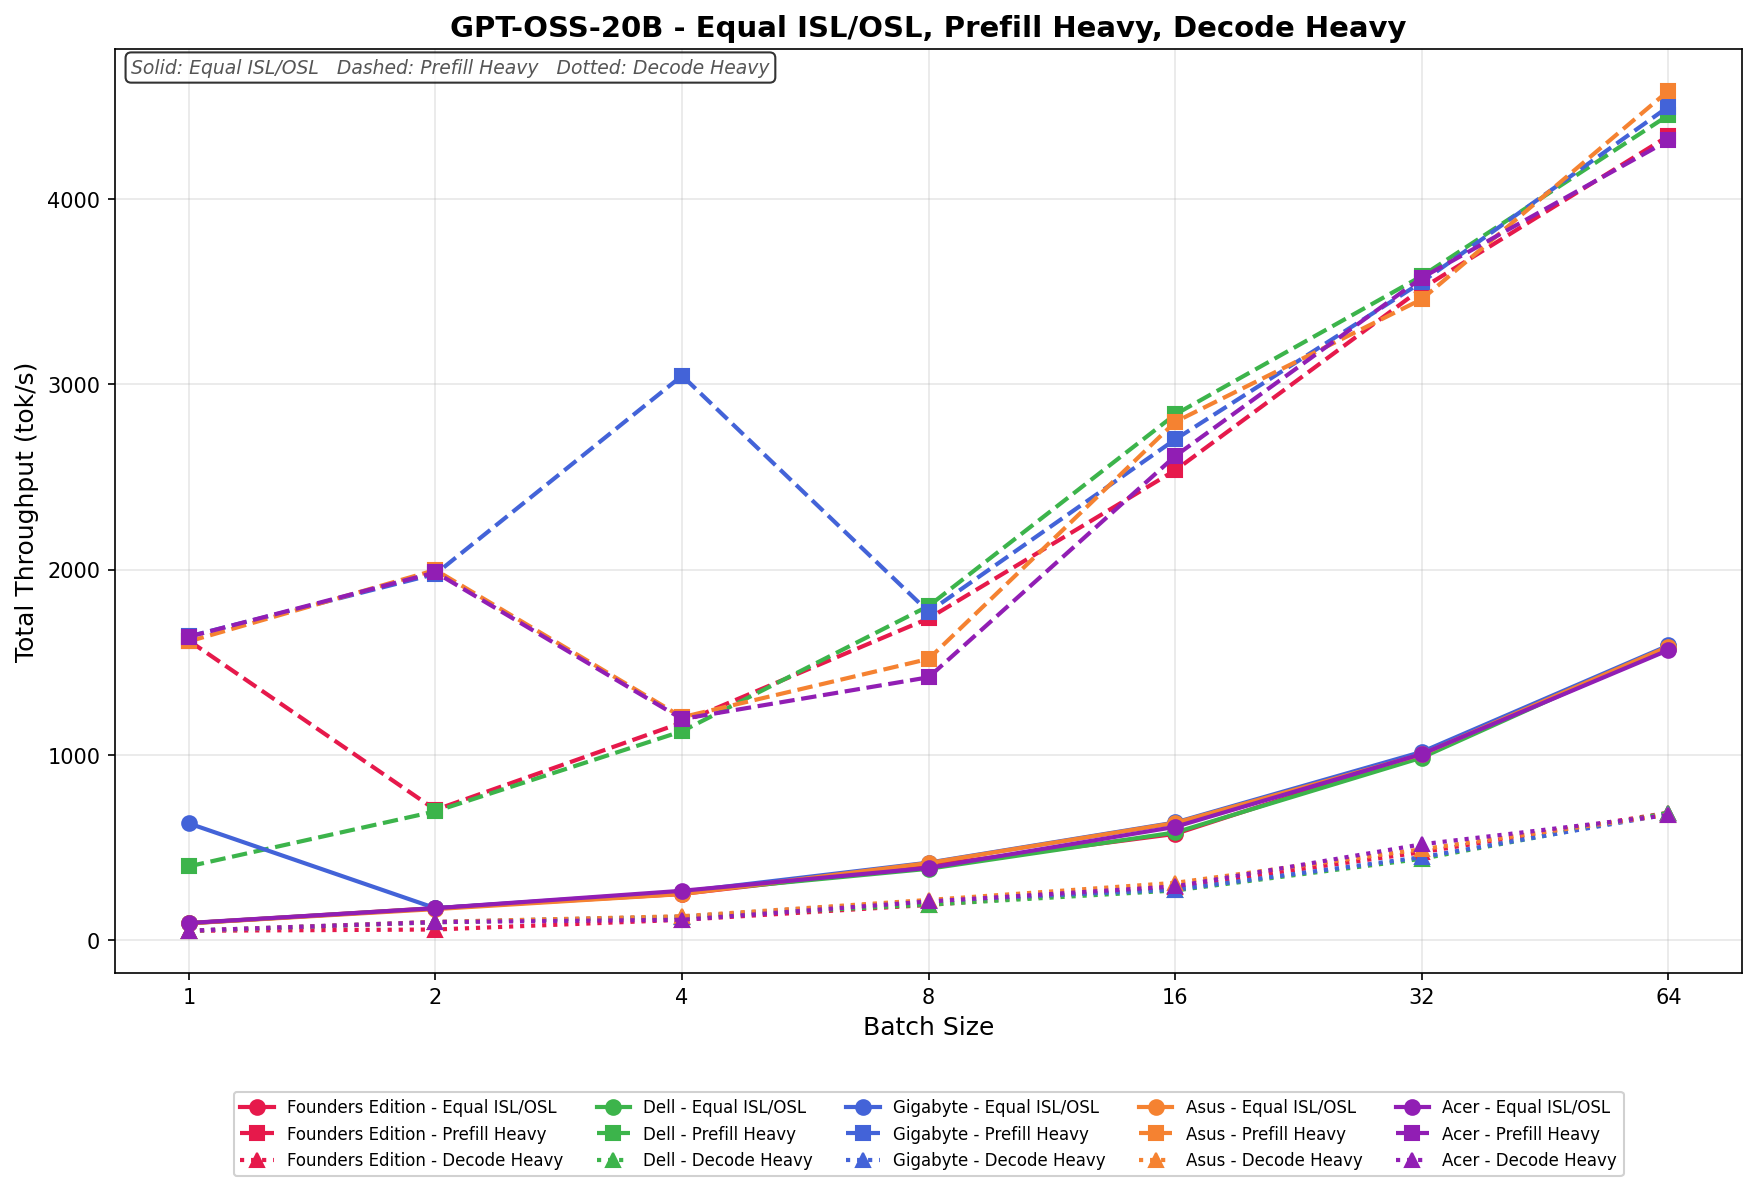
GPT-OSS-20B
동일한 ISL/OSL 조건에서 GIGABYTE는 641.73 tok/s에서 1,587.62 tok/s까지 확장성을 보이며, 배치 크기 1에서 강력한 출발을 보이다가 배치 크기 2에서 다소 하락한 후 배치 크기가 커짐에 따라 꾸준히 향상됩니다. 배치 크기 8부터는 확장성이 정상화되어 다른 경쟁사들과 유사한 추세를 보이며 배치 크기 64에서 최상위권에 근접합니다.
Prefill Heavy는 1,650.32 tok/s에서 시작하여 배치 크기 64에서 4,401.27 tok/s로 정점을 찍습니다. 배치 16부터는 확장성이 일관적이고 경쟁력 있게 유지되어 상위 배치 크기에서도 Dell 및 Asus와 보조를 맞춥니다.
디코딩 부하가 높은 작업의 경우, 성능 향상은 63.18~688.44 tok/s 범위에서 나타나며, 전체 범위에 걸쳐 선형적인 확장성을 보입니다. 성능 향상은 점진적이지만 일관적이며, 다른 플랫폼과 유사한 양상을 보이고, 디코딩 부하가 높은 작업에서 흔히 나타나는 제한적인 확장 동작을 반영합니다.
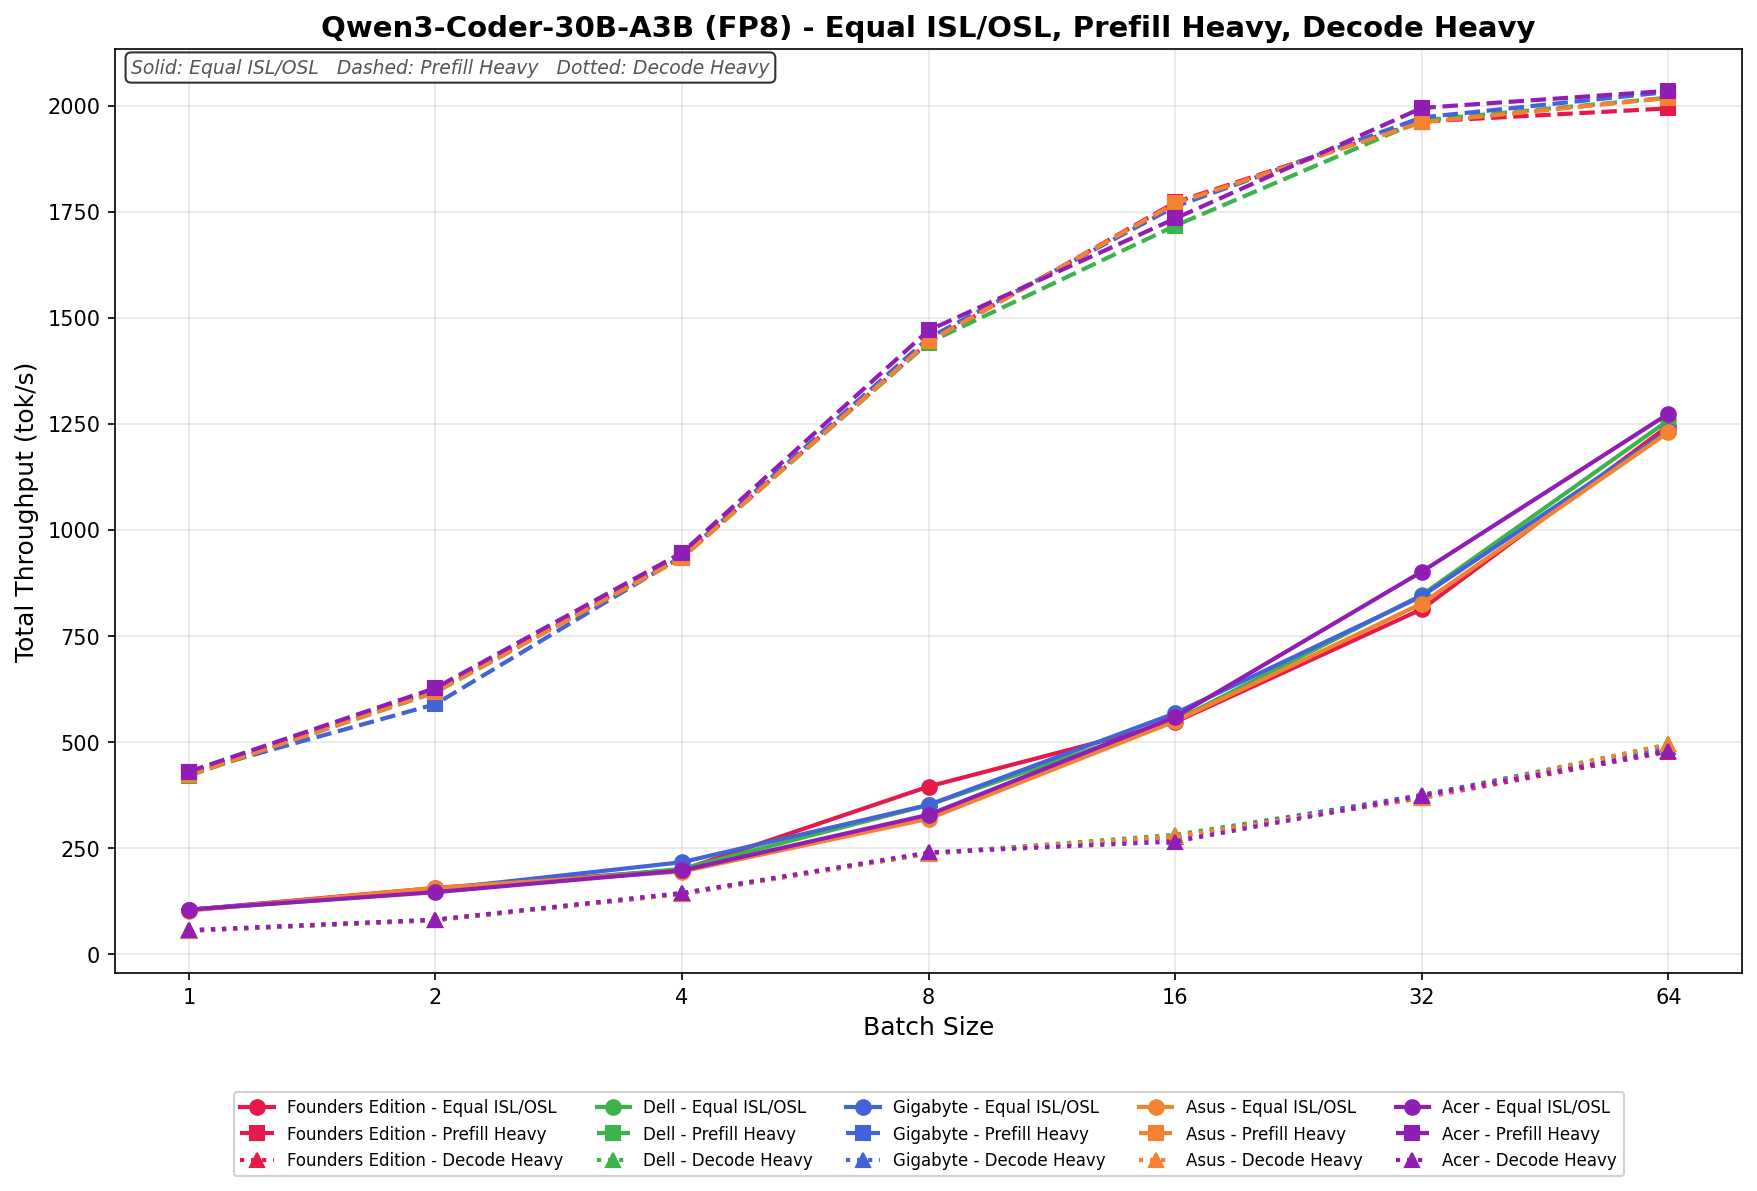
Qwen3 코더 30B A3B FB8
동일한 ISL/OSL 환경에서 GIGABYTE는 101.27 tok/s에서 1,251.84 tok/s까지 확장되는 성능을 보여주며, 배치별 성능 향상 폭이 일정하게 유지됩니다. 16번째 배치까지는 Dell 및 Asus와 비슷한 성능을 보이다가 64번째 배치까지 꾸준히 상승하여 상위권에 근접하는 성능을 보여주며, 눈에 띄는 성능 저하 현상은 나타나지 않습니다.
Prefill Heavy는 428.66 tok/s에서 시작하여 배치 크기가 64로 증가함에 따라 2,026.94 tok/s까지 확장됩니다. 모든 배치 크기에 걸쳐 성장은 부드럽고 일관적이며, GIGABYTE는 전반적인 경쟁 업체들과 유사한 수준을 유지합니다.
Decode Heavy의 처리 속도는 61.18~482.73 tok/s 범위이며, 배치 크기가 증가함에 따라 예측 가능한 점진적인 향상이 나타납니다.
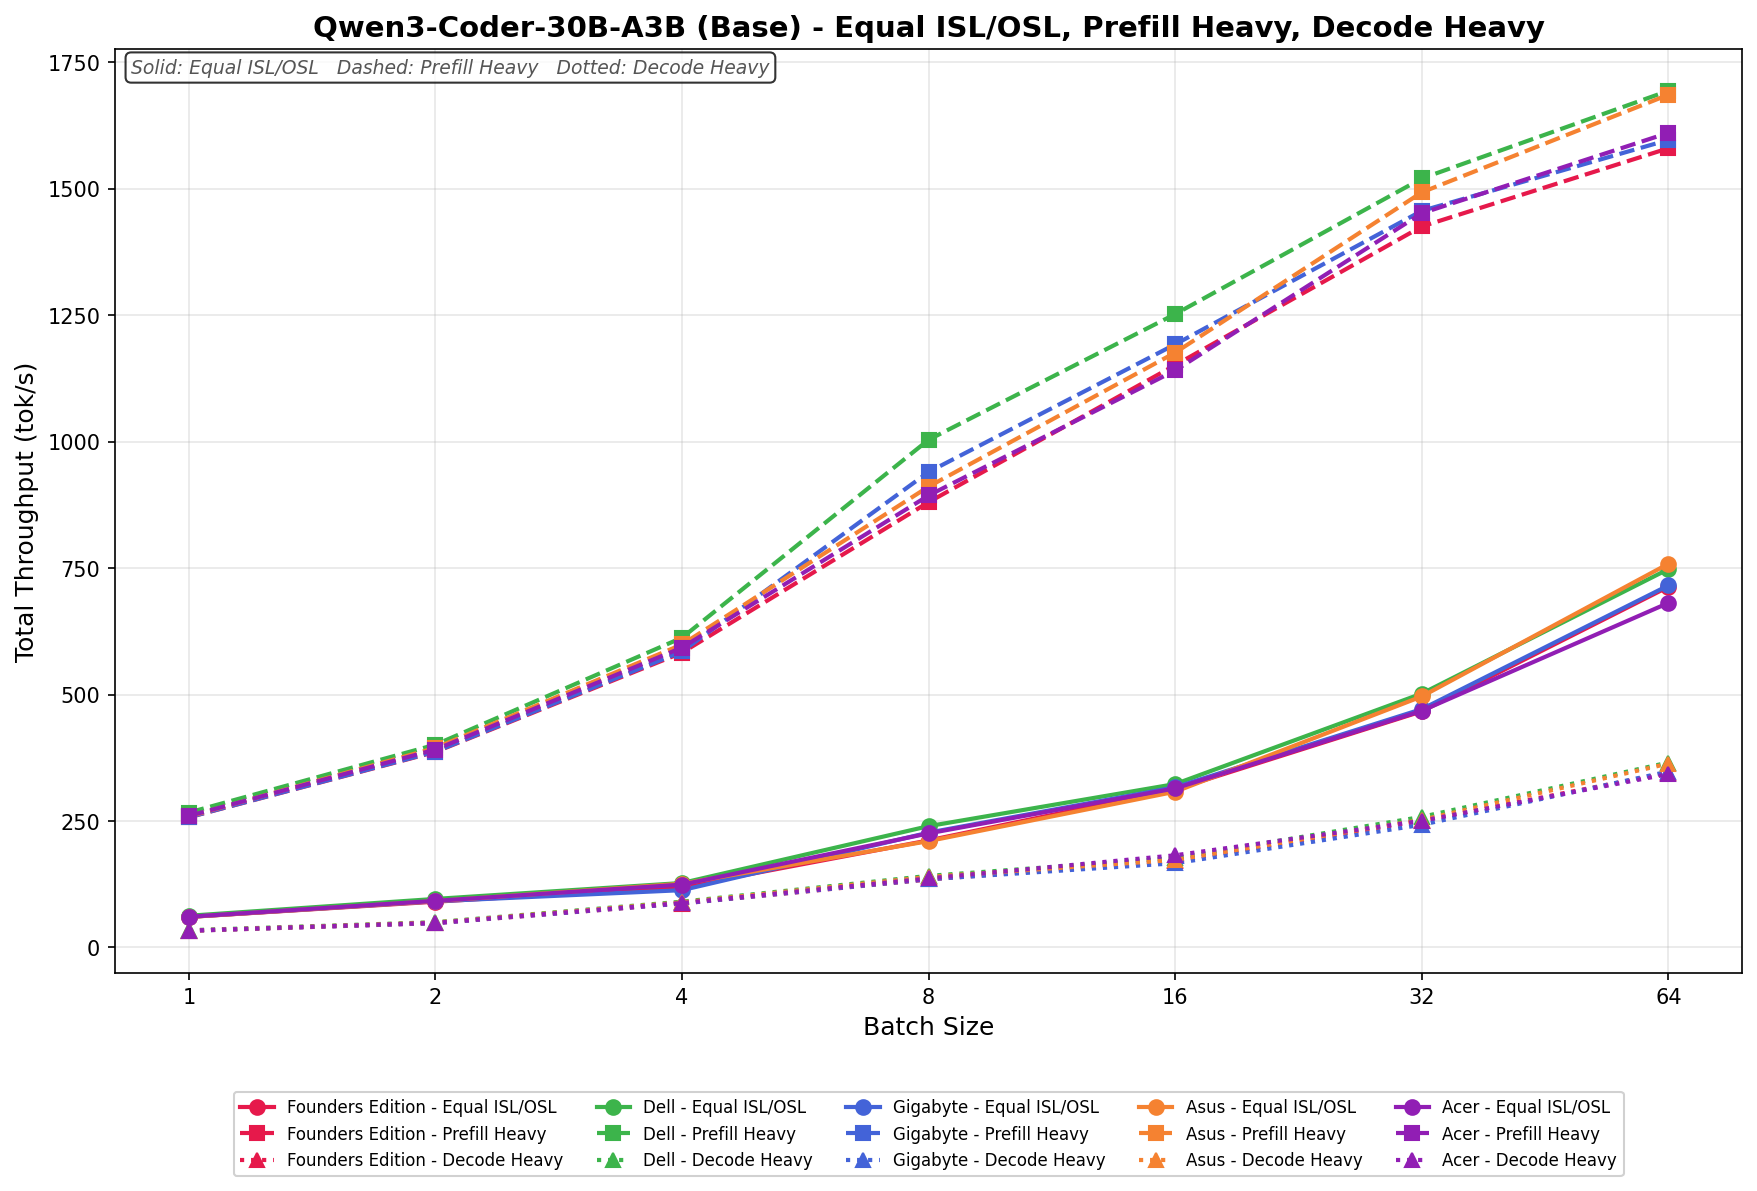
Qwen3 코더 30B A3B 베이스
동일한 ISL/OSL 조건에서 GIGABYTE는 63.42 tok/s에서 721.08 tok/s까지 꾸준히 확장되는 성능을 보여주며, 배치 범위 전체에 걸쳐 안정적인 향상을 나타냈습니다. 이러한 성능은 배치 16까지는 다른 제품들과 유사한 추세를 보였고, 배치 64까지 지속적으로 안정적인 확장을 이어가며 선형적인 동작에서 눈에 띄는 편차 없이 경쟁력 있는 수준으로 마무리되었습니다.
Prefill Heavy는 258.11 tok/s에서 시작하여 배치 크기 64에서 1,603.74 tok/s까지 상승합니다.
Decode Heavy의 범위는 33.57~349.82 tok/s이며, 스윕 전체에 걸쳐 선형적으로 점진적으로 증가합니다.
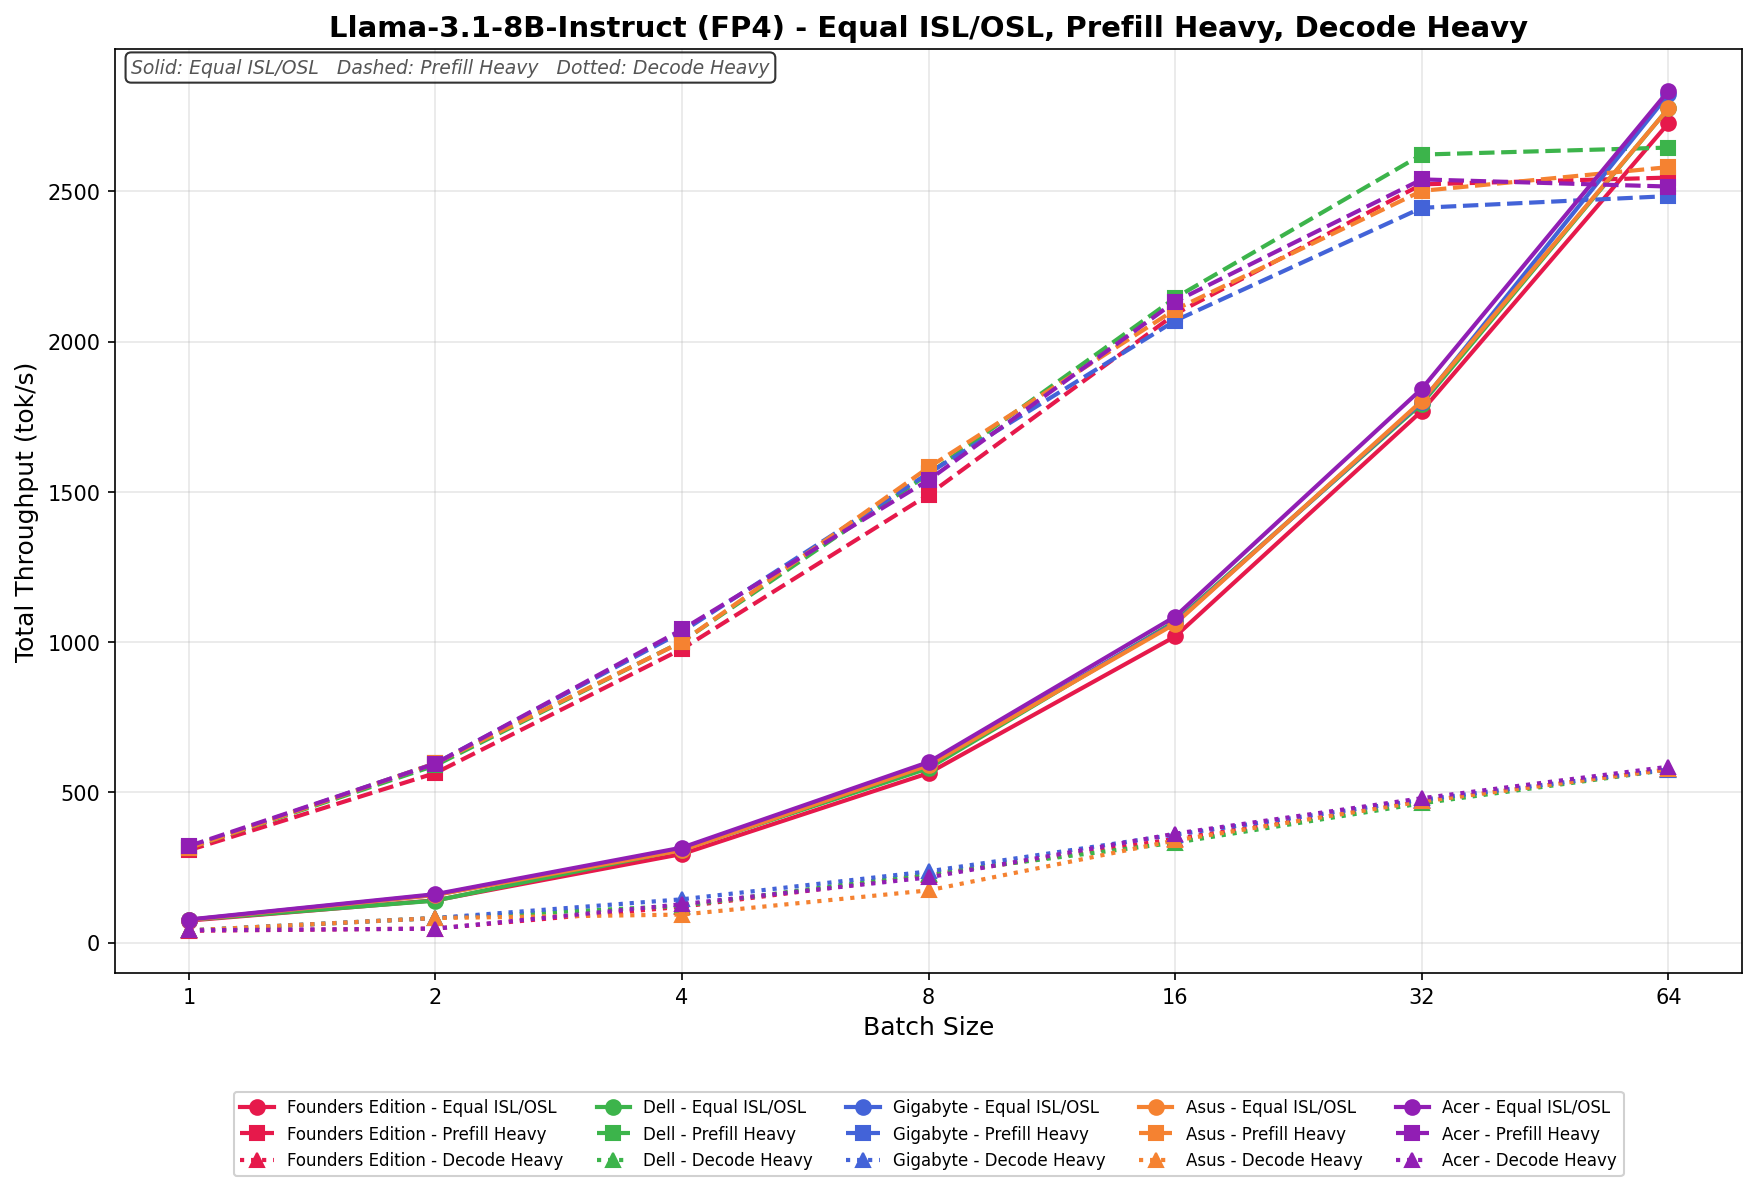
Llama 3.1 8B 명령어 FP4
동일한 ISL/OSL 조건에서 GIGABYTE는 배치 처리량 전반에 걸쳐 69.84 tok/s에서 2,756.91 tok/s로 증가했습니다. 확장성은 배치 32까지 점진적이고 균형 있게 이루어지며, 이 지점에서 처리량이 상위권에 근접하다가 배치 64에서 급격히 증가하여 높은 동시 처리량 수준에서 선두 시스템 대열에 합류합니다.
Prefill Heavy는 321.67 tok/s에서 시작하여 배치 크기 64에서 2,493.52 tok/s에 도달합니다. 배치 16까지 꾸준히 증가하다가 배치 크기가 커질수록 최고 성능 제품에 비해 증가폭이 약간 감소하는데, 이는 대량 생산에 있어 견고하지만 압도적인 효율성은 아님을 나타냅니다.
Decode Heavy의 처리 속도는 48.92~575.84 tok/s 범위이며, 배치 크기가 증가함에 따라 일관되게 점진적인 향상을 보입니다.
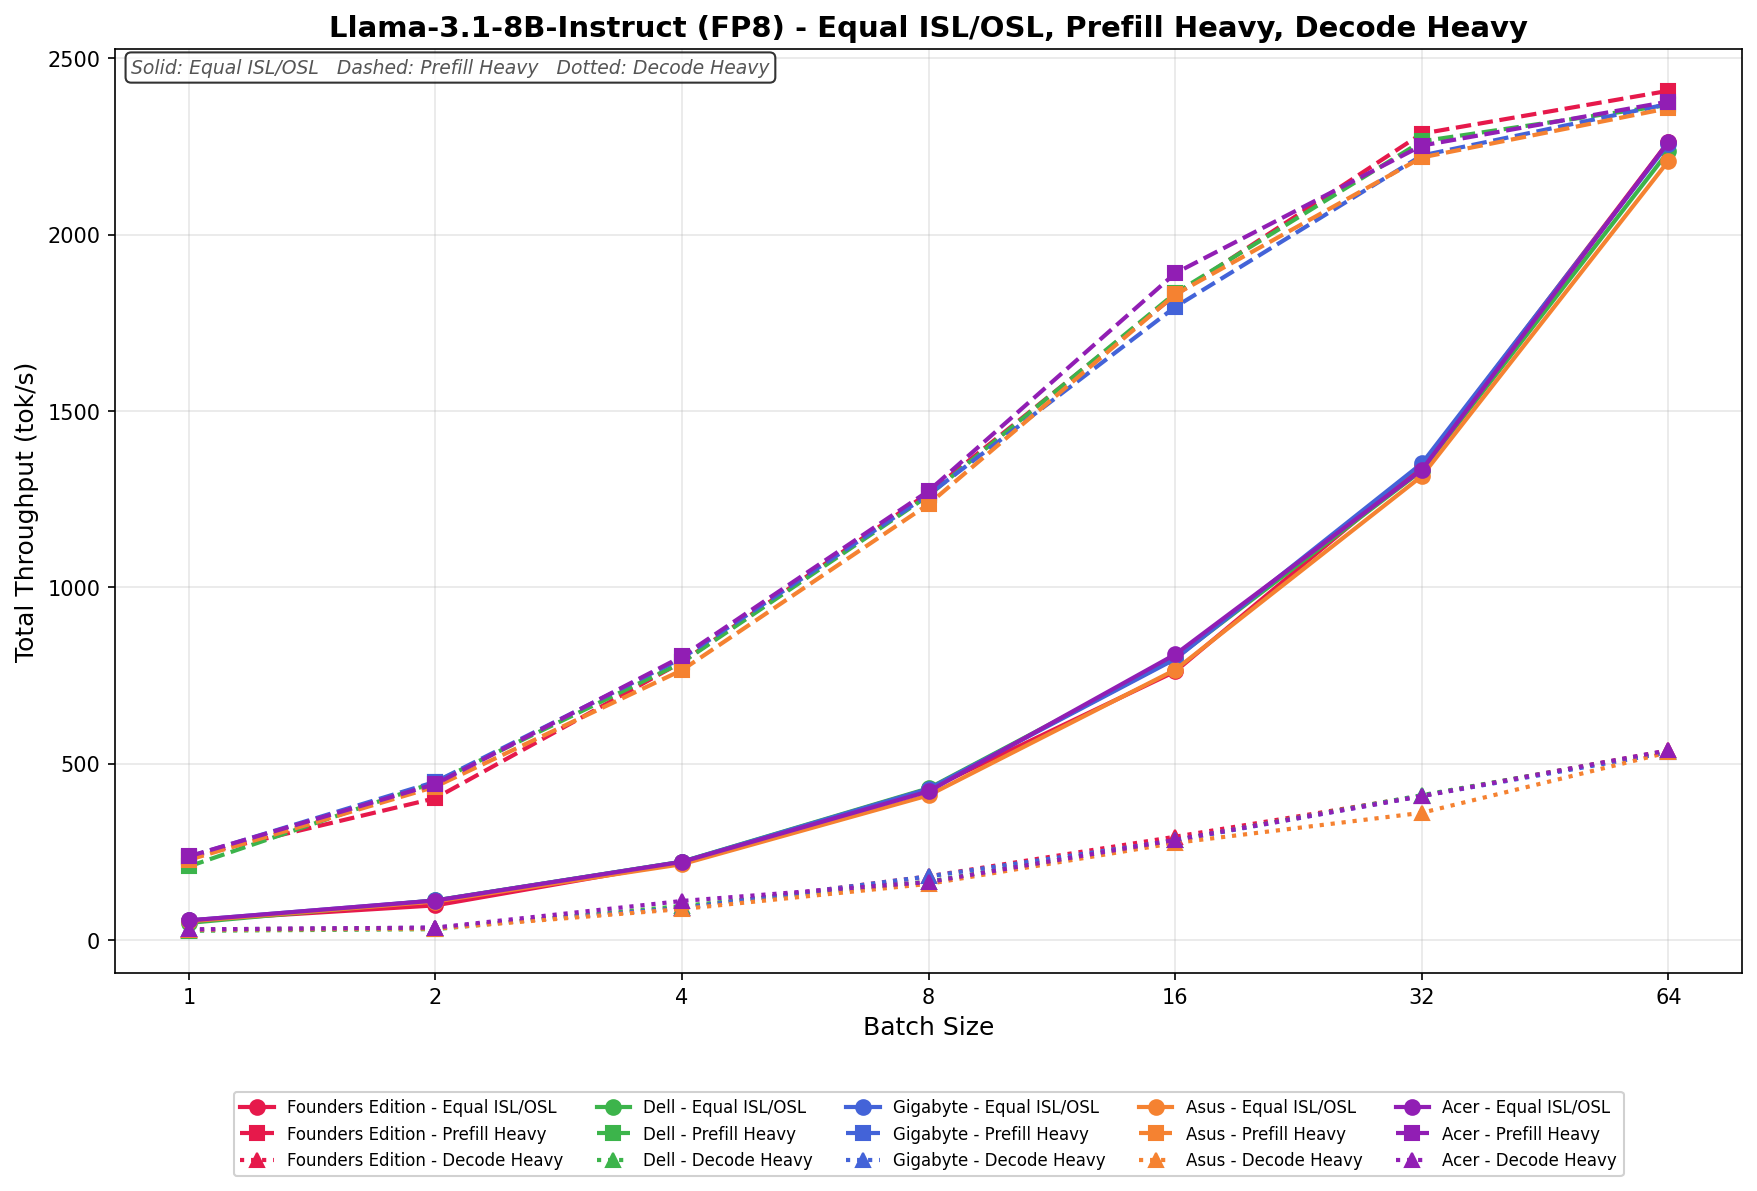
Llama 3.1 8B 명령어 FP8
동일한 ISL/OSL 환경에서 GIGABYTE는 54.12 tok/s에서 2,314.87 tok/s까지 확장 가능하며, 배치 32까지는 부드럽고 선형적인 성장을 보이고 배치 64에서 강력한 성능 향상을 보여 더 높은 동시 처리 수준에서도 경쟁력을 유지합니다.
Prefill Heavy는 226.43 tok/s에서 시작하여 배치 크기 64에서 2,332.19 tok/s에 도달합니다. 스케일링은 전체 범위에 걸쳐 일관적이며, 광범위한 분야와 밀접하게 연관되어 있으며, 배치 크기가 커질수록 견고한 효율성을 유지합니다.
Decode Heavy의 처리 속도는 32.88~522.41 tok/s 범위이며, 배치 크기가 증가함에 따라 꾸준히 향상됩니다. 예상대로 확장성은 Equal 및 Prefill 워크로드에 비해 제한적입니다.
GPU 직접 스토리지
Spark에서 수행한 테스트 중 하나는 MagnumIO GPU Direct Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브나 기타 고속 저장 장치에 저장된 데이터에 액세스할 때 CPU를 거치지 않고 바로 접근할 수 있도록 합니다. GDS는 CPU와 시스템 메모리를 거치지 않고 GPU와 저장 장치 간의 직접 통신을 가능하게 하여 지연 시간을 크게 줄이고 데이터 처리량을 향상시킵니다.
기가바이트는 AI TOP ATOM에 4TB 삼성 PM9E1 Gen5 SSD를 사용했는데, 이는 현재까지 시중에서 가장 빠른 2242 M.2 드라이브입니다. 이 SSD는 FE Spark와 Acer Veriton GN100에도 사용된 것과 동일한 제품입니다.
GPU 직접 스토리지 작동 방식
기존 방식에서는 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때, 데이터가 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 했습니다. 이 과정에서 CPU가 중간 역할을 하여 병목 현상을 일으키고, 지연 시간을 증가시키며 시스템 리소스를 소모했습니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 접근할 수 있도록 함으로써 이러한 비효율성을 해결합니다. 이러한 직접 경로는 데이터 이동 오버헤드를 줄여 더욱 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥 러닝과 관련된 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 훈련하려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송이 지연되면 GPU 활용도가 낮아지고 훈련 시간이 길어질 수 있습니다. GPU Direct Storage는 데이터가 가능한 한 빨리 GPU에 전달되도록 하여 유휴 시간을 최소화하고 계산 효율성을 극대화함으로써 이러한 과제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
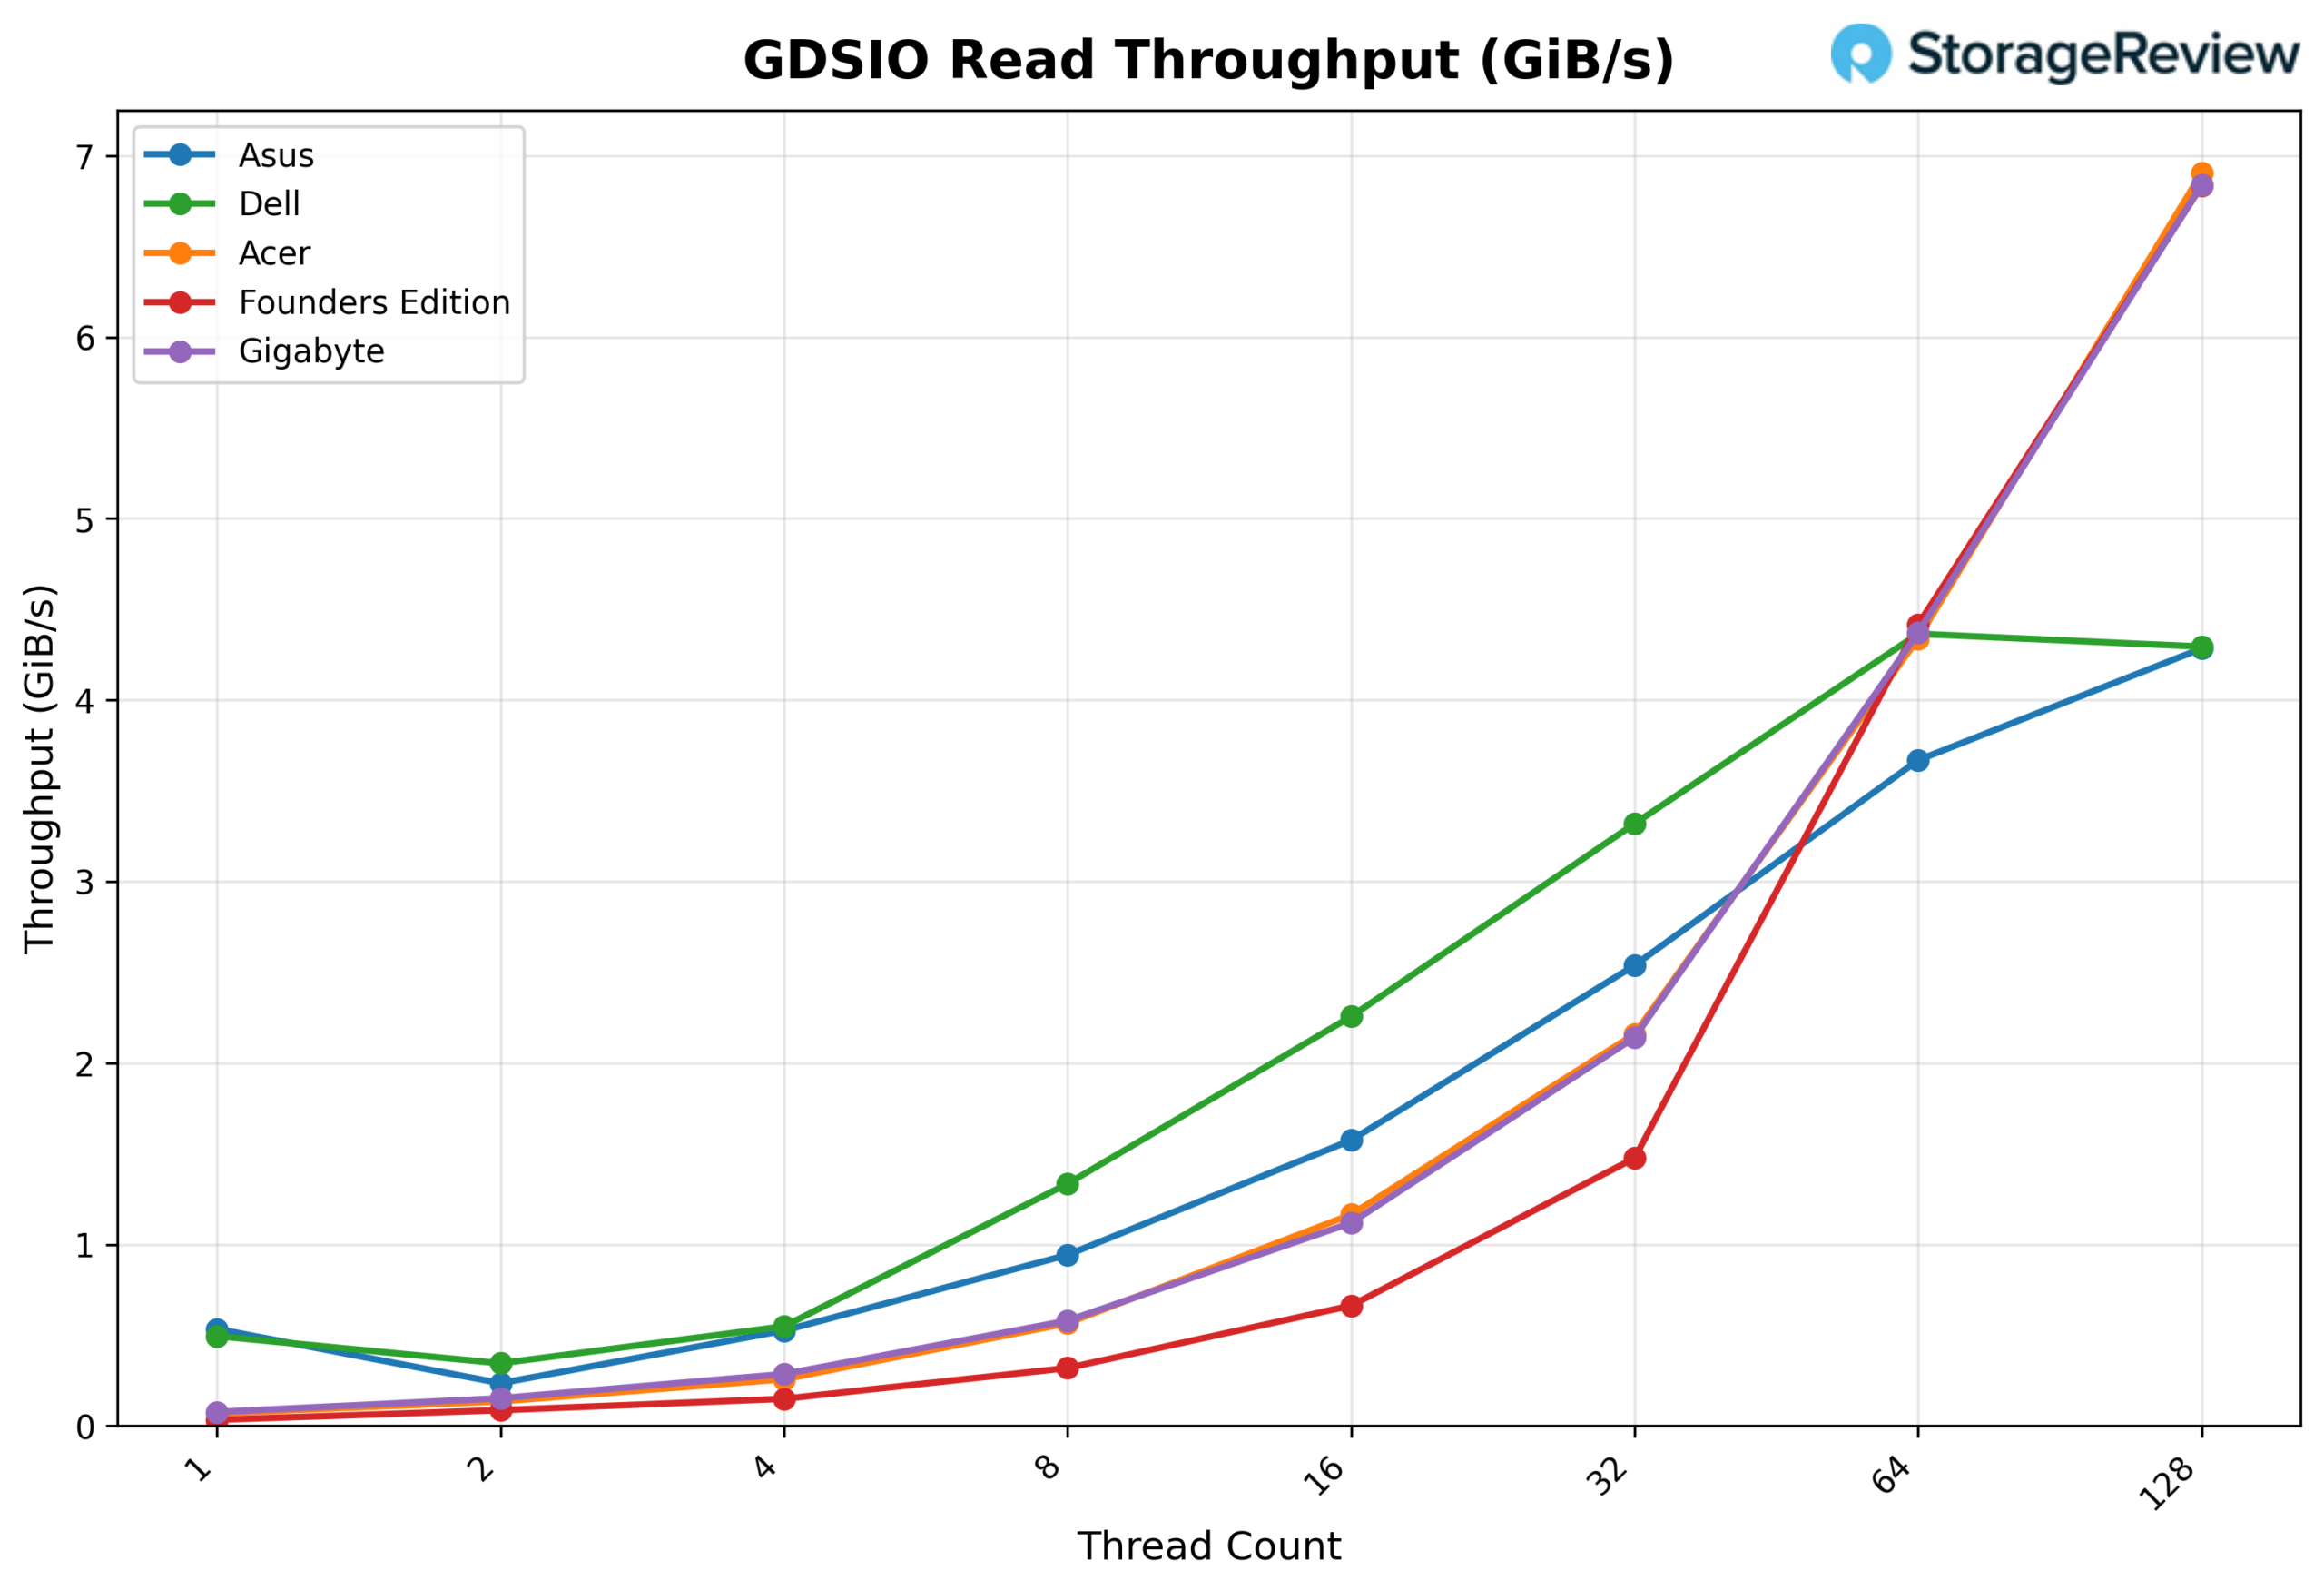
GDSIO 읽기 처리량 16k
GIGABYTE의 GDSIO 읽기 처리량 16K를 살펴보면, 스레드 1개에서 약 0.08GiB/s로 시작하여 스레드 8개에서 0.58GiB/s까지 증가합니다. 이후 스레드 16개(1.12GiB/s)와 32개(2.14GiB/s)에서도 꾸준히 증가하다가 스레드 64개에서 4.37GiB/s로 급격히 상승합니다. 128개 스레드에서도 GIGABYTE는 6.84GiB/s까지 계속해서 증가하며, 스레드 수의 최대치에서도 성능 저하 조짐을 보이지 않습니다.
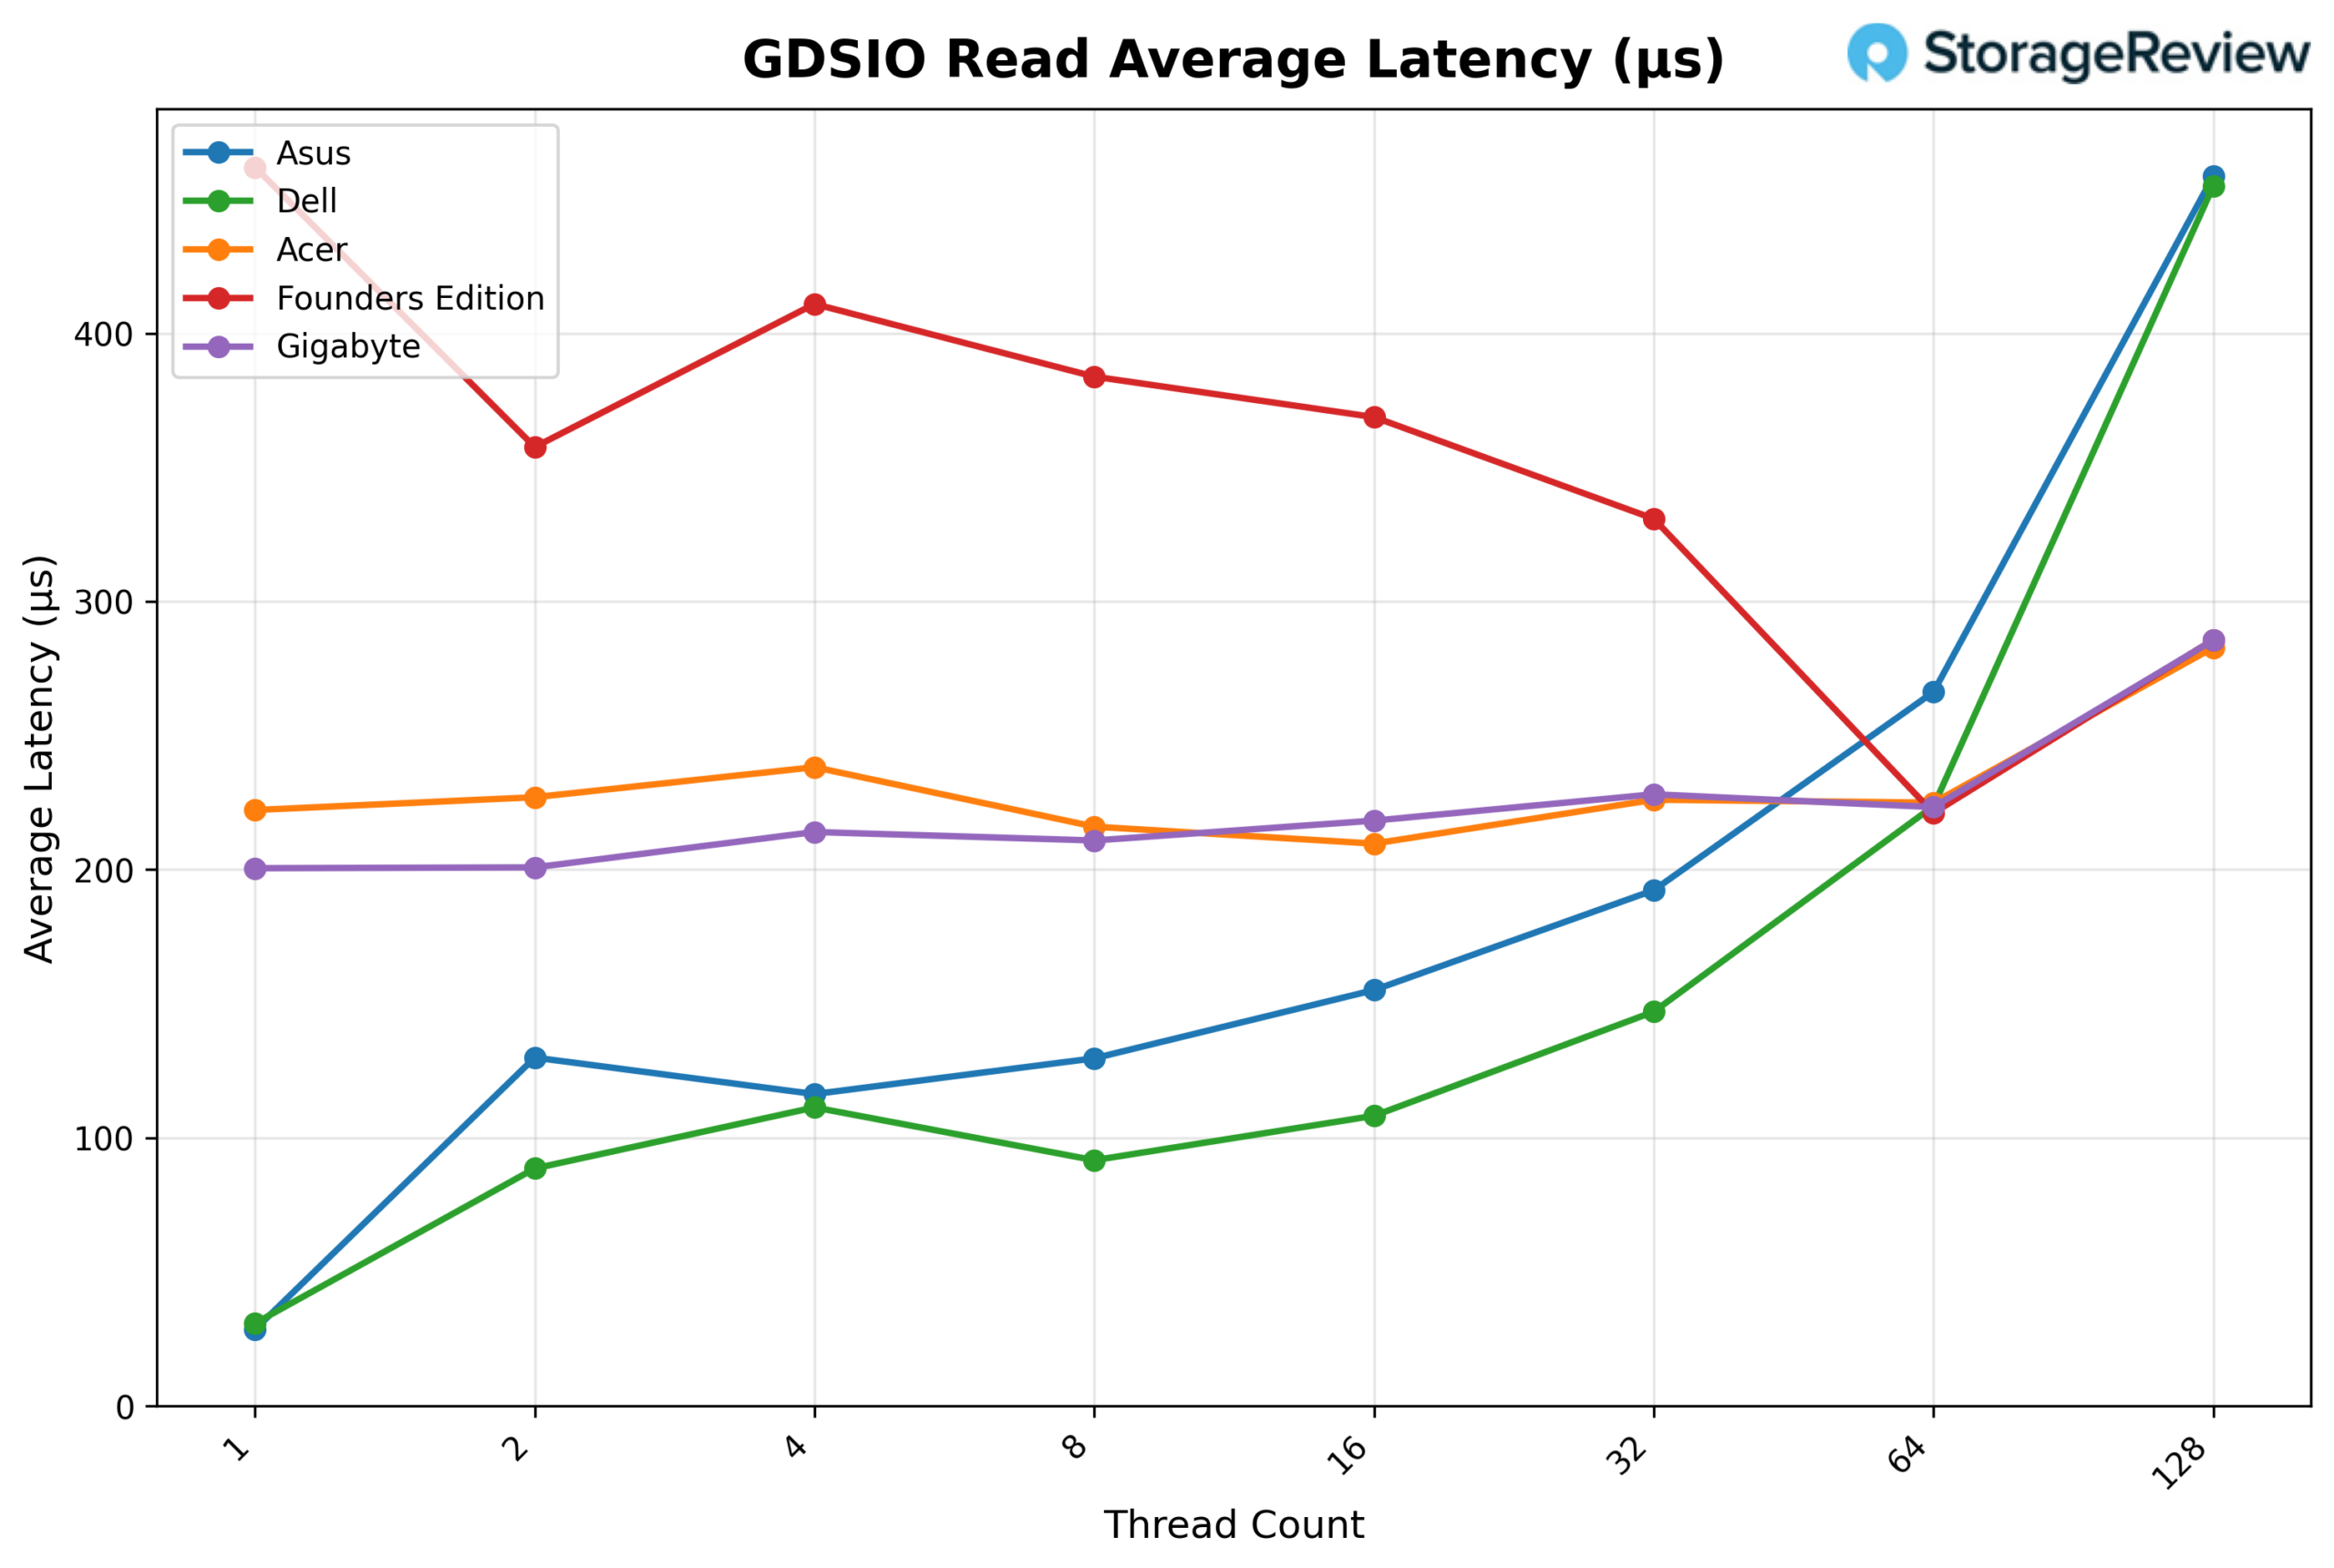
GDSIO 읽기 평균 지연 시간 16K
GDSIO 읽기 평균 지연 시간(16K)을 살펴보면, GIGABYTE는 대부분의 구간에서 매우 안정적인 지연 시간을 유지합니다. 1개 스레드에서 약 0.201ms로 시작하여 2개 스레드부터 64개 스레드까지 ~0.21~0.23ms 범위 내에서 밀집된 값을 보입니다(예: 8개 스레드에서 0.211ms, 16개 스레드에서 0.218ms, 32개 스레드에서 0.228ms, 64개 스레드에서 0.223ms). 128개 스레드에 이르러서야 지연 시간이 약 0.286ms로 눈에 띄게 증가하지만, 처리량은 계속해서 증가합니다.
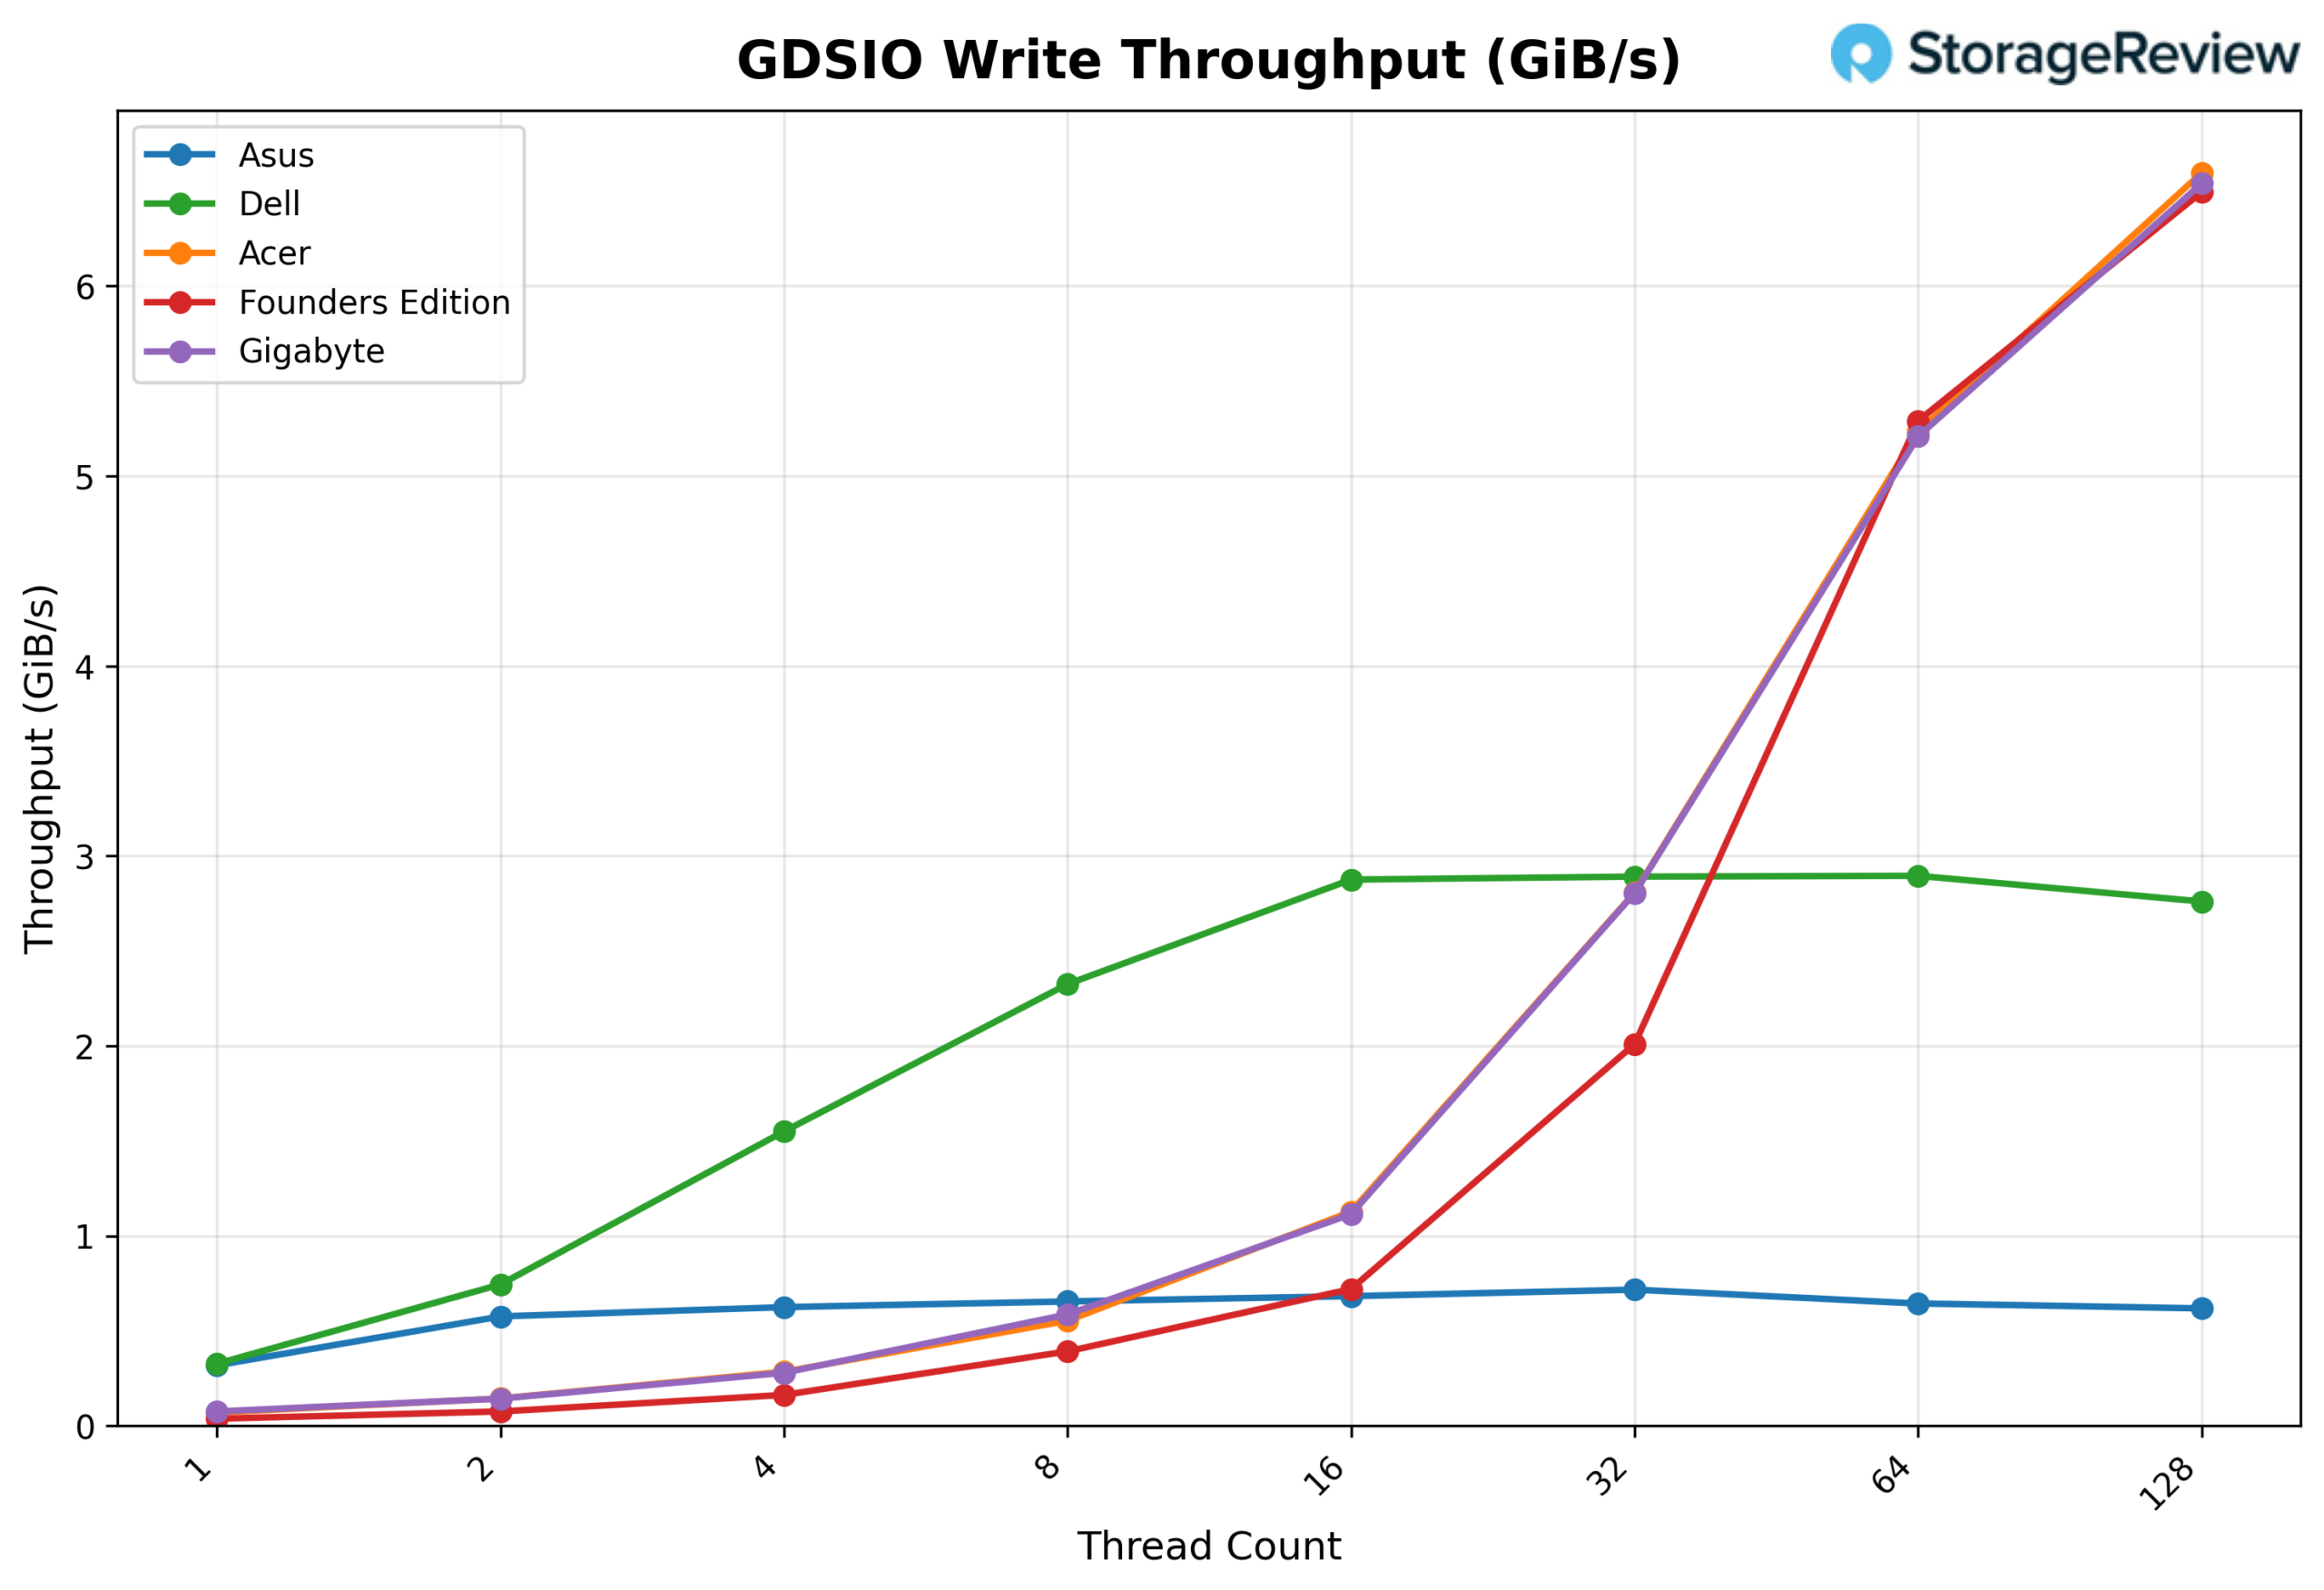
GSDIO 쓰기 처리량 16K
GIGABYTE의 GDSIO 쓰기 처리량 16K를 살펴보면, 1개 스레드에서 약 0.08GiB/s로 시작하여 2개 스레드에서 0.14GiB/s, 4개 스레드에서 0.28GiB/s까지 꾸준히 증가합니다. 8개 스레드(0.59GiB/s)와 16개 스레드(1.11GiB/s)에서도 성능이 꾸준히 상승하다가 32개 스레드(2.80GiB/s)에서 더욱 가파르게 증가합니다. 64개 스레드(5.21GiB/s)에서도 강력한 확장성을 유지하며 128개 스레드에서 6.54GiB/s로 정점을 찍으며, 초기에 정체기 없이 지속적인 상승세를 보여줍니다.
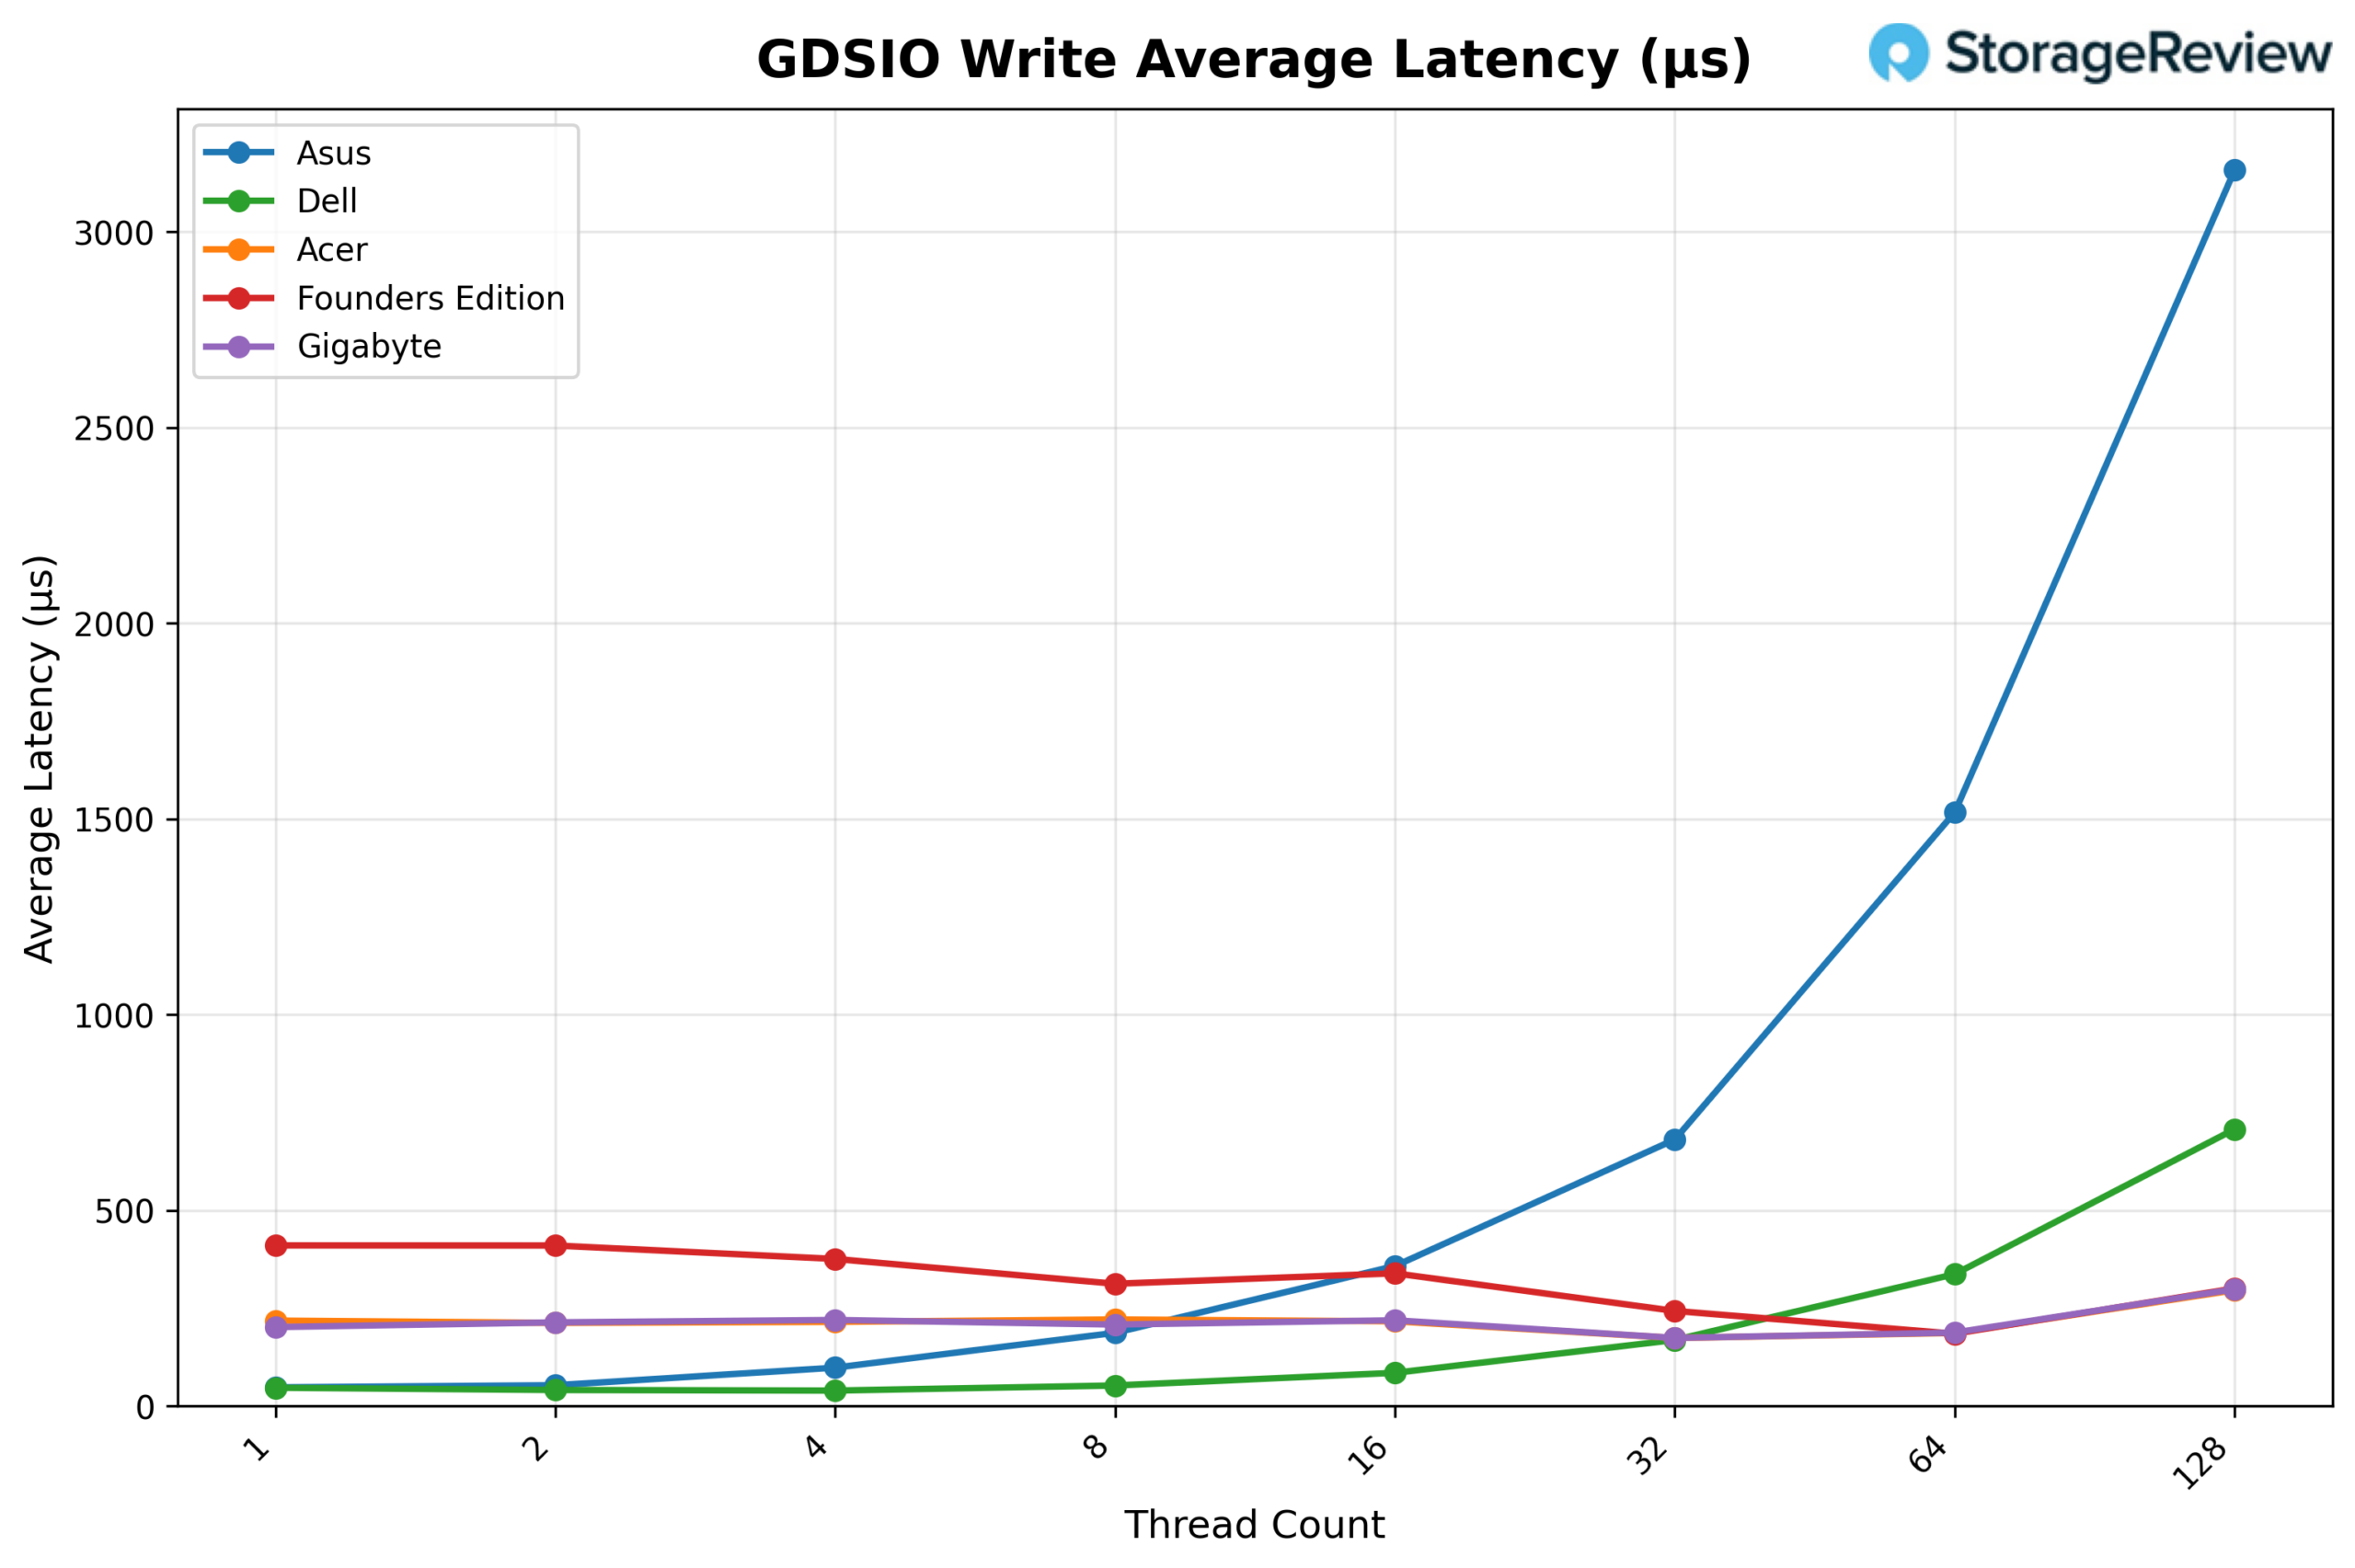
GDSIO 쓰기 평균 지연 시간 16K
GDSIO 쓰기 평균 지연 시간(16K)을 살펴보면, GIGABYTE는 대부분의 구간에서 비교적 안정적인 지연 시간을 유지합니다. 1개 스레드에서 약 0.20ms로 시작하여 16개 스레드까지는 약 0.21~0.22ms 범위를 유지합니다. 32개 스레드에서는 지연 시간이 약 0.17ms로 약간 개선되고, 64개 스레드에서는 0.19ms로 소폭 증가합니다. 지연 시간이 눈에 띄게 증가하는 것은 최고 처리량 수준에 해당하는 128개 스레드에서부터이며, 이때 지연 시간은 약 0.30ms에 이릅니다.
GDSIO 읽기 처리량 1M
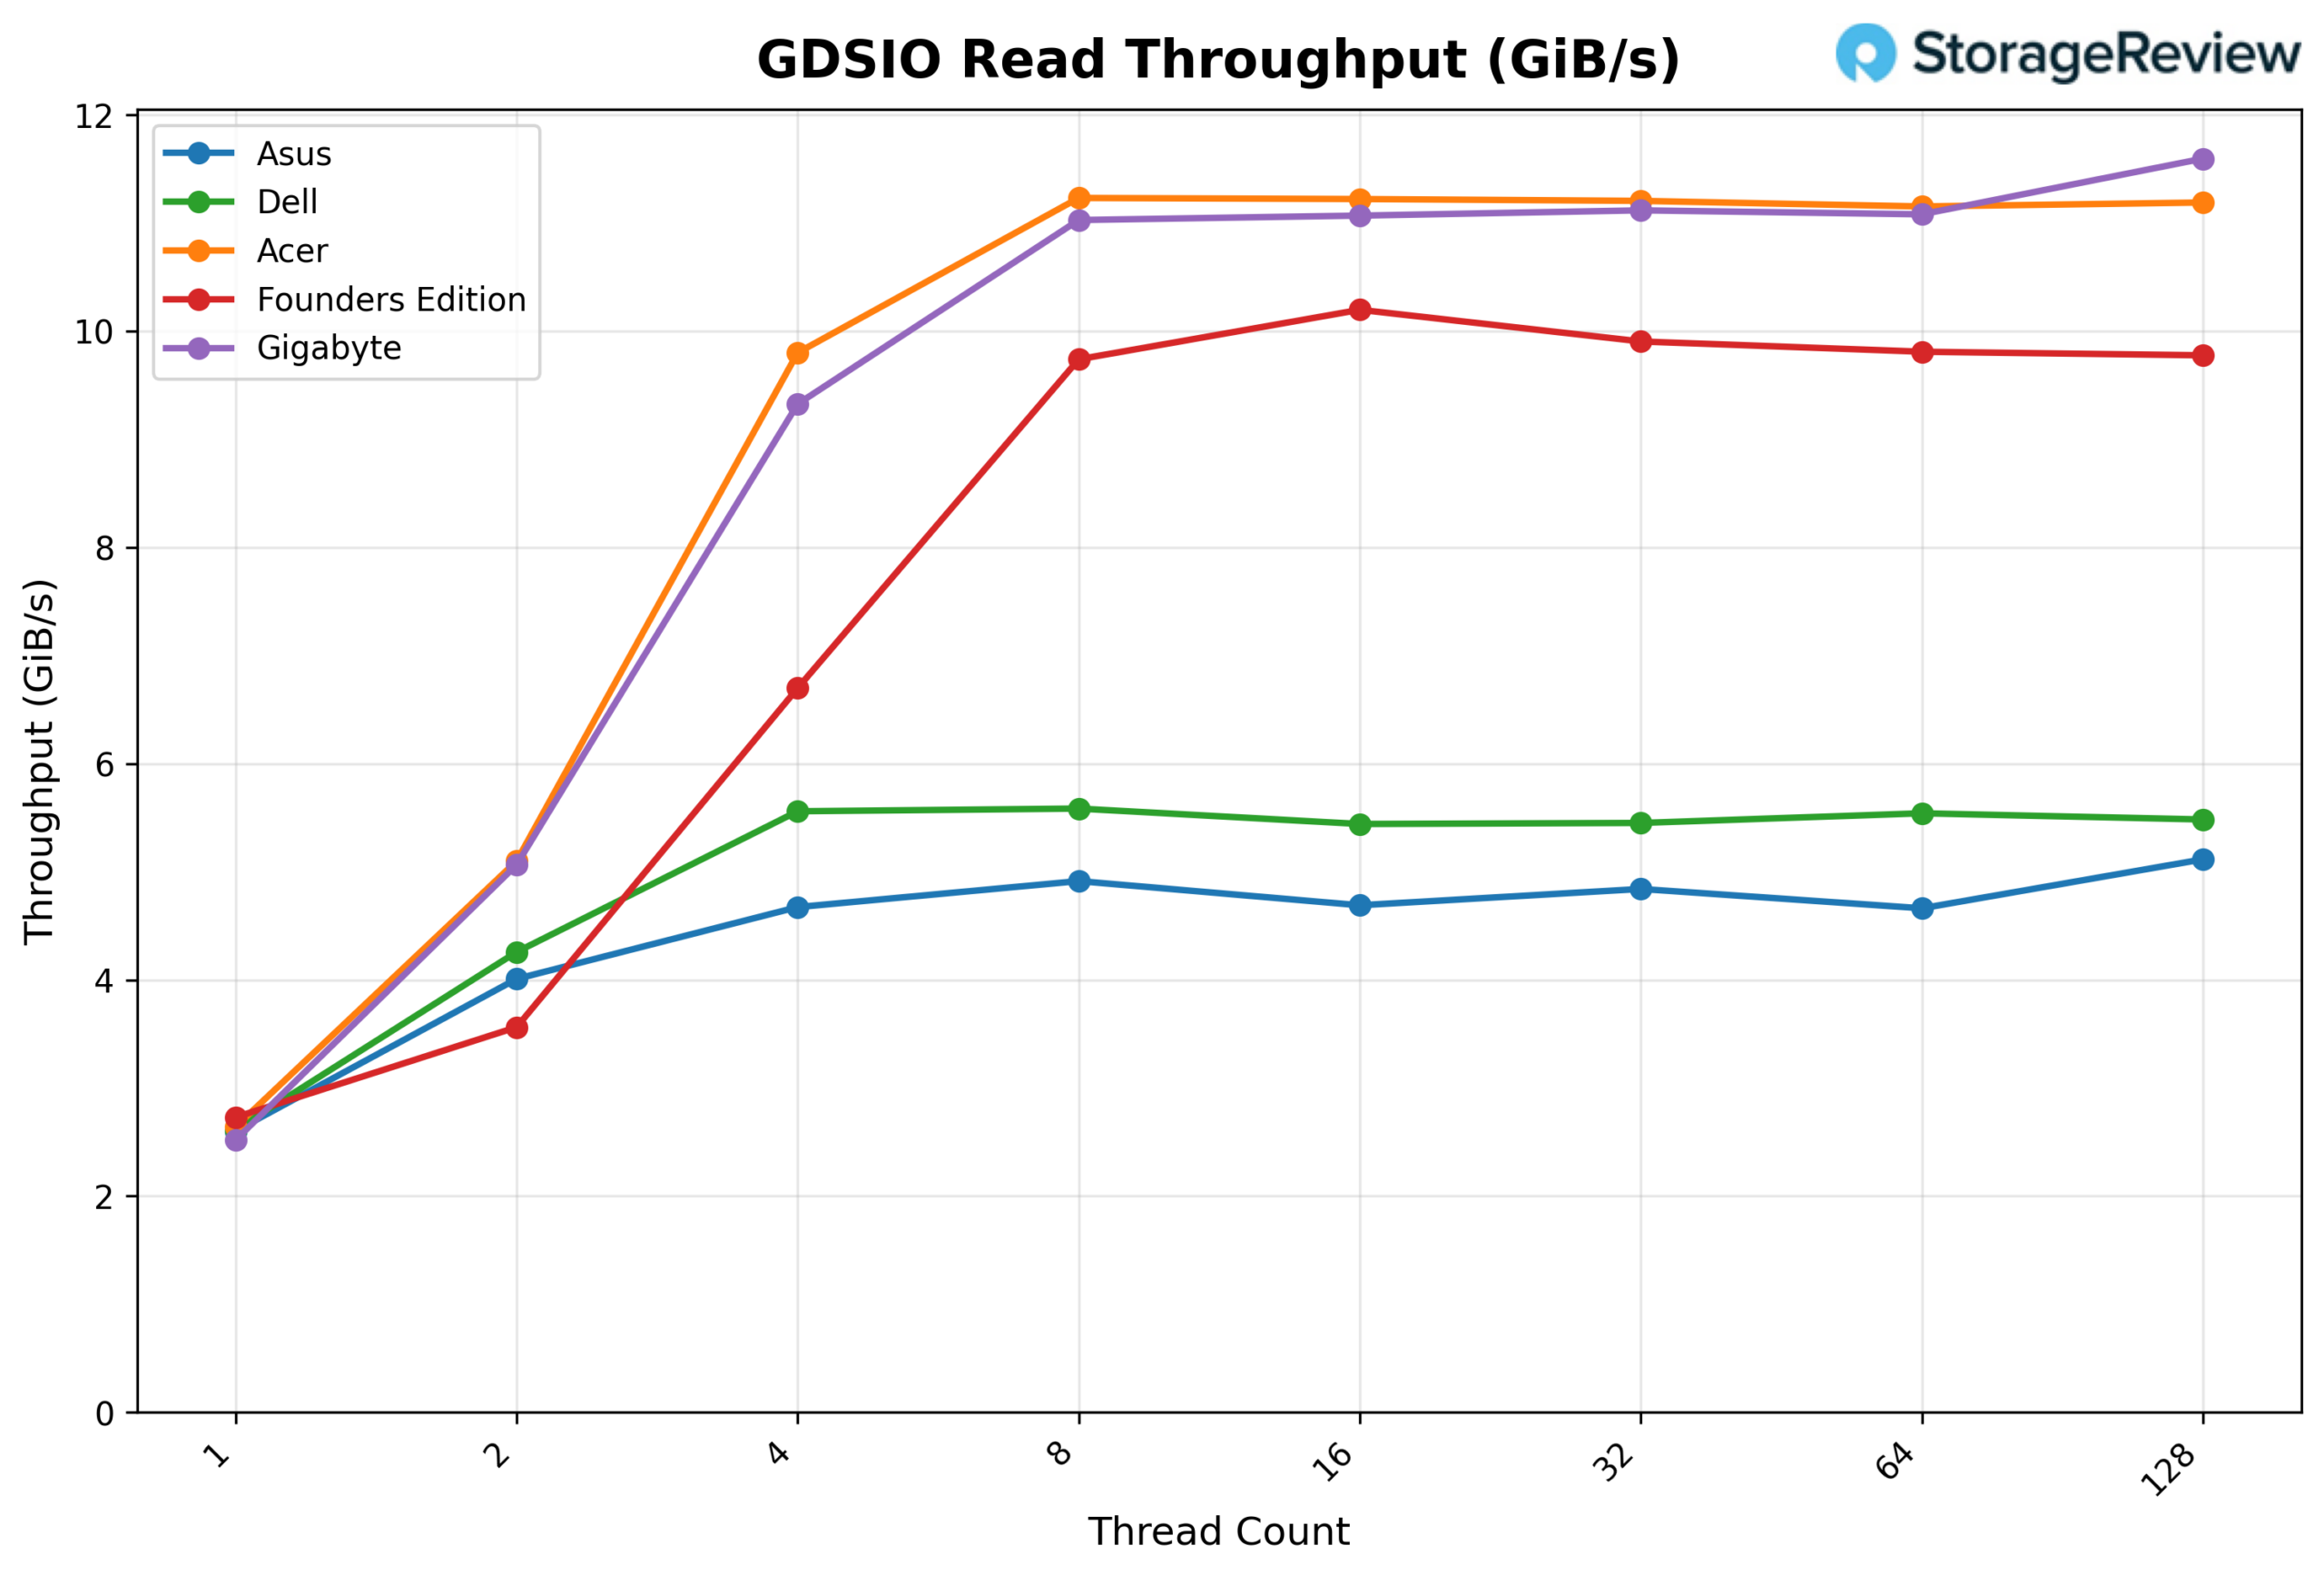
GDSIO 읽기 처리량 1M을 살펴보면, GIGABYTE는 1개 스레드에서 2.52GiB/s로 시작하여 2개 스레드에서 5.07GiB/s, 4개 스레드에서 9.33GiB/s까지 증가합니다. 8개 스레드에서는 처리량이 11.03GiB/s에 도달한 후 플랫폼은 사실상 포화 상태에 이릅니다. 16개 스레드(11.07GiB/s), 32개 스레드(11.12GiB/s), 64개 스레드(11.08GiB/s)에서도 성능은 안정적으로 유지되며 평탄한 구간을 보입니다. 128개 스레드에서는 처리량이 11.60GiB/s로 약간 증가하여 이번 테스트에서 관찰된 최고 결과를 기록했습니다.
GDSIO 읽기 평균 지연 시간 1M
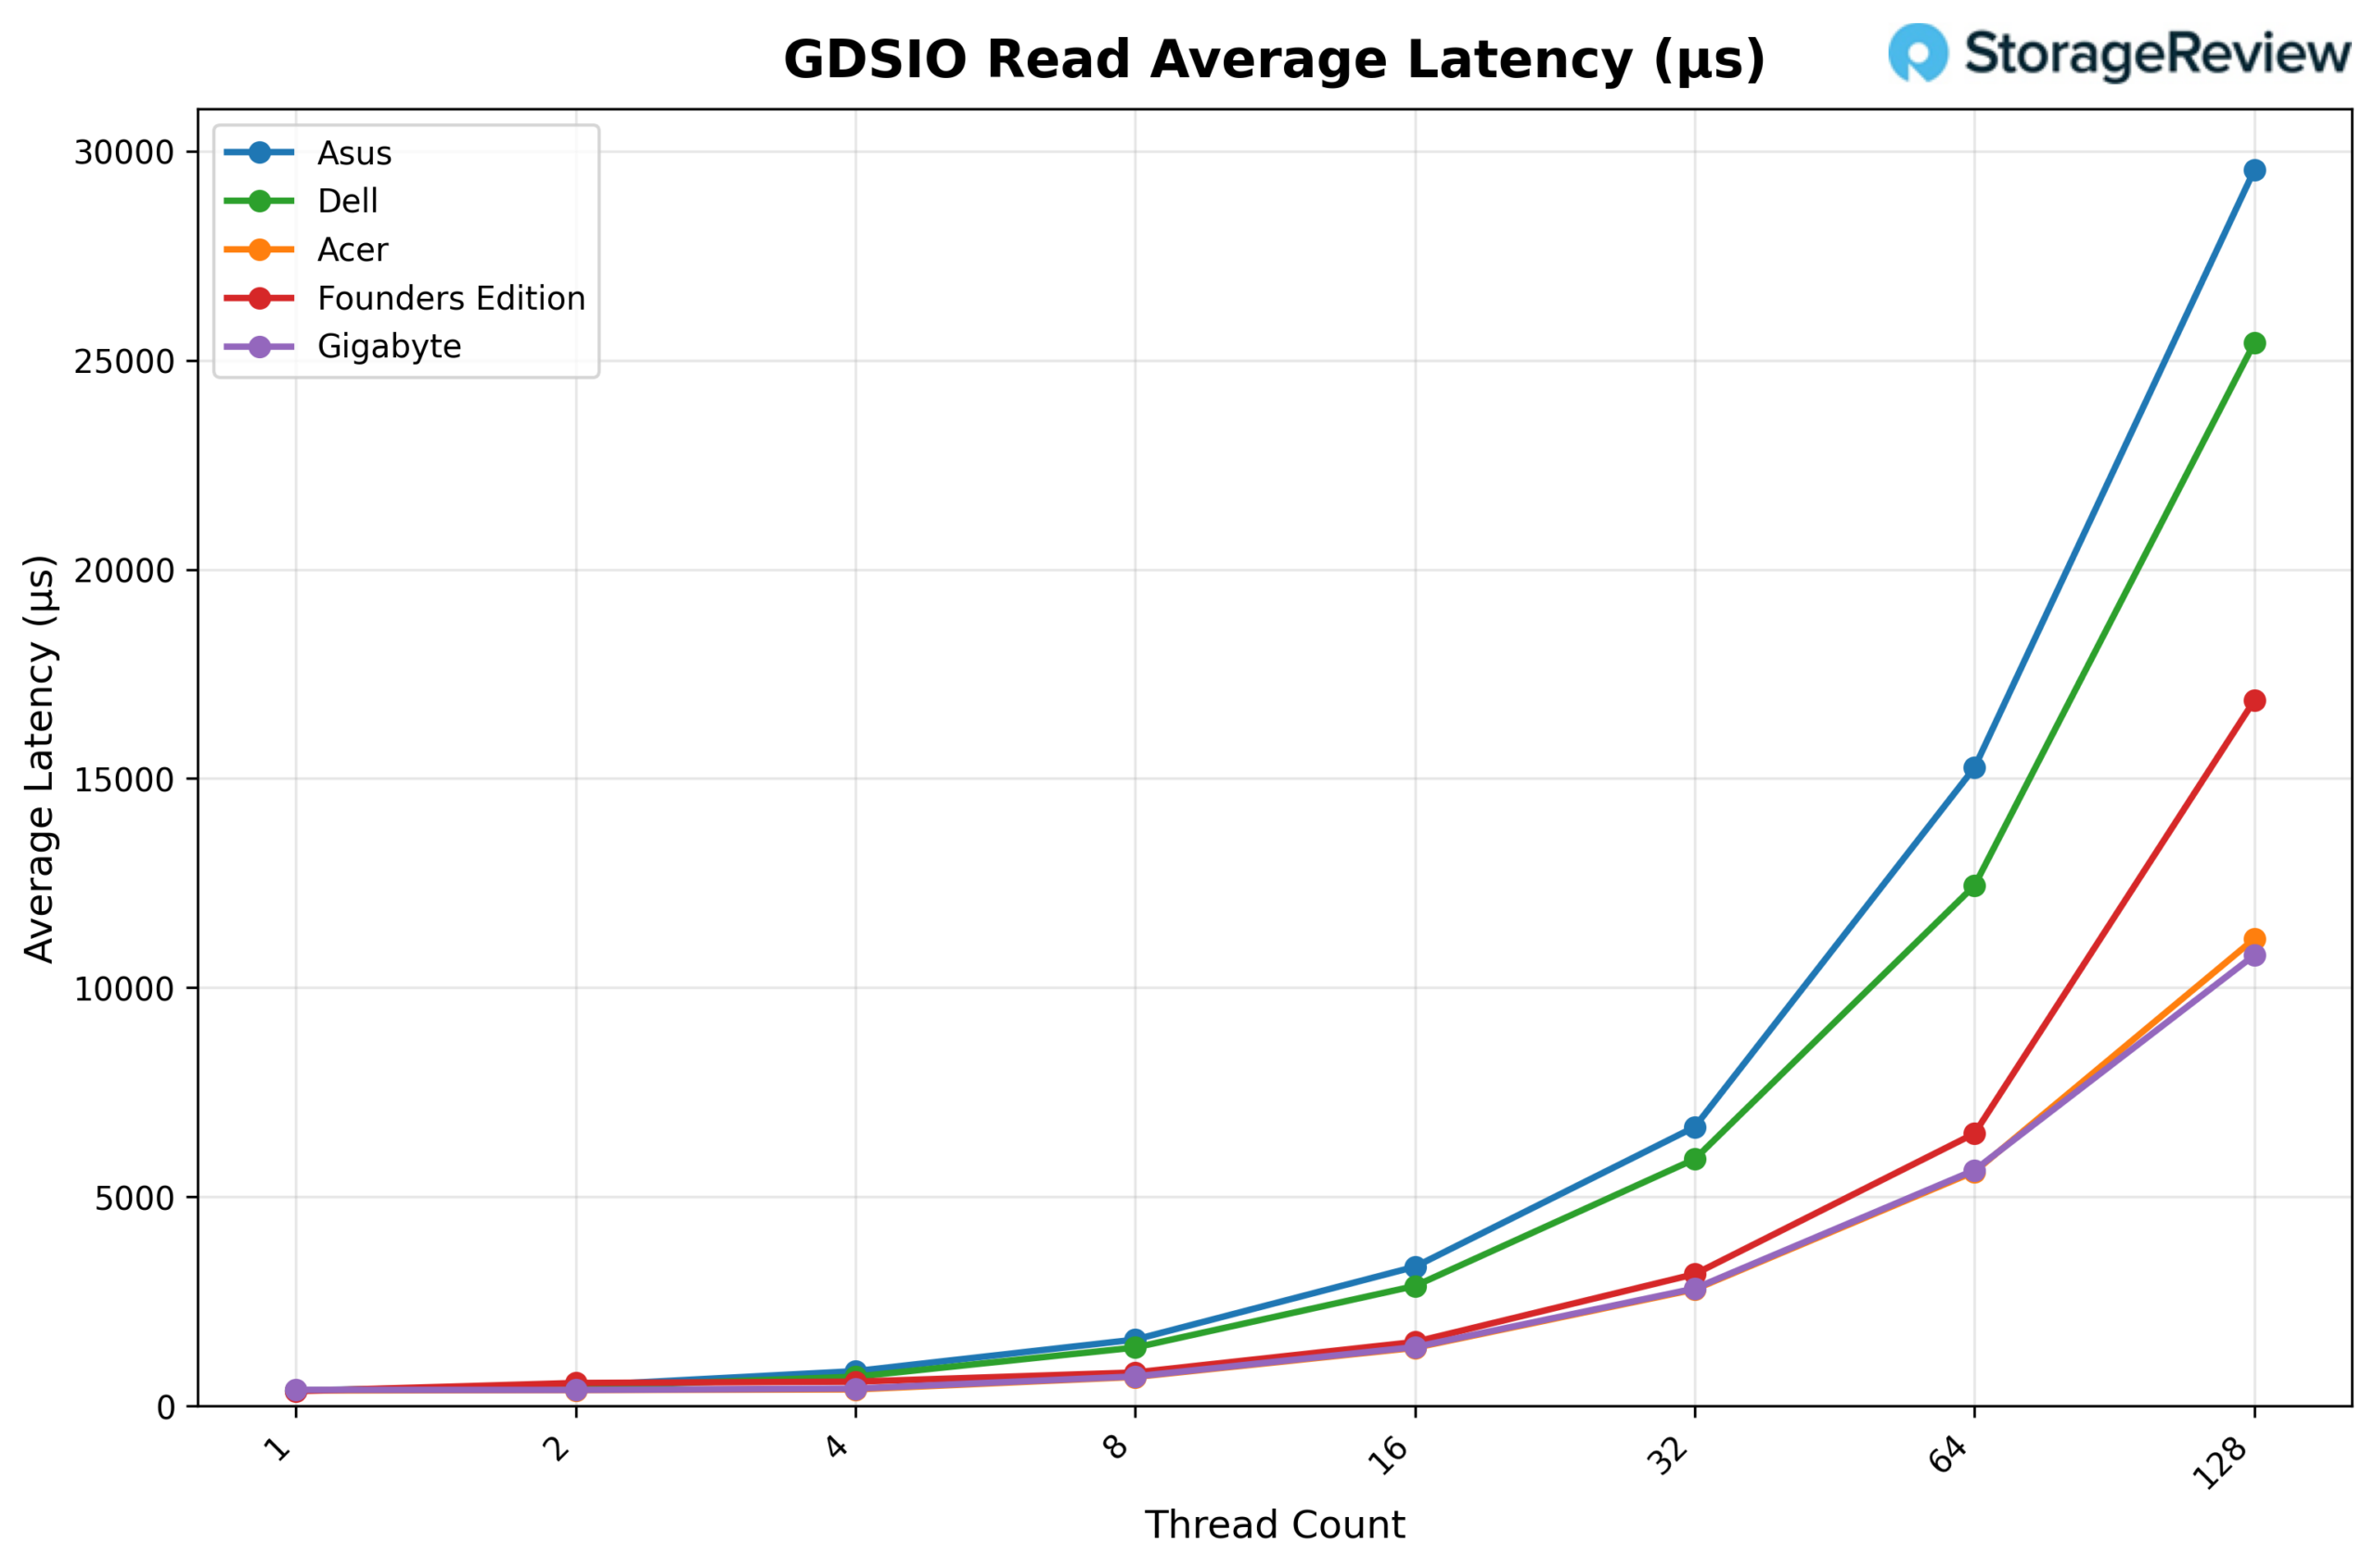
GDSIO 읽기 평균 지연 시간(1M)을 살펴보면, GIGABYTE는 스레드 1개에서 약 0.39ms로 시작하여 스레드 2개(0.39ms)와 4개(0.42ms)에서도 비슷한 수준을 유지합니다. 동시 실행 스레드 수가 증가함에 따라 지연 시간도 증가하여 스레드 8개에서 0.71ms, 16개에서 1.41ms, 32개에서 2.81ms에 이릅니다. 이러한 상승 추세는 스레드 64개(5.64ms)에서도 계속되어 최대 동시 실행 수준인 128개에서는 10.78ms에 도달하지만, 처리량은 대체로 안정적으로 유지됩니다.
GDSIO 쓰기 처리량 1M
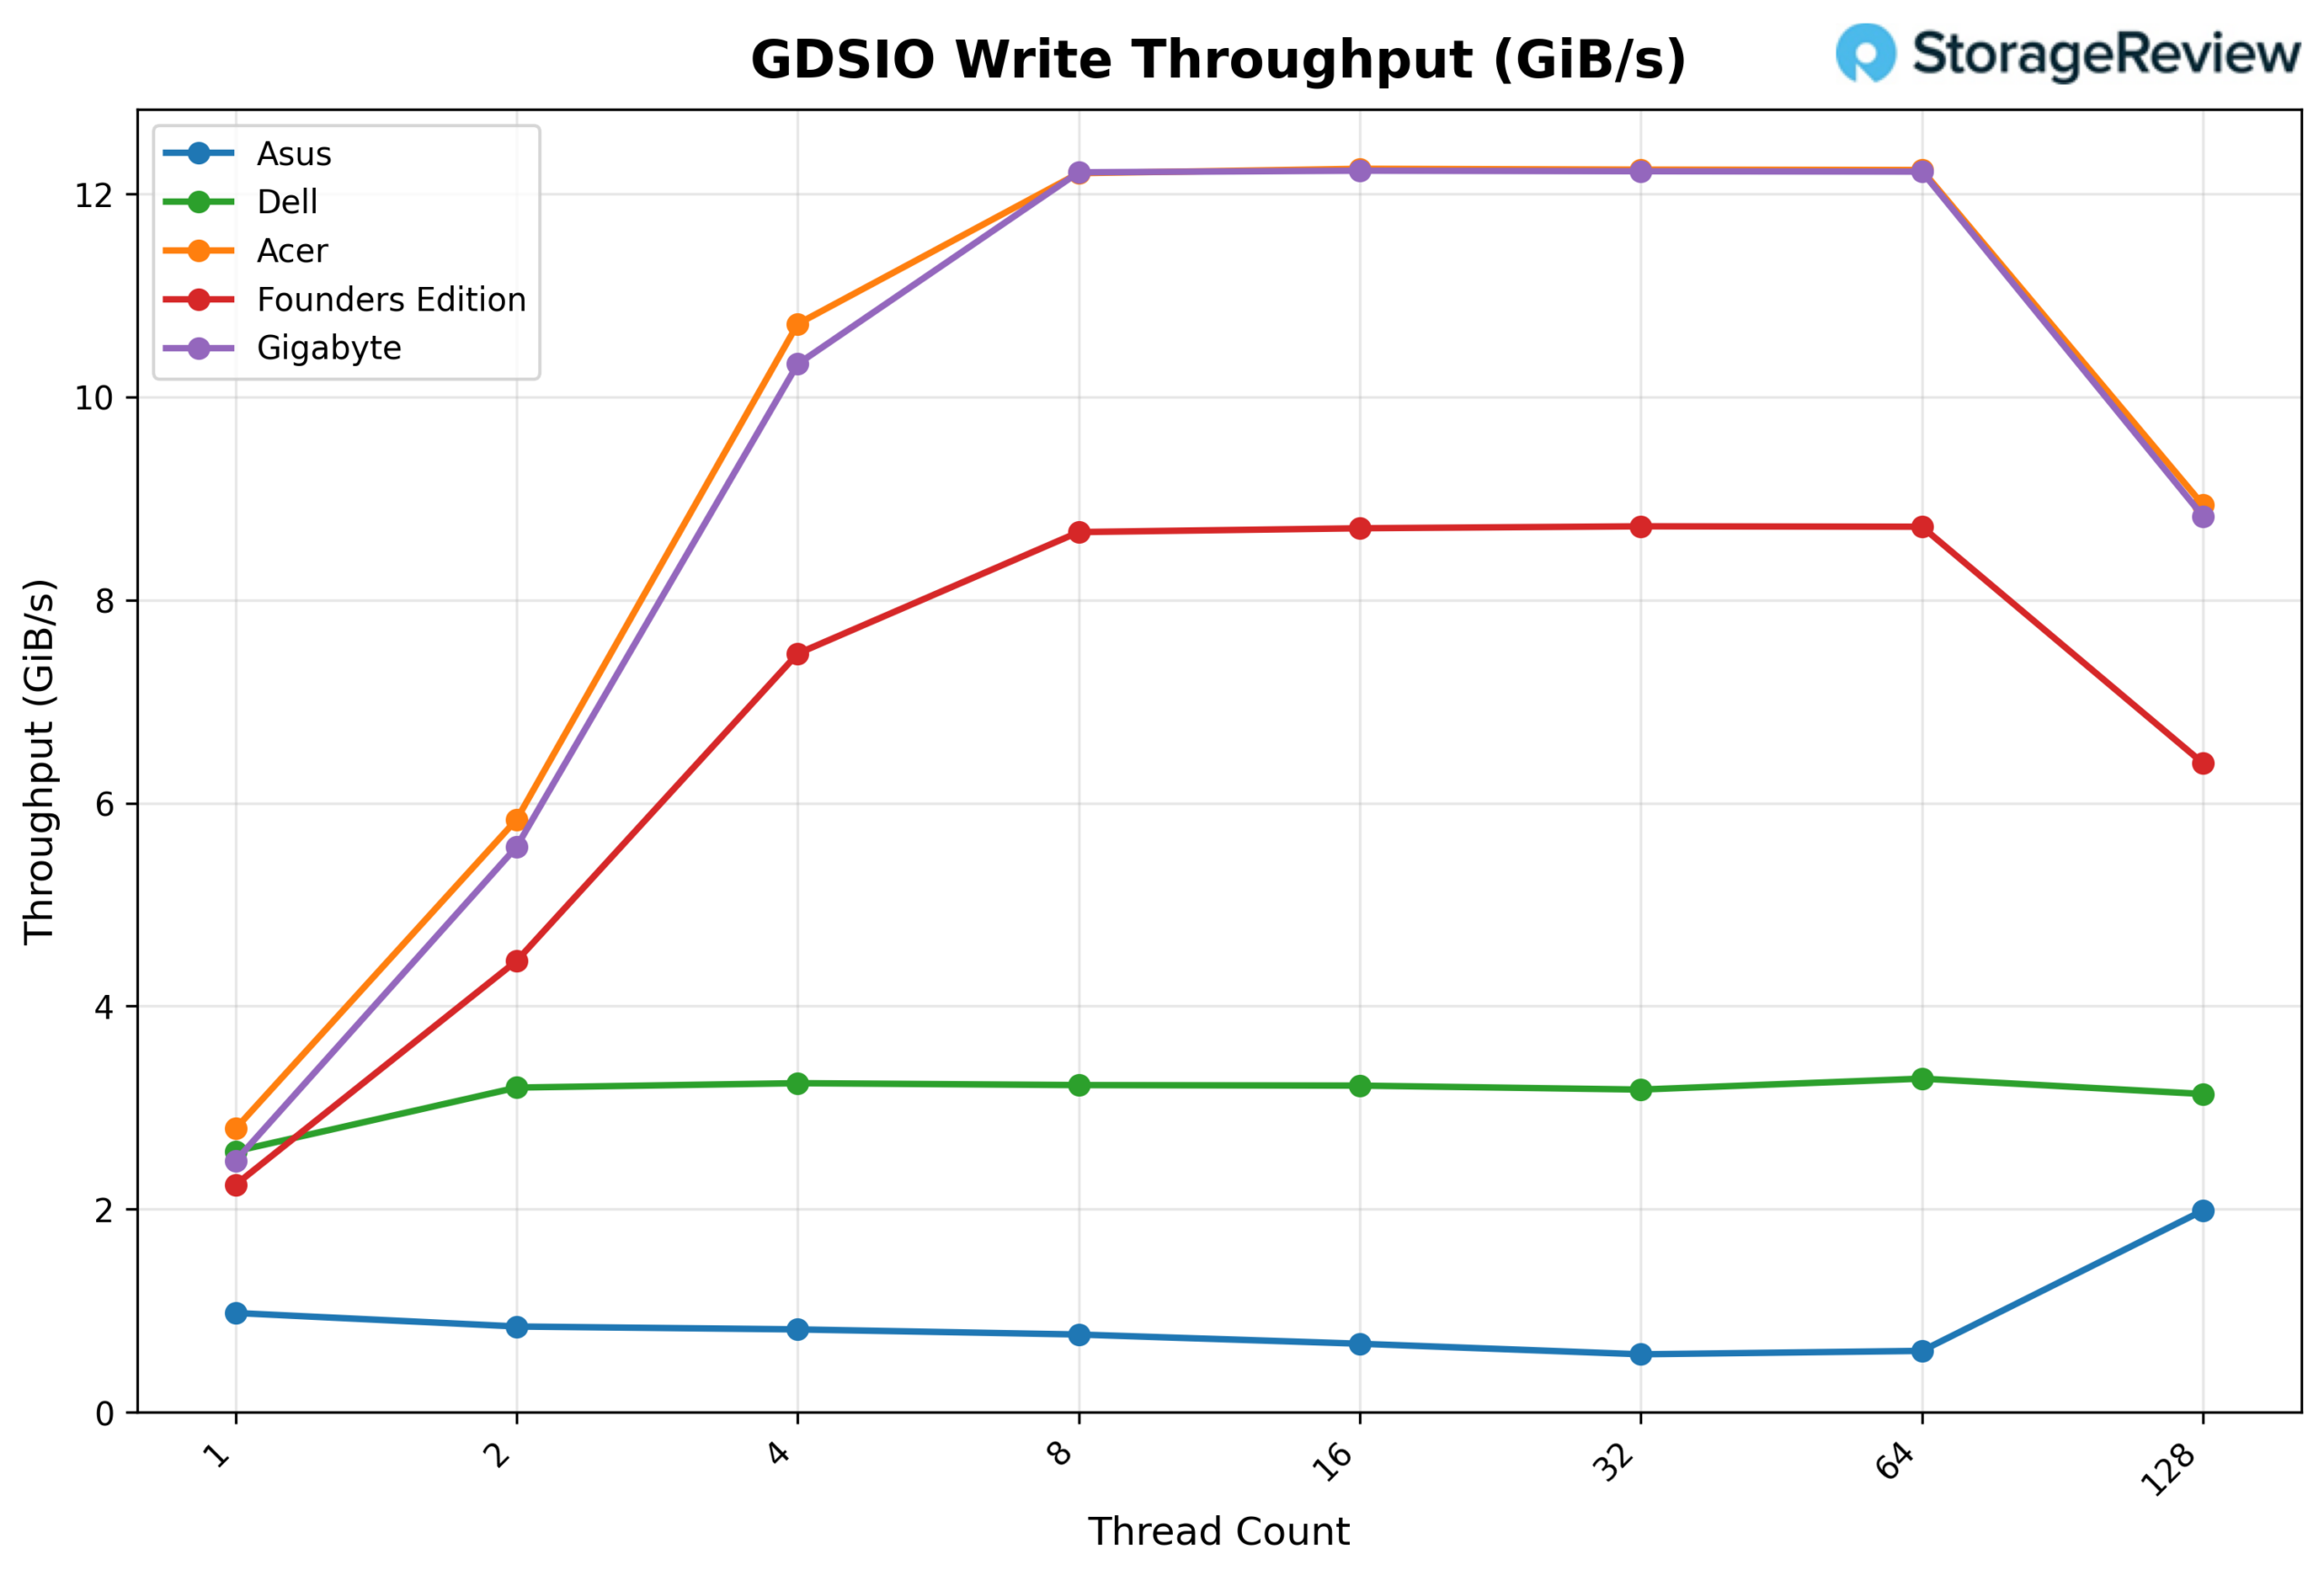
GDSIO 쓰기 처리량 1M을 살펴보면, GIGABYTE는 1개 스레드에서 2.48GiB/s로 시작하여 2개 스레드에서 5.57GiB/s, 4개 스레드에서 10.32GiB/s로 급격히 증가합니다. 8개 스레드에서는 처리량이 12.21GiB/s에 도달하여 플랫폼이 사실상 포화 상태에 이릅니다. 16개 스레드(12.23GiB/s), 32개 스레드(12.22GiB/s), 64개 스레드(12.22GiB/s)에서는 성능이 일정하게 유지되어 초기 포화 상태에 도달함을 보여줍니다. 128개 스레드에서는 처리량이 8.82GiB/s로 감소하여 시스템이 최적의 동시 실행 범위를 벗어났음을 시사합니다.
GDSIO 쓰기 평균 지연 시간 1M
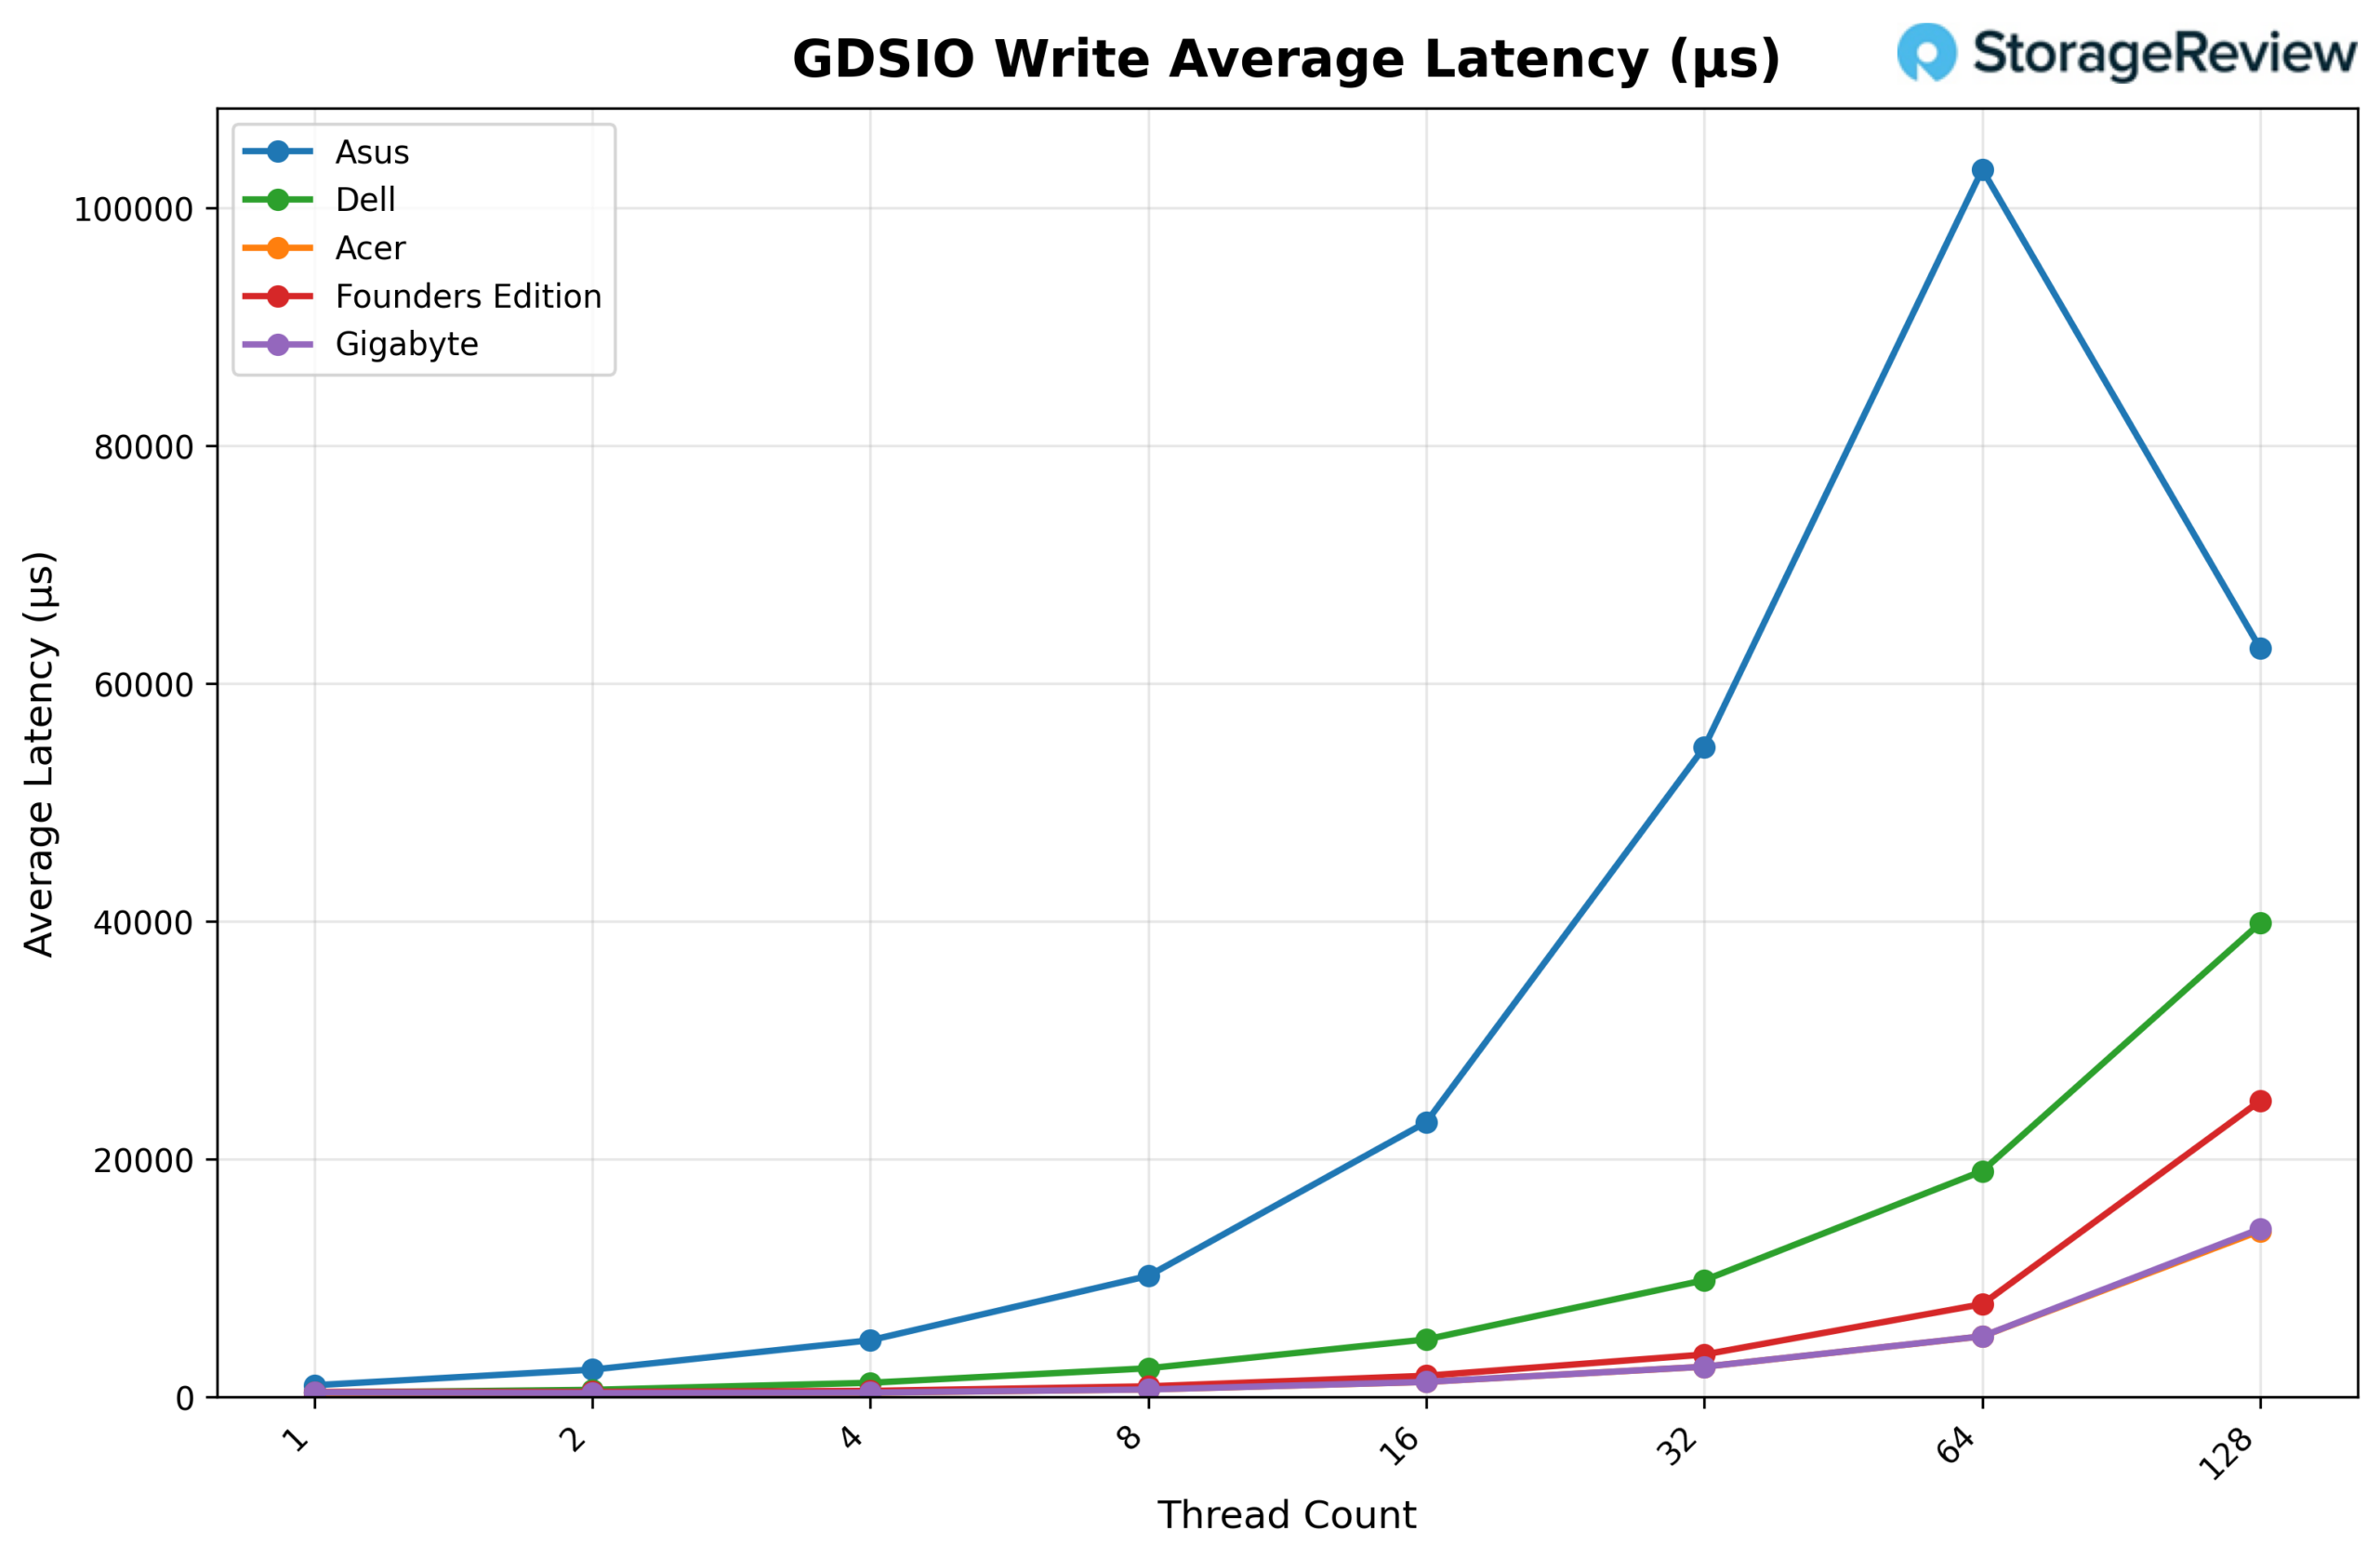
GDSIO 쓰기 평균 지연 시간(1M)을 살펴보면, GIGABYTE는 스레드 1개에서 약 0.39ms로 시작하여 스레드 2개(0.35ms)와 4개(0.38ms)까지 비교적 안정적인 지연 시간을 유지합니다. 스레드 수가 증가함에 따라 지연 시간은 더욱 눈에 띄게 증가하여 스레드 8개에서 0.64ms, 16개에서 1.28ms, 32개에서 2.56ms까지 상승합니다. 이러한 추세는 스레드 64개(5.11ms)까지 계속 증가하다가 128개에서 14.16ms까지 급격히 증가하는데, 이는 최고 동시 실행 수준에서 관찰된 처리량 감소와 일치합니다.
맺음말
GIGABYTE AI TOP ATOM은 NVIDIA의 GB10 기반 Spark 플랫폼의 또 다른 구현체로, 저희가 테스트한 다른 제품들과 동일한 보드와 실리콘을 사용합니다. 예상대로 vLLM에서의 코어 컴퓨팅 성능은 다른 제품들과 유사한 양상을 보였습니다. GPT-OSS, Qwen3-Coder, Llama 3.1 모델 전반에 걸쳐 확장성 또한 예측 가능했으며, 동시 실행량이 증가함에 따라 강력한 사전 채우기 처리량과 안정적인 이퀄 및 디코딩 성능을 보여주었습니다.
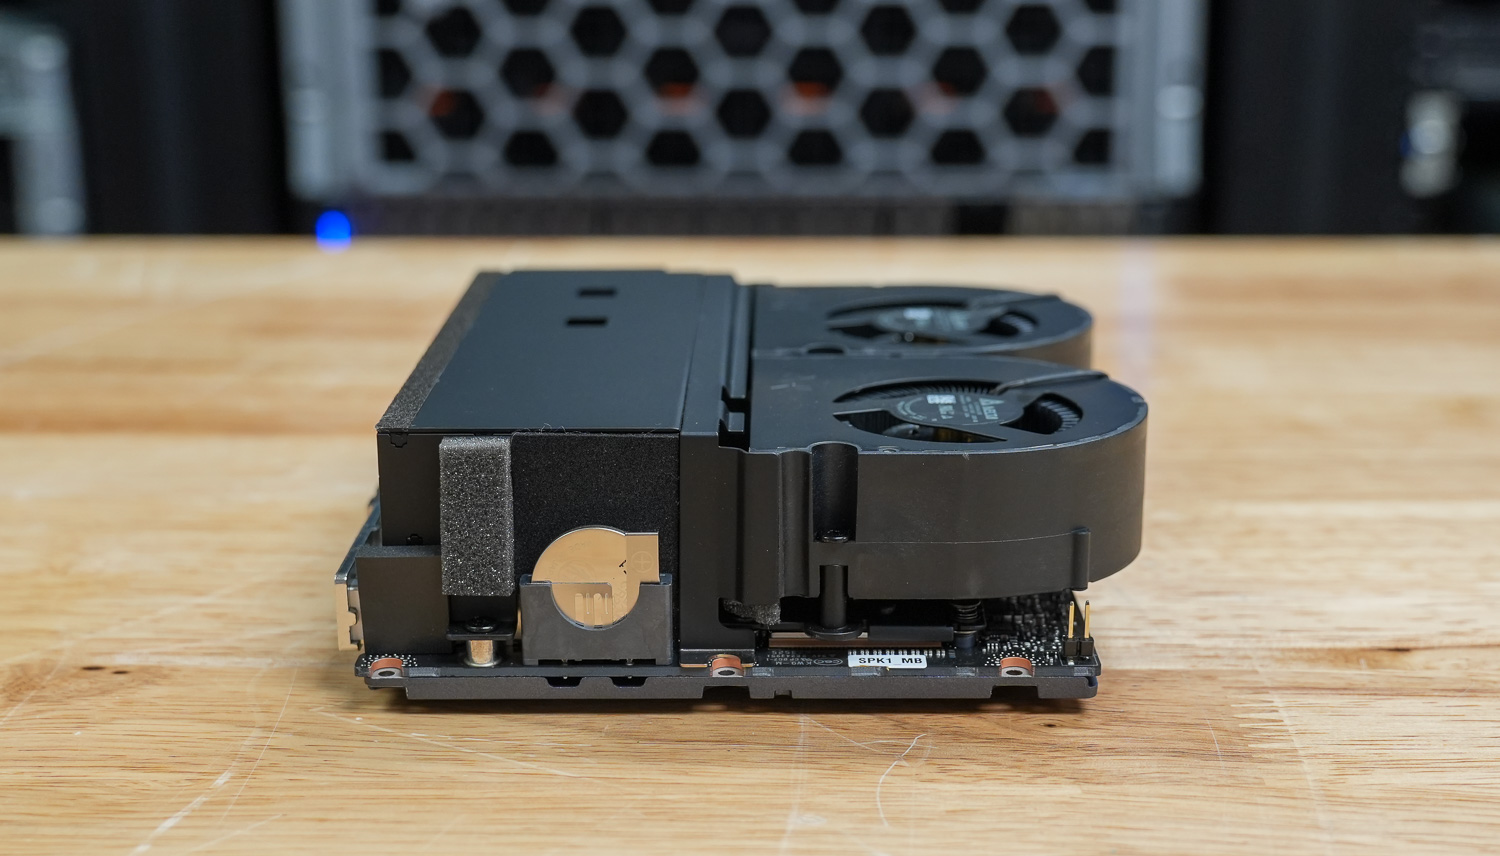
열 관리 측면에서 GIGABYTE는 다소 공격적인 순간 부하 처리를 허용했습니다. CPU는 프리필 작업량이 많은 전환 과정에서 최고 90°C, GPU는 81°C를 기록했으며, GPU 전력 소비는 75.54W에 달했습니다. 작업 부하가 정상화되자 온도는 안정화되었고, 지속적인 스로틀링 현상은 나타나지 않았습니다. 실제로 이러한 높은 온도 상승은 시스템 불안정성보다는 단기적인 전력 할당 결정에 따른 것으로 해석할 수 있습니다.
이 제품이 확실히 차별화되는 부분은 스토리지입니다. GIGABYTE는 4TB Gen5 Samsung PM9E1을 사용하여 Spark 제품군에서 가장 뛰어난 GDSIO 성능을 보여주었습니다. 읽기 및 쓰기 처리량은 16개 및 1만 개 워크로드 모두에서 안정적으로 확장되었으며, 예상되는 동시 접속 수준에서 조기에 포화 상태에 도달했고, 지연 시간 증가는 주로 스레드 수가 가장 많은 경우에 발생했습니다.
모든 Spark 시스템은 동일한 GB10 기반을 공유하기 때문에 AI 추론 벤치마크에서 성능 차이는 크지 않습니다. 실제 사용 환경에서의 시스템 선택은 근본적인 컴퓨팅 성능 차이보다는 섀시 설계, 순간 발열 관리, 스토리지 구성, 그리고 벤더 선택에 따라 결정됩니다.
순위표: GIGABYTE AI TOP ATOM은 로컬 AI용 최고 데스크톱 순위표 테스트 대상 제품 중 하나입니다.


 아마존