

Phison의 Pascari X 시리즈 라인업은 다양한 엔터프라이즈 스토리지 요구 사항을 충족하도록 개발되었으며, 읽기 및 쓰기 집약적인 워크로드에 맞춤형 솔루션을 제공합니다. X200P는 대용량 모델로, 30.72 DWPD(Drive Writes Per Day)로 최대 5TB를 지원합니다. Gen3 PCIe, TLC NAND를 사용하며 U.2, U.3, E200.S 폼 팩터로 제공됩니다. XXNUMXP는 대규모 콘텐츠 전송, AI 추론, 콜드 데이터 아카이빙 등 다양한 사용 사례에 적합하도록 설계되었습니다.
Phison은 또한 쓰기 집약적 워크로드에 최적화된 X200E 고내구성 모델을 제공하며, 최대 1.6개의 DWPD와 25.6TB~XNUMXTB의 용량을 지원하여 트랜잭션 데이터베이스, 실시간 분석 및 로그 처리에 적합합니다.
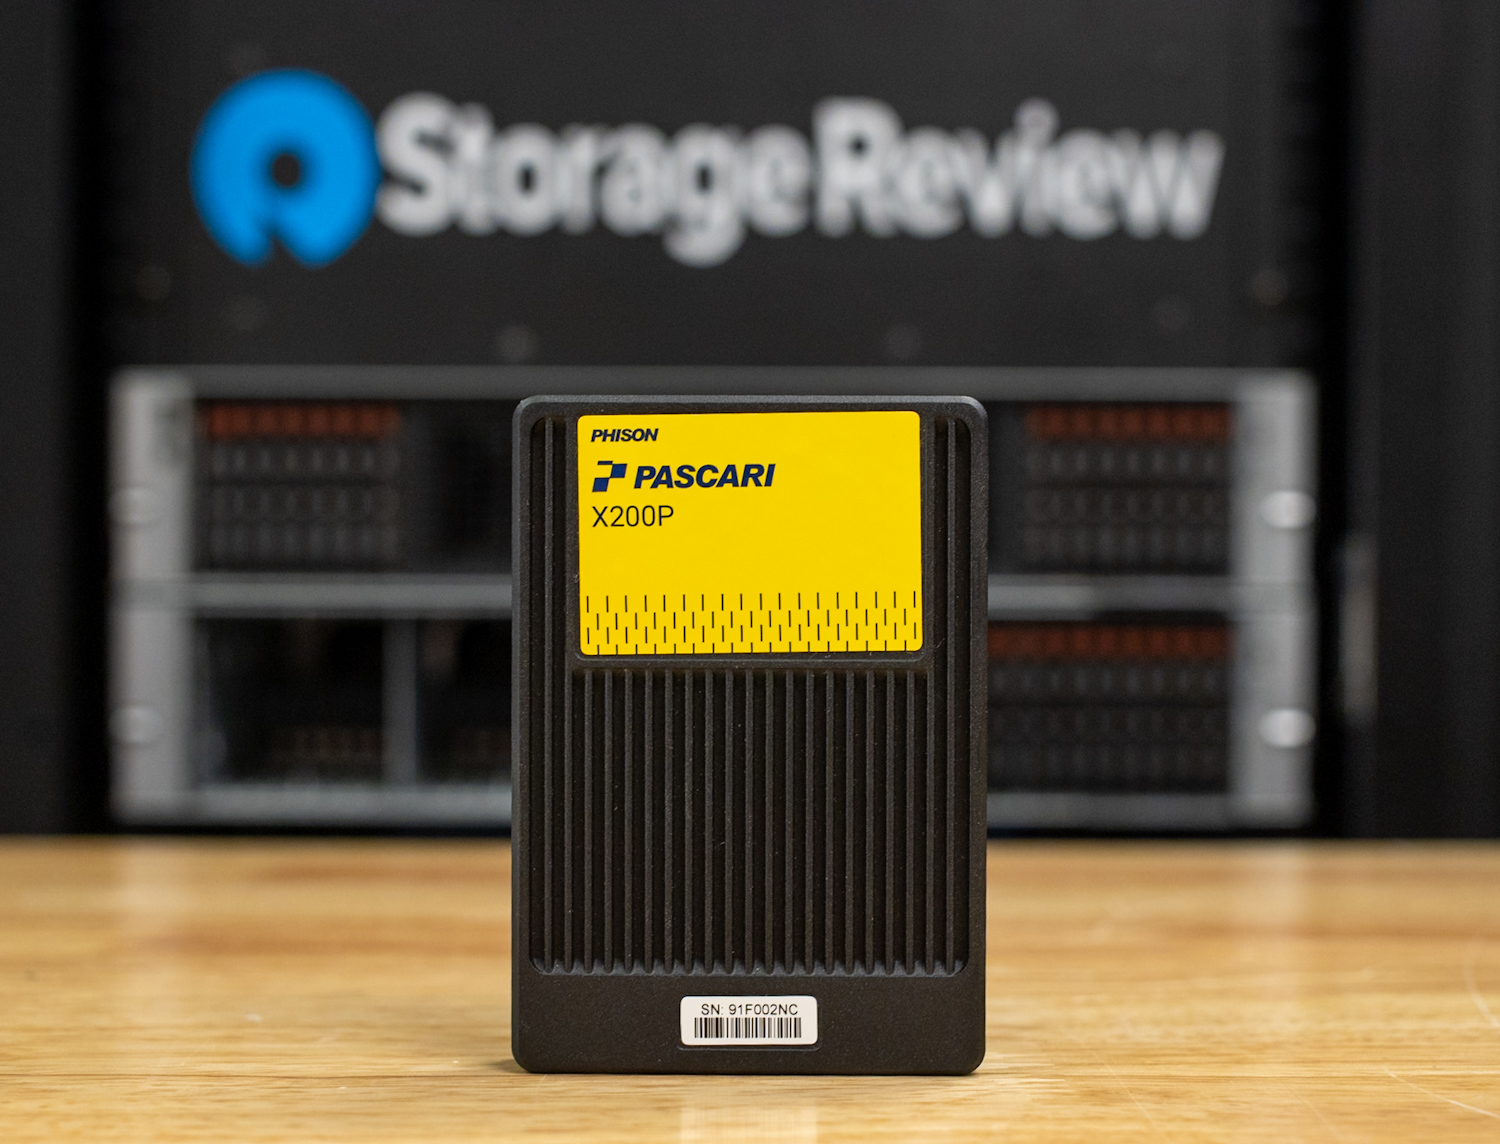
이 리뷰를 위해 Phison에서 7.68TB X200P U.2 모델을 보내주셨습니다. 저희는 전체 엔터프라이즈 벤치마크를 통해 부하 상황에서의 성능을 평가했습니다.
피손 파스카리 X200P 연속 기술 사양
| Phison Pascari X200P 시리즈 사양 | 1.92TB | 3.84TB | 7.68TB | 15.36TB | 30.72TB |
|---|---|---|---|---|---|
| 폼 팩터 | U.2 | ||||
| 인터페이스 | PCIe 5.0 x4, 2×2 | ||||
| NVMe | 2.0 | ||||
| NAND 플래시 | 3D TLC | ||||
| 순차 읽기 (MB / s) | 14,800 | 14,800 | 14,800 | 14,800 | 14,000년(추정) |
| 순차적 쓰기 (MB / s) | 4,300 | 8,600 | 8,700 | 8,350 | 7,500년(추정) |
| 4K 랜덤 읽기(IOPS) | 2,400K | 3,000K | 3,000K | 3,000K | 2,300K(추정) |
| 4K 랜덤 쓰기(IOPS) | 170K | 380K | 500K | 500K | 283K(추정) |
| 읽기 대기 시간(μs) | 60 | ||||
| 쓰기 대기 시간(μs) | 10 | ||||
| 전력 - 활성(W) | <25 | ||||
| 전력 - 공회전(W) | 5 | ||||
| DWPD(7) | 1 | ||||
| 우버 | <1당 섹터 10개18 비트 읽기 | ||||
| MTBF(백만 시간) | 2.5 | ||||
| 제한 보증(년) | 5 | ||||
| 작동 온도. (° C) | 0 ~ 70 | ||||
| 비작동 온도(°C) | 40까지 85 | ||||
| 크기 (mm) | 100.10(L) x 69.85(W) x 15.00(H) | ||||
| 무게 (g) | 188 | 199 | 201 | 168 | <250 |
Pascari X200P 7.68TB 빌드 및 디자인
테스트 대상 제품은 고성능 엔터프라이즈 스토리지 애플리케이션을 처리하도록 설계된 7.68TB U.2 2.5인치 X200P 버전입니다. PCIe 5.0 인터페이스를 사용하며 NVMe 2.0 사양을 완벽하게 준수합니다. 내구성이 뛰어난 3D TLC NAND를 기반으로 제작되었으며 최대 30.72TB의 용량을 지원합니다.
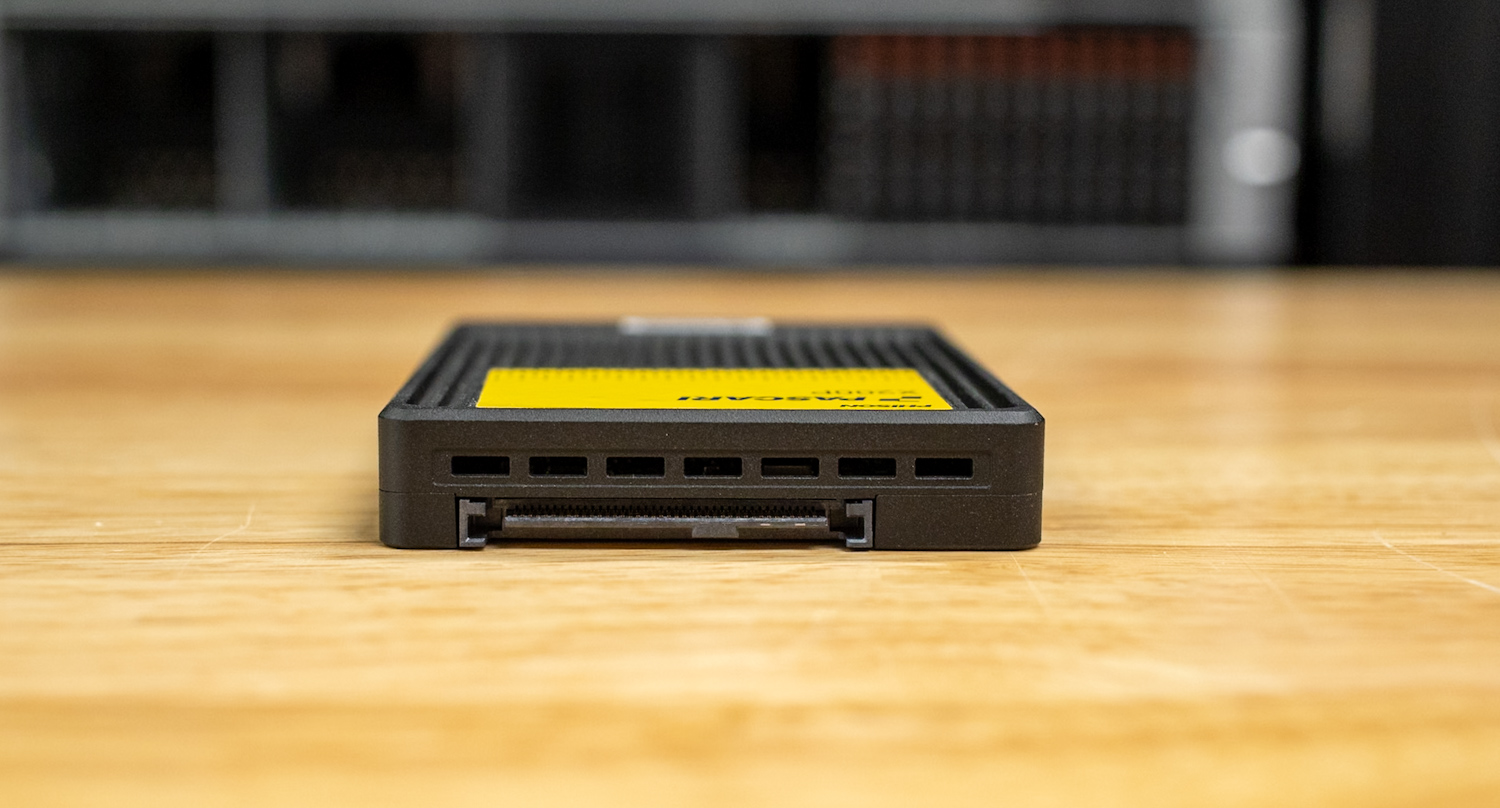
X200P는 표준 2.5인치 U.2 폼팩터를 갖추고 있으며, 길이 100.10mm, 너비 69.85mm, 높이 15.00mm, 무게는 201g입니다. 전체 시스템은 세련된 검은색 알루미늄 케이스에 내장되어 있으며, 패시브 냉각 시스템이 통합되어 지속적인 고부하 작업 시에도 열을 효율적으로 관리하도록 설계되었습니다. 또한, 고밀도 스토리지 환경에서의 유연성을 위해 E3.S 구성을 지원합니다.
성능 측면에서는 최대 14,800MB/s의 순차 읽기 속도, 8,700MB/s의 순차 쓰기 속도, 그리고 최대 3만 IOPS의 임의 읽기 속도와 500만 IOPS의 임의 쓰기 속도를 제공합니다. 이 드라이브는 활성 전력 소비량을 25W 미만으로 유지하고, 유휴 상태에서는 5W에 불과하여 지속적인 고처리량 작업에 효율적인 옵션입니다.
내구성 등급은 1 DWPD이며, MTBF는 2.5만 시간, 5년 제한 보증이 제공됩니다. 24시간 연중무휴 엔터프라이즈 워크로드에 적합하도록 설계되었으며, 작동 온도 범위는 7°C~0°C입니다.
Phison에는 포괄적인 엔터프라이즈급 데이터 보호 및 관리 기능 세트가 포함되어 있습니다.
- 전력 손실 보호(PLP)
- ISE(Instant Secure Erase), TCG Opal 2.0 지원
- AES-XTS 256비트 암호화
- 엔드 투 엔드 데이터 경로 보호
- 메타데이터 보호
- SECDED(단일 오류 정정 이중 오류 감지)
- 위생 작업
- NVMe-MI(관리 인터페이스)
- SMBus 호환성
- 최대 128개의 네임스페이스 지원
전반적으로 Pascari X200P 라인업은 견고한 산업용 빌드 품질과 최첨단 성능, 엔터프라이즈급 안정성을 결합하여 클라우드, AI/ML, 가상화 인프라와 같은 까다로운 스토리지 환경에 적합한 강력한 후보가 되었습니다.
성능 시험
드라이브 테스트 플랫폼
본 리뷰에서는 모든 워크로드 테스트를 위해 Ubuntu 22.04.02 LTS가 설치된 Dell PowerEdge R760 서버를 테스트 플랫폼으로 사용했습니다. Serial Cables Gen5 JBOF 를 장착하여 U.2, E1.S, E3.S 및 M.2 SSD와 폭넓은 호환성을 제공합니다. 시스템 구성은 아래와 같습니다.
- 2 x Intel Xeon Gold 6430(32코어, 2.1GHz)
- 16 x 64GB DDR5-4400
- 480GB 델 보스 SSD
- 직렬 케이블 Gen5 JBOF
드라이브 비교
- 파스카리 X200P 7.68TB
- 마이크론 9550 7.68TB
- 샌디스크 SN861 7.68TB
- 솔리드다임 PS1010 7.68TB
- 킹스턴 DC3000ME 7.68TB
Pascari X200P를 크기가 비슷하고 TLC NAND 플래시를 사용하는 7.68TB PCIe Gen5 NVMe SSD 그룹과 비교했습니다. 비교 대상에는 Micron 9550, SanDisk SN861, Solidigm PS1010, Kingston DC3000ME가 포함되었습니다. 이 드라이브들은 고성능 환경을 위해 설계된 중간 용량 엔터프라이즈급 솔루션입니다. CDN, FIO, GDSIO를 포함한 다양한 실제 환경 및 합성 벤치마크를 사용하여 지속적인 처리량, 지연 시간, 혼합 I/O 패턴 및 GPU 가속 워크로드 전반에 걸친 성능을 측정했습니다. 용량, 인터페이스 및 NAND 유형을 표준화함으로써, 이 평가는 까다로운 조건에서 Pascari X200P가 동급 제품과 비교하여 어떤 성능을 보이는지 명확하게 비교합니다.
CDN 성능
현실적인 혼합 콘텐츠 CDN 워크로드를 시뮬레이션하기 위해, SSD는 콘텐츠 집약적인 엣지 서버의 I/O 패턴을 재현하도록 설계된 다단계 벤치마킹 시퀀스를 거쳤습니다. 테스트 절차는 크고 작은 다양한 블록 크기를 포함하며, 무작위 및 순차 작업에 분산되어 있으며, 다양한 동시성 수준을 갖습니다.
주요 성능 테스트 전에 각 SSD는 100MB 블록을 사용하는 1% 순차 쓰기 패스로 전체 장치 채우기를 완료했습니다. 이 프로세스는 동기식 I/O와 128의 대기열 깊이를 활용하여 98.51개의 동시 작업이 가능하도록 했습니다. 이 단계는 드라이브가 실제 사용 환경을 나타내는 정상 상태 조건에 진입하도록 보장합니다. 순차 쓰기 완료 후, 가중 블록 크기 분할(블록 크기/백분율) 분포를 사용하여 128시간 동안 무작위 쓰기 포화 단계를 추가로 실행했습니다. 이 단계에서는 8K 전송(XNUMX%)이 가장 많이 사용되었으며, XNUMXK 미만 블록에서 XNUMXK까지의 전송은 미미하게 사용되었습니다. 이 단계는 분산 캐시 환경에서 흔히 나타나는 단편화되고 불균일한 쓰기 패턴을 에뮬레이트합니다.
주요 테스트 제품군은 가변적인 대기열 길이와 작업 동시성 환경에서 드라이브의 동작을 측정하기 위해 확장된 무작위 읽기 및 쓰기 작업에 중점을 두었습니다. 각 테스트는 300분(XNUMX초) 동안 실행되었으며, 이후 XNUMX분간의 유휴 시간이 이어졌습니다. 이를 통해 내부 복구 메커니즘을 통해 성능 지표를 안정화할 수 있었습니다.
- 128K(98.51%)를 선호하는 고정 블록 크기 분포를 사용하여 실행되었으며, 나머지 1.49%의 작업은 64K에서 8K 사이의 작은 전송 크기로 구성되었습니다. 각 구성은 1, 2, 4개의 동시 작업에 걸쳐 다양하게 구성되었으며, 대기열 깊이는 1, 2, 4, 8, 16, 32로 설정하여 일반적인 에지 쓰기 조건에서 처리량 확장성과 지연 시간을 프로파일링했습니다.
- CDN 콘텐츠 검색을 모방한, 매우 혼합된 블록 크기 프로필을 사용했습니다. 128K(83.21%)의 주요 구성 요소로 시작하여 30K에서 4K까지 124개 이상의 작은 블록 크기로 구성된 긴 꼬리가 이어졌으며, 각 블록 크기는 부분적인 빈도 표현을 가졌습니다. 이러한 분포는 비디오 세그먼트 가져오기, 썸네일 액세스 및 메타데이터 조회 중에 발생하는 다양한 요청 패턴을 반영합니다. 이러한 테스트는 작업 수와 대기열 깊이의 전체 매트릭스에서도 실행되었습니다.
사전 조건화, 포화 및 혼합 크기 무작위 액세스 테스트를 조합한 이 테스트는 SSD가 지속적인 CDN 유사 환경을 처리하는 방식을 파악하도록 설계되었으며, 대역폭이 많이 필요하고 고도로 병렬화된 시나리오에서 응답성과 효율성을 강조합니다.
CDN 작업 부하 읽기 1
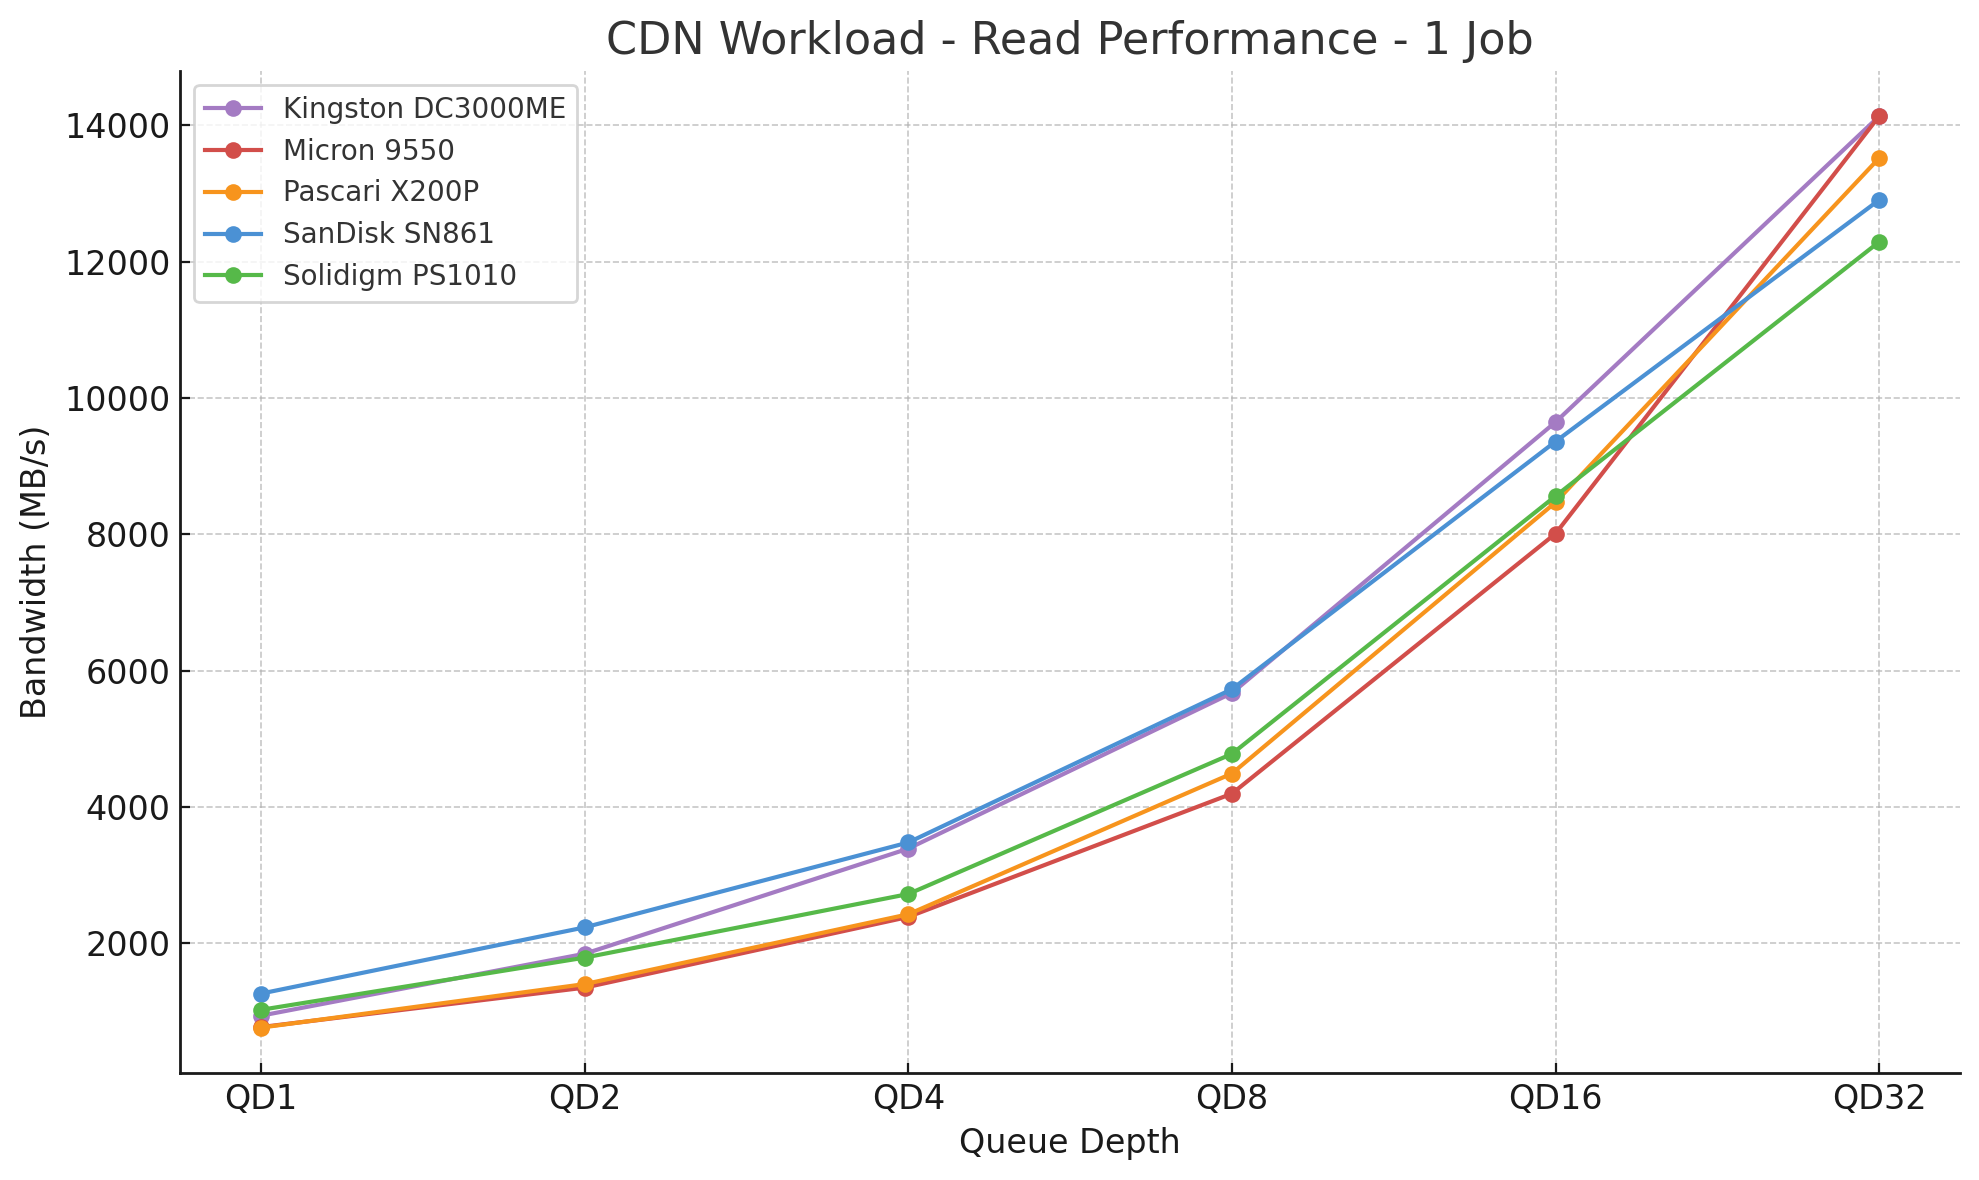
가벼운 콘텐츠 전송 트래픽을 시뮬레이션하는 이 단일 작업 읽기 테스트에서 Pascari X200P는 QD1에서 765MB/s, QD2에서 1,403MB/s로 하위권에서 시작합니다. 대기열 깊이가 증가함에 따라 드라이브는 효율적으로 확장되어 QD8과 QD16을 거쳐 중간 수준으로 이동합니다. QD32에서 X200P는 13,516.8MB/s에 도달하여 Kingston DC3000ME와 Micron 9550에 이어 전체 861위를 차지했으며, 최상위권에서는 SanDisk SN1010과 Solidigm PSXNUMX을 능가했습니다.
CDN 작업 부하 읽기 2
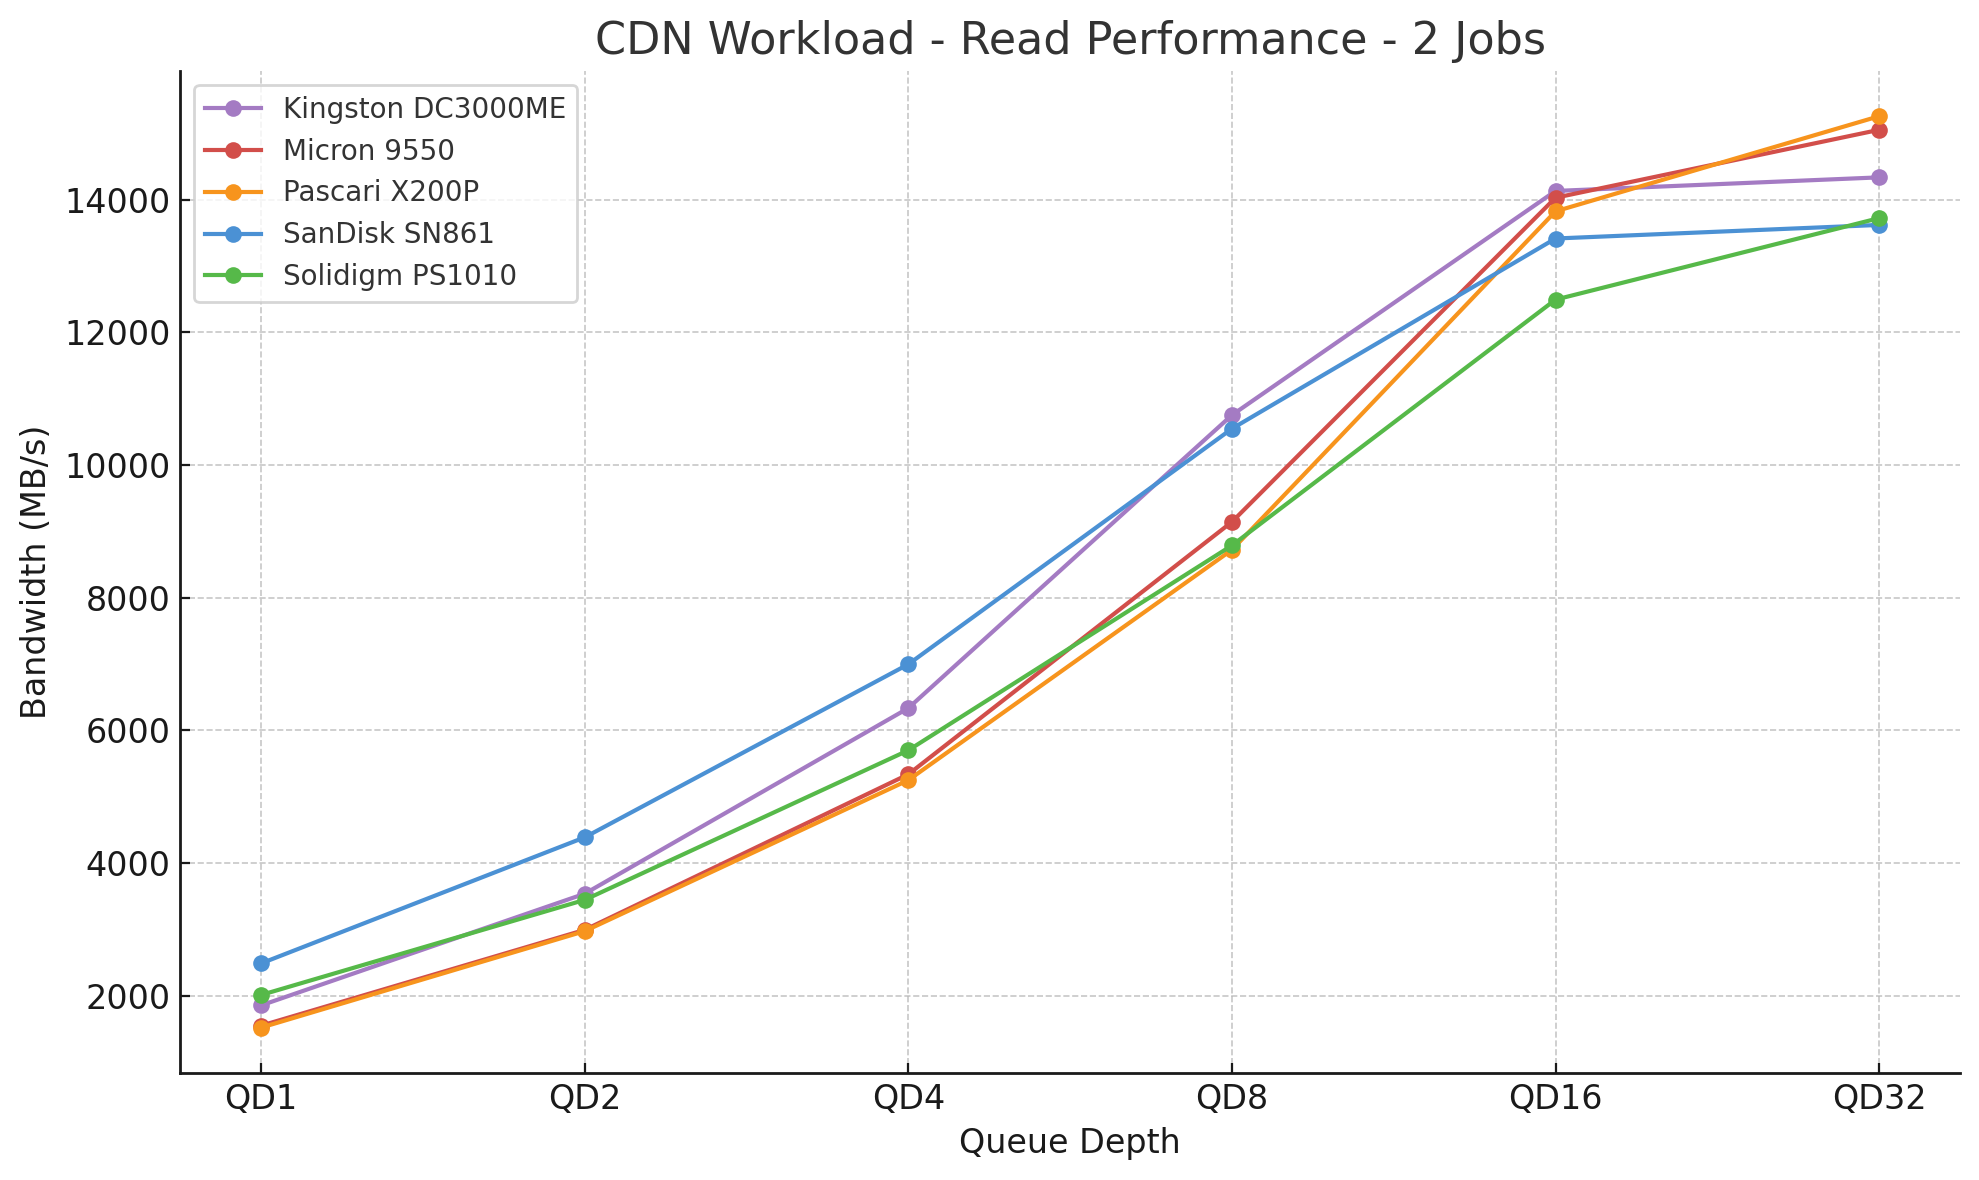
두 가지 작업을 적용했을 때, Pascari X200P는 1단계(QD1,519)에서 2MB/s로 하위권에서 시작하지만, 대기열 깊이가 증가함에 따라 지속적으로 성능이 향상됩니다. 이 드라이브는 4단계와 8단계(QD32)까지 지속적으로 성능이 향상되어 200단계에서는 선두와의 격차를 줄입니다. 15,257.6단계(QD9550)에서 Pascari X3000P는 1010MB/s로 전체 861위를 차지하며, Micron XNUMX, Kingston DCXNUMXME, Solidigm PSXNUMX, SanDisk SNXNUMX을 앞지릅니다.
CDN 작업 부하 읽기 4
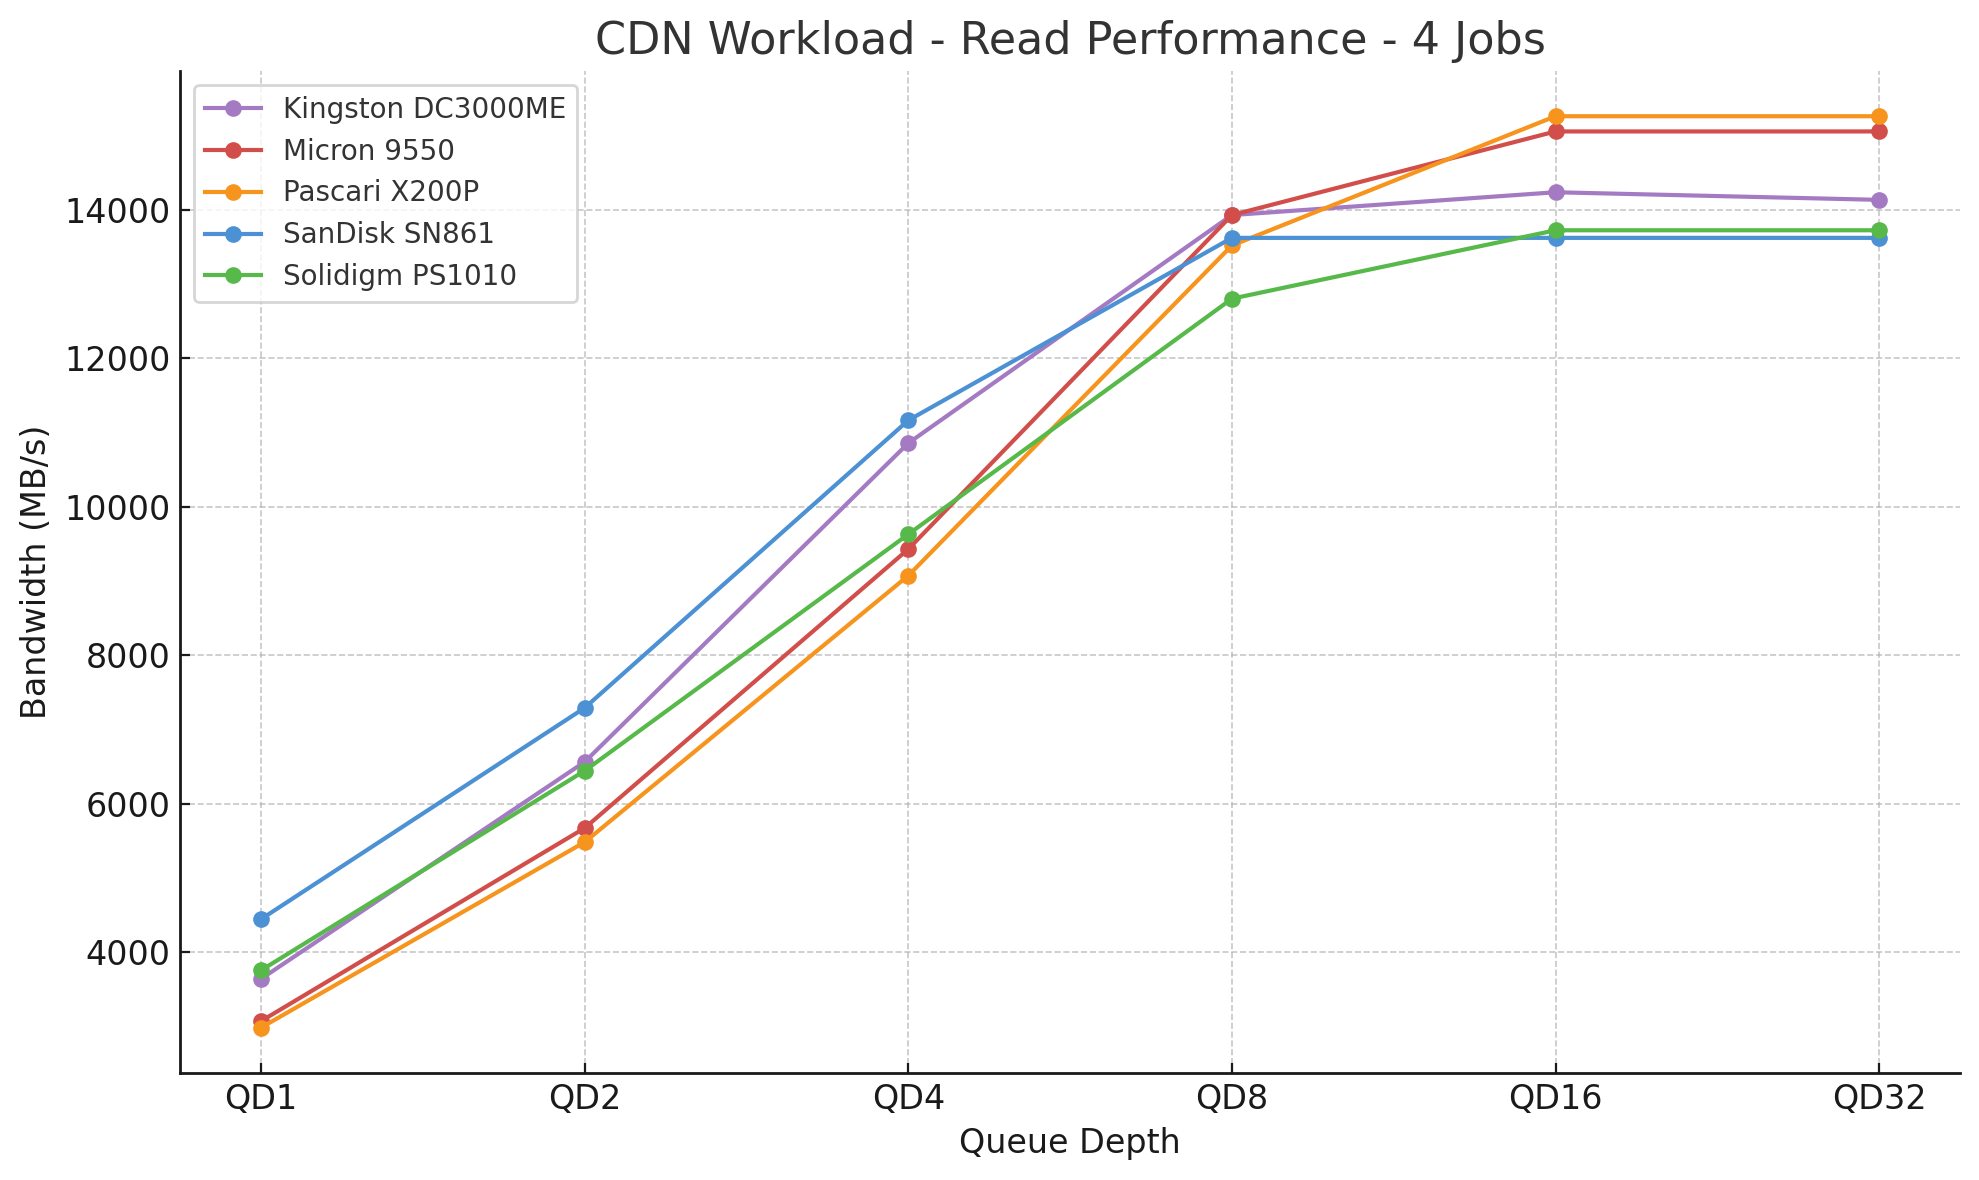
네 가지 작업을 적용한 결과, Pascari X200P는 대기열 깊이에서 다시 한번 강력한 확장성을 보여줍니다. 이 드라이브는 QD2,982에서 최대 속도 1MB/s를 달성하여 테스트된 모든 드라이브보다 뒤처졌지만, QD2와 QD4에서는 꾸준히 순위가 상승했습니다. QD8에서는 X200P가 선두로 올라서기 시작하여 QD16과 QD32에서도 이 선두를 유지했습니다. Pascari X200P는 QD32에서 15,257.6MB/s로 전체 9550위를 차지하며 Micron 3000과 Kingston DCXNUMXME를 앞섰습니다.
CDN 워크로드 쓰기 1
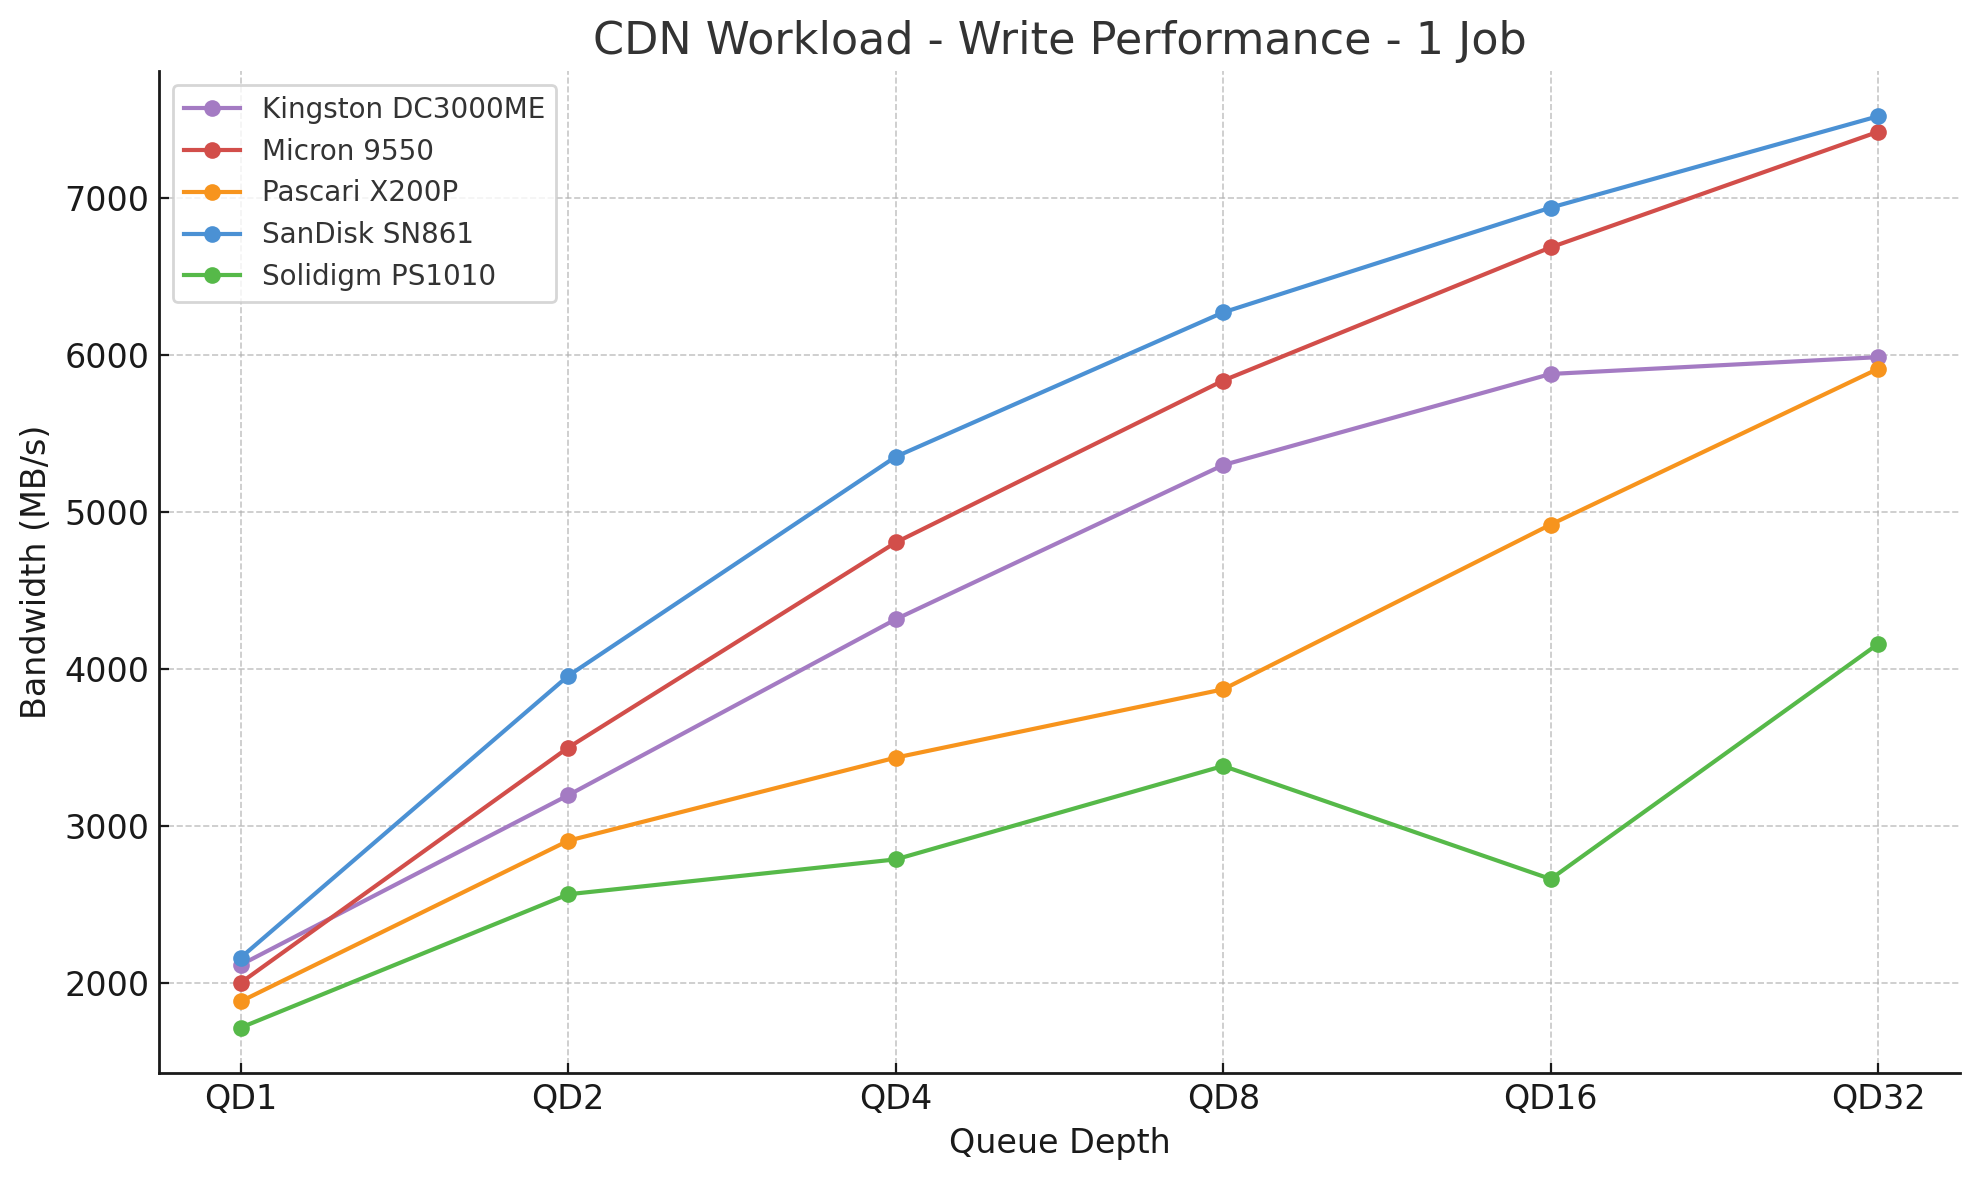
CDN 쓰기 작업 하나를 적용한 Pascari X200P는 이 쓰기 테스트에서 다른 제품들에 비해 뒤처졌습니다. 이 드라이브는 QD1,885에서 최대 1MB/s의 속도를 달성하고 QD32까지 점진적으로 확장하여 최종적으로 5,913MB/s로 전체 861위를 기록했습니다. SanDisk SN9550과 Micron 3000이 이 그룹을 이끌고 있으며, Kingston DC200ME가 그 뒤를 따릅니다. Pascari X4P는 일관된 확장성을 통해 XNUMX위를 안정적으로 유지했지만, 이 저스레드 환경에서는 쓰기 성능이 다소 저조한 것으로 나타났습니다.
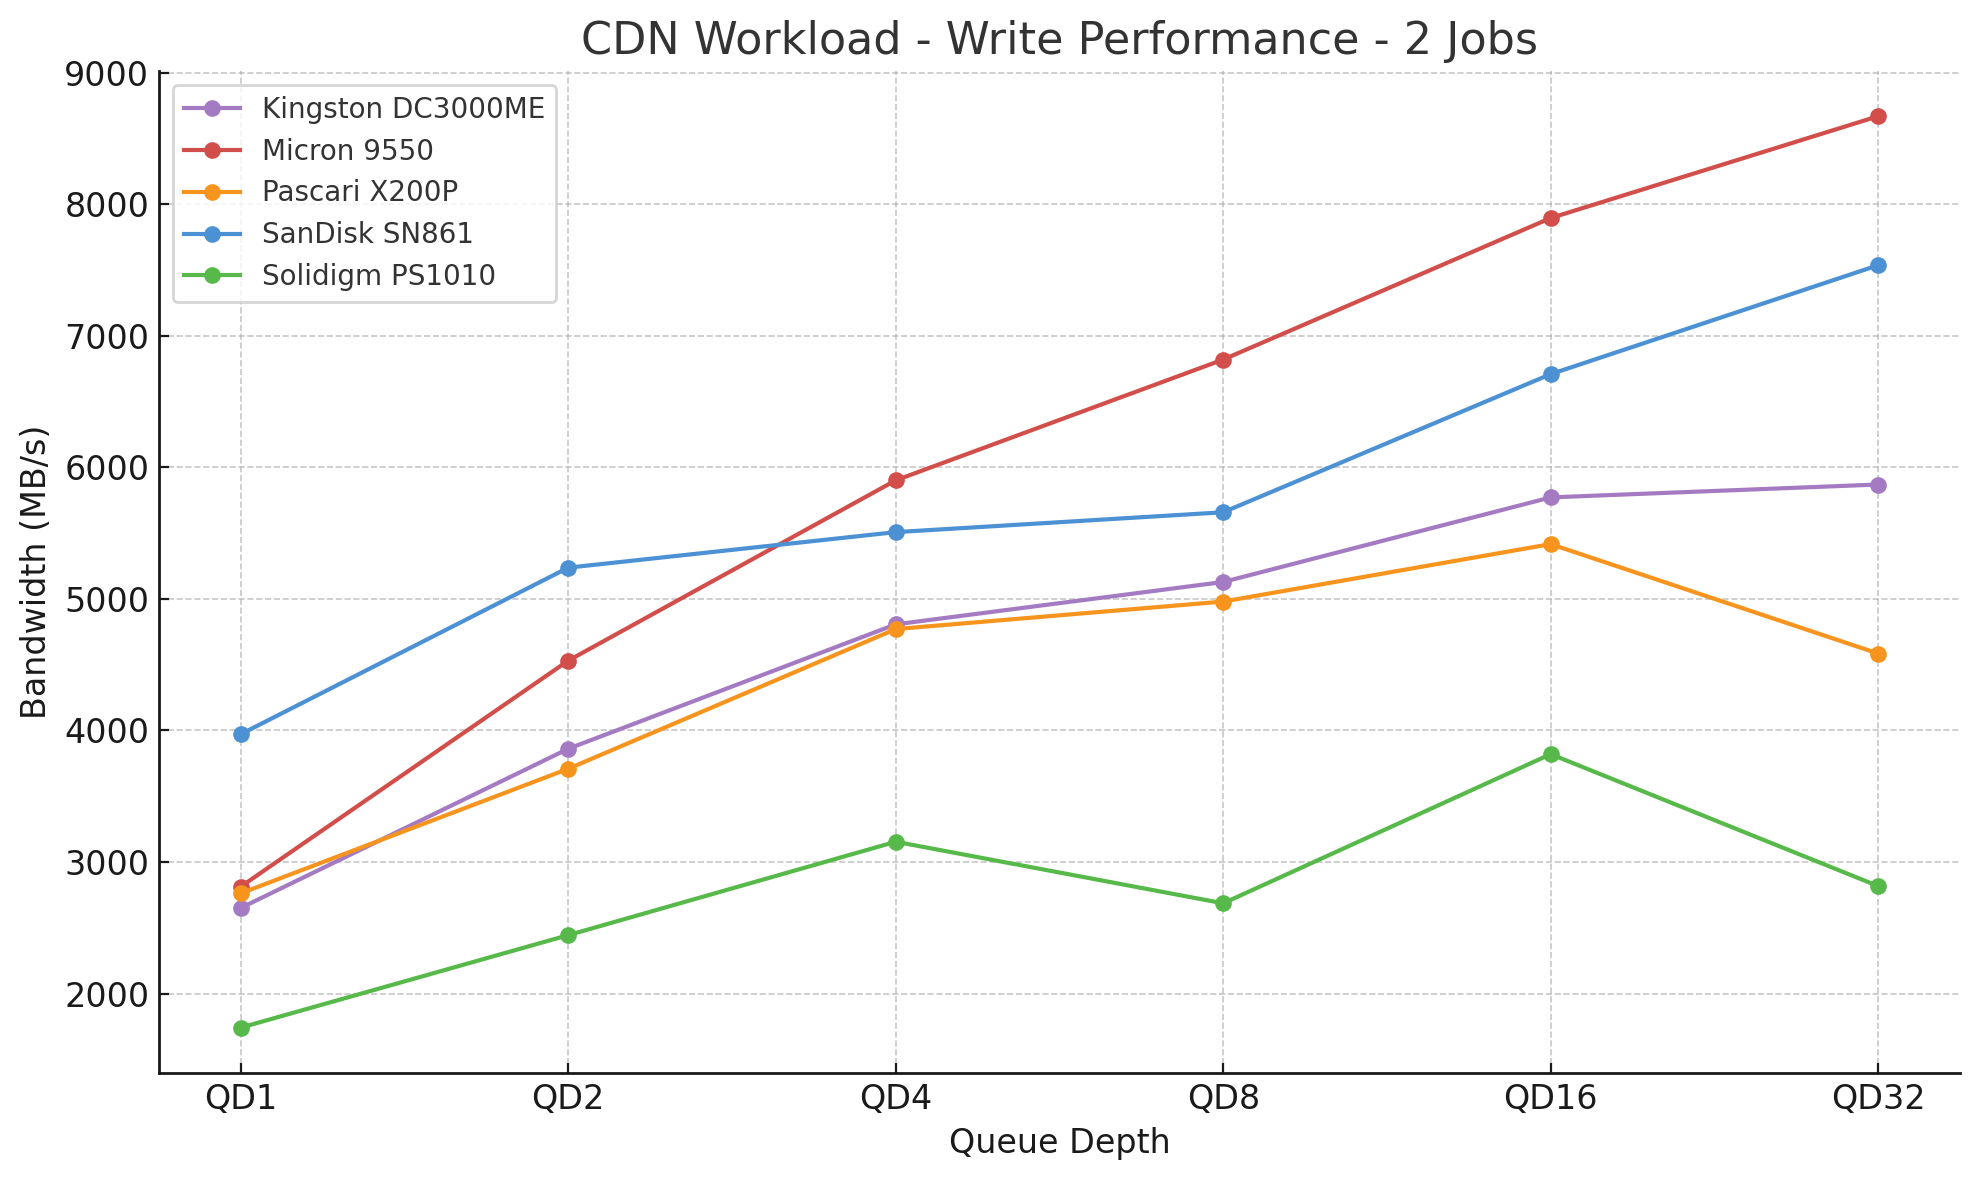
두 가지 작업을 적용한 Pascari X200P는 이 CDN 쓰기 테스트에서 전체 2,762위를 차지했습니다. 이 드라이브는 QD1에서 최대 16MB/s의 속도를 달성하고 QD32까지 확장되지만, QD4,585에서는 다소 감소하여 최종적으로 최대 9550MB/s에 도달합니다. Micron 861과 SanDisk SN3000이 이 부문에서 선두를 달리고 있으며, Kingston DC200ME가 그 뒤를 따릅니다. XXNUMXP는 중간 대기열 깊이에서는 안정적인 성능을 유지하지만, 이 두 스레드 쓰기 워크로드에서는 선두 주자들보다 뒤처집니다.
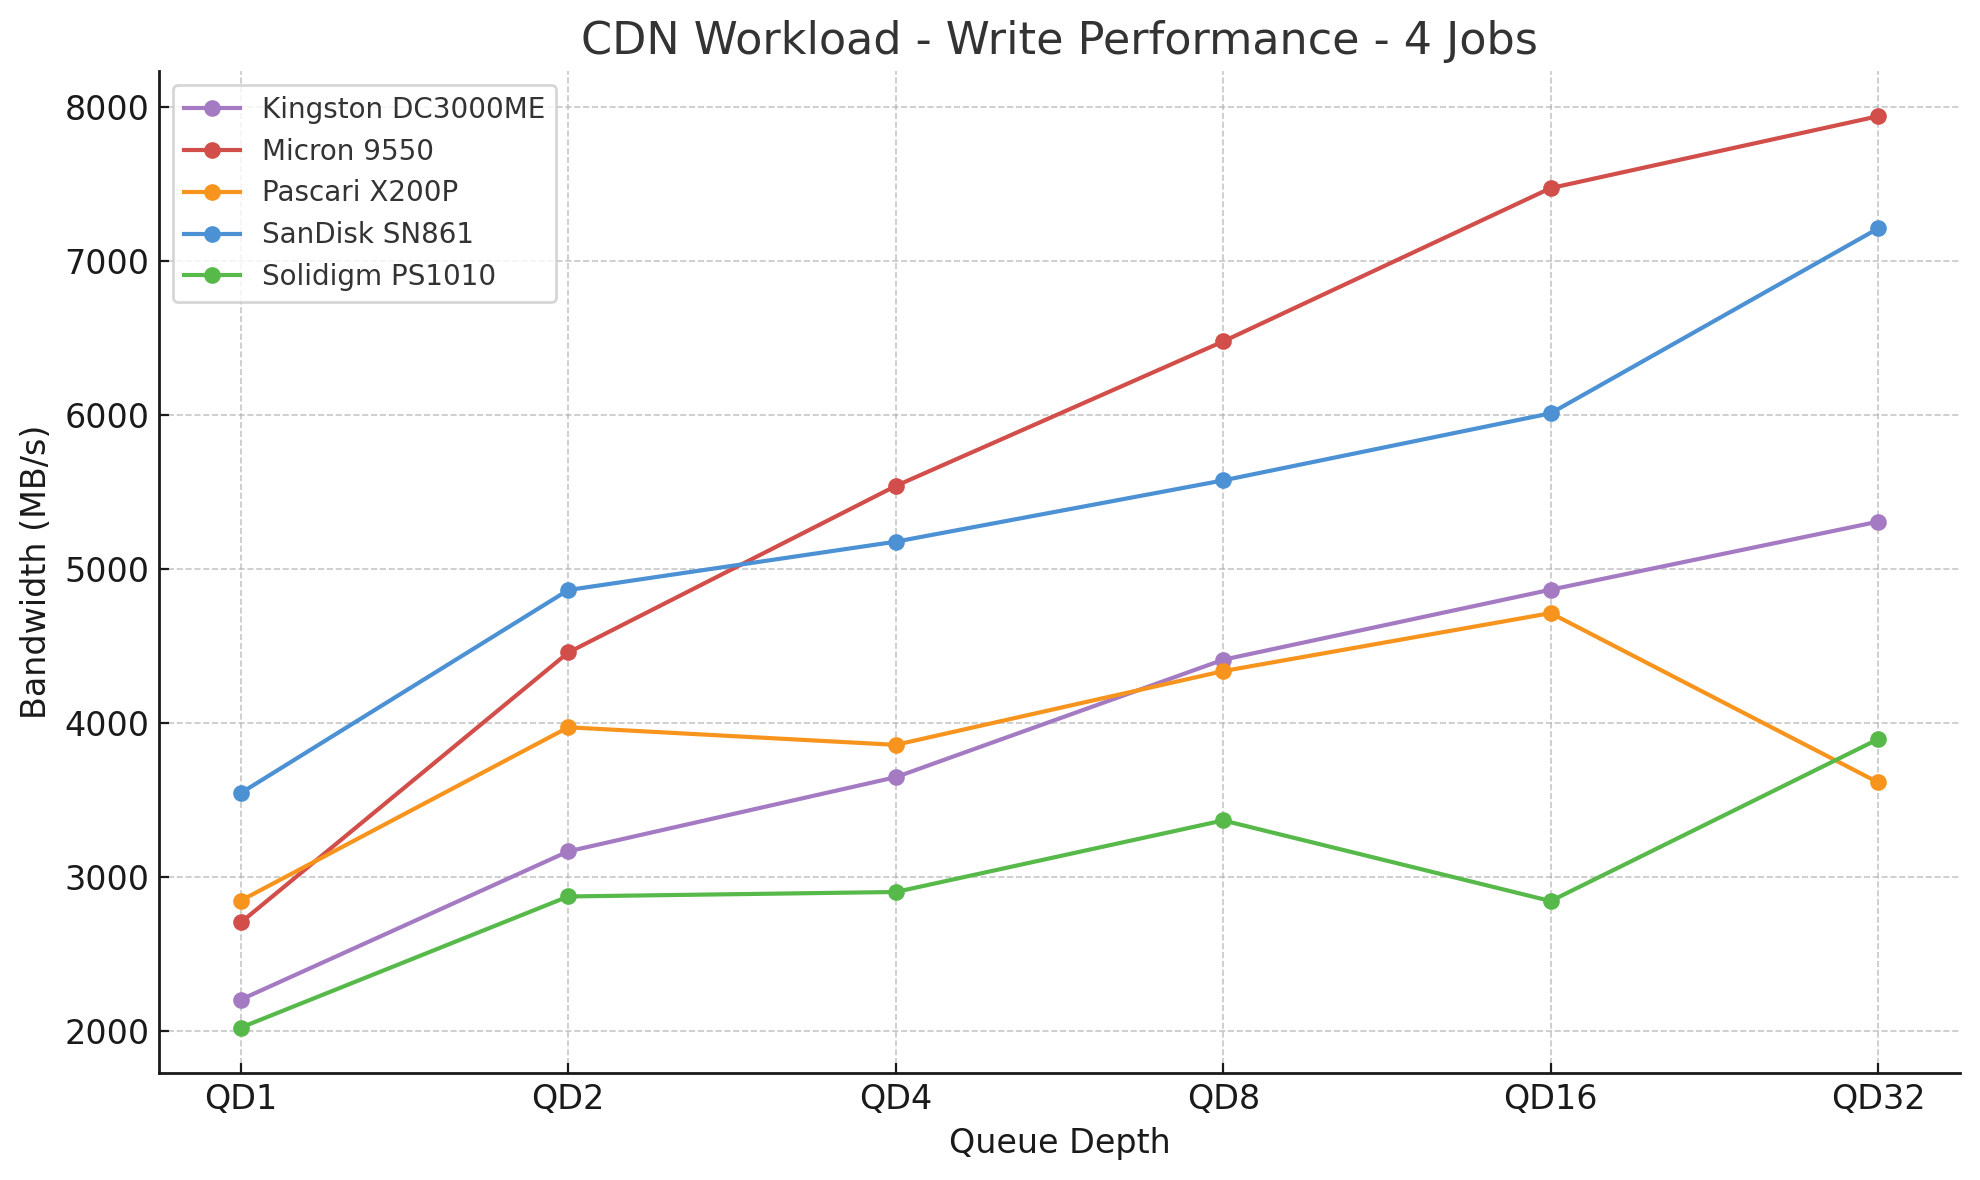
네 가지 작업을 적용한 Pascari X200P는 이 CDN 쓰기 테스트 대부분에서 중간 수준의 성능을 유지합니다. 이 드라이브는 QD2,845에서 최대 1MB/s의 처리량을 달성하며, 중간 대기열 깊이에서는 Kingston DC3000ME 및 Solidigm PS1010과 경쟁력을 유지합니다. QD32에서는 X200P가 3,613MB/s로 소폭 하락하여 전체 9550위를 기록했습니다. Micron 861과 SanDisk SN3000이 선두를 달리고 있으며, Kingston DC200ME는 XNUMX위를 유지하고 있습니다. XXNUMXP는 전체 범위에서 중간 수준의 부하에서는 일관된 쓰기 확장성을 제공하지만, 이 XNUMX스레드 작업 부하에서 대기열 깊이가 깊어지면 어느 정도 한계를 보입니다.
DLIO 체크포인팅 벤치마크
AI 학습 환경에서 SSD의 실제 성능을 평가하기 위해 데이터 및 학습 입출력(DLIO) 벤치마크 도구를 활용했습니다. Argonne National Laboratory에서 개발한 DLIO는 딥러닝 워크로드에서 I/O 패턴을 테스트하도록 특별히 설계되었습니다. 이 도구는 스토리지 시스템이 체크포인팅, 데이터 수집, 모델 학습과 같은 과제를 어떻게 처리하는지에 대한 통찰력을 제공합니다. 아래 차트는 두 드라이브가 36개의 체크포인트에서 프로세스를 처리하는 방식을 보여줍니다. 머신러닝 모델을 학습할 때 체크포인트는 모델의 상태를 주기적으로 저장하여 중단이나 정전 시 진행 상황 손실을 방지하는 데 필수적입니다. 이러한 스토리지 요구는 특히 지속적이거나 집중적인 워크로드에서 강력한 성능을 요구합니다. 2.0년 13월 2024일 출시된 DLIO 벤치마크 버전 XNUMX을 사용했습니다.
벤치마킹이 실제 시나리오를 반영하는지 확인하기 위해 LLAMA 3.1 405B 모델 아키텍처를 기반으로 테스트를 진행했습니다. 모델 매개변수, 옵티마이저 상태, 계층 상태를 캡처하기 위해 torch.save()를 사용하여 체크포인팅을 구현했습니다. 4개의 GPU로 구성된 시스템을 시뮬레이션하여 2방향 텐서 병렬 처리와 1,636방향 파이프라인 병렬 처리를 XNUMX개의 GPU에 분산하는 하이브리드 병렬 처리 전략을 구현했습니다. 이 구성의 결과, 체크포인트 크기는 XNUMXGB로, 최신 대용량 언어 모델 학습 요구 사항을 충족했습니다.
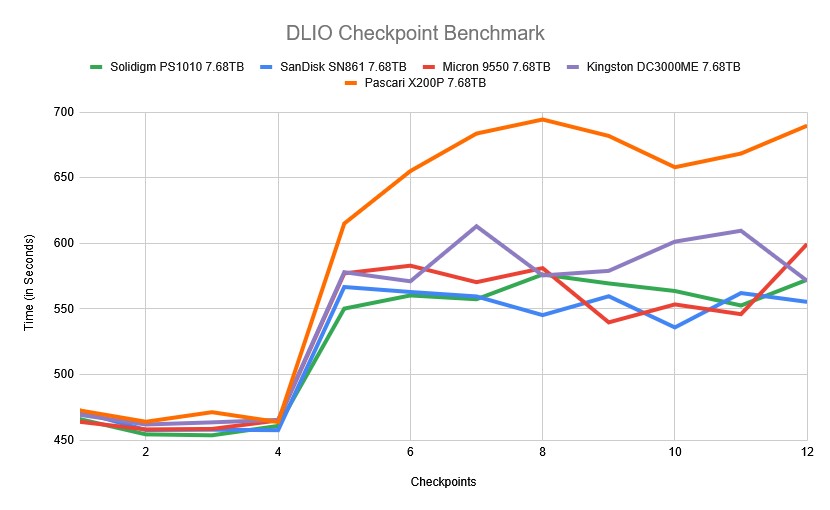
DLIO 체크포인트 벤치마크에서 Pascari X200P SSD는 초기 응답성이 우수했지만, 작업 부하가 증가함에 따라 체크포인트 시간이 증가하는 경향을 보였습니다. 초기 단계(체크포인트 1~4)에서 X200P는 평균 467초로 다른 SSD들과 비슷한 수준을 유지하며 Solidigm PS1010 및 Micron 9550과 같은 드라이브와 비슷한 수준을 유지했습니다.
그러나 벤치마크 중간 지점(체크포인트 5~9)에서 X200P의 성능은 격차가 벌어지기 시작합니다. 드라이브의 체크포인트 시간이 급격히 증가하여 그룹에서 가장 높은 체크포인트 689.68에서 12초로 정점을 찍습니다. 마지막 세 체크포인트에서 X200P의 평균 시간은 672초로, 두 번째로 느린 드라이브(Kingston DC19.3ME)보다 약 3000%, 그룹 평균보다 23% 느립니다.
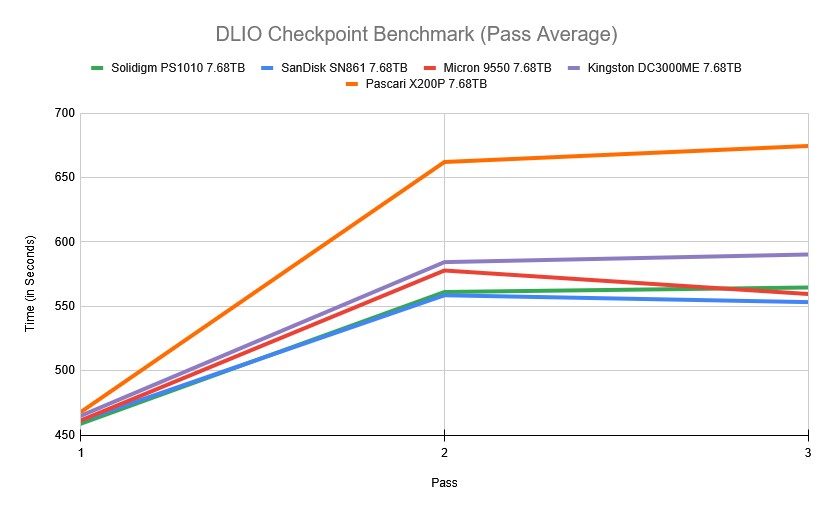
패스 평균을 통해 살펴보면, X200P는 시간 경과에 따른 성능 저하의 명확한 궤적을 보여줍니다. 패스 1에서 X467.93P는 평균 XNUMX초를 기록하여 다른 경쟁 제품들보다 약간 뒤처졌지만, 여전히 경쟁력 있는 수준입니다.
패스 2에서 X200P는 662.04초를 기록하며 그룹에서 크게 벗어나, 두 번째로 느린 드라이브(킹스턴 DC14.5ME)보다 3000%, 해당 패스의 그룹 평균보다 17.4% 느렸습니다. 이러한 추세는 패스 3에서도 이어졌고, 674.48초를 기록하며 가장 느린 드라이브 자리를 유지했습니다. 다른 네 드라이브의 평균(약 567초)과 비교했을 때, X200P는 18.9% 더 느렸습니다.
FIO 성능 벤치마크
일반적인 업계 지표에서 각 SSD의 스토리지 성능을 측정하기 위해 FIO를 활용합니다. 각 드라이브는 동일한 테스트 프로세스를 거치는데, 여기에는 순차적 쓰기 워크로드를 포함하는 두 번의 전체 드라이브 채우기 전처리 단계와 정상 상태 성능 측정이 포함됩니다. 측정되는 각 워크로드 유형이 변경됨에 따라, 새로운 전송 크기에 대한 전처리 채우기를 다시 실행합니다.
이 섹션에서는 다음 FIO 벤치마크에 초점을 맞춥니다.
- 128K 순차
- 64K 랜덤
- 16K 랜덤
- 4K 랜덤
128K 순차적 전제 조건(IODepth 256 / NumJobs 1)
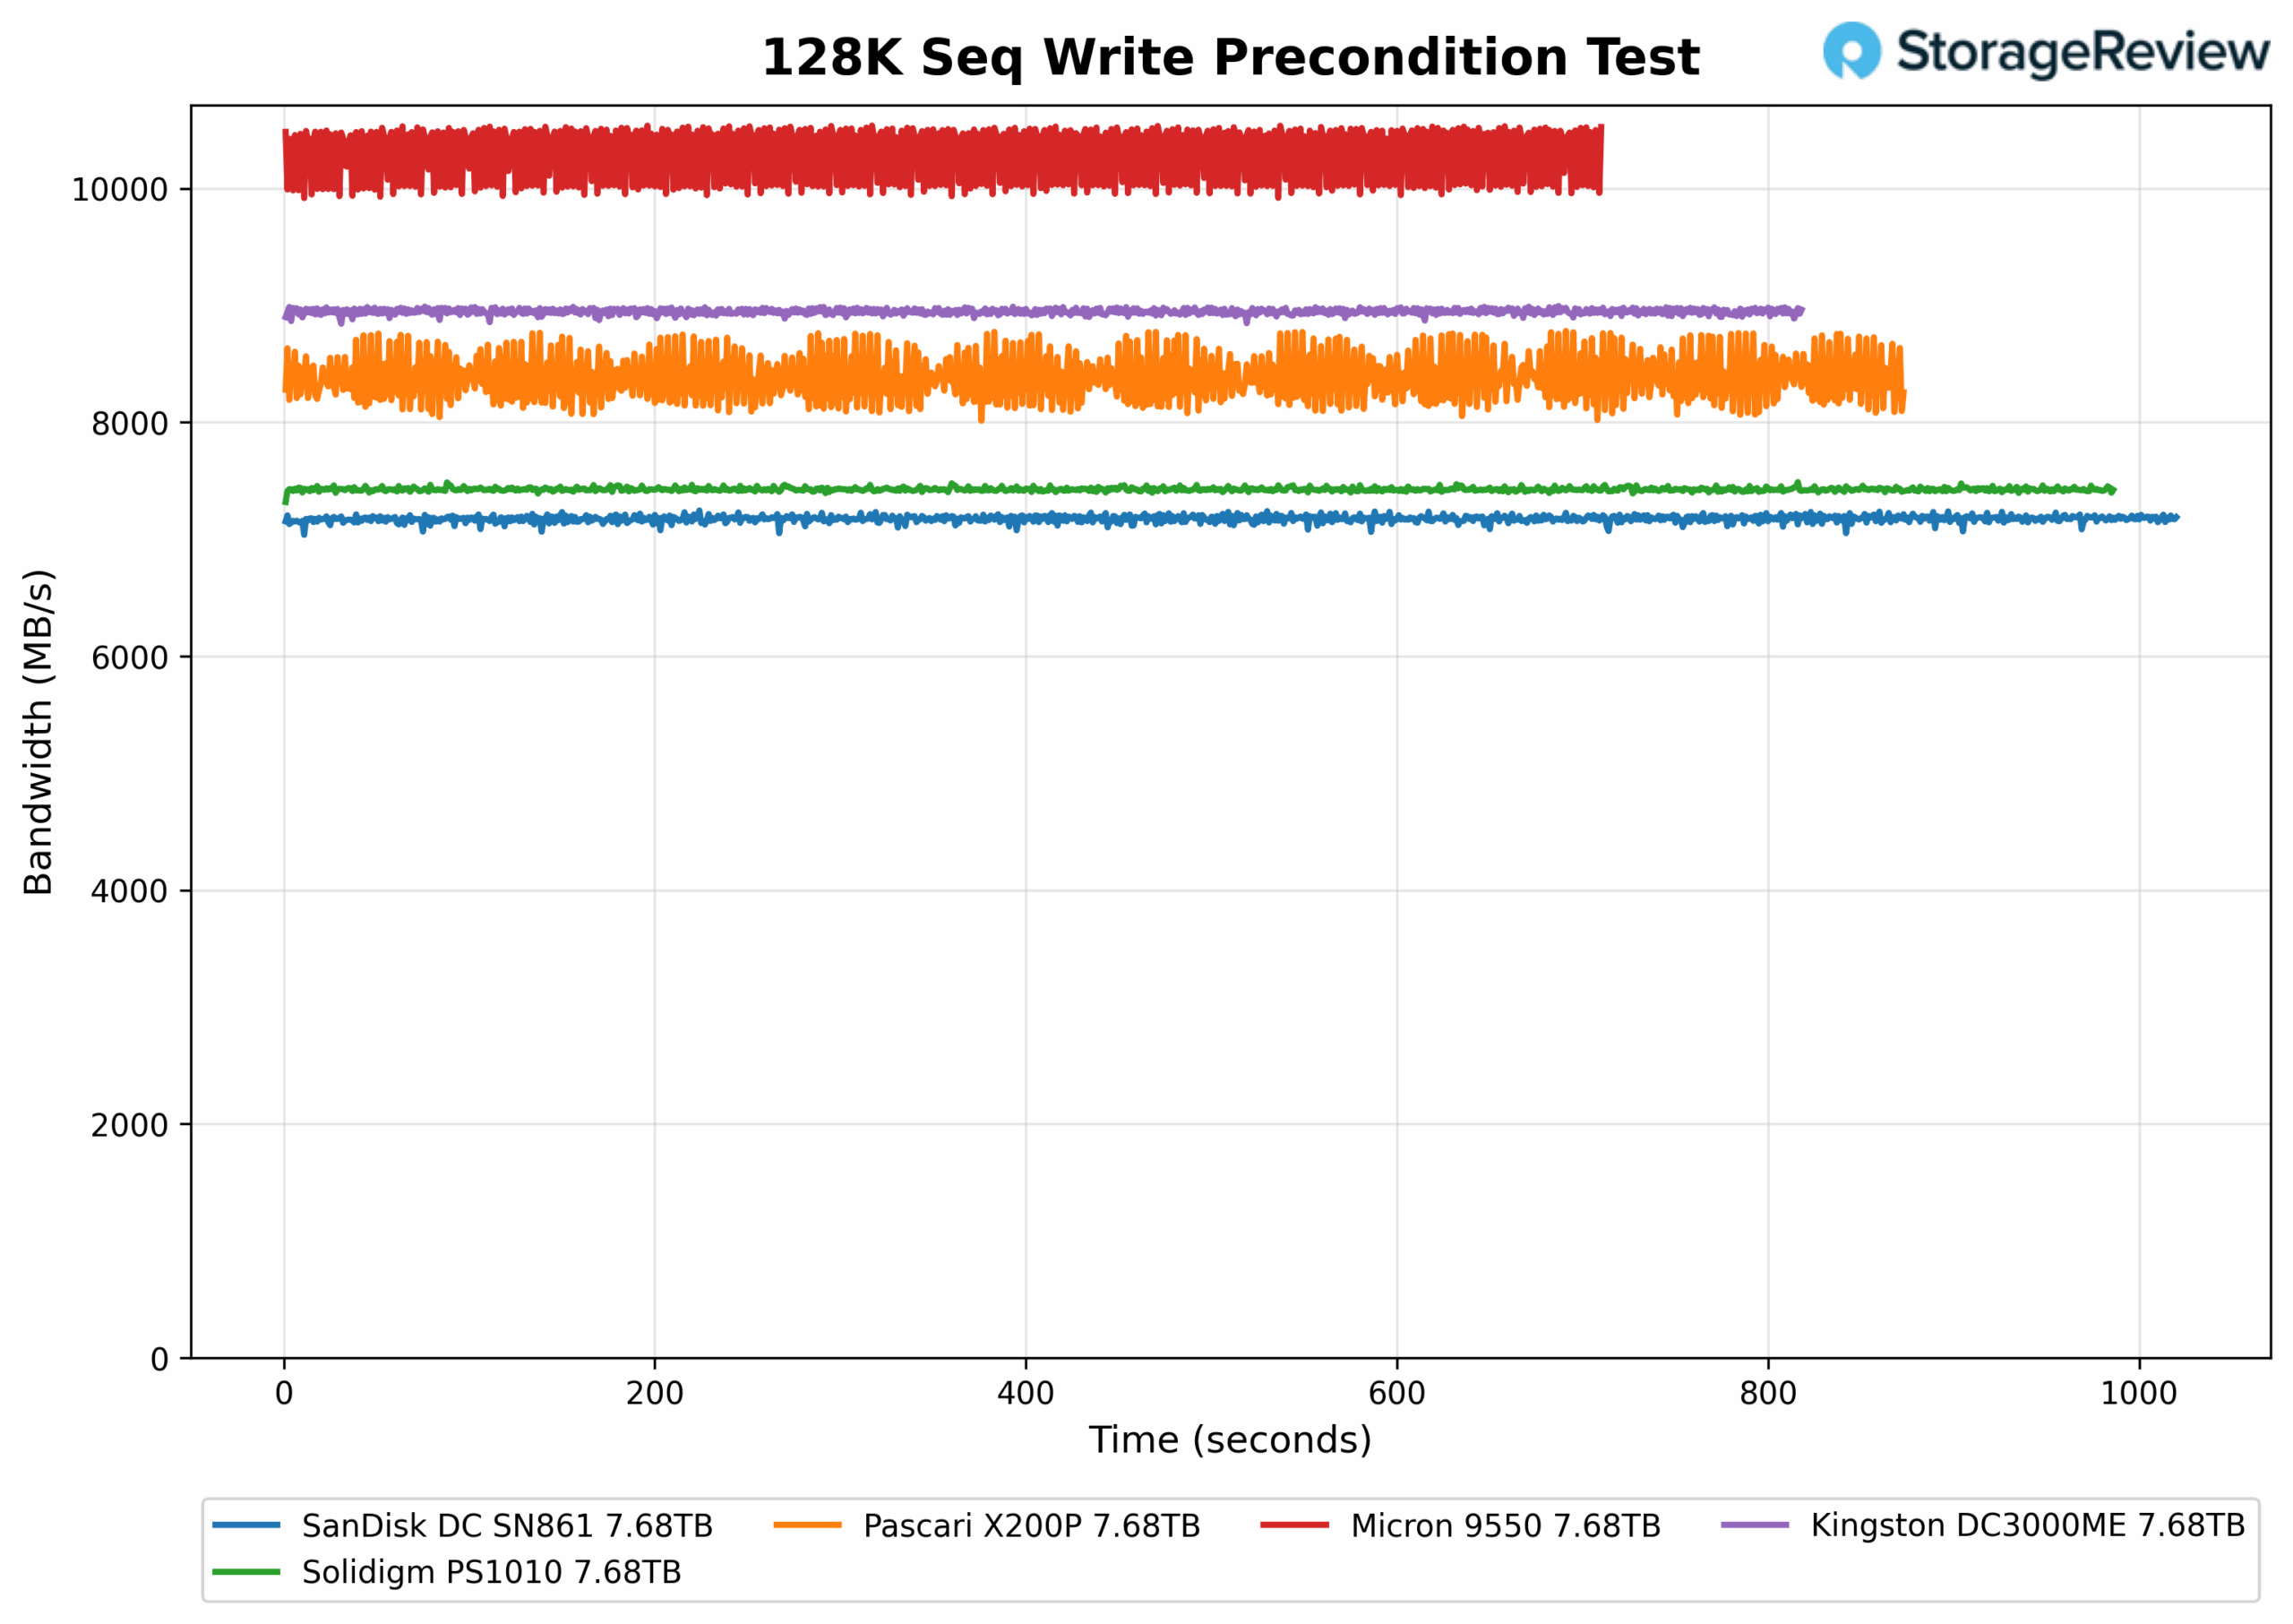
128K 순차 쓰기 전제 조건 테스트에서 X200P는 평균 대역폭 8,371MB/s로 전체 9550위를 차지했습니다. 강력한 성능을 유지하지만, 대역폭이 약간씩 반복적으로 변동하는 모습을 보이며, 이는 상위에 있는 Micron 3000과 Kingston DCXNUMXME의 평평하고 안정적인 성능에 비해 일관성이 낮음을 나타냅니다.
128K 순차적 사전 조건 대기 시간(IODepth 256 / NumJobs 1)
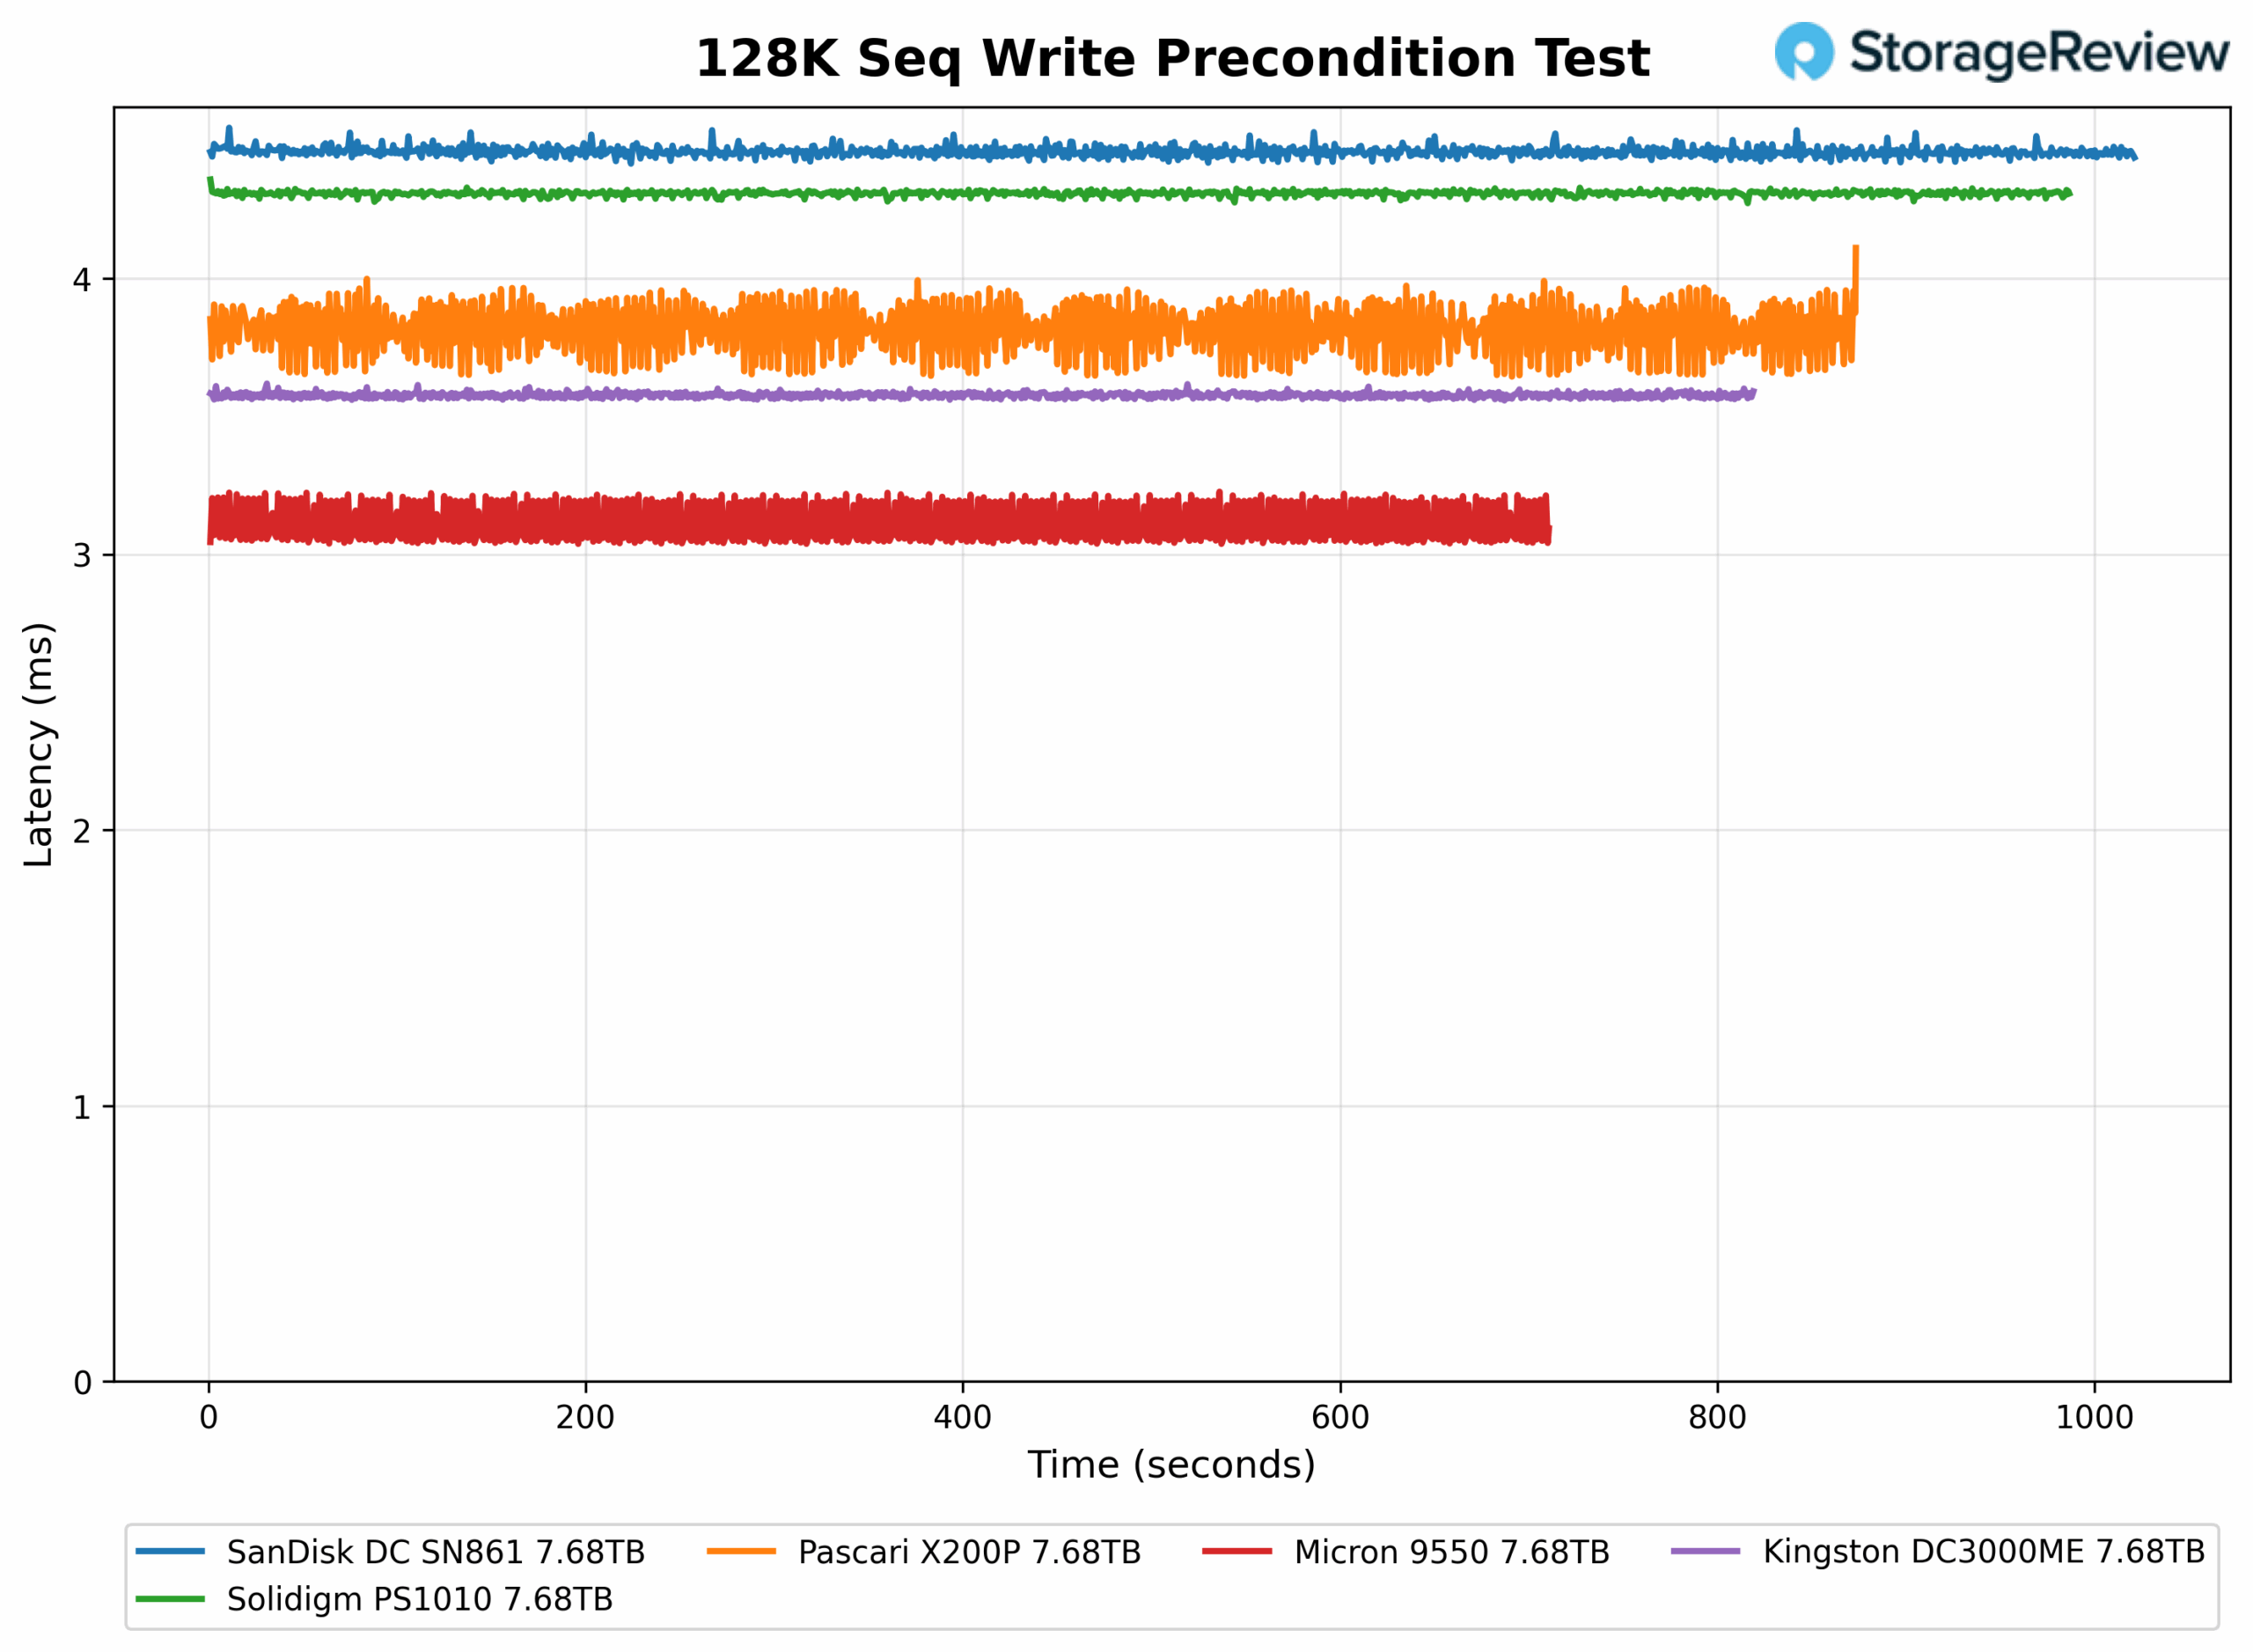
128K 순차 쓰기 전제 조건 지연 시간 테스트에서 X200P는 평균 3.822ms의 지연 시간을 기록하며 전체 9550위를 차지했습니다. Micron 3000과 Kingston DCXNUMXME에 이어 두 번째입니다. 대역폭 패턴과 유사하게, Pascari는 완만한 지연 시간 변동을 보이며, 지속적인 쓰기 작업 시 약간의 변동성을 나타내면서도 상위권의 자리를 굳건히 지키고 있습니다.
128K 순차 쓰기(IODepth 16 / NumJobs 1)
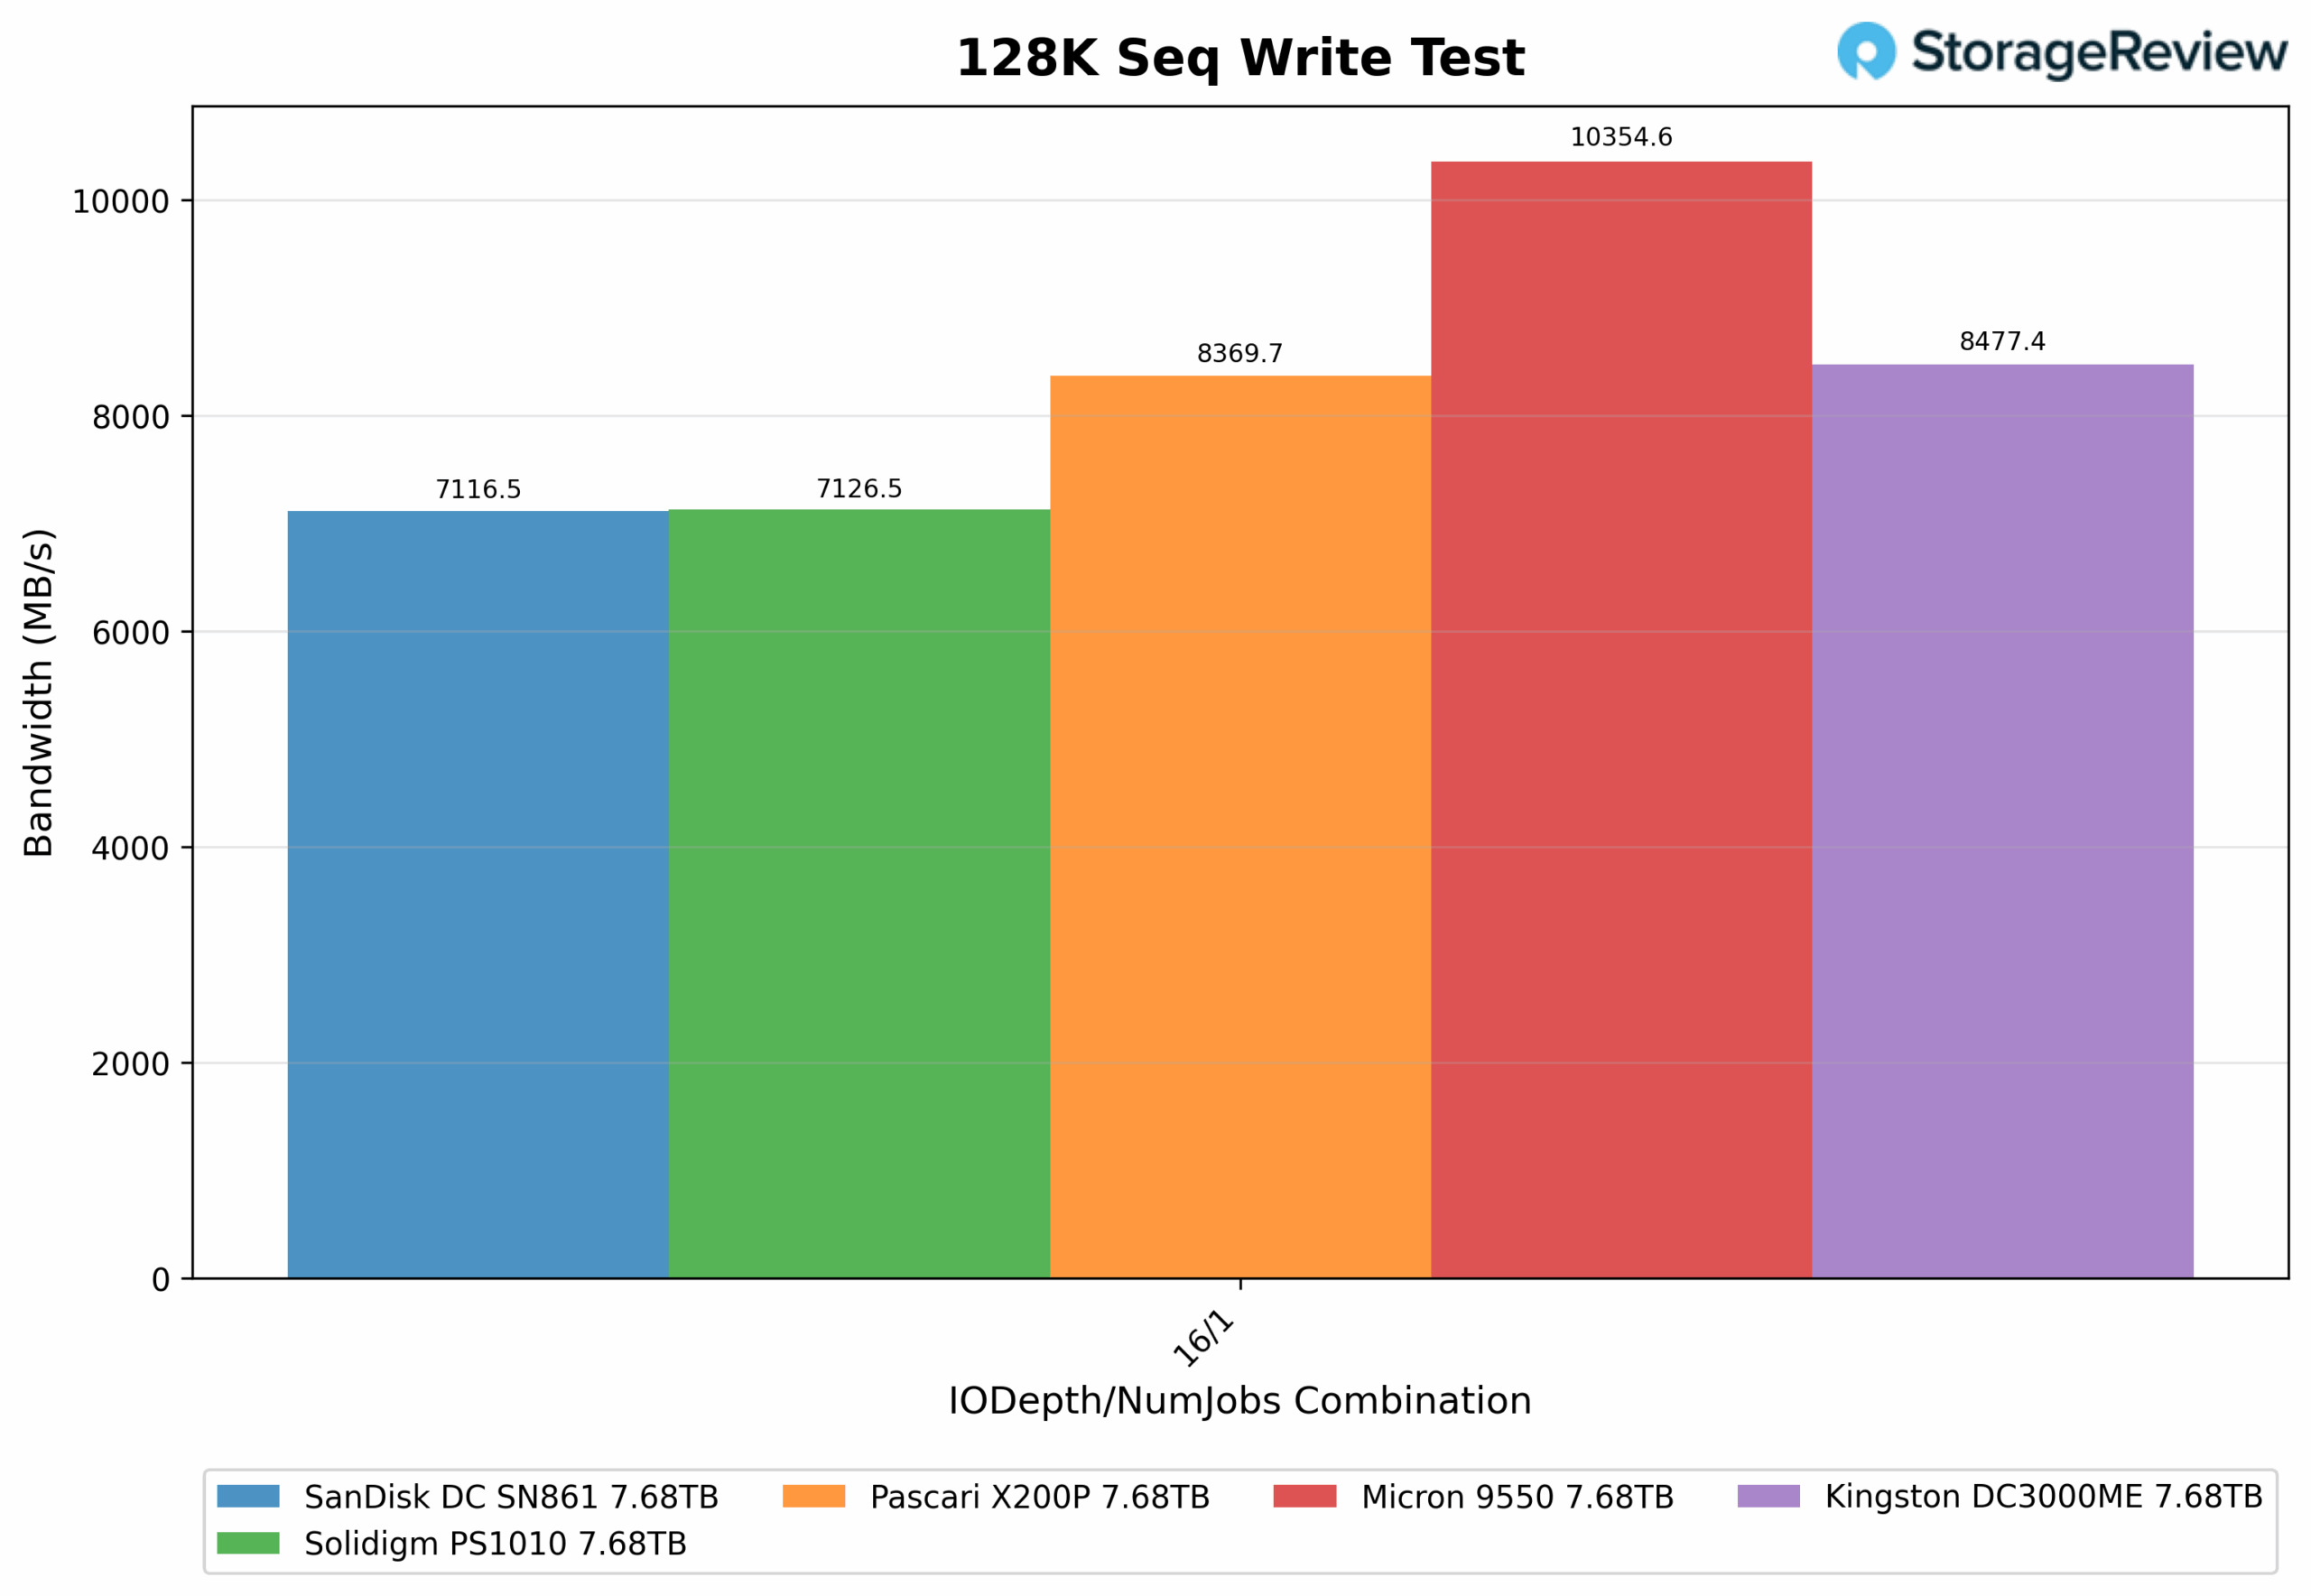
128K 순차 쓰기 테스트에서 X200P는 평균 8369.7MB/s의 대역폭을 달성하여 전체 9550위를 차지했습니다. Micron 3000과 Kingston DC1010ME보다는 낮지만, Solidigm PS861과 SanDisk SNXNUMX보다는 높습니다.
128K 순차 쓰기 대기 시간(IODepth 16 / NumJobs 1)
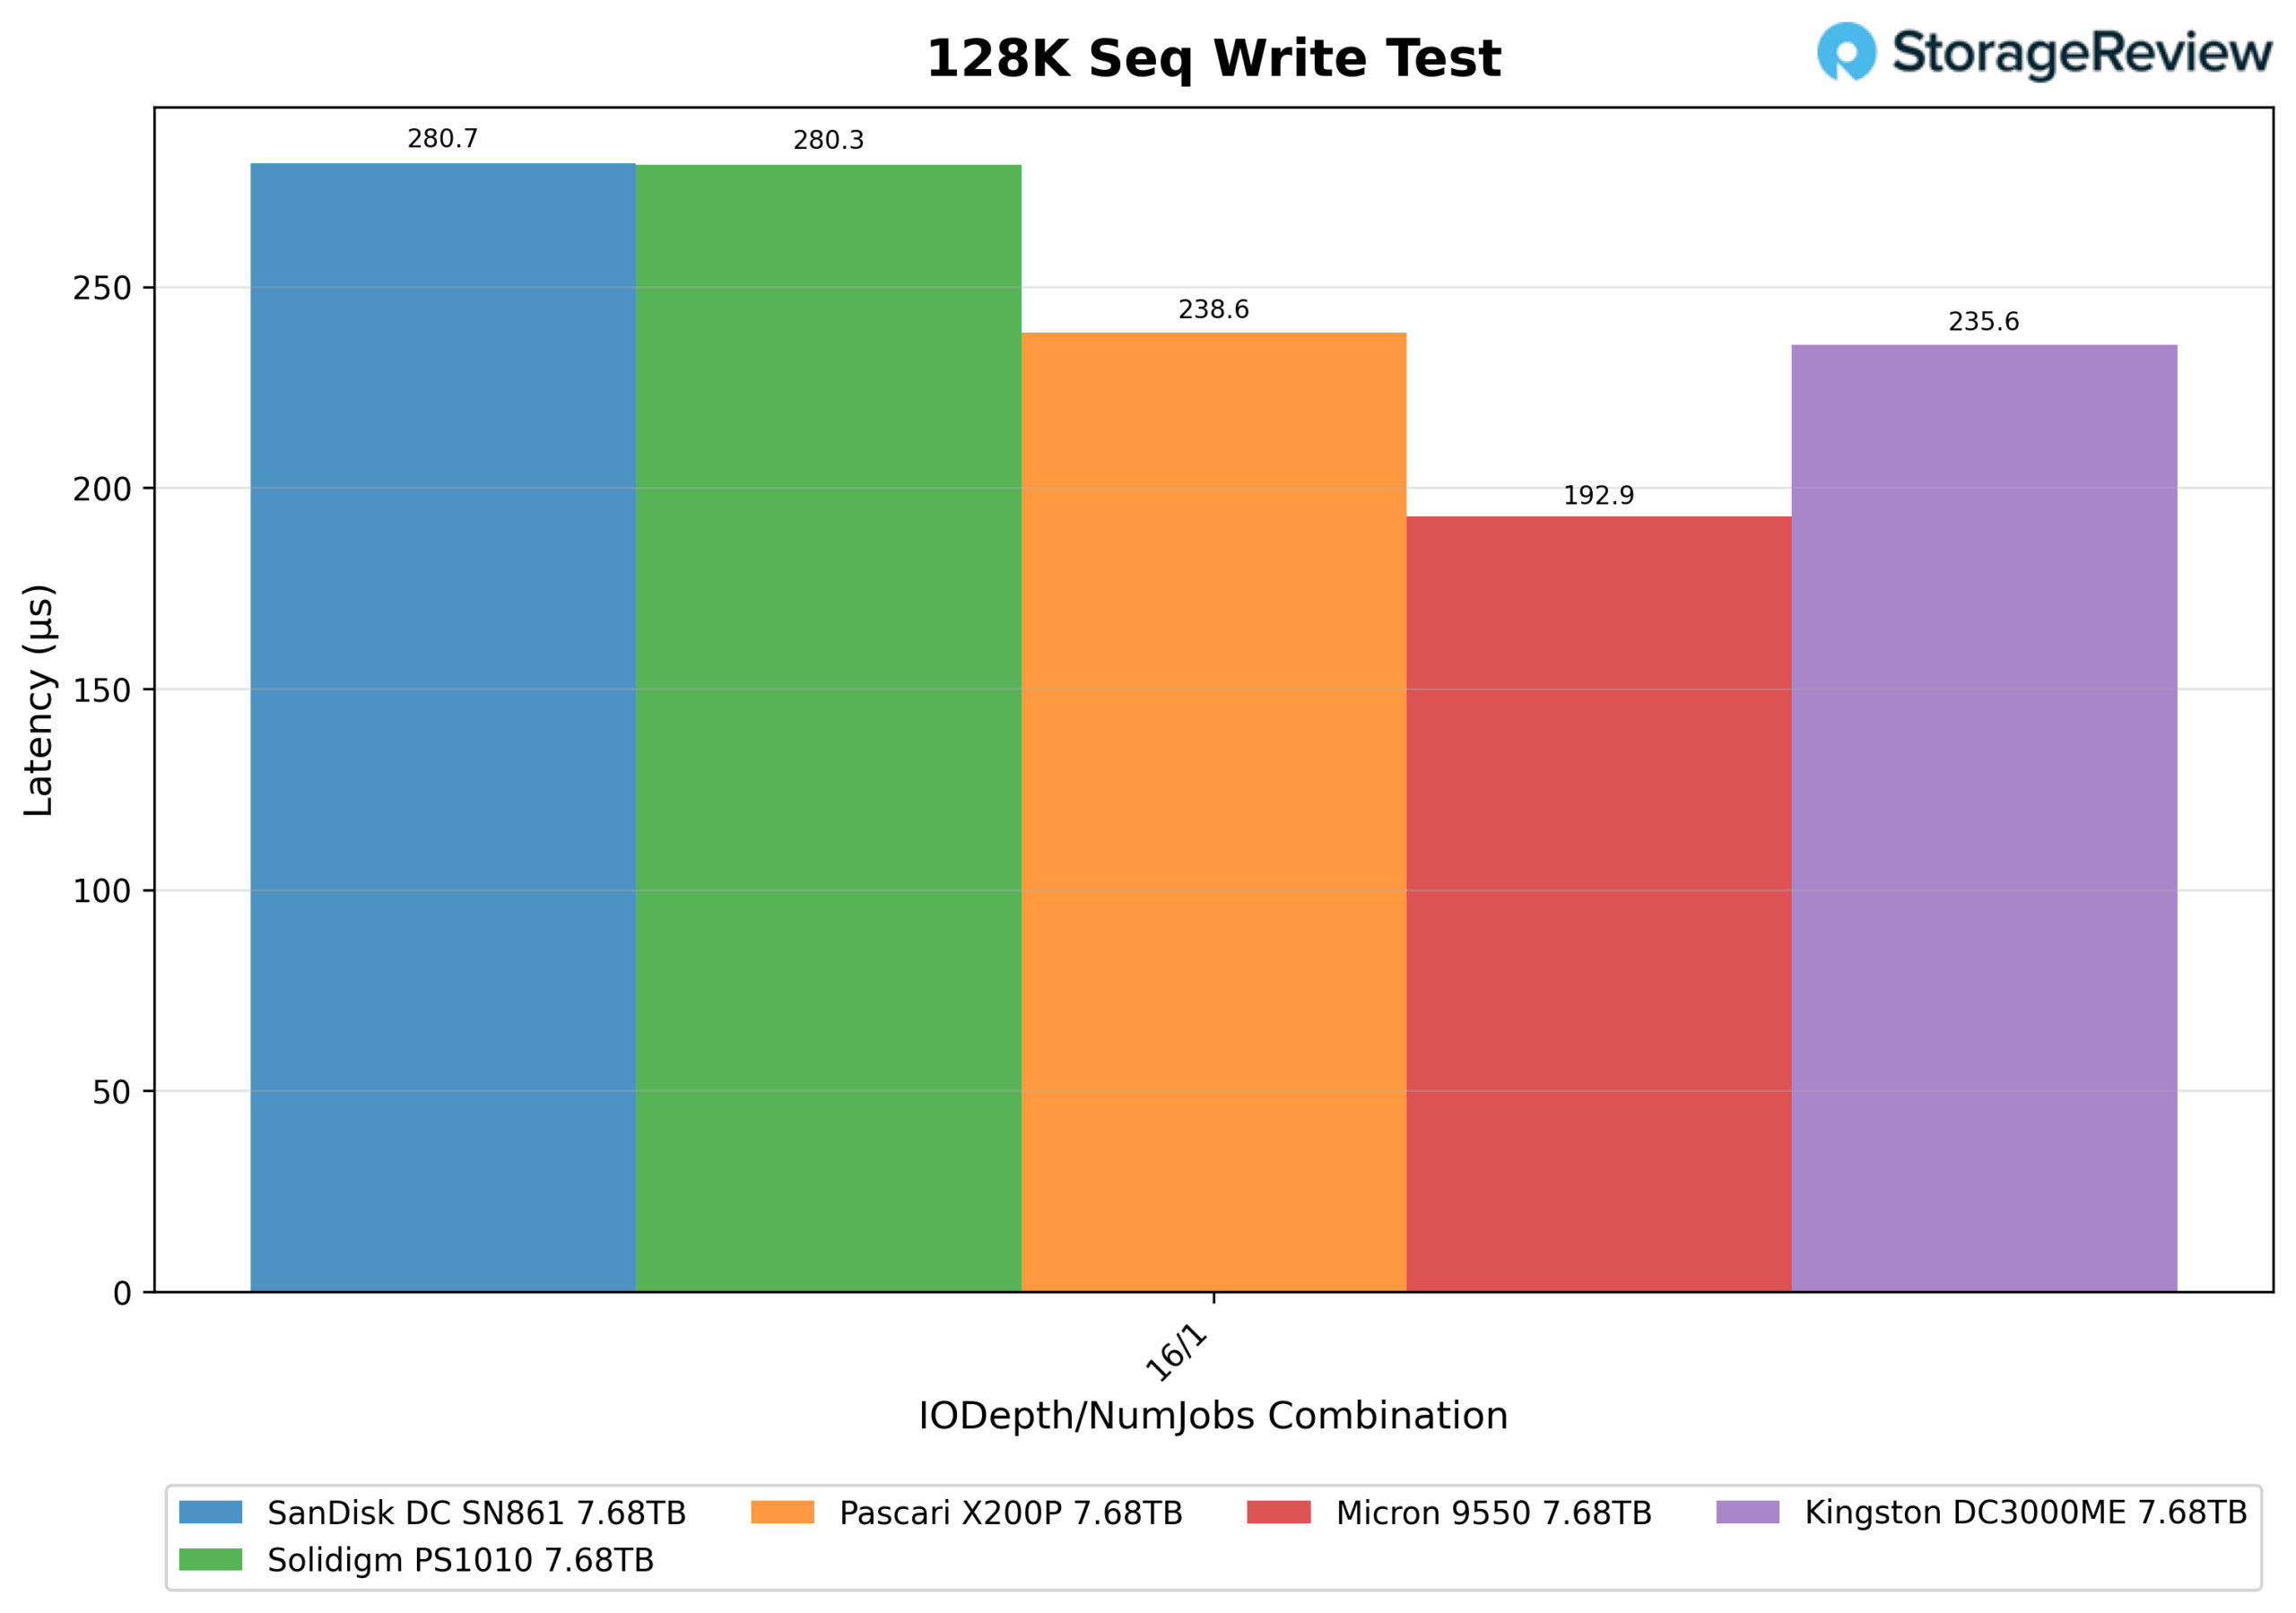
128K 순차 쓰기 테스트 지연 시간 차트에서 X200P는 평균 0.238ms의 지연 시간을 기록했습니다. 이는 Kingston DC3000ME(0.235ms)에 이어 전체 1010위이며, Solidigm PS861과 SanDisk SN9550보다 앞서 있습니다. 대부분의 제품보다 지연 시간이 짧지만, 최고 성능 제품인 Micron XNUMX보다는 여전히 뒤처집니다.
128K 순차 읽기(IODepth 64 / 작업 수 1)
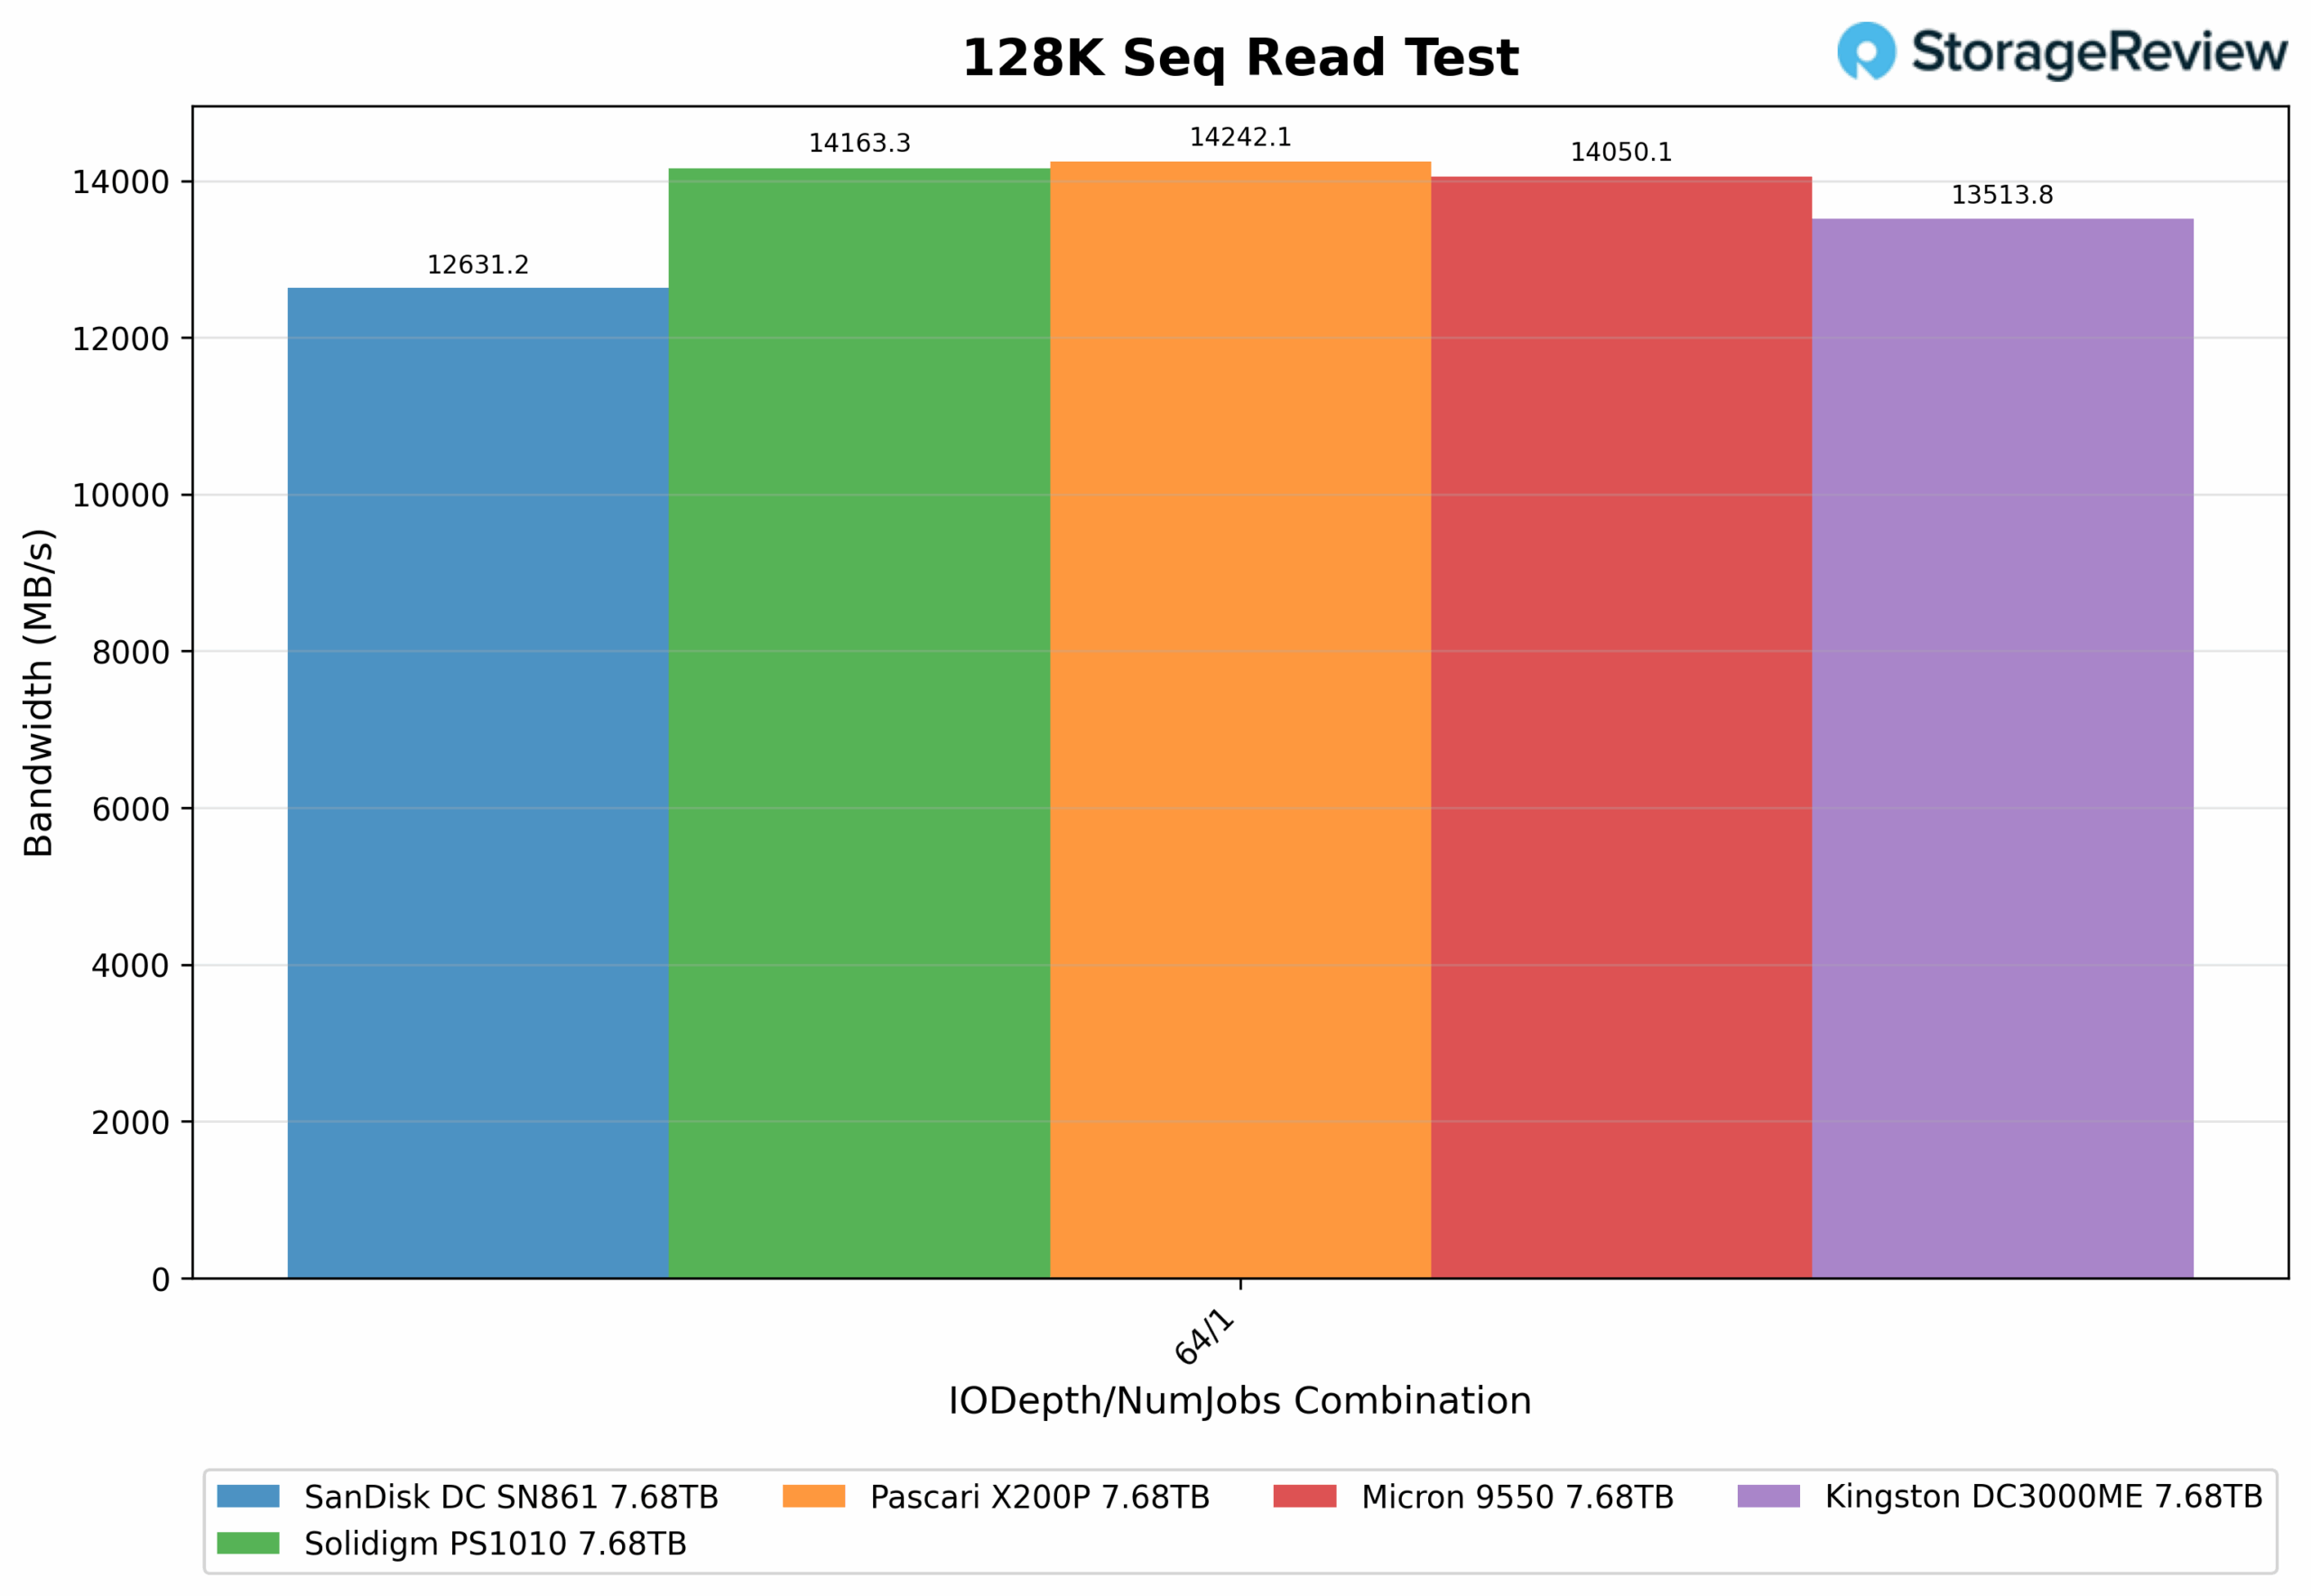
128K 순차 읽기 테스트에서 X200P는 14,242.1MB/s의 대역폭으로 전체 1010위를 차지했으며, Solidigm PS9550과 Micron XNUMX을 근소한 차이로 앞섰습니다. 읽기 처리량에서 선두를 달리고 있으며, 높은 대기열 깊이에서도 뛰어난 성능을 보였습니다.
128K 순차 읽기 대기 시간(IODepth 64 / NumJobs 1)
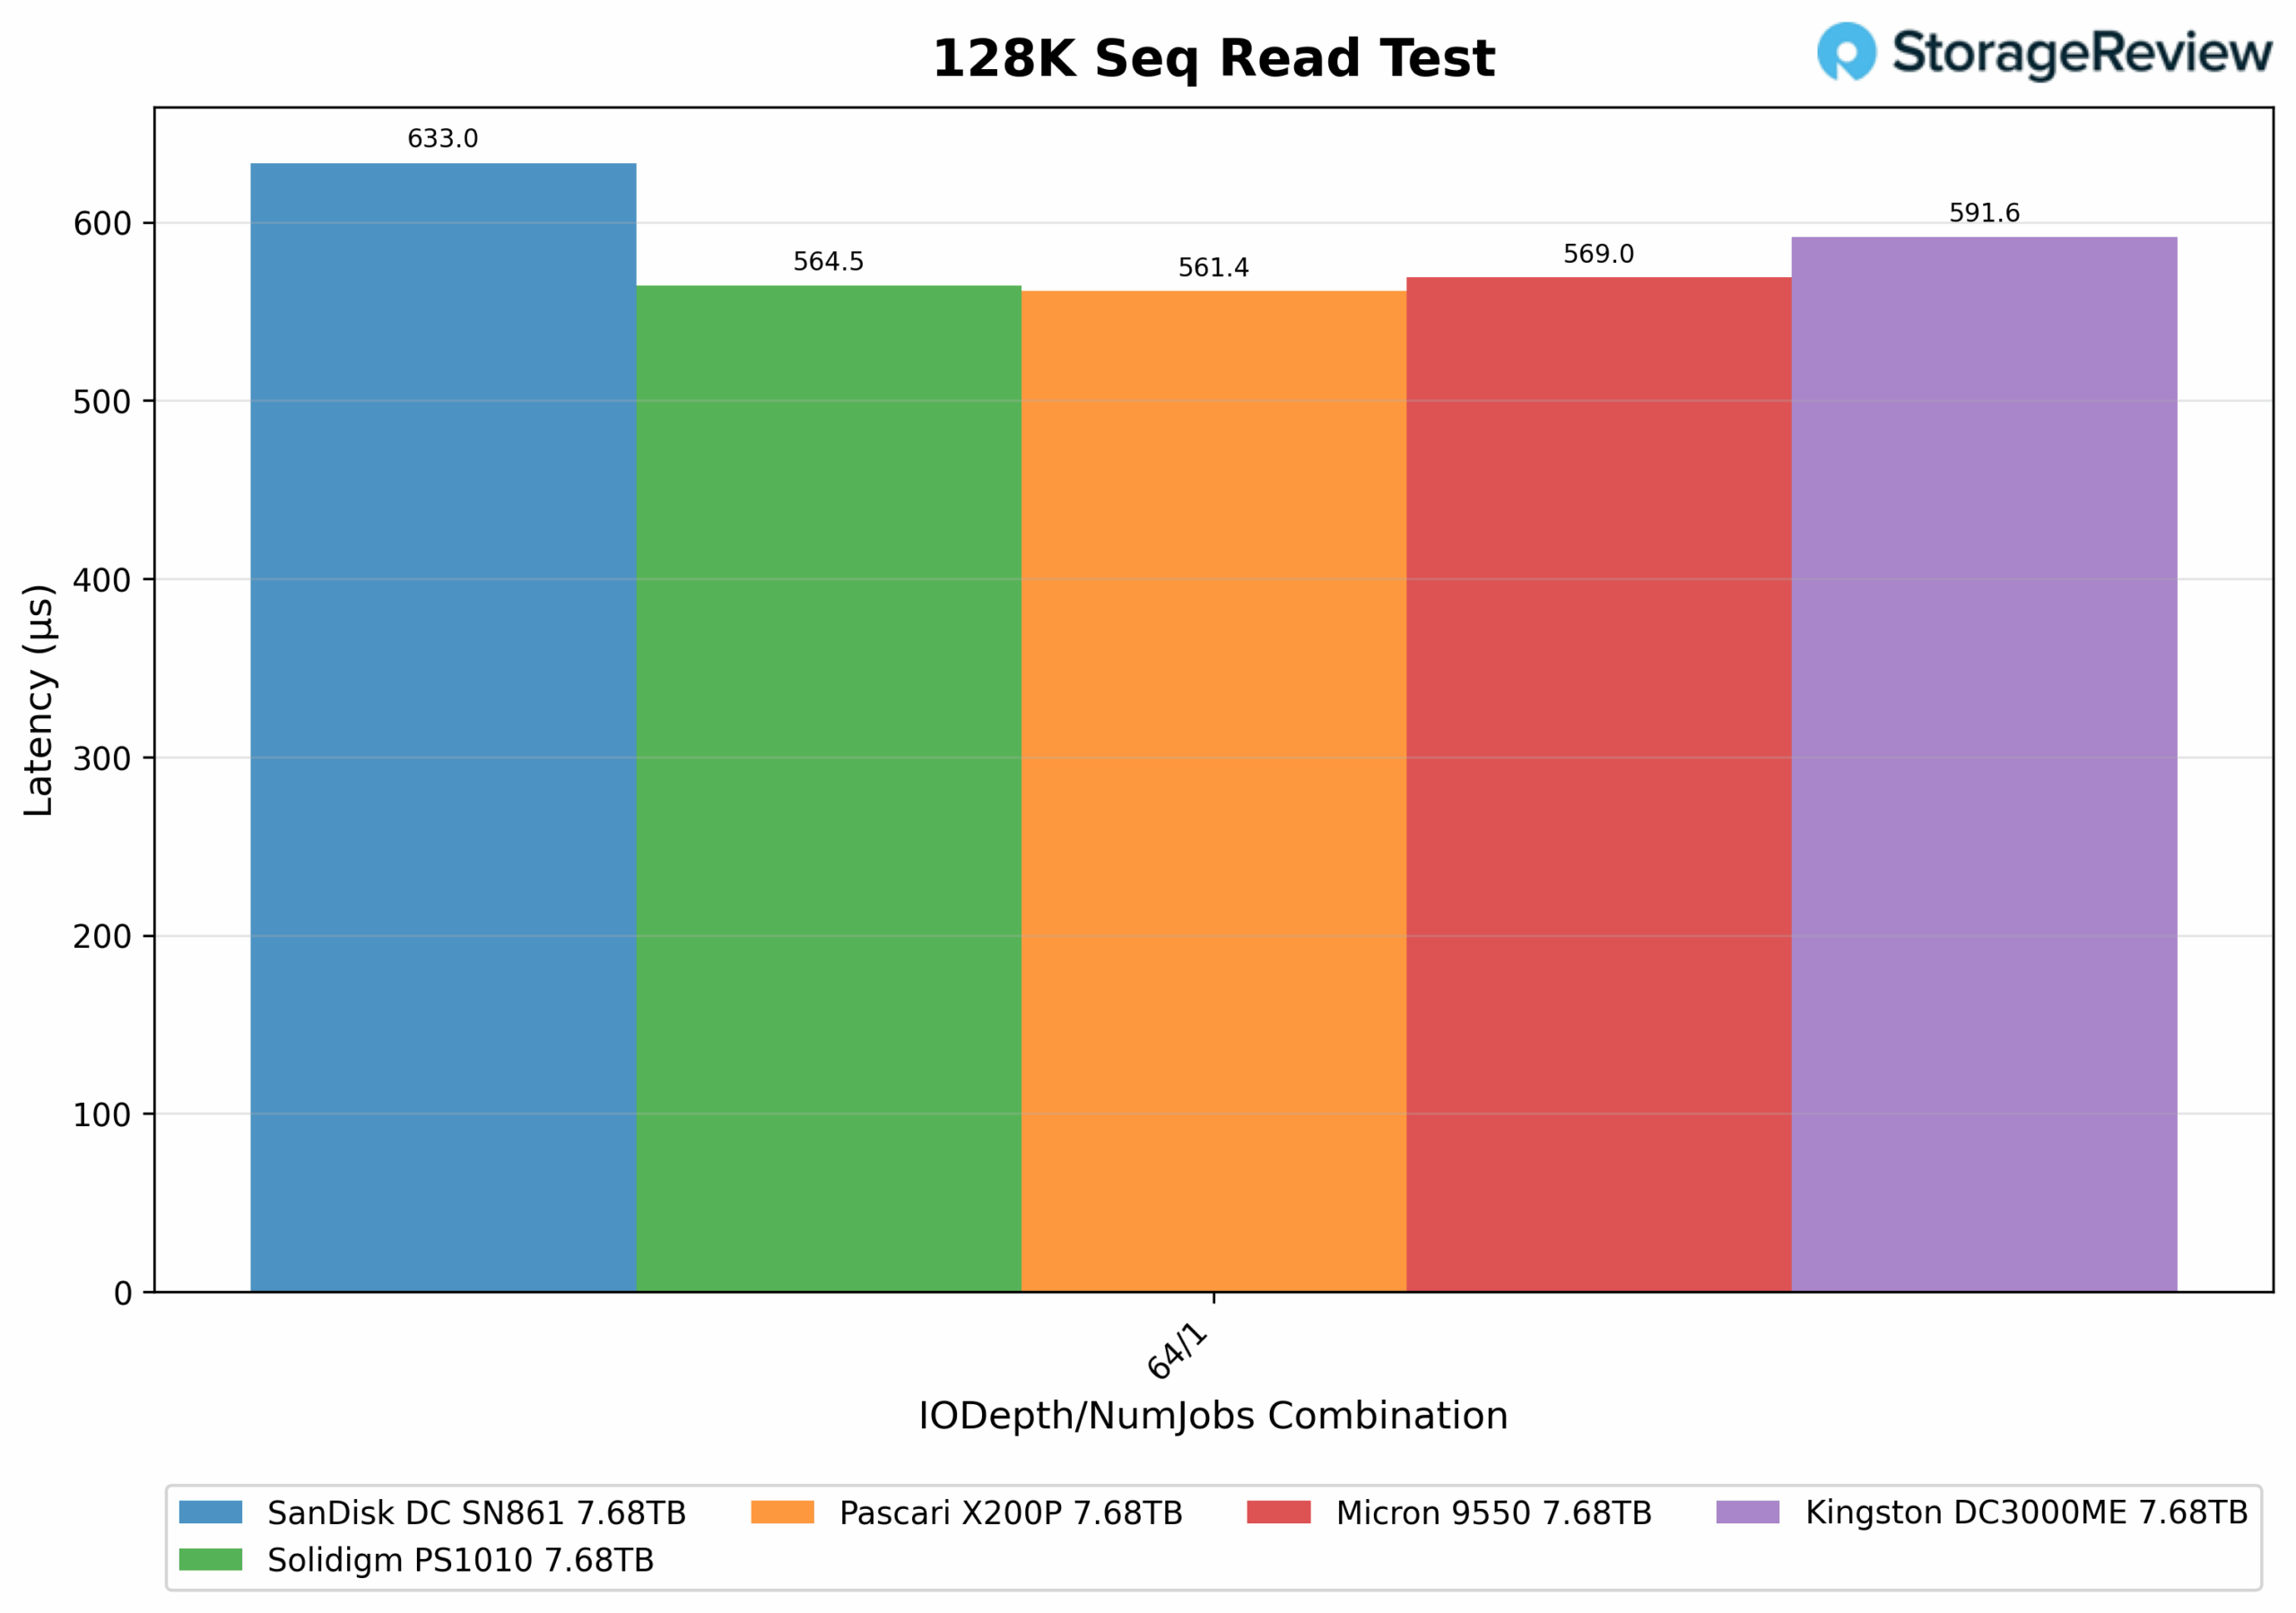
128K 순차 읽기 테스트 지연 시간 차트에서 X200P는 평균 561.4ms의 지연 시간을 기록하여 전체 지연 시간 측면에서 1010위를 차지했습니다. Solidigm PS9550보다 약간 뒤처지며, Micron 3000, Kingston DC861ME, SanDisk SNXNUMX보다 우수한 성능을 보입니다.
64K 랜덤 쓰기
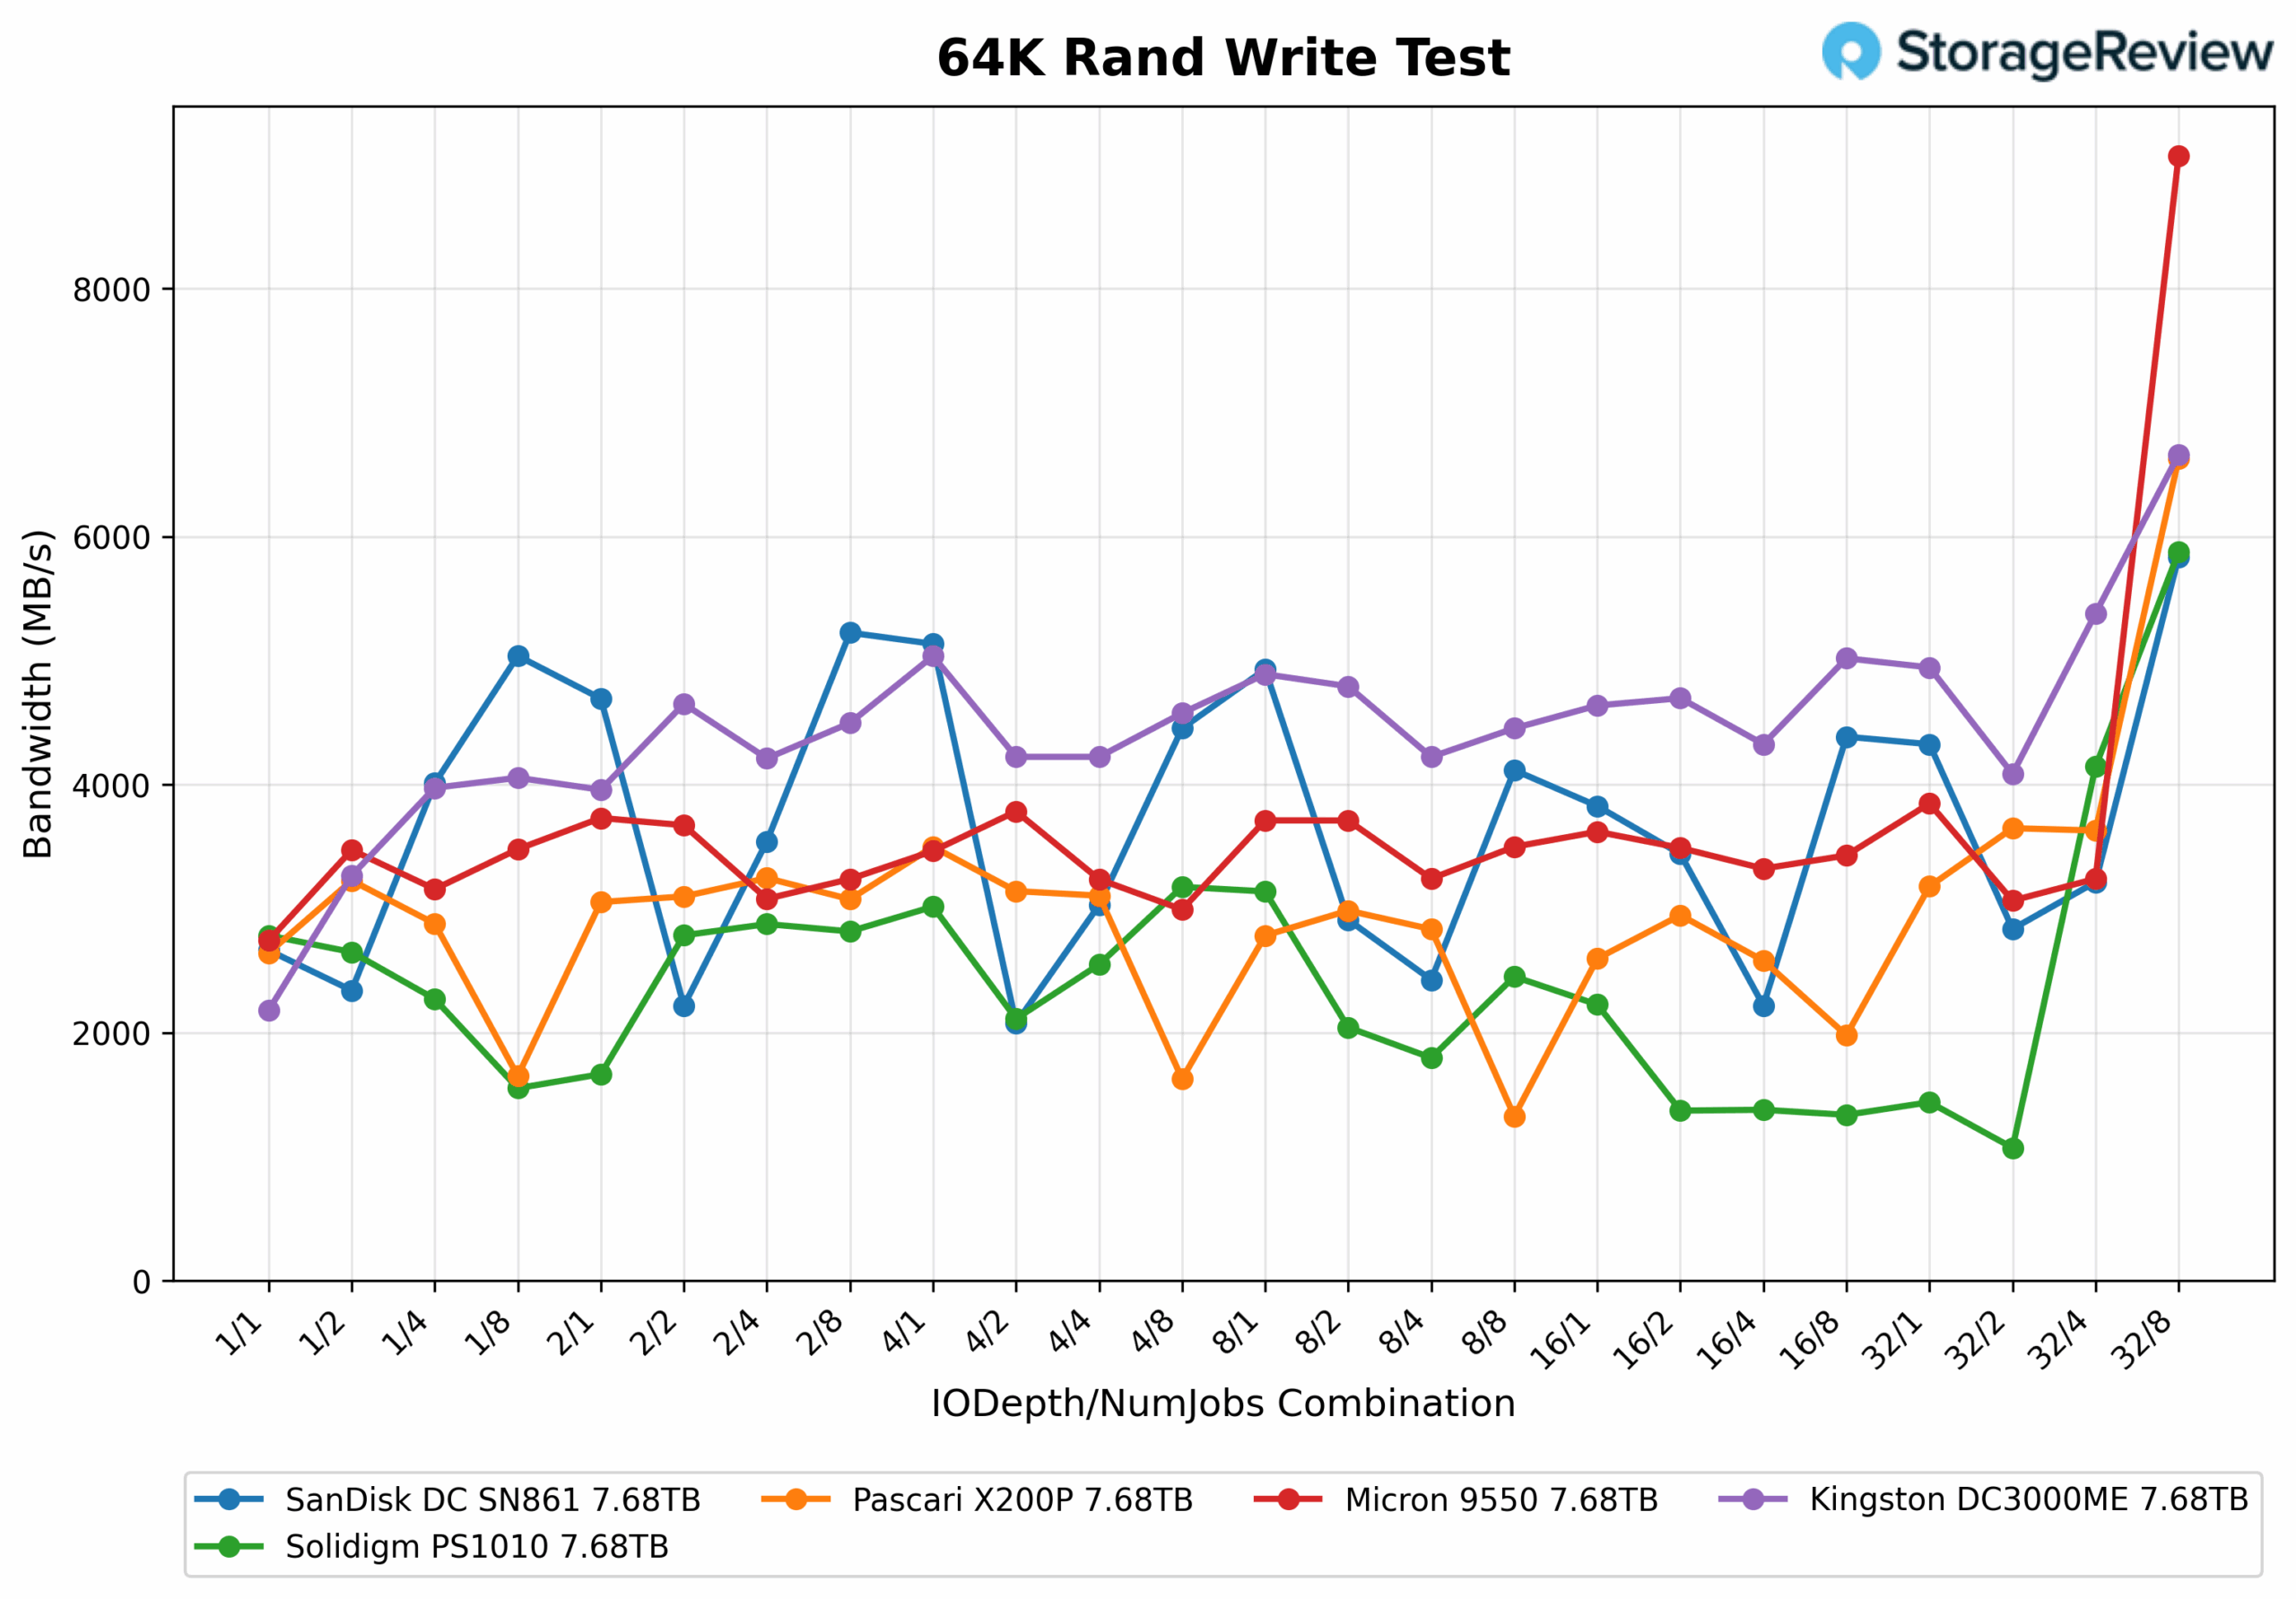
64K 랜덤 쓰기 테스트에서 X200P는 전반적으로 중간 수준의 성능을 보였으며, 대기열 깊이와 스레드 조합에 따라 약간의 변동이 있었습니다. 드라이브는 특정 범위 내에서 결과를 보여주지는 않지만, 대부분의 테스트 세트에서 2,500MB/s에서 3,600MB/s 사이의 안정적인 성능을 유지했습니다. 최대 대역폭은 6,625.92/32 IODepth/NumJobs 조합에서 8MB/s에 도달했는데, 이는 테스트에서 가장 높은 점수 중 하나이며, 강력한 결과를 보여줍니다.
Pascari 드라이브는 전반적으로 가장 일관된 성능을 보이는 것은 아니지만, 더 무거운 나사산 부하에서도 성능이 유지되고 대기열 깊이가 높아질수록 성능이 더 좋아집니다.
64K 임의 쓰기 지연 시간
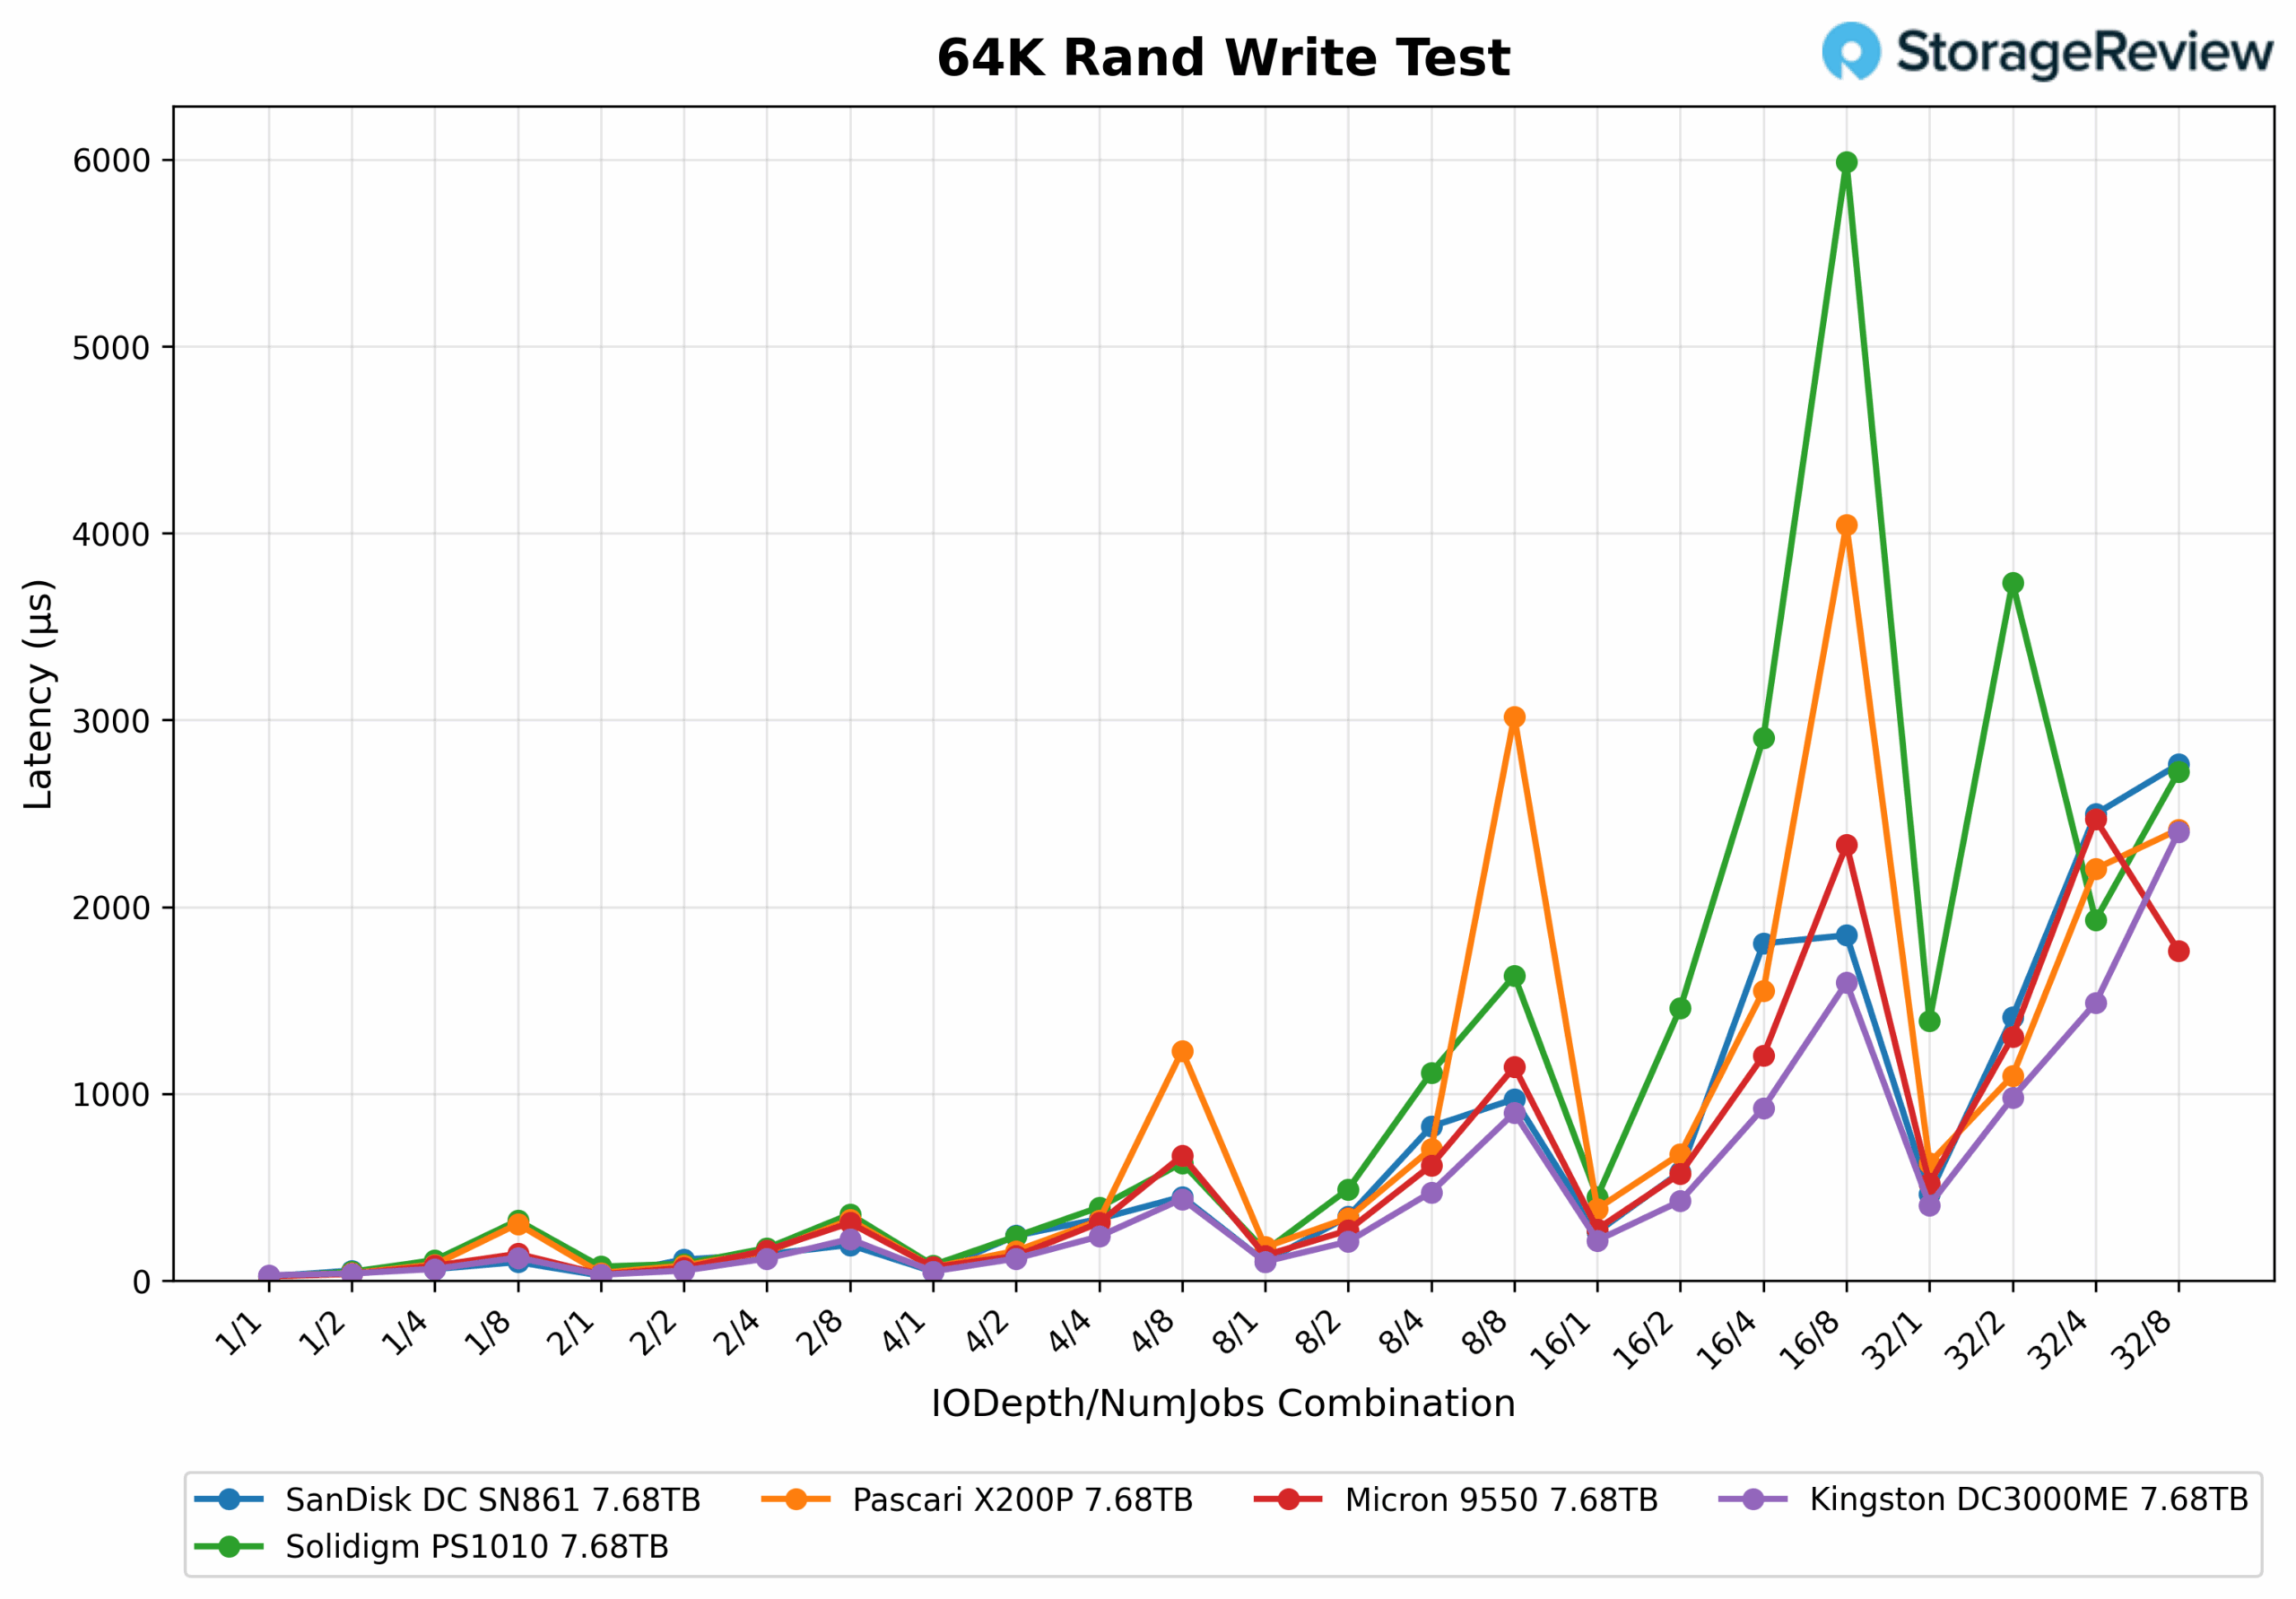
64K 랜덤 쓰기 지연 시간 테스트에서 X200P는 일반적으로 대기열 깊이가 낮거나 중간일 때 낮은 지연 시간을 보였으며, 0.023/1에서 1ms, 0.041/2에서 1ms의 두드러진 값을 보였습니다. 그러나 16/8 및 8/8과 같이 스레드와 대기열이 더 많은 조합에서는 지연 시간이 크게 증가하여 각각 4.045ms와 3.019ms까지 치솟았습니다.
64K 랜덤 읽기
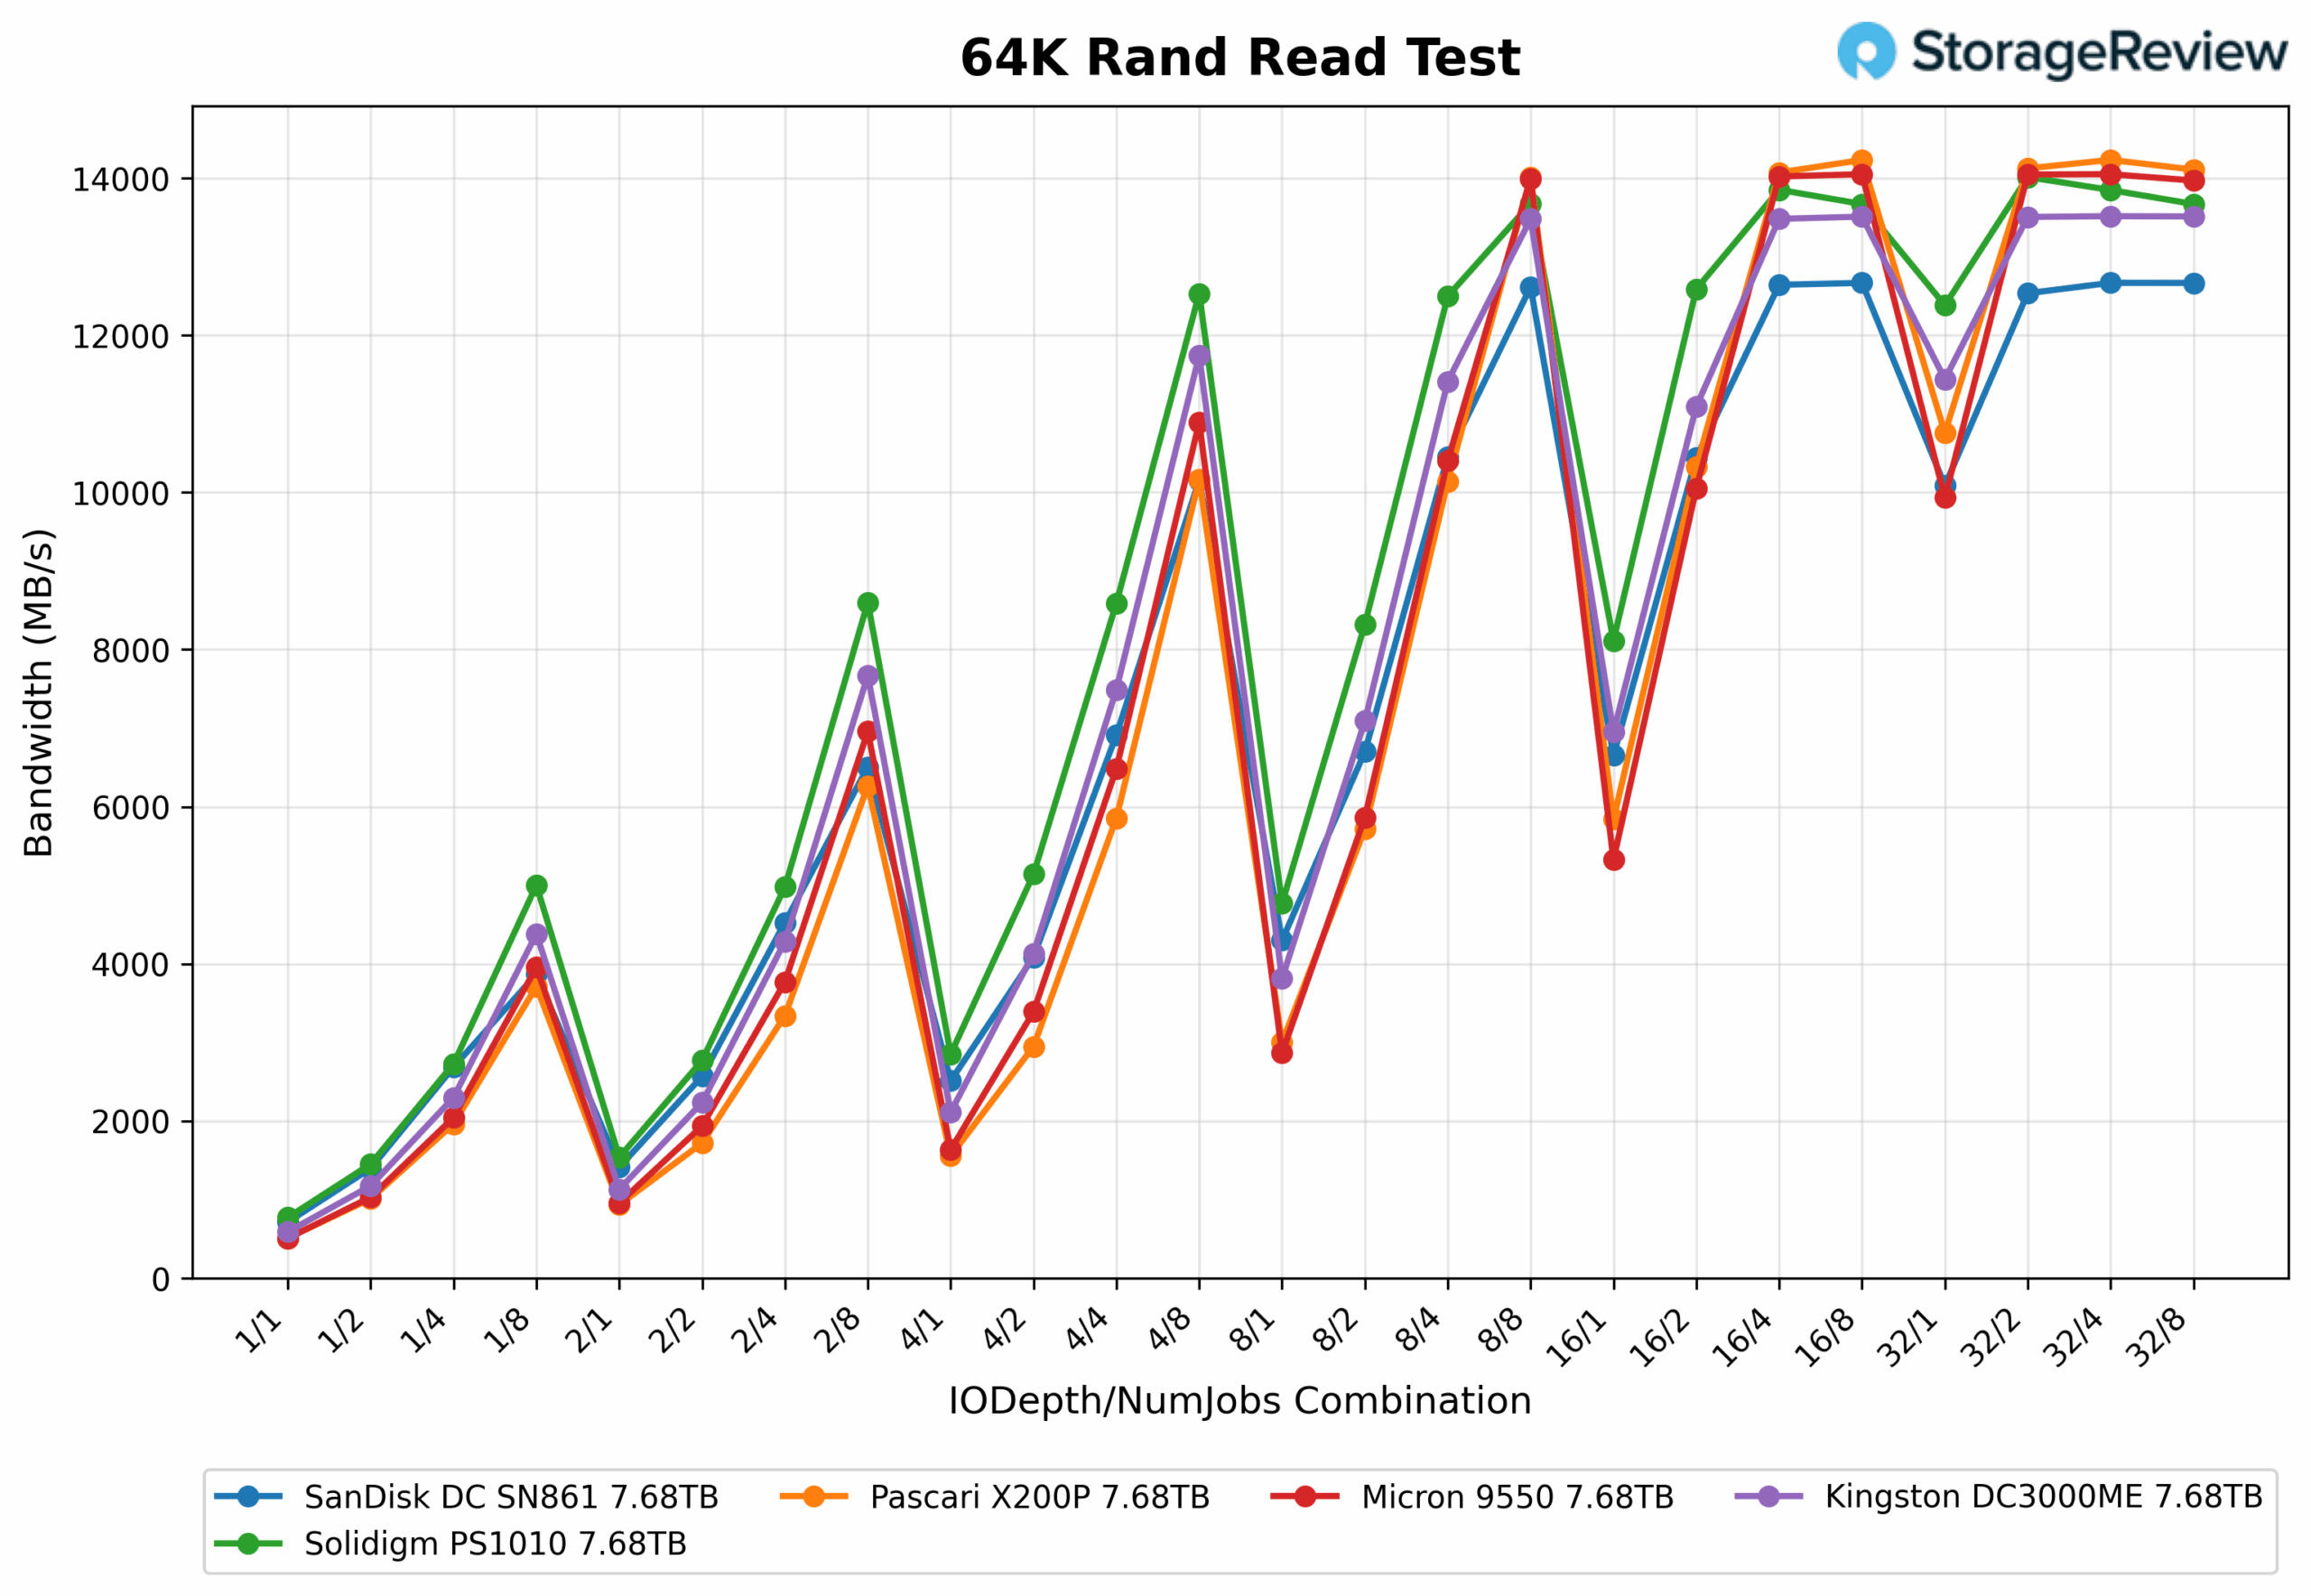
64K 랜덤 읽기 테스트에서 X200P는 전체 대기열 깊이와 스레드 수 범위에서 일관되게 우수한 성능을 보이며, 최상위 드라이브들을 전반적으로 따라잡았습니다. 처음에는 16위를 차지하지 못했지만, QD 8/32 및 8/14,232에서 선두를 차지하며 최대 대역폭 XNUMXMB/s에 도달하여 최고 부하 수준에서 경쟁 제품들과 동등하거나 앞서 나갔습니다. 이는 이 드라이브가 과도한 병렬 액세스 환경에서도 확장 가능한 성능을 보여준다는 것을 보여줍니다.
64K 랜덤 읽기 대기 시간
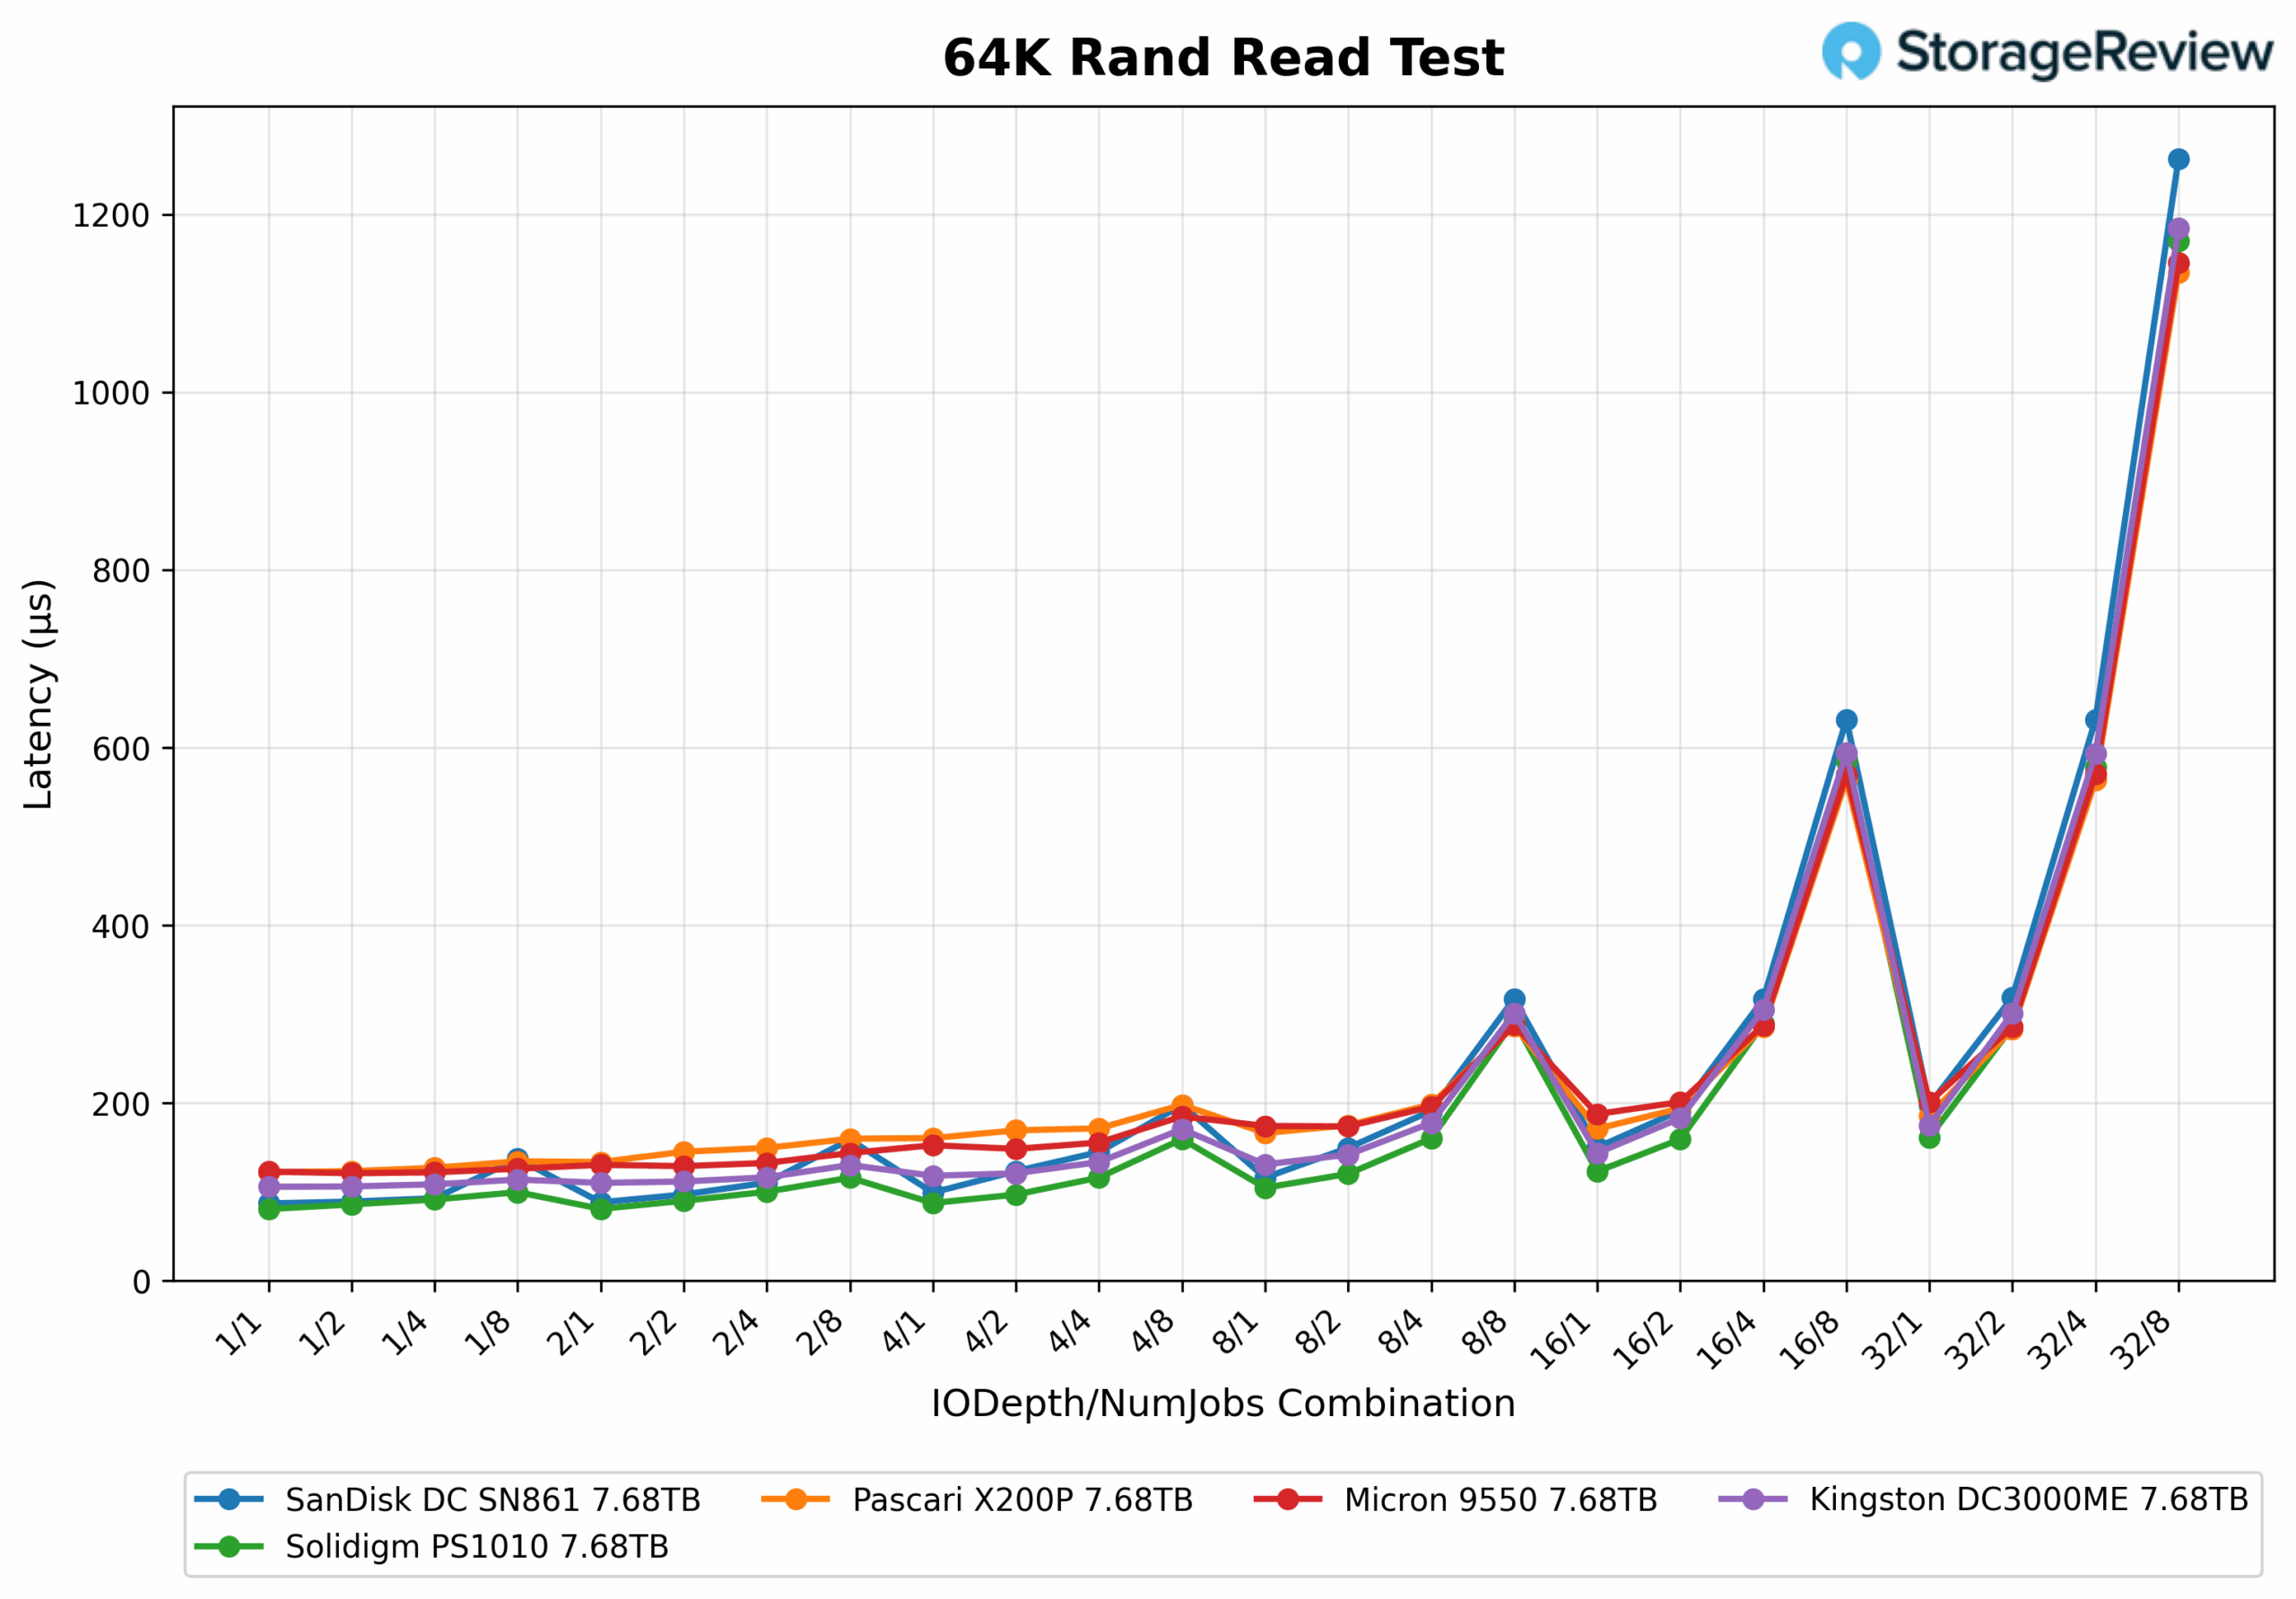
64K 랜덤 읽기 지연 시간 테스트에서 X200P는 대기열 깊이와 스레드 수에 관계없이 낮은 지연 시간을 일관되게 유지하며, 일반적으로 0.2밀리초 미만을 유지합니다. 지연 시간은 QD16/4에서 더욱 눈에 띄게 증가하여 0.285ms에 도달한 후 QD32/4에서 0.563ms로 더욱 증가합니다. 가장 큰 증가는 QD32/8에서 발생하며, 지연 시간은 1.135ms로 최고치를 기록합니다.
16K 랜덤 쓰기
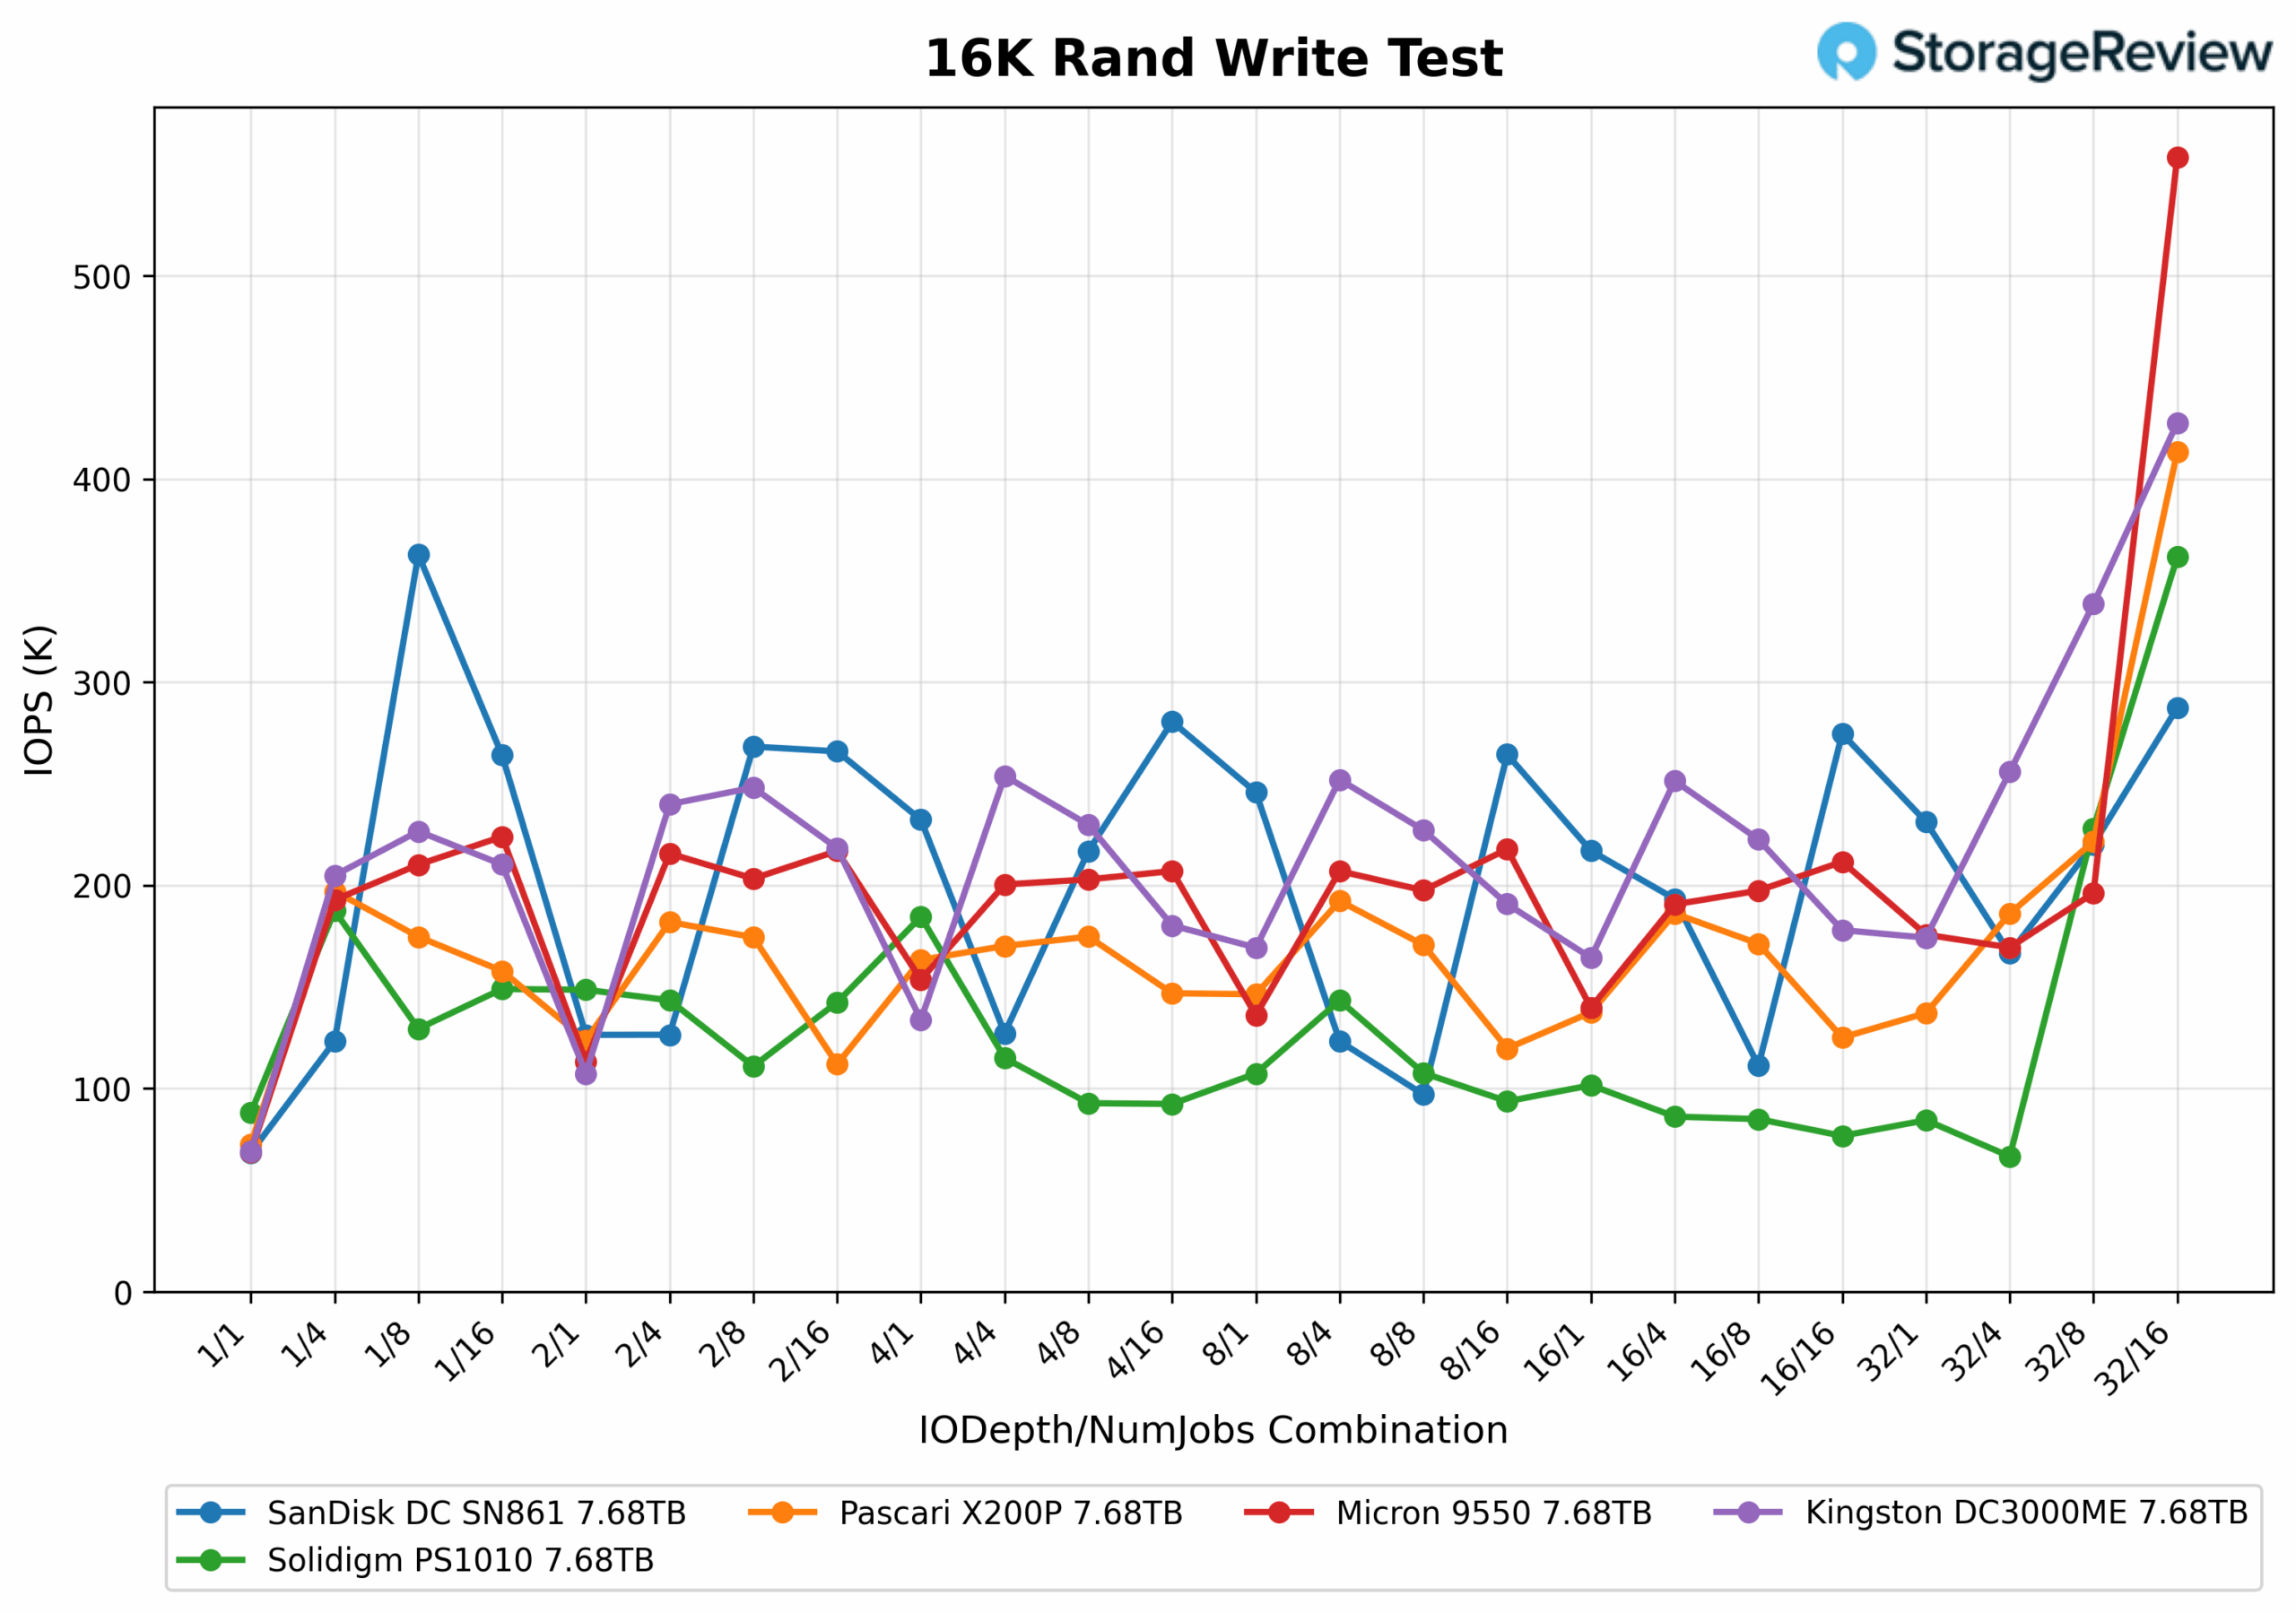
16K 랜덤 쓰기 테스트에서 X200P는 대부분의 큐 및 스레드 조합에서 견고한 중간 순위를 유지하며, 170/190, 4/4, 8/4과 같은 일반적인 구성에서 4K에서 8K IOPS 사이의 성능을 제공합니다. 성능은 부하가 더 높아지면 유의미하게 증가하기 시작하여 221/32에서 8K IOPS로 급등하고 413/32에서 16K IOPS로 최고치를 기록합니다. 이 시점에서 X3000P는 Kingston DC428ME(XNUMXK IOPS) 바로 아래에 위치하며, Kingston DCXNUMXME는 근소한 차이로 앞서 있습니다. 이러한 강력한 성능은 Pascari가 XNUMX위를 차지하지 못하더라도 최대 쓰기 부하 상황에서도 효과적으로 성능을 확장할 수 있음을 보여줍니다.
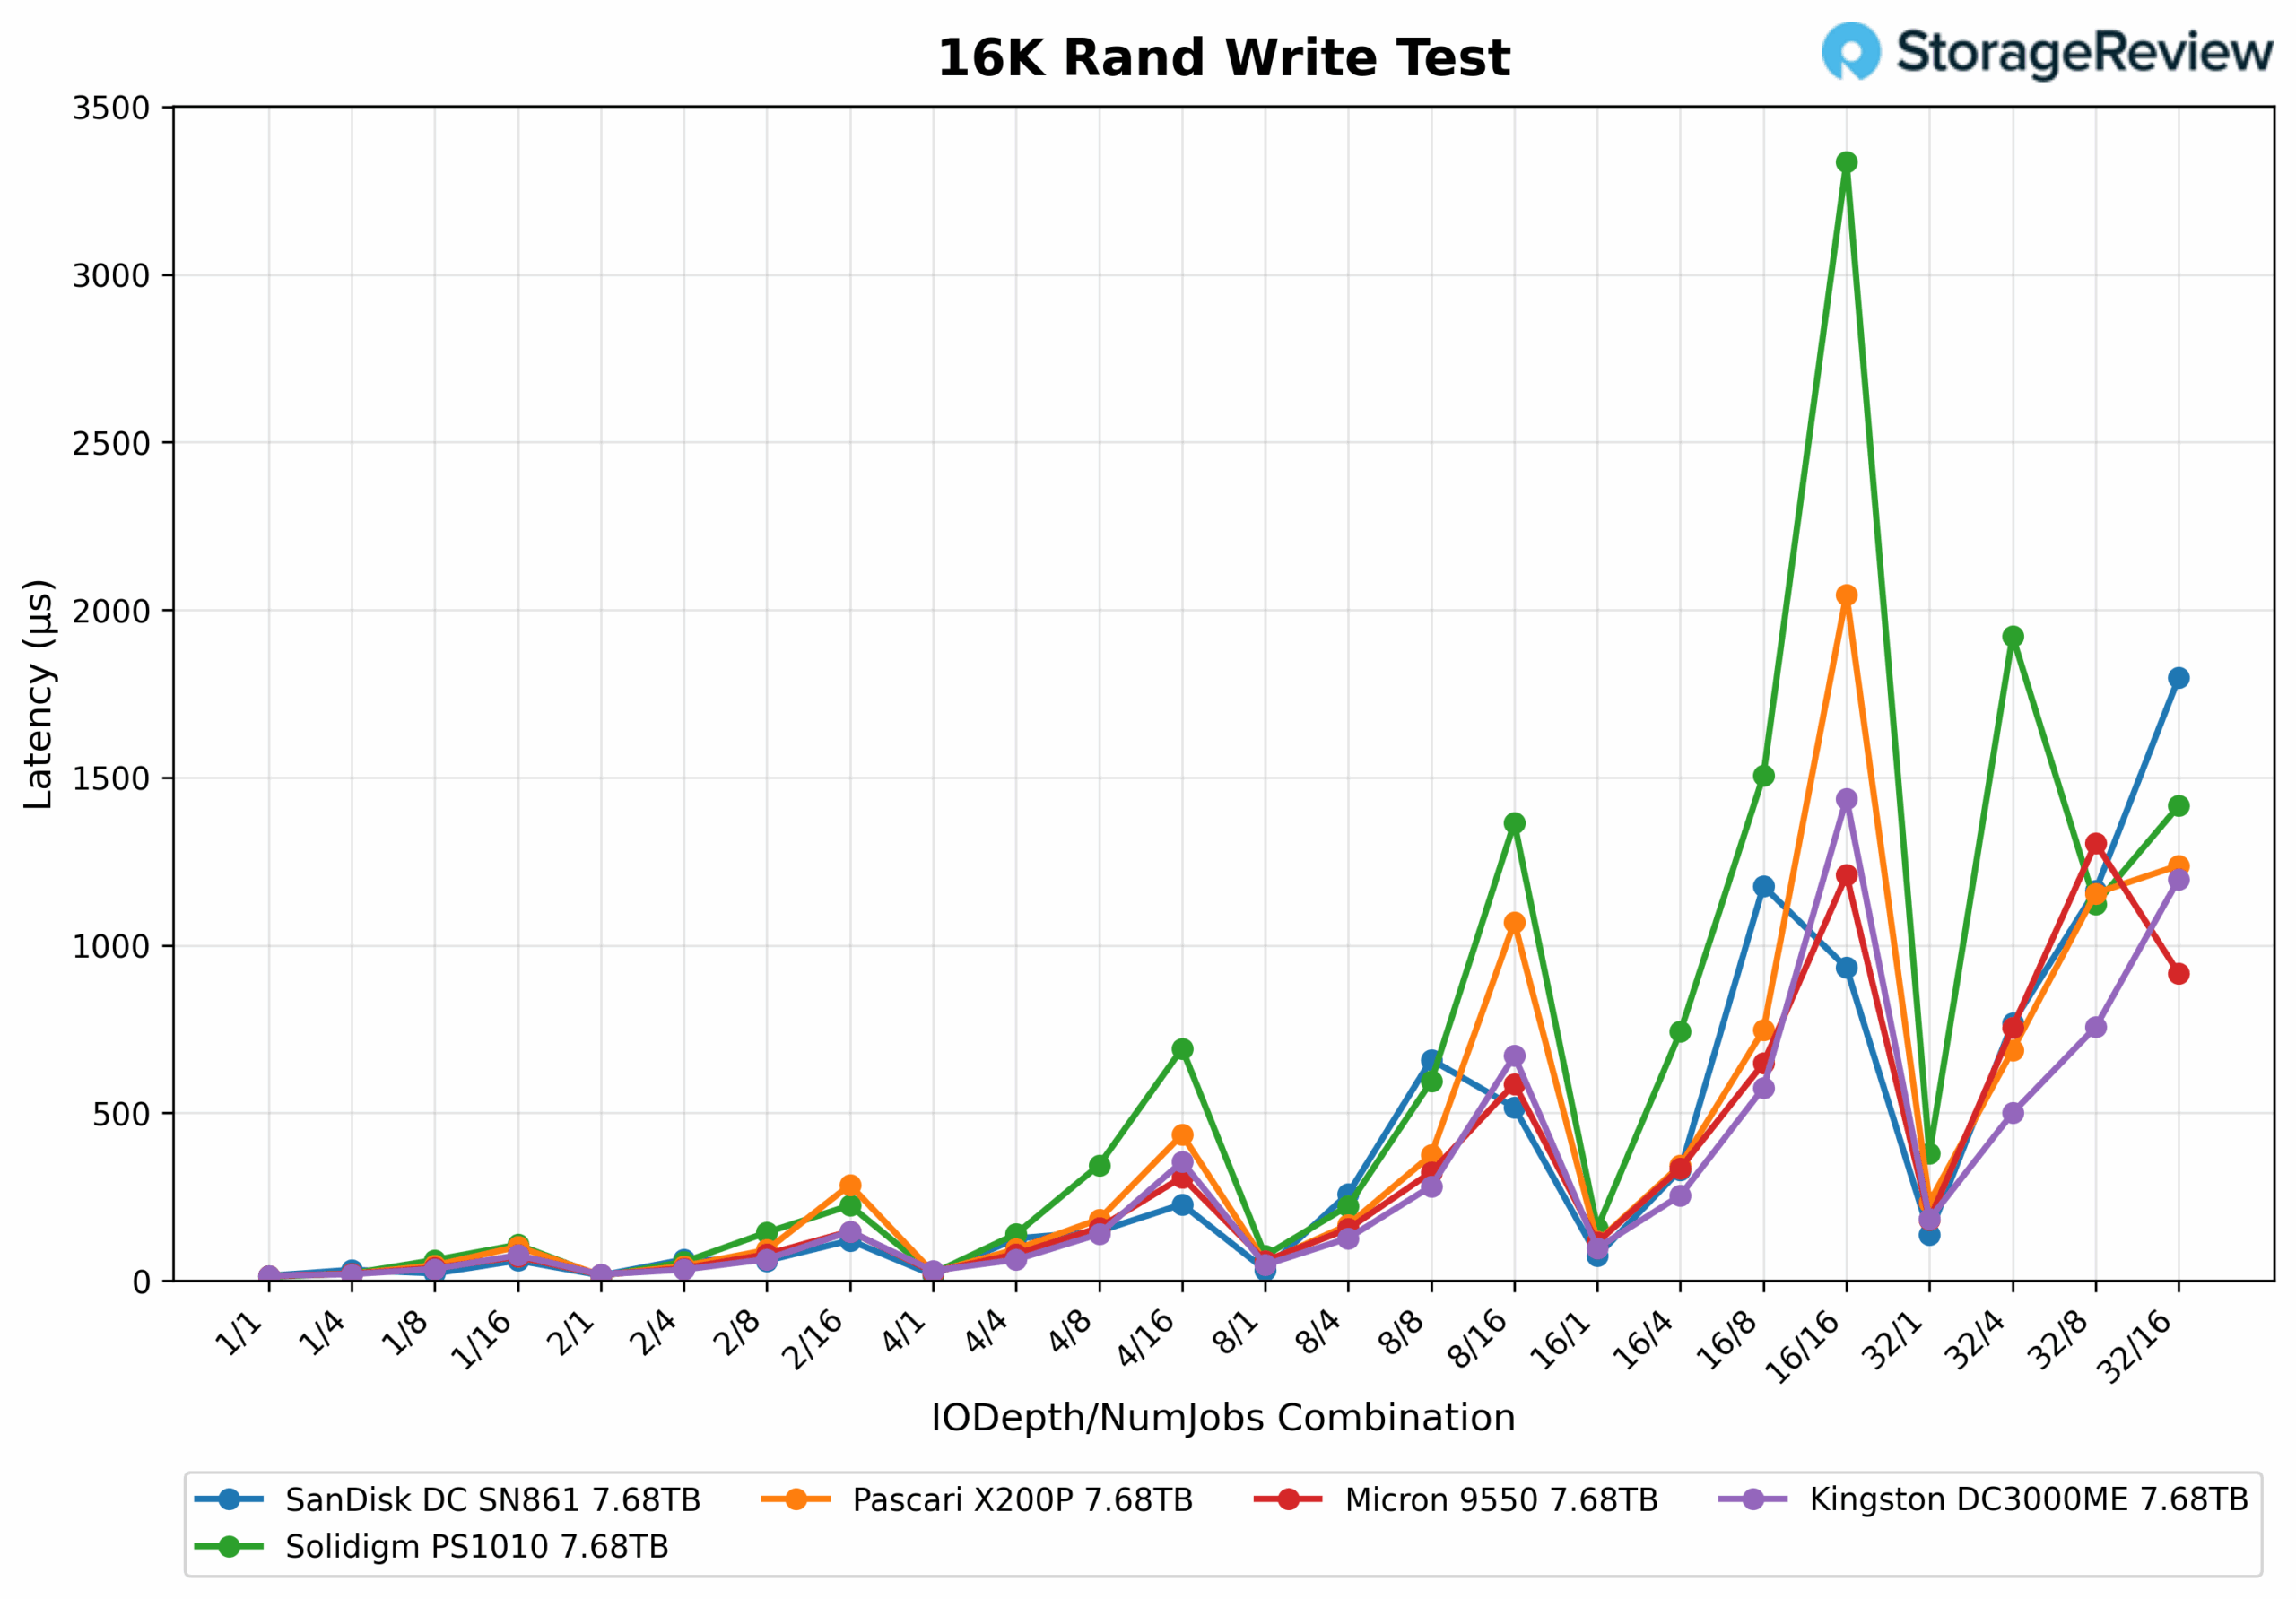
16K 랜덤 쓰기 지연 테스트에서 X200P는 대부분 구성에서 매우 낮은 지연 시간을 유지하며, 일반적으로 0.2/4, 4/8 및 4/2과 같은 설정에서 8ms 미만을 유지합니다. QD16/4에서 적당히 상승하기 시작하여 0.343ms에 도달하고 QD32/4에서 더 급격하게 0.687ms에 도달합니다. 가장 높은 부하에서 QD16/16과 QD32/8은 각각 1.068ms와 1.155ms로 지연 시간이 더욱 증가합니다. 최대 지연 시간은 QD16/16에서 2.045ms로 발생하고 바로 직전에 QD32/16에서 1.238ms로 다시 약간 안정됩니다. 전반적으로 Pascari는 가장 평평한 지연 곡선을 가지고 있지 않지만 합리적인 제어를 유지하며 차트 상단에서 Kingston 바로 뒤에 위치합니다.
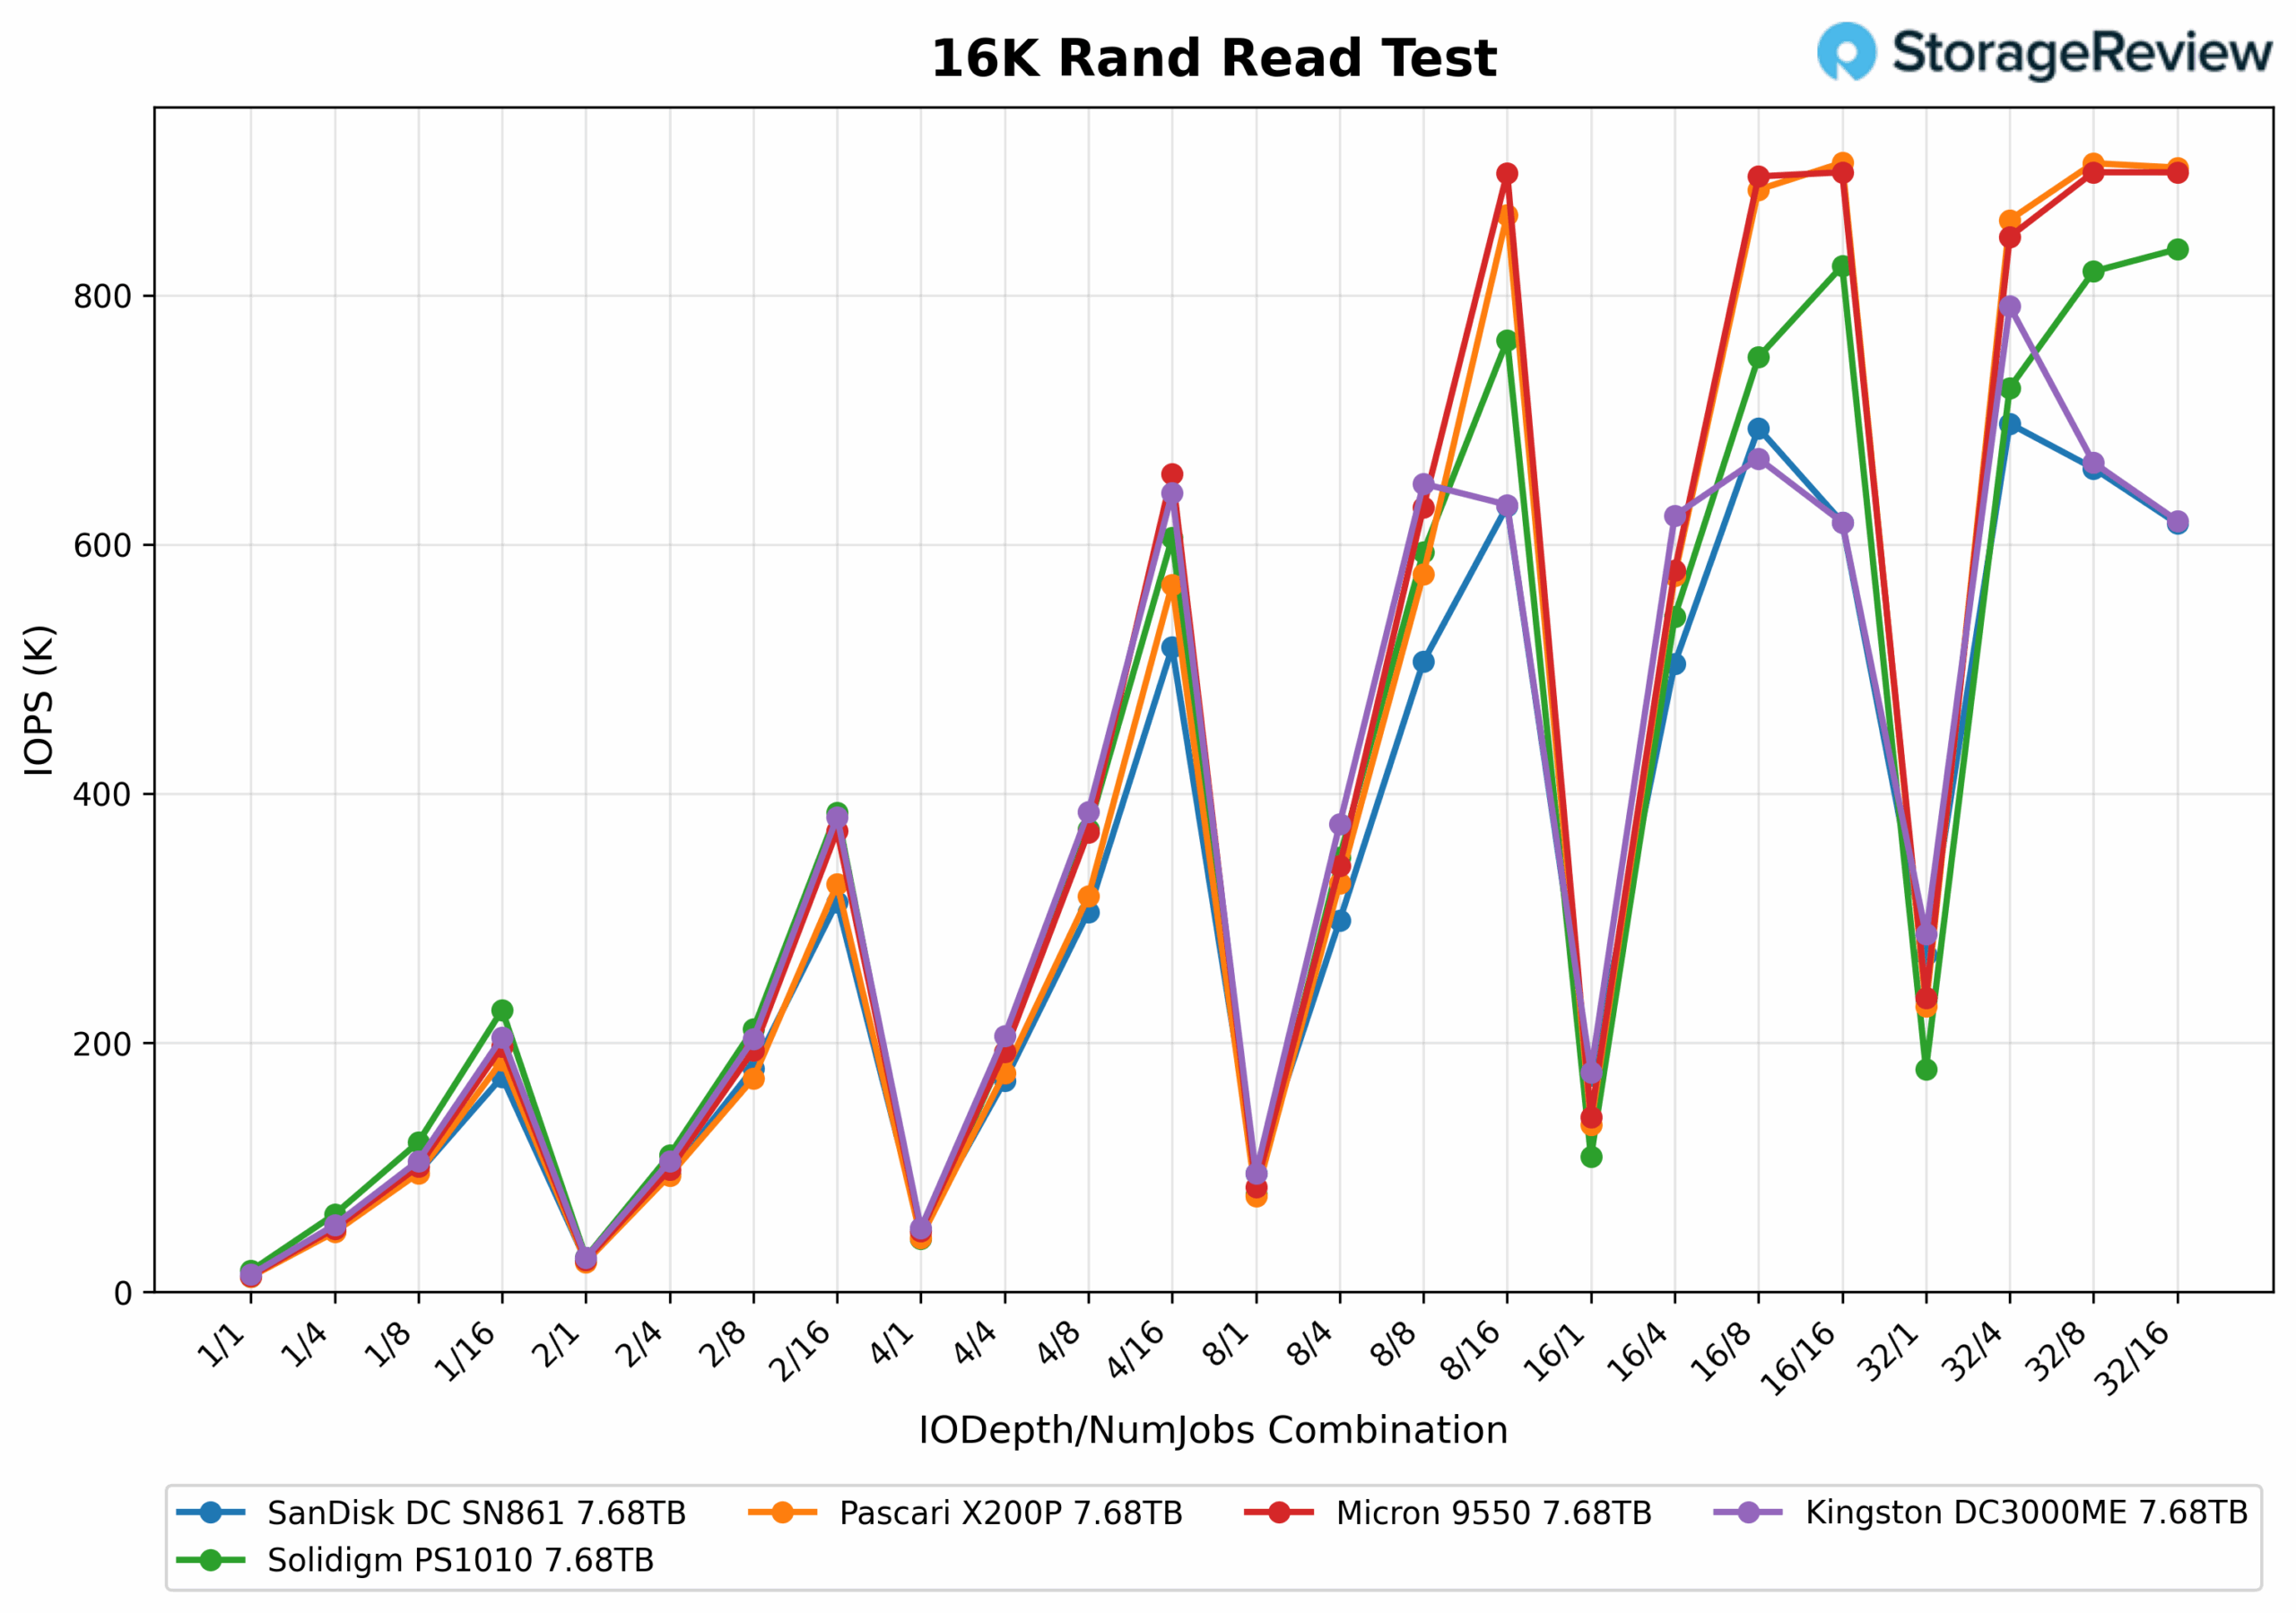
16K 랜덤 읽기 테스트에서 X200P는 큐 깊이와 스레드 수에 걸쳐 깔끔한 확장성을 보이며 견고한 성능을 제공합니다. 906/16 QD에서 16K IOPS로 최고 성능을 기록했으며, 905.9/32 QD에서도 거의 동일한 8K IOPS를 기록했습니다. 또한 32/16 QD에서도 902.4K IOPS로 강력한 성능을 유지하며 상위권에 확고히 자리매김했습니다. 낮은 큐 깊이에서는 선두를 차지하지 못했지만, Pascari는 꾸준히 성능을 향상시키며 지속적인 읽기 압박 속에서도 상위권 자리를 굳건히 지켜내며 높은 처리량과 효과적인 확장성을 입증했습니다.
16K 랜덤 읽기 대기 시간
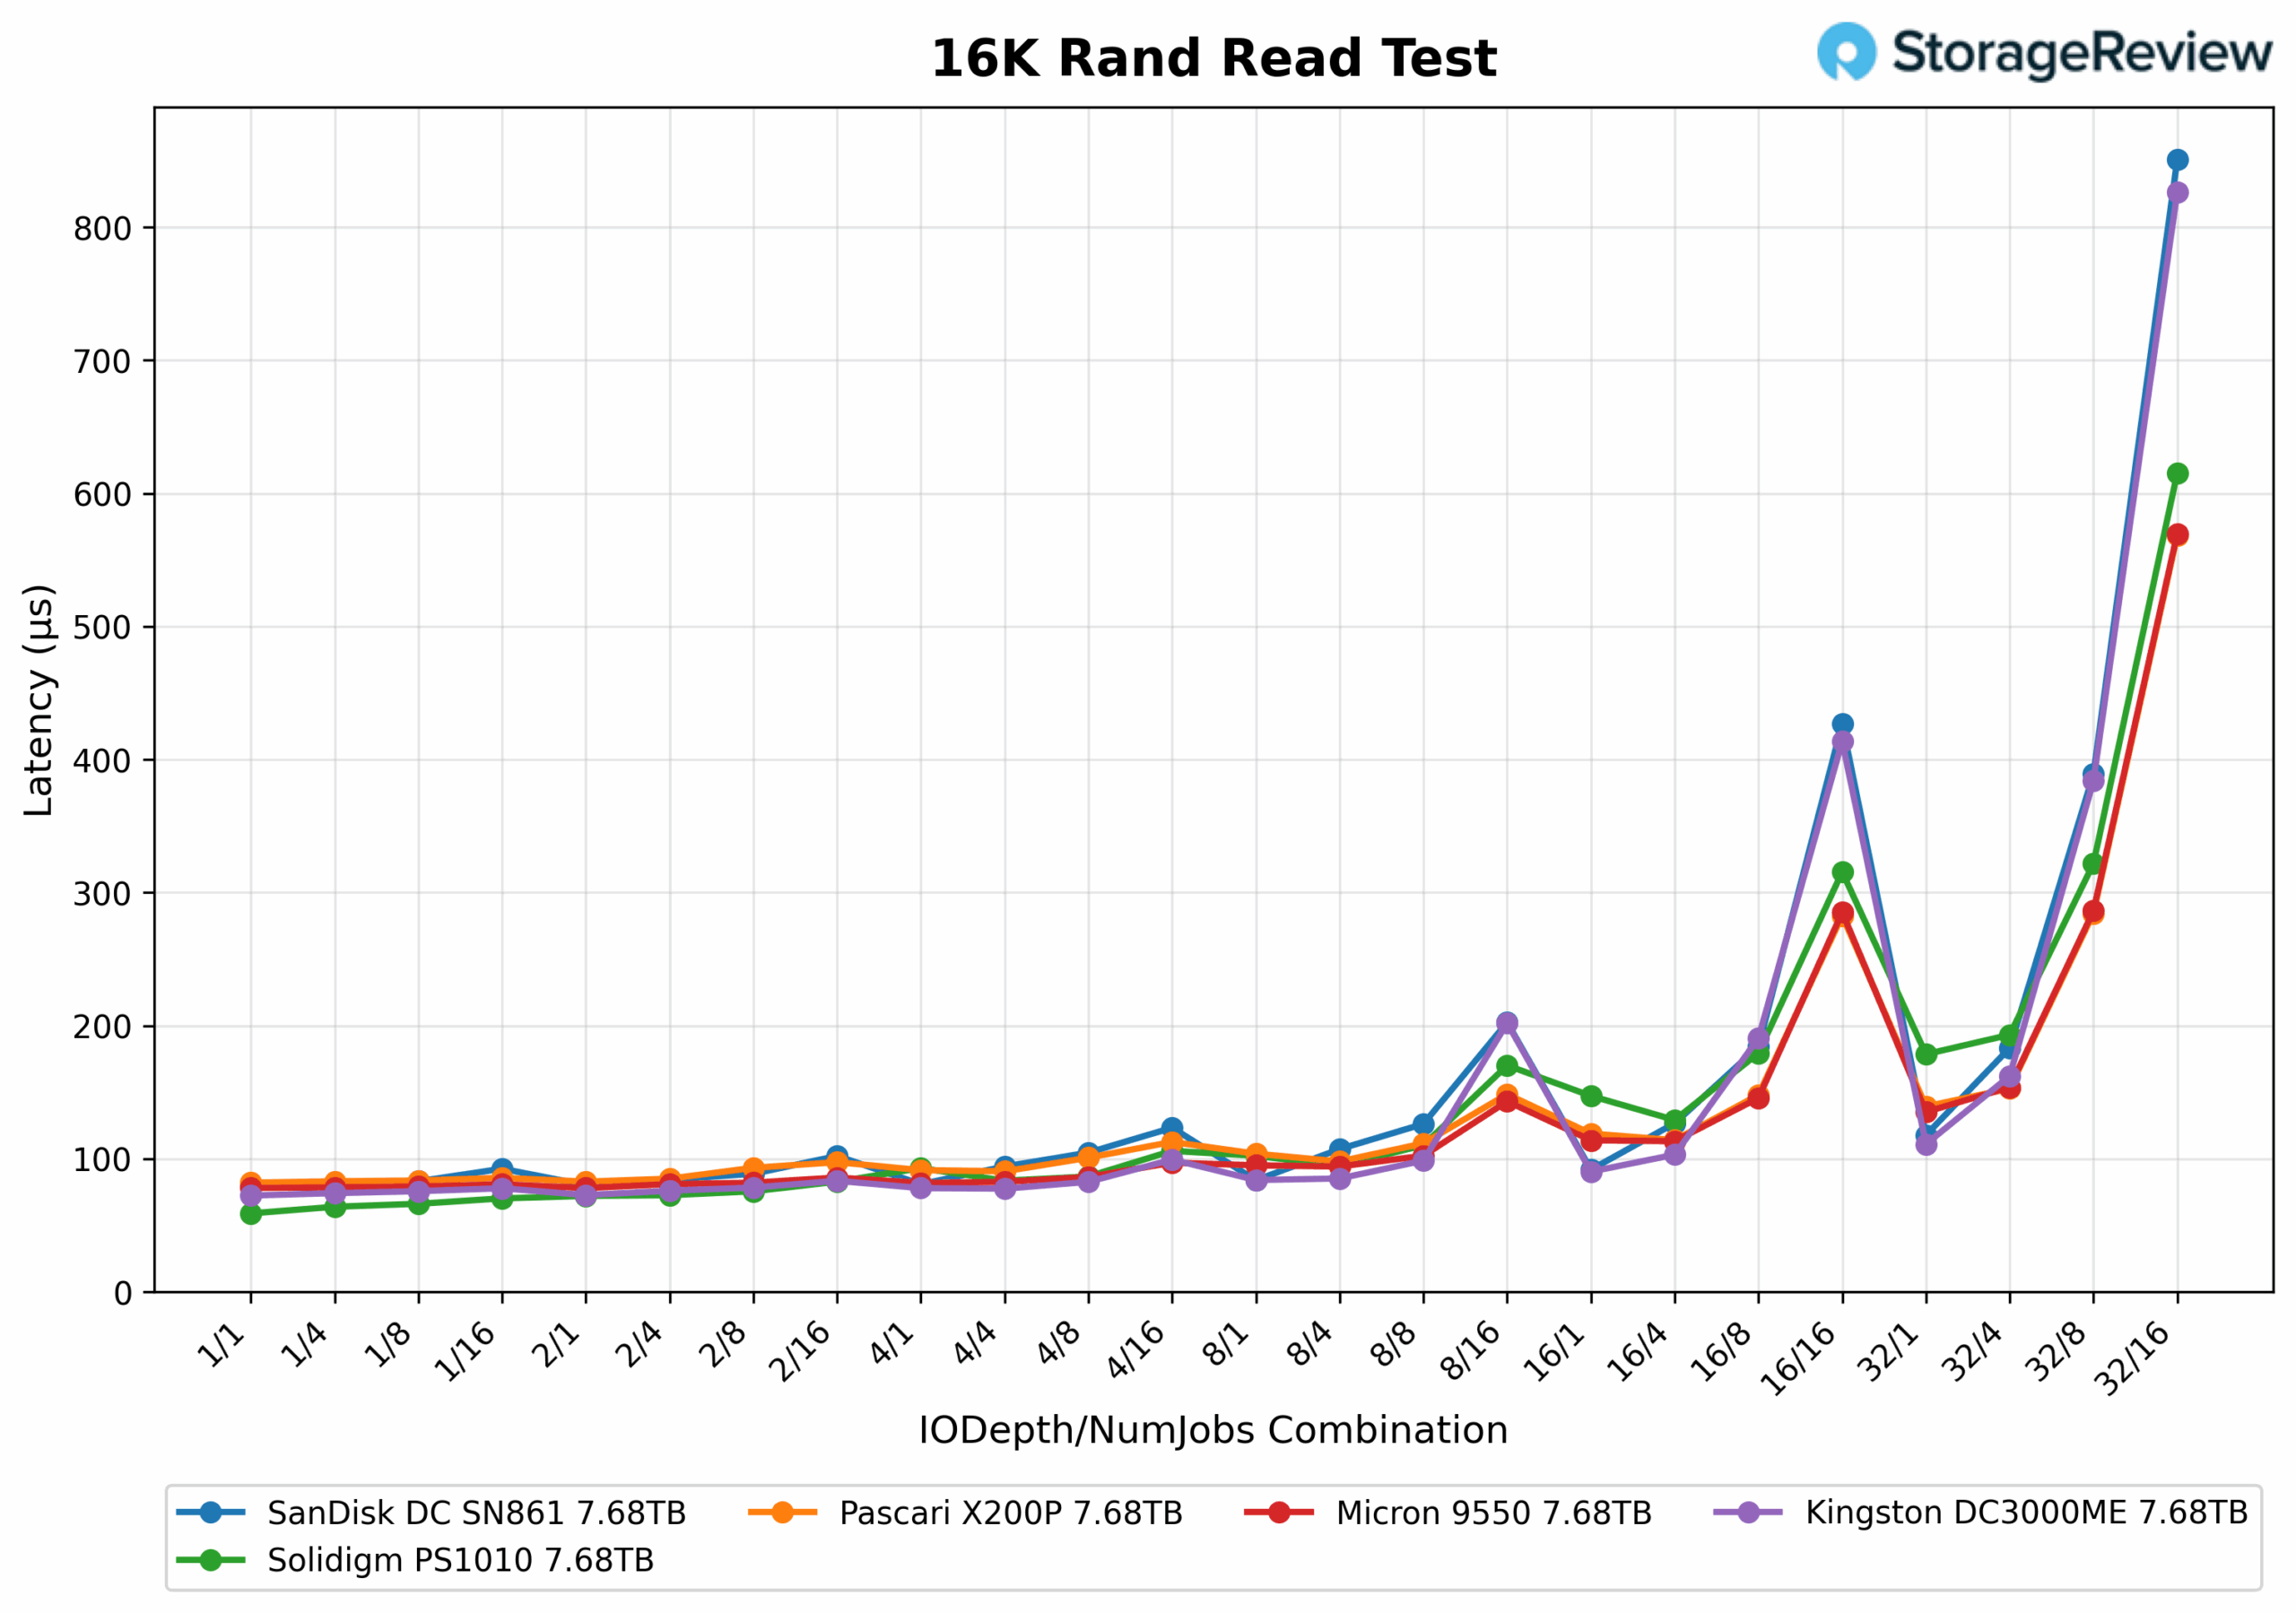
16K 랜덤 읽기 지연 시간 테스트에서 X200P는 대부분의 대기열 깊이와 스레드 수에서 낮고 일관된 지연 시간을 유지했습니다. QD0.082/1에서 1ms로 시작하여 QD0.1/0.091과 QD4/1에서 4ms, QD4/0.093에서 2ms를 포함한 여러 중간 범위 조합에서 8ms 미만을 유지했습니다. 부하가 증가함에 따라 지연 시간은 소폭 증가하기 시작하여 QD0.114/16에서 4ms, QD0.148/16에서 8ms에 도달했습니다. 가장 높은 지연 시간은 QD32/16에서 0.568ms로 나타났으며, 이 경우에도 드라이브는 902K IOPS를 유지했습니다.
4K 랜덤 쓰기
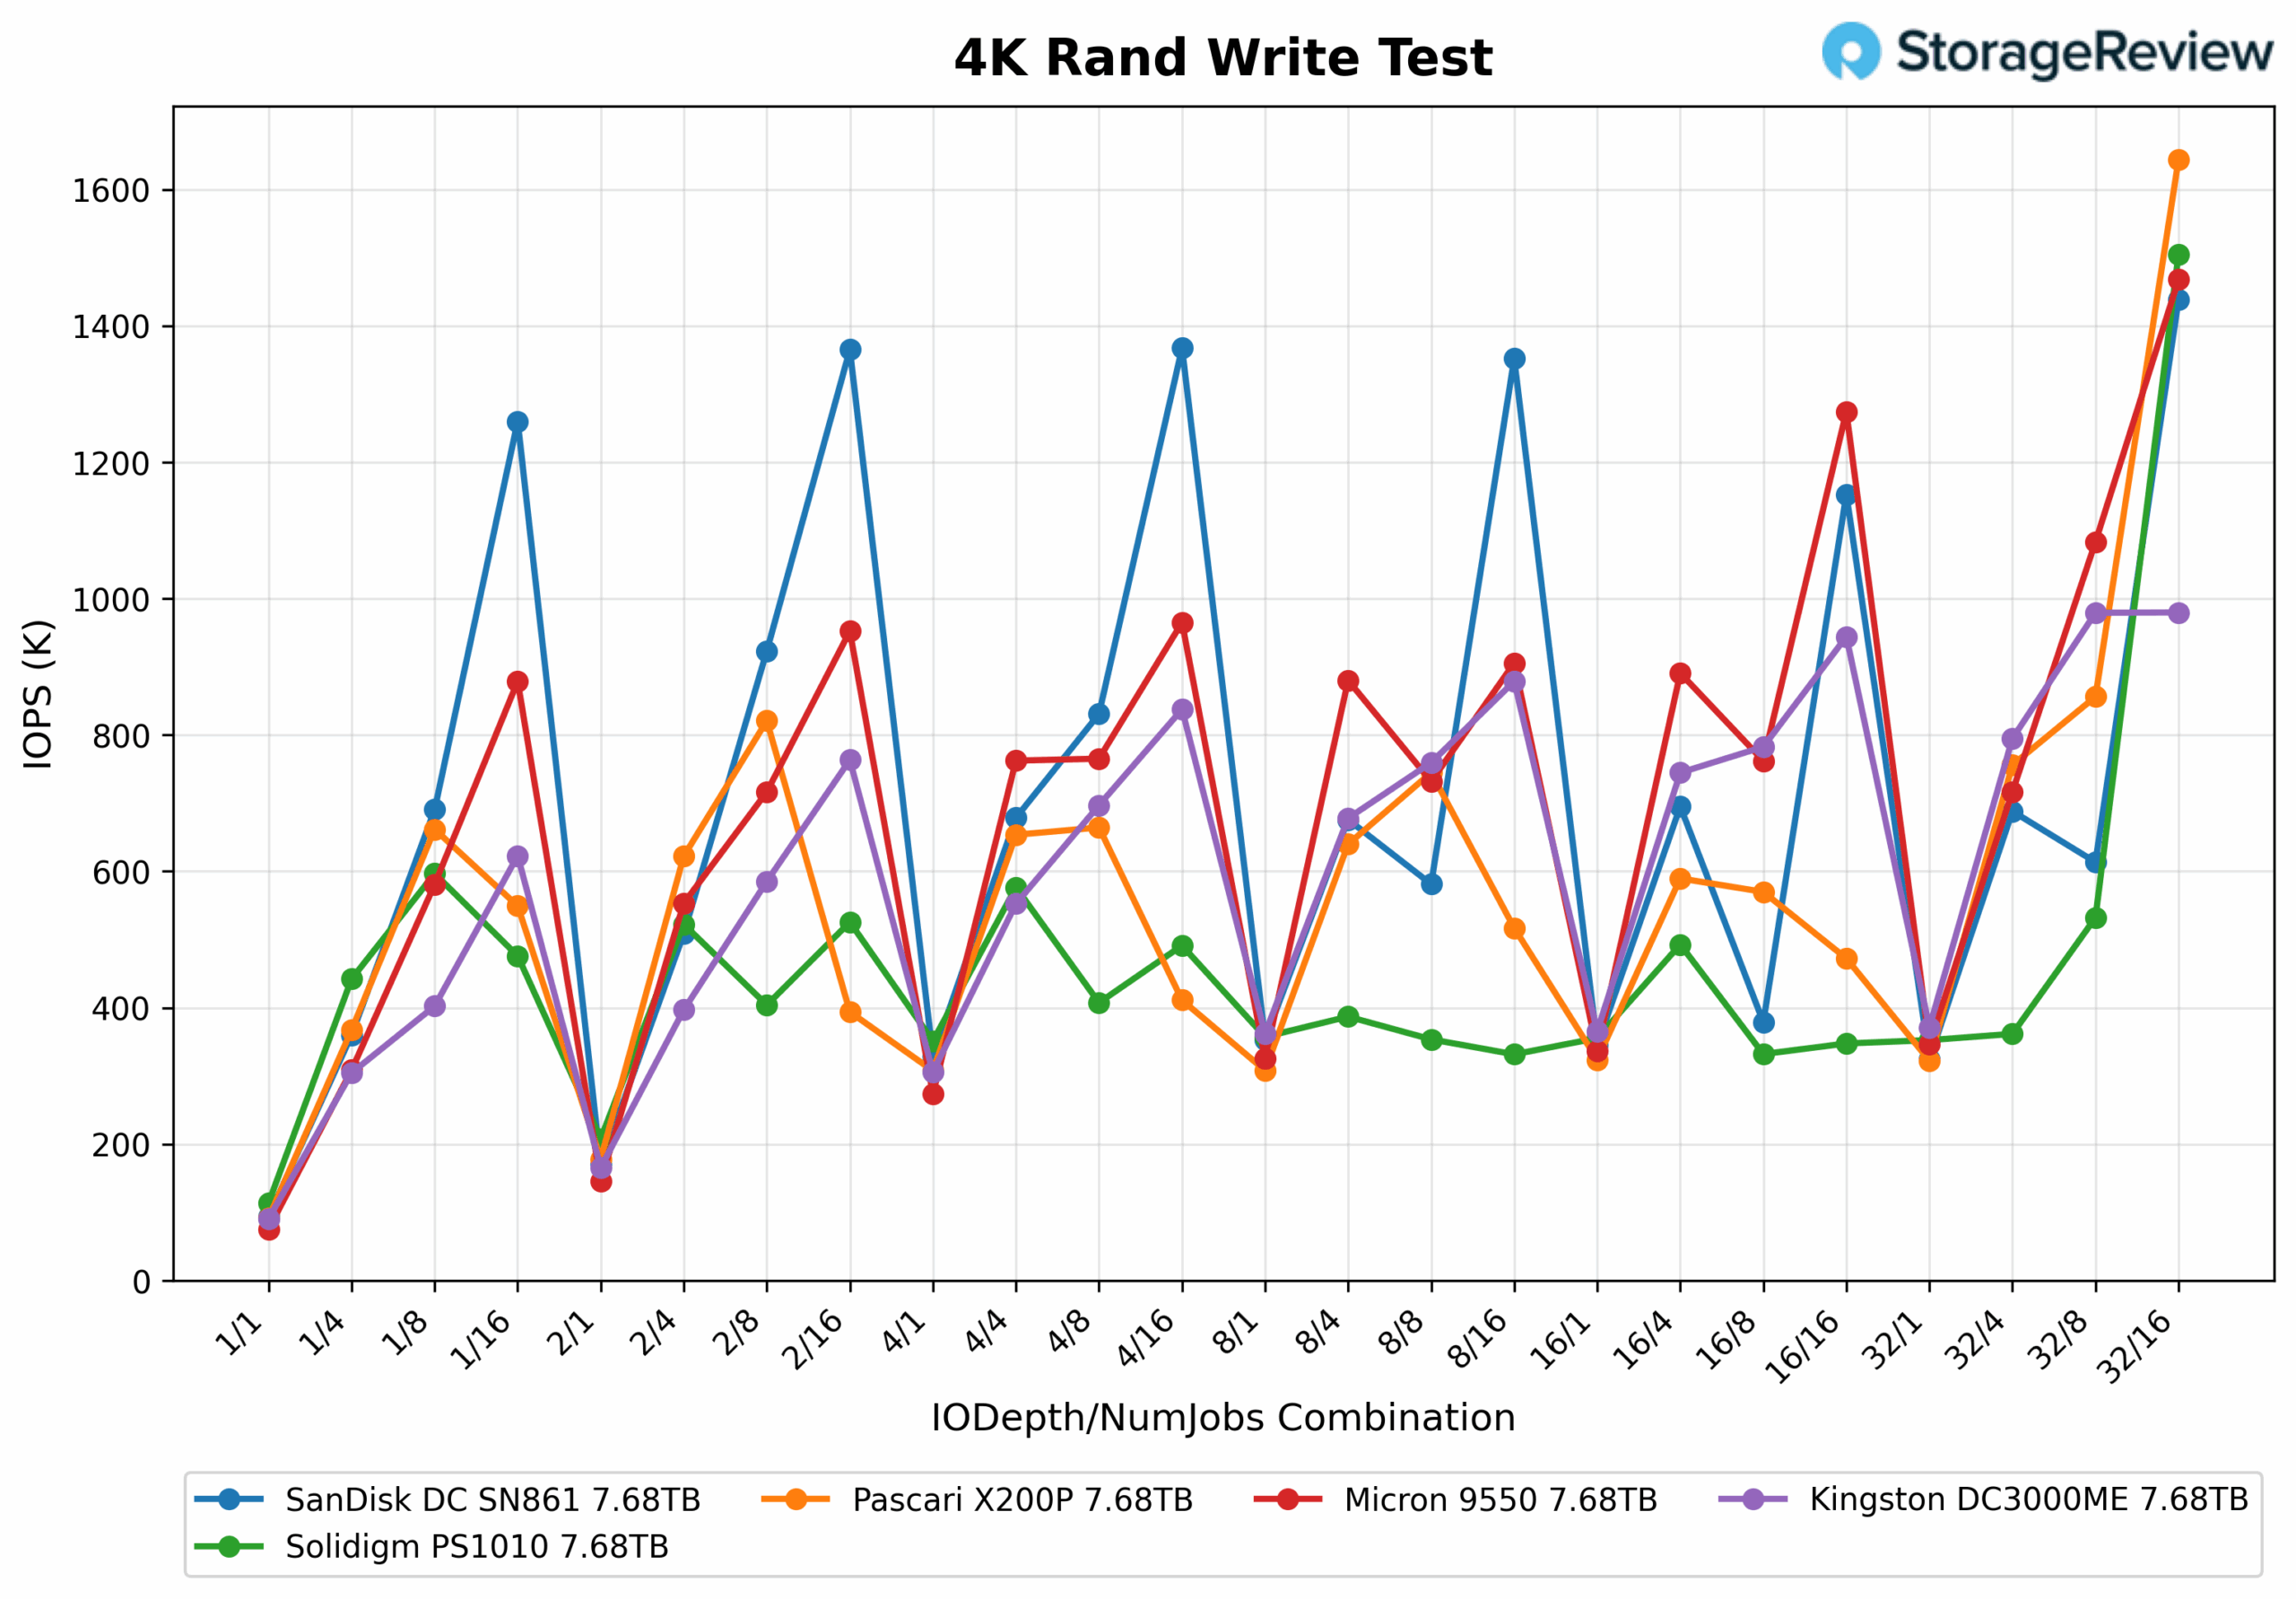
4K 랜덤 쓰기 테스트에서 X200P는 depth/jobs 1/1부터 안정적인 결과를 보였습니다. 이 드라이브는 91.9K IOPS를 달성했으며, 대부분의 대기열 깊이와 스레드 조합에서 전반적으로 중간에서 낮은 수준을 기록했습니다. 최대 처리량은 1.64/32에서 16만 IOPS에 도달하여 경쟁력 있는 성능을 보였지만, 특정 부분에서는 SanDisk와 Micron의 최고 성능에 미치지 못했습니다.
4K 임의 쓰기 지연 시간
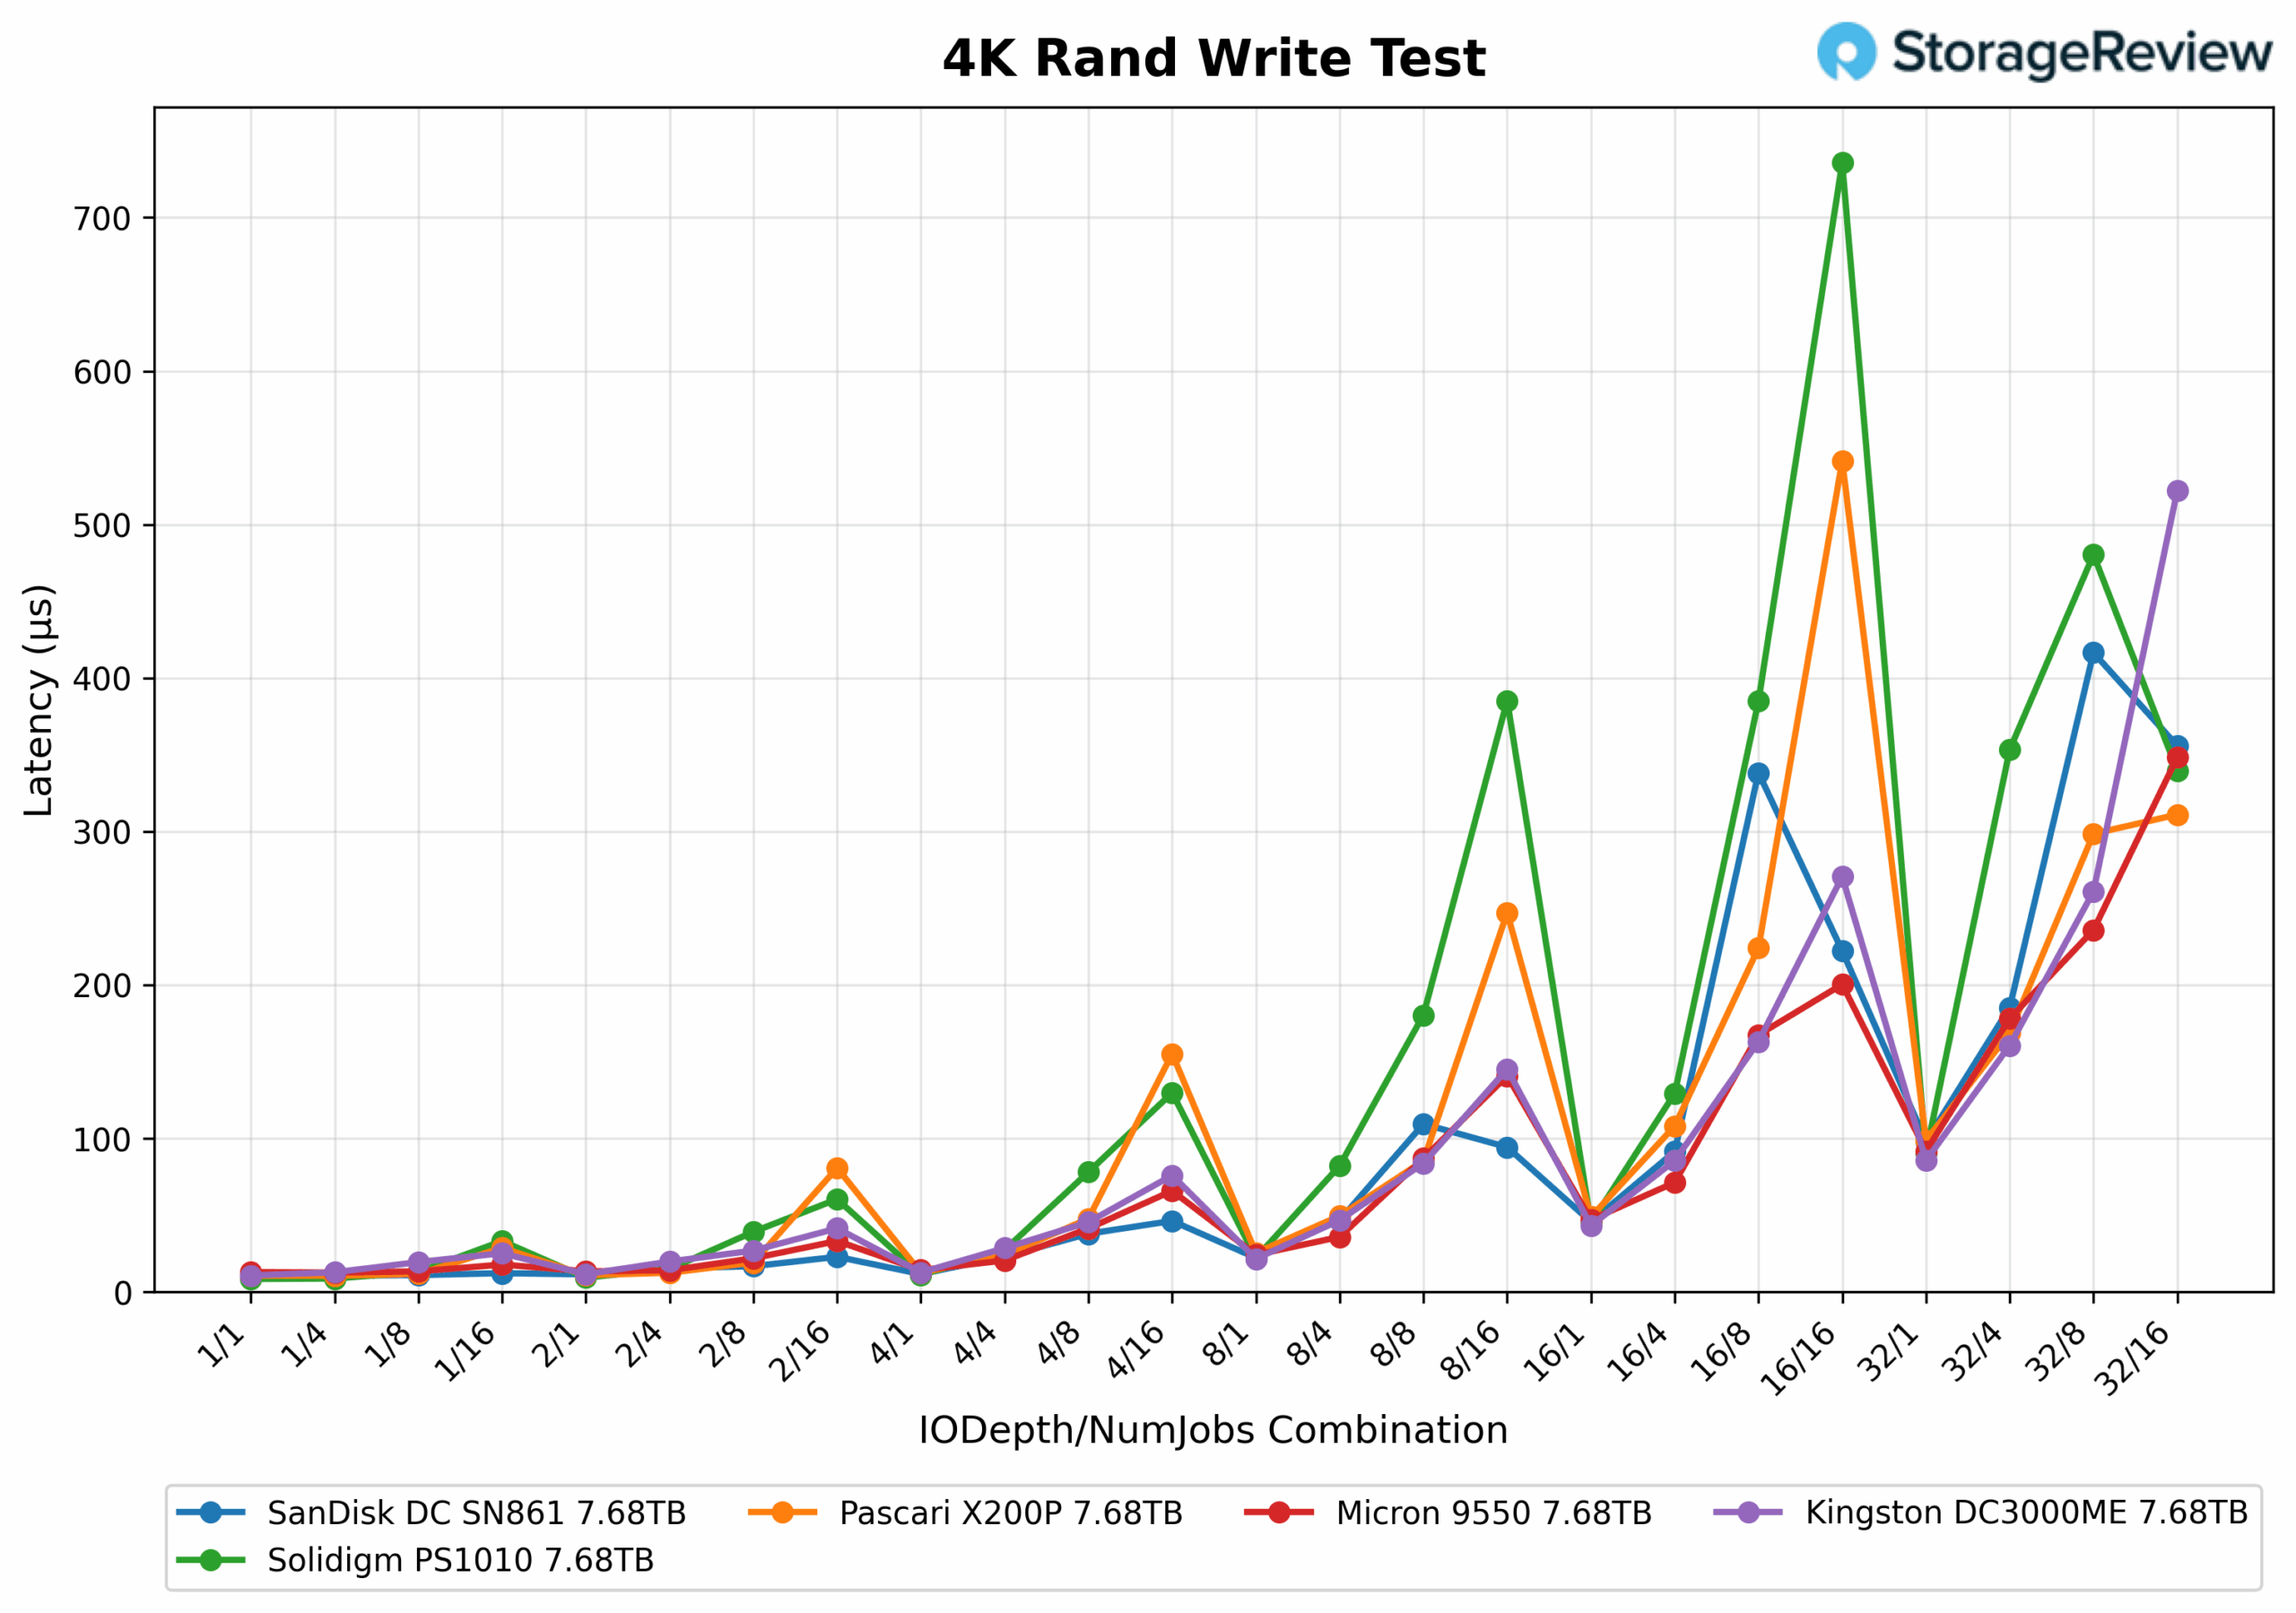
4K 랜덤 쓰기 지연 시간에서 X200P는 가벼운 작업 부하에서도 우수한 성능을 보이며, 최고 사양 드라이브와 동일한 0.010ms를 기록했습니다. 그러나 부하가 높아질수록 지연 시간은 빠르게 증가하여 0.247/8에서 16ms에 도달했고, 0.541/16에서는 16ms로 두 번째로 높은 최고치를 기록했습니다.
4K 랜덤 읽기
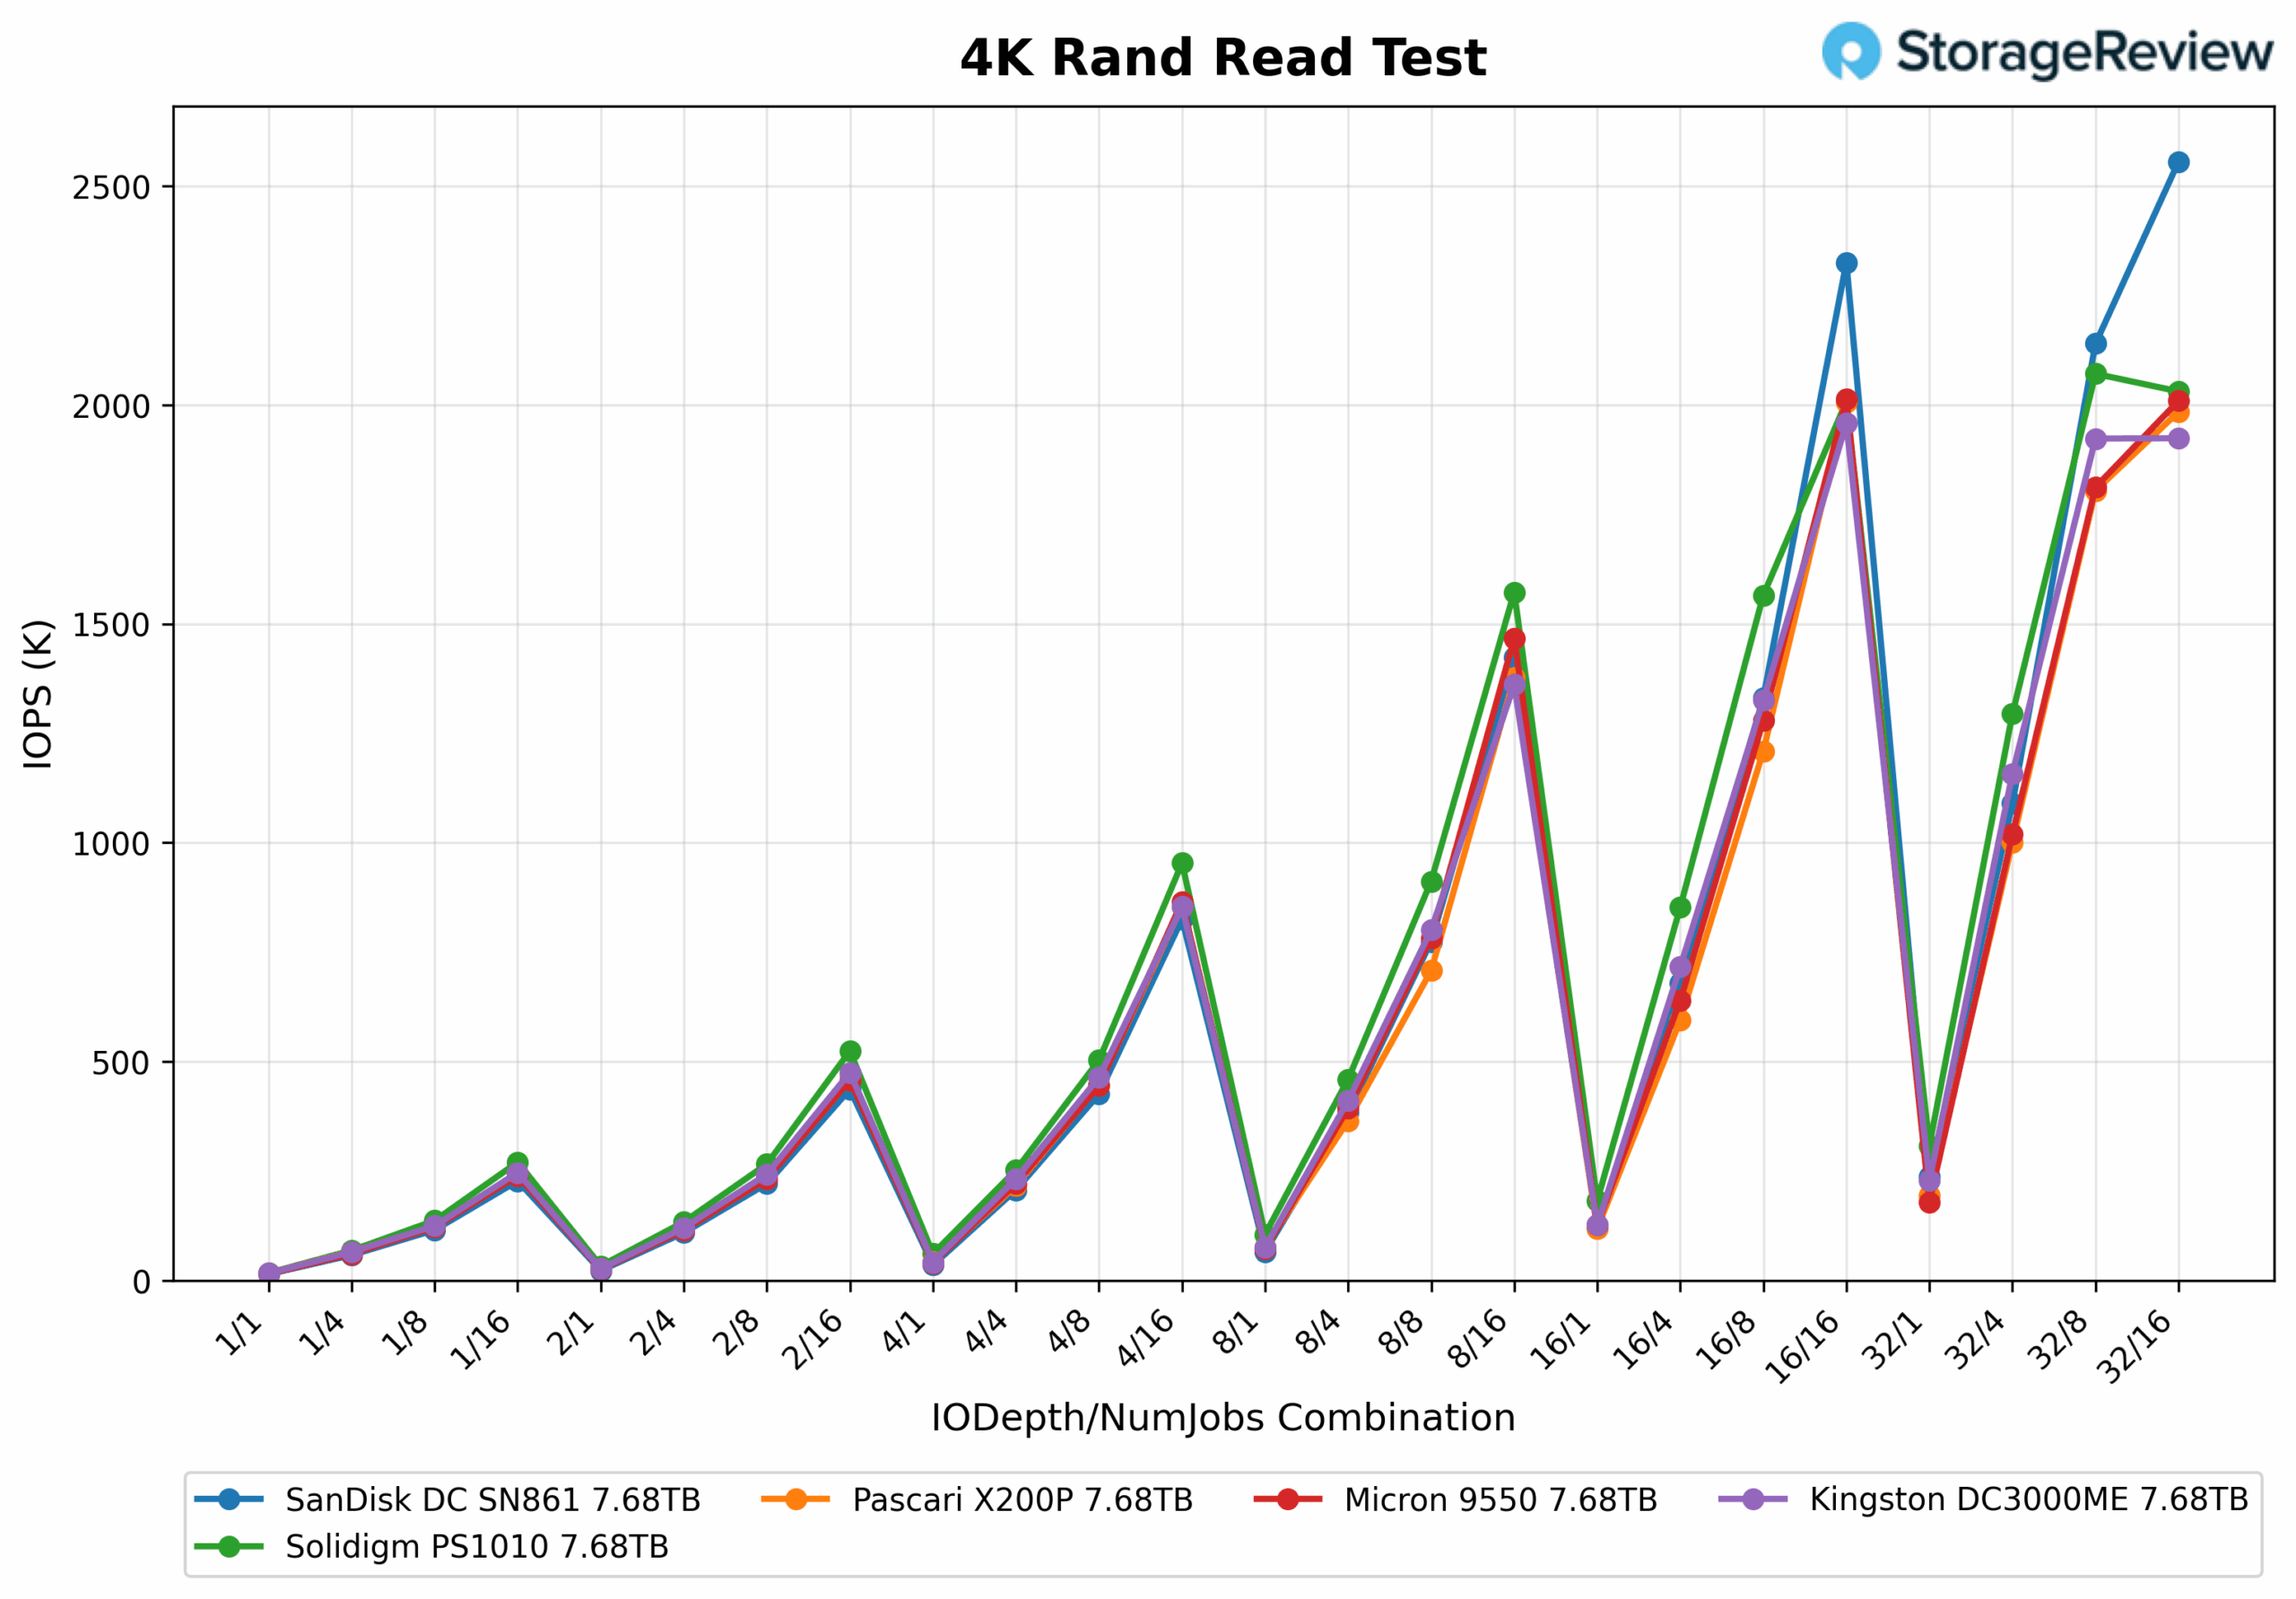
4K 랜덤 읽기 성능 곡선에서 X200P는 16.6/1에서 1K IOPS로 낮은 수준에서 시작하지만, 중간 범위에서는 예측 가능하게 확장되어 365/8에서 4K IOPS, 707/8에서 8K IOPS를 기록합니다. 더 높은 대기열 깊이로 갈수록 꾸준한 가속력을 보이며 1.2/16에서 8만 IOPS에 도달하고 2/16에서 16만 IOPS까지 이어집니다. 특히 Pascari는 32만 IOPS로 Kingston 바로 아래에 위치하며 16/1.98을 기록하여 중간 수준에 위치합니다. 이 드라이브는 8/16부터 강력한 상승 모멘텀을 유지하며 꾸준히 백만 IOPS 티어로 올라가 가장 까다로운 워크로드에서도 일관된 성능을 제공합니다.
4K 랜덤 읽기 대기 시간
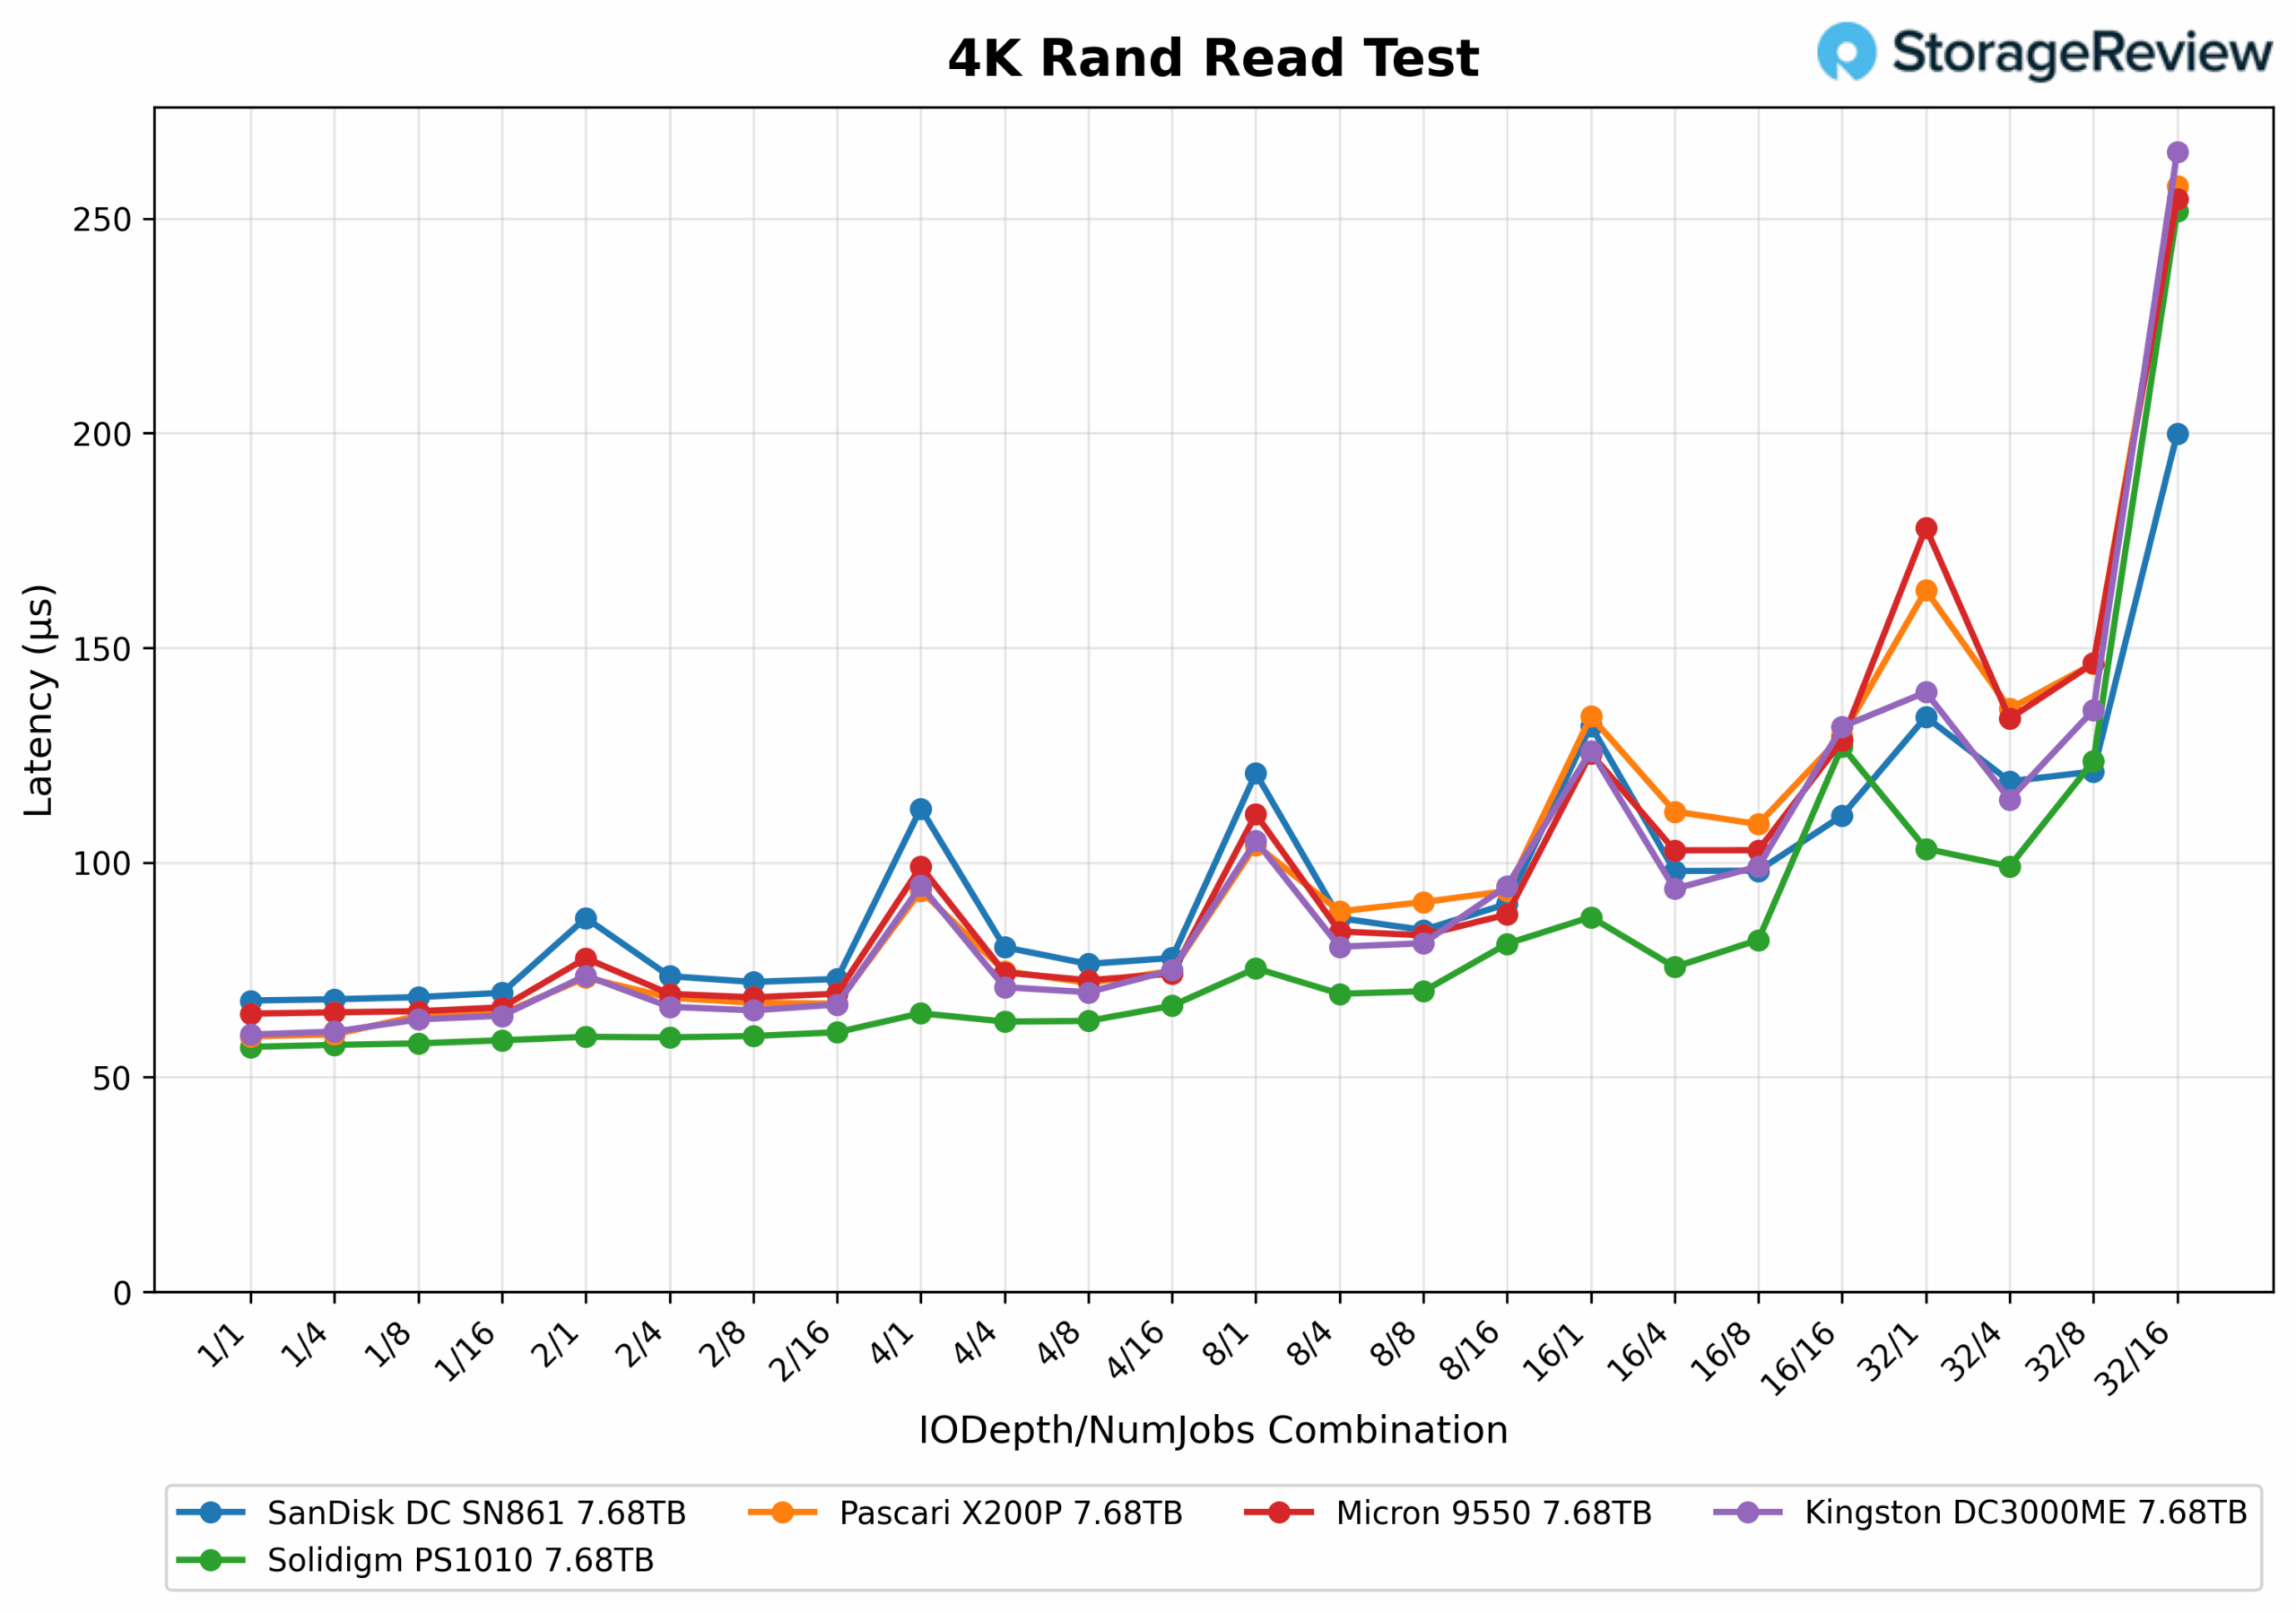
4K 랜덤 읽기 지연 시간 테스트에서 X200P는 워크로드 곡선 전반에 걸쳐 경쟁력 있는 성능을 유지합니다. 0.059/1에서 1ms로 시작하여 0.060/1에서 4ms, 0.064/1에서 8ms, 0.067/2에서 8ms로 효율적으로 지속됩니다. 대기열 깊이가 증가함에 따라 Pascari는 다른 엔터프라이즈 드라이브와 비슷한 수준을 유지하며 0.075/4에서 4ms, 0.089/8에서 4ms, 0.109/16에서 8ms를 기록했습니다. 32/4와 같은 더 높은 워크로드에서는 0.136ms, 0.163/32에서 1ms에 도달했습니다. 최대 지연 시간은 32/16에서 0.258ms로 Solidigm보다 약간 높지만 Kingston과 Micron과 유사하며 중간 수준입니다.
GPU 직접 스토리지
이 테스트벤치에서 수행한 테스트 중 하나는 Magnum IO GPU Direct Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브나 다른 고속 스토리지 장치에 저장된 데이터에 액세스할 때 CPU를 우회할 수 있도록 해줍니다. GDS는 CPU와 시스템 메모리를 통해 데이터를 라우팅하는 대신 GPU와 스토리지 장치 간의 직접 통신을 가능하게 하여 대기 시간을 크게 줄이고 데이터 처리량을 개선합니다.
GPU 직접 스토리지 작동 방식
전통적으로 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때 데이터는 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 합니다. 이 프로세스는 CPU가 중개자가 되어 지연 시간을 늘리고 귀중한 시스템 리소스를 소모하기 때문에 병목 현상이 발생합니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 액세스할 수 있도록 하여 이러한 비효율성을 제거합니다. 이 직접 경로는 데이터 이동과 관련된 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥 러닝과 관련된 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 훈련하려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송이 지연되면 GPU 활용도가 낮아지고 훈련 시간이 길어질 수 있습니다. GPU Direct Storage는 데이터가 가능한 한 빨리 GPU에 전달되도록 하여 유휴 시간을 최소화하고 계산 효율성을 극대화함으로써 이러한 과제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
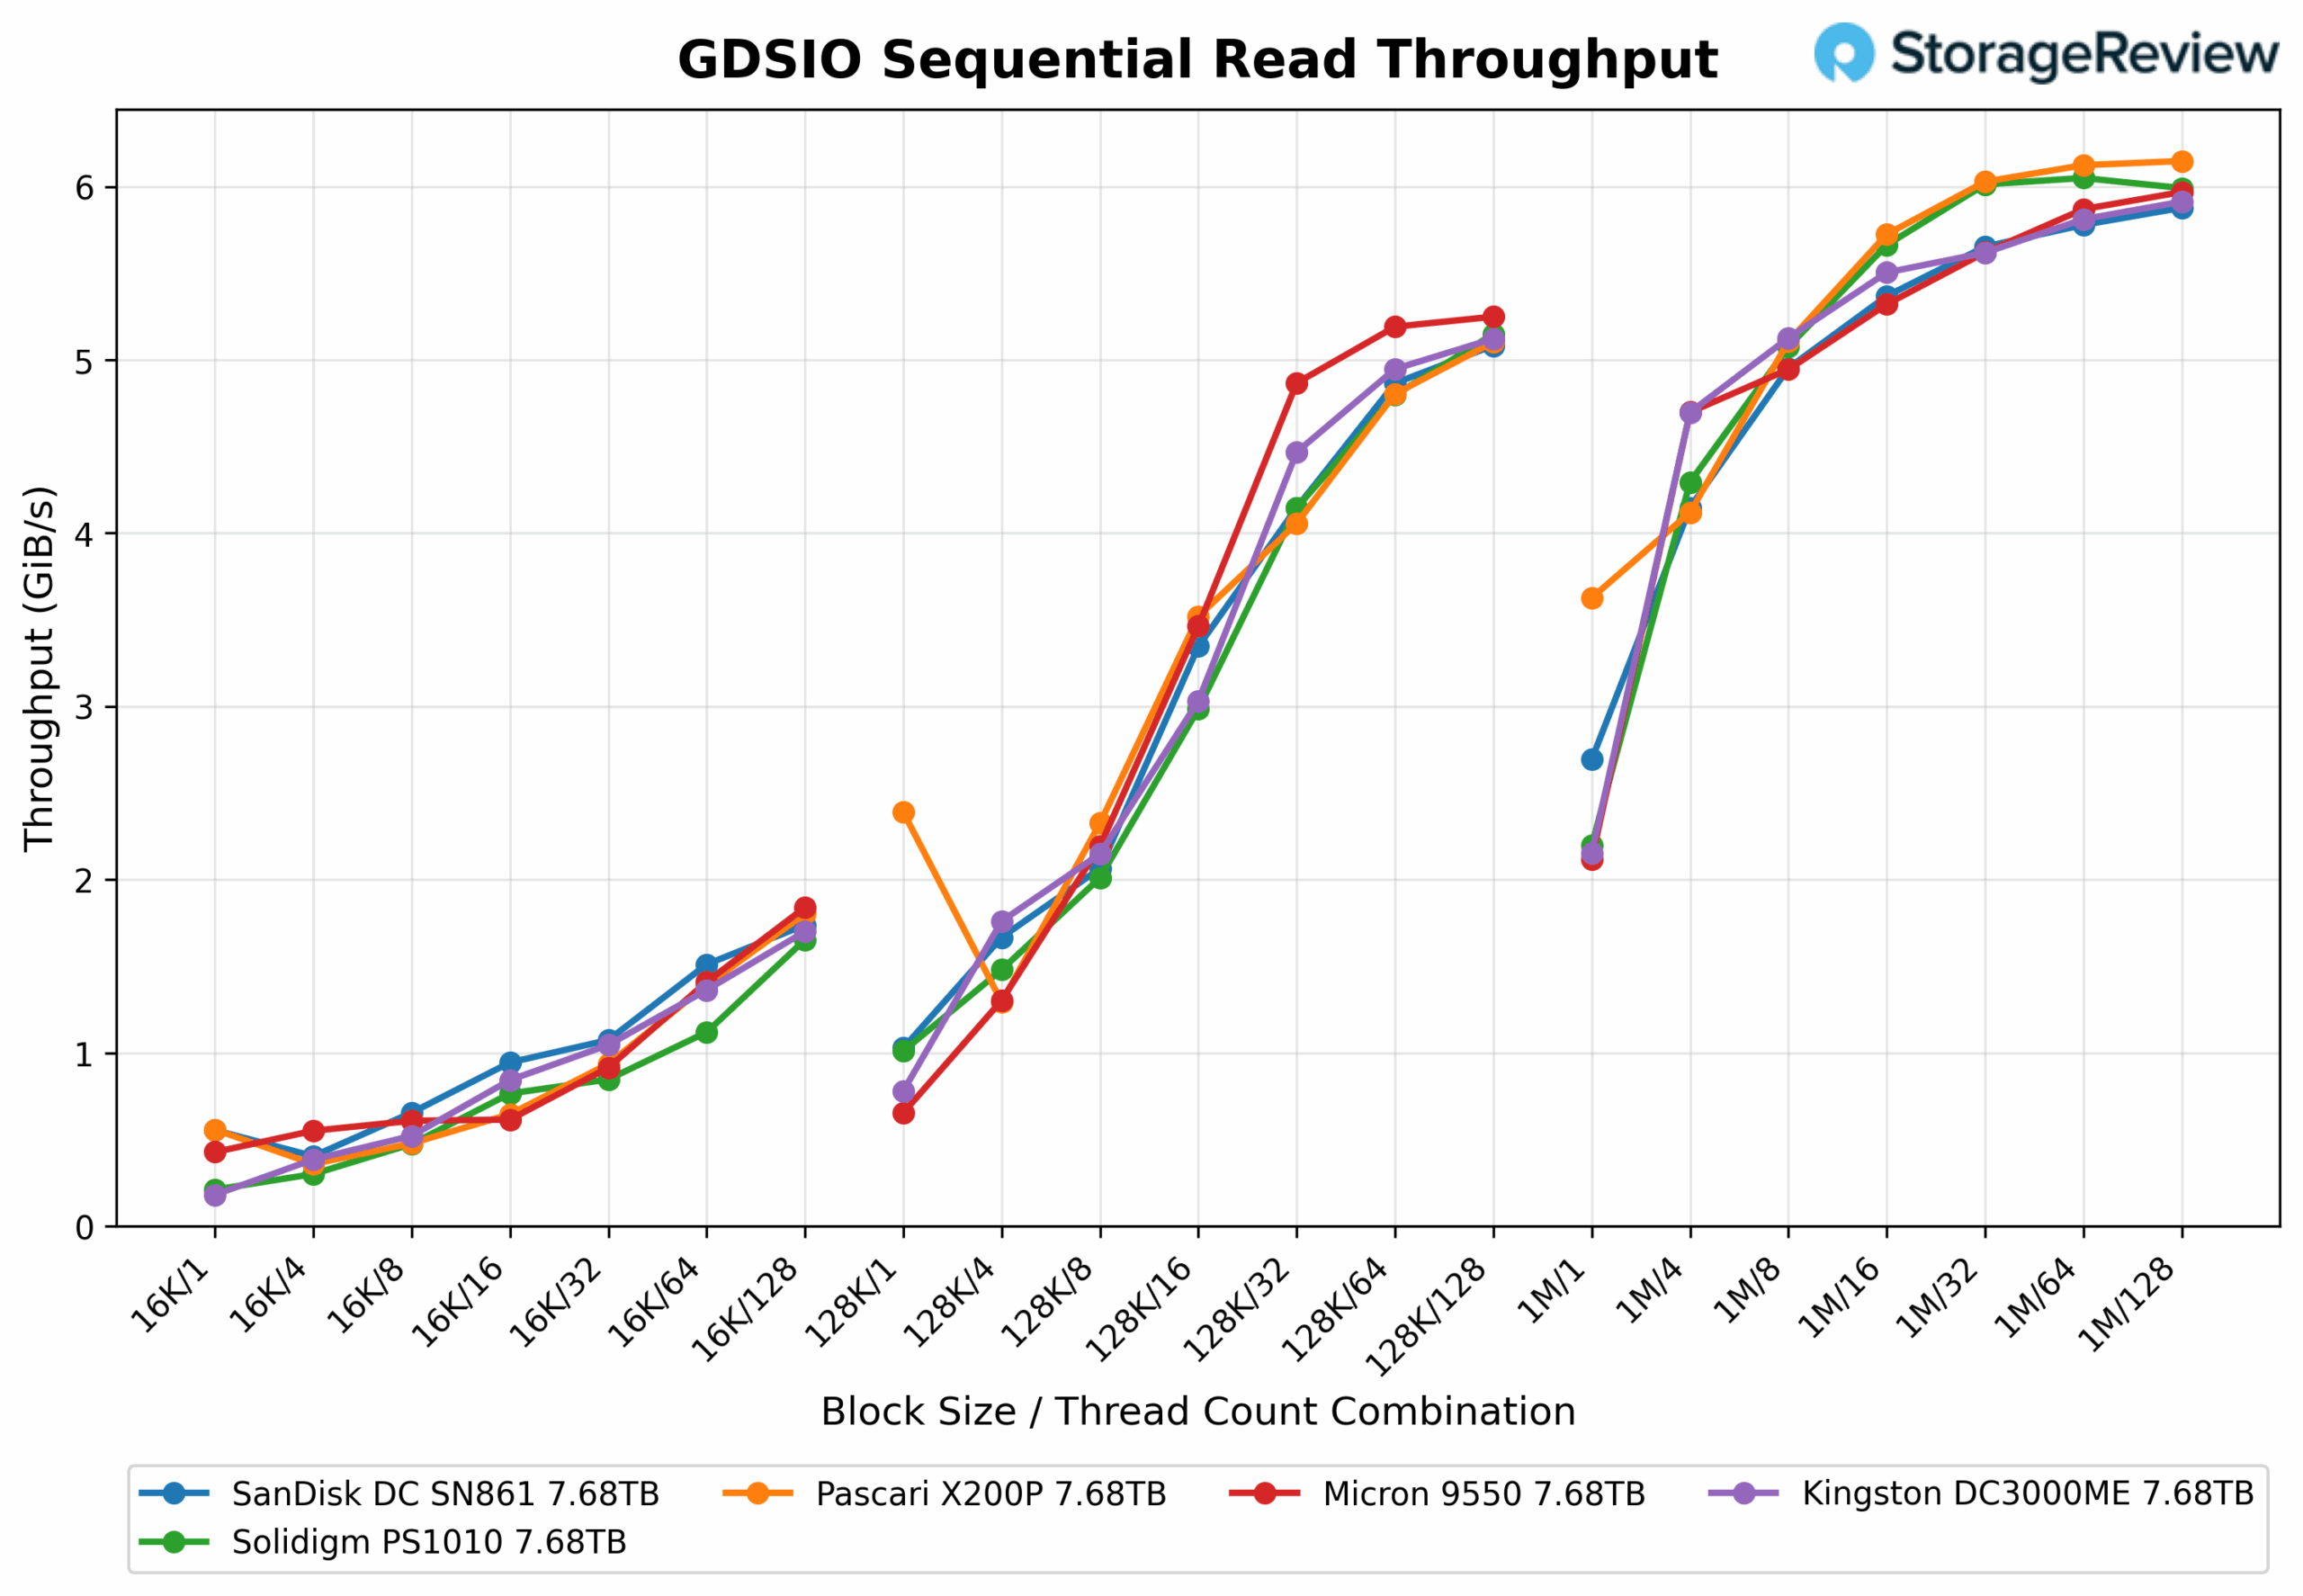
처리량은 0.56GiB/s(QD1)에서 시작하여 QD1.80에서 128GiB/s로 증가합니다. 확장성은 크지 않지만 안정적이며, 이는 더 작은 전송 크기에서도 만족스러운 성능을 보여줍니다.
성능이 눈에 띄게 향상되어 QD2.39에서 1GiB/s였던 것이 QD5.10에서는 128GiB/s로 증가했습니다. 이는 드라이브가 대용량 읽기 작업을 처리할 때 확장 효율성이 향상되고 활용도가 높아짐을 보여줍니다.
처리량은 3.63GiB/s에서 시작하여 QD6.15에서는 최대 128GiB/s까지 확장됩니다. 이 경우 성능 향상 폭은 크지 않지만, 이 드라이브는 이 범위에서 가장 높은 절대 읽기 대역폭을 제공하여 대용량 순차 전송에 적합합니다.
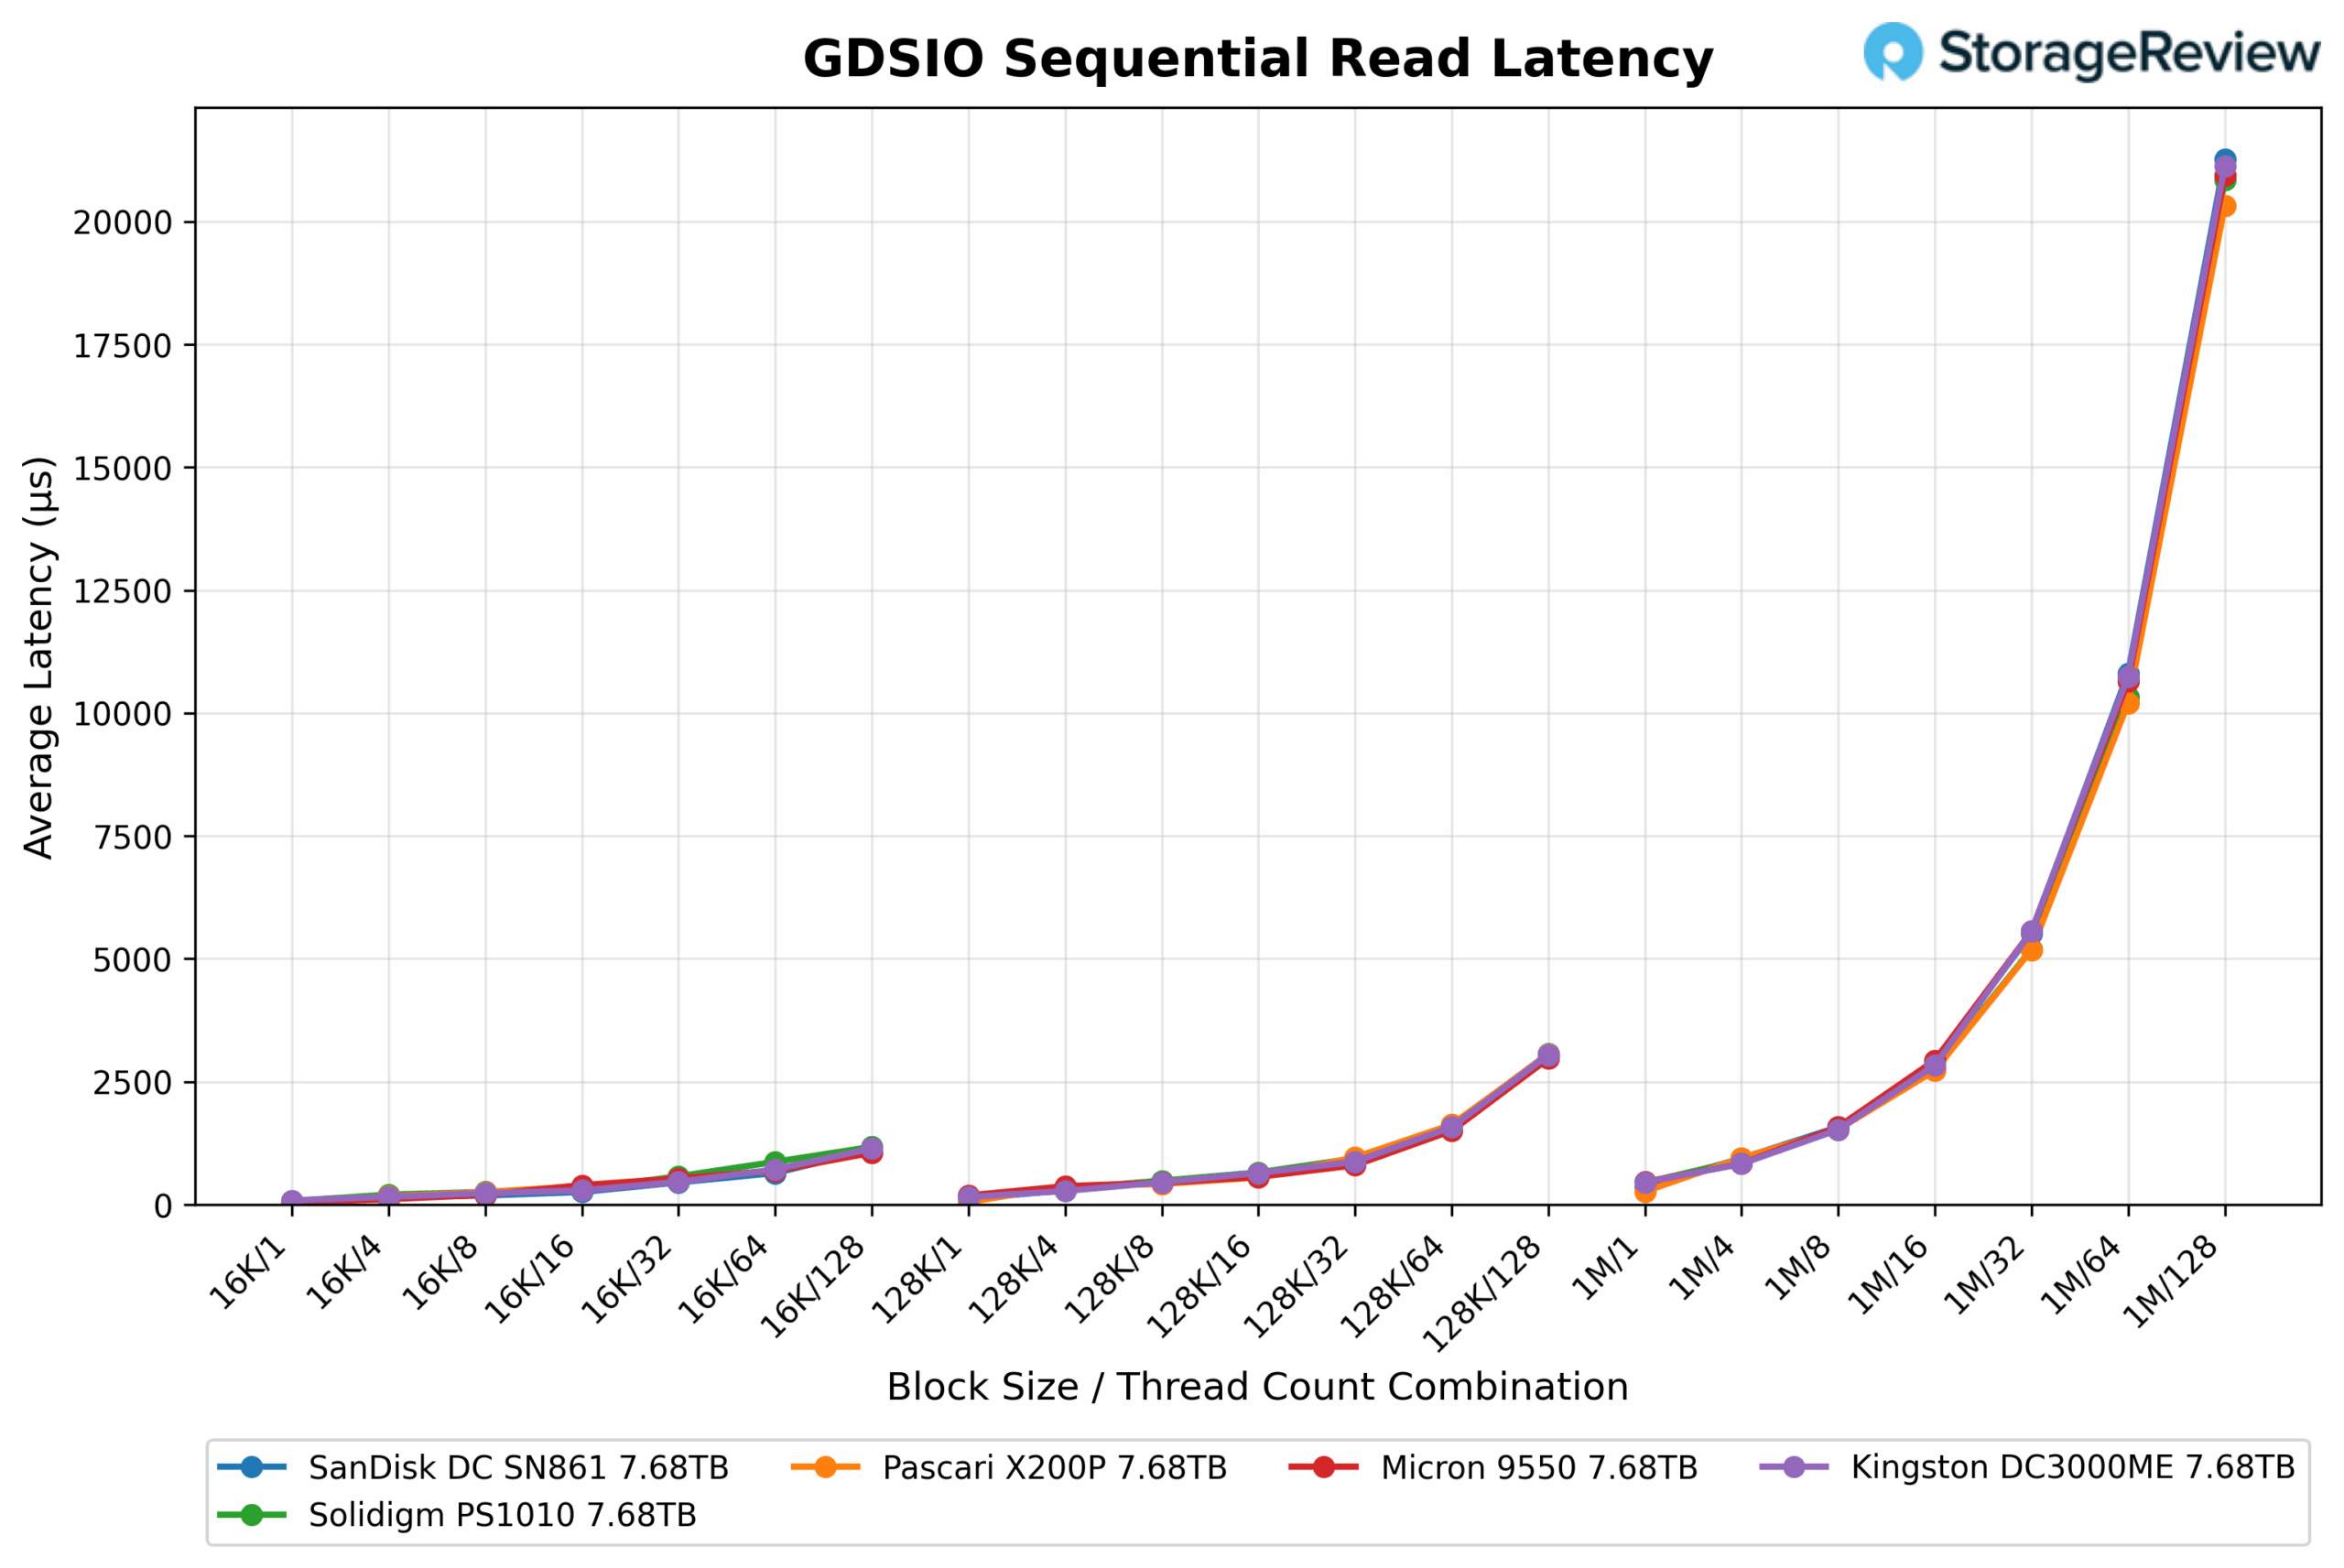
Pascari X200P의 GDSIO 읽기 지연 결과는 블록 크기, 스레드 수, 지연 시간 간의 명확한 상관관계를 보여줍니다. 단일 스레드를 사용하는 16K 블록 크기에서 드라이브의 평균 지연 시간은 0.026ms에 불과합니다. 그러나 동일한 블록 크기에서 스레드 수를 128개로 확장하면 지연 시간이 1.076ms로 크게 증가합니다. 128K 블록의 경우 단일 스레드에서 지연 시간은 0.050ms이고, 3.056개 스레드에서는 128ms로 증가합니다. 더 큰 1M 블록의 경우 단일 스레드에서 지연 시간은 0.268ms에서 시작하여 최대 병렬 처리에서 20.324ms로 급증합니다.
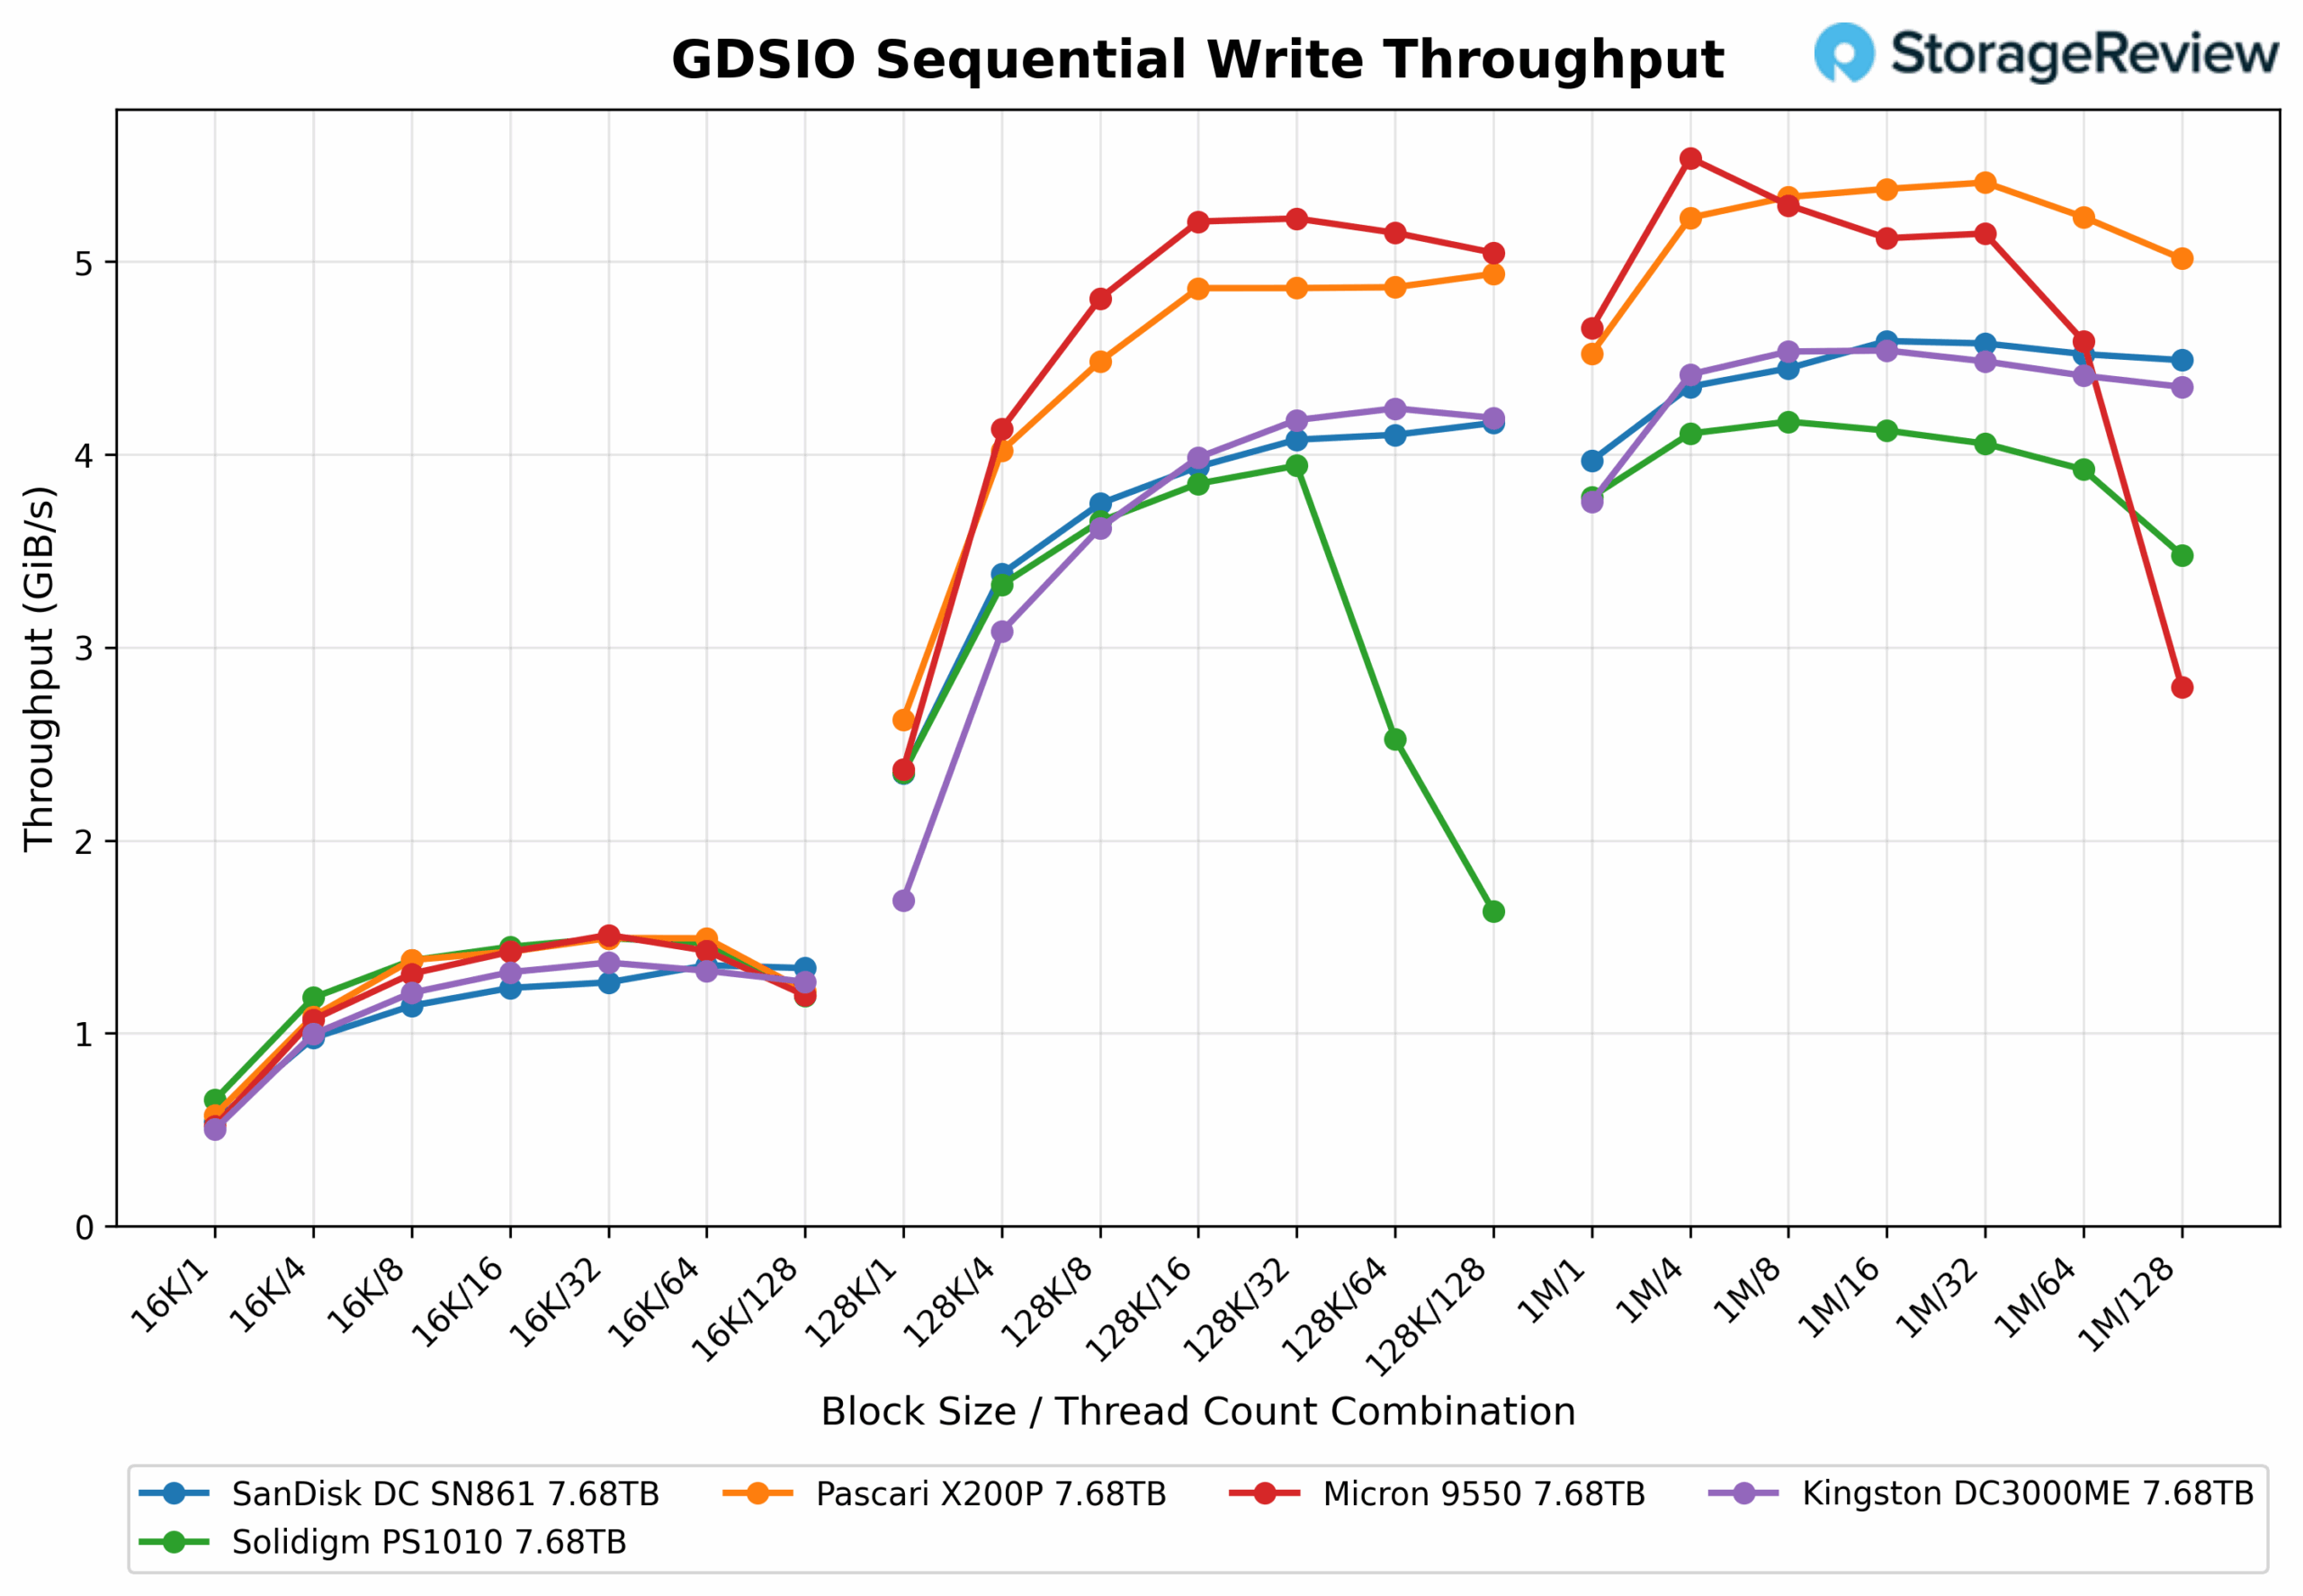
16K 블록 크기에서 X200P 처리량은 QD0.58에서 25.17GiB/s(지연 시간 1µs)로 시작하여 QD1.22에서 1.59GiB/s(지연 시간 128ms)로 증가합니다. 이는 대역폭은 소폭 증가하지만 지연 시간은 급격히 증가하여 이 작은 I/O 크기에서 조기 포화 상태를 시사합니다.
128K에서는 성능이 더 잘 확장되어 2.63GiB/s(45.55µs)에서 시작하여 QD4.94에서는 3.16GiB/s(128ms)까지 증가합니다. 이는 처리량이 상당히 증가했음을 의미하지만, 대기 시간이 급격히 증가하여 대기열 깊이가 높은 상황에서 오버헤드가 증가함을 나타냅니다.
1M 블록 크기에서 드라이브는 4.52GiB/s(215µs)에서 강력한 속도로 시작하여 QD5.02에서 24.9GiB/s(128ms)로 최대 속도를 보입니다. 처리량 증가는 128K에 비해 미미하며, QD128에서의 지연 시간은 모든 테스트 중 가장 높습니다. 이는 128K 이상의 대용량 전송에서 큐가 깊어질수록 효율성 향상이 제한적임을 시사합니다.
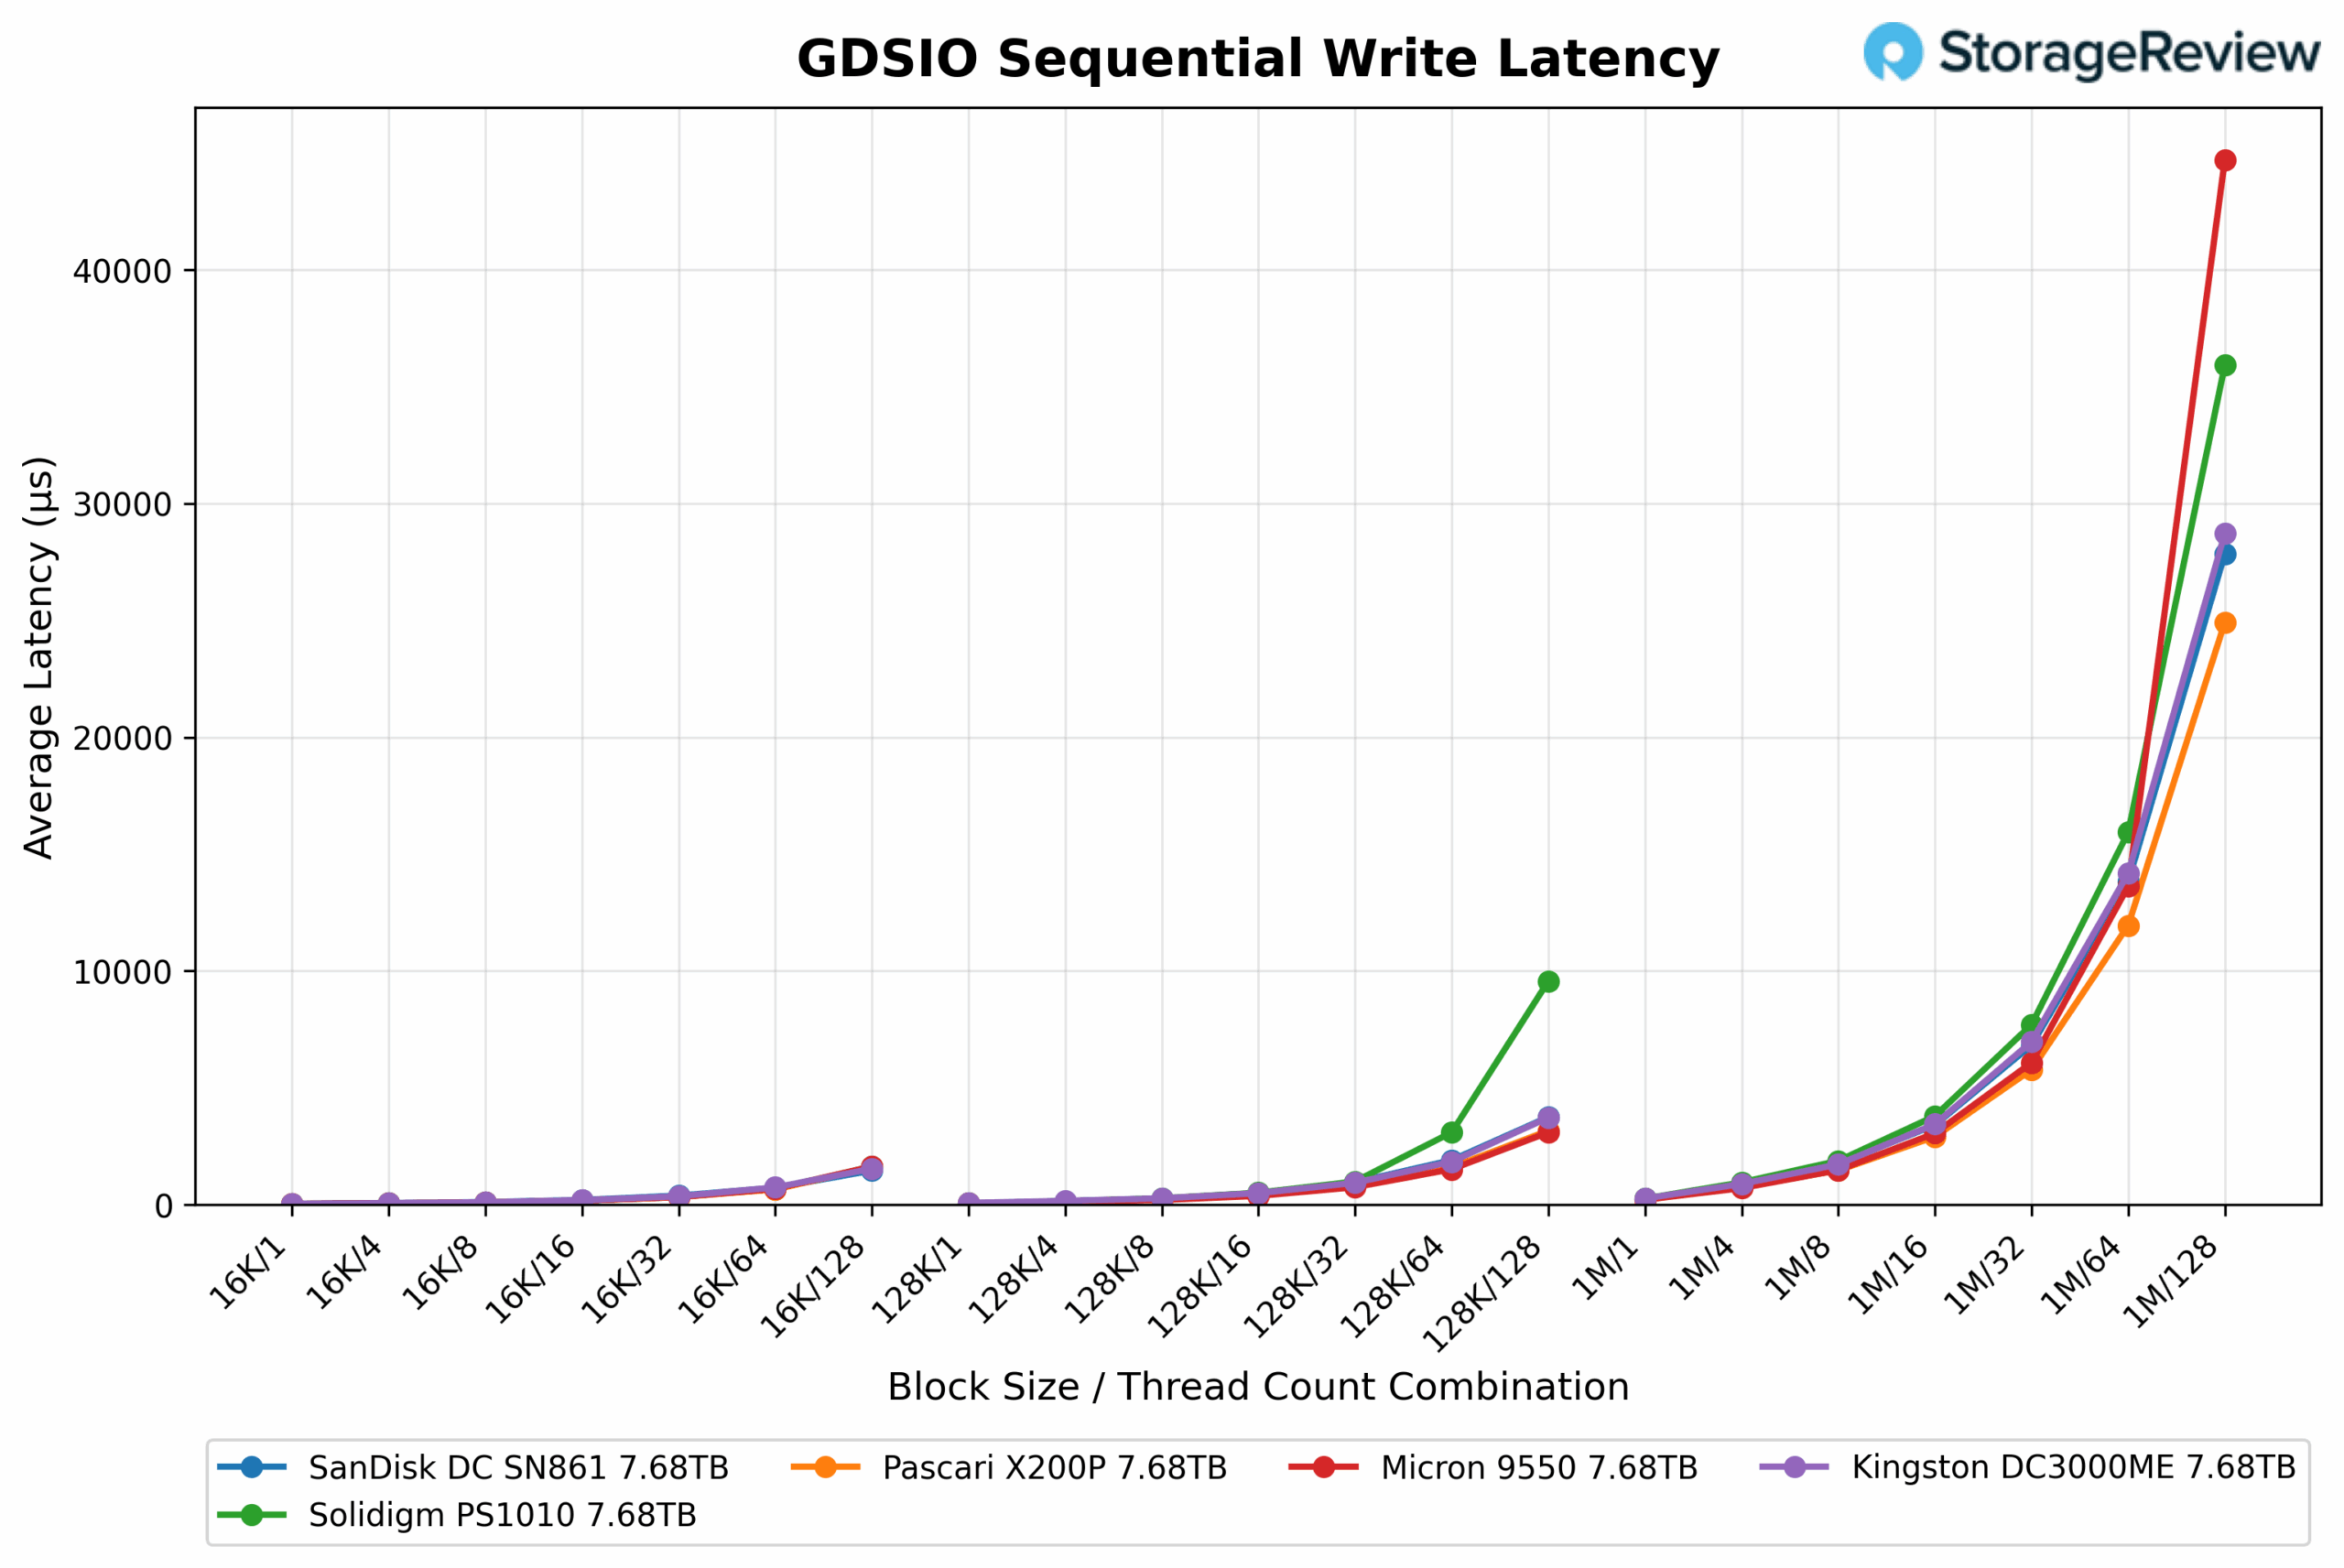
Pascari X200P의 GDSIO 쓰기 지연 시간 결과는 일관된 확장 패턴을 보이며, 블록 크기와 스레드 수가 증가함에 따라 지연 시간이 증가합니다. 단일 스레드를 사용하는 16K 블록 크기에서 드라이브는 평균 0.025ms의 지연 시간을 기록했으며, 1.595개 스레드에서는 128ms로 증가했습니다. 128K 블록에서는 동일한 조건에서 지연 시간이 0.046ms에서 3.159ms로 증가했습니다. 가장 큰 1M 블록 크기에서는 지연 시간이 0.215ms에서 시작하여 최대 스레드 깊이에서 24.917ms에 도달했습니다. 예상되는 지연 시간 증가에도 불구하고, Pascari X200P는 높은 블록 크기와 스레드 수에서 다른 그룹보다 앞서 있으며, 높은 병렬 쓰기 작업 부하에서도 가장 낮은 지연 시간을 유지했습니다.
맺음말
Phison Pascari X200P 7.68TB SSD는 TLC NAND를 탑재하고 PCIe Gen5 성능에 최적화된 엔터프라이즈급 드라이브로, 일반 용도 및 콘텐츠 집약적인 워크로드에 적합합니다. 높은 처리량, 강력한 확장성, 그리고 배포 유연성이 하이퍼스케일별 튜닝보다 우선시되는 환경에 적합하게 설계되었습니다. U.2, U.3, E3.S 폼 팩터를 지원하고 전력 손실 보호, AES-XTS 256비트 암호화, NVMe-MI 관리 등의 기능을 갖춘 X200P는 스토리지 인프라를 위한 견고한 기반을 제공합니다.
성능 측면에서 X200P는 순차 및 읽기 집약적인 시나리오에서 탁월한 성능을 발휘하며, 128K 및 64K 테스트에서 꾸준히 상위권을 기록하고 CDN 워크로드에서도 효과적으로 확장합니다. FIO 테스트는 순차 읽기에서의 강점을 확인하고 랜덤 읽기 워크로드에서도 경쟁력 있는 성능을 보여줍니다. 쓰기 집약적이고 동시성이 높은 환경에서는 마이크론이나 샌디스크와 같은 최상위 드라이브에 뒤처지지만, 예측 가능하고 효율적인 쓰기 동작 덕분에 다양한 미드티어 엔터프라이즈 환경에 적합합니다.
GDSIO 테스트는 처리량 중심 애플리케이션에서 이 드라이브의 강점을 더욱 강조합니다. X200P는 작은 블록 크기에서도 우수한 지연 시간을 유지하며, 대용량 블록 전송이 포함된 과중한 병렬 액세스 환경에서도 우수한 성능을 보입니다. 대기열 크기가 커지면 지연 시간이 증가하지만, Phison의 튜닝을 통해 드라이브는 지속적인 부하 상황에서도 안정성과 응답성을 유지합니다.
전반적으로 Pascari X200P는 강력한 성능과 실제 워크로드에 최적화된 기능을 갖춘 다재다능한 엔터프라이즈 SSD입니다. Phison이 컨트롤러 중심 기업에서 심층적인 통합 드라이브 솔루션을 제공하는 기업으로 전환할 수 있을지 지켜보는 것이 흥미로울 것입니다. 지금까지 X200P는 그러한 방향으로 나아가는 데 유망한 출발점으로 보입니다.


 아마존