

고가용성은 더 이상 데이터 센터의 사치품이 아니라 일반적인 복원력 계획의 필수 항목으로 자리 잡았습니다. 소규모 기업과 엣지 사이트는 이제 POS 시스템, 감시 시스템, 공유 스토리지 등을 운영하고 있는데, 이러한 시스템이 다운될 때마다 손실이 발생합니다. 하지만 기존의 해결책이었던 듀얼 컨트롤러 엔터프라이즈 어레이는 데이터 센터 규모에 맞춰 설계되었고 가격 또한 높아 지점 사무실이나 벽걸이형 랙에는 적합하지 않습니다. 이러한 불일치로 인해 소규모 IT 부서는 데이터 보호를 위한 백업 및 스냅샷은 확보했지만, 업무 연속성을 위한 기반은 마련하지 못했습니다. 아무리 잘 설계된 단일 컨트롤러 NAS라 할지라도 단일 장애 지점으로 남을 수밖에 없습니다.
QNAP은 듀얼 컨트롤러 하드웨어와 복제 기반 복구 경로를 제공해 온 만큼 고가용성은 새로운 영역이 아닙니다. QuTS hero h6.0 에서 달라진 점은 효율성입니다. 새로운 고가용성 관리자는 일반 하드웨어에서 운영 체제에 클러스터링 기능을 내장하여 두 대의 동일한 NAS 장치가 단일 IP 주소 뒤에서 액티브-패시브 클러스터를 구성할 수 있도록 합니다. 따라서 한 장치에 장애가 발생하더라도 다른 장치가 그 역할을 인계받아 고객은 거의 영향을 받지 않습니다. IT 투자 규모를 최적화하려는 조직에게 이는 두 번째 NAS를 추가하는 비용으로 고가용성을 확보할 수 있는 것이며, 새로운 유형의 인프라를 구축할 필요가 없다는 것을 의미합니다.
핵심은 이것입니다. 실제 환경에서 어떻게 작동하는지 확인하기 위해, Seagate IronWolf Pro 하드 드라이브와 QNAP E1.S SSD를 캐시로 사용하는 두 대의 QNAP TS-h765eU 시스템으로 연구실에 HA 클러스터를 구축한 다음, 실제 엣지 환경에서 장애가 발생하는 방식과 동일하게 클러스터를 파괴해 보았습니다. 전송 도중 활성 노드의 전원을 차단하기도 하고, 하트비트는 유지하면서 네트워크 연결을 끊기도 했습니다. 두 경우 모두 동일한 질문을 던졌습니다. 파일 전송이 성공적으로 완료되는가? 그리고 장애가 발생한 노드가 다시 작동할 때 복구는 어떻게 이루어지는가?
QNAP TS-h765eU 개요
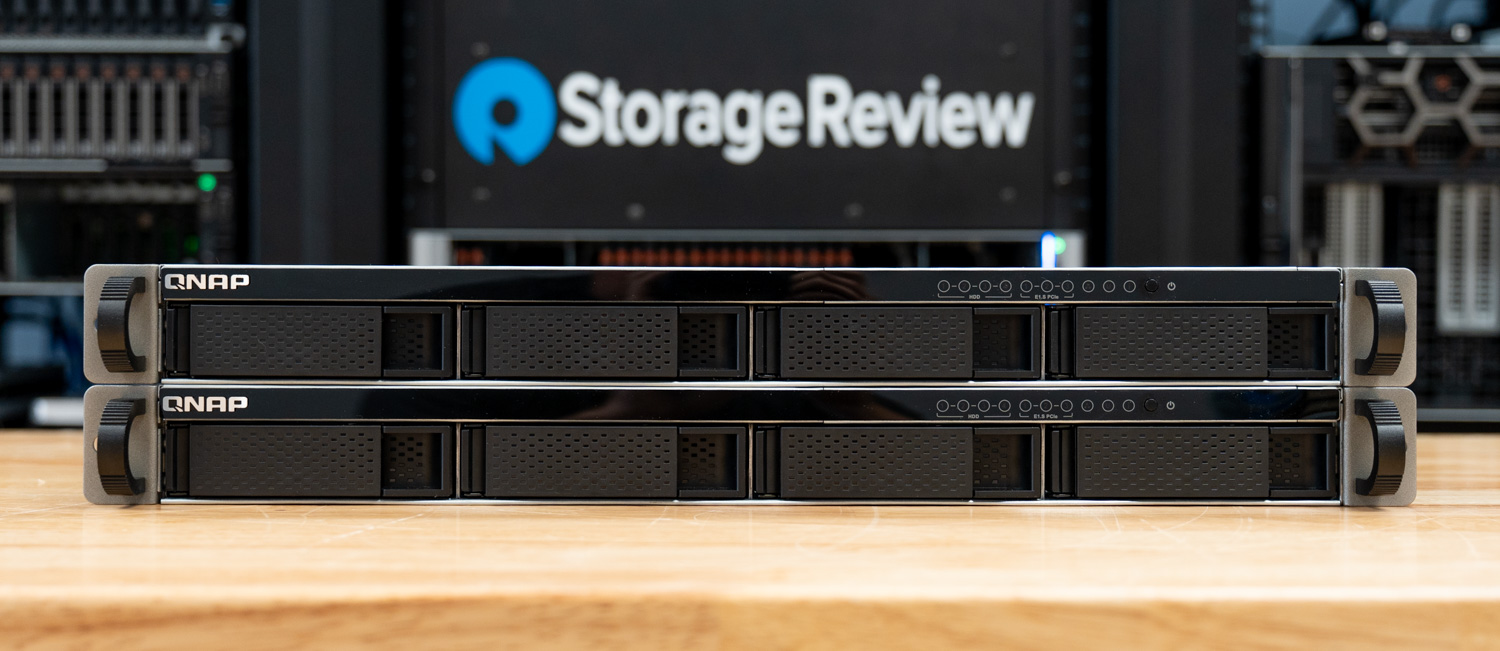
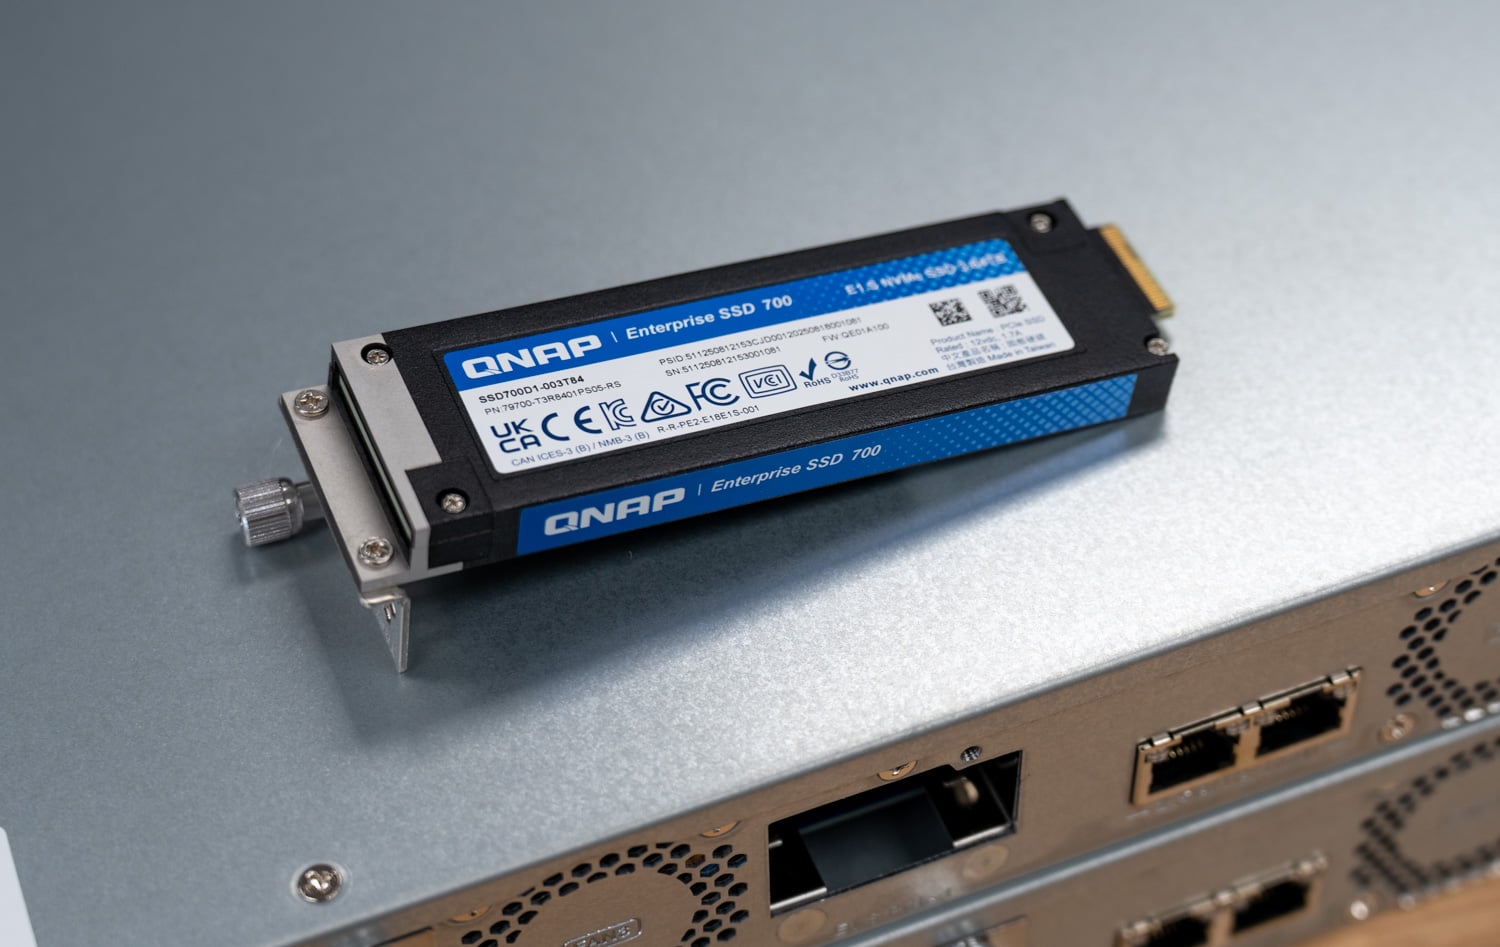
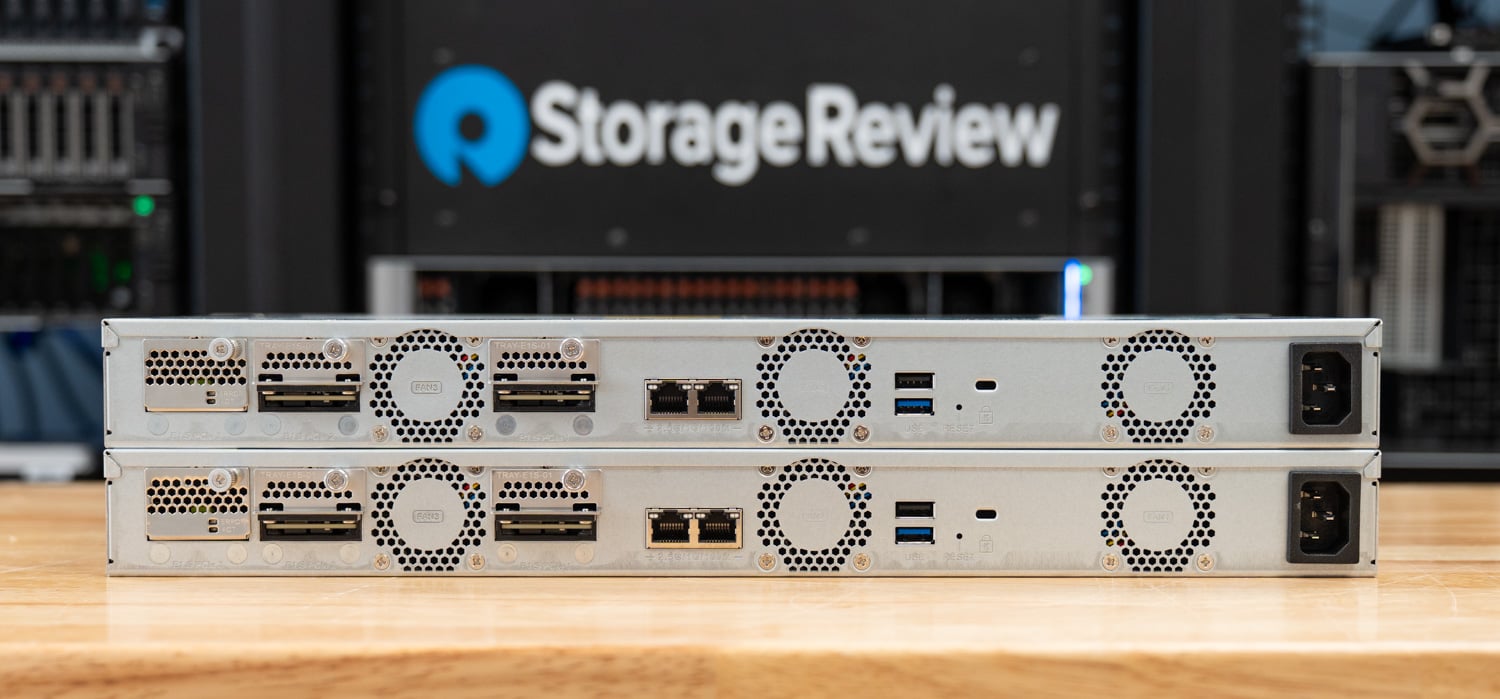
TS-h765eU는 비교적 단순한 하드웨어 구성 덕분에 고가용성(HA) 구축에 있어 흥미로운 선택입니다. 이 제품은 1U 크기의 랙 마운트형 NAS로, 깊이가 292.1mm(12인치)에 불과하여 소형 미디어 캐비닛, 벽걸이형 네트워크 랙, 그리고 일반적인 크기의 섀시가 설치될 수 없는 엣지 환경에 적합합니다. 각 유닛은 전면에 3.5인치 SATA 드라이브 베이 4개와 후면에 E1.S/M.2 PCIe NVMe 슬롯 3개를 제공하여 용량 증대를 위한 HDD와 캐싱 또는 고속 처리를 위한 플래시 메모리를 모두 활용할 수 있는 하이브리드 스토리지 구성을 제공합니다.
QNAP은 또한 이 제품을 2031년까지 공급이 보장되는 장기 공급 모델로 지정했는데, 이는 여러 사업장에서 플랫폼을 표준화하려는 조직에 중요한 요소입니다.
내부에는 TS-h765eU는 최대 3.4GHz의 클럭 속도를 제공하는 인텔 아톰 x7405C 쿼드코어 칩과 8GB DDR5 메모리(16GB까지 업그레이드 가능, 인밴드 ECC 지원)를 탑재하고 있습니다. 네트워크는 듀얼 2.5GbE 포트로 시작하며, E1.S 베이를 QNAP의 QXG-ES10G1T 모듈로 교체하면 10GbE까지 확장할 수 있습니다.
| 스펙 | 큐냅 TS-h765eU |
|---|---|
| CPU | 인텔 아톰 x7405C 쿼드코어, 최대 3.4GHz |
| 메모리 | 8GB DDR5, 16GB까지 업그레이드 가능 (인밴드 ECC) |
| 드라이브 베이 | 4개의 3.5인치 SATA |
| 플래시 슬롯 | 3 x E1.S / M.2 PCIe NVMe |
| 네트워킹 | 2개의 2.5GbE 포트, 옵션 QXG-ES10G1T E1.S 모듈을 통한 10GbE 포트 지원 |
| 폼 팩터 | 1U 소형 랙마운트, 깊이 292.1mm(12인치) |
| 운영체제 | QuTS hero h6.0 (ZFS 기반) |
| 이용 가능 여부 (Availability) | 2031년까지의 장기 공급 모델 |
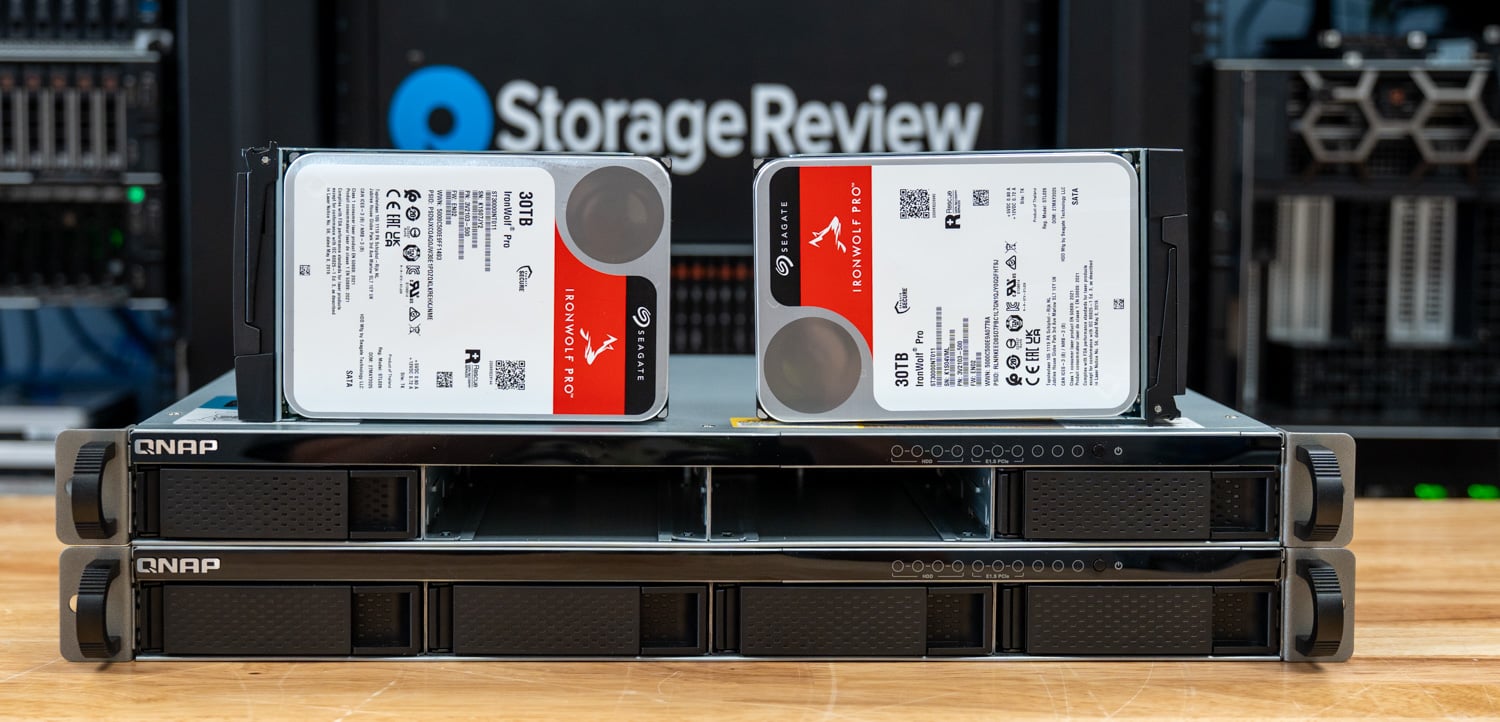
이번 평가를 위해 각 노드에는 RAID 5 스토리지 풀로 구성된 Seagate IronWolf Pro 30TB 하드 드라이브(ST30000NT011) 4개와 캐시로 RAID 0으로 구성된 QNAP SSD700 E1.S 3.84TB 드라이브(SSD700D1-003T84) 2개가 장착되었습니다. 두 시스템 모두 QuTS hero h6.0.0.3500과 High Availability Manager 2.0.421을 실행했습니다.
QuTS hero h6.0 및 HA 관리자 아키텍처
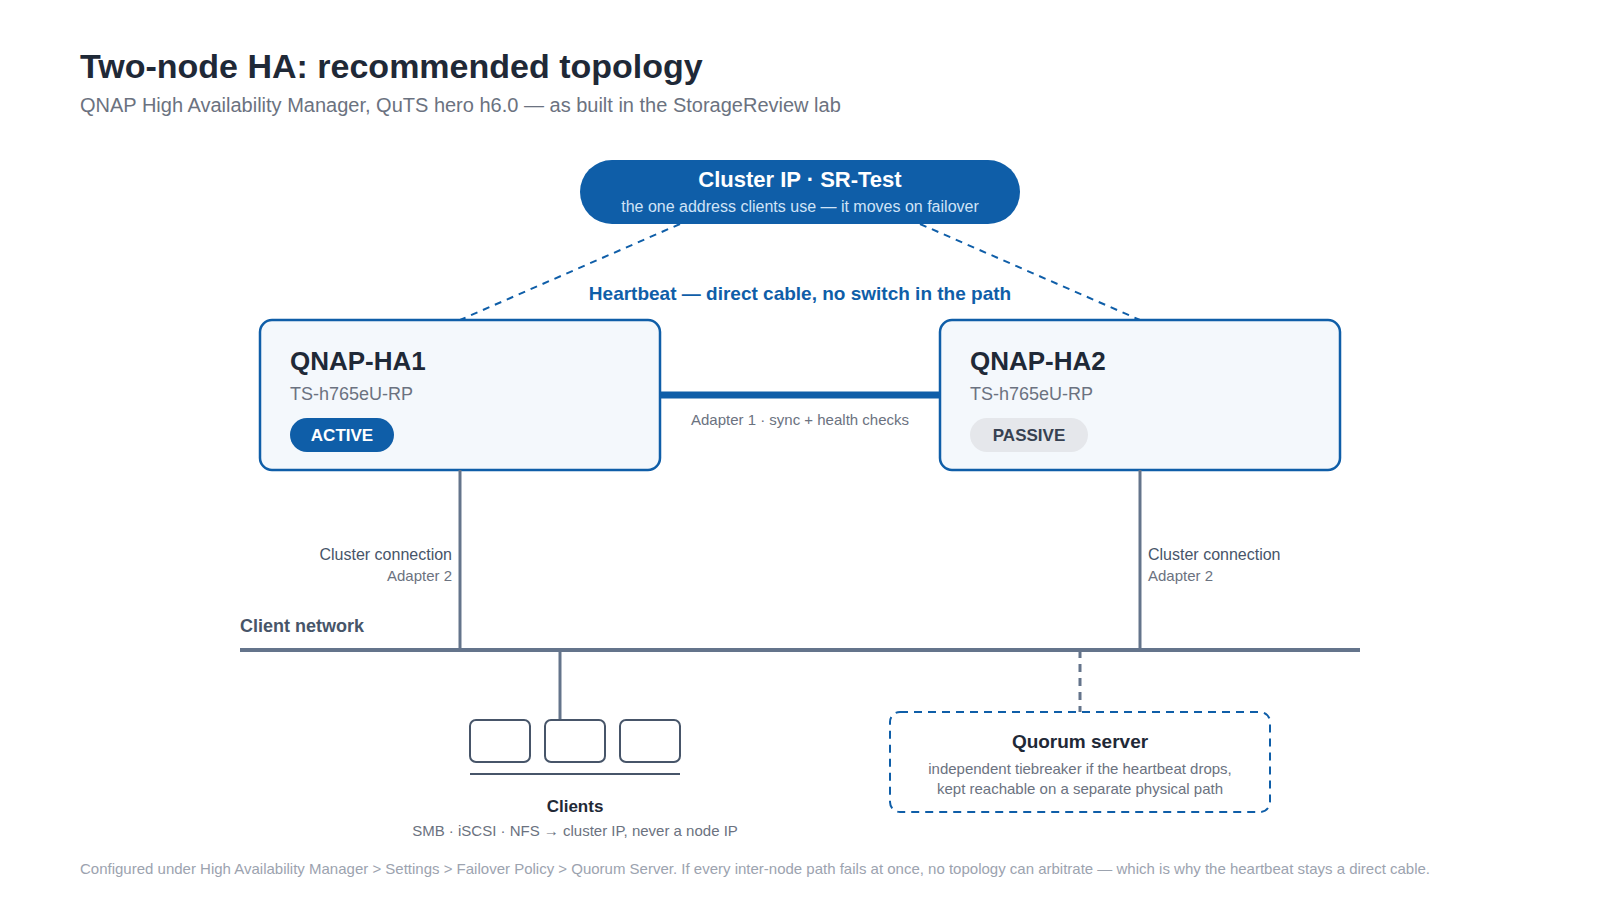
QuTS hero h6.0의 핵심 기능은 고가용성 관리자(High Availability Manager)로, 고전적인 액티브-패시브 설계를 구현합니다. 하나의 NAS(액티브 노드)는 모든 데이터와 서비스를 제공합니다. 두 번째 NAS(패시브 노드)는 전용 하트비트 연결을 통해 액티브 노드와 지속적으로 동기화되며, 장애 발생 시 즉시 인계받을 준비를 합니다. 클라이언트는 어느 노드와도 직접 통신하지 않습니다. 대신 클러스터는 단일 IP 주소와 호스트 이름을 제공하며, 현재 활성화된 노드가 이에 응답합니다. 장애 조치가 발생하면 클러스터 IP가 백엔드에서 트래픽을 리디렉션하므로 매핑된 드라이브, iSCSI 이니시에이터 및 백업 작업을 다시 지정할 필요가 없습니다.
하트비트 링크는 설계의 핵심입니다. QNAP은 두 장치 간에 스위치 없이 직접 연결을 요구하며, 이 링크를 통해 노드 간 상태 점검 트래픽과 블록 수준 데이터 동기화를 처리합니다. 별도의 클러스터 연결은 일반 네트워크를 통해 클라이언트 측 트래픽을 처리합니다. 스플릿 브레인 방지 기능을 완성하는 것은 쿼럼 서버입니다. 쿼럼 서버는 네트워크 상의 세 번째 감시자로서, 하트비트 신호가 끊겼을 때 노드가 스스로를 상위 노드로 승격시켜야 하는지 여부를 판단하는 데 도움을 줍니다. 스플릿 브레인 및 이를 방지하는 구축 토폴로지에 대해서는 이 리뷰 후반부에서 자세히 다룹니다.
QNAP은 h6.0에서 NAS 서비스의 90% 이상이 고가용성(HA)을 지원하며, JBOD 확장 인클로저를 사용하여 클러스터 용량을 확장할 수 있다고 밝혔습니다. 하지만 몇 가지 주의 사항이 있습니다. h6.0의 주요 기능 중 하나인 불변 스냅샷은 현재 HA 클러스터 내에서 지원되지 않으므로 관리자는 당분간 두 가지 보호 기능 중 하나를 선택해야 합니다. 또한 HA를 사용하려면 모델과 펌웨어가 동일한 두 대의 시스템이 필요하며, 페어링 마법사는 진행하기 전에 이 조건을 확인합니다.
QNAP HA 클러스터 구축하기
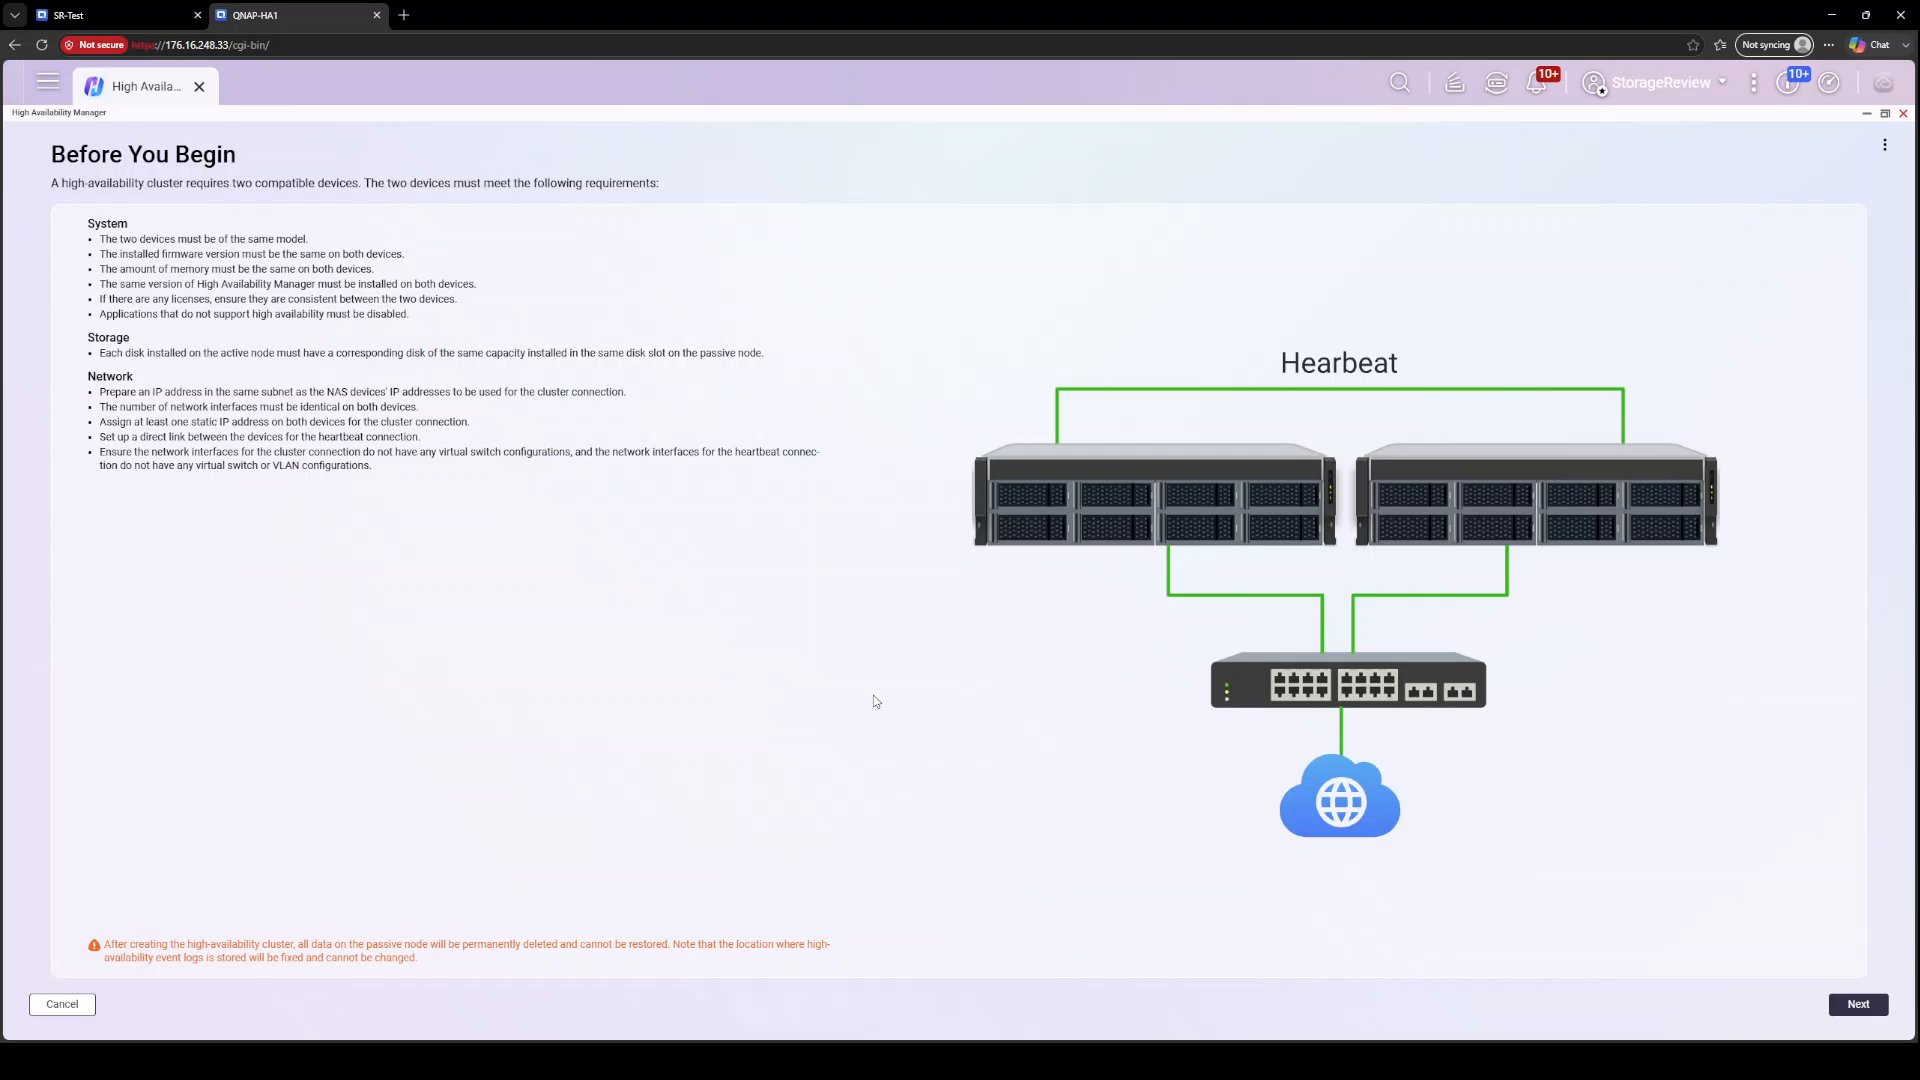
클러스터 생성은 동일한 하드웨어를 갖춘 두 대의 독립적으로 구성된 TS-h765eU 장치에서 시작됩니다. 지정된 활성 노드에서 고가용성 관리자 마법사가 간단한 페어링 프로세스를 안내합니다. 마법사는 하트비트 링크를 통해 수동 노드를 검색한 다음 네트워크 인터페이스에 역할을 할당하도록 요청합니다. 하나는 클러스터에 액세스하기 위한 통신 채널 역할을 하는 클러스터 연결이고, 다른 하나는 QNAP에서 데이터 동기화 전용이며 장치 간 직접 연결이어야 한다고 명시한 하트비트 연결입니다. 저희 구성에서는 마법사가 어댑터 1에 하트비트 연결을, 어댑터 2에 클러스터 연결을 할당했습니다.
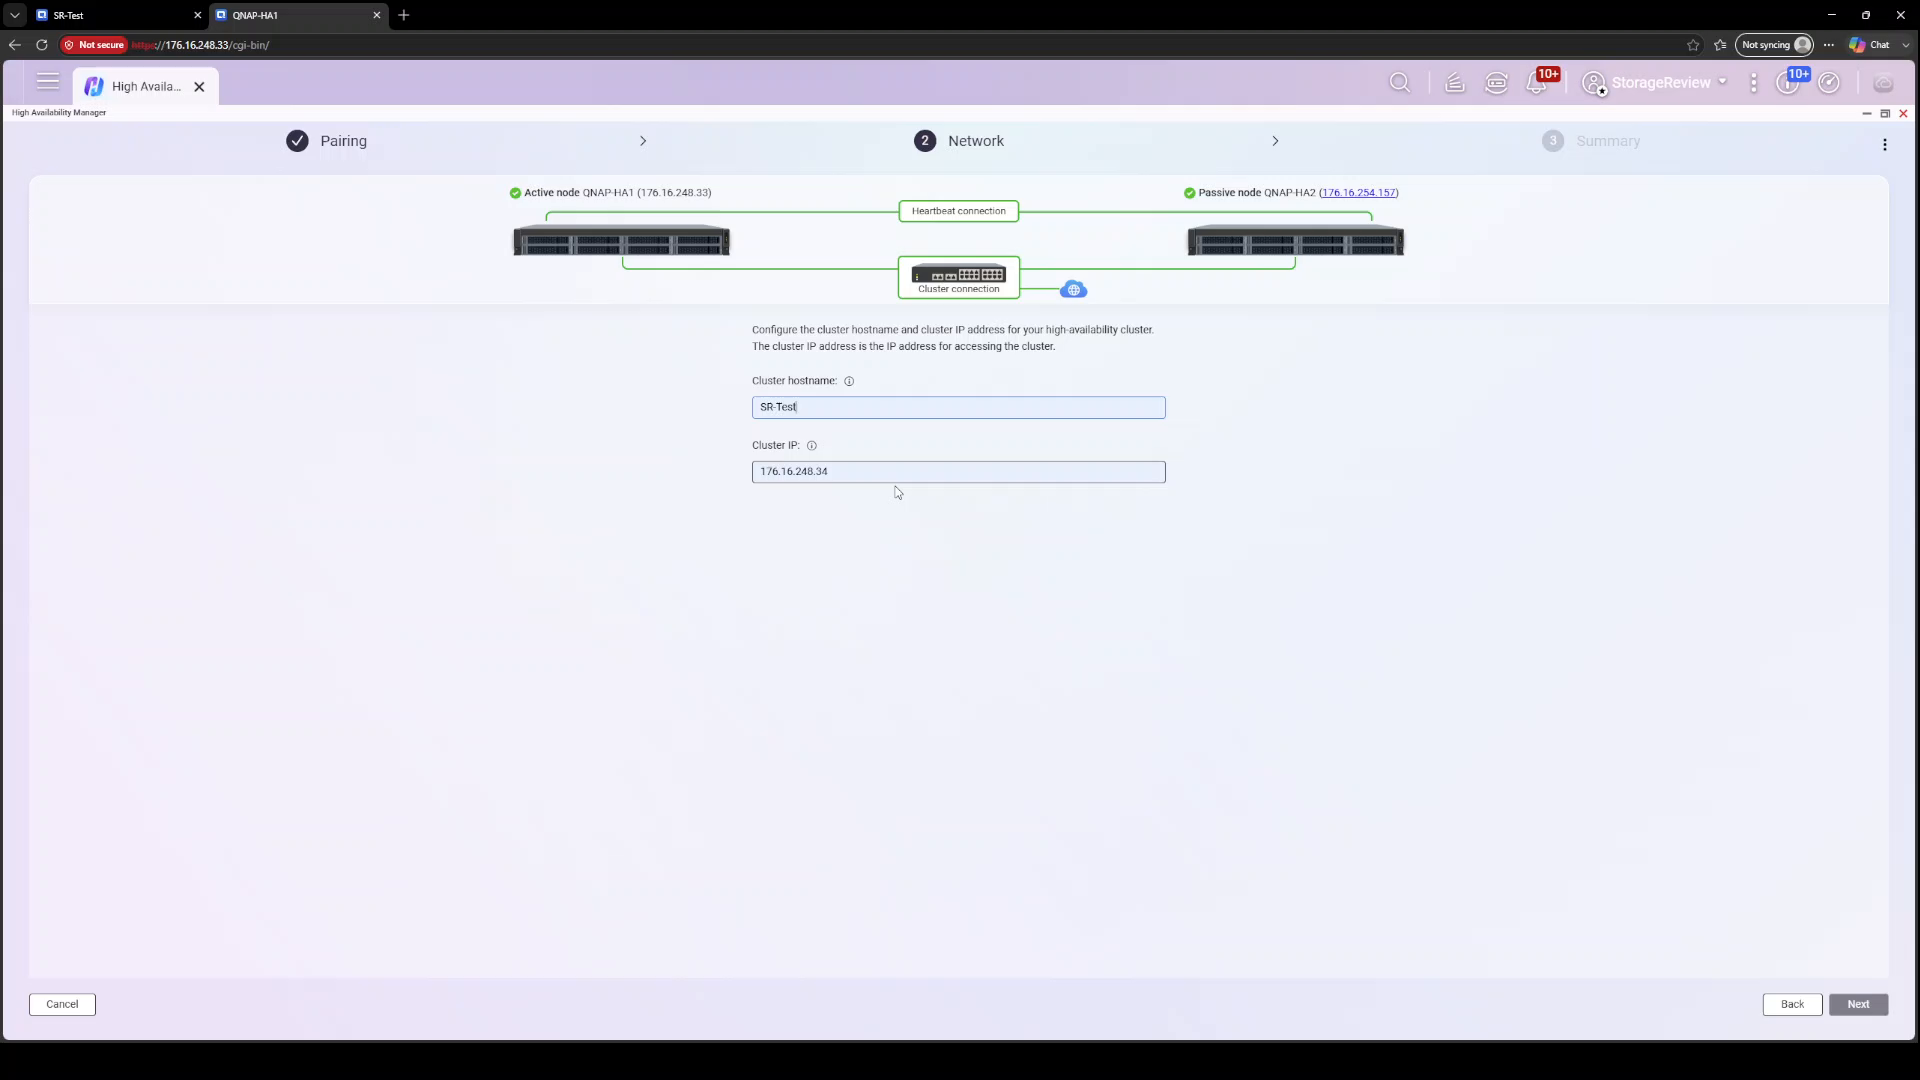
다음은 클러스터 ID 설정입니다. 클러스터 호스트 이름과 클러스터 IP 주소를 할당하면, 이후 클라이언트가 사용하는 단일 주소가 됩니다. 저희 클러스터는 SR-Test라는 이름으로 176.16.248.34 IP 주소를 사용했으며, QNAP-HA1(176.16.248.33)과 QNAP-HA2(176.16.254.157) 노드 앞에 위치했습니다. 두 노드는 연구실 네트워크의 서로 다른 /24 서브넷에 있었고, 마법사는 아무 문제 없이 두 노드를 연결했습니다.
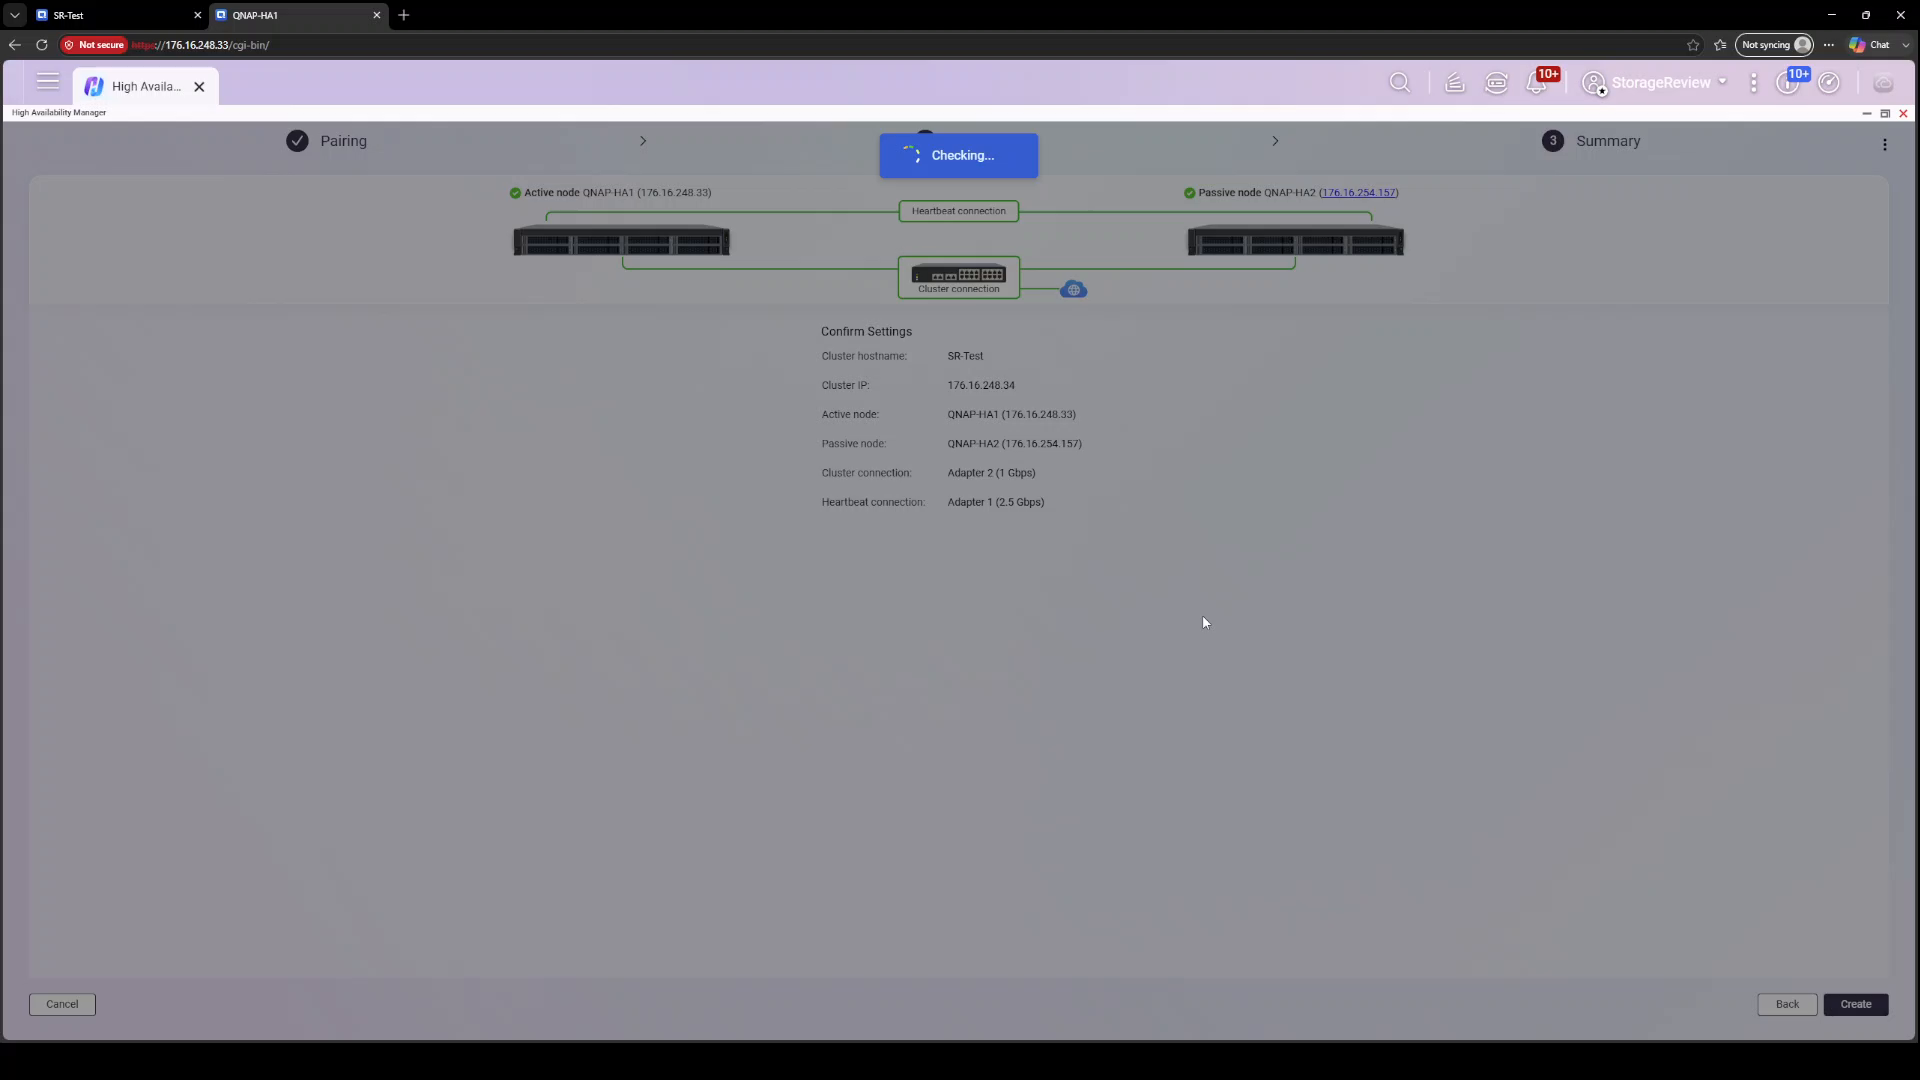
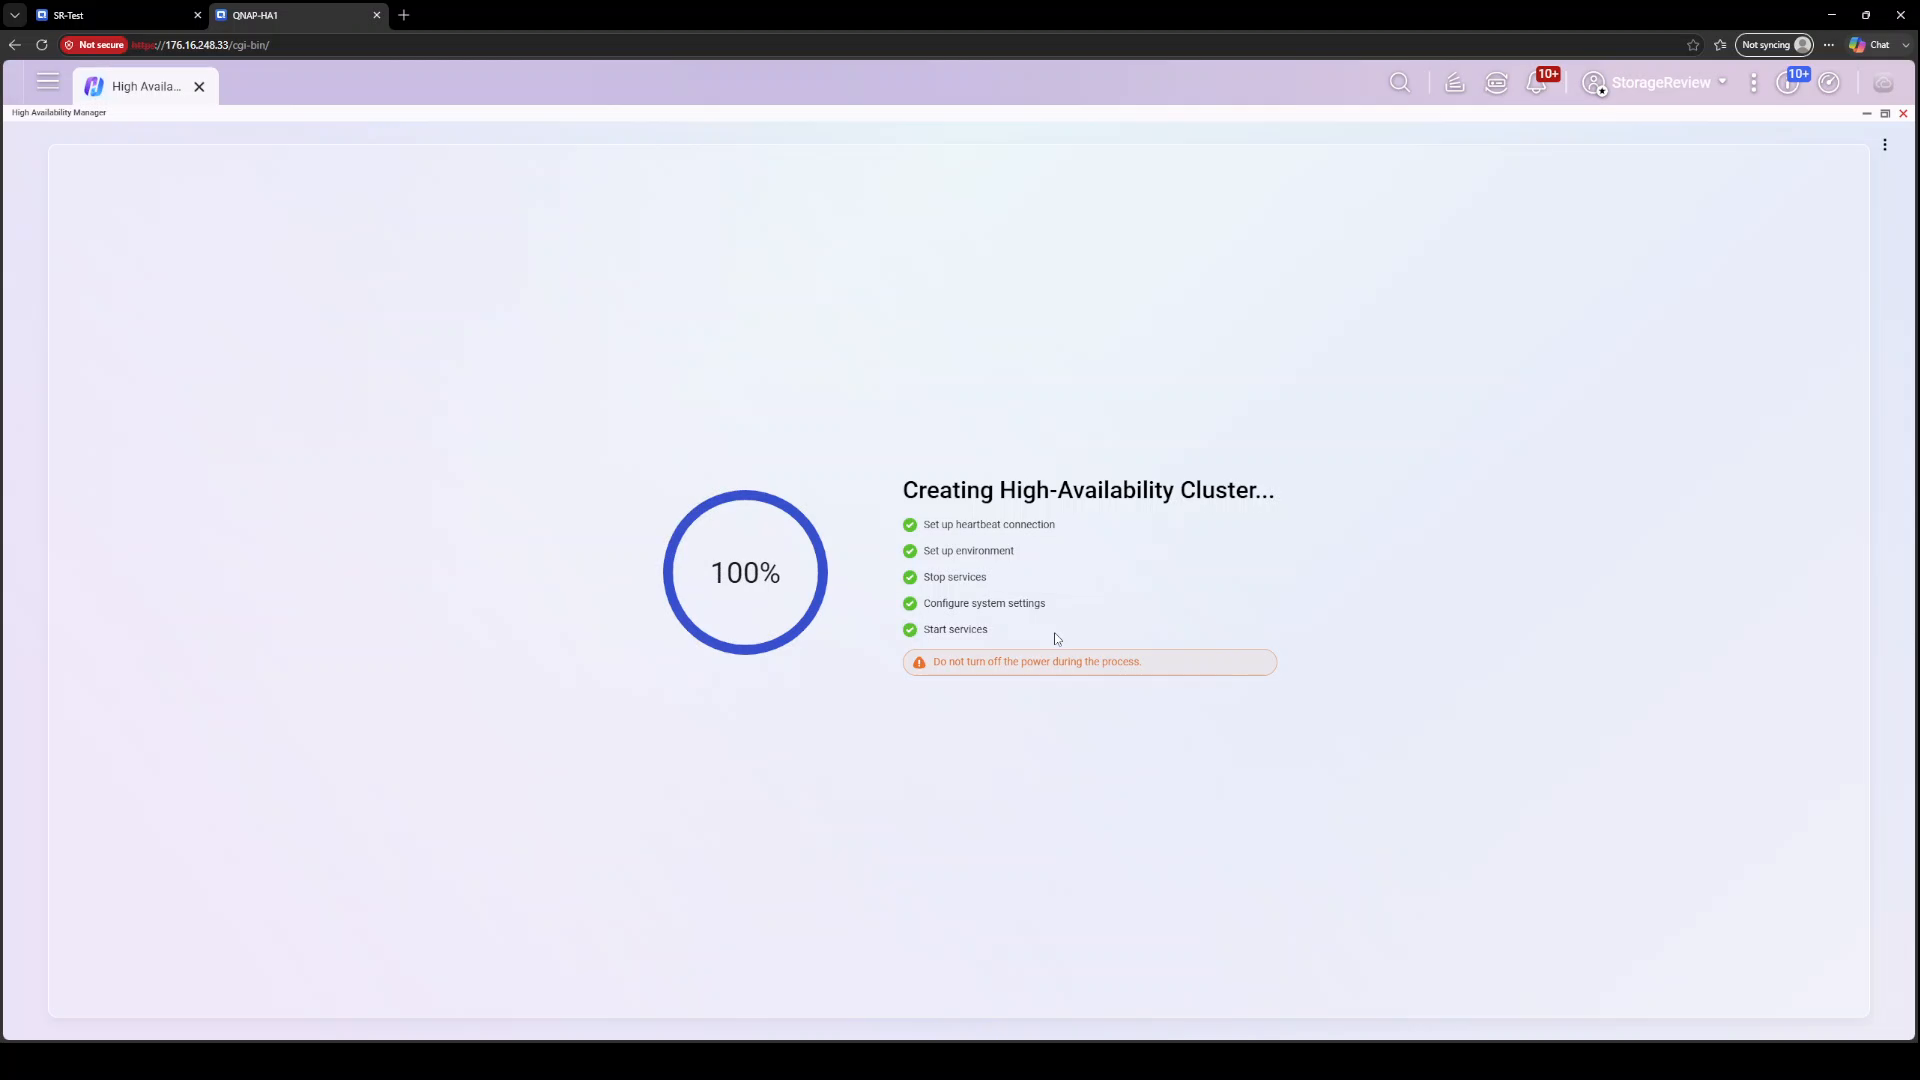
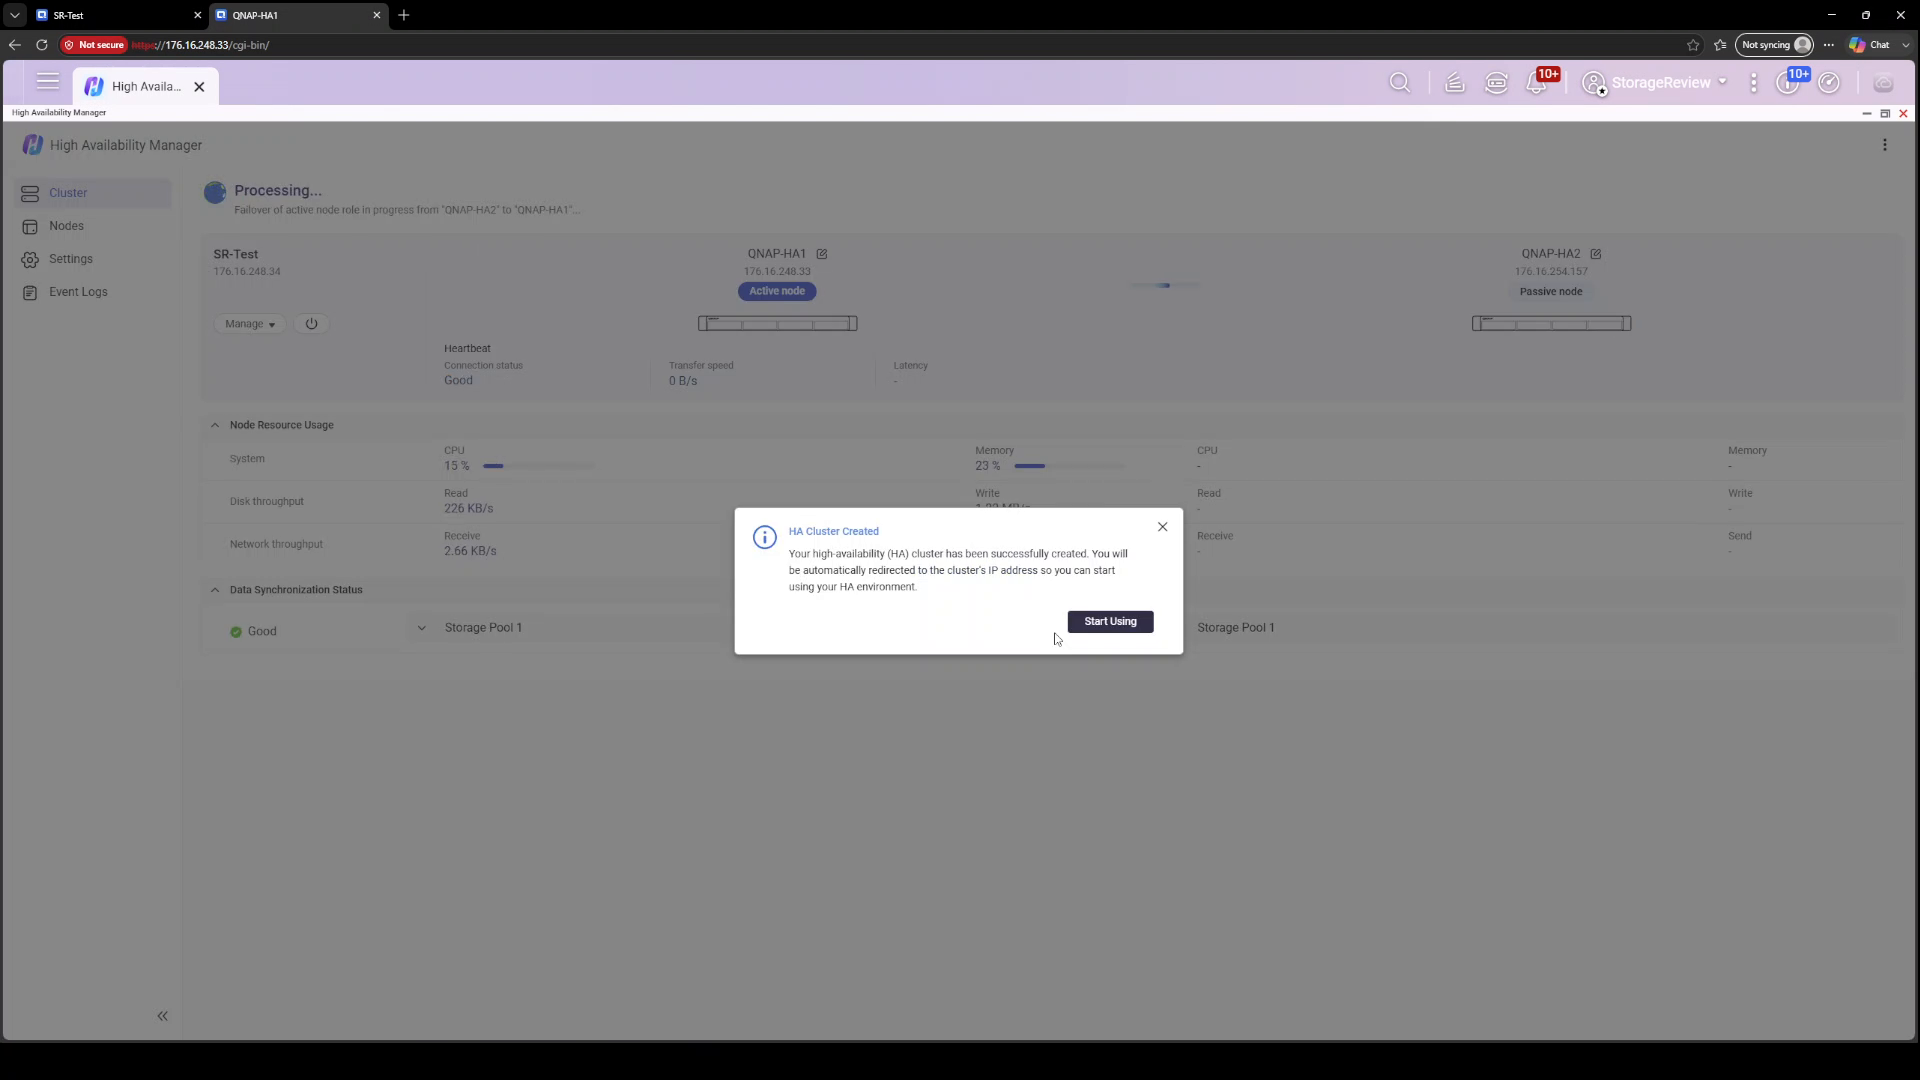
설정을 확인하면 마법사가 5단계 빌드 과정을 실행합니다. 하트비트 연결 설정, 환경 설정, 서비스 중지, 시스템 설정 구성, 서비스 시작 순으로 진행됩니다. 사용자 인터페이스는 이 과정 동안 어떤 장치의 전원도 끄지 말라고 강조합니다. 저희 시스템에서는 빌드 자체가 약 5분 30초 만에 완료되었고, 그 후 HA Manager에서 클러스터가 생성되었다고 보고하고 클러스터 IP 주소로 리디렉션했습니다. 두 대의 독립형 NAS 장치를 서비스 클러스터로 구성하는 데 마법사를 사용한 전체 과정은 10분도 채 걸리지 않았습니다.
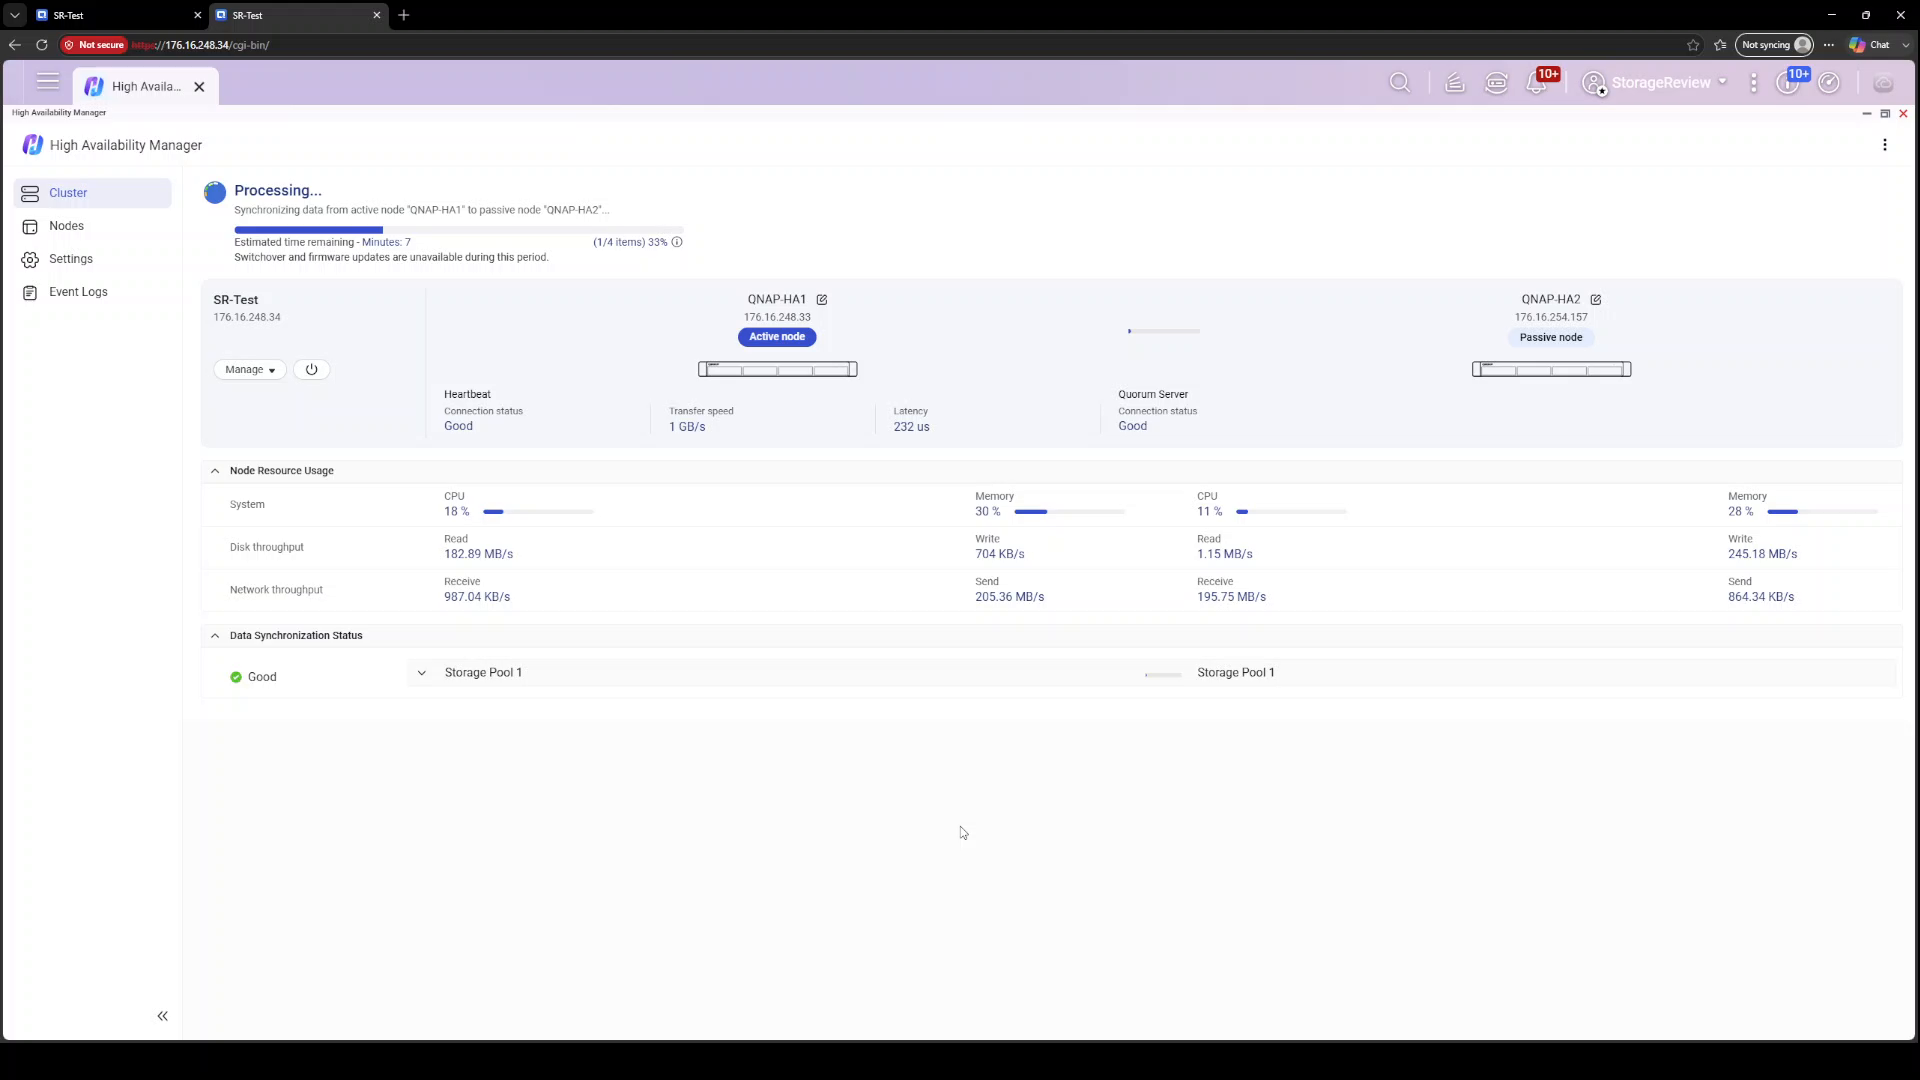
가장 중요한 작업은 초기 동기화입니다. 이 단계에서 활성 노드는 스토리지 풀을 수동 노드로 블록 단위로 복제합니다. HA Manager는 대시보드 상단에 진행률 표시줄, 항목 수, 예상 소요 시간을 명확하게 표시하고, 동기화가 완료될 때까지 스위치오버 및 펌웨어 업데이트를 사용할 수 없다는 경고를 함께 보여줍니다. 이 단계에서 하트비트 통계를 관찰하는 것은 매우 인상적인 부분이었습니다. 전송 속도는 약 900MB/s에서 1.2GB/s까지 다양했으며, 지연 시간은 수백 마이크로초 수준이었습니다. 특히 1GB/s의 속도에 232마이크로초라는 놀라운 기록을 보여주기도 했습니다. 초기 동기화는 약 10분 만에 완료되었는데, 이는 대시보드에 표시된 예상 소요 시간인 9분과 정확히 일치했습니다.
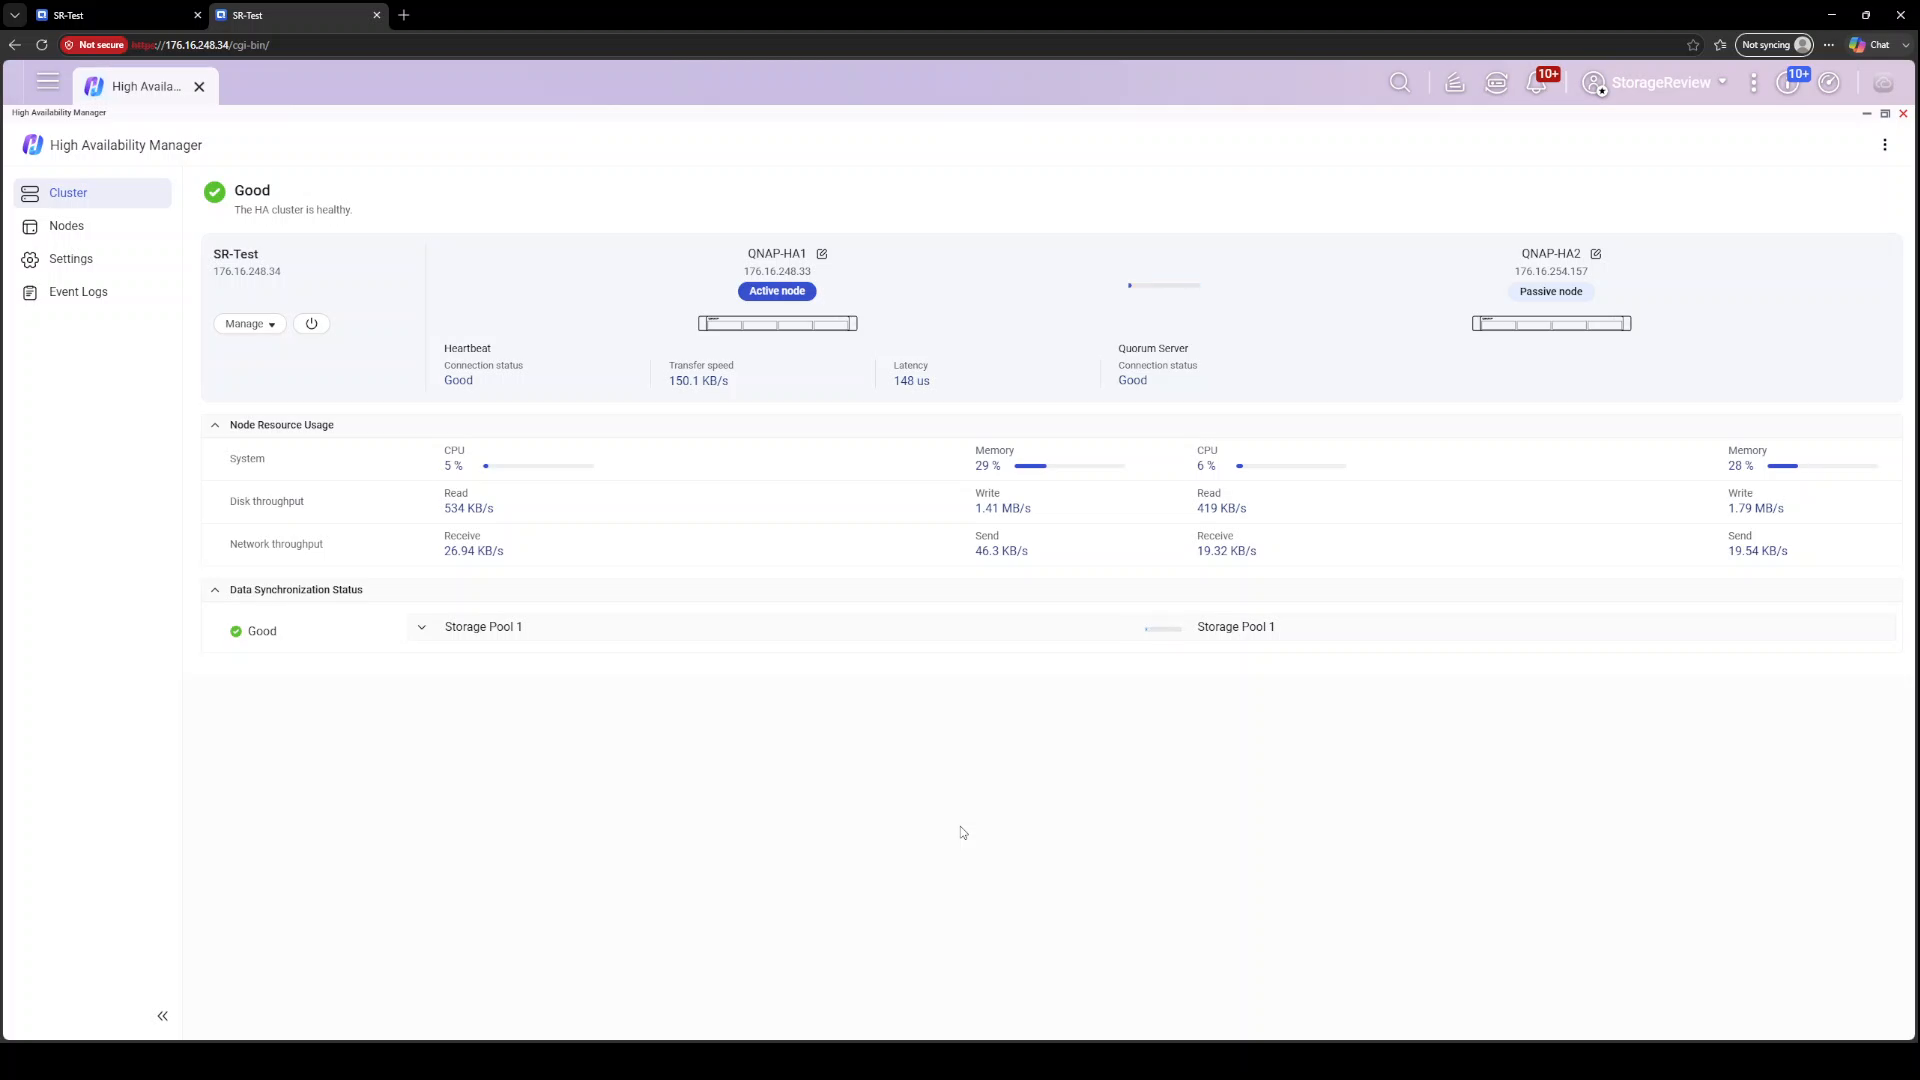
동기화가 완료되면 대시보드는 '양호' 상태로 안정화됩니다. 클러스터가 정상이고, 하트비트가 연결되었으며, 두 노드의 CPU, 메모리, 디스크 처리량 및 네트워크 통계가 나란히 표시되고, 그 아래에는 풀별 동기화 상태가 표시됩니다. 이는 관리자가 실제로 궁금해하는 두 가지 질문, 즉 클러스터가 정상인지, 데이터가 동기화되었는지에 대한 답을 제공하는 깔끔하고 정보가 풍부한 화면입니다.
장애 조치 테스트 1: 활성 노드의 전원 손실
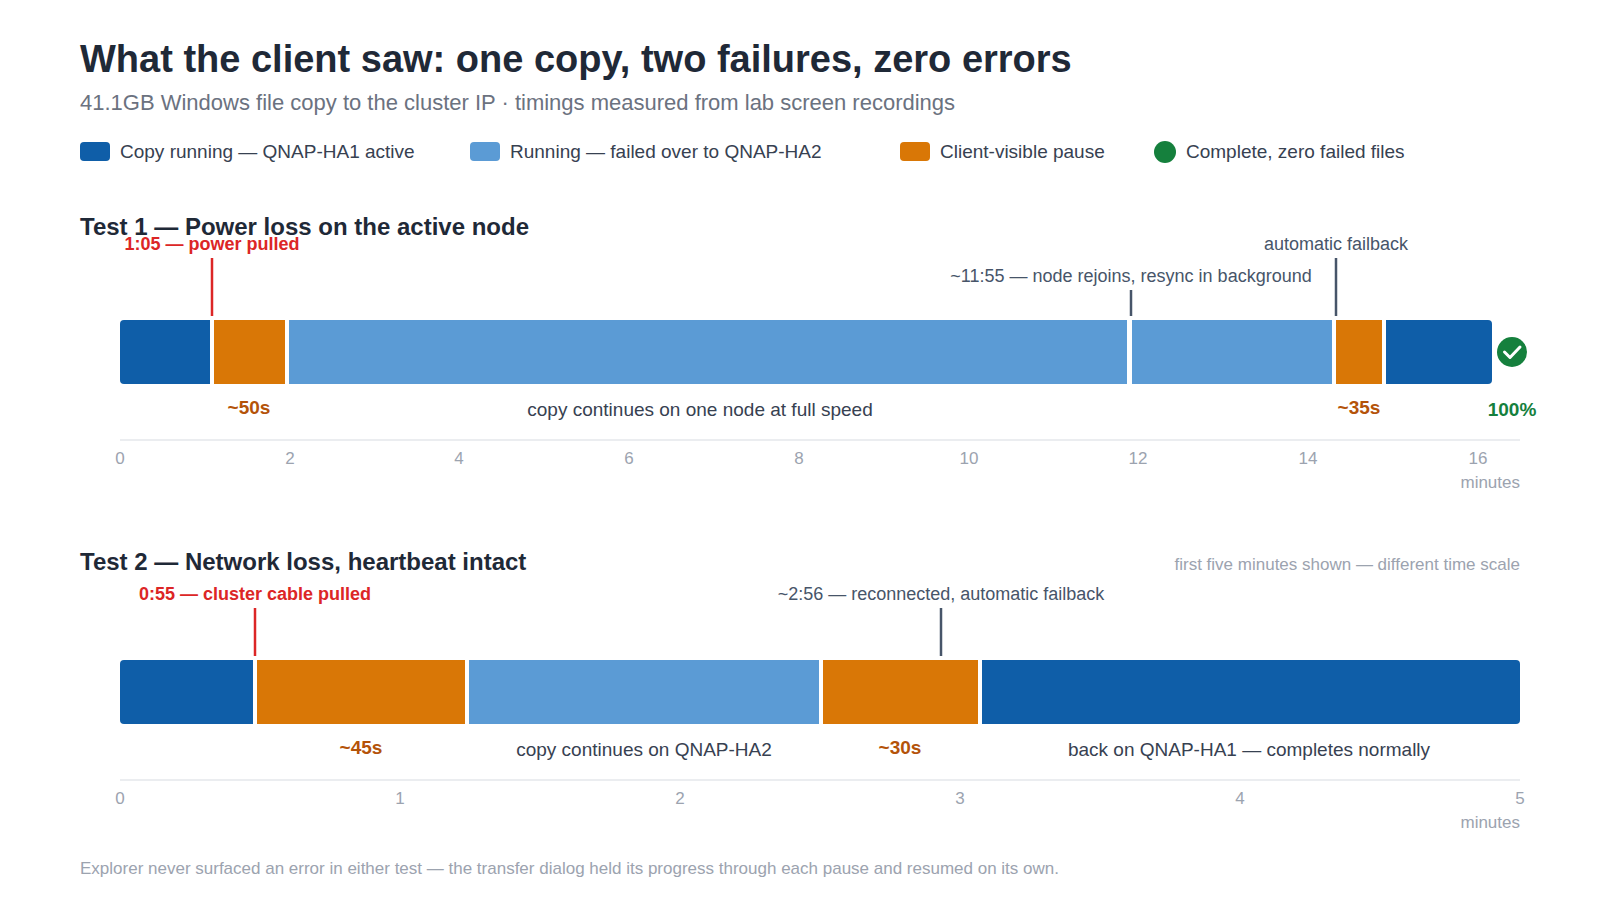
첫 번째 장애 시나리오는 가장 극단적인 경우, 즉 활성 노드의 전원이 완전히 차단되는 상황입니다. 클라이언트에서 클러스터 IP의 SMB 공유 폴더로 Windows 파일 복사를 시작했는데, Windows 11 및 Rocky Linux ISO 파일과 Kali Linux VM 아카이브 두 개를 포함한 41.1GB 용량의 파일 6개를 복사하는 중 QNAP-HA1의 전원이 차단되었습니다.
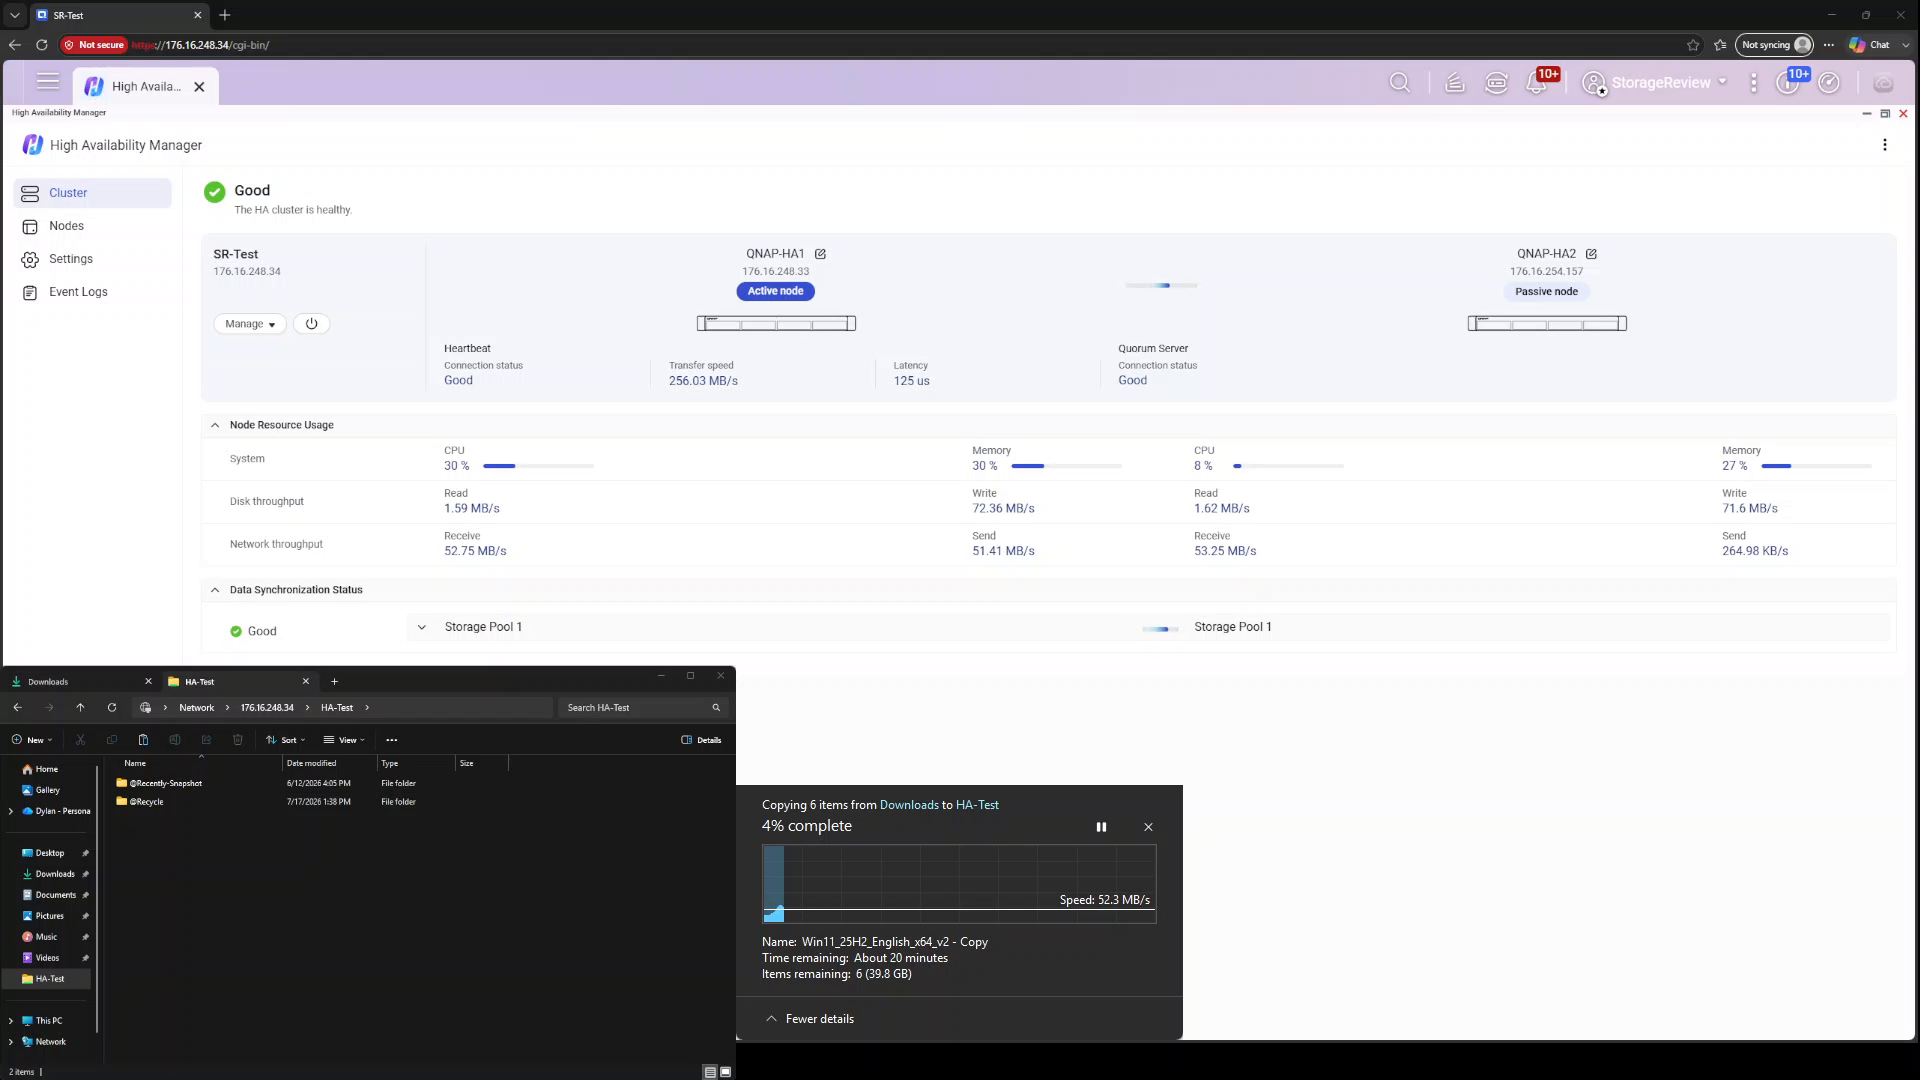
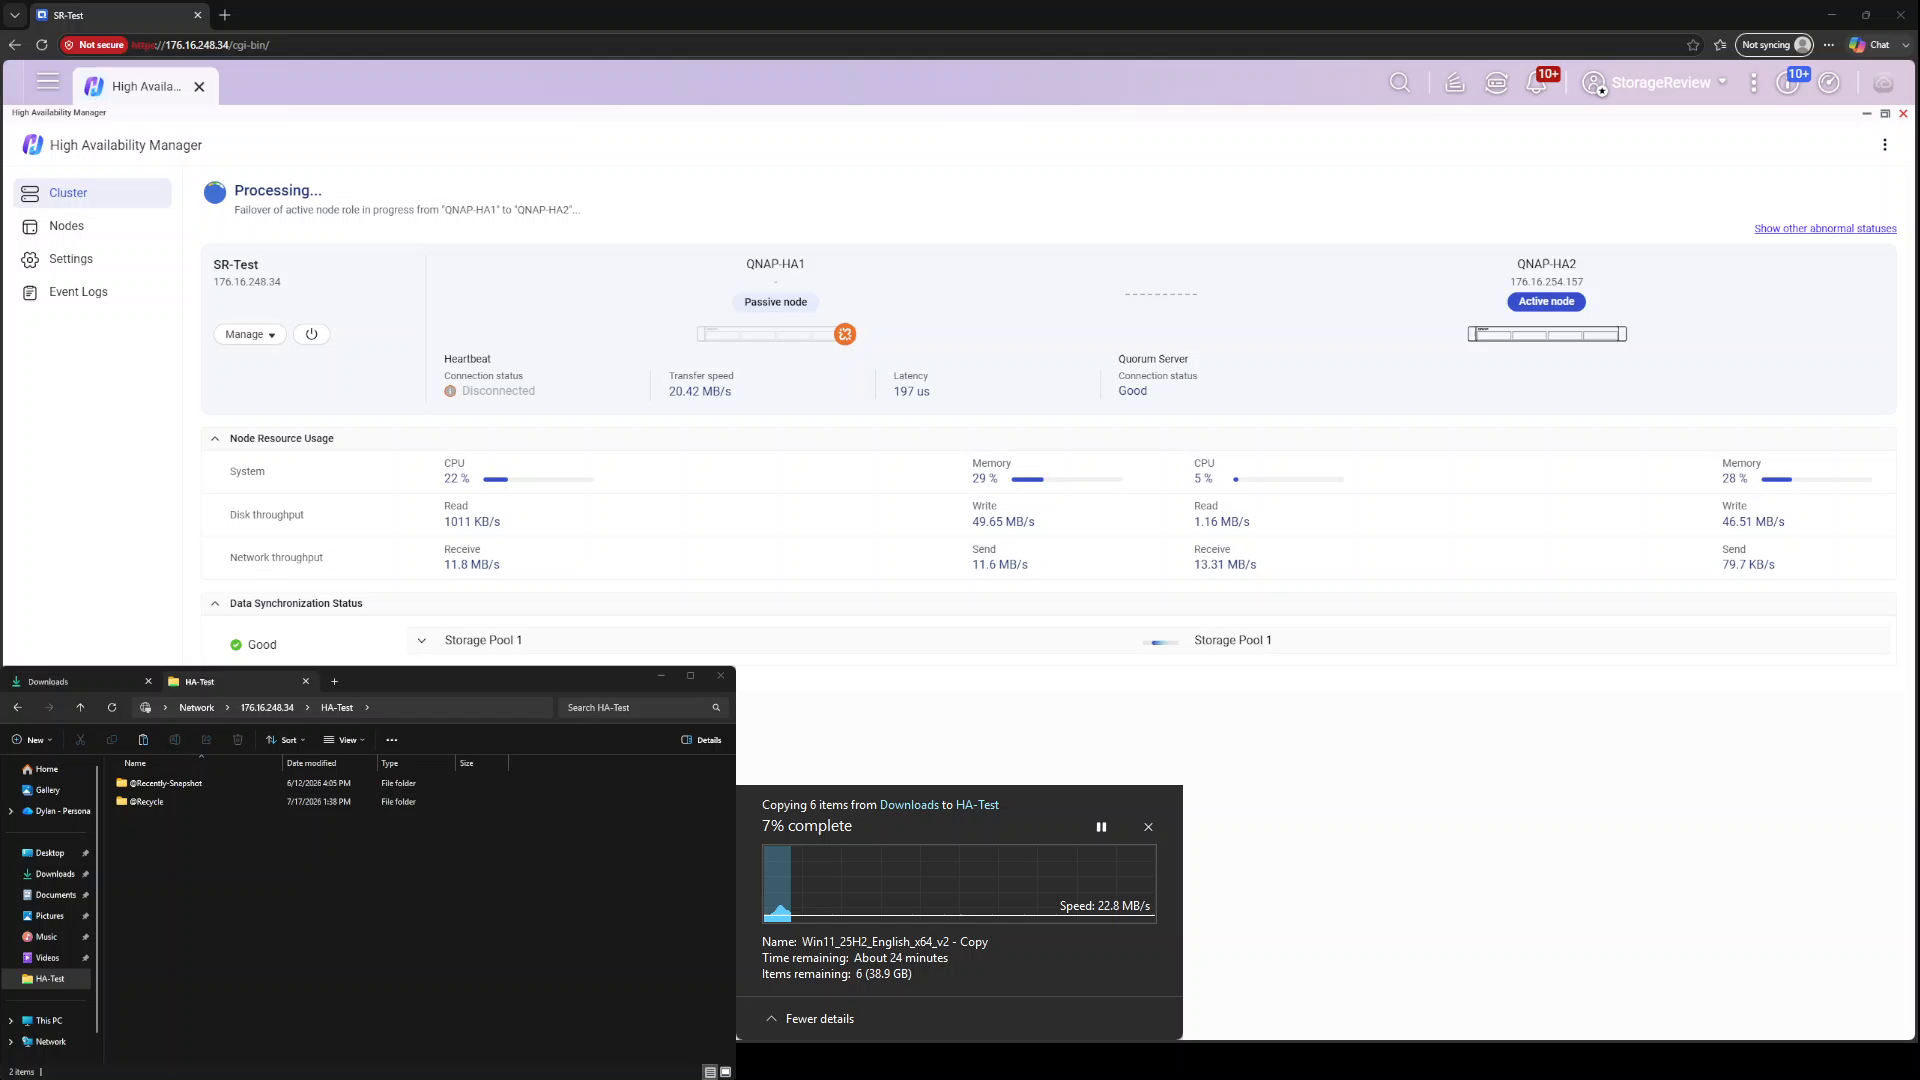
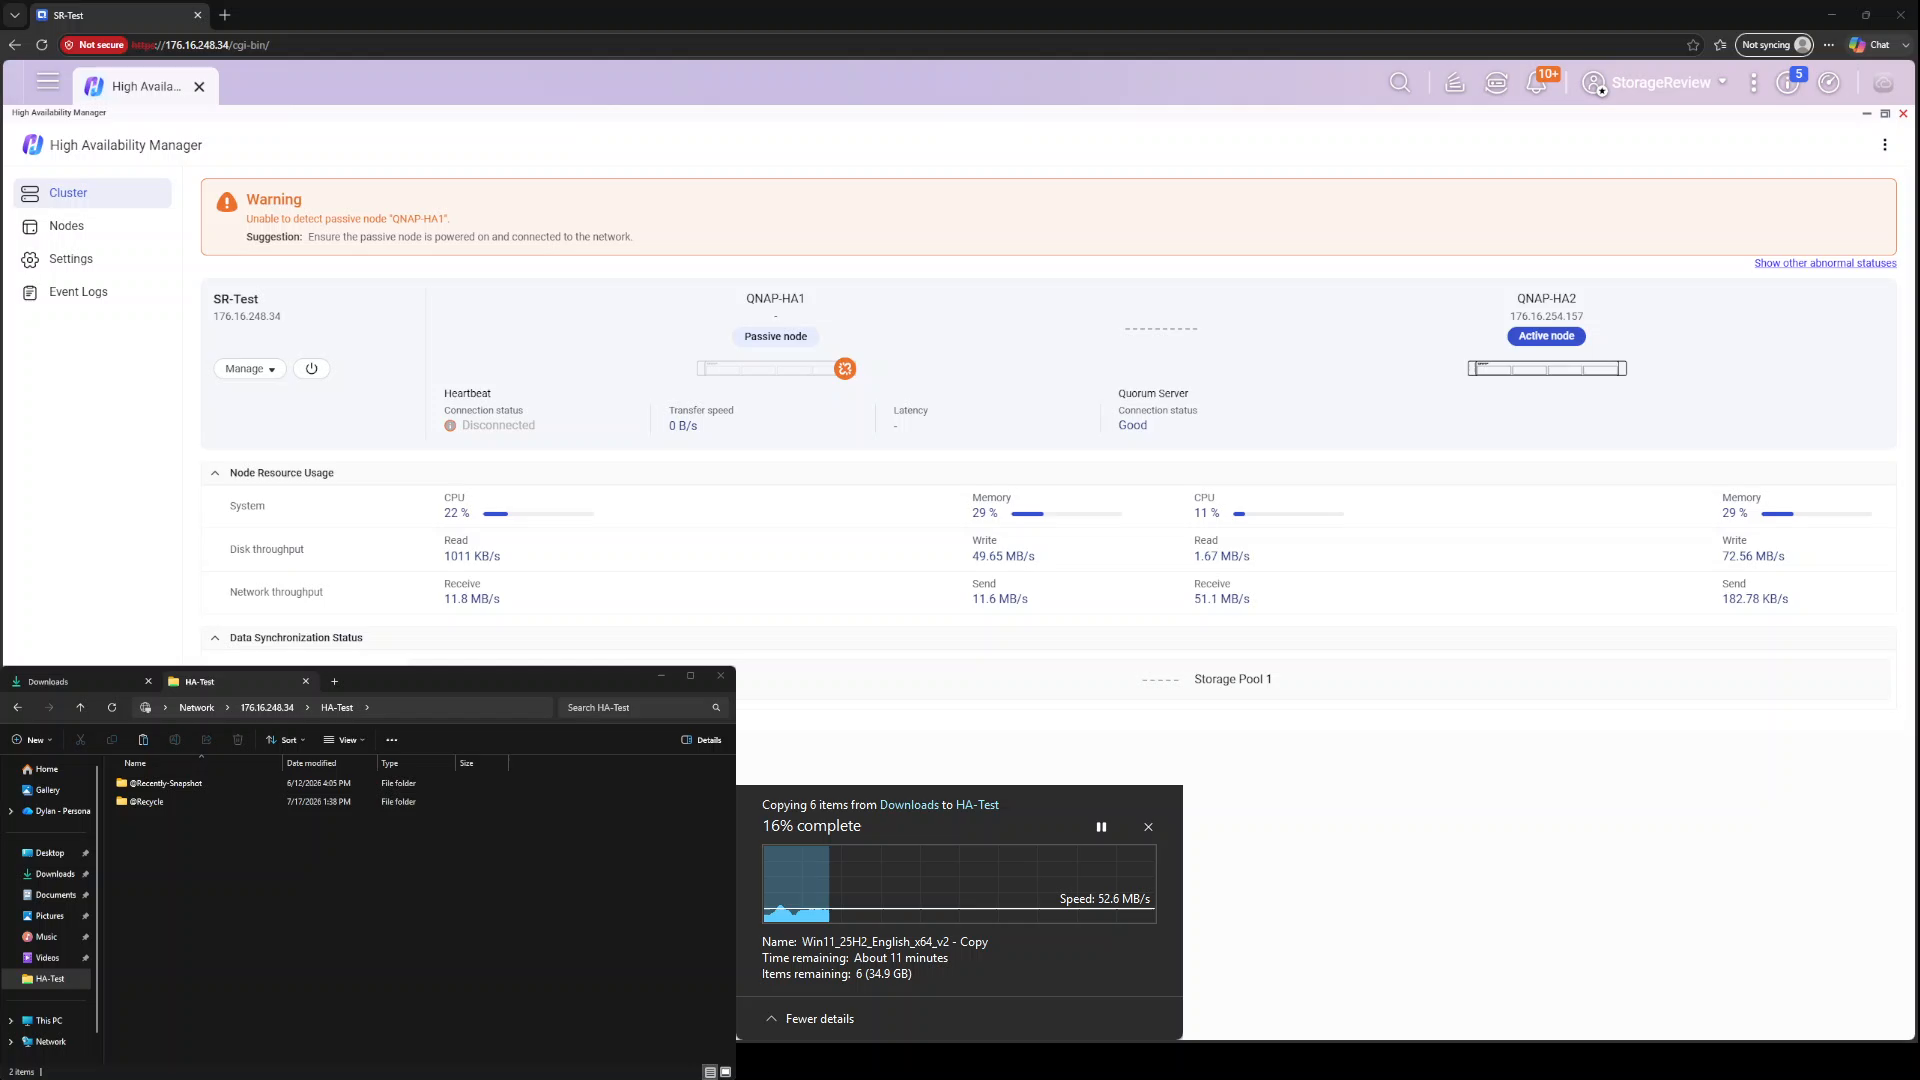
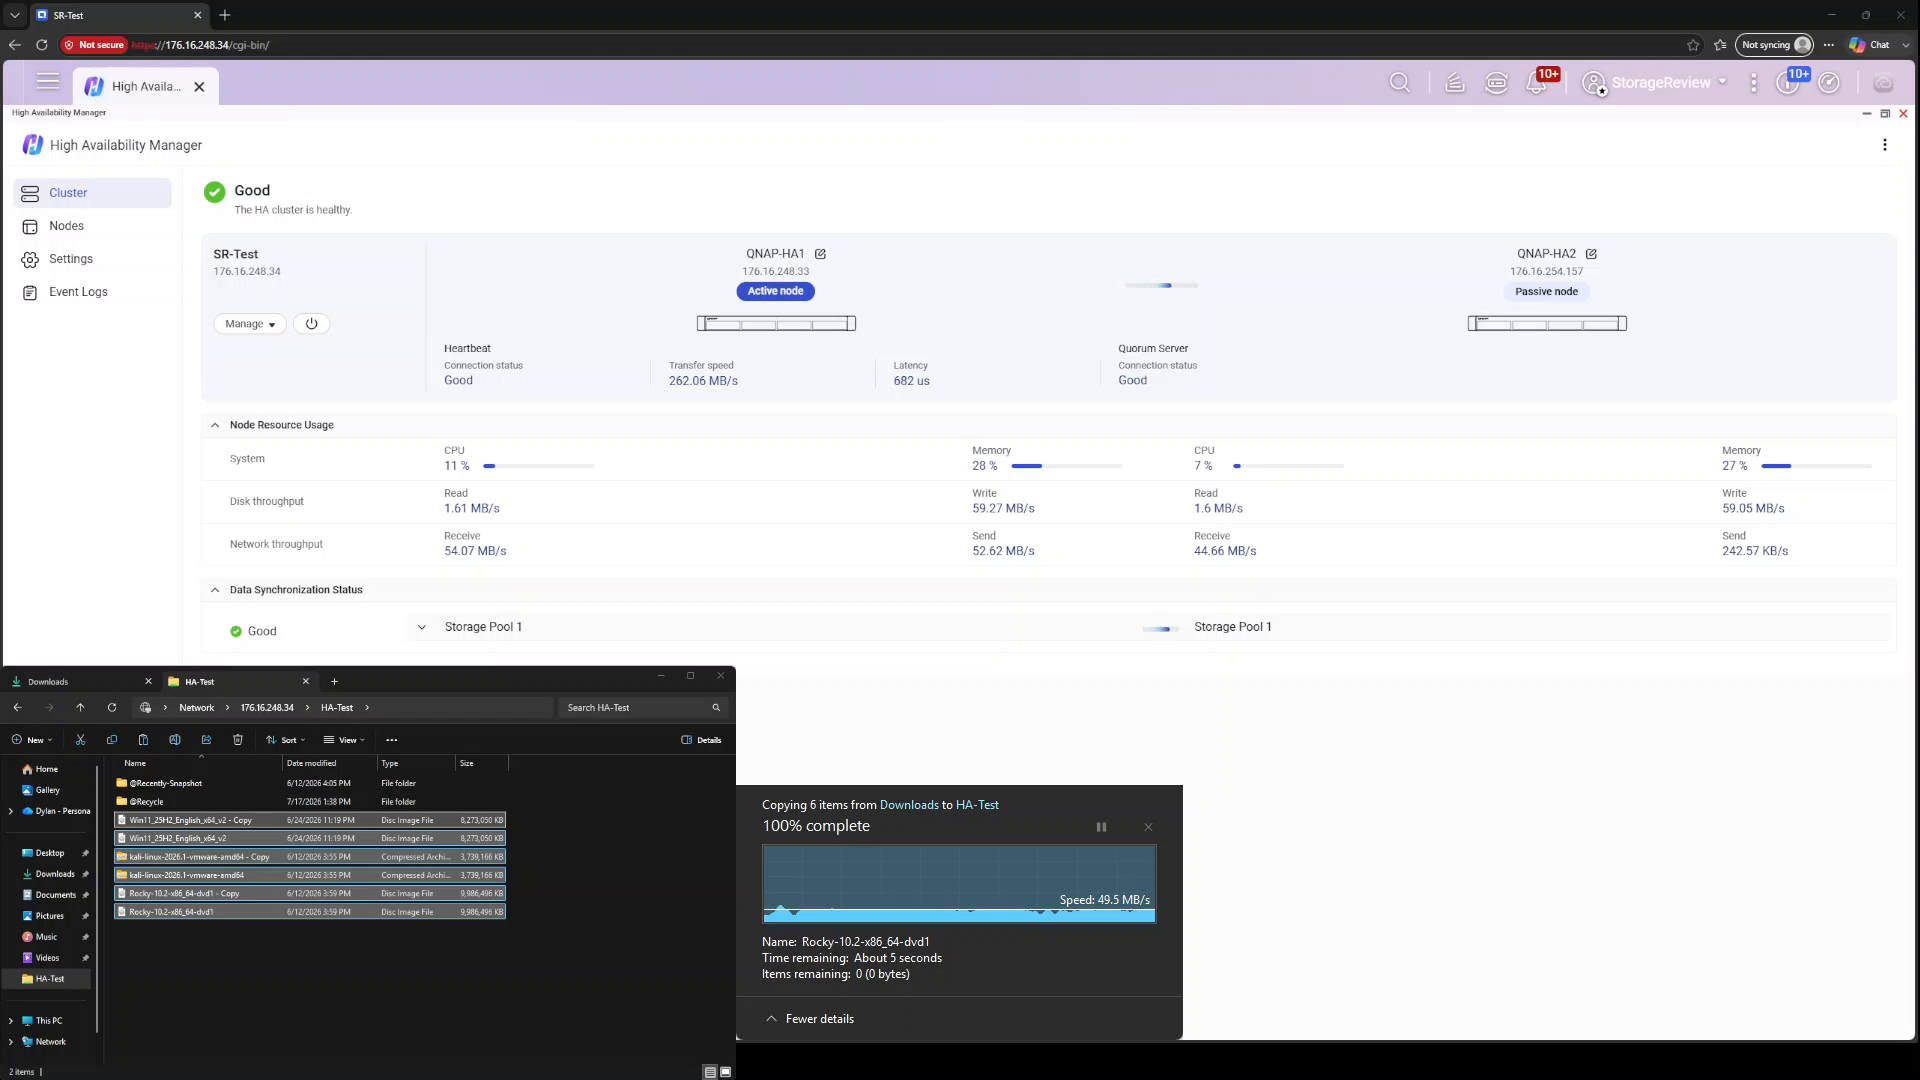
클라이언트 입장에서 보면, 전원이 차단된 후 데이터가 다시 전송되기까지 약 50초 정도 복사가 중단되었고, 탐색기에는 오류가 표시되지 않았습니다. 전송 대화 상자는 진행 상황을 멈췄다가 QNAP-HA2가 활성 노드로 전환되면서 다시 전송을 시작했습니다. HA Manager는 활성 노드 역할의 페일오버가 진행 중임을 잠시 보고한 후, 수동 노드 QNAP-HA1을 감지할 수 없다는 경고 배너를 표시하고 해당 노드의 전원이 켜져 있고 네트워크에 연결되어 있는지 확인하라는 메시지를 보여주었습니다. 클러스터가 단일 노드에서 실행되는 동안에도 동일한 클러스터 IP 주소를 대상으로 전송이 최대 속도로 계속되었는데, 이는 HA가 보장하는 성능 저하 상태이지만 작동 가능한 상태입니다.
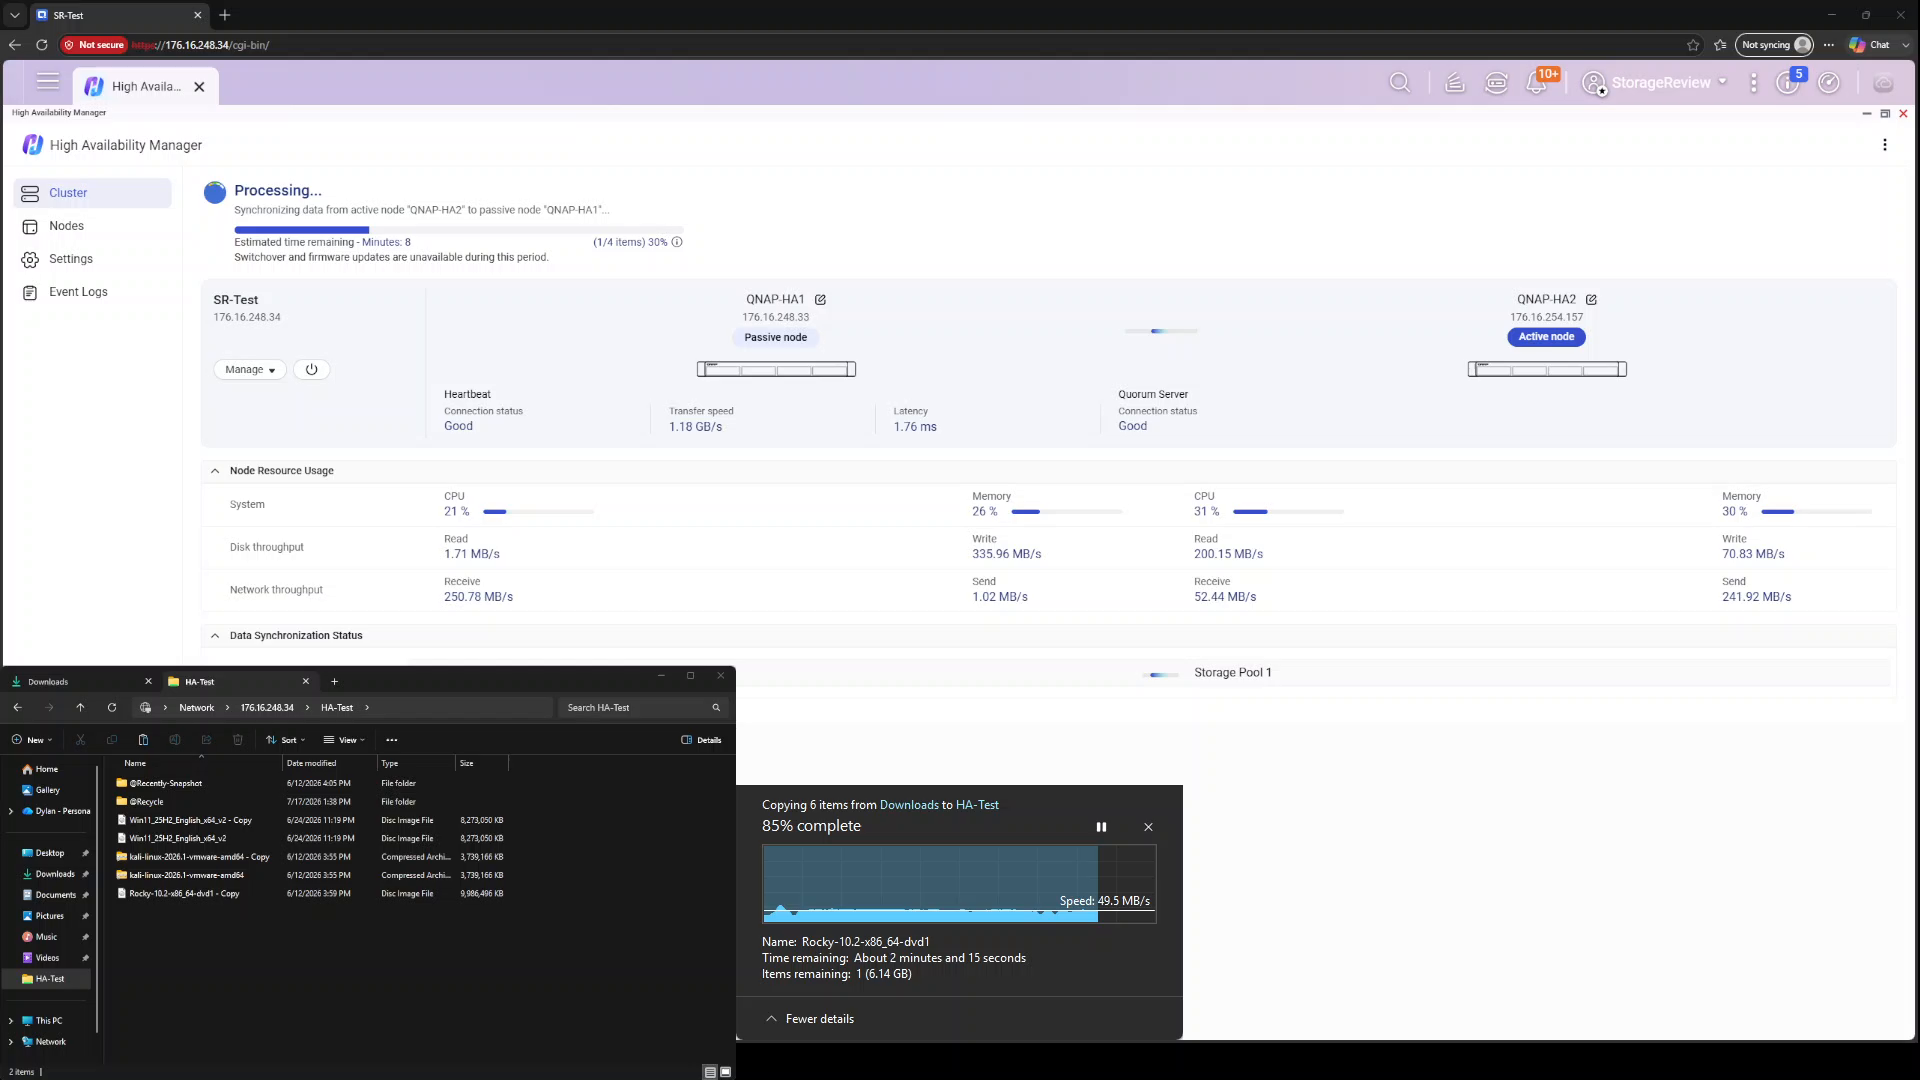
QNAP-HA1에 전원을 복구하자 역방향 프로세스가 자동으로 시작되었습니다. 노드는 전원이 끊긴 후 약 10분 만에 부팅되어 수동 멤버로 다시 연결되었고, HA Manager는 활성 노드인 QNAP-HA2에서 QNAP-HA1으로 데이터 동기화를 시작했습니다. 대시보드에서 진행 상황과 예상 소요 시간을 확인할 수 있었고, 파일 복사 작업은 중단 없이 계속되었습니다. 페일백에는 별도의 조치가 필요하지 않았습니다. 재동기화가 완료되면 클러스터는 약 35초 동안 전송을 일시 중지하고 QNAP-HA1에 활성 역할을 반환한 후 복사 작업을 완료했습니다. 작업이 완료될 무렵 클러스터는 정상 상태로 돌아왔고 전송률은 100%였습니다. 이는 단일 복사 작업 내에서 발생한 심각한 전원 장애, 단일 노드 작동 기간, 노드 복구 및 페일백을 모두 성공적으로 견뎌낸 결과입니다.
장애 조치 테스트 2: 하트비트 유지 상태에서 네트워크 손실 발생 시
두 번째 시나리오는 좀 더 미묘하고 실제 환경에서 더 흔하게 발생할 수 있습니다. 활성 노드가 클라이언트와의 네트워크 연결을 잃는 경우(스위치 포트 오류, 케이블 단선 또는 트랜시버 불량)가 발생하지만, 노드 자체는 계속 실행되고 하트비트 링크도 유지됩니다. 이 경우 두 노드 모두 살아있고 서로를 인식할 수 있으므로 클러스터가 어떤 노드가 클러스터 IP를 소유해야 하는지 결정해야 하기 때문에 스플릿 브레인 보호가 매우 중요합니다.
클러스터 IP 주소를 대상으로 동일한 Windows 파일 복사 작업을 반복한 후 활성 노드의 클러스터 네트워크 인터페이스 연결을 끊었습니다. 클러스터가 서비스를 다른 노드로 이동하는 동안 전송이 약 45초 동안 일시 중단되었다가 오류 없이 재개되었습니다. HA Manager는 오류를 정확하게 표시하여 해당 노드의 클러스터 네트워크 인터페이스 어댑터 2 연결이 끊어졌다고 경고하고 스위치 연결 상태를 확인하도록 권장했습니다. 더 나아가 연결이 끊어진 노드가 해당 인터페이스를 통해 쿼럼 서버에 더 이상 연결할 수 없다고 지적했습니다. 이처럼 정확한 인터페이스, 노드, 그리고 그 결과를 명시하는 구체적인 정보는 일부 HA 구현에서 사용하는 일반적인 성능 저하 플래그보다 훨씬 더 정확한 진단 정보를 제공합니다.
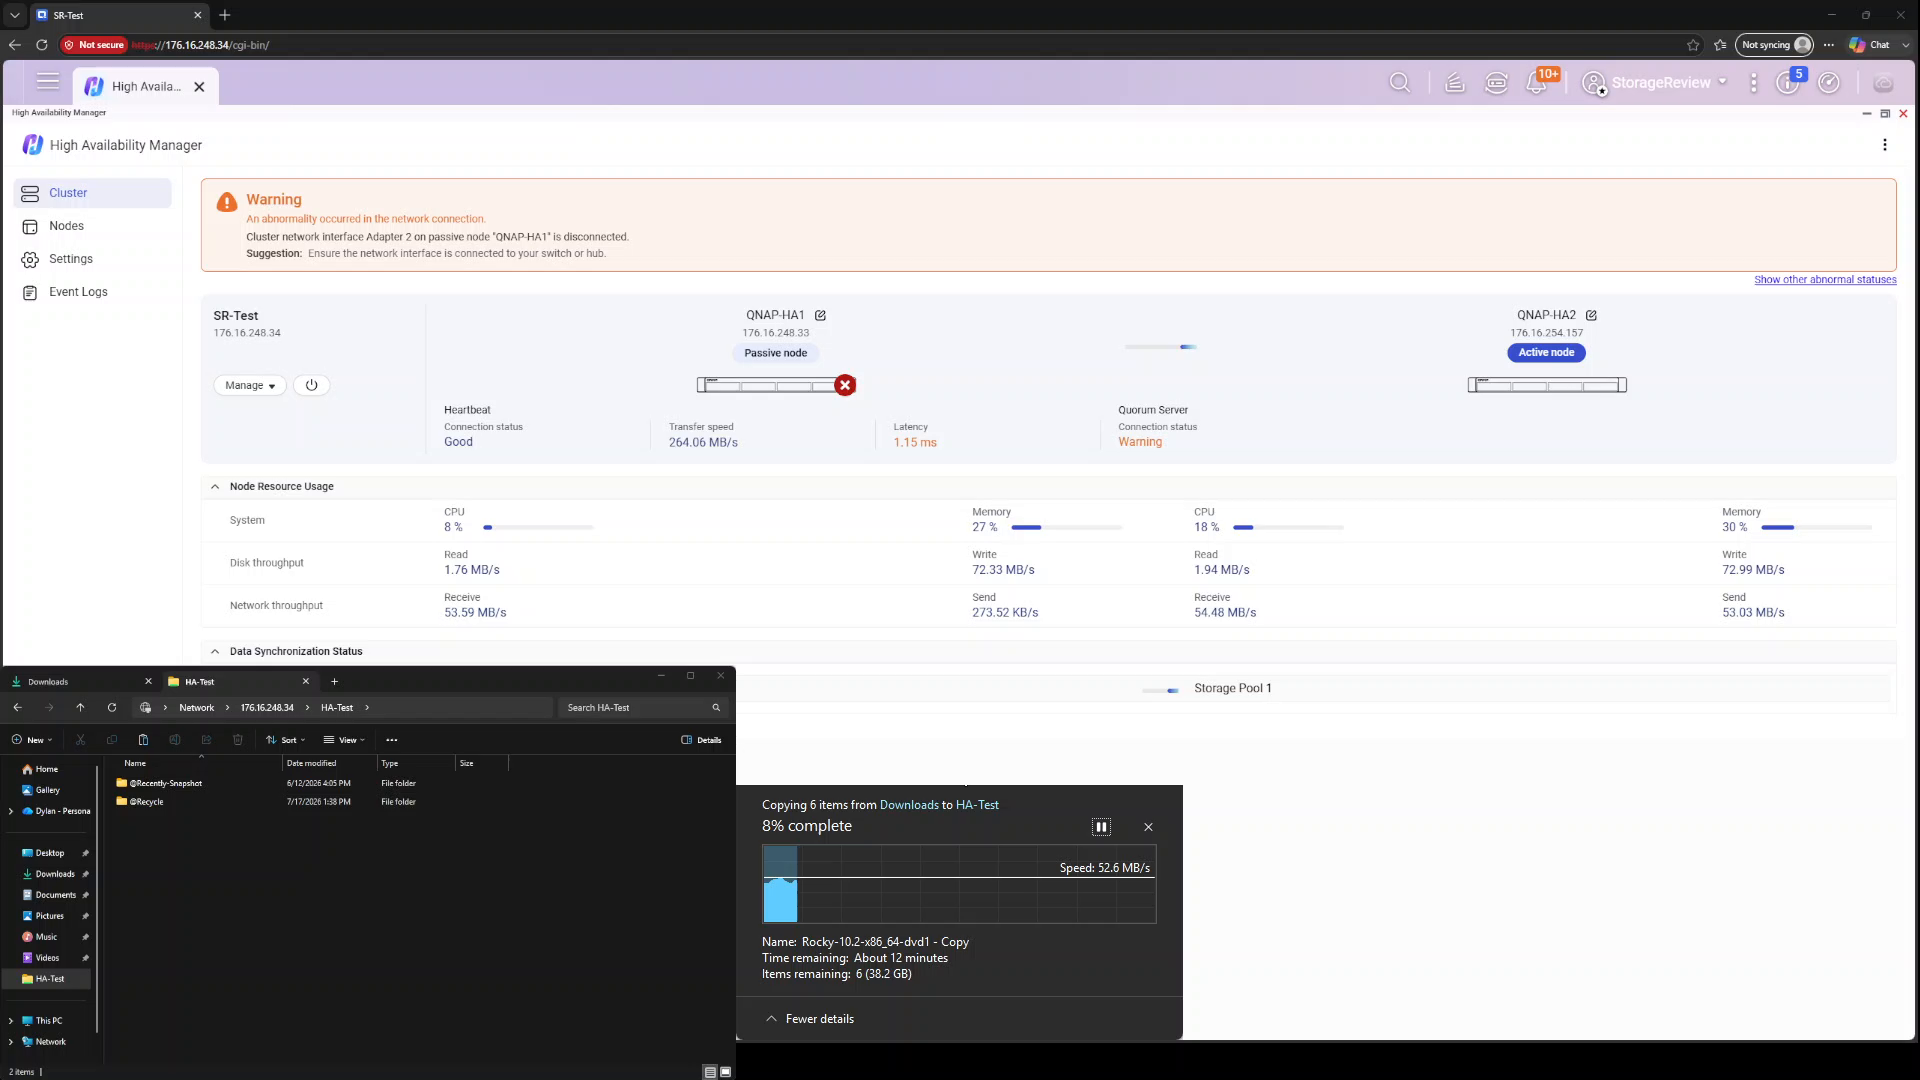
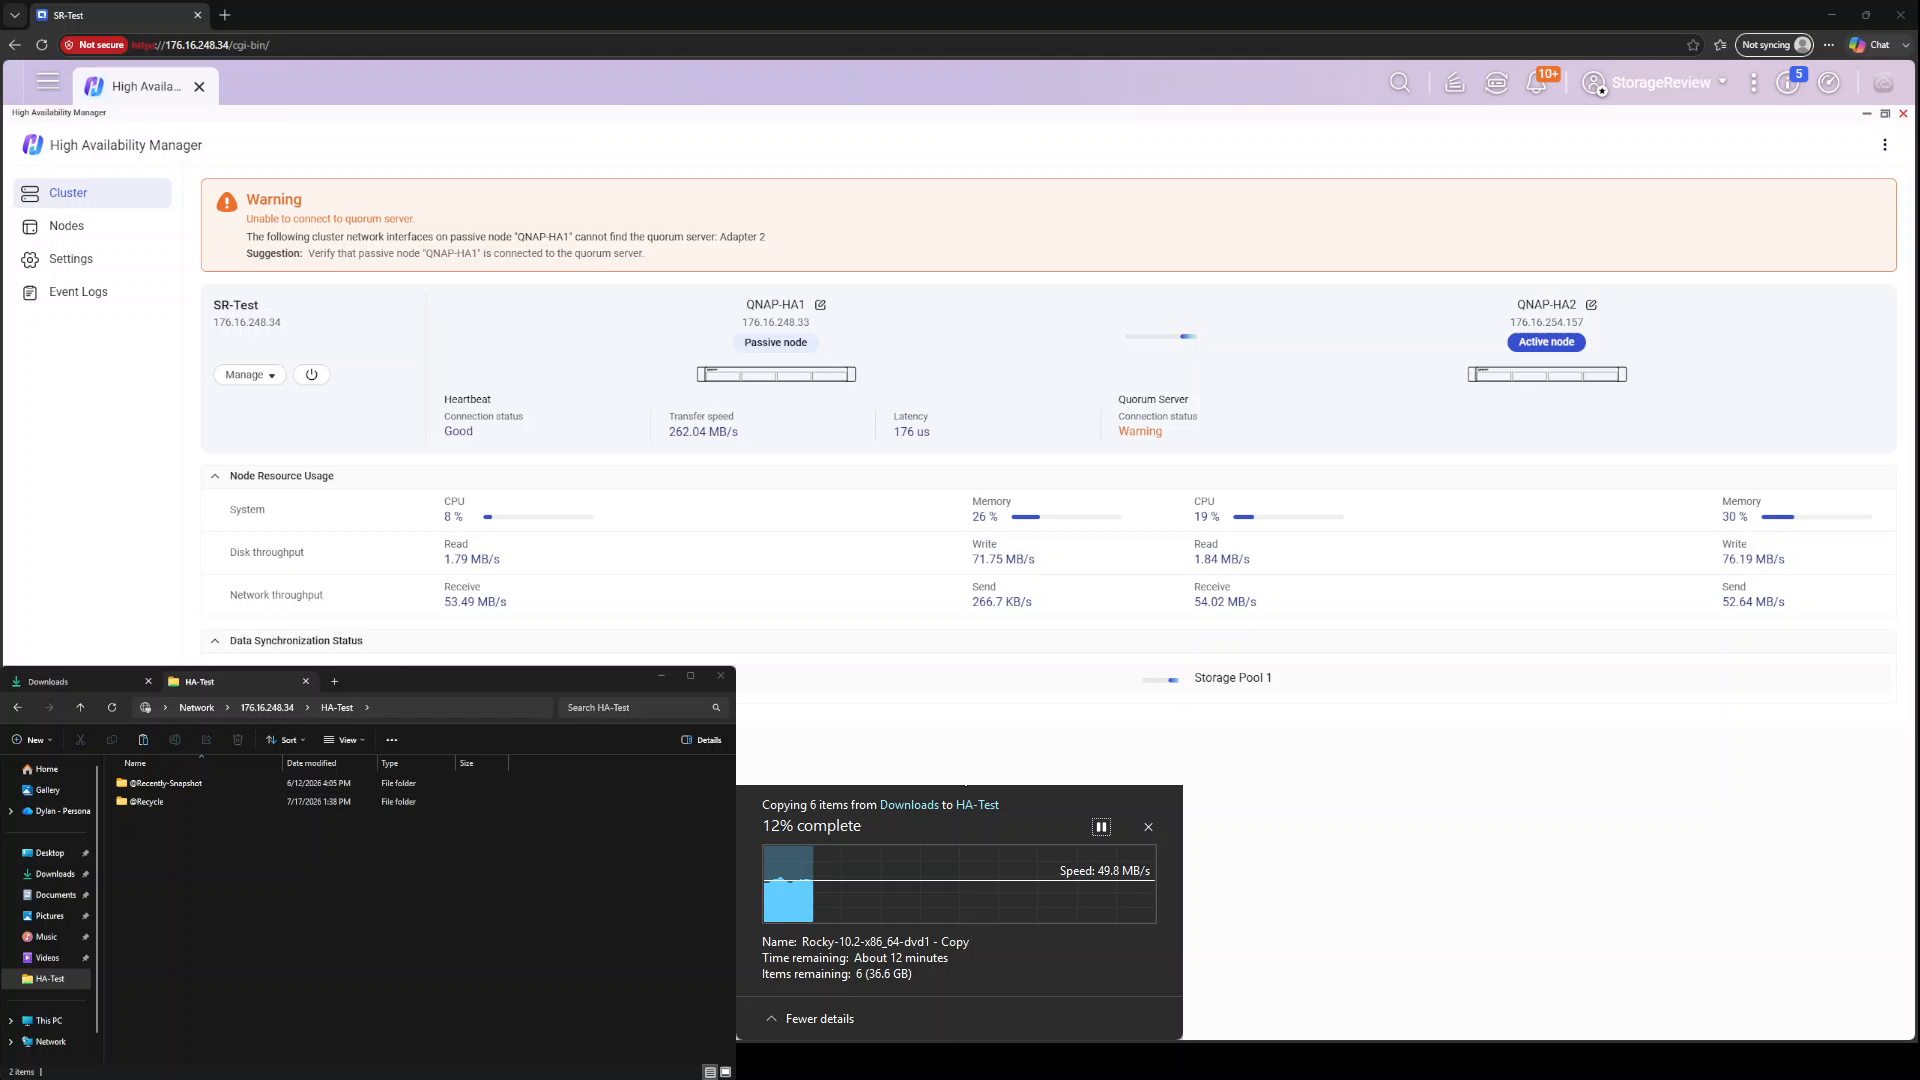
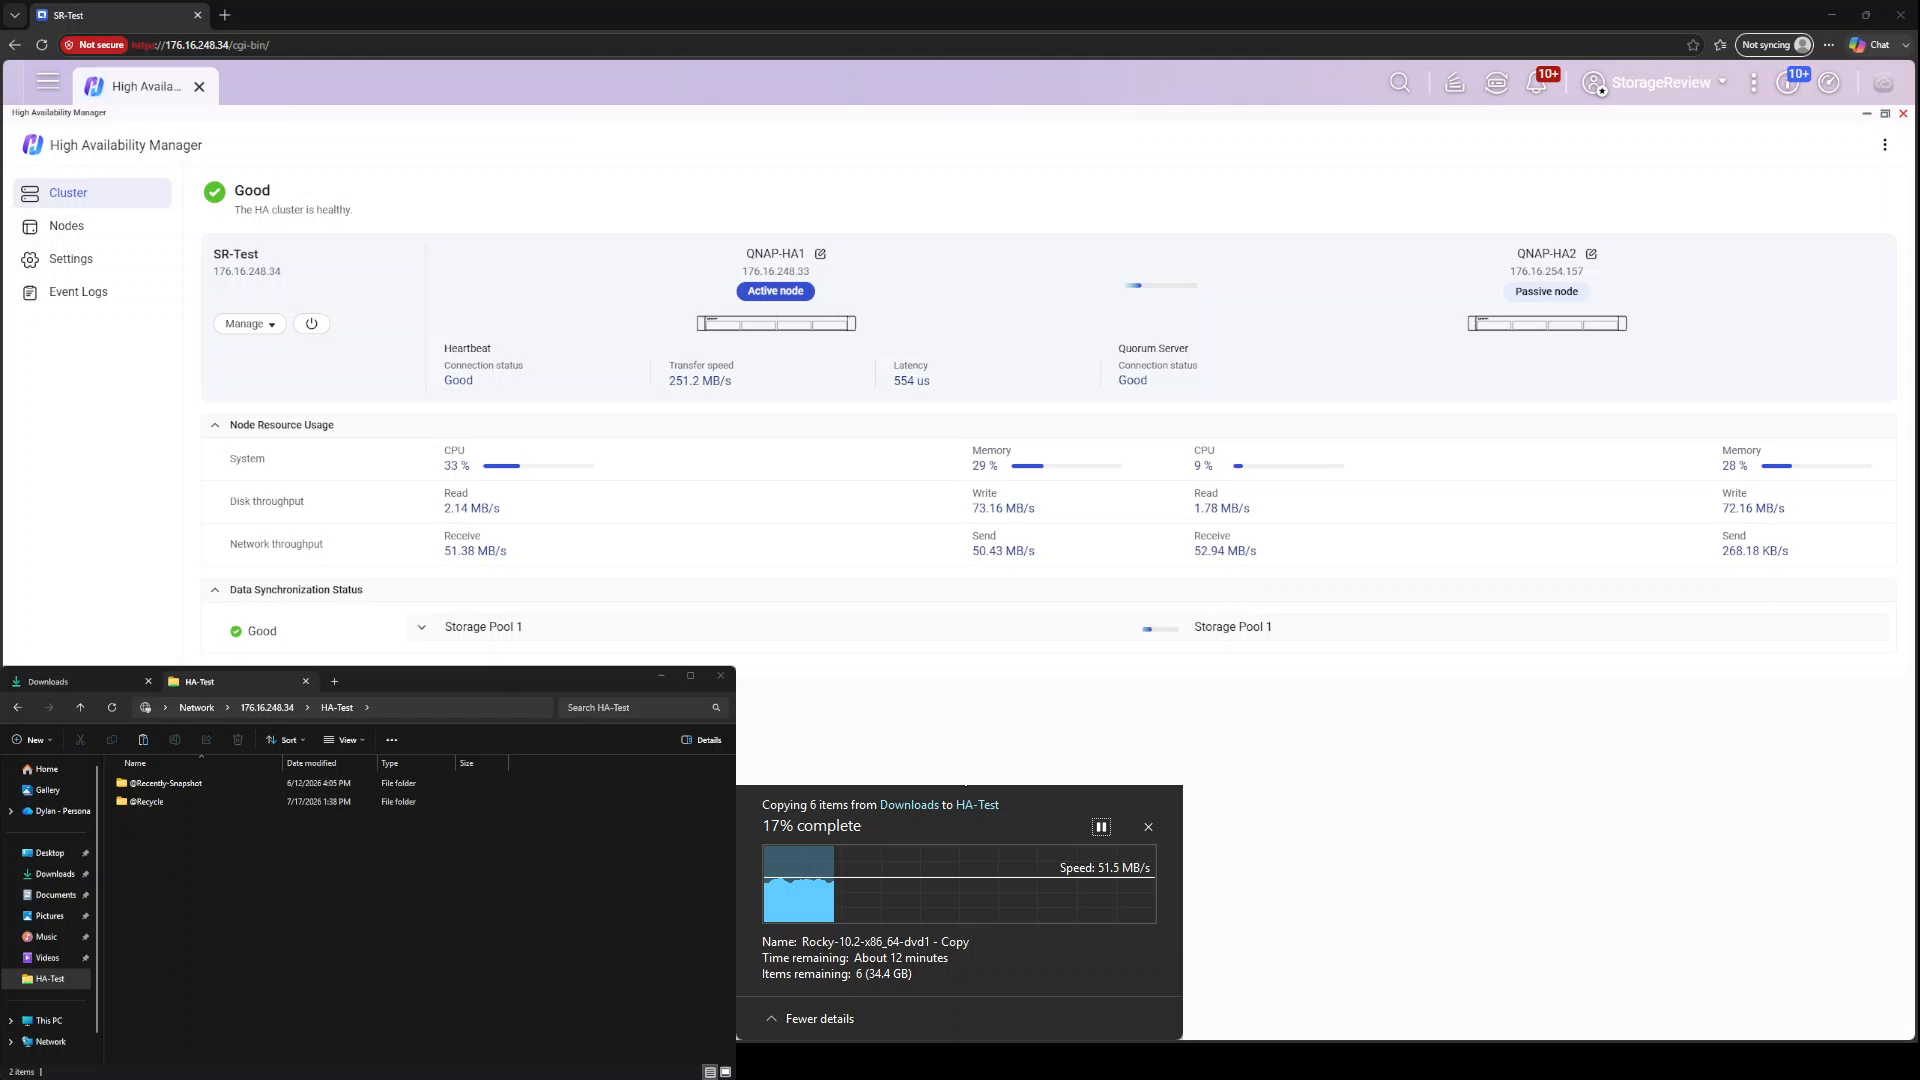
네트워크 연결이 복구되자 노드가 클러스터에 다시 합류했고, 페일백은 1분 이내에 자동으로 이루어졌습니다. 활성 역할이 QNAP-HA1으로 복귀하는 데 약 30초 정도의 일시적인 지연이 있었을 뿐, 클라이언트 측에서는 아무런 변화도 감지되지 않았습니다. 동일한 복사 작업은 두 번의 연속적인 스위치오버에도 불구하고 단 하나의 파일도 실패하지 않았습니다. 훨씬 사소한 이유로 SMB 세션이 종료되는 것을 경험해 본 사람이라면, 이것이야말로 이번 테스트의 가장 중요한 결과라고 할 수 있습니다.
고가용성(HA)을 올바르게 구축하는 방법: 스플릿 브레인 및 네트워크 토폴로지
저희와 같은 페일오버 테스트는 클러스터가 제대로 작동함을 입증하지만, 실제 운영 환경에서 HA 쌍이 얼마나 잘 작동하는지는 NAS 장치 자체뿐만 아니라 주변 네트워크 환경에도 크게 좌우됩니다. HA Manager가 설계된 시나리오(노드 장애, 스위치 포트 먹통, 업링크 연결 끊김)는 모두 한 가지 공통된 가정을 전제로 합니다. 바로 두 노드 간의 통신 경로 중 적어도 하나는 장애 발생 시에도 유지된다는 것입니다. 이 가정을 지키는 것은 HA 구축에서 가장 중요한 결정입니다. 왜냐하면 그렇지 않을 경우 모든 고가용성 아키텍처가 피하고자 하는 상황인 스플릿 브레인이 발생하기 때문입니다.
QNAP은 이러한 시나리오를 문서화했습니다. 스플릿 브레인은 두 노드가 서로 통신이 두절되었지만 각각 독립적으로 작동하며 활성 역할을 수행할 때 발생합니다. 두 노드가 각각 클러스터의 소유권을 주장하고 쓰기 작업을 허용하려고 하면, 각 노드가 공유 리소스를 동시에 제어하려고 시도하여 데이터 불일치 또는 스토리지 손상으로 이어질 수 있습니다. 문서화된 원인은 예상대로 노드 간 네트워크 연결 끊김, 하트비트 실패, 불안정한 네트워크 경로입니다. 이러한 원인들의 공통점을 살펴보겠습니다. 스플릿 브레인은 단일 노드 장애로 발생하는 것이 아니라, 두 정상 노드 사이의 모든 경로가 동시에 실패할 때 발생합니다. 이는 토폴로지 문제이며, 토폴로지적 해결책이 있습니다.
배포 규칙은 예상대로 적용됩니다.
하트비트 신호는 두 노드 사이에 직접 케이블로 연결하십시오. QNAP은 하트비트 신호 전송에 직접 연결을 요구하며, 이는 바로 그 때문입니다. 스위치, 트랜시버, 공유 인프라 없이 경로에 직접 연결하면 하트비트 신호가 중단될 수 있는 유일한 원인은 노드 자체이며, 이는 페일오버가 설계된 목적과 정확히 일치합니다. 이러한 소형 랙형 TS-h765eU 장치가 나란히 설치되는 동일 랙 환경에서는 다른 연결 방식을 사용할 이유가 없습니다.
노드가 분리되어 있는 경우, 하트비트와 클라이언트 트래픽을 물리적으로 독립적인 경로로 유지해야 합니다. 직접 케이블 연결이 불가능한 경우에는 클러스터 연결에 사용되는 스위치와는 다른 스위치를 통해 하트비트를 라우팅해야 합니다. 두 연결이 동일한 스위치를 거치는 순간, 해당 스위치는 모든 노드 간 경로를 동시에 차단할 수 있는 단일 장애 지점이 되어 일반적인 스위치 장애도 스플릿 브레인 현상으로 이어질 수 있습니다. 하나의 공유 인프라로 두 NAS 장치를 서로 격리할 수 있다면 NAS를 두 대 구입하는 의미가 없어집니다. 이것이 바로 저희 네트워크 장애 조치 테스트 방법론의 핵심 논리입니다. 하트비트는 연결된 상태로 클라이언트 연결 케이블을 분리하는 것은 제대로 분리된 토폴로지에서 실제로 발생할 수 있는 스위치 또는 케이블 장애를 시뮬레이션하는 것으로, 하트비트가 계속 작동하여 장애 발생 시 안정적으로 네트워크를 인계받도록 합니다.
쿼럼 서버를 활성화하십시오. QNAP의 세 번째 안전 장치는 고가용성 관리자(HA Manager) > 설정 > 장애 조치 정책 > 쿼럼 서버에서 구성할 수 있는 네트워크상의 감시 서버입니다. 노드들이 직접 연결이 끊어졌지만 네트워크에는 여전히 연결할 수 있는 경우, 쿼럼 서버는 두 노드를 계속 모니터링하고 상태를 중계하여 각 노드가 자체적으로 승격하기 전에 독립적인 결정권을 갖도록 합니다. 쿼럼 서버의 연결 상태는 HA Manager 대시보드에 하트비트와 함께 지속적으로 표시되므로 한눈에 상태를 확인할 수 있습니다.
만약 최악의 상황이 발생하더라도 QuTS Hero는 스플릿 브레인 현상을 방어적으로 처리합니다. 연결이 복구되어 노드 간 통신이 재개되면, 노드들은 상태 정보를 교환하고 두 노드 모두 활성 역할을 수행했음을 인식한 후, 서로 다른 두 데이터셋이 병합되는 것을 방지하기 위해 SMB 및 iSCSI를 포함한 대부분의 서비스를 의도적으로 중지합니다. 그런 다음 HA Manager는 두 가지 복구 경로를 제공하는 스플릿 브레인 복구 마법사를 표시합니다. 첫 번째 옵션은 사용자가 선택한 단일 노드의 데이터를 보존하는 것입니다. 다른 노드는 데이터가 완전히 삭제되고 수동 멤버로 재설정된 후 다시 동기화됩니다. 이는 어느 쪽 노드에 올바른 데이터가 있는지 알고 있을 때 가장 빠른 방법입니다. 두 번째 옵션은 한 노드의 서비스를 재개하고 다른 노드를 클러스터에서 완전히 제거하여 두 노드의 데이터를 모두 보존하는 것입니다. 이를 통해 사용자는 수동으로 클러스터에 다시 추가하기 전에 데이터를 확인하고 일치시킬 수 있습니다. 이는 합리적인 복구 모델이지만, 복구 과정에는 여전히 다운타임과 전체 재동기화가 필요합니다. 스플릿 브레인은 복구를 계획하는 것이 아니라 구축 설계 단계에서 예방해야 하는 상황이며, 위의 세 가지 규칙은 케이블 하나와 설정 패널에서 5분 정도만 투자하면 구현할 수 있습니다.
모니터링 및 관리
2일차 운영은 HA Manager 앱에서 이루어지며, 이 앱은 클러스터 상태, 노드별 리소스 사용량, 이벤트 로그 및 수동 전환을 포함한 노드 관리를 단일 화면에서 통합 관리합니다. 테스트 과정에서 대시보드의 경고 배너는 일반적인 성능 저하 플래그 대신 오류가 발생한 정확한 인터페이스와 노드 이름을 명시하여 진단에 매우 유용했습니다.
QNAP은 하드웨어 자체에 HA 인식 기능을 통합했습니다. HA 클러스터에서 각 NAS의 LCD 패널에는 클러스터 이름, 노드의 현재 역할, 클러스터 IP 주소가 표시되며, 상태 LED를 통해 HA 상태를 한눈에 확인할 수 있습니다. 활성 노드는 녹색으로, 비활성 노드는 녹색으로 깜빡이는 것으로, HA 오류는 빨간색으로 표시됩니다. 동일한 소형 NAS 장치들이 랙에 가득 차 있는 경우, 브라우저를 열지 않고도 활성 노드를 식별할 수 있다는 점은 기술 담당자들이 매우 유용하게 여길 만한 기능입니다. 대규모 구축 환경에서는 AMIZcloud를 통해 HA 그룹을 중앙 집중식으로 클라우드에서 모니터링하여 클러스터 상태, 지연 시간, 경고 등을 모든 사이트에서 확인할 수 있습니다.
최종 생각
고가용성 관리자는 우리가 테스트한 두 가지 장애 모드 모두에서 핵심적인 약속을 충실히 이행했습니다. 활성 노드의 전원이 완전히 차단되었을 때 Windows 파일 복사 작업은 약 50초 정도 지연되었지만, 실패한 파일은 하나도 없었습니다. 클라이언트 네트워크 연결이 끊어졌을 때는 약 45초 정도 지연되었습니다. 두 경우 모두, 동일한 복사 작업은 노드 복구 및 자동 페일백 과정을 거치면서 1분 미만의 짧은 지연 시간만 발생하며 정상적으로 완료되었습니다. 클라이언트는 IP 주소를 다시 지정할 필요가 전혀 없었습니다. 애플리케이션, 파일 공유 및 사용자 워크플로는 페일오버 전, 도중 및 후에도 단일 IP 주소와 호스트 이름을 통해 계속 작동했습니다. 설정 또한 간편합니다. 두 대의 독립 실행형 장치가 마법사를 통해 10분 이내에 서비스 클러스터로 구성되었고, 초기 동기화에 10분 정도 소요되었습니다. 또한 대시보드는 문제가 발생할 때마다 어떤 인터페이스, 노드 및 연결에 문제가 있는지 정확하게 알려주었습니다.
완전한 HA 스택: 두 대의 TS-h765eU 장치와 그 안에 장착된 IronWolf Pro 드라이브.
하지만 HA 구성 비용을 간과해서는 안 됩니다. 모든 구성 요소를 두 개씩 구매해야 하며, 패시브 노드는 활성화될 때까지 유휴 상태로 남아 있게 됩니다. h6.0의 또 다른 핵심 보안 기능인 불변 스냅샷은 현재 HA 클러스터 환경에서는 사용할 수 없으므로 관리자는 둘 중 하나를 선택해야 합니다. 또한 동일한 하드웨어가 필요하기 때문에 업그레이드는 항상 두 개씩 짝을 지어 진행되므로 예산에 제약이 따를 수 있습니다.
결국 핵심은 적정 규모 설정인데, HA Manager는 중소기업 및 엣지 컴퓨팅 환경에 가장 적합합니다. 듀얼 컨트롤러 엔터프라이즈 어레이와 비교했을 때, TS-h765eU 소형 유닛 두 대는 SMB 시장에서 듀얼 컨트롤러 구매의 주요 원인인 컨트롤러 손실 장애 시나리오를 효과적으로 보호하면서 비용 측면에서 완전히 다른 경쟁력을 제공합니다. 자체 복제 방식, 스냅샷 전송, rsync 작업, 백업 및 복원 방식과 비교했을 때, HA Manager의 가장 큰 장점은 복구 시간입니다. 이러한 방식들은 데이터를 보호하지만 클라이언트 연결을 재구축하는 데 몇 시간이 걸리는 반면, HA Manager는 테스트 결과 클라이언트에서 가장 눈에 띄는 장애 발생 시에도 1분 정도의 연결 끊김 현상만 보였습니다. 또한, 모든 노드 간 경로가 동시에 끊어지는 최악의 장애 상황도 직접 하트비트 케이블 연결, 분리된 네트워크 경로, 그리고 쿼럼 서버 활성화를 통해 예방할 수 있습니다. 이러한 토폴로지 구성은 케이블 하나와 설정 패널에서 5분 정도만 투자하면 간단하게 완료할 수 있습니다.
마지막으로 2노드 설계에 특화된 한 가지 중요한 점은 클러스터에서 가장 취약한 시점이 재동기화 시간이라는 것입니다. 이때 한 노드에만 데이터의 정상적인 복사본이 저장되고 나머지 드라이브들은 최대 부하를 받게 됩니다. 따라서 고가용성(HA) 구성에서는 드라이브 선택에 신중을 기해야 하며, 저희 구축에 사용된 Seagate IronWolf Pro 30TB와 같은 NAS 등급 디스크가 독립형 시스템보다 더욱 중요한 이유도 바로 여기에 있습니다. 이러한 디스크의 역할은 재동기화 시간 동안 문제가 발생하지 않도록 보호하는 것입니다.
QNAP TS-h765eU 및 QuTS hero h6.0은 현재 구매 가능합니다. 자세한 내용은 QNAP TS-h765eU 제품 페이지를 참조하십시오.
본 보고서는 QNAP의 후원을 받아 작성되었습니다. 본 보고서에 제시된 모든 견해와 의견은 검토 대상 제품에 대한 당사의 객관적인 관점을 바탕으로 합니다.


 아마존