ArmazenamentoReview.com
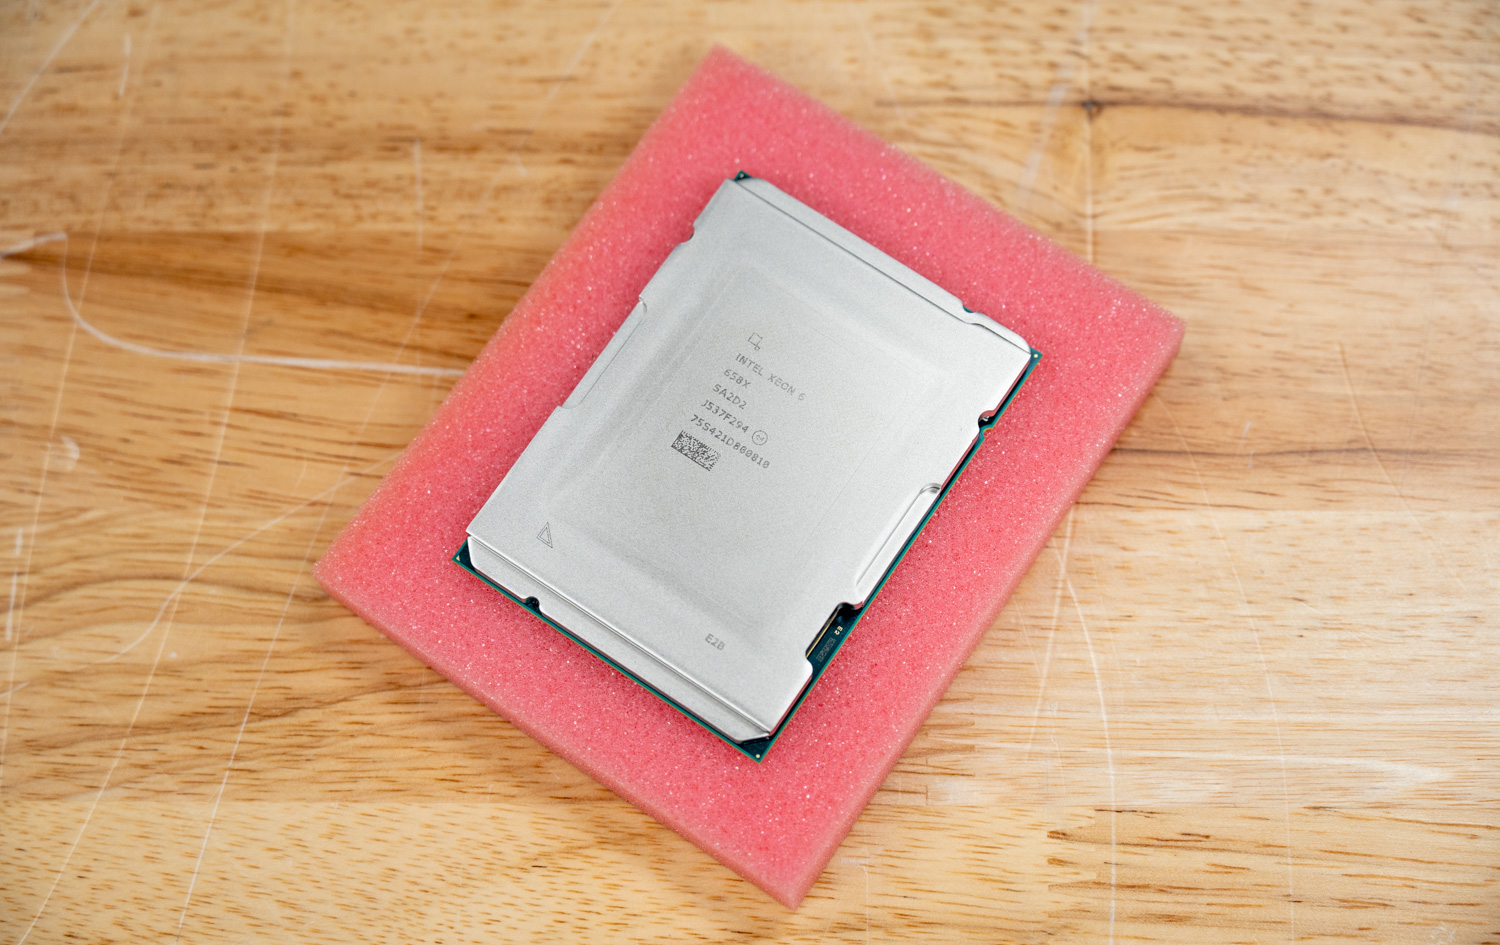
Processador Intel Xeon 6 sobre espuma antiestática no laboratório da StorageReview, uma das duas famílias de CPUs x86 que a oneDNN irá abordar para PyTorch.
Empreendimento  ◇  Software

AMD e Intel tornam o oneDNN o caminho x86 padrão no PyTorch, integrando o ZenDNN e alinhando extensões de computação de IA.

A AMD e a Intel anunciaram que irão combinar seus trabalhos de otimização de CPU x86 para PyTorch no oneDNN, a biblioteca de aprendizado profundo de código aberto gerenciada pela Unified Acceleration Foundation (UXL), e que o definirão como a biblioteca de código aberto padrão para aceleração x86 dentro do PyTorch. A AMD está incorporando suas otimizações do ZenDNN ao oneDNN e se uniu à Intel.
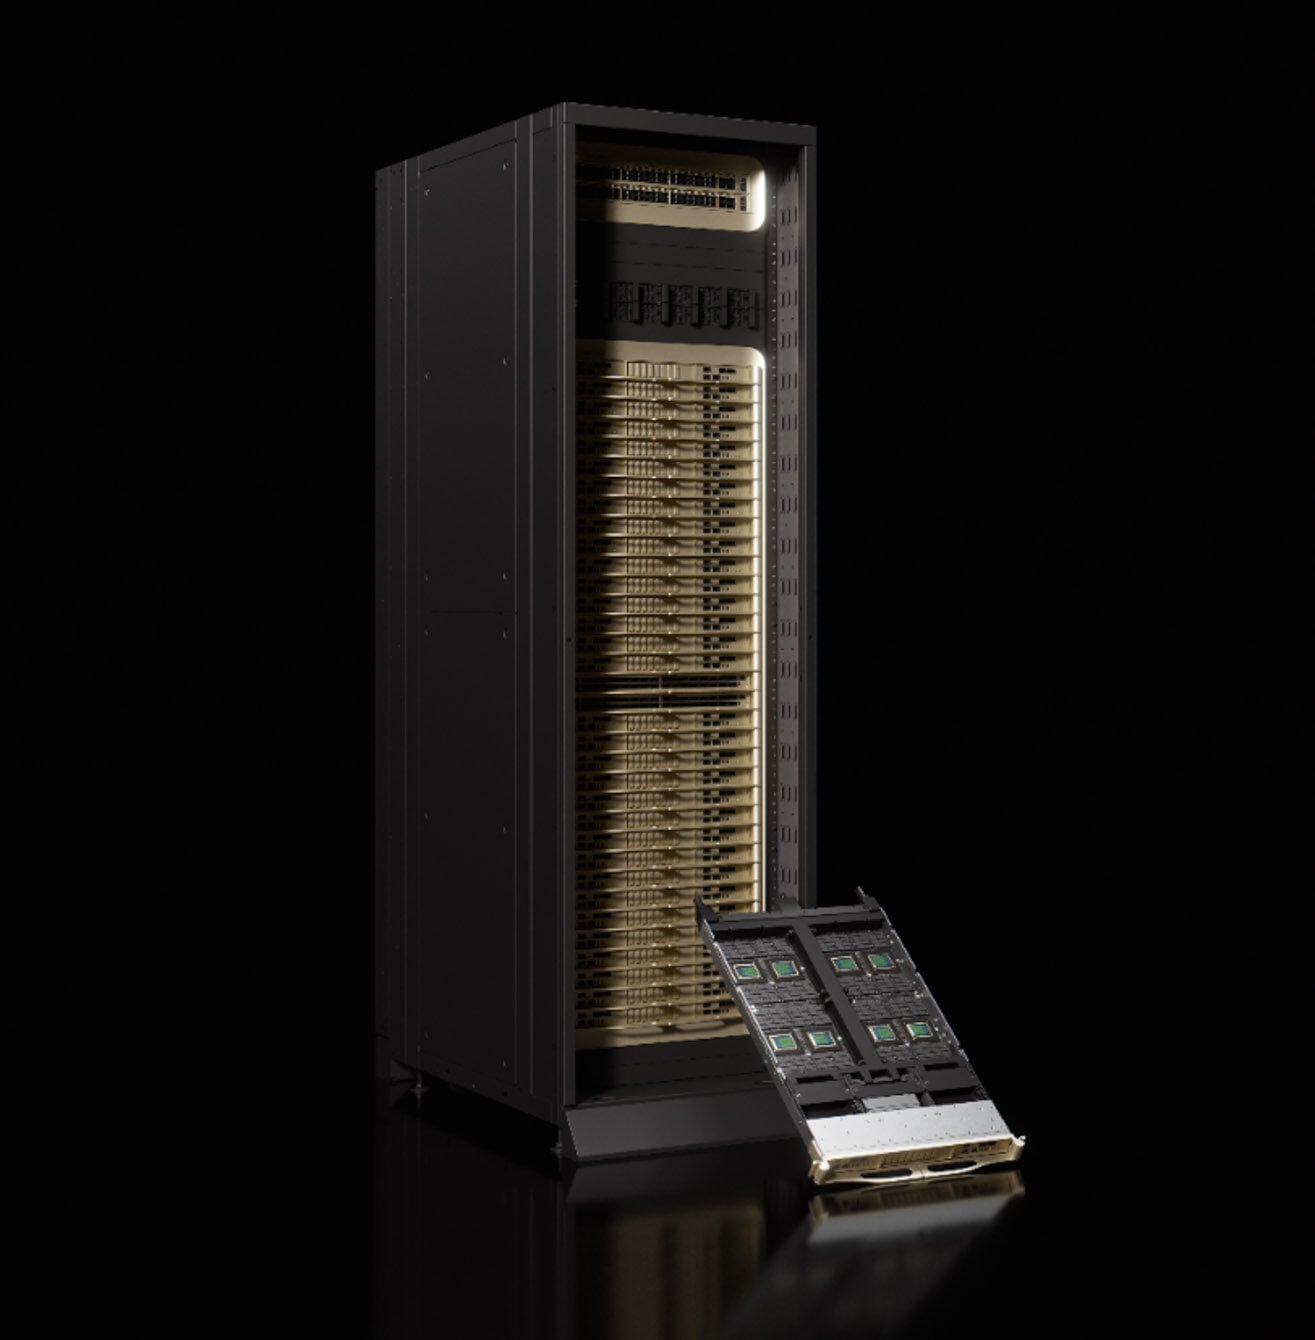
Renderização da NVIDIA de um rack de CPUs Vera com uma bandeja de computação puxada para a frente, mostrando os soquetes do processador na bandeja.
AI  ◇  Empreendimento

Rack de CPUs Supermicro NVIDIA Vera: 256 CPUs Vera, 400 TB de LPDDR5X e 22,500 ambientes sandbox para agentes em um gabinete 48U com refrigeração líquida de 208 kW.

A Supermicro anunciou hoje o rack para CPUs NVIDIA Vera, um rack de 48U com refrigeração líquida completa que comporta 256 CPUs NVIDIA Vera, totalizando 22,528 núcleos e 45,056 threads, e que a Supermicro classifica para até 22,500 sandboxes de agentes simultâneos. É o membro mais recente do portfólio Data Center Building Block Solutions (DCBBS), projetado para operar em conjunto com...

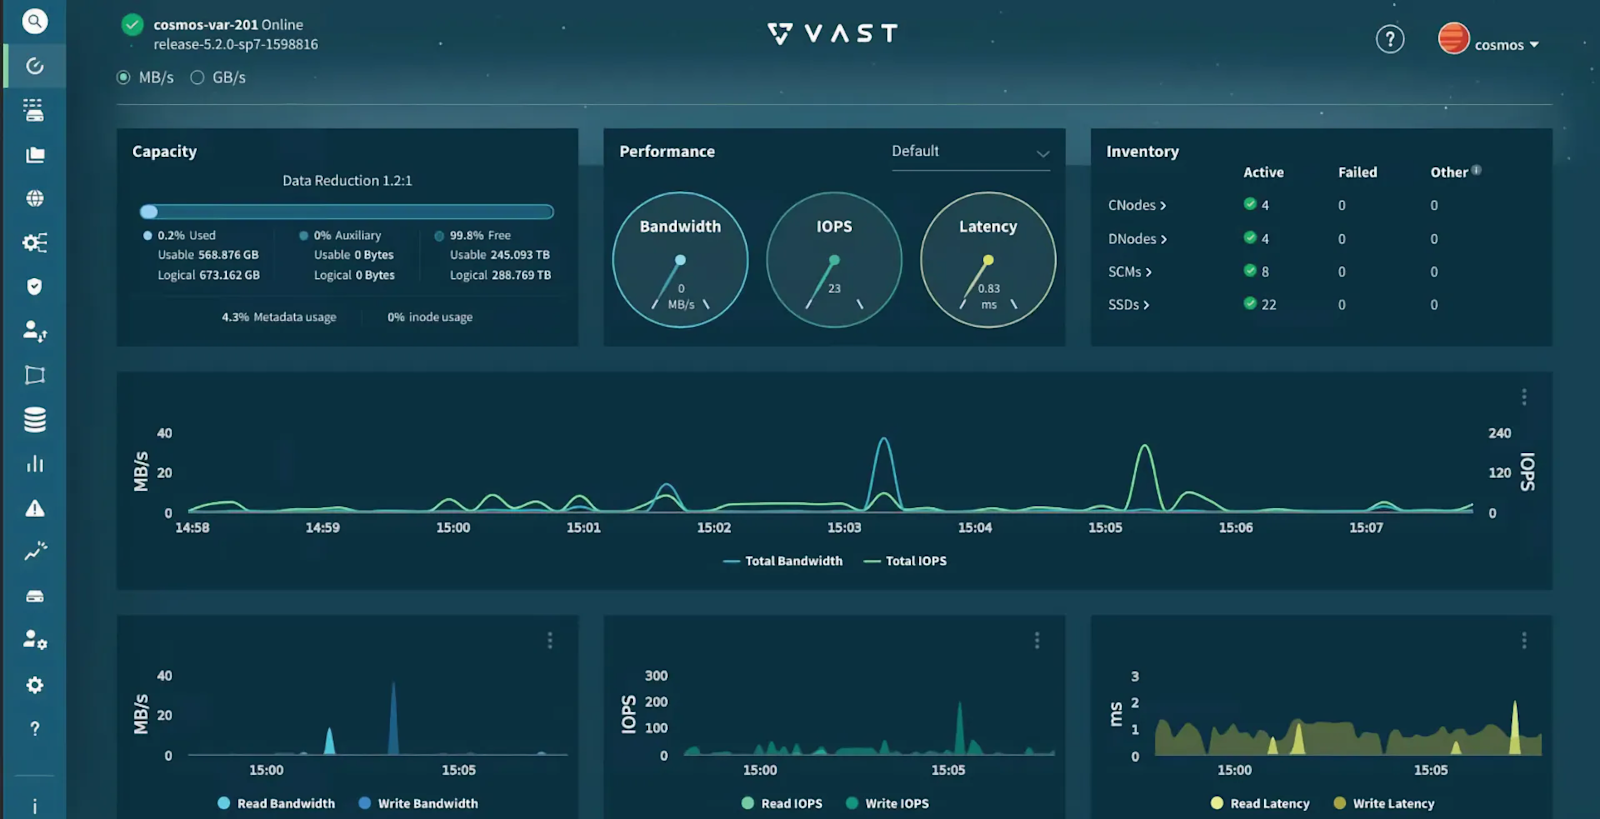
Painel do sistema de gerenciamento VAST em um cluster de laboratório da StorageReview, mostrando capacidade, largura de banda, IOPS e latência, a camada de telemetria do VAST Agent Sandbox Foundation Stack.
AI  ◇  Empreendimento

A pilha VAST Agent Sandbox Foundation coloca os sandboxes do NVIDIA OpenShell em clones sem cópia e registra todas as chamadas de ferramentas.

A VAST Data anunciou o Agent Sandbox Foundation Stack com a NVIDIA na NVIDIA GTC Berlin, uma arquitetura de referência que executa agentes NVIDIA NemoClaw dentro de sandboxes NVIDIA OpenShell no sistema operacional VAST AI. O OpenShell lida com a execução isolada e a aplicação de políticas em torno de cada agente, e a VAST lida com as partes que precisam sobreviver ao sandbox: o agente.

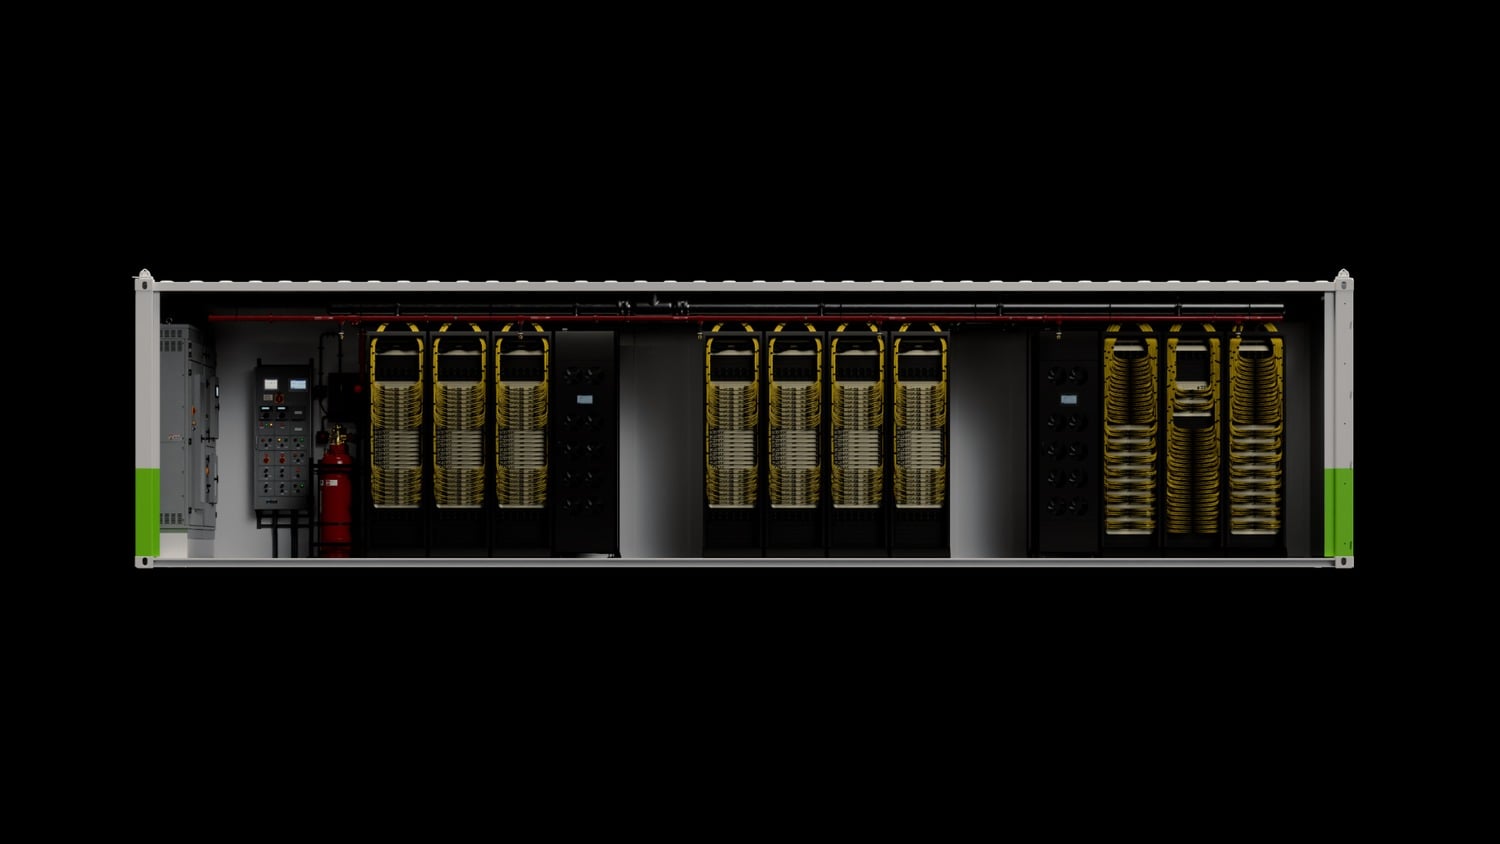
Renderização do NVIDIA DSX POD: um contêiner de transporte seccionado para mostrar três grupos de racks Vera Rubin com cabeamento amarelo, distribuição de energia e gabinetes de supressão de incêndio na extremidade esquerda.
AI  ◇  Empreendimento

NVIDIA GTC Berlin: Fábricas de IA DSX POD de 14 dias, uma expansão do Substrate 2.5 vezes maior e a arquitetura de referência OpenShell.

Os anúncios da NVIDIA na GTC Berlin de hoje abrangem infraestrutura Vera Rubin conteinerizada, uma expansão de 2.5 vezes no fornecimento de substratos e software para gerenciamento de energia e segurança de agentes em fábricas de IA, além de programas para telecomunicações, veículos autônomos, robótica e saúde. O número principal é uma meta de implantação: a NVIDIA afirma que seu novo design de referência DSX POD reduz o tempo de implantação de uma fábrica de IA.

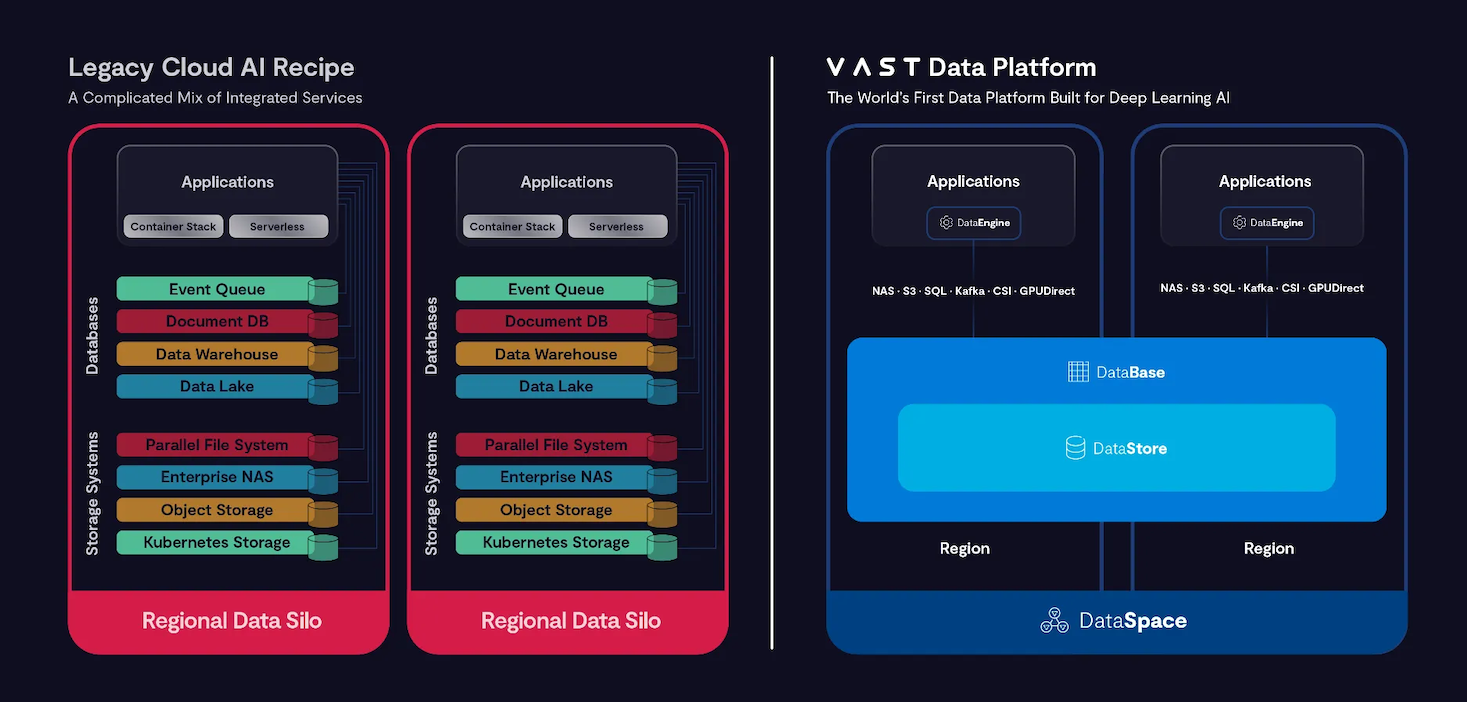
O diagrama da VAST Data contrasta uma infraestrutura legada de IA em nuvem, composta por bancos de dados e sistemas de armazenamento isolados em silos regionais, com as camadas de Banco de Dados, Armazenamento de Dados e Espaço de Dados da Plataforma VAST Data, que abrangem diversas regiões.
AI  ◇  Empreendimento

A DeepL implementa o sistema operacional de IA VAST para treinamento em tradução de voz, esperando triplicar a capacidade de seu NVMe atual.

A VAST Data anunciou que a DeepL está implementando o Sistema Operacional de IA da VAST como base de dados para os ambientes de pesquisa por trás de sua tradução de voz escrita e em tempo real. Com base nos planos de implementação atuais, a DeepL espera triplicar a capacidade de armazenamento do hardware NVMe que já utiliza e usará o SyncEngine da VAST para migrar os dados.

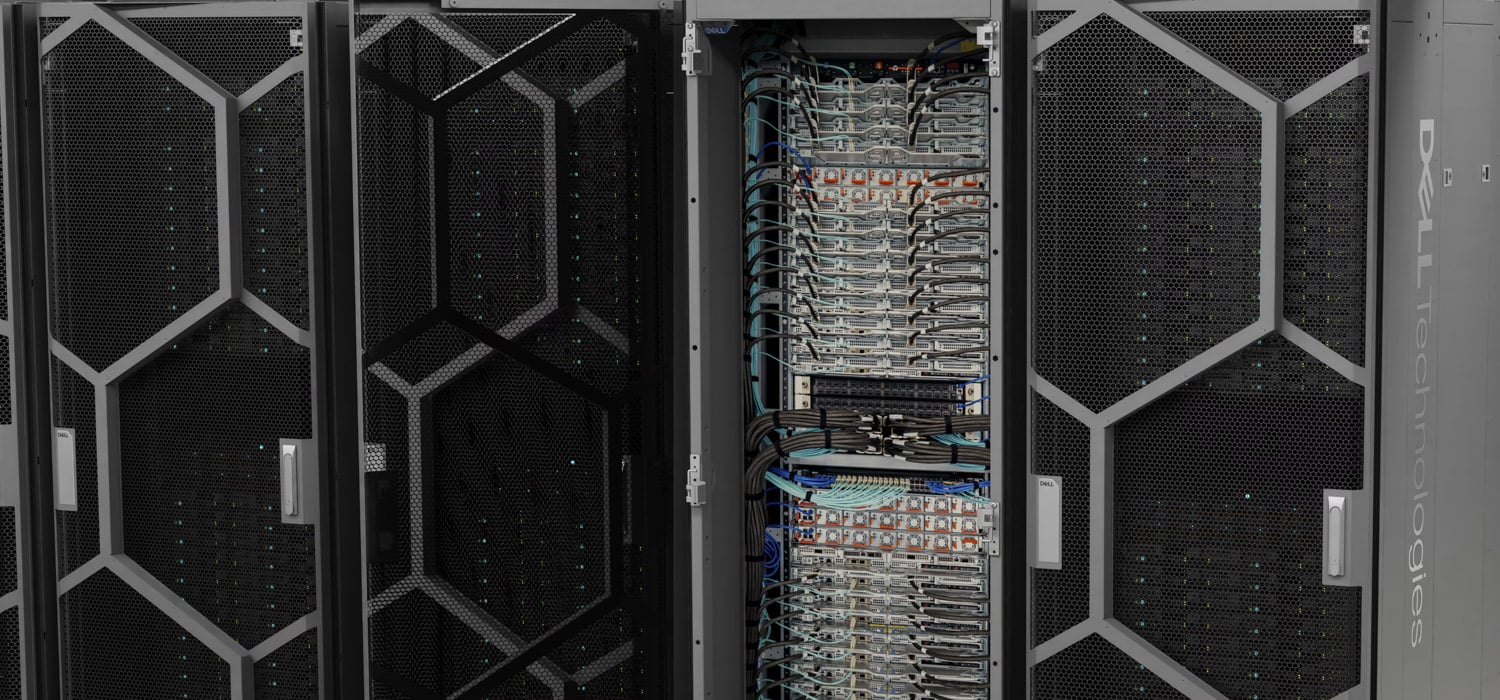
Gabinetes Dell Integrated Rack Scalable Systems com o rack central aberto, exibindo uma coluna de servidores PowerEdge M7725 e cabeamento, o hardware em escala de rack por trás da Dell AI Factory com NVIDIA.
AI  ◇  Empreendimento

A Dell AI Factory com NVIDIA adiciona um rack Vera de 256 CPUs, um rack de inferência Groq 3 LPU e um desktop GB10 de 64 GB.

A Dell Technologies expandiu hoje a Dell AI Factory com a NVIDIA na NVIDIA GTC Berlin com um rack PowerEdge M9882 de 48U contendo 256 CPUs NVIDIA Vera para execução de cargas de trabalho com agentes, o sistema de inferência em escala de rack PowerEdge XE9810 baseado em LPUs Groq 3, um servidor Vera de dois sockets com refrigeração a ar, um Dell Pro Precision de 64 GB com GB10 e um conjunto de

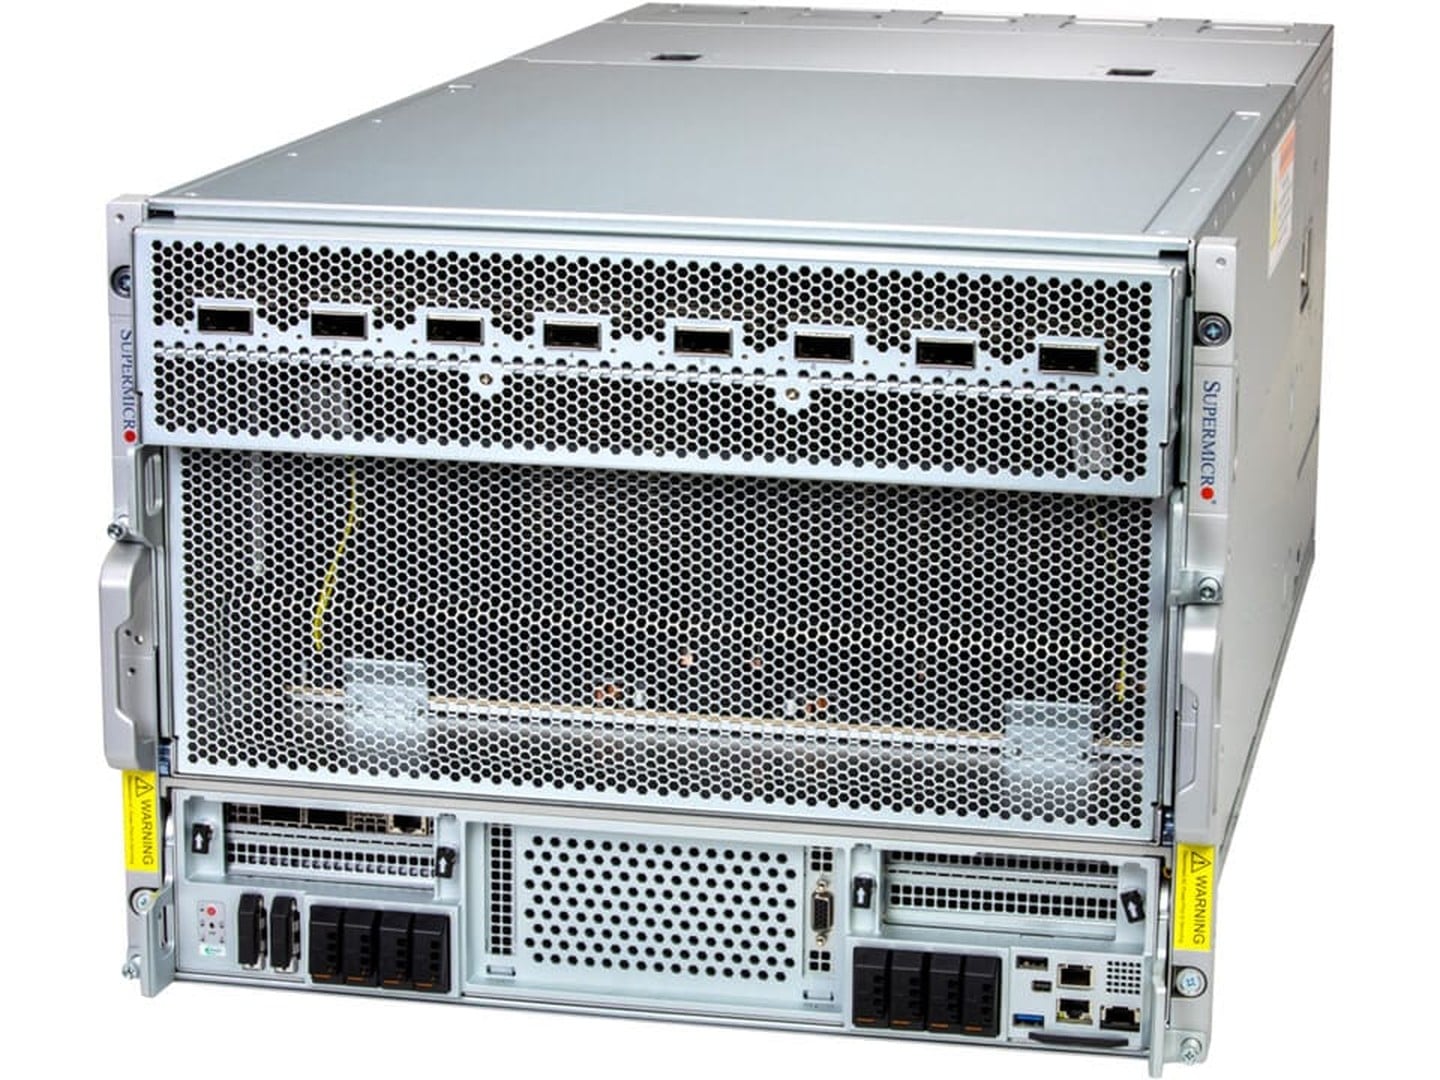
Servidor Supermicro AS-8126GS-NB3RT 8U com placa-mãe NVIDIA HGX B300 de oito GPUs, vista frontal mostrando os slots E1.S e M.2, uma das classes de servidores por trás do sistema de inferência privado Nutanix.
AI  ◇  Empreendimento

O sistema de inferência privada da Nutanix, em parceria com a Supermicro, utiliza oito GPUs NVIDIA B300 Blackwell Ultra por nó, com gerenciamento dedicado e clusters de armazenamento NX. O lançamento está previsto para o início de 2027.

A Nutanix anunciou hoje três colaborações na NVIDIA GTC Berlin: um sistema de inferência privado desenvolvido em conjunto com a Supermicro, baseado em servidores com oito GPUs NVIDIA B300 Blackwell Ultra por nó; suporte imediato para CPUs NVIDIA Vera, começando com NKP Bare Metal; e uma pilha multitenant com a Netris que estende o isolamento de tenants para a rede física.

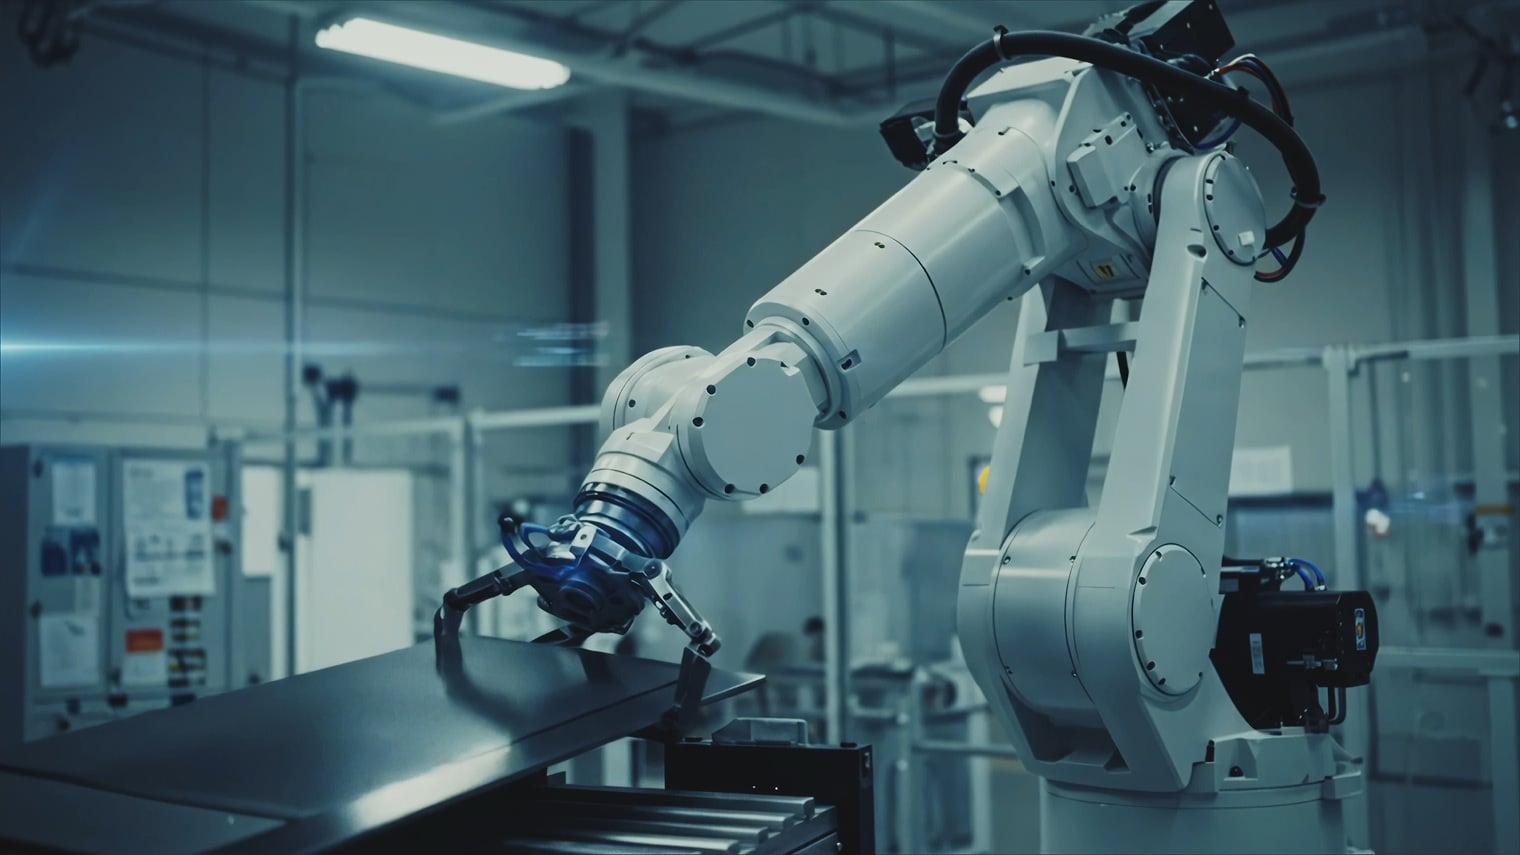
Um braço robótico industrial seleciona uma peça de uma mesa em uma célula de fábrica. Imagem principal da CoreWeave para Dispositivos Físicos de IA Lançados.
AI  ◇  Empreendimento

Os dispositivos de lançamento físico com IA da CoreWeave colocam Isaac Sim, CARLA e MuJoCo sob um único comando, com uma estrutura de IA de confiança zero de seis camadas.

A CoreWeave lançou hoje, na NVIDIA GTC Berlin, o Physical AI Launchables e o CoreWeave Zero Trust AI Framework. O Launchables é um catálogo de modelos testados e prontos para uso em ferramentas de robótica e veículos autônomos. Cada modelo é iniciado com um único comando e combina ambientes para NVIDIA Isaac Sim, CARLA, MuJoCo, NVIDIA AlpaSim e NVIDIA Cosmos 3 com habilidades de agentes de codificação otimizadas.

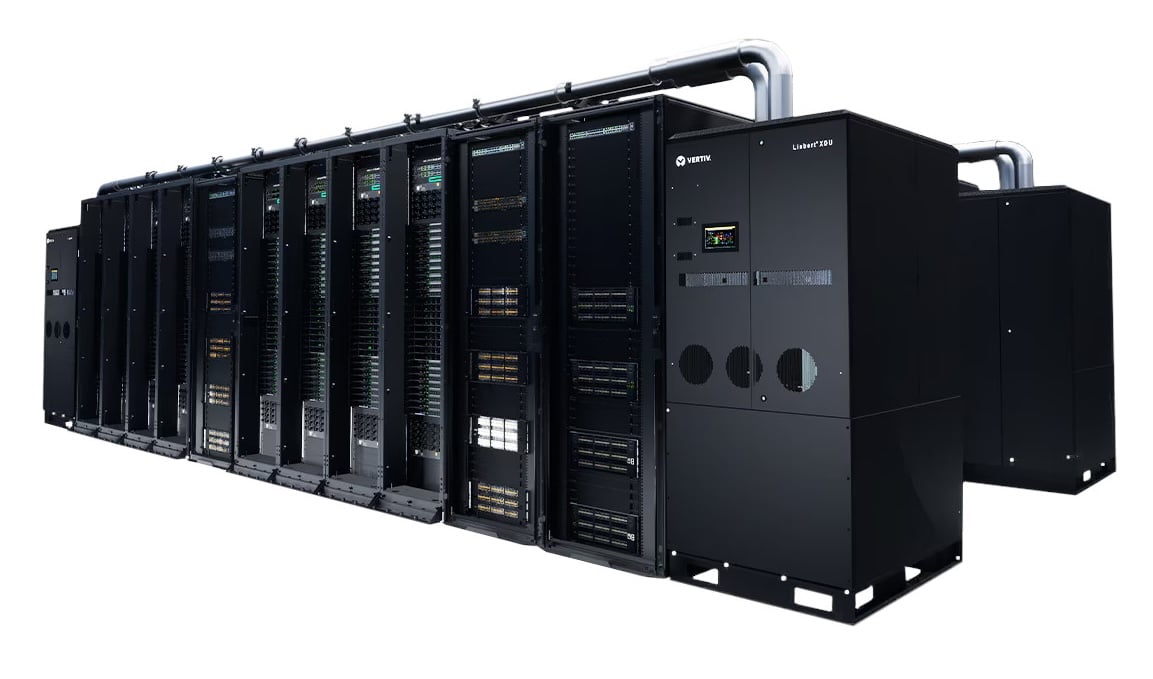
HPE AI Factory com renderização NVIDIA de uma fileira de racks de computação com unidades de distribuição de refrigerante Vertiv Liebert XDU no final da fileira.
AI  ◇  Empreendimento

A HPE Private Cloud AI adiciona servidores MCP, clusters mistos H200 e RTX PRO 6000 e um rack NVIDIA Vera com 256 CPUs.

A HPE anunciou hoje, durante a NVIDIA GTC Berlin, atualizações para o HPE AI Factory com a NVIDIA, e a maioria das mudanças impacta o HPE Private Cloud AI. Desenvolvedores, fornecedores independentes de software e agentes de IA agora têm acesso controlado à inferência, aos modelos e aos pipelines da plataforma por meio de APIs de produção e servidores do Protocolo de Contexto de Modelo (MCP). Os clusters agora podem ser combinados.

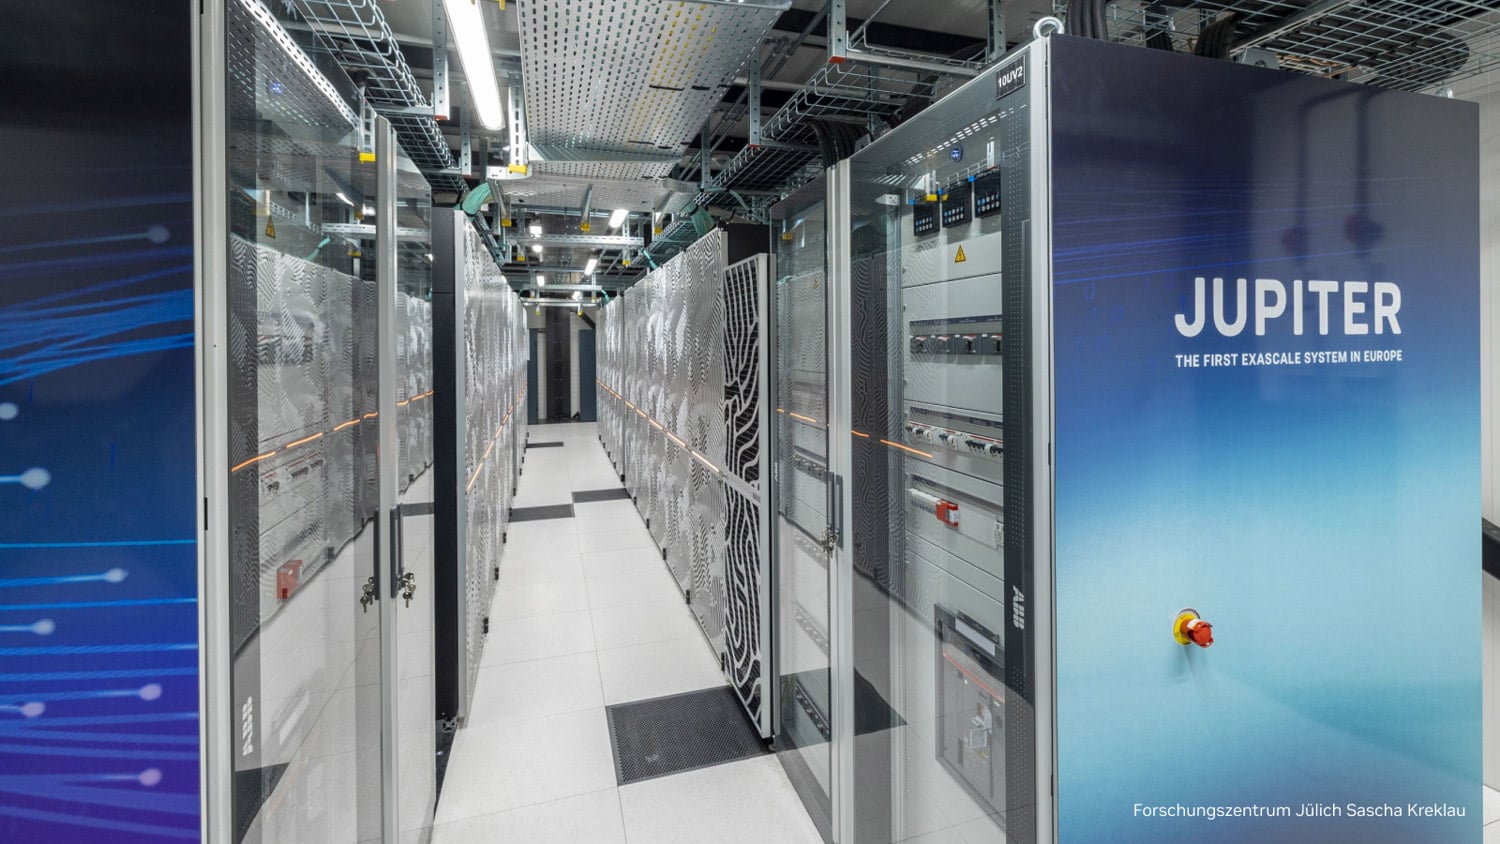
Corredor de rack de supercomputador JUPITER no Forschungszentrum Jülich com um painel JUPITER O primeiro sistema Exascale da Europa no gabinete final
AI  ◇  Empreendimento

A simulação quântica NVIDIA JUPITER modela um processador tolerante a falhas de 104 qubits em 8,192 GPUs GH200 e 512 TiB.

A NVIDIA executou uma simulação de 104 qubits de um processador quântico tolerante a falhas no JUPITER, o primeiro supercomputador exascale da Europa, localizado no Centro de Supercomputação de Jülich, utilizando 8,192 GPUs GH200. Anunciada antes da GTC Berlin, a simulação modela o cultivo de estados mágicos, um método para produzir os estados não-Clifford que um computador tolerante a falhas consome durante operações lógicas, sob ruído de hardware realista.