

Updated October 24, 2026: The HP ZBook Ultra G3a 16 preview now notes that US orders opened in October; picks unchanged. On October 16, RTX Spark laptops joined the page in a section of their own, led by the HP OmniBook Ultra 16 and the Lenovo Yoga 9n 2-in-1 16.
Todos os notebooks classificados aqui passaram pelo laboratório da StorageReview. Medimos o desempenho de IA local diretamente: o UL Procyon AI Text Generation executa os mesmos modelos em todos os sistemas que podem suportá-los e, quando o hardware justifica, aprofundamos os testes com o LM Studio e o Ollama. Nenhuma classificação nesta página se baseia em especificações técnicas, e cada opção contém um link para a análise que fornece os dados.
Existem dois caminhos para executar modelos de IA em um laptop em 2026. As GPUs NVIDIA RTX PRO dedicadas oferecem a maior velocidade de processamento, mas o modelo precisa caber na VRAM da placa, que varia de 8 GB a 24 GB. Os designs de memória unificada e compartilhada, liderados pelas plataformas Ryzen AI Max+ (Strix Halo) da AMD e Core Ultra LPCAMM2 da Intel, priorizam a capacidade em detrimento da velocidade bruta: a GPU pode utilizar a maior parte da memória do sistema, permitindo que modelos muito maiores sejam carregados. As opções abaixo abrangem ambos os caminhos, além da classe de eficiência com foco na NPU.
Num relance
| Categoria | System | Motor AI | Resultado Chave | Revisão completa |
|---|---|---|---|---|
| Melhor laptop para IA local em geral | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon), o laptop mais rápido que já testamos. | Análise do Pro Max 18 Plus |
| Ideal para modelos grandes | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395, até 96 GB de memória unificada atribuível | DeepSeek-R1 carregado com 70B; Gemma 3 com 27B a 9 tok/s | Análise do ZBook Ultra G1a |
| Melhor equilíbrio de 16 polegadas | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi) com 6 horas e 21 minutos de bateria | Análise do Pro Max 16 Plus |
| Melhor ultraportátil | Lenovo ThinkPad P14s Gen 7 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi) a 3.59 lb | Análise do P14s Gen 7 |
| Melhor opção sem uma GPU dedicada | Dell Pro Precision 5 14s Intel | Intel Arc Pro B390 iGPU, 64 GB de memória LPCAMM2 compartilhada. | Testei modelos com mais de 8 GB de VRAM e bateria com duração de 23 horas e 50 minutos. | Análise do Pro Precision 5 14s |
| Melhor sistema NPU fino e leve | HP EliteBook 6 G1q | Snapdragon X Plus, NPU Hexagon de 45 TOPS, 32 GB | Llama 3.2 3B a 37 tok/s no LM Studio | Análise do EliteBook 6 G1q |
| Melhor notebook RTX Spark | HP OmniBook Ultra 16 | RTX Spark N1X, CPU de 20 núcleos / GPU Blackwell de 6,144 núcleos, 128 GB (64 GB para a GPU) | Tarefa do agente de codificação 35B concluída em 72.0 s a 89.5 tok/s, 3 de 3 execuções aprovadas. | Análise do OmniBook Ultra 16 |
| Notebook RTX Spark com o menor aquecimento | Lenovo Yoga 9n 2 em 1 16 | RTX Spark N1X, CPU de 20 núcleos / GPU Blackwell de 6,144 núcleos, 64 GB (32 GB para a GPU) | Pico de 72 °C durante 30 minutos de carga sustentada, contra 98 °C no HP OmniBook Ultra 16. | Análise do Yoga 9n 2 em 1 16 |
As Escolhas
Melhor notebook para IA local: Dell Pro Max 18 Plus
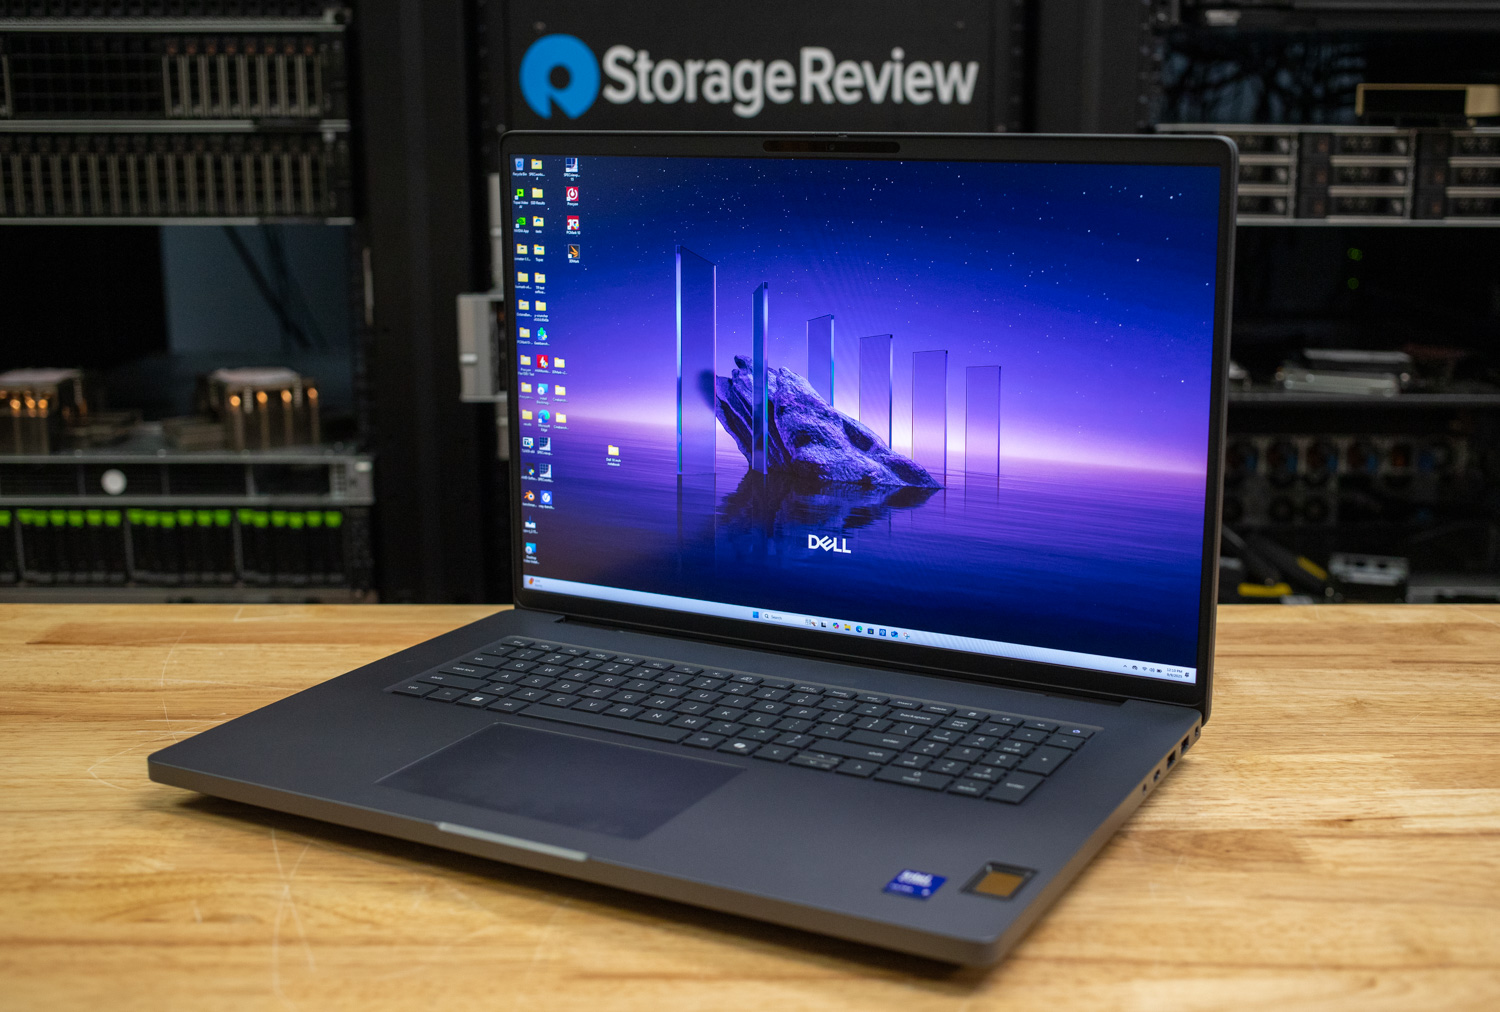
O Pro Max 18 Plus apresentou os resultados mais rápidos em IA local entre todos os notebooks testados no laboratório da StorageReview. No teste de geração de texto com IA UL Procyon, sua placa de vídeo RTX PRO 5000 Blackwell (24 GB GDDR7) impulsionou o Phi a 185.1 tokens por segundo, o Mistral a 140.5 e o Llama 3 a 119.7, com tempo até o primeiro token inferior a 0.35 segundos em todos os modelos. O processador Core Ultra 9 285HX e os 128 GB de memória CAMM2 mantêm o restante do processamento sob controle, e os 24 GB de VRAM suportam confortavelmente modelos quantizados de classe 20B.
As desvantagens são exatamente o que o chassi sugere: 7.17 kg e 3 horas e 39 minutos de duração da bateria, o menor tempo de execução em nosso conjunto de dados de laptops. Este é um computador de mesa que por acaso é dobrável. Seu preço de tabela era de US$ 9,245 no momento da análise. Se a velocidade de inferência local é o que importa, esta é a resposta.
Análise: Dell Pro Max 18 Plus: Desempenho de sobra com a Blackwell RTX PRO 5000
Melhor opção para modelos grandes: HP ZBook Ultra G1a 14
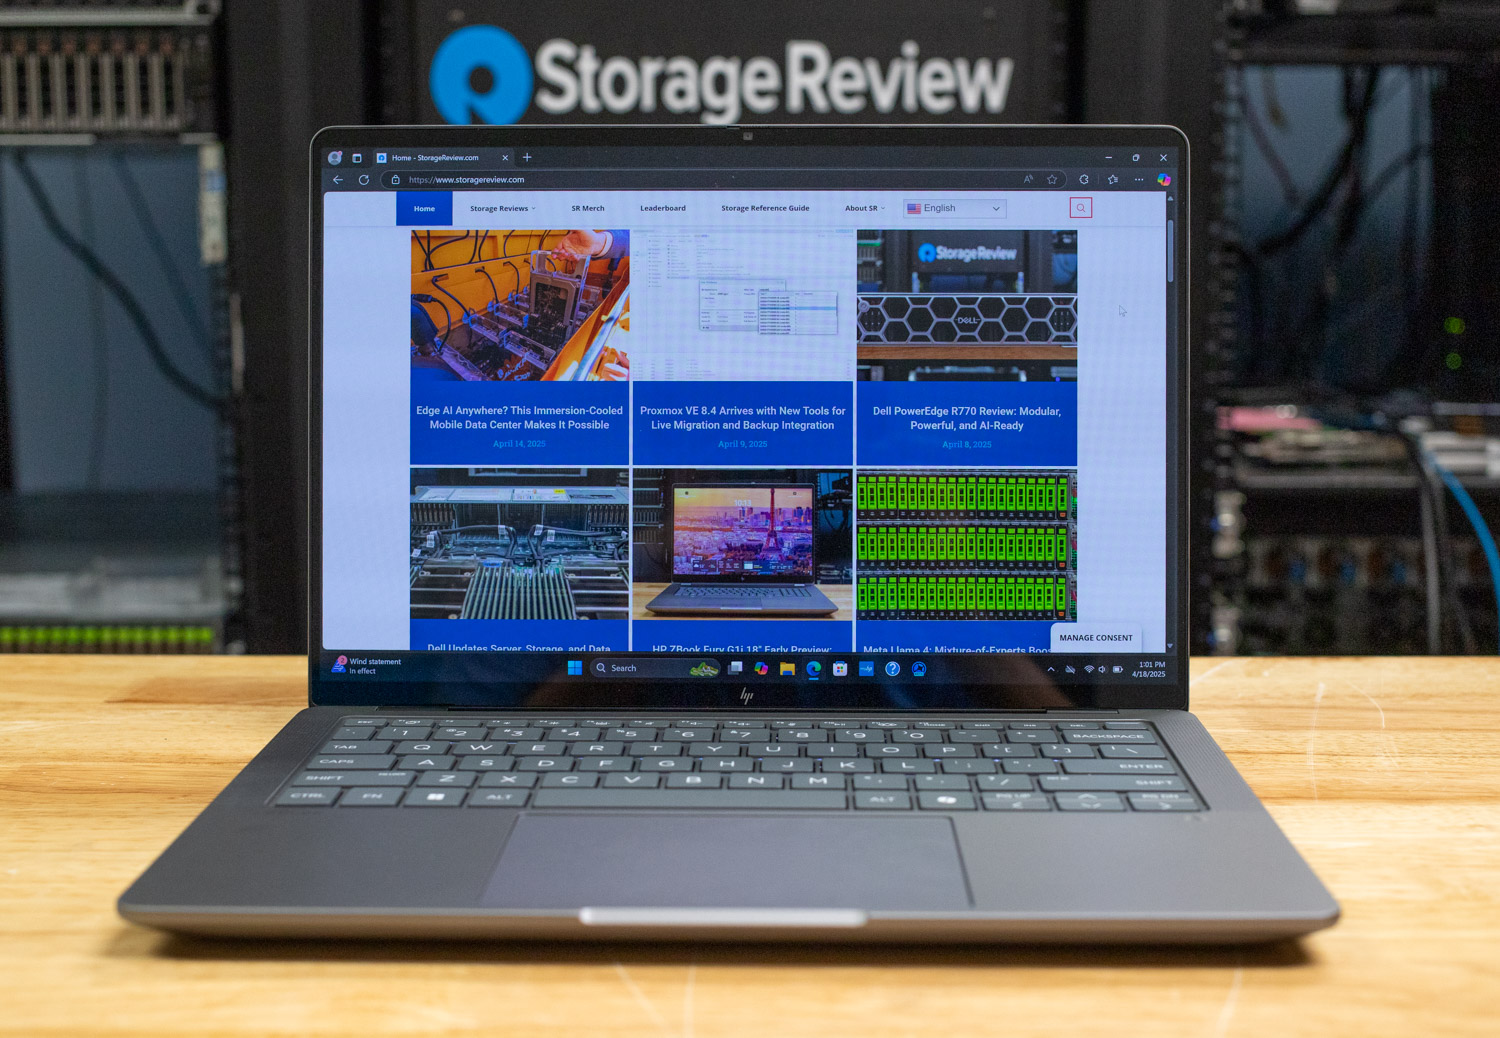
Velocidade é um eixo; capacidade é o outro. O ZBook Ultra G1a combina o processador AMD Ryzen AI Max+ PRO 395 com 128 GB de memória unificada LPDDR5X, dos quais até 96 GB podem ser atribuídos à GPU Radeon 8060S. Essa quantidade de memória nos permitiu carregar modelos que nenhum laptop com GPU dedicada consegue executar: DeepSeek-R1 70B e QwQ 32B rodaram localmente no LM Studio e no Ollama, e Gemma 3 27B gerou 8.96 tokens por segundo com processamento de prompts a 73 tokens por segundo.
O desempenho do Procyon fica atrás de todas as máquinas RTX PRO aqui (Phi com 65 tokens por segundo), então esta não é a escolha ideal para bate-papo rápido em modelos compactos. É a escolha certa quando o modelo em si é o foco, e cumpre esse papel com apenas 3.3 kg e 10 horas e 35 minutos de bateria. Essa é a mesma história de memória unificada que o Strix Halo da AMD apresenta em nossos desktops, só que em um chassi de 14 polegadas.
Análise: Análise do HP ZBook Ultra G1a 14
No horizonte: HP ZBook Ultra G3a 16
O modelo escolhido acima como o Melhor para Grandes Notebooks pode estar prestes a entregar a categoria ao seu próprio sucessor. O ZBook Ultra G3a 16 traz 192 GB de memória unificada LPDDR5X-8533, com até 160 GB atribuíveis à GPU (o G1a 14 atinge o máximo de 128 GB e 96 GB), um processador Ryzen AI Max+ PRO 495 e um sistema de resfriamento redesenhado que suporta 100 W, enquanto o G1a suportava 55 W. A capacidade garantiu a posição do G1a, enquanto o consumo de energia limitava seu desempenho; o G3a ataca ambos os quesitos simultaneamente.
HP opened US orders in October, with configurations from $3,149, and the G3a enters the rankings when the full Procyon and LM Studio runs are in. Our prévia manual A análise inicial do hardware foi feita em uma unidade de pré-produção, sem permissão para testes de desempenho, e a análise completa será publicada quando uma unidade comercial chegar ao laboratório.
Melhor equilíbrio entre notebooks de 16 polegadas: Dell Pro Max 16 Plus
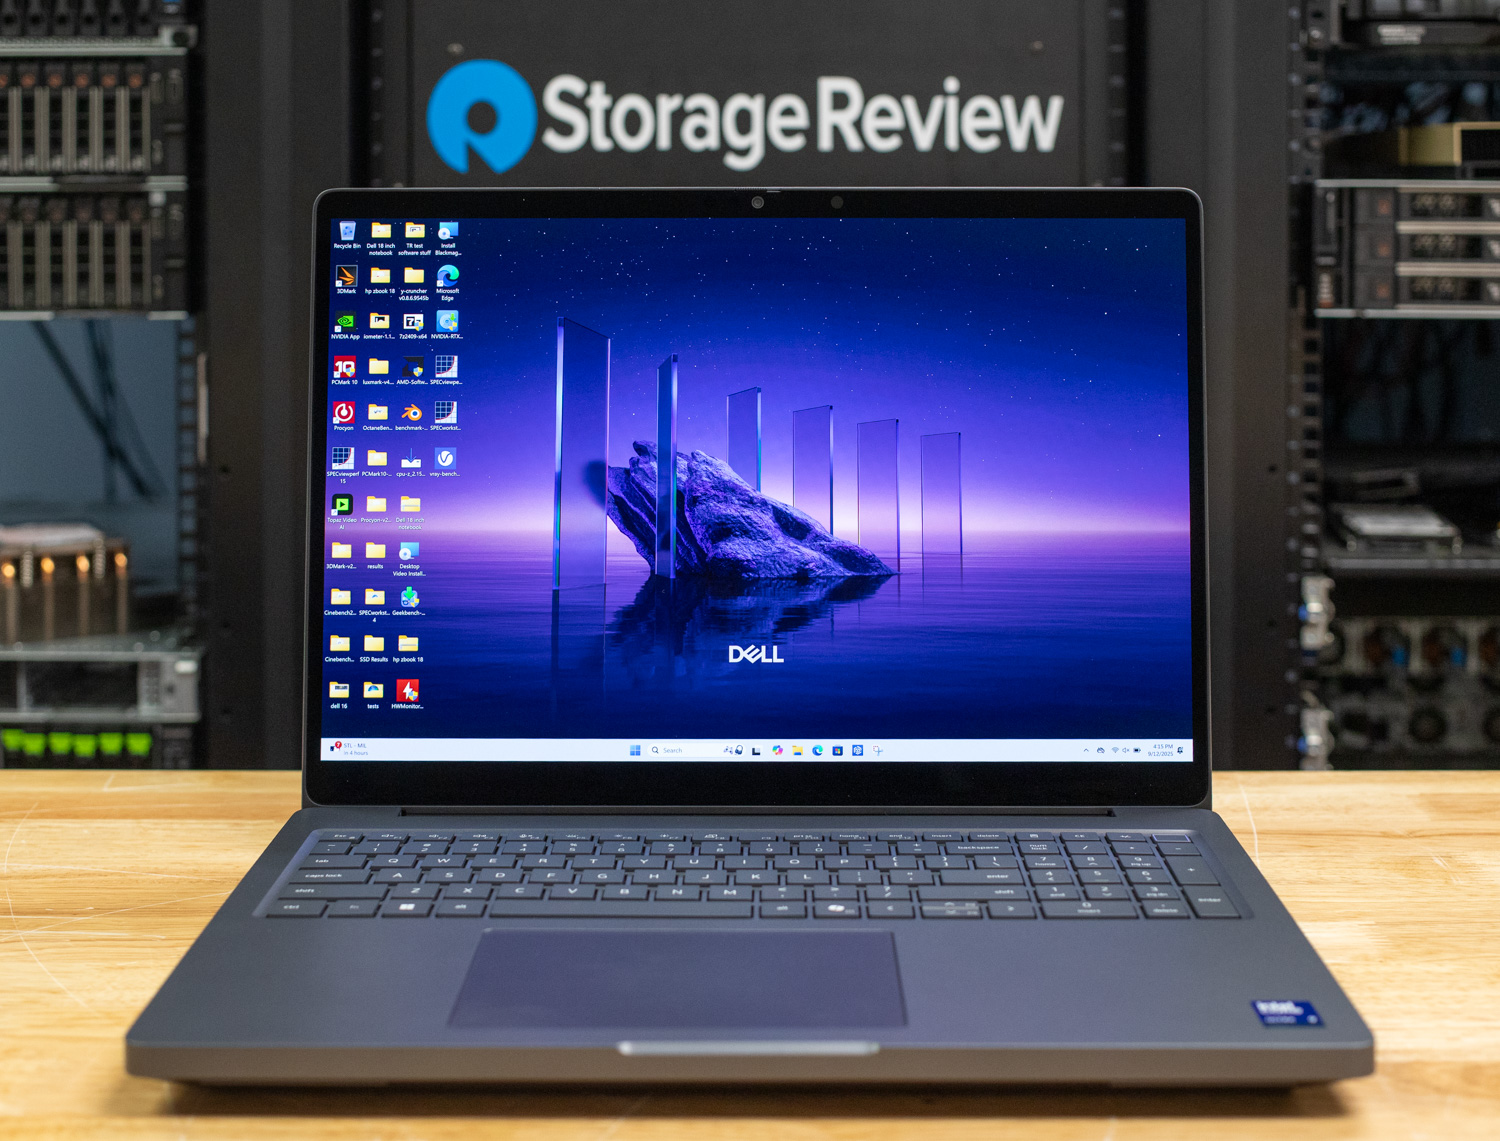
O Pro Max 16 Plus utiliza a mesma RTX PRO 5000 Blackwell de 24 GB do 18 Plus e não perde praticamente nada em desempenho: Phi com 178.6 tokens por segundo, Mistral com 134.2 e Llama 3 com 114.7, aproximadamente 96% do desempenho do modelo topo de linha. Em contrapartida, pesa a partir de 5.63 kg contra 7.17 kg e oferece quase o dobro da duração da bateria, com 6 horas e 21 minutos.
Para a maioria das pessoas que desejam inferência local robusta em um único dispositivo, esta é a melhor opção entre as duas. Ela também ocupa o primeiro lugar como Melhor Estação de Trabalho Móvel em nossa lista das Melhores Estações de Trabalho Móveis , portanto, a velocidade da IA já vem com o conjunto completo de aplicativos profissionais validados.
Análise: Dell Pro Max 16 Plus: Projetado para longos dias e grandes tarefas
Melhor ultrabook: Lenovo ThinkPad P14s Gen 7
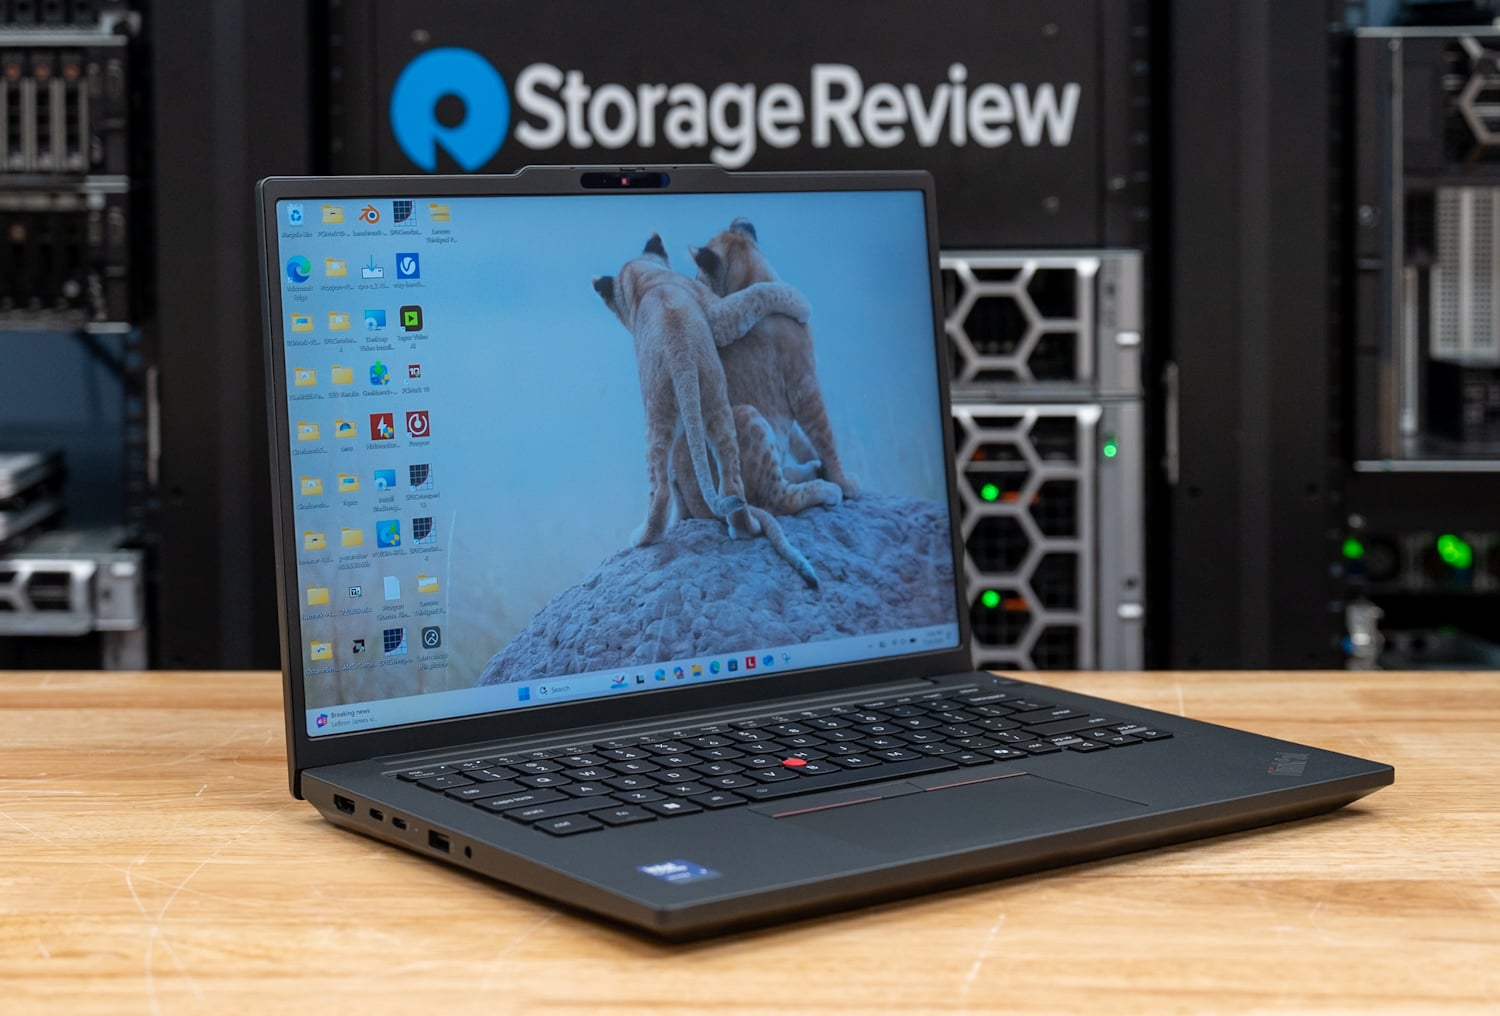
Com apenas 3.59 kg, o P14s Gen 7 é o notebook mais leve desta lista com uma GPU Blackwell dedicada. A RTX PRO 1000 (8 GB GDDR7) alcançou 55.1 tokens por segundo no teste Phi e 40.3 no Mistral, velocidades realmente interativas para modelos da classe 7B, e a NPU de 50 TOPS do Panther Lake o torna uma máquina Copilot+. A duração da bateria de 15 horas e 52 minutos significa que o uso de inteligência artificial não compromete sua jornada de trabalho.
Saiba qual é o limite antes de comprar: nosso teste com o Llama 2 13B não foi concluído porque esse modelo exige cerca de 12 GB de memória gráfica através do caminho Procyon, e a GPU possui 8 GB. Para modelos quantizados de até 7 bilhões de bits, este é um desempenho excelente; para modelos maiores, consulte a página.
Análise: Lenovo ThinkPad P14s Gen 7
Melhor opção sem placa de vídeo dedicada: Dell Pro Precision 5 14s Intel
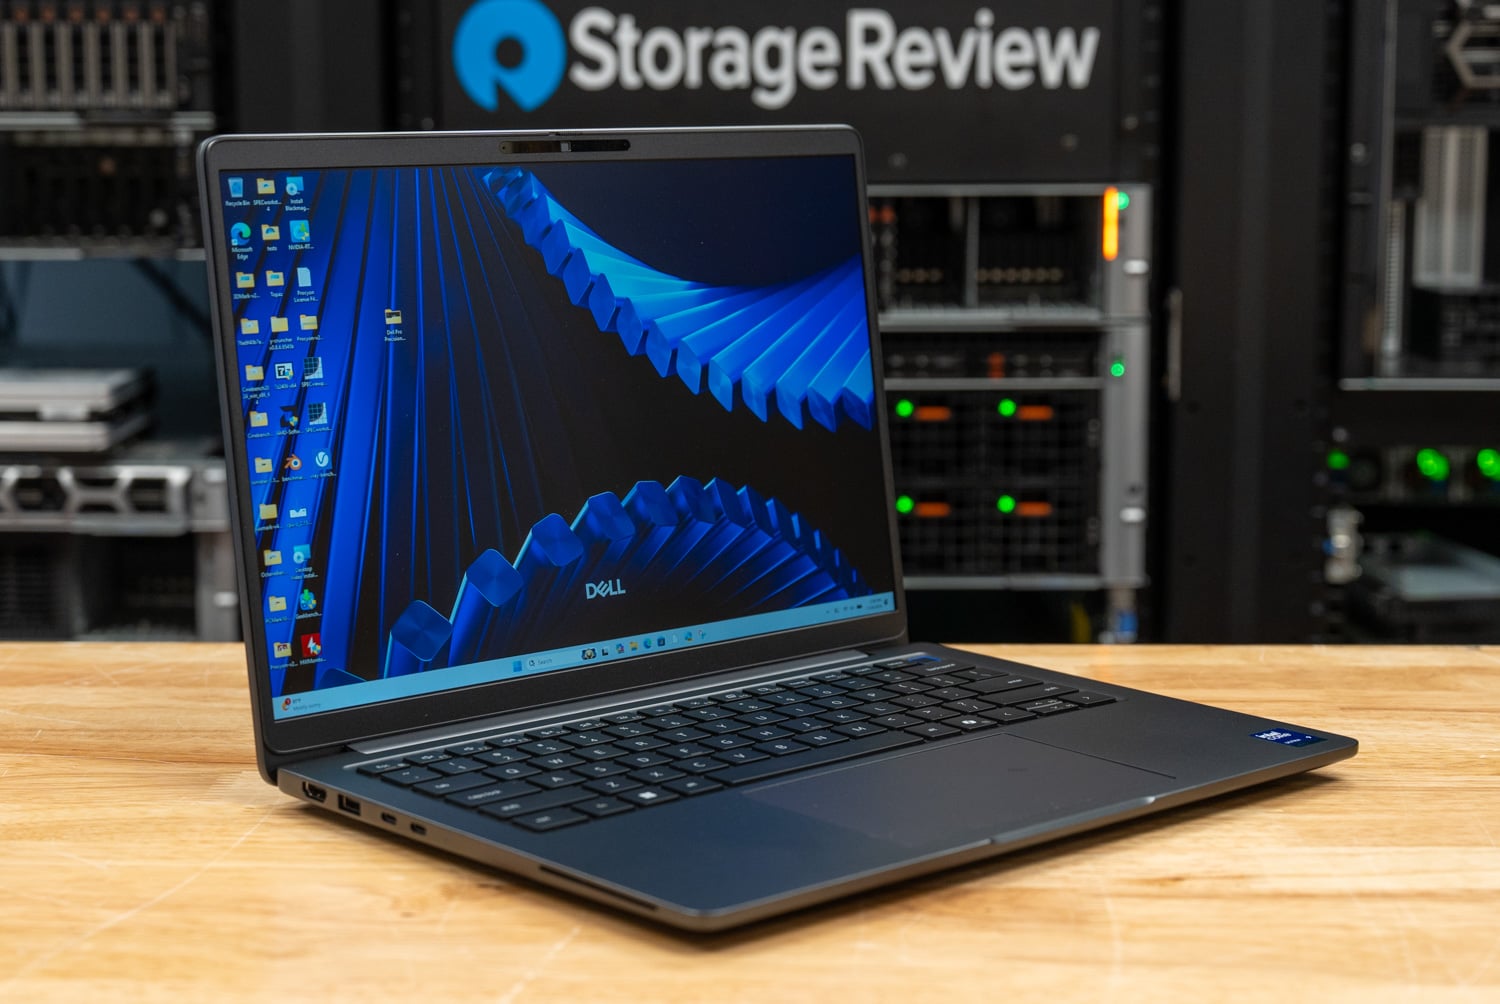
A ausência de uma GPU dedicada não é um problema, dentro de certos limites: o Pro Precision 5 14s Intel combina o Core Ultra X9 388H (NPU de 50 TOPS) com a placa gráfica integrada Intel Arc Pro B390, que utiliza um pool de memória compartilhada LPCAMM2 de 64 GB. Em nossos testes, esse pool executou cargas de trabalho de IA locais maiores do que as suportadas por placas dedicadas de 8 GB, concluindo todo o conjunto de testes Procyon AI Text Generation (pontuações de 887 no Phi e 786 no Llama 2), onde sistemas com VRAM limitada apresentaram falhas.
A velocidade de geração de dados é modesta em comparação com o chip RTX PRO, sendo mais adequada para tarefas em segundo plano do que para sessões interativas intensivas. O restante do conjunto é notável: 3.12 kg e 23 horas e 50 minutos de duração da bateria, a segunda maior em todo o nosso conjunto de dados. Também ocupa o primeiro lugar como Melhor Estação de Trabalho Ultraportátil em nossa lista das Melhores Estações de Trabalho Móveis.
Análise: Dell Pro Precision 5 14s Intel
Melhor sistema NPU fino e leve: HP EliteBook 6 G1q
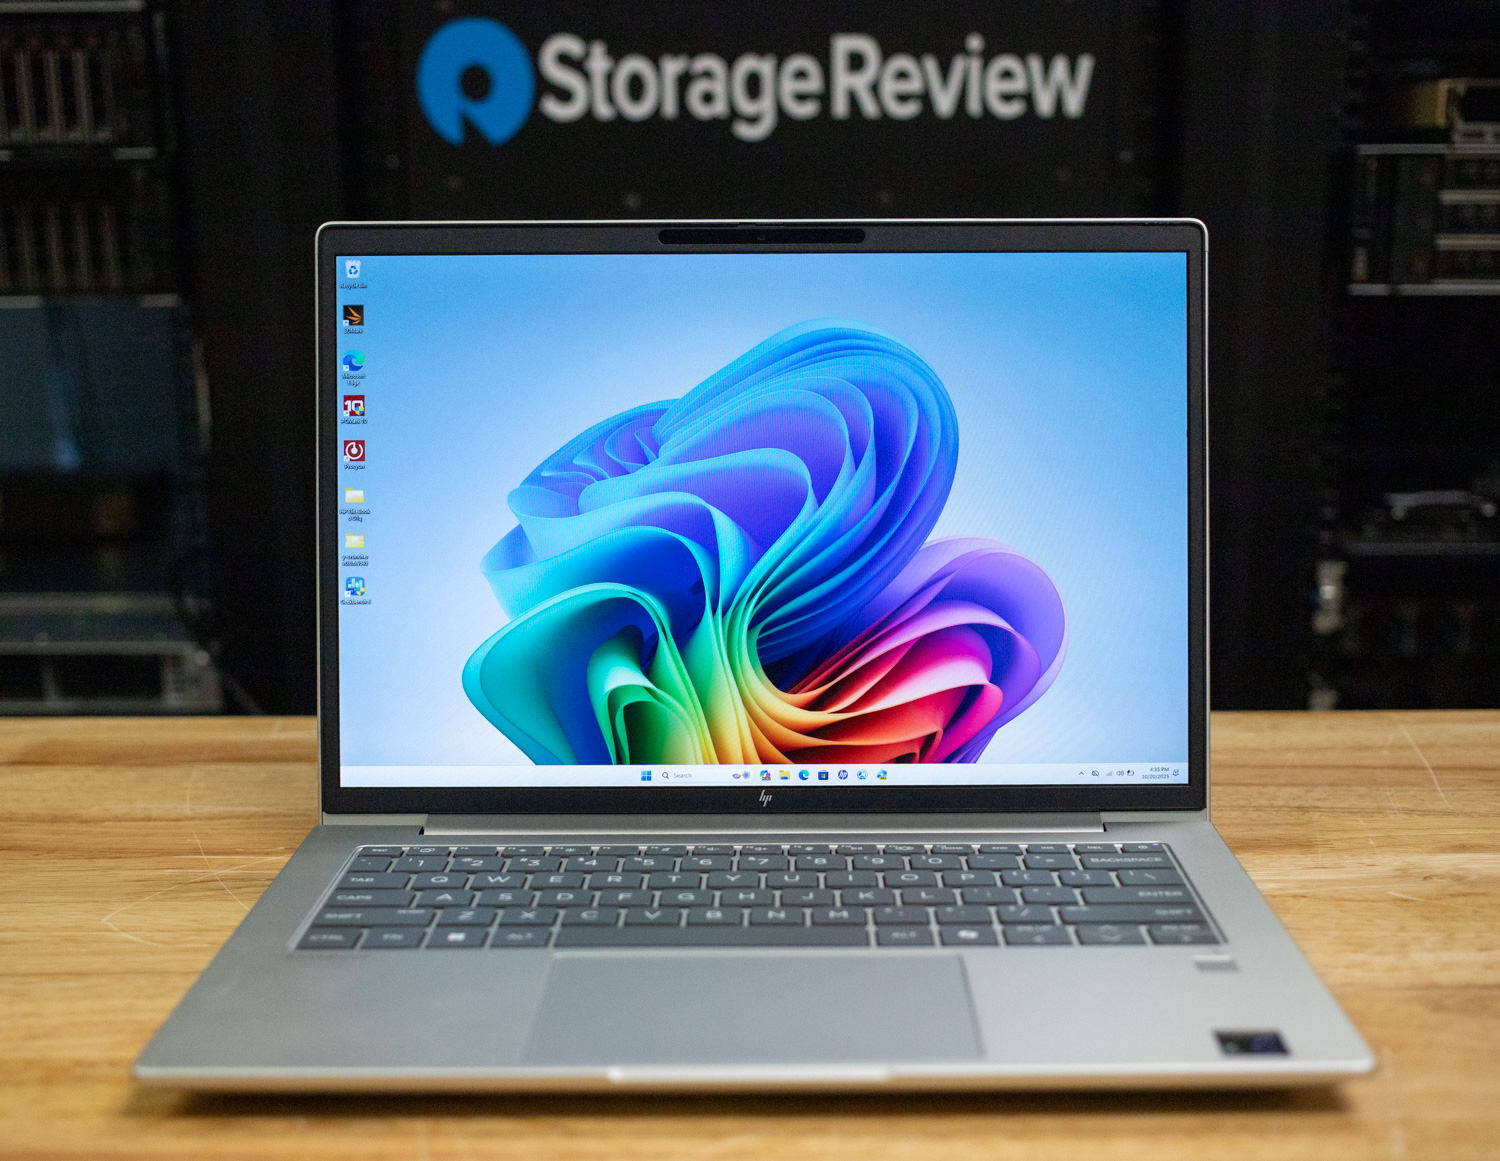
O EliteBook 6 G1q responde a uma pergunta diferente: quão pequeno você precisa de uma máquina para ter inteligência artificial (IA) útil no próprio dispositivo? Seu Snapdragon X Plus com uma NPU Hexagon de 45 TOPS executou o Llama 3.2 3B a 36.7 tokens por segundo e o Gemma 3 4B a 29.3 no LM Studio, com os modelos de 1B atingindo mais de 62 tokens por segundo. Essas são velocidades de bate-papo utilizáveis em uma máquina de 1,44 kg (3.17 libras) que apresentou uma autonomia de bateria de 19 horas e 35 minutos.
O limite é baixo; o modelo com 4 bilhões de parâmetros foi o maior que testamos, portanto, ele é indicado para bate-papo local, resumo e assistentes offline, sendo os modelos mais complexos inacessíveis. Custando cerca de US$ 3,100 na configuração utilizada na avaliação, também foi o sistema mais barato desta página.
Análise: HP EliteBook 6 G1q: Potência para o dia todo em um laptop leve
Notebooks RTX Spark: Testados em nosso novo pacote de software cliente.
A NVIDIA RTX Spark N1X traz o superchip GB10 do DGX Spark para laptops com Windows, com um pool de LPDDR5X compartilhado entre uma CPU Grace e uma GPU Blackwell. Os laptops terão duas variantes com TDP de 45 a 80 W: uma CPU de 20 núcleos com uma GPU de 6,144 núcleos e uma CPU de 18 núcleos com uma GPU de 5,120 núcleos. Testamos esses sistemas com o sr-client 1.2, nosso novo conjunto de clientes nativos para Arm64, portanto, seus resultados não correspondem exatamente aos números do Procyon mencionados acima. Nossa cobertura do lançamento da RTX Spark contém todos os detalhes da plataforma.
Memory decides which models each configuration can run. A firmware setting splits the pool between Windows and the GPU, and our smallest local AI model tier needs at least 16GB of GPU-usable memory, so a 32GB system set to 12GB for the GPU cannot load the 12.8GB gpt-oss:20b.
Melhor laptop RTX Spark: HP OmniBook Ultra 16
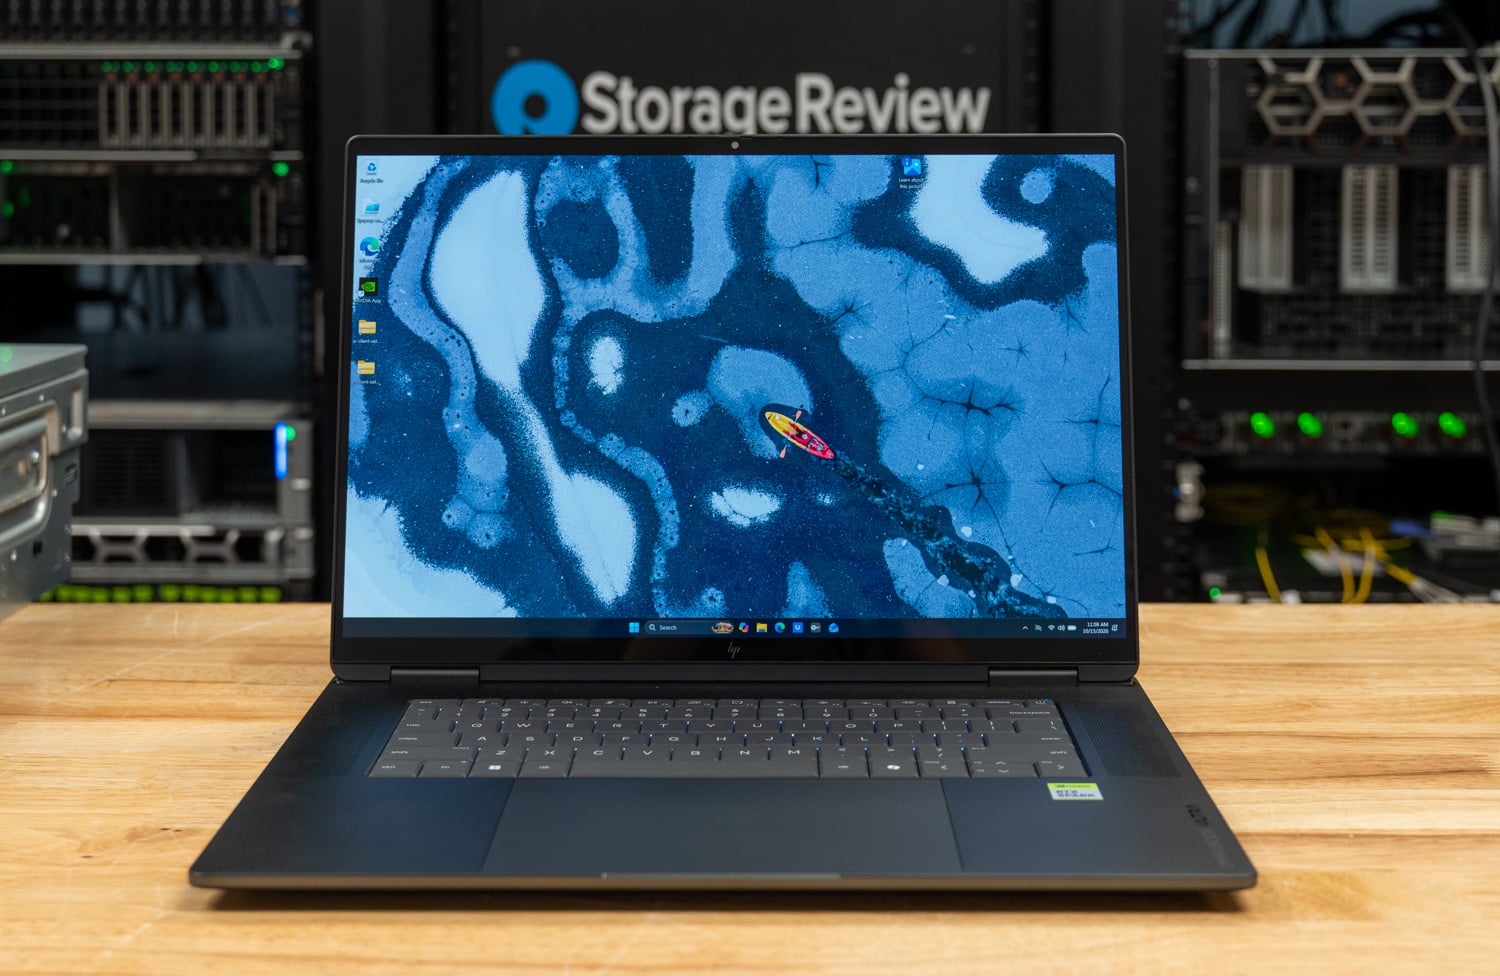
O OmniBook Ultra 16 de 128 GB é o notebook RTX Spark mais completo que já testamos. Com 62.5 GB de memória utilizável pela GPU, ele executa ambos os nossos modelos de IA locais, gerando gpt-oss:20b a 58.0 tokens por segundo e Qwen3.6-35B-A3B a 89.5. Ele passou em todas as nove execuções do agente de codificação e concluiu a tarefa Qwen3.6 em 72.0 segundos, o mais rápido do grupo, e completou a resolução OpenBLAS em todos os núcleos a 98 °C, o teste que desligou duas unidades do Surface Laptop Ultra.
A pontuação de 7,004 no teste multi-core do Cinebench 2026 foi o melhor resultado de CPU nessa comparação, 35% à frente do Razer Blade 16. A RTX 5090 do Blade ainda gera tokens 2.3 vezes mais rápido nos modelos que comportam seus 24 GB de RAM, e o navegador do OmniBook apresentou uma queda de desempenho de 1.73 vezes enquanto o agente de codificação era executado na GPU compartilhada. A versão de 128 GB e 2 TB que testamos é vendida exclusivamente pela HP.com, onde a HP a precificava em US$ 6,229.99 em 14 de outubro. O modelo de 32 GB, por US$ 3,199.99, mantém a velocidade da CPU, mas não permite o carregamento dos nossos níveis de desempenho, e os resultados da bateria ainda não foram divulgados.
Análise: HP OmniBook Ultra 16: RTX Spark com 128 GB supera nosso teste de agente de codificação local
Notebook com RTX Spark e melhor desempenho térmico: Lenovo Yoga 9n 2 em 1 de 16 polegadas
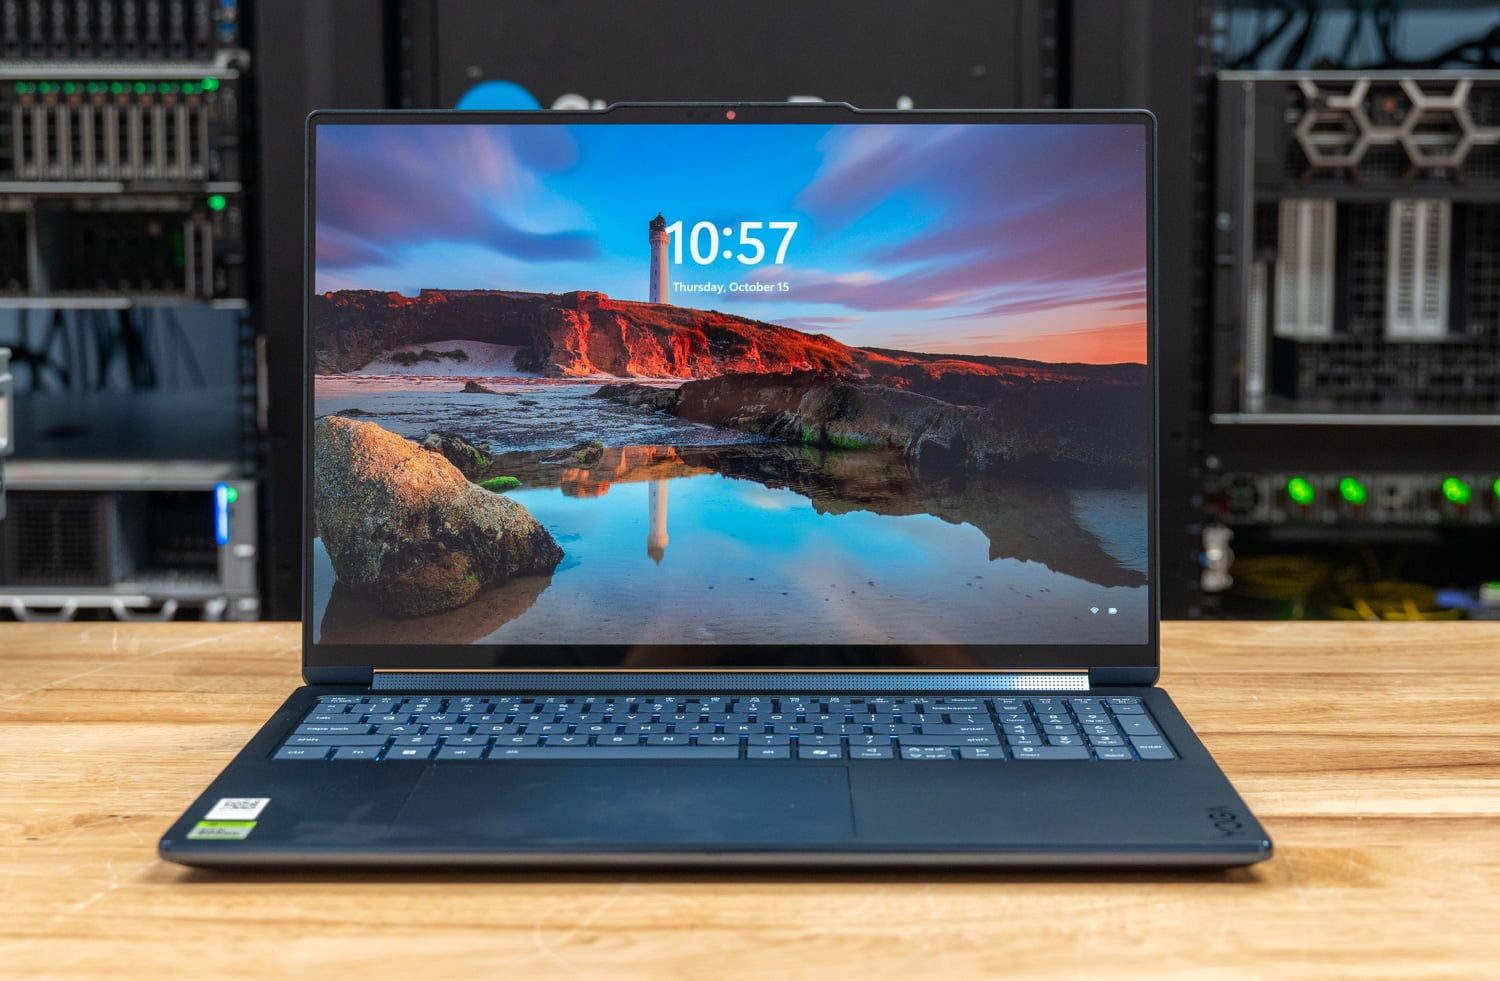
O Yoga 9n 2 em 1 de 16 polegadas apresentou a temperatura mais baixa que qualquer outro notebook com RTX Spark que testamos. Durante nosso teste contínuo de 30 minutos, a CPU atingiu um pico de 72 °C e manteve 3,015 MHz, terminando com 100.1% da sua primeira passagem. O HP OmniBook Ultra 16 e o Surface Laptop Ultra registraram 98 °C, e o Lenovo Pro 9n 15 chegou a 92 °C, todas as medições feitas através das zonas térmicas do Windows, o único sensor de CPU disponível nesses sistemas. A Lenovo atribui esse resultado às aberturas de ventilação maiores, à saliência térmica elevada e à dobradiça conversível que permite a circulação de ar atrás das aberturas.
O ajuste de resfriamento sacrifica um pouco da velocidade de processamento em todos os núcleos do Yoga em comparação com o HP. Os resultados multithread ficam de 4 a 10% abaixo do OmniBook na maioria dos testes, e o agente de codificação tornou o navegador 2.44 vezes mais lento no Yoga, contra 1.73 vezes no HP. Sua configuração de 64 GB oferece 32 GB para a GPU, o suficiente para gpt-oss:20b a 58.0 tokens por segundo, mas insuficiente para o nosso nível de 35B. Para um conversível de 16 polegadas que pode ser usado tanto como tablet quanto no colo, essa troca faz sentido. O preço sugerido para o modelo testado era de US$ 3,749.99, e os resultados da bateria ainda não foram divulgados.
Análise: Lenovo Yoga 9n 2 em 1 de 16 polegadas: O notebook com RTX Spark mais frio
Também testado na nova suíte:
- Lenovo Pro 9n 15O N1X de 18 núcleos com 32 GB de memória em um chassi de 3.64 kg. O Llama 3.1 8B atingiu 55.1 tokens por segundo no MLPerf Client, ficando a apenas 2% de um N1X de 20 núcleos com a mesma distribuição de 12 GB de GPU. Seus clocks mais altos em todos os núcleos o mantêm entre 8% e 11% abaixo da versão de 20 núcleos em renderização e compilação, com pico de 93 °C. Com 12 GB de GPU, ele não passou nos nossos testes de carregamento de modelos e agentes de codificação, então compradores de IA local devem configurar com mais memória. A Lenovo lista o modelo a partir de US$ 2,999.99 para a configuração de 18 núcleos, 32 GB e 512 GB de armazenamento.
- Microsoft Surface Laptop Ultra para Empresas (Conforme testado): a unidade de 128 GB gerou gpt-oss:20b e Qwen3.6-35B-A3B a uma taxa de 58 a 89 tokens por segundo e obteve 6,963 pontos no Cinebench 2026 multi-core. Este resultado consta apenas nos testes realizados, pois duas unidades desligaram sob nossa carga completa de OpenBLAS.
O Dell XPS 16 Creator Edition deve chegar em breve ao laboratório e será adicionado a esta seção assim que o testarmos. Os resultados da bateria para todos os sistemas RTX Spark aguardam nosso novo teste de bateria multiplataforma.
Também testado
Esses sistemas passaram pelo mesmo processo de laboratório e merecem ser analisados pelo comprador certo, mesmo que não ocupem um lugar específico na categoria atualmente.
- Lenovo ThinkPad P16 geração 3: a terceira máquina RTX PRO 5000 da frota (Phi a 141.2 tok/s); nossa unidade veio com 32 GB de RAM, o que limitou o restante do desempenho do fluxo de trabalho.
- HP ZBook Fury G1i 18Possui a mesma GPU Blackwell de 24 GB do Pro Max 18 Plus, porém com desempenho um pouco inferior (Phi de 157.4 tok/s) e custando US$ 11,687, conforme testado na análise.
- Dell Pro Precision 7 16 IntelA RTX PRO 3000 Blackwell com 12 GB de VRAM apresenta o melhor desempenho entre as GPUs de gama média nesta categoria (pontuação de geração de texto Procyon de 2,244 no Phi via DirectML); seus 12 GB abrem caminho para a classe de 14 bits, algo que as placas de 8 GB não conseguem alcançar.
- Lenovo ThinkPad P1 geração 8RTX PRO 2000 de 8 GB em um chassi de 4.06 kg com 12 horas e 59 minutos de bateria; Phi a 77.3 tok/s.
- Dell Pro Max 14 PremiumRTX PRO 2000 8GB com 3.55 libras; Phi a 54.1 tok/s.
- Dell Pro Max 16 (Ryzen)RTX PRO 1000 8GB com duração de bateria de 16 horas e 2 minutos; Phi em 61.9 tok/s.
- Lenovo ThinkPad P14s Gen 6RTX PRO 500 6GB; entrada Blackwell AI a 45.7 tok/s em Phi.
- Dell Pro Precision 5 16s Intel: o modelo de 16 polegadas equivalente à nossa escolha sem GPU dedicada, na mesma plataforma de memória compartilhada, com a maior duração de bateria para workstations que já medimos, de 24 horas e 43 minutos.
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU e um pool compartilhado de 64 GB; o caminho da imagem Procyon INT8 da AMD ainda não estava disponível no momento do teste, o que limita a comparação. Dell Pro Precision 5 16s AMD A placa-mãe Pro Precision traz o mesmo processador Ryzen AI 9 HX PRO 475 e NPU de 60 TOPS para um chassi de 16 polegadas e apresentou o melhor desempenho em LLM local da linha Pro Precision em nossos testes, superando com folga sua equivalente da Intel tanto no Llama3 quanto no Llama2, tornando-a a melhor opção desta família para trabalhos de inferência local.
- HP EliteBook X G1aRyzen AI 9 HX 375 com uma NPU de 55 TOPS; ainda não executamos nosso conjunto de testes LLM nele.
Como classificamos
A geração de texto por IA do UL Procyon é nosso parâmetro de comparação para toda a frota: os mesmos quatro modelos (Phi, Mistral, Llama 3 e Llama 2, quando disponíveis) em todos os laptops que os suportam, portanto, os números de tokens por segundo aqui são diretamente comparáveis. Quando o hardware torna a análise interessante, aprofundamos o assunto com o LM Studio e o Ollama rodando em modelos maiores. Cada laptop é classificado uma vez por critério de métrica, e um sistema só aparece nesta página se produziu resultados de IA locais utilizáveis em nosso laboratório.
RTX Spark systems ran sr-client 1.2, our new client suite, so they are compared with each other on this page and not with the Procyon results behind the other picks.
Os preços flutuam rapidamente neste mercado, portanto, qualquer valor em dólares nesta página corresponde ao preço testado no momento da publicação da análise. Não fazemos afirmações sobre o valor do produto sem verificar os preços atuais nos configuradores dos fornecedores e, quando o fazemos, indicamos a data da verificação.
Perguntas frequentes sobre IA local para laptops
O que é mais importante para IA local em um laptop: VRAM ou memória total?
Ambos, por razões diferentes: um modelo precisa caber na memória que a GPU consegue acessar: em placas dedicadas, essa memória é a VRAM (de 8 GB a 24 GB neste caso), e nosso teste Llama 2 13B falhou em placas de 8 GB porque precisava de cerca de 12 GB. Projetos de memória unificada e compartilhada invertem a situação: o Ryzen AI Max+ da AMD pode alocar até 96 GB de RAM do sistema para a GPU, e os pools compartilhados do LPCAMM2 da Intel chegam a 64 GB, permitindo que modelos muito maiores sejam carregados, embora em velocidades mais baixas. O tamanho do modelo determina se ele será executado; o silício determina a velocidade de execução.
Qual o maior modelo que a StorageReview já testou em um laptop?
O DeepSeek-R1 70B foi carregado localmente no HP ZBook Ultra G1a 14 através de seu pool de memória unificada atribuível de 96 GB. Para geração sustentada, medimos o Gemma 3 27B a 8.96 tokens por segundo na mesma máquina. Em nossos desktops, o nível de exigência é maior; o ranking dos Melhores Desktops para IA Local abrange sistemas que atendem modelos muito maiores.
As classificações NPU TOPS são relevantes para a execução de mestrados em direito?
Menos do que o marketing sugere hoje, porque a maioria dos tempos de execução LLM locais dependem da GPU, e todos os números de tokens por segundo nesta página vieram da inferência da GPU, exceto o Snapdragon EliteBook, onde o foco está na pilha de IA da plataforma. As NPUs atualmente justificam seu investimento em eficiência e em caminhos de geração de imagens INT8, e são por isso que várias dessas máquinas se qualificam como PCs Copilot+, então priorize a GPU e a memória na sua compra.
O que acontece com a duração da bateria quando você executa modelos localmente?
A inferência é uma das tarefas mais exigentes e contínuas que um laptop pode executar, portanto, planeje usar uma tomada durante sessões de uso intenso. Os números de duração da bateria nesta página são resultados do PCMark 10 Modern Office, uma métrica de produtividade, e a diferença é enorme: 3 horas e 39 minutos em nosso laptop com IA mais rápido, contra quase 24 horas no Dell com memória compartilhada. Nosso Ranking de Duração da Bateria de Laptops classifica todos os modelos disponíveis.
Como os notebooks RTX Spark se comparam aos notebooks classificados aqui?
RTX Spark laptops run NVIDIA’s N1X, which shares one pool of LPDDR5X between a Grace CPU and a Blackwell GPU. We test them on sr-client 1.2, our new client suite, so their numbers do not line up row for row with the Procyon results behind the picks on this page. On the 128GB HP OmniBook Ultra 16, gpt-oss:20b and Qwen3.6-35B-A3B generated at 58.0 and 89.5 tokens per second, and the 35B coding task passed three of three runs in 72.0 seconds.
The memory split decides which models load: the 32GB Lenovo Pro 9n 15, set to 12GB for the GPU, could not load the 12.8GB gpt-oss:20b. The Lenovo Yoga 9n 2-in-1 16 ran coolest, peaking at 72 C through a 30-minute sustained load. The Surface appears as tested only, because two units powered off under our all-core OpenBLAS load.
Devo comprar um computador desktop para usar IA localmente?
Se o computador ficar em uma mesa, sim, provavelmente. Sistemas para uso em mesa oferecem mais memória por dólar, melhor dissipação de calor e não comprometem a duração da bateria; nossa lista dos Melhores Desktops para IA Local começa com preços semelhantes aos dos laptops de gama média aqui apresentados. Os laptops desta página são para pessoas cujo trabalho de IA precisa ser transportado.


 Amazon