ArmazenamentoReview.com

Análises de IA Empresarial

Nossas análises atuais de sistemas de IA se concentram na inferência em laboratório, com modelos de peso aberto das famílias Llama, Qwen, DeepSeek e gpt-oss executados por meio de vLLM ou SGLang e medidos em termos de taxa de transferência de saída e latência do primeiro token. A cobertura abrange desde a borda até o nó de GPU completo: a NVIDIA RTX PRO 4500 Server Edition apresentou uma mediana de 2.7 vezes mais tokens de saída por segundo do que a GPU de camada 4 que ela foi projetada para substituir em um HPE ProLiant DL145 Gen11, com um consumo de energia cerca de 105 W maior; as versões da Dell, GIGABYTE e HP do DGX Spark executaram inferência distribuída como clusters de dois nós em uma rede de 200 Gb; e o programa JumpStart da Supermicro nos proporcionou experiência prática com um sistema NVIDIA HGX B200 e um AMD Instinct MI350X. O armazenamento recebe o mesmo tratamento, pois o caminho dos dados determina o nível de ocupação das GPUs. Por isso, medimos a taxa de transferência do GPUDirect Storage com GDSIO e testamos o descarregamento do cache KV para memória flash em cargas de trabalho de contexto longo e com agentes.

Se você estiver dimensionando o hardware para IA, a página Melhores Servidores lista nossas escolhas atuais de inferência de IA e edge computing com base nos dados dessas análises; a página Melhores SSDs Empresariais aborda os drives que alimentam as GPUs; e a página Melhores Arrays de Armazenamento abrange as plataformas de armazenamento de IA por trás de clusters de treinamento e neoclouds.


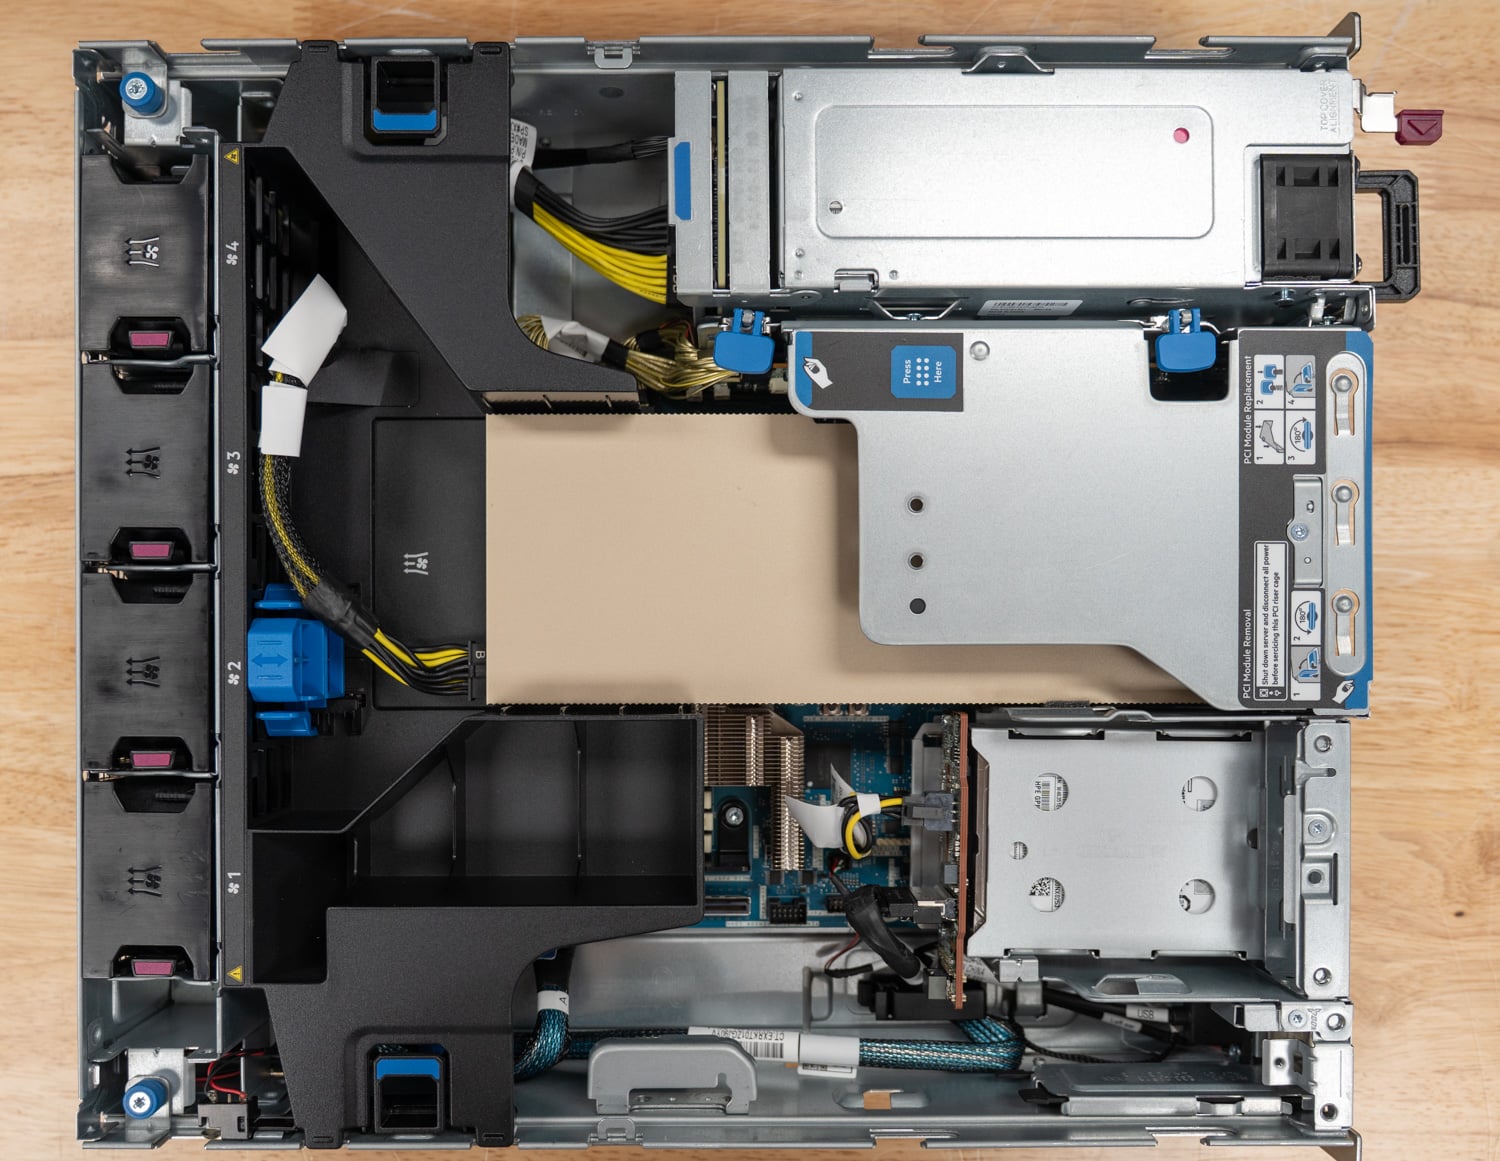
Análise da RTX PRO 4500 edge: visão superior do interior do HPE ProLiant DL145 Gen11 com a RTX PRO 4500 Server Edition instalada no riser de altura total e seu cabo de alimentação de 16 pinos conectado.
AI  ◇  Empreendimento

Análise da NVIDIA RTX PRO 4500 Edge: 2.7 vezes mais potente que um servidor L4 em um HPE ProLiant DL145 Gen11.

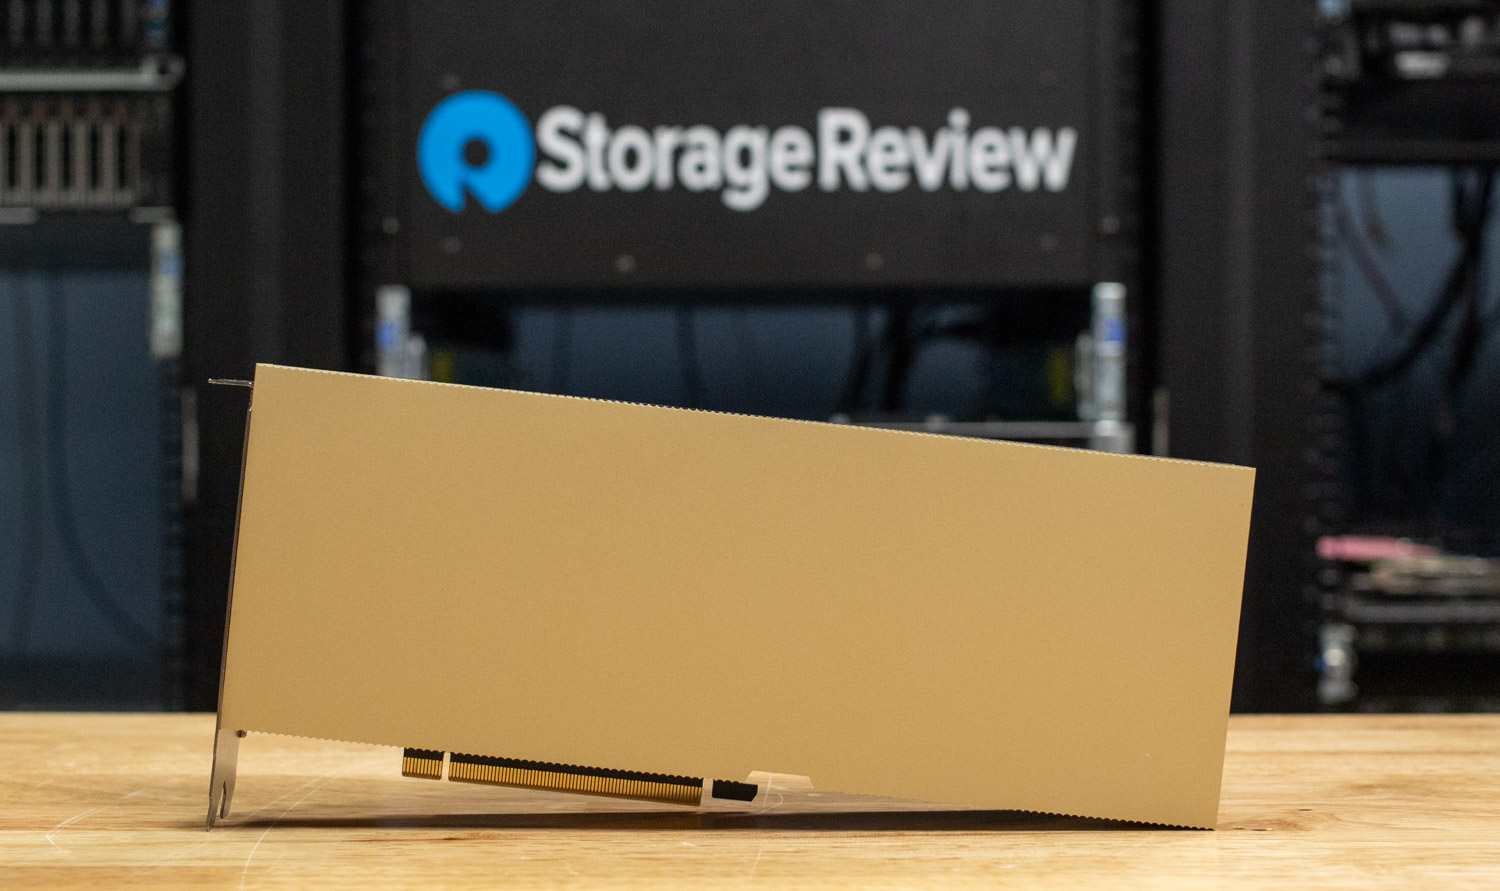
A NVIDIA RTX PRO 4500 Blackwell Server Edition é a placa que a NVIDIA desenvolveu principalmente para substituir o cache L4 em servidores que operam fora do data center: slot único, PCIe Gen5, resfriamento passivo, 165 W, com 32 GB de GDDR7 e o conjunto completo de recursos Blackwell, incluindo Tensor Cores FP4 e GPU Multi-Instance. A HPE nos enviou um servidor ProLiant DL145.

AI  ◇  Empreendimento

O caminho eficiente em termos de tokens para inferência de contexto longo: descarregamento do cache KV para a memória flash.

A infraestrutura de IA empresarial passou de otimizar modelos de treinamento para fornecê-los, e isso altera a economia. O treinamento é um projeto de capital com um ponto final definido. A inferência é uma carga de trabalho de produção que é executada enquanto o serviço estiver ativo, com a saída medida em tokens. Este é o problema de tokenomics que os operadores de IA enfrentam agora: uma vez que o

AI  ◇  Empreendimento

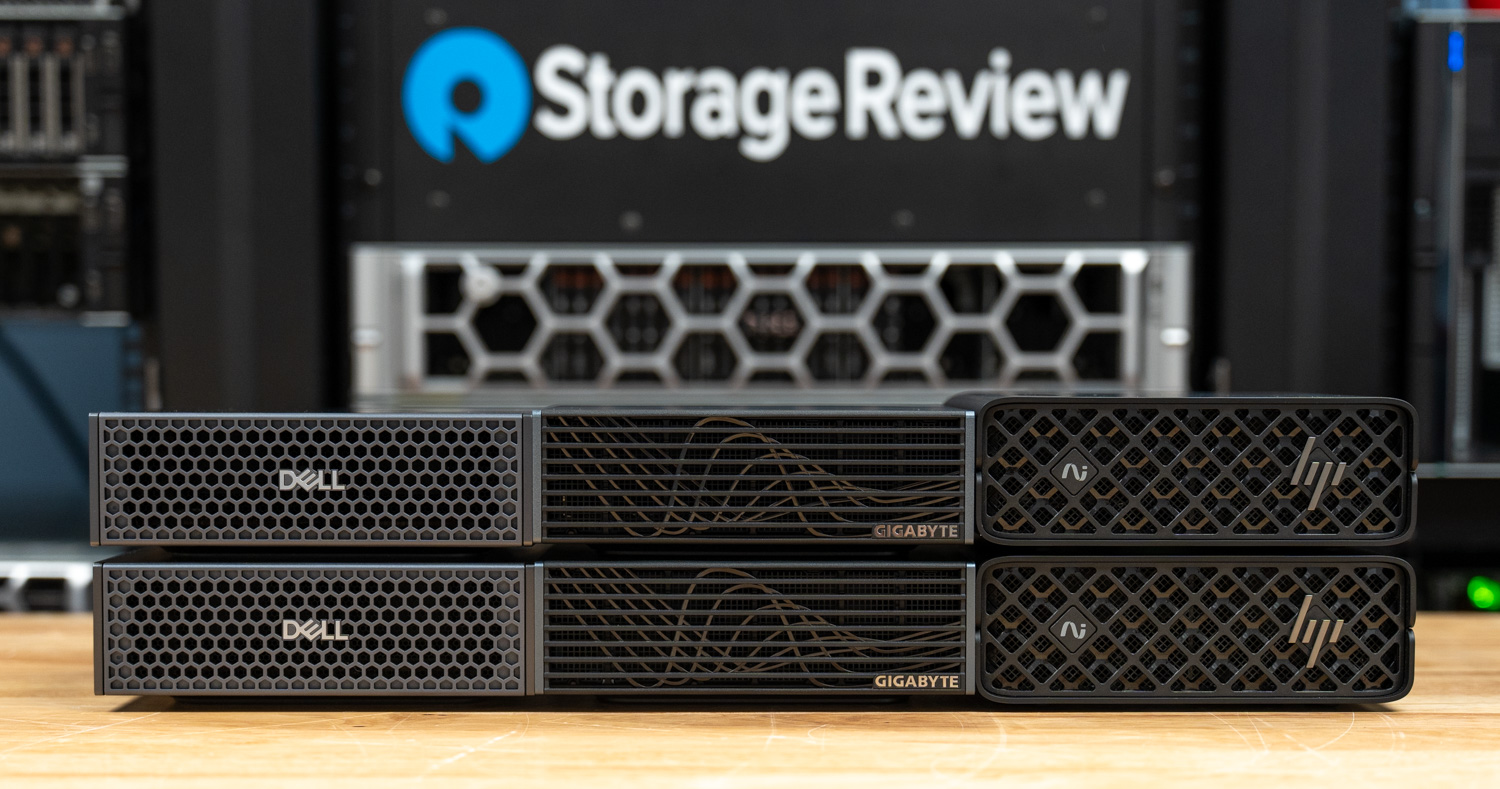
Análise do cluster NVIDIA DGX Spark: Inferência distribuída em servidores Dell, GIGABYTE e HP

Duas coisas costumam vir à tona quando a conversa gira em torno do NVIDIA DGX Spark. A primeira é a especificação principal: 128 GB de memória unificada em um computador desktop de aproximadamente US$ 4,000, um número que pareceria implausível para um engenheiro há apenas dois anos. A segunda é a quantidade de 200...

AI  ◇  Empreendimento

Como a Metrum AI e a Universidade Estadual do Oregon estão construindo o novo padrão para avaliação acadêmica.

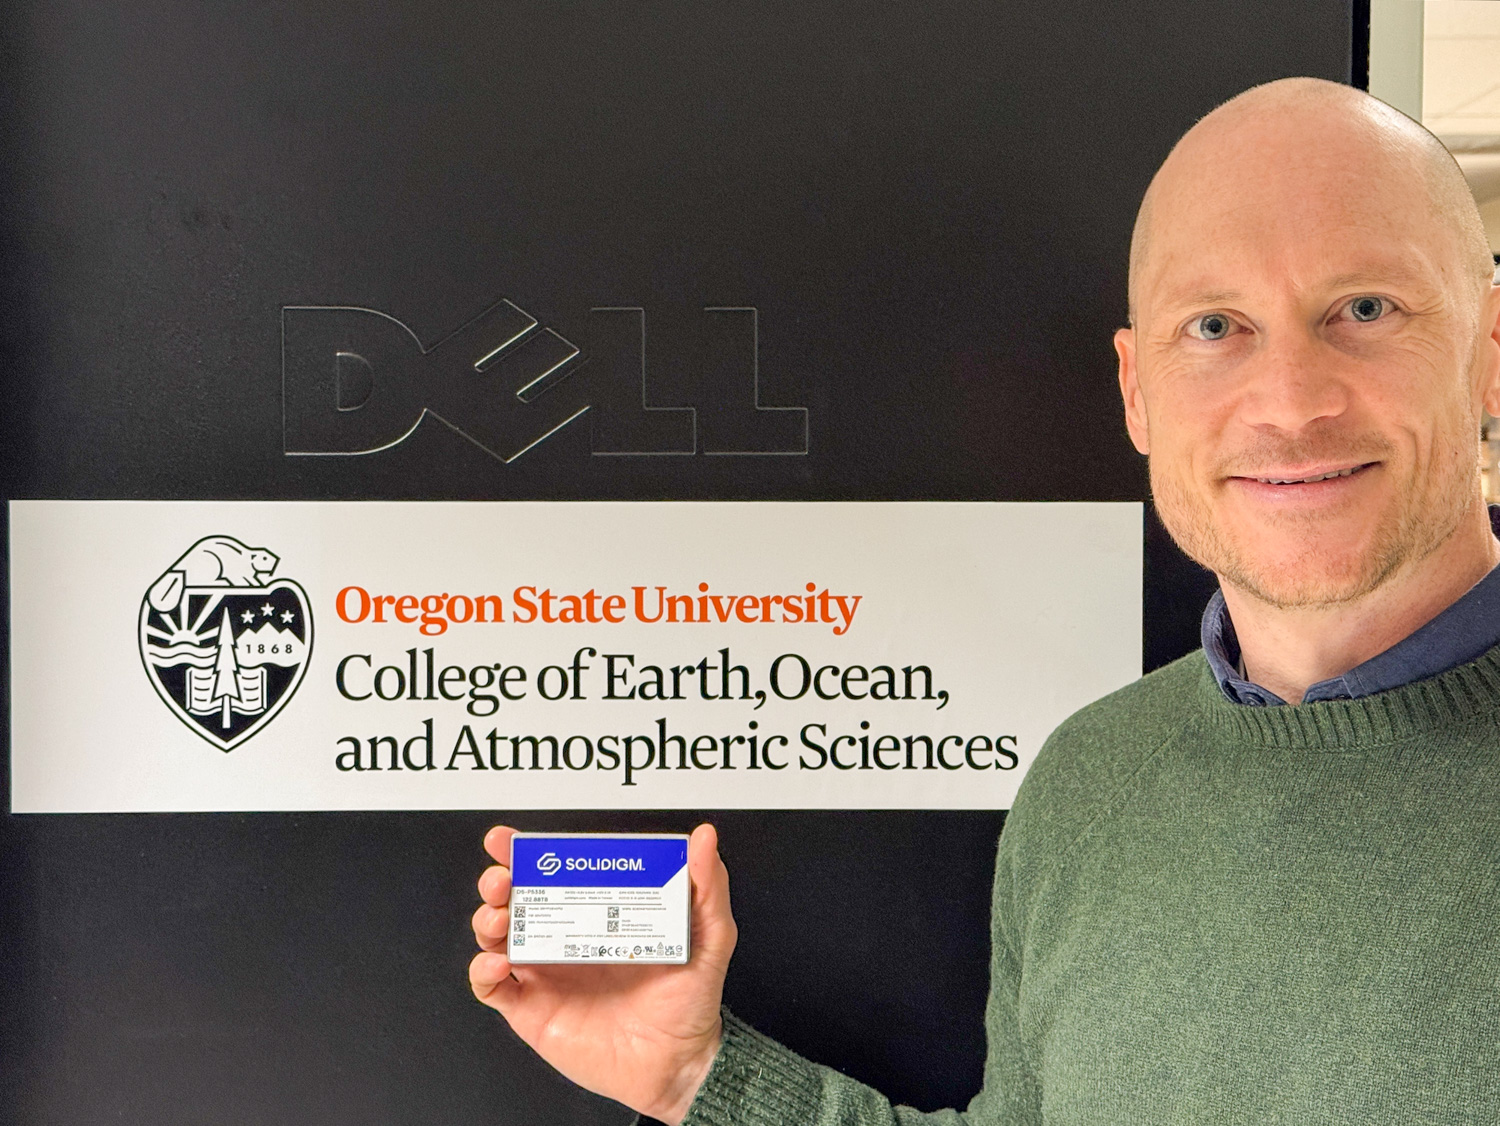
Quando publicamos nossa matéria sobre a pesquisa de imagens de plâncton da Universidade Estadual do Oregon em novembro passado, a manchete era a ciência: infraestrutura acelerada por IA a bordo de navios de pesquisa, processando terabytes de dados oceânicos em tempo quase real, antes mesmo do navio chegar ao porto. Mas algo mais aconteceu silenciosamente nas semanas seguintes. A notícia se espalhou pelo campus sobre o que...

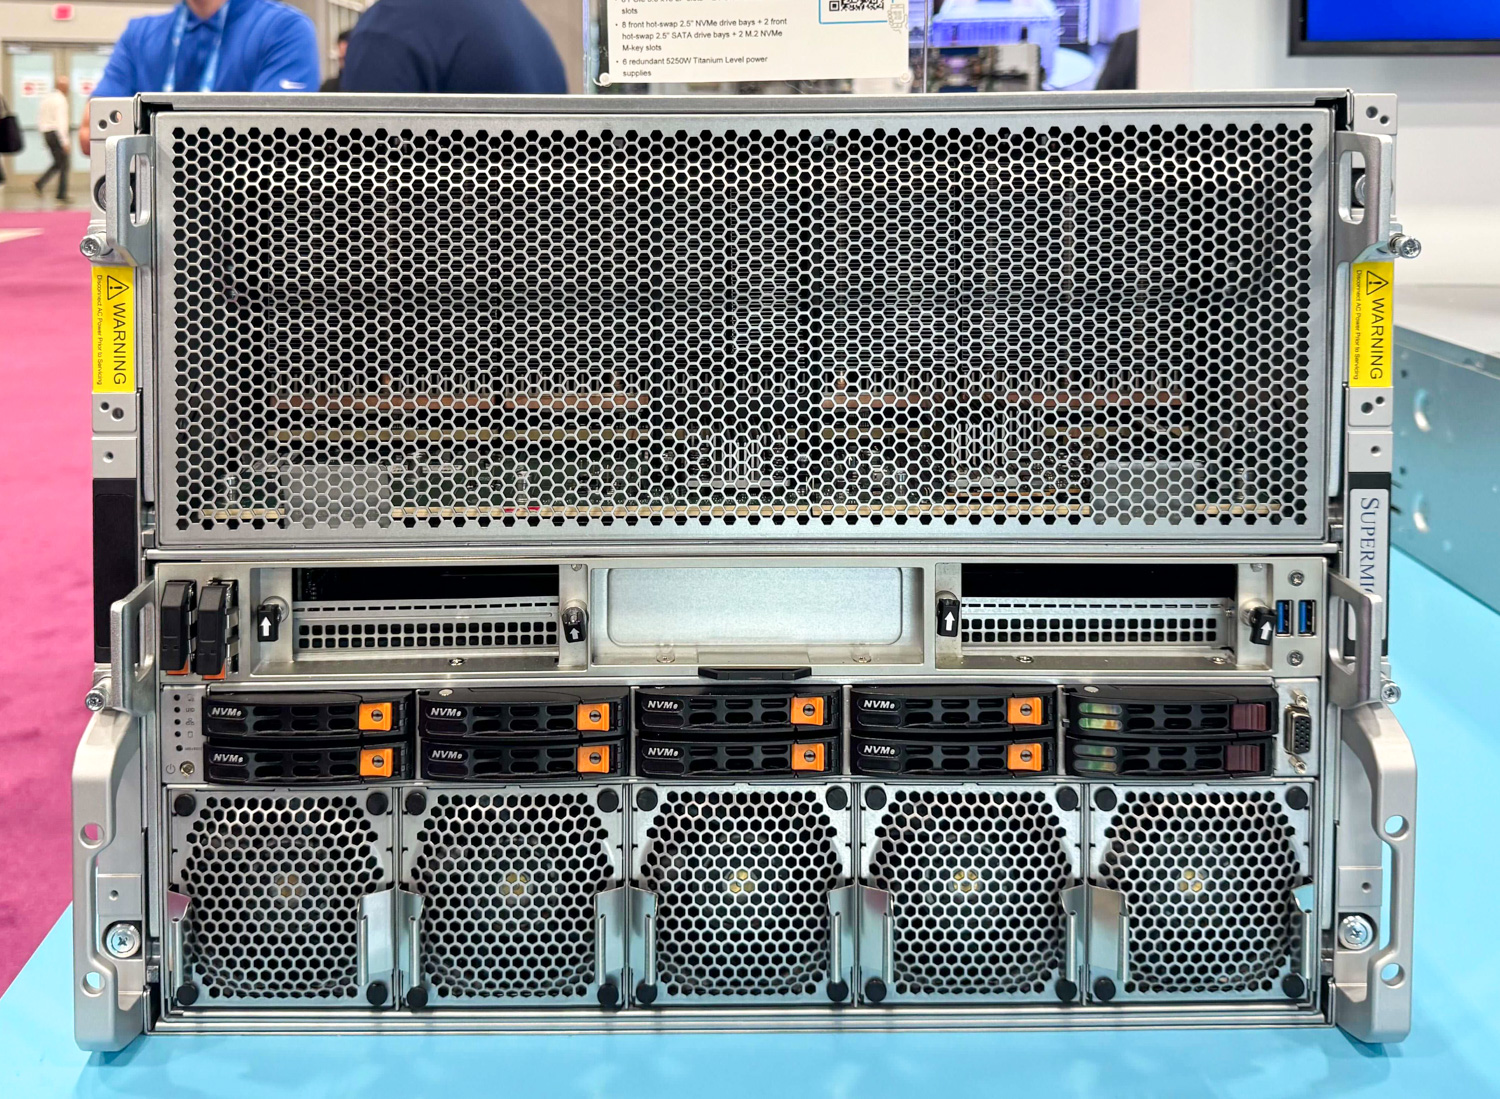
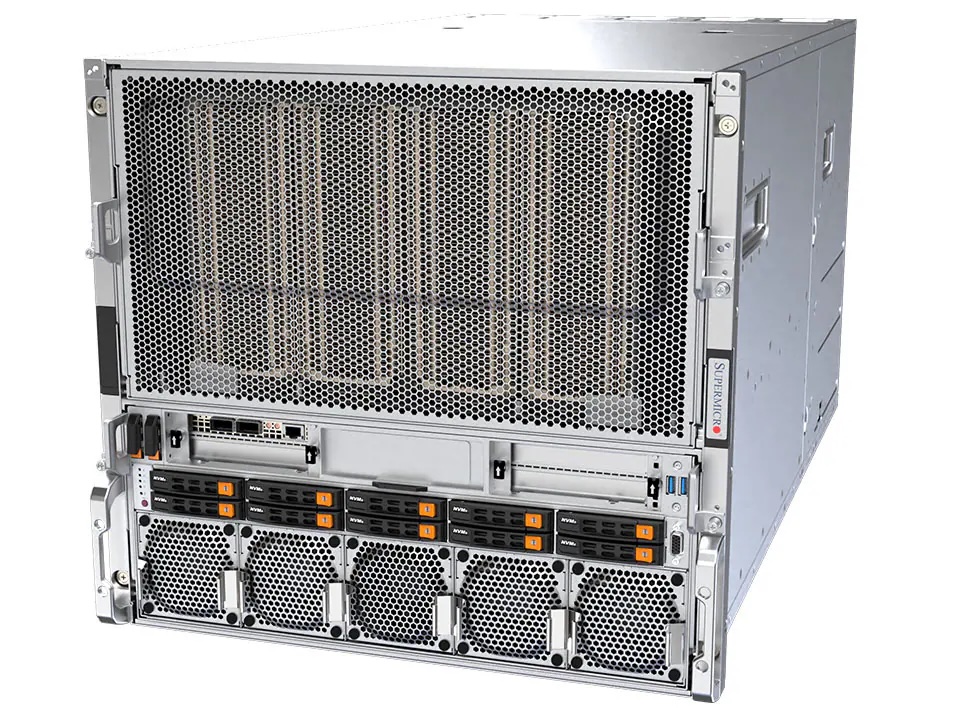
Servidor Supermicro H14 com GPUs AMD Instinct MI350X, vista frontal mostrando a parede de ventoinhas e os compartimentos para unidades NVMe.
AI  ◇  Empreendimento

Análise do Supermicro JumpStart: H14 com AMD Instinct MI350X

O programa JumpStart da Supermicro se consolidou como uma das ferramentas mais úteis no conjunto de ferramentas de avaliação pré-compra para infraestrutura de IA. Em vez de uma demonstração roteirizada em um ambiente compartilhado, o JumpStart oferece aos usuários qualificados acesso gratuito e por tempo limitado a servidores de produção reais via SSH, IPMI e VNC, permitindo que eles executem cargas de trabalho em hardware real.