

Atualizado em 24 de outubro de 2026: A resposta para o Mac Studio agora reflete os modelos M5 Max e M5 Ultra que a Apple começou a enviar em setembro, e a nota para o DGX Spark de 64 GB reflete seu lançamento em 23 de outubro; as opções permanecem inalteradas. Em 20 de outubro, o requisito mínimo passou a ser duas ou mais GPUs em vLLM sob Linux, ou um pool de memória compartilhada com pelo menos 96 GB disponíveis para os modelos.
Todos os sistemas classificados nesta página foram testados no laboratório da StorageReview. Avaliamos diretamente o desempenho local de IA: taxa de transferência de serviço online do vLLM, tempo até o primeiro token e tempo por token de saída em modelos como GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B e Qwen3 Coder 30B, além de testes de eficiência computacional do MAMF e de armazenamento do GDSIO. Nenhum sistema é classificado com base em sua ficha técnica.
A questão crucial para um desktop de IA local em 2026 é memória unificada versus VRAM discreta . Dispositivos de mesa como o DGX Spark da NVIDIA, baseado no GB10, e os sistemas Ryzen AI Max (Strix Halo) da AMD oferecem 128 GB de memória unificada em um único chip a preços acessíveis, viabilizando modelos que, de outra forma, exigiriam várias GPUs discretas.
As torres de workstation respondem com desempenho bruto: as placas RTX PRO 6000 Blackwell oferecem uma taxa de transferência muito maior, a um custo e consumo de energia várias vezes maiores. Esta página classifica ambas, em níveis separados, com base em um conjunto de testes consistente, pois a resposta correta depende do modelo mais potente que você pretende usar e da velocidade de resposta necessária.
Num relance
| Categoria | System | Memória | GPUs (Testadas / Máximas) | Revisão completa |
|---|---|---|---|---|
| Melhor sistema de IA para uso em desktops no geral | NVIDIA DGX Spark | 128 GB LPDDR5X unificado | GB10 integrado (fixo) | Análise do DGX Spark |
| Melhor implementação do GB10 | Acer Veriton GN100 | 128 GB LPDDR5X unificado | GB10 integrado (fixo) | Análise do Veriton GN100 |
| Melhor alternativa x86 | AMD Ryzen AI Halo (Strix Halo) | Até 128 GB de memória LPDDR5X unificada. | Radeon 8060S integrada (fixa) | Análise do Ryzen AI Halo |
| Melhor opção sem uma GPU dedicada | HP Z2 Mini G1a | LPDDR5X unificado (executou GPT-OSS 120B) | Integrado, sem GPU dedicada (fixo) | Análise do Z2 Mini G1a |
| Melhor sistema GB300 | MSI XpertStation WS300 (alternativa: ASUS ET900N G3) | 748 GB coerentes (252 GB HBM3e + 496 GB LPDDR5X) | GB300 integrado (fixo) | Análise do XpertStation WS300 |
| Melhor Torre para IA Local | Dell Precision 7875 | 192 GB GDDR7 (2 × 96 GB) | 2× RTX PRO 6000 / 2 máx. | Análise do Precision 7875 |
| Melhor plataforma multi-GPU | HP Z8 Fury G6i | 192 GB GDDR7 (conforme testado) / até 384 GB | 2× RTX PRO 6000 testadas / 4 máx. | Análise do Z8 Fury G6i |
| A Escolha Extrema | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8 × 96 GB) | 8× RTX PRO 6000 / 8 máx. | Crítica Comino Grando |
Dispositivos de IA para uso em mesas de trabalho
A linha de appliances, que a Dell chama de IA de mesa e a NVIDIA chama de supercomputador pessoal de IA , prioriza a capacidade de processamento em detrimento da capacidade de processamento, eficiência energética e preço. Com 128 GB de memória unificada, esses sistemas suportam confortavelmente modelos da classe 70B com alta quantização e podem chegar à classe 120B, cargas de trabalho que exigiriam várias GPUs discretas em um gabinete torre.
Leitura essencial para este nível de desempenho: nosso teste térmico DGX Spark compara os projetos de refrigeração dos fabricantes originais (OEMs) nos sistemas GB10 abaixo e se aplica a todas as unidades desta classe até que essas plataformas sejam revisadas.
Melhor sistema de IA para uso em mesa: NVIDIA DGX Spark
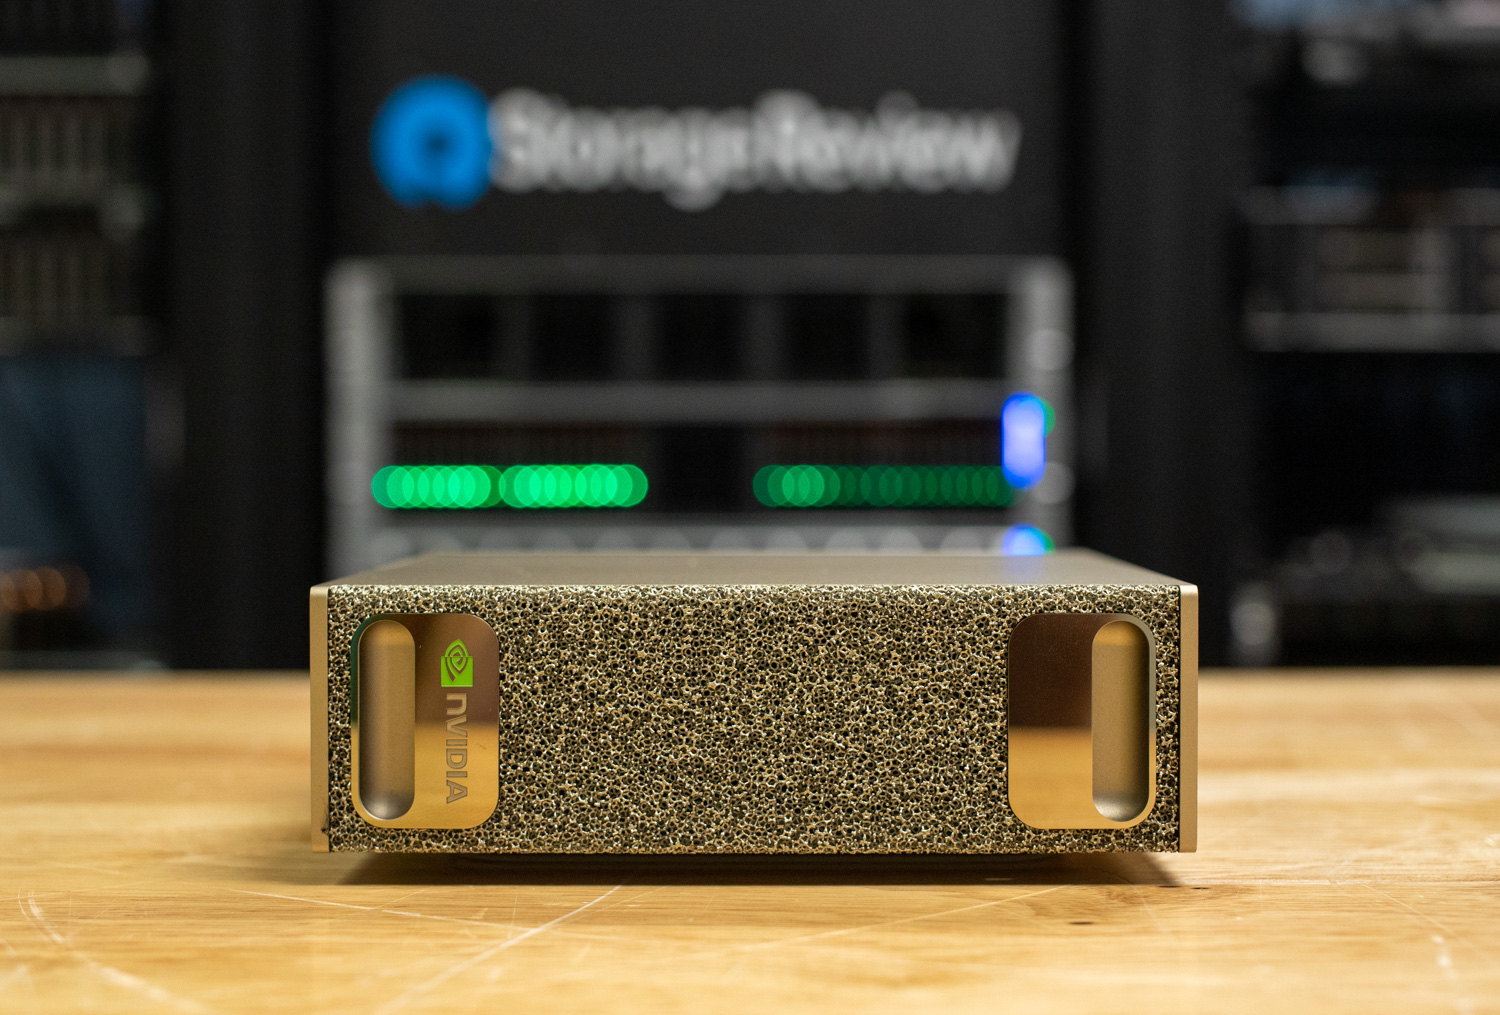
O DGX Spark é o ponto de referência com o qual todos os outros dispositivos de IA para uso em mesa são avaliados. O superchip GB10 Grace Blackwell combina uma CPU Arm de 20 núcleos com 128 GB de memória LPDDR5X unificada, e as duas portas ConnectX-7 de 200 GbE fazem dele o único dispositivo da nossa classe que testamos capaz de formar clusters imediatamente: nossos testes de inferência distribuída em dois nós executaram cargas de trabalho paralelas em pipeline em nós Dell, GIGABYTE e HP via 200 GbE.
Essa história de clusterização agora tem uma opção mais acessível: a NVIDIA lançou uma SKU DGX Spark de 64 GB em 23 de outubro por US$ 4,999 , vendida pelos mesmos seis OEMs, e duas delas podem ser pareadas por um cabo 200GbE para compartilhar 128 GB; a NVIDIA afirma que o par em cluster atinge até 1.7x o desempenho de uma única unidade de 128 GB no Qwen3.8 27B, uma afirmação que ainda não testamos. O conjunto de software CUDA continua sendo o mais completo do segmento.
A única limitação da plataforma é o armazenamento: cada sistema GB10 atinge um máximo de cerca de 4 TB em um único slot M.2 curto. Nossa configuração de armazenamento compartilhado com oito Sparks é a solução ideal para frotas: um único array QLC gerenciado, servido pelas portas 100GbE que cada Spark já possui, onde um cliente atingiu uma velocidade de leitura de 10.8 GiB/s, igualando o M.2 interno mais rápido que já medimos em um sistema GB10, e um modelo de 78 GB hospedado centralmente apresentou uma carga de apenas 13% em relação ao NVMe local.
Leia a análise completa do DGX Spark.
Melhor implementação do GB10: Acer Veriton GN100
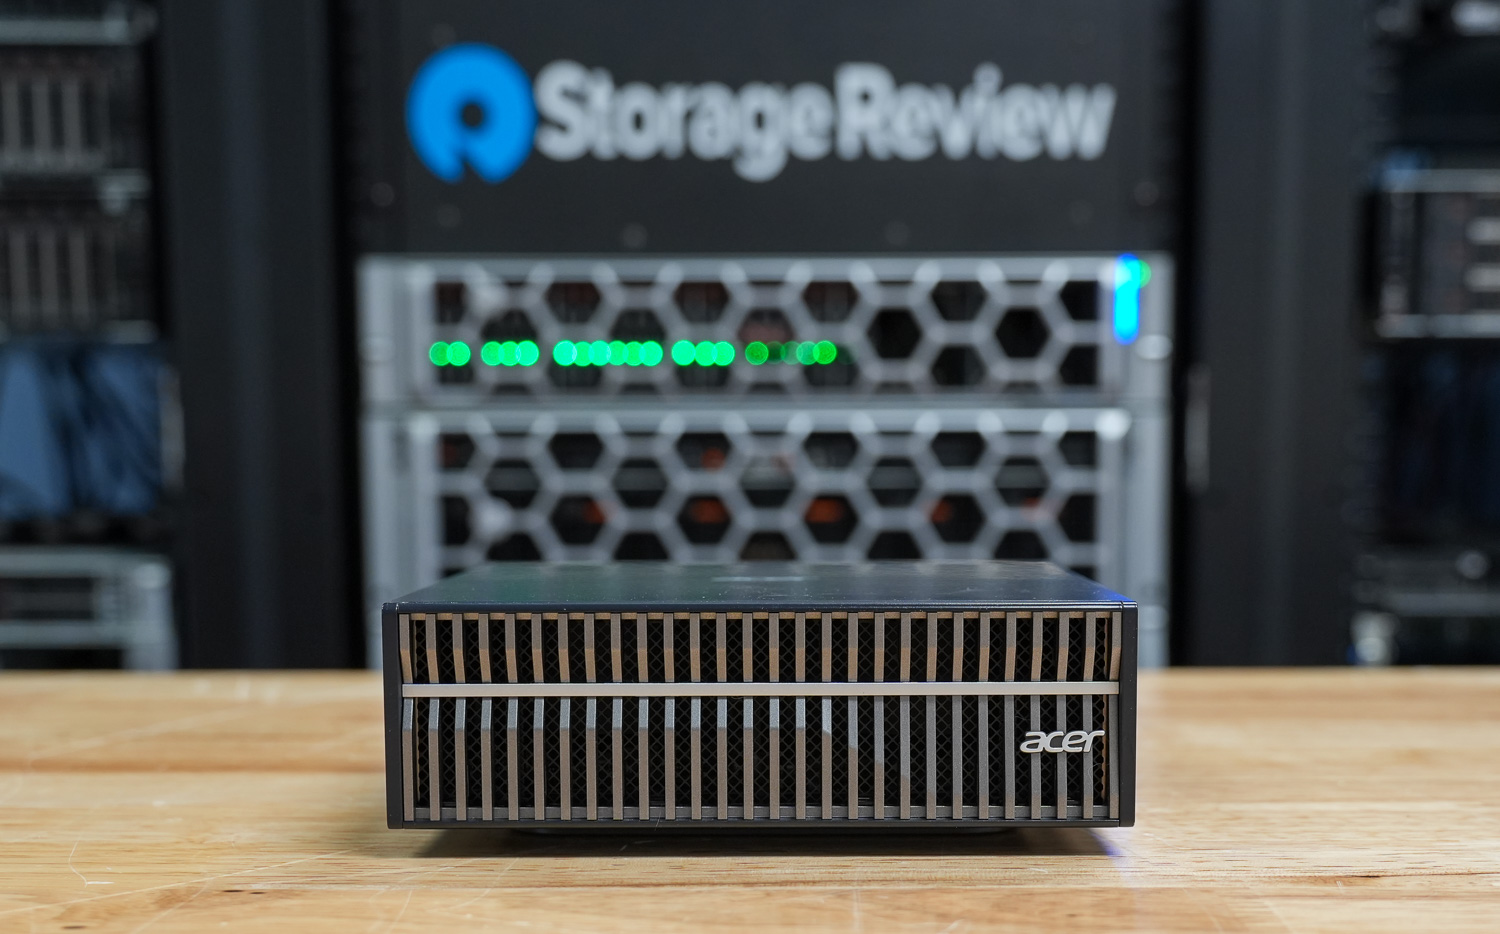
Entre os sistemas GB10 de fabricantes de equipamentos originais (OEMs), o design térmico é o verdadeiro diferencial, e o Veriton GN100 se destacou em nossos testes. Todos os servidores GB10 compartilham a mesma configuração de silício e memória, portanto, o desempenho sustentado depende da refrigeração. Nossa comparação térmica multi-OEM é, até onde sabemos, a única desse tipo publicada.
Leia a análise completa do Veriton GN100.
Melhor alternativa x86: AMD Ryzen AI Halo
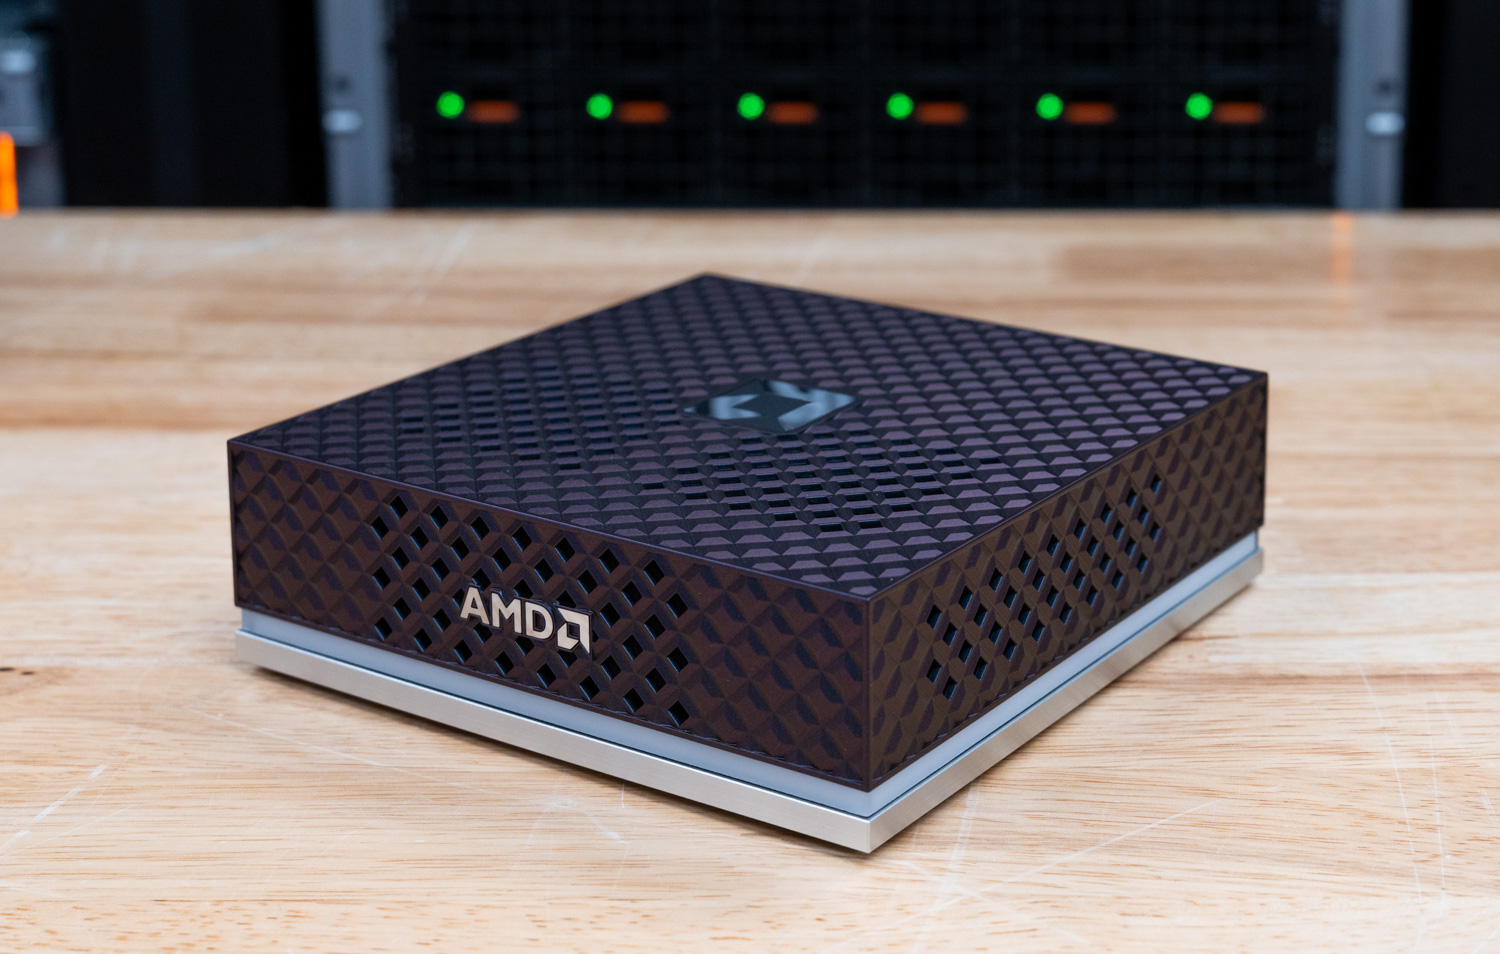
Se você precisa do Windows ou de um conjunto de softwares x86 padrão, o Strix Halo é a solução ideal para desktops. A plataforma Ryzen AI Max+ 395 da AMD combina 128 GB de memória unificada com uma configuração de sistema operacional duplo e, em nossos testes, lidou com modelos de 200 bilhões de parâmetros, representando uma ameaça direta ao DGX Spark sem a necessidade do sistema operacional Arm/DGX.
Leia a análise completa do Ryzen AI Halo.
Melhor opção sem placa de vídeo dedicada: HP Z2 Mini G1a
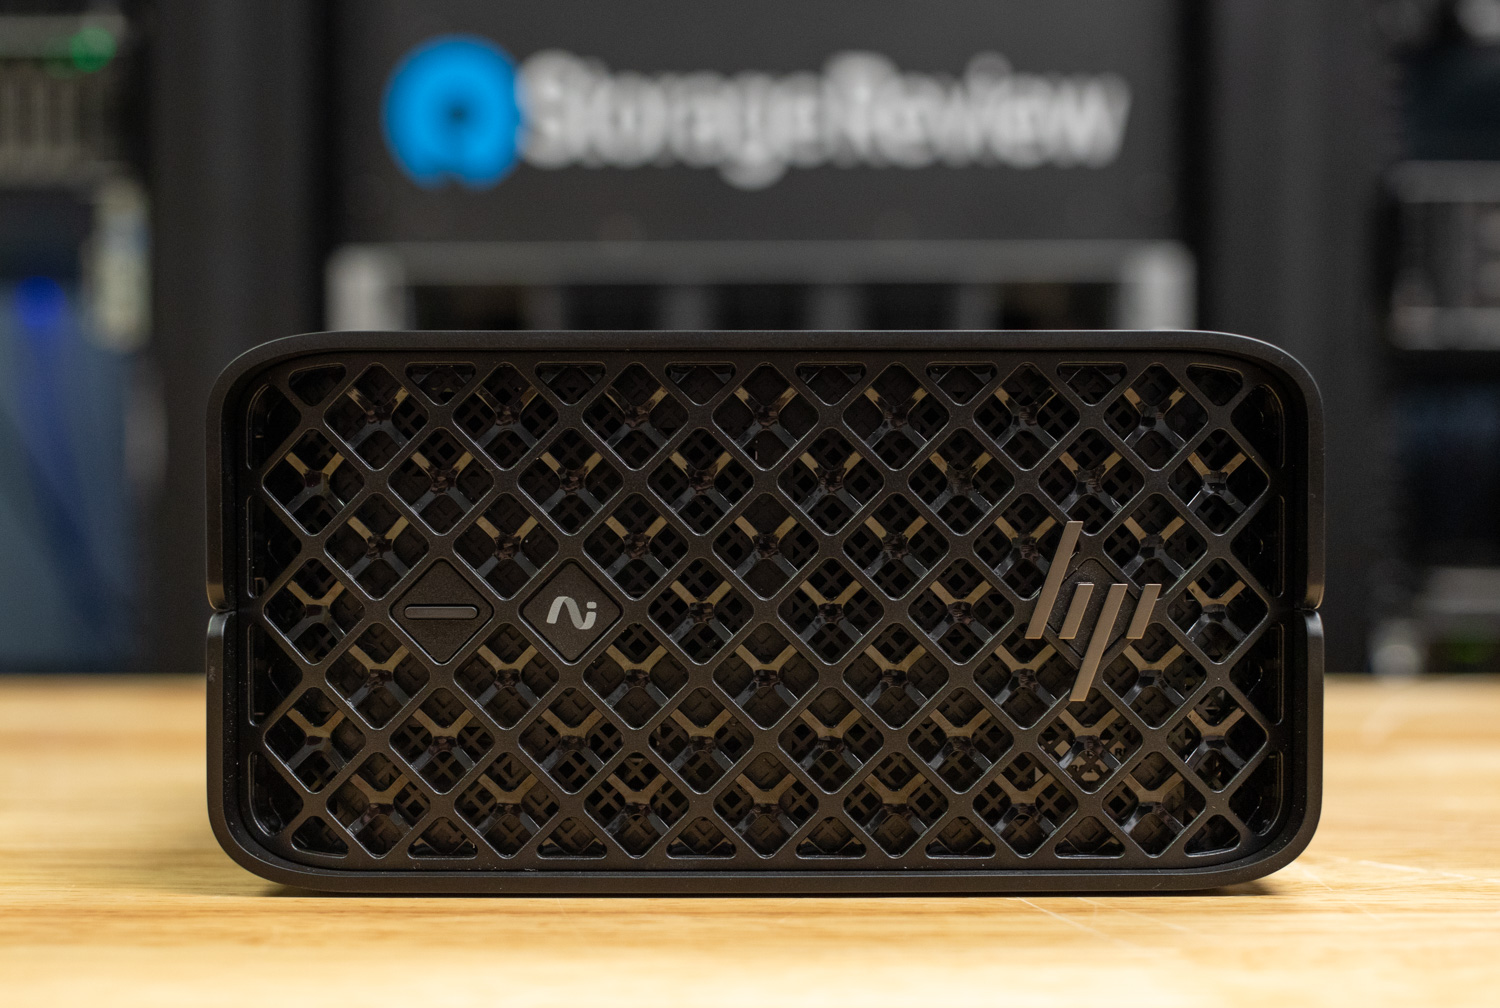
O Z2 Mini G1a executava GPT-OSS 120B sem nenhuma GPU dedicada. A mini workstation da HP utiliza o processador AMD Ryzen AI Max+ PRO em um chassi compacto, silencioso e ideal para profissionais de TI, e continua sendo a demonstração mais clara de que os sistemas x86 com memória unificada transformaram o que um pequeno computador de escritório pode fazer em comparação com modelos maiores.
Leia a análise completa do Z2 Mini G1a
Melhor sistema GB300: MSI XpertStation WS300
O WS300 é a primeira estação GB300 DGX a passar pelo nosso laboratório e redefine o padrão para a categoria de appliances. O superchip Grace Blackwell Ultra reúne 748 GB de memória coerente, sendo 252 GB de HBM3e e 496 GB de LPDDR5X, com 20 petaFLOPS de poder computacional FP4. Em nossos testes, ele serviu como um checkpoint GLM-5.2 de 433 GB, com 216 GB de pesos de especialistas armazenados na memória Grace – um modelo que não deveria funcionar ao lado de uma mesa. Como todo sistema da classe DGX, ele executa o sistema operacional DGX em vez do Windows; esse é o compromisso que tanta memória exige.
O preço e a potência o colocam mais próximo dos extremos da categoria de torres do que dos modelos GB10 acima, mas nenhum outro dispositivo na classe de eletrodomésticos possui um modelo tão grande. A pergunta óbvia, se um componente de 1,300 W sofre throttling em uma torre, agora tem uma resposta comprovada: nossa análise térmica detalhada do WS300 registrou 2.8 horas de funcionamento contínuo com o chip Blackwell Ultra mantido a 60 °C, um clock estável de 2.07 GHz sem quedas e aproximadamente 20 °C de margem térmica restante em carga máxima.
Alternativa ao GB300: o ASUS ExpertCenter Pro ET900N G3 é a segunda estação GB300 DGX que testamos e confirma a plataforma: em 14 modelos e duas cargas de trabalho, 24 das 28 comparações de taxa de transferência máxima ficaram dentro de 2% do WS300, e os modelos com pool coerente apresentaram desempenho igual ou superior. A ASUS adicionou alças de transporte à torre de 27 kg, uma ventoinha dedicada sobre as gaiolas de óptica 400G e uma fonte de alimentação com certificação 80 PLUS Titanium. Ambas as torres oferecem a plataforma; leia nossa análise do ET900N G3 para uma comparação entre as duas torres.
Escalabilidade do cluster: duas dessas torres interligadas por meio de suas próprias portas 400G agora são medidas, não apenas garantidas: nosso teste de cluster GB300 combinou as estações ASUS e HP com dois DACs, atingiu 98% da taxa de linha nos coletivos NCCL e transformou o GLM-5.2, um modelo de 433 GB que uma única estação só consegue processar, transferindo 215 GB de pesos para a memória Grace, de 139 tokens de saída por segundo em 32 fluxos para 1,525, chegando a 3,141 em 256.
Os modelos que se adaptam a uma escala de estação de forma diferente: a desagregação de pré-preenchimento/decodificação triplicou a taxa de transferência de prompts curtos do GLM-5.3 Flash, e o DeepSeek V4.1 Flash registrou 5,248 tokens por segundo, a maior produção do conjunto.
Leia a análise completa do XpertStation WS300.
No laboratório: Estação de IA HP ZGX Fury
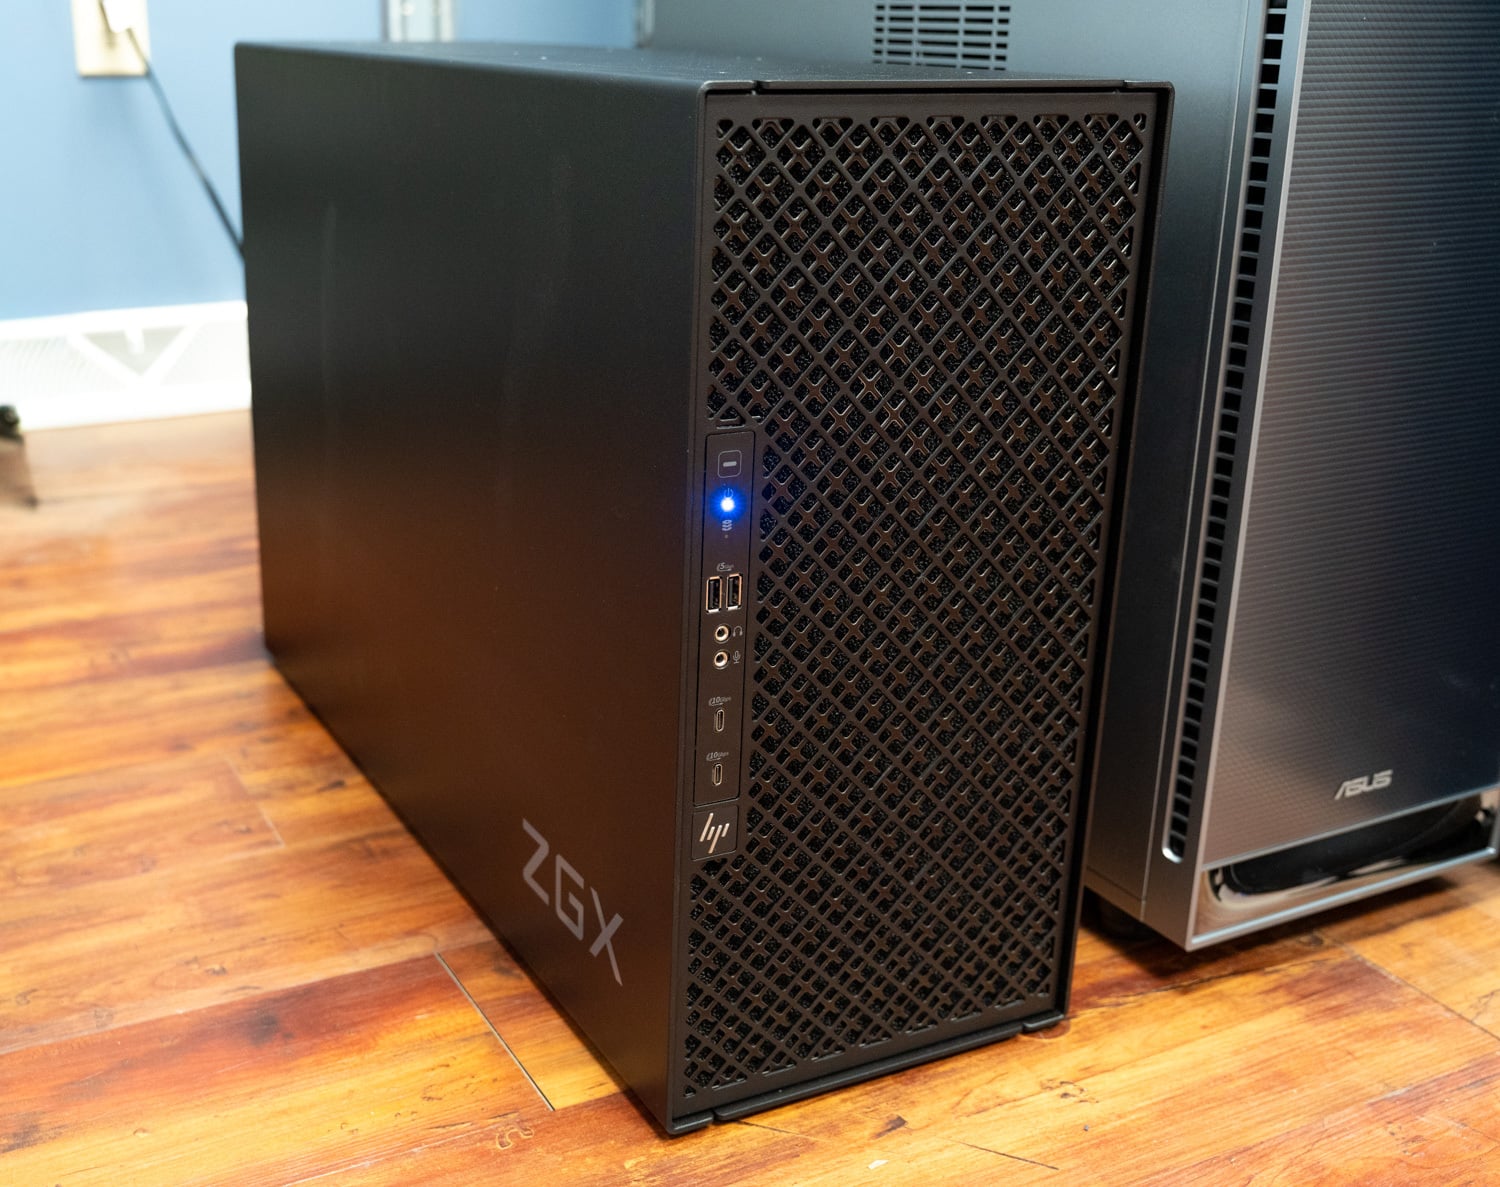
A estação de trabalho HP ZGX Fury AI Station, o terceiro sistema da classe GB300 a chegar ao nosso laboratório, segue o MSI WS300 e o ASUS ET900N G3, cujos resultados em configuração de duas torres apresentaram uma diferença de apenas 2%.
A estação de IA ZGX Fury da HP já está em nosso laboratório. Ela é construída na mesma plataforma NVIDIA GB300 Grace Blackwell Ultra que a MSI XpertStation WS300 mencionada anteriormente, o que a torna a primeira oportunidade de comparar as implementações da arquitetura DGX Station de dois fornecedores diferentes na mesma bancada: desempenho térmico, acústico, frequências de clock sustentadas e a experiência prática de uso da máquina.
Os primeiros números públicos já foram divulgados: o ZGX Fury serviu como a segunda torre em nosso teste de cluster GB300 com duas estações , executando a decodificação para a configuração Flash GLM-5.3 desagregada e metade de cada execução tensor-paralela. A análise individual está em andamento e o ZGX Fury entrará no ranking quando seus próprios resultados de benchmark forem divulgados.
O ZGX Fury também é um dos dois primeiros sistemas que a Microsoft nomeou para o DGX Station para Windows , juntamente com o Dell Pro Precision com GB300, com a NVIDIA listando a versão para Windows para o quarto trimestre. O hardware corresponde às torres GB300 que testamos no Ubuntu, e resta saber se os servidores serão executados nativamente no Windows ou sob o WSL.
No horizonte: Estação Halo do AMD Threadripper
Anunciada na IFA 2026 e ainda não disponível em laboratório, a Threadripper Halo Station da AMD é a primeira resposta direta à classe GB300 mencionada anteriormente. A proposta inverte a aposta da NVIDIA: em vez de um único pool de memória coerente de grande porte, a AMD combina um Threadripper PRO de 96 núcleos em uma plataforma com até 2 TB de DDR5 de oito canais e 128 pistas PCIe 5.0 com dois aceleradores Instinct MI350P de 600 W, cada um com 144 GB de HBM3E, e uma possibilidade declarada de expansão para quatro placas e 576 GB de HBM. Todo o sistema possui refrigeração líquida, e o host x86 contorna os problemas de compatibilidade com a cadeia de ferramentas Arm que mencionamos na análise da WS300.
A questão em aberto é o quão bem os modelos se saem em conjunto com placas PCIe e com a coerência NVLink-C2C, e a AMD não divulgou benchmarks, preços ou disponibilidade, então este é um item para acompanhar, não uma escolha definitiva. Mais detalhes estão em nossa cobertura do anúncio ; ele entrará no ranking assim que o hardware chegar aos nossos laboratórios.
Testamos também: Dispositivos de IA para uso em mesas de escritório
Esses sistemas passaram pelo mesmo processo de laboratório e são opções sólidas que não ocuparam um espaço em uma categoria específica: Dell Pro Max com GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n e HP EliteDesk 8 Mini G1a.
Torres de estações de trabalho para IA local
Quando o tempo de resposta é mais importante que o custo de aquisição (assistentes de codificação interativos, servidores multiusuário, pipelines com agentes e longas cadeias de chamadas de ferramentas), a VRAM discreta ainda reina. Estas torres são classificadas aqui com base na taxa de transferência de inferência e no limite de memória, e para cada uma listamos a configuração de GPU que testamos, juntamente com a capacidade máxima do gabinete, já que a capacidade final de um gabinete é tão importante quanto o que foi incluído em nossa configuração; uma torre precisa de duas ou mais GPUs para ser classificada nesta seção. Torres com uma única GPU, incluindo aquelas com uma RTX PRO 6000 de 96 GB, são classificadas em nossa página de Melhores Estações de Trabalho Desktop em nosso conjunto de clientes Windows, porque respondem a uma pergunta diferente.
Melhor torre para IA local: Dell Precision 7875
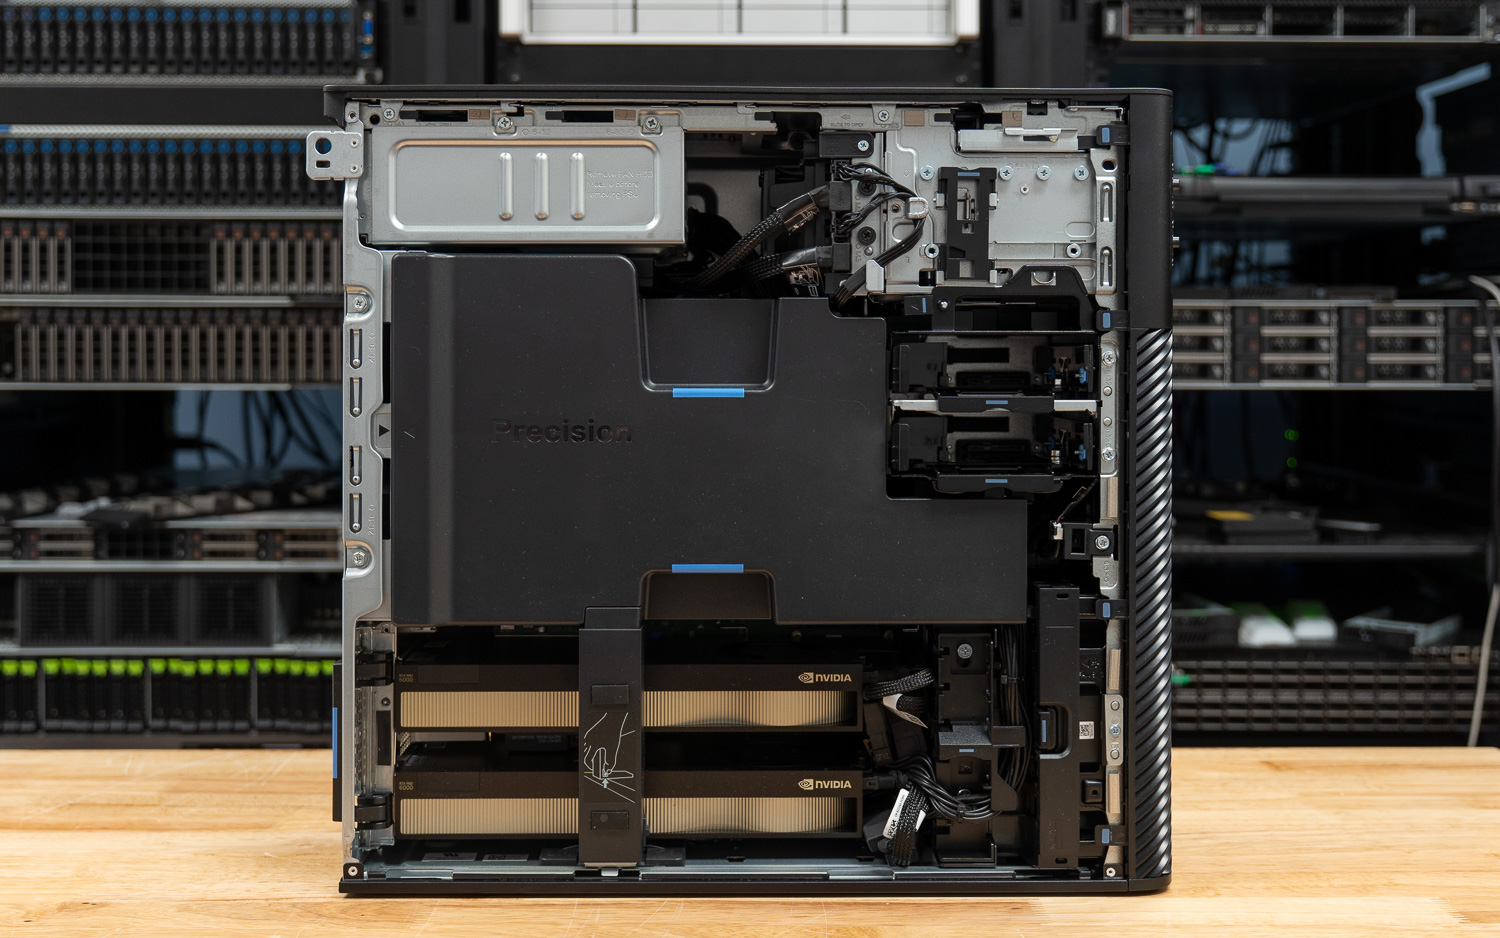
As duas GPUs RTX PRO 6000 Blackwell fazem do Precision 7875 o sistema de formato padrão mais rápido que já testamos para inferência local. Com um Threadripper PRO 9995WX e 192 GB de VRAM combinada em duas placas, ele armazena modelos de classe 100B inteiramente na memória da GPU, oferecendo um tempo até o primeiro token (TTFT) de nível interativo que nenhum outro dispositivo com memória unificada consegue alcançar. No entanto, esteja ciente do limite: o chassi do 7875 suporta no máximo duas placas de vídeo de largura dupla, portanto, nossa configuração com duas GPUs é a configuração máxima; não é possível adicionar uma terceira posteriormente.
Leia a análise completa do Precision 7875.
Melhor plataforma multi-GPU: HP Z8 Fury G6i
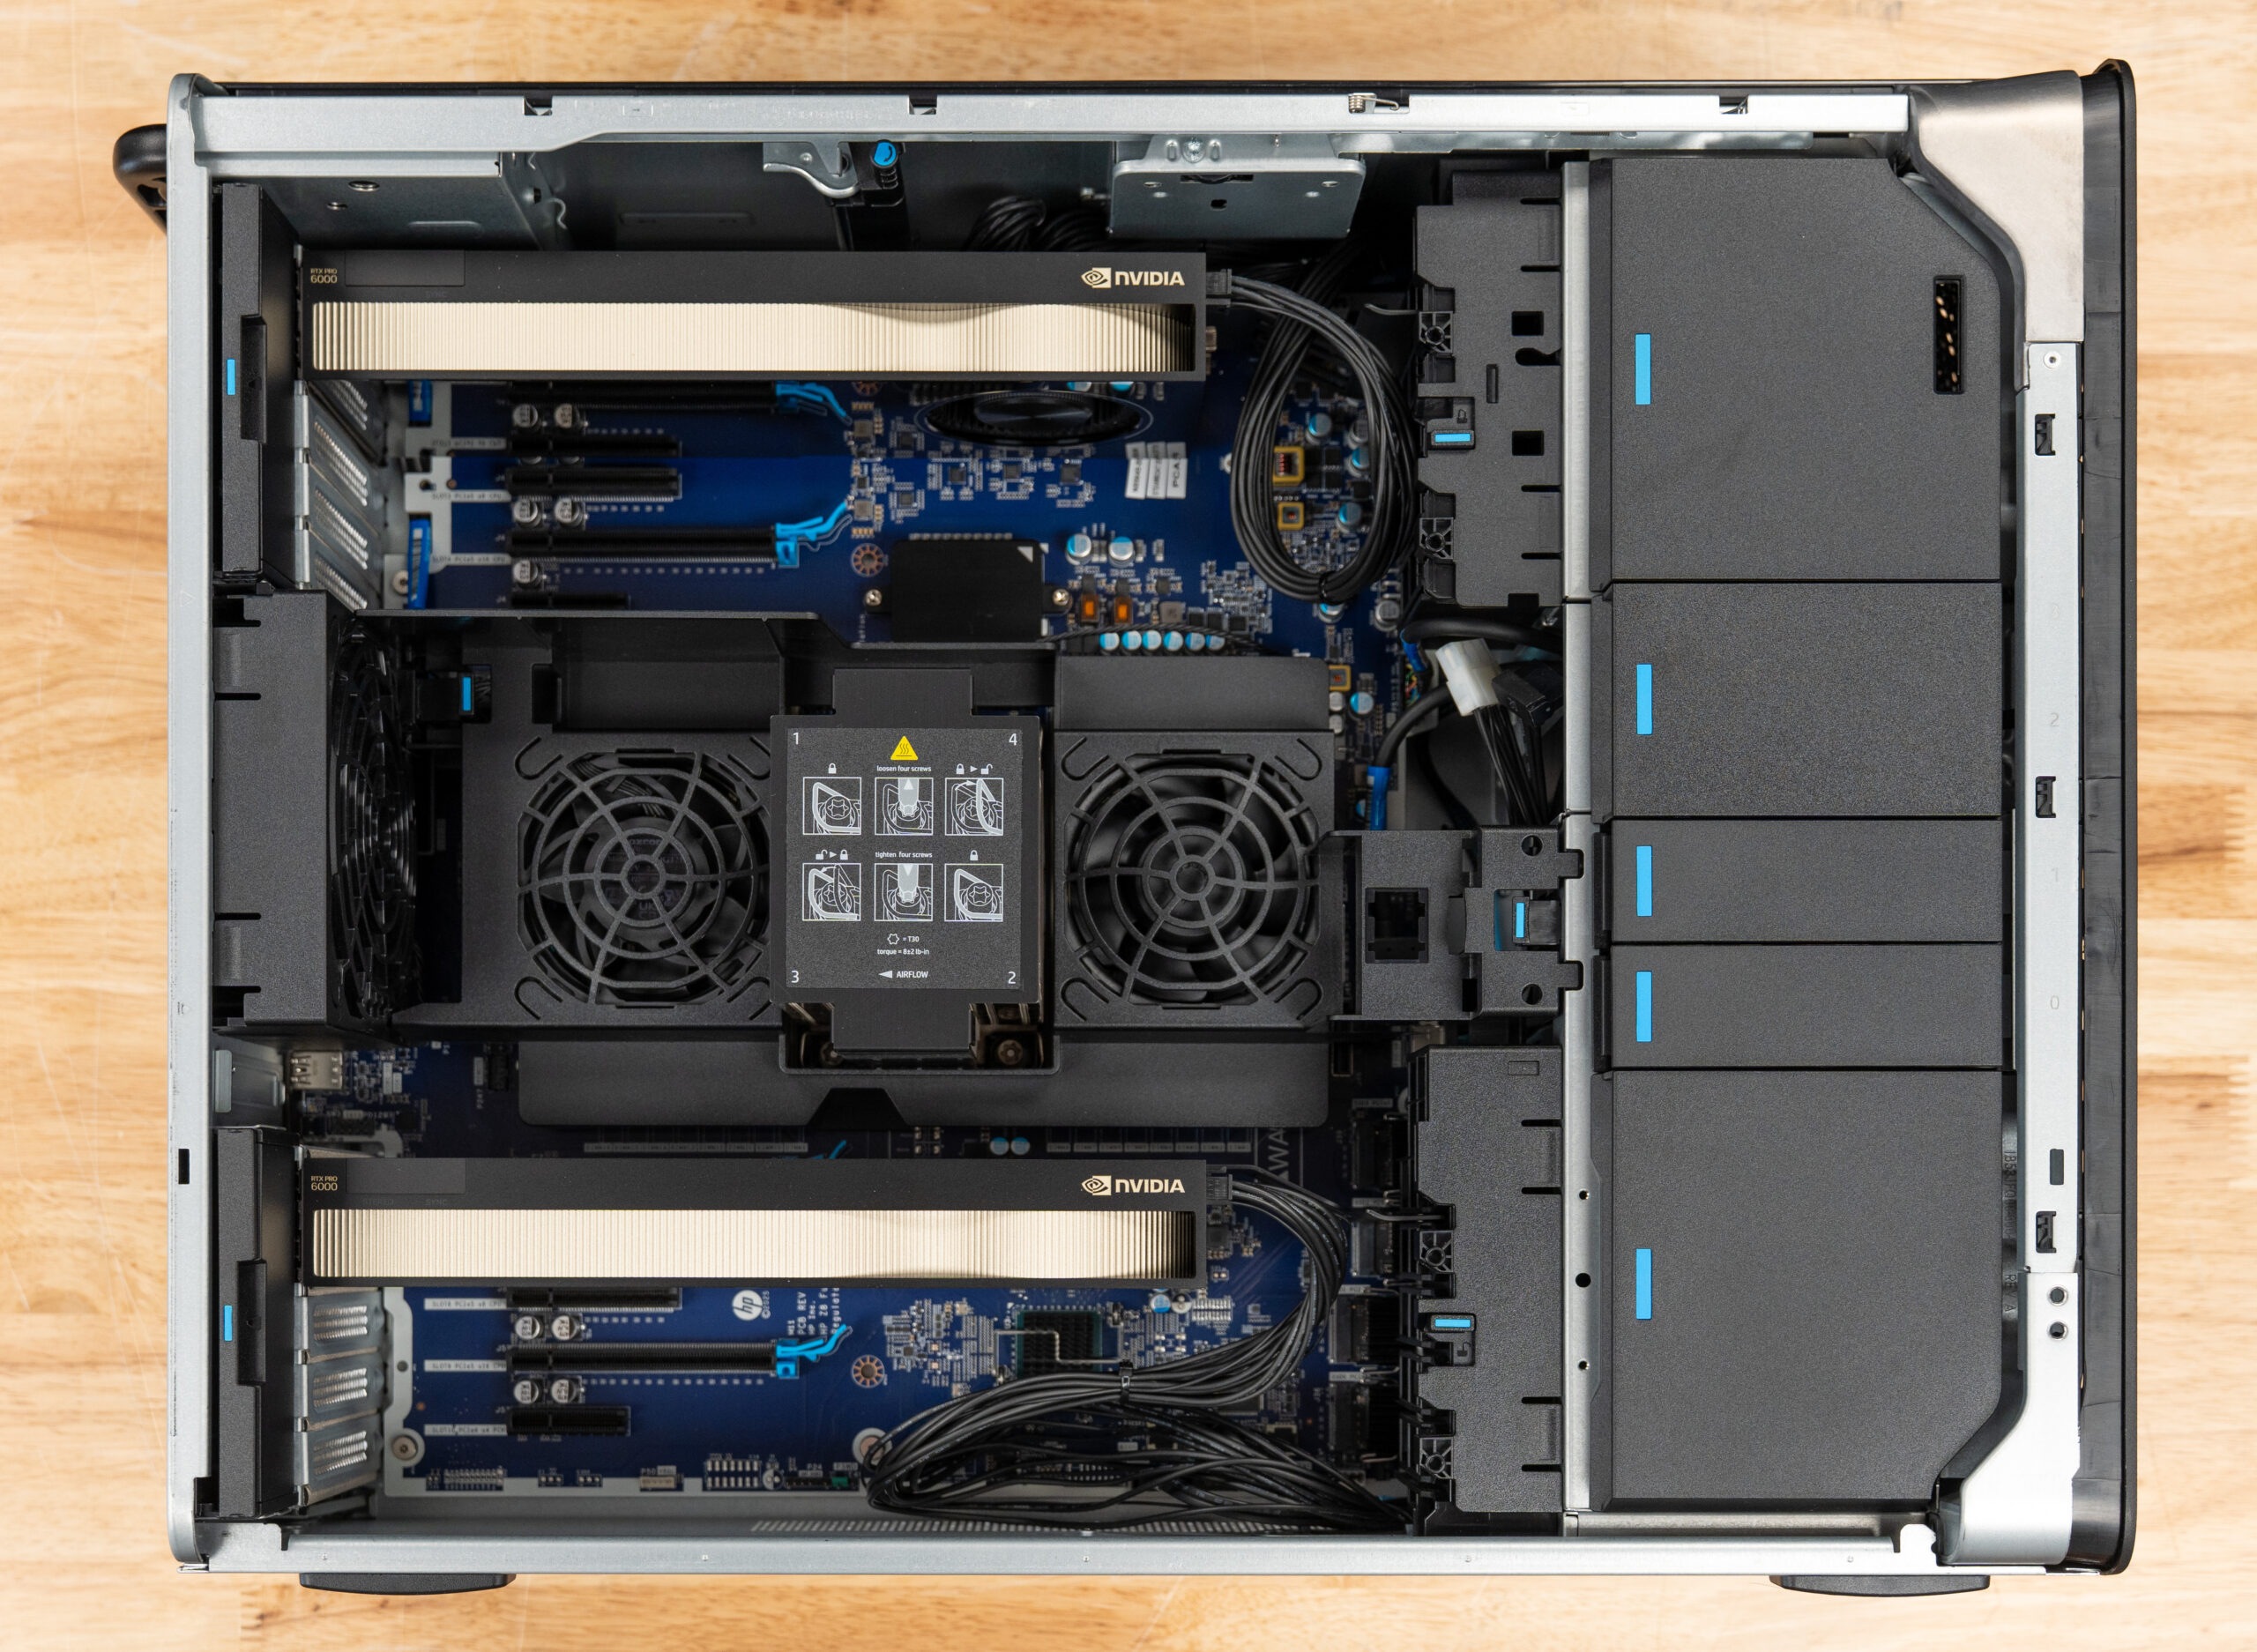
O Z8 Fury G6i é o gabinete ideal para quem planeja expandir sua coleção de GPUs. Nossa configuração de teste utilizou duas placas RTX PRO 6000 Max-Q, totalizando 192 GB de VRAM, mas o chassi, alimentado por duas fontes de alimentação que somam 2700 W, suporta até quatro placas Blackwell e 384 GB de VRAM. Essa diferença entre a configuração testada e a máxima é justamente o ponto principal: nenhum gabinete de fabricante padrão que testamos oferece mais espaço para GPUs, e a expansão de duas para quatro placas não exige a troca do chassi.
Leia a análise completa do Z8 Fury G6i.
A escolha extrema: Comino Grando RTX PRO 6000
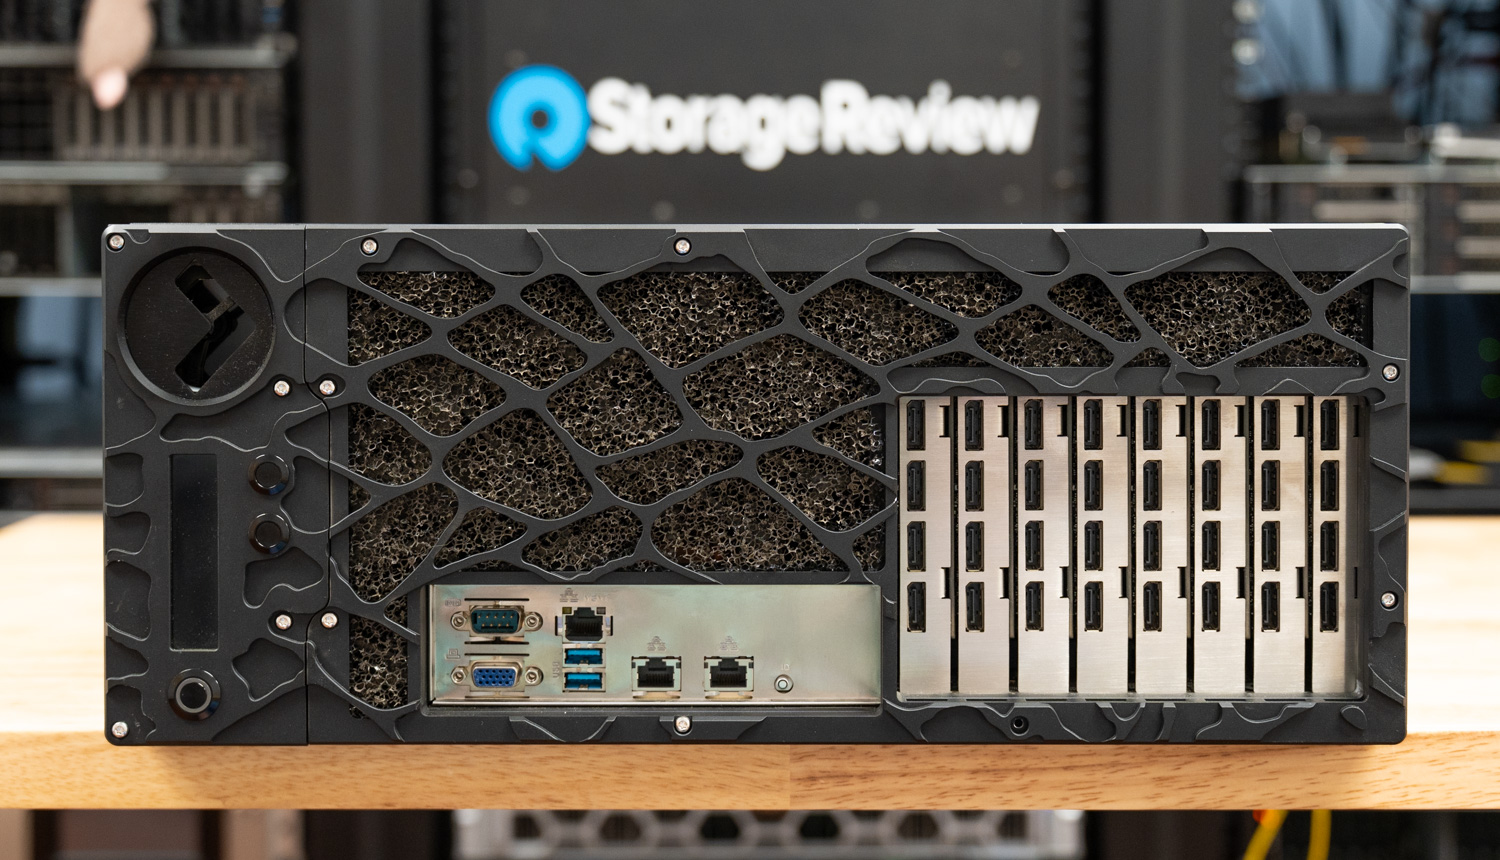
768 GB de VRAM em um chassi 4U com refrigeração líquida: o Grando existe para o comprador cujo perfil não se encaixa em nenhum outro lugar. Nossa unidade de teste veio com oito placas RTX PRO 6000 Blackwell de 96 GB cada, o máximo suportado pelo chassi, e o sistema de refrigeração líquida da Comino mantém todas as oito placas em TDP máximo o tempo todo, sem throttling. Isso representa mais memória de GPU do que muitos servidores rack, em um dispositivo que ainda pode ficar ao lado de uma mesa. Seu preço é alto, não sua acústica, e ele é propositalmente o ponto fora da curva nesta lista: uma prova de onde está o limite para servidores de mesa.
Leia a resenha completa de Comino Grando
Como classificamos
Três regras regem todos os rankings do StorageReview, e a primeira é que apenas sistemas testados em laboratório são classificados : se não os tivermos testado em benchmarks, eles podem ser mencionados, mas não podem ocupar uma categoria. Em segundo lugar, os sistemas são classificados uma única vez por critério de métrica. Os computadores acima também figuraram no nosso ranking de estações de trabalho desktop por desempenho SPECworkstation e renderização até outubro de 2026, quando essa página passou a exibir apenas sistemas com GPU única; seus resultados lá permanecem em suas análises, e aqui eles são classificados por taxa de transferência de inferência e limite de memória.
Em terceiro lugar, há um requisito básico: um sistema precisa de duas ou mais GPUs, testadas com o serviço vLLM em Linux, ou um pool de memória compartilhada com pelo menos 96 GB disponíveis para os modelos. Torres com uma única GPU, mesmo com uma placa de 96 GB, estão classificadas na nossa página de Melhores Estações de Trabalho Desktop em nosso conjunto de clientes Windows.
A classificação é derivada de uma combinação de taxa de transferência de serviço online do vLLM, tempo até o primeiro token, tempo por token de saída, eficiência computacional do MAMF, desempenho de armazenamento do GDSIO e preço de mercado. Em caso de empate dentro das faixas de pontuação, a equipe editorial decide. Os fornecedores não visualizam a classificação antes da publicação e nenhum posicionamento nesta página é pago.
Perguntas frequentes sobre IA local para desktop
Qual é o melhor ambiente de desktop para IA agente?
Cargas de trabalho com agentes, como agentes de codificação, pipelines de chamadas de ferramentas e tarefas autônomas de várias etapas, são sensíveis à taxa de transferência e à latência de uma forma que o uso em chats individuais não é, porque os agentes encadeiam muitas chamadas de modelo com grande contexto. Isso favorece o nível torre: a VRAM dedicada do Dell Precision 7875 oferece o tempo de resposta sustentado necessário para manter longas cadeias de agentes responsivas. Para experimentação com agentes com orçamento limitado, um appliance da classe GB10 executa as mesmas pilhas em velocidade mais baixa. Nosso guia completo de dimensionamento está em RAM, GPU e Armazenamento para IA com Agentes.
De quanta memória eu preciso para executar um modelo 70B localmente?
Como regra geral, um modelo de 70 bits com quantização de 4 bits precisa de aproximadamente 40 a 48 GB de memória acessível ao modelo antes do contexto; o uso interativo confortável com um contexto extenso exige mais. É por isso que dispositivos com memória unificada de 128 GB lidam bem com modelos da classe de 70 bits e por que torres com uma única GPU são classificadas em nossa página de Melhores Estações de Trabalho Desktop.
Preciso de alguma fonte de alimentação especial para operar esses sistemas?
Para servidores de pequeno porte, não: os modelos GB10 e os sistemas Strix Halo funcionam perfeitamente em uma tomada padrão de escritório. Já os servidores torre merecem uma conversa séria com o proprietário do prédio. Um HP Z8 Fury G6i totalmente configurado pode suportar duas fontes de alimentação, totalizando até 2700 W, mais do que um circuito padrão de 15 amperes e 120 V consegue fornecer. O Comino Grando especifica fontes hot-swap de 2000 W que requerem entrada de 180-264 V, reduzindo para unidades de 1000 W em uma rede de 110 V.
Antes de comprar qualquer item desta página, verifique a capacidade da sua tomada; um circuito dedicado ou uma instalação de 208/240V pode representar parte do custo total de um sistema de vídeo completo. O mesmo princípio se aplica ao calor, já que cada watt consumido acaba dissipado no ambiente.
Que tal um Mac Studio?
Ainda não, pois ainda não testamos nenhum em laboratório. A Apple começou a enviar o Mac Studio com M5 Max e M5 Ultra em 22 de setembro, com o M5 Max oferecendo até 128 GB de memória unificada a partir de US$ 2,499 e o M5 Ultra até 512 GB a partir de US$ 5,499. A configuração de 512 GB, a mais importante para modelos de grande capacidade, está prevista para o final de outubro, com preço ainda não divulgado pela Apple. Se testarmos algum, ele será classificado com base nos resultados das medições, como todos os outros sistemas desta página.


 Amazon