

Atualizado em 2 de outubro de 2026: O cartão da NetApp adiciona Novus — metadados pNFS separados dos nós de dados AFF A90, já disponíveis para encomenda — o Claims Tracker registra sua alegação de "armazenamento mais rápido do planeta" com a projeção da Omdia por trás, e a introdução do rastreador agora distingue a procedência auditada por analistas dos testes internos do fornecedor.
Todos os principais fornecedores de armazenamento afirmam vender o melhor array de armazenamento, e durante anos o indicador de melhor era a velocidade. Quase nenhum permite testes independentes. Dell, Everpure (antiga Pure Storage), VAST, Weka, IBM, NetApp e Huawei anunciam liderança em desempenho, e quase todos os números que sustentam essas afirmações vêm de testes internos dos próprios fornecedores, com a ressalva de que "o desempenho real pode variar".
Esta página existe para esclarecer isso. Dividimos as evidências de desempenho de armazenamento em três classes e rotulamos cada número nesta página de acordo: submissões de benchmarks auditadas (MLPerf Storage, IO500, SPC-1, onde os fornecedores submetem resultados de acordo com regras publicadas), alegações do fornecedor (folhas de especificações e números de lançamento sem verificação independente) e resultados de laboratório do StorageReview (sistemas que medimos nós mesmos). Quando um fornecedor não nos permite testar seu array, informamos isso; a ausência de dados verificáveis faz parte da história.
Os líderes em armazenamento de IA
Esses são os fornecedores que aparecem quando um cluster de treinamento de IA ou uma neocloud é construída. Não os classificamos porque não há consenso sobre uma métrica única. O que podemos fazer é fornecer a cada um o mesmo conjunto de informações: o que a plataforma realmente é, onde está implantada em nome de um cliente, se a NVIDIA a validou, se possui resultados de benchmark auditados e quais de suas alegações de desempenho permanecem sem comprovação. Sempre que um fornecedor divulga alguma dessas informações, atualizamos o perfil.
Os quatro primeiros são especialistas em armazenamento nativo para IA. Os demais são fornecedores consolidados de armazenamento corporativo com linhas de produtos de IA. Ambos os grupos conquistam implantações reais; porém, chegam com níveis de evidência bastante diferentes.
Dados VAST
Plataforma: Sistema Operacional VAST AI, construído sobre a arquitetura DASE (Disaggregated, Shared-Everything). Contêineres de computação sem estado atuam como uma camada de acesso a um conjunto de gabinetes NVMe sobre NVMe-oF, apresentando um único namespace para acesso a arquivos, objetos e bancos de dados. Mídia totalmente QLC com buffer de gravação em memória de classe de armazenamento.
Implantações nomeadas: CoreWeave, sob um acordo plurianual de 1.17 bilhão de dólares anunciado em novembro de 2025, que a VAST descreve como seu maior cliente. A VAST também foi adicionada à expansão xAI Colossus Frontier AI Factory e alimenta as fábricas de IA da Mistral Compute, executadas em NVIDIA GB300 NVL72.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA e validado para DGX SuperPOD.
Resultado da auditoria: Nenhum. O VAST nunca foi submetido ao MLPerf Storage.
Alegações em aberto: Uma alegação conjunta da VAST e da AMD de um tempo até o primeiro token 9 vezes mais rápido por meio do descarregamento do cache KV no Instinct, com base em testes do fornecedor. A Série F de abril de 2026, com uma avaliação de 30 bilhões de dólares, cria expectativas, mas não se trata de um número de desempenho.
Nossa cobertura do ano passado:
- A VAST e a AMD afirmam que o tempo até o primeiro token é 9 vezes mais rápido com o descarregamento do cache KV. (Jul 2026)
- Cloudera e VAST visam combater a escassez de GPUs. (Jul 2026)
- O VAST alimenta as fábricas de IA da Mistral Compute no GB300 NVL72. (Maio 2026)
- A VAST revela seu sistema operacional de IA com agentes. (Fevereiro 2026)
- O VAST Amplify tem como objetivo fazer com que os SSDs existentes pareçam 6 vezes maiores. (Jan 2026)
- VAST introduz arquitetura de inferência nativa para DPU (Jan 2026)
WEKA
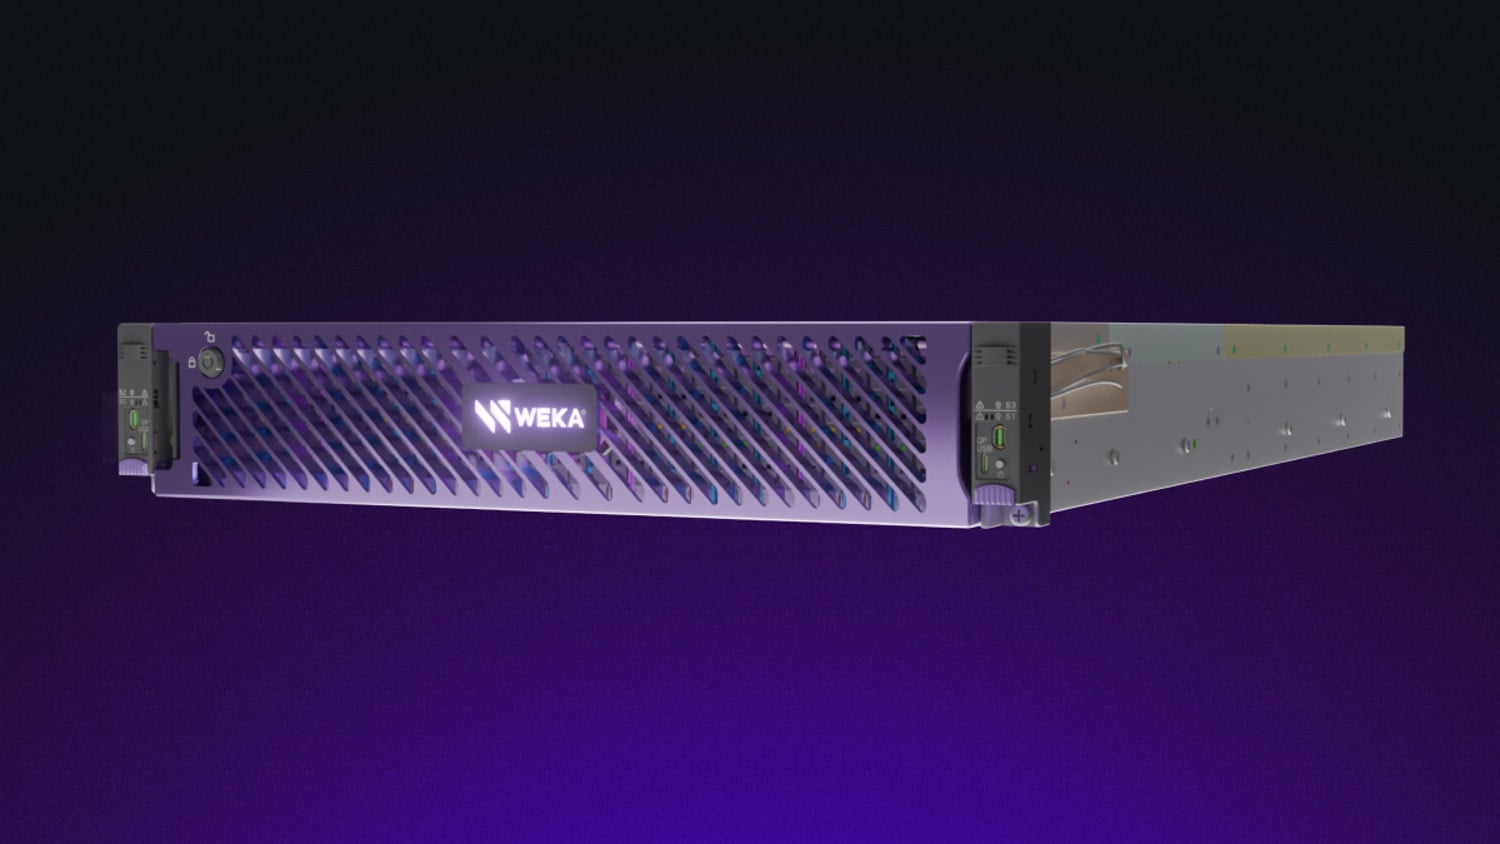
Plataforma: NeuralMesh, o sistema de arquivos paralelo definido por software anteriormente conhecido como WekaFS, vendido como software e como dispositivos WEKApod. O NeuralMesh Axon incorpora o mesmo plano de dados em servidores com GPU, permitindo que o NVMe local participe do cluster em vez de ficar ocioso.
Implantações específicas: A Nebius utiliza o NeuralMesh como o nível premium de sua nuvem de IA. A Andromeda padronizou o uso do NeuralMesh em aproximadamente 50 fornecedores de GPUs em julho de 2026. O WEKA também faz parte da arquitetura de múltiplos fornecedores da CoreWeave.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA, com validações para DGX SuperPOD e BasePOD.
Resultado da auditoria: O WEKA foi submetido ao MLPerf Storage v1.0 em setembro de 2024, mas não foi submetido à v2.0 em agosto de 2025. Seus números auditados mais recentes são de uma geração anterior.
Alegações em aberto: O WEKApod 3 com NeuralMesh 6 é declarado com 1.1 EB e 10.2 TB/s em um único rack. Dados do fornecedor, sem nenhuma submissão auditada que os respalde.
É importante saber: a HPE encerrou suas parcerias com a WEKA, a Qumulo e a Scality em novembro de 2025, portanto a WEKA não chega mais aos compradores por meio do canal da HPE.
Nossa cobertura do ano passado:
- Andromeda padroniza o uso do NeuralMesh em mais de 50 fornecedores de GPUs. (Jul 2026)
- WEKApod 3 rompe a barreira do exabyte em um único rack. (Jul 2026)
- NeuralMesh AIDP chega ao público em geral. (Mar 2026)
- O NeuralMesh integra-se com a NVIDIA STX para memória de inferência. (Mar 2026)
- WEKApod Prime e Nitro: plataformas de próxima geração (Novembro 2025)
DDN
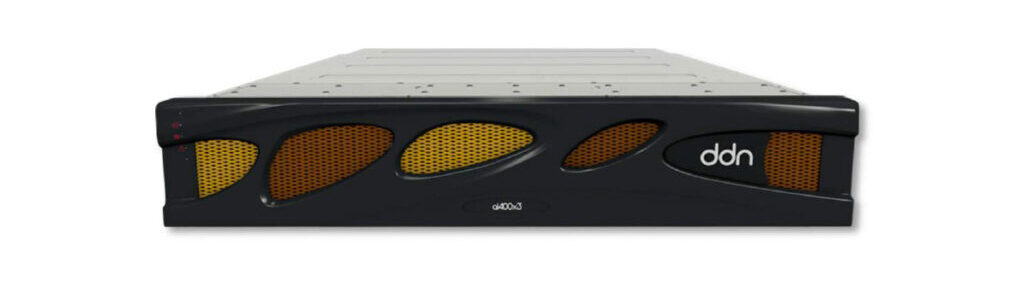
Plataforma: Duas linhas. O EXAScaler, o sistema de arquivos paralelo derivado do Lustre que está por trás dos appliances AI400X3 e AI400X3M, lida com o treinamento. O Infinia, uma plataforma de objetos chave-valor que adicionou suporte a multilocação e POSIX na versão 2.4, é voltado para cargas de trabalho de inferência e fábricas de IA.
Implantações nomeadas: xAI Colossus, anunciado em novembro de 2024 com 200,000 GPUs, em EXAScaler e Infinia. A DDN também possui uma longa lista de instalações em laboratórios nacionais e HPC que são anteriores ao ciclo da IA.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA, com validação do DGX SuperPOD.
Resultado auditado: Sim, e está atualizado. No MLPerf Storage v2.0, o AI400X3 manteve 120.68 GB/s em 3D U-Net em vários nós e lidou com checkpoints Llama3-8b a 30.6 GB/s de leitura e 15.3 GB/s de gravação em um appliance 2RU. Com base nas evidências, a DDN é a opção mais robusta desta lista.
Alegações em aberto: Aceleração de cache KV por meio do NVIDIA Dynamo, validada em conjunto com a Nebul, e não por um órgão independente.
Nossa cobertura do ano passado:
- A DDN lança o AI400X3M na ISC 2026. (Jun 2026)
- O Infinia 2.4 adiciona suporte a multi-tenancy e POSIX. (Jul 2026)
- DDN e Nebul validam a aceleração de cache KV (Jul 2026)
A DDN liderou o MLPerf Storage v2.0 em densidade de desempenho, mas não participou da rodada v3.0.
Espaço do Martelo
Plataforma: A Plataforma Global de Dados Hammerspace, e Tier 0, que transforma o NVMe local já presente nos servidores com GPU em capacidade compartilhada e com suporte a checkpoints. Ela é construída com base em padrões, utiliza NFS paralelo (NFS 4.2 com FlexFiles) e roda em servidores comuns, em vez de um appliance proprietário. Não há nenhum dispositivo Hammerspace para fotografar, o que é justamente a proposta da arquitetura.
Implantações nomeadas: A Meta documentou o Hammerspace em dois clusters H100 com 24,576 GPUs cada, em seu próprio blog de engenharia. Esse é o relato mais específico e direto de uma implantação de armazenamento de IA em larga escala de qualquer fornecedor nesta página, pois foi escrito pelo operador e não pelo fornecedor.
Validação NVIDIA: Nenhuma. A Hammerspace não possui as certificações DGX SuperPOD, DGX BasePOD, arquitetura de referência NCP ou designação de armazenamento certificado pela NVIDIA.
Resultado auditado: Sim, tanto no MLPerf Storage v1.0 quanto no v2.0. No v2.0, o Tier 0 atingiu 420.8 GB/s no 3D U-Net em cinco nós com 96.4% de utilização do acelerador, alimentando 140 H100s simulados. A Hammerspace tem o melhor histórico de participação auditada nesta lista e o histórico de validação da NVIDIA mais fraco, o inverso de quase todos os outros aqui.
Nossa cobertura: A Hammerspace ainda não passou pelos testes de laboratório da StorageReview, e nossa cobertura recente é escassa. Essa é uma lacuna da nossa parte, não uma crítica à plataforma.
Hammerspace, um participante da versão 2.0, também ficou de fora da rodada da versão 3.0.
Tecnologias Dell
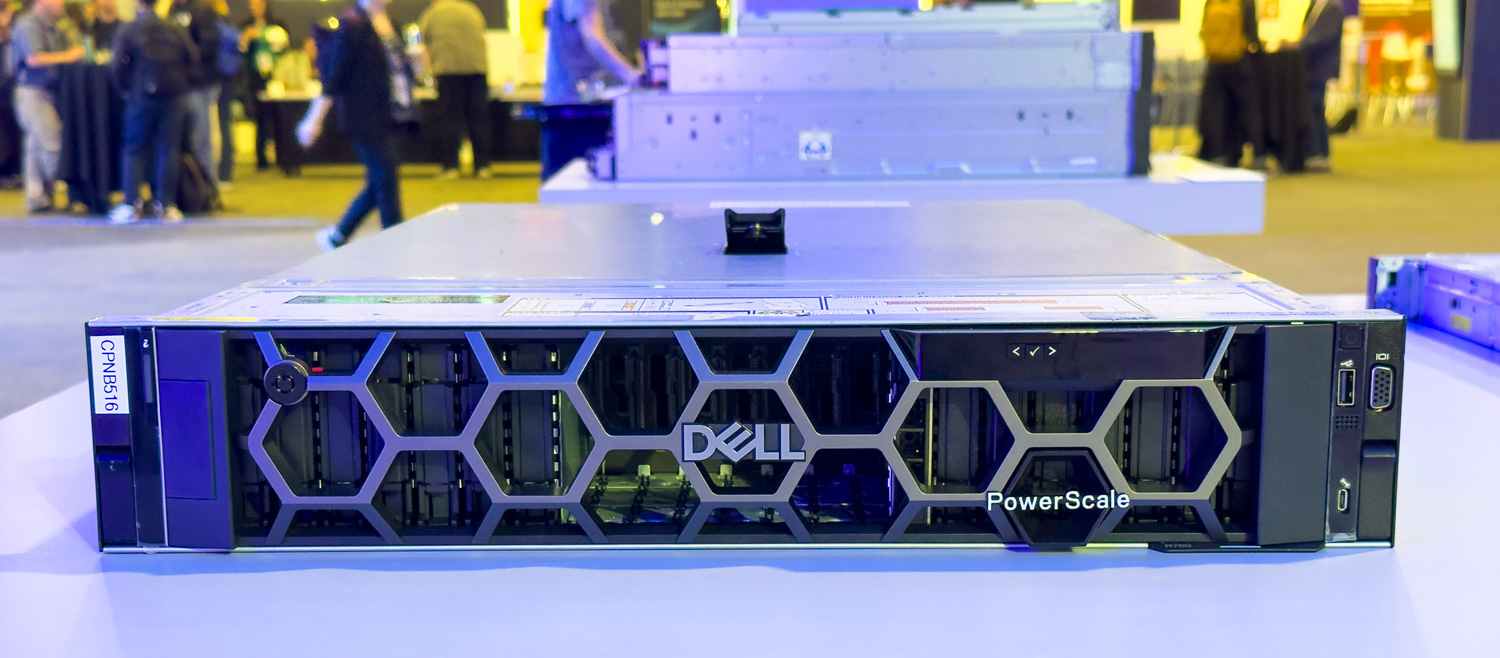
Plataforma: Três componentes, direcionados a diferentes partes do pipeline. PowerScale é a linha de NAS scale-out, com nós all-flash da série F. ObjectScale é a camada S3, que adotou S3 sobre RDMA e descarregamento de cache KV em 2026. Lightning File System é um novo sistema de arquivos paralelo que foi lançado oficialmente em abril de 2026 e é o componente que a Dell posiciona contra DDN, VAST e WEKA.
Implantações nomeadas: Não conseguimos confirmar nenhuma implantação de treinamento de IA em larga escala com nome específico em armazenamento Dell. A referência pública mais concreta é a Subaru, que opera um laboratório de IA para segurança do motorista em PowerScale. Para um fornecedor desse porte, essa é uma lacuna impressionante em comparação com os sucessos em neocloud que os fornecedores de IA nativa divulgam.
Validação NVIDIA: Parceiro de lançamento certificado pela NVIDIA para armazenamento, e o PowerScale obteve a certificação do programa NVIDIA Cloud Partner em julho de 2025.
Resultado da auditoria: Nenhum. A Dell nunca submeteu dados ao MLPerf Storage.
Alegações em aberto: A Dell afirma que o Lightning é o sistema de arquivos paralelo mais rápido do mundo, com base em análises internas, e cita o Exascale Storage com velocidades de vários TB/s por rack. Ambos estão listados no rastreador de alegações abaixo. Uma ressalva prática para compradores: o Lightning já está disponível para o público em geral, mas seu uso é limitado a instalações de fábrica com foco em IA, e a maioria dos leitores não o encontrará em uma cotação padrão.
Nossa cobertura do ano passado:
- A Dell mantém sua posição de Líderes no Quadrante Mágico do Gartner de 2026 para Armazenamento Empresarial. (Agosto 2026)
- O ObjectScale atinge 9.83 PB em 2U com SSDs Kioxia de 245 TB e S3 sobre RDMA. (Agosto 2026)
- A Dell supera as vendas combinadas das outras cinco maiores empresas do ranking da IDC no primeiro trimestre em armazenamento externo. (Jul 2026)
- Reiniciar o PowerStore Gen 3 (Maio 2026)
- Análise detalhada do PowerStoreOS 5.0, a metade de software da reinicialização de 3ª geração. (Sep 2026)
- Sistema de arquivos Lightning e armazenamento em exaescala na GTC 2026 (Mar 2026)
- Nossa análise do PowerEdge R5715, um servidor 2U focado em armazenamento que testamos na prática. (Mar 2026)
HPE
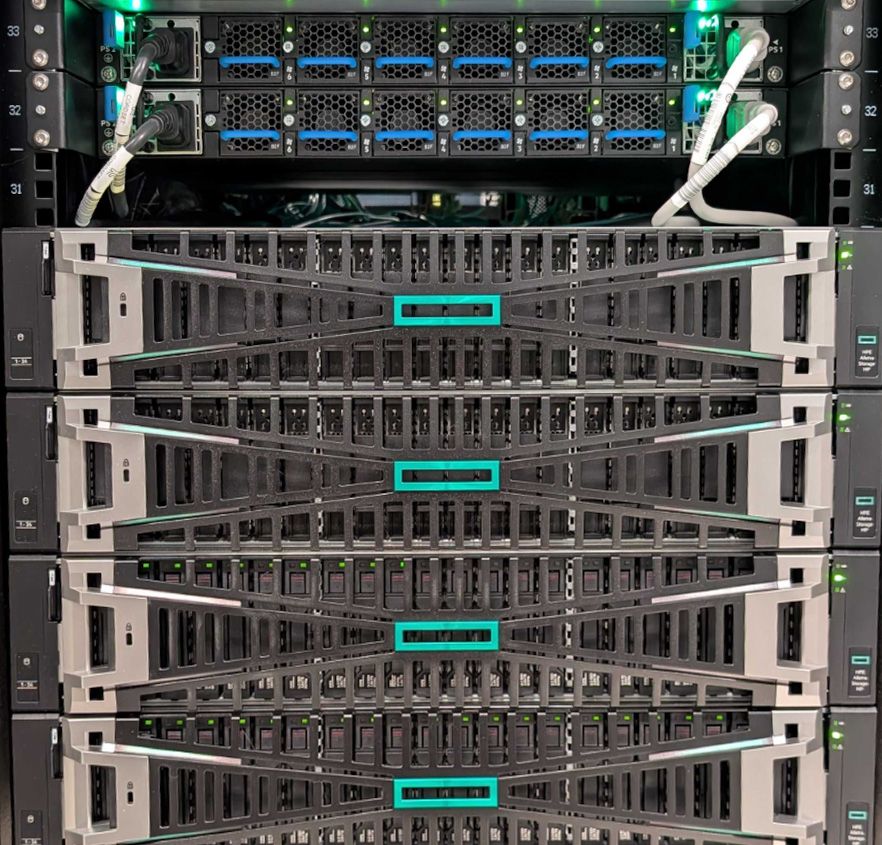
Plataforma: Alletra Storage MP, dividida em B10000 para blocos e X10000 para objetos, além do GreenLake para arquivos. A HPE também vende os recursos de computação e rede associados, que é como a maior parte de seu armazenamento para IA é comercializada.
Implantações específicas: IA soberana e fábricas de IA onde a HPE fornece toda a infraestrutura. Nenhuma implementação específica em neocloud comparável aos exemplos VAST, WEKA ou DDN mencionados anteriormente.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA, com validações para DGX BasePOD e SuperPOD.
Resultado auditado: A HPE participou de todas as edições do MLPerf Storage, da versão 1.0 à 3.0, o que a coloca à frente da Dell e da NetApp em termos de participação. No entanto, leia atentamente os resultados relacionados a arquivos: os melhores resultados da HPE em IA para arquivos foram obtidos por meio de submissões conjuntas com a WEKA, e a HPE encerrou essa parceria, juntamente com a Qumulo e a Scality, em novembro de 2025. Esses resultados não descrevem mais um produto que a HPE possa vender atualmente.
Nossa cobertura do último ano: Testamos a plataforma Alletra na prática.
- A HPE mantém sua posição de Líder no Quadrante Mágico do Gartner de 2026 para Armazenamento Empresarial. (Agosto 2026)
- Alletra Storage MP B10000 com NIST CSF 2.0: nossos testes práticos. (Jun 2026)
- Alletra Storage MP X10000 com o nó Data Protection Accelerator. (Fevereiro 2026)
- CloudCasa adiciona recuperação de desastres (DR) para Kubernetes ao B10000 (Jun 2026)
- MLPerf Storage v3.0: 345.8 GiB/s em 3D U-Net com o K3000, um dos dois únicos fornecedores nesta página a submeter resultados nesta rodada.
IBM
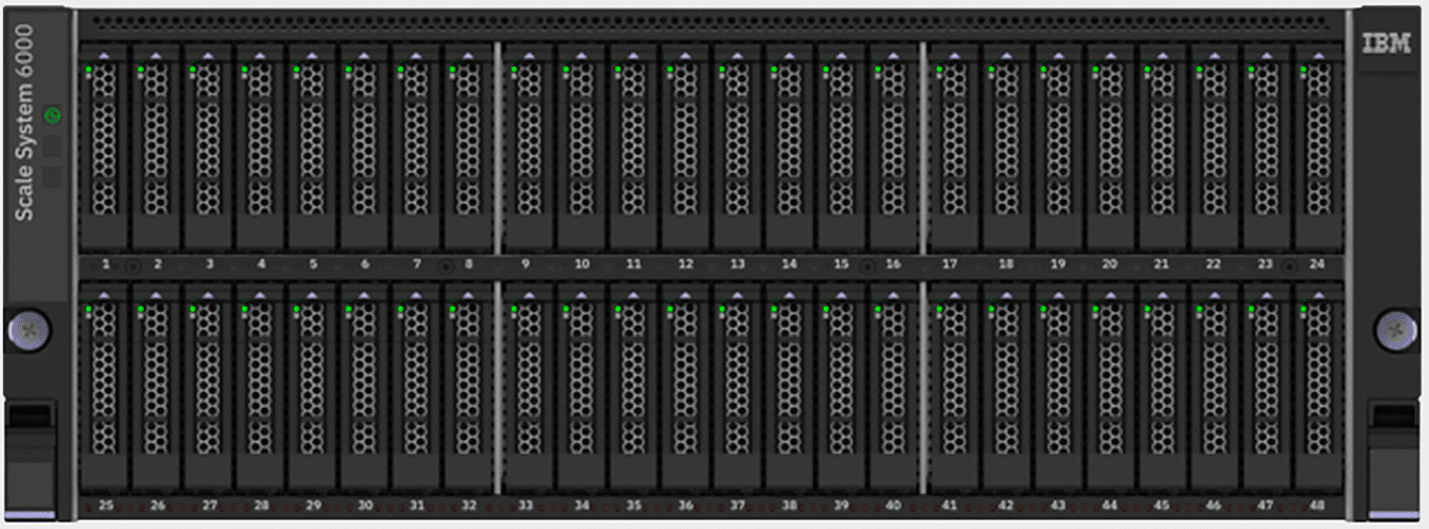
Plataforma: IBM Storage Scale, o sistema de arquivos paralelo com linhagem GPFS, vendido como software e como appliances Storage Scale System, com o Fusion integrando-o ao Kubernetes e pipelines de IA.
Implantações específicas: Parte da infraestrutura de múltiplos fornecedores da CoreWeave. A IBM Cloud também está construindo um cluster de inferência dedicado HGX B300 de 240 milhões de dólares com a Together AI, anunciado para agosto de 2026, embora a camada de armazenamento não tenha sido divulgada.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA.
Resultado auditado: Sim, no MLPerf Storage v2.0, incluindo a carga de trabalho de checkpoint, onde o Storage Scale registrou 656.7 GiB/s de leitura em um modelo Llama 3.1 de 1T. A restauração de checkpoint é a métrica que determina a porcentagem de uma execução de treinamento de ponta perdida devido a uma falha, e poucos fornecedores publicaram um número auditado para ela.
Alegações em aberto: Nada de excepcional na categoria de arrays mais rápidos. A IBM comercializa o Storage Scale com base na escalabilidade e integração, em vez de um recorde de throughput.
Nossa cobertura do ano passado:
- A IBM mantém sua posição de Líderes no Quadrante Mágico do Gartner de 2026 para Armazenamento Empresarial. (Agosto 2026)
- A IBM e a Together AI investiram US$ 240 milhões em um cluster de inferência HGX B300 dedicado. (Agosto 2026)
- A IBM apresenta o Content-Aware Storage para cargas de trabalho RAG. (Abr 2026)
- FlashSystem de última geração com IA ativa. (Fevereiro 2026)
- Sistema de escala de armazenamento 6000, armazenamento unificado para IA e HPC. (Novembro 2025)
- Nossa análise do IBM FlashSystem 5300, uma experiência prática com o array compacto da IBM e uma visão geral útil de como os sistemas maiores se comportam. (Sep 2024)
Everpure (anteriormente Pure Storage)
Plataforma: FlashBlade//EXA é a solução com inteligência artificial, separando os caminhos de metadados e dados para que o plano de dados seja dimensionado independentemente. FlashBlade//S e FlashArray cobrem o restante. A Everpure fabrica seus próprios módulos DirectFlash em vez de comprar SSDs prontos, razão pela qual seus números de densidade e resistência não acompanham os do restante do mercado. A empresa tornou-se oficialmente Everpure em 23 de fevereiro de 2026.
Implantações nomeadas: Fazem parte da pilha de múltiplos fornecedores da CoreWeave. Não foi possível confirmar uma implantação nomeada de treinamento de IA especificamente no FlashBlade//EXA.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA.
Resultado auditado: MLPerf Storage v3.0 (setembro de 2026), primeira submissão da Everpure: gravação de checkpoint de 877.5 GiB/s com leitura de 833.0 GiB/s em 30 nós de dados FlashBlade//EXA, os maiores números de checkpoint da rodada, além do maior resultado de cache KV da rodada, com 1,623.4 GiB/s. Também detém o recorde SPECstorage Solution 2020_ai_image com 6,300 trabalhos de IA, publicado em 17 de fevereiro de 2026. Benchmark diferente, modelo de carga de trabalho diferente, mas é uma submissão real sob um conjunto de regras publicado com um processo de revisão, e conta.
Alegações em aberto: O FlashBlade//EXA é comercializado como a plataforma de armazenamento de dados de maior desempenho do setor, com uma taxa de transferência projetada acima de 10 TB/s em um único namespace. Projetada, não medida.
Nossa cobertura do ano passado:
- A Everpure lidera ambos os eixos do Quadrante Mágico do Gartner de 2026 pelo segundo ano consecutivo. (Agosto 2026)
- Everpure lança Data Stream para pipelines de IA empresariais. (Jun 2026)
- Aprimoramentos em Inteligência de Dados e Nuvem de Dados Empresariais (Jun 2026)
- Emulex SecureHBA com Everpure XL130 R5: não um benchmark de IA, mas uma experiência prática com o hardware da Everpure. (Mar 2026)
- MLPerf Storage v3.0 (setembro de 2026): primeira submissão, gravação de checkpoint de 877.5 GiB/s e leitura de 833 GiB/s no FlashBlade//EXA, além de leitura de 1,623 GiB/s no cache KV, os maiores números de checkpoint e inferência da rodada. Cobertura completa da versão 3.0.
NetApp
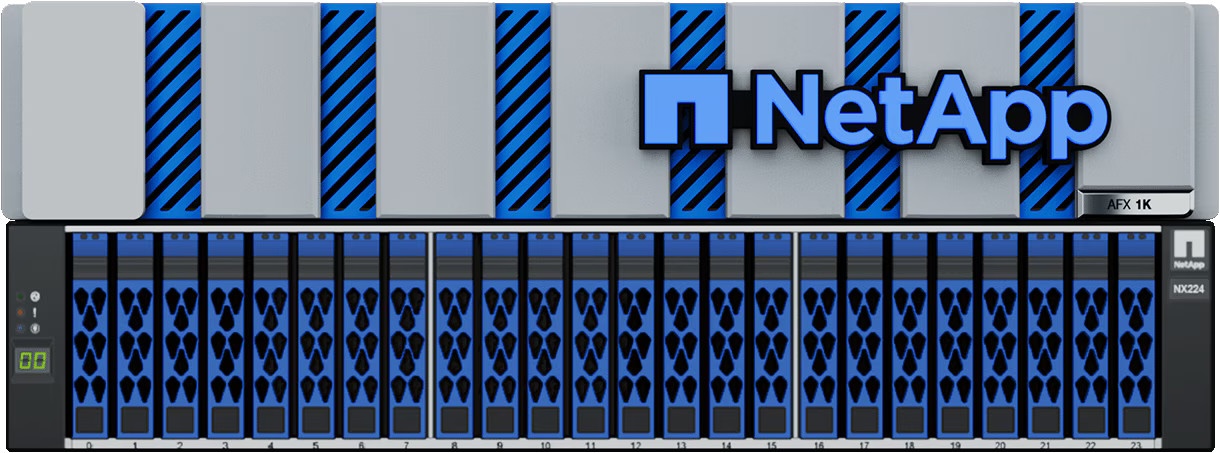
Plataforma: AFX, anunciada em outubro de 2025, é uma plataforma ONTAP all-flash desagregada, criada para pipelines de dados de IA, com o AI Data Engine integrado. O AIPod é o design de referência validado pela NVIDIA. O Novus, anunciado no INSIGHT 2026 e já disponível para encomenda, fica acima do AFX para fábricas de IA: os metadados pNFS são transferidos para nós do Data Director executados em servidores Supermicro qualificados, enquanto pares AFF A90 HA transportam os dados, e os clientes utilizam Linux pNFS padrão, sem nenhum agente proprietário nos servidores com GPU.
Implantações nomeadas: Nenhuma que possamos confirmar em escala de treinamento de IA. Os artefatos públicos mais relevantes são arquiteturas validadas, e não nomes de clientes, incluindo os projetos de IA FlexPod com a Cisco, de junho de 2026.
Validação NVIDIA: Parceiro de lançamento de armazenamento certificado pela NVIDIA, com certificação DGX SuperPOD.
Resultado auditado: Nenhum no MLPerf Storage, categoria na qual a NetApp nunca participou. Por trás do Novus, a NetApp cita um teste auditado pela Omdia que demonstra escalabilidade quase linear à medida que os clusters ONTAP se unem em um mesmo namespace; a taxa de transferência de 100 TB/s divulgada é uma modelagem da Omdia baseada nesse teste, e não um resultado medido.
Nossa cobertura do ano passado:
- Novus divide metadados pNFS de nós de dados AFF A90, visando 100 TB/s. (Oct 2026)
- A NetApp mantém sua posição de Líder no Quadrante Mágico do Gartner de 2026 para Armazenamento Empresarial. (Agosto 2026)
- A HCLTech une a Keystone à U4X para armazenamento de IA baseado em consumo. (Agosto 2026)
- A NetApp adquire a DataPelago para processamento de dados em GPUs. (Jul 2026)
- O StorageGRID 12.1 adiciona um namespace federado e até 12 TB/s. (Jun 2026)
- FlexPod validou arquiteturas de IA com a Cisco. (Jun 2026)
- O lançamento AFX (Oct 2025)
Uma nota sobre a Huawei
A Huawei apresentou o maior throughput absoluto no MLPerf Storage v2.0, 698 GiB/s em 3D U-Net, proveniente de um OceanStor A800 de 8U com dois nós, alimentando 255 H100s simulados, e está listada na tabela auditada abaixo. Optamos por não incluí-la nos perfis de líderes, pois não é uma compra viável para compradores nos EUA, Europa ou na maioria dos mercados atendidos por esta página. O número é real; a disponibilidade, não. O Quadrante Mágico do Gartner de 2026 alcança o mesmo equilíbrio na direção oposta, mantendo a Huawei em seu quadrante de Líderes, graças à força do OceanStor fora da América do Norte.
O que dizem os analistas
A classificação por analistas é uma categoria de evidência por si só: não se trata de um benchmark auditado, mas sim de uma avaliação independente da execução e da visão, que se aproxima mais da forma como esses sistemas são efetivamente adquiridos. No Quadrante Mágico do Gartner para Plataformas de Armazenamento Empresarial de 2026 , os mesmos seis fornecedores ocupam o quadrante de Líderes do ano passado: Everpure, Huawei, HPE, NetApp, Dell e IBM, com a Everpure apresentando a melhor capacidade de execução e a visão mais abrangente pelo segundo ano consecutivo. Duas observações importantes são relevantes para esta página. O Gartner avalia o mercado de armazenamento primário e acompanha o segmento de armazenamento de arquivos e objetos de alto desempenho em pesquisas separadas, que é onde se encontram os especialistas em IA nativos mencionados acima. Portanto, a ausência deles no Quadrante representa um limite de categoria, não um veredicto. E quando seis dos oito fornecedores avaliados conquistam o título de Líder, o título em si diz pouco aos compradores; o que realmente importa são as posições relativas.
O que mudaria esta lista?
Quatro coisas, em ordem de importância que lhes daríamos: Um fornecedor nos dá acesso para testar sua plataforma de acordo com nossa metodologia, seja hardware que podemos hospedar internamente ou acesso a uma implementação maior. Um fornecedor se inscreve em uma rodada auditada atual, como MLPerf Storage ou SPECstorage. Um operador, em vez de um fornecedor, documenta uma implementação da mesma forma que a Meta fez com o Hammerspace. Ou um fornecedor perde uma certificação ou parceria da qual seu posicionamento atual depende, como aconteceu com a separação entre WEKA e HPE, que mudou a forma como ambas as empresas se conectam com compradores de IA. Atualizamos os perfis conforme esses eventos ocorrem.
O que os benchmarks auditados realmente mostram
O treinamento de IA e os provedores de neocloud que o atendem são onde a corrida pelo desempenho de armazenamento realmente acontecerá em 2026, e este é o único segmento com um benchmark auditado robusto: o MLCommons MLPerf Storage. A versão publicada mais recente é a 3.0 (setembro de 2026), com 19 organizações participantes e 143 resultados. Pela primeira vez, o benchmark abrange todo o pipeline de IA: taxa de transferência de treinamento, checkpointing e dois novos testes de inferência (Banco de Dados Vetorial e Cache KV), além do suporte ao armazenamento de objetos S3, utilizado por cerca de um sexto das submissões. Como a versão 3.0 mudou seus aceleradores simulados de H100 para B200, os resultados não são comparáveis com as versões anteriores. O MLPerf Storage não elege um único vencedor; diferentes sistemas se destacam em diferentes cargas de trabalho e métricas.
| System | Resultado auditado (MLPerf Storage v3.0) | Aula |
|---|---|---|
| Everpure FlashBlade//EXA | Gravação de checkpoint de 877.5 GiB/s e leitura de 833 GiB/s em 30 nós de dados; leitura de cache KV de 1,623 GiB/s. | Líder de checkpoint e inferência |
| YanRongTech F9000X | 543.9 GiB/s em uma U-Net 3D alimentando 99 aceleradores B200 simulados. | Maior taxa de transferência de treinamento submetida |
| TuringData F9200 | 541.5 GiB/s em 3D U-Net a partir de três nós de armazenamento; Checkpoint-70B com 539.9 GiB/s de leitura e 307.1 GiB/s de gravação | Densidade de desempenho novato |
| Azure Managed Lustre | Taxa de gravação de checkpoint de 642.2 GiB/s a partir de uma implantação de nuvem gerenciada de 4,096 TiB. | Primeiro serviço de nuvem hiperescalável submetido |
| NVIDIA AIStore | 20 submissões em armazenamento de objetos S3 em OCI, AWS e GCP. | Armazenamento de objetos em um contexto de sistemas de arquivos paralelos. |
No segmento de HPC, a lista IO500 (edição ISC 2026) é liderada pelo Sugon ParaStor no SCNet, com 26,888 GiB/s de largura de banda medida em 500 nós de clientes. Os sistemas Intel DAOS (Argonne Aurora, LRZ) ocupam várias posições de destaque, e o Weka aparece por meio do Samsung SSC-24. A mudança para a versão 3.0 é tão relevante quanto os números: os líderes em throughput da versão 2.0, DDN, Huawei, Hammerspace e Lightbits, ficaram de fora desta rodada, enquanto 11 empresas participaram pela primeira vez, incluindo Azure e NVIDIA. Análise completa em nossa cobertura do MLPerf Storage v3.0.
Quem realmente alimenta as neonuvens?
Os sucessos de implantação não são benchmarks, mas são evidências reais do que os operadores compram quando o desempenho é o seu negócio. Observe que as maiores fábricas de IA são de múltiplos fornecedores; nenhuma empresa de armazenamento detém a propriedade integral desses sites.
| AI Nuvem | Armazenamento | Detalhes |
|---|---|---|
| CoreWeaveGenericName | VAST Data (com WEKA, DDN, IBM Storage Scale e Everpure na pilha) | Contrato plurianual de 1.17 bilhão de dólares, com vigência a partir de novembro de 2025, para o maior cliente da VAST. |
| xAI Colosso | DDN EXAScaler e Infinia, com VAST Data adicionado na expansão Frontier AI Factory. | A DDN anunciou em novembro de 2024 a disponibilidade de 100 mil GPUs; suporte a múltiplos fornecedores a partir do final de 2025. |
| Nébio | WEKA NeuralMesh | Nível Premium do Nebius AI Cloud, anunciado em junho de 2025. |
| Juntos IA | IBM Cloud (sistemas HGX B300) | Acordo de 240 milhões de dólares anunciado para agosto de 2026; camada de armazenamento ainda não divulgada. |
O Rastreador de Reclamações
Estas são as atuais alegações de "maior velocidade" no segmento de armazenamento de IA. Nenhuma foi verificada de forma independente na escala alegada; a maioria é citada pelos fornecedores como testes internos, e a fonte mais robusta na tabela é um teste auditado por analistas que serve de base para uma projeção inicial.
| Reclamação do fornecedor | Sessão | Status |
|---|---|---|
| Everpure FlashBlade//EXA, “a plataforma de armazenamento de dados de maior desempenho do setor” (março de 2025) | Projeção de mais de 10 TB/s de leituras em um único espaço de nomes. | Projeção do fornecedor; sem apresentação auditada. |
| Dell Lightning File System, “o sistema de arquivos paralelo mais rápido do mundo” (disponibilidade geral em abril de 2026) | Até 150 GB/s por unidade de rack, com base em análises internas da Dell. | Reivindicação do fornecedor; nenhuma submissão auditada. |
| Armazenamento Dell Exascale (GTC 2026) | Até 6 TB/s por rack | Reivindicação do fornecedor; nenhuma submissão auditada. |
| Huawei OceanStor Dorado de nova geração (setembro de 2024) | Especificações técnicas com limite de 100 milhões de IOPS e latência de 0.03 ms. | Especificações do fornecedor; um teste da Omdia encomendado pela Huawei mediu 2.58 milhões de IOPS sustentados a 70 microssegundos em uma carga de trabalho real do Oracle RAC, uma verificação útil da realidade em relação aos máximos das especificações técnicas. |
| WEKA, WEKApod 3 com NeuralMesh 6, capacidade de armazenamento de exabytes em um único rack (julho de 2026) | 1.1 EB e 10.2 TB/s em um único rack | Alegação do fornecedor: WEKA foi submetido ao MLPerf Storage pela última vez na versão 1.0 e a versão 2.0 foi ignorada. |
| VAST Data e AMD, descarregamento de cache KV no Instinct (julho de 2026) | Tempo até o primeiro token 9 vezes mais rápido | Testes conjuntos de fornecedores; a VAST nunca submeteu seus dados ao MLPerf Storage. |
| DDN e Nebul, aceleração de cache KV com NVIDIA Dynamo (julho de 2026) | Aumento de velocidade declarado pelo fornecedor em cargas de trabalho de inferência. | Validação de parceiros, não uma auditoria independente; a DDN possui resultados atuais do MLPerf Storage v2.0. |
| NetApp Novus, “o armazenamento mais rápido do planeta” (outubro de 2026) | Projeção de 100 TB/s de leituras sequenciais em um único namespace pNFS. | Escalabilidade quase linear auditada pela Omdia em um cluster menor; o valor de 100 TB/s é uma projeção da Omdia a partir desse teste, não uma medição. |
O que aconteceu com o SPC-1?
O SPC-1 era o benchmark de referência do setor para armazenamento em bloco, e agora está semi-inativo: os fornecedores americanos o abandonaram por volta de 2018, deixando um cenário dominado por fornecedores chineses. O recorde atual aceito não é o amplamente citado resultado da Huawei. O ExponTech WDS V3 detém a maior pontuação aceita, com 27.2 milhões de IOPS no SPC-1 (aceito em novembro de 2023), à frente do Inspur, com 23.0 milhões, e os famosos 21.0 milhões da Huawei, de 2020, agora em quarto lugar. Uma submissão superior da FlashNexus, de 30.0 milhões de IOPS, está em análise desde fevereiro de 2025, e não a consideramos um recorde até que o Storage Performance Council a aceite.
Como funciona esta página
Três regras. Primeiro, cada número é rotulado de acordo com sua classe de evidência: submissão auditada, alegação do fornecedor ou medição do StorageReview. Segundo, não repetimos superlativos que não podemos comprovar com dados atuais; várias alegações famosas de "mais rápido" nesta página são antigas e estão marcadas como tal. Terceiro, o caminho para o lado verificado desta página está aberto a qualquer fornecedor: envie para o MLPerf Storage ou IO500, ou nos dê acesso para testar de acordo com nossa metodologia padrão. Esta página abrange apenas armazenamento de IA e neocloud. Armazenamento corporativo convencional em bloco e arquivo, e armazenamento SMB, terão suas próprias páginas em vez de serem incluídos aqui, porque as evidências disponíveis em cada segmento são diferentes. Atualizamos os perfis dos líderes conforme as notícias são divulgadas e fazemos uma revisão completa quando uma nova rodada de auditoria é publicada.
Perguntas frequentes sobre armazenamento mais rápido
Qual é o sistema de armazenamento mais rápido do mundo?
Não existe uma única resposta verificada, e qualquer pessoa que a forneça está citando um fornecedor. Com base em dados auditados até setembro de 2026: o FlashBlade//EXA da Everpure registrou o maior número de checkpoint do MLPerf Storage v3.0, com 877.5 GiB/s de gravação; o F9000X da YanRongTech liderou o throughput de treinamento com 543.9 GiB/s; o Sugon ParaStor lidera a lista de largura de banda do IO500; e a ExponTech detém o recorde aceito de IOPS do SPC-1. Os maiores números alegados, incluindo as projeções de armazenamento Exascale por rack da Dell, permanecem sem verificação independente.
Qual é o armazenamento mais rápido para treinamento de IA?
Com base no MLPerf Storage v3.0, o único benchmark de armazenamento para IA auditado, os líderes em taxa de transferência de treinamento são YanRongTech, TuringData e UBIX, enquanto Everpure lidera em checkpointing e inferência de cache chave-valor, e o Azure lidera entre os serviços em nuvem. Considerando as implantações dos maiores operadores de IA, VAST, DDN e WEKA dominam o ranking de soluções em nuvem, embora nenhuma das três tenha sido submetida à versão 3.0. Ambos os tipos de evidência aparecem acima, devidamente identificados.
Por que existem tão poucos benchmarks independentes de arrays empresariais?
Como a maioria dos fornecedores de armazenamento corporativo proíbe contratualmente a publicação de resultados de benchmarks, e os principais fabricantes de arrays abandonaram os benchmarks públicos que utilizavam, principalmente o SPC-1, por volta de 2018, os fornecedores voltados para IA reverteram parcialmente essa tendência, já que a participação no MLPerf Storage tornou-se um requisito de vendas. Atualizamos esta página conforme novos resultados auditados são publicados.
A criptografia resistente à computação quântica deve ser levada em consideração na compra de um array?
Para setores regulamentados, sim, e os prazos estão mais próximos do que parecem. A diretriz CNSA 2.0 da NSA exige que novas instalações do Sistema Nacional de Segurança (NSS) estejam em conformidade até janeiro de 2027, com o descomissionamento de sistemas não conformes até o final de 2030. Além disso, as estruturas NIS2 e DORA da UE possuem seus próprios requisitos de criptografia. O padrão FC-SP-3, já concluído, torna isso um detalhe de aquisição, e não um projeto: os HBAs compatíveis com FC-SP-3 criptografam o tráfego SAN em trânsito, na velocidade da linha, com algoritmos pós-quânticos. Como a criptografia ocorre na camada de transporte, o array ainda recebe dados que podem ser compactados, desduplicados e verificados em busca de anomalias de ransomware, serviços que a criptografia em nível de aplicação impede. Especificar a conectividade FC-SP-3 em compras de atualização regulares, realizadas a cada três a cinco anos, garante um SAN totalmente criptografado até 2030 como consequência. A parte de hardware já está disponível nos modelos de gama média: todos os Dell PowerStore Gen 3 já vêm com placas Fibre Channel compatíveis com EDIF nos slots OCP, e a Dell planeja disponibilizar a criptografia de rede em uma atualização de software não disruptiva do PowerStoreOS 5.1, que você pode conferir em nossa análise detalhada do PowerStoreOS 5.0 . Nossa análise detalhada do FC-SP-3 aborda o padrão, os prazos e os modelos de implementação.


 Amazon