

Existem várias opções de armazenamento disponíveis no mercado hoje. A maioria dos diferenciais envolve velocidades diferentes, mais 9s em disponibilidade ou suporte GUI variável. No geral, os arrays são muito semelhantes; eles apenas oferecem preços e suporte diferentes ou recursos voltados para um determinado grupo de clientes. DataGravity entrou em cena oferecendo algo que é realmente diferente. O foco da DataGravity não está na rapidez com que os dados podem ser armazenados ou recuperados, nem em quantas unidades você pode colocar em um fator de forma 2U; pelo menos ainda não de qualquer maneira. O DataGravity é sobre ser capaz de entender seus dados e ajudar os clientes a encontrá-los facilmente, relatar sobre eles e garantir a conformidade com as políticas internas ou do setor.
Compreender a nuance de onde o DataGravity se encaixa é importante. Dentro da empresa, muitas vezes há equipes analíticas e de segurança de big data que são encarregadas de encontrar e proteger dados, mas esse não é o mercado que a DataGravity está buscando. O DataGravity é voltado para o mercado de médio porte que, na maioria dos casos, tem uma equipe de TI limitada, mas os mesmos desafios de dados das grandes empresas. Por que o DataGravity focaria um processo tão complicado em alguém que parece mal equipado para usá-lo? Porque, como afirma a fundadora da DataGravity, Paula Long, se você pode navegar na web, pode usar este produto. A automação é a chave para resolver esses problemas.
A família DataGravity Discovery Series funciona compreendendo os dados dentro dos arquivos. Ao ser capaz de investigar um documento do Word, por exemplo, para verificar números de previdência social, o array DataGravity oferece visibilidade imediata dos arquivos que uma empresa está armazenando. DataGravity então pode entender esses dados, relatar sobre eles e garantir que informações confidenciais não sejam compartilhadas com partes inapropriadas. Além de compreender os dados armazenados no array, todos os acessos a arquivos e atividades do usuário são auditados, ajudando as empresas a cumprir seus requisitos de conformidade e segurança. Esta é uma distinção importante para entender o que é DataGravity e o que não é. O DataGravity está muito focado neste caso de uso de dados não estruturados, que é um playground comum para NASs e similares. Embora suportem iSCSI, NFS e SMB, o principal caso de uso do DataGravity não é o caso de uso de aplicativos de negócios convencionais, como e-mail, banco de dados transacional e outros. A plataforma pode chegar lá eventualmente, e provavelmente irá, mas hoje seu alvo está extremamente bem definido.
Dados como números de previdência social, IDs de pacientes, números de telefone, números de cartão de crédito e outros são fáceis de definir e entender. Na verdade, o DataGravity suporta muitas tags de conformidade comuns prontas para uso. No entanto, não se limita a eles. Para organizações que têm necessidades únicas, como muitas empresas, o DataGravity oferece um editor que permite que as organizações estabeleçam suas próprias tags. Isso garante que os usuários da plataforma possam responder rapidamente aos requisitos de segurança, conformidade e eDiscovery específicos de seu setor. A visibilidade dos dados armazenados também oferece maior valor comercial ao tornar tudo pesquisável, com base nas regras de acesso, é claro.
DataGravity oferece arrays em várias configurações que utilizam HDDs nearline para capacidade e flash como um cache de leitura. As unidades são controladoras duplas, com cada controlador "ativo" e fazendo um trabalho específico no qual nos aprofundaremos mais abaixo. O DG1100 vem com capacidade de disco bruto de 18 TB e o DG1200 vem com 36 TB brutos. O DG2200 oferece 48 TB e o DG2400 traz 96 TB para a mesa. Atualmente, eles não são expansíveis, no entanto, a DataGravity vê claramente a necessidade de resolver isso; provavelmente com prateleiras de expansão e/ou uma interface de gerenciamento que associa vários sistemas em uma única visualização de gerenciamento. Nosso teste para esta revisão é totalmente centrado na usabilidade; passamos dois dias com a DataGravity em seu escritório em Nashua, NH, e concluímos o trabalho de acompanhamento remotamente. Isso nos deu algum tempo prático com uma unidade DG1100.
Plataforma
O DataGravity possui controladores ativos-ativos duplos com uma torção. Normalmente, um controlador duplo ativo-ativo significa que ambos os controladores estão ativos com processamento de E/S. No entanto, com o DataGravity, a arquitetura imita ativo-passivo, com o nó primário servindo dados e o nó de inteligência manipulando a análise de dados. A DataGravity chama isso de "ativo-proativo". A configuração básica é a seguinte: vários GBs de DRAM, NVRAM com bateria, SSDs para metadados e cache e, em seguida, HDDs nearline.
Com uma quantidade não tão insignificante de dados fluindo por DRAM e NVRAM com bateria, os espelhos DataGravity gravam entre o nó primário e o nó de inteligência como uma primeira ordem de negócios. Isso é feito por meio de uma ponte PCIe interna, oferecendo alta largura de banda e comunicação de baixa latência. Esse link rápido é aproveitado na arquitetura DataGravity para sua proteção contínua de dados e análise de dados. Os dados em andamento são espelhados até que o nó primário possa confirmá-los no disco. Colocando os dois controladores para funcionar, a série Discovery aproveita um nó de armazenamento primário para E/S de produção e coloca o nó secundário normalmente ocioso para funcionar como um nó de inteligência. O nó de inteligência aproveita os metadados e as gravações de granularidade espelhadas para este controlador para proteção contínua e processamento analítico com reconhecimento de dados.
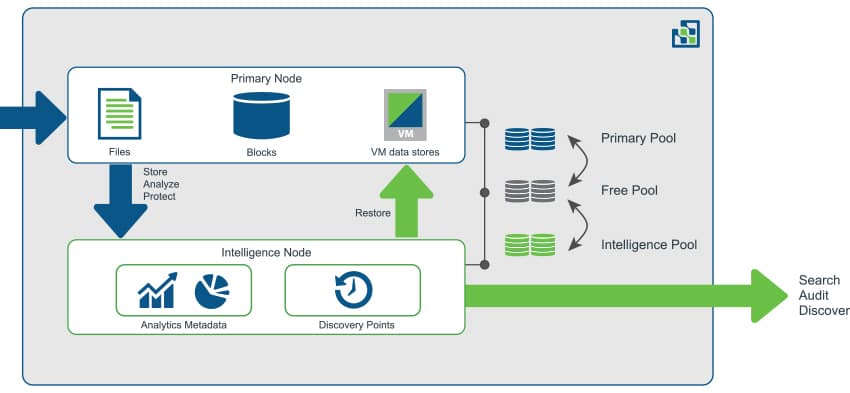
Embora ativo-ativo (ou ativo-proativo, neste caso) tenha a vantagem de usar o que foi pago (versus ativo-passivo, em que o segundo nó fica inativo até que o primário falhe), uma pergunta que sempre tende a surgir: o que acontece com o desempenho se um nó falhar? Se o DataGravity precisa de dois nós para fazer sua mágica e um é perdido, onde isso deixa os clientes? No caso de falha de um nó, o nó restante assume o básico para produção. Os usuários ainda poderão acessar e usar arquivos como fariam em suas operações diárias normais. No entanto, a maior parte das análises é suspensa até que o nó com falha seja restaurado. Em outras palavras, a disponibilidade permanece, mas os recursos centrados em metadados são reduzidos até a restauração do nó.
Usabilidade
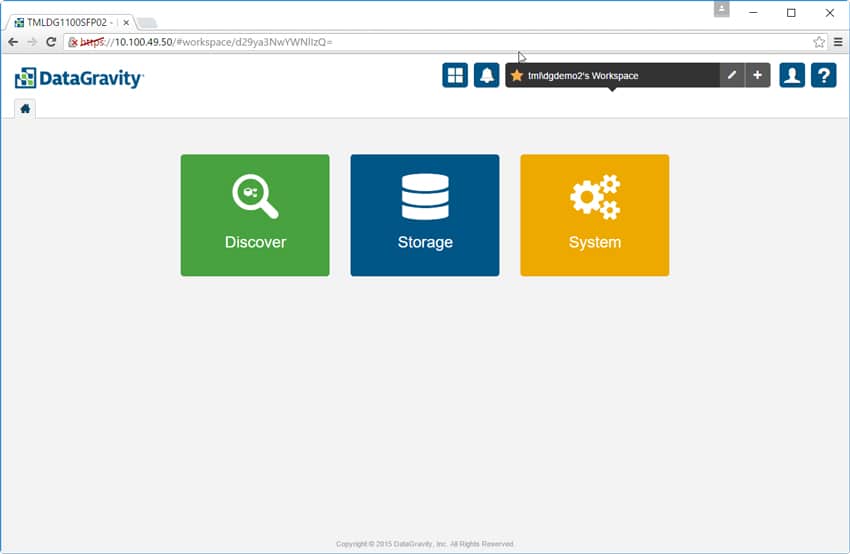
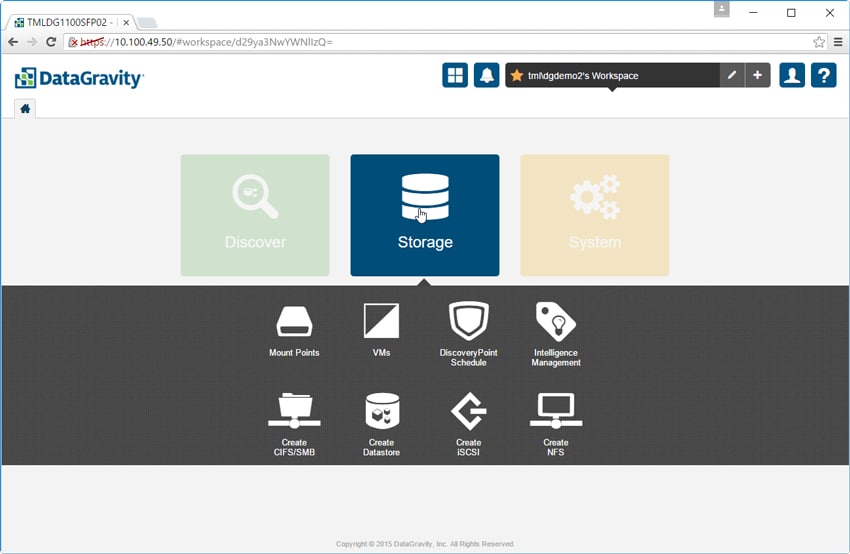
A GUI DataGravity é baseada em HTML 5 e apresenta um layout muito simples e utilizável. A guia inicial tem apenas três opções para escolher: Descobrir, Armazenamento ou Sistema. No canto superior direito, vemos o Painel de acesso global, que contém ícones para o painel do sistema e alertas, área de trabalho, perfil e ajuda online.
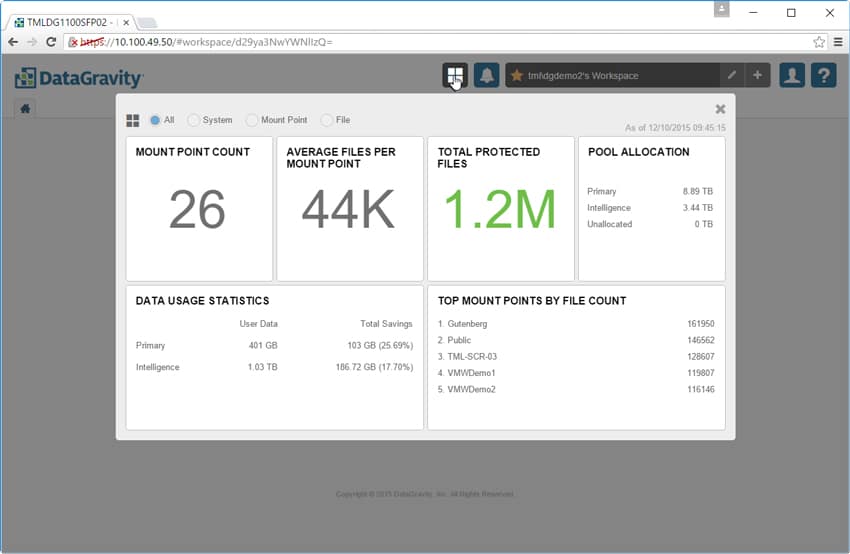
O painel do sistema oferece aos usuários uma visão rápida das estatísticas, como número de pontos de montagem, total de arquivos protegidos, alocação de pool e estatísticas de uso de dados.
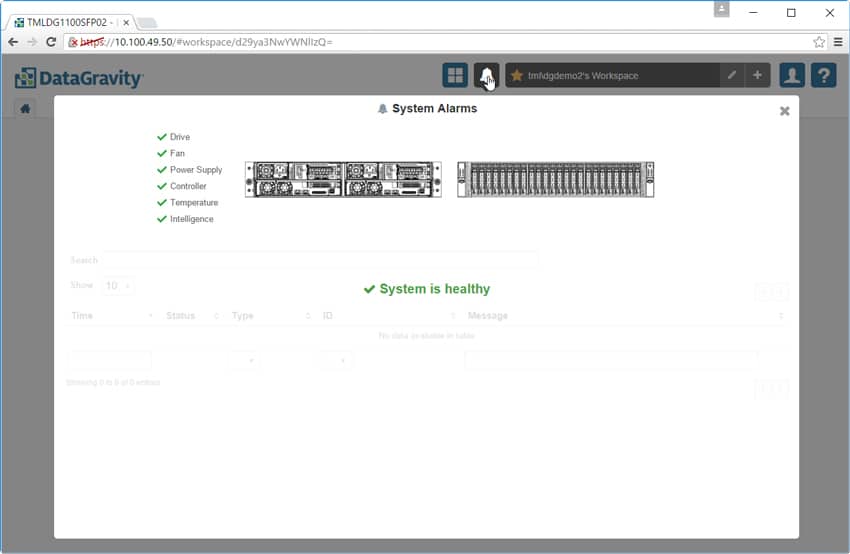
A guia de alarmes do sistema é o que parece, fornecendo aos usuários uma lista de alarmes e onde eles ocorreram no sistema.
À direita da guia de alarme está a guia Espaço de trabalho. Aqui os usuários podem renomear ou adicionar áreas de trabalho. Os espaços de trabalho permitem que os usuários configurem e gerenciem sua visão privada do sistema. Os usuários podem configurar vários espaços de trabalho, dependendo de suas necessidades.

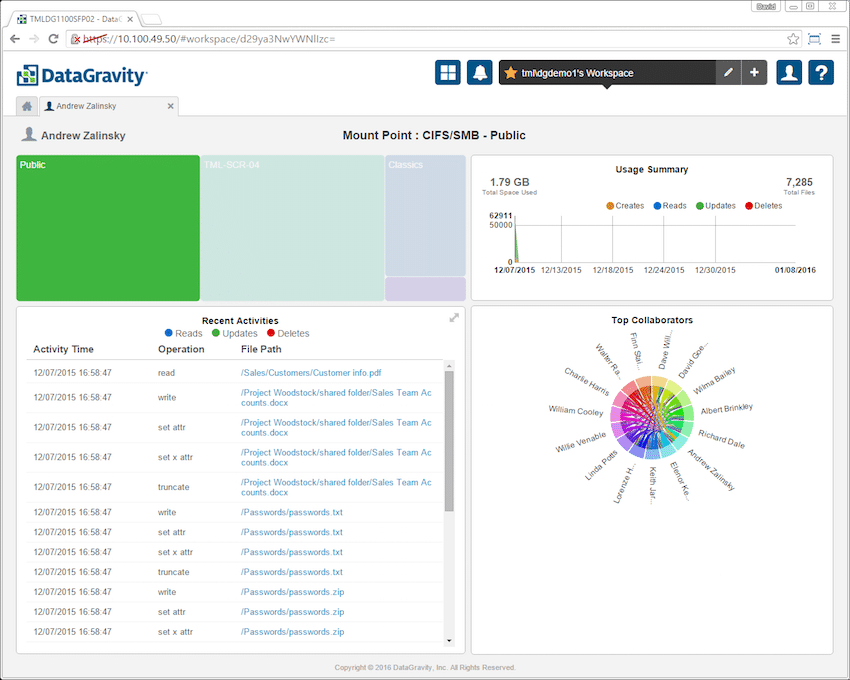
O próximo ícone é o ícone de Perfis. Ao clicar no ícone Perfis, um usuário autorizado pode gerenciar seu perfil; assinaturas de e-mail para pesquisas salvas e podem sair do sistema. Após o login, a GUI fornece vários blocos que exibem informações como resumo de uso ao longo do tempo e atividade recente (cada um dividido por leituras, atualizações, exclusões e, no caso de criação de uso. Há também um diagrama de acordes que mostra quem cada usuário está colaborando com e em que capacidade.
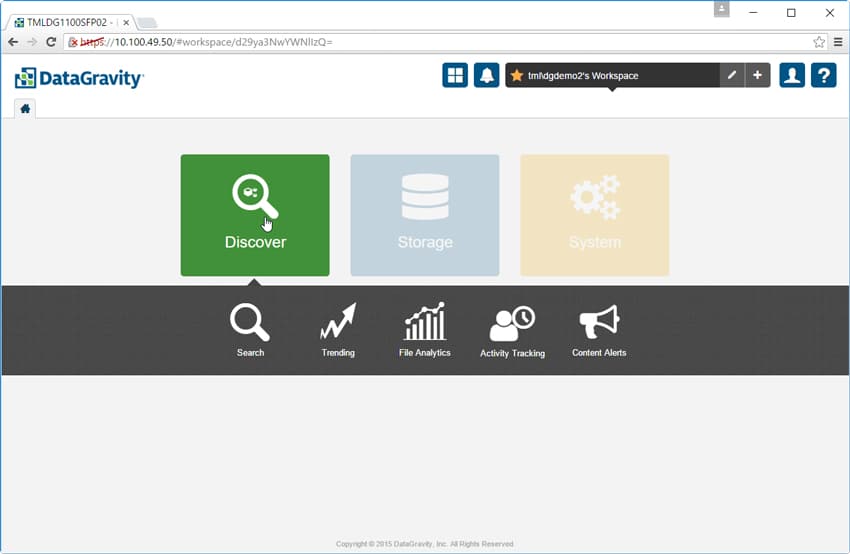
Voltando à guia inicial, o ícone mais à esquerda é o pão com manteiga do DataGravity, a guia Descobrir. Clicar na guia oferece aos usuários opções como pesquisa, tendências, análise de arquivos, rastreamento de atividades e alertas de conteúdo.
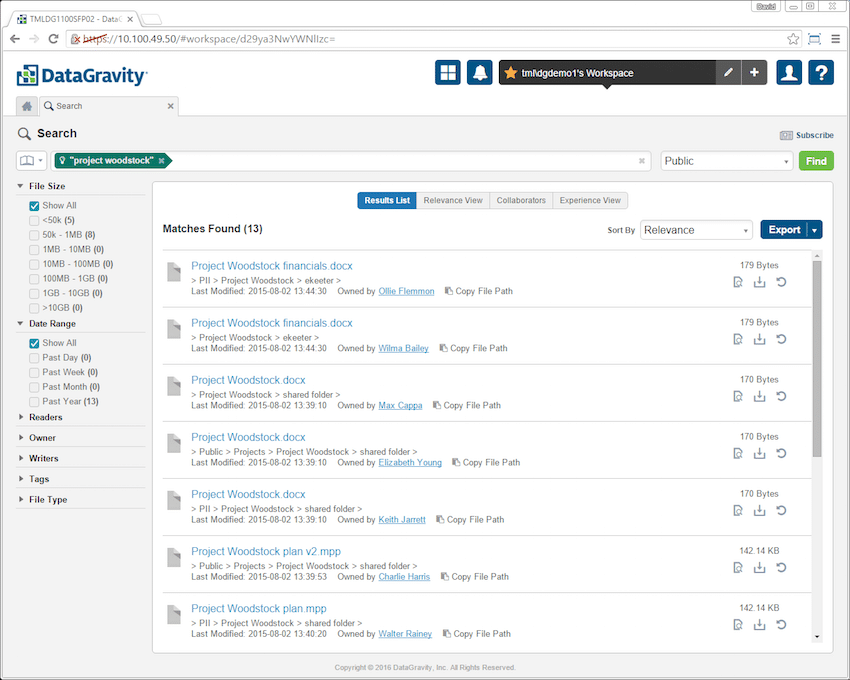
A pesquisa é o que parece. Uma barra de pesquisa aparece e os usuários só precisam digitar a palavra-chave ou o nome do arquivo que estão procurando. Antes de pesquisar, os usuários precisam selecionar o ponto de montagem em que desejam pesquisar. Na imagem abaixo, a pesquisa é por "projeto woodstock". Isso retornou todos os arquivos no ponto de montagem Público que continham esses termos. Os filtros à esquerda permitem restringir ainda mais os resultados.
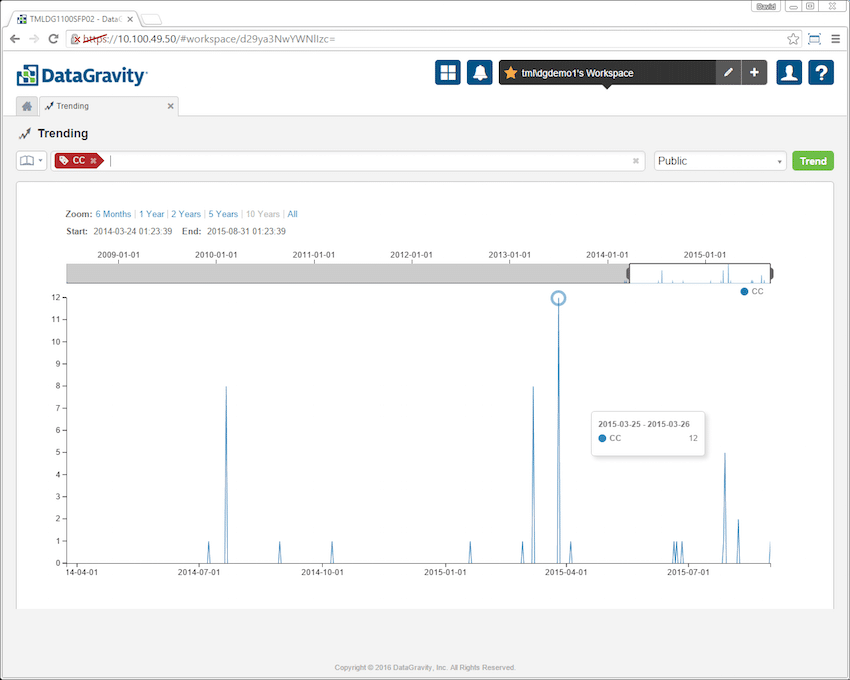
A tendência é semelhante à pesquisa, só que aqui os usuários colocam a palavra-chave ou tag que estão procurando e a solução fornecerá uma representação gráfica dos dados. Isso permite que as empresas vejam como os dados estão sendo acessados em arquivos ativos e excluídos ao longo do tempo. Na captura de tela abaixo, a etiqueta do cartão de crédito (CC) foi inserida em tendência. Os resultados mostram a tendência dos números de cartão de crédito ao longo do tempo no ponto de montagem público.
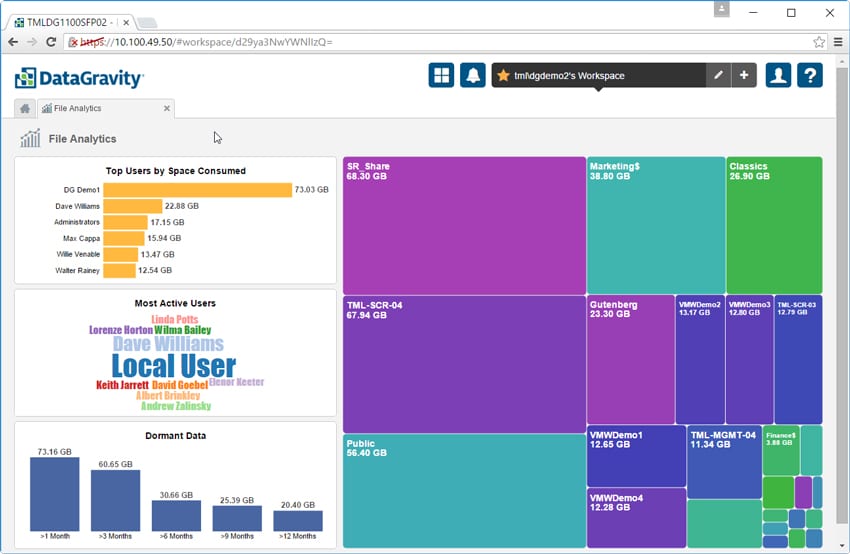
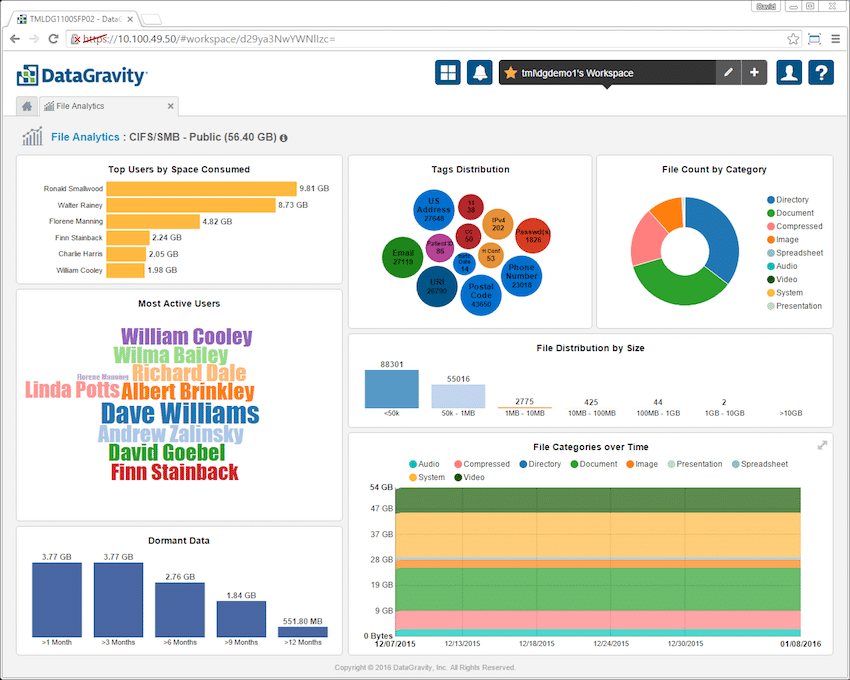
File Analytics é outro lugar onde DataGravity se separa do resto dos fornecedores de armazenamento. Por meio desse painel, os usuários podem ver facilmente os compartilhamentos de arquivos e as máquinas virtuais representadas por blocos coloridos no lado direito. Quanto maior for a quota, tanto quanto a capacidade consumida, maior será o bloco colorido. Os usuários também podem ver os 10 principais usuários por espaço consumido em um gráfico de barras, os usuários mais ativos (quanto mais ativo o usuário, maior seu nome aparece) e os dados inativos e há quanto tempo os dados estão inativos agrupados por 1, 3, 6 , categorias de 9 e 12 meses.
Clicar em um compartilhamento de arquivo individual ou VM detalha ainda mais essas informações. À esquerda estão as informações sobre os usuários mais ativos (conforme medido pelas operações de leitura/gravação/exclusão) e os principais usuários por espaço dentro do compartilhamento ou VM. Há também uma listagem de dados inativos. À direita estão quatro blocos adicionais: distribuição de tags, contagem de arquivos por categoria, distribuição de arquivos por tamanho e categorias de arquivos ao longo do tempo. Clicar em cada bloco fornece mais detalhes.
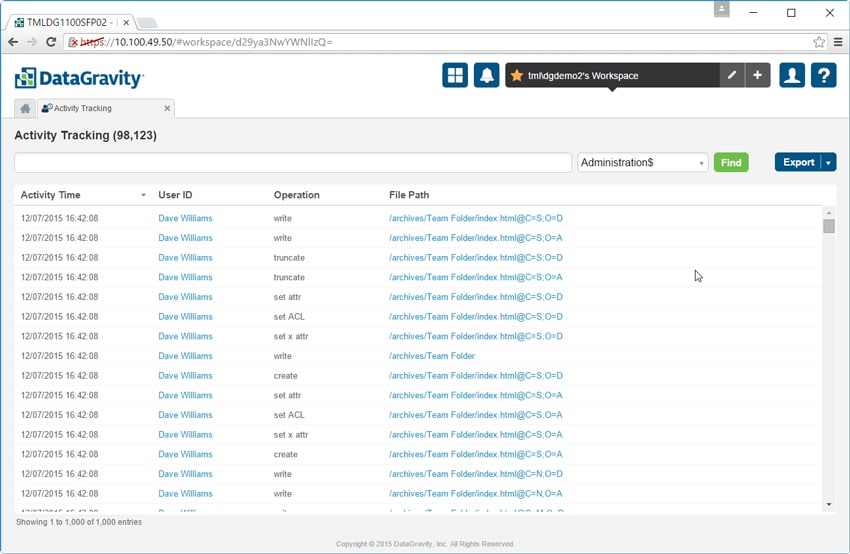
A próxima guia na seção de descoberta é o Rastreamento de atividades. Como o nome indica, administradores e usuários de segurança podem ver rapidamente qual usuário executou qual atividade durante um período de tempo específico. Os administradores só precisam escolher qual ponto de montagem pesquisar e o usuário e o intervalo de datas.
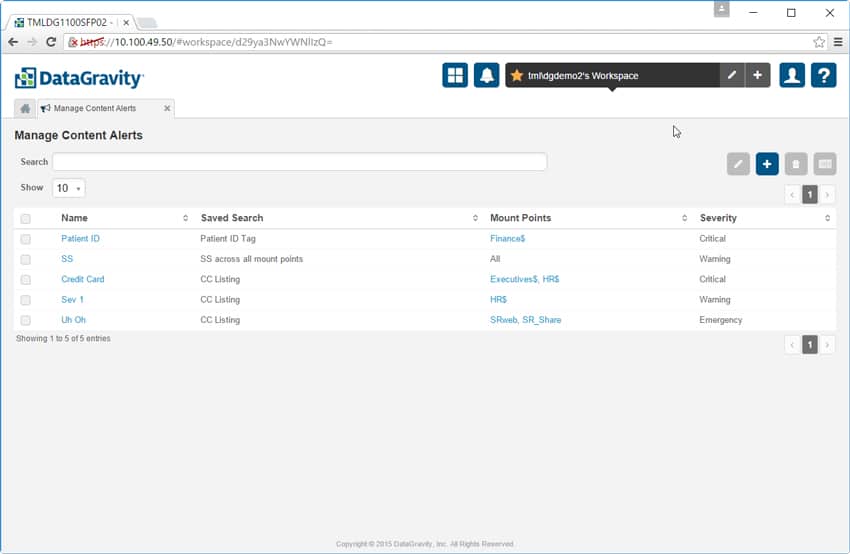
A guia final na seção Descobrir permite que os administradores gerenciem alertas de conteúdo. No exemplo abaixo, o administrador configurou alertas para ser notificado quando números de segurança social ou de cartões de crédito forem encontrados em texto aberto, formatos não criptografados e em locais aos quais não pertencem. Isso dá às empresas a capacidade de localizar e mover rapidamente dados críticos que foram colocados em locais inseguros.
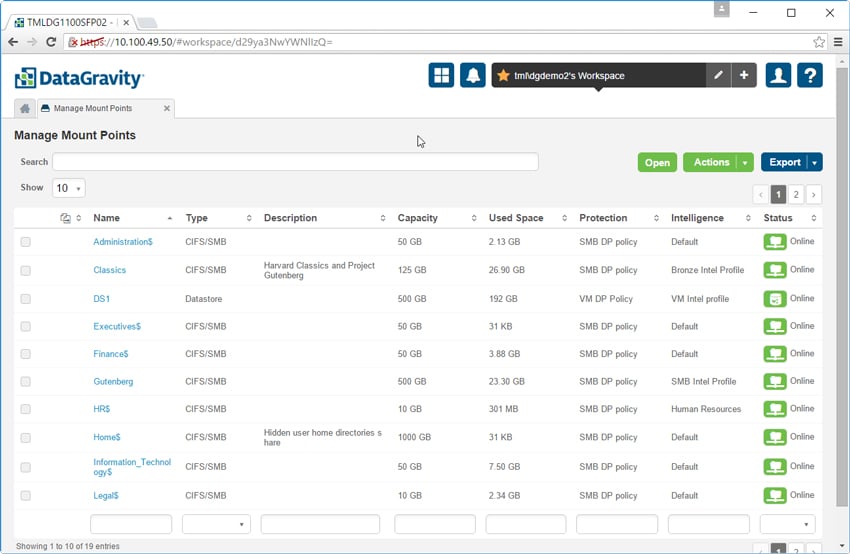
A próxima guia principal é a guia Armazenamento. Existem 8 subguias aqui: Mount Points, VMs, DiscoveryPoint Schedule, Intelligence Management, Create CIFS/SMB, Create Datastore, Create iSCSI e Create NFS.
A guia Gerenciar pontos de montagem permite que os usuários vejam as configurações de cada ponto de montagem, bem como criem novos. Aqui os usuários podem ver a capacidade de cada ponto de montagem (assim como a quantidade usada), uma breve descrição de cada um, sua política de proteção e seu status. Cada novo ponto de montagem criado aqui pode ter essas configurações ajustadas conforme necessário.
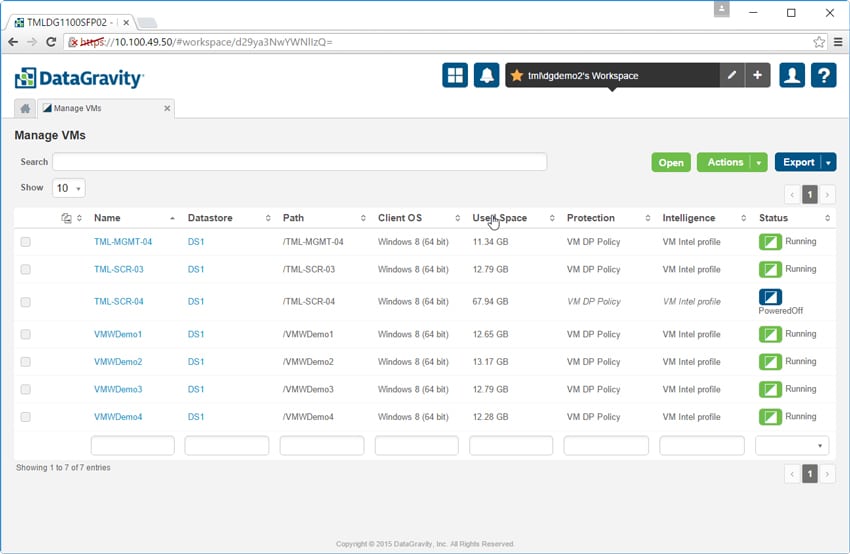
A guia Gerenciar VMs é semelhante à anterior. Aqui é possível visualizar e configurar informações sobre as VMs. O nome da VM é listado, bem como sua localização, sistema operacional, capacidade usada, política de proteção, perfil de inteligência e se a VM está em execução ou desligada. Clicar em uma VM fornece detalhes adicionais.
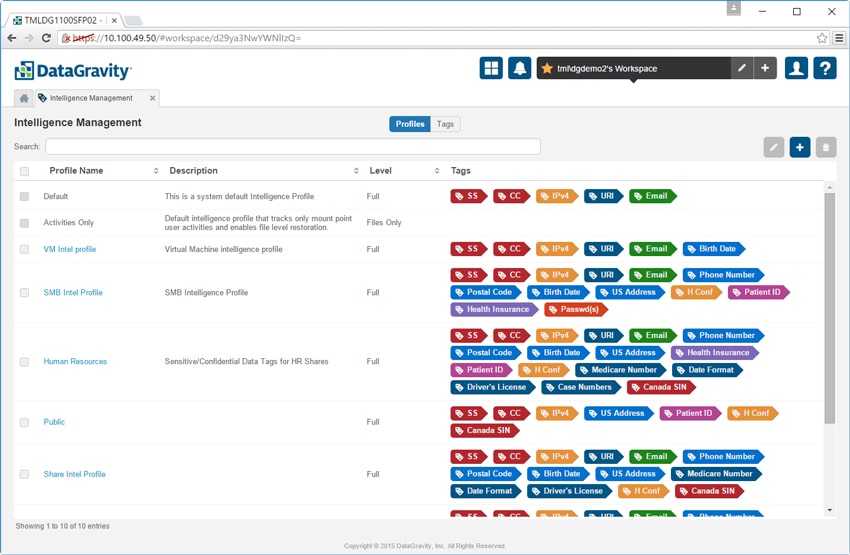
A guia Intelligence Management permite que os administradores configurem perfis de inteligência para casos de uso específicos e os apliquem a pontos de montagem e VMs. O botão Tags permite que os administradores definam padrões ou frases de conteúdo que contenham dados confidenciais usando um editor de expressão regular integrado.
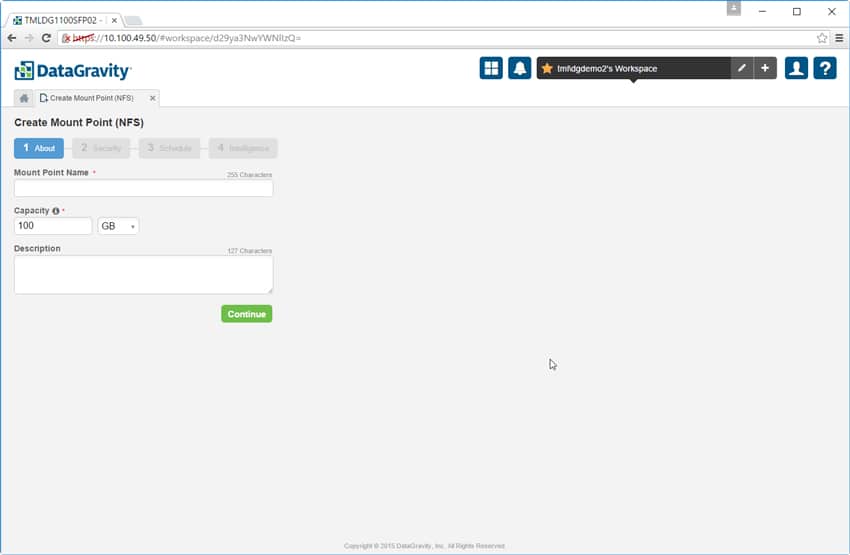
As próximas quatro guias lidam com a criação de um ponto de montagem e seu protocolo de acesso, seja CIFS/SMB, VM-aware NFS DataStore, iSCSI ou NFS (imagem abaixo). Os administradores adicionam um nome para o ponto de montagem, adicionam uma descrição se quiserem, selecionam a capacidade, definem a política de segurança, definem a programação do DiscoveryPoint e escolhem o perfil de inteligência.
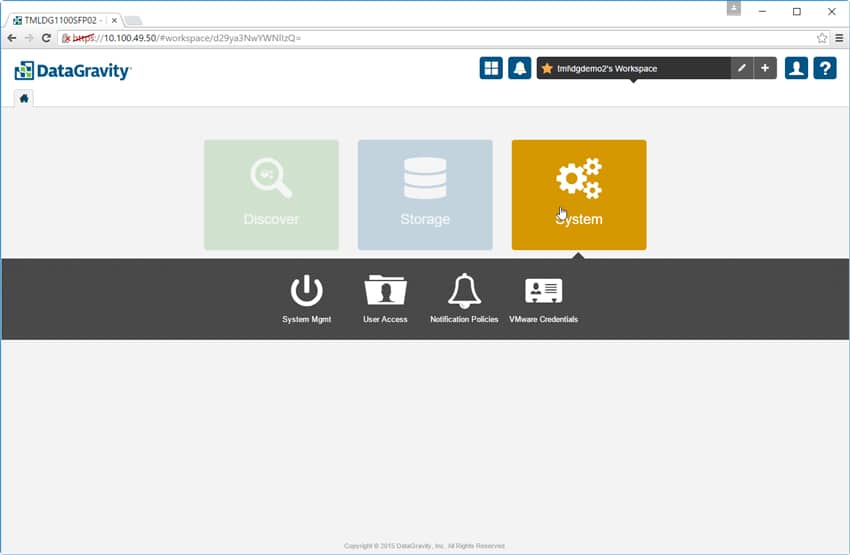
A última seção principal é a guia Sistema. Clicar nele nos dá quatro subguias: System Management, User Access, Notification Policies e VMware Credentials.
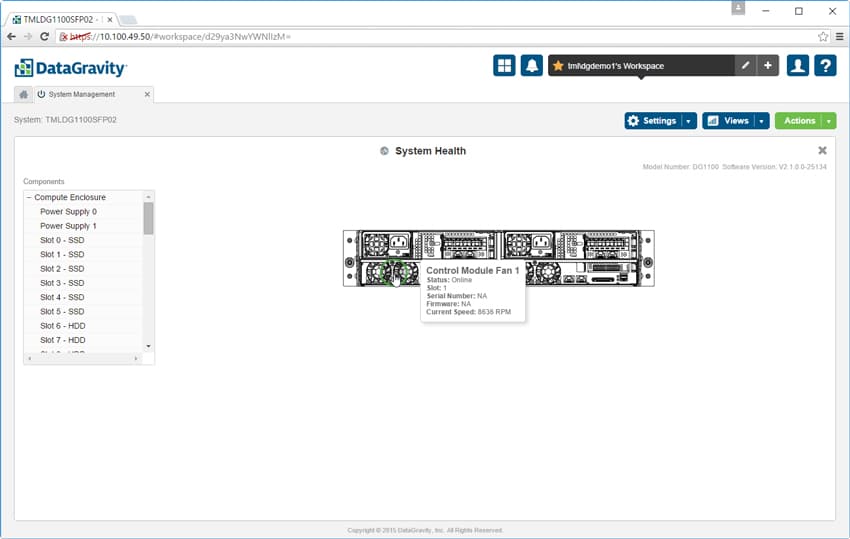
A guia System Mgmt tem várias opções, incluindo System Health, que fornece uma visão da integridade do sistema físico. À esquerda está uma lista de todos os componentes da solução. À direita está uma representação gráfica que dará ao usuário mais informações passando o mouse sobre ela.
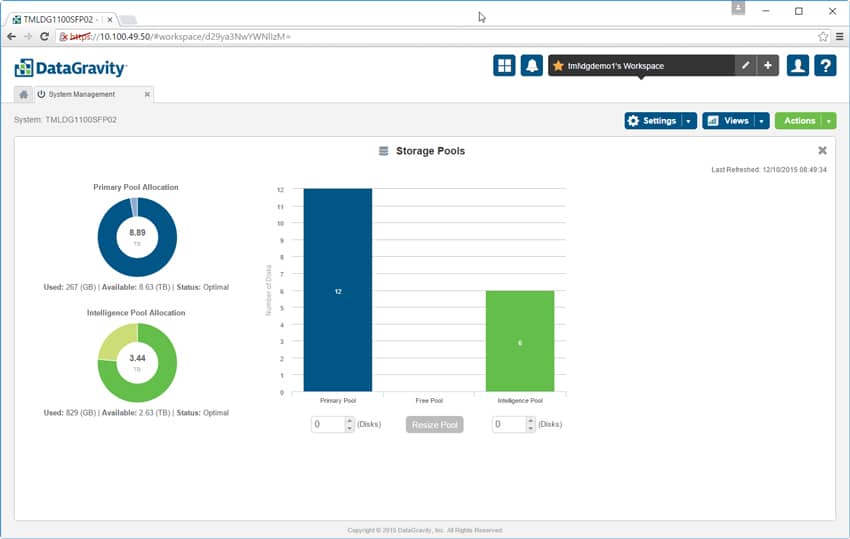
Também dentro do System Mgmt está a seção Storage Pools, que fornece uma visão de três pools diferentes no sistema DataGravity: o pool principal ou o pool alocado para uso diário, o pool de inteligência e o pool livre para armazenamento que tem ainda a ser alocado. Nessa tela, os usuários podem redimensionar os pools conforme necessário.
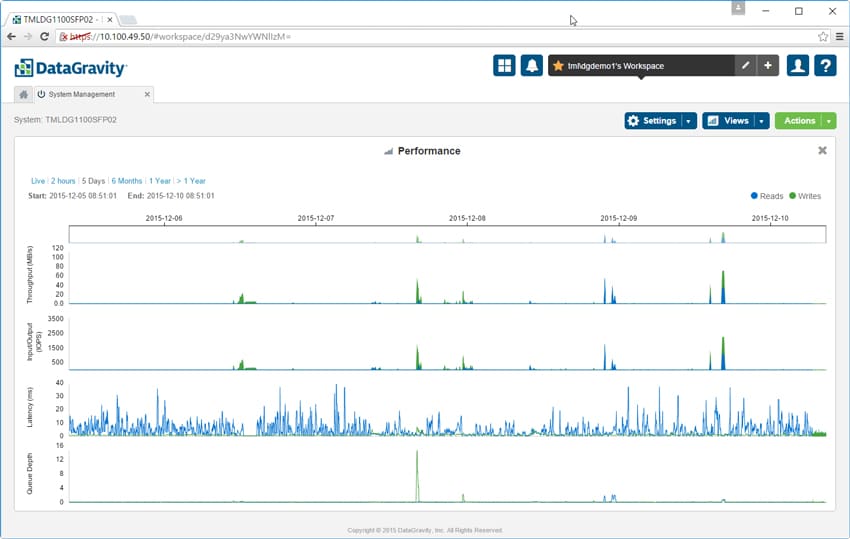
Há também uma opção para ver o desempenho do sistema. A exibição de desempenho mostra E/S de leitura e gravação e fornece detalhes como taxa de transferência em MB/s, IOPS, latência e profundidade da fila. Os usuários podem ver o desempenho durante um período de tempo ou ver uma leitura em tempo real do desempenho.
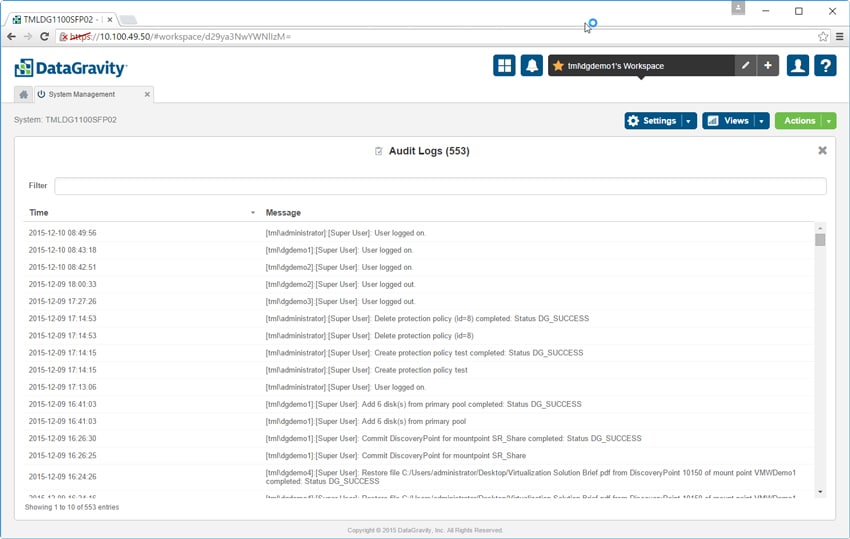
E, finalmente, em System Mgmt, os administradores podem visualizar os logs de auditoria. Eles não apenas podem ver quem se conectou e o que estavam fazendo, como também os logs podem ser filtrados para facilitar o acesso à visualização e encaminhados para outro sistema para processamento adicional.
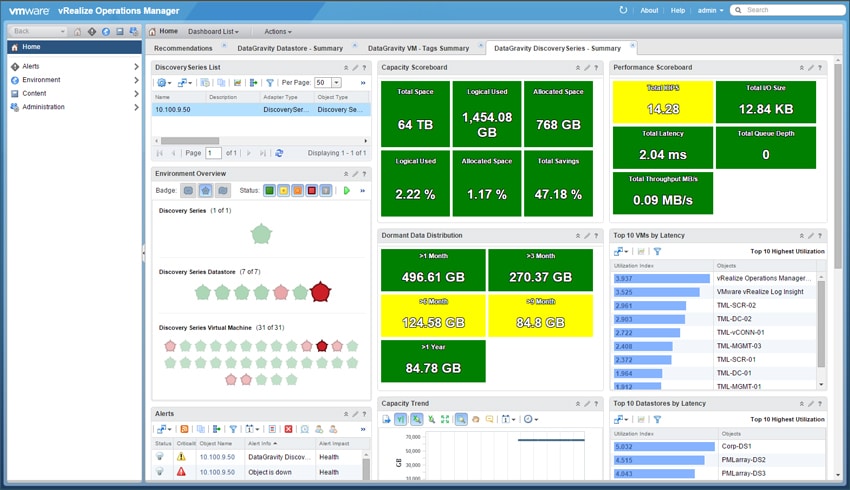
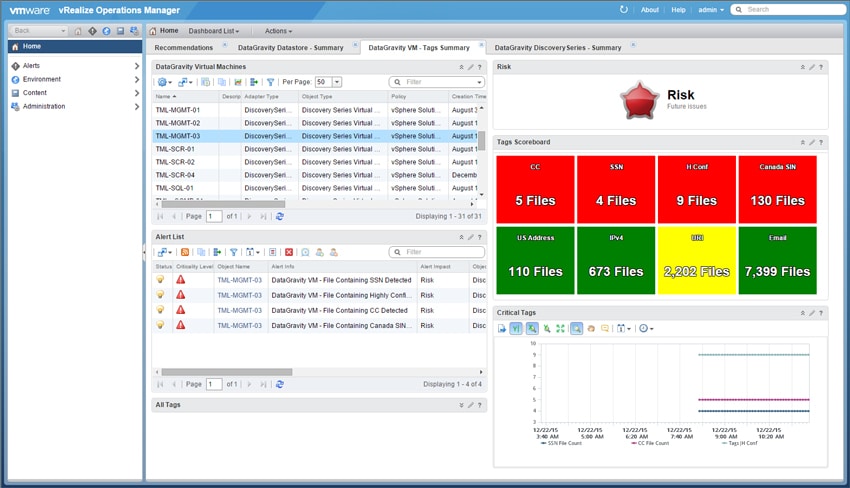
O DataGravity também se integra ao VMware vRealize Operations manager (vROPS) para exibir as análises do sistema DataGravity no console centralizado que o vROPS fornece. O DataGravity não tem uma presença virtual per se, portanto, essa integração permite que o administrador de virtualização visualize o sistema sem estar conectado à interface de usuário do DataGravity. Embora todas as informações estejam presentes, as visualizações de dados são limitadas em comparação com a GUI do DataGravity.
A integração vROPS exibe visualizações resumidas da Discovery Series, DataStore ou VM. Abaixo está uma visão do painel de resumo do Discovery Series que mostra a capacidade geral e o desempenho do sistema, bem como a latência para os armazenamentos de dados e VMs armazenados no sistema com a pontuação de risco para cada um.
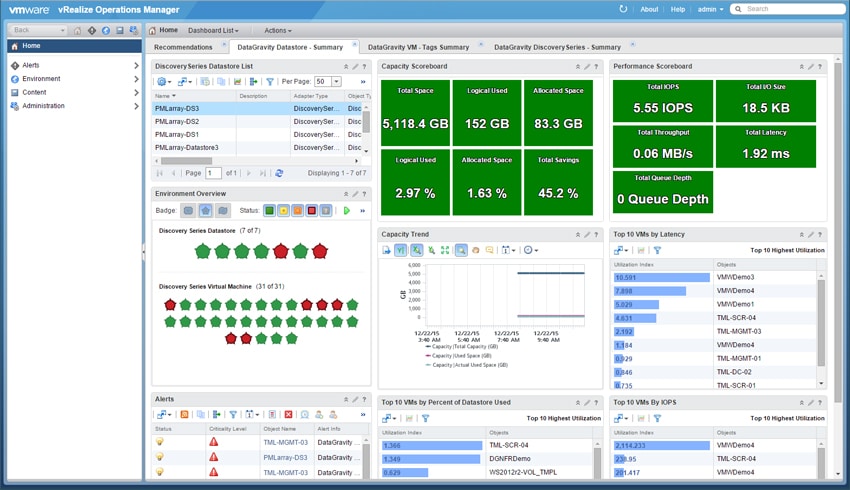
Ao visualizar o painel DataGravity Datastore Summary, métricas semelhantes são exibidas para armazenamentos de dados NFS com reconhecimento de dados DataGravity.
A integração do vROPS também exibe mapas de “calor” mostrando possíveis áreas problemáticas com base em valores predefinidos para utilização de espaço e tags de inteligência crítica encontrados em VMs, armazenamentos de dados e no sistema Discovery Series.
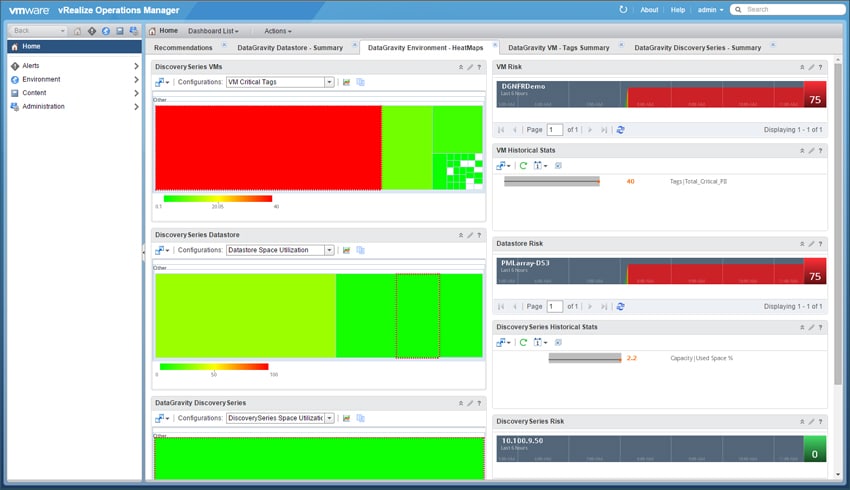
E os administradores de virtualização podem ver quais dados em que VM estão em risco. Por meio do sistema de marcação, eles podem até ver mais especificamente o tipo de dado que está em risco.
Conclusão
A série Discovery da DataGravity é uma matriz de armazenamento que muda o foco do desempenho absoluto e das janelas de backup e recuperação para o reconhecimento de dados. Em outras palavras, a DataGravity construiu um sistema que oferece aos usuários visibilidade de todos os seus dados por meio de uma GUI fácil de usar. Ele não apenas permite que os usuários vejam onde seus dados residem no sistema, mas também fornece um método detalhado para rastrear os dados, quem os está acessando e se dados confidenciais podem ser expostos. O DataGravity permite que os usuários marquem a maioria dos tipos de arquivo, o que ajuda a localizar e monitorar rapidamente arquivos de dados específicos. Isso não apenas torna os dados de uma empresa mais seguros ao encontrar problemas (intencionais ou maliciosos), mas também permite que uma empresa use totalmente todos os seus dados armazenados, compreendendo a localização, o acesso, as necessidades de retenção e a conformidade dos dados.
Normalmente, na StorageReview, examinamos o hardware subjacente e testamos seu desempenho por meio de uma série de benchmarks. No caso do DataGravity, o software é o ponto de venda mais forte. Embora a empresa ofereça várias capacidades de 18 TB a 96 TB e tenha uma combinação de RAM, NVRAM, SSDs e HDDs nearline em sua solução, o hardware subjacente existe para dar suporte à plataforma de análise DataGravity. É claro que todo hardware existe para oferecer suporte a software, no entanto, a maioria dos fornecedores usa os dois em conjunto para oferecer recursos de armazenamento clássicos. O DataGravity não afirma ser o de maior desempenho ou a menor latência. Em vez disso, o foco do DataGravity está no reconhecimento de dados e na facilidade de uso. Neste ponto, a empresa claramente se destaca.
A equipe StorageReview foi ao local para testar a solução. Como nosso foco desta vez era a usabilidade, não precisávamos de um dispositivo físico em nosso laboratório para executar nossos testes de desempenho. Antes de chegarmos, o DataGravity ingeriu uma grande parte do conteúdo do nosso site em sua matriz, fornecendo dados para pesquisa com os quais estávamos intimamente familiarizados. Com apenas uma visão geral básica do sistema, pudemos começar a usar intuitivamente a solução para pesquisar palavras-chave em vários tipos de arquivos, criar compartilhamentos, reatribuir pools de dados, bem como ver como nosso uso da solução estava sendo rastreado.
Em última análise, o que a DataGravity está fazendo é excepcionalmente diferente do restante da indústria de armazenamento. A equipe veterana decidiu ir atrás de solucionar problemas de negócios legítimos primeiro, usando a visibilidade da conformidade de armazenamento como gancho. Essa ênfase na inteligência é fundamental para o que é o DataGravity, que varia muito das compras de armazenamento tradicionais baseadas em uma necessidade de capacidade ou taxa de transferência. Embora a abordagem DataGravity faça muito sentido em setores regulamentados, até mesmo nosso caso de uso de pequenas empresas obteve benefícios imediatos, uma vez que pudemos ter uma visão aprofundada de até mesmo uma parte de nosso conteúdo voltado para o exterior. Junte esse insight ao mesmo para diretórios pessoais de usuários, pastas compartilhadas para grupos de trabalho e o restante dos ativos de negócios e os benefícios aumentam rapidamente. Também é muito intuitivo de usar, tornando o DataGravity uma boa opção para oficinas de TI pequenas ou sobrecarregadas.
Concluindo!
A série Discovery da DataGravity permite que as empresas façam pleno uso de todos os seus dados, mantendo-os seguros e acionáveis por meio de uma interface fácil de usar. A ênfase na análise e na visibilidade dos dados é verdadeiramente única no setor de armazenamento, dando ao DataGravity um importante ponto de diferenciação em um setor que geralmente carece de criatividade.


 Amazon