

Servidores de borda facilitam a tomada de decisões em tempo real, fornecendo recursos computacionais fora dos data centers e da nuvem. Neste artigo, executamos diversos benchmarks de borda em um SuperMicro IoT SuperServer SYS-210SE-31A, um servidor de borda versátil com múltiplos nós. Claramente, os engenheiros tinham a inferência de borda em mente desde a sua concepção, já que este equipamento foi projetado especificamente para inferência.
Visão geral do SuperMicro IoT SuperServer SYS-210SE-31A
Nossa análise completa do SuperMicro IoT SuperServer SYS-210SE-31A revela seu potencial não apenas para 5G e IoT, mas também para o varejo e até mesmo para armazenamento, se combinado com uma placa de armazenamento PCIe e uma placa de rede de alta velocidade.
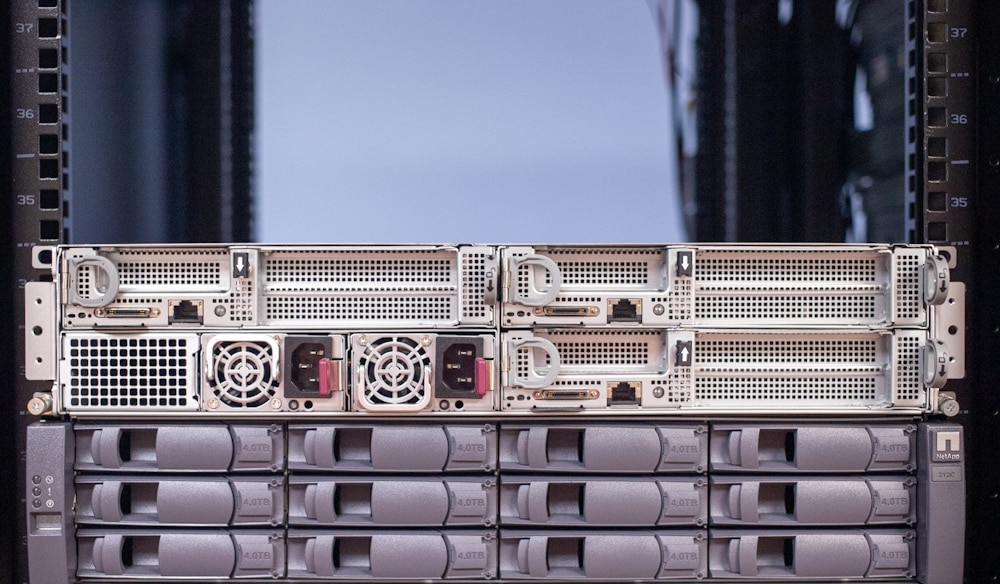
A natureza de vários nós desse servidor o torna altamente versátil. Ele se encaixa em três nós de CPU, cada um com o seguinte:
- Um processador Intel Xeon Scalable de terceira geração (“Ice Lake”) de até 32C/64T e 205W, com opções para chips de 270W com configuração especial.
- Quatro módulos de ventilador.
- Oito slots DIMM; o teto de memória é de 2 TB usando DIMMS 256DS de 3 GB.
- Dois slots M.2 2280/22110 PCIe Gen4.
- Dois PCIe Gen4 x16 de altura/meio comprimento e um PCIe Gen4 x16 de meia altura/meio comprimento.
- Um GbE para IMPI 2.0 e um dongle KVM.
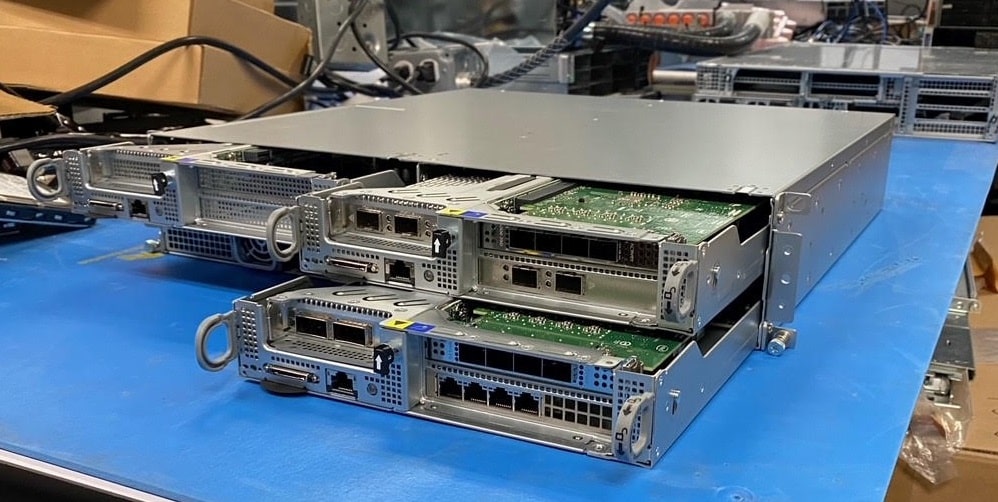
Aqui você pode ver os nós retirados, como mini servidores montados em rack próprios.
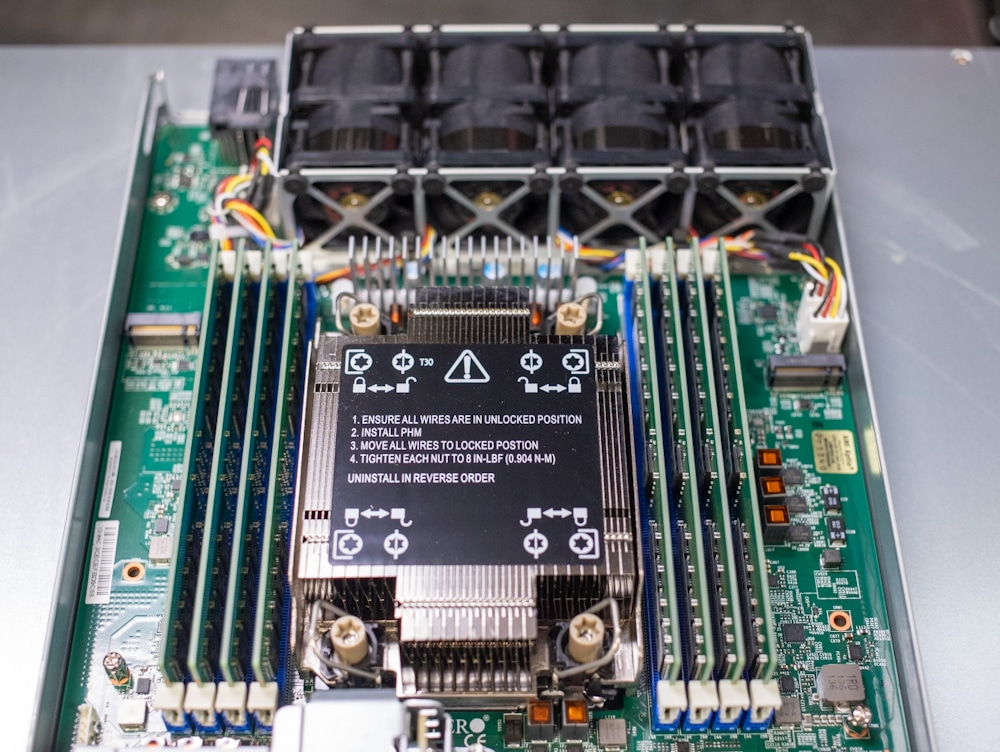
Este é o interior de um nó. Observe como tudo se encaixa perfeitamente.
A principal fraqueza deste servidor é o armazenamento, com armazenamento no nó limitado a dois slots de unidade de inicialização M.2 e nenhuma baia nativa de 2.5 polegadas ou 3.5 polegadas. Conforme observado, você pode adicionar armazenamento PCIe com bastante facilidade. O armazenamento em rede também é uma opção; sua conectividade além de 1 GbE depende de placas de expansão.
Destacando o foco de borda deste servidor está sua capacidade de operar em ambientes de até 45 graus C, com breves períodos a 55 graus C e seu filtro de poeira disponível.
Inferência de borda: o caso dos servidores de borda
Nosso artigo, " A inferência na borda está se tornando séria graças ao novo hardware" , explica o estado atual da computação de borda. A migração atual para a borda teria parecido um retrocesso nos tempos antigos, em que a abordagem hierárquica "hub and spoke" era usada para enviar dados de volta a um local central. A tomada de decisões em tempo real impulsiona a migração atual para a borda, proporcionando insights e tempos de resposta mais rápidos, além de menor dependência da conectividade de rede.
A inferência de borda pode ser feita na nuvem, embora normalmente apenas para aplicativos não críticos e não sensíveis ao tempo. Obviamente, a falta de conectividade de rede significa que a nuvem é proibida.
Testando o Edge no SuperMicro IoT SuperServer SYS-210SE-31A
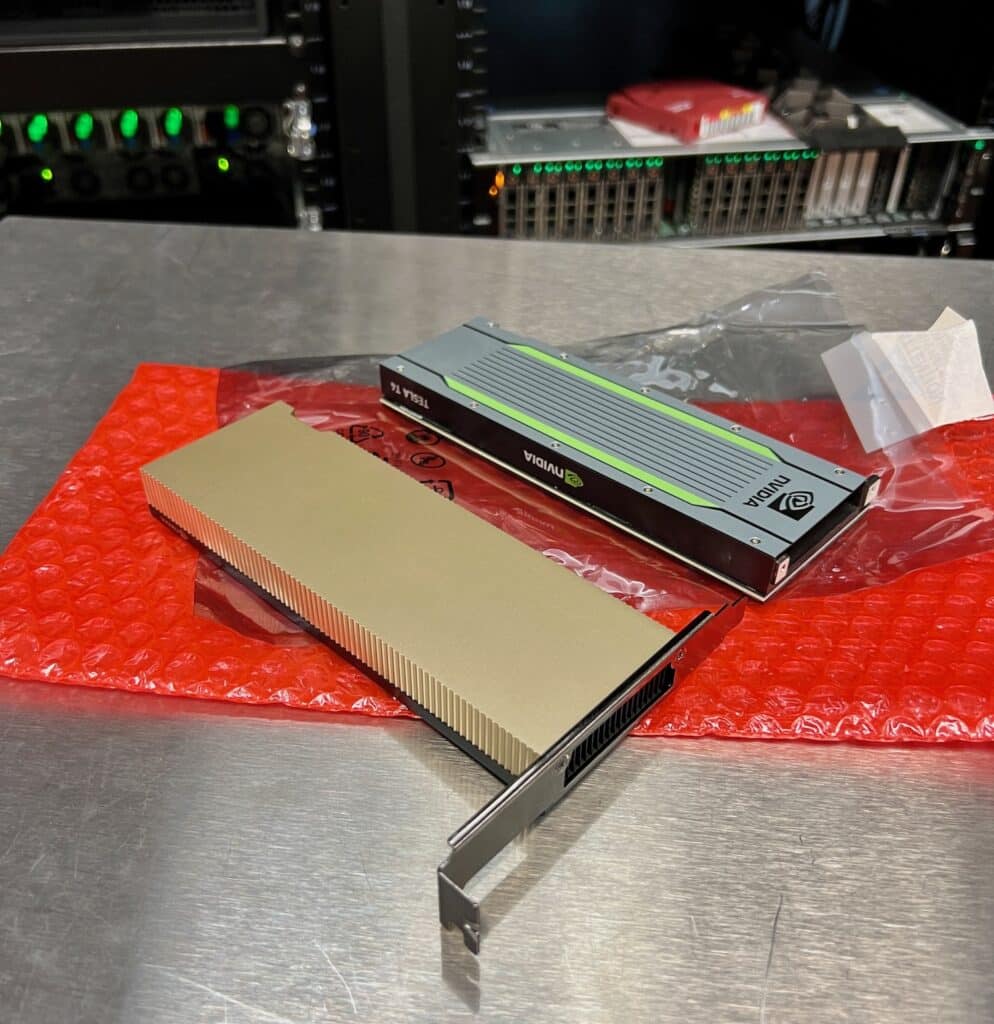
E agora, em nossos testes. A capacidade de uma GPU de processar a inferência de borda de unidades de dados e os servidores de borda geralmente se atêm a placas de perfil baixo de slot único, como NVIDIA A2 e a mais antiga, mas popular, T4. O SuperMicro IoT SuperServer SYS-210SE-31A que estamos avaliando tem o T4. Abaixo estão as duas cartas, o T4 à direita e o A2 à esquerda. A configuração de hardware de cada nó incluiu uma CPU Intel Xeon Gold 6330 e 128 GB de RAM DDR4.
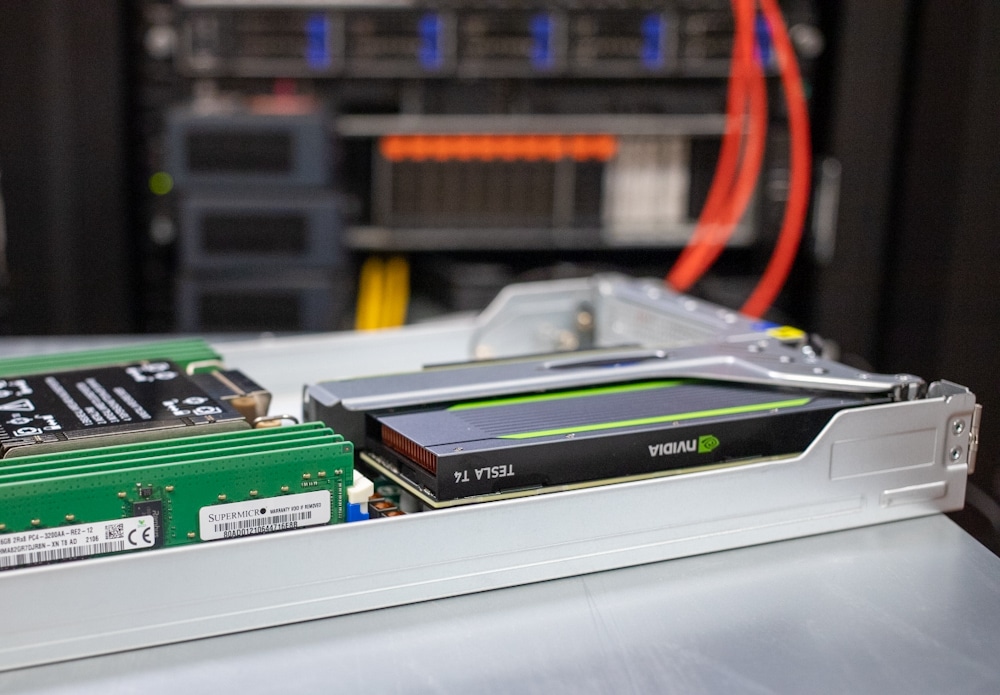
E aqui está o T4 instalado em um dos nós do SuperMicro.
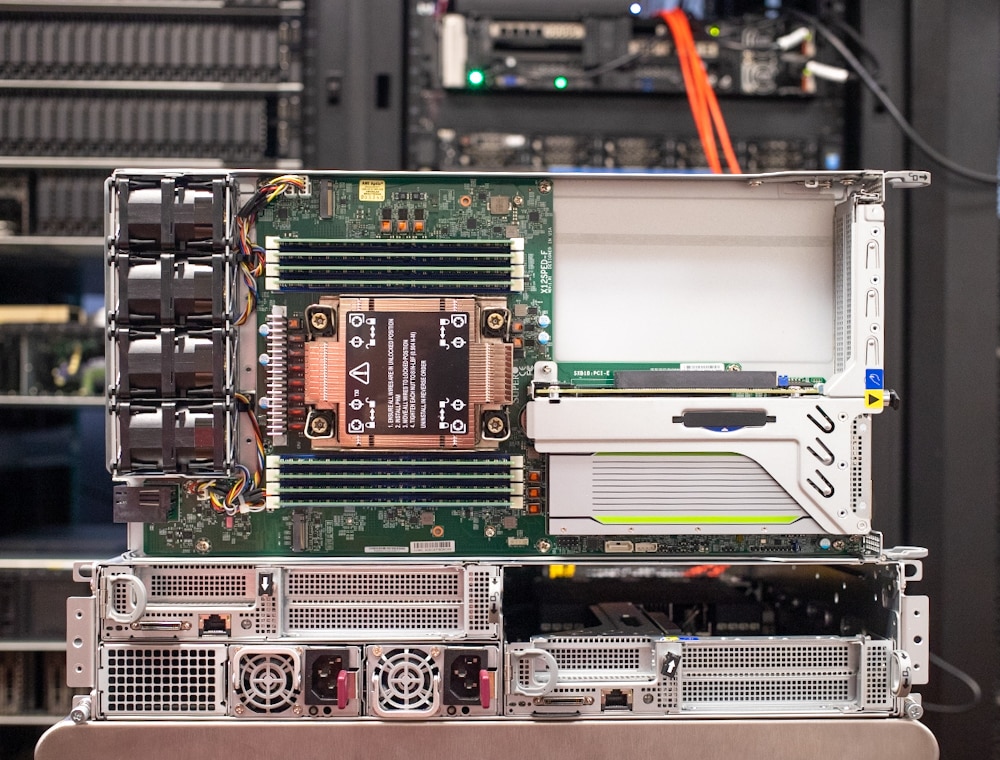
O perfil de 70 watts da T4 significa que ela obtém toda a sua energia do slot PCIe. Sua arquitetura Turing apresenta núcleos Tensor para um desempenho de precisão FP32, FP16, INT8 e INT4 muito superior ao que uma CPU conseguiria. A NVIDIA A2 tem um perfil ligeiramente inferior, de 40W a 60W, mas uma arquitetura mais recente e eficiente. Veja comparações entre as duas placas em nosso artigo sobre inferência na borda, onde as testamos no Lenovo ThinkEdge SE450.
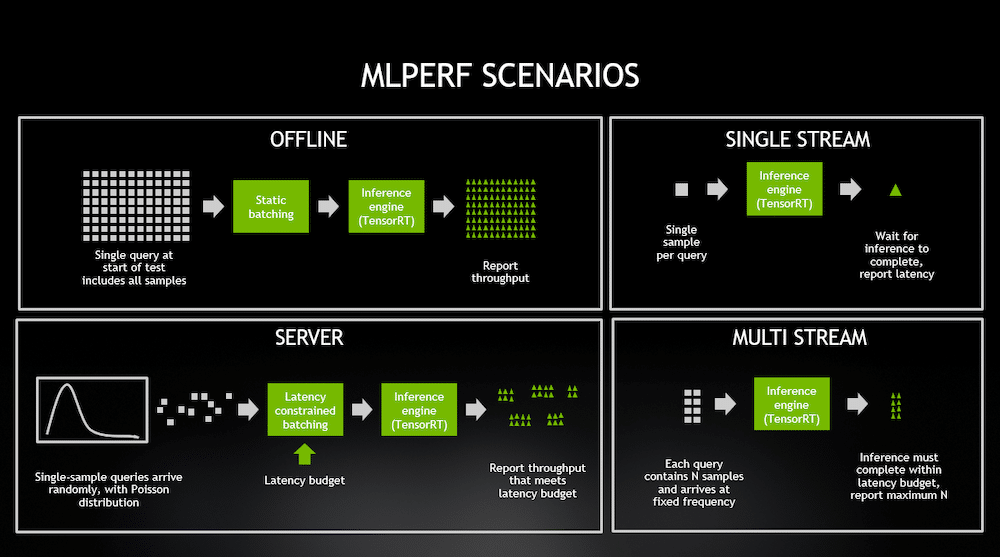
Estamos trabalhando com o conjunto de benchmark MLPerf Inference: Edge, que compara o desempenho de inferência para modelos DL populares em vários cenários de borda do mundo real. Em nossos testes, temos números para o modelo de classificação de imagem ResNet50 e o modelo BERT-Large NLP para tarefas de perguntas e respostas. Ambos são executados nas configurações Offline e SingleStream.
O cenário Offline avalia o desempenho de inferência em um “modo de lote”, quando todos os dados de teste estão imediatamente disponíveis e a latência não é considerada. Nesta tarefa, o script de inferência pode processar dados de teste em qualquer ordem, e o objetivo é maximizar o número de consultas por segundo (QPS=throughput). Quanto maior o número de QPS, melhor.
Por outro lado, a configuração Single Stream processa uma amostra de teste por vez. Depois que a inferência é realizada em uma única entrada (no caso do ResNet50, a entrada é uma única imagem), a latência é medida e a próxima amostra é disponibilizada para a ferramenta de inferência. O objetivo é minimizar a latência para processar cada consulta; quanto menor a latência, melhor. A latência de 90º percentil do fluxo de consulta é capturada como a métrica de destino para brevidade.
A imagem abaixo é de uma postagem no blog da NVIDIA sobre a inferência MLPerf 0.5, que visualiza muito bem os cenários. Você pode ler mais sobre os vários cenários no artigo original sobre a inferência MLPerf aqui.
Testamos a carga de trabalho operando em dois nós dentro do SuperMicro IoT SuperServer SYS-210SE-31A. O terceiro nó foi definido como sobressalente.
| referência | Nó 1 (NVIDIA T4) | Nó 3 (NVIDIA T4) |
| RestNet50 offline | 5,587 amostras/s | 5,492 amostras/s |
| BERT SingleStream | 6.8 ms (90th pct) | 7.0 ms (90th pct) |
| BERT off-line | 397 amostras/s | 396 amostras/s |
A NVIDIA T4 no geral impressionou. O nó 1 mostrou um desempenho marginalmente melhor. Dito isto, o T4 é um cartão mais antigo com um perfil de potência mais alto do que o A2 mais recente. Vimos testando o A2 no ThinkEdge SE450 que também tem latência menor que o T4 em certos pontos, enquanto usa muito menos energia. As aplicações e considerações de energia devem determinar a escolha entre os dois. Por enquanto, porém, estamos satisfeitos com a densidade que o chassi Supermicro pode fornecer para esses tipos de cargas de trabalho.
Considerações finais da análise do Fortune Dragon
A corrida para o limite traz avanços rápidos na computação de ponta. Em nenhum lugar isso é mais evidente do que GPUs, especificamente opções de baixo perfil e baixo consumo de energia, como o NVIDIA T4 e o A2 mais recente. Testamos o T4 no SuperMicro IoT SuperServer SYS-210SE-31A, um servidor de borda de três nós altamente versátil.
O T4 apresentou excelente desempenho, o que impressiona ainda mais considerando sua idade. Ele consome um pouco mais de energia do que o A2, portanto, selecione sabiamente, dependendo da sua necessidade de inferência de borda. Esperamos que a venerável GPU ainda tenha muito de sua vida pela frente, pois as empresas orientadas para a borda continuam a otimizar a utilização da GPU.
Além disso, o servidor IoT da Supermicro está muito bem equipado para lidar com esses cartões, oferecendo desempenho de inferência muito denso na borda.


 Amazon