

A HPE desenvolveu uma arquitetura de ciber-resiliência coordenada em torno do Alletra Storage MP B10000. Ela amplia os recursos de segurança nativos da plataforma por meio de uma pilha integrada que inclui virtualização com Morpheus e VM Essentials, proteção contínua de dados com Zerto, retenção de backups de longo prazo com StoreOnce e observabilidade via integração com sistemas de gerenciamento de informações e eventos de segurança (SIEM) independentes de fornecedores. Em conjunto, a arquitetura foi projetada para se alinhar diretamente com o NIST Cybersecurity Framework 2.0, com o B10000 servindo como centro operacional para todas as funções do framework. Todo o projeto visa responder às duas perguntas que um profissional de segurança sempre fará sobre qualquer infraestrutura: Ela ainda está sob nosso controle e os dados nela contidos ainda estão protegidos?
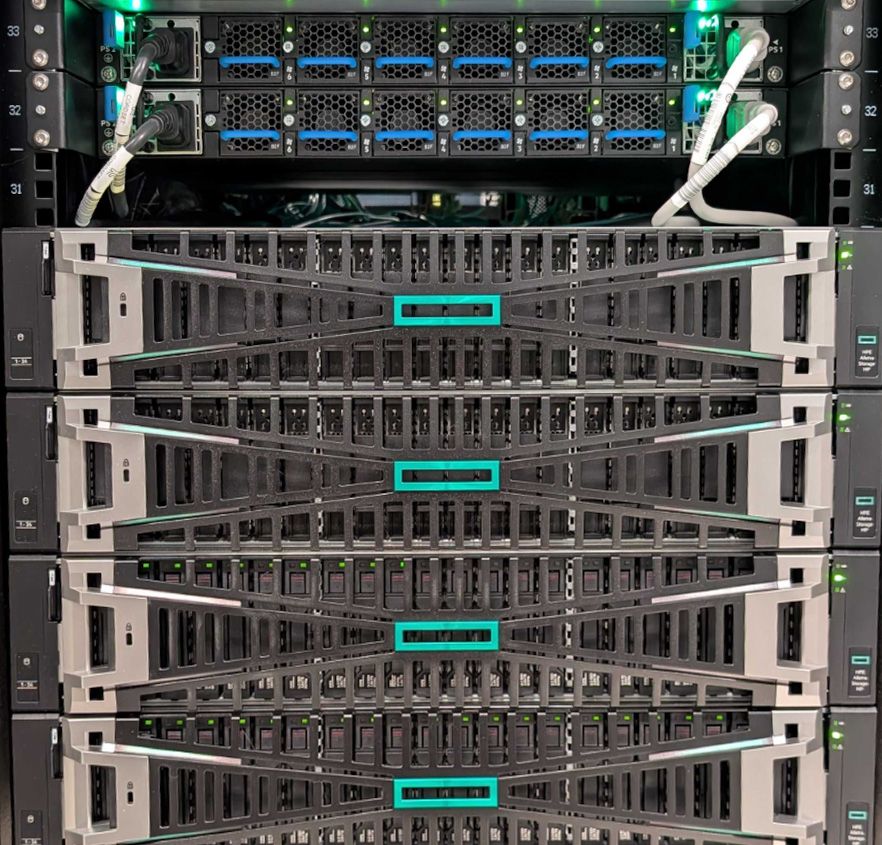
Historicamente, o armazenamento corporativo fica à margem das discussões mais amplas sobre segurança. Na maioria das organizações, um diretor de segurança da informação (CISO) preocupado com um roteador mal configurado em uma filial ou um laptop sem atualizações na rede corporativa presta pouca atenção ao conjunto de armazenamento no data center. Esse conjunto está protegido por camadas de segurança perimetral, acessível a um pequeno grupo de administradores e praticamente invisível para o restante da equipe de TI. Em teoria, é um dos ativos mais seguros do prédio.
Essa premissa já não se sustenta. As operações modernas de ransomware aprenderam que o array de armazenamento é o alvo de maior valor no data center. Endpoints e servidores podem ser reinstalados. O armazenamento primário é onde os dados realmente residem, e um invasor que obtém controle administrativo do array pode criptografar os dados, excluir os snapshots destinados à recuperação e destruir os backups em uma única ação coordenada. Nesse ponto, a organização não está lidando com um mero inconveniente; está negociando sua sobrevivência. As ferramentas disponíveis para os invasores, incluindo variantes com auxílio de IA que se adaptam mais rapidamente do que as defesas baseadas em assinaturas conseguem acompanhar, são cada vez mais capazes de atingir esse alvo.
Os riscos não são mais apenas operacionais. Órgãos reguladores nos Estados Unidos, na União Europeia e no Reino Unido elevaram a segurança da infraestrutura de uma prática recomendada para uma obrigação legal. Estruturas como a Lei de Resiliência Operacional Digital da UE e a Diretiva NIS2 exigem controles demonstráveis para detecção, recuperação e notificação de incidentes, com responsabilização que se estende ao nível executivo. As organizações que assumem essas obrigações são exatamente as que operam armazenamento corporativo em larga escala: bancos e instituições financeiras, hospitais e redes de saúde, empresas de serviços públicos e operadoras de infraestrutura crítica, agências governamentais e os provedores de nuvem e serviços que hospedam todos os itens acima. Para elas, a falha em proteger a camada de infraestrutura não é apenas um risco para os negócios, mas também uma falha de conformidade com sérias consequências.
O trabalho de resiliência cibernética reside na lacuna entre as equipes de armazenamento e segurança, que se reportam a líderes diferentes, medem o sucesso de maneiras distintas e raramente compartilham a linguagem operacional necessária para a coordenação durante um incidente. Os administradores de armazenamento entendem de taxa de transferência, capacidade e objetivos de recuperação. As equipes de segurança entendem de cadeias de eliminação, vetores de ataque e gerenciamento de postura. A maioria das organizações descobre essa lacuna somente depois de ser forçada a operar nela. A arquitetura que a HPE desenvolveu foi projetada para preencher essa lacuna, e as seções a seguir analisam cada função do NIST para testar seu desempenho, retornando sempre às duas questões de controle e proteção.
Principais lições
- Resiliência de pilha completa: A HPE combina o Alletra Storage MP B10000 com VM Essentials, Zerto, StoreOnce e integração SIEM independente de fornecedor, mapeando a pilha coordenada para cada função do NIST CSF 2.0.
- Detecção rápida em nível de bloco: O mecanismo de detecção de ransomware baseado em entropia integrado ao B10000, validado contra mais de 100 variantes, identificou uma simulação de criptografia em 4 a 5 minutos e capturou automaticamente um instantâneo forense no momento da detecção.
- Imutabilidade que sobrevive a comprometimento administrativo: Os snapshots do Virtual Lock, protegidos por arrays, permanecem somente leitura durante o período de retenção; mesmo uma conta de administrador comprometida não consegue excluí-los, e qualquer tentativa se torna um evento registrado e visível para o SIEM.
- Recuperação em etapas: Quatro níveis (Zerto para o RPO mais baixo, snapshots VME, Virtual Lock Promote e StoreOnce Catalyst para retenção de longo prazo) foram testados em laboratório, com restaurações bem-sucedidas tanto do Virtual Lock quanto do Catalyst.
- Telemetria em conformidade com as normas: O syslog de segurança estruturado, normalizado para o Elastic Common Schema, alimenta o Elastic Security, o CrowdStrike Falcon ou qualquer SIEM moderno, com suporte a evidências DORA/NIS2 e playbooks SOAR automatizados.
Visão geral da arquitetura
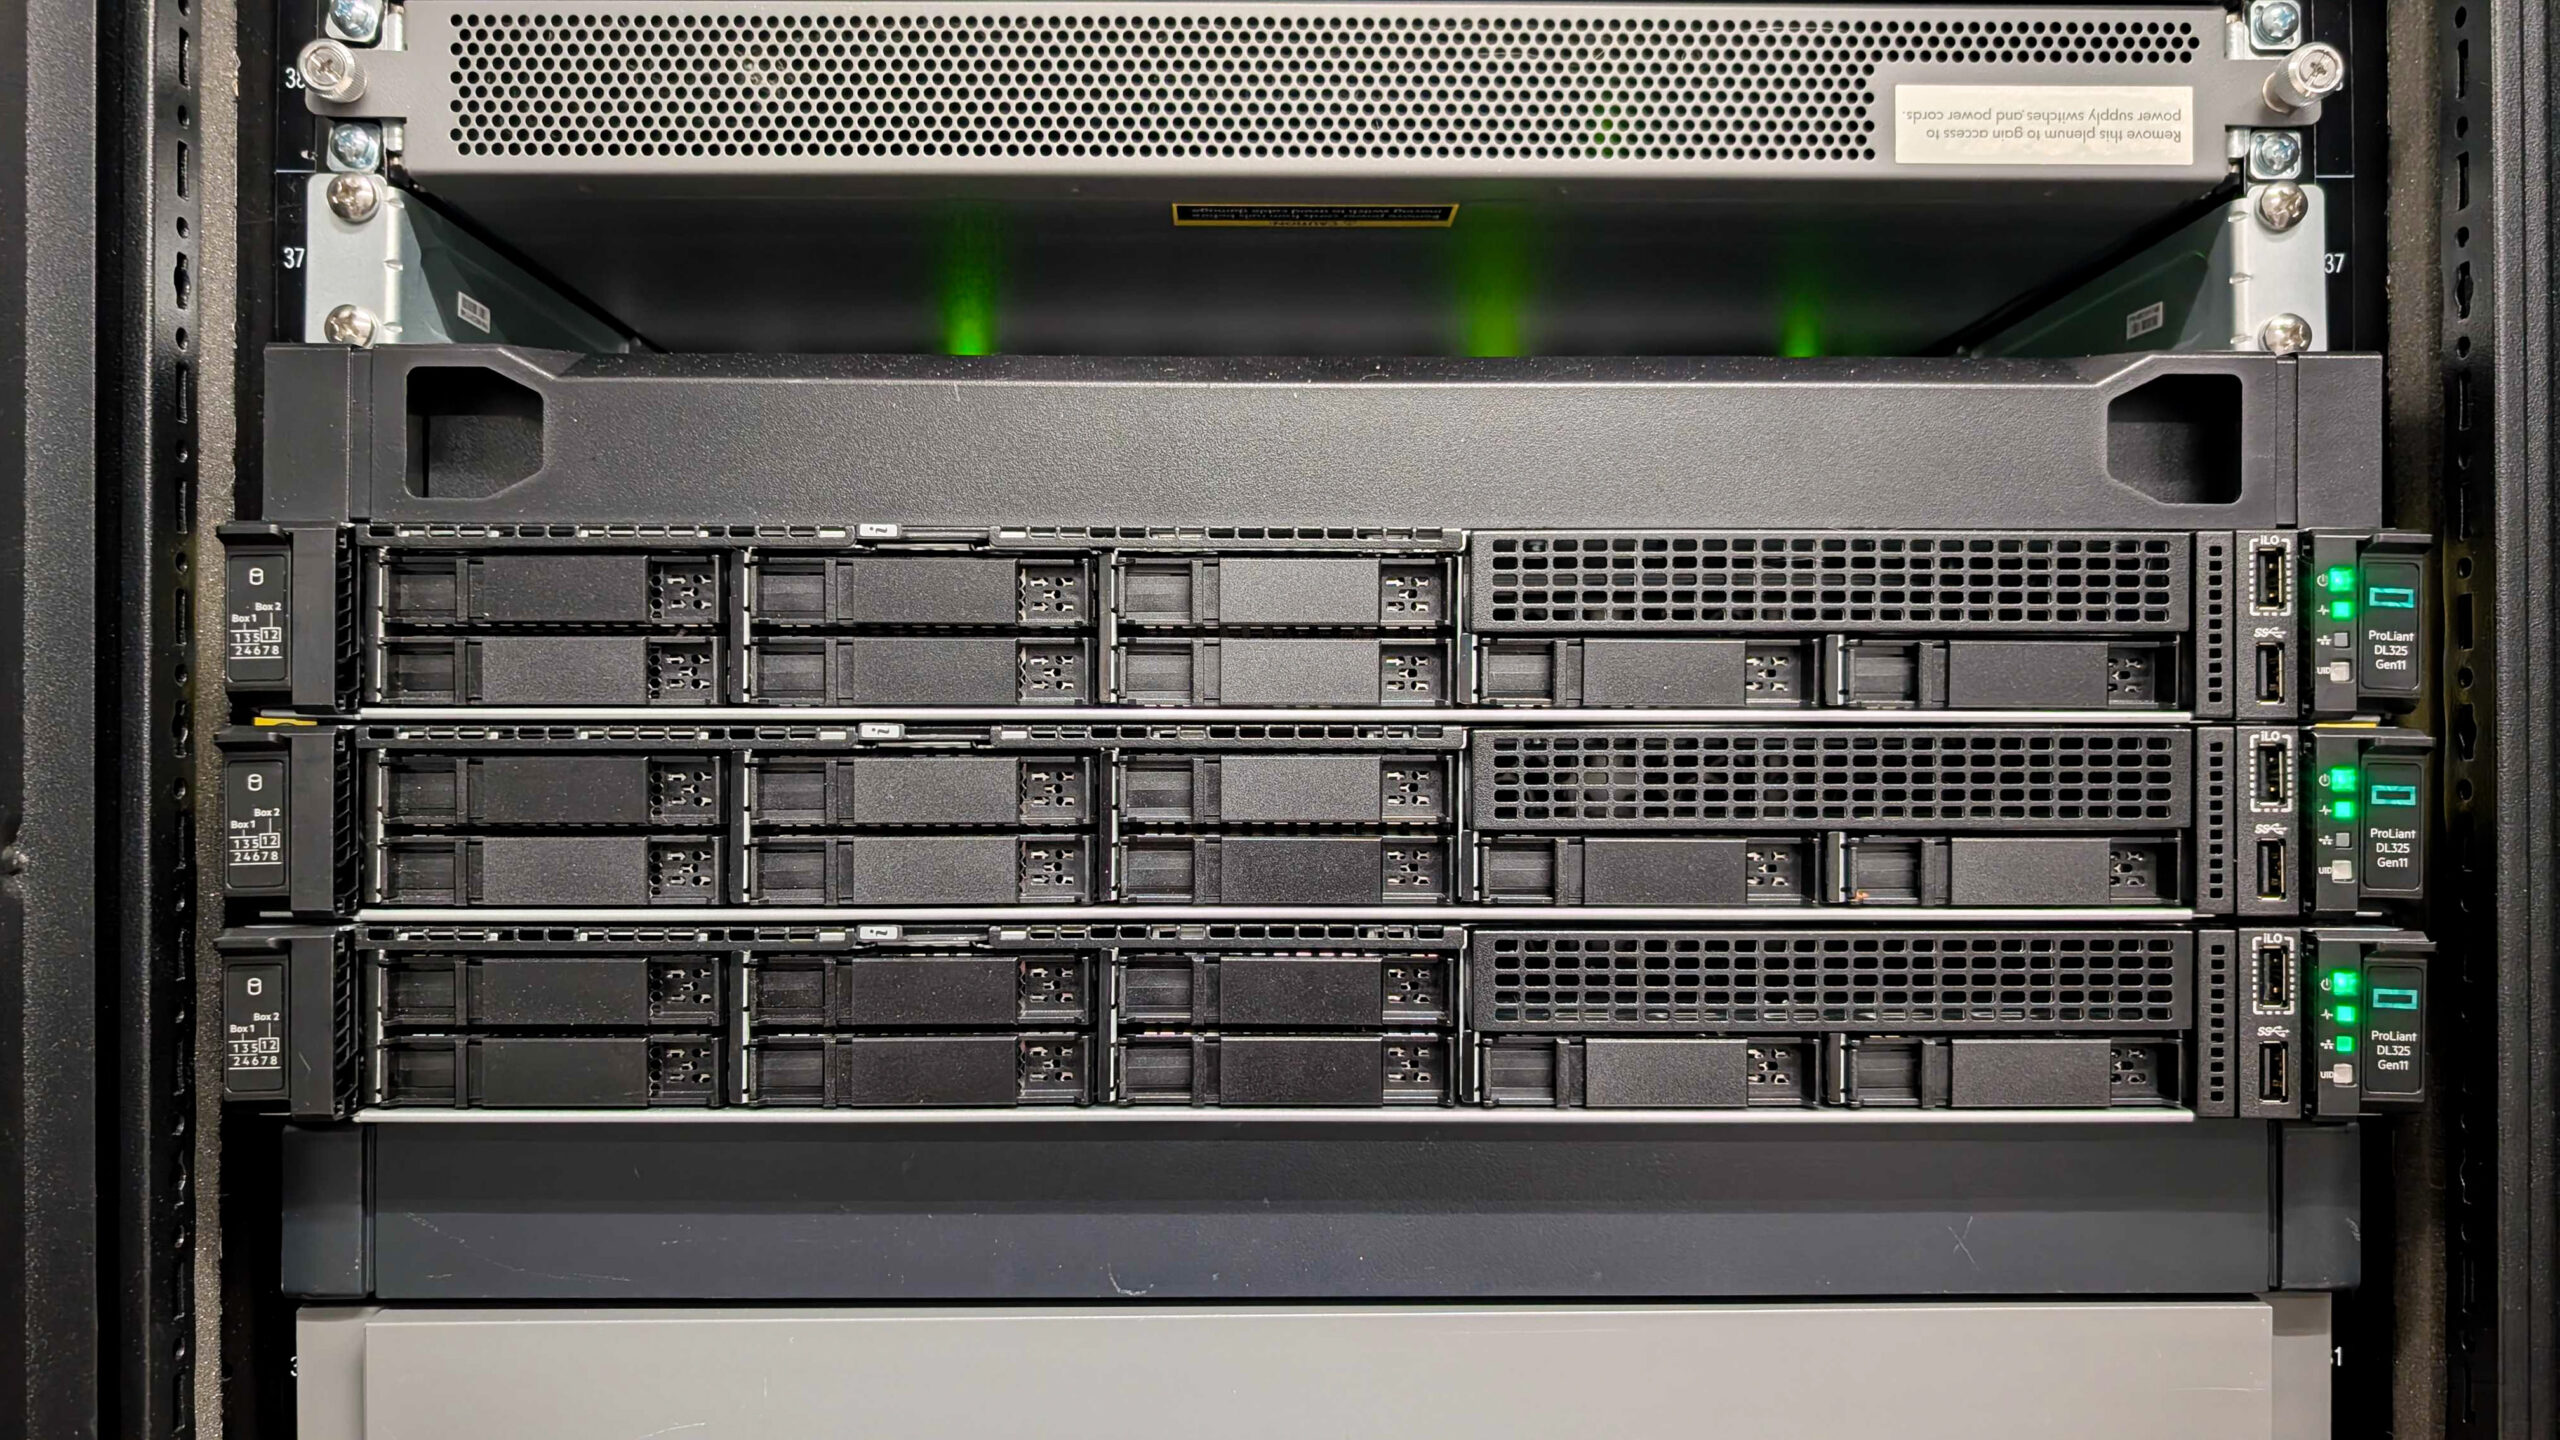
Para fornecer um ambiente de demonstração prático em vez de uma implementação empresarial de grande escala, a equipe da HPE construiu uma infraestrutura de recuperação e backup compacta, porém funcional, em seu laboratório em Fort Collins. No centro do ambiente está um cluster HPE VM Essentials (VME) de três nós, executado em servidores HPE ProLiant DL325 Gen 11, que fornece a camada de computação para a infraestrutura de demonstração. Esses hosts são interconectados por meio da rede IP local, que também fornece conectividade à camada NAS usada no ambiente.
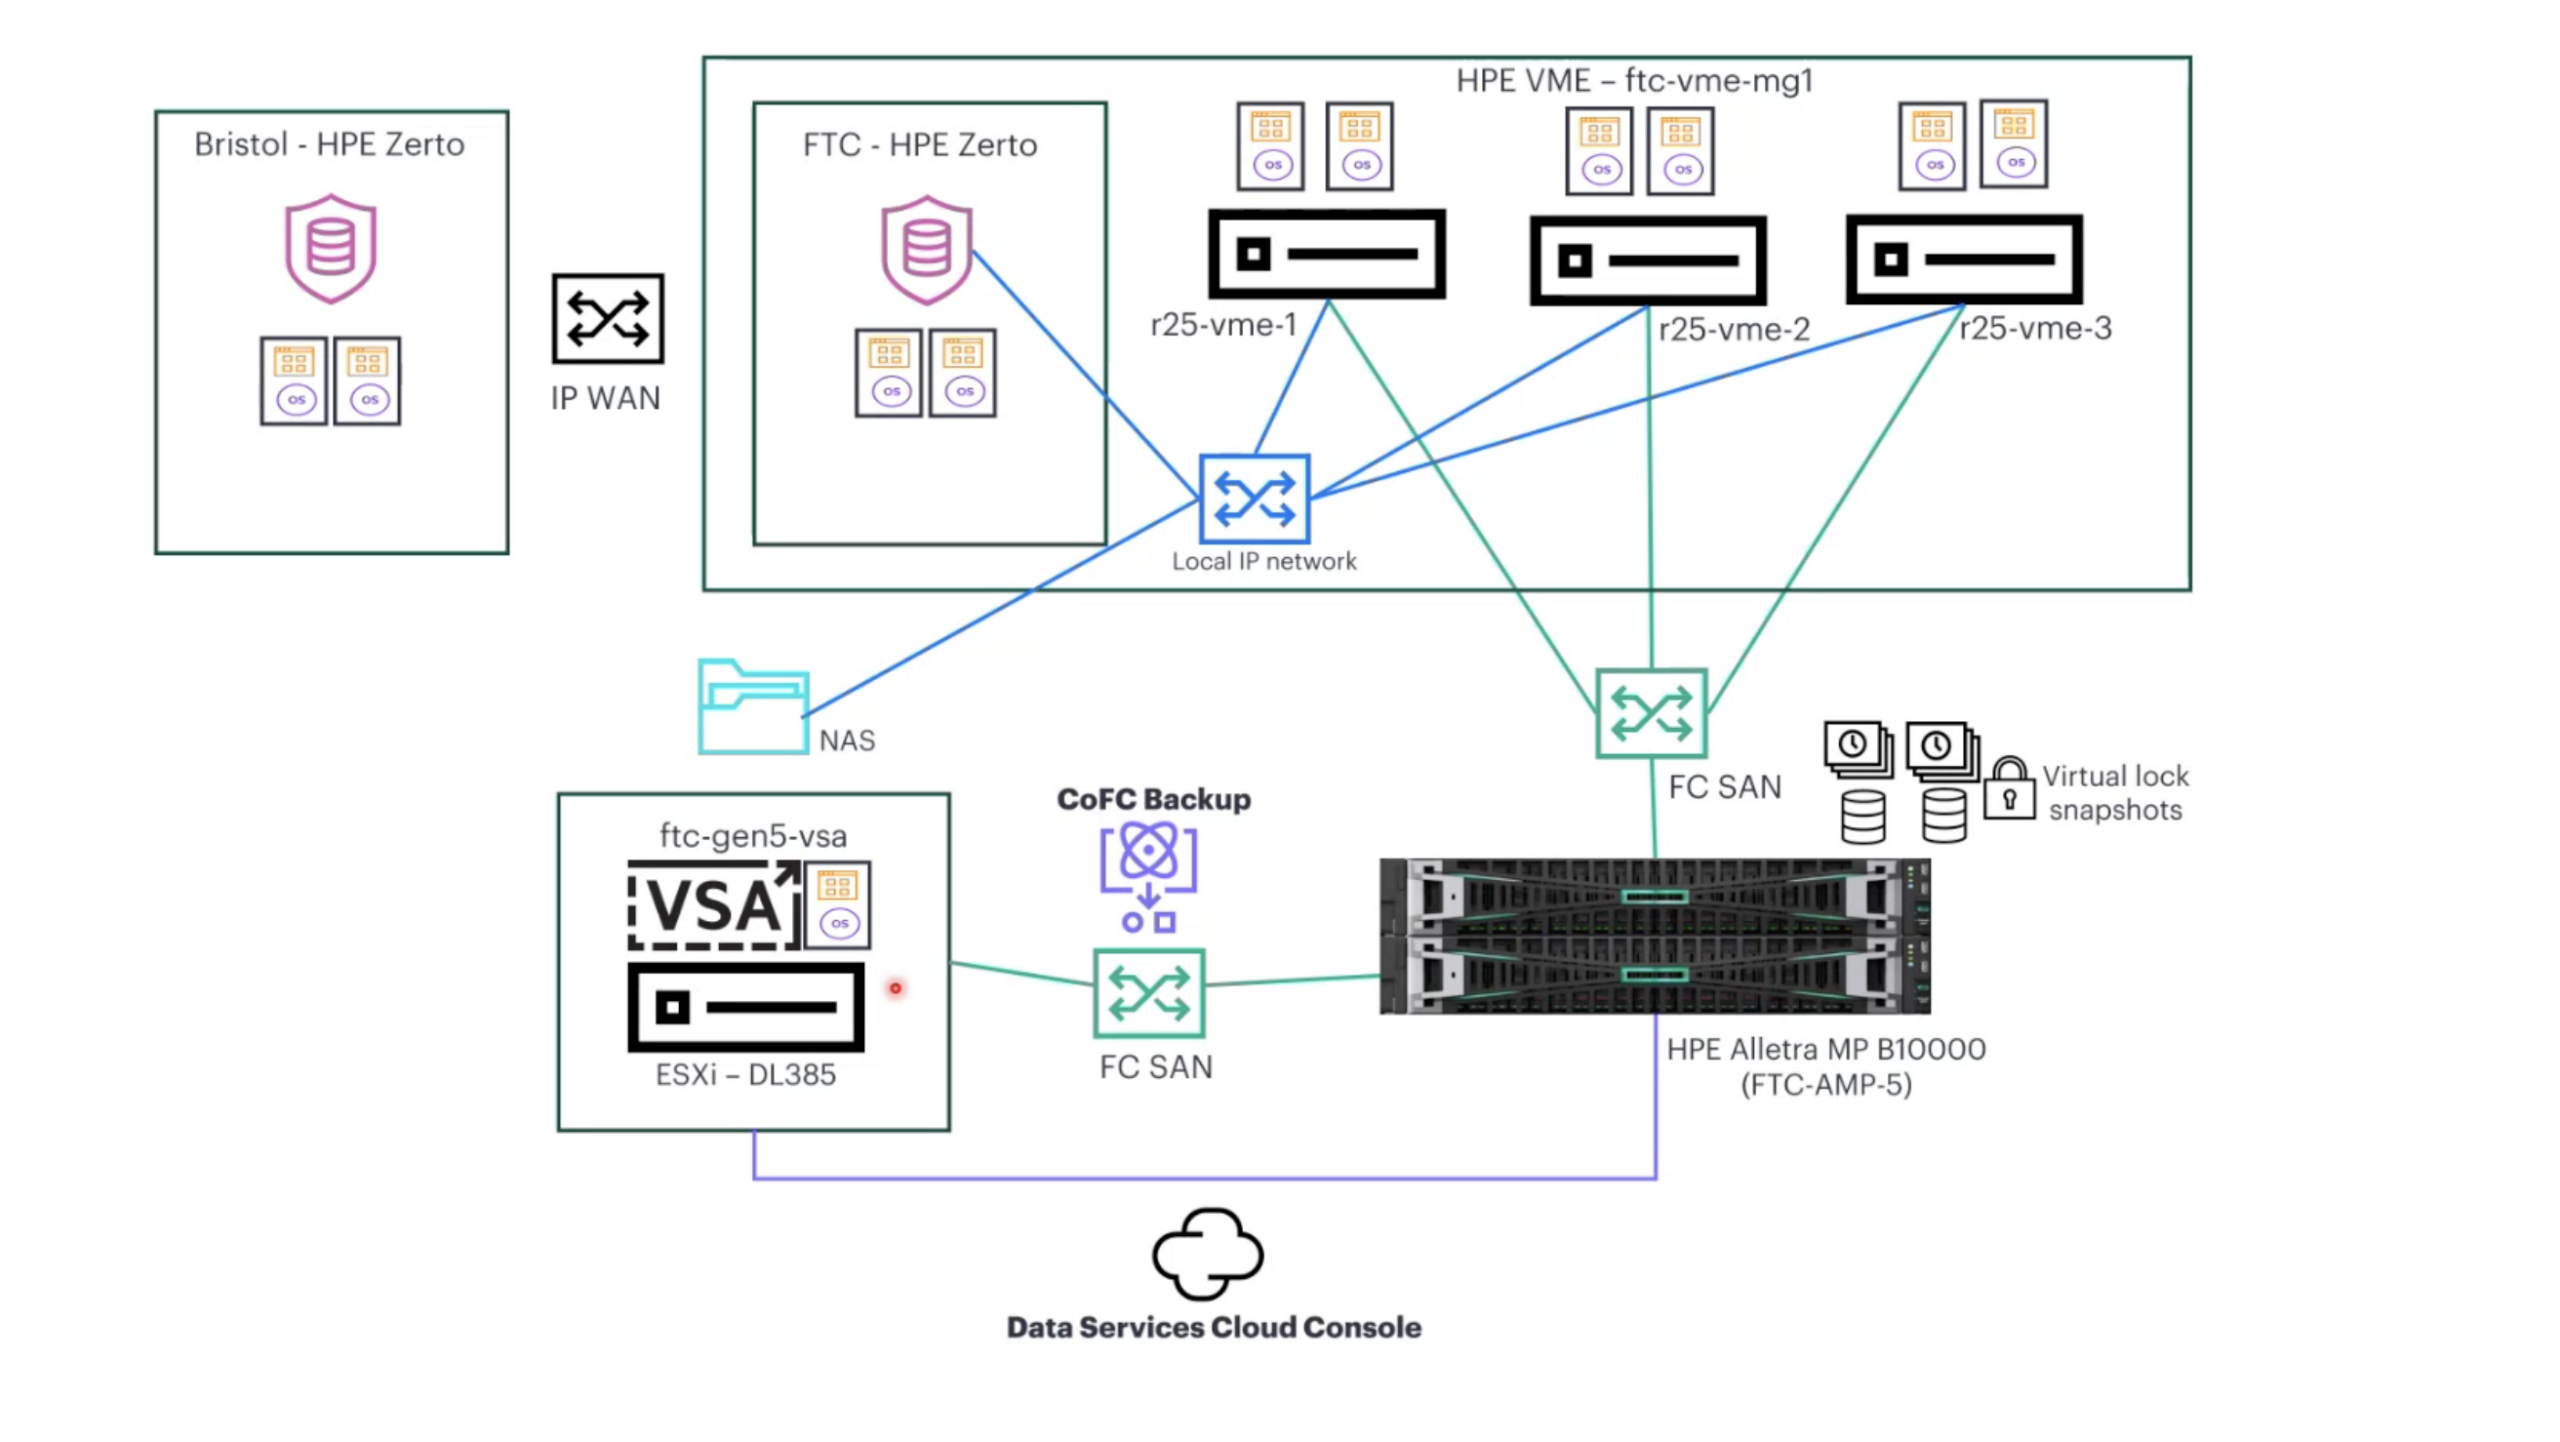
Dentro do cluster VME, são executadas as máquinas virtuais HPE Zerto, configuradas de forma semelhante à maneira como muitas organizações implementam o Zerto em um ambiente VMware tradicional. Embora a infraestrutura subjacente utilize o HPE VME, o fluxo operacional e a funcionalidade de recuperação permanecem familiares para administradores com experiência em fluxos de trabalho de recuperação de desastres baseados em VMware.
Um ambiente secundário Zerto conectado por WAN está disponível no laboratório de Bristol, no Reino Unido, com regras de firewall e caminhos de rede configurados para suportar a replicação a partir de Fort Collins. O objetivo dessa topologia é a recuperação em múltiplos locais: replicação contínua e orquestração de recuperação de desastres em locais geograficamente separados. Isso permitiria que as cargas de trabalho protegidas em Fort Collins fossem transferidas para Bristol caso o local primário ficasse indisponível.
Durante este projeto, a HPE executou a replicação Zerto localmente em Fort Collins devido a restrições de largura de banda e distância, e porque um segundo cluster VME paralelo não estava disponível para simular o fluxo completo entre locais. A parte de Bristol é documentada aqui como infraestrutura configurada e disponível, e não como um failover entre locais realizado nesta sessão.
A conectividade de armazenamento no ambiente é dividida entre redes IP e Fibre Channel, dependendo da carga de trabalho. A estrutura SAN FC conecta os hosts VME diretamente à plataforma HPE Alletra MP B10000, fornecendo acesso compartilhado ao armazenamento corporativo em todo o cluster. O B10000 também apresenta o Catalyst sobre Fibre Channel para o StoreOnce Virtual Storage Appliance (VSA), que é o caminho usado para backups consistentes com o aplicativo entre o array e o destino do backup. Os snapshots do Virtual Lock desempenham um papel central nos fluxos de trabalho de resiliência e imutabilidade contra ransomware na plataforma e são detalhados nas seções de Proteção e Recuperação.
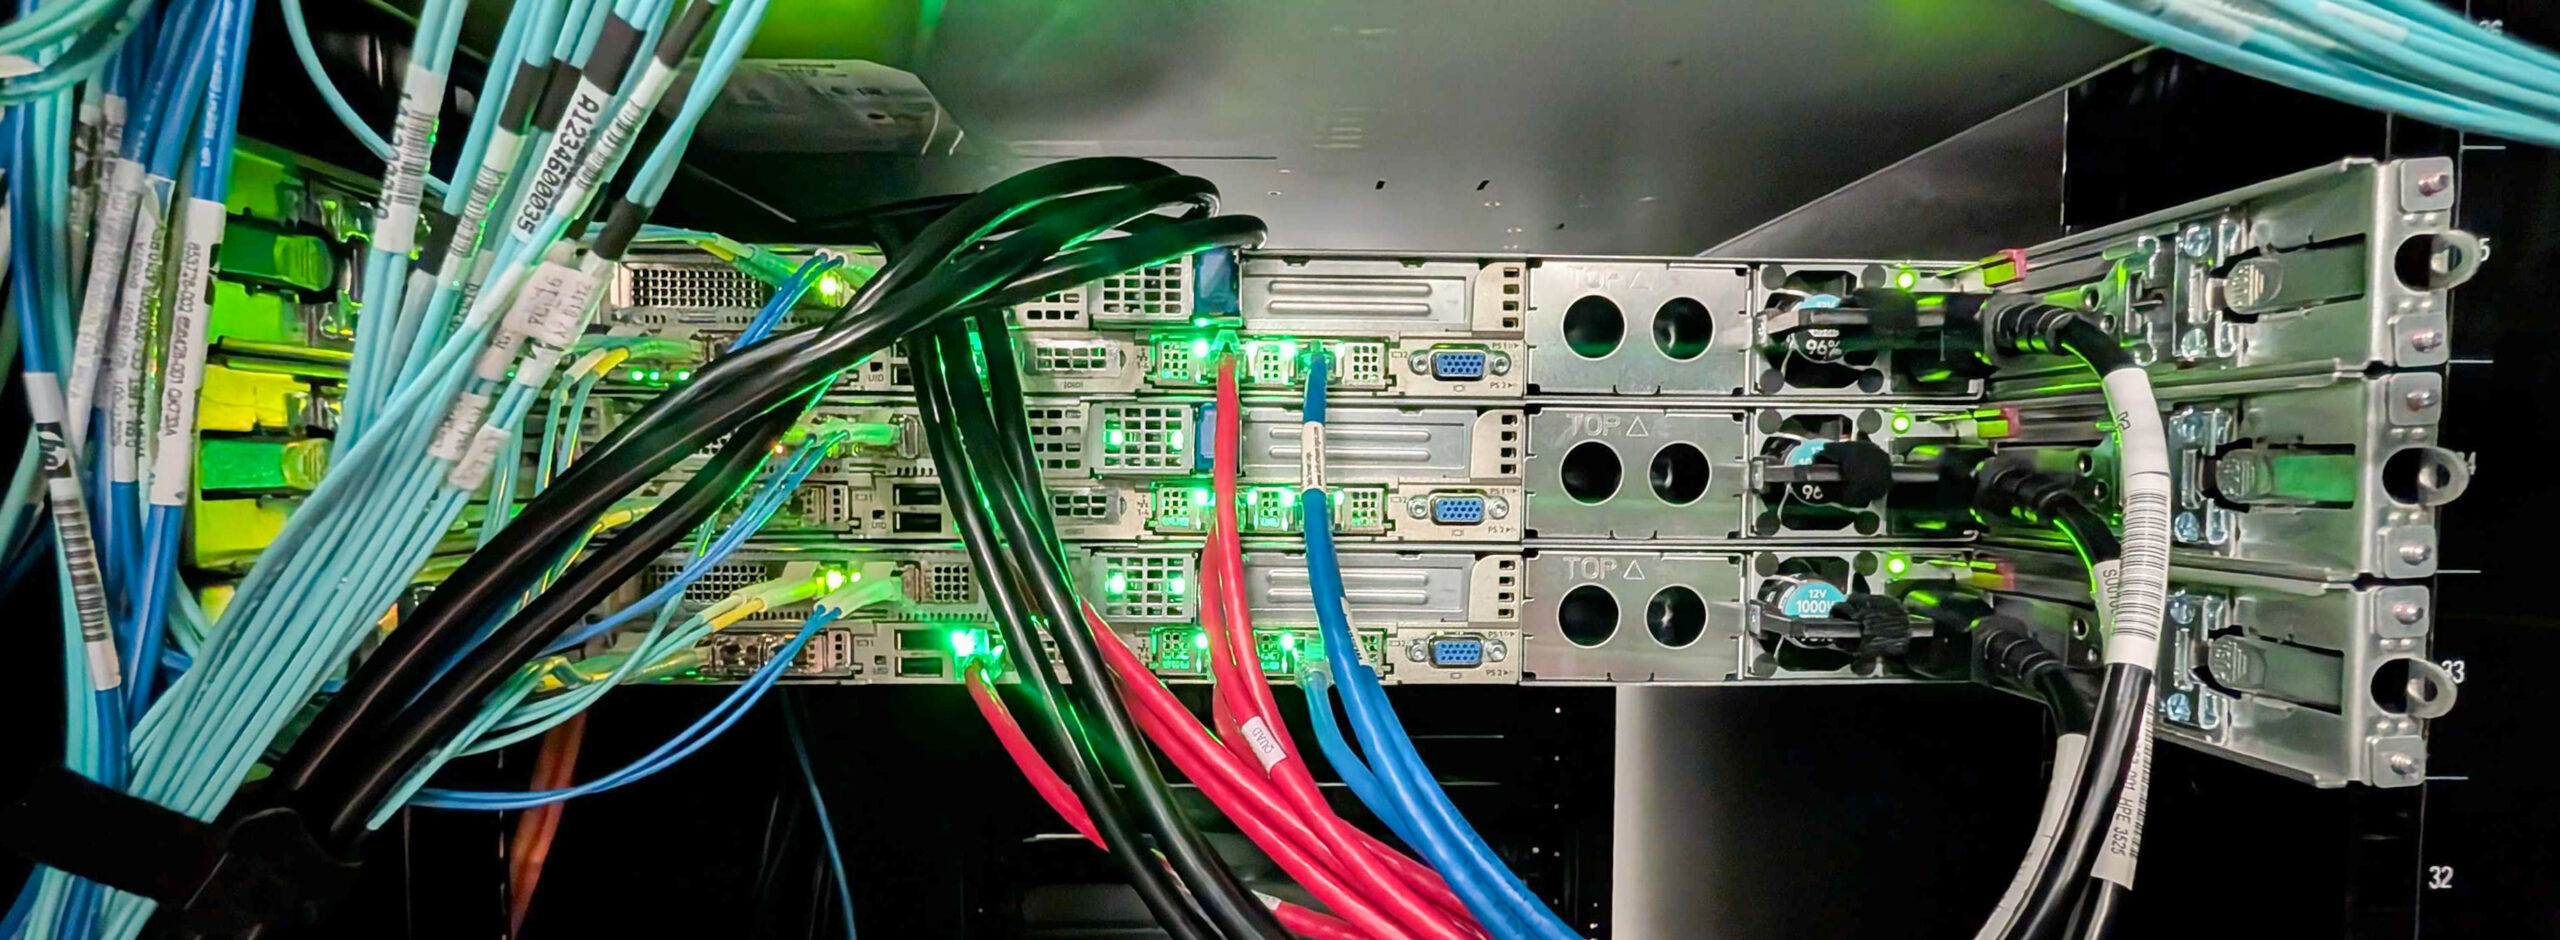
Para a infraestrutura de backup, a HPE implementou um StoreOnce Gen5 VSA executado em um único servidor HPE no laboratório. O VSA expõe a mesma funcionalidade principal do StoreOnce que o appliance dedicado. A deduplicação, a apresentação do destino do backup, o comportamento de replicação e a integração com o conjunto mais amplo de soluções de proteção de dados da HPE permanecem fundamentalmente os mesmos, seja implementado como um VSA ou em hardware dedicado. O VSA é ideal para laboratórios, filiais, ambientes de teste e casos de uso de produção de menor escala, tornando esta demonstração compacta prática para implementação.
O dispositivo físico StoreOnce oferece uma vantagem que vai além da escalabilidade e da capacidade de processamento, e é especialmente relevante no contexto de ransomware analisado neste artigo. Um VSA (Virtual Security Application) é executado como um convidado em um hipervisor. Se um invasor comprometer a camada de virtualização, todas as cargas de trabalho nela presentes, incluindo um destino de backup do VSA, estarão vulneráveis. Um dispositivo físico StoreOnce não possui essa dependência. Ele é executado em hardware dedicado fora do hipervisor, que um invasor teria que atravessar, mantendo o backup de último recurso em uma infraestrutura que o invasor ainda não tenha comprometido. Para implantações em produção onde o StoreOnce representa a camada de retenção de longo prazo em um projeto de resiliência cibernética, o dispositivo físico é a escolha mais robusta exatamente por esse motivo.
Tanto o sistema HPE Alletra MP quanto o StoreOnce VSA foram integrados ao HPE Data Services Cloud Console, proporcionando gerenciamento e visibilidade centralizados e baseados em nuvem em todo o ambiente. Por meio do Data Services Cloud Console, a infraestrutura pode ser monitorada, gerenciada e integrada a fluxos de trabalho mais amplos de serviços de dados da HPE a partir de uma única interface, interligando as operações de armazenamento, backup e recuperação.
Governar: Implementando sua estratégia
A HPE não elabora seu plano de governança. Sua organização, sua seguradora e sua equipe jurídica definem a política. A HPE fornece as interfaces (APIs, CLIs, Console do Data Services Cloud e os guias de segurança publicados) que permitem implementar essa política, comprová-la e auditá-la.
Essa distinção é importante porque a maioria dos fornecedores de armazenamento assume silenciosamente o oposto. Eles fornecem configurações padrão tendenciosas disfarçadas de melhores práticas e tratam a deriva de configuração como um problema de suporte, em vez de um sinal de governança. O B10000 inverte essa postura. Cada ação administrativa é registrada. Cada configuração relevante para a política é exposta por meio da API. O fluxo de syslog de segurança é estruturado para alimentar o mesmo SIEM onde o restante das evidências de governança da organização já reside. Quando um auditor pergunta quem alterou a política de senhas em uma data específica, a resposta está no mesmo painel que todos os outros sistemas governados no ambiente.
Duas disciplinas de governança merecem destaque específico. A primeira é o alinhamento regulatório. A arquitetura de registro de auditoria e integração com SIEM do B10000 suporta os controles operacionais exigidos pela Lei de Resiliência Operacional Digital da UE e pela Diretiva NIS2, abrangendo atividades de detecção, resposta e recuperação, fluxos de trabalho de relatórios de incidentes e a visibilidade de supervisão executiva esperada da liderança. A centralização da auditoria e da telemetria de segurança no SIEM operacionaliza essas obrigações. Os controles que o auditor espera ver não são adicionados posteriormente. São os mesmos controles que o centro de operações de segurança (SOC) já utiliza para operar a plataforma no dia a dia.
O segundo ponto é a supervisão executiva. As estruturas regulatórias exigem cada vez mais que a liderança demonstre visibilidade consolidada e oportuna dos riscos de tecnologia da informação e comunicação (TIC). Um array de armazenamento que oculta seu registro de auditoria por trás de um portal de suporte exclusivo do fornecedor não atende a esse requisito. Um que transmite eventos de auditoria e segurança diretamente para o SIEM do cliente, sim. O B10000 foi projetado para o segundo padrão.
A plataforma oferece diversas funcionalidades concretas. Guias de segurança documentados definem a postura inicial. Controles de acesso baseados em funções e mecanismos de dupla autorização reforçam a segregação de responsabilidades. A autenticação multifator é integrada. As diretrizes de segurança do Guia de Implementação Técnica de Segurança da Agência de Sistemas de Informação de Defesa (DISA STIG) são publicadas para ambientes que as exigem. O fluxo de logs de segurança transforma cada ação relevante para a governança em um evento consultável. O planejamento é do cliente. A instrumentação é de responsabilidade da plataforma.
Identificar: Confiança na Plataforma
Identificar, na estrutura do NIST CSF 2.0, significa entender o que a organização possui, de onde veio e quais riscos ela acarreta. Para uma plataforma de armazenamento, isso se traduz em integridade da cadeia de suprimentos, práticas de desenvolvimento seguras e uma postura inicial verificável.
A cadeia de suprimentos de hardware e software da HPE é fundamental. Os componentes são obtidos por meio de canais auditados, o firmware é assinado e as plataformas são enviadas com embalagens e lacres invioláveis que a equipe de recebimento pode verificar comparando-os com os manifestos de remessa. A avaliação da cadeia de suprimentos é um processo documentado que o Centro de Excelência em Segurança Cibernética da HPE utiliza para verificar se um B10000 que sai da fábrica em uma semana tem a mesma procedência que um B10000 que sai em outra semana.
As práticas de desenvolvimento seguro estendem essa cadeia ao software. O sistema operacional B10000 passa por testes de penetração estruturados, incluindo exercícios internos de equipe vermelha e engajamentos com terceiros, com as descobertas sendo incorporadas ao ciclo de lançamento. A identificação não é uma atividade pontual concluída na instalação. Trata-se da verificação contínua de que a plataforma confiável no primeiro dia ainda é a mesma plataforma presente no dia 400. O B10000 fornece os artefatos (firmware assinado, downloads com hash verificado, guias de reforço de segurança, documentação de desenvolvimento seguro e o fluxo de logs de auditoria) que possibilitam essa verificação. O que a equipe de segurança faz com esses artefatos é, novamente, uma decisão da equipe de segurança.
Proteção: Manutenção da Postura
A proteção do B10000 baseia-se em quatro mecanismos: agendamento imutável de snapshots de Virtual Lock, separação deliberada entre snapshots do array e snapshots do hipervisor, replicação para um segundo site através do Remote Copy nativo do array e do Zerto, e detecção contínua de desvios através do fluxo de logs de auditoria.
Agendamento de snapshots de bloqueio virtual imutável
Os snapshots de bloqueio virtual são criados de acordo com uma programação definida no array e aplicada diretamente pela plataforma de armazenamento B10000. Os snapshots permanecem imutáveis e somente leitura durante todo o período de retenção configurado, impedindo modificações ou exclusões até a expiração. As ações administrativas contra snapshots protegidos são registradas no log de auditoria. Esses registros podem ser encaminhados para plataformas SIEM externas, proporcionando visibilidade das tentativas de violação de políticas, incluindo tentativas de exclusão contra pontos de recuperação protegidos.
Snapshots B10000 versus snapshots VME
Nesse ambiente, as informações instantâneas provêm de dois lugares diferentes, e a formulação de políticas depende de mantê-los distintos.
Os snapshots agendados pelo B10000 são imutáveis e somente leitura, sendo regidos pela retenção do Virtual Lock. Os snapshots do VME, criados pelo HPE Morpheus VM Essentials na camada do hipervisor, são mutáveis e permitem leitura e gravação para fluxos de trabalho operacionais em nível de máquina virtual.
Se um invasor obtiver acesso ao hipervisor, os snapshots do VME se tornarão acessíveis. Os snapshots do Virtual Lock não são. O cronograma do Virtual Lock define o limite mínimo de retenção. Os snapshots do VME preenchem a camada operacional acima dele.
Replicação: nativa do array e em nível de aplicação
Um snapshot de Virtual Lock no site primário não protege contra eventos em nível de site, e a arquitetura oferece dois caminhos de replicação distintos para lidar com isso. O primeiro é nativo do array: o B10000 Remote Copy replica volumes de forma assíncrona para um segundo B10000 em outro site e, quando combinado com agendamentos de snapshots de Virtual Lock no destino, resulta em um cofre imutável e fisicamente separado que não depende do hipervisor ou de qualquer software da camada de aplicação. O segundo é o Zerto, que opera na camada de aplicação com replicação quase síncrona e registro contínuo de logs, fornecendo o caminho de recuperação granular e com baixo objetivo de ponto de recuperação (RPO) descrito na seção Recuperação.
As duas soluções são complementares, e não redundantes. O Remote Copy preserva as garantias de imutabilidade impostas pelo array entre os sites, enquanto o Zerto oferece granularidade de checkpoint e failover orquestrado em nível de máquina virtual. Neste projeto, a topologia foi configurada para suportar a replicação do Zerto de Fort Collins para as instalações da HPE em Bristol, Reino Unido, mas durante a sessão de teste, a replicação foi executada localmente em Fort Collins devido a limitações de largura de banda e cluster paralelo. O trecho de Bristol está disponível como uma topologia para uma atividade subsequente, não como uma demonstração de recuperação entre sites.
Detecção de desvio de configuração
O guia de segurança define uma linha de base. O fluxo contínuo de logs de auditoria permite que um SIEM verifique, em tempo quase real, se a linha de base não sofreu desvios. Alterações nas políticas de senhas, alterações nas políticas de bloqueio, novas contas, elevações de função, modificações de agendamento e alterações nos destinos de replicação são todos identificados como eventos consultáveis. O ambiente de laboratório não incluía um SIEM, portanto, a detecção de desvios neste projeto foi observada no nível do log de auditoria B10000, em vez de em uma ferramenta de correlação centralizada. Em um ambiente de cliente com um SIEM implementado, os mesmos eventos de auditoria são enviados ao SIEM por meio da integração com o syslog descrita na seção Detectar.
Detectar: Visibilidade e Alerta Antecipado
O B10000 vem com um mecanismo integrado de detecção de ransomware que monitora os padrões de E/S de armazenamento em tempo real e emite um alerta quando a assinatura estatística de criptografia em larga escala aparece nas gravações no array. O Centro de Excelência em Segurança Cibernética da HPE validou o mecanismo contra mais de 100 variantes de ransomware líderes.
A detecção é habilitada individualmente para cada armazenamento de dados no lado do VME. Quando um armazenamento de dados é criado ou editado no VME em um servidor de armazenamento B10000, a opção de Detecção de Ransomware é ativada por padrão para cada volume provisionado nesse armazenamento, com personalização por volume disponível após a criação. Essa funcionalidade requer a versão 10.5.0 ou posterior do sistema operacional B10000. No laboratório de Fort Collins, o armazenamento de dados ftc-vme-mg1 foi configurado para se conectar ao FTC-AMP-5 B10000 via Fibre Channel, com a detecção de ransomware habilitada. Essa configuração foi utilizada para a simulação de ataque de ransomware descrita posteriormente nesta seção.
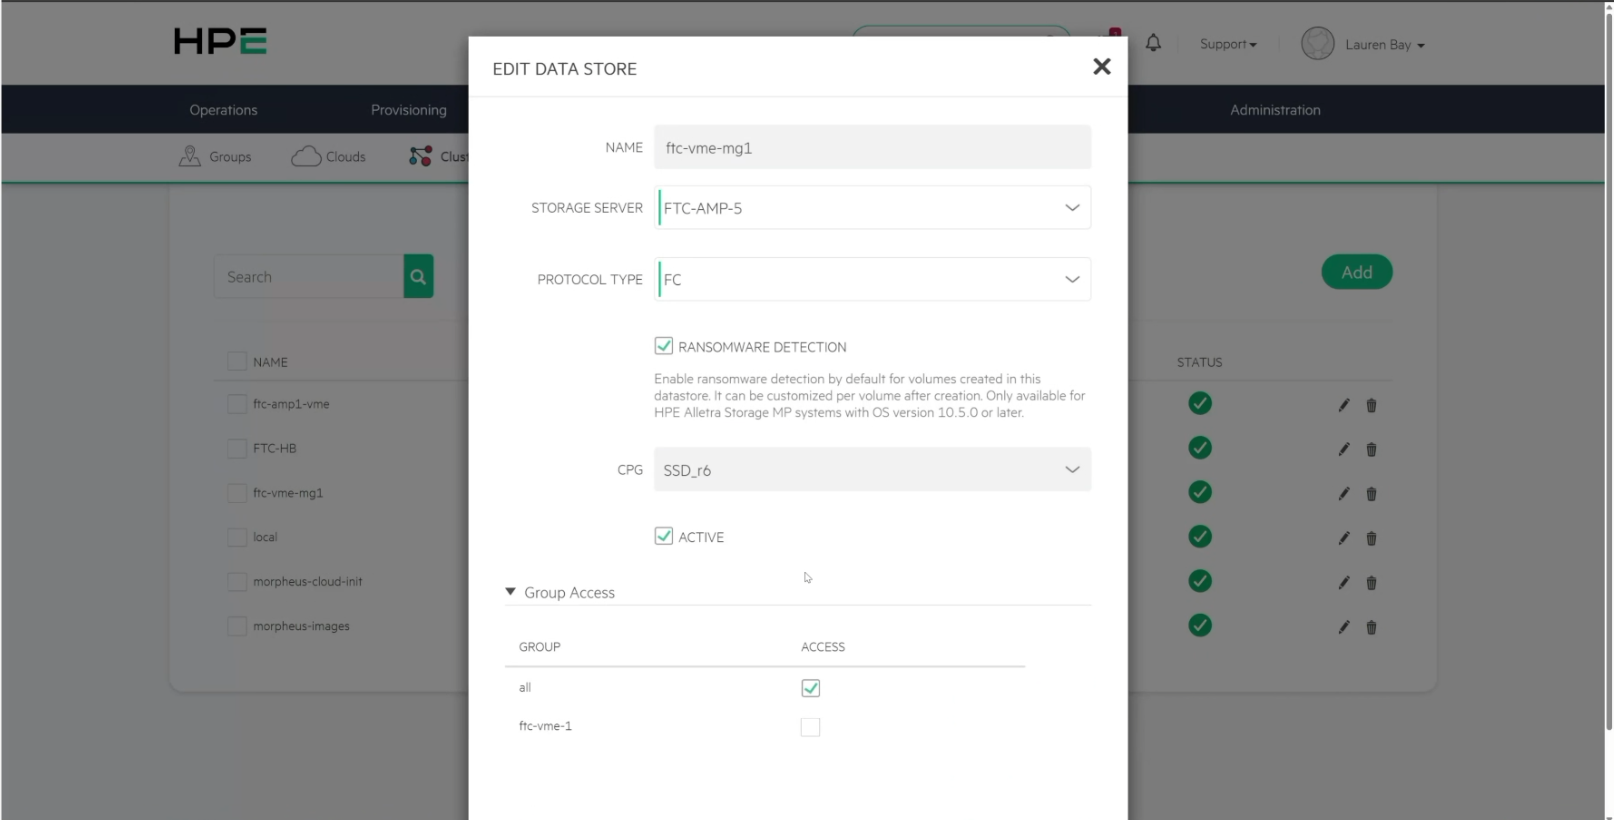
Configuração do armazenamento de dados VME mostrando o armazenamento de dados ftc-vme-mg1 no FTC-AMP-5 B10000 via Fibre Channel, com a Detecção de Ransomware ativada.
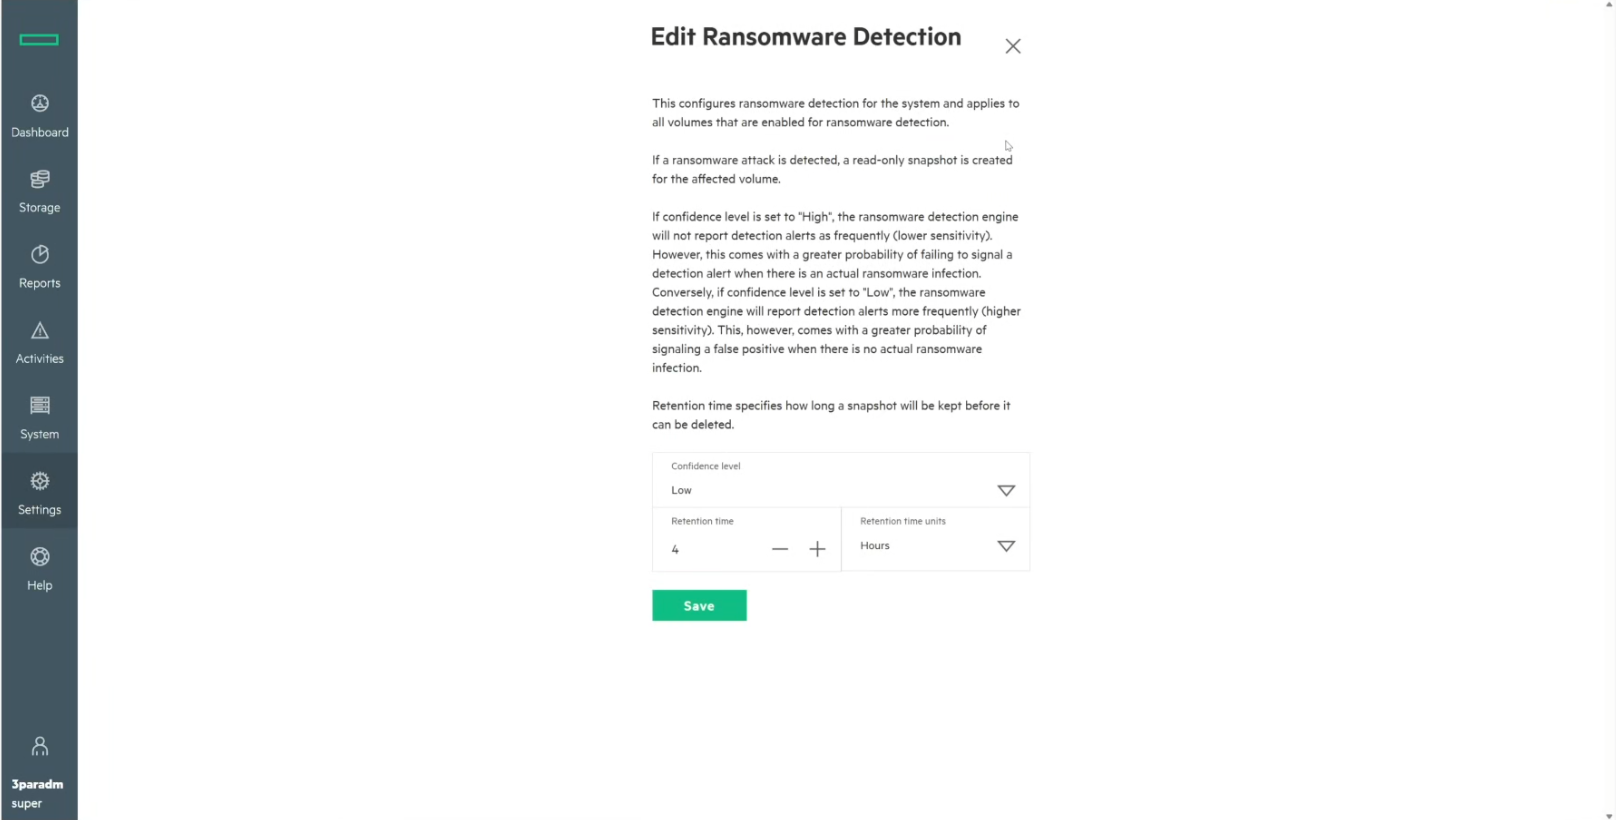
O B10000 também oferece suporte a políticas de detecção de ransomware em todo o sistema diretamente no array de armazenamento, permitindo que os administradores definam a sensibilidade de detecção global e o comportamento de retenção automática de snapshots em todos os volumes protegidos. Como mostrado abaixo, o ambiente de Fort Collins teve a política de detecção de ransomware em nível de array habilitada com um perfil de sensibilidade de baixa confiança e retenção automática de snapshots configurada. Isso fornece uma camada adicional de proteção além da habilitação por armazenamento de dados no VME, garantindo que o mecanismo de detecção permaneça aplicado de forma consistente no nível da plataforma, independentemente de como os volumes individuais são provisionados.
A lógica de detecção para ambos os casos é baseada em entropia. Dados aleatórios, que representam a aparência dos dados criptografados em nível de bloco, possuem alta entropia. Dados legítimos de carga de trabalho, mesmo quando comprimidos, possuem uma estrutura que o mecanismo reconhece. O mecanismo utiliza um cálculo de entropia CuSum para medir a desordem nas gravações recebidas em relação a uma linha de base estabelecida. Essa linha de base é aprendida durante uma janela de treinamento, quando um novo volume é protegido pela primeira vez, e mantida por um perfil de E/S contínuo de uma hora, de modo que mudanças legítimas na carga de trabalho não gerem falsos positivos. Quando a entropia se desvia da linha de base por uma margem estatisticamente significativa, o mecanismo sinaliza o volume.
Para o SOC, o ponto crucial é que este é um mecanismo de detecção de criptografia que serve como última linha de defesa para o ambiente, e não como substituto da proteção de endpoints. O endpoint é onde o ransomware deve ser detectado primeiro. O B10000 detecta o que o endpoint não detectou.
Integração SIEM
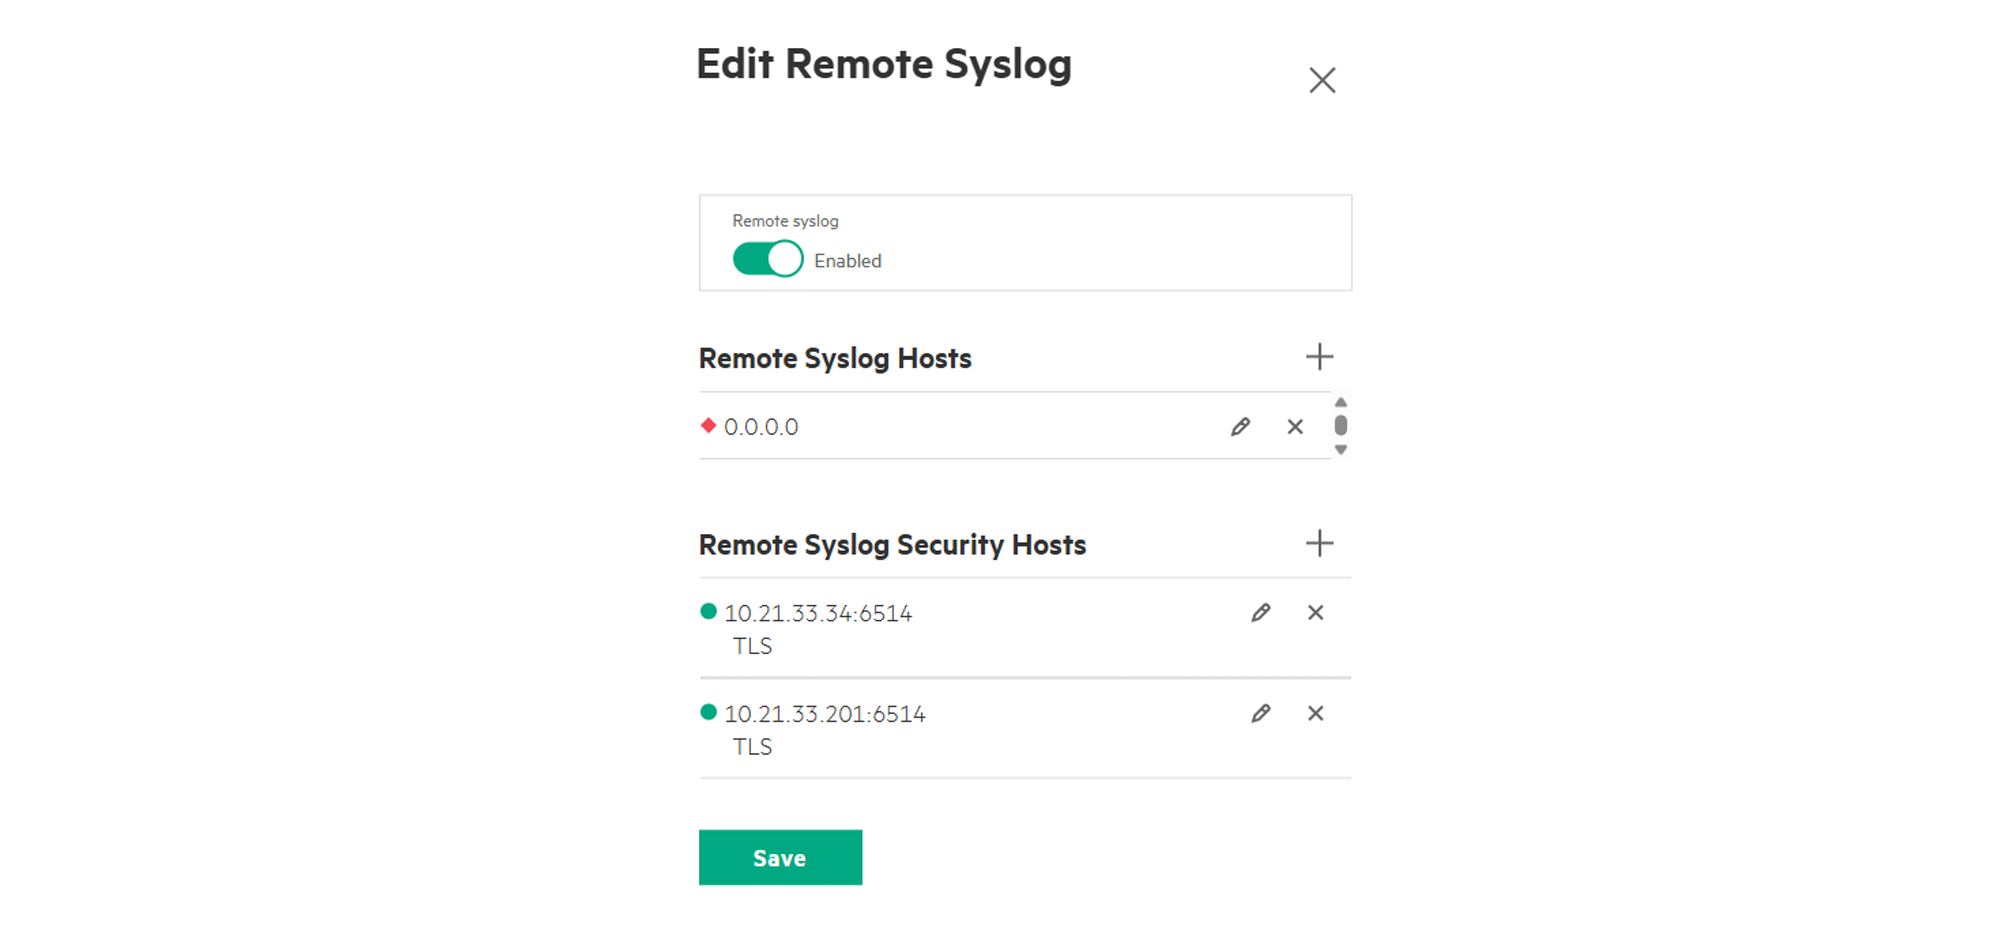
A integração é propositalmente independente de fornecedores. O papel da HPE é fornecer a base e as ferramentas para que o B10000 possa alimentar qualquer SIEM que a organização já utilize com dados de auditoria e logs de segurança, em vez de direcionar os clientes para uma única ferramenta preferida pela HPE. Alertas de detecção e eventos de auditoria são exportados através do fluxo syslog de segurança. O agregador baseado em Fluentd, publicado pela HPE no GitHub, recebe a mensagem syslog bruta, normaliza-a para o Elastic Common Schema e marca o evento com campos como “event.kind: alert” e “event.severity: high”, para que o mecanismo de regras existente da plataforma receptora o reconheça sem necessidade de análise personalizada. A distinção importante é que esses dados não são apenas compatíveis com SIEMs modernos; eles são ativos. Chegam estruturados para acionar alertas automatizados e respostas subsequentes, em vez de ficarem arquivados em um arquivo de logs aguardando consulta posterior. O Elastic Security e o CrowdStrike Falcon Next-Gen SIEM são plataformas que a HPE validou explicitamente, e o formato syslog aberto significa que o Microsoft Sentinel e outros SIEMs modernos podem ser integrados com um esforço comparável.
Simulação de ransomware em um host Windows
Durante testes remotos no laboratório da HPE em Fort Collins, uma carga de trabalho simulada de ransomware foi executada contra um host Windows conectado a um volume protegido por Virtual Lock no B10000. A simulação executou um script de criptografia controlado que produziu o padrão de gravação de alta entropia característico de um evento de criptografia de ransomware, sem usar malware real.
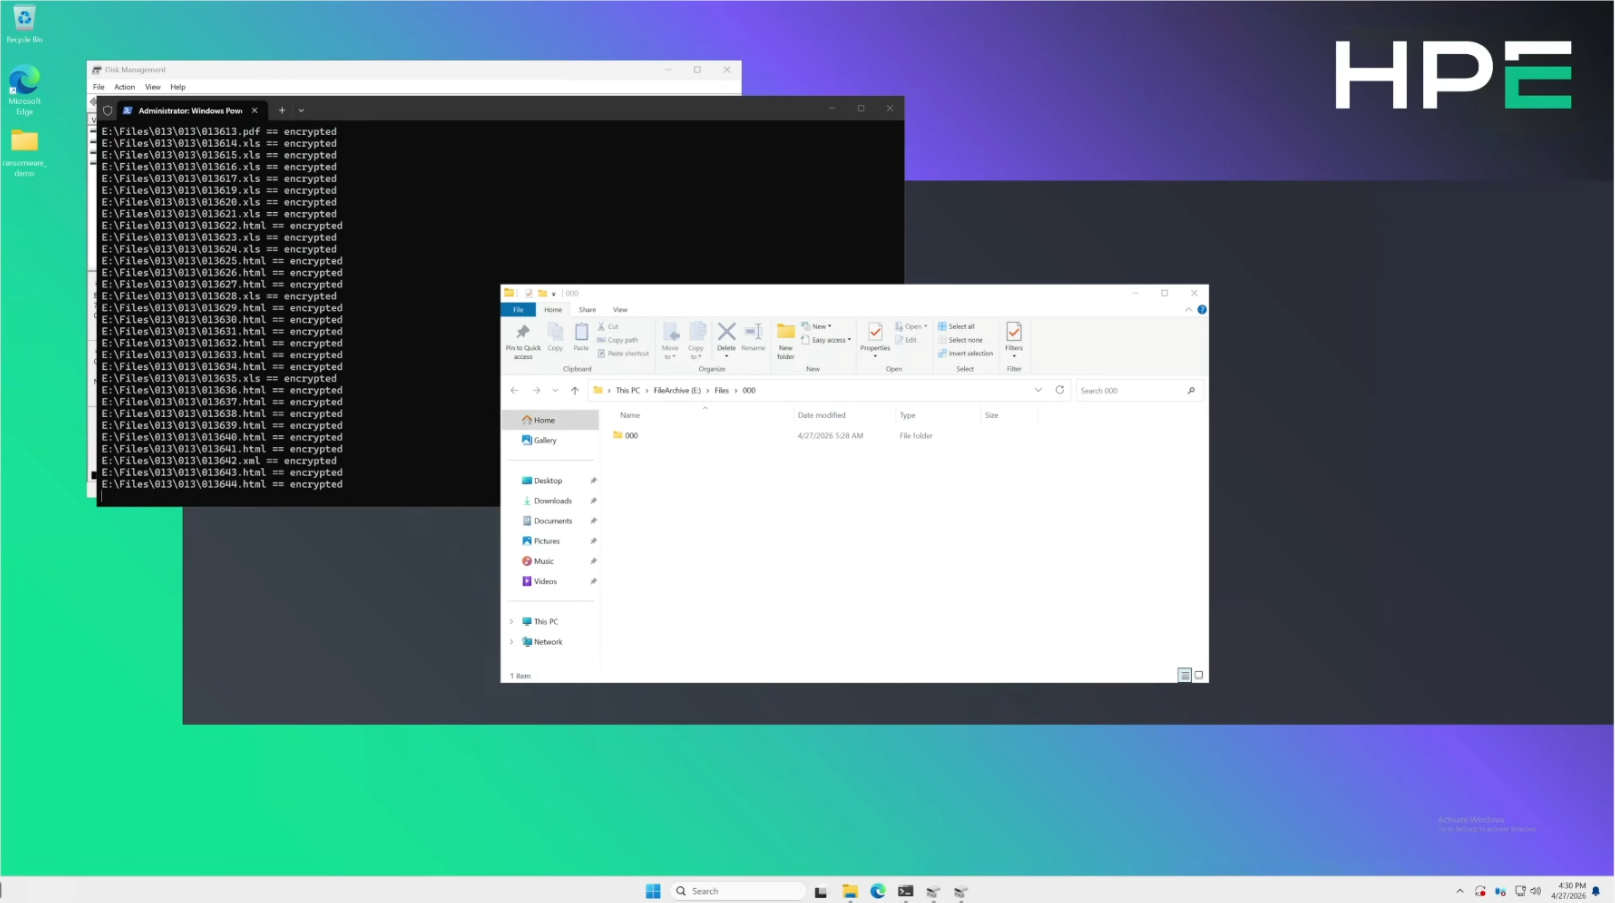
O mecanismo de detecção B10000 gerou o alerta entre quatro e cinco minutos após o início da gravação do script de criptografia no volume. O alerta foi exibido no console de gerenciamento do B10000, com a identificação do volume afetado.
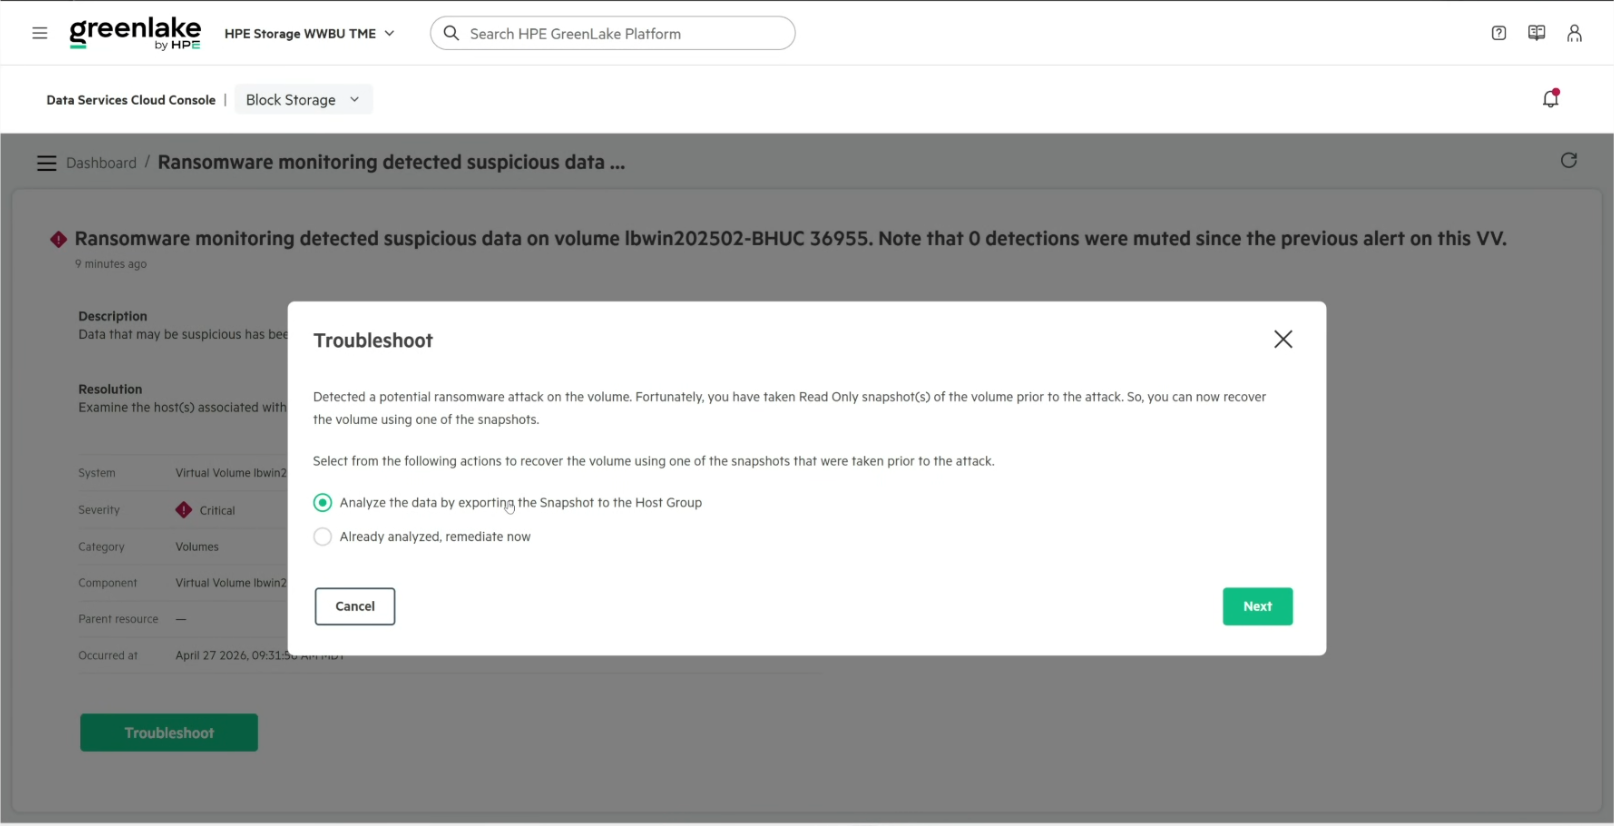
A janela de quatro a cinco minutos é curta o suficiente para que snapshots imutáveis, tirados no momento da detecção ou próximo a ele, capturem um ponto no tempo preciso antes que o invasor termine de percorrer o volume. É mais rápido do que a maioria das análises comportamentais executadas na camada de aplicação, porque o B10000 vê as gravações no nível do bloco assim que elas ocorrem.
Responder: do alerta à ação
Quando o mecanismo de detecção de ransomware B10000 é acionado, a plataforma toma medidas de proteção por conta própria, antes que qualquer sistema externo seja envolvido. No momento da detecção, o array captura um snapshot imutável do volume afetado e marca seu status como degradado. Este snapshot de alerta não é um ponto de recuperação limpo e não deve ser usado para restauração, pois pode conter dados criptografados. Ele se destina à análise forense, preservando o estado do volume no momento em que o ataque foi detectado. Notavelmente, o array não bloqueia o acesso ao volume. Os dados permanecem acessíveis, o que é uma escolha de projeto deliberada. O array dispara o alarme e preserva as evidências. Ainda assim, deixa a decisão de como proceder para os operadores, que estão em melhor posição para avaliar se o evento é um ataque genuíno ou um falso positivo, como uma grande carga de trabalho legítima de criptografia ou compressão.
Esse comportamento autônomo representa o limite mínimo, e não o máximo, da capacidade de resposta. Como é executado diretamente no array, não depende da ativação de uma regra SIEM, da integridade do fluxo syslog ou da disponibilidade de uma ferramenta de automação externa. Se todas as outras camadas falharem, o registro instantâneo do momento ainda existirá. Essa independência é o ponto crucial: a resposta mais importante ocorre independentemente do funcionamento do restante da infraestrutura.
Acima desse nível, a integração ativa com o SIEM descrita na seção Detectar permite a resposta orquestrada. Como os alertas do B10000 chegam estruturados para acionar ações em vez de serem arquivados, o cliente pode criar fluxos de trabalho automatizados na plataforma SIEM ou de orquestração, automação e resposta de segurança (SOAR) que já utiliza, seja estendendo a retenção de snapshots nos volumes afetados, isolando o host, abrindo um chamado de incidente ou notificando a equipe de resposta. A HPE fornece o sinal ativo e estruturado. A lógica de orquestração reside nas ferramentas escolhidas pelo cliente, mantendo a resposta alinhada aos fluxos de trabalho de execução e aprovação já criados pela equipe de segurança.
Um esclarecimento é importante aqui, pois a linguagem da interface pode ser complexa. O alerta B10000 oferece uma opção para analisar os dados, mas o próprio sistema não busca nem identifica malware específico. Essa opção pressupõe que o cliente possua suas próprias ferramentas de varredura e análise forense para identificar os dados afetados. A função do B10000 é a detecção e preservação, não a remediação.
Recuperação: Restauração e Validação em Camadas
A recuperação é um conjunto hierárquico de decisões: qual ponto de recuperação, a partir de qual nível, restaurado para qual ambiente, validado por qual processo. A arquitetura construída no laboratório de Fort Collins suporta um modelo de recuperação de quatro níveis, onde cada nível existe porque os outros não resolvem o mesmo problema.
Nível 1: Zerto para proteção contínua. A replicação quase síncrona com registro contínuo em diário oferece o menor RPO da pilha. A restauração granular permite que a equipe de resposta a incidentes reverta uma única VM ou arquivo para um ponto de verificação de instantes antes do evento de criptografia. Esta é a camada ideal quando o alerta é acionado rapidamente e a janela de oportunidade do invasor é curta.
Nível 2 : Proteção nativa do VME para restauração diária em nível de VM. O fluxo de snapshots do HPE Morpheus VM Essentials oferece recuperação operacional com granularidade de VM. Este é o nível que lida com o trabalho rotineiro de restauração e serve como alternativa caso o Nível 1 esteja indisponível.
Nível 3: Snapshots imutáveis do Virtual Lock B10000 para reversão em nível de volume. Este é o nível mais importante em casos de ransomware. Os snapshots do Virtual Lock são protegidos contra exclusão e modificação, e a operação de promoção é nativa do B10000, sem dependências de fornecedores independentes de software (ISVs) de terceiros.
Nível 4: Restauração do StoreOnce Catalyst para retenção de longo prazo e recuperação entre arrays. Os níveis 1 a 3 protegem contra eventos que duram horas ou dias. O nível 4 protege contra eventos que duram semanas ou meses, em casos onde o invasor estabeleceu persistência muito antes da criptografia ser acionada e quando o único ponto de recuperação limpo é mais antigo do que o período de retenção de qualquer snapshot do armazenamento primário. Os armazenamentos Catalyst são deduplicados, imutáveis e podem ser replicados entre sistemas StoreOnce ou desanexados para o armazenamento de objetos Cloud Bank. O Catalyst Copy e o Cloud Bank Detach juntos fornecem o "1" no modelo 3-2-1-1. Este também é o nível onde a distinção entre físico e VSA, mencionada na visão geral da arquitetura, tem maior peso. Como opção de recuperação de último recurso, o nível 4 deve ser capaz de sobreviver a uma violação do hipervisor. Esse é o argumento para implantar o StoreOnce em um appliance físico dedicado em vez de um VSA em produção.
Avaliação de Encerramento
As duas perguntas que um profissional de segurança faz sobre uma plataforma de armazenamento são se a infraestrutura permanece sob o controle da organização e se os dados permanecem protegidos. Após analisar a arquitetura no laboratório de Fort Collins, o B10000 responde a ambas as perguntas de forma mais completa do que um array de armazenamento isolado normalmente consegue, porque a resposta não se limita ao array.
A plataforma registra todas as ações administrativas, expõe todas as configurações relevantes para as políticas por meio de sua API e transmite os dados de auditoria e telemetria de segurança resultantes para qualquer SIEM que a organização já utilize. O plano de governança continua sendo de responsabilidade do cliente, mas a instrumentação necessária para implementá-lo, comprová-lo e apresentá-lo a um auditor está presente e exposta, em vez de oculta atrás de um portal do fornecedor. Os snapshots imutáveis do Virtual Lock significam que mesmo uma conta de administrador comprometida não pode destruir silenciosamente os pontos de recuperação, e qualquer tentativa nesse sentido se torna um evento registrado e consultável.
Em termos de proteção, o ciclo de detecção e recuperação no centro da arquitetura foi o que se mostrou mais eficaz. O B10000 sinalizou a carga de trabalho de criptografia simulada em quatro a cinco minutos, no nível de bloco, e capturou um snapshot forense no momento da detecção, sem depender de um sistema externo. O volume afetado foi recuperado com sucesso tanto por meio de um snapshot agendado do Virtual Lock quanto por uma restauração do StoreOnce Catalyst. Essa é a sequência mais importante durante um incidente, e tudo isso ocorreu sem a necessidade de um produto de terceiros na cadeia de dependências.
O que diferencia a arquitetura não é o fato de o B10000 ser dramaticamente mais seguro do que os arrays concorrentes quando considerados isoladamente. É que a HPE é uma das poucas fornecedoras posicionadas para oferecer armazenamento, virtualização, replicação, backup e observabilidade como um sistema coordenado, e para testar esse sistema como um todo contra ransomware em seu próprio laboratório, em vez de validar cada componente isoladamente. Para uma empresa que possui a infraestrutura, mas responde a uma equipe de segurança separada e a um órgão regulador externo, essa coordenação representa a diferença entre um conjunto de produtos competentes e uma estratégia de resiliência que pode ser operada sob pressão.
A arquitetura também está avançando rapidamente. A HPE mantém um ritmo constante de lançamentos em toda a sua plataforma, com integração mais estreita entre o VM Essentials e o B10000, detecção de ransomware expandida para tipos de dados adicionais além de volumes de blocos e uma arquitetura de referência completa publicada, tudo isso previsto para o curto prazo. A tendência aponta para uma maior coordenação gerenciada nativamente pela plataforma e um modelo mais claro para a implementação do tipo de design de resiliência analisado neste artigo.
Durante anos, o sistema de armazenamento foi tratado como um dos ativos mais seguros do edifício, principalmente porque ninguém lhe dava a devida atenção. A proposta desta arquitetura é que o sistema de armazenamento deveria ser o oposto: não a caixa esquecida no canto, mas um participante ativo na detecção e sobrevivência a um ataque, desde que a organização se esforce para transformar as capacidades em um plano.
Página do produto HPE B10000
Recursos adicionais
HPE Alletra Storage MP B10000 – Resiliência cibernética com detecção de ransomware adaptável a dados
Estrutura de proteção contra ransomware para o HPE Alletra Storage MP B10000
HPE Alletra Storage MP B10000 – integração SIEM
Guia de segurança para administradores do HPE Alletra Storage MP B10000
Guia de segurança do HPE Alletra Storage MP B10000
Vídeos
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-r6-ransomware-detection-with…
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-and…
Este relatório é patrocinado pela HPE. Todas as visões e opiniões expressas neste relatório são baseadas em nossa visão imparcial do(s) produto(s) em consideração.



 Amazon