

O Lenovo ThinkSystem SR650 V4 é um servidor rack 2U flexível e poderoso com 2 sockets, projetado para atender às necessidades de setores como serviços em nuvem, telecomunicações e computação de alto desempenho (HPC). Seja para otimizar cargas de trabalho escaláveis ou para preparar seu data center para o futuro com computação de alta densidade, o SR650 V4 oferece melhorias significativas em relação ao seu antecessor, o SR650 V3.

Diferenças entre Lenovo SR650 V4 e SR650 V3
Processadores
As capacidades do processador representam uma das melhorias mais significativas do SR650 V4. Enquanto o SR650 V3 utilizava processadores Intel Xeon Scalable de 4ª geração, o SR650 V4 introduz a plataforma Intel Xeon 6 (anteriormente conhecida pelo codinome “Granite Rapids”). Nossa análise se concentra na arquitetura P-core (Performance-core), projetada especificamente para cargas de trabalho com uso intensivo de computação. O V4 suporta um ou dois processadores com até 86 núcleos P por soquete (até 172 threads), oferecendo velocidades de núcleo mais altas (até 4 GHz) e TDPs de até 350 W.
Essa transição permite que as organizações lidem com aplicações mais exigentes por servidor, reduzindo sua infraestrutura física. A arquitetura cria uma base robusta para virtualização e operações de banco de dados complexas. Além disso, a arquitetura do V4 suporta largura de banda PCIe massiva, com até 88 pistas PCIe 5.0 por processador, o que é essencial para alimentar adaptadores de rede modernos de alta velocidade e arrays de armazenamento NVMe sem gargalos.
| Modelo de CPU | Cores / Fios | Base Freq | Max turbo | L3 Cache | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350 W |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350 W |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330 W |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330 W |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300 W |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300 W |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270 W |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270 W |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205 W |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350 W |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245 W |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250 W |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210 W |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165 W |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225 W |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255 W |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225 W |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210 W |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190 W |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150 W |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150 W |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150 W |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150 W |
Memória
Em relação à memória, o SR650 V4 aprimora significativamente os recursos do V3, maximizando o desempenho do subsistema. Ele suporta velocidades de memória DDR5 de até 6400 MHz (1 DIMM por canal), um salto substancial em relação ao limite de 4800 MHz da geração anterior. O sistema possui 32 slots DIMM (16 por processador) distribuídos em oito canais de memória por processador. Ele suporta RDIMMs padrão, RDIMMs 3DS e os novos DIMMs de classificação multiplexada (MRDIMMs), que podem operar em velocidades de até 8000 MHz para aplicações que exigem muita largura de banda. Utilizando RDIMMs 3DS de 256 GB, o servidor suporta uma enorme capacidade de memória total do sistema de 8 TB.

Além disso, a versão 4 introduz suporte para expansão de memória CXL 2.0 (Compute Express Link). Os administradores podem instalar até 12 módulos de memória CXL nos compartimentos de unidade E3.S (especificamente no formato E3.S 2T). Isso permite que o sistema expanda a capacidade e a largura de banda da memória além dos limites tradicionais conectados ao processador, reduzindo a latência de computação para cargas de trabalho de última geração e diminuindo o Custo Total de Propriedade (TCO) ao reduzir o tempo ocioso de memória.
Armazenamento
As capacidades de armazenamento do Lenovo SR650 V4 demonstram uma mudança em direção à alta densidade de NVMe de alto desempenho e formatos flexíveis. Embora suporte unidades legadas de 3.5 e 2.5 polegadas, o V4 introduz suporte massivo para o formato NVMe E3.S. O sistema pode acomodar até 32 unidades E3.S de 1 TB ou 12 unidades E3.S de 2 TB, oferecendo maior densidade e gerenciamento térmico aprimorado em comparação com os SSDs U.2 tradicionais.

Fundamentalmente, a V4 suporta conectividade NVMe direta sem sobreassinatura (1:1), garantindo que o armazenamento de alta velocidade não seja limitado pelo compartilhamento de pistas PCIe. A inclusão de opções de unidade de inicialização hot-swap M.2 aprimora ainda mais a facilidade de manutenção.
Networking
Para conectividade de rede, o SR650 V4 possui dois slots OCP 3.0 dedicados, ambos compatíveis com PCIe Gen 5 x16. Essa é uma atualização fundamental que possibilita redes redundantes de alta velocidade (por exemplo, duas portas 200GbE ou uma única porta 400GbE) sem ocupar slots riser PCIe padrão. A transição para PCIe 5.0 dobra a largura de banda teórica (32 GT/s em vez de 16 GT/s), tornando o V4 capaz de lidar com o tráfego de rede mais exigente em nuvem e IA.

Potência e refrigeração
O SR650 V4 oferece opções aprimoradas de fonte de alimentação, variando de 800 W a 3200 W, disponíveis nos níveis de eficiência Titanium e Platinum. O sistema também suporta opções de -48 V CC e HVAC/HVDC para atender aos requisitos específicos de data centers.

Para gerenciar o calor gerado por processadores e memórias de alto TDP, a Lenovo apresenta as opções de resfriamento líquido Neptune. O "Módulo Neptune Core para Complexo de Computação" utiliza resfriamento líquido em circuito aberto para remover o calor de processadores, memórias e reguladores de tensão, sendo capaz de capturar mais de 80% do calor do servidor e reduzir significativamente os custos de refrigeração do data center.
Em geral, o SR650 V4 representa um grande avanço em desempenho, densidade e eficiência térmica para ambientes empresariais modernos.
Especificações do Lenovo ThinkSystem SR650 V4
| Especificação | Detalhes |
|---|---|
| Especificações do sistema | |
| Fator de Forma | Rack 2U |
| Subcontratante | Até 2 processadores Intel Xeon série 6700/6400 (núcleos P); até 86 núcleos por CPU; TDP de até 350 W. |
| Memória | 32 slots DIMM (16 por processador); suporta TruDDR5 RDIMMs até 6400 MHz e MRDIMMs até 8000 MHz. |
| Expansão de memória | Suporta módulos de memória CXL 2.0 no formato E3.S 2T (até 12 DIMMs). |
| Memória Máxima | Memória do sistema de até 8 TB (usando módulos RDIMM 3DS de 256 GB) |
| Compartimentos de unidade de disco | Frente: Até 24 slots NVMe/SAS/SATA de 2.5", 16 slots SAS/SATA de 3.5" ou 32 slots NVMe E3.S. Meio: Até 8 unidades de 2.5" com troca simples. Traseira: Até 8 slots de 2.5" ou 4 slots de 3.5" com troca a quente. |
| Controlador de Armazenamento | Até 36 portas NVMe integradas (conectividade 1:1); suporte a RAID/HBA |
| Interfaces de rede | Dois slots OCP 3.0 SFF com interface de host PCIe 5.0 x16 |
| Slots de expansão PCI | Até 10 slots PCIe 5.0 (traseiros); slots PCIe frontais opcionais. |
| Suporte GPU | Até 10 GPUs de largura única ou 2 GPUs de largura dupla |
| Portos | Frente: Porta de diagnóstico externa, USB opcional e Mini-DP. Traseira: 2 portas USB 3.0, 1 porta VGA, 1 porta RJ-45 para gerenciamento, porta serial opcional. |
| Resfriamento | Até 6 ventoinhas hot-swap (redundância N+1); Módulos de refrigeração líquida Neptune opcionais |
| Fonte de alimentação do laboratório | Até duas fontes de alimentação CA/CC redundantes com troca a quente (800 W a 3200 W) |
| Gerenciamento de Sistemas | Controlador XClarity 3 (XCC3); XCC3 Premier opcional |
| Recursos de Segurança | TPM 2.0, Raiz de Confiança PFR (NIST SP800-193), intrusão no chassi, moldura com trava |
| Sistemas operacionais | Microsoft Windows Server, RHEL, SLES, Ubuntu Server |
| Garantia | Garantia básica de 3 anos (configurável) |
| Dimensões | 87 mm (3.4 pol.) A x 440 mm (17.3 pol.) L x 800 mm (31.5 pol.) P |
| Peso | Peso máximo: 38.8 kg (85.5 lb) |
Lenovo ThinkSystem SR650 V4 Design e construção
O Lenovo ThinkSystem SR650 V4 é uma plataforma padrão 2U que aproveita ao máximo seu espaço físico, equilibrando a densidade de componentes com o fluxo de ar e a facilidade de manutenção. O chassi mede 3.4 cm de altura, 17.3 cm de largura e 31.5 cm de profundidade, com um peso máximo configurado de 85.5 kg. Essas dimensões o colocam em linha com outros servidores corporativos 2U, ao mesmo tempo que oferecem profundidade suficiente para CPUs de alto desempenho, configurações de memória densas e backplanes de armazenamento flexíveis.
O consagrado design industrial ThinkSystem da Lenovo é imediatamente reconhecível, com um chassi rígido de aço e identificação clara e funcional. Internamente, o layout é limpo e focado na funcionalidade, priorizando o fluxo de ar direto, zonas de componentes modulares e acesso sem ferramentas para manutenção de rotina. A construção geral transmite robustez e engenharia de ponta, refletindo uma plataforma projetada para operação contínua em ambientes de data center, em vez de priorizar a estética.
Painel frontal
O painel frontal é altamente configurável. Nosso sistema de teste está equipado com um backplane de 8 baias para unidades de 2.5 polegadas, mas o chassi pode ser facilmente expandido para 16 ou até mesmo 24 baias com o mínimo de esforço. Os clientes também podem optar por baias de 3.5 polegadas para maior capacidade bruta ou pelas opções de backplane E3.S mais recentes para alta densidade de NVMe de alto desempenho. O suporte AnyBay permite que unidades SAS, SATA e NVMe coexistam na mesma gaiola de unidades, proporcionando flexibilidade substancial para implantações de armazenamento misto.

O painel frontal inclui controles essenciais para o operador: um botão liga/desliga, um botão de identificação e LEDs indicadores de status que mostram a integridade do sistema e a atividade da rede. Uma aba retrátil com informações fornece acesso rápido à etiqueta de acesso à rede XCC e ao número de série. A conectividade local opcional inclui uma porta Mini DisplayPort e portas USB para acesso ao carrinho de emergência, o que é essencial para a solução de problemas em data centers remotos.
Painel traseiro
A parte traseira do chassi foi projetada para máxima densidade de E/S. Ela pode acomodar até 10 slots PCIe Gen 5, dependendo da configuração dos risers. A inclusão de dois slots OCP 3.0 libera os risers PCIe padrão para outras placas adicionais, como GPUs ou controladores de armazenamento.
Além da expansão, o painel traseiro abriga a porta de rede de gerenciamento BMC integrada, duas portas USB-A e uma saída VGA para acesso local ao console. Duas fontes de alimentação hot-swap estão montadas na parte traseira, mantendo a facilidade de manutenção sem afetar o fluxo de ar ou os layouts de expansão.
Interno
Internamente, o layout é limpo e otimizado para o fluxo de ar. 32 slots DIMM flanqueiam dois soquetes de CPU, dispostos para manter o resfriamento desobstruído da frente para trás, graças a um conjunto de seis ventoinhas hot-swap de alto desempenho na parte frontal do gabinete. As ventoinhas são totalmente substituíveis sem ferramentas, e toda a bandeja de ventoinhas pode ser removida sem o uso de ferramentas. A remoção da bandeja proporciona acesso direto e desobstruído à área de armazenamento AnyBay, simplificando a manutenção, atualizações e trocas do backplane.

Os cabos de armazenamento são organizados cuidadosamente ao longo das laterais do chassi para evitar obstruir o fluxo de ar para as CPUs e a memória. Para configurações que utilizam módulos de refrigeração líquida Neptune, o layout interno sofre pequenas alterações para acomodar os circuitos de refrigeração, mas a facilidade de manutenção dos componentes principais permanece alta. O módulo de inicialização M.2 é montado no defletor de ar ou na gaiola de unidades, permitindo fácil acesso sem a necessidade de remover outros componentes.
Controlador XClarity 3
O SR650 V4 apresenta o novo XClarity Controller 3 (XCC3). Este mecanismo de gerenciamento oferece uma melhoria significativa de desempenho em relação às gerações anteriores, com tempos de inicialização mais rápidos e uma interface HTML5 mais responsiva. O Platform Resource Manager fornece telemetria detalhada sobre o status de energia e temperatura, ajudando os administradores a otimizar a eficiência do data center.
O XCC3 oferece suporte a uma ampla gama de funções de gerenciamento remoto, incluindo controle remoto (KVM), montagem de mídia virtual e atualizações de firmware. A interface é intuitiva, fornecendo uma visão geral do status do sistema, eventos ativos e inventário de hardware. Para automação, o XCC3 oferece suporte completo às APIs REST do Redfish.
Desempenho do Lenovo ThinkSystem SR650 V4
Esta seção examina os resultados dos benchmarks do Blender, y-cruncher, vLLM e Phoronix. Os testes iniciais foram conduzidos no Lenovo ThinkSystem SR650 V4 equipado com processadores Intel Xeon 6740P, permitindo-nos avaliar a arquitetura P-core da plataforma, focada em desempenho, e a taxa de transferência geral sob cargas de trabalho com uso intensivo de CPU. No meio da análise, ajustamos a configuração do sistema para habilitar testes com aceleração por GPU. A transição foi simples, facilitada pelo kit de atualização para GPU da Lenovo, que inclui ventoinhas de alto desempenho, dissipadores de calor aprimorados, uma cobertura de fluxo de ar revisada e risers compatíveis com GPU, projetados para suportar aceleradores de maior potência. A instalação não exigiu alterações significativas no chassi e integrou-se perfeitamente ao layout existente do sistema.
Com os componentes de refrigeração e fluxo de ar aprimorados instalados, adicionamos uma única GPU NVIDIA L40S à plataforma. Isso nos permitiu expandir os testes para incluir cargas de trabalho aceleradas por GPU, como renderização por GPU no Blender e benchmarks focados em inferência, mantendo temperaturas estáveis e comportamento consistente do sistema. A natureza modular da atualização destaca a flexibilidade do SR650 V4, permitindo que ele transite facilmente de uma configuração de CPU voltada para eficiência para uma plataforma equilibrada de CPU+GPU, adequada para cargas de trabalho computacionais mistas.
Configuração do Lenovo ThinkSystem SR650 V4:
- CPU: 2x Intel Xeon 6740P
- Memória: 1 TB de RAM
- Armazenamento: 4 SSDs de 960 GB
- GPU: NVIDIA L40S
Blender 4.5
O Blender é um aplicativo de modelagem 3D de código aberto. Este benchmark foi executado usando o utilitário Blender Benchmark. A pontuação é medida em amostras por minuto, com valores mais altos indicando melhor desempenho.
No teste de desempenho de CPU do Blender, o Lenovo ThinkSystem SR650 V4 apresentou um desempenho sólido de renderização em todas as cenas, atingindo 1136.99 amostras por minuto em Monster, 707.60 em Junkshop e 562.53 em Classroom. Os resultados refletem a forte escalabilidade multithread dos dois processadores Intel Xeon 6740P, com desempenho consistente mesmo com o aumento da complexidade da cena.
| CPU do Blender (Amostras por minuto; quanto maior, melhor) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| Monstro | 1136.99 |
| sucata | 707.60 |
| Sala de aula | 562.53 |
No teste de benchmark Blender CPU sem SMT, o SR650 V4 demonstra um aumento significativo na taxa de transferência de renderização, atingindo 4686.40 amostras por minuto no cenário Monster, 2223.96 no Junkshop e 2385.98 no Classroom. Os resultados da GPU destacam a capacidade do sistema de acelerar cargas de trabalho de renderização complexas, oferecendo uma taxa de transferência substancialmente maior em comparação com a renderização somente por CPU.
| Processamento da CPU do Blender (sem SMT) (Amostras por minuto; quanto maior, melhor) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| Monstro | 4686.40 |
| sucata | 2223.96 |
| Sala de aula | 2385.98 |
triturador de y
O y-cruncher é um programa multithread e escalável que calcula o Pi e outras constantes matemáticas com trilhões de dígitos. Desde o seu lançamento em 2009, tornou-se uma aplicação popular para testes de desempenho e estresse entre overclockers e entusiastas de hardware.
No teste y-cruncher, o Lenovo SR650 V4 apresenta um desempenho consistente à medida que o tamanho do problema aumenta, evidenciando a alta capacidade de processamento multithread e a ampla largura de banda da memória da plataforma. Com dois processadores Intel Xeon 6740P e 1 TB de RAM, o sistema completa um cálculo de Pi com 1 bilhão de dígitos em pouco mais de 20 segundos e mantém uma eficiência consistente até 25 bilhões de dígitos, levando 362 segundos. Os resultados demonstram uma escalabilidade previsível sob pressão constante de CPU e memória, tornando o SR650 V4 ideal para cargas de trabalho matemáticas complexas e cenários de teste de estresse.
| Y-Cruncher (tempo total de cálculo) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1TB RAM) |
|---|---|
| 1 bilhões | 20.715 s |
| 2.5 bilhões | 44.412 s |
| 5 bilhões | 81.937 s |
| 10 bilhões | 152.743 |
| 25 bilhões | 362.566 |
Desempenho de inferência do vLLM Online Serving LLM
O vLLM é o mecanismo de inferência e serviço de alto desempenho mais popular para LLMs. O benchmark de serviço online do vLLM é uma ferramenta de avaliação de desempenho que mede as capacidades de serviço em situações reais desse mecanismo de inferência sob solicitações simultâneas. Ele simula cargas de trabalho de produção enviando solicitações para um servidor vLLM em execução com parâmetros configuráveis, incluindo taxa de solicitações, comprimentos de entrada/saída e o número de clientes simultâneos. O benchmark mede métricas importantes, incluindo taxa de transferência (tokens por segundo), tempo até o primeiro token e tempo por token de saída (TPOT), ajudando os usuários a entender o desempenho do vLLM sob diferentes condições de carga.
Testamos o desempenho de inferência em um conjunto abrangente de modelos que abrangem várias arquiteturas, escalas de parâmetros e estratégias de quantização, e avaliamos a taxa de transferência sob diferentes perfis de concorrência.
Desempenho do modelo denso
Os modelos densos seguem a arquitetura LLM convencional, na qual todos os parâmetros e ativações são usados durante a inferência, resultando em um processamento computacional mais intensivo do que suas contrapartes esparsas. Para avaliar de forma abrangente as características de desempenho em diferentes escalas de modelo e estratégias de quantização, comparamos várias configurações de modelos densos da família Llama 3.1 8B.
Llama 3.1 8B Precision FP8
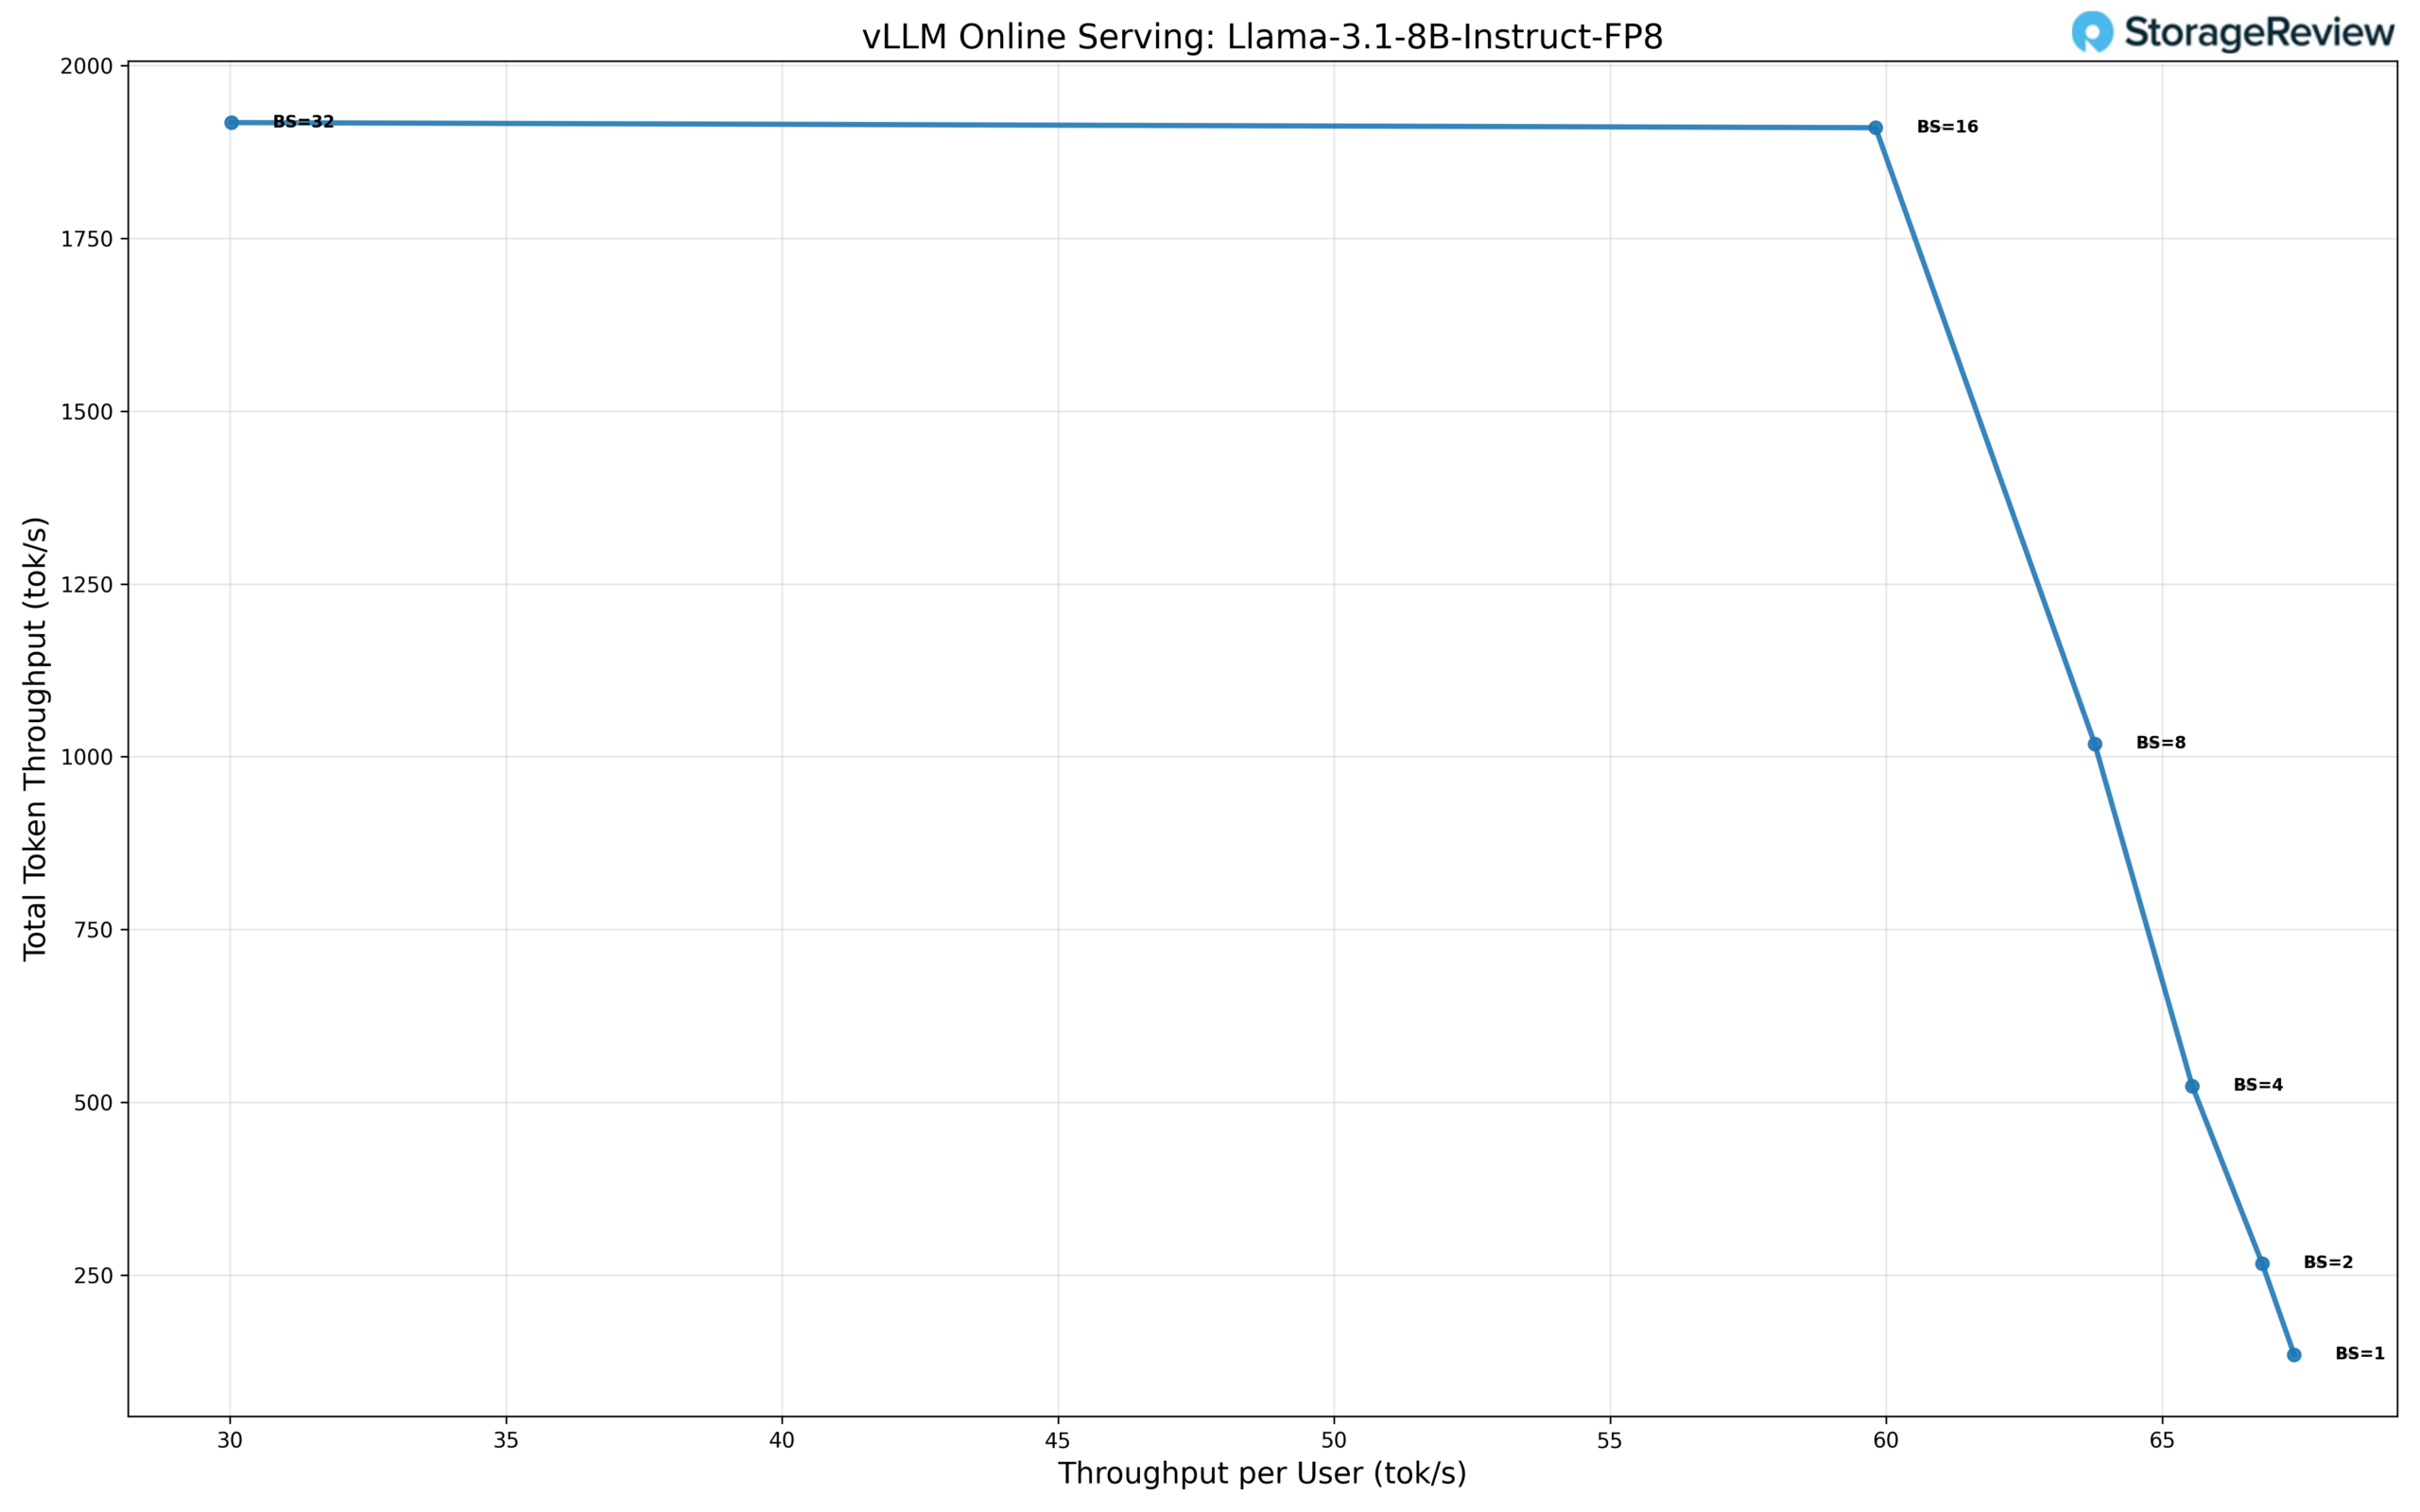
O modelo Llama 3.1 8B, executado em precisão FP8, apresenta um perfil de escalabilidade diferente da configuração de precisão padrão, priorizando a eficiência em níveis moderados de concorrência, enquanto sacrifica o desempenho máximo em tamanhos de lote maiores. Com concorrência de usuário único (BS=1), o modelo entrega 67.8 tok/s por usuário, com uma taxa de transferência total de 135.6 tok/s e um TPOT de aproximadamente 3.1 ms, estabelecendo uma linha de base de fluxo único inferior em comparação com a precisão total.
À medida que o tamanho do lote aumenta, a taxa de transferência total escala rapidamente, enquanto a taxa de transferência por usuário diminui de forma controlada. Com BS=2, a taxa de transferência aumenta para 271 tok/s no total, com 66.8 tok/s por usuário. Com BS=4, a taxa de transferência total atinge 523 tok/s e, com BS=8, o modelo entrega 1,017 tok/s, com 63.6 tok/s por usuário. A latência permanece estável nesses níveis de concorrência mais baixos, tornando o FP8 adequado para cenários de inferência multiusuário leves.
O escalonamento continua até BS=16, onde o modelo mantém uma taxa de transferência total de 1,918 tok/s, com 60.0 tok/s por usuário. Em BS=32, a taxa de transferência total se estabiliza em aproximadamente 1,920 tok/s, com a taxa de transferência por usuário caindo para 30.0 tok/s. Essa estabilização indica que a configuração FP8 atinge seu ponto de saturação mais cedo do que a precisão padrão, priorizando a eficiência e a previsibilidade em detrimento da taxa de transferência agregada máxima.
De forma geral, o FP8 alcança um aumento de aproximadamente 14 vezes na taxa de transferência total, de BS=1 até seu pico em BS=16-32. A latência permanece consistente até BS=16, depois se estabiliza juntamente com a taxa de transferência em níveis de concorrência mais altos, destacando o FP8 como uma escolha prática para cargas de trabalho de inferência balanceadas e sensíveis à latência, em vez de escalonamento em lote extremo.
Lhama 3.1 8B Precisão Padrão
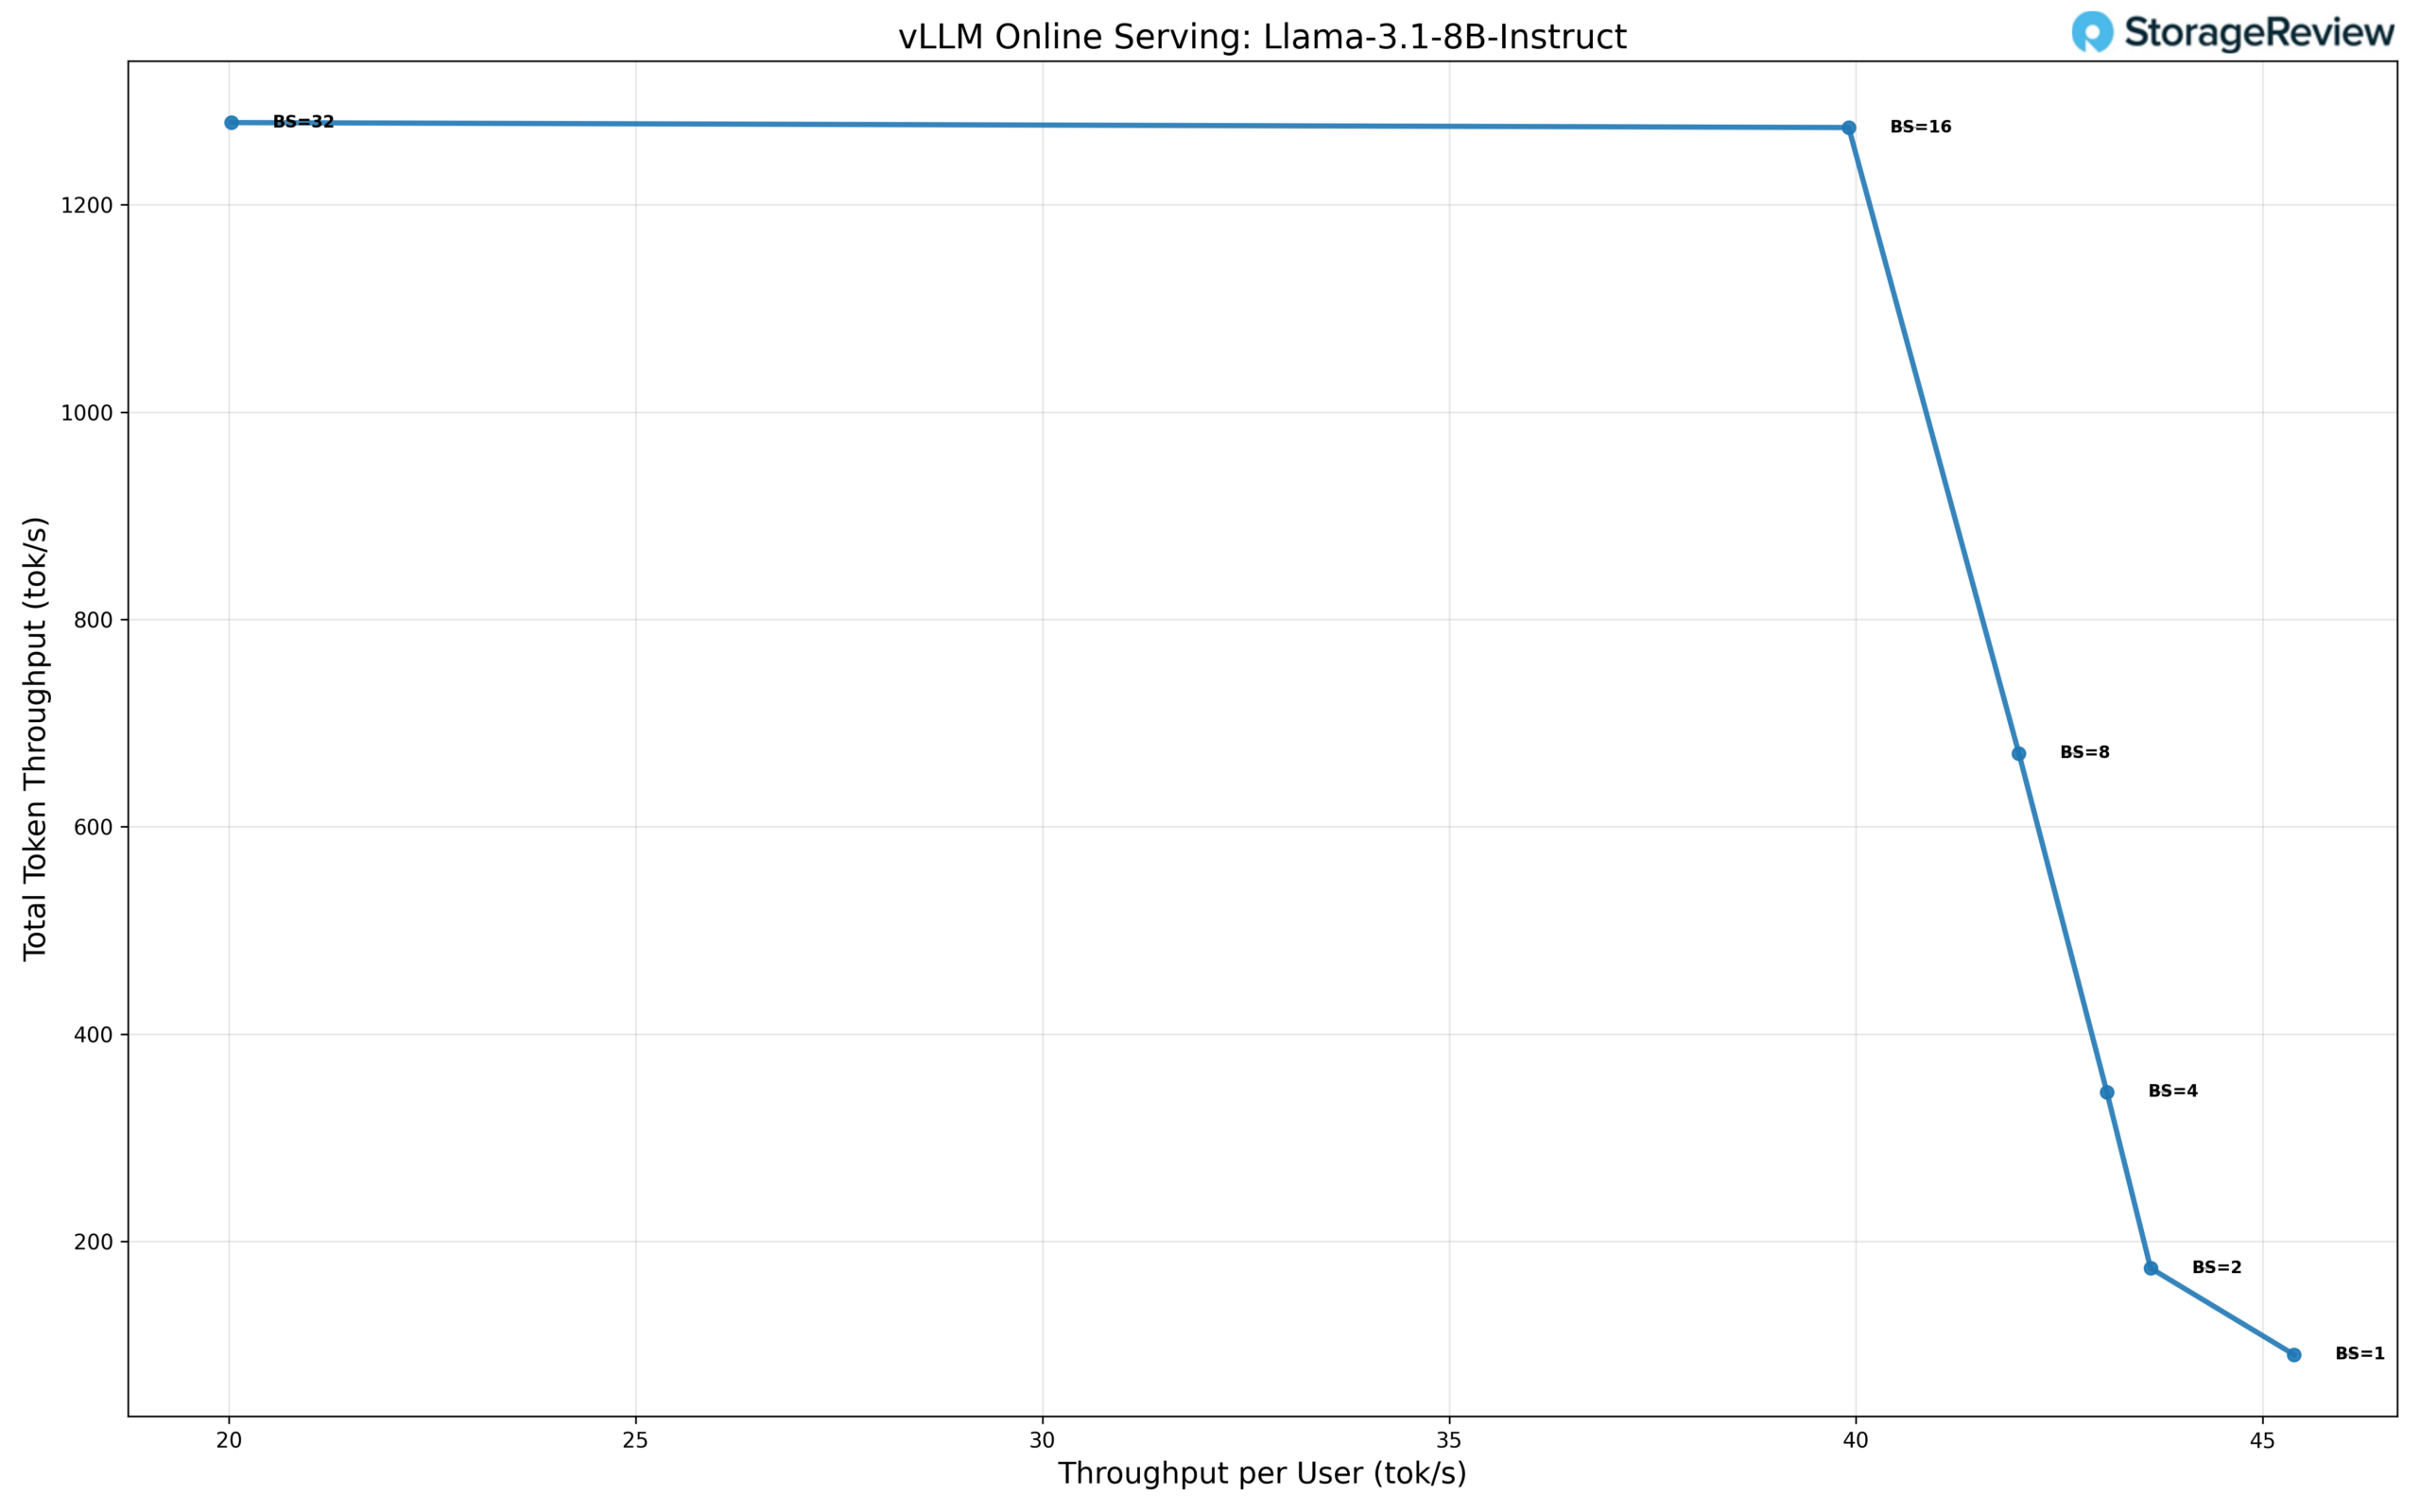
Com precisão padrão, o modelo Llama 3.1 8B demonstra um comportamento de escalabilidade previsível em níveis de concorrência mais baixos, com forte desempenho por usuário em tamanhos de lote pequenos e um aumento constante na taxa de transferência agregada à medida que a concorrência aumenta. Em operação com um único usuário (BS=1), o modelo oferece aproximadamente 45.8 tok/s por usuário, resultando em uma taxa de transferência total de 91.6 tok/s e estabelecendo uma base sólida para cargas de trabalho sensíveis à latência.
À medida que a concorrência aumenta, a taxa de transferência total escala de forma eficiente, enquanto a taxa de transferência por usuário diminui gradualmente. Em BS=2, a taxa de transferência total sobe para 176 tok/s, com 44.0 tok/s por usuário, e em BS=4, a taxa de transferência atinge 344 tok/s, com 43.0 tok/s por usuário. Esse comportamento continua até BS=8, onde o modelo mantém uma taxa de transferência total de 672 tok/s, com 42.0 tok/s por usuário, indicando boa utilização sem degradação significativa por usuário.
A escalabilidade continua até BS=16, onde a taxa de transferência total atinge um pico de aproximadamente 1,280 tok/s, com 40.0 tok/s por usuário. Em BS=32, a taxa de transferência total permanece praticamente estável em torno de 1,280 tok/s, enquanto a taxa de transferência por usuário cai para 20.0 tok/s, sinalizando a saturação do pipeline de execução. Esse platô sugere que, na precisão padrão, o modelo atinge seu ponto de operação ideal em torno de BS=16, equilibrando taxa de transferência e capacidade de resposta.
Em geral, a precisão padrão alcança um aumento de aproximadamente 14 vezes na taxa de transferência total de BS=1 até seu pico, com desempenho estável por usuário em níveis moderados de concorrência. Esse perfil torna a precisão padrão ideal para implantações que priorizam latência consistente e escalabilidade previsível em vez de expansão agressiva de lotes.
Desempenho do modelo esparso
Modelos esparsos, particularmente arquiteturas de Mistura de Especialistas (MoE), são uma abordagem emergente para escalar modelos de linguagem de forma eficiente. Essas arquiteturas mantêm um alto número total de parâmetros, ativando apenas um subconjunto de parâmetros por token, o que potencialmente oferece melhor desempenho por parâmetro ativo.
Desempenho do Qwen3-Coder-30B-A3B FP8
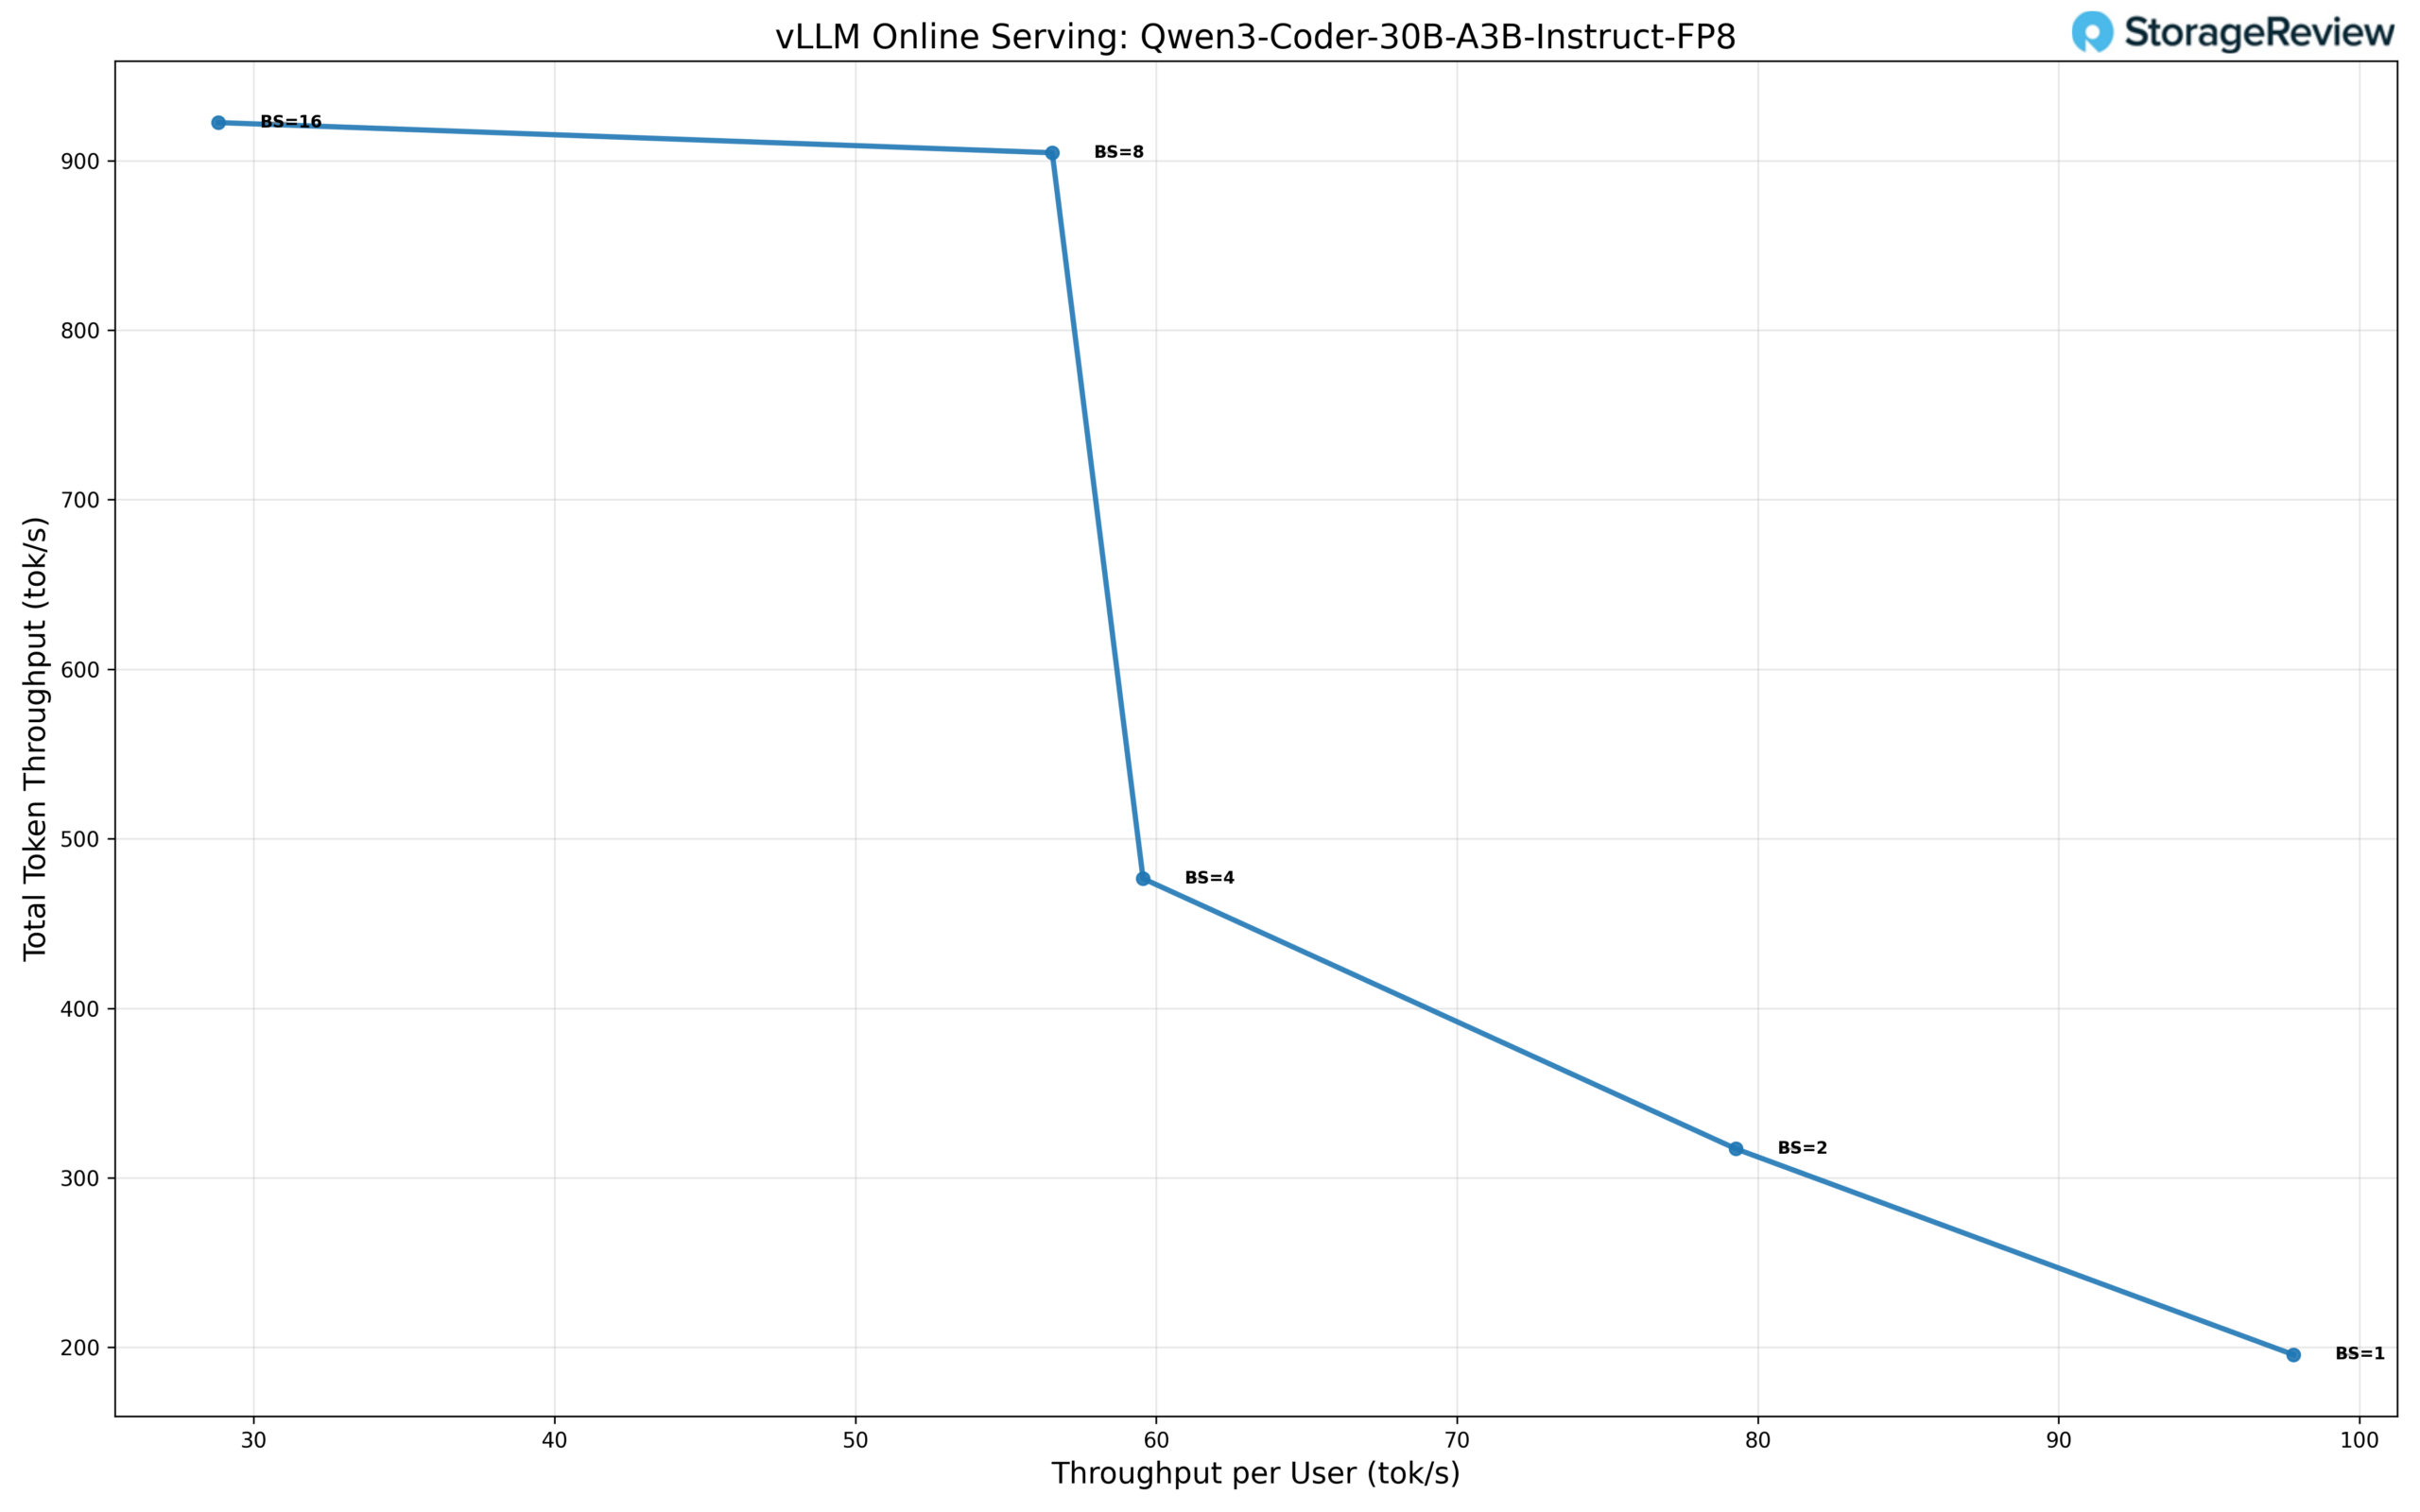
O modelo Qwen3-Coder-30B-A3B, executado em precisão FP8, apresenta um perfil de escalabilidade otimizado para concorrência moderada, oferecendo alto desempenho por usuário e atingindo a saturação mais cedo do que modelos menores. Em operação com um único usuário (BS=1), o modelo alcança aproximadamente 98 tok/s por usuário, com uma taxa de transferência total de 196 tok/s, estabelecendo uma alta linha de base de fluxo único que reflete a otimização do modelo para cargas de trabalho de geração de código.
À medida que a concorrência aumenta, a taxa de transferência total escala de forma eficiente, enquanto a taxa de transferência por usuário diminui de maneira controlada. Com BS=2, a taxa de transferência total sobe para 317 tok/s, com 79 tok/s por usuário, e com BS=4, o modelo atinge uma taxa de transferência total de 477 tok/s, com 59 tok/s por usuário. Esses resultados demonstram a utilização eficaz dos recursos computacionais disponíveis por meio de processamento em lotes de baixa a moderada complexidade, sem degradação abrupta na capacidade de resposta por usuário.
O modelo atinge seu pico de taxa de transferência agregada em BS=8, mantendo aproximadamente 905 tok/s de taxa de transferência total, com 56 tok/s por usuário. O escalonamento continua marginalmente até BS=16, onde a taxa de transferência total aumenta ligeiramente para 920 tok/s, enquanto a taxa de transferência por usuário cai para 29 tok/s, indicando a saturação do pipeline de inferência. Além desse ponto, a concorrência adicional proporciona ganhos mínimos na taxa de transferência total, ao mesmo tempo que impacta significativamente o desempenho por usuário.
De forma geral, o Qwen3-Coder-30B-A3B FP8 proporciona um aumento de aproximadamente 4.7 vezes na taxa de transferência total, desde BS=1 até seu pico em BS=16. As características de latência e taxa de transferência sugerem que essa configuração é mais adequada para cargas de trabalho de codificação multiusuário moderadas que exigem alto desempenho por requisição. Ainda assim, o escalonamento extremo em lote não é o objetivo principal.
Desempenho de tipo de dados em microescala
A microescala representa uma abordagem avançada de quantização que aplica fatores de escala refinados a pequenos blocos de pesos, em vez de uma quantização uniforme em grandes grupos de parâmetros. O formato NVFP4 da NVIDIA implementa essa técnica por meio de uma representação em bloco de ponto flutuante, onde cada bloco de microescala de 8 a 32 valores compartilha um expoente típico como fator de escala. Essa abordagem granular preserva a precisão numérica, ao mesmo tempo que alcança uma representação de 4 bits, mantendo a faixa dinâmica essencial para arquiteturas de transformadores. O formato integra-se à arquitetura Tensor Core da NVIDIA, permitindo computação eficiente de precisão mista com descompressão em tempo real durante operações matriciais.
Desempenho GPT-OSS-20b
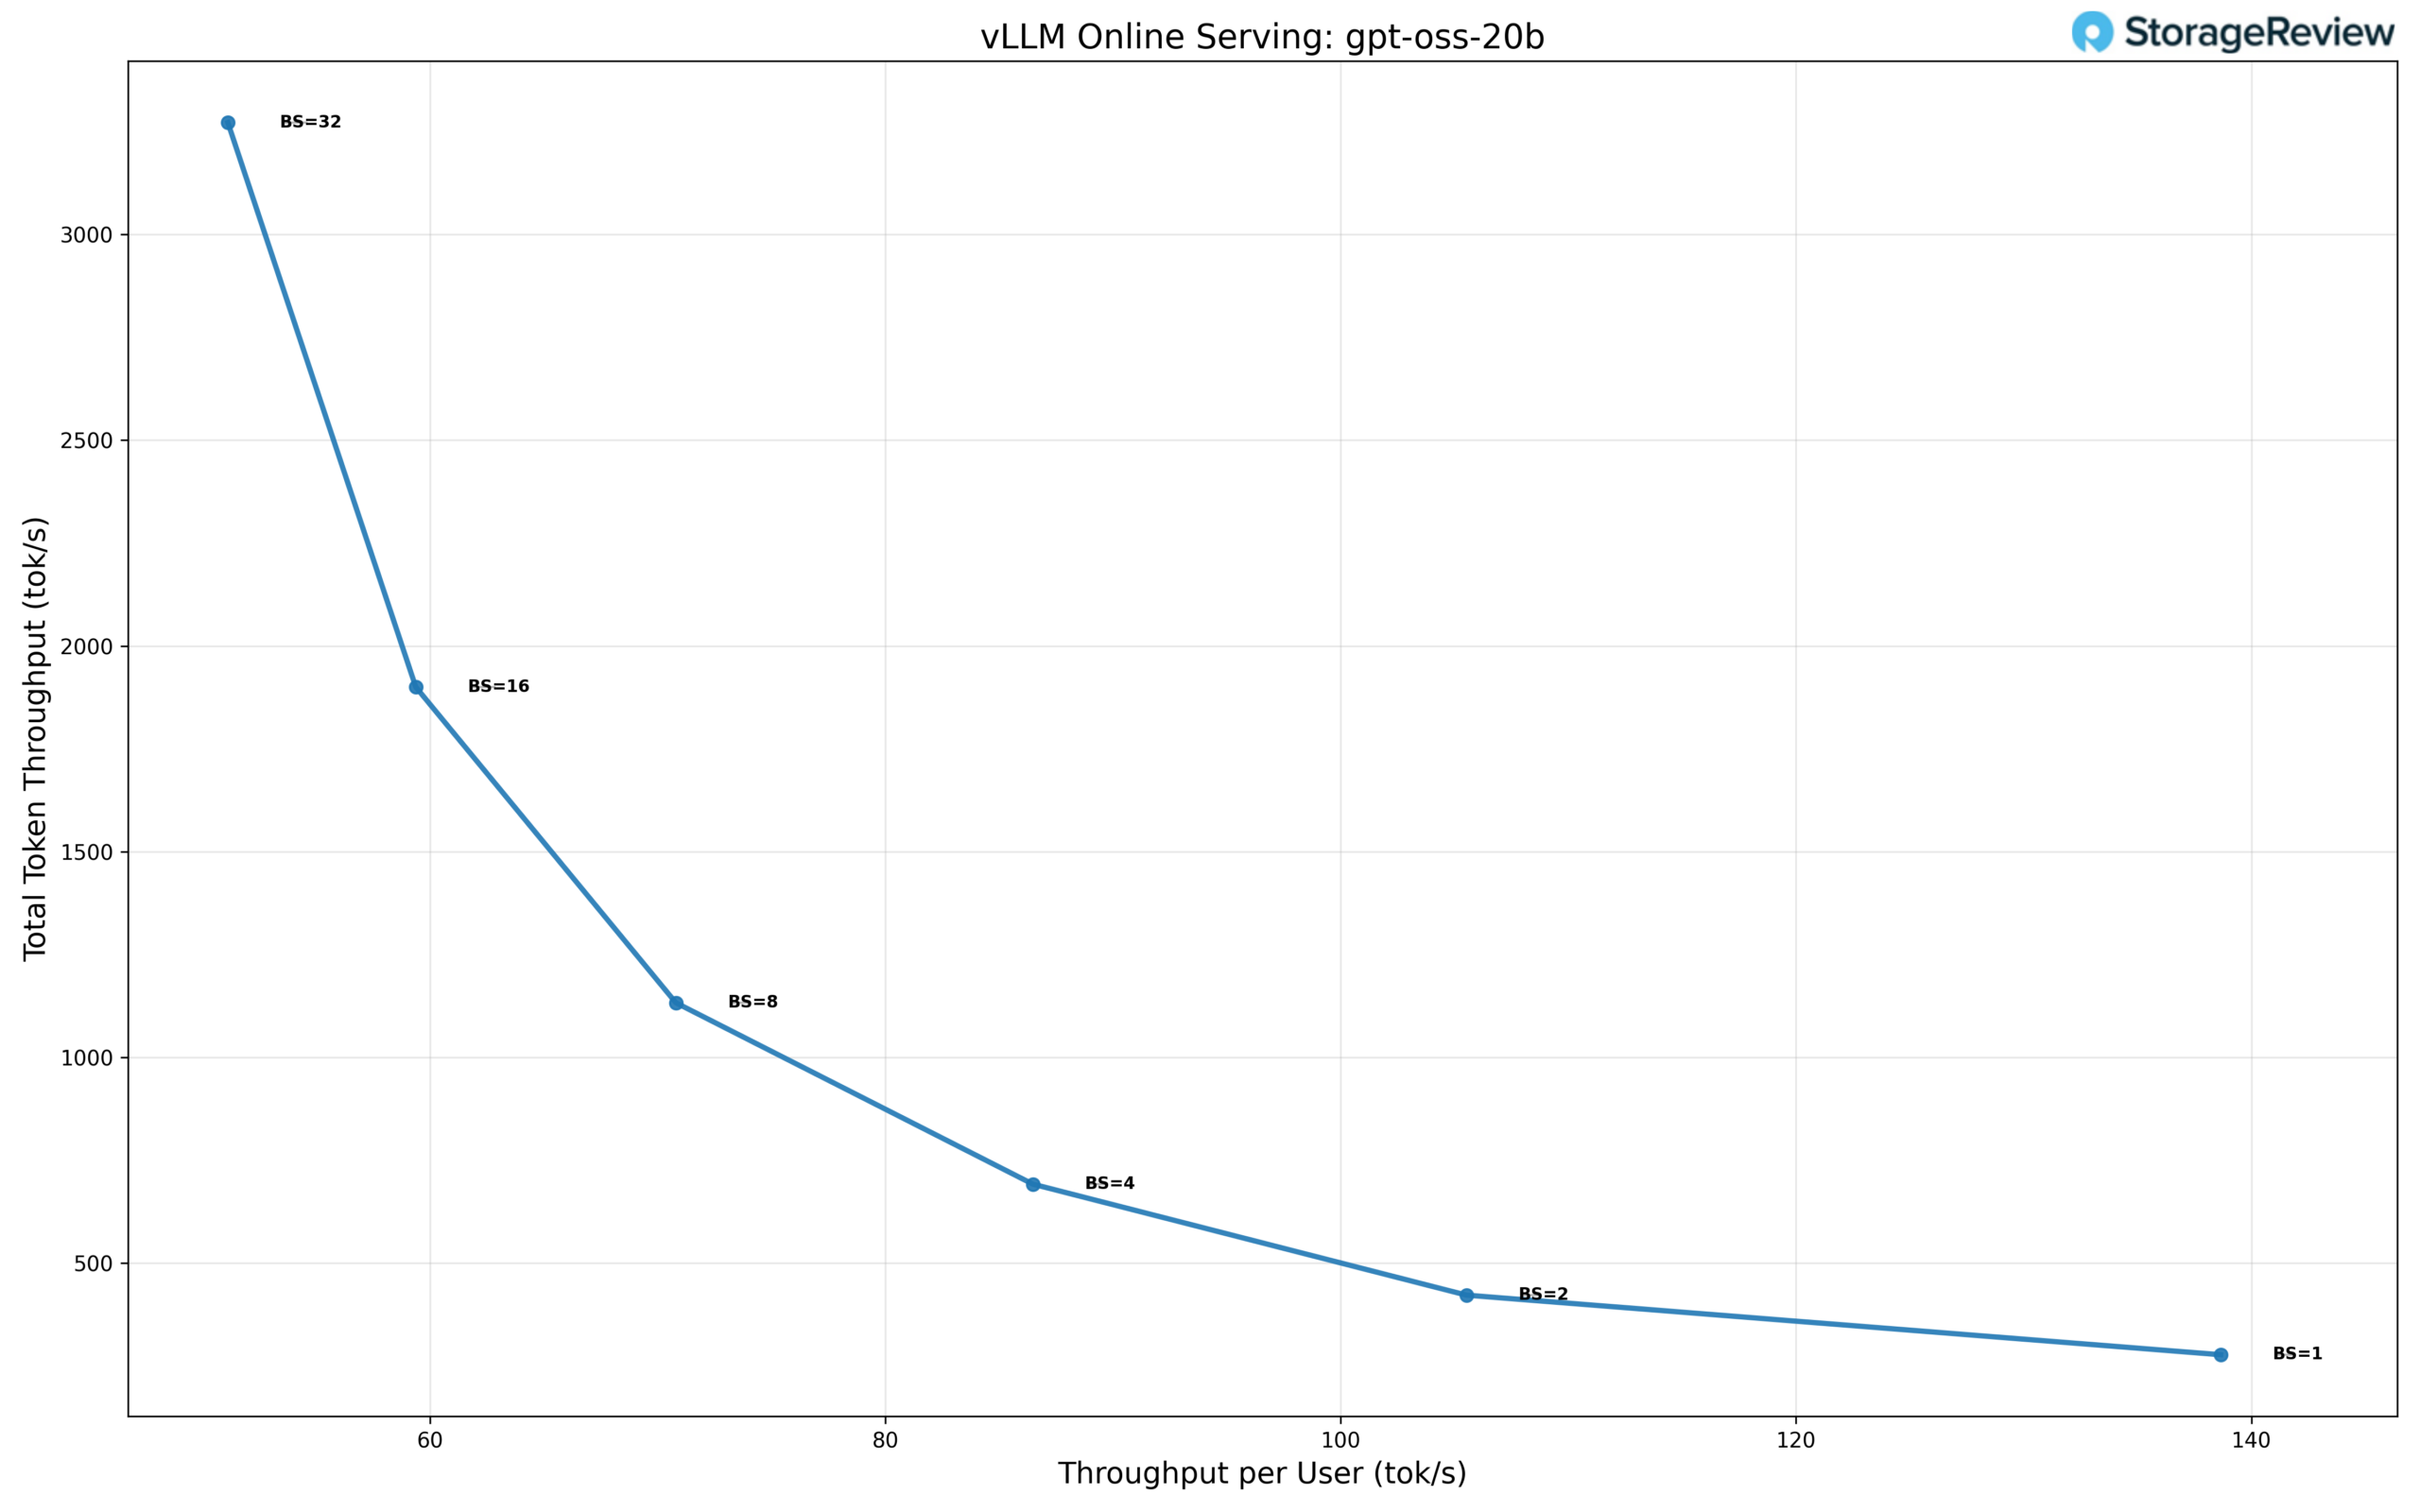
O modelo gpt-oss-20b demonstra fortes características de escalabilidade em níveis crescentes de concorrência, com uma taxa de transferência agregada particularmente alta em tamanhos de lote maiores. Na concorrência de um único usuário (BS=1), o modelo oferece aproximadamente 138 tok/s por usuário, resultando em uma taxa de transferência total de 276 tok/s, estabelecendo uma base sólida para inferência de fluxo único.
À medida que a concorrência aumenta, a taxa de transferência total escala agressivamente, enquanto a taxa de transferência por usuário diminui como esperado. Com BS=2, a taxa de transferência total sobe para 420 tok/s, com 105 tok/s por usuário, e com BS=4, a taxa de transferência atinge 690 tok/s no total, com 86 tok/s por usuário. Essa progressão constante indica uma utilização eficiente dos recursos computacionais disponíveis por meio de processamento em lotes de baixa a moderada complexidade.
A escalabilidade continua até BS=8, onde o modelo atinge uma taxa de transferência total de aproximadamente 1,120 tok/s com 70 tok/s por usuário, e BS=16, onde a taxa de transferência total aumenta para 1,900 tok/s, com 60 tok/s por usuário. Esses resultados mostram que o gpt-oss-20b mantém um desempenho relativamente alto por usuário mesmo com o aumento da concorrência, tornando-o adequado para cenários de serviço multiusuário.
O modelo atinge seu pico de taxa de transferência agregada em BS=32, fornecendo aproximadamente 3,250 tok/s de taxa de transferência total, com a taxa de transferência por usuário caindo para 50 tok/s. Isso representa um aumento de 11.8 vezes na taxa de transferência total em comparação com o desempenho de um único usuário. Embora a taxa de transferência por usuário continue a diminuir em tamanhos de lote maiores, a eficiência geral de escalabilidade permanece alta, indicando que o modelo se beneficia de maior concorrência sem atingir um ponto de saturação precoce.
De forma geral, o gpt-oss-20b apresenta um perfil de escalabilidade equilibrado, combinando alto desempenho para usuários individuais com forte escalabilidade em lote. Isso o torna uma opção atraente para implantações que exigem tanto inferência individual ágil quanto alta taxa de transferência agregada sob cargas multiusuário mais pesadas.
Benchmarks da Phoronix
O Phoronix Test Suite é uma plataforma de benchmarking automatizada e de código aberto que suporta mais de 450 perfis de teste e mais de 100 conjuntos de testes através do OpenBenchmarking.org. Ele cuida de tudo, desde a instalação de dependências até a execução de testes e a coleta de resultados, tornando-o ideal para comparações de desempenho, validação de hardware e integração contínua.
Largura de banda da memória de fluxo
O SR650 V4 apresentou uma largura de banda de memória de 369.6 GB/s, demonstrando um alto rendimento para cargas de trabalho com uso intensivo de dados e confirmando um desempenho robusto da memória multicanal.
Compressão 7-Zip
Com 584,499 MIPS, o sistema apresentou excelente desempenho de compressão e descompressão, refletindo uma sólida eficiência multi-core e uma forte capacidade de computação de números inteiros.
Compilação do Kernel
O servidor concluiu a compilação do kernel allmod em 256.175 segundos, um resultado respeitável que destaca sua capacidade de lidar com compilação paralela e fluxos de trabalho de desenvolvedores de forma eficiente.
Apache Web Server
Com 61,654 R/s, o SR650 V4 demonstrou um forte desempenho em servidores web, mantendo uma alta taxa de transferência de requisições, adequada para hospedagem front-end ou stacks de virtualização leves.
Verificação OpenSSL
Atingindo 712.6 bilhões de bytes por segundo, a plataforma demonstrou um desempenho robusto em verificação criptográfica, confirmando a capacidade da CPU para operações seguras e que exigem muitos certificados.
| Benchmarks da Phoronix | Lenovo Think System SR650 V4 |
|---|---|
| Corrente | 369,58.3 MB / s |
| 7-zip | 584,499 MIPS |
| Compilação do Kernel (allmod) | 256.175 segundos |
| Apache (solicitações por segundo) | 61,654.47 R/s |
| SSL aberto | 712,633,776,990 bytes/s |
Conclusão
O ThinkSystem SR650 V4 é o tipo de atualização de plataforma que faz a diferença, pois não se trata apenas de uma troca de CPU. A Lenovo aproveitou esta geração para implementar melhorias significativas em áreas que limitam as implementações no mundo real: largura de banda da memória, disponibilidade de pistas PCIe, densidade de armazenamento e a capacidade de adaptar a configuração conforme as necessidades mudam. A adoção do Intel Xeon 6 traz mais opções de núcleos e mais capacidade de E/S por soquete, e o trabalho na plataforma em si, incluindo a memória DDR5 mais rápida com suporte a MRDIMM e expansão CXL opcional, garante ao SR650 V4 uma posição sólida para se manter relevante à medida que as cargas de trabalho se tornam cada vez mais exigentes em termos de memória.
No que diz respeito ao armazenamento, apesar da nossa configuração de avaliação limitada com U.2, a aposta da Lenovo no E3.S oferece maior densidade de NVMe com conectividade 1:1 e características térmicas mais limpas, alinhando-se com a forma como a infraestrutura moderna está sendo construída, especialmente para stacks de virtualização que necessitam de mais flash local e para pipelines adjacentes à IA, onde alimentar as GPUs é tão importante quanto o poder computacional bruto. Os dois slots OCP 3.0 Gen5 x16 também representam uma atualização prática: você pode implementar uma rede robusta sem sacrificar slots PCIe que preferiria reservar para aceleradores, armazenamento ou adaptadores especializados.
Se você utiliza o SR650 V3 e se sente limitado pela velocidade da memória, pela capacidade PCIe ou pela densidade NVMe, o SR650 V4 representa um avanço significativo. Ele preserva a facilidade de manutenção e a configurabilidade que tornaram a linha SR650 popular, ao mesmo tempo que adiciona a capacidade de expansão que ajuda as equipes de TI a evitarem situações em que possam se encontrar em situações sem saída. Seja para criar um cluster de virtualização, modernizar serviços de escalabilidade horizontal ou montar um nó com CPU/GPU balanceado, o SR650 V4 atende aos requisitos essenciais e deixa espaço para o que está por vir.
Entre os melhores: The L40S tested here holds Best Mainstream Inference GPU Still Shipping on our Melhores GPUs para empresas Entre os melhores.


 Amazon