

Aqueles no mercado para uma matriz de armazenamento all-flash de alto desempenho seriam bem atendidos com o NetApp AFF A800. O array NVMe de ponta a ponta oferece desempenho massivo e vem da forte linha de arrays AFF da NetApp. Anteriormente, analisamos o A800 em Fibre Channel e descobrimos que ele é uma besta de desempenho, ganhando nosso prêmio Editor's Choice. Para esta revisão, estamos testando o mesmo array, mas desta vez aproveitando o NVMe sobre Fabrics (NVMeOF).
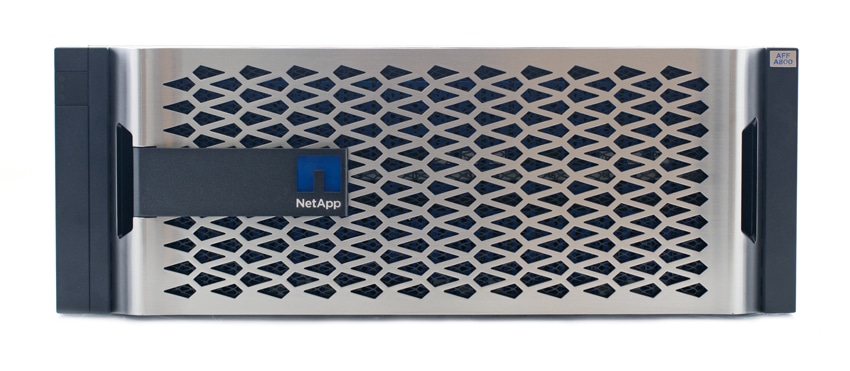
Como esta é uma análise complementar, não abordaremos aspectos como design e construção, especificações ou gerenciamento. Nossa análise inicial já cobriu bem cada uma dessas áreas. A configuração para esta análise é essencialmente a mesma, com uma interface de rede diferente para que possamos observar a diferença de desempenho. É importante ressaltar que esta não é exatamente uma comparação direta. O array oferece diversas opções de conectividade para atender às necessidades de diferentes usuários, e estamos analisando diferentes tipos para que esses usuários tenham uma ideia do que esperar de cada opção.
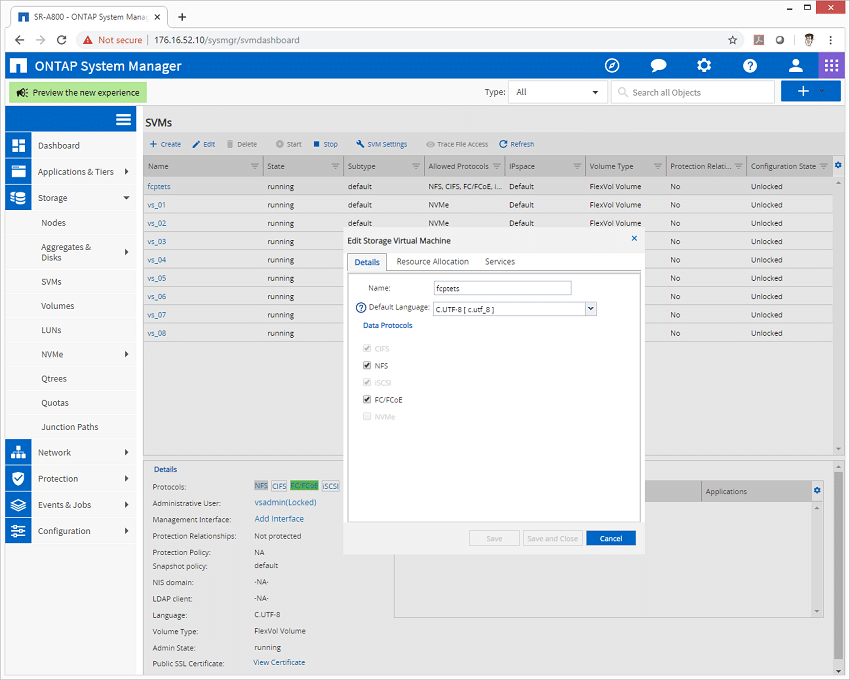
Introduzido pela primeira vez em 2014, o NVMeOF é o conceito de usar um protocolo de transporte em uma rede em vez de apenas aproveitar os dispositivos NVMe por meio do barramento PCIe. NVM Express, Inc. publicou o padrão para NVMeOF em 2016. NVMeOF permite que o host NVMe se conecte a um armazenamento de destino NVMe enquanto mantém a latência baixa. A ideia geral é obter mais desempenho sem aumentar substancialmente a latência. Até o momento, houve muitas abordagens de diferentes fornecedores em que o protocolo está sendo suportado ou pode ser executado em vários modos ao mesmo tempo. O AFF A800 equipado com ONTAP é capaz de executar CIFS, NFS, iSCSI, FCP e FC NVMeOF ao mesmo tempo, tudo isso sem esforço. Nem todas as plataformas são feitas dessa maneira, mesmo o NetApp EF600 (projetado com objetivos ligeiramente diferentes em mente) pode ser executado em FCP ou FC NVMeOF, mas não em ambos ao mesmo tempo.
Configuração de Desempenho
A configuração de nosso NetApp AFF A800 incluiu 8 portas FC de 32 Gb com 24 SSDs NVMe de 1.92 TB instalados. Dos 24 SSDs de 1.92 TB implantados em nosso A800, nós os dividimos em dois agregados RAID-DP, com efetivamente 23 SSDs em uso e duas meias partições mantidas como hot-spare. Metade de cada SSD é particionada para ambos os controladores, para que cada controlador possa utilizar o desempenho de todos os SSDs instalados. O array foi conectado via 32 Gb por meio de dois switches Brocade G620, que então tinham 16 links de 32 Gb para 12 servidores Dell PowerEdge R740xd executando SLES 12 SP4.
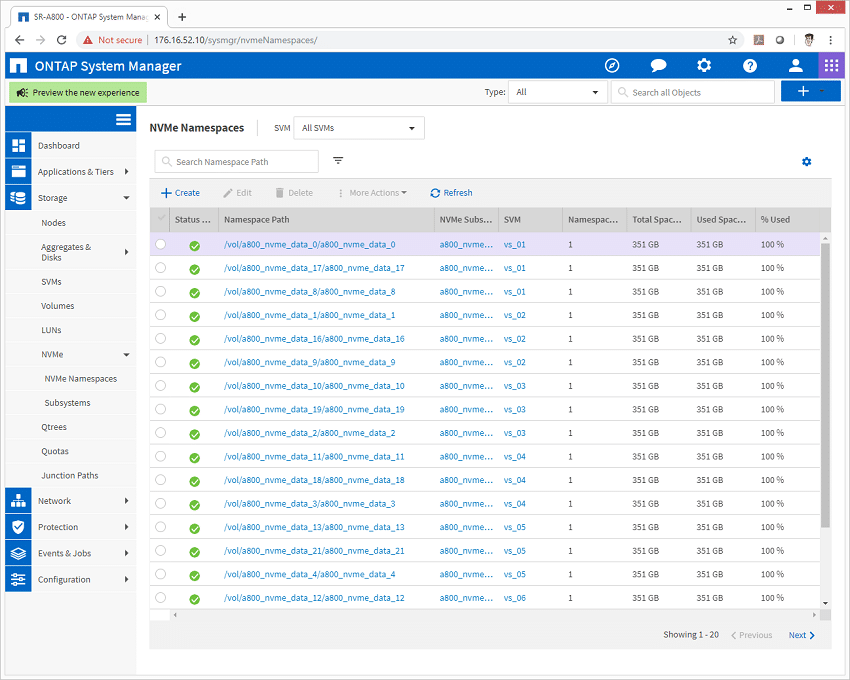
Cada servidor foi provisionado com 2 LUNs de 350 GB, ocupando um espaço de armazenamento total de 8.4 TB.
Desempenho
Quando se trata de matrizes de armazenamento de comparação, o teste de aplicativo é o melhor e o teste sintético vem em segundo lugar. Embora não seja uma representação perfeita das cargas de trabalho reais, os testes sintéticos ajudam a estabelecer a linha de base dos dispositivos de armazenamento com um fator de repetibilidade que facilita a comparação entre soluções concorrentes. Essas cargas de trabalho oferecem uma variedade de perfis de teste diferentes, desde testes de "quatro cantos", testes de tamanho de transferência de banco de dados comuns, bem como capturas de rastreamento de diferentes ambientes VDI. Todos esses testes utilizam o gerador de carga de trabalho vdBench comum, com um mecanismo de script para automatizar e capturar resultados em um grande cluster de teste de computação. Isso nos permite repetir as mesmas cargas de trabalho em uma ampla variedade de dispositivos de armazenamento, incluindo arrays flash e dispositivos de armazenamento individuais.
perfis:
- Leitura aleatória em 4K: 100% de leitura, 128 threads, 0-120% de atualização
- Gravação aleatória em 4K: 100% de gravação, 64 threads, 0-120% de atualização
- Leitura sequencial de 64K: 100% de leitura, 16 threads, 0-120% iorado
- Gravação sequencial de 64K: 100% gravação, 8 threads, 0-120% iorado
- Banco de Dados Sintético: SQL e Oracle
A principal vantagem de desempenho do NVMeOF com o A800 é um aumento no desempenho de leitura e menor latência. Com nossos testes anteriores focando o desempenho dentro do VMware usando o protocolo FCP, com VMDKs anexados a várias VMs, nossos testes NVMeOF se concentram no desempenho bare-metal. Portanto, você não pode fazer uma comparação direta de um para um com nossos dados existentes. É importante observar também que, para testes consistentes em todas as nossas matrizes de armazenamento, mantivemos a mesma contagem de threads para cada matriz de armazenamento. Com o teste NVMeOF no A800, notamos algumas áreas onde nosso teste terminou antes de um aumento significativo de latência. Em primeiro lugar, isso mostra que a plataforma está funcionando excepcionalmente bem, gerando baixa latência com estatísticas de desempenho impressionantes. A desvantagem, porém, é que alguma quantidade de desempenho foi deixada na mesa. A NetApp afirmou que, sob certas circunstâncias, o A800 pode gerar um desempenho ainda maior do que o que medimos.
Começando com leitura 4K, o A800 com NVMeOF começou em 217,460 IOPS com uma latência de apenas 196.8 µs e atingiu o pico em 2,184,220 IOPS com uma latência de 1.22 ms.
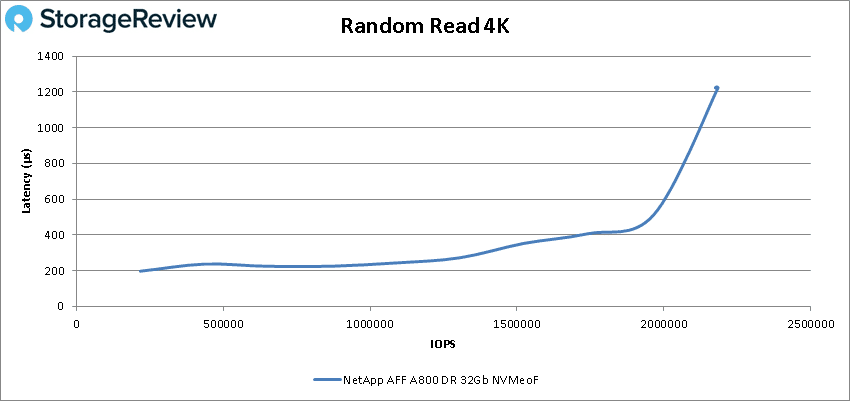
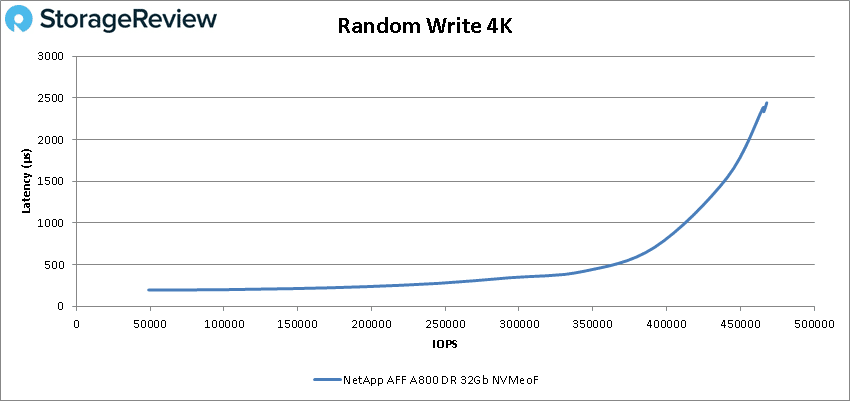
Para gravações em 4K, o array começou em 48,987 IOPS com uma latência de 196 µs e chegou ao pico de 465,445 IOPS com uma latência de 2.44 ms.
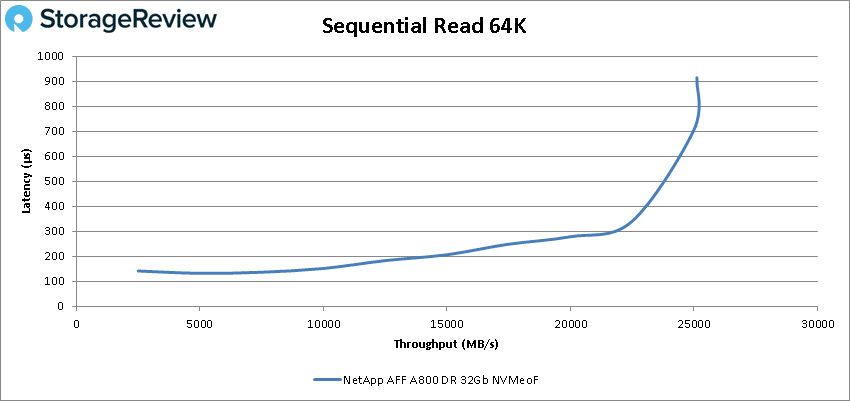
A seguir estão nossas cargas de trabalho sequenciais de 64K. Para leitura de 64K, o A800 foi capaz de manter uma latência abaixo de milissegundos com um desempenho máximo de cerca de 403K IOPS ou 25GB/s com uma latência de 800µs antes de uma ligeira queda.
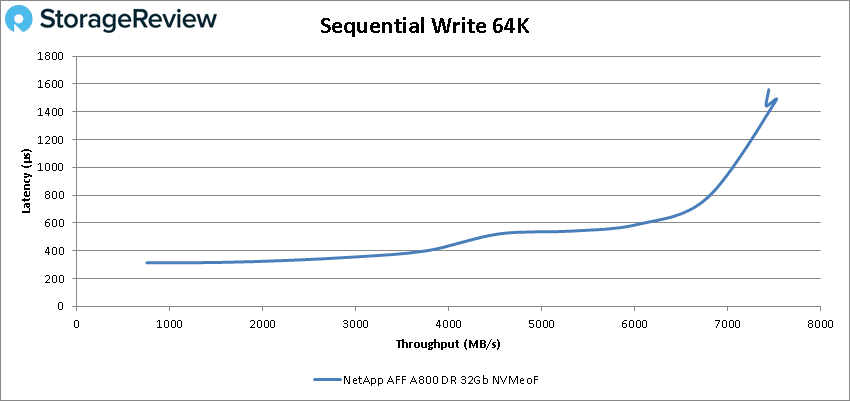
Para gravação de 64K, o A800 com NVMeOF começou forte e permaneceu abaixo de 1ms até cerca de 110K IOPS ou cerca de 7GB/s e atingiu o pico de 120,314 IOPS ou 7.52GB/s com uma latência de 1.48ms.
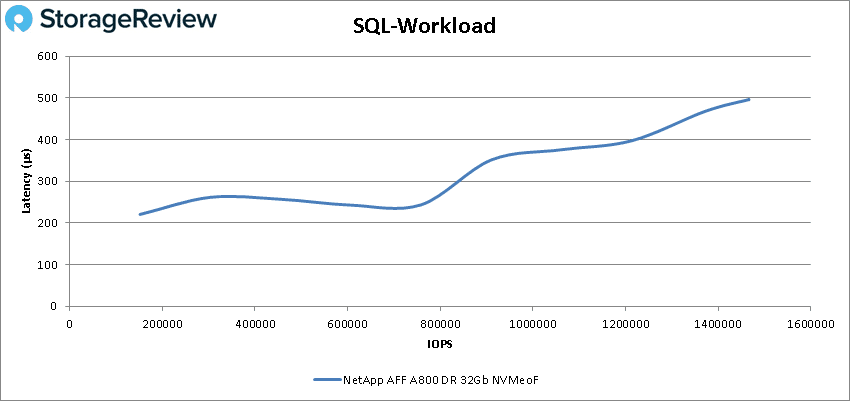
Nosso próximo lote de benchmarks são nossos testes SQL. Em SQL o A800 ficou abaixo de 1ms com um pico impressionante de 1,466,467 IOPS em uma latência de apenas 496.6µs.
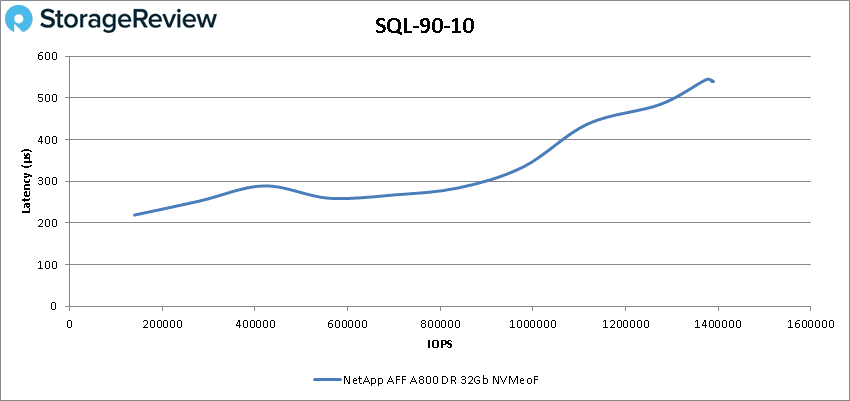
Para SQL 90-10, o A800 com NVMeOF teve outro desempenho impressionante de latência abaixo de milissegundos, começando em 139,989 IOPS e atingindo um pico de 1,389,645 IOPS com uma latência de apenas 539.6 µs.
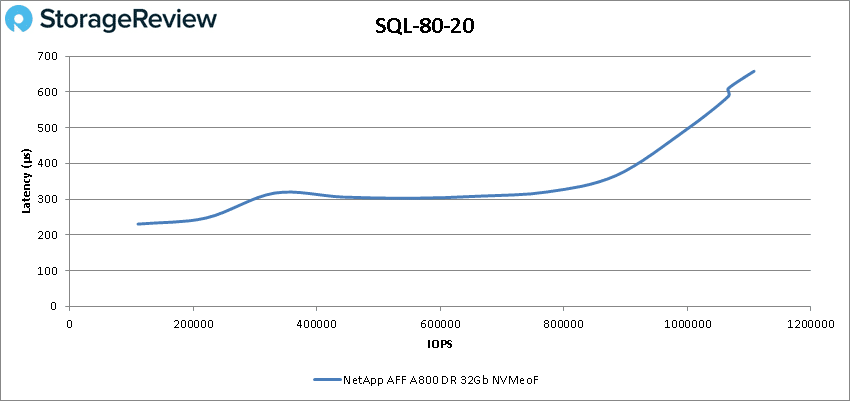
O SQL 80-20 mais uma vez apresentou latência abaixo de milissegundos com um pico de 1,108,068 IOPS com latência de 658µs.
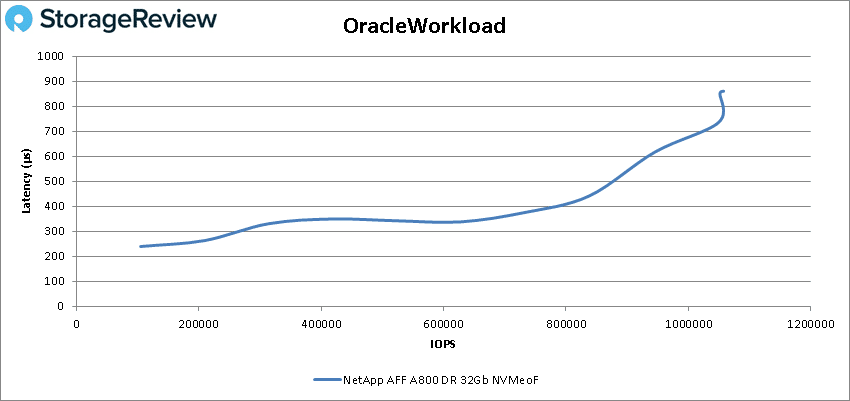
Passando para nossas cargas de trabalho Oracle, o A800 com NVMeOF ficou abaixo de 1ms com uma pontuação máxima de 1,057,570 IOPS em uma latência de 860.4µs.
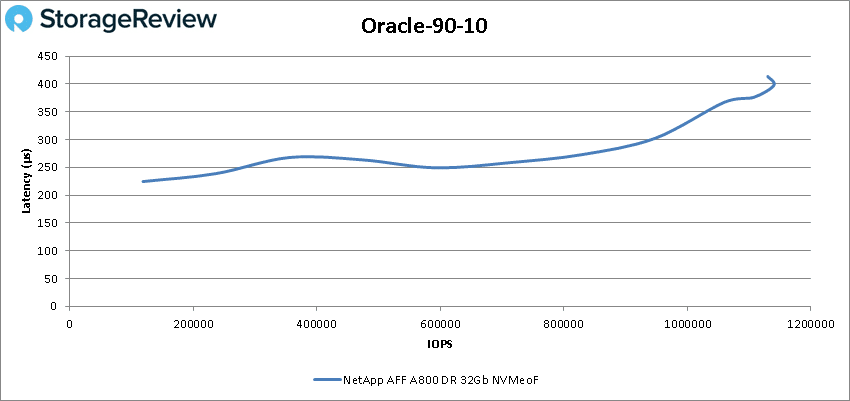
O Oracle 90-10 viu o A800 começar com 118,586 IOPS e atingir o pico de 1,140,178 IOPS com uma latência de 397.6 µs.
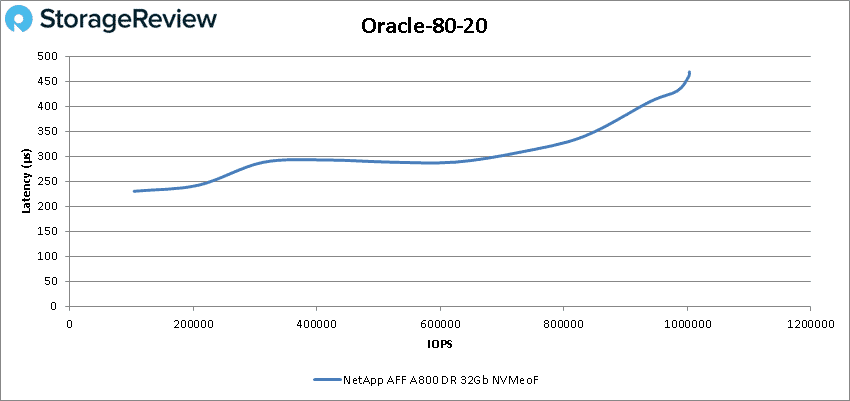
No Oracle 80-20, vimos que o A800 mais uma vez tinha latência abaixo de milissegundos, começando em 104,206 IOPS e chegando a 1,003,577 IOPS com latência de 468.8 µs.
Conclusão
O NetApp AFF A800 é um array all-flash de 4U que suporta acesso a blocos e arquivos, além de suporte NVMe de ponta a ponta. O A800 é voltado para aqueles com as cargas de trabalho mais exigentes, que necessitam de alto desempenho e grande capacidade de armazenamento, com uma capacidade efetiva máxima de 316.8 PB. Enquanto nossa primeira análise premiada avaliou este array em Fibre Channel tradicional, esta análise utiliza NVMe sobre Fabrics para verificar os resultados.
Para nossas cargas de trabalho VDBench, o NetApp AFF A800 ofereceu um conjunto impressionante de números em toda a linha. Em nossa execução básica de quatro cantos, vimos um desempenho máximo de 4K aleatório de 2.2 milhões de IOPS lidos e 465K IOPS gravados. Em nossas cargas de trabalho sequenciais de 64 K, vimos 25 GB/s de leitura e 7.52 GB/s de gravação. Em nossas cargas de trabalho SQL, vimos picos de 1.5 milhão de IOPS, o SQL 90-10 registrou 1.4 milhão de IOPS e o SQL 80-20 registrou 1.1 milhão de IOPS. Nossos testes Oracle mostraram impressionantes 1.1 milhão de IOPS, o Oracle 90-10 nos deu 1.14 milhão de IOPS e o Oracle 80-20 teve 1 milhão de IOPS. O mais impressionante foi que as cargas de trabalho SQL e Oracle permaneceram abaixo de 1 ms de latência.
Apesar de termos visto ótimos resultados com o A800 configurado para NVMeOF, principalmente em termos de desempenho de leitura, vale ressaltar que o sistema ainda tem mais a oferecer. Em nossos testes, os servidores de geração de carga foram todos baseados em hipervisor VMware, o que adiciona outra camada de complexidade. Além disso, o VMware não oferece suporte total ao NVMeOF no momento. Para empresas convencionais que desejam aproveitar ao máximo o NVMeOF com sistemas NetApp, o bare metal proporcionará o melhor desempenho. Dito isso, muitos desejarão usar sistemas NVMeOF ONTAP em uma configuração híbrida, usando malhas e conectividade Fibre Channel padrão. Em ambos os casos, a NetApp continua liderando em termos de adoção e implantação de tecnologias de ponta para garantir que seus arrays estejam prontos para o que seus clientes precisarem, sempre que precisarem. O A800 se sai especialmente bem aqui, e é por isso que o premiamos com a Escolha do Editor em nossa análise inicial. O NVMeOF adiciona um enorme aumento de desempenho que deve atrair empresas que exigem rendimento máximo e latência de microssegundos para seus aplicativos críticos de negócios.


 Amazon