

Em novembro, participamos da Conferência Internacional de Computação, Rede, Armazenamento e Análise de Alto Desempenho de 2017 — mais conhecida como 2017 Supercomputing Conference (SC17). Todos os anos, na Supercomputing Conference, pesquisadores e fornecedores da academia e da indústria montam o SCinet: um supercomputador e malha de rede que serve como teste e prova de conceito para novas tecnologias de computação, rede e armazenamento de alto desempenho. A Premio é um dos fornecedores que contribuíram com hardware e experiência para o SCinet 2017 na forma de dois compartimentos de nó de dados FlacheSAN1N4C-D4, com cada nó comparando até 24 GB/s (168 Gbps) de taxa de transferência de leitura sustentada e até 3.6 milhões de IOPS. Isso permitiu que o SCinet tivesse a capacidade de transferir grandes conjuntos de dados em uma velocidade de cache rápida.
Os nós Premio FlacheSAN assumiram várias funções distintas durante a Conferência de Supercomputação de 2017, incluindo ponto de teste para grandes projetos de transferência de dados, uma plataforma para projetos de grande fluxo e um provedor de serviços de rede experimental tolerante a atrasos/interrupções para a conferência SC e a WAN SCinet . Essa primeira função é provavelmente a mais significativa para observadores da indústria como nós, que estavam examinando a SCinet este ano em busca de indicações sobre o futuro da tecnologia de transferência de grandes dados.
A SCinet tem um histórico de demonstração de tecnologias de rede que posteriormente entraram no mercado de tecnologia da informação empresarial, incluindo o Modo de Transferência Assíncrona, a Interface de Dados Distribuídos por Fibra e a Interface Paralela de Alto Desempenho (HiPPi). Durante o SC17, Brian Beeler, editor-chefe da StorageReview, conversou com membros de uma equipe de pesquisa da Northwestern University que trabalha com o FlacheSAN1N4C-D4. Fora da Supercomputing Conference propriamente dita, o FlacheSAN1N4C-D4 do Premio está sendo usado para migrar conjuntos de dados em escala de petabytes do Large Hadron Collider do CERN, pois os dados são escalonados do primeiro nível do CERN em Chicago, Illinois, para o Caltech em Pasadena, Califórnia.
O setor de armazenamento corporativo trabalha há anos para permanecer pronto para a quantidade cada vez maior de dados que estão sendo gerados e processados. Um desafio específico que está assumindo uma importância crescente hoje é a necessidade de mover grandes quantidades de dados de forma rápida e fluida. No futuro, será cada vez mais comum transferir grandes conjuntos de dados por longas distâncias geográficas, entre plataformas diferentes e de maneiras que possam lidar com atrasos e outras interrupções inerentes à transferência de dados complexos e em grande escala. Nesse sentido, a SCinet está lidando com realidades de transferência de dados hoje com as quais as empresas estarão lidando dentro de cinco a dez anos.
Para usar o projeto de pesquisa da Caltech como exemplo, um experimento do Grande Colisor de Hádrons pode facilmente gerar dados brutos de sensor na vizinhança de 25 petabytes, que por sua vez são encaminhados para instituições de pesquisa afiliadas em todo o mundo para análise. Na verdade, são as restrições de computação, rede e armazenamento que provaram ser os principais gargalos para a taxa na qual a experimentação pode ser conduzida no colisor, portanto, melhorar o desempenho nessas áreas é uma preocupação crítica. Do lado da empresa, avanços recentes em Inteligência Artificial e outras análises de Big Data sugerem que não demorará muito para que a transferência de tais conjuntos de dados massivos se torne comum no setor privado (pense em tudo, desde carros autônomos até sensores ambientais em locais de recuperação de mineração). .
O FlacheSAN1N4C-D4 é alimentado por processadores Intel Xeon E5-2600v4/v3 Broadwell/Haswell duplos, que gerenciam uma matriz de armazenamento composta por quatro unidades Flash NVMe PCIe3 x8. O FlacheSAN1N4C-D4 é capaz de se beneficiar da tecnologia de processador Broadwell de 14 NM da Intel porque aumenta o consumo de energia e melhores frequências de clock em TDPs equivalentes ou mais baixos do que seu antecessor. O FlacheSAN1N4C-D4 é especificado para taxa de transferência de leitura sustentada de 24 GB/s de 3.6 milhões de IOPS, desempenho essencial para mover as enormes quantidades de dados exigidas pela SCinet e outras redes de computação de alto desempenho de ponta.
Especificações do Prêmio FlacheSAN1N4C-D4
- CPU suportada: Dual Intel Xeon E5-2600v4/v3 Broadwell/Haswell até 135 W TDP soquete R3
- Chipset: Chipset Intel C612
- Suporte de memória: 16x DDR4 ECC RDIMM/LRDIMM 1600/1866/2133/2400MT/s máx. capacidade de 1 TB
- Slots de expansão: Suporta até 2x PCIe3 x16 de altura total 1x PCIe3 x8 IO Module
- Armazenamento:
- 4x PCIe3 x8 NVMe de baixo perfil com troca a quente
- 2 baias internas de 2.5 polegadas para sistema operacional
- Rede:
- Dual GbE Intel i210
- Opcional 56Gb FDR Infiniband QSFP+ ou Dual 40GbE Ethernet através do módulo de E/S
- 1 porta RJ45 de gerenciamento IPMI
- 2 x slots PCIe3 x16 para outra opção de placa NIC
- Potência: 1+1 750 W AC/DC 80 Plus Platinum Redundant PSU
- Segurança: Intel Trusted Execution Technology; TPM 1.2
- SO suportados: Windows 2012 R2, RHEL 6.5, SLES 11 SP3, Windows 208 R2, VMWare ESXi 5.5, FreeBSD 9.2, Centos 6.5
- Painel frontal: ligar/desligar com LED, interruptor de reset, interruptor NMI, interruptor de localização com LED, 4 LEDs de LAN, LED de advertência
- E / S traseira:
- DB15 VGA, 2x RJ45 1GbE, 1x DB9 serial,
- 1x RJ45 MGMT, 2x USB 3.0, 2x USB 2.0
- 1x LED de ID, QSFP+ duplo opcional
- Resfriamento: 3x ventiladores de 97 mm
- Outros recursos: GbE dedicado para IPMI 2.0
- Peso
- Bruto: 23KG/50LBS
- Líquido: 17KG/37.4LBS
- Dimensões do sistema: 31.38" x 19" x 1.75" (CxLxA)
- Embalagem: 37.8" x 24" x 9.45" (CxLxA)
- Logística Código HTS: 8473 30 5100; ECCN: 4A994
- Temperatura operacional ambiental: 0°C a 35°C
- Temperatura fora de operação: -20°C a 70°C
- Umidade: 5% para 95% sem condensação
- Conformidade CE, FCC Classe A, compatível com RoHS 6/6
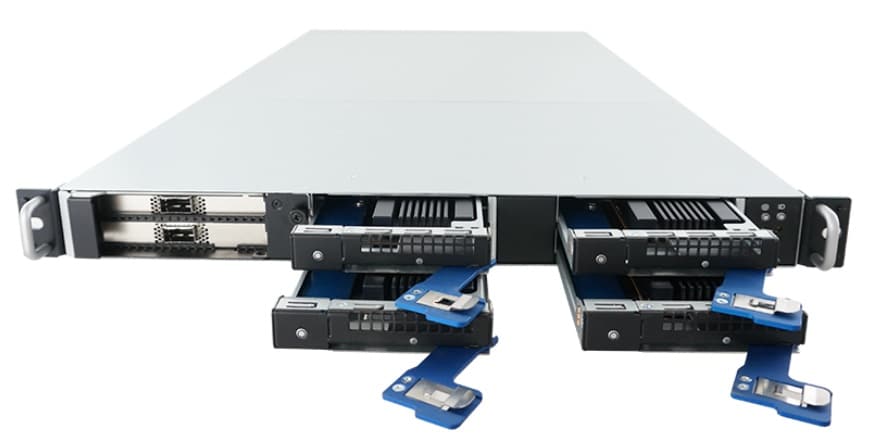
O FlacheSAN1N4C-D4 incorpora quatro baias de acesso frontal para armazenamento PCIe3 x8 NVMe de baixo perfil. Esses slots NVMe compreendem o armazenamento, que está disponível para uso por dados em trânsito em uma implantação de nó de transferência de dados. Duas unidades internas de 2.5 polegadas hospedam o sistema operacional.
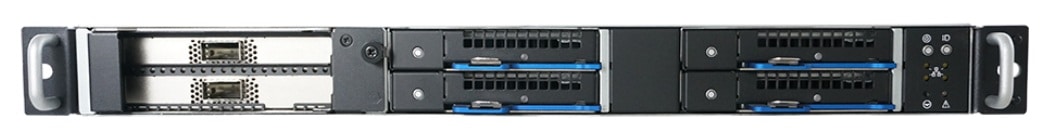
O pool de armazenamento deste array FlacheSAN é hot-swappable e certificado para uso com diversos dispositivos de armazenamento NVMe. A Premio publica uma Lista de Fornecedores Aprovados na página de informações do produto FlacheSAN1N4C-D4, derivada de testes internos de laboratório da Premio.
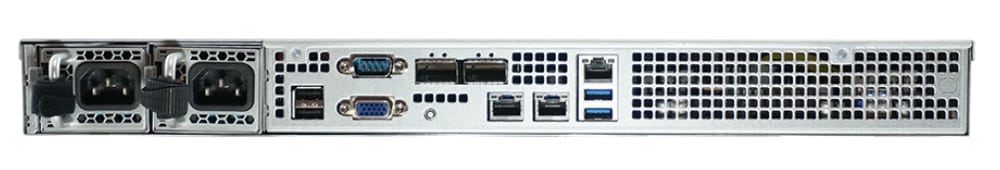
A parte traseira do array fornece acesso às interfaces integradas Dual GbE Intel i210. O array pode opcionalmente ser configurado com 56Gb FDR Infiniband QSFP+ ou Dual 40GbE Ethernet através de módulos de E/S. Há também uma porta de gerenciamento IPMI RJ45 junto com dois slots PCIe3 x16 para outras opções de NIC.
A linha de servidores FlacheStreams do Premio concentra-se em arrays NVMe Flash como o veículo para a estratégia de eliminação de gargalos de "arquitetura balanceada" do Premio, que equilibra recursos entre as unidades NVMe e as placas Ethernet. Os sistemas FlacheStreams também podem fornecer acesso direto ao armazenamento NVMe do array na malha de rede para reduzir a latência.
Com base na experiência do Premio trabalhando com a Caltech para classificar dados experimentais de Chicago a Pasadena, a empresa contribuiu com dois arrays FlacheSAN1N4C-D4 para a SCinet para servir como servidores DTN (Data Transfer Node). No total, os dois Premio DTNs ofereceram 400 Gigabits de taxa de transferência de disco para disco para demonstrações de tecnologia, incluindo o front-end Jupyter integrado para fluxos de trabalho científicos com uso intensivo de dados, malhas de rede que exigem uma API programável e a API de monitoramento DTN do array.
Os tipos de cargas de trabalho gerenciadas pela rede experimental de distribuição de dados do Grande Colisor de Hádrons, bem como aquelas modeladas pela SCinet na Supercomputer Conference, são indicadores importantes de como a tecnologia de transferência de grandes dados pode ser implantada no setor privado no futuro. Seja transferindo por grandes distâncias ou entre sistemas de gerenciamento de informações diferentes, grandes transferências de dados serão a nova realidade.


 Amazon