

A alta disponibilidade deixou de ser um luxo de data center para se tornar um item essencial no planejamento de resiliência do dia a dia. Pequenas empresas e locais de borda agora utilizam sistemas de ponto de venda, vigilância e armazenamento compartilhado que geram custos adicionais a cada minuto de inatividade. No entanto, a solução clássica, um array empresarial com dois controladores, é dimensionada e precificada para data centers, e não para salas de servidores ou racks de parede. Essa discrepância deixou pequenas equipes de TI com backups e snapshots para proteção de dados, mas sem nenhuma garantia de continuidade: um NAS com um único controlador, por melhor que seja, continua sendo um ponto único de falha.
Alta disponibilidade não é novidade para a QNAP, que já oferecia hardware com controlador duplo e caminhos de recuperação baseados em replicação. A novidade do QuTS hero h6.0 é a eficiência. O novo Gerenciador de Alta Disponibilidade integra o clustering ao sistema operacional em hardware comum, permitindo que duas unidades NAS idênticas formem um cluster ativo-passivo sob um único endereço IP. Assim, quando uma unidade falha, a outra assume o controle e os clientes praticamente não percebem. Para uma organização que busca otimizar seus investimentos em TI, isso significa alta disponibilidade ao custo de um segundo NAS, em vez de uma segunda classe de infraestrutura.
Essa é a proposta: para ver como se comporta na prática, construímos um cluster de alta disponibilidade (HA) em laboratório com dois sistemas QNAP TS-h765eU equipados com discos rígidos Seagate IronWolf Pro e SSDs QNAP E1.S para cache. Em seguida, simulamos falhas da mesma forma que ocorrem em locais de borda. Desligamos a energia do nó ativo durante a transferência. Desconectamos sua rede, mantendo o sinal de atividade (heartbeat) intacto. Em ambos os casos, a pergunta era a mesma: a transferência de arquivos é concluída com sucesso e como ocorre a recuperação quando o nó com falha retorna?
Visão geral do QNAP TS-h765eU
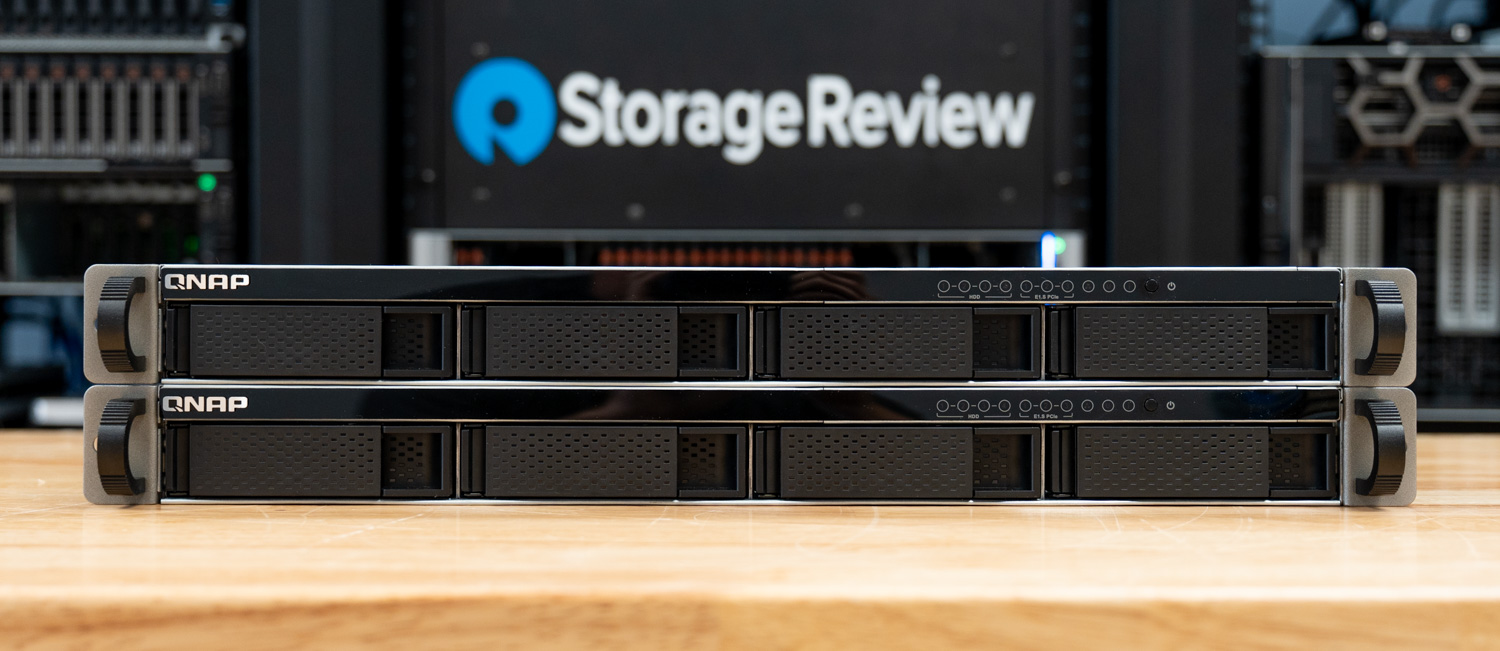
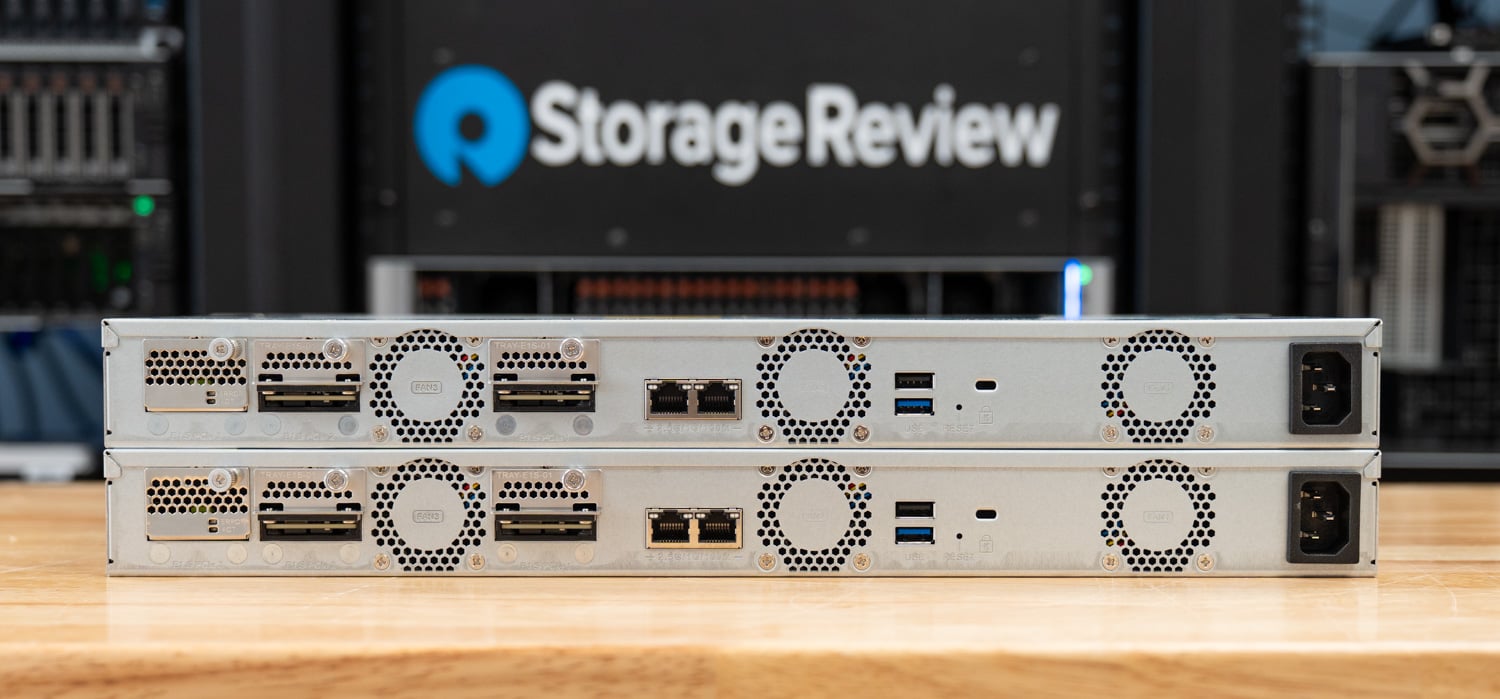
O TS-h765eU é uma escolha interessante como componente de alta disponibilidade (HA) justamente por ser um hardware relativamente simples. O gabinete é um NAS de rack de 1U com profundidade reduzida, apenas 292.1 mm (12 polegadas) de profundidade, projetado para pequenos gabinetes de mídia, racks de rede montados na parede e implantações de borda onde um chassi de profundidade total não caberia. Cada unidade oferece quatro baias para discos SATA de 3.5 polegadas na parte frontal, além de três slots PCIe NVMe E1.S/M.2 na parte traseira, conferindo-lhe uma personalidade de armazenamento híbrida: disco rígido para capacidade e memória flash para cache ou camadas de alta velocidade.
A QNAP também o designou como um modelo de fornecimento de longo prazo com disponibilidade garantida até 2031, o que é importante para organizações que padronizam uma plataforma em diferentes locais.
Por dentro, o TS-h765eU utiliza o processador Intel Atom x7405C, um chip quad-core que oferece até 3.4 GHz, combinado com 8 GB de memória DDR5, expansível até 16 GB, com ECC em banda. A conectividade de rede começa com duas portas 2.5GbE, com a opção de 10GbE disponível ao substituir um compartimento E1.S pelo módulo QXG-ES10G1T da QNAP.
| Especificação | QNAP TS-h765eU |
|---|---|
| CPU | Processador Intel Atom x7405C quad-core, até 3.4 GHz |
| Memória | 8 GB DDR5, expansível até 16 GB (ECC em banda) |
| Baias | 4 x SATA de 3.5 polegadas |
| Slots Flash | 3 x E1.S / M.2 PCIe NVMe |
| Networking | 2 x 2.5 GbE, 10 GbE via módulo opcional QXG-ES10G1T E1.S |
| Fator de Forma | Rackmount 1U de profundidade reduzida, 292.1 mm (12 pol.) de profundidade |
| Sistema Operacional | QuTS hero h6.0 (baseado em ZFS) |
| Disponibilidade | Modelo de fornecimento de longo prazo até 2031 |
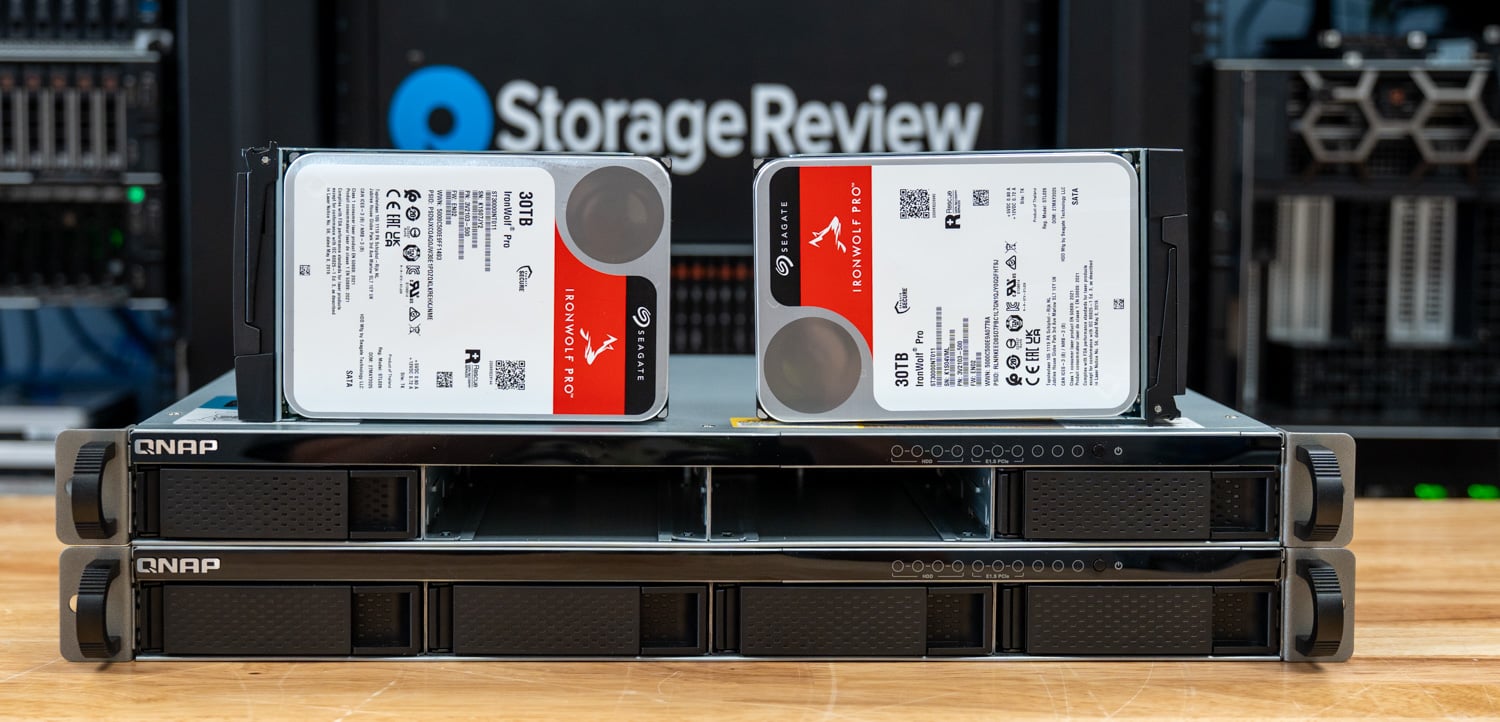
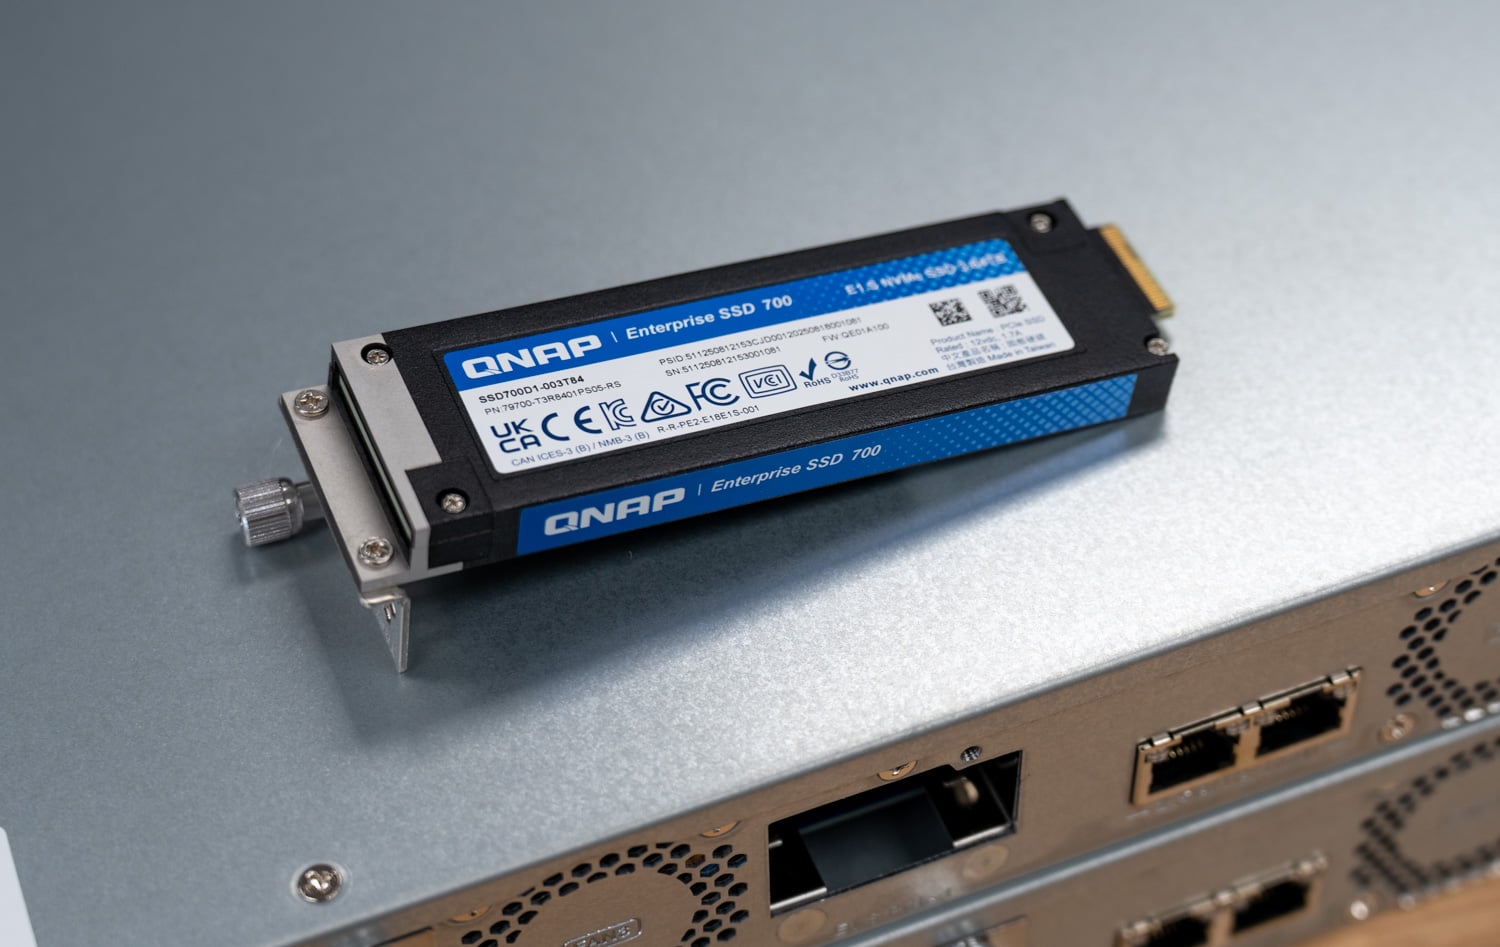
Para esta avaliação, cada nó foi configurado com quatro discos rígidos Seagate IronWolf Pro de 30 TB (ST30000NT011) em um pool de armazenamento RAID 5, além de dois discos QNAP SSD700 E1.S de 3.84 TB (SSD700D1-003T84) em RAID 0 como cache. Ambos os sistemas executaram o QuTS hero h6.0.0.3500 com o High Availability Manager 2.0.421.
QuTS hero h6.0 e a arquitetura do HA Manager
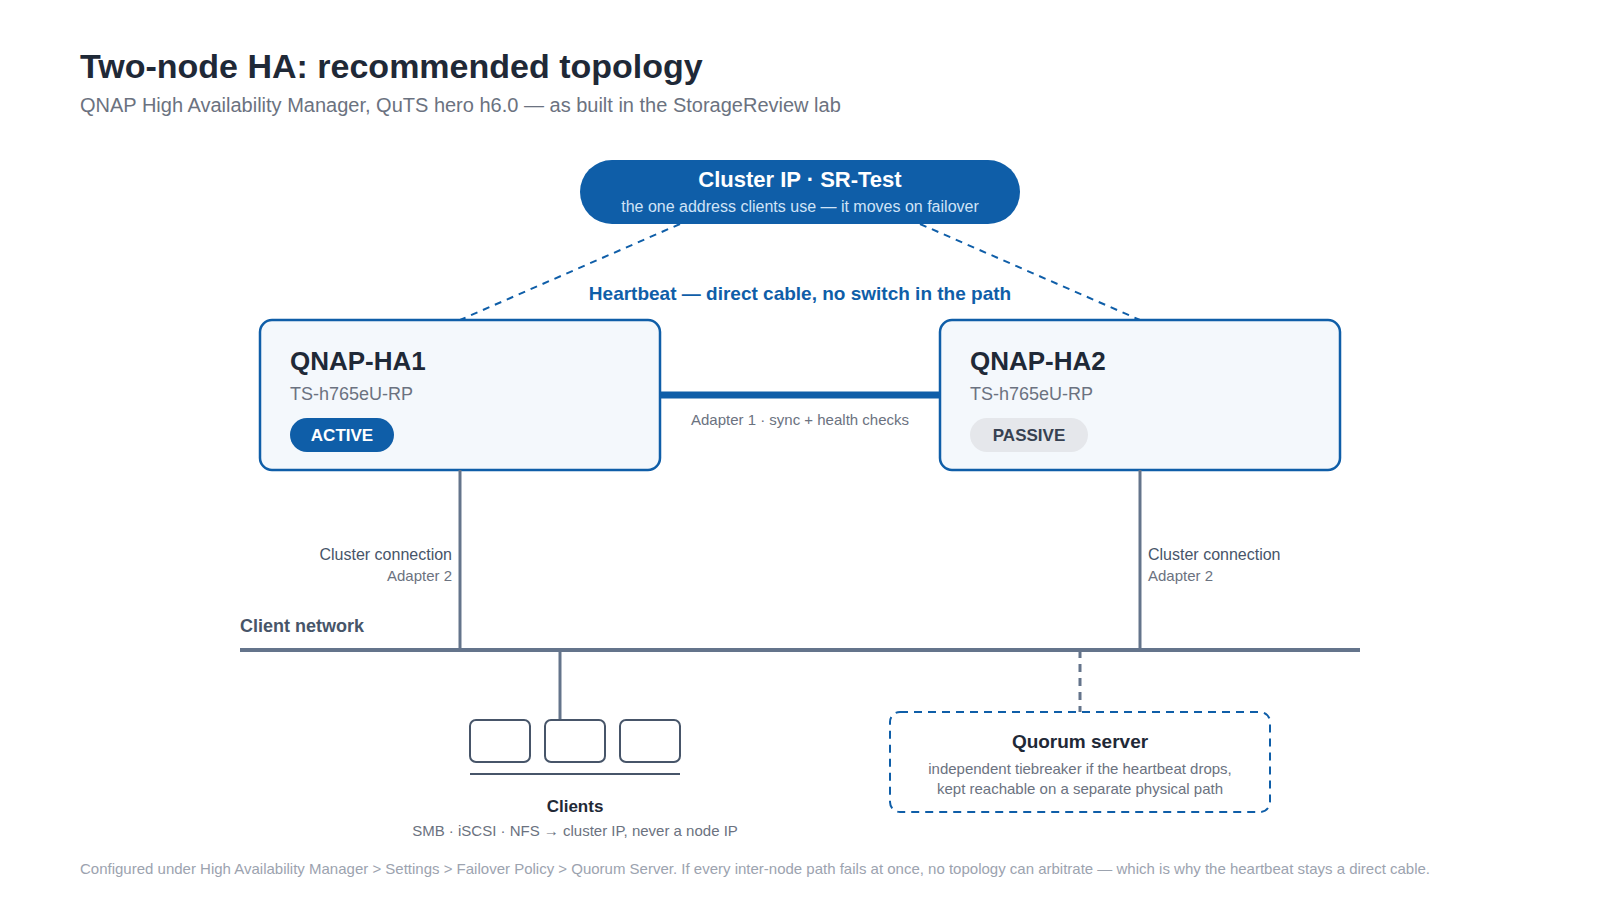
O High Availability Manager é o principal recurso do QuTS hero h6.0, implementando um design clássico ativo-passivo. Um NAS, o nó ativo, fornece todos os dados e serviços. O segundo NAS, o nó passivo, sincroniza continuamente com o nó ativo por meio de uma conexão dedicada de heartbeat e está pronto para assumir o controle. Os clientes nunca se comunicam diretamente com nenhum dos nós; em vez disso, o cluster apresenta um único endereço IP e nome de host, e o nó que estiver ativo no momento responde a ele. Quando ocorre uma falha, o IP do cluster redireciona o tráfego no backend, de modo que unidades mapeadas, iniciadores iSCSI e tarefas de backup não precisam ser reconfigurados.
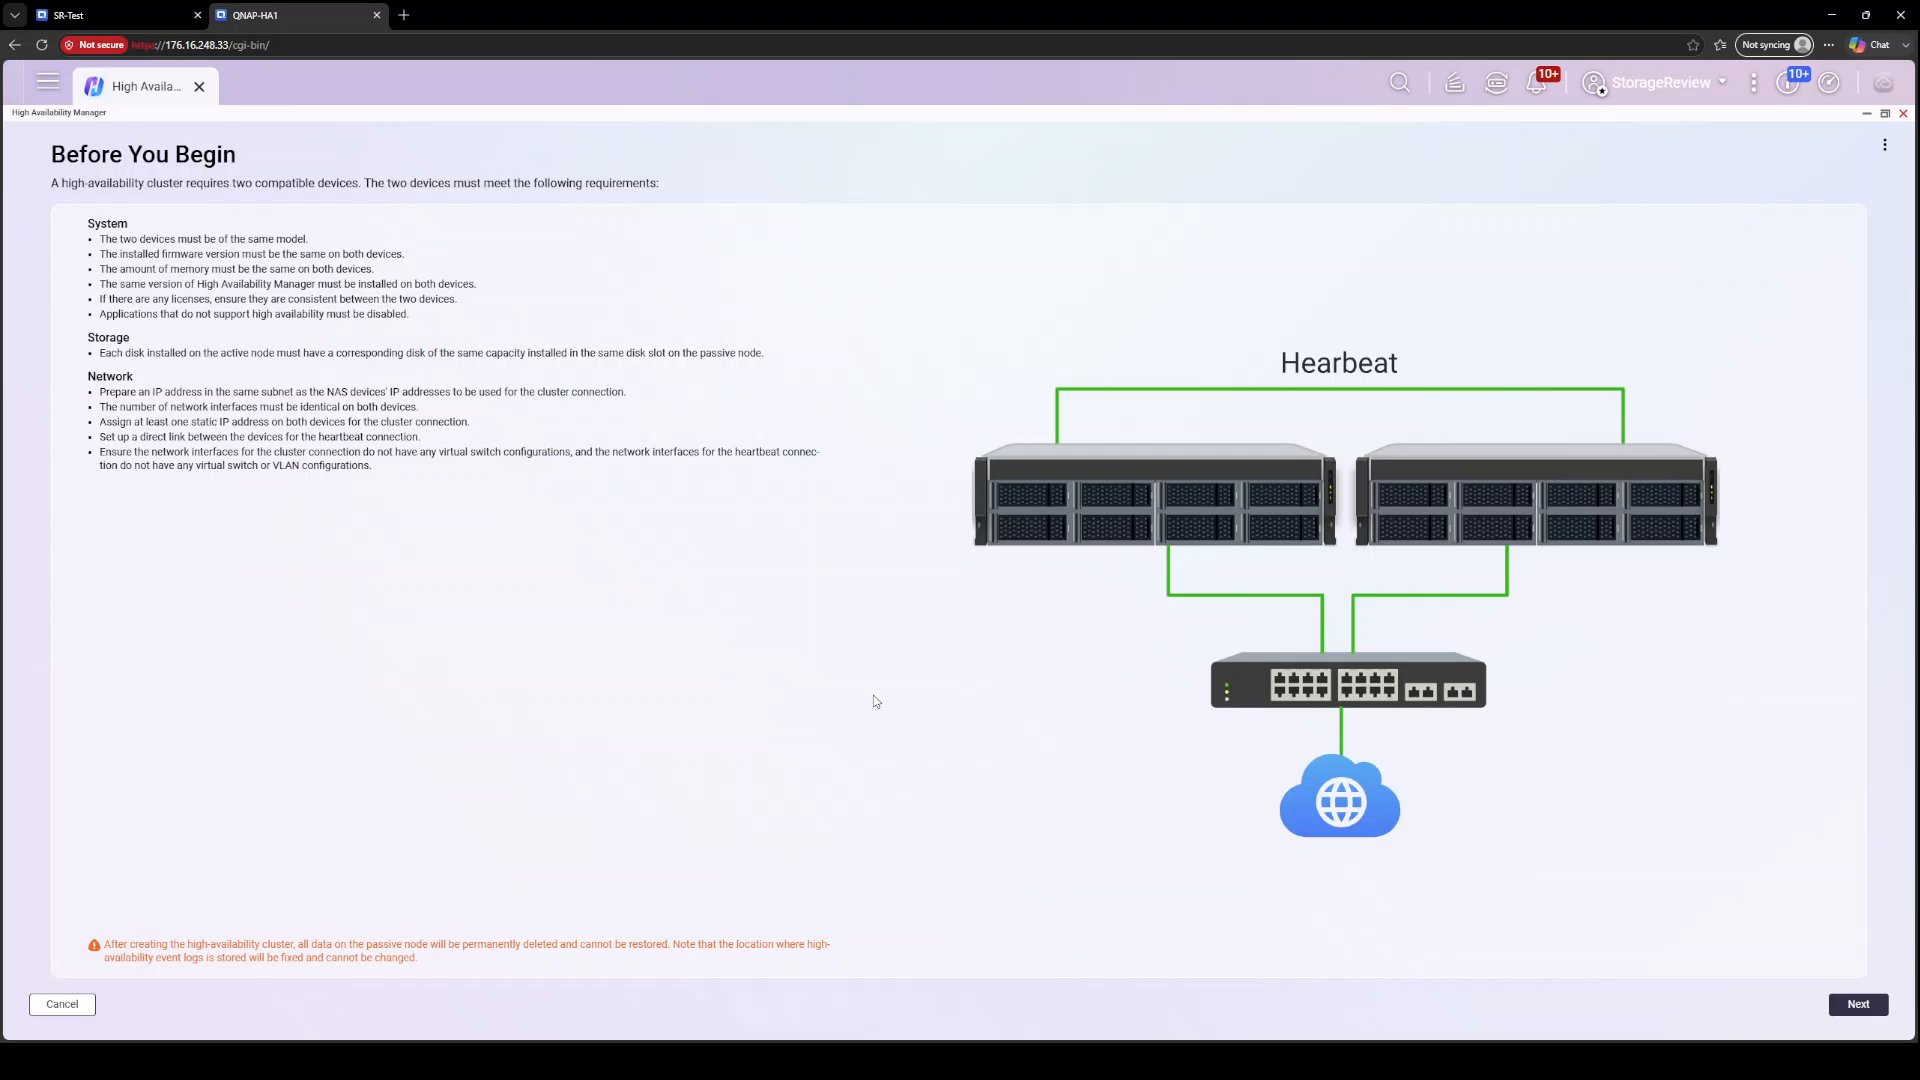
O link de heartbeat é a espinha dorsal do projeto. A QNAP exige uma conexão direta entre as duas unidades, sem switches no caminho, e transporta tanto o tráfego de verificação de integridade quanto a sincronização de dados em nível de bloco entre os nós. Uma conexão de cluster separada lida com o tráfego voltado para o cliente através da rede normal. Complementando a proteção contra split-brain, há um servidor de quorum, uma terceira testemunha na rede que ajuda um nó a determinar se deve se promover quando o heartbeat para de funcionar. Abordaremos o split-brain e a topologia de implantação que o previne em detalhes mais adiante nesta análise.
A QNAP afirma que mais de 90% dos serviços NAS estão prontos para alta disponibilidade (HA) no h6.0, e o cluster pode expandir a capacidade com gabinetes de expansão JBOD. Existem, porém, algumas ressalvas. Os snapshots imutáveis, outro recurso importante do h6.0, não são suportados atualmente em um cluster HA, portanto, os administradores terão que escolher entre as duas proteções por enquanto. A alta disponibilidade também exige dois sistemas idênticos, com modelo e firmware correspondentes, requisito que o assistente de emparelhamento impõe antes de permitir que você prossiga.
Construindo o cluster de alta disponibilidade (HA) do QNAP
A criação do cluster começa com duas unidades TS-h765eU configuradas independentemente com hardware idêntico. A partir do nó ativo designado, o assistente do High Availability Manager executa um breve processo de emparelhamento. O assistente descobre o nó passivo através do link de heartbeat e, em seguida, solicita que você atribua funções às suas interfaces de rede: uma conexão de cluster que serve como canal de comunicação para acesso ao cluster e a conexão de heartbeat, que, segundo a QNAP, é dedicada à sincronização de dados e deve ser um link direto entre os dispositivos. Em nossa configuração, o assistente atribuiu a função de heartbeat ao Adaptador 1 e a conexão de cluster ao Adaptador 2.
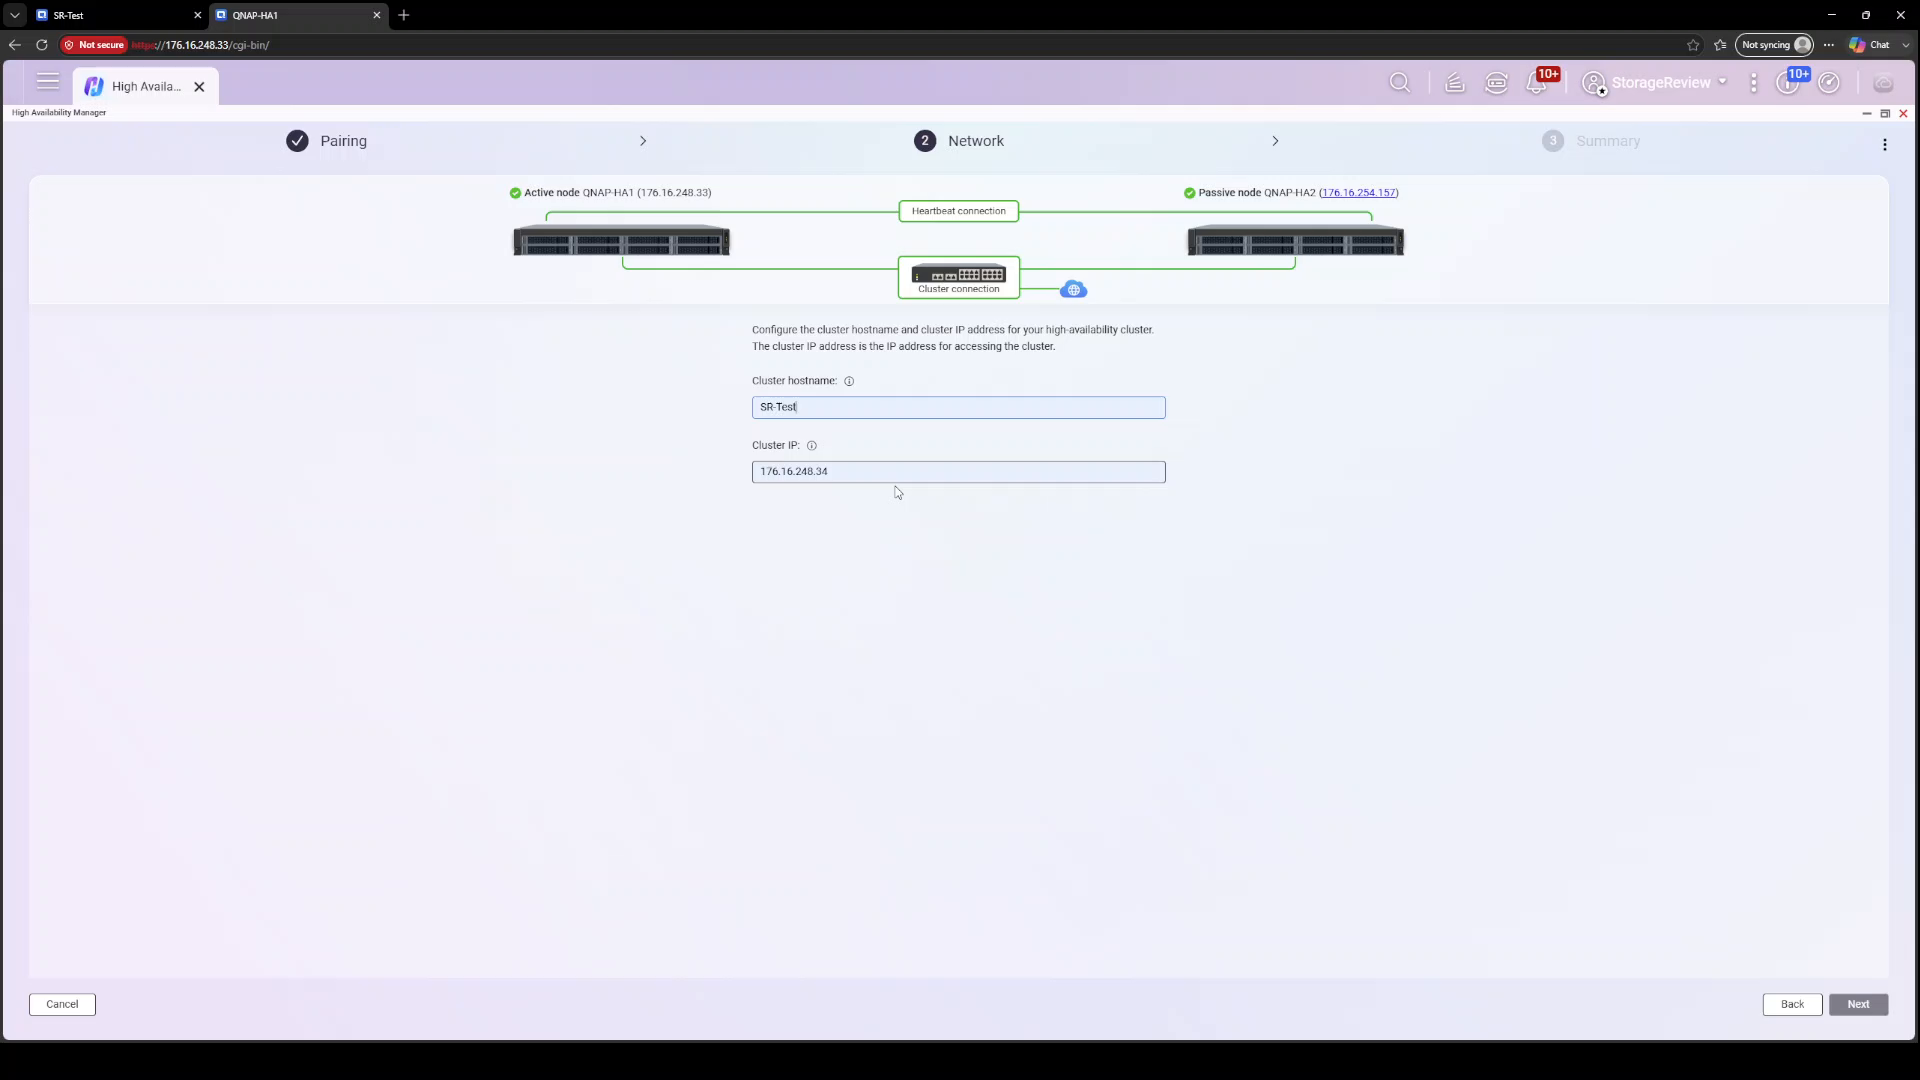
Em seguida, vem a identidade do cluster. Você atribui um nome de host e um endereço IP ao cluster, que se tornam o único endereço usado pelos clientes a partir desse momento. Nosso cluster foi nomeado SR-Test em 176.16.248.34, localizado à frente dos nós QNAP-HA1 (176.16.248.33) e QNAP-HA2 (176.16.254.157), os dois nós situados em sub-redes /24 diferentes na rede do laboratório; o assistente os emparelhou sem problemas.
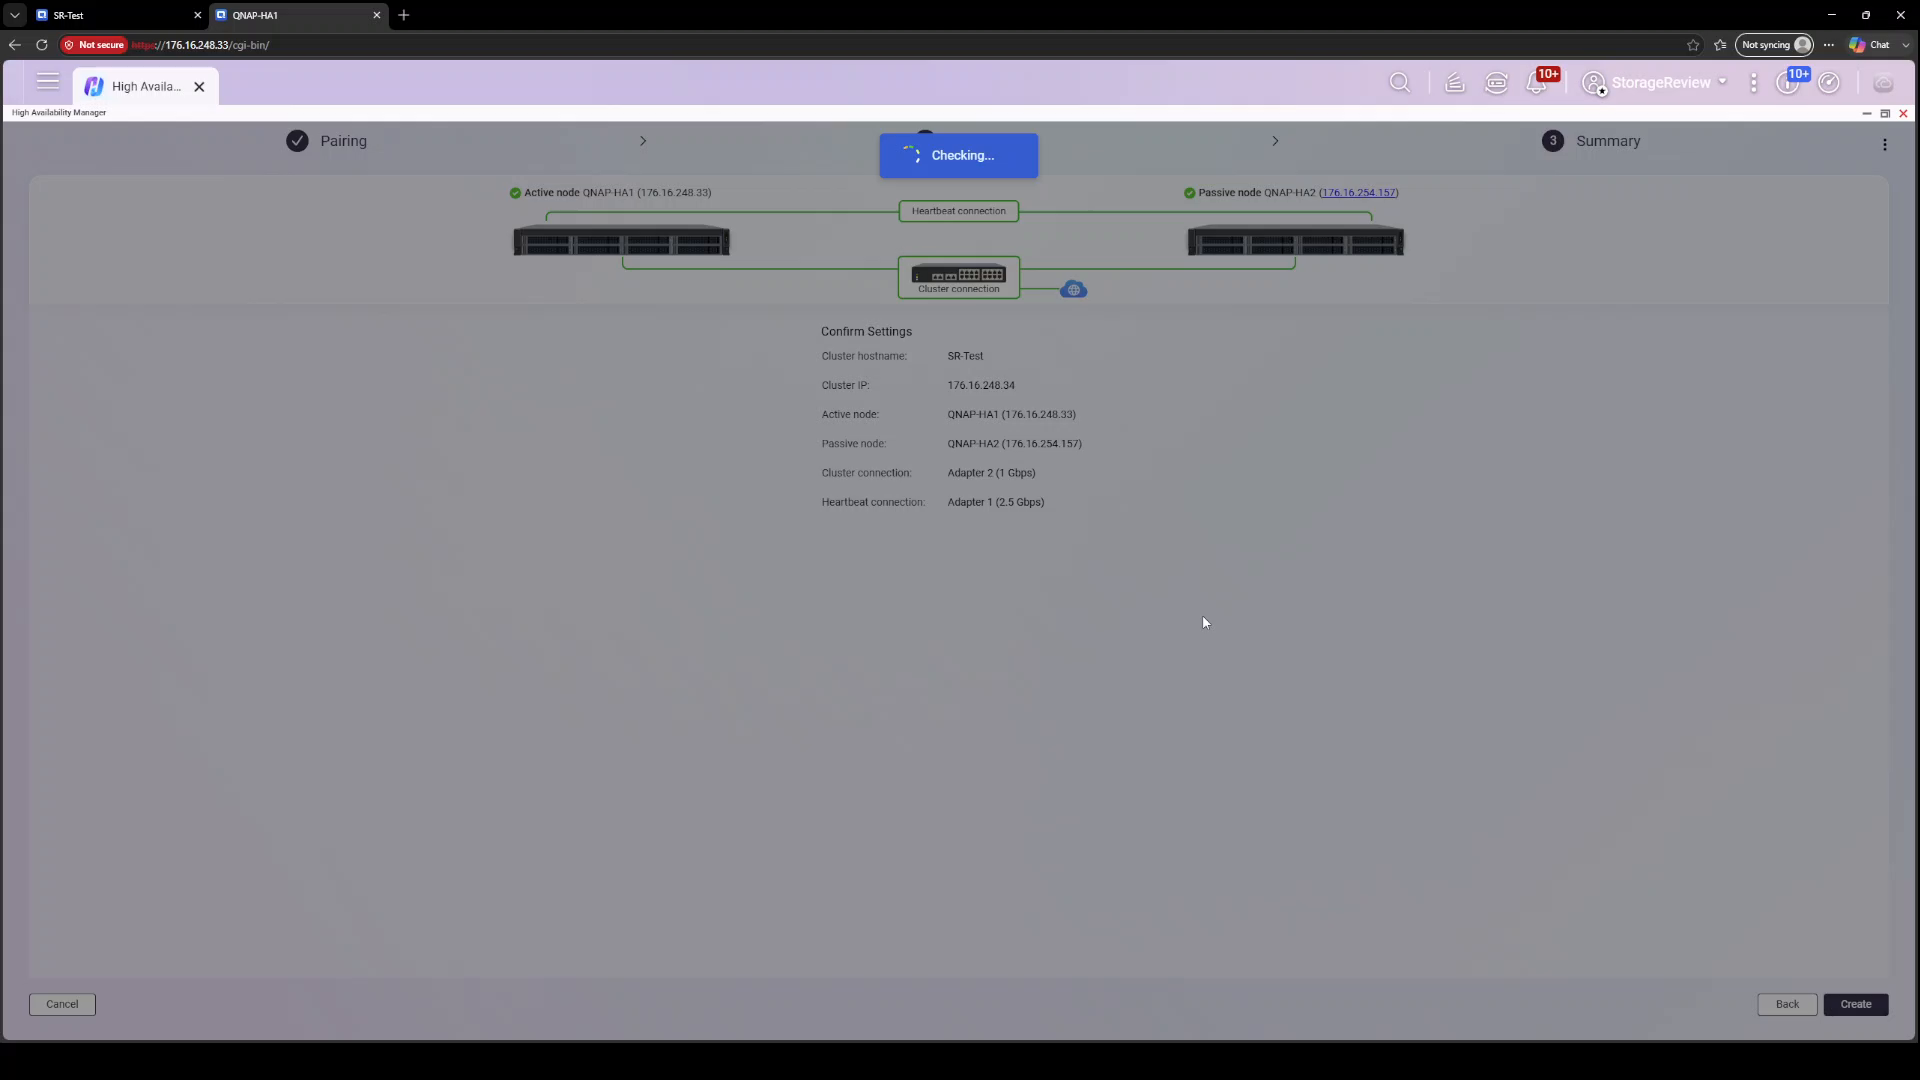
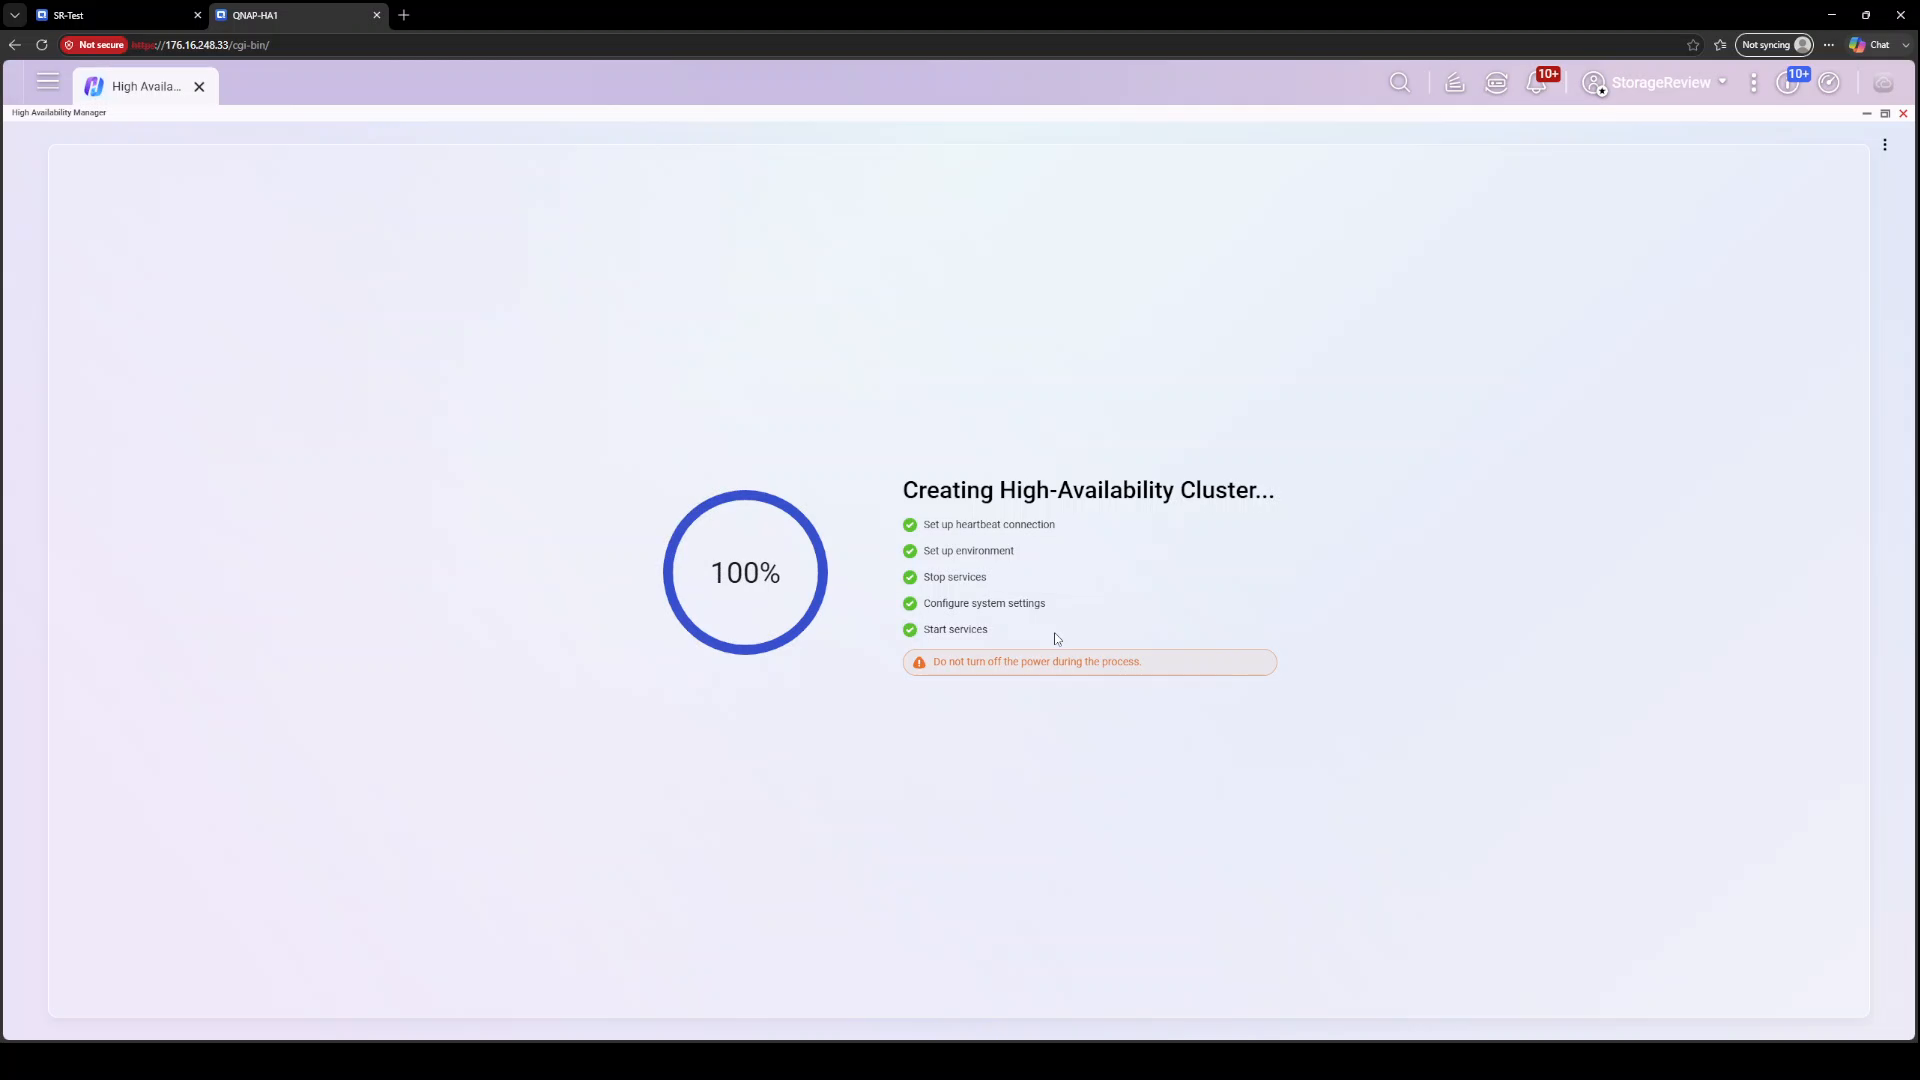
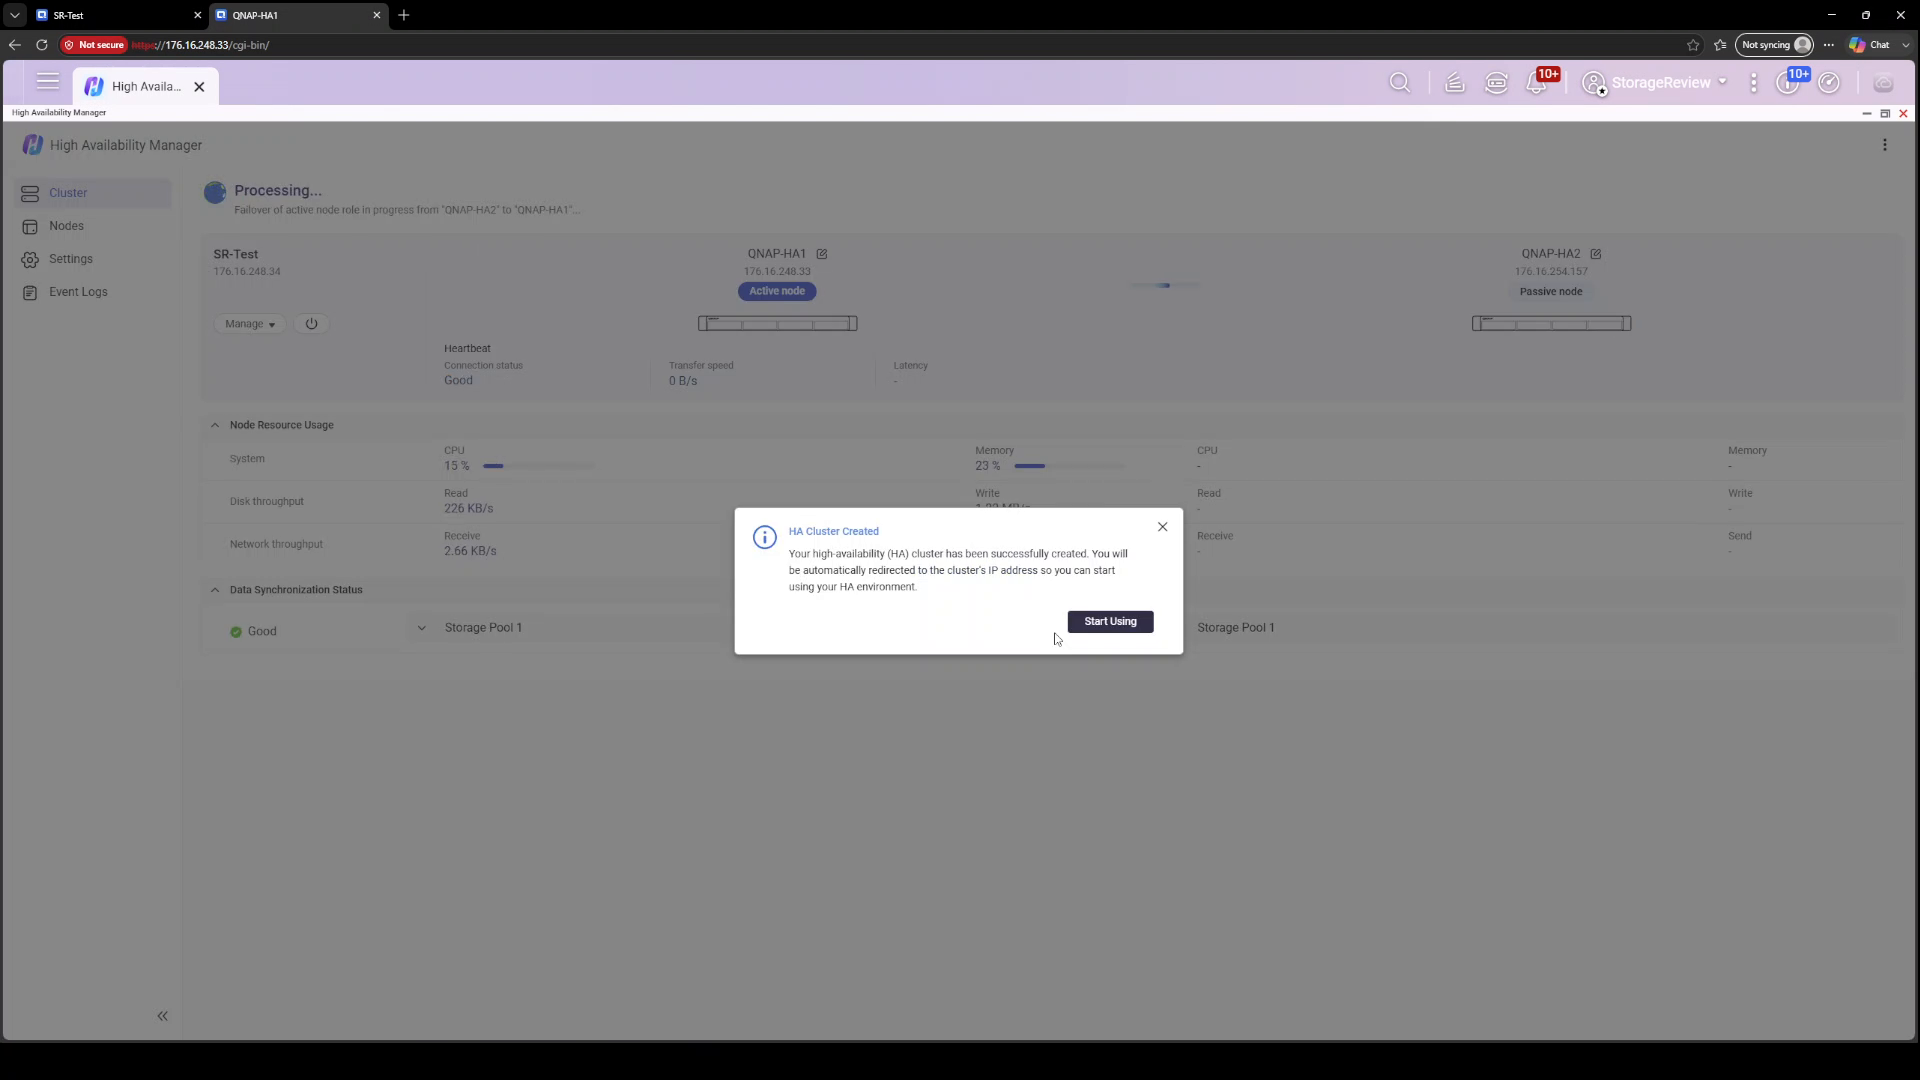
Com as configurações confirmadas, o assistente executa uma configuração em cinco etapas: configurar a conexão de pulsação, configurar o ambiente, parar os serviços, configurar as definições do sistema e iniciar os serviços. A interface do usuário enfatiza que você não deve desligar nada durante esse período. Em nossos sistemas, a configuração em si foi concluída em cerca de cinco minutos e meio, após os quais o HA Manager informou que o cluster foi criado e nos redirecionou para o endereço IP do cluster. Do início ao fim, a transformação de duas unidades NAS independentes em um cluster de serviço levou menos de dez minutos de tempo do assistente.
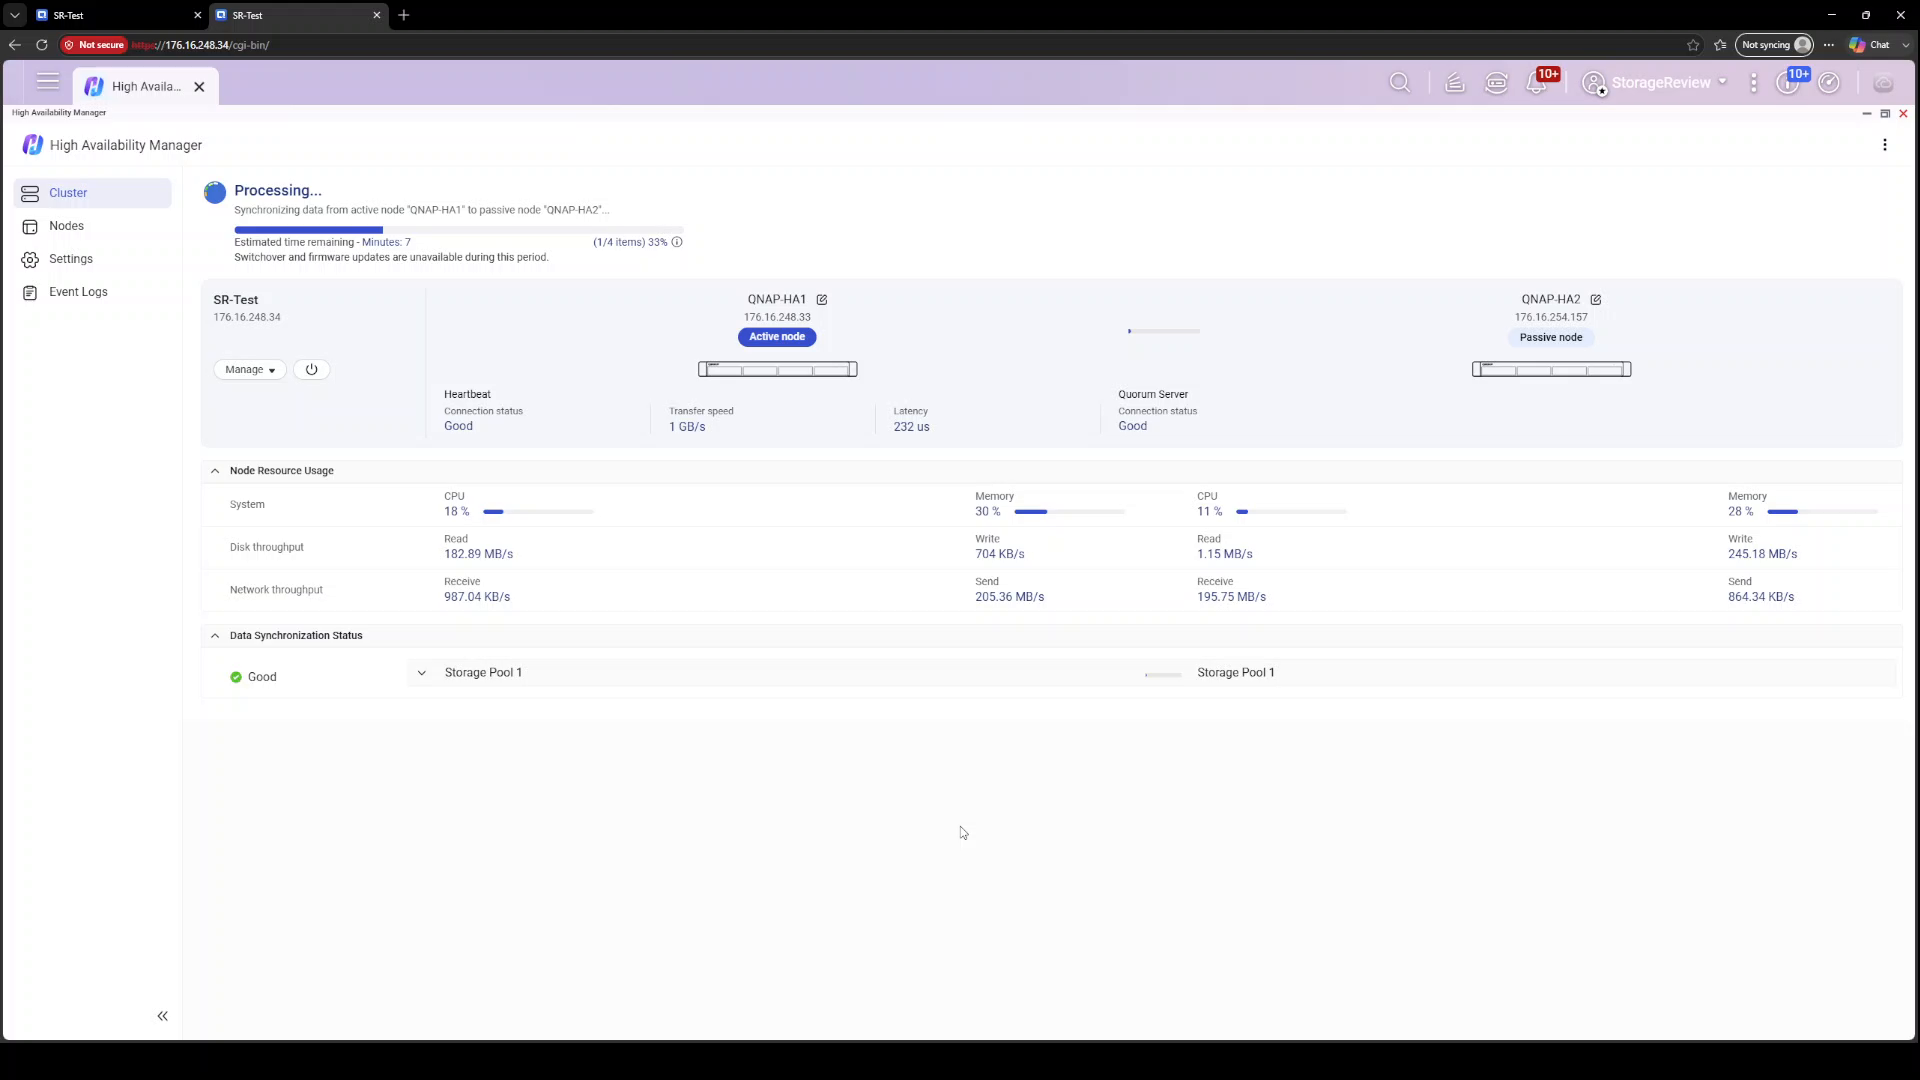
A etapa mais complexa é a sincronização inicial, na qual o nó ativo replica seu pool de armazenamento para o nó passivo, bloco por bloco. O HA Manager exibe isso claramente com uma barra de progresso, contagem de itens e estimativa de tempo na parte superior do painel, juntamente com um aviso de que a troca de nós e as atualizações de firmware não estarão disponíveis até que a sincronização seja concluída. Observar as estatísticas de pulsação durante essa fase foi uma das partes mais impressionantes do processo: as velocidades de transferência variaram de aproximadamente 900 MB/s a 1.2 GB/s, com latência na casa das centenas de microssegundos, incluindo uma leitura representativa de 1 GB/s em 232 microssegundos. Nossa sincronização inicial foi concluída em cerca de dez minutos, exatamente de acordo com a estimativa inicial do painel de nove minutos.
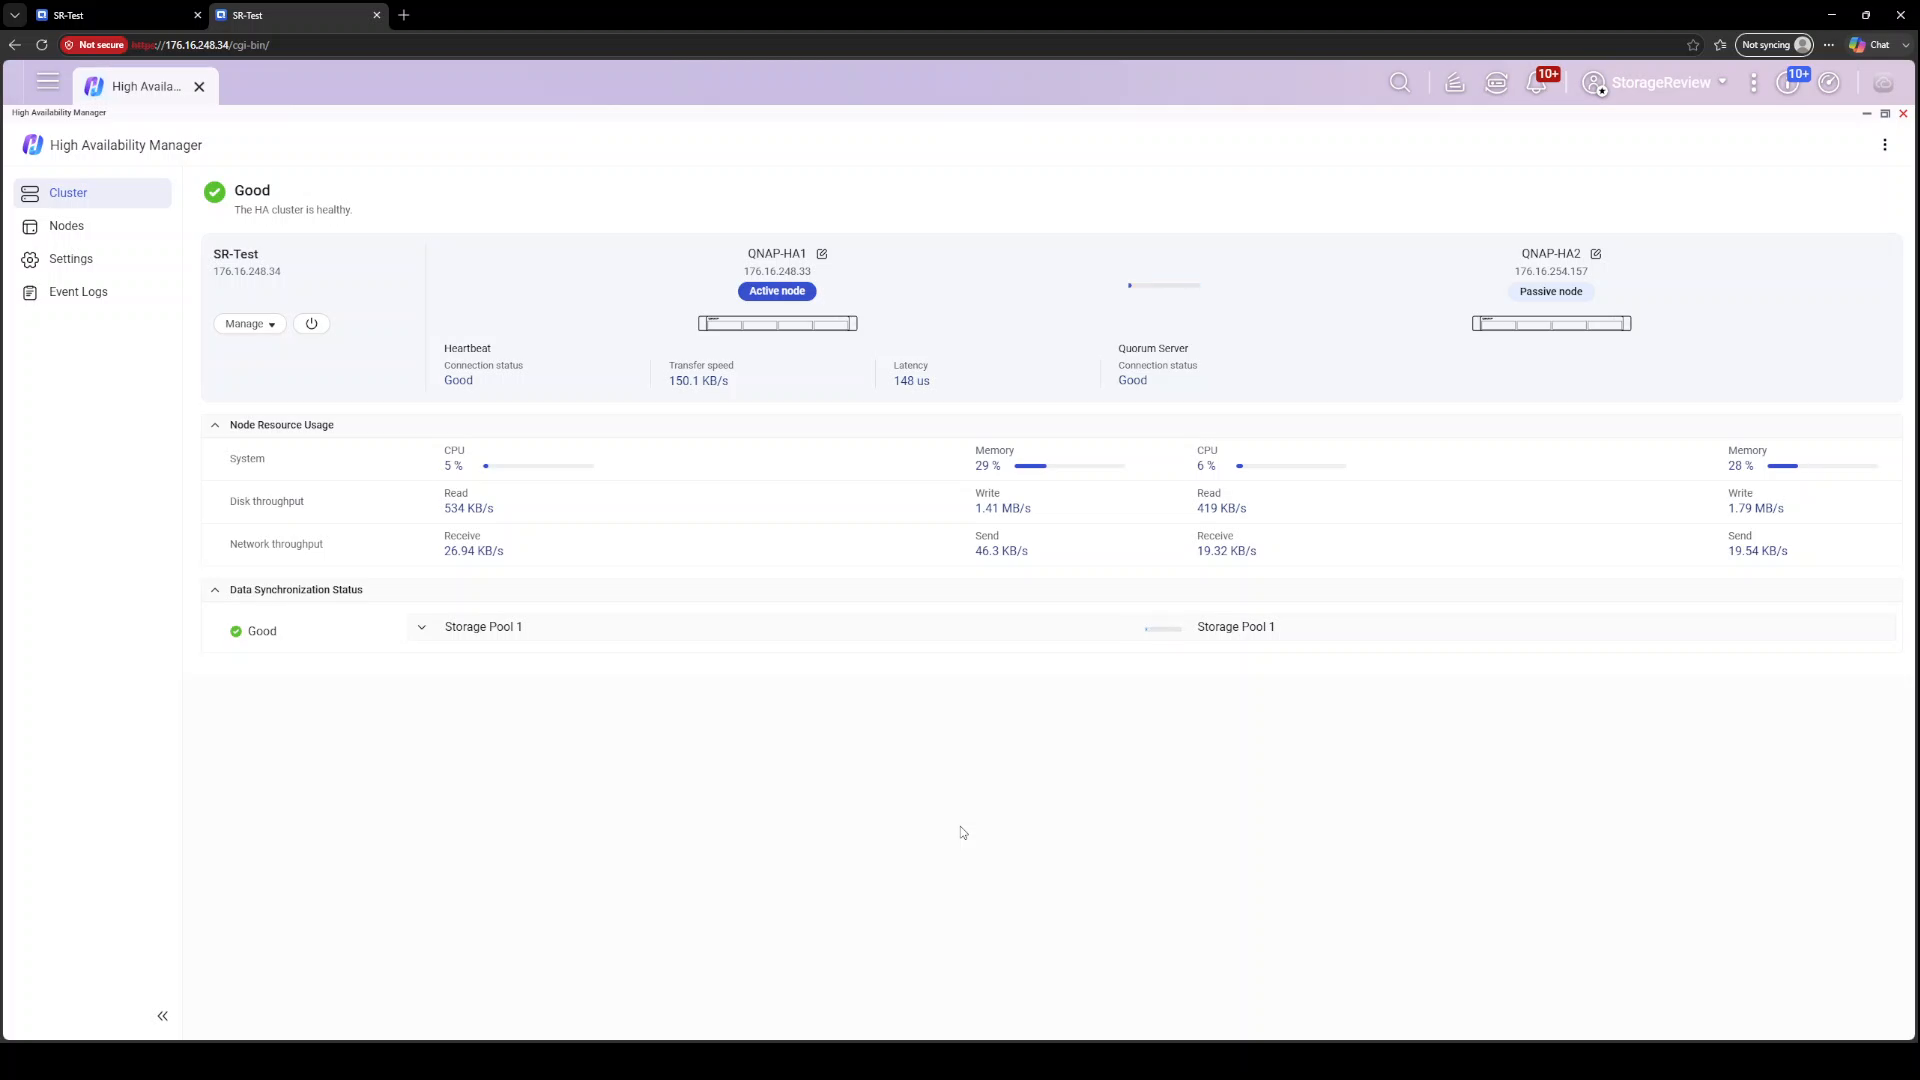
Assim que a sincronização termina, o painel exibe o status "Bom": cluster íntegro, sinal de atividade conectado, ambos os nós visíveis com estatísticas em tempo real de CPU, memória, taxa de transferência de disco e rede lado a lado, e o status de sincronização por pool logo abaixo. É uma visualização clara e repleta de informações que responde às duas perguntas essenciais para um administrador: o cluster está íntegro e meus dados estão sincronizados?
Teste de Failover 1: Perda de energia no nó ativo
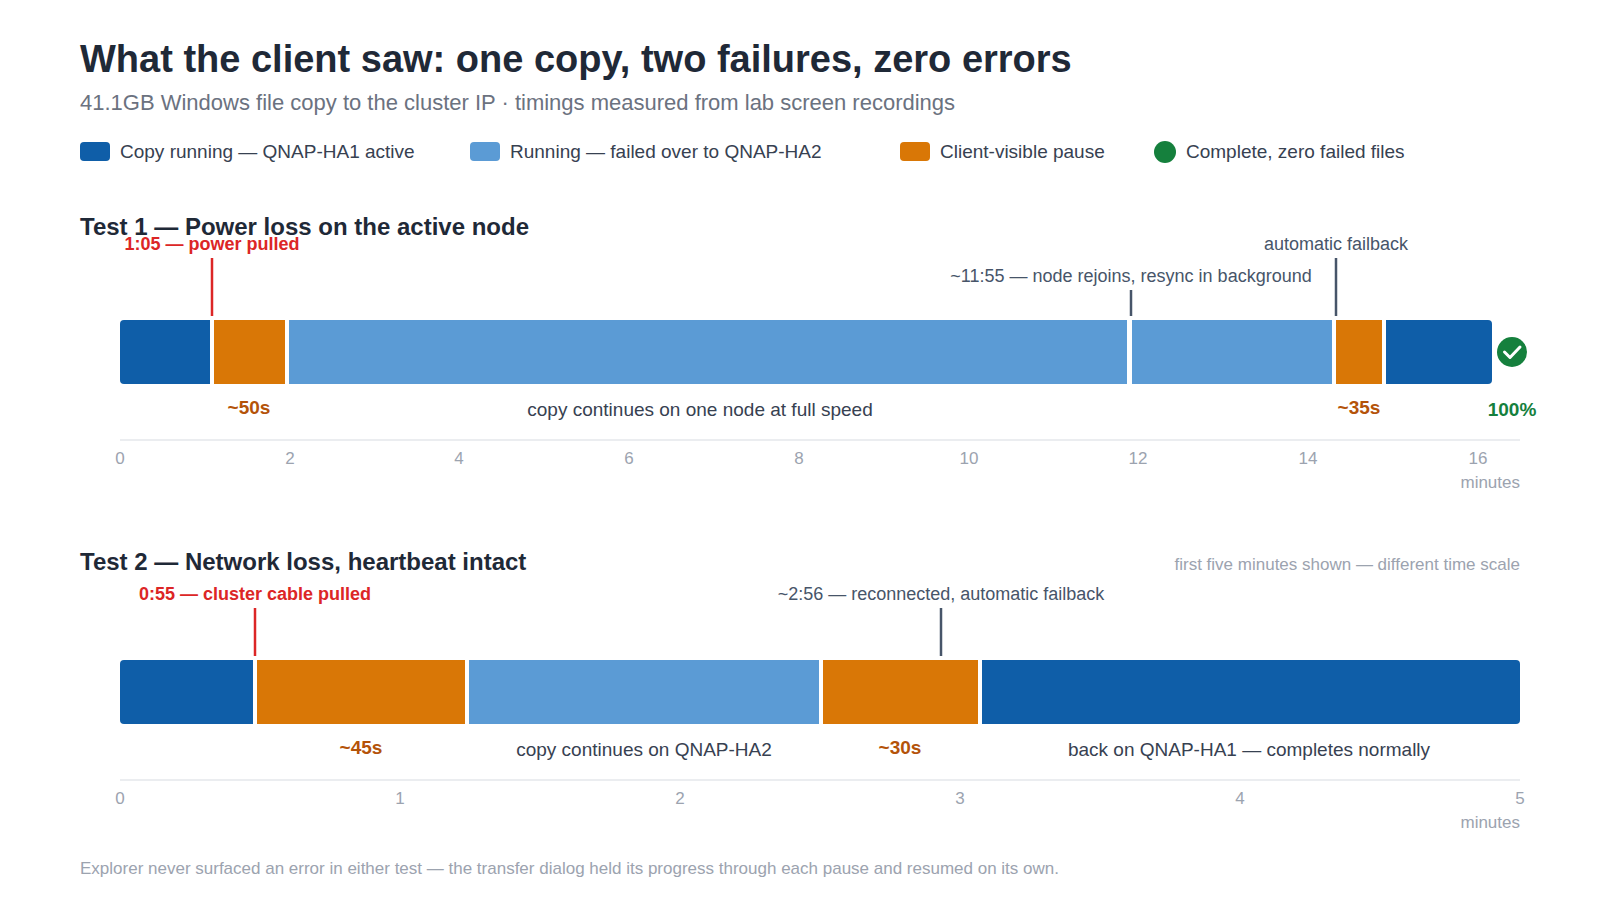
Nosso primeiro cenário de falha é o mais óbvio: perda total de energia no nó ativo. Iniciamos uma cópia de arquivos do Windows de um cliente para um compartilhamento SMB no IP do cluster, um lote de 41.1 GB com seis arquivos, incluindo ISOs do Windows 11 e do Rocky Linux e dois arquivos de máquinas virtuais do Kali Linux, e então desligamos o QNAP-HA1 no meio da transferência.
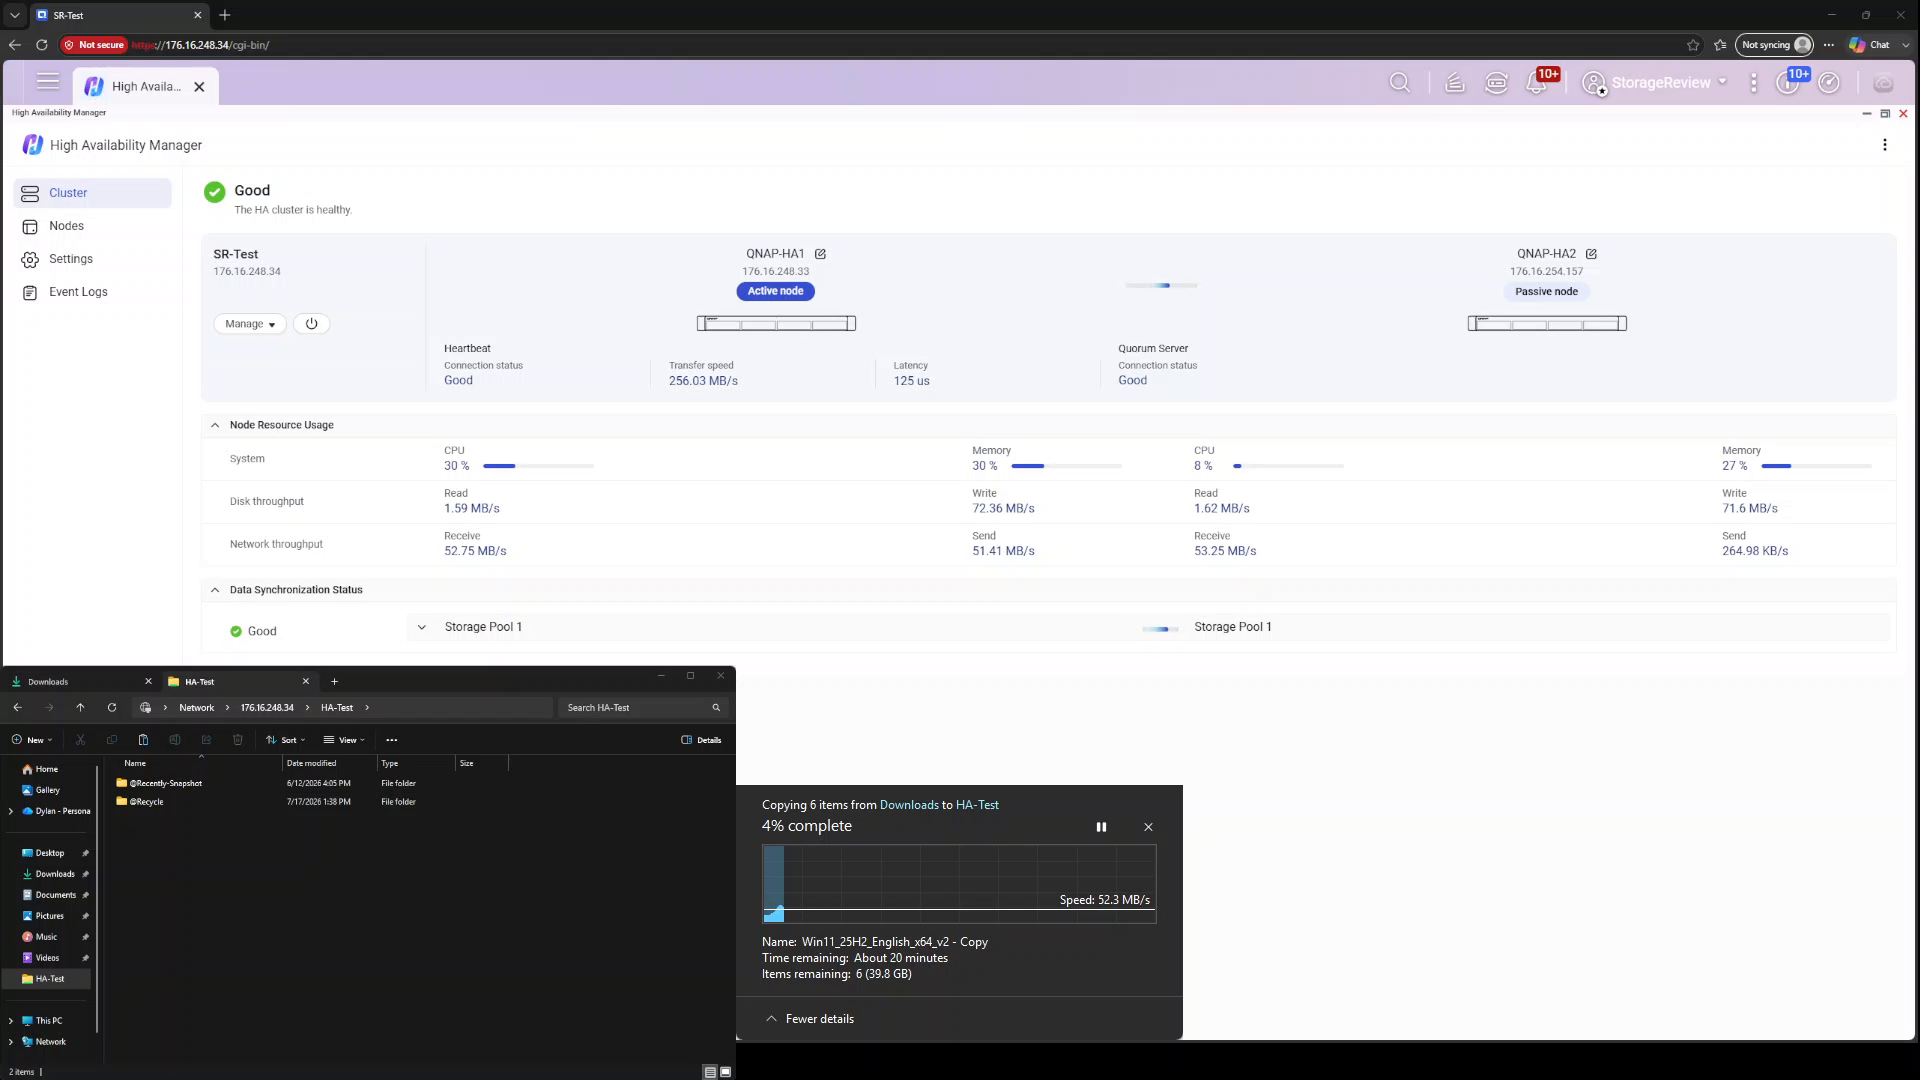
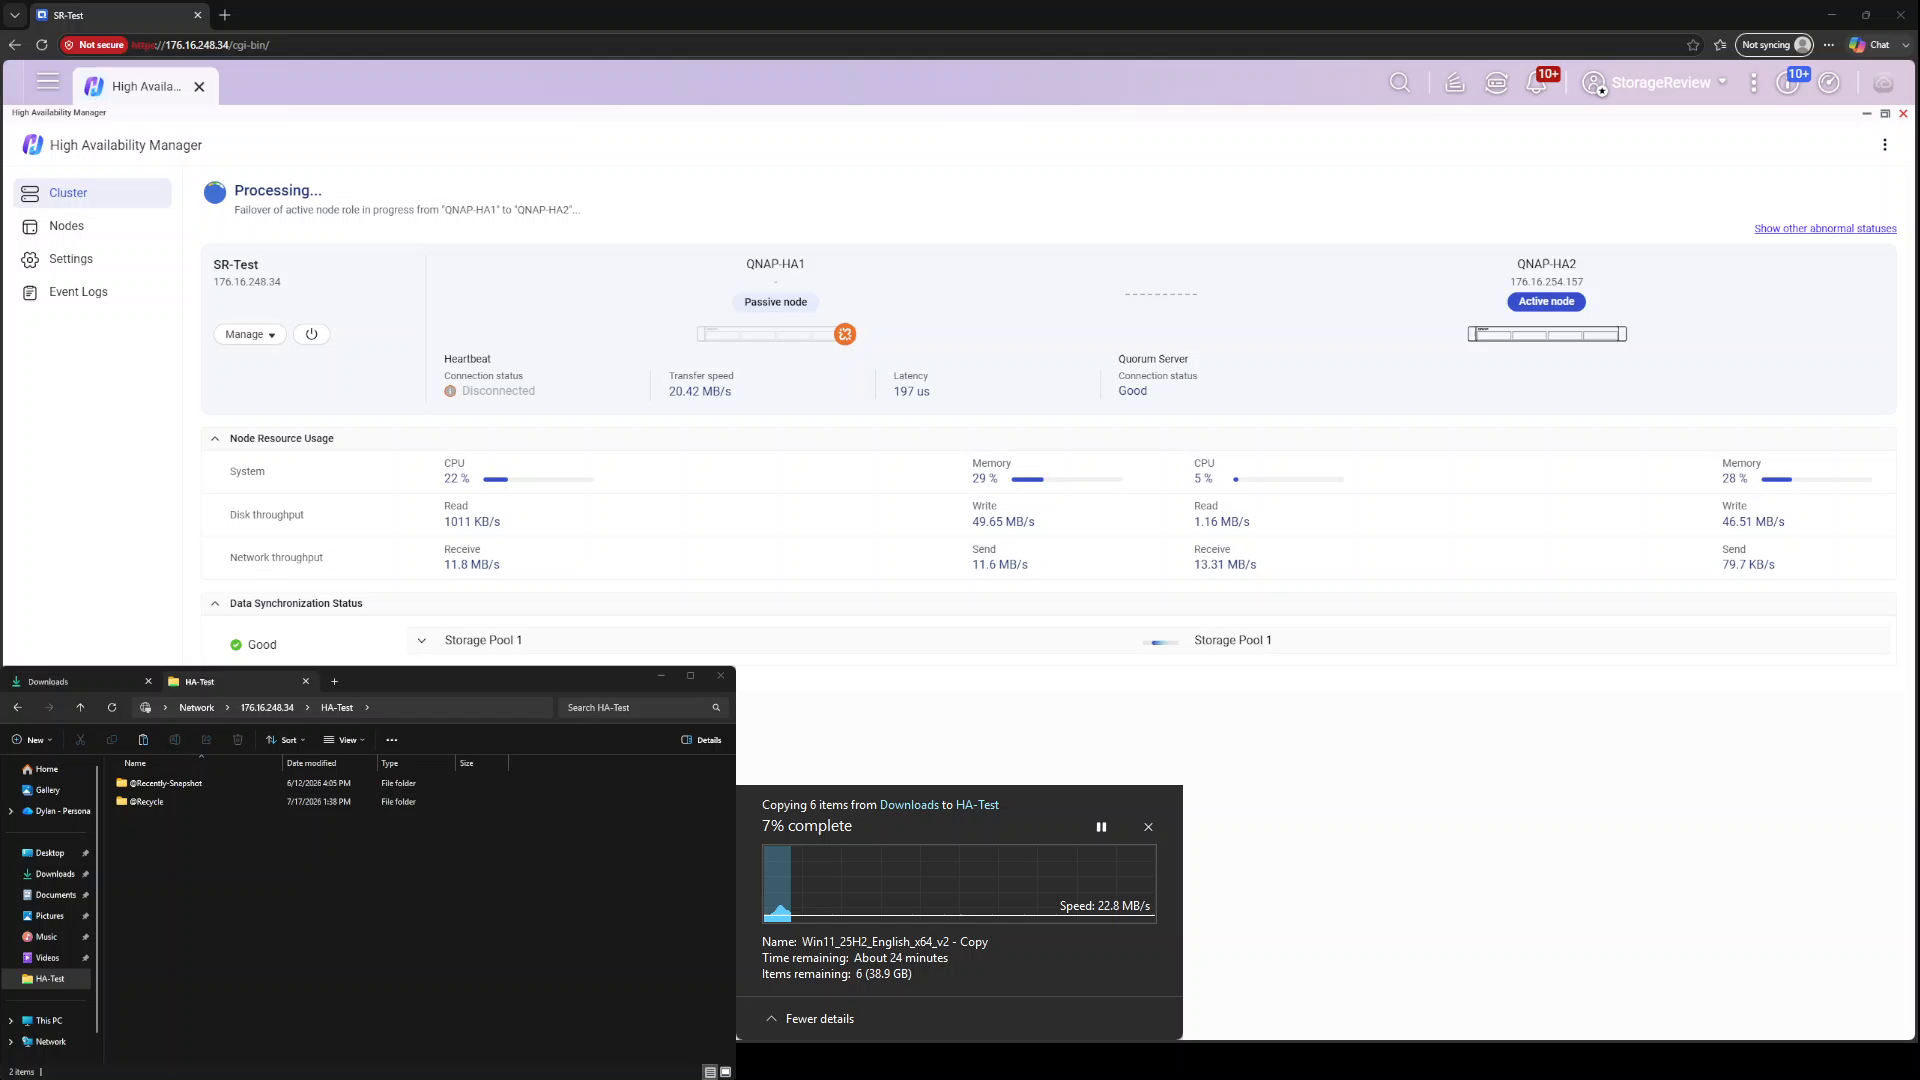
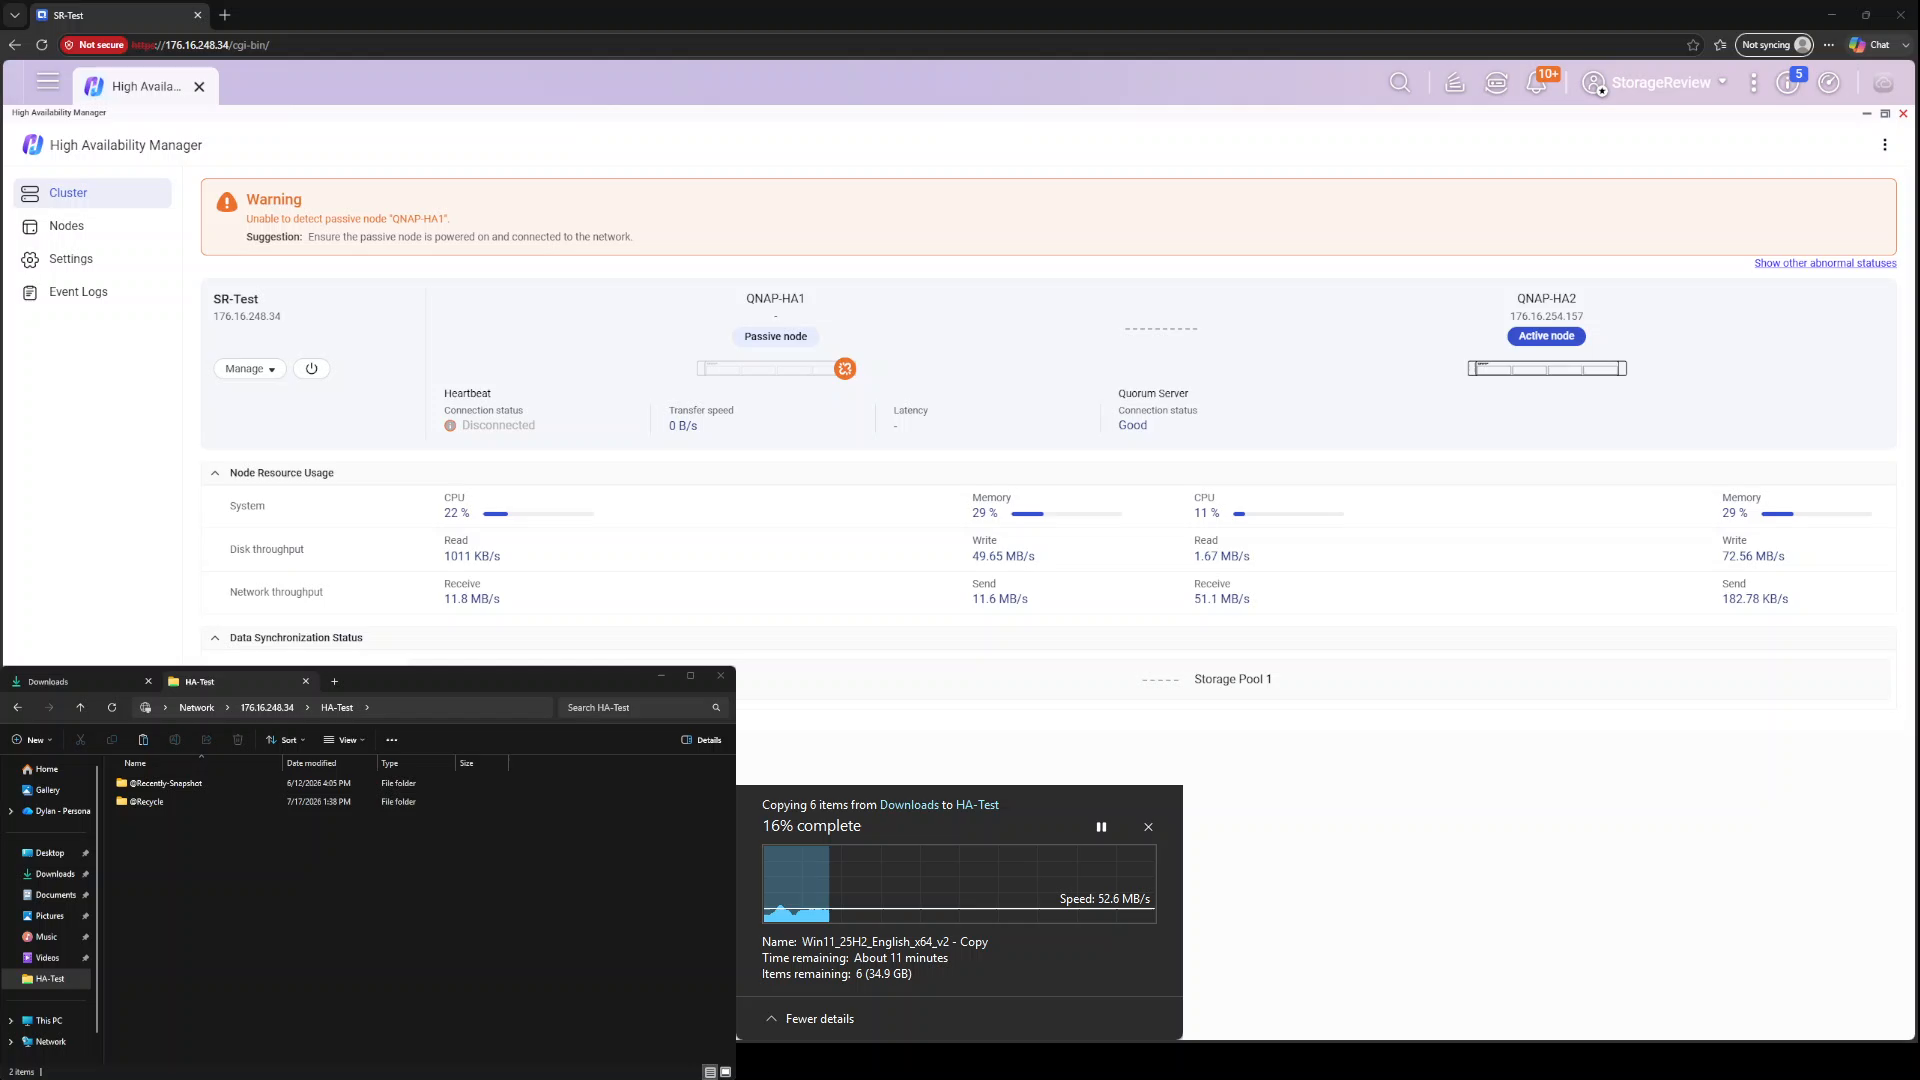
Do ponto de vista do cliente, a cópia ficou parada por pouco menos de um minuto, aproximadamente 50 segundos, desde o desligamento da energia até a retomada da transferência de dados, e o Explorador de Arquivos nunca exibiu um erro; a caixa de diálogo de transferência manteve o progresso e, em seguida, retomou quando o QNAP-HA2 se promoveu a nó ativo. O Gerenciador de HA informou brevemente que a transição para a função de nó ativo estava em andamento e, em seguida, exibiu um aviso: não foi possível detectar o nó passivo QNAP-HA1, com a sugestão de garantir que o nó estivesse ligado e conectado à rede. A transferência continuou em velocidade máxima para o mesmo endereço IP do cluster enquanto o cluster operava em um único nó, que é exatamente o estado degradado, porém operacional, que o HA promete.
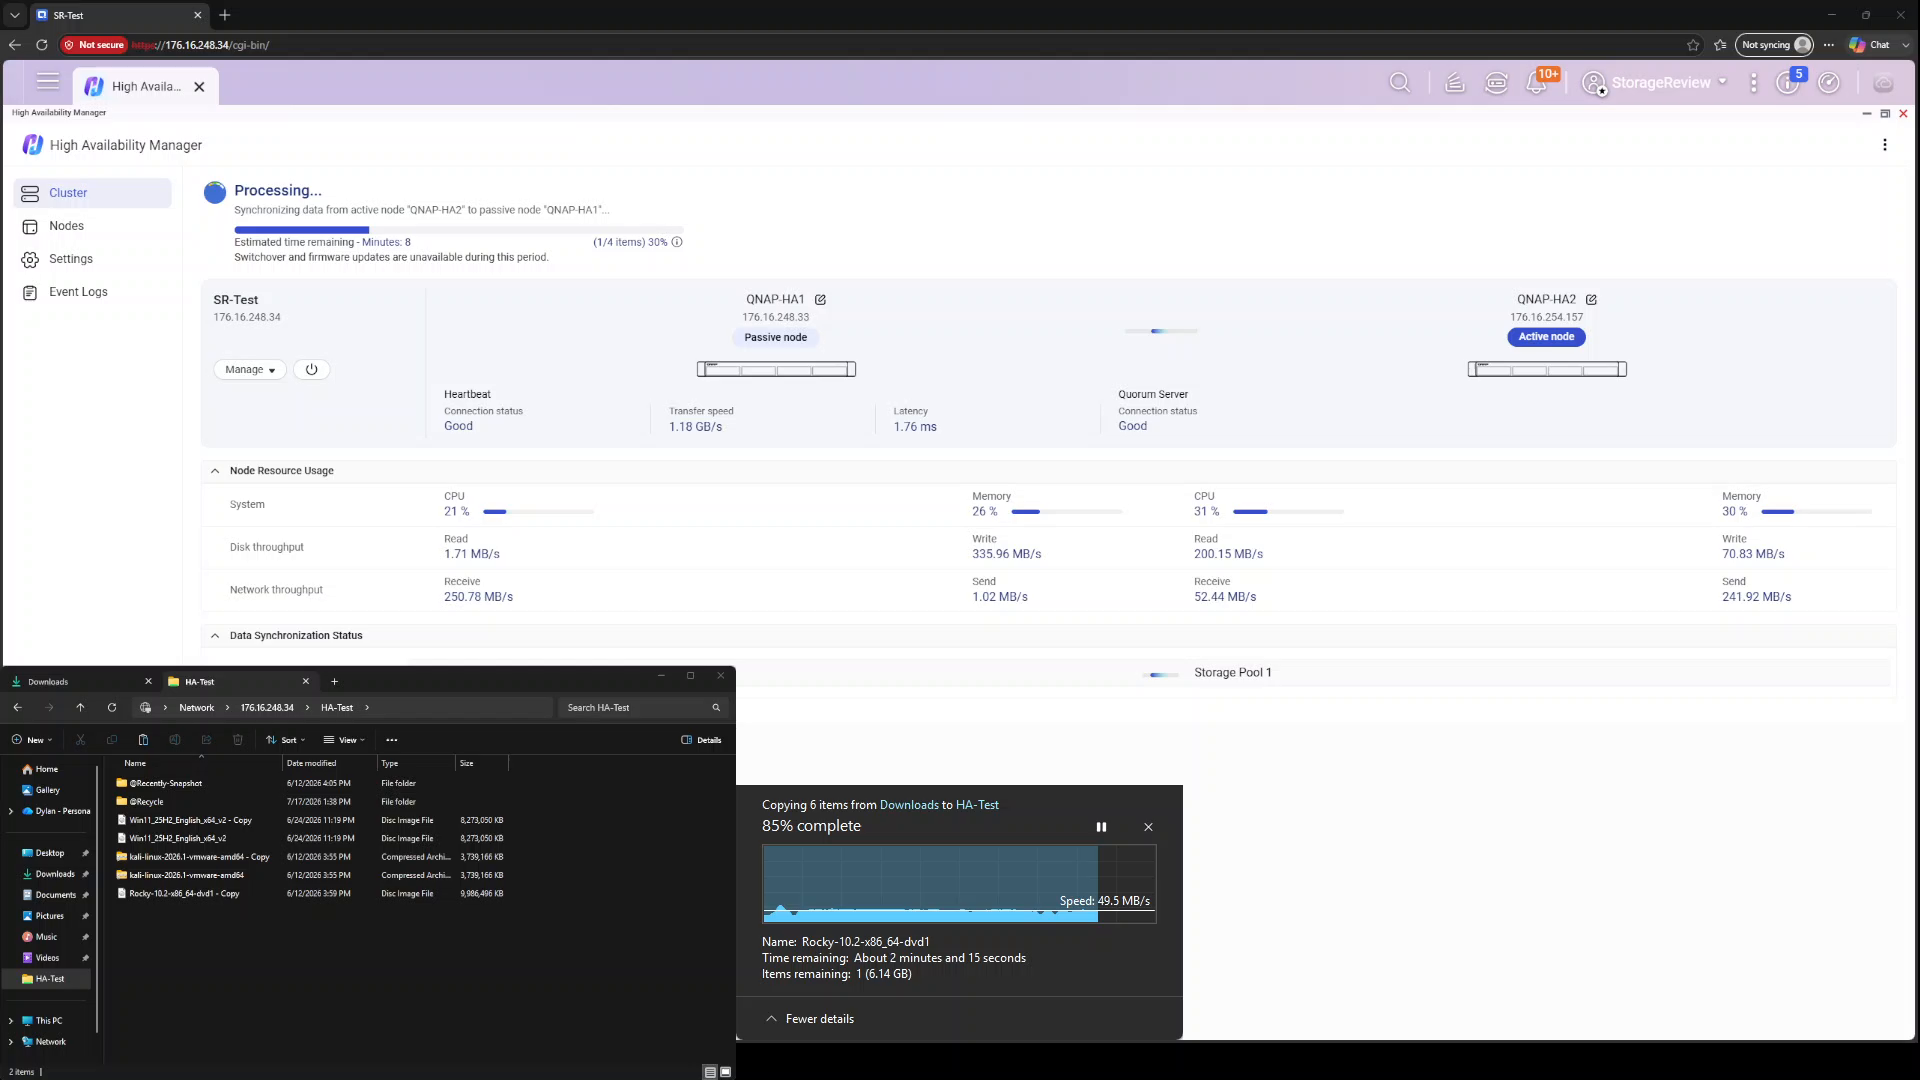
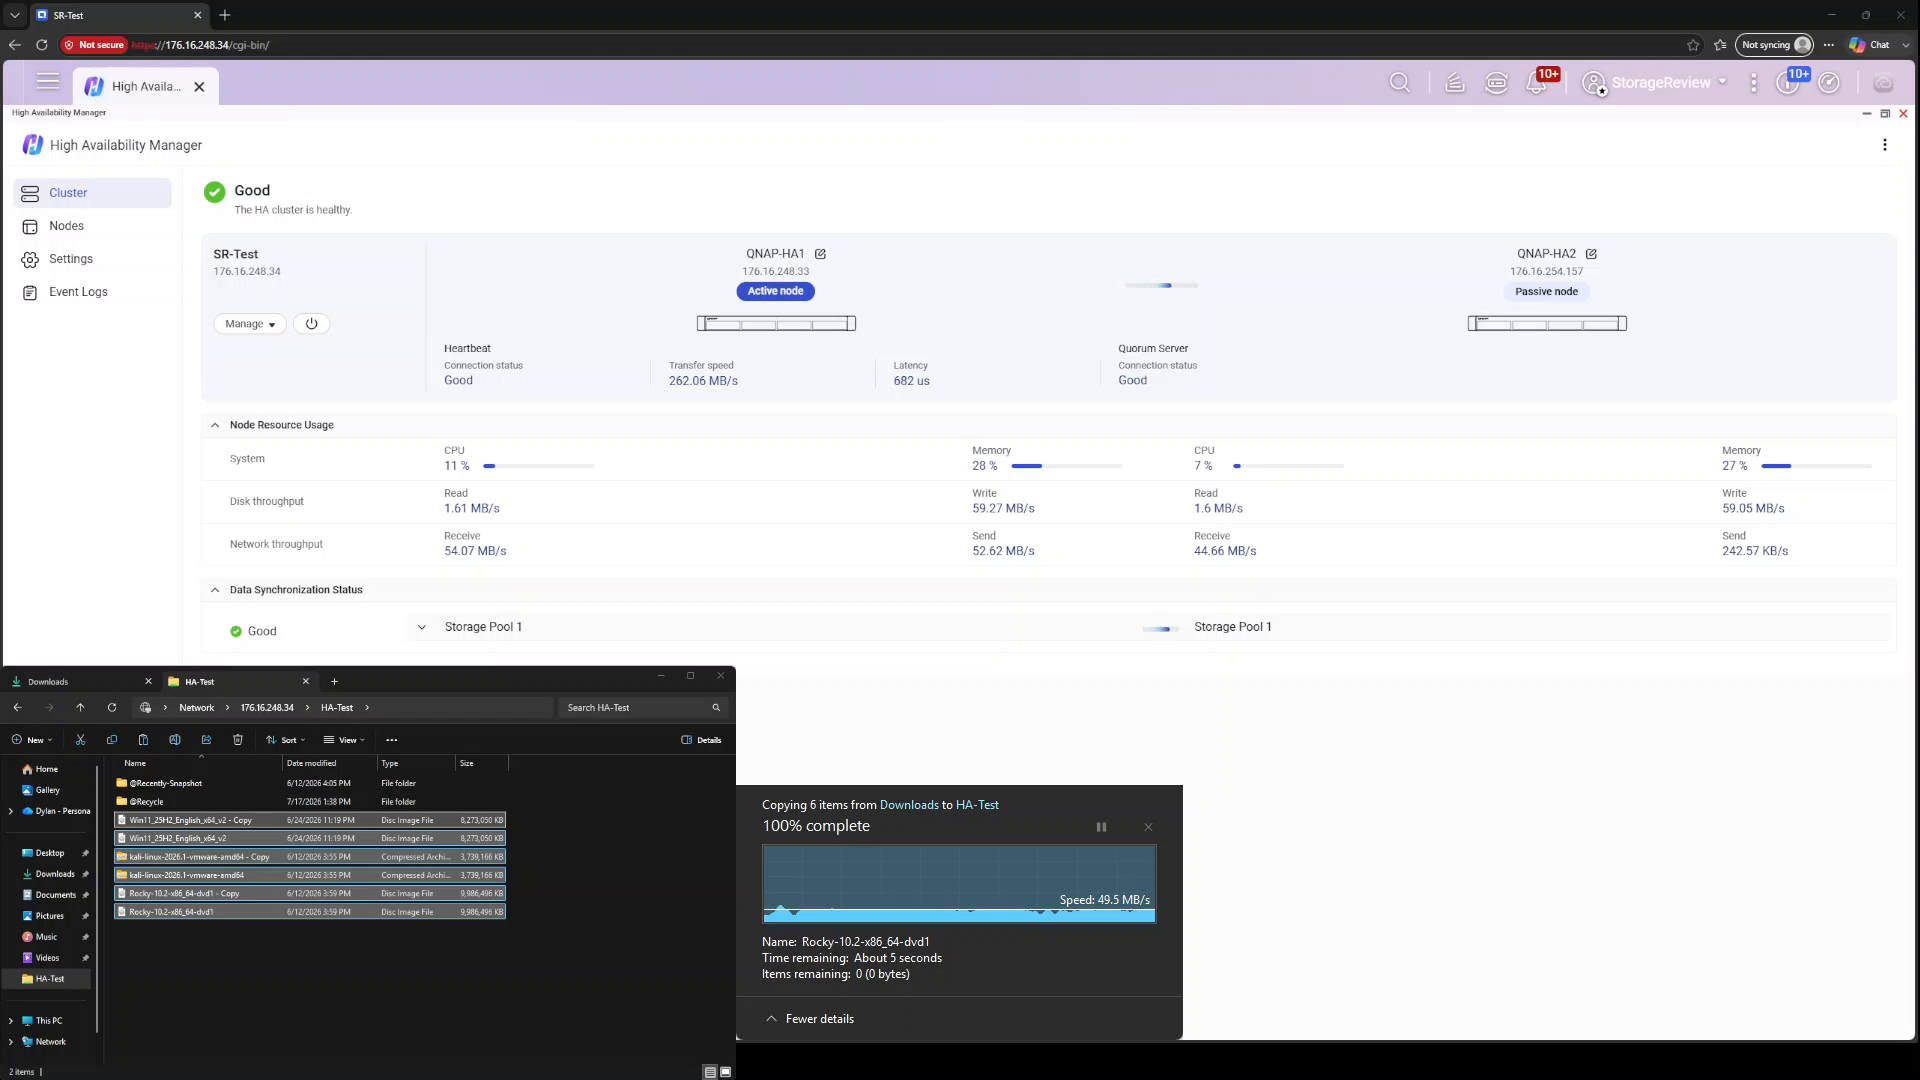
O restabelecimento da energia no QNAP-HA1 acionou automaticamente o processo inverso. O nó inicializou e voltou a funcionar como membro passivo cerca de dez minutos após a queda de energia, e o HA Manager começou a sincronizar os dados do nó ativo QNAP-HA2 de volta para o QNAP-HA1, novamente com o progresso e as estimativas de tempo visíveis no painel, enquanto nossa cópia de arquivos continuava sem interrupções. O failback não exigiu intervenção: assim que a ressincronização foi concluída, o cluster pausou a transferência por cerca de 35 segundos enquanto retornava a função ativa para o QNAP-HA1 e, em seguida, permitiu que a cópia fosse concluída. Ao final da execução, o cluster estava de volta ao status Bom, com a transferência em 100%, tendo sobrevivido a uma falha de energia grave, um período com um único nó, uma restauração de nó e um failback em uma única tarefa de cópia.
Teste de Failover 2: Perda de Rede com Pulsação Intacta
O segundo cenário é mais sutil e, possivelmente, mais comum no mundo real: o nó ativo perde sua conexão de rede com o cliente (uma porta de switch com falha, um cabo desconectado ou um transceptor defeituoso), enquanto o próprio nó continua funcionando e o link de heartbeat permanece ativo. É nesse caso que a proteção contra split-brain se torna crucial, pois ambos os nós estão ativos e conseguem se comunicar, e o cluster precisa decidir qual nó deve ser o proprietário do endereço IP do cluster.
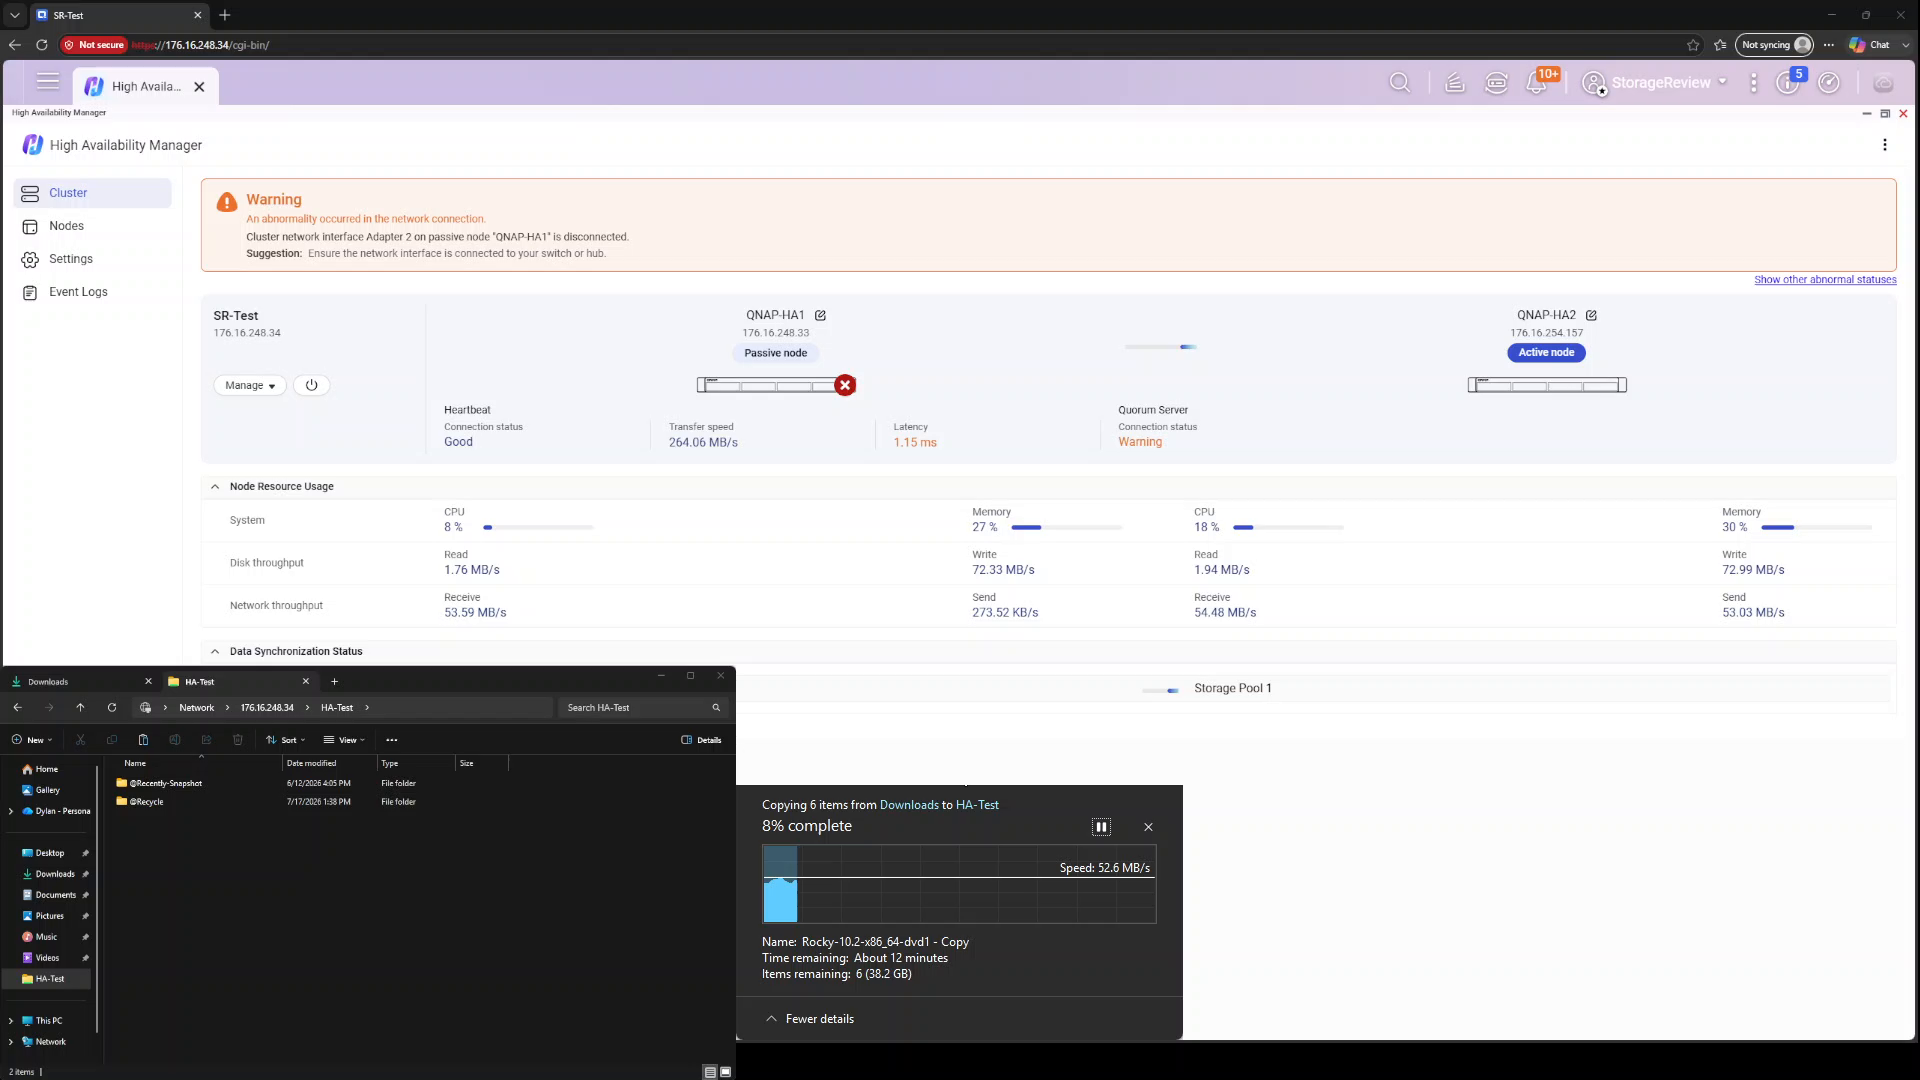
Repetimos a mesma cópia de arquivo do Windows para o IP do cluster e desconectamos a interface de rede do cluster no nó ativo. A transferência foi pausada por cerca de 45 segundos enquanto o cluster migrava os serviços para o outro nó, e então foi retomada sem falhas. O HA Manager sinalizou a falha com precisão, alertando que a interface de rede do cluster, Adaptador 2, no nó estava desconectada e sugerindo uma verificação da conexão do switch. Além disso, ele informou que o nó desconectado não conseguia mais alcançar o servidor de quorum por meio dessa interface. Essa especificidade, nomeando a interface exata, o nó e a consequência, é mais diagnóstica do que o sinalizador genérico de degradação que algumas implementações de alta disponibilidade utilizam.
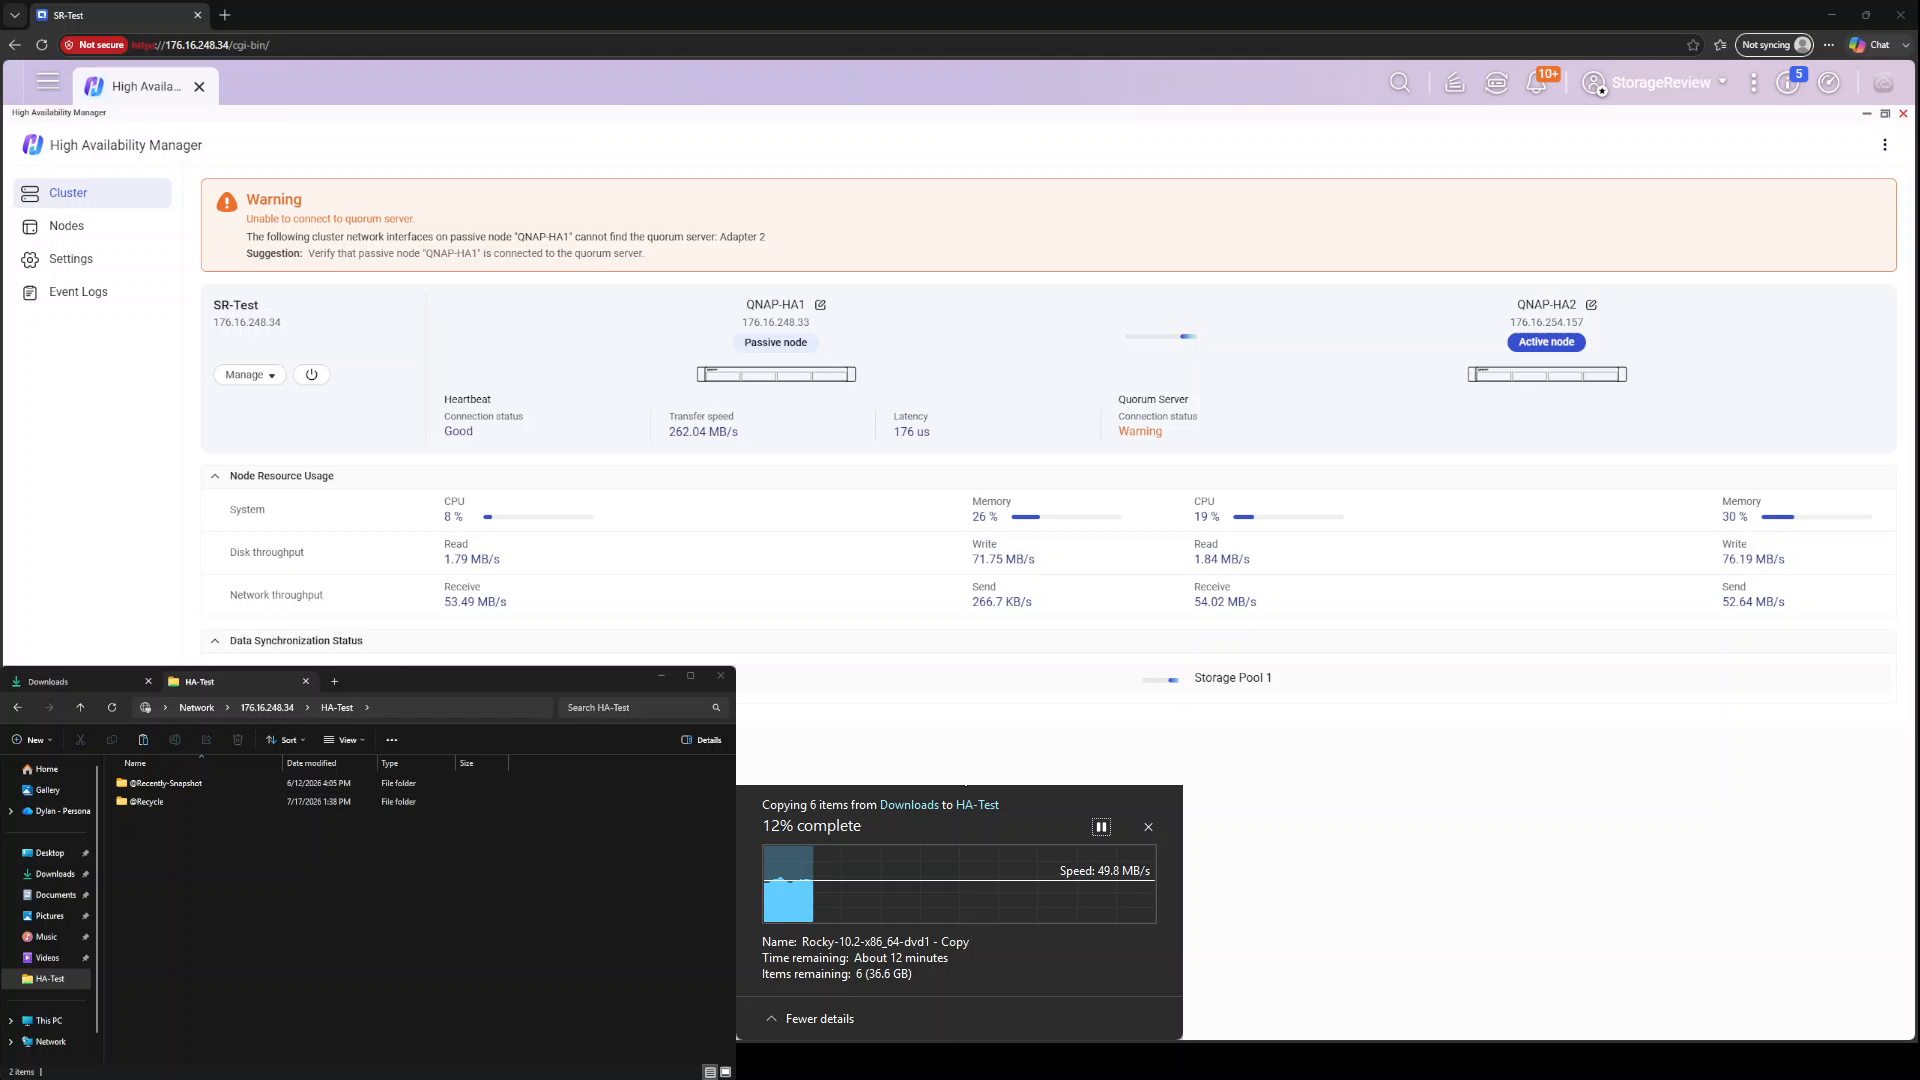
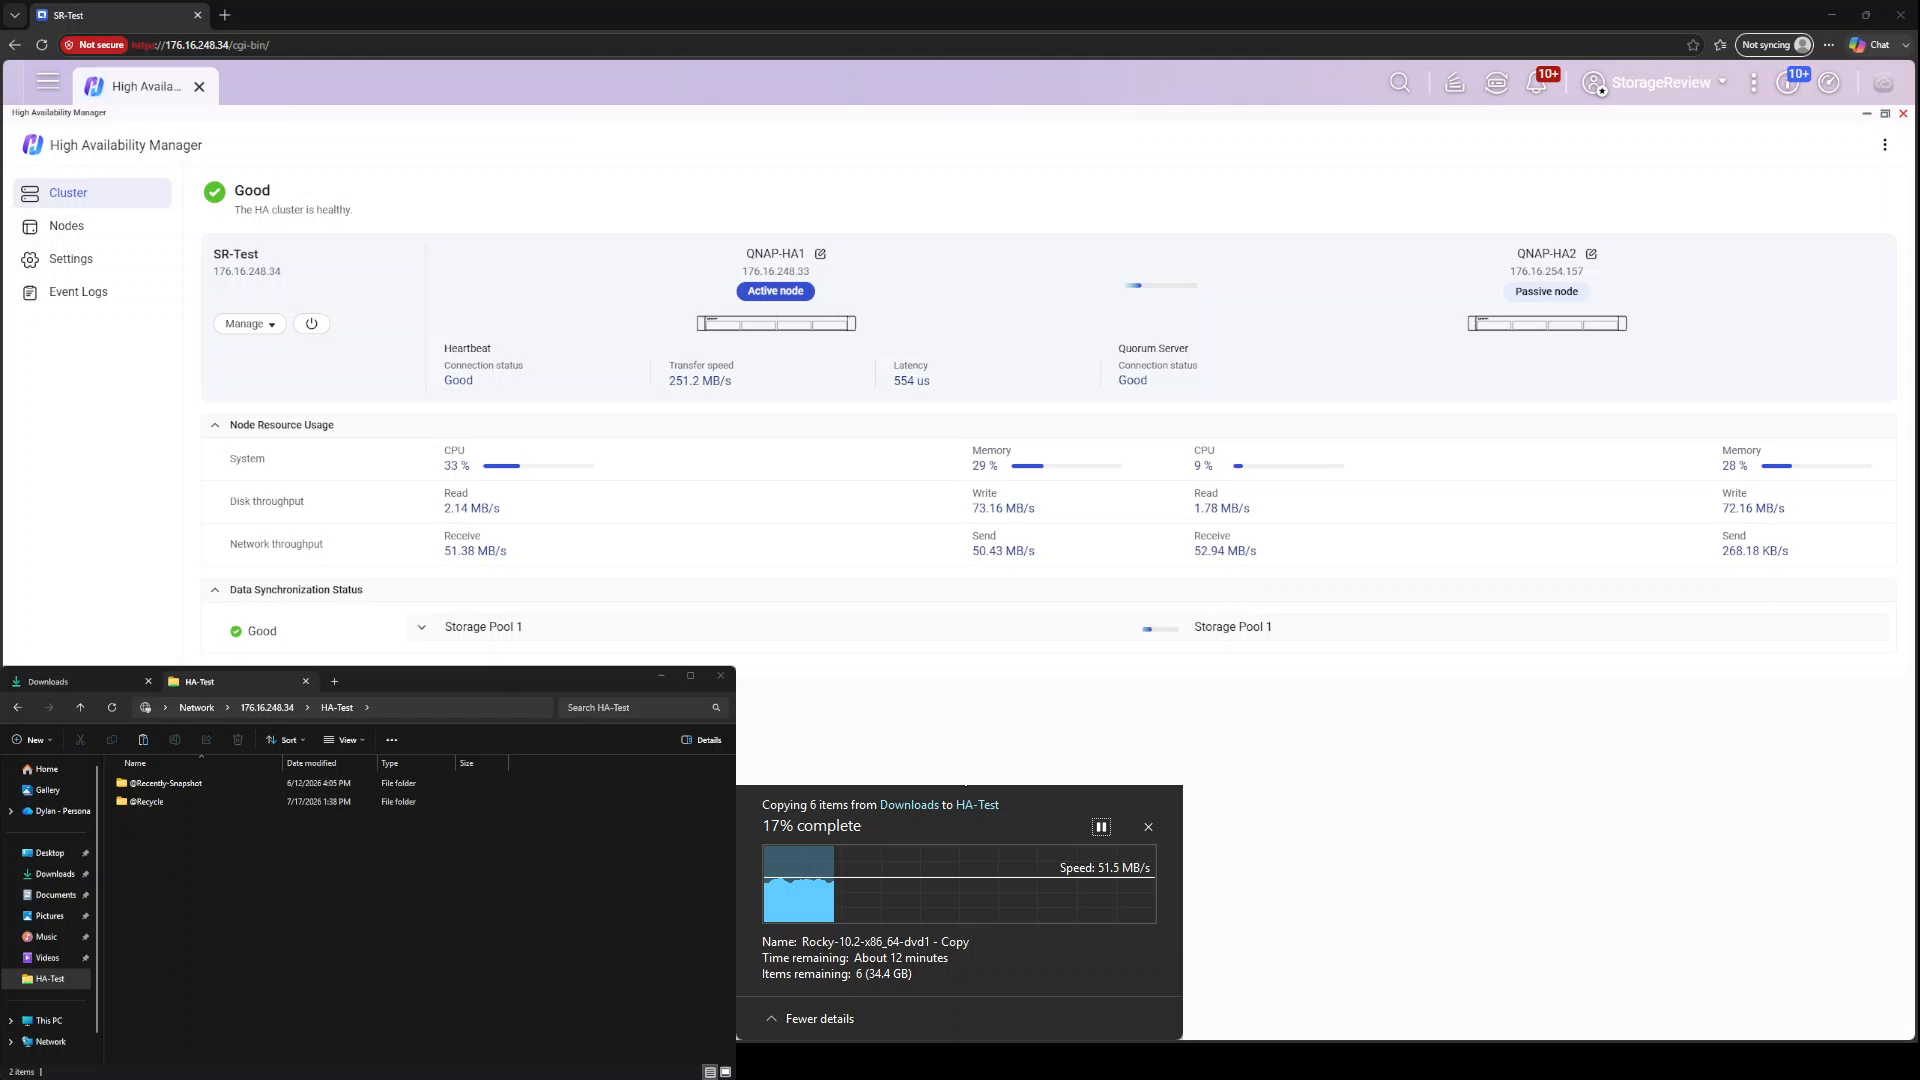
Reconectar a rede trouxe o nó de volta ao cluster, e o failback ocorreu automaticamente em menos de um minuto: uma segunda pausa de aproximadamente 30 segundos, enquanto a função ativa retornava ao QNAP-HA1, foi a única evidência visível para o cliente de que algo havia acontecido. A mesma tarefa de cópia sobreviveu a duas trocas consecutivas sem nenhuma falha de arquivo. Para quem já viu uma sessão SMB ser interrompida por motivos bem menos graves, esse é o principal resultado de todo esse teste.
Implementando Alta Disponibilidade da Maneira Correta: Topologia de Rede e Split-Brain
Testes de failover como os nossos comprovam que o cluster funciona, mas o desempenho de um par HA em produção depende tanto da rede circundante quanto das próprias unidades NAS. Os cenários para os quais o HA Manager foi projetado (um nó com falha, uma porta de switch inativa, um uplink desconectado) compartilham uma premissa: pelo menos um caminho de comunicação entre os dois nós sobrevive à falha. Proteger essa premissa é a decisão mais importante em uma implementação de HA, pois a alternativa é a condição que toda arquitetura de alta disponibilidade visa evitar: o "split-brain" (cérebro dividido).
A QNAP documenta o cenário. O "split-brain" ocorre quando ambos os nós perdem a comunicação entre si, mas permanecem operacionais independentemente, cada um assumindo o papel ativo. Dois nós, cada um acreditando ser o dono do cluster e cada um disposto a aceitar gravações, representam uma receita para inconsistência de dados ou corrupção de armazenamento, já que cada um pode tentar controlar recursos compartilhados simultaneamente. As causas documentadas são exatamente o que você esperaria: desconexões de rede entre os nós, falhas no heartbeat e caminhos de rede instáveis. Observe o que esses fatores têm em comum. O "split-brain" não é desencadeado pela falha de um único nó; ele é desencadeado quando todos os caminhos entre dois nós saudáveis falham simultaneamente. Isso é um problema de topologia e tem uma solução de topologia.
As regras de implantação se desenrolam conforme o esperado:
Configure o sinal de pulsação como um cabo direto entre os dois nós. A QNAP exige uma conexão direta para o sinal de pulsação, e este é o motivo. Sem switch, transceptor ou infraestrutura compartilhada no caminho, a única coisa que pode interromper o sinal de pulsação é o próprio nó, que é exatamente para o que o failover de eventos foi projetado. Em uma implantação no mesmo rack, onde essas unidades TS-h765eU de profundidade reduzida provavelmente estarão lado a lado, não há motivo para fazer nada diferente.
Se os nós estiverem separados, mantenha o tráfego de heartbeat e o tráfego do cliente em caminhos fisicamente independentes. Quando um cabo direto for impraticável, direcione o heartbeat por switches diferentes daqueles usados para a conexão do cluster. No momento em que ambas as conexões atravessam o mesmo switch, esse switch se torna um ponto único de falha capaz de interromper todos os caminhos entre os nós simultaneamente, transformando uma falha comum de switch em um potencial evento de "split-brain". O objetivo de comprar duas unidades NAS é completamente anulado se uma única peça de infraestrutura compartilhada puder isolá-las uma da outra. Essa é a lógica por trás da nossa metodologia de teste de failover de rede: desconectar o cabo voltado para o cliente enquanto o heartbeat permanece conectado simula a falha de switch ou cabeamento que uma topologia devidamente separada realmente experimentaria, com o heartbeat ativo para arbitrar a transição de forma limpa.
Habilite o servidor de quorum. A terceira medida de segurança da QNAP é um servidor testemunha na rede, configurado em Gerenciador de Alta Disponibilidade > Configurações > Política de Failover > Servidor de Quorum. Se os nós perderem a conexão direta, mas ainda conseguirem acessar a rede, o servidor de quorum continua monitorando ambos e retransmitindo seus status, dando a cada nó um critério de desempate independente antes de se promover. O status da conexão do servidor de quorum é exibido permanentemente no painel do Gerenciador de Alta Disponibilidade, juntamente com o sinal de atividade, para que seu status seja visível rapidamente.
Caso o pior aconteça, o QuTS Hero lida com o problema de "split-brain" de forma defensiva. Assim que a conectividade é restaurada e os nós podem se comunicar novamente, eles trocam informações de status, reconhecem que ambos detinham a função ativa e interrompem deliberadamente a maioria dos serviços, incluindo SMB e iSCSI, para evitar a fusão de dois conjuntos de dados divergentes. O HA Manager então apresenta um assistente de Recuperação de Split-Brain com dois caminhos. A primeira opção preserva os dados em um único nó selecionado; o outro nó é apagado, redefinido como membro passivo e resincronizado, o caminho mais rápido quando você sabe qual lado possui os dados corretos. A segunda opção preserva os dados em ambos os nós, retomando os serviços em um nó enquanto remove o outro completamente do cluster, permitindo que você verifique e reconcilie os dados antes de reintegrá-lo manualmente. É um modelo de recuperação sensato, mas a recuperação ainda significa tempo de inatividade e uma resincronização completa. O split-brain é uma condição que você previne por meio do projeto de implantação, não algo do qual você planeja se recuperar, e as três regras acima não custam nada além de um cabo e cinco minutos em um painel de configurações.
Monitoramento e Gestão
As operações do segundo dia são gerenciadas pelo aplicativo HA Manager, que consolida o status do cluster, o uso de recursos por nó, os registros de eventos e o gerenciamento de nós, incluindo a troca manual, em um único painel. Os avisos do painel se mostraram específicos o suficiente para serem diagnósticos durante nossos testes, indicando a interface e o nó exatos com falha, em vez de um indicador genérico de degradação.
A QNAP também incorporou o conceito de alta disponibilidade (HA) ao próprio hardware. Em um cluster HA, o painel LCD de cada NAS exibe o nome do cluster, a função atual do nó e o endereço IP do cluster. O LED de status indica o estado do HA rapidamente: verde fixo para o nó ativo, verde piscando para o nó passivo e vermelho fixo para um erro de HA. Em um rack cheio de unidades idênticas de baixa profundidade, a capacidade de identificar o nó ativo sem precisar abrir um navegador é um pequeno detalhe que os técnicos certamente apreciarão. Para implantações em larga escala, o AMIZcloud adiciona monitoramento centralizado em nuvem de grupos HA, exibindo informações sobre a integridade do cluster, latência e alertas em todos os locais.
Considerações finais da análise do Fortune Dragon
O High Availability Manager cumpriu sua principal promessa em ambos os cenários de falha que simulamos. Uma queda brusca de energia no nó ativo causou uma interrupção de aproximadamente 50 segundos no processo de cópia de arquivos do Windows, sem perda de arquivos; uma conexão de rede do cliente interrompida custou cerca de 45 segundos. Em ambos os casos, a mesma tarefa de cópia prosseguiu durante a restauração do nó e o failover automático, com uma pausa de menos de um segundo. Os clientes não precisaram reconfigurar nenhum endereço IP. Aplicativos, compartilhamentos de arquivos e fluxos de trabalho do usuário continuaram operando com um único IP e nome de host antes, durante e depois do failover. A configuração também é simples; duas unidades independentes se transformaram em um cluster de servidores em menos de dez minutos de assistente, mais uma sincronização inicial de dez minutos, e o painel nos informava exatamente qual interface, nó e conexão deveriam ser monitorados sempre que algo apresentava problemas.
A configuração completa de alta disponibilidade (HA): duas unidades TS-h765eU e os discos rígidos IronWolf Pro que as preenchiam.
Os custos da alta disponibilidade (HA) não devem ser ignorados. Você está comprando dois de tudo, e o nó passivo representa capacidade ociosa até o dia em que deixar de estar. Os snapshots imutáveis, outro recurso de proteção importante do h6.0, não são mais viáveis em um cluster HA atualmente, então os administradores precisam escolher entre as duas opções. Além disso, a exigência de hardware idêntico significa que as atualizações ocorrem em pares, o que pode restringir os orçamentos.
A questão central é o dimensionamento correto, e é para pequenas empresas e implantações de borda que o HA Manager se destaca. Em comparação com arrays corporativos de controladores duplos, um par de unidades TS-h765eU de profundidade reduzida apresenta um custo-benefício completamente diferente, ao mesmo tempo que cobre o cenário de falha — perda de controlador — que motiva a maioria das compras de controladores duplos no segmento de pequenas e médias empresas. Em comparação com esquemas de replicação personalizados, envio de snapshots, tarefas rsync e backup e restauração, a diferença reside no tempo de recuperação: esses esquemas protegem os dados, mas exigem horas de reconstrução das conexões dos clientes, enquanto o pior evento visível para o cliente no HA Manager, em nossos testes, foi uma pausa de um minuto. Igualmente importante, a falha que ele não consegue absorver — a interrupção simultânea de todos os caminhos entre nós — pode ser evitada com um cabo de heartbeat dedicado, caminhos de rede separados e um servidor de quorum habilitado: uma solução que se resume a um cabo e cinco minutos de configuração.
Um último ponto específico para um design de dois nós: o momento mais vulnerável do cluster é durante uma resincronização, quando um nó contém a única cópia íntegra dos seus dados e os discos subjacentes estão trabalhando ao máximo. Isso reforça a importância de se levar a sério a seleção de discos em um par de alta disponibilidade (HA), e é por isso que discos com classificação NAS, como as unidades Seagate IronWolf Pro de 30 TB em nossa configuração, são mais relevantes aqui do que em um servidor independente: sua função é garantir que esse período seja livre de problemas.
Os modelos QNAP TS-h765eU e QuTS hero h6.0 já estão disponíveis. Para mais informações, visite a página do produto QNAP TS-h765eU.
Este relatório é patrocinado pela QNAP. Todas as opiniões e pontos de vista expressos neste relatório são baseados em nossa análise imparcial do(s) produto(s) em questão.


 Amazon