

A QSAN desenvolve soluções de armazenamento empresarial desde 2004, e essa experiência fica evidente na linha XN4. O XN4226D em nosso laboratório é um array 2U, 26 baias, totalmente NVMe, com dois controladores ativos, proporcionando alta disponibilidade como armazenamento unificado de blocos e arquivos. O software QSAN 4 adiciona os serviços de dados esperados, incluindo snapshots, opções de replicação, redução de dados e uma experiência de gerenciamento simplificada. O XN4 foi projetado para equipes que buscam velocidade NVMe sem comprometer a flexibilidade multiprotocolo, tudo a um preço muito acessível.
Principais lições
- Bloco e arquivo unificados com HA real. Controladores ativos duplos e QSM 4 oferecem alta disponibilidade com uma plataforma para bloco e arquivo.
- NVMe-oF feito corretamente. Protocolo completo espalhado com NVMe-oF sobre TCP e RDMA junto com iSCSI, Fibre Channel, NFS, SMB, FTP e WebDAV.
- Rendimento comprovado. Medimos até 21.21 GB/s em grandes leituras sequenciais com TCP e 11.14 GB/s em grandes gravações sequenciais com RDMA.
- Construído para tubulações modernas. 26 baias all-NVMe em 2U, gerenciamento simples e opções de E/S que podem ser dimensionadas para 100–200 GbE para mídia, análise de vigilância, VDI, bancos de dados e inferência de IA.
A plataforma suporta NVMe-oF sobre TCP e RDMA, além de iSCSI, Fibre Channel, NFS, SMB, FTP e WebDAV. Também concluímos um estudo focado em NVMe-oF, comparando o comportamento e o dimensionamento de TCP e RDMA. Em nossos testes, levamos a unidade ao seu limite com grandes leituras sequenciais, alcançando uma taxa de transferência impressionante de 21.21 GB/s. O posicionamento deste sistema importa tanto quanto os números brutos. O XN4226D atende a ambientes mistos que combinam VMware ou Proxmox para VMs, VDI e camadas de banco de dados, bem como serviços de arquivo criativos, nós de inferência de IA que exigem caminhos NVMe previsíveis, backups de mídia e ingestão de alta largura de banda para cargas de trabalho de vigilância e sensores. O QSAN XN4226D é adequado para praticamente qualquer carga de trabalho.
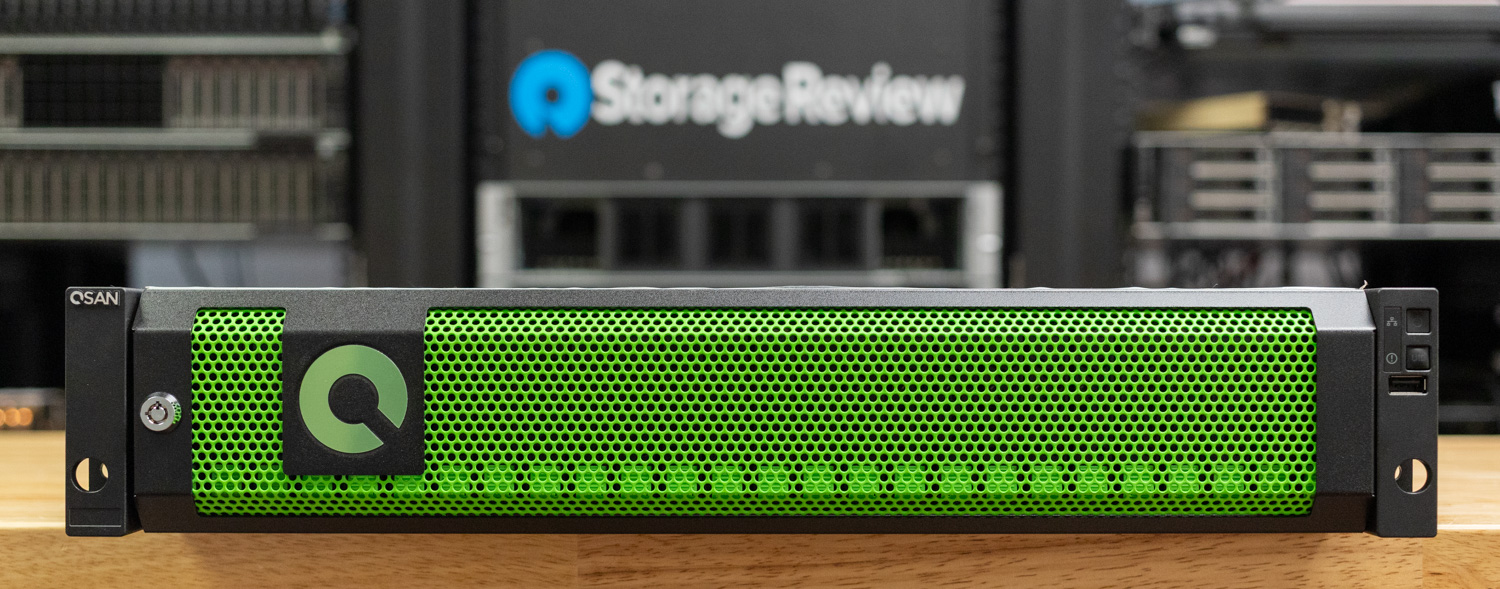
A QSAN observou um crescimento significativo na produção de mídia, incluindo transmissões ao vivo, opções de replay, aprimoramento de vídeo por IA e OTT/cache de borda, bem como em análises de vídeo de vigilância, como CFTV em cidades inteligentes, detecção de anomalias e replay em tempo real. Essas cargas de trabalho são idealmente suportadas com taxa de transferência de 100 a 200 GbE.
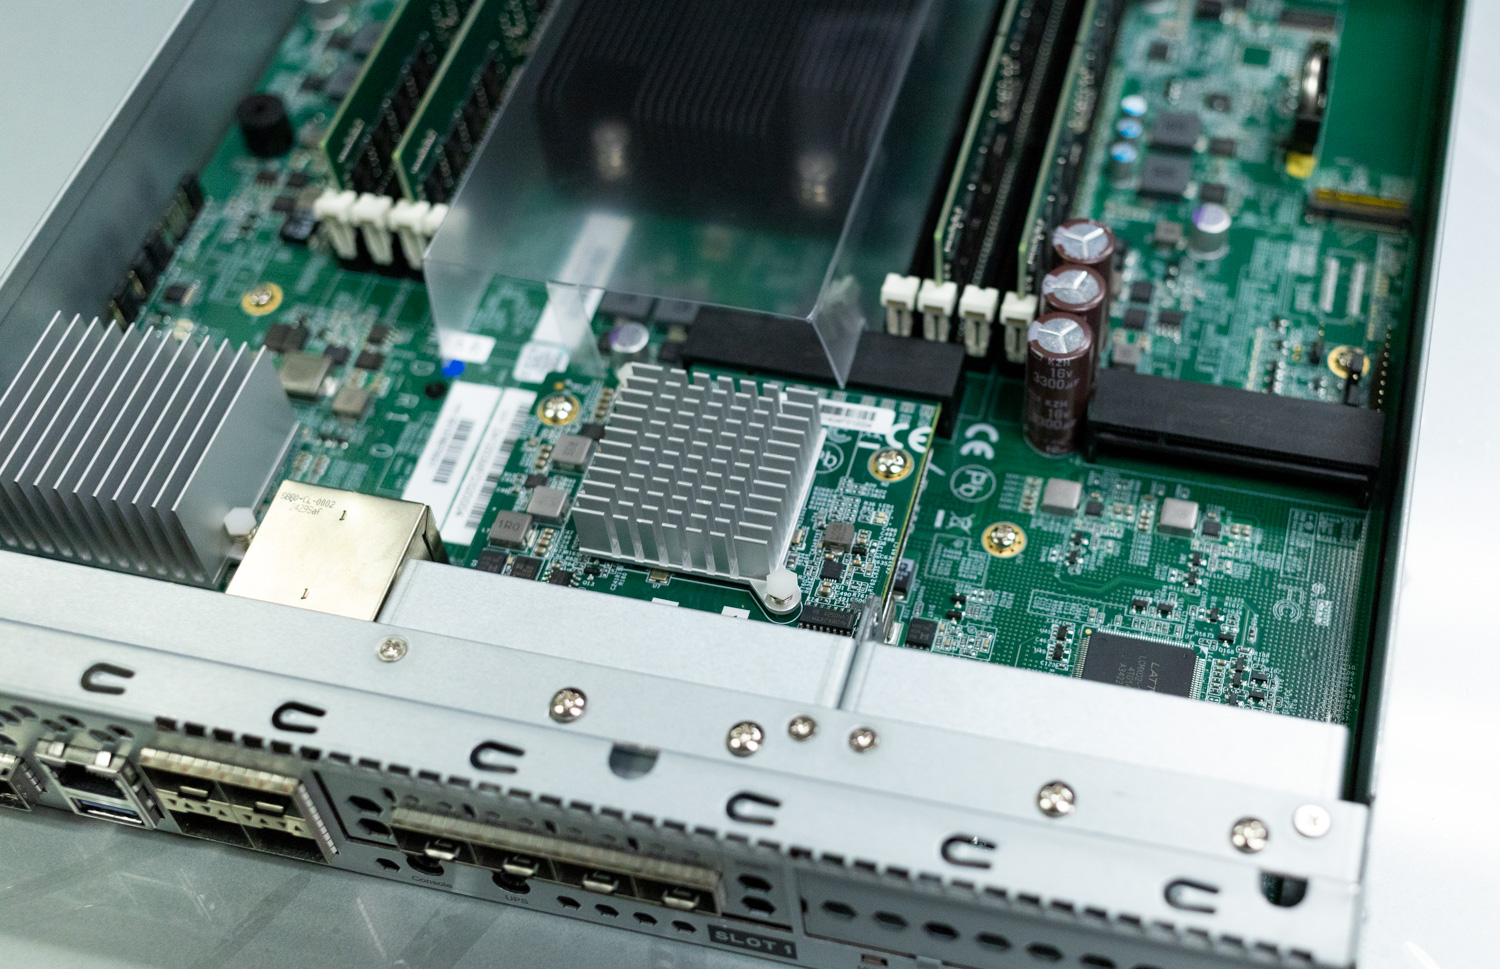
Em última análise, o valor é direto. Você obtém alta disponibilidade unificada, NVMe em todo o chassi e opções de E/S de até 100 GbE ou Fibre Channel de 32 Gb conforme as necessidades aumentam. O desempenho acompanha o que muitos arrays de nível 1 oferecem, enquanto o licenciamento permanece mais acessível e a cobertura de protocolos permanece ampla em NVMe-oF, iSCSI, Fibre Channel, SMB e NFS. Para empresas de olho no InfiniBand, mas com orçamento limitado, a abordagem Ethernet da QSAN oferece capacidade de resposta próxima à do IB em equipamentos padrão na escala de 100 a 200 GbE.
Para equipes que priorizam resultados de aplicações no mundo real, a longevidade, o software intuitivo e o design de hardware limpo do QSAN fazem do XN4226D um equipamento all-flash confiável para se desenvolver.
Hardware QSAN XN4
Os arrays de armazenamento da série QSAN XN4 vêm em um chassi de servidor compatível com rack de 19”, 2U e 26 baias, com opções de controlador único ou duplo, abrigando CPUs Intel Xeon de 4 ou 8 núcleos para atender às necessidades de redundância e desempenho das menores e maiores empresas. Com todos os 26 compartimentos preenchidos, um único chassi da série XN4 pode armazenar até 798 terabytes de dados em unidades de estado sólido NVMe U.2/U.3 de 2.5”. Até 20 unidades de expansão conectadas via SAS também podem ser adicionadas, aumentando a capacidade total de um array para impressionantes 16.773 petabytes.
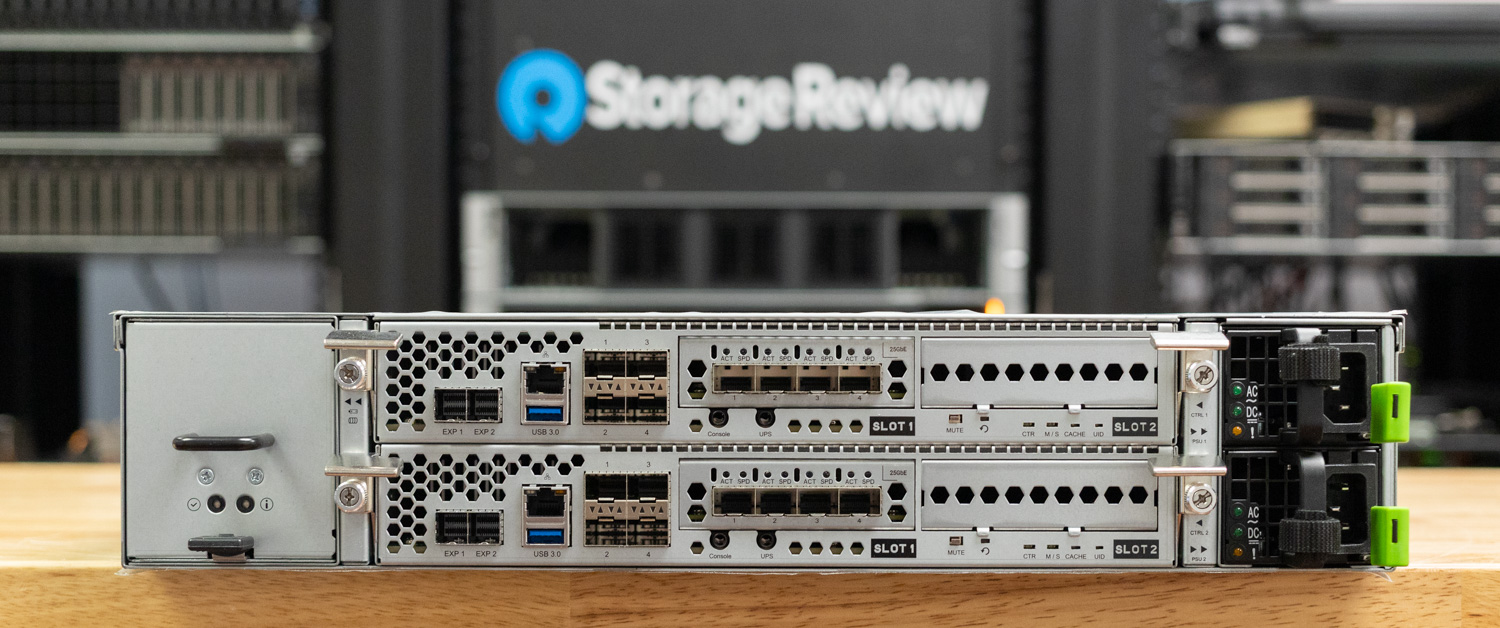
Cada controlador integrado possui uma única porta Ethernet RJ45 de 2.5 Gbps, quatro portas SFP+ de 10 Gbps e duas portas SAS wide de 12 Gbps. Há também opções de upgrade para portas RJ45 de 10 Gbps, SFP28 de 25 Gbps e QSFP de 100 Gbps. Também é possível adicionar suporte a Fibre Channel, com adaptadores SFP+ de 16 Gbps e SFP28 de 32 Gbps.
A tabela abaixo compara as especificações dos sistemas de armazenamento XN4226D-4C e XN4226S-4C. Essas são as variantes 4C, projetadas com controladores ativos duplos ou controladores únicos atualizáveis, dependendo do modelo. Para implantações que exigem mais poder de processamento, uma versão 8C desses sistemas também está disponível.
| Especificação | XN4226D-4C | XN4226S-4C |
|---|---|---|
| Nome do modelo | XN4226D-4C | XN4226S-4C |
| Plataforma | Controlador duplo ativo | Controlador único atualizável |
| CPU | Intel® Xeon® 4 núcleos × 2 | Intel® Xeon® de 4 núcleos |
| Memória | ||
| Módulo de memória pré-instalado | RDIMM DDR32 de 4 GB | RDIMM DDR16 de 4 GB |
| Total de slots de memória | 16 | 8 |
| Memória expansível até | 2,048GB | 1,024GB |
| Armazenamento | ||
| Baias | Ranhura de 2.5″ × 26 | Ranhura de 2.5″ × 26 |
| Máximo de baias de acionamento com unidade de expansão | 546 | 546 |
| Tipo de unidade compatível | SSD NVMe U.2 / U.3 de duas portas de 2.5″ SSD SAS de 2.5″ (para unidades de expansão) HDD SAS de 3.5″ (para unidades de expansão) |
SSD NVMe U.2 / U.3 de porta única de 2.5″ SSD SAS de 2.5″ (para unidades de expansão) HDD SAS de 3.5″ (para unidades de expansão) |
| Interface da unidade | U.2 NVMe (PCIe Geração 4) SAS 12 Gb/s (para unidades de expansão) |
U.2 NVMe (PCIe Geração 4) SAS 12 Gb/s (para unidades de expansão) |
| Capacidade bruta interna máxima | 798TB | 798TB |
| Capacidade Bruta Máxima com Expansão | 16,773TB | 16,773TB |
| Unidade Hot Swappable | Sim | Sim |
| Porta de Conectividade | ||
| Expansão PCIe | (Slot Gen 4×8) × 4 | (Slot Gen 4×8) × 2 |
| Porta LAN RJ45 2.5 GbE | 2 (a bordo) | 1 (a bordo) |
| Porta LAN SFP+ 10 GbE | 8 (a bordo) / 16 (opcional) | 4 (a bordo) / 8 (opcional) |
| Porta LAN RJ45 10 GbE | 16 (opção) | 8 (opção) |
| Porta LAN SFP28 de 25 GbE | 16 (opção) | 8 (opção) |
| Porta LAN QSFP 100 GbE | 8 (opção) | 4 (opção) |
| Canal de Fibra SFP+ de 16 Gb | 16 (opção) | 8 (opção) |
| Canal de Fibra SFP28 de 32 Gb | 16 (opção) | 8 (opção) |
| Expansão e Porta Externa | ||
| Porta ampla SAS de 12 Gb/s | 4 (a bordo) | 2 (a bordo) |
| Porta USB | 1 (frente) / 2 (traseira) | 1 (frente) / 1 (traseira) |
| Outros | Porta do console × 2, porta de serviço × 2 | Porta do console × 1, porta de serviço × 1 |
| Especificação do software | ||
| SO de armazenamento | MQS 4 | MQS 4 |
| Tipo RAID | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| Eficiência de armazenamento | Provisionamento fino / Compressão e desduplicação (opcional) | |
| Aceleração de software | Cache SSD / Hierarquização automática / RDMA | |
| Proteção de dados | Snapshot / Assíncrono / Síncrono (opção) | |
| Serviço de Backup | Rsync / backup S3 / backup em nuvem / XMirror* / backup de e-mail do Microsoft 365 | |
| Total | SSL / SSH / iSCSI CHAP / ISE e SED / WORM / RBAC / Windows ACL / Antivírus | |
| Protocolos de suporte | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| e Autônoma | Interface de usuário da Web / Windows AD / LDAP / API RESTful / SES / LCM | |
| Aparência | ||
| Dimensão (A × L × P) | X | X |
| Peso líquido | 19.6kg | 16.5kg |
| Peso bruto | 28.6kg | 25.5kg |
| Outros | ||
| Proteção de Memória | Módulo Cache-to-Flash (integrado) | |
| Ventilador do sistema | pcs 8 | pcs 4 |
| Carregador | 850 W × 2 (80 Plus Platinum) | |
| Entrada de energia | 100 - 240 VAC, 50/60 Hz | |
| Consumo de energia | 812 W / 2,770 BTU | |
| Certificação | CE / FCC / BSMI | |
| Garantia padrão | Sistema: 5 anos | Módulo Cache-to-Flash: 1 ano | |
Capacidades do QSAN XN4
Os arrays XN4 vêm de fábrica com os protocolos de conexão mais recentes necessários para suportar modelos de computação de alto desempenho e IA com alto consumo de dados, incluindo NVMe sobre Fabrics (NVMe-oF) servidos por TCP e RDMA. Conexões por iSCSI, NFS, FCP, CIFS/SMB, FTP e WebDAV também são possíveis, permitindo que o array atenda às necessidades de armazenamento em bloco e arquivo de data centers com uma combinação de sistemas legados e de ponta.
As vantagens do NVMe-oF
Embora protocolos como iSCSI, NFS e FCP ainda sejam amplamente utilizados em aplicações de armazenamento corporativo, o NVMe-oF oferece melhorias significativas em latência. Os padrões NVMe foram projetados desde o início para unidades de estado sólido conectadas diretamente ao barramento PCIe de um sistema. Em contraste, protocolos mais antigos, como iSCSI e NFS, foram desenvolvidos em torno das limitações e tempos de acesso mais lentos das unidades de disco rígido tradicionais. Em quase todos os casos, as tecnologias NVMe-oF superam os protocolos de conexão mais antigos, com maior largura de banda e tempos de acesso mais rápidos. O NVMe-oF também pode aproveitar interfaces de rede com recursos de Acesso Direto à Memória Remota (RDMA), permitindo que os dados sejam transferidos diretamente para a memória de um computador de destino sem a necessidade de processamento da CPU.
Recursos de redução e otimização de dados
O conjunto de hardware de alto desempenho do conjunto de armazenamento XN4 é ainda mais aprimorado por diversos recursos de software conhecidos e apreciados pelos administradores de armazenamento. Provisionamento fino, compactação e desduplicação permitem que as empresas maximizem a capacidade de sua SAN, enquanto o cache SSD e o armazenamento em camadas automático aceleram os tempos de acesso para arquivos e objetos usados com frequência. O sistema operacional QSM 4 do dispositivo também facilita o teste e a reversão de alterações com ferramentas de snapshot integradas.
Recursos de segurança e gerenciamento
A QSAN levou em consideração a evolução dos requisitos de segurança e gerenciamento de seus clientes com a linha XN4. O XN4 é compatível com Instant Secure Erase (ISE) e Self-Encrypting Drives (SED), além de protocolos de segurança como SSL/TLS, autenticação via Role-Based Access Control (RBAC) e suporte para servidores Active Directory/LDAP. O conjunto pode ser gerenciado usando uma interface web HTTPS ou uma API RESTful, permitindo a automação por meio de uma ampla variedade de ferramentas, como Ansible ou Terraform.
Gestão QSM 4
O QSM 4, o sistema operacional da série QSAN XN4, facilita a configuração e o gerenciamento do conjunto de armazenamento para administradores de armazenamento de todos os níveis de experiência. A implantação imediata é simples: criação rápida de pools, atribuição intuitiva de hosts e gerenciamento simplificado via interface web e APIs REST — tudo projetado para equipes de TI menores sem profundo conhecimento em armazenamento.
A tela do Painel exibe informações de status do sistema e eventos recentes registrados pelo servidor.
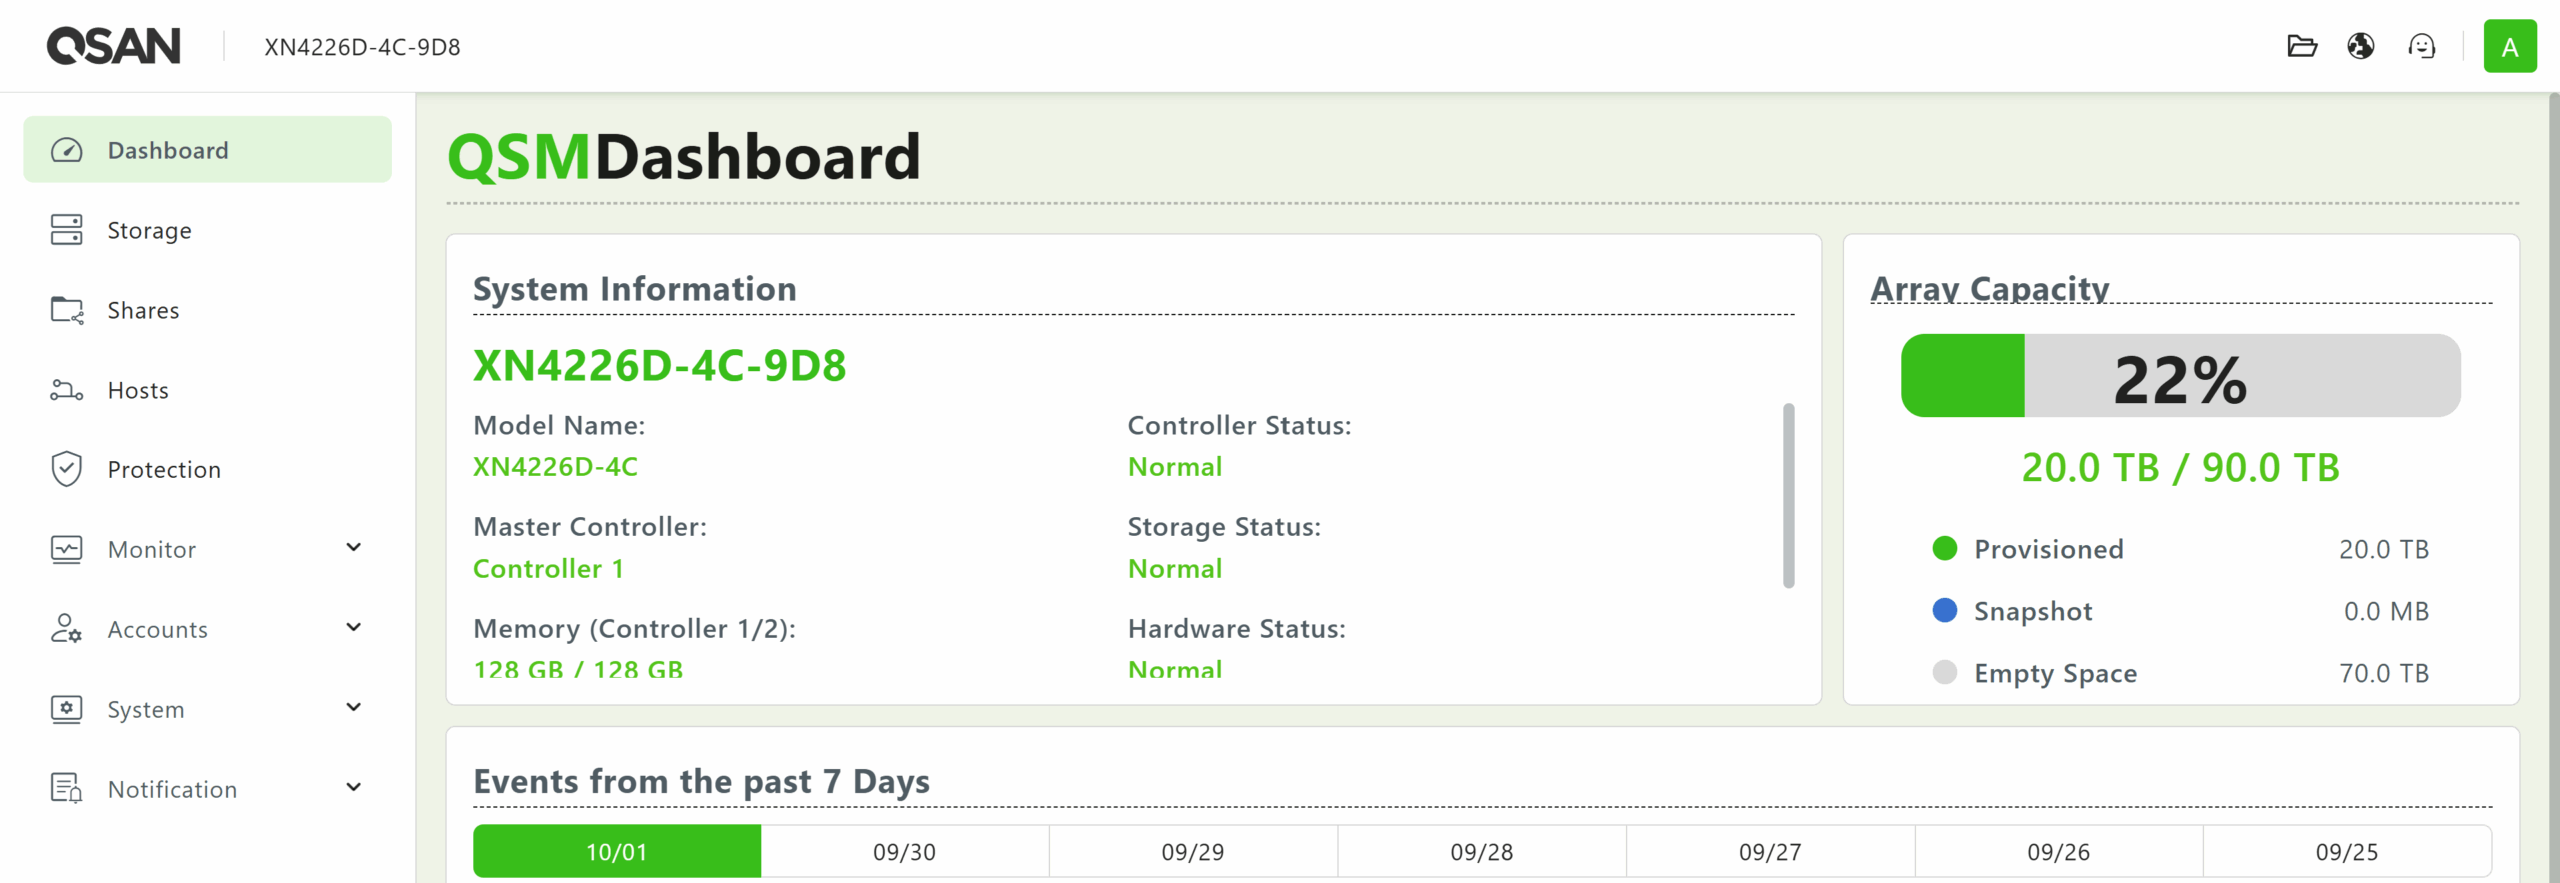
Após o login, o usuário é apresentado à tela do Painel, que fornece uma visão geral rápida da integridade da SAN. A partir daí, você pode acessar qualquer submenu da lista no painel à esquerda.
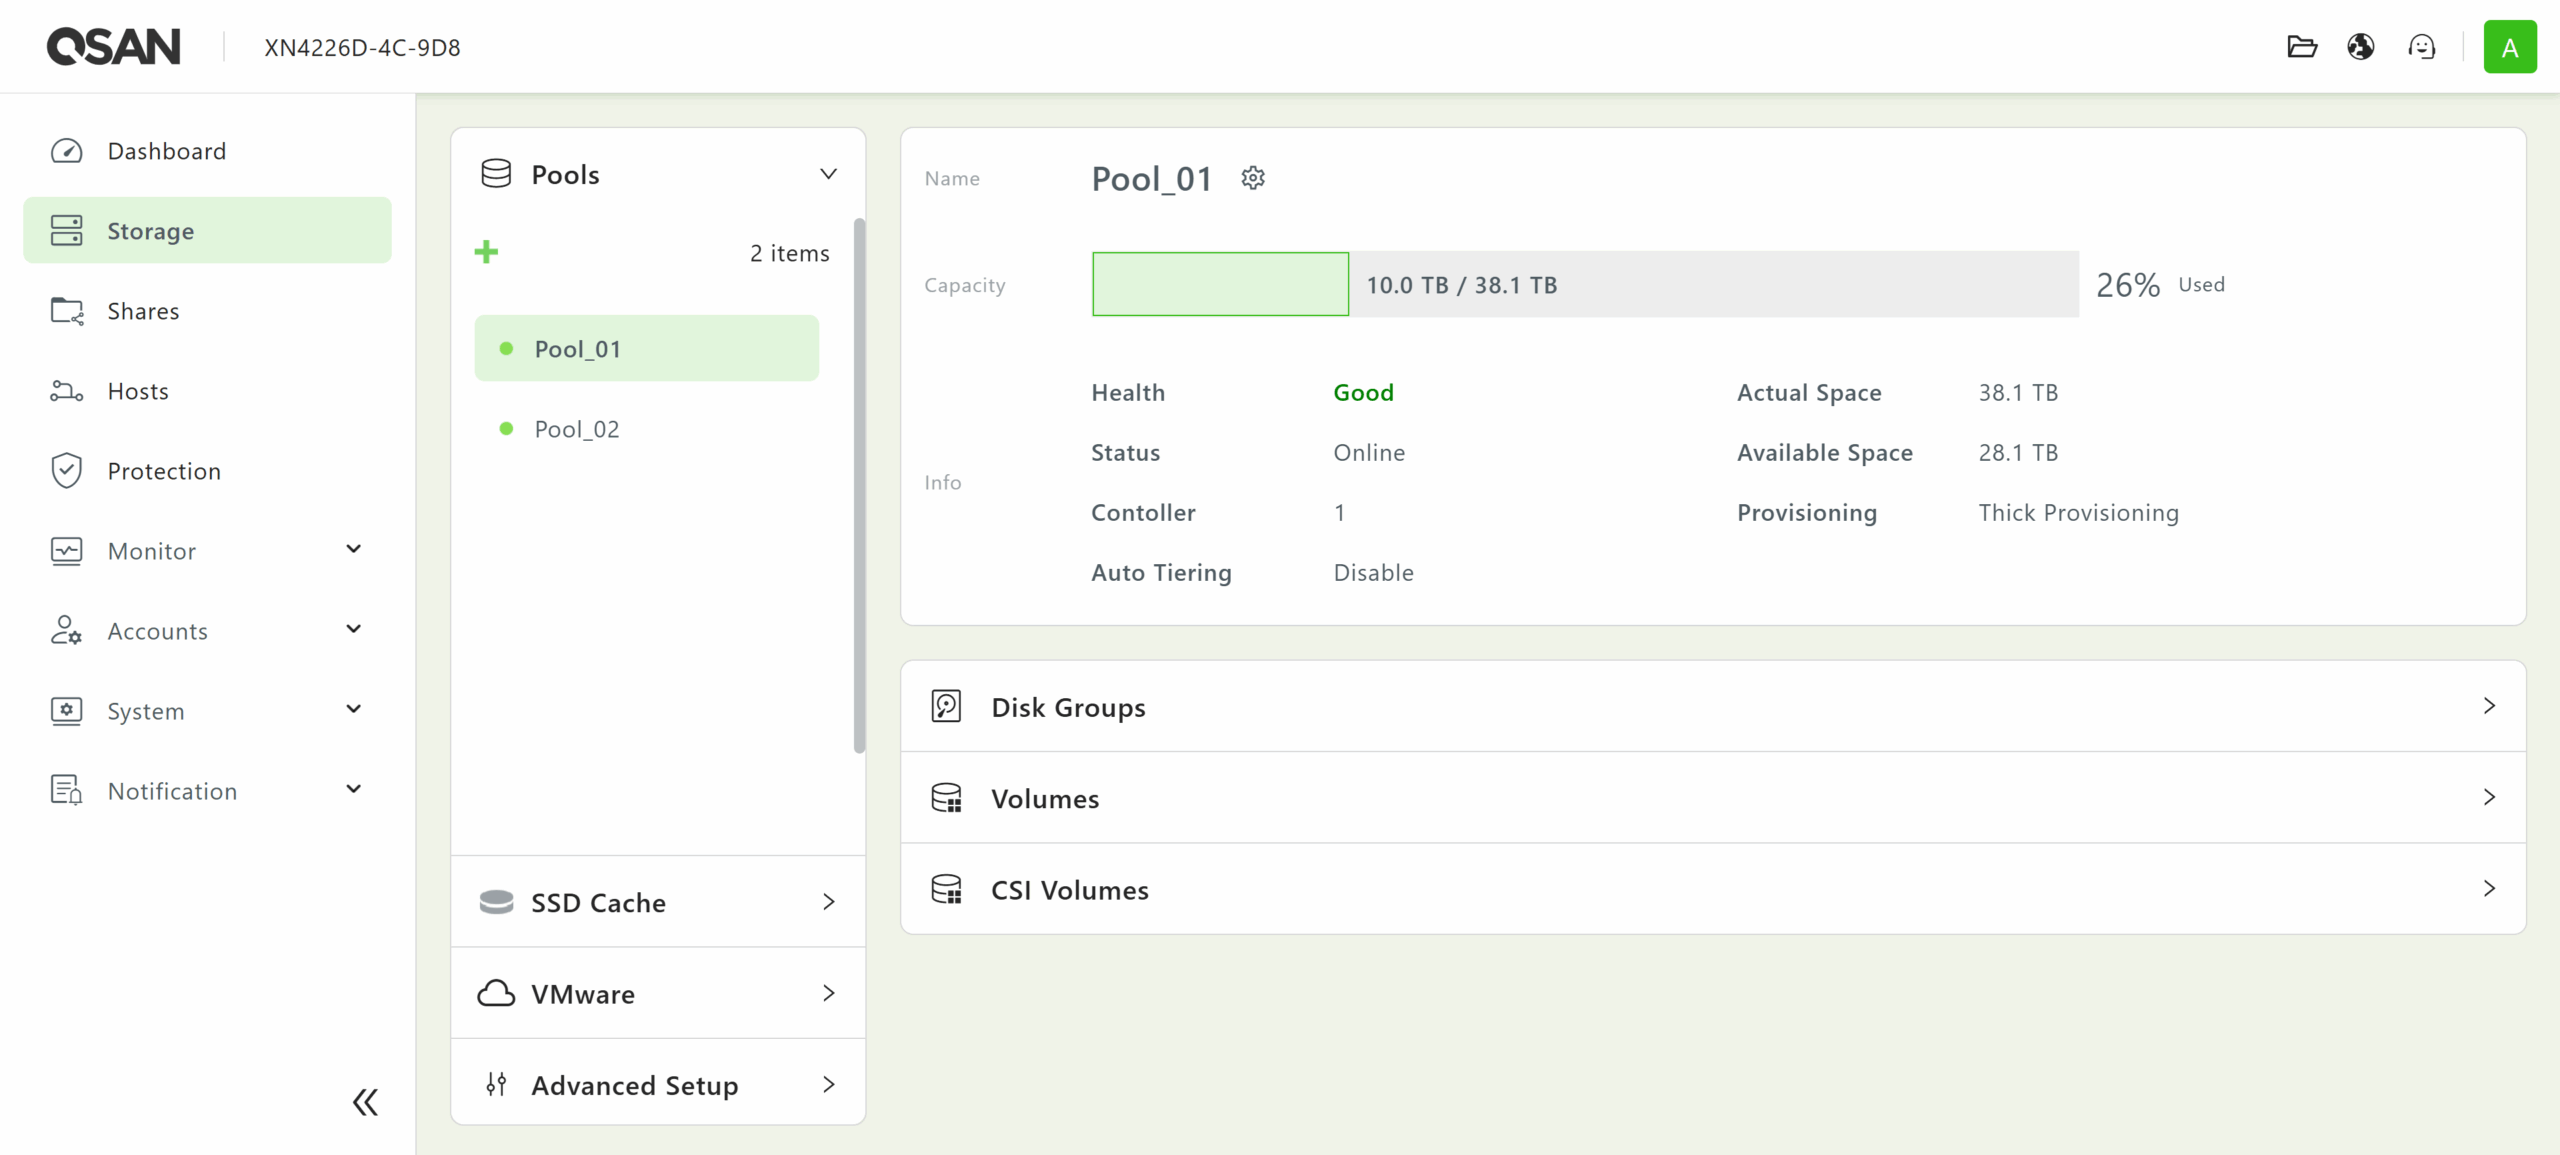
No menu Armazenamento, os administradores podem criar e gerenciar pools de unidades e seus volumes associados.
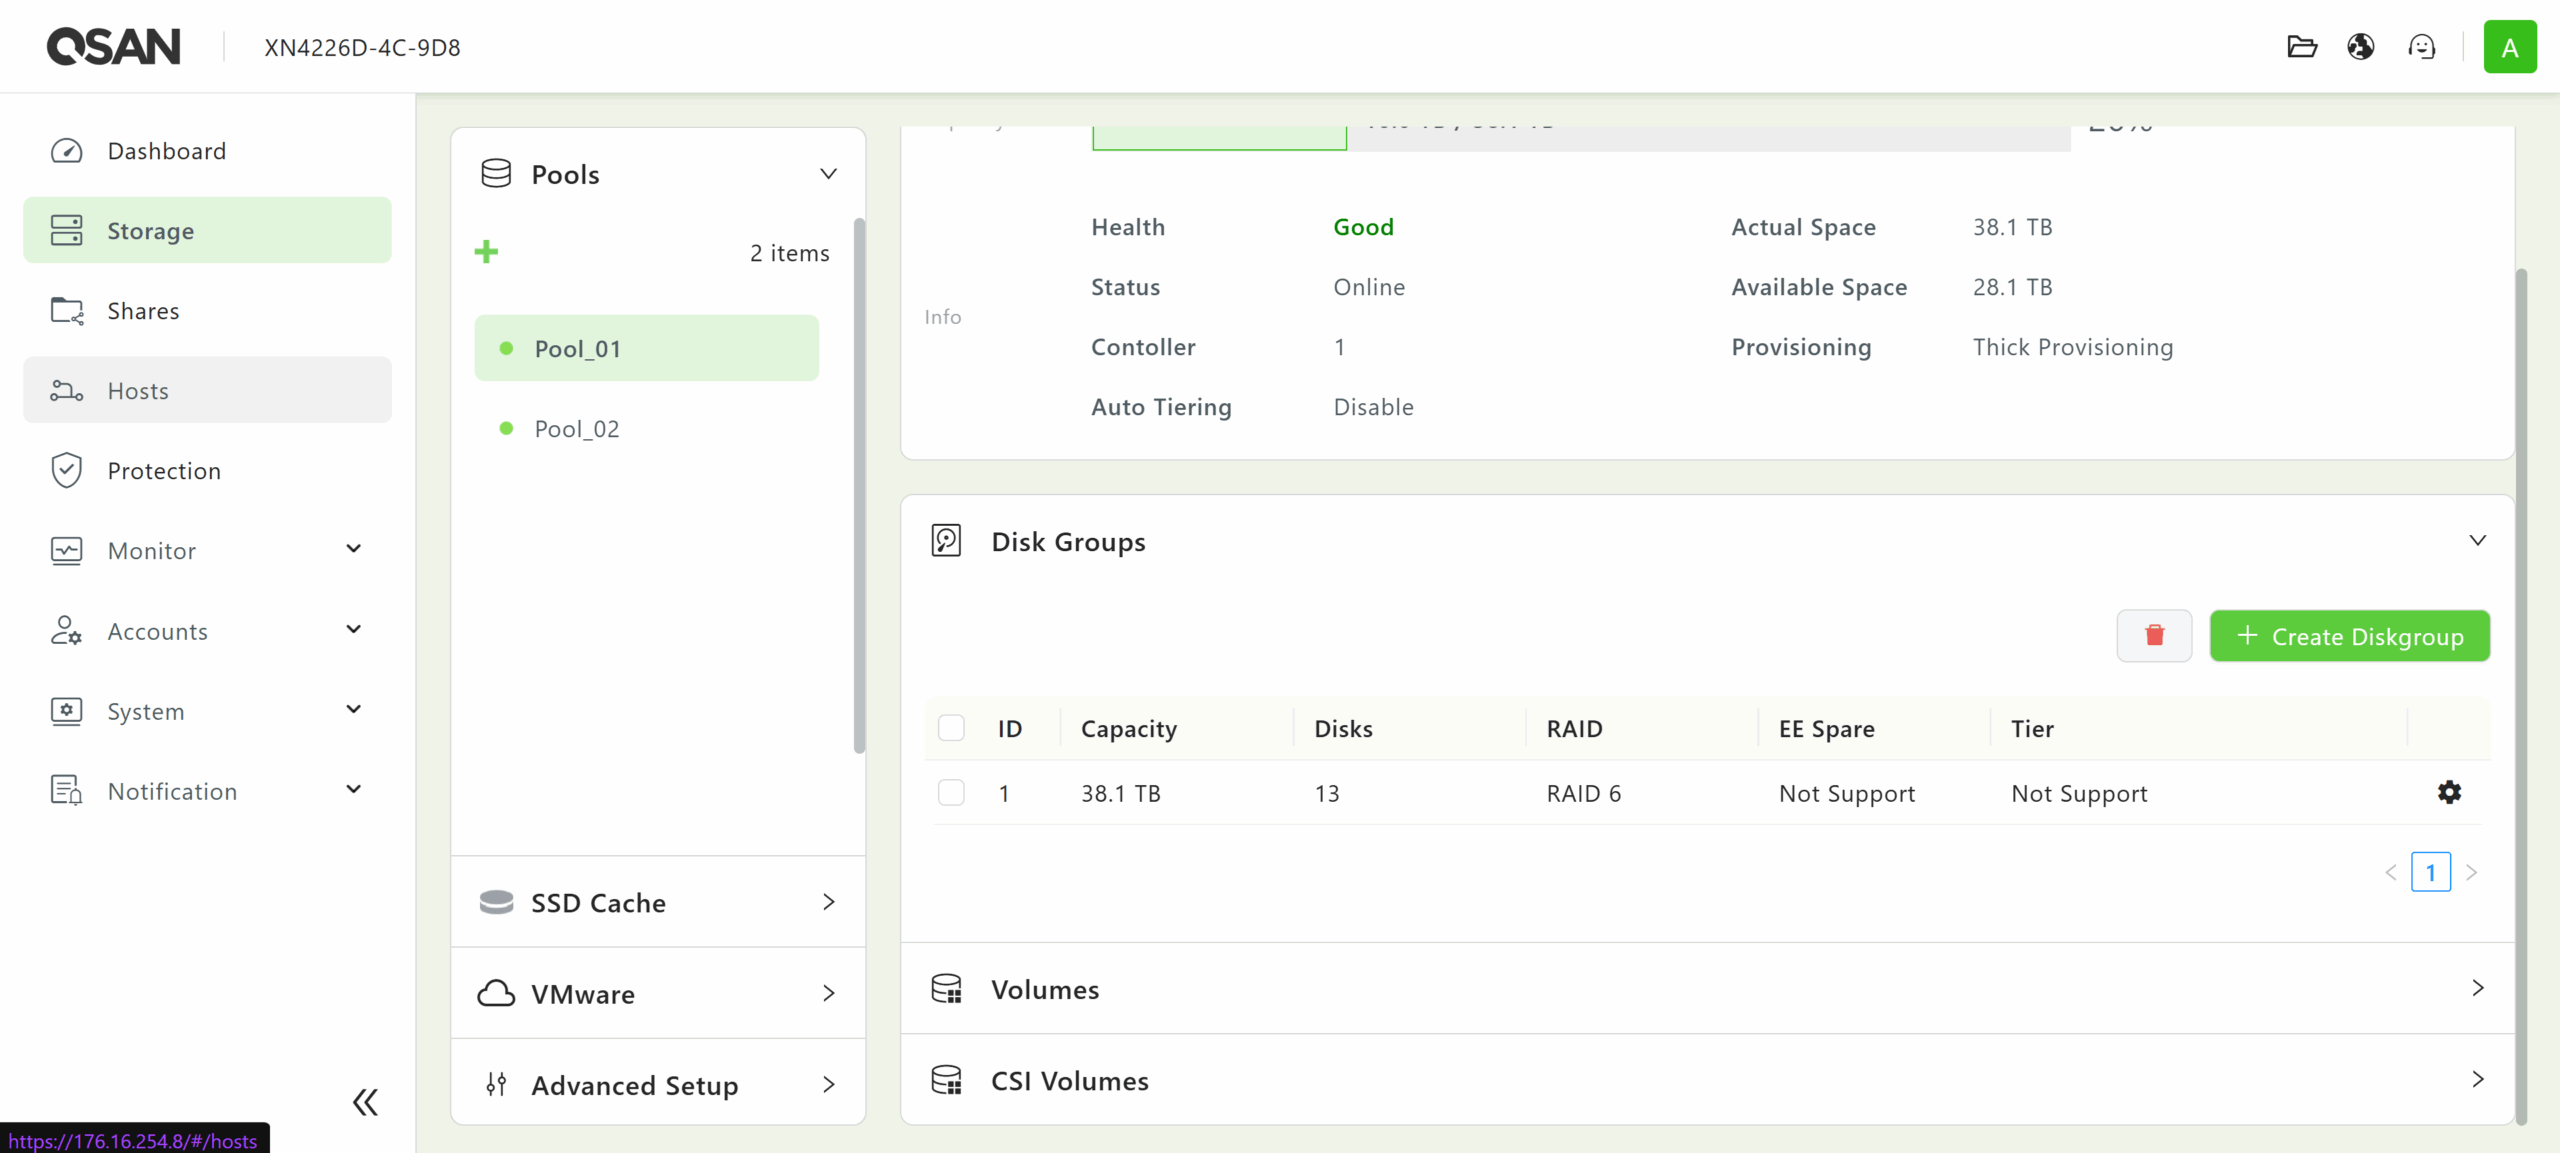
Os grupos de discos que compõem cada pool podem ser gerenciados na aba "Grupos de Discos". Este recurso suporta vários níveis de RAID, incluindo 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE e 60EE, dependendo do número de unidades já atribuídas.
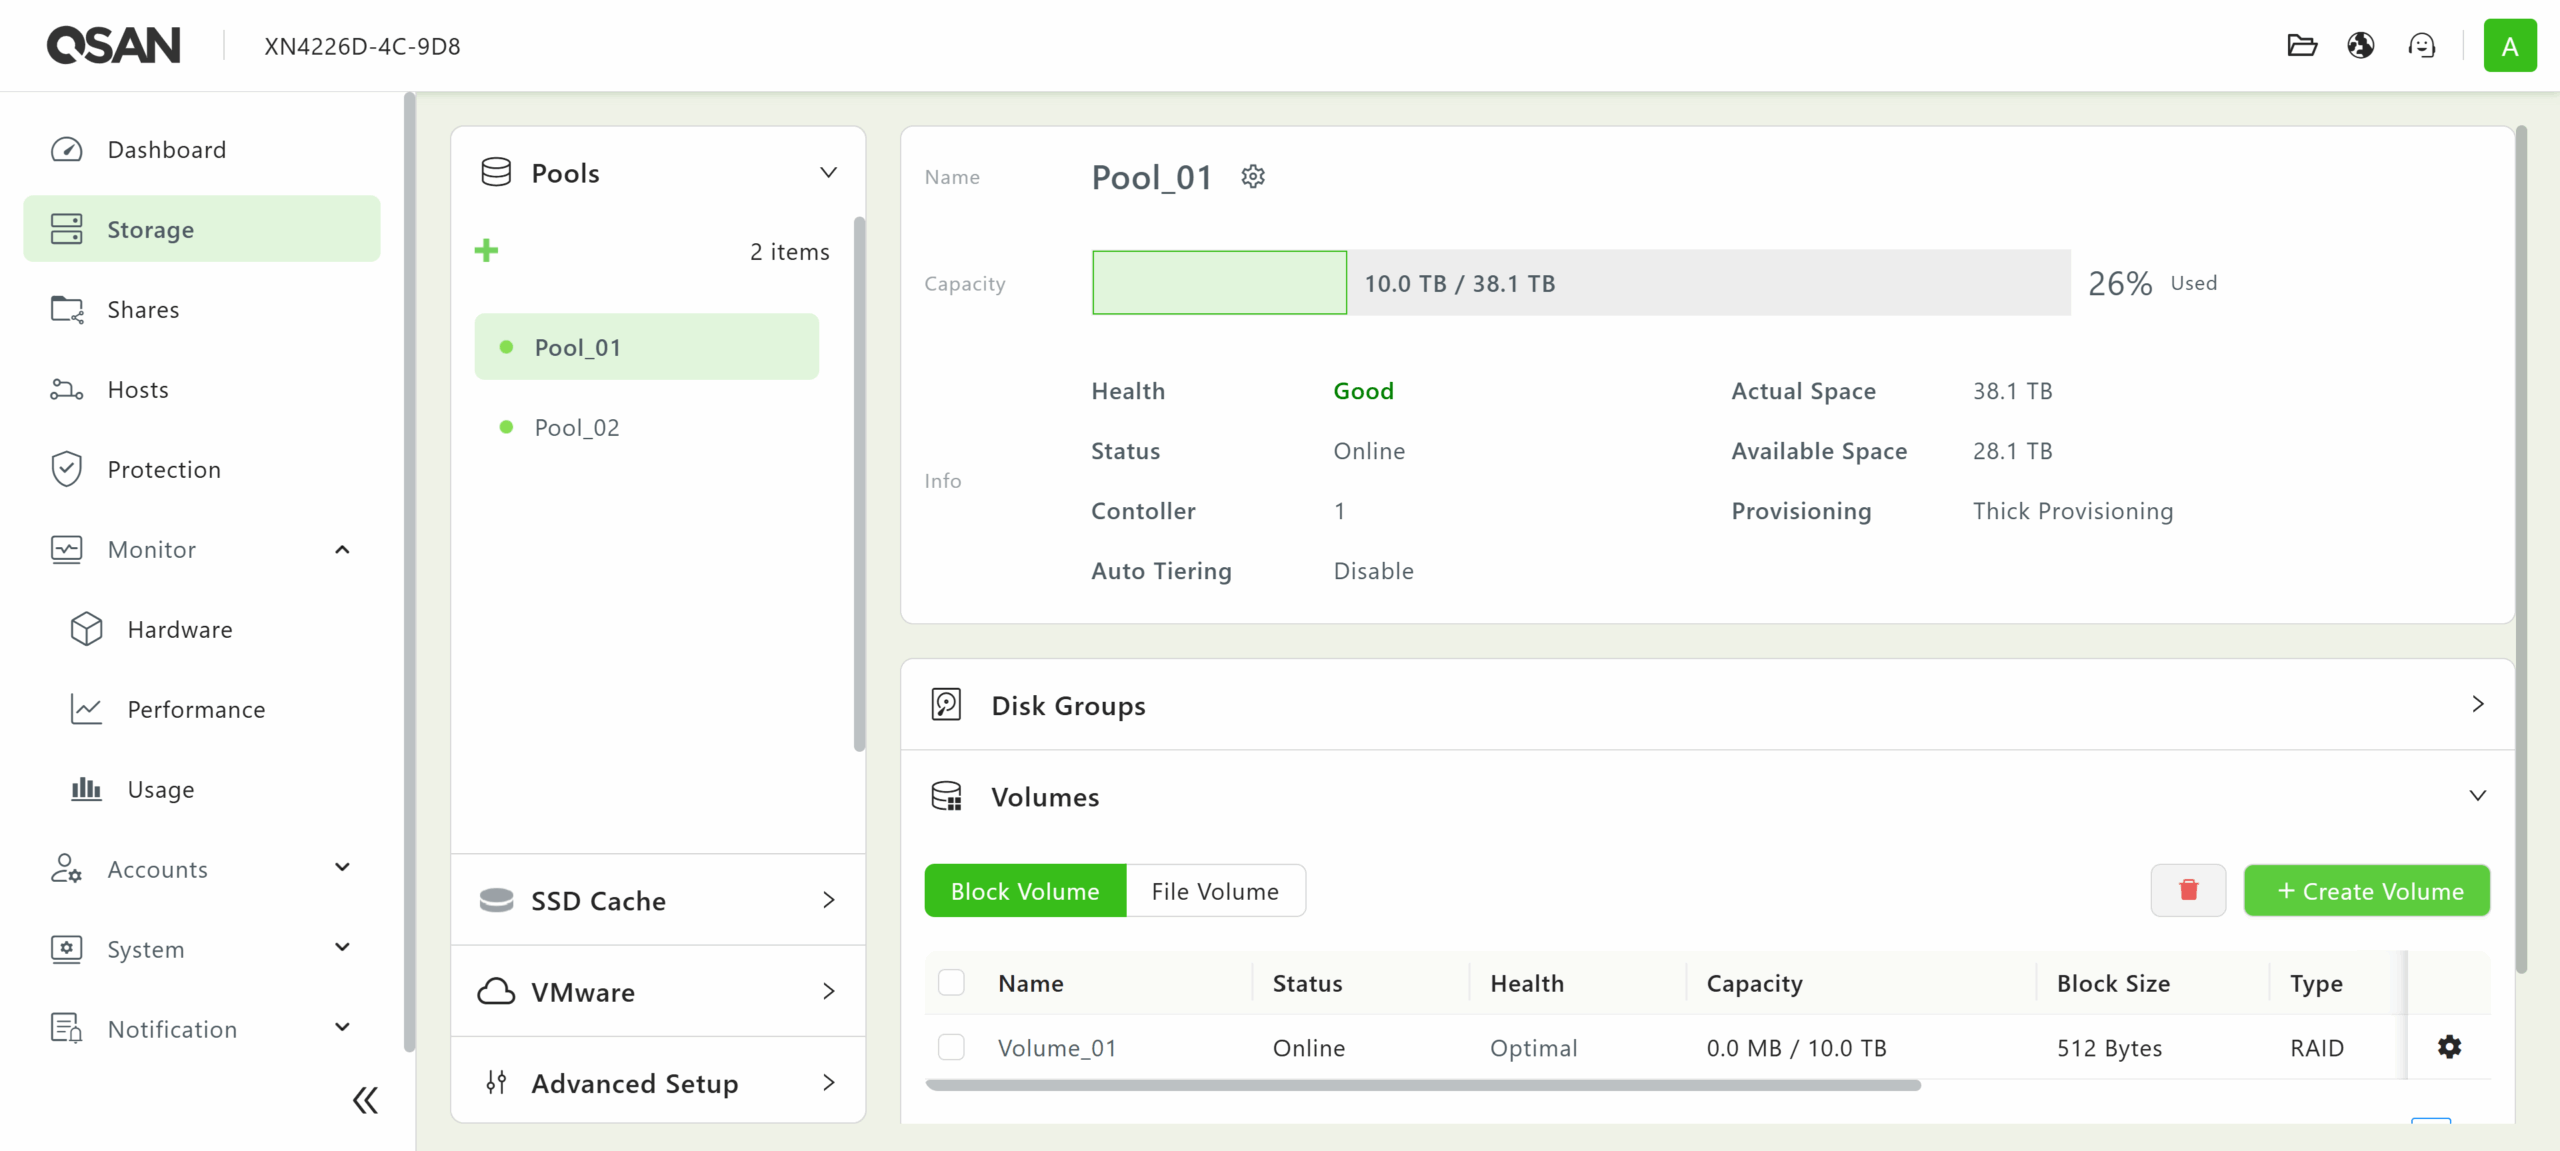
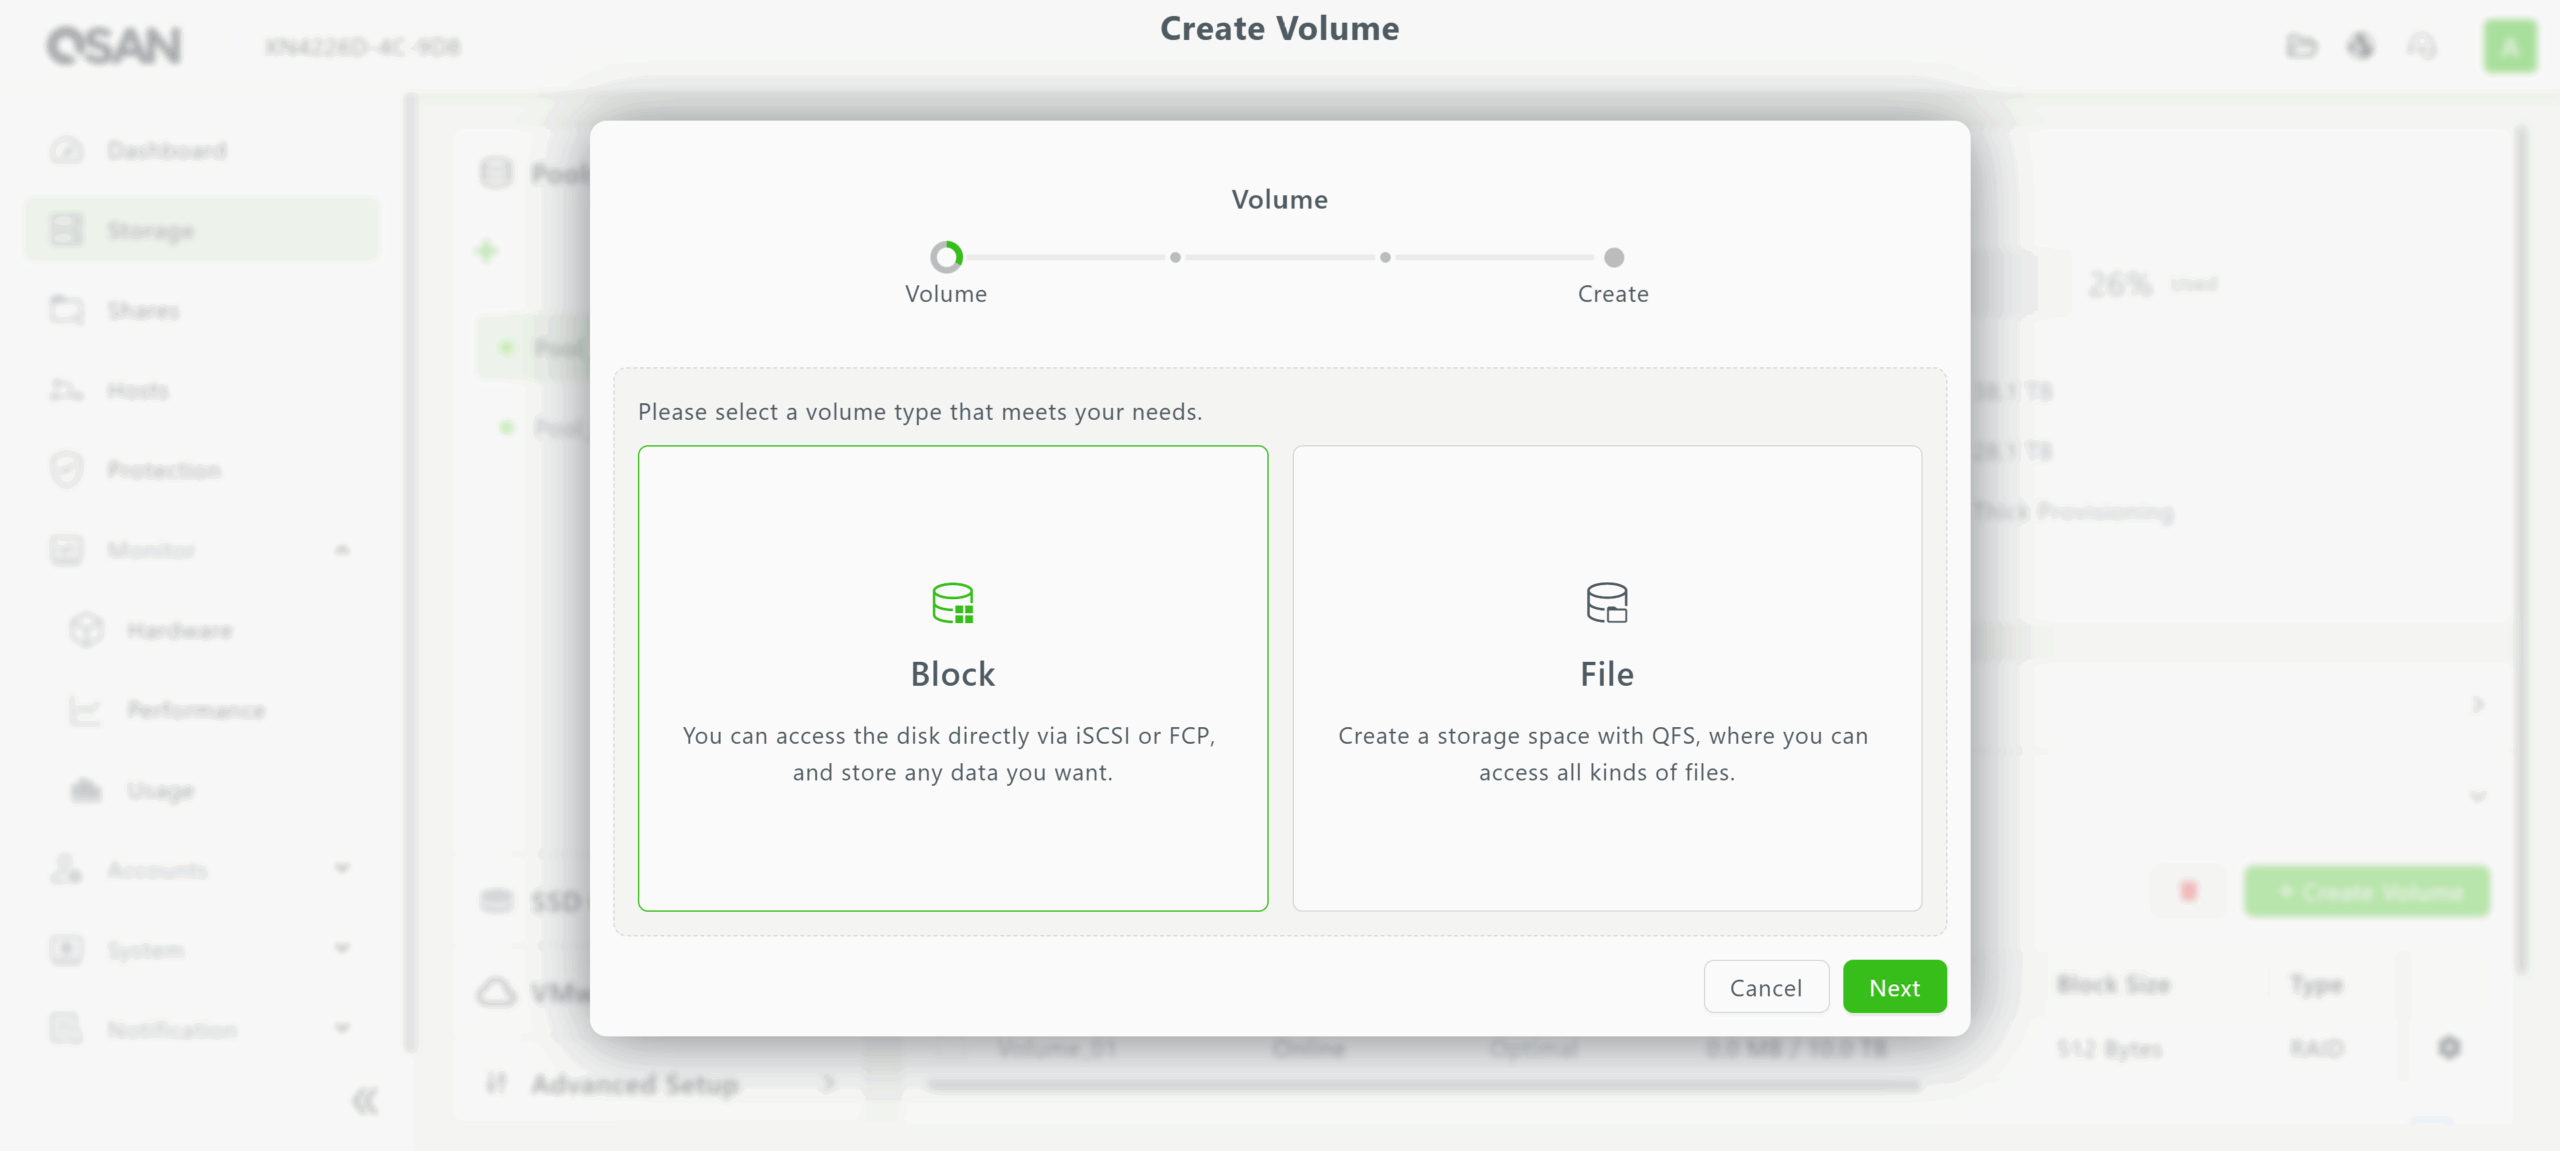
Volumes para armazenamento em blocos e arquivos podem ser criados sobre pools. Usando o assistente, a capacidade e o tamanho dos blocos de cada volume podem ser definidos para atender às necessidades dos clientes conectados.
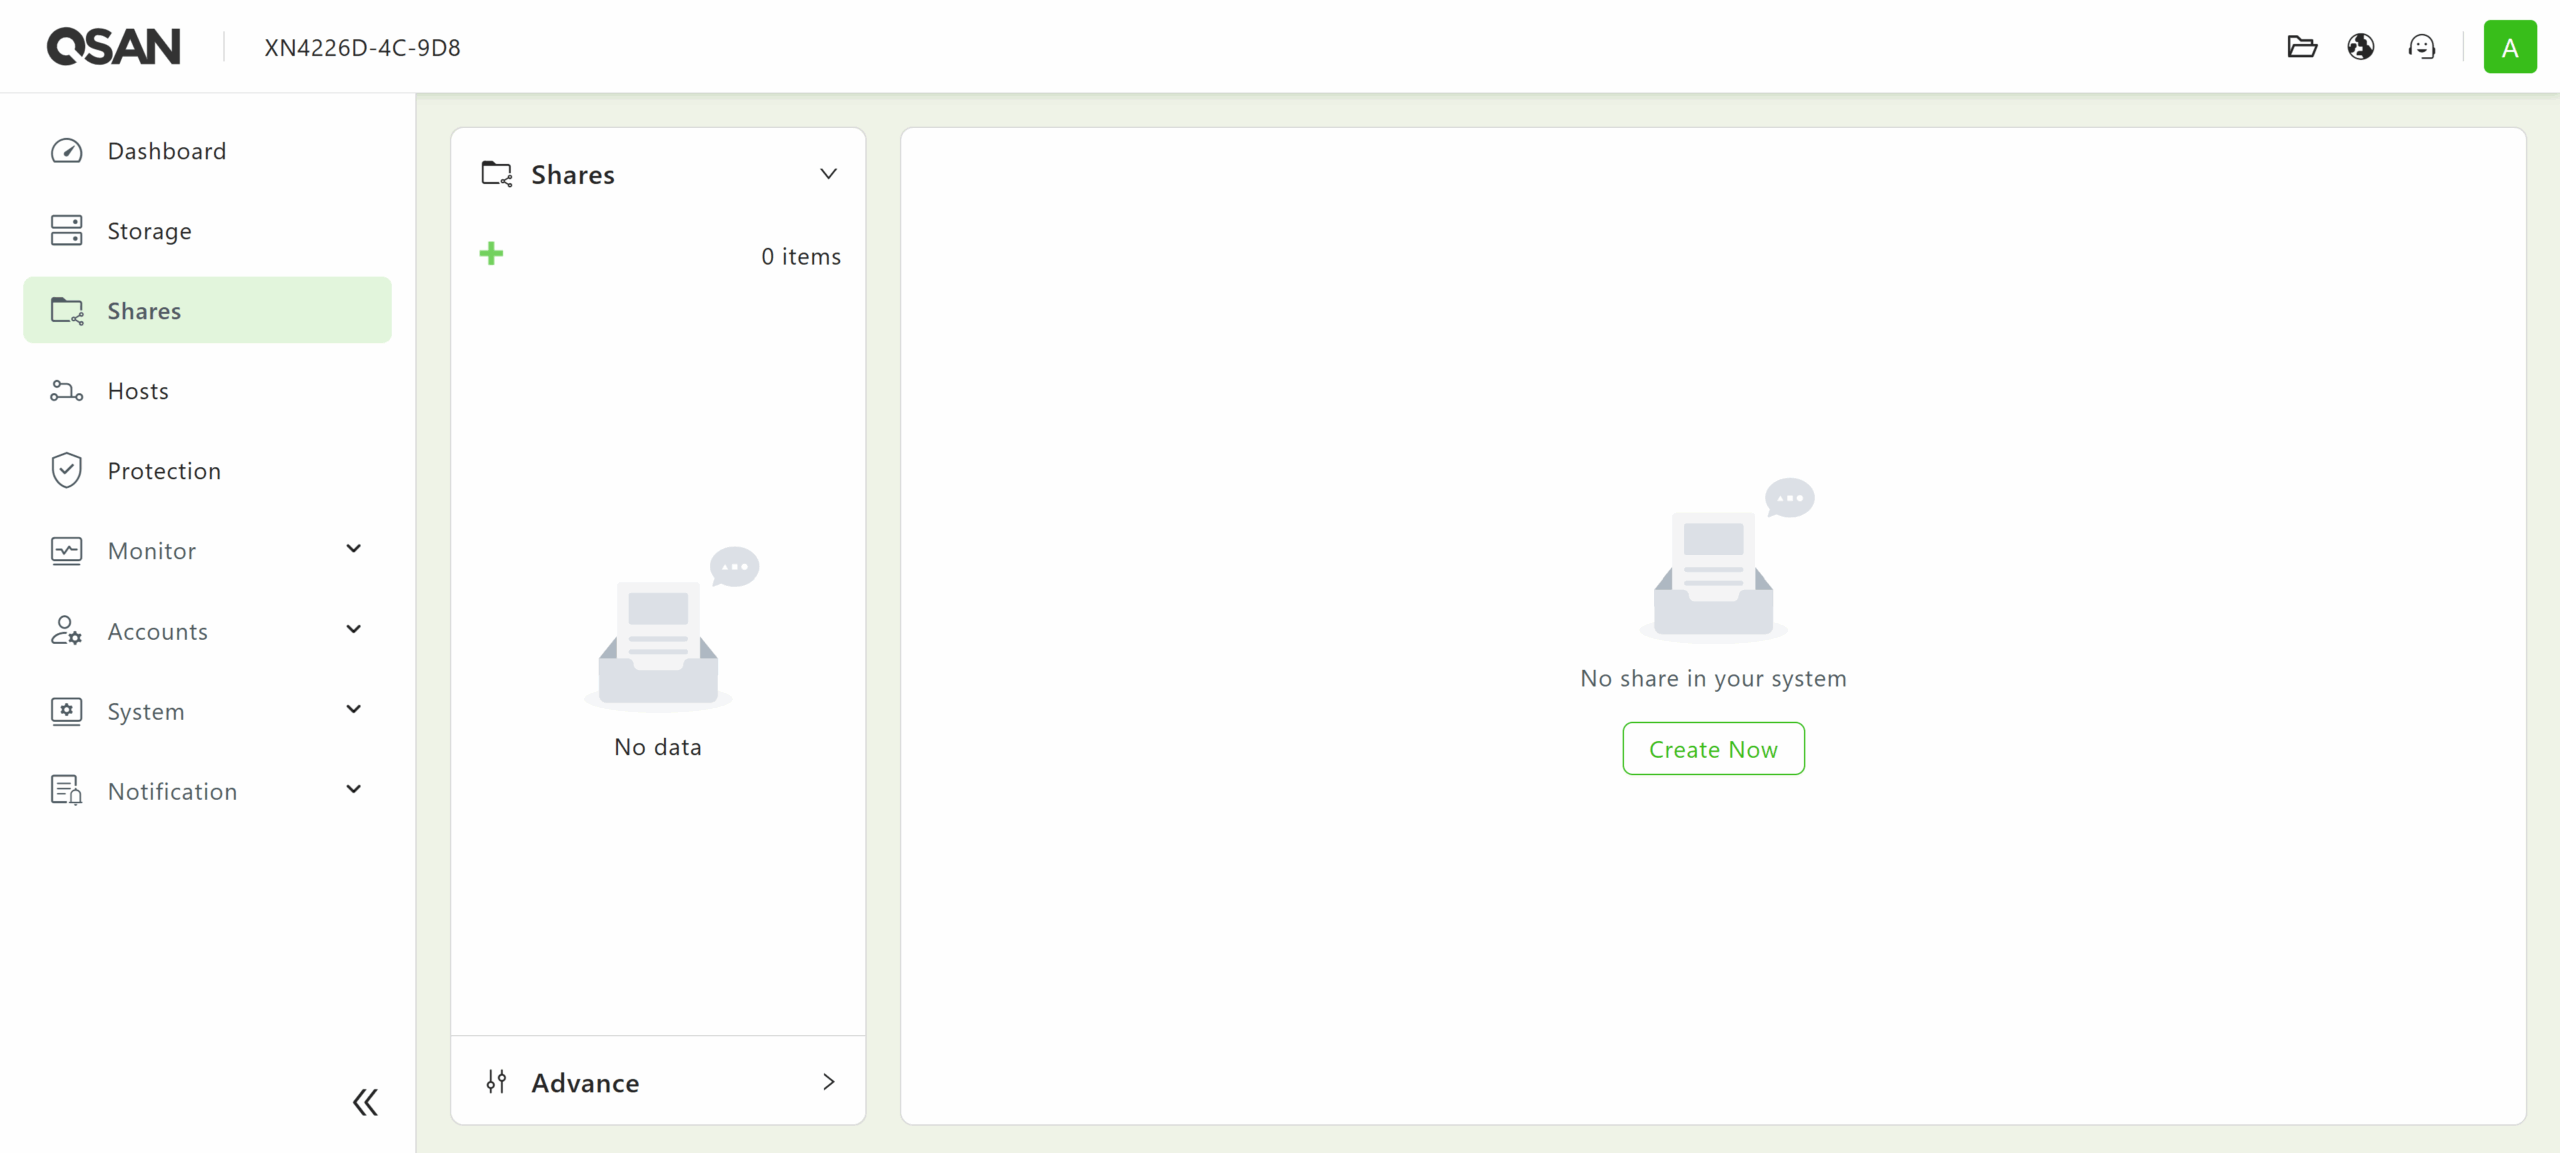
Descendo a lista, o menu Compartilhamentos pode ser usado para criar um objeto de compartilhamento sobre um volume de arquivo. Os protocolos de compartilhamento suportados incluem CIFS (SMB), FTP, NFS e WebDAV.
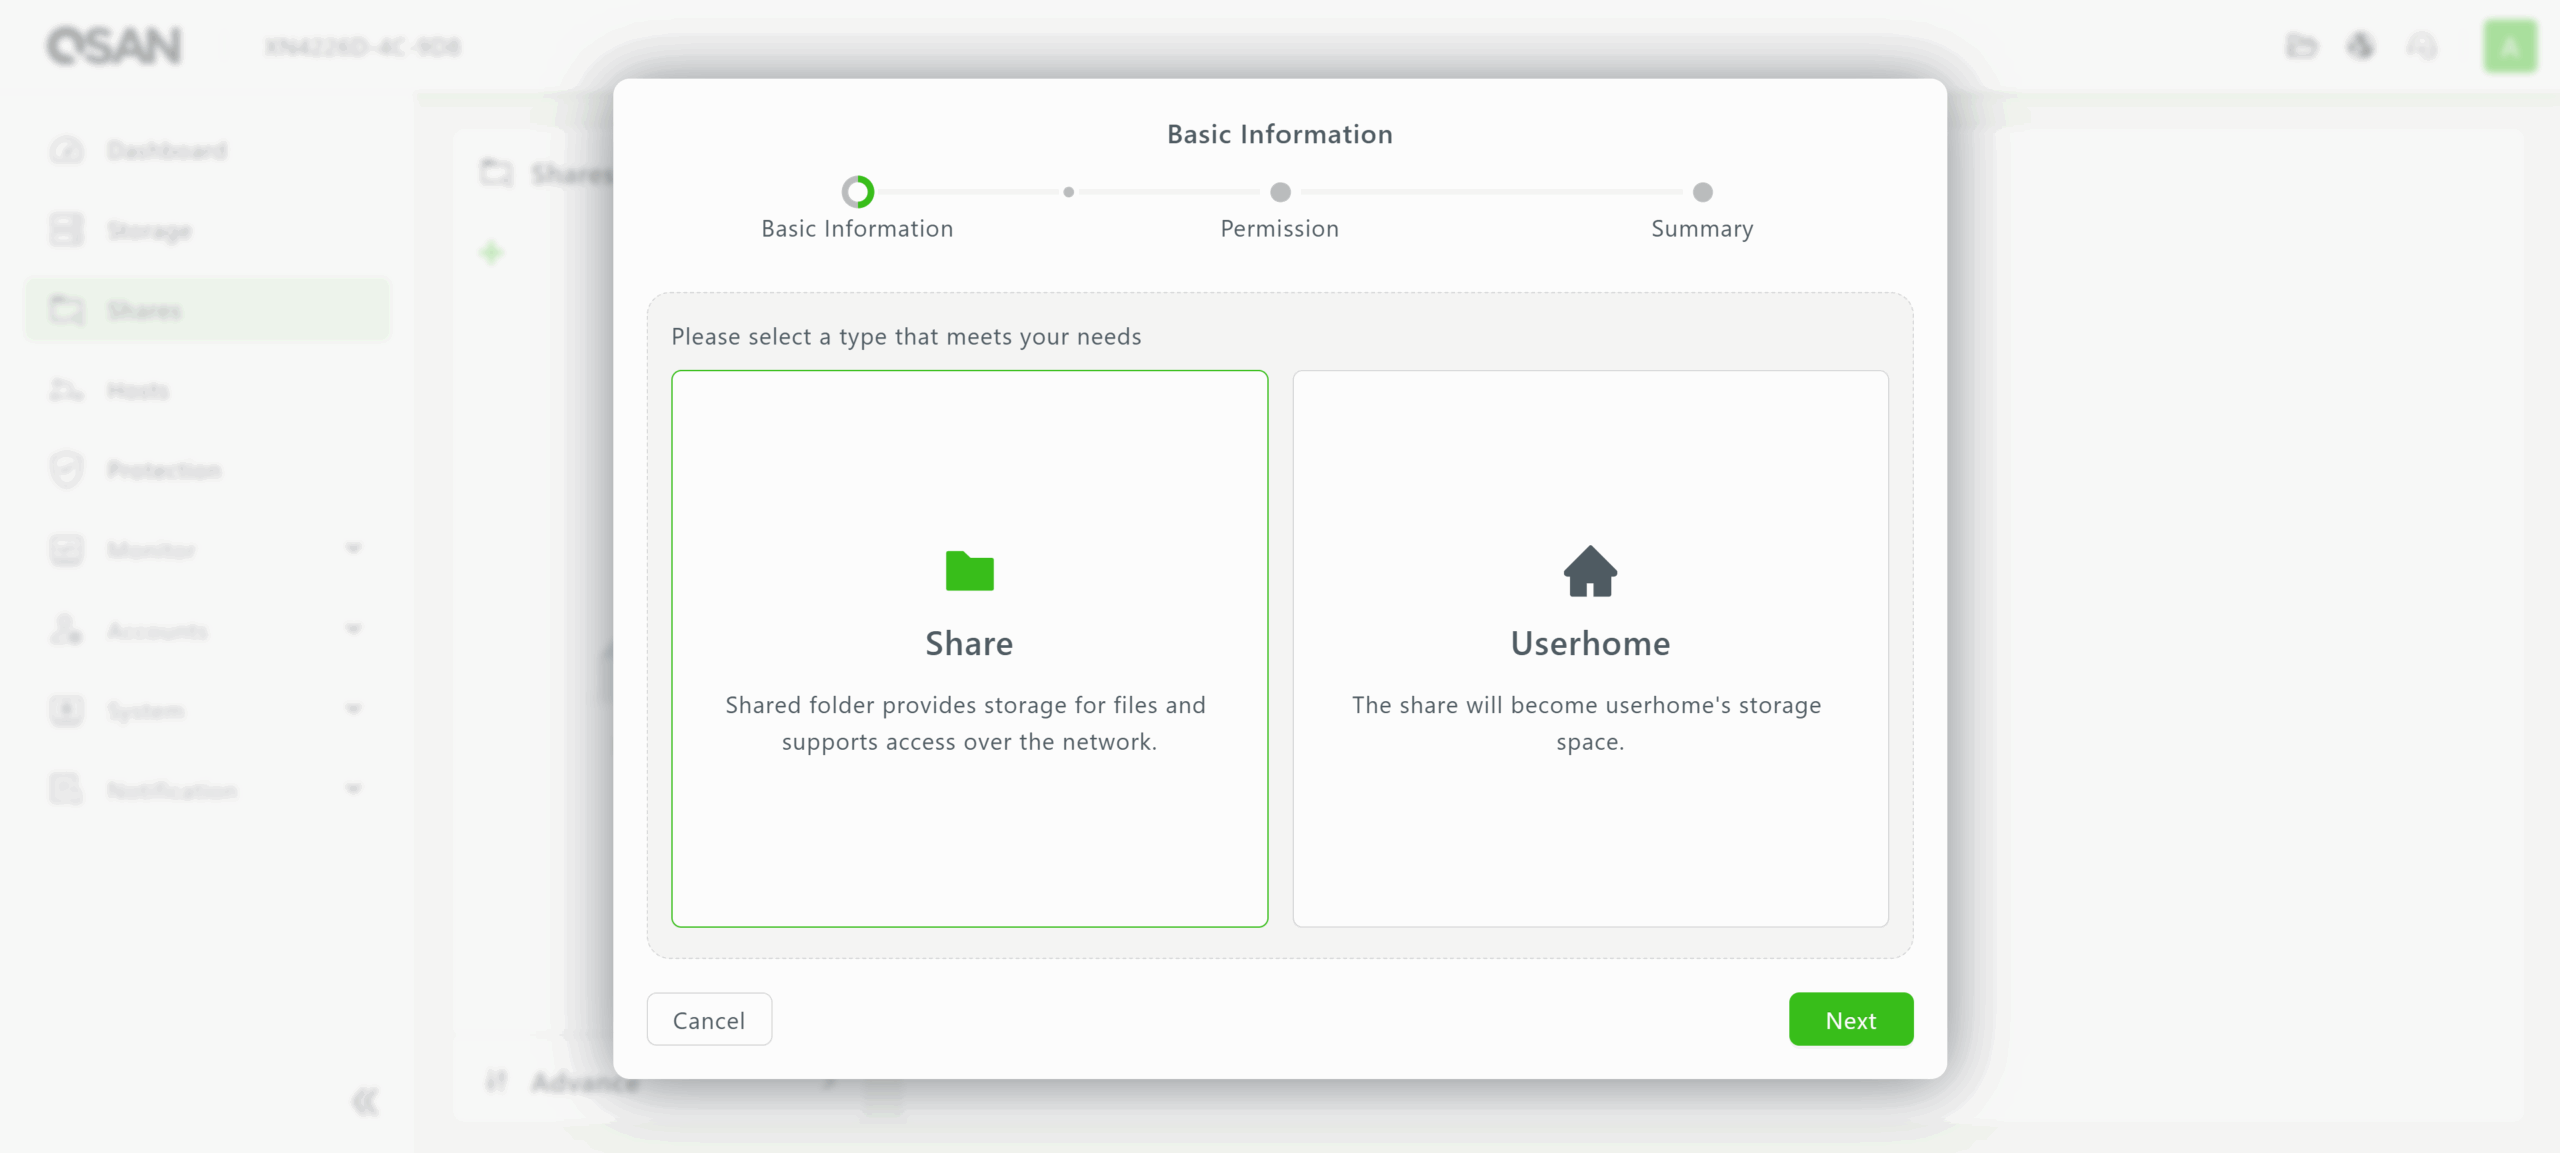
 Ao criar um novo compartilhamento, o QSM 4 fornece duas opções: um compartilhamento de rede padrão para hospedar arquivos que vários usuários acessarão e um compartilhamento userhome, que foi projetado para armazenar pastas pessoais para usuários que só podem ser acessadas individualmente.
Após a criação de um volume de bloco ou volume de arquivo e compartilhamento, ele deve ser atribuído a um endereço IP ou nome de host no menu Hosts. Os hosts são organizados de acordo com sua correspondência com armazenamento em bloco ou em arquivo (compartilhamento), conforme mostrado nas capturas de tela abaixo.
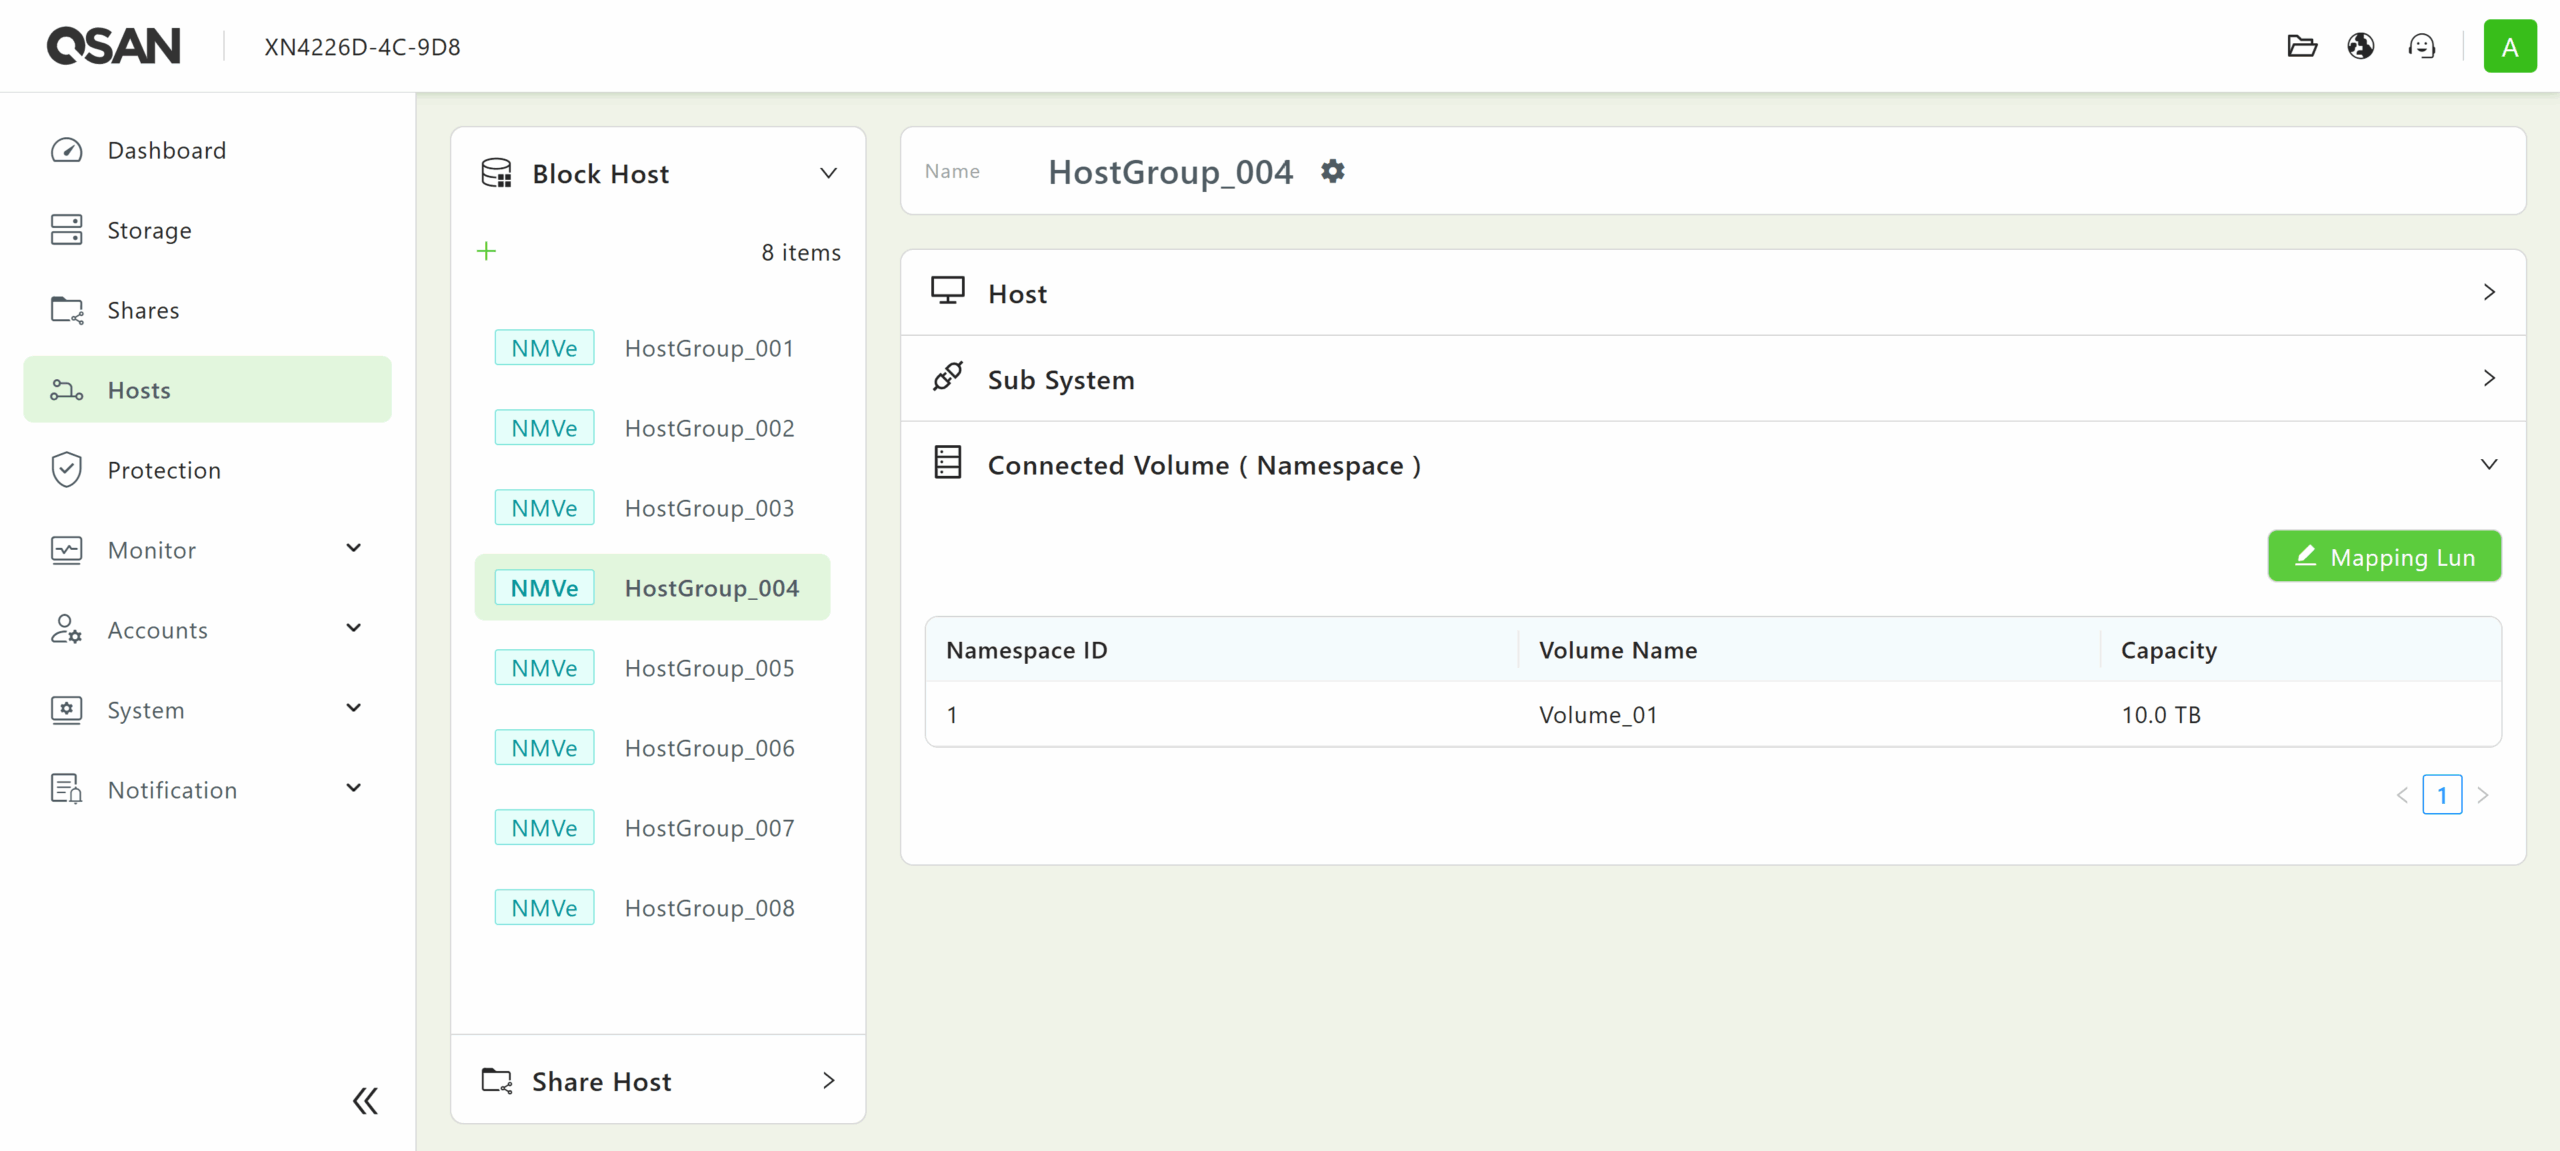
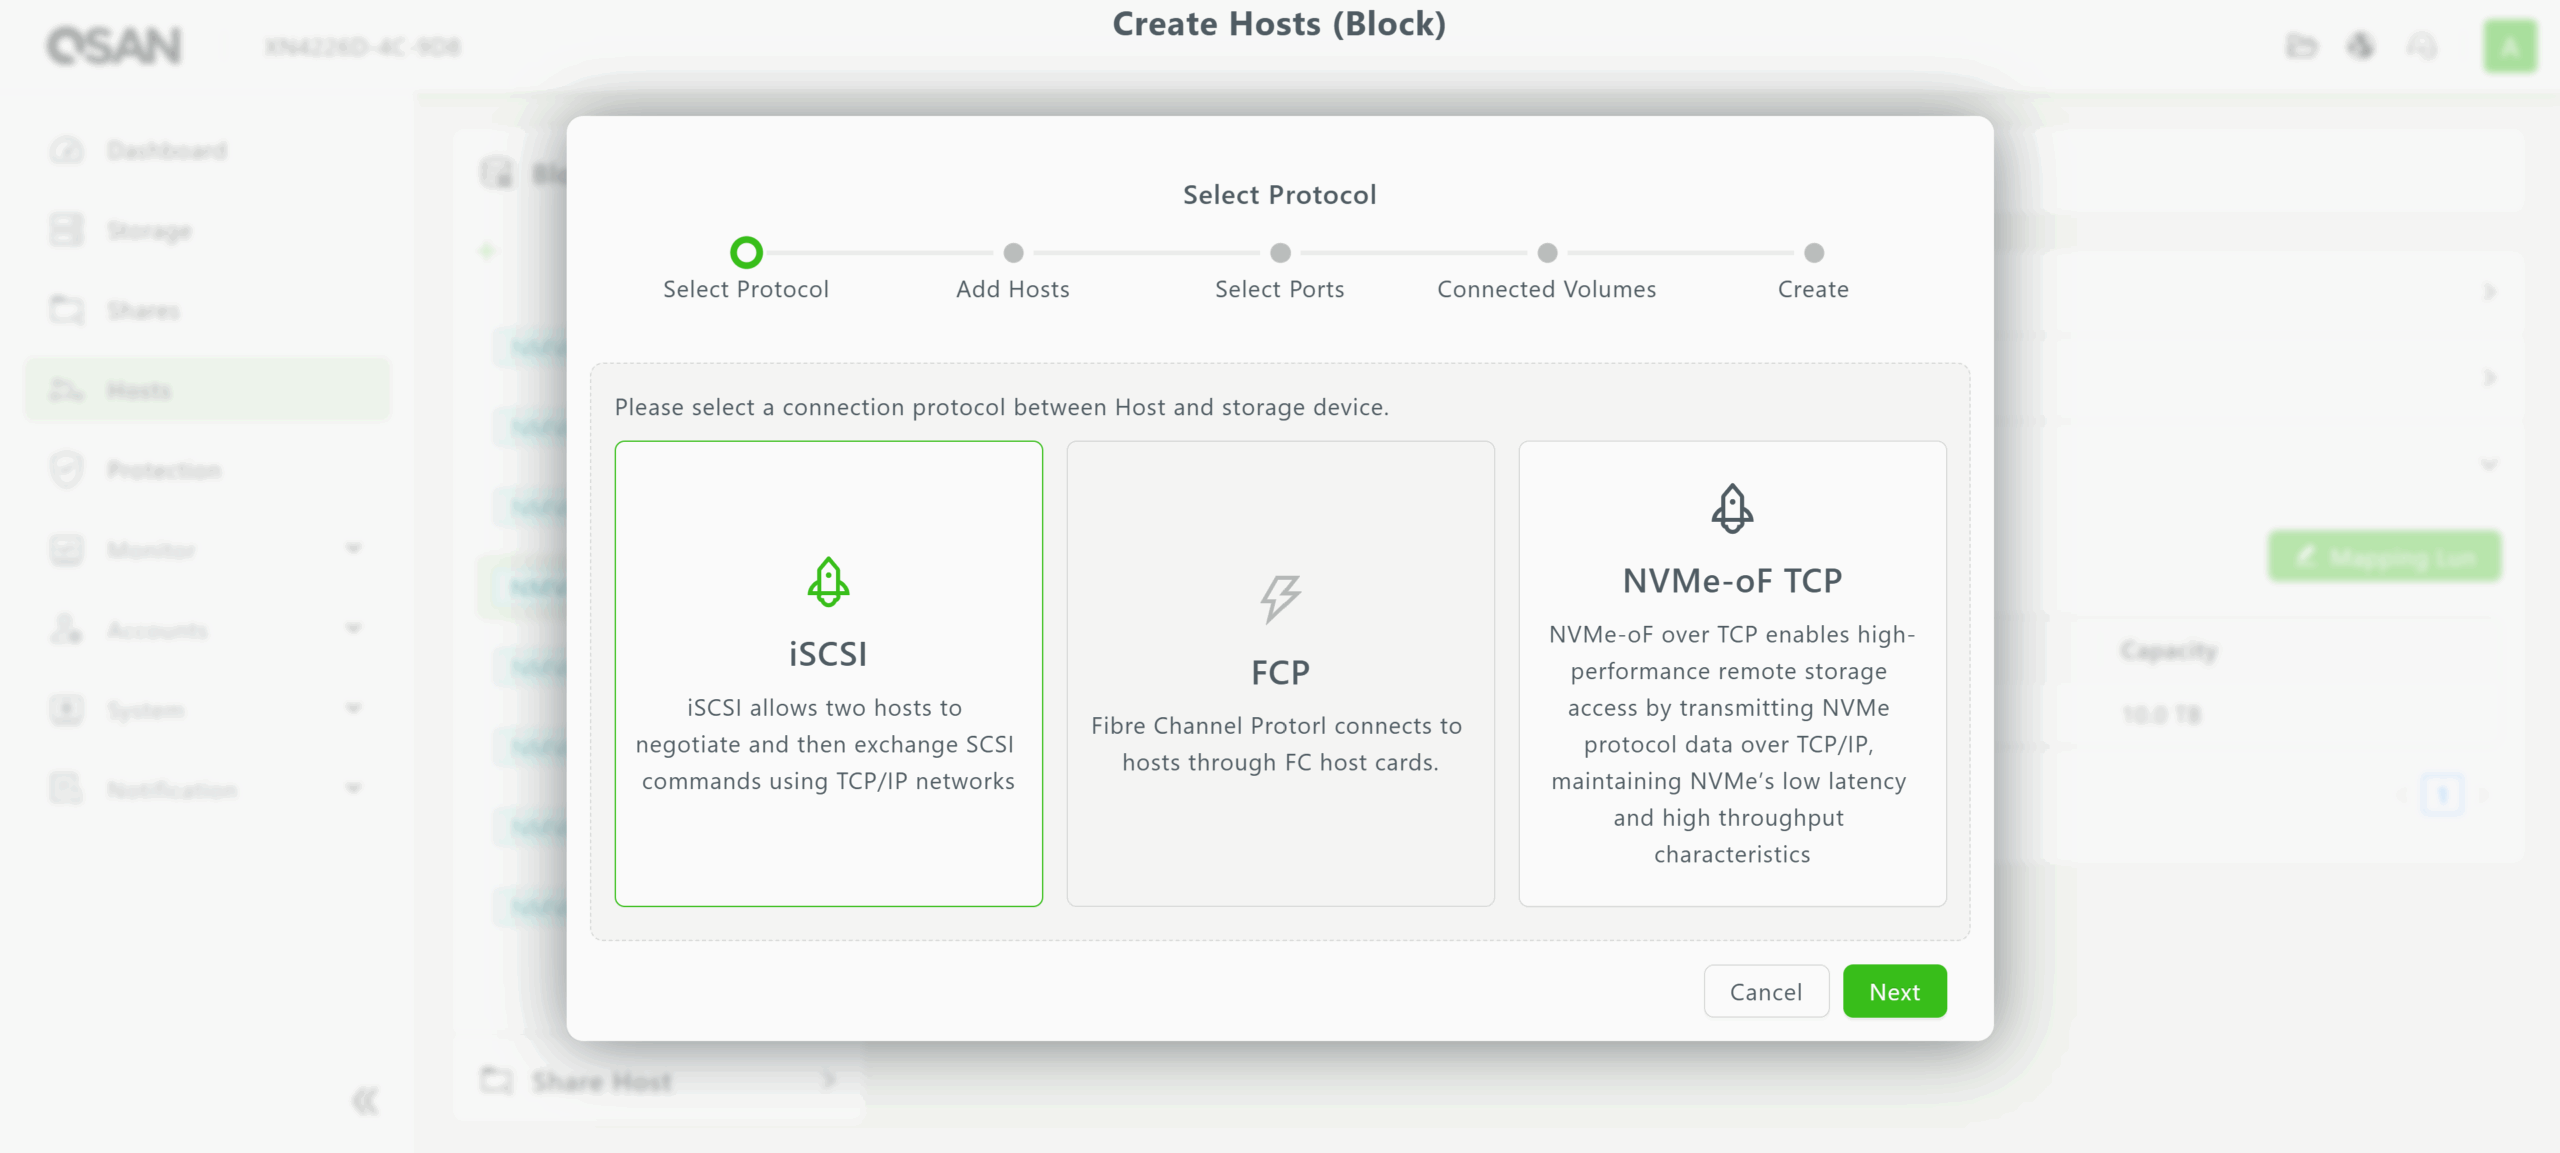
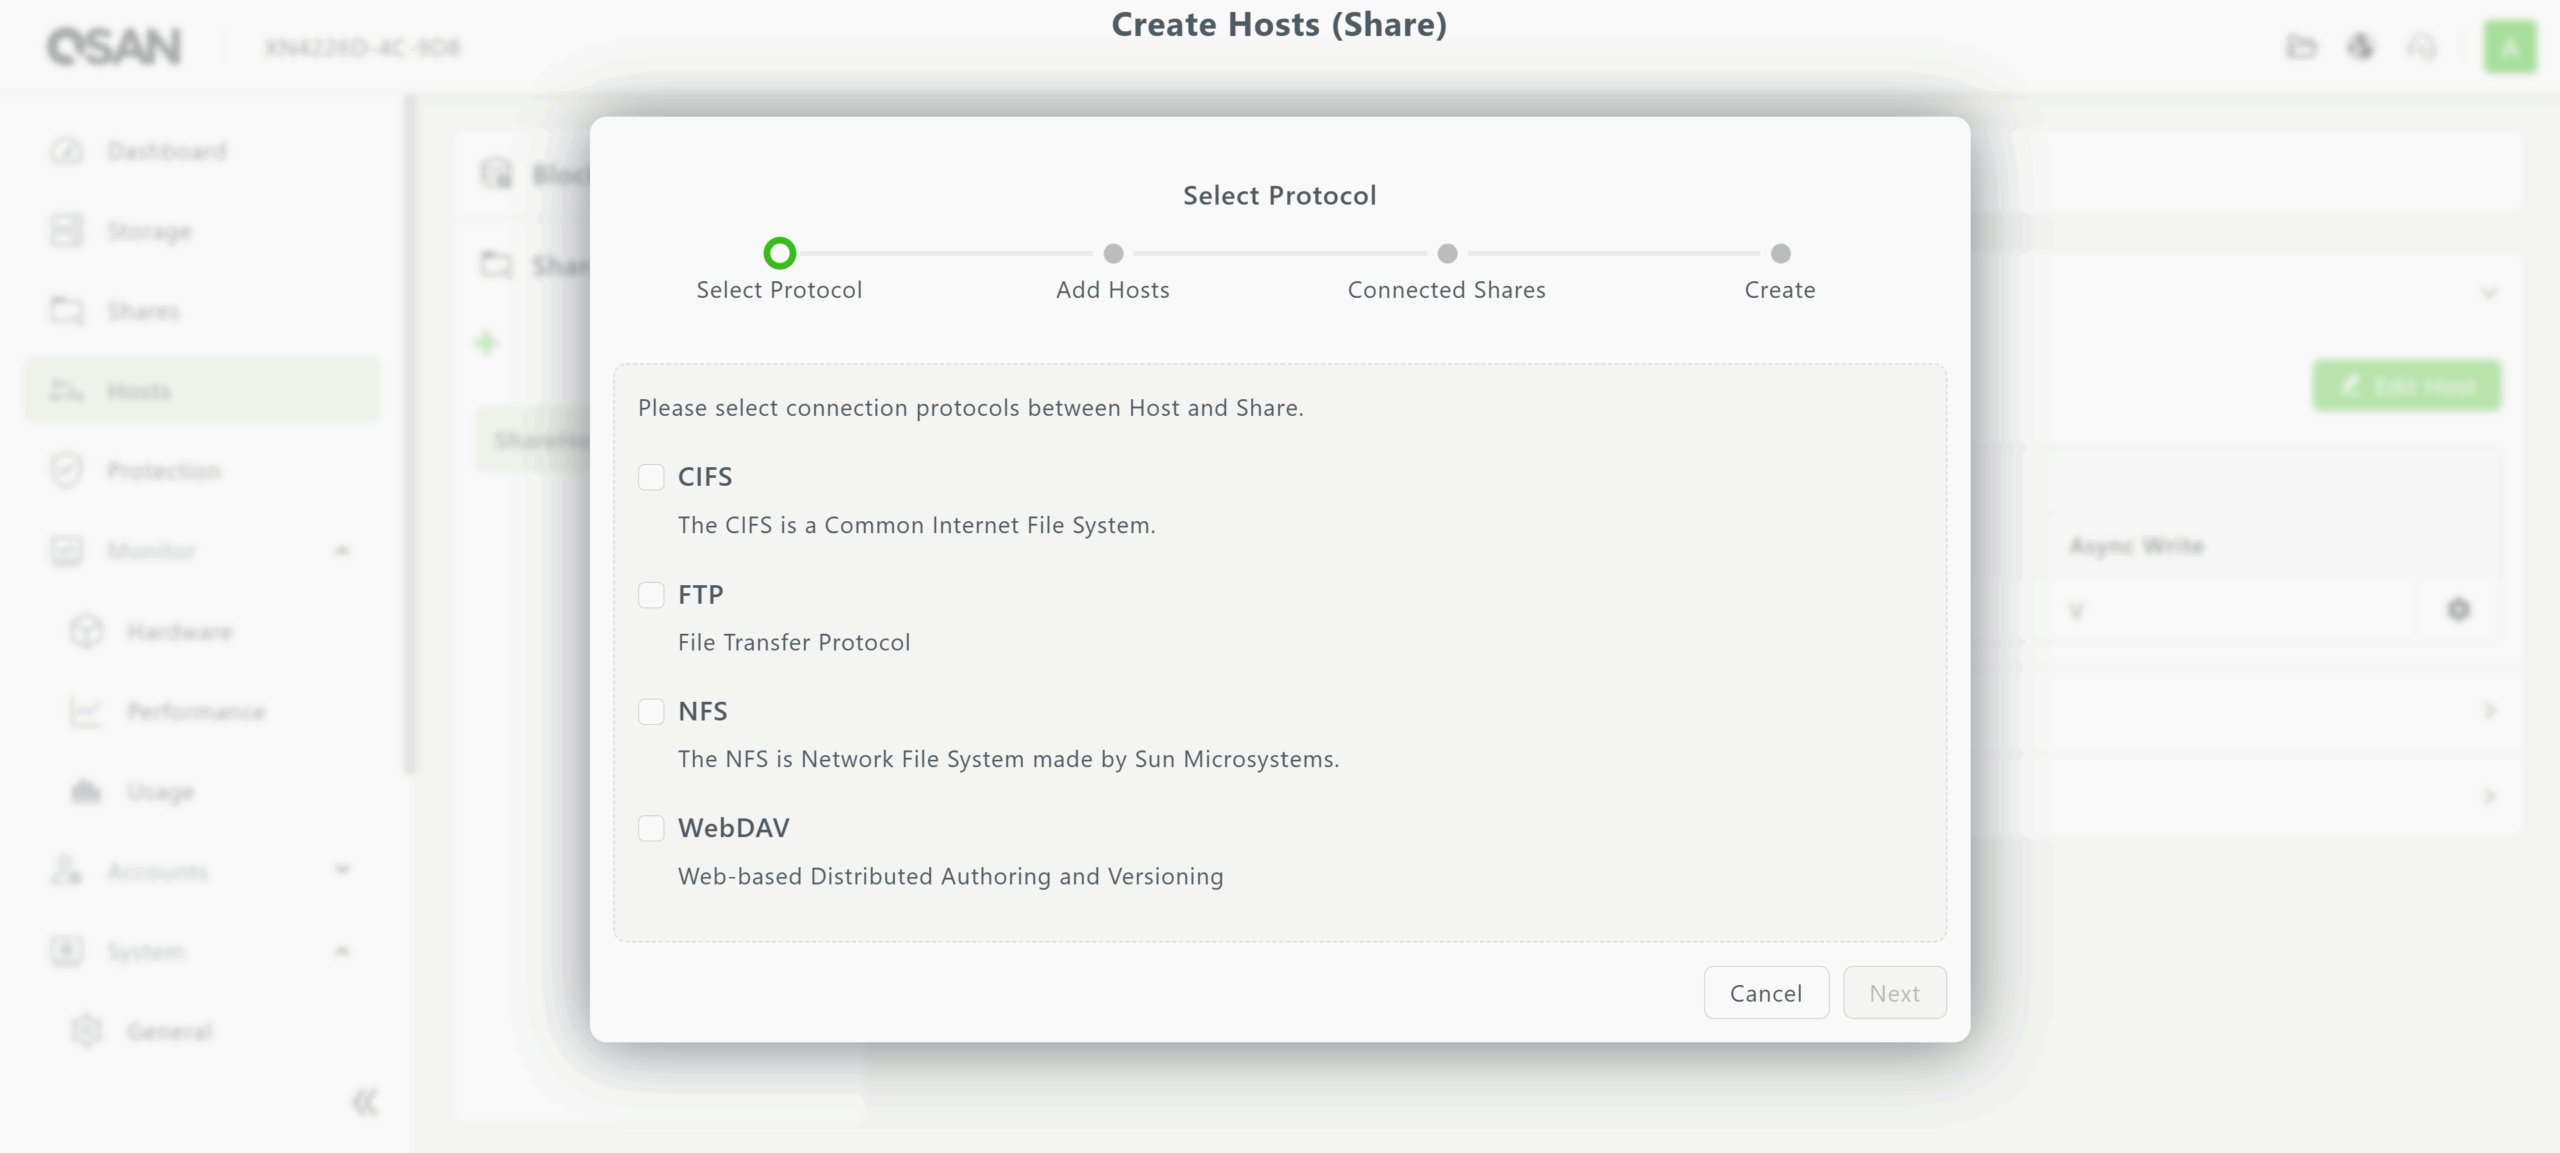
Hosts para armazenamento em bloco podem utilizar iSCSI, FCP ou NVMe-oF sobre TCP para um volume. Em contraste, hosts para armazenamento de arquivos (compartilhamento) podem suportar vários protocolos simultaneamente, oferecendo flexibilidade essencial para data centers com diversos requisitos de compartilhamento de arquivos.
O QSM 4 também fornece recursos básicos de monitoramento no menu Monitor, exibindo os status de vários módulos de hardware e unidades dentro do array, bem como estatísticas de unidade, pool de armazenamento, CPU e uso de memória.
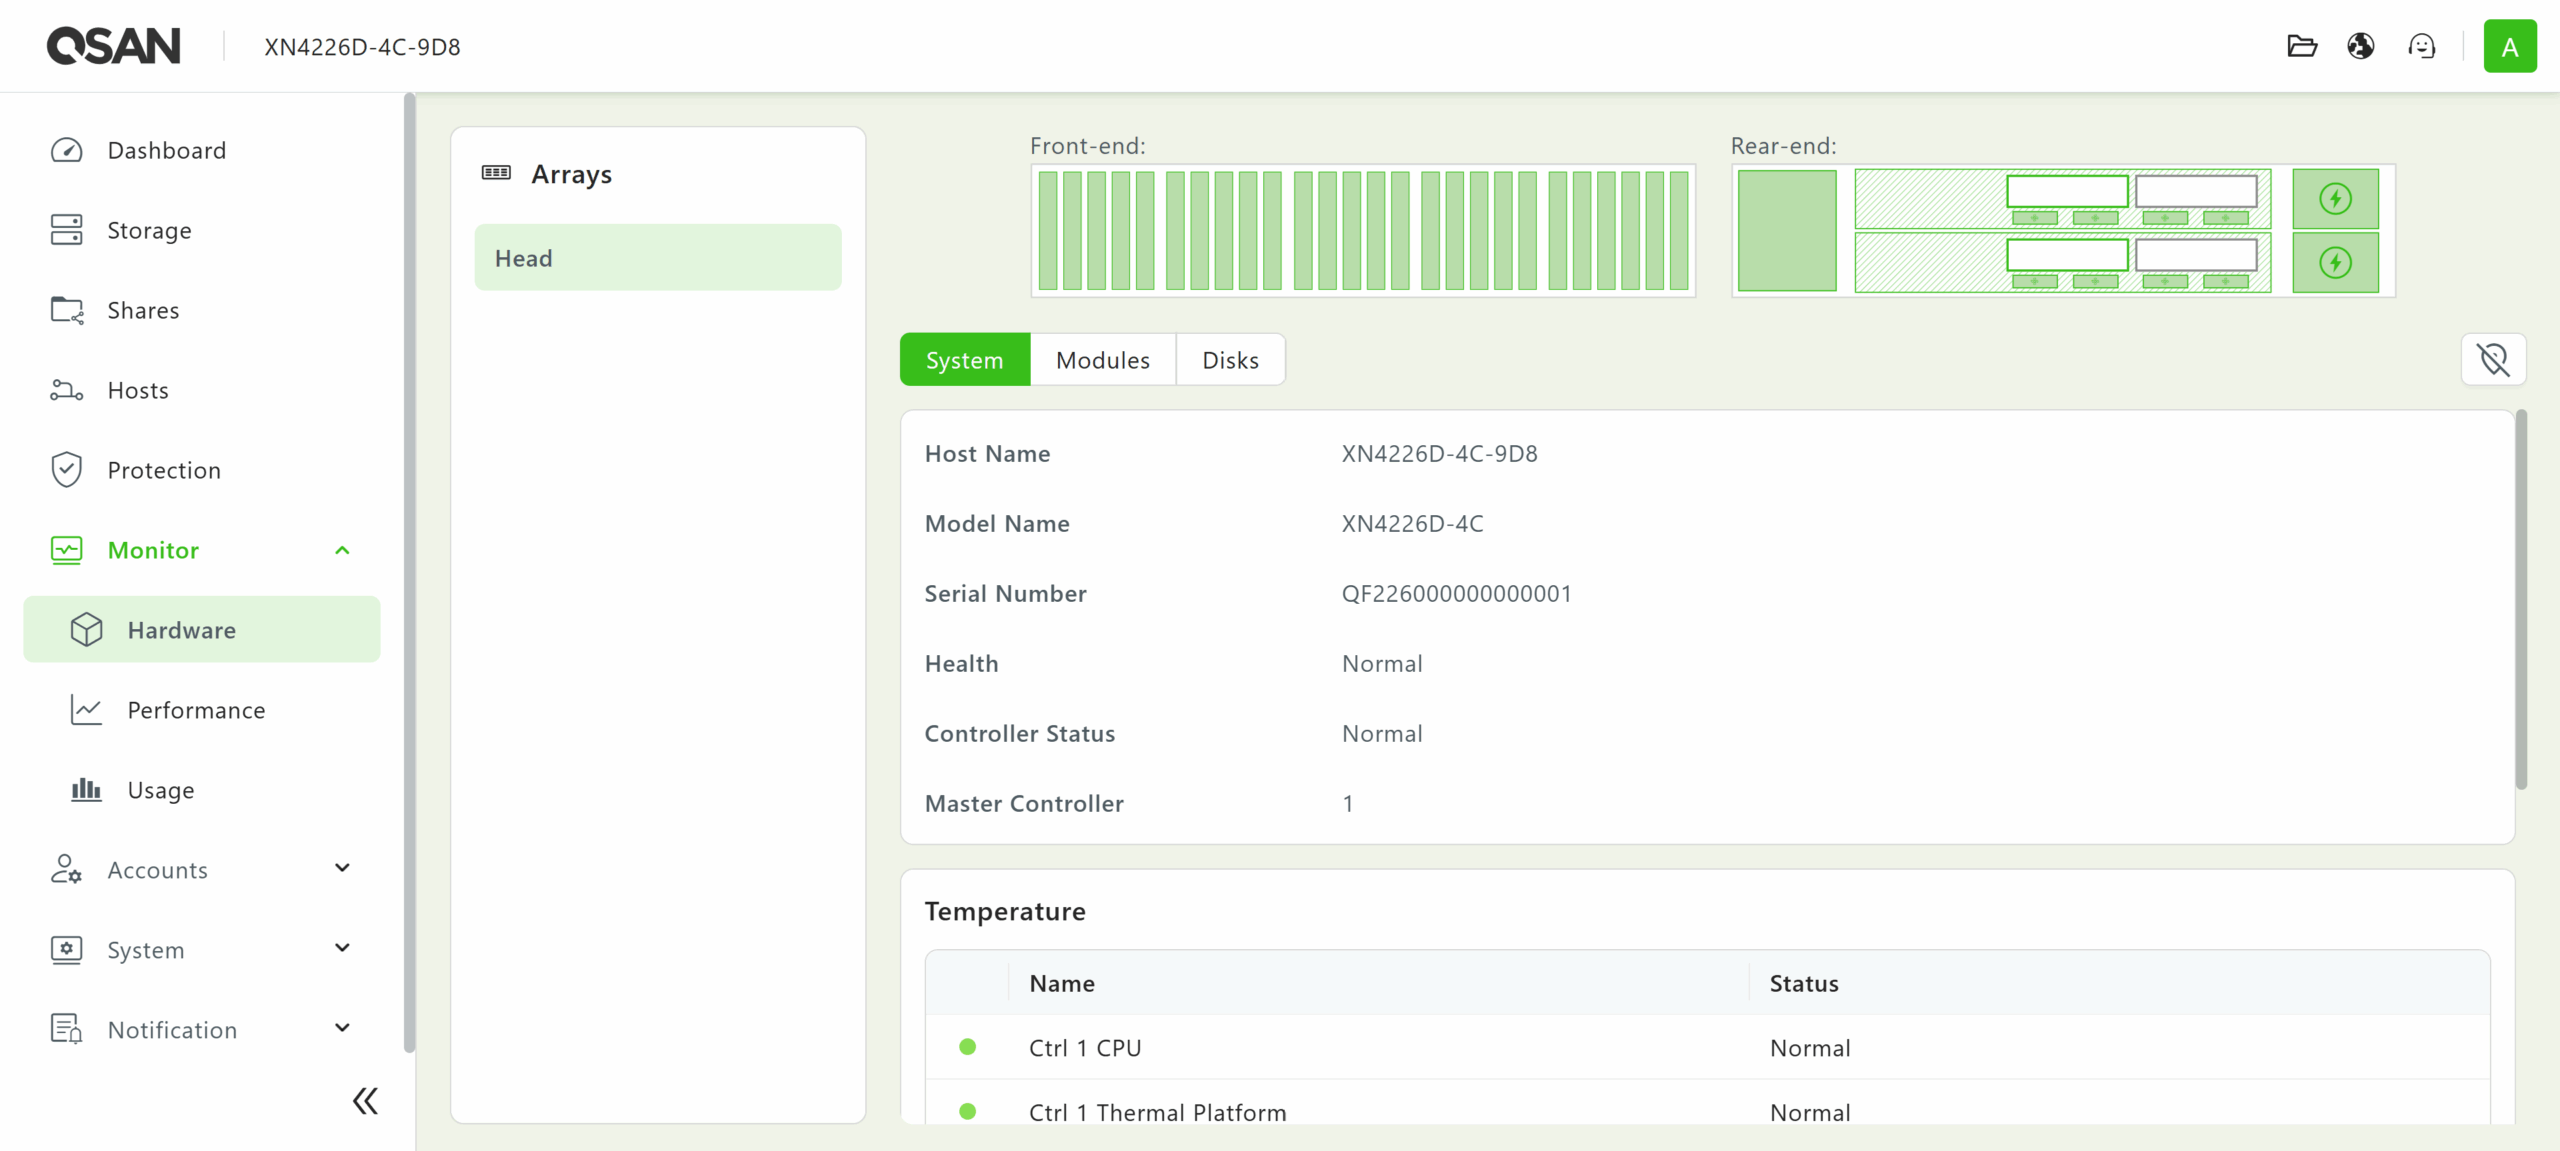
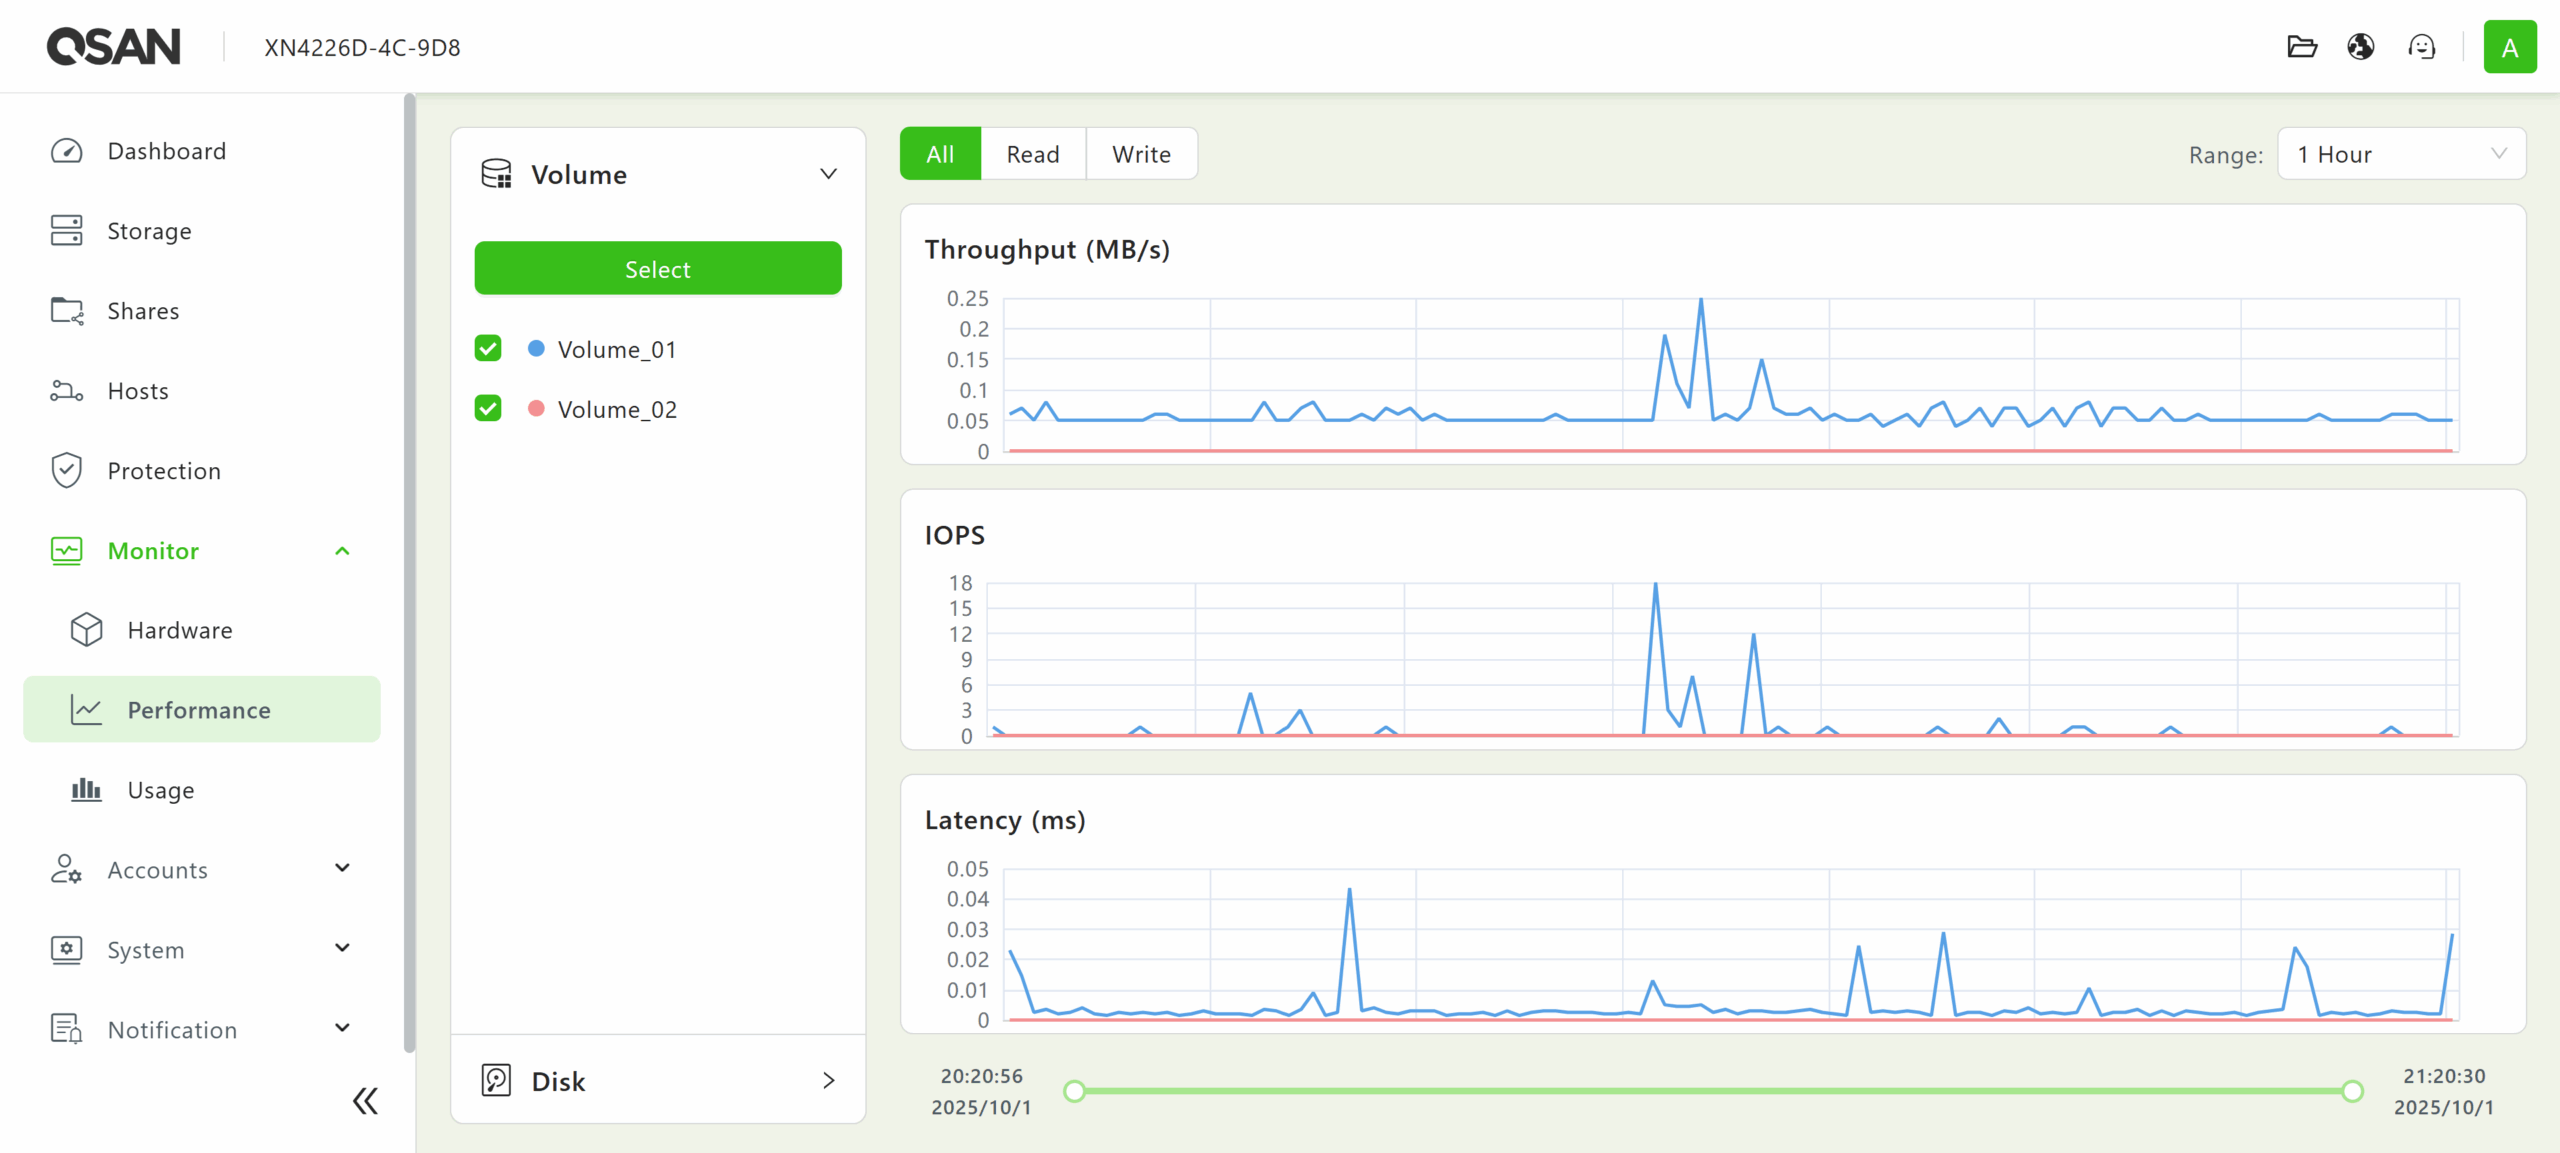
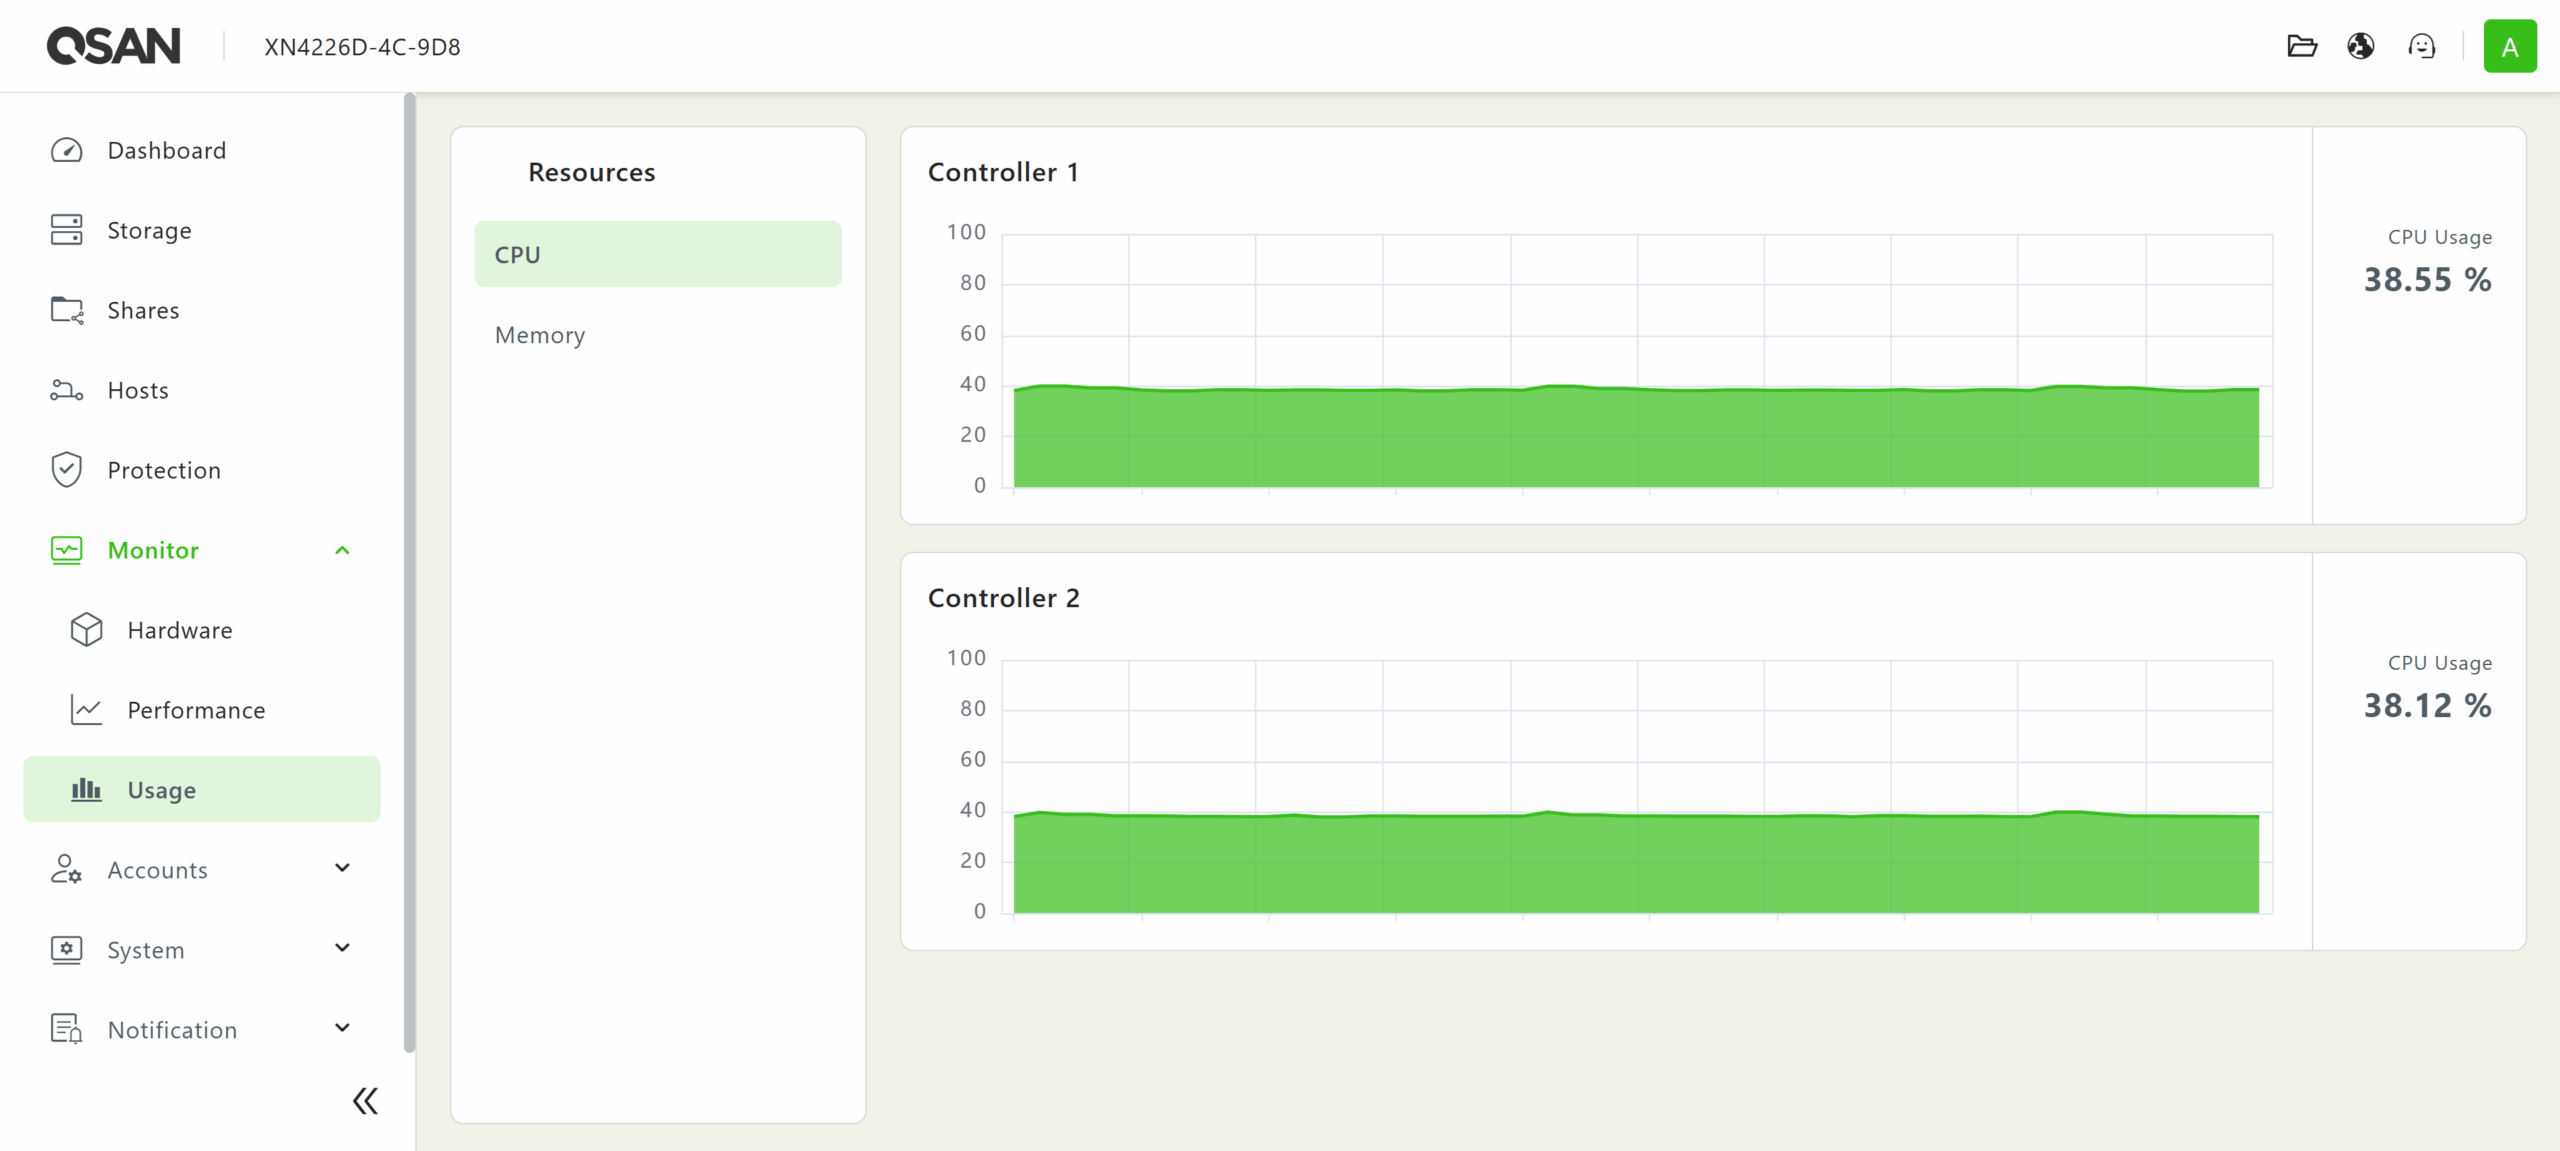
A interface web do QSM 4 também oferece gerenciamento de usuários, grupos e domínios no menu Contas. Há também diversas opções de configuração para toda a SAN disponíveis no menu Sistema. As funcionalidades de registro e alertas podem ser acessadas no menu Notificação. Por fim, os ícones Gerenciador de Arquivos QSAN, Suporte a Idiomas e Gerenciamento de Saída/Energia podem ser encontrados no canto superior direito da barra de menus.
Integração simples com Proxmox
O Proxmox oferece suporte nativo a NVMe sobre Fabrics (NVMe-oF), permitindo a fácil integração de matrizes de armazenamento de alto desempenho em um cluster. O processo começa com o provisionamento de alvos NVMe-oF no seu sistema de armazenamento. Em seguida, use o host Proxmox para descobrir e se conectar a esses alvos. Após a conexão, você precisa configurar o sistema para garantir que essas conexões persistam após reinicializações.
Em nosso exemplo, a descoberta é realizada usando comandos shell, que especificam o endereço IP e a porta de serviço do array.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
Em seguida, conecte-se aos namespaces provisionados referenciando seus NQNs.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
Para garantir que a configuração seja persistente durante reinicializações, os endereços de descoberta podem ser anexados ao arquivo de configuração de descoberta do NVMe.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
Por fim, ative o serviço de conexão automática para que o Proxmox restabeleça as sessões NVMe automaticamente na inicialização.
systemctl enable nvmf-autoconnect.serviceO Proxmox pode ser perfeitamente integrado ao armazenamento QSAN, oferecendo o desempenho de baixa latência e alta largura de banda do NVMe, juntamente com a flexibilidade das estruturas de rede.
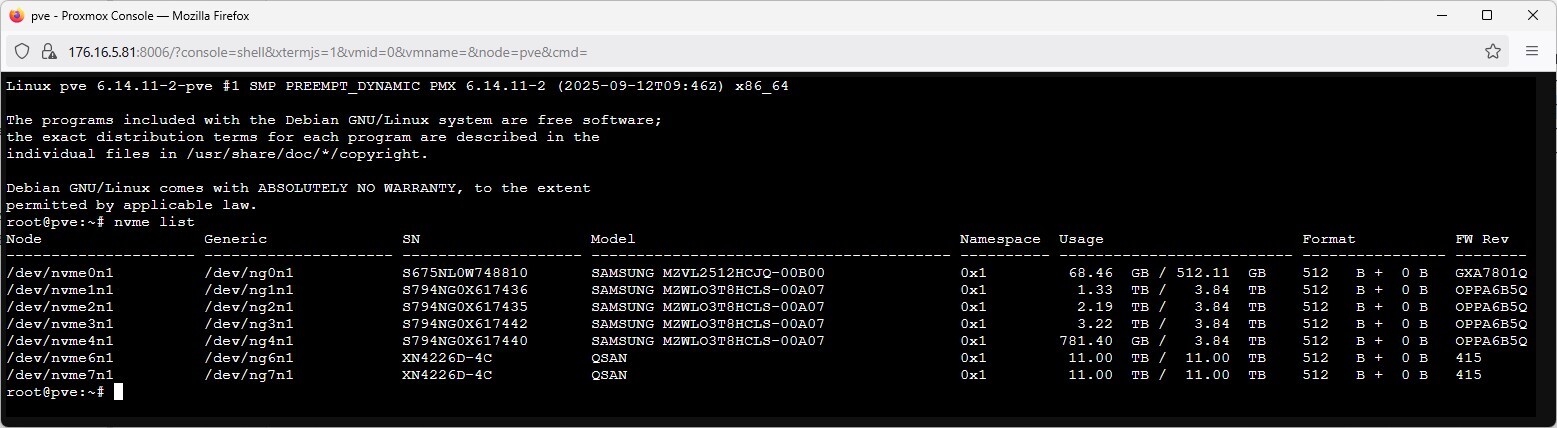
Depois de anexar nosso QSAN, podemos emitir o comando “nvme list” do shell Proxmox para exibir todos os dispositivos NVMe, onde os volumes QSAN recém-adicionados aparecem como /dev/nvme6n1 e /dev/nvme7n1, cada um com 11 TB de armazenamento.
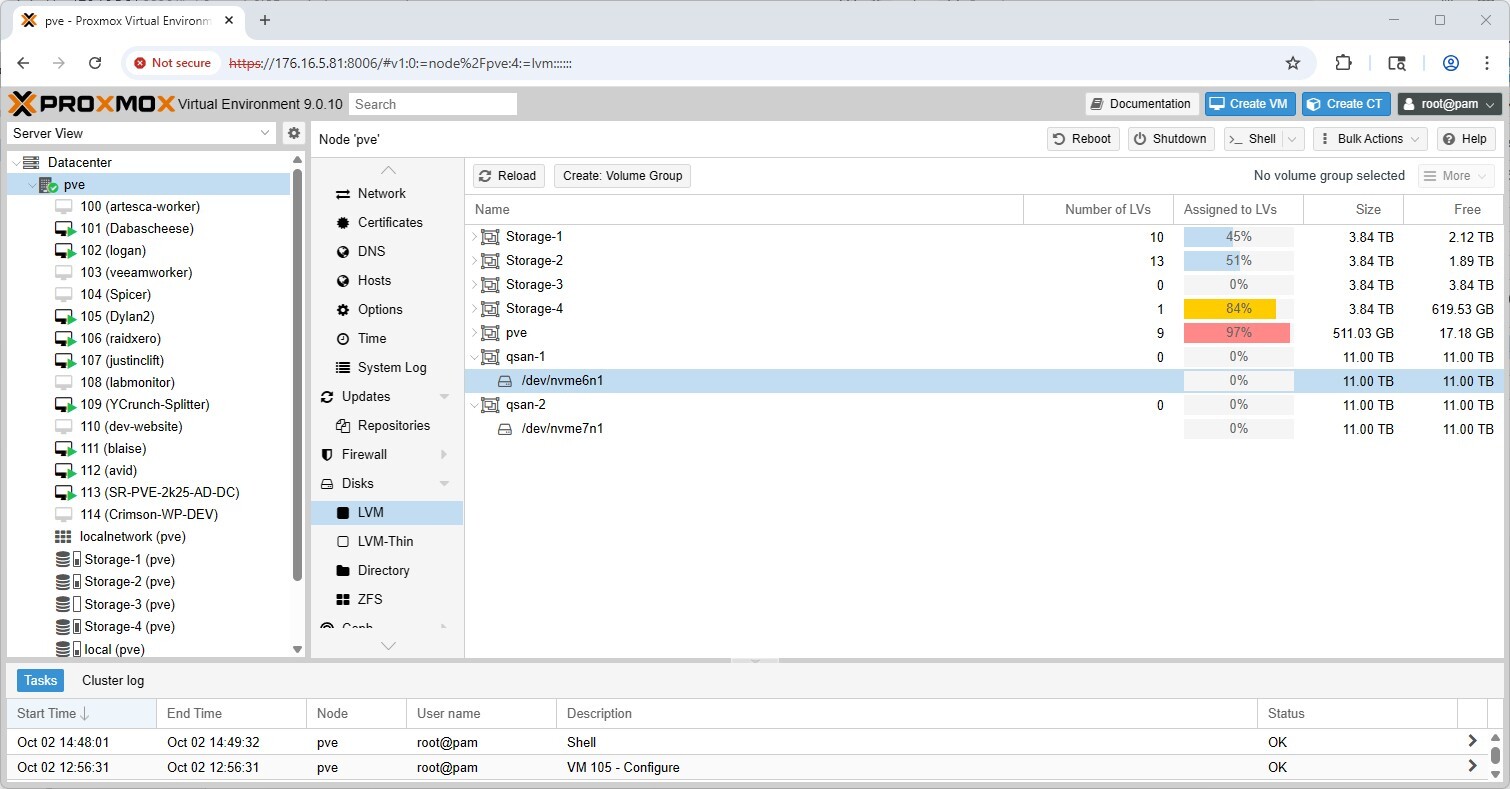
Assim que o armazenamento QSAN estiver visível na GUI do Proxmox, podemos criar um novo grupo de volumes LVM: pve > Discos > LVM, os dois dispositivos de 11 TB (/dev/nvme6n1 e /dev/nvme7n1) aparecem e podem ser inicializados como grupos de volumes separados (por exemplo, qsan-1 e qsan-2) para uso com VMs e contêineres.
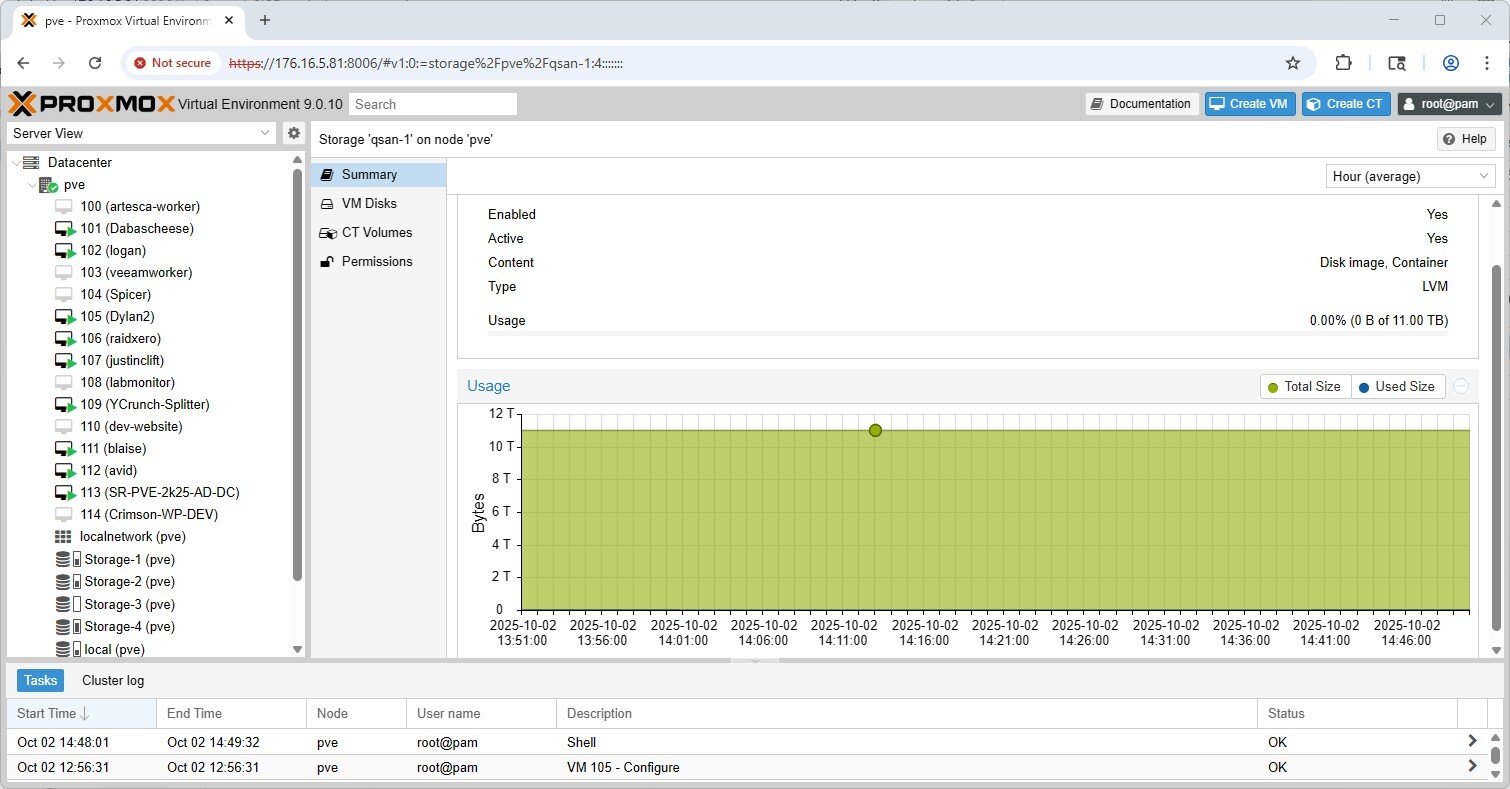
Clicar em um dos nossos novos pools de LVM (qsan-1) no painel de armazenamento ilustra que ele está online, habilitado e disponível para uso, com a capacidade total de 11 TB e pronto para provisionamento de VM e contêiner.
Teste de Desempenho
Testamos o QSAN XN4226D em dois ambientes, utilizando diferentes plataformas de teste. Nosso primeiro ambiente foi construído em um Dell PowerEdge R750, equipado com quatro placas de rede NVIDIA ConnectX-5 de duas portas e 25G. Conectamos o QSAN XN4226D diretamente a este servidor usando oito cabos DAC. Essa configuração utilizou todas as portas de rede disponíveis no QSAN, permitindo-nos demonstrar seu desempenho de pico mais alto.
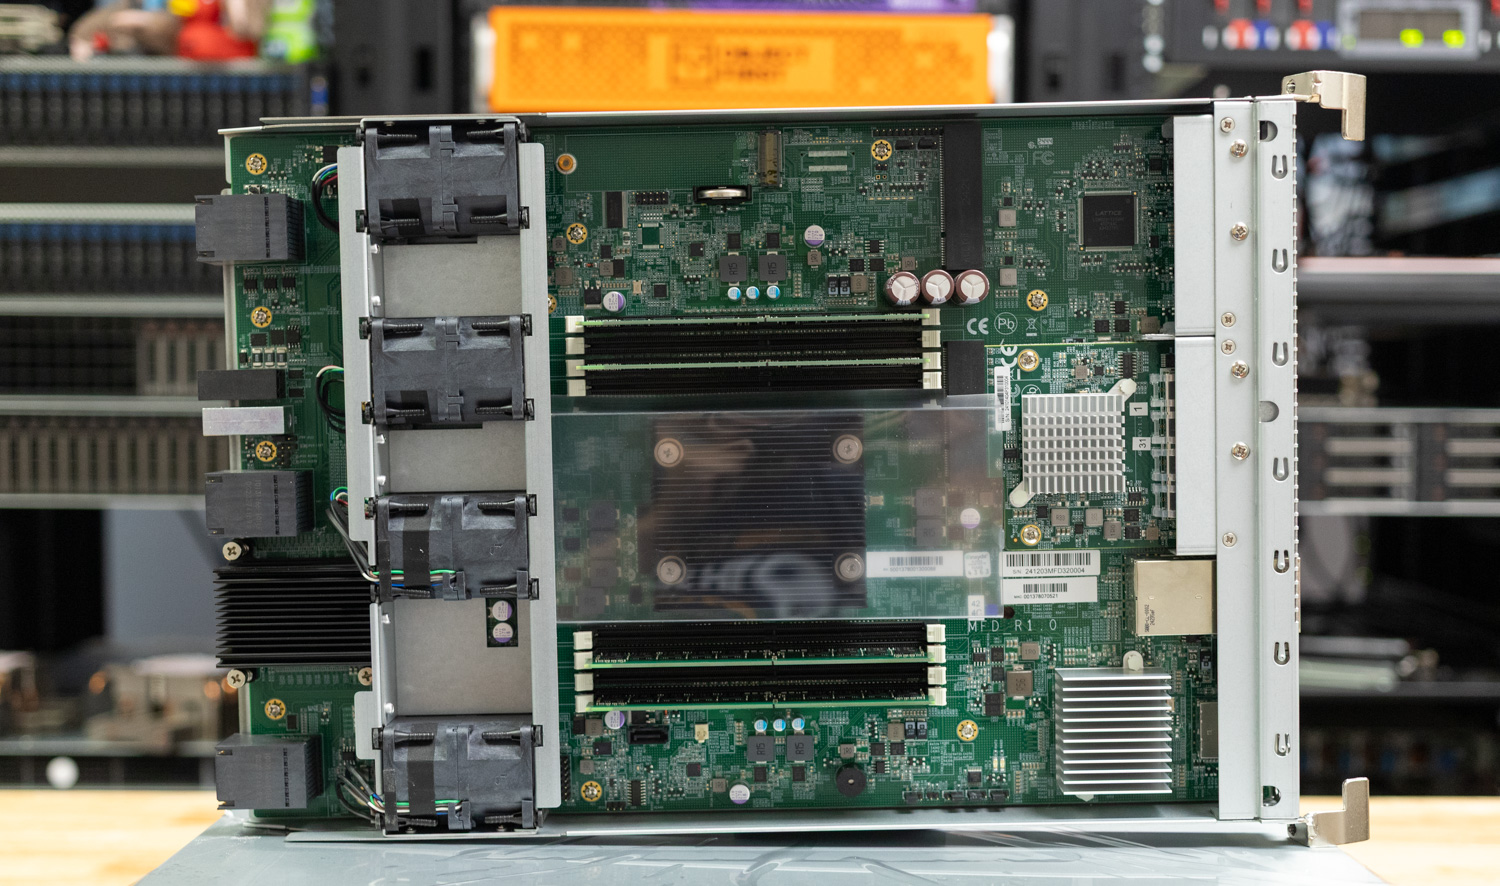
Para o teste de FIO, utilizamos dois pools de armazenamento RAID6, criando oito volumes de bloco distribuídos uniformemente entre os dois controladores. Cada volume foi atribuído a um destino exclusivo, dedicando um único endereço IP a cada volume. Medimos NVMe-oF RDMA e TCP nesta plataforma.
O segundo ambiente para GDSIO utilizou um Dell PowerEdge R7715, equipado com duas GPUs NVIDIA H100 e uma placa de rede Broadcom 25G de quatro portas. Nesse ambiente, mantivemos o mesmo layout de volumes QSAN, embora tenhamos reduzido o número de volumes de oito para quatro. Com uma placa de rede de quatro portas, usamos quatro conexões 25G para conectar diretamente o servidor ao array de armazenamento.
Referência de desempenho da FIO
Para medir o desempenho de armazenamento do QSAN XN4226D, aplicamos métricas comuns do setor e utilizamos a ferramenta FIO. Cada dispositivo de armazenamento passa pelo mesmo processo de teste, que inclui uma etapa de pré-condicionamento envolvendo dois carregamentos completos do disco com uma carga de trabalho de gravação sequencial, seguida pela medição do desempenho em estado estacionário. À medida que cada tipo de carga de trabalho medida muda, executamos outro carregamento de pré-condicionamento desse novo tamanho de transferência.
Nesta seção, nos concentramos nos seguintes benchmarks de FIO:
- 1M Sequencial
- 64K aleatório
- 16K aleatório
- 4K aleatório
Largura de banda de gravação sequencial de 1M
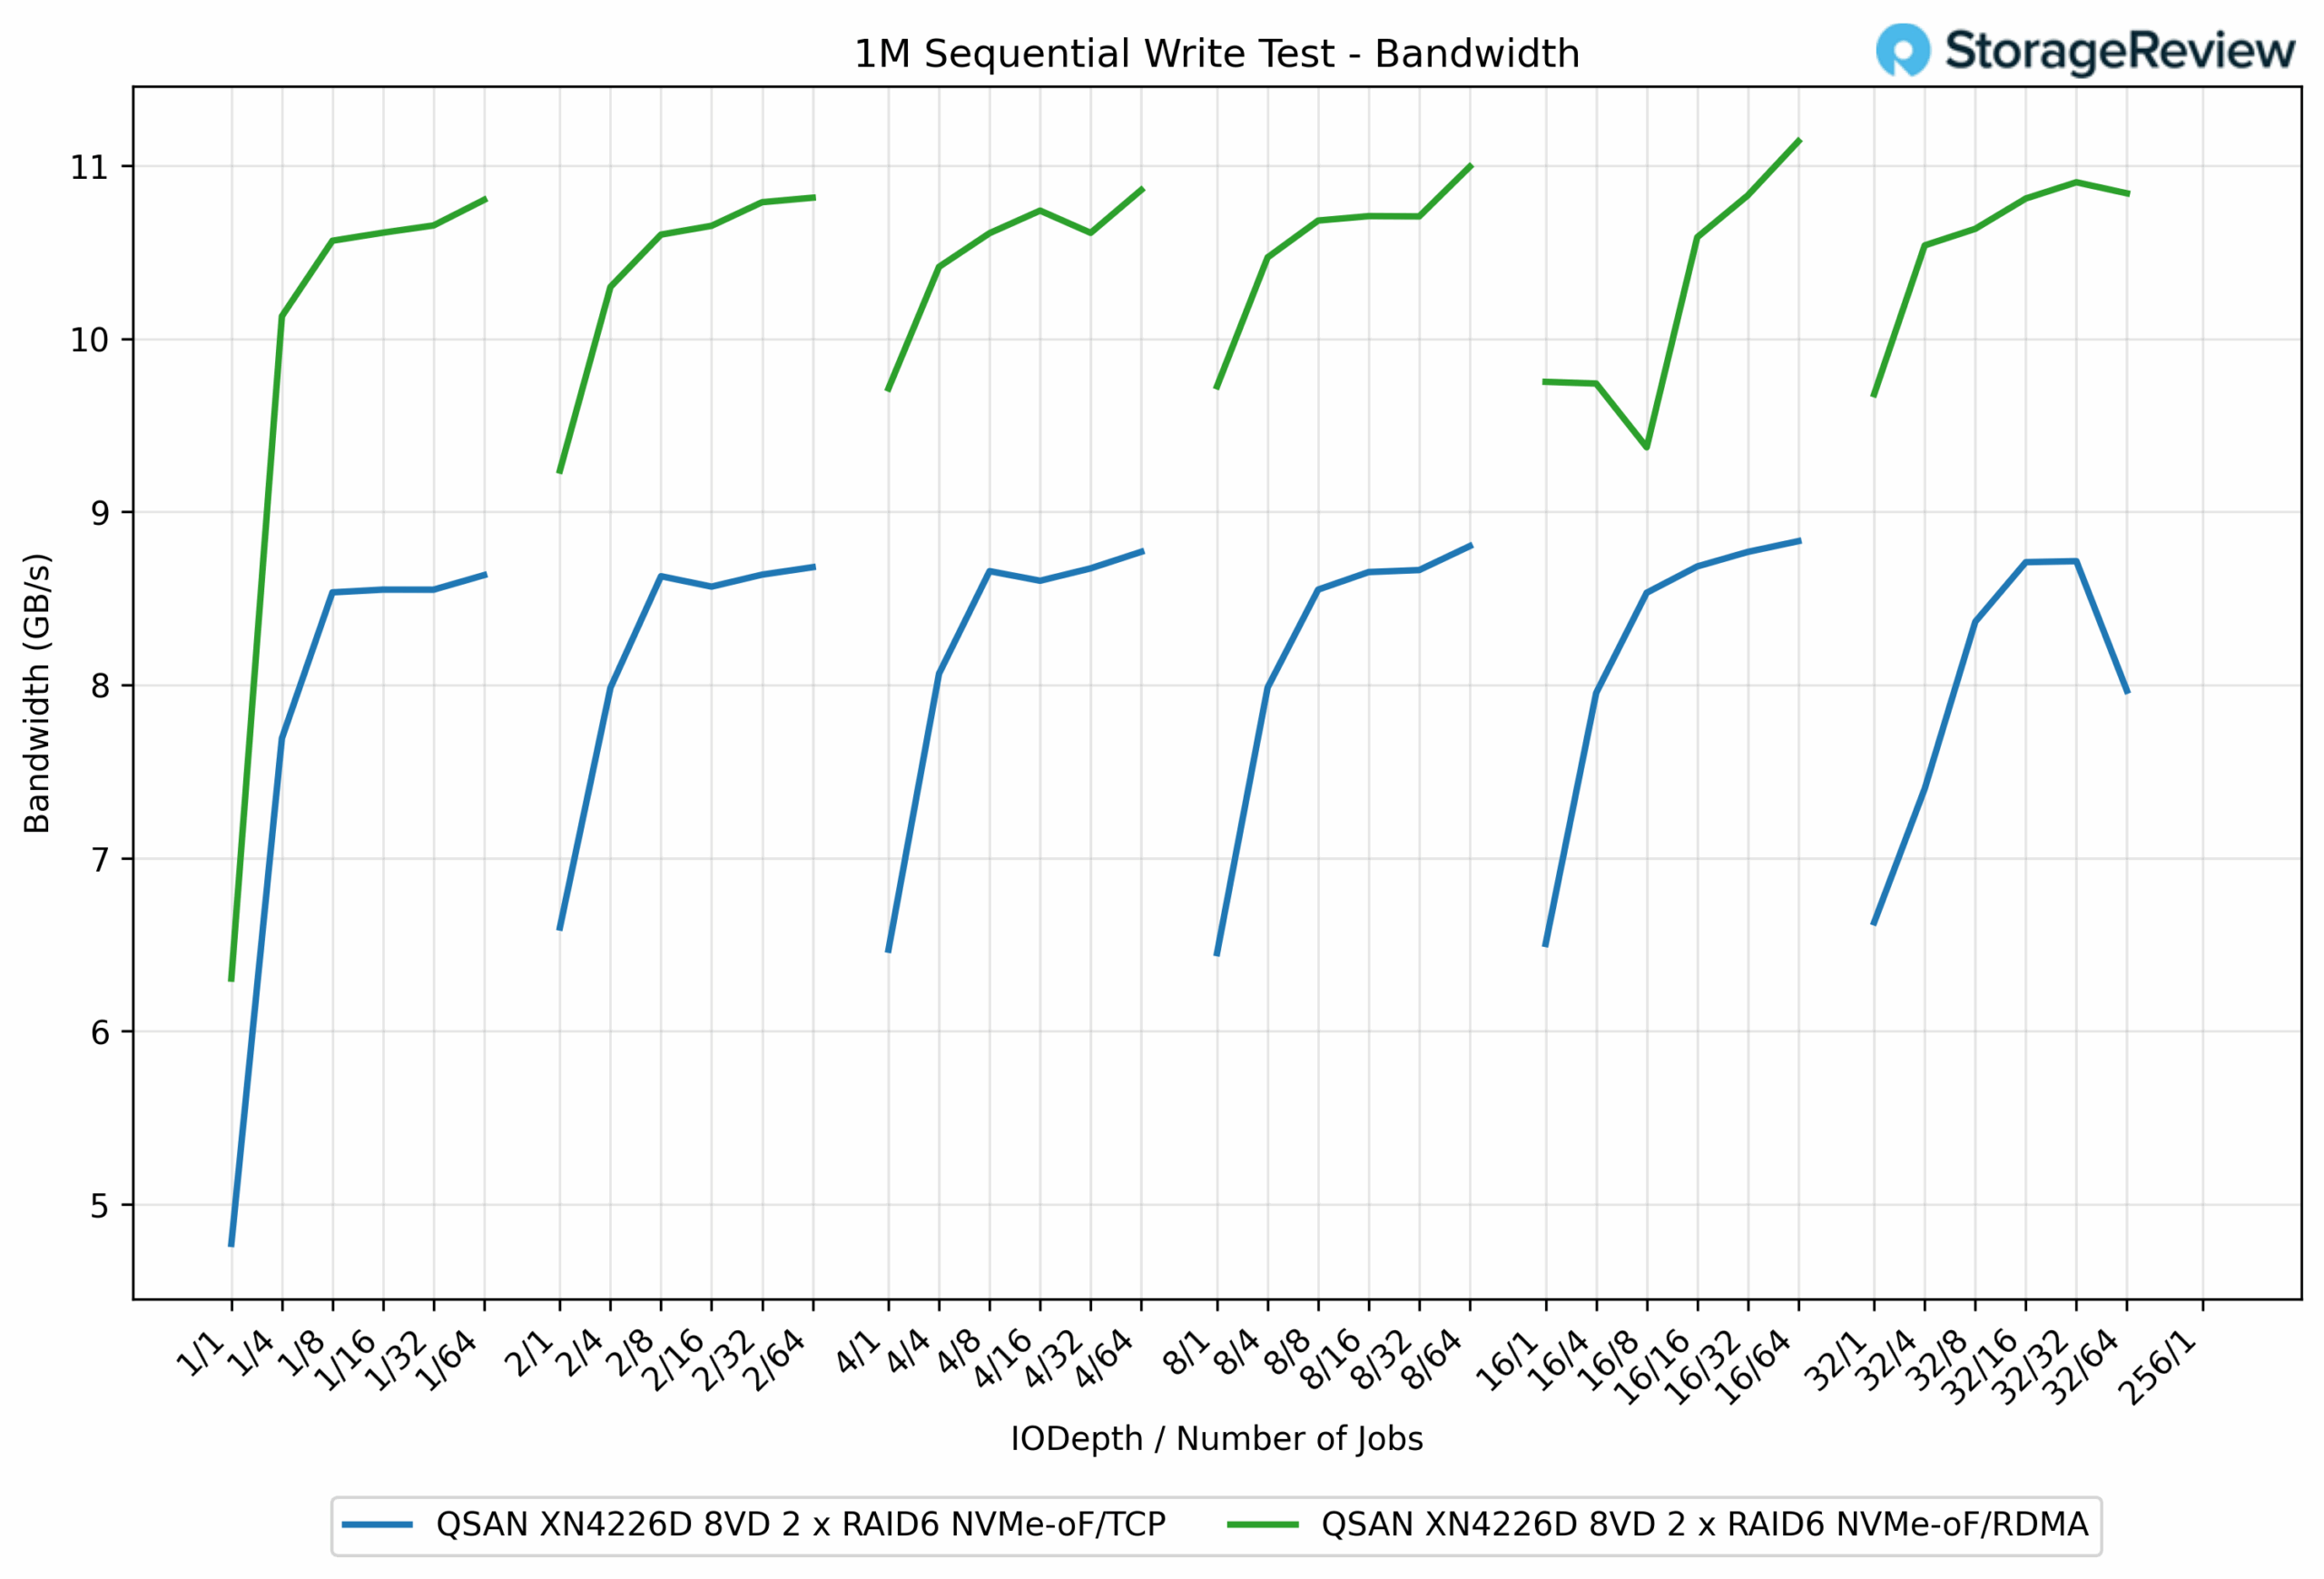
No teste de Gravação Sequencial de 1M, o NVMe sobre RDMA proporcionou consistentemente maior largura de banda em quase todas as profundidades de fila e contagens de tarefas em comparação com o NVMe sobre TCP. No pico, o RDMA atingiu 11.14 GB/s, enquanto o TCP atingiu 8.83 GB/s, uma diferença de aproximadamente 26% a favor do RDMA. Mesmo em profundidades de fila menores, o RDMA manteve sua vantagem. Por exemplo, no trabalho QD1/1, registrou 6.30 GB/s, superando os 4.77 GB/s do TCP em aproximadamente 32%.
A diferença de desempenho entre os dois protocolos diminuiu um pouco com o aumento da escala das cargas de trabalho, mas o RDMA ainda demonstrou uma clara vantagem em todos os aspectos. O TCP oscilou consistentemente na faixa de 8.5 a 8.8 GB/s em vários pontos de teste, enquanto o RDMA frequentemente ultrapassou a marca de 10.5 GB/s, atingindo um pico de pouco mais de 11 GB/s.
Latência de gravação sequencial de 1M
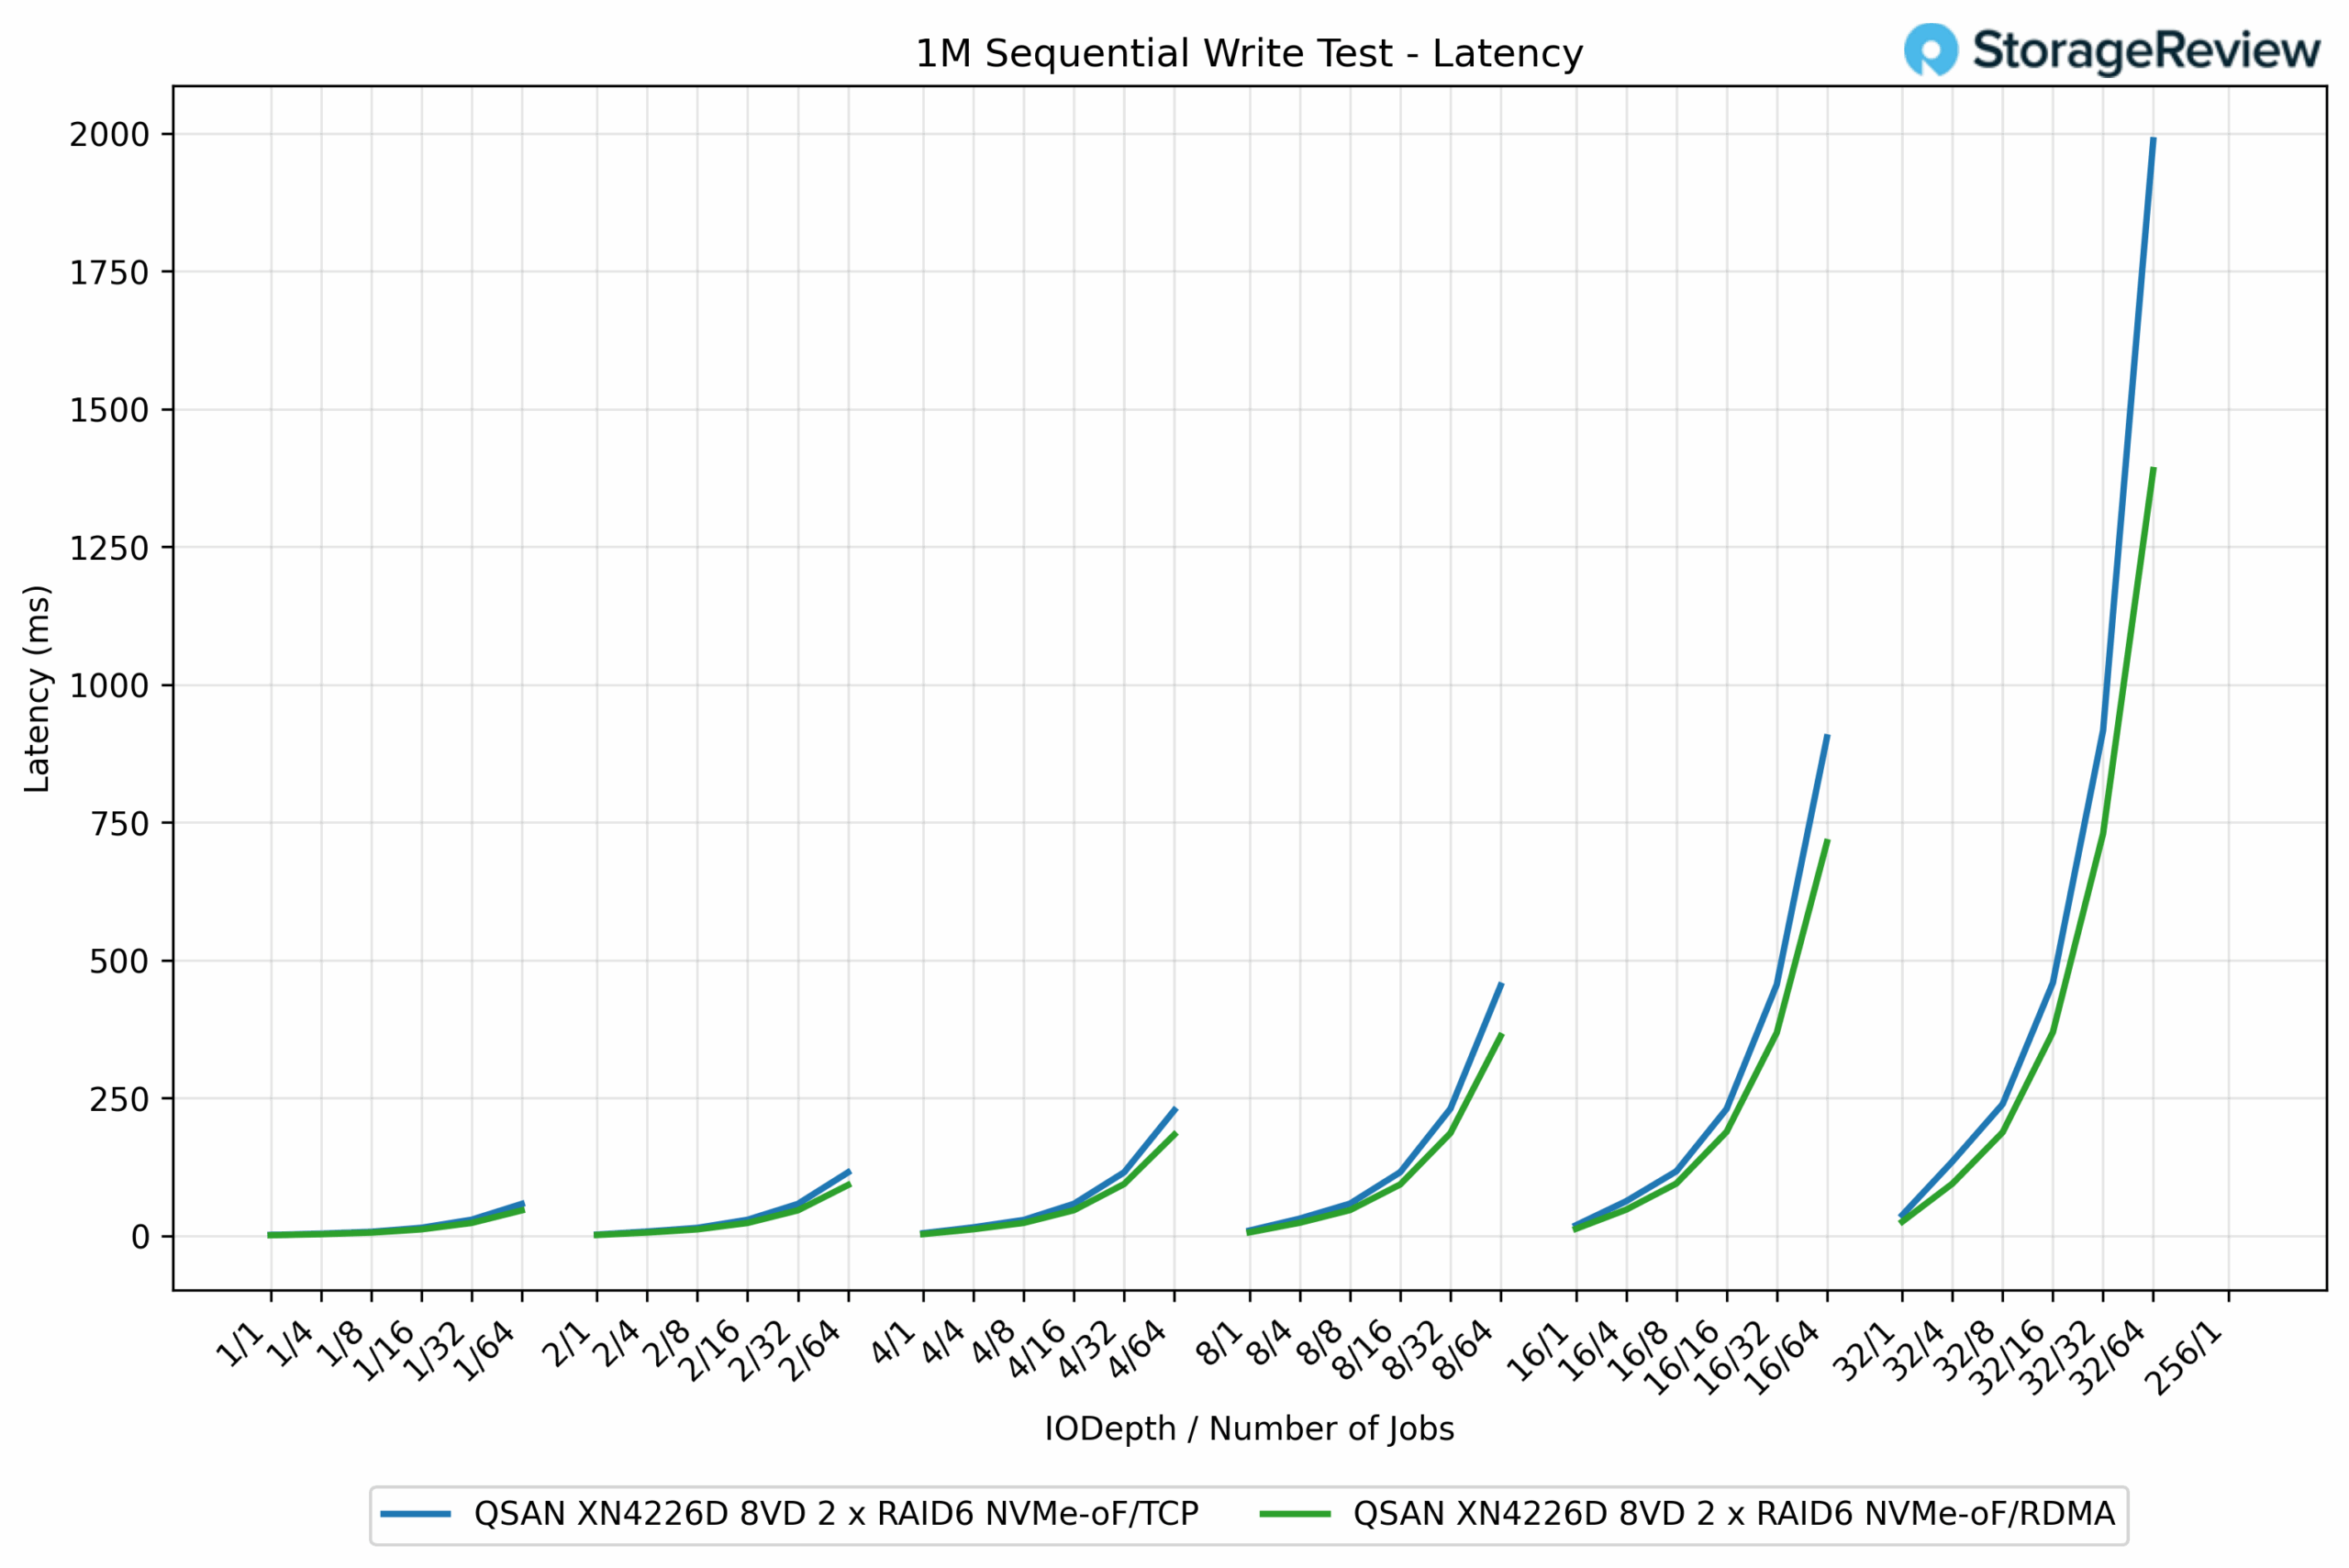
No teste de latência de gravação sequencial de 1M, o RDMA novamente manteve uma clara vantagem de eficiência sobre o TCP na maioria das profundidades de fila e contagens de tarefas. Em cargas de trabalho mais leves, os dois protocolos apresentaram desempenho semelhante, ambos apresentando latências abaixo de 5 ms. No entanto, à medida que a simultaneidade aumentava, as diferenças se tornavam mais evidentes. Por exemplo, nas tarefas QD16/16, o RDMA registrou 368.48 ms, enquanto o TCP registrou 455.95 ms, uma melhoria de 19% para o RDMA.
A divergência tornou-se ainda mais significativa em escalas extremas. No trabalho QD256/1, o RDMA foi concluído em 1,389.16 ms, enquanto o TCP subiu para 1,987.39 ms, refletindo uma redução de latência de 43% em favor do RDMA. Essa tendência destaca a capacidade do RDMA de sustentar uma taxa de transferência mais alta, mantendo a latência sob controle, especialmente em cenários de alta carga.
Largura de banda de leitura sequencial de 1M
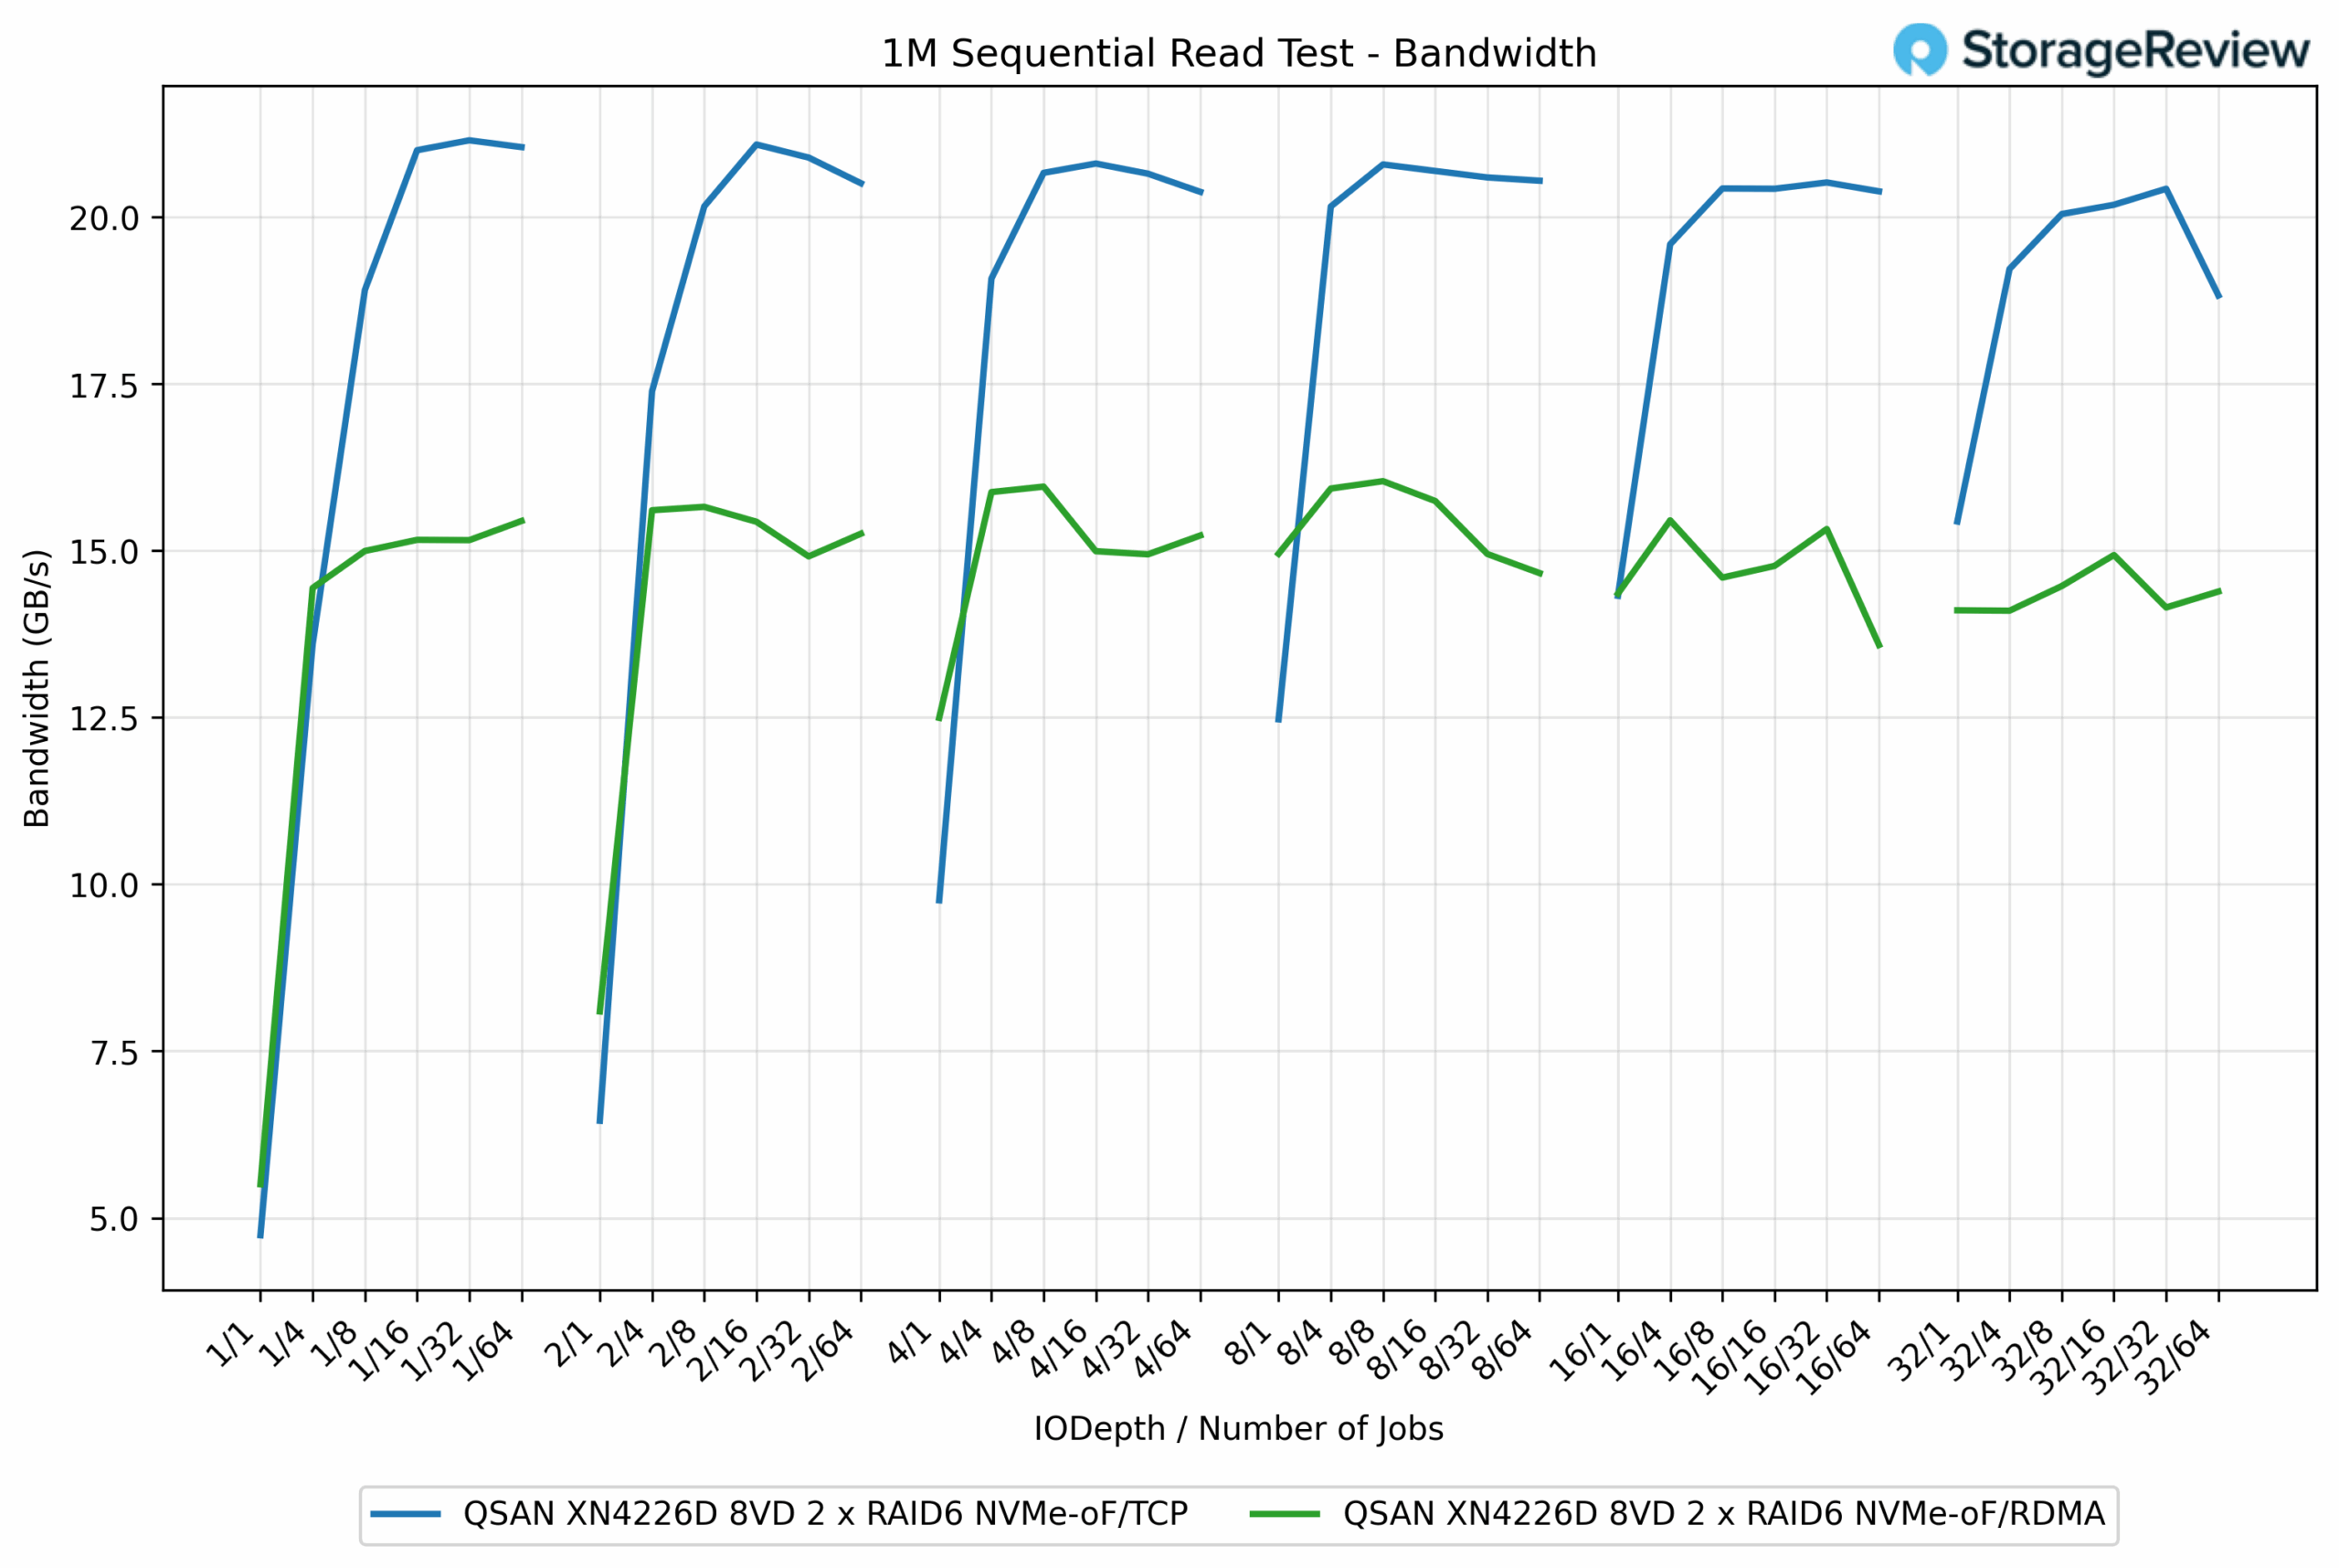
No teste de Leitura Sequencial de 1M, a dinâmica de desempenho mudou, com o TCP superando claramente o RDMA em todos os aspectos. O TCP atingiu um pico de 21.21 GB/s, enquanto o RDMA atingiu um pico de 15.96 GB/s, uma diferença de aproximadamente 33% a favor do TCP. Mesmo em profundidades de fila menores, o TCP avançou rapidamente. Por exemplo, em tarefas QD1/4, o TCP entregou 18.91 GB/s, em comparação com 15.05 GB/s do RDMA, uma diferença de mais de 25%.
A vantagem do TCP foi consistente em quase todas as escalas de carga de trabalho. Após a saturação, o TCP manteve os resultados na faixa de 20 a 21 GB/s, enquanto o RDMA se estabilizou em torno de 15 GB/s. Isso indica que, enquanto o RDMA se destaca em operações com alta demanda de gravação e sensíveis à latência, o TCP demonstra maior eficiência de largura de banda de leitura sequencial com a configuração NVMe RAID6 testada.
Latência de leitura sequencial de 1M
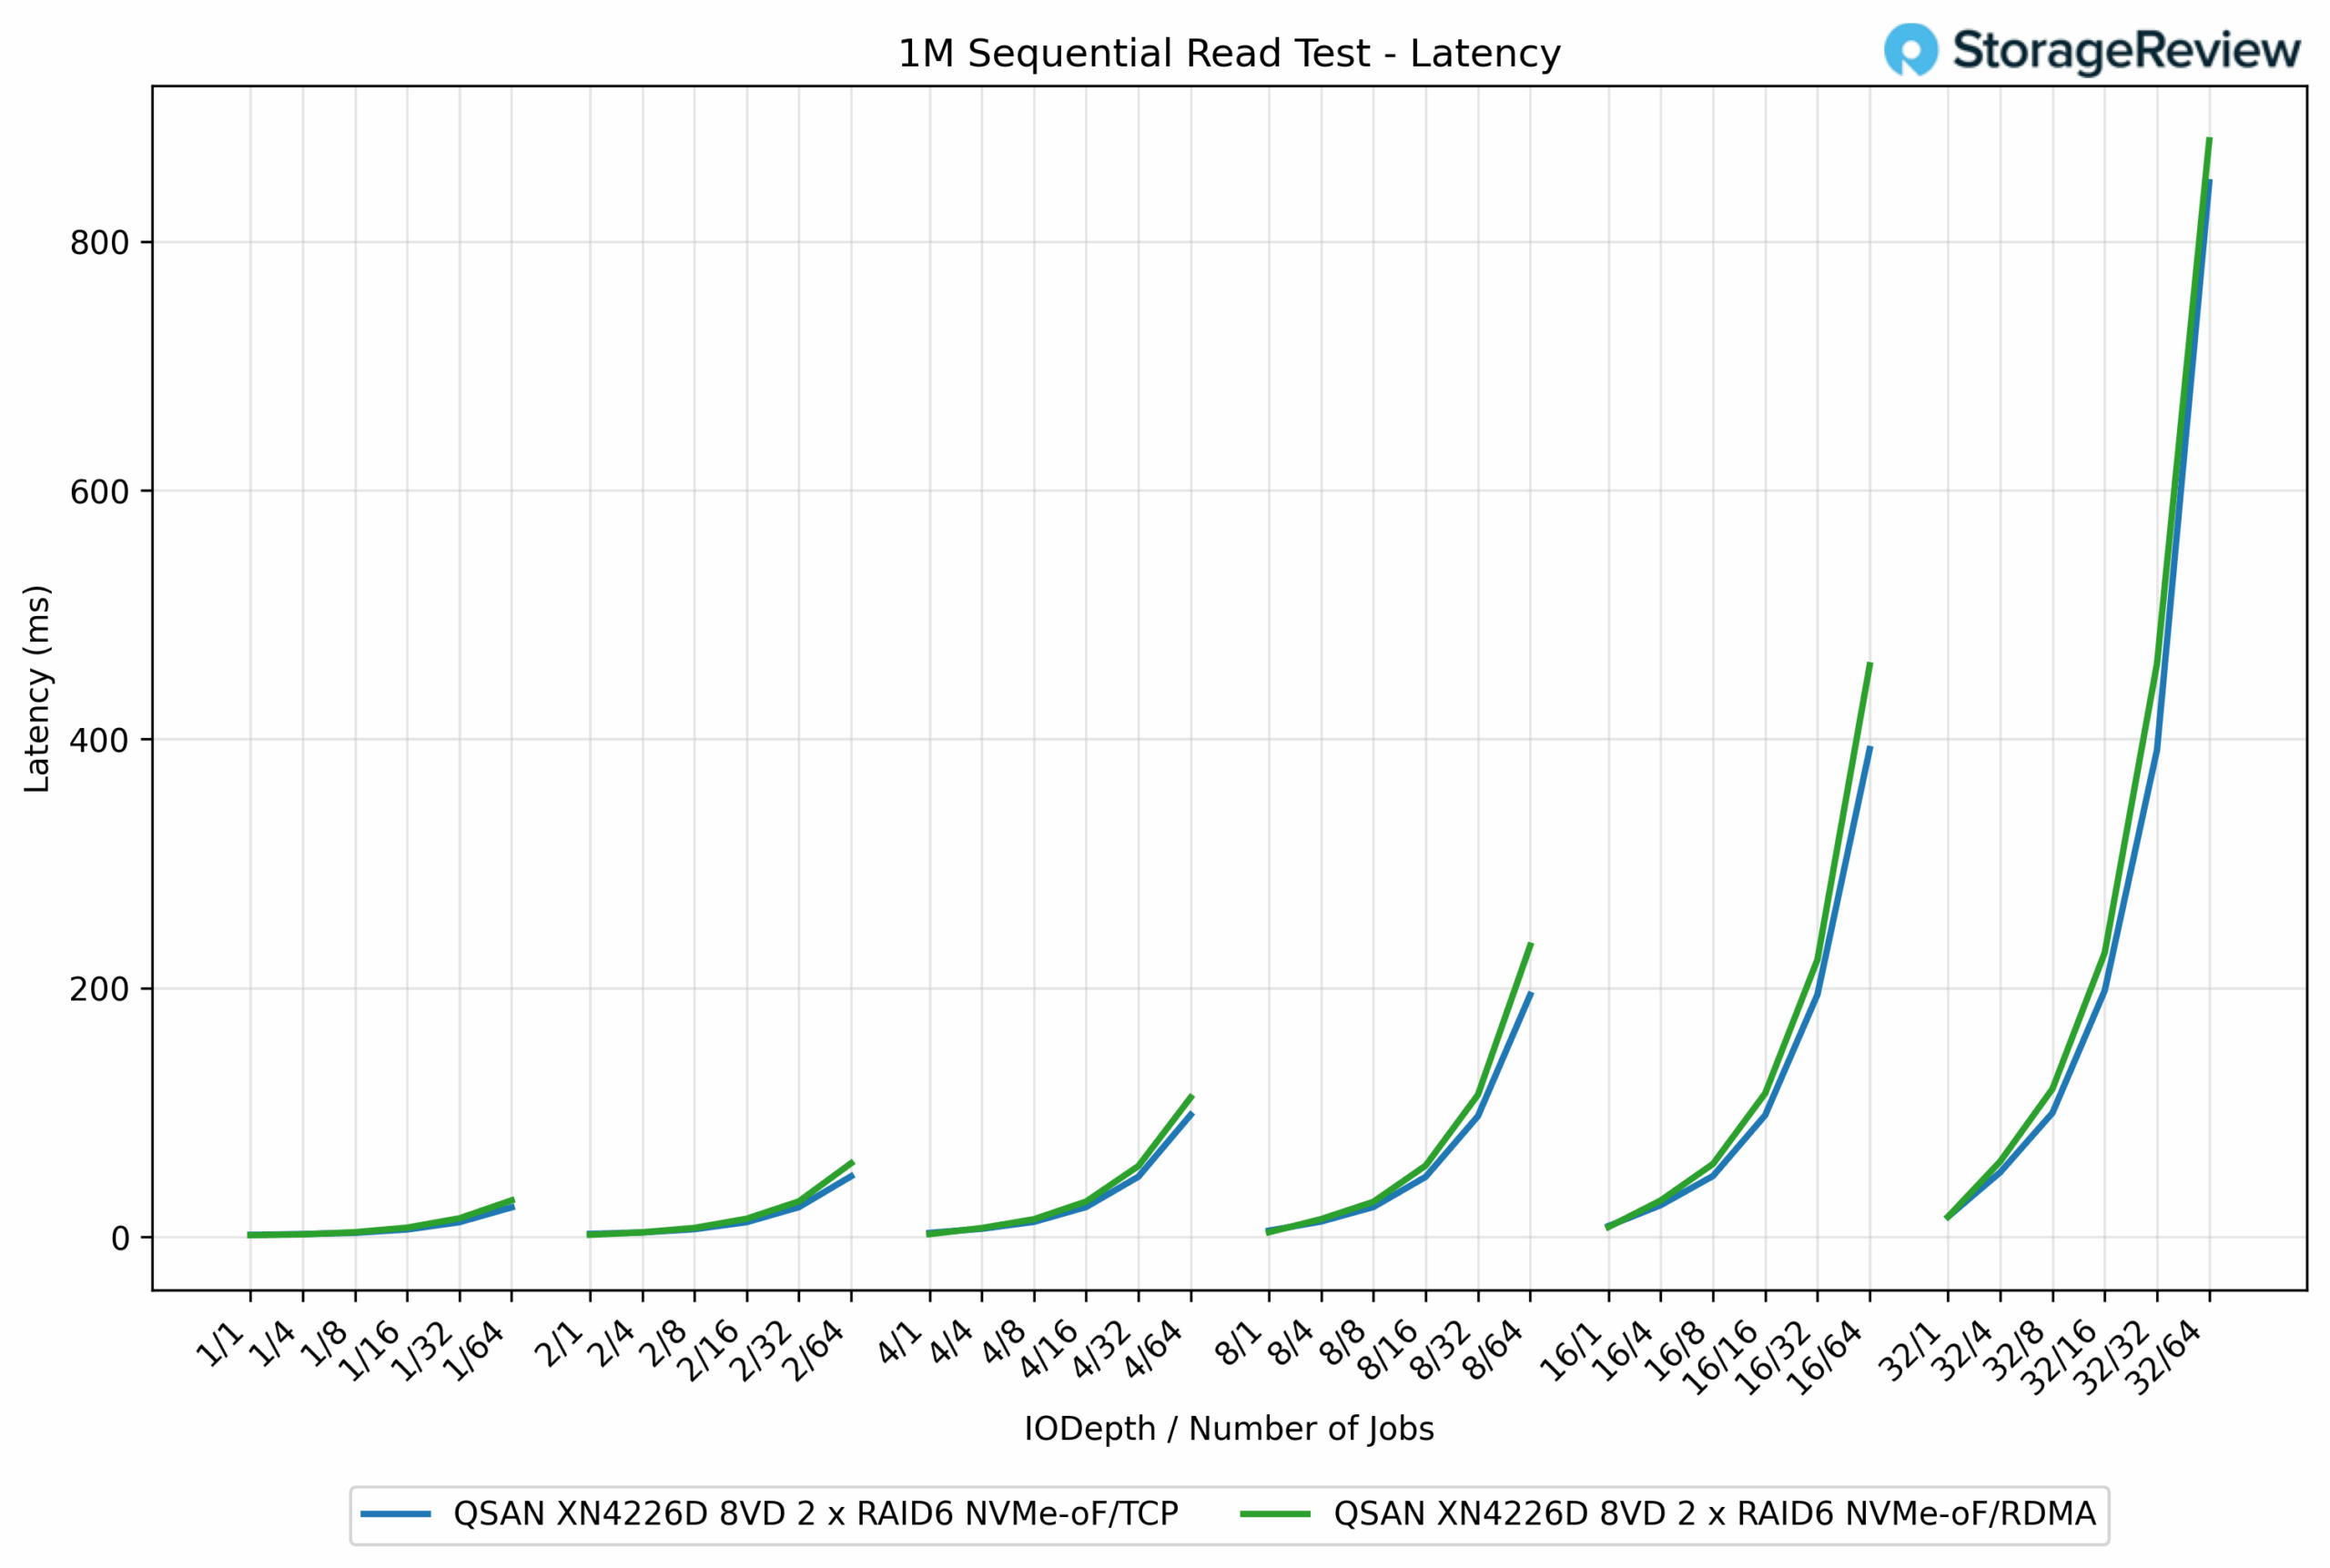
No teste de latência de leitura sequencial de 1M, os resultados foram mais próximos entre os dois protocolos, embora o RDMA, em geral, tenha tido uma ligeira vantagem em profundidades de fila maiores. Em cargas de trabalho mais leves, os perfis de latência foram quase idênticos, ambos permanecendo abaixo de 5 ms até que a simultaneidade começou a aumentar. Por exemplo, em tarefas QD8/64, o TCP registrou 234.09 ms, enquanto o RDMA apresentou um valor menor, 194.54 ms, refletindo uma redução de 17%.
Essa tendência continuou com cargas mais pesadas. Em tarefas QD32/64, o RDMA registrou 847.59 ms, em comparação com 881.31 ms do TCP, uma pequena melhoria de 3.8%, mas ainda consistente com a menor sobrecarga de pilha do RDMA. Dito isso, ambos os protocolos escalaram em um padrão semelhante, com a latência aumentando previsivelmente à medida que a carga de trabalho se intensificava.
64k IOPS de gravação aleatória
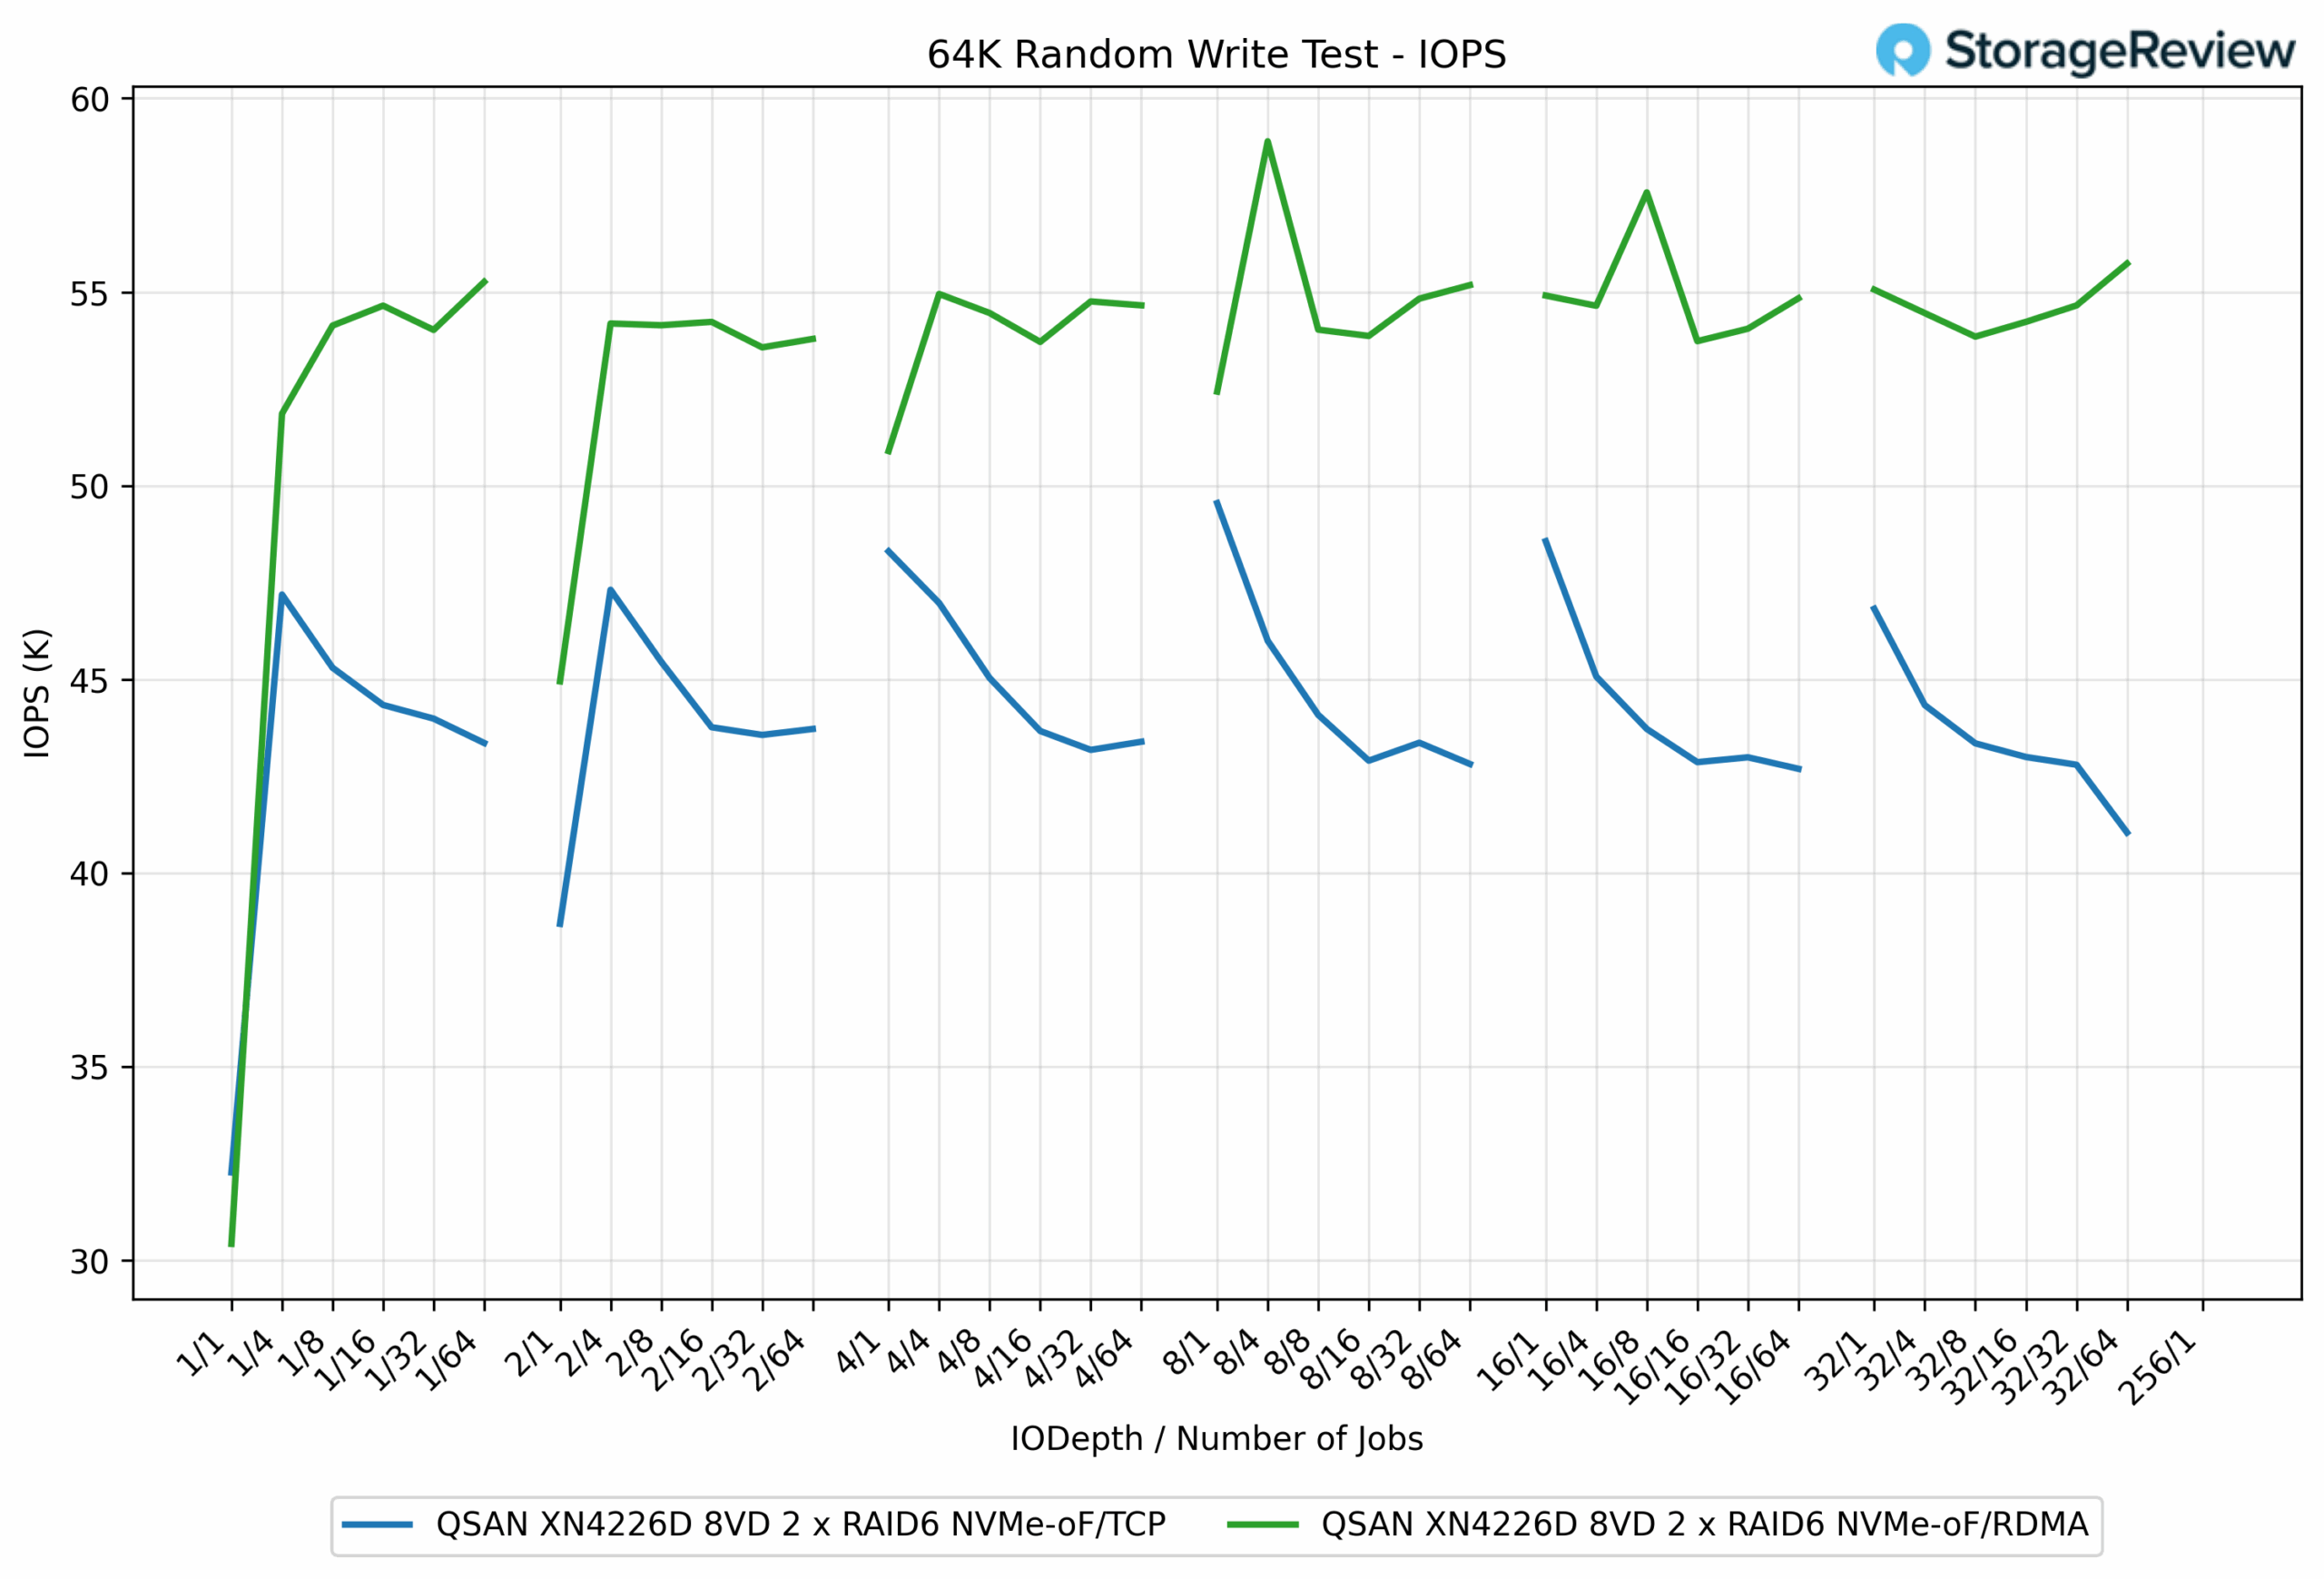
No teste de gravação aleatória de 64K, o RDMA apresentou consistentemente IOPS mais altos do que o TCP, destacando sua eficiência no processamento de operações aleatórias paralelizadas. No pico, o RDMA atingiu 58.89K IOPS, enquanto o TCP ficou atrás, com 48.57K IOPS, representando uma vantagem de desempenho de 21%.
A diferença entre os dois protocolos esteve presente durante todo o teste. Por exemplo, nos jobs QD1/16, o RDMA registrou 54.13 mil IOPS, em comparação com 45.30 mil IOPS do TCP, uma diferença de quase 16%. À medida que a carga de trabalho aumentava, o RDMA manteve os resultados na faixa de 53 mil a 55 mil IOPS, enquanto o TCP manteve a faixa de 42 mil a 46 mil IOPS.
Latência de gravação aleatória de 64K
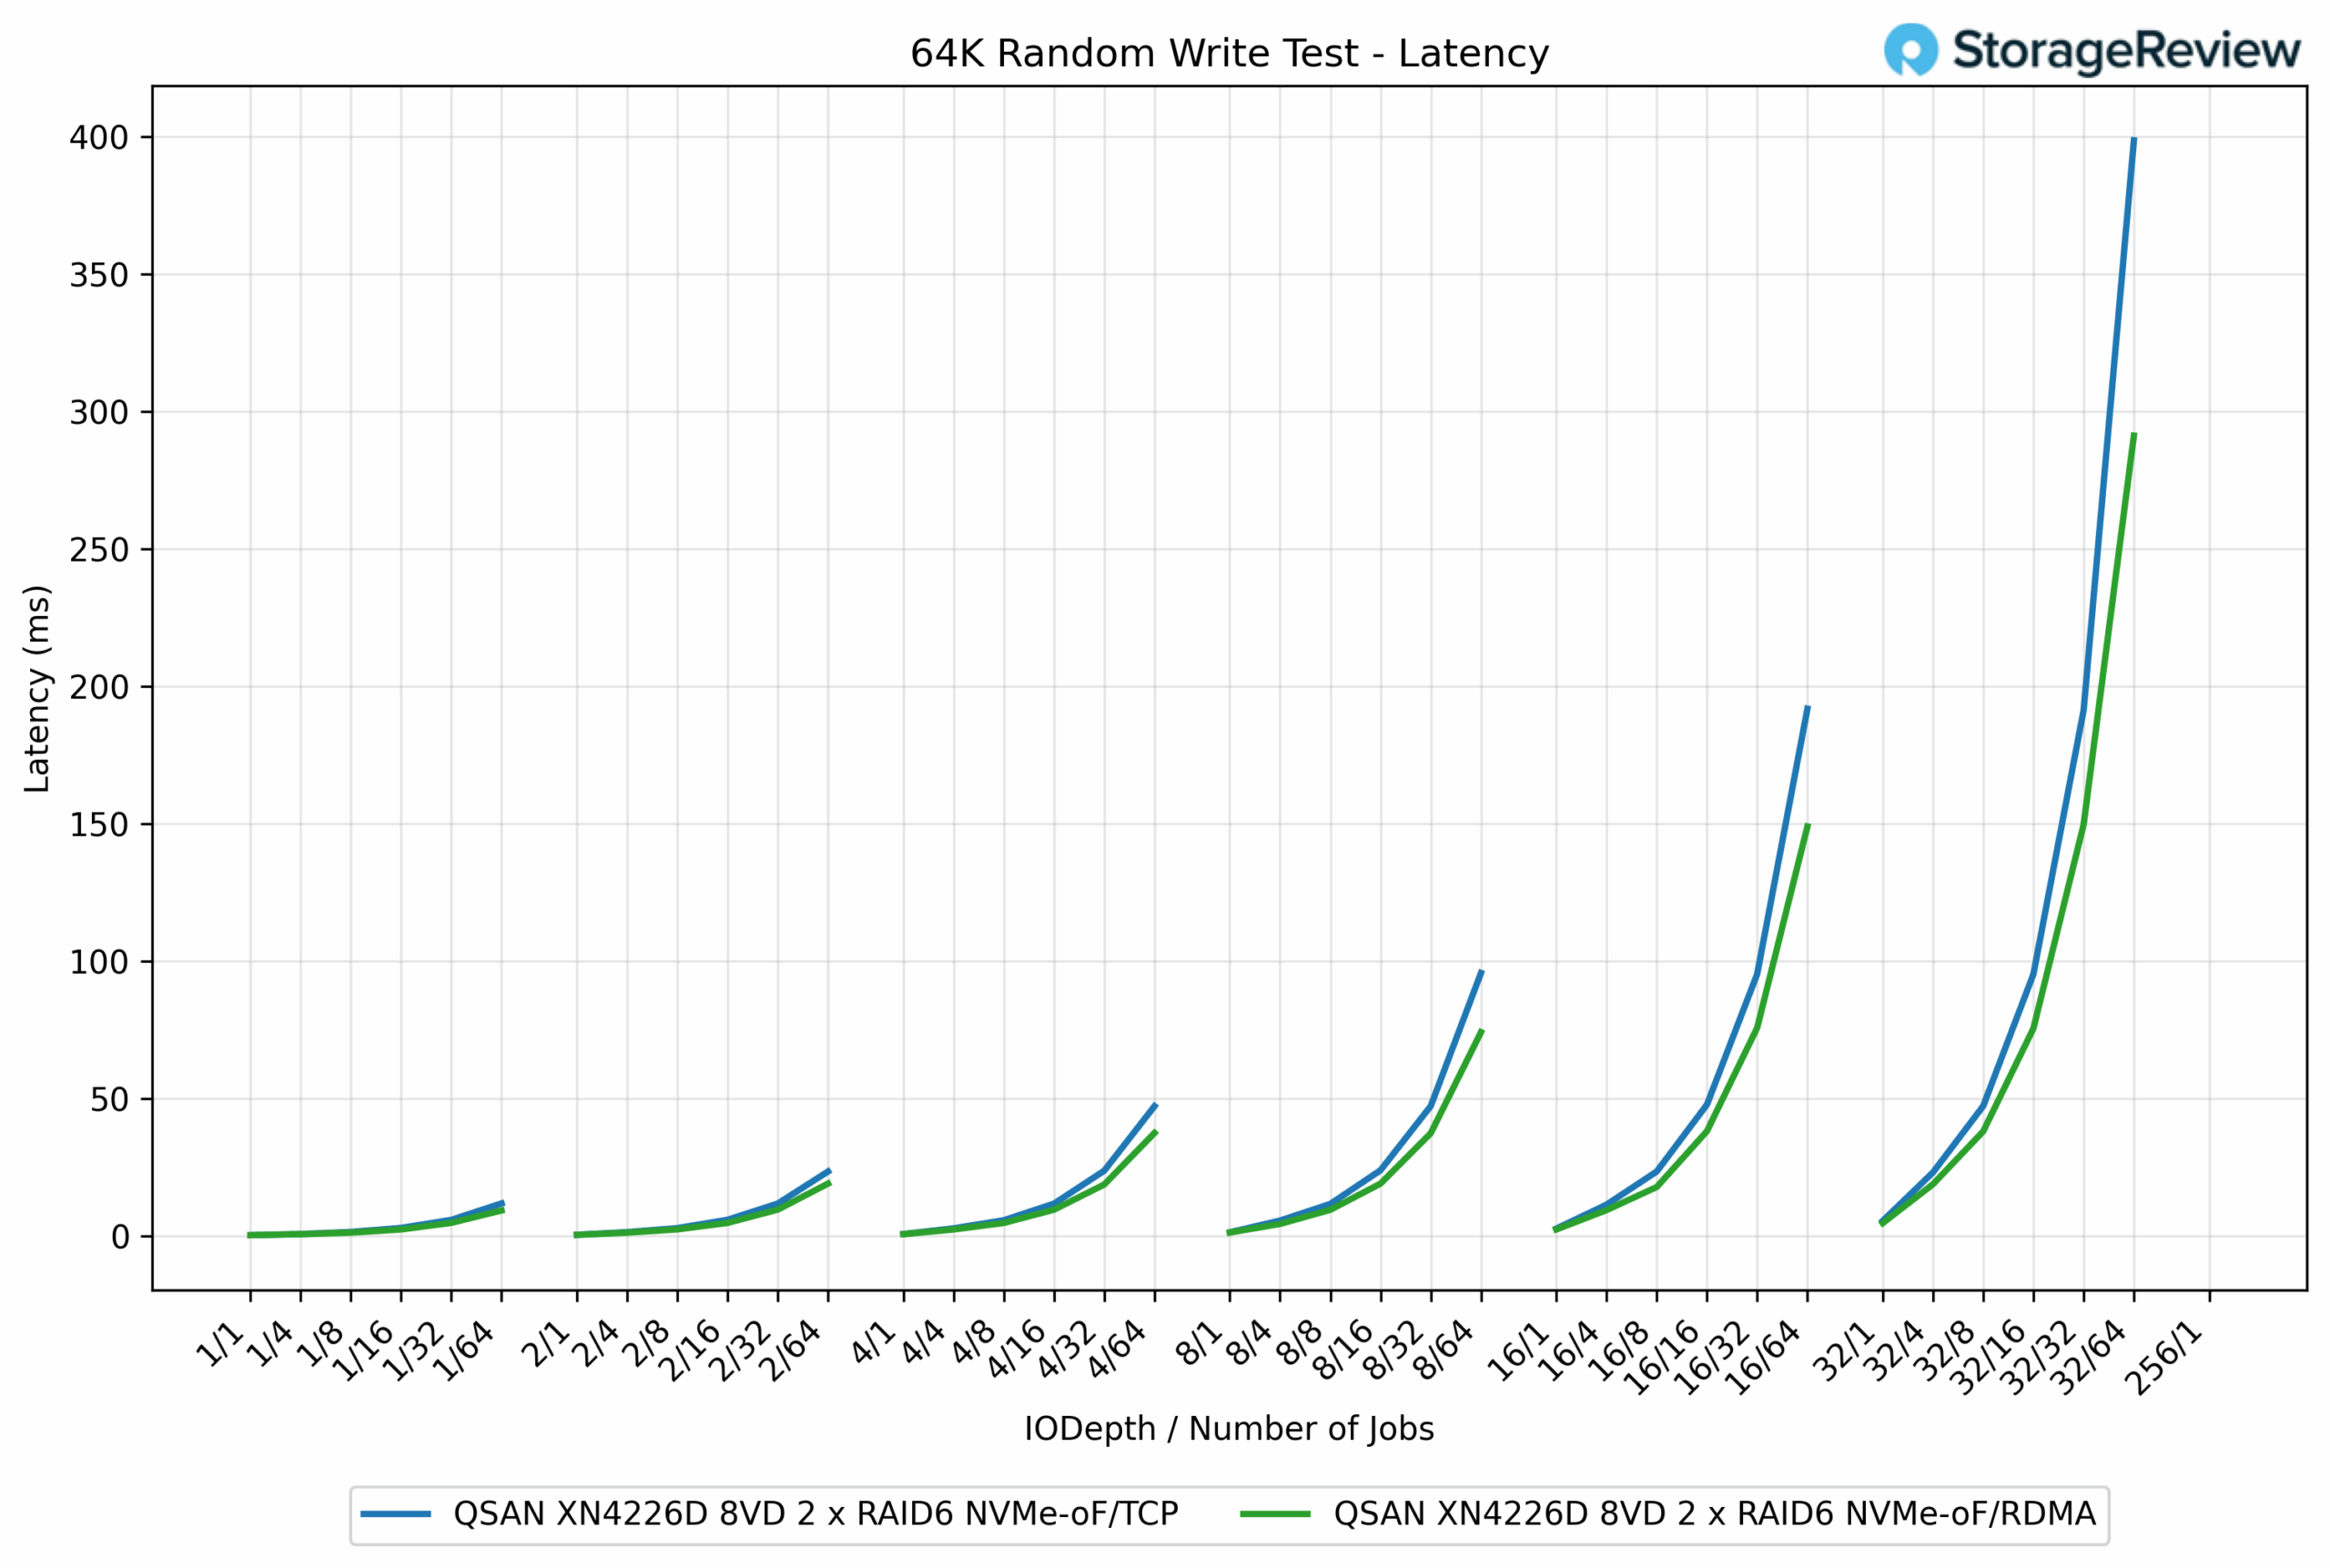
No teste de latência de gravação aleatória de 64K, o RDMA demonstrou novamente tempos de resposta mais baixos em comparação ao TCP, notadamente com o aumento da profundidade da fila e da contagem de tarefas. Em cargas mais baixas, ambos os protocolos apresentaram desempenho quase idêntico, permanecendo abaixo de 1 ms. Por exemplo, na tarefa QD1/1, o TCP registrou 0.26 ms, enquanto o RDMA permaneceu essencialmente o mesmo, com 0.25 ms.
No entanto, com o aumento da carga de trabalho, o RDMA manteve sua vantagem em termos de eficiência. Nos jobs QD16/64, o RDMA registrou 74.09 ms, em comparação com 95.64 ms do TCP, uma diferença de aproximadamente 23%. A diferença aumentou ainda mais sob estresse máximo no job QD256/1, onde o RDMA registrou 291.13 ms, enquanto o TCP subiu para 398.56 ms, um aumento de quase 37%.
IOPS de leitura aleatória em 64K
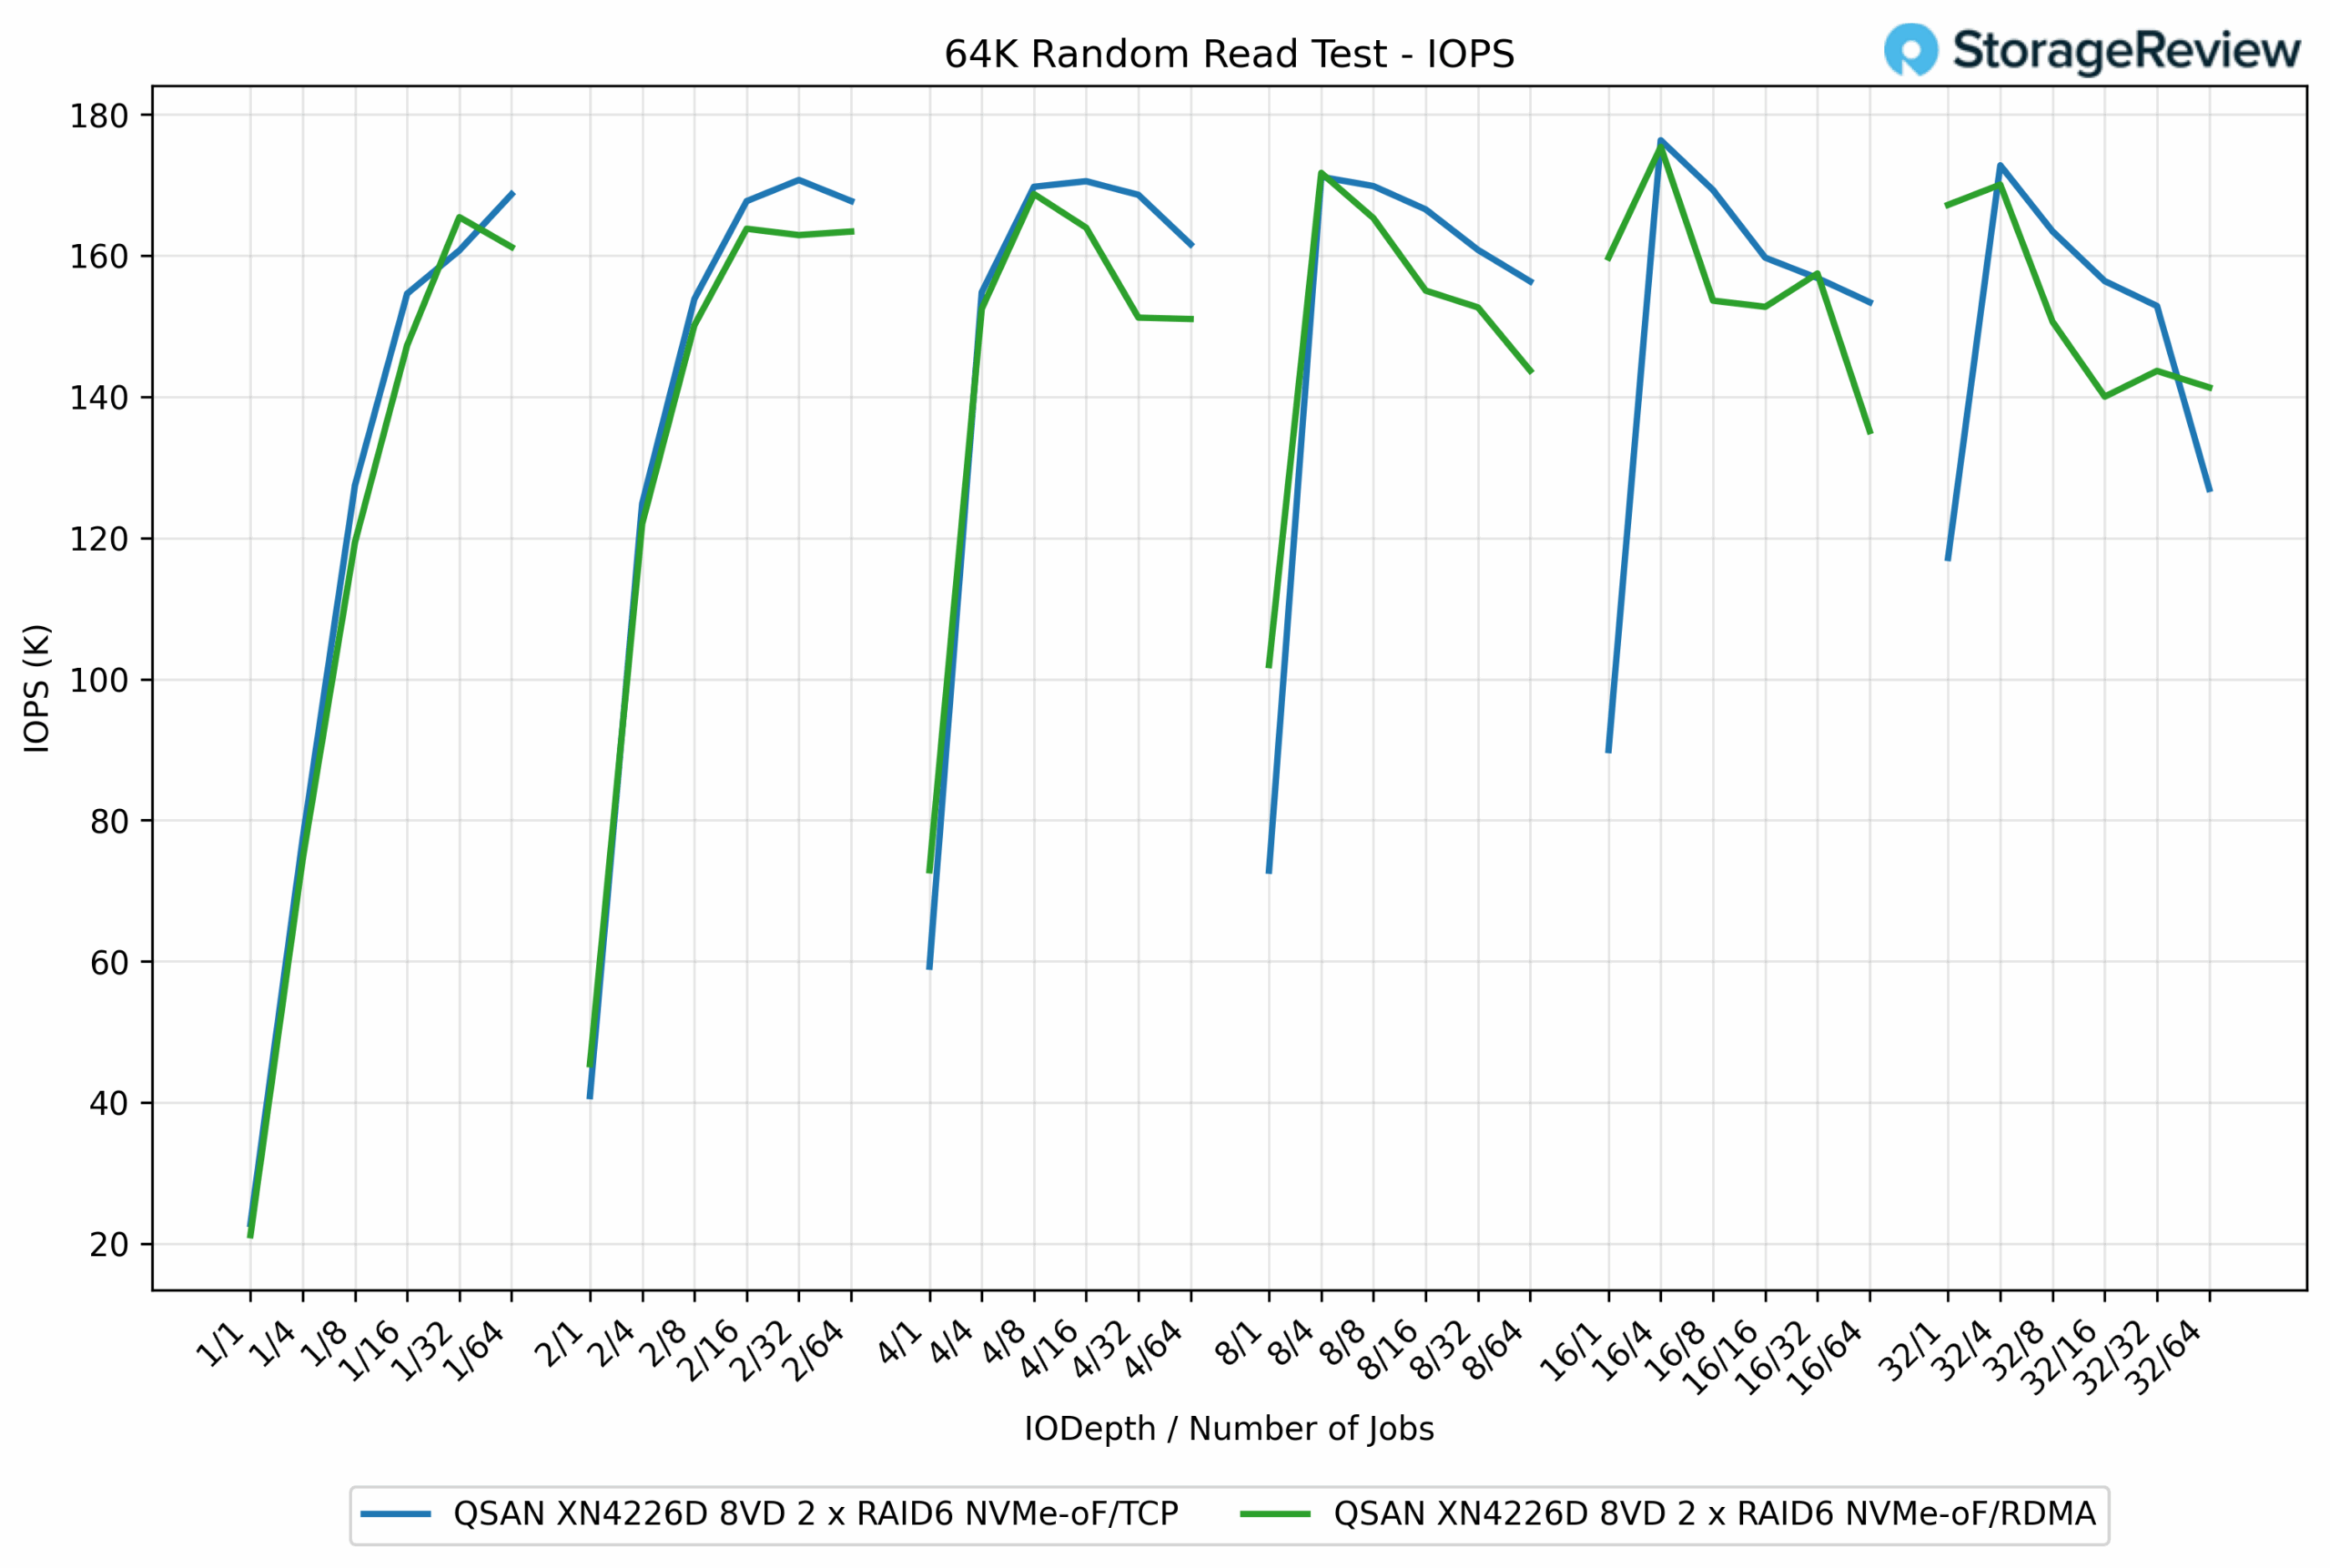
No teste de leitura aleatória de 64K, TCP e RDMA apresentaram desempenho geral muito semelhante, com a liderança oscilando ligeiramente entre os dois protocolos dependendo da carga de trabalho. O TCP atingiu um pico de 176.33K IOPS, enquanto o RDMA ficou logo atrás, com 175.40K IOPS, apresentando uma diferença de apenas 0.5%.
Em profundidades moderadas, os resultados permaneceram agrupados de forma compacta. Por exemplo, nos jobs do QD4/16, o TCP registrou 168.60 mil IOPS, enquanto o RDMA seguiu com 163.94 mil IOPS, uma diferença de menos de 2.8%. Em outros pontos, o RDMA apresentou uma ligeira alta, como nos jobs do QD8/1, onde atingiu 171.71 mil IOPS, em comparação com os 171.15 mil IOPS do TCP, praticamente um empate.
Latência de leitura aleatória de 64K
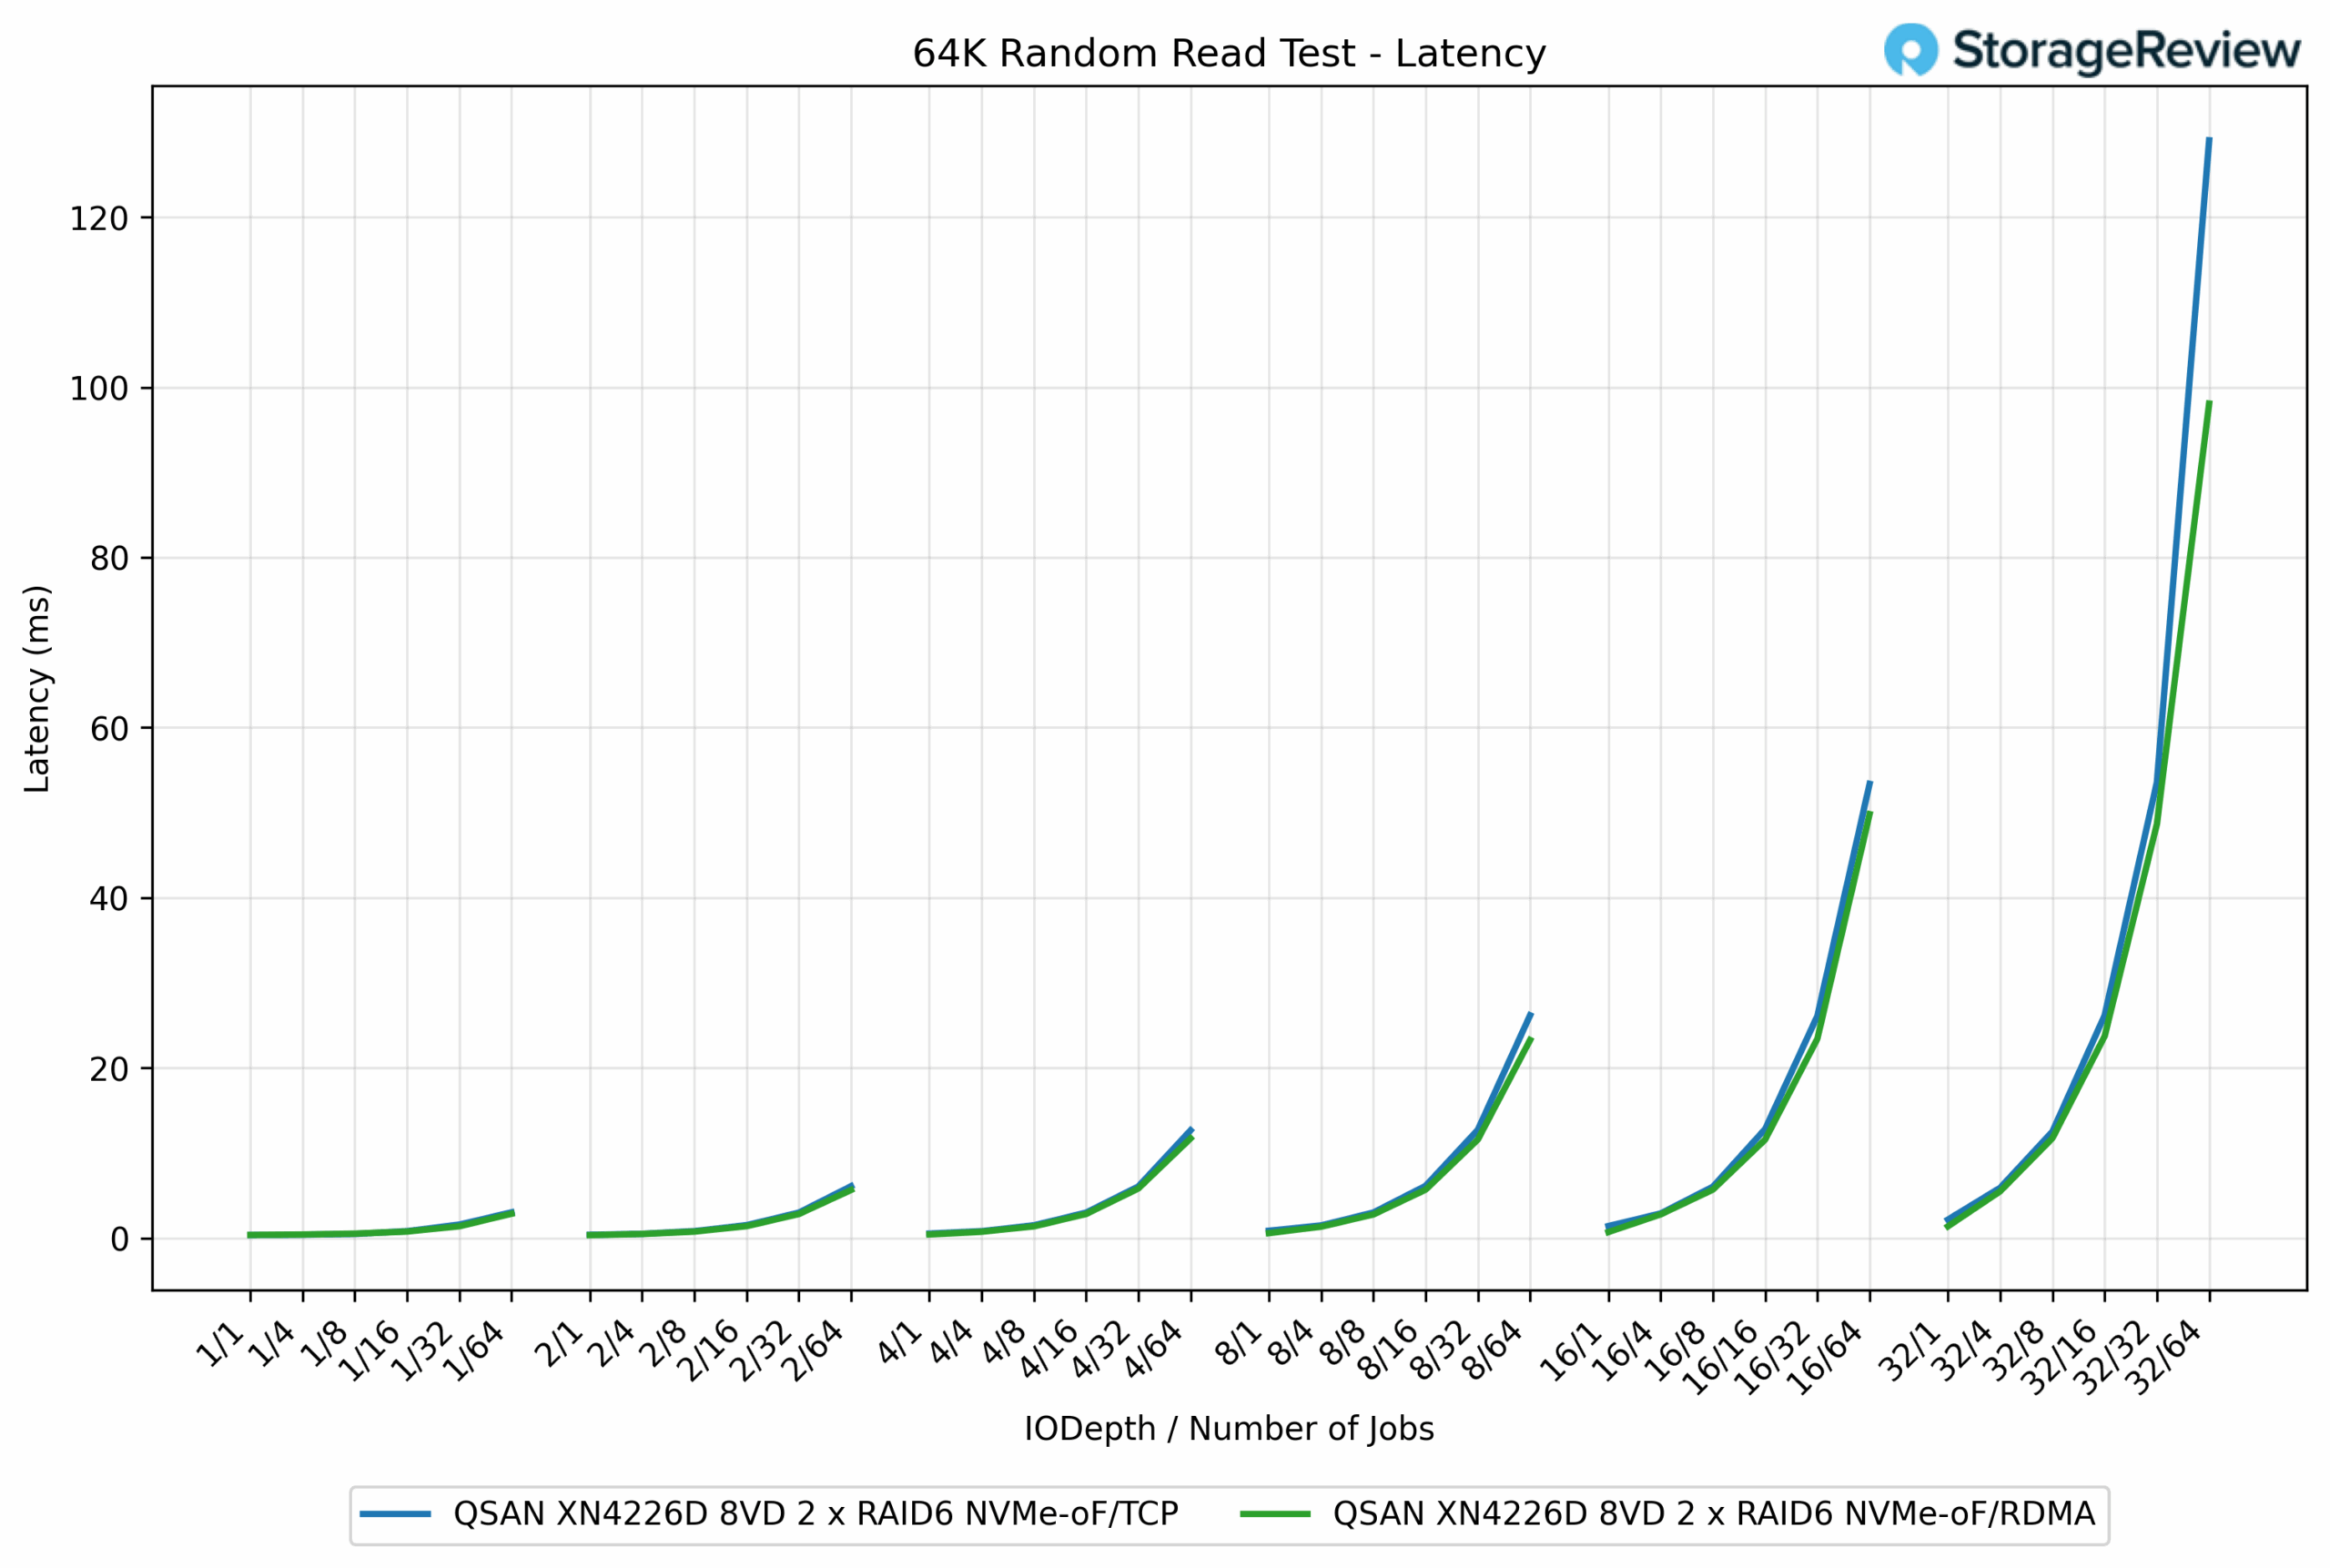
No teste de latência de leitura aleatória de 64K, os dois protocolos apresentaram desempenho muito próximo, embora o RDMA tenha apresentado uma ligeira vantagem sob carga mais alta. Em cargas de trabalho leves, tanto o TCP quanto o RDMA apresentaram latências inferiores a 1 ms, praticamente indistinguíveis. Por exemplo, na tarefa QD1/1, o TCP obteve 0.43 ms, enquanto o RDMA obteve 0.38 ms.
À medida que a simultaneidade aumentava, a diferença se tornava mais perceptível. Nos jobs QD16/64, o RDMA registrou 23.28 ms, enquanto o TCP registrou 26.19 ms, uma melhoria de 12%. A dispersão aumentou sob estresse máximo, com o RDMA atingindo 98.08 ms contra 129.02 ms do TCP, uma redução de 24%.
IOPS de gravação aleatória em 16K
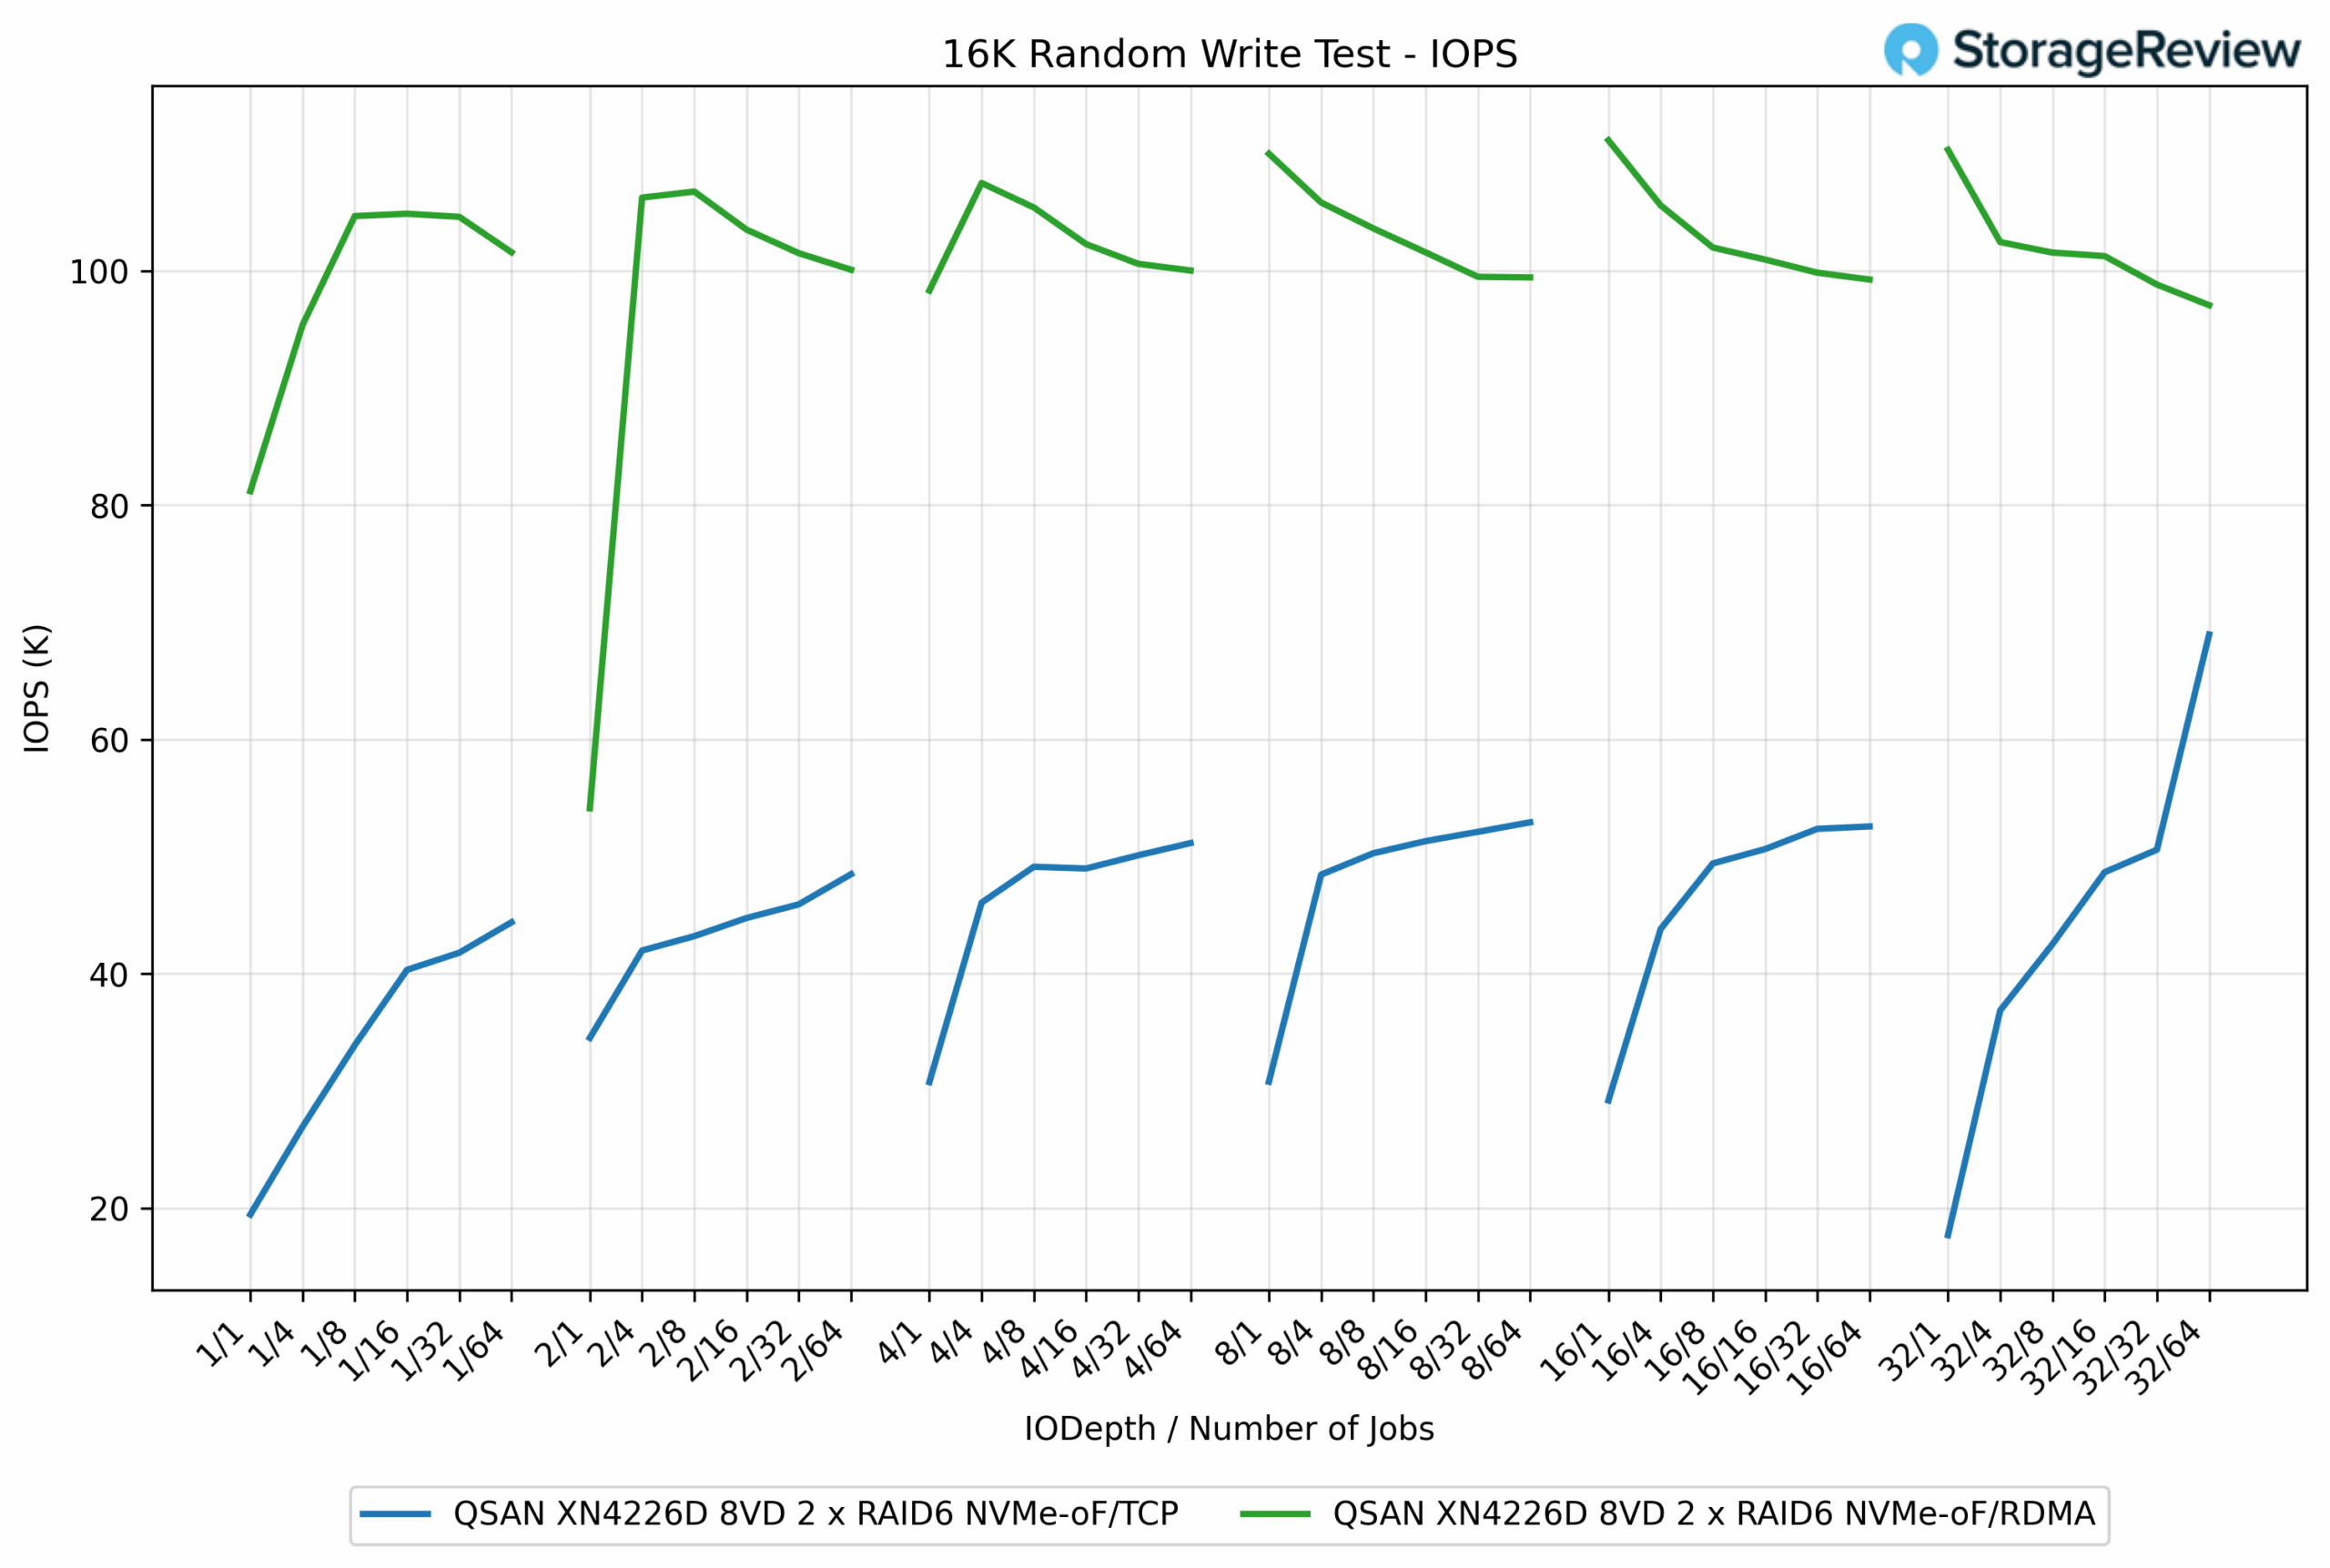
No teste de gravação aleatória de 16K, a diferença de desempenho entre os dois protocolos foi substancial, com o RDMA entregando mais que o dobro de IOPS do TCP na maioria dos casos. O RDMA atingiu o pico de 111.13K IOPS, enquanto o TCP atingiu o máximo de 68.95K IOPS, refletindo uma vantagem de 61% para o RDMA.
Em profundidades de fila menores, a diferença era evidente. Por exemplo, nos jobs QD1/16, o RDMA registrou 104.86 mil IOPS, em comparação com 41.78 mil IOPS do TCP, o que representa um aumento de 151% a favor do RDMA. Em toda a faixa de carga de trabalho, o RDMA manteve consistentemente os resultados na faixa de 100 mil a 111 mil IOPS, enquanto o TCP permaneceu, em geral, na faixa de 40 mil a 50 mil IOPS, exceto por um pico tardio na profundidade máxima.
Latência de gravação aleatória de 16K
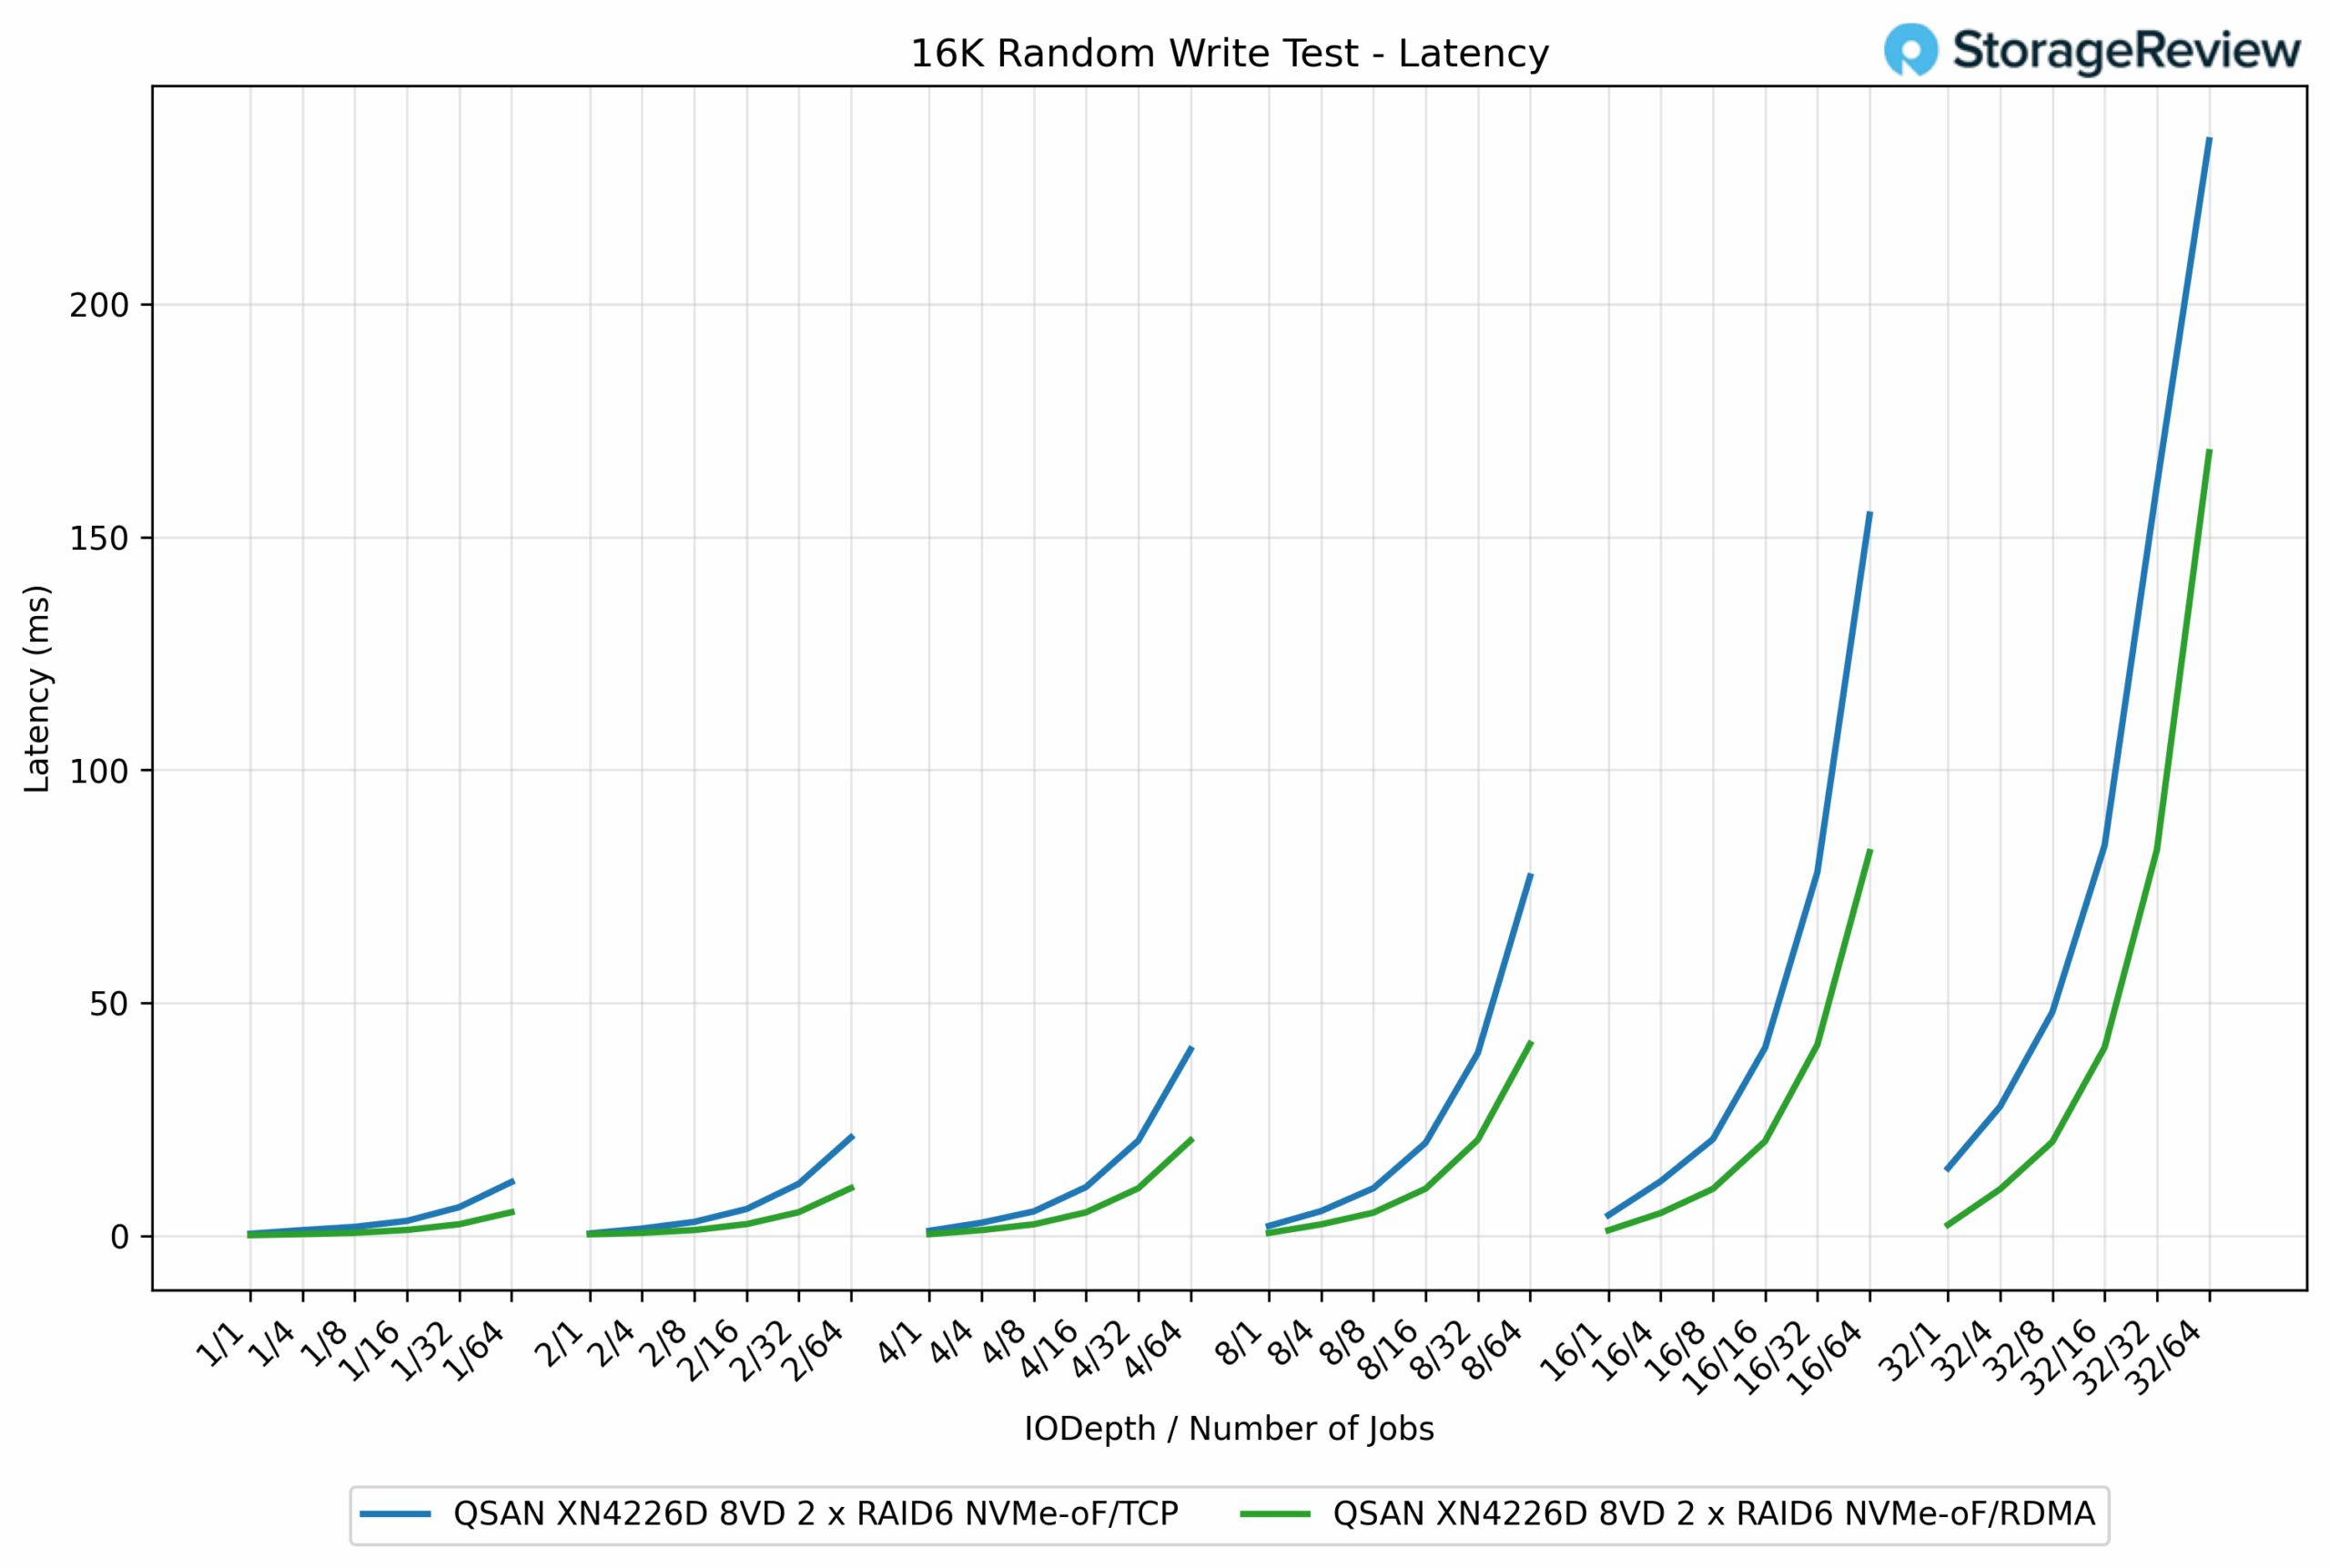
No teste de latência de gravação aleatória de 16K, o RDMA mais uma vez manteve uma clara vantagem sobre o TCP à medida que as cargas de trabalho aumentavam. Em cargas mais leves, ambos os protocolos foram quase idênticos, com tempos de resposta abaixo de 2 ms. Por exemplo, no trabalho QD1/1, o TCP registrou 0.40 ms, em comparação com 0.41 ms do RDMA.
À medida que a simultaneidade aumentava, o RDMA começou a se separar. Nos jobs QD16/64, o RDMA registrou 21.15 ms, enquanto o TCP registrou 77.12 ms, uma redução drástica de 72%. Essa vantagem persistiu nas profundidades mais altas. Nos jobs QD32/64, o RDMA concluiu a 161.13 ms, em comparação com 235.17 ms do TCP, representando uma melhoria de 31%.
IOPS de leitura aleatória em 16K
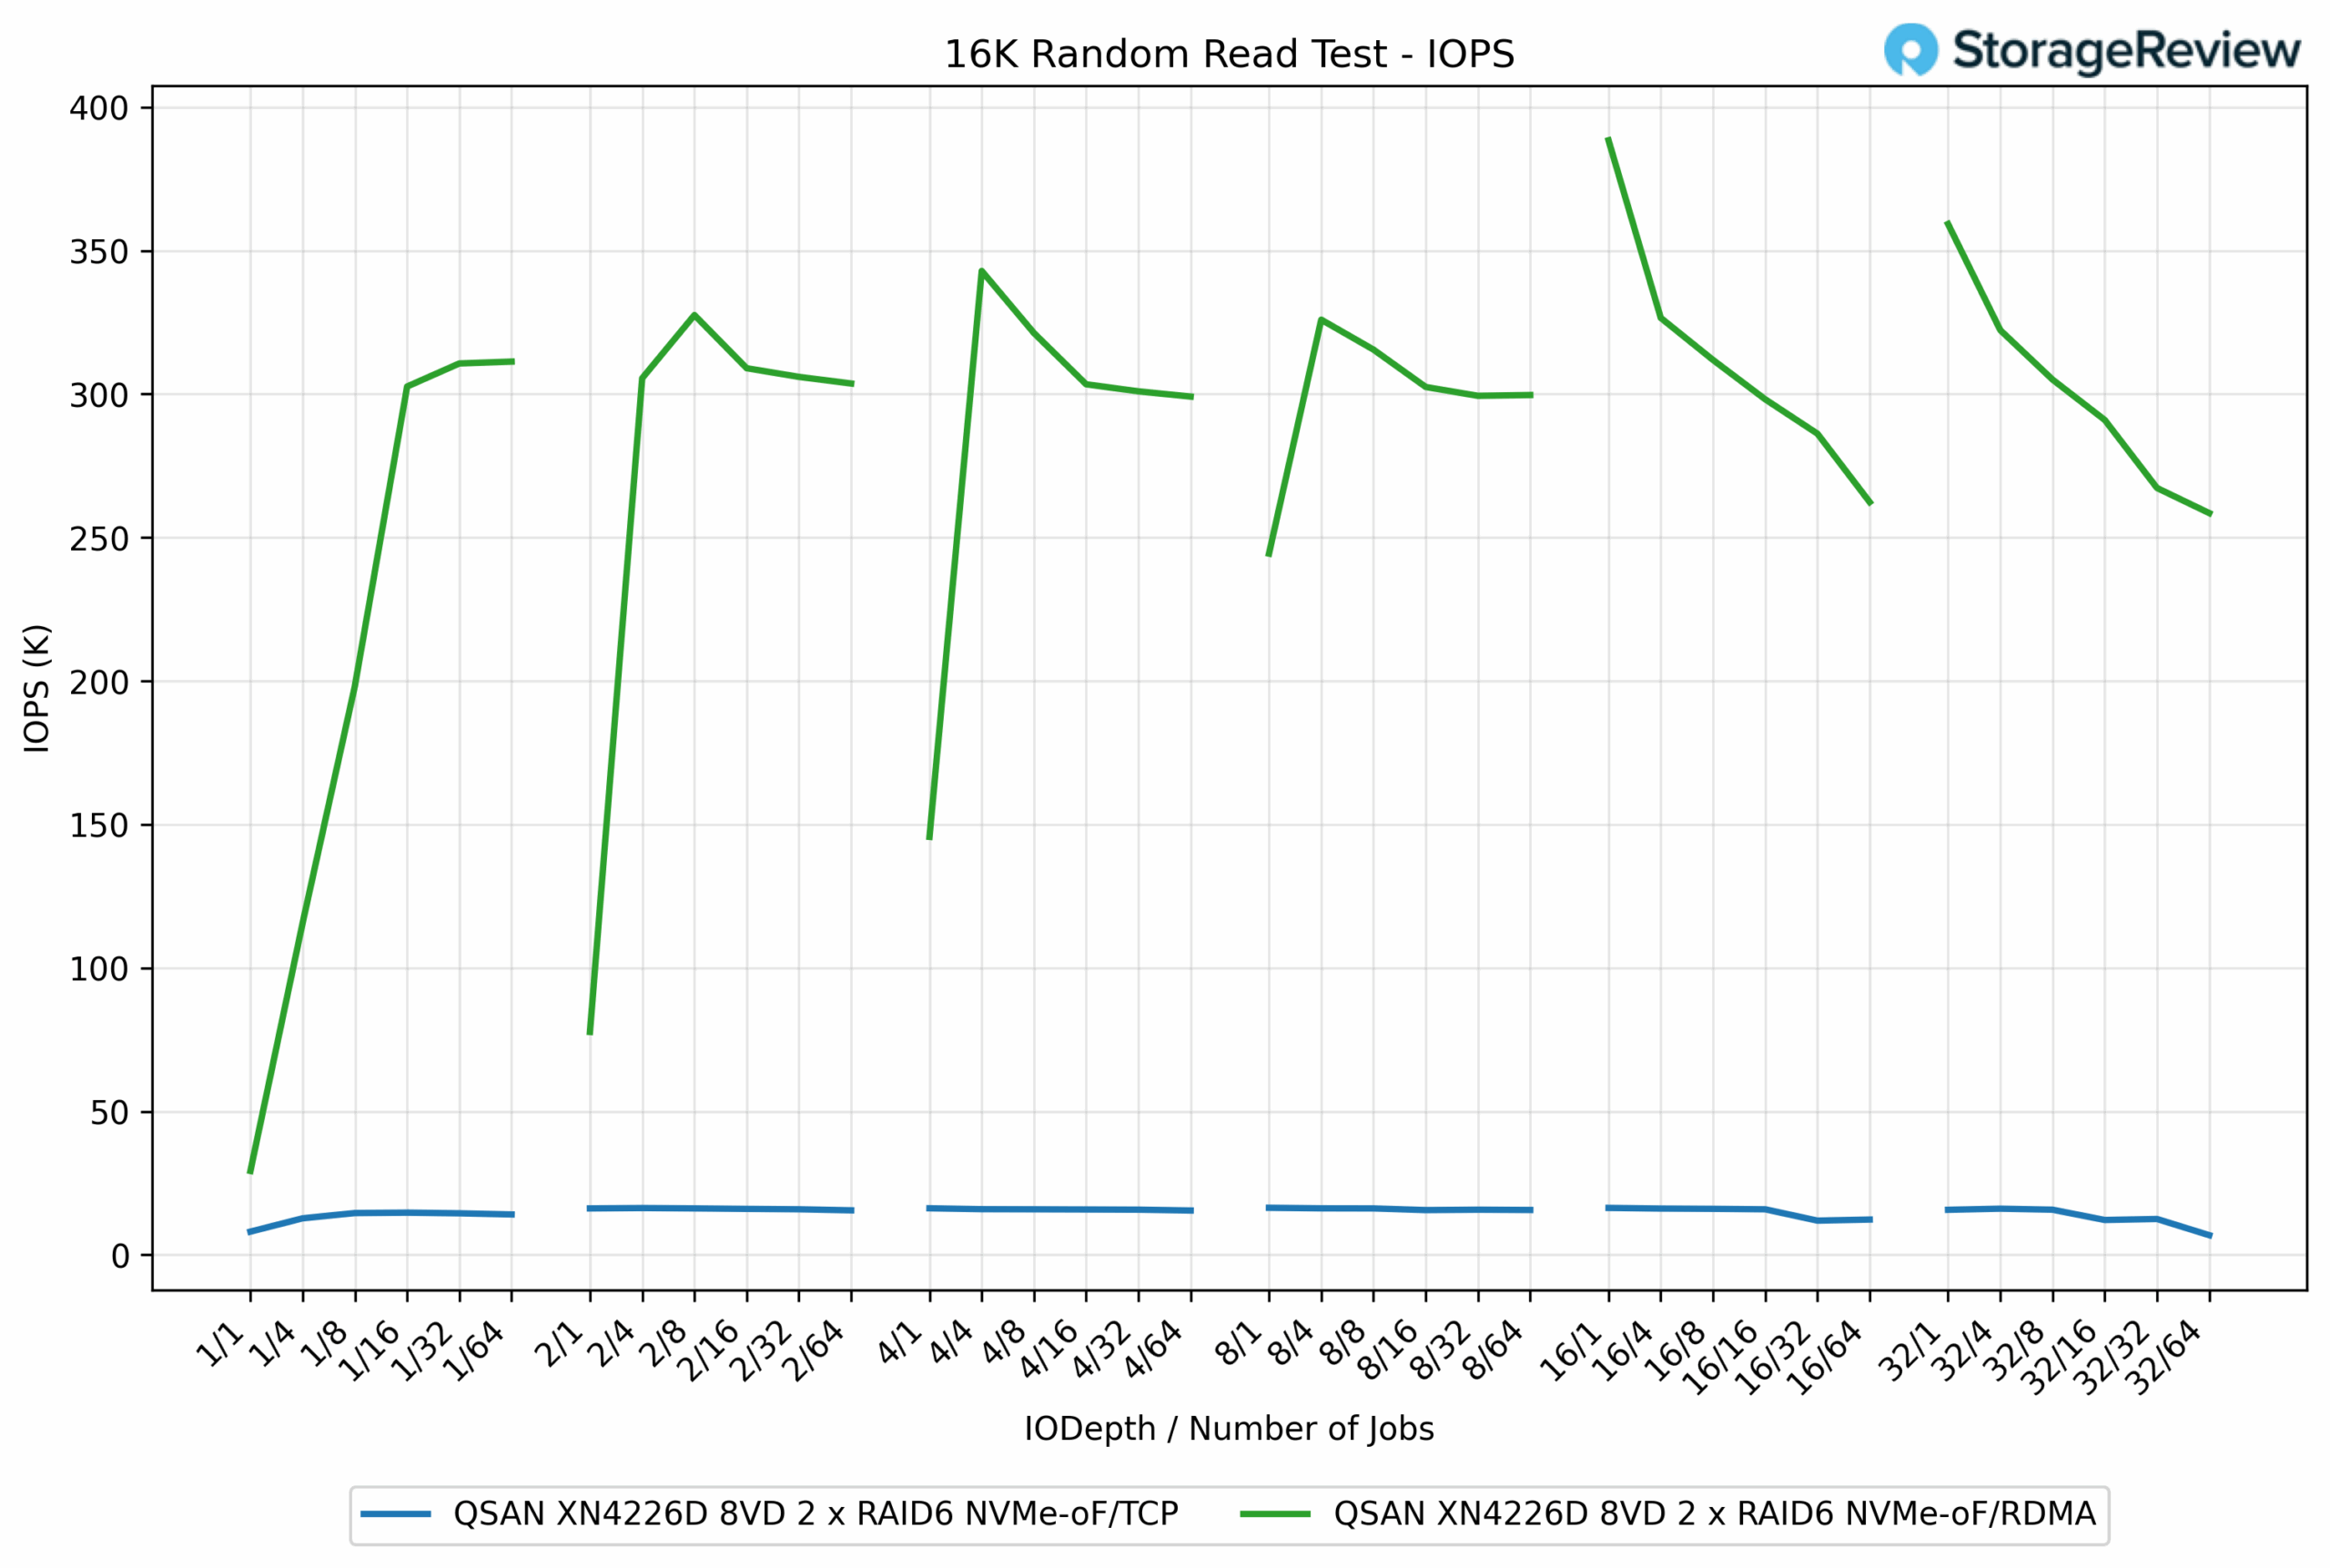
No teste de leitura aleatória de 16K, o RDMA superou completamente o TCP em toda a gama de cargas de trabalho. O RDMA atingiu um pico de 388.44K IOPS, enquanto o TCP atingiu apenas 16.42K IOPS, demonstrando uma vantagem de mais de 23x para o RDMA.
A disparidade era visível desde o início. No job QD1/1, o RDMA entregou 29.27 mil IOPS, enquanto o TCP conseguiu apenas 8.10 mil IOPS. À medida que a simultaneidade aumentava, o RDMA rapidamente atingiu a faixa de 300 mil a 380 mil IOPS, enquanto o TCP se estabilizou em torno de 15 mil a 16 mil IOPS, mesmo em profundidades de fila maiores.
Latência de leitura aleatória de 16K
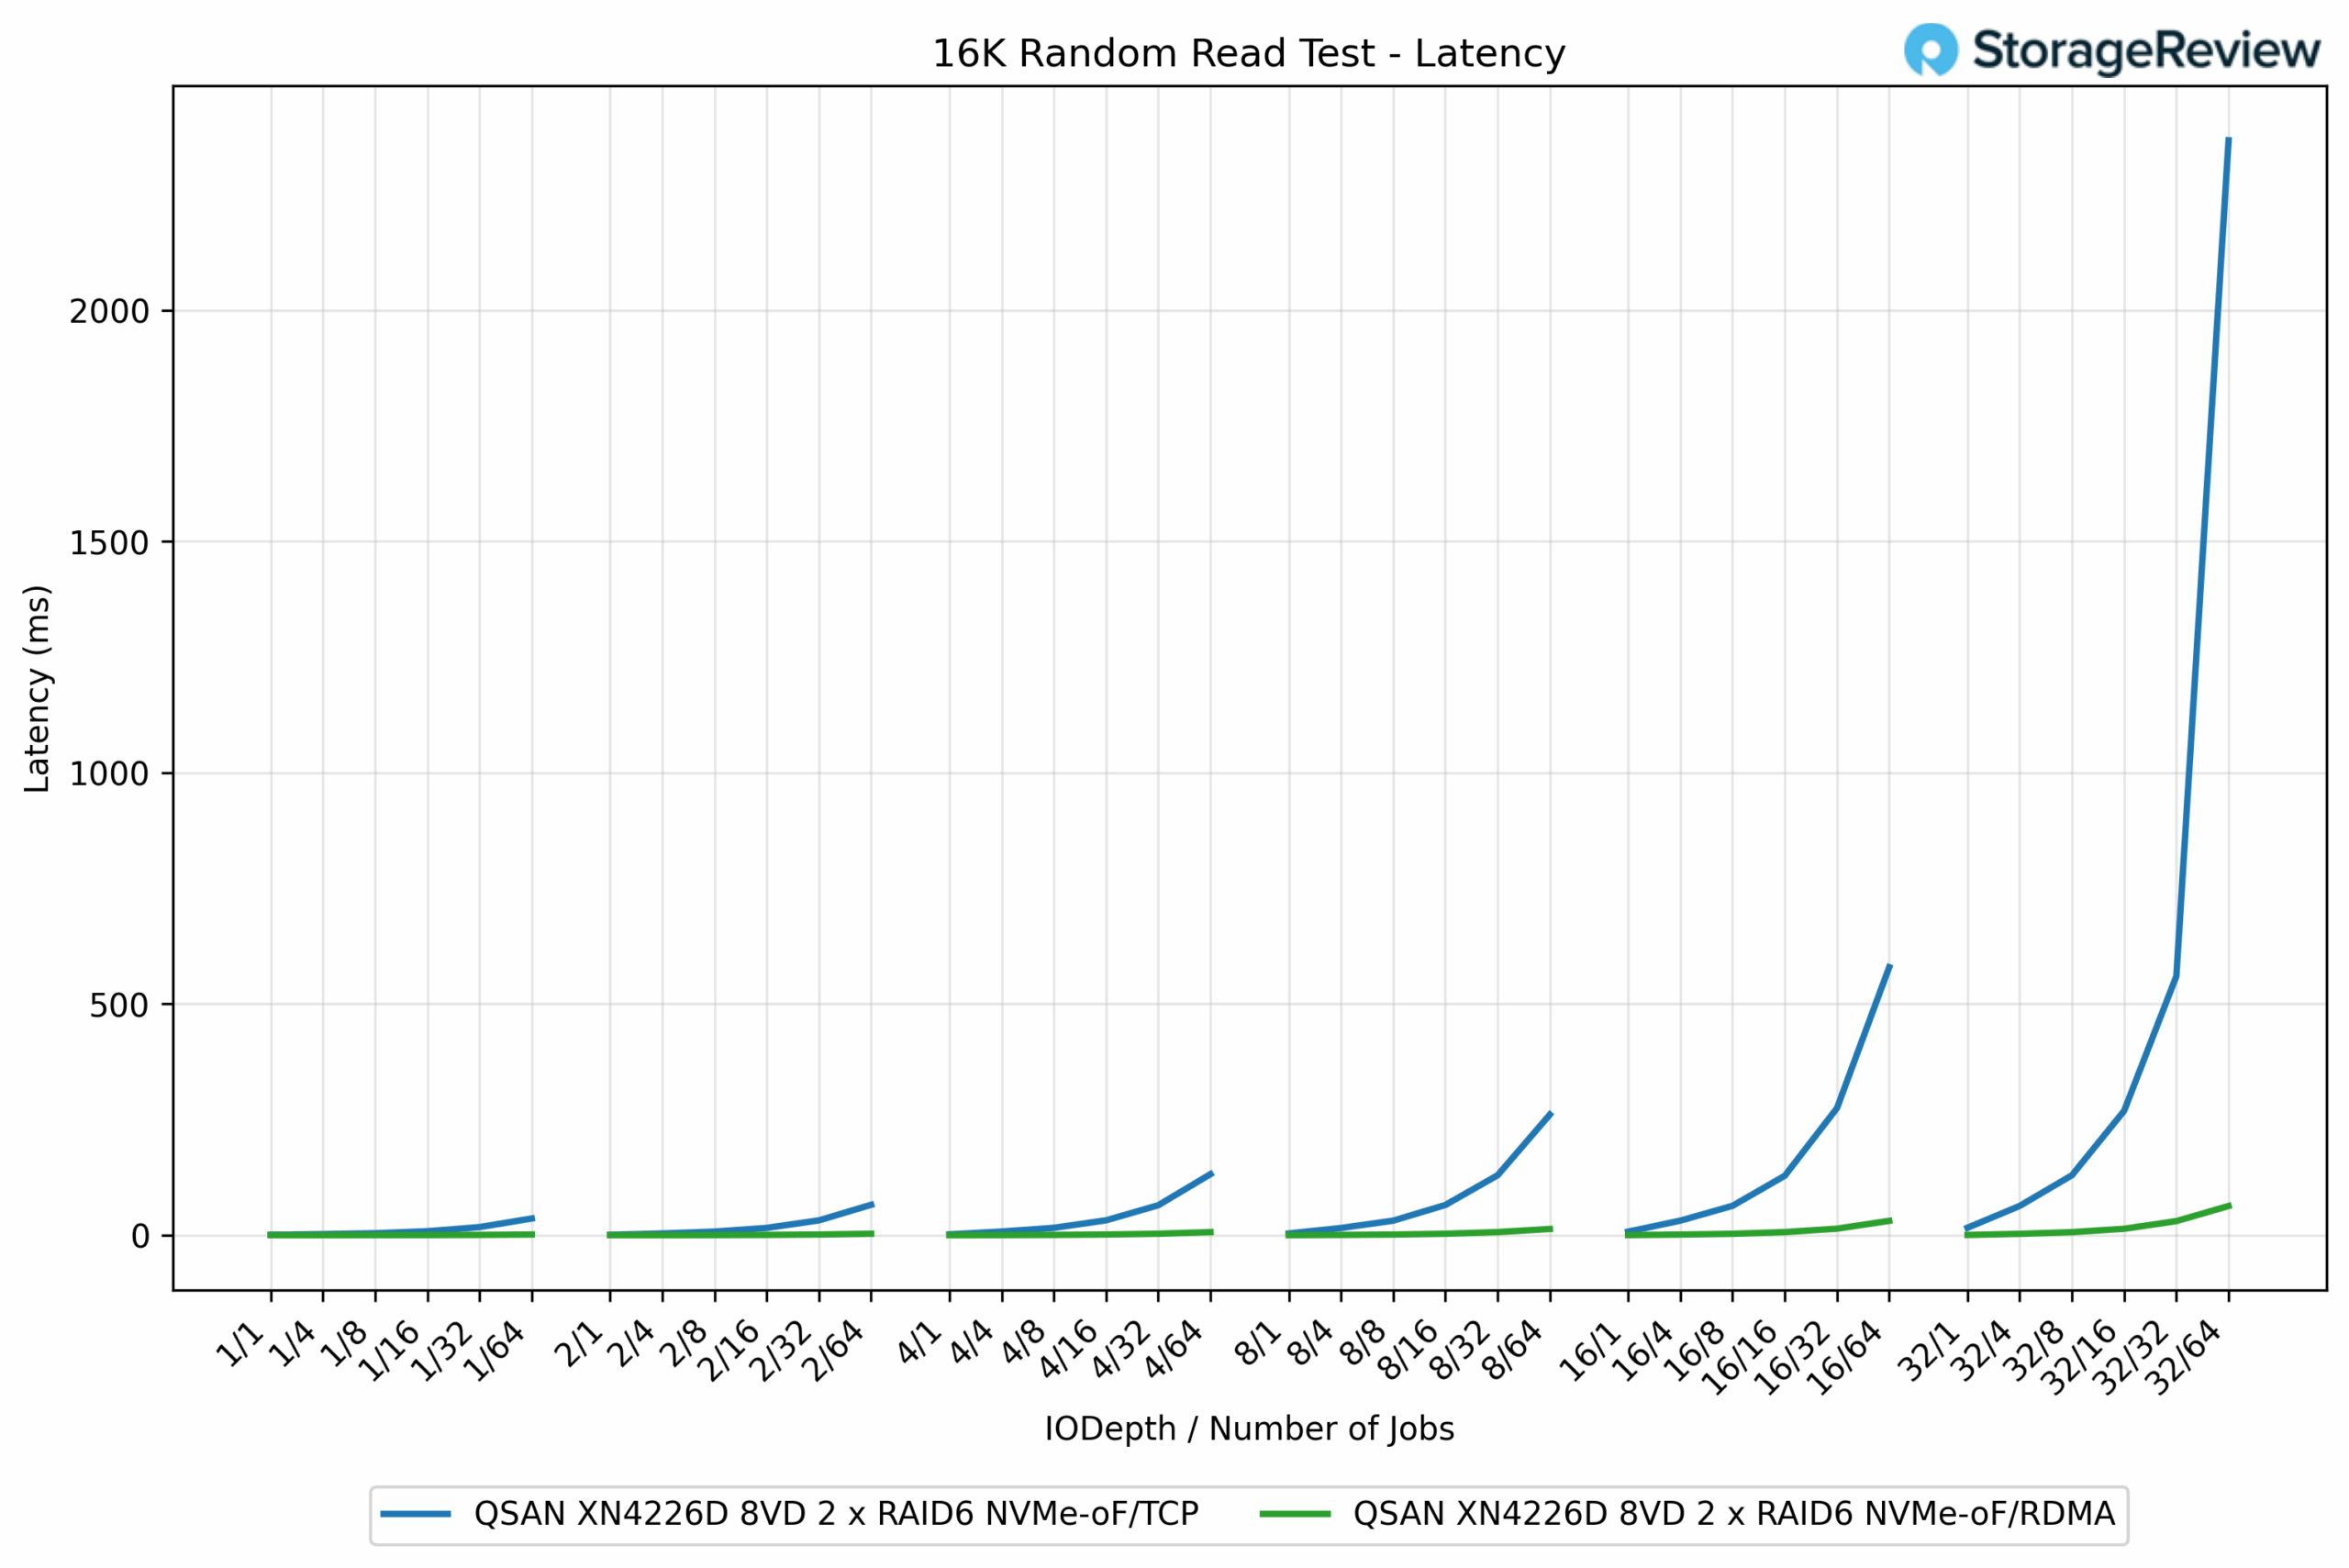
No teste de latência de leitura aleatória de 16K, a diferença entre RDMA e TCP foi drástica, refletindo os resultados do IOPS. Em cargas de trabalho leves, os dois protocolos foram quase idênticos, com latências variando de 1 a 10 ms.
À medida que as cargas de trabalho aumentavam, o RDMA controlava bem a latência, enquanto o TCP se degradava significativamente. Nos trabalhos Q8/64, o RDMA registrou 13.65 ms, em comparação com 260.90 ms do TCP, uma melhoria de quase 19 vezes. No final, os trabalhos QD32/64 concluíram o RDMA em 63.28 ms, enquanto o TCP levou 2,366.99 ms, quase 37 vezes mais tempo.
IOPS de gravação aleatória em 4K
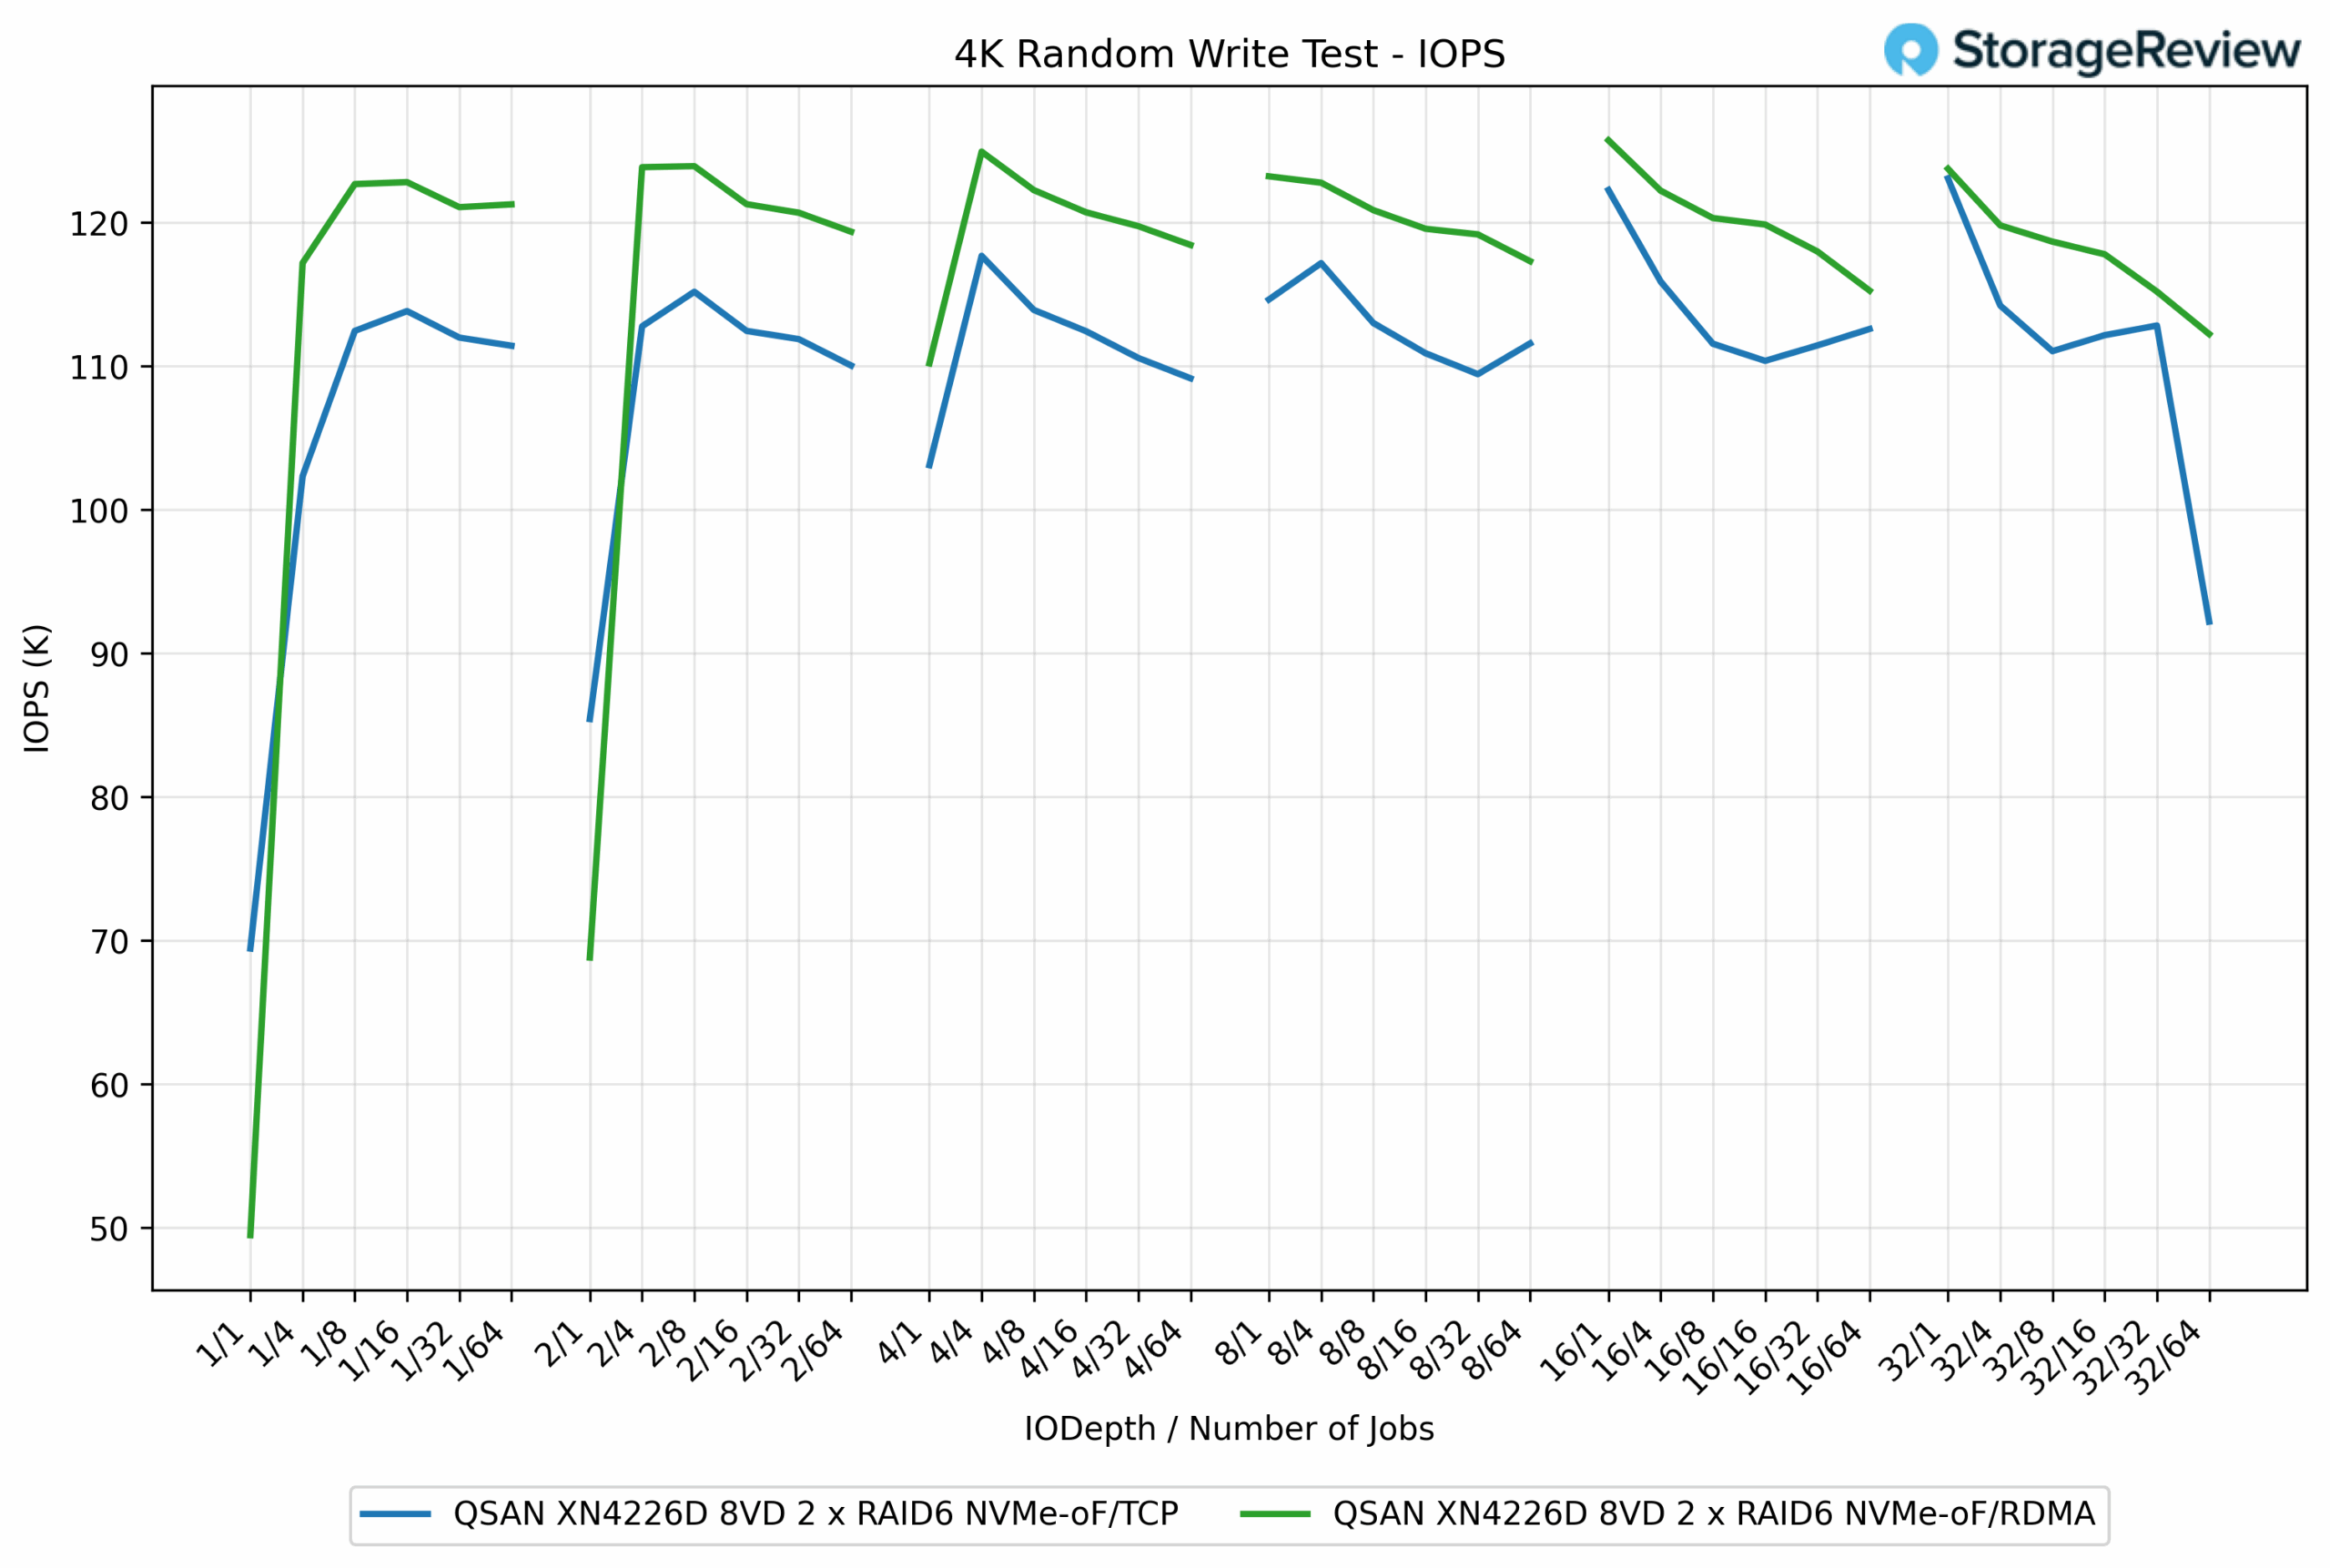
No teste de gravação aleatória em 4K, o RDMA superou consistentemente o TCP, embora a margem tenha sido menor em comparação com as cargas de trabalho com blocos maiores. O RDMA atingiu um pico de 125.73 mil IOPS, enquanto o TCP atingiu 115.89 mil IOPS, resultando em uma vantagem de aproximadamente 8.5% para o RDMA.
Em profundidades de fila menores, o TCP ficou ligeiramente atrás do RDMA, mas ainda apresentou desempenho competitivo. Por exemplo, nos jobs QD1/16, o RDMA atingiu 122.82 mil IOPS, em comparação com os 111.91 mil IOPS do TCP, uma melhoria de quase 10%. Na maioria dos pontos de teste, o RDMA ficou na faixa de 120 mil a 125 mil IOPS, enquanto o TCP manteve os resultados entre 110 mil e 116 mil IOPS, com uma queda tardia nos jobs QD32/64 para 92.21 mil IOPS.
Latência de gravação aleatória de 4K
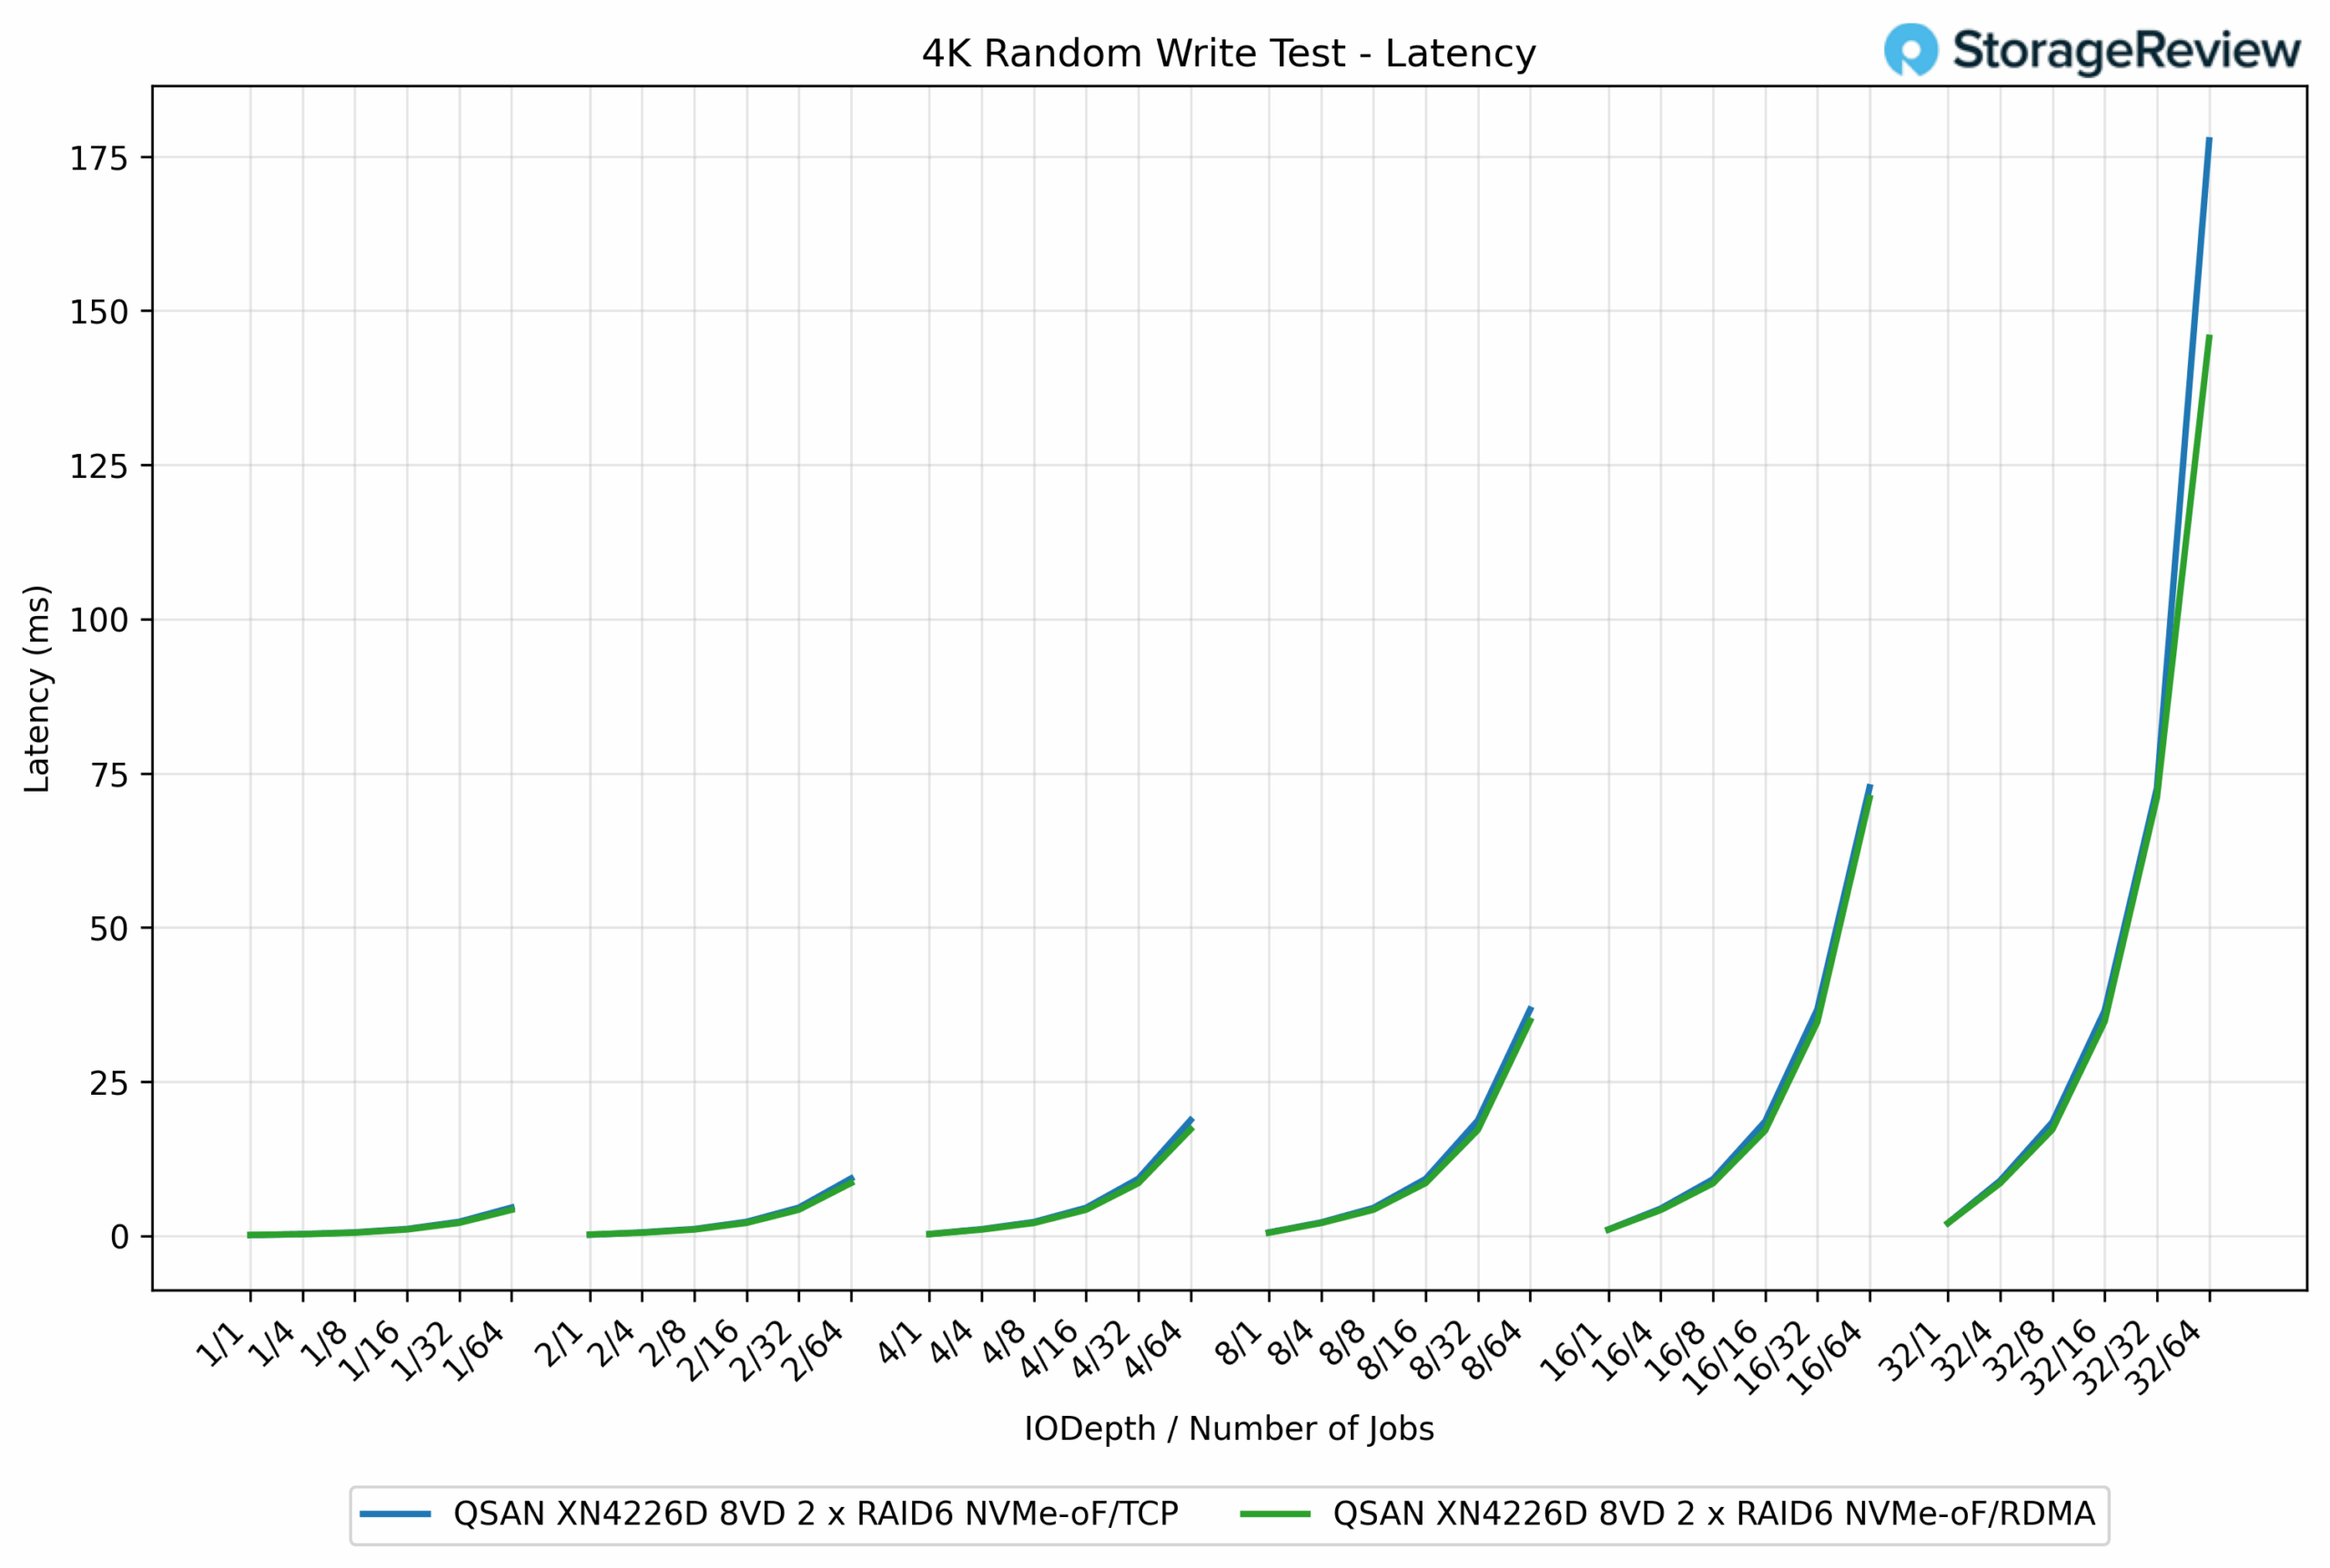
No teste de latência de gravação aleatória em 4K, o RDMA apresentou consistentemente tempos de resposta mais baixos que o TCP, embora as margens fossem menores em comparação com as cargas de trabalho com blocos maiores. Em cargas mais leves, ambos os protocolos foram quase idênticos, cada um ficando abaixo de 1 ms. Por exemplo, em QD1/1, o TCP registrou 0.16 ms, enquanto o RDMA registrou 0.21 ms.
À medida que a simultaneidade aumentava, as diferenças se tornavam mais evidentes. Nos jobs QD16/64, o RDMA registrou 19.36 ms, em comparação com 36.20 ms do TCP, resultando em uma redução de 46% na latência do RDMA. Na profundidade máxima, o RDMA concluiu a 145.61 ms, enquanto o TCP subiu para 177.62 ms, uma melhoria de 22% para o RDMA.
IOPS de leitura aleatória em 4K
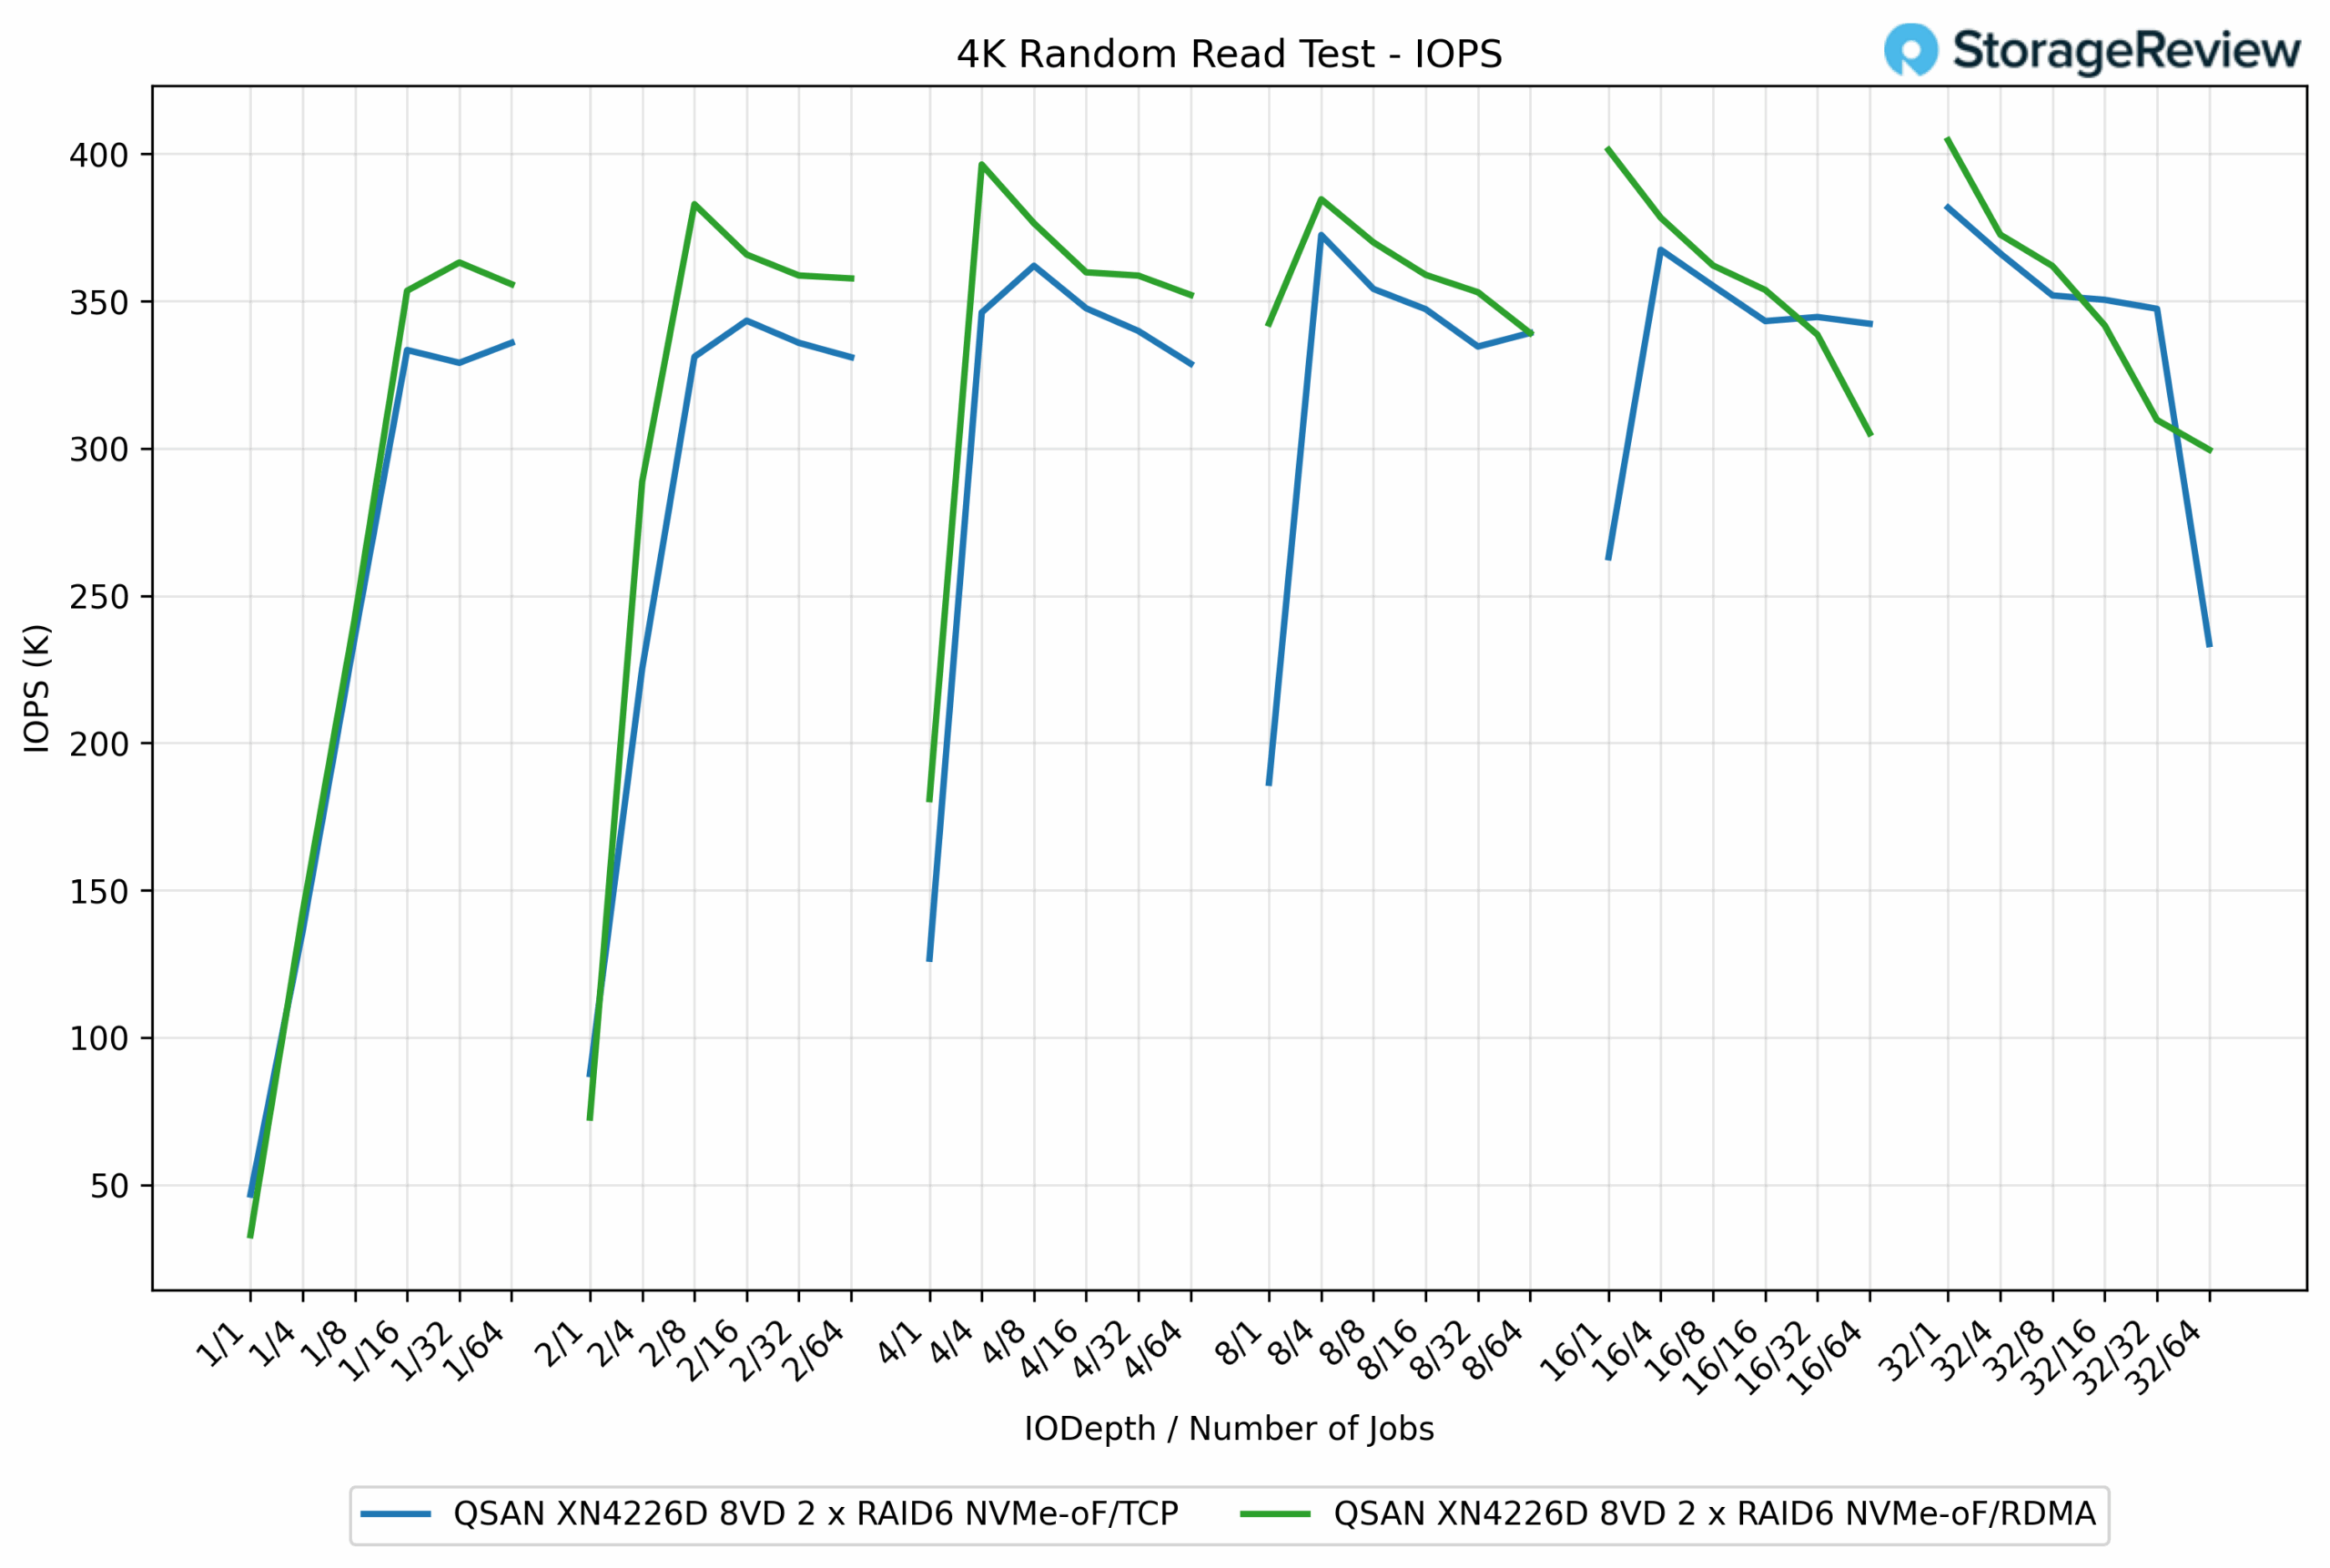
No teste de leitura aleatória em 4K, ambos os protocolos apresentaram bom desempenho, embora o RDMA tenha mantido uma ligeira vantagem sobre o TCP. O RDMA atingiu um pico de 404.64 mil IOPS, enquanto o TCP atingiu o pico de 382.96 mil IOPS, dando ao RDMA uma vantagem de 5.7%.
Em profundidades menores, os resultados já eram favoráveis ao RDMA. Por exemplo, nos jobs QD1/16, o RDMA atingiu 353.57 mil IOPS, em comparação com 329.10 mil IOPS do TCP, uma diferença de cerca de 7.5%. À medida que as cargas de trabalho aumentavam, o RDMA manteve a liderança, operando normalmente na faixa de 360 mil a 400 mil IOPS, enquanto o TCP se manteve próximo de 330 mil a 380 mil IOPS.
Latência de leitura aleatória de 4K
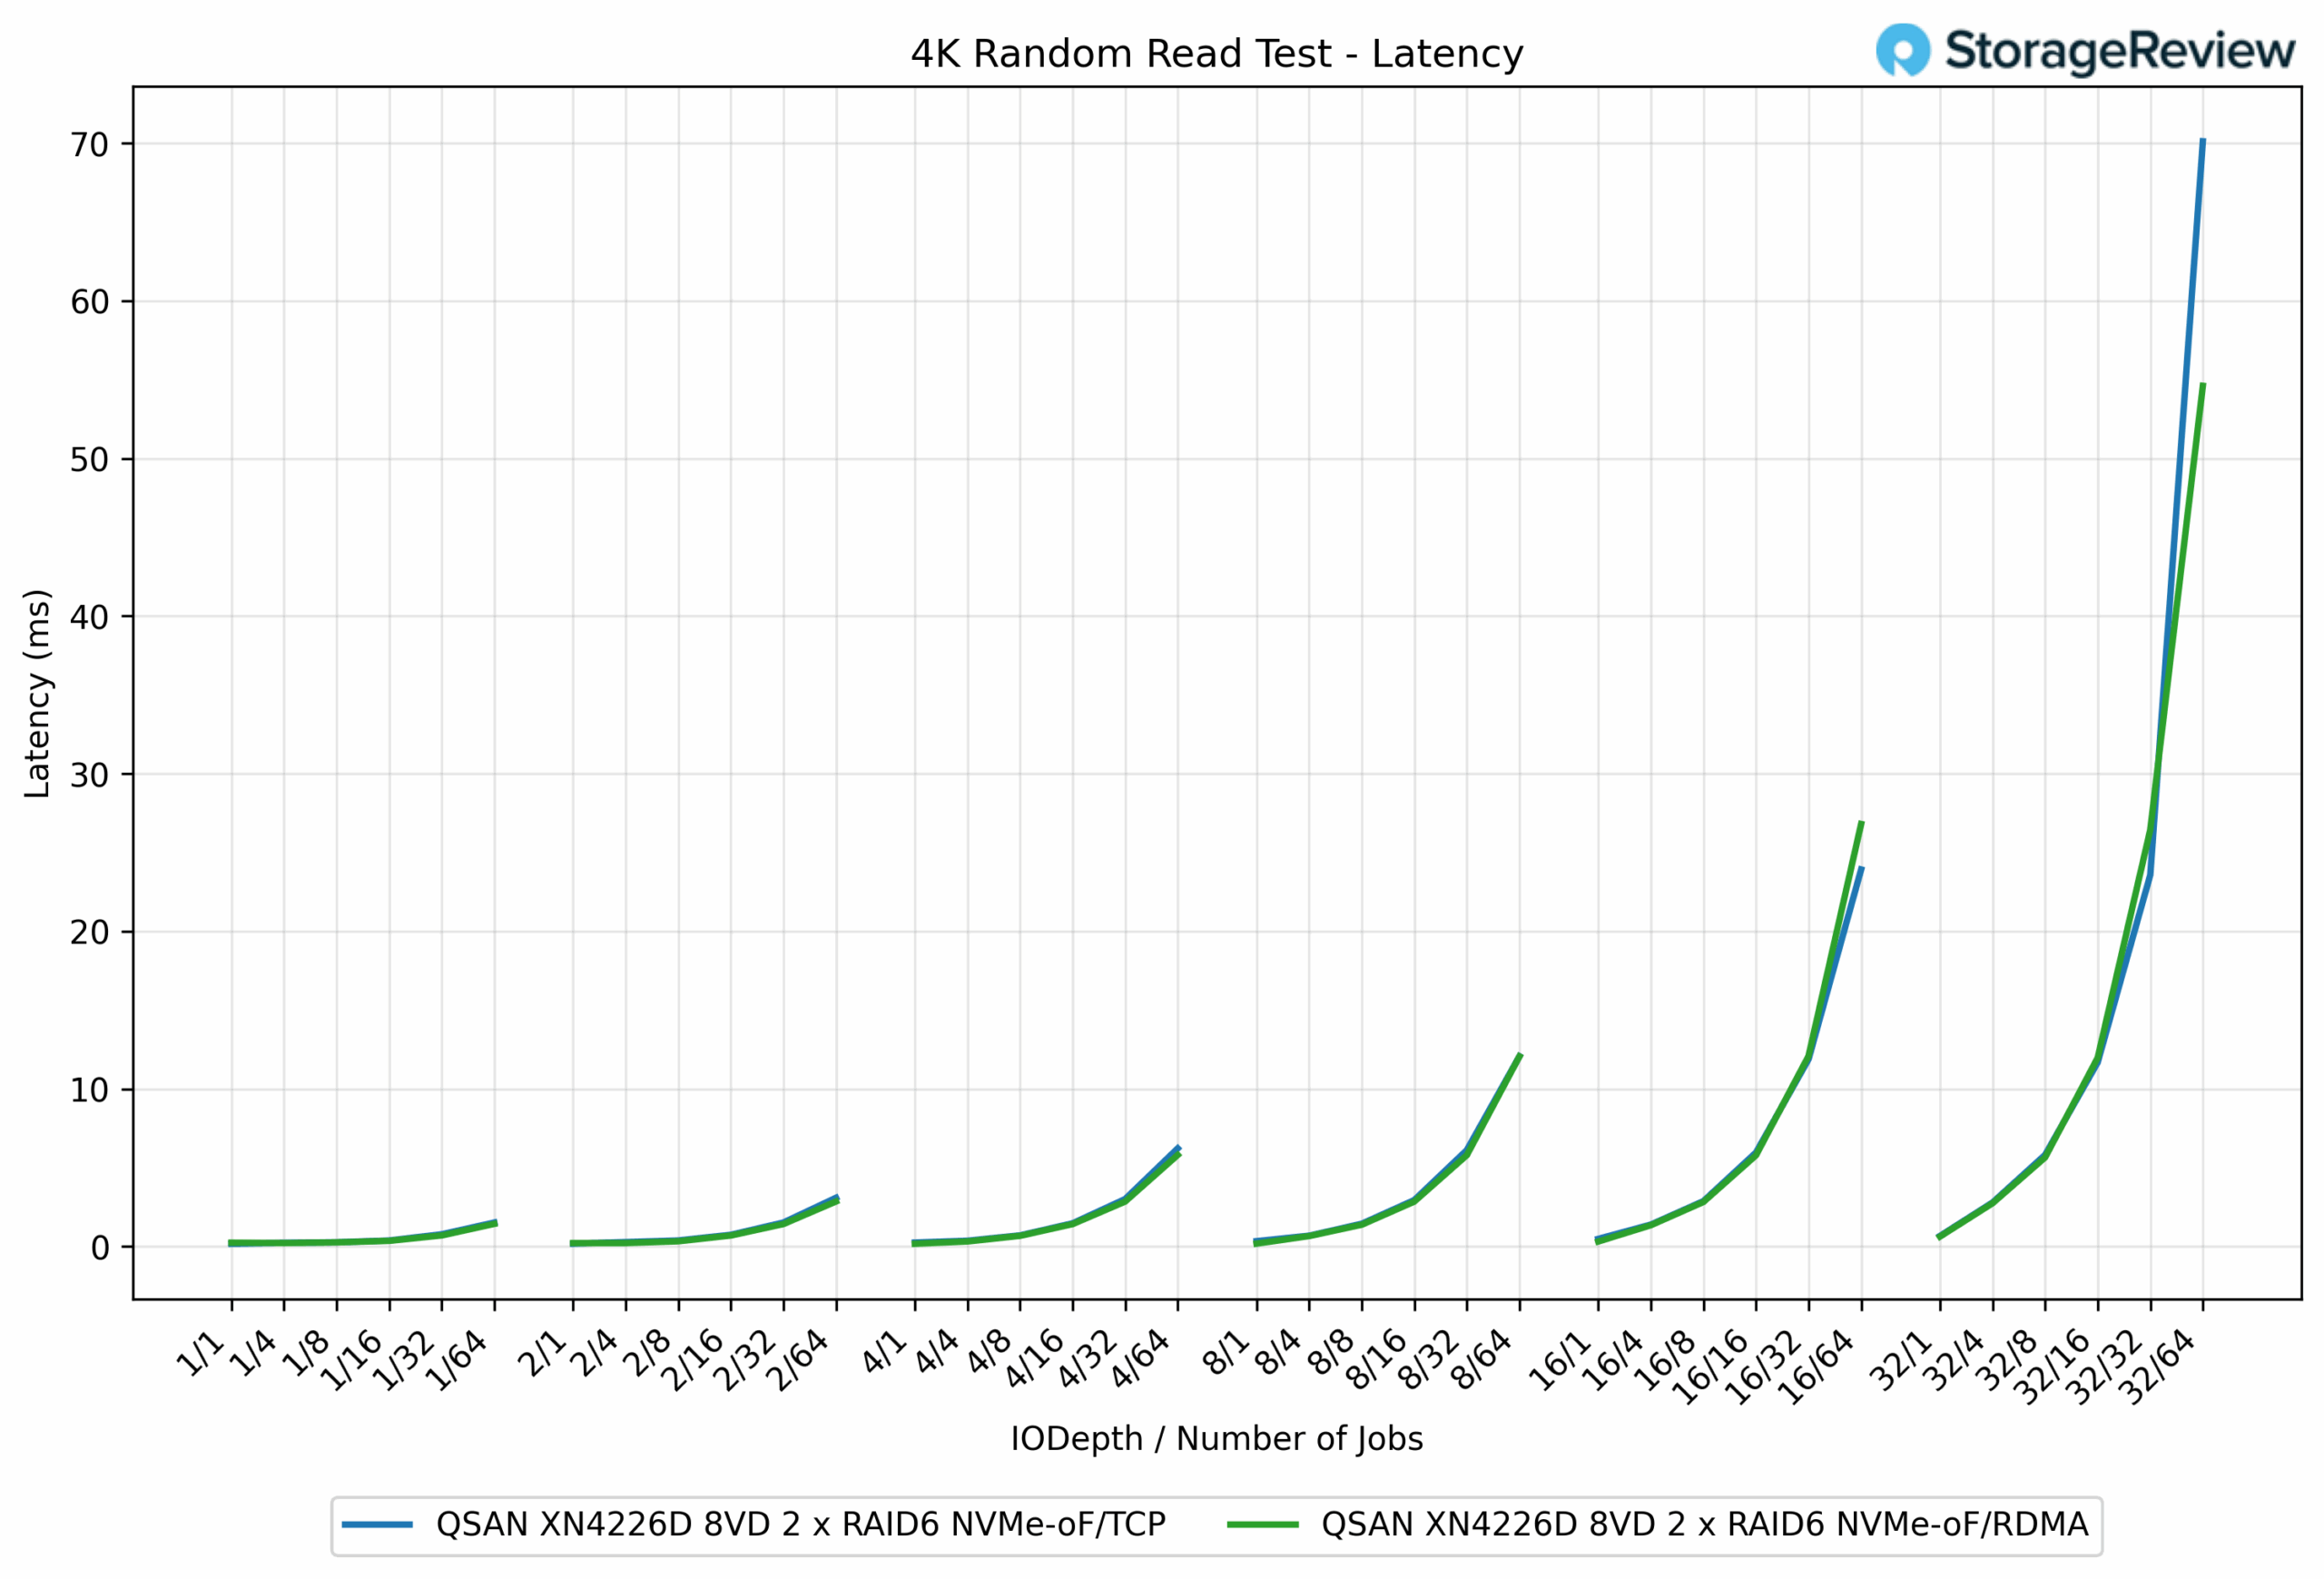
No teste de latência de leitura aleatória em 4K, o RDMA demonstrou uma clara vantagem de eficiência sobre o TCP, notadamente à medida que as cargas de trabalho aumentavam em escala. Em profundidades de fila leves, os dois protocolos foram quase idênticos. Por exemplo, no trabalho QD1/1, o TCP registrou 0.24 ms, enquanto o RDMA ficou logo atrás, com 0.27 ms.
Com o aumento da simultaneidade, o RDMA assumiu a liderança. Nos jobs QD16/64, o RDMA atingiu 23.92 ms, enquanto o TCP atingiu 26.81 ms, uma melhoria de 10.8%. Na carga máxima de jobs QD32/64, o RDMA concluiu a 54.61 ms, enquanto o TCP disparou para 70.12 ms, uma redução de 22% na latência do RDMA.
Desempenho de armazenamento GPUDirect
Um dos testes que realizamos neste banco de testes foi o Magnum IO GPUDirect Storage (GDS). O GDS é um recurso desenvolvido pela NVIDIA que permite que as GPUs ignorem a CPU ao acessar dados armazenados em unidades NVMe ou outros dispositivos de armazenamento de alta velocidade. Em vez de rotear os dados pela CPU e pela memória do sistema, o GDS permite a comunicação direta entre a GPU e o dispositivo de armazenamento, reduzindo significativamente a latência e melhorando a taxa de transferência de dados.
Como funciona o armazenamento GPUDirect
Tradicionalmente, quando uma GPU processa dados armazenados em uma unidade NVMe, os dados precisam primeiro passar pela CPU e pela memória do sistema antes de chegar à GPU. Esse processo cria gargalos, pois a CPU se torna um intermediário, aumentando a latência e consumindo recursos valiosos do sistema. O GPUDirect Storage elimina essa ineficiência, permitindo que a GPU acesse os dados diretamente do dispositivo de armazenamento por meio do barramento PCIe. Esse caminho direto reduz a sobrecarga associada à movimentação de dados, permitindo transferências de dados mais rápidas e eficientes.
Cargas de trabalho de IA, especialmente aquelas que envolvem aprendizado profundo, exigem um alto consumo de dados. O treinamento de grandes redes neurais requer o processamento de terabytes de dados, e qualquer atraso na transferência de dados pode levar à subutilização de GPUs e a tempos de treinamento mais longos. O GPUDirect Storage aborda esse desafio garantindo que os dados sejam entregues à GPU o mais rápido possível, minimizando o tempo ocioso e maximizando a eficiência computacional.
Além disso, o GDS é particularmente benéfico para cargas de trabalho que envolvem streaming de grandes conjuntos de dados, como processamento de vídeo, processamento de linguagem natural ou inferência em tempo real. Ao reduzir a dependência da CPU, o GDS acelera a movimentação de dados e libera recursos da CPU para outras tarefas, aprimorando ainda mais o desempenho geral do sistema.
Além da largura de banda bruta, o GPUDirect com NVMe-oF (TCP/RDMA) também oferece E/S de latência ultrabaixa. Isso garante que as GPUs nunca fiquem sem dados, tornando o sistema ideal para inferência de IA em tempo real, pipelines de análise e reprodução de vídeo.
Para muitas implantações práticas, isso se traduz em uma taxa de transferência utilizável de 100–200 GbE, alinhando-se perfeitamente com cargas de trabalho como inferência de IA (2–4 GPUs), produção de mídia (reprodução de transmissão, cache de borda OTT), análise de vídeo de vigilância e pontos de verificação de HPC.
Taxa de transferência de leitura
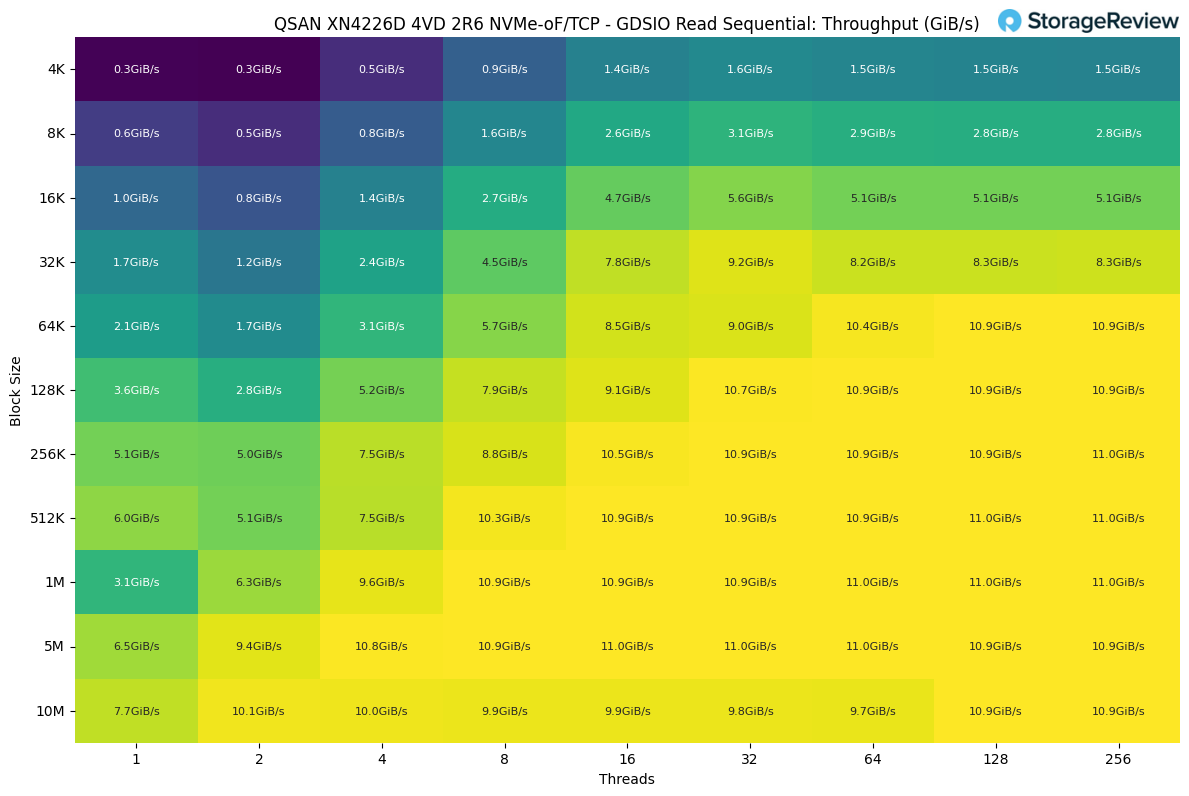
Na carga de trabalho de Leitura Sequencial do GDSIO, a taxa de transferência aumentou de forma constante, tanto com o tamanho do bloco quanto com a contagem de threads, atingindo um máximo de 11.0 GiB/s em vários pontos de teste. Os resultados mais altos foram mantidos quando os tamanhos de bloco atingiram 512 K ou mais, onde a taxa de transferência se estabilizou consistentemente entre 10.9 e 11.0 GiB/s, independentemente da contagem de threads.
Em tamanhos de bloco menores, o desempenho começou bem abaixo. Por exemplo, com blocos de 4K, a taxa de transferência começou em apenas 0.3 GiB/s com uma única thread e se estabilizou em 1.5 GiB/s mesmo com 256 threads. Em comparação, aumentar o tamanho do bloco para 64K permitiu que o sistema escalasse até 10.9 GiB/s, quase saturando a taxa de transferência com contagens de threads mais altas.
O ponto ideal pareceu ser entre 128K e 256K blocos, onde a taxa de transferência ultrapassou 10GiB/s com 32 ou mais threads e permaneceu consistente nos maiores tamanhos de bloco testados. Isso demonstra como a plataforma atinge a saturação total da largura de banda quando os tamanhos de bloco se tornam suficientemente grandes, com apenas ganhos incrementais acima de 256K.
Latência de leitura
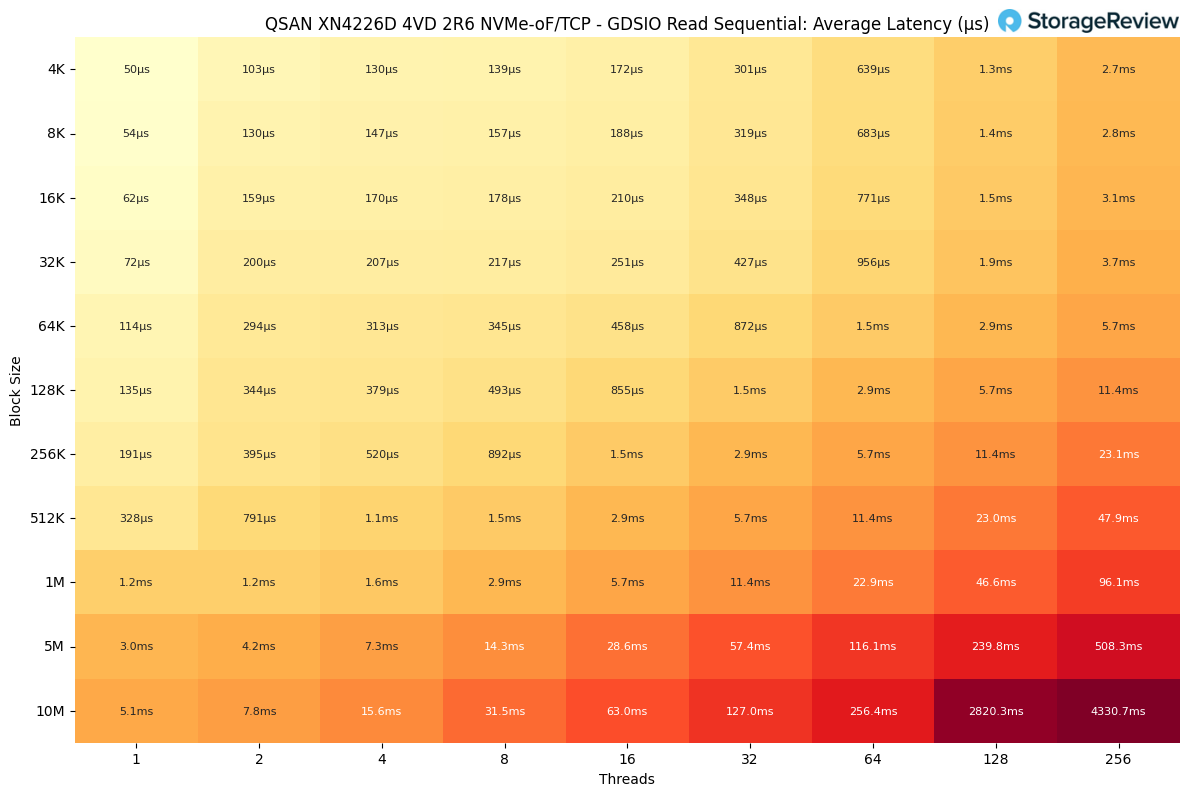
Nos resultados de latência de leitura sequencial do GDSIO, os tempos de resposta aumentaram previsivelmente com o tamanho do bloco e a contagem de threads. Nas menores cargas de trabalho, a latência permaneceu extremamente baixa. Por exemplo, com blocos de 4K em uma única thread, a latência foi de apenas 50µs, permanecendo abaixo de 200µs em blocos de até 32K com simultaneidade mínima.
À medida que a contagem de threads aumentava, a latência começou a aumentar de forma mais perceptível. Com 64 mil blocos e 64 threads, a latência atingiu 1.5 ms, dobrando para 2.9 ms com 128 threads e subindo para 5.7 ms com 256 threads. Em contraste, blocos menores, como 4 K e 8 K, atingiram apenas a faixa de 2.7 a 2.8 ms, mesmo no máximo de 256 threads, demonstrando um controle mais rigoroso em granularidades mais finas.
Blocos maiores geraram saltos mais drásticos. Com 1 milhão de blocos e 256 threads, a latência atingiu 96.1 ms, enquanto blocos de 10 milhões com 256 threads atingiram 4.3 s, demonstrando claramente os limites de escalabilidade do sistema em condições extremas.
Taxa de transferência de gravação
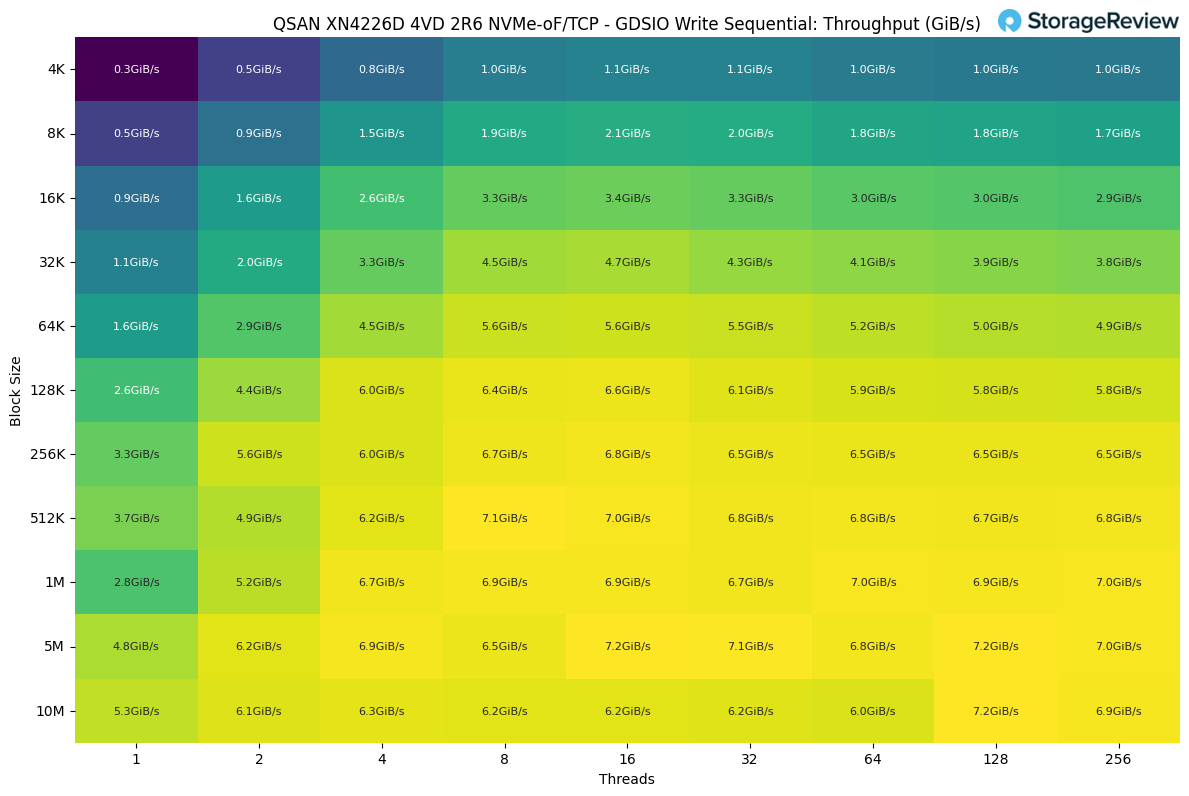
Na carga de trabalho de Gravação Sequencial do GDSIO, a taxa de transferência aumentou com o tamanho do bloco e a contagem de threads, mas ficou bem abaixo do teto de desempenho de leitura. O sistema atingiu um pico de 7.2 GiB/s, utilizando tamanhos de bloco maiores, como 5M e 10M, com 128 threads.
Nos menores tamanhos de bloco, a taxa de transferência foi modesta. Com blocos de 4K, o desempenho começou em 0.3 GiB/s com uma única thread e aumentou para 1.0 GiB/s com 32 threads, estabilizando-se em seguida. Aumentar o tamanho do bloco para 64K liberou mais largura de banda, atingindo 5.6 GiB/s com oito threads, antes de cair ligeiramente com maior simultaneidade.
O melhor equilíbrio ocorreu entre 512K e 1M de blocos, onde a taxa de transferência variou de 6.7 a 7.1GiB/s em diferentes contagens de threads, indicando que o sistema atingiu a saturação nessa faixa. Além desse ponto, threads adicionais não geraram ganhos significativos e, em alguns casos, o desempenho caiu ligeiramente devido ao aumento da sobrecarga.
Gravar Latência
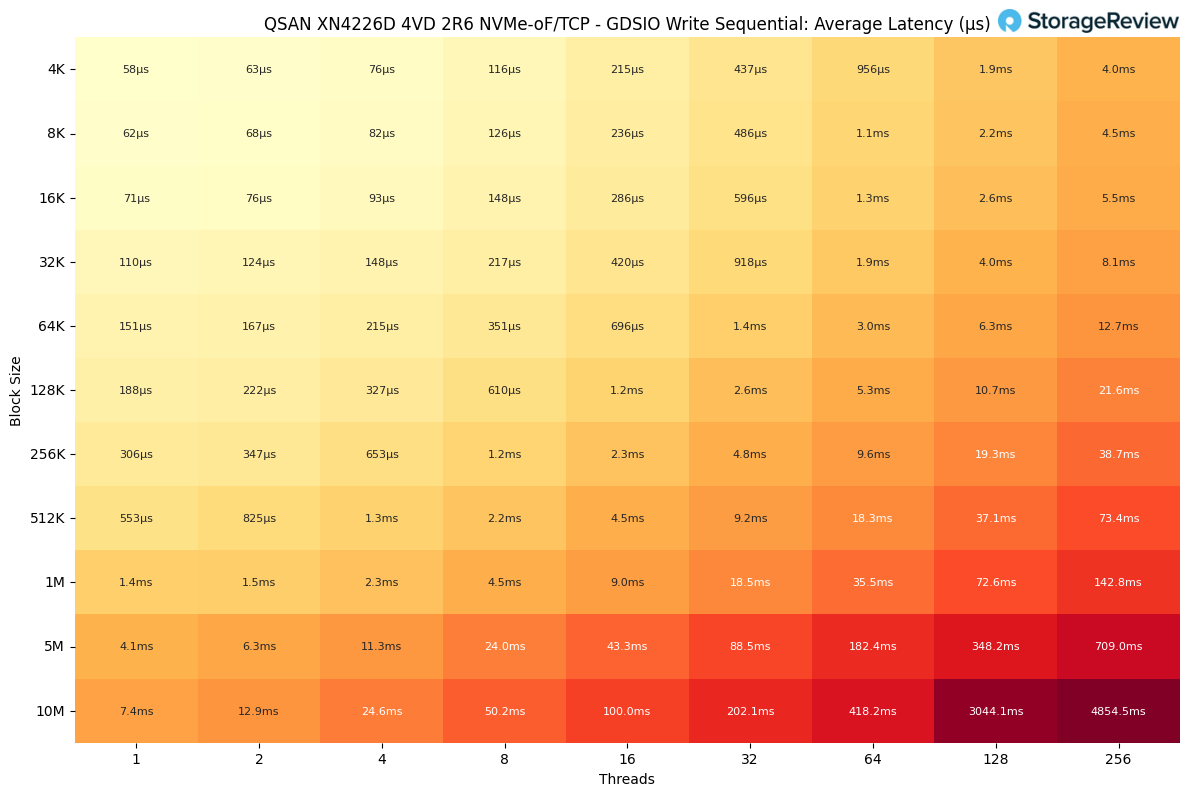
Nos resultados de latência de gravação sequencial do GDSIO, os tempos de resposta aumentaram suavemente em tamanhos de bloco menores, mas aumentaram acentuadamente quando o tamanho do bloco e a contagem de threads aumentaram.
Nas menores cargas de trabalho, a latência foi mínima. Com blocos de 4K e uma única thread, a latência média foi de apenas 58µs e permaneceu abaixo de 200µs em blocos de 16K com até quatro threads. Mesmo com blocos de 32K e simultaneidade moderada, a latência permaneceu abaixo de 1ms.
À medida que o sistema migrou para blocos maiores, os atrasos se tornaram mais pronunciados. Com 128 mil blocos e 64 threads, a latência atingiu 5.3 ms, dobrando novamente para 10.7 ms com 128 threads. Com 512 mil blocos, os resultados se estenderam ainda mais, chegando a 73.4 ms com 256 threads.
Os casos mais pesados, blocos de 5M e 10M em 256 threads, experimentaram um pico drástico na latência para 709 ms e 4.8 segundos, respectivamente, revelando os limites superiores do dimensionamento de gravação sequencial.
Considerações finais da análise do Fortune Dragon
O XN4226D da QSAN atende exatamente onde muitas equipes de TI precisam. É uma plataforma NVMe unificada e com controlador duplo que suporta protocolos modernos e legados sem exigir alterações arquitetônicas. Em nossos testes, o TCP liderou as leituras sequenciais de grande porte a 21.21 GB/s, enquanto o RDMA produziu as gravações sequenciais de grande porte mais potentes a 11.14 GB/s e manteve a latência mais baixa à medida que a simultaneidade aumentava. Em tamanhos de bloco menores, o RDMA melhorou consistentemente a eficiência da gravação aleatória e manteve o comportamento da cauda sob controle. A conclusão é simples. Use o TCP NVMe-oF para ampla compatibilidade e alta largura de banda de leitura e opte pelo RDMA quando a latência e a consistência da gravação mais importam.
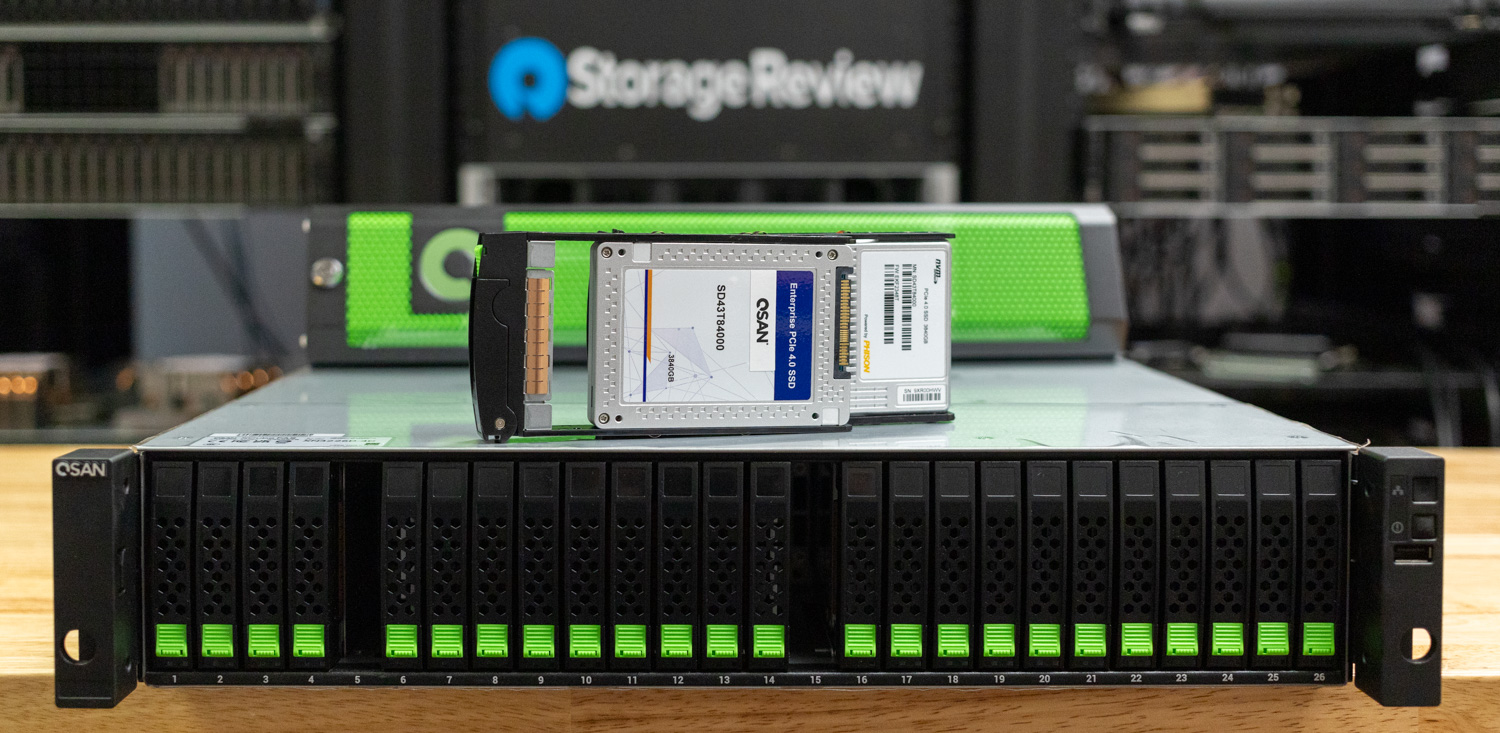
O hardware é prático. Você obtém 26 baias frontais para unidades NVMe U.2 ou U.3 em um chassi 2U, com alta disponibilidade ativa e expansão direta para prateleiras SAS quando a capacidade tem prioridade sobre a velocidade bruta do NVMe. O QSM 4 oferece os serviços de dados esperados e uma interface de usuário limpa, juntamente com uma API REST que facilita a integração perfeita com a automação existente. Pequenas equipes de TI devem achar o QSM 4 fácil de configurar e gerenciar. Para validar isso, integramos facilmente nosso cluster Proxmox, fornecendo a essas VMs acesso a armazenamento de alta velocidade. Para cargas de trabalho mais avançadas, o QSAN está bem preparado para atender às necessidades de IA de PMEs.
Para organizações que valorizam desempenho previsível, gerenciamento limpo e alcance multiprotocolo, o XN4226D é fácil de recomendar. Ele oferece throughput NVMe real, alta latência de gravação com RDMA e uma experiência de software que não causará lentidão. Adicione o preço acessível e esta plataforma QSAN pode ancorar ambientes mistos sem problemas.


 Amazon