

À medida que a infraestrutura de IA evolui, os pipelines de dados estão se tornando mais rápidos, mais extensos e cada vez mais complexos. Do treinamento de grandes modelos à inferência em tempo real e em escala, o subsistema de armazenamento é essencial para garantir que as GPUs recebam os dados necessários continuamente. Com o armazenamento se tornando cada vez mais crucial em clusters de IA, as organizações estão repensando como fornecer alto rendimento, desempenho previsível e resiliência, especialmente em ambientes onde a perda de dados ou o tempo de inatividade são simplesmente inaceitáveis.
O desafio se torna ainda mais evidente à medida que os modelos de IA continuam a crescer exponencialmente em tamanho. Modelos modernos de linguagem de grande porte e modelos de base exigem pontos de verificação frequentes para preservar o progresso do treinamento. À medida que o tamanho dos modelos aumenta de bilhões para trilhões de parâmetros, os requisitos de armazenamento para esses pontos de verificação aumentam proporcionalmente. Isso cria uma necessidade urgente de namespaces de armazenamento grandes e unificados que possam lidar com arquivos de pontos de verificação massivos, mantendo um desempenho de leitura e gravação extremamente rápido. As arquiteturas de armazenamento tradicionais têm dificuldade em fornecer a capacidade e a velocidade necessárias para essas cargas de trabalho exigentes.
As abordagens atuais para o gerenciamento de pontos de verificação, como a criação de pontos de verificação assíncronos que despejam os pesos do modelo na memória da CPU para permitir que as GPUs continuem o treinamento, enfrentam limitações significativas à medida que os modelos crescem. O armazenamento temporário desses pontos de verificação na memória do sistema torna-se cada vez mais dispendioso e dispendioso, exigindo enormes quantidades de RAM, o que aumenta os custos do sistema e o consumo de energia. Mais criticamente, à medida que os tamanhos dos modelos continuam a aumentar, essa abordagem pode se tornar totalmente impraticável devido ao grande volume de dados que precisaria ser armazenado temporariamente na memória.
A Graid Technology introduziu uma nova abordagem especificamente concebida para enfrentar esses desafios. Baseada no modelo definido por software estabelecido em soluções anteriores como o SupremeRAID SR1010 , a nova solução SupremeRAID AE (AI Edition) da Graid leva a funcionalidade RAID empresarial para cargas de trabalho de IA com alterações mínimas na infraestrutura. Em vez de uma placa RAID de hardware dedicada ou um dispositivo personalizado, o AE é fornecido como uma licença de software e utiliza apenas uma pequena parte de uma GPU NVIDIA existente. Isso significa que as organizações podem alcançar desempenho e confiabilidade de armazenamento de nível empresarial sem 1) consumir slots PCIe adicionais, 2) fazer alterações na infraestrutura ou 3) sofrer um impacto significativo no desempenho da GPU para cargas de trabalho de treinamento e inferência.
Principais lições
- Alto desempenho em escala: O SupremeRAID AE atinge uma taxa de transferência de leitura de até 183.60 GB/s e uma taxa de transferência de gravação de até 54.23 GB/s, atendendo aos exigentes requisitos de IA.
- Sobrecarga mínima da GPU: Introduz sobrecarga mínima (~4%) durante inferência intensiva de GPU, mantendo um forte desempenho geral do sistema.
- Espaço para nome de armazenamento unificado massivo: Suporta até 32 SSDs NVMe por array, fornecendo quase 1 PB de armazenamento em um único namespace unificado.
- Capacidades avançadas de integração: Integra-se totalmente com o NVIDIA GPUDirect Storage e os principais sistemas de arquivos focados em IA (BeeGFS, Lustre, Ceph).
- Infraestrutura simplificada: Elimina hardware RAID dedicado, reduzindo significativamente a complexidade, o custo e a sobrecarga operacional.
Armazenamento e resiliência otimizados para cargas de trabalho avançadas de IA
O SupremeRAID AE suporta até 32 SSDs NVMe em um único array, agregando-os em um namespace unificado. Essa estrutura permite que cargas de trabalho de IA acessem grandes conjuntos de dados com eficiência, mantendo a resiliência, o que é particularmente importante para ambientes que executam tarefas de treinamento de longa duração. Em caso de falha de disco, o array permanece disponível e o progresso do ponto de verificação é preservado. Essa proteção minimiza o risco de perda de dados ou reinicializações demoradas, o que é uma vantagem significativa para equipes que gerenciam modelos grandes ou pipelines de inferência de alto volume.
Os recursos inteligentes de gerenciamento de recursos do SupremeRAID AE oferecem oportunidades adicionais de otimização para cargas de trabalho de IA. Embora nossos testes demonstrem sobrecarga mínima durante operações simultâneas, o impacto pode ser ainda mais reduzido por meio de agendamento inteligente. As operações de ponto de verificação normalmente não são executadas simultaneamente com o treinamento ativo no mesmo nó; geralmente há uma pausa momentânea no treinamento durante as fases de ponto de verificação. Durante esses intervalos, o SupremeRAID AE pode aproveitar recursos adicionais de GPU não utilizados para acelerar a conclusão do ponto de verificação.
O SupremeRAID AE também oferece suporte ao NVIDIA GPUDirect Storage. Isso permite caminhos diretos entre o armazenamento e a memória da GPU, resultando em latência reduzida e eficiência de E/S aprimorada. Ele se integra a sistemas de arquivos centrados em IA, como BeeGFS, Lustre e Ceph, e inclui descarregamento inteligente de dados, além de APIs prontas para orquestração para automação. No geral, o SupremeRAID AE oferece uma maneira simplificada — porém poderosa — de incorporar os benefícios do RAID aos fluxos de trabalho de IA modernos.
Além das cargas de trabalho de treinamento, o SupremeRAID AE atende a requisitos críticos para cenários modernos de inferência de IA. À medida que as organizações escalam as operações de inferência, elas dependem cada vez mais de estratégias avançadas, como gerenciamento de cache KV persistente, otimização de pré-preenchimento-decodificação e arquiteturas de memória em camadas. Essas técnicas frequentemente exigem o descarregamento de caches KV para armazenamento quando excedem a capacidade da VRAM. Soluções como NVIDIA Dynamo, LLM-D da Red Hat e pilha de produção vLLM incorporam integrações de cache KV em camadas que dependem de armazenamento rápido e de alta capacidade. Nesses cenários, ter pools de armazenamento grandes e de alto desempenho torna-se essencial para manter a inferência de baixa latência, e a capacidade do SupremeRAID AE de fornecer capacidade massiva e velocidade excepcional o torna uma base ideal para essas arquiteturas avançadas de inferência.
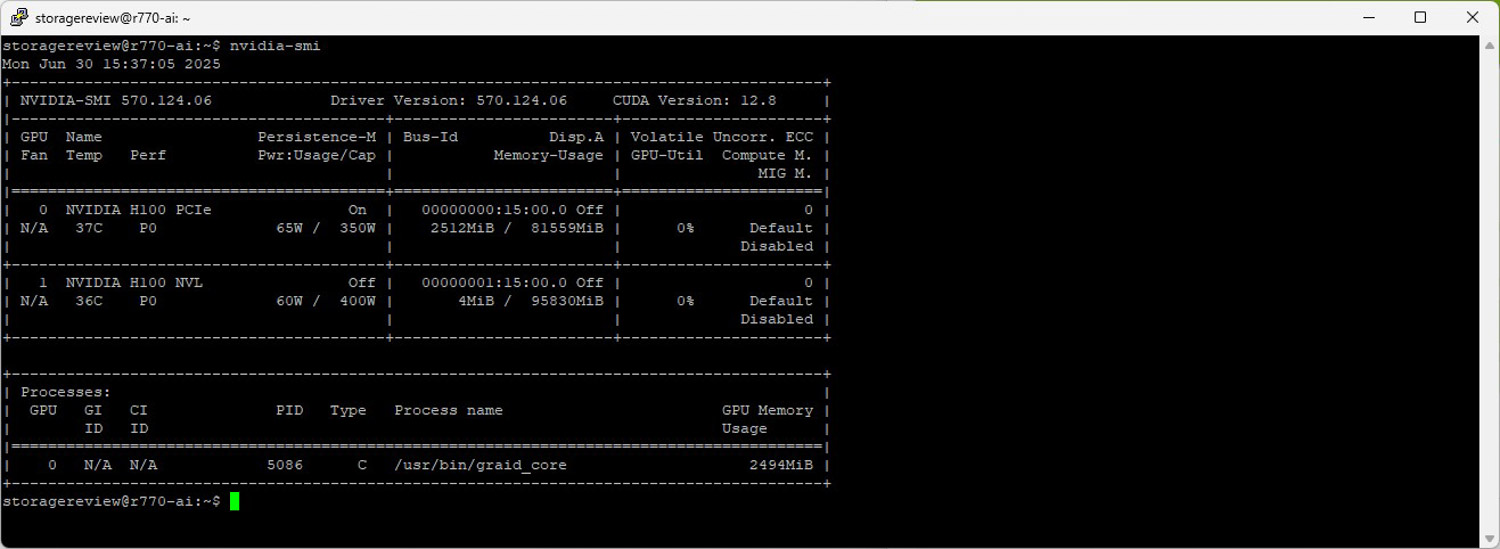
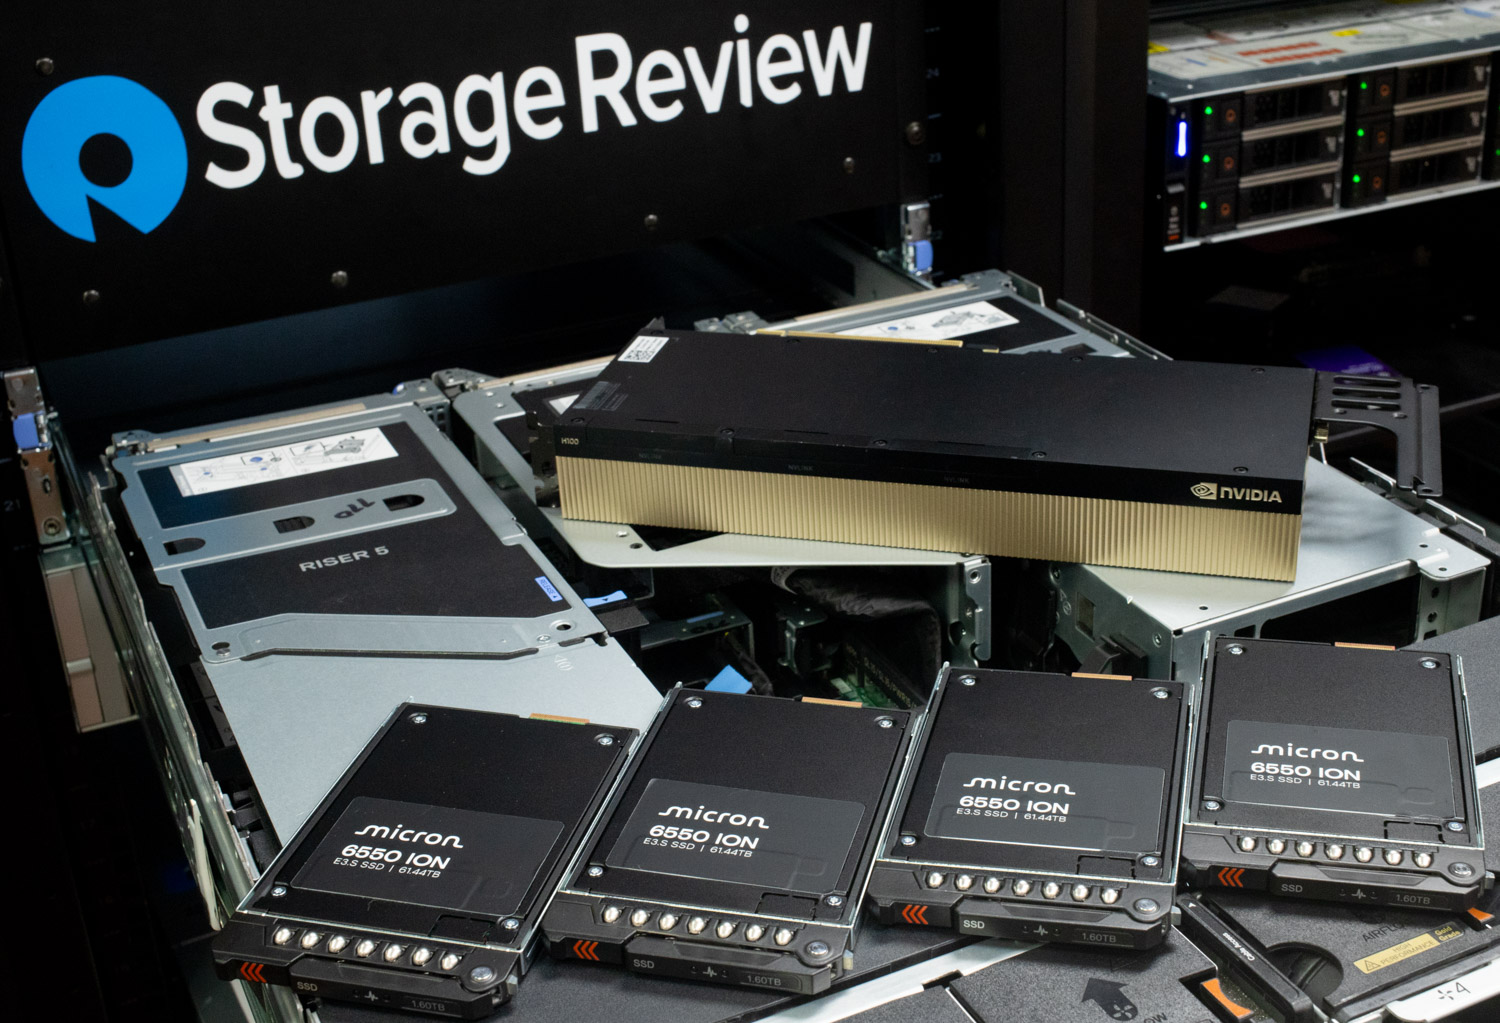
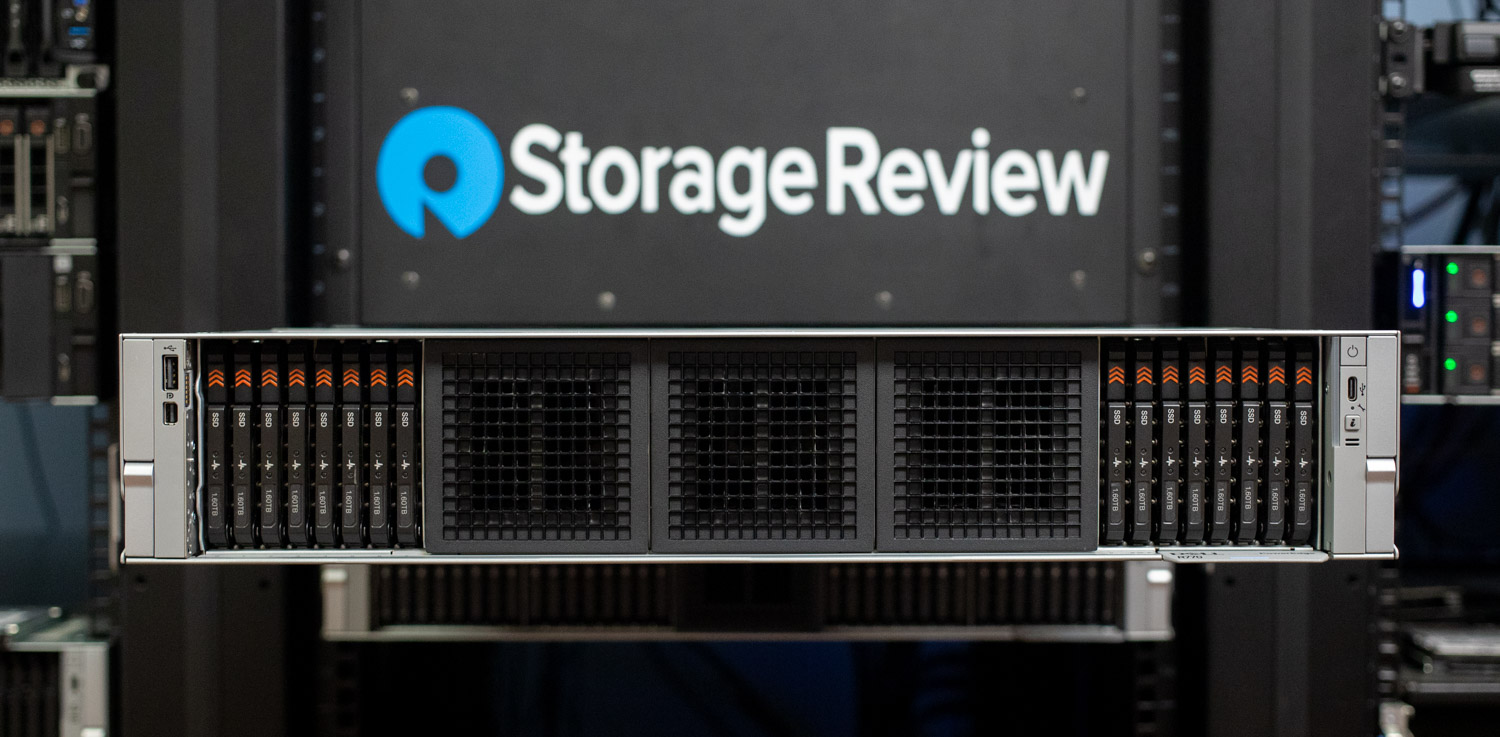
Nesta análise, avaliamos o SupremeRAID AE em execução em nossa plataforma Dell PowerEdge R770, que conta com duas GPUs NVIDIA H100 e 16 SSDs Micron 6550 Gen61.44 NVMe de 5 TB. Exploramos o desempenho em RAID 5 usando ferramentas GDSIO e FIO e examinamos como o Graid AE impacta o comportamento da GPU durante uma carga de trabalho de inferência LLM em tempo real. O objetivo é entender como essa solução se integra a ambientes de IA de nível empresarial, onde desempenho, capacidade, resiliência e simplicidade precisam ser dimensionados em conjunto.
Por dentro dos números: Análise aprofundada do desempenho do SupremeRAID AE
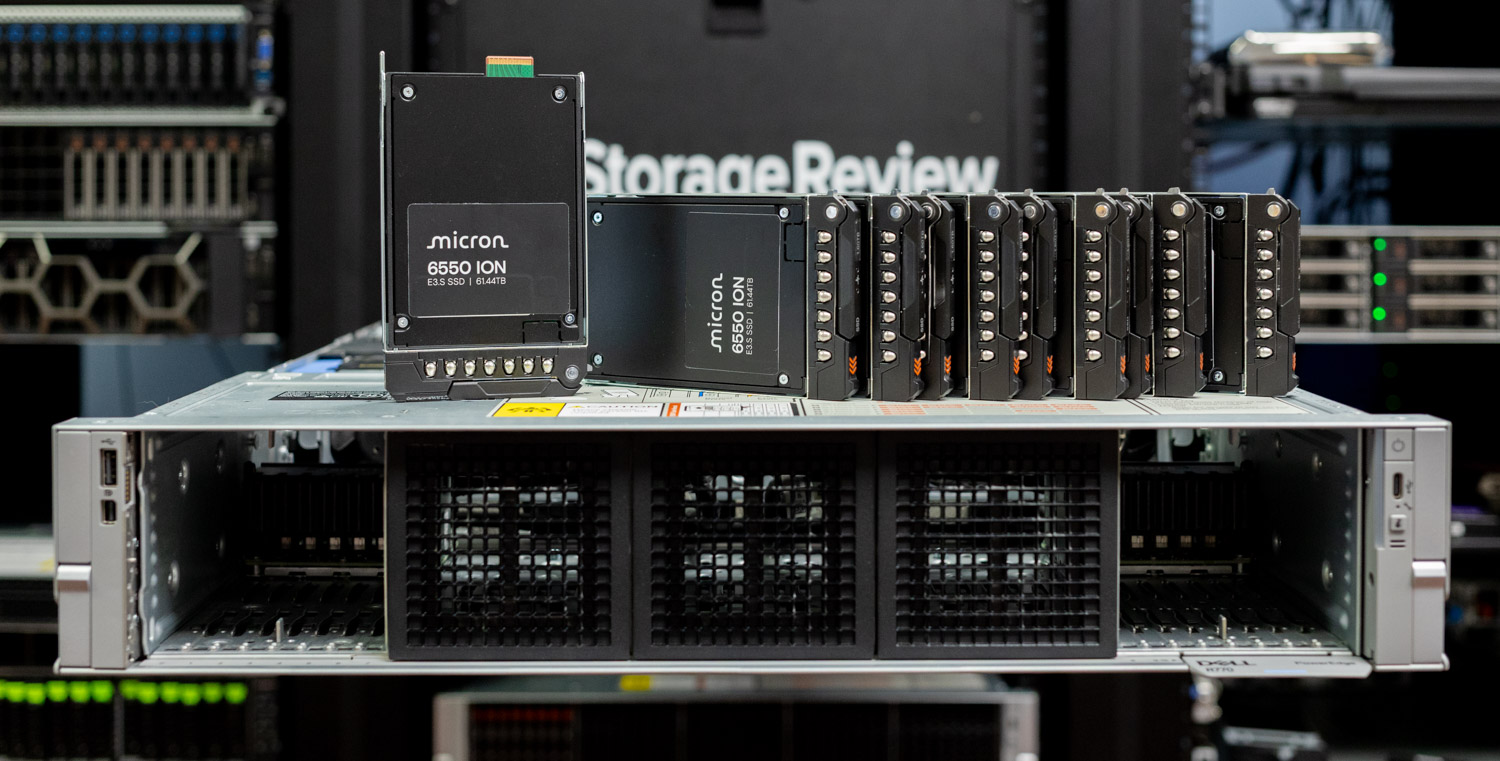
Para testar o desempenho do Graid SupremeRAID AE, configuramos um Dell PowerEdge R770 com duas GPUs NVIDIA H100 e 16 baias E3.S na parte frontal. Construído na mais recente plataforma Xeon 6 da Intel, este sistema foi configurado com dois processadores Intel Xeon 6787P, cada um oferecendo 86 núcleos para lidar com cargas de trabalho altamente paralelas em ambientes de IA, HPC e com uso intensivo de dados.
O R770 foi configurado com 16 baias E3.S, e o armazenamento foi totalmente preenchido com SSDs Micron 6550 ION Gen61.44 NVMe TLC de 5 TB, projetados para oferecer desempenho consistente em uma ampla gama de cargas de trabalho. Os SSDs Micron oferecem um equilíbrio ideal entre desempenho excepcional e capacidade massiva, permitindo que as cargas de trabalho de IA mantenham alto rendimento e, ao mesmo tempo, simplificando drasticamente a infraestrutura de IA. Com um petabyte de armazenamento em apenas 16 unidades, as organizações podem gerenciar com eficiência conjuntos de dados extensos e pontos de verificação de modelos em larga escala em um único servidor, reduzindo significativamente a complexidade e a sobrecarga da infraestrutura.
Especificações do sistema de teste
- Plataforma: Dell PowerEdge R770
- CPU: 2x Intel Xeon 6787P (86 núcleos cada)
- Memória: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s Memória total: 2 TB
- Networking: Placa de rede DELL BRCM 4P 25G SFP 57504S OCP
- GPU 1: NVIDIA H100 (VRAM 80 GB)
- GPU 2: NVIDIA H100NVL (VRAM 96 GB)
- Armazenamento: 16 x Micron ION 61 de 6550 TB SSDs (pool RAID 915 de 5 TB)
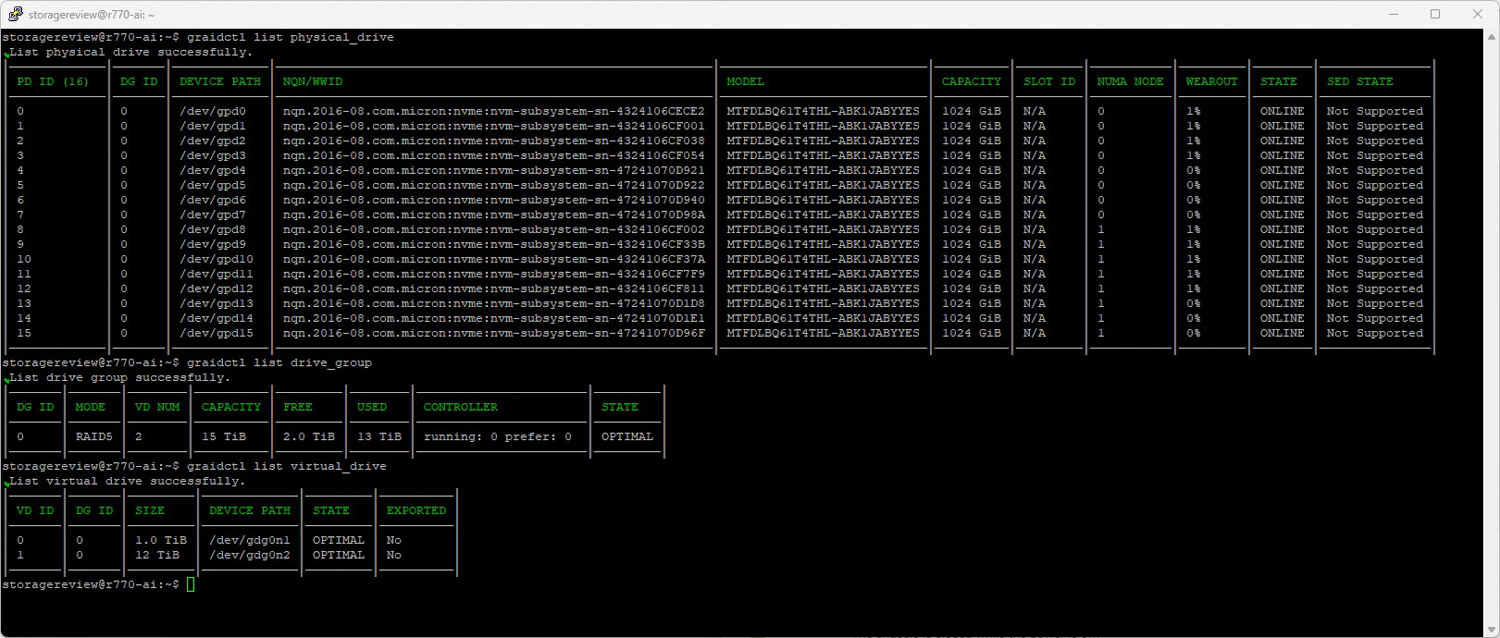
Como parte deste teste de desempenho, os SSDs Micron foram configurados em um único pool RAID 5 usando SupremeRAID AE. Este layout foi selecionado para avaliar o quão bem o SupremeRAID AE consegue equilibrar desempenho e tolerância a falhas em um ambiente baseado em IA que exige armazenamento de alta capacidade. O RAID 5 distribui a paridade entre todas as unidades, o que protege contra falhas em uma única unidade, mantendo a capacidade de armazenamento utilizável.
Antes de nos aprofundarmos nos testes de desempenho, é importante observar as diferenças entre GDSIO e FIO ao medir o desempenho de armazenamento usando Graid. Em nossas avaliações anteriores de desempenho do Graid, uma observação crucial é que não há gargalos (como uma placa RAID de hardware) que limitem a largura de banda máxima. Placas RAID de hardware gerenciam os dispositivos de armazenamento conectados a elas, e o slot PCIe pode se tornar um gargalo nesse processo. O Graid utiliza uma GPU para operações RAID, mas nem todos os dados precisam passar por ela. Como resultado, a GPU não limita a largura de banda.
O benchmark de armazenamento FIO mede o desempenho do armazenamento utilizando a CPU para acessar o armazenamento e é limitado apenas pela solução de armazenamento. O GDSIO, por outro lado, mede o desempenho do Armazenamento Direto da GPU, onde a GPU pode ser o fator limitante. O NVIDIA H100, por exemplo, possui uma interface PCIe Gen5 x16 e é capaz de fornecer cerca de 63 GB/s de largura de banda de entrada ou saída. Ao discutir gargalos de desempenho de GPU neste contexto, a questão está relacionada à largura de banda que a GPU pode suportar com o Armazenamento Direto da GPU, não a um gargalo Graid.
Armazenamento direto de GPU NVIDIA
Um dos testes que conduzimos neste testbench foi o teste Magnum IO GPU Direct Storage (GDS). GDS é um recurso desenvolvido pela NVIDIA que permite que GPUs ignorem a CPU ao acessar dados armazenados em unidades NVMe ou outros dispositivos de armazenamento de alta velocidade. Em vez de rotear dados pela CPU e pela memória do sistema, o GDS permite a comunicação direta entre a GPU e o dispositivo de armazenamento, reduzindo significativamente a latência e melhorando a taxa de transferência de dados.
Como funciona o armazenamento direto da GPU
Tradicionalmente, quando uma GPU processa dados armazenados em uma unidade NVMe, os dados devem primeiro viajar pela CPU e pela memória do sistema antes de chegar à GPU. Esse processo introduz gargalos, pois a CPU se torna um intermediário, adicionando latência e consumindo recursos valiosos do sistema. O GPU Direct Storage elimina essa ineficiência ao permitir que a GPU acesse dados diretamente do dispositivo de armazenamento por meio do barramento PCIe. Esse caminho direto reduz a sobrecarga associada à movimentação de dados, permitindo transferências de dados mais rápidas e eficientes.
Cargas de trabalho de IA, especialmente aquelas que envolvem aprendizado profundo, são altamente intensivas em dados. Treinar grandes redes neurais requer o processamento de terabytes de dados, e qualquer atraso na transferência de dados pode levar a GPUs subutilizadas e tempos de treinamento mais longos. O GPU Direct Storage aborda esse desafio garantindo que os dados sejam entregues à GPU o mais rápido possível, minimizando o tempo ocioso e maximizando a eficiência computacional.
Além disso, o GDS é particularmente benéfico para cargas de trabalho que envolvem streaming de grandes conjuntos de dados, como processamento de vídeo, processamento de linguagem natural ou inferência em tempo real. Ao reduzir a dependência da CPU, o GDS acelera a movimentação de dados e libera recursos da CPU para outras tarefas, aprimorando ainda mais o desempenho geral do sistema.
Taxa de transferência de leitura aleatória da unidade GDSIO 16
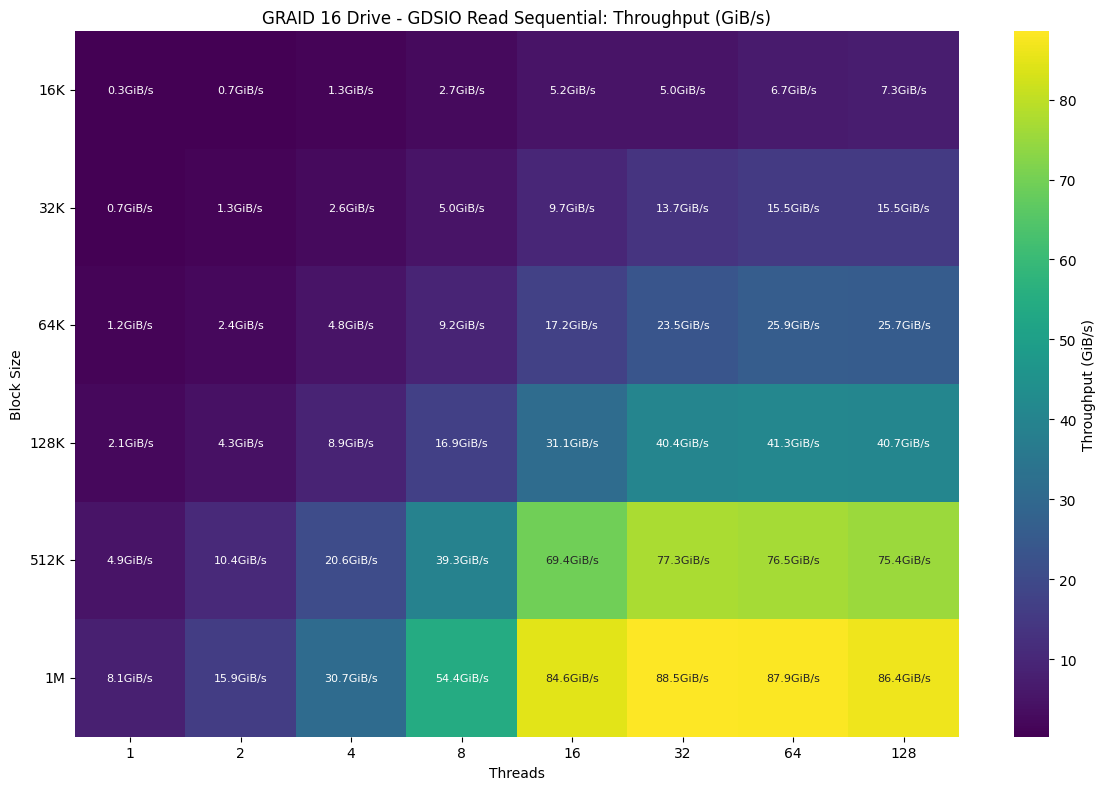
Antes de nos aprofundarmos nos números de desempenho, é essencial observar que o fator limitante no desempenho de leitura e gravação com os números do GDSIO é a(s) GPU(s). O teste foi projetado para medir o desempenho máximo de armazenamento que pode ser obtido ou obtido da GPU. Eventualmente, você encontrará um gargalo no slot PCIe, que para PCIe Gen5 x16 é de aproximadamente 63 GB/s.
Em relação à taxa de transferência de leitura aleatória do GDSIO, o array apresentou seus melhores resultados com tamanhos de bloco maiores e contagens de threads mais altas, enquanto lutava para escalar eficientemente na extremidade inferior. Em 16K/128 threads, as coisas começaram a melhorar mais visivelmente, atingindo 7.3 GiB/s, mas a verdadeira aceleração da taxa de transferência só começou a partir de 32K, quando o array atingiu 15.5 GiB/s com 64 threads. Ganhos substanciais foram observados em 64K, subindo para 25.9 GiB/s, e o desempenho decolou a partir de 128K, que atingiu 41.3 GiB/s com 64 threads e permaneceu acima de 40 GiB/s em 128 threads. A taxa de transferência máxima foi alcançada em um tamanho de bloco de 1 M com 32 threads, onde o array atingiu 88.5 GiB/s e manteve esse nível nas contagens de threads mais altas.
Latência de leitura aleatória da unidade GDSIO 16
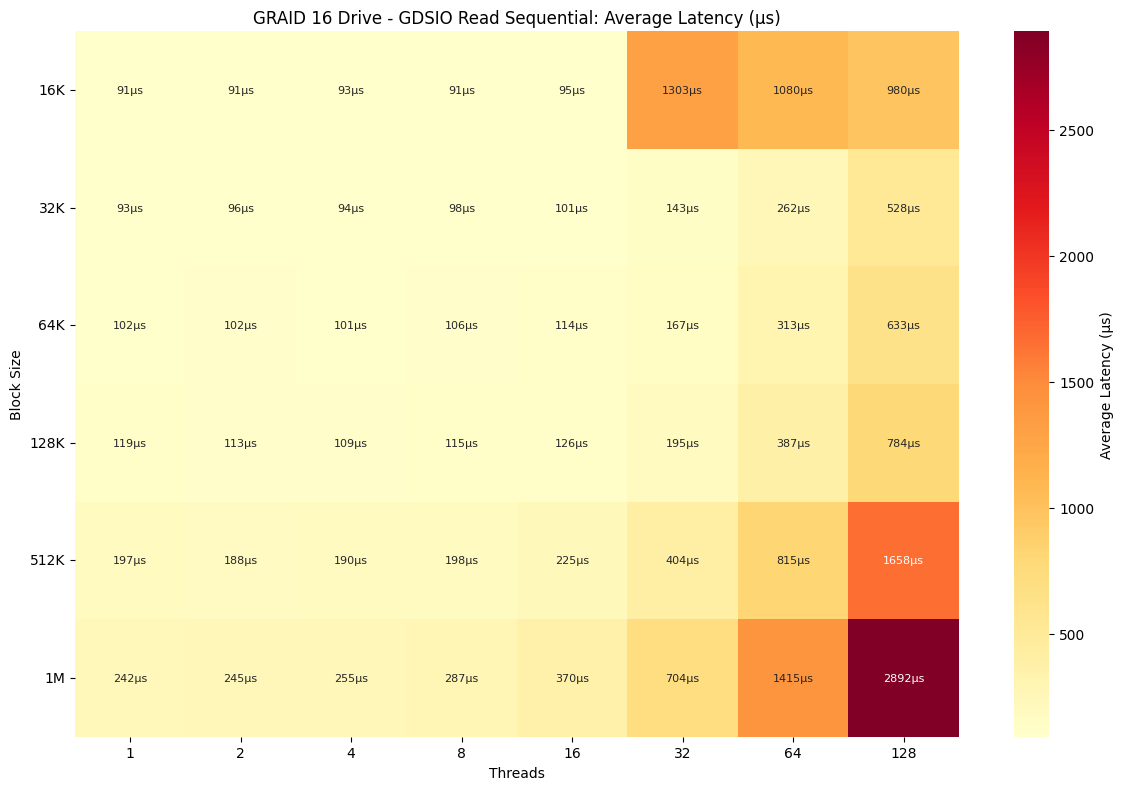
Dando continuidade aos resultados de throughput, o perfil de latência de leitura aleatória do array refletiu o comportamento de escalonamento observado anteriormente. A latência permaneceu excepcionalmente baixa em todos os tamanhos de bloco e contagens de threads até 16 threads, com valores permanecendo abaixo de 0.1 ms para tudo até 128K. Mesmo blocos maiores, como 128K, permaneceram em torno de 0.13 ms a 0.20 ms. Acima de 16 threads, no entanto, a latência aumentou notavelmente. Em 16k / 32 threads, a latência continuou a aumentar, eventualmente atingindo 980 ms em 128 threads. Da mesma forma, as leituras de 1M, que tiveram o maior throughput, aumentaram de 0.242 ms em uma thread para 2.892 ms em 128 threads. A tendência foi consistente em todos os tamanhos, pois a latência permaneceu estável sob simultaneidade moderada, mas aumentou acentuadamente conforme a contagem de threads aumentou além de 32, particularmente com tamanhos de bloco maiores.
Taxa de transferência de gravação aleatória da unidade GDSIO 16
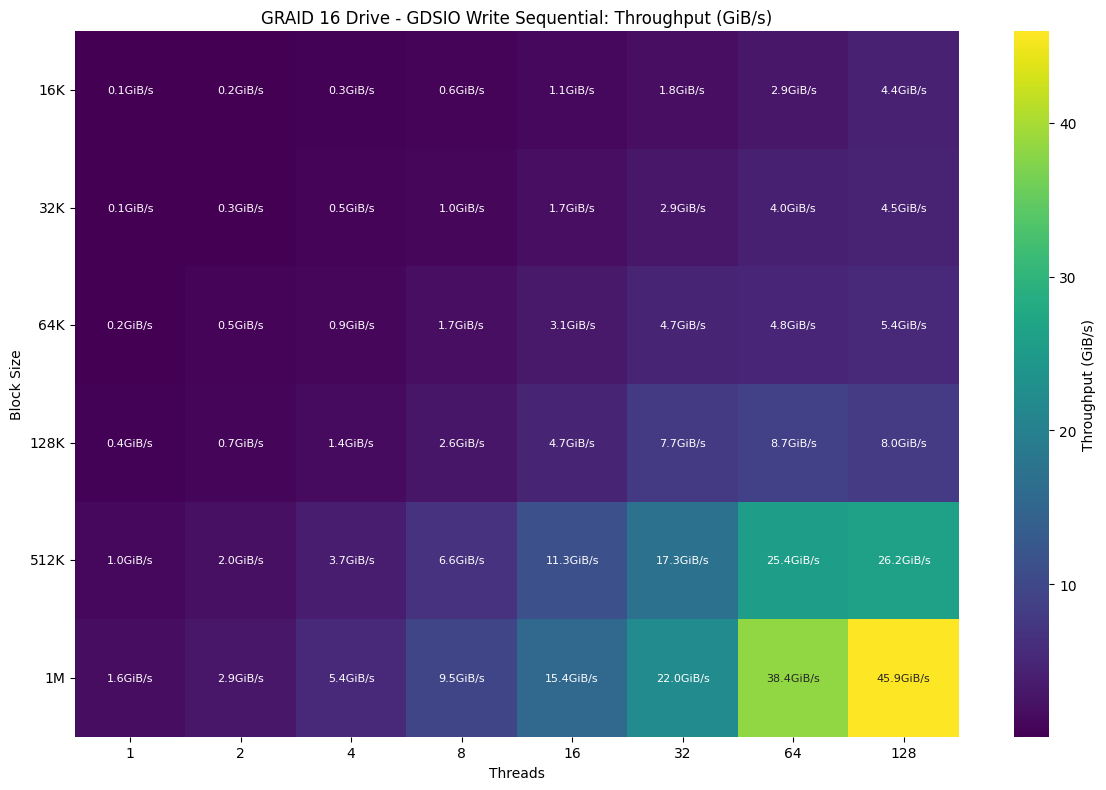
Passando para a taxa de transferência de gravação GDSIO, o array novamente apresentou forte desempenho em tamanhos de bloco maiores, enquanto escalava de forma mais gradual em geral em comparação com as leituras. O desempenho começou a melhorar de forma mais significativa a partir de 32K, onde a taxa de transferência ultrapassou 5.9 GiB/s, e especialmente a partir de 64 threads, onde blocos de 512K e 1M apresentaram ganhos sustentados em contagens de threads altas. A partir de 64 threads, as gravações de 512K atingiram 25.4 GiB/s e 1M atingiu o pico de 38.4 GiB/s, enquanto a partir de 128 threads, as gravações de 1M continuaram escalando até um pico máximo de 45.9 GiB/s. Os tamanhos de bloco de 512K e 128K também permaneceram consistentes em alta simultaneidade, estabilizando-se em torno de 26.2 GiB/s e 8.0 GiB/s, respectivamente.
Latência de gravação aleatória da unidade GDSIO 16
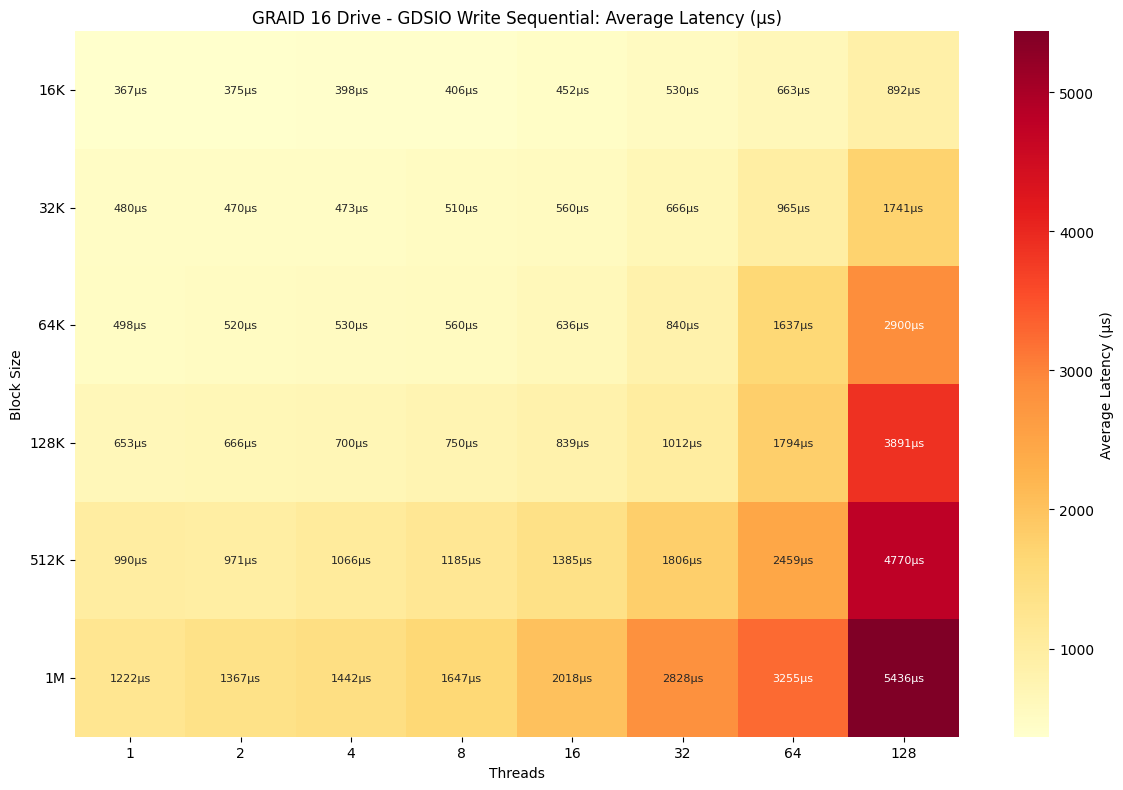
Após o forte escalonamento da taxa de transferência de gravação, o perfil de latência para gravações aleatórias no array apresentou um aumento constante à medida que o tamanho do bloco e a contagem de threads aumentavam. Mesmo com contagens baixas de threads, a latência de gravação começou notavelmente mais alta do que as leituras, começando em 0.367 ms e aumentando com cada tamanho de bloco até 1.222 ms em 1M. À medida que a simultaneidade aumentava, a latência aumentava gradualmente até 16 threads e, em seguida, acelerava de forma mais agressiva. Com 64 threads, as gravações atingiram 0.663 ms, enquanto as gravações de 1M aumentaram para 3.255 ms. Em 128 e 256 threads, a latência aumentou significativamente, principalmente com tamanhos de bloco grandes. Por exemplo, gravações de 512 K atingiram 4.770 ms em 128 threads, e 512 K e 1M ultrapassaram a marca de 5 ms, chegando a 5.436 ms em 1M.
FIO Benchmark de desempenho
Em seguida, passamos a medir o desempenho da FIO em um único pool RAID5. Embora o GDSIO dependa, em última análise, do desempenho das GPUs instaladas no sistema e de sua largura de banda PCIe, a FIO pode ser maior com base no desempenho dos SSDs, bem como da própria solução RAID.
Todo o conjunto passa por um processo de teste consistente, começando com uma fase de pré-condicionamento que consiste em dois preenchimentos de volume total usando uma carga de trabalho de gravação sequencial, seguida por nossas cargas de trabalho sequenciais e aleatórias. Isso garante que as unidades atinjam uma condição de estado estável antes do início da medição de desempenho.
Para cada novo tipo de carga de trabalho, reiniciamos o pré-condicionamento usando o tamanho de transferência correspondente para manter a precisão e a consistência nos resultados.
Esta seção destaca os seguintes benchmarks FIO de leitura/gravação aleatórios aplicados ao array Graid 16 SSD RAID 5:
- 1M de gravação/leitura aleatória
- 64K Gravação/Leitura Aleatória
- 16K Gravação/Leitura Aleatória
- 4K Gravação/Leitura Aleatória
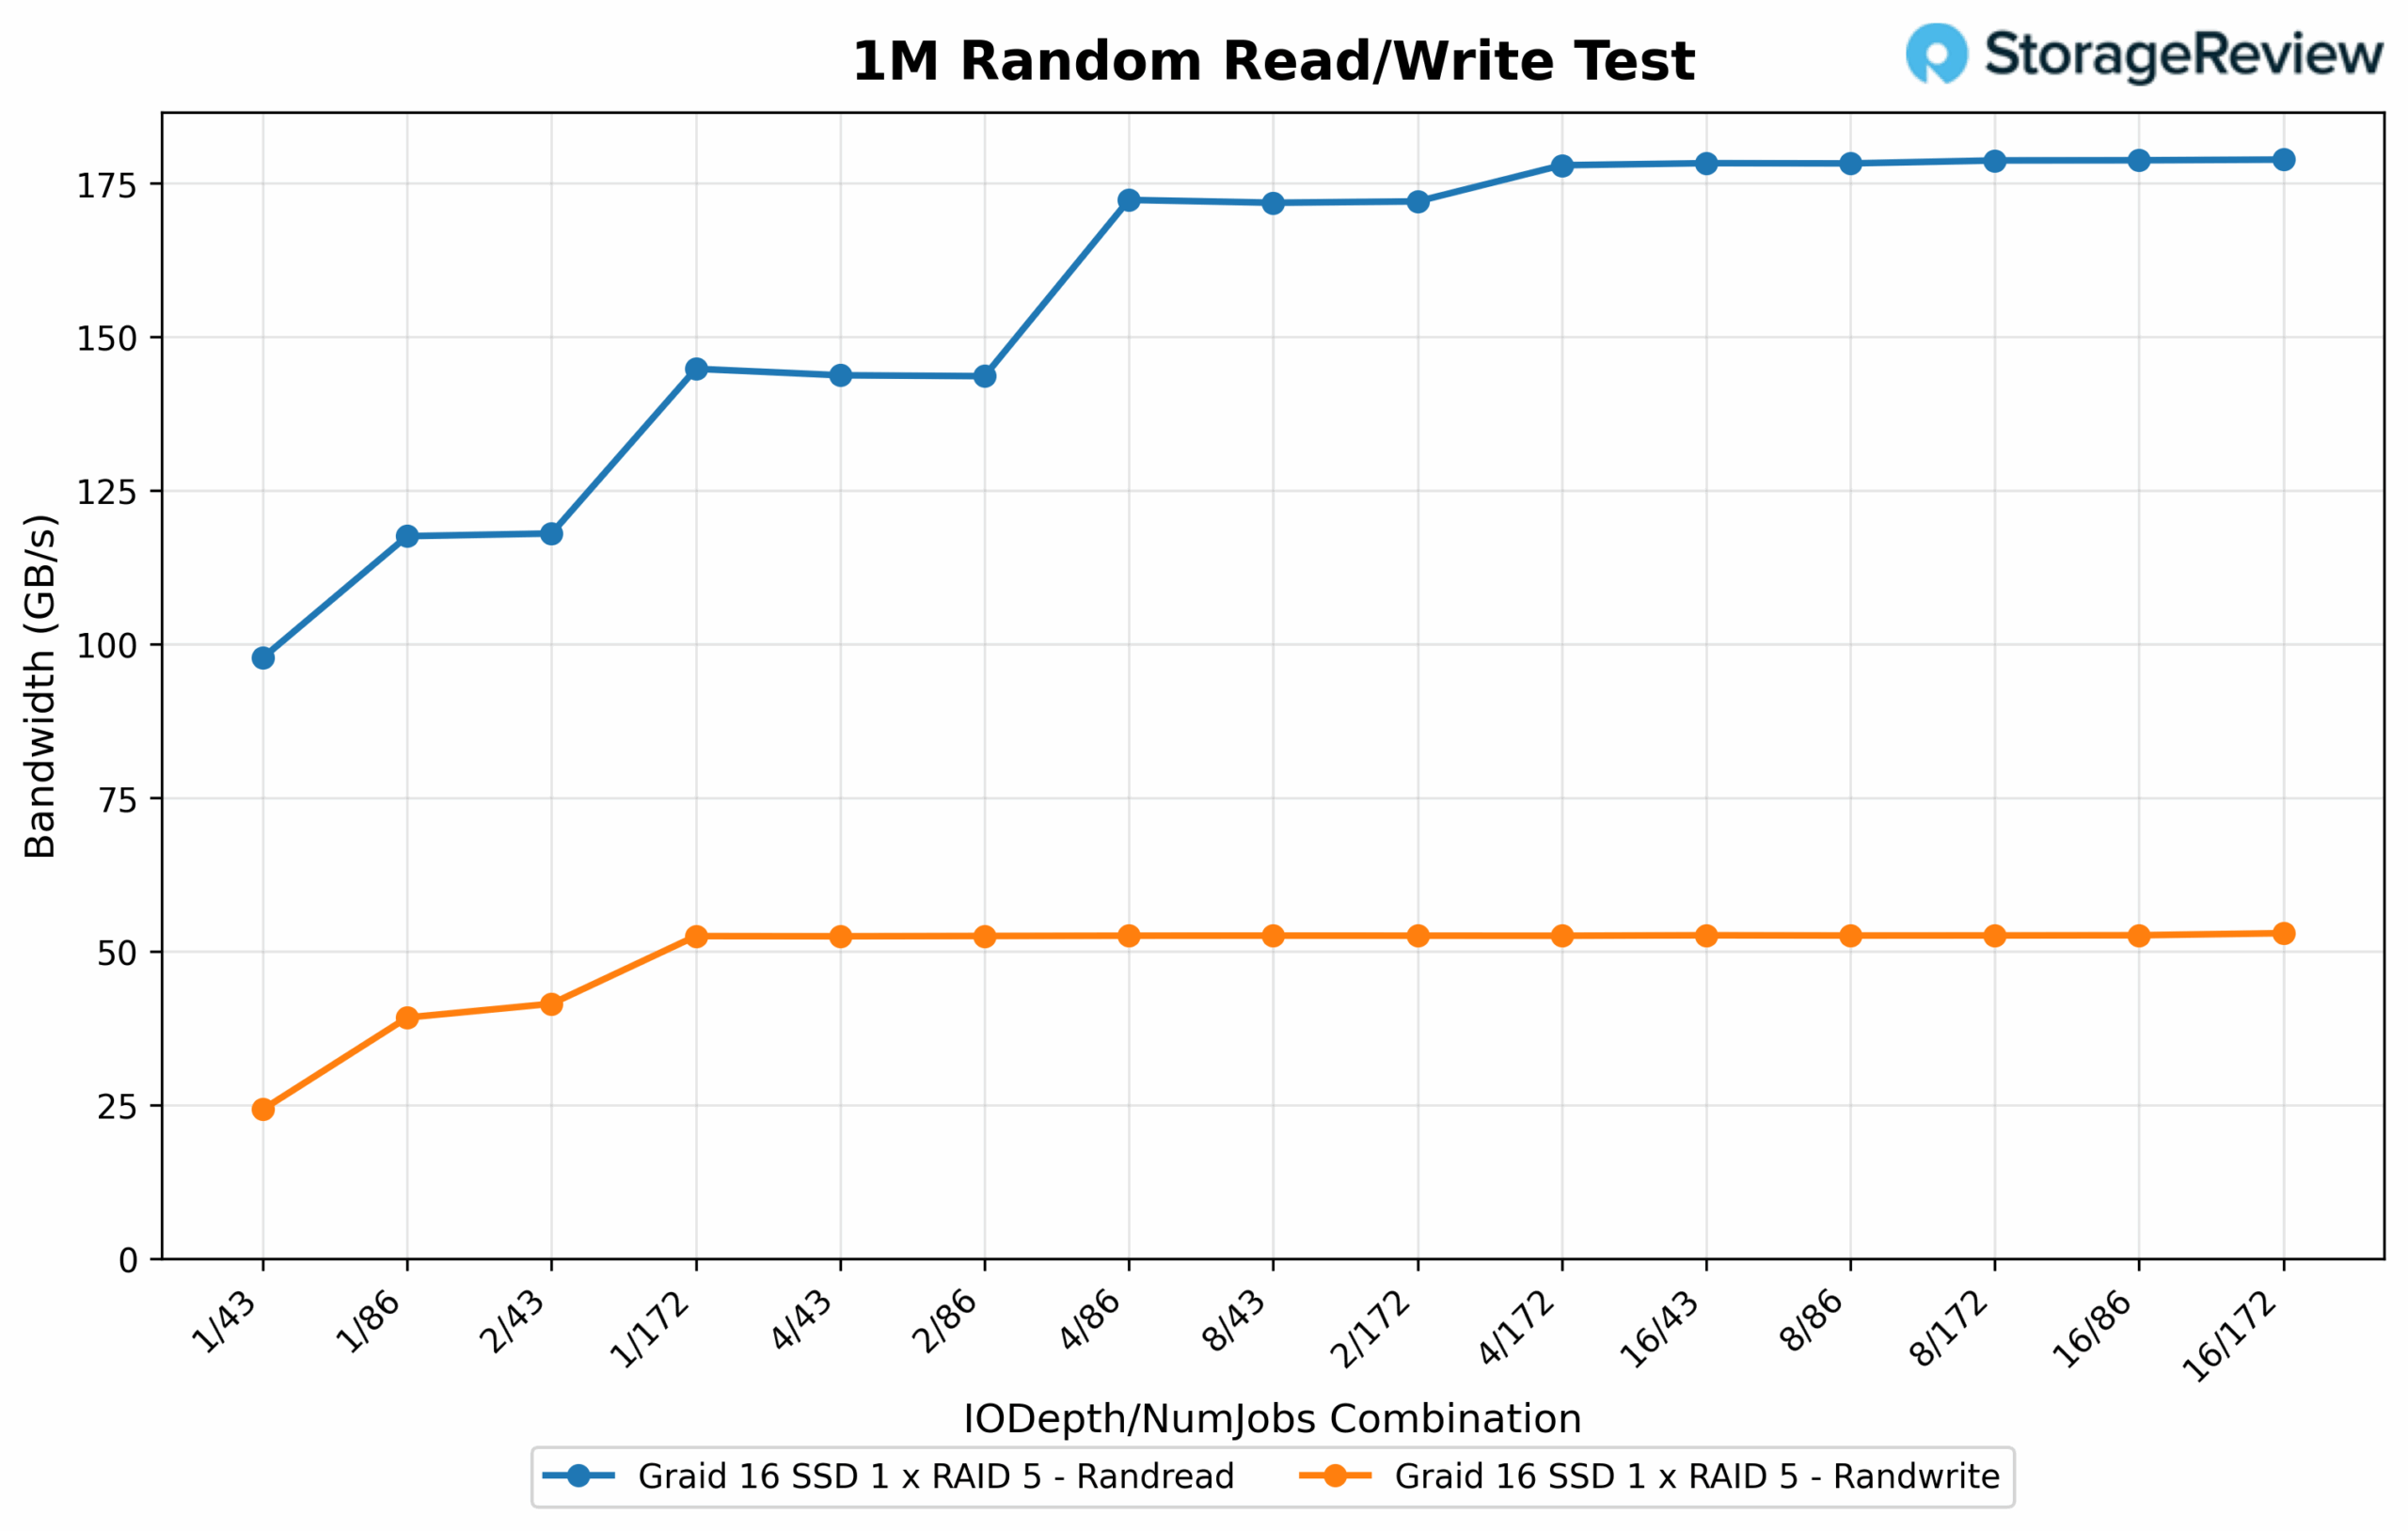
Largura de banda de leitura/gravação aleatória de 1M
Passando para operações aleatórias de 1M, a largura de banda de leitura liderou a curva de desempenho, atingindo um pico de 183.60 GB/s usando uma profundidade de E/S de 16 com 172 trabalhos, a configuração mais agressiva testada. Resultados semelhantes de alta taxa de transferência foram registrados em 8/172 e 4/172, ambos excedendo 182 GB/s, o que destaca a capacidade do array de escalar com o aumento da contagem e profundidade de trabalhos. Mesmo configurações de médio porte, como 4/86 e 16/43, mantiveram-se fortes, sustentando mais de 147 GB/s, mostrando desempenho de leitura consistente em vários níveis de simultaneidade. Na transição para gravações, a largura de banda aleatória de 1M atingiu um pico de 54.233 GB/s em 8/172, com 53.77 GB/s quase idênticos em 2/86, validando o escalonamento de gravação eficiente em cargas de trabalho paralelas. O desempenho foi reduzido suavemente em combinações de threads mais baixas, como 1/43 e 2/43, que produziram 24.88 GB/s e 42.48 GB/s, respectivamente, ainda refletindo uma forte curva de saturação mesmo em níveis moderados de simultaneidade.
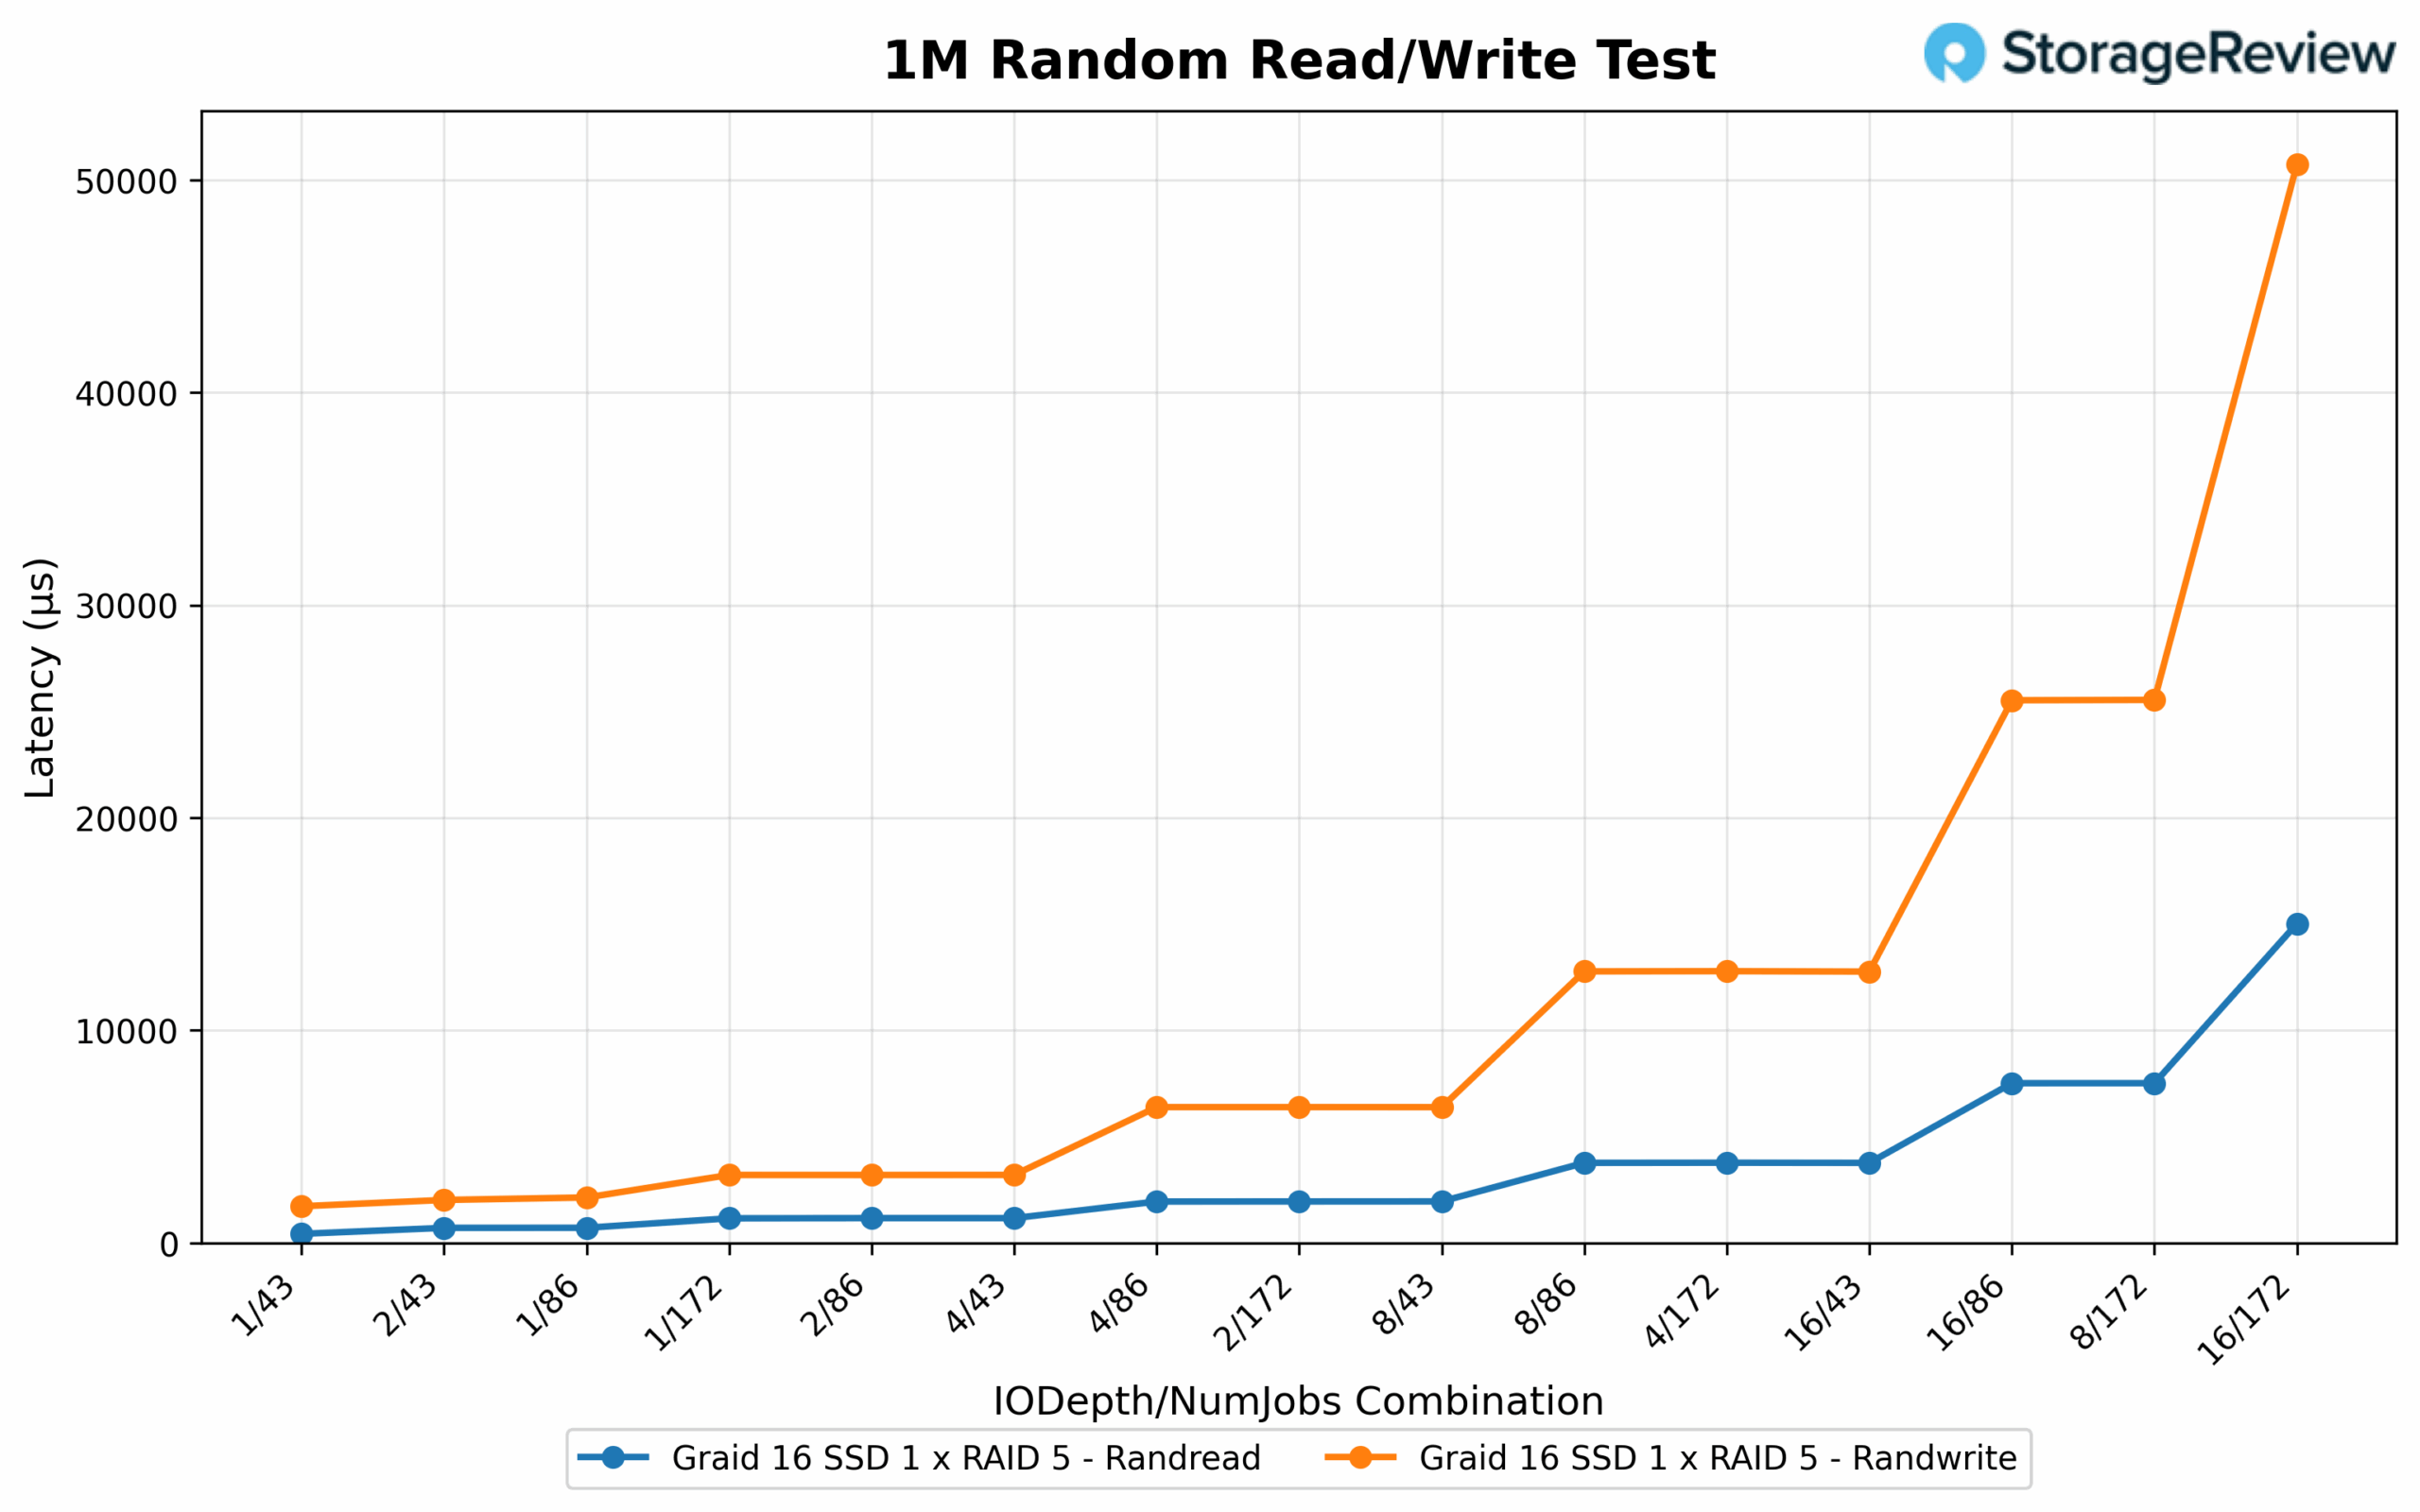
Latência de leitura/gravação aleatória de 1M
A latência permaneceu controlada para leituras em todo o intervalo de teste. A menor latência observada foi de 0.714 ms em 2/86 e 4/86, enquanto cargas de maior profundidade, como 8/172 e 4/172, permaneceram abaixo de 2 ms. A configuração que produziu a maior taxa de transferência de leitura, 16/172, apresentou a maior latência, de 7.516 ms — uma compensação clara, pois filas mais profundas aumentaram os tempos de resposta. No lado da gravação, a latência seguiu um padrão semelhante. A menor latência de gravação foi medida em 1.727 ms com 1/43. Um forte equilíbrio entre taxa de transferência e latência foi alcançado em 2/86, com 3.197 ms. Opções de maior simultaneidade, como 8/43, registraram 6.389 ms, e a configuração 16/172, embora tenha apresentado desempenho máximo de gravação, registrou a maior latência em 50.741 ms, ressaltando a conhecida relação inversa entre taxa de transferência e capacidade de resposta em profundidades extremas.
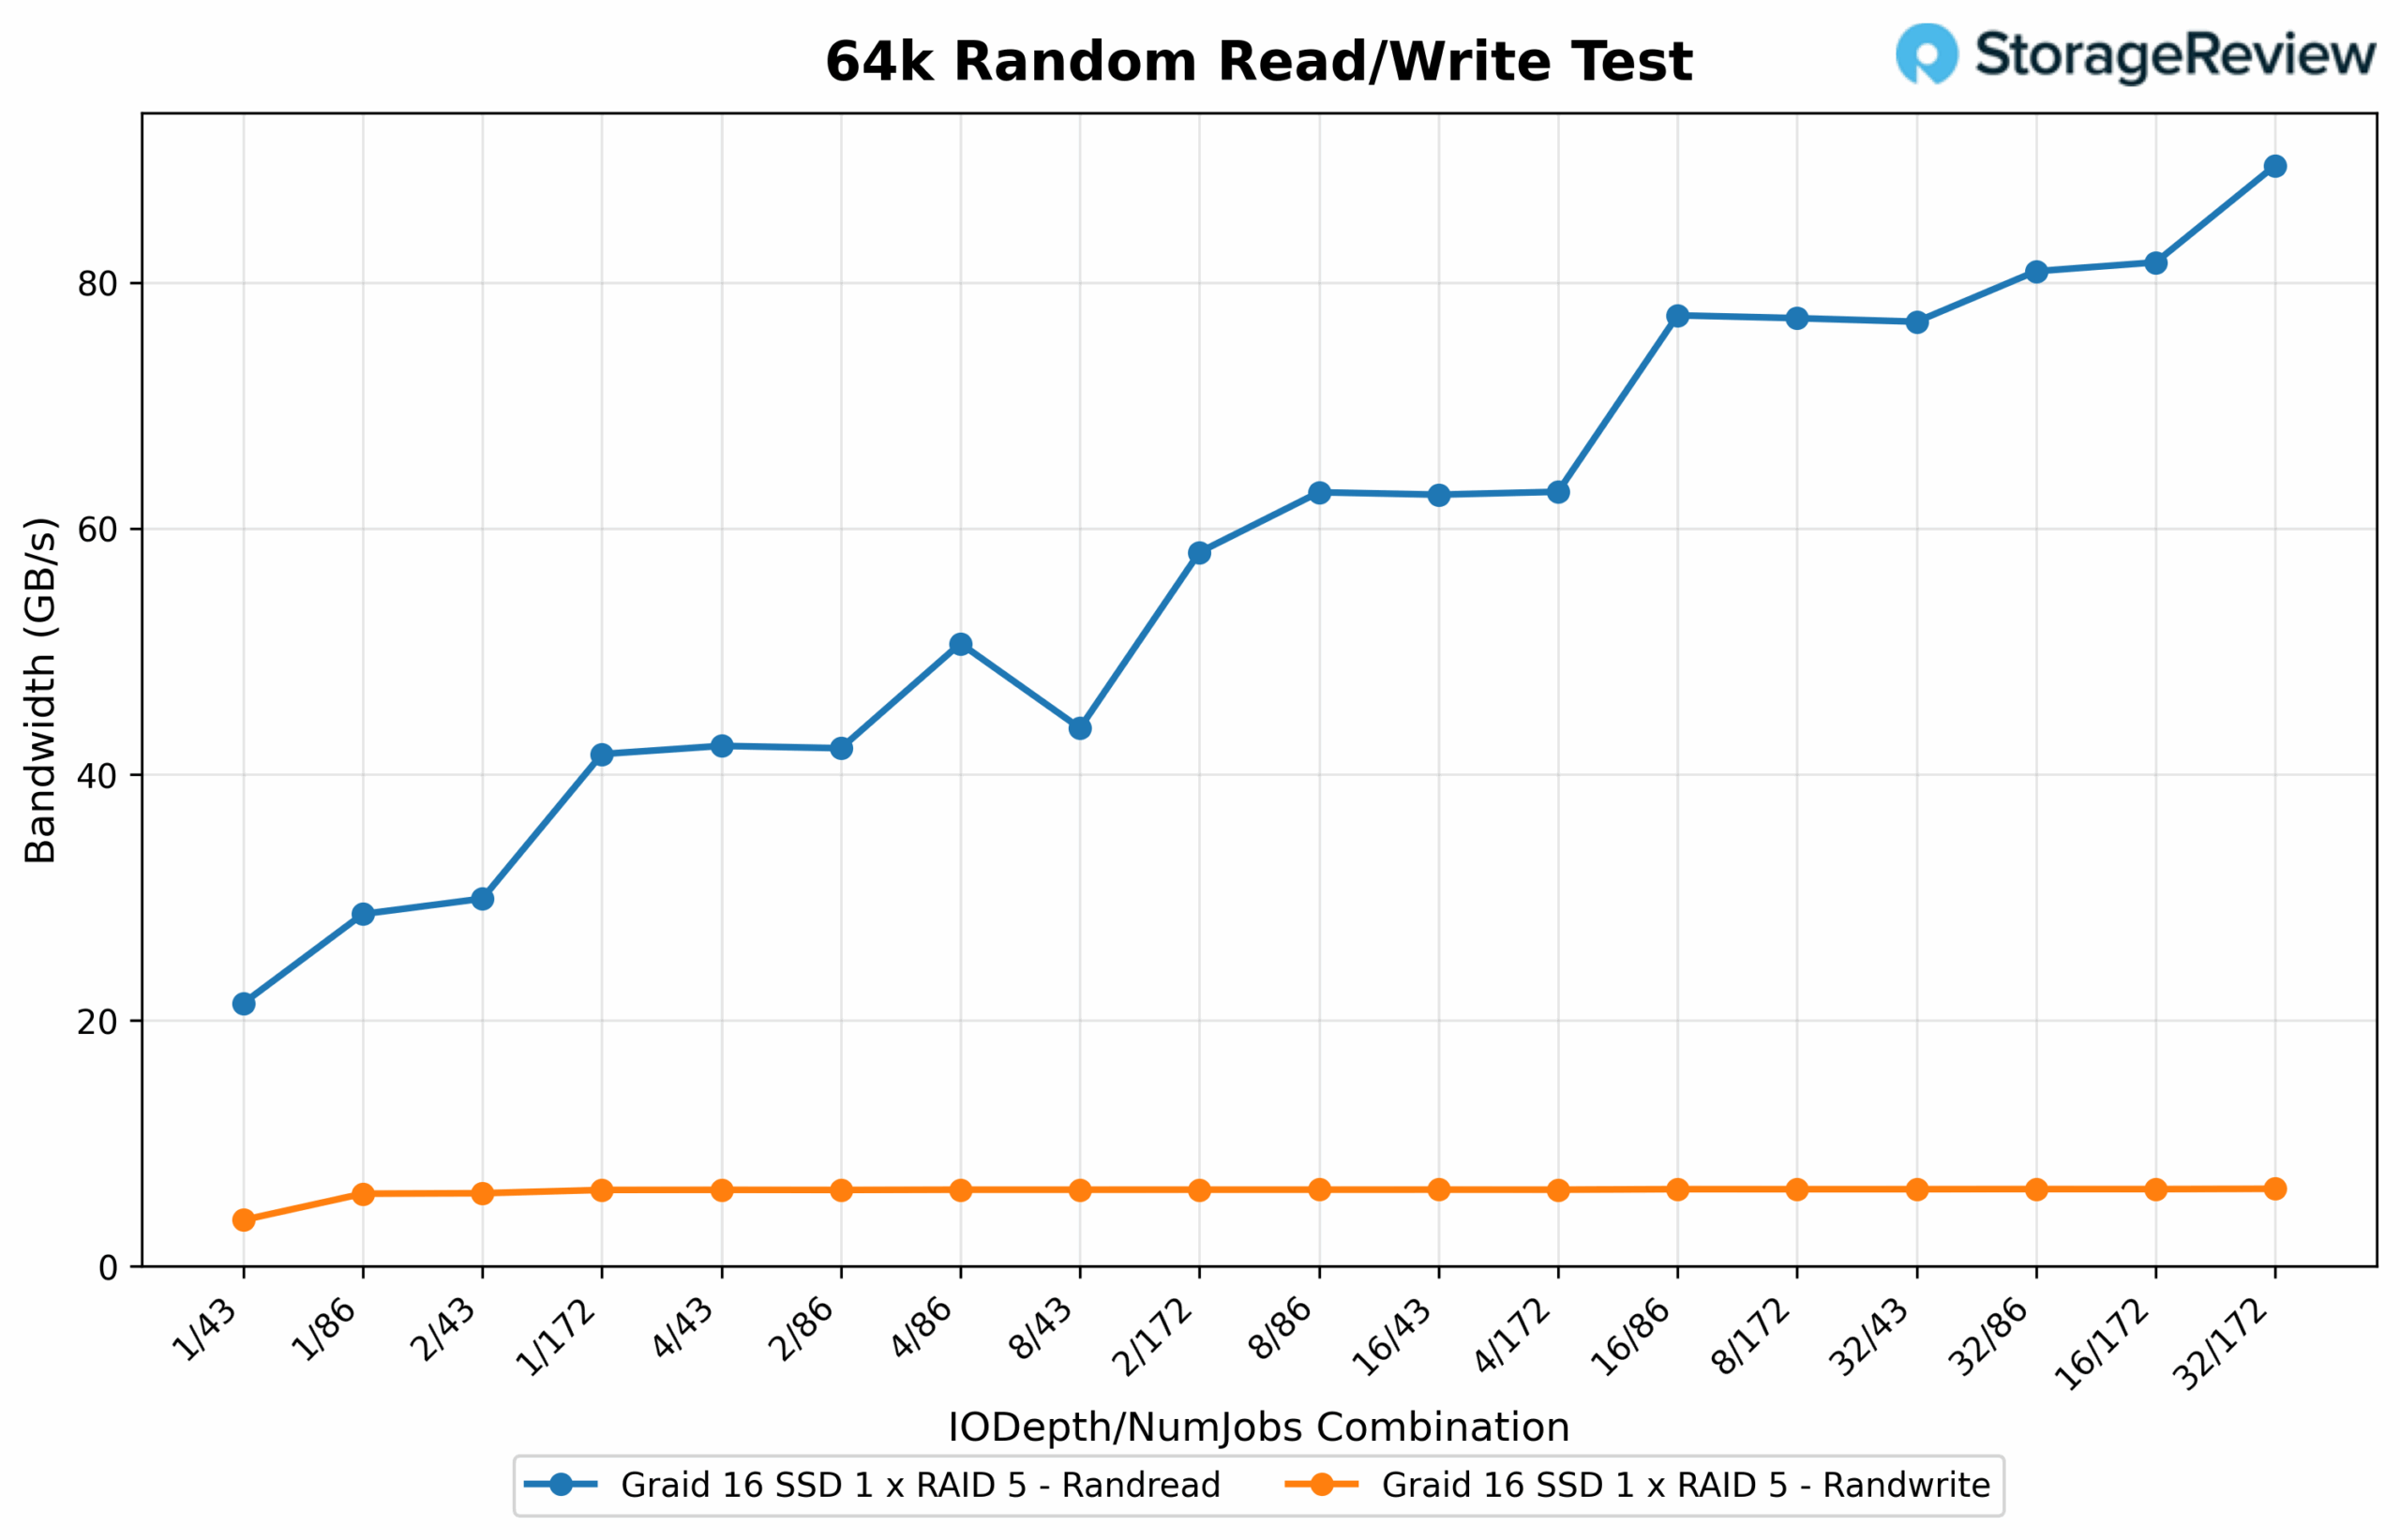
Largura de banda de leitura/gravação aleatória de 64K
Com a mudança para operações aleatórias de 64K, a largura de banda de leitura melhorou significativamente com maior profundidade de fila e contagem de trabalhos, atingindo um pico de 91.65 GB/s a 32 de profundidade de E/S com 172 trabalhos. Diversas outras configurações seguiram de perto, incluindo 16/172 a 83.59 GB/s e 32/86 a 82.85 GB/s, destacando ganhos consistentes de desempenho à medida que a carga de trabalho aumentava. Configurações intermediárias, como 8/172 e 16/86, mantiveram resultados sólidos entre 78 GB/s e 79 GB/s. Em contraste, combinações de menor simultaneidade, como 1/43 e 1/172, produziram níveis de throughput reduzidos, variando de 21.89 GB/s a 42.63 GB/s, ilustrando a dependência do array em paralelismo para desempenho máximo. No lado da gravação, a largura de banda aleatória de 64K atingiu o pico de 6.44 GB/s com 32/86. Outras configurações de alto desempenho, incluindo 32/172 e 16/86, apresentaram desempenho bastante similar, registrando 6.41 GB/s e 6.36 GB/s, respectivamente. A maioria dos pontos de teste se concentrou entre 6.3 GB/s e 6.4 GB/s, demonstrando consistência estável em diferentes profundidades de fila. Configurações leves, como a 1/43, apresentaram o menor desempenho de gravação, com 3.83 GB/s, reforçando a tendência de ganhos progressivos em cargas de trabalho mais pesadas.
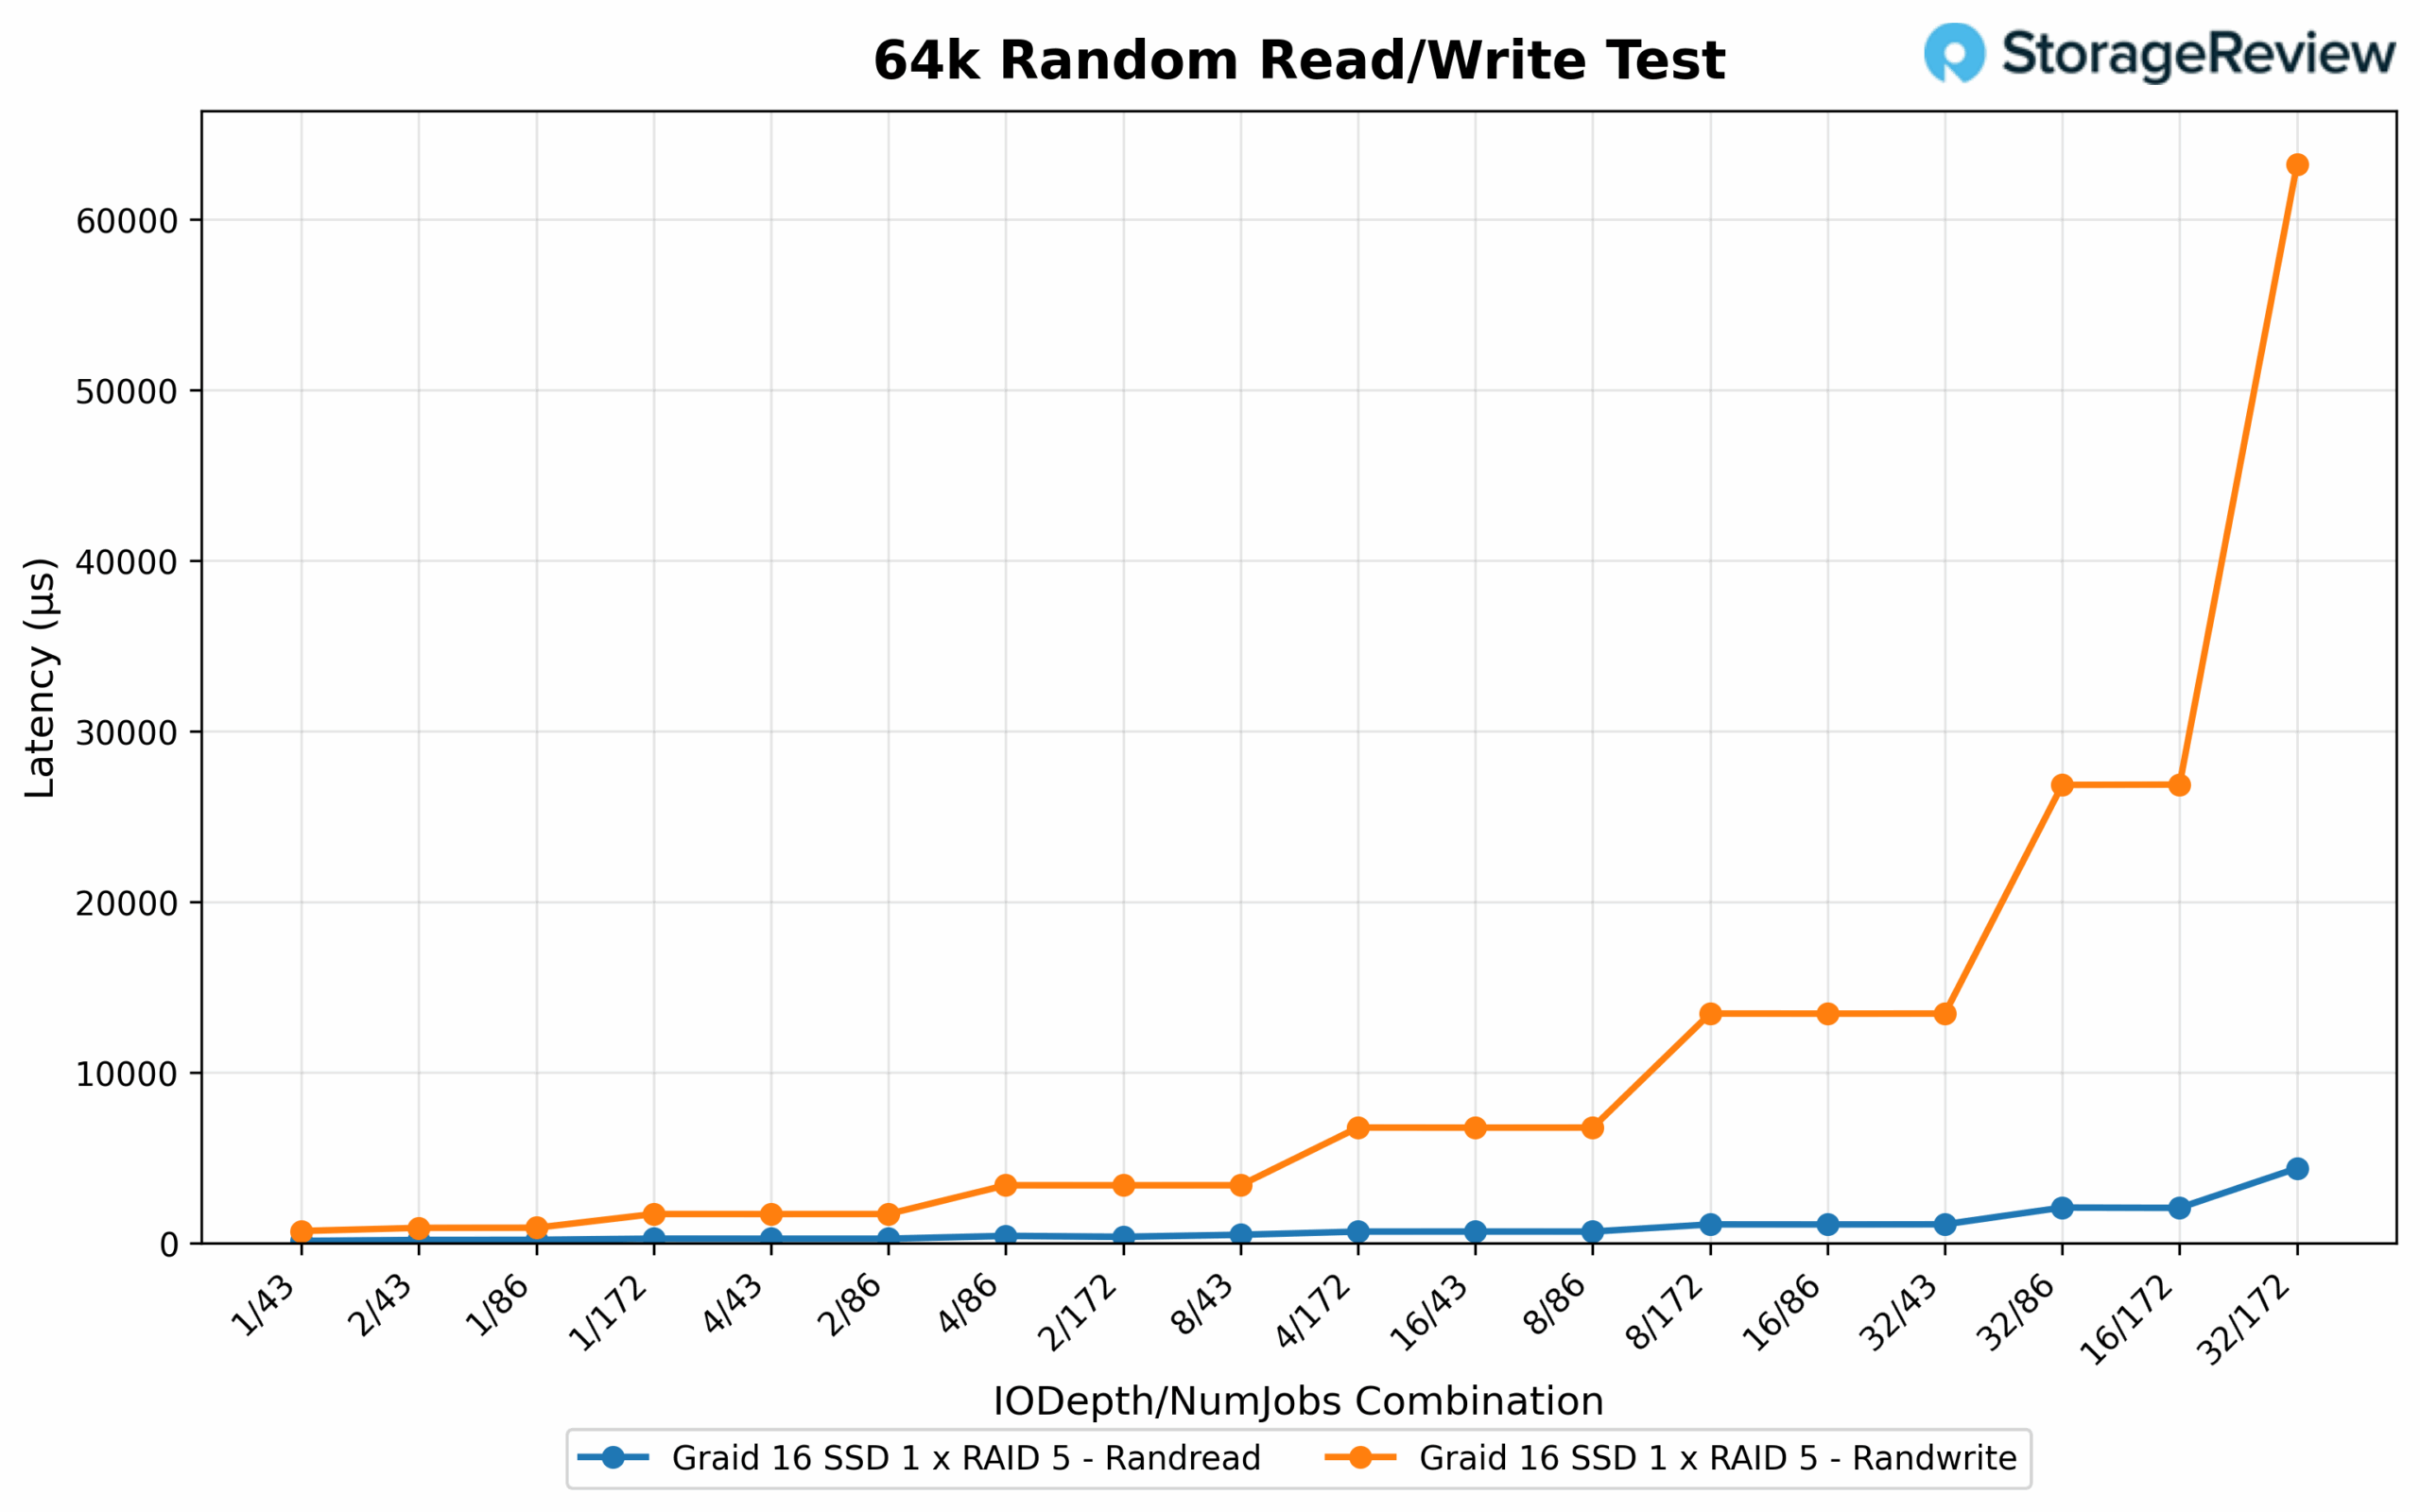
Latência de leitura/gravação aleatória de 64K
A latência de leitura aleatória de 64K permaneceu consistentemente baixa na maioria dos casos de teste. A menor latência foi de 0.123 ms em 1/43, seguida por 0.175 ms em 1/86. À medida que a taxa de transferência aumentava, a latência permaneceu dentro de uma faixa controlada: 4/172 registraram 0.666 ms, enquanto 16/172 atingiram 2.057 ms. Mesmo sob condições de carga mais pesadas, a capacidade de resposta permaneceu eficiente, com 32/86 registrando 2.076 ms, apesar de apresentar um dos melhores resultados de largura de banda. No lado da gravação, a latência aumentou mais acentuadamente com a profundidade e a contagem de tarefas. A menor latência veio de 2/43, com 0.887 ms, com 4/43 e 2/86 logo atrás, com 1.694 ms e 1.697 ms, respectivamente. Configurações mais pesadas mostraram sinais claros de compensação no tempo de resposta: 8/172 registraram 13.445 ms, 16/172 subiram para 26.862 ms e 32/172 atingiram o pico de 63.201 ms, enfatizando o aumento da sobrecarga de filas conforme as cargas de trabalho se intensificavam.
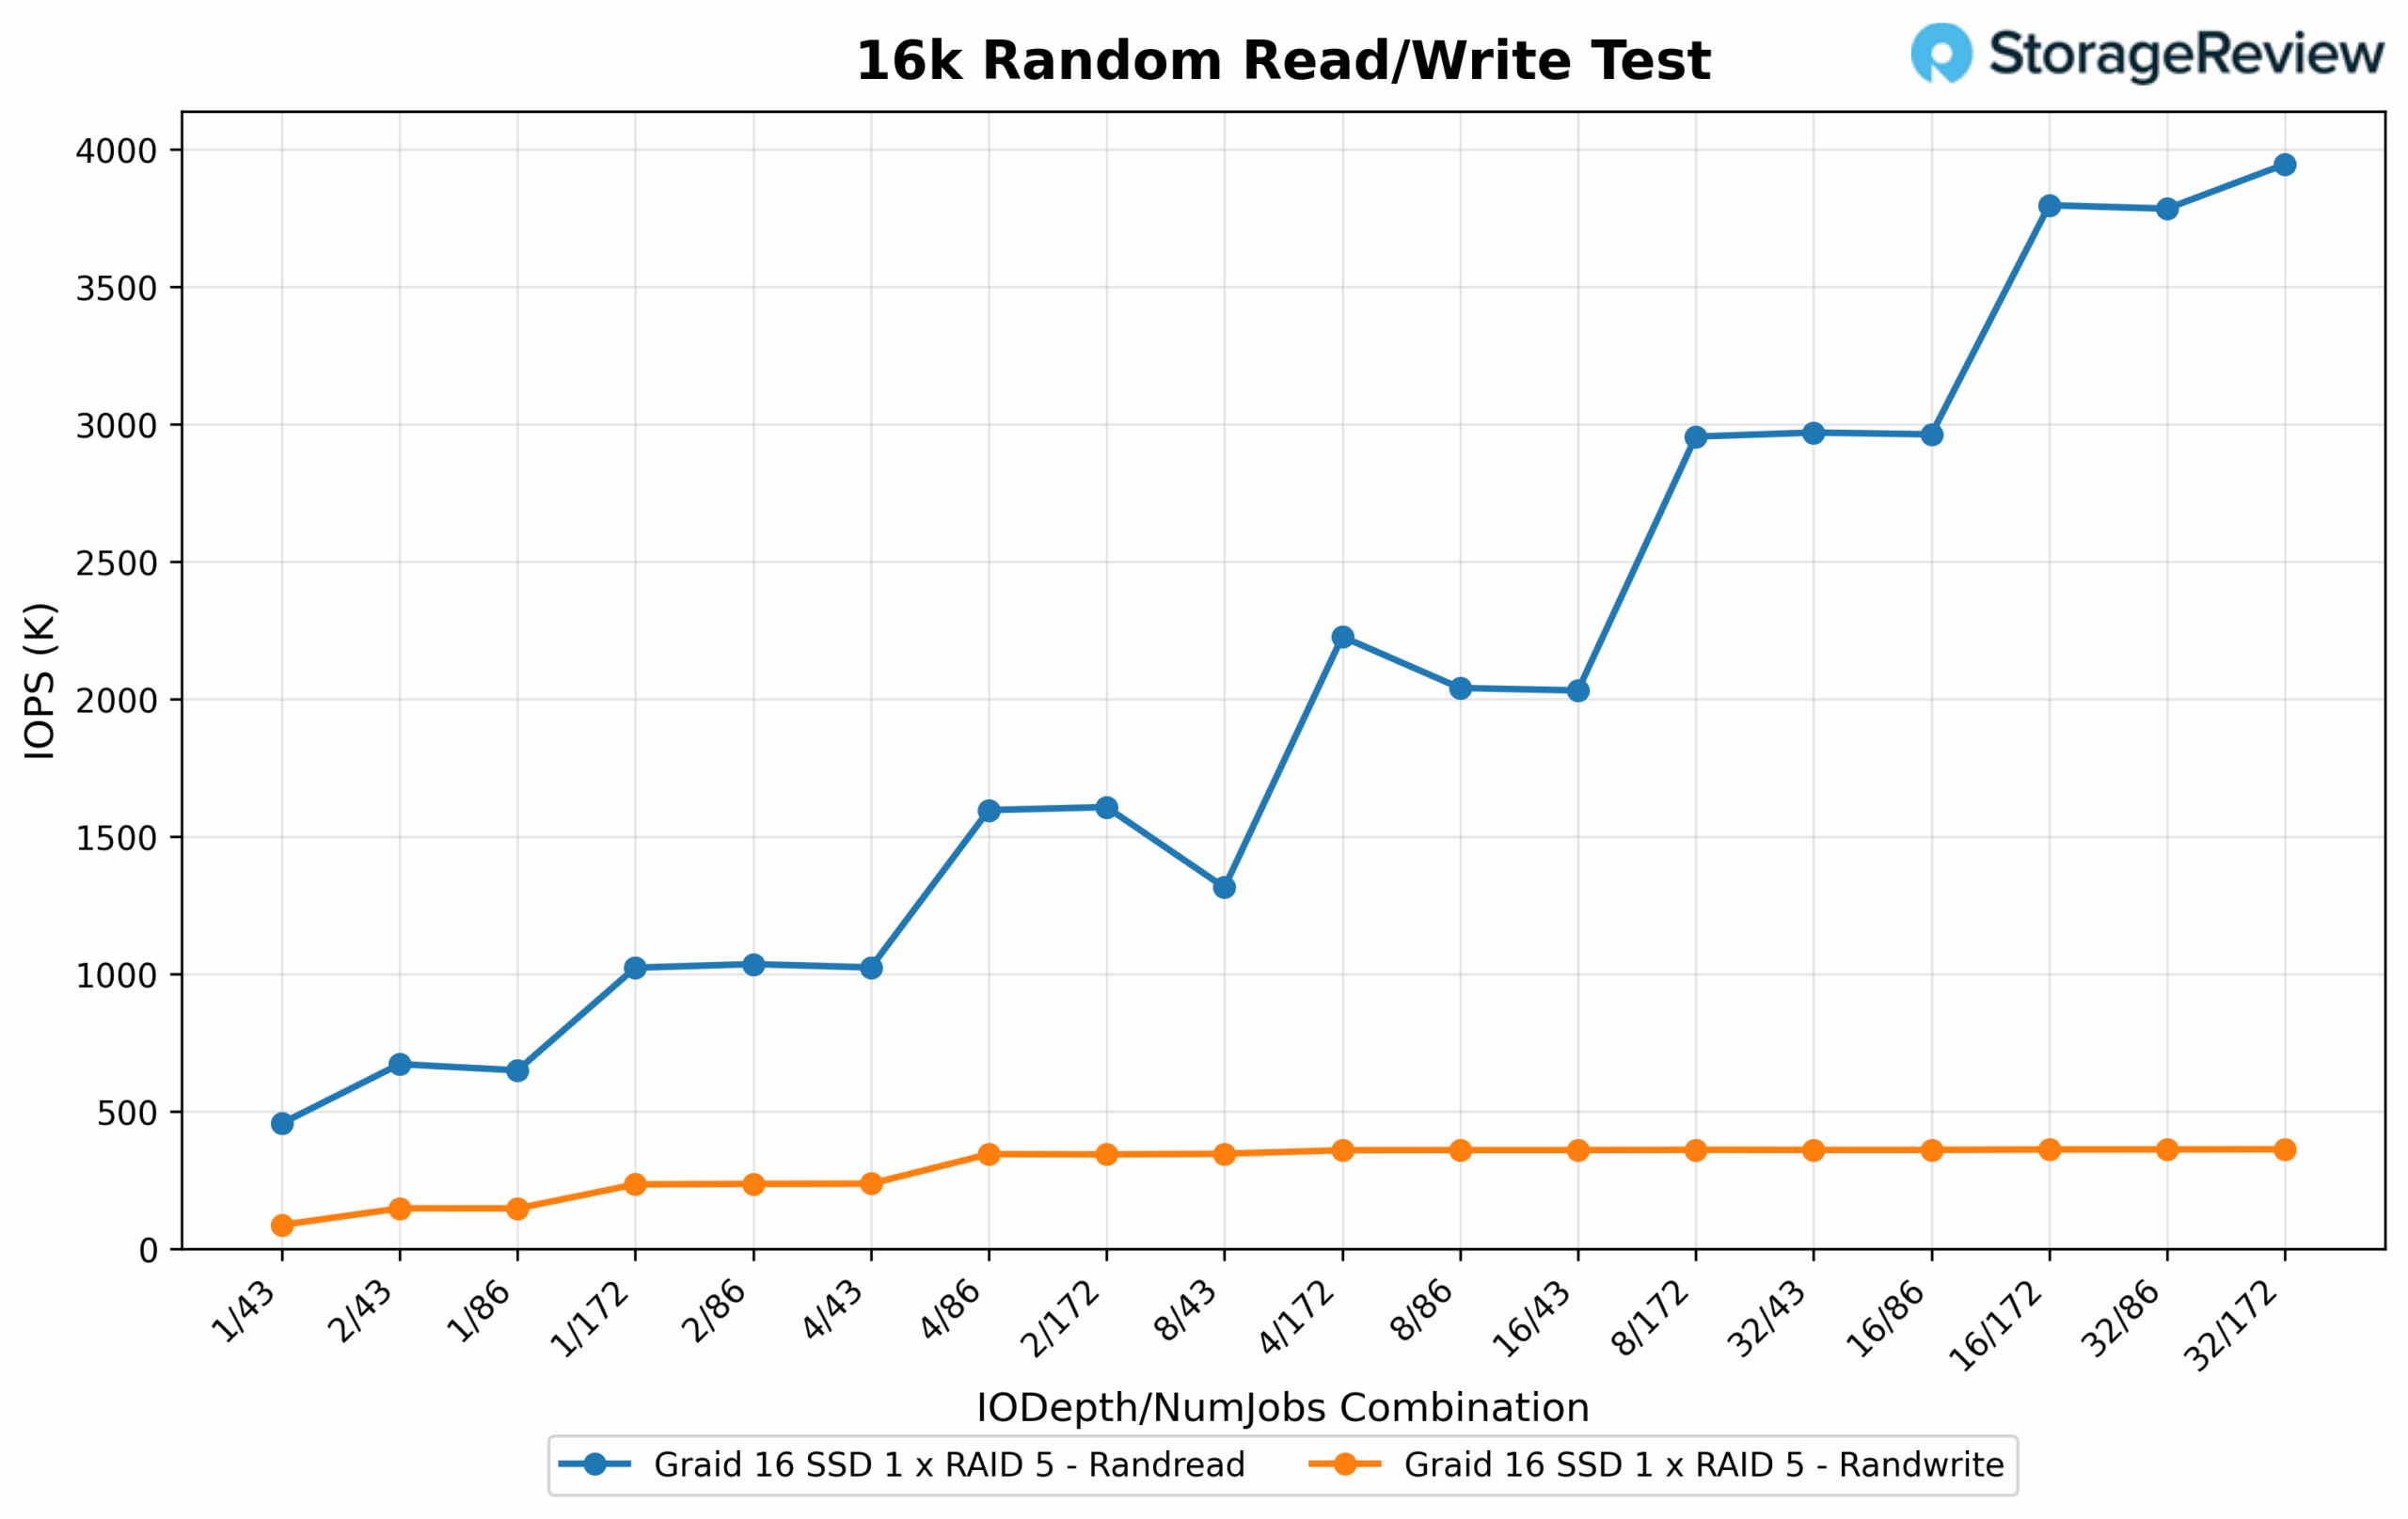
16K IOPS de leitura/gravação aleatória
A latência de leitura aleatória de 16K permaneceu baixa mesmo no pico de IOPS. A melhor responsividade foi observada em configurações mais leves, com 1/43 atingindo apenas 0.087 ms e 1/86 chegando a 0.114 ms. Combinações de maior simultaneidade, como 4/86 e 8/86, mediram 0.236 ms e 0.420 ms, respectivamente. Mesmo as configurações de melhor desempenho mantiveram latência razoável, com 16/172 registrando 1.143 ms e 32/172 atingindo 2.372 ms, demonstrando escalonamento eficiente com um impacto gerenciável no tempo de resposta. Para gravações aleatórias de 16K, a menor latência foi registrada em 2/43 com 0.848 ms, seguida por 1.253 ms em 4/43 e 1.415 ms em 1/43. À medida que a profundidade e a contagem de trabalhos aumentaram, a latência aumentou gradualmente: 8/172 atingiu 5.574 ms, enquanto 16/172 e 32/172 subiram para 10.455 ms e 22.958 ms, respectivamente, destacando a compensação esperada à medida que a saturação da fila aumentava.
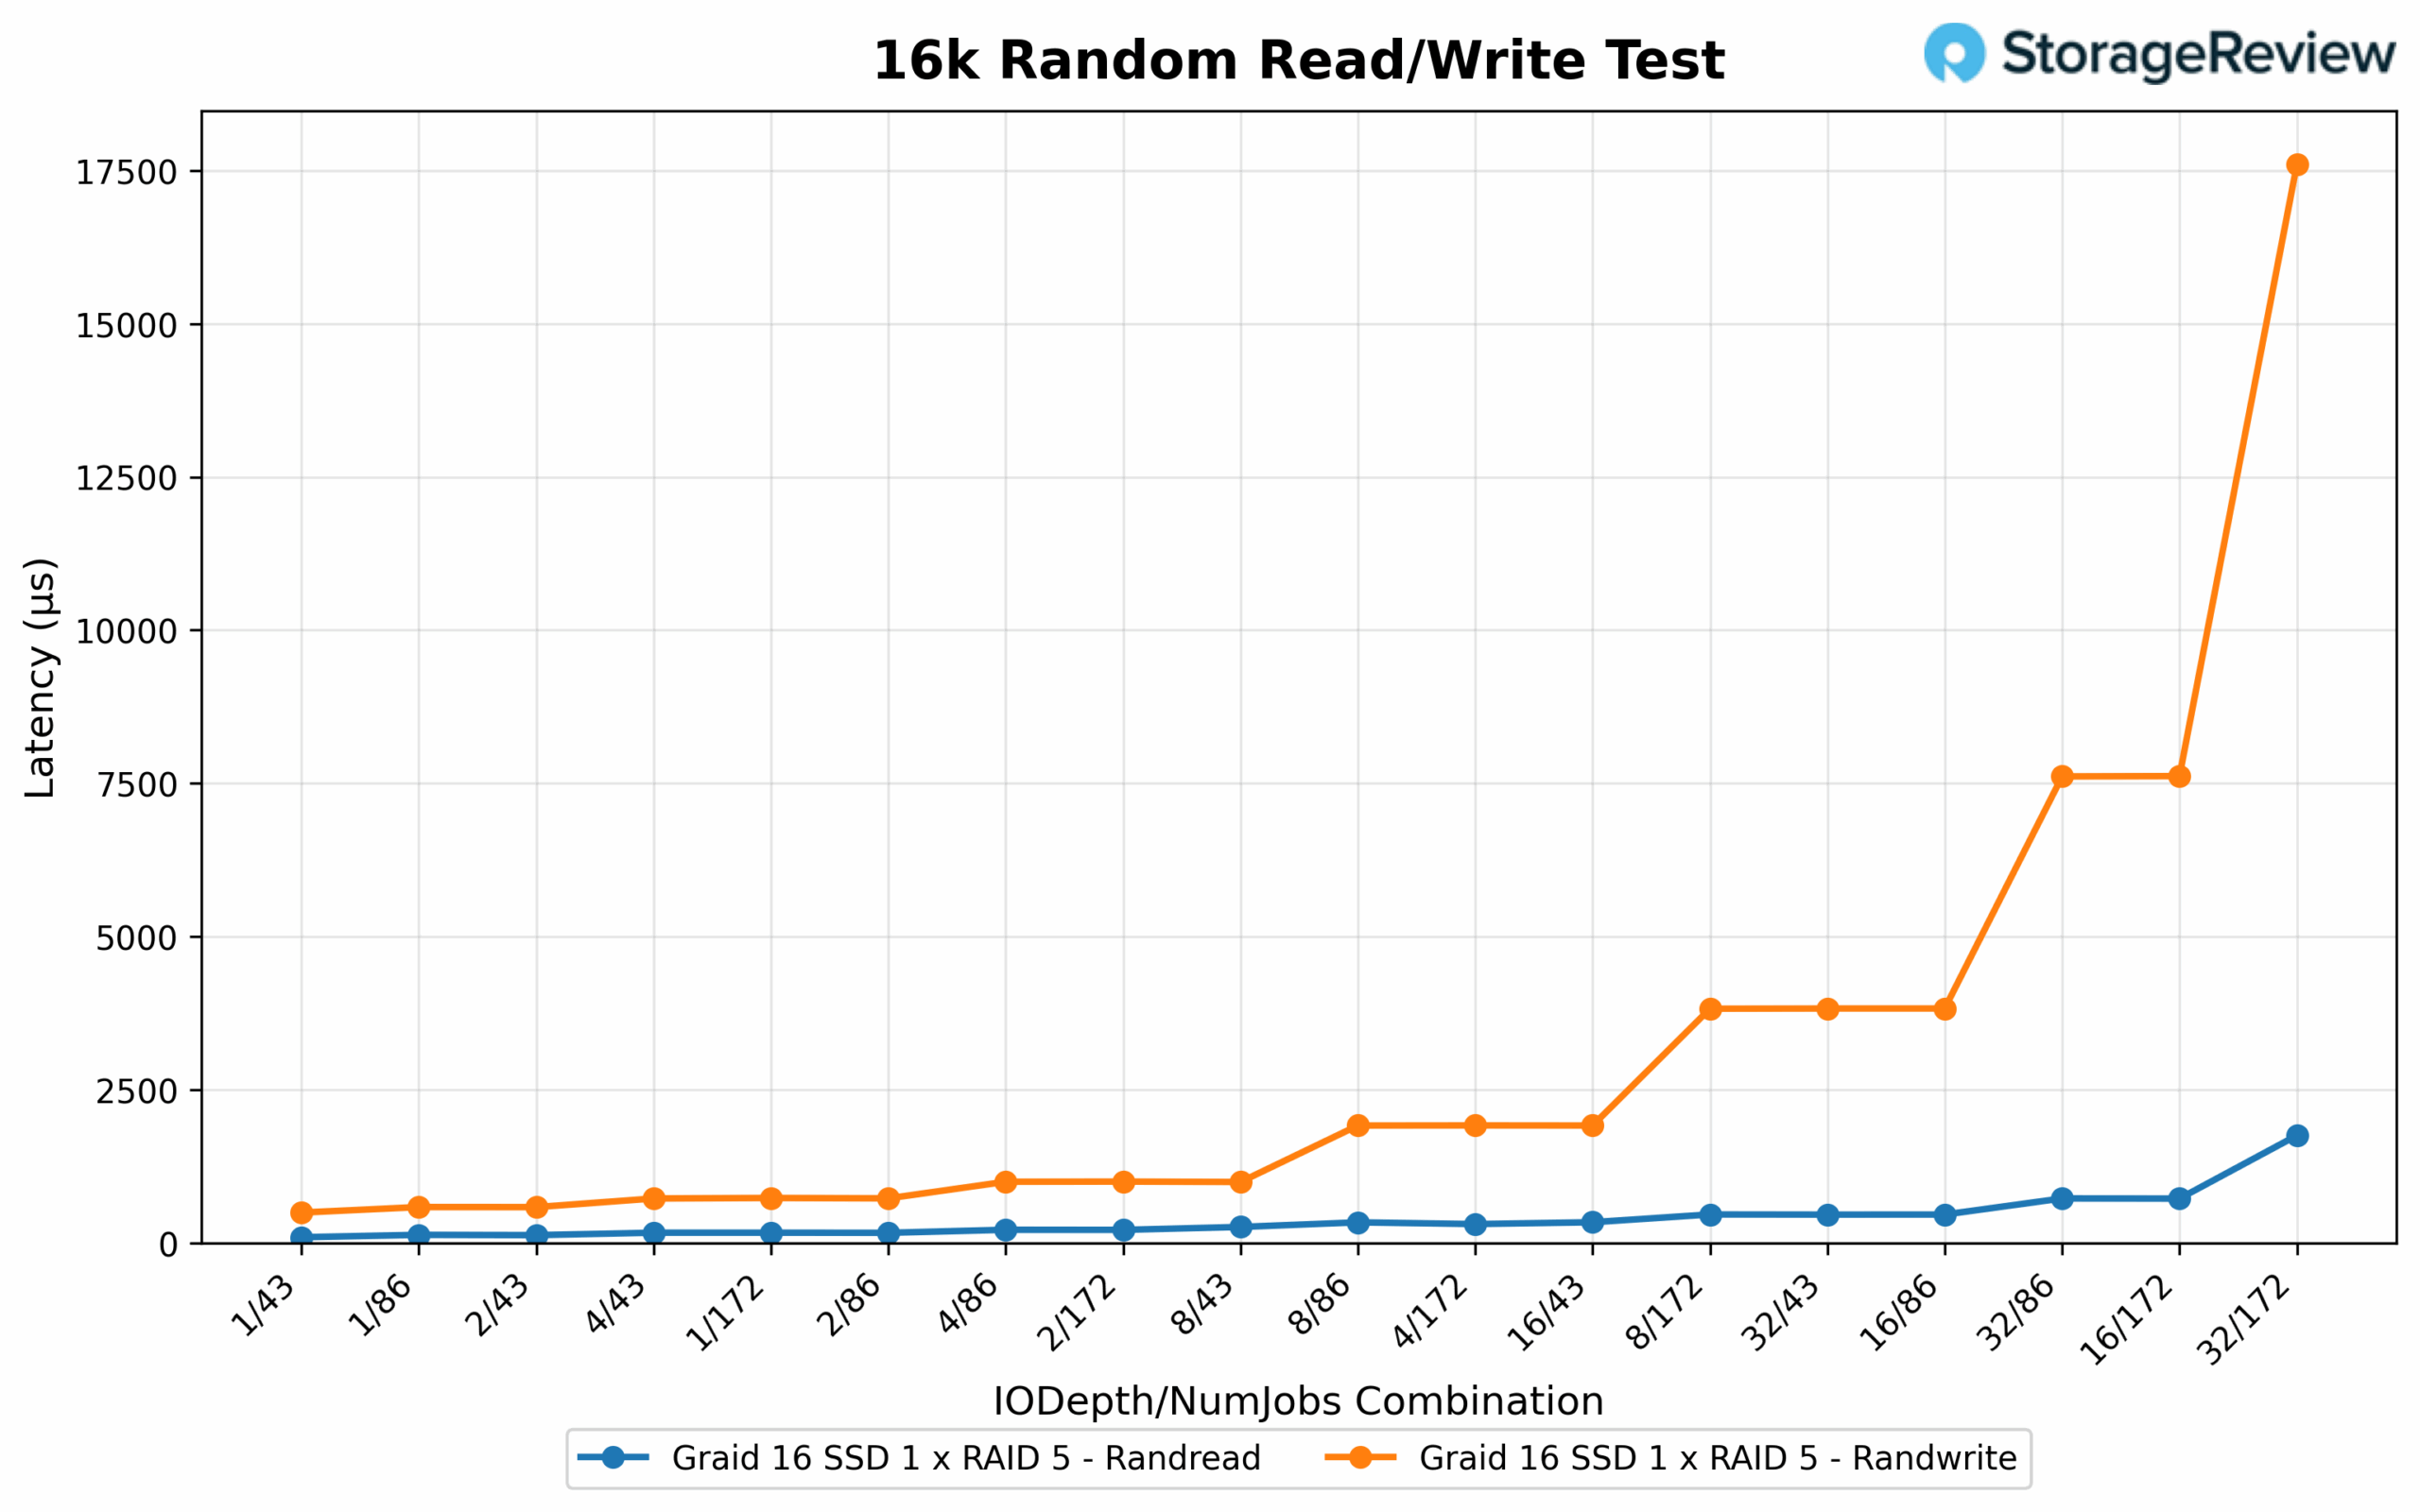
Latência de leitura/gravação aleatória de 16K
A latência de leitura aleatória de 16K permaneceu consistentemente baixa em todos os aspectos. A configuração mais responsiva foi 1/43 a 0.123 ms, seguida de perto por 1/86 a 0.175 ms. Mesmo sob pressão máxima, configurações como 32/172 e 16/172 mantiveram a latência abaixo de 2.1 ms, mostrando que o array manteve tempos de resposta rápidos ao lidar com IOPS elevados. Em contraste, a latência de gravação aleatória de 16K exibiu uma variância mais ampla. A menor latência foi de 0.496 ms em 1/43, com execuções eficientes adicionais como 2/86 e 4/43 ficando abaixo da marca de 1 ms. À medida que a simultaneidade e a profundidade aumentaram, a latência aumentou de forma correspondente: 16/172 registrou 7.017 ms e 32/172 atingiu 17.246 ms, reforçando o trade-off esperado entre pico de throughput e responsividade na saturação máxima.
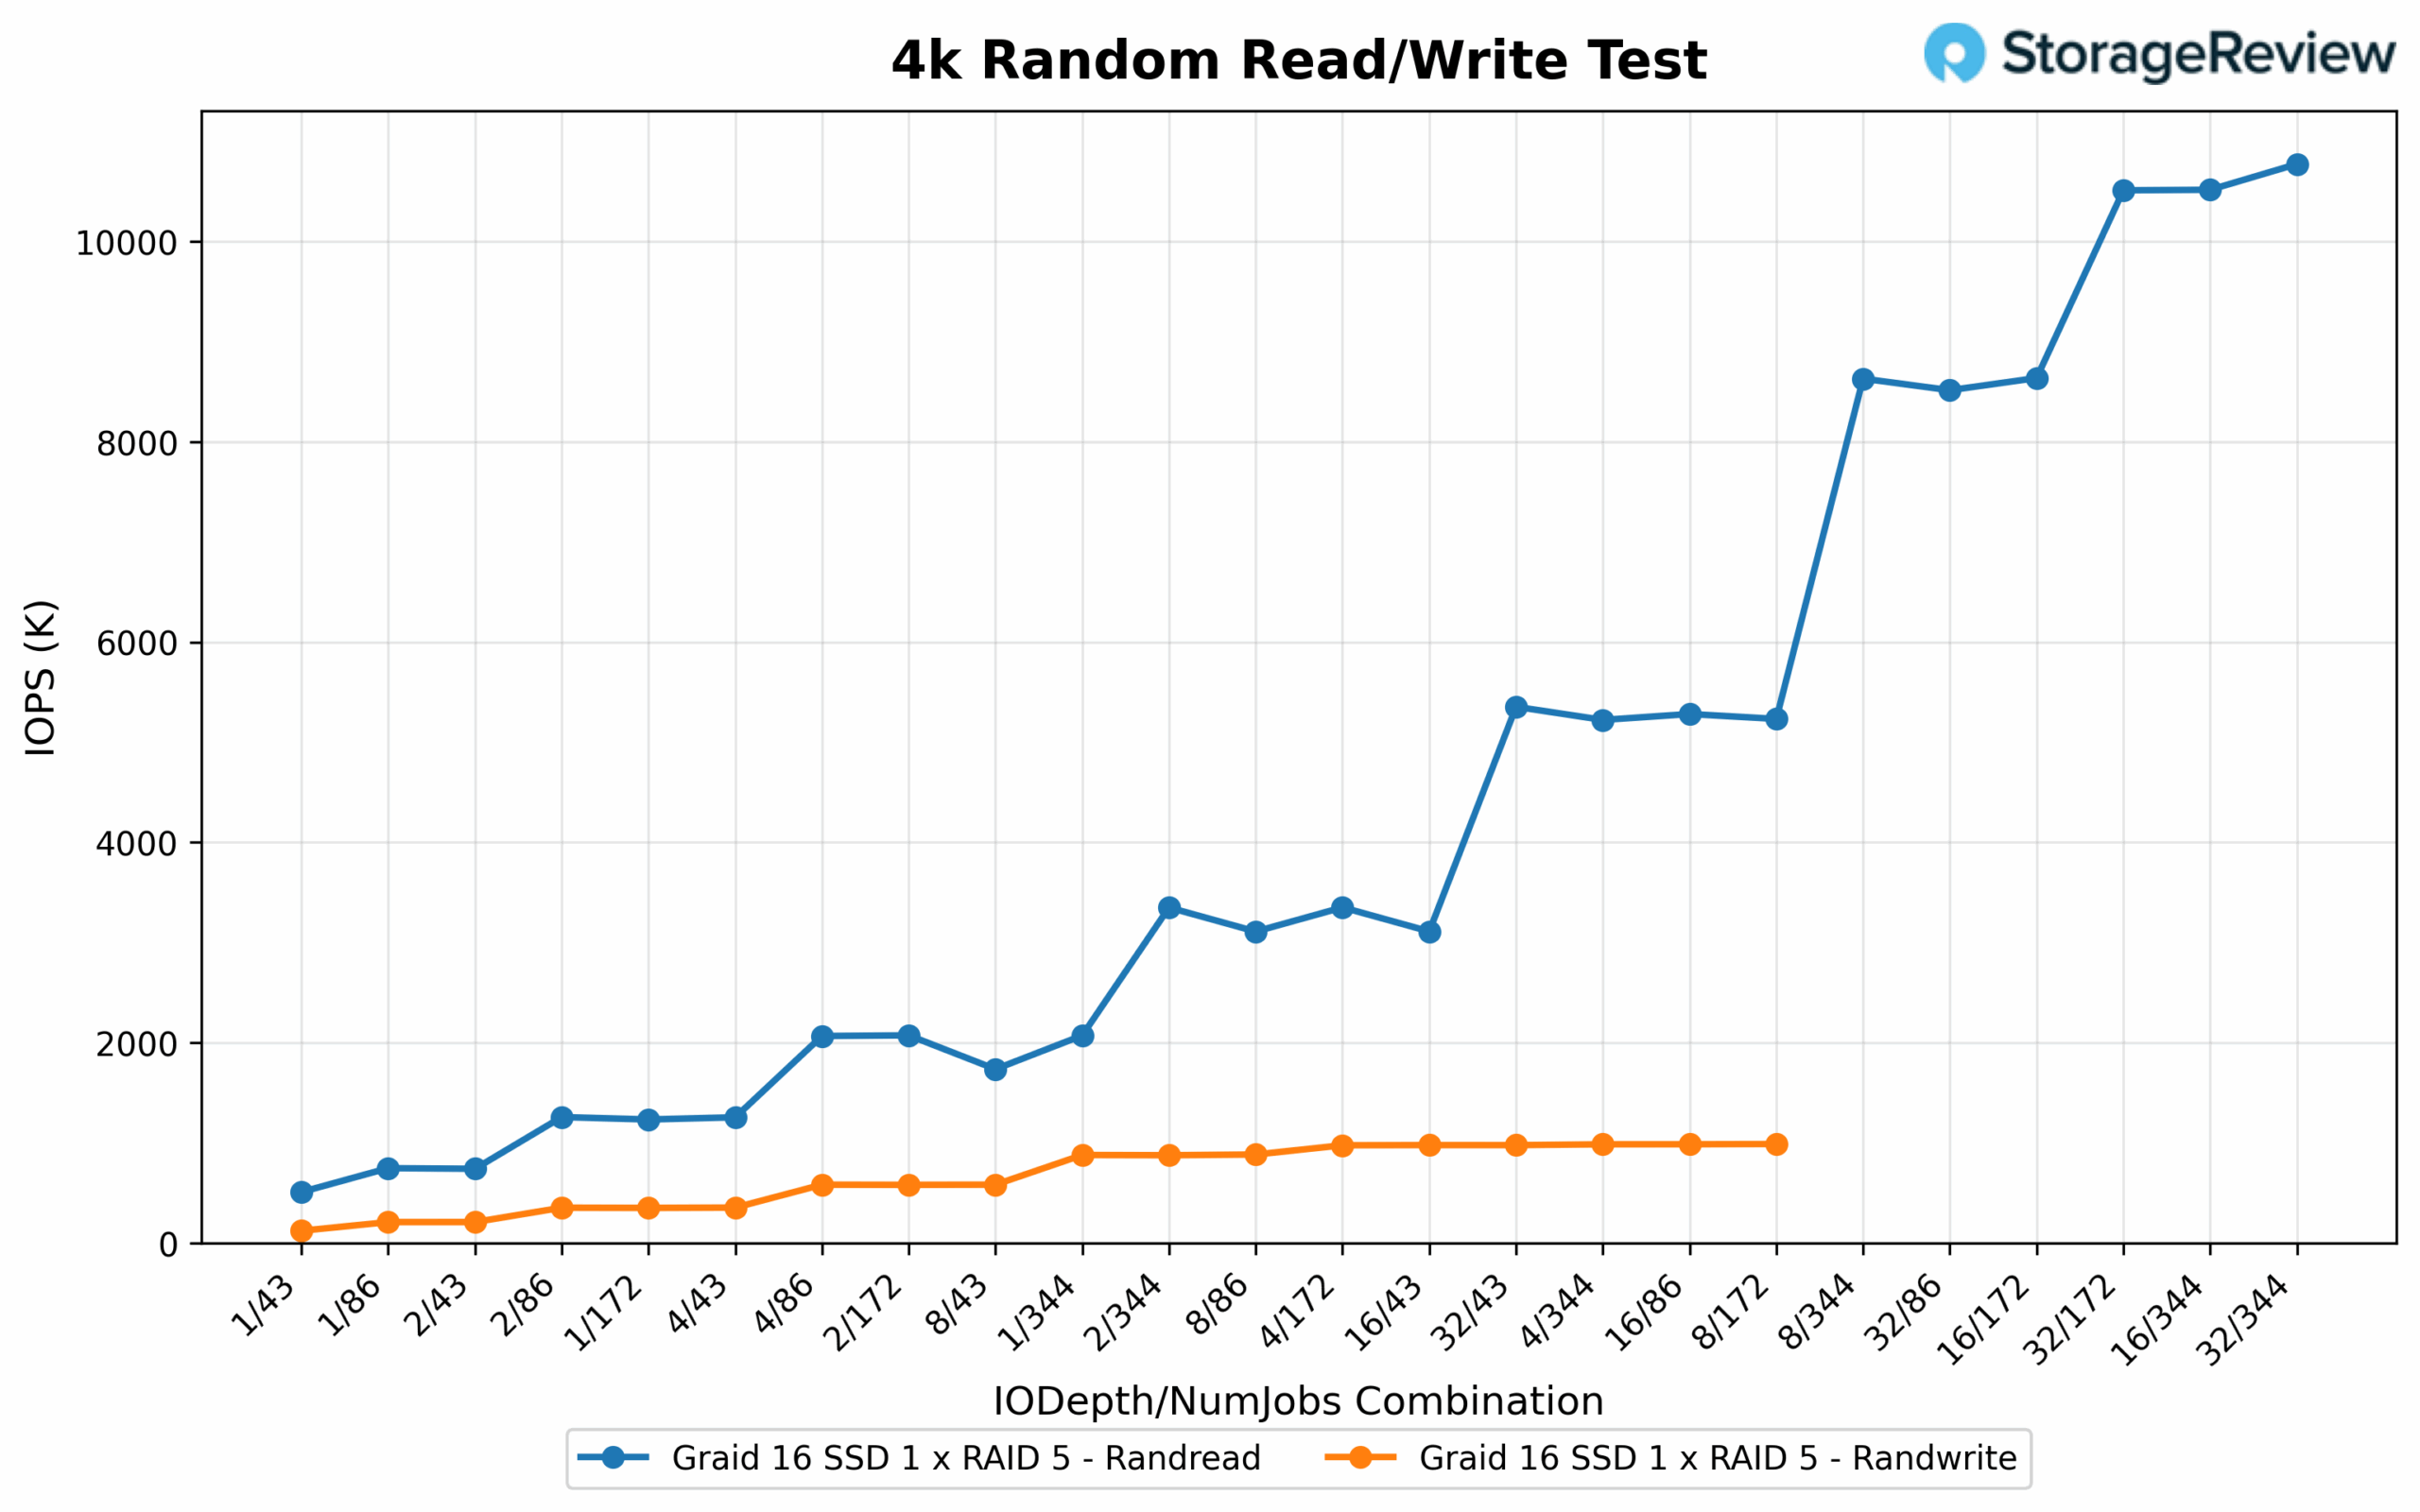
4K IOPS de leitura/gravação aleatória
Sob uma carga de simultaneidade mais pesada, as IOPS de leitura aleatória de 4K atingiram um pico impressionante de 10.77 milhões a uma profundidade de E/S de 32, com 344 trabalhos. Outras configurações seguiram de perto, incluindo 16/344 a 10.52 M, 4/344 a 10.51 M e 8/344 a 10.42 M, todas demonstrando escalonamento excepcional com combinações agressivas de fila e profundidade de trabalho. Mesmo opções de profundidade reduzida, como 8/172 e 16/172, mantiveram um throughput robusto entre 5.23 M e 5.35 M de IOPS, destacando ainda mais a capacidade do array de lidar com cargas de trabalho paralelas exigentes. No lado da gravação, as IOPS de 4K atingiram o pico de 987.9 K com 32/172. Configurações semelhantes de alta eficiência incluíam 32/86 a 985.1 K, 16/172 a 985.6 K e 8/172 a 976.9 K. Combinações adicionais de 8/86 a 16/86 mantiveram o desempenho na faixa de 875 K a 977 K, reforçando a consistência e a confiabilidade do array quando totalmente saturado com operações de gravação simultâneas.
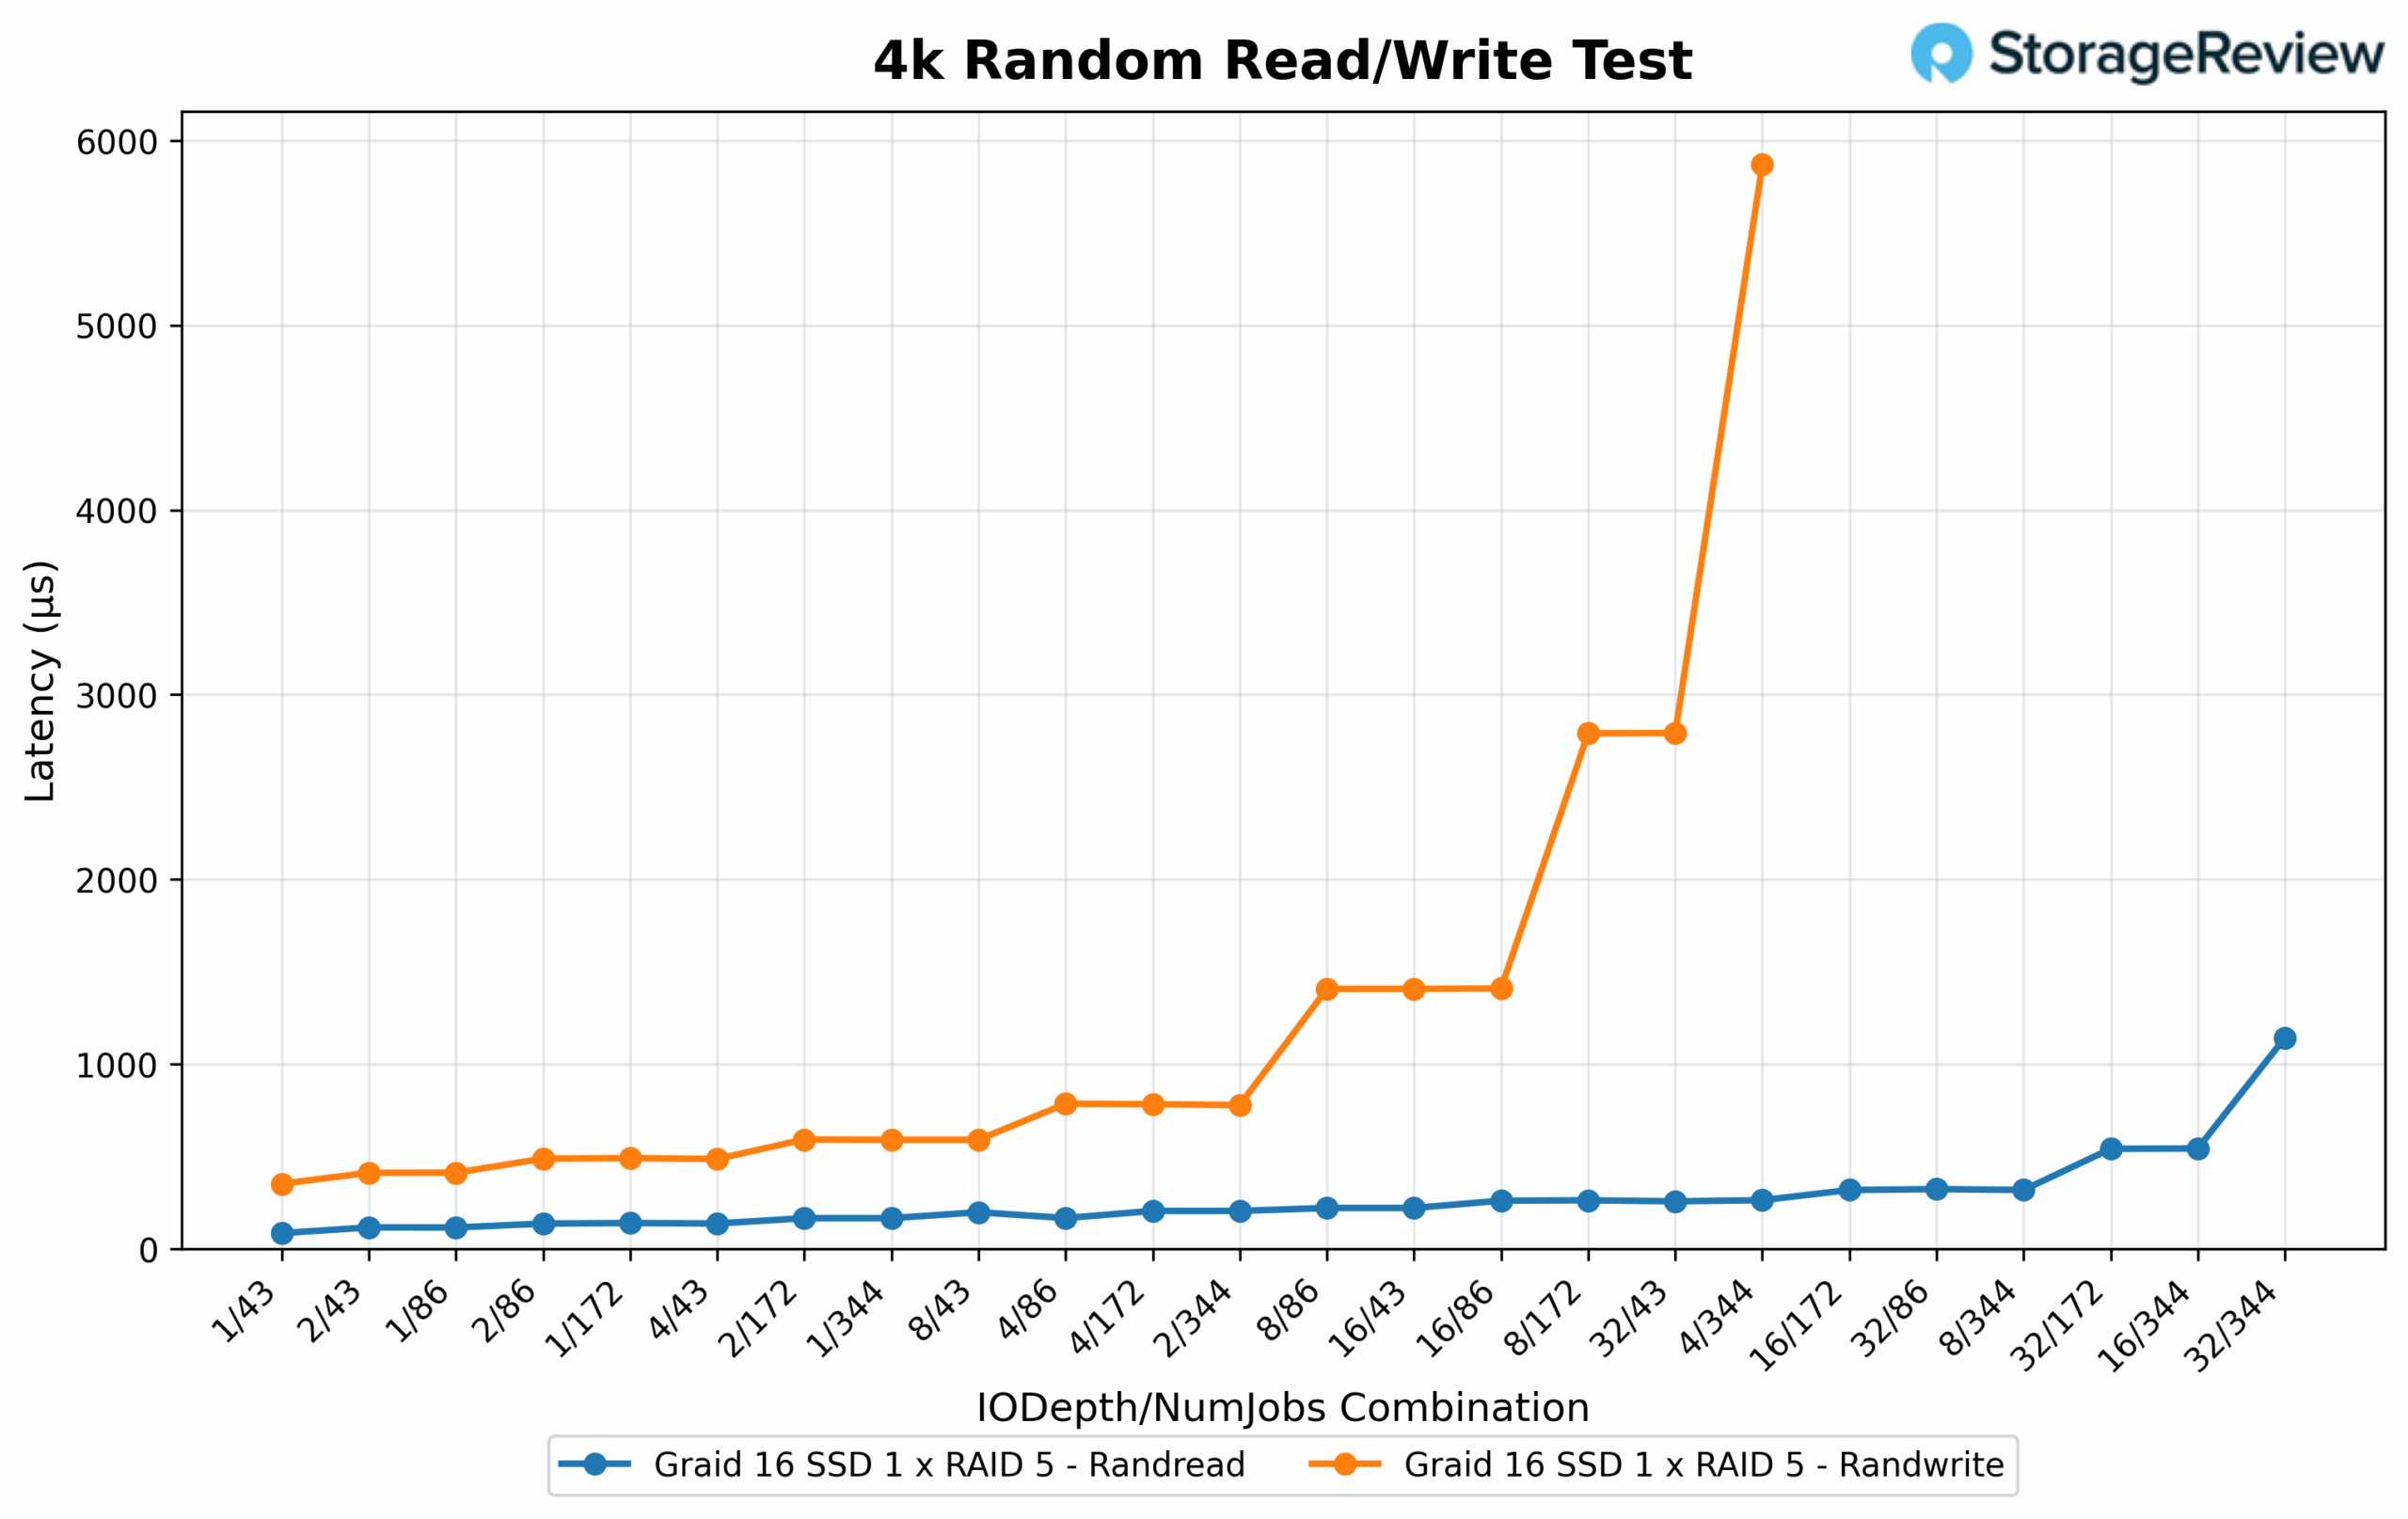
Latência de leitura/gravação aleatória de 4K
A latência de leitura aleatória em 4K permaneceu extremamente baixa em todos os aspectos. O tempo de resposta mais rápido foi de 0.084 ms em 1/86, com várias outras configurações — incluindo 1/43, 2/43 e 4/43 — todas ficando abaixo de 0.12 ms. Mesmo no pico de IOPS, a latência permaneceu bem controlada, com a configuração de 32/344 de melhor desempenho mantendo-se em apenas 1.142 ms. Isso reflete uma excelente capacidade de resposta, mesmo com o array atingindo seu potencial máximo de throughput. No lado da gravação, a latência aleatória em 4K também foi bem gerenciada. O menor valor registrado foi de 0.352 ms em 1/43, enquanto outras configurações altamente eficientes, como 1/86, 2/43 e 4/43, permaneceram abaixo de 0.6 ms. Configurações de alto rendimento, como 32/172 e 32/86, apresentaram latência modestamente aumentada para entre 2.79 ms e 5.87 ms, permanecendo dentro de uma faixa aceitável considerando os níveis de saturação de gravação sustentados.
Medindo a sobrecarga da GPU Graid SupremeRAID AE
Ao examinarmos as métricas de desempenho de armazenamento SupremeRAID AE da Graid, é essencial considerar como o SupremeRAID, que compartilha recursos de GPU, pode impactar cargas de trabalho que também utilizam essas mesmas GPUs. Em implantações anteriores do SupremeRAID, a GPU do sistema era dedicada à Graid. Com esta solução, você a implanta em uma plataforma que já contém GPUs que a Graid pode utilizar e compartilhar recursos. Para medir o impacto da sobrecarga, criamos um cenário de inferência LLM usando o vLLM. Medimos o desempenho de linha de base da carga de trabalho com a Graid ociosa e, novamente, com a Graid lendo 172 GB no pool RAID 5. Isso simula a carga de trabalho de inferência, pré-alocando a próxima carga de trabalho enquanto uma estiver em execução. Com o vLLM levando as GPUs a 100% de utilização, qualquer operação da Graid afetará as taxas de token e a latência.
Para a carga de trabalho de IA, executamos inferência com o vLLM usando o modelo Llama 3.3 70B com precisão total (BF16) e um tamanho de cache de 16K KV. Isso utilizou quase completamente a VRAM em ambos os cartões (78G no cartão de 80G e 86G no cartão de 94G). Em seguida, executamos o script de benchmarking do vLLM com um comprimento máximo de saída de 256 tokens. Cada teste executou 256 consultas com uma simultaneidade máxima de 32 solicitações, utilizando lotes contínuos para simular um padrão de solicitação realista. As métricas que coletamos são Tok/s, Tempo até o Primeiro Token (TTFT), Tempo por Token de Saída (TPOT) e Latência Inter-Token (ITL). A carga de trabalho FIO que iniciamos durante o teste de inferência consistiu em 172 trabalhos de leitura aleatória de 16K, cada um lendo 1GB.
A taxa de transferência apresentou um declínio modesto em todos os níveis. A taxa de transferência de solicitações caiu de 1.86 para 1.78 solicitações por segundo, uma queda de 4.3%. A taxa de transferência de tokens de saída caiu de 225.44 para 215.94 tokens por segundo, representando uma redução de 4.2%. A taxa de transferência total de tokens caiu de 2029.77 para 1944.30 tokens por segundo, representando uma queda semelhante de 4.2%. Isso sugere que a transferência introduziu alguma sobrecarga que impactou ligeiramente o desempenho.
Métricas de latência revelaram resultados mistos. O TTFT médio aumentou 3.6%, de 6,704 ms para 6,945 ms, enquanto o TTFT mediano aumentou 1.5%. Curiosamente, o TTFT do P99 melhorou, diminuindo 2.8%, de 14,199 ms para 13,803 ms, indicando melhor desempenho final nessa métrica. Para o TPOT, a média aumentou 5.3%, enquanto a mediana permaneceu relativamente estável, com um aumento de 0.65%. No entanto, o TPOT do P99 aumentou acentuadamente em 24.6%, de 127.69 ms para 159.15 ms, mostrando que o pior tempo de geração de tokens foi significativamente impactado. A latência entre tokens (ITL) exibiu tendências semelhantes, com a média aumentando 5.1%, a mediana permanecendo essencialmente inalterada e o P99 aumentando 2.2%.
O SupremeRAID AE da Graid, executado em conjunto com nossa carga de trabalho vLLM, apresentou uma pequena, porém consistente, queda na taxa de transferência (aproximadamente 4%), juntamente com aumentos moderados na latência média e degradação perceptível no desempenho do P99 para geração de tokens. Com esses impactos, o sistema permaneceu totalmente estável e responsivo, demonstrando que a inferência de alta simultaneidade com modelos grandes, como o Llama 3.3 70B, ainda pode funcionar de forma confiável em conjunto com o SupremeRAID AE da Graid.
| Métrica (menor duração / maior tok/s é melhor) | Linha de Base | Com operação de leitura FIO de 172 GB |
| Solicitações bem-sucedidas | 256 | 256 |
| Duração do benchmark (s) | 137.68 | 143.73 |
| Tokens de entrada total | 248,414 | 248,414 |
| Tokens totais gerados | 31,037 | 31,037 |
| Taxa de transferência de solicitação (req/s) | 1.86 | 1.78 |
| Taxa de transferência do token de saída (tok/s) | 225.44 | 215.94 |
| Taxa de transferência total de tokens (tok/s) | 2029.77 | 1944.30 |
| Tempo para o primeiro token (TTFT) (latência mais baixa é melhor) | ||
| TTFT médio (ms) | 6,704.43 | 6,945.72 |
| TTFT mediana (ms) | 6,469.88 | 6,569.80 |
| P99 TTFT (ms) | 14,199.21 | 13,803.62 |
| Tempo por Token de Saída (TPOT, excluindo o 1º token) (quanto menor a latência, melhor) | ||
| TPOT médio (ms) | 81.44 | 85.72 |
| TPOT mediana (ms) | 80.38 | 80.90 |
| P99 TPOT (ms) | 127.69 | 159.15 |
| Latência entre tokens (ITL) (quanto menor a latência, melhor) | ||
| ITL médio (ms) | 79.94 | 83.99 |
| ITL mediana (ms) | 49.75 | 49.78 |
| P99 ITL (ms) | 539.07 | 550.73 |
Pensamentos de Encerramento
O Graid SupremeRAID AE oferece uma solução prática e de alto impacto para organizações que criam ou escalam infraestrutura de IA. Ao substituir o RAID de hardware tradicional por uma abordagem definida por software e orientada por GPU, o SupremeRAID AE simplifica a implantação e remove gargalos comuns que paralisam os fluxos de trabalho de IA modernos.
Nossos testes demonstraram sua capacidade de unificar até 32 SSDs NVMe em um único namespace resiliente, fornecendo quase 1 PB de capacidade em um servidor com desempenho excepcional. Os resultados máximos de 183 GB/s de taxa de transferência de leitura e 54 GB/s de gravação, combinados com sobrecarga mínima de GPU durante a inferência ao vivo, comprovam sua capacidade de atender às demandas duplas de pontos de verificação de modelos massivos e inferência de baixa latência em escala.
Ao eliminar o custo e a complexidade do hardware RAID dedicado e integrar-se perfeitamente a tecnologias como NVIDIA GPUDirect Storage e sistemas de arquivos focados em IA, o SupremeRAID AE cria uma base de armazenamento preparada para o futuro. Para organizações focadas em otimizar a inferência e reduzir o risco operacional, o SupremeRAID AE oferece o desempenho, a simplicidade e a resiliência necessários para ambientes de IA de produção.


 Amazon