

Seit Jahren ist automatisiertes Storage Tiering (Speicherschichtung) eine unverzichtbare Lösung für Unternehmen, die ihren Rechenzentrumsfußabdruck eficiente verwalten und gleichzeitig die Gesamtbetriebskosten (TCO) senken möchten. Die Strategie ist einfach: Man verwendet Algorithmen and Richtlinien mit automatischer Zeitsteuerung und hält die active Daten auf dem Primärspeicher, während inaktive Daten in kostengünstige Speicherkategorien verschoben werden. No Letzten Jahren hat sich Cloud Tiering als eine robusto, kostengünstige Lösung herauskristallisiert, die the Verlagerung inaktiver Daten auf kostengünstige Objektspeicher in der Cloud verwaltet. Mit der ThinkSystem DM-Serie ermöglicht Lenovo Unternehmen die Verwaltung von Daten und Cloud-Alternativen mit einer smarten Speicherlösung. Diese Cloud-Strategie befasst sich erfolgreich mit Kapazität, Agilität und Sicherheit in Hybrid-Cloud-Umgebungen, ohne die Verwaltbarkeit, Sicherheit oder Leistung zu beeinträchtigen.
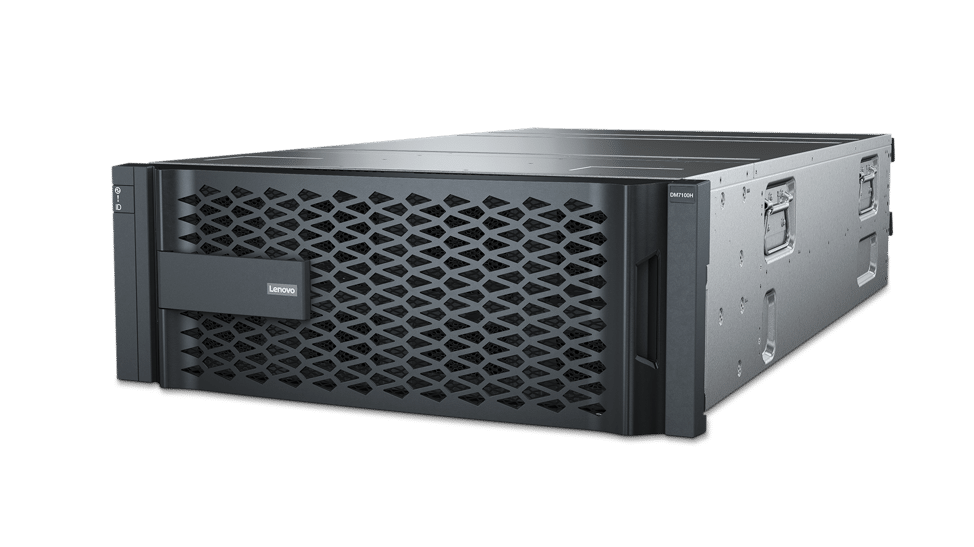
Este artigo foi escrito, como Lenovo ThinkSystem Speicherlösungen e a série DM uma estratégia ponta a ponta para recuperação, desde a instalação inicial até a nuvem. O primeiro recurso foi uma configuração básica para o gerenciamento de dados, para o Cloud Tiering e para um novo gerenciamento de gerenciamento de recursos. Wirfen werfen einen Blick auf do Datenmanagement-Ökosystem of Lenovo und darauf, wie sich das Unternehmen mit der DM-Serie auf dem Speichermarkt hervorhebt. Além disso, será necessário clicar no software ONTAP e na linha FabricPool-Storage-Tiering. E schließlich zeigen wir von unserem Labor aus die Einrichtung und Validierung der Cloud-Tiering-Lösung von Lenovo.
Em um modelo tradicional de Rechenzentrums, você começa a usar o Unternehmen com o Sammeln kritischer Daten und Dateien em seinen Räumlichkeiten. Diese Daten sind jedoch irgendwann veraltet und es wird nur noch selten auf sie zugegriffen, wodurch wertvolle Leistung und Kapazität des primären und sekundären Speichers in Anspruch genommen wird, was sich auf kritische Arbeitslasten auswirkt. Die Archivierung dieser Daten war in der Vergangenheit eine praktische Lösung für Unternehmen; dadurch stehen die Daten jedoch nicht sofort zur Verfügung, wenn sie plötzlich benötigt werden.
Este problema é causado pela organização de TI das organizações de TI, falando com recursos limitados, custos e taxas de imposto em Betracht zu ziehen. Darüber hinaus müssen sie die Anforderungen an das Datenwachstum über mehrere und Cloud-Umgebungen hinweg anerkennen und darauf vorbereitet sein, estes zu erfüllen. O Cloud Tiering é a solução e é essencial para a arquitetura de arquitetura moderna. Andernfalls wird ein wachsender Datenfußabdruck die Investitionen des Unternehmens in hochleistungsfähige Primärspeicher in seinem Rechenzentrum überfordern.
Die Cloud como Speicherstufe
Quando fortschrittlichere Technologien zugänglich werden, können bestehende Speicherebenen nach Bedarf transformiert und weitere hinzugefügt werden, um die mehrstufige Speicherarchitektur weiter zu diversifizieren. Die Cloud hat IT-Organisationen neue Möglichkeiten eröffnet, indem sie Speicherlösungen von öffentlichen Cloud-Anbietern als zusätzliche (untere) Ebene ermöglicht. Wenn sie gut konzipiert und ausgeführt wird, ist die Cloud ausgezeichnete und kostengünstigere Lösung als eine niedrigere On-Prem-Tier-Lösung.
Auf primären Speicherebenen, die Flash für extrem hohe Leistung nutzen, könnten etwa 50% der kalten Daten der Cloud zugewiesen werden. Snapshot-Kopien und unstrukturierte Daten gehören häufig in diese Kategorie, einschließlich unternehmenskritischer Anwendungen. Auf sekundären Ebenen können bis zu 90 % der im Speicher befindlichen Cold-Daten aus Sicherungskopien stammen. All diese wertvollen Daten, auf die nur gelegentlich zugegriffen wird, könnten ebenfalls in die Cloud verschoben werden. Você pode confiar em Cloud-Anbietern und -Diensten, die bereit sind, inaktive Daten in die Cloud zu verschieben, gehören Azure Blob-Speicher, AWS S3 e Google Cloud Storage.
Wie beim automatisierten Speicher-Tiering vort können wir Richtlinien und Regeln zur Verwaltung der Daten for the Cloud erstellen. Die Bedingungen erlauben es uns, Dateien direct von vor Ort in die öffentliche Cloud zu übertragen. Die Richtlinien werden auf verschiedene Weise angewendet Beispielsweise können Daten auf der Grundlage der Dateierweiterung, von Musttern, die im Dateinamen enthalten sind, oder danach, wie oft innerhalb eines bestimmten Zeitraums auf die Datei zugegriffen wird, verschoben werden. Essa opção letzte ist wahrscheinlich das beste Szenario, bei dem Speicherdateien und -blöcke mit Temperaturwerten versehen werden, wobei neu geschriebene Daten als heiß und inaktive als kalt gekennzeichnet werden. Durch die Implementierung einer Reihe von Richtlinien für die Speicherausrichtung können kalte Daten schnell in die Cloud verschoben werden, indem Regeln nach Bedarf oder nach Zeitplan ausgeführt werden.
Neue Herausforderungen bei der Speicherverwaltung
Os Haupttherausforderungen, die heute auf dem Markt im Zusammenhang mit der Verwaltung of Hybrid-Cloud-Daten zu beobachten sind, bestehen aus Volumen und Vielfalt, Datengeschwindigkeit und Datenintegrität.
Das Datenvolumen wächst nahezu exponentiell. IT-Organisationen müssen nicht nur das Datenwachstum in den Griff bekommen, sondern auch das Datenwachstum und die Datenverwaltung in verschiedenen Umgebungen. Die Menge und Vielfalt der erzeugten Daten ist nach wie vorwältigend. Ohne die Möglichkeit, diese Daten in einer Hybrid-Cloud-Lösung zu speichern, zu categorisieren und zu verarbeiten, entgehen Unternehmen wichtige Erkenntnisse über ihre Kunden und ihr Geschäft. Darüber hinaus wird vorhergesagt, dass das Datenvolumen bis 2025 um das 10-fache (ca. 163ZB) ansteigen wird, angetrieben durch IoT und Spitzentechnologie. Wenn Daten das wertvollste Gut sind, müssen sie mit Sorgfalt behandelt werden und in der Lage sein, Erkenntnisse für gezielte Entscheidungen zu liefern und gleichzeitig einen Blick in die Zukunft zu ermöglichen. Darüber hinaus ist es für die Kaufentscheidungen der Kunden von entscheidender Bedeutung, effizientere Wege zur Verarbeitung dieser Daten zu finden, um sie in einen Wert umzuwandeln.
Auch IT-Bedrohungen entwickeln sich weiter – und die Sicherheit der Infrastruktur ist ein ständiger Kampf. Eine gute Sicherheitsstrategie besteht darin, eine solide Grundlage zu schaffen, die darauf beruht, genau zu wissen, wann, wo und wie Daten gespeichert werden Eine solche Strategie hilft Unternehmen, die steigenden Kosten zu vermeiden, die mit Datenverstößen sowie mit neuer Malware , Katastrophen und Vorschriften verbunden sind, die erhebliche Risiken für den Betrieb darstellen. Datensicherheit ist für Unternehmen von absoluter Wichtigkeit, sei es zum Schutz vor Datenverlust oder zur Gewährleistung der Datenintegrität. Hier deckt Lenovo alle Möglichkeiten ab und stellt sicher, dass die Daten seiner Kunden stets geschützt sind.
Lenovo ThinkSystem Speicherlösung
Neue Entwicklungen zu antizipieren ist ebenso eine Herausforderung wie die beste Speicher- und Cloud-Strategie zu verfolgen. Die Branche hat jedoch bereits enorme Investitionen in Forschungsökosysteme und -plattformen getätigt, die dem Unternehmen einen Mehrwert und Möglichkeiten bieten. Mit dem nächsten strategischen Schritt für die Speicherbranche hat Lenovo seine Lösung auf die wichtigsten Herausforderungen im Datenmanagement zugeschnitten. Dieser kluge Schritt von Lenovo zielt darauf ab, seinen Kunden die ultimative Lösung zu bieten und bietet eine einzigartige Mischung aus Produkten und Dienstleistungen, die es Unternehmen ermöglicht, die Hybrid-Cloud ideal zu nutzen.
Lenovo ist eines der einzigartigen Technologieunternehmen auf dem Markt, das über die Lenovo Data Center Group (DCG) eine End-to-End-Rechenzentrumslösung anbietet. Darüber hinaus bietet Lenovo mit seinem Intelligent Device Group (IDG)-Ökosystem eine End-to-End-Sicherheits- und Software-Verwaltung. Mit diesen Angeboten und der ThinkSystem DM-Series von Lenovo können Unternehmen ihre Infrastruktur verbessern und jede in ihrer Umgebung laufende Arbeitslast last bewältigen.
A série ThinkSystem DM é o conjunto de bandeira da Lenovo, que possui um conjunto de gerenciamento de dados bastante completo para dados estruturados e não estruturados. Você precisa de uma classe específica para obter uma classe média superior e duas funções intensivas de data, como redução de dados integrada, proteção de dados e datação, pois a série DM pode integrar funções de nuvem híbrida integradas para a configuração da nuvem pública. Gleichzeitig baut Lenovo seine End-to-End NVMe-Angebote mit der kürzlich veröffentlichten DM7100F-Serie aus und plant notch in this angebot of End-to-End NVMe auf weitere Einstiegs-Workloads for Kunden auszuweiten, uma eine infrastrukturweite Estrutura NVMe para Unternehmen zu Schaffen.
Piscinas de tecido
Die Data Management Suite der DM-Series vereinheitlicht die Datenverwaltung über Flash, Festplatte und Cloud und vereinfacht so Speicherumgebungen. Este software umfassende é avançado e flexível, para gerenciamento eficiente de recursos e integração de nuvem mais robusta e robusta. Insgesamt zielt die DM-Serie darauf ab, die Bereitstellung und Verwaltung von Daten zu vereinfachen und Unternehmensanwendungen zu fördern, dh sie ist zukunftssicher für Dateninfrastrukturen.
Neben der bordeigenen Datenmanagement-Funktionalität steht die FabricPool Cloud Tiering-Technologie zur Verfügung. Sie ermöglicht das automatisierte Tiering von Daten auf kostengünstige S3-Objektspeicherebenen, die sich entre vor Ort oder in der öffentlichen Cloud befinden. Im Gegensatz zu manuellen Tiering-Lösungen automatisiert FabricPool das Tiering von Daten, um die Speicherkosten zu senken. Daten ativo verbleiben auf Hochleistungslaufwerken und inaktive Daten werden zum Objektspeicher gestaffelt, wobei die Funktionalität und die Dateneffizienz der DM-Serie erhalten bleiben.
FabricPool unterstützt eine breite Palette von öffentlichen Cloud-Anbietern und deren Speicherdienste. Dazu gehören Amazon S3, Alibaba Cloud Object Storage Service, Microsoft Azure Blob Storage, Google Cloud Storage, IBM Cloud Object Storage e nuvens privadas. Você também pode aproveitar o Beibehaltung der integrierten Datenreduzierungsfunktionen beim Verschieben von Daten in und aus der Cloud. Dies spart Transportkosten, wenn Daten aus der Cloud zurückversetzt werden müssen. Darüber hinaus schützt die integrierte Datenverschlüsselung sowohl die Daten während der Übertragung in die Cloud als auch die Daten in der Cloud. Dadurch wird sichergestellt, dass es während des gesamten Cloud-Tiering-Prozesses keine Schwachstellen gibt.
TecidoPool Richtlinien
FabricPool hat zwei primäre Anwendungsfälle: die Rückgewinnung von Kapazität auf dem Primärspeicher oder die Verkleinerung des sekundären Speicherplatzes. Unser Schwerpunkt in diesem Artikel liegt auf der Möglichkeit, Kapazität im Primärspeicher zurückzugewinnen. Ele oferece várias opções e recursos avançados para o Cloud Tiering de Primärspeicher: Auto-Tiering, Nur Snapshots e All-Tiering.
Die Beibehaltung von Daten, auf die nur selten zugegriffen wird und die mit Produktivitätssoftware, abgeschlossenen Projekten und alten Datensätzen auf Primärspeicher verbunden sind, ist eine ineffiziente Nutzung von Hochleistungs-Flash-Speicher. Das Tiering dieser Daten zu einem Objektspeicher ist eine einfache Möglichkeit, vorhandene Flash-Kapazität zurückzugewinnen und die erforderliche Kapazität in Zukunft zu reduzieren. Die Auto-Tiering-Richtlinie verschiebt alle Cold Blocks im Volumen auf the Cloud-Ebene. Wenn sie durch zufällige Lesevorgänge gelesen werden, werden kalte Datenblöcke auf der Cloud-Ebene heiß und werden auf die lokale Ebene übertragen. Beim Lesen durch sequentielle Lesevorgänge, z. B. in Verbindung mit Index- und Antiviren-Scans, bleiben kalte Datenblöcke auf der Cloud-Ebene kalt und werden nicht auf die lokale Ebene geschrieben.
Snapshot-Kopien können häufig mehr als 10 % einer typeischen Speicherumgebung beanspruchen. Obwohl this Point-in-Time-Kopien für die Datensicherung und die Notfallwiederherstellung unerlässlich sind, werden sie nur selten verwendet stllen eine ineffiziente Nutzung von Hochleistungs-Flash dar. Die Snapshot-Only Tiering Policy für FabricPool ist eine einfache Möglichkeit, Speicherplatz auf Flash-Speicher zurückzugewinnen. Während unserer Tests wurde Snapshot-Only als Richtlinie zum Testen von Cloud-Tiering-Operationen verwendet. Kalte Snapshot-Blöcke im Volume, die nicht für das ative Dateisystem freigegeben sind, werden in the Cloud-Ebene verschoben. Wenn sie gelesen werden, werden kalte Datenblöcke auf der Cloud-Ebene heiß und werden auf die lokale Ebene übertragen.
Uma das principais respostas do FabricPool é a mais comum dos dados em nuvens. Projetos abrangentes, Legacy-Reports ou relatórios históricos são candidatos ideais, morrendo em um conjunto de objetos de grande prestígio que pode ser usado. O volume obtido é aumentado durante a instalação de toda a política de camadas em um volume. Esta linha rica foi inserida na primeira linha para volumes de dados e datas consistentes. Você também pode usar todos os dados em volumes Lese-/Schreib para funcionários.
Datan in Volumen, die die All Tiering Policy verwenden, werden sofort als kalt gekennzeichnet und so schnell wie möglich in the Cloud gestaffelt. Es muss nicht eine Mindestanzahl von Tagen abgewartet werden, bevor die Daten als “kalt” und “gestaffelt” gekennzeichnet werden. Wenn sie gelesen werden, bleiben kalte Datenblöcke auf der Cloud-Ebene kalt und werden nicht auf die lokale Ebene zurückgeschrieben.
Mit Lenovo steht auch eine vierte Option für die Abstufung zur Verfügung, die treffend als “Keine” Abstufung bezeichnet wird. Bei diesem Vorgang werden keine Daten gestaffelt, então dass alle Daten in Flash verwaltet werden können. Ein gutes Beispiel für ihre Verwendung sind Snapshots in DevOps-Umgebungen, in denen häufig die früheren Point-in-Time-Kopien verwendet werden.
Configuração do Lenovo Storage Cloud Tiering
Um dos recursos e funções do Lenovo Speicherlösung para a nuvem a ser testado foi em nosso trabalho um modelo DM7000F integrado.
Zunächst haben with mit Azure Blob Storage, unserer Cloud-Lösung für diesen Test, einen Speichercontainer erstellt. Auch hier ist es gut, die breite Palette der von Lenovo angebotenen Optionen zu beachten, zu denen Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud e outros gehören. Quando os testes começarem, o Microsoft Azure Blob Storage para a nuvem e a camada de nuvem para o FabricPool está disponível. Nachdem wir die Einrichtung des Cloud-Speichers abgeschlossen hatten, war es an der Zeit, sich bei der GUI-Oberfläche des DM7000 anzumelden.
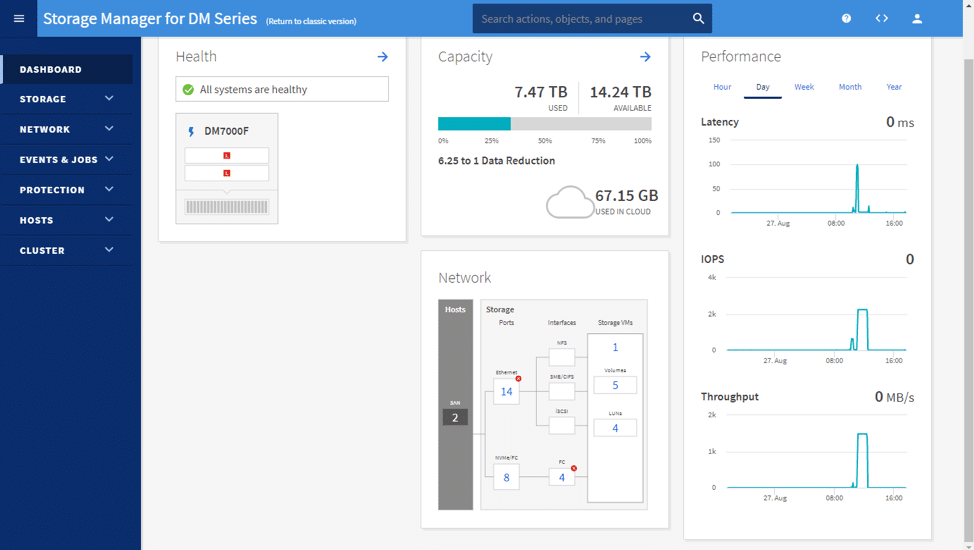
Sobald man angemeldet ist, erscheint the Standard-Dashboard-Seite. O painel mantém o suporte, a capacidade, a configuração e as informações da rede de matrizes fracionadas.
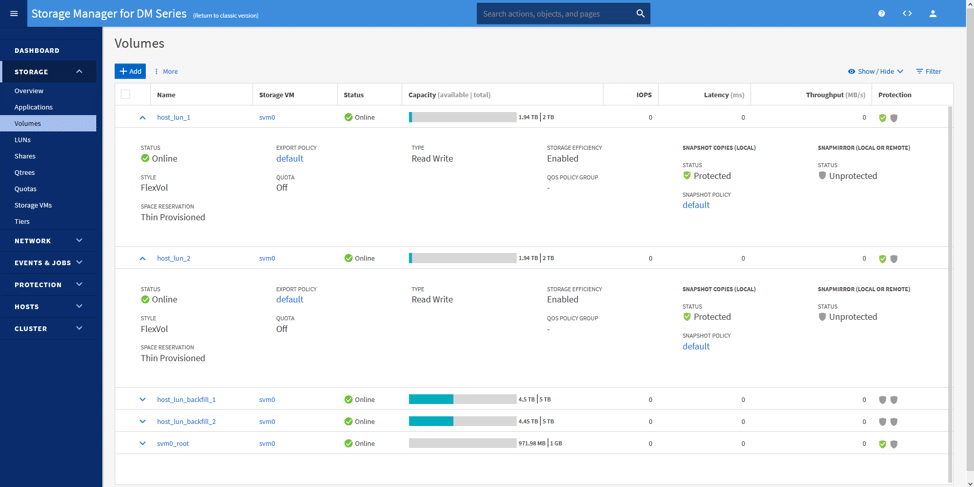
Wir haben dann zwei Volumen (eines pro Controller) e zwei VMs (eines für jedes Volumen) erstellt. Der Plan war, diese VMs laufen zu lassen und sie dann für eine Weile untätig zu lassen. Das folgende Bild zeigt die verwendeten Volumen: host_lun_1 e host_lun_2.
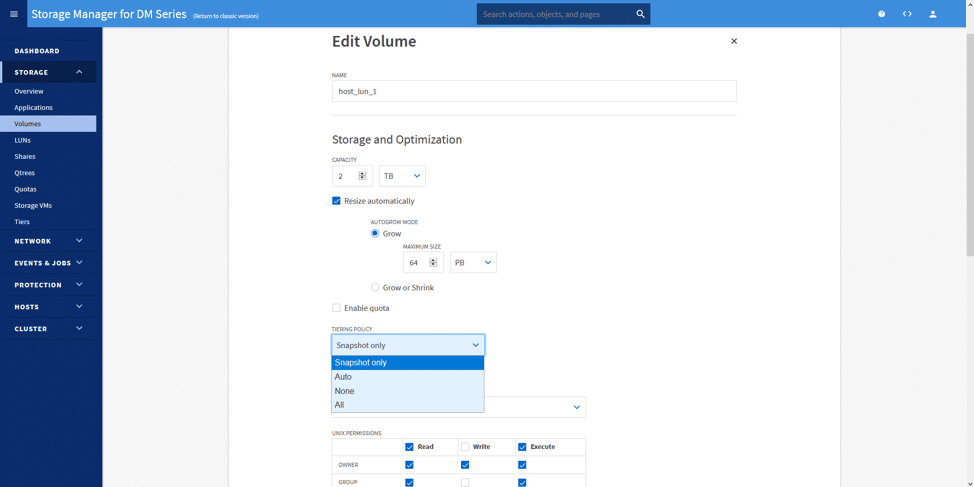
Während der Bearbeitung oder Erstellung des Volumens können wir die gewünschte Einstufungsrichtlinie auswählen. Hier haben wir nur Snapshot ausgewählt. Quando usarmos essa política de níveis, você poderá navegar por datas (o instantâneo que você acabou de usar) no Armazenamento de Blobs do Azure, em um Hintergrundintervall erstellt wurde. Das Intervall läuft zu seiner eigenen Zeit und sagt voraus, wann die Arbeitslasten am wenigsten beeinträchtigt werden.
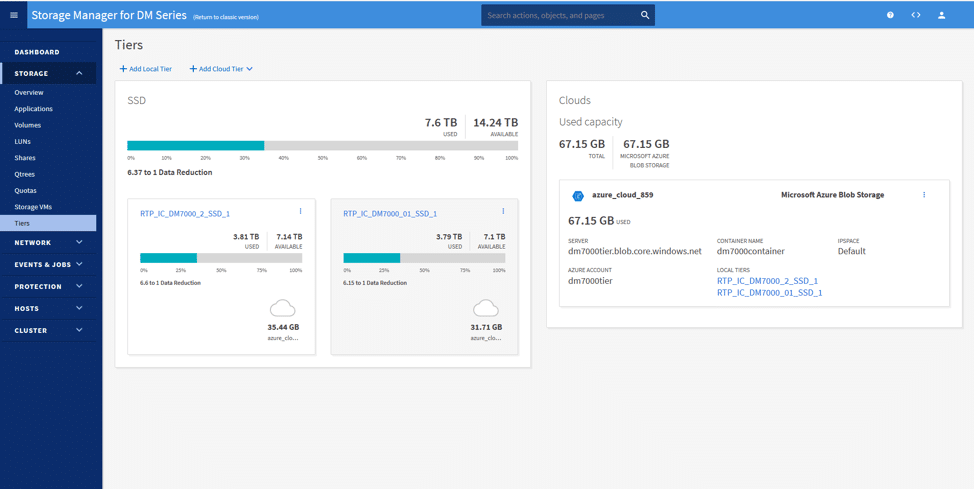
Unter der Tiers-Seite können wir unsere Cloud-Ebene aus den öffentlichen Clouds hinzufügen. Aqui estão os recursos de armazenamento de blob do Azure incluídos e com os comentários locais descritos. Unter dem Bild unten sehen Sie zwei Ressourcen, die mit Azure verbunden sind.
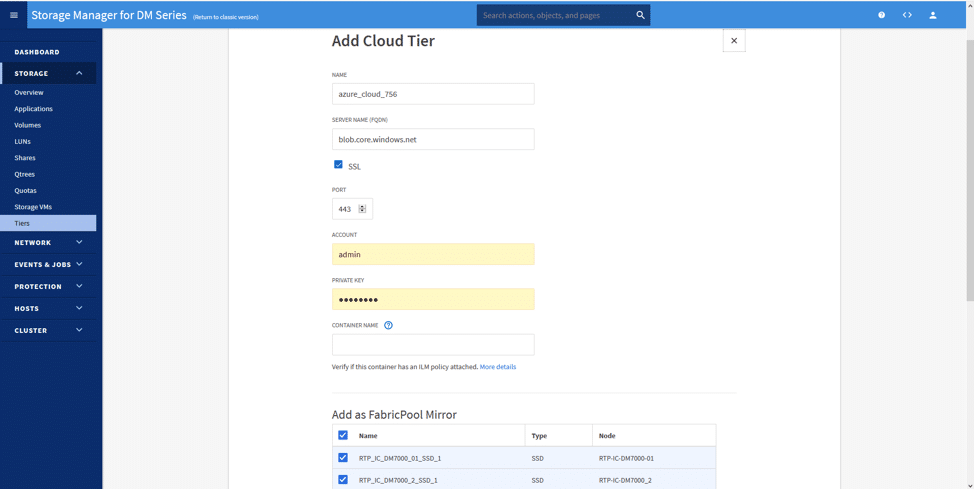
Die Konfiguration ist einfach; durch Klicken auf “Add Cloud Tier” (Cloud-Ebene hinzufügen) and Auswahl der gewünschten Cloud (in diesem Szenario Azure) könnten wir sofort the Cloud-Ebene einrichten.
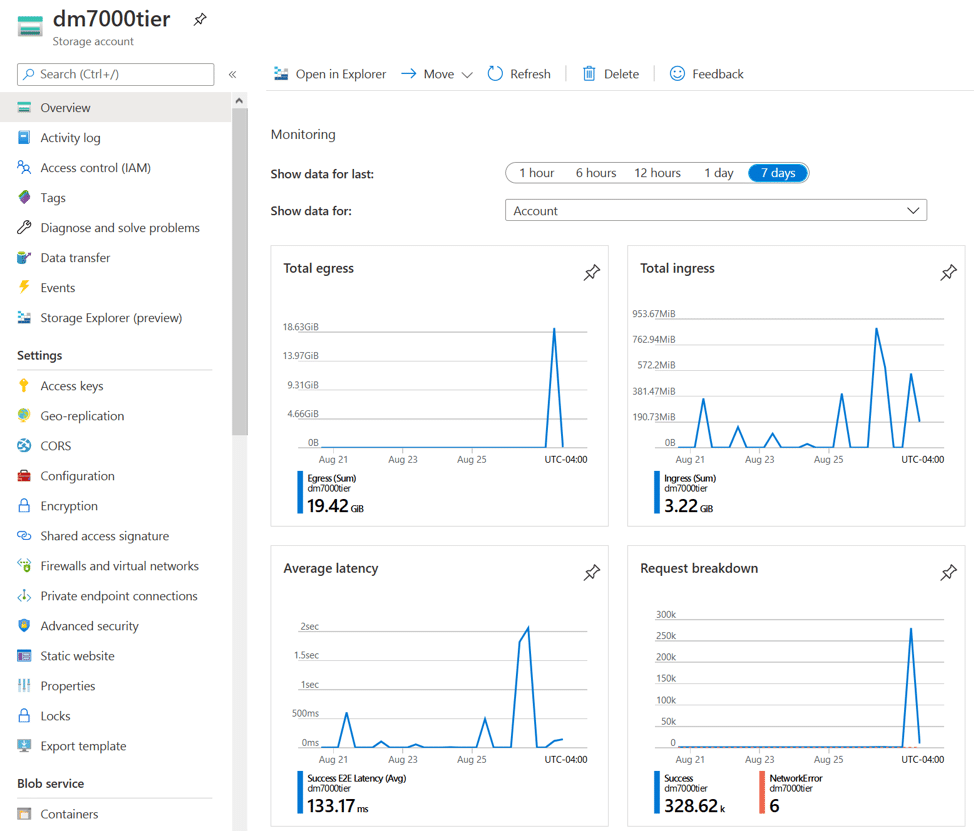
Schließlich wollten wir von unserem Azure Storage-Account-Dashboard aus sowohl Daten anzeigen, die in Azure eingehen (entrada), auch Daten, die aus Azure herausgehen (saída). Die kleinen Spitzenwerte, die jeden Tag angezeigt werden, sind neue Momentaufnahmen von Daten, die nach Azure übertragen werden. Auf der anderen Seite zeigen die Austrittsspitzen ausgehende Daten und illustrieren eine Snapshot-Wiederherstellung von einem Volume zum Zurückfahren.
Discurso de encerramento
Im Allgemeinen ist die Cloud und die Verwaltung der Daten ein breites, sich entwickelndes Thema in Unternehmen. Lenovo möchte Lösungen anbieten, die Kunden auf wechselnde Anforderungen vorbereiten, sei es im Rechenzentrum oder über Hybrid-Cloud-Umgebungen. Wir bei StorageReview sind ziemlich beeindruckt von Lenovos Ansatz für ihre Speicher-Arrays. Durch diese Evaluierung haben wir erfahren, wie das Tiering von Daten in die Cloud vom Storage Manager for the DM-Serie funktioniert und wie wertvolle Flash-Kapazität zurückgewonnen oder in die Cloud erweitert wird. Wichtig ist, dass DM7000F-Speichersystem diese Flexibilität bietet, ohne Änderungen an der Infrastruktur vorzunehmen. Darüber hinaus ist die Funktionalität einfach zu implementieren
Unterstützt von der DCG und der IDG sehen wir Lenovo in einer starken Position auf dem Datenspeichermarkt. Ihre Speicherlösungen ermöglichen es den Kunden, das zu kaufen, was sie heute benötigen, und gleichzeitig die Cloud zu nutzen, um die Anforderungen an das Datenwachstum der Zukunft zu erfüllen. Das Ergebnis ist, dass das Lenovo Cloud Tiering die Kosten reduziert und Unternehmen die Flexibilität ermöglicht, die sich wünschen, wenn sie eine Investition in Speicherlösungen in Erwägung ziehen.
Lenovo ThinkSystem DM Series Speicher-Arrays
Dieser Bericht wurde von Lenovo unterstützt. Alle in diesem Bericht zum Ausdruck gebrachten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die in Frage kommende(n) Product(e).


 Amazon