

Updated November 13, 2026: The Dell Pro Precision 9 T4 joins as Best Xeon Tower for Local AI, the tower section now groups picks by host platform, and How We Rank now covers towers tested on our llama.cpp suite under Linux. On October 24, the Mac Studio answer was updated for the M5 Max and M5 Ultra models Apple began shipping in September.
Fiecare sistem clasat pe această pagină a trecut prin laboratorul StorageReview. Evaluăm direct performanța AI locală: debitul de servire online vLLM, timpul până la primul token și timpul per token de ieșire pentru modele precum GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B și Qwen3 Coder 30B, plus eficiența de calcul MAMF și testarea stocării GDSIO. Niciun sistem nu este clasat pe baza unei fișe tehnice.
Întrebarea definitorie pentru un desktop local cu inteligență artificială în 2026 este memoria unificată versus VRAM discretă . Dispozitivele desktop, cum ar fi DGX Spark bazat pe GB10 de la NVIDIA și sistemele Ryzen AI Max (Strix Halo) de la AMD, oferă 128 GB de memorie unificată în spatele unui singur cip la prețuri de aparate, găzduind modele care altfel ar necesita mai multe GPU-uri discrete.
Turnurile pentru stațiile de lucru răspund cu un randament brut: plăcile RTX PRO 6000 Blackwell oferă mult mai multe tokenuri pe secundă, la un cost și un consum de energie de câteva ori mai mari. Această pagină le clasifică pe ambele, în niveluri separate, dintr-o suită de teste consistentă, deoarece răspunsul corect depinde de cel mai mare model pe care intenționați să îl rulați și de cât de repede trebuie să răspundă.
La o privire
| Categorii | Sistem și | Memorie | GPU-uri (Testate / Maxim) | Intreg opinie |
|---|---|---|---|---|
| Cel mai bun sistem de inteligență artificială pentru birou în general | NVIDIA DGX Spark | LPDDR5X unificat de 128 GB | GB10 integrat (fix) | Recenzie DGX Spark |
| Cea mai bună implementare GB10 | Acer Veriton GN100 | LPDDR5X unificat de 128 GB | GB10 integrat (fix) | Recenzie Veriton GN100 |
| Cea mai bună alternativă x86 | AMD Ryzen AI Halo (Strix Halo) | Până la 128 GB de memorie LPDDR5X unificată | Placă video integrată Radeon 8060S (fixă) | Recenzie Ryzen AI Halo |
| Cel mai bun fără un GPU discret | HP Z2 Mini G1a | LPDDR5X unificat (a rulat GPT-OSS 120B) | Integrat, fără dGPU (fix) | Recenzie Z2 Mini G1a |
| Cel mai bun sistem GB300 | MSI XpertStation WS300 (alternativă: ASUS ET900N G3) | 748 GB coerent (252 GB HBM3e + 496 GB LPDDR5X) | GB300 integrat (fix) | Recenzie XpertStation WS300 |
| Cel mai bun turn pentru inteligența artificială locală | Dell Precision 7875 | 192 GB GDDR7 (2 × 96 GB) | 2× RTX PRO 6000 / 2 max | Recenzie Precision 7875 |
| Cel mai bun turn Xeon pentru inteligența artificială locală | Dell Pro Precision 9 T4 | 192 GB GDDR7 (2 × 96 GB) | 2× RTX PRO 6000 Max-Q / 2 max | Recenzie Pro Precision 9 T4 |
| Cea mai bună platformă multi-GPU | HP Z8 Fury G6i | 192 GB GDDR7 conform testelor / până la 384 GB | 2× RTX PRO 6000 testate / 4 max. | Recenzie Z8 Fury G6i |
| Alegerea Extremă | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8 × 96 GB) | 8× RTX PRO 6000 / 8 max | Recenzie Comino Grando |
Aparate AI de birou
Nivelul de aparate, pe care Dell îl numește inteligență artificială la nivelul biroului , iar NVIDIA îl numește supercomputer cu inteligență artificială personală , oferă un randament maxim pentru capacitatea modelului, eficiența energetică și preț. Cu 128 GB de memorie unificată, aceste sisteme pot gestiona confortabil modele din clasa 70B la cuantizare ridicată și pot ajunge la sarcini de lucru din clasa 120B care ar necesita mai multe GPU-uri discrete într-un turn.
Lectură esențială de laborator pentru acest nivel: testul nostru termic DGX Spark compară modelele de răcire OEM din sistemele GB10 de mai jos și se aplică fiecărei unități din această clasă până când aceste platforme vor fi revizuite.
Cel mai bun sistem AI pentru birou în general: NVIDIA DGX Spark
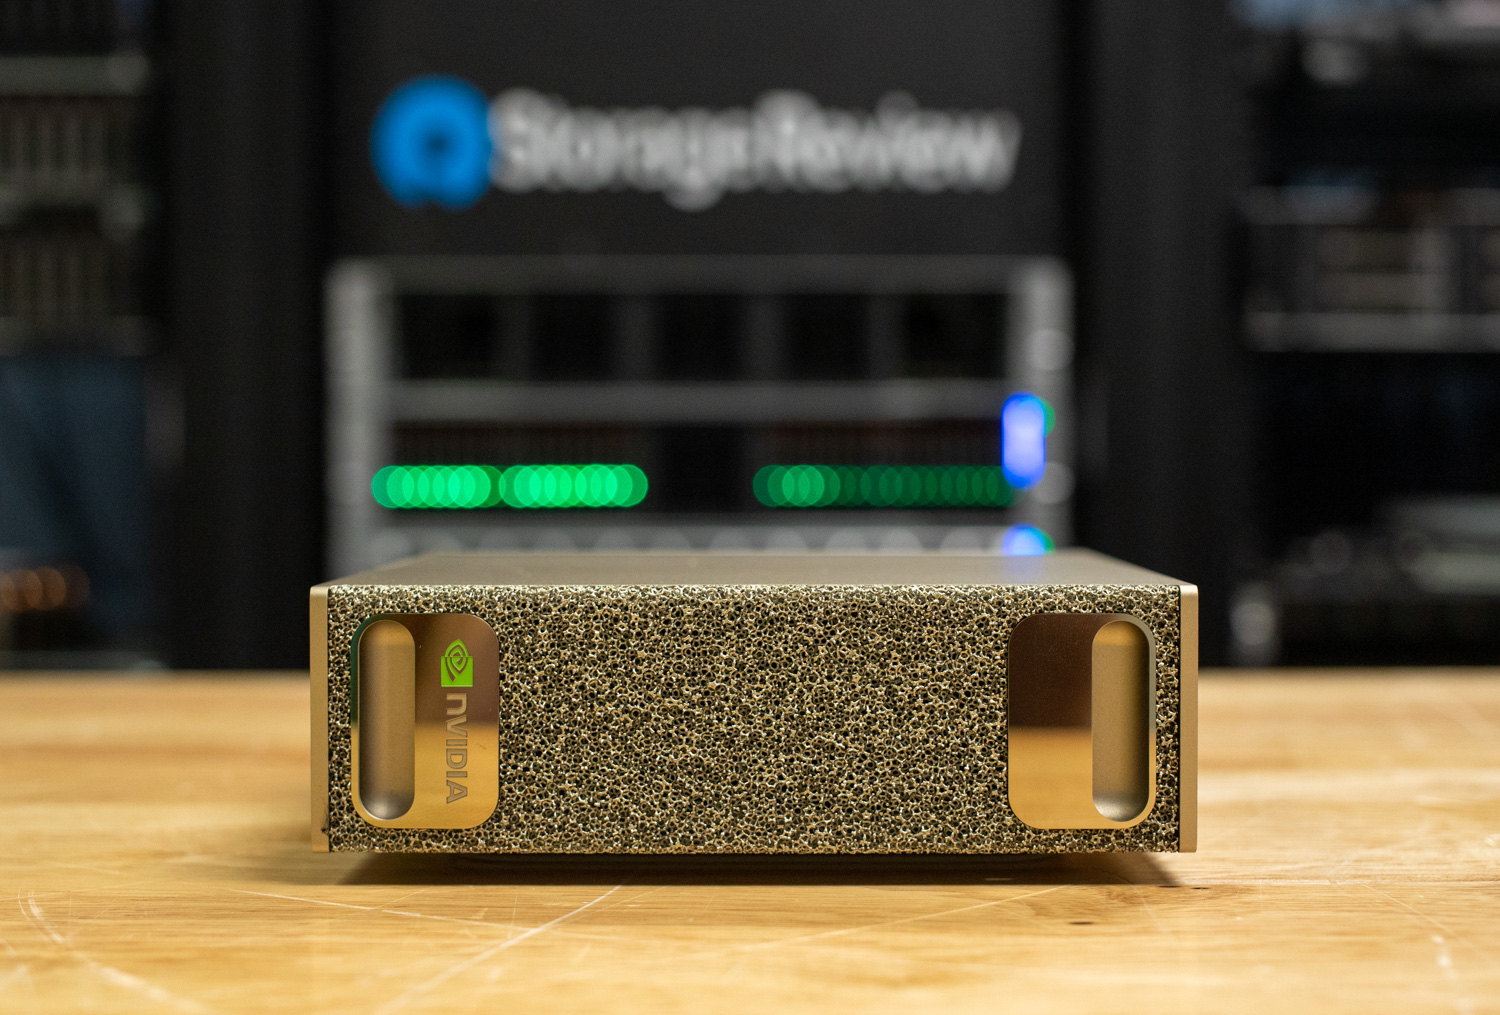
DGX Spark este punctul de referință în raport cu care se compară orice alt dispozitiv AI de birou. Supercip-ul GB10 Grace Blackwell combină un procesor Arm cu 20 de nuclee cu 128 GB de memorie LPDDR5X unificată, iar porturile duale ConnectX-7 200GbE îl fac singura clasă de dispozitive pe care am testat-o care funcționează în cluster direct din cutie: testele noastre de inferență distribuită pe două noduri au rulat sarcini de lucru paralele cu pipeline pe noduri Dell, GIGABYTE și HP de peste 200GbE.
Povestea clusterizării are acum o rampă de acces mai ieftină: NVIDIA a lansat un SKU DGX Spark de 64 GB pe 23 octombrie la 4,999 de dolari , vândut prin aceiași șase producători de echipamente originale, iar doi dintre ei se conectează printr-un cablu de 200 GbE pentru a grupa 128 GB; NVIDIA estimează că perechea clusterizată ajunge la până la 1.7 ori mai mult decât o singură unitate de 128 GB pe Qwen3.8 27B, o afirmație pe care nu am testat-o încă. Stiva de software CUDA rămâne cea mai complexă din segment.
Singura limită strictă a platformei este stocarea: fiecare sistem GB10 atinge un maxim de aproximativ 4 TB pe un singur slot M.2 scurt. Construcția noastră de stocare partajată cu opt Spark-uri este răspunsul la flotă: o singură matrice QLC guvernată, deservită prin porturile de 100 GbE pe care le are deja fiecare Spark, unde un client citea la 10.8 GiB/s, egalând cel mai rapid M.2 intern pe care l-am măsurat într-un sistem GB10, și un model de 78 GB găzduit central, încărcat în limita a 13% din NVMe local.
Citește recenzia completă a DGX Spark
Cea mai bună implementare GB10: Acer Veriton GN100
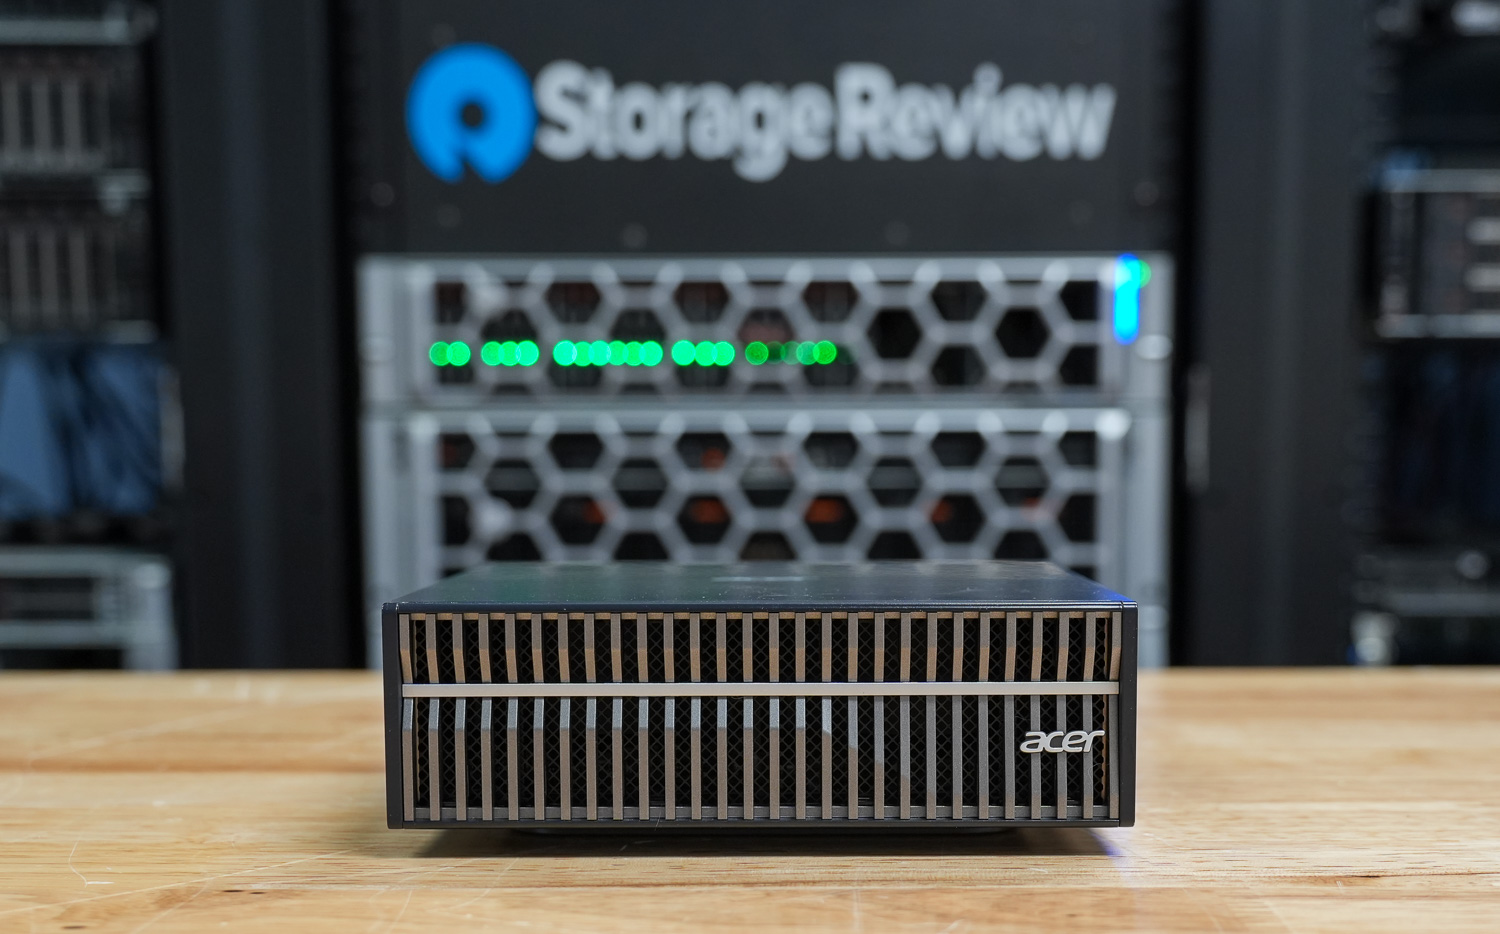
Printre sistemele OEM GB10, designul termic este adevăratul factor de diferențiere, iar Veriton GN100 s-a remarcat în testele noastre. Toate sistemele GB10 au aceeași configurație de silicon și memorie, așa că performanța susținută se reduce la răcire. Comparația noastră termică multi-OEM este, din câte știm, singura de acest fel publicată.
Citește recenzia completă a Veriton GN100
Cea mai bună alternativă la x86: AMD Ryzen AI Halo
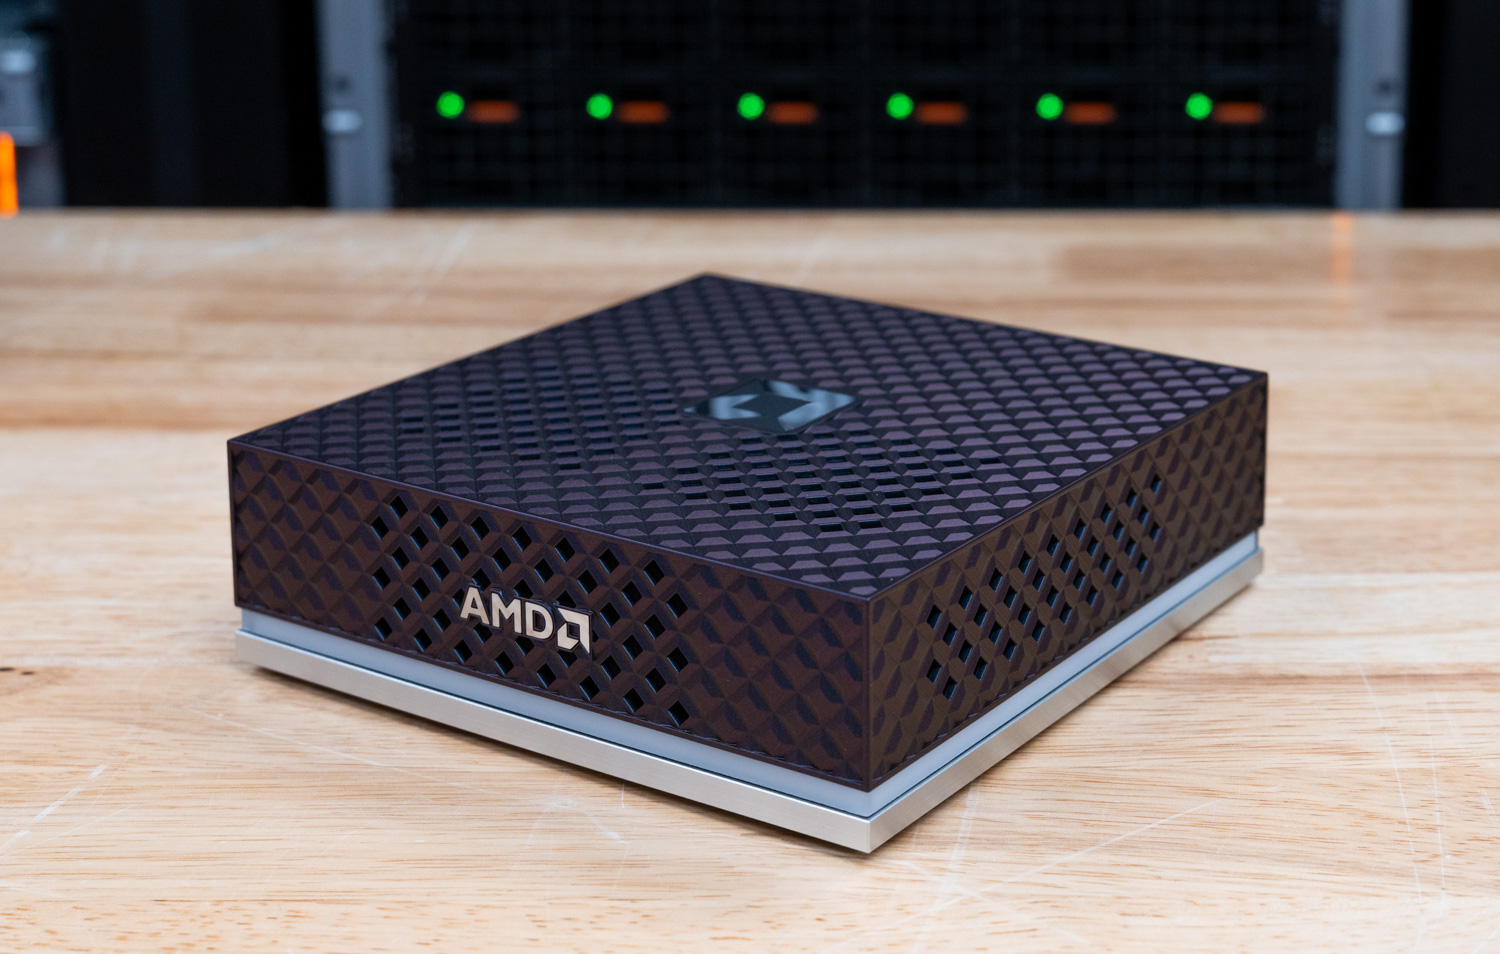
Dacă aveți nevoie de Windows sau de un pachet software x86 standard, Strix Halo este răspunsul ideal pentru desktop. Platforma Ryzen AI Max+ 395 de la AMD combină 128 GB de memorie unificată cu o configurație dual-OS, iar în testele noastre a gestionat modele din clasa de parametri 200B, o încercare directă de a concura cu DGX Spark fără angajamentul de a avea un sistem de operare Arm/DGX.
Citește recenzia completă a Ryzen AI Halo
Cel mai bun fără un GPU dedicat: HP Z2 Mini G1a
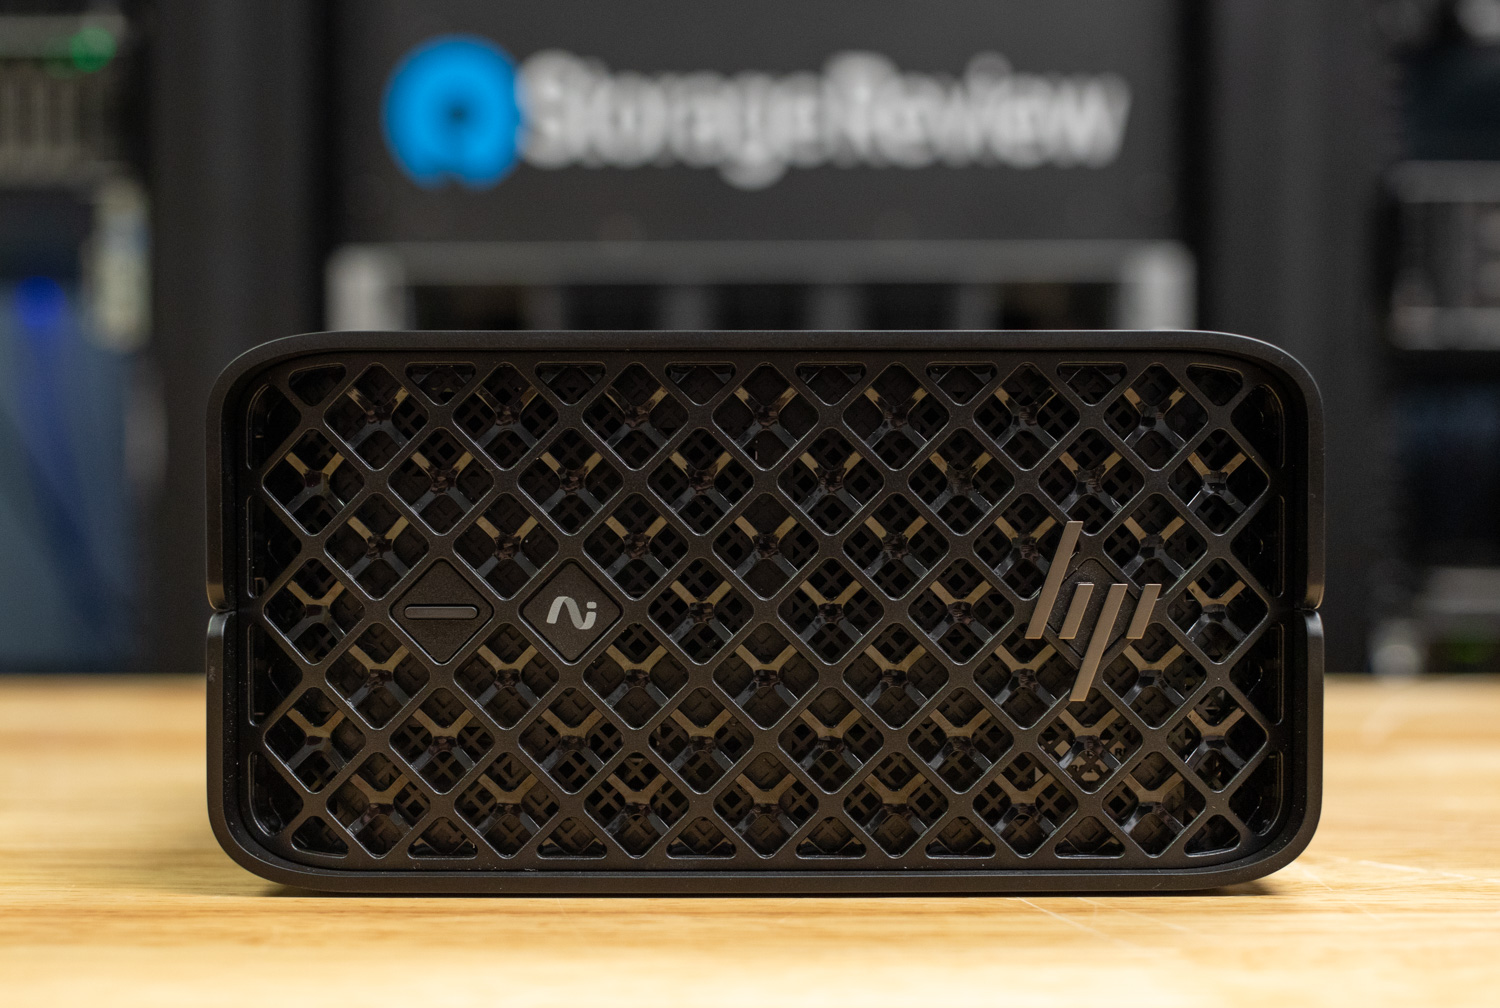
Z2 Mini G1a rula GPT-OSS 120B fără nicio placă grafică dedicată. Mini-stația de lucru HP include procesorul de siliciu Ryzen AI Max+ PRO de la AMD într-o carcasă compactă, silențioasă și prietenoasă cu IT-ul, rămânând cea mai clară demonstrație a faptului că sistemele x86 cu memorie unificată au schimbat ceea ce poate face un birou mic cu modele mari.
Citește recenzia completă a Z2 Mini G1a
Cel mai bun sistem GB300: MSI XpertStation WS300
WS300 este prima stație GB300 DGX din laboratorul nostru și resetează plafonul pentru nivelul de dispozitive. Supercipul Grace Blackwell Ultra are în combină 748 GB de memorie coerentă, 252 GB de HBM3e plus 496 GB de LPDDR5X, în spatele a 20 petaFLOPS de procesare FP4, iar în testele noastre a servit un punct de control GLM-5.2 de 433 GB cu 216 GB de ponderări expert stocate în memoria Grace, un model care nu are ce căuta lângă un birou. Ca orice sistem din clasa DGX, rulează sistemul de operare DGX în loc de Windows; acesta este angajamentul pe care îl cere această cantitate mare de memorie.
Prețul și puterea îl plasează mai aproape de extremele gamei tower decât de carcase GB10 de mai sus, dar nimic altceva din clasa de electrocasnice nu are un model atât de mare. Întrebarea evidentă, dacă o placă de 1,300 W are o putere de accelerare parțială într-o placă tower, are acum un răspuns clar: analiza noastră detaliată a temperaturilor WS300 a înregistrat o funcționare susținută de 2.8 ore cu matrița Blackwell Ultra menținută la 60 °C, o frecvență de ceas plată de 2.07 GHz fără scăderi de temperatură și o marjă termică de aproximativ 20 °C rămasă la sarcină maximă.
Alternativă la GB300: ASUS ExpertCenter Pro ET900N G3 este a doua stație GB300 DGX în testele noastre și confirmă platforma: pe 14 modele și două sarcini de lucru, 24 din 28 de comparații privind debitul maxim s-au situat la o diferență de 2% față de WS300, iar modelele cu pool coerent au funcționat la paritate sau mai bine. ASUS adaugă mânere de transport pe turnul de 27 kg, un ventilator dedicat peste carcasele optice de 400G și o sursă de alimentare 80 PLUS Titanium. Ambele turnuri oferă platforma; citește recenzia noastră ET900N G3 pentru o comparație între două turnuri.
Scalarea clusterului: două dintre aceste turnuri cablate împreună prin propriile porturi de 400G sunt acum măsurate, nu promise: testul nostru pe cluster GB300 a asociat stațiile ASUS și HP cu două DAC-uri, a atins o rată de linie de 98% pe colectivele NCCL și a transformat GLM-5.2, un model de 433 GB pe care o singură stație îl poate servi doar prin distribuirea a 215 GB de greutăți în memoria Grace, de la 139 de jetoane de ieșire pe secundă la 32 de fluxuri la 1,525, ajungând apoi la 3,141 la 256.
Modele care se potrivesc diferit pe o scară de stație: dezagregarea prin pre-umplere/decodare a triplat randamentul GLM-5.3 Flash cu prompturi scurte, iar DeepSeek V4.1 Flash a înregistrat 5,248 de jetoane pe secundă, cea mai mare producție din set.
Citește recenzia completă a XpertStation WS300
În laborator: Stația de inteligență artificială HP ZGX Fury
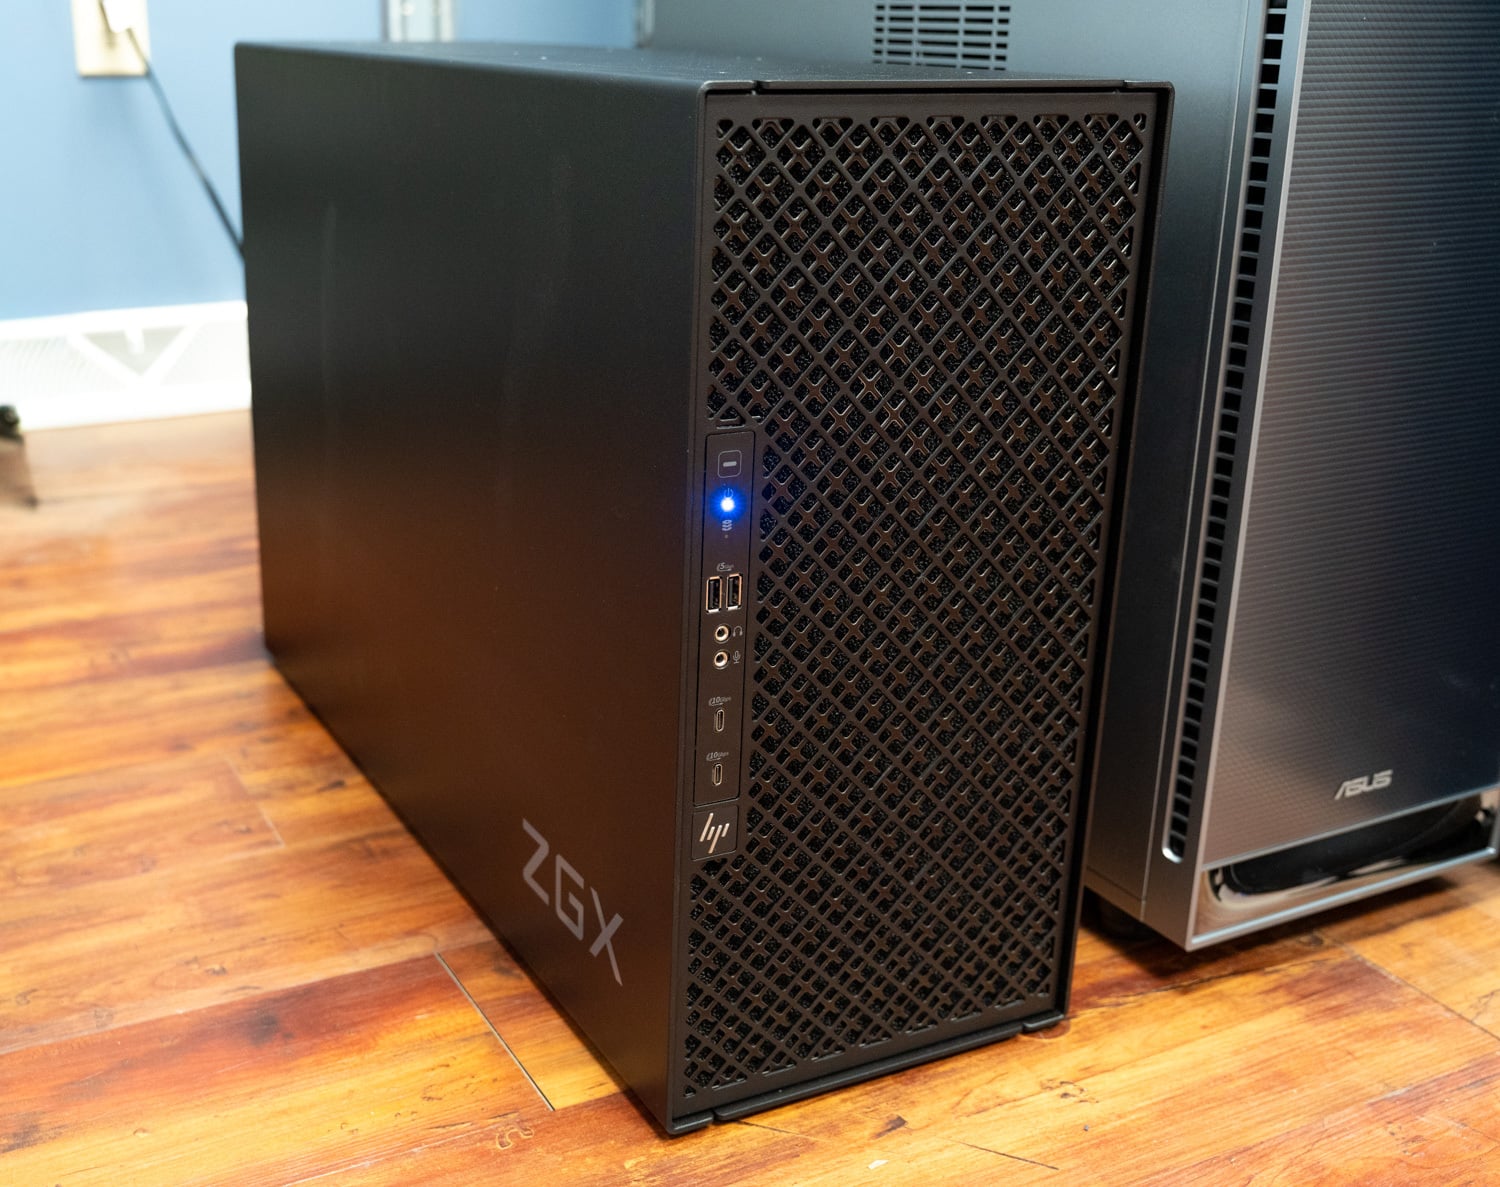
Stația de inteligență artificială HP ZGX Fury se află acum în laboratorul nostru. Este construită pe aceeași platformă NVIDIA GB300 Grace Blackwell Ultra ca și MSI XpertStation WS300 de mai sus, ceea ce o face prima șansă de a vedea cum se compară implementările arhitecturii DGX Station de către doi furnizori pe același banc de lucru: temperaturi, acustică, frecvențe de ceas susținute și experiența practică de utilizare a mașinii.
Primele sale cifre publice au fost deja publicate: ZGX Fury a servit ca a doua turn în testul nostru cu cluster GB300 cu două stații , rulând decodare pentru configurația GLM-5.3 Flash dezagregată și jumătate din fiecare rulare tensor-paralelă. Recenzia individuală este în curs de desfășurare, iar ZGX Fury intră în clasament atunci când propriile sale cifre de testare vor fi publicate.
ZGX Fury este, de asemenea, unul dintre primele două sisteme pe care Microsoft le-a numit după DGX Station pentru Windows , alături de Dell Pro Precision cu GB300, NVIDIA listând versiunea pentru Windows pentru al patrulea trimestru. Hardware-ul se potrivește cu turnurile GB300 pe care le-am testat pe Ubuntu, iar întrebarea dacă stivele de servire rulează nativ pe Windows sau sub WSL este deschisă pentru această versiune.
La orizont: Stația AMD Threadripper Halo
Anunțată la IFA 2026 și neprezentată încă în niciun laborator, stația Threadripper Halo de la AMD este primul răspuns direct la clasa GB300 de mai sus. Această propunere inversează pariul NVIDIA: în loc de un singur pool de memorie coerent, mare, AMD combină un Threadripper PRO cu 96 de nuclee pe o platformă cu până la 2 TB de DDR5 pe opt canale și 128 de benzi PCIe 5.0 cu două acceleratoare Instinct MI350P de 600W, fiecare cu câte 144 GB de HBM3E, și o cale declarată către patru plăci video și 576 GB de HBM. Întregul sistem este răcit cu lichid, iar gazda x86 evită fricțiunea din lanțul de instrumente Arm pe care am semnalat-o în recenzia WS300.
Întrebarea deschisă este cât de bine modelele se potrivesc plăcilor PCIe cu coerența NVLink-C2C, iar AMD nu a prezentat teste comparative, prețuri sau disponibilitate, așa că acesta este un produs de urmărit, nu o alegere. Detalii sunt în raportul nostru despre anunțuri ; intră în clasament dacă și când hardware-ul ajunge în laborator.
De asemenea, testate: dispozitive de inteligență artificială pentru birou
Aceste sisteme au trecut prin același proces de laborator și sunt alegeri solide care nu au ocupat un loc în categorie: Dell Pro Max cu GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n și HP EliteDesk 8 Mini G1a.
Turnuri de stații de lucru pentru inteligență artificială locală
Când timpul de răspuns contează mai mult decât costul de achiziție (asistenți de codare interactivi, servicii multi-utilizator, conducte de agenție cu lanțuri lungi de apeluri de instrumente), VRAM-ul discret este încă dominant. Aceste turnuri sunt clasificate aici în funcție de debitul de inferență și plafonul de memorie, iar pentru fiecare listăm configurația GPU pe care am testat-o alături de maximul șasiului, deoarece ceea ce poate stoca în cele din urmă un șasiu contează la fel de mult ca ceea ce a fost inclus în construcția noastră; un turn are nevoie de două sau mai multe GPU-uri pentru a se clasa în această secțiune. Turnurile cu un singur GPU, inclusiv cele cu un RTX PRO 6000 de 96 GB, sunt clasate pe pagina noastră Cele mai bune stații de lucru desktop din suita noastră client Windows, deoarece răspund la o întrebare diferită.
We also group towers by host platform, because the CPU and memory behind the cards decide how a tower handles models that spill out of GPU memory, vector search, and the simulation work that often shares the machine. The Precision 7875 leads the Threadripper lane and holds the overall tower pick, the Pro Precision 9 T4 leads the Xeon lane, and the Core Ultra lane opens when a dual-GPU Core Ultra tower comes through our lab.
Cel mai bun turn pentru inteligența artificială locală: Dell Precision 7875
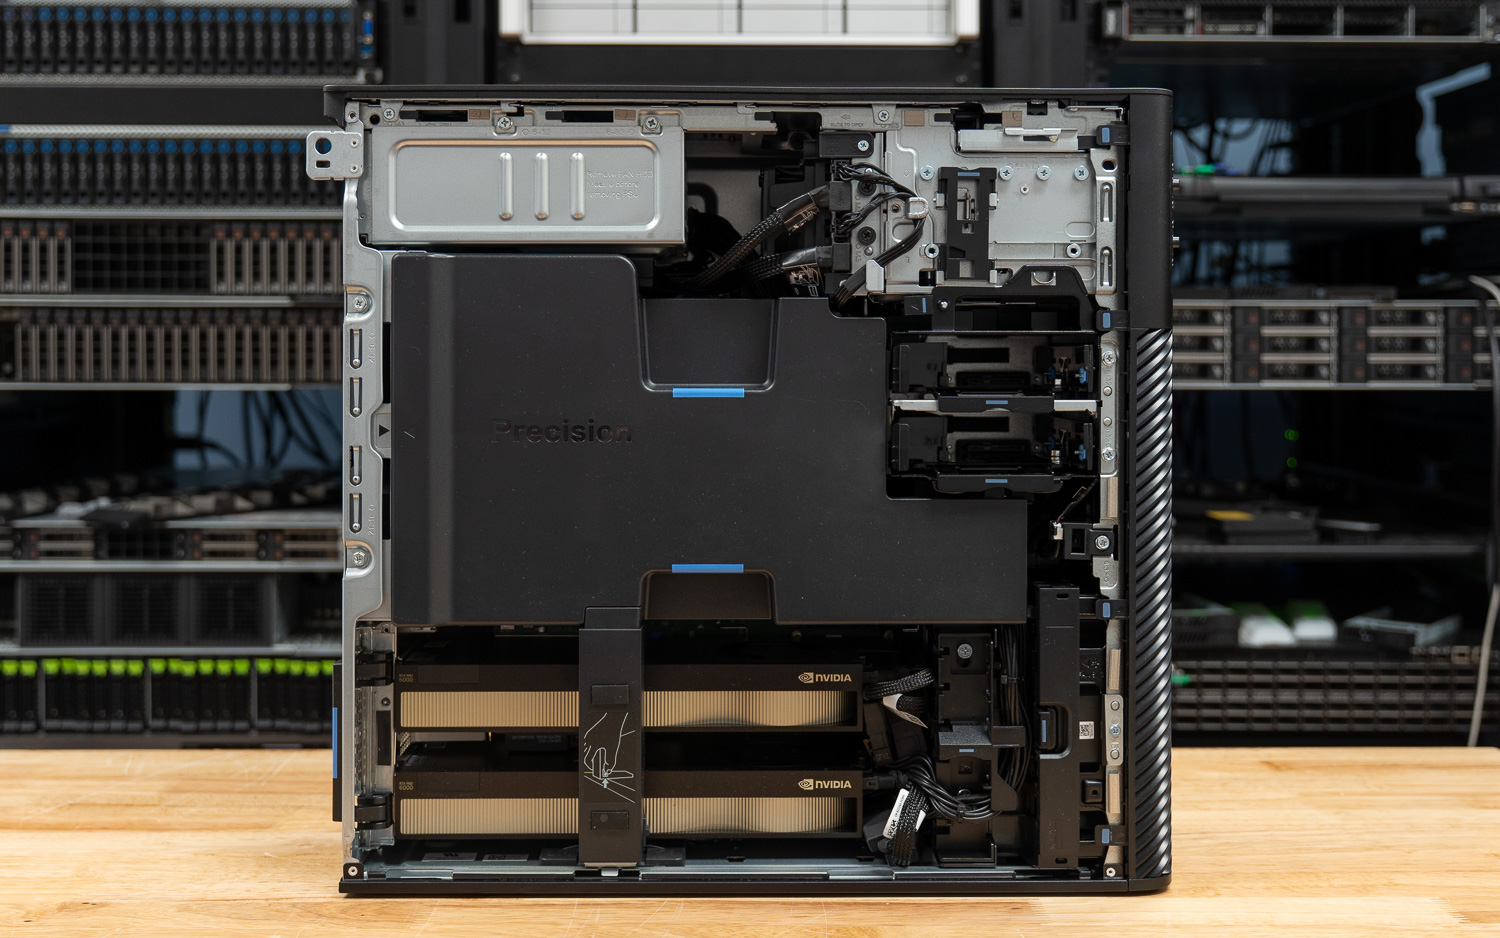
GPU-urile duale RTX PRO 6000 Blackwell fac din Precision 7875 cel mai rapid sistem standard pe care l-am testat pentru inferență locală. Cu o placă video Threadripper PRO 9995WX și 192 GB de VRAM combinată pe două plăci video, acesta stochează modele din clasa 100B în întregime în memoria GPU, oferind în același timp un timp de atingere a primului token de nivel interactiv, pe care niciun dispozitiv cu memorie unificată nu îl atinge. Cunoașteți însă limita: carcasa 7875 acceptă maximum două plăci video cu lățime duală, așa că configurația noastră cu două GPU este configurația maximă; nu există posibilitatea de a adăuga o a treia ulterior.
Citește recenzia completă a Precision 7875
Best Xeon Tower for Local AI: Dell Pro Precision 9 T4
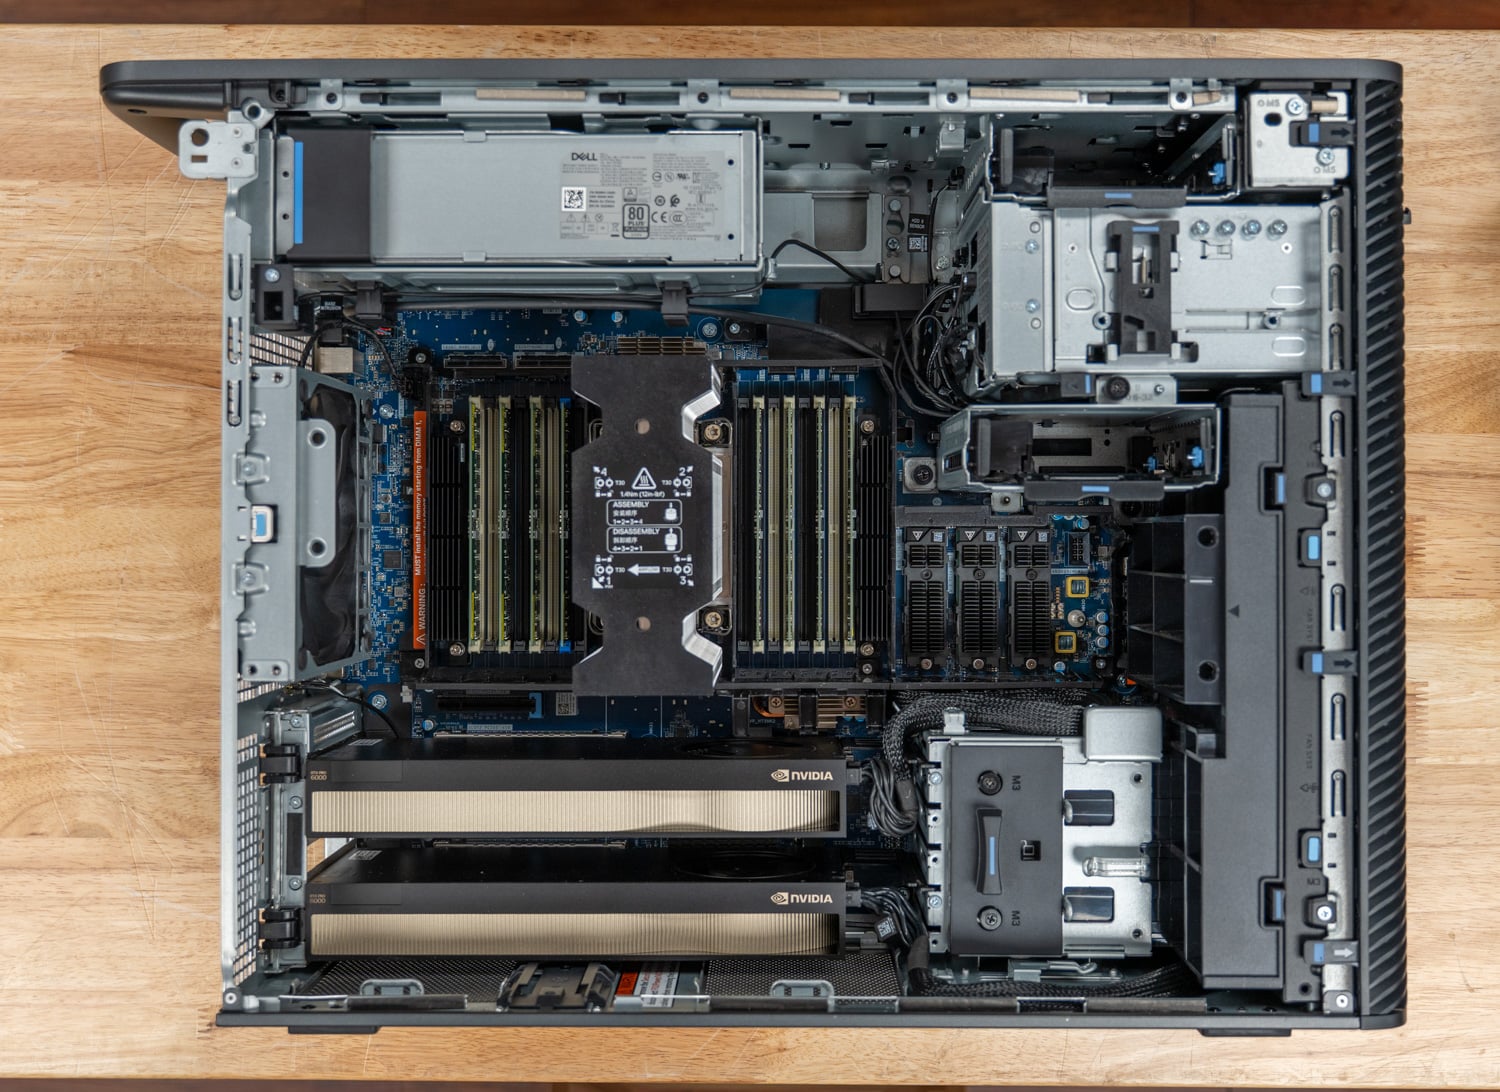
The Pro Precision 9 T4 matches the Precision 7875 on the GPUs and leads it on everything the Xeon feeds. Its two RTX PRO 6000 Max-Q cards ran within 1 to 9 percent of the 7875’s identical pair in single-GPU serving and within 10 percent on two-GPU embedding and fine-tuning. Split across both cards, MiniMax M2.7, a 129.3GB model too large for one card, generated 83.7 tokens per second for one user against 85.0 on the 7875.
The difference is the host: eight channels of DDR5-6400 give the 86-core Xeon 698X 328GB/s of memory bandwidth, 53 percent more than the 7875, and it shows in the work around the models. HNSW vector search ran at 1.51 times the 7875’s rate, the index built in 27.3 seconds against 34.8, and the OpenFOAM drivAer solve finished in 293 seconds against 556. Its Gen5 boot drive also loaded gpt-oss:120b cold in 15.2 seconds against 25.8.
The 7875 keeps the overall pick because it edges the T4 on every GPU-bound throughput test, and its Threadripper runs core-bound rendering and compile work 18 to 38 percent faster. The T4 is the tower for teams that serve and embed models alongside simulation and analytics on one machine, and Dell’s configurator caps it at two RTX PRO 6000 cards. It listed at about $66,600 as configured on Dell.com at review time.
Read the full Pro Precision 9 T4 review
Cea mai bună platformă multi-GPU: HP Z8 Fury G6i
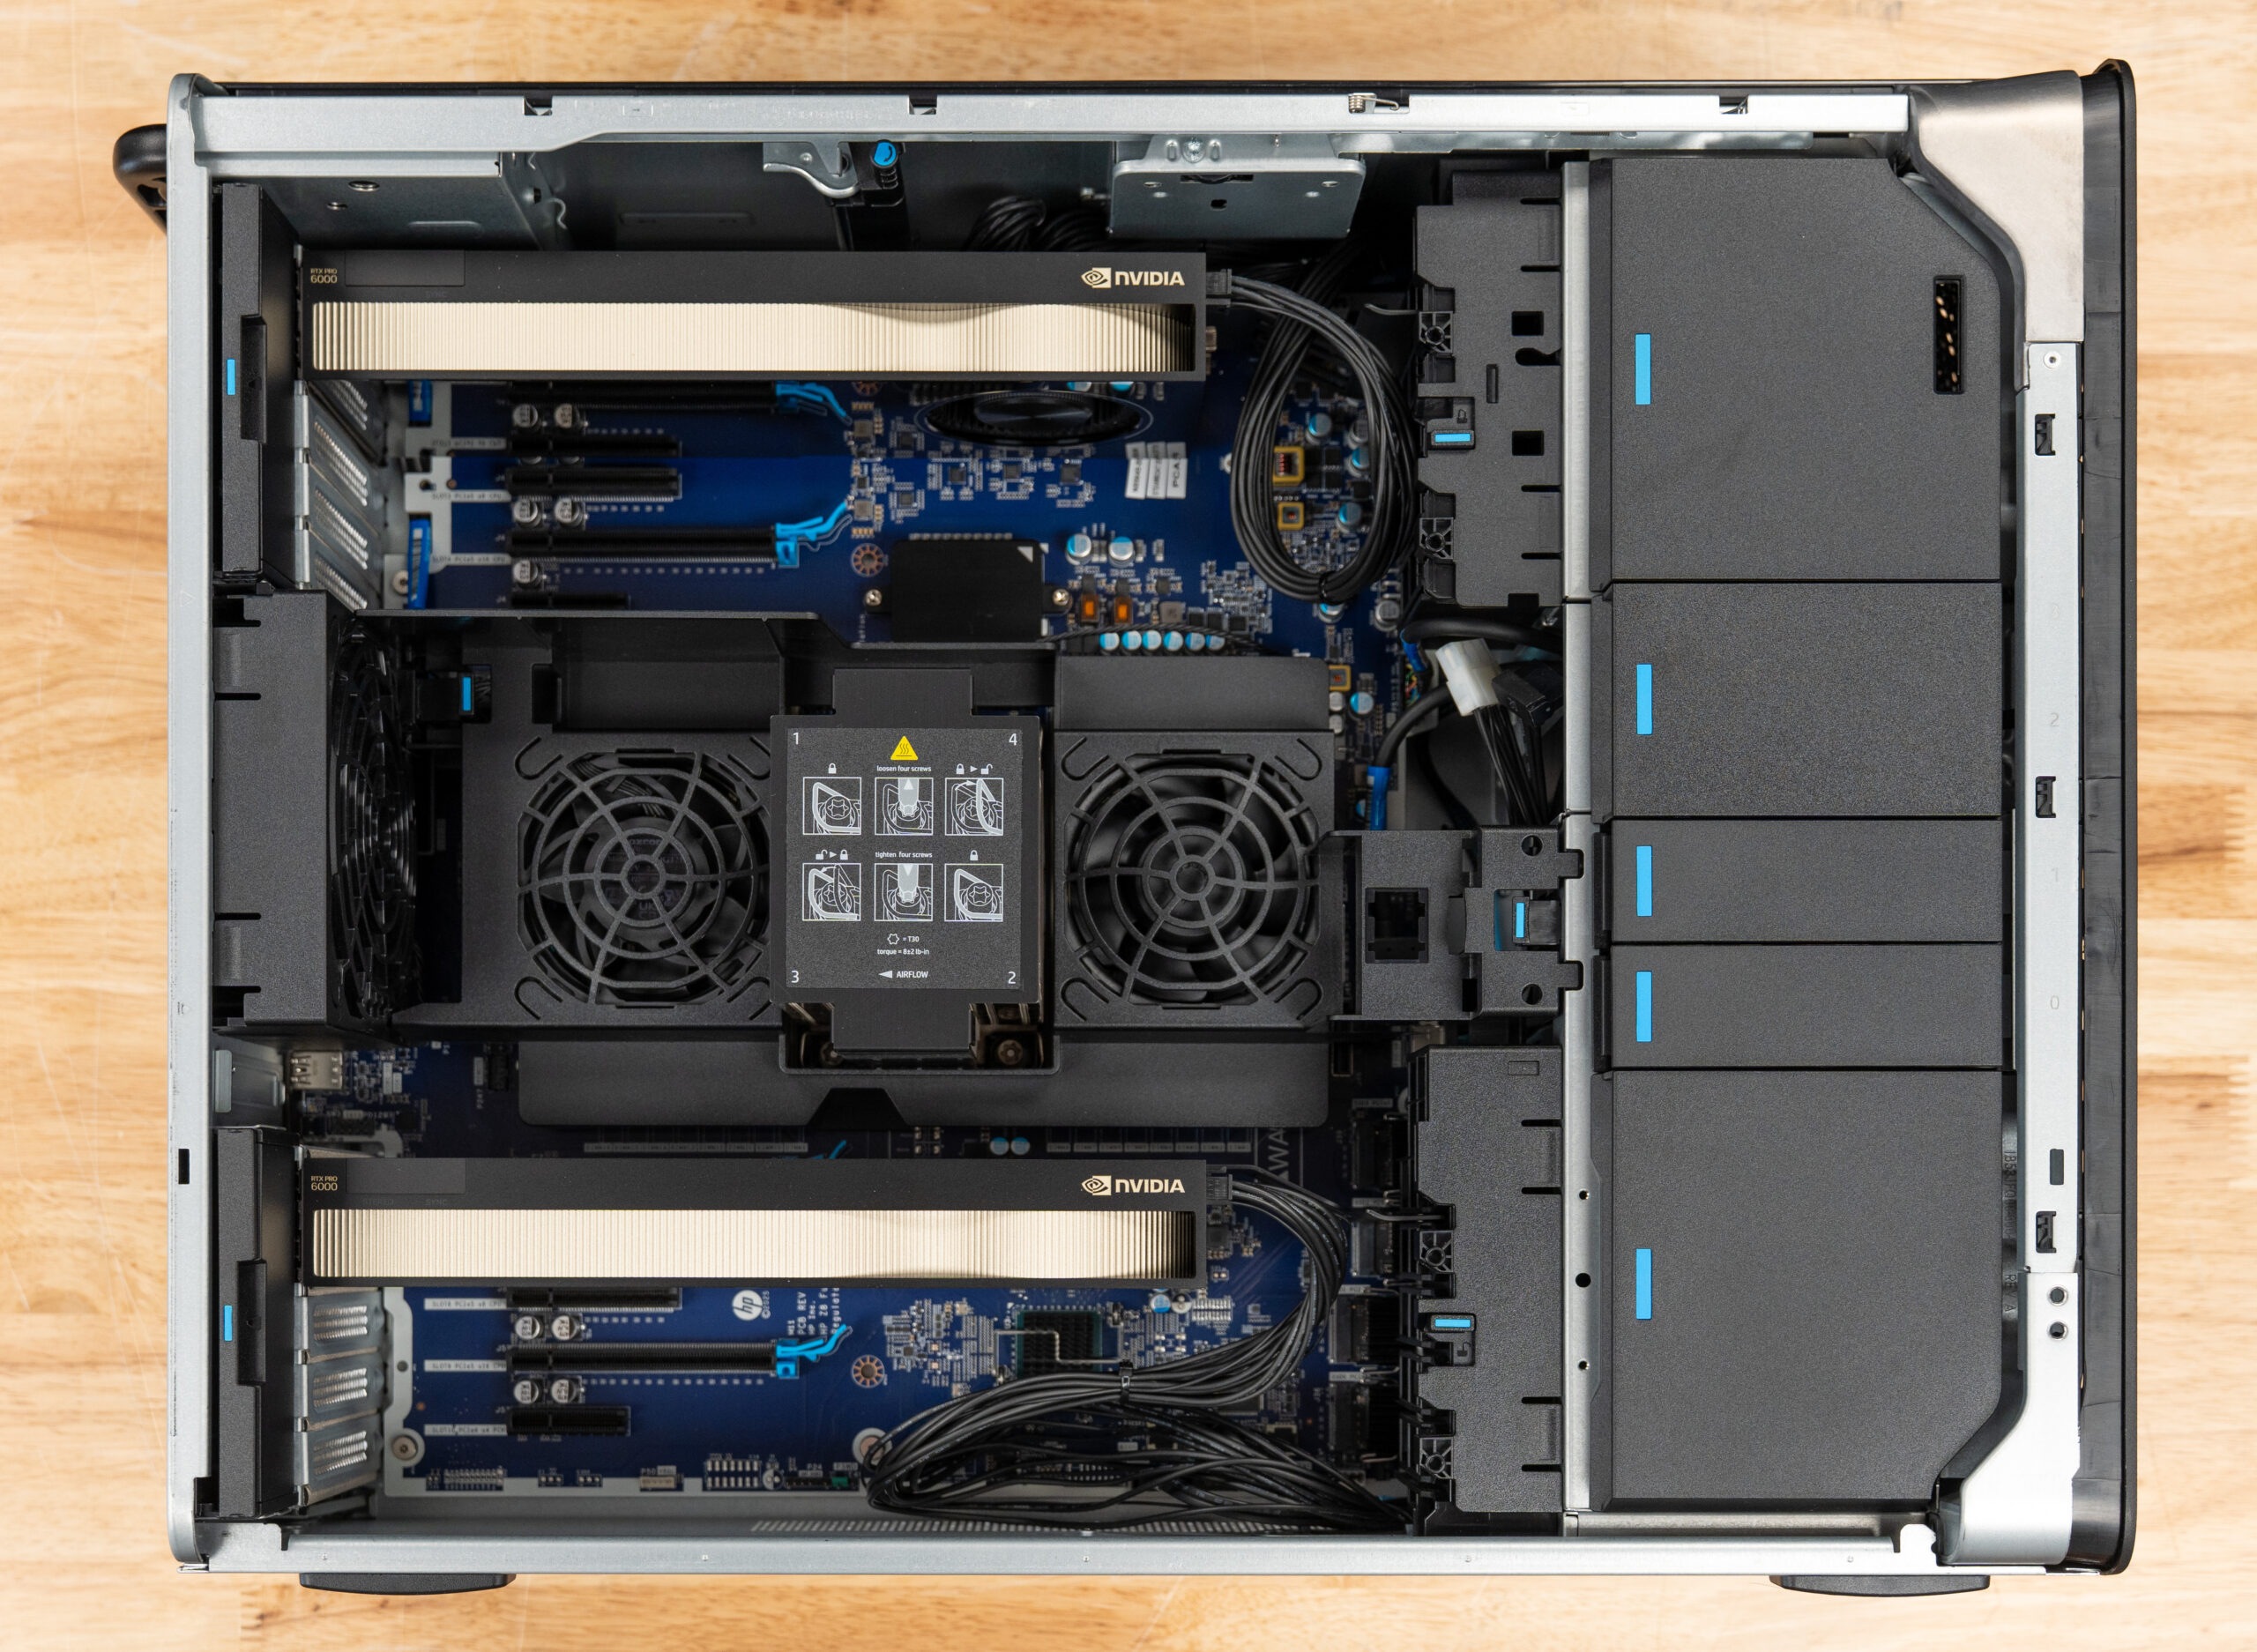
Z8 Fury G6i este turnul pe care îl cumperi atunci când plănuiești să extinzi placa video cu mai multe plăci video. Versiunea noastră de testare a rulat două plăci RTX PRO 6000 Max-Q pentru 192 GB de VRAM combinat, dar carcasa, alimentată de surse de alimentare duale care totalizează până la 2700 W, suportă până la patru plăci Blackwell și 384 GB de VRAM. Această diferență între valorile testate și cele maxime este esențială: niciun turn OEM standard pe care l-am testat nu oferă mai mult spațiu pentru GPU, iar trecerea de la două plăci video la patru nu necesită schimbarea carcasei.
Citește recenzia completă a Z8 Fury G6i
Alegerea extremă: Comino Grando RTX PRO 6000
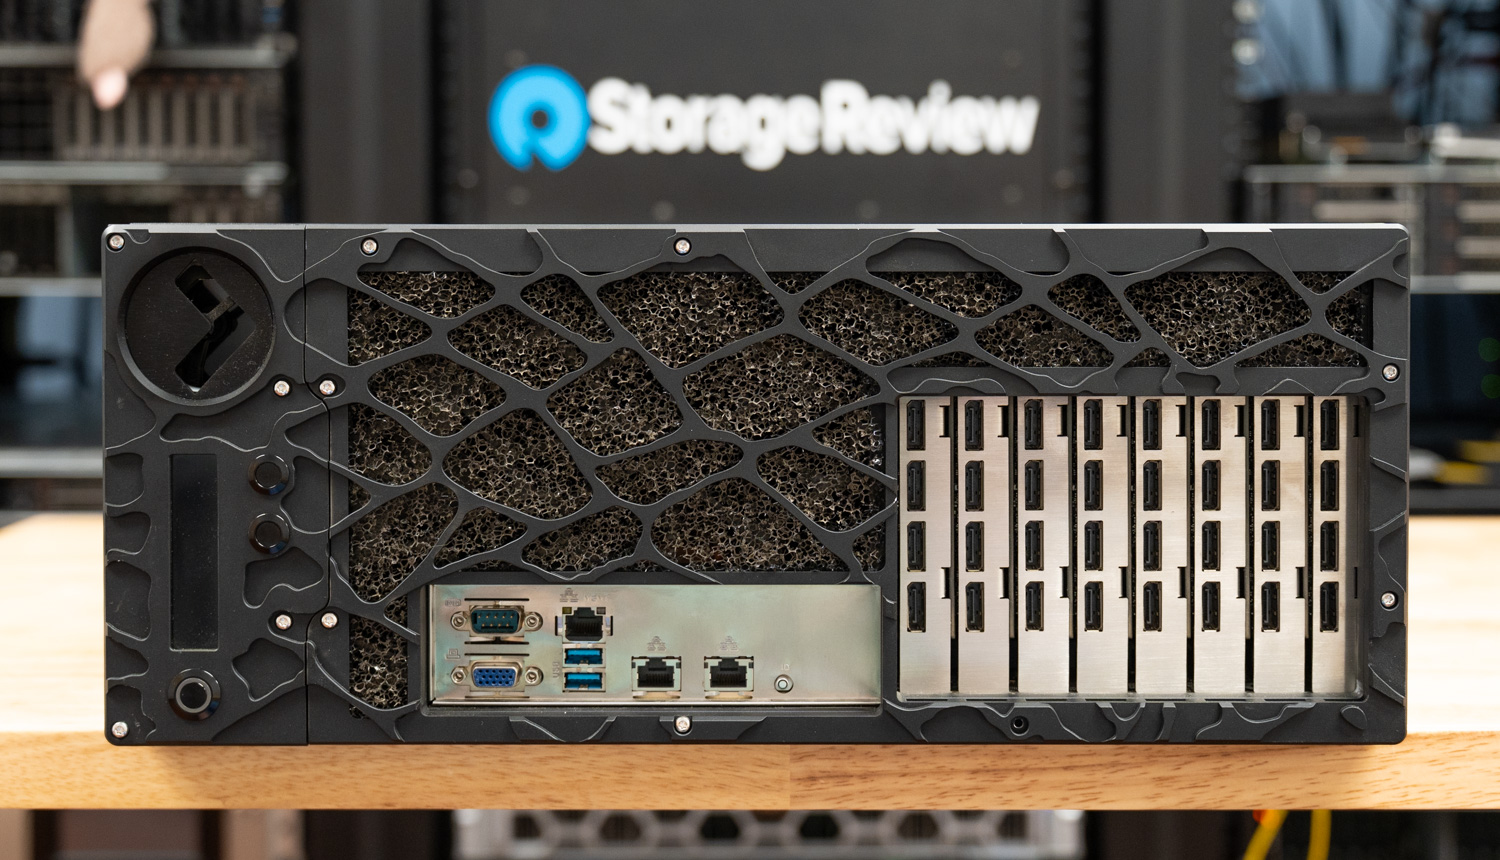
768 GB de VRAM într-o carcasă 4U răcită cu lichid: Grando există pentru cumpărătorul al cărui model nu se potrivește în altă parte. Unitatea noastră de test a fost livrată cu opt plăci RTX PRO 6000 Blackwell la câte 96 GB fiecare, maximul carcasei, iar răcirea cu lichid a Comino le susține pe toate cele opt la TDP maxim non-stop, fără throttling. Aceasta este mai multă memorie GPU decât multe servere rack, într-un sistem care poate sta totuși lângă un birou. Este zgomotos la preț, nu la acustică, și este în mod deliberat excepția de pe această listă: o dovadă a locului unde se află tavanul de lângă birou.
Citește recenzia completă a lui Comino Grando
Cum ne clasificăm
Trei reguli guvernează fiecare clasament StorageReview, iar prima este că sunt clasificate doar sistemele testate în laborator : dacă nu le-am evaluat, pot fi menționate, dar nu pot deține o categorie. În al doilea rând, sistemele sunt clasificate o dată pe bază de măsurare. Tower-urile de mai sus s-au clasat și în clasamentul nostru pentru stațiile de lucru desktop în funcție de performanța SPECworkstation și de randare până în octombrie 2026, când pagina respectivă a trecut la sistemele cu un singur GPU; rezultatele lor de acolo rămân în recenziile lor, iar aici sunt clasificate în funcție de debitul de inferență și de plafonul memoriei.
În al treilea rând, există o bară de intrare: a system needs two or more GPUs, tested with vLLM serving or our llama.cpp suite under Linux, or a shared memory pool with at least 96GB available to models. Single-GPU towers, even with a 96GB card, are ranked on our Cele mai bune stații de lucru desktop pagină din suita noastră client Windows.
Rankings are derived from a composite of vLLM online serving throughput, time-to-first-token, time-per-output-token, MAMF compute efficiency, GDSIO storage performance, and street price. Editorial judgment breaks ties within scoring bands. Towers tested on our newer llama.cpp suite rank on its serving throughput, time to first token, model-load, RAG, and fine-tuning results, and we retest the comparison towers on that suite when we rank a new one. Vendors do not see rankings before publication, and no placement on this page is paid.
Întrebări frecvente despre desktopul local cu inteligență artificială
Care este cel mai bun desktop pentru inteligența artificială agentială?
Lucrările de lucru agentice, cum ar fi agenții de codare, conductele de apelare a instrumentelor și sarcinile autonome în mai mulți pași, sunt sensibile la debit și latență într-un mod în care utilizarea unui singur chat nu este, deoarece agenții înlănțuie multe apeluri de model cu context extins. Acest lucru favorizează nivelul tower: memoria VRAM discretă a Dell Precision 7875 oferă timpul susținut până la primul token care menține lanțurile lungi de agenți receptivi. Pentru experimentarea agentică conștientă de buget, un dispozitiv din clasa GB10 rulează aceleași stive la o viteză mai mică. Îndrumările noastre complete privind dimensionarea se află în secțiunea RAM, GPU și stocare pentru AI agentică.
De câtă memorie am nevoie pentru a rula local un model 70B?
Ca regulă generală de lucru, un model 70B cu cuantizare pe 4 biți necesită aproximativ 40-48 GB de memorie accesibilă modelului înainte de context; utilizarea interactivă confortabilă cu un context lung necesită mai multă memorie. Acesta este motivul pentru care dispozitivele cu memorie unificată de 128 GB gestionează bine modelele din clasa 70B și de aceea turnurile cu un singur GPU sunt clasate pe pagina noastră Cele mai bune stații de lucru desktop.
Am nevoie de energie specială pentru a rula aceste sisteme?
Pentru nivelul de electrocasnice, nu: boxele din clasa GB10 și sistemele Strix Halo funcționează confortabil la o priză standard de birou. Turnurile merită o conversație serioasă cu oricine deține clădirea. Un HP Z8 Fury G6i complet configurat poate transporta surse de alimentare duble cu o putere totală de până la 2700W, mai mult decât poate furniza un circuit standard de 15 amperi și 120V, iar Comino Grando specifică surse hot-swap de 2000W care necesită o intrare de 180-264V, scăzând la unități de 1000W pe un serviciu de 110V.
Înainte de a cumpăra de la partea de sus a acestei pagini, verificați ce poate alimenta peretele; un circuit dedicat sau o priză de 208/240V ar putea face parte din costul real al unei încărcări complete a GPU-ului. Căldura urmează același calcul, deoarece fiecare watt consumat ajunge în cameră.
Ce zici de un Mac Studio?
Încă nu, pentru că nu am testat unul în laborator. Apple a început să livreze Mac Studio cu M5 Max și M5 Ultra pe 22 septembrie, M5 Max având până la 128 GB de memorie unificată, începând de la 2,499 USD, iar M5 Ultra până la 512 GB, începând de la 5,499 USD. Configurația de 512 GB, cea care contează cel mai mult pentru modelele foarte mari, este programată pentru sfârșitul lunii octombrie la un preț pe care Apple nu l-a anunțat. Dacă testăm unul, acesta este clasificat pe baza rezultatelor măsurate, ca orice sistem de pe această pagină.
What is the best Xeon workstation for local AI?
Dell Pro Precision 9 T4, our Best Xeon Tower for Local AI. With two RTX PRO 6000 Max-Q cards it ran within 1 to 9 percent of the Threadripper-based Precision 7875 in single-GPU serving and split a 129.3GB MiniMax M2.7 model across both cards at 83.7 tokens per second, while its eight channels of DDR5-6400 delivered 53 percent more memory bandwidth for vector search and simulation. The Precision 7875 remains our overall tower pick on GPU throughput.


 Amazon