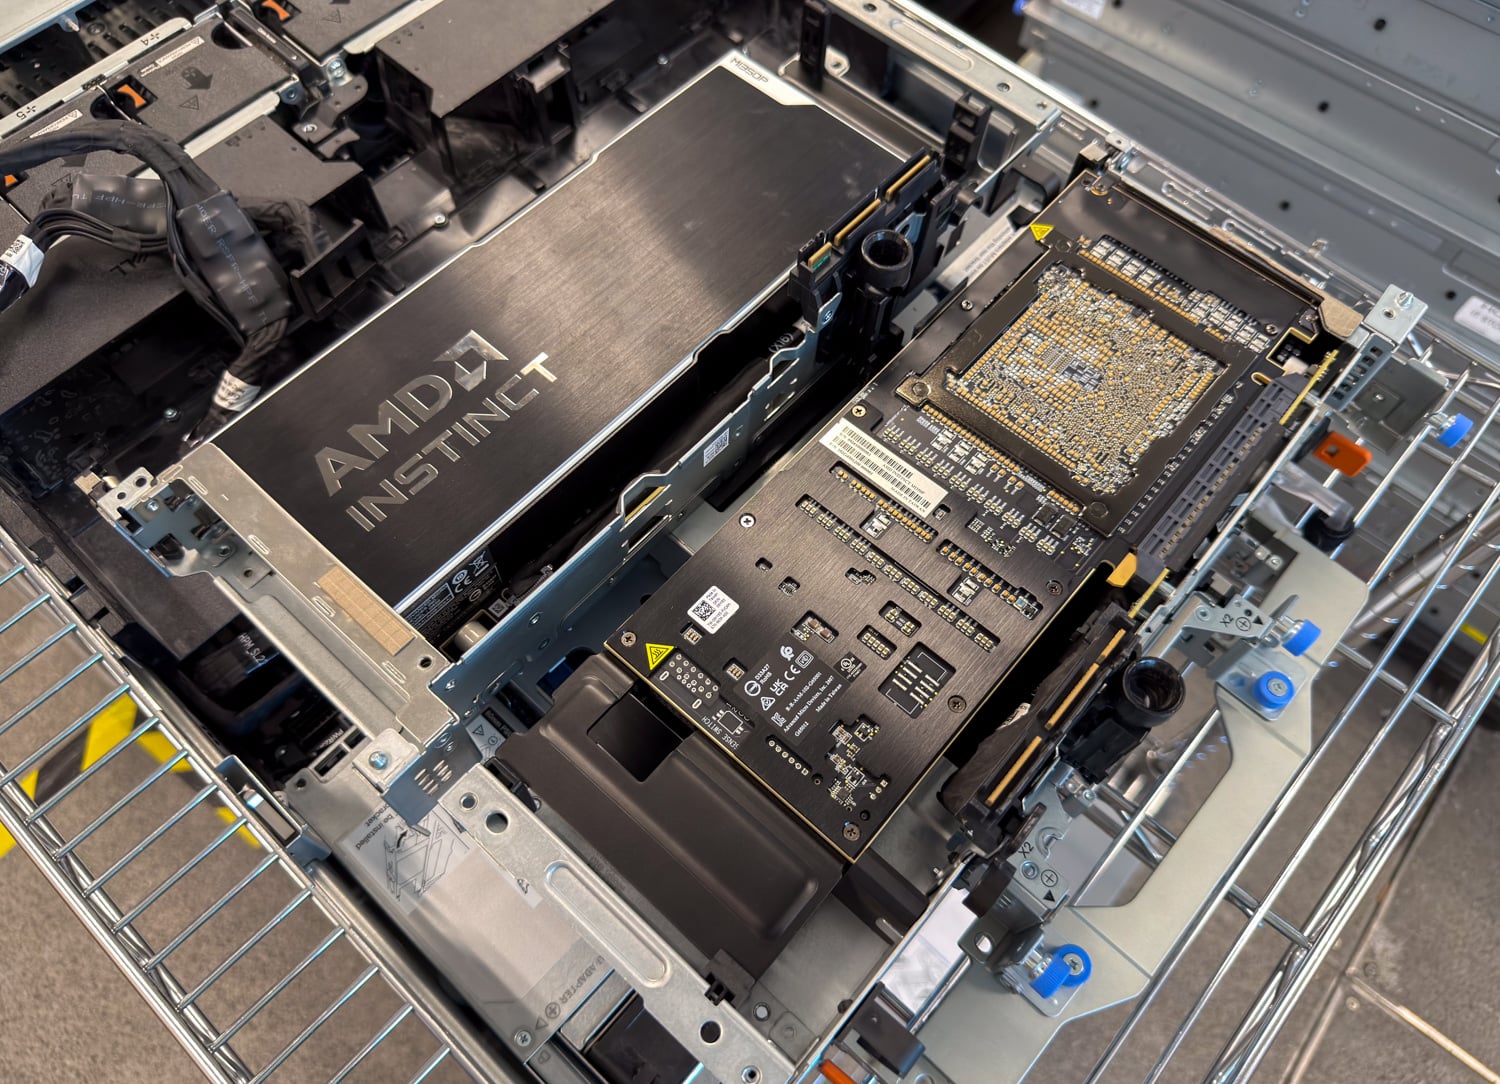
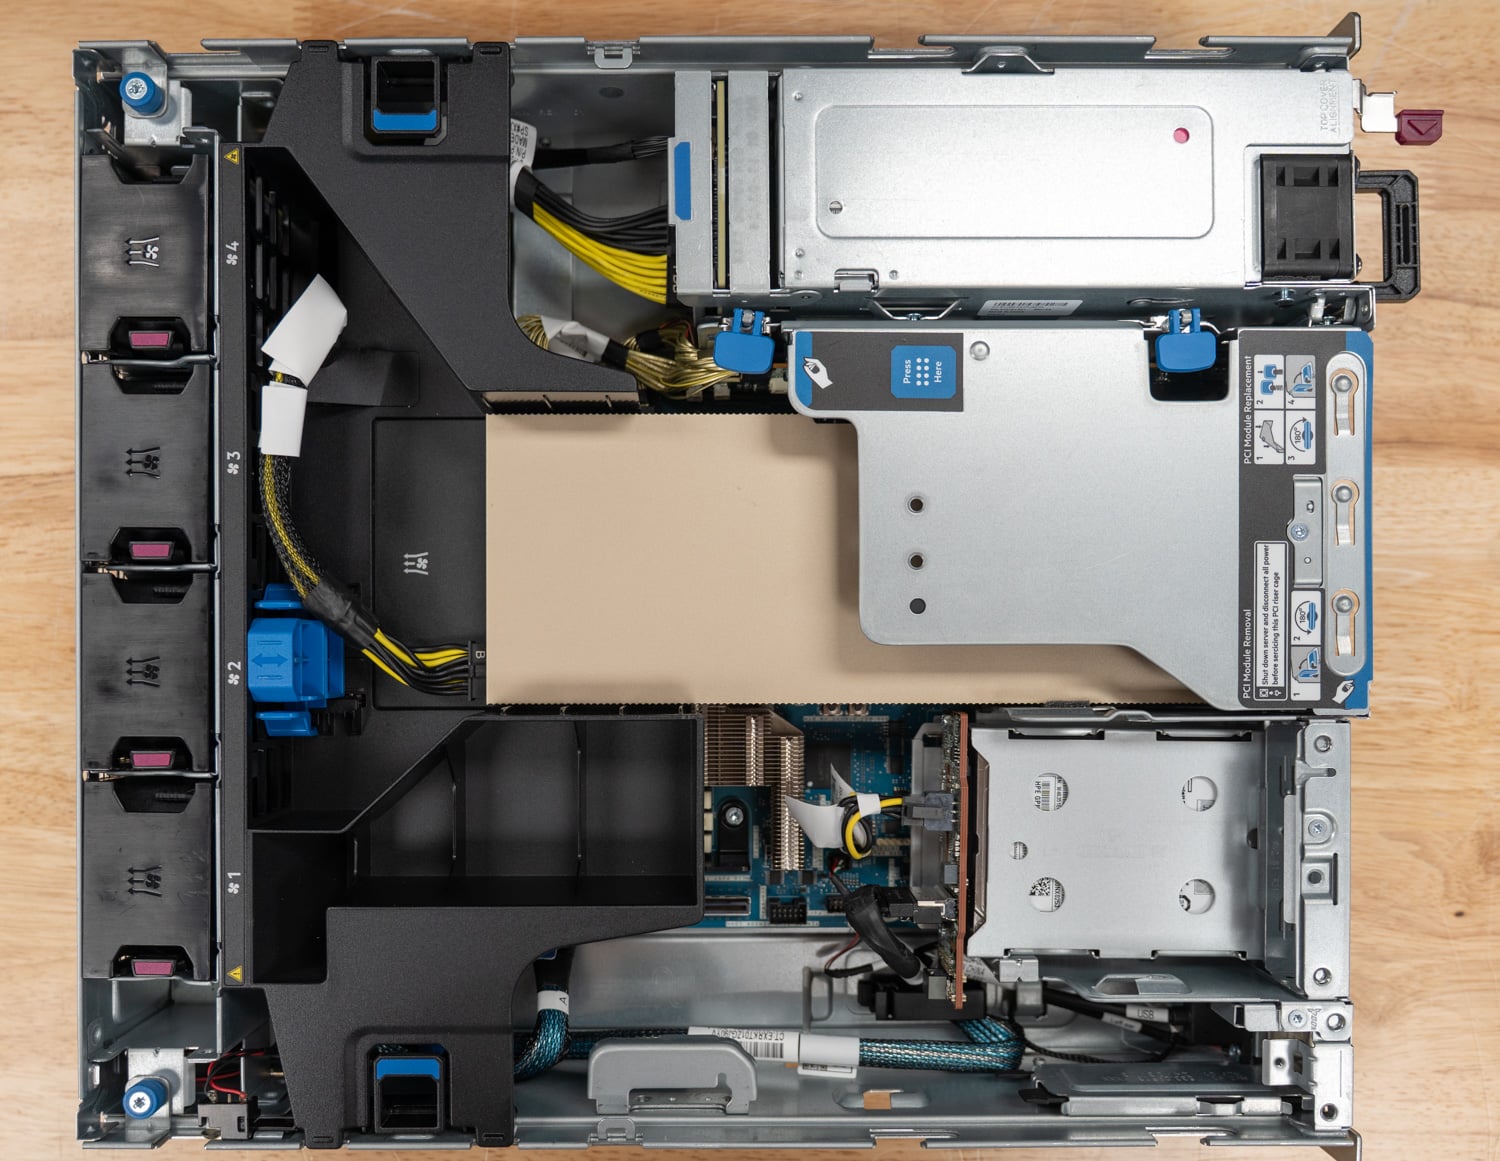
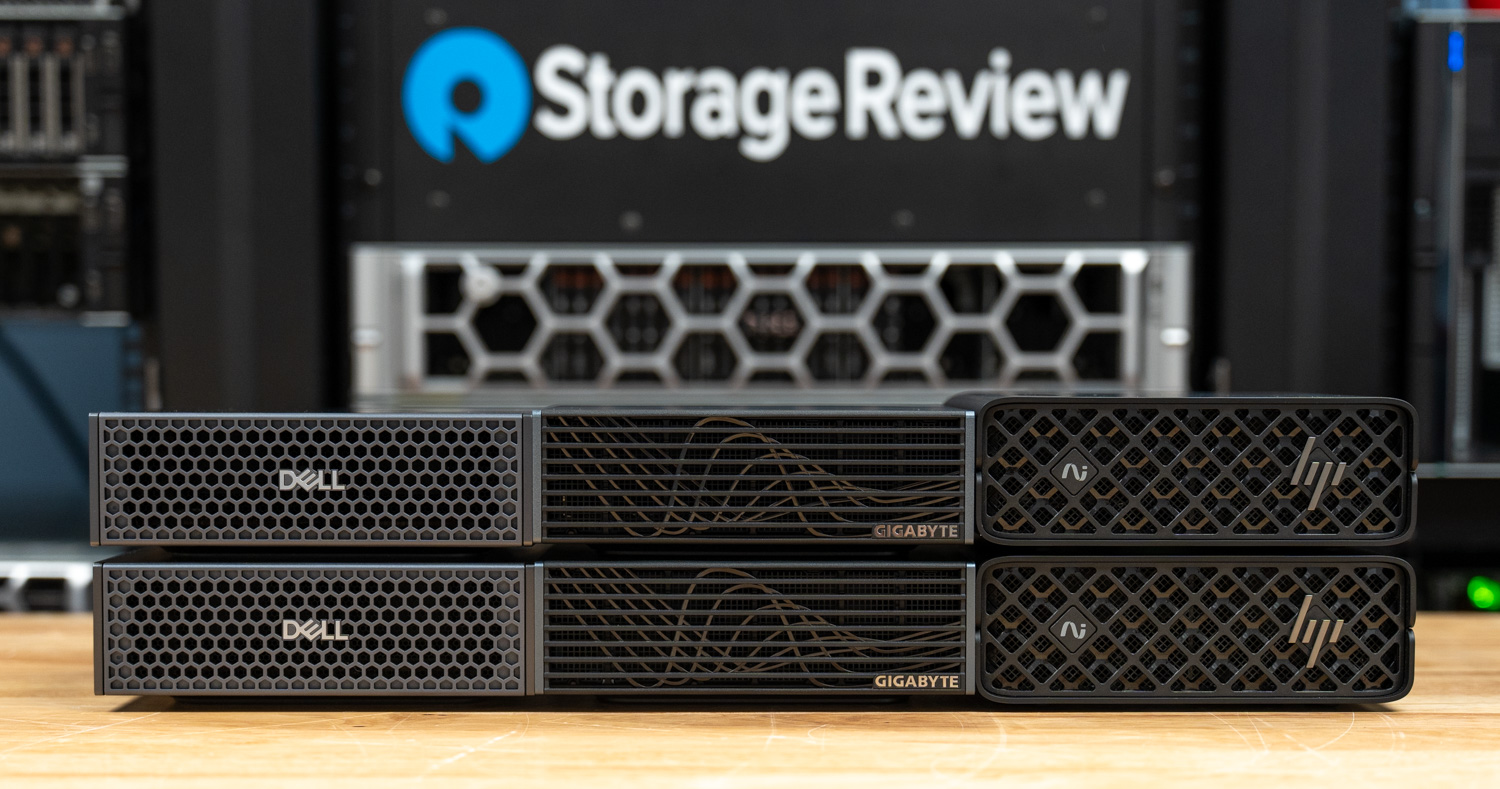
Recenziile noastre actuale ale sistemelor de inteligență artificială se concentrează pe servirea inferenței în laborator, cu modele open-weight din familiile Llama, Qwen, DeepSeek și gpt-oss care rulează prin vLLM sau SGLang și sunt măsurate în funcție de debitul de ieșire și latența primului token. Acoperirea se întinde de la edge până la nodul GPU complet: NVIDIA RTX PRO 4500 Server Edition a furnizat o medie de 2.7 ori mai multe token-uri de ieșire pe secundă decât L4-ul pe care a fost construit să îl înlocuiască în interiorul unui HPE ProLiant DL145 Gen11, pentru aproximativ 105W mai mult la perete; versiunile Dell, GIGABYTE și HP ale DGX Spark au rulat inferență distribuită ca clustere cu două noduri pe structura de 200 Gb; iar Supermicro JumpStart ne-a oferit timp practic cu un sistem NVIDIA HGX B200 și un sistem AMD Instinct MI350X. Stocarea este tratată în același mod, deoarece calea de date decide cât de ocupate rămân acele GPU-uri, așa că măsurăm debitul GPUDirect Storage cu GDSIO și testăm descărcarea cache-ului KV către flash pentru sarcini de lucru cu context lung și agențice.
Dacă dimensionați hardware pentru inteligență artificială, pagina Cele mai bune servere prezintă inferențele noastre actuale despre inteligență artificială și recomandările noastre avantajoase pe baza datelor din aceste recenzii, Cele mai bune SSD-uri pentru întreprinderi acoperă unitățile care alimentează GPU-urile, iar Cele mai bune matrice de stocare acoperă platformele de stocare inteligență artificială din spatele clusterelor de antrenament și neocloud-urilor.




 Amazon