

Actualizat pe 3 noiembrie 2026: AMD Instinct MI350P se alătură listei „Also Tested” de la prima noastră analiză la 450W, iar rezultatele sale pentru două plăci video se alătură Configurațiilor Scale-Out; se clasează după ce finalizează scara Ministral 3 la 600W. Publicat pe 14 octombrie 2026. Cinci acceleratoare PCIe s-au clasat pe un container vLLM și un set de modele, H100 NVL și MI350P fiind incluse în „Also Tested”; H200 NVL are o notă de putere explicată mai jos.
Fiecare accelerator clasat pe această pagină a trecut prin laboratorul StorageReview ca o singură placă PCIe. Piața GPU-urilor pentru întreprinderi este împărțită între modulele HGX și OAM care umplu fabricile de inteligență artificială și plăcile suplimentare care se integrează în serverele 2U și 4U pe care majoritatea centrelor de date le rulează deja, iar această pagină acoperă doar al doilea grup: GPU-urile pentru centre de date pe care le puteți comanda dintr-un configurator de servere mainstream și le puteți introduce într-un rack pe care îl aveți deja.
Aceasta este piața inferenței pentru întreprinderi, iar inferența pentru întreprinderi reprezintă volumul de muncă pe baza căruia este clasificat fiecare card de aici. Fiecare alegere face trimitere la recenzia care conține datele, iar clasamentul provine din același test pe fiecare card.
Testul respectiv este vLLM online servering, stiva pe care rulează majoritatea inferențelor la nivel de întreprindere, gestionată de la 1 la 32 de fluxuri simultane pe fiecare placă și până la 128 pe cele două plăci Hopper, pe patru modele în același container NGC vLLM 26.08 (vLLM 0.27.1 pe CUDA 13.4.1) și același driver 595.71.05.
Cinci dintre cele șase plăci video au rulat în Dell PowerEdge R770 la puterea pe care serverul o furnizează unui slot GPU; RTX PRO 6000 a rulat în Dell Pro Max Tower T2 pe același container și driver. Ordinea pe care o vedeți mai jos a fost menținută pentru fiecare model și ambele forme de solicitări pe care le-am rulat, deci clasamentul nu este doar un rezultat de vârf.
Memoria decide mai multe decât puterea de calcul în această clasă. O placă de 24 GB sau 32 GB deservește modele mici și medii la lungimea chat-ului și rămâne fără memorie cache KV odată ce se acumulează solicitări lungi; o placă de 48 GB sau 96 GB este potrivită pentru modele de dimensiuni medii, cu spațiu pentru concurență multi-tenant, iar plăcile HBM de 94 GB și 141 GB sunt cele care permit unui model din banda 70B - 120B să rămână pe un singur GPU. Alegerile sunt organizate în jurul acestei diviziuni, iar Întrebările frecvente din partea de jos răspund la întrebările comparative pe care cumpărătorii le pun cel mai des, de la RTX PRO 6000 versus H100 până la cât valorează 450W versus 600W într-un 2U.
La o privire
Jetoanele de ieșire pe secundă provin de la Ministral 3 14B Instruct FP8 la 32 de fluxuri simultane, cel mai greu punct finalizat de fiecare card, pe forma de chat de 512 intrări și 512 ieșiri și pe forma de document de 8,192 intrări și 1,024 ieșiri. FP8 este rezultatul maxim matmul realizabil de MAMF în TFLOPS, o măsurătoare GEMM densă susținută, nu vârful furnizorului.
| Categorii | Accelerator | Memorie / Lățime de bandă | Sloturi / Putere conform testului | Chat 512/512 (tok/s) | Document 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Intreg opinie |
|---|---|---|---|---|---|---|---|
| Cel mai bun accelerator PCIe AI per total | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Două sloturi / 450W* | 3,435 | 1,038 | 1,262 | Recenzie ET900N G3 (date H200 NVL) |
| Cea mai bună GPU de inferență pentru întreprinderi | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Dual-slot / 600W (a fost testată și capacitatea de 450W) | 2,283 | 608 | 774 | Recenzie RTX PRO 6000 |
| Cea mai bună placă grafică cu un singur slot | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Un singur slot / 165W | 1,107 | 190 | 280 | Recenzie RTX PRO 4500 SE |
| Cea mai bună placă grafică Inference Mainstream încă disponibilă | NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Două sloturi / 350W | 995 | 230 | 369 | Recenzie RTX PRO 4500 SE (date L40S) |
| Cea mai bună placă alimentată prin slot pentru 1U și Edge | NVIDIA L4 | 24 GB GDDR6 / 300 GB/s | HHHL cu un singur slot / 72W | 364 | 42 | 116 | Recenzie L4 |
*H200 NVL a fost testat la 450W, maximul pe care îl oferă un slot pentru GPU Dell PowerEdge R770. Placa are o putere nominală de 600W și nu am testat-o acolo, așa că valorile de pe această pagină sunt minime. Valorile RTX PRO 6000 provin de la Workstation Edition; NVIDIA evaluează ambele ediții la 600W, iar profilul lor este identic în testele noastre, iar Server Edition este placa pasivă, fără headset, cu aceeași GPU și memorie.
Alegerile
Cel mai bun accelerator PCIe AI per total: NVIDIA H200 NVL
H200 NVL este cea mai rapidă placă de extensie pe care am măsurat-o și este singura de pe această pagină care continuă să scaleze peste 32 de fluxuri. La 32 de fluxuri simultane pe Ministral 3 14B FP8, a servit 3,435 de jetoane de ieșire pe secundă față de 3,096 pentru H100 NVL și 2,283 pentru RTX PRO 6000, iar decalajul s-a mărit pe măsură ce concurența a crescut: 7,336 de jetoane pe secundă la 128 de fluxuri, unde plăcile RTX se opriseră deja. Pe forma documentului cu 8,192 de jetoane, cei 141 GB de HBM3e nu au rămas niciodată epuizați, iar placa a terminat cu 21 până la 23% înaintea H100 NVL pe fiecare model la concurență potrivită.
Avansul față de placa Blackwell este mai mare decât sugerează fișele tehnice. La 32 de stream-uri, H200 a funcționat cu 50 până la 81% înaintea RTX PRO 6000 pe cele trei modele FP8 și BF16, iar la o rezoluție de intrare de 8K a deținut 1,038 de token-uri pe secundă pe modelul 14B față de 608 de pe placa RTX, deoarece fluxurile HBM de 4.8 TB/s se decodează într-un mod în care 1.6 TB/s de GDDR7 nu o pot face.
Două sau patru plăci video fac legătura prin NVLink la 900GB/s, o performanță pe care nicio altă placă de aici nu o oferă. Cifrele noastre NVL pentru H200 apar alături de RTX PRO 6000 și GB300 DGX Station în recenzia ET900N G3, unde Station a atins 22,041 de jetoane de ieșire pe secundă pe GPT-OSS-20B la 128 de fluxuri, față de 6,022 pentru această placă.
Nota despre putere contează pentru un cumpărător 2U: această placă a funcționat la cei 450W pe care îi permite un slot PowerEdge R770, iar puterea sa de 600W a rămas netestată în laboratorul nostru. Singura sarcină de lucru în care nu prezintă niciun avantaj este versiunea NVFP4 a Qwen3.8-27B, unde placa nu are hardware FP4 și vLLM se decuantizează din mers, ajungând la 467 de tokenuri pe secundă față de 616 pentru RTX PRO 6000. Cumpărați-o pentru memorie și lățime de bandă, ceea ce este necesar pentru o implementare de 70B până la 120B.
Citește recenzia ASUS ET900N G3, care conține rezultatele noastre despre testul NVL H200.
Cea mai bună placă grafică Enterprise Inference: NVIDIA RTX PRO 6000 Blackwell Server Edition
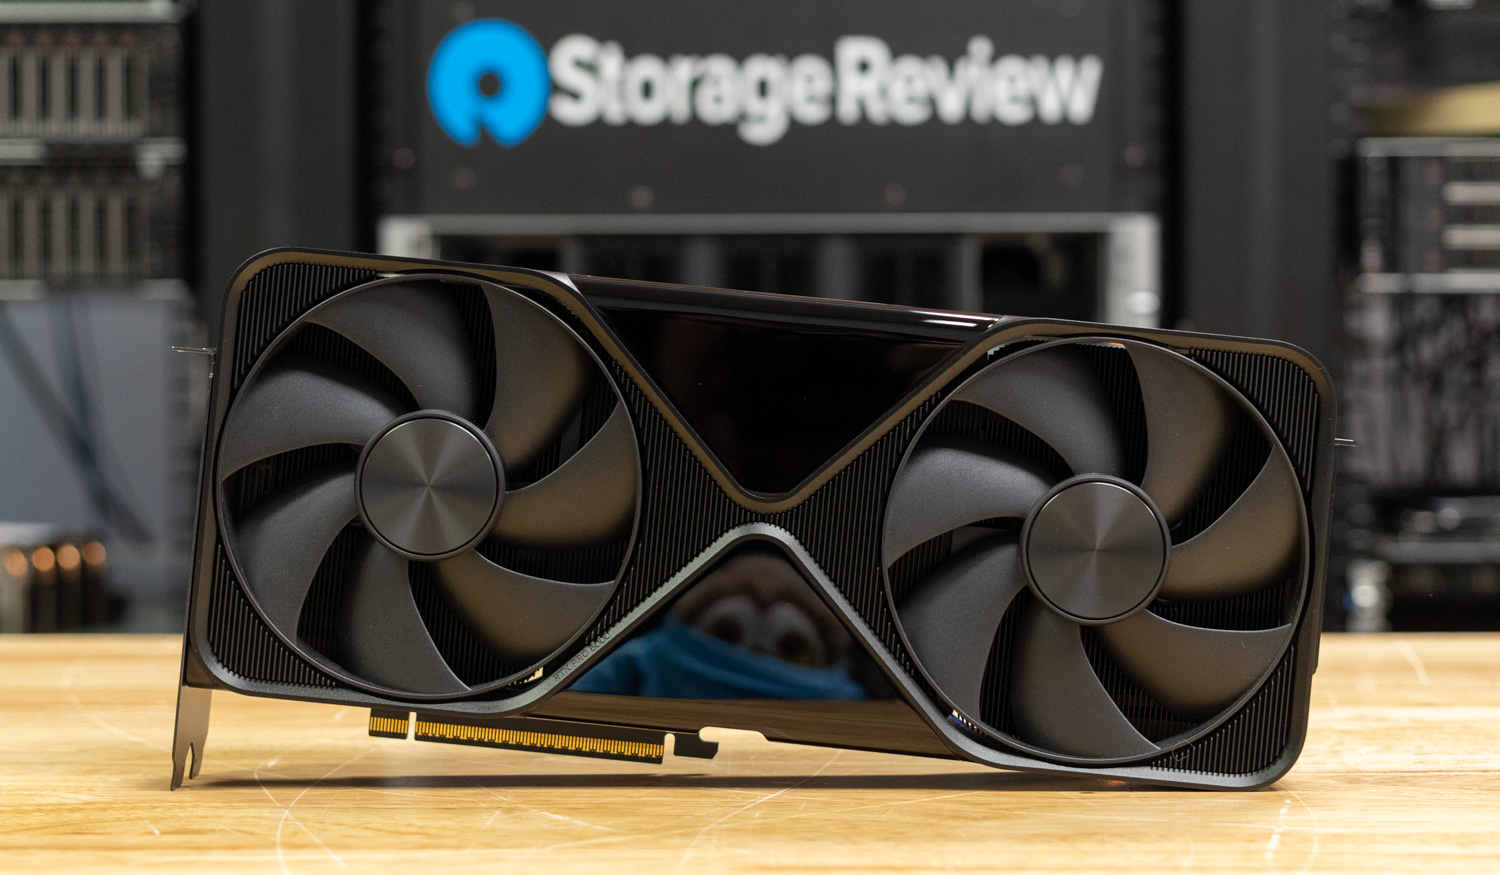
RTX PRO 6000 este placa grafică de inferență pentru întreprinderi de pe această pagină: placa Blackwell construită pentru serverele de inferență 2U și 4U pe care întreprinderile le cumpără acum, cu cel mai mare buffer de cadre sub nivelul HBM și cel mai larg set de funcții dintre toate plăcile de aici. La 600W, a livrat 2,283 de token-uri de ieșire pe secundă la 32 de fluxuri pe Ministral 3 14B FP8, 2,139 pe modelul 8B și 4,155 pe 3B, aproximativ de 2 ori mai mult decât RTX PRO 4500 la context scurt și de 2.7x până la 3.5x la intrare 8K, unde cei 96 GB ai săi continuă să urce la 32 de fluxuri, în timp ce plăcile de 32 GB și 48 GB se aplatizează.
În MAMF, a atins 774 TFLOPS în FP8 și 1,481 în NVFP4, cea mai mare cifră FP4 de pe pagină.
Limita de putere de 450W îi spune unui cumpărător 2U cât valorează ultimii 150W. Menținută la 450W, maximul oferit de un slot PowerEdge R770, placa a cedat între 2 și 5% în context scurt și între 4 și 9% în context lung, iar rezultatul MAMF FP8 nu s-a modificat. La limita respectivă, oferă 4.8 token-uri de ieșire pe secundă per watt nominal pe modelul 14B față de 3.8 la 600W, motiv pentru care un cumpărător 2U pierde puțin dacă o folosește la această putere.
Este, de asemenea, singura placă de pe această pagină cu nuclee RT, patru encodere și decodere și ieșiri de afișare, așa că un server care combină inferența cu randarea, transcodarea sau stațiile de lucru virtuale sub vGPU primește o singură placă pentru toate acestea. Statisticile noastre provin de la Workstation Edition într-un Dell Pro Max Tower T2; NVIDIA evaluează ambele ediții la 600W, au un profil identic în testele noastre, iar Server Edition este versiunea pasivă, headless, cu aceeași GPU GB202 și 96 GB de GDDR7 cu ECC.
De asemenea, în laboratorul nostru: patru plăci Server Edition în HPE ProLiant DL380a Gen12 , două și patru plăci în Dell PowerEdge XE7740 din recenzia ET900N G3 , placa unică din Dell Pro Max Tower T2 care a produs cifrele de mai sus, ambele plăci Max-Q de 300W și 600W din Dell Pro Precision 9 T2 , unde placa de 600W a costat Xeon cu 4 până la 5% pe munca CPU all-core, opt plăci și 768 GB în Comino Grando și două plăci Max-Q în Dell Precision 7875 și HP Z8 Fury G6i.
Citește recenzia completă a plăcii NVIDIA RTX PRO 6000
Cea mai bună placă grafică cu un singur slot: NVIDIA RTX PRO 4500 Blackwell Server Edition
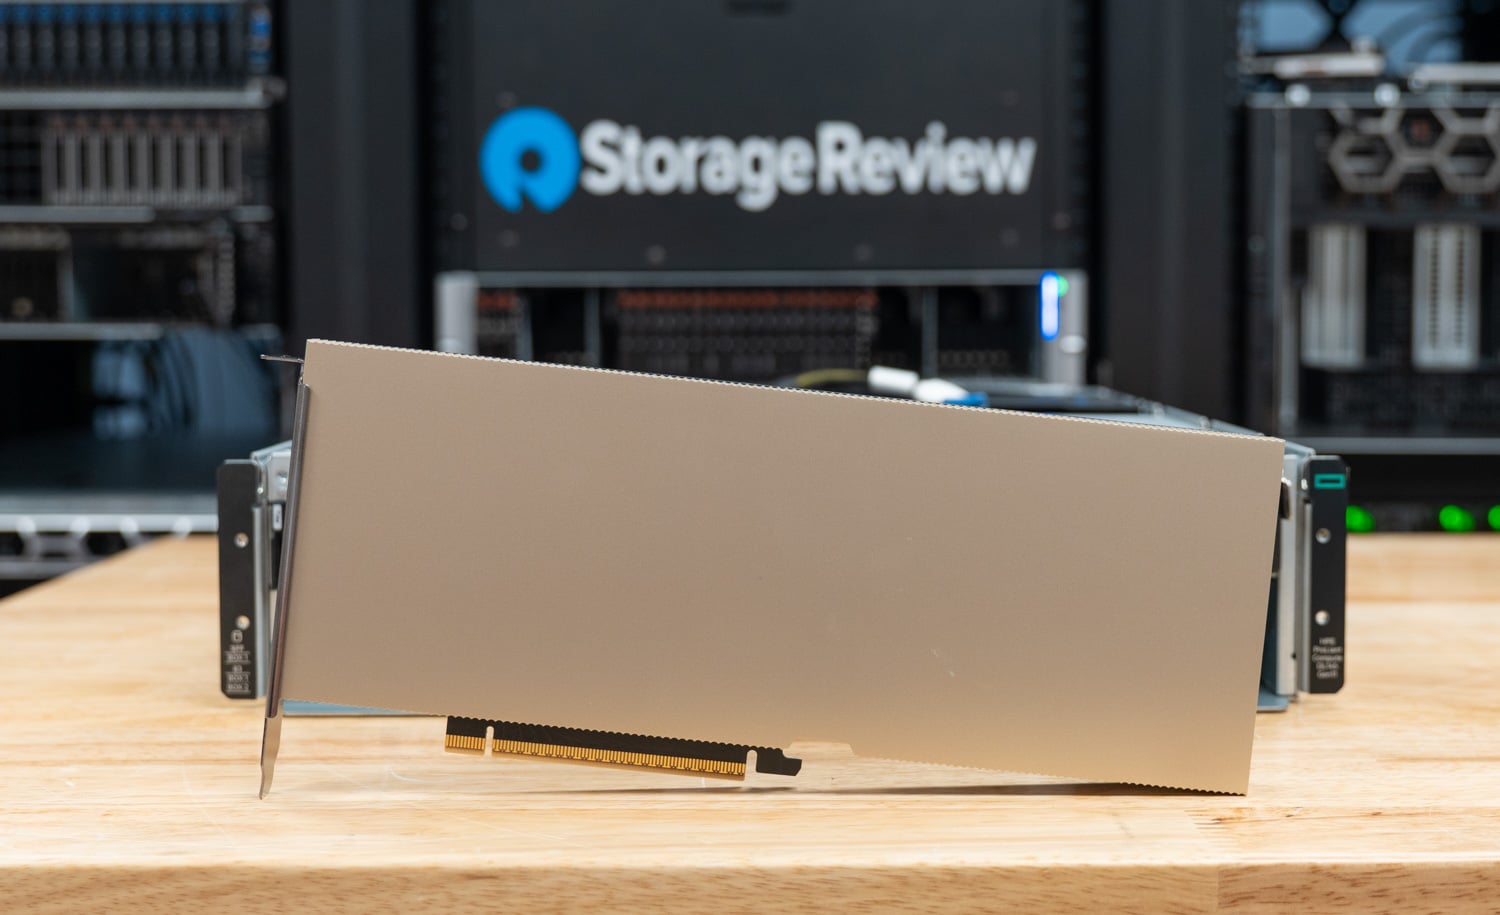
RTX PRO 4500 Server Edition oferă un randament L40S de la o placă de 165W cu un singur slot, aceasta fiind schimbarea pe care majoritatea serverelor mainstream o așteptau. La 32 de stream-uri pe chat shape, a egalat sau chiar a depășit L40S pe fiecare model FP8 și BF16: 1,107 față de 995 de token-uri pe secundă pe Ministral 3 14B FP8 și 2,006 față de 1,988 pe modelul 3B, pentru o placă evaluată la 47% din puterea L40S și jumătate din sloturile sale. Față de L4 pe care o înlocuiește, a rulat de 2.8x până la 3.6x mai rapid, la o putere de 2.3x mai mare decât placa de bază, iar o carcasă 2U care găzduiește patru plăci cu două sloturi găzduiește opt dintre acestea.
Limita este de 32 GB: la o intrare de 8,192 de jetoane, placa a fost în urma L40S cu 17 până la 33%, iar curbele sale s-au aplatizat la opt fluxuri, unde placa de 48 GB a continuat să urce până la 16, deoarece memoria cache KV, nu cea de calcul, s-a epuizat. De asemenea, este o placă de bază de înălțime completă și lungime completă, cu un conector cu 16 pini, astfel încât plăcile de bază 1U și semi-înălțime ale L4 nu o suportă fără o carcasă construită pentru plăci FHFL.
NVFP4 este cealaltă avertizare, comună fiecărei plăci pe care am testat-o pe această versiune vLLM: pe Qwen3.8-27B, 4500 a produs 320 de tokenuri pe secundă la 32 de fluxuri, în timp ce hardware-ul său FP4 a atins 569 TFLOPS în MAMF, deci avantajul FP4 există la nivelul GEMM și nu a ajuns încă în stiva de servire. Două partiții MIG de 16 GB, calcul confidențial și vGPU 20 completează un set de caracteristici pentru centre de date pe care ediția Workstation a aceleiași plăci nu le are.
Tot în laboratorul nostru: aceeași placă împotriva L4 din interiorul unui HPE ProLiant DL145 Gen11 , recenzia serverului edge care a precedat-o pe aceasta.
Citește recenzia completă a plăcii NVIDIA RTX PRO 4500 Blackwell Server Edition
Cea mai bună GPU Inference Mainstream încă disponibilă: NVIDIA L40S
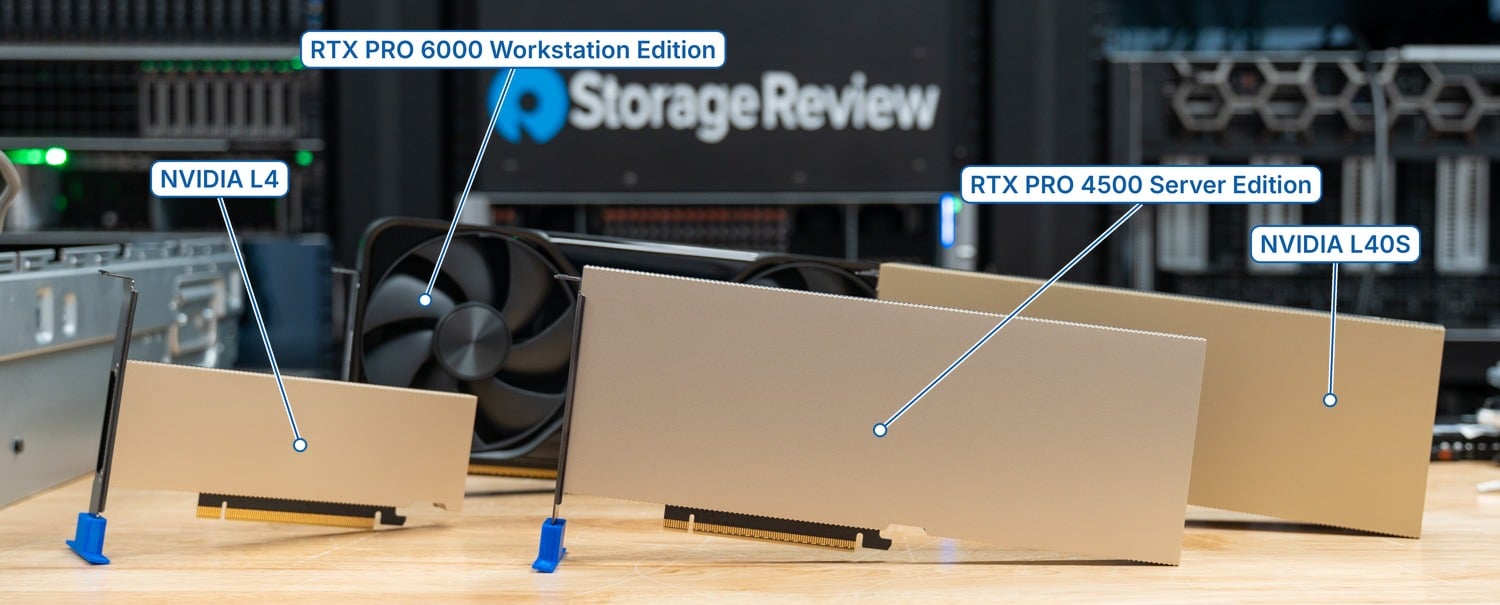
L40S a fost placa de memorie mainstream implicită timp de doi ani, iar cei 48 GB sunt motivul pentru care încă își merită un loc pe o pagină din epoca Blackwell. În forma chat-ului, a servit 995 de jetoane de ieșire pe secundă la 32 de fluxuri pe Ministral 3 14B FP8, 1,005 pe modelul 8B și 1,988 pe 3B.
Aceasta valoare se situează la o diferență de 12% față de RTX PRO 4500 la nivel global și înaintea lui la formatul de fișiere 8K, la 230 față de 190 la modelul 14B, 277 față de 185 la modelul 8B și 475 față de 384 la modelul 3B. Curbele sale continuă să urce până la 16 fluxuri în context lung, unde placa de 32 GB se oprește la opt.
Costul acelei memorii este o placă de bază de 350W, cu două sloturi, pe PCIe 4.0 și fără hardware FP4; pe versiunea NVFP4 a Qwen3.8-27B, a atins 480 de tokenuri pe secundă prin dequantizare, depășind cu 1.5 ori cei 4500 de pe această versiune software. Plafoanele MAMF sunt de 220 TFLOPS în BF16 și 369 în FP8, puțin sub jumătate din cele ale RTX PRO 6000. Pentru o flotă care rulează deja pe L40S și ale cărei sarcini de lucru se află în context lung, nu este o placă de înlocuit încă; pentru un nou 2U, placa 4500 cu un singur slot face aceeași muncă de lungime a chatului la jumătate din sloturi și putere.
Tot în laboratorul nostru: o singură placă grafică L40S în Lenovo ThinkSystem SR650 V4 și partea grafică a plăcii grafice în piesa noastră L40S pentru Omniverse.
Citește rezultatele noastre despre L40S în recenzia RTX PRO 4500 Server Edition
Cea mai bună placă de bază pentru 1U și Edge: NVIDIA L4
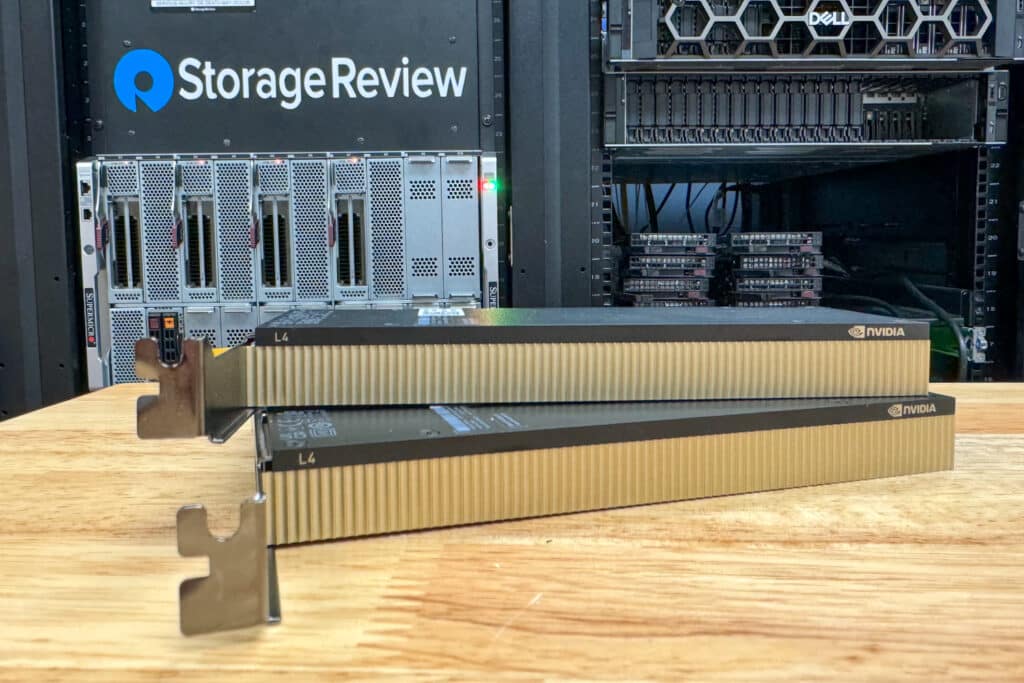
L4 este singura placă de pe această pagină care își folosește alimentarea din slot și se potrivește unui bay de jumătate de înălțime, ceea ce o menține în serverele 1U și în boxele edge în care nimic mai nou nu poate intra. La 72W, a livrat 364 de jetoane de ieșire pe secundă la 32 de fluxuri pe Ministral 3 14B FP8, 279 pe modelul 8B și 704 pe 3B, iar cele 5.1 jetoane de ieșire pe secundă per watt nominal pe modelul 14B depășesc L40S la 2.8 și RTX PRO 6000 la 600W la 3.8.
Plafoanele MAMF de 50 TFLOPS în BF16 și 116 în FP8 sunt cele mai scăzute aici și nu are o cale FP4, așa că modelul NVFP4 de 27B nu se potrivea cu cei 24 GB ai săi.
Contextul lung este punctul în care se oprește totul: la configurația cu 8,192 de jetoane, L4 a fost plat de la patru fluxuri pe fiecare model, de la 34 la 130 de jetoane pe secundă, deoarece 24 GB și 300 GB/s dețin foarte puține contexte de 8K simultan. RTX PRO 4500 Server Edition rulează de 2.8x până la 3.6x mai rapid, dar are nevoie de un slot FHFL și un cablu cu 16 pini, astfel încât o flotă L4 într-un șasiu 1U sau de jumătate de înălțime nu primește un înlocuitor drop-in. Recenzia noastră RTX PRO 4500 edge a măsurat ambele plăci în interiorul unui HPE ProLiant DL145 Gen11, unde 4500 a livrat de 2.7 ori mai mult decât L4.
De asemenea, în laboratorul nostru: L4 la marginea serverului Dell PowerEdge XR7620 , patru L4 în Dell PowerEdge T560 și placa de bază pentru RTX PRO 4500 în HPE ProLiant DL145 Gen11.
Citește recenzia completă a NVIDIA L4
De asemenea, testat
NVIDIA H100 NVL
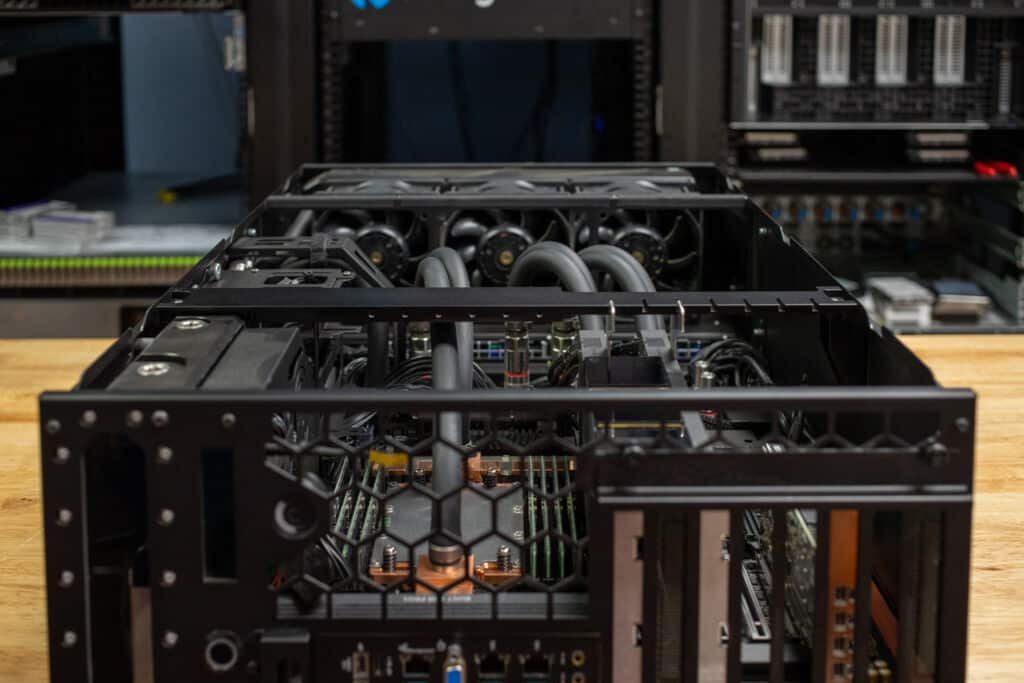
H100 NVL a rulat aceeași scară în același R770 și se află în „Also Tested” doar pentru că nu are niciun Hopper pe această pagină pentru a-i permite să se țină o categorie împotriva sa. Cu o generație în urmă, era încă cu 36 până la 61% mai rapid decât RTX PRO 6000 la concurență egală pe modelele FP8 și BF16 pe care le-am rulat.
În același R770, pe același container, a livrat 3,096 de jetoane de ieșire pe secundă la 32 de fluxuri pe Ministral 3 14B FP8, 3,449 pe modelul de raționament 8B și 5,873 pe 3B și a scalat la 128 de fluxuri ca și succesorul său, ajungând la 6,038 pe modelul 14B. Rezultatul său MAMF de 1,047 TFLOPS în FP8 este cu 35% peste 774 al RTX PRO 6000.
Motivul este reprezentat de cei 94 GB de memorie HBM3 la o viteză de 3.9 TB/s. În ceea ce privește forma documentului, acesta a stocat 859 de tokenuri pe secundă la 32 de fluxuri pe modelul 14B, cu 41% mai mult decât RTX PRO 6000 la 600W, cu aceeași formă a curbei pe care o prezintă H200 la o înălțime cu 21 până la 23% mai mică. Două plăci electronice suprapun NVLink la 600GB/s, configurația acoperită de recenzia noastră Comino Grando H100, iar placa consumă între 350 și 400W, configurabil într-o carcasă pasivă cu două sloturi care se potrivește cu aceleași console ca un L40S.
Unde se dovedește a fi insuficient în același loc cu H200: la punctele de control NVFP4, nu are hardware pentru. Pentru un cumpărător care are nevoie de capacitate HBM și are la îndemână o ofertă NVL H100, datele arată că rămâne a doua cea mai rapidă placă de extensie pe care am testat-o, după H200 NVL de mai sus.
Tot în laboratorul nostru: aceeași pereche de NVL-uri H100 din placa noastră R770 a alimentat testele de stocare directă pentru GPU Graid SupremeRAID AE .
Citește recenzia completă a Comino Grando H100
AMD Instinct MI350P
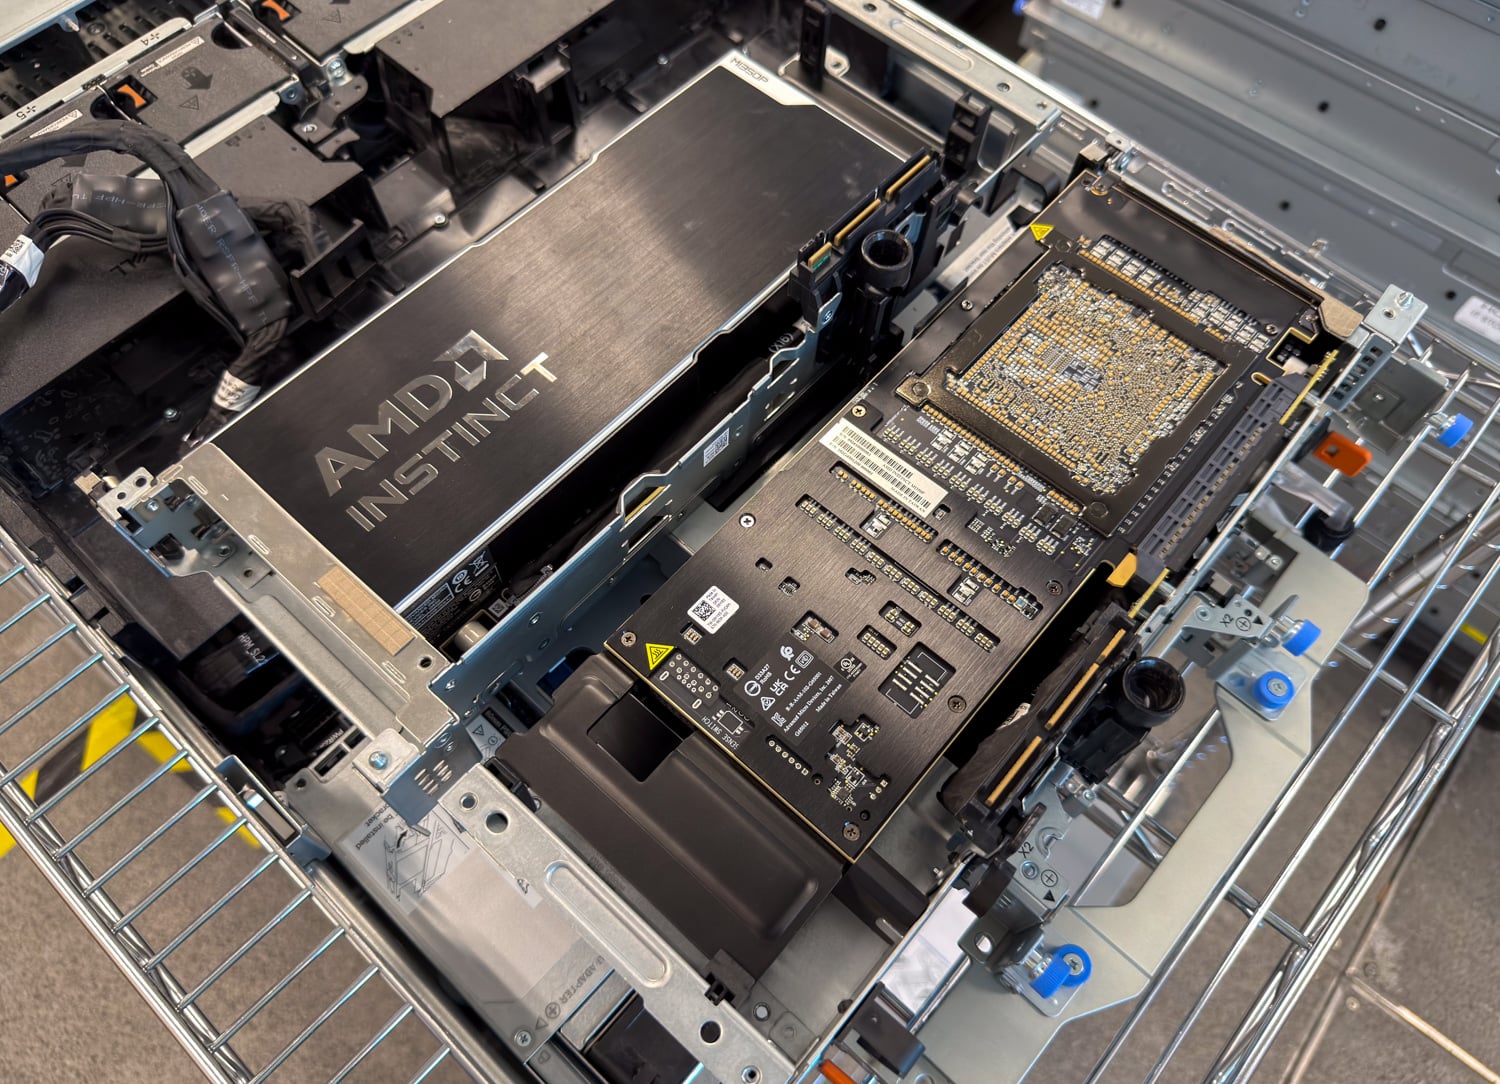
MI350P este prima placă PCIe Instinct nouă de la AMD din ultimii patru ani și se află în categoria „Also Tested” (Testate suplimentar) deoarece nu a parcurs încă clasamentul de mai sus. Această structură de accelerare folosește containerul NGC și setul de modele Ministral 3; prima noastră analiză a folosit placa pe vLLM standard pentru ROCm la 450W într-un PowerEdge R7725 2U, față de o putere nominală de 600W. Placa are 144GB de HBM3E la 4TB/s, cea mai mare memorie dintre toate acceleratoarele PCIe pe care le-am testat, cu 3GB peste NVL-ul H200.
În testele care se suprapun, aceasta se situează între cele două plăci video NVIDIA. MAMF a atins 1,120 TFLOPS în FP8 și 2,228 în FP4 scalat pe blocuri la 450W, cu 36 până la 38% peste RTX PRO 6000 de 600W la fiecare precizie din testele din acea analiză și în spatele H200 NVL în BF16 și FP8. Pe GPT-OSS-120B la 128 de fluxuri pe forma de chat, o placă a servit 5,057 de token-uri de ieșire pe secundă față de 3,064 pentru RTX PRO 6000 și 3,376 pentru H200 NVL, iar pe prompt-uri de 512 token-uri a depășit RTX PRO 6000 cu 35 până la 65% pe fiecare model FP8, BF16 și GPT-OSS.
H200 NVL se menține cu 4 până la 18% înaintea modelelor dense FP8 și BF16 la 128 de fluxuri pe prompturi de chat, iar pe prompturi cu 8,192 de token-uri, MI350P este în urma sa cu 25 până la 58% pe aceleași modele și se aplatizează cu 16 fluxuri pe Llama 3.1 8B și MiniMax M2.7. Rezultatele sale pentru două plăci video, unde o pereche conține versiuni MXFP4 de MiniMax M3 și GLM-5.2 care acceptă patru RTX PRO 6000, au rulat pe ROCm 7.2.3 și apar în secțiunea Configurații Scale-Out.
Se clasează în top după ce finalizează clasamentul Ministral 3 la 600W într-un PowerEdge XE7745, pe care Dell îl suportă cu opt MI350P-uri. Până atunci, pentru un cumpărător ale cărui modele se situează între 96GB și 144GB, este una dintre cele două plăci PCIe care le mențin pe un singur GPU și singura care depășește 141GB.
Citește prima prezentare a AMD Instinct MI350P
Configurații scalabile
O carte își câștigă rangul pe această pagină ca o singură carte. Rezultatele cu mai multe cărți sunt raportate aici ca configurații, neclasificate, deoarece rulează seturi de modele și stive de software diferite și nu pot fi ordonate unele față de altele sau față de scara cu o singură carte de mai sus. Fiecare rând conține rezultatul măsurat și recenzia din care provine.
| Configuraţie | Gazdă | Rezultat Măsurat | Stivui | Sursa |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 jetoane de ieșire/s la 16 fluxuri, 759 la 32 (512/512) | NGC vLLM 26.08, decodare speculativă MTP | Recenzie ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 token-uri/s totale la lotul 64, 3,956 la lotul 32; Llama 3.2 90B Vision: 1,372 token-uri/s totale la lotul 128 | Servire online vLLM | Recenzie DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 jetoane de ieșire/s la 128 fluxuri (512/512), 511 pe 8K/1K | NGC vLLM 26.08 | Recenzie ET900N G3 |
| 4x Intel Gaudi 3 PCIe (512 GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: aproximativ 3,600 de jetoane/s în total la 128 de cereri simultane (1,024/1,024); căi FP8 mai lente decât BF16 pe această versiune | Furcă Intel vLLM 2.7.1 pe Gaudi Docker 1.22.2 | Recenzie XE7740 (sponsorizată de Dell) |
| 2x AMD Instinct MI350P (288 GB), 450 W per placă | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 jetoane de ieșire/s la 16 fluxuri, 1,509 la 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 jetoane de ieșire/s la 32 fluxuri (512/512), 621 pe 8K/1K | vLLM pe ROCM 7.2.3 | Prima privire la MI350P |
Furca Intel vLLM nu optimizase încă căile FP8 în momentul testării, iar FP8 rula mai lent decât BF16. Rezultatul MiniMax M3 arată plafonul scalării PCIe pe un model care abia încape în 384 GB, unde patru plăci au depășit o singură stație GB300 DGX la 16 fluxuri și au scăzut la 32 pe măsură ce prompturile lungi au consumat memoria cache.
Dincolo de slot
Un model care depășește 141 GB pe o singură placă sau o încărcare de servere care necesită zeci de fluxuri pe un punct de control din clasa 400B a părăsit piața plăcilor de extensie. Clasa GB300 DGX Station este clasată în topul nostru Cele mai bune desktopuri pentru placă de bază AI locală, unde o singură placă grafică Blackwell Ultra cu 252 GB de HBM3e se află alături de H200 NVL în aceleași grafice, iar sistemele HGX B200 și AMD Instinct MI350X din recenziile noastre Supermicro JumpStart aparțin topului Cele mai bune servere . Aceste sisteme sunt măsurate ca sisteme, nu ca plăci de bază și nu sunt clasate aici.
Cum ne clasificăm
Trei reguli guvernează fiecare clasament StorageReview, iar prima este că sunt clasificate doar plăcile testate în laborator: orice nu am evaluat comparativ poate fi menționat, dar nu poate deține o categorie. În al doilea rând, plăcile sunt testate ca plăci individuale într-o gazdă care le acceptă, la puterea oferită de gazdă, iar această putere este menționată la fiecare intrare; nota H200 NVL de mai sus este singurul caz în care ratingul și puterea testată diferă.
În al treilea rând, plăcile pentru stații de lucru sunt excluse de pe această pagină, cu o singură excepție menționată: în cazul în care NVIDIA vinde aceeași placă de bază ca și componentă de server și cele două profiluri sunt identice, placa pentru stații de lucru este inclusă, iar intrarea specifică acest lucru.
Clasamentele provin din debitul de ieșire al serviciului online vLLM, din volumul de lucru al inferenței la nivel de întreprindere, la concurență potrivită pe un set de modele partajat, cu forma documentului de 8,192 de jetoane și rezultatele calculului MAMF rupând egalitățile, iar capacitatea memoriei stabilește nivelul de viabilitate. Furnizorii nu văd clasamentele înainte de publicare, nicio plasare pe această pagină nu este plătită, iar acolo unde este citat un articol sponsorizat, acesta este identificat ca atare. Fișele noi intră pe măsură ce finalizează același test pe același container, iar jurnalul de modificări din partea de sus înregistrează fiecare modificare.
Seturile de software se schimbă la fiecare câteva săptămâni, așa că fiecare figură de pe această pagină provine din runda care a stabilit clasamentul, iar recenziile ulterioare pot raporta runde mai noi ale aceleiași cărți. Reclasificăm atunci când o rundă mai nouă modifică ordinea, nu când un număr se schimbă.
Întrebări frecvente despre GPU-urile pentru întreprinderi
Care este cel mai bun GPU pentru inferența în cadrul întreprinderilor?
Pentru serverele de inferență 2U și 4U pe care majoritatea companiilor le cumpără, RTX PRO 6000 Blackwell Server Edition, deoarece combină 96 GB, cea mai mare capacitate de calcul FP4 pe care am măsurat-o la o placă PCIe, MIG, vGPU și motoare grafice și video într-o placă care pierde doar 2 până la 9% din debitul său la cei 450 W pe care îi oferă un slot mainstream.
Placa H200 NVL este cea mai rapidă atunci când memoria și lățimea de bandă decid volumul de lucru și a fost cea mai performantă din toate modelele pe care le-am rulat, așa că o implementare construită în jurul modelelor de 70B până la 120B la concurență ridicată ar trebui să înceapă de acolo. RTX PRO 4500 Server Edition este alegerea ideală atunci când slotul este single-width sau bugetul de alimentare este de 165W.
RTX PRO 6000 vs H100 NVL: care este mai rapid pentru inferență?
H100 NVL este cu 36 până la 61% mai rapid la concurență corespondentă pe modelele FP8 și BF16 pe care le-am rulat în același container vLLM și cu 41 până la 52% mai rapid pe forma de document cu 8,192 de token-uri, deoarece 94 GB de HBM3 la fluxuri de 3.9 TB/s decodează mai rapid decât 96 GB de GDDR7 la 1.6 TB/s. RTX PRO 6000 câștigă la punctele de control NVFP4, unde H100 nu are hardware FP4 și este singurul dintre cele două cu capacitate grafică, video și de afișare. Cumpărați H100 NVL pentru debit pe modelele FP8 și BF16; cumpărați RTX PRO 6000 pentru o sarcină de lucru mixtă sau pentru o foaie de parcurs FP4.
H100 NVL vs H200 NVL: merită upgrade-ul?
H200 NVL a funcționat cu 10 până la 12% înaintea H100 NVL la 32 de fluxuri pe forma de chat și cu 21 până la 23% înaintea 128 de fluxuri și pe forma de document cu 8,192 de token-uri, cu 141 GB față de 94 GB de memorie și 4.8 TB/s față de 3.9 TB/s. Aceste cifre provin de la H200 la 450 W, maximul pe care îl oferă un slot 2U R770, iar puterea sa nominală de 600 W nu este testată în laboratorul nostru, așa că diferența este un minim. Diferența de capacitate este decizia majorității cumpărătorilor: un model din clasa 120B în FP8 care încape 141 GB are nevoie de două H100 NVL-uri.
L40S vs RTX PRO 6000: ce cumpără placa mai mare?
Pe scurt, RTX PRO 6000 a oferit un debit de ieșire de 2.1x până la 2.3x față de L40S la 32 de fluxuri pe setul Ministral, iar la o intrare de 8,192 de token-uri, raportul a crescut la 2.2x până la 2.6x, deoarece placa de 48 GB a rămas fără memorie cache KV la 16 fluxuri, în timp ce placa de 96 GB a continuat să scaleze. 6000 vine, de asemenea, cu hardware FP4, PCIe 5.0 și MIG cu patru partiții de 24 GB, la 600W față de 350W. Pentru lucrul în context lung sau cu mai mulți utilizatori, este o achiziție mai bună; pentru servirea pe chat de lungă durată la puterea L40S, RTX PRO 4500 cu un singur slot este cea mai potrivită alegere.
L4 vs RTX PRO 4500: ar trebui o flotă L4 să fie modernizată?
RTX PRO 4500 Server Edition a avut o capacitate de ieșire de 2.8 până la 3.6 ori mai mare decât L4 în context scurt în R770-ul nostru și de 2.7 ori mai mare într-un HPE ProLiant DL145 Gen11, la 165W față de 72W și cu 32GB față de 24GB. Problema este fizică: 4500 este o placă de lungime și înălțime completă cu un conector cu 16 pini, iar L4 este o placă de înălțime medie, alimentată prin slot, astfel încât serverele 1U și carcasele mici de tip edge construite în jurul L4 nu acceptă 4500. Faceți upgrade acolo unde carcasa are un slot FHFL; păstrați L4 acolo unde nu are.
RTX PRO 6000 Server Edition vs Workstation Edition: care este diferența?
Aceeași placă grafică GB202, 96 GB de memorie GDDR7 cu ECC și o putere de 600 W; NVIDIA le evaluează identic, iar profilul lor este același în testele noastre, motiv pentru care datele Workstation Edition înlocuiesc Server Edition pe această pagină. Server Edition este pasivă și fără headset, construită pentru fluxul de aer al carcasei, cu setul de funcții de centru de date MIG, confidențial computing și vGPU; Workstation Edition este răcită activ cu patru ieșiri DisplayPort. Un cumpărător de server își dorește Server Edition; cifrele sunt aceleași în ambele cazuri.
Care este diferența dintre o placă grafică PCIe și un modul SXM sau HGX?
Un accelerator PCIe este o placă suplimentară care se conectează într-un slot standard și consumă între 72W și 600W, motiv pentru care se potrivește serverelor 2U și 4U deja aflate într-un rack, iar comunicarea multi-card se realizează prin PCIe sau o punte NVLink. Modulele SXM și OAM sunt lipite pe o placă de bază în interiorul sistemelor special construite, cum ar fi platformele HGX B200 sau MI350X, funcționează la 700W până la 1,400W per GPU și se conectează printr-o rețea NVLink sau Infinity Fabric completă. Această pagină clasează primul tip; al doilea este acoperit pe serverul nostru și pe plăcile de bază pentru desktopuri cu inteligență artificială locală.
De câtă memorie GPU are nevoie un server de inferență?
Depinde de model și context. Pe această pagină, plăcile de 24 GB și 32 GB au servit confortabil modele de la 3 GB la 14 GB la lungimea chat-ului și au fost aplatizate de patru până la opt fluxuri la o intrare de 8,192 de token-uri; 48 GB au continuat să crească până la 16 fluxuri, 96 GB nu au rămas niciodată epuizați pe aceleași modele, iar NVL-ul H200 de 141 GB a conținut GPT-OSS-120B pe o singură placă în testarea noastră ET900N G3. Bugetați mai întâi ponderile, apoi memoria cache KV pentru concurența așteptată și tratați munca în context lung sau cu mai mulți chiriași ca o cerință de 48 GB și mai mult.
Contează 450W față de 600W într-un server 2U?
Mai puțin decât sugerează diferența de putere, pe placa pe care am măsurat-o în ambele sensuri. Limitată la 450W, maximul oferit de un slot PowerEdge R770, RTX PRO 6000 a cedat între 2 și 5% din debitul de ieșire în context scurt și între 4 și 9% în context lung, iar rezultatul FP8 MAMF nu s-a modificat, returnând 25% din bugetul său de putere pentru un cost de 2 până la 9%. H200 NVL de pe această pagină a fost testat la 450W din același motiv, iar rezultatul său complet de 600W nu a fost încă măsurat. AMD Instinct MI350P, în prima noastră analiză, a funcționat, de asemenea, la 450W într-un PowerEdge R7725 2U, față de o putere de 600W, iar vom măsura diferența într-un PowerEdge XE7745.


 Amazon