

L40S umple o lacună critică în ecosistemul GPU-urilor pentru centrele de date. În timp ce GPU-urile pentru antrenamentul bazate pe inteligență artificială, precum Nvidia H100, prioritizează performanța brută, dar omit complet accelerarea grafică, plăcile de vizualizare profesionale tradiționale nu dispun de obicei de capacitățile de calcul bazate pe inteligență artificială cerute de sarcinile de lucru moderne cu inferență și de aplicațiile grafice emergente bazate pe inteligență artificială. Această poziționare o face deosebit de valoroasă pentru generarea de date sintetice, dezvoltarea multimodală bazată pe inteligență artificială și aplicațiile Omniverse, unde atât performanța de calcul, cât și cea grafică sunt esențiale.
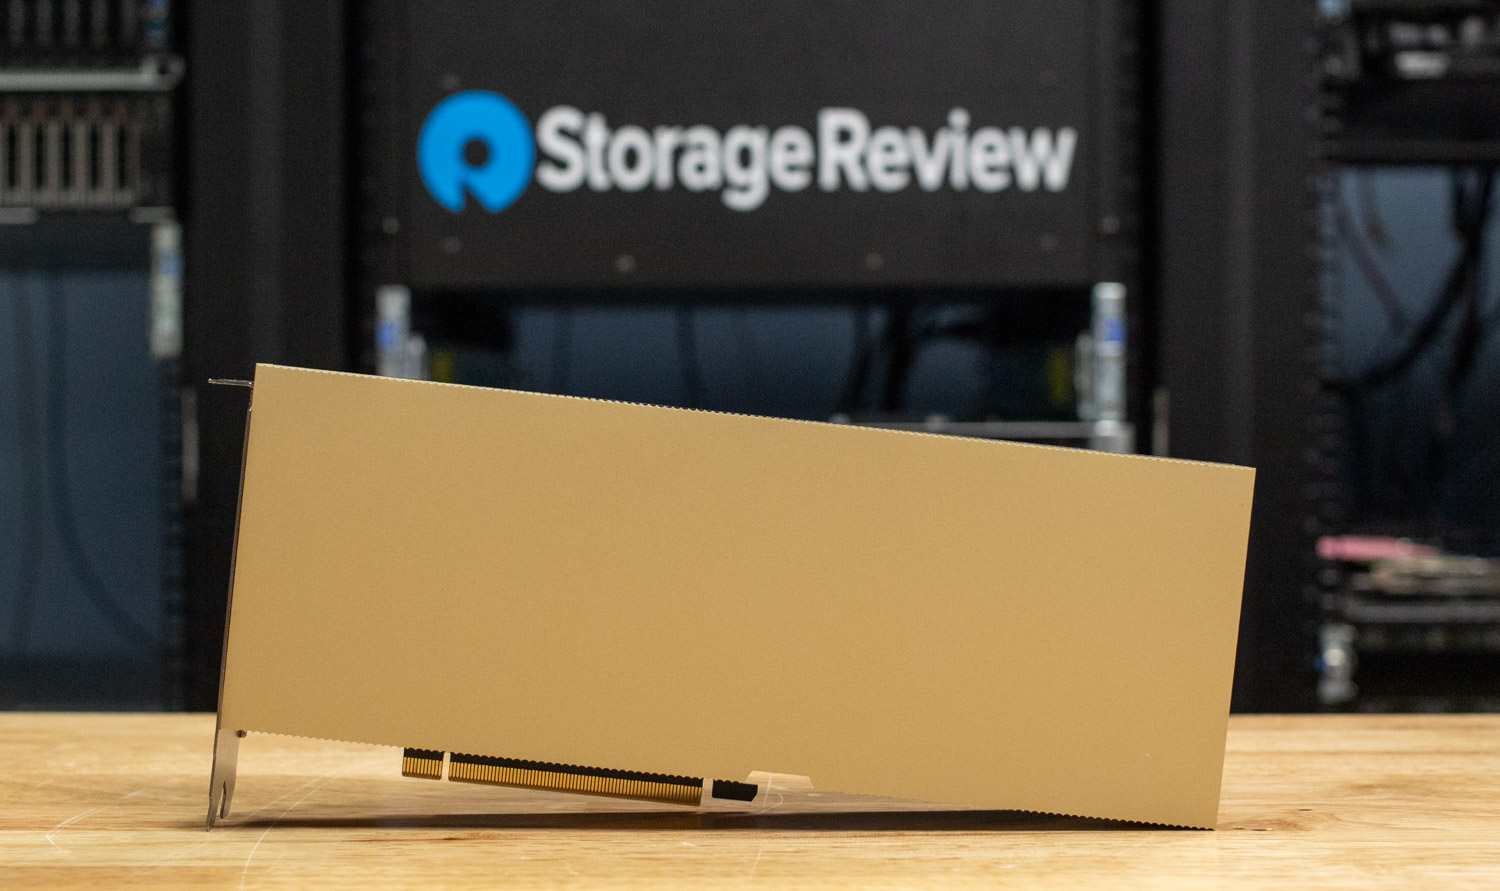
Specificații NVIDIA L40S
| Specificație | L40 | L40S | H100 80G PCIe |
| Arhitectura GPU | Ada lovelace | Ada lovelace | coș |
| GPU Die | AD102 | AD102 | GH100 |
| CUDA Cores | 18,176 | 18,176 | 14,592 |
| Miezuri tensoare | 568 (a 4-a generație) | 568 (a 4-a generație) | 456 |
| RT Cores | 142 (a treia generație) | 142 (a treia generație) | - |
| Memoria GPU | 48 GB GDDR6 cu ECC | 48 GB GDDR6 cu ECC | 80 GB HBM2e |
| Memorie Bandwidth | 864 GB / s | 864 GB / s | 2 TB / s |
| Interfața de memorie | 384-bit | 384-bit | 5120-bit |
| Max Consum de energie | 300W | 350W | 350W |
| Form Factor | 4.4″ Î x 10.5″ L: Slot dublu | 4.4″ Î x 10.5″ L: Slot dublu | 4.4″ Î x 10.5″ L: Slot dublu |
| Soluție termică | Pasiv | Pasiv | Pasiv |
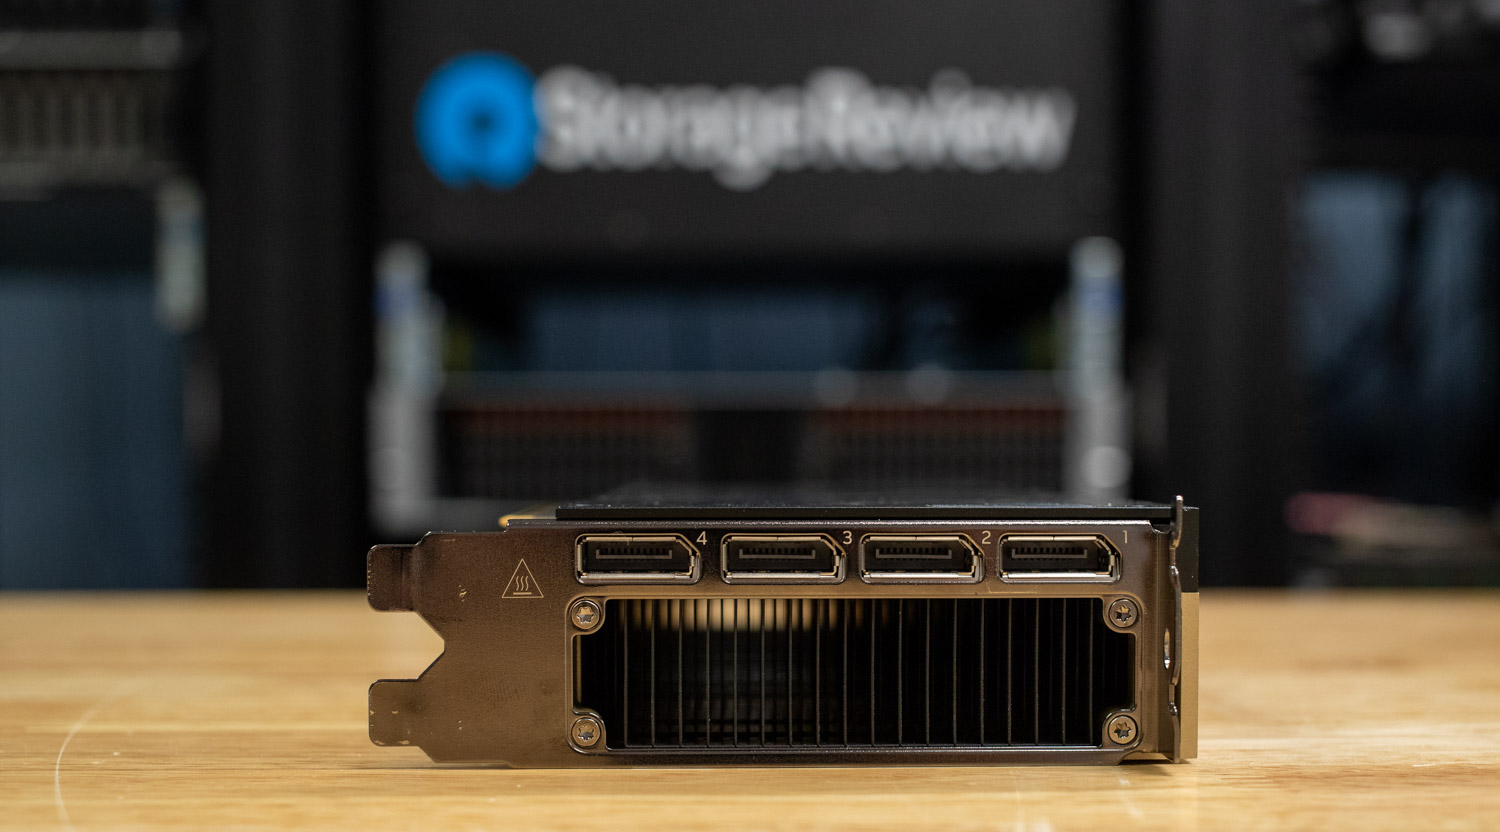
| Conectori de afișare | 4x DisplayPort 1.4a | 4x DisplayPort 1.4a | - |
| Interfață PCIe | Gen4x16 | Gen4x16 | Gen5x16 |
| Stecher | 16-pin | 16-pin | 16-pin |
| Suport vGPU | Da | Da | Nu |
| GPU cu instanțe multiple (MiG) | Nu | Nu | Da |
| Asistență NVLink | Nu | Nu | Nu |
Specificatii ale performantei
| metric | Performanța L40 | Performanța L40S | Performanță H100 |
| Performanță FP32 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| Miez tensor TF32 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| Miez tensor FP16 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| Miez tensor FP8 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Peak INT8 Tensor TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| RT Core Performance | 209 TFLOPS | 212 TFLOPS | - |
(Numerele de performanță sunt rare)
NVIDIA L40S vs. H100
O analiză detaliată a specificațiilor dezvăluie filozofiile distincte de design din spatele NVIDIA L40S și H100. L40S este construit pe arhitectura Ada Lovelace, folosind aceeași matriță AD102 întâlnită la plăcile grafice NVIDIA pentru stații de lucru de înaltă performanță. Această moștenire îi conferă un număr masiv de 18,176 de nuclee CUDA, ceea ce duce la performanțe excelente FP32 cu precizie simplă, care este o piatră de temelie a redării grafice tradiționale și a calculului științific. În schimb, arhitectura Hopper a H100 și matrița GH100 sunt special concepute pentru sarcini de lucru bazate pe inteligență artificială și HPC, mai presus de orice.
Cel mai important diferențiator este configurația nucleului. L40S include 142 de nuclee RT de a treia generație și 568 de nuclee Tensor de a patra generație. Nucleele RT sunt hardware specializat pentru accelerarea ray tracing-ului, o caracteristică complet absentă la H100, ceea ce face ca L40S să fie unic în ceea ce privește randarea fotorealistă. Deși H100 are mai puține nuclee Tensor, acestea sunt mai rapide și mai avansate, optimizate pentru noile formate de date AI, cum ar fi FP8, ceea ce îi conferă un avantaj important în ceea ce privește performanța AI brută.
Acest compromis este evident și în subsistemele de memorie. H100 utilizează 80 GB de memorie HBM2e de mare cost, oferind o lățime de bandă uimitoare de 2 TB/s. Acest lucru este esențial pentru alimentarea SM-urilor în timpul antrenamentului și inferenței modelelor AI la scară largă. L40S utilizează o memorie GDDR6 mai convențională de 48 GB, oferind o lățime de bandă de 864 GB/s. Deși este mai puțin de jumătate din cea a lui H100, aceasta este totuși o cantitate substanțială, perfect adecvată pentru încărcarea scenelor 3D mari, a texturilor de înaltă rezoluție și a modelelor AI de dimensiuni considerabile pentru inferență.
În cele din urmă, setul de caracteristici prezintă rolurile preconizate ale acestora. L40S include patru ieșiri DisplayPort 1.4a și suport robust vGPU, ceea ce îl face ideal pentru stații de lucru virtualizate, ferme de randare și implementări de jocuri în cloud. H100, lipsit de ieșiri de afișare sau capabilități vGPU, oferă în schimb tehnologia Multi-Instance GPU (MiG), care permite partiționarea în mai multe instanțe GPU mai mici, izolate, pentru a deservi simultan mai multe sarcini de lucru intensive în calcul. Designul termic pasiv, cu două sloturi partajate, și anvelopa de putere de 350 W a L40S și PCIe H100 permit flexibilitatea implementării într-o gamă largă de servere standard din industrie.
Când comparăm L40S cu modelul emblematic H100 de la NVIDIA, diferențele în rolurile lor preconizate devin clare. H100 este liderul incontestabil în ceea ce privește performanța brută de antrenament AI pentru acea generație de GPU-uri, dar această comparație spune doar o parte din poveste. Merită menționat faptul că L40 face parte și el din gama NVIDIA, cu un TDP mai mic de 300W în comparație cu puterea de 350W a L40S, oferind capabilități similare la un consum redus de energie.
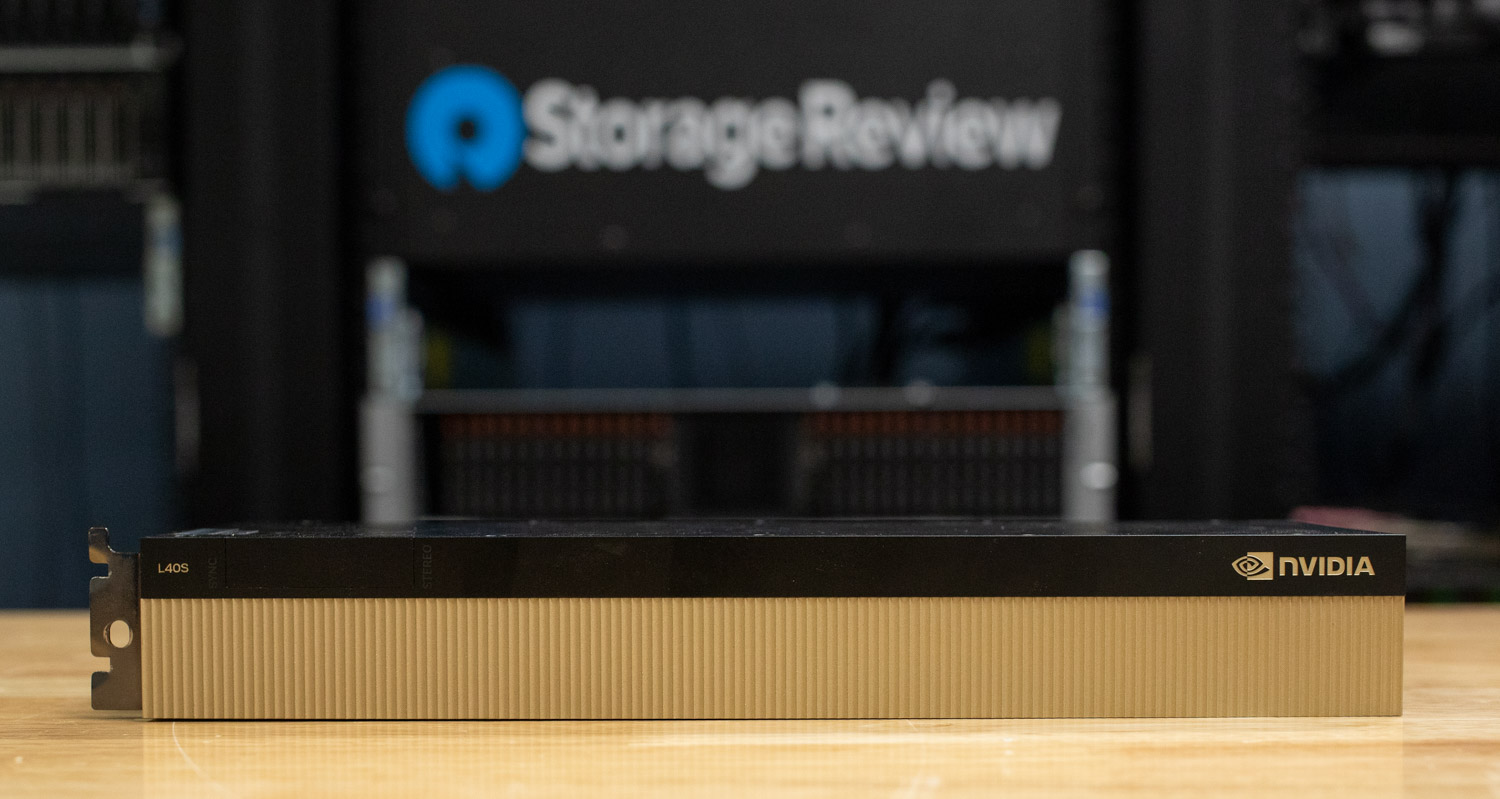
Placa video H100 pe care o examinăm aici este versiunea originală PCIe de 80 GB cu memorie HBM2e. De atunci, NVIDIA a extins această gamă cu variante precum H100 NVL, care înlocuiește modelul original PCIe de 80 GB, oferind 94 GB de memorie și un TDP mai mare de 400 W, adăugând în același timp suport NVLink pentru configurații cu două GPU-uri. Familia H100 se extinde și la configurații SXM cu 8 GPU-uri și la noul H200, care are aceeași placă grafică, dar oferă performanțe îmbunătățite atât în formatul PCIe, cât și în cel SXM.
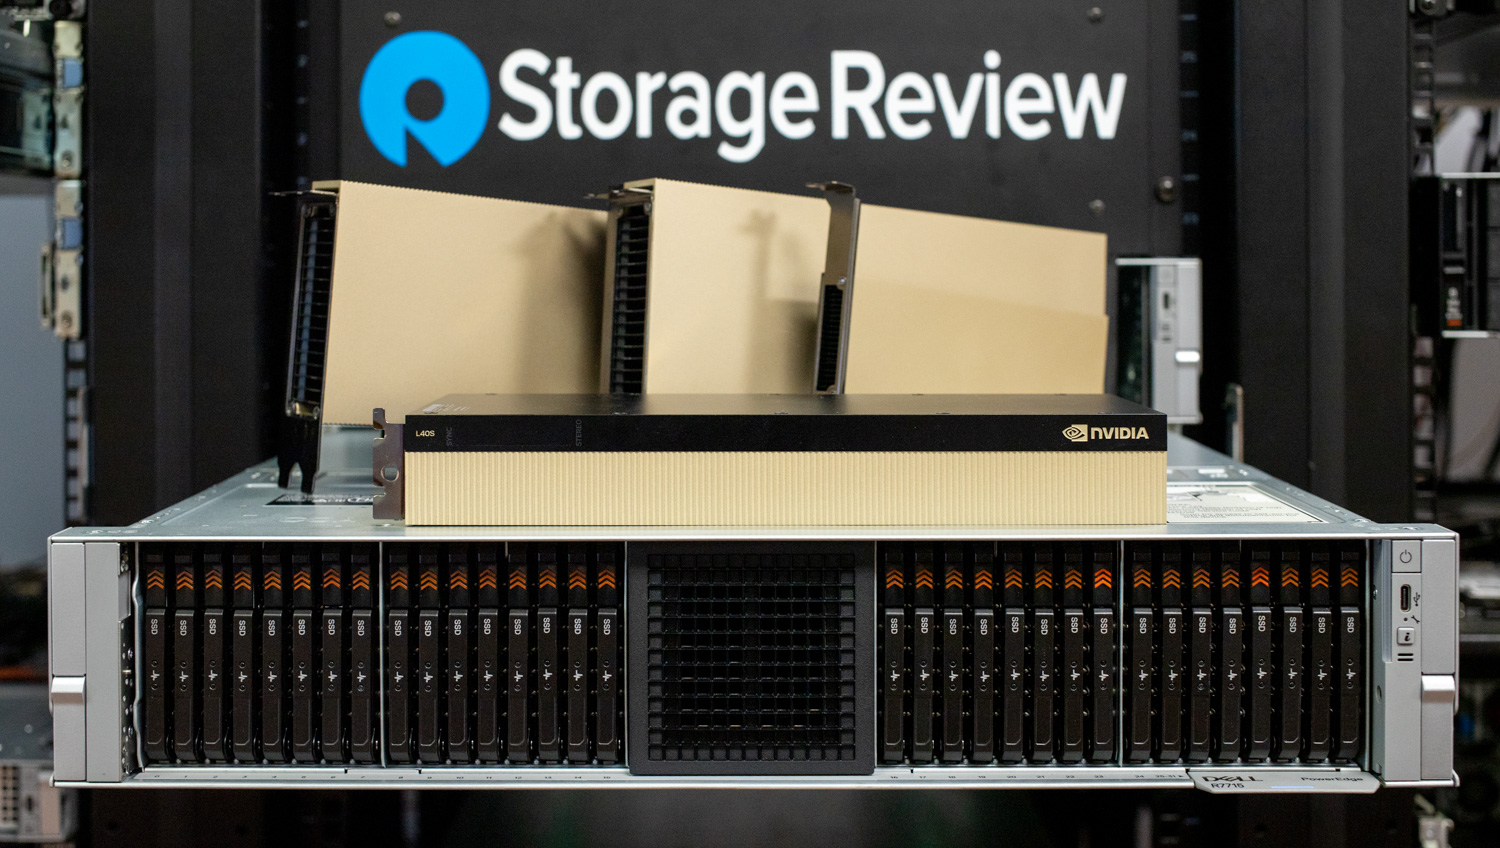
Distincția dintre L40S și H100 evidențiază o divergență strategică în designul GPU-urilor pentru centrele de date. H100 este o placă de bază axată exclusiv pe calcul, optimizată exclusiv pentru sarcini de lucru bazate pe inteligență artificială și calcul de înaltă performanță. Ținta este antrenamentul inteligenței artificiale la scară largă, unde debitul maxim de calcul este obiectivul principal. Fiecare aspect al designului său, de la lățimea de bandă masivă a memoriei HBM2e până la nucleele Tensor specializate, este conceput pentru cele mai solicitante scenarii de antrenament pentru rețele neuronale.
În schimb, L40S este un GPU universal conceput pentru versatilitate, vizând inferența AI alături de sarcini de lucru cu grafică intensivă și implementări NVIDIA vGPU. Deși servește ca o soluție competentă și rentabilă pentru inferența AI, adevăratul său punct forte constă în suportarea unei game diverse de aplicații cu grafică intensivă pentru care H100 pur și simplu nu este conceput.
Sarcini de lucru cu grafică intensivă și aplicații profesionale
L40S excelează în numeroase domenii cu grafică intensivă, care necesită atât putere de calcul, cât și capacități avansate de randare. În randarea 3D și animație, studiourile se bazează pe L40S pentru randarea scenelor complexe, unde nucleele sale RT accelerează calculele de ray tracing care ar fi imposibile pe GPU-urile doar de calcul. Casele de producție de film și televiziune utilizează aceste capacități pentru previzualizarea în timp real, permițând regizorilor și directorilor de imagine să vadă randări fotorealiste ale scenelor CGI în timpul filmărilor, reducând dramatic timpul și costurile de post-producție.
Firmele de arhitectură și inginerie utilizează L40S pentru vizualizare arhitecturală în timp real și proiectare de produse, unde clienții pot parcurge randări fotorealiste ale clădirilor sau pot examina prototipuri detaliate ale produselor înainte de începerea construcției fizice. Capacitățile grafice profesionale ale plăcii o fac, de asemenea, ideală pentru stațiile de lucru CAD, unde inginerii au nevoie atât de putere de calcul pentru simulări complexe, cât și de accelerarea grafică pentru o performanță fluidă și de înaltă fidelitate a viewport-ului.
În sectorul media și divertisment, L40S este utilizat pentru ferme de randare care procesează cadre de animație de calitate finală. În același timp, capacitățile sale vGPU permit fluxuri de lucru creative bazate pe cloud, unde artiștii pot accesa de la distanță stații de lucru grafice puternice. Facilitățile de editare video și post-producție utilizează L40S pentru procesarea efectelor în timp real, gradarea culorilor și fluxuri de lucru de compoziție care necesită atât accelerare grafică, cât și resurse de calcul substanțiale.
Piața infrastructurii desktop virtuale (VDI) reprezintă o altă zonă cheie de aplicații, unde tehnologia vGPU a modelului L40S permite mai multor utilizatori să partajeze resurse GPU pentru desktopuri virtuale cu accelerare grafică. Acest lucru face ca capabilitățile grafice profesionale să fie accesibile în mediile enterprise fără a dedica GPU-uri individuale fiecărui utilizator.
Evoluția către antrenamentul bazat pe fizică în domeniul inteligenței artificiale
Mai important, L40S oferă capabilități pe care H100 le lipsește complet. Diferențiatorul cheie constă în cele 142 de nuclee RT de a treia generație ale L40S, care permit ray tracing-ul în timp real și randarea fotorealistă. Deși H100 nu are nuclee RT și nu poate efectua accelerare grafică, nucleele RT ale L40S îl fac alegerea clară pentru aplicațiile care necesită atât calcule AI, cât și grafică avansată.
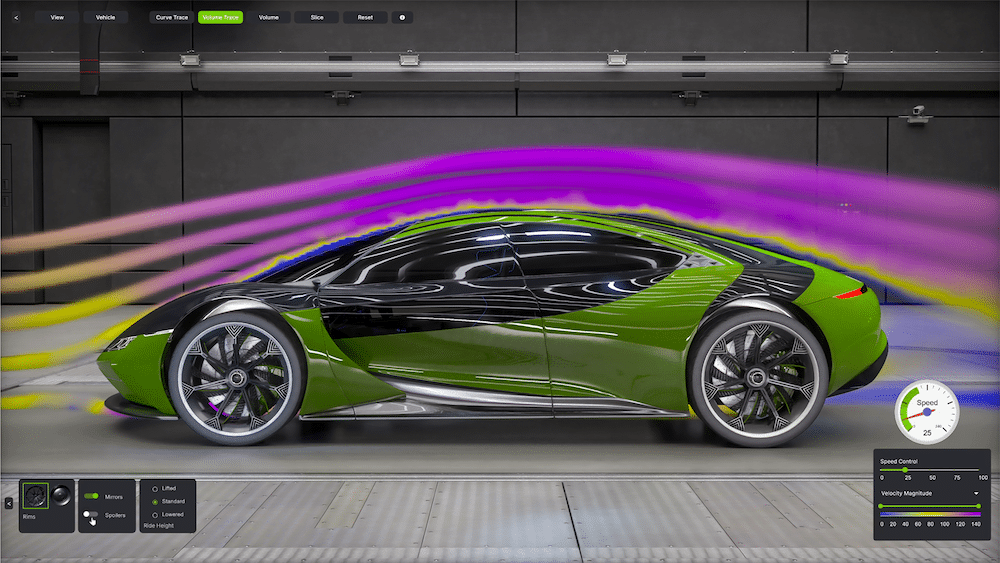
Sursa: Nvidia
Această distincție devine din ce în ce mai critică pe măsură ce asistăm la creșterea popularității modelării 3D generate de inteligența artificială, a simulărilor digitale gemene și a fluxurilor de lucru de tip Universal Scene Description (OpenUSD). Următoarea frontieră în inteligența artificială nu constă doar în antrenarea unor modele lingvistice mai ample; ci în dezvoltarea de modele globale care înțeleg fizica, relațiile spațiale și interacțiunile din lumea reală. Această evoluție necesită o schimbare fundamentală în modul în care abordăm generarea de date pentru antrenament.
În timp ce antrenarea modelelor tradiționale de inteligență artificială se bazează în mare măsură pe GPU-urile de calcul emblematice de la NVIDIA, antrenarea următoarei generații de modele de lume ancorate fizic necesită o abordare diferită. Aceste sisteme avansate de inteligență artificială au nevoie de cantități vaste de date de antrenament care să capteze nu doar informații vizuale, ci și proprietăți fizice, comportamentul iluminării, interacțiunile materialelor și relațiile spațiale. GPU-urile precum L40S devin esențiale pentru generarea de date de antrenament la scară largă, unde nucleele lor RT permit crearea unor medii sintetice precise din punct de vedere fizic, care servesc drept bază pentru antrenarea unor modele de inteligență artificială mai sofisticate.
Această capacitate de randare grafică avansată, susținută de nucleele RT dedicate, este exact ceea ce face din L40S motorul ideal pentru platforma Omniverse de la NVIDIA și pentru ecosistemul mai larg de dezvoltare a inteligenței artificiale bazate pe fizică.
omniversului
Omniverse este o platformă de dezvoltare de API-uri, SDK-uri și servicii care permite dezvoltatorilor să construiască aplicații și fluxuri de lucru bazate pe Universal Scene Description (OpenUSD). Este concepută pentru a crea și conecta lumi virtuale 3D în timp real, cu precizie fizică. Acest lucru se realizează prin integrarea tehnologiei RTX de la NVIDIA pentru randare fotorealistă, cu ray-tracing, direct în fluxurile de lucru de simulare industrială și robotică. L40S, cu nucleele sale RT puternice, oferă accelerarea hardware esențială pentru a gestiona aceste sarcini de lucru de randare RTX solicitante, permițând dezvoltatorilor să simuleze lumina, materialele și fizica cu un realism uimitor.
Mai mult decât un simplu instrument de vizualizare, Omniverse este o platformă pentru dezvoltarea următoarei generații de inteligență artificială fizică. Prin crearea acestor lumi virtuale fidele realității, sau „gemeni digitali”, dezvoltatorii pot simula instalații industriale complexe, pot testa flote întregi de roboți și pot valida vehicule autonome într-un cadru virtual sigur înainte de implementarea în lumea reală. Un aspect crucial este că aceste simulări de înaltă fidelitate devin fundamentul pentru generarea unor cantități vaste de date sintetice bazate pe date fizice; o resursă critică pentru antrenarea modelelor puternice de inteligență artificială care rulează pe GPU-uri axate pe calcul.
Generarea de mișcare prin manipulare sintetică pentru robotică
Planul NVIDIA Isaac GR00T pentru generarea mișcării de manipulare sintetică oferă un cadru pentru antrenamentul în robotică, demonstrând modul în care capacitățile RT Core ale L40S permit crearea de seturi mari de date din demonstrații umane minime. Acest flux de lucru abordează una dintre provocările cheie în dezvoltarea roboticii: procesul consumator de timp și costisitor de colectare a unor date de antrenament suficiente de înaltă calitate pentru sarcinile de manipulare a roboților.
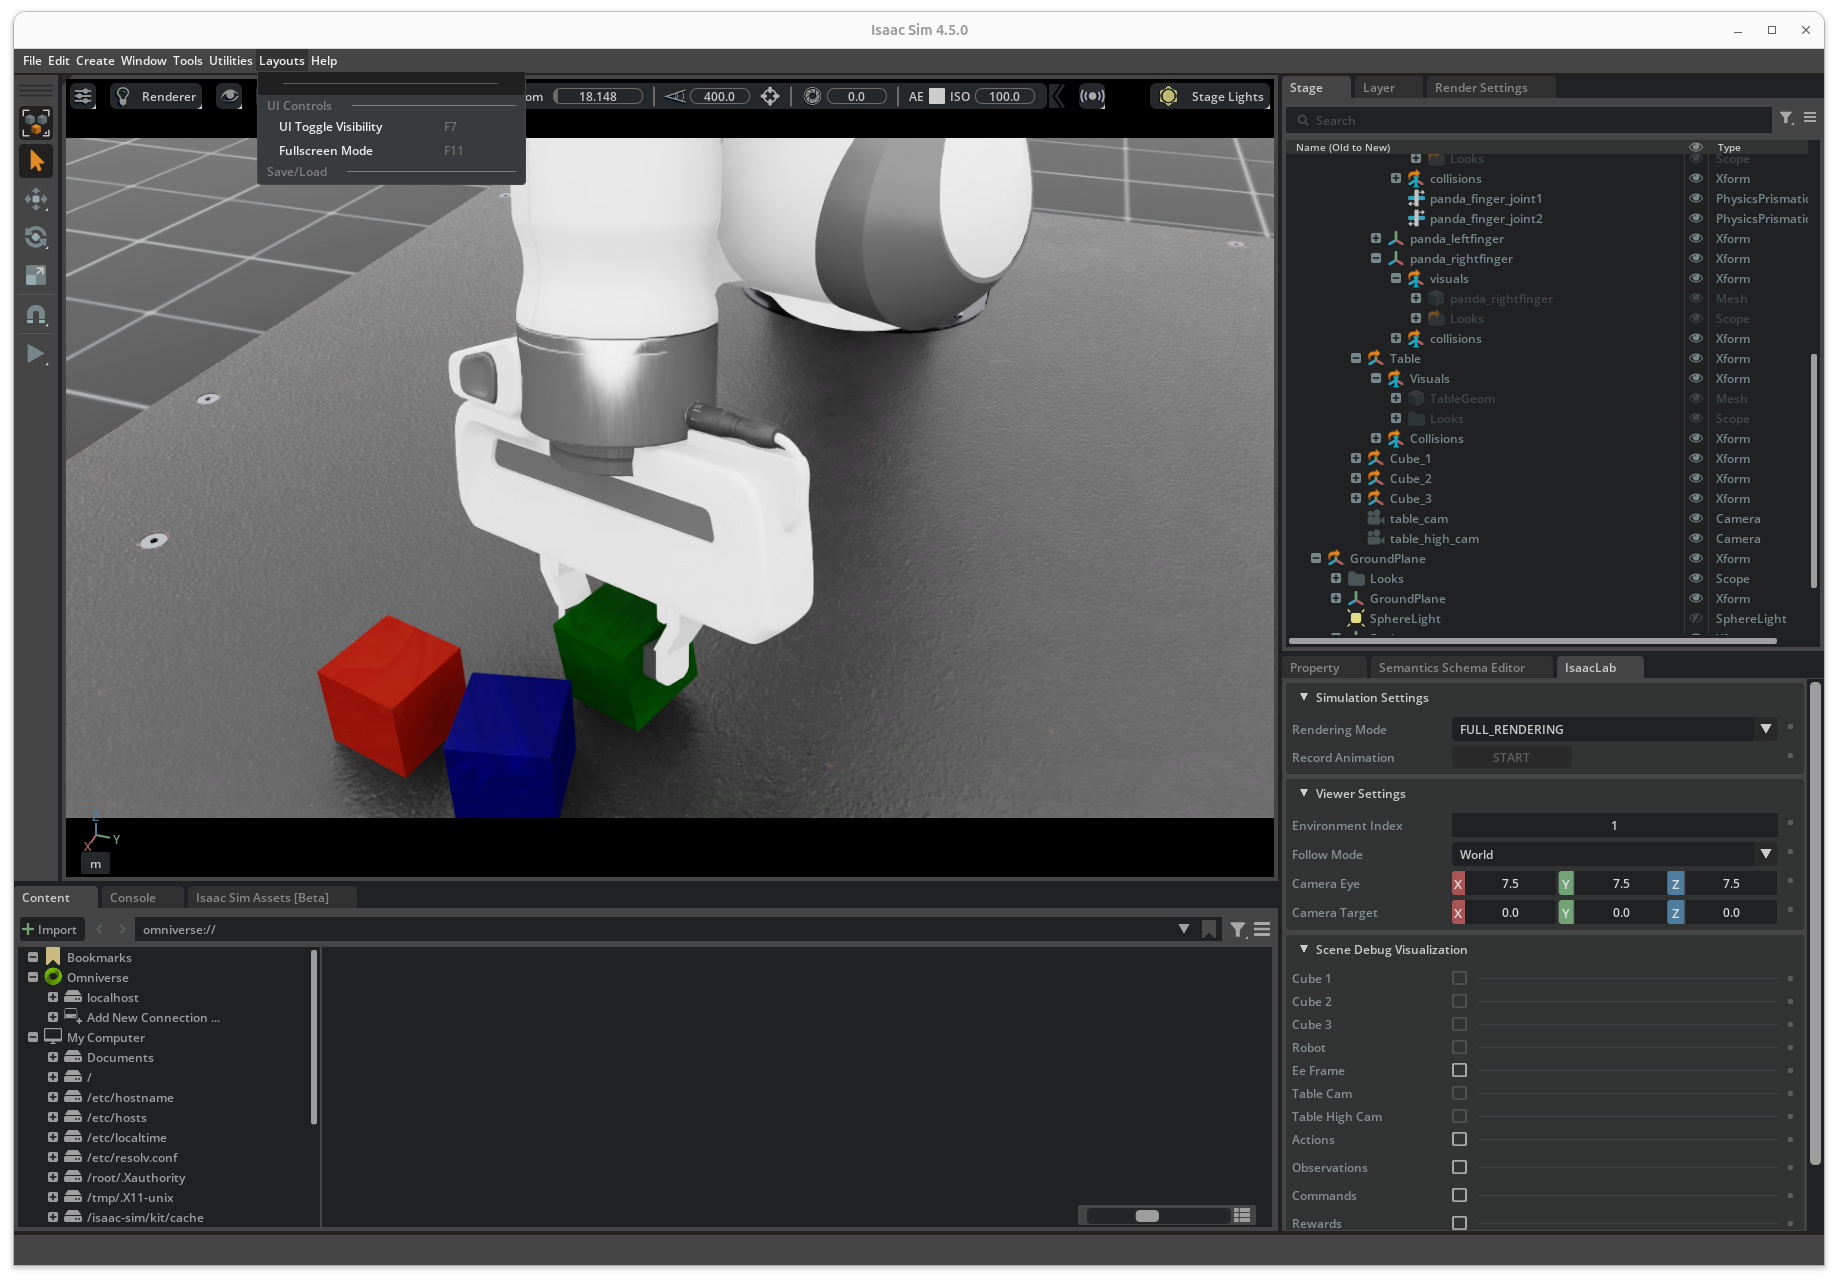
Antrenamentul tradițional în robotică se bazează în mare măsură pe învățarea supravegheată sau prin imitație, în care roboții dobândesc noi abilități observând și imitând demonstrațiile umane ale experților. Cu toate acestea, crearea unor demonstrații perfecte este o provocare, iar colectarea unor seturi de date extinse, de înaltă calitate, în lumea reală este anevoioasă, consumatoare de timp și costisitoare. Un operator uman instruit corespunzător are nevoie de obicei de aproximativ un minut pentru a înregistra o singură demonstrație de înaltă calitate, ceea ce este dificil de scalat din cauza efortului uman semnificativ necesar și a potențialului de erori.
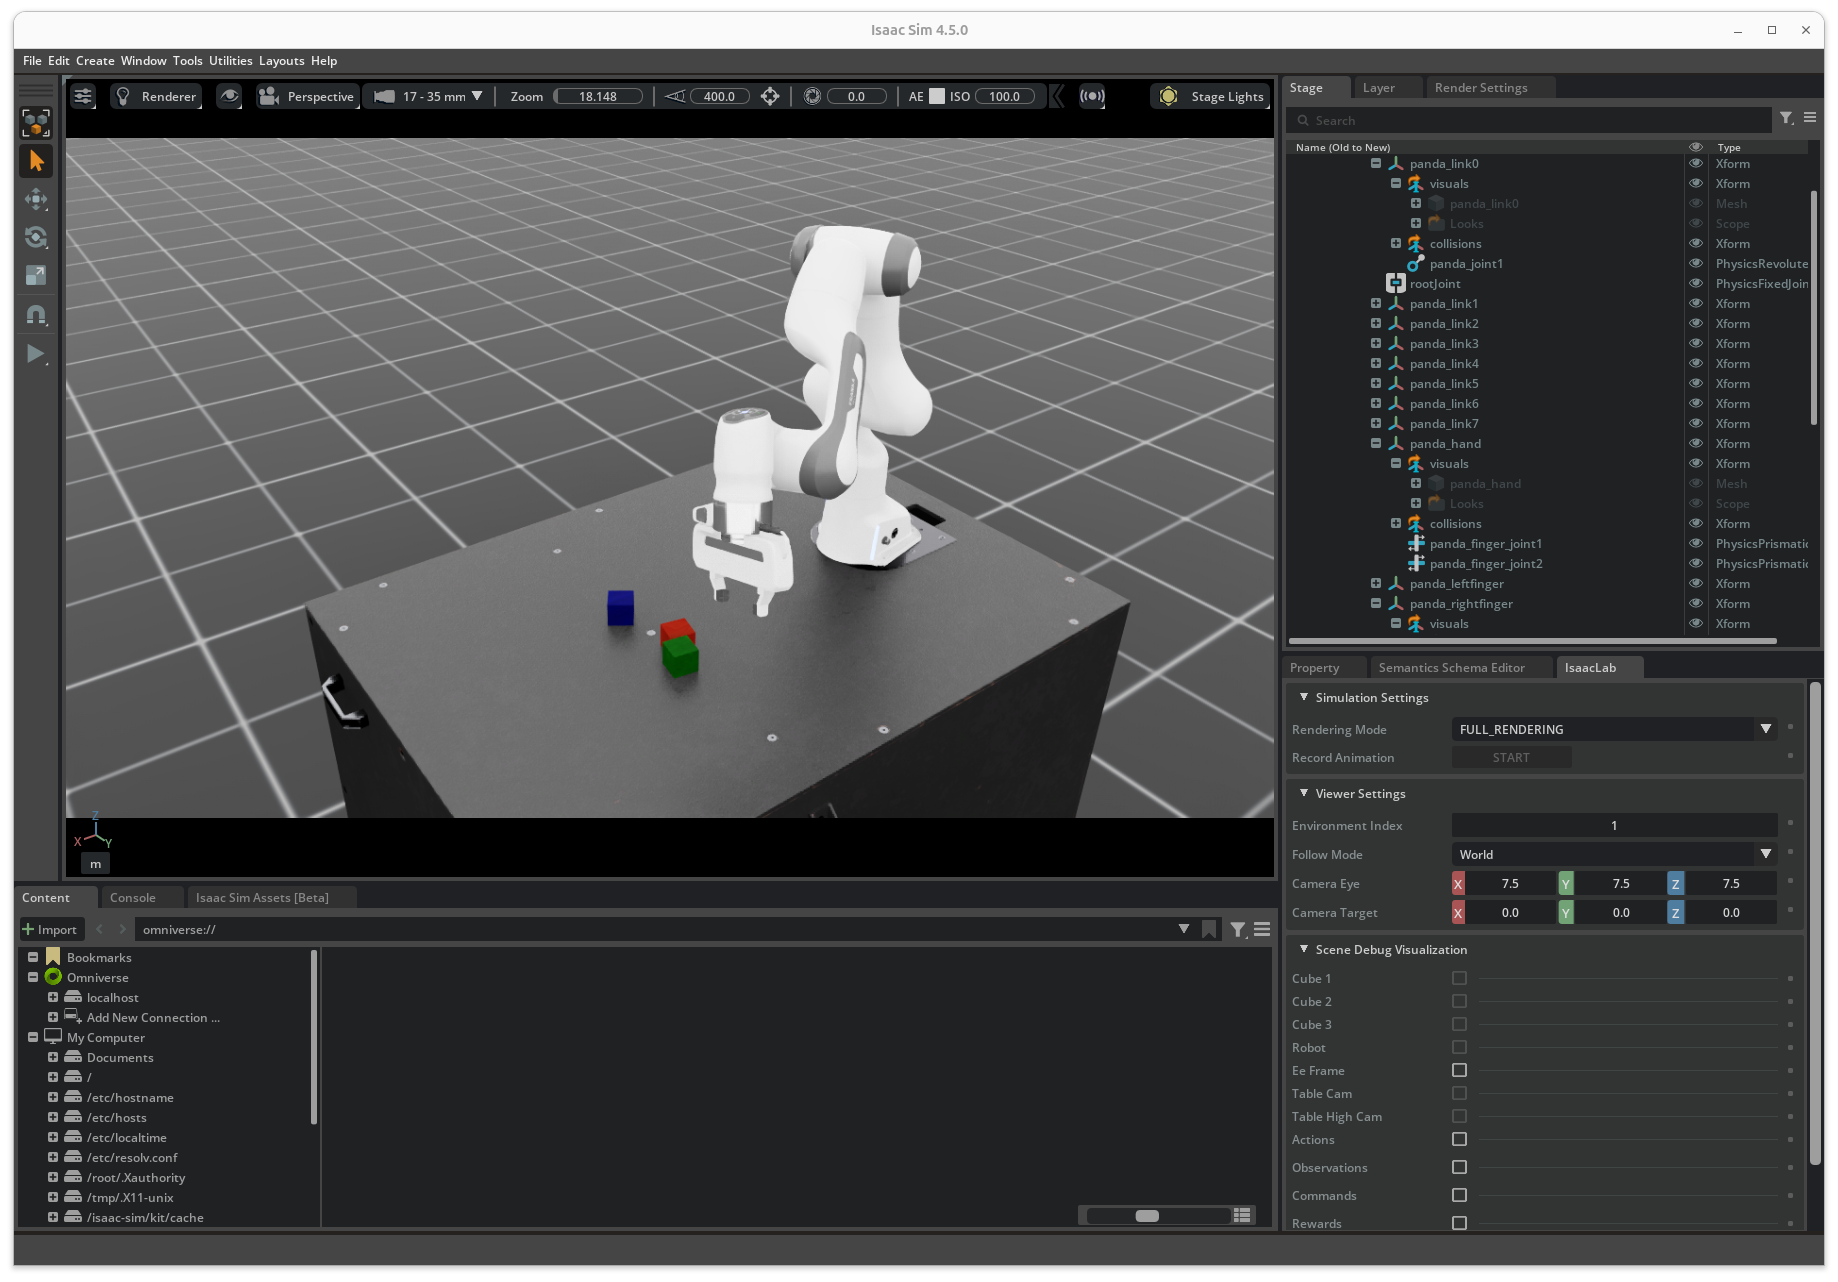
Planul Isaac GR00T abordează această provocare prin valorificarea datelor sintetice generate din simulări precise din punct de vedere fizic pentru a accelera procesul de colectare a datelor. Organizațiile pot colecta exponențial mai multe date din doar câteva ore de demonstrații umane.
Planul Isaac GR00T constă din trei componente cheie care lucrează împreună pentru a crea o conductă cuprinzătoare de generare a datelor sintetice:
- GR00T-Teleop permite operatorilor umani calificați să controleze roboți virtuali folosind dispozitive de calcul spațial precum Apple Vision Pro. Acest sistem permite operatorilor să demonstreze sarcini complexe de manipulare în medii virtuale fotorealiste, captând nu numai traiectoriile de mișcare, ci și contextul ambiental și interacțiunile obiectelor. Apple Vision Pro transmite date de urmărire a mâinilor către Isaac Lab, care transmite simultan o imagine captivantă a mediului robotului înapoi către dispozitiv, permițând un control intuitiv și interactiv al robotului.
- GR00T-Mimic preia demonstrațiile înregistrate și le multiplică în seturi de date sintetice mai mari folosind tehnici avansate de simulare. Această componentă folosește demonstrațiile înregistrate ca date de intrare pentru a genera traiectorii de mișcare sintetice suplimentare în Isaac Lab, suportând atât manipularea roboților umanoizi cu un singur braț, cât și cu cele bimanuale. Procesul implică adnotarea punctelor cheie din demonstrații și utilizarea interpolării pentru a se asigura că traiectoriile sintetice sunt line și adecvate contextual.
- GR00T-Gen Utilizează platformele NVIDIA Omniverse și Cosmos pentru a extinde seturi de date sintetice prin upscaling 3D și randomizare a domeniilor. Această componentă adaugă diversitate suplimentară prin randomizarea fundalului, a iluminării și a altor variabile din scenă. Amplifică imaginile generate prin NVIDIA Cosmos Transfer, obținând un fotorealism care ajută la reducerea decalajului dintre simulare și realitate.
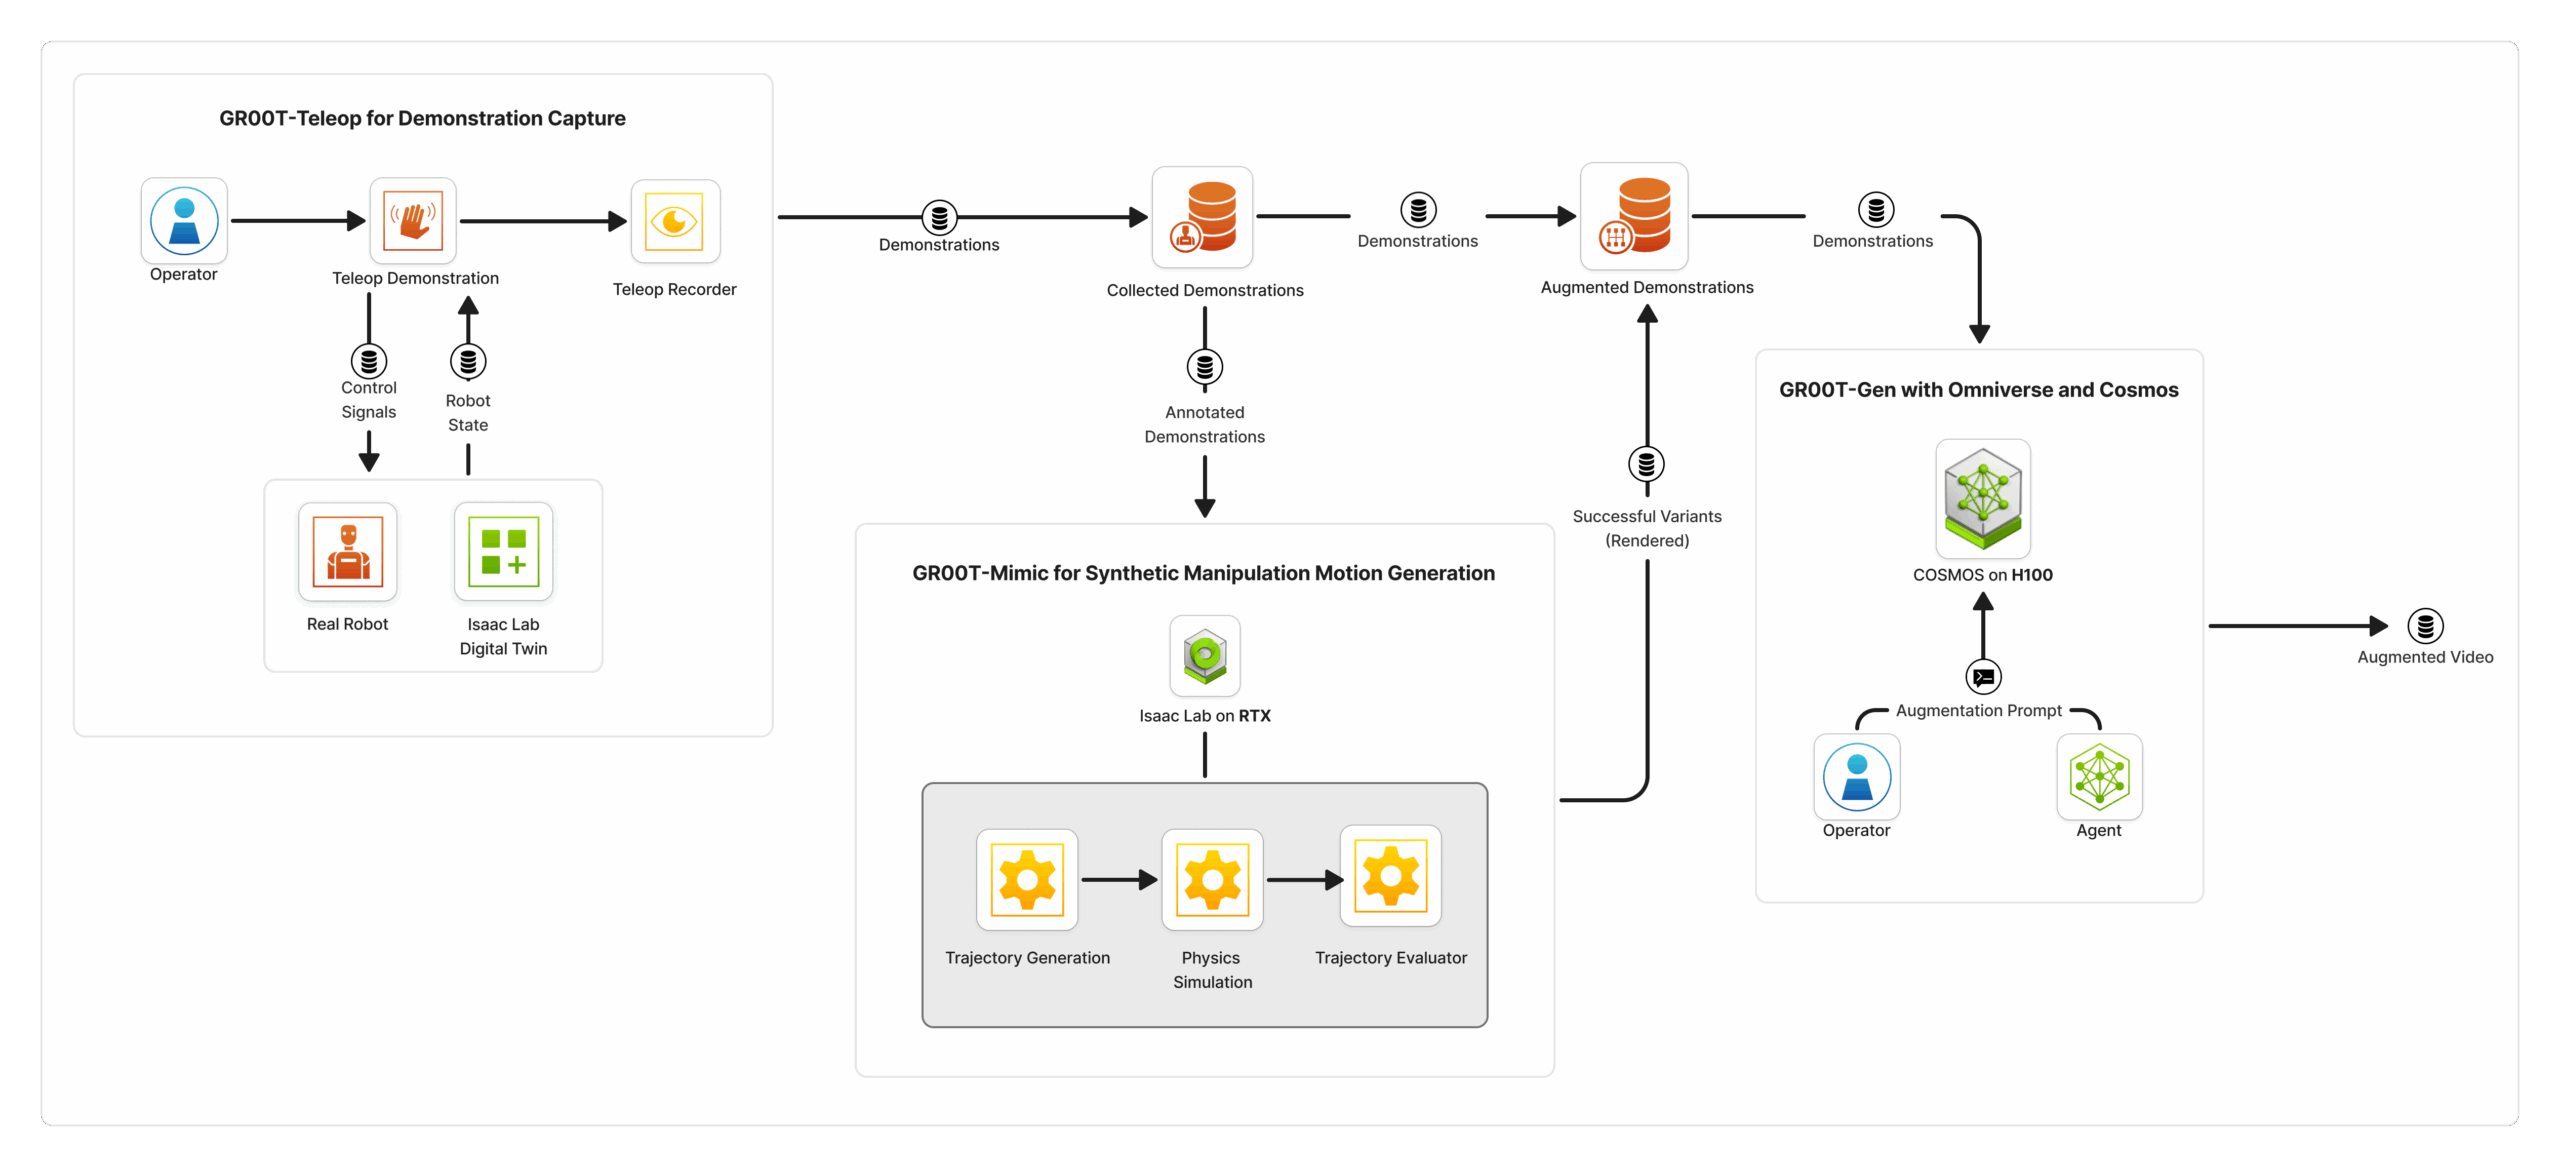
Această pipeline ilustrează perfect rolurile specializate și complementare ale GPU-urilor moderne pentru centrele de date. L40S, cu nucleele sale RT dedicate, servește drept constructor de lumi. Este indispensabil pentru etapele inițiale ale generării de date, unde gestionează randarea fizică, ray tracing-ul în timp real și randomizarea domeniilor necesare pentru a crea un mediu virtual fotorealist și divers.
Această lume virtuală de înaltă fidelitate devine apoi pânza pentru următoarea etapă de generare. Modelele de inteligență artificială generativă, precum cele din NVIDIA Cosmos , sunt rulate pe GPU-uri centrate pe calcul, cum ar fi H100, pentru a produce datele finale de antrenament. H100 valorifică mediul realist creat de L40S pentru a genera milioane de scenarii dinamice, conștiente din punct de vedere fizic.
Benchmark-uri de performanță pentru inferența inteligenței artificiale
Un alt caz de utilizare în care plăcile video precum L40S sunt populare este cel pentru inferențe eficiente din punct de vedere al costurilor. Pentru a evalua capacitățile de inferență AI în lumea reală ale L40S în comparație cu H100, am comparat performanța LLM folosind vLLM care rulează modelul de parametri Open Reasoning Nemotron 14B de la Nvidia la BF16 cu o lungime maximă a token-ului de 32K.
Rezultate Benchmark vLLM
H100 demonstrează o performanță clară, oferind un randament de aproximativ 4.2 ori mai mare decât L40S. Acest avantaj provine direct din performanța dublă a Tensor Core a modelului H100 și din lățimea de bandă a memoriei mai mult decât dublată (2 TB/s față de 864 GB/s).
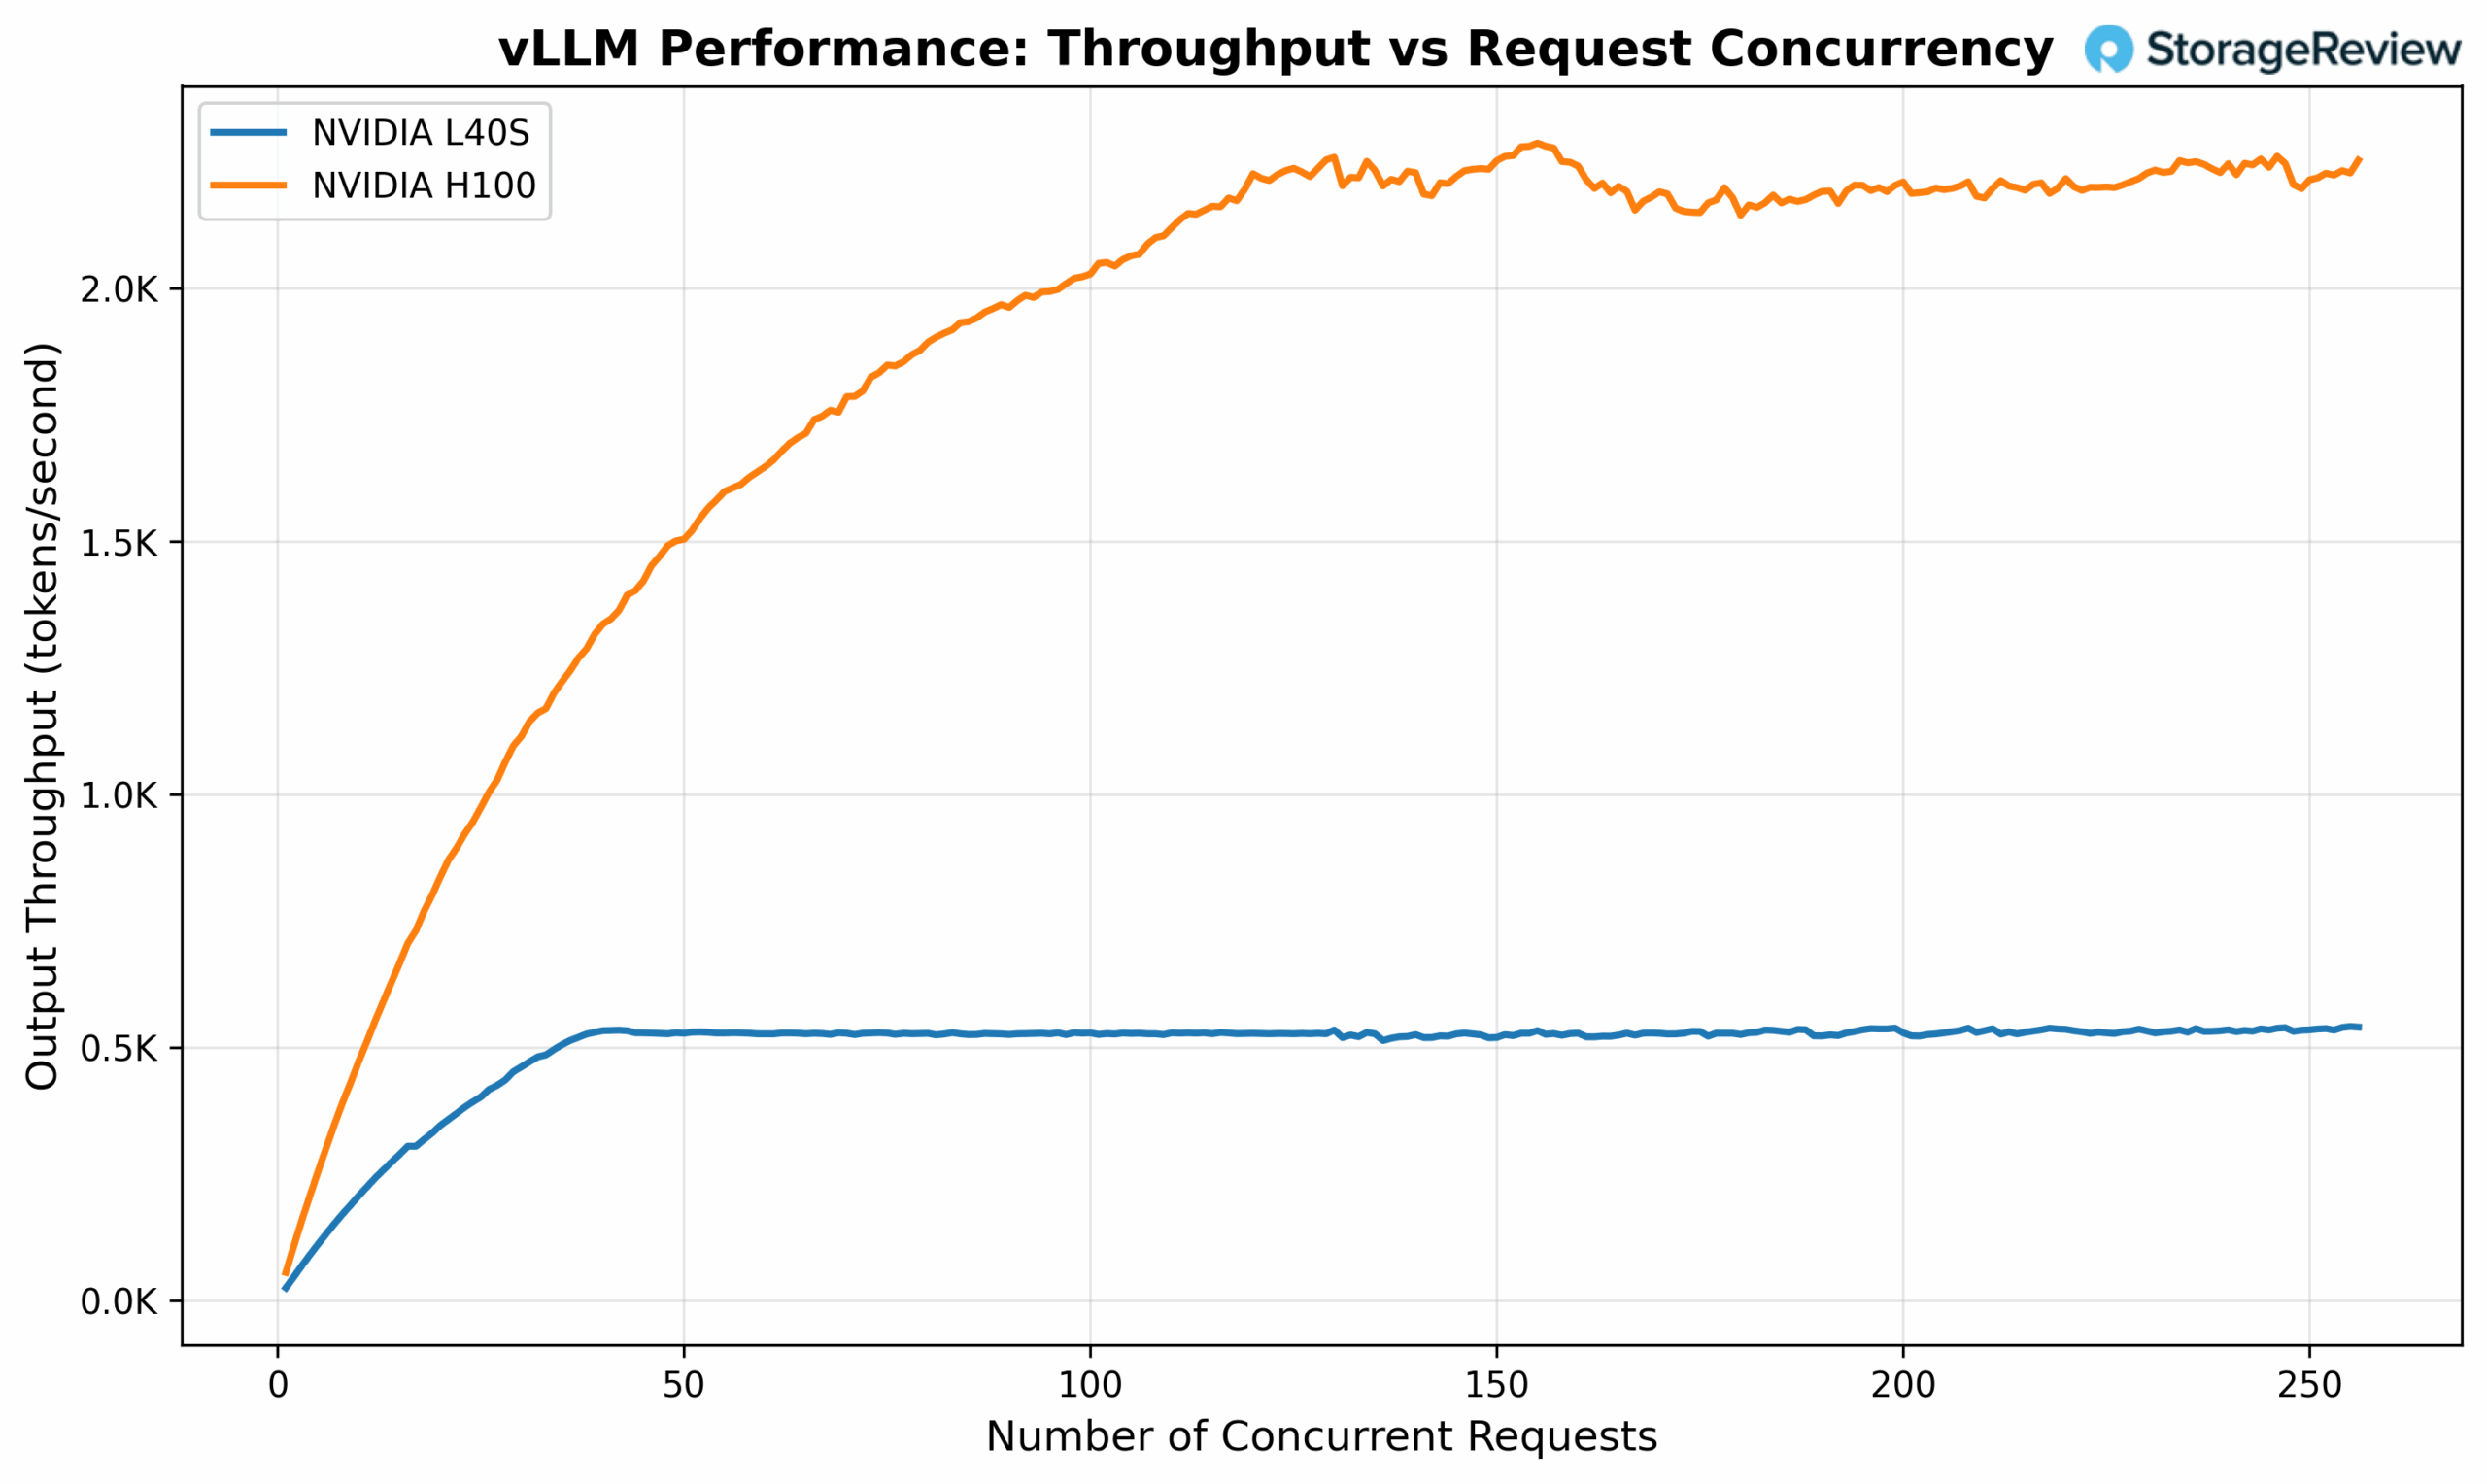
Totuși, performanța per dolar spune o poveste diferită. L40S costă de obicei mai puțin de o treime din prețul unui H100, ceea ce îl face mai rentabil pentru multe sarcini de lucru cu inferență. Organizațiile care rulează servicii de inferență unde performanța maximă absolută nu este critică constată adesea că L40S oferă un cost total de proprietate mai bun.
Dacă dăm dublu clic pe secțiunea cu performanță liniară, observăm că L40S oferă un nivel foarte acceptabil de performanță, fiind capabil să deservească 16 cereri simultane cu un SLO TPOT (Time Per Output Token - Timp Per Jeton de Ieșire).
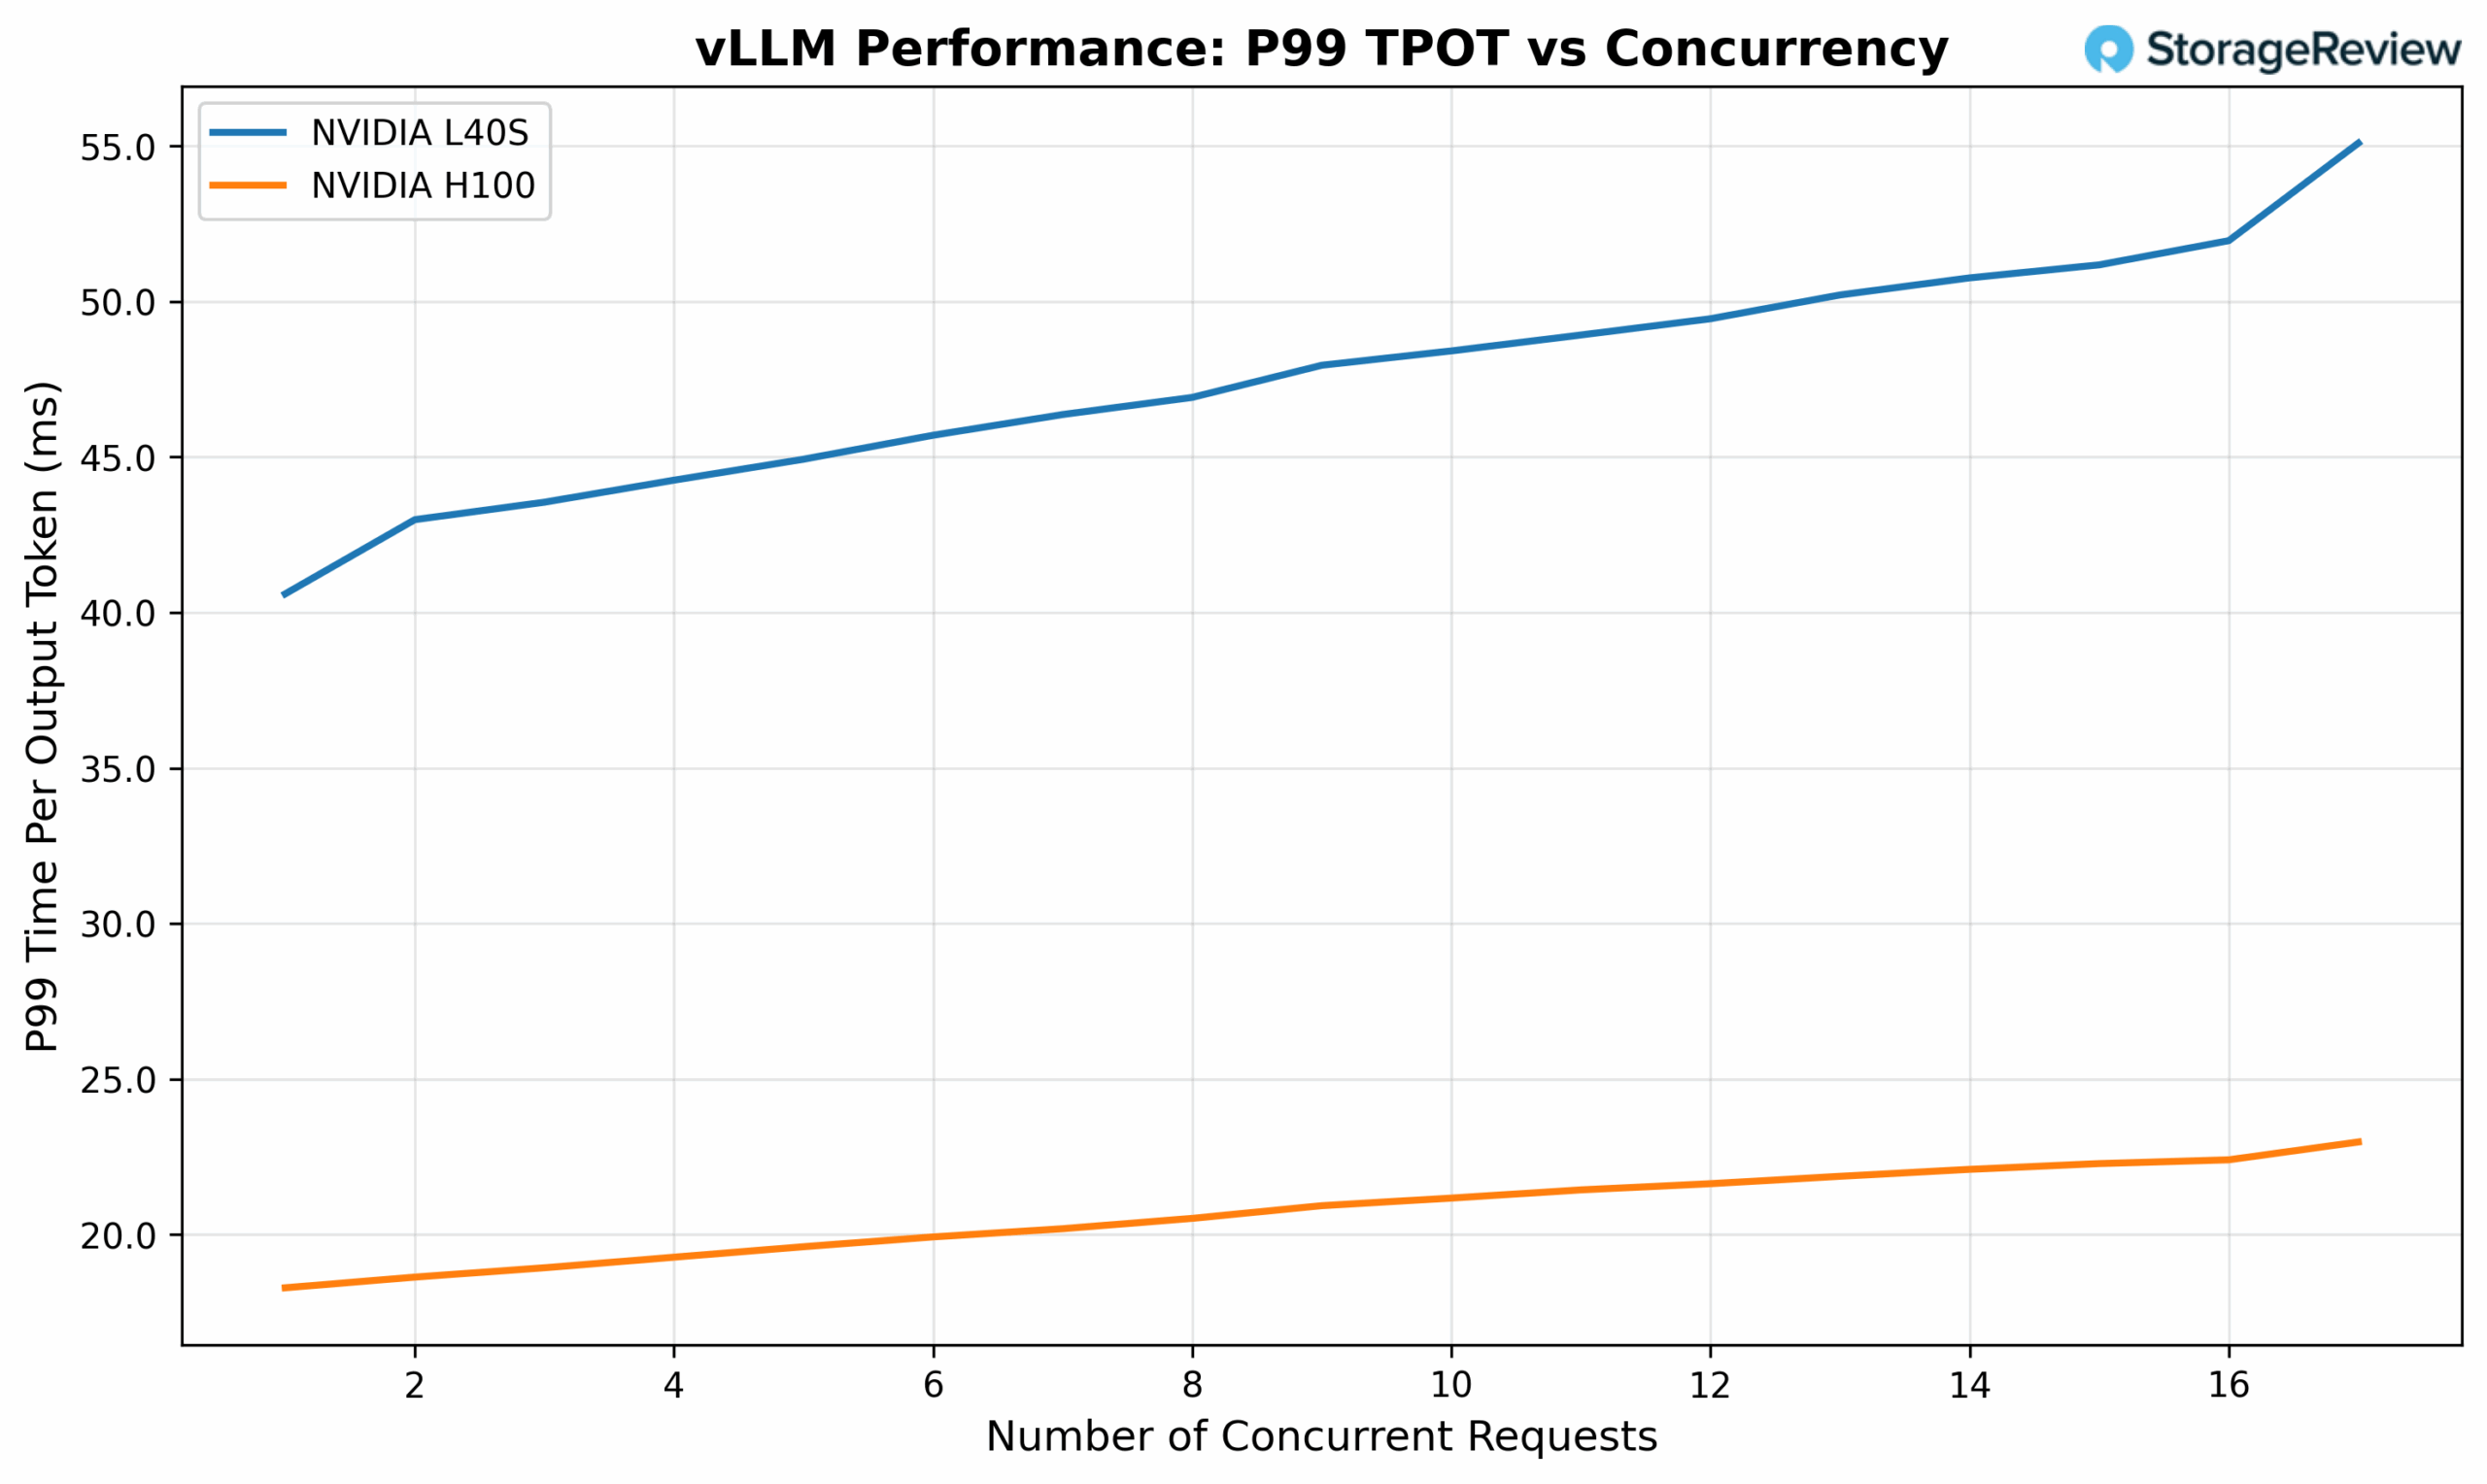
Un factor important de reținut este faptul că inferența prin inteligență artificială, în special faza de decodare a generării de text, este fundamental o operațiune care necesită o lățime de bandă mare a memoriei. În timpul inferenței, modelul trebuie să acceseze în mod repetat ponderile stocate în memoria GPU pentru a genera fiecare token nou, ceea ce face ca debitul memoriei să fie un blocaj critic al performanței. Această caracteristică explică de ce H100, cu lățimea de bandă superioară a memoriei și performanța îmbunătățită a Tensor Core, atinge în mod natural un debit de inferență mai mare.
Totuși, pentru scenariile de implementare care necesită atât inferență AI, cât și accelerare grafică, cum ar fi randarea în timp real cu efecte îmbunătățite de AI, aplicații interactive cu funcții bazate pe AI, L40S devine singura opțiune viabilă.
Concluzie
NVIDIA L40S și cei mai recenti succesori ai Blackwell RTX Pro 6000 apar ca un GPU poziționat strategic, care răspunde cerințelor în continuă evoluție ale centrelor de date moderne, unde calculul bazat pe inteligență artificială și capacitățile grafice avansate converg din ce în ce mai mult. În timp ce clasele de GPU-uri H100 și B200 rămân liderii incontestabili pentru antrenamentul pur al inteligenței artificiale și sarcinile de lucru inferențiale, L40S își conturează o nișă distinctă și valoroasă ca GPU universală, care reduce decalajul dintre plăcile AI axate pe calcul și soluțiile tradiționale de vizualizare profesională.
Propunerea de valoare unică a modelului L40S devine cel mai evidentă în scenariile care necesită atât capacități de inferență AI, cât și accelerare grafică. Cele 142 de nuclee RT de a treia generație permit aplicații care sunt pur și simplu imposibile pe GPU-uri doar de calcul, precum H100, de la ray tracing în timp real în fluxuri de lucru profesionale până la generarea de date sintetice fotorealiste pentru antrenamentul AI de generație următoare. Această dublă capacitate îl face indispensabil pentru aplicațiile emergente în dezvoltarea gemenilor digitali, antrenamentul AI bazat pe fizică și ecosistemul Omniverse în creștere.
Dintr-o perspectivă economică, L40S oferă o valoare convingătoare pentru organizațiile care nu necesită performanța de vârf a inteligenței artificiale a modelului H100. Cu aproximativ o treime din costul unui H100, L40S oferă performanțe de inferență respectabile, oferind în același timp capabilități grafice care adaugă o versatilitate extraordinară implementărilor în centrele de date. Pentru multe organizații, această combinație de rentabilitate și versatilitate face din L40S o alegere mai practică decât investiția în soluții separate de inteligență artificială și grafică.

Clasament: L40S deține premiul pentru cea mai bună GPU cu inferență mainstream, încă disponibilă, în clasamentul nostru pentru cele mai bune GPU-uri Enterprise , clasat pe baza rezultatelor noastre de servire vLLM.


 Amazon