

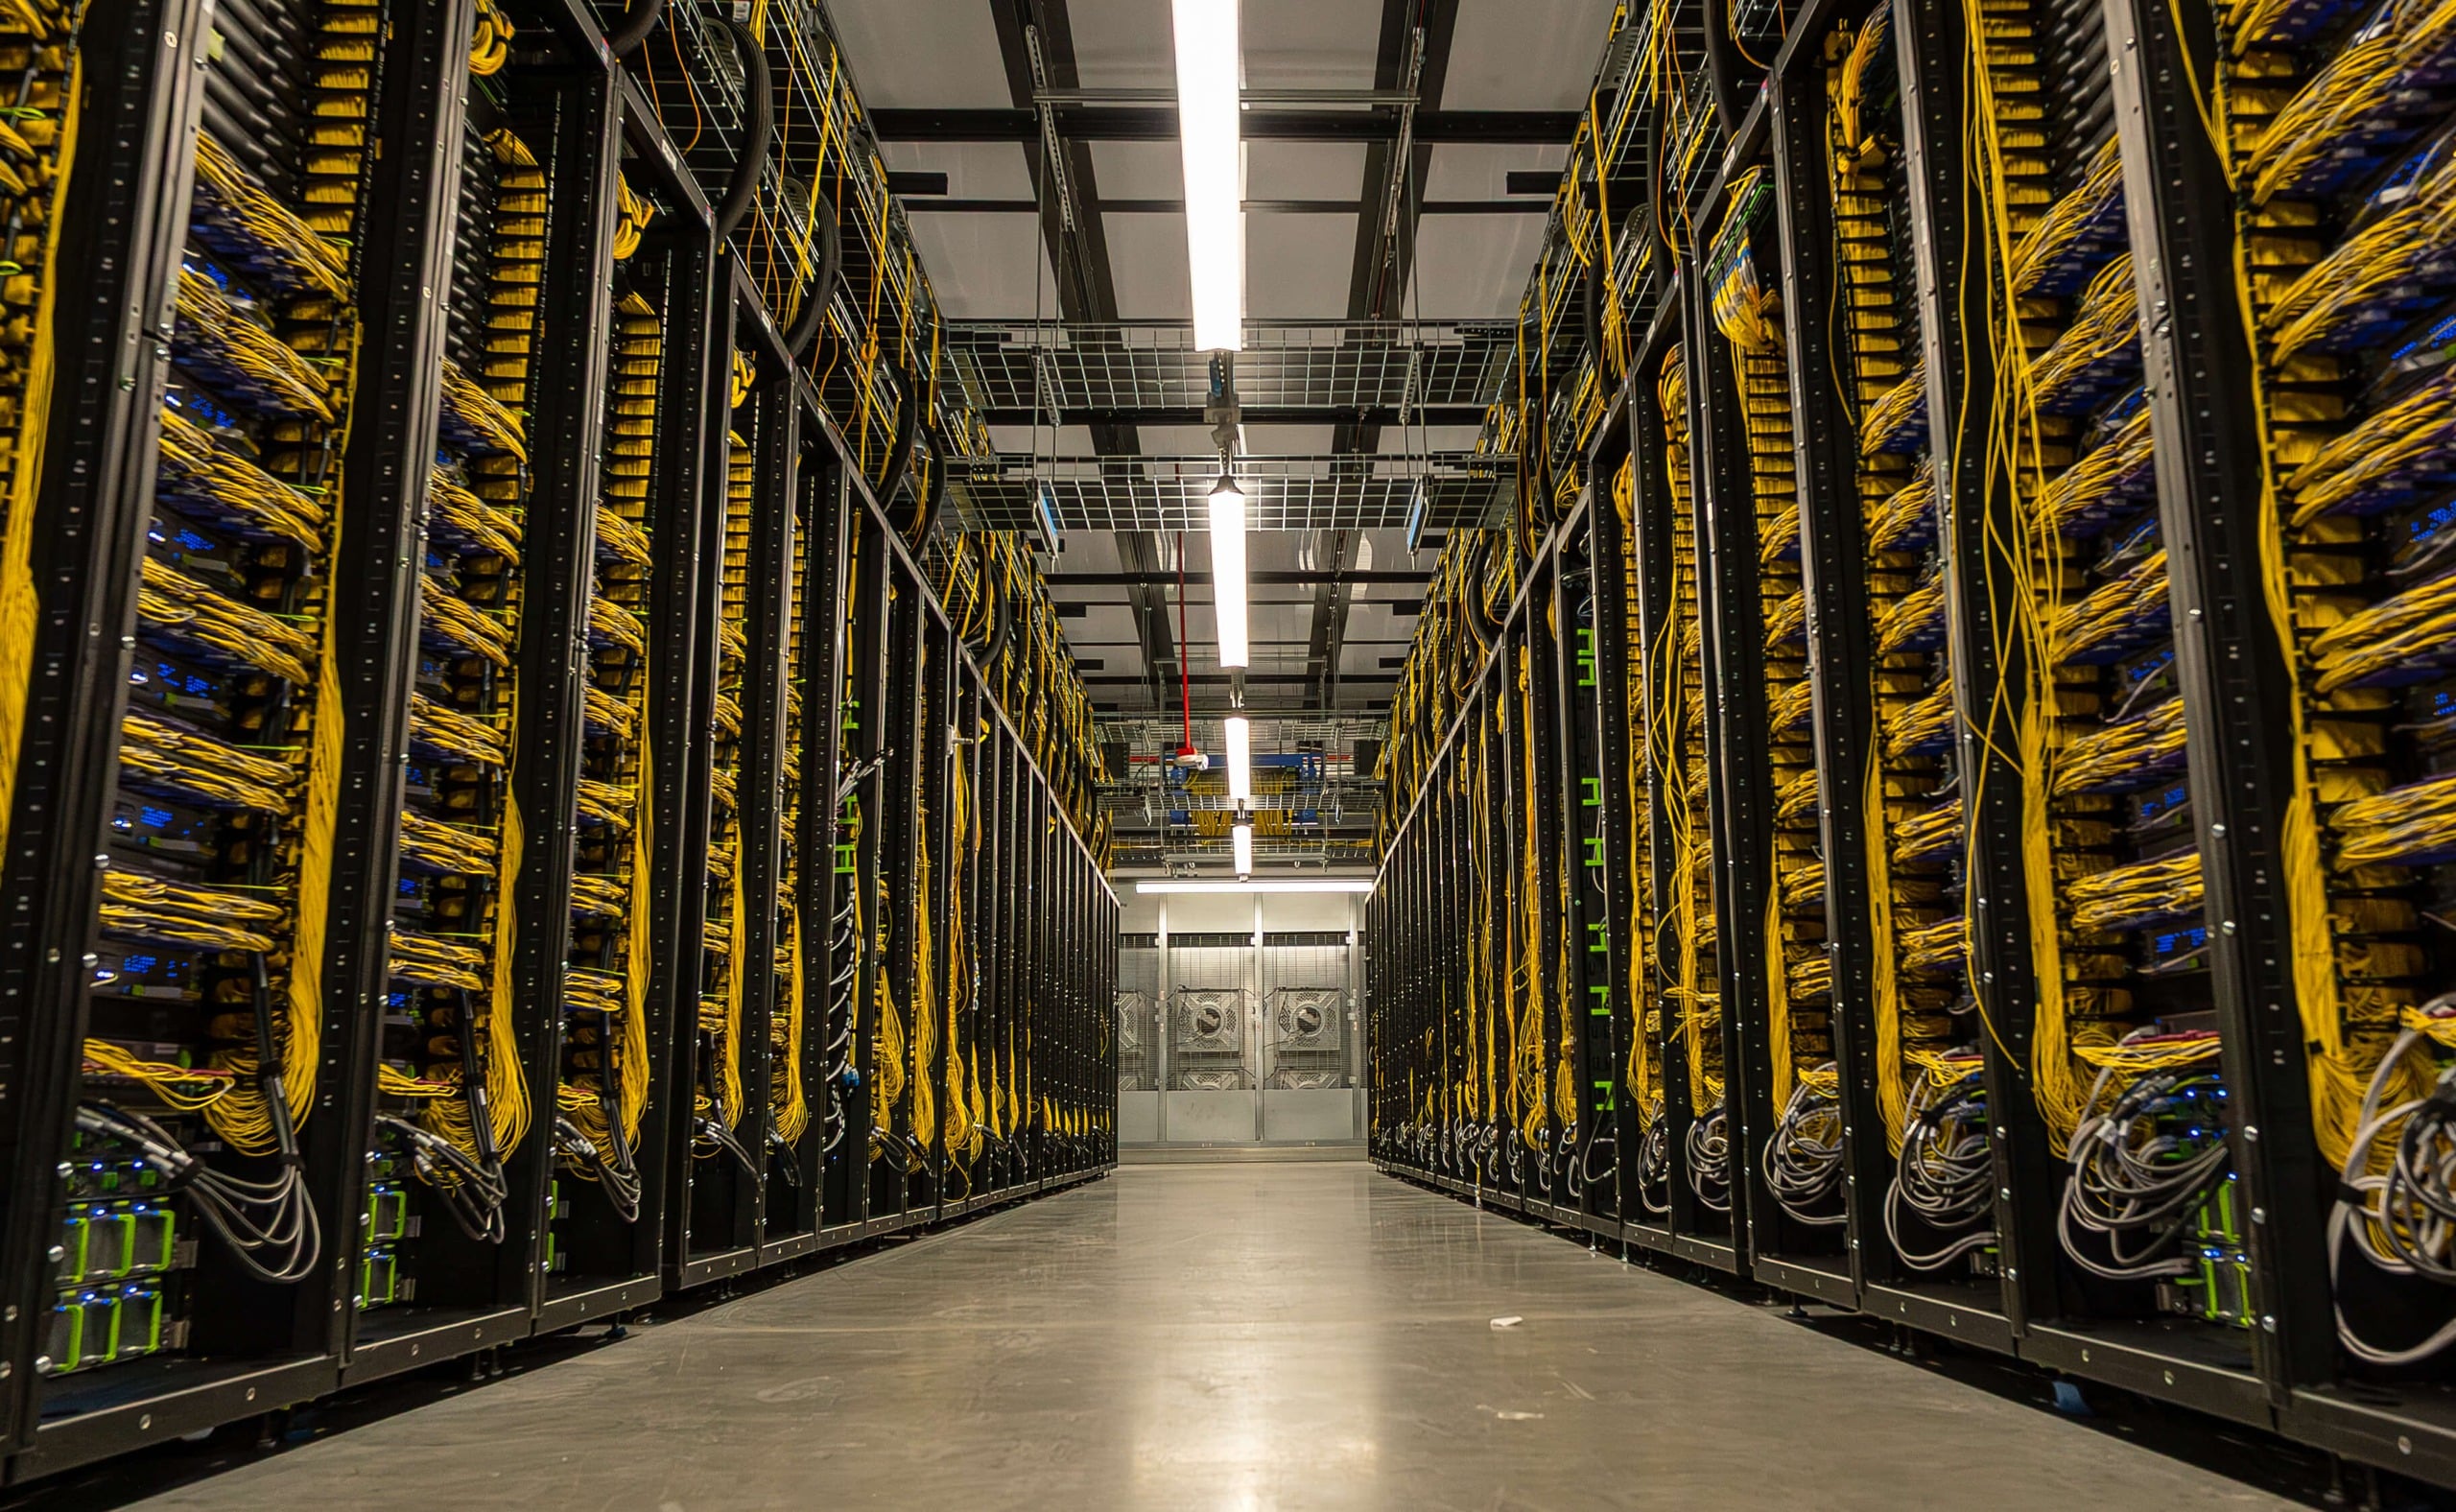
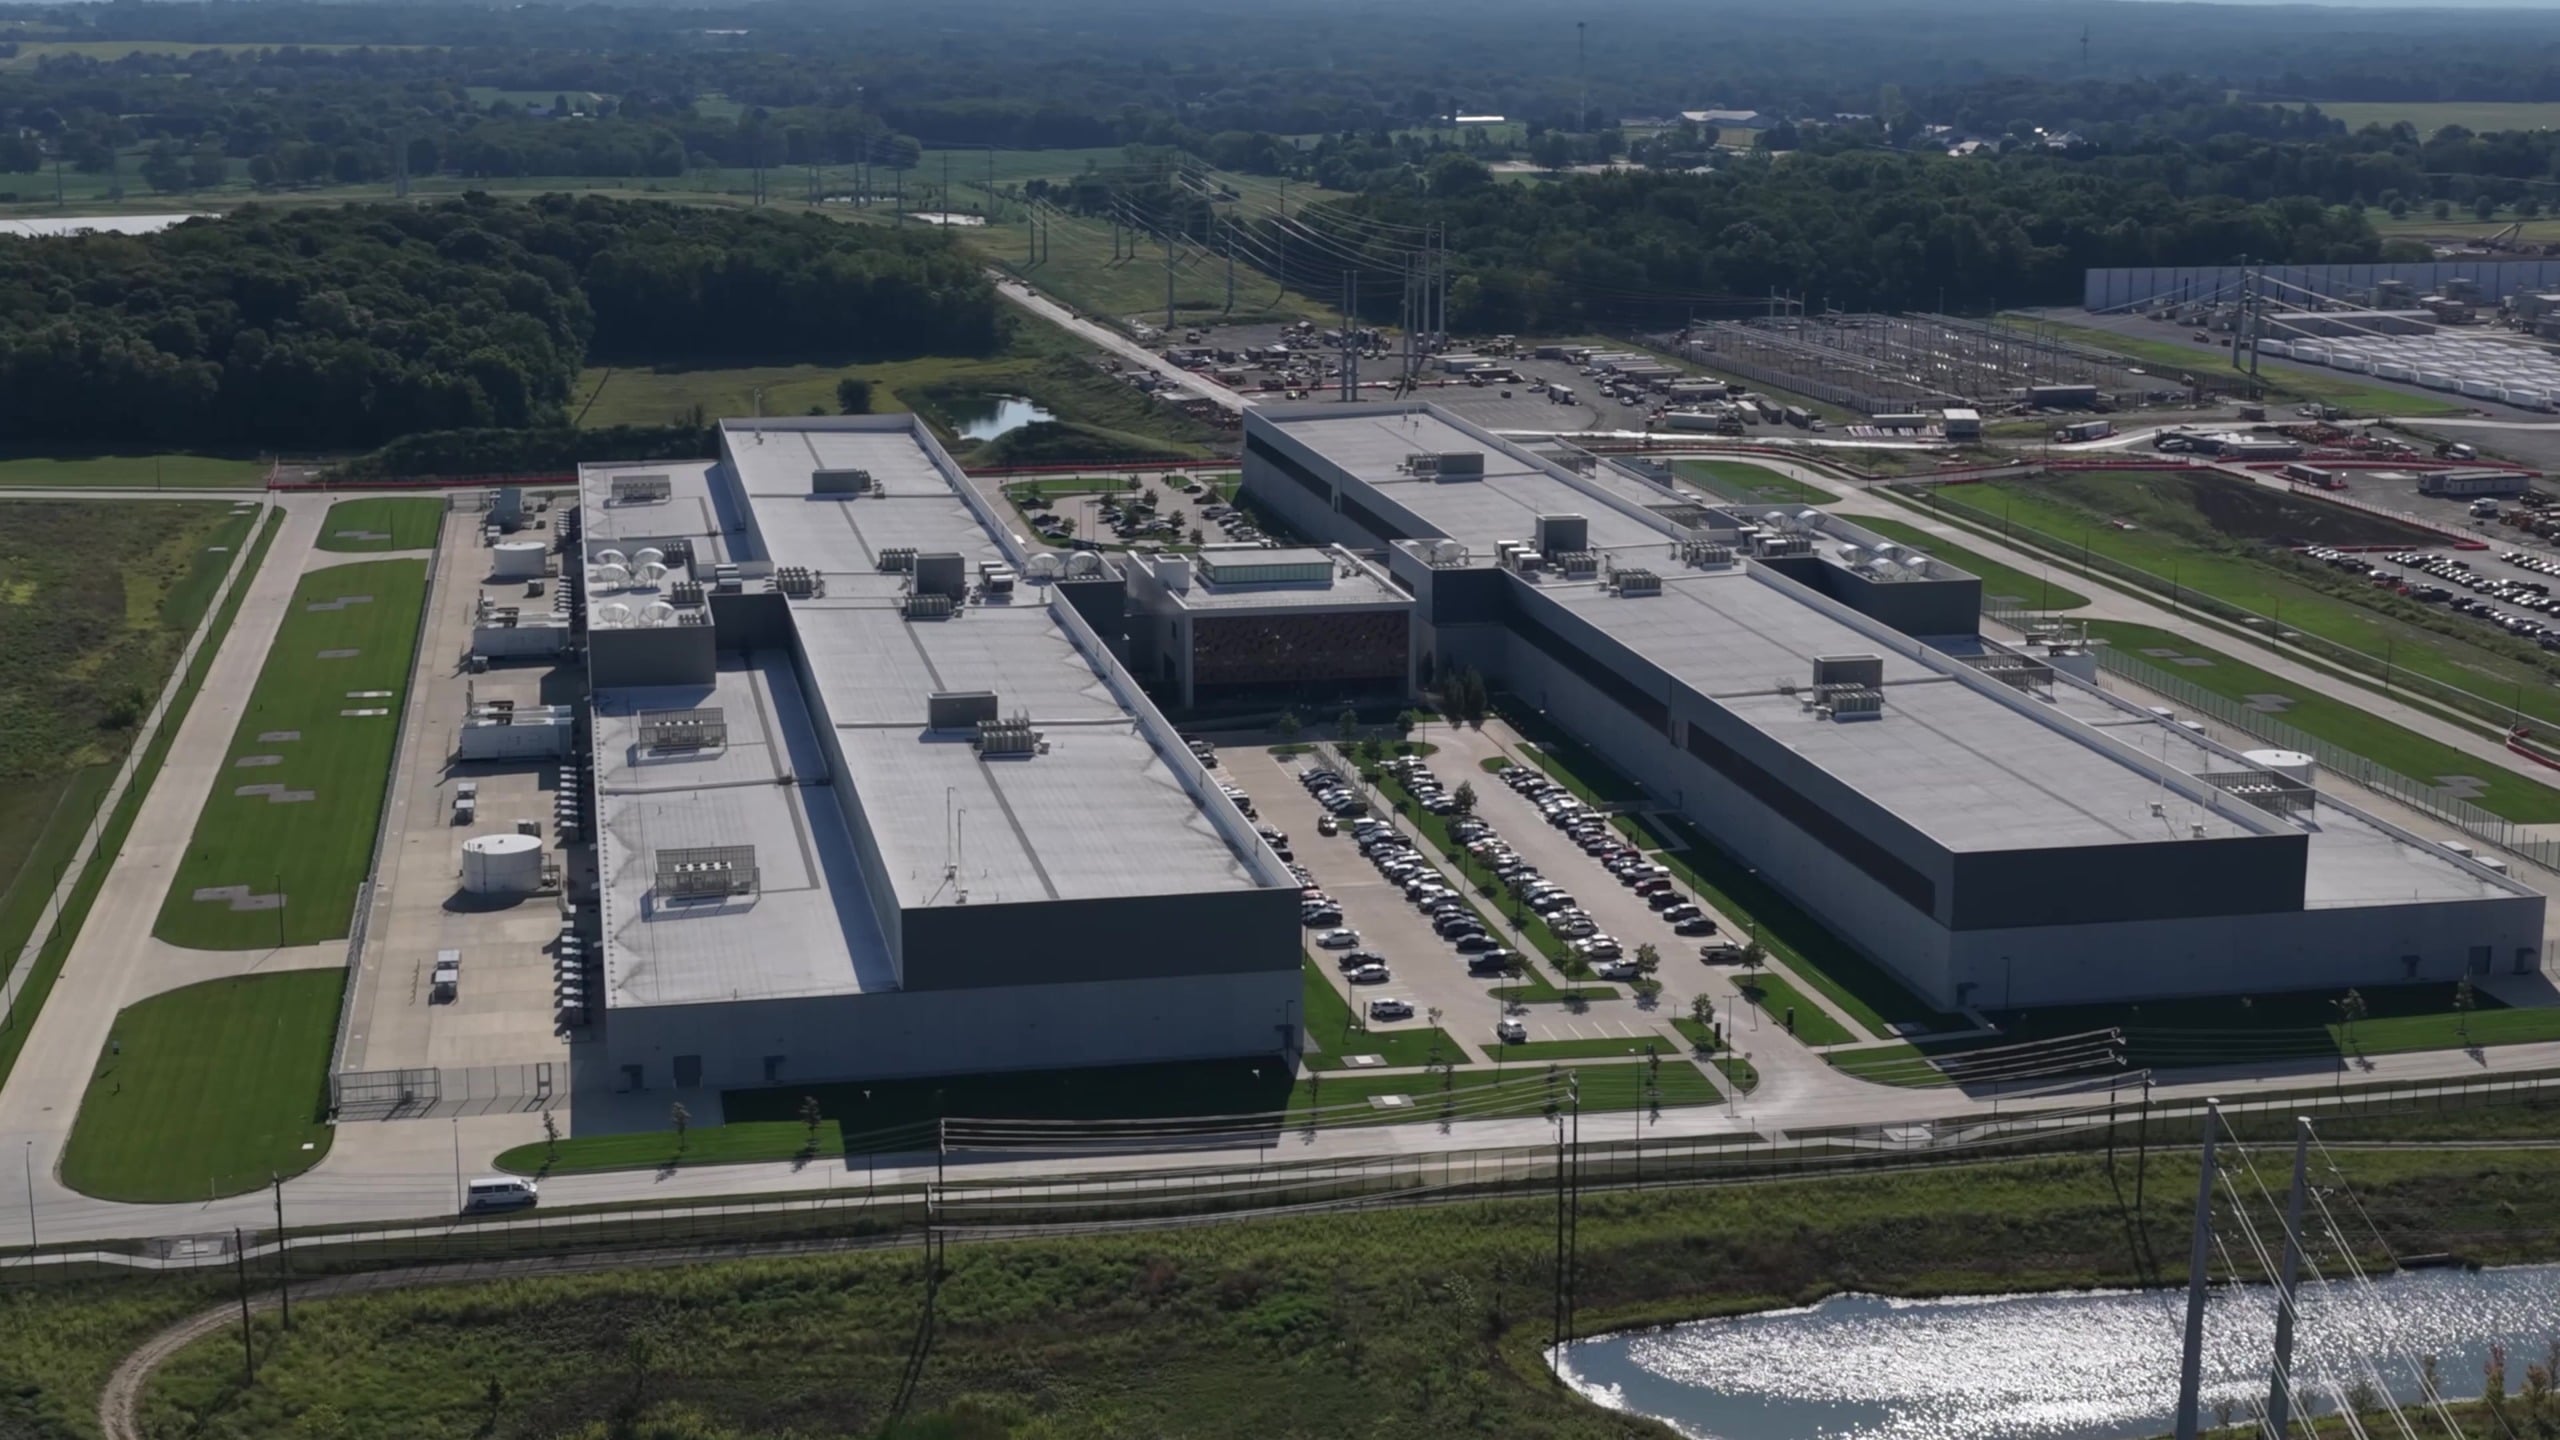
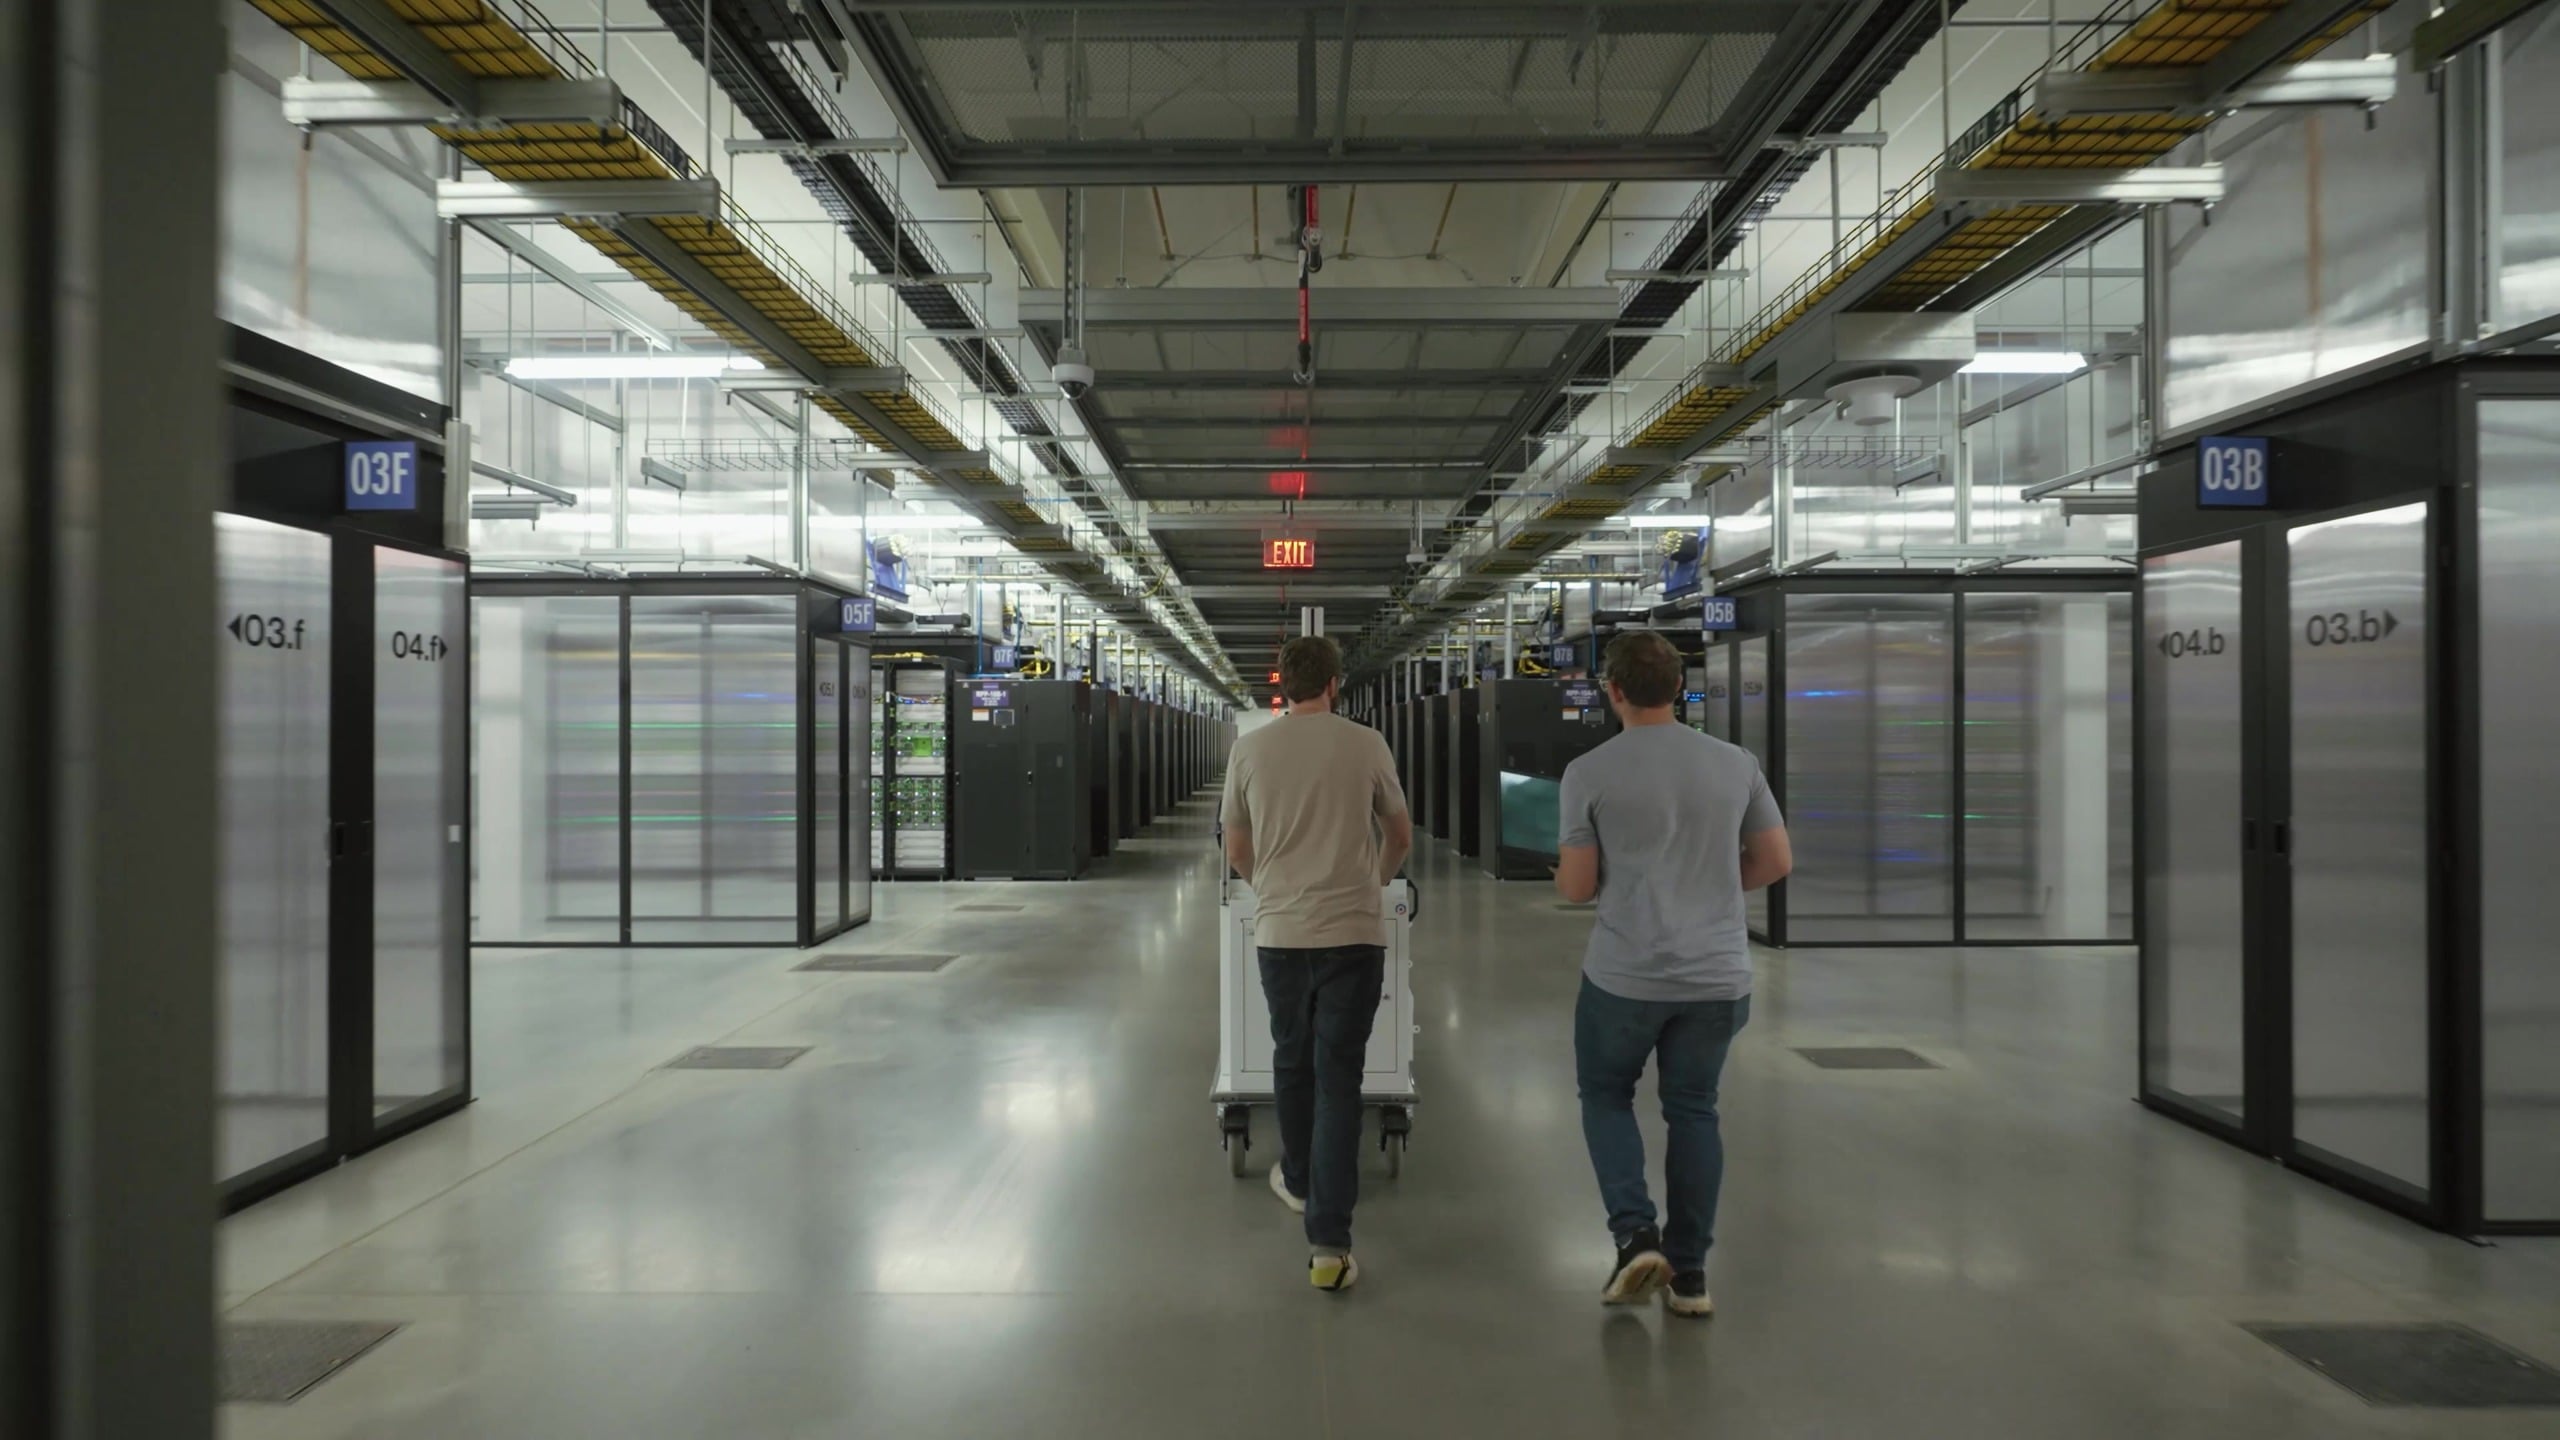
Сегодня компания Meta опубликовала подробный обзор Prometheus — суперкластера искусственного интеллекта гигаваттного масштаба, который она строит в Нью-Олбани, штат Огайо. Первый этап завершен, и на нем обучены базовые модели семейства Muse, включая модели Muse Wonder. Meta заявляет, что масштабирование площадки планируется до примерно 1 миллиона графических процессоров. Два года назад на этом же кампусе располагался обычный центр обработки данных, обслуживающий веб-трафик. В публикации инженеров Meta Кевина Ли, Яшара Баяни, Ахмеда Шарифа и Йи Цзюнь Сонга рассматриваются аппаратное обеспечение, сеть и работа по обеспечению надежности, которая поддерживает работу задач обучения.
Компания Meta также раскрыла некоторые из наиболее интересных данных, касающихся выполнения больших задач обучения: показатели надежности. Meta сообщает о более чем 85% успешности при предварительном обучении с использованием Muse Wonder и более чем 90% при обучении с подкреплением, при этом среднее время между прерываниями составляет около 47 000 часов работы графического процессора. Последующие обновления прошивки позволили увеличить среднее время между прерываниями до более чем 54 000 часов работы графического процессора. Заявленная цель Meta — два прерывания на каждые 8,000 графических процессоров в день, что составляет примерно 100 000 часов работы графического процессора между прерываниями.
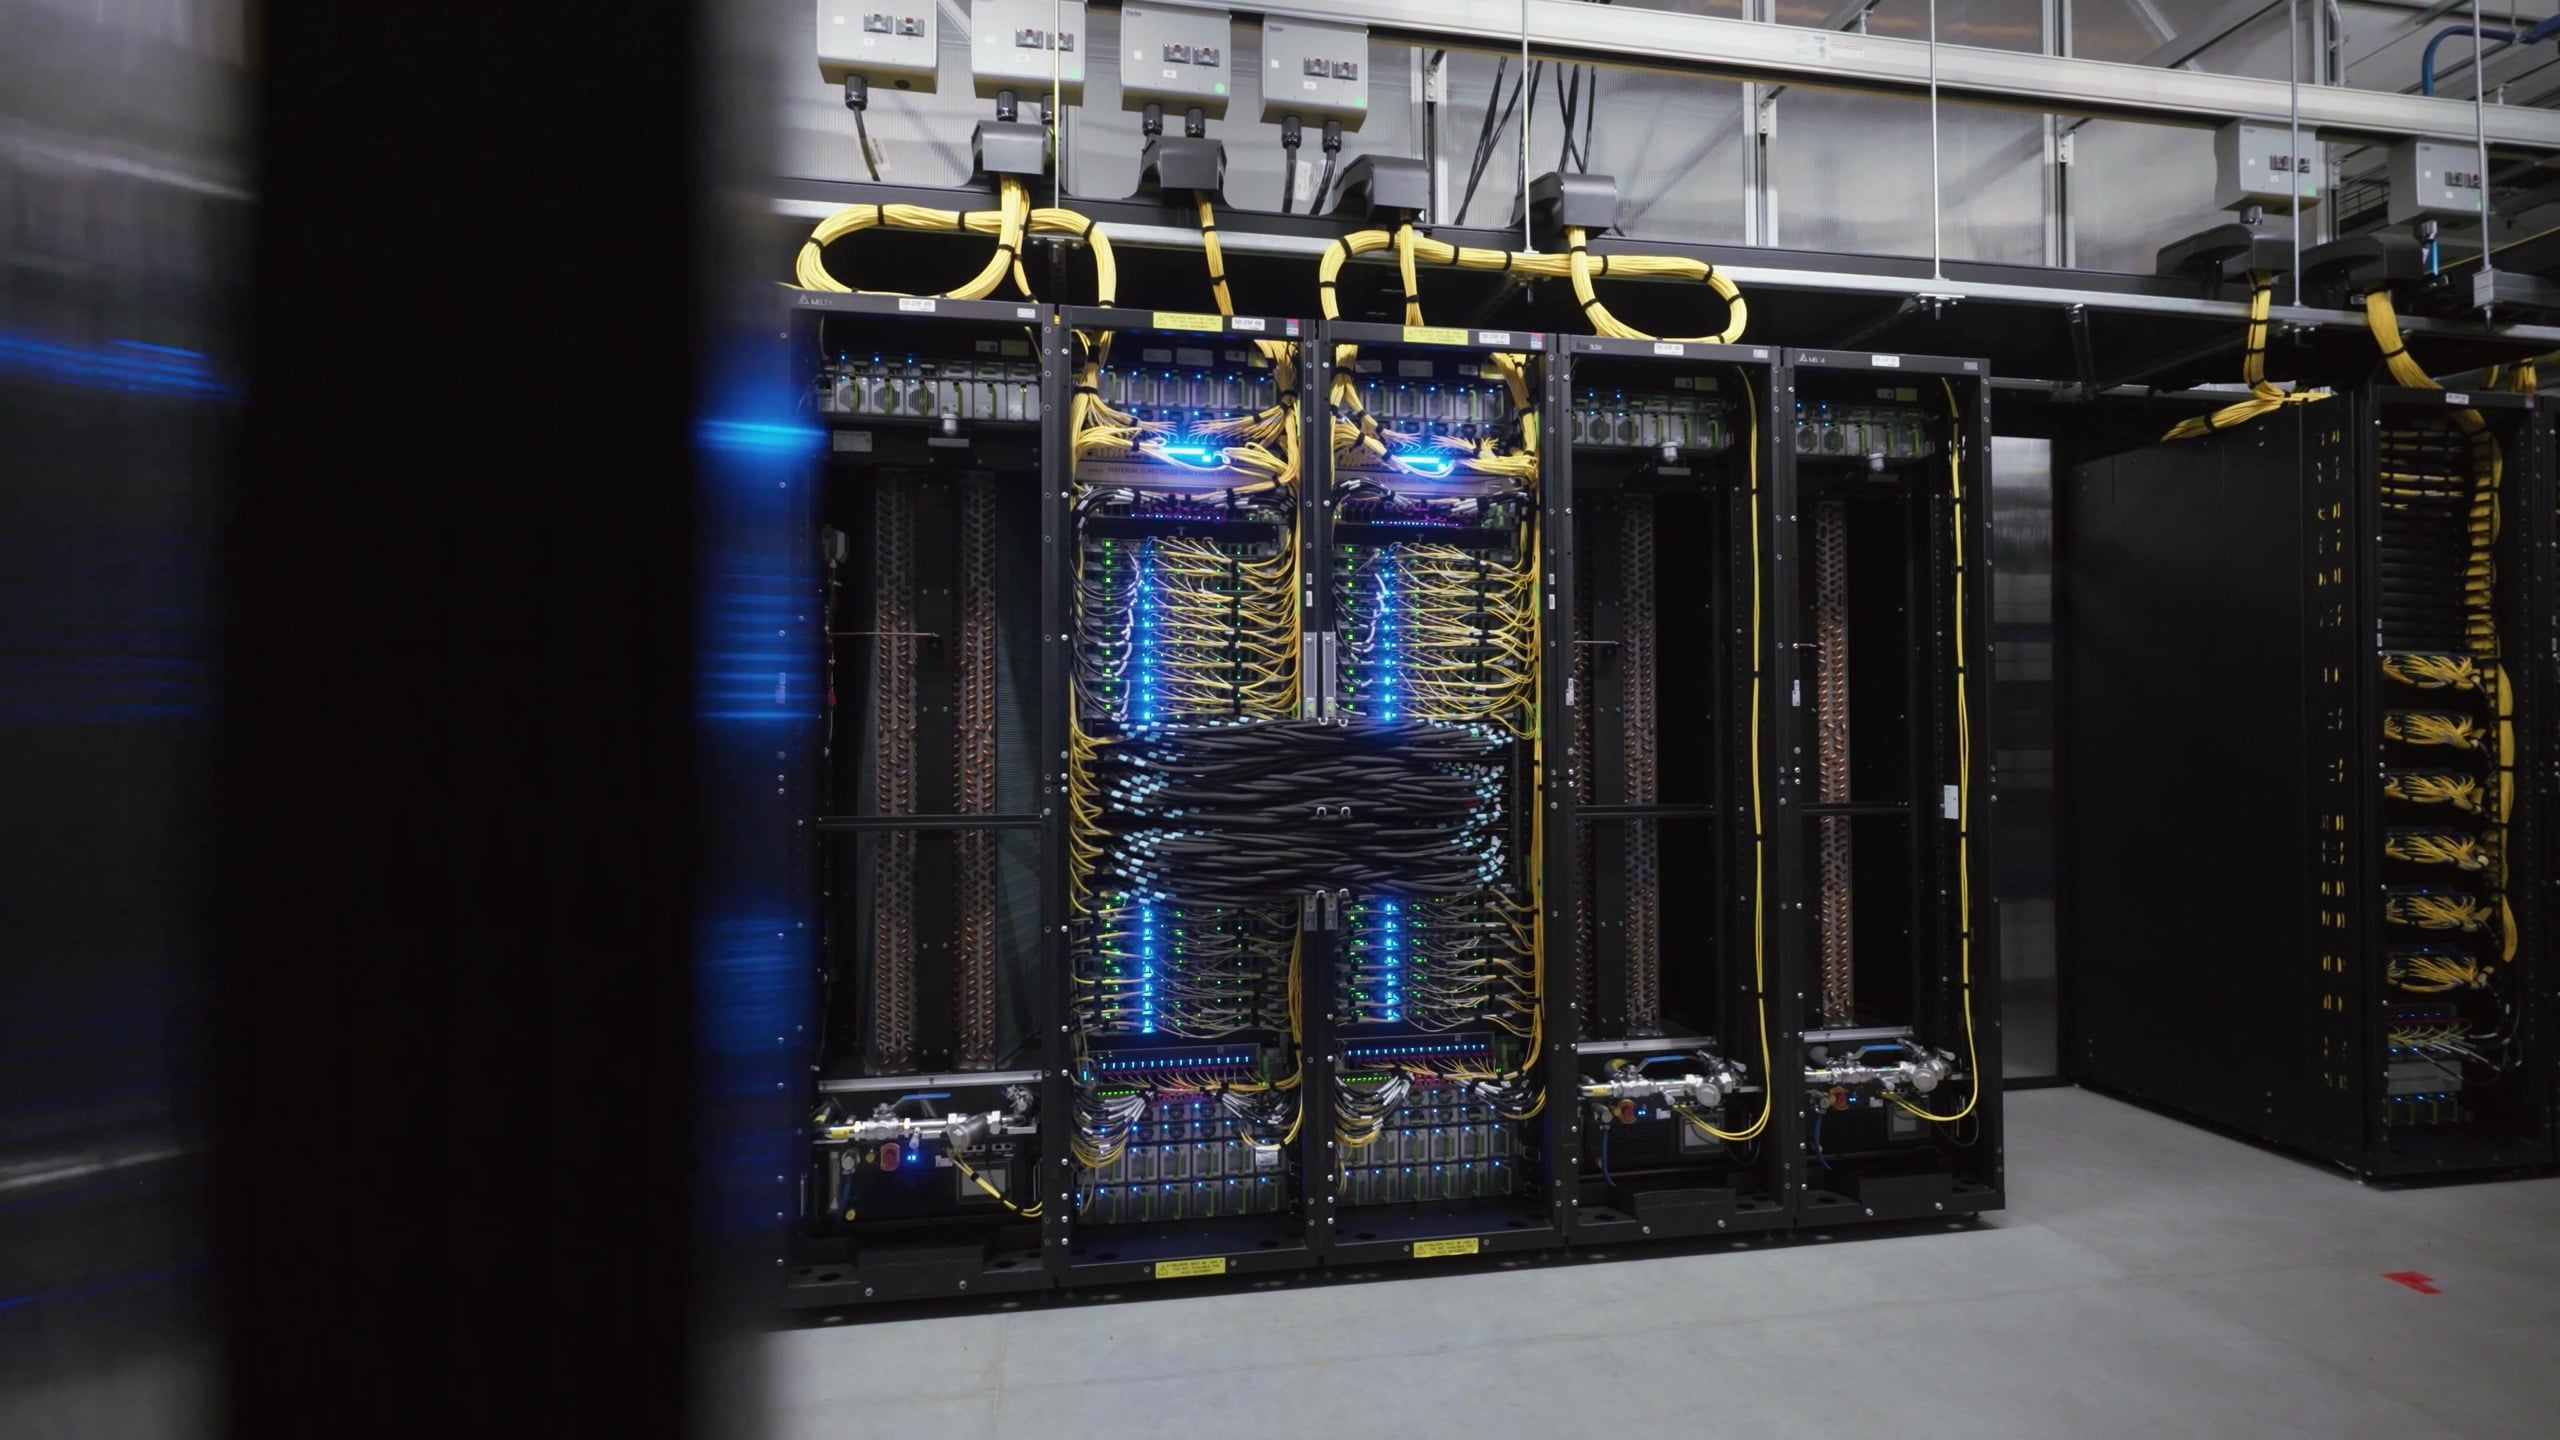
В производстве находятся два поколения NVL72, Vera Rubin Next.
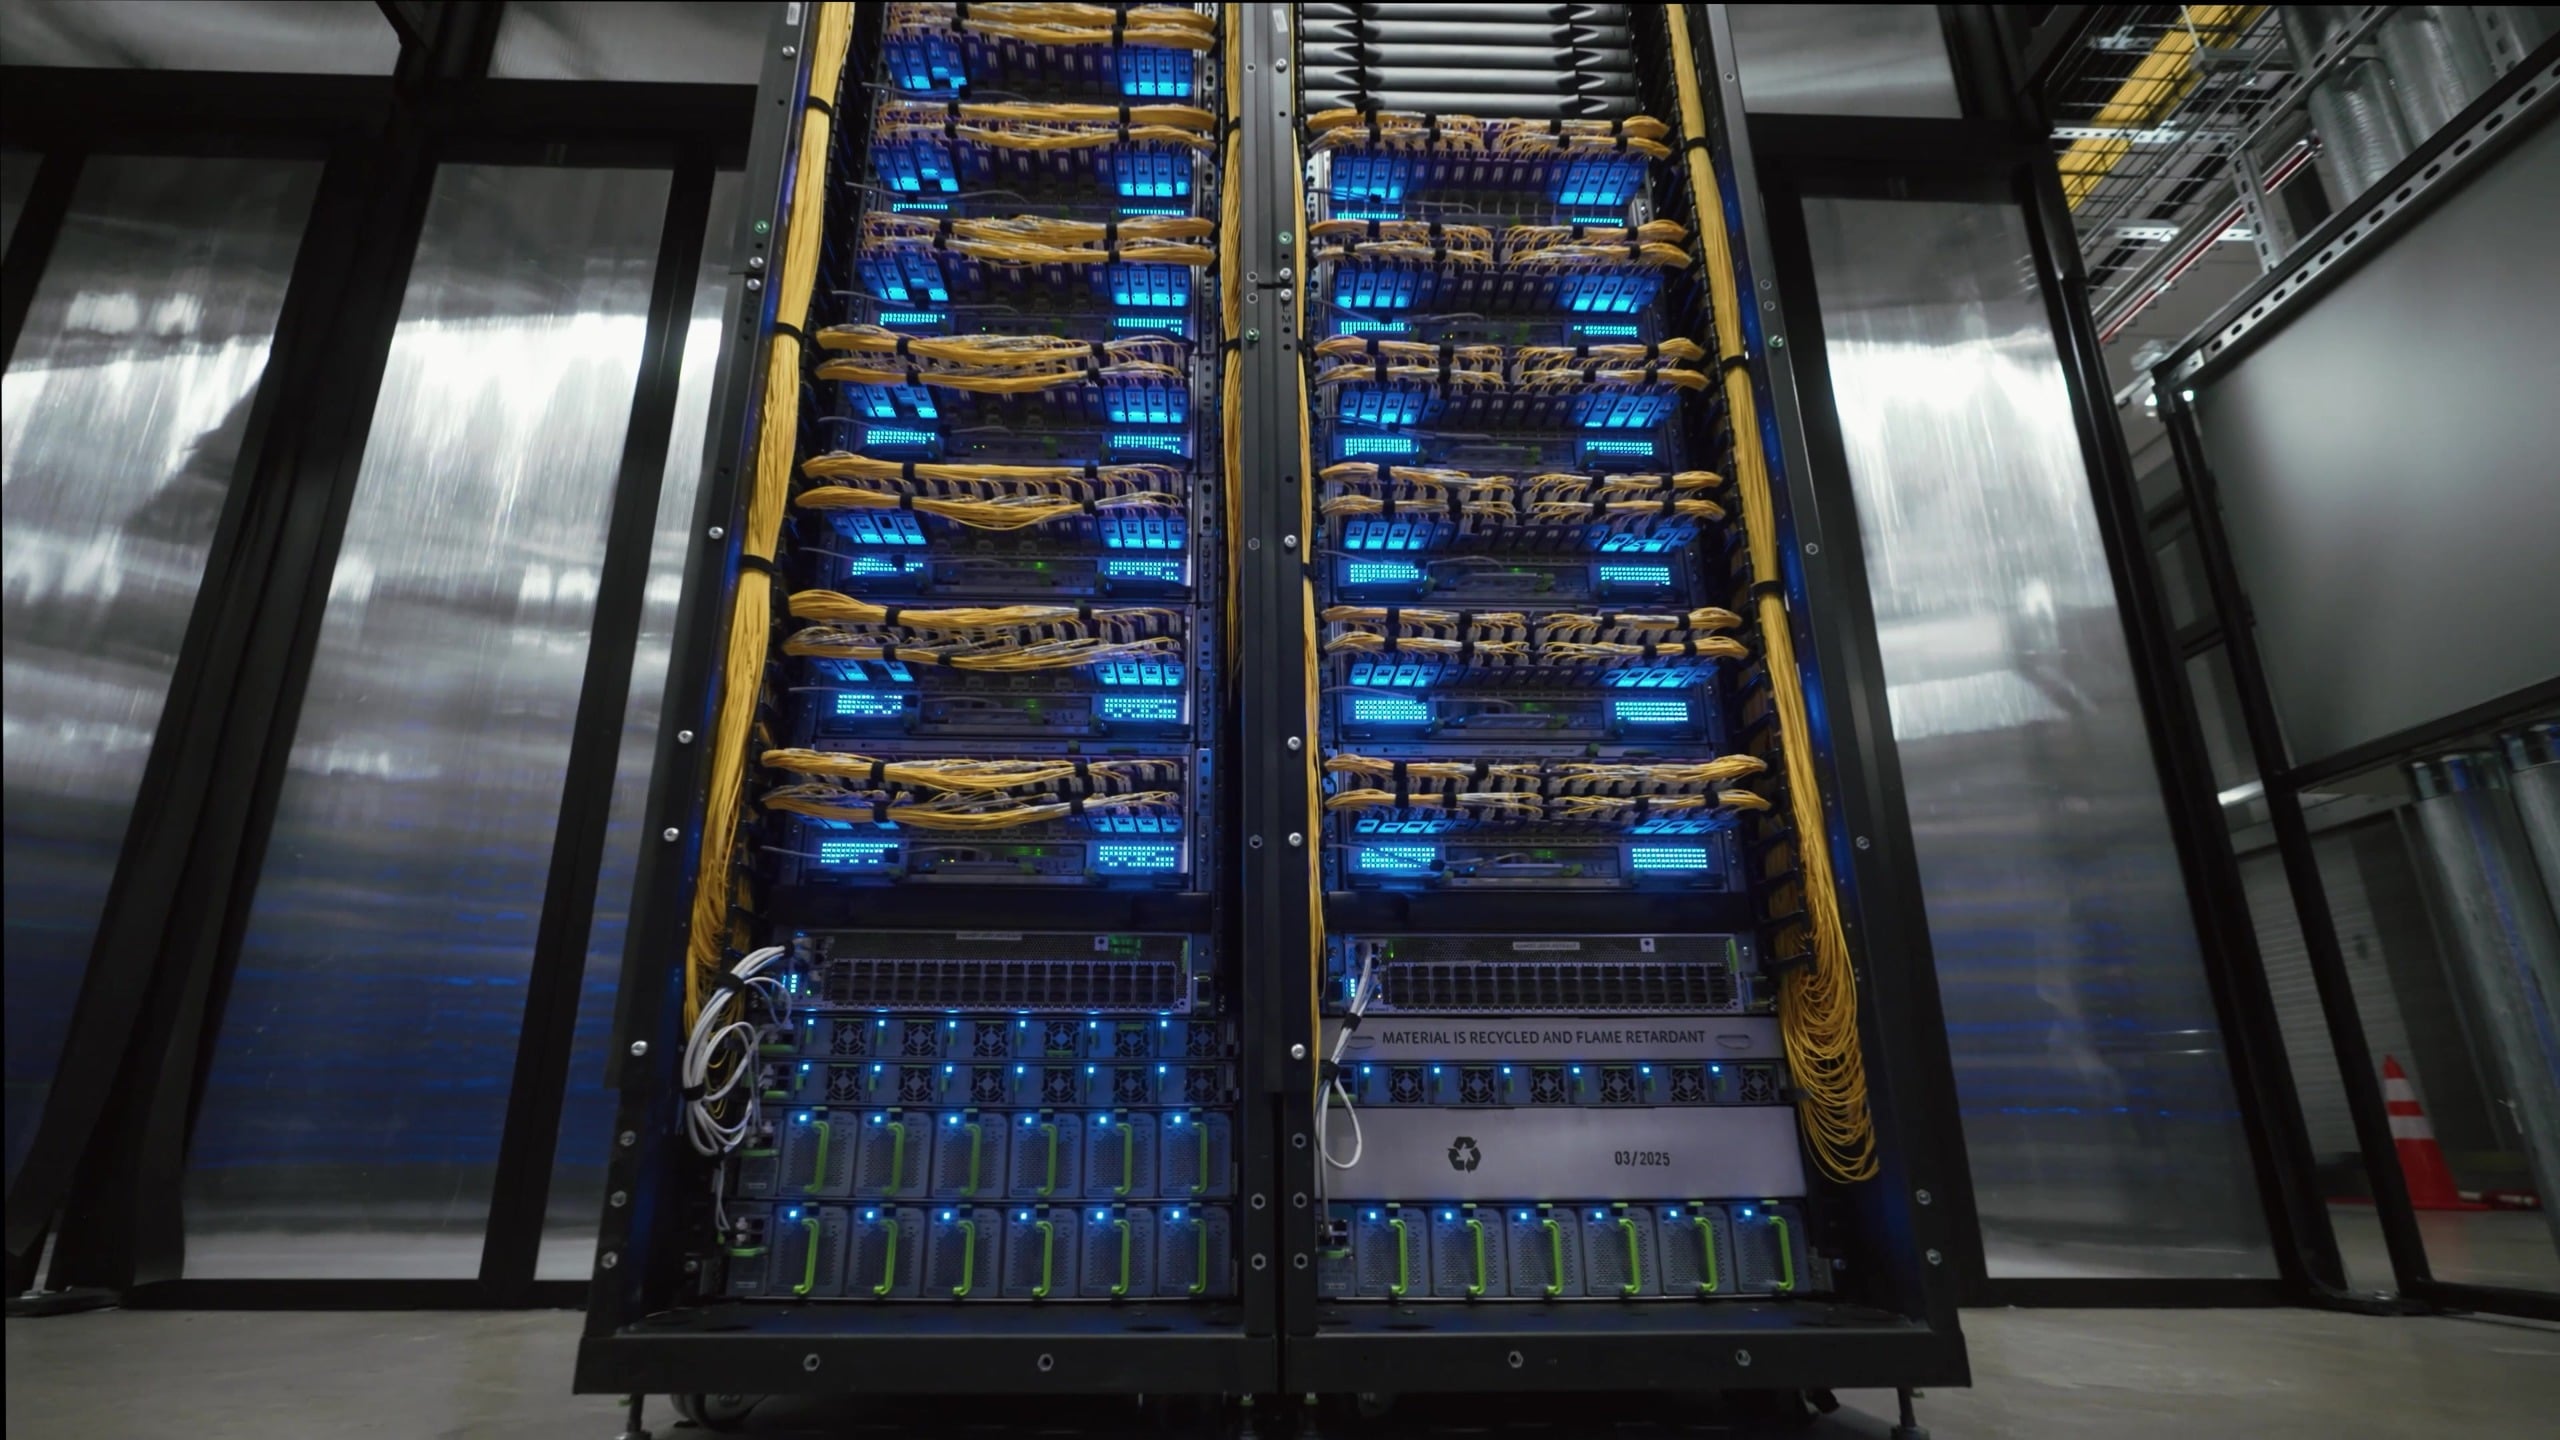
В настоящее время Prometheus использует две платформы NVIDIA GPU, обе построенные на стоечной архитектуре NVL72, где 72 графических процессора используют один домен NVLink. Вскоре появится третья платформа на базе Vera Rubin NVL72. Первая, которую Meta называет Catalina, использует GB200 NVL72 в варианте Ariel: двухстоечная конфигурация с 36 графическими процессорами на стойку, построенная на основе высокопроизводительной стоечной конструкции Meta Open Rack V3, разработанной в рамках проекта Open Compute Project. Каждый графический процессор Blackwell работает в паре с процессором Grace и двумя сетевыми адаптерами ConnectX-7 400G, обеспечивая соотношение 1:1 между процессором и графическим процессором, что дает каждому графическому процессору 800 Гбит/с пропускной способности.
Компания Meta заявляет, что выбрала Ariel, потому что GB200 NVL72 обеспечивал масштабируемость по FLOPS, пропускной способности HBM, пропускной способности масштабируемого расширения и размеру домена значительно превосходящие показатели H100, в то время как стандартное масштабирование оставалось бы на уровне 400 ГБ на каждый графический процессор, и компания ожидала, что этот дисбаланс снизит производительность. По данным Meta, пара Catalina содержит 72 графических процессора Blackwell с 13.4 ТБ HBM3e (192 ГБ на каждый графический процессор), пиковую вычислительную мощность 720 PFLOPS для обучения FP8 (1,440 PFLOPS для FP4), пропускную способность NVLink внутри домена 130 ТБ/с, суммарную пропускную способность памяти 576 ТБ/с и потребляет около 120 кВт на две стойки.
Вторая платформа, Clemente, использует GB300 NVL72. Объем памяти HBM на каждый графический процессор увеличивается в 1.5 раза до 288 ГБ, пропускная способность обработки FP4-файлов с высокой плотностью кадров возрастает примерно в один раз, а ускорение внимания увеличивается примерно вдвое. Сетевые карты ConnectX-8 SuperNIC обеспечивают 800 Гбит/с на каждый графический процессор, поэтому запас масштабируемости, заложенный Meta в Ariel, становится базовым, а соотношение GPU к CPU 2:1 позволяет разместить весь домен из 72 графических процессоров в одной стойке. Meta указывает 20.7 ТБ памяти HBM3e, что превышает эксафлопс пиковой вычислительной мощности FP4, пропускную способность NVLink 130 ТБ/с (1.8 ТБ/с в двунаправленном режиме на каждый графический процессор), потребление энергии около 135 кВт на стойку и прирост производительности на 5-10 процентов по сравнению с GB200 NVL72.
В своих новых зданиях, оптимизированных для искусственного интеллекта, компания Clemente использует либо модульную систему жидкостного охлаждения с воздушной поддержкой от Meta, либо систему жидкостного охлаждения для всего здания, а Meta утверждает, что удобство обслуживания повышается за счет уменьшения количества кабелей.
Следующая платформа Meta, San Miguel, интегрирует Vera Rubin NVL72 в ту же сетевую инфраструктуру. По данным Meta, для этой стойки предусмотрено 288 ГБ памяти HBM4 на каждый графический процессор со скоростью 19.2 ТБ/с, пиковая вычислительная производительность FP4 в 2.52 эксаФЛОПС и FP8 в 1.26 эксаФЛОПС, пропускная способность NVLink 216 ТБ/с (3 ТБ/с на каждый графический процессор), общая пропускная способность памяти около 1,500 ТБ/с, полностью жидкостное охлаждение вычислительных блоков с потребляемой мощностью более 170 кВт на стойку и прирост производительности на ватт на 10-20% по сравнению с GB300 NVL72. Компания CoreWeave запустила Vera Rubin NVL72 в производство в начале этого месяца.
Выделенная сеть Ethernet для передачи данных между зданиями.
Обучающий трафик проходит по второй сети центра обработки данных через Ethernet, отдельной от фронтальной сети, по которой передается обычный сервисный трафик. Архитектура соответствует схеме обучающего задания: параллельные реплики данных хранят свои чувствительные к задержкам и ресурсоемкие группы внутри здания, в то время как более устойчивый к задержкам трафик между репликами проходит через агрегирующий слой, связывающий здания. Компания Meta внедрила ту же иерархию в свои более ранние кластеры масштаба здания с 24 000 графическими процессорами и в свой региональный кластер с более чем 100 000 графическими процессорами, прежде чем распространить ее на Prometheus.
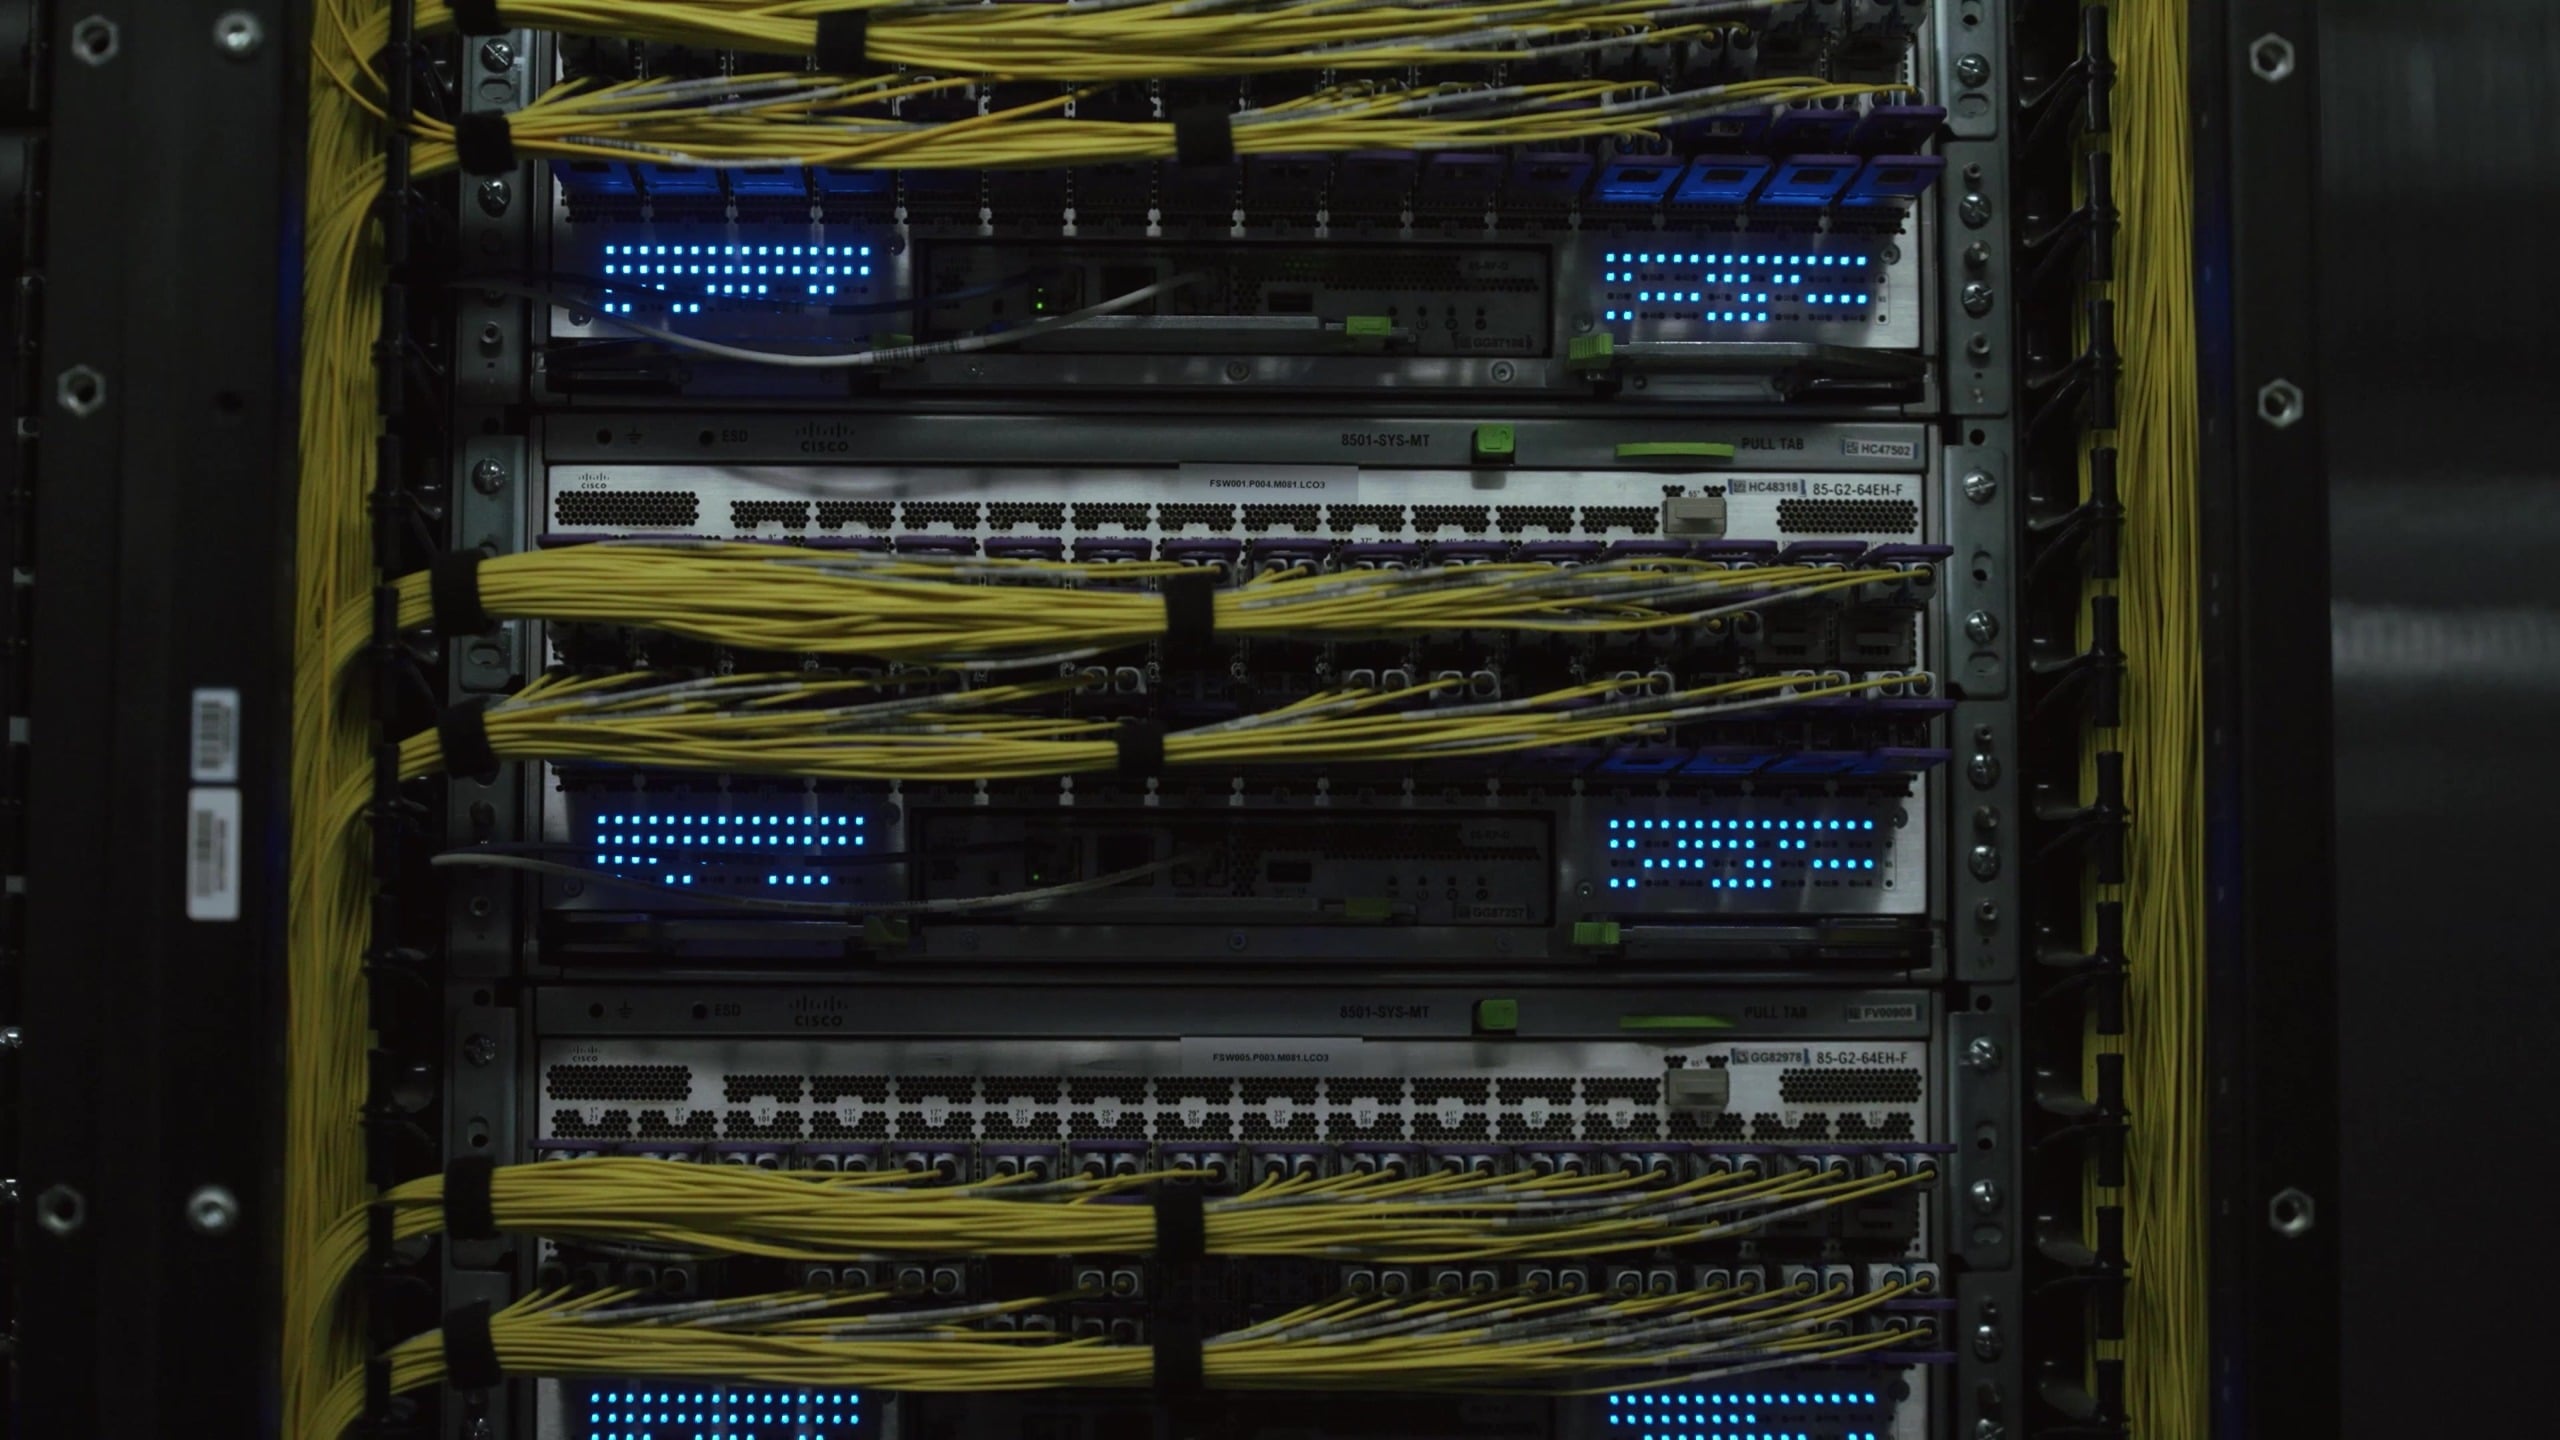
Каждая сетевая инфраструктура здания объединяет до 20 736 графических процессоров. Первоначальная разработка Meta представляла собой дезагрегированную планируемую сетевую инфраструктуру, использующую многопутевую маршрутизацию субпакетов, переупорядочивание внутри инфраструктуры, виртуальные выходные очереди и управление потоками на основе кредитов, чтобы предотвратить коллизии нескольких больших, долгоживущих потоков обучающего коллектива. По мере того, как сетевые карты получили возможность переупорядочивать пакеты на конечной точке, Meta перешла к непланируемой сетевой инфраструктуре, построенной на коммутаторах 51.2T с неглубоким буфером: Minipack3 с динамической балансировкой нагрузки и Minipack3N, использующий микросхему NVIDIA Spectrum-4 ASIC с адаптивной маршрутизацией на сетевых картах ConnectX, причем обе работают на сетевом стеке FBOSS от Meta.
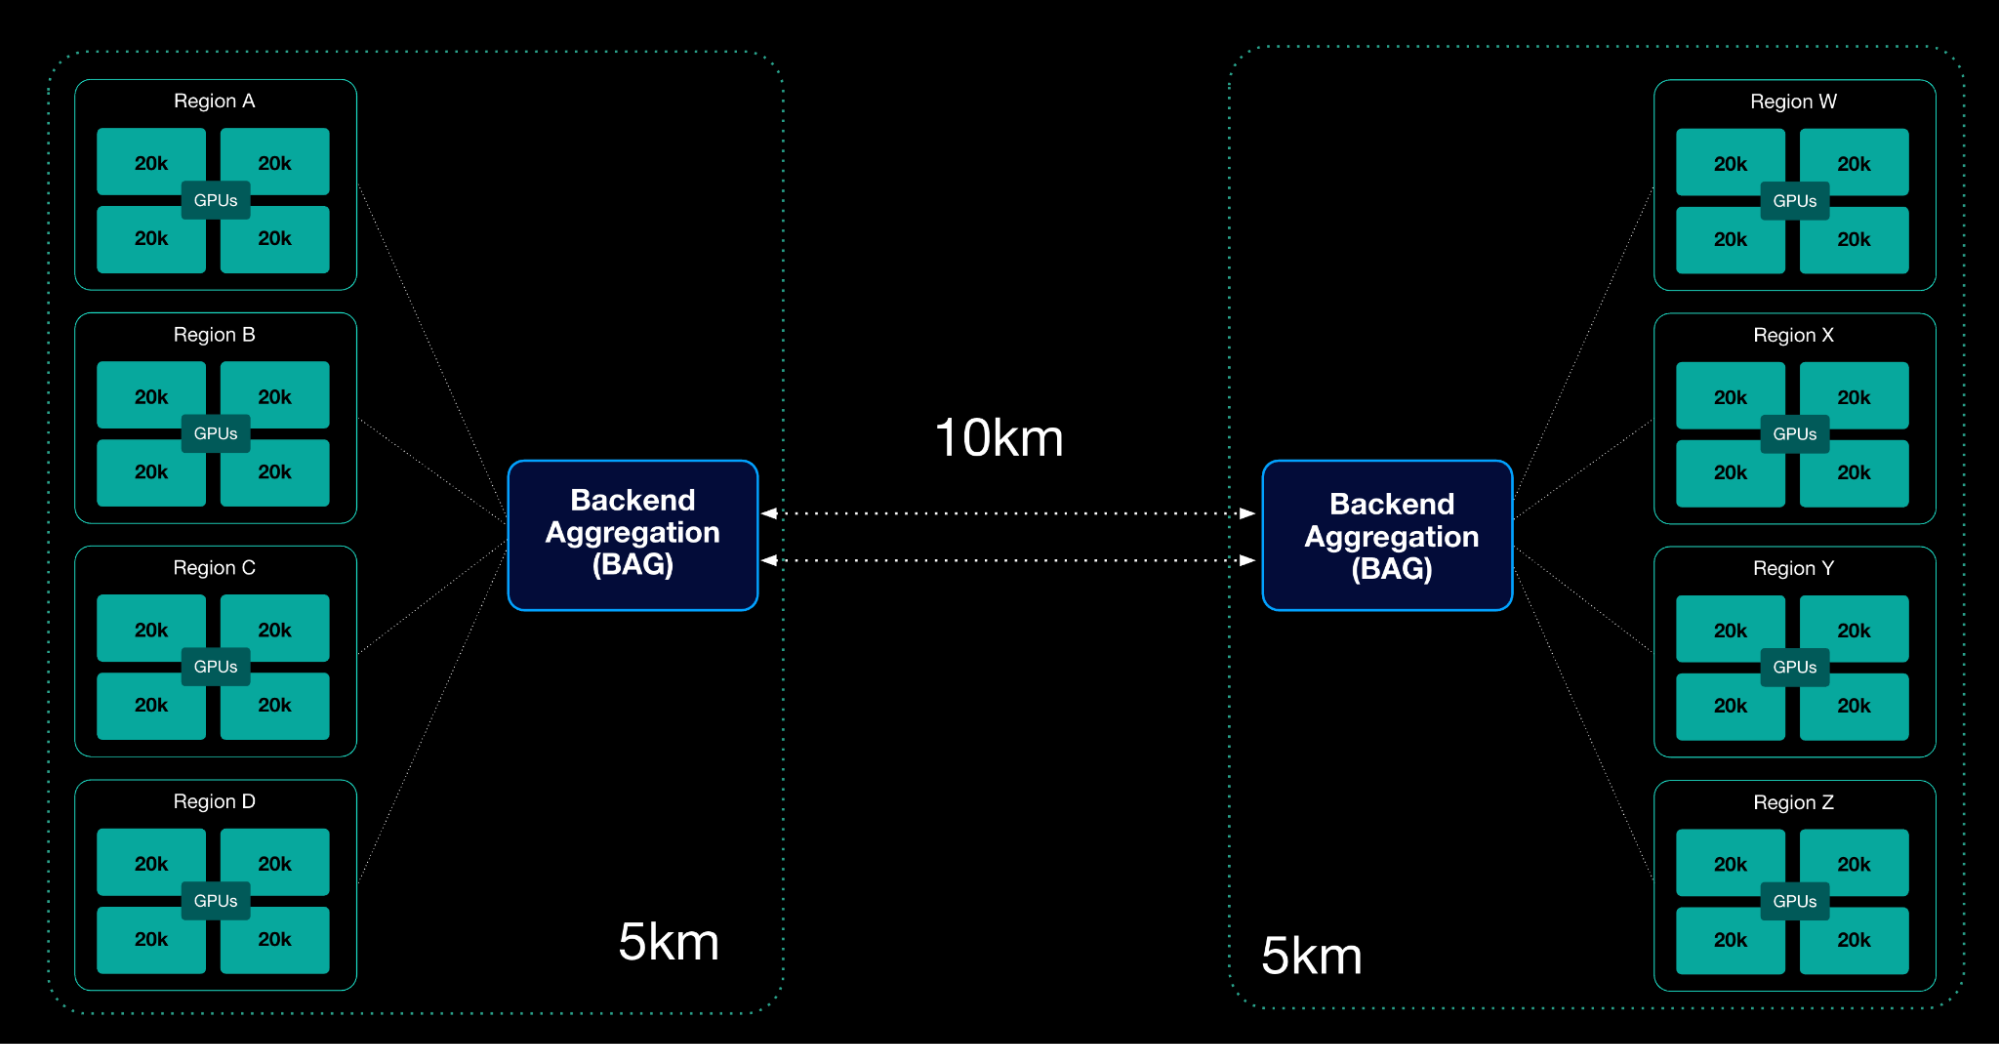
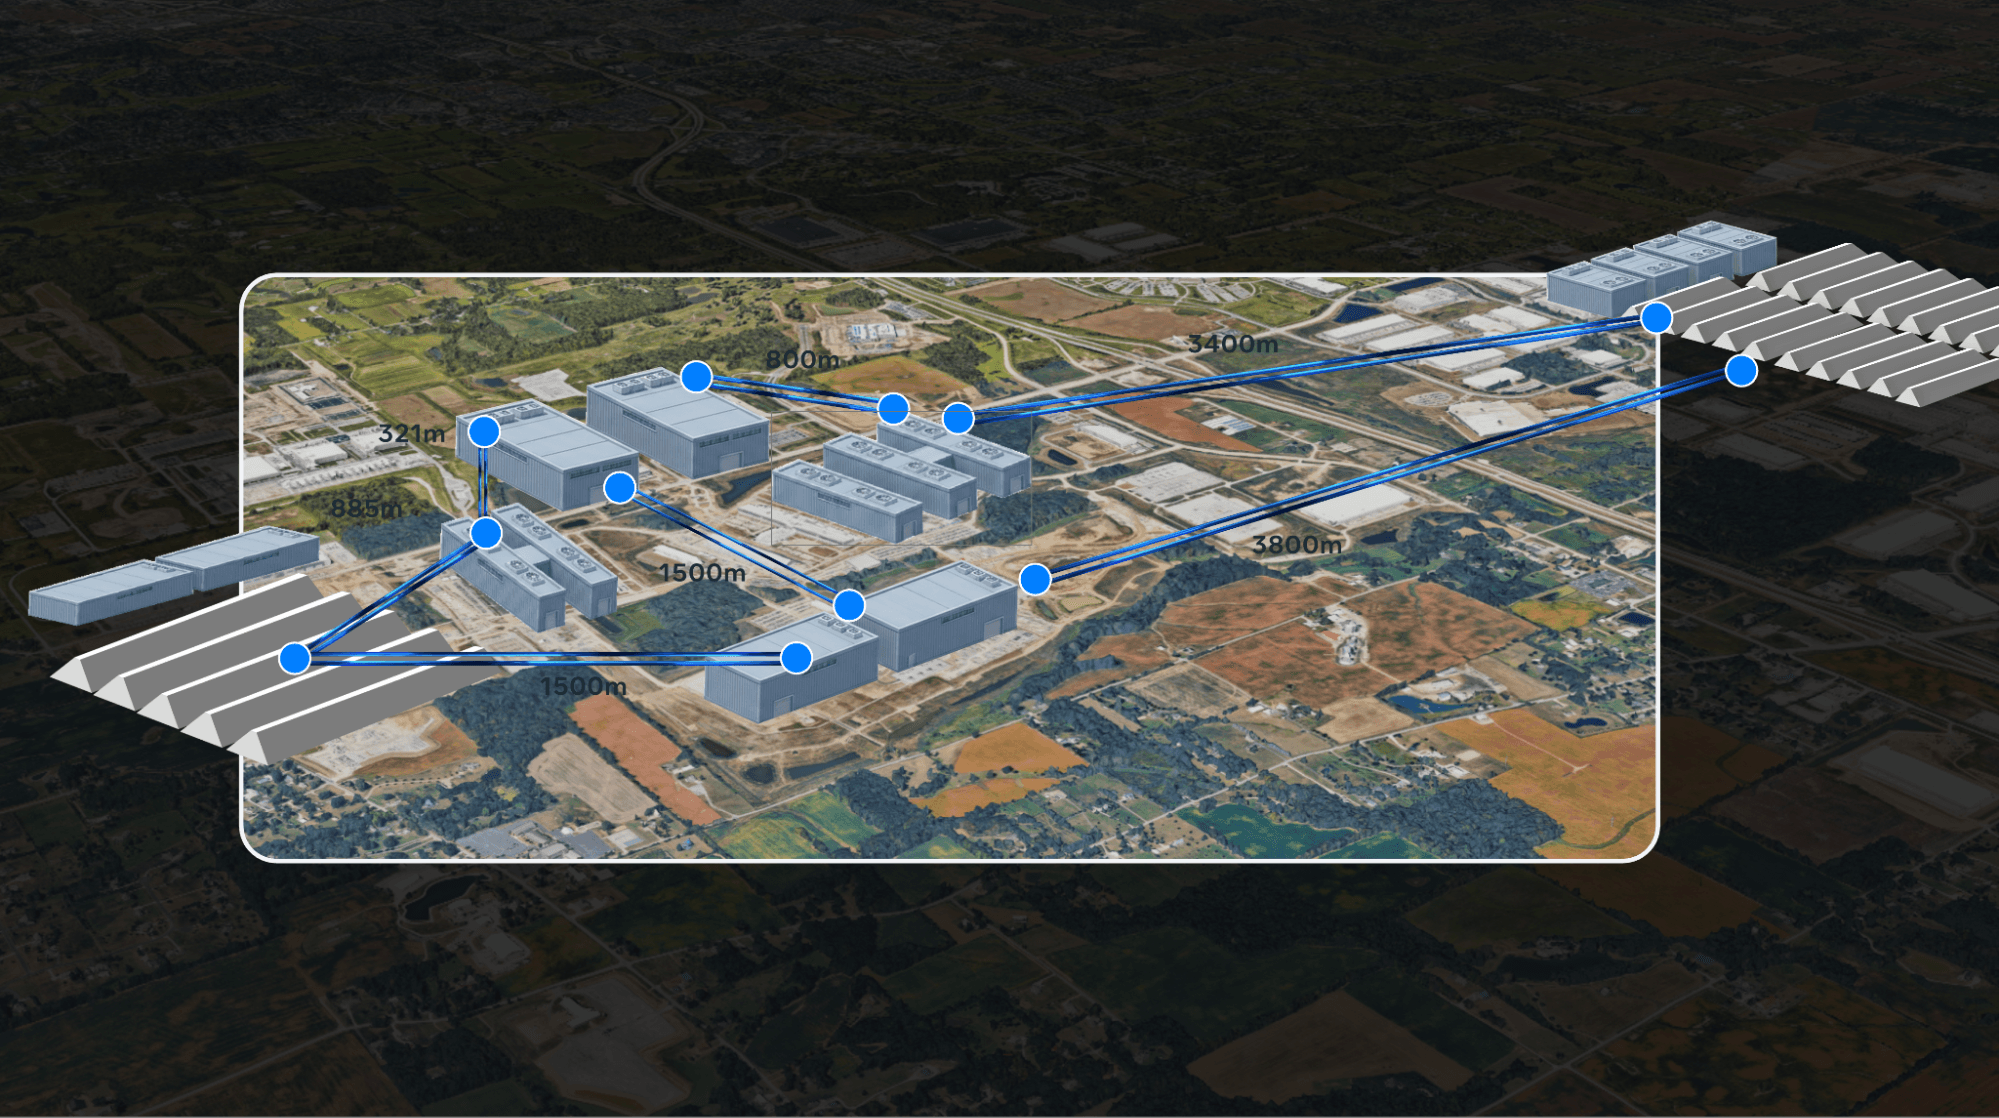
Над зданиями расположена сеть агрегации бэкэнда — многоуровневая архитектура типа «звезда», построенная на шасси Arista 7800-й серии с глубокобуферизованными чипами Broadcom Jericho3. Она охватывает расстояние от 2 км до более чем 100 км и обеспечивает передачу данных со скоростью в несколько петабит в секунду между парами регионов. Компания Meta заявляет, что для проведения предварительного обучения на таких расстояниях потребовались специальные усилия по оптимизации в лаборатории Meta Superintelligence Labs из-за задержки, измеряемой скоростью света. В основе сети лежат миллионы миль оптоволоконных кабелей, десятки тысяч коммутаторов и миллионы оптических элементов, от подключаемых модулей FR4 LITE 2x400G внутри зданий до когерентной оптики 800G-ZR для каналов связи на расстоянии более 10 км.
64 из каждых 72 графических процессоров выполняют эту работу.
Переход от домена NVLink с восемью графическими процессорами поколения H100 к NVL72 увеличил радиус поражения при сбоях в девять раз, и теперь Meta планирует мощности, исходя из стойки с 72 графическими процессорами. Поскольку параллелизм обучения лучше всего соответствует группам с размерами, кратными степени двойки, каждый домен NVL72 работает с блоком из 64 графических процессоров, а остальные восемь графических процессоров остаются резервными в стойке. В случае отказа графического процессора, резервный процессор берет на себя выполнение задачи, и задание перезапускается с последней контрольной точки без ожидания восстановления. При сбоях всей стойки Meta оставляет в резерве около 2% дополнительных стоек.
Для тренировочного запуска с 32 768 графическими процессорами: 523 стойки NVL72, или 37 656 графических процессоров, что примерно на 13 процентов превышает активную площадь, причем 11 из них приходится на геометрию среза 64 из 72. Нагрузка на целостность сигнала, необходимая для обеспечения такой надежности, значительна; один домен NVL72 передает 5,184 настроенных дифференциальных пары каналов со скоростью 200 Гбит/с, каждый из которых проходит через SerDe-интерфейсы графических процессоров, печатные платы вычислительных лотков, кабельные картриджи и интерфейсы коммутационных лотков.
Для обработки возникающих сбоев предусмотрены два пути восстановления. Если сбой локализован в одной реплике, обрабатывающей данные параллельно, функция отказоустойчивости Meta, учитывающая параллелизм, отключает эту реплику, в то время как остальная часть кластера повторяет этот шаг и продолжает обучение, а срез перезапускается на резервных хостах и синхронизируется. Более крупные сбои возвращают всю задачу к последней контрольной точке, поэтому Meta часто создает контрольные точки, сохраняя состояние модели, включая градиенты и данные оптимизатора, асинхронно в многоуровневое хранилище с дельта-контрольными точками и промежуточным хранением в оперативной памяти для минимизации снижения пропускной способности.
Снижение количества перебоев на 99 процентов.
Несмотря на весь прогресс, который демонстрируют эти цифры, Prometheus изначально не был стабильным. В середине 2025 года, на начальном этапе, частота сбоев достигла пика, составив почти 1,000 событий на 8,000 графических процессоров в день. Год межфункциональной работы сократил это число на 99 процентов, и теперь кластер поддерживает несколько параллельных задач обучения, каждая из которых обрабатывает десятки тысяч графических процессоров. Мета объясняет это моделью совместной разработки с NVIDIA, в рамках которой команды NVIDIA находятся на площадке в Нью-Олбани, обмениваются телеметрией и проводят совместные сессии по анализу причин сбоев, при этом Мета отвечает за планирование и исправление инфраструктуры, а NVIDIA — за прошивку, диагностику сигналов и обработку памяти.
Первой проблемой на GB200 стала целостность сигнала NVLink. При более чем 600 000 NVLink-соединений в кластере, нестабильные каналы связи часто вызывали циклы восстановления, поэтому Meta добавила непрерывную телеметрию, автоматическую маркировку и диагностическое тестирование L11 для выявления слабых мест до начала производства. С появлением GB300 с большим объемом памяти основной причиной стали сбои памяти в HBM и LPDDR, и в ответ на это были усовершенствованы настройки прошивки HBM, очистка памяти, улучшенный алгоритм коррекции ошибок LPDDR и прогнозируемое удаление из строя устройств. Состояние коммутатора отслеживается с разрешением в миллисекунды, а события канала связи на уровне агрегации перенаправляются аппаратно без прерывания трафика графического процессора.
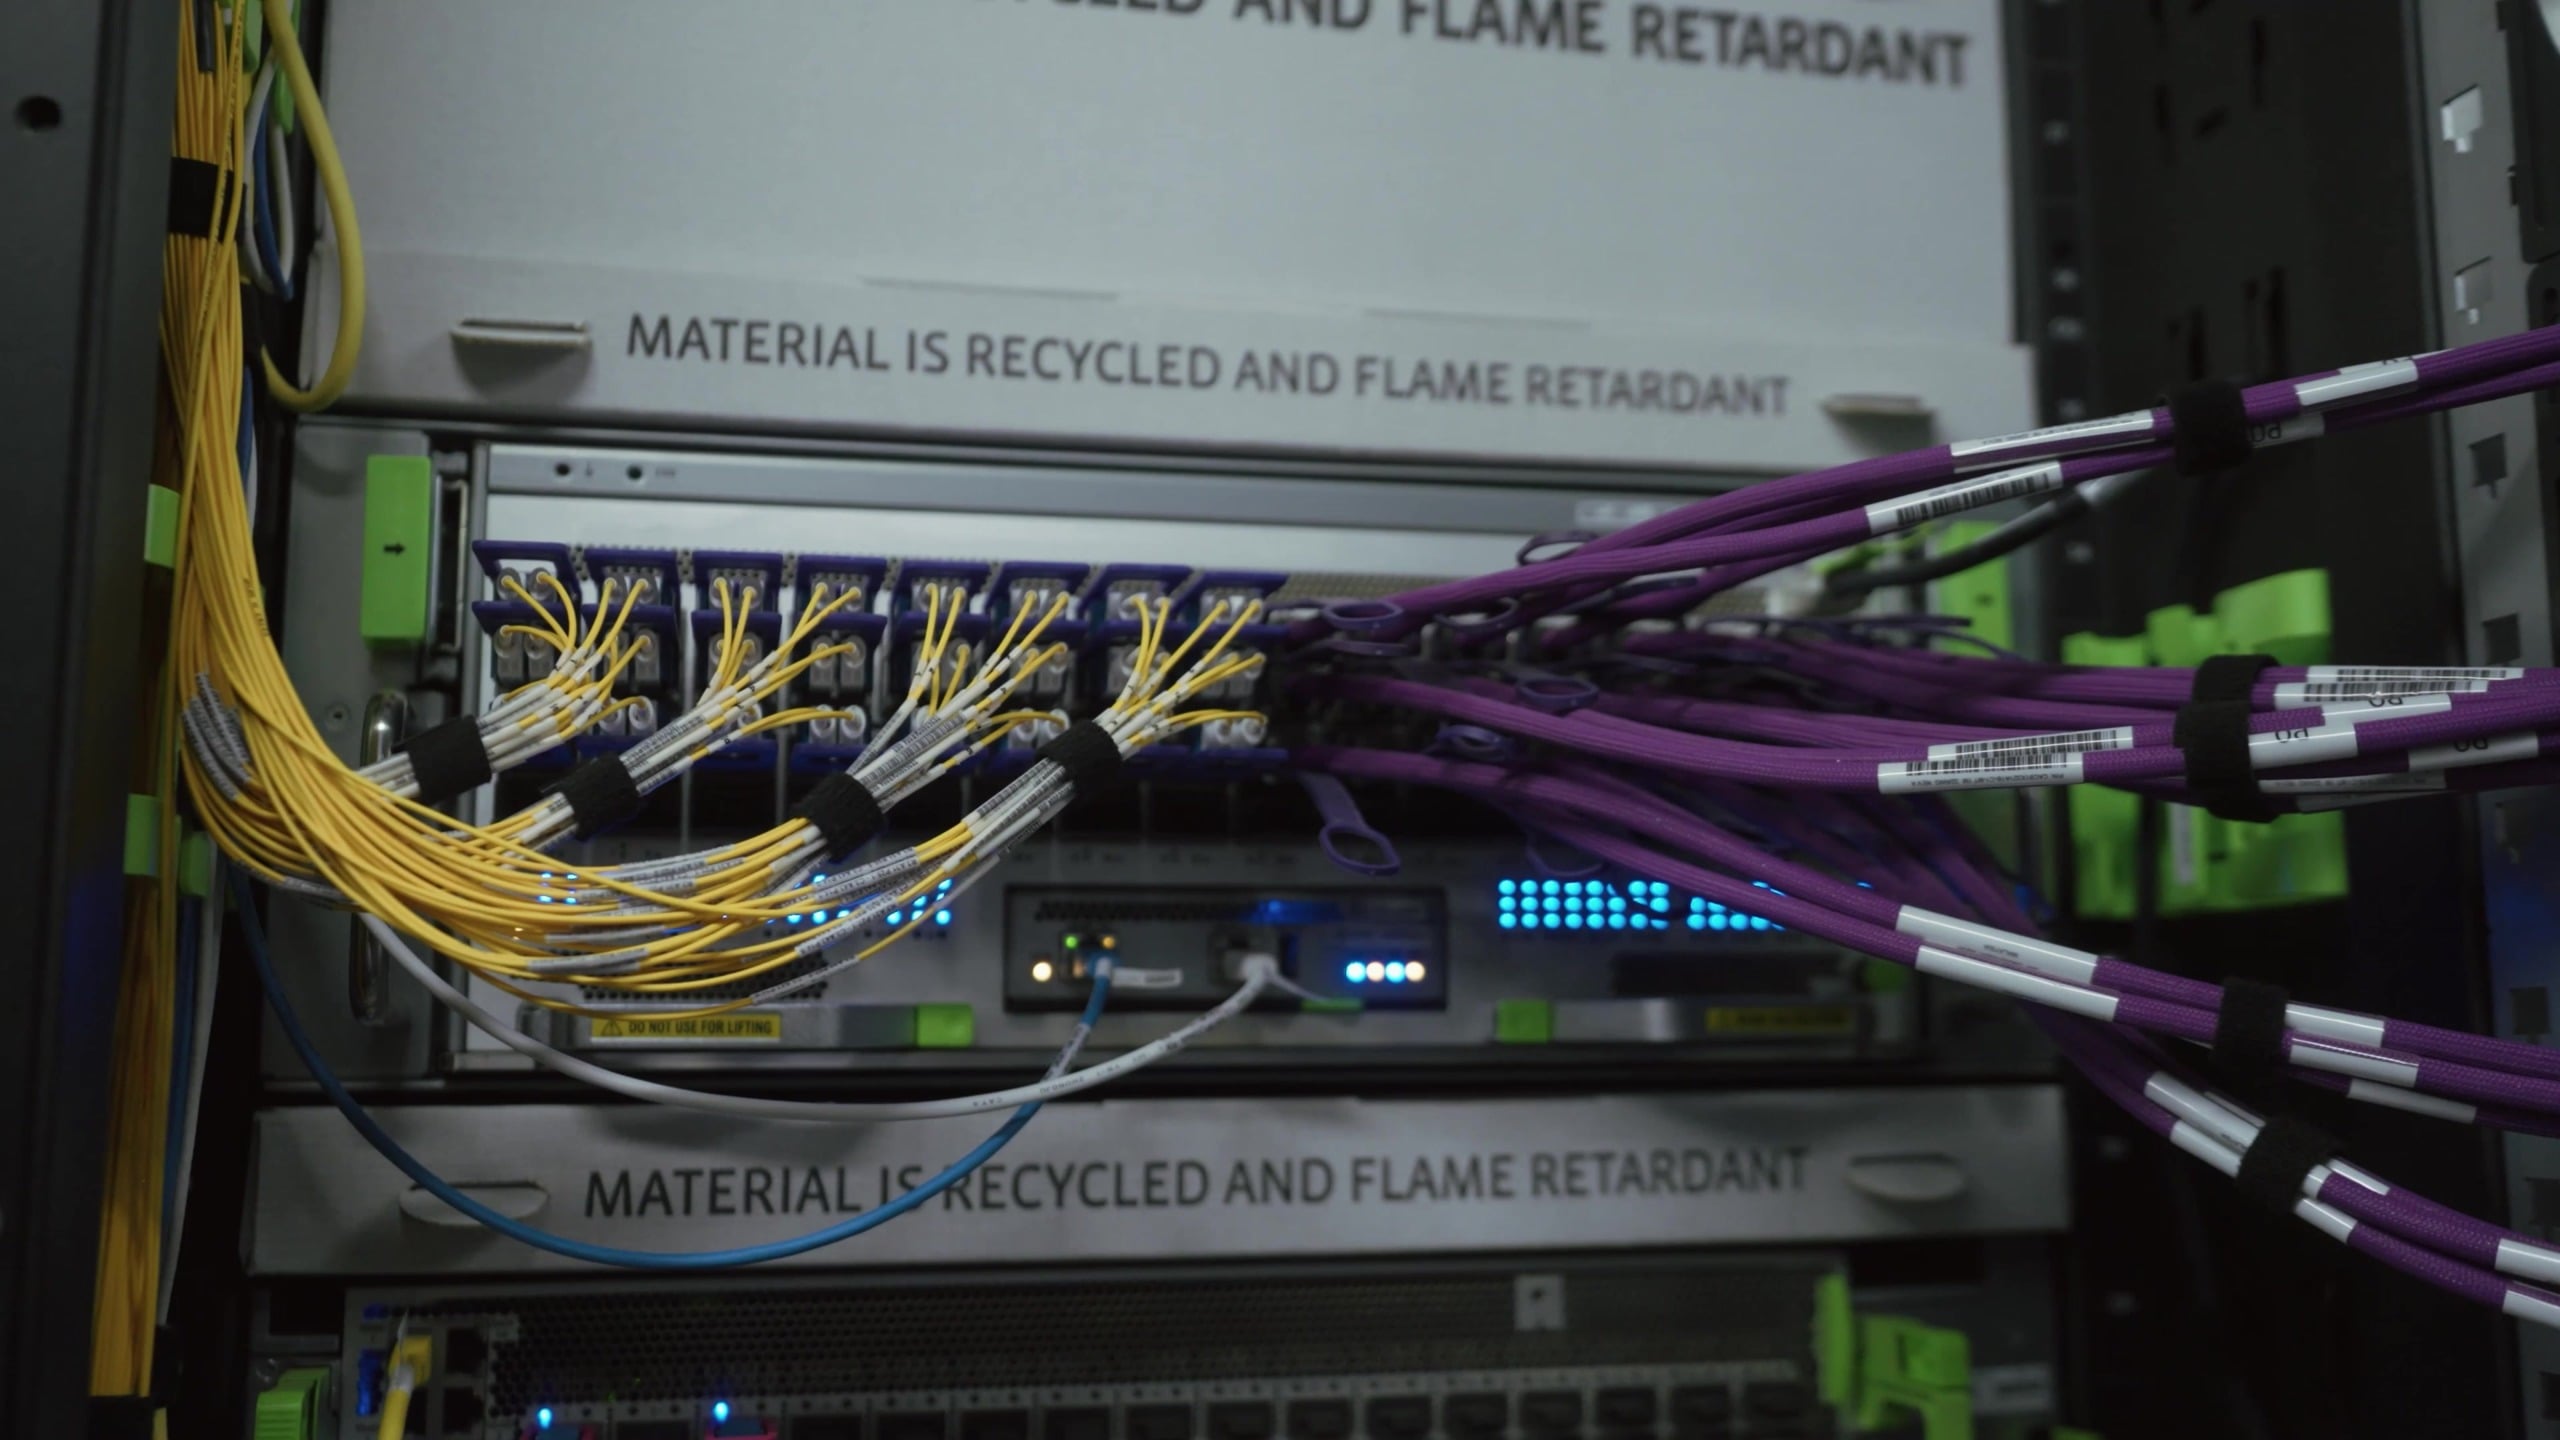
Эксплуатация сотен тысяч ускорителей первого поколения превратила разработку аппаратного обеспечения в отдельную дисциплину. Автоматизация прошивки Meta позволяет за несколько часов установить исправления драйверов и прошивки на более чем 100 000 графических процессоров, а время обновления одного модуля по стандарту P90 сократилось с более чем семи часов на начальном этапе внедрения GB200 до двух часов. Стресс-тестирование системы питания проверяет поведение модулей блока питания и регуляторов напряжения под нагрузкой в 1,400 Вт от одного графического процессора, и каждая отремонтированная система находится в карантине до прохождения проверки. В ходе мартовского спринта по обеспечению стабильности Meta синхронизировала исправления по всей системе.
Переходные процессы в энергосистеме и смешанный парк холодильных установок
Синхронное обучение обеспечивает синхронное распределение мощности, и десятки тысяч графических процессоров, одновременно переходящих в фазу вычислений или обмена данными, изменяют нагрузку кластера на 30–40 процентов, а запуск или приостановка крупной задачи могут перераспределить десятки мегаватт за считанные секунды. Dynamo Dimmer, система управления питанием кластера от Meta, постепенно ограничивает мощность графических процессоров по мере приближения кластера к его максимальному энергопотреблению, чтобы задачи продолжали выполняться. Модули резервного питания на уровне стойки поглощают пиковые нагрузки, конденсаторные блоки сглаживают пики, за ними располагается система хранения энергии на основе батарей масштаба предприятия, а Meta координирует с энергоснабжающими компаниями профиль нагрузки.
Системы охлаждения различаются в зависимости от здания, поскольку проект Prometheus был быстро реализован в центрах обработки данных с открытым доступом, быстроразвертываемых конструкциях, арендованных мощностях и специально построенном здании для ИИ. В старых помещениях используется модульное жидкостное охлаждение с воздушной поддержкой; в здании, оптимизированном для ИИ, используется жидкостное охлаждение в замкнутом контуре, которое, по описанию Meta, является наиболее эффективным и водосберегающим способом охлаждения серверов с графическими процессорами. Meta поделилась такими разработками, как IcePack, ее сетевая стойка с жидкостным охлаждением, через OCP. Чтобы увидеть, что представляет собой гораздо меньшая по размеру установка GB300 NVL72 с жидкостным охлаждением, см. тестовый стенд GAIFA компании Giga Computing.
Следующим будет Гиперион.
Компания Meta продолжит расширять Prometheus, используя комбинацию стоек GB300 NVL72 и Vera Rubin NVL72, при этом Vera Rubin будет интегрирована в существующую сетевую инфраструктуру через платформу San Miguel. Опыт, полученный в Нью-Олбани, используется в Hyperion, суперкластере, который Meta проектирует с нуля в округе Ричленд, штат Луизиана, с замкнутой системой жидкостного охлаждения, полным подключением к сети через Entergy и сетевыми решениями следующего поколения. Meta заявляет, что оплачивает полную стоимость энергии на обеих площадках и компенсирует ее потребление за счет новых чистых и возобновляемых источников энергии.
Большая часть опубликованной Meta информации — это оперативные детали, которые крупные операторы обычно держат в секрете: конфигурация резервных графических процессоров, частота прерываний, время развертывания прошивки и причины выбора конфигурации Ariel. Главная мысль заключается в том, что в таком масштабе оборудование — это лишь отправная точка, а работа по превращению сотен тысяч графических процессоров в пригодные для обучения ресурсы заключается в сети, отказоустойчивости и телеметрии. Для предприятий, стремящихся развернуть ИИ в масштабе, этот подробный анализ Meta — хорошая отправная точка, чтобы хотя бы понять, где могут возникнуть проблемы, и позволить организациям планировать работу всей своей инфраструктуры центров обработки данных.



 Amazon