

LPU, или Language Processing Unit (блок обработки языка), — это специализированный ускоритель выполнения задач искусственного интеллекта, разработанный и созданный компанией Groq, Inc. Основанная в 2016 году Джонатаном Россом, бывшим инженером Google, которого считают одним из первоначальных изобретателей TPU, компания Groq потратила годы на разработку детерминированной, программно-определяемой архитектуры процессора с нуля. В отличие от графических процессоров (GPU), которые полагаются на динамическое аппаратное планирование и многоуровневые иерархии кэша, LPU использует принципиально иной подход: он исключает все реактивные аппаратные компоненты и помещает всю плоскость управления в компилятор, обеспечивая полностью предсказуемое выполнение вплоть до тактового цикла.
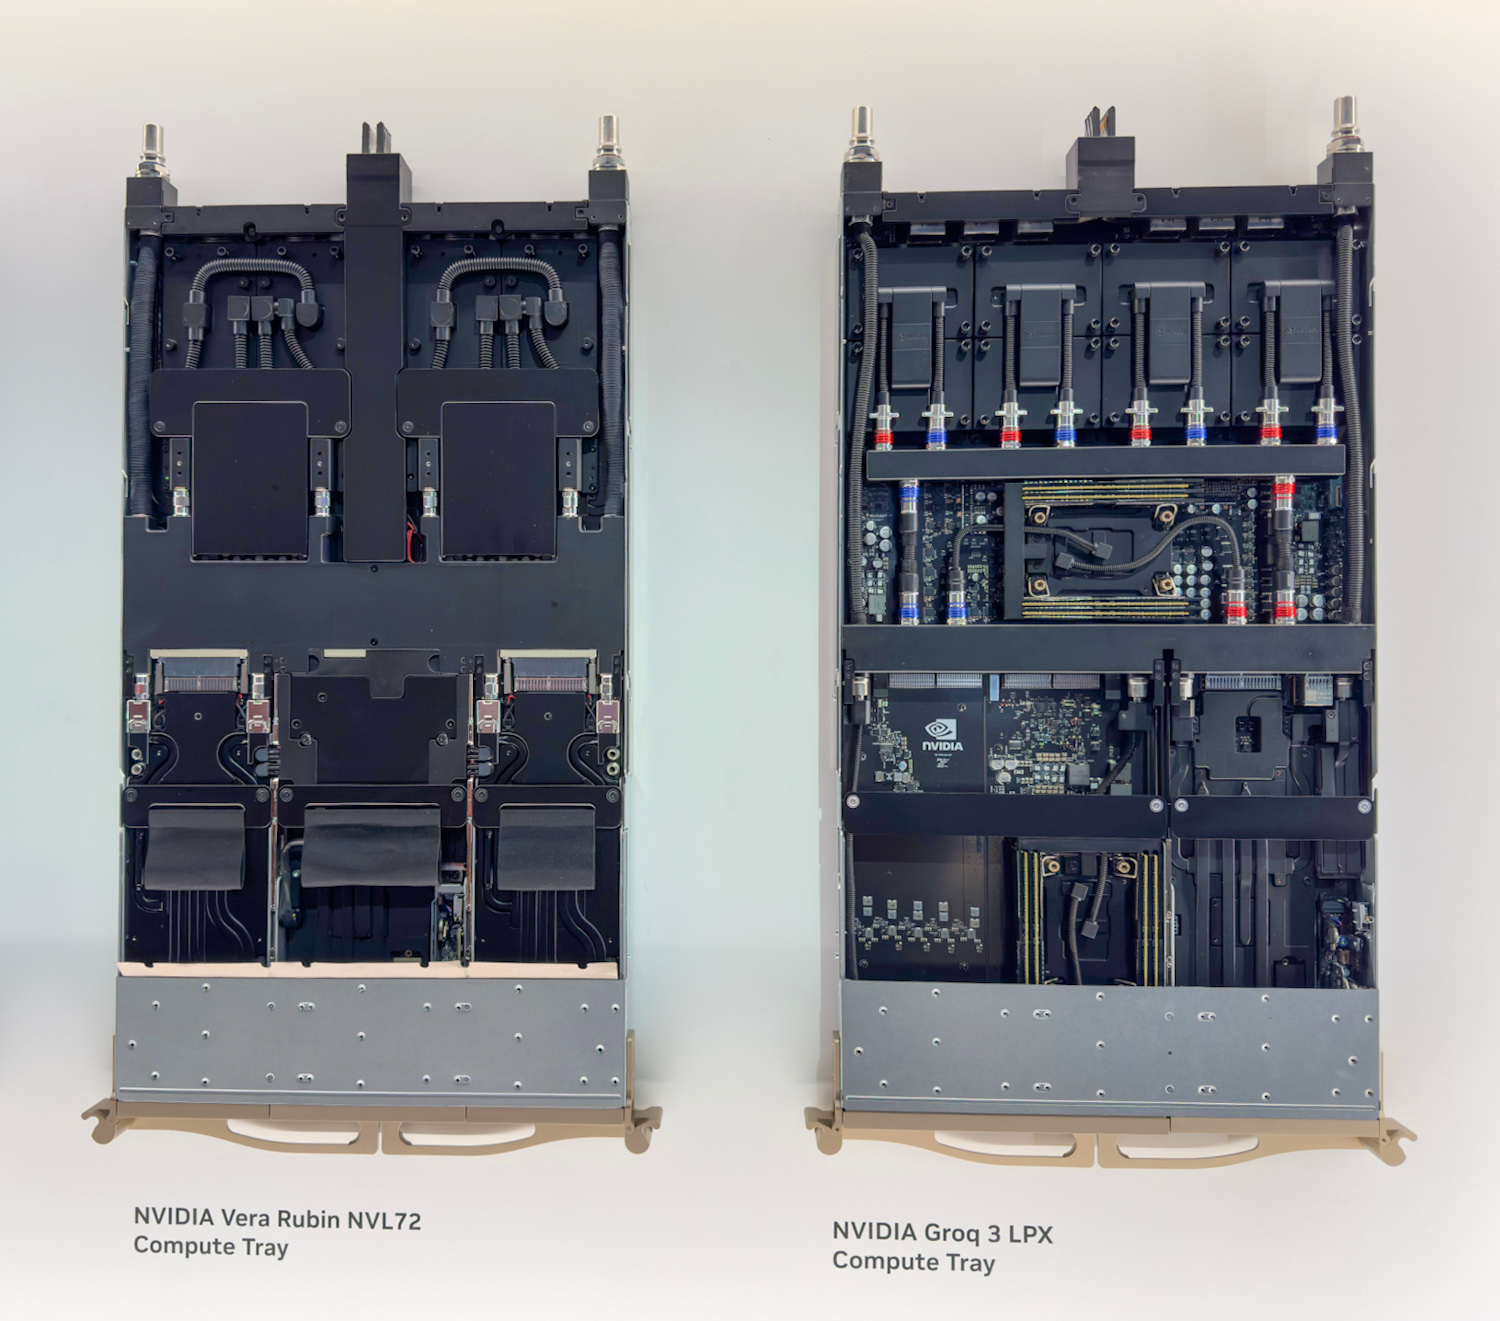
В декабре прошлого года NVIDIA приобрела Groq, в результате чего архитектура LPU вошла в состав NVIDIA. Это приобретение вызвало огромный интерес в отрасли и сразу же породило предположения о том, как NVIDIA интегрирует технологию Groq в свою экосистему центров обработки данных. Ответы на эти вопросы наконец-то были получены на GTC 2026, где NVIDIA представила Groq 3 LPX как седьмой чип платформы Vera Rubin, объединяющий 256 ускорителей LPU в стоечной системе вместе с Vera Rubin NVL72.
Что случилось с CPX?
В прошлом году на саммите AI Infra Summit компания NVIDIA также анонсировала стойку CPX в нескольких конфигурациях, предназначенных для ускорения запросов на вывод с использованием длинного контекста. После нашего первоначального освещения этого анонса у нас возникло несколько вопросов о фактической функции CPX. На первый взгляд, хотя это была интересная архитектурная концепция, CPX, казалось, не предлагал ничего существенного, кроме самого графического процессора Rubin, за исключением, возможно, дополнительного ускорения операций внимания. Затем последовало приобретение Groq, которое вызвало предположения о том, как NVIDIA интегрирует технологию LPU от Groq в более широкую платформу Vera Rubin.
Компания NVIDIA прояснила ситуацию на GTC 2026, анонсировав LPX. Судя по представленной информации, концепция CPX Rack эволюционировала в Groq 3 LPX Rack, где первоначальный акцент CPX на контекстной обработке уступил место принципиально иной архитектуре ускорения декодирования, построенной на основе кремниевых чипов Groq. LPX Rack полностью охлаждается жидкостью, построен на инфраструктуре MGX и будет доступен во второй половине 2026 года, одновременно с более масштабным запуском Vera Rubin. NVIDIA заявляет о до 35-кратном увеличении пропускной способности при выводе данных на мегаватт и до 10-кратном увеличении возможностей получения дохода для моделей с триллионами параметров благодаря этому новому дополнению.
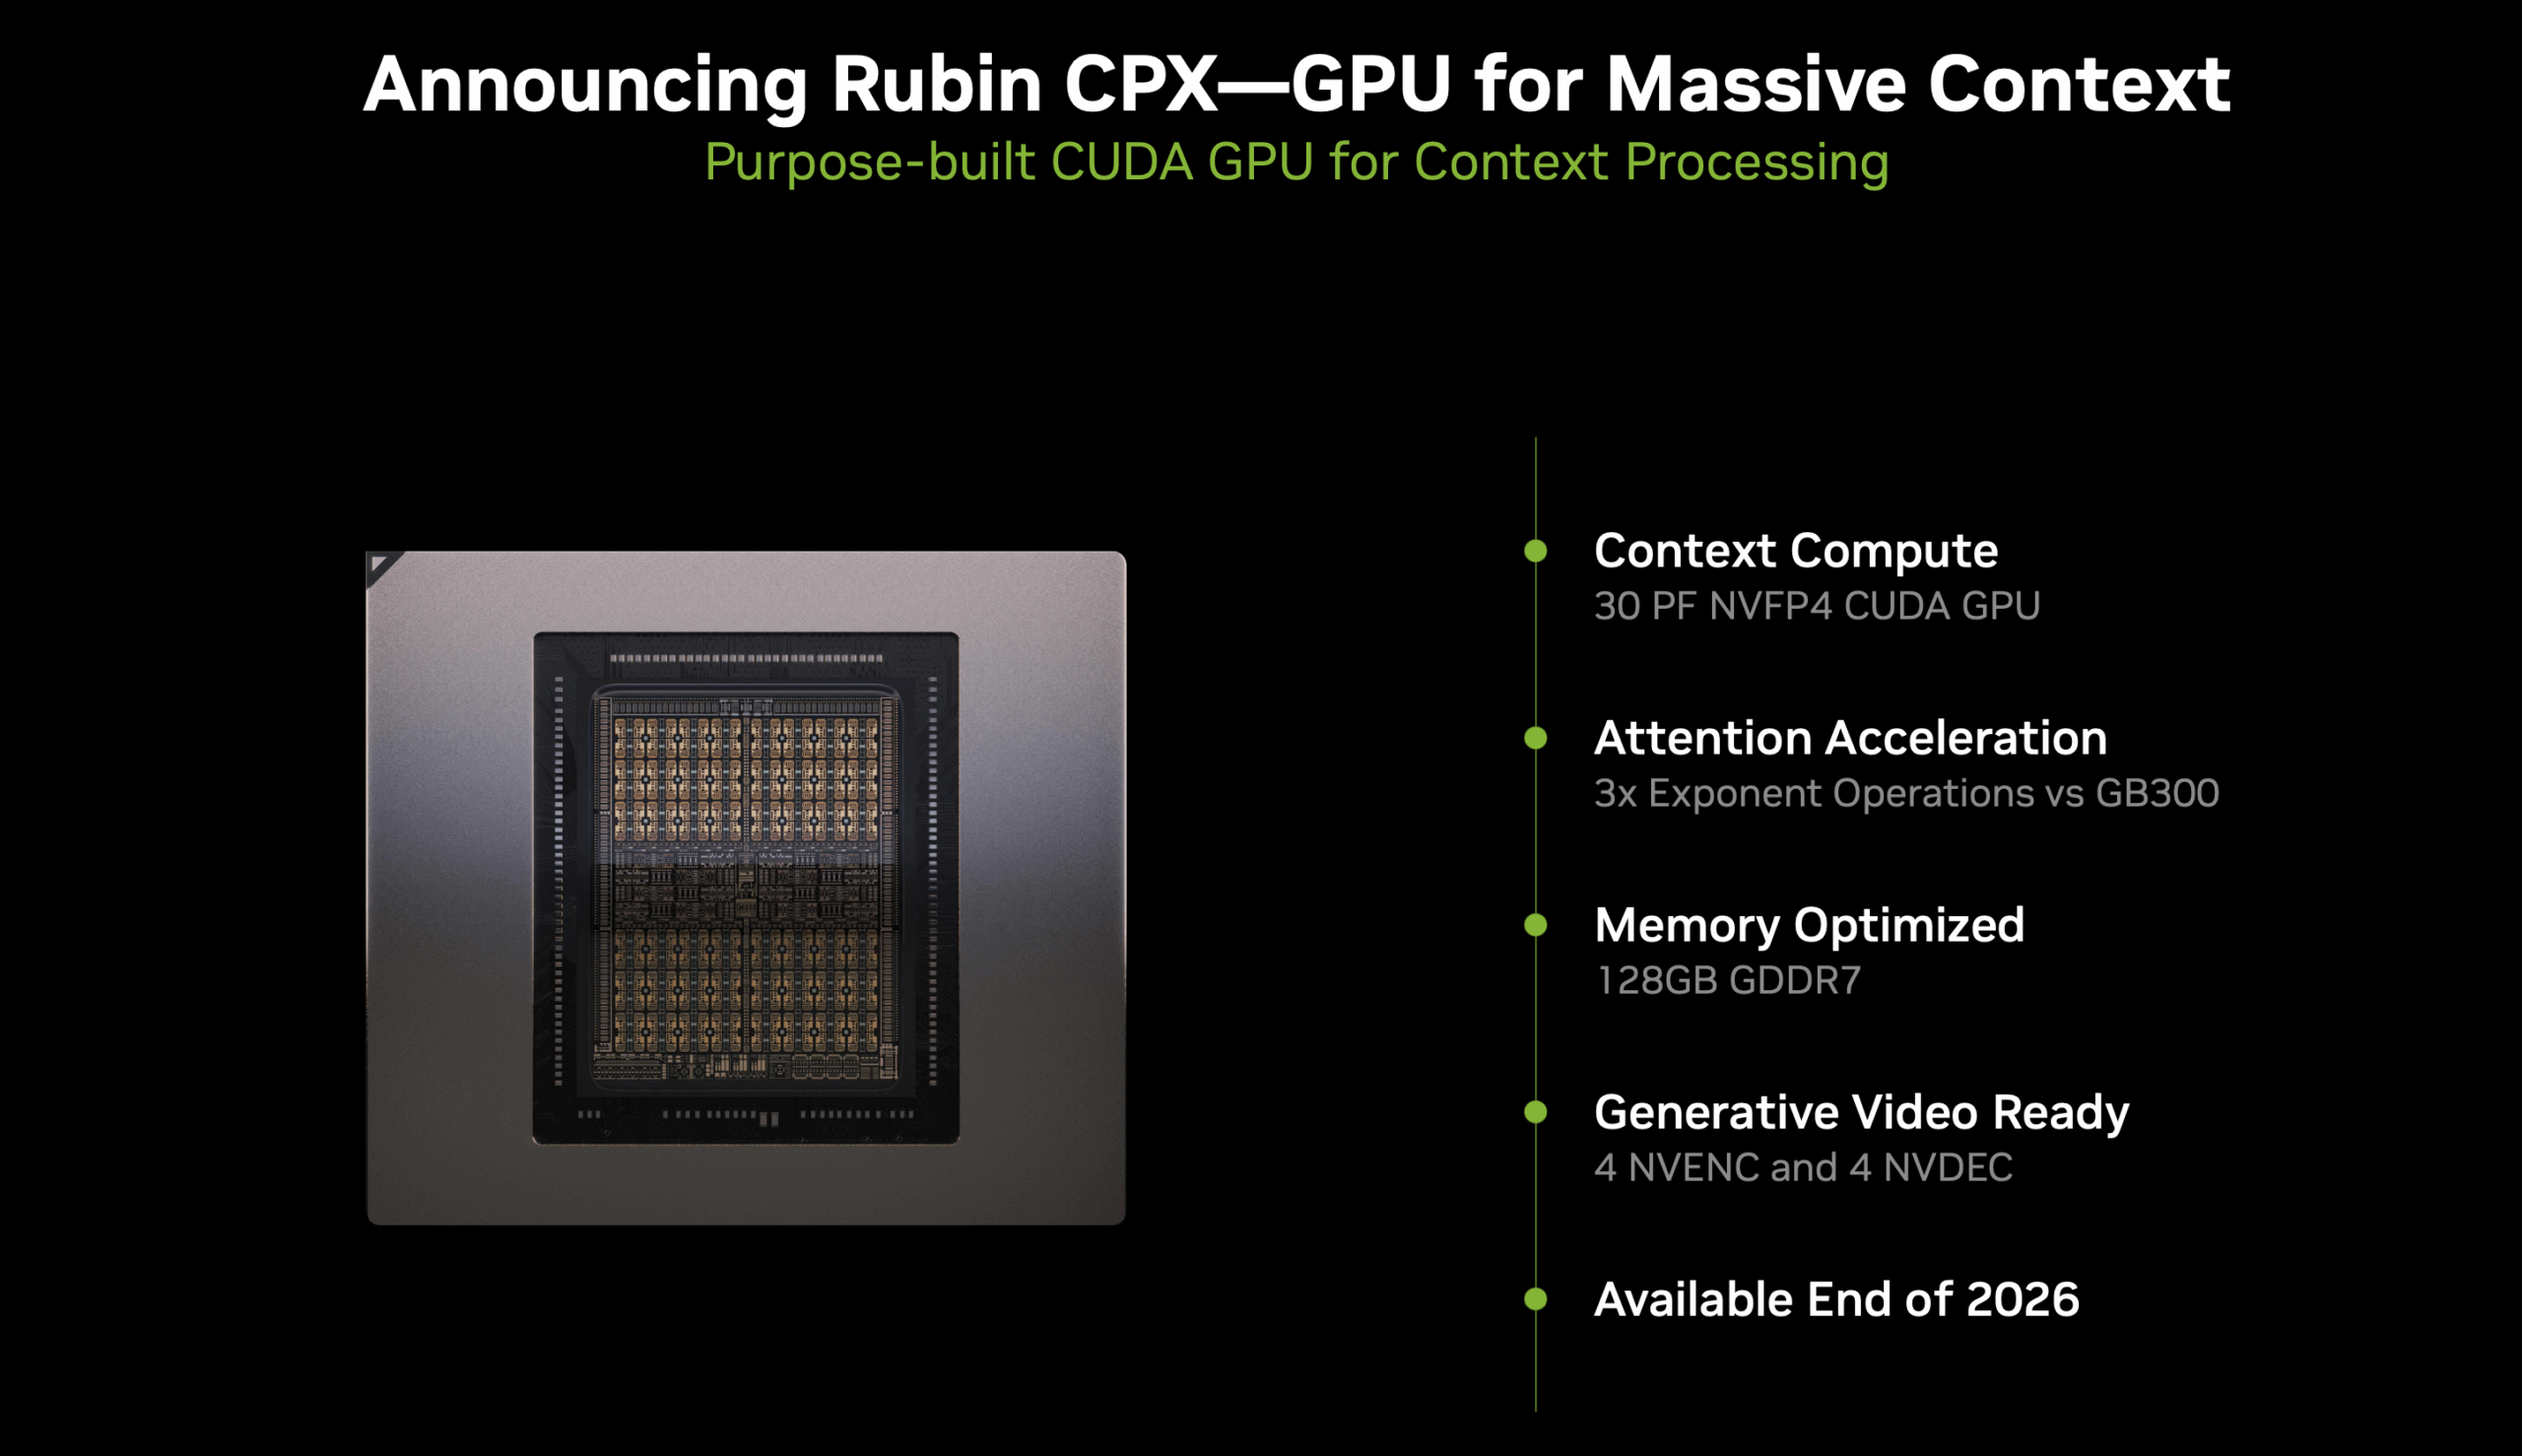
Но что еще важнее, NVIDIA подтвердила, что LPU работает как ускоритель в рамках существующего стека CUDA, запущенного на платформах Vera и NVL72, при этом вычисления прозрачно переносятся на основе каждого токена. Во время сессии вопросов и ответов на GTC NVIDIA описала LPU как «ускоритель декодирования моделей» и объяснила, что они будут тесно сотрудничать с лабораториями ИИ и передовыми разработчиками моделей, развертывающими модели с триллионами параметров, чтобы обеспечить следующее поколение премиальных моделей.
После решения вопроса о CPX возникает закономерный вопрос: что же это за LPU, вокруг которого NVIDIA строит целую систему стоечного масштаба?
Что такое ЛПУ?
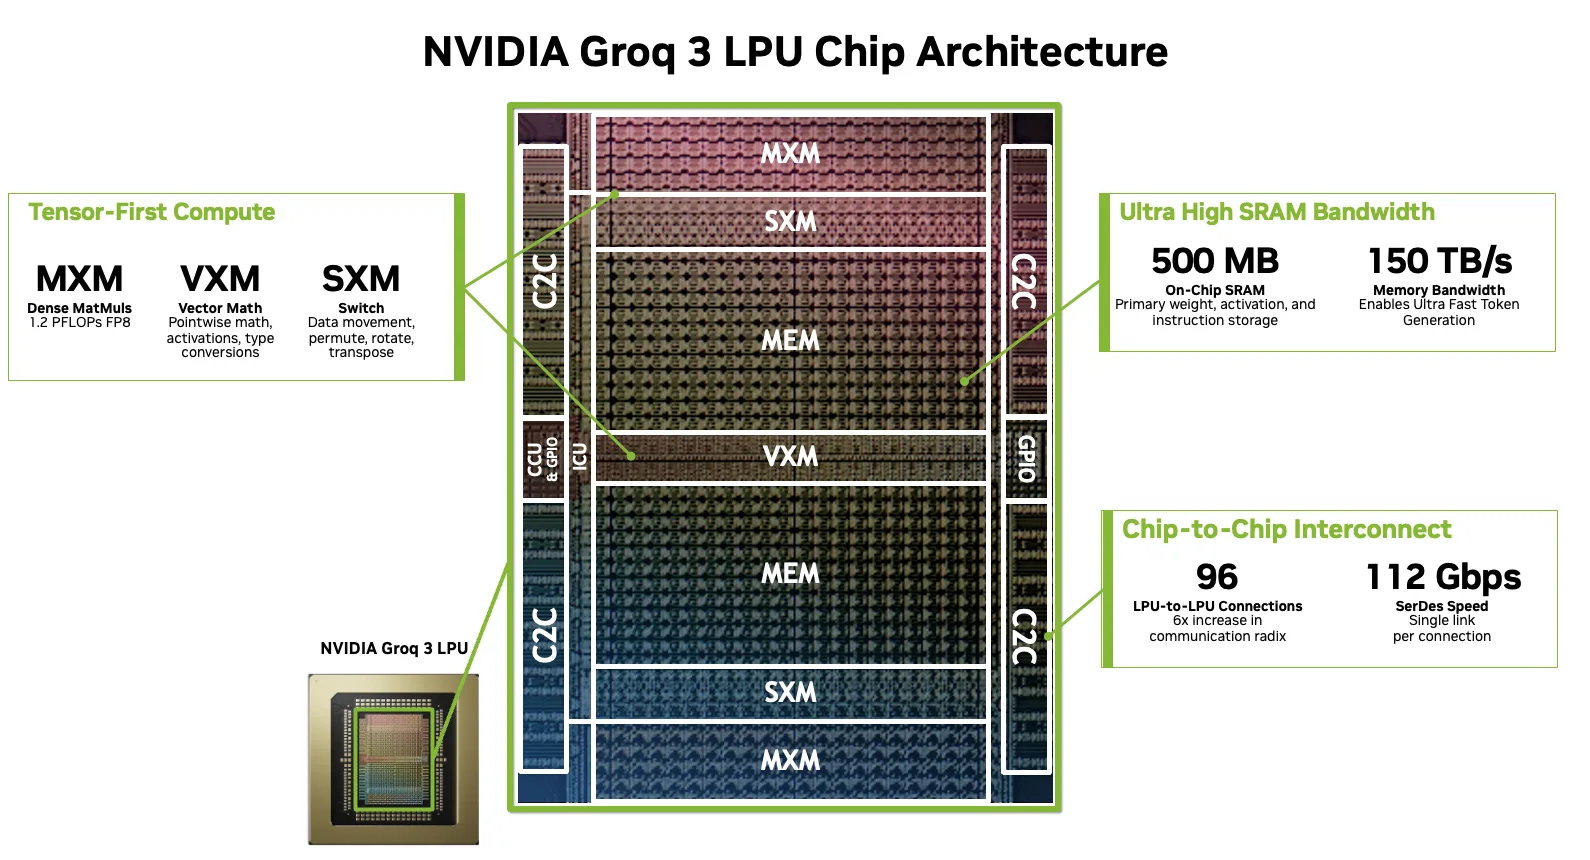
По своей сути, LPU — это очень большой векторный процессор. Фундаментальной единицей как вычислений, так и обмена данными является 320-элементный вектор, состоящий из 320 байт в INT8 и 640 байт в FP16. Каждая операция на чипе, будь то арифметическая операция, доступ к памяти, изменение формы данных или передача данных между чипами, выполняется с использованием этих векторов фиксированного размера.
Источник: Нвидия
Архитектура построена на основе единого базового блока: функционального блока SIMD в паре с облегченным блоком диспетчеризации инструкций. Groq рассматривает это как базовый класс, который подразделяется на четыре различных типа, каждый из которых оптимизирован для определенной категории операций:
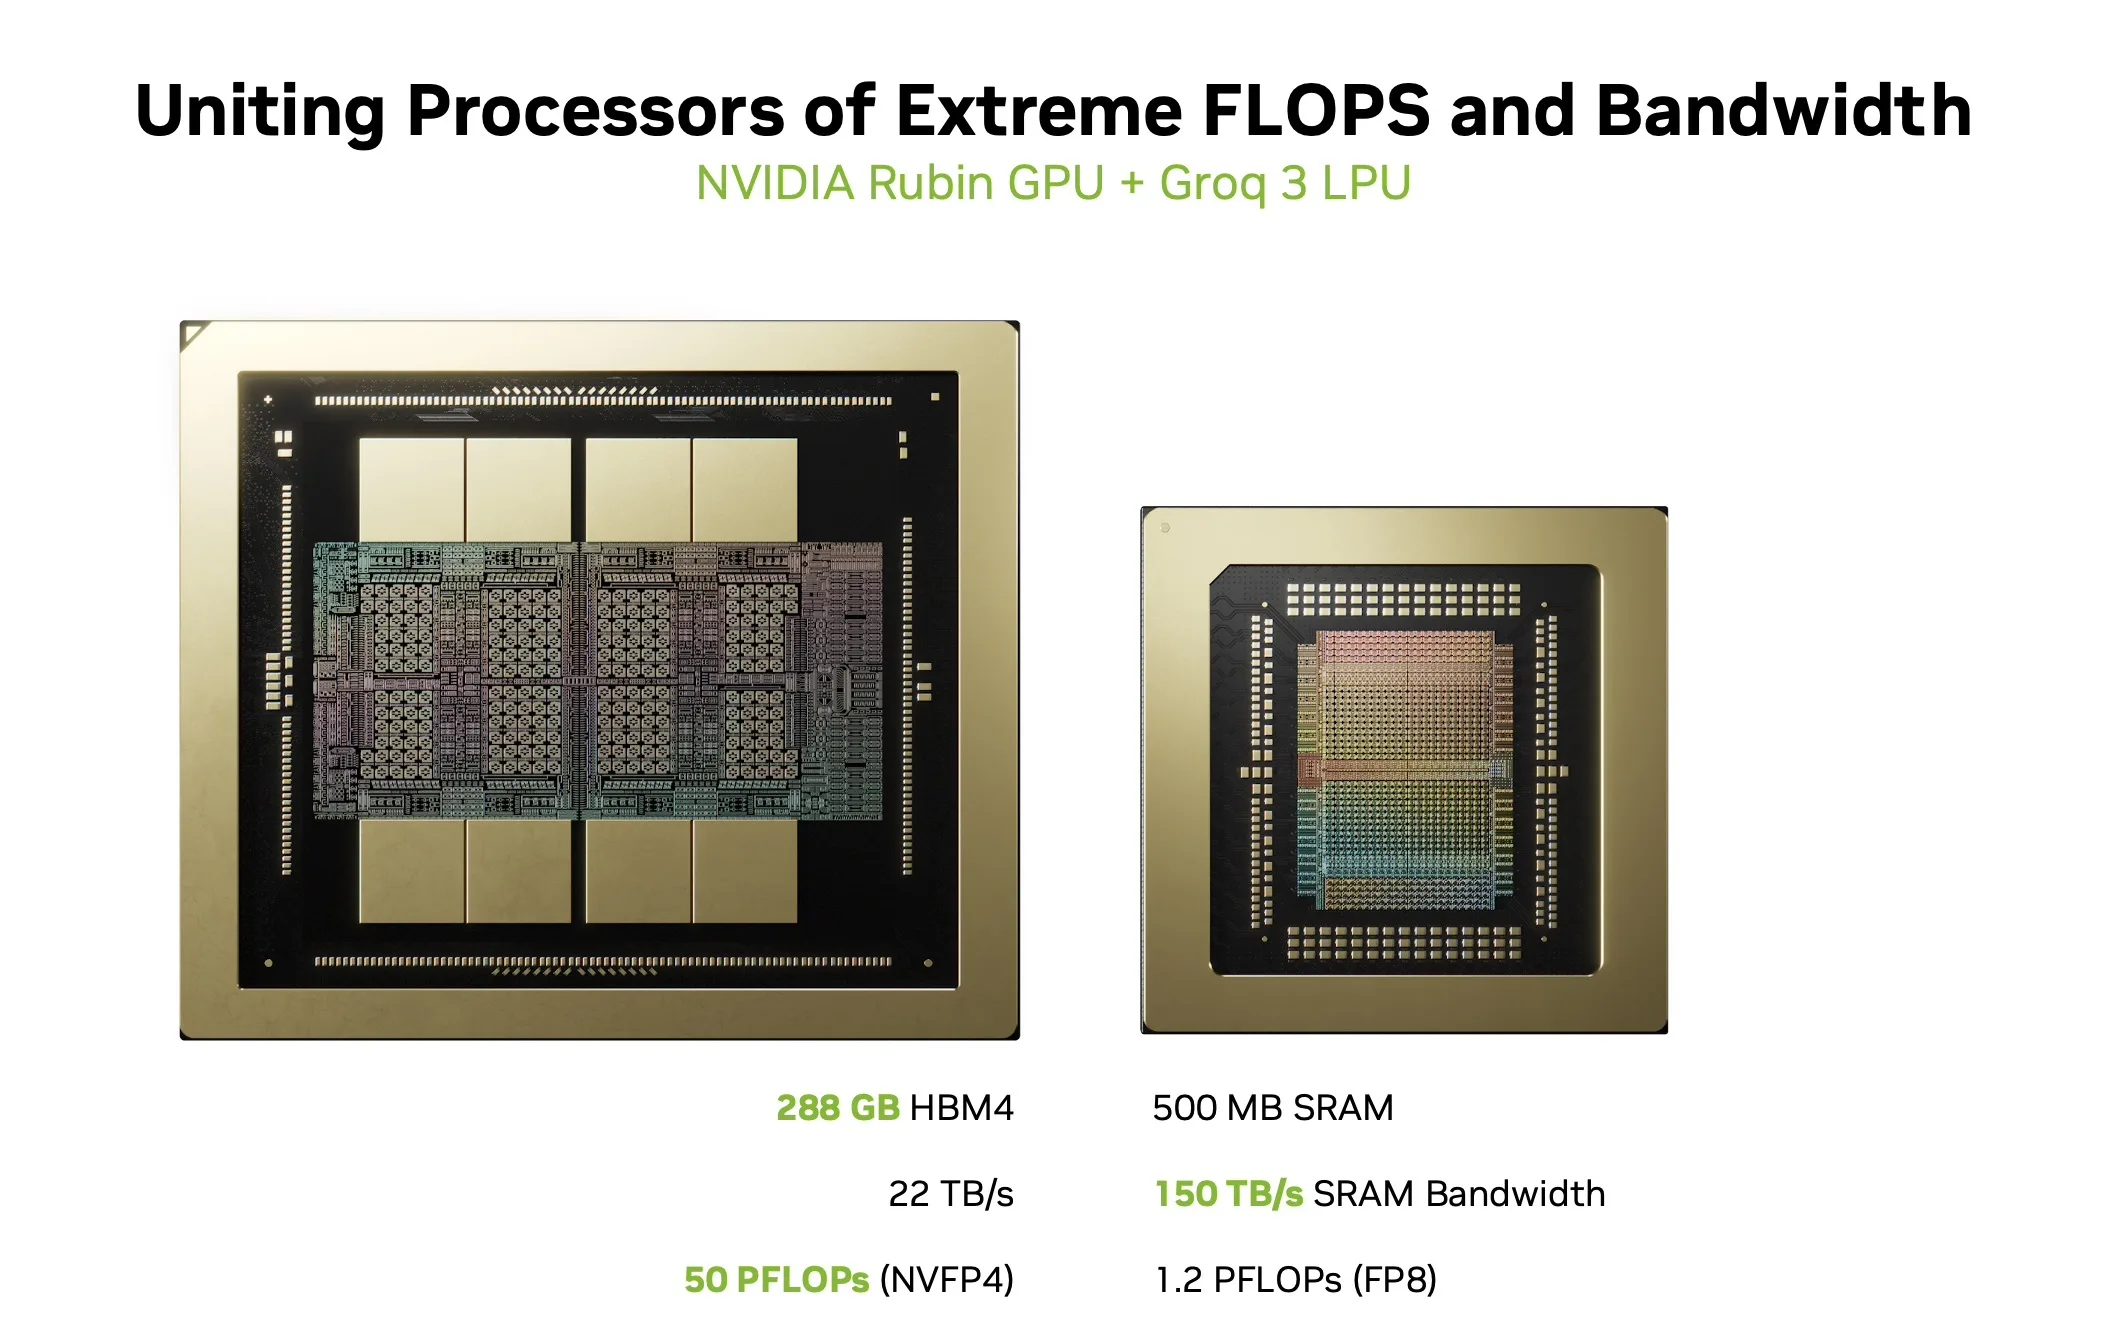
Модули матричного выполнения (MXM): основная вычислительная платформа, обеспечивающая возможность плотного умножения-накопления для матрично-векторных и матрично-матричных операций. Каждый из 8 чипов Groq 3 LP30 в стойке NVIDIA LPX обеспечивает 1.2 PFLOPS вычислительной мощности FP8 на чип, что в сумме составляет 9.6 PFLOPS вычислительной мощности FP8 на один блок LPX.
Векторные исполнительные модули (VXM): обрабатывают поточечную арифметику, логические операции, преобразования типов и функции активации. VXM содержит массив АЛУ, которые компилятор автоматически объединяет в цепочки для формирования составных операций (например, редукция с последующим сложением по смещению, затем активация, затем приведение типов) за один проход.
Модули переключения выполнения (SXM): выполняют перемещение структурированных данных, включая перестановку, вращение, распределение и транспонирование векторов.
Блоки памяти (MEM): Плоская архитектура памяти, в первую очередь SRAM, без кэшей, иерархии и понятия промаха кэша. Groq 3 LP30 предоставляет 500 МБ встроенной SRAM с пропускной способностью 150 ТБ/с. Компилятор напрямую обращается к физическим ячейкам банков памяти, зная точное положение всех данных на протяжении всего выполнения программы.
На горизонтальной стороне микросхемы нанесено несколько копий каждого типа функционального блока. Инструкции поступают сверху и снизу к середине, а потоки данных — с востока на запад, пересекая функциональные блоки для выполнения операций.
Одномерное соединение, потоковые регистры и детерминизм
Потоковые регистры и одномерное межсоединение
Связь между функциональными блоками на LPU осуществляется через потоковые регистры — намеренно простую одномерную систему межсоединений. Существуют два пути связи: один направлен на восток, другой — на запад, при этом каждый потоковый регистр представляет собой один переход. Данные перемещаются ровно на один переход за такт, что означает, что компилятор может рассчитать время передачи между любыми двумя функциональными блоками, выполнив простое сложение или вычитание на основе их физического положения на кристалле.
Внутри межсоединения отсутствуют очереди и механизмы конкуренции. Это упрощает задачу планирования, превращая сложную двумерную задачу упаковки в контейнеры в гораздо более разрешимую одномерную задачу. Игорь Арсовски, главный архитект Groq, лучше всего описывает это так: компилятор точно знает, где будет находиться фрагмент данных через 10 циклов, потому что он будет ровно в 10 шагах от него. Нет никакой неоднозначности, никаких предположений и никакого оборудования, принимающего независимые решения по маршрутизации.
Детерминизм
Отличительной характеристикой LPU является детерминизм. В отличие от обычных процессоров, где динамическое планирование, поведение кэша и конкуренция за доступ к памяти вносят вариативность во время выполнения, LPU работают без вариативности, и каждый функциональный блок функционирует синхронно.
Этот детерминизм достигается за счет устранения таких элементов, как аппаратные блокировки, и переноса всего процесса принятия решений в компилятор; оборудование просто выполняет полученное расписание. Другие преимущества такого подхода заключаются в том, что все работает с абсолютно одинаковой задержкой, и даже энергопотребление предсказуемо в каждый момент времени.
Детерминизм распространяется и на числовую область благодаря технологии TruePoint, которую Groq называет технологией, гарантирующей порядок операций в архитектуре, что позволяет достигать точности уровня FP32 при входных данных FP16 с помощью скалярного произведения из 320 элементов с одним шагом округления. Подробности о том, почему численный детерминизм важен для вывода LLM и почему недетерминированное оборудование выдает незначительно отличающиеся результаты в разных запусках, подробно рассматриваются в техническом документе Thinking Lab «Победа над недетерминизмом в выводе LLM» . Это не является предметом данной статьи, но читатели, заинтересованные в последствиях для численной точности, могут найти соответствующий анализ в технической документации Groq по технологии TruePoint, ссылка на которую приведена в конце статьи.
Как подключаются LPU: RealScale, конвейерная линия и стоечная топология.
Конвейерная линия: как перемещаются данные
На самом простом уровне перемещение данных между LPU работает как конвейер. Когда модель компилируется для системы, компилятор разделяет её на этапы и пространственно отображает каждый этап на группу чипов LPU. Каждая группа хранит необходимые ей параметры весов в локальной встроенной памяти SRAM. Во время вывода между группами чипов передаются только промежуточные выходные данные активации с предыдущего этапа. Данные передаются от чипа к чипу, как продукт, движущийся по конвейерной ленте, при этом каждая станция выполняет назначенные ей вычисления и передает результат следующей. Это принципиально отличается от GPU, где каждый этап вычислений требует извлечения полного набора весов из внешней памяти HBM и записи результатов обратно. На LPU веса уже находятся в памяти SRAM на каждой станции; перемещаются только тензоры активации.
Примечание о C2C-соединениях: RealScale, а не NVIDIA C2C.
Прежде чем перейти к деталям топологии, важно прояснить потенциальный источник путаницы. В системе LPX используются межчиповые соединения (C2C) на основе технологии RealScale C2C от Groq. Это не то же самое, что технология C2C от NVIDIA, используемая в других частях экосистемы NVIDIA. Эти две технологии архитектурно различны:
- NVIDIA C2C — это кэш-когерентный межсоединитель, предназначенный для соединения двух различных типов чипов в рамках тесно связанного модуля, например, для связи между ЦП и ГП. Он использует когерентный протокол с высокоскоростными SerDes и предназначен для гетерогенной связи между чипами в одном корпусе или модуле.
- Groq RealScale C2C — это программно-планируемая, детерминированная, двухточечная межсоединение. Сетевые каналы явно управляются компилятором по потоку и планируются как функциональные блоки первого класса, подобно вычислительным блокам MXM или VXM. Отсутствует аппаратная арбитражная обработка или адаптивная маршрутизация, а пакеты не содержат заголовков источника или назначения. Каналы синхронизированы по фазе и работают как высокоскоростные провода с фиксированной задержкой между микросхемами. Плезиохронный протокол детерминированно учитывает естественный дрейф тактовой частоты между микросхемами, предоставляя компилятору единую общую временную область для всей сети.
Каждое соединение C2C в стойке LPX, будь то внутри лотка, между лотками через магистраль или между стойками через порты на передней панели, использует технологию RealScale. Это та же самая фундаментальная технология межсоединений, которую Groq использует со времен оригинального GroqNode, масштабированная по скорости канала (с 30 Гбит/с до 112 Гбит/с на линию), но с неизменной архитектурой.
Примечание: Следующий раздел, объясняющий возможности подключения, основан на нашем понимании архитектуры, исходя из документации Groq (ссылка в конце), сообщения в блоге NVIDIA и описания стойки, предоставленного нам на стенде GTC:
- Используемые в стоечных модулях LPX каналы связи C2C — это технология Groq, и они отличаются от каналов связи C2C, используемых в других стоечных системах от NVIDIA.
- Четыре C2C-соединения на передней панели каждого из стоечных блоков LPX используются для подключения к соседним стоечным блокам на том же уровне.
- Внутри стойки осуществляется связь между блоками обработки данных (LPU) по принципу «все со всеми».
- Процессор в стойке LPX — x86.
Внутрилотковая связь
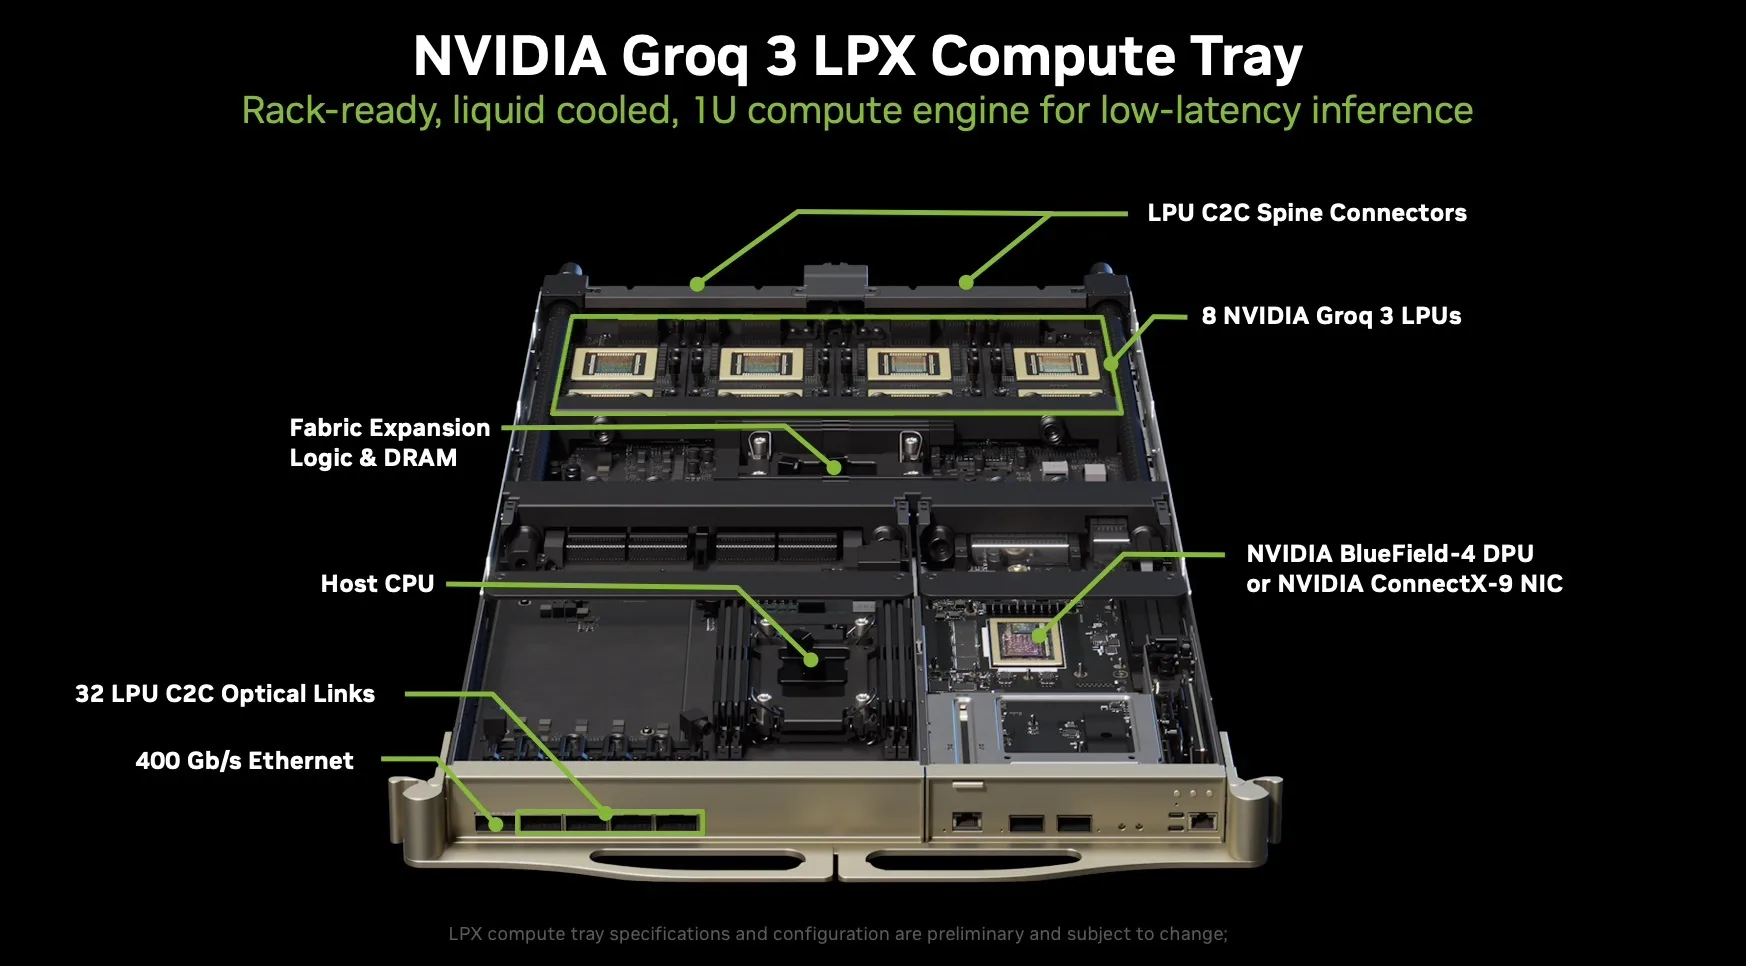
Фундаментальный элемент сетевой топологии Groq не изменился от оригинального GroqNode до NVIDIA Groq 3 LPX. Каждый вычислительный блок форм-фактора 1U содержит ровно восемь чипов LP30, плотно соединенных в полный граф (взаимодействие «все со всеми»), где каждый чип может напрямую взаимодействовать с каждым другим чипом с одинаковой скоростью.
Источник: Нвидия
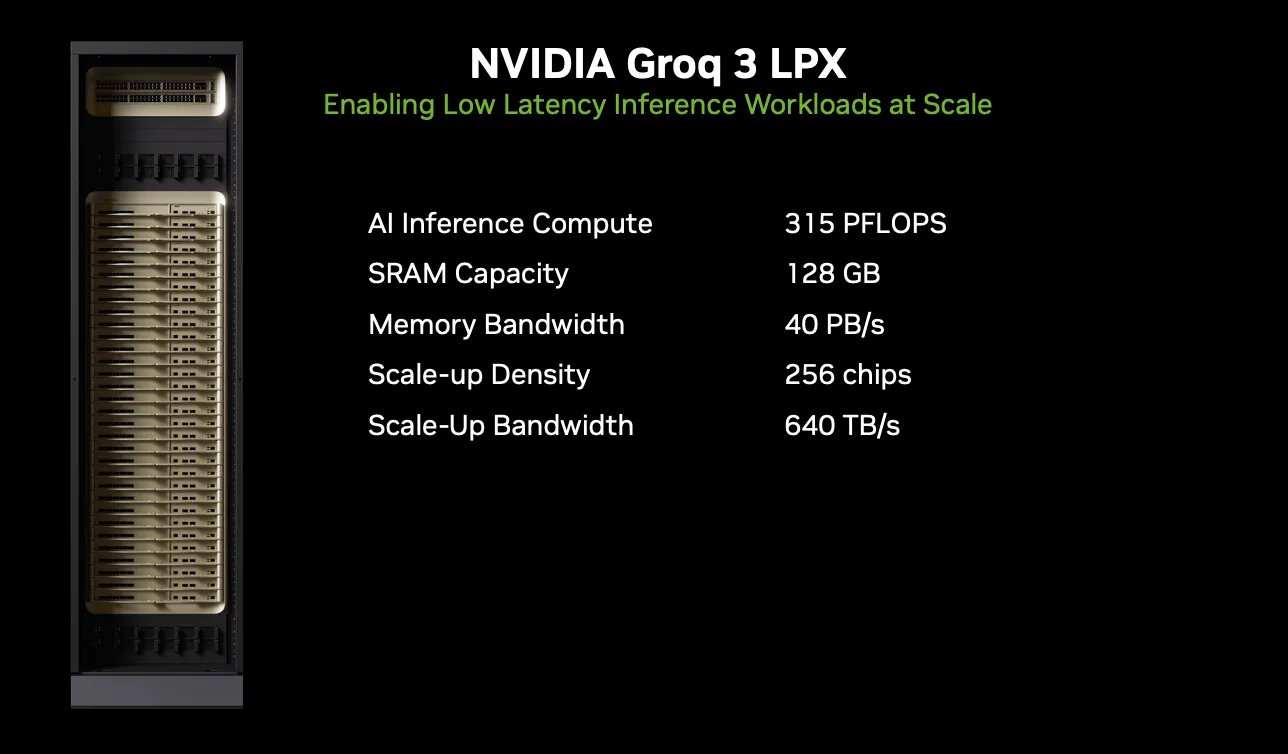
Каждый чип LP30 имеет 96 каналов C2C, каждый из которых работает на скорости 112 Гбит/с, обеспечивая двунаправленную пропускную способность 2.5 ТБ/с на чип. В полной графовой структуре из 8 чипов каждый чип имеет 7 соседей. Количество уникальных ребер между чипами внутри лотка составляет C(8,2) = 28. Часть из 96 каналов каждого чипа выделена для этих внутрилотковых соединений «все со всеми», а оставшиеся каналы направляются к объединительной плате (для магистрали стойки) и передней панели (для межстоечных соединений). В опубликованной спецификации NVIDIA указана общая пропускная способность масштабирования 20 ТБ/с на лоток, что представляет собой суммарную пропускную способность внутрилоткового и магистрального соединений. Мы можем это проверить: каждый лоток имеет 8 чипов × 96 каналов = 768 каналов в общей сложности. Вычитая 32 межстоечных канала передней панели, остается 736 каналов для масштабирования. При скорости 112 Гбит/с на канал это составляет 736 × 112 Гбит/с = 82 432 Гбит/с, или приблизительно 10.3 ТБ/с в каждом направлении, что в сумме дает примерно 20.6 ТБ/с в двунаправленном режиме. Это хорошо согласуется с заявленной NVIDIA скоростью 20 ТБ/с на лоток.
Эта группа из 8 чипов, работающих по принципу «все ко всем», образует «локальную группу» топологии сети типа «стрекоза». Оригинальный GroqChip 1 имел 11 каналов C2C на каждой карте, каждый со скоростью 30 Гбит/с на линию (четыре линии на канал), что в сумме составляло 330 ГБ/с на карту. 96 каналов Groq 3 LP30 со скоростью 112 Гбит/с представляют собой огромный скачок в пропускной способности ввода-вывода на чипе при сохранении той же топологической структуры.
Внутристоечное соединение
В одной стойке LPX 32 вычислительных блока (всего 256 микросхем) соединены между собой четырьмя магистралями ETL в объединительной плате. Эти магистрали передают трафик RealScale C2C между блоками, создавая область масштабирования в масштабе стойки. Суммарная пропускная способность масштабирования по всей стойке составляет 640 ТБ/с (32 блока × 20 ТБ/с на блок). При распределении между четырьмя магистралями каждая магистраль передает приблизительно 160 ТБ/с двунаправленной пропускной способности.
Межстоечное соединение
Каждый вычислительный блок форм-фактора 1U имеет четыре порта QSFP C2C на передней панели, обеспечивая в общей сложности 32 линии (8 линий на порт) для межстоечной связи. Эти порты подключаются к соседним стойкам симметрично: два порта (16 линий) подключаются к левой соседней стойке, а два порта (16 линий) — к правой соседней стойке. Каждая позиция U подключается к соответствующей позиции U в соседней стойке (первая позиция U в стойке A подключается к первой позиции U в стойке B, вторая — ко второй и так далее).
Источник: Нвидия
При скорости 112 Гбит/с на линию, 32 межстоечные линии каждого лотка обеспечивают 32 × 112 Гбит/с = 3,584 Гбит/с, или приблизительно 448 ГБ/с в каждом направлении на каждый лоток межстоечной полосы пропускания. В общей сложности 32 лотка обеспечивают 32 × 32 = 1,024 межстоечных линии. Это составляет 1,024 × 112 Гбит/с = 114 688 Гбит/с, или приблизительно 14.3 ТБ/с в каждом направлении для каждого соседнего лотка (равномерное распределение: ~7.2 ТБ/с в каждом направлении для левого соседа и ~7.2 ТБ/с в каждом направлении для правого соседа).
Пропускная способность между стойками по своей конструкции более разреженная, чем внутристоечная. Внутри стойки масштабируемый домен 640 ТБ/с обеспечивает плотную доступность «все ко всем» по всей магистрали. Между стойками каналы связи на передней панели обеспечивают более разреженные глобальные соединения топологии «стрекоза». Это та же архитектурная схема, что и в оригинальной GroqRack, где четыре внешних канала C2C на чип соединяли локальные группы (узлы), образуя многостоечные системы с малым диаметром сети (максимум три перехода в развертывании из 264 чипов).
В итоге: та же архитектура, в 4 раза больше плотности.
Первоначальная конфигурация GroqRack, состоящая из четырех стоек, включала 264 процессора GroqChip. В одной стойке LPX размещается 256 чипов LP30 в одной стойке MGX ETL, что примерно в 4 раза увеличивает плотность размещения чипов в одном корпусе стойки с жидкостным охлаждением и беспроводным объединительным платом. 8-чиповая локальная группа «все ко всем», топология «стрекоза» и программно-планируемая маршрутизация остаются неизменными. Фундаментальная сетевая технология Groq не изменилась; она масштабирована.
Для моделей, превышающих объем оперативной памяти одной стойки (всего 128 ГБ на 256 микросхемах), несколько стоек LPX или рядов стоек можно соединить через порты C2C на передней панели, чтобы еще больше расширить сборочную линию. Подробнее о том, что это означает для реальных размеров моделей, — в следующем разделе.
Зачем нужны слои FFN? Понимание того, что NVIDIA переносит на серверы.
Почему компании Decode становится все сложнее оказывать услуги
Прежде чем углубляться в детали того, что NVIDIA переносит на LPX и почему, полезно понять более широкие тенденции, на которые указывает NVIDIA, делающие это архитектурное решение необходимым. Выполнение ИИ-вычислений — это не единая, однородная рабочая нагрузка. В рамках одного запроса фаза предварительного заполнения (получение запроса и создание кэша ключ-значение) и фаза декодирования (генерация токенов по одному) предъявляют совершенно разные требования к оборудованию, и эти требования меняются в зависимости от размера пакета, длины контекста и структуры модели.
По мере того, как модели выдают более длинные результаты рассуждений и многошаговые цепочки мыслей, всё большая часть каждого запроса переходит в фазу последовательного декодирования. В то же время такие методы, как кэширование префиксов, снижают стоимость предварительного заполнения за счёт повторного использования общего состояния подсказки в разных запросах, что только усиливает относительную стоимость декодирования. Контекстные окна также увеличиваются до сотен тысяч токенов, что создаёт всё большую нагрузку на пропускную способность памяти во время вычислений механизма внимания. А в агентных рабочих процессах задержка накапливается при многочисленных вызовах модели, взаимодействиях с инструментами и циклах проверки. В результате задержка декодирования всё чаще становится узким местом, которое ощущают пользователи, и оборудование, оптимизированное исключительно для максимальной совокупной пропускной способности, не всегда является оптимальным решением для рабочих нагрузок, требующих быстрой и предсказуемой генерации токенов для каждого отдельного запроса.
Кроме того, как показал пример с запуском быстрого режима от Anthropic , меньшая задержка и более высокая пропускная способность токенов приводят к увеличению доходов, при этом стоимость быстрого вывода данных от Anthropic в 6 раз выше, чем при обычных запросах.
Благодаря анонсу LPX мы понимаем, что NVIDIA хочет переложить самое большое узкое место в процессе декодирования на LPU: слои нейронной сети прямого распространения (FFN). Чтобы понять, почему именно FFN является целью, и оценить масштабы этого решения, мы проанализировали количество параметров FFN для самых популярных на сегодняшний день моделей с открытым исходным кодом.
Что такое слои FFN и почему они доминируют?
Каждый слой Transformer состоит из двух основных блоков: блока внимания и блока прямой связи (FFN). Блок внимания позволяет токенам анализировать и смешивать информацию от других токенов в последовательности. Блок FFN работает с каждым токеном независимо: он проецирует представление токена в многомерное пространство, применяет нелинейность и проецирует его обратно. Его можно рассматривать как хранилище знаний модели, где хранятся фактические ассоциации и изученные преобразования.
Архитектура MoE, или «смесь экспертов», стала доминирующей среди ведущих современных моделей обработки больших языков с открытым исходным кодом: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 и GPT-OSS 120B от OpenAI.
В этих моделях MoE именно блок FFN реплицируется в сотни меньших независимых копий, называемых экспертами, в то время как внимание остается общим. Легковесная функция маршрутизации, основанная на обучении, динамически выбирает небольшое подмножество экспертов для активации для каждого токена. В результате получается модель, которая хранит огромное общее количество параметров, но активирует лишь часть из них для каждого токена, получая преимущества масштабируемости в плане качества без пропорциональной вычислительной стоимости.
Однако, как вы, должно быть, уже поняли, это создает еще одну проблему: слои FFN составляют большую часть весов модели. В частности, для моделей MoE это может составлять до 90% весов модели.
Внутри DeepSeek R1: пример работы
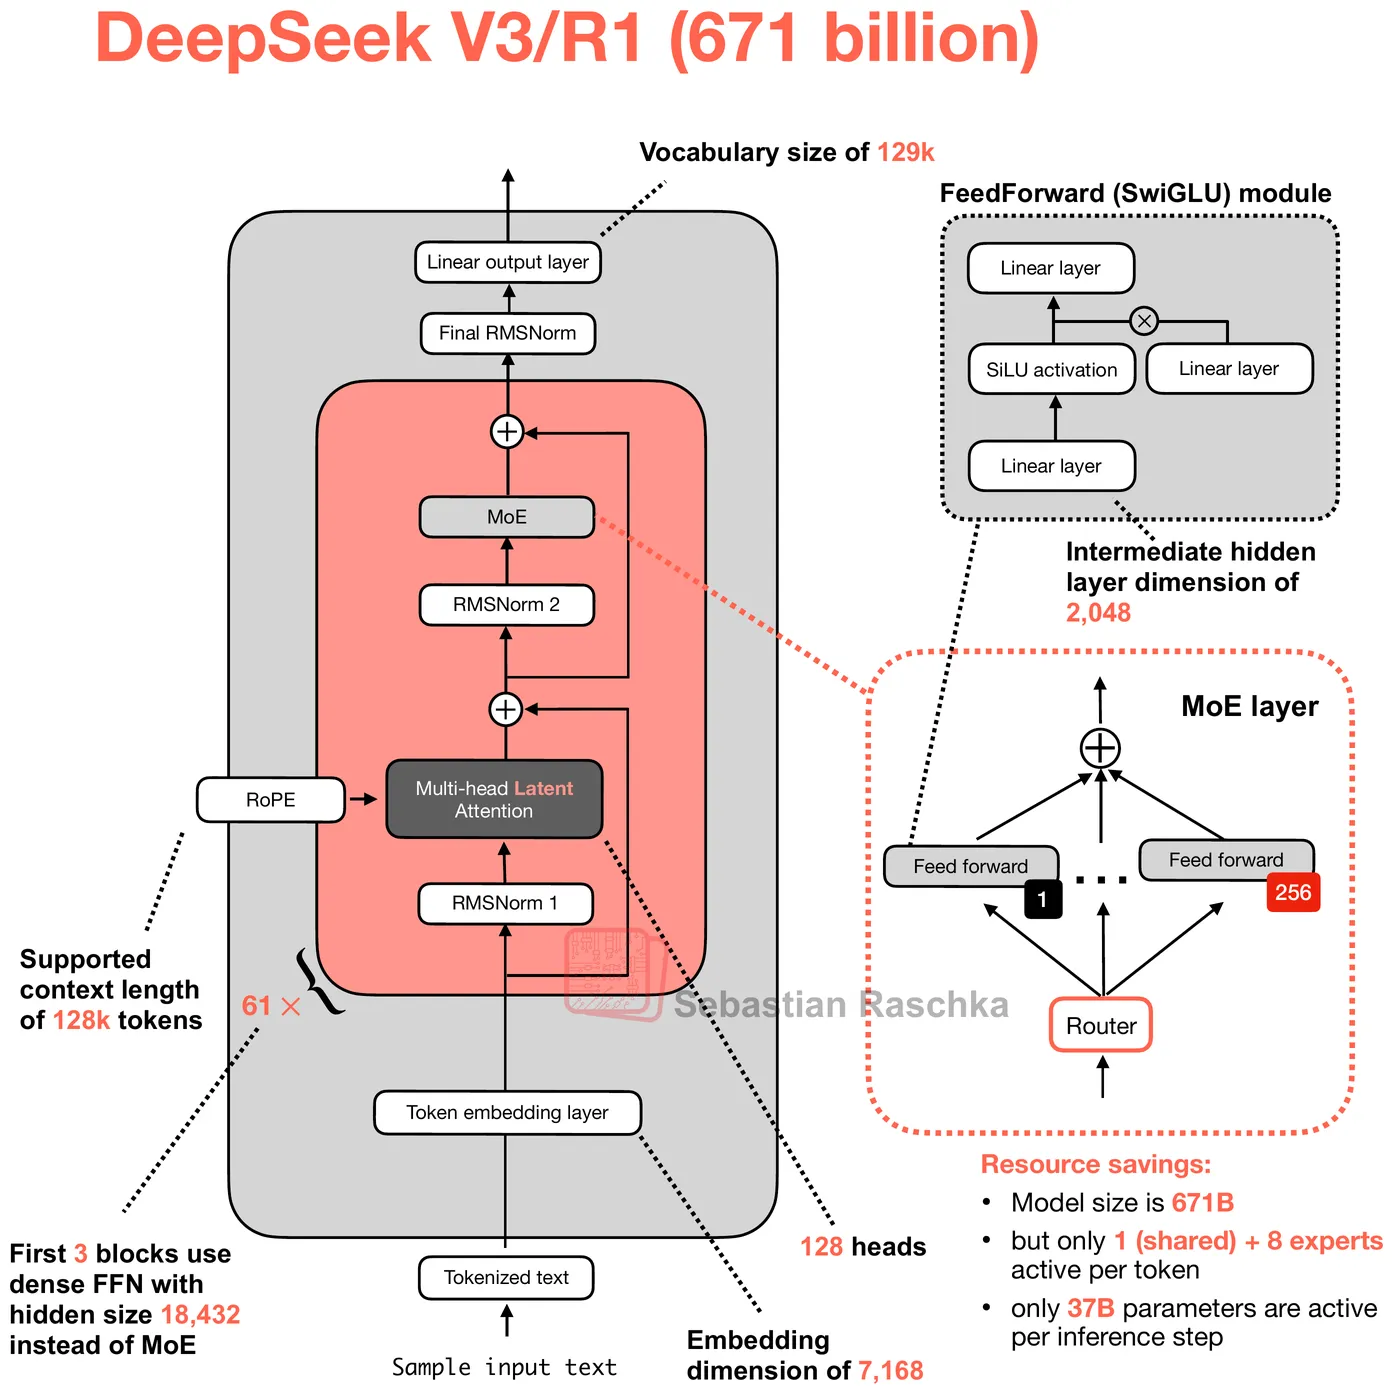
Для наглядности рассмотрим DeepSeek R1. Модель имеет 61 слой Transformer с размерностью скрытого слоя (H) 7,168. Первые 3 слоя используют стандартную плотную FFN, а оставшиеся 58 — MoE (плюс 1 дополнительный слой MTP со своими экспертами, всего 59 слоев MoE). Современные LLM используют вариант, называемый SwiGLU, который имеет три матрицы весов вместо двух. Прямой проход вычисляет w2(SiLU(w1(x)) ⊙ w3(x)), где w1 (проекция вентиля) и w3 (проекция вверх) расширяют размерность скрытого слоя с H до промежуточного размера I, а w2 (проекция вниз) сжимает ее обратно. ⊙ — это поэлементное умножение между путями с вентилями и без вентилей. Ни одна из этих матриц не содержит смещений, поэтому каждый блок SwiGLU FFN содержит ровно 3 × H × I параметров.
Источник: Себастьян Рашка
Для плотных слоев DeepSeek R1 (первые 3) промежуточная размерность составляет 1.8 432, что дает 3 × 7 168 × 18 432 = 396.4 миллиона параметров на слой. Для слоев MoE каждый из 256 маршрутизируемых экспертов представляет собой полный блок SwiGLU с меньшей промежуточной размерностью 2,048, поэтому каждый эксперт имеет 3 × 7 168 × 2,048 = 44.0 миллиона параметров. Умножив на 256 экспертов, вы получите 11.27 миллиарда параметров только в маршрутизируемых экспертах на слой. Кроме того, каждый слой MoE имеет один общий эксперт (один и тот же блок SwiGLU с 44 миллионами параметров, всегда активированный для каждого токена), шлюз маршрутизатора (линейная проекция формы [256, 7,168] = 1,8 миллиона параметров) и небольшой вектор смещения из 256 значений FP32, используемый для балансировки нагрузки во время маршрутизации.
Полная модель FFN содержит приблизительно 669.1 миллиарда параметров. В формате FP8 E4M3 (1 байт на вес) это соответствует примерно 623.1 ГБ данных FFN. Это составляет 97.7% от предполагаемого общего размера модели на диске. Оставшиеся ~2.3% — это веса механизма внимания, эмбеддинги, выходной заголовок, нормы слоев и метаданные масштабирования FP8.
Декодирование и дезагрегация
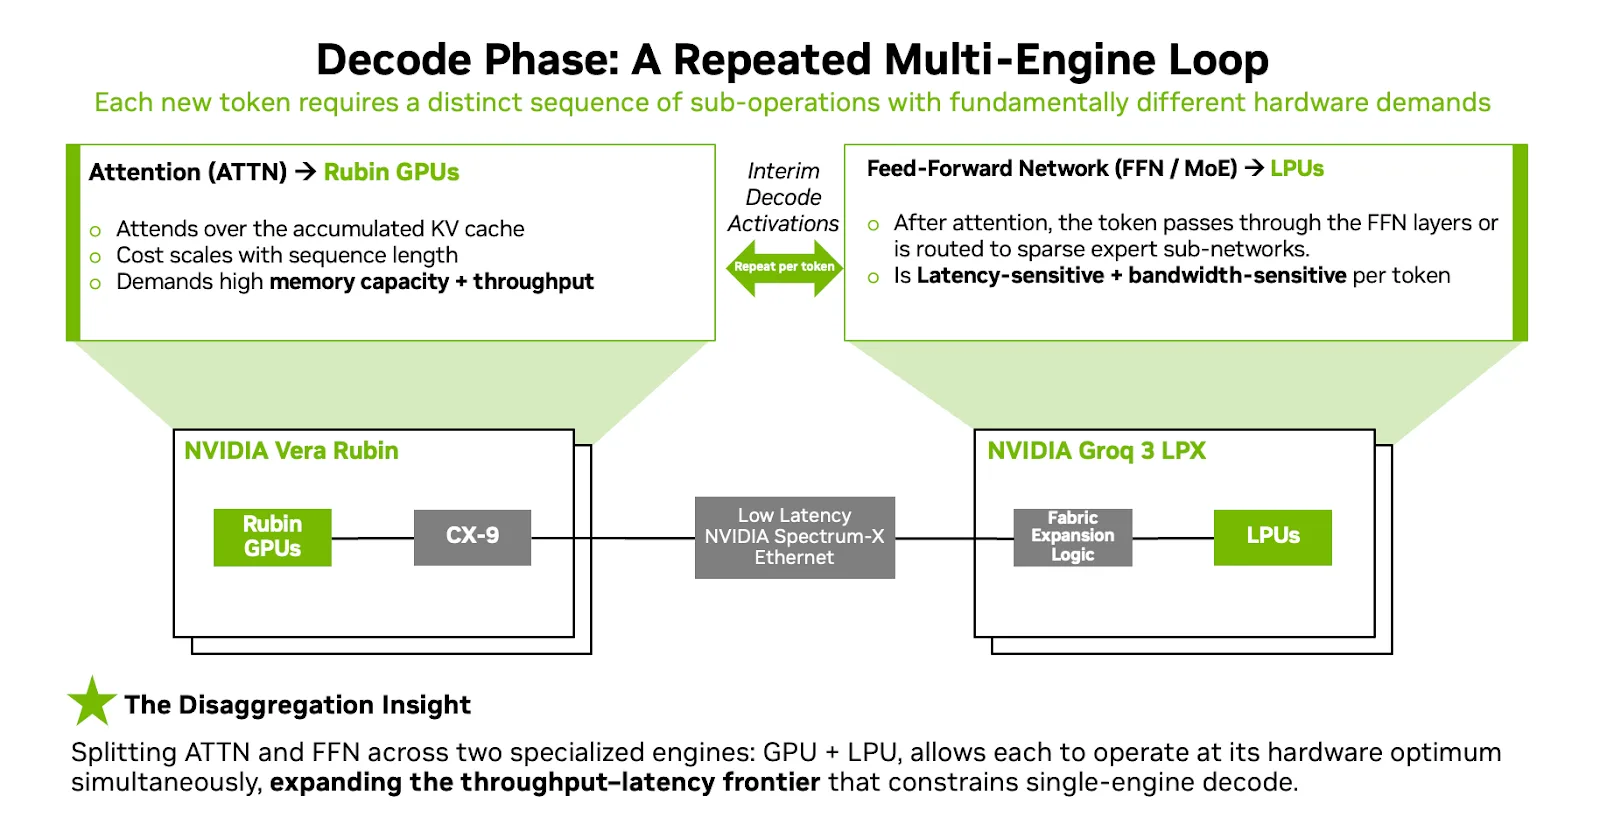
Теперь NVIDIA рассматривает фазу декодирования не как монолитную операцию, а как повторяющийся цикл для каждого токена, где разные части нагружают разные аппаратные узкие места. Фаза предварительного заполнения в основном состоит из обработки больших входных данных и построения кэша ключ-значение — задача, которая выигрывает от плотных параллельных вычислений и большого объема памяти. Vera Rubin NVL72 эффективно справляется с этим, особенно для задач с длинным контекстом, где запрос может быть огромным и сильно варьироваться.
Источник: Нвидия
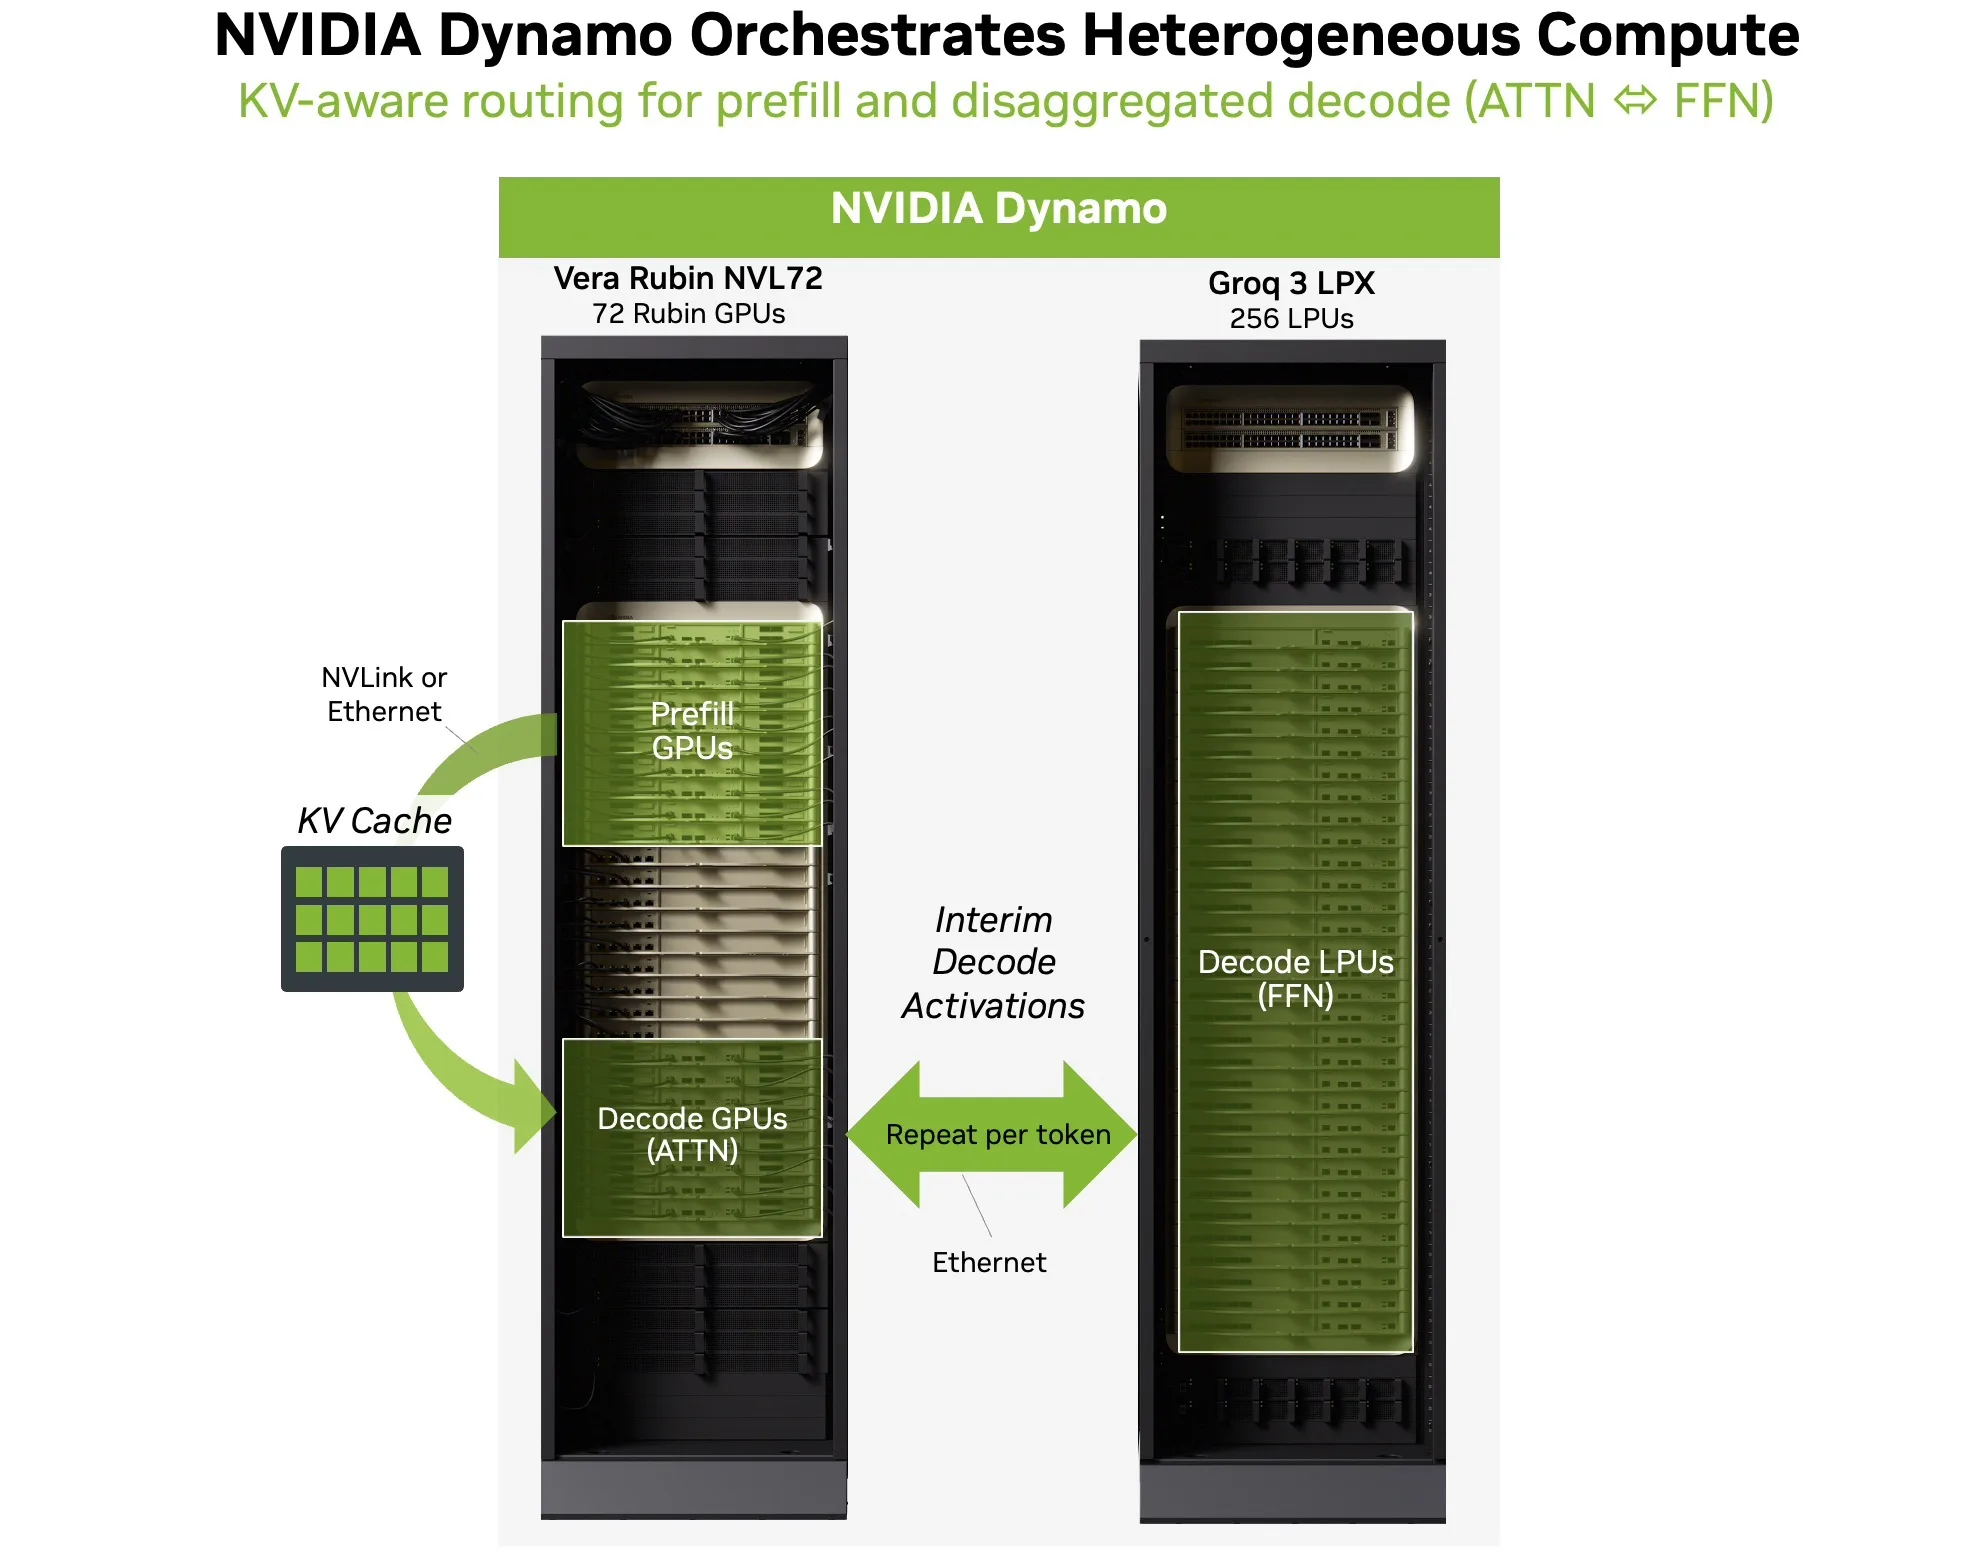
Процесс декодирования отличается. Для каждого нового токена система должна выполнить механизм внимания по всему накопленному кэшу ключ-значение, а затем запустить вычисление FFN/MoE на выходе механизма внимания. В архитектуре NVIDIA Attention-FFN Disaggregation (AFD) эти два шага разделены между двумя движками. Графические процессоры Rubin обрабатывают декодирование механизма внимания: чтение кэша ключ-значение из HBM, вычисление оценок внимания и создание промежуточной активации. Этот тензор активации (то, что NVIDIA называет «промежуточным состоянием тензора») затем передается в LPX, который выполняет экспертное вычисление FFN или MoE с экстремальной пропускной способностью и детерминированной задержкой, прежде чем вернуть результат на графический процессор для продолжения генерации токенов.
Передача данных происходит для каждого отдельного токена. Тензоры активации, которыми обмениваются GPU и LPU, малы по сравнению с данными весов, что как раз и является областью, где сетевые накладные расходы LPU с почти нулевыми затратами проявляют себя наилучшим образом. Разделение использует основные сильные стороны каждого процессора: GPU обеспечивают емкость HBM и гибкое выполнение, необходимые для внимания переменной длины в больших кэшах ключ-значение, в то время как LPU обеспечивают пропускную способность SRAM и детерминированное планирование, необходимые для весов FFN, ограниченных пропускной способностью и статически планируемых.
Источник: Нвидия
Здесь стоит отметить тонкое, но важное свойство масштабирования. По мере увеличения длины контекста вычислительные и оперативные требования к операции внимания также увеличиваются: кэш ключ-значение расширяется линейно с каждым дополнительным токеном контекста, и каждый новый шаг декодирования должен обрабатывать весь накопленный кэш. Однако FFN вообще не увеличивается с ростом контекста. Матрицы весов FFN (w1, w2, w3 в SwiGLU) являются фиксированными константами архитектуры модели. Они имеют одинаковый размер независимо от того, составляет ли контекст 1,000 токенов или 1 000 000 токенов, и каждый токен проходит через них независимо. Это означает, что в архитектуре AFD по мере дальнейшего роста контекстных окон сторона GPU поглощает возрастающие затраты (больше HBM для кэша ключ-значение, больше вычислительных ресурсов для внимания), в то время как сторона LPX остается полностью статичной. Количество стоек LPX, необходимых для обслуживания FFN модели, определяется исключительно архитектурой модели, а не длиной контекста в конфигурации обслуживания. Это позволяет легко решить одну из самых больших проблем, исторически существовавших для ускорителей, использующих только SRAM: растущие потребности в контексте в конечном итоге превышают фиксированную емкость встроенной памяти. В схеме AFD контекстно-зависимая работа остается на аппаратном уровне с расширяемой памятью HBM, а LPU обрабатывает только контекстно-независимую работу, которая естественным образом помещается в фиксированную память SRAM.
NVIDIA Dynamo обеспечивает работу гетерогенного декодирования.
Для обеспечения работоспособности этой двухпроцессорной схемы в производственной среде требуется нечто большее, чем просто оборудование. Именно слой оркестровки NVIDIA Dynamo делает гетерогенное декодирование практичным. Dynamo координирует дезагрегированное обслуживание между бэкэндами GPU и LPU, обрабатывая классификацию, маршрутизацию и передачу активации для каждого токена, необходимые для AFD.
Источник: Нвидия
На практике Dynamo направляет предварительное заполнение на рабочие процессы GPU для обработки входных данных и построения кэша ключ-значение. Во время декодирования Dynamo управляет циклом AFD: GPU выполняют обработку накопленного кэша ключ-значение, промежуточные активации передаются на LPU для выполнения FFN/MoE, а выходные данные возвращаются на GPU для продолжения генерации токенов. В результате получается единый согласованный путь обслуживания, а не две разрозненные системы.
Dynamo также обеспечивает маршрутизацию с учетом ключ-значение (запросы попадают на рабочие процессы, которые уже имеют соответствующий кэш ключ-значение), планирование на основе целевых значений задержки (чтобы интерактивные сессии не попадали в длинные очереди) и управление передачей данных с низкими накладными расходами. Эти возможности важны, поскольку в реальных производственных условиях с переменной длиной контекста, смешанными типами запросов и прерывистой параллельностью уровень оркестрации поддерживает стабильную задержку в конце цепочки и предотвращает ухудшение пользовательского опыта из-за межплатформенных колебаний.
Размеры FFN для всех основных моделей с открытым исходным кодом и размеры LPX.
Теперь, когда мы понимаем, как работает LPX и какие проблемы он пытается решить, давайте рассмотрим, что это означает с точки зрения требований к оборудованию.
Мы рассчитали количество параметров и размер FFN на диске для популярных моделей, используя файлы config.json и model.safetensors.index.json, доступные на Huggingface.
| Модель | Параметры FFN | Размер FFN (на диске) | ФФН % | Dтип | Экспертов |
|---|---|---|---|---|---|
| DeepSeek R1 и DeepSeek V3.2 | 669.1B | 623.1 ГБ | 97.7% | FP8 | 256 |
| Кими К2 | 1.02T | 948.0 ГБ | 98.9% | FP8 | 384 |
| Кими К2.5 | 1.02T | 474.0 ГБ | 98.5% | INT4 | 384 |
| МиниМакс М2.5 | 224.7B | 209.3 ГБ | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 ГБ | 95.4% | MXFP4 | 128 |
| ГЛМ 5 | 738.1B | 1,374.8 ГБ | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 ГБ | 96.6% | BF16 | 128 |
Полученная закономерность подтверждает то, что мы исследовали ранее: во всех моделях в этом анализе параметры FFN составляют от 95% до 99% от общего размера модели на диске. Kimi K2 — наиболее яркий пример: 384 маршрутизируемых эксперта на слой увеличивают количество параметров FFN до более чем 1 триллиона, что составляет почти 99% от общего числа. Даже самая маленькая модель в наборе, GPT-OSS 120B от OpenAI со 128 экспертами, хранящимися в формате MXFP4, по-прежнему имеет FFN, составляющий 95.4% от общего числа. Размеры на диске варьируются от скромных 53 ГБ для GPT-OSS 120B (благодаря 4-битному квантованию) до почти 1.4 ТБ для GLM 5 (хранящейся в формате BF16 без квантования).
Эти цифры помогают нам понять размеры LPX. Одна стойка LPX обеспечивает 128 ГБ оперативной памяти (SRAM) на 256 чипах. Для такой модели, как OpenAI GPT-OSS 120B с 53 ГБ FFN, объем памяти FFN комфортно помещается в одной стойке, и еще остается место. Для DeepSeek R1 объемом 623 ГБ потребуется примерно пять стоек LPX, а для GLM 5 объемом 1.4 ТБ в BF16 — более десяти (хотя квантование до FP8 сократит это примерно вдвое). Именно поэтому необходимы межстоечные порты C2C на передней панели: они позволяют соединять несколько стоек LPX последовательно, расширяя сборочную линию для размещения более крупных моделей.
Ускорение спекулятивного декодирования с помощью LPX
Помимо цикла декодирования AFD, NVIDIA выделяет еще один важный вариант использования LPX: в качестве механизма генерации черновиков в спекулятивном декодировании.
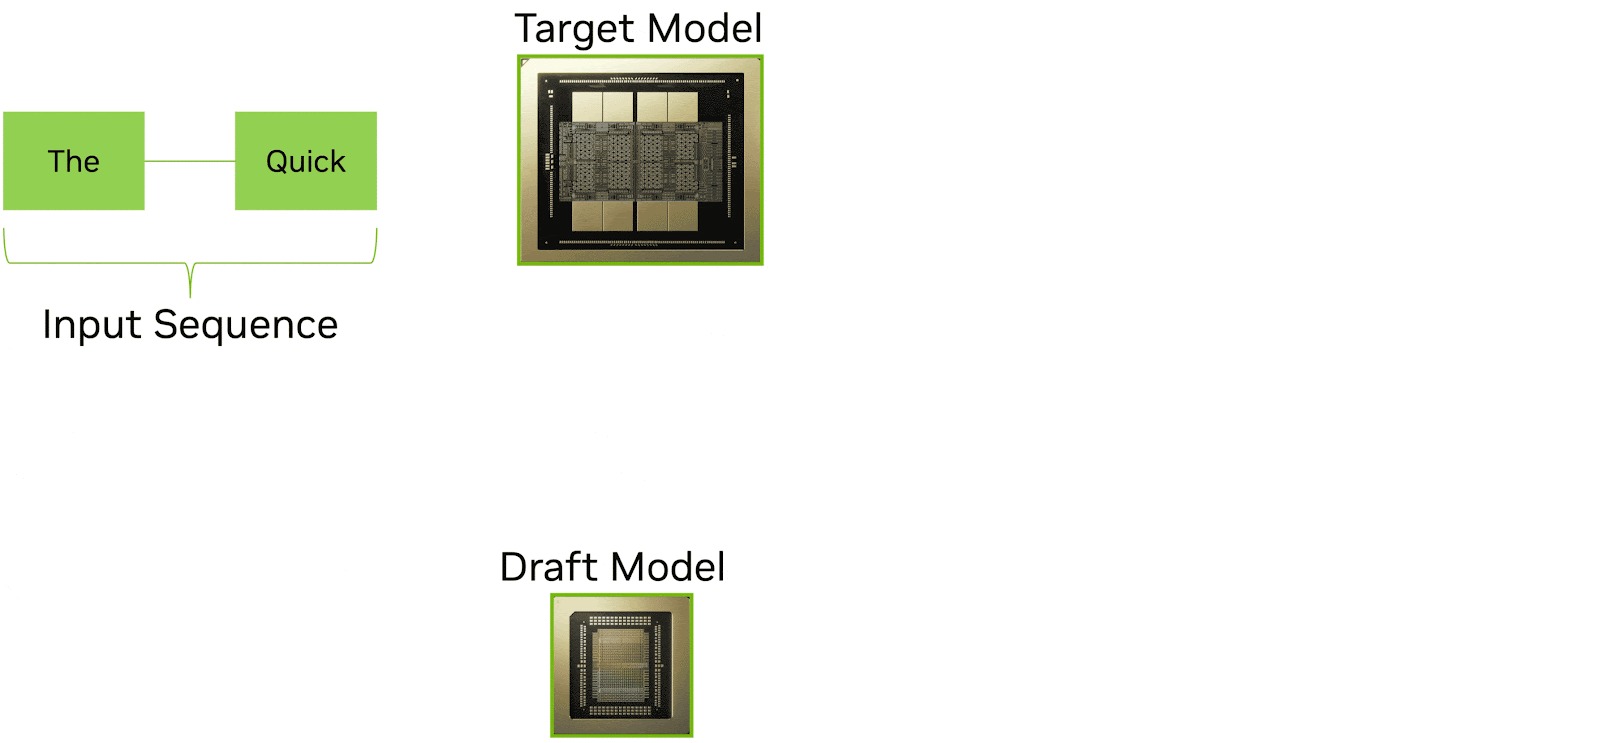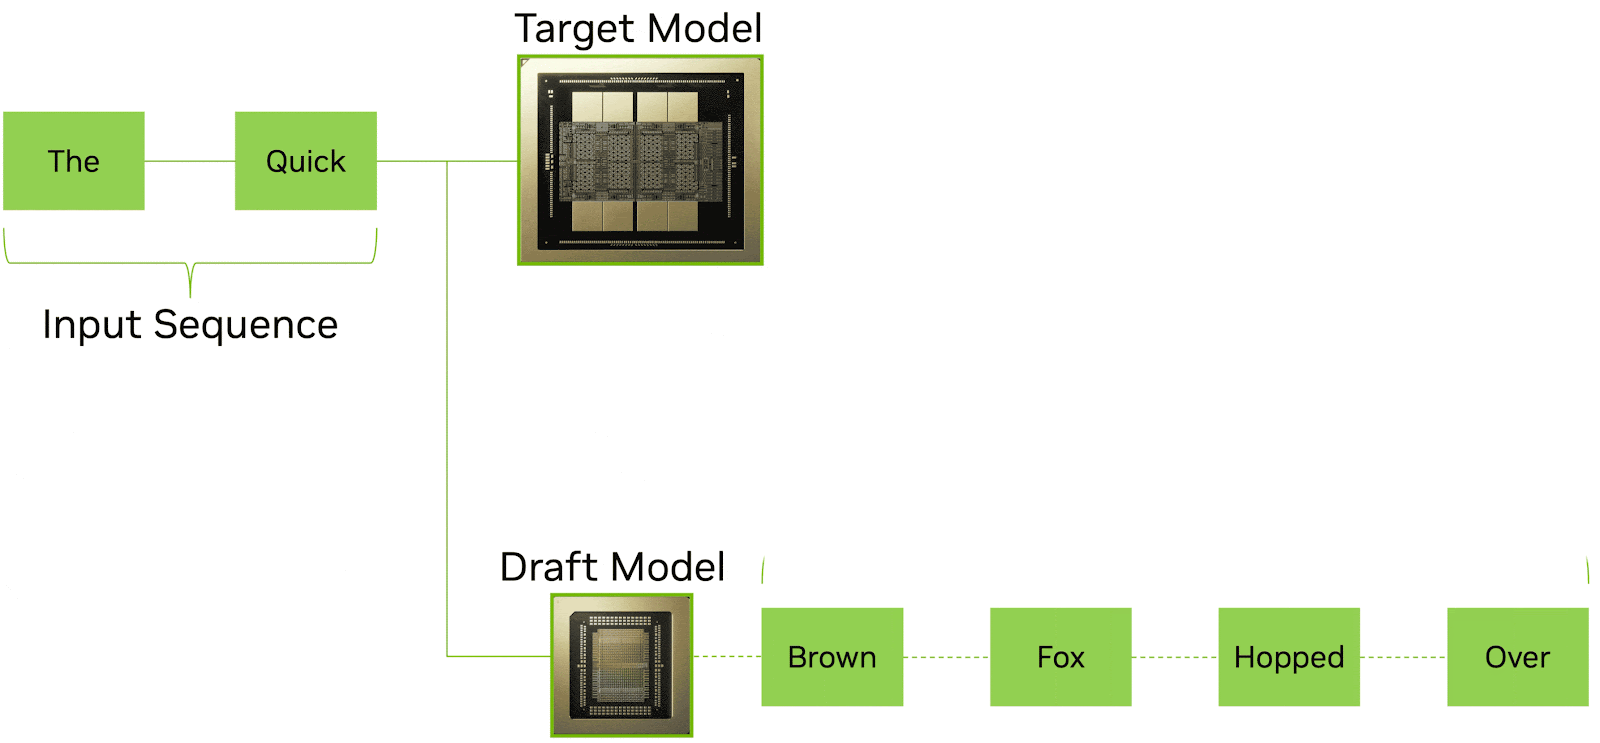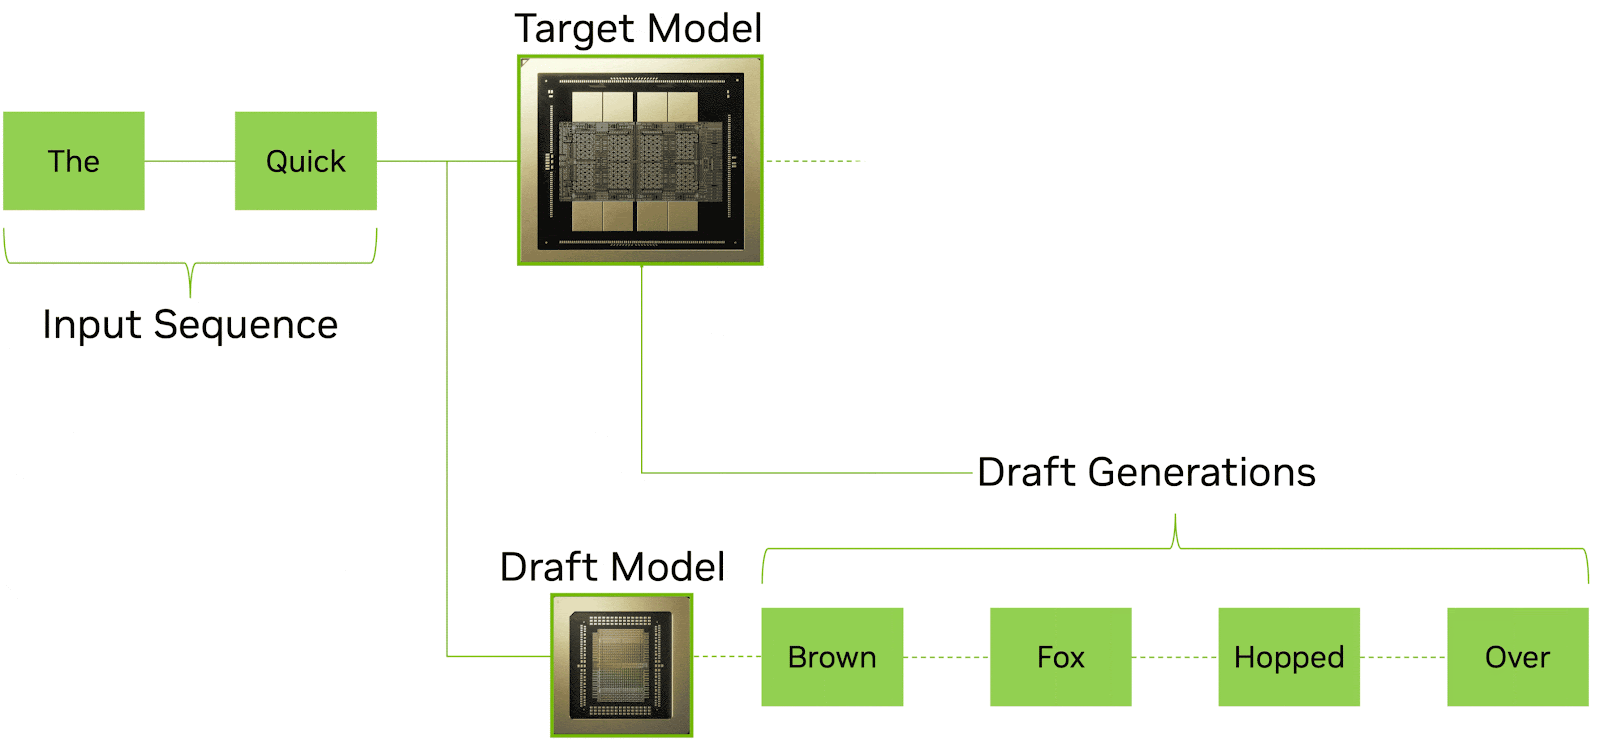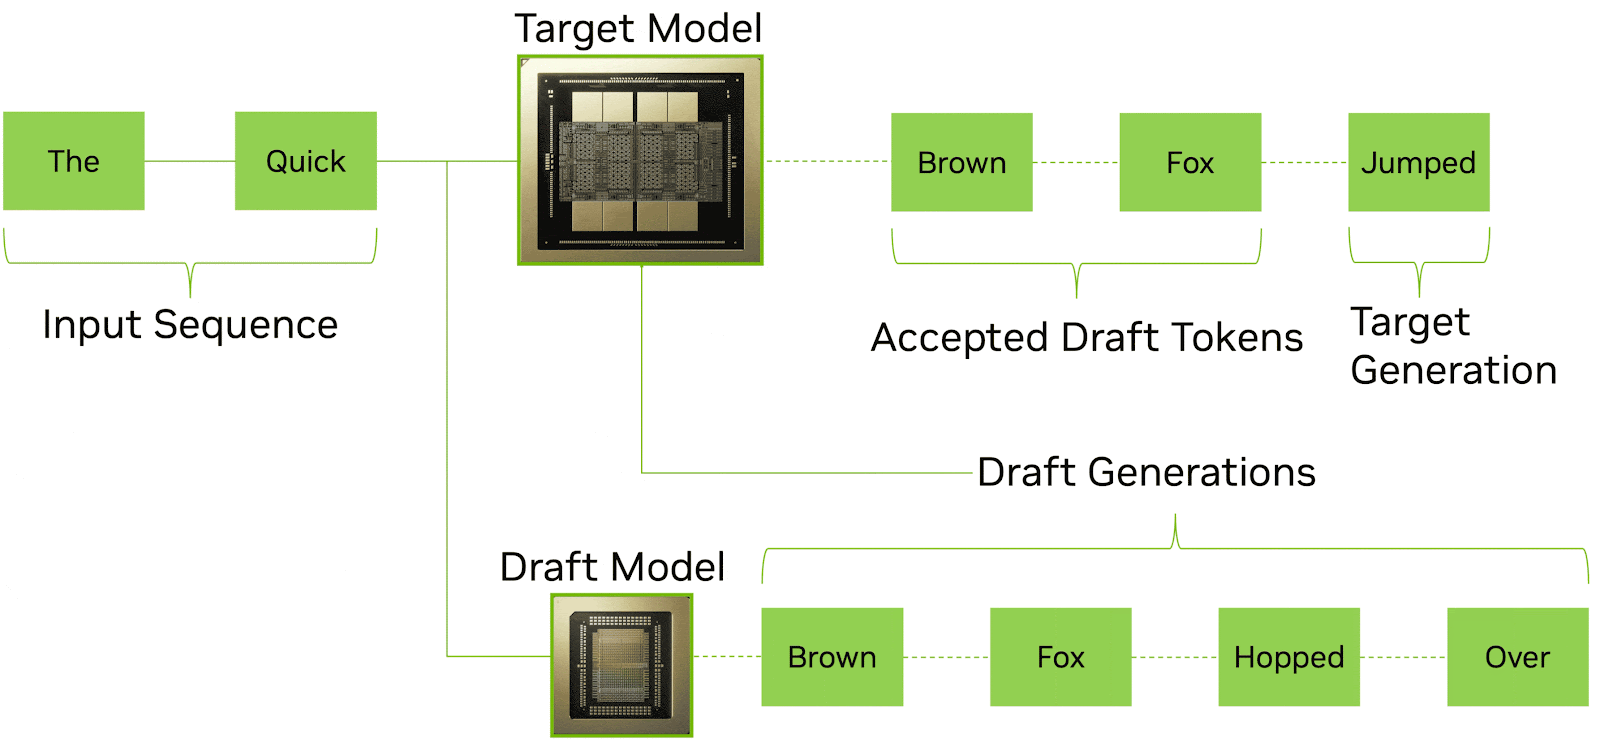
Спекулятивное декодирование — это всё более важный метод снижения задержки при выводе LLM-кода. Идея проста: меньшая и более быстрая черновая модель заранее генерирует несколько потенциальных токенов, в то время как большая целевая модель параллельно проверяет и принимает их. Когда предсказания черновой модели верны (что часто бывает для обычного текста), несколько токенов могут быть зафиксированы одновременно на одном этапе проверки. В результате значительно увеличивается эффективная производительность (количество токенов в секунду) и снижается воспринимаемая пользователем задержка.
Источник: Нвидия
Проблема заключается в том, что спекулятивное декодирование требует от черновой модели чрезвычайно высокой скорости работы. Каждая миллисекунда, которую черновая модель тратит на генерацию кандидатов, — это миллисекунда ожидания верификатора. В обычной конфигурации только с графическим процессором и черновая модель, и целевая модель конкурируют за одни и те же аппаратные ресурсы, а скорость черновой модели ограничена теми же ограничениями пропускной способности HBM, которые влияют на все остальное.
LPX отлично подходит для этой роли. Детерминированная модель выполнения и чрезвычайно высокая пропускная способность встроенной SRAM LP30 обеспечивают очень быструю и предсказуемую генерацию черновых токенов. Меньшая по размеру модель чернового токена удобно помещается в SRAM одного лотка LPX или небольшого количества лотков, а детерминированное планирование гарантирует, что генерация черновых токенов происходит с постоянной и предсказуемой скоростью без отклонений, которые затруднили бы конвейерную обработку с верификатором.
В этой конфигурации система объединяет два процессора для выполнения взаимодополняющих функций: LPX быстро генерирует черновые токены, используя свою архитектуру с низкой задержкой, в то время как графические процессоры Rubin эффективно проверяют и завершают обработку токенов, используя свои высокопроизводительные вычисления и большой объем памяти HBM. Такое разделение позволяет выполнять спекулятивное декодирование на гетерогенных процессорах, вместо того чтобы обе модели использовали один графический процессор, что потенциально повышает скорость генерации черновых токенов и пропускную способность проверки по сравнению с однородной конфигурацией.
Компания NVIDIA выделила спекулятивное декодирование, наряду с AFD, как ключевую рабочую нагрузку для LPX, что свидетельствует о том, что она рассматривает это как значительную часть ценностного предложения системы. По мере развития передовых моделей и удлинения цепочек рассуждений, возможность параллельной генерации и проверки токенов на специализированном оборудовании может стать важным рычагом для поддержания интерактивной отзывчивости.
Заключительные мысли: Экстремальное совместное проектирование аппаратного и программного обеспечения.
Одна из особенностей подхода NVIDIA к платформе Vera Rubin и LPX заключается в том, насколько точно нацелен каждый компонент. В потребительском сегменте мы регулярно сталкиваемся с продуктами, которые пытаются решить проблемы, которых на самом деле ни у кого нет, от компаний, которые не до конца понимают потребности своих клиентов. Стратегия NVIDIA здесь резко контрастирует. Совершенно очевидно, что они понимают проблемы конвейера вывода на чрезвычайно детальном уровне и оптимизируют каждый сегмент этого конвейера, чтобы помочь своим клиентам максимизировать отдачу от оборудования.
Разделение функций внимания и FFN — это не маркетинговая концепция. Это прямой ответ на измеренный профиль узкого места в обслуживании моделей MoE с триллионом параметров. Решение о переносе именно FFN (а не внимания) и преобразовании стойки CPX в стойку LPX отражает точное понимание того, какие операции ограничены пропускной способностью, а какие — производительностью, какие — статически планируемыми, а какие — динамически изменяемыми, и какая архитектура процессора лучше всего подходит для каждой из них. Уровень оркестрации Dynamo, прозрачная интеграция CUDA и беспроводная конструкция стойки MGX — все это указывает на то, что инженерная организация продумала весь жизненный цикл развертывания.
В отношении LPX и новых продуктов NVIDIA по-прежнему остается много неизвестного. Один из главных вопросов, который нас волнует, — каково назначение «Fabric Expansion Logic и DRAM», какой тип кремния для них используется, и, как многие уже заметили, учитывая инвестиции Intel в прошлом году и конструкцию крепления радиатора, скорее всего, это процессор Intel, но какая именно часть — пока остается большой загадкой.
Первоначально развертывание LPX будет ориентировано на разработчиков моделей и поставщиков услуг, а не на широкую доступность. Реальная производительность в условиях производственного трафика, с переменной длиной контекста, смешанными типами запросов и пиковой параллельностью, а также энергоэффективность еще предстоит независимо проверить. Мы с нетерпением ждем возможности получить доступ к этим системам для независимого тестирования.
Ссылки на источники:
Groq: Что такое блок обработки естественного языка?
Groq: Технология межчипового соединения реального масштаба
Groq: низкая задержка для ИИ в реальном времени и высокопроизводительных вычислений
Groq: Детерминизм и тензорный потоковый процессор
Nvidia: Внутри Nvidia Groq 3 LPX…


 Amazon