

На этой неделе на саммите OCP Global Summit в Сан-Хосе компания Samsung демонстрирует пул памяти CXL, протестированный совместно с AMD. Он построен на основе модулей памяти CMM-D CXL и предназначен для выполнения задач искусственного интеллекта с использованием агентов. Компании совместно протестировали память CXL как способ масштабирования объема памяти и пропускной способности в соответствии с количеством ядер ЦП, исходя из предположения, что рабочие нагрузки агентов приводят к резкому увеличению загрузки ЦП, в то время как объем памяти не успевает за ростом числа ядер. Демонстрация пула памяти от Samsung показывает сокращение времени до первого токена до 38% и увеличение пропускной способности до 3.3 раз по сравнению со статическим распределением.
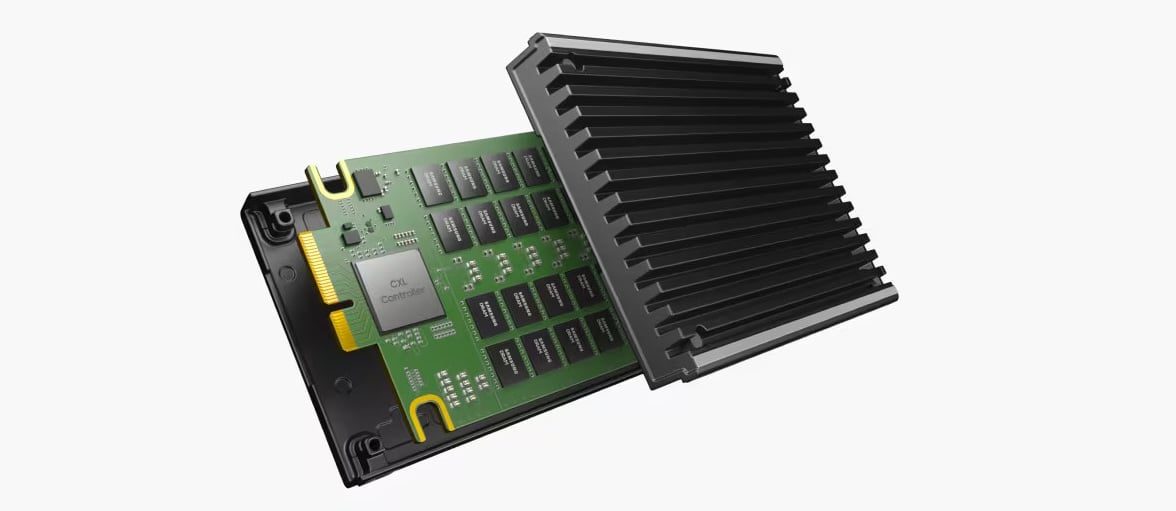
На стенде Samsung, C41 в выставочном зале, линейка памяти и хранилищ разделена на решения для токенизации, охватывающие HBM4E и LPDDR5X-PIM, и решения для кэширования ключ-значение (KV-Cache), включающие модуль CMM-D MD310 CXL, серверный модуль SOCAMM2 LPDDR, твердотельный накопитель PM1763 PCIe Gen6 и BM1773, который Samsung позиционирует как первый твердотельный накопитель E3.S QLC объемом 256 ТБ. Структура соответствует двум этапам конвейера LLM: предварительное заполнение и генерация токенов, которые хранятся в высокоскоростной памяти, и контекст, который должен где-то храниться во время генерации модели.
Архитектура объединения памяти CXL и совместное использование на нескольких узлах.
Демонстрация работы с пулом памяти запускает рабочую нагрузку агента ИИ на сервере с графическим процессором, используя пул памяти CXL, построенный на основе семантики Dynamic Capacity Device (DCD) — механизма CXL, который позволяет пулу передавать память хосту и забирать ее обратно во время выполнения. Несколько экземпляров LLM используют пул с эластичным распределением, поэтому экземпляр, столкнувшийся с пиком контекста или параметра, заимствует емкость и возвращает ее после завершения задания, в отличие от обычной схемы, где каждый узел рассчитывается на пиковую нагрузку, а избыток остается неиспользованным.
Показатели Samsung для демонстрации демонстрируют снижение TTFT до 38 процентов и увеличение пропускной способности до 3.3 раз по сравнению со статическим распределением; это результаты производителя, и мы не проводили их тестирование или проверку.
Сотрудничество с AMD подтверждает эффективность того же подхода на вычислительной платформе AMD, где заявленная проблема заключается в замедлении работы ЦП по мере масштабирования агентных нагрузок, а также в том, что объем памяти и пропускная способность не увеличиваются пропорционально количеству ядер. Samsung утверждает, что CMM-D максимизирует количество одновременно работающих пользователей агентного ИИ, масштабируя их работу пропорционально ЦП. Ни одна из компаний не опубликовала конфигурацию сервера, топологию коммутатора CXL, а также данные о задержке и пропускной способности межсоединений для совместной установки, а вопрос совместного использования нескольких хостов будет обсуждаться на сессии XCENA 15 октября, посвященной динамическому объединению ресурсов, совместному использованию и разгрузке обработки вблизи памяти.
Компания Samsung также располагает производственными данными по уровню памяти, создаваемому этим пулом. Ее узел AI Memory Node с CMM-D работает в американском кампусе Samsung Semiconductor, обслуживая внутренний агент ИИ-программирования и другие приложения, и, по словам Samsung, добавление так называемого компонуемого уровня памяти L3.5 обеспечило увеличение использования кэша KV в 5-7 раз. Эта работа была выполнена лабораторией решений для памяти Samsung, командой по интеграции платформ ИИ и компанией SGLang.
Масштабирование инфраструктуры ИИ
Ходжун Шим, корпоративный вице-президент и руководитель группы разработки приложений в подразделении памяти Samsung, провел 12 октября презентацию для руководителей под названием «Масштабирование инноваций для эпохи ИИ: поддерживайте максимальную производительность вычислительных процессов с помощью масштабируемой памяти». Аргумент, изложенный Samsung на стенде, заключается в том, что одной лишь скорости памяти недостаточно для обеспечения постоянной загрузки вычислительных ресурсов по мере масштабирования моделей, и решение состоит в иерархии: высокоскоростная память для активных вычислений, CXL-матрицы, расширяющие емкость по требованию, и уровни с поддержкой SSD для кэша ключ-значение и сохранения данных моделей.
Вторая сессия, состоявшаяся 13 октября, с участием Джинина Со и Ёнха Чоя из подразделения Samsung по разработке памяти, объединила эту иерархию в одном названии: «Многоуровневая организация памяти агента: от пула CXL до разгрузки кэша ключ-значение на SSD», что соответствует той же многоуровневой организации, которую мы тестировали в нашей работе по разгрузке кэша ключ-значение на флэш-память . В демонстрациях Samsung рассматриваются такие аспекты, как гибкое размещение данных и увеличение максимального размера передачи данных NVMe внутри LMCache для хранения кэша ключ-значение, а также концептуальная модель векторной базы данных, которая переносит вычисления расстояния на SSD.
лексемизацию
Что касается токенизации, Samsung демонстрирует HBM4E, тестирование которой началось в мае , а на выставке FMS в августе компания показала её вместе с моделью HBM5, а также LPDDR5X-PIM, которая размещает процессор в памяти в каждом банке DRAM. Samsung заявляет о до 8-кратном увеличении эффективной пропускной способности по сравнению со стандартной LPDDR5X и до 3-кратном увеличении количества токенов в секунду на своём ускорителе Edge AI Accelerator, согласно результатам тестов, проведённых Samsung на Llama 3.1 8B. Идея заключается в выполнении ресурсоёмких частей обработки данных внутри корпуса DRAM, что позволяет сократить объём данных, передаваемых по межсоединению, а значит, и энергопотребление, и время обработки.
Аппаратное обеспечение и архитектура
Все представленные образцы — это демонстрации или уже существующие продукты: Samsung не указала артикул контроллера CXL для пула, дату начала продаж или мощность, характерные для продукции AMD, а демонстрации HBM4E и LPDDR5X-PIM не содержат информации о сроках выпуска, помимо уже объявленного выпуска HBM4E. CMM-D MD310, PM1763 и BM1773 — это уже отгружаемые компоненты.
| Параметр | Samsung на глобальном саммите OCP 2026 |
|---|---|
| Демонстрации CXL | |
| Сотрудничество с AMD | Память CXL протестирована совместно с AMD для масштабирования объема и пропускной способности памяти в зависимости от количества ядер ЦП и снижения задержек ЦП в агентном ИИ. |
| Демонстрация объединения модулей CMM-D | Пул памяти CXL на основе DCD с эластичным распределением между несколькими экземплярами LLM на сервере с графическим процессором. До 38% меньше TTFT и до 3.3 раз выше пропускная способность по сравнению со статическим распределением (данные Samsung). |
| Узел памяти с искусственным интеллектом и модулем CMM-D | Развертывание производственных мощностей на территории американского кампуса Samsung Semiconductor. Компонуемый уровень памяти L3.5, использование кэша KV в 5-7 раз выше (данные Samsung). |
| Решения по токенизации | |
| HBM4E | Образцы из 12 слоев отгружаются с мая. |
| LPDDR5X-PIM | Блок PIM в каждом банке Эффективная пропускная способность до 8 раз выше по сравнению с LPDDR5X и до 3 раз выше в TPS на Samsung Edge AI Accelerator, Llama 3.1 8B (данные Samsung). |
| Решения KV-Cache | |
| CMM-D MD310 | модуль расширения памяти CXL |
| SOCAMM2 | Модуль серверной памяти на базе LPDDR |
| PM1763 | Твердотельный накопитель PCIe Gen6, скорость последовательного чтения до 28.4 ГБ/с, показан с жидкостным охлаждением. |
| BM1773 | SSD-накопитель E3.S QLC объемом 256 ТБ |
| Другие демо | Накопитель AiSIO с прямым доступом к ускорителю (100 млн операций ввода-вывода в секунду, загрузка модели с холодным запуском до 10 раз быстрее, данные Samsung) FDP и более крупные NVMe MDTS в LMCache Вычисление векторного расстояния NCVS в SSD Компонуемое хранилище с возможностью миграции в реальном времени на стандартных NVMe |
| Доступность | |
| Объединение CXL с AMD | Демонстрация технологии; артикул, дата выпуска и номинальная мощность не объявлены. |


 Amazon