

Uppdaterad 19 oktober 2026: Open WebUI blir det andra valet med uppmätta riktvärden (115.32 och 75.06 tokens per sekund på RTX 5000 Ada-bänken, jämfört med 123 och 82 för januari). Valet täcker nu Windows-skrivbordsappen och server v0.12.2, och Guide-kolumnen länkar till praktiska tester av Open WebUI. Ursprungligen publicerad 19 augusti 2026.
Det finns fyra skäl att köra en språkmodell på din egen hårdvara, och bara en av dem är ideologisk. Integritet: ett dokument som du lämnar till en lokal modell lämnar aldrig maskinen, vilket är hela konversationen för klientkod, kontrakt, patientdata och outgivna produkter.
Kostnadsstruktur: molnbaserad AI mäts och agentiska arbetsbelastningar mångdubblar antalet tokens tillräckligt snabbt för att en kapabel arbetsstation ska kunna betala för sig själv; hårdvaran du äger körs till elpriset. Tillgänglighet: inga tariffgränser, inga avbrott, inget e-postmeddelande om utfasning som ändrar ditt arbetsflöde på en tisdag. Och kontroll: den modell du validerade är den modell du kör tills du bestämmer dig för annat.
Motvikten är att molnmodeller i frontlinjen fortfarande är mer kapabla, och för långsiktigt agentarbete är gapet verkligt. Där lokala modeller har nått paritet är begränsat arbete: chatt, sammanfattningar, kod i en enda fil och frågor och svar om dokument. Det råkar vara det mesta av vad de flesta gör hela dagarna. Om din drivkraft är maximal kapacitet till varje pris, använd molnet. Om din drivkraft är integritet, kostnad eller kontroll är lokalt gångbart idag, och den här sidan är kartan.
Den inramningen bör bestämma din hårdvarubudget, eftersom lokala AI-utgifter är ett minnesbeslut framför något annat. 16 GB VRAM eller 32 GB enhetligt minne täcker 7 till 8B-klassen, vilket hanterar det begränsade arbetet ovan. 24 till 32 GB VRAM, eller 48 GB enhetligt, når 30B-klassen där agentkodning slutar vara en demo. 96 till 128 GB enhetligt minne kör modellerna över 100B som närmar sig frontlinjekvalitet. Överköp köper hastighet som du kanske inte märker; underköp innebär att den modellklass du ville ha aldrig laddas alls.
Våra kort för bästa bärbara datorer för lokal AI och bästa stationära datorer för lokal AI rangordnar maskinerna efter nivå. Den här sidan beskriver vad som ska köras på dem.
Programvarusidan har inte mognat lika smidigt som hårdvaran. Ungefär en tredjedel av de verktyg du hittar rekommenderade i ett sökresultat idag är döda, och de flesta sidor som rekommenderar dem har inte märkt det.
Den här sidan spårar vad som fungerar och på vilken hårdvara, från och med oktober 2026. Vi rangordnar efter GitHub-stjärnor för tillfället, eftersom det är en neutral och verifierbar signal, och vi anger när ett verktyg är sluten källkod och inte har något stjärnantal att ge. Varje verktygsnamn i tabellerna länkar till dess officiella nedladdning. När varje val går igenom labbet fylls Guide-kolumnen i med en praktisk installationsgenomgång och våra egna siffror, med början i januari.
Tre regler styr den här sidan, med början i skillnaden mellan en lokal modell och en lokal agent . Flera produkter körs på din maskin medan varje inferensanrop går till ett leverantörsmoln; det är en integritetspolicy, inte offline-funktion, och dessa verktyg listas separat längst ner så att skillnaden förblir synlig. För det andra har varje post ett realistiskt hårdvaruminimum, eftersom "den körs på en bärbar dator" är meningslös utan en minnessiffra. För det tredje spårar vi vad som dog, med datum, i FAQ.
Valen
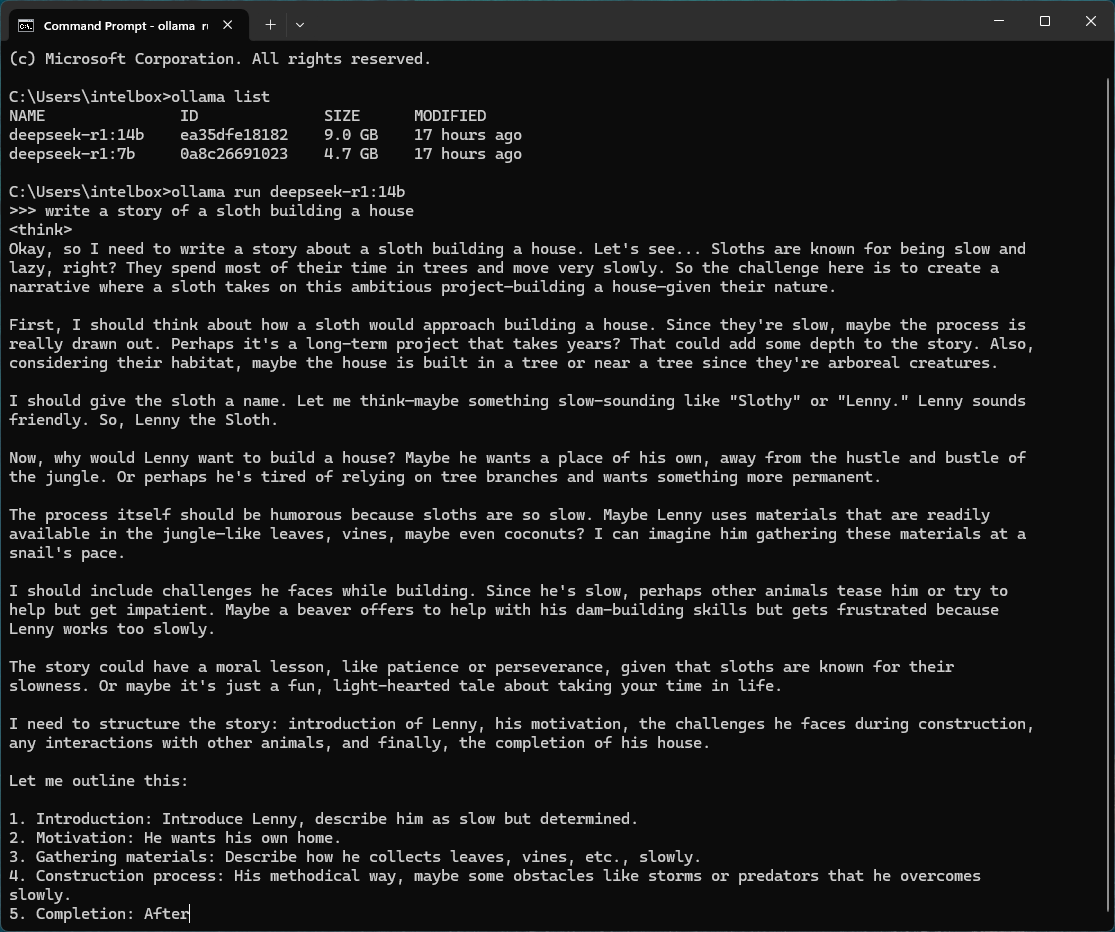
Bästa lokala LLM-körtid totalt: Ollama
Ollama är standardsvaret och det som de flesta andra verktyg kommunicerar med. MIT-licensierad, ungefär 179 000 GitHub-stjärnor, och den levererar nu ett skrivbordsgränssnitt bredvid CLI. Den hämtar modeller med ett kommando, exponerar en OpenAI-kompatibel slutpunkt på localhost, och i januari 2026 lade den till Anthropic Messages API-kompatibilitet, vilket är hur folk nu pekar Claude Code mot en lokal modell. Minimum: 8 GB system-RAM för en 3B-modell, 16 GB för 7-8B, 24 GB VRAM för 30B-klassen.
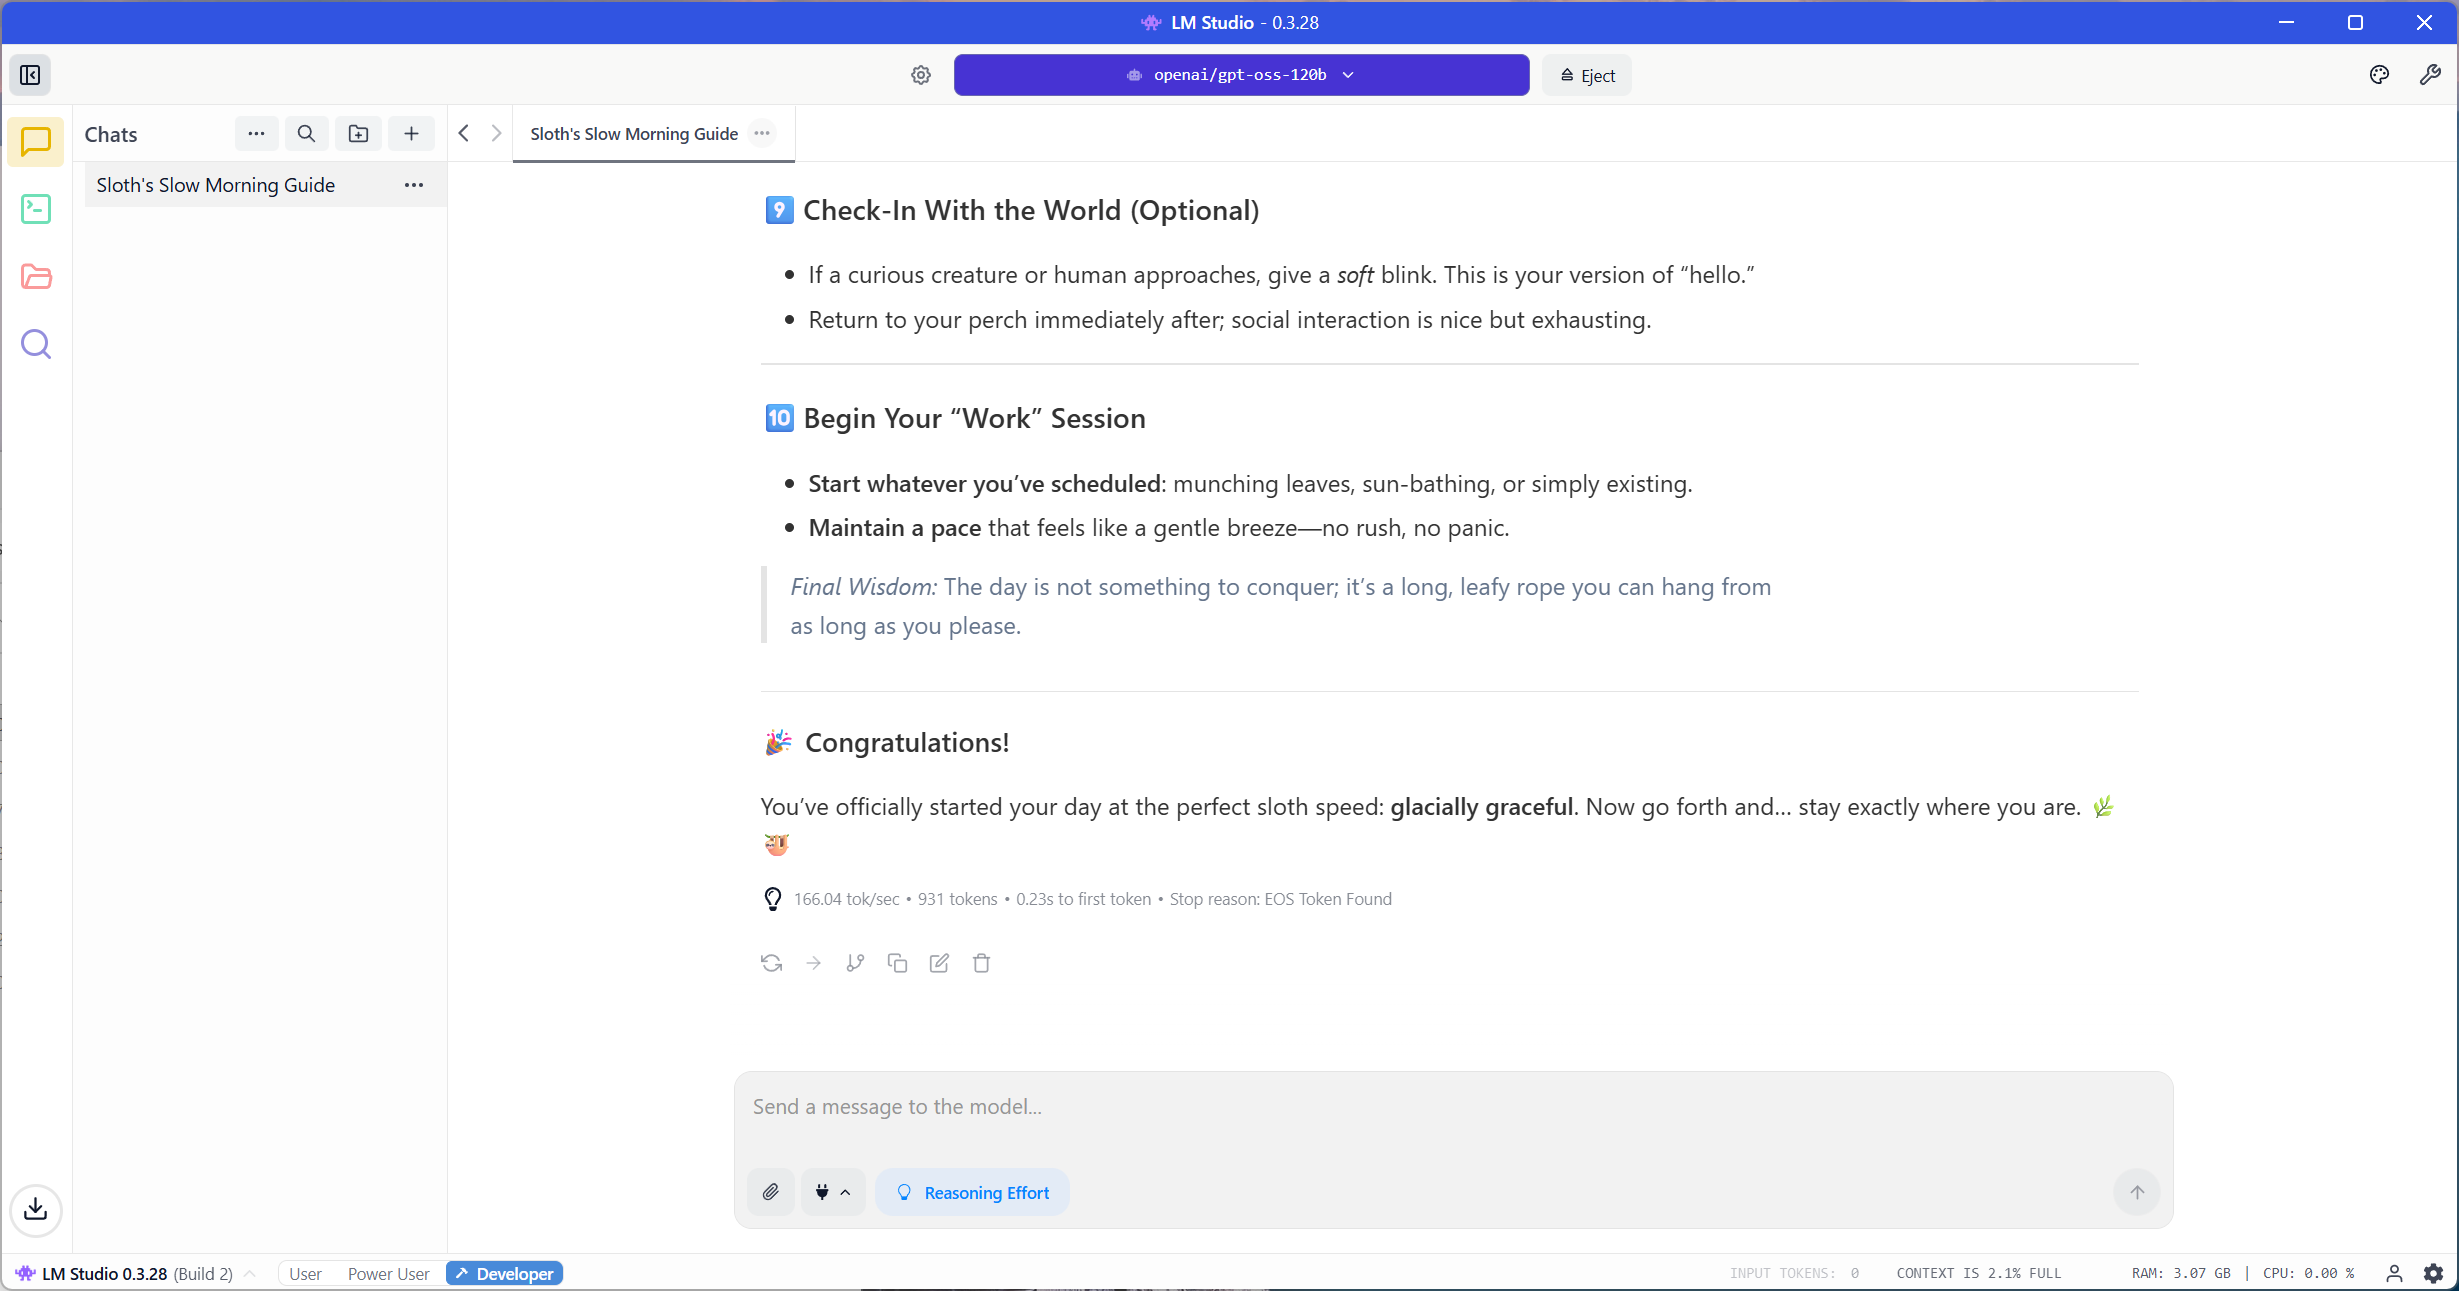
Bäst för benchmarking av hårdvara: LM Studio
Sluten källkod, så den har inget stjärnantal, och den förtjänar sin plats ändå. LM Studio paketerar både llama.cpp och MLX och exponerar de kontroller som är viktiga när du mäter en maskin istället för att använda en: GPU-avlastningslager, kvantiseringsval, kontextlängd och beteende hos flera GPU:er. Det har varit gratis för kommersiellt bruk sedan juli 2025. Detta är verktyget bakom de flesta tokens-per-sekund-siffrorna på våra arbetsstations- och bärbara datorkort. Minimum: 16 GB RAM; 24 GB VRAM eller 32 GB enhetligt minne för att vara intressant.
Bästa underliggande motor: llama.cpp
Nästan allt annat på den här sidan är nedströms llama.cpp. MIT-licensierad, ungefär 124 700 stjärnor, med flera taggade versioner publicerade per dag. Det är viktigt för en hårdvarupublik av en specifik anledning: backend-listan är enorm och täcker CUDA, ROCm, Metal, Vulkan, SYCL, CANN och OpenCL, och leverantörsingenjörer bidrar nu med optimeringar direkt till den. En Intel Arc-förfyllningsförbättring i version 8688 var värd ungefär 5 gånger, och varje Ollama- och LM Studio-användare fick den utan att installera någonting. Minimum: körs på enbart CPU; 8 GB RAM för att vara användbar.
Bästa lokala skrivbordsapp: Jan
Apache 2.0, ungefär 44 100 stjärnor, v0.8.6 från och med oktober 2026. Jan paketerar llama.cpp, så det finns inget annat att installera, och det fungerar med nätverkskabeln utdragen. Det låter som en låg ribba tills man kollar hur många appar i den här kategorin som är molnklienter med ett Ollama-fält. Det här är den man ska ge till en kollega som aldrig öppnar en terminal.
Det är också den första plattformen på den här sidan med våra egna siffror bakom sig: på vår RTX 5000 Ada-bänk avkodades Jan V3.5 4B med en medianhastighet på 123 tokens per sekund och Jan V2 VL High med 82, med 4.8 GB och 8.2 GB GPU-minne, med GPU-acceleration aktiverad vid första uppstarten och ingen CUDA-installation. Den fullständiga genomgången, från installation till OpenAI-kompatibla API:et, finns i vår praktiska guide för januari ; dokumentet RAG är den enda del av appen som den inte täckte. Minsta: 8 GB RAM.
Bästa lokala dokument-RAG: AnythingLLM
MIT, ungefär 64 800 stjärnor. Den paketerar en vektordatabas och hanterar chunking och inbäddning utan konfiguration, vilket gör den till den mest kompletta dokumentchatten i skrivbordsklassen. Två saker vi inte kommer att begrava: en sårbarhet från mars 2026, klassad CVSS 9.6, tillät fjärrkodkörning utlöst av modellens eget strömmande svar, åtgärdat i 1.11.2, så uppdatera innan du använder det. Och telemetri levereras som standard i en app som marknadsförs som lokalt först, vilket du stänger av i Inställningar. Minst: 16 GB RAM för dokumentarbete.
Bästa självhostade fleranvändargränssnitt: Open WebUI
Ungefär 149 000 stjärnor och den djupaste konfigurerbarheten för hämtning här, och vi testade server v0.12.2. Den började som en självhostad server med Docker som startpunkt, och en Windows-skrivbordsapp installerar den nu med en medföljande Python-miljö och sin egen llama.cpp-körningstid. En sak att veta innan du bygger vidare på den: licensen ändrades i april 2025 från BSD-3 till en anpassad licens som inte är OSI-godkänd, med en klausul mot att ta bort Open WebUI-varumärket, med en undantagsgräns för under femtio användare under ett trettiodagarsfönster. Kör den omodifierad i liten skala, och ingenting ändras för dig.
Det är den andra plattformen på den här sidan med våra egna siffror. På vår Jan-bänk och modellfiler avkodade Open WebUI Desktop Jan V3.5 4B med en medianhastighet på 115.32 tokens per sekund och Jan V2 VL High med 75.06, 6.2 respektive 8.5 procent efter Jan på en annan llama.cpp-version. Det är i installationsprogrammet som de skiljer sig åt: vi fäste llama.cpp-versionen b11612, lade till CUDA-runtime-DLL:er manuellt och återställde en kontext med 8 192 tokens efter en ominstallation som lät den allokera upp till 169 984 tokens per plats. Förinställningar, bildinmatning, DDGS-webbsökning och det lokala API:et fungerade sedan alla, enligt vår Open WebUI-hands-on-guide . Minimum: en separat runtime plus 4 GB för containern, eller skrivbordsappen med dess medföljande llama.cpp.
Bästa lokala kodningsagenten: Cline
Apache 2.0, ungefär 63 900 stjärnor. Cline har gjort mer verklig ingenjörskonst på den lokala vägen än någon konkurrent, inklusive en kompakt systemprompt byggd specifikt för Ollama och LM Studio och inbyggda verktygsanrop per modellfamilj. Deras egen dokumentation är ovanligt uppriktig om var molnet fortfarande vinner. Minimum: 24 GB VRAM eller 36 GB enhetligt minne, och inställt kontext till 32 K eller högre.
Bästa offline-terminalkodning: Aider
Apache 2.0, ungefär 48 300 stjärnor, och arkitekturmässigt det mest pålitliga lokala alternativet av en anledning värd att förstå. Aider använder inte JSON-verktygsanrop alls. Den analyserar diff- och helfilsredigeringsformat från vanlig text, vilket kringgår exakt det felläge som förstör de flesta agenter på lokala modeller. Förbehållet är underhåll: en enda författare skrev 96 procent av commits, och releasekadensen har kollapsat till ungefär en stabil release år 2026. Minimum: 24 GB VRAM eller 36 GB unified.
Bästa självhostade agentplattform: OpenHands
MIT, ungefär 84 500 stjärnor. OpenHands dokumenterar lokala modeller korrekt och, ännu mer användbart, berättar när problemet inte är din konfiguration: deras egna dokument anger att om agenten beter sig som en chatbot eller ständigt misslyckas med verktyg, är modellen begränsningen. De vill ha ett minimum av 22K kontext och rekommenderar 32K. Minimum: 24 GB VRAM för kvantiserade modeller, eller 64 GB enhetligt minne.
Bästa gratis offline-överraskning: GitHub Copilot CLI
Sedan april 2026 körs Copilot CLI mot Ollama, vLLM och Foundry Local. GitHub-autentisering är valfri och ingen Copilot-prenumeration krävs. Om COPILOT_OFFLINE ställs in stoppas all telemetri och nätverkskontakt, och dess underagenter ärver din lokala leverantör. De flesta jämförelseartiklar listar det fortfarande som endast molnbaserat. Observera uppdelningen: IDE-tillägget skickar fortfarande inline-kompletteringar till molnet även under "bring-your-own-key". Minimum: en modell med ett kontextfönster på 128K, så 32 GB VRAM eller 64 GB enhetligt.
Bästa leverantörsstödda server: Lemonade
Apache 2.0, ungefär 5 400 stjärnor, och det enda leverantörsnära verktyget här som vi skulle rekommendera enbart på merit. AMD-ingenjörer underhåller det, och det körs på NVIDIA CUDA, Apple Metal, Vulkan och vanliga processorer samt på Radeon och Ryzen AI NPU:er. Det levereras ungefär varannan vecka och flyttade sin skrivbordsapp från Electron till Tauri i april 2026. Minst: 16 GB RAM; Ryzen AI 300-serien eller senare för NPU-sökvägen.
Bästa filsystemomfattande lokala RAG: Nexa AI Hyperlink
Nexa AI Hyperlink är gratis och har sluten källkod, och den indexerar hela ditt filsystem på enheten och svarar med inline-citat. Den finns med på den här listan eftersom det är det enda nya lokala RAG-verktyget med publicerade accelerationssiffror på konsumenthårdvara: ungefär 3 gånger snabbare indexering och 2 gånger snabbare inferens på ett RTX 5090, där en 1 GB-mapp minskar från cirka femton minuter till fyra eller fem. Minimum: ett modernt RTX-GPU; 16 GB RAM.
Körtider: Vad som kör modellen
Dessa fem är motorerna, och allt i de nästföljande två tabellerna är ett användargränssnitt som kommunicerar med en av dem, så tabellen är ordnad efter GitHub-stjärnor precis som resten av sidan.
Guidekolumnen här överlappar apparna, så den är begränsad därefter: Ollama får en egen guide eftersom det är den plockning och backend som de flesta andra verktyg pekar på, LM Studio visas i båda tabellerna och får en guide, llama.cpp täcks genom de appar som bundlar den, med början i Jan hands-on, och MLX täcks genom LM Studio på Apple Silicon. vLLM är en servermotor, och dess test finns redan i vår recension av GB300-kluster med två torn.
| Runtime | Stjärnor | Licens | Minsta hårdvara | Acceleration | guide |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 GB RAM (3 GB), 16 GB (7–8 GB), 24 GB VRAM (klass 30 GB) | CUDA, ROCm, Metal, Vulkan | Kommer snart |
| call.cpp | ~ 124,700 | MIT | 8 GB RAM, fungerar endast med CPU | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Täckt genom jan och Öppna WebUI praktiska |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 GB enhetligt minne | Metal; CUDA-backend tillagd 2026 | Via LM Studio-guiden (kommer snart) |
| LM Studio | Sluten källa | Egenutvecklad, fri för kommersiellt bruk | 16 GB RAM; 24 GB VRAM eller 32 GB enhetligt minne | Paketerar llama.cpp och MLX | Kommer snart |
| vLLM | Produktionsservering | Apache 2.0 | 24 GB VRAM realistiskt golv | CUDA, ROCm | Testad i vår GB300-klustergranskning |
Skrivbordsappar och lokal RAG
Det här är apparna som en läsare installerar, och kolumnen Local-First är den du ska läsa noggrant: den skiljer programvara som kör en modell på din dator från programvara som har lagt till ett fält för en Ollama-URL.
| Applikation | Stjärnor | Licens | Lokalt först | Minsta hårdvara | guide |
|---|---|---|---|---|---|
| Öppna WebUI | ~ 149,000 | Anpassad, inte OSI-godkänd | Kompatibel; server, plus en Windows-skrivbordsapp som paketerar llama.cpp | Separat runtime + 4 GB för container eller skrivbordsappen | Praktisk guide för Open WebUI |
| Vad som helst LLM | ~ 64,800 | MIT | Kompatibel; telemetri aktiverad som standard | 16GB RAM | Kommer snart |
| jan | ~ 44,100 | Apache 2.0 | Ja, paketerar llama.cpp | 8GB RAM | Jans praktiska guide |
| LM Studio | Sluten källa | Patentskyddad | Ja | 16 GB RAM; 24 GB VRAM för att vara intressant | Kommer snart |
| Msty | Sluten källa | Proprietär, gratis nivå | Ja, paket Ollama, MLX, llama.cpp | 8GB RAM | Kommer snart |
| Nexa AI-hyperlänk | Sluten källa | Egenutvecklad, gratis | Ja, indexering på enheten | Modern RTX-grafikkort, 16 GB RAM | Kommer snart |
Kodnings- och agentverktyg
Det här är de mest hårdvarukrävande inläggen på sidan, eftersom agentarbete behöver ett stort kontextfönster och långa sessioner. Betrakta 32 GB VRAM eller 64 GB enhetligt minne som den punkt där detta slutar vara en demo.
| Verktyget | Stjärnor | Licens | Lokal väg | Minsta hårdvara | guide |
|---|---|---|---|---|---|
| ÖppnaHänder | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 GB VRAM eller 64 GB enhetligt minne; 32 000 kontextminne | Kommer snart |
| Cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, OpenAI-kompatibel | 24 GB VRAM eller 36 GB enhetligt minne | Kommer snart |
| Goose | ~ 52,900 | Apache 2.0 | Ollama förstklassig; nu Linux Foundation | 24 GB VRAM eller 36 GB enhetligt minne | Kommer snart |
| hjälpa | ~ 48,300 | Apache 2.0 | Ollama, OpenAI-kompatibel; inga verktygsanrop | 24 GB VRAM eller 36 GB enhetligt minne | Kommer snart |
| Zed | v1.0, april 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB VRAM eller 36 GB enhetligt minne | Kommer snart |
| GitHub Copilot CLI | Sluten källa | Proprietär, ingen prenumeration krävs | Ollama, vLLM, lokal gjuteriexpert | 32 GB VRAM eller 64 GB enhetligt minne; 128 000 kontextminne | Kommer snart |
Leverantörsinitiativ
Varje leverantör av kisel och operativsystem levererar något för lokal AI, och kategorin förtjänar en egen artikel eftersom namngivningen är förvirrande och dödligheten är hög. Mönstret under 2026 är konsekvent: leverantörerna slutade konkurrera med tredjepartsstacken och började mata den. NVIDIA tog bort båda sina egna lokala AI-produkter och publicerar nu optimeringar för Ollama, llama.cpp och ComfyUI. AMD samarbetar med LM Studio. Qualcomm levererade sin NPU-kapacitet genom att porta någon annans app.
Det enda som leverantörsverktyg gör som Ollama och LM Studio inte kan: nå NPU:n . llama.cpp har ingen NPU-backend, så på en Snapdragon- eller Ryzen AI-maskin lämnar dessa verktyg den neurala motorn vid noll procents utnyttjande. Om du betalade för 40 till 60 TOPS är det bara en leverantörsväg som använder den. Sätt förväntningarna därefter, eftersom NPU:er för närvarande toppar runt 7B-modeller, och vinsten är batteritiden på ständigt påslagna småmodeller, inte dataflödet. En separat GPU slår NPU:n på hastighet varje gång.
| Leverantör | Vad det är | Typ | Hårdvara krävs | Status | guide |
|---|---|---|---|---|---|
| AMD-lemonad | Server, GUI och SDK; ~5 400 stjärnor, Apache 2.0 | App + server | 16 GB RAM; Ryzen AI 300+ för NPU. Körs även med NVIDIA, Apple och processorer | Aktiv, skickas ~varannan vecka | Kommer snart |
| Intel OpenVINO GenAI | Körtid och SDK; ~10 700 stjärnor | SDK | Core Ultra, Arc A/B-serien; 16 GB RAM | Aktiv, 2026.3 i augusti 2026 | Spårad, ingen guide planerad |
| Apple Foundation-modeller | Modeller på enheten som exponeras av operativsystemet | OS-ramverk | Apple Silicon; redan installerat | Aktiv; öppen för alla leverantörer vid WWDC 2026 | Spårad, ingen guide planerad |
| Microsoft Foundry Local | Lokal inferens-SDK och CLI; ~2 400 stjärnor | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA april 2026; kurerad modellkatalog | Spårad, ingen guide planerad |
| AMD GAIA | Lokal LLM-app för Ryzen AI; ~1 400 stjärnor, MIT | App + SDK | Ryzen AI 300-serien minst; 16 GB RAM, 64 GB rekommenderas | Aktiv, v0.20.0 juni 2026 | Spårad, ingen guide planerad |
| Intel AI Playground | Skrivbordsapp; ~900 stjärnor | Applikation | Arc A-serien 8 GB+, Arc B-serien, Core Ultra | Aktiv men fortfarande beta efter två år | Spårad, ingen guide planerad |
| Qualcomm GenieX | GGUF-körtid på enheten för Snapdragon NPU | Runtime | Snapdragon X / X Elite, 8 Elite | Förhandsvisning för utvecklare, juli 2026 | Spårad, ingen guide planerad |
| NVIDIA Project G-Assist | Enhetsbaserad 8B-assistent för systemkontroll | Applikation | RTX 20-serien eller senare, 6 GB VRAM | Aktiv men fortfarande märkt som förhandsrelease | Spårad, ingen guide planerad |
Namngivningen ökar förvirringen, eftersom NVIDIAs "RTX AI Garage" låter som en produkt och inte är det; det är en bloggserie. Microsofts stack har bytt namn upprepade gånger: Copilot Runtime API:er blev Windows AI API:er, Azure AI Foundry blev Microsoft Foundry, och DirectML är nu i underhållsläge med endast säkerhetsfixar. Qualcomm AI Hub är en molntjänst som tillhandahåller fysiska enheter på distans, inte något du kör lokalt.
Det som vanligtvis går sönder
De flesta rapporter om att lokala modeller "inte fungerar" är konfigurationsproblem, inte modellproblem. Fyra i synnerhet står för en stor andel av dem, och alla fyra är saker en hårdvarupublik bör känna till innan de skyller på kiseln.
1. Ollama använder som standard en kontext med 4 096 tokens. Den genererar inget fel när du överskrider den. Den avkortas tyst, och en agentisk loop dör tyst. Varje seriös harness behöver mer: OpenHands vill ha minst 22K och rekommenderar 32K, Codex behöver 32K, Copilot CLI behöver 128K och Cline sätter 262 144. Denna enda inställning är förmodligen den vanligaste orsaken till de felrapporter du hittar online.
2. KV-cachekvantisering försämrar specifikt verktygsanrop , och det gör den innan den allmänna utdatakvaliteten synbart försämras. Dokumentationen llama.cpp varnar direkt för det. Om du kör en agent, stäng av den.
3. Verktygsantalet är en klippa, inte en lutning. Över ungefär fem eller sex verktyg i omfattning slutar vissa modeller tyst att skicka giltiga JSON-verktygsanrop och börjar istället bädda in XML i svarstexten, vilket harnessen läser som "inget verktyg använt". En populär agent levererade elva verktyg som standard och bröt sin egen rekommenderade modell fram till början av 2026. Vi hittade en version av detta i vår Open WebUI-testning, där inbyggda verktygsinstruktioner drev en kort benchmarkförfrågan förbi en kontext med 8 192 tokens. Den praktiska konsekvensen är kontraintuitiv: att ladda många MCP-servrar är aktivt skadligt på lokala modeller på ett sätt som det inte är på frontiermodeller.
4. Q4_K_M är det praktiska golvet. Under det faller verktygskvalitetens tillförlitlighet snabbare än den allmänna kvaliteten, så modellen låter fortfarande bra men gör i tysthet ingenting.
Minne är begränsningen
För alla verktyg på den här sidan är frågan som avgör vad du kan köra hur mycket minne acceleratorn kan se. Det här är de parningar vi ser citerade oftast för agentarbete, och de vi avser att verifiera i labbet.
| hårdvara | Modell | Fotavtryck | Rapporterad genomströmning |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~21 GB | 160–180 tok/s, 262K kontext |
| RTX 5090, 32 GB | Qwen3-Kodare-30B-A3B Q4_K_M | ~19 GB | 50-90 tok/s på 24GB-klass |
| RTX 5090, 32 GB | Devstral Small 24B Q4_K_M | ~14 GB | Specialbyggd för verktygsanrop |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~63 GB | 100B-klassen på ett enda arbetsstationskort; GPU:n från vår labbgranskning |
| RTX PRO 5000 bärbar dator, 24 GB GDDR7 | Qwen3-Kodare-30B-A3B Q4_K_M | ~19 GB | Största bärbara grafikkort vi testat (ThinkPad P16 Gen 3); 30B-klassen passar in i kontexten för att spara |
| 96–128 GB enhetlig, M-serien | gpt-oss-120b Q6_K | ~93 GB | 14–20 tok/s; renaste verktygsanrops-JSON av alla öppna viktmodeller |
Värt att säga, eftersom marknadsföringen inte gör det: de största modellerna med öppen vikt är inte arbetsstationsmodeller. GLM-5.2 har ungefär 744B parametrar och behöver i storleksordningen 744 GB i FP8, vilket är en datacenternod med åtta GPU:er. Kimi K2 och DeepSeek V4 tillhör samma kategori. Alla guider som säger att du ska köra dessa på en stationär dator är fel.
Dataflödessiffrorna ovan är hämtade från publicerade tredjepartstester och leverantörsmaterial och är ännu inte resultat från StorageReview-labb, med undantag för avkodningssiffrorna för januari och öppen webbgränssnitt i valen ovan. Vi kommer att ersätta dem med våra egna siffror allt eftersom varje val går igenom guideprocessen.
Molnbaserade verktyg och varför de inte rankas här
En lokal agent är inte en lokal modell , och verktygen nedan visar skillnaden: var och en körs på din maskin samtidigt som de skickar varje inferensanrop till ett leverantörsmoln.
| Verktyget | Stöd för lokal modell | Anmärkningar |
|---|---|---|
| Markör | Nej | Officiella dokument anger att alla förfrågningar går via Cursor-servrar; anpassade nycklar fungerar endast med större molnleverantörer, och tabbkomplettering använder alltid Cursor-modeller. Förvärvades av SpaceX 2026 |
| Devin Desktop (tidigare Windsurf) | Nej | Bytte namn i juni 2026. Varje modell är molnbaserad. |
| Google Antigravitation | Nej | Dokumentationen anger uttryckligen att den inte kan använda Ollama, LM Studio eller en anpassad slutpunkt. |
| Gemini CLI | Nej | Lokalt stöd finns endast i community gafflar |
| Qodo | Nej | ”On-prem” avser självhostad infrastruktur som fortfarande anropar molnmodeller. |
| GitHub Copilot i IDE:n | Partiell | Chatten kan använda lokala modeller; inline-kompletteringar förblir molnbaserade även med "bring-your-own-key" |
| ChatGPT | Nej | Skrivbords- och mobilapparna är klienter för OpenAI:s molnmodeller. OpenAI:s öppna gpt-oss-modeller körs lokalt, men genom körtiderna ovan, inte genom ChatGPT-appen. |
| Claude | Nej | Claude-appar och Cowork körs på Anthropics molnmodeller. Claude Code kan pekas mot en lokal modell via Ollamas Anthropic-kompatibla API, vilket fungerar men är en konfiguration som inte stöds. |
| Allmänna agentassistenter | Nej | Verktyg i den här klassen körs på din dator men är beroende av en molnmodell för resonemang |
Det finns en flitigt återkommande genre av guider som "anslut markören till Ollama". Cursors egen dokumentation motsäger dem. Om offline-drift är ett krav för dig, är den skillnaden hela poängen.
Vad gäller bild- och videogenerering?
Lokal bildgenerering är en av de största communitiesna inom lokal AI. ComfyUI ensamt överväger de flesta verktygen som rankas ovan av GitHub-stjärnor, och lokal videogenerering framstår som den mest VRAM-krävande konsumentarbetsbelastningen som finns. Den förtjänar en egen topplista, och den kommer att få en; att lägga till en fjärde kategori på den här sidan skulle begrava den. Fram till dess överförs hårdvarulogiken på den här sidan direkt: bild- och videoarbete är ännu mer minnesbundet än språkmodeller, och samma nivåer gäller.
Så här fungerar den här sidan
Tre regler styr rankningen, och den första är att ordningen för närvarande sker efter GitHub-stjärnor. Det är inte idealiskt, men det är neutralt, verifierbart och kräver inte att vi låtsas att vi har testat saker vi inte har. Verktyg med sluten källkod markeras som sådana och ges ingen påhittad poäng. Eftersom våra egna tester ger tydliga favoriter kommer ordningen att ändras för att återspegla uppmätta resultat, och vi kommer att säga det; Jan och Open WebUI har nu labnummer bakom sig, så den förändringen har börjat. För det andra har varje post ett minnesminimum, eftersom det är det nummer som avgör om en modell laddas.
För det tredje är Guide-kolumnen ett åtagande som är specifikt för valen: varje rankat val får en praktisk genomgång av installationen med våra siffror på vår hårdvara, en körning som ingår i en app täcks av den appguiden, och leverantörsinitiativ spåras i deras tabell utan en sådan. Länken visas här när varje guide publiceras.
Vanliga frågor om lokala LLM-verktyg
Vilket lokalt LLM-verktyg ska jag börja med?
Ollama om du är bekväm i en terminal, LM Studio om du hellre vill ha ett fönster med kontroller, och Jan om du vill ha något som fungerar direkt ur lådan och aldrig ber dig installera något annat. Alla tre är gratis, alla tre körs helt offline, och alla tre använder llama.cpp under, så modellens beteende är detsamma. Skillnaden är gränssnittet, inte hastigheten.
Vad hände med NVIDIA ChatRTX, GPT4All och Continue.dev?
De är borta, tillsammans med ett förvånansvärt antal av sina konkurrenter, och detta är det absolut viktigaste att veta innan man följer en äldre rekommendation. NVIDIA ChatRTX avvecklades den 21 januari 2026, dess arkiv arkiverades och dess supportforum låstes, utan någon namngiven ersättare.
GPT4All är det knepigaste fallet: det har inte haft några commits på tolv månader, och dess senaste utgåva var februari 2025, men arkivet är inte arkiverat och visar fortfarande ett stort antal stjärnor, så det ser levande ut. Det har bara någonsin stödt en begränsad uppsättning kvantiseringsformat och kan inte ladda de flesta aktuella modellutgåvor.
Continue.dev , som under två år var standardrekommendationen för lokal modellkodning, förvärvades av Cursor och avvecklades i juni 2026. Roo Code stängdes ner i maj 2026, Void arkiverades i juni 2026, Twinny i november 2025 och Reor i mars 2026. Khoj lade ner sin hostade tjänst i april 2026, även om den självhostade versionen finns kvar. På leverantörssidan arkiverades Intel IPEX-LLM i januari 2026 och flaggades för kända säkerhetsproblem utan publicerad migreringsväg, och NVIDIA RTX AI Toolkit avvecklades i november 2025.
Hur mycket VRAM behöver jag för att köra en lokal LLM?
För chatt kör 8 GB system-RAM en 3B-modell, och 16 GB kör en 7 till 8B-modell acceptabelt på enbart processorn. För användbar hastighet vill du ha modellen i VRAM eller enhetligt minne: 16 GB hanterar 7 till 14B-klassen, 24 GB når 30B-klassen vid Q4, och 32 GB eller mer är där agentkodning slutar vara frustrerande. Över det spelar kapacitet större roll än bandbredd, vilket är anledningen till att maskiner med 96 till 128 GB enhetligt minne kör modeller som inget konsumentgrafikkort kan hantera.
Använder lokala LLM-verktyg min NPU?
Vanligtvis inte, eftersom llama.cpp inte har någon NPU-backend, så Ollama och LM Studio kommer att lämna den neurala motorn på noll procent på en Snapdragon- eller Ryzen AI-maskin och köra på CPU eller GPU istället. För att nå NPU:n krävs för närvarande en leverantörsväg: Qualcomm GenieX, AMD Lemonade med sin NPU-körtid, Intel OpenVINO eller Apples Neural Engine genom operativsystemramverken. Vinsten är batteritid och låg strömförbrukning, eftersom NPU:er också toppar runt 7B-modeller idag och en diskret GPU kommer att slå en på dataflöde varje gång.
Ska jag köra lokal AI på Windows eller Linux?
För skrivbordsapparna på den här sidan är Windows och macOS den smidigare resan. LM Studio, Jan, AnythingLLM och Ollama installeras alla direkt, GPU-drivrutiner kommer från de vanliga ställena, och ingenting kräver en terminal. Linux förtjänar sin plats en nivå lägre: produktionsmotorerna, vLLM och SGLang, är Linux-först, multi-GPU-servern tar effektivt över det, och några av de nyaste accelerationsvägarna landar där före någon annanstans, inklusive AMD:s Ryzen AI NPU-stöd, som kom på Linux och vill ha en mycket ny kärna.
Klyftan är mindre än den brukade vara. AMD enhetligade sina ROCm-utgåvor för Windows och Linux år 2026, och WSL2 täcker merparten av resten, vilket är så Docker-baserade verktyg som Open WebUI fungerar utan problem på en Windows-maskin. Den praktiska regeln: om du installerar från skrivbordsapptabellen, håll dig kvar på det operativsystem du har; om du bygger en dedikerad serverbox eller jagar varje accelerationsväg, bygg den på Linux.
Är lokala modeller tillräckligt bra för att ersätta en molnmodell för kodning?
Det beror helt på uppgiften, och uppdelningen är skarpare än vad de flesta täckningar medger. Vid begränsat arbete, generering av en enda fil, enhetstester, standardtester och att förklara kod, är nuvarande öppna modeller på en bra arbetsstation ungefär i paritet med molnmodeller på gränsen. Vid agentarbete med lång horisont, omfaktorering av flera filer över ett stort arkiv, förlorar de tydligt, och fellägena är av den obehagliga typen: tysta no-ops och självsäkert rapporterat arbete som aldrig hände. Om din anledning till att gå lokalt är integritet, krav på luftgap eller kostnad, är det gångbart idag. Om din anledning är kapacitet, är det inte det än.
Är det säkrare att köra en modell lokalt än att använda en molntjänst?
För datalagring, ja, och det är anledningen till att de flesta väljer lokalt. För programvarusäkerhet är svaret nej som standard: en lokal AI-app som fick CVSS-betyget 9.6 i mars 2026 skulle kunna drivas att exekvera kod på värden av modellens egen strömmande utdata, eftersom skrivbordsappen var paketerad med osäkra standardinställningar. Lokalt betyder att dina data stannar kvar, och det betyder inte att programvaran är härdad, eftersom den här kategorin levererar mycket snabb kod.
Vad är en sandlåda för AI-agenter, och behöver jag en för lokal AI?
En sandlåda är en isolerad miljö, vanligtvis en container eller en lätt virtuell maskin, där en AI-agent kör de kommandon och den kod som den genererar, så att ett misstag eller en skadlig instruktion inte kan nå värdsystemet. Den existerar eftersom agenter gör mer än att svara på frågor: de kör shell-kommandon, redigerar filer och bläddrar, och var och en av dessa åtgärder drivs av modellutdata som kan manipuleras. Att köra modellen lokalt ändrar inte den matematiken alls.
Sandboxing handlar om att isolera vad agenten gör, inte var modellen finns, och den ovan beskrivna sårbarheten för kodkörning visade precis vad som menas med en lokalt fokuserad app. Vissa verktyg på den här sidan levereras med inbyggd sandboxing, och de som kör agenter med obegränsad värdåtkomst förtjänar en närmare granskning innan de vidrör en maskin du bryr dig om. I takt med att agentanvändning ökar i affärsmiljöer kan du förvänta dig att sandboxing blir en huvudfunktion, och att vi börjar väga in det i hur vi utvärderar dessa verktyg.
Kan lokal hårdvara köra agentiska arbetsbelastningar med dussintals underagenter?
Detta är gränsen, och det korta svaret är att en enskild arbetsstation snabbt får slut på utrymme. Arbetsbelastningar med flera agenter skapar underagenter som var och en bär sin egen kontext, och på inferenssidan innebär varje aktiv kontext sin egen KV-cache i minnet, så fotavtrycket skalas med samtidighet såväl som modellstorlek. Vart dessa cacher tar vägen när de växer ur minnet är ett eget tekniskt problem; vår djupdykning i KV-cache-avlastning till flash , byggd på Dell- och Solidigm-hårdvara, är den bästa behandlingen av det ämnet vi har publicerat.
En maskin som bekvämt hanterar en agentsession av klass 30B kan vanligtvis hantera ett fåtal parallella sessioner via en batchserver innan latensen försämras; dussintals samtidiga underagenter är serverns territorium, med tillräckligt med minne för att hantera många live-kontexter och en servingsmotor som vLLM byggd för kontinuerlig batchning. Det finns också ett kvalitetstak, eftersom lokala modeller redan förlorar tillförlitlighet i takt med att antalet verktyg växer, och orkestrering mångfaldigar verktyg och överlämningar.
Vår uppfattning är att arbete med en enda agent och få agenter är ett legitimt arbetsstationsjobb idag, och stora underagentflottor är ett infrastrukturjobb. Den gränsen, och den hårdvara som krävs för att överskrida den, är något vi planerar att utforska mycket mer ingående.


 Amazon