

Updated October 2, 2026: NetApp’s card adds Novus — pNFS metadata split from AFF A90 data nodes, orderable now — the Claims Tracker logs its “fastest storage on the planet” claim with the Omdia projection behind it, and the tracker’s intro now distinguishes analyst-audited provenance from vendor-internal testing.
Varje större lagringsleverantör påstår sig sälja den bästa lagringsmatrisen, och i åratal var representationen för bäst snabbast. Nästan ingen tillåter oberoende tester. Dell, Everpure (tidigare Pure Storage), VAST, Weka, IBM, NetApp och Huawei är alla ledande på marknaden för prestanda, och nästan varje siffra bakom dessa påståenden kommer från leverantörens egna interna tester, med fotnoten "faktisk prestanda kan variera".
Den här sidan finns för att reda ut det. Vi delar in bevis för lagringsprestanda i tre klasser och märker varje siffra på sidan därefter: granskade benchmarkrapporter (MLPerf Storage, IO500, SPC-1, där leverantörer skickar in resultat enligt publicerade regler), leverantörspåståenden (specifikationsblad och lanseringssiffror utan oberoende verifiering) och StorageReview-labbresultat (system vi själva har mätt). När en leverantör inte låter oss testa sin disk, säger vi det; avsaknaden av verifierbara data är en del av historien.
Ledarna inom AI-lagring
Det här är de leverantörer som dyker upp när ett AI-utbildningskluster eller ett neocloud byggs. Vi rangordnar dem inte eftersom vi inte har kommit överens om någon enskild mätning. Vad vi kan göra är att ge var och en samma faktauppsättning: vad plattformen faktiskt är, var den distribueras under ett kundnamn, om NVIDIA har validerat den, om den har ett granskat benchmarkresultat och vilka av dess prestandapåståenden som förblir overifierade. Om en leverantör publicerar nyheter om något av dessa uppdaterar vi profilen.
De fyra första är AI-baserade lagringsspecialister. Resten är etablerade leverantörer av företagslagring med AI-produktlinjer. Båda grupperna vinner riktiga driftsättningar; de anländer med väldigt olika mängder bevis.
VAST-data
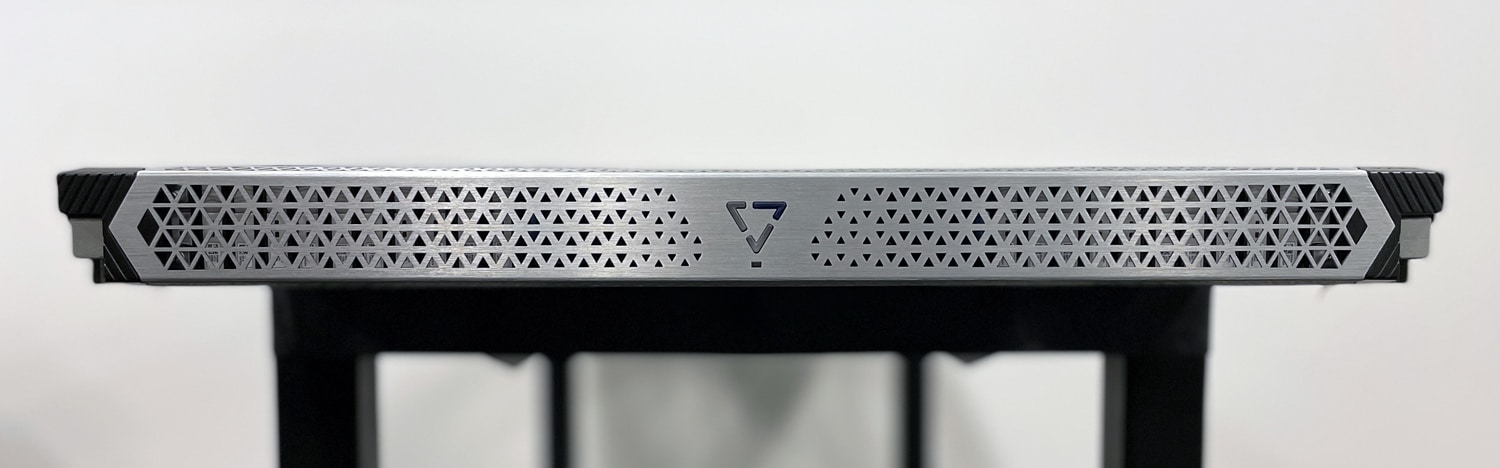
Plattform: VAST AI-operativsystem, byggt på DASE-arkitekturen (Disaggregated, Shared-Everything). Tillståndslösa beräkningsbehållare styr en pool av NVMe-kapslingar över NVMe-oF och presenterar ett enda namnutrymme för fil-, objekt- och databasåtkomst. Helt QLC-media med en skrivbuffert för lagringsklassminne.
Namngivna driftsättningar: CoreWeave, under ett flerårigt avtal värt 1.17 miljarder dollar som tillkännagavs i november 2025, vilket VAST beskriver som sin största kund. VAST lades också till i xAI Colossus Frontier AI Factory-expansionen, och det driver Mistral Compute AI-fabriker som körs på NVIDIA GB300 NVL72.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner och validerad för DGX SuperPOD.
Granskat resultat: Inget. VAST har aldrig skickat in till MLPerf Storage.
Öppna påståenden: Ett gemensamt VAST- och AMD-påstående om 9 gånger snabbare time-to-first-token genom KV-cache-avlastning på Instinct, baserat på leverantörstester. April 2026 års Series F med en värdering på 30 miljarder dollar sätter förväntningar, men det är inte ett prestandasiffra.
Vår bevakning från det gångna året:
- VAST och AMD hävdar 9 gånger snabbare tid till första token med KV-cacheavlastning (Jul 2026)
- Cloudera och VAST siktar på GPU-svält (Jul 2026)
- VAST driver Mistral Computes AI-fabriker på GB300 NVL72 (Maj 2026)
- VAST presenterar sitt agentbaserade AI-operativsystem (Feb 2026)
- VAST Amplify siktar på att få befintliga SSD-diskar att kännas 6 gånger större (Jan 2026)
- VAST introducerar DPU-baserad inferensarkitektur (Jan 2026)
WEKA
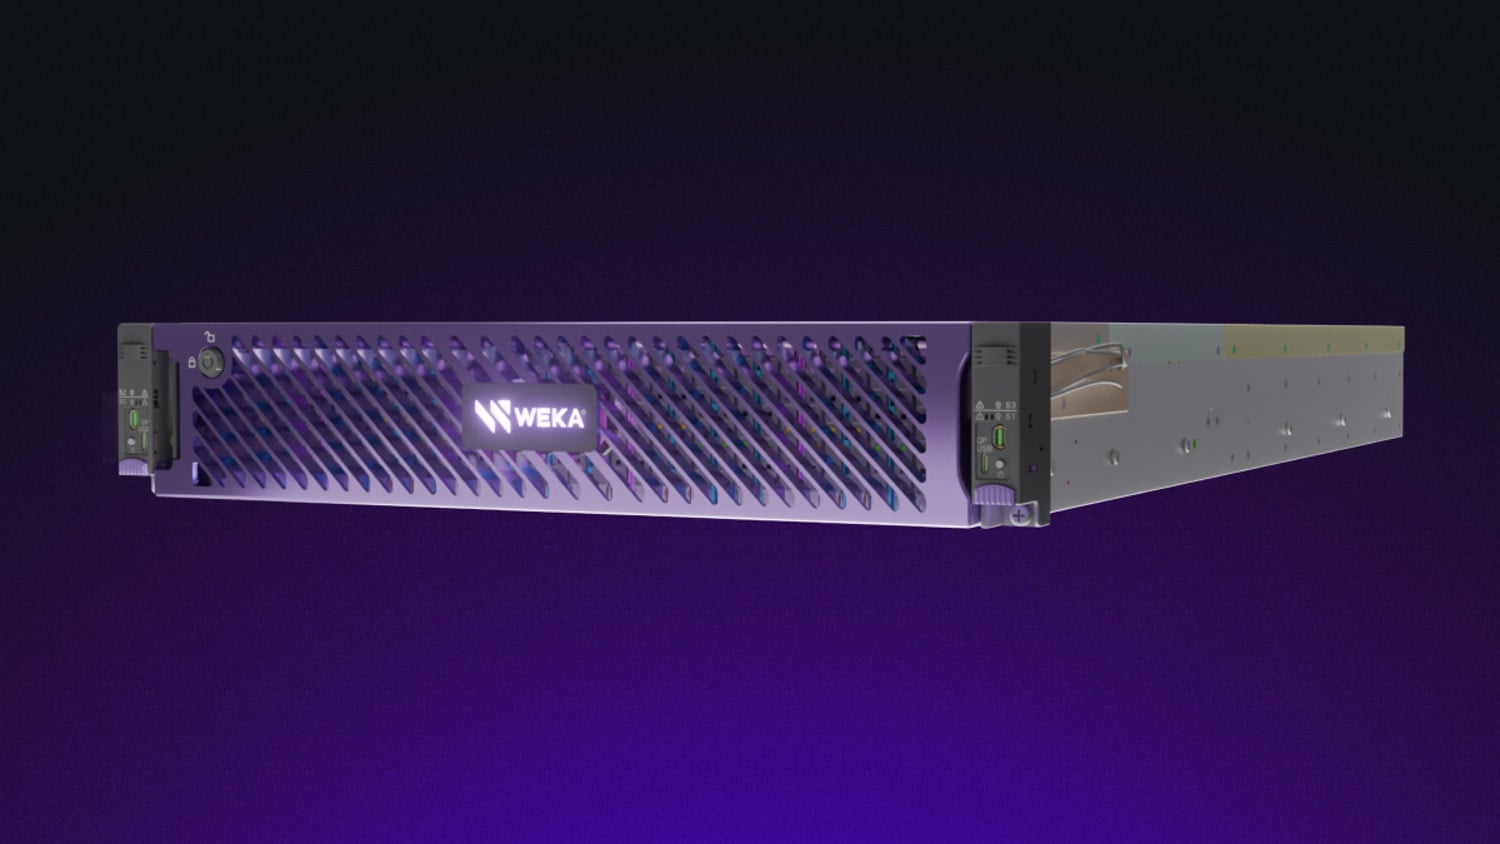
Plattform: NeuralMesh, det programvarudefinierade parallella filsystemet tidigare känt som WekaFS, såldes som programvara och som WEKApod-apparater. NeuralMesh Axon bäddar in samma dataplan i GPU-servrar så att lokal NVMe ansluter till klustret istället för att stå inaktiv.
Namngivna driftsättningar: Nebius kör NeuralMesh som premiumnivån i sitt AI-moln. Andromeda standardiserade NeuralMesh hos ungefär 50 GPU-leverantörer i juli 2026. WEKA är också en del av multi-vendor stacken hos CoreWeave.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner, med DGX SuperPOD- och BasePOD-valideringar.
Reviderat resultat: WEKA skickade in till MLPerf Storage v1.0 i september 2024 men skickade inte in till v2.0 i augusti 2025. Dess senaste reviderade siffror är en generation gamla.
Öppna anspråk: WEKApod 3 med NeuralMesh 6 påstås ha 1.1 EB och 10.2 TB/s i ett enda rack. Leverantörssiffror, ingen granskad inlämning bakom dem.
Värt att veta: HPE avslutade sina partnerskap med WEKA, Qumulo och Scality i november 2025, så WEKA når inte längre köpare via HPE-kanalen.
Vår bevakning från det gångna året:
- Andromeda standardiserar NeuralMesh hos fler än 50 GPU-leverantörer (Jul 2026)
- WEKApod 3 bryter exabyte-barriären för ett enda rack (Jul 2026)
- NeuralMesh AIDP blir allmänt tillgängligt (Mar 2026)
- NeuralMesh integreras med NVIDIA STX för inferensminne (Mar 2026)
- WEKApod Prime och Nitro nästa generations plattformar (Nov 2025)
DDN
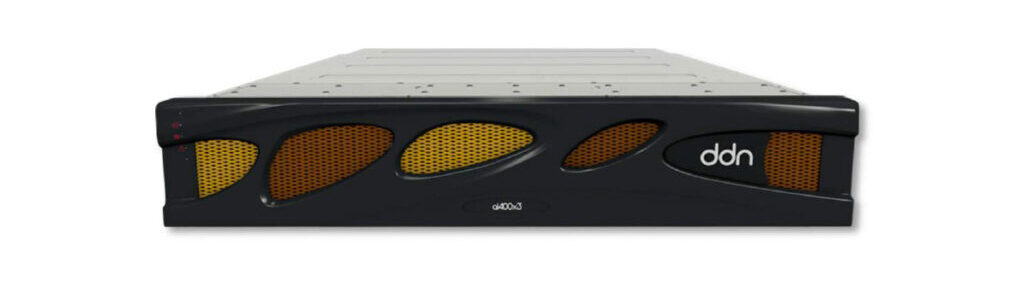
Plattform: Två linjer. EXAScaler, det Lustre-deriverade parallella filsystemet bakom AI400X3- och AI400X3M-enheterna, hanterar träning. Infinia, en plattform för nyckelvärdesobjekt som lade till stöd för flera innehavare och POSIX i 2.4, riktar sig mot inferens och AI-fabriksarbetsbelastningar.
Namngivna driftsättningar: xAI Colossus, tillkännagavs i november 2024 vid 200 000 GPU:er, på EXAScaler och Infinia. DDN har också en lång lista över nationella lab- och HPC-installationer som föregår AI-cykeln.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner med DGX SuperPOD-validering.
Granskat resultat: Ja, och det är aktuellt. I MLPerf Storage v2.0 klarade AI400X3 120.68 GB/s på 3D U-Net över flera noder och hanterade Llama3-8b-kontrollpunkter med 30.6 GB/s läsning och 15.3 GB/s skrivning från en 2RU-enhet. DDN är bevisligen den starkaste posten på den här listan.
Öppna anspråk: KV-cacheacceleration genom NVIDIA Dynamo, validerad gemensamt med Nebul snarare än av ett oberoende organ.
Vår bevakning från det gångna året:
- DDN lanserar AI400X3M på ISC 2026 (juni 2026)
- Infinia 2.4 lägger till stöd för flera hyresgäster och POSIX (Jul 2026)
- DDN och Nebul validerar KV-cacheacceleration (Jul 2026)
DDN ledde MLPerf Storage v2.0 vad gäller prestandatäthet men klarade sig inte i v3.0-rundan.
Hammerspace
Plattform: Hammerspace Global Data Platform och Tier 0, som omvandlar den lokala NVMe som redan finns inuti GPU-servrar till delad, kontrollpunktskapacitet. Den är byggd på standarder, parallell NFS (NFS 4.2 med FlexFiles) och körs på vanliga servrar snarare än en proprietär enhet. Det finns ingen Hammerspace-box att fotografera, vilket är poängen med arkitekturen.
Namngivna distributioner: Meta dokumenterade Hammerspace över två H100-kluster med 24 576 GPU:er på sin egen ingenjörsblogg. Det är den mest specifika förstapartsbeskrivningen av en storskalig AI-lagringsdistribution från någon leverantör på den här sidan, eftersom operatören skrev den snarare än leverantören.
NVIDIA-validering: Ingen. Hammerspace har ingen DGX SuperPOD-, DGX BasePOD-, NCP-referensarkitektur eller NVIDIA-certifierad lagringsstatus.
Granskat resultat: Ja, i både MLPerf Storage v1.0 och v2.0. I v2.0 levererade Tier 0 420.8 GB/s på 3D U-Net över fem noder med 96.4 procents acceleratorutnyttjande, vilket matade 140 simulerade H100:or. Hammerspace har det bästa granskade deltagandet i den här listan och den svagaste NVIDIA-valideringshistorien, tvärtom jämfört med nästan alla andra här.
Vår bevakning: Hammerspace har inte gått igenom StorageReview-labbet, och vår senaste täckning är tunn. Det är en lucka från vår sida, inte en nackdel med plattformen.
Hammerspace, en v2.0-inskickare, avstod också från v3.0-rundan.
Dell Technologies
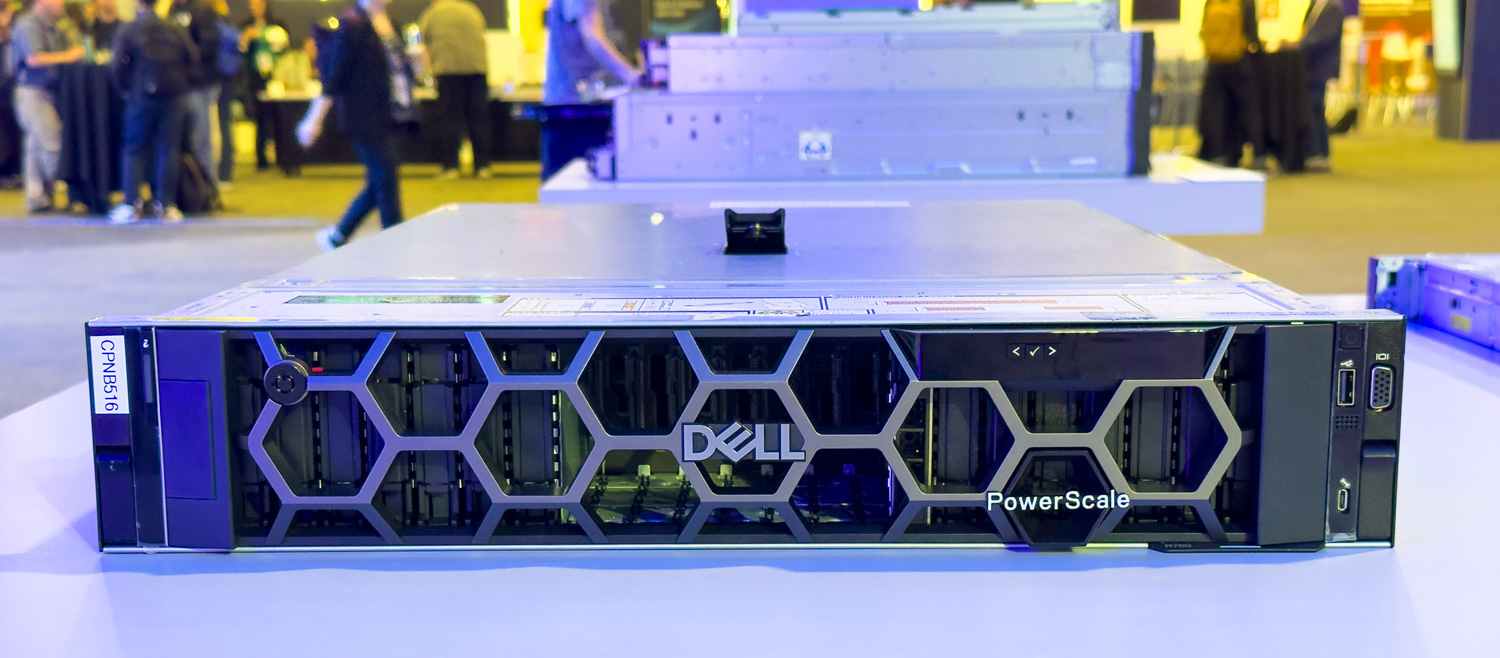
Plattform: Tre saker, riktade mot olika delar av pipelinen. PowerScale är den skalbara NAS-linjen, med helt flashiga F-serienoder. ObjectScale är S3-lagret, som tog över S3 över RDMA- och KV-cache-avlastning år 2026. Lightning File System är ett nytt parallellt filsystem som gick över till allmän överenskommelse (GA) i april 2026 och är den del som Dell positionerar sig mot DDN, VAST och WEKA.
Namngivna distributioner: Vi kunde inte bekräfta en namngiven storskalig AI-utbildningsdistribution på Dells lagring. Den mest konkreta offentliga referensen är Subaru, som driver ett AI-labb för förarsäkerhet på PowerScale. För en leverantör av denna storlek är det en slående lucka jämfört med de neocloud-vinster som AI-nativa leverantörer publicerar.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner och PowerScale fick NVIDIA Cloud Partner-programcertifiering i juli 2025.
Granskat resultat: Inget. Dell har aldrig skickat in till MLPerf Storage.
Öppna anspråk: Dell kallar Lightning för världens snabbaste parallella filsystem baserat på intern analys och anger Exascale Storage till flera TB/s per rack. Båda finns med i anspråksspåraren nedan. En praktisk varning för köpare: Lightning är GA, men det är begränsat till AI-fabriksbyggnationer, och de flesta läsare kommer inte att se det i en standardoffert.
Vår bevakning från det gångna året:
- Dell behåller sin ledande position i 2026 års Gartner MQ för företagslagring (Aug 2026)
- ObjectScale når 9.83 PB i 2U med 245 TB Kioxia SSD-diskar och S3 över RDMA (Aug 2026)
- Dell säljer bättre än resten av IDC:s fem största lagringsenheter tillsammans under första kvartalet (Jul 2026)
- Inuti PowerStore Gen 3-återställningen (Maj 2026)
- Djupgående granskning av PowerStoreOS 5.0, programvarudelen av Gen 3-återställningen (sep 2026)
- Lightning-filsystem och exaskalalagring på GTC 2026 (Mar 2026)
- Vår PowerEdge R5715-recension, en lagringsorienterad 2U som vi testat praktiskt (Mar 2026)
HPE
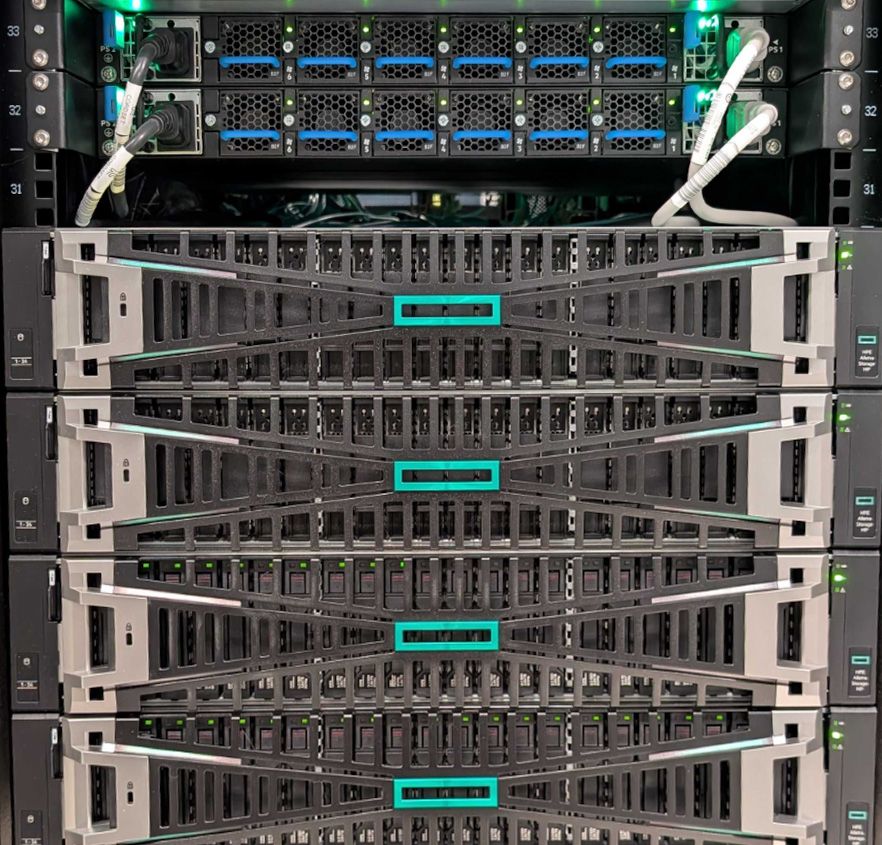
Plattform: Alletra Storage MP, uppdelat i B10000 för block och X10000 för object, plus GreenLake för File. HPE säljer även beräknings- och nätverkstekniken kring den, vilket är hur merparten av deras AI-lagring faktiskt levereras.
Namngivna distributioner: Suverän AI och AI-fabriksversioner där HPE levererar hela stacken. Ingen namngiven neocloud-vinst jämförbar med VAST-, WEKA- eller DDN-exemplen ovan.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner, med DGX BasePOD- och SuperPOD-valideringar.
Granskat resultat: HPE har medverkat i varje MLPerf Storage-omgång, från v1.0 till v3.0, vilket ger dem ett försprång före Dell och NetApp i deltagande. Läs dock noggrant igenom bidragen på filsidan: HPEs starkaste AI-filresultat kom genom gemensamma bidrag med WEKA, och HPE avslutade det partnerskapet, tillsammans med Qumulo och Scality, i november 2025. Dessa resultat beskriver inte längre en produkt som HPE kan sälja dig idag.
Vår bevakning från det gångna året: Vi har testat Alletra-plattformen praktiskt.
- HPE behåller sin ledande position i 2026 års Gartner MQ för företagslagring (Aug 2026)
- Alletra Storage MP B10000 med NIST CSF 2.0, våra praktiska tester (juni 2026)
- Alletra Storage MP X10000 med noden Data Protection Accelerator (Feb 2026)
- CloudCasa lägger till Kubernetes DR för B10000 (juni 2026)
- MLPerf Storage v3.0: 345.8 GiB/s på 3D U-Net med K3000, en av endast två leverantörer på den här sidan som skickade in denna omgång.
IBM
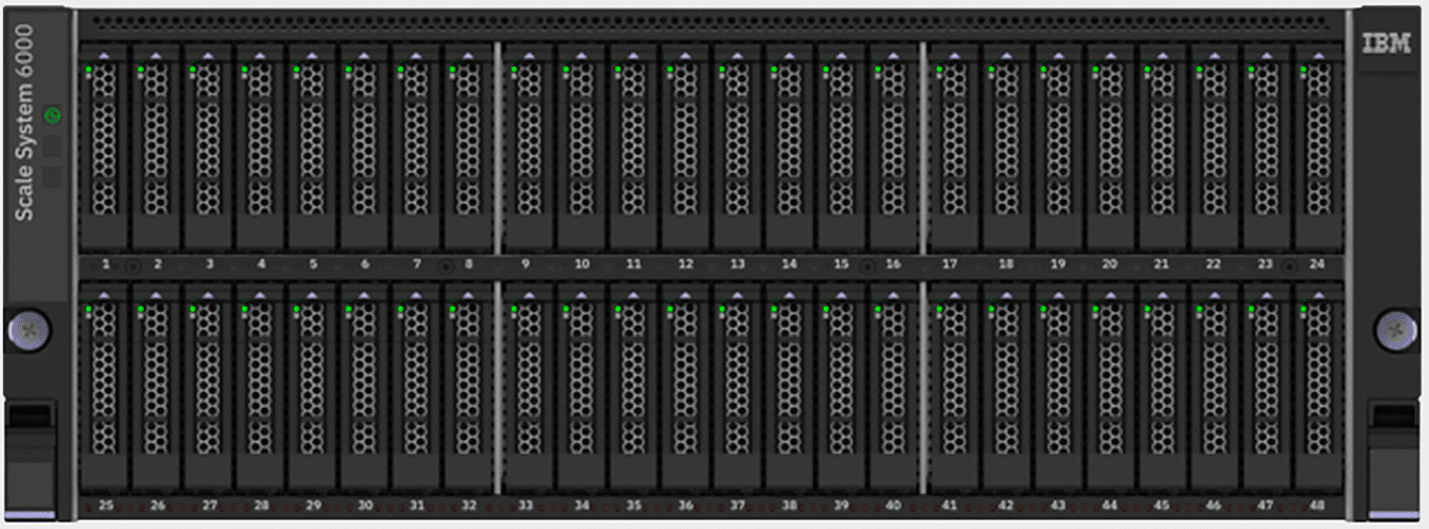
Plattform: IBM Storage Scale, det parallella filsystemet med GPFS-härkomst, som säljs som programvara och som Storage Scale System-apparater, med Fusion som paket för Kubernetes och AI-pipelines.
Namngivna driftsättningar: En del av multi-vendor stacken på CoreWeave. IBM Cloud bygger också ett dedikerat HGX B300-inferenskluster värt 240 miljoner dollar med Together AI, vilket tillkännagavs i augusti 2026, även om lagringslagret inte har avslöjats.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner.
Granskat resultat: Ja, i MLPerf Storage v2.0, inklusive kontrollpunktsarbetsbelastningen, där Storage Scale publicerade 656.7 GiB/s läsning på en Llama 3.1 1T-modell. Kontrollpunktsåterställning är det mätvärde som avgör hur mycket av en frontier-träningskörning du förlorar på grund av ett fel, och väldigt få leverantörer har publicerat ett granskat värde för det.
Öppna anspråk: Inget enastående i kategorin snabbaste arrayer. IBM marknadsför Storage Scale baserat på skala och integration snarare än ett rekord för dataflöde.
Vår bevakning från det gångna året:
- IBM behåller sin ledande position i 2026 års Gartner MQ för företagslagring (Aug 2026)
- IBM och Together AI investerar 240 miljoner dollar i ett dedikerat HGX B300-inferenskluster (Aug 2026)
- IBM introducerar innehållsmedveten lagring för RAG-arbetsbelastningar (April 2026)
- Nästa generations FlashSystem med agent AI (Feb 2026)
- Storage Scale System 6000, enhetlig lagring för AI och HPC (Nov 2025)
- Vår IBM FlashSystem 5300-recension, praktisk introduktion till IBMs kompakta system och användbar smak för hur de större systemen beter sig (sep 2024)
Everpure (tidigare Pure Storage)
Plattform: FlashBlade//EXA är AI-plattformen, som delar upp metadata och datavägar så att dataplanet skalas oberoende av varandra. FlashBlade//S och FlashArray täcker resten. Everpure bygger sina egna DirectFlash-moduler istället för att köpa färdiga SSD-diskar, vilket är anledningen till att deras densitets- och uthållighetssiffror inte följer resten av marknaden. Företaget blev juridiskt Everpure den 23 februari 2026.
Namngivna distributioner: Del av multi-vendor stacken hos CoreWeave. Vi kunde inte bekräfta en namngiven AI-utbildningsdistribution specifikt på FlashBlade//EXA.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner.
Granskat resultat: MLPerf Storage v3.0 (september 2026), Everpures första inlämning: 877.5 GiB/s checkpoint-skrivning med 833.0 GiB/s läsning vid 30 FlashBlade//EXA-datanoder, rundans största checkpoint-antal, plus rundans största KV-cacheresultat på 1 623,4 GiB/s. Den har också SPECstorage Solution 2020_ai_image-rekordet på 6 300 AI-jobb, publicerat 17 februari 2026. Annat riktmärke, annan arbetsbelastningsmodell, men det är en riktig inlämning under en publicerad regeluppsättning med en granskningsprocess, och den räknas.
Öppna anspråk: FlashBlade//EXA marknadsförs som branschens högst presterande datalagringsplattform, med en beräknad dataflödeshastighet på över 10 TB/s i ett enda namnutrymme. Prognostiserat, inte mätt.
Vår bevakning från det gångna året:
- Everpure toppar båda axlarna i Gartner MQ 2026 för andra året i rad (Aug 2026)
- Everpure lanserar Data Stream för företags AI-pipelines (juni 2026)
- Förbättringar av dataintelligens och företagsdatamoln (juni 2026)
- Emulex SecureHBA med Everpure XL130 R5, inte ett AI-riktmärke, men praktisk tid med Everpure-hårdvara (Mar 2026)
- MLPerf Storage v3.0 (september 2026): första inlämning, 877.5 GiB/s checkpoint-skrivning och 833 GiB/s läsning på FlashBlade//EXA, plus 1 623 GiB/s KV Cache-läsning, det största antalet checkpoint- och inferensdata i rundan. Fullständig v3.0-täckning.
NetApp
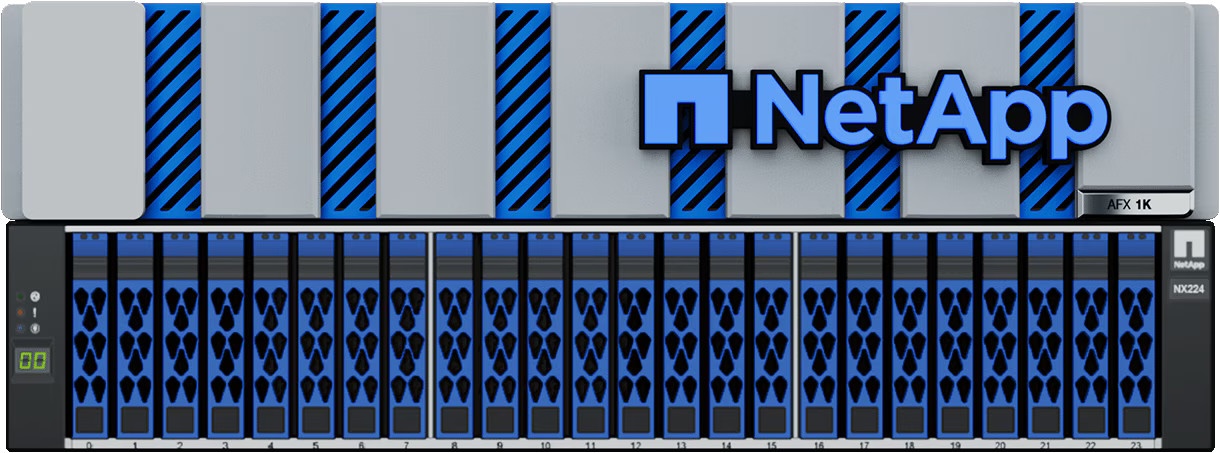
Plattform: AFX, announced in October 2025, is disaggregated all-flash ONTAP built for AI data pipelines, with the AI Data Engine layered on top. AIPod is the NVIDIA-validated reference design. Novus, announced at INSIGHT 2026 and orderable now, sits above AFX for AI factories: pNFS metadata moves onto Data Director nodes running on qualified Supermicro servers while AFF A90 HA pairs carry the data, and the clients are stock Linux pNFS, with no proprietary agent on the GPU servers.
Namngivna distributioner: Inga vi kan bekräfta i AI-utbildningsskala. De starkaste publika artefakterna är validerade arkitekturer snarare än kundnamn, inklusive FlexPod AI-designerna med Cisco från juni 2026.
NVIDIA-validering: NVIDIA-certifierad lagringslanseringspartner med DGX SuperPOD-certifiering.
Reviderat resultat: None in MLPerf Storage, which NetApp has never entered. Behind Novus, NetApp cites an Omdia-audited test showing near-linear scaling as ONTAP clusters joined one namespace; the 100 TB/s headline is Omdia’s modeling from that test, not a measured result.
Vår bevakning från det gångna året:
- Novus splits pNFS metadata from AFF A90 data nodes, targeting 100 TB/s (Okt 2026)
- NetApp behåller sin ledande position i Gartner MQ för företagslagring 2026 (Aug 2026)
- HCLTech kopplar Keystone till U4X för konsumtionsbaserad AI-lagring (Aug 2026)
- NetApp köper DataPelago för GPU-databehandling (Jul 2026)
- StorageGRID 12.1 lägger till ett federerat namnutrymme och upp till 12 TB/s (juni 2026)
- FlexPod validerade AI-arkitekturer med Cisco (juni 2026)
- AFX-lanseringen (Okt 2025)
En kommentar om Huawei
Huawei hade den högsta absoluta dataflödet i MLPerf Storage v2.0, 698 GiB/s på 3D U-Net från en 8U OceanStor A800 med dubbla noder som matar 255 simulerade H100:er, och den listas i den granskade tabellen nedan. Vi utelämnar den från ledarprofilerna eftersom det inte är ett praktiskt köp för köpare i USA, Europa eller de flesta av de marknader som den här sidan betjänar. Siffran är verklig; tillgängligheten är det inte. 2026 års Gartner Magic Quadrant når samma balans från andra hållet, vilket håller Huawei i sin ledarkvadrant tack vare OceanStor utanför Nordamerika.
Vad analytikerna säger
Analytikerplacering är en egen klass av bevis: inte ett granskat riktmärke, utan en oberoende bedömning av utförande och vision, vilket ligger närmare hur dessa system faktiskt köps in. I 2026 års Gartner Magic Quadrant for Enterprise Storage Platforms innehar samma sex leverantörer ledarkvadranten som förra året: Everpure, Huawei, HPE, NetApp, Dell och IBM, med Everpure högst på förmåga att genomföra och längst på fullständighet i visionen för andra året i rad. Två avgränsningsanteckningar är viktiga för denna sida. Gartner utvärderar den primära lagringsmarknaden och spårar den högpresterande gruppen av filer och objekt i separat forskning, vilket är där de AI-nativa specialisterna ovan finns, så deras frånvaro från kvadranten är en kategorigräns, inte en dom. Och när sex av åtta utvärderade leverantörer får ledaretiketten, säger själva etiketten köparna lite; de relativa positionerna bär signalen.
Vad skulle förändra den här listan
Fyra saker, i ordning efter hur mycket vikt vi skulle ge dem. En leverantör ger oss tillgång att testa sin plattform enligt vår metod, oavsett om det är hårdvara vi kan hosta själva eller tillgång till en större driftsättning. En leverantör skickar in till en aktuell granskningsrunda, MLPerf Storage eller SPECstorage. En operatör, snarare än en leverantör, dokumenterar en driftsättning på samma sätt som Meta gjorde med Hammerspace. Eller så förlorar en leverantör en beteckning eller ett partnerskap som dess nuvarande positionering är beroende av, hur WEKA- och HPE-uppdelningen förändrade hur båda företagen når AI-köpare. Vi uppdaterar profilerna allt eftersom.
Vad de granskade riktmärkena faktiskt visar
AI-utbildning och de neocloud-leverantörer som betjänar den är där lagringsprestandakapplöpningen faktiskt körs 2026, och det är det enda segmentet med ett hälsosamt granskat benchmark: MLCommons MLPerf Storage. Den nuvarande publicerade omgången är v3.0 (september 2026), med 19 inskickade organisationer och 143 resultat. För första gången spänner benchmarket över hela AI-pipelinen: utbildningsgenomströmning, kontrollpunkter och två nya inferenstester (Vector Database och KV Cache), plus S3-objektlagringsstöd som ungefär en sjättedel av inskickade bidrag använde. Eftersom v3.0 flyttade sina simulerade acceleratorer från H100 till B200 är resultaten inte jämförbara med tidigare omgångar. MLPerf Storage kröner inte en enda vinnare; olika system leder till olika arbetsbelastningar och mätvärden.
| Systemkrav | Granskat resultat (MLPerf Storage v3.0) | Klass |
|---|---|---|
| Everpure FlashBlade//EXA | 877.5 GiB/s checkpoint-skrivning och 833 GiB/s läsning vid 30 datanoder; 1 623 GiB/s KV-cacheläsning | Kontrollpunkts- och inferensledare |
| YanRongTech F9000X | 543.9 GiB/s på 3D U-Net som matar 99 simulerade B200-acceleratorer | Högsta inskickade utbildningsgenomflöde |
| TuringData F9200 | 541.5 GiB/s på 3D U-Net från tre lagringsnoder; Checkpoint-70B vid 539.9 GiB/s läsning och 307.1 GiB/s skrivning | Nykomling i prestandatäthet |
| Azure Managed Luster | 642.2 GiB/s kontrollpunktsskrivning från en hanterad molndistribution på 4 096 TiB | Första hyperskaliga molntjänsten inskickad |
| NVIDIA AIStore | 20 inskickade objekt över S3-objektlagring i OCI, AWS och GCP | Objektlagring i parallellt filsystemsområde |
På HPC-sidan leds IO500-listan (ISC 2026-utgåvan) av Sugon ParaStor på SCNet med 26 888 GiB/s uppmätt bandbredd över 500 klientnoder, där Intel DAOS-system (Argonne Aurora, LRZ) har flera toppplatser och Weka dyker upp via Samsung SSC-24. V3.0-omsättningen är lika nyhetsvärd som siffrorna: v2.0-genomströmningsledarna DDN, Huawei, Hammerspace och Lightbits klarade alla denna runda, medan 11 förstagångsinskickare dök upp, bland annat Azure och NVIDIA. Fullständig analys i vår MLPerf Storage v3.0-bevakning.
Vem driver egentligen Neoclouds?
Vinster i driftsättningen är inte riktmärken, men de är verkliga bevis på vad operatörer köper när prestanda är deras huvudsakliga uppgift. Observera att de största AI-fabrikerna har flera leverantörer; inget enskilt lagringsföretag äger någon av dessa anläggningar helt och hållet.
| AI Cloud | lagring | Detaljer |
|---|---|---|
| CoreWeave | VAST Data (plus WEKA, DDN, IBM Storage Scale, Everpure i stacken) | Flerårigt avtal värt 1.17 miljarder dollar, november 2025, VASTs största kund |
| xAI Colossus | DDN EXAScaler och Infinia, med VAST Data tillagd i Frontier AI Factory-expansionen | DDN tillkännagav 100 000 GPU:er i november 2024; flera leverantörer från slutet av 2025 |
| Nebius | WEKA NeuralMesh | Premiumnivån av Nebius AI Cloud, tillkännagavs i juni 2025 |
| Tillsammans AI | IBM Cloud (HGX B300-system) | Avtal värt 240 miljoner dollar tillkännagavs i augusti 2026; lagringslagret ännu inte avslöjat |
Kravspåraren
These are the current “fastest” claims in the AI storage segment. None has been independently verified at the claimed scale; most are footnoted by their vendors as internal testing, and the strongest provenance in the table is an analyst-audited test behind a projected headline.
| Leverantörsanspråk | Antal | Status |
|---|---|---|
| Everpure FlashBlade//EXA, “branschens högst presterande datalagringsplattform” (mars 2025) | Prognostiserade läsningar på 10+ TB/s i ett enda namnutrymme | Leverantörsprognos; ingen granskad inlämning |
| Dell Lightning-filsystem, "världens snabbaste parallella filsystem" (GA april 2026) | Upp till 150 GB/s per rackenhet, baserat på Dells interna analys | Leverantörsanspråk; ingen granskad inlämning |
| Dell Exascale-lagring (GTC 2026) | Upp till 6 TB/s per rack | Leverantörsanspråk; ingen granskad inlämning |
| Huaweis nya generation OceanStor Dorado (september 2024) | 100 miljoner IOPS enligt specifikationsblad vid 0.03 ms latens | Leverantörsspecifikation; ett Omdia-test beställt av Huawei mätte 2.58 miljoner ihållande IOPS vid 70 mikrosekunder på en verklig Oracle RAC-arbetsbelastning, en användbar verklighetskontroll av specifikationsbladets maxvärden. |
| WEKA, WEKApod 3 med NeuralMesh 6, exabyte-anspråk i ett enda rack (juli 2026) | 1.1 EB och 10.2 TB/s i ett rack | Leverantörsanspråk; WEKA skickades senast till MLPerf Storage i v1.0 och hoppade över v2.0 |
| VAST Data och AMD, KV cache-avlastning på Instinct (juli 2026) | 9 gånger snabbare tid till första token | Gemensam leverantörstestning; VAST har aldrig skickat in till MLPerf Storage |
| DDN och Nebul, KV-cacheacceleration med NVIDIA Dynamo (juli 2026) | Leverantörsdefinierad hastighetsökning av inferensarbetsbelastningar | Partnervalidering, inte en oberoende granskning; DDN har aktuella MLPerf Storage v2.0-resultat |
| NetApp Novus, “the fastest storage on the planet” (October 2026) | Projected 100 TB/s of sequential reads across a single pNFS namespace | Omdia-audited near-linear scaling on a smaller cluster; the 100 TB/s figure is Omdia’s projection from that test, not a measurement |
Vad hände med SPC-1?
SPC-1 var branschens riktmärke för blocklagring, och det är nu halvt vilande: Amerikanska leverantörer övergav det i praktiken runt 2018, vilket lämnade en topplista dominerad av kinesiska leverantörer. Det nuvarande accepterade rekordet är inte det allmänt citerade Huawei-resultatet. ExponTech WDS V3 har den högsta accepterade poängen på 27.2 miljoner SPC-1 IOPS (godkänt november 2023), före Inspur på 23.0 miljoner, med Huaweis berömda 21.0 miljoner från 2020 nu fyra. En högre FlashNexus-rapport på 30.0 miljoner IOPS har legat oaccepterad i granskning sedan februari 2025, och vi behandlar det inte som ett rekord förrän Storage Performance Council gör det.
Så här fungerar den här sidan
Tre regler. För det första är varje siffra märkt med sin bevisklass: granskad inlämning, leverantörspåstående eller StorageReview-mätning. För det andra upprepar vi inte superlativ som vi inte kan använda för att hitta aktuell data; flera kända "snabbaste" påståenden på den här sidan är flera år gamla och är markerade i enlighet därmed. För det tredje är vägen till den verifierade sidan av den här sidan öppen för alla leverantörer: skicka in till MLPerf Storage eller IO500, eller ge oss tillgång till tester enligt vår standardmetodik. Den här sidan täcker endast AI och neocloud-lagring. Vanliga företagsblock och -filer, och SMB-lagring, får sina egna sidor snarare än att läggas in här, eftersom bevisen som finns tillgängliga i varje segment är olika. Vi uppdaterar ledarprofilerna när nyheter dyker upp och gör en fullständig genomgång när en ny granskad runda publiceras.
Vanliga frågor om snabbaste lagring
Vilken är världens snabbaste lagringsarray?
Det finns inget enda verifierat svar, och alla som ger ett citerar en leverantör. Baserat på granskade data från och med september 2026: Everpures FlashBlade//EXA publicerade MLPerf Storage v3.0:s högsta kontrollpunktssiffra på 877.5 GiB/s skrivning, YanRongTechs F9000X-ledda träningsgenomströmning på 543.9 GiB/s, Sugon ParaStor toppar IO500-bandbreddslistan och ExponTech innehar det accepterade SPC-1 IOPS-rekordet. De största påstådda siffrorna, inklusive Dells prognoser för Exascale Storage per rack, förblir oberoende overifierade.
Vilken är den snabbaste lagringen för AI-träning?
Bedömt utifrån MLPerf Storage v3.0, det enda granskade AI-lagringsriktmärket, är ledarna inom träningsgenomströmning YanRongTech, TuringData och UBIX, medan Everpure leder inom checkpointing och KV-cacheinferens och Azure leder bland molntjänster. Bedömt utifrån vad de största AI-operatörerna använder dominerar VAST, DDN och WEKA neocloud-vinsterna, även om ingen av de tre som skickats in till v3.0. Båda typerna av bevis visas ovan, märkta.
Varför finns det så få oberoende riktmärken för företagsmatriser?
Eftersom de flesta leverantörer av företagslagring kontraktuellt förbjuder publicering av benchmarkresultat, och de vanliga tillverkarna av arrayer övergav de offentliga benchmarks de en gång använde, särskilt SPC-1, runt 2018, har leverantörerna som använder AI delvis vänt trenden eftersom deltagande i MLPerf Storage blev ett försäljningskrav. Vi uppdaterar den här sidan allt eftersom nya granskade resultat publiceras.
Bör kvantresistent kryptering vara en del av köpet av en array?
För reglerade branscher, ja, och tidsfristerna är närmare än de ser ut. NSA:s riktlinjer för CNSA 2.0 kräver att nya installationer av nationella säkerhetssystem ska uppfylla kraven senast i januari 2027, med avveckling av icke-kompatibla system senast i slutet av 2030, och EU:s NIS2- och DORA-ramverk har sina egna krypteringskrav. Den färdiga FC-SP-3-standarden gör detta till en upphandlingsdetalj snarare än ett projekt: FC-SP-3-kompatibla HBA:er krypterar SAN-trafik under färd med linjehastighet med postkvantalgoritmer, och eftersom kryptering sker på transportlagret tar arrayen fortfarande emot data som den kan komprimera, deduplicera och skanna efter ransomware-avvikelser, vilket tjänstens kryptering på applikationsnivå besegrar. Att specificera FC-SP-3-anslutning i normala uppdateringsköp vart tre till femte år ger ett helt krypterat SAN senast 2030 som en biprodukt. Hårdvarusidan levereras redan i mellanregistret: varje Dell PowerStore Gen 3 har idag EDIF-kompatibla Fibre Channel-kort i sina OCP-kortplatser, och Dell planerar att själva krypteringen för en störningsfri PowerStoreOS 5.1-programuppdatering, vilket tas upp i vår djupgående granskning av PowerStoreOS 5.0 . Vår djupgående granskning av FC-SP-3 täcker standarden, deadlines och distributionsmodellerna.


 Amazon