StorageReview.com

Recensioner av företags-AI

Våra nuvarande AI-systemgranskningar fokuserar på inferenshantering i labbet, med öppna modeller från Llama-, Qwen-, DeepSeek- och gpt-oss-familjerna som körs genom vLLM eller SGLang och mäts på utdataflöde och latens för första token. Täckningen sträcker sig från kanten till den fullständiga GPU-noden: NVIDIA RTX PRO 4500 Server Edition levererade i median 2.7 gånger så många utdatatokens per sekund som L4-processorn den byggdes för att ersätta i en HPE ProLiant DL145 Gen11, för cirka 105 W mer vid väggen; Dell-, GIGABYTE- och HP-versionerna av DGX Spark körde distribuerad inferens som tvånodskluster över 200 Gb-strukturen; och Supermicro JumpStart gav oss praktisk tid med ett NVIDIA HGX B200- och ett AMD Instinct MI350X-system. Lagring får samma behandling eftersom datasökvägen avgör hur upptagna dessa GPU:er förblir, så vi mäter GPUDirect Storage-genomströmning med GDSIO och testar KV-cache-avlastning för att flasha för långkontextiga och agentiska arbetsbelastningar.

Om du dimensionerar hårdvara för AI, listar sidan Bästa servrar våra nuvarande AI-inferens- och edge picks baserat på data från dessa recensioner, Bästa företags-SSD: er täcker de enheter som förser GPU:erna med matning, och Bästa lagringsmatriser täcker AI-lagringsplattformarna bakom träningskluster och neoclouds.


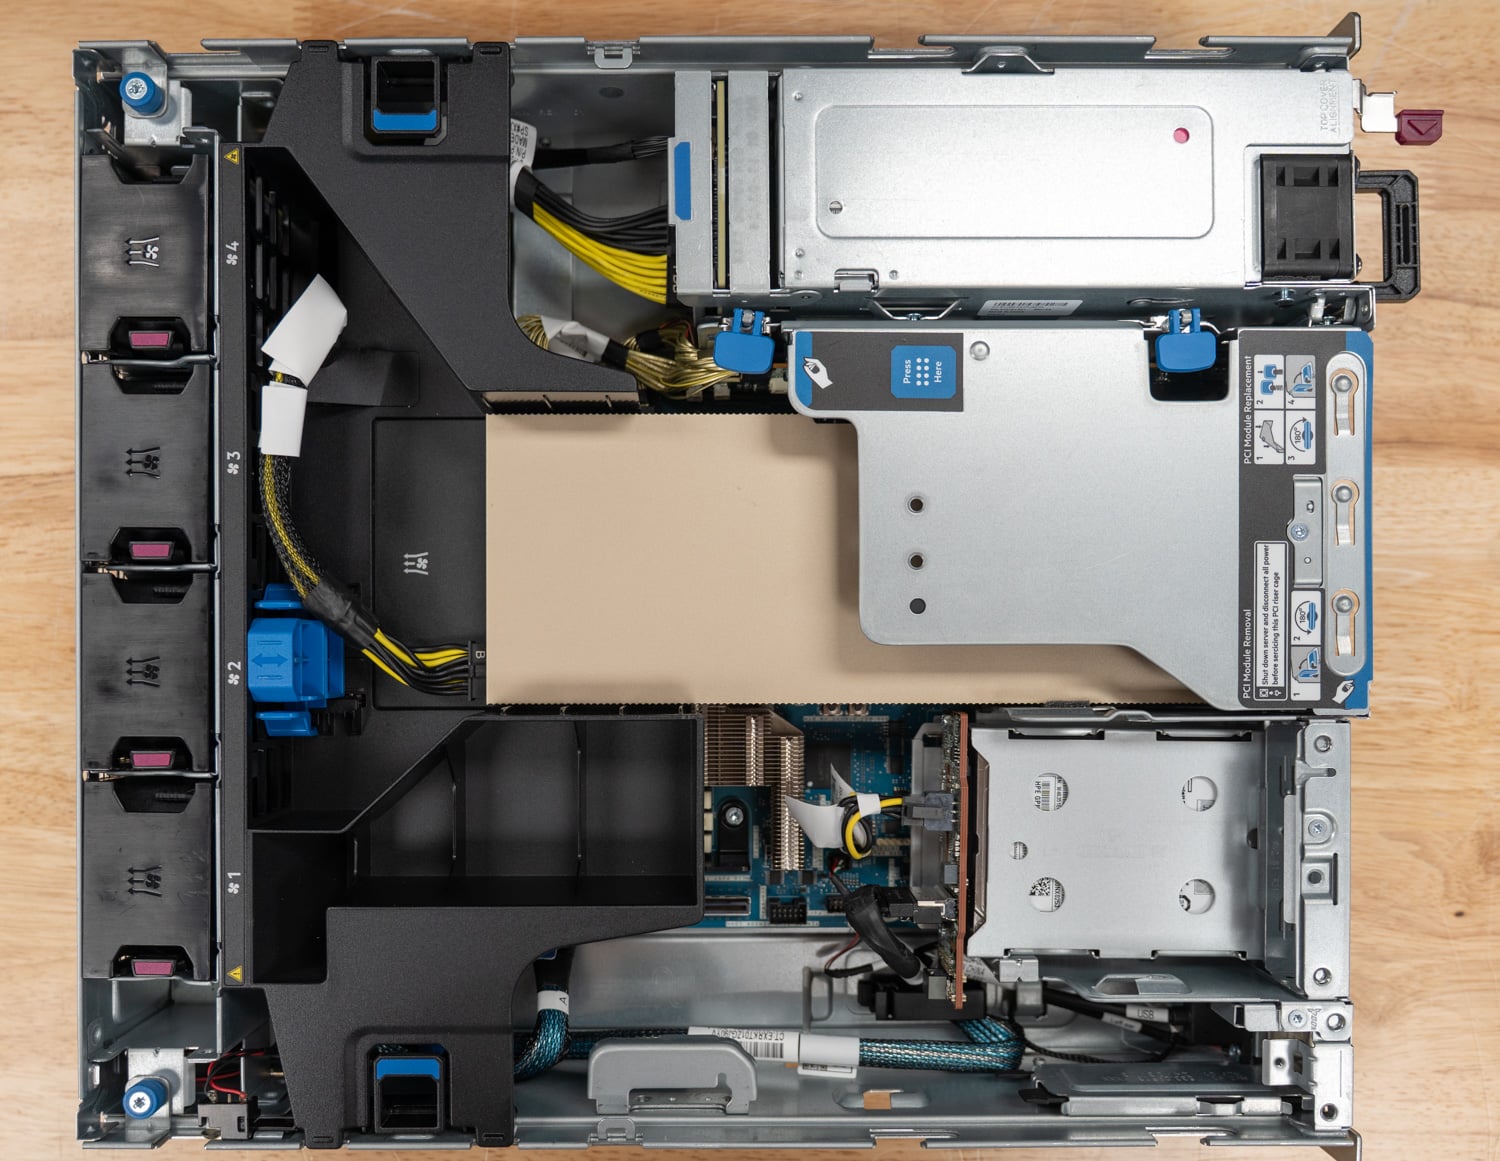
RTX PRO 4500 edge-recension: vy uppifrån och ner inuti HPE ProLiant DL145 Gen11 med RTX PRO 4500 Server Edition installerad på fullhöjdsrisern och dess 16-poliga strömkabel ansluten.
AI  ◇  Företag

NVIDIA RTX PRO 4500 Edge Recension: 2.7 gånger L4 Inuti en HPE ProLiant DL145 Gen11

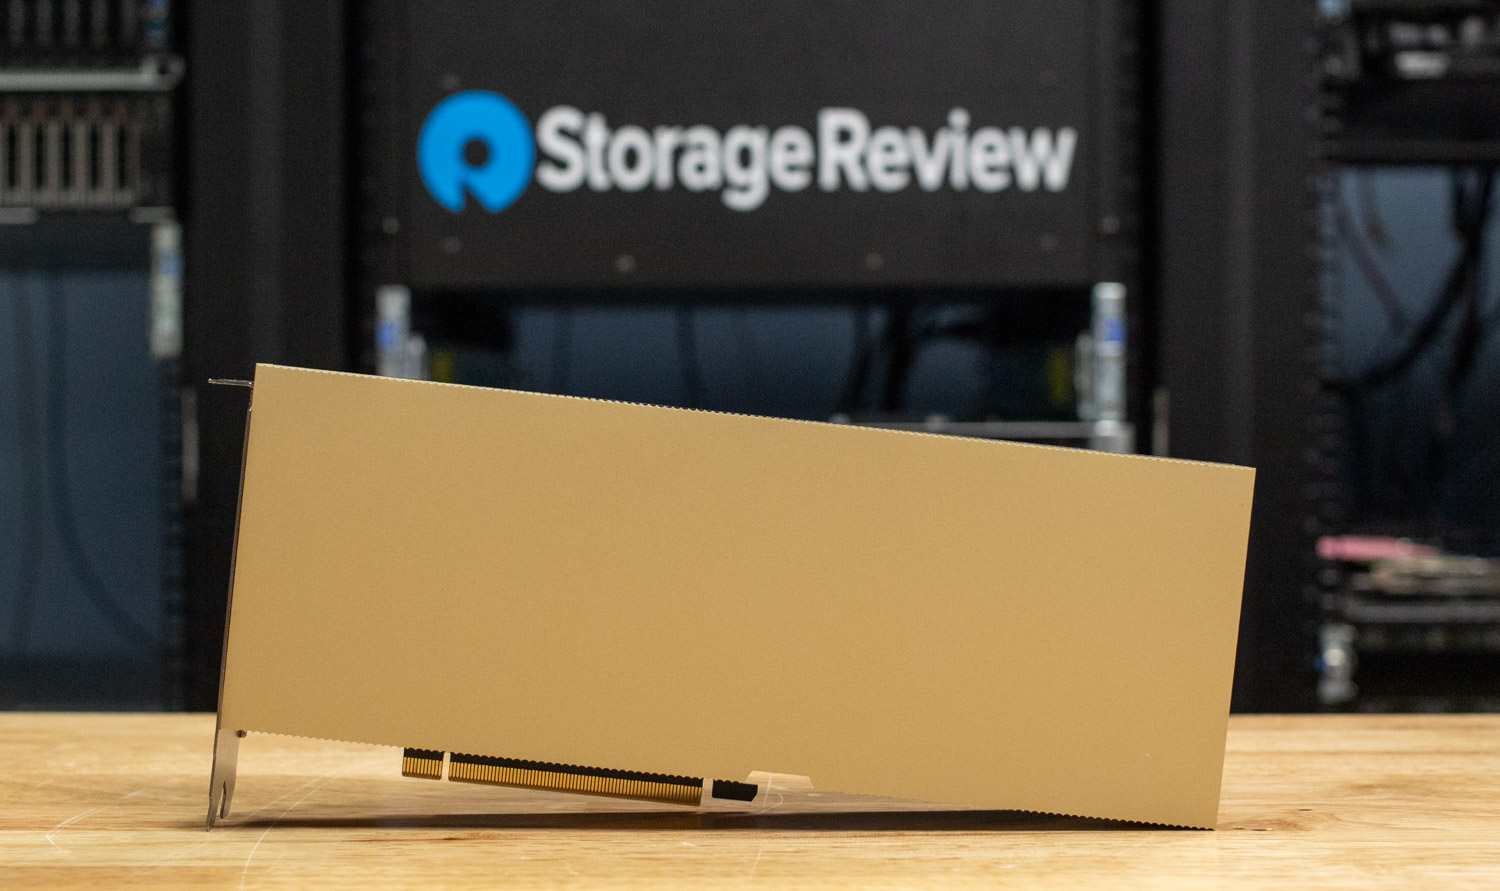
NVIDIA RTX PRO 4500 Blackwell Server Edition är kortet som NVIDIA främst byggt för att ersätta L4 i servrar som befinner sig utanför datacentret: single-slot, PCIe Gen5, passivt kylt, 165W, med 32 GB GDDR7 och hela Blackwell-funktionsuppsättningen, inklusive FP4 Tensor Cores och Multi-Instance GPU. HPE skickade oss en ProLiant DL145.

AI  ◇  Företag

Den tokeneffektiva vägen för långkontextinferens: KV-cache-avlastning till Flash

Företagsinfrastruktur för AI har gått från att optimera träningsmodeller till att betjäna dem, och det förändrar ekonomin. Träning är ett kapitalprojekt med en slutpunkt. Inferens är en produktionsarbetsbelastning som körs så länge tjänsten är live, med output mätt i tokens. Detta är tokenomics-problemet som AI-operatörer nu står inför: när

AI  ◇  Företag

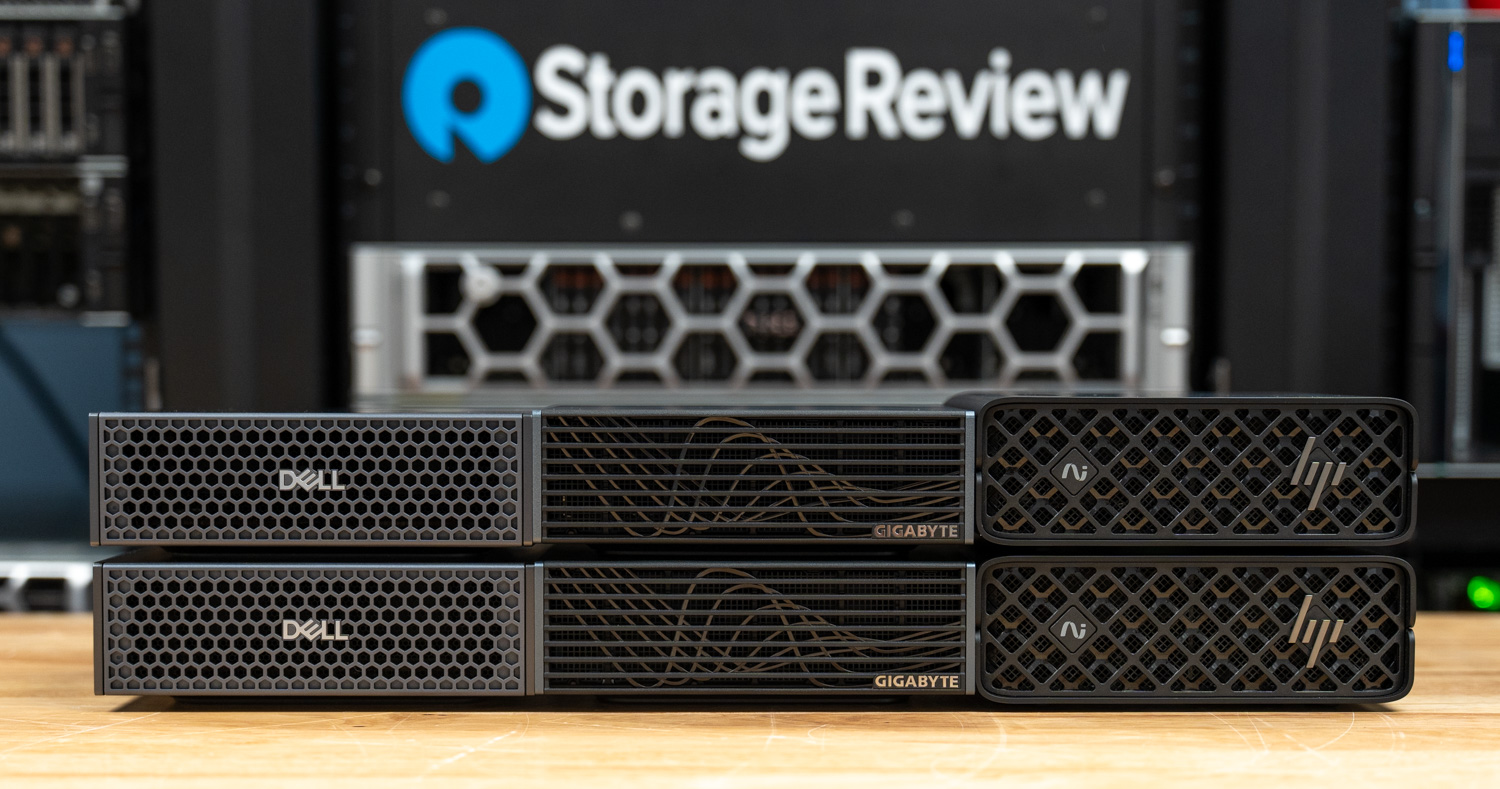
NVIDIA DGX Spark Cluster Recension: Distribuerad inferens på Dell, GIGABYTE och HP

Två saker brukar dyka upp först när samtalet kommer in på NVIDIA DGX Spark. Den första är huvudspecifikationen: 128 GB enhetligt minne i en stationär datorlåda för ungefär 4 000 dollar, en siffra som hade verkat osannolik att lägga på en ingenjörs skrivbord för bara två år sedan. Den andra är 200

AI  ◇  Företag

Hur Metrum AI och Oregon State University bygger den nya standarden för akademisk bedömning

När vi publicerade vår artikel om Oregon State Universitys planktonavbildningsforskning i november förra året var rubriken vetenskapen: AI-accelererad infrastruktur ombord på forskningsfartyg, som bearbetar terabyte av havsdata i nästan realtid innan fartyget ens nådde hamn. Men något annat hände i tysthet under de följande veckorna. Ryktet spreds över campus om vad en

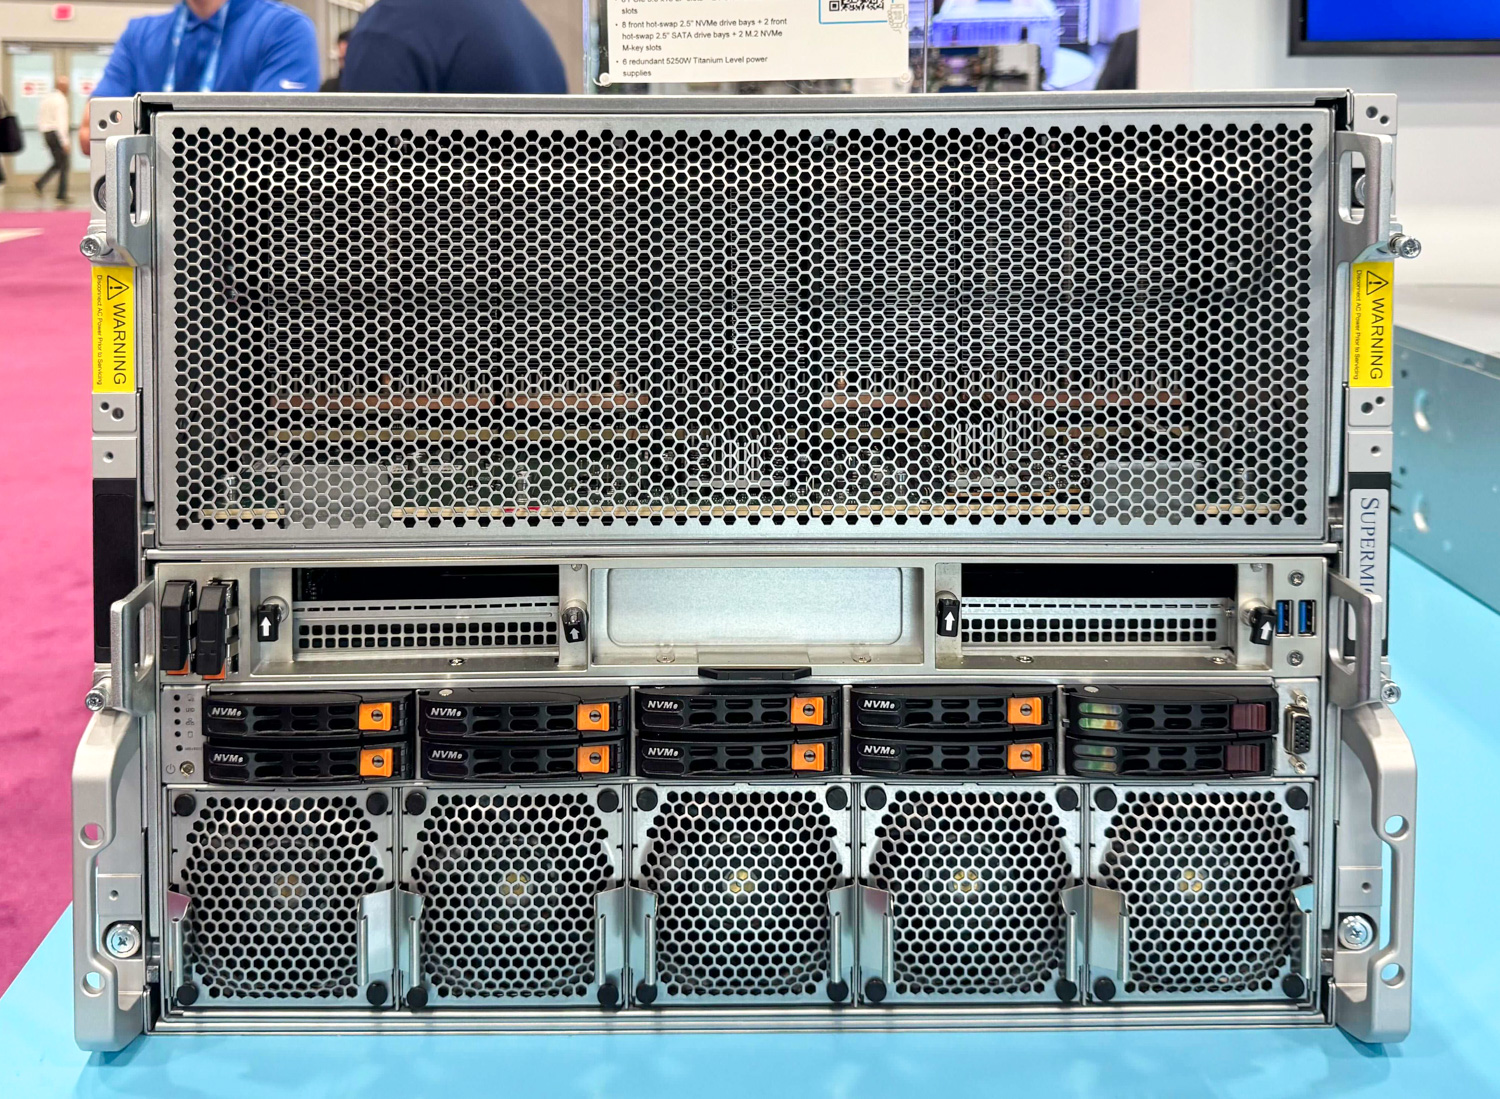
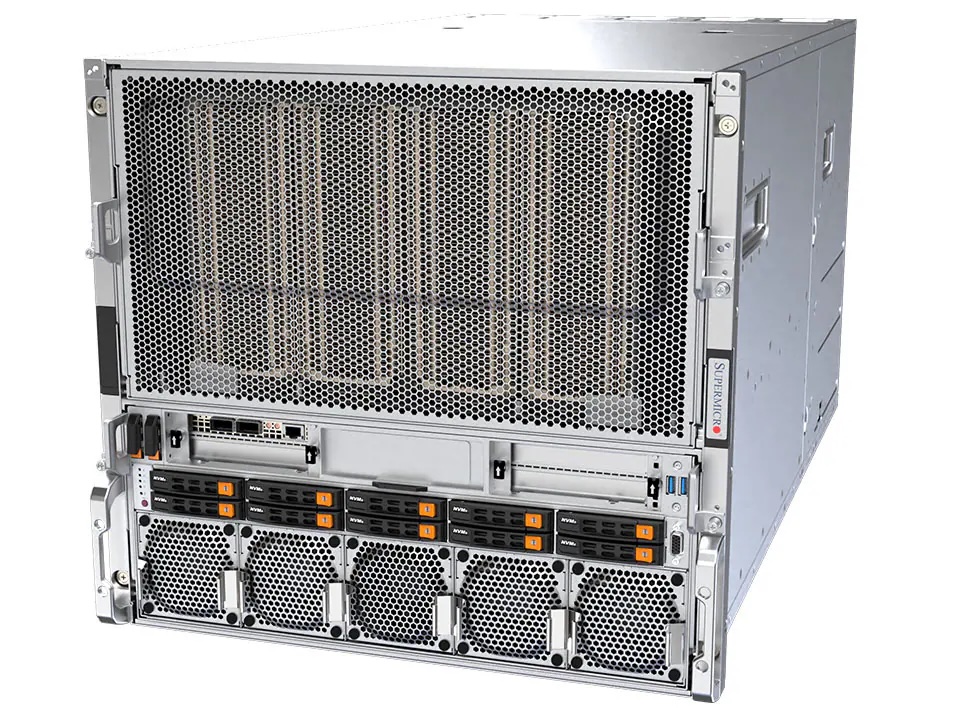
Supermicro H14-server med AMD Instinct MI350X GPU:er, framifrån som visar fläktväggen och NVMe-enhetsfacken
AI  ◇  Företag

Supermicro JumpStart-recension: H14 med AMD Instinct MI350X

Supermicros JumpStart-program har etablerat sig som ett av de mer användbara verktygen i utvärderingsverktygslådan för AI-infrastruktur före köp. Istället för en skriptbaserad demo i en delad miljö ger JumpStart kvalificerade användare gratis, tidsbegränsad, bare-metal-åtkomst till riktiga produktionsservrar via SSH, IPMI och VNC, vilket gör det möjligt för dem att köra arbetsbelastningar på faktisk hårdvara.