

Uppdaterad 20 oktober 2026: Inmatningsfältet visar nu två eller fler GPU:er på vLLM under Linux, eller en delad minnespool med minst 96 GB tillgängligt för modeller, och tornmodeller med ett enda GPU rankas på Bästa stationära arbetsstationer. HP Z8 Fury G6i och Dell Precision 7875 rankas nu endast på den här sidan; valen är oförändrade.
Varje system som rankas på den här sidan har genomgått StorageReview-labbet. Vi jämför lokala AI-prestanda direkt: vLLM online-serverflöde, tid till första token och tid per utgångstoken för modeller inklusive GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B och Qwen3 Coder 30B, plus MAMF-beräkningseffektivitet och GDSIO-lagringstestning. Inget system rankas från ett specifikationsblad.
Den avgörande frågan för en lokal AI-skrivbordsdator år 2026 är enhetligt minne kontra diskret VRAM . Skrivbordsenheter som NVIDIAs GB10-baserade DGX Spark och AMDs Ryzen AI Max (Strix Halo)-system har 128 GB enhetligt minne bakom ett enda kretskort till enhetspriser, vilket rymmer modeller som annars skulle kräva flera diskreta grafikkort.
Arbetsstationstorn svarar med rå dataflöde: RTX PRO 6000 Blackwell-kort levererar betydligt högre tokens per sekund, till flera gånger högre kostnad och strömförbrukning. Den här sidan rangordnar båda, i separata nivåer, från en enhetlig testsvit, eftersom rätt svar beror på den största modellen du tänker köra och hur snabbt du behöver att den ska svara.
Kortfattat
| Kategori | Systemkrav | Minne | Grafikkort (testade / max) | Full Review |
|---|---|---|---|---|
| Bästa övergripande skrivbordsbaserade AI-systemet | NVIDIA DGX Spark | 128 GB enhetlig LPDDR5X | GB10 integrerad (fast) | DGX Spark-recension |
| Bästa GB10-implementering | Acer Veriton GN100 | 128 GB enhetlig LPDDR5X | GB10 integrerad (fast) | Veriton GN100 Recension |
| Bästa x86-alternativet | AMD Ryzen AI Halo (Strix Halo) | Upp till 128 GB enhetlig LPDDR5X | Radeon 8060S integrerad (fast) | Ryzen AI Halo Recension |
| Bäst utan en separat GPU | HP Z2 Mini G1a | Unified LPDDR5X (körde GPT-OSS 120B) | Integrerad, ingen dGPU (fast) | Z2 Mini G1a Recension |
| Bästa GB300-systemet | MSI XpertStation WS300 (alternativ: ASUS ET900N G3) | 748 GB koherent (252 GB HBM3e + 496 GB LPDDR5X) | GB300 integrerad (fast) | XpertStation WS300 Recension |
| Bästa tornet för lokal AI | Dell Precision 7875 | 192 GB GDDR7 (2× 96 GB) | 2× RTX PRO 6000 / 2 max | Precision 7875 Recension |
| Bästa Multi-GPU-plattformen | HP Z8 Fury G6i | 192 GB GDDR7 enligt tester / upp till 384 GB | 2× RTX PRO 6000 testad / max 4 | Z8 Fury G6i Recension |
| Det extrema valet | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8× 96 GB) | 8× RTX PRO 6000 / 8 max | Comino Grando recension |
AI-apparater för skrivbordet
Apparatnivån, det som Dell kallar stationär AI och NVIDIA kallar den personliga AI-superdatorn , byter maximal dataöverföring mot modellkapacitet, energieffektivitet och pris. Med 128 GB enhetligt minne klarar dessa system bekvämt modeller i 70B-klassen med hög kvantisering och kan sträcka sig till 120B-klassen, arbetsbelastningar som skulle kräva flera separata grafikkort i ett torn.
Viktig labläsning för denna nivå: vårt DGX Spark-termiska test jämför OEM-kyldesigner över GB10-systemen nedan och gäller för alla enheter i denna klass tills dessa plattformar revideras.
Bästa AI-systemet för skrivbordet totalt: NVIDIA DGX Spark
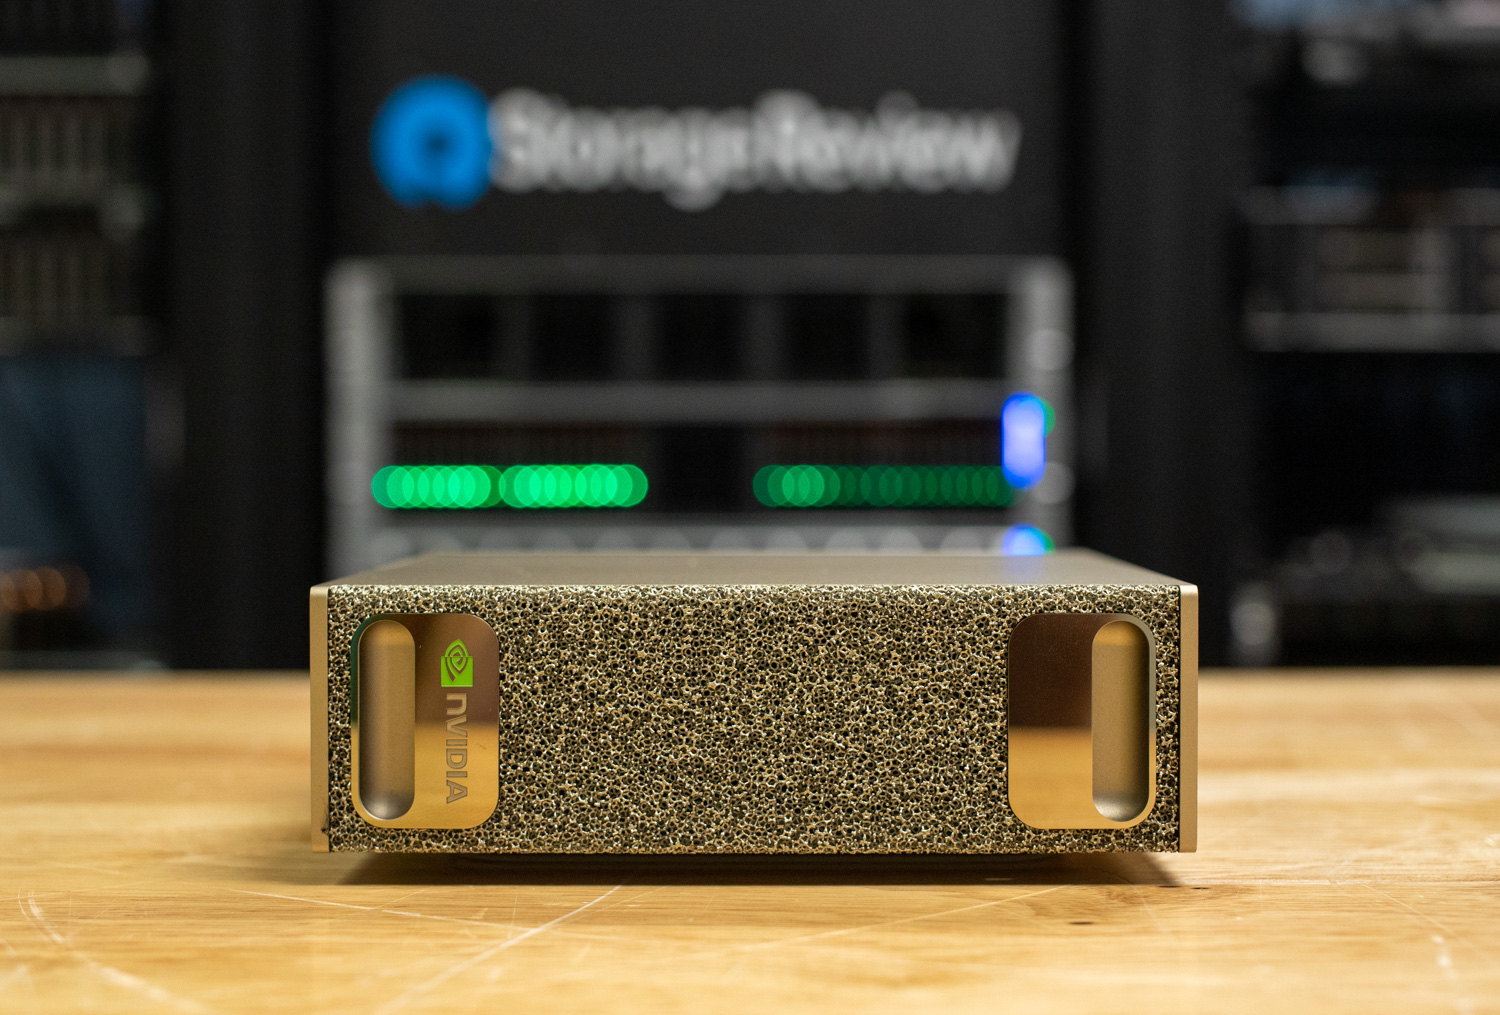
DGX Spark är referenspunkten som alla andra stationära AI-datorer mäts mot. GB10 Grace Blackwell-superchippet kombinerar en 20-kärnig Arm-processor med 128 GB enhetlig LPDDR5X, och dubbla ConnectX-7 200GbE-portar gör den till den enda enhetsklassen vi har testat som klustrar direkt ur lådan: våra tvånods distribuerade inferenstester körde pipelineparallella arbetsbelastningar över Dell-, GIGABYTE- och HP-noder över 200GbE.
Den där klusterhistorien har nu en billigare inkörsport: NVIDIA lägger till en 64 GB DGX Spark SKU den 23 oktober för 4 999 dollar , som säljs via samma sex OEM-tillverkare, och två av dem paras ihop över en 200 GbE-kabel för att samla 128 GB; NVIDIA uppskattar att det klustrade paret kan ge upp till 1.7x en enda 128 GB-enhet på Qwen3.8 27B, ett påstående vi ännu inte har testat. CUDA-programvarustacken är fortfarande den djupaste i segmentet.
Plattformens enda hårda gräns är lagring: varje GB10-system når upp till cirka 4 TB på en enda kort M.2-kortplats. Vår delade lagringslösning med åtta Spark-enheter är lösningen: en enda styrd QLC-matris som serveras över de 100 GbE-portar som varje Spark redan har, där en klient läser med 10.8 GiB/s, vilket matchar den snabbaste interna M.2 vi har uppmätt i ett GB10-system, och en 78 GB-modell som hostas centralt laddad inom 13 % av lokal NVMe.
Läs hela DGX Spark-recensionen
Bästa GB10-implementering: Acer Veriton GN100
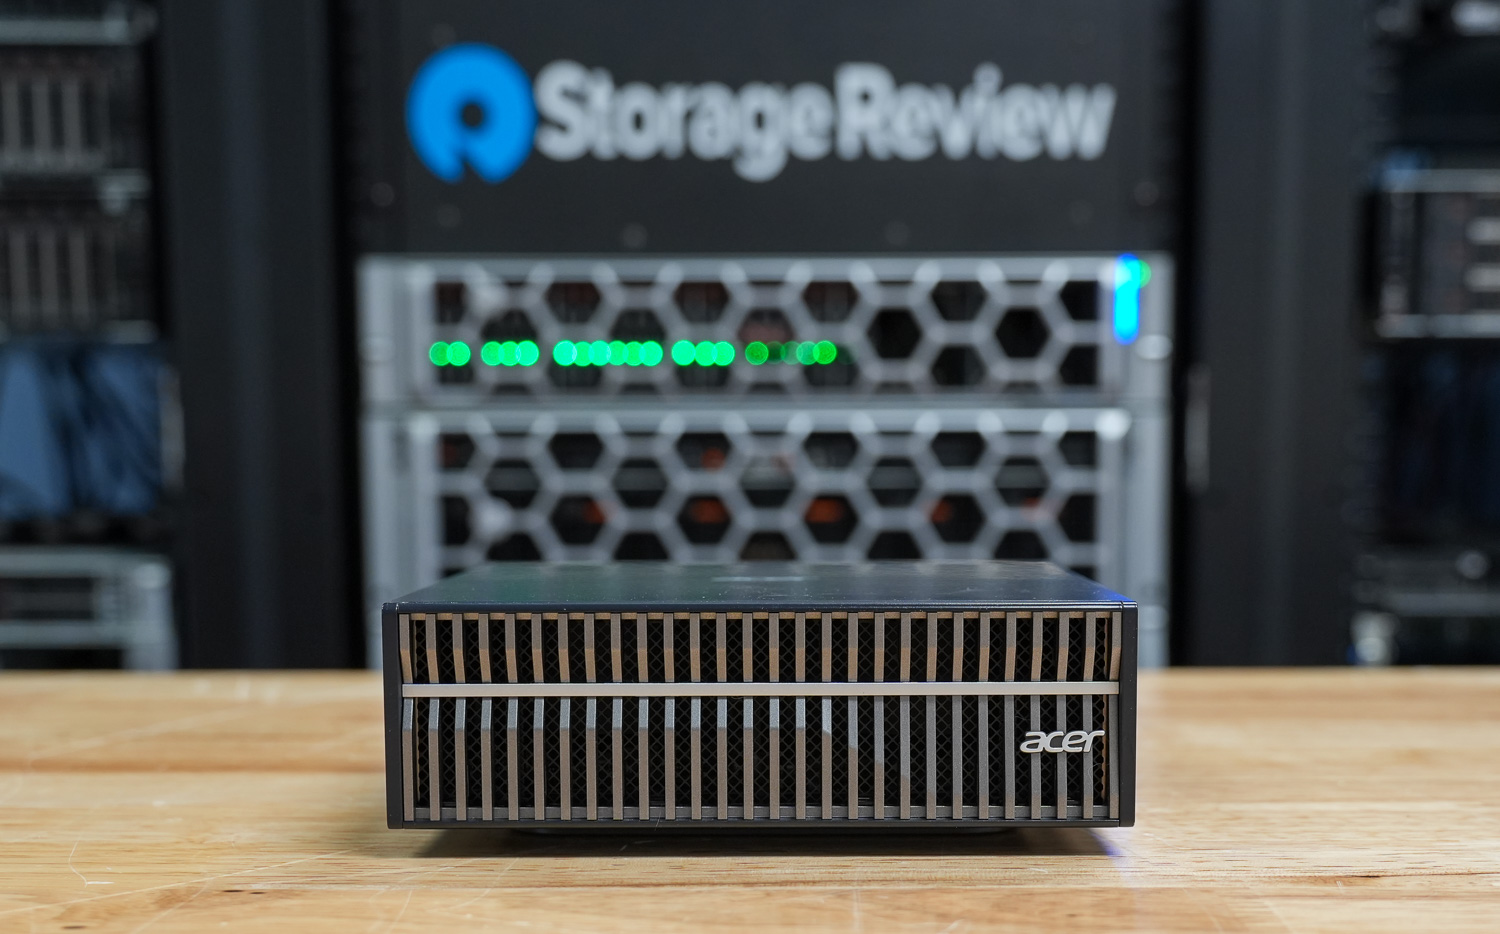
Bland GB10 OEM-systemen är den termiska designen den verkliga skillnaden, och Veriton GN100 utmärkte sig i våra tester. Alla GB10-datorer delar samma kisel- och minneskonfiguration, så hållbar prestanda handlar om kylning. Vår termiska jämförelse med flera OEM-system är, såvitt vi vet, den enda i sitt slag som publicerats.
Läs hela Veriton GN100-recensionen
Bästa x86-alternativet: AMD Ryzen AI Halo
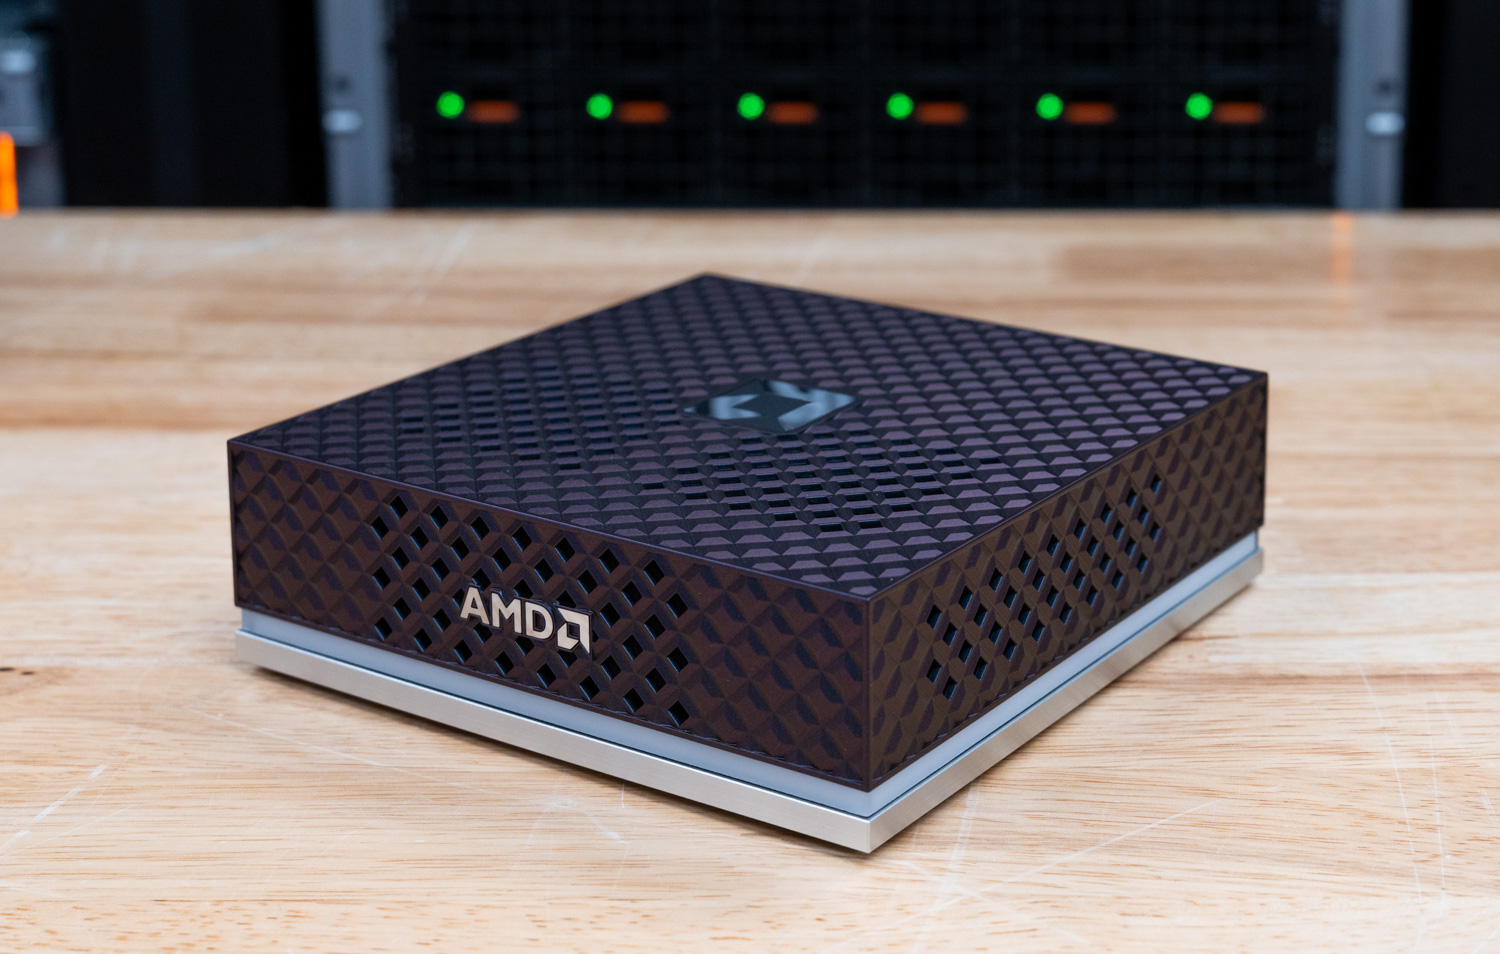
Om du behöver Windows eller en standard x86-programvaruplattform är Strix Halo lösningen för skrivbordsmiljön. AMD:s Ryzen AI Max+ 395-plattform kombinerar 128 GB enhetligt minne med en dubbel OS-konfiguration, och i våra tester hanterade den modeller med 200B-parameterklass, en direkt attack mot DGX Spark utan Arm/DGX OS-åtagandet.
Läs hela Ryzen AI Halo-recensionen
Bäst utan separat grafikkort: HP Z2 Mini G1a
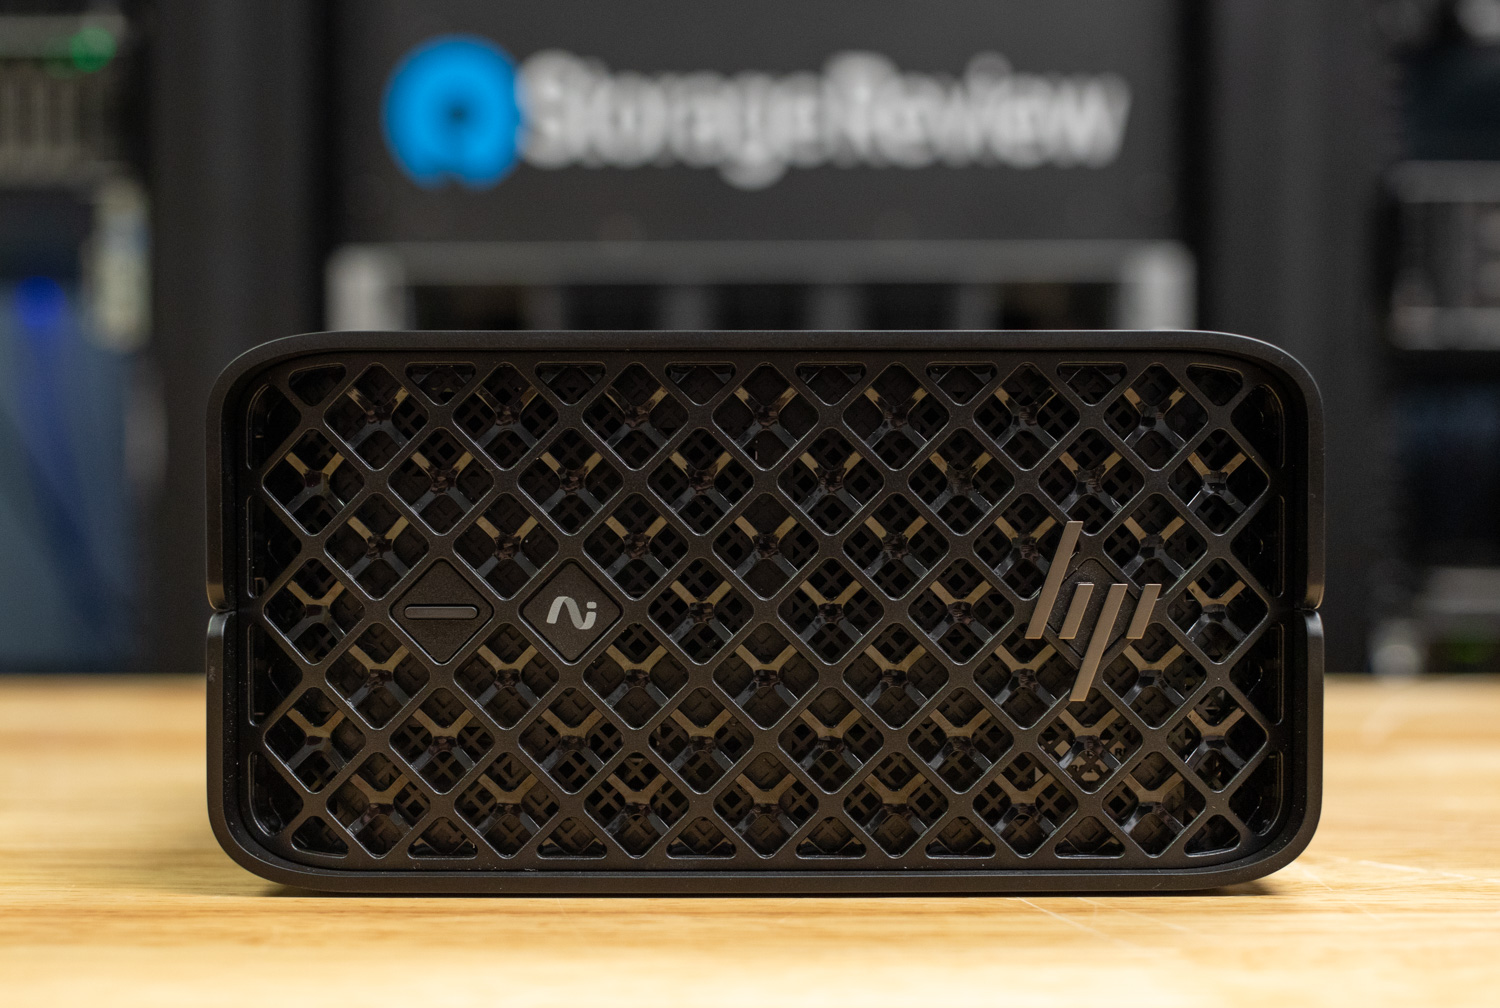
Z2 Mini G1a körde GPT-OSS 120B utan någon separat grafikkortsprocessor alls. HPs mini-arbetsstation placerar AMD:s Ryzen AI Max+ PRO-kisel i ett kompakt, tyst och IT-vänligt chassi, och det är fortfarande den tydligaste demonstrationen av att Unified-Memory x86-system har förändrat vad en liten kontorsdosa kan göra med stora modeller.
Läs hela recensionen av Z2 Mini G1a
Bästa GB300-systemet: MSI XpertStation WS300
WS300 är den första GB300 DGX-stationen i vårt labb, och den återställer taket för enhetsnivån. Grace Blackwell Ultra-superchippet har 748 GB koherent minne, 252 GB HBM3e plus 496 GB LPDDR5X, bakom 20 petaFLOPS FP4-beräkning, och i våra tester fungerade den som en 433 GB GLM-5.2-kontrollpunkt med 216 GB expertminne i Grace-minne, en modell som inte har något att köra bredvid ett skrivbord. Liksom alla system i DGX-klassen kör den DGX OS snarare än Windows; det är den ambitionen som så mycket minne kräver.
Pris och effekt placerar den närmare ytterligheterna i tornklassen än GB10-boxarna ovan, men inget annat i apparatklassen håller en modell så här stor. Den uppenbara frågan, huruvida en 1 300W-komponent stryper i ett torn, har nu ett noggrant svar: vår WS300-temperaturdjupdyk loggade en 2.8 timmars ihållande körning med Blackwell Ultra-chipet hållet vid 60°C, en platt 2.07 GHz klockfrekvens utan dippar och ungefär 20°C temperaturmarginal kvar vid full belastning.
GB300-alternativ: ASUS ExpertCenter Pro ET900N G3 är den andra GB300 DGX-stationen genom våra tester, och den bekräftar plattformen: över 14 modeller och två arbetsbelastningar landade 24 av 28 jämförelser av toppkapacitet inom 2 % av WS300, och modellerna med koherent pool kördes med paritet eller bättre. ASUS lägger till bärhandtag på 27 kg-tornet, en dedikerad fläkt över 400G-optikburarna och en 80 PLUS Titanium-försörjning. Båda tornen levererar plattformen; läs vår ET900N G3-recension för jämförelsen av två torn.
Klusterskalning: två av dessa torn som är sammankopplade via sina egna 400G-portar är nu mätta, inte utlovade: vårt GB300-klustertest parade ihop ASUS- och HP-stationerna med två DAC:er, nådde 98 % linjehastighet på NCCL-kollektiven och förvandlade GLM-5.2, en 433 GB-modell som en enda station bara kan betjäna genom att lägga till 215 GB vikter i Grace-minnet, från 139 utdatatokens per sekund vid 32 strömmar till 1 525, på väg till 3 141 vid 256.
Modeller som passar in på en stations skala olika: förfyllnings-/avkodningsuppdelning tredubblade GLM-5.3 Flashs korttidsdataflöde, och DeepSeek V4.1 Flash publicerade 5 248 tokens per sekund, den högsta utdata i uppsättningen.
Läs hela recensionen av XpertStation WS300
I labbet: HP ZGX Fury AI-station
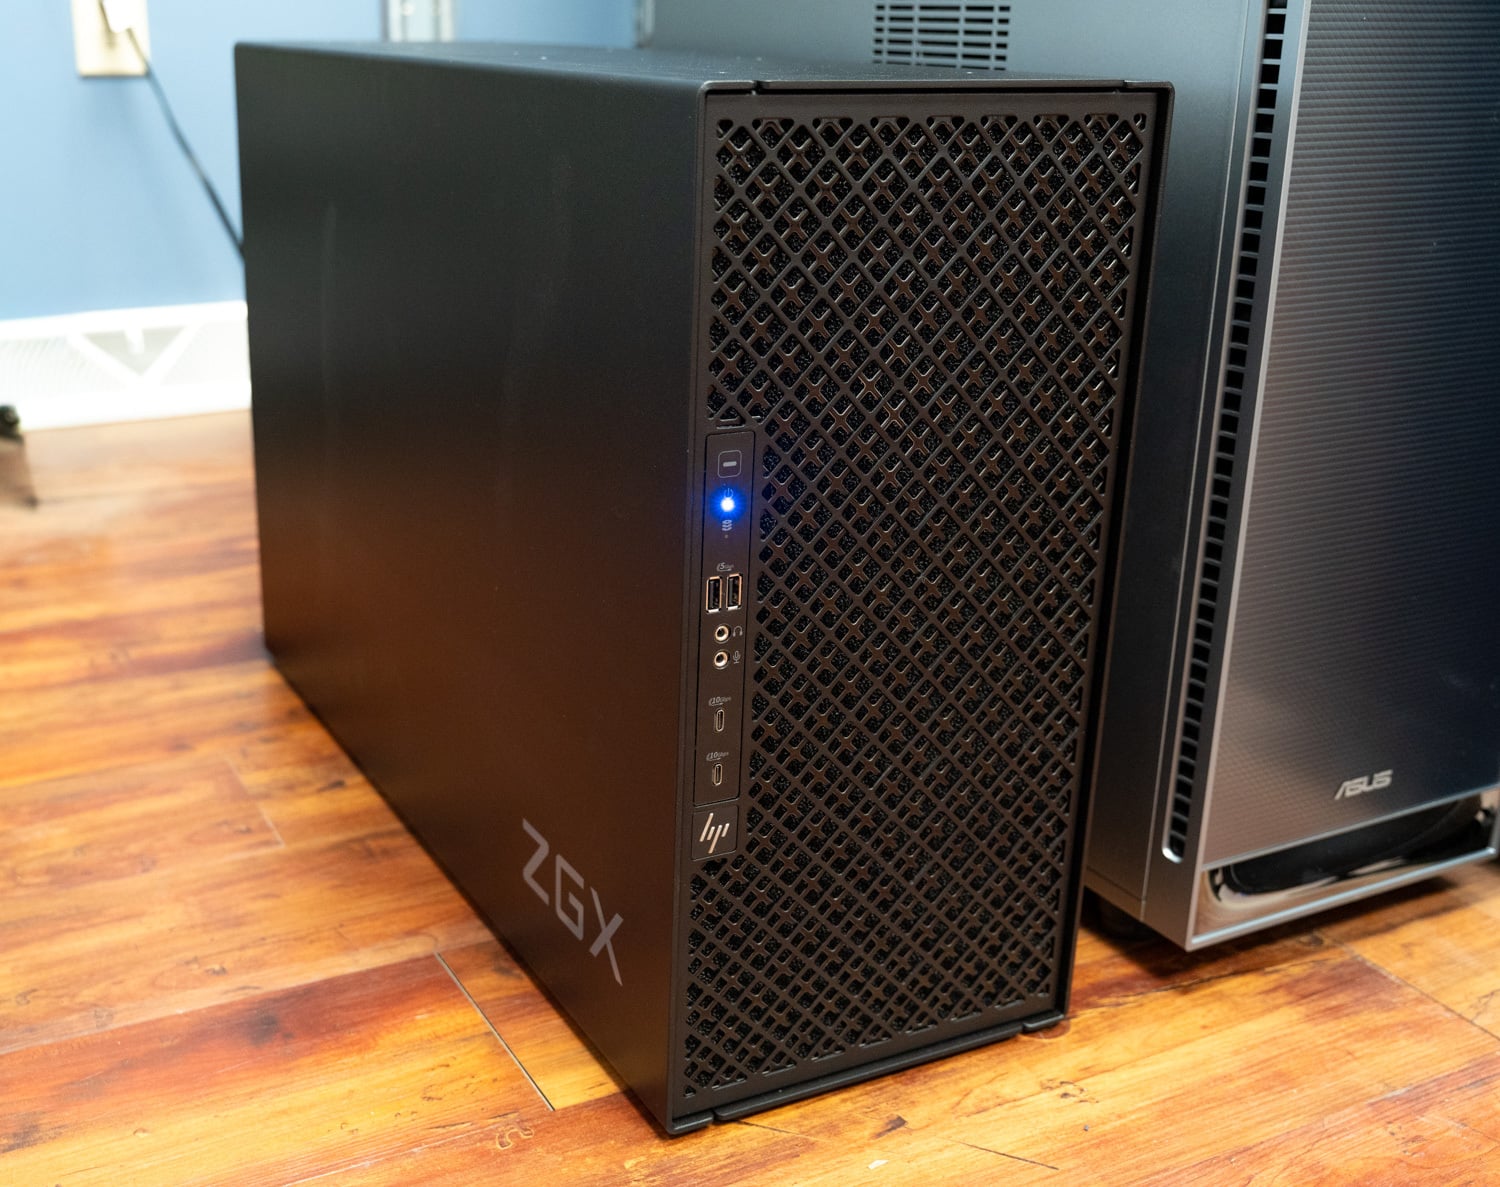
HP ZGX Fury AI Station, det tredje systemet i GB300-klassen som når vårt labb, efter MSI WS300 och ASUS ET900N G3 vars resultat för två torn hamnade inom 2 % av varandra.
HPs ZGX Fury AI Station finns nu i vårt labb. Den är byggd på samma NVIDIA GB300 Grace Blackwell Ultra-plattform som MSI XpertStation WS300 ovan, vilket gör det till den första chansen att se hur två leverantörers implementeringar av DGX Station-arkitekturen står sig i jämförelse på samma bänk: temperatur, akustik, uthållig klockfrekvens och den praktiska upplevelsen av att leva med maskinen.
Dess första offentliga siffror är redan ute: ZGX Fury fungerade som det andra tornet i vårt tvåstations GB300-klustertest , där den körde avkodning för den disaggregerade GLM-5.3 Flash-konfigurationen och hälften av varje tensor-parallell körning. Solo-granskningen är igång, och ZGX Fury kommer in i rankingen när dess egna bänksiffror är klara.
ZGX Fury är också ett av de två första systemen som Microsoft döpte till DGX Station för Windows , tillsammans med Dell Pro Precision med GB300, där NVIDIA listar Windows-versionen för fjärde kvartalet. Hårdvaran matchar de GB300-torn som vi har testat på Ubuntu, och huruvida serverstackarna körs direkt på Windows eller under WSL är den öppna frågan för den här versionen.
På horisonten: AMD Threadripper Halo Station
AMDs Threadripper Halo Station, som tillkännagavs på IFA 2026 och ännu inte har använts i något labb, är det första direkta svaret på GB300-klassen ovan. Argumentet vänder på NVIDIAs satsning: istället för en stor koherent minnespool parar AMD ihop en 96-kärnig Threadripper PRO på en plattform med upp till 2 TB åttakanalig DDR5 och 128 PCIe 5.0-banor med två 600W Instinct MI350P-acceleratorer som bär 144 GB HBM3E vardera, och en angiven väg till fyra kort och 576 GB HBM. Hela systemet är vätskekylt, och x86-värden kringgår Arm-verktygskedjans friktion som vi flaggade i WS300-recensionen.
Den öppna frågan är hur väl modellerna klarar av att hantera PCIe-anslutna kort mot NVLink-C2C-koherens, och AMD har inte visat några riktmärken, prissättning eller tillgänglighet, så detta är en produkt att bevaka, inte ett val. Detaljer finns i vår tillkännagivanderapportering ; den kommer att inkluderas i rankningen om och när hårdvaran når labbet.
Även testad: Skrivbordsbaserade AI-apparater
Dessa system har genomgått samma laboratorieprocess och är solida val som inte fick någon kategoriplats: Dell Pro Max med GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n och HP EliteDesk 8 Mini G1a.
Arbetsstationstorn för lokal AI
När svarstiden är viktigare än anskaffningskostnaden (interaktiva kodningsassistenter, fleranvändarserver, agentpipelines med långa verktygsanropskedjor) är det fortfarande diskret VRAM som gäller. Dessa tornmodeller rankas här baserat på inferensdataflöde och minnestak, och för varje modell listar vi den GPU-konfiguration vi testade tillsammans med chassits maximala kapacitet, eftersom vad ett chassi i slutändan kan hålla spelar lika stor roll som vad som medföljde i vår version; ett tornmodell behöver två eller fler GPU:er för att rankas i detta avsnitt. Tornmodeller med en enda GPU, inklusive de med ett 96 GB RTX PRO 6000, rankas på vår sida om bästa stationära arbetsstationer i vår Windows-klientsvit, eftersom de besvarar en annan fråga.
Bästa torndatorn för lokal AI: Dell Precision 7875
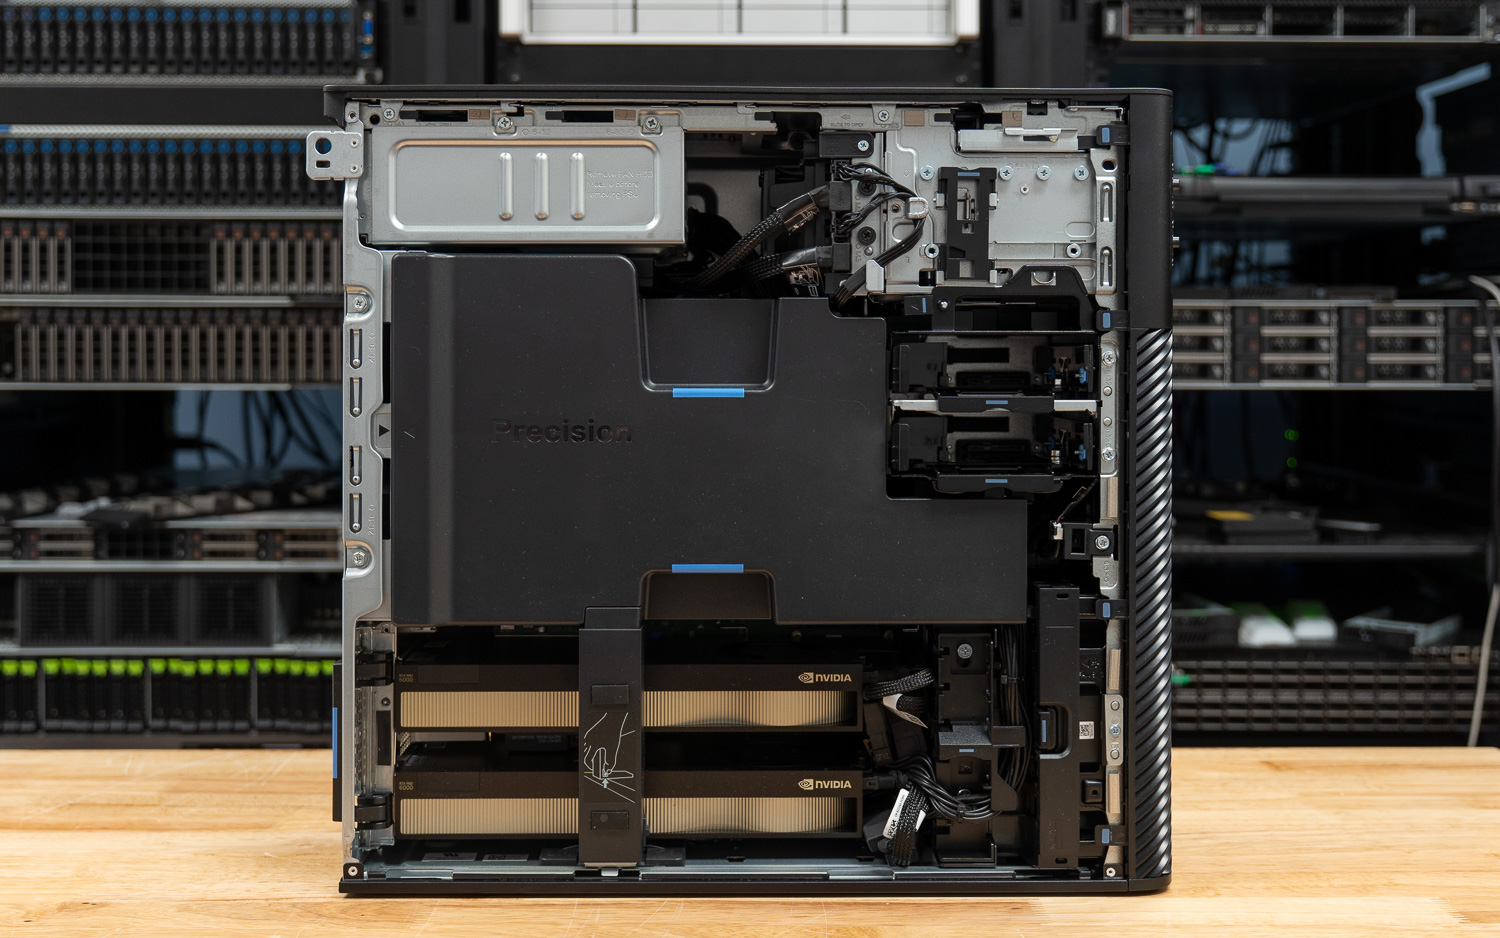
Dubbla RTX PRO 6000 Blackwell-grafikkort gör Precision 7875 till det snabbaste standardformfaktorsystemet vi har testat för lokal inferens. Med ett Threadripper PRO 9995WX och 192 GB kombinerat VRAM över två kort, lagrar det modeller i 100B-klassen helt i GPU-minne samtidigt som det levererar en interaktiv "time-to-first-token" som ingen Unified Memory Appliance når. Men var medveten om gränsen: 7875-chassit stöder maximalt två kort med dubbel bredd, så vår byggnation med dubbla grafikkort är den maximalt utnyttjade konfigurationen; det finns inget sätt att lägga till ett tredje kort senare.
Läs hela recensionen av Precision 7875
Bästa Multi-GPU-plattform: HP Z8 Fury G6i
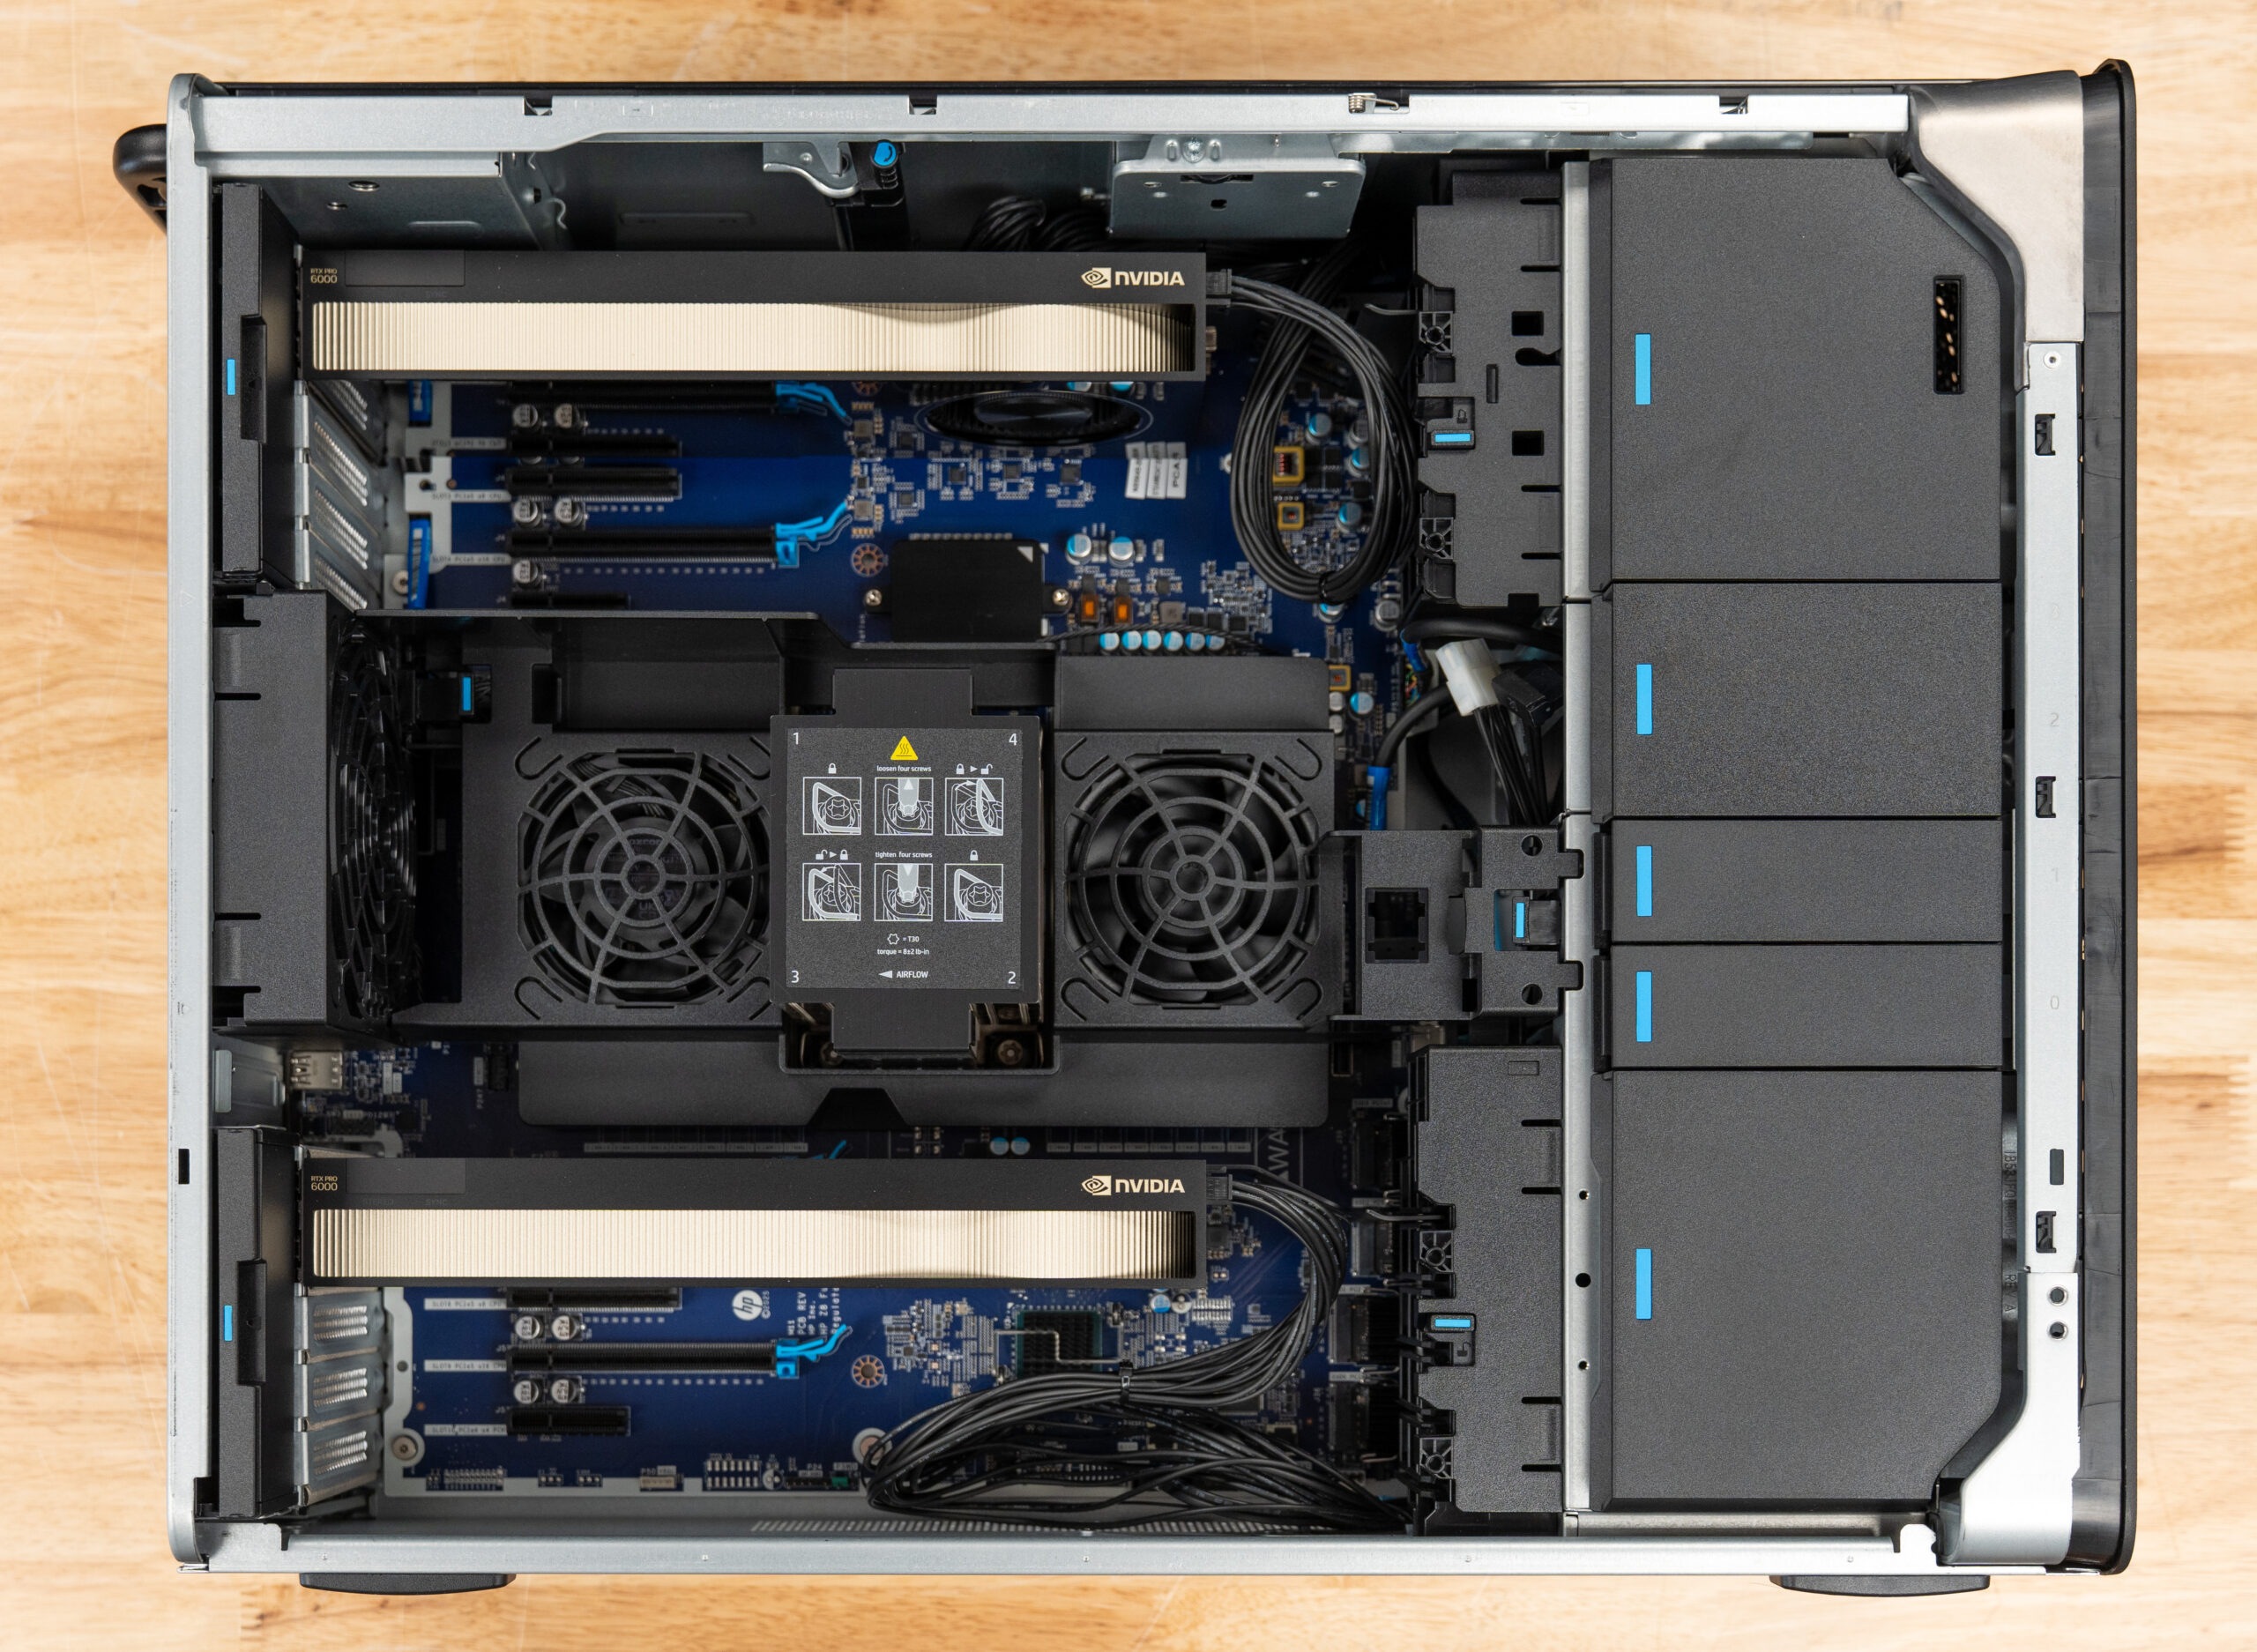
Z8 Fury G6i är tornet du köper när du planerar att utöka med fler grafikkort. Vår testversion körde två RTX PRO 6000 Max-Q-kort för 192 GB kombinerat VRAM, men chassit, som matas av dubbla nätaggregat på upp till 2700 W, stöder upp till fyra Blackwell-kort och 384 GB VRAM. Det är skillnaden mellan testat och maximalt är poängen: inget standard OEM-torn som vi har testat erbjuder mer GPU-utrymme, och vägen från två kort till fyra kräver inget chassibyte.
Läs hela recensionen av Z8 Fury G6i
Det extrema valet: Comino Grando RTX PRO 6000
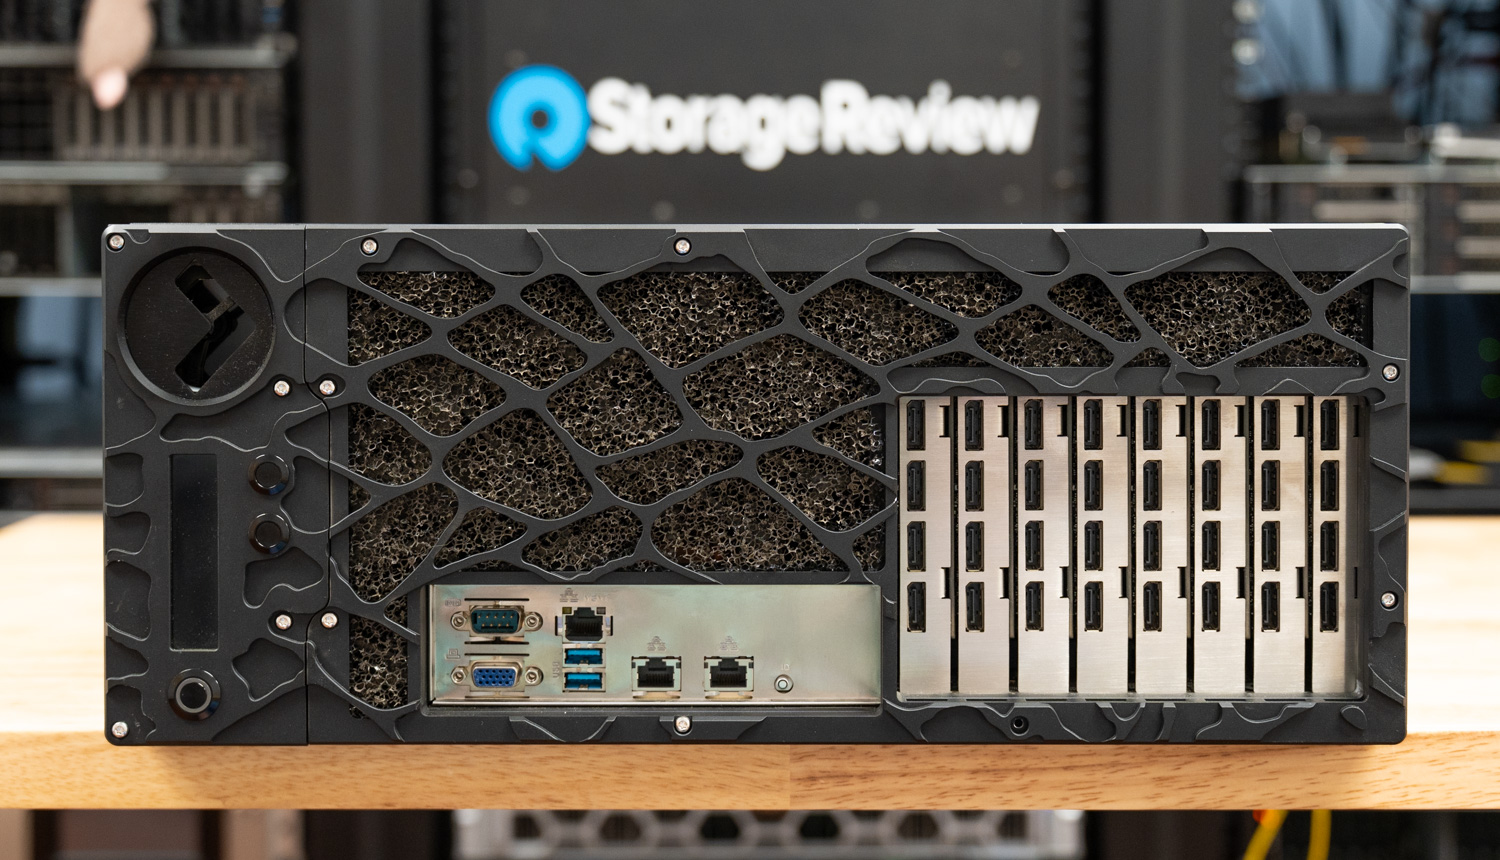
768 GB VRAM i ett vätskekylt 4U-chassi: Grando finns för köparen vars modell inte får plats någon annanstans. Vår testenhet levererades med åtta RTX PRO 6000 Blackwell-kort på 96 GB vardera, chassits maximala kapacitet, och Cominos vätskekylning klarar alla åtta av full TDP dygnet runt utan strypning. Det är mer GPU-minne än många rackservrar, i något som fortfarande kan stå bredvid ett skrivbord. Den är högljudd prismässigt, inte akustikmässigt, och den är medvetet avvikaren på den här listan: ett bevis på var skrivbordstaket sitter.
Läs hela recensionen av Comino Grando
Hur vi rankar
Tre regler styr varje StorageReview-topplista, och den första är att endast laboratorietestade system rankas : om vi inte har jämfört det kan det nämnas, men det kan inte ha en kategori. För det andra rankas systemen en gång per mätning. Tornen ovan rankade också på vår topplista för stationära arbetsstationer efter SPECworkstation och renderingsprestanda fram till oktober 2026, då den sidan flyttades till system med ett enda GPU; deras resultat där finns kvar i deras recensioner, och här rankas de efter inferensdataflöde och minnestak. För det tredje finns det en ingångsgräns: ett system behöver två eller fler GPU:er, testade med vLLM som serveras under Linux, eller en delad minnespool med minst 96 GB tillgängligt för modeller. Torn med ett enda GPU, även med ett 96 GB-kort, rankas på vår sida Bästa stationära arbetsstationer i vår Windows-klientsvit.
Rankningarna härleds från en sammansättning av vLLM online-serverflöde, tid till första token, tid per utdatatoken, MAMF-beräkningseffektivitet, GDSIO-lagringsprestanda och försäljningspris. Redaktionell bedömning bryter skillnader inom poängintervallen. Leverantörer ser inte rankningar före publicering, och ingen placering på denna sida betalas.
Vanliga frågor om lokala AI-skrivbord
Vilken är den bästa skrivbordsmiljön för agentisk AI?
Agentiska arbetsbelastningar som kodningsagenter, pipelines för verktygsanrop och autonoma uppgifter i flera steg är dataflödes- och latenskänsliga på ett sätt som användning av en enda chatt inte är, eftersom agenter kedjar många modellanrop med stor kontext. Det gynnar tornnivån: Dell Precision 7875:s diskreta VRAM levererar den ihållande time-to-first-token som håller långa agentkedjor responsiva. För budgetmedvetna agentiska experiment kör en GB10-klassad enhet samma stackar med lägre hastighet. Vår fullständiga storleksguide finns i RAM, GPU och lagring för Agentic AI.
Hur mycket minne behöver jag för att köra en 70B-modell lokalt?
Som en fungerande regel behöver en 70B-modell vid 4-bitars kvantisering ungefär 40–48 GB modellåtkomligt minne före kontext; bekväm interaktiv användning med en lång kontext kräver mer. Det är därför 128 GB Unified-minnesenheter hanterar modeller i 70B-klassen bra, och varför torn med ett enda GPU istället rankas på vår sida om bästa stationära arbetsstationer.
Behöver jag särskild strömförsörjning för att driva dessa system?
För apparatnivån, nej: GB10-klassade boxar och Strix Halo-system fungerar bekvämt i ett vanligt kontorsuttag. Torndatorerna förtjänar ett riktigt samtal med den som äger byggnaden. En fullt konfigurerad HP Z8 Fury G6i kan bära dubbla nätaggregat på totalt upp till 2700 W, mer än vad en vanlig 15-ampere, 120 V-krets kan leverera, och Comino Grando specificerar 2000 W hot-swap-aggregat som kräver 180-264 V ingång, vilket sjunker till 1000 W-enheter vid 110 V-anslutning.
Innan du köper från toppen av den här sidan, kontrollera vad vägguttaget kan mata; en dedikerad krets eller 208/240V-anslutning kan ingå i den verkliga kostnaden för en komplett GPU-belastning. Värme följer samma beräkning, eftersom varje watt som dras hamnar i rummet.
Vad sägs om en Mac Studio?
Inte just nu, och inte bara för att vi ännu inte har testat en i ett laboratorium. Apple har slutat sälja Mac Studio-konfigurationerna med högt minne, vilket var maskinens enda verkliga fördel för lokal AI: tillräckligt med enhetligt minne för att hålla mycket stora modeller. Utan dessa konfigurationer är den nuvarande uppställningen inte en seriös kandidat för den här sidan. Apple förväntas uppdatera Mac Studio i år; om alternativen med högt minne återkommer kommer vi att testa en och ompröva.


 Amazon