

Google har presenterat ännu en ny molnteknik inom sin Cloud Platform-serie, Google Cloud Dataproc. Denna nya molnteknik syftar till att göra Hadoop och Spark enklare att distribuera och hantera inom Google Cloud Platform. Precis som det senaste tillkännagivandet från Dell och Cloudera möjliggör denna teknik användning av Hadoop utan de höga utbildningskostnader som är förknippade med det.
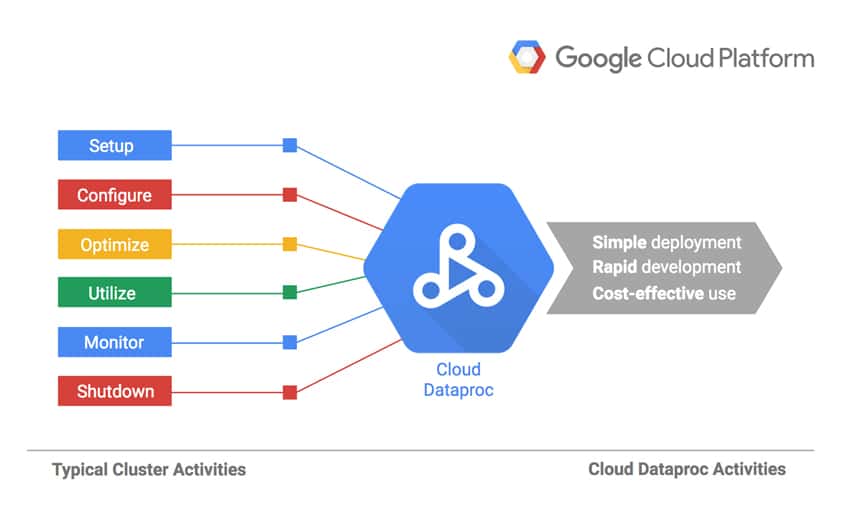
Eftersom datamängder fortsätter att växa i storlek och komplexitet kommer fler kraftfulla verktyg att behövas för att analysera dessa datamängder. Medan verktygen finns lägger de ofta till ytterligare ett lager av komplexitet och kan vara kostsamt att utbilda administratörer i ny teknik eller ta in konsulter. Google introducerar Dataproc, en automatisk och hanterad tjänst för Hadoop och Spark. Med Dataproc kan användare dra fördel av dataverktyg med öppen källkod för batchbearbetning, förfrågningar, streaming och maskininlärning samtidigt som de använder sin automatisering för att snabbt skapa och hantera kluster. Dataproc tillåter också att kluster stängs av när de inte används, vilket hjälper till att spara kostnader eftersom fakturering sker minut för minut.
Fördelarna inkluderar:
- Cloud Dataproc kostar endast 1 cent per virtuell CPU i en kunds kluster per timme, utöver de andra Cloud Platform-resurserna som används. Cloud Dataproc-kluster kan inkludera borttagbara instanser som har lägre beräkningspriser, vilket minskar kostnaderna ytterligare. Istället för att avrunda användningen upp till närmaste timme, debiterar Cloud Dataproc kunderna endast för det som används med minut för minut fakturering och en faktureringsperiod på minst tio minuter.
- Utan att använda Dataproc kan det ta allt från 5 till 30 minuter att skapa Spark- och Hadoop-kluster på plats eller via IaaS-leverantörer. Som jämförelse är Cloud Dataproc-kluster snabba att starta, skala och stänga av med var och en av dessa operationer som tar i genomsnitt 90 sekunder eller mindre. Detta innebär att användare kan spendera mindre tid på att vänta på kluster och mer praktisk tid att arbeta med sina data.
- Cloud Dataproc har inbyggd integration med andra Google Cloud Platform-tjänster, som t.ex BigQuery, Molnlagring, Cloud Bigtable, Cloud Logging och Cloud Monitoring, så att kunder har mer än bara ett Spark- eller Hadoop-kluster – de har en komplett dataplattform. Till exempel kan de använda Cloud Dataproc för att utan ansträngning ETL terabyte med rå loggdata direkt till BigQuery för affärsrapportering.
- Kunder kan enkelt interagera med kluster och Spark- eller Hadoop-jobb via Google Developers Console, Google Cloud SDK eller Cloud Dataproc REST API. När de är klara med ett kluster kan de helt enkelt stänga av det så att pengar inte slösas bort på ett ledigt kluster. Det finns ingen oro för att förlora data, eftersom Cloud Dataproc är integrerat med Cloud Storage, BigQuery och Cloud Bigtable.
- Det finns inget behov av att lära sig nya verktyg eller API:er för att använda Cloud Dataproc, vilket gör det enkelt att flytta befintliga projekt till Cloud Dataproc utan omutveckling. Spark, Hadoop, Pig och Hive uppdateras ofta, så att användare kan vara produktiva snabbare.
Tillgänglighet och prissättning
Google Cloud Dataproc är tillgänglig nu som en betatjänst från 0.01 USD per virtuell CPU.


 Amazon