

Advancing AI 2026 var AMDs hittills största lanseringsevenemang, tillräckligt stort för att vi delade upp vår bevakning i två delar. Vår första artikel behandlade Instinct MI455X och Helios-racket med 72 grafikkort; den här artikeln behandlar det som inte bekvämt fick plats bredvid dem: 6:e generationens EPYC-serverprocessorer, med kodnamnet Venice, och Verano-värdprocessorn. Processorn förtjänar en egen rubrik. Venice har upp till 256 kärnor och 512 trådar per sockel, 1.6 TB/s minnesbandbredd, den första PCIe Gen 6 i en serverprocessor och 18 gånger högre dataflöde än den första generationens EPYC från 2017.
Venice är inte heller ett chip. Det är en portfölj, en poäng som AMD upprepar i varje session: en CPU-profil passar inte alla. Samma Zen 6-generation sprider sig i en densitetsdel, en företagsdel, en HPC-del med stacked-cache och en strömsnål LPDDR-värd. Så innan hastigheter och strömförsörjning, låt oss titta på sortimentet.
Venedig och Verano-uppställningen
AMD sorterar det moderna datacentret i tre serverklasser, och portföljen är byggd för att fylla alla. Generella CPU-servrar driver webbgateways, cacher, applikationsnivåer, databaser och lagring som allt annat lutar sig mot. GPU-servrar behöver en värd-CPU som håller acceleratorerna matade, ett jobb där enkeltrådad hastighet och I/O-bandbredd slår antalet kärnor. Den tredje klassen är täta CPU-servrar för orkestrerings- och verktygsexekveringskod som har vuxit fram kring AI-tjänster; den koden är grentung och benägen att stanna, och den vill ha trådar framför allt.
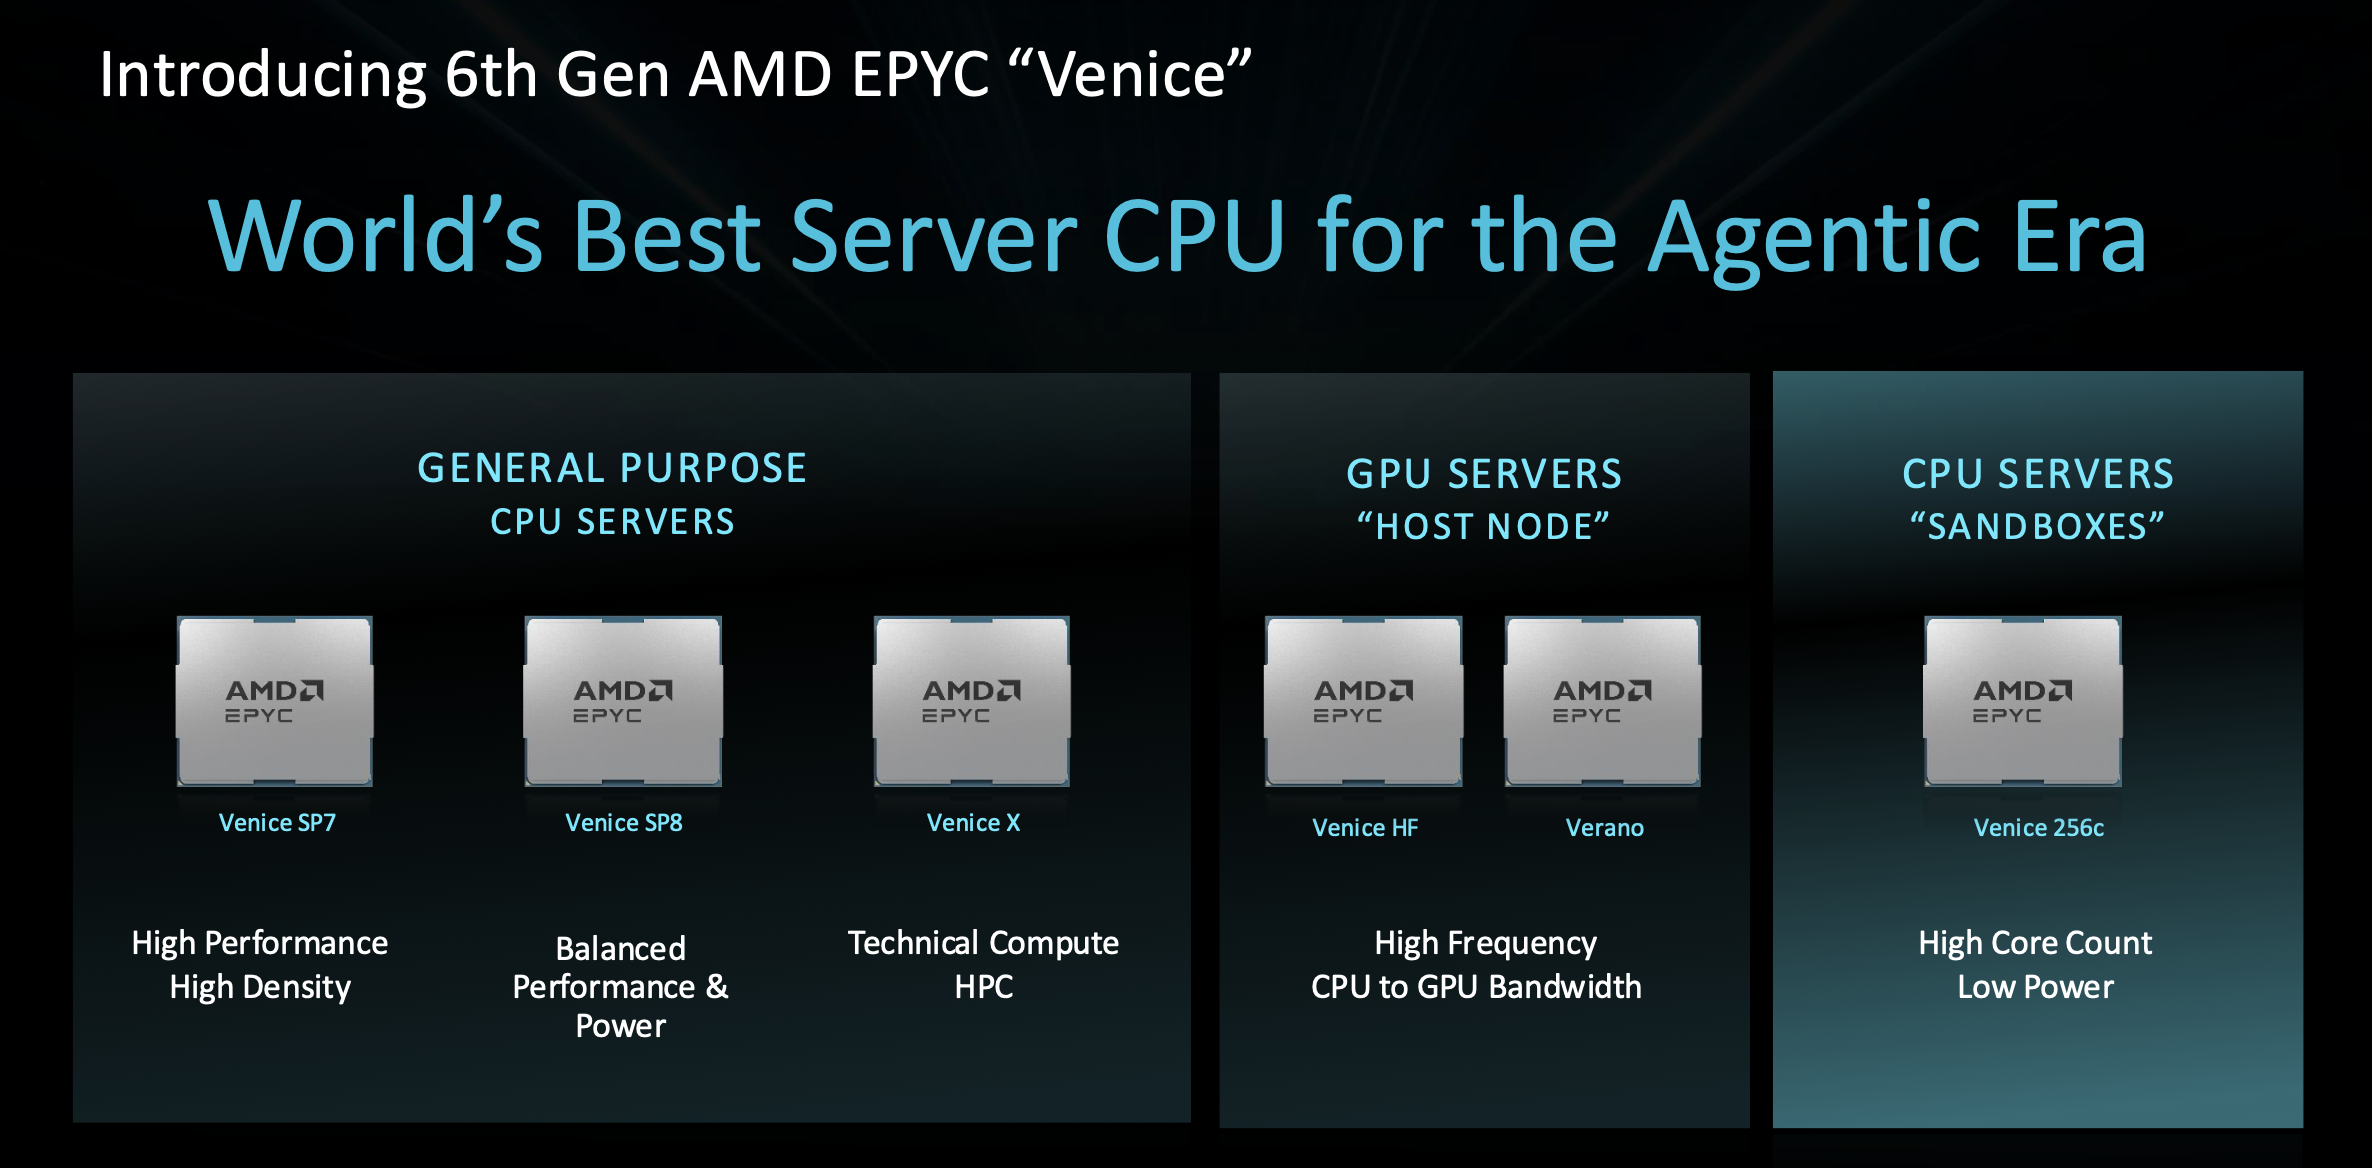
Sortimentet består av fyra produkter, och plattformarna anländer i vågor: Venice SP7 under fjärde kvartalet 2026, Venice SP8 under första halvåret 2027, och Venice-X och Verano under andra halvåret. AMD delar upp samma kisel på sex sätt, och den finare processorn mappas direkt till de tre nivåerna. Allmänna funktioner får Venice SP7, SP8 och Venice-X. Värdminnet parar ihop en högfrekvent Venice-bin med Verano och dess LPDDR-minne. Dense computing får vad racketen kallar Venice 256c: högt antal kärnor vid låg strömförbrukning, byggd för att packa så många trådar i ett rack som strömförbrukningsbudgeten tillåter. Verano arbetar också extra: AMD säger att utvalda kunder kommer att driftsätta den som en allmän processor där prestanda per systemwatt är den bindande begränsningen.
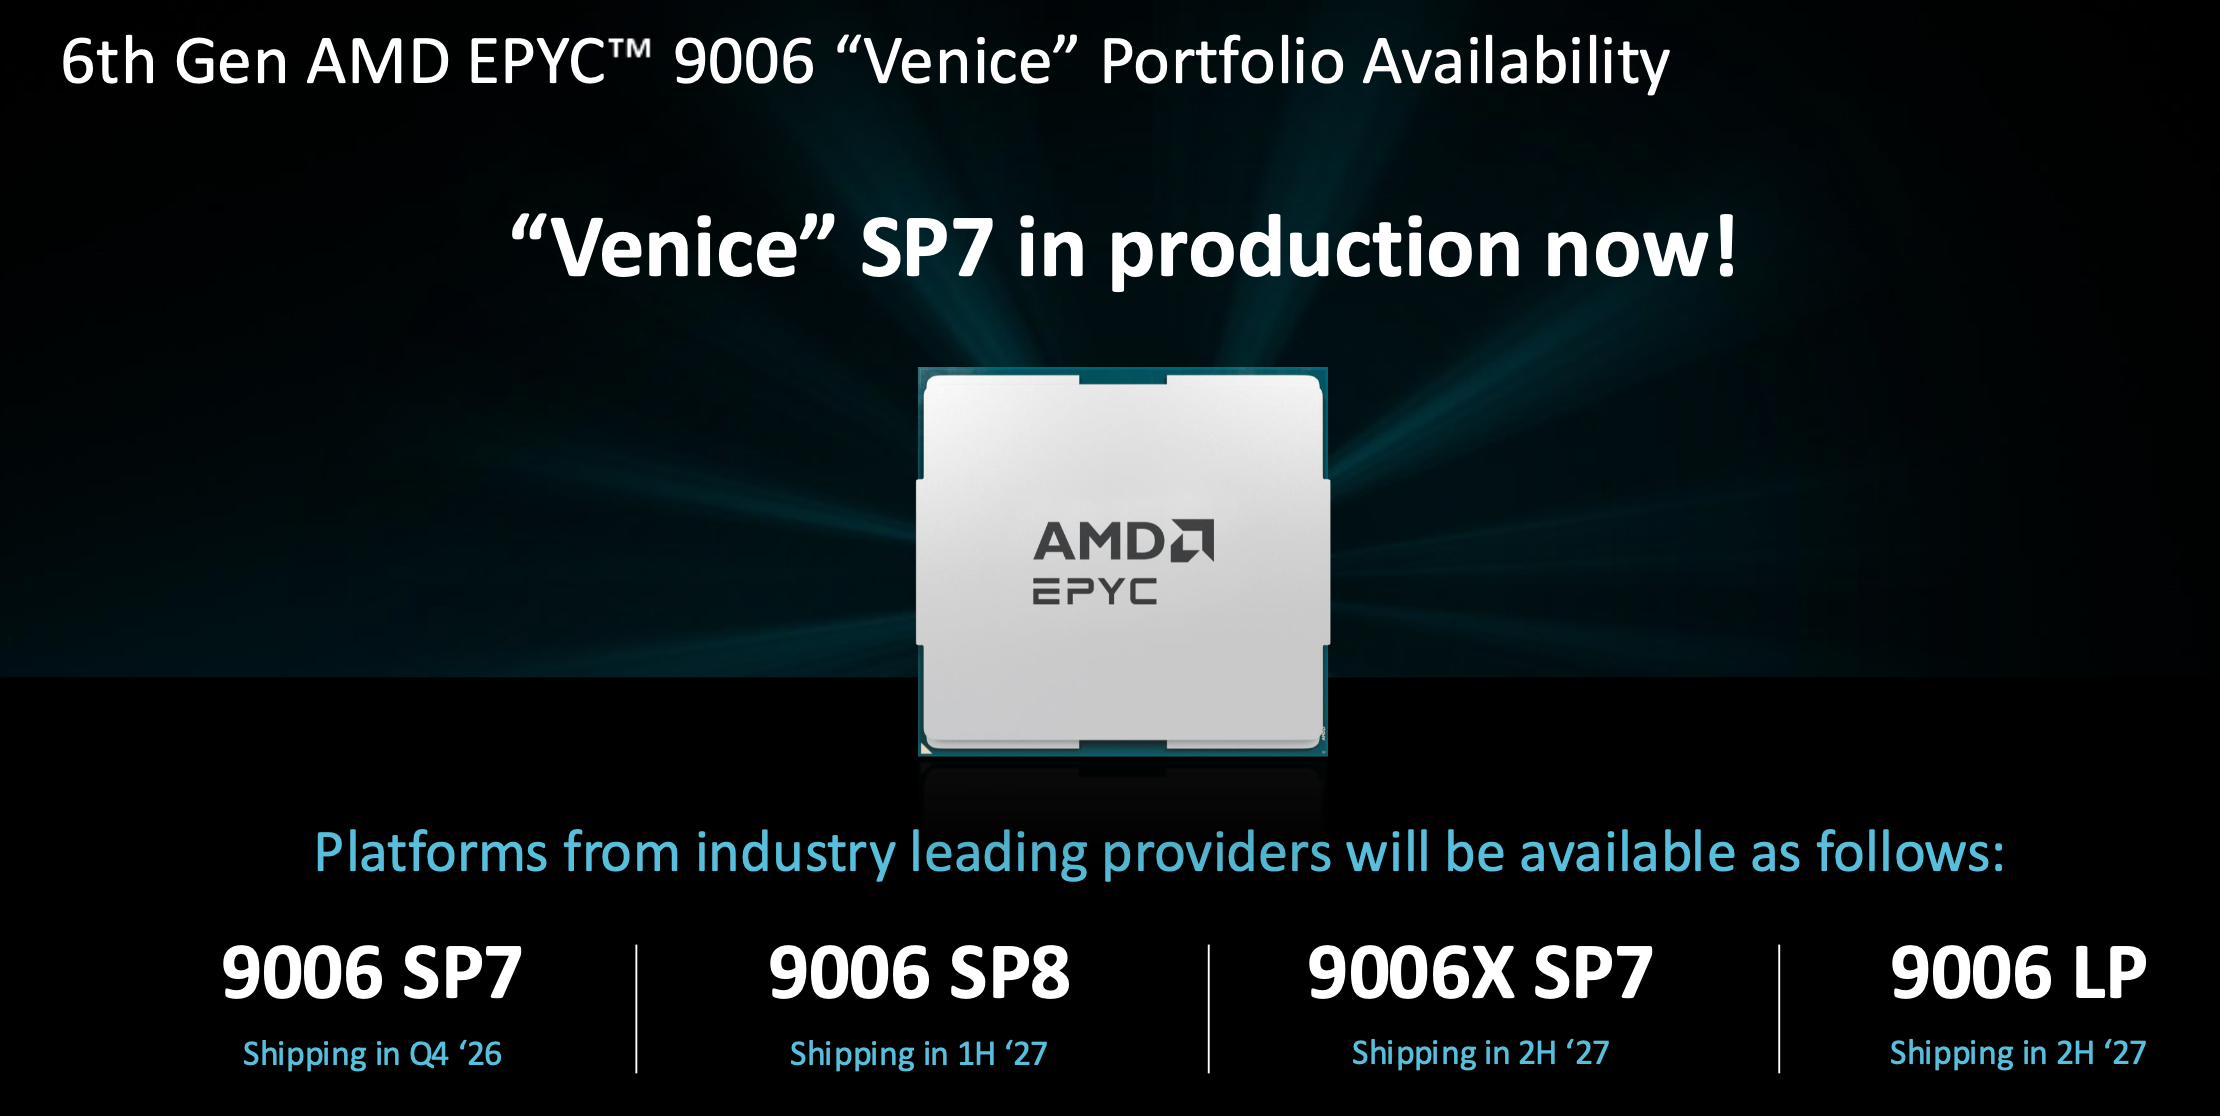
Vi får en smygtitt på SKU:erna tack vare fotnoterna. 256-kärnig EPYC 9996 leder stacken, 9956 har samma kärnor på 400W, och 96-kärnig 9686F är den högfrekventa värdkomponenten. Helios har sin egen version av den värdkiseln, EPYC 9G76, i varje datorfack.
Kompromisslös nivå
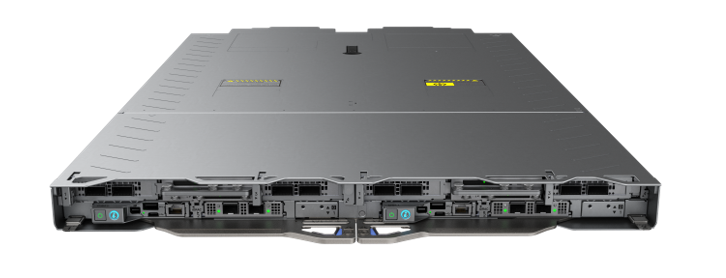
Innan specifikationstabellerna, ett ord om var den stora sockeln landar. Venice SP7 är reserverad för AMD:s högsta prestandanivå utan kompromisser: datacenter, hyperscaler och HPC-beräkningsinstallationer, där dataflödet per rack är den avgörande faktorn, utan att spara på några kostnader. Serverleverantörerna omnivåerar redan kring den. Dell har delat upp sitt etablerade PowerEdge-namnschema för att göra plats, och denna klass av datorer finns nu i en ny 9000-serie ledd av PowerEdge R9825 och Rack Scale M9825, flaggskeppsmodellerna med två Venice-chip i ett 3U-chassi.
Rubrikspecifikationerna
Hela familjen bygger på en plattform, och nästan varje hörn av den är ny sedan Turin.
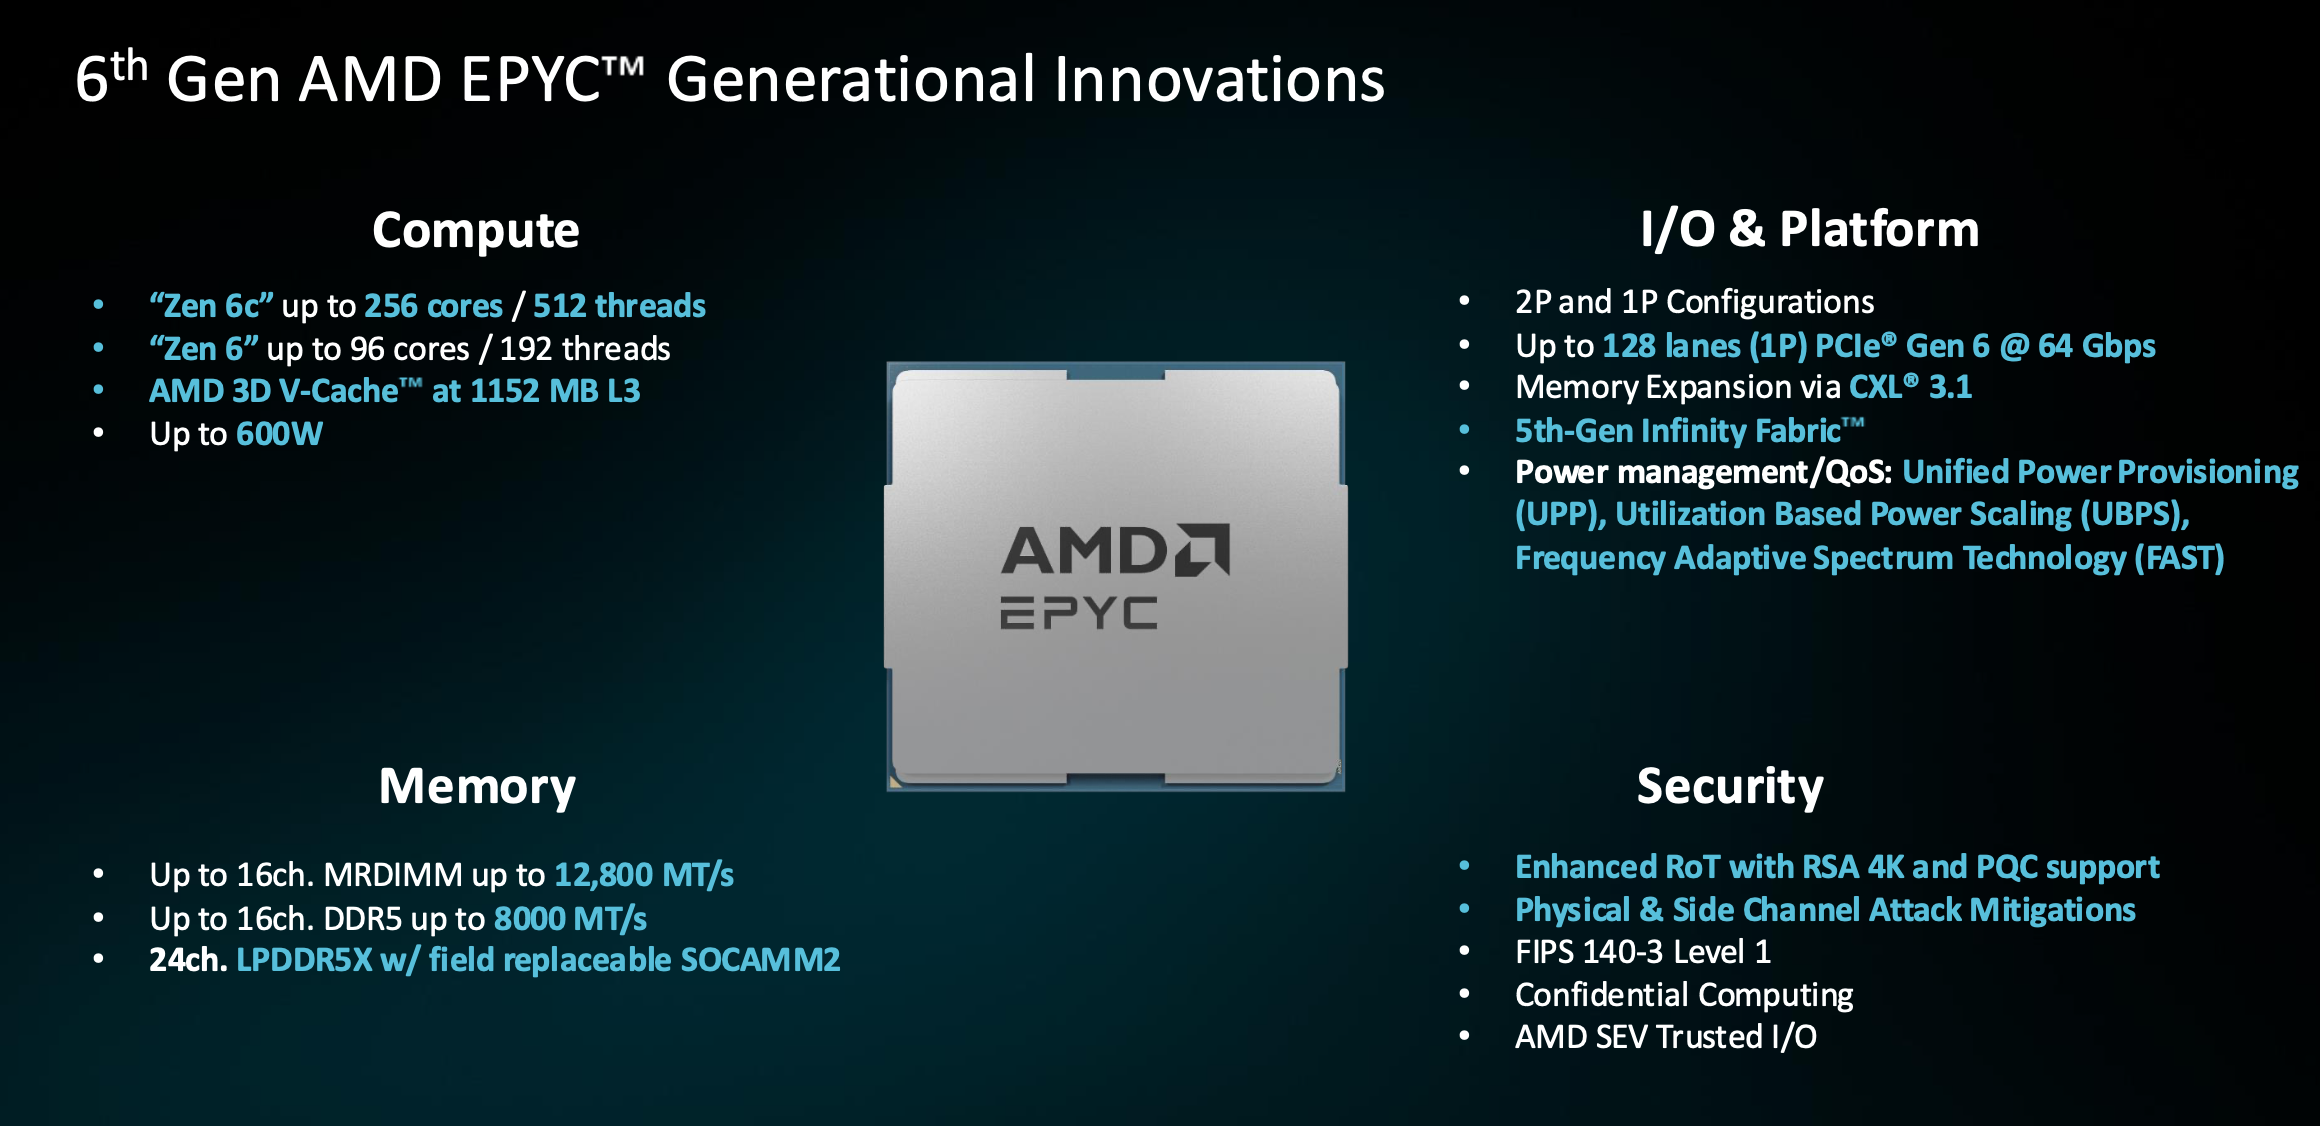
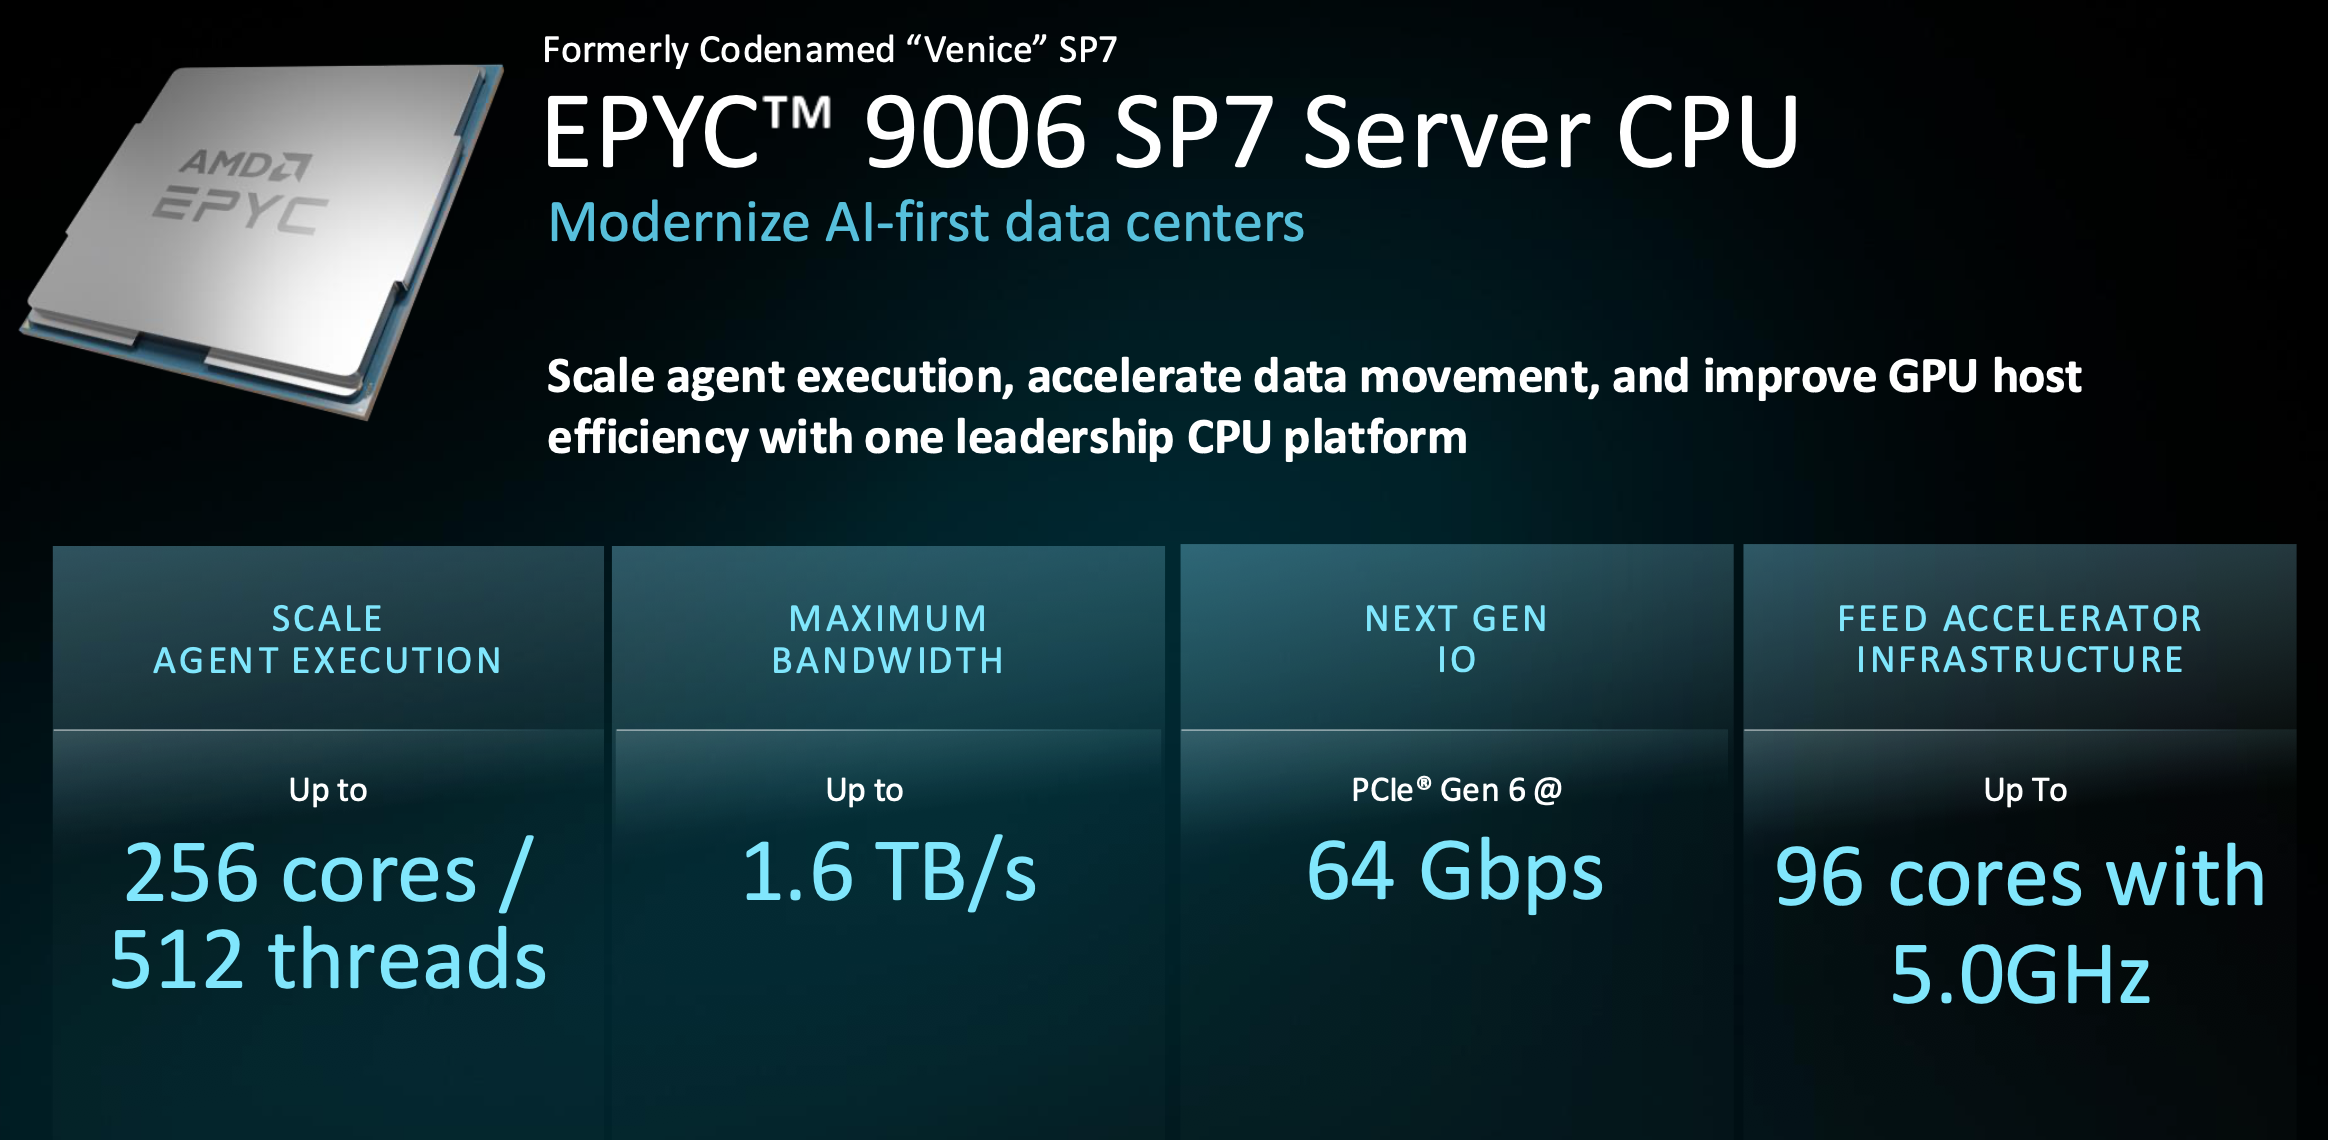
Börja med kärnorna. Zen 6 finns i två varianter: den kompakta Zen 6c har 256 kärnor och 512 trådar i en sockel på upp till 600W, medan standardkärnan stannar vid 96 men klockar till 5 GHz. AMD hävdar upp till 20 % mer prestanda per kärna än konkurrerande komponenter vid matchande kärnantal, och densiteten tunnar inte ut cachen: även 256-kärnig chips har cirka 4 MB L3 per kärna, en hel gigabyte på flaggskeppet. AVX-512 hanterar tokenizers och modellerna med 3 till 8 miljarder parametrar som i allt högre grad körs på själva processorn.
Att mata dessa kärnor kräver ett mycket större minnessystem: 16 kanaler DDR5 vid 8 000 MT/s, eller MRDIMM vid 12 800, vilket ger 1.6 TB/s per sockel, medan Turin klarade 614 GB/s från 12 kanaler. I/O gör samma hopp. Venice är den första server-CPU:n med PCIe Gen 6, 128 banor vid 64 GT/s, dubbelt så mycket bandbredd per ban som allt annat som ansluts till acceleratorer idag, och grunden för värdnod-påståendet kommer vi att analysera senare. CXL 3.1 använder dessa banor för minnesexpansion, och utvalda AI-värdplattformar med två socklar byter xGMI-bredd mellan socklar för I/O för att nå 160 användbara banor. Två tystare tillägg flyttar data utan att bränna kärnor: SDXI avlastar minneskopior och 30 till 50 kärnors krypto, och Smart Data Cache Injection släpper nätverkspaket direkt i cachen istället för att dirigera dem via DRAM.
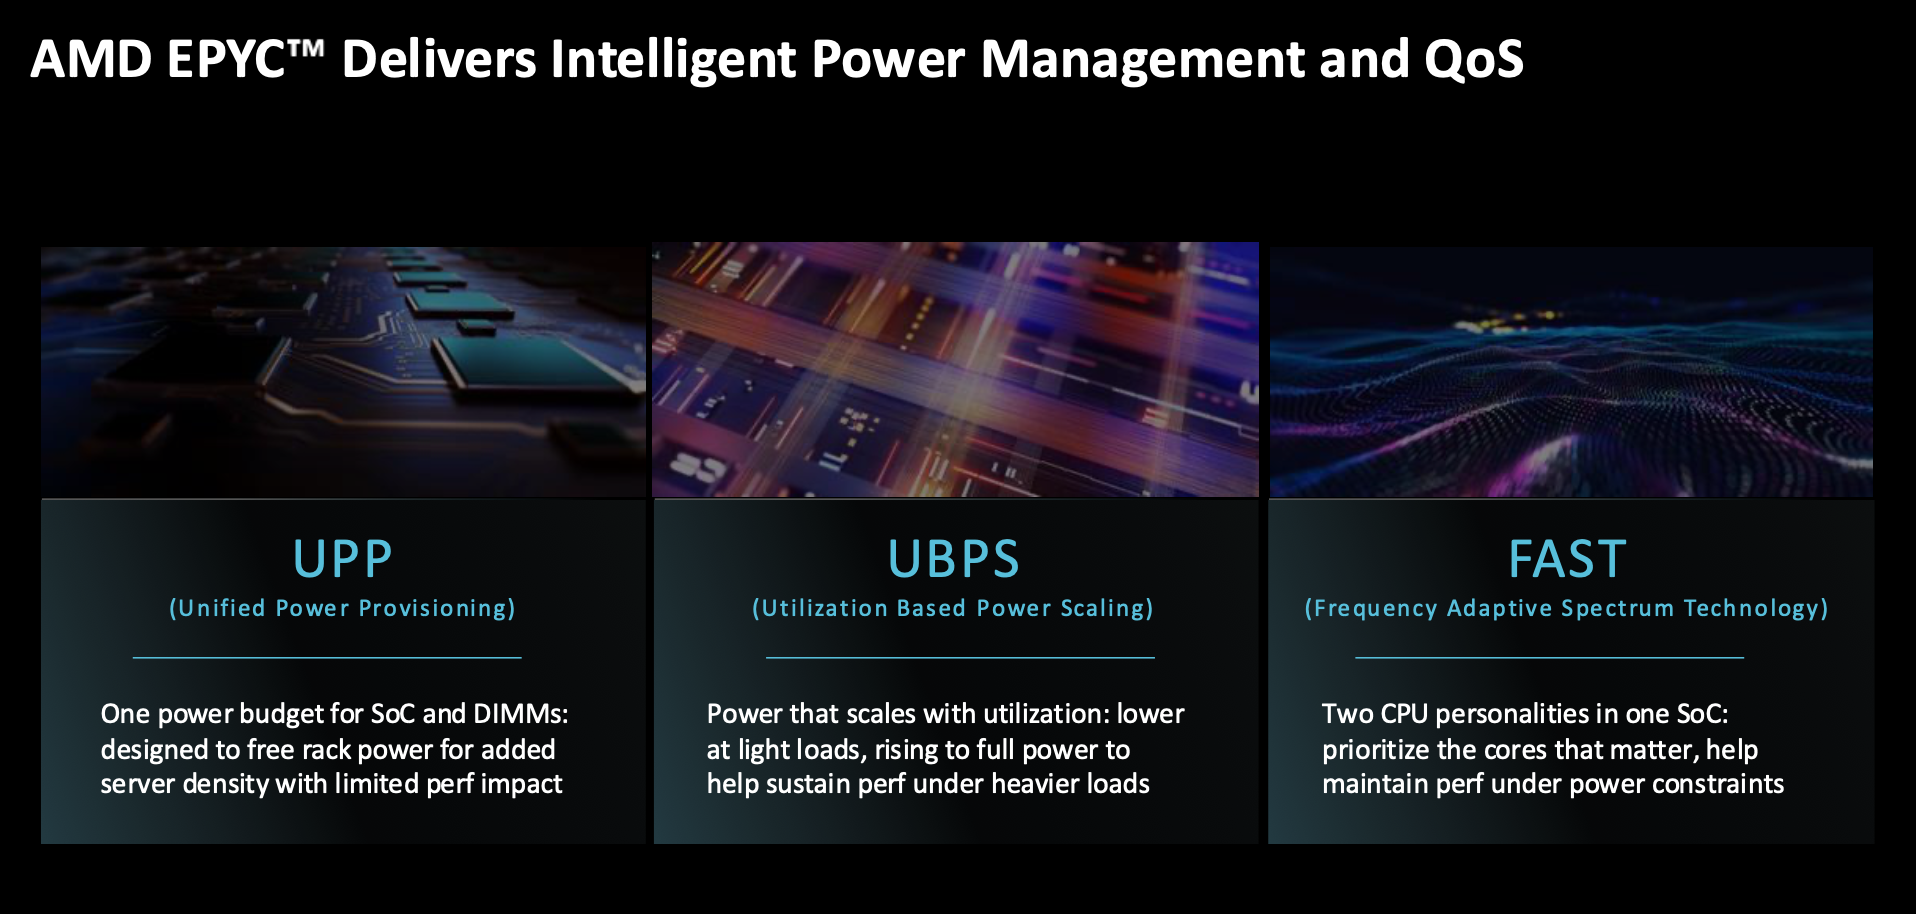
Strömhantering får tre nya rattar, och de spelar roll eftersom varje rackjämförelse som AMD gör senare sker inom en strömbudget. UPP slår samman SoC- och DIMM-budgetarna till en, så en minnesbunden arbetsbelastning flyttar watt till DIMM-modulerna och en beräkningsbunden drar tillbaka dem, vilket antingen höjer prestandan inom en fast budget eller frigör rackkraft för fler noder. UBPS begränsar strömförbrukningen vid låg användning och byter ut den vanliga prestandaökningen vid lätt belastning mot en platt, förutsägbar belastningslinje; operatörer som föredrar ökningen kan stänga av den. FAST delar upp en SoC i två personligheter, vilket håller prioriterade kärnor på hög frekvens medan bakgrundskärnor körs långsammare, så att latenskritiskt arbete som delar en socket med batchjobb inte lider.
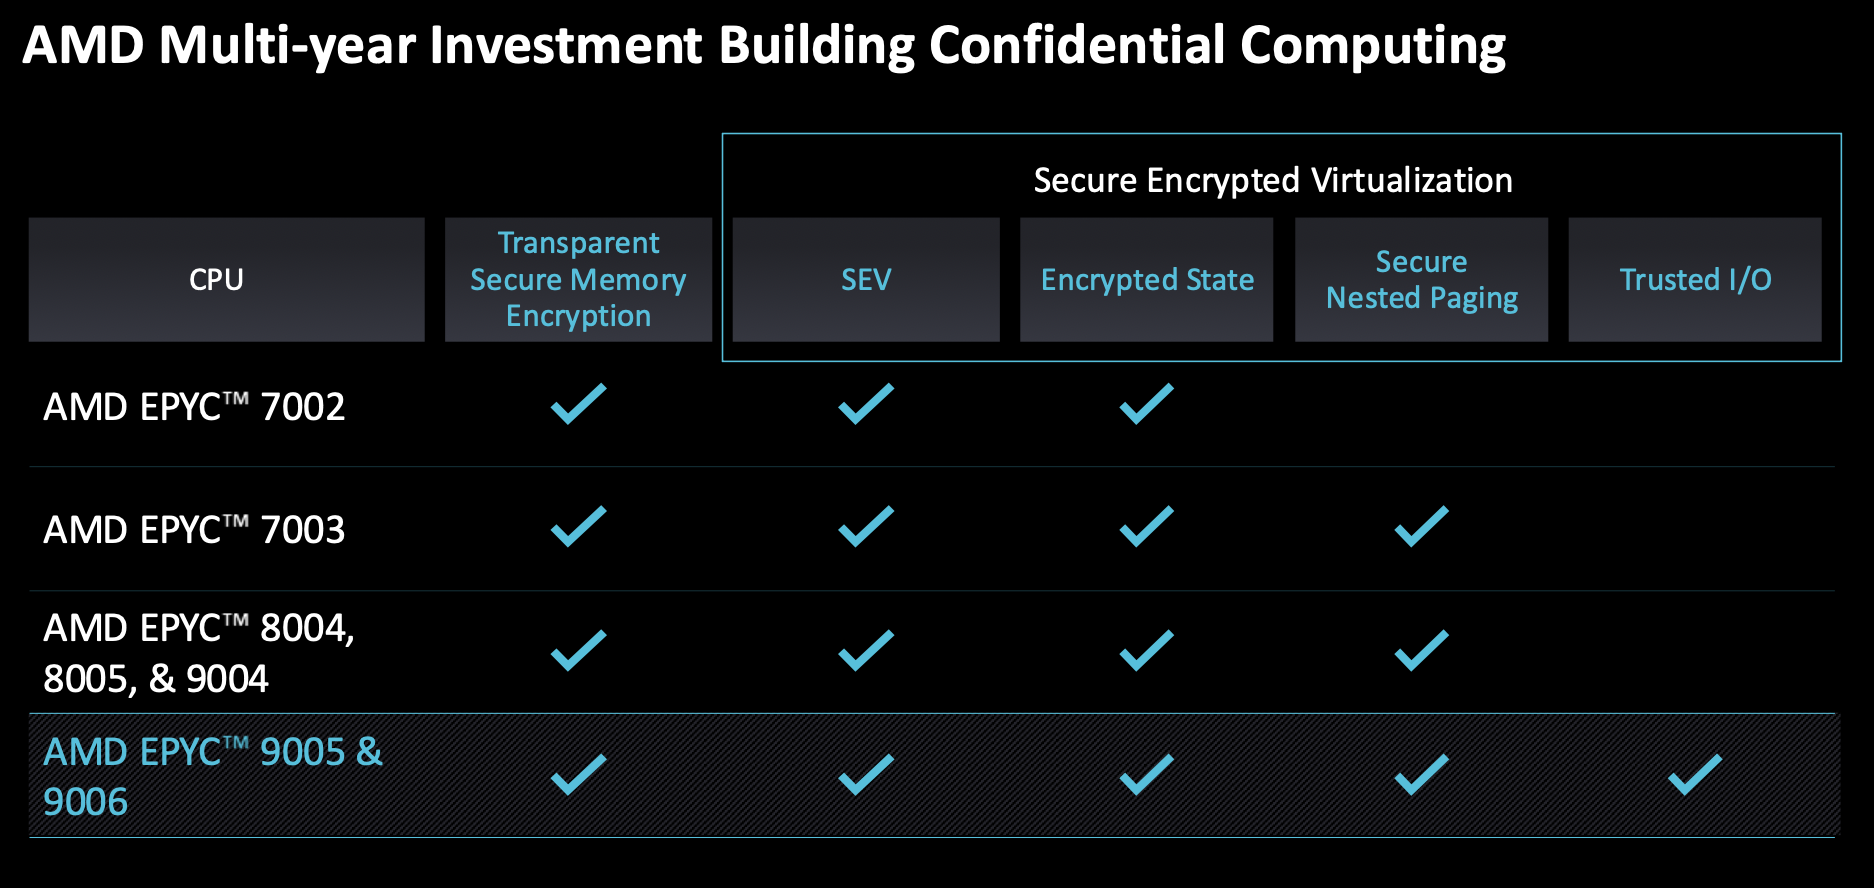
För säkerheten utökar Venice en konfidentiell databehandlingslinje som går från SEV på EPYC 7002 genom krypterat tillstånd, säker kapslad paging och den Trusted I/O som kom med Turin. Nytt för den här generationen: en förbättrad förtroendebaserad algoritm med RSA-4K och post-kvantumalgoritmer, skydd mot fysiska och sidokanalsattacker, FIPS 140-3 nivå 1-certifiering och Device Provenance, en påvisbar tillverkningshistorik som Venice kommer att vara bland de första AMD-produkterna att bära.
Inuti portföljen
De fyra delarna skiljer sig mer åt än det gemensamma namnet antyder.
| Specifikation | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “Verano” |
|---|---|---|---|---|
| Kärnor | Upp till 256 (512 trådar) | 8 till 128 | Upp till 96 | Upp till 72 |
| Toppfrekvens | 5.0 GHz med 96 kärnor (HF) | HF-alternativ erbjuds | ~5.15 GHz | Upp till 5.0 GHz |
| Minne | 16 kanaler, upp till 1.6 TB/s | 8-kanalig med 2 DIMM-moduler per kanal | 16-kanalig MRDIMM vid 12 800 MT/s | 24-kanalig LPDDR5X, SOCAMM2 |
| L3 cache | Upp till 1024MB | Beroende på kärnantal | 1152 MB (3D V-cache) | Beroende på kärnantal |
| I / O | PCIe Gen 6, 96 banor | 128 PCIe-banor, 1P och 2P | PCIe Gen6 | Förbättrad xGMI vid 112 GT/s |
| Riktad mot | Hyperskalig densitet, AI-värd | Företags-, Edge-, NEBS-vänlig | HPC, AI-förbehandling | Rackskalig AI-värd |
EPYC 9006 SP7
SP7 är flaggskeppssockeln och den som är i produktion nu; partnerplattformar följer under fjärde kvartalet. Dess högfrekventa kretsar ersätter de Turin HF-delar som AMD säger var bland deras snabbast växande SKU:er, och deras största utbyggnad är Helios, där värd-CPU:n i varje beräkningsbricka ansluter till rackets koherenta minnesdomän över Infinity Fabric med 1 TB DDR5 bakom sig. Eftersom sockeln är standard passar vilken SP7 SKU som helst upp till flaggskeppsmodellen med 256 kärnor, en punkt som vi tog upp i systerartikeln.
EPYC 9006 SP8
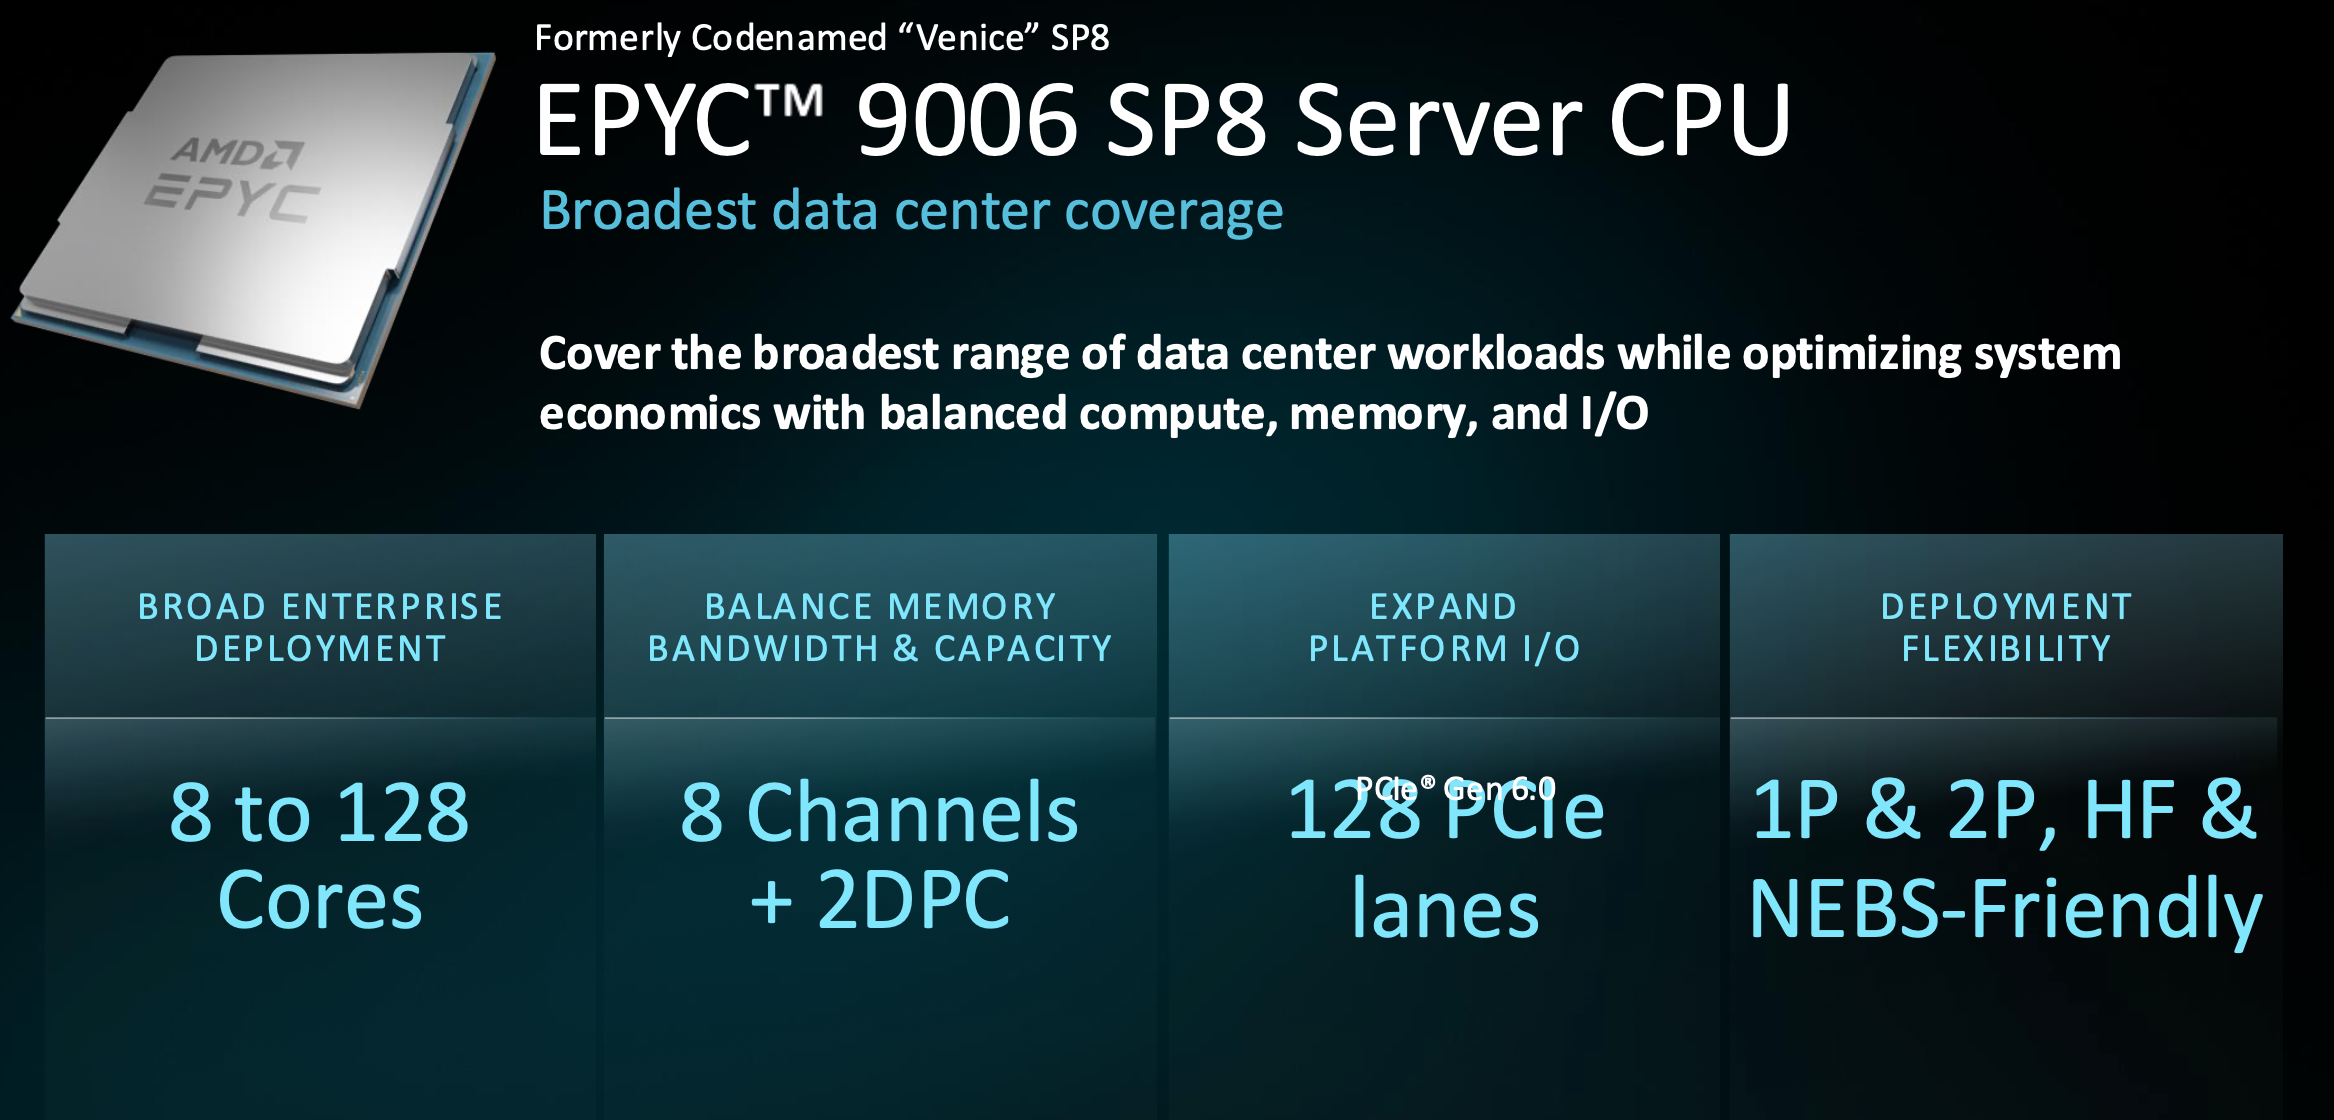
SP8 byter ut den gigantiska sockeln mot systemekonomi. Den sträcker sig över 8 till 128 kärnor, kör 8 minneskanaler med 2 DIMM-moduler per kanal, har 128 PCIe-banor och finns i 1P och 2P med högfrekventa och NEBS-vänliga alternativ för telekom- och edge-distributioner. AMDs argument är rätt prestanda för företaget, där det mätvärde som vinner affärer är prestanda per systemdollar snarare än per rack.
EPYC 9006X “Venedig-X”
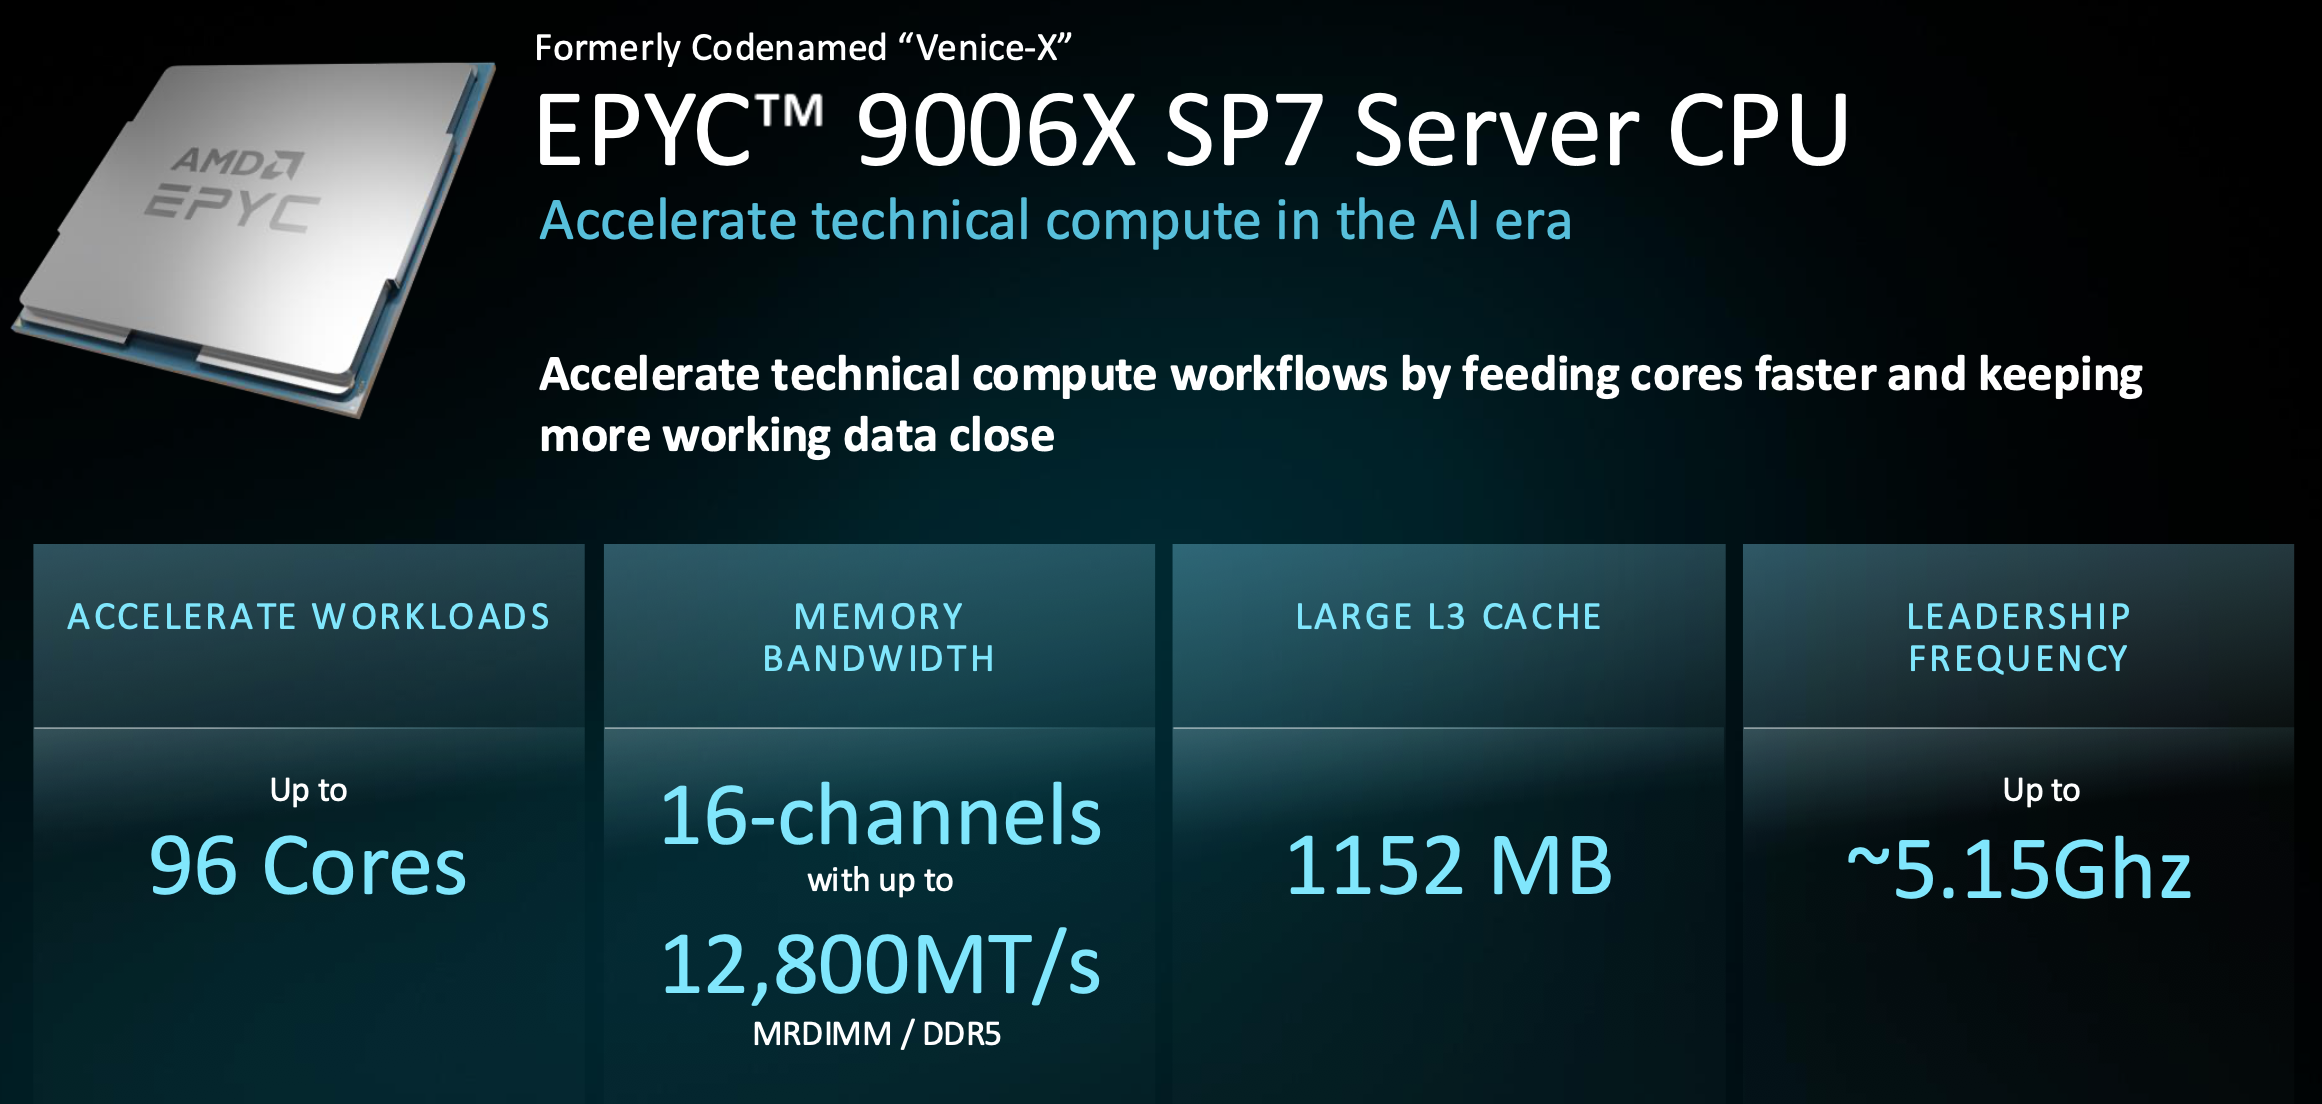
Venice-X staplar 3D V-Cache på den 96-kärniga högfrekvenskonfigurationen och tar L3 till 1152 MB, ungefär 3 gånger cachen per kärna jämfört med standard SP7-komponenterna. Klockfrekvenserna når cirka 5.15 GHz, och hela 16-kanals minnessystemet med 12 800 MT/s fortsätter. Målen är simulering och modellering, storskalig analys, minnesdatabaser och AI-förbehandling som matar träningspipelines – arbetsbelastningar där en arbetsuppsättning som lagras i cachen är viktigare än extra kärnor.
EPYC 9006 LP “Verano”
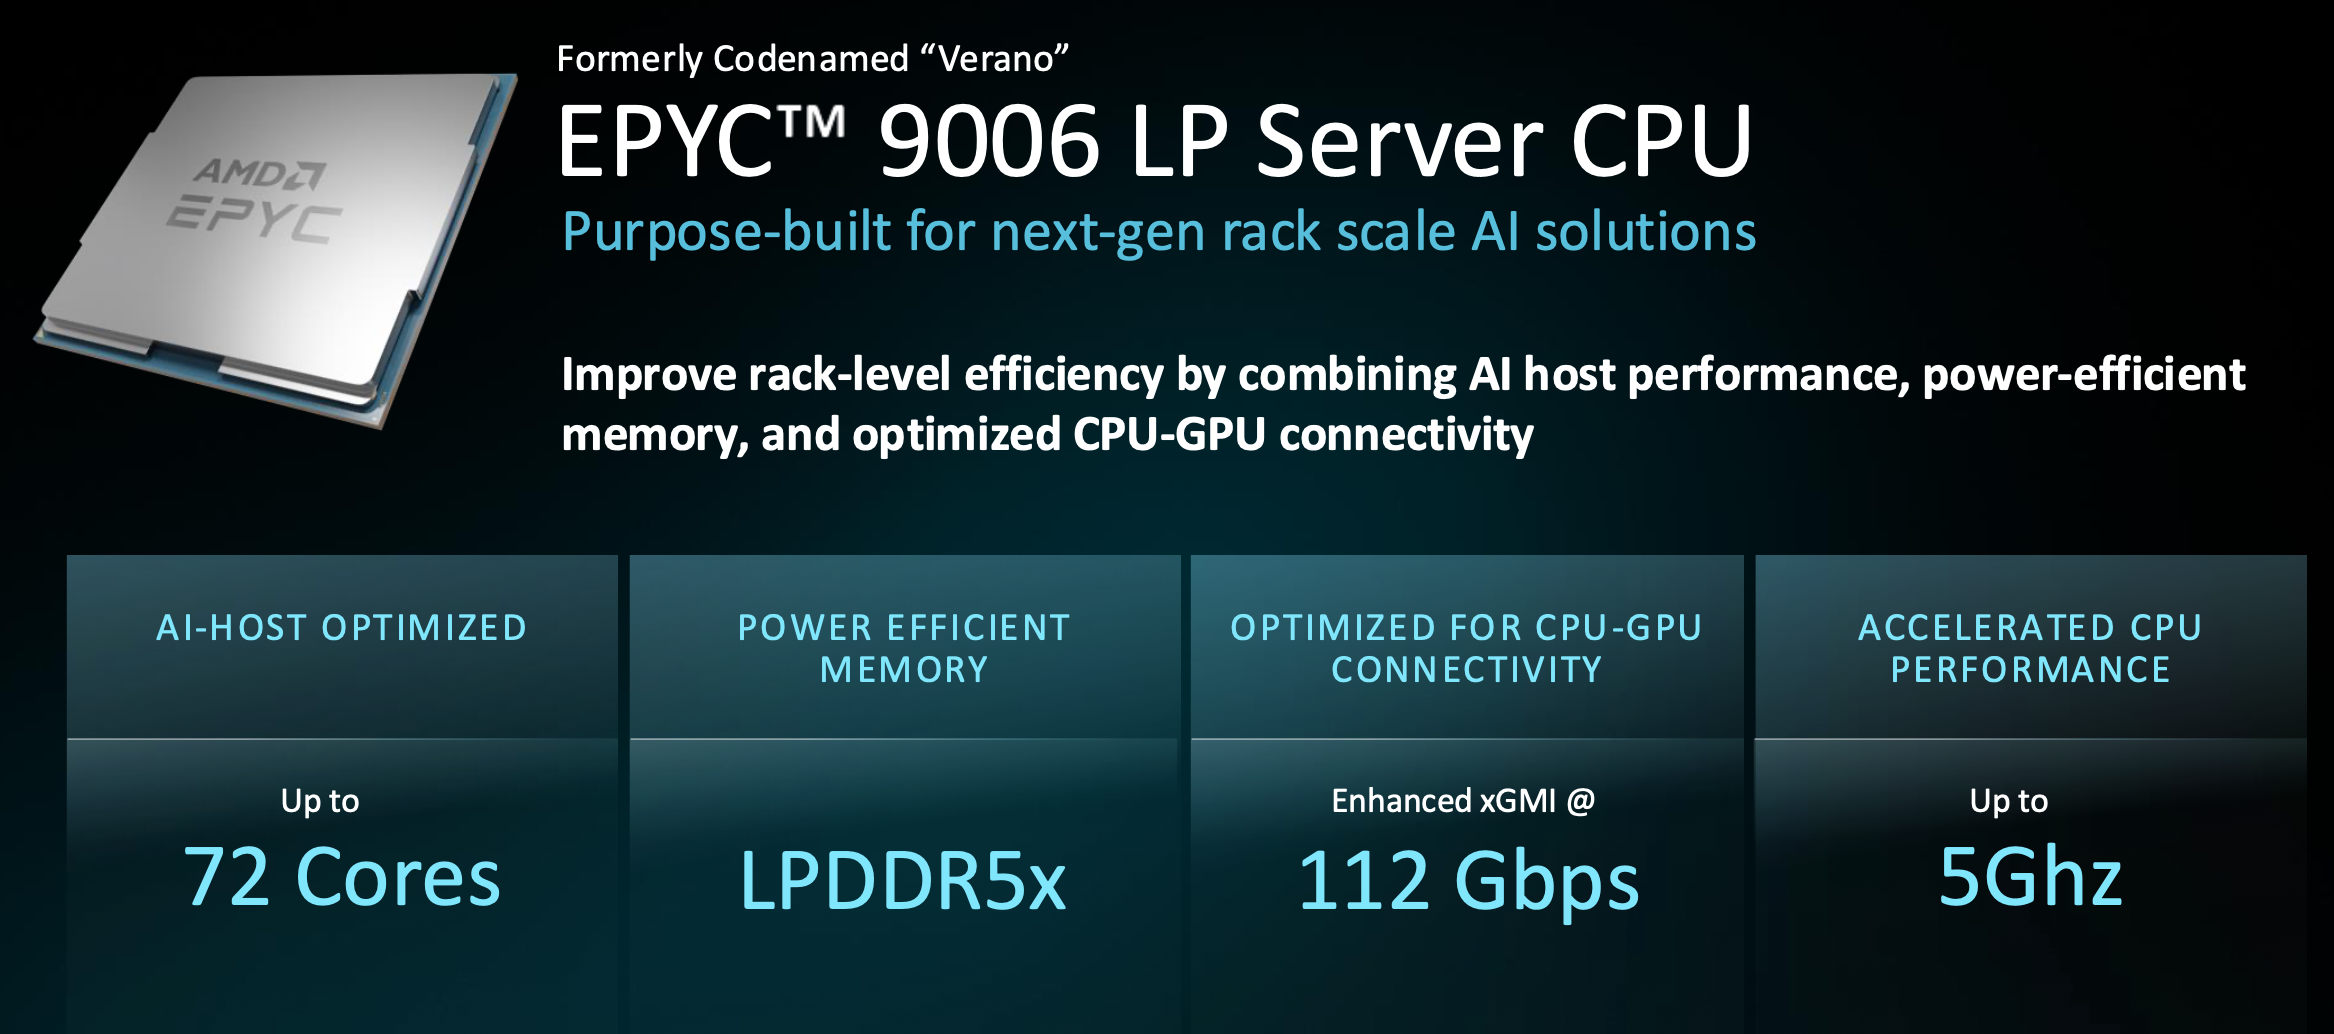
Verano är den mest fokuserade delen i familjen: först och främst en AI-värdnod, med upp till 72 kärnor vid 5 GHz, 24 kanaler med LPDDR5X och en förbättrad 112 GT/s xGMI-länk för CPU-till-GPU-trafik. LPDDR sitter på SOCAMM2-moduler som kan bytas ut i fält, vilket är viktigt i en flotta där ett fastlödt minnesfel annars skulle förstöra ett helt moderkort. Det är också AMDs direkta svar på NVIDIAs Vera, en matchning vi återkommer till, för AMD gjorde verkligen det.
Hur Venedig står sig
AMD gjorde sitt i två omgångar, med Turin som ledare och sedan Venedig som ledare.
Turins ledning idag
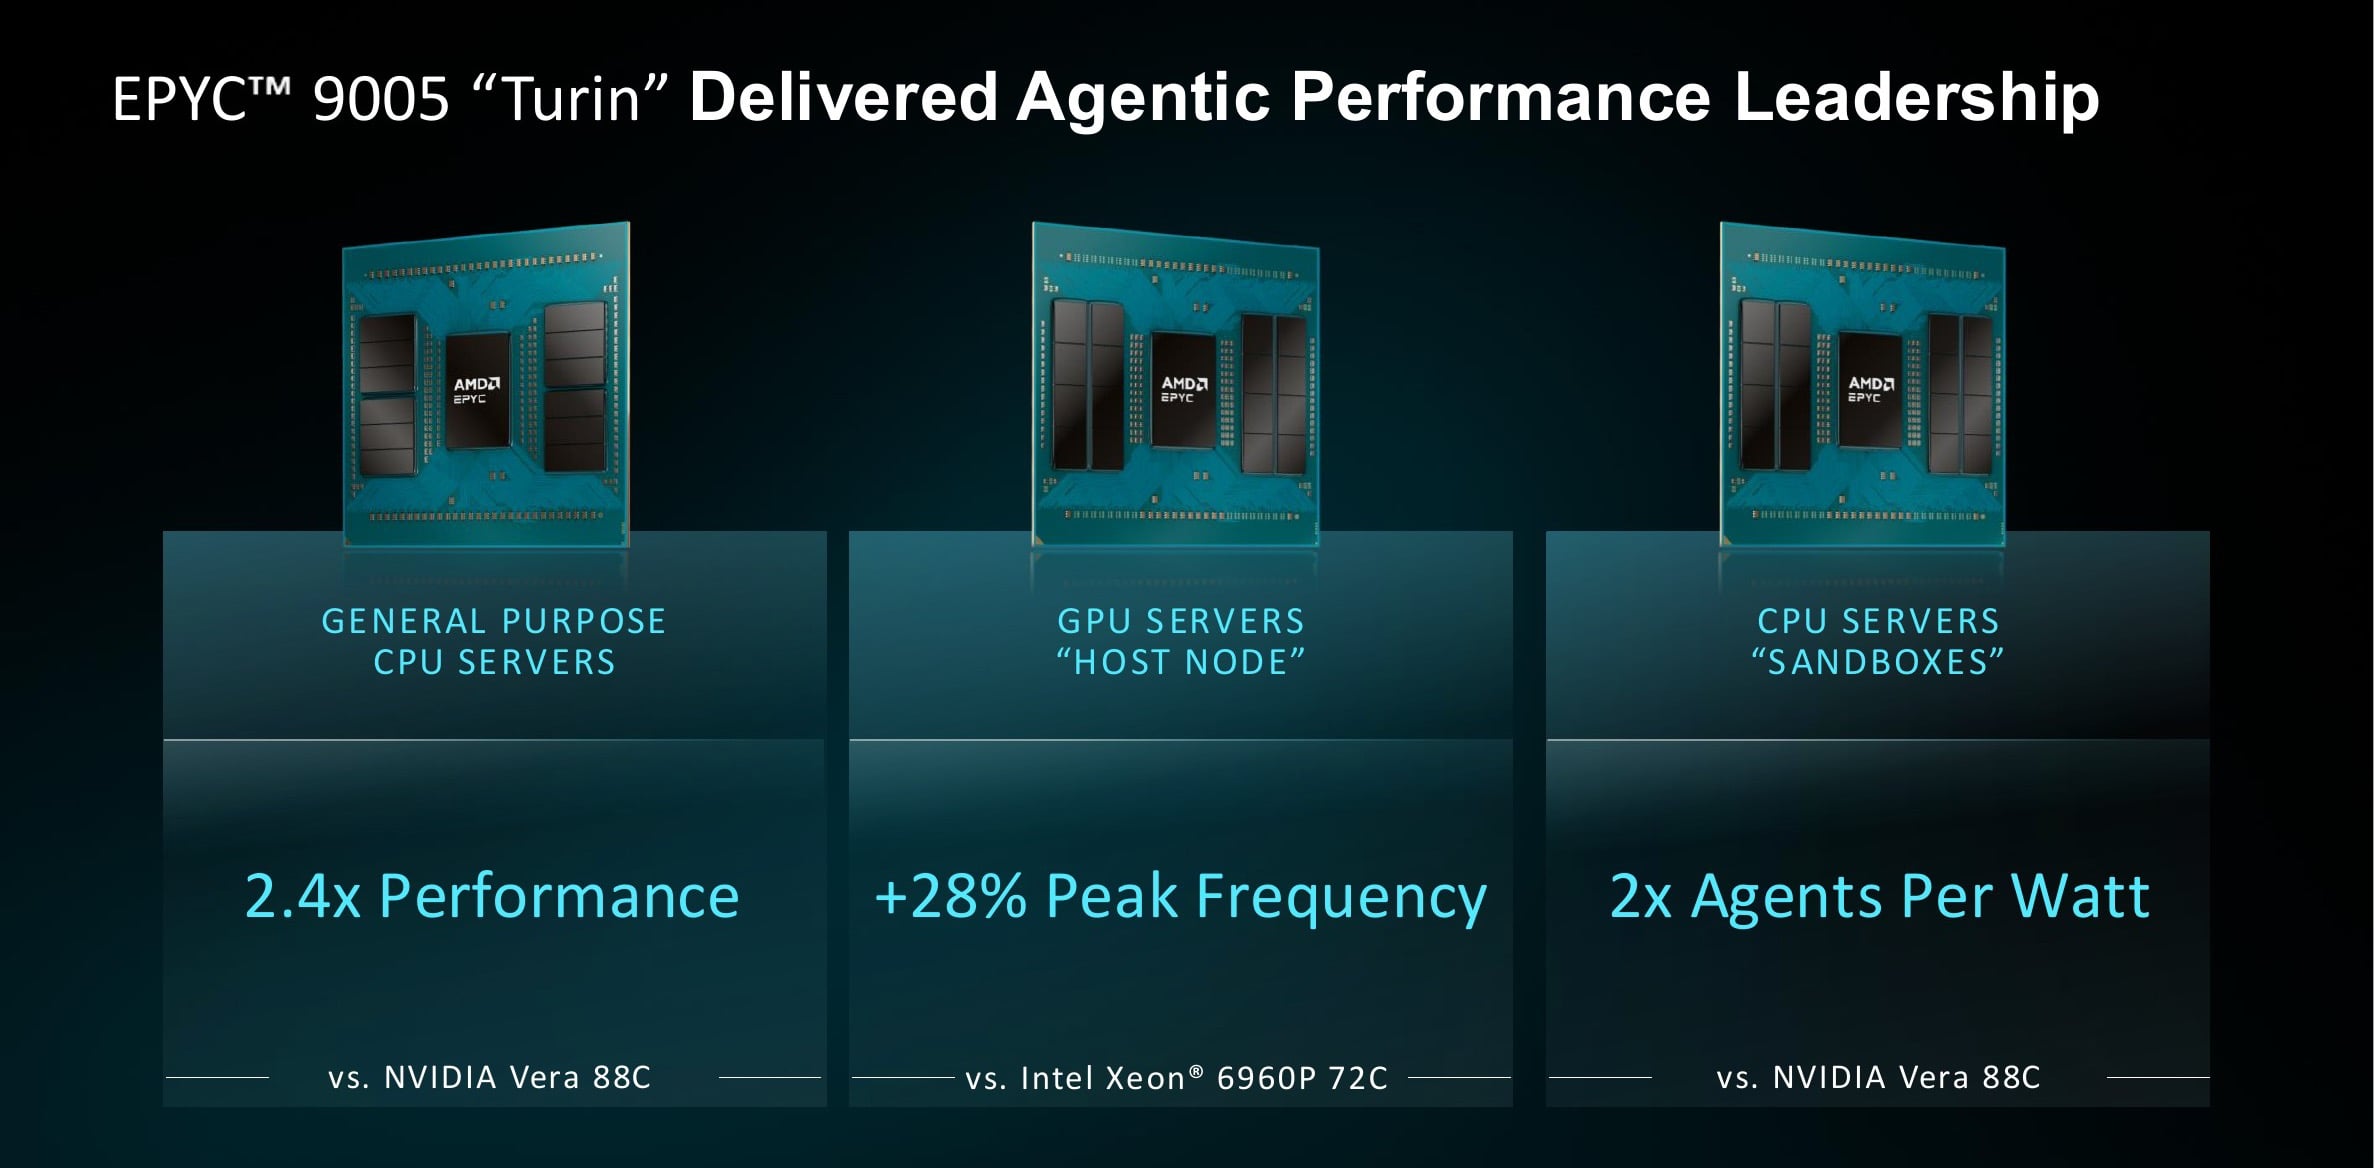
AMD riktade de flesta av sina jämförelser mot NVIDIAs Vera, Arm-processorn i Vera Rubin-plattformen, och de inledde med den generation de redan levererar. Enligt AMDs racknivåmodellering levererar ett Turin-rack 2.4 gånger Veras generella dataflöde och dubbelt så många agenter per watt. Modellen fixerar båda racken vid en strömbudget på 100 kW, matchar ett 2P EPYC 9965 med 384 kärnor mot ett 2P Vera-kort med 176, och beräknar medelvärdet av resultaten över sex arbetsbelastningar: uppskattad SPECrate 2017, serversides-Java, NGINX, Redis, Memcached och ett TPC-C-derivat.
Två förbehåll gäller här och för resten av den här artikeln. Vera har inte levererats, så varje Vera-siffra är en AMD-uppskattning av den 88-kärniga, 450W-del som NVIDIA har beskrivit i sitt offentliga material. Och eftersom det inte finns något standardriktmärke för agentiska arbetsbelastningar räknar AMD hårdvarutrådar som en representation av agenter i sin beräkning av agenter per watt.
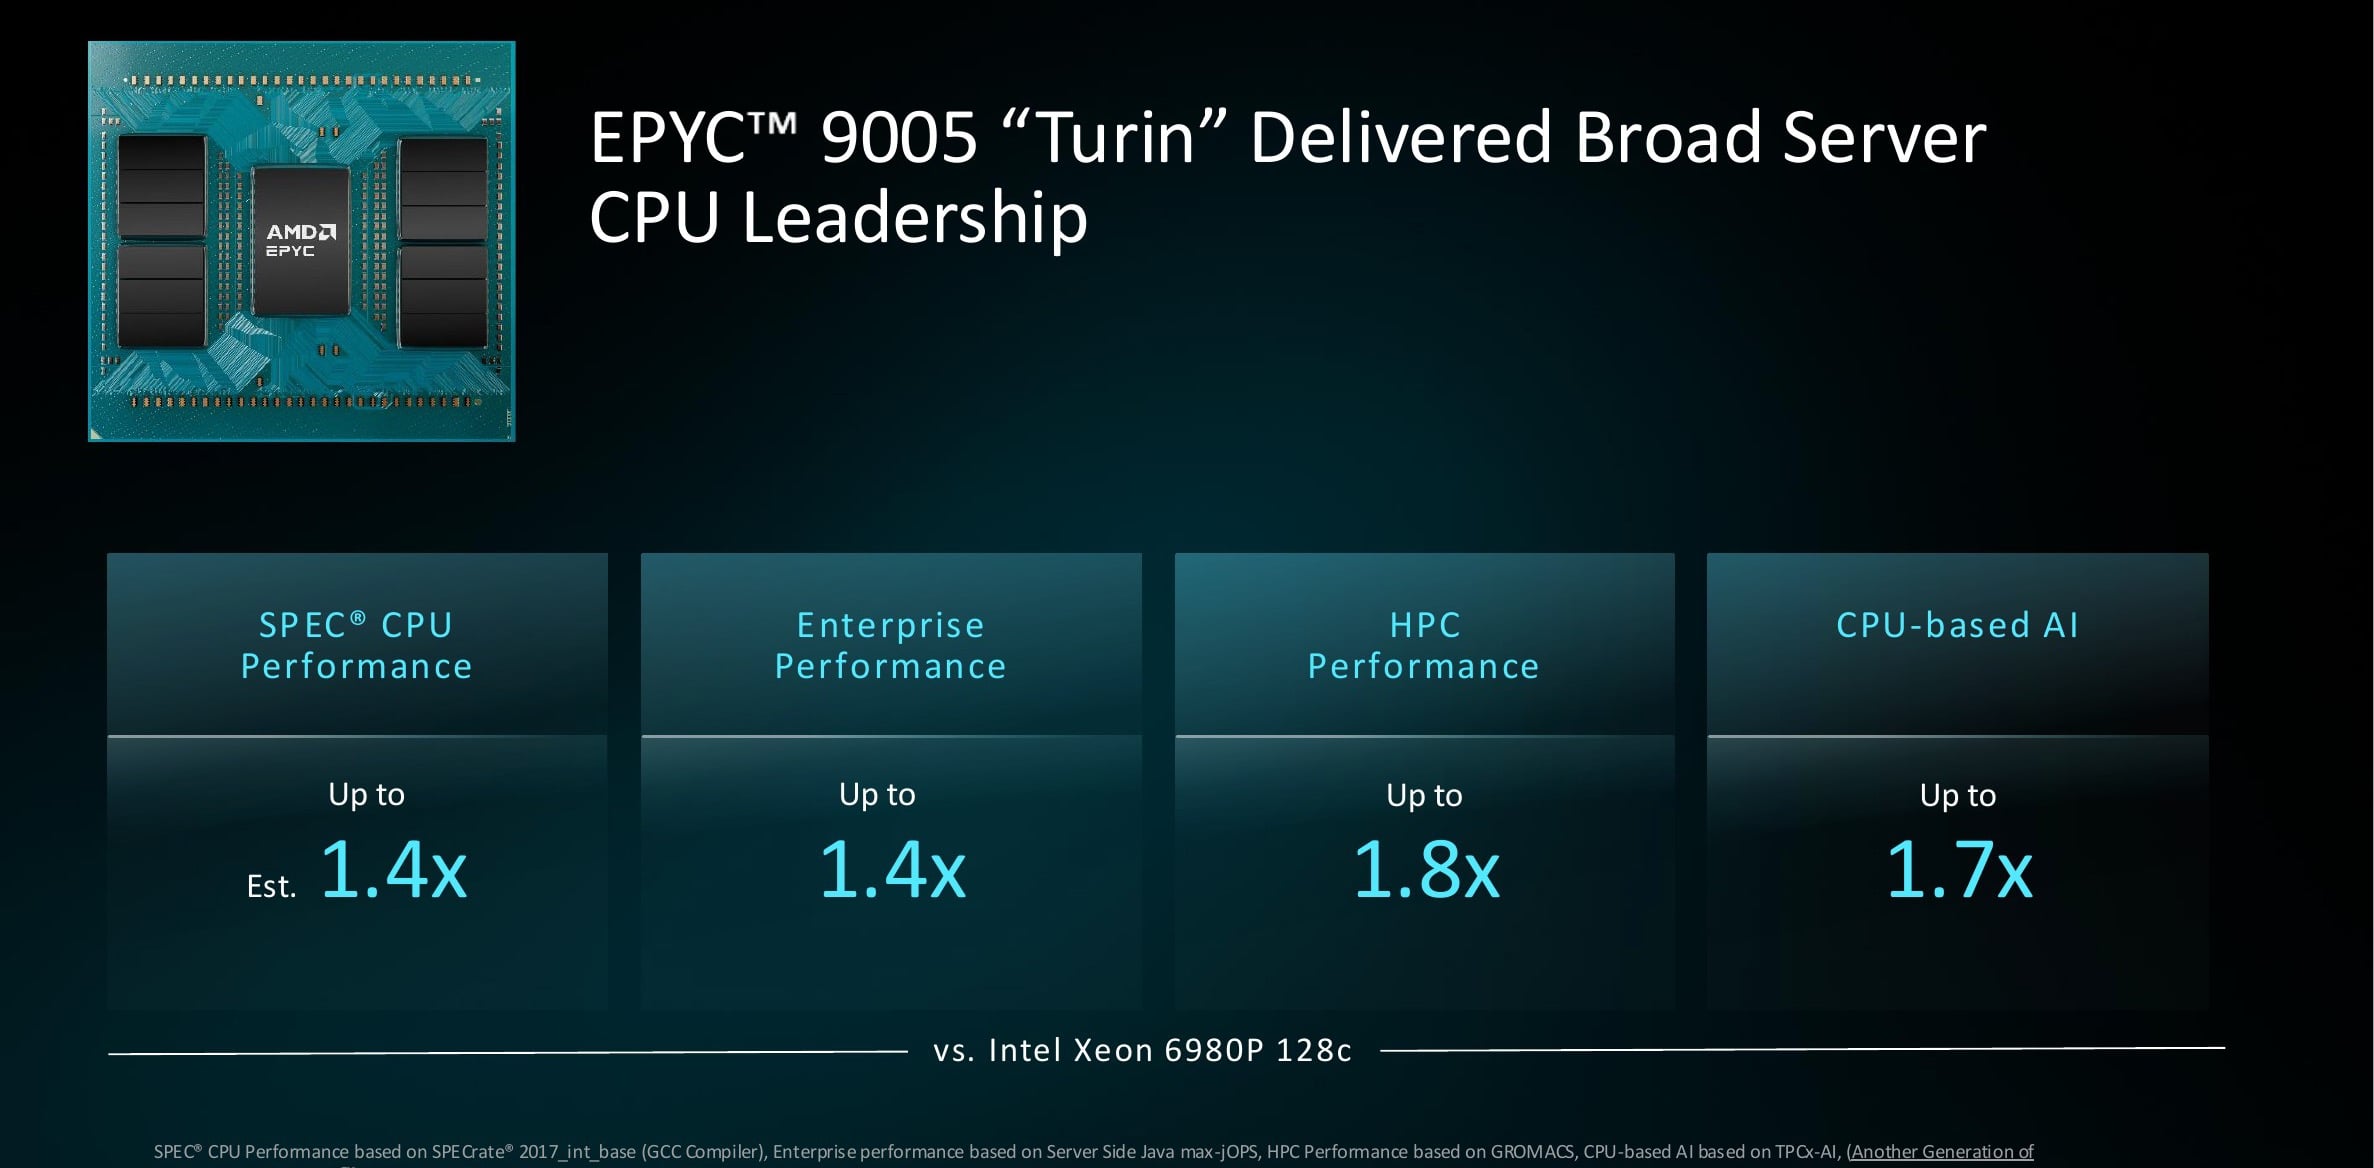
Intels jämförelse vilar på fastare grund, eftersom båda sidor levererar komponenter som AMD skulle kunna jämföra direkt. Turins värdprocessorer når 5.0 GHz, medan jämförbara Xeon når som mest 3.9 GHz, en frekvensfördel på 28 % som är viktig när enstaka trådar matar GPU:er. Socket-för-socket jämfört med 128-kärniga Xeon 6980P, mäter AMD Turin på upp till 1.4X på SPEC-processor, 1.4X på företags-Java, 1.8X på HPC och 1.7X på CPU-baserad AI.
Venedig vidgar varje gap
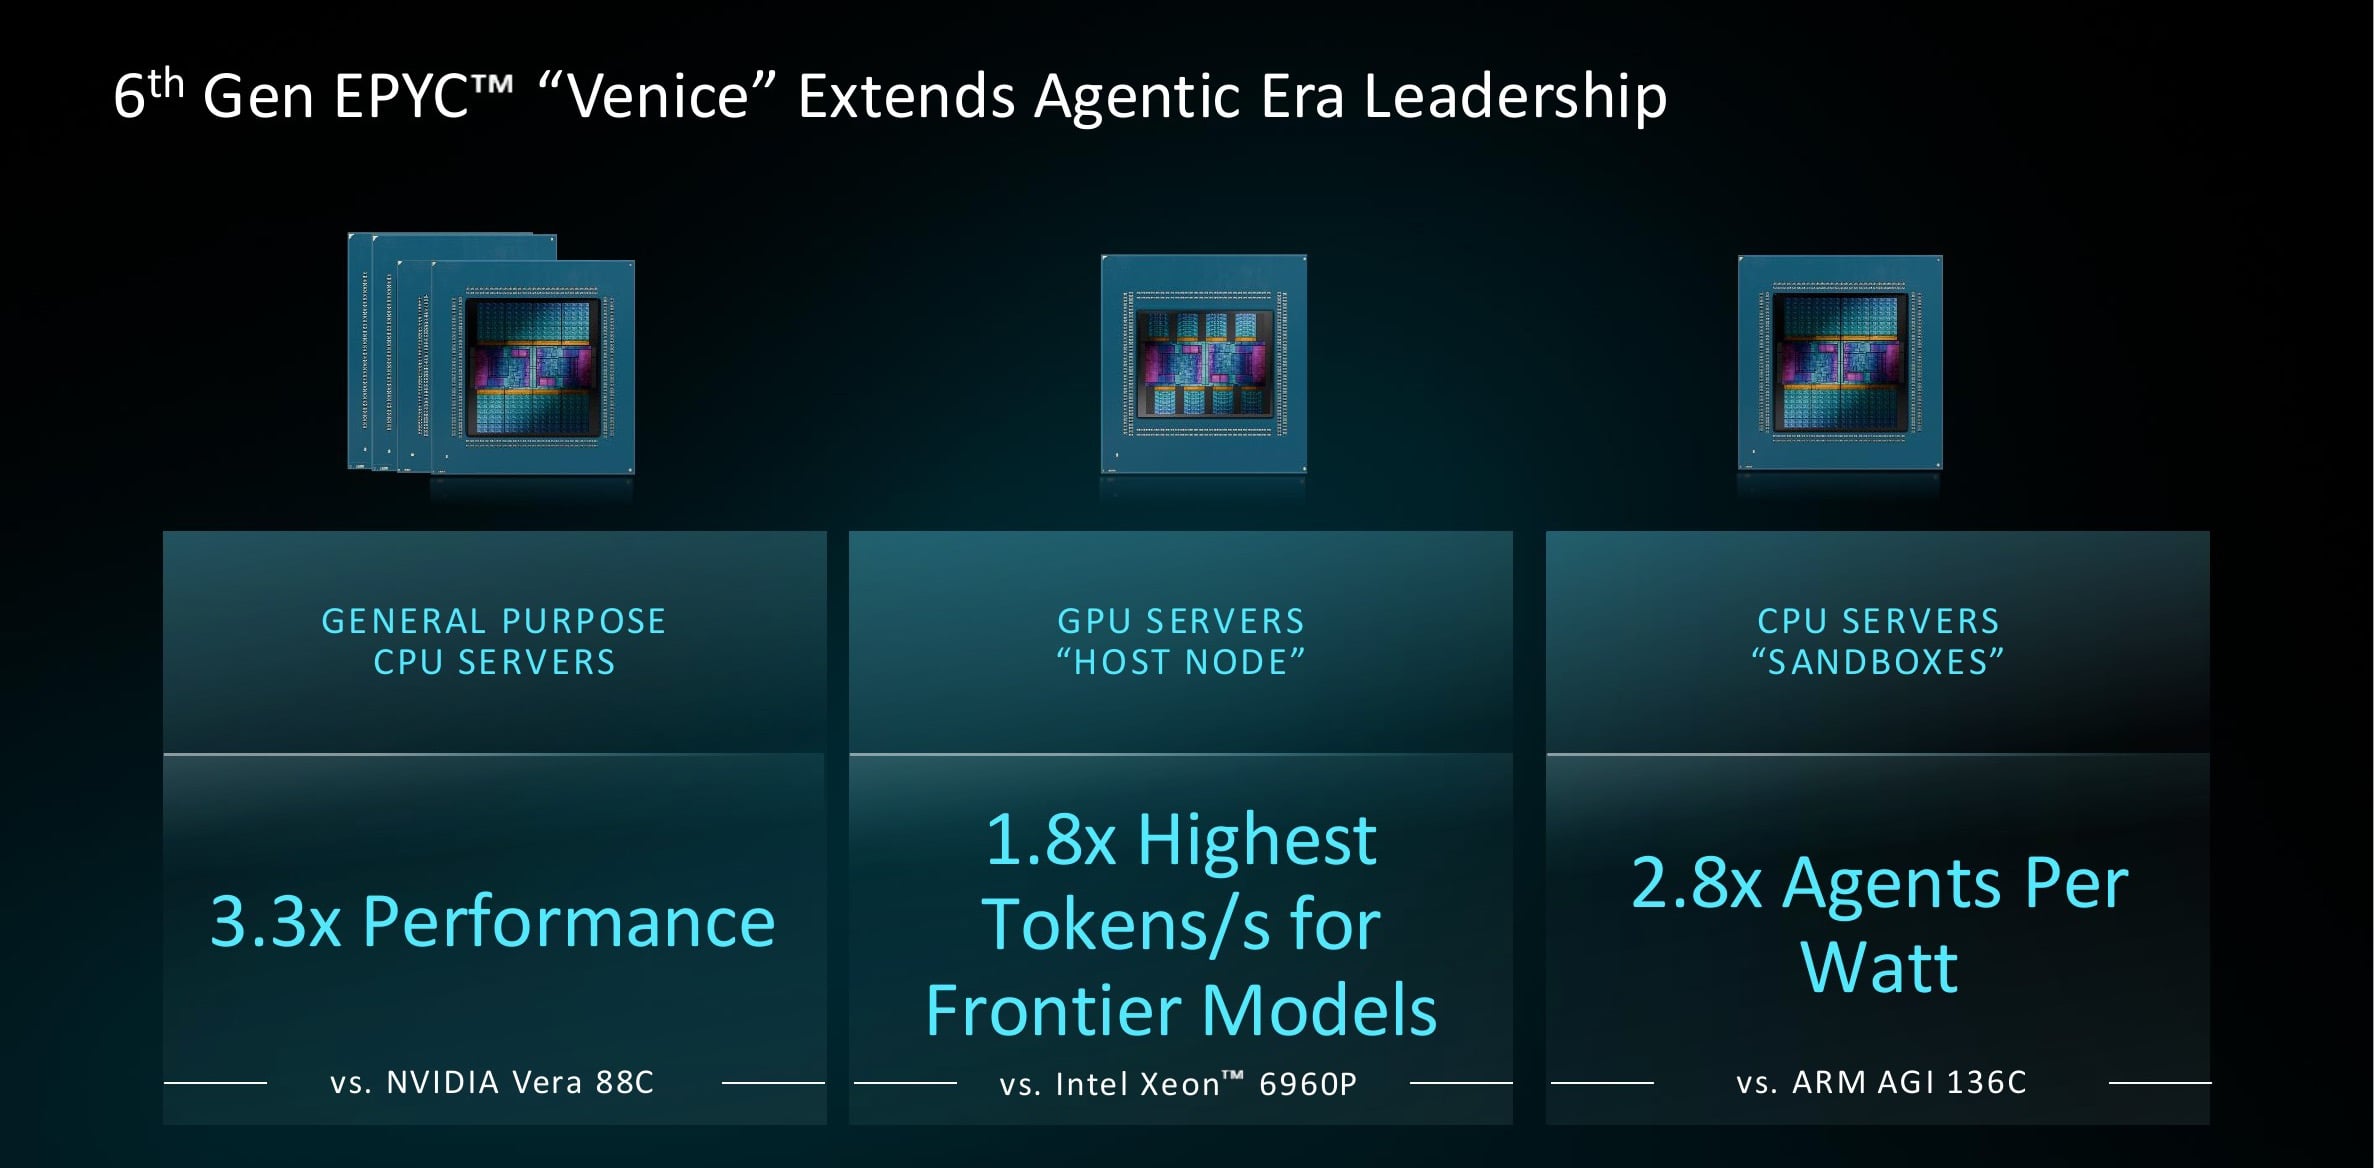
Venice utökar alla dessa fördelar. Med samma 100 kW rackmodell, nu med 512 Venice-kärnor mot Veras 176, hävdar AMD att Veras prestanda är 3.3 gånger högre för generella ändamål än Veras. Venice uppnår 2.8 gånger så många agenter per watt som den 136-kärniga Arm AGI, och 1.8 gånger så många tokens per sekund på frontier-modeller när Venice är värd för GPU:er. Den siffran på 1.8 gånger mäter ett snävare scenario än vad rubriken antyder, och vi återkommer till det i avsnittet om värdnoder nedan.
En möte med Vera
På SPECrate 2026 uppskattar AMD en 2P Venice 9996 till 2070 jämfört med 925 för Vera, en 2.2X fördel med dataflödet, och placerar 96-kärnig högfrekvensdel cirka 1.2× före Vera per kärna. Båda resultaten sammanställdes med GCC 15.2, samma verktygskedja som NVIDIA använde för sina publicerade Vera-siffror.
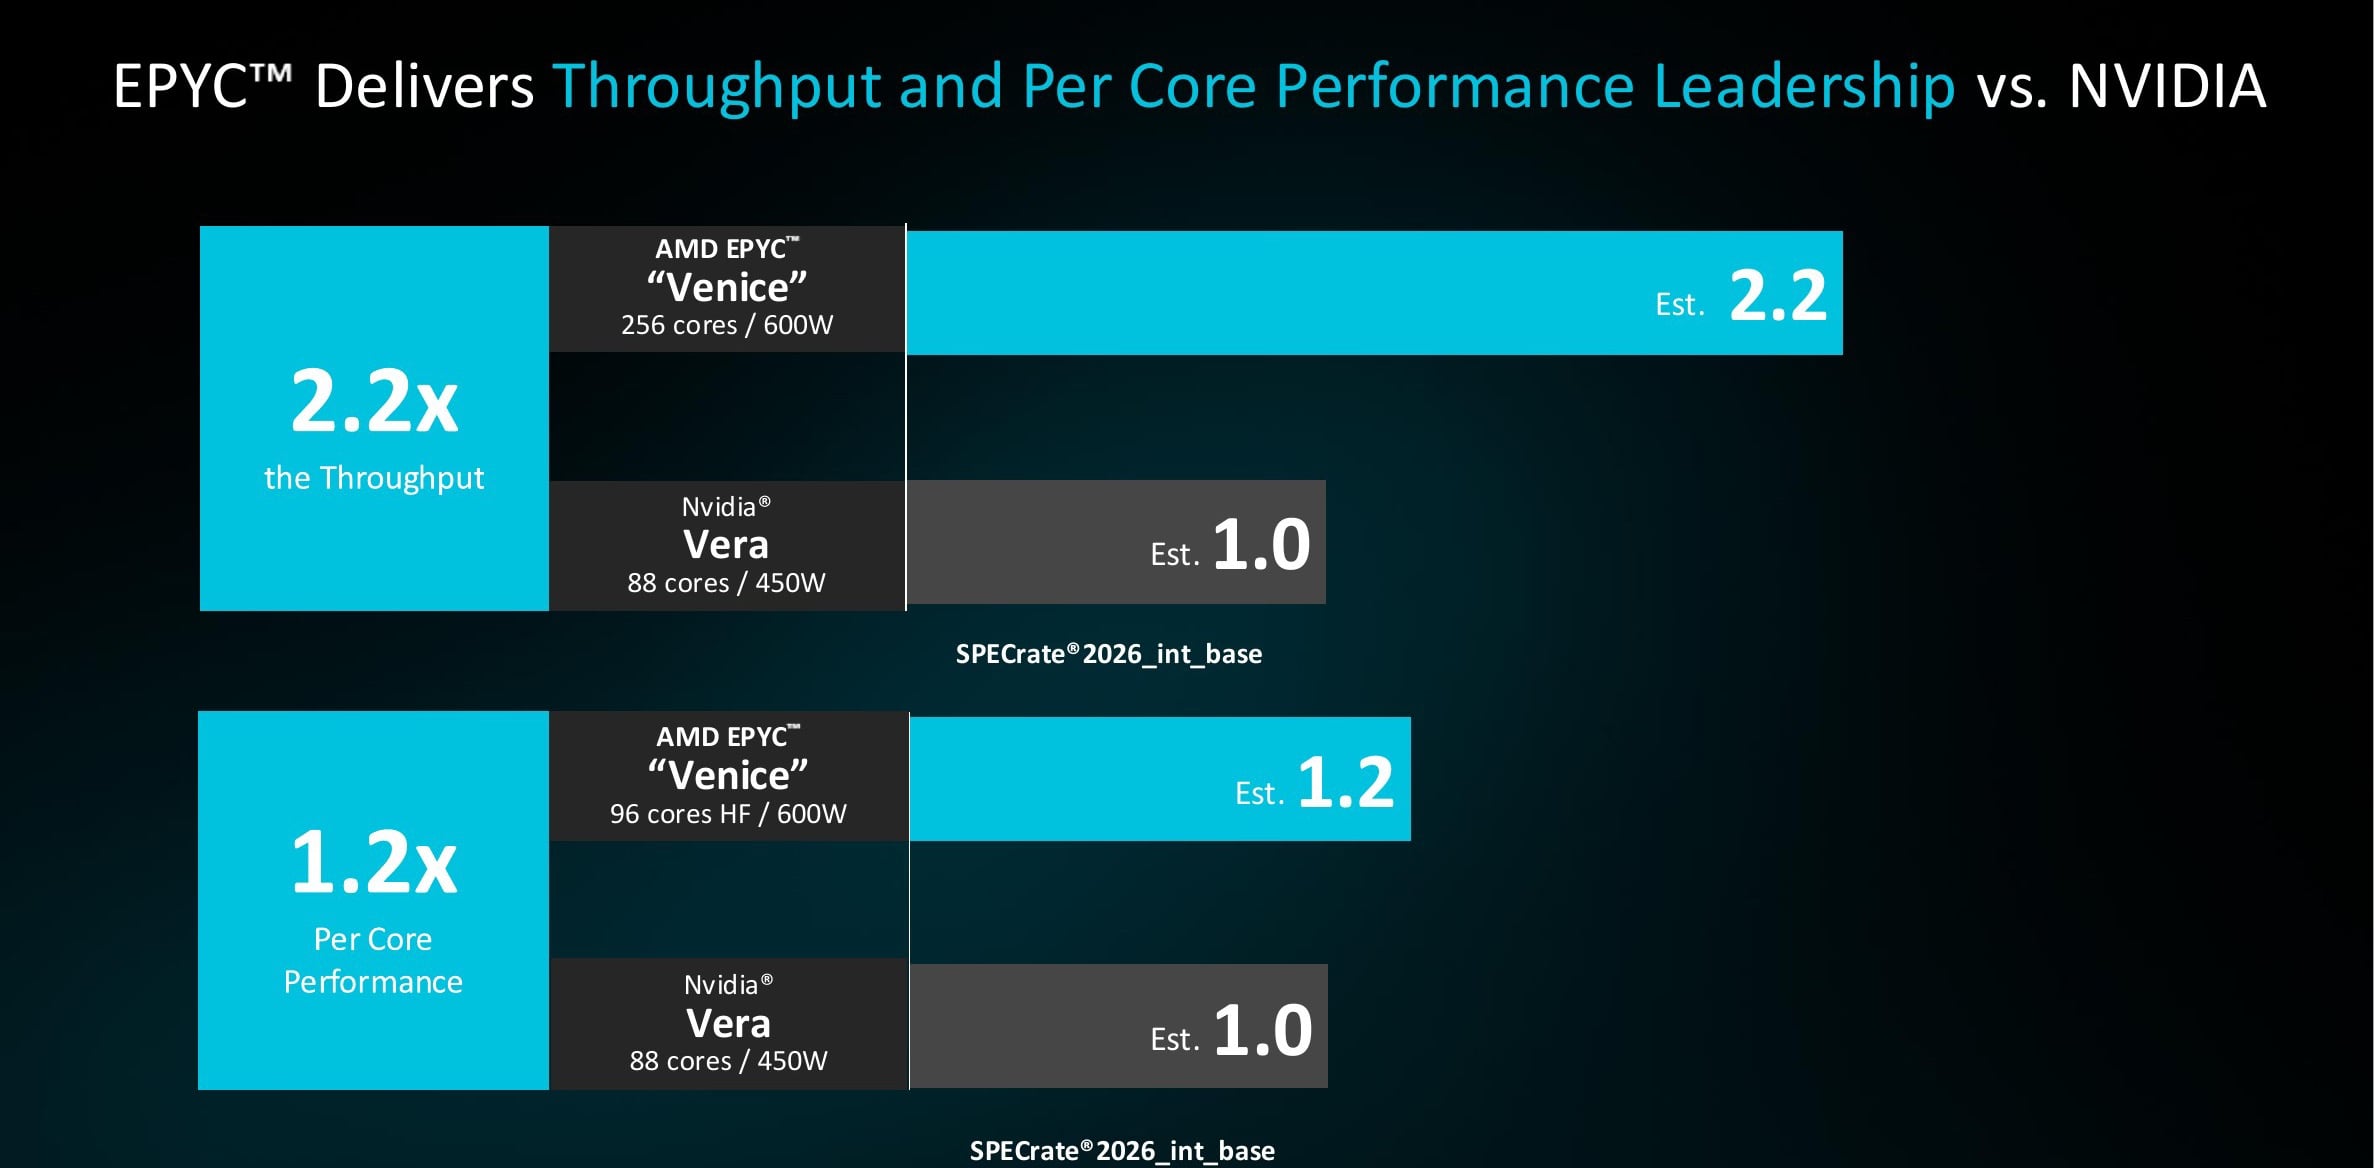
Påståendet per kärna ökade faktiskt under lanseringsveckan. Ravi Kuppuswamy, som ansvarar för AMDs CPU-teknik, berättade för pressen att AMD ursprungligen hade hävdat en fördel på 10 % per kärna. Efter att NVIDIA publicerat sina egna Vera-siffror tidigare i veckan, gjorde deras team om jämförelsen med samma kompilator och inställningar och mätte en ledning på 20 %, med oavslutad finjustering. Genomströmningsgapet på 2.2 gånger, sa han, matchade AMD:s interna prognoser hela tiden. En separat slutnot beräknar om jämförelsen per kärna på SPECrate 2017 med AMD:s egen AOCC-kompilator och kommer fram till 1.7 gånger, vilket gör 20 % till den mer konservativa av de två beräkningarna.
Intel och Arm
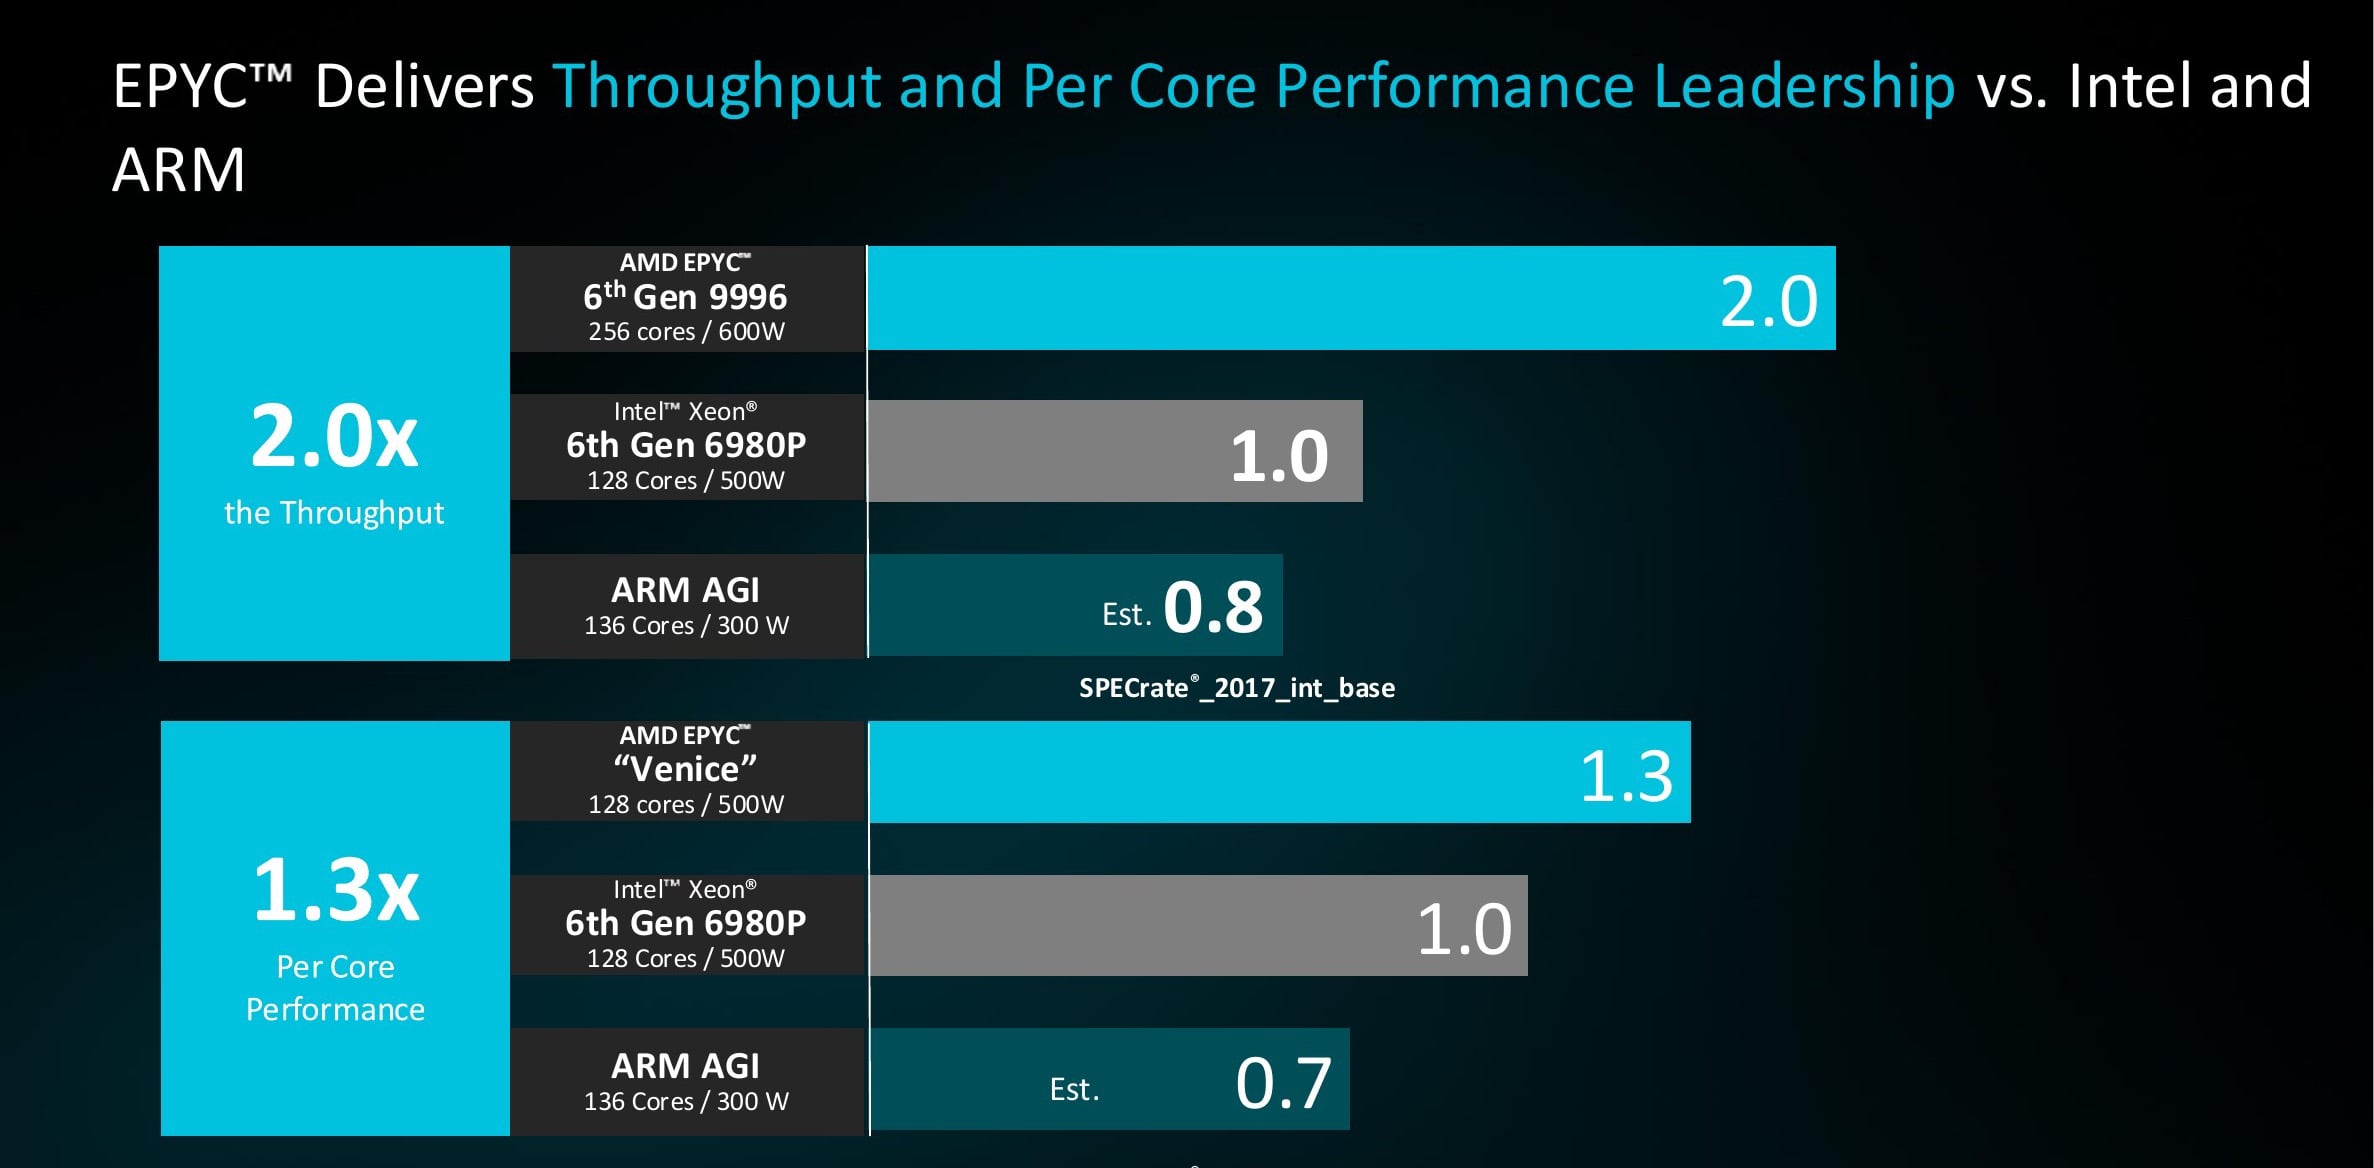
AMD visade också en bredare SPECrate 2017-rankning. Venice 9996 leder med 4900 (256 kärnor, 600W, 14 904 dollar vid 1Ku), följt av Turin 9965 med 3240, Intels Xeon 6980P med 2510 (128 kärnor, 500W, 1.3 955 dollar), Arm AGI med 1944 (136 kärnor, 300W) och Vera med 1459. Siffrorna för 9996, AGI och Vera är AMD-uppskattningar; Turin- och Intel-poängen är publicerade resultat. Mot Intel motsvarar det ungefär dubbelt så hög dataöverföringshastighet vid ett jämförbart listpris, eller dubbelt så hög prestanda per dollar. Per kärna får en Venice-konfiguration med 128 kärnor och 500W 13 gånger högre poäng än 6980P, medan Arm AGI landar på 0.7 gånger. Till skillnad från Vera-jämförelsen ovan, producerades varje leverantörs poäng här med sin egen bästa verktygskedja: AOCC för AMD, OneAPI för Intel och GCC 13 för Arm.
Molnbaserad och HPC
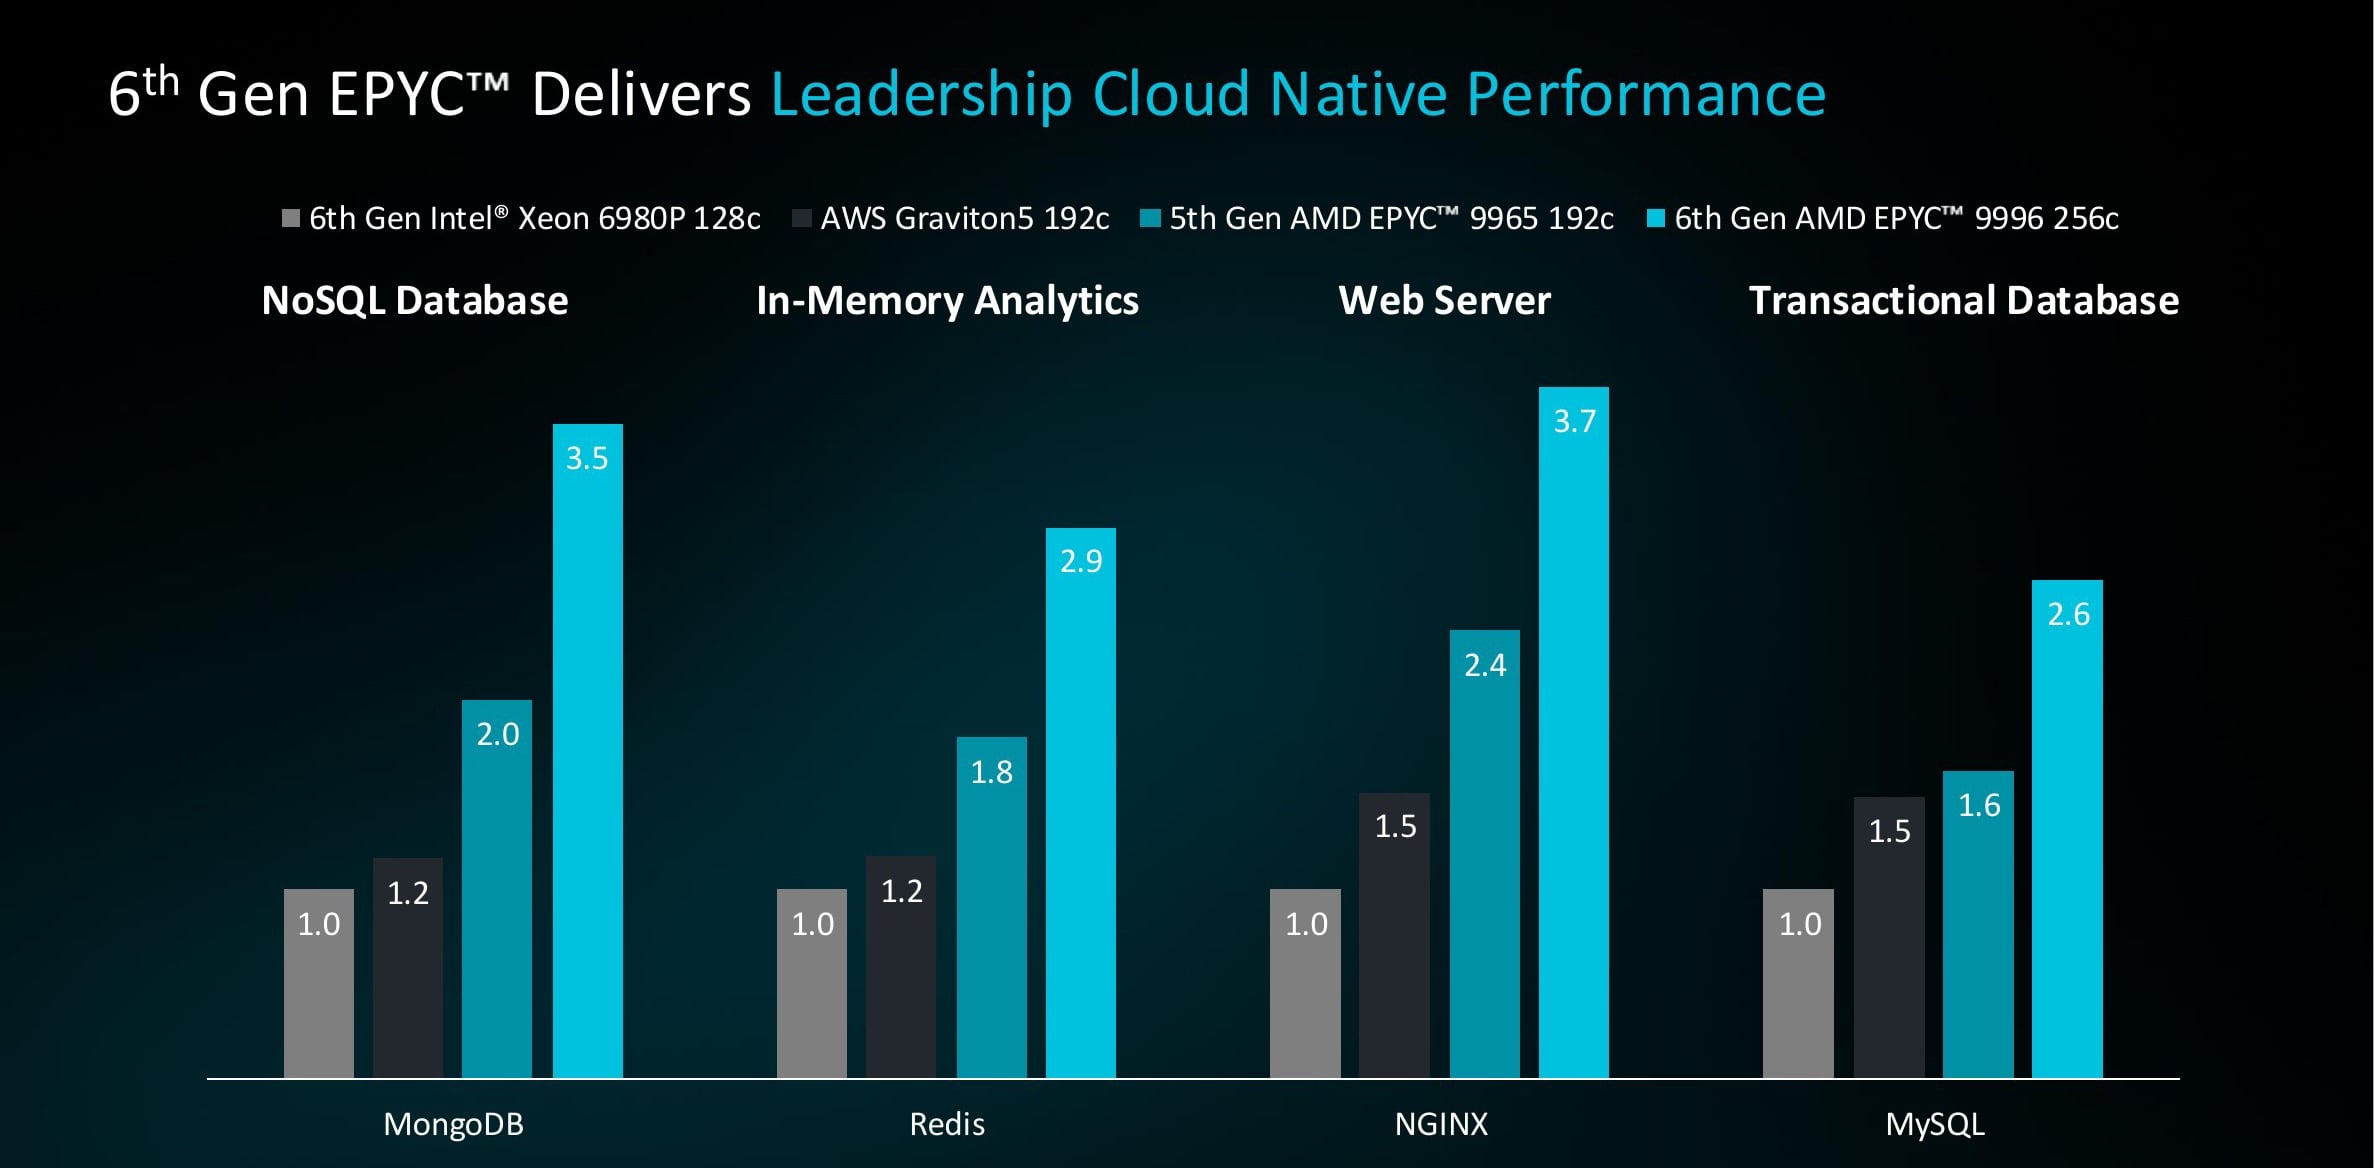
AMD delade också upp jämförelsen efter arbetsbelastning, där varje resultat indexerades till Intels 6980P vid 1.0. På molnbaserad sida har 256-kärniga Venice 9996 3.5X på MongoDB, 2.9X på Redis, 3.7X på NGINX och 2.6X på MySQL. Turin landar mellan 1.6X och 2.4X på samma tester, och Graviton5 mellan 1.2X och 1.5X.
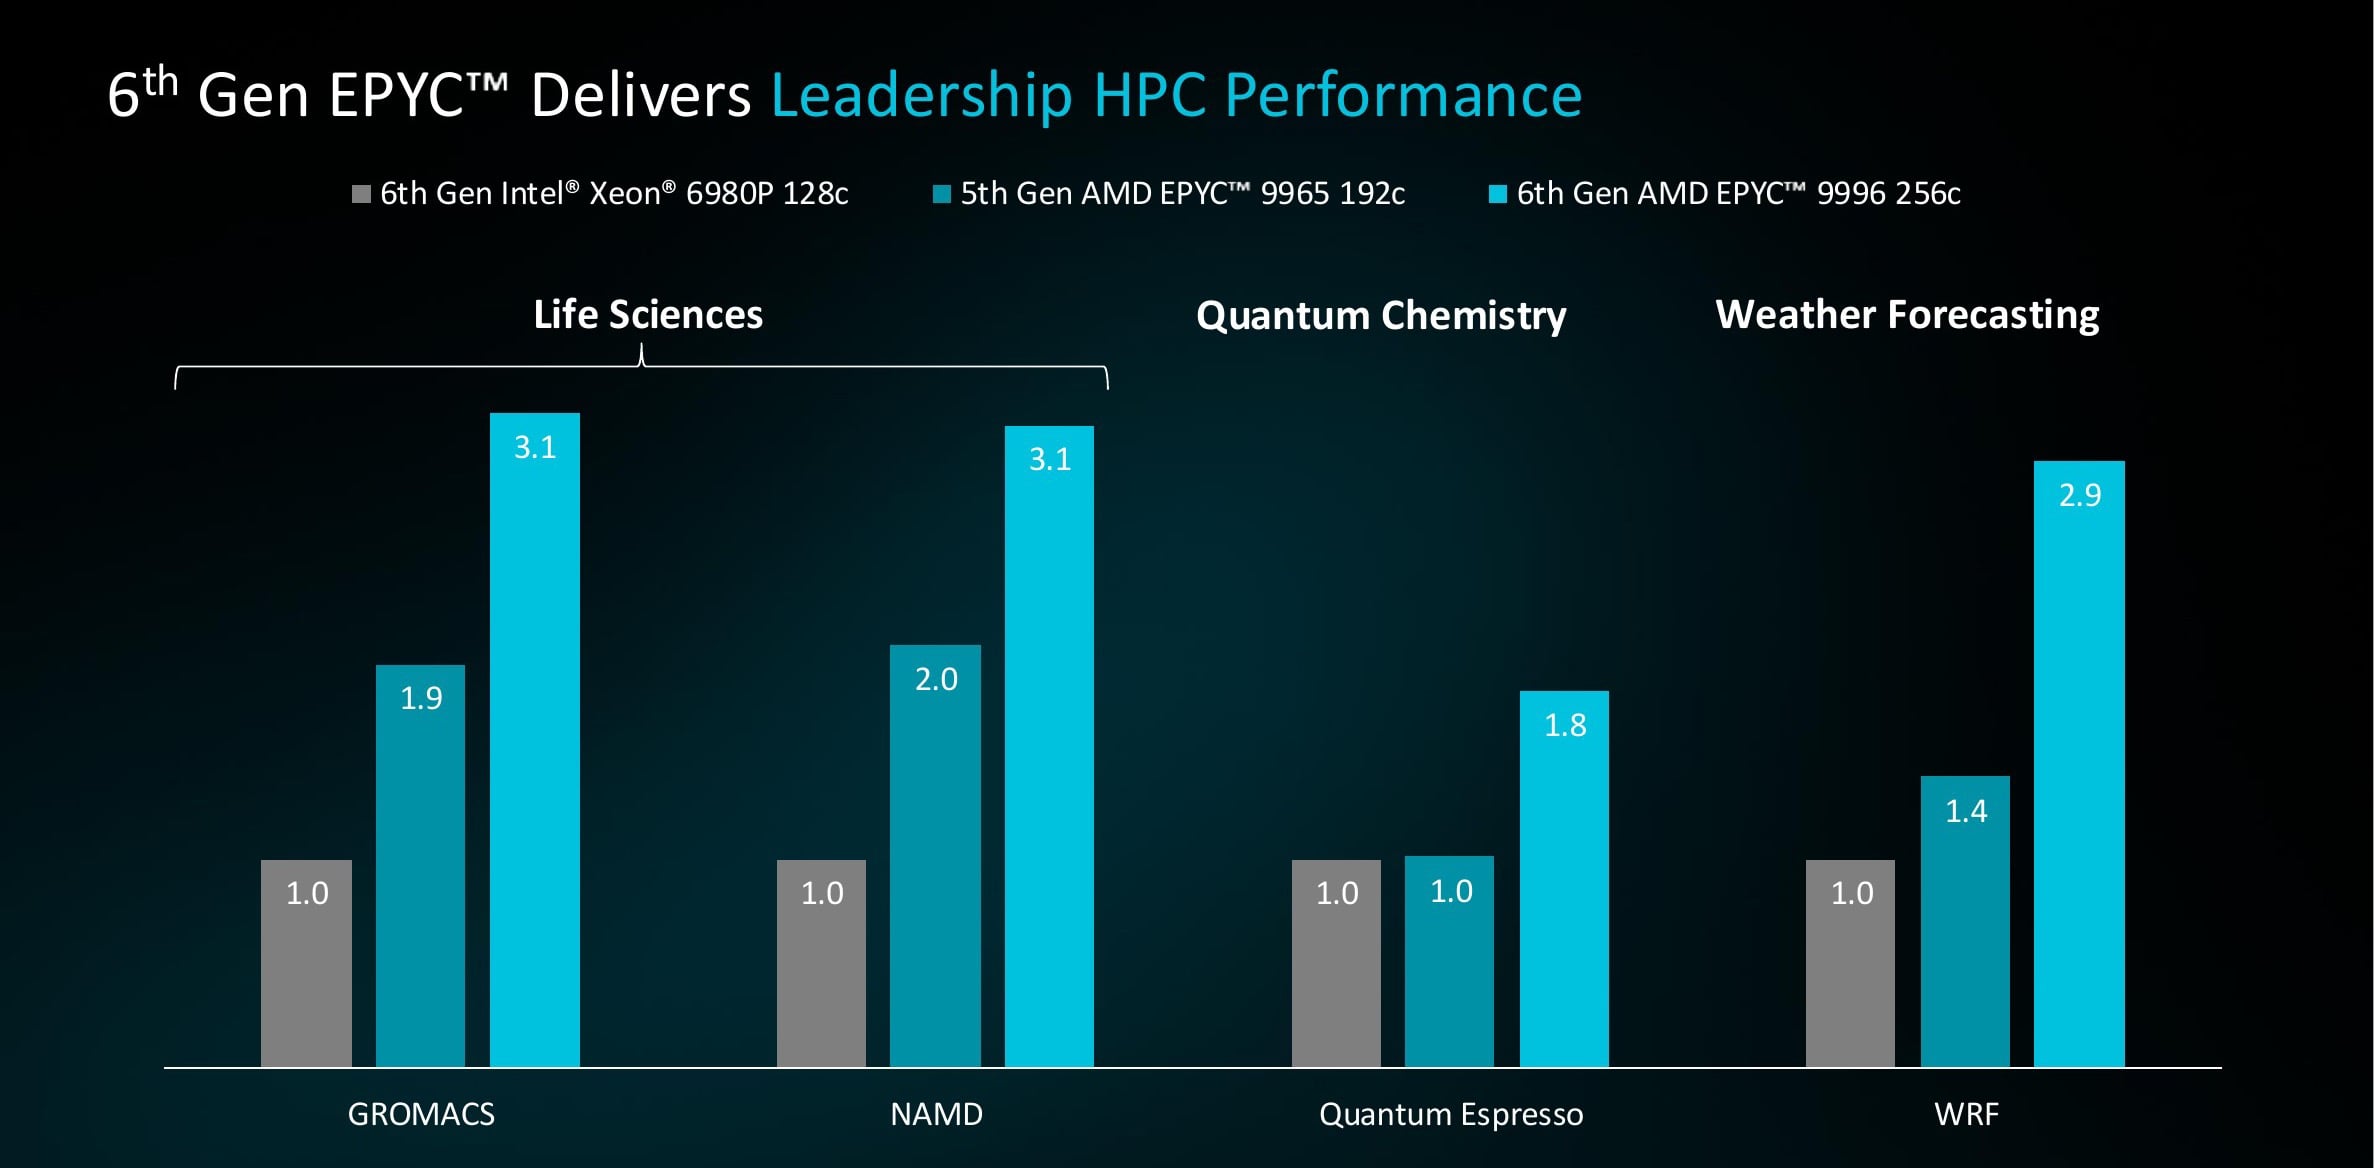
Inom HPC får Venice 3.1X på GROMACS och NAMD, 2.9X på WRF och 1.8X på Quantum Espresso. Minneskonfigurationen förändrar dessa siffror avsevärt. Med standard 8 000 MT/s RDIMM-minnen får Venice 2.81X jämfört med Xeons baslinje på GROMACS; 12 800 MT/s MRDIMM-minnen höjer det till 3.13X, och samma uppgradering tar WRF från 2.25X till 2.90X. AMD sammanfattar sin HPC-ledning som allt från 1.8X till 3.5X beroende på arbetsbelastning och minne. Intels baslinje använde 8 800 MT/s MRDIMM-minnen, så skillnaden kommer inte från att para ihop uppgraderat AMD-minne med en långsam Intel-konfiguration.
Värdnoden och 1.8×-anspråket
Detta leder oss tillbaka till påståendet om 1.8 gånger tokens per sekund. Hårdvaruförbättringarna bakom det är enkla att lista: 5 GHz-värddelen har nu 96 kärnor istället för 64, värdminnets bandbredd ökar från 614 GB/s till 1.6 TB/s, och PCIe Gen 6 fördubblar bandbredden för CPU-till-GPU-länken.
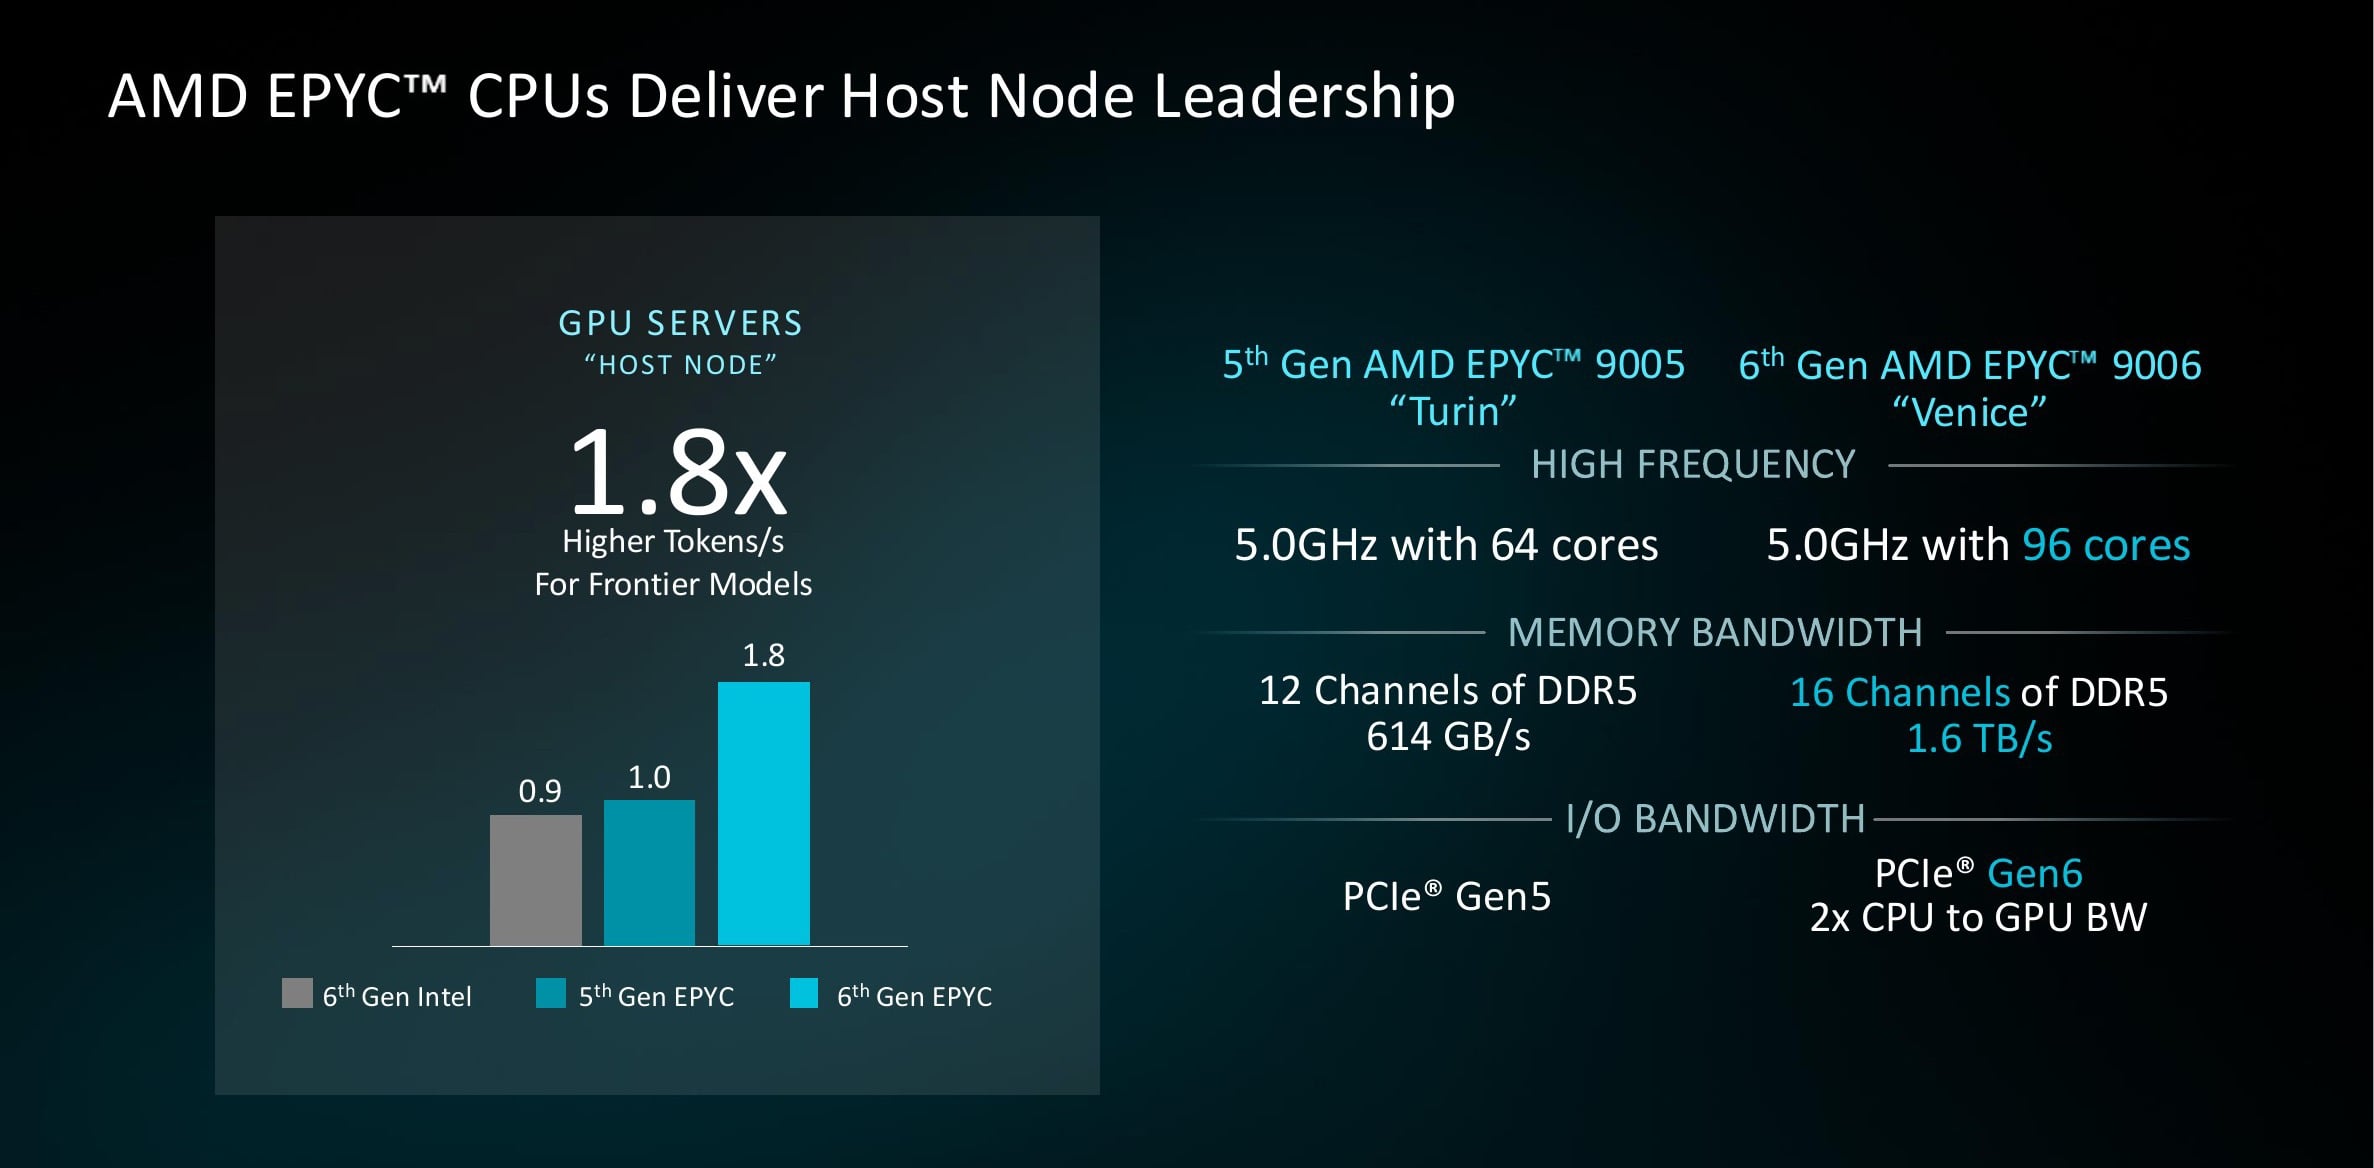
Det första man bör kontrollera är baslinjen. AMD indexerade detta diagram till Turin vid 1.0 snarare än Intel, och placerade den 6:e generationens Xeon vid 0.9, vilket är anledningen till att samma påstående närmar sig 2× när det jämförs med Xeon 6960P. Den projicerade vinsten kommer nästan helt från I/O-bandbredd. AMD körde ett CPU-offload-test som strömmade Qwen3-30B:s BF16-vikter från värdminne till GPU:n och fann att PCIe Gen 5 x16-mottagningsvägen kördes vid 89 % till 95 % av dess teoretiska tak, medan värd-DRAM-läsningar låg under 10 % av deras teoretiska tak. Avkodningshastigheten begränsades av överföringen, så att fördubla länken med PCIe Gen 6 ger en förbättring på 1.8X till 1.9X i detta test. Venice är för närvarande den enda server-CPU:n som erbjuder PCIe Gen 6 till acceleratorer, så fördelen är verklig och för tillfället exklusiv. Dess omfattning är dock snäv: 1.8X beskriver ett bandbreddsbundet avlastningsmönster, och det bör inte läsas som ett löfte om att GPU:er levererar varje modell 1.8 gånger snabbare på Venedig-värdar. Inom hårdvaruleverans idag slår en Turin-värd en Xeon 6960P med ett geometriskt medelvärde på 13 % i tid till första token över vLLM- och NIM-arbetsbelastningar på samma 8X B200-system, med en förbättring i bästa fall på 36 %.
Rackdensitet
Det sista påståendet gäller densitet: 49 152 Venedigkärnor i ett rack, mot 36 864 för Turin och 22 528 för Vera, där varje del bär dubbelt så många trådar som kärnor. Av alla påståenden i kortleken förändras detta mest när slutnoterna appliceras.
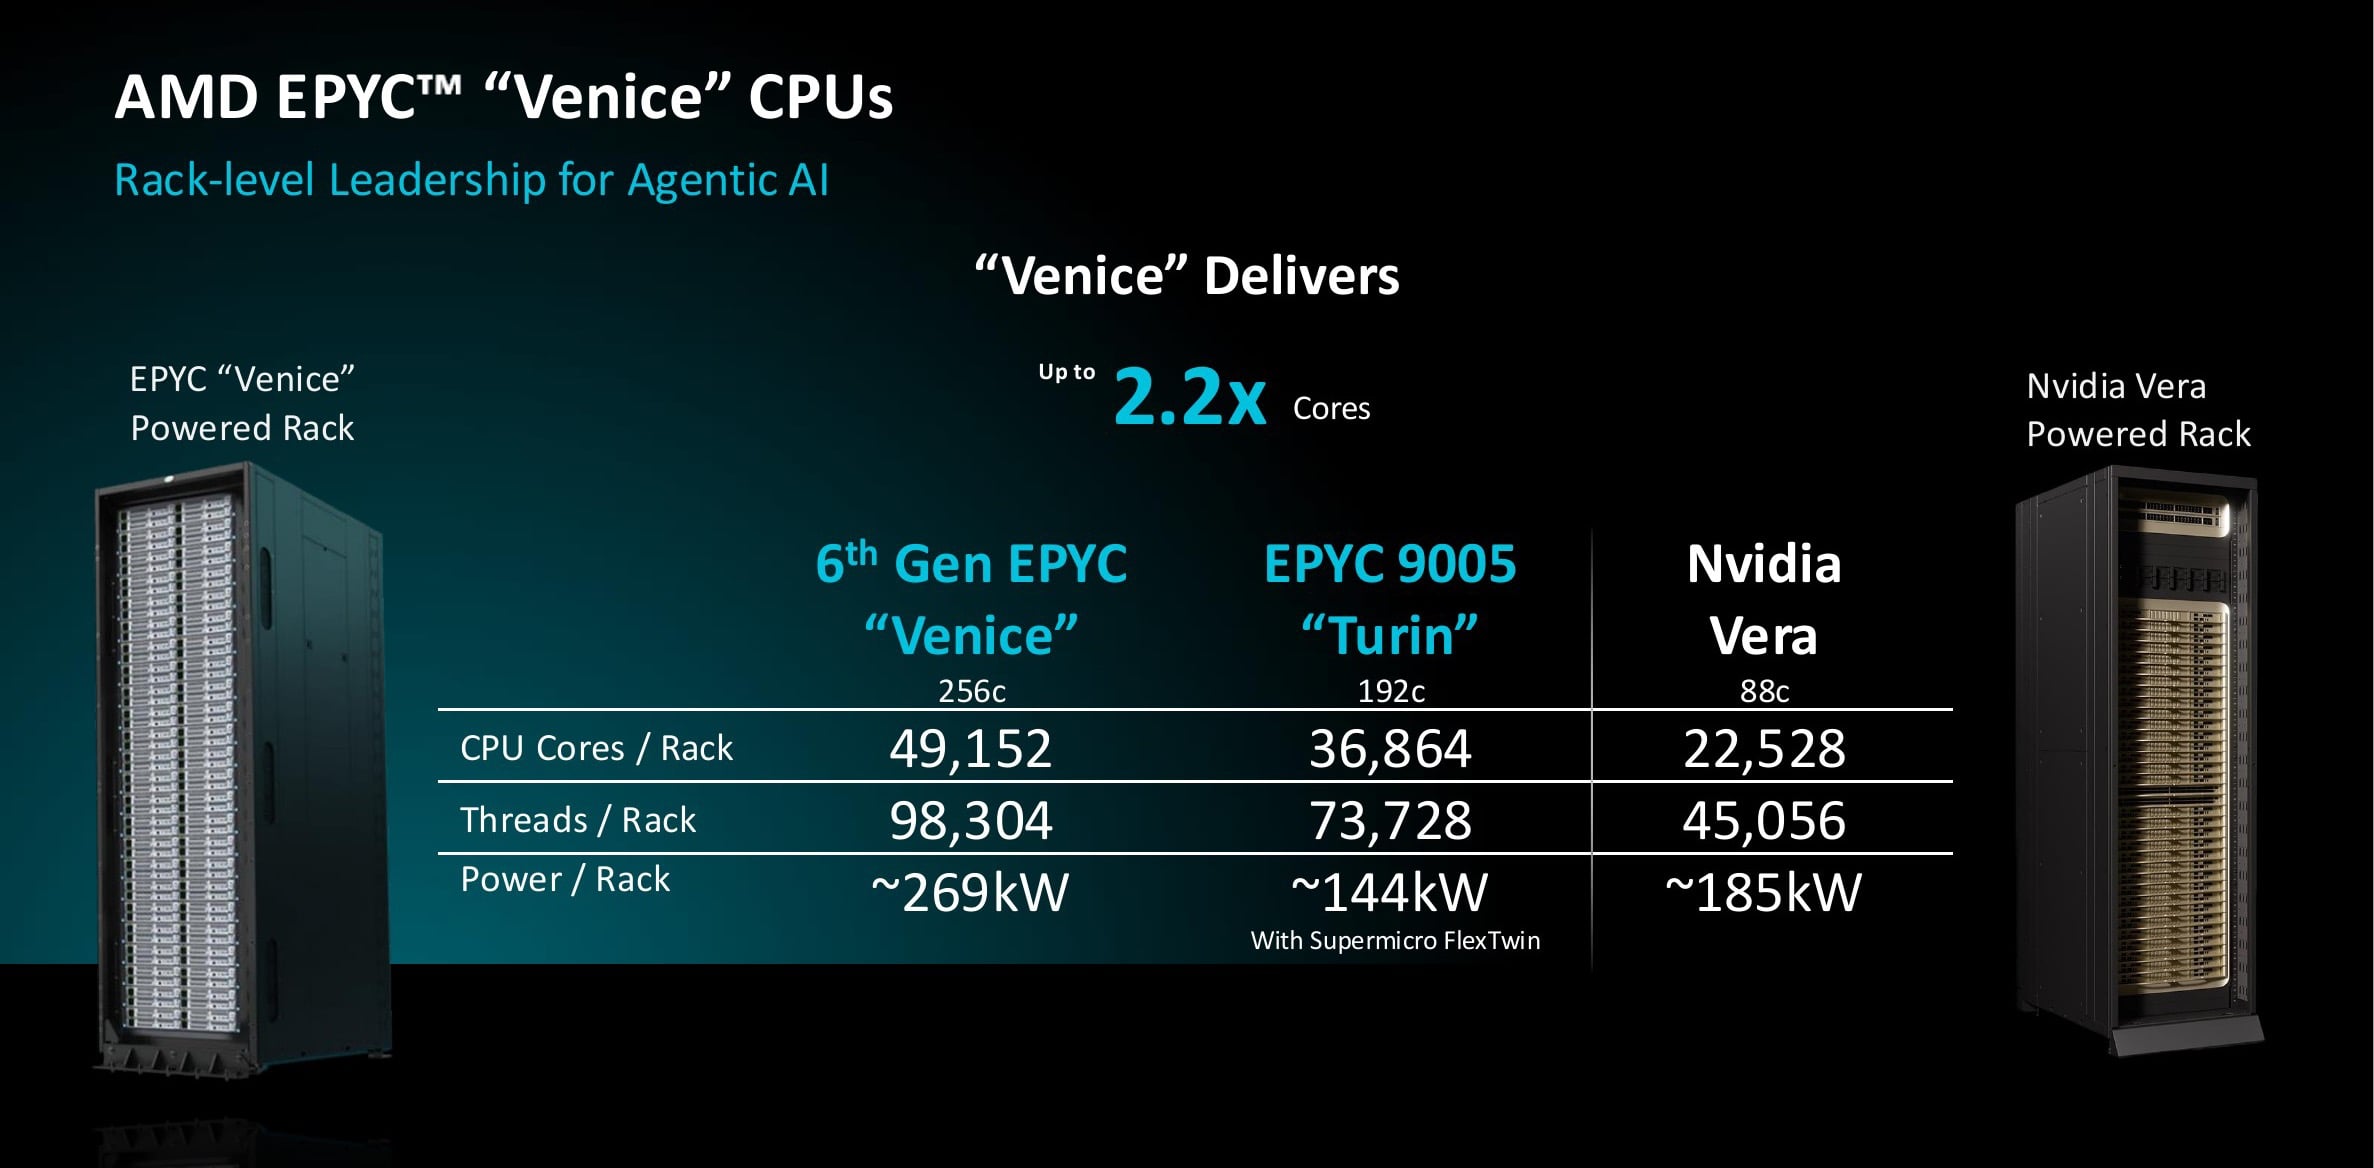
Rubriken är 2.2 gånger Veras kärnor, men Venice-racket når det med en strömförbrukning på 269 kW, jämfört med Veras 185 kW, så de två racken jämförs inte vid matchad effekt. AMD:s slutnoter anger normaliserade versioner. Med båda racken hållna till ett 100 kW-kuvert levererar 9996 2.08 gånger Veras kärnor, 1.86 gånger Turin och 1.24 gånger Intels 6980P. Genom att ersätta flaggskeppet med 400 W EPYC 9956 uppskattar AMD 1.91 gånger Veras kärnor med 26 % mindre effekt, vilket resulterar i 2.57 gånger kärnor per rackwatt. Beroende på vilken effektbudget som hålls fast landar ledningen mellan 1.9 gånger och 2.2 gånger, och, som med alla Vera-siffror i den här artikeln, är NVIDIA-racket modellerat utifrån publicerade specifikationer snarare än uppmätt hårdvara. Densitetsfördelen överlever normaliseringen; den är helt enkelt mindre än 2.2X-rubriken.
Den stora mobbaren
Bortsett från de enskilda påståendena: i toppen av marknaden för server-CPU:er har AMD för närvarande ingen direkt rival. Intels bästa del ligger efter Turin, den generation som AMD redan ersätter. Arm-utmanarna ligger under Turin på alla diagram som AMD visade. Vera har inte levererat några processorer, och AMDs uppskattning sätter deras genomströmning på mindre än hälften av en Turin 9965, som har funnits på marknaden i ett och ett halvt år, där Venice ungefär fördubblar Turins genomströmning igen. Den positionen har lett till att AMD står för 46 % av intäkterna från server-CPU:er, enligt Mercury Research. Marknadsbevisen pekar på samma sätt. Efterfrågan på EPYC-delar i toppklass överstiger för närvarande utbudet, och ledtiderna har förlängts som ett resultat.
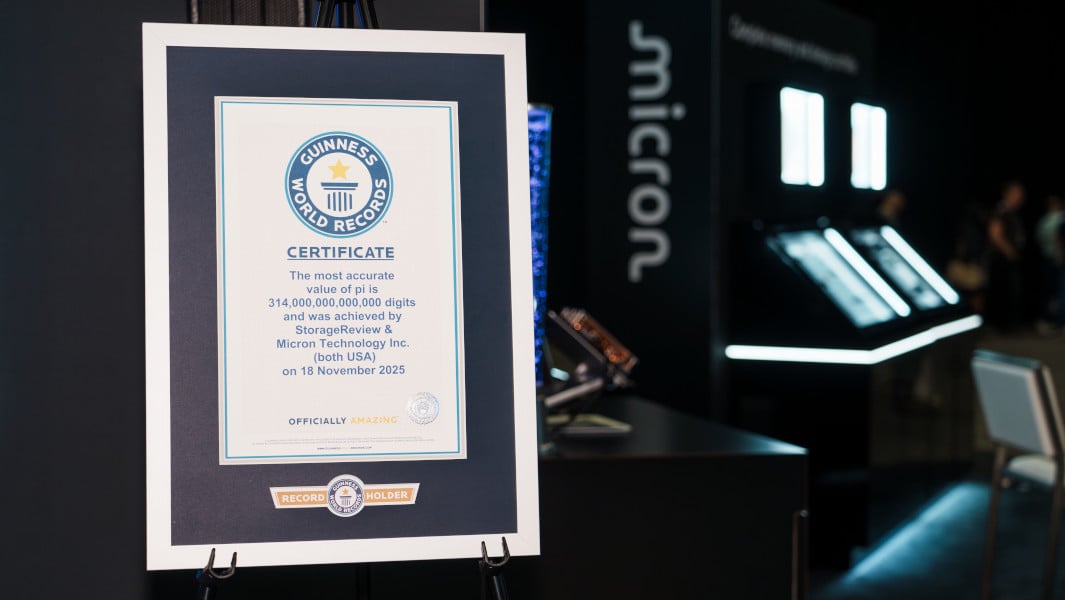
Vi kan lägga till vår egen datapunkt här. Vårt världsrekord på 314 biljoner siffror för Pi sattes på en Dell PowerEdge R7725 med två 192-kärniga EPYC 9965-processorer och 1.5 TB DDR5, samma 384-kärniga 2P-konfiguration som AMD använder i sina Turin-rack. Beräkningen höll varje kärna laddad i 110 dagar och slutfördes utan en sekunds driftstopp; ett enda minnesfel eller en krasch när som helst skulle ha omintetgjort försöket. Strömförbrukningen låg i genomsnitt på cirka 1 600 W, och hela körningen förbrukade 4 305 kWh, eller 13.7 kWh per biljon siffror, jämfört med uppskattningsvis 33 600 kWh under ungefär 225 dagar för det tidigare rekordet på 300 biljoner siffror.
Slutsats
Venedig är den starkaste server-CPU-lanseringen AMD någonsin har iscensatt, och dess verkliga tema är bredd. En Zen 6-generation sträcker sig från en del med 256 kärnor, via en enterprise-sockel och ett 1152 MB stacked-cache HPC-chip till en LPDDR-värdnod, så att en kund kan bygga alla nivåer i ett datacenter på samma arkitektur och mjukvarubas. Siffrorna som förankrar lanseringen håller i sig när slutkommentarerna är lästa: ungefär dubbelt så mycket Intels dataflöde till ett jämförbart listpris, 20 % ledning per kärna jämfört med Vera på en matchande kompilator, och rackdensitet mellan 1.9 gånger och 2.2 gånger NVIDIAs värd-CPU, beroende på strömförbrukningen.
Den kommersiella halvan av historien behöver ingen prognos. SP7 är i produktion nu, med partnerplattformar planerade under fjärde kvartalet; SP8 följer under första halvåret 2027, med Venice-X och Verano bakom sig. Företaget som säljer dem står redan för 46 % av intäkterna från server-CPU:er, och efterfrågan på dess nuvarande delar överstiger vida utbudet, så köpare väntar i kö snarare än att defekta. Venice skulle kunna halka ett år, och jämförelserna i den här artikeln skulle fortfarande läsas som ledarskap, eftersom Turin redan överträffar allt annat på listan, levererat eller ej levererat. AMD ligger så långt före att dess närmaste konkurrent, för tillfället, är deras egen förra generation.


 Amazon