

AMD uppgav att de har uppnått en uppskattad 4-faldig ökning av AI-energieffektivitet från 2024 till mitten av 2026, vilket överträffar deras beräknade 3-faldiga mål för perioden. De arbetar mot en 20-faldig förbättring av AI-träning och inferenseffektivitet i rackskala till 2030 , ett mål som de satte i juni 2025.
Företaget mäter framstegen mot en baslinje för 2024 med hjälp av prestanda per watt-mått över representativa AMD-rackkonfigurationer. AMD noterade att deras resultat för 2026 kombinerar uppmätta produktdata med modellerade uppskattningar där slutliga prestandadata inte var tillgängliga. När AMD satte 20x-målet sa de att målet i sig överträffade branschens förbättringstrende från 2018 till 2025 med nästan 3 gånger; det interimistiska 4x-resultatet ligger före även den accelererade lutningen.
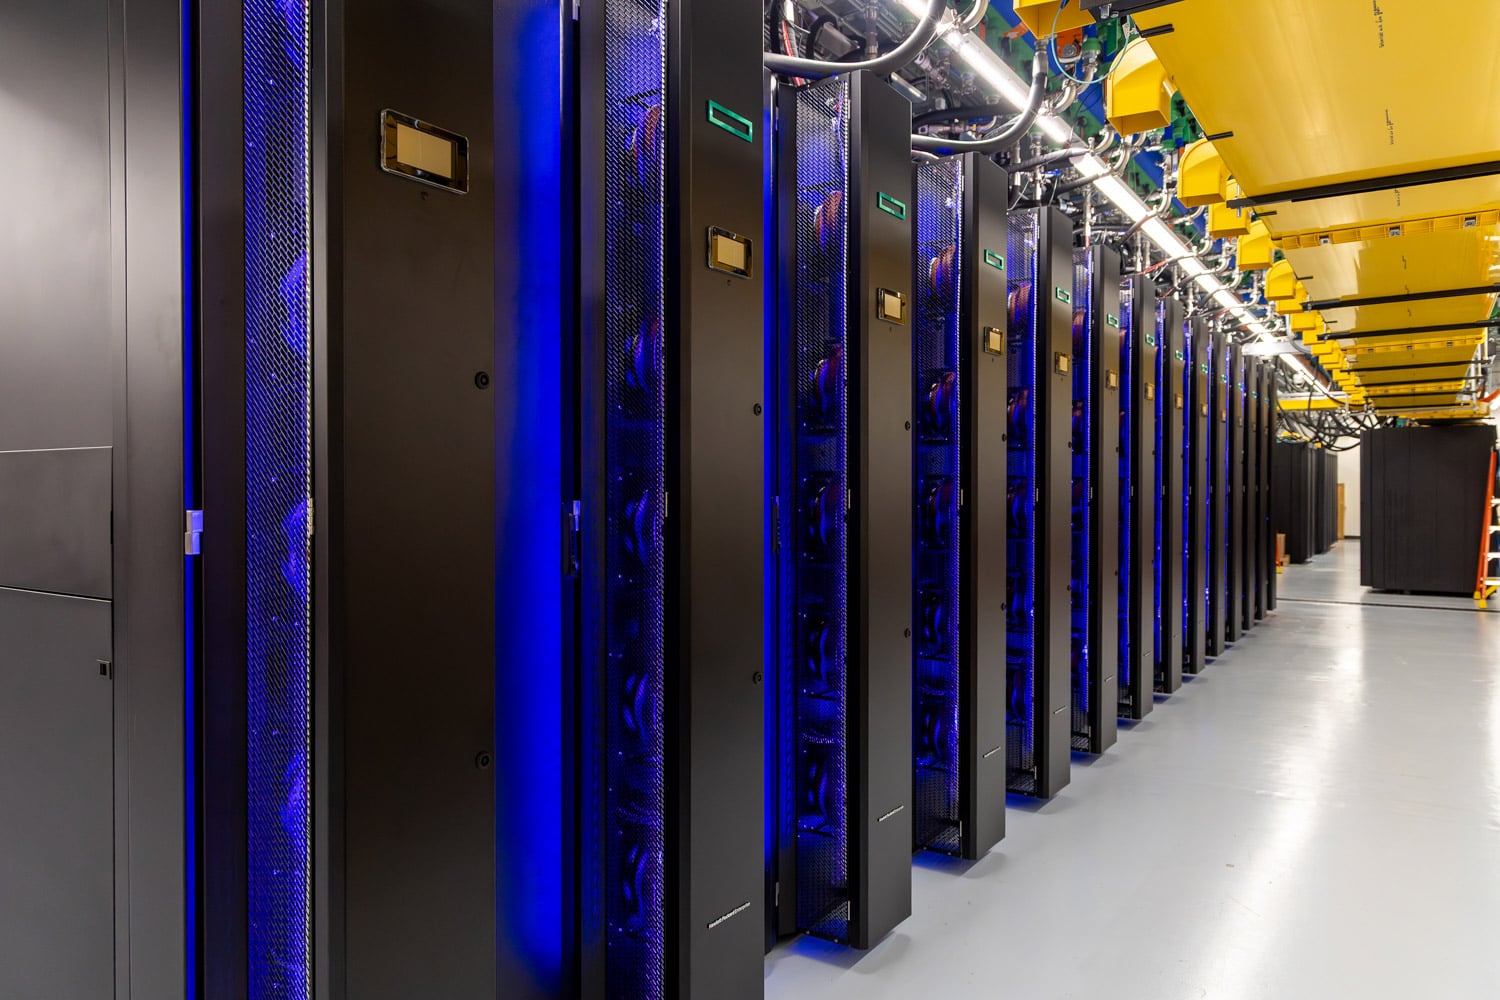
Superdatorn Lux är under uppbyggnad vid Oak Ridge National Laboratory i Tennessee. Lux, som drivs av AMD-teknik, är utformad för att vara den första operativa Genesis Mission-plattformen och kommer att bidra till att utöka det amerikanska energidepartementets ledarskap inom AI och påskynda framsteg och innovation inom energiforskning, materialvetenskap, medicin och avancerad tillverkning. (Bild: Oak Ridge National Laboratory)
Rack-skala, inte komponentnivå
AMDs 20×30-initiativ riktar sig mot förbättringar i rackskala snarare än enbart förbättringar på komponentnivå. Företaget positionerar sin strategi kring samordnade framsteg inom beräkningskisel, processteknik, minnes- och sammankopplingsbandbredd, programvara och systemdesign. Detta återspeglar den växande betydelsen av fullstackoptimering i takt med att AI-infrastrukturen skiftar från individuella acceleratorer till tätt integrerade rack. ”Nästa våg av AI-effektivitet kommer att bero på en tätare samoptimering över beräkningskisel, minne, sammankopplingar, programvara och rackskalig systemdesign”, säger Sam Naffziger, AMD:s senior vice president och Corporate Fellow, i tillkännagivandet. Det är samma fullstack-pitch bakom Lux, det AMD-drivna systemet som blev den första Genesis Mission-superdatorn vid Oak Ridge National Laboratory.
Företaget förväntar sig att högre energieffektivitet kommer att ge två resultat fram till 2030, beroende på hur kunderna använder den tillgängliga prestandan. I ett scenario förutspår AMD att ungefär två framtida rack skulle kunna leverera samma beräkningskapacitet som 570 rack från 2024, vilket minskar elförbrukningen i användningsfasen med 20 gånger och koldioxidintensiteten med 28 gånger. Alternativt skulle de planerade förbättringarna kunna möjliggöra 20 gånger mer beräkningsförmåga, mätt i flyttal per sekund per watt, med samma energianvändning.
Minnes- och sammankopplingstekniker är centrala för den satsningen. AMD identifierade högbandbreddsminne, större cacheminnen och tätare minne-till-datorintegration som mekanismer för att hålla beräkningsresurserna matade samtidigt som energiintensiv dataförflyttning minskas. Snabbskalbara sammankopplingar , strukturen i centrum för AMDs 72-GPU MI455X Helios-rack, förväntas också bli allt viktigare eftersom större AI-arbetsbelastningar kräver effektivare kommunikation mellan GPU:er, processorer, minne och andra komponenter på racknivå.
Programvara kan öka den till 100 gånger
Programvara är fortfarande en annan del av företagets effektivitetsstrategi. AMD sa att deras ROCm-programvarustack, öppna standarder och kundoptimeringsinsatser är avsedda att förbättra AI-träning och inferensgenomströmning samtidigt som energianvändningen per genererad token minskas. Företaget förväntar sig att framsteg på programvaru-, algoritmisk och modellnivå kommer att komplettera hårdvaru- och systemvinster, vilket potentiellt kan stödja upp till en 100-faldig total förbättring av AI-energieffektiviteten till 2030.
Fokus ligger alltmer på användbar beräkningskraft per tillgänglig watt. I takt med att strömförsörjning, kylkapacitet och fysisk infrastruktur blir begränsningar för AI-expansion, kan förbättringar av rackprestanda per watt minska elförbrukningen och förbättra infrastrukturutnyttjandet utan att strömförbrukningen behöver skalas linjärt med beräkningsbehovet.


 Amazon