

Microsoft presenterade idag Azure Maia 300 på OCP Global Summit, den tredje generationen av deras egenutvecklade inferensaccelerator och den första byggda som en multi-chiplet-komponent. Varje accelerator parar ihop en TSMC N2P-beräkningskrets med åtta HBM4-stackar för 288 GB minne med 18 TB/s inuti en 950W TDP, och ett Maia 300-rack rymmer 96 av dem i ett 167 kW-hölje. Microsoft hävdar att de har 40 % fler tokens per megawatt än ledande GPU-baserade system och upp till 7 gånger högre token-genomströmning i rackskala än Maia 200. Produktionsdistributionerna börjar 2027 som en del av vad Microsoft beskriver som Maia-distributioner med flera gigawatt.
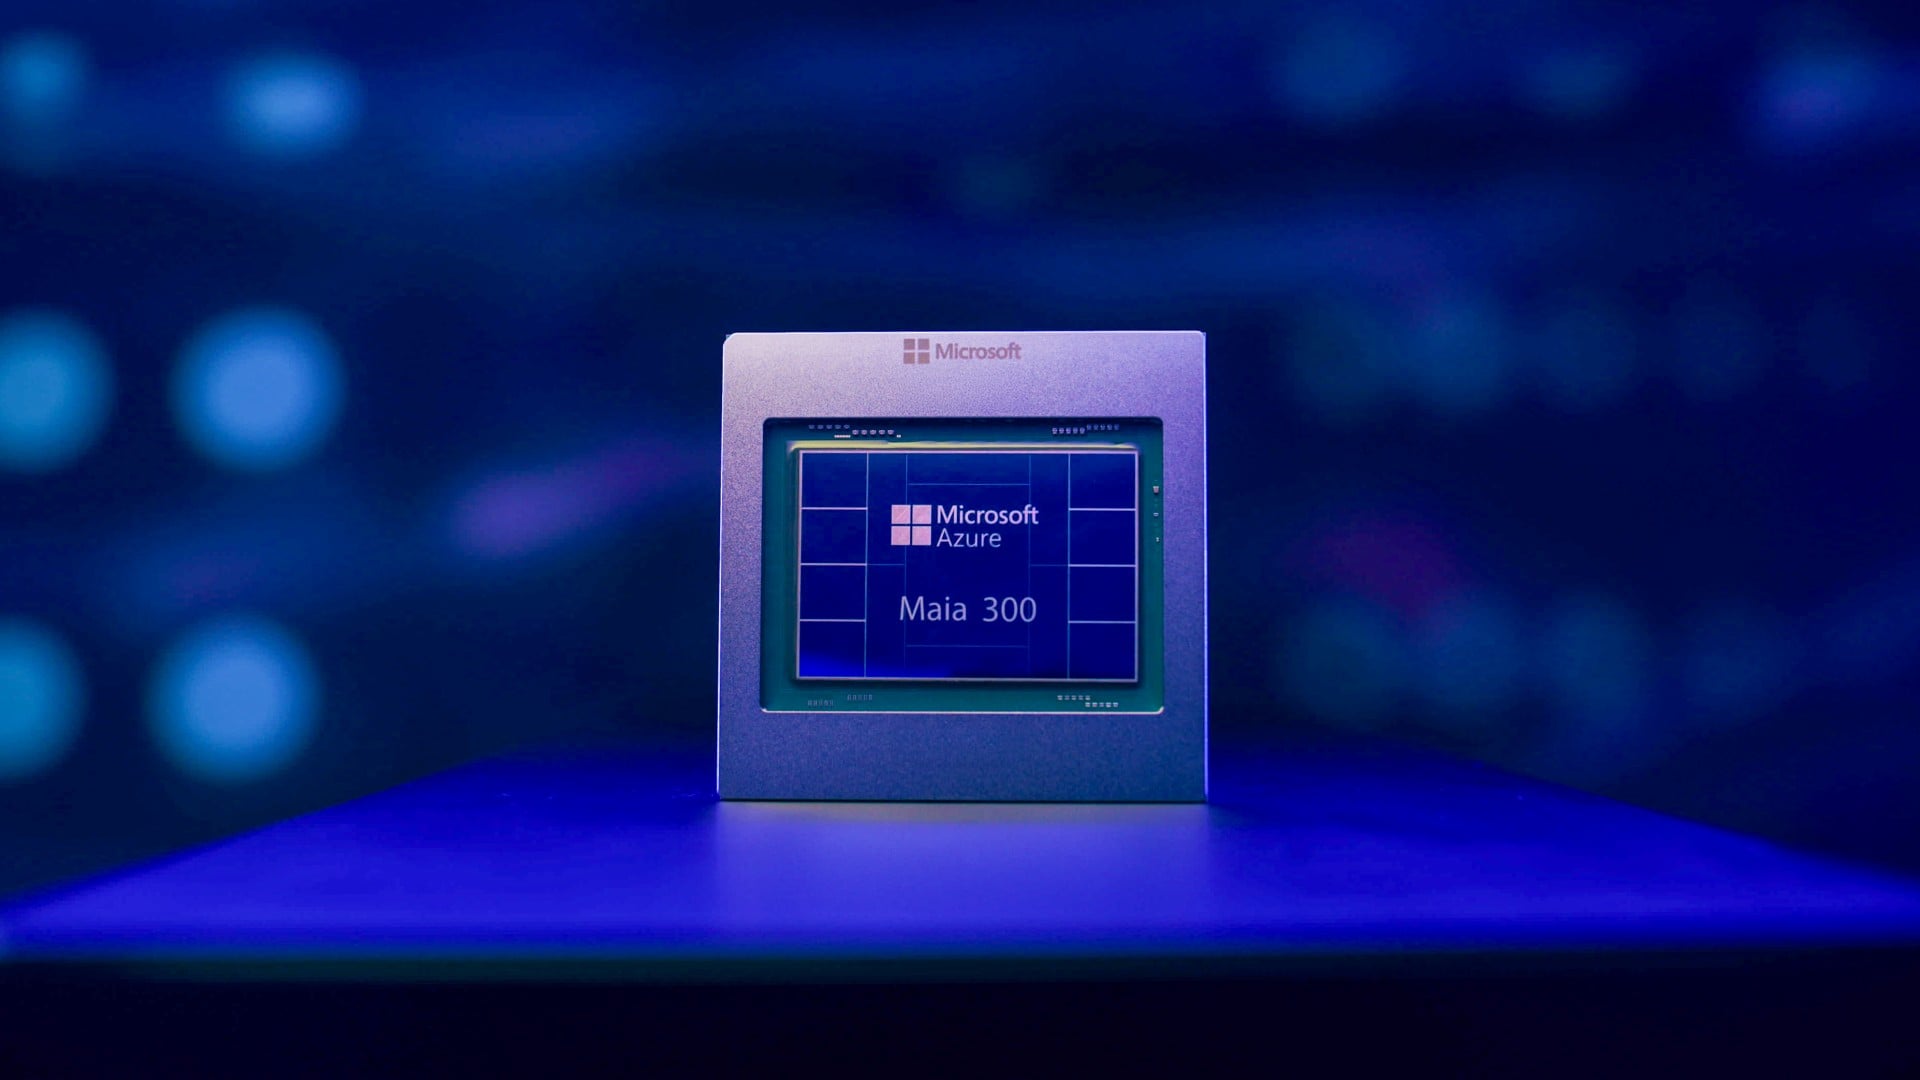
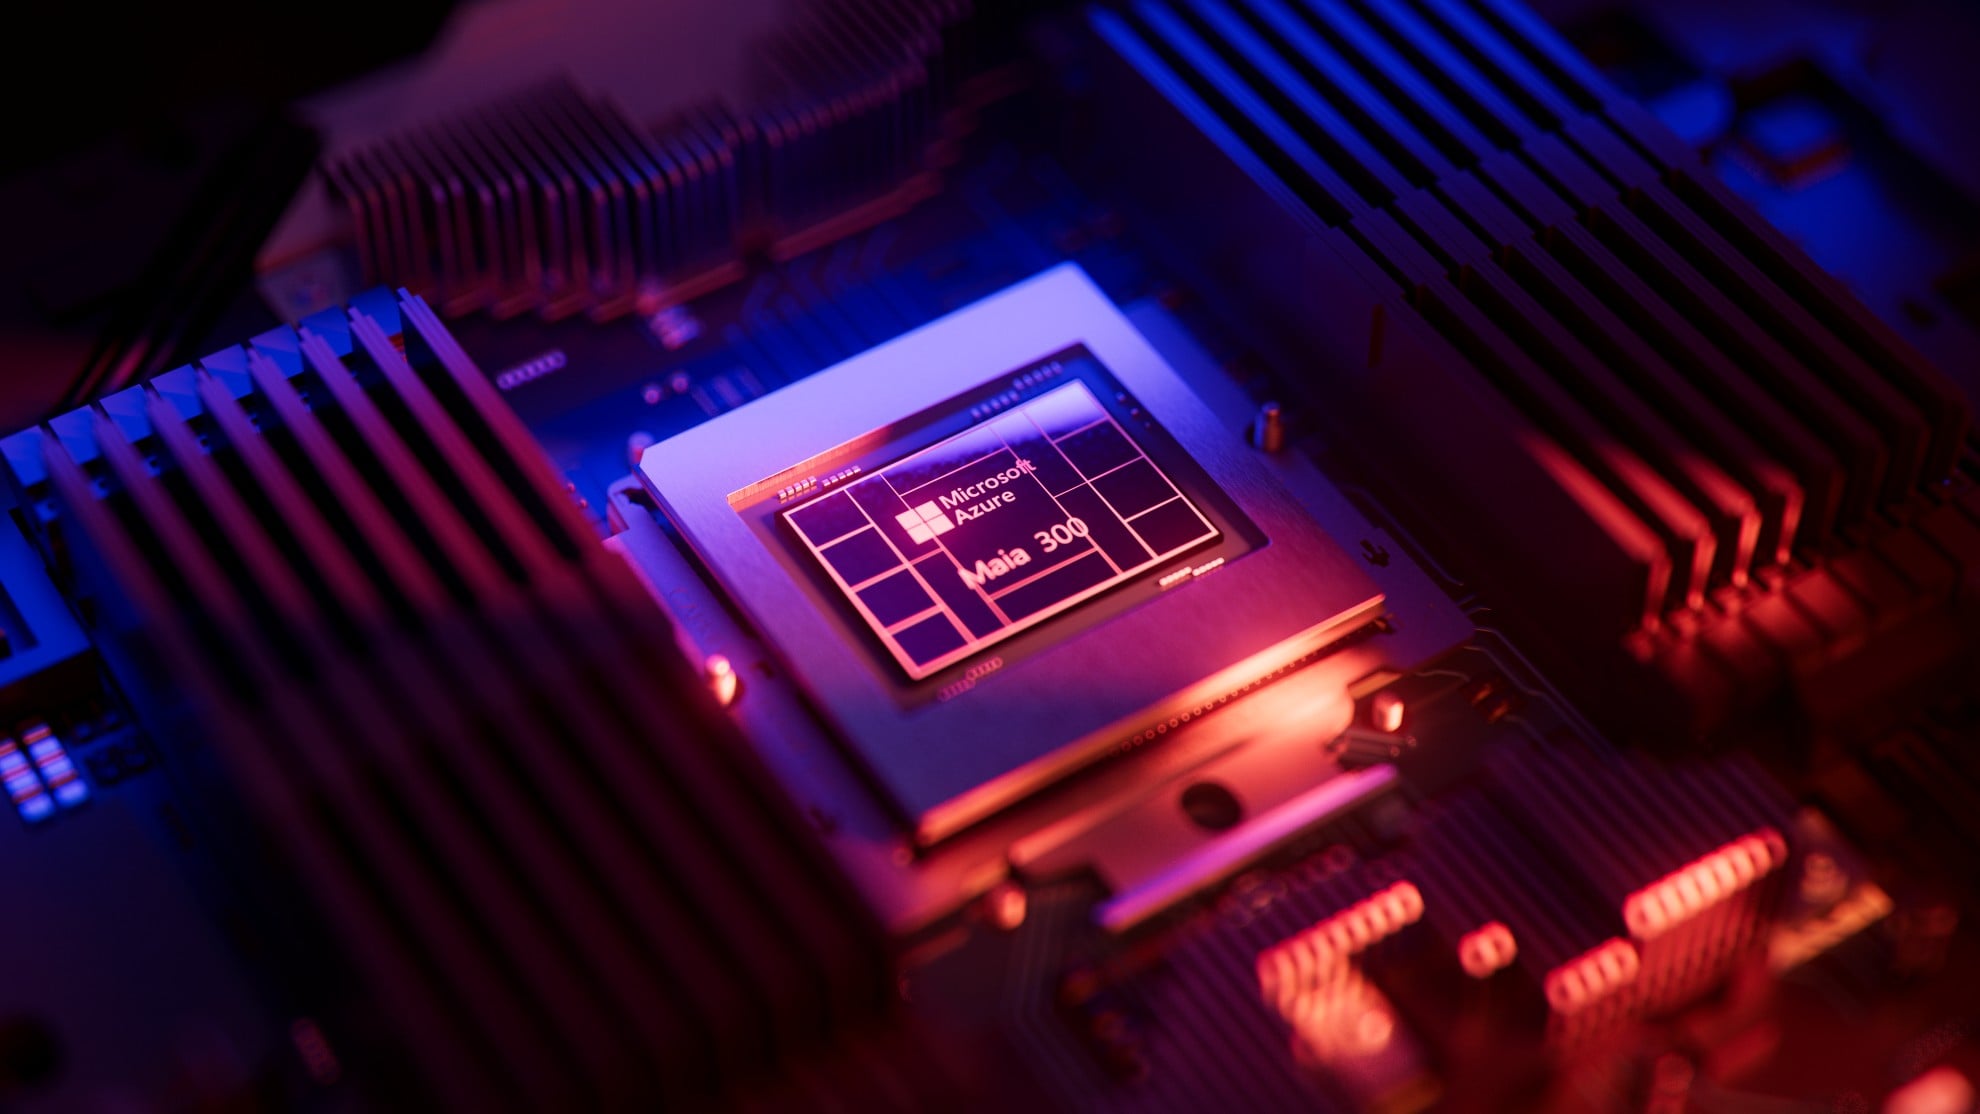
Maia 300 Silicon: N2P-beräkningschip, åtta HBM4-stackar, 32 portar på 400G
Maia 200 var en monolitisk N3P-chip med sex HBM3E-stackar. Maia 300 delar upp designen i en huvudberäkningschip på N2P, två I/O-chips och fyra minneschips, där de åtta HBM4-stackarna tar kapacitet från 216 GB till 288 GB och bandbredd från 7.1 TB/s till 18 TB/s. Maximal beräkningshastighet rör sig mindre: 13.8 POPS vid FP4 och 6.9 POPS vid FP8, upp från 10.1 och 5.1, så genereringen är en 37 % ökning i FP4-beräkning jämfört med en 2.5x ökning i minnesbandbredd. Microsofts sammanfattning av chipet är 2.5 gånger bandbredden, 33 % mer kapacitet och cirka 2 gånger HBM-bandbredden per watt för Maia 200.
Beräkningssidan är organiserad som fyra kluster med 12 plattor, där varje platta bär en tensorenhet, en vektorprocessor, en omformare, en DMA-motor och lokalt SRAM, med ett delat kluster-SRAM och ett nätverk-på-chip ovanför det. Microsoft kallar metoden för en programvarudefinierad dataflödesarkitektur: programvara placerar data över dessa lokala minnen, DMA-motorer och nätverket. SoC:n exponerar PCIe Gen6 x16 för värden och 32 portar med 400 Gb/s Ethernet via en AI-nätverksstyrenhet på dien, vilket är uppskalningsstrukturen.
På Maia 300 går minnesorganisationen från enhetlig åtkomst till en NUMA-layout över chiplets så att data kan placeras nära den dator som använder den, och precisionen sjunker ytterligare med förbättrad MXFP4 och hårdvarukonvertering av datatyper, som syftar till att minska antalet byte som flyttas per token för både beräknings- och KV-cachelagring. Kärnor kan också använda on-die SRAM som en programvaruhanterad scratchpad för att hålla trafik borta från HBM. Microsoft tillskriver ökningen per watt till dessa förändringar, eftersom TDP ökar från 750 W till 950 W medan företaget hävdar mer än 2.5 gånger prestandan per watt.
96 acceleratorer per rack, 12 288 i en Superpod
Ett Maia 300-rack fördubblar antalet acceleratorer till 96 och ökar rackeffekten från 64 kW till 167 kW, vilket motsvarar cirka 1.74 kW per acceleratorplats inklusive nätverk, kylning och effektomvandling. Över racket motsvarar det 27.6 TB HBM, 1 728 TB/s aggregerad HBM-bandbredd och 1 324 POPS FP4 enligt Microsofts siffror, jämfört med 10.4 TB, 341 TB/s och 485 POPS för ett Maia 200-rack. Bandbredden för dubbelriktad uppskalning per accelerator ökar från 2.8 TB/s till 3.2 TB/s, och det tvåskiktade Ethernet-skalningsnätverket med Microsofts anpassade AI-transport når nu en superpod på 12 288 acceleratorer, dubbelt så många som cirka 6 000 från föregående generation.
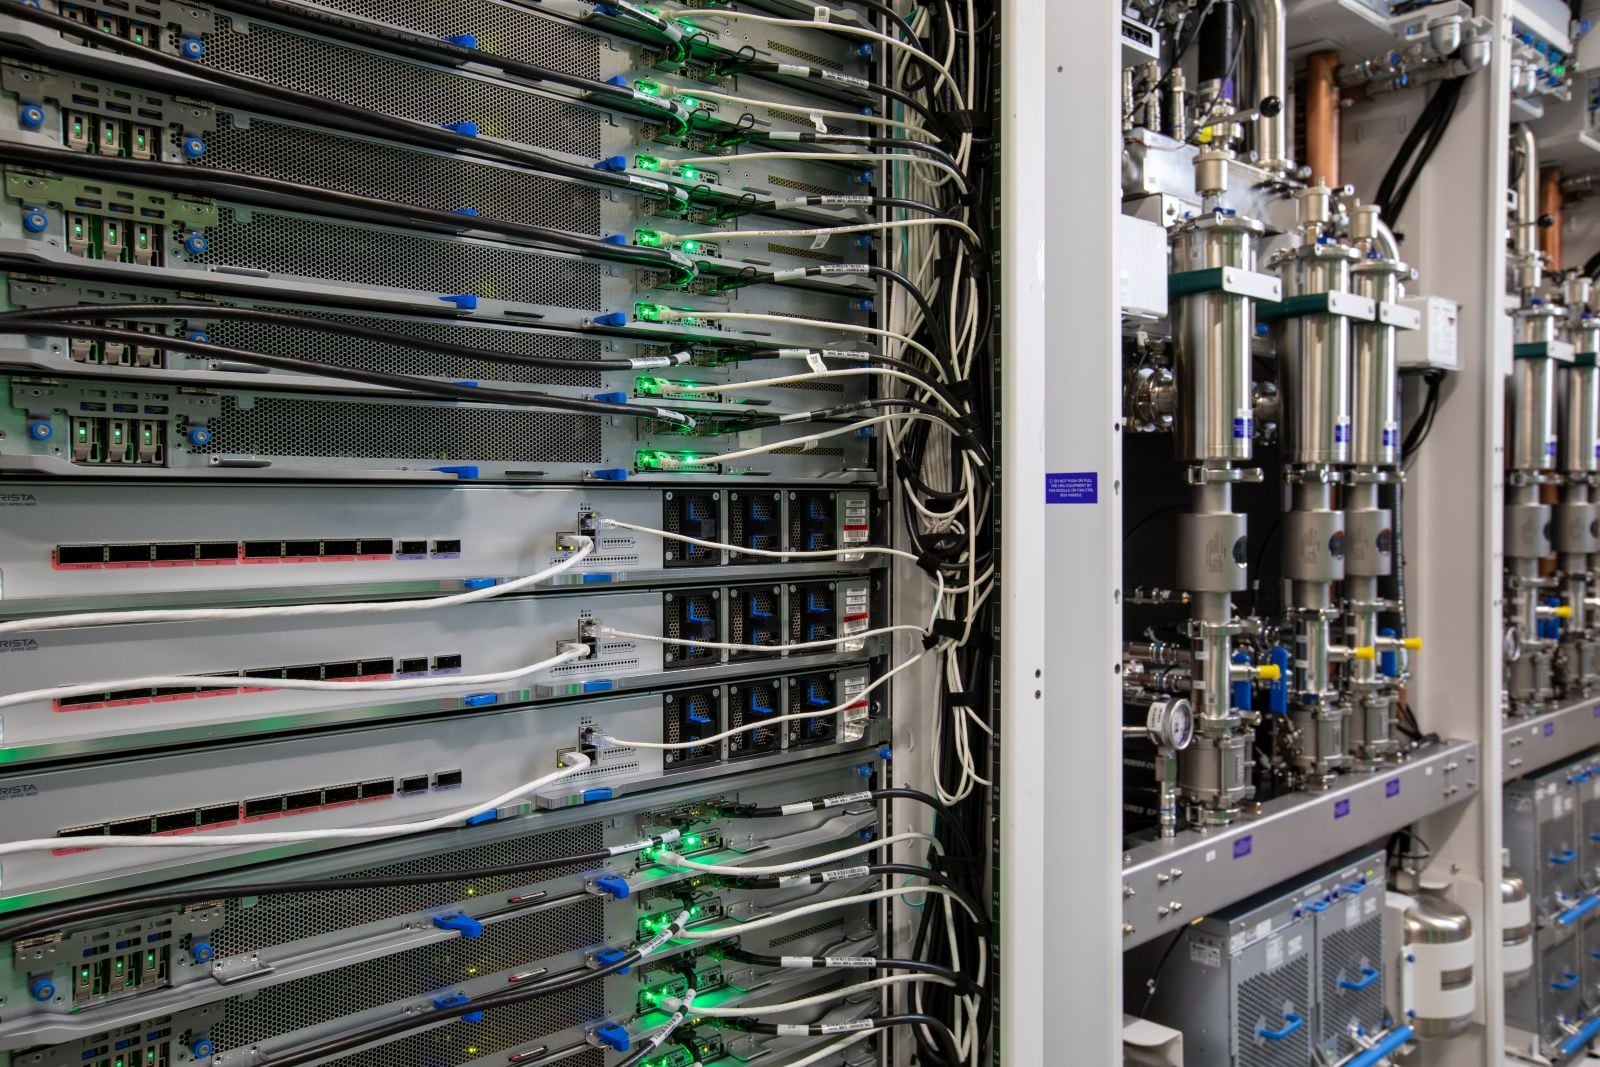
Microsofts rackdiagram visar jobb shardade över rack över scale-up-strukturen med expertparallell trafik mellan shards, vilket är det trafikmönster som stora blandningsmodeller av experter genererar vid serveringstillfället. Företaget säger att samma kommunikationsmodell täcker alla acceleratorer i superpoden, så ett jobb med 16 acceleratorer och ett jobb som sträcker sig över fyra rack använder samma semantik.
Maia 300 Specifikationer
| Specifikation | Maya 300 | Maya 200 |
|---|---|---|
| Accelerator | ||
| Behandla | Multi-chiplet, N2P-beräkningsmatris | Monolitisk N3P |
| FP4-topp | 13.8 POPS | 10.1 POPS |
| FP8-topp | 6.9 POPS | 5.1 POPS |
| SoC TDP | 950W | 750W |
| HBM | 8 x HBM4, 288 GB, 18 TB/s | 6 x HBM3E, 216 GB, 7.1 TB/s |
| Värdgränssnitt | PCIe Gen6 x16 | Ej angivet |
| Skalbar bandbredd (dubbelriktad) | 3.2 TB/s | 2.8 TB/s |
| Backend-nätverk | Tvåskiktad Ethernet-uppskalning med AI-transport, 32 x 400 Gb/s | Tvånivås Ethernet-uppskalning med AI-transport |
| Rack- och skalbarhetsdomän | ||
| Acceleratorer per rack | 96 | 48 |
| Rackkraft | 167 kW | 64 kW |
| Rack HBM-kapacitet | 27.6TB | 10.4TB |
| Rack HBM-bandbredd | 1,728 TB/s | 341 TB/s |
| Rack FP4-topp | 1,324 POPS | 485 POPS |
| Skala upp domän | Cirka 6 000 acceleratorer | Cirka 6 000 acceleratorer |
Var Maia 300 passar in och vad påståendena vilar på
Maia 200 är nu i produktion bakom Microsoft Copilot och MAI-modellteamet, med GitHub Copilot och Microsoft Foundry som planeras att gå över till det i slutet av året, och Microsoft säger att de distribuerar över hela USA, Europa och Australien med upp till 1.7 gånger fler tokens per watt än deras GPU-infrastruktur för de inbyggda AI-funktionerna i Teams, Copilot och Cowork.
”Vi kommer att skala upp vår Azure Maia-familj till driftsättningar på flera gigawatt med början 2027, vilket gör Maia till det primära inferenssystemet för Microsofts produkter och tjänster”, skrev Scott Guthrie, vice vd för Cloud + AI, när han tillkännagav Maia 300. NVIDIA och AMD finns kvar i Microsofts träningsflotta, och företaget har inte erbjudit Maia som en instanstyp som Azure-kunder kan hyra. Det huvudsakliga påståendet om effektivitet, 40 % fler tokens per megawatt än ledande GPU-baserade system, nämner inte GPU:n, modellen eller serverkonfigurationen, och eftersom Maia bara körs inuti Microsoft kan ingen utanför företaget testa den.
De publicerade specifikationerna stöder designen: minnesbandbredden per accelerator ökade med 2.5 gånger medan FP4-beräkningshastigheten ökade med 37 %, och racket levererar 5.1 gånger HBM-bandbredden jämfört med ett Maia 200-rack med 2.6 gånger högre effekt. Det är ett chip byggt för avkodningsfasen av långkontext- och agentinferens, där flaskhalsen matar de aritmetiska enheterna, och det indikerar hur en hyperskalare dimensionerar en inferensdel när den äger arbetsbelastningen från början till slut. Vi bevakade Maia 200-lanseringen i januari, och Microsoft säger att mer information kommer på Ignite i november.



 Amazon