

MinIO har presenterat MemKV, ett kontextminneslagringssystem utformat för att hantera en växande flaskhals i storskaliga AI-inferensmiljöer. MemKV, som positioneras som den andra kärnkomponenten i företagets portfölj vid sidan av AIStor , utökar MinIOs datainfrastruktur till minnesnivån och riktar in sig på persistent, delad kontext för agentiska AI-arbetsbelastningar som arbetar över GPU-kluster.
I takt med att AI-system utvecklas från interaktioner med ett enda svar till flerstegsresonemang och uppgiftskörning har det blivit avgörande att bibehålla kontext över inferenscykler. I nuvarande arkitekturer förloras ofta kontext på grund av begränsad kapacitet i GPU-angränsande minnesnivåer som HBM och DRAM. Detta tvingar GPU:er att beräkna om tidigare genererat kontext, vilket ökar latens, beräkningsutnyttjande och energiförbrukning. MinIO karakteriserar detta som en omberäkningsskatt som ökar i stor skala, särskilt i hyperskaliga och molnmiljöer.
MemKV är utformat för att mildra detta problem genom att tillhandahålla ett delat, persistent minneslager som kan hämta mikrosekunder på petabyteskala. Genom att bibehålla kontext över inferensoperationer minskar plattformen redundant beräkning och förbättrar den totala systemets effektivitet. I interna riktmärken rapporterar MinIO förbättringar i tid till första token vid samtidighetsnivåer i produktionen. I en representativ implementering med 128 GPU:er och kontextfönster med 128 000 token ökade GPU-utnyttjandet från cirka 50 procent till över 90 procent, vilket resulterade i betydande årliga kostnadsbesparingar för beräkningar.
MinIOs ledning noterade att omräkningskostnader historiskt sett har maskerats i mindre implementeringar men blir en strukturell ineffektivitet i stor skala. I takt med att GPU-kluster växer ökar kostnaden för att upprepade gånger regenerera kontext, både vad gäller strömförbrukning och infrastrukturkrav, vilket gör specialbyggda minnessystem nödvändiga för hållbar AI-verksamhet.
Att hantera avvägningen mellan minne och skala
Traditionell AI-infrastruktur tvingar fram en avvägning mellan hastighet och skalbarhet. Högpresterande minnesnivåer som HBM och DRAM ger mikrosekundslatens men är kapacitetsbegränsade och dyra. Omvänt erbjuder lagringssystem skalbarhet men introducerar millisekundslatens, vilket är olämpligt för realtidsinferens och långsiktigt resonemang.
MemKV är utformat för att överbrygga detta gap genom att introducera en delad minnesnivå som kombinerar åtkomst med låg latens med storskalig kapacitet. Byggd för att köras på NVIDIA BlueField-4 STX och integrerad med NVIDIA Dynamo och NIXL, gör plattformen det möjligt för ett helt GPU-kluster att få åtkomst till en gemensam pool av kontextdata med hastigheter som är anpassade till inferenskrav. Denna metod eliminerar behovet av att växla kontext mellan olika minnes- och lagringslager, vilket minskar latensen och förbättrar dataflödet.
Arkitektur optimerad för inferensarbetsbelastningar
MemKV är specialbyggt för inferensdatasökvägen och överensstämmer med MinIO:s beskrivning av G3.5-lagret i GPU-minneshierarkin. Den levererar petabyte-skalig kapacitet på NVMe-baserad infrastruktur samtidigt som den bibehåller åtkomstegenskaper på mikrosekundnivå, vilket effektivt frikopplar minnesskala från GPU-beräkningsresurser.
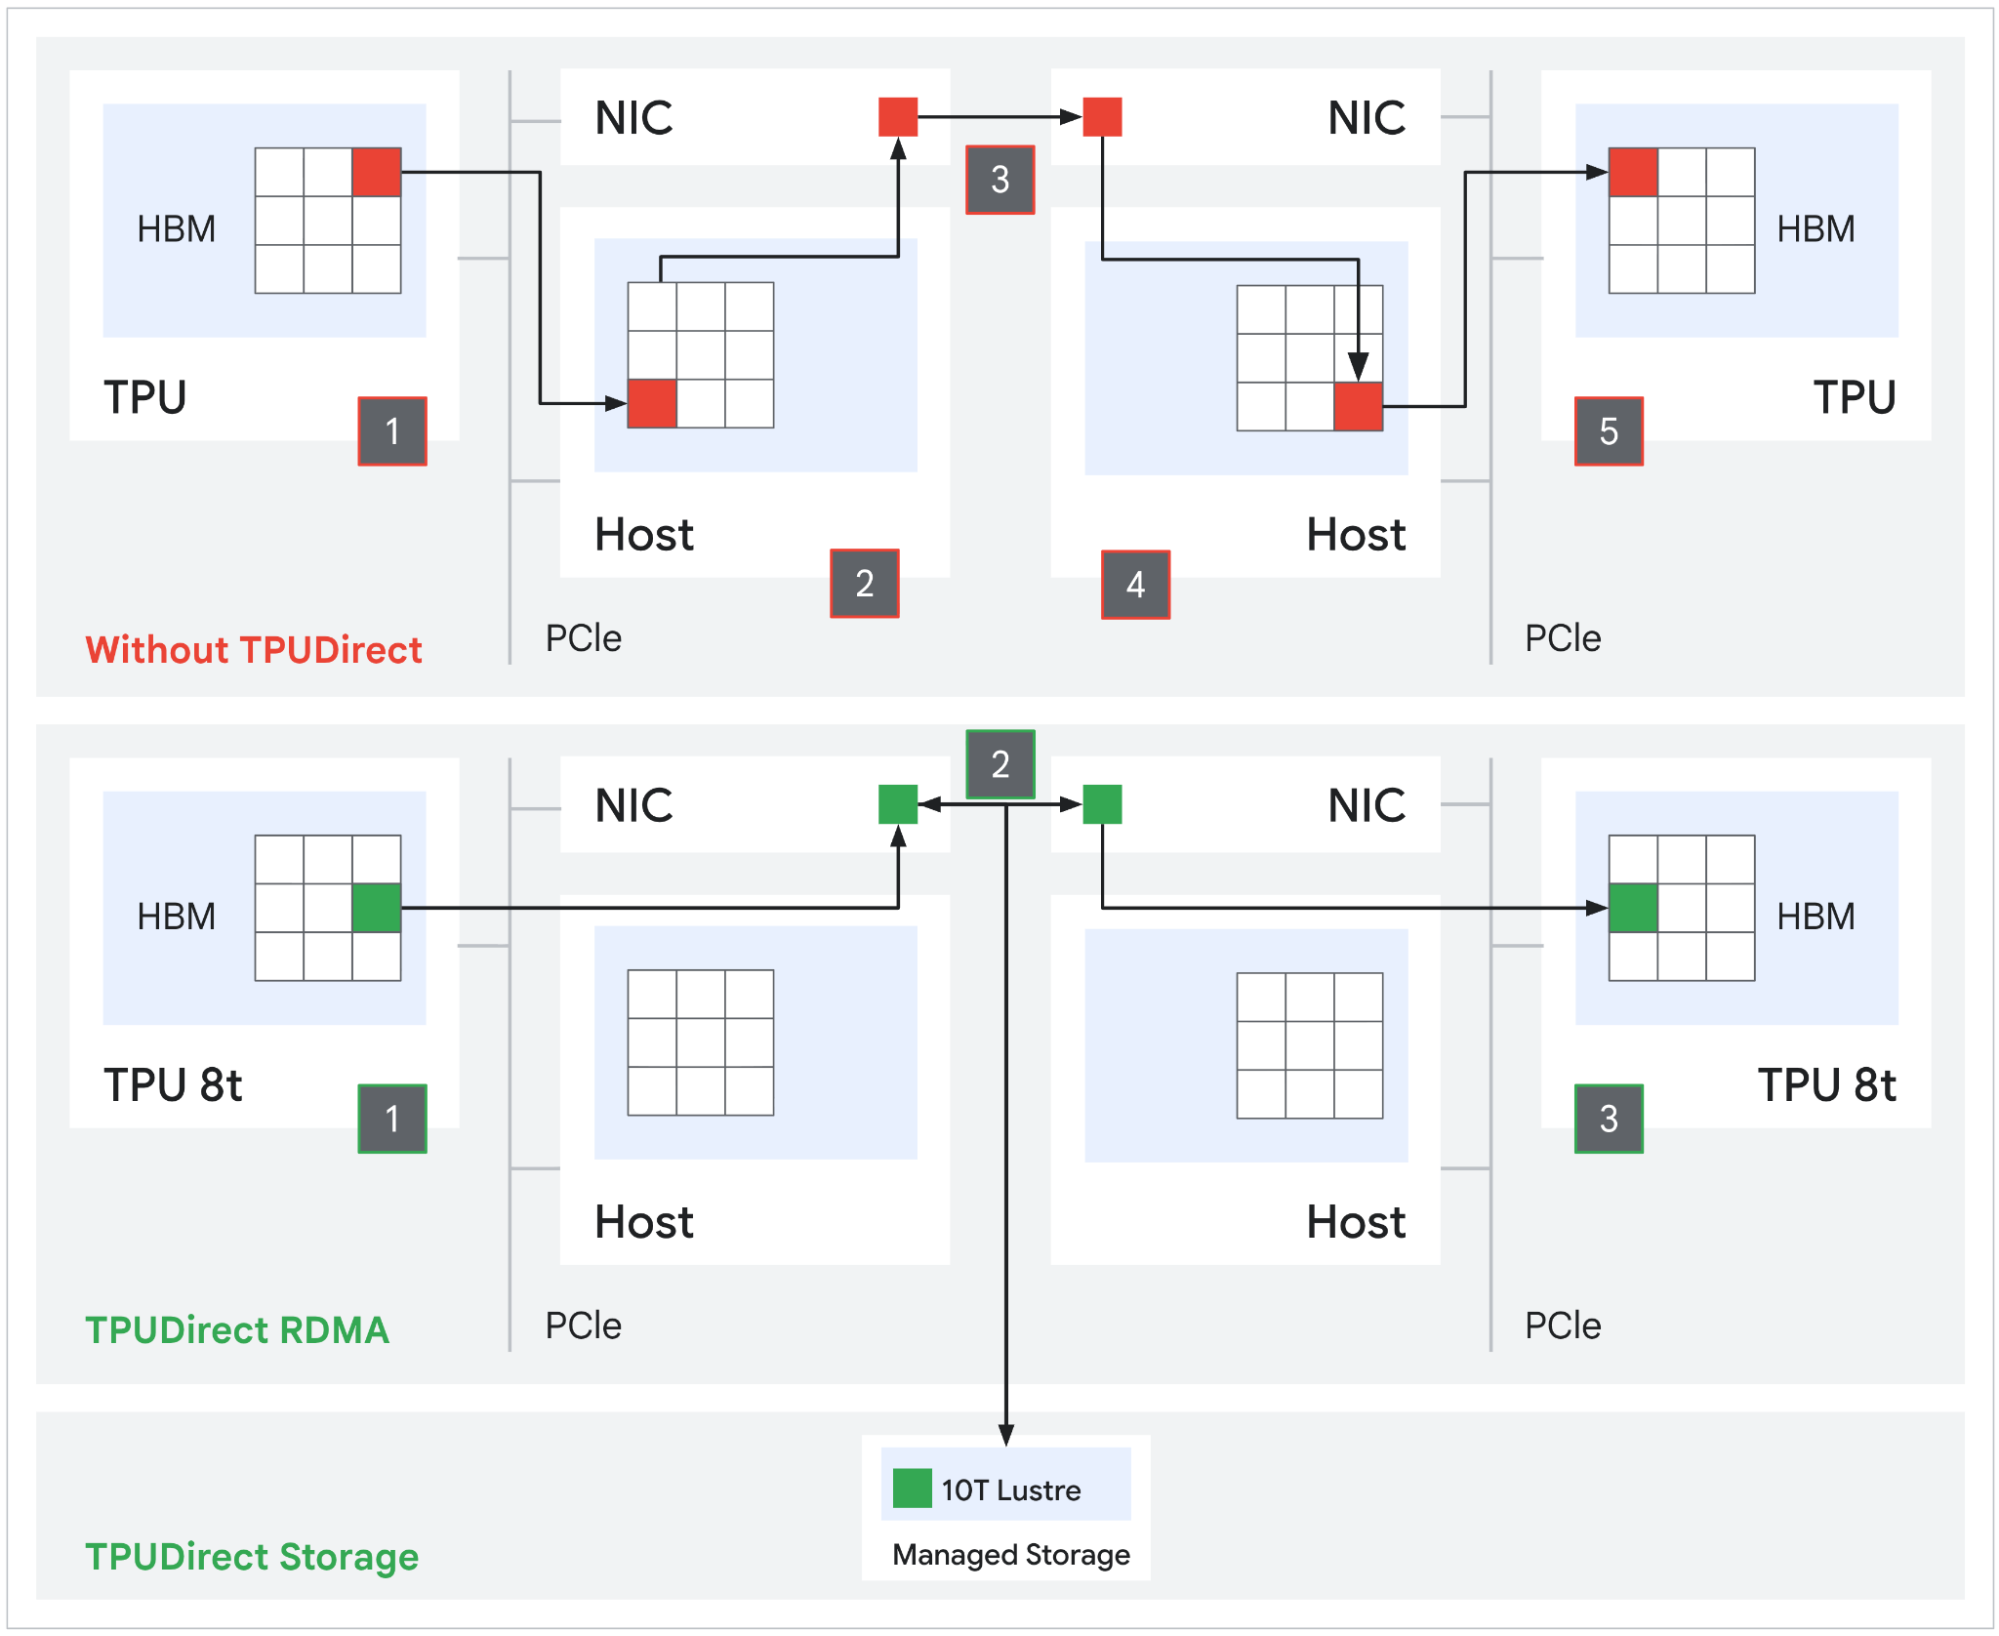
Systemet undviker traditionella lagringsabstraktioner genom att flytta data direkt från NVMe till AI-datavägen via end-to-end RDMA-transport . Detta eliminerar overhead från HTTP-protokoll, filsystemsöversättning och mellanliggande lagringsservrar, vilket är vanligt i objekt- och filbaserade arkitekturer.
Källa: Google
Viktiga arkitekturelement inkluderar native exekvering på NVIDIA BlueField-4 STX som en ARM64-binärfil inbäddad i lagringslagret, vilket minskar beroendet av externa x86-lagringsnoder. Dataöverföringar sker via RDMA från GPU-minne till NVMe, och kringgår konventionella lagringsstackar. MemKV använder också större blockstorlekar, från 2 MB till 16 MB, optimerade för GPU-genomströmningsmönster snarare än äldre 4 KB-lagringsblock. Nätverksprestanda är anpassad till moderna höghastighetsstrukturer, inklusive NVIDIA Spectrum-X Ethernet och PCIe Gen6, vilket möjliggör dataöverföring med nära trådhastighet över klustret.
Tillgänglighet
MinIO MemKV är tillgänglig omedelbart.


 Amazon