

Under flera hårdvarugenerationer har minnes- och nätverksleverantörer identifierat olika flaskhalsar i högpresterande datorkluster. Minnestillverkare fokuserade på minnesbandbredd i paketet, medan nätverksstrukturleverantörer fokuserade på dataflöde mellan chassin och mellan rack. Idag har dessa två perspektiv konvergerat kring exakt samma flaskhals: bandbreddsväggen som begränsar datarörelsen mellan distribuerade beräkningsnoder och minnespooler.
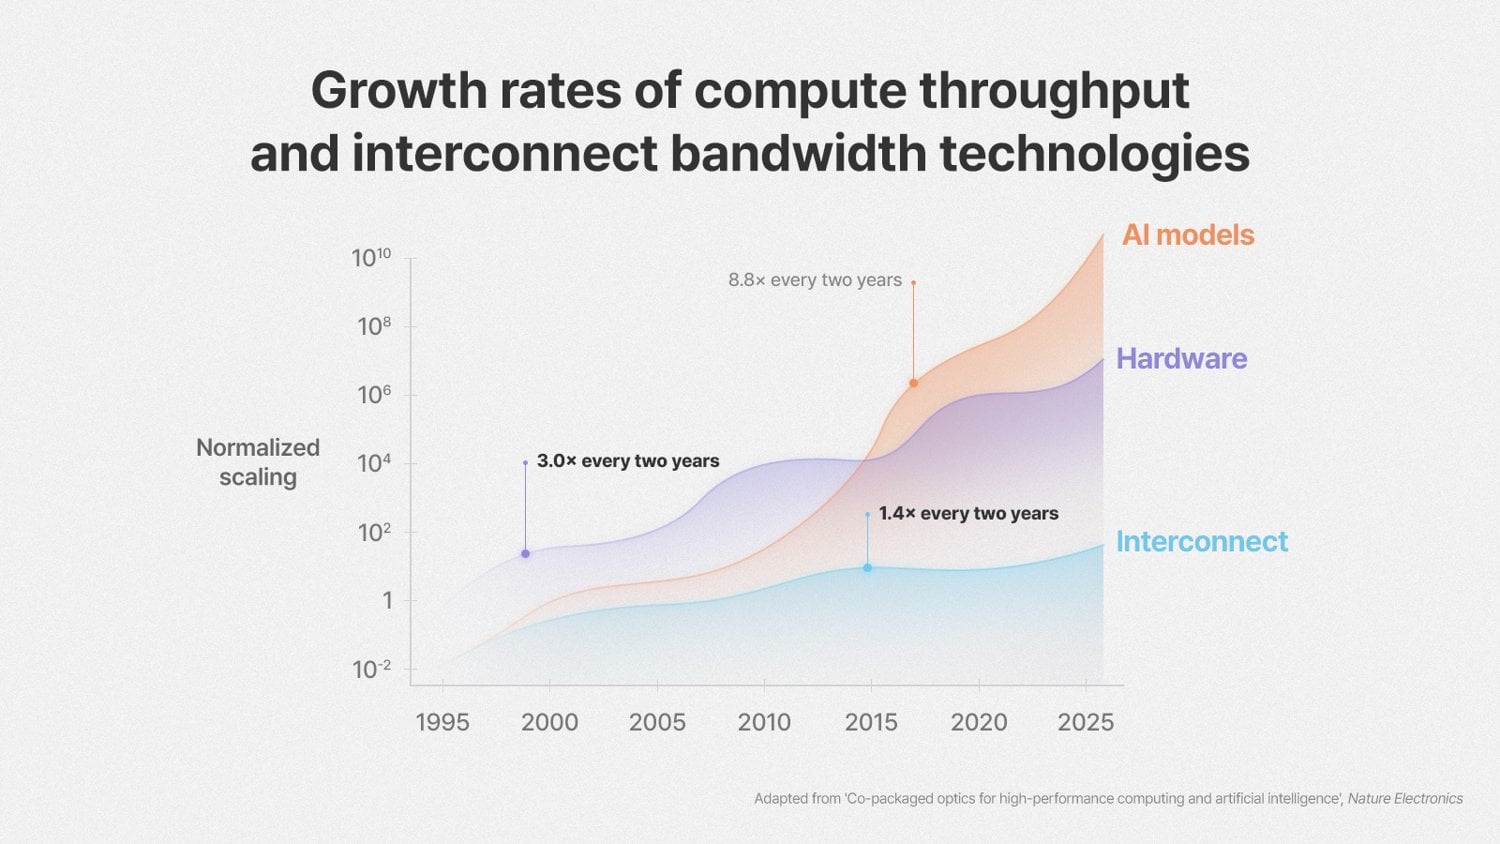
Medan High Bandwidth Memory (HBM) effektivt löste bandbreddsbegränsningar på paketnivå för enskilda AI-acceleratorer, skalas moderna hyperskaliga tränings- och inferensarbetsbelastningar nu över tiotusentals processorer distribuerade över rack och poddar. I dessa distribuerade topologier har beräkningsdataflödet historiskt sett ökat med ungefär 3 gånger vartannat år, medan sammankopplingsbandbredden har ökat med ungefär 1.4 gånger under samma period. Den resulterande obalansen placerar den primära skalningsflaskhalsen direkt på det fysiska sammankopplingslagret.
Bedömningen kommer från en perspektivartikel som publicerades den 20 augusti i Nature Electronics med titeln *Co-packaged optics for high-performance computing and artificial intelligence*, medförfattad av SK hynix och forskare från University of Virginia, University of Illinois Urbana-Champaign, MIT, Nanyang Technological University och Yonsei University. SK hynix AI Infra Team Lead Seunghoon Hong och UVA-professor Kyusang Lee var korresponderande författare.
| Etapp | Resultat |
|---|---|
| Flaskhalsförskjutning i AI-kluster | |
| HBM-paket | Åtgärdade minnesflaskhalsen i paketet/på dien |
| Kopparspår | Träffar fysisk dämpning / kraftvägg utanför chipet |
| CPO-integration | Konvergerar det optiska tyget direkt på substratet |
För att hantera denna begränsning publicerade SK hynix, i samarbete med forskare från University of Virginia, UIUC, NTU, MIT och Yonsei University, en studie i Nature Electronics med titeln ”Co-packaged optics for high-performance computing and artificial intelligence”. Artikeln beskriver hur co-packaged optics (CPO) och optiska beräkningskopplingar (OCI) måste utvecklas tillsammans med minnes- och paketeringsarkitekturer för att upprätthålla framtida klusterskalning.
De fysiska begränsningarna för kopparförbindelser
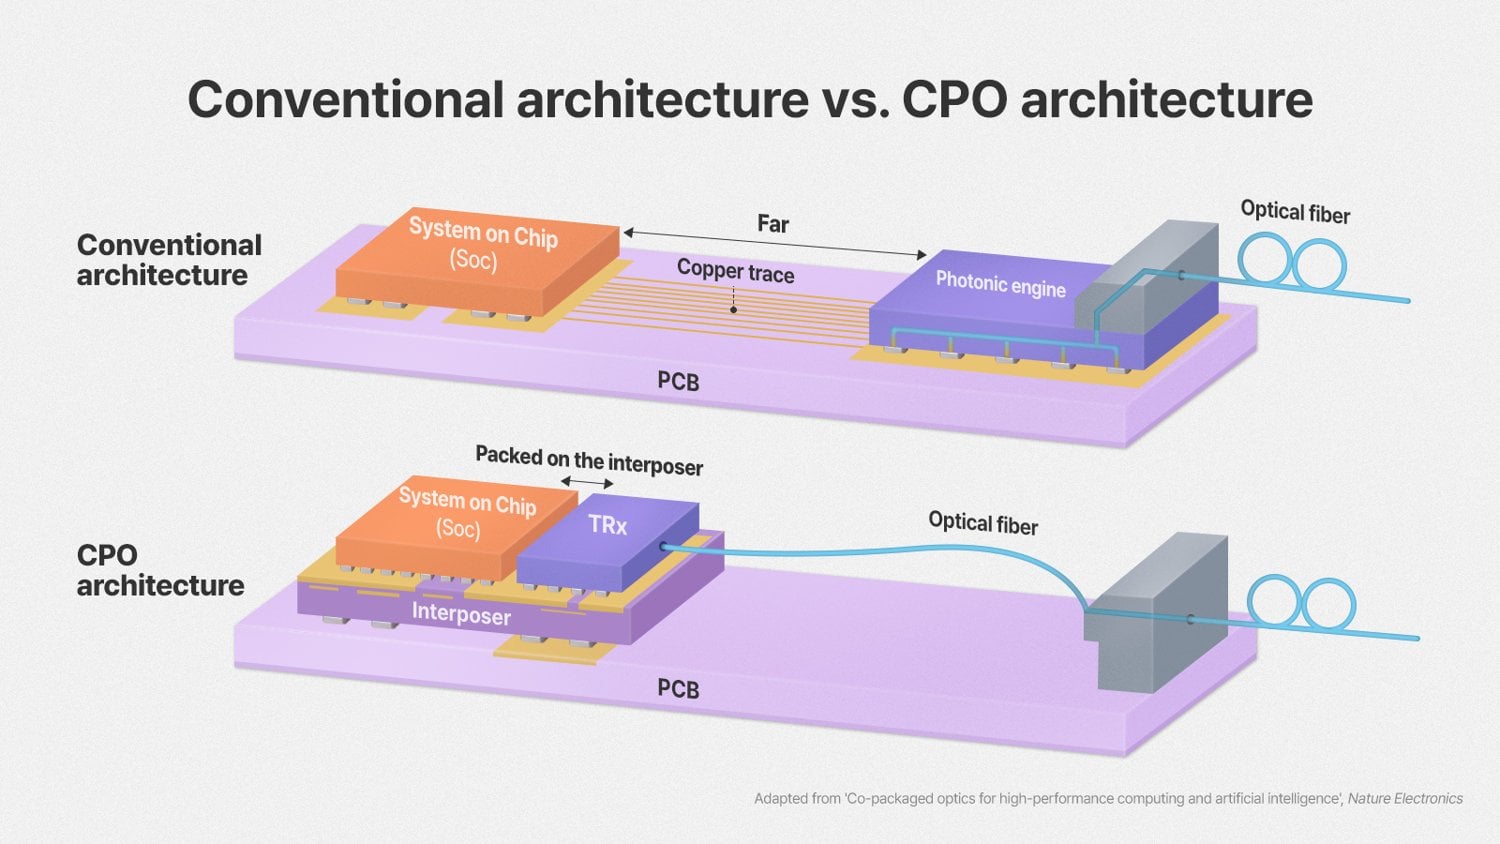
Standard elektriska sammankopplingar som förlitar sig på kopparspår och direktkopplade kopparkablar är fortfarande praktiska över korta fysiska avstånd. Men i takt med att datahastigheterna ökar lider den elektriska signaleringen av kraftig signaldämpning, insättningsförlust och ökad strömförbrukning. Att hantera höghastighetssignaler över längre kortspår och bakplan kräver komplex utjämnings- och retimingkretsar, vilket introducerar ytterligare latens och förbrukar betydande strömförbrukning.
Hur sampaketerad optik förändrar vägen
CPO motverkar dessa fysiska begränsningar genom att montera optiska sändtagare direkt på samma substrat som värdprocessorerna eller acceleratorerna. Genom att konvertera höghastighetselektriska signaler till fotoniska kanaler direkt intill beräkningskislet minimeras elektriska spårlängder, vilket minskar parasitkapacitans och signalförsämring. Denna arkitektur möjliggör optisk överföring med låg förlust och hög bandbredd över kort, rack och pods, samtidigt som den bibehåller högre bandbreddsdensitet och förbättrad immunitet mot elektromagnetisk störning.
| metrisk | Målspecifikation |
|---|---|
| Målspecifikationer för CPO-noder | |
| Nodbandbreddsdensitet | > 100 Tb/s per nod |
| Energieffektivitet | < 1 pJ/bit |
| Chip-till-chip-sammankopplingslatens | <10 ns |
| Integrationsväg | 2.5D interposer till 3D heterogen |
Färdplanen visar en arkitektonisk utveckling som går från standard 2D-multichipmoduler och 2.5D-kiselinterposerintegration mot 3D heterogen stackning. Den slutgiltiga arkitektoniska milstolpen involverar att utöka optiska länkar direkt in i själva minnesundersystemet.
Genom att använda en fotonisk mellanläggare för att direkt koppla samman minnesstackar med beräkningsmotorer kan system kringgå konventionella routningsbegränsningar på kortnivå. Denna metod möjliggör disaggregerade delade minnespooler med låg latens där flera beräkningsmotorer kan komma åt delad kapacitet över ett optiskt bakplan utan de serialiserings- och deserialiseringspåföljder som är typiska för traditionella nätverksstrukturer.
Tekniska utmaningar för kommersiell driftsättning
Att övergå till CPO från avancerade paketeringsdemonstrationer till hårdvara för produktionsdatacenter innebär flera olösta tekniska hinder. Integrering av kiselfotoniska komponenter med låg effekt tillsammans med högeffektsvärdlogik kräver sofistikerad termisk isolering och avancerade mikrofluidiska eller direkt-till-paket-kylningsdesigner.
Dessutom måste industrin utveckla standardiserade koherensprotokoll med låg latens som kan orkestrera optiskt kopplade minnestransaktioner utan proprietär mjukvaruoverhead. Tillförlitlig kommersialisering kommer att kräva heltäckande hårdvarudesign som omfattar DRAM-chiptopologier, anpassade minneskontroller, fotoniska motorer och heterogen substratkapsling. För SK hynix löper den optiska färdplanen parallellt med den konventionella; företaget detaljerade 16-High HBM4 och waferbondad 375-lagers NAND vid FMS 2026.


 Amazon