

NVIDIA presenterar på Stanfords Hot Chips-konferens med ett tydligt budskap: datacentret är datorn, och dess prestandagräns bestäms mer av den sammankopplade strukturen än av råa FLOPS. Under fem sessioner kommer NVIDIA att visa hur Spectrum-XGS Ethernet, femte generationens NVLink med NVLink Fusion, CPO-drivna fotoniska switchar och den nya stationära superdatorn DGX Spark fungerar tillsammans. Denna integration syftar till att förvandla tiotusentals GPU:er till en enda, intäktsgenererande AI-fabrik.
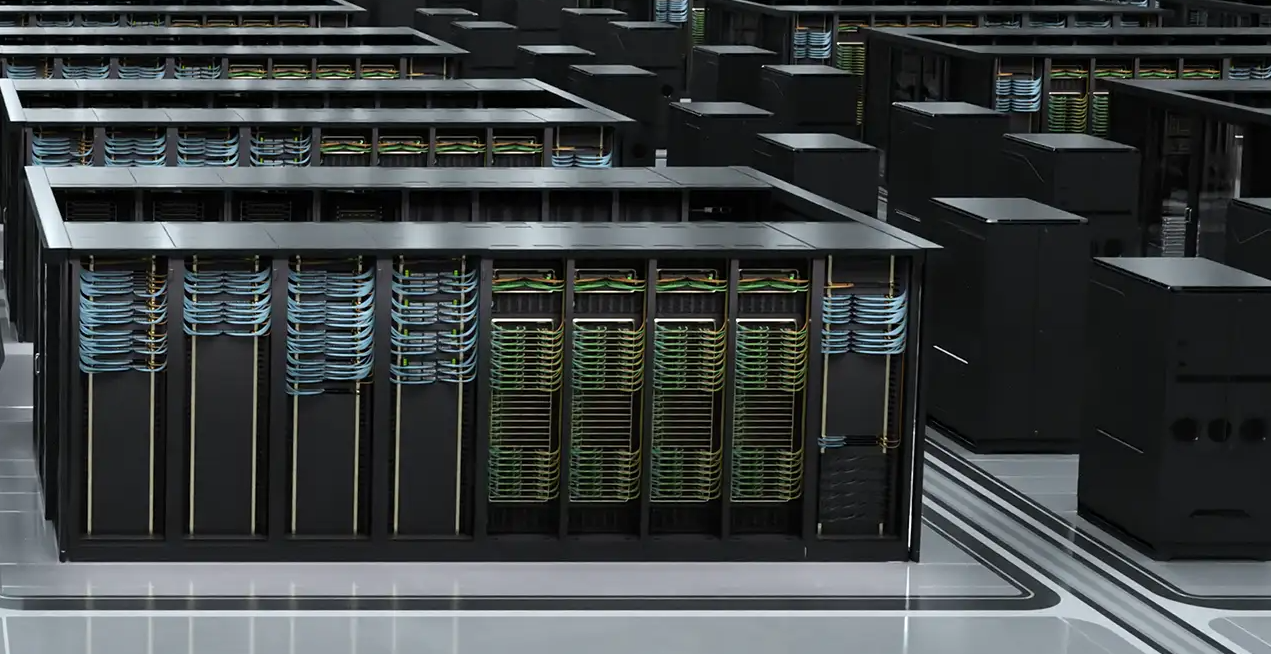
Ett trelagerstyg för AI-fabriker
Moderna LLM:er är implicit distribuerade applikationer. De strömmar biljoner parametrar över GPU:er, synkroniserar gradientuppdateringar med mikrosekundkadens och måste returnera en första token till en användare på mindre än ett hjärtslag. Den arbetsbelastningen driver en hierarki av sammankopplingar:
- Skala upp i ett rack så att GPU:er fungerar som kärnor på en enda, stor processor.
- Skala ut över rack så att klustret fungerar som ett enhetligt system.
- Skala över hela datacenter för georedundans, kapacitetsdelning och efterlevnad av regelverk.
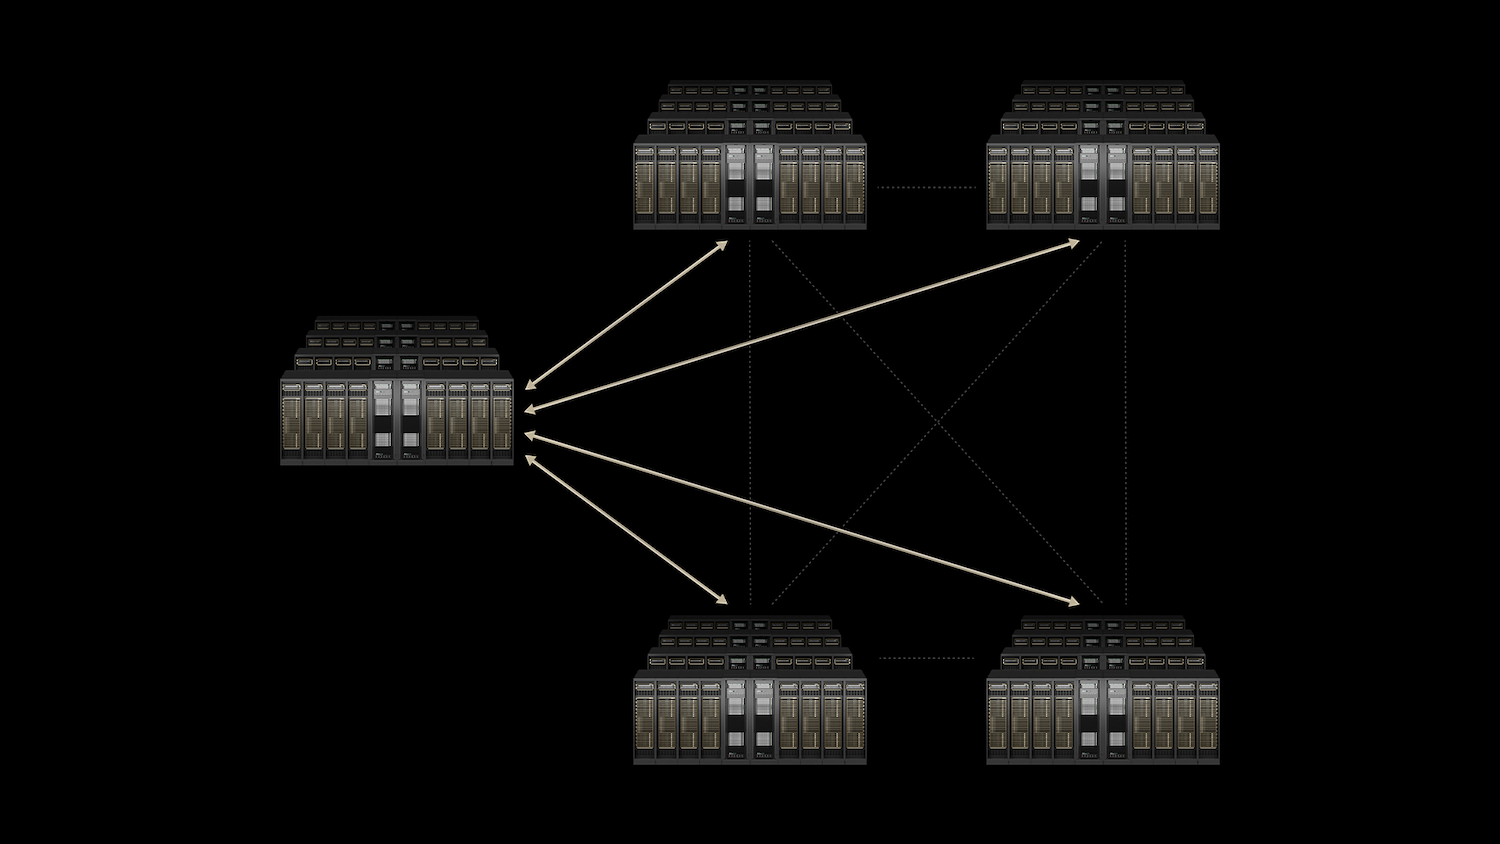
NVIDIAs svar är en vertikalt integrerad stack. NVLink och NVLink Switch äger skalbarhetsdomänen; Quantum InfiniBand och Spectrum-X äger skalbarhetsdomänen; det nya Spectrum-XGS Ethernet utökar förlustfri, AI-anpassad nätverksteknik över datacenter. Co-Packaged Optics (CPO) minskar effekt- och densitetsgränserna som miljontals GPU-kluster annars skulle nå.
Spectrum-XGS Ethernet
Traditionell Ethernet-teknik var främst utformad för att hantera trafik med bästa möjliga prestanda, vilket innebär att den fungerade bra för enkel kommunikation mellan en enda server. Men i takt med att vi går in i en värld som blir alltmer beroende av AI står vi inför nya utmaningar.
Med uppkomsten av AI-kollektiv och inferenssystem med flera hyresgäster har kraven på nätverksprestanda utvecklats avsevärt. Dessa moderna applikationer kräver en nivå av tillförlitlighet och hastighet som traditionellt Ethernet helt enkelt inte kan erbjuda.
Mer specifikt kräver de noll jitter, vilket innebär ingen variation i latens, vilket är avgörande för realtidsbehandling. Dessutom säkerställer deterministisk latens att svaren är förutsägbara och konsekventa, vilket är avgörande för applikationer som är beroende av omedelbar feedback. Slutligen är dataflöde nära linjehastighet avgörande för att hantera den höga datavolymen som bearbetas under mikroburstbelastningar, där datatrafiken kan öka oväntat.
Spectrum-X är en lösning som fungerar sömlöst i ett datacenter, medan Spectrum-XGS tar denna innovation till nästa nivå genom att utöka sina möjligheter över flera datacenter. Den integrerar avancerade Spectrum-6- eller -4 ASIC-baserade switchar med supersnabba 800 Gb/s SuperNIC-kort, specifikt BlueField-3- eller ConnectX-8-varianterna. Dessa tekniker arbetar tillsammans för att effektivt hantera överbelastning och omordna paket, vilket säkerställer ett smidigt dataflöde.
Det som skiljer det här systemet från mängden är dess intelligenta telemetri som samlar in data från varje port och matar in den i logiken för överbelastningskontroll i switchen, vilket möjliggör omformning av trafik i realtid. I produktionskluster resulterar detta i anmärkningsvärd prestanda, med en dataflödeshastighet på över 95 procent av den teoretiska kapaciteten vid en häpnadsväckande GPU-skala på 32k. Däremot har traditionellt 800G Ethernet det svårt och uppnår bara cirka 60 procents dataflöde vid kollektiva kollisioner.
Dessutom garanterar Spectrum-XGS efterlevnad av standarder, vilket gör SONiC och Cumulus Linux till integrerade komponenter i sitt ekosystem. Det innebär att moln- och företagsoperatörer kan behålla sina befintliga automationsstackar samtidigt som de drar nytta av den överlägsna determinism som vanligtvis förknippas med InfiniBand. Förbättringarna leder till högre GPU-utnyttjande och minskad latens, vilket resulterar i fler tokens per watt och striktare servicenivåmål. Dessutom ger det operatörer möjlighet att integrera nya hyresgäster i samma flotta utan att uppleva prestandaförsämringar, vilket gör det banbrytande i branschen.
NVLink och NVLink Fusion: Racket som en enda gigantisk GPU
Femte generationens NVLink levererar imponerande 1.8 TB/s punkt-till-punkt-bandbredd och imponerande 130 TB/s aggregerad bandbredd i ett NVL72-rack. Denna förbättrade anslutning gör att varje GPU kan kommunicera direkt med alla andra GPU:er i bara ett enda hopp, vilket effektivt förvandlar hela racket till en sammanhängande minnesdomän. Tack vare NVIDIA Collective Communications Library (NCCL), som nu har finjusterats under tio år, kan applikationsutvecklare enkelt uppnå nära-tråd-hastigheter utan att behöva skriva anpassad kommunikationskod för olika topologier.
Dessutom öppnar det nyligen publicerade NVLink Fusion upp spännande möjligheter för hyperscalers. Denna innovation gör det möjligt för anpassade processorer eller XPU:er att sömlöst integrera NVLink SERDES eller chiplets via UCIe för acceleratorer, eller NVLink-C2C för processorer, vilket gör att dessa komponenter kan placeras direkt på NVLink-strukturen. En betydande fördel med Fusion är dess modulära MGX-rackspecifikation, som levereras med en fullt kvalificerad leveranskedja. Det innebär att samma leverantörer som för närvarande levererar NVL72-rack också kan leverera Fusion-rack, vilket avsevärt minskar time-to-market för företag som vill implementera denna teknik.
När det gäller inferensekonomi är NVLinks inflytande tydligt på den traditionella Pareto-gränsen mellan dataflöde per watt och latens. Genom att övergå från en PCIe-mesh till en NVLink Switch-nod förbättras både dataflöde och latens, och ytterligare förbättringar kan uppnås genom att uppgradera till NVLink-racket. Detta innebär att fler användarfrågor per kilowattimme bearbetas samtidigt som den amorterade kapitalutgiften per genererad token sänks, vilket gör NVLink till ett kraftfullt verktyg för att förbättra den operativa effektiviteten.
Femte generationens NVLink levererar 1.8 TB/s punkt-till-punkt-bandbredd och 130 TB/s aggregerad bandbredd i ett NVL72-rack. Med NVLink Switch ser varje GPU varandra i ett enda hopp, vilket gör hela racket till en sammanhängande minnesdomän. Kollektiva operationer körs genom NCCL, ett bibliotek som nu är inne på sitt tionde produktionsår, justerat för alla tänkbara topologier och automatiskt topologimedvetet. Så applikationsutvecklare behöver ingen anpassad kommunikationskod för att uppnå nära-trådshastigheter.
Sampaketerad optik (CPO): Bryter kraftväggen vid 800 Gb/s och mer
Traditionella switchar med instickbara moduler har varit nätverksstandarden ett tag nu. Emellertid blir ineffektiviteten i dessa system alltmer uppenbar. När data lämnar ASIC:n färdas den längs långa PCB-spår och passerar genom flera kontakter innan den når en DSP-tung optisk modul. Denna resa resulterar i betydande förluster, ofta upp till 22 dB i den elektriska domänen, och förbrukar häpnadsväckande 30 W per port bara för att återställa signalen. I takt med att vi strävar mot högre datahastigheter, som 200 G PAM4 idag och ambitiösa 1.6 T inom en snar framtid, blir begränsningarna för denna arkitektur tydliga, vilket leder till explosiva effektbudgetar och begränsningar av frontplattdensiteten.
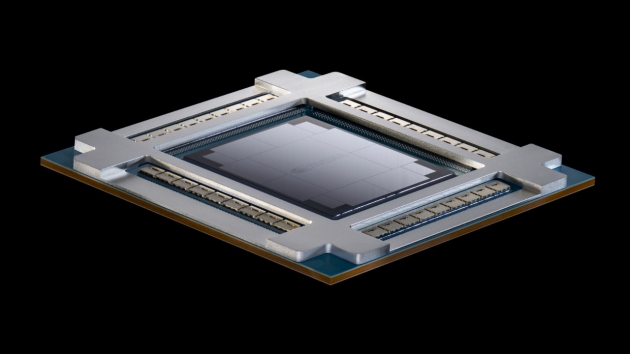
Här är NVIDIAs innovativa lösningar: Quantum-X Photonics för InfiniBand och Spectrum-X Photonics för Ethernet. Genom att integrera de optiska motorerna direkt i switchpaketet minskar de drastiskt den elektriska väglängden. Detta minimerar inte bara förlusten till cirka 4 dB utan sänker också portens strömförbrukning till cirka 9 W – en imponerande förbättring.
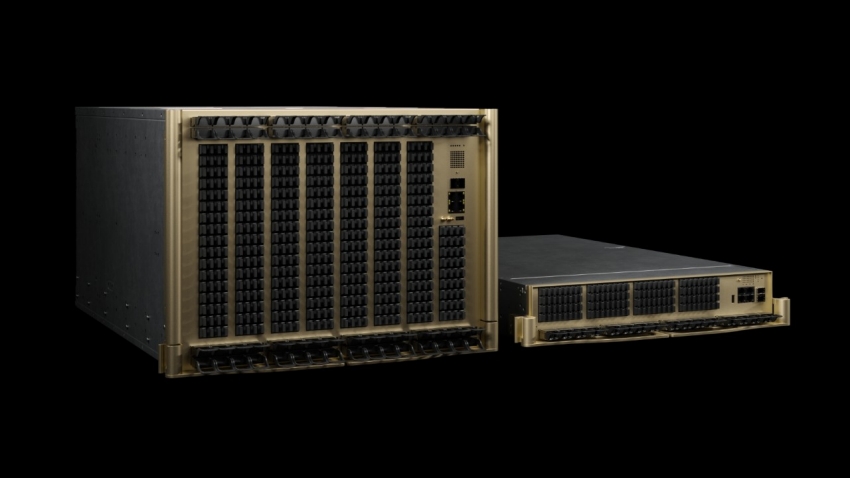
Nästa vecka får vi se lanseringen av två banbrytande vätskekylda chassin: 128-portarsmodellen, som kan skryta med en genomströmning på hela 102.4 Tb/s, och 512-portarsmodellen, som tänjer på gränsen ytterligare till 409.6 Tb/s. Den senare modellen har en integrerad fiberomkoppling, vilket säkerställer att varje port ansluts sömlöst till rätt fiberbunt utan behov av besvärlig manuell patchning. Initiala fältdata är lovande och indikerar en anmärkningsvärd 3.5 gånger bättre energieffektivitet och cirka 10 gånger längre medeltid mellan fel jämfört med traditionella pluggbara kretsar. Dessutom är uppstartsfönstret per kluster 1.3 gånger snabbare, vilket effektiviserar driftsättningen.
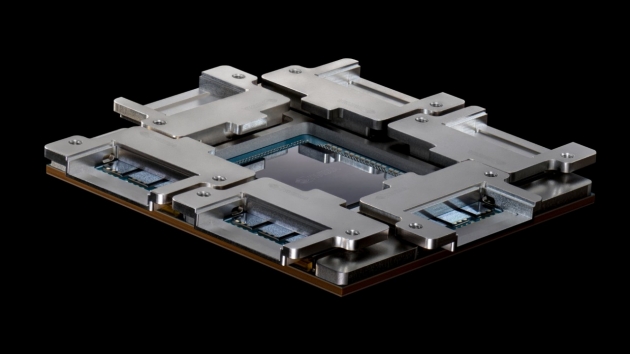
Även om dessa avancerade lösningar inte kommer att vara tillgängliga förrän 2026, är design-in-lösningar redan igång. Detta är avgörande för operatörer som planerar anläggningar i gigawattklass eller regeringar som överväger nationella laboratorier med miljoner grafikkort. NVIDIAs CPO-teknik (Coherent Photonics Optics) definierar tydligt en väg till att hålla sig inom effektgränserna och undvika den fruktade mardrömmen med optiskt underhåll, vilket banar väg för en mer effektiv och kraftfull framtid inom högpresterande nätverk.
DGX Spark och systemet: Från stationär prototyp till rackskalig produktion
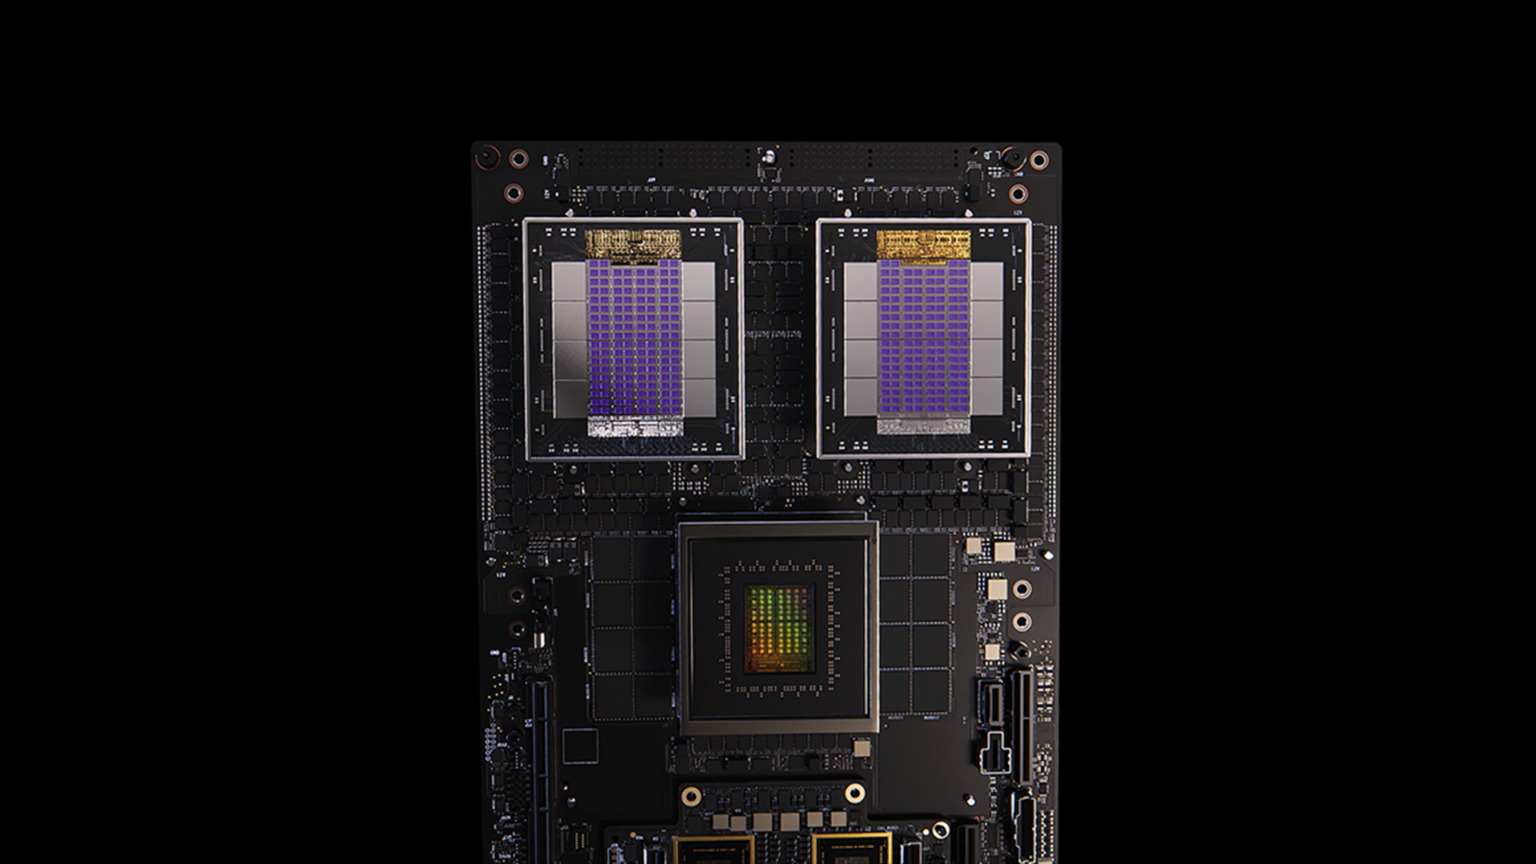
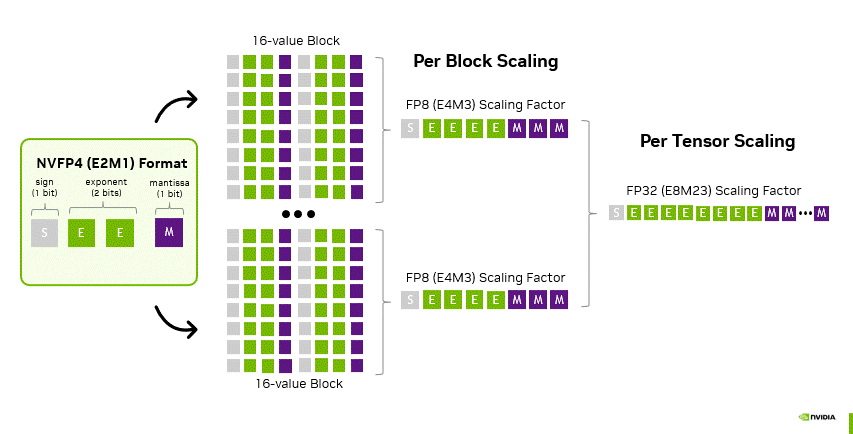
Inte alla arbetsbelastningar börjar i hyperskala. DGX Spark , som drivs av det nya GB10 Superchip, komprimerar Blackwell Tensor Cores, NVFP4 (4-bitars flyttal) inferens och alla CUDA-X-bibliotek till ett skrivbordschassi. Utvecklare tränar, finjusterar och RAG-komponerar lokalt, och lyfter sedan och flyttar identiska containrar till GB200- eller GB300 NVL72-rack när arbetsbelastningarna mognar.
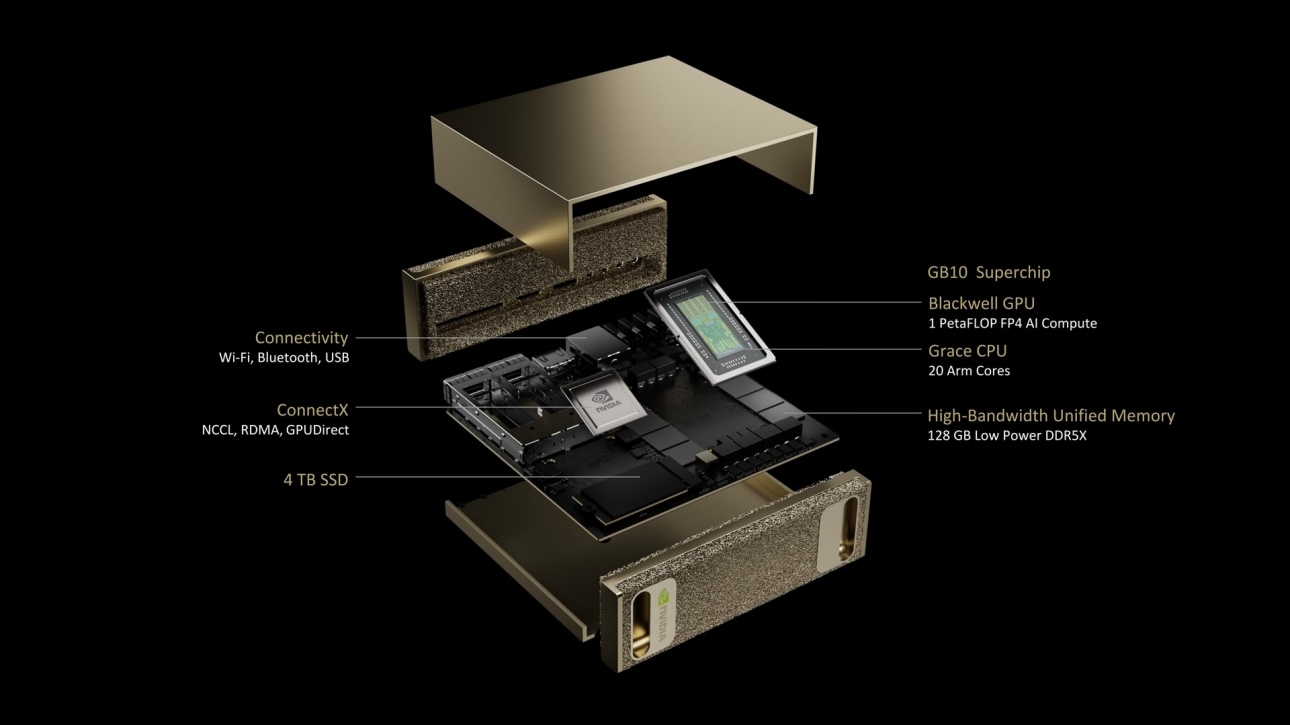
Det kontinuumet låter företag testa agentisk AI, robotperception eller multimodala generativa uppgifter utan att blockera klusterplatser. För fältet är Spark en trojansk häst: placera en i ett kundlabb, låt deras forskare se 4-bitars inferenshastighetsökningar på nära håll, och expansioner följer.
Programvarumultiplikatorn: TensorRT-LLM, Dynamo och NIM Microservices
Hårdvarukopplingar sätter tak; programvara avgör hur nära verkliga arbetsbelastningar kommer. NVIDIA kommer att demonstrera TensorRT-LLM som kör GPT-OSS-modellen med 120 miljarder parametrar i NVFP4, vilket ger fyra gånger högre interaktivitet än standard TorchServe på långa kontexter. På GB200-rack ser DeepSeek-R1 vid 671 B 2.5 gånger högre dataflöde per GPU med Dynamos disaggregerade pipeline-schemaläggare, utan att höja kostnaden per fråga. Allt detta anländer som NIM-mikrotjänster – containeriserade slutpunkter som släpps in i Kubernetes-kluster eller lokala bare-metal-stackar.
Öppen källkod ligger till grund för stacken. RAPIDS accelererar ETL från början till slut på GPU:er; CUTLASS-mallar möjliggör anpassade högpresterande kärnor; NeMo och BioNeMo utökar PyTorch för banbrytande LLM och proteinveckningsträning samtidigt som de bibehåller 100 procent OSS. Budskapet till köpare som är försiktiga med inlåsning: NVIDIA är "öppet där det spelar roll, optimerat där det räknas".
Konkurrensmässiga och kommersiella konsekvenser
NVIDIA har skapat en unik position i tekniklandskapet genom sitt vertikalt integrerade tillvägagångssätt, särskilt i kontrast till leverantörer av merchant-kisel-switchar och startups med separata acceleratorer. Denna strategi gör det möjligt för NVIDIA att erbjuda inte bara enskilda komponenter utan heltäckande lösningar som omfattar en referensarkitektur. Denna arkitektur stöds av en beprövad leveranskedja, en tydligt definierad tvåårig färdplan och en högnivå-API-yta som kallas NIM, vilket förenklar komplexiteten i kabeldragningen för utvecklare.
För hyperskalare är NVIDIAs erbjudanden övertygande tack vare deras betoning på deterministiska servicenivåavtal (SLA) och minimal driftsrisk. Genom att implementera NVLink-rack kan dessa organisationer uppnå förstklassiga inferensfunktioner, vilket är avgörande för applikationer som kräver snabb databehandling. Dessutom underlättar Spectrum-X-tekniken kapacitetsutskalning, vilket gör det möjligt för hyperskalare att utöka sin infrastruktur sömlöst. Introduktionen av Spectrum-XGS möjliggör sammanslagning av regioner, vilket förbättrar effektiviteten i resursallokering över geografiskt distribuerade datacenter. Denna integration stöder driften av standard Ethernet-kontrollplan, vilket säkerställer kompatibilitet och enkel hantering inom befintlig infrastruktur.
För företag ligger NVIDIAs tekniks attraktionskraft i dess förmåga att maximera intäkterna per rack. Spectrum-X-systemet förbättrar till exempel effektiviteten hos GPU-cykler avsevärt – enligt uppgift med upp till 35 procent. Detta innebär att företag kan uppnå större produktion, oavsett om det är i form av tokens, bilder eller automatiserade åtgärder, utan att öka kapitalutgifterna. Följaktligen kan företag få ut mer värde av sina befintliga investeringar, vilket överensstämmer med dagens behov av effektivitet och kostnadseffektivitet på en konkurrensutsatt marknad.
The Bottom Line
Berättelsen kring Hot Chips markerar ett anmärkningsvärt skifte i datorteknikens landskap, särskilt i relation till artificiell intelligens (AI). Den betonar att nätverk nu betraktas som en grundläggande accelerator inom databehandling, jämförbar i betydelse med framsteg som tensorkärnor.
Tekniker som NVLink är avgörande eftersom de omvandlar ett rack av servrar till ett sammanhängande logiskt chip, vilket förbättrar prestanda och effektivitet. Spectrum-X spelar en avgörande roll för att underlätta kollektiva data på sub-millisekunder över omfattande nätverk, medan Spectrum-XGS utökar denna högpresterande struktur på global skala. Dessutom är CPO utformad för att säkerställa att effekt- och densitetskraven är framtidssäkrade och tillgodoser de ständigt föränderliga kraven från AI-applikationer. DGX Spark, å andra sidan, är avgörande för att främja införandet av dessa tekniker och uppmuntrar företag att anamma innovativa lösningar.
Sammantaget har dessa framsteg potential att förändra den ekonomiska dynamiken i både inferens- och utbildningsprocesser. Detta är särskilt relevant eftersom företag för närvarande står vid ett vägskäl och väger sina alternativ mellan att bygga ny infrastruktur, hyra befintliga lösningar eller skjuta upp investeringar i storskaliga AI-funktioner. NVIDIAs ståndpunkt är entydig: organisationer bör investera i att bygga sin egen infrastruktur, men med betoning på ett nätverksramverk som är noggrant utformat – från kopparryggraden till den fotoniska switchen – för att stödja den kommande eran som domineras av AI-drivna fabriker.


 Amazon