

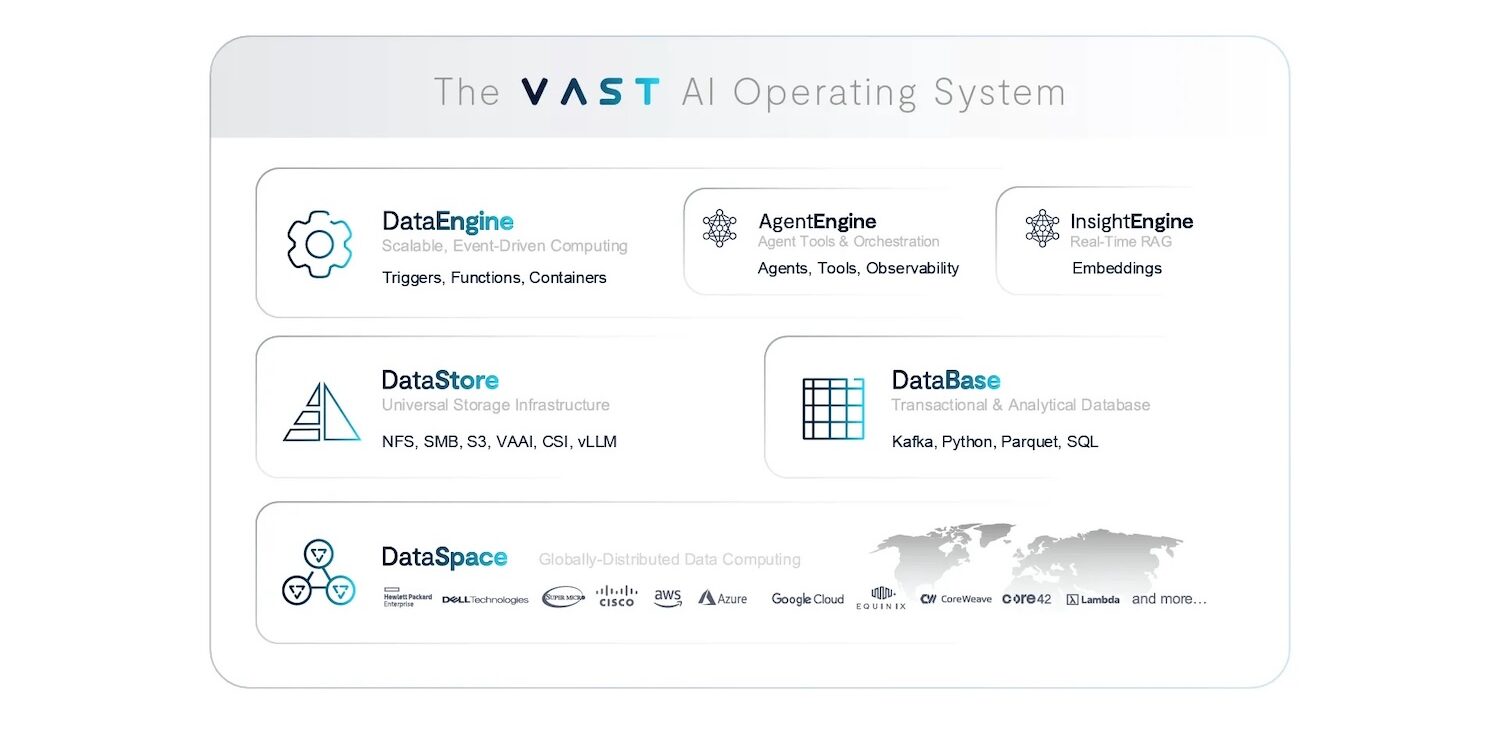
VAST Data har lanserat en ny inferensarkitektur som stöder NVIDIA Inference Context Memory Storage Platform. Detta system fokuserar på AI-applikationer som involverar pågående, agentdrivna sessioner med flera varv. VAST presenterar denna plattform som en lagringsklass designad för AI, vilket förbättrar åtkomsten till nyckelvärdescache (KV), möjliggör snabb delning av inferenskontext mellan noder och förbättrar energieffektiviteten. Designen använder NVIDIA BlueField-4 DPU:er och Spectrum-X Ethernet-nätverk, medan VAST AI Operating System (AI OS) tillhandahåller den nödvändiga programvaran för att hantera denna delade infrastrukturresurs effektivt.
För mer information om vikten av KV Cache, kolla in den här djupdykningen vi genomförde med Pliops.
Tillkännagivandet signalerar en förändring i de faktorer som begränsar inferensprestanda i verkliga applikationer. I takt med att inferensen övergår från enkla uppmaningar till kontinuerligt resonemang över flera agenter och användare, blir idén att kontexten stannar inom en enda GPU-server föråldrad. I dessa situationer beror den övergripande prestandan i allt högre grad på hur väl inferenshistoriken lagras, återställs, återanvänds, utökas och delas under pågående operationer. KV-cachen utvecklas från en intern optimering till en primär datasökväg, vilket påverkar time-to-first-token (TTFT), GPU-användning och klustereffektivitet.
Återuppbygga inferensdatavägen runt DPU:er
VASTs strategi är att köra VAST AI OS-programvaran direkt på NVIDIA BlueField-4 DPU:er. Istället för att se lagrings- och kontexttjänster som externa komponenter som nås via en typisk klient-servermodell, integrerar arkitekturen dessa datatjänster direkt i GPU-servern, där inferens sker, samtidigt som den stöder dedikerade datanodkonfigurationer. Denna metod syftar till att minimera flaskhalsar och eliminera onödiga kopior och förseningar som saktar ner prestandan när samtidigheten ökar.
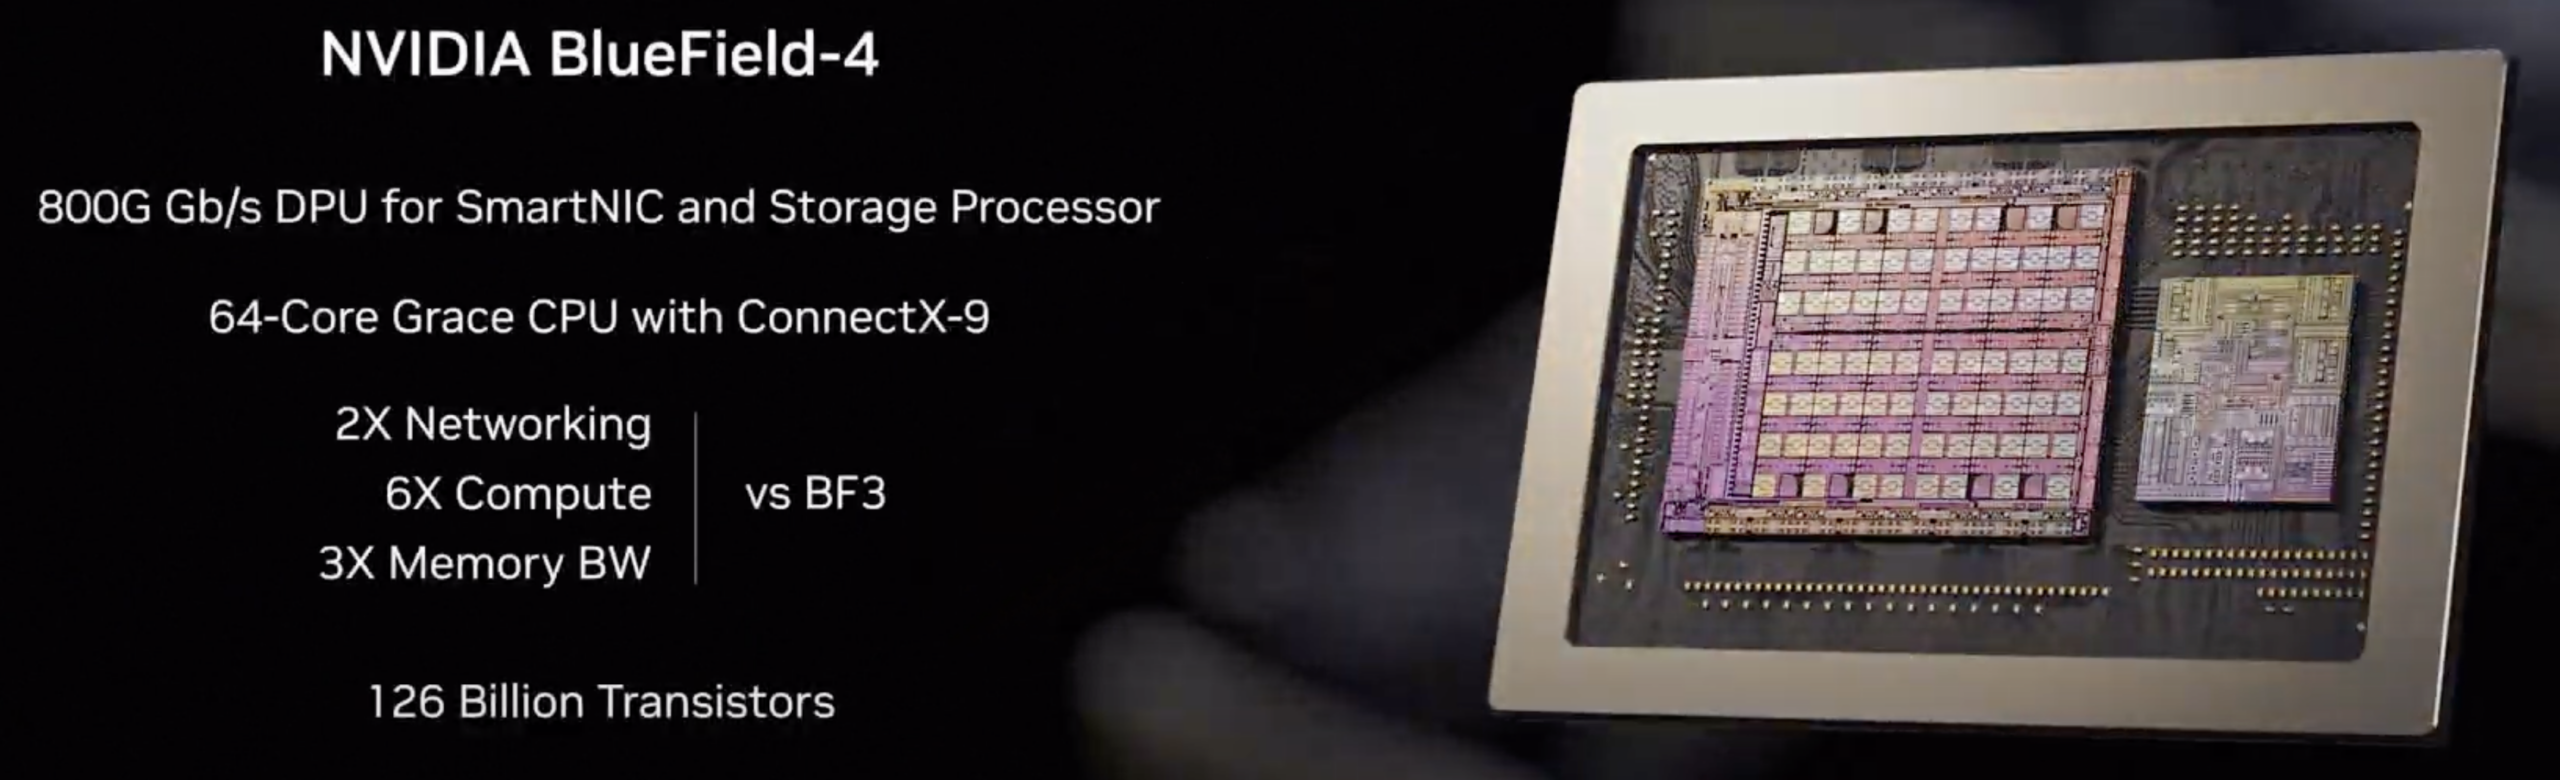
Denna DPU-nativa design adresserar explicit de praktiska behoven hos stora inferenssystem. När hundratals eller tusentals sessioner körs samtidigt, förvandlas hanteringen av KV-cachen till kontinuerligt input/output (I/O)-arbete. Systemet måste snabbt läsa kontext för att hålla sessioner igång, lagra det för långsiktig användning och dela det mellan arbetare för att förhindra dubbelbehandling när infrastrukturen kanaliserar operationer genom långsammare vägar eller kräver omfattande samordning. TTFT ökar, vilket gör att GPU:er väntar snarare än bearbetar. VAST hävdar att flytt av dataplanet till servern via BlueField-4 ger effektivare kontexttrafik, högre dataflöde och mer tillförlitlig latens, närmare GPU-bearbetningsslingan.
VAST betonar också en effektiv väg från GPU-minne till permanent NVMe-lagring med hjälp av RDMA-strukturer. Detta gör det möjligt att överföra kontext smidigt mellan GPU-servrar och lagring, vilket minskar den repetitiva datahanteringen som är vanlig i traditionella system. Målet är att säkerställa att kontextförflyttningen förblir "inom band" med högpresterande nätverk samtidigt som CPU-inblandning och klientsidesoverhead minimeras.
Delat, sammanhängande sammanhang i stor skala
Den nya arkitekturen fungerar tillsammans med VASTs parallella Disaggregated Shared Everything (DASE)-design. VAST förklarar att detta gör det möjligt för varje värd att få åtkomst till ett delat, globalt konsekvent kontextnamnområde utan de koordineringskostnader som vanligtvis uppstår i stor skala. I långvarig, agentdriven inferens blir denna detalj avgörande. Kontext är inte bara stor utan delas i allt högre grad.
Agentsystem kräver ofta samtidig verktygsanvändning, överlämningar mellan flera agenter och minnesliknande beteenden under interaktioner. Detta kräver återanvändning av kontext snarare än att återskapa den och dela den mellan inferensarbetare snarare än att knyta den till en enda nod. Om system inte kan bibehålla kontextlokalitet på grund av schemaläggning, borttagning eller felåterställning, måste de snabbt återställa och fortsätta sessioner utan att bearbeta långa prompthistoriker. På så sätt omvandlas KV-cachen till en viktig klusterresurs, vilket flyttar utmaningen till att göra den allmänt tillgänglig utan att bli en synkroniseringsflaskhals.
VASTs perspektiv är att kombinationen av DPU-baserade datatjänster med en delad lagringslösning skapar ett globalt tillgängligt kontextlager som förblir effektivt när antalet samtidiga sessioner ökar. Istället för att skala genom att lägga till isolerade kontextavsnitt, möjliggör plattformen att kluster expanderar samtidigt som de drar nytta av återanvändning och delning.
Kontext som det nya prestationshöljet
VAST-chefen John Mao noterade att konkurrensfördelen för stora inferenssystem skiftar från ren datorkraft till minnes- och kontextsystem. Han sammanfattade att de mest effektiva klustren inte bara kommer att vara de med de högsta topparna i FLOPS; de kommer att vara de som kan dela och hantera kontext i realtid. Han betonade också vikten av omedelbar åtkomst till kontext på begäran som ett viktigt prestandaområde och varnade för att utan snabb kontexthämtning och återanvändning förblir GPU:er inaktiva och effektiviteten blir lidande.
Denna synvinkel överensstämmer med många operatörers erfarenheter i takt med att modeller skalas och sessionslängderna ökar. Inferensflottor är ofta konfigurerade för maximal tokenproduktion, men upplevelsen formas av svansfördröjning och TTFT under stress. När prompter förlängs och sessioner kvarstår ökar tiden som läggs på kontexthantering. Om kontext inte snabbt kan återställas eller återanvändas slösas GPU-cykler bort på att återställa tillstånd eller vänta på att data ska flyttas. VASTs arkitektoniska tillvägagångssätt behandlar KV-cachen som delad infrastruktur, vilket minskar dessa problem och ökar den totala klustereffektiviteten.
Att gå från experiment till styrd produktionsinferens
VAST presenterar också plattformen som en övergång från experimentella driftsättningar till produktionsklara inferenstjänster, inklusive i reglerade miljöer. I takt med att inferens blir en intäktsgenererande tjänst med specifika säkerhets- och efterlevnadskrav kräver hanteringen av KV-cachen mer än bara hastighet; det kräver tillsyn.
I långa sessioner kan kontexten inkludera känsliga uppmaningar, resonemangssteg, verktygsutdata och användarinformation. Företag kräver i allt högre grad policykontroller, isoleringsåtgärder, revisionsspår och livscykelhantering för det sammanhanget. VAST hävdar att dessa AI-nativa datatjänster är inbyggda i AI-operativsystemet, vilket gör det möjligt för organisationer att behandla KV-cachen som en hanterbar resurs snarare än ett tillfälligt tillstånd.
Ur ett operativt perspektiv syftar VAST till att ta itu med vanliga utmaningar i stora inferensmiljöer: kontextåteruppbyggnadsstormar som uppstår när cacheminnen går förlorade eller inte kan delas, och slöseri med GPU-tid när kontext blir flaskhalsen snarare än beräkning. Företaget anser att förbättrad kontextpersistens och återanvändning kommer att minska omberäkning och öka användningen, vilket förbättrar både dataflödet per watt och dataflödet per dollar i takt med att kontextstorlekar och sessionssamtidighet ökar.
NVIDIA: Kontexthantering driver skalningsekonomi
Kevin Deierling, Senior Vice President för nätverk på NVIDIA, betonade vikten av kontext inom AI och liknade det vid mänskligt minne. Han konstaterade att effektiv hantering av kontext är avgörande för att skala multi-turn och multi-user inferens, vilket i sin tur förändrar hur kontextminne hanteras i stor skala. Han noterade att VAST Data AI OS, i kombination med NVIDIA BlueField-4, stöder detta genom att tillhandahålla en stabil dataväg med hög genomströmning när arbetsbelastningen ökar. Detta partnerskap är viktigt eftersom det integrerar DPU:er och Ethernet-struktur i den centrala inferenskontexten, inte bara för primär lagringsåtkomst eller nätverk. Den viktigaste poängen är att kontext nu utgör en utmaning för både nätverk och lagring, förutom att vara ett GPU-problem, och moderna inferensinställningar kommer att kräva fokuserad acceleration och tillförlitlig dataförflyttning för att GPU:erna ska fungera effektivt.
Om VASTs arkitektur ger de utlovade fördelarna kommer den verkliga effekten att handla mindre om toppresultat och mer om konsekvent tjänsteprestanda: lägre TTFT när många sessioner är aktiva, färre prestandaförluster när kontexten ökar, bättre utnyttjande genom att minska behovet av kontextåteruppbyggnad och en enklare väg till inferens över flera noder där kontextdelning är en fördel snarare än en nackdel. Den driver också inferensinfrastrukturen mot en mer "AI-nativ" modell, där KV-cachen behandlas som en hanterad minnesnivå, stödd av persistent NVMe och delad mellan noder med snäva latensgränser.
VAST Forward-konferensen
VAST Data kommer att presentera sin strategi vid den första VAST Forward-användarkonferensen, planerad till den 24–26 februari 2026 i Salt Lake City, Utah. Företaget planerar att inkludera detaljerade tekniska sessioner, praktiska labb och certifieringsprogram, med VASTs ledning , kunder och partners.


 Amazon