

Om du följer StorageReview regelbundet kanske du har sett artikeln om OSU Ocean Study i realtid. Vi pratade med Chris Sullivan, chef för forskning och akademisk databehandling vid Oregon State University, för att bättre förstå hur teknik hjälper forskare att studera havsliv och hur det påverkar den globala miljön.
Brian träffade Chris på SC25 för att diskutera ämnet vidare. Det är sällan vi skriver om hur teknik används i verkliga situationer, som OSU:s planktonforskning, så det här inslaget och podden gav oss den möjligheten.
Medan Brian och Chris diskuterar forskningen som bedrivs vid OSU, finns det en genuin entusiasm över hur tekniken går framåt för att stödja pågående oceaniska studier. Chris har varit vid Oregon State University i över 24 år och har varit chef för bioberäkning de senaste tre åren.
Den här livepodden visar Chris entusiasm för vetenskap och teknologi. Han kallade SC25 för "godislandet".
Detta är en livlig och ärlig diskussion (med lite humor) som ger genuina insikter i hur forskning använder teknik för att leverera resultat i realtid.
Det är en kort podcast värd att lyssna på, men om du har ont om tid har vi tillhandahållit en transkription som låter dig hoppa till de mest relevanta avsnitten.
0:00 – 5:00
Förvandla ett forskningsfartyg till en flytande superdator
Chris Sullivan från Oregon State University förklarar hur ny teknik fundamentalt förändrar hur havsforskning bedrivs, särskilt massiva planktonstudier som utförs från fartyg som i grunden är små, flytande datacenter.
- Teknologi är inte bara "cool utrustning"; den förändrar direkt vilken vetenskap som är möjlig och omfattningen av bias i resultaten.
- Vetenskaplig bias: begränsade eller snedvridna urval som leder till felaktiga slutsatser; botemedlet är fler datapunkter över fler platser.
- Mål: Samla in stora, mångsidiga datamängder så att statistiska analyser inte förvrängs genom att bara sampla en plats eller en uppsättning villkor.
- Traditionella HPC-konfigurationer tvingade fram en avvägning: snabba lokala NVMe/SSD-diskar med begränsad kapacitet kontra stora men långsammare nivå-ett-lagringssystem.
- För stora experiment var Chris tvungen att förlita sig på nivå ett-lagring i hela klustret eftersom lagringen på noden (nivå noll) var för liten för att lagra massiva datamängder.
- Stora, delade lagrings-"superpods" blev nödvändiga för att förse GPU:er med ström, men de är dyra och inte realistiska att driftsätta i fält eller till sjöss.
5:00 – 10:00
Havsrobotar, plankton och en miljondollarkryssning
Det här avsnittet fördjupar sig i vad som faktiskt händer ombord på fartyget – hur de bogserar instrument, fångar häpnadsväckande mängder bilddata och varför halvrealtidsbehandling är avgörande när fartygets tid kostar cirka 1 miljon dollar per 10-dagars kryssning.
- Det nya NSF-stödda forskningsfartyget är byggt som ett "mini Star Trek Enterprise", fullpackat med teknik och cirka 200 mil kablage på en 200 meter lång båt.
- Tidigare var Chris tvungen att rulla sin egen datorhårdvara ombord på fartyget, koppla fiber genom korridorer och driva utan ett ordentligt datacenter ombord.
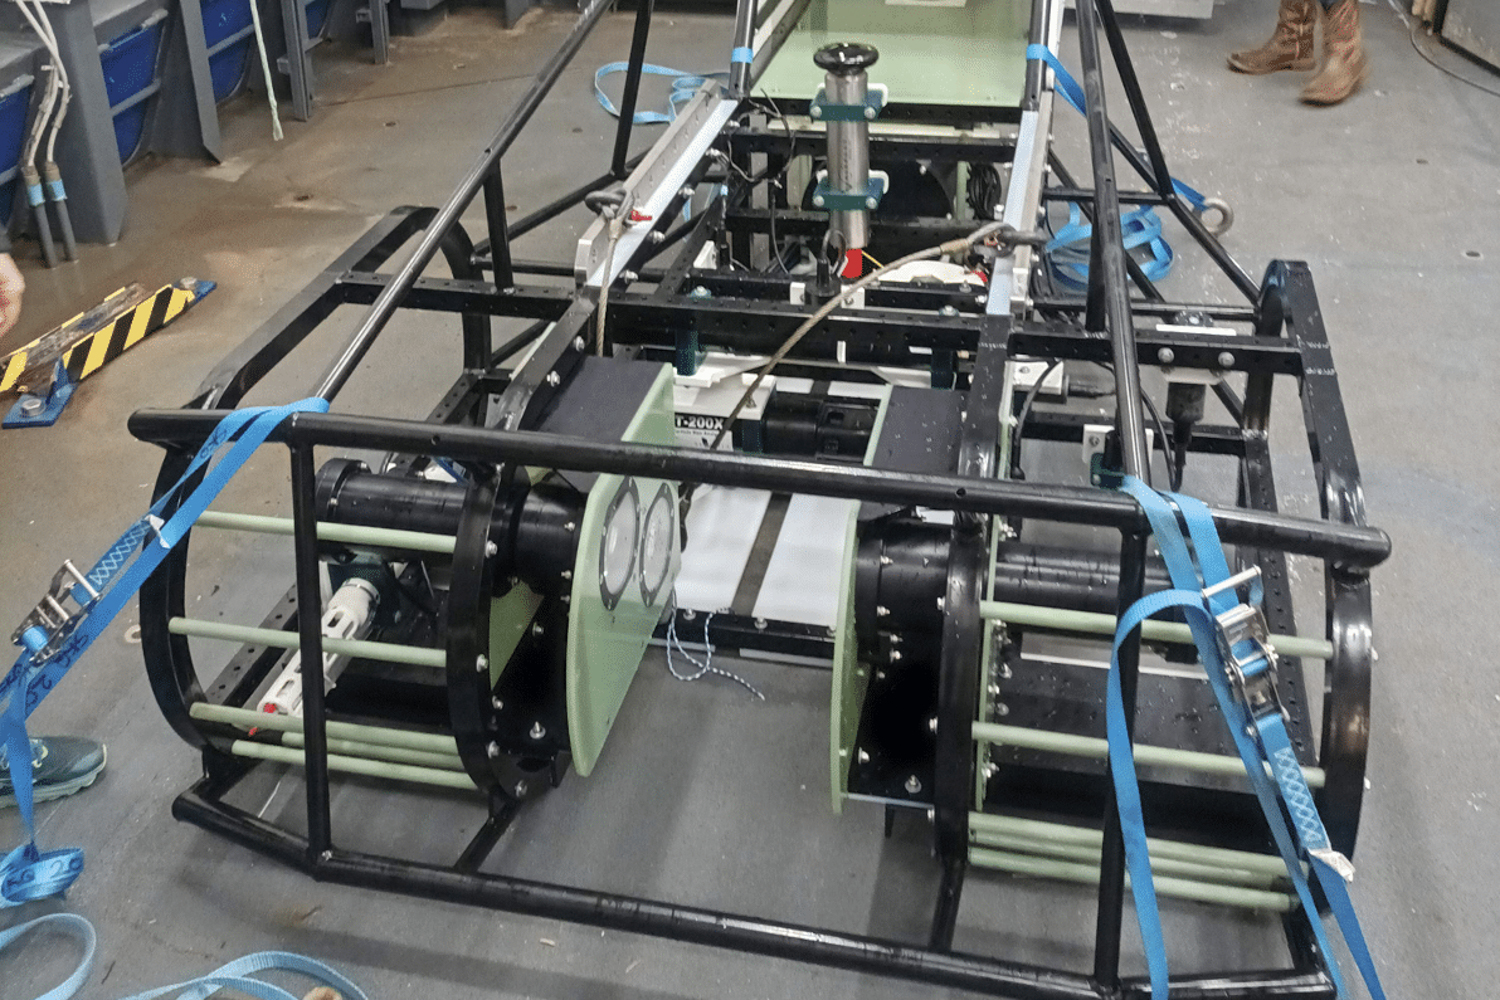
- Planktonsystemet: en bogserad enhet rör sig upp och ner genom vattnet i 5 knop, drar ~162 liter vatten per sekund och genererar ~10 GB bilddata varje minut.
- Ett enda 10-dagars planktonexperiment: ~100 TB rådata; efter bearbetning, segmentering och klassificering, utökas det till ~300–400 TB användbar data.
- De måste bearbeta detta i semi-realtid; annars kan en tiodagarskryssning för 1 miljon dollar komma tillbaka med dålig eller värdelös data och ingen möjlighet att omdirigera fartyget.
- Plankton är mestadels utlämnade till strömmar (inte starka simmare), men de är avgörande: ~50 % av jordens syre, ~25 % av kolsänkan, ~17 % av den globala maten per capita och basen för den marina näringsväven.
10:00 – 15:00
Edge AI till sjöss och i skogen
Fokus flyttas från fartyget till det bredare "kantproblemet": hur man kan driva beräkningsförmågan närmare där data skapas – på båtar, på rangerstationer och över skogar fyllda med autonoma sensorer.
- Nya SSD-baserade system med hög kapacitet låter dem bygga en sann nivå noll på en enda enhet: lagra hundratals TB data, bearbeta i semirealtid och flytta den aldrig igen.
- Tidigare tester med mindre NVMe-diskar krävde konstant avlastning för att skapa utrymme, vilket förbrukade värdefull I/O-bandbredd och saktade ner forskningen.
- Det finns i princip ingen dedikerad IT-personal ombord; en person sköter skeppets system och håller sig borta från experiment, så doktorander och postdoktorer måste själva hantera hårdvara och pipelines.
- Detta driver ett designkrav: enkla, robusta pipelines och självständiga enheter – inget ömtåligt nät av arrayer, monteringar och volymer.
- Vid skogsbrynet (t.ex. Owl-projektet) driver de ~5 000 autonoma inspelningsenheter och kan identifiera ~130 fågelarter enbart genom ljud.
- Smärtpunkten: människor måste fortfarande samla SD-kort; när informationen väl är tillbaka är mycket av det tidsmässiga värdet borta. Kantbehandling syftar till att utvinna insikter. blir omedelbart vid fångstpunkten.
15:00 – 20:00
Matcha rätt grafikkort och lagring till jobbet
Här utforskar de GPU-strategi, Omniverse-baserad träning och varför flashminne med hög kapacitet är lika viktigt som rå beräkning för AI och vetenskaplig visualisering.
- Chris betonar att man använder rätt GPU för jobbet: stora, dyra acceleratorer (t.ex. H100/Hopper, ”gräshoppor”) bör fokusera på träning, medan mer kostnadseffektiva kort som RTX 6000 hanterar inferens i stor skala.
- Historiskt sett har det funnits förvirring: för många överlappande GPU-SKU:er, oklara "simbanor" och mycket pengar slösas bort på överdriven hårdvara för enkel slutledning.
- RTX 6000 ger dem en dubbel roll: högpresterande inferens plus grafik- och renderingsfunktioner som GPU:er enbart för datacenter saknar.
- De bygger en digital tvilling av Omniverse-skeppet för att:
- Utbilda studenter och postdoktorer virtuellt medan fartyget är till sjöss.
- Planera fysiska layouter och lastning av utrustning i trånga, rörliga utrymmen.
- Undvik att slösa dyr fartygstid på grundläggande utbildning och trial-and-error-uppställningar.
- På ett fartyg i rörelse är allt med rörliga delar en risk; solid state-lagring är att föredra för tillförlitlighet och motståndskraft.
- SSD-diskar med hög kapacitet i ett litet strömförbrukningsområde frigör energibudget för fler GPU:er, minskar behovet av separata arrayer och krymper det totala hårdvaruavtrycket.
20:00 – 25:00
Från arkivskåp till fiberanslutna hav
Zoomar man ut, hur billig lagring låste upp modern AI, hur havsobservatorier strömmar data i land och varför nätverk och lagring tillsammans möjliggör nya typer av vetenskap.
- Chris menar att AI:s verkliga upplåsning inte var ny matematik – de flesta modeller går tillbaka till 1950- och 70-talen – utan billig hårddisk på 1990-talet, som flyttade data från arkivskåp till sökbara, beräkningsbara medier.
- Under "arkivskåpseran" hade de massor av data men var "informationsfattiga" – ingen sökning, ingen redundans och ingen skalbar bearbetning.
- Det har alltid funnits en kapprustning mellan processorhastighet och datatillgänglighet; SSD-diskar med hög kapacitet tippar nu balansen igen genom att mata moderna grafikkort med betydligt mer data.
- Oregon State leder cyberinfrastrukturen för Ocean Observatories Initiative (OOI), ett NSF/WHOI-projekt värt en miljard dollar som använder glidflygplan, bojar och bottenfästen för att strömma havsdata.
- De lagrar ~9 PB OOI-data, med en fiberstamkabel uppgraderad från 200 Gbps till 400 Gbps via Link Oregon, vilket möjliggör dataöverföring i realtid från havet till datacentret.
- Även med Starlink på fartyget och på landprojekt (som ugglearbetet) begränsar satellitbandbredd och kostnad vad som kan skickas, så de testar LoRaWAN och andra mesh-nätverk för att skicka data tillbaka till en enda, Starlink-ansluten rangerstation.
25:00 – 27:52
Lärdomar för företag: Ert datacenter är nu i försprång
Samtalet avslutas med att översätta dessa forskningslärdomar till företag och lyfta fram den hårdvara Chris skulle "stjäla" från mässgolvet.
- Kärnbudskapet till företag: om ni inte bearbetar vid kanten av kedjan, slösar ni tid och arbete på att släpa rådata fram och tillbaka. Och missar möjligheter i realtid.
- Edge AI och agenter bör förbehandla, filtrera och analysera lokalt för att omdirigera mänskliga ansträngningar från logistik till uppgifter och beslutsfattande med högre värde.
- Verkliga analoger:
- Detaljhandeln använder edge-analys i butiker för att spåra trafik, ge rekommendationer och leverera dynamiska upplevelser, ungefär som skogsbruk använder edge-inferens för att skydda utrotningshotade arter samtidigt som det möjliggör avverkning.
- Fiskebeståndet vill ha ”smarta fällor” och bojar så de skickar bara ut båtar när det faktiskt finns krabbor i tinorna.
- För Chris är det ideala mönstret lokala datacenter som blir kanten anläggningar integrerade med molnet för stora utbildningsomgångar och längre arbetsbelastningar.
- Favorithårdvara från programmet: Dells PowerEdge 7745; han vill ha fler av dem för VR-labb och fältimplementeringar eftersom de har rätt balans mellan kraft och format, flexibilitet och funktioner (rendering + inferens + edge work).
- Han ser system som 7745 som mallen: tillräckligt flexibla för att fungera i ett datacenter eller under tuffa fältförhållanden, med stöd för både traditionell HPC och avancerad AI/visualisering vid kanten.


 Amazon