

Hög tillgänglighet har gått från att vara en lyx i datacenter till en post i vanlig resiliensplanering. Småföretag och edge-sites använder nu kassasystem, övervakning och delad lagring som kostar pengar varje minut de är nere, men den klassiska lösningen, en företagsarray med dubbla styrenheter, är dimensionerad och prissatt för datacentret snarare än en filialgarderob eller ett väggmonterat rack. Denna obalans har lämnat mindre IT-butiker med säkerhetskopior och ögonblicksbilder för dataskydd men inga för kontinuitet: en NAS med en enda styrenhet, hur välbyggd den än är, förblir en enda felpunkt.
Hög tillgänglighet är inte nytt för QNAP, som har erbjudit hårdvara med dubbla styrenheter och replikeringsbaserade återställningsvägar. Det som förändras med QuTS hero h6.0 är effektiviteten. Den nya High Availability Manager bygger in kluster i operativsystemet på vanlig hårdvara, vilket låter två identiska NAS-enheter bilda ett aktivt-passivt kluster bakom en enda IP-adress, så att när en box går ner tar den andra över och klienterna knappt märker det. För en organisation som försöker dimensionera sin IT-investering är det HA på bekostnad av en andra NAS snarare än en andra klass av infrastruktur.
Det är tanken: för att se hur det håller i praktiken byggde vi ett HA-kluster i labbet från två QNAP TS-h765eU-system laddade med Seagate IronWolf Pro-hårddiskar och QNAP E1.S SSD-diskar för cache, och satte sedan igång med att bryta det på samma sätt som fel uppstår i edge-positioner. Vi stängde av strömmen till den aktiva noden mitt under överföringen. Vi ryckte ur dess nätverksanslutning medan vi lämnade heartbeat intakt. I båda fallen var frågan densamma: överlever filöverföringen, och hur ser återställningen ut när den felaktiga noden kommer tillbaka?
QNAP TS-h765eU Översikt
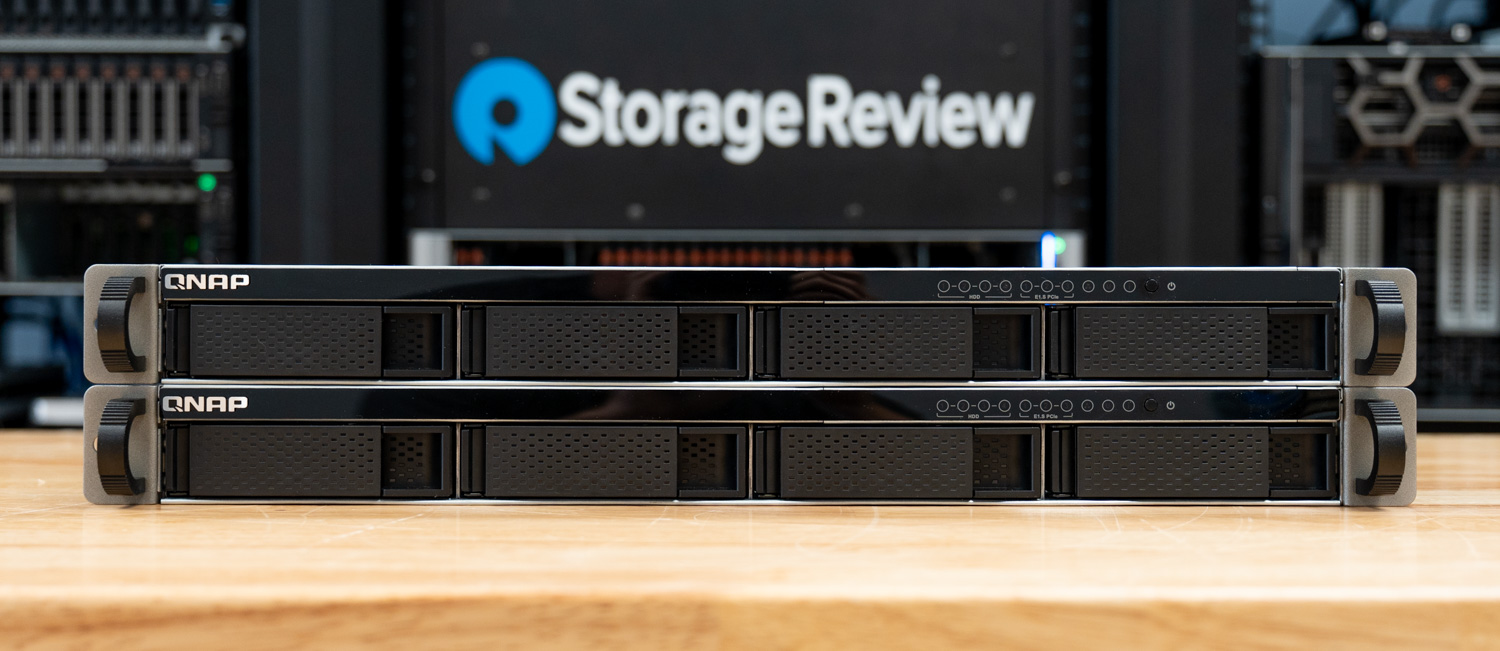
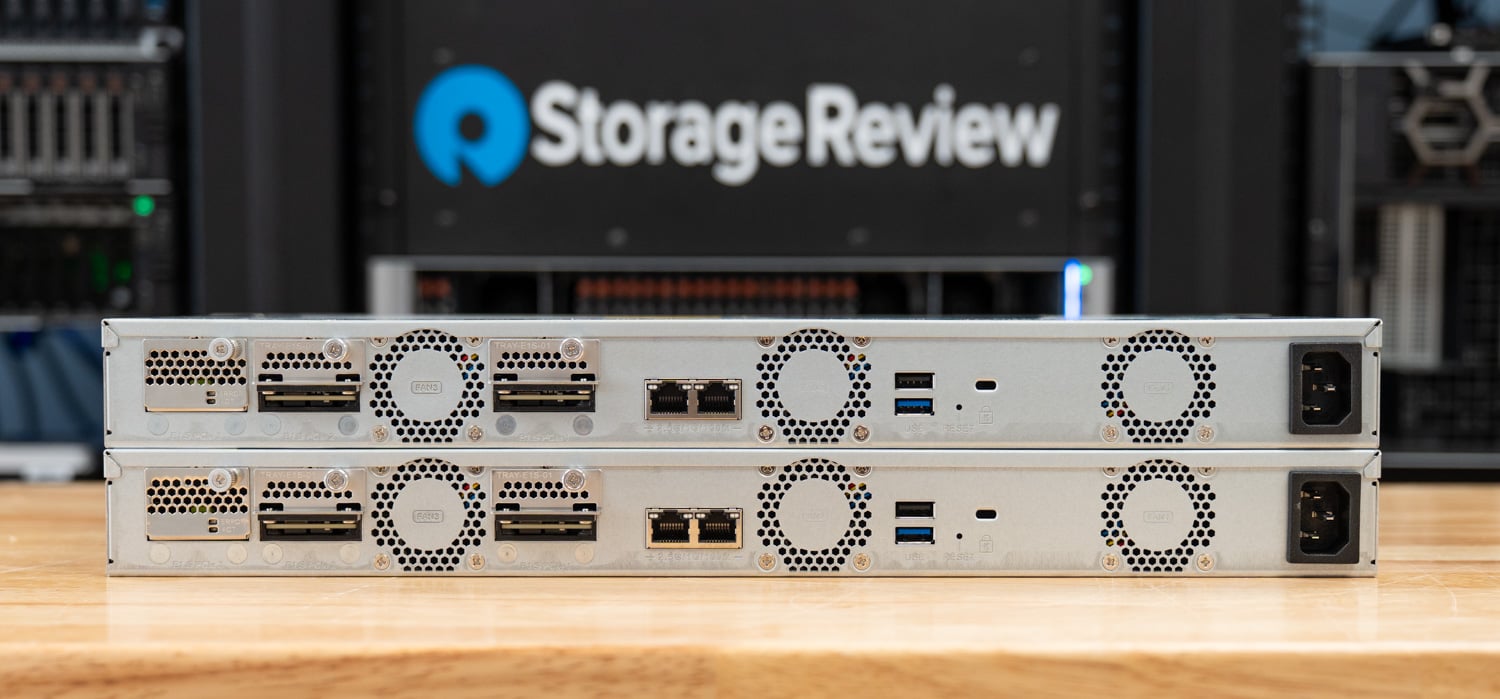
TS-h765eU är ett intressant val som HA-byggsten just för att den har relativt enkel hårdvara. Kabinettet är en 1U rackmonterad NAS med kort djup, bara 292.1 mm (12 tum) djup, designad för små medieskåp, väggmonterade nätverksrack och kantinstallationer där ett chassi med full djup inte får plats. Varje enhet erbjuder fyra 3.5-tums SATA-enhetsfack framtill, plus tre E1.S/M.2 PCIe NVMe-kortplatser på baksidan, vilket ger den en hybridlagringspersonlighet: snurrande disk för kapacitet, flash för cachning eller snabba nivåer.
QNAP har också utsett den till en långsiktig leveransmodell med garanterad tillgänglighet fram till 2031, vilket är viktigt för organisationer som standardiserar på en plattform över flera anläggningar.
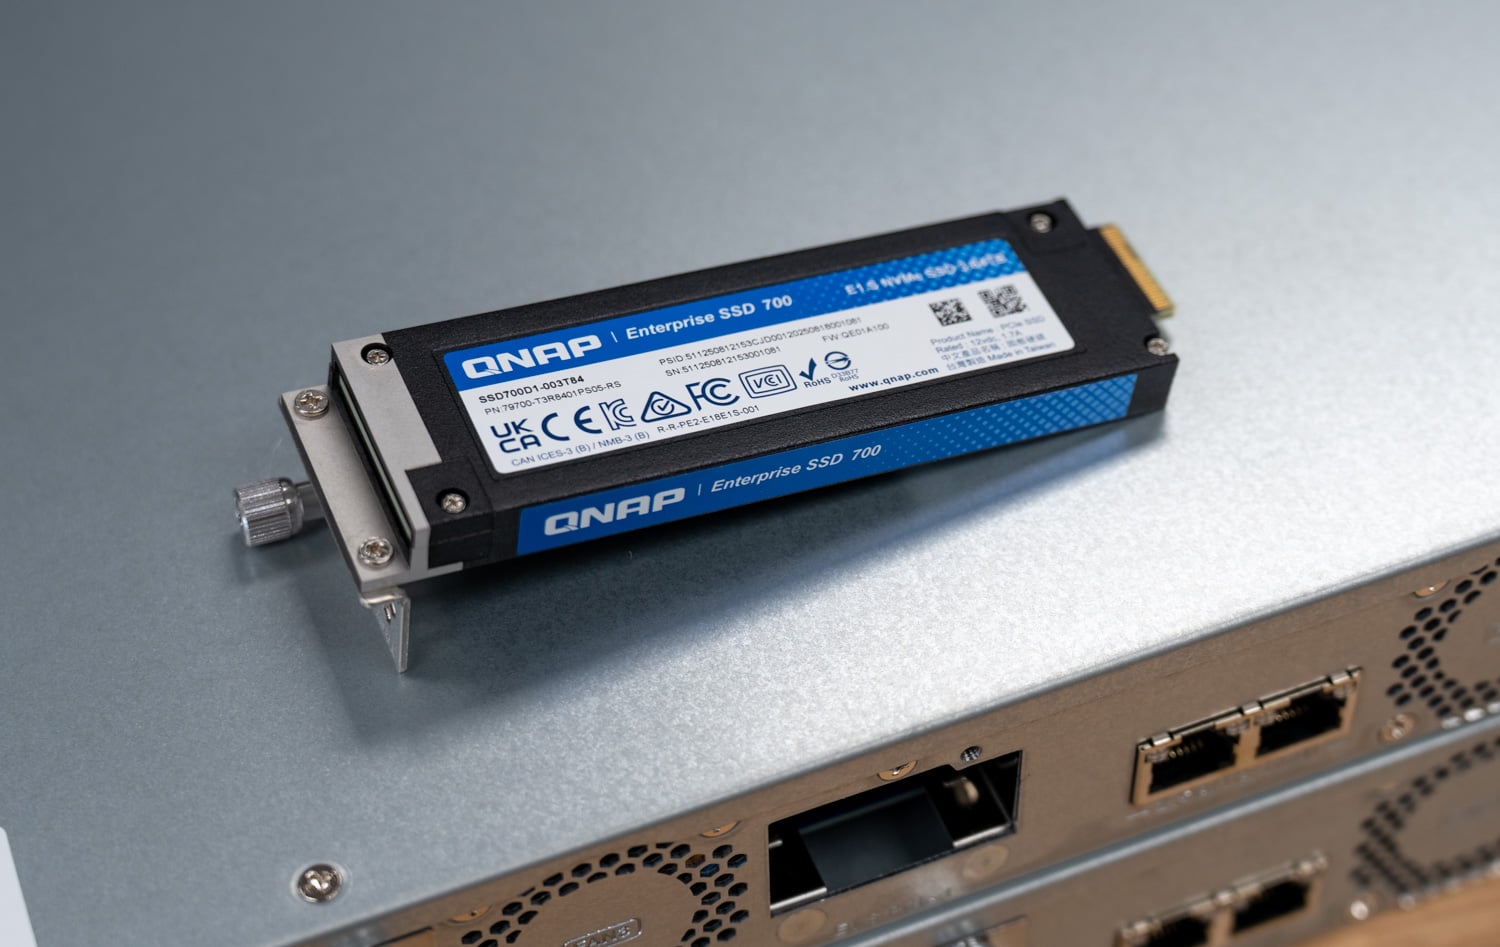
Inuti kör TS-h765eU Intels Atom x7405C, ett fyrkärnigt chip som erbjuder upp till 3.4 GHz, i kombination med 8 GB DDR5-minne, uppgraderingsbart till 16 GB, med In-Band ECC. Nätverksuppkopplingen börjar med dubbla 2.5 GbE-portar, där 10 GbE är tillgängligt genom att byta ut ett E1.S-fack mot QNAP:s QXG-ES10G1T-modul.
| Specifikation | QNAP TS-h765eU |
|---|---|
| CPU | Intel Atom x7405C fyrkärnig processor, upp till 3.4 GHz |
| Minne | 8 GB DDR5, uppgraderingsbart till 16 GB (In-Band ECC) |
| Enhetsfack | 4 x 3.5-tums SATA |
| Flash-slots | 3 x E1.S / M.2 PCIe NVMe |
| nätverk | 2 x 2.5 GbE, 10 GbE via valfri QXG-ES10G1T E1.S-modul |
| Formfaktor | 1U rackmontering med kort djup, 292.1 mm (12 tum) djup |
| Operativ system | QuTS hero h6.0 (ZFS-baserad) |
| Tillgänglighet | Långsiktig leveransmodell fram till 2031 |
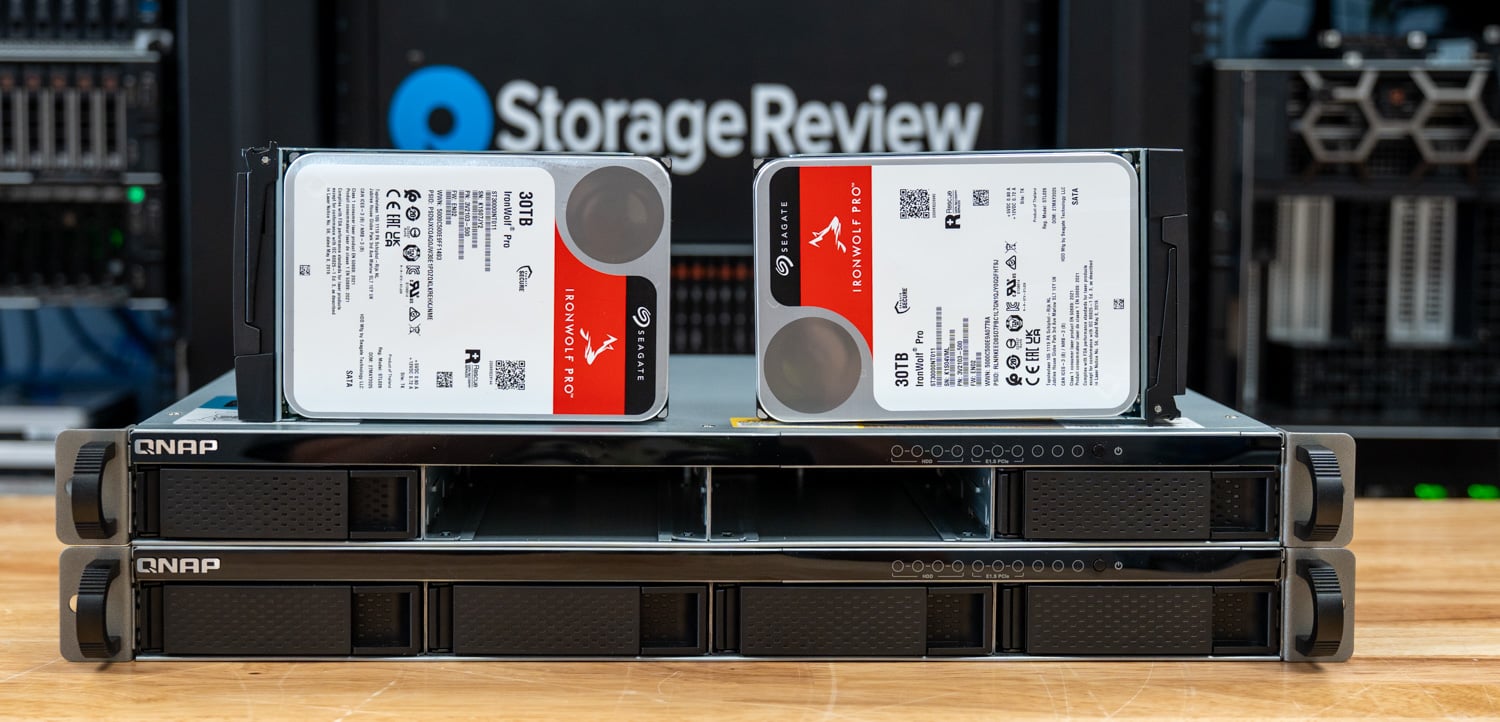
För denna utvärdering befolkades varje nod med fyra Seagate IronWolf Pro 30TB hårddiskar (ST30000NT011) i en RAID 5-lagringspool, plus två 3.84TB QNAP SSD700 E1.S-diskar (SSD700D1-003T84) i RAID 0 som cache. Båda systemen körde QuTS hero h6.0.0.3500 med High Availability Manager 2.0.421.
QuTS hero h6.0 och HA Manager-arkitekturen
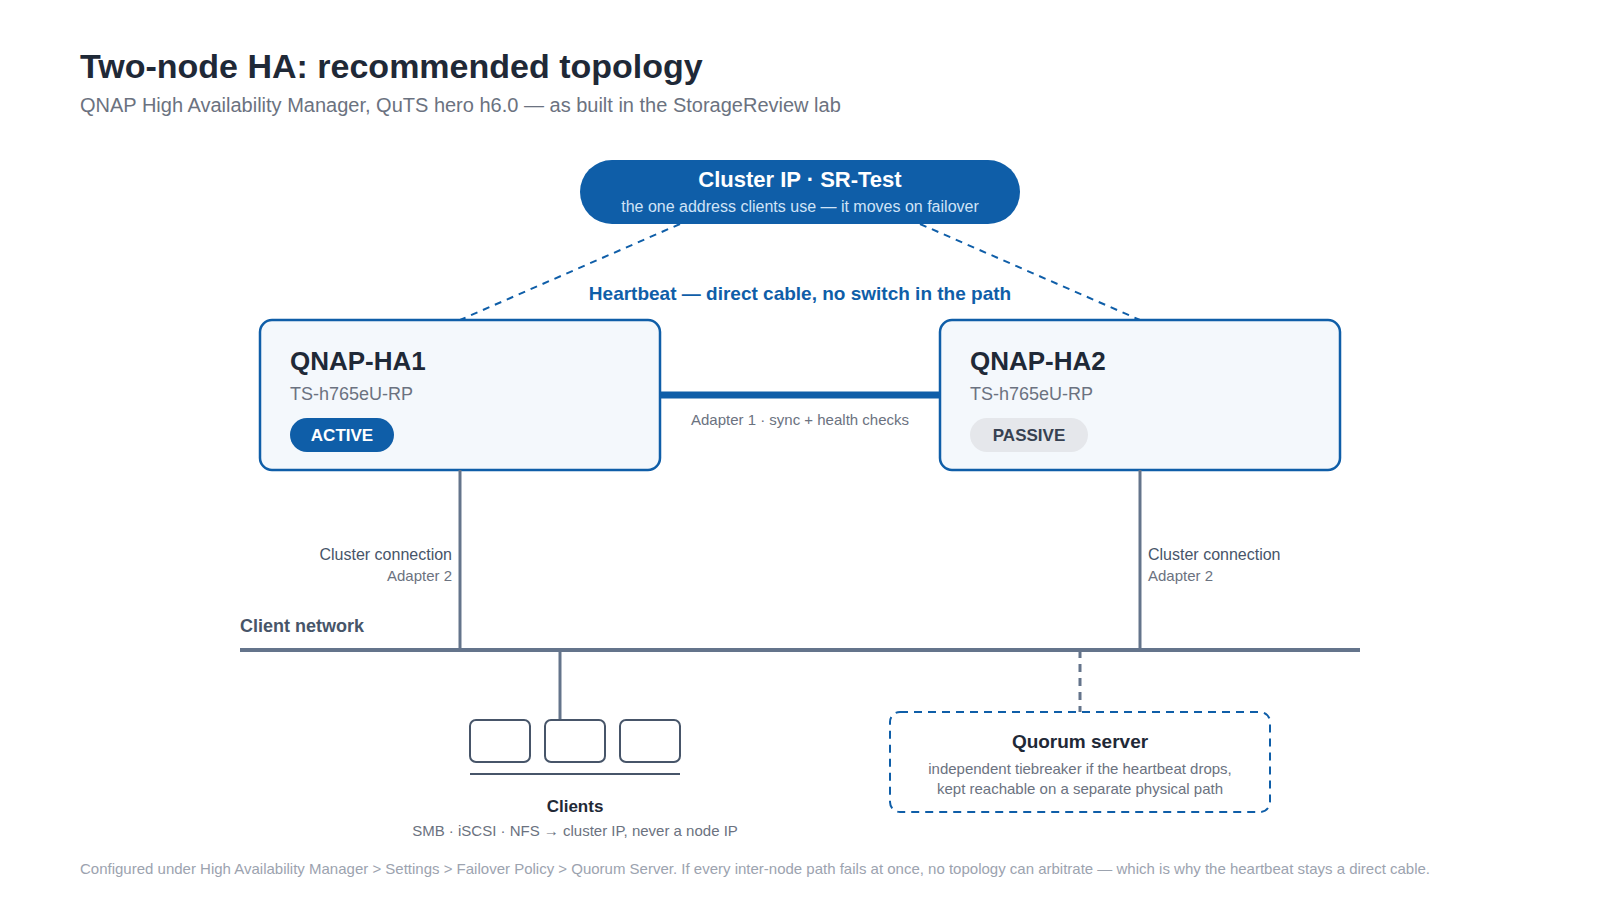
High Availability Manager är huvudfunktionen i QuTS hero h6.0, som implementerar en klassisk aktiv-passiv design. En NAS, den aktiva noden, hanterar all data och alla tjänster. Den andra NAS:en, den passiva noden, synkroniserar kontinuerligt med den aktiva noden via en dedikerad heartbeat-anslutning och är redo att ta över. Klienter kommunicerar aldrig direkt med någon av noderna; istället presenterar klustret en enda IP-adress och ett enda värdnamn, och den nod som för närvarande är aktiv svarar på det. När en redundansväxling inträffar omdirigerar klustrets IP-adress trafik på backend, så mappade enheter, iSCSI-initiatorer och säkerhetskopieringsjobb behöver inte pekas om.
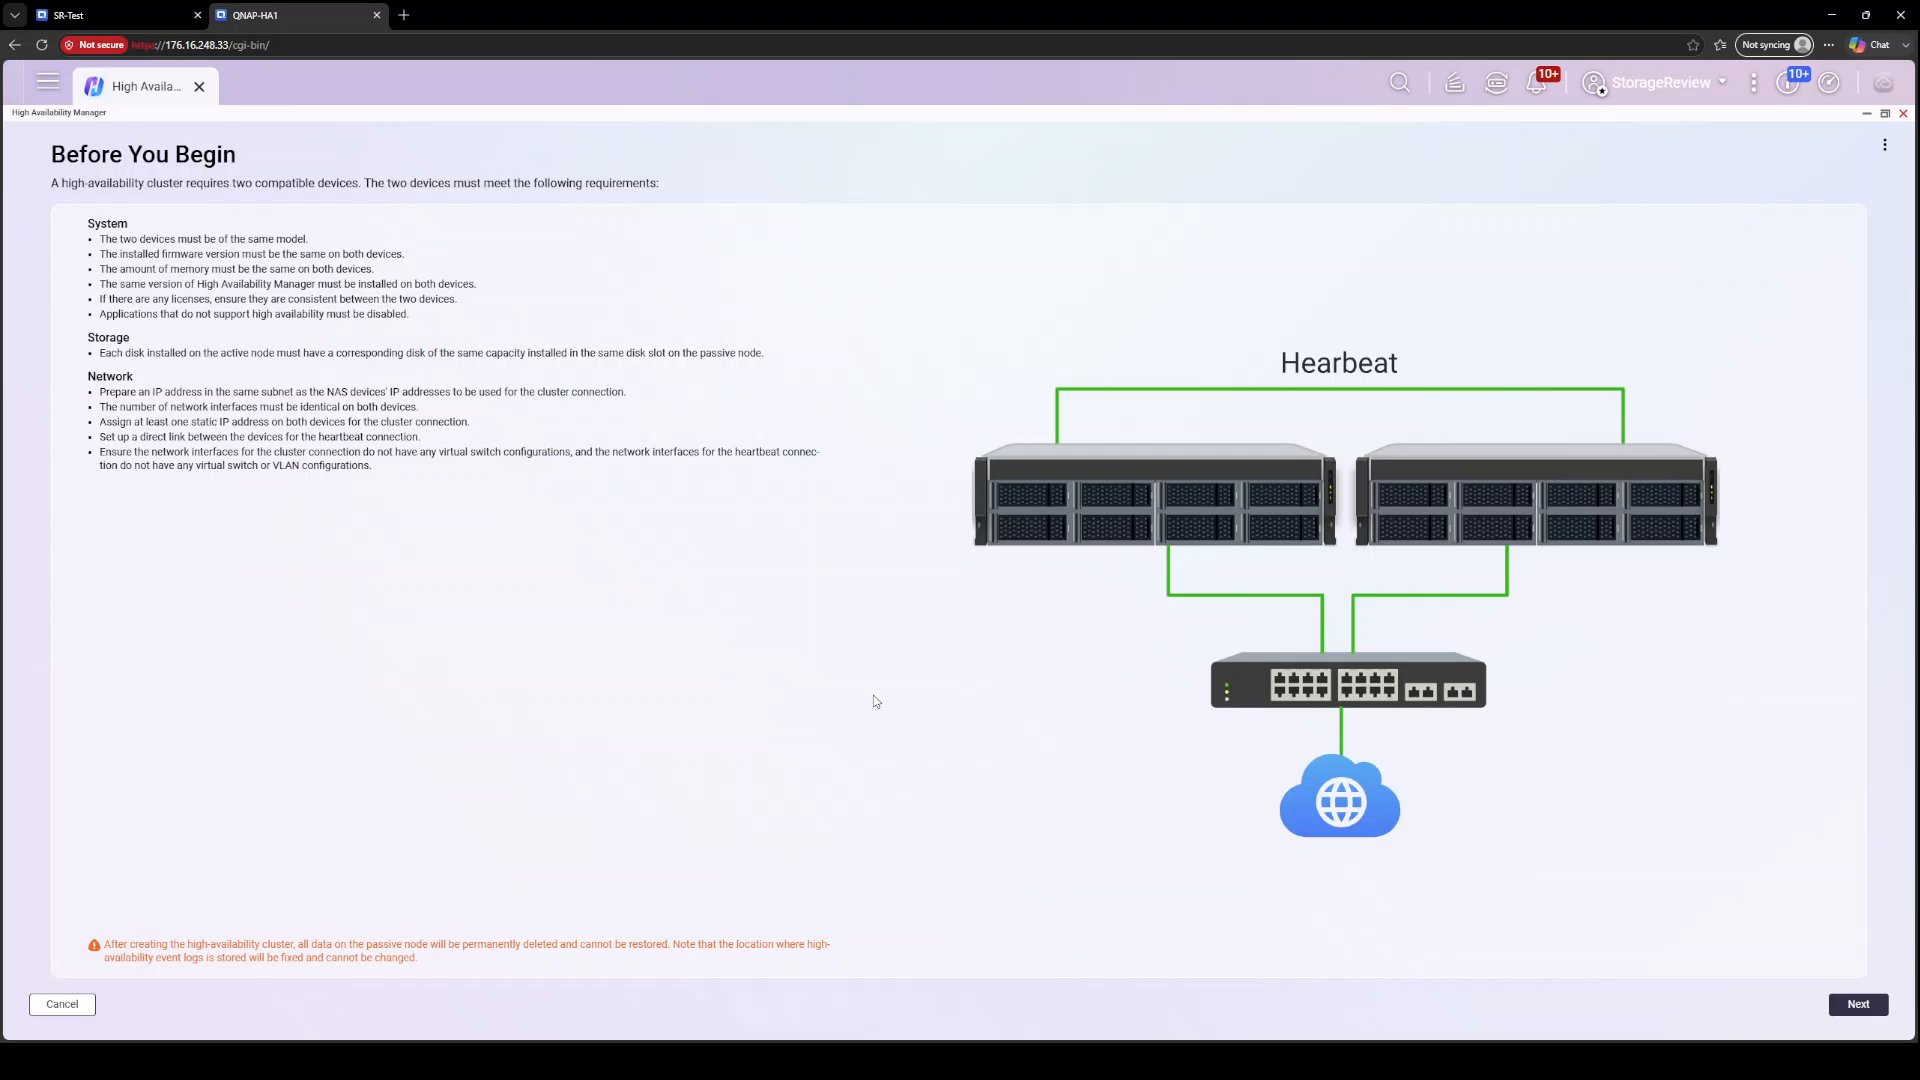
Hjärtslagslänken är ryggraden i designen. QNAP kräver en direkt anslutning mellan de två enheterna, utan switchar i sökvägen, och den hanterar både hälsokontrolltrafik och blocknivåsynkronisering av data mellan noder. En separat klusteranslutning hanterar klientriktad trafik genom det vanliga nätverket. Split-brain-skyddet kompletteras av en kvorumserver, ett tredje vittne i nätverket som hjälper en nod att avgöra om den ska promotera sig själv när hjärtslaget tystnar. Vi går igenom split-brain och den distributionstopologi som förhindrar det i detalj senare i den här recensionen.
QNAP säger att över 90 procent av NAS-tjänsterna är HA-klara i h6.0, och klustret kan utöka kapaciteten med JBOD-expansionskabinett. Det finns vissa förbehåll. Oföränderliga snapshots, en annan viktig h6.0-funktion, stöds för närvarande inte i ett HA-kluster, så administratörer måste för tillfället välja mellan de två skydden. HA kräver också två identiska system, matchande modell och firmware, vilket parkopplingsguiden tillämpar innan du kan fortsätta.
Bygga QNAP HA-klustret
Klusterskapandet börjar med två oberoende konfigurerade TS-h765eU-enheter med identisk hårdvara. Från den angivna aktiva noden går guiden för High Availability Manager igenom en kort parkopplingsprocess. Guiden upptäcker den passiva noden via heartbeat-länken och ber dig sedan att tilldela roller till dina nätverksgränssnitt: en klusteranslutning som fungerar som kommunikationskanal för åtkomst till klustret, och heartbeat-anslutningen, som QNAP noterar är dedikerad till att synkronisera data och måste vara en direkt länk mellan enheterna. I vår version tilldelade guiden heartbeat till Adapter 1 och klusteranslutningen till Adapter 2.
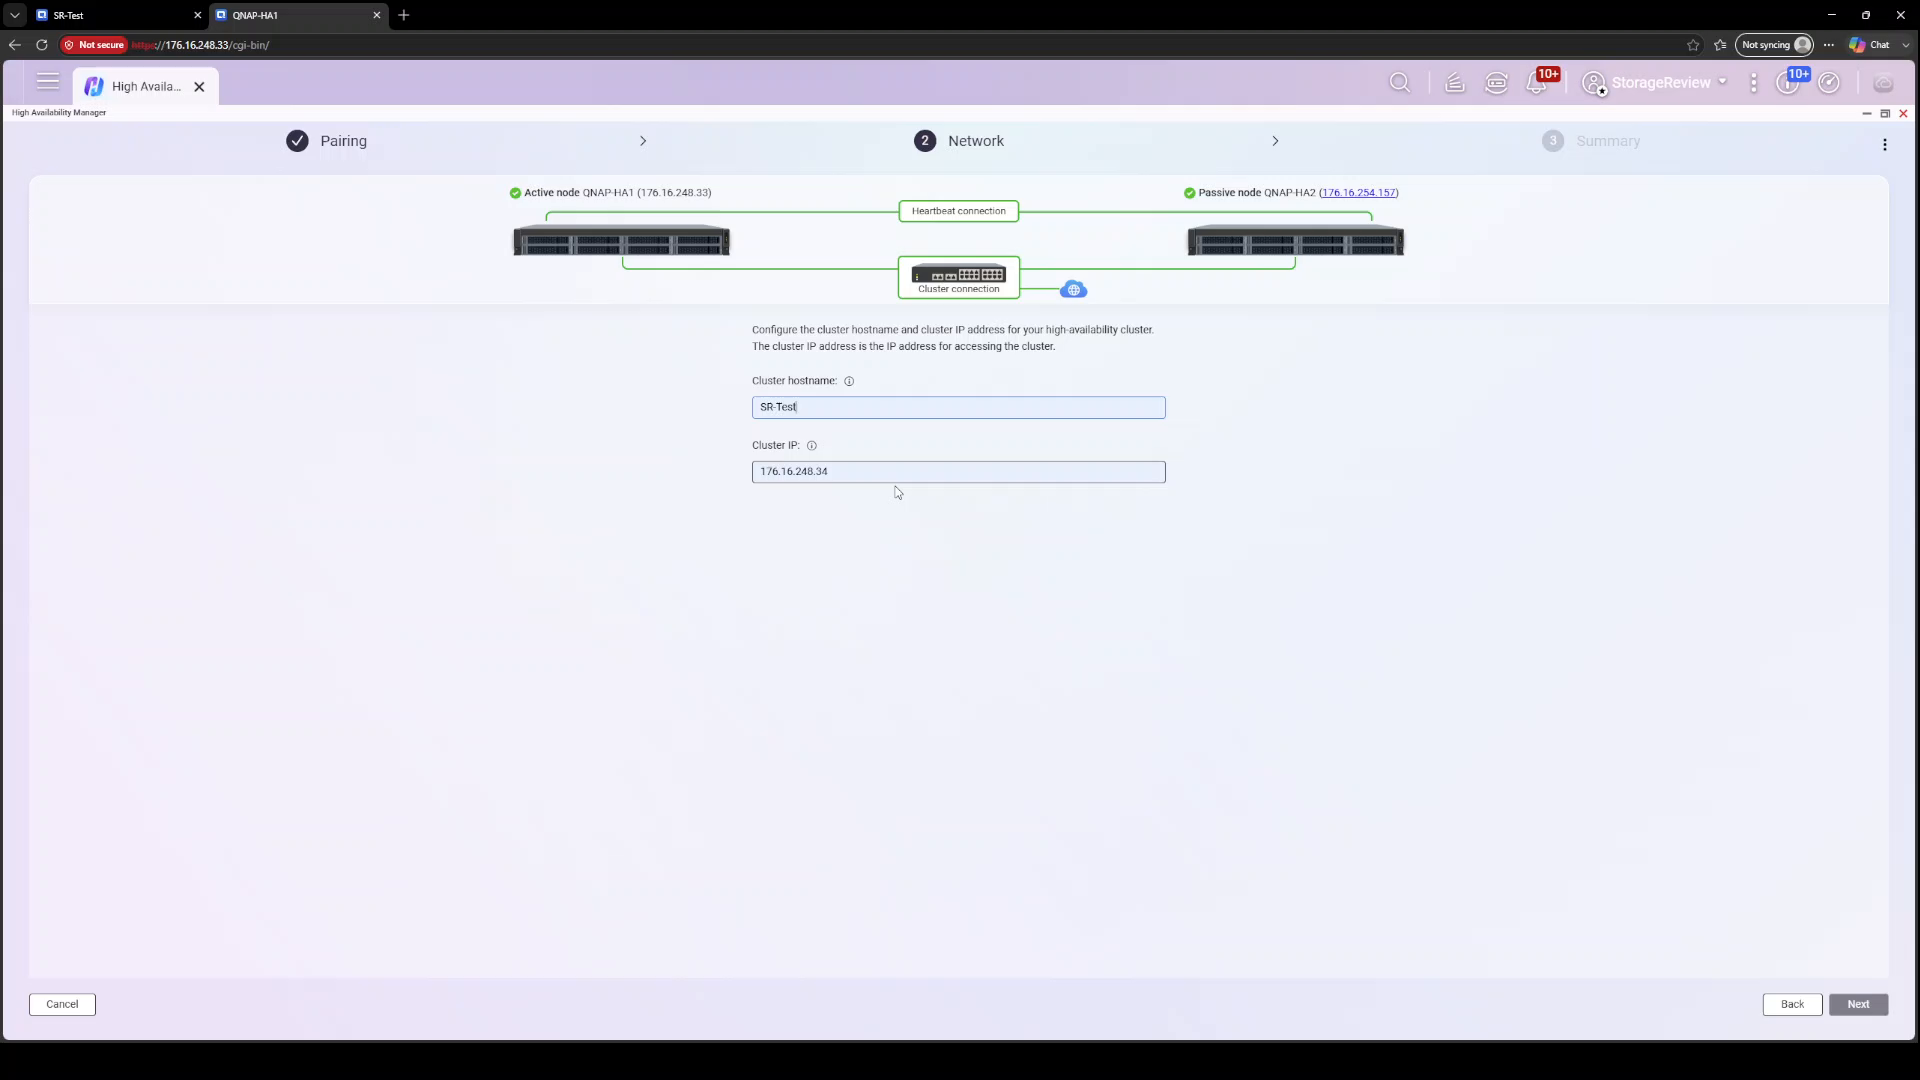
Nästa steg är klusteridentitet. Du tilldelar ett klustervärdnamn och en kluster-IP-adress, vilka blir den enda adress som klienterna använder från och med den tidpunkten. Vårt kluster hette SR-Test på 176.16.248.34, och ligger framför noderna QNAP-HA1 (176.16.248.33) och QNAP-HA2 (176.16.254.157), vilka två noderna sitter i olika /24-subnät i labbets nätverk; guiden parade ihop dem utan att klaga.
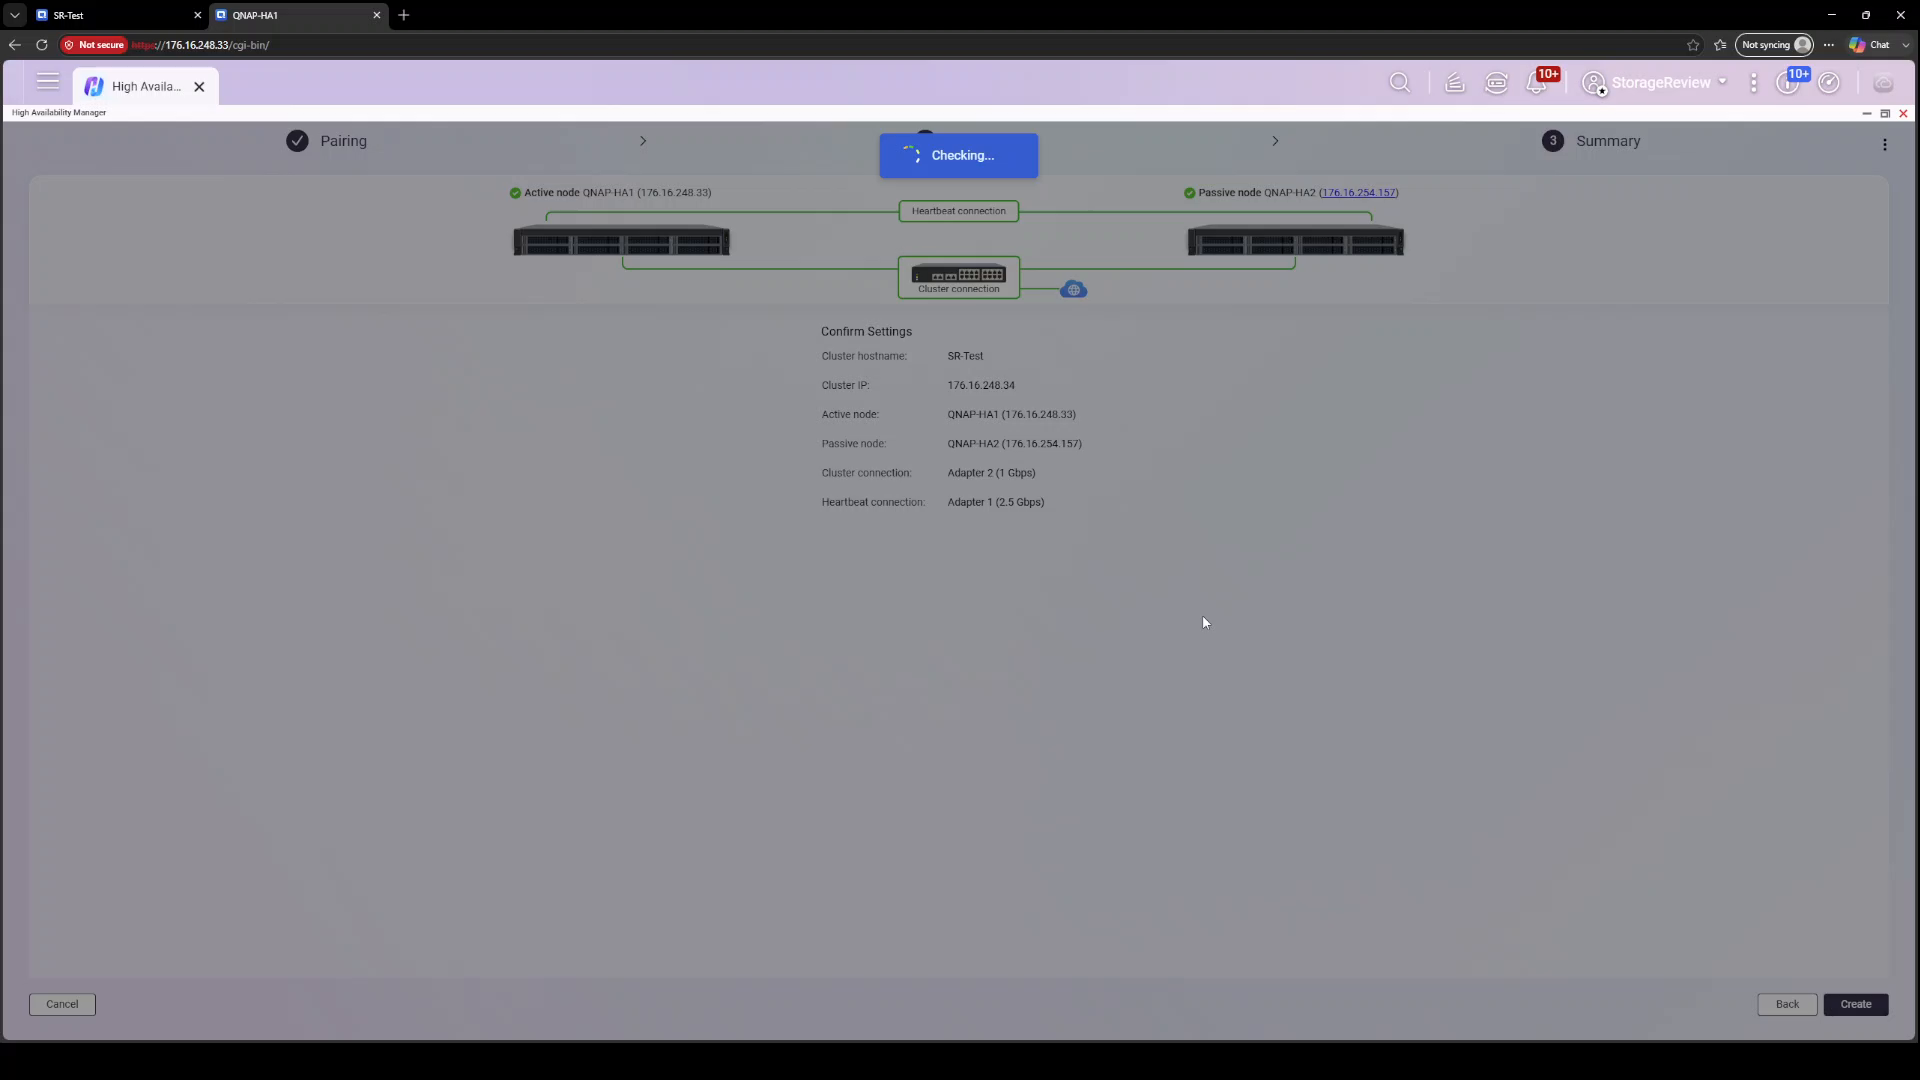
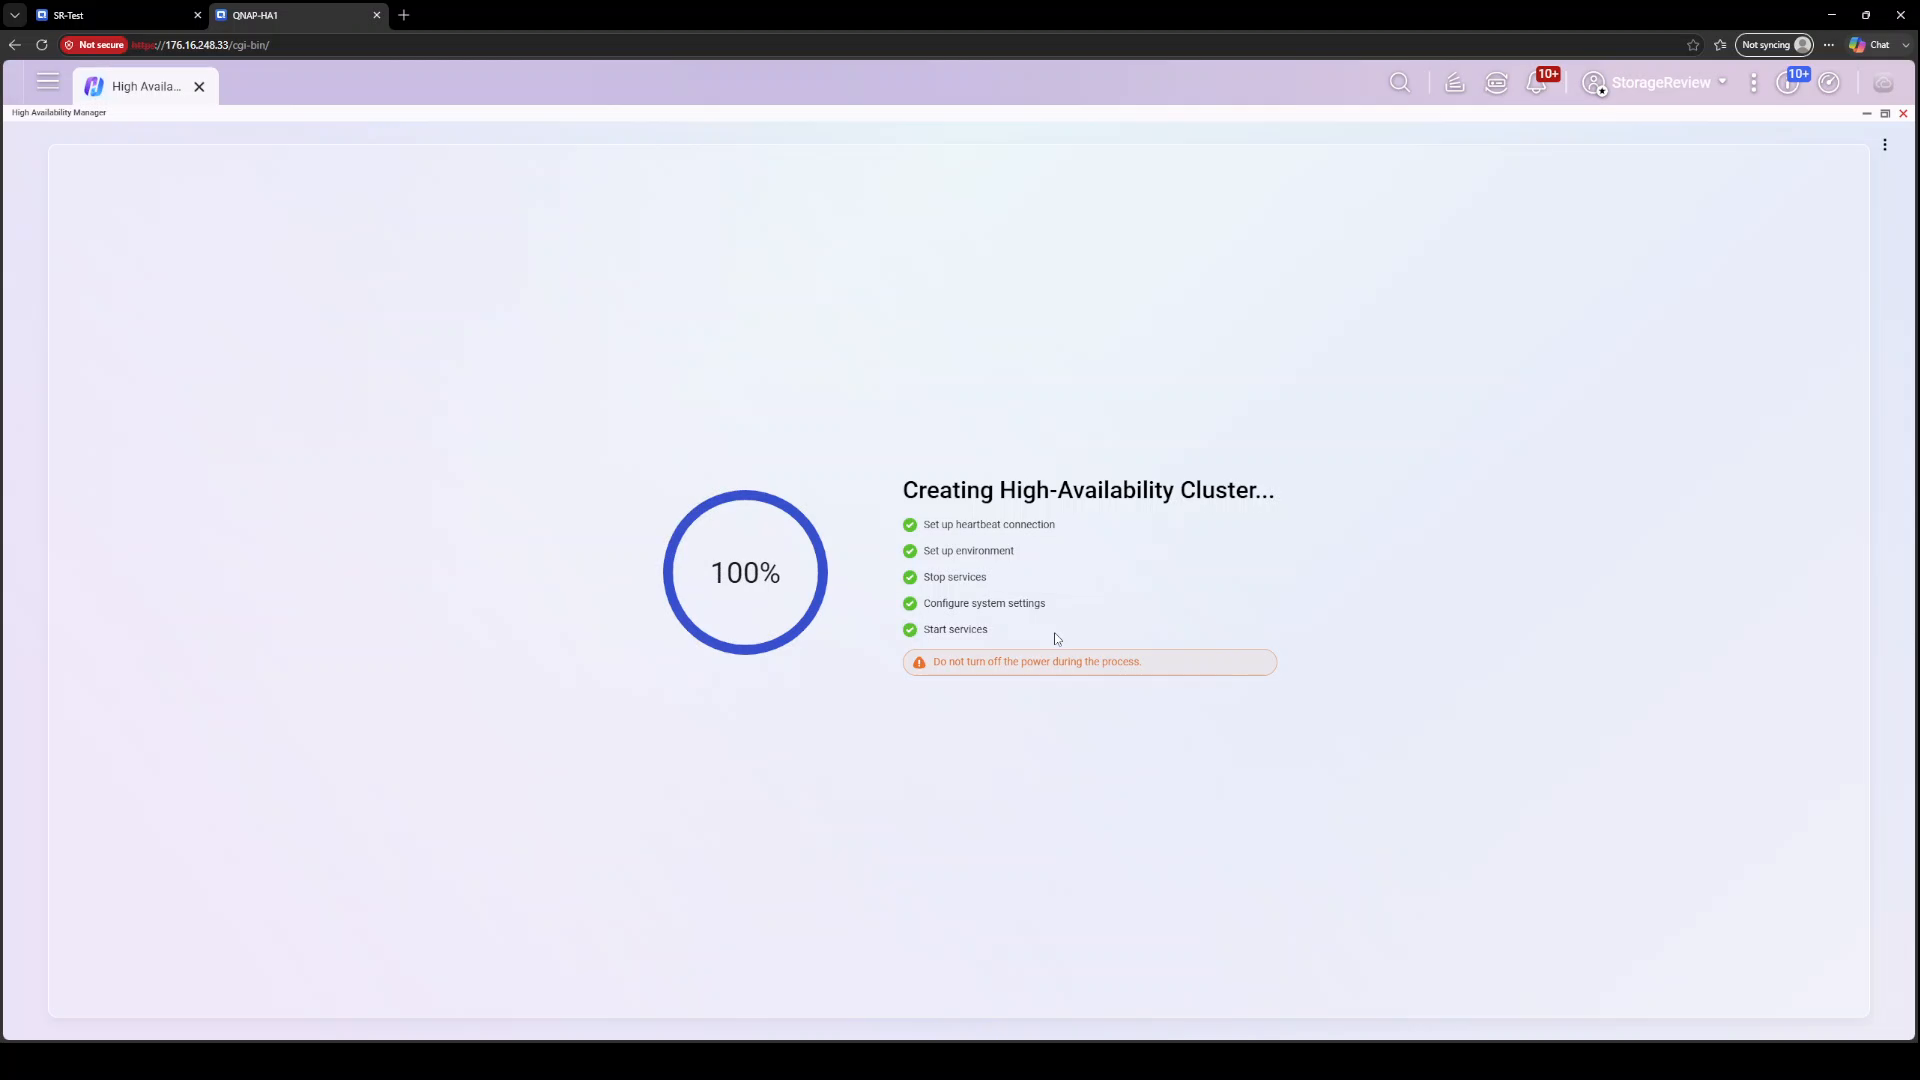
När inställningarna är bekräftade kör guiden en femstegsbyggnation: konfigurera heartbeat-anslutningen, konfigurera miljön, stoppa tjänster, konfigurera systeminställningar och starta tjänster. Användargränssnittet betonar att du inte ska stänga av någonting under detta fönster. På våra system slutfördes själva byggnationen på cirka fem och en halv minut, varefter HA Manager rapporterade att klustret hade skapats och omdirigerade oss till klustrets IP-adress. Från början till slut tog det under tio minuter av guiden att gå från två fristående NAS-enheter till ett serverande kluster.
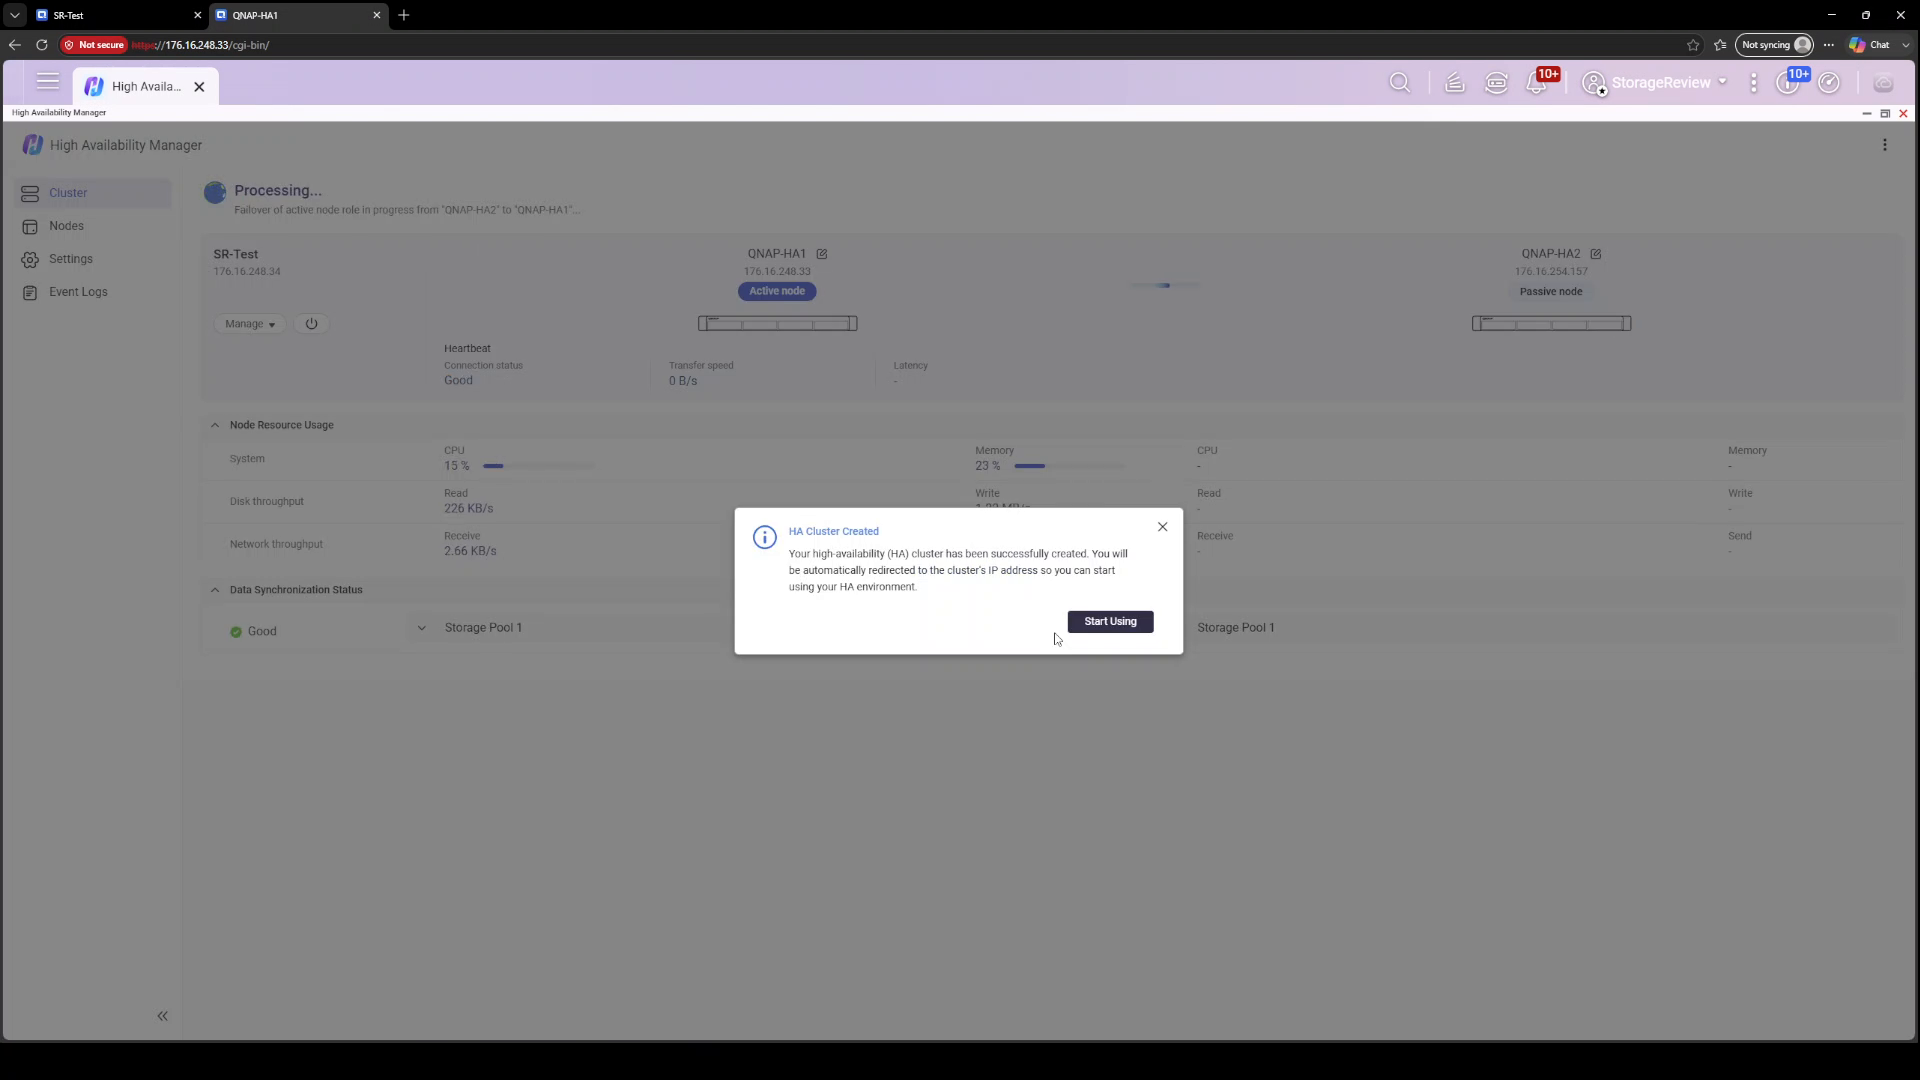
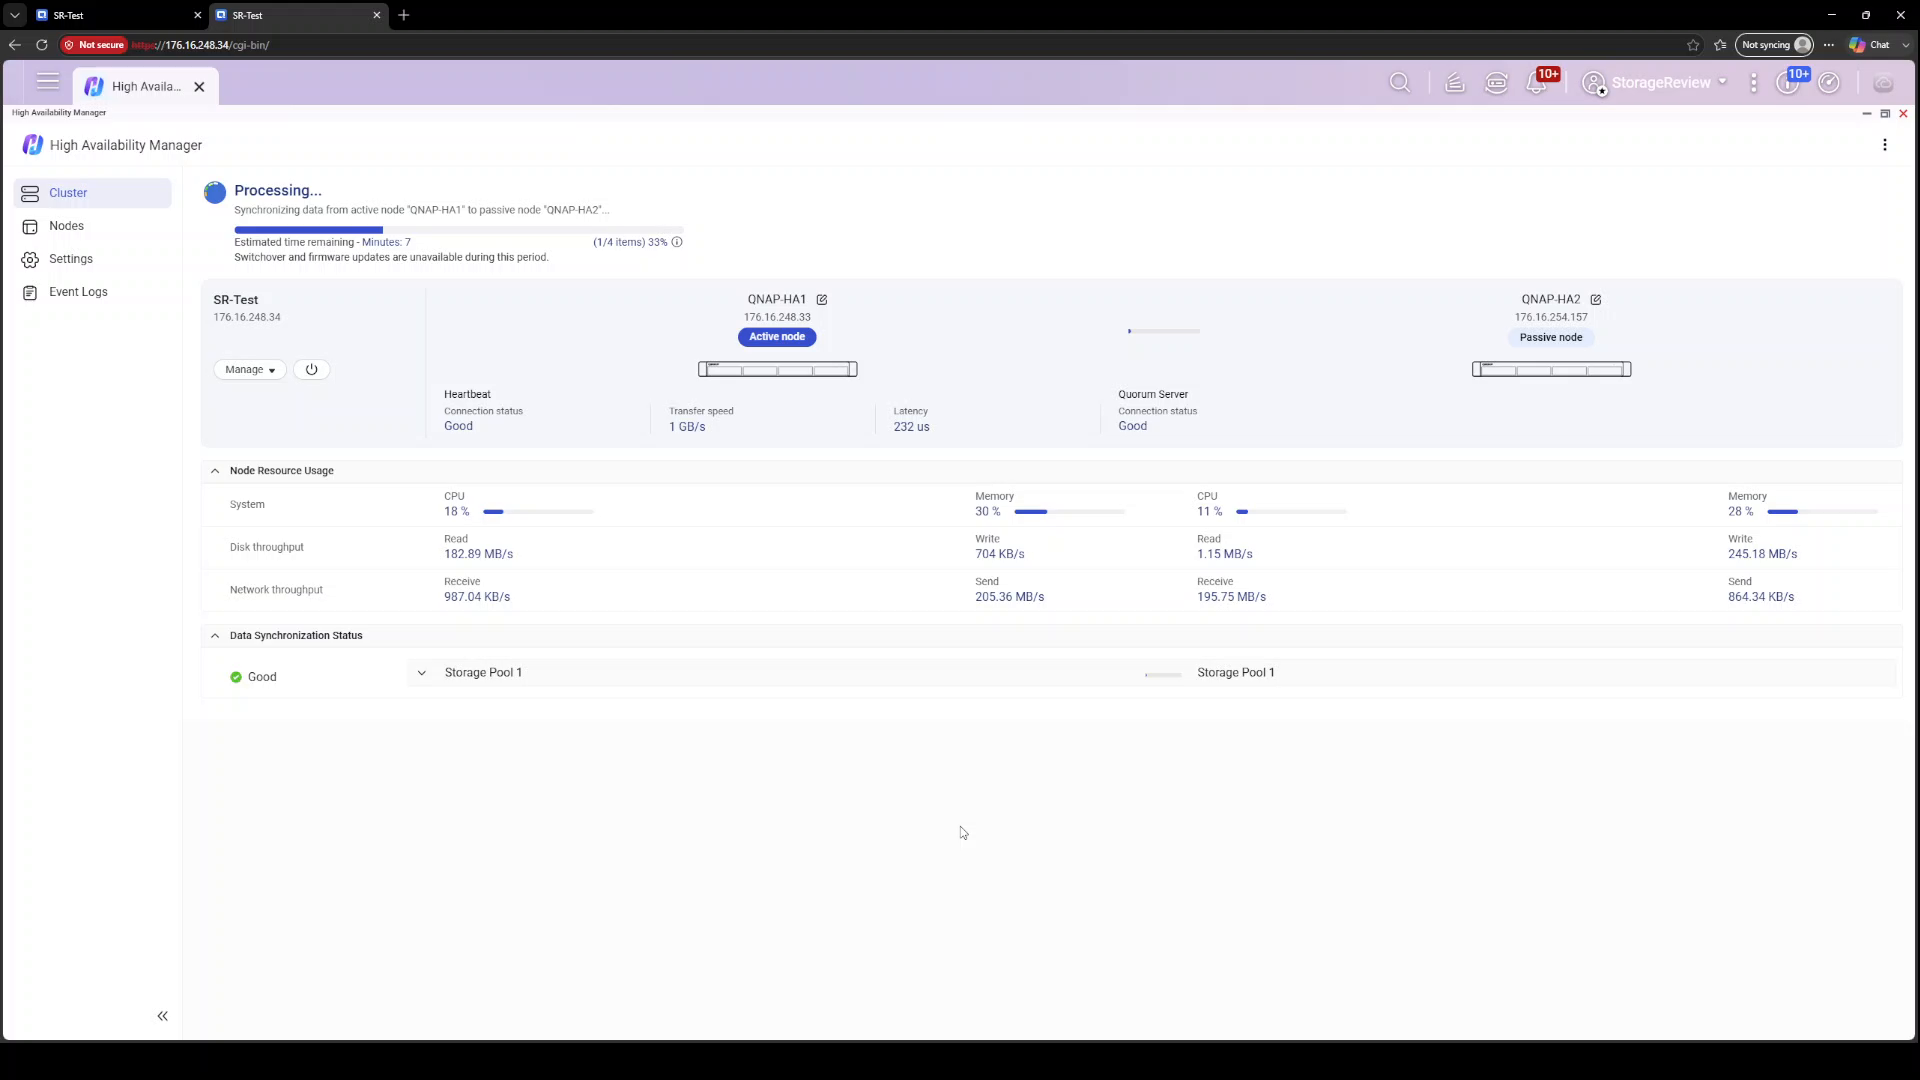
Det tyngre lyftet är den initiala synkroniseringen, där den aktiva noden replikerar sin lagringspool till den passiva noden, block för block. HA Manager visar detta tydligt med en förloppsindikator, antal objekt och tidsuppskattning högst upp på instrumentpanelen, tillsammans med en varning om att övergång och firmwareuppdateringar inte är tillgängliga förrän synkroniseringen är klar. Att titta på hjärtslagsstatistiken under denna fas var en av de mer imponerande delarna av processen: överföringshastigheterna varierade från ungefär 900 MB/s till 1.2 GB/s, med latens på hundratals mikrosekunder, inklusive en representativ avläsning på 1 GB/s vid 232 mikrosekunder. Vår initiala synkronisering slutfördes på ungefär tio minuter, precis i linje med instrumentpanelens inledande uppskattning på nio.
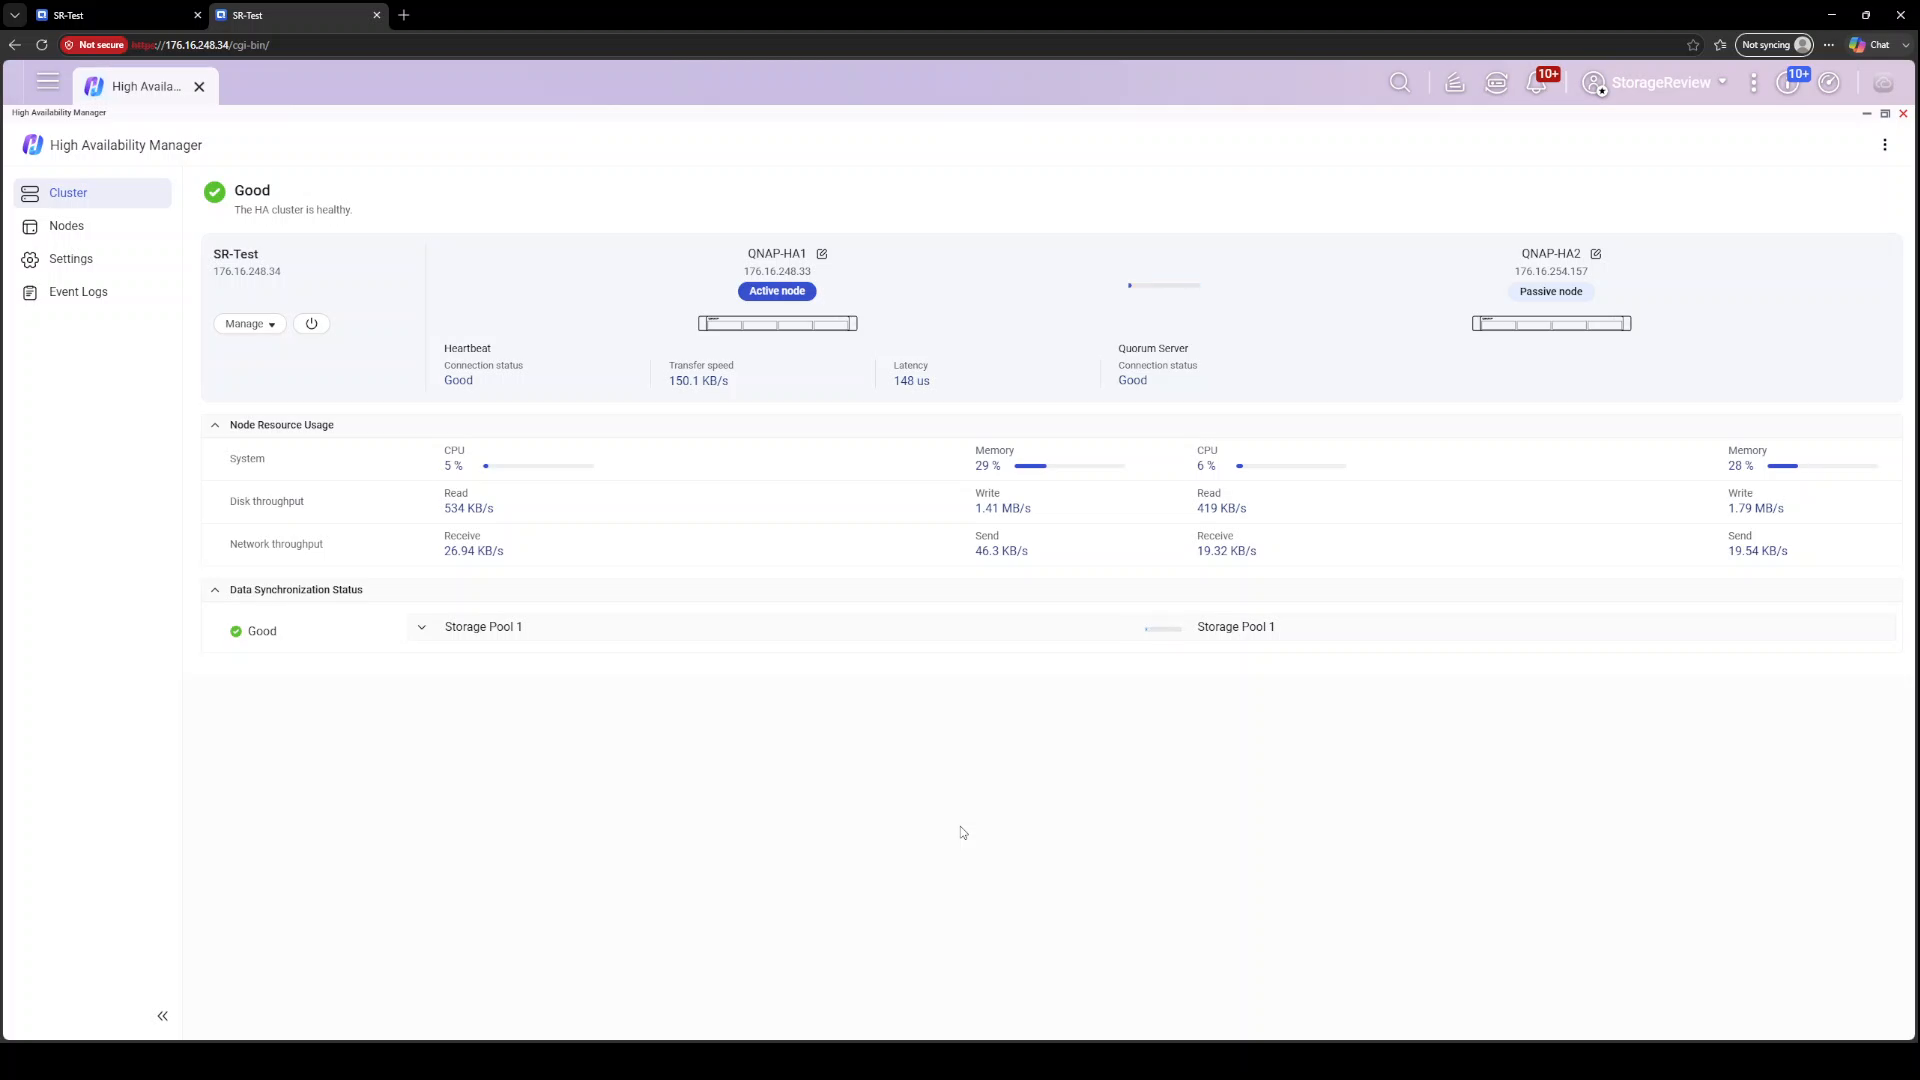
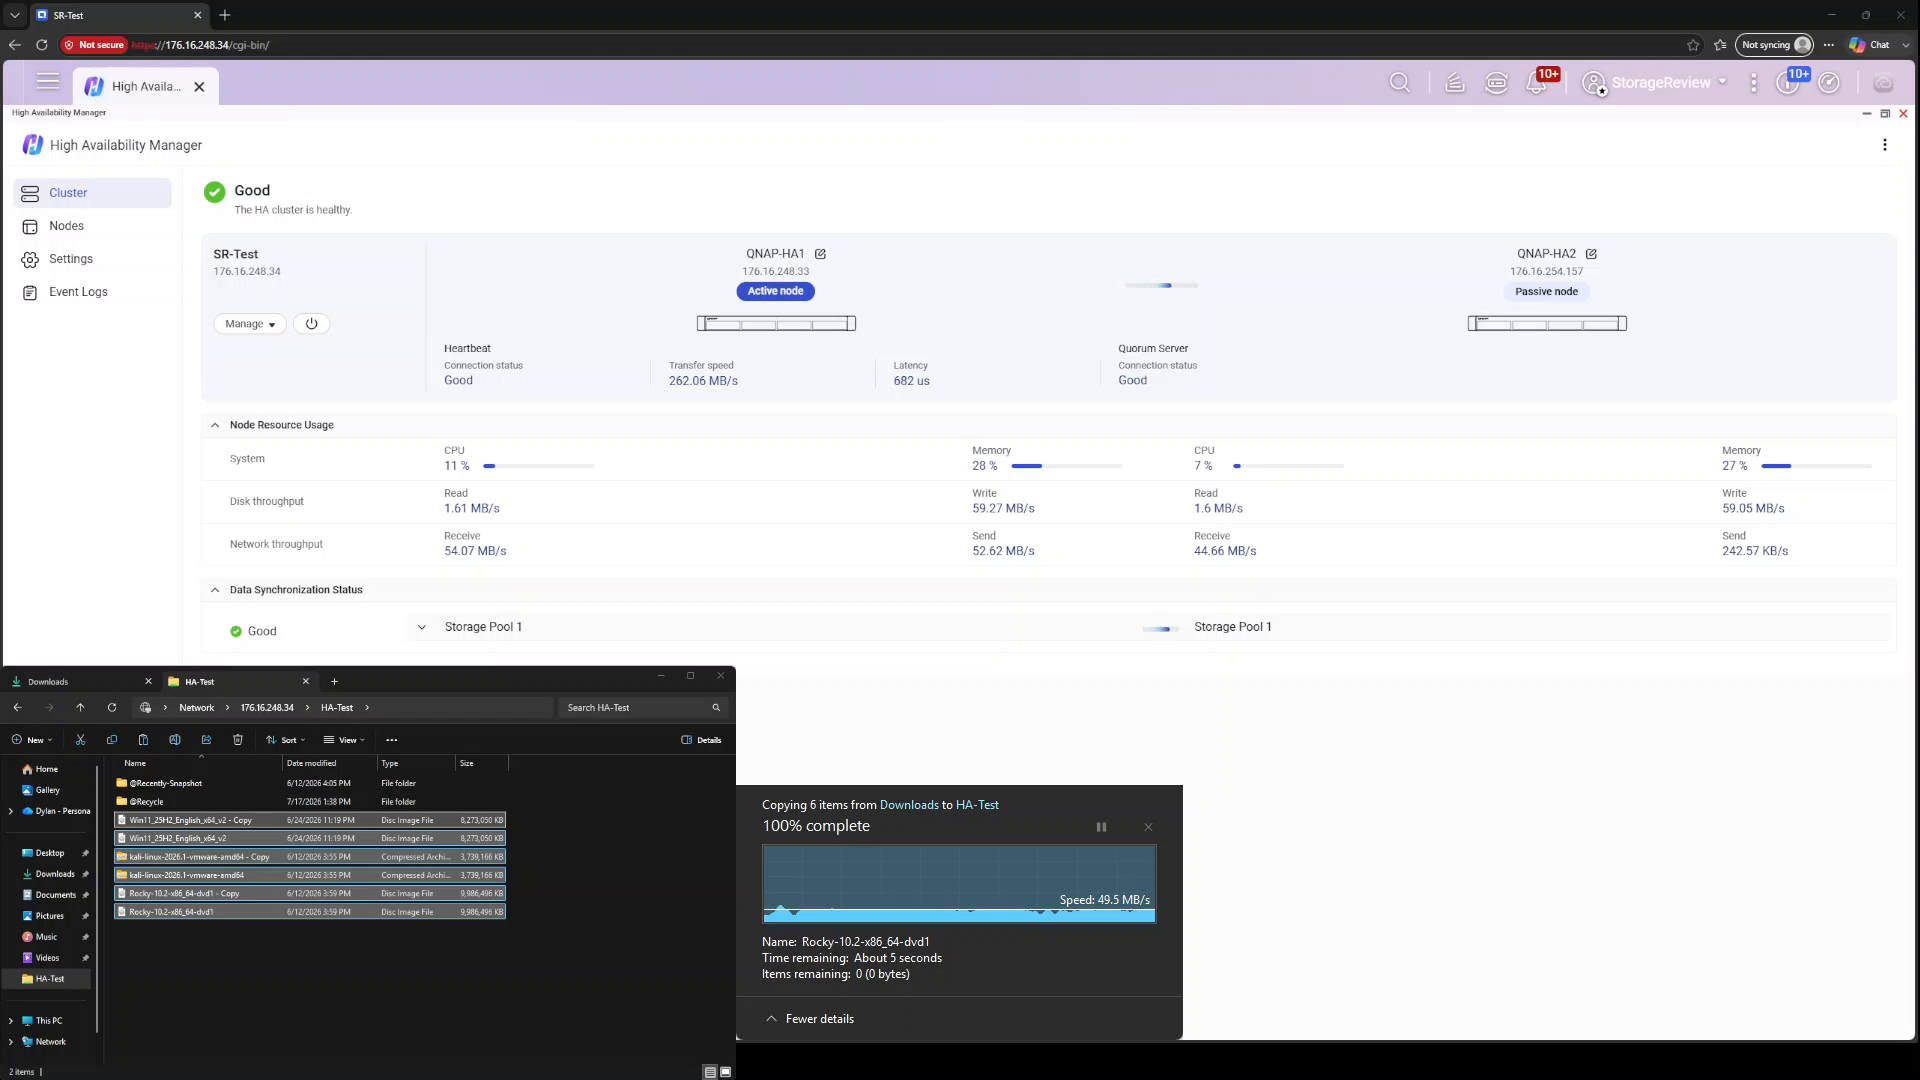
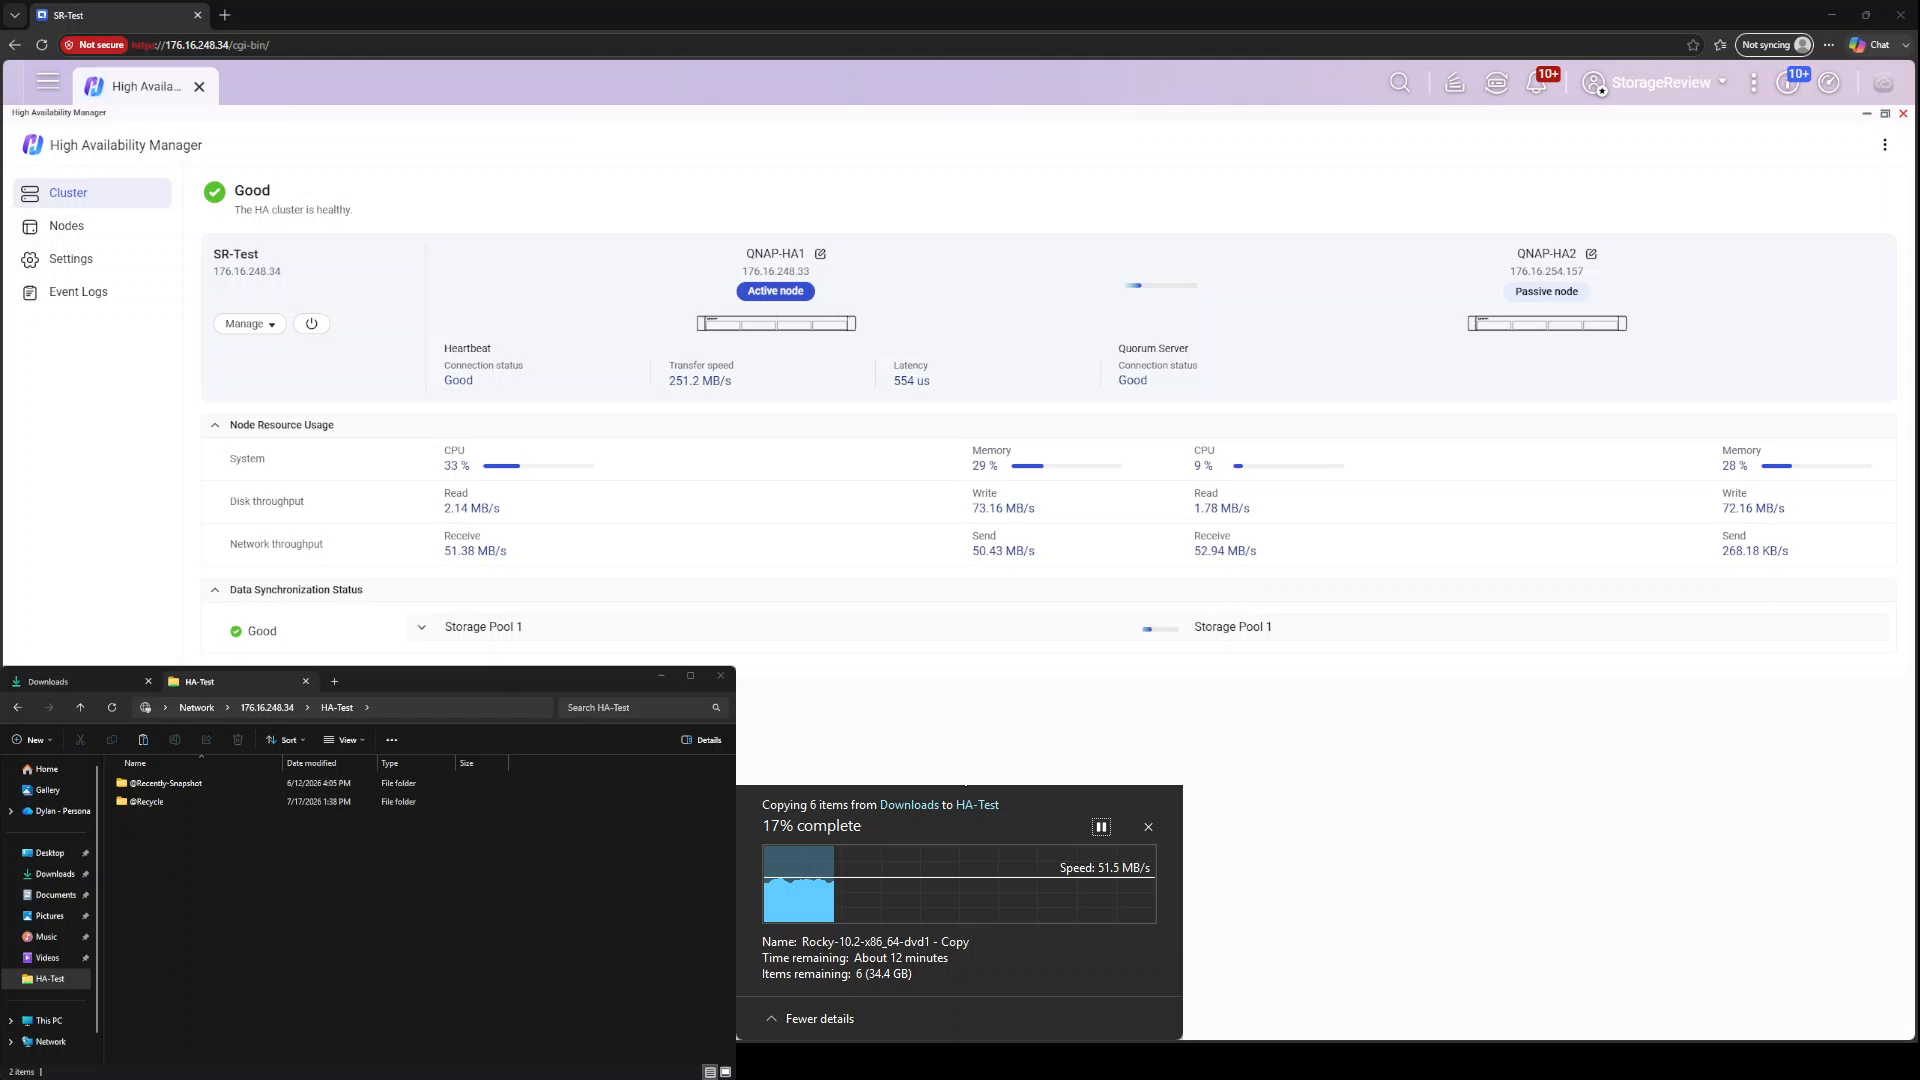
När synkroniseringen är klar återgår instrumentpanelen till statusen Bra: klustret är i gott skick, pulsslag anslutet, båda noderna synliga med livestatistik för processor, minne, diskdataflöde och nätverk sida vid sida, och synkroniseringsstatus per pool nedan. Det är en tydlig, informationsrik vy som besvarar de två frågor en administratör faktiskt har: Är klustret i gott skick och är mina data synkroniserade?
Failover-test 1: Strömförlust på den aktiva noden
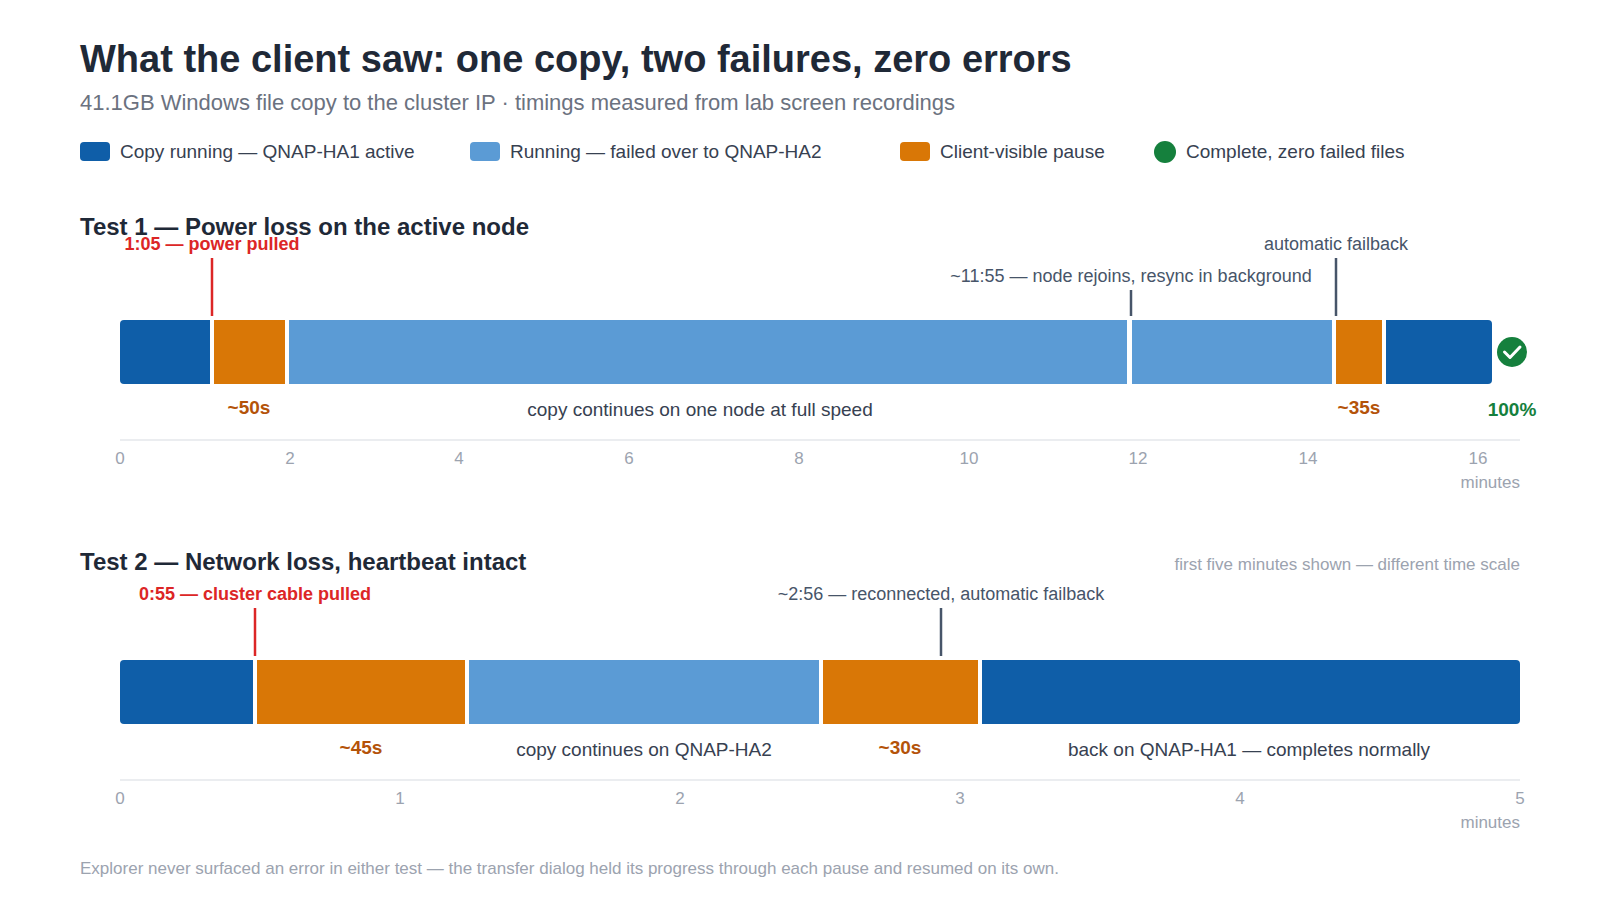
Vårt första felscenario är det raka: totalt strömavbrott på den aktiva noden. Vi startade en Windows-filkopiering från en klient till en SMB-resurs på kluster-IP:n, en 41.1 GB stor batch med sex filer inklusive Windows 11- och Rocky Linux-ISO:er och ett par Kali Linux VM-arkiv, och stängde sedan av strömmen till QNAP-HA1 mitt under överföringen.
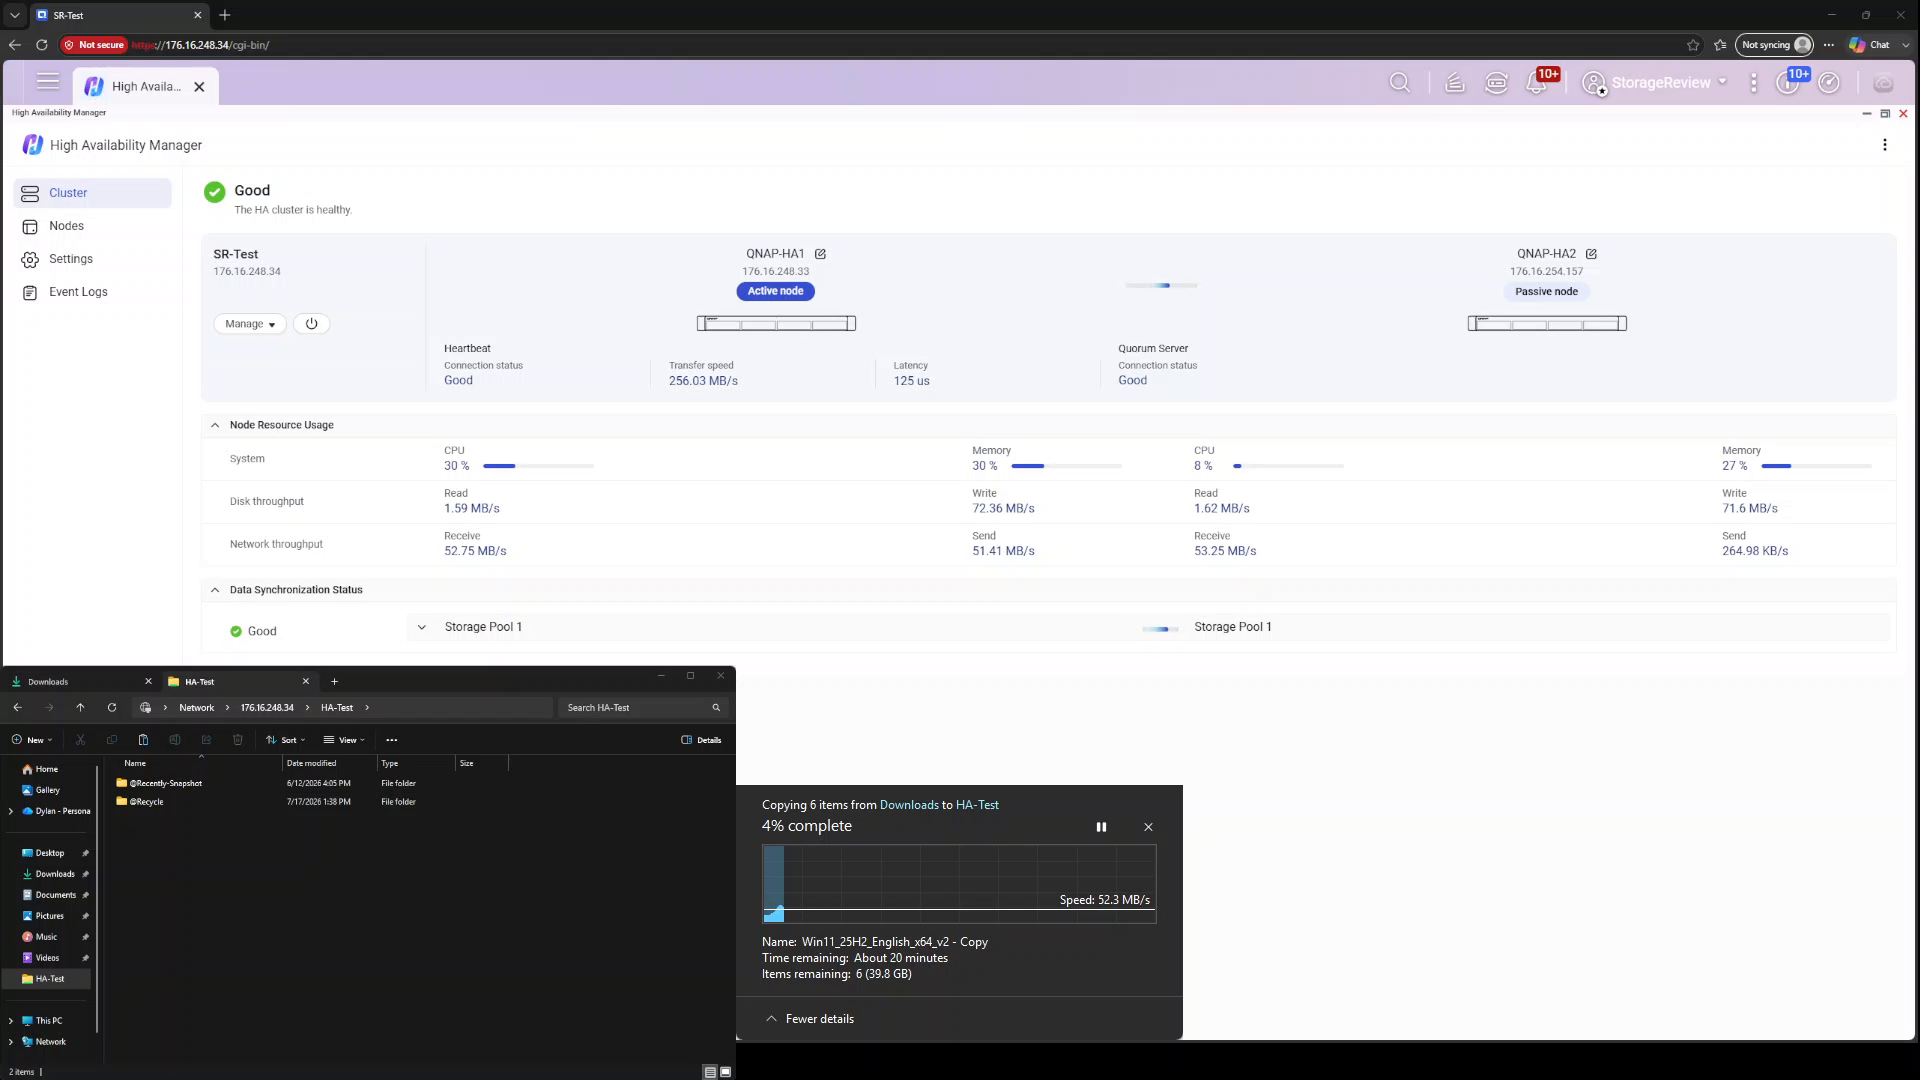
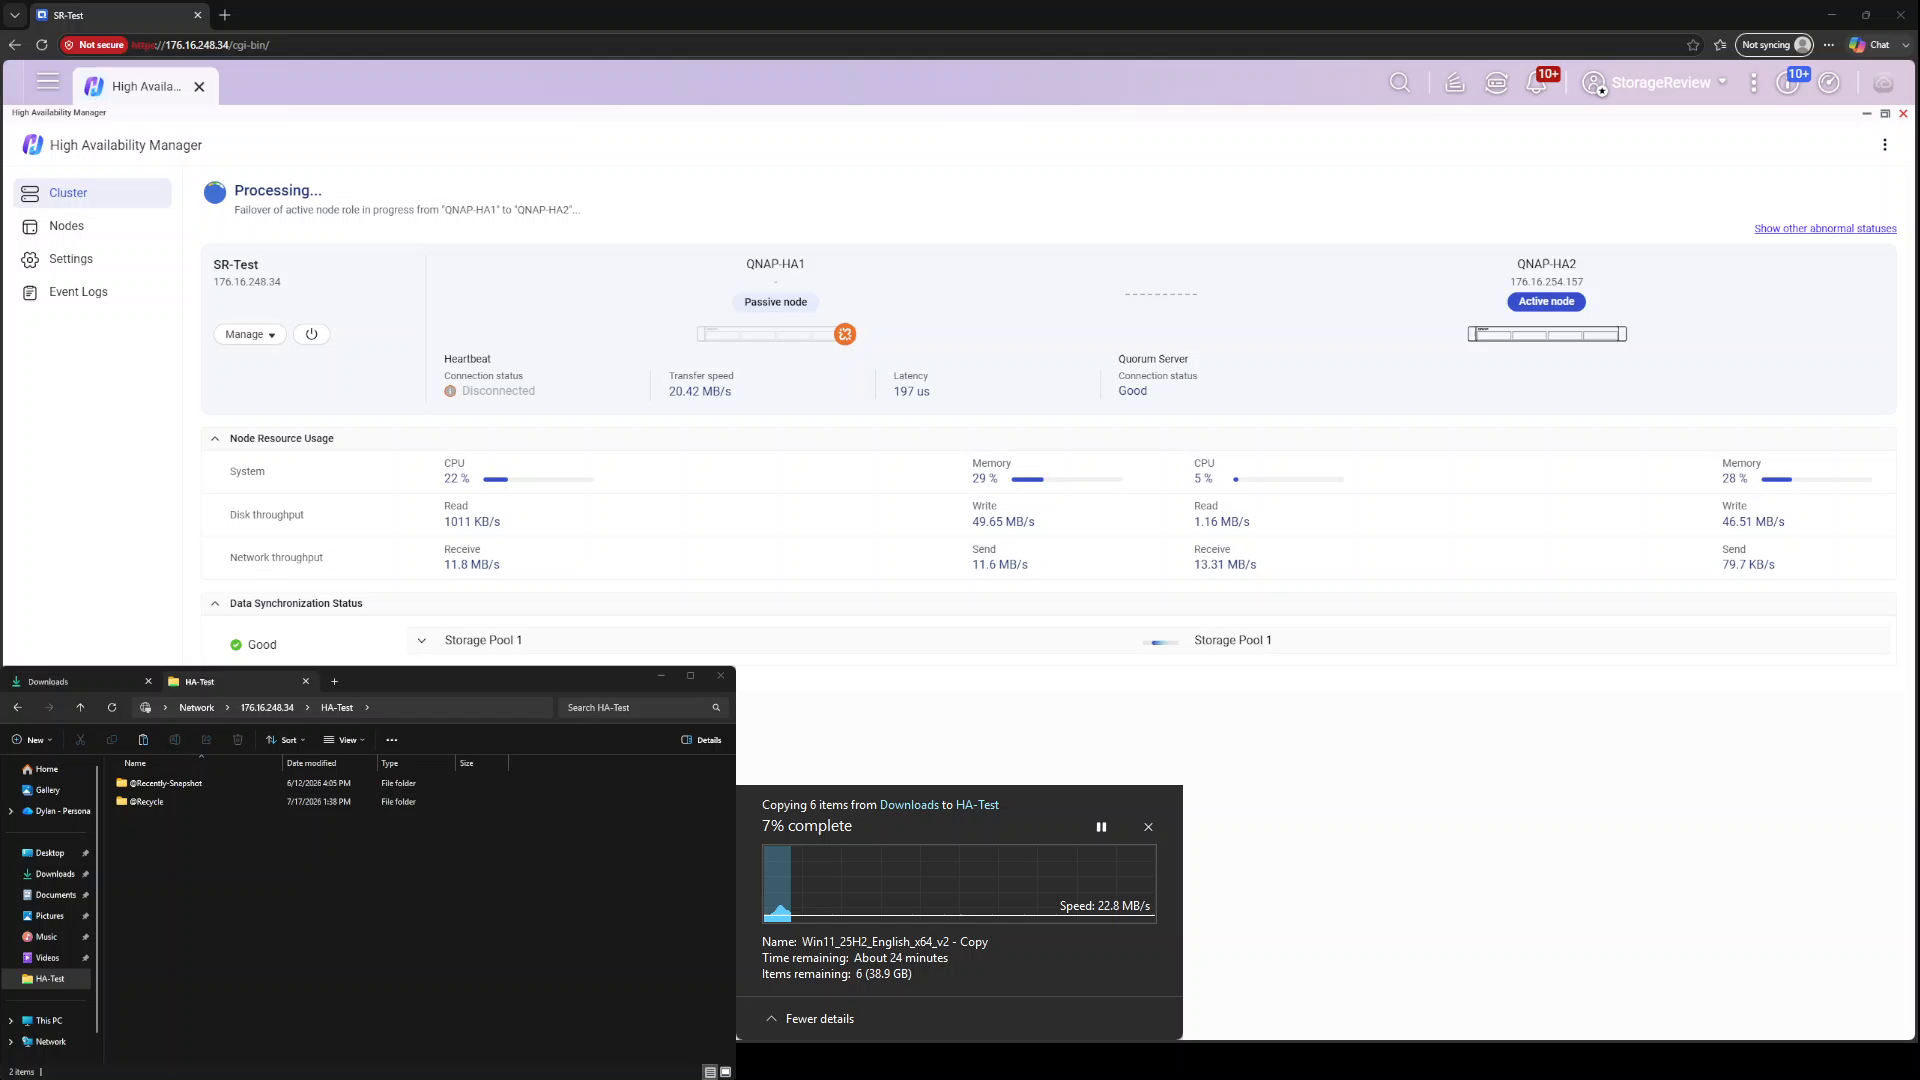
Ur klientens perspektiv stannade kopieringen i strax under en minut, ungefär 50 sekunder, från strömavbrottet till att data flyttades igen, och Explorer visade aldrig något fel; överföringsdialogrutan stoppade sin process och återupptogs sedan när QNAP-HA2 aktiverade sig själv. HA Manager rapporterade kortfattat att redundansväxlingen för den aktiva nodrollen pågick och visade sedan en varningsbanner: det gick inte att upptäcka den passiva noden QNAP-HA1, med förslaget att säkerställa att noden är påslagen och ansluten till nätverket. Överföringen fortsatte mot samma kluster-IP i full hastighet medan klustret kördes på en nod, vilket är exakt det försämrade men operativa tillstånd som HA utlovar.
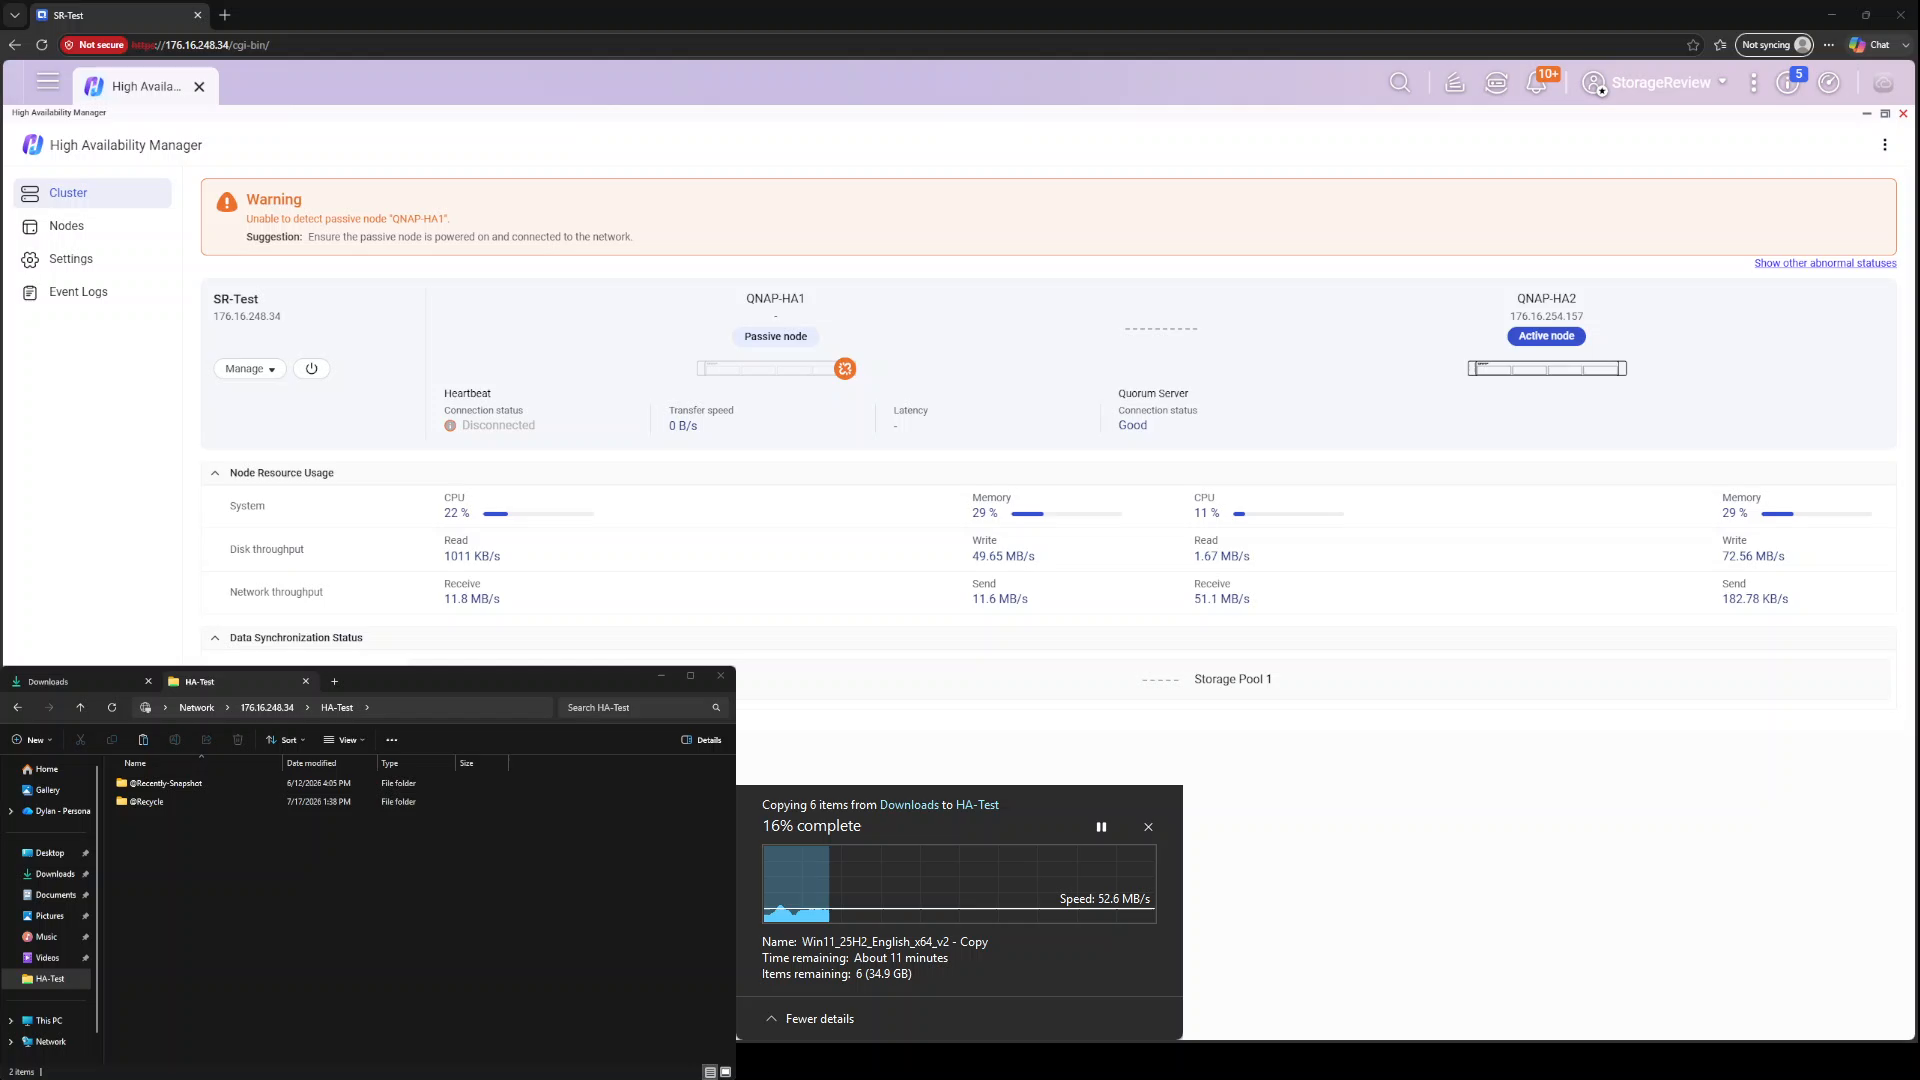
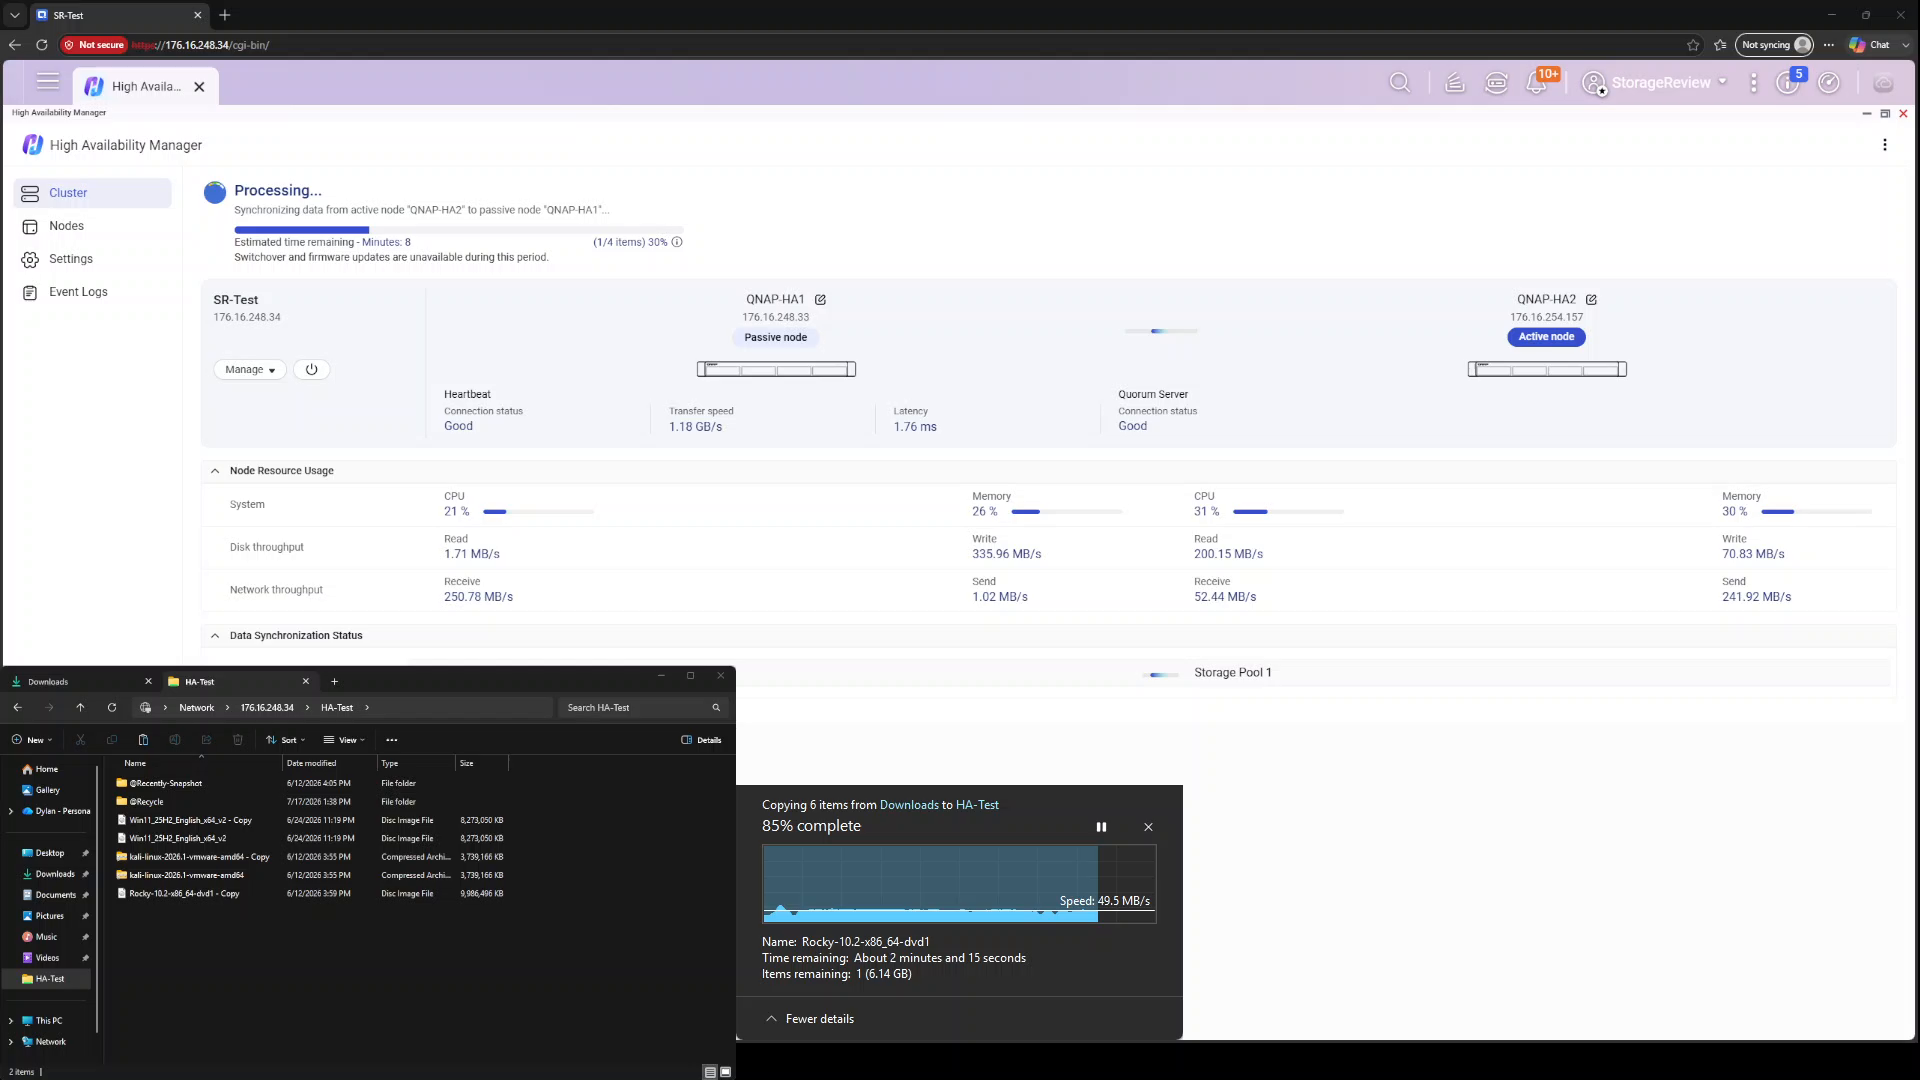
Återställning av strömmen till QNAP-HA1 utlöste automatiskt den omvända processen. Noden startade och återansluts som passiv medlem ungefär tio minuter efter att strömmen förlorats, och HA Manager började synkronisera data från den aktiva noden QNAP-HA2 tillbaka till QNAP-HA1, återigen med förlopps- och tidsuppskattningar synliga på instrumentpanelen, medan vår filkopiering fortsatte ostört. Återställning efter fel krävde ingen åtgärd: när omsynkroniseringen var avslutad pausade klustret överföringen i cirka 35 sekunder medan det återställde den aktiva rollen till QNAP-HA1, och lät sedan kopieringen köras till slut. I slutet av körningen var klustret tillbaka till Bra status med överföringen på 100 procent, efter att ha överlevt ett hårt strömavbrott, en period med en enda nod, en nodåterställning och en återställning efter fel inom ett jobb med en enda kopia.
Failover-test 2: Nätverksförlust med intakt hjärtslag
Det andra scenariot är mer subtilt och förmodligen vanligare i verkligheten: den aktiva noden förlorar sin klientvända nätverksanslutning (en trasig switchport, en dragna kabeln eller en trasig sändtagare) medan själva noden fortsätter att fungera och heartbeat-länken förblir aktiv. Detta är fallet där split-brain-skydd är avgörande eftersom båda noderna är aktiva och kan se varandra, och klustret måste bestämma vilken nod som ska äga klustrets IP-adress.
Vi upprepade samma Windows-filkopiering mot klustrets IP-adress och kopplade bort klustrets nätverksgränssnitt på den aktiva noden. Överföringen pausade i cirka 45 sekunder medan klustret flyttade tjänster till den andra noden, och återupptogs sedan utan fel. HA Manager flaggade felet exakt, varnade för att klustrets nätverksgränssnittsadapter 2 på noden var frånkopplad och föreslog en kontroll av switchanslutningen, och gick sedan ett steg längre och noterade att den frånkopplade noden inte längre kunde nå kvorumservern via det gränssnittet. Den specificiteten, att namnge det exakta gränssnittet, noden och konsekvensen, är mer diagnostisk än den generiska degraderade flaggan som vissa HA-implementeringar nöjer sig med.
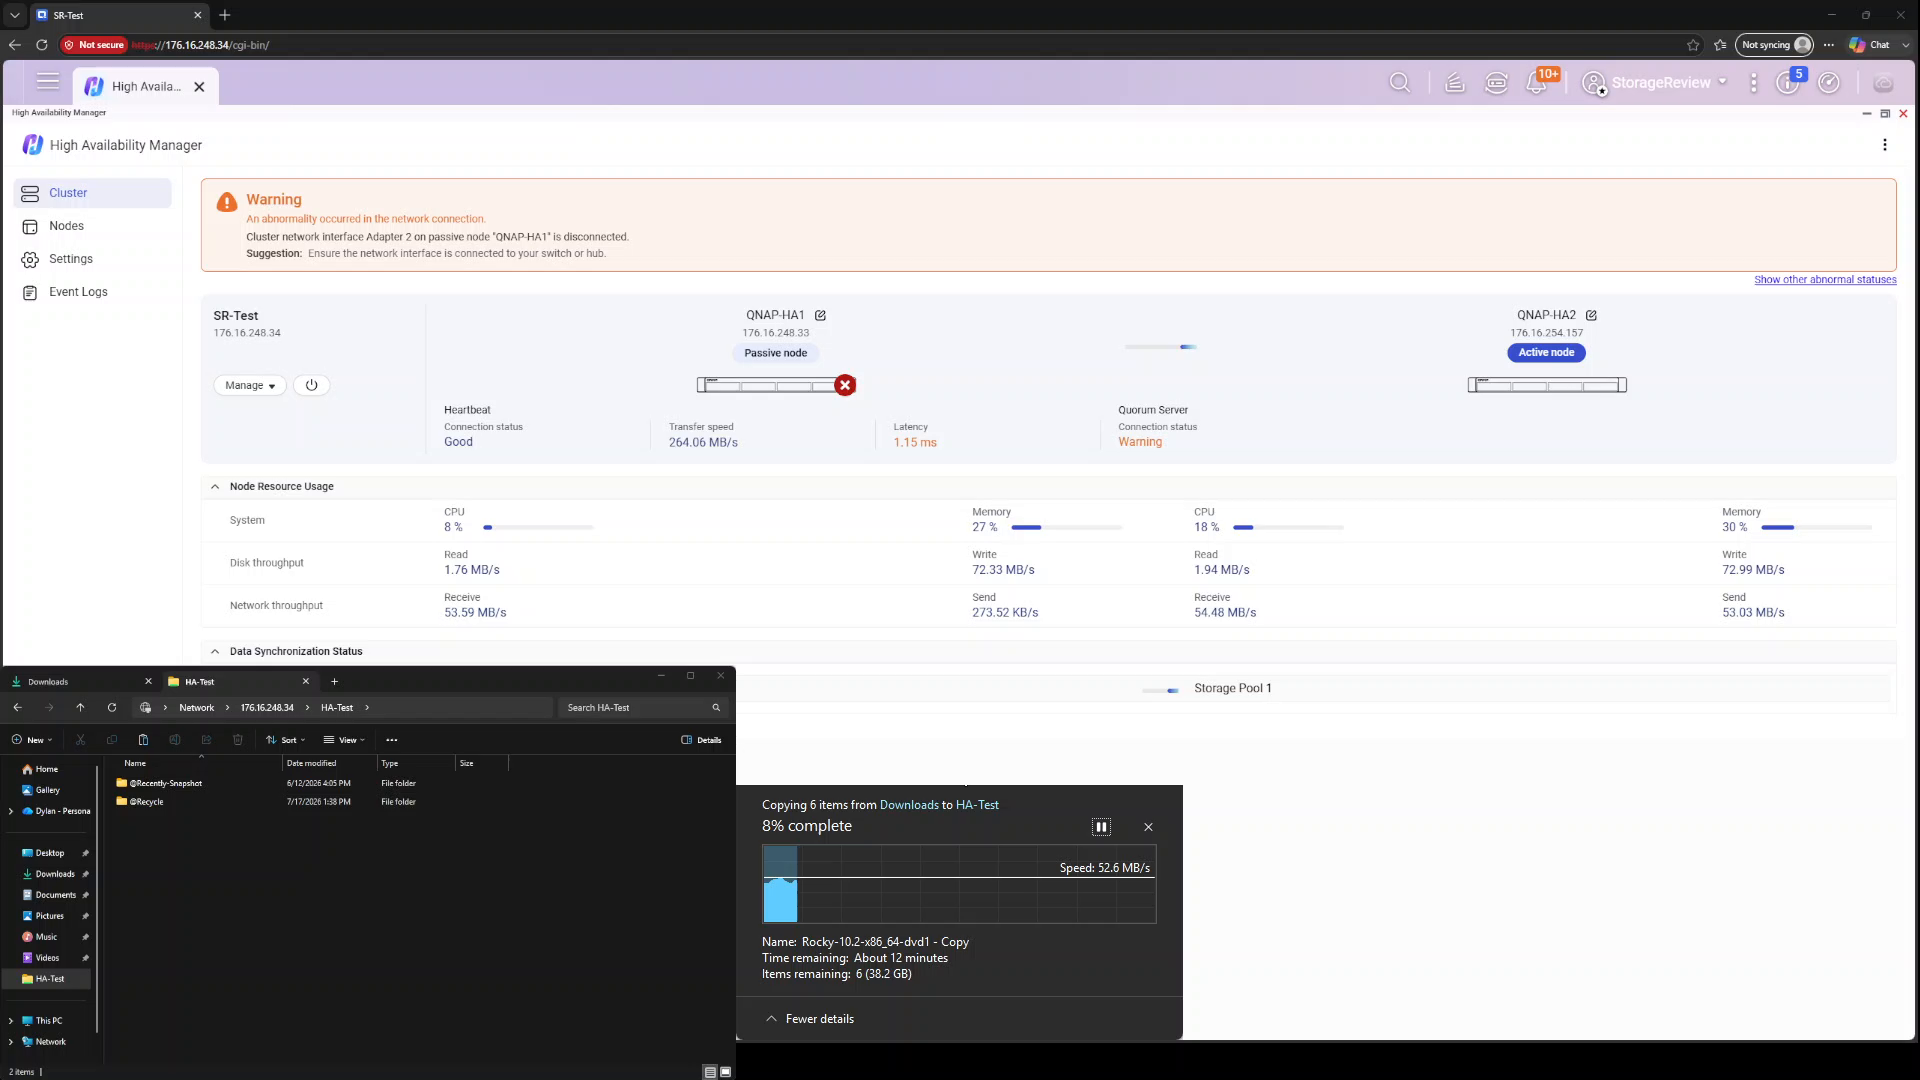
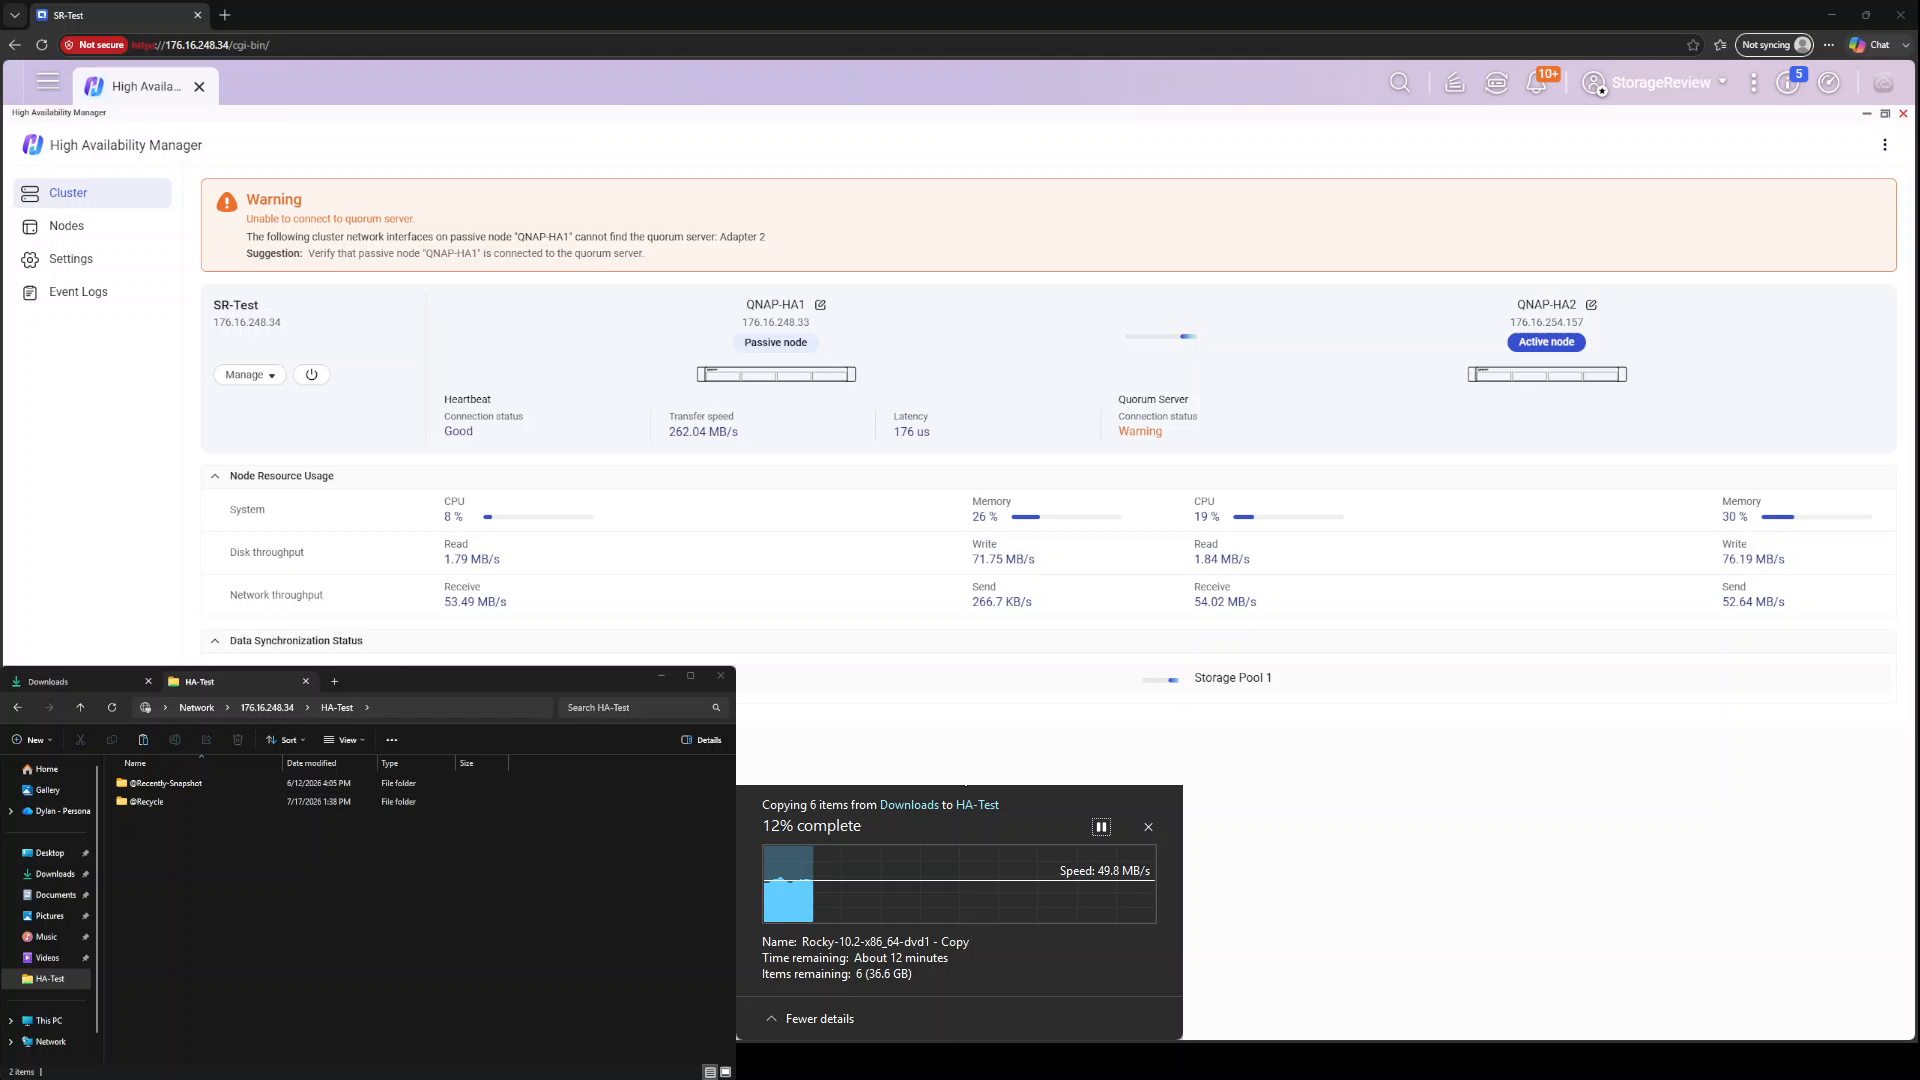
Genom att återansluta nätverket återfördes noden till klustret, och återställningen kom av sig själv inom en minut: en andra paus på ungefär 30 sekunder medan den aktiva rollen återgick till QNAP-HA1 var det enda klientsynliga beviset på att något hade hänt. Samma kopieringsjobb överlevde två omkopplingar i rad utan en enda misslyckad fil. För alla som har sett en SMB-session dö av betydligt mindre, är det det viktigaste resultatet av hela denna övning.
Implementera HA på rätt sätt: Split-Brain och nätverkstopologi
Failover-tester som vår visar att klustret fungerar, men hur bra ett HA-par håller i produktion beror lika mycket på det omgivande nätverket som på själva NAS-enheterna. De scenarier som HA Manager är utformad för (en felaktig nod, en död switchport, en draen upplänk) delar alla ett antagande: minst en kommunikationsväg mellan de två noderna överlever felet. Att skydda det antagandet är det enskilt viktigaste beslutet i en HA-distribution, eftersom alternativet är det enda villkoret som varje högtillgänglighetsarkitektur är byggd för att undvika: split-brain.
QNAP dokumenterar scenariot. Split-brain uppstår när båda noderna förlorar kommunikationen med varandra men förblir operativa oberoende av varandra, där var och en tar på sig den aktiva rollen. Två noder, som var och en tror att de äger klustret och var och en är villig att acceptera skrivningar, är ett recept för datainkonsekvens eller korrupt lagring, eftersom var och en kan försöka kontrollera delade resurser samtidigt. De dokumenterade orsakerna är exakt vad man kan förvänta sig: nätverksavbrott mellan noder, hjärtslagsfel och instabila nätverksvägar. Observera vad dessa har gemensamt. Split-brain utlöses inte av ett enda nodfel; det utlöses när alla vägar mellan två friska noder misslyckas samtidigt. Det är ett topologiproblem, och det har en topologilösning.
Distribueringsreglerna faller ut som förväntat:
Kör heartbeat som en direkt kabel mellan de två noderna. QNAP kräver en direktlänk för heartbeat, och det är därför. Utan switch, transceiver och delad infrastruktur i vägen är det enda som kan sänka heartbeat en nod i sig, vilket är precis den händelse som redundansövergången är utformad för. I en same-rack-distribution, där dessa korta TS-h765eU-enheter sannolikt kommer att ligga sida vid sida, finns det ingen anledning att göra något annat.
Om noderna är separerade, håll pulsfrekvensen och klienttrafiken på fysiskt oberoende vägar. Om en direkt kabel är opraktisk, led pulsfrekvensen genom andra switchar än de som används för klusteranslutningen. I det ögonblick som båda anslutningarna passerar samma switch blir den switchen en enda felpunkt som kan separera alla vägar mellan noderna samtidigt, vilket förvandlar ett vanligt switchfel till en potentiell split-brain-händelse. Hela poängen med att köpa två NAS-enheter försvinner om en enda delad infrastruktur kan isolera dem från varandra. Detta är logiken bakom vår metod för nätverks-redundanstest: att dra ut den klientvända ledningen medan pulsfrekvensen förblir ansluten simulerar det switch- eller kabelfel som en korrekt separerad topologi faktiskt skulle uppleva, med pulsfrekvensen aktiv för att effektivt avgöra övertagandet.
Aktivera kvorumservern. QNAP:s tredje skyddsåtgärd är ett vittne i nätverket, konfigurerat under High Availability Manager > Inställningar > Failover-policy > Kvorumserver. Om noderna förlorar sin direkta länk men fortfarande kan nå nätverket fortsätter kvorumservern att övervaka båda och vidarebefordrar deras status, vilket ger varje nod en oberoende tiebreaker innan den befordrar sig själv. Kvorumserverns anslutningsstatus visas permanent på HA Manager-instrumentpanelen tillsammans med hjärtslaget, så dess hälsa syns med en blick.
Om det värsta ändå skulle hända hanterar QuTS hero split-brain defensivt. När anslutningen är återställd och noderna kan kommunicera igen utbyter de statusinformation, identifierar att båda hade den aktiva rollen och stoppar medvetet de flesta tjänster, inklusive SMB och iSCSI, för att undvika att slå samman två divergerade datamängder. HA Manager presenterar sedan en guide för återställning från Split-brain med två sökvägar. Alternativ ett bevarar data på en enda nod som du väljer; den andra noden raderas, återställs som passiv medlem och synkroniseras om, den snabba vägen när du vet vilken sida som har korrekt data. Alternativ två bevarar data på båda noderna genom att återuppta tjänster på en nod samtidigt som den andra tas bort helt från klustret, vilket gör att du kan verifiera och stämma av data innan du manuellt återansluter till den. Det är en sund återställningsmodell, men återställning innebär fortfarande driftstopp och en fullständig omsynkronisering. Split-brain är ett tillstånd som du förhindrar genom distributionsdesign, inte ett du planerar att återställa från, och de tre reglerna ovan kostar ingenting utöver en kabel och fem minuter i en inställningspanel.
Övervakning och förvaltning
Dag två driften sker i HA Manager-appen, som samlar klusterstatus, resursanvändning per nod, händelseloggar och nodhantering, inklusive manuell övergång, i en enda ruta. Instrumentpanelens varningsbanners visade sig vara tillräckligt specifika för att vara diagnostiska under våra tester, och namngav exakt det felaktiga gränssnittet och noden snarare än en generisk flagga för degraderat problem.
QNAP har också integrerat HA-medvetenhet i själva hårdvaran. I ett HA-kluster kan LCD-panelen på varje NAS visa klusternamnet, nodens nuvarande roll och klustrets IP-adress, och status-LED:n indikerar HA-statusen med en snabb blick: fast grönt sken för den aktiva noden, blinkande grönt för den passiva noden och fast rött sken för ett HA-fel. I ett rack fullt av identiska kortdjupsenheter är det en liten detalj som tekniker kommer att uppskatta att kunna identifiera den aktiva noden utan att öppna en webbläsare. För driftsättningar av flottor lägger AMIZcloud till centraliserad molnövervakning av HA-grupper, vilket visar klusterhälsa, latens och varningar över olika platser.
Avslutande tankar
High Availability Manager levererade sitt kärnlöfte i båda de fellägen vi gav oss i kast med. Ett hårt strömavbrott på den aktiva noden kostade vår Windows-filkopiering ungefär 50 sekunder av avstannat förlopp och noll misslyckade filer; en avbruten klientnätverksanslutning kostade cirka 45 sekunder. I varje fall gick samma kopieringsjobb sedan igenom nodåterställning och en automatisk återställning efter fel, med inget värre än en andra paus på under en minut. Klienter behövde aldrig ompeka någonting. Program, fildelningar och användararbetsflöden fortsatte att fungera via en enda IP-adress och värdnamn före, under och efter redundansväxlingen. Installationen är också lättillgänglig; två fristående enheter blev ett serverkluster på under tio minuters guidetid plus en tio minuters initial synkronisering, och instrumentpanelen berättade exakt vilket gränssnitt, vilken nod och vilken anslutning vi skulle oroa oss för varje gång vi hade förstört något.
Hela HA-stacken: två TS-h765eU-enheter och IronWolf Pro-hårddiskar som fyllde dem.
Kostnaderna för HA bör dock inte ignoreras. Du köper två av allt, och den passiva noden har ledig kapacitet tills den dag den inte längre är det. Oföränderliga snapshots, h6.0:s andra viktiga skydd, är uteslutna i ett HA-kluster idag, så administratörer måste välja mellan de två. Och kravet på identisk hårdvara innebär att uppgraderingar sker parvis, vilket kan begränsa budgetar.
Var detta slutar är en fråga om rätt storlek, och det är småföretag och edge-distribution som HA Manager bäst betjänar. Mot företagsmatriser med dubbla styrenheter spelar ett par TS-h765eU-enheter med kort djup ett helt annat ekonomiskt spel samtidigt som de täcker felscenariot, styrenhetsförlust, som driver de flesta inköp av dubbla styrenheter i SMB-nivån. Mot gör-det-själv-replikeringsscheman, snapshot-leverans, rsync-jobb och säkerhetskopiering och återställning är skillnaden återställningstiden: dessa scheman skyddar data men gör att du måste återuppbygga klientanslutningar i timmar, medan HA Managers värsta klientsynliga händelse i våra tester var en minutlång paus. Lika viktigt är att felet som den inte kan absorbera, där varje sökväg mellan noder dör på en gång, kan förebyggas med en direkt hjärtslagskabel, separerade nätverksvägar och en aktiverad kvorumserver: en topologifaktura som uppgår till en kabel och fem minuter i en inställningspanel.
En sista punkt specifikt för en design med två noder: klustrets mest sårbara fönster är en omsynkronisering, när en nod har den enda bra kopian av dina data och hårddiskarna under arbetar hårdast. Det är ett argument för att ta hårddiskval på allvar i ett HA-par, och det är därför NAS-klassade hårddiskar som Seagate IronWolf Pro 30TB-enheterna i vår version spelar större roll här än i en fristående låda: deras jobb är att hålla det fönstret händelsefritt.
QNAP TS-h765eU och QuTS hero h6.0 finns tillgängliga nu. För mer information, besök QNAP TS-h765eU:s produktsida.
Denna rapport är sponsrad av QNAP. Alla åsikter och uppfattningar som uttrycks i rapporten är baserade på vår opartiska syn på den/de aktuella produkten/produkterna.


 Amazon