

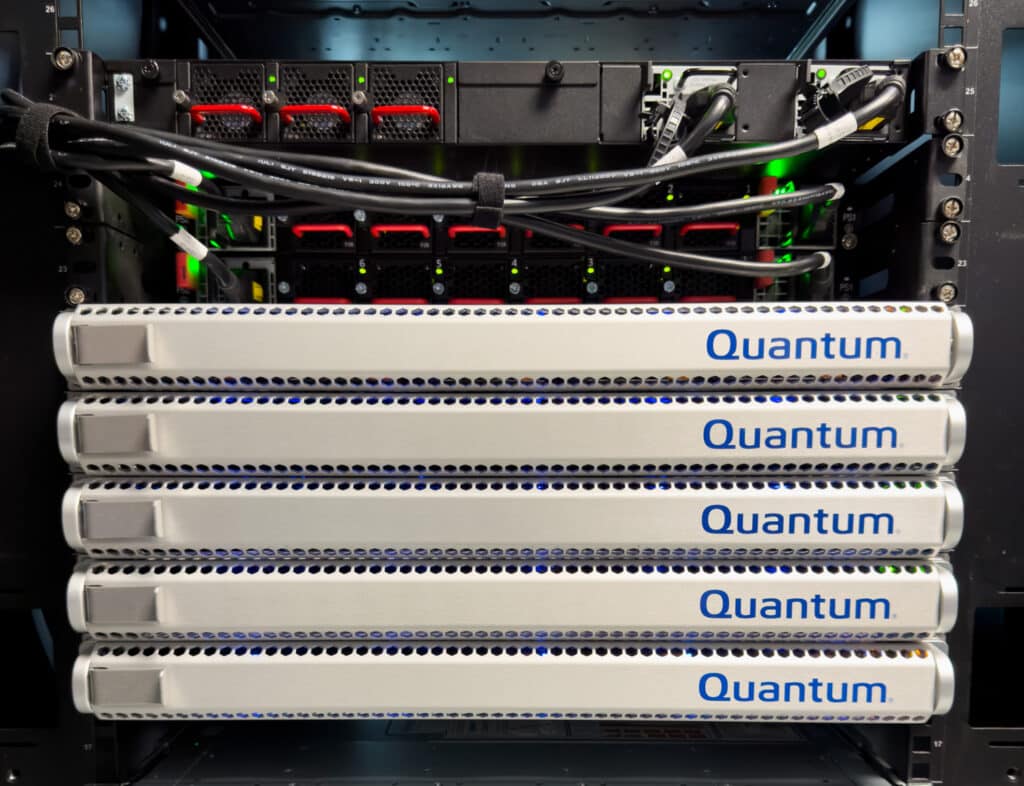
År 2023 lanserade Quantum en ny, modern tolkning av programvarudefinierad lagring med Myriad. Vi genomförde en djupdykning i Myriad sent förra året och blev imponerade av dess extremt kapabla och motståndskraftiga arkitektur. Myriads mångsidiga funktionsuppsättning och protokollflexibilitet utökar användningsområdet utöver företags fildelningsbehov. Och det finns ingen applikation som är mer efterfrågad just nu än AI.
AI förvandlar i grunden företagslandskapet genom att tillföra nya insikter i beslutsfattande, automatisera komplexa processer och skapa nya sätt för företag att interagera med kunder och hantera verksamheten. Här är några nyckelområden där AI påverkar:
Automatisering : AI automatiserar rutinmässiga, felbenägna uppgifter som datainmatning och kundsupport med chatbotar och hittar till och med sätt att optimera komplexa processer som supply chain management. Detta sparar tid och låter folk fokusera på mer kreativa eller strategiska uppgifter.
Dataanalys : Den gräver igenom massiva högar av data för att hitta mönster och insikter snabbare än någon människa kan. Detta hjälper företag att fatta smartare beslut, förutsäga marknadstrender och bättre förstå sina kunder.
Personalisering : Företag använder AI för att skräddarsy sina tjänster och sin marknadsföring efter enskilda kunder, som rekommendationsmotorer som lär sig vad en användare gillar sett på Netflix eller Spotify.
Förbättrad säkerhet : AI är en viktig aktör inom cybersäkerhet och hjälper till att upptäcka och reagera på hot direkt. Den är alltid på sin vakt och skannar efter allt som kan vara skumt.
Innovation : AI driver innovation genom att hjälpa till att utveckla nya produkter och tjänster – från läkemedel till nya material – genom att simulera varje aspekt av en produkts design, utseende, känsla och underhåll. Den kan till och med förutsäga resultat före fysiska läkemedelsprövningar.
Utmaningarna med skalbarhet och flexibilitet
Äldre lagringssystem misslyckas ofta med att skala effektivt, en förmåga som är avgörande för AI-applikationer som genererar och bearbetar stora datavolymer. Traditionell lagring kan kräva betydande stilleståndstid eller komplexa uppgraderingar och nätverkskonfiguration och tilldelning för att öka kapaciteten. Detta är inte möjligt i dynamiska AI-miljöer, som kräver snabb skalbarhet, noll stilleståndstid och modelldistribution utan att förlora prestanda.
AI-arbetsbelastningar kräver också hög datahastighet och låg latens samtidigt. Äldre system, vanligtvis utrustade med mekaniska enheter och föråldrade nätverk, kan inte uppfylla dessa hastighetskrav, vilket leder till flaskhalsar som hindrar AI-drift. Modern AI drar dramatisk nytta av snabbare tekniker som NVMe och GPU-acceleration, och dessa är ofta inkompatibla med äldre system.
AI-applikationer kräver dataåtkomst och analys i realtid från olika källor. Äldre lagring, ofta i silo, hindrar dataintegration och rörelse, vilket begränsar effektiv dataanalys och maskininlärning. Äldre hanteringsverktyg kämpar också med komplex datastyrning och automatiserad nivåindelning som krävs för AI.
Underhåll och uppgraderingar av äldre lagringsutrymmen är också kostsamma och ineffektiva för AI-krav, inklusive höga driftskostnader för kraft, kylning och utrymme. Att bygga om gamla system för att stödja ny teknik är ekonomiskt ohållbart.
AI frodas på moderna lagringsfunktioner som automatisk nivåindelning, realtidsanalys och robusta säkerhetsåtgärder som kryptering. Äldre system saknar dessa kritiska funktioner, som är viktiga för att skydda AI-data och uppfylla regulatoriska standarder.
Att modernisera datahantering och lagringsinfrastruktur är avgörande för att utnyttja AI:s transformativa potential. Nästa generations lagringslösningar designade för AI-komplexitet kan avsevärt förbättra prestanda, skalbarhet och kostnadseffektivitet och främja innovativa applikationer och affärsmodeller.
Möt Quantum Myriad
Quantum Myriad är en högpresterande, mjukvarudefinierad all-flash-lagringslösning designad för att möta kraven från moderna applikationer, särskilt de som kräver hög genomströmning och låg latens. Detta gäller särskilt för AI, datavetenskap, VFX och animation. Myriads molnbaserade arkitektur ger flexibilitet, enkel implementering och automatiska svar på systemändringar, oavsett om det är lokalt eller i en offentlig molnmiljö som AWS.
Myriads design nollställer sig på att leverera konsekvent låg latens och hög bandbredd. Dessa egenskaper är absoluta måsten för applikationer som kräver blixtsnabb databehandling och realtidsprestanda.
Myriads arkitektur är mycket flexibel och rymmer enkelt både små och stora installationer. Det är lätt att börja med ett litet system och sedan odla ett Myriad-kluster. När du lägger till fler noder skalas den upp linjärt samtidigt som saker och ting fortfarande är effektiva och balanserade.
Att hantera kluster med Myriad är enkelt. Den är fullspäckad med funktioner som lagringsexpansion med noll klick och en användarvänlig hanteringsportal, som hjälper till att minska behovet av konstant administrativ uppmärksamhet. Myriad täcker dataintegritet med ett transaktionsnyckel-värdelager spritt över dess noder och felkorrigering hanteras över alla tillgängliga lagringsnoder.
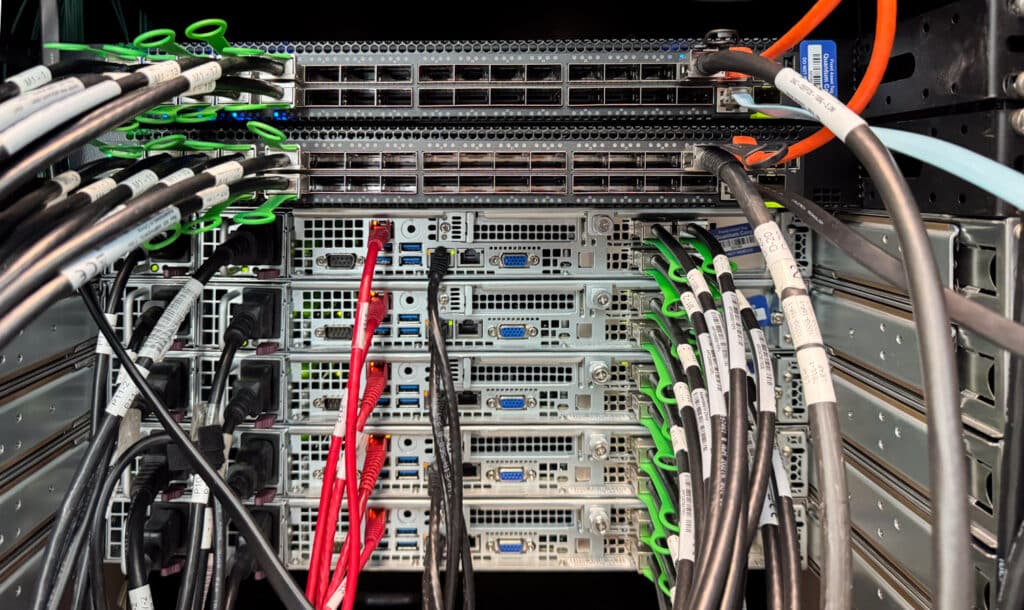
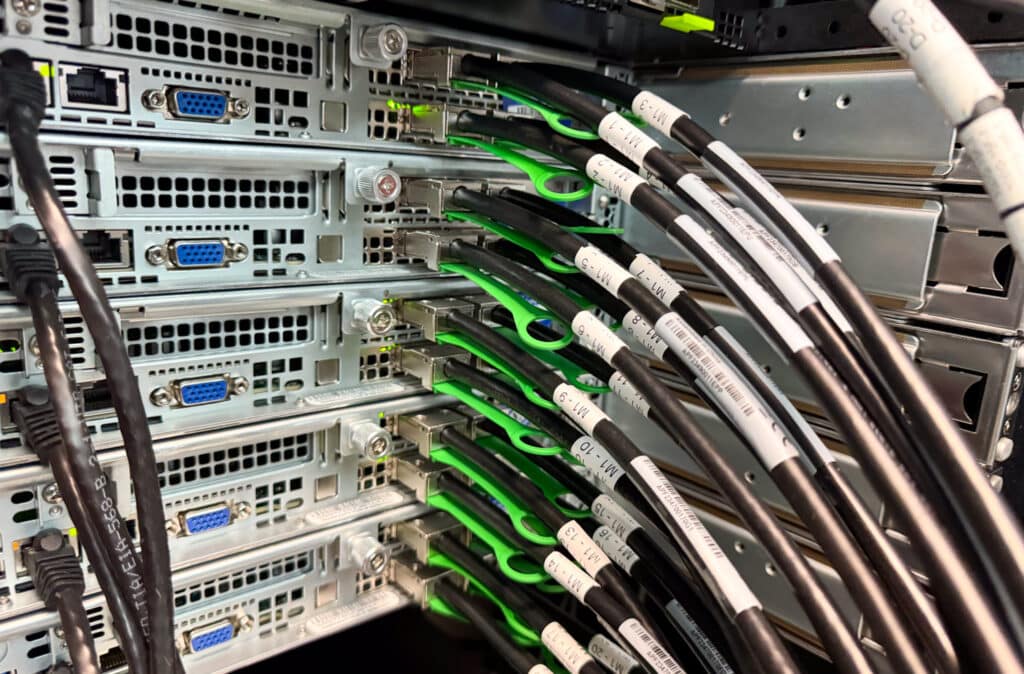
Myriad kommer med imponerande nätverksstöd. Med stöd för RDMA over Converged Ethernet (RoCE) och integration med befintliga nätverksinstallationer via BGP-routing kan data enkelt flöda in och ut ur Myriad-klustret samtidigt som man drar fördel av avancerade nätverksfunktioner.
Myriad är designad för att vara användarvänlig och kräver minimala steg för att konfigurera och köra eller lägga till extra delningsplatser. Detta gör den perfekt för företag som behöver anpassa sig snabbt till förändrade lagringsbehov, särskilt eftersom lösningen körs på standardservrar. Plus, om du tittar på molnet, Myriad spelar bra med plattformar som AWS så att du kan sträcka dig bortom din lokala installation.
Quantum Myriad-konfiguration som testad
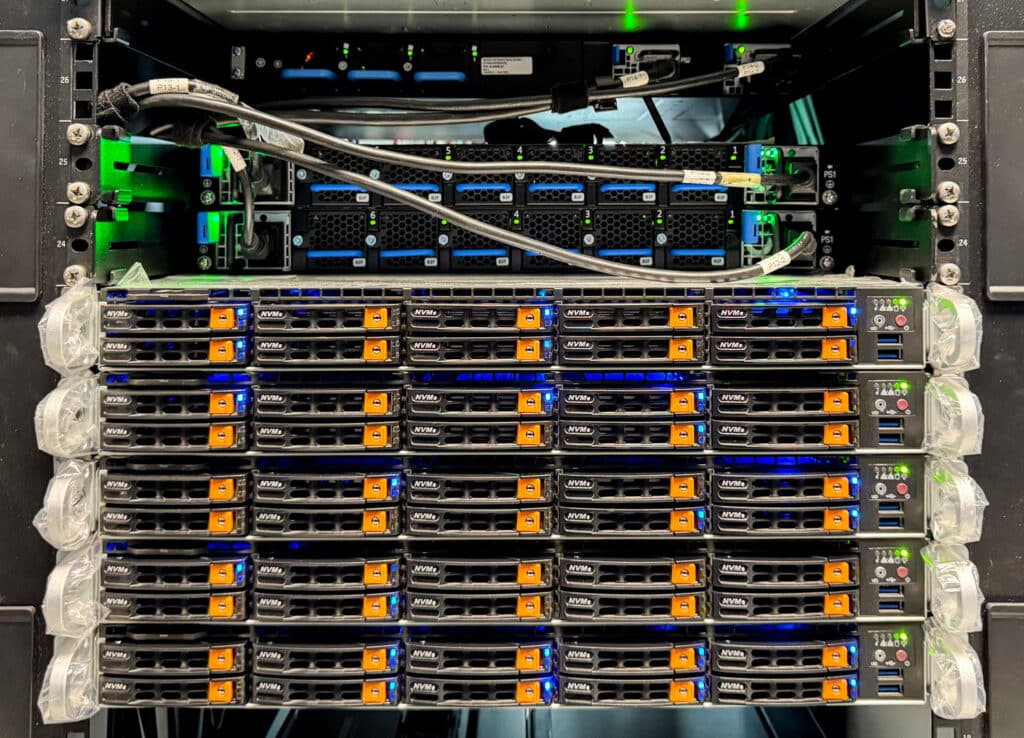
Quantum Myriad som testades var en baskonfiguration av fem noder. Varje nod var utrustad med tio 15 TB SSD:er, totalt en betydande mängd snabbåtkomstlagring över hela klustret. Den här basinställningen tillät betydande datalagringskapacitet samtidigt som den hastighet som krävs för höga I/O-operationer och snabb datahämtning bibehölls – allt väsentligt för realtidsbearbetning och AI-beräkningar. Lagringsnoderna specificeras och konfigureras från SuperMicro och NVMe-enheterna är lätt tillgängliga från Samsung.
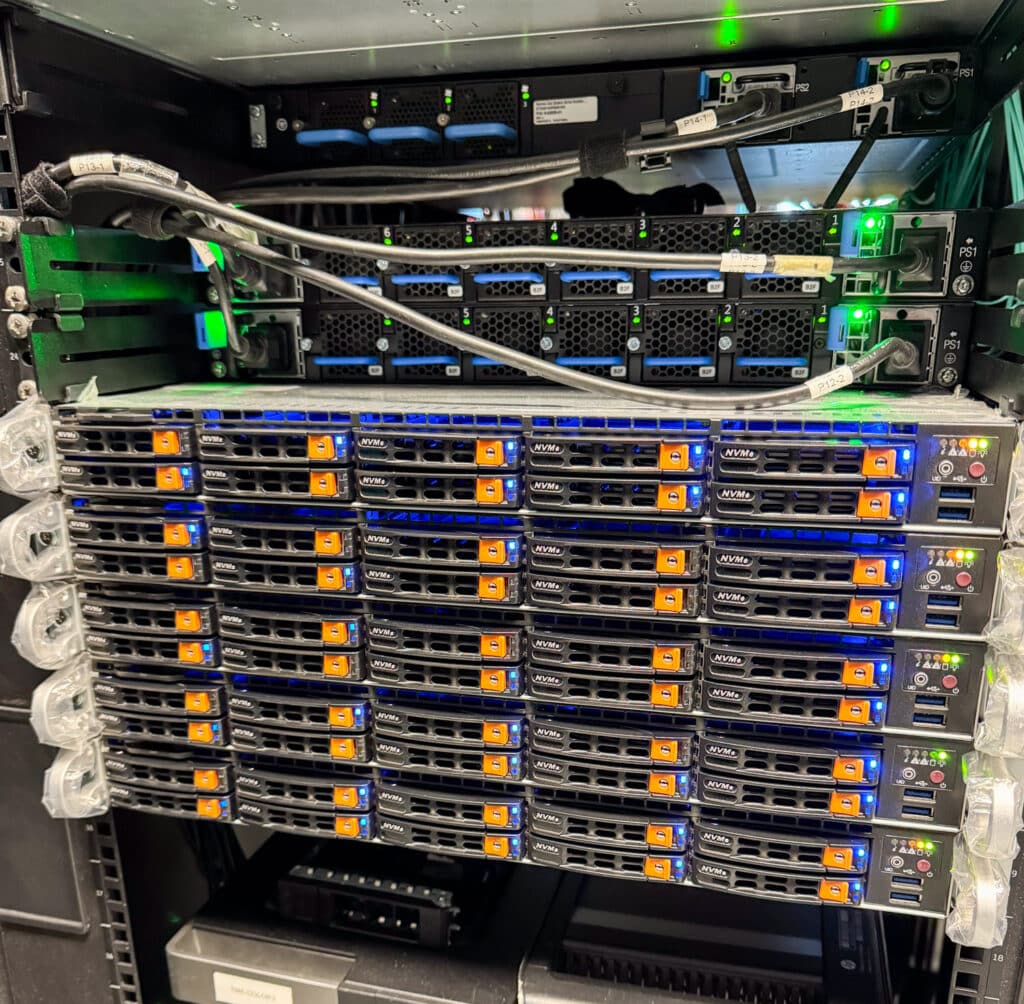
Som testat använde vi en Myriad-plattform konfigurerad i ett 5 nodkluster, var och en med följande nyckelspecifikationer:
- Quantum Myriad N1010 Storage Node med en enda 64-kärnig AMD EPYC CPU
- 10 x 15.36 TB NVMe TLC
- 2 x Dual Port 100 GbE Ethernet-portar
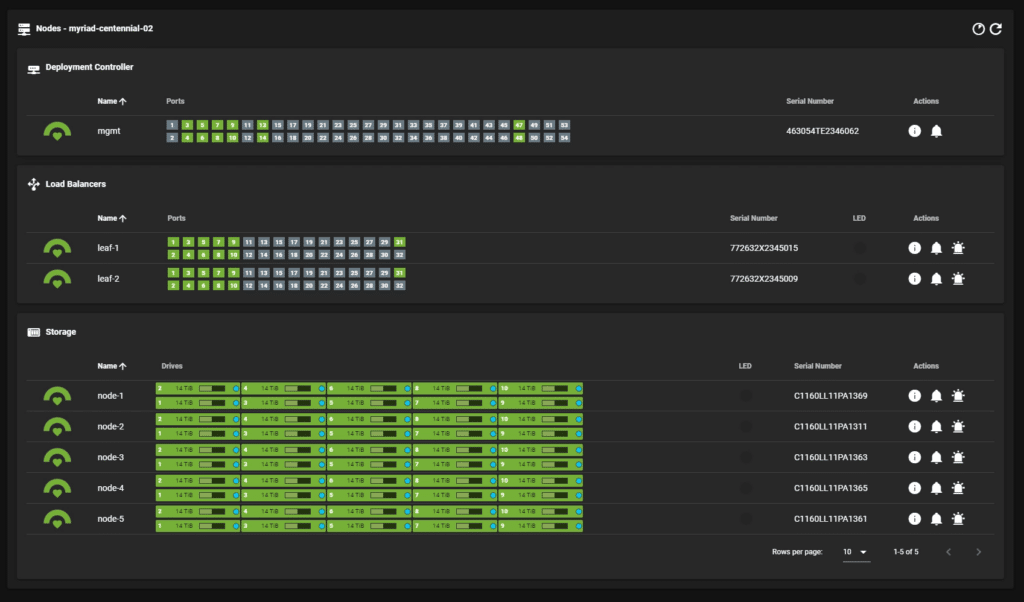
En integrerad del av Myriad är lastbalanseringsnoderna som är utplacerade i ett redundant par som är korsanslutna över alla lagringsnoder. Dessa är avgörande för att hantera datatrafiken till och från lagringsnoderna. Paret av lastbalanserare säkerställer att nätverkstrafiken är jämnt fördelad mellan lagringsnoderna, vilket förhindrar att någon enskild nod blir en flaskhals. Där samtidig dataåtkomst och bearbetning krävs är detta extremt viktigt i miljöer där hastigheten och tillförlitligheten för dataåtkomst kan påverka systemets övergripande prestanda avsevärt.
Användning av flera noder och lastbalanserare ökar prestandan och förbättrar systemets tillförlitlighet och feltolerans. Genom att distribuera lagrings- och nätverksbelastningen kan systemet fortsätta att fungera effektivt även om en nod stöter på problem. Denna installation är avgörande för att upprätthålla drifttid och säkerställa dataintegritet i kritiska affärsapplikationer.
Baskonfigurationen är designad för att vara flexibel och kan skalas upp genom att lägga till fler lagringsnoder efter behov. Du kan utöka din lagringskapacitet genom att införliva ytterligare noder, använda tätare NVMe-enheter eller båda. Till exempel kan du lägga till en ny lagringsnod utrustad med 30 TB-enheter till ett system som för närvarande använder 15 TB-enheter, eller så kan du uppgradera till tätare enhetsmoduler inom det befintliga utrymmet. Denna skalbarhet är avgörande för företag som förväntar sig att se tillväxt i sina databehov eller uppleva varierande dataanvändningsmönster.
Comino GPU Ladda Gen-servrar
För att träna Myriad-systemet och generera våra riktmärken använde vi ett par Comino Grando-system. Comino Grando-systemen är högpresterande, vätskekylda inställningar designade specifikt för att maximera GPU-effektiviteten och stabiliteten under belastning. De är särskilt lämpliga för intensiva beräkningsuppgifter som de som finns i AI, dataanalys och grafikintensiva applikationer. Här är en sammanfattning av de viktigaste aspekterna som vi konfigurerade för detta test:
| Grando Server | Grando arbetsstation | |
|---|---|---|
| CPU | Threadripper Pro W5995WX | Threadripper Pro 3975WX |
| Ram | 512GB RAM | 512GB RAM |
| GPU | 2X NVIDIA A100 | 2X NVIDIA A100 |
| NIC | 4x NVIDIA ConnectX 6 200G EN/IB | 4x NVIDIA ConnectX 6 200G EN/IB |
| PSU | 4x 1600w nätaggregat | 3x 1000 SFX-L PSU |
| lagring | 2TB NVMe | 2TB NVMe |
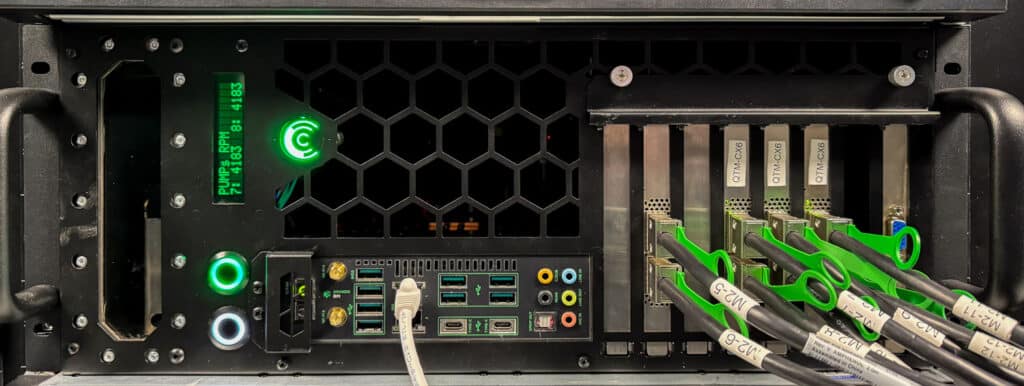
Comino Grando använder ett sofistikerat vätskekylningssystem för processorn och GPU:erna, som inkluderar droppfria anslutningar och ett stort vattenfördelningsblock som effektivt hanterar kylvätskeflödet för att bibehålla prestanda även under ansträngande belastningar. Denna inställning förbättrar prestanda och minimerar brus.
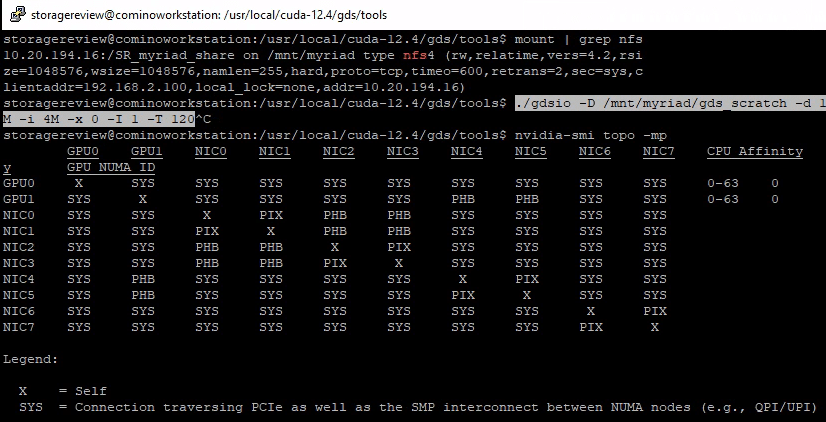
Använda nvidia-smi top -mp kommandot visar GPU- och NIC-mappningen i vårt system och vägarna som data måste ta. Här är legenden:
X = Själv
SYS = Anslutning som korsar PCIe såväl som SMP-sammankopplingen mellan NUMA-noder (t.ex. QPI/UPI)
NOD = Anslutning som korsar PCIe såväl som sammankopplingen mellan PCIe Host Bridges inom en NUMA-nod
PHB = Anslutning som går över PCIe samt en PCIe Host Bridge (typiskt CPU)
PXB = Anslutning som korsar flera PCIe-bryggor (utan att passera PCIe Host Bridge)
PIX = Anslutning passerar kl mest en enda PCIe-brygga
Härifrån kan vi säga att vi inte skulle vilja använda GPU1 med NIC4 och NIC5 för optimal prestanda, även om detta spelar en begränsad roll i våra syntetiska tester.
Quantum Myriad AI-testning
Vi genomförde en teknisk analys för att utvärdera prestandan för Quantum Myriad-lagringsklustret och dess inverkan på verkliga AI-arbetsbelastningar. Vår analys fokuserade på klustrets förmåga att optimera resursutnyttjandet och skala effektivt. Under hela denna testning använde vi avancerade Comino-rackarbetsstationer utrustade med NVIDIA ConnectX-6 200GbE NIC och dubbla NVIDIA A100 GPU:er. Dessa är avgörande eftersom de representerar en robust testmiljö som liknar vad som kan användas i storskaliga AI-projekt.
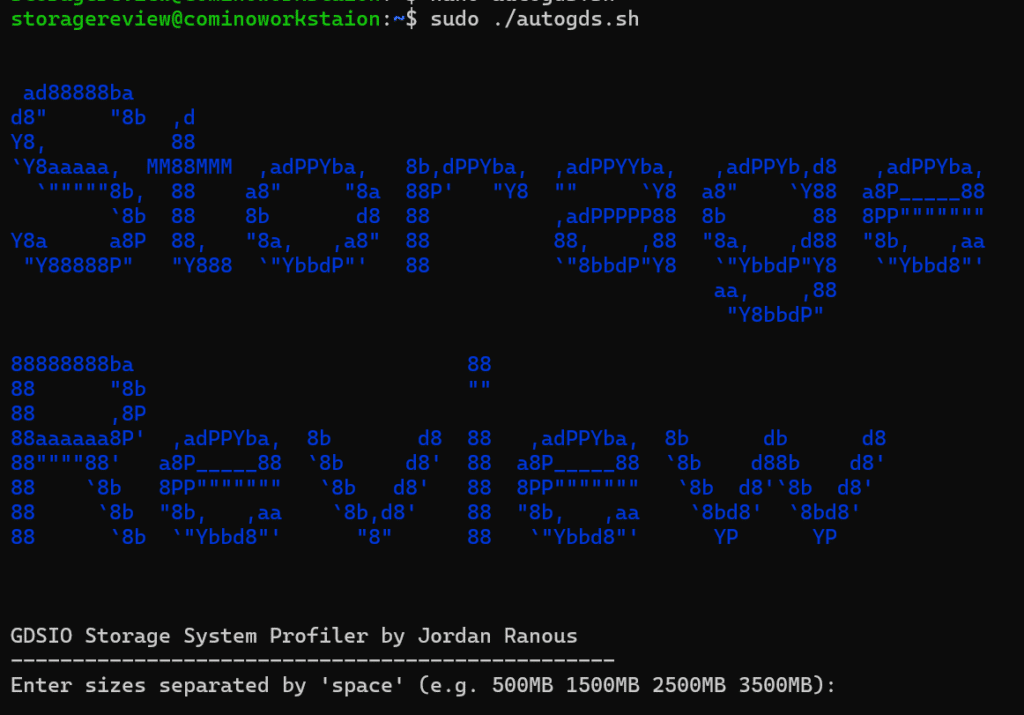
Vi använde ett enkelt skalskript för att skapa GDS-testskript och analysera utdata. ASCII Art for Style Points
Det primära syftet med dessa tester var att bedöma Quantum Myriad-klustrets förmåga att hantera intensiva IO-operationer och hur väl det kan hantera genomströmning från högkapacitets GPU:er, som är avgörande för AI-beräkningar. Med tanke på att AI-arbetsbelastningen är starkt beroende av den snabba bearbetningen av datamängder, påverkar förmågan hos en lagringslösning att leverera data med hastigheter som matchar GPU-bearbetningskapaciteten direkt systemets övergripande effektivitet och prestanda.
Vårt primära verktyg för att testa här var NVIDIAs GPUDirect Storage I/O (GDSIO). GPUDirect är en nyckelteknologi designad för att förbättra dataöverföringseffektiviteten mellan lagringssystem och GPU: er, effektivisera arbetsflöden som är avgörande för högpresterande datoranvändning, artificiell intelligens och big data-analys.
Den här tekniken möjliggör direkt minnesåtkomst (DMA) från lagring direkt till GPU-minne, vilket i själva verket kringgår processorn. Detta eliminerar onödiga datakopior, vilket minskar latensen och förbättrar genomströmningen. GDSIO är den syntetiska implementeringen av GPUDirect och är särskilt representativ för applikationer som kräver snabb bearbetning av stora datamängder. Detta inkluderar utbildning i maskininlärning eller dataanalys i realtid. Det ger också profilerings- och inställningsfeedback för lagrings- och nätverksinfrastruktur.
I samband med lagringsbenchmarking spelar GDSIO en avgörande roll för att noggrant bedöma prestandan hos lagringslösningar i miljöer som använder GPU:er. Genom att tillhandahålla en mer direkt väg för dataöverföring tillåter GDSIO benchmarking för att mäta den verkliga potentialen hos lagringssystem för att stödja GPU-accelererade applikationer.
AI Share Configuration
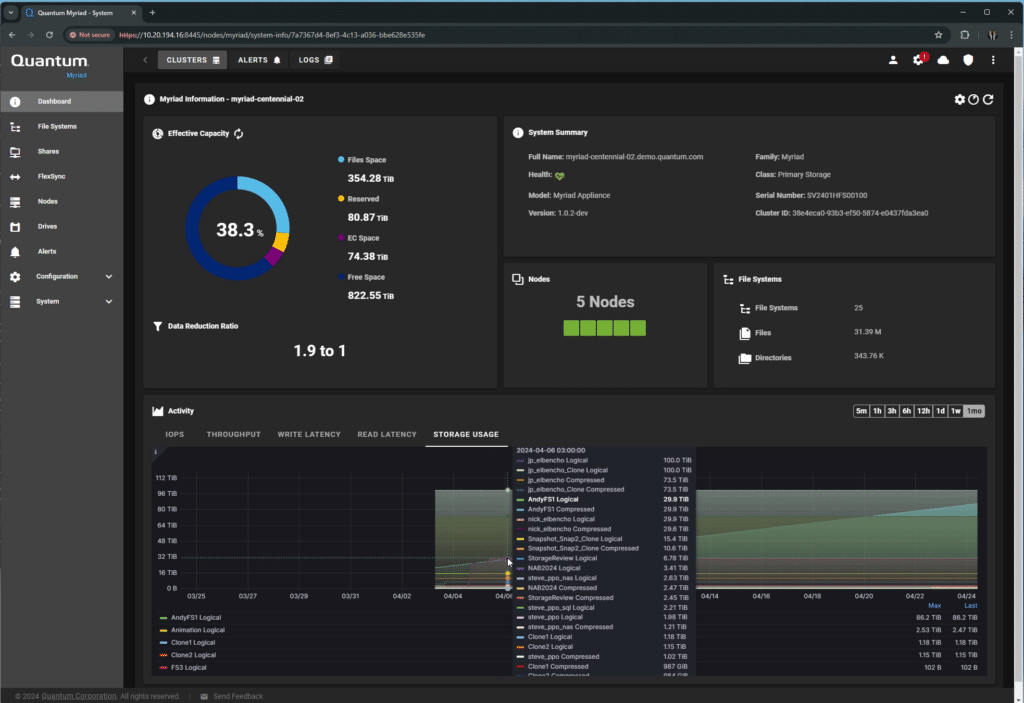
När användaren loggar in på Myriad presenteras en dashboard som visar en översikt på hög nivå över klustrets nuvarande prestanda och specifikationer. Användare kan enkelt se telemetridata som IOPS, genomströmning, latens och användning.
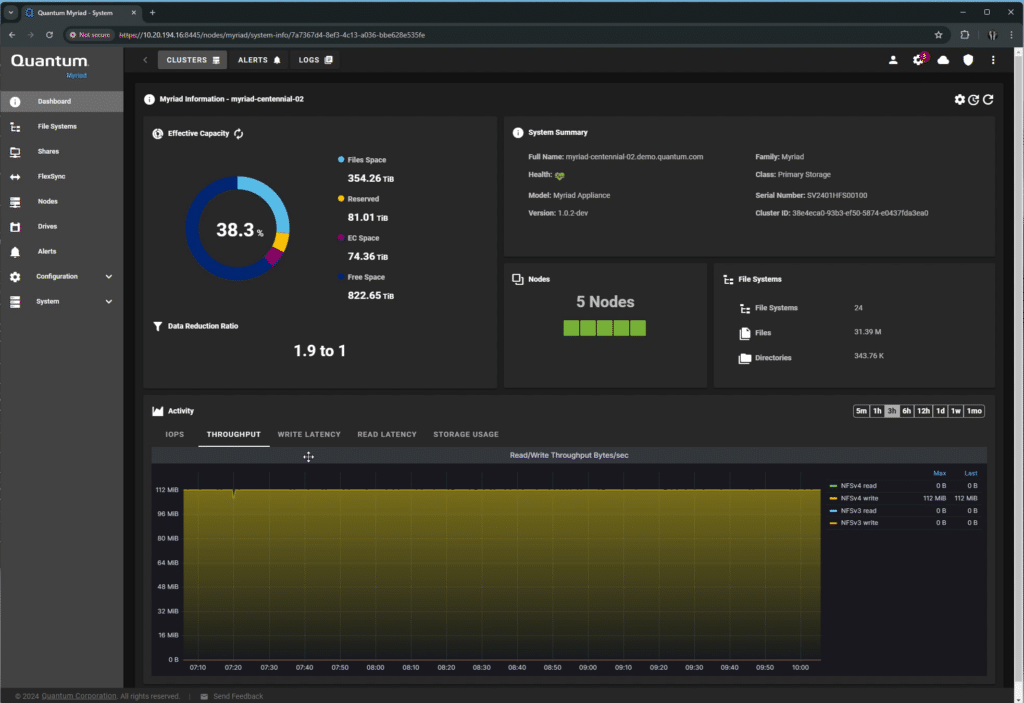
Om du för musen över något av diagrammen får du mycket detaljerad prestandainformation.
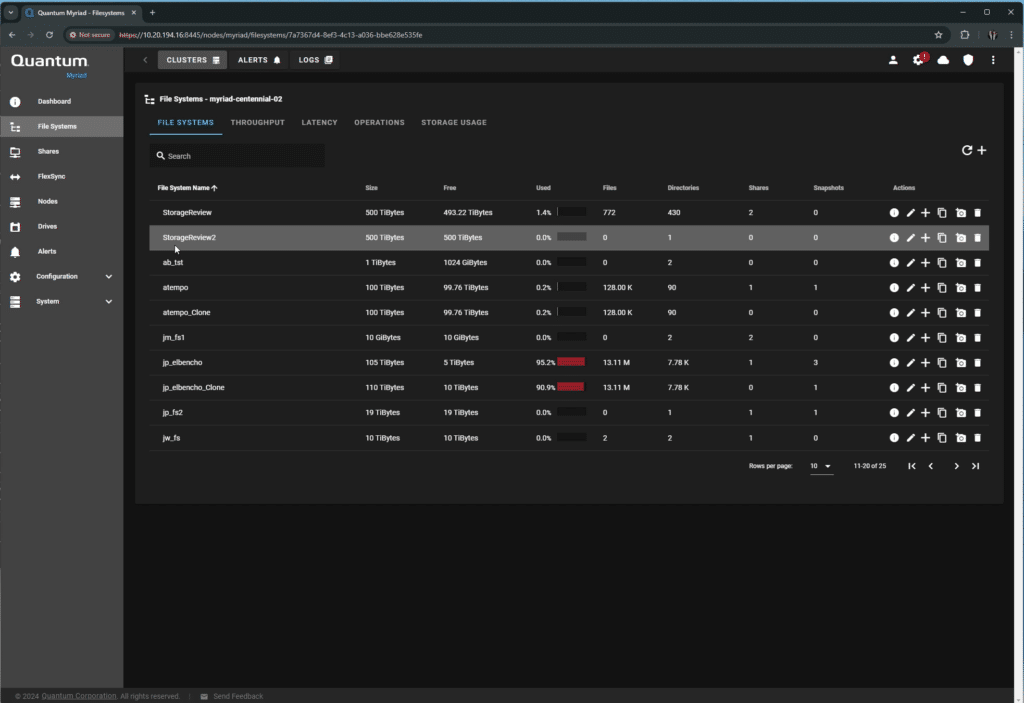
Om du tittar på skärmen Filsystem är de för närvarande konfigurerade monteringspunkterna för resurser intuitivt synliga.
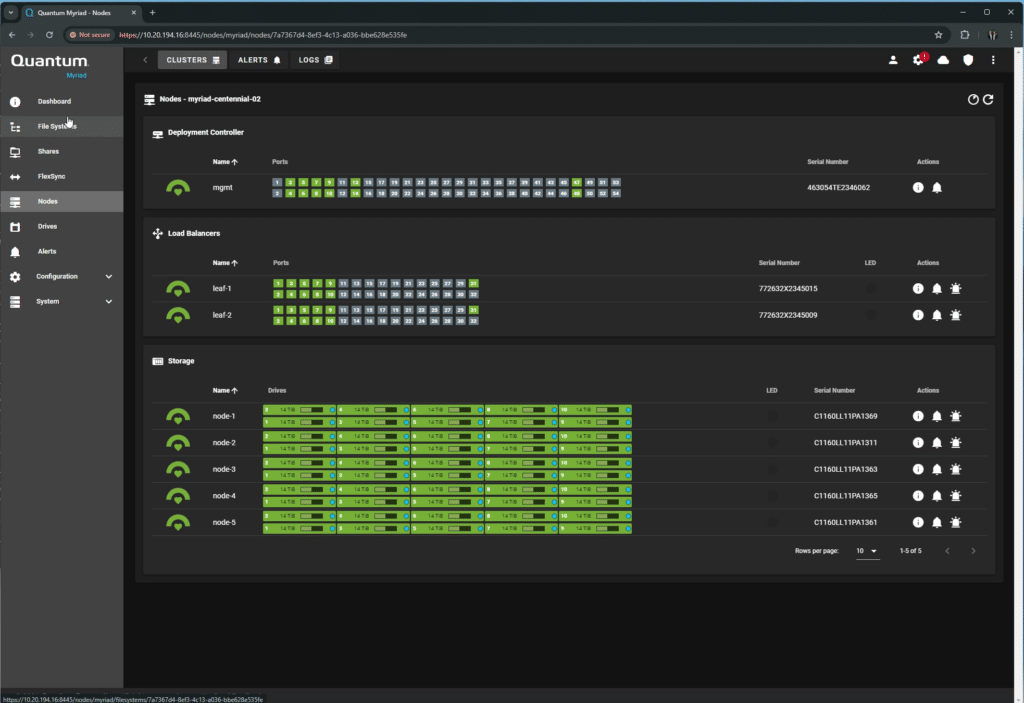
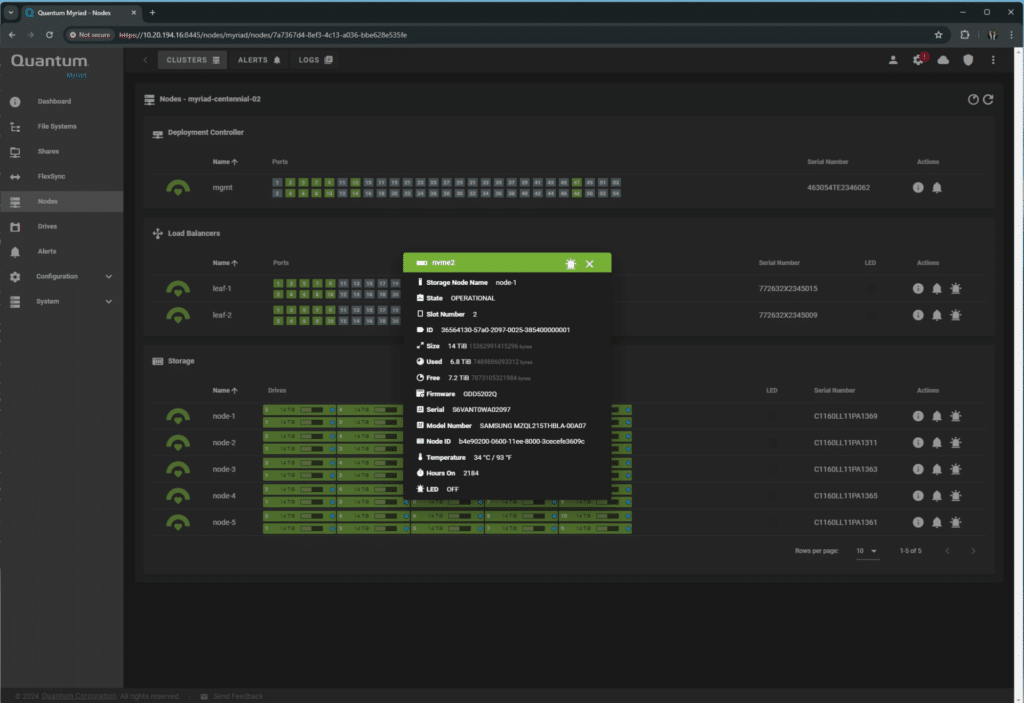
Sidan med noder är intressant, den visar den fysiska kartan över klustret, styrenheten och lastbalanserarna, tillsammans med portaktivitet och NVMe-enheter.
Om du klickar på någon av enheterna visas statusen som rapporterats av värden.
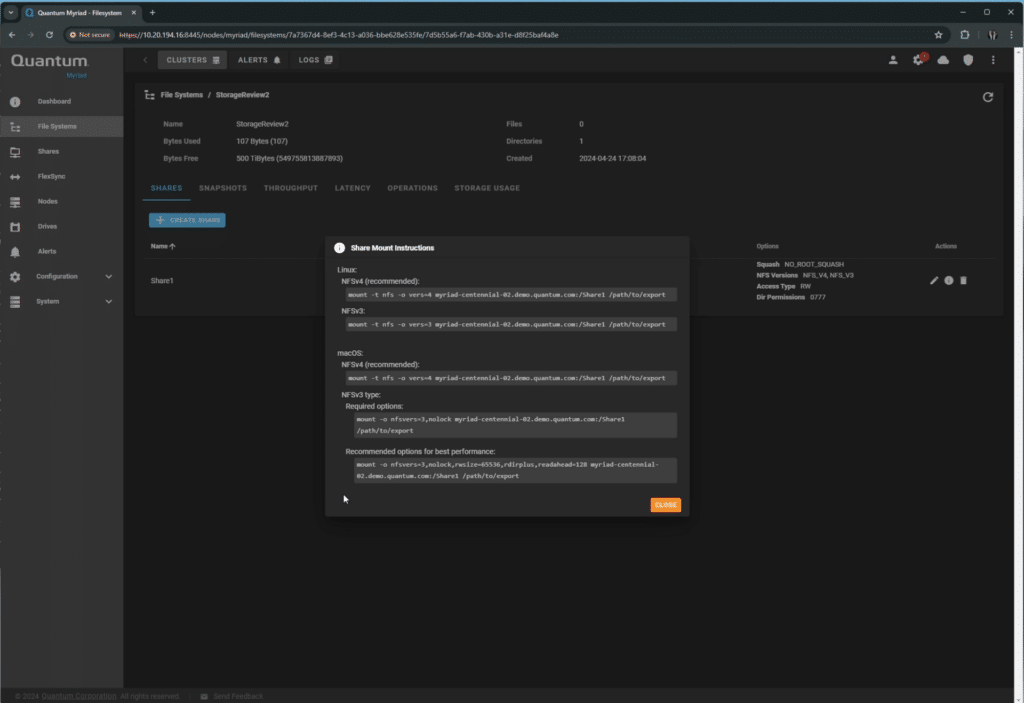
På väg till Shares kan användare enkelt konfigurera delarna efter behov och få instruktioner för att montera dem i olika operativsystem.
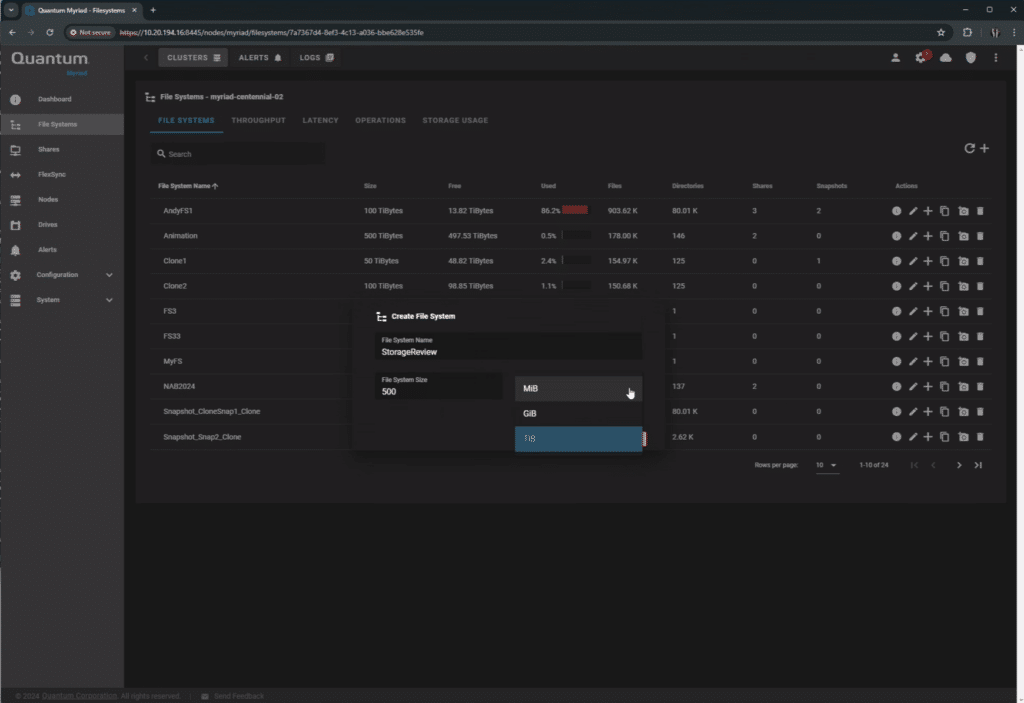
Vi arbetade med Quantum för att skapa en dedikerad NFS-andel för våra tester. Dessa monterades kl /mnt/myriad/
Detta uppnåddes med det användarvänliga Myriad UI, som erbjuder en enkel peka-och-klicka-konfiguration. Under testperioden var SMB-alternativet i Early Access, medan NFS förblev det föredragna protokollet för våra Linux-baserade arbetsbelastningsmaskiner.
Vår NFS-monteringspunkt konfigurerades för 500 TB utrymme, men du kan använda vad du behöver genom att utöka filsystemet. Du kan fritt överprovisionera lagring utan påföljder, och det finns ingen hård gräns för storlek. Detta blir väldigt intressant när man tänker på Myriads datakomprimering, som väsentligt minskar fotavtrycket av data på NVMe SSD:erna.
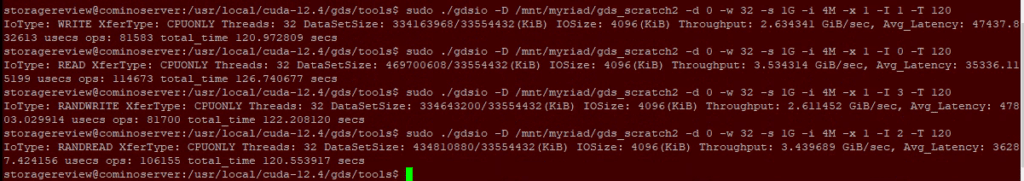
Med en monteringspunkt per värd har varje GPU sin egen undermapp, med sin egen NIC för att undvika en NFSv4-begränsning.
Quantum Myriad AI-resultat och analys
Låt oss först titta på den övergripande prestandan för en av våra loadgen-körningar. Detta exempel på en GPU:s perspektiv på lagringen representerar den prestanda vi kunde se över alla noder/GPU:er.
| IO typ | IO-storlek (KiB) | Genomströmning (GiB/sek) | Genomsnittlig fördröjning (användare) | Operationer |
|---|---|---|---|---|
| RANDWRITE | 1024 | 2.57 | 10,087.74 | 78,820 |
| RANDLÄS | 1024 | 6.92 | 2,277.86 | 209,319 |
| RANDWRITE | 4096 | 3.44 | 18,193.14 | 56,616 |
| RANDLÄS | 4096 | 3.64 | 6,481.70 | 73,715 |
| RANDWRITE | 4 | 0.03 | 2,307.57 | 237,512 |
| RANDLÄS | 4 | 0.12 | 497.05 | 941,971 |
| SKRIVA | 1024 | 2.79 | 5,609.64 | 94,017 |
| LÄSA | 1024 | 3.11 | 5,021.91 | 95,556 |
| SKRIVA | 4096 | 2.77 | 22,551.26 | 31,716 |
| LÄSA | 4096 | 3.50 | 17,875.32 | 31,871 |
| SKRIVA | 4 | 0.08 | 812.93 | 580,169 |
| LÄSA | 4 | 0.12 | 507.34 | 926,909 |
Testresultat visar betydande insikter i Myriads prestanda över olika IO-operationer och storlekar. Några av våra resultat inkluderar:
- Små och stora blockprestanda: Testerna visar en markant skillnad i genomströmning och latens vid hantering av små (4 KiB) jämfört med stora (1024 KiB och 4096 KiB) blockstorlekar. Till exempel visade stora block RANDREAD-operationer vid 4096 KiB den högsta genomströmningen på cirka 9.64 GiB/sek, med en relativt lägre genomsnittlig latens på 6,481.70 XNUMX mikrosekunder. Detta indikerar utmärkta prestanda för storskaliga databearbetningsuppgifter som är vanliga i maskininlärningsmodellutbildning, där stora datamängder ofta används.
- GPU-mättningsförmåga: Genomströmningen som uppnås under stora blocktester, särskilt för RANDREAD-operationer, tyder på att Myriad-lagringsklustret är ganska kapabelt att backa upp NVIDIA A100 GPU:erna i arbetsbelastningar av inferenshämtningstyp och för att avlasta kontrollpunkter till en central plats under träningsbelastningar. Med tanke på att A100 kan hantera enorma mängder data för djupinlärning är de höga genomströmningshastigheterna väsentliga för att säkerställa att dessa GPU:er inte lämnas på tomgång i väntan på data, vilket maximerar beräkningseffektiviteten.
- Hantering av låg blockstorlek: Omvänt, när vi undersökte operationer med 4 KiB-block, observerade vi en dramatisk ökning av antalet operationer och latens, med en betydande nedgång i genomströmning. Det här scenariot är avgörande för att förstå prestanda i miljöer där flera små filtransaktioner förekommer, till exempel i onlinetransaktionsbehandlingssystem eller databaser som hanterar många små frågor.
Men vänta, det finns mer!
Med fokus på 4K-testerna tog det en intressant vändning när vi laddade upp Myriad med fler GPU:er. På grund av monteringsprotokollets begränsningar, som upptäcktes i de första körningarna under upptäcktsfasen, betedde sig Myriad som avsett men med en överraskande twist. När vi laddade upp Myriad över alla GPU:er samtidigt, tack vare några skripthack, var resultaten imponerande. Myriad levererade i princip samma prestanda till alla noder samtidigt.
4K-filstorlek
Här är en sammanställning av fem samtidiga körningar av 4K-arbetsbelastningen:
| Nod | IO typ | Genomströmning (MiB/sek) | Genomsnittlig fördröjning (användare) | Operationer |
|---|---|---|---|---|
| 1 | RANDLÄS | 125.73 | 497.05 | 941,971 |
| 2 | RANDLÄS | 121.29 | 506.67 | 907,642 |
| 3 | RANDLÄS | 128.37 | 474.73 | 906,847 |
| 4 | RANDLÄS | 122.93 | 487.88 | 966,441 |
| Totalt slumpmässig läsning | 498.31 | 491.58 | 3,722,901 | |
| 1 | RANDWRITE | 27.08 | 2,307.57 | 237,512 |
| 2 | RANDWRITE | 26.88 | 2,285.62 | 231,625 |
| 3 | RANDWRITE | 26.10 | 2,406.89 | 228,983 |
| 4 | RANDWRITE | 28.27 | 2,341.65 | 245,172 |
| Total slumpmässig skrivning | 108.34 | 2,335.43 | 943,292 | |
| 1 | LÄSA | 123.19 | 507.34 | 926,909 |
| 2 | LÄSA | 125.69 | 511.23 | 900,136 |
| 3 | LÄSA | 123.90 | 502.04 | 945,949 |
| 4 | LÄSA | 123.77 | 502.36 | 948,850 |
| Totalt läst | 496.54 | 505.74 | 3,721,844 | |
| 1 | SKRIVA | 76.87 | 812.93 | 580,169 |
| 2 | SKRIVA | 80.17 | 839.88 | 551,311 |
| 3 | SKRIVA | 78.62 | 783.24 | 556,060 |
| 4 | SKRIVA | 73.40 | 811.62 | 597,226 |
| Totalt skriv | 309.06 | 811.92 | 2,284,766 | |
4MB filstorlek
| Nod | IO typ | Genomströmning (GiB/sek) | Genomsnittlig fördröjning (användare) | Operationer |
|---|---|---|---|---|
| 1 | RANDLÄS | 3.44 | 6,481.70 | 73,715 |
| 2 | RANDLÄS | 3.97 | 6802.17 | 75,689 |
| 3 | RANDLÄS | 3.83 | 6498.16 | 73,277 |
| 4 | RANDLÄS | 3.50 | 6,589.43 | 70,443 |
| Totalt slumpmässig läsning | 14.75 | 6,593 | 293,124 | |
| 1 | RANDWRITE | 3.44 | 18,193.14 | 56,616 |
| 2 | RANDWRITE | 3.4048 | 19090.38 | 54,725 |
| 3 | RANDWRITE | 3.4349 | 18125.25 | 56,277 |
| 4 | RANDWRITE | 3.5084 | 17018.30 | 54,397 |
| Total slumpmässig skrivning | 13.78 | 18,107 | 222,015 | |
| 1 | LÄSA | 3.50 | 17,875.32 | 31,871 |
| 2 | LÄSA | 3.4388 | 17110.93 | 31,119 |
| 3 | LÄSA | 3.5133 | 18124.53 | 31,096 |
| 4 | LÄSA | 3.3035 | 17755.53 | 31,257 |
| Totalt läst | 13.75 | 17,717 | 125,343 | |
| 1 | SKRIVA | 2.77 | 22,551.26 | 31,716 |
| 2 | SKRIVA | 2.8845 | 23674.69 | 33,017 |
| 3 | SKRIVA | 2.7008 | 22661.31 | 30,971 |
| 4 | SKRIVA | 2.7719 | 22798.83 | 29,519 |
| Totalt skriv | 11.13 | 22,922 | 125,223 | |
Quantum Myriads unika lagringsarkitektur ger dubbel tillgänglighet som gynnar både GPU-drift och samtidiga användaraktiviteter utan prestandaförlust. Detta är särskilt effektivt i miljöer med hög efterfrågan där samtidig dataåtkomst och bearbetning krävs, liknande en användargemenskap av AI och maskininlärningsserver och slutanvändaranalytiker. Genom att stödja tillgänglighet för stora datablock för GPU:er tillsammans med andra användaroperationer säkerställer Myriad ett effektivt resursutnyttjande och förhindrar flaskhalsar. Detta är avgörande för att upprätthålla höga driftshastigheter och datanoggrannhet i applikationer som realtidsanalys och AI-modellutbildning.
Det är värt att notera här att festtricket med Quantum Myriad är dess förmåga att skickligt hantera flera dataströmmar ända upp till begränsningarna för NFSv4, som lätt kan träffas under intensiva GPU-belastningar. Systemets sofistikerade datahanteringsfunktioner förhindrar att dessa gränser påverkar den övergripande Myriad-plattformens prestanda, vilket säkerställer att GPU-uppgifter med hög efterfrågan inte saktar ner andra operationer på samma nätverk. Den här funktionen är särskilt fördelaktig för industrier som kräver robusta databearbetningsmöjligheter utan att offra prestanda för samtidiga uppgifter, vilket stödjer ett sömlöst arbetsflöde för alla användare.
Verkliga konsekvenser och skalning
Quantum Myriad har potential att enkelt arbeta med verkliga applikationer och skalningsscenarier. Dess förmåga att hantera stora blockstorlekar med hög genomströmning och låg latens gynnar AI-arbetsbelastningar, inklusive träning av djupinlärningsmodeller där stora datamängder bearbetas i omgångar. Hög genomströmning säkerställer att data matas in i GPU:erna utan fördröjning, vilket är avgörande för att upprätthålla högt utnyttjande och effektiv inlärning.
En annan väsentlig egenskap är skalbarhet. Prestandan hos Quantum Myriad-lagringsklustret i våra tester tyder på att det effektivt kan stödja större konfigurationer. När antalet anslutna enheter (t.ex. ytterligare GPU eller andra högpresterande datorenheter) ökar, verkar lagringssystemet kunna upprätthålla höga nivåer av dataleverans utan att bli en flaskhals.
Quantum Myriad-lagringsklustrets prestanda under RANDREAD-operationer med stora block var särskilt anmärkningsvärd under våra tester. Denna förmåga är avgörande när man överväger behoven hos moderna AI- och maskininlärningsramverk.
RANDREAD-testet, med sin betydande genomströmning, visar Myriads förmåga att snabbt och effektivt hämta stora datamängder. Detta blir särskilt viktigt i samband med slutledningsarbetsbelastningar, där hastigheten med vilken data kan nås direkt påverkar prestandan för AI-modeller i produktionsmiljöer. Slutledningsuppgifter, som ofta kräver snabb åtkomst till stora datamängder för beslutsfattande i realtid, drar oerhört nytta av de höghastighetsdatahämtningsmöjligheter som Myriad-klustret uppvisar. Till exempel, i applikationer som bildigenkänning i realtid eller komplexa beslutsmotorer som driver automatiserade system, säkerställer förmågan att dra stora datablock med minimal latens att slutledningsmotorerna kan arbeta med maximal effektivitet utan att stanna för data.
Under testfasen visade Myriad robusthet i att hantera kontrollpunktsdata under träningsbelastningar, vilket är lika viktigt som klustrets prestanda under skrivoperationer. Att träna moderna AI-modeller, särskilt nätverk för djupinlärning, involverar iterativa processer där kontrollpunkter är avgörande. Dessa kontrollpunkter, som representerar modellens tillstånd vid en viss iteration, måste sparas med jämna mellanrum för att säkerställa att framstegen inte går förlorade och att modellerna effektivt kan finjusteras utan att behöva tränas om från början. Myriad avlastar effektivt stora skrivoperationer till lagringsklustret, vilket minskar I/O-tiden och låter GPU:er fokusera på beräkning istället för datahantering.
Myriads arkitektur säkerställer att eftersom data kräver skalning, oavsett om det beror på ökade datauppsättningsstorlekar eller mer komplexa modellutbildningskrav, kan systemet skalas därefter utan att skapa flaskhalsar, stillestånd eller förlust av användaranslutningar. Denna skalbarhet är avgörande i en tid där arbetsbelastningar för AI och maskininlärning utvecklas snabbt, vilket kräver lagringslösningar som håller jämna steg med nuvarande krav och som är framtidssäkrade mot kommande framsteg inom AI-forskning och -utveckling.
Slutsats
Quantum Myriad lagringskluster uppvisar exceptionell prestanda för att hantera olika och krävande I/O-operationer. Det är en mångsidig lösning för traditionella affärsbelastningar och banbrytande AI-applikationer. Tack vare sin höga genomströmning och låga latens sträcker sig Myriads kapacitet bortom traditionella datalageruppgifter som är avgörande för att upprätthålla smidig drift och effektiv datahämtning.
Utöver dessa konventionella användningsområden gör Myriads robusta prestandaegenskaper den till en idealisk kandidat för de mer intensiva kraven på AI-arbetsflöden. Här utmärker sig klustret i scenarier som kräver snabb dataåtkomst och höghastighetsbearbetning, avgörande för att träna sofistikerade maskininlärningsmodeller och driva komplexa neurala nätverk. Möjligheten att snabbt läsa och skriva stora, delade datamängder kan öka GPU-användningen och säkerställa att AI-beräkningar kan utföras utan fördröjning.
Denna omfattande testning av Myriad-klustret fungerar som ett avgörande riktmärke för att förstå dess skalbarhet och prestanda i miljöer som kombinerar traditionella IT- och affärsbehov med de höga kraven på AI-forskning och -utveckling. Resultaten belyser Myriads tekniska skicklighet och dess potential att underlätta AI-applikationer med hög insats och maskininlärningsprojekt, vilket understryker dess anpassningsförmåga och effektivitet över ett brett spektrum av beräkningsuppgifter. Sådana förmågor bekräftar Myriads roll som en grundläggande teknik som stödjer företag när de navigerar i nuvarande behov och framtida tekniska landskap.
Denna rapport är sponsrad av Quantum. Alla åsikter och åsikter som uttrycks i denna rapport är baserade på vår opartiska syn på produkten/de produkter som övervägs.



 Amazon