

Checkpointing är avgörande för AI-modellträning, vilket säkerställer motståndskraft, effektivitet och förmågan att återuppta eller finjustera träning från sparade tillstånd. Kraven på moderna AI-arbetsbelastningar, med allt mer komplexa modeller och omfattande utbildningsdatauppsättningar, pressar dock lagringen till sin gräns.
Kontrollpunkternas roll i AI-arbetsflöden
Checkpointing i AI-träning är en kritisk process som innebär att regelbundet spara hela modellens tillstånd under träning. Det här tillståndet inkluderar modellens vikter och parametrar, optimerartillstånd, inlärningshastighetsscheman och träningsmetadata. Checkpointing skapar en omfattande ögonblicksbild av träningsprocessen vid specifika intervall, vilket ger träningskontinuitet och återhämtning vid avbrott.
Kontrollpunkter tas vanligtvis med iterationsbaserade intervaller (t.ex. vart tusende träningssteg). Modern LLM-utbildning, som kan sträcka sig över veckor eller månader och konsumerar enorma beräkningsresurser, förlitar sig starkt på dessa kontrollpunkter som ett skyddsnät mot potentiella misslyckanden. Till exempel kan träning av en modell som GPT-4-klassen generera kontrollpunkter som sträcker sig från flera hundra gigabyte till flera terabyte, beroende på modellstorlek och träningskonfiguration.
Utbildningsprocess genererad av DALL-E
Det primära syftet med checkpointing sträcker sig längre än bara säkerhetskopieringsfunktioner. Det fungerar som en avgörande mekanism för att träna motståndskraft, vilket möjliggör återupptagande av träning från det senast sparade tillståndet snarare än att börja från början i händelse av systemfel, strömavbrott eller hårdvaruproblem. Dessutom är kontrollpunkter ovärderliga för modellanalys, vilket gör det möjligt för forskare att undersöka modellens utveckling vid olika utbildningsstadier och potentiellt rulla tillbaka till tidigare tillstånd om prestationsförsämring upptäcks.
Skrivmönstren under checkpointing är särskilt intressanta ur ett lagringsperspektiv. När en kontrollpunkt utlöses måste systemet skriva enorma mängder data i ett skurmönster. Detta skapar en distinkt I/O-profil som kännetecknas av perioder med relativt låg lagringsaktivitet under träningsberäkningar, följt av intensiva skrivoperationer med hög bandbredd under checkpointing. Dessa skrivoperationer är vanligtvis sekventiella och kan dra stor nytta av lagringssystem optimerade för sekventiell skrivning med hög bandbredd.
Olika parallellitetsstrategier i distribuerad träning kan avsevärt påverka kontrollbeteendet. Dessa parallellitetsstrategier påverkar när checkpointing sker under träning och vilken del av modellen som checkpoints. I moderna distribuerade träningsuppställningar kan flera GPU:er samtidigt skriva olika delar av samma lager, vilket skapar komplexa I/O-mönster. Denna parallella skrivförmåga är nyckeln för effektivitet men kräver noggrann koordinering och robusta lagringssystem som kan hantera samtidiga skrivoperationer samtidigt som datakonsistensen bibehålls. Lagringssystemet måste kunna hantera dessa samtidiga skrivningar effektivt, eftersom alla flaskhalsar i denna process kan övergå i övergripande träningsförseningar.
Långsam checkpointing kan skapa betydande träningsflaskhalsar, eftersom hela träningsprocessen måste pausas medan checkpointen skrivs till lagring. Till exempel, i en storskalig träningsuppställning, om checkpointing tar 30 minuter med några timmars mellanrum, kan detta resultera i flera timmars ackumulerad driftstopp under hela träningsperioden. Detta påverkar utbildningseffektiviteten direkt och ökar driftskostnaderna, särskilt i molnmiljöer där datorresurser faktureras efter tid.
Med snabbare kontrollpunkter har teamen också råd att skapa kontrollpunkter oftare, vilket minskar den maximala potentiella dataförlusten vid fel. Detta möjliggör mer aggressiva träningsmetoder och bättre experimentella iterationscykler. Dessutom underlättar snabba laddningstider för kontrollpunkter snabbare experiment med olika träningskonfigurationer och modellarkitekturer, eftersom forskare lättare kan återställa från tidigare tillstånd för att prova alternativa tillvägagångssätt.
Lagringssystemets förmåga att effektivt hantera dessa checkpointoperationer blir en central faktor i den övergripande utbildningsinfrastrukturen. Högpresterande lagringslösningar som kan hantera både burst-skrivmönstren för checkpointing och ihållande läs/skriv-operationer av utbildning kan avsevärt påverka den totala tiden och kostnaden för att träna stora språkmodeller. Sålunda är lagringsundersystemets prestandaegenskaper, särskilt vid hantering av stora sekventiella skrivningar och upprätthållande av konsekvent hög bandbredd, avgörande överväganden vid utformningen av LLM-utbildningsinfrastruktur.
För den här rapporten ville vi utvärdera SSD-prestanda för AI-kontrollpunkter, utvärdera fördelarna med de senaste Gen5 SSD:erna när kontrollpunktshastigheten är kritisk, jämfört med de största QLC SSD:erna på marknaden, som kan lagra ett stort antal kontrollpunkter om det skulle vara mer fördelaktigt för modellen som tränas.
Checkpoint Performance – Benchmarking med DLIO
För att utvärdera Solidigm SSD:s prestanda i verkliga AI-träningsmiljöer använde vi benchmarkverktyget Data and Learning Input/Output (DLIO) . DLIO, som utvecklats av Argonne National Laboratory, är specifikt utformat för att testa I/O-mönster i djupinlärningsarbetsbelastningar. Det ger insikter i hur lagringssystem hanterar kontrollpunkter, datainmatning och utmaningar med modellträning.
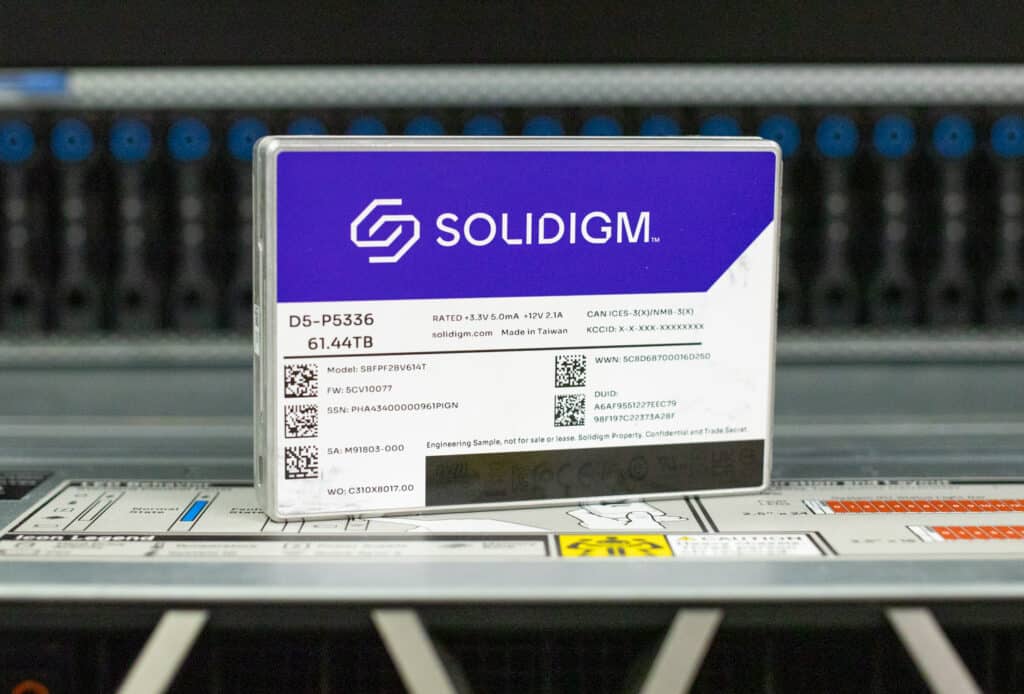
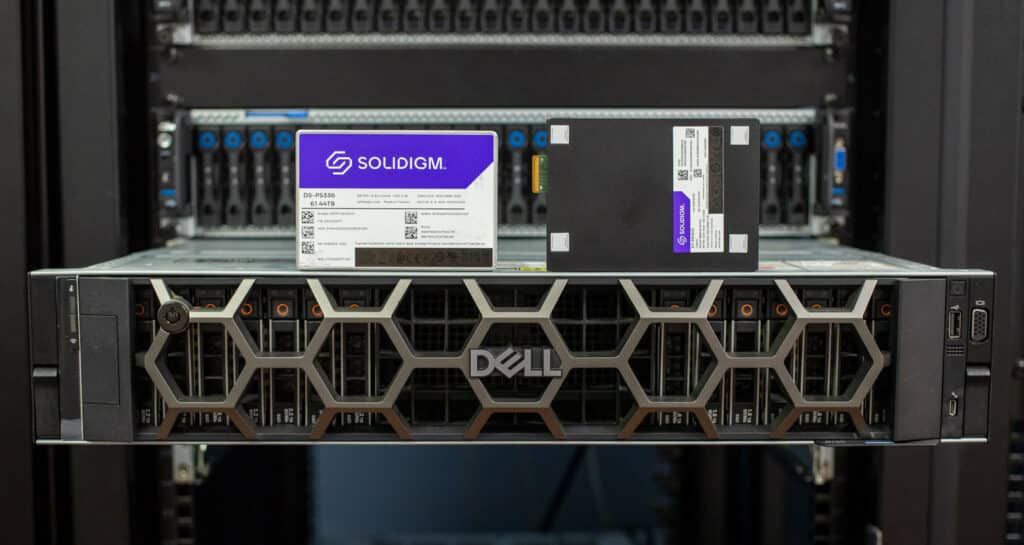
Genom att arbeta med DLIO strävade vi efter att mäta enhetens genomströmning, latens och tillförlitlighet under intensiva kontrollpunkter. Även om denna testning utfördes på 61.44TB D5-P5336, visade initiala prestandadata att Solidigm D5-P5336 122TB-versionen erbjuder en liknande prestandaprofil. Vi inkluderade även resultat från en TLC-baserad D7-PS1010 för att visa fördelarna med PCIe Gen5 i detta test. Vi valde dessa två enheter för att visa båda vinklarna på checkpoints, den ena är den snabbaste möjliga checkpointtiden och den andra lagrar flest checkpoints på en enda SSD.
Plattformen som valdes för detta arbete var vår Dell PowerEdge R760 som kör Ubuntu 22.04.02 LTS. Vi använde DLIO benchmark version 2.0 från releasen den 13 augusti 2024. Vår systemkonfiguration beskrivs nedan:
- 2 x Intel Xeon Gold 6430 (32-kärniga, 2.1 GHz)
- 16 x 64 GB DDR5-4400
- 480 GB Dell BOSS SSD
- Seriekablar Gen5 JBOF
- 7.68 TB Solidigm D7-PS1010
- 61.44TB Solidigm D5-P5336
För att säkerställa att vår benchmarking återspeglar verkliga scenarier, baserade vi våra tester på LLAMA 3.1 405B-modellarkitekturen, och implementerade checkpointing genom torch.save() för att fånga modellparametrar, optimerartillstånd och lagertillstånd. Vår installation simulerade ett 8-GPU-system, och implementerade en hybrid parallellitetsstrategi med 4-vägs tensor parallell och 2-vägs pipeline parallell bearbetning fördelade över de åtta GPU:erna. Denna konfiguration resulterade i checkpointstorlekar på 1,636 XNUMX GB, representativt för moderna utbildningskrav för stora språkmodeller.
Vår testprocess för DLIO-kontrollpunktens arbetsbelastning bestod av att fylla varje enhet till en liknande användningsnivå. För 61.44 TB Solidigm D5-P5336 inkluderade varje pass 33 kontrollpunktsintervall, totalt 54 TB. Den mindre 7.68 TB D7-PS1010 passar bekvämt tre kontrollpunktsintervall, med ett totalt fotavtryck på 4.9 TB. En extra kontrollpunkt skulle kunna passa in i D7-PS1010, även om den gjorde användningen något högre än vi ville.
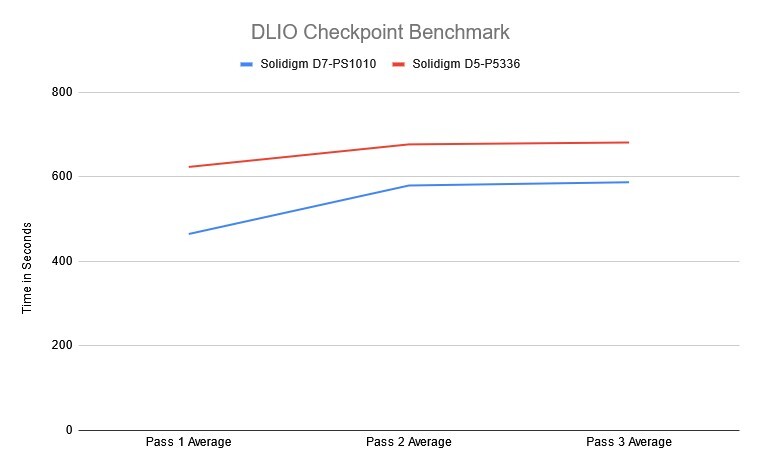
DLIO-kontrollpunktens arbetsbelastning gav intressanta resultat när vi jämförde den Gen4 QLC-baserade 61.44TB D5-P5536 med den Gen5 TLC-baserade 7.68TB D7-PS1010. Under det första passet, när enheterna fylldes på, såg vi ett större gap i prestanda mellan de två SSD-modellerna. Den snabbare Gen5 PS1010 klarade varje kontrollpunkt i genomsnitt på 464 sekunder, jämfört med 623 sekunder från Gen4 P5336. I pass två och tre minskade gapet till 579 och 587 sekunder för PS1010 och 676 och 680 sekunder för P5336.
För företag som vill ha minsta möjliga lucka i kontrollintervaller, erbjuder den TLC-baserade Gen5 PS1010 en fördel i den snabbaste slutföringstiden. Om målet är att behålla många kontrollpunkter kostnadseffektivt kan den QLC-baserade Gen4 P5336 göra just det. Vi mätte en skillnad i genomsnittliga checkpointtider på mindre än 17 % mellan båda körningarna under pass två och tre.
GPUDirect Storage Bandwidth
Medan DLIO visar flashprestanda i ett AI-arbetsflöde, är arbetsbelastningen helt skrivbaserad tills en kontrollpunkt återställs. För att måla en mer fullständig bild av Solidigm D7-PS1010 och D5-P5336 i AI-arbetsbelastningar inkluderade vi avlästa bandbreddsmätningar med GDSIO.
Hur GPU Direct Storage fungerar
Traditionellt, när en GPU bearbetar data lagrad på en NVMe-enhet, måste data först färdas genom CPU:n och systemminnet innan de når GPU:n. Denna process introducerar flaskhalsar, eftersom CPU:n blir en mellanhand, lägger till latens och förbrukar värdefulla systemresurser. GPU Direct Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar de omkostnader som är förknippade med datarörelser, vilket möjliggör snabbare och mer effektiva dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte med data, och varje fördröjning i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPU Direct Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar vilotiden och maximerar beräkningseffektiviteten.
Liksom DLIO-testet är målet att bättre förstå och karakterisera skillnaderna mellan höghastighets Gen5 SSD:er och QLC-enheter med hög kapacitet. Inte varje AI-arbetsbelastning är densamma, och varje enhet erbjuder distinkta fördelar, beroende på behovet.
Testar konfigurationsmatris
Vi testade systematiskt varje kombination av följande parametrar med en NVIDIA L4 i vår testplattform:
- Blockstorlekar: 1M, 128K, 64K, 16K, 8K
- Antal trådar: 128, 64, 32, 16, 8, 4, 1
- Antal jobb: 16
- Batchstorlekar: 16
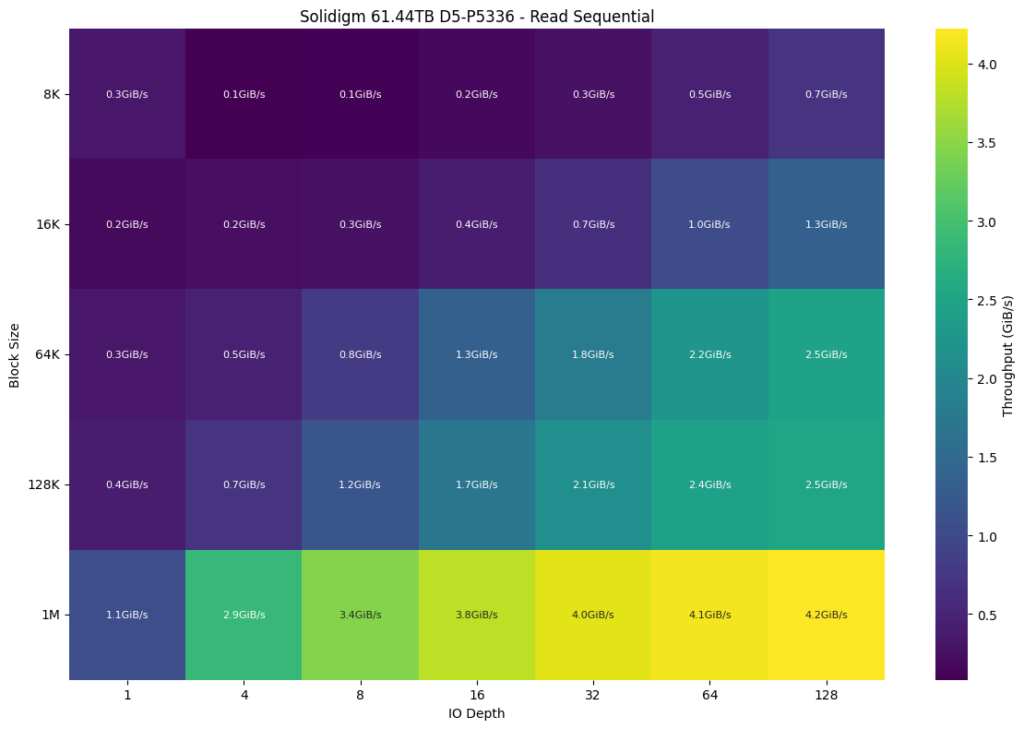
Vår första titt var på den QLC-baserade D5-P5336, som toppade med 4.2GiB/s med en överföringsstorlek på 1M på ett IO-djup av 128. Effekten av blockstorlekar gav en avsevärd ökning av bandbredden, och gick upp från 8K till 1M. Fördelen med ökat IO-djup började minska vid 32, där arbetsbelastningen började plana ut.
Därefter tittar vi på Gen5 PS-1010, som kan skala upp till 6.2GiB/s vid en 1M blockstorlek och ett IO-djup på 128. Överlag överträffade den Gen4-baserade P5336, med speciella arbetsbelastningar som visar en betydande lyfta. Ett anmärkningsvärt förbättringsområde kom i blockstorleken på 128K, där PS64 vid ett IO-djup på 128 och 1010 erbjöd dubbelt så mycket läsbandbredd som P5336.
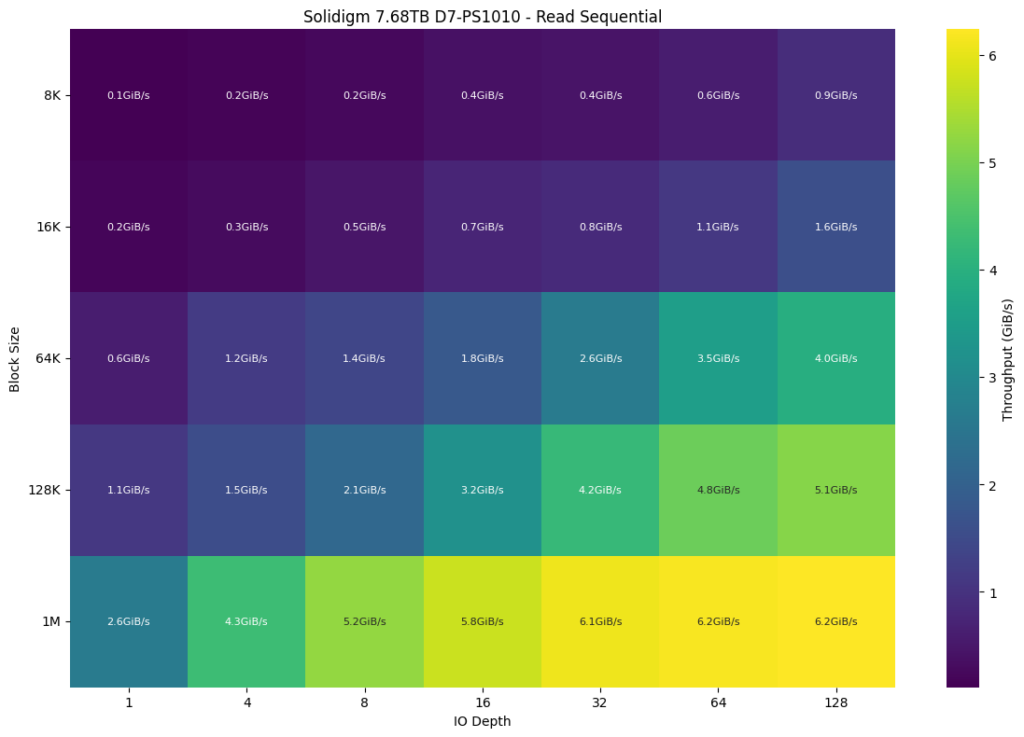
Det är viktigt att notera att båda SSD-diskarna testades med NVIDIA L4. Medan Gen4 D5-P5336 är på eller nära sin toppnivå, uppvisade NVIDIA GPU:er i högre modeller som H100 högre prestanda med D7-PS1010. En disks hastighet är den avgörande faktorn för vissa kunder, medan andra prioriterar den totala densiteten. Solidigm erbjuder lösningar för båda, med sina QLC- och TLC SSD-erbjudanden.
Slutsats
När omfattningen och komplexiteten för AI-träning fortsätter att öka, måste den underliggande lagringsinfrastrukturen inte bara hålla jämna steg utan också sätta tempot. Våra tester med två mycket olika SSD:er illustrerar vikten av att anpassa lagringslösningar med specifika träningsprioriteringar, som att minimera kontrollpunktslatens eller maximera kontrollpunktstätheten för kostnadseffektiv skalbarhet.
I vår utvärdering testade vi Solidigm D5-P5336 (61.44TB) och D7-PS1010 (7.68TB) under realistiska AI-träningsförhållanden med hjälp av DLIO-riktmärket och ett omfattande hybridparallellt LLM-checkpointing-arbetsflöde. Vi fångade mätvärden som återspeglar skrivprestanda för kontrollpunkter över flera körningar när enheterna fylldes, och lyfte fram skillnader i färdigställandetider mellan Gen4 QLC-baserade D5-P5336 och Gen5 TLC-baserade D7-PS1010.
Medan D7-PS1010 levererade de snabbaste möjliga kontrollpunkterna, visade D5-P5336 övertygande kostnadseffektivitet och kapacitetsfördelar med endast en blygsam prestationsstraff. Vi undersökte vidare GPU Direct Storage-läsbandbredder med GDSIO genom en NVIDIA L4 GPU. Vi fann att Solidigm D5-P5336 erbjöd upp till 4.2GiB/s läsbandbredd med en överföringsstorlek på 1M, medan D7-PS1010 erbjöd en avsevärd höjning till 6.2GiB/s. Du skulle se en ännu starkare prestanda genom att utnyttja en ännu större GPU, som NVIDIA L40s eller H100/H200.
När man ser framåt står den oöverträffade kapaciteten hos Solidigm D5-P5336 122TB SSD för att omforma AI-träning och implementering. När modellstorlekar och krav på kontrollpunkter fortsätter att öka, öppnar dessa massiva enheter dörrar till nya nivåer av effektivitet och flexibilitet, vilket möjliggör träningsstrategier som tidigare var utom räckhåll. Solidigms ledarskap inom SSD-lösningar med hög kapacitet ger organisationer möjlighet att lagra mer data och kontrollpunkter på färre enheter och hjälper till att framtidssäkra deras infrastruktur mot nästa våg av AI-komplexitet.
Denna rapport är sponsrad av Solidigm. Alla åsikter och åsikter som uttrycks i denna rapport är baserade på vår opartiska syn på produkten/de produkter som övervägs.


 Amazon