

CoreWeaveは、エージェントAIワークロードを目的とした単一のスケールアウト環境に数百のRubin GPUを接続するマルチラックNVIDIA Vera Rubin NVL72クラスタをCoreWeave Cloudに展開しました。Dell製の各ラックには、72個のRubin GPU、36個のVera CPU、スケールアップファブリックとしてのNVLink 6、 BlueField-4 DPU、およびGPUごとに2つのConnectX-9 SuperNICが搭載されており、ラックはNVIDIA Spectrum-X Ethernetを介して2層のノンブロッキングファブリックで接続され、CoreWeaveによると、約128,000個のGPUまで拡張可能です。CoreWeaveは、単一のVera Rubin NVL72を検証して起動し、その測定パフォーマンスを公開した最初のクラウドプロバイダーです。プラットフォームの最初のピアレビューされた数値は先週MLPerf Inference v6.1で発表され、CoreWeave自身の提出物はGB300 NVL72で実行されました。 CoreWeave AI Object Storageは、コンピューティング機能に加え、リージョン間書き込みアクセラレーションと新しいアーカイブ層を備えています。
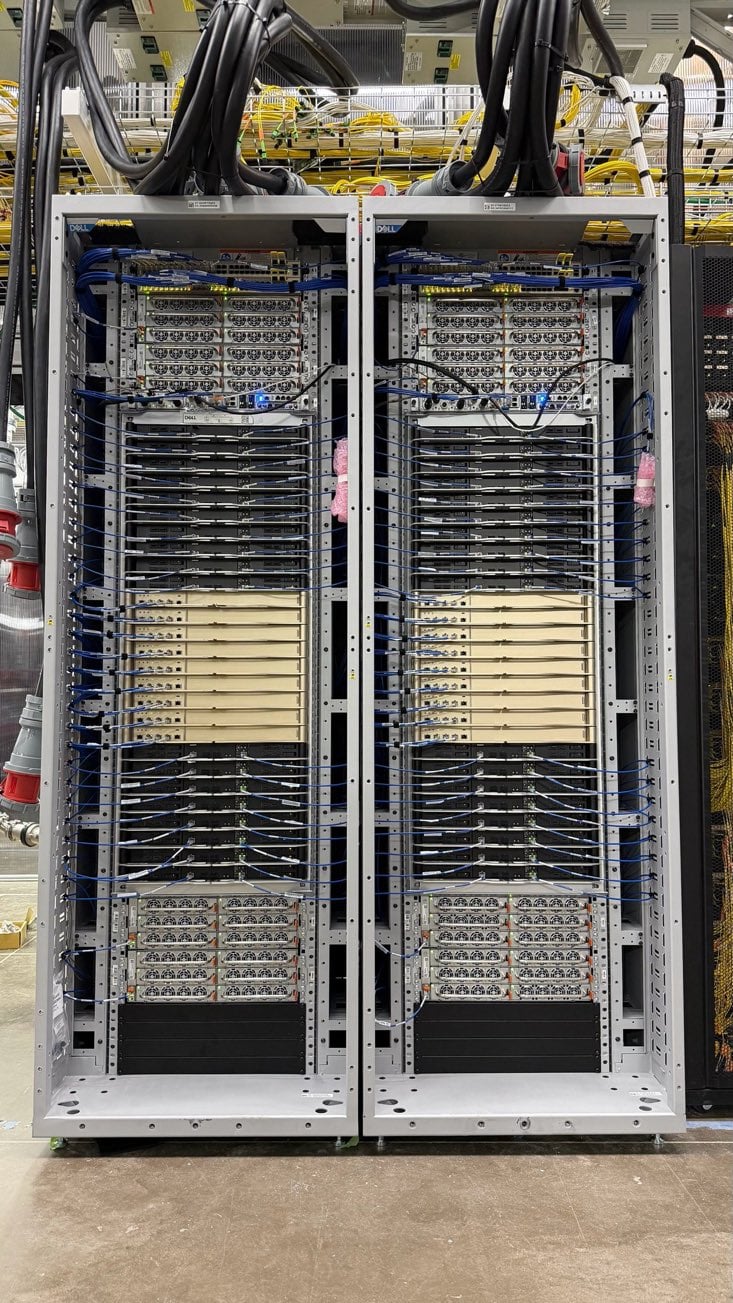
マルチラック対応NVIDIA Vera Rubin NVL72アーキテクチャ
マルチラック構成は、シリアルな推論ループと外部ツール呼び出しによって分散インフラストラクチャ全体でデータアクセス遅延が増大するエージェント実行パスを対象としています。各Rubin GPUに搭載された2つのConnectX-9 SuperNICは、マルチレール、マルチプレーンパスを介してGPUあたり最大1.6 Tb/sのバックエンドネットワーク接続を提供し、CoreWeaveはファブリックをモジュール式と説明しているため、容量が増加するにつれて追加のNVL72ラックを同じノンブロッキングトポロジーに追加できます。ラックは45℃の液体冷却で動作します。
CoreWeaveは、Mission Controlソフトウェアを通じてラック同士を連携させます。ラックライフサイクルコントローラは、各ラックのプロビジョニングとライフサイクル管理、ファームウェアのフラッシュによるハードウェア検出、検証、電源、および熱ループを管理します。Rackyと呼ばれるラック管理レイヤーは、電源とインフラストラクチャを制御します。Valveyと呼ばれるプログラマブル冷却コントローラは、液体冷却ループと環境センサーに対するソフトウェア定義の可視性と制御を提供します。
ラックは、段階的な検証パスを経て初めて本番環境に移行します。ノードレベルでは、これは数時間にわたるGPU診断、CPU-GPU間転送チェック、負荷がかかった状態での相互接続と熱検証、および現実的なトレーニング実行を意味します。ラックレベルでは、72個のGPUすべてにわたる同期ジョブによってNVLinkのGPU間パフォーマンスが検証され、想定範囲を下回るシステムはすべてトラブルシューティングの対象となります。ラック全体では、CoreWeaveは分散ワークロードを実行し、意図的にNVLinkパスを無効にしてトラフィックをバックエンドネットワーク経由で強制し、物理ファブリックを監視して不安定なリンク、エラー率の上昇、ハードウェアの過熱、および不均一なトラフィックを検出します。負荷パターンは、エージェントアプリケーションを模倣しており、突然の需要スパイク、同時実行性の変化、通信のバーストなどが含まれます。CoreWeaveによるマルチラックの立ち上げに関する解説では、各段階が詳しく説明されており、興味深い読み物となっています。
AIオブジェクトストレージのアップデート:リージョン間書き込みとアーカイブ層
ストレージ面は、CoreWeave AI Object Storageと、CoreWeave Kubernetes ServiceのすべてのGPUおよびCPUノードで実行され、ノードローカルNVMe上にオブジェクトを保持するキャッシングプロキシであるLocal Object Transport Accelerator(LOTA)を基盤としています。CoreWeaveは、キャッシュされた読み取り速度がGPUあたり最大7 GB/秒で、p99読み取りレイテンシがバケットからの読み取りよりも8倍以上低いと報告しており、15,000を超えるGPUと20PBのキャッシュでLOTAを実行し、ヒット率が99.7%である最先端モデルプロバイダーの例を挙げています。LOTAには追加料金はかかりません。
リージョン間書き込みアクセラレーションにより、アプリケーションはAPIやSDKを変更することなく、ローカルのレイテンシでリモートリージョンのバケットに書き込むことができます。アプリケーションはLOTAエンドポイントに標準のS3書き込みを発行します。オブジェクトデータはローカルリージョンに永続的に保存され、メタデータはリモートリージョンにコミットされます。オブジェクトは、書き込みを行ったジョブを含め、すぐに読み取り可能になり、データはバックグラウンドでリモートリージョンに移行されます。アプリケーションは、統一されたIAMポリシー、ライフサイクルルール、およびアクセス制御を備えた単一のバケット名前空間をリージョン間で参照できるため、通常サイト間でチェックポイントを配布する際に必要となるリージョンごとのフォークやレプリケーションパイプラインが不要になります。
「当社のデータセットは複数の地域にまたがっており、地域間のデータ取得の遅延によってトレーニングスケジュールが左右されるような事態は避けたいと考えています」と、Cohere社の内部インフラストラクチャ担当ディレクター、セシル・ロベール=ミション氏は述べています。「CoreWeave AI Object Storageは、地域をまたいでデータセットのフットプリントを統一し、読み取りデータをローカルにキャッシュすることで、ネットワーク待ちをなくします。」
アーカイブ層は、ホット、ウォーム、コールドに加えて4番目のストレージクラスであり、古いトレーニングチェックポイントや生データセットなど、一度書き込まれてめったに読み取られないデータ向けに設計されています。基本容量料金が低く設定されており、取得、キャッシュ、リクエストごとの料金、早期削除、階層化、およびデータ転送の料金が免除されます。CoreWeaveが推奨するパターンでは、最新のチェックポイントは高速な階層に保持され、すぐに再起動できます。また、60日間読み取りがないと自動的にアーカイブ層に移行されます。リージョン間書き込みとアーカイブ層は現在利用可能です。設定の詳細については、CoreWeaveのストレージに関する記事をご覧ください。


 Amazon