

DDNは、顧客が業界標準の認定サーバーにインストールするソフトウェアとしてEXAScalerを提供する予定で、これは次期EXAScaler 7リリースに伴う変更点です。Lustreベースの並列ファイルシステムであるEXAScalerは、これまでDDN専用アプライアンスまたはクラウドパートナーを通じてのみ販売されていましたが、この新しいオプションはDDN AI2200から提供開始され、その後、認定されたサードパーティ製アプライアンスにも提供される予定です。2027年初頭には限定ベータ版が予定されており、DDNは2027年前半にEXAScalerにマルチテナント機能、データ保護機能、パフォーマンス機能を別途追加する予定です。
AIとHPCのためのソフトウェア定義型Lustre
DDNはEXAScalerを、AI I/O最適化、自動展開、エンタープライズサポートを備えたオープンなLustreと説明しています。並列ファイルシステムは複数のストレージサーバーから同時に読み取りを行うことで、AIやHPCジョブが生成する小さなファイル、メタデータの多い読み取り、頻繁なチェックポイントに対応します。EXAScalerは、DDNがISC 2026で発表したAI400X3Mなどのアプライアンスに搭載されているファイルシステムであり、DDNは完全なDDNソリューションを求める顧客向けに専用システムを構築し続けると述べています。
EXAScaler 7では、DDNが「検証済みハードウェア」と呼ぶ、拡大を続けるサプライヤーのエコシステム(まずはAI2200サーバー)上で同じソフトウェアが動作します。DDNはこのオプションを、既にストレージインフラストラクチャを保有しているハイパースケーラーやクラウドプロバイダー、そして要件に合ったハードウェアを選択したいAIプラットフォームチームに提案しています。DDNはサードパーティのハードウェアベンダー名を公表しておらず、最小ハードウェア要件も公開していません。また、ソフトウェアのライセンスについても明らかにしていません。
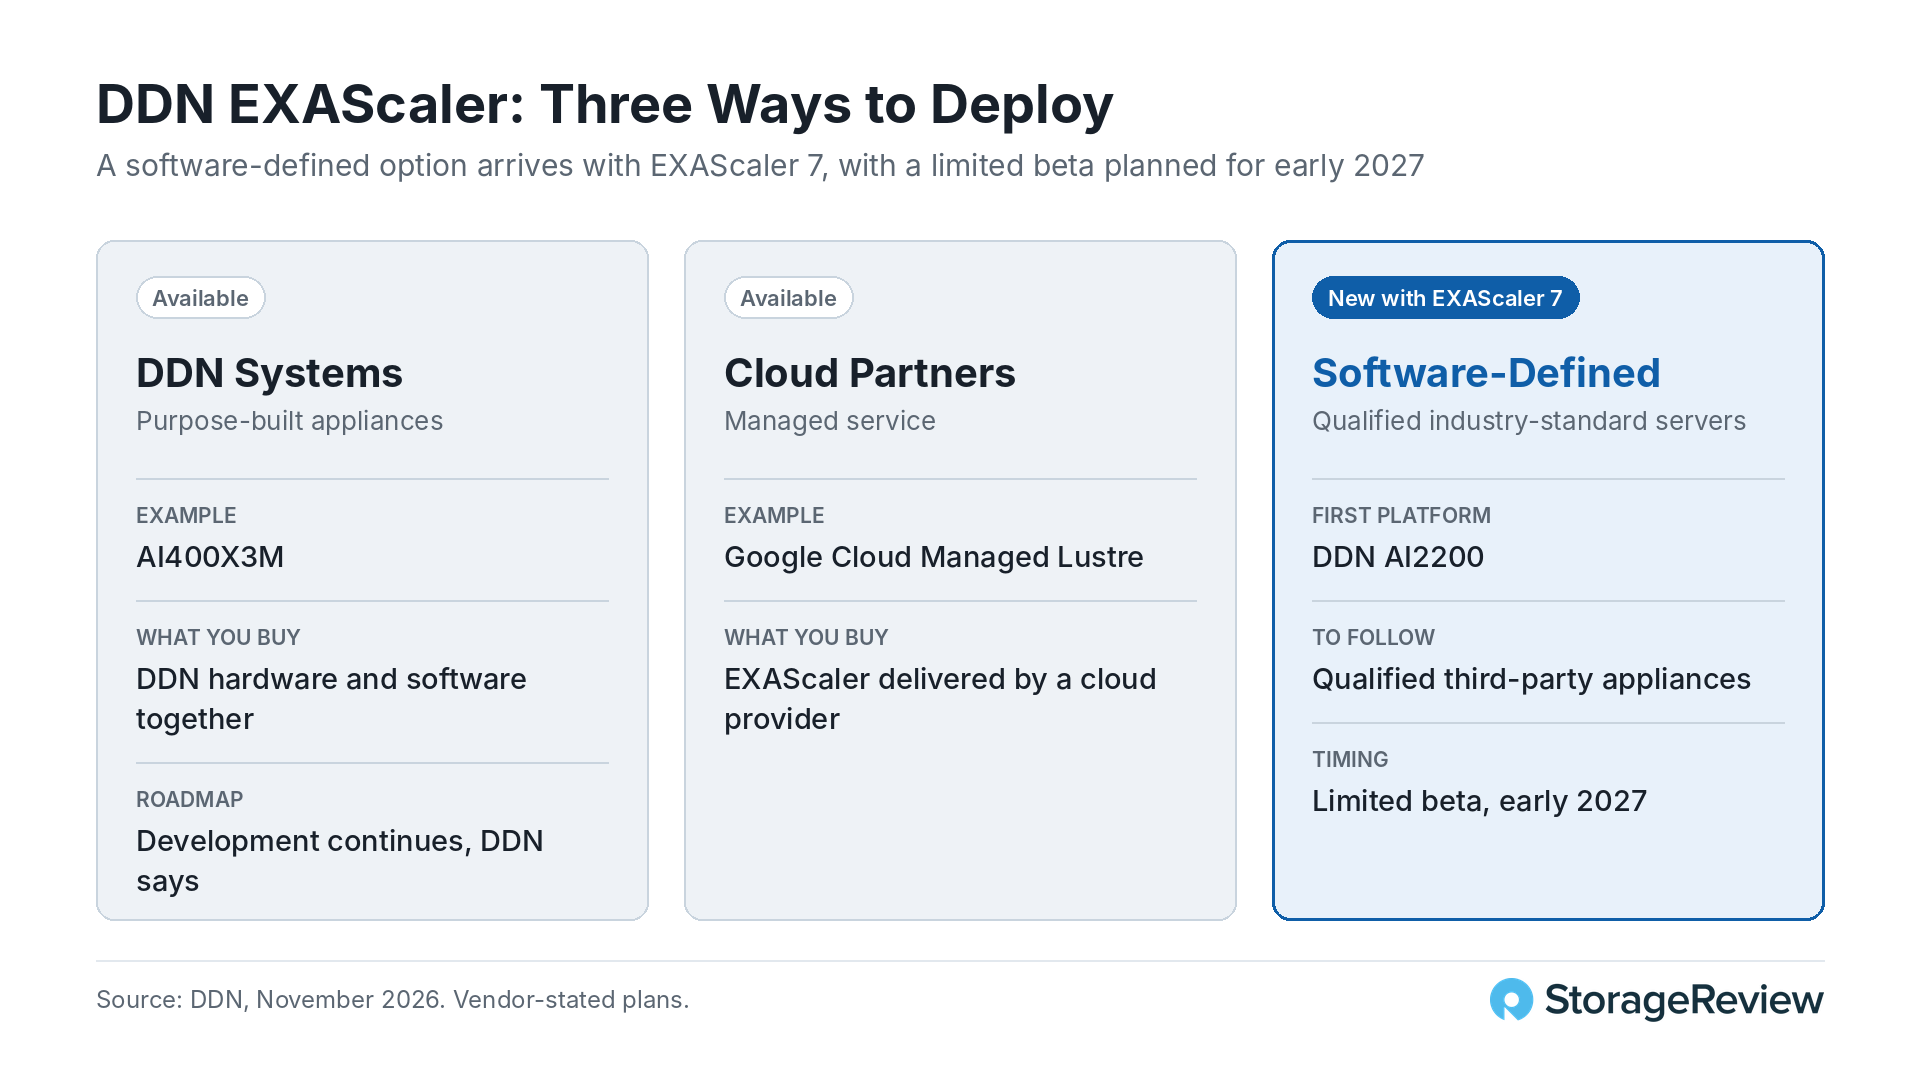
DDNの最高製品責任者であるオメル・アサド氏は、今回の動きを他の製品ラインナップと関連付け、「EXAScalerをソフトウェアとして提供することで、当社のポートフォリオ全体に柔軟性を広げています」と述べた。バージョン2.4でマルチテナンシーとPOSIXサポートを獲得したDDN Infiniaは既にソフトウェア定義型フォーマットで提供されているため、両方のDDNデータプラットフォームでこのオプションを利用できる。EXAScalerは、Google Cloud Managed Lustreなどのクラウドパートナーを通じても引き続き利用可能だ。
テナント管理とデータ保護
EXAScaler 7では、テナントごとのサービス品質制限と公平な共有を適用するマルチテナントREST APIが追加され、複数のチームがジョブ間の干渉を最小限に抑えながら1つのシステムを共有できるようになります。ファイル復元機能は誤って削除されたファイルを復元し、監査ログは調査をサポートします。パフォーマンス面では、DDNはスループットとIOPSを向上させるインテリジェントなハイブリッドI/Oを挙げています。同社はこれらの機能のパフォーマンス数値をまだ公開しておらず、検証済みのデータは後日公開するとしています。
シミュレーションとAIトレーニングのための共有データ
DDNがソフトウェア定義オプションの例として挙げているのは、環境間でデータをコピーすることなく、同じデータに対してHPCシミュレーションとAIトレーニングを実行するサイトです。ライフサイエンス分野では、研究者は分子動力学シミュレーションの出力に基づいてAIサロゲートモデルをトレーニングし、すべてのシミュレーションを再実行することなくタンパク質の挙動を予測します。DDNは、2027年初頭のベータ版以降、ソフトウェア定義展開の一般提供開始日を明らかにしておらず、これらの日付はすべて目標であり、変更される可能性があると述べています。
AMPHIX HyperPODテストレポートによると、Infinia上でGPU使用率は98.8%に達した。
DDN はまた、AMPHIX に設置された最初の DDN Enterprise AI HyperPOD、RAVEL および Strata Expanse 展開モデルの結果も公開し、RT-One を最初の商用顧客として発表しました。HyperPOD は Supermicro サーバー上に構築されたパッケージ システムで、NVIDIA アクセラレーテッド コンピューティングと DDN Infinia をストレージとして使用しているため、この結果は DDN の他のデータ プラットフォームに適用され、EXAScaler 上で実行されたものではありません。カリフォルニア州の AMPHIX Center of Excellence で行われた 24 時間のトレーニング テストでは、RAVEL は、サーマル スロットリングや GPU エラーがゼロで、ピーク負荷時に 37℃ の熱的余裕があり、GPU 使用率が 98.8% を記録しました。
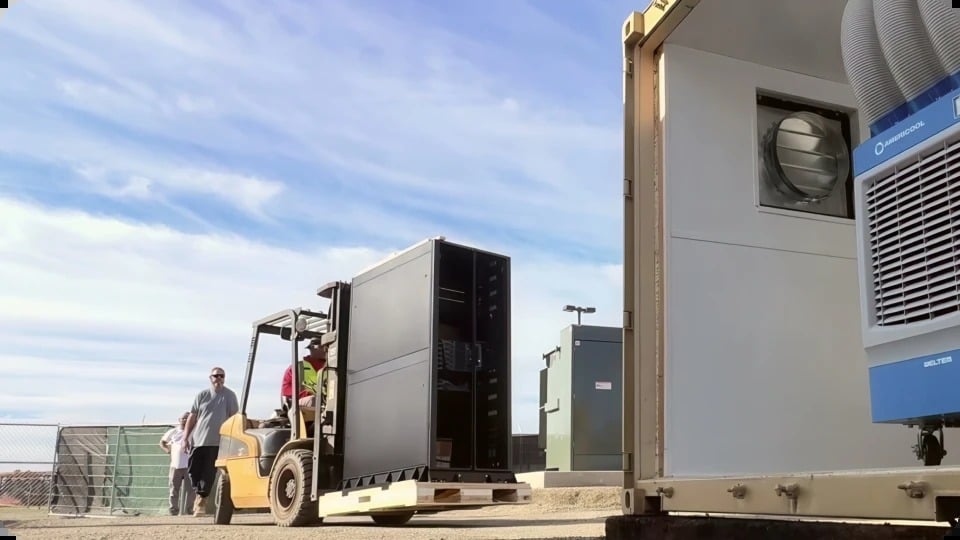
DDNによると、このシステムにはNVIDIA RTX PRO 6000 GPUが8基搭載され、Supermicroのハードウェア上で500TBのInfiniaが稼働していたとのことです。このジョブでは、GPT-2アーキテクチャに基づく大規模な言語モデルを70TBの生データから学習させ、そのデータはすべてネットワーク経由でS3ストレージから読み書きされました。GPUの使用率は実行時間の98%で95%以上を維持し、ハードウェアテレメトリは1秒に1回サンプリングされました。DDNはこのテストをAMPHIXの社内テストと説明しており、弊社は実行も結果の監査も行っていません。
通常、1台のサーバーには8個のGPUが搭載されるため、今回のテストでは小型のHyperPODがS3経由でトレーニングデータをストリーミングしながら1日中GPUをフル稼働させている様子が示されており、クラスタ規模での動作は測定されていません。DDNは、トレーニングのスループット、RAVELが収集した推論結果、サーバーおよびネットワーク構成を公開していません。AMPHIXはカリフォルニアの拠点で顧客向けに概念実証用のシステムを提供しており、Strata ExpanseとRAVELは100以上の拠点を接続する計画を明らかにしています。


 Amazon