

NVIDIAは、大規模データセンターと小型ワークステーションの両方を対象とした新しいハードウェアを発表し、プロフェッショナル向けGPUラインナップを拡大しています。SIGGRAPH 2025において、同社はエンタープライズサーバー向けのRTX PRO 6000 Blackwell Server Editionに加え、4000つの新しいデスクトップGPU、RTX PRO 2000 Small Form Factor (SFF) EditionとRTX PRO XNUMX Blackwellを発表しました。これらの発表は、AIモデルのトレーニングや産業シミュレーションからエンジニアリング設計やメディア制作まで、幅広いプロフェッショナル向けワークロードにおいてBlackwellアーキテクチャのパフォーマンスを実現するための取り組みを強調するものです。ハードウェアに加え、NVIDIAとそのパートナーは、これらのGPUを活用して、生成AIからロボティクス、物理AIアプリケーションまで、あらゆるアプリケーションを高速化できる統合AIソフトウェアプラットフォームにも力を入れています。
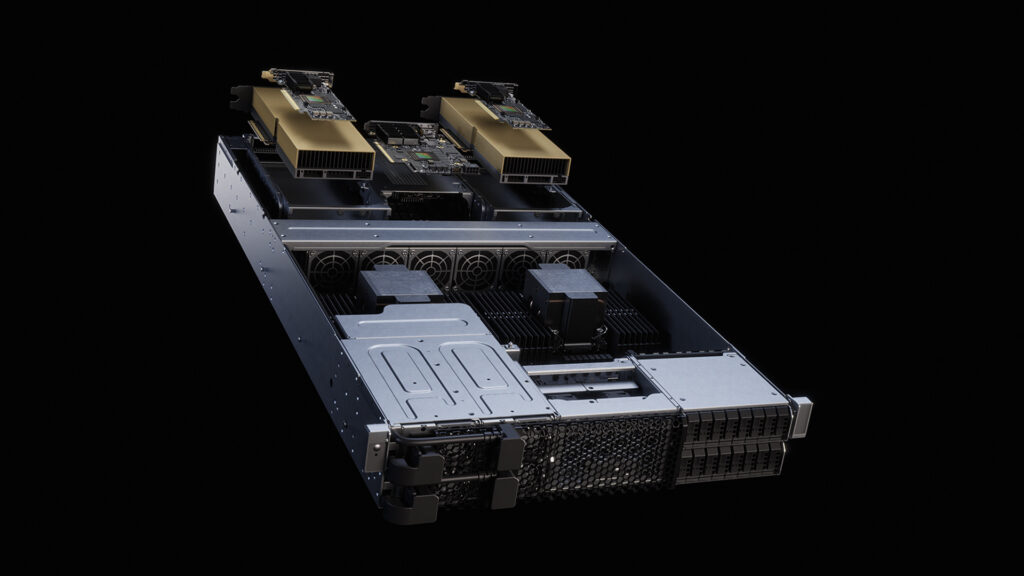
NVIDIA RTX PRO 6000 Blackwell Server Edition: データセンターに新たなパワーを
NVIDIAは、RTX PRO 6000 Blackwell Server Edition GPUが、幅広い主流エンタープライズサーバー向けにまもなく提供開始されることを発表しました。これにより、NVIDIAの最新GPUアーキテクチャが2Uラックシステム(最も広く導入されているサーバーフォームファクターの一つ)に搭載されます。これらの新しい構成は、従来のCPUのみで構成されるデータセンター構成から、GPUアクセラレーション対応プラットフォームへの移行を支援することを目的としています。
RTX PRO 6000は、NVIDIAのBlackwellアーキテクチャをベースに構築され、24,064基のCUDA並列処理コアを搭載し、要求の厳しい様々なワークロードに対応します。AIのトレーニングと推論を高速化する第752世代NVIDIA Tensorコアを5基、リアルタイムレイトレーシングを実現する第188世代RTコアを117基搭載しています。スペック的には、単精度(FP32)演算で3.7テラフロップス、FP4 AI演算で354.5ペタフロップス、そしてRTコアでXNUMXテラフロップスを実現しています。この組み合わせにより、このカードは高度な計算とハイエンドレンダリングの両方を必要とするジョブにも対応可能です。
メモリ容量は96GBのGDDR7(ECC対応)で、処理中のデータ整合性を向上させます。512ビットのメモリインターフェースと1,597GB/sの帯域幅を備えたこのGPUは、シミュレーション、AIモデルのトレーニング、高解像度の可視化において非常に重要な大規模データセットの転送を可能にします。この設計はvGPUと、それぞれ24GBの専用メモリを備えた最大XNUMXつのマルチインスタンスGPU(MIG)パーティションをサポートし、同一の物理カード上で分離されたワークロードを同時に実行できます。ビデオおよび画像処理タスクは、XNUMXつのNVENCエンコーダー、XNUMXつのNVDECデコーダー、そしてXNUMXつのJPEGエンジンによって高速化されます。
セキュリティと信頼性を高める機能として、機密コンピューティングのサポート、ルート・オブ・トラストによるセキュアブート、高速接続を実現するPCI Express 5.0 x16インターフェースなどが挙げられます。このカードは2.1つのDisplayPort 4.4コネクタを介して出力し、高さ10.5インチ(約5cm)、長さ16インチ(約600cm)で、デュアルスロット構成に対応しています。冷却はパッシブ方式で、電源はXNUMXつのPCIe CEMXNUMX XNUMXピンコネクタから供給され、消費電力は最大XNUMXワットまで設定可能です。
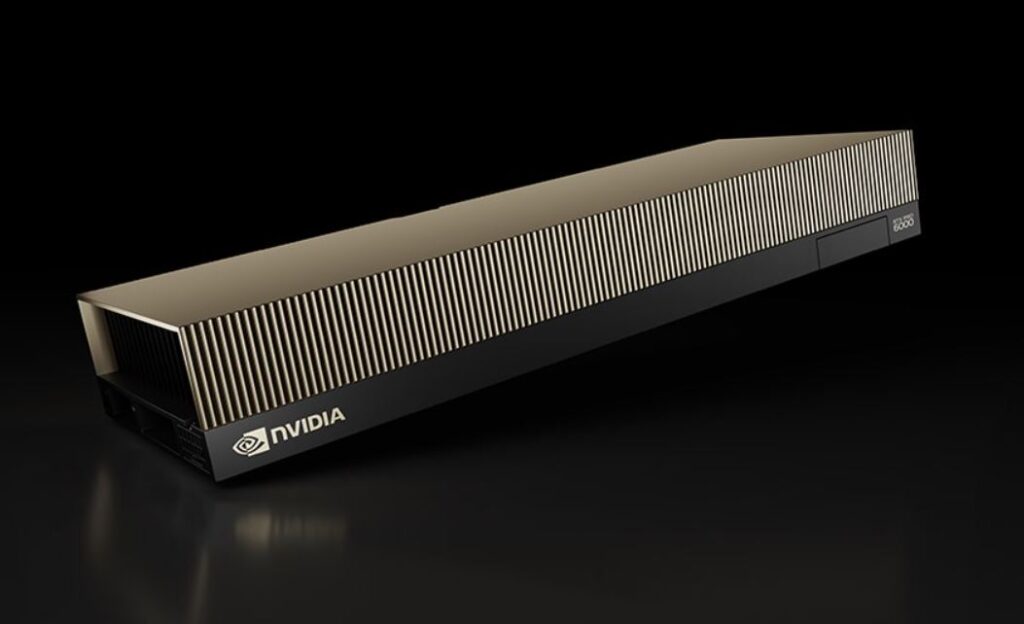
Cisco、Dell Technologies、HPE、Lenovo、Supermicroのシステムは、新しい2U RTX PROサーバーを搭載して最初に出荷される製品群の一つです。各サーバーは、RTX PRO 6000 Blackwell GPUの様々な構成をサポートします。このアーキテクチャは、AIモデルのトレーニングと推論、データ分析、科学シミュレーション、フォトリアリスティックレンダリング、産業用ロボット工学、その他の「フィジカルAI」開発など、幅広いワークロードを高速化するように設計されています。
| NVIDIA RTX PRO 6000 ブラックウェル サーバー エディション | |
| GPUアーキテクチャ | NVIDIA Blackwellアーキテクチャ |
| CUDA並列処理コア | 24,064 |
| NVIDIAテンソルコア | 752(第5世代) |
| NVIDIARTコア | 188(第4世代) |
| 単精度パフォーマンス(FP32) | 117 TFLOPS |
| ピークFP4 AI PFLOPS | 3.7PFLOPS |
| RTコアパフォーマンス | 354.5 TFLOPS |
| GPUメモリ | 96 GB GDDR7、ECC付き |
| メモリインターフェイス | 512ビット |
| メモリ帯域幅 | 1597 GB / sの |
| 消費電力 | 最大600W(構成可能) |
| マルチインスタンスGPU | 最大 4 MIG @ 24GB |
| NVENC | NVDEC | JPEG | 4倍 | 4倍 | 4倍 |
| 機密コンピューティング | サポート |
| ルート・オブ・トラストによるセキュアブート | はい |
| グラフィックバス | PCI Express 5.0 x16 |
| ディスプレイコネクタ | DisplayPort 4 x 2.1 |
| フォームファクター | 4.4インチ(高さ)×10.5インチ(長さ)、デュアルスロット |
| 熱ソリューション | パッシブ |
| 電源コネクタ | 1x PCIe CEM5 16ピン |
前世代のNVIDIA L40S GPUと比較して、パフォーマンスは大幅に向上するはずです。FP5精度をサポートする新しい第2世代Tensorコアと第4世代Transformerエンジンは、推論速度を最大XNUMX倍に高速化します。第XNUMX世代RTXグラフィックステクノロジーは、レンダリングと視覚化のスループットを最大XNUMX倍向上させます。
これらの新しいRTX PRO 6000システムは、パフォーマンスの向上に加え、効率性も考慮して設計されています。NVIDIAによると、CPUのみの18Uサーバーと比較して最大2倍のエネルギー効率を実現しており、これは特にスペースと電力に制約のある施設にとって重要です。この速度と効率性のバランスは、大規模シミュレーション、合成データ生成、ロボットトレーニングなど、結果が出るまでの時間が極めて重要なワークロードにとって極めて重要です。
HPEは、このGPUをProLiant Compute製品ラインに統合します。これには、新しい385U RTX PROフォームファクターで11基のRTX PRO 6000 GPUをサポートするDL2 Gen380、および12U設計で最大4基のGPUをサポートするDLXNUMXa GenXNUMXが含まれます。これらのシステムは、HPEのプライベートクラウドAIプラットフォームと連携し、エージェントAI向けのNemotron、ロボティクス向けのCosmos Reason、そして最新のビデオ検索・要約ツールなど、NVIDIAの最新AIモデルのサポートが追加されます。
これらのサーバーモデルの出荷は2025年9月2日から開始されます。
NVIDIA RTX PRO 4000 SFF および RTX PRO 2000 Blackwell GPU: コンパクトワークステーションのアクセラレーション
サーバーに重点を置いた発売と並行して、NVIDIA は、プロフェッショナル ワークステーション向けの Blackwell ベースの新しい 4000 つのモデル、RTX PRO 2000 SFF エディションと RTX PRO XNUMX を追加し、デスクトップ GPU のラインナップを拡張しています。どちらも、エンジニアリング、メディア制作、建築などの業界全体で、コンパクトでエネルギー効率の高いワークステーションに次世代 AI とグラフィックス アクセラレーションの利点をもたらすように設計されています。
RTX PRO 4000 SFFエディションは、第4世代RTコアと第2.5世代Tensorコアを搭載しながら、標準GPUの半分の物理サイズに収まります。前モデルと比較して、AI性能は最大1.7倍、レイトレーシング性能は1.5倍、メモリ帯域幅は70倍向上し、これらすべてをXNUMXWの消費電力で実現しています。
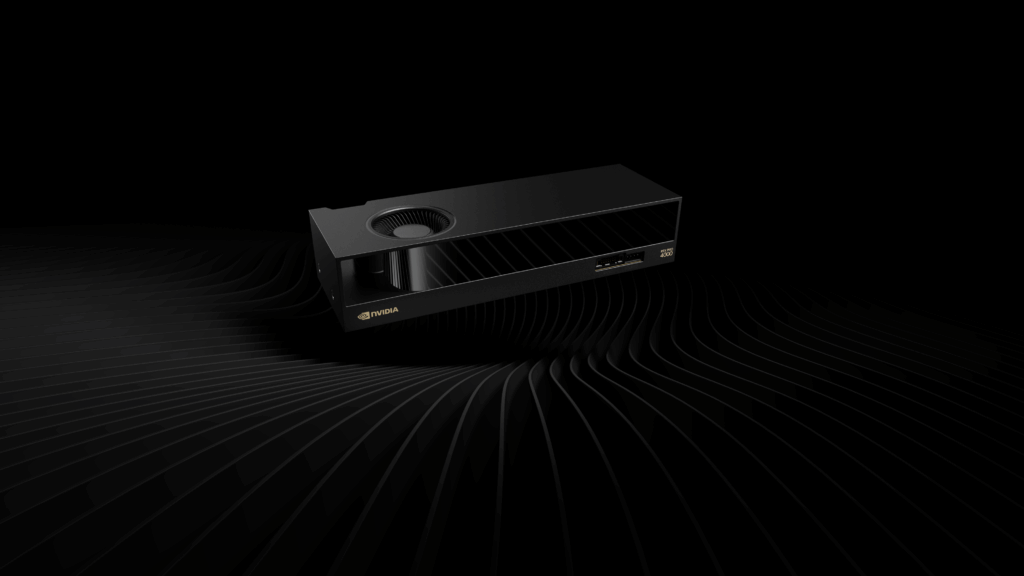
RTX PRO 2000は、主流の設計およびAIタスクをターゲットとしており、NVIDIAは前世代と比較して、1.6Dモデリングが最大3倍、CADパフォーマンスが最大1.4倍、レンダリング速度が最大1.6倍高速化されていると主張しています。また、生成AIワークロードにおいても顕著な飛躍をもたらし、画像作成速度が1.4倍、テキスト生成速度が2.3倍向上し、より迅速なプロトタイピングとイテレーションを可能にします。
NVIDIAは、マイルハイ洪水地区、カンタブリア州政府地理空間局、Studio Tim Fuなどのデザインスタジオといった組織による実世界テストで、このカードが大規模データセット、地理空間ワークロード、AI主導の設計ワークフローの処理において有用であることを実証したと述べています。エンジニアリング会社Thornton Tomasettiによるベンチマークテストでは、RTX PRO 2000は構造解析を前世代機の約27倍、CPUベースの手法のXNUMX倍以上高速に実行することが示されました。
両モデルとも、主要な自動車メーカーおよび販売代理店を通じて、今年後半に発売される予定です。
SIGGRAPH フォーカス: フィジカル AI 時代のワークステーション
SIGGRAPHにおいて、NVIDIAはRTX PROワークステーションラインナップ(新製品のRTX PRO 4000 SFFとRTX PRO 2000を含む)がプロフェッショナルAIおよびシミュレーションワークフローの強化に果たす役割を強調しました。ハードウェアに加え、NVIDIAはソフトウェアエコシステムを普及の推進力の中核として位置付けています。
NVIDIA AI Enterprise スイートは、インフラストラクチャ全体にわたる AI の開発と拡張のためのツールを提供し、Cosmos プラットフォームは、ロボティクス、オートメーション、エッジ AI 向けに最適化された基盤モデルを提供します。Omniverse プラットフォームは、3D シミュレーション、共同設計、デジタルツイン ワークフローの中核を担い、ハードウェアの AI 機能と直接統合されます。
コンパクトで効率的なGPUと、高度に開発されたAIソフトウェアスタックの組み合わせは、業界がいかに変化しているかを示しています。AIアクセラレーション・コンピューティングは、もはや巨大なデータセンターでのみ実現されるものではありません。かつてははるかに大規模で電力消費量の多いシステムを必要としていた、生成型AIコンテンツの作成からロボット工学シミュレーションまで、同じ種類のジョブを、より小型のワークステーションで処理できるようになりました。
Dell、NVIDIAとElasticの提携でAIデータプラットフォームを拡張
また、NVIDIAとElasticの共同開発による、データ取り込みから推論までAIワークフロー全体を処理できるDell AI Data Platformのアップデートも発表されました。Elasticのベクトル検索を基盤とする新しい非構造化データエンジンは、セマンティック検索とハイブリッドキーワード検索機能を追加し、大規模な非構造化データセットへのより高速で正確なアクセスを実現します。GPUアクセラレーションを活用し、フェデレーテッドSQLエンジン、大規模データ処理、高速AI対応ストレージといった既存のツールと連携して動作します。
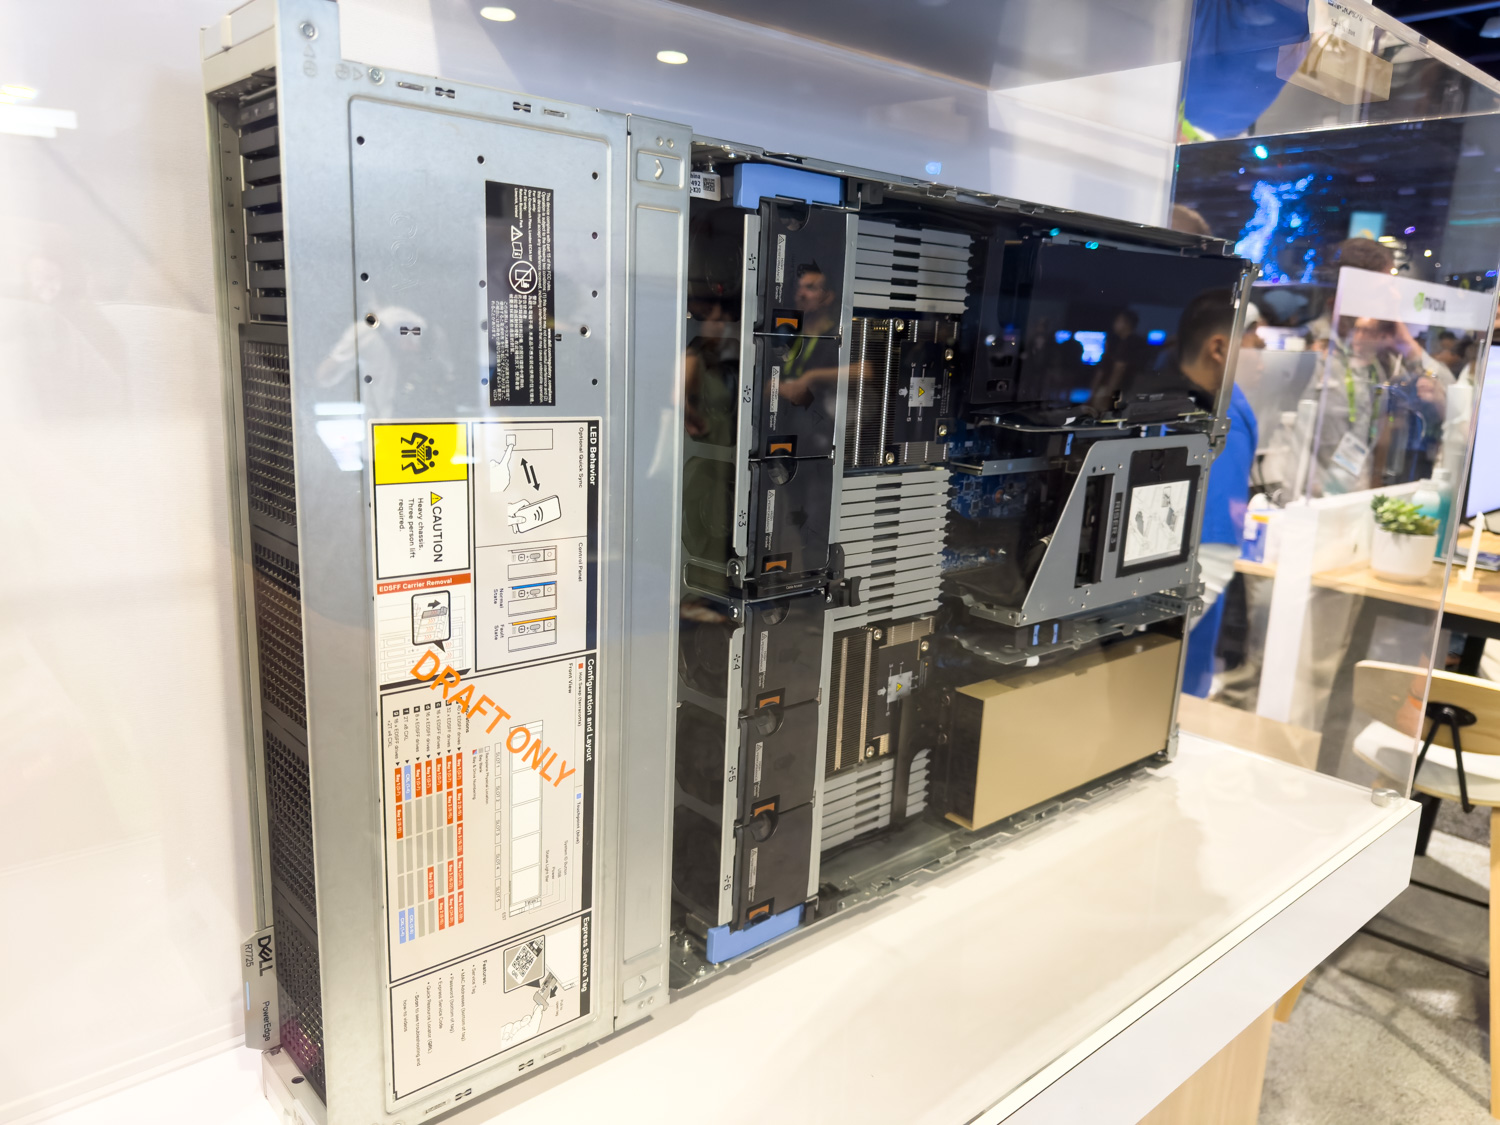
このプラットフォームは、NVIDIA AIデータプラットフォームのリファレンスデザインと統合され、ストレージ、コンピューティング、ネットワーク、AIソフトウェアを組み合わせた検証済みのアーキテクチャを提供します。この構成を最初に採用するハードウェアは、前述のNVIDIA RTX PRO 6000 Blackwell Server Edition GPUを搭載した2Uサーバー、Dell PowerEdge R7725です。これらのシステムは、大規模な言語モデル推論、エンジニアリングシミュレーション、NVIDIA NeMoやCosmosなどのモデルを用いたAI推論といったワークロードを対象としています。
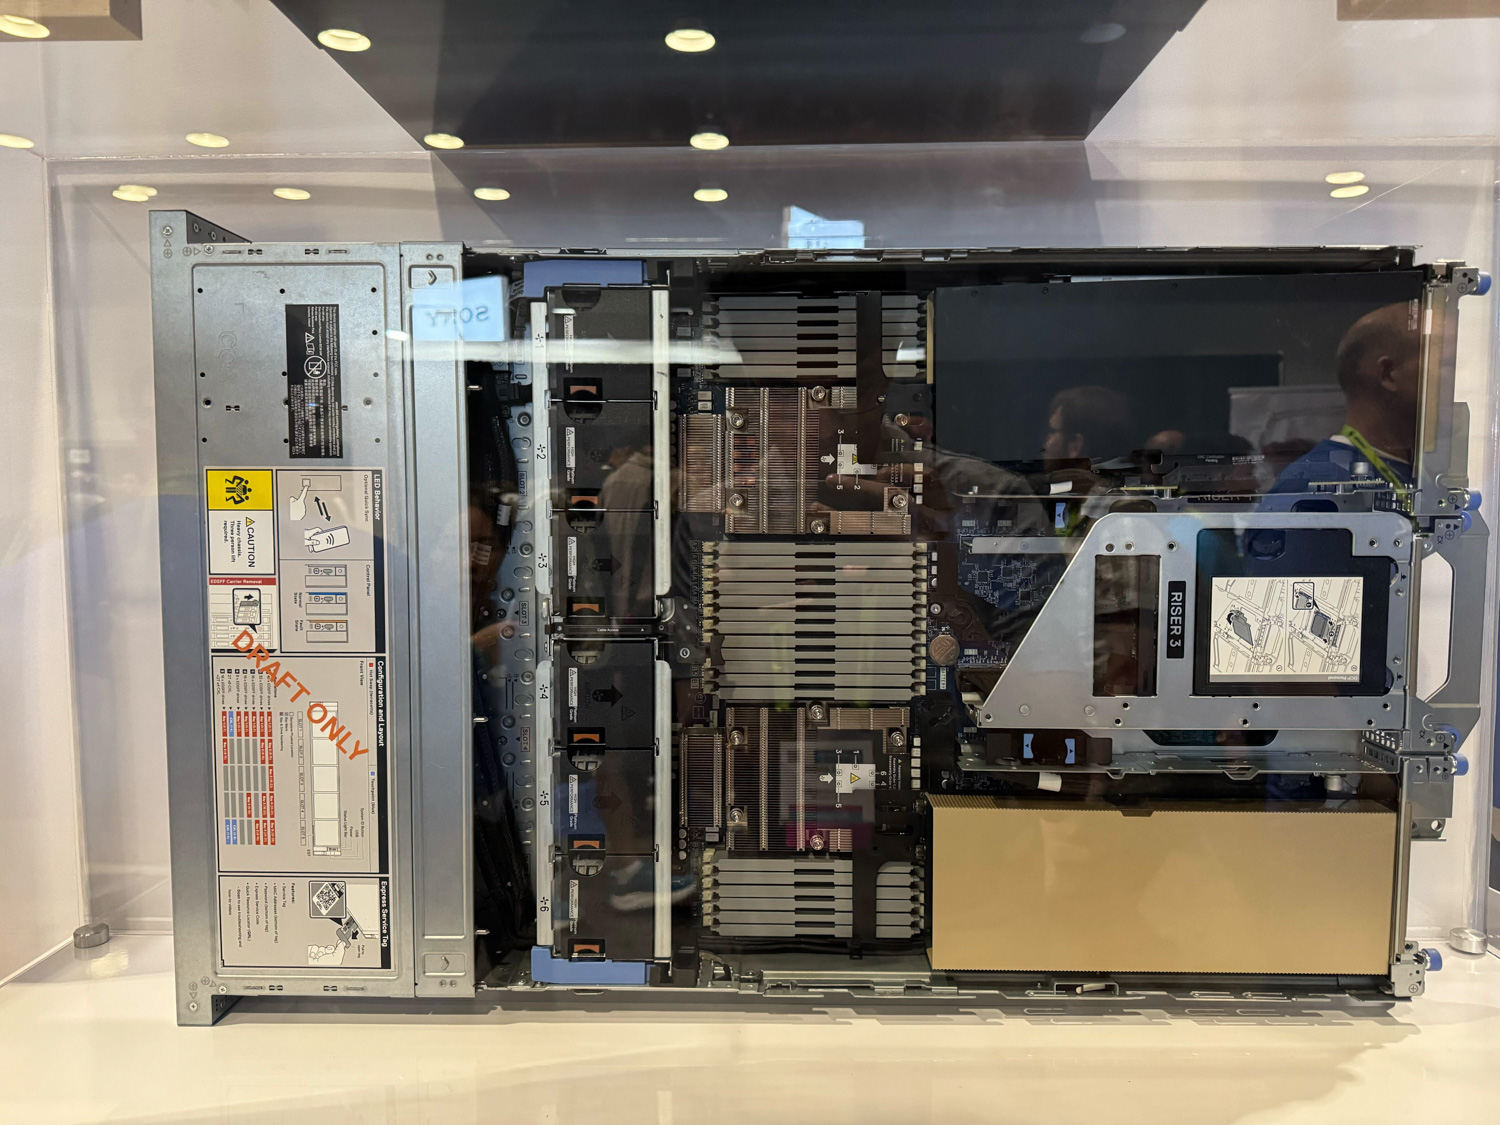
Dellによると、RTX PRO 6000は、前世代と比較してLLMトークンスループットが最大7725倍、エンジニアリングシミュレーション性能がXNUMX倍、MIG同時ユーザー数がXNUMX倍に向上します。RXNUMXとアップデートされたプラットフォームを組み合わせることで、カスタムシステム設計なしで、より高速な推論、応答性の高いセマンティック検索、そしてより大規模なAIワークロードを処理できるターンキーオプションが提供されます。
DellはSIGGRAPH 2025でこれらの機能をDell Pro Max PCラインナップとともに実演しており、まもなくコンパクトなPro MaxにGB10 AI開発者ワークステーションが追加される予定です。
HPE、RTX PRO 6000 BlackwellをProLiantサーバーに搭載
最後に、HPEのNVIDIA AI Computing by HPEポートフォリオに新たな製品が追加され、RTX PRO 6000 Blackwell Server Edition GPUが2UフォームファクターのProLiant Computeサーバーにも搭載されます。2つの構成が用意されます。ProLiant DL385 Gen11は、新しい2U RTX PRO Serverフォームファクターで最大2基のRTX PRO 6000 GPUを搭載でき、ProLiant DL380a Gen12は4U設計で最大8基のGPUをサポートします。出荷開始は2025年9月2日です。
これらのサーバーは、生成AIやエージェントAIからロボティクス、産業用アプリケーション、シミュレーション、ビジュアルコンピューティングまで、幅広いワークロードに対応するように設計されています。Gen12 ProLiantモデルには、Silicon Root of Trust(SIL)に対応したHPE Integrated Lights Out (iLO) 7、セキュアエンクレーブ、耐量子ファームウェア署名といった階層化セキュリティ機能が搭載されています。HPE Compute Ops Managementは、導入とメンテナンスを一元的に自動化することで、サーバー管理時間を短縮し、ダウンタイムを削減します。
HPEは、NVIDIAと共同開発した次世代プライベートクラウドAIプラットフォームのプレビューも発表しました。このアップデートでは、RTX PRO 6000 GPUをサポートし、GPU世代間のシームレスな拡張性を提供するほか、エアギャップ管理やエンタープライズマルチテナントといった機能も搭載されます。また、このプラットフォームは、NVIDIAの最新のエージェントAI向けNemotron推論モデル、ロボティクスおよび物理AI向けCosmos Reasonビジョン言語モデル、そしてアップデートされたビデオ検索および要約のためのブループリント(VSS 2.4)との互換性も備えています。これらの機能追加により、企業は大量の動画・映像データを処理・分析できるAIエージェントを迅速に導入できるようになります。


 Amazon