

Hammerspaceは、ソフトウェア定義のデータプラットフォームをHammerspace Data Systemへと進化させ、初めてハードウェアを含む完全なシステムとして販売する。その中心となるのがHammerspace Open Flash Platform(OFP)だ。これは1Uサイズのトレイに5つのDPUベースのフラッシュノードを搭載し、x86ストレージサーバーは含まれていない。同社によれば、書き込み速度は390GB/秒、1ラックユニットあたり1500万IOPS、生データ容量は最大9.83PBとなる。今回の発表では、データインテリジェンスレイヤーとGPUローカルNVMe用のKVキャッシュ機能も追加される。OFPは現在見積もり受付中で、2027年前半に出荷予定。
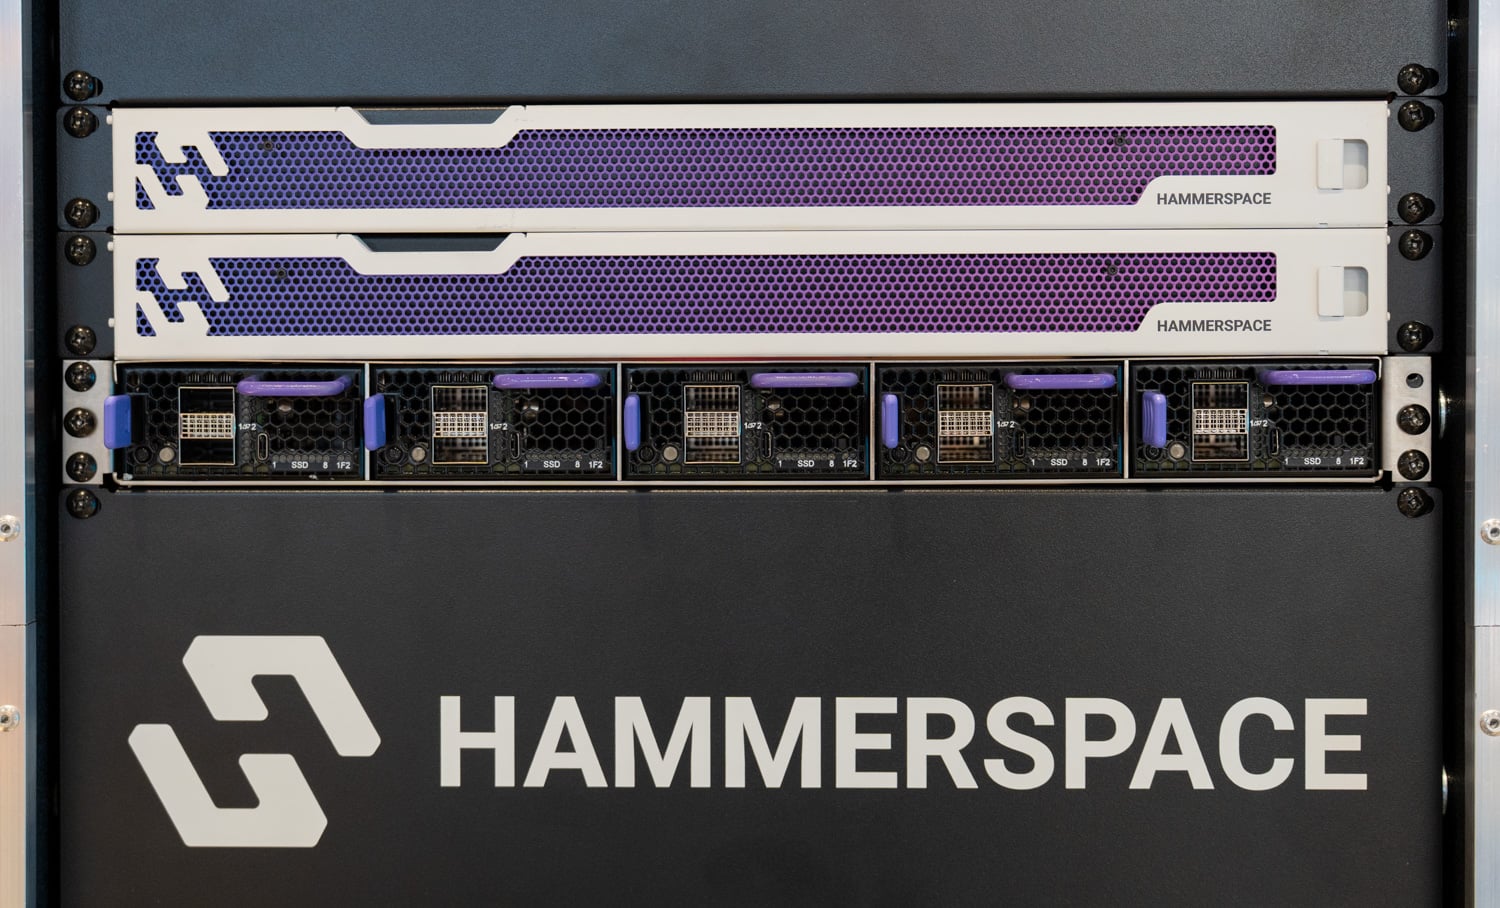
データプラットフォームからデータシステムへ
Hammerspaceの中核製品は、メタデータをデータパスから分離し、既存のNAS、オブジェクトストレージ、クラウドストレージをpNFS、NFS、SMB、S3上で単一のネームスペースとして提供する並列グローバルファイルシステムです。クライアントは、HammerspaceがNFS仕様向けに設計したFlex Filesレイアウトを使用し、独自のエージェントを必要とせず、標準的なLinuxディストリビューションに組み込まれているNFSv4.2クライアントを介してアクセスします。同社は、データシステムをそのソフトウェアの拡張機能と位置付けており、データ統合、インテリジェンス、オーケストレーション、アクセラレーション、ストレージの5つの機能を中心に構成されています。インテリジェンスとストレージは、このうち新しい機能です。
今回の商用面での変更点は、ソフトウェア、メタデータノード、ストレージのインストールとサポートを含め、システム全体をHammerspaceから購入できるようになったことです。HammerspaceがAnvilと呼ぶメタデータノードは、StandardおよびLarge Mシリーズ構成の1U x86サーバーで、2つの100GbEデータポートを備え、各サイトに高可用性ペアとして展開され、ネームスペースを管理し配置ポリシーを実行するコントロールプレーンを実行します。顧客ハードウェアへのソフトウェアのみの展開は引き続き可能で、Dell、Supermicro、Hitachi VantaraのHammerspace Ready Nodesや、AWS、Azure、Google Cloud、Oracle Cloudのマーケットプレイスイメージも引き続き利用できます。
このシステムオプションは、Hammerspaceが販売において経験してきたパターンに対応するものです。つまり、ソフトウェアは技術評価で合格したものの、顧客は購入手続きの簡便さを理由に、別のベンダーから統合製品を購入するというケースです。このソフトウェアは、管理対象容量に応じて価格が設定されるサブスクリプション方式でライセンス供与されます。Hammerspaceストレージは通常、新しいGPUクラスタに高性能ストレージが必要になった際に導入されます。顧客の既存データはNetApp、PowerScale、またはオブジェクトシステム上にあり、Hammerspaceがそれらをそのまま引き継ぐことができます。
各サイトのクラスタは、これらのAnvilをデータサービスノードのセットとペアにし、クラスタは1つのグローバルファイルシステムに統合されます。メタデータは、遠隔地間で約1秒の遅延でサイト間で継続的に複製されますが、データ自体はポリシーまたはアクセス要求があった場合にのみ移動します。ジョブスケジューラは、APIとネイティブコネクタを介してこの移動を開始できます。同社は、ライフサイエンス分野の顧客が、SMB経由で計測データを取り込み、pNFS経由で処理し、同じシステムからS3経由で提供する例を挙げました。
評価は通常、概念実証として実施され、セルフサービス方式としてライセンス持ち込み型のクラウドイメージが使用されます。ディスク容量は、ハードドライブサプライヤーが構築したJBODおよびストレージサーバーから供給されます。OFPはHammerspaceの設計に基づき、契約製造業者によって構築され、再販業者およびインテグレーションパートナーがシステムを提供します。ブロックアレイは、NFS経由でマウント可能な場合にのみネームスペースに参加します。
「単にストレージ容量を増やすだけでは解決にはならない」と、Hammerspaceの創業者兼CEOであるデビッド・フリン氏は述べた。フリン氏は、今回のサービス開始は、AIファクトリー設計がコンピューティングにもたらした統合をデータにもたらすものだと説明した。
Open Flash Platformの内部
OFPスレッドはそれぞれ、ラックユニットの5分の1の幅を持つ完全なストレージノードであり、取り外し可能な4ドライブパック2つに8台のU.2またはU.3 NVMe SSD、2つの400GbE QSFP-DDポート、およびx86マザーボードの代わりに64コアのArm DPUを搭載しています。DPUはXsight Labs E1で、XsightがTSMCの5nmプロセスで製造したもので、64個のArm Neoverse N2コア、2つの400G MAC、PCIe Gen5を搭載し、消費電力は標準で70Wです。標準のLinuxが動作し、各スレッドはHammerspaceファイルシステムからNFSサーバーとして認識されます。
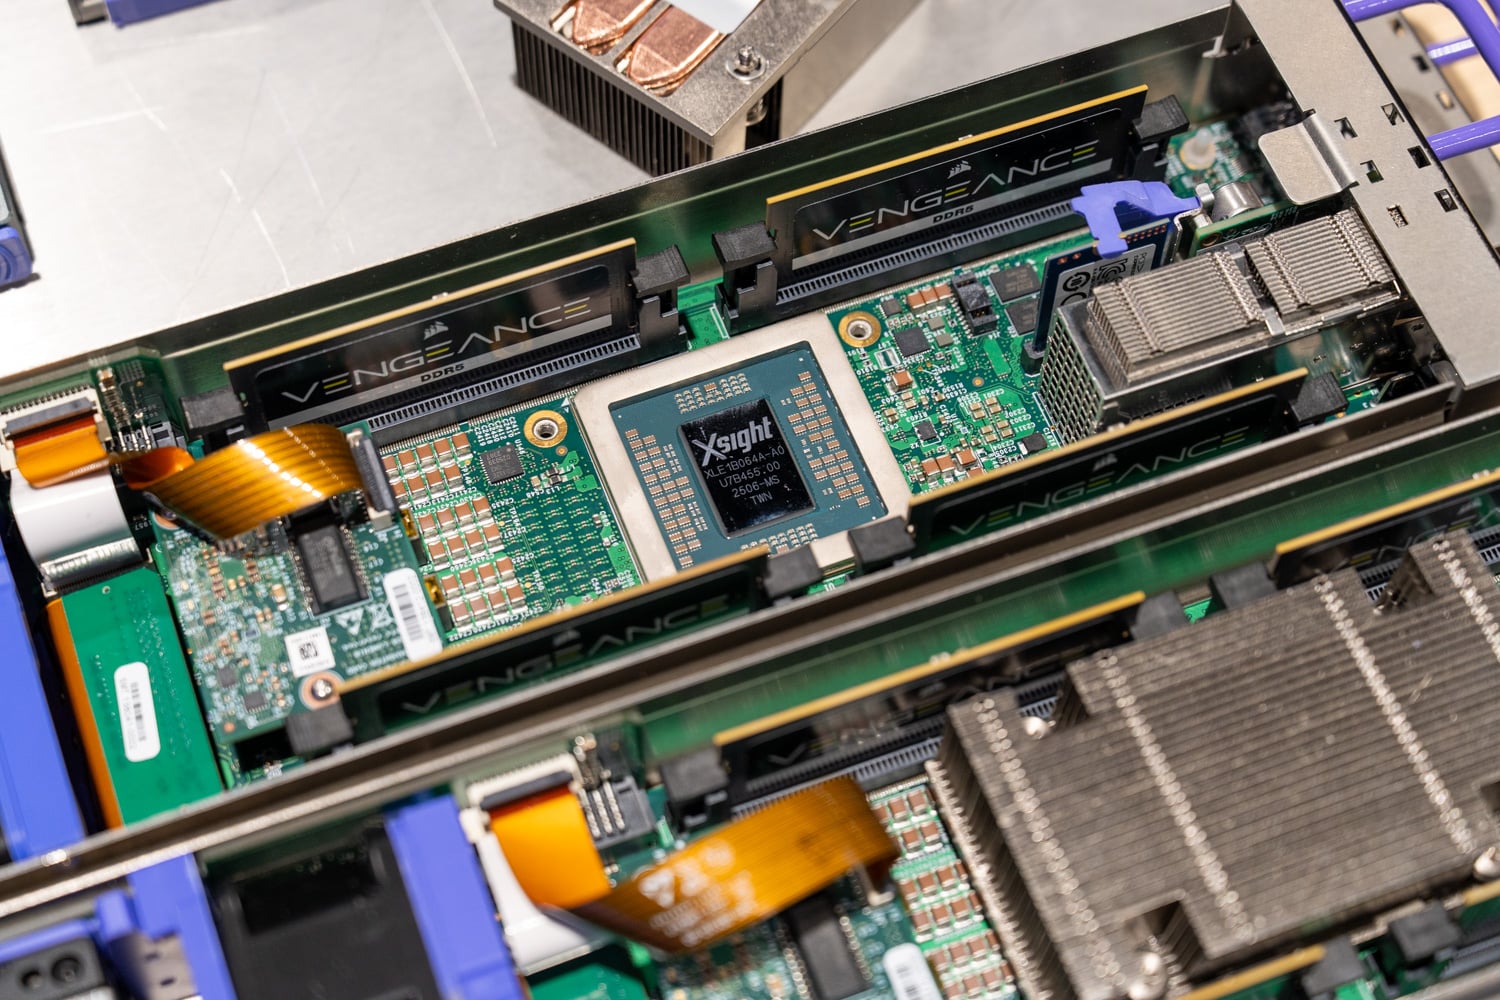
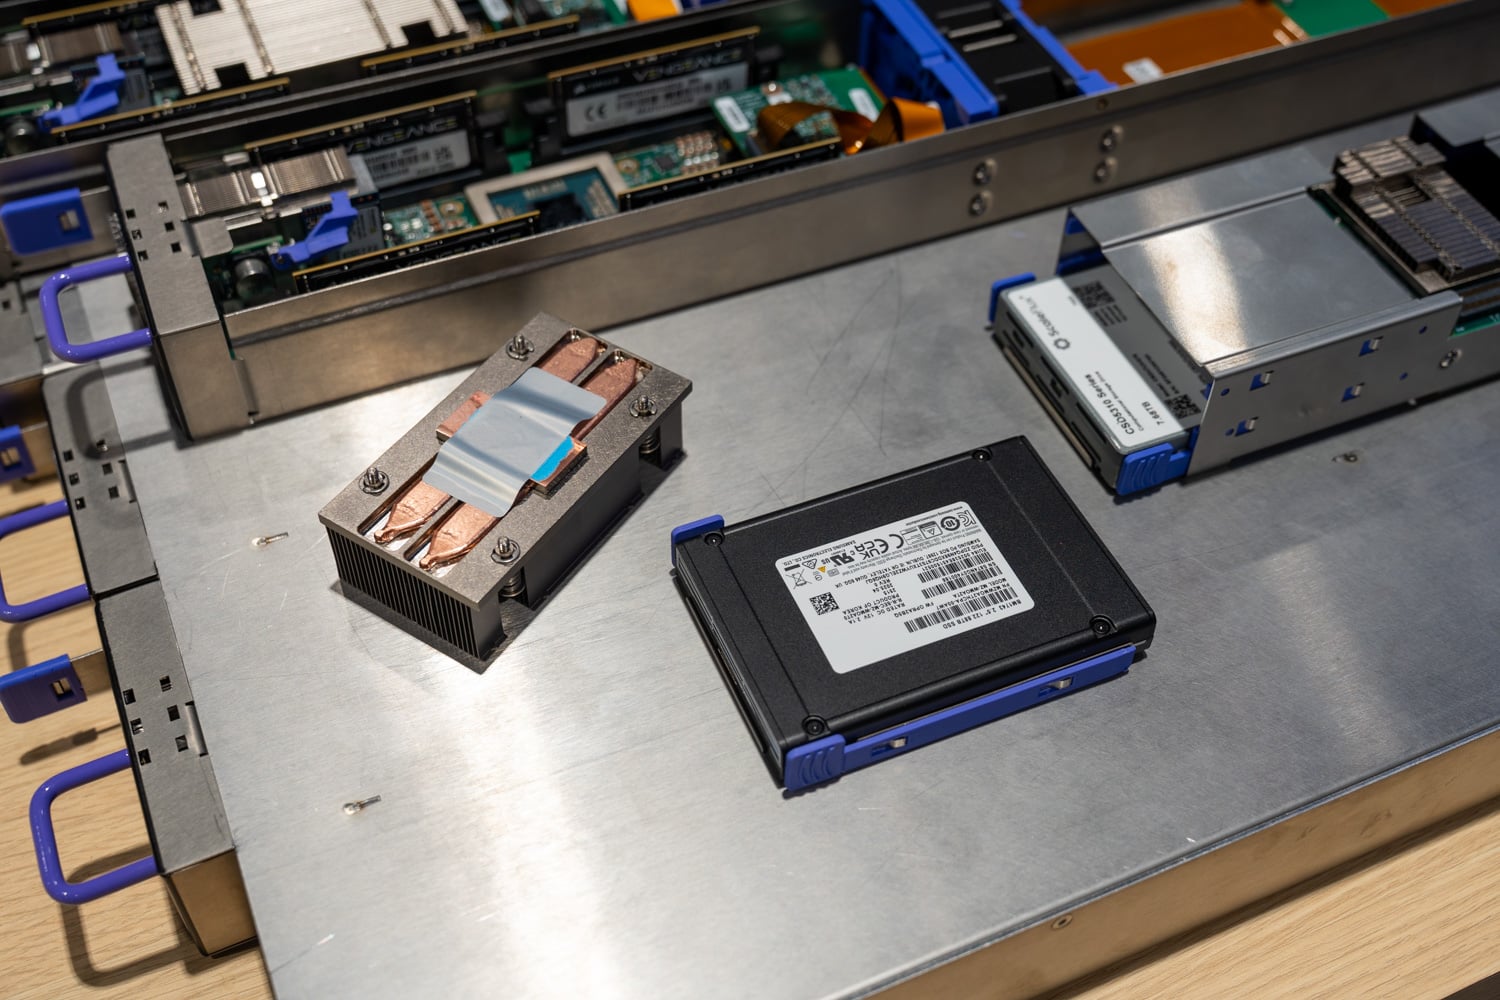
1U トレイには 1 ~ 5 個のスレッドが搭載され、ラック ユニットあたり最大 40 台のドライブ、320 個の Arm コア、および 10 個の 400GbE ポートが収容されます。Hammerspace は、デュアル 2,160W Titanium 電源でスレッドあたり最大 360W、トレイあたり最大 1,800W としており、スレッドとドライブ パックのツール レス サービス、管理には IPMI と Redfish が使用されています。トレイの奥行きは 106.64cm で、1,200mm のラックが必要なため、より浅いエンタープライズ キャビネットは使用できません。Hammerspace は、ドライブ密度を一般的な 2U、24 ベイ NVMe サーバーの 3.3 倍とし、4U で 48 台に対し 160 台の SSD を搭載しています。
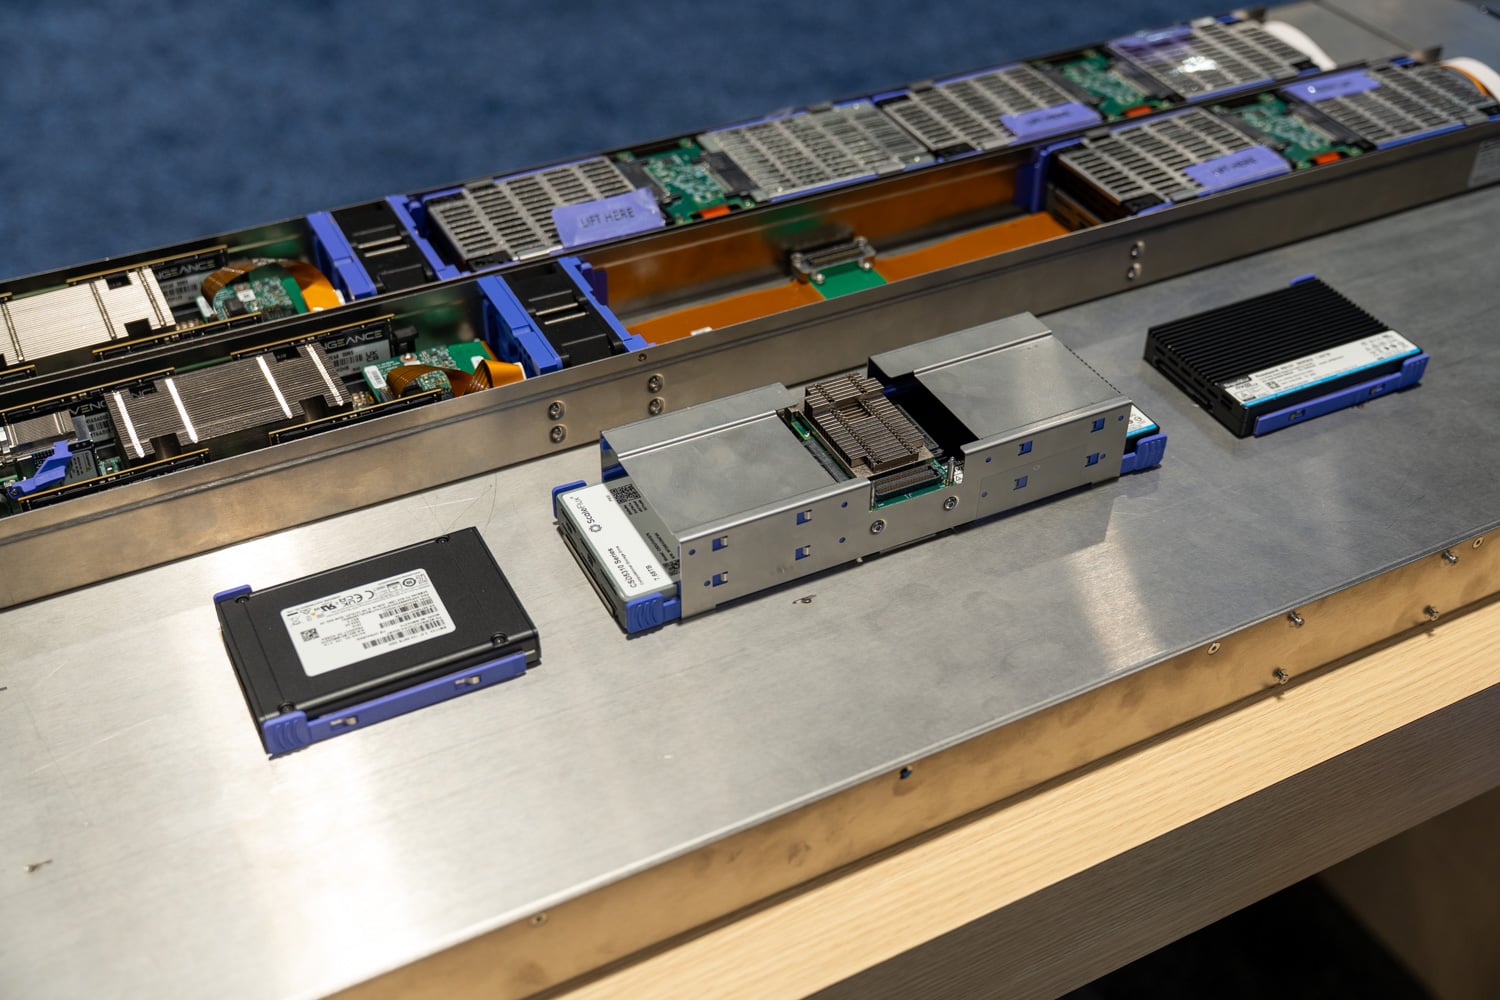
Hammerspaceがリストしている最大の容量である8台の245.76TB QLC SSDとKIOXIA LC9などのドライブの容量では、スレッドには1.97PBの生データ、フルサイズのトレイには9.83PBの生データが格納されます。トレイの最大消費電力1,800Wでは、生データ1ペタバイトあたり約183Wになります。スレッドはPCIe Gen5以前のTLCまたはQLCドライブに対応しており、Hammerspaceはパフォーマンス重視でTLC、容量重視でQLCを推奨しています。トレイを満載した42Uラックには約413PBの容量があり、最大75.6kWの電力を消費します。
この設計は、Hammerspaceが2025年に開始したOpen Flash Platformイニシアチブに端を発しており、Xsight Labsやロスアラモス国立研究所などが参加企業として名を連ねている。Hammerspaceは2025年10月、量産システムは2026年初頭に利用可能になると発表しており、スケジュールは約1年前倒しになった。このスレッドは、現在大量出荷されているU.2およびU.3ドライブを使用しており、Hammerspaceはより高密度なフォームファクタを念頭に置いて設計を行った。HammerspaceとXsightは、ラックあたり1エクサバイトの容量を実現する道筋を示しており、これは現在最大のドライブを42Uいっぱいに積載した場合の2倍以上の容量となる。
Hammerspace社によると、このスレッドのプロトタイプ開発は約2年前に始まり、初期の採用はハイパースケーラー企業によるもので、彼らは各GPUラックの上部に1つまたは2つのトレイを配置し、電力消費の削減よりもラックの密度とパフォーマンスを重視しているという。この構成では、Hammerspace社はGPUサーバー内部のNVMeをNVIDIAがG3と呼ぶティアに、各ラック内のTLCを充填したOFPトレイをG4にマッピングしている。
性能に関する主張および試験条件
Hammerspaceは、ミラーリングなしの5スレッドトレイの書き込みスループットを390GB/s、4Kランダム読み取りIOPSを1500万と評価しています。記載されている条件は、エンタープライズGen5 TLC SSDを搭載した400GbEファブリック上のpNFS over TCPを使用したNFSv4.2です。読み取りはスレッドあたり最大80GB/s、トレイあたり最大400GB/sと評価されています。これは、スレッドの2つの400GbEポートそれぞれを介して約40GB/sであり、プロトコルのオーバーヘッドを考慮すると、実質的にリンクが飽和状態になるため、ネットワークポートが読み取りスループットの上限を決定します。
保護はミラーリングによって行われ、ポリシーによってファイルまたはディレクトリごとに設定され、オンラインで変更可能です。書き込み速度は、双方向ミラーリングでトレイあたり195GB/秒、3方向ミラーリングで130GB/秒に低下し、双方向ミラーリングでは使用可能な容量も半分になり、フル稼働のQLCトレイで約4.9PBになります。Hammerspaceは、KVキャッシュなど、再生成可能なデータについてはミラーリングなしで実行することを推奨しています。同社は、名前を明かしていない最も近い競合他社のラックユニットあたりのパフォーマンスの2~5倍であると主張しています。OFPのレイテンシ、クライアント数、IO500およびMLPerf Storageの結果は公開されておらず、当社もこれらのテストを実行または監査していません。
| 製品仕様 | Hammerspace Open Flash Platform |
|---|---|
| プラットフォームの概要 | |
| アーキテクチャ | x86ストレージサーバーを持たないDPUベースのフラッシュストレージノード |
| スレッド | U.2/U.3 NVMe SSD 8台(4台入りパック×2) 64コアArm DPU(Xsight Labs E1) 2 x 400GbE QSFP-DD |
| 1Uトレイ | そり1台から5台 最大40台のSSD 最大320個のArmコア 最大 10 x 400GbE |
| ドライブサポート | 認定されたU.2/U.3 SSD、PCIe Gen5以前 TLC または QLC |
| 最大生容量 | そり1台あたり1.97PB 1トレイあたり9.83PB 245.76TB QLC SSDをベースにしています |
| プロトコル | NFSv4.2とpNFS |
| Data Protection | ファイルまたはディレクトリごとのポリシーによるミラーリング:なし、2方向、または3方向 |
| パフォーマンス(Hammerspace社の数値、第5世代TLC SSD、400GbE、TCP) | |
| 読み取りスループット | スレッドあたり80GB/秒 トレイあたり400GB/秒 |
| 書き込みスループット、ミラーなし | スレッドあたり78GB/秒 トレイあたり390GB/秒 |
| 書き込みスループット、2ウェイミラー | スレッドあたり39GB/秒 トレイあたり195GB/秒 |
| 書き込みスループット、3ウェイミラー | スレッドあたり26GB/秒 トレイあたり130GB/秒 |
| 4Kランダム読み取り | スレッドあたり3万IOPS トレイあたり15万IOPS |
| パワーと身体 | |
| 最大出力 | そり1台あたり360W トレイあたり1,800W |
| 直流安定化電源 | トレイあたり2,160Wチタン製デュアル |
| フォームファクター | 1Uトレイ、奥行き106.64cm 1,200mmのラックが必要です |
| 冷却 | 空気、海面における最大吸気温度40℃ |
| マネジメント | IPMI、レッドフィッシュ |
| 利用状況 | 見積もり中 2027年前半に出荷予定 |
ティア0とKVキャッシュ
HammerspaceはOFPをTier 1として位置付け、GPUサーバーに既に搭載されているNVMeで構成されるTier 0の背後に配置しています。NFS経由でエクスポートされたデータは、計算ノード上にクライアントやエージェントが存在しない共有クラスタ全体の階層に集約されます。そこに書き込まれたデータは、保護のためにクラスタ全体にミラーリングされ、ポリシーに基づいて他の階層に移動されます。Hammerspaceによると、一般的なパターンは、トレーニングチェックポイントをローカルに書き込み、古いチェックポイントをシステムにオブジェクトストレージに移動させることです。Hammerspaceは、テスト構成を公開せずに、Tier 0のシーケンシャル帯域幅が外部共有ストレージと比較して4.4倍、レイテンシが56%低いと述べています。
KVキャッシュの役割では同じティアを使用します。これは、共有ストレージから会話の計算済みコンテキストを再ロードできる推論サーバーは、GPU上でこれらのトークンを再計算する必要がないという考えに基づいています。Hammerspaceはキャッシュマネージャとして機能せず、推論ソフトウェアのキャッシュマネージャが使用できるPOSIXストレージとして、OFPを背後に持つプールされたTier 0 NVMeを提供します。
データインテリジェンス:カタログ、ディープスキャン、および自然言語クエリ
データインテリジェンス層は、データ移動をせずにネームスペース内のすべてのストレージシステムにわたるファイルとオブジェクトのメタデータをインデックス化するカタログから始まります。第2層であるDeepScanは、オンデマンドまたはスケジュールに基づいてファイルを開き、個人情報、財務情報、および保護対象医療情報を検索し、その結果を検索可能なタグにします。クエリは、顧客が選択した言語管理ツール(LLM)を介して自然言語で記述できます。結果は、Hammerspaceが目標と呼ぶ既存のポリシーエンジンにフィードされるため、管理者はトレーニング準備完了または特定の国に制限されているタグが付けられたすべてのファイルを見つけ、そのセットに対して配置ルールを設定できます。
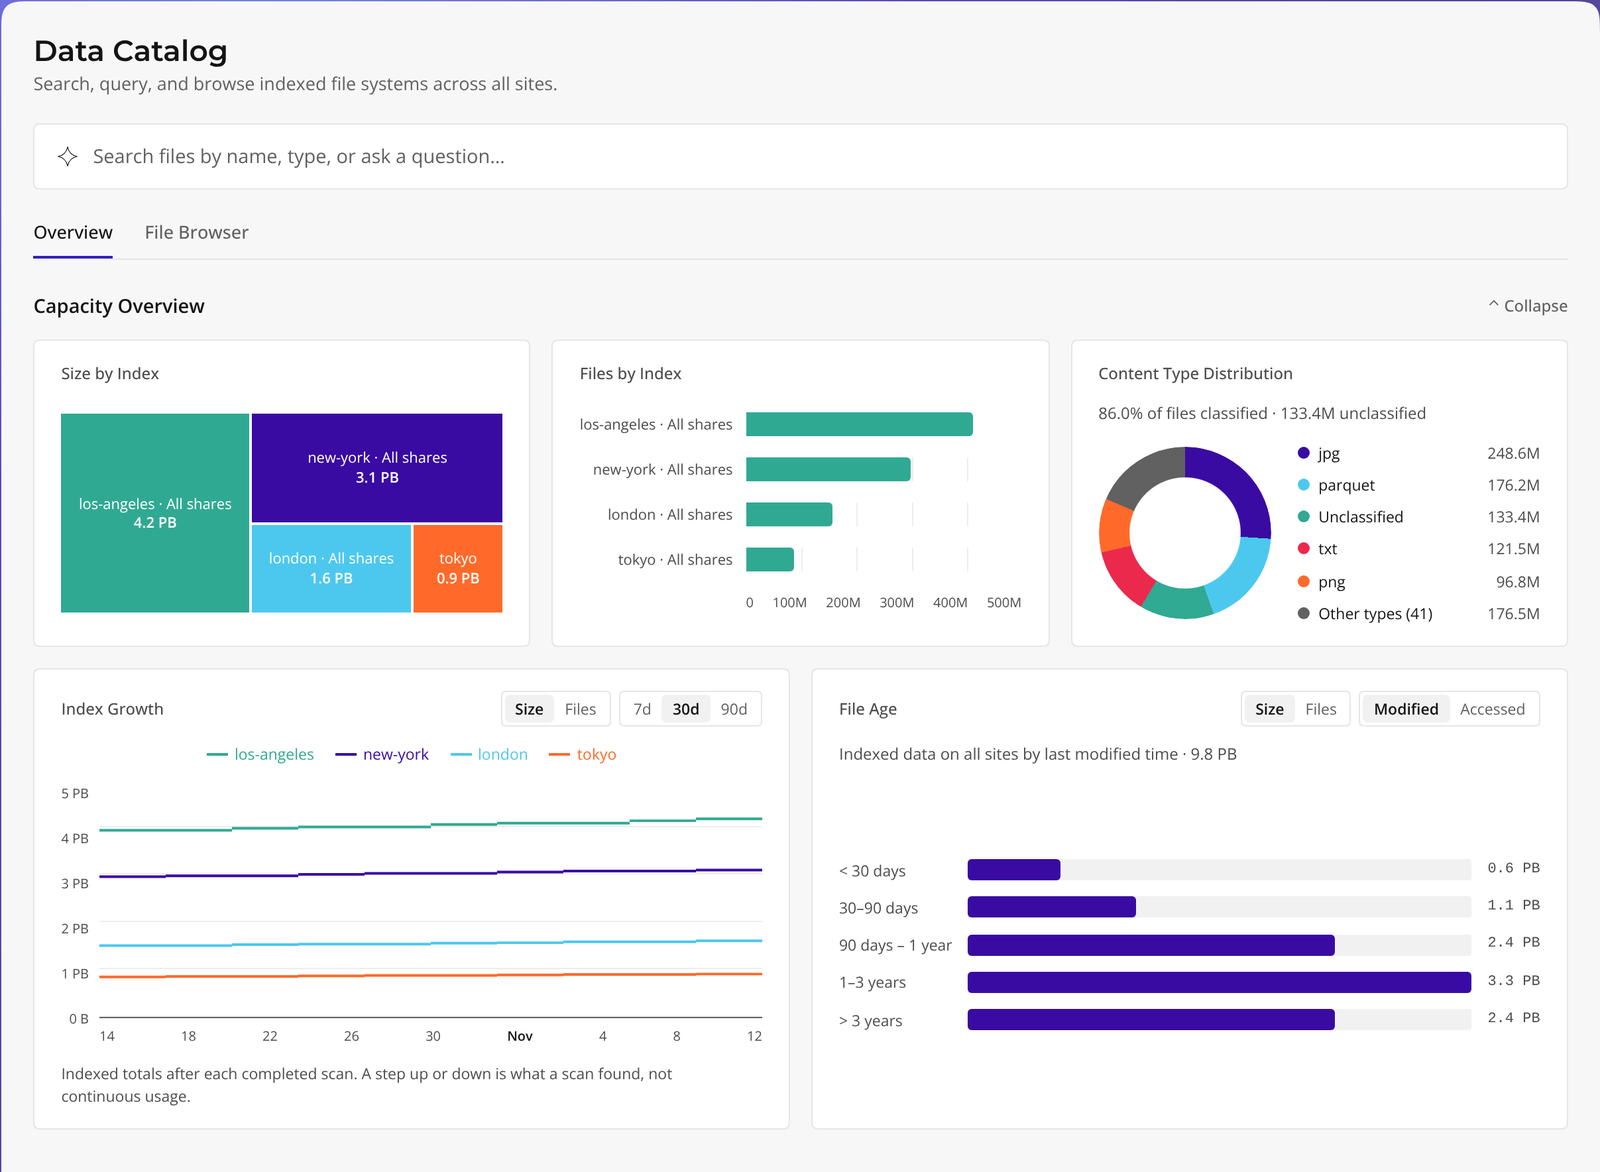
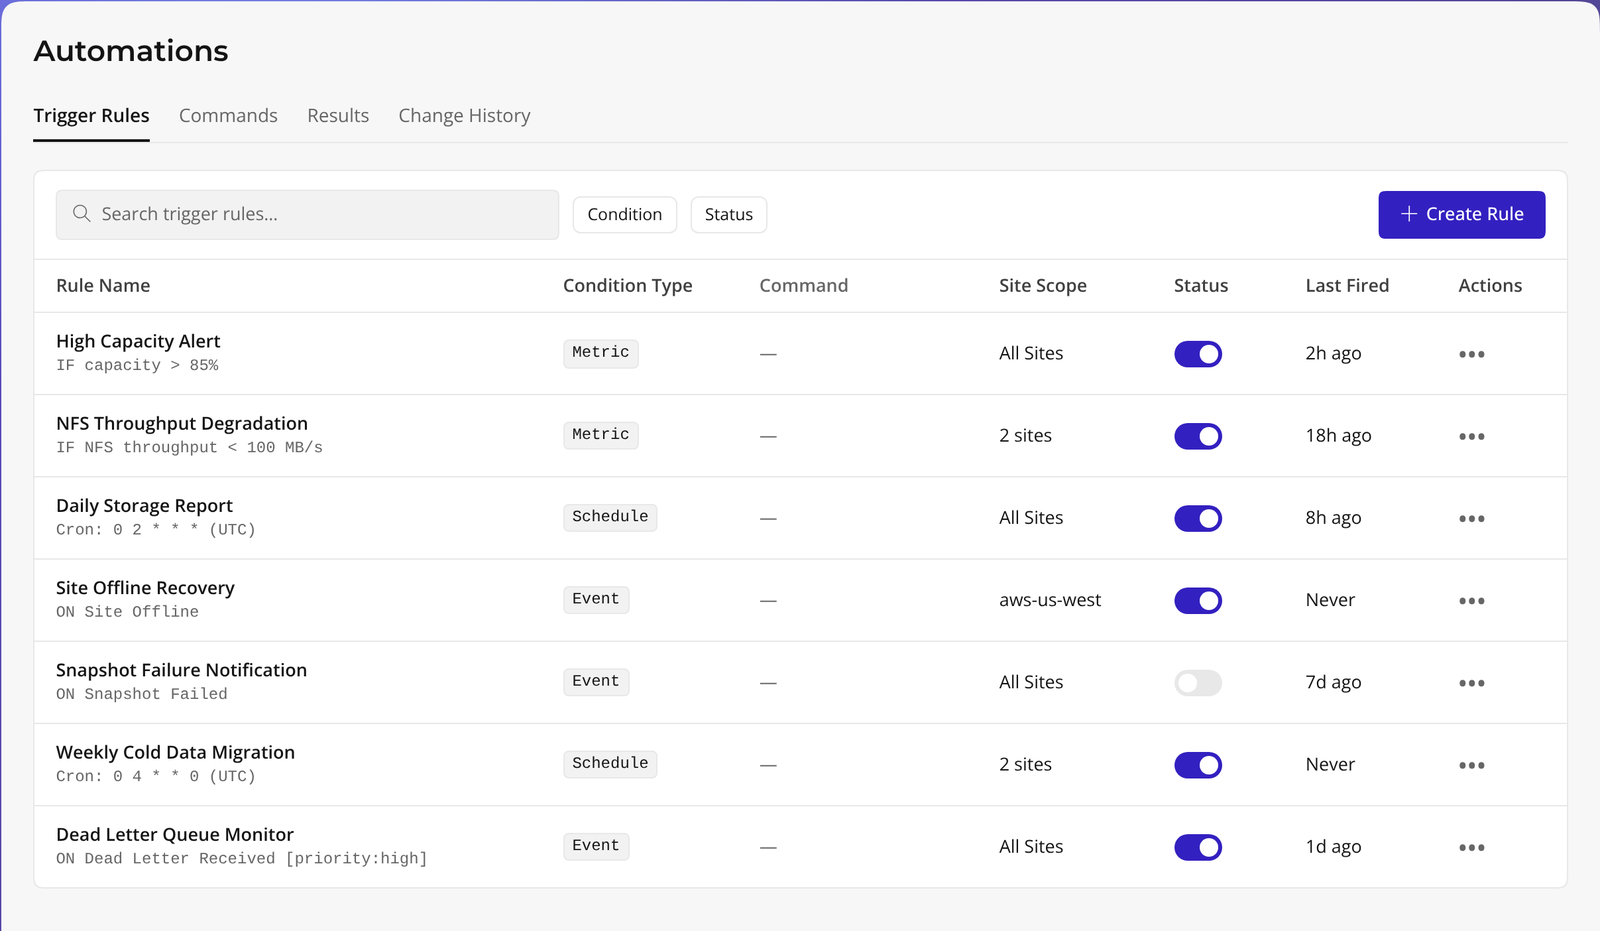
目標とは、共有、ボリューム、ディレクトリ、またはファイルに紐づけられた宣言的なルールであり、例えば、30日間変更されていないデータを移動する、3つの場所に3つのコピーを保持する、といったルールです。新しい自動化機能は、容量しきい値、スケジュール、イベントなどの条件に基づいて目標をトリガーし、変更が承認される前にプレビュー手順が実行されます。タグはディレクトリツリーを継承し、ストレージシステム間やクラウド間でファイルを追跡します。このソフトウェアは、あらゆるベンダーのファイルストアおよびオブジェクトストアに対応しており、構造化データは管理しません。
初期顧客と今後の展望
ローンチ時のリファレンス顧客は、アムステルダムとチューリッヒにオフィスを構え、画像データと病理データに基づいてモデルをトレーニングする臨床AI企業、kaikoです。kaikoは、Microsoft AzureとNebulおよびNebius GPUクラウドを1つのネームスペースとしてHammerspace上で運用し、トレーニングにはGPUノードのNVMeをTier 0として使用し、ポリシーに基づいてAzure Blob Storageにチェックポイントを配置しています。Hammerspaceによると、kaikoのこれら3つのクラスター上のすべてのMLエンジニアリングワークフローがHammerspaceシステムに移行したとのことです。このケーススタディにはOFPハードウェアは含まれていません。
Hammerspaceによると、kaikoはNebius上で約128個のGPUから1,000個以上に拡張する際にHammerspaceシステムを採用し、Nebulクラウド上の既存のオールフラッシュNASをそのままネームスペースに取り込んだとのことです。また、同社は、Lustreが1年間で最大のサポートチケット発生源となった後、Amazon FSx for LustreをAWS上の30PBのHammerspaceクラスターに置き換えた、名称非公開のハイパースケールAI研究ラボについても説明し、現在はネームスペースをオンプレミスのデータセンターに拡張していると述べています。Hammerspaceは、このラボでは大容量ファイルの操作が約3倍高速になったとしています。
OFPは、ストレージサーバーのプロセッサがあった場所にDPUを配置する他の設計( NVIDIAがGTCで発表したBlueField-4 STXリファレンスアーキテクチャなど)に加わるもので、Hammerspaceのバージョンは、ハードウェアなしでも動作するファイルシステムと組み合わせる点で異なっている。HammerspaceはSC26でこのハードウェアをデモ展示しているが、価格はまだ発表していない。
SC26でHammerspace社と共同でOFPスレッドとトレイのウォークスルー動画を撮影しました。記事が公開され次第、この動画をこの記事に追加します。


 Amazon