

インテルはSC26で高性能コンピューティング計画を発表し、その中心となるのが次世代Xeonサーバーアーキテクチャ「Diamond Rapids」だ。インテルによると、このプラットフォームは最大256個の高性能コア、最大1.6TB/sのメモリ帯域幅、最大1.28GBのラストレベルキャッシュまで拡張可能となる。この概要は、データセンター戦略プログラム担当副社長兼ゼネラルマネージャーのジェフ・マクベイ氏によるもので、インテルGPU Dシリーズ、HPCソフトウェア、シリコンフォトニクス、量子開発についても触れている。インテルはDiamond Rapidsの発売日は明らかにしなかった。
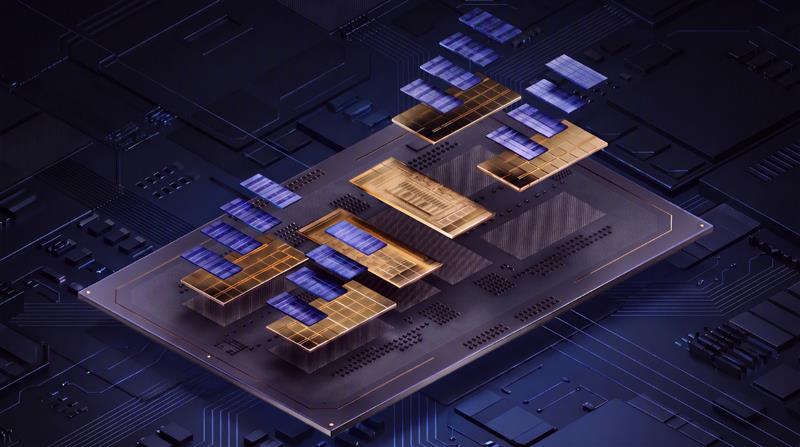
ダイアモンドラピッズCPUアーキテクチャ
Intelは、Hot Chipsで18A-P設計として詳細を発表したDiamond Rapidsについて、演算密度の向上とメモリ帯域幅の拡大、キャッシュの大型化、CPUアクセラレーションの拡張を組み合わせたものだと説明しています。Intel Advanced Performance Extensions(APX)はスレッドごとのパフォーマンス向上を目的としており、Intelが「統合メモリファブリック」と呼ぶ技術によって1.6TB/sという数値が実現されています。Intelは、この数値の背後にあるメモリチャネルの数やメモリ速度、あるいはソケットごとに適用されるかどうかについては明らかにしていません。
このアーキテクチャは、Intel AVX 10.2と拡張版Intel Advanced Matrix Extensions(Intel AMX)もサポートしています。Intelは、次世代Xeonを、HPCおよびAIワークロード向けのマトリックス演算機能を内蔵した唯一のx86サーバーCPUと位置付けています。コア数の参考として、今回レビューしたAMD EPYC Veniceの最上位モデルは、ソケットあたり256個のZen 6cコアを搭載しています。
マクベイ氏は、CPUがワークフローを統括し並列通信ライブラリを実行する一方で、アクセラレータがAI処理を担当する混合システムを中心としたロードマップを提示し、HPCの未来は「オープンで、異種混在で、バランスの取れたもの」になると述べている。
Intel GPU DシリーズとHPCソフトウェア
Intel GPU Dシリーズは、AIアクセラレーションと倍精度(FP64)演算を空冷式PCIeカードに統合し、FP4、MXFP4からFP64までのデータ型をサポートしています。IntelブランドのGPU D270は、160GBのLPDDR5Xメモリを搭載し、メモリ帯域幅は1.5TB/sです。パートナー設計の構成では、最大480GBまで拡張可能です。Intelは、研究施設向けにメモリ容量を重視しており、カード上に大きな作業データセットを保持することで、科学ワークフローを遅くするパーティショニングやホストからアクセラレータへのデータ転送を削減できるとしています。また、Intelは、コードを生成して計算ジョブを起動する常時稼働のAIエージェント向けにもこのカードを推奨しています。
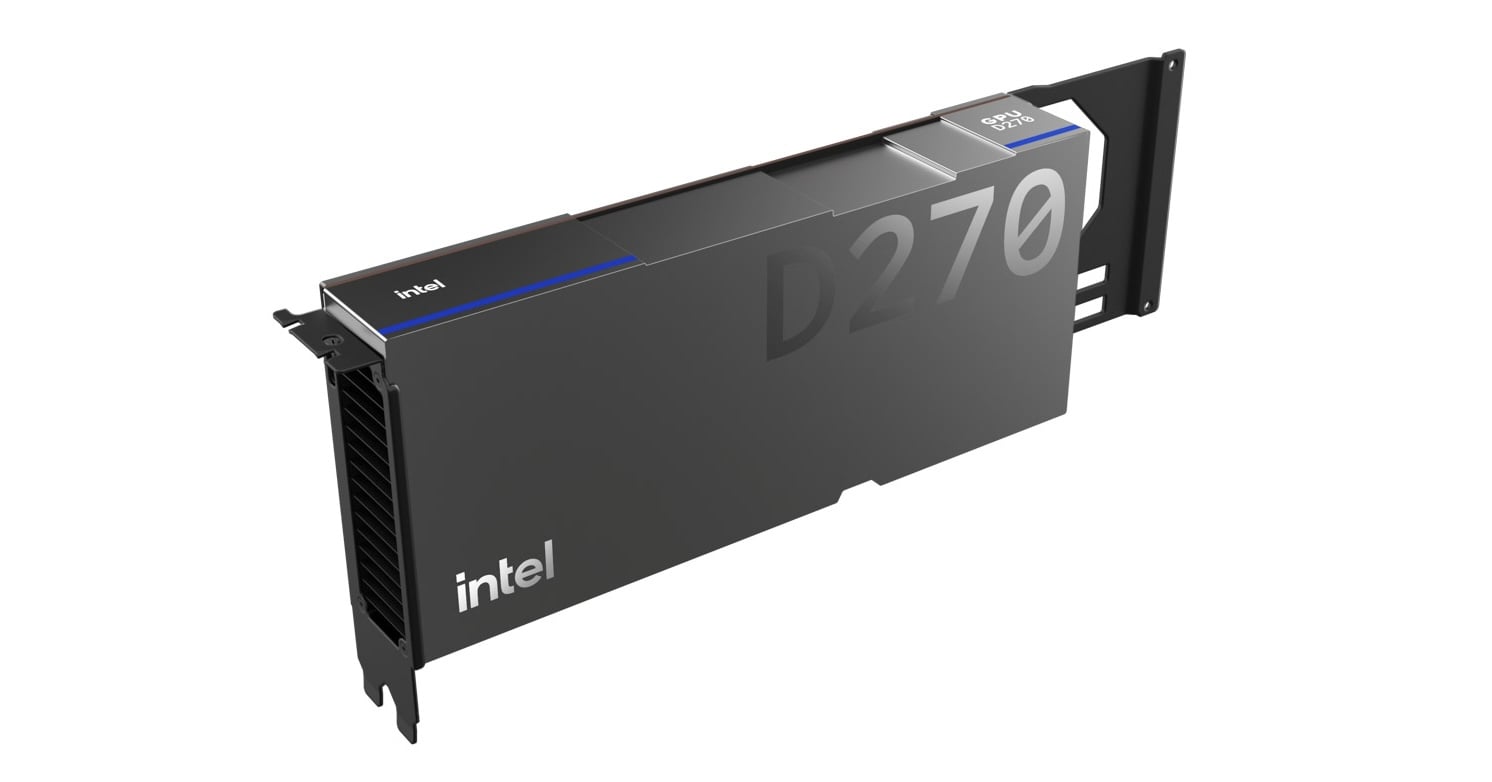
IntelはSC26のブースで、かつてCrescent Islandというコードネームで呼ばれていたDシリーズカードであるGPU D270のライブデモを2つ実施している。1つ目は、Veridien社がHIPとCUDAからSYCLに1か月足らずで移植した地震画像処理ミニアプリケーションで、Intelによると、カーネルの90%はIntel独自の最適化なしで正常に動作したという。2つ目は、推論パイプラインをD270カード(プリフィル処理)とSambaNova SN50ユニット(デコード処理)に分割し、Xeon 6およびXeon 6+プロセッサがそれらを統括するデモだ。
IntelはNVIDIAのRTX PRO 6000 Blackwell Server Editionとの比較も公開した。FP64の金融ワークロードでは、D270が350W、NVIDIAカードが600Wで、ヨーロピアンモンテカルロで最大5.9倍、ヨーロピアンブラックショールズで5.6倍、二項価格設定で4.6倍、アメリカンブラックショールズで1.92倍のスループットを実現したと主張している。推論では、Drex v2.0で最大29%低いレイテンシ、FP8でのQwen3-30B-A3Bで1.12倍の出力トークンスループットを実現したと主張している。
これらはベンダーが試作シリコン上で実施した結果であり、弊社では実行や監査を行っていません。インテルの財務テスト構成では、8枚のNVIDIAカードと1枚のD270を比較していますが、結果がカードごとに正規化されているかどうかは明記されていません。また、NVIDIAの推論実行にはAWSの仮想マシンが使用されました。
ソフトウェアに関して、インテルはIntel MPI、Fortran、コンパイラ最適化、およびoneAPIへの投資を継続し、既存の並列コードベースがCPUとGPUが混在するシステムでも引き続き良好に動作するようにすると述べています。また、AIフレームワーク、推論ランタイム、および展開環境との上流統合にも取り組んでいます。目標は、Dシリーズなどの新しいハードウェアが展開された初日から、標準的なモデルとツールが動作するようにすることです。
光接続と量子開発
インテルはまた、同社のシリコンフォトニクス技術についても言及した。この技術は光を利用してデータを長距離伝送するもので、同社によれば銅線リンクに比べてはるかに少ないエネルギーで済むという。ただし、インテルはこの主張を裏付ける数値や製品化の時期については明らかにしなかった。
量子コンピューティングに関して、インテルはClassiq社の買収案を改めて支持した。この買収により、Classiq社の自動量子アルゴリズム合成プラットフォームと、インテルのシリコンスピン量子ビット技術およびチップ製造技術が統合されることになる。インテルは、規制当局の承認を条件として、この買収は2027年前半に完了する見込みだと述べている。


 Amazon