

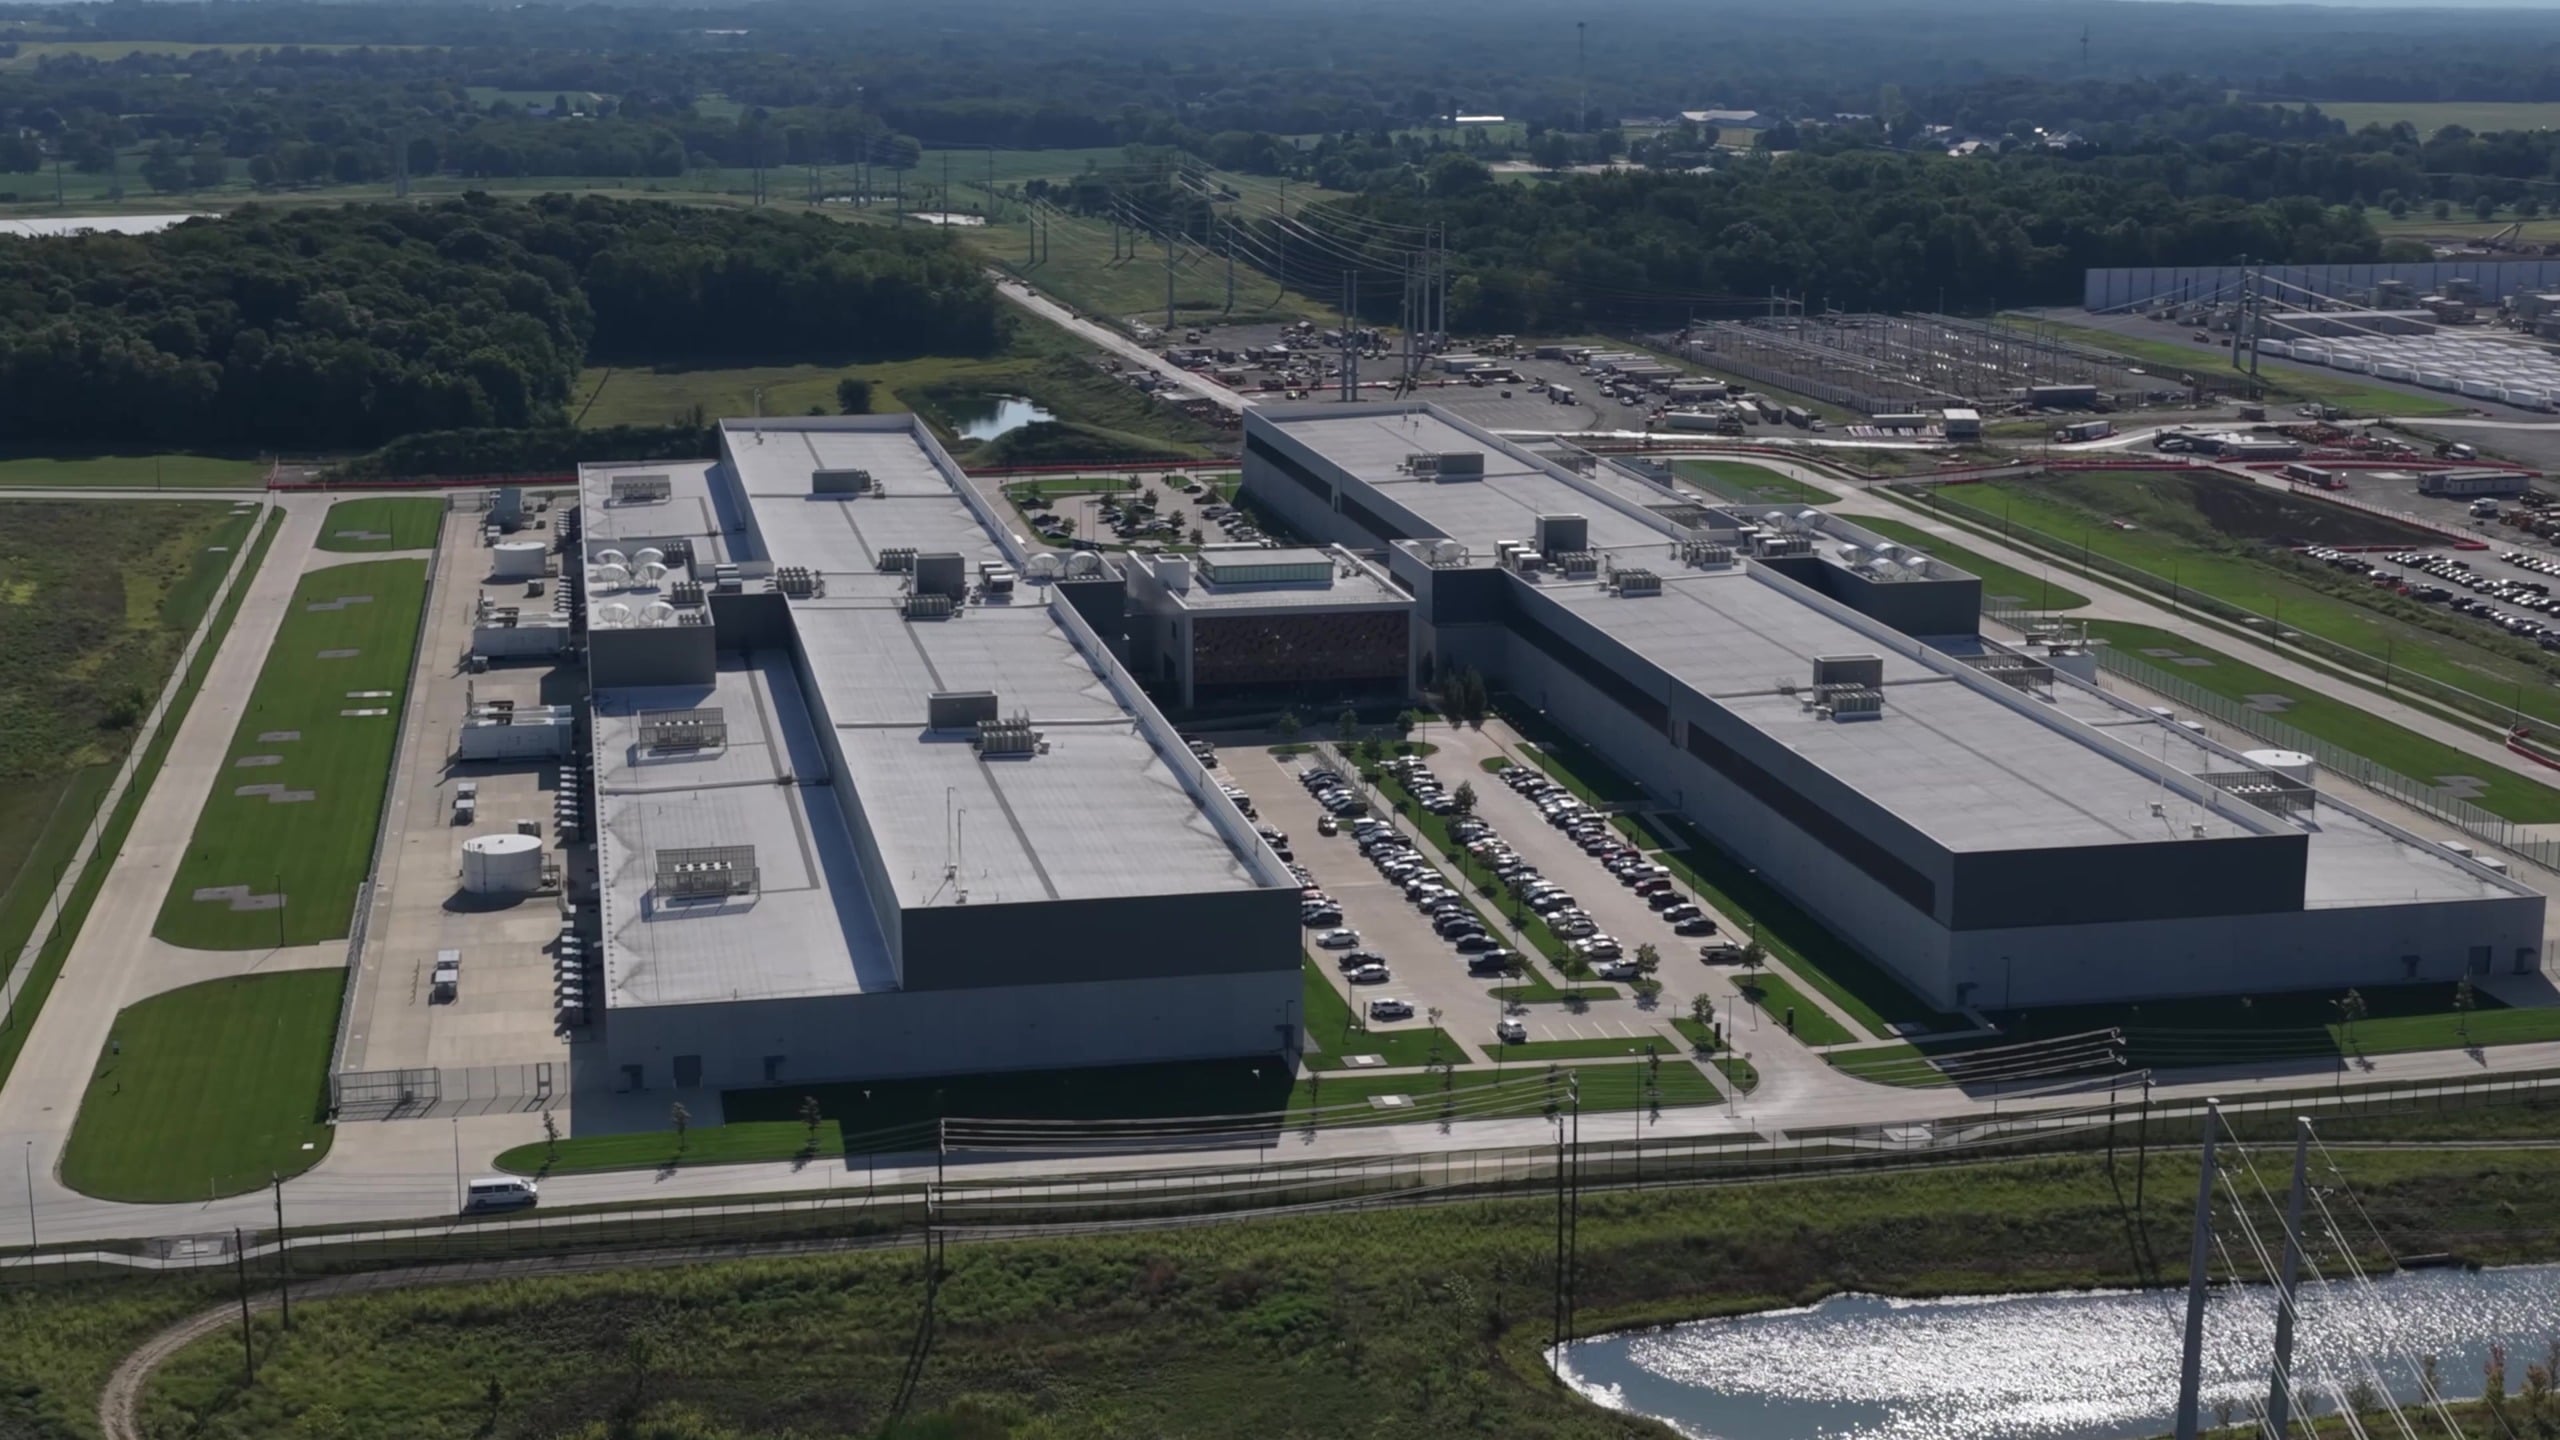
Metaは本日、オハイオ州ニューアルバニーに構築中のギガワット級AIスーパークラスター「Prometheus」の内部構造を詳細に紹介する記事を公開した。第1フェーズは完了し、Muse Wonderモデルを含むMuseファミリーの基礎モデルのトレーニングが完了した。Metaによると、このサイトはGPU数を約100万個にまで拡張する予定だという。2年前、同じキャンパスはウェブトラフィックを処理する従来型のデータセンターだった。MetaのエンジニアであるKevin Lee、Yashar Bayani、Ahmed Sharif、Yee Jiun Songによるこの記事では、ハードウェア、ネットワーク、そしてトレーニングジョブの実行を維持するための信頼性確保の取り組みについて解説している。
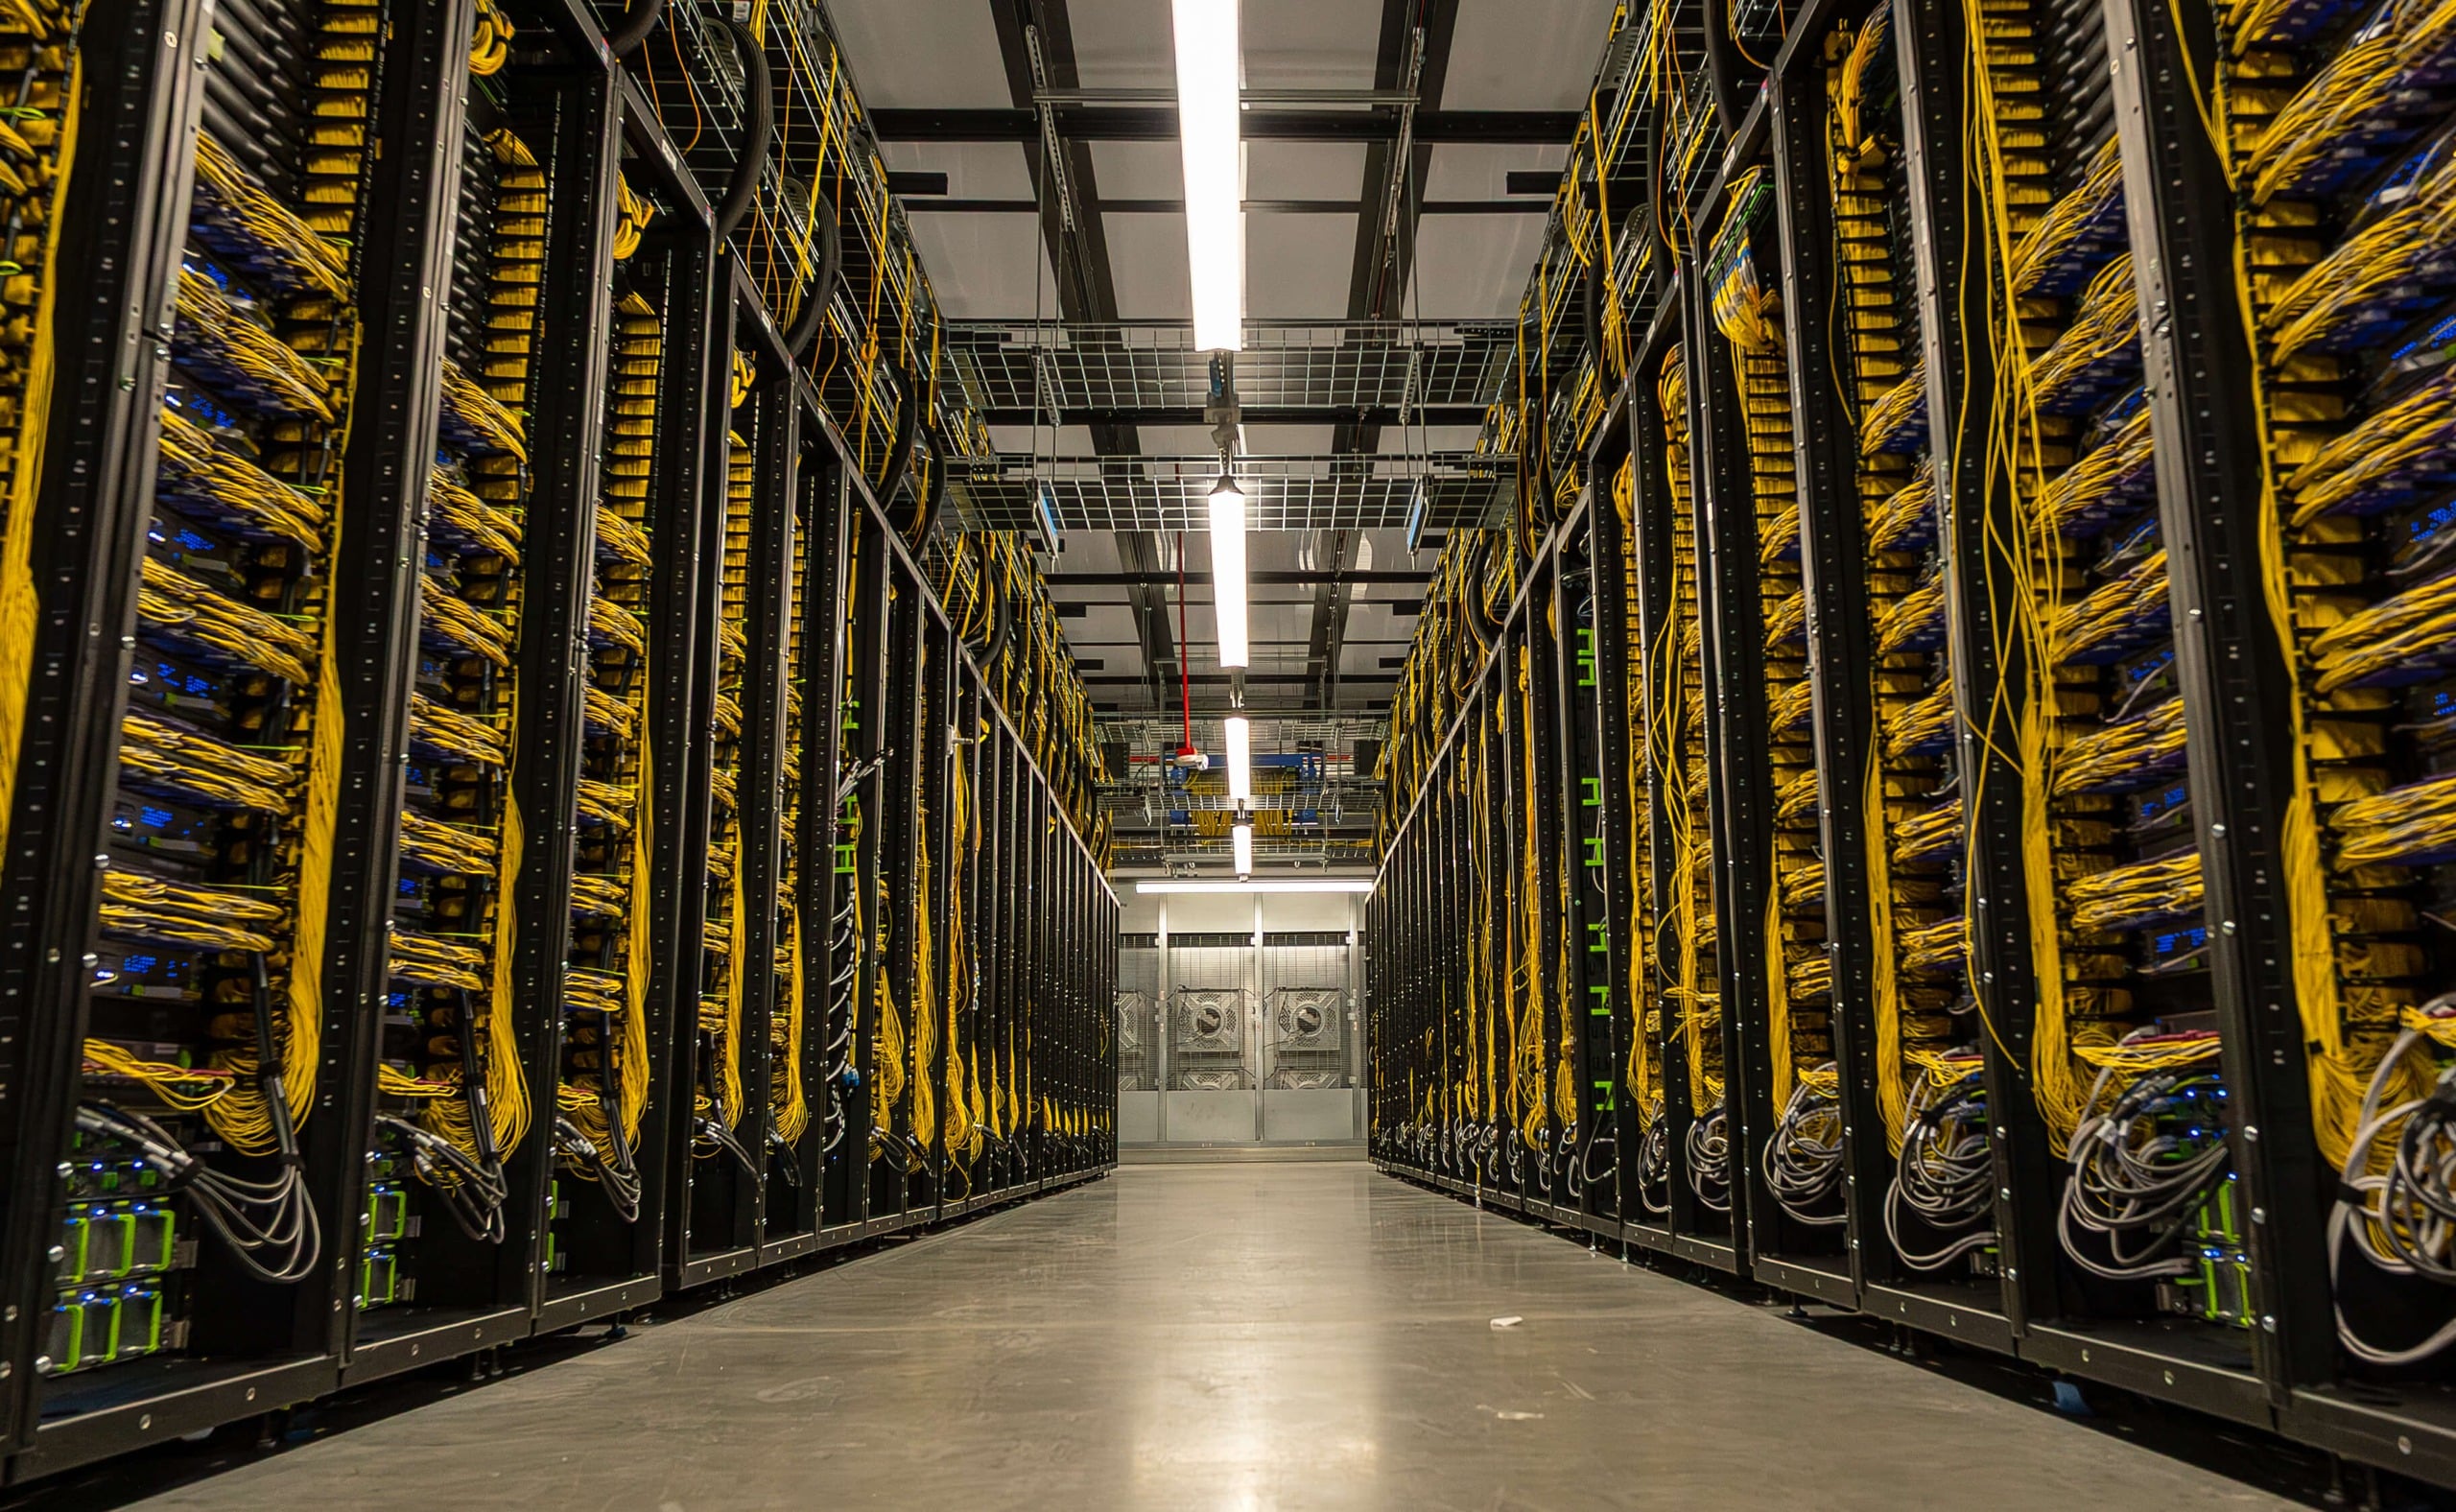
Metaは、大規模なトレーニングジョブの実行に関する最も興味深いデータ、つまり信頼性に関する数値も公開しました。Metaは、Muse Wonderの事前トレーニング実行で85%以上のグッドパット、強化学習実行で90%以上のグッドパットを達成し、これらの実行中の中断間の平均時間(実時間)は約47,000 GPU時間であると報告しています。その後リリースされたファームウェアの修正により、MTBIは54,000 GPU時間を超えました。Metaが掲げる目標は、1日あたり8,000 GPUあたり2回の中断であり、これは中断間の平均時間が約100,000 GPU時間に相当します。
NVL72の2世代が生産中、Vera Rubin Next
Prometheusは現在、2つのNVIDIA GPUプラットフォームで動作しており、どちらも72個のGPUが1つのNVLinkドメインを共有するNVL72ラックアーキテクチャに基づいて構築されています。3つ目のプラットフォームはVera Rubin NVL72に基づいており、まもなく登場予定です。MetaがCatalinaと呼ぶ最初のプラットフォームは、ArielバリアントのGB200 NVL72を使用しています。これは、ラックあたり36個のGPUを備えた2ラック構成で、Open Compute Projectに貢献したMetaのOpen Rack V3ハイパワーラック設計に基づいて構築されています。各Blackwell GPUはGrace CPUと2つのConnectX-7 400G NICとペアになっており、CPUとGPUの比率は1:1で、各GPUに800Gのスケールアウト帯域幅を提供します。
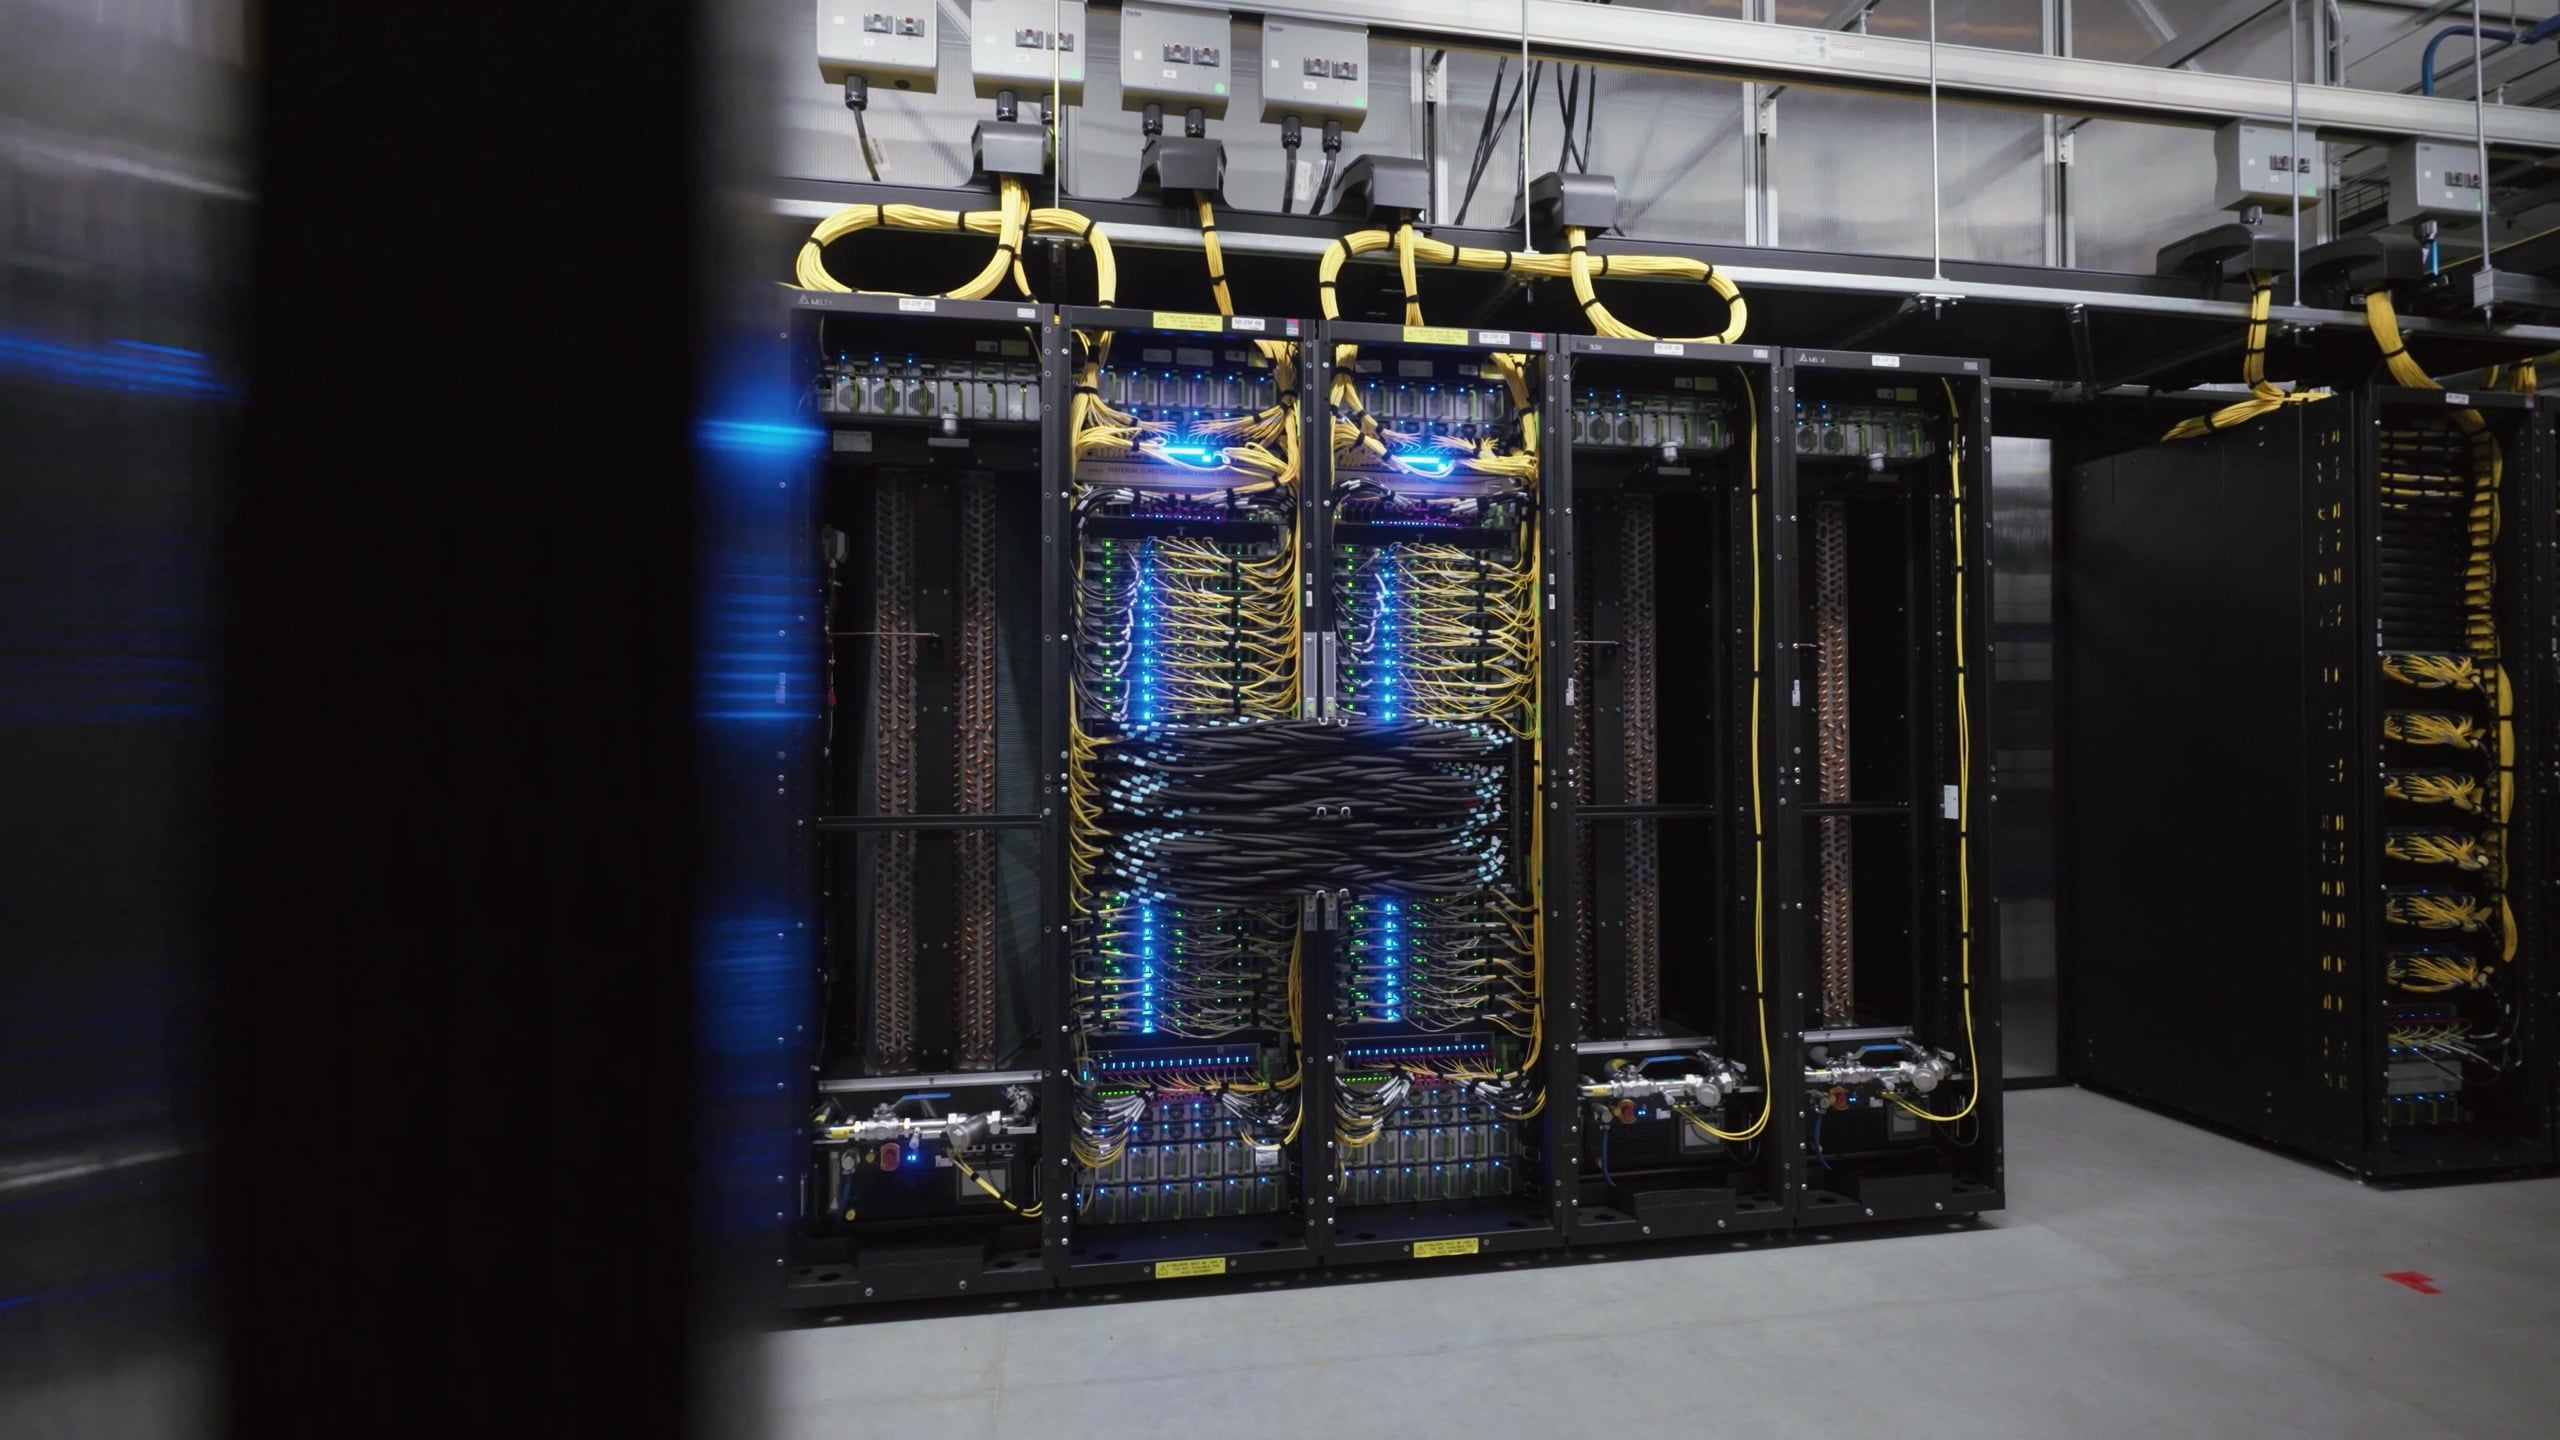
Meta社は、GB200 NVL72がFLOPS、HBM帯域幅、スケールアップ帯域幅、ドメインサイズをH100をはるかに超えて拡張できる一方、標準的なスケールアウトではGPUあたり400Gに留まり、その不均衡がパフォーマンスの低下につながると予想したため、Arielを選んだと述べています。Meta社によると、Catalinaペアは72個のBlackwell GPUを搭載し、13.4TBのHBM3e(GPUあたり192GB)、ピークFP8トレーニング計算で720 PFLOPS(FP4では1,440 PFLOPS)、ドメイン内で130TB/sのNVLink帯域幅、合計576TB/sのメモリ帯域幅を備え、2つのラック全体で約120kWの電力を消費します。
2 番目のプラットフォームである Clemente は GB300 NVL72 に移行します。GPU あたりの HBM は 1.5 倍の 288GB に増加し、高密度 FP4 スループットも同様に増加し、アテンション アクセラレーションは約 2 倍になります。ConnectX-8 SuperNIC は GPU あたり 800G をネイティブに提供するため、Meta が Ariel に組み込んだスケールアウトの余裕がベースラインとなり、GPU と CPU の比率が 2:1 であるため、72 個の GPU ドメイン全体を 1 つのラックに収めることができます。Meta は、20.7TB の HBM3e、1 エクサフロップを超えるピーク FP4 演算、130TB/s の NVLink 帯域幅 (GPU あたり双方向 1.8TB/s)、ラックあたり約 135kW、GB200 NVL72 と比較して 5 ~ 10 パーセントのパフォーマンス向上をリストしています。
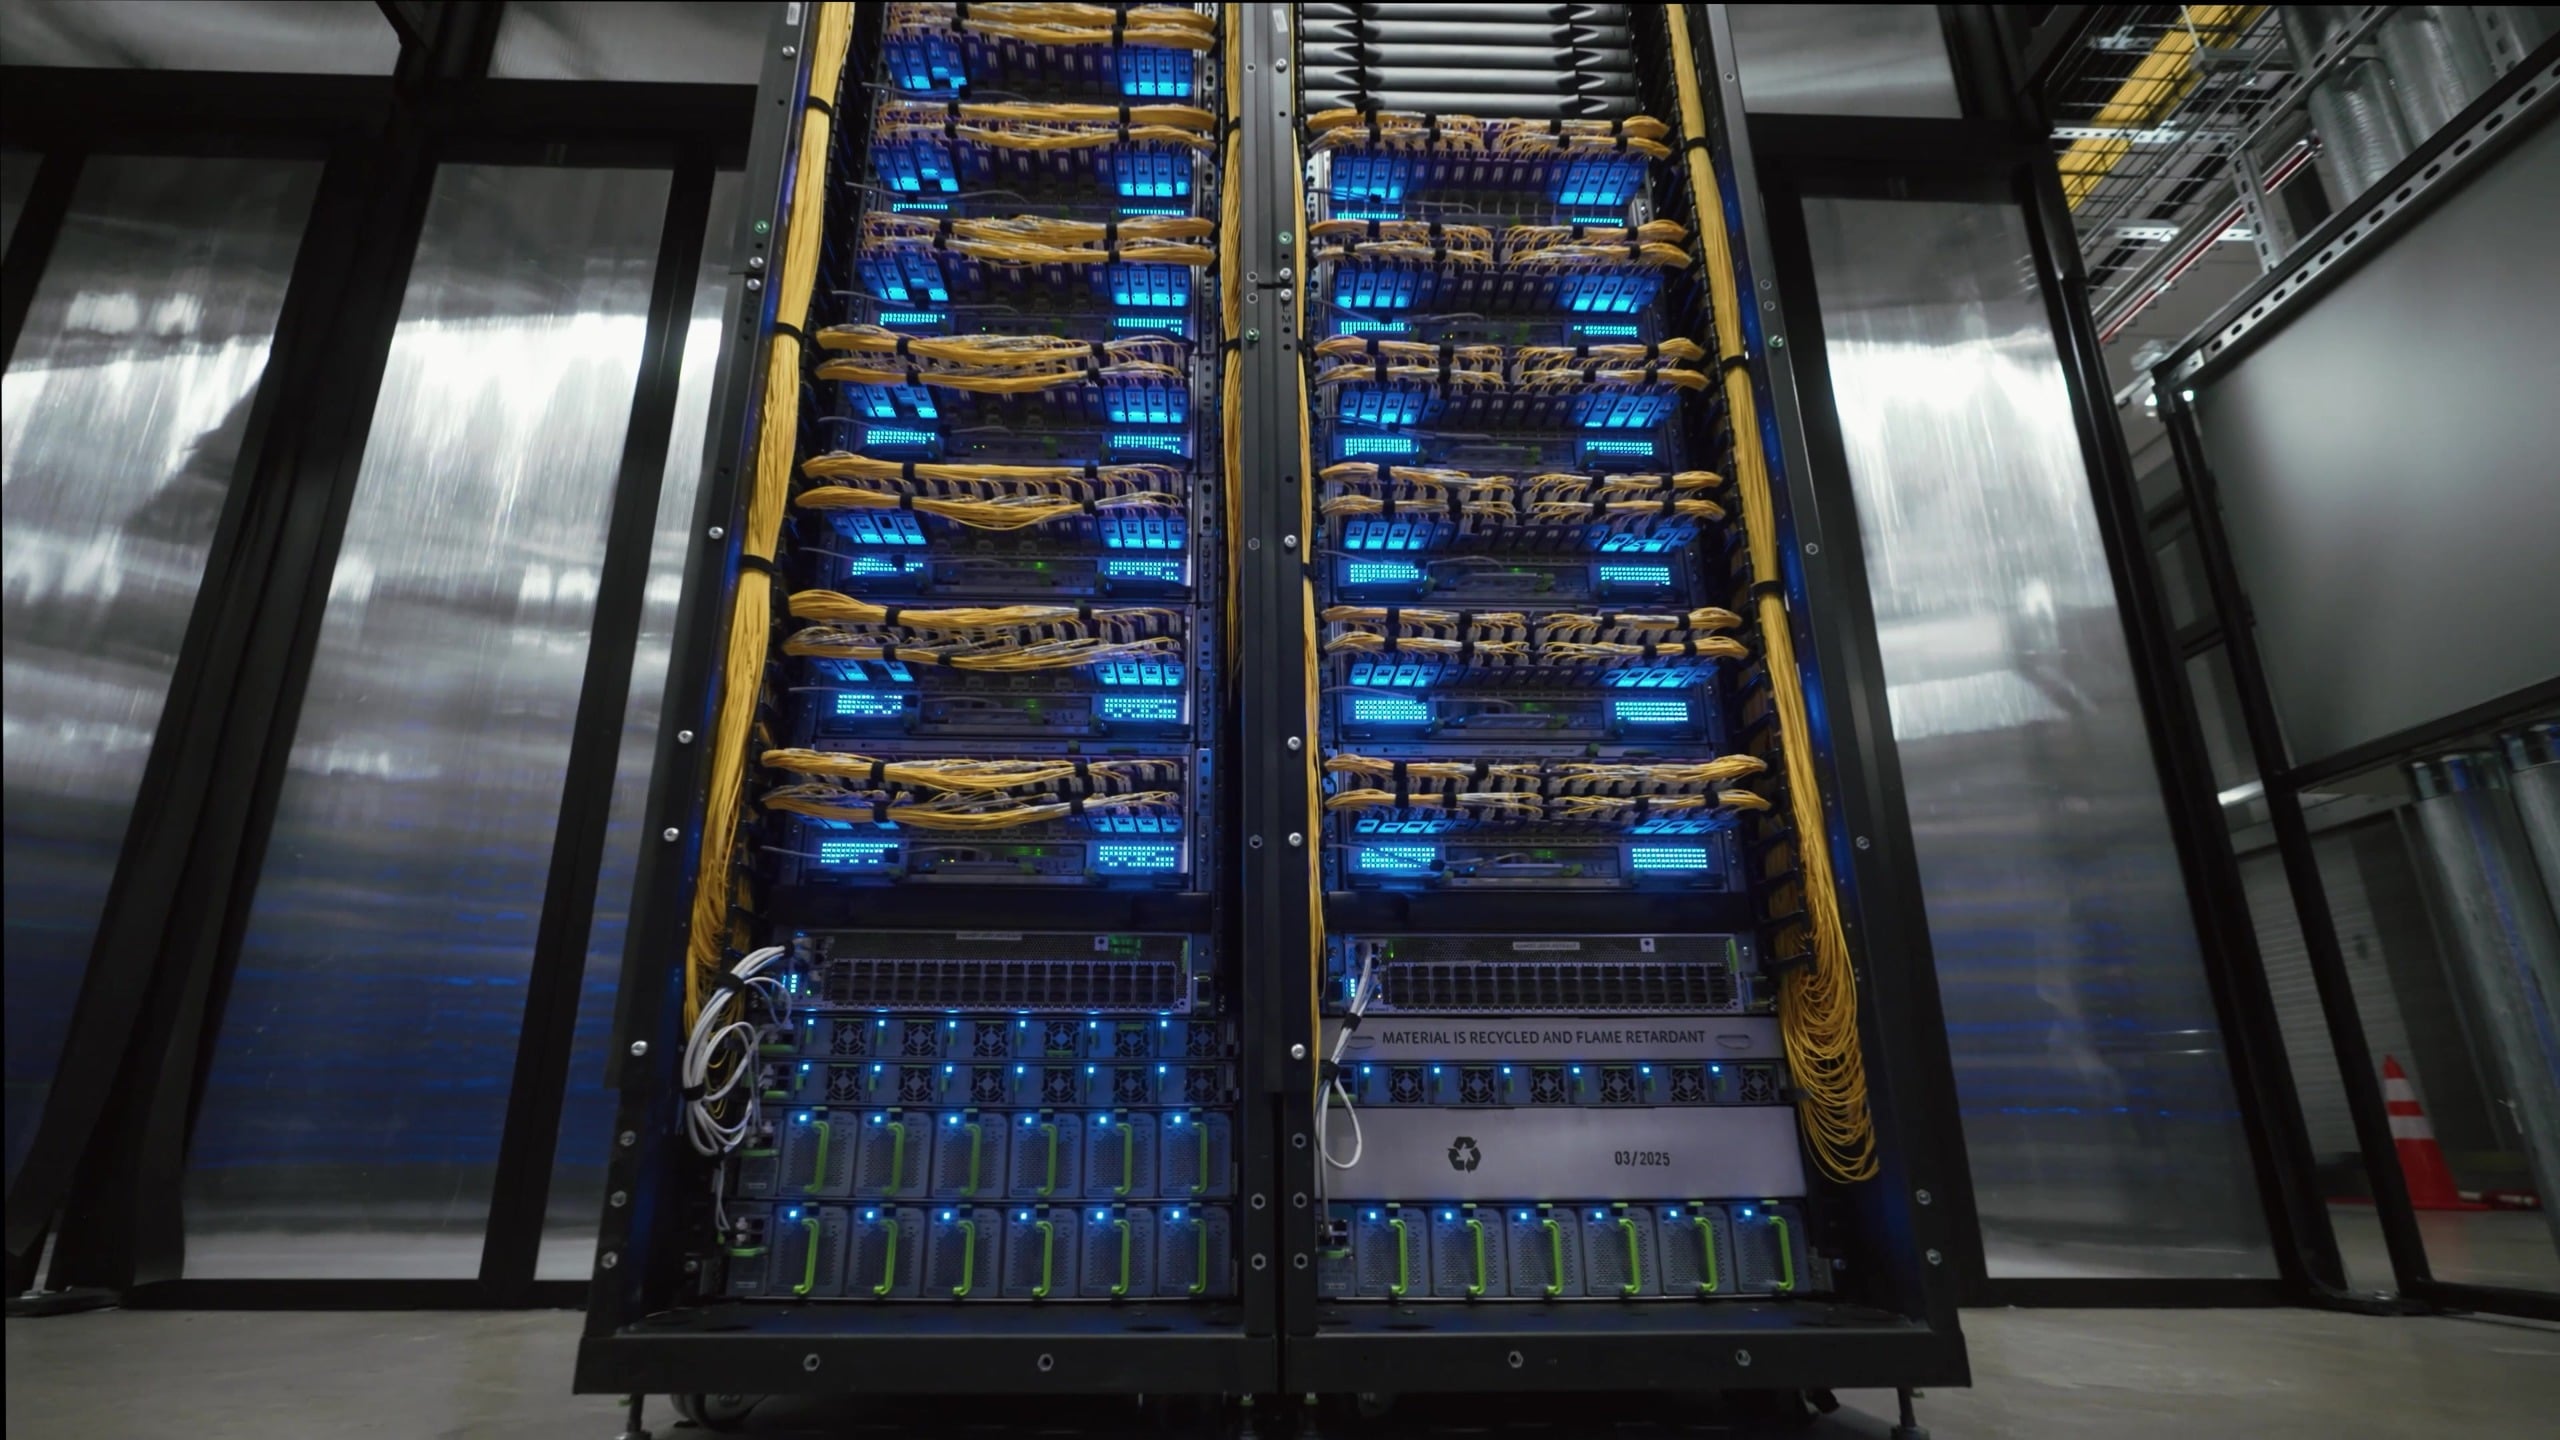
クレメンテ社は、最新のAI最適化ビルにメタ社のモジュール式空冷式液冷システムまたは施設液冷システムを導入しており、メタ社によれば、配線が少なくなることで保守性が向上するとのことだ。
Metaの次期プラットフォームであるSan Miguelは、Vera Rubin NVL72を同じネットワークファブリックに統合します。Metaのこのラックのスペックは、GPUあたり288GBのHBM4(19.2TB/s)、FP4トレーニング演算のピーク値が2.52 exaFLOPS、FP8が1.26 exaFLOPS、NVLink帯域幅が216TB/s(GPUあたり3TB/s)、総メモリ帯域幅が約1,500TB/s、ラックあたり170kWを超える完全液冷式演算トレイ、そしてGB300 NVL72と比較してワットあたりの性能が10~20%向上しています。CoreWeaveは今月初めにVera Rubin NVL72の生産を開始しました。
建物をまたぐ専用イーサネットバックエンド
トレーニングトラフィックは、通常のサービストラフィックを伝送するフロントエンドネットワークとは別の、イーサネット経由の第2のデータセンターネットワークで実行されます。この設計はトレーニングジョブの形状に倣っており、データ並列レプリカはレイテンシに敏感で帯域幅を多く消費する集合体をビルファブリック内に保持し、レプリカ間のより許容度の高いトラフィックはビルを接続する集約レイヤーを通過します。Metaは、この階層構造を以前の24,000 GPU規模のビル規模クラスターや100,000 GPUを超える地域クラスターにも構築し、その後Prometheusに拡張しました。
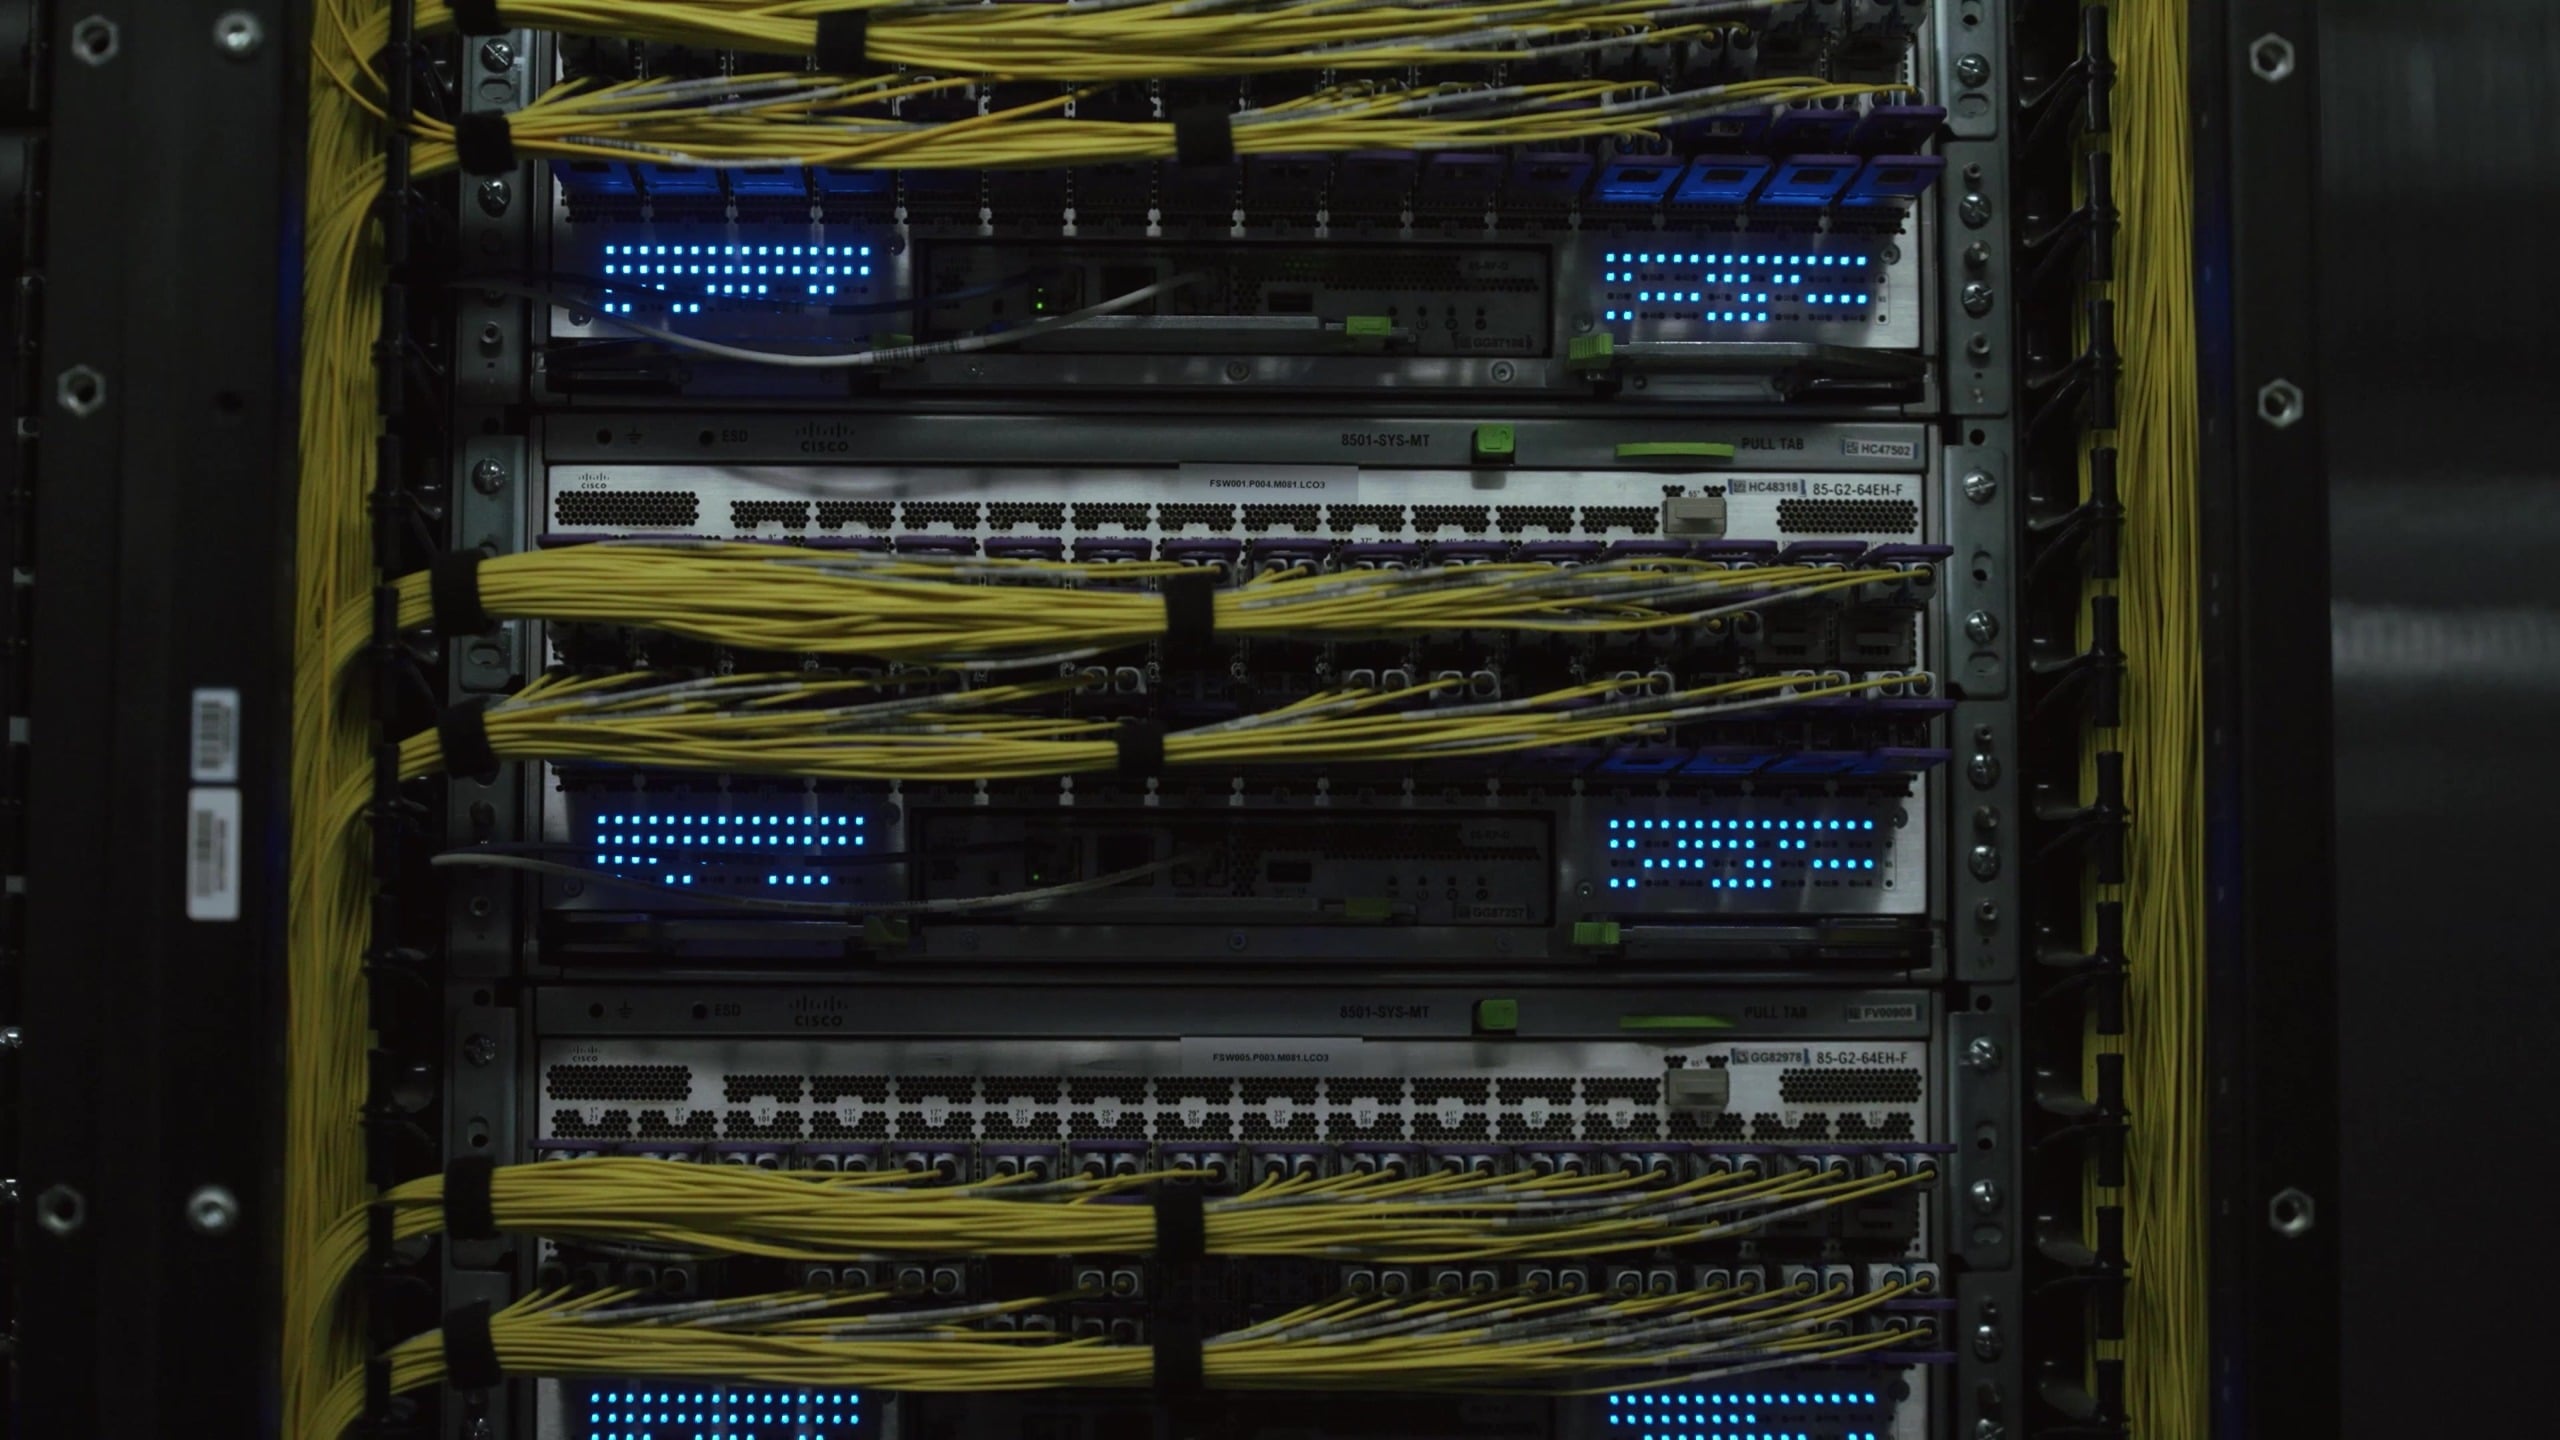
各ビルディングファブリックは最大 20,736 個の GPU を接続します。Meta の最初の設計は、サブパケットマルチパスルーティング、ファブリック内再順序付け、仮想出力キュー、およびクレジットベースのフロー制御を使用して、トレーニングコレクティブの少数の大規模で長寿命のフローが衝突しないようにする、分散スケジューリングファブリックでした。NIC がエンドポイントでパケットを再順序付ける機能を獲得すると、Meta は、浅いバッファ 51.2T スイッチ上に構築された非スケジューリングファブリックに移行しました。動的負荷分散を備えた Minipack3 と、ConnectX NIC 上で適応ルーティングを備えた NVIDIA Spectrum-4 ASIC を使用する Minipack3N があり、どちらも Meta の FBOSS ネットワークスタックを実行します。
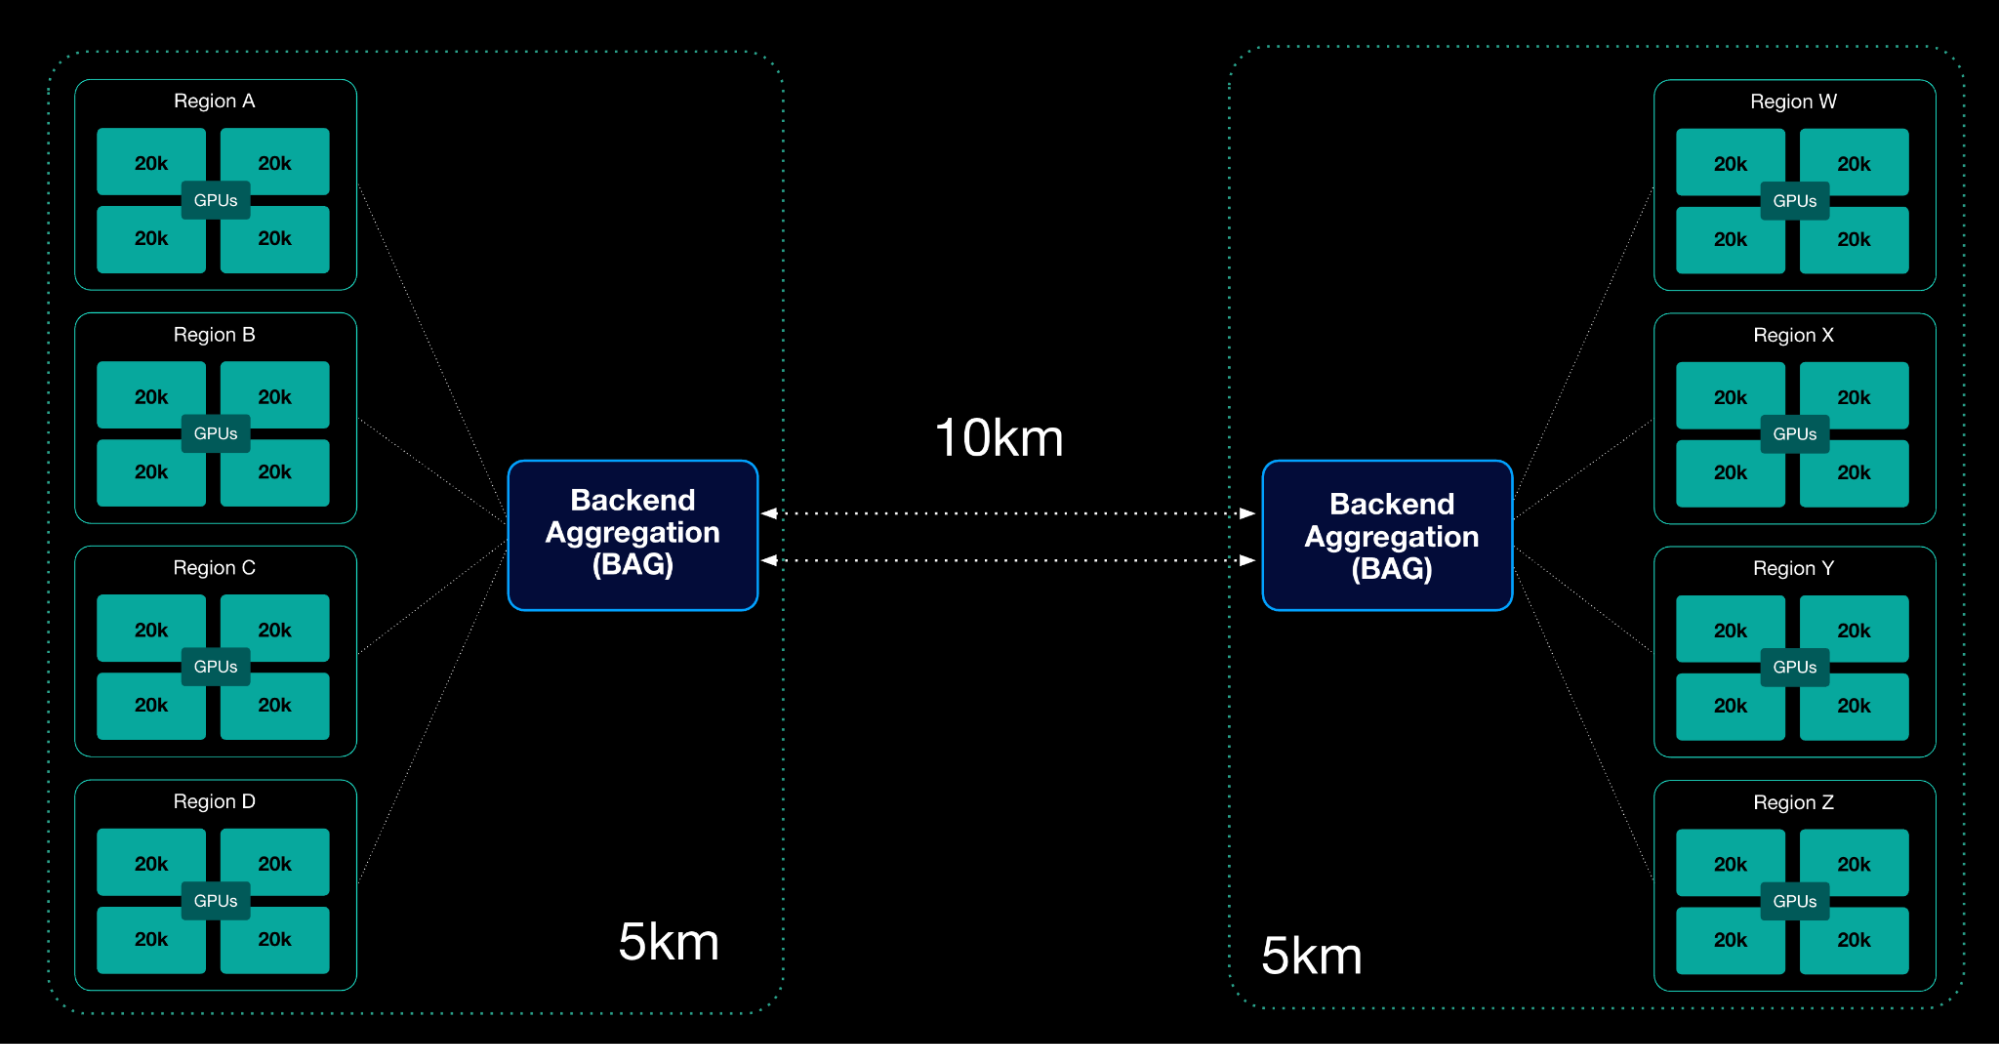
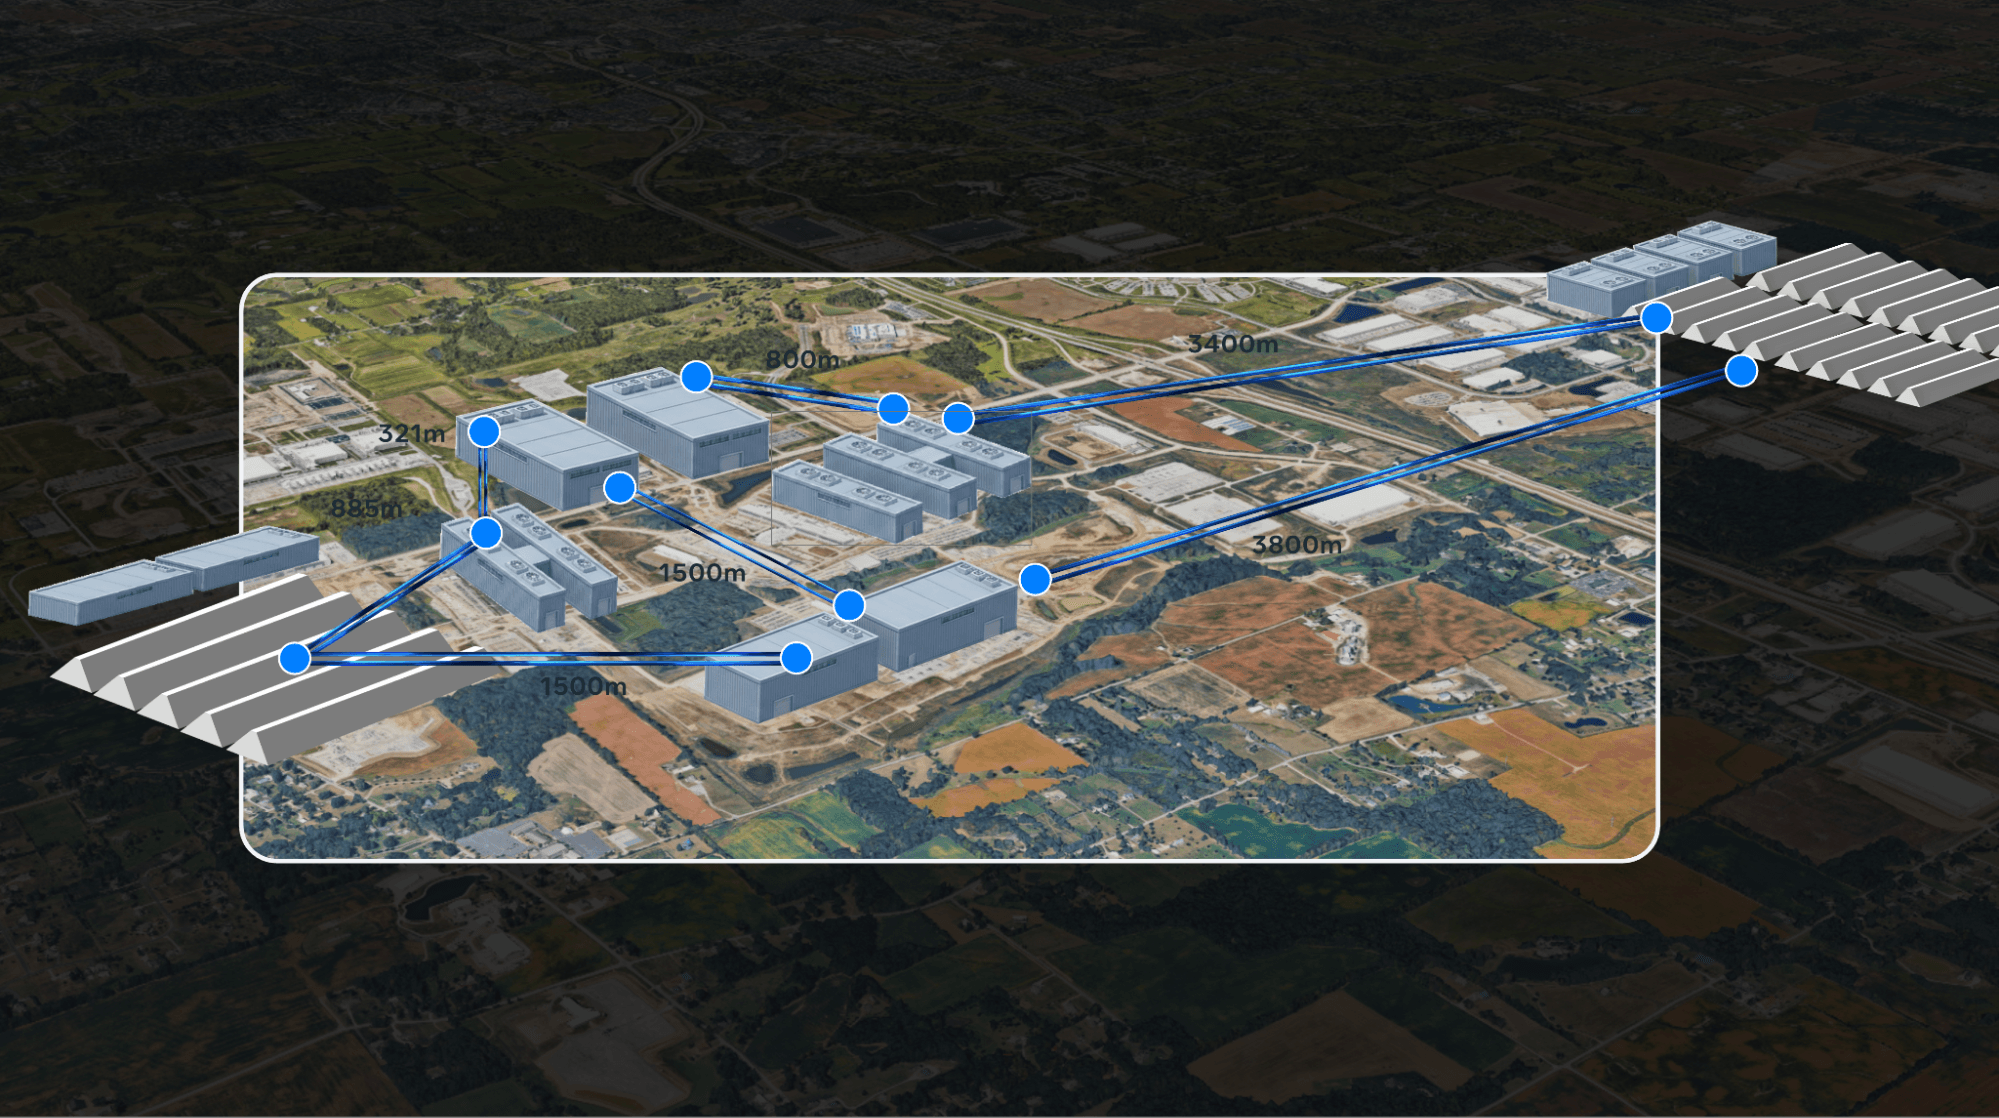
建物の上の階には、Arista 7800 シリーズシャーシとディープバッファ付き Broadcom Jericho3 シリコンをベースに構築された多層ハブアンドスポーク設計のバックエンド集約ネットワークが設置されています。このネットワークは 2km から 100km を超える距離に及び、地域ペア間で毎秒数ペタビットのデータを伝送します。Meta によると、光速の遅延のため、これらの距離にわたって事前学習を実行するには、Meta Superintelligence Labs との専用の最適化作業が必要だったとのことです。このネットワークの背後にある設備には、数百万マイルの光ファイバー、数万台のスイッチ、数百万個の光モジュールが含まれており、建物内の 2x400G FR4 LITE プラグインから、約 10km を超えるリンク用の 800G-ZR コヒーレント光モジュールまで多岐にわたります。
72個のGPUのうち64個が作業を行う
H100世代の8GPU構成のNVLinkドメインからNVL72に移行したことで、障害発生時の衝撃範囲は9倍に拡大したため、Metaは現在、72GPUラックを基準に容量計画を立てている。トレーニングの並列処理は2のべき乗のグループサイズに最適にマッピングされるため、各NVL72ドメインは64GPUのスライスを実行し、残りの8GPUをラック内の予備として保持する。GPUに障害が発生した場合、予備GPUが引き継ぎ、修復を待つことなくジョブは最後のチェックポイントから再開される。ラック全体の障害に備え、Metaは約2%のラックを予備として確保している。
32,768個のGPUを使用したトレーニング実行の場合、523個のNVL72ラック、つまり37,656個のGPUが必要となり、これはアクティブなフットプリントを約13%上回るもので、そのうち11ポイントは72スライス中64スライスのジオメトリによるものです。この信頼性を支える信号完全性の負担は相当なものです。1つのNVL72ドメインは、200Gbpsで調整された5,184個の差動ペアリンクを伝送し、それぞれがGPU SerDes、コンピュートトレイPCB、ケーブルカートリッジ、スイッチトレイインターフェースを横断します。
発生した障害に対処するため、2つの復旧パスが用意されています。障害が1つのデータ並列レプリカに限定されている場合、Metaの並列処理対応フォールトトレランス機能により、そのレプリカがオフラインになり、クラスタの残りの部分はステップを繰り返してトレーニングを継続します。また、スライスは予備ホストで再起動し、再同期します。より大きな障害が発生した場合は、ジョブ全体が最後のチェックポイントに戻されるため、Metaは頻繁にチェックポイントを作成し、勾配やオプティマイザデータを含むモデルの状態を、デルタチェックポイントとインメモリステージングを使用して、非同期的にマルチティアストレージに保存することで、スループットへの影響を最小限に抑えます。
中断が99%減少
これらの数字が示す進歩にもかかわらず、Prometheusは最初から安定していたわけではありません。初期段階の2025年半ばには、中断率が1日あたり8,000個のGPUあたり約1,000件のイベントでピークに達しました。1年間の部門横断的な取り組みにより、中断率は99%削減され、現在ではクラスターはそれぞれ数万個のGPUからなる複数のトレーニングジョブを並列でサポートしています。Metaは、NVIDIAとの共同エンジニアリングモデルを高く評価しています。このモデルでは、NVIDIAのチームがニューアルバニーの拠点に集まり、テレメトリを共有し、すべての停止を根本原因に分解する共同トリアージセッションを実施しています。Metaはスケジューリングとインフラストラクチャの修正を担当し、NVIDIAはファームウェア、信号診断、メモリ処理を担当しています。
GB200では、NVLinkの信号整合性が最初のボトルネックでした。クラスタ内に600,000万を超えるNVLink接続があったため、リンクの不具合により頻繁にリカバリサイクルが発生しました。そこでMetaは、継続的なテレメトリ、自動フラグ付け、L11診断バーンを追加し、生産前に弱いリンクを特定しました。GB300ではメモリ容量が増加したため、HBMとLPDDRのメモリ障害が主な原因となり、HBMファームウェア設定の改良、メモリスクラビング、LPDDRエラー訂正アルゴリズムの改善、劣化デバイスの予測的な廃棄といった対策が講じられました。スイッチの状態はミリ秒単位で監視され、集約レイヤーのリンクイベントはGPUトラフィックを中断することなくハードウェアで再ルーティングされます。
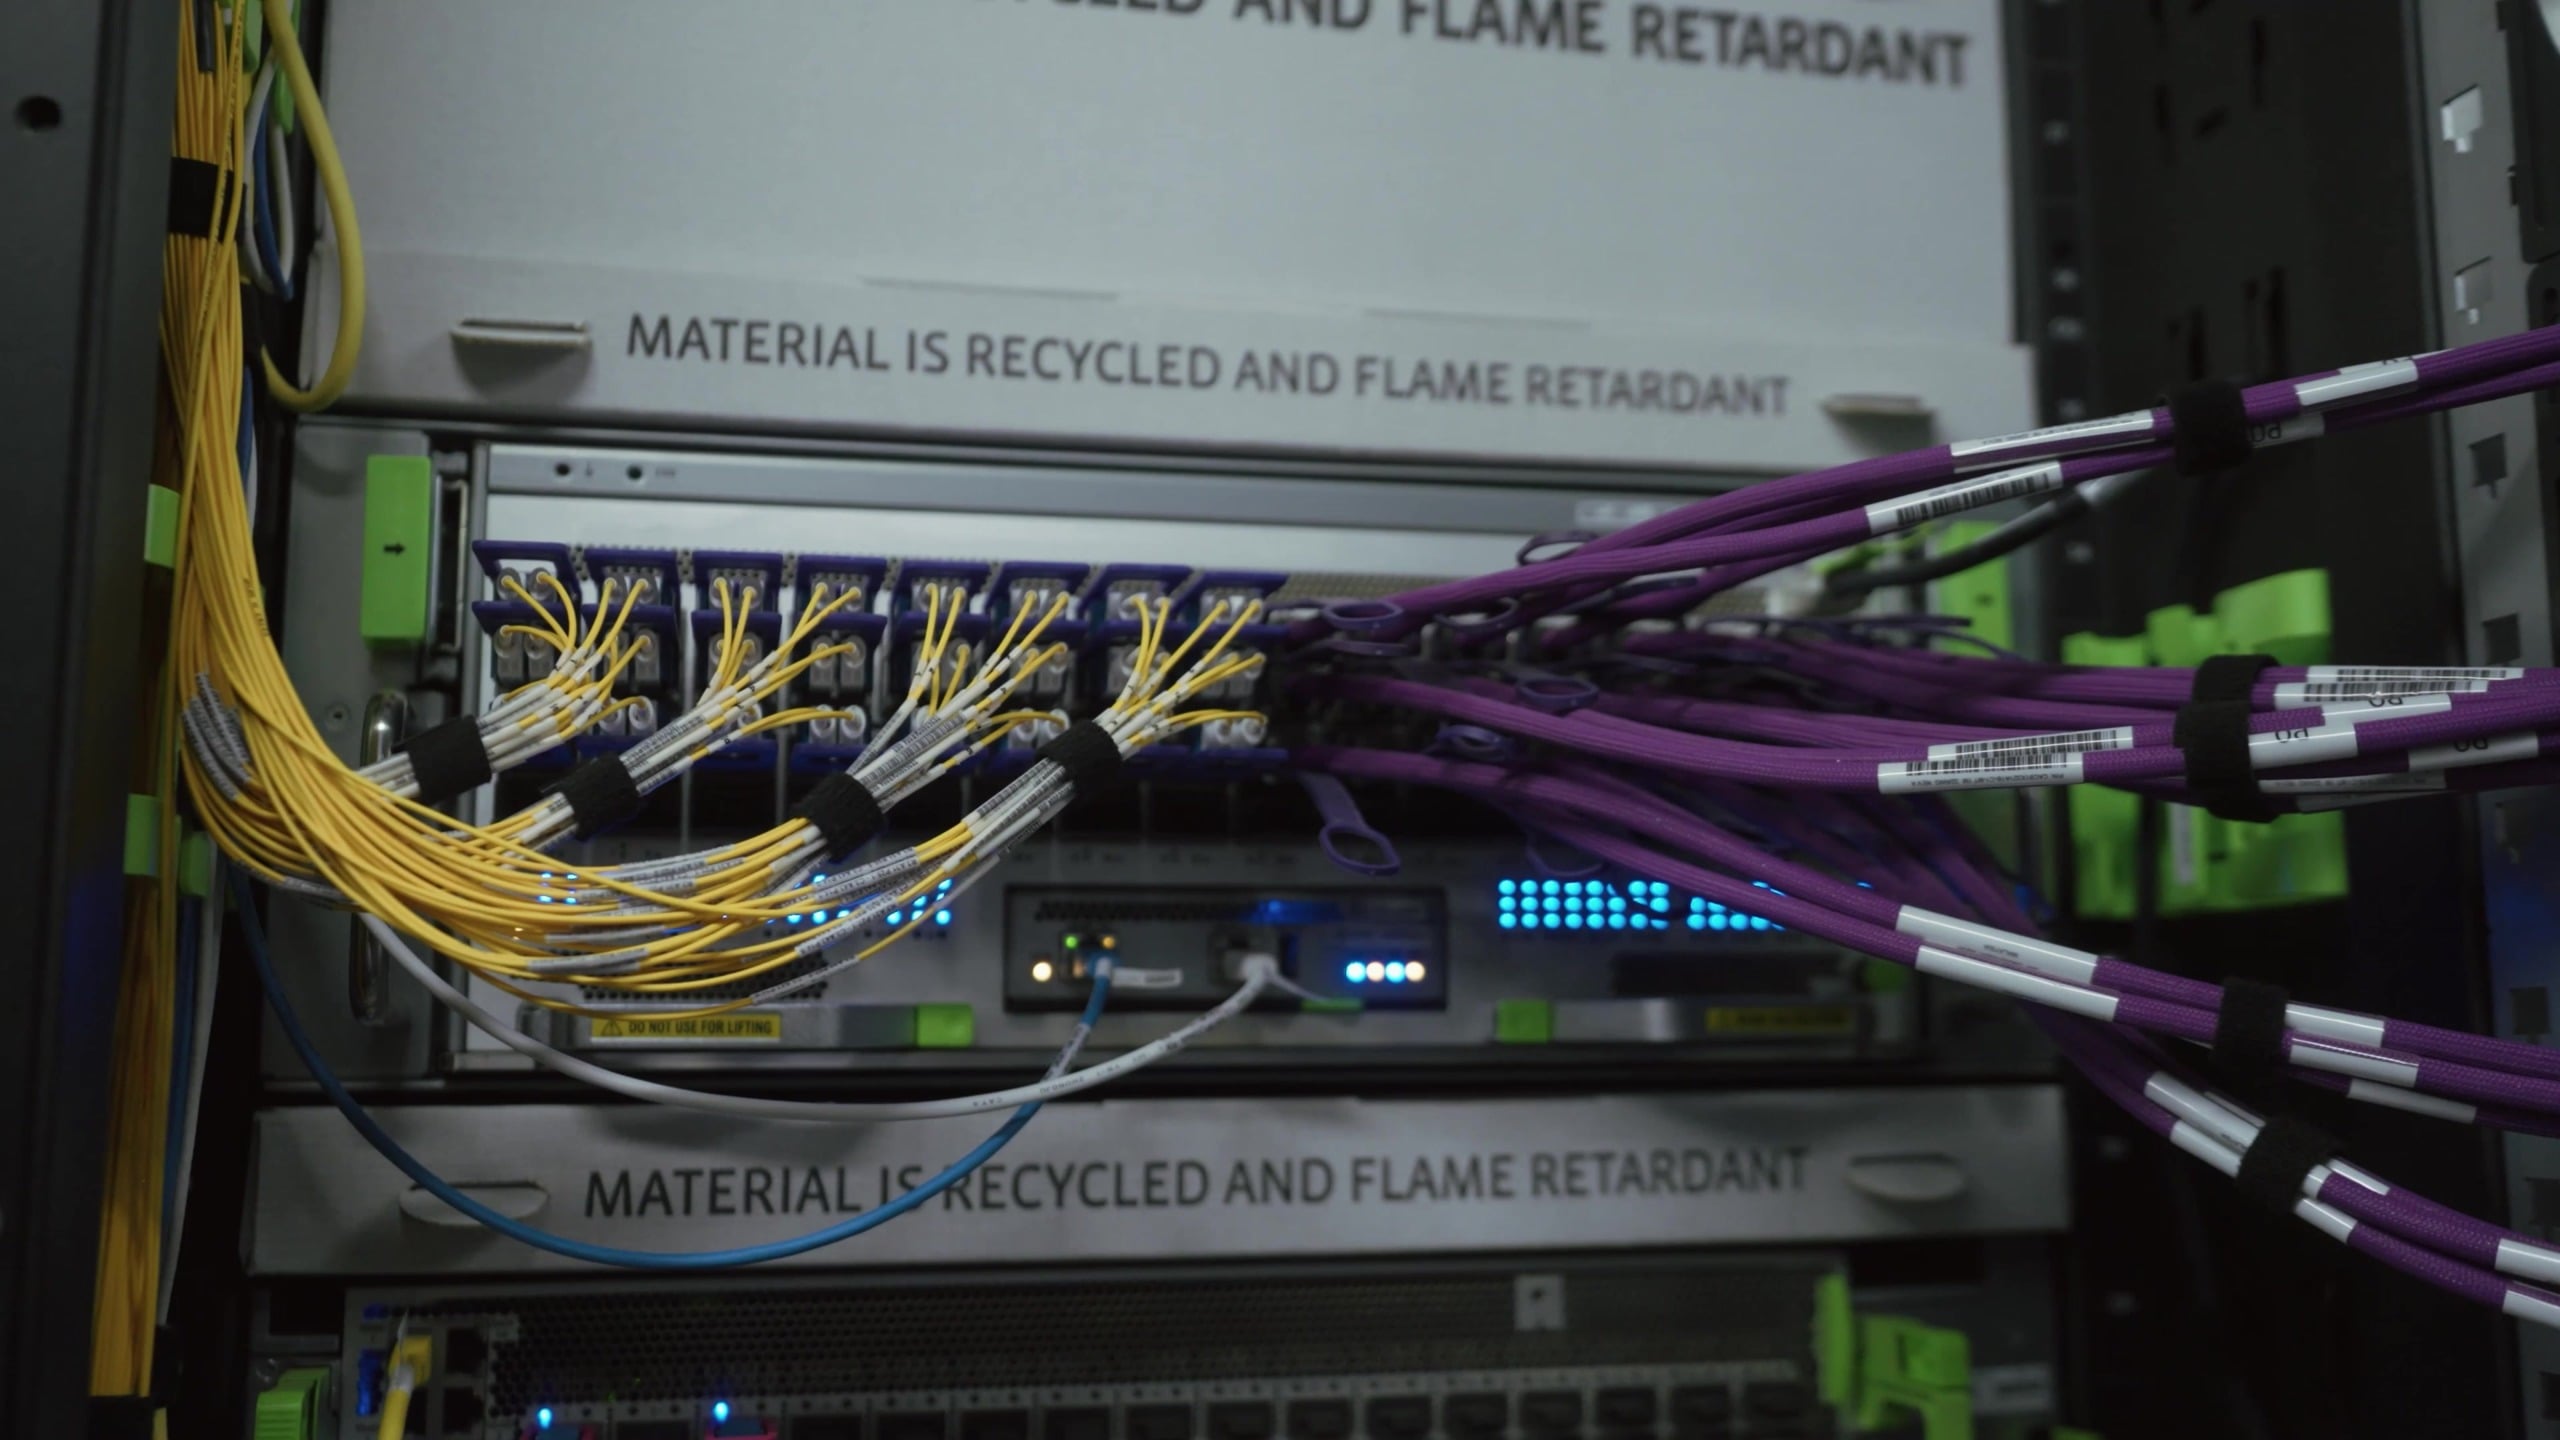
何十万台もの第一世代アクセラレータを運用することで、ハードウェアの成熟は独自の分野となりました。Metaのファームウェア自動化により、数時間で10万台以上のGPUにドライバとファームウェアの修正を適用でき、P90では、GB200導入当初の7時間以上から、1台のポッドをアップグレードするのに2時間以上かかっていた時間が短縮されました。電力供給ストレステストでは、1台のGPUの1,400Wの負荷の下でPSUモジュールと電圧レギュレータがどのように動作するかを調べ、修理されたシステムはすべて検証に合格するまで隔離されます。Metaの3月の安定性スプリントでは、スタック全体で修正が同期されました。
電力過渡現象と混合冷却装置群
同期トレーニングは電力を同期して移動させ、数万個のGPUが同時に計算フェーズまたは通信フェーズに入ると、クラスタの負荷が30~40%変動します。また、大規模なジョブの開始または一時停止によって、数秒で数十メガワットの電力をシフトさせることができます。Metaのクラスタ全体の電力管理フレームワークであるDynamo Dimmerは、クラスタの電力が上限に近づくにつれてGPUの電力を徐々に制限し、ジョブの実行を継続させます。ラックレベルのバッテリーバックアップモジュールがスパイクを吸収し、コンデンサトレイがピークを平滑化し、施設規模のバッテリーエネルギー貯蔵システムがその背後に配置され、Metaは電力会社と連携して負荷プロファイルを調整します。
Prometheusは、屋外データセンター、迅速展開構造、リース容量、および専用に構築されたAIビルにまたがって迅速に構築されたため、冷却方法はビルごとに異なります。古いスペースではモジュール式の空冷式液体冷却が使用されています。AIに最適化されたビルでは、閉ループの設備液体冷却が使用されています。MetaはこれをGPUサーバーを冷却する最も効率的な方法であり、最も水効率の良い方法であると説明しています。Metaは、液体冷却ネットワークラックであるIcePackなどの設計をOCPを通じて共有しています。はるかに小規模なGB300 NVL72液体冷却展開の内容については、Giga ComputingのGAIFAテストベッドを参照してください。
次はハイペリオンだ
Metaは、GB300 NVL72とVera Rubin NVL72ラックを組み合わせてPrometheusを拡張し続け、Vera Rubinは既存のネットワークファブリック上のサンミゲルプラットフォームを経由して導入される。ニューアルバニーでの経験は、Metaがルイジアナ州リッチランド郡でゼロから設計しているスーパークラスターHyperionに活かされており、クローズドループ液冷、Entergyによる完全なグリッド接続、次世代ネットワーク設計が採用されている。Metaは、両サイトでエネルギーの全コストを負担し、その使用量を新しいクリーンで再生可能な発電で相殺していると述べている。
Metaが公開した情報のほとんどは、ハイパースケーラーが通常非公開にしている運用上の詳細情報です。例えば、予備GPUの構成、中断率、ファームウェアの展開時間、そしてAriel構成を選択した理由などです。共通しているのは、この規模ではハードウェアはあくまで出発点であり、数十万個のGPUを実用的なトレーニング能力に変換する作業は、ネットワーク、フォールトトレランス、そしてテレメトリにあるということです。大規模なAI導入を検討している企業にとって、このMetaの詳細な分析は、少なくとも問題が発生する可能性のある箇所を理解するための良い出発点となり、組織はデータセンター全体にわたって事前に計画を立てることができます。



 Amazon